Monitoraggio dei commenti con Antigravity CLI: configurazione e dati reali
Monitora per 24 ore i commenti su YouTube e Bilibili con Antigravity CLI. Dati reali: 100 commenti coprivano 5 ore; una giornata comporta 0,023 $ di costi API.
Le prime 24 ore dopo la pubblicazione di un video decidono il tono della sezione commenti. Tre tipi di commenti richiedono un rapido intervento umano: lamentele, vere e proprie domande e commenti che, se restano senza risposta, danno un'impressione di distacco. In questa guida configuriamo un controllo periodico dei commenti con Antigravity CLI, l'agente da terminale di Google che ha sostituito Gemini CLI. Il comando è agy. Ogni qualche ora, un timer di sistema avvia agy -p; l'agente recupera i nuovi commenti e scrive un breve report.
I dati dei commenti arrivano dal server MCP remoto di EveryInfra. Per YouTube usiamo youtube/comments e youtube/video. Per Bilibili usiamo bilibili/comments, bilibili/danmaku e bilibili/video. Abbiamo eseguito davvero la parte dati il 3 novembre 2026, dalle 00:17 alle 01:22 ora di Singapore (SGT).
Abbiamo fatto tre giri di controllo su due video molto attivi, con 20 chiamate a pagamento e 0,01137 $ di costi API in totale. Non abbiamo installato Antigravity CLI sulla nostra macchina di test. Pertanto, ogni file mcp_config.json, ogni Skill e ogni script del timer riportati di seguito costituiscono esempi di configurazione basati sulla documentazione ufficiale. Non abbiamo eseguito agy noi stessi.
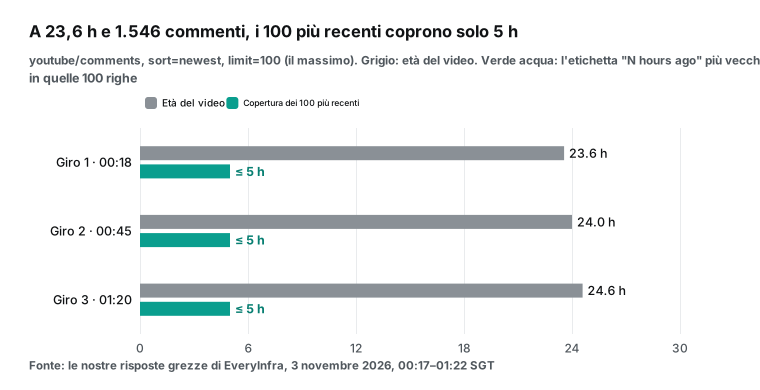
Alcuni numeri di questa guida non compaiono in nessuna documentazione. Un video YouTube aveva 1.546 commenti dopo 23,6 ore. I 100 commenti più recenti, il massimo per chiamata, coprivano solo le ultime 5 ore. Nel secondo giro, 27 minuti dopo, solo 9 di quei 100 commenti erano nuovi. Su Bilibili, un video aveva 4.075 commenti dopo meno di 3 ore.
L'endpoint dei commenti ha restituito 3, 10 e 3 commenti popolari nei tre giri. Un prefiltro per parole chiave ha segnalato 34 commenti YouTube su 100, ma solo 13 meritavano il tempo del creator. Con un giro ogni 2 ore, una giornata intera comporta 0,023 $ di costi API. L'utilizzo del modello costa circa 0,103 $ ai prezzi pubblici dell'API Gemini 3.8 Flash, e gran parte del costo deriva dall'overhead fisso del prompt.
Il compito: cosa deve intercettare un controllo dei commenti di 24 ore
La maggior parte dei commenti sotto un nuovo video non richiede alcuna azione. Emoji, battute, «first» e chiacchiere tra fan costituiscono la maggior parte. Un controllo serve a trovare la piccola parte che richiede un intervento e a mostrarla in una sola schermata. Un social media manager dovrebbe leggere il report sul telefono in due minuti. Nessuno dovrebbe scorrere 1.500 commenti in YouTube Studio per trovare tre problemi reali.
Abbiamo scelto due video in situazioni diverse. Il video YouTube è «GTA 6 on PC May be Coming Sooner than We Thought» di Linus Tech Tips (pagina del video). È stato pubblicato il 2 novembre alle 00:45 SGT. Al momento del primo recupero, erano trascorse 23,6 ore dalla pubblicazione; il video aveva 794.104 visualizzazioni e 1.546 commenti.
Il video Bilibili è il primo caricamento dell'account DeepSeek Harness, pubblicato il 2 novembre alle 21:28 SGT (pagina del video). Al momento del primo recupero, erano trascorse 2,9 ore dalla pubblicazione; il video aveva 225.698 visualizzazioni, 4.075 commenti e 342 danmaku. Un video si trova alla fine della finestra di 24 ore e l'altro all'inizio.
| Una riga del report | Campo di origine | Nota |
|---|---|---|
| ID del commento, piattaforma, video | id da youtube/comments o bilibili/comments, più video_id | Conserva l'ID, scarta il nome utente |
| Testo (troncato a 200 caratteri) | text | I danmaku vanno in una colonna separata |
| Finestra temporale | YouTube fornisce «2 hours ago», Bilibili l'ora in formato ISO | Converti le etichette di YouTube al momento del recupero |
| Engagement | like_count e reply_count | I commenti nuovi di solito mostrano 0 |
| Categoria | Prefiltro con script più verifica del modello | Lamentela, domanda, richiede risposta, altro |
| Gravità e bozza di risposta | Output del modello vincolato a uno schema JSON | Per gli elementi ad alto rischio non viene generata alcuna bozza: vengono affidati a una persona |


Cos'è Antigravity CLI e quali sono le quattro funzionalità necessarie per questo lavoro
Molti di quelli che cercano «antigravity cli» pensano ancora che sia un nuovo nome di Gemini CLI. È uno strumento diverso. Il 19 maggio 2026 il Google Developers Blog ha annunciato il passaggio da Gemini CLI ad Antigravity CLI per gli utenti individuali (Google Developers Blog). Il nuovo strumento è stato reso disponibile a tutti quello stesso giorno.
Dal 18 giugno, Gemini CLI e le estensioni IDE di Gemini Code Assist non sono più disponibili per gli utenti Google AI Pro, Ultra e gratuiti. Le organizzazioni con licenze enterprise di Gemini Code Assist o chiavi API a pagamento hanno mantenuto l'accesso. La stessa tempistica compare nella discussione GitHub #27274.
Secondo il post, il team ha riscritto lo strumento in Go e ha chiamato il comando agy. Le Agent Skills, gli hook, i subagent e le estensioni rimangono, ma ora le estensioni si chiamano plugin. La CLI condivide inoltre un unico core dell'agente con l'app desktop Antigravity 2.0. Per questa guida contano due fatti.
Primo: Antigravity CLI è closed source. Il repository google-antigravity/antigravity-cli contiene note di installazione, note di rilascio e discussioni, non codice. Quindi ogni comportamento descritto in questa guida viene dalla documentazione ufficiale e dalle note di rilascio.
Secondo: la CLI cambia in fretta. L'API delle release di GitHub elenca 20 release dalla 1.3.0 del 2026-10-06 alla 1.4.12 del 2026-10-30 UTC (note di rilascio 1.4.12). Alcune tappe intermedie: 1.4.0 il 2026-10-16, 1.4.4 il 2026-10-21, 1.4.8 il 2026-10-27 e 1.4.10 il 2026-10-29. Vuol dire una release ogni uno o due giorni.
| Versione | Data (UTC) | Modifica rilevante per un controllo pianificato |
|---|---|---|
| 1.2.9 | 2026-09-23 | La modalità headless attende le attività in background fino a --print-timeout, al massimo 30 minuti |
| 1.2.10 | 2026-09-24 | Una risposta in streaming che fallisce a metà termina con codice 3 |
| 1.3.4 | 2026-10-13 | Se il nome passato a --agent è sconosciuto, la modalità headless termina con codice 1 |
| 1.3.6 | 2026-10-15 | La modalità headless salta le domande dei subagent |
| 1.4.7 | 2026-10-24 | Meno CPU nelle esecuzioni -p; i risultati MCP fino a 10 KB arrivano direttamente all'agente |
| 1.4.11 | 2026-10-30 | L'output JSON aggiunge finished_reason |
Prima di copiare uno degli esempi qui sotto, confronta la versione locale indicata da agy --version con quella riportata nella documentazione.
| Funzionalità usata in questo lavoro | Cosa dice la documentazione | Fonte (consultata il 2026-11-03) |
|---|---|---|
Modalità headless agy -p | Esegue un solo prompt, stampa il risultato e termina. --output-format json restituisce un envelope con status e usage. --json-schema impone un output strutturato | Modalità headless |
| MCP remoto | I server stanno in mcp_config.json. Un server remoto usa serverUrl più headers. enabledTools espone solo alcuni strumenti | documentazione MCP, guida alla migrazione |
| Agent Skills | Le Skill del workspace vanno in .agents/skills/. Le Skill globali vanno in ~/.gemini/skills/ o ~/.gemini/antigravity-cli/skills/ | Agent Skills |
| Pianificazione | /schedule rimane attivo solo nella conversazione corrente. I sidecar funzionano tra una sessione e l'altra, ma sono indicati per l'app desktop. La CLI può essere avviata da un timer del sistema operativo | /schedule e Sidecars |
Configurazione MCP di Antigravity CLI: dove si trova mcp_config.json e cosa contiene
Antigravity CLI sposta i server MCP dal file di impostazioni principale a mcp_config.json. Il file globale è ~/.gemini/config/mcp_config.json. Il file di progetto va in .agents/mcp_config.json nella root del progetto (guida alla migrazione, «MCP config formatting changes»). La chiave dell'indirizzo per un server remoto è passata da url o httpUrl in Gemini CLI a serverUrl.
La documentazione MCP aggiunge che funziona anche url. L'autenticazione va negli headers personalizzati. La chiave enabledTools è un'allowlist, quindi l'agente non vede nessun altro strumento di quel server. La chiave timeoutSeconds ha come valori predefiniti 300 secondi per la connessione e 180 secondi per ogni chiamata a uno strumento (documentazione MCP, «MCP configuration properties»).
Questo è l'esempio per il progetto di controllo dei commenti. Mettilo in .agents/mcp_config.json:
{
  "mcpServers": {
    "everyinfra": {
      "serverUrl": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer <your EveryInfra API key>" },
      "enabledTools": ["everyinfra_call_api", "everyinfra_get_job", "everyinfra_list_capabilities"],
      "timeoutSeconds": 120
    }
  }
}
Ogni riga è una scelta. In enabledTools teniamo solo tre strumenti. Alle 00:22 SGT del 3 novembre, una chiamata tools/list senza chiave mostrava 12 strumenti sul server MCP di EveryInfra. Diversi di questi strumenti, come la consultazione dell'account e i ticket di assistenza, non hanno niente a che fare con il controllo dei commenti. Gli strumenti in più occupano spazio nel contesto e danno al modello un'occasione in più di sbagliare.
Impostiamo timeoutSeconds a 120 invece di 180. La nostra chiamata sincrona più lenta ha richiesto 70,48 secondi: 50 commenti YouTube ordinati per popolarità. Per una chiamata che può superare gli 85 secondi, aggiungi "mode":"async" alla richiesta ed esegui il polling di everyinfra_get_job. Il polling è gratuito. Non continuare ad alzare il timeout.
La chiave è la riga che richiede più attenzione. L'esempio remoto ufficiale inserisce Bearer YOUR_API_TOKEN direttamente negli headers. La documentazione non dice che headers espande ${ENV_VAR}. La vecchia documentazione di Gemini CLI supportava $VAR_NAME e ${VAR_NAME} negli header (documentazione MCP di Gemini CLI).
Un utente di Reddit riferisce che Antigravity invia ${MY_VAR} come stringa letterale (thread su r/google_antigravity). Finché la documentazione non dirà il contrario, presumi che l'espansione non sia supportata. Metti la chiave nel file globale e rendilo leggibile solo da te, oppure usa il file di progetto ma aggiungi .agents/mcp_config.json a .gitignore. Non fare mai il commit di quel file.
Il secondo file riguarda i permessi. Secondo la documentazione MCP, uno strumento MCP senza regola usa «Ask» per impostazione predefinita, quindi ogni chiamata attende l'approvazione di una persona. Le regole di autorizzazione hanno la forma mcp(server/tool) o mcp(server/*) (documentazione MCP, permessi, documentazione sui permessi). In modalità headless nessuno approva niente. Quindi scrivi le regole in anticipo in ~/.gemini/antigravity-cli/settings.json:
{
  "permissions": {
    "allow": [
      "mcp(everyinfra/everyinfra_call_api)",
      "mcp(everyinfra/everyinfra_get_job)",
      "mcp(everyinfra/everyinfra_list_capabilities)",
      "write_file(reports/)"
    ]
  }
}
Non usiamo mcp(everyinfra/*) né --dangerously-skip-permissions. Un'allowlist per nome è più sicura di un carattere jolly: se in seguito il server aggiunge uno strumento, una regola per nome non lo copre. Un altro utente di Reddit si è bloccato proprio su questo passaggio. Il server MCP risultava connesso, ma l'agente diceva di non riuscire a raggiungerlo.
La soluzione era un'autorizzazione esplicita in /permissions. Lo stesso utente ha anche scoperto che la configurazione era stata scritta in ~/.gemini/antigravity-cli/ invece che in ~/.gemini/config/ (r/google_antigravity, «Antigravity CLI MCP Servers Pain»). Dopo la configurazione, apri una volta la CLI interattiva. Esegui /mcp per controllare lo stato del server e poi /permissions per controllare le regole. Affida il lavoro a un timer solo dopo che entrambi i controlli sono andati a buon fine.
Un round trip reale: cosa invia l'agente e cosa torna indietro
Non abbiamo potuto eseguire agy, ma le richieste che invia a un server MCP remoto sono messaggi MCP standard. Il client invia prima tools/list per ottenere il catalogo degli strumenti e poi tools/call quando serve. La specifica MCP chiama questo trasporto Streamable HTTP: il client invia in POST un messaggio JSON-RPC e il server risponde con JSON o con uno stream SSE (specifica MCP 2026-07-28, «Transports»). Quindi saltiamo il client e inviamo la stessa richiesta all'endpoint MCP di EveryInfra.
Quello che vediamo è la risposta grezza che il server restituisce all'agente. La CLI può comunque modificare ciò che l'agente legge. Per esempio, le note di rilascio della 1.4.7 dicono che i risultati degli strumenti oltre i 10 KB finiscono in un file. Non abbiamo testato questo livello.
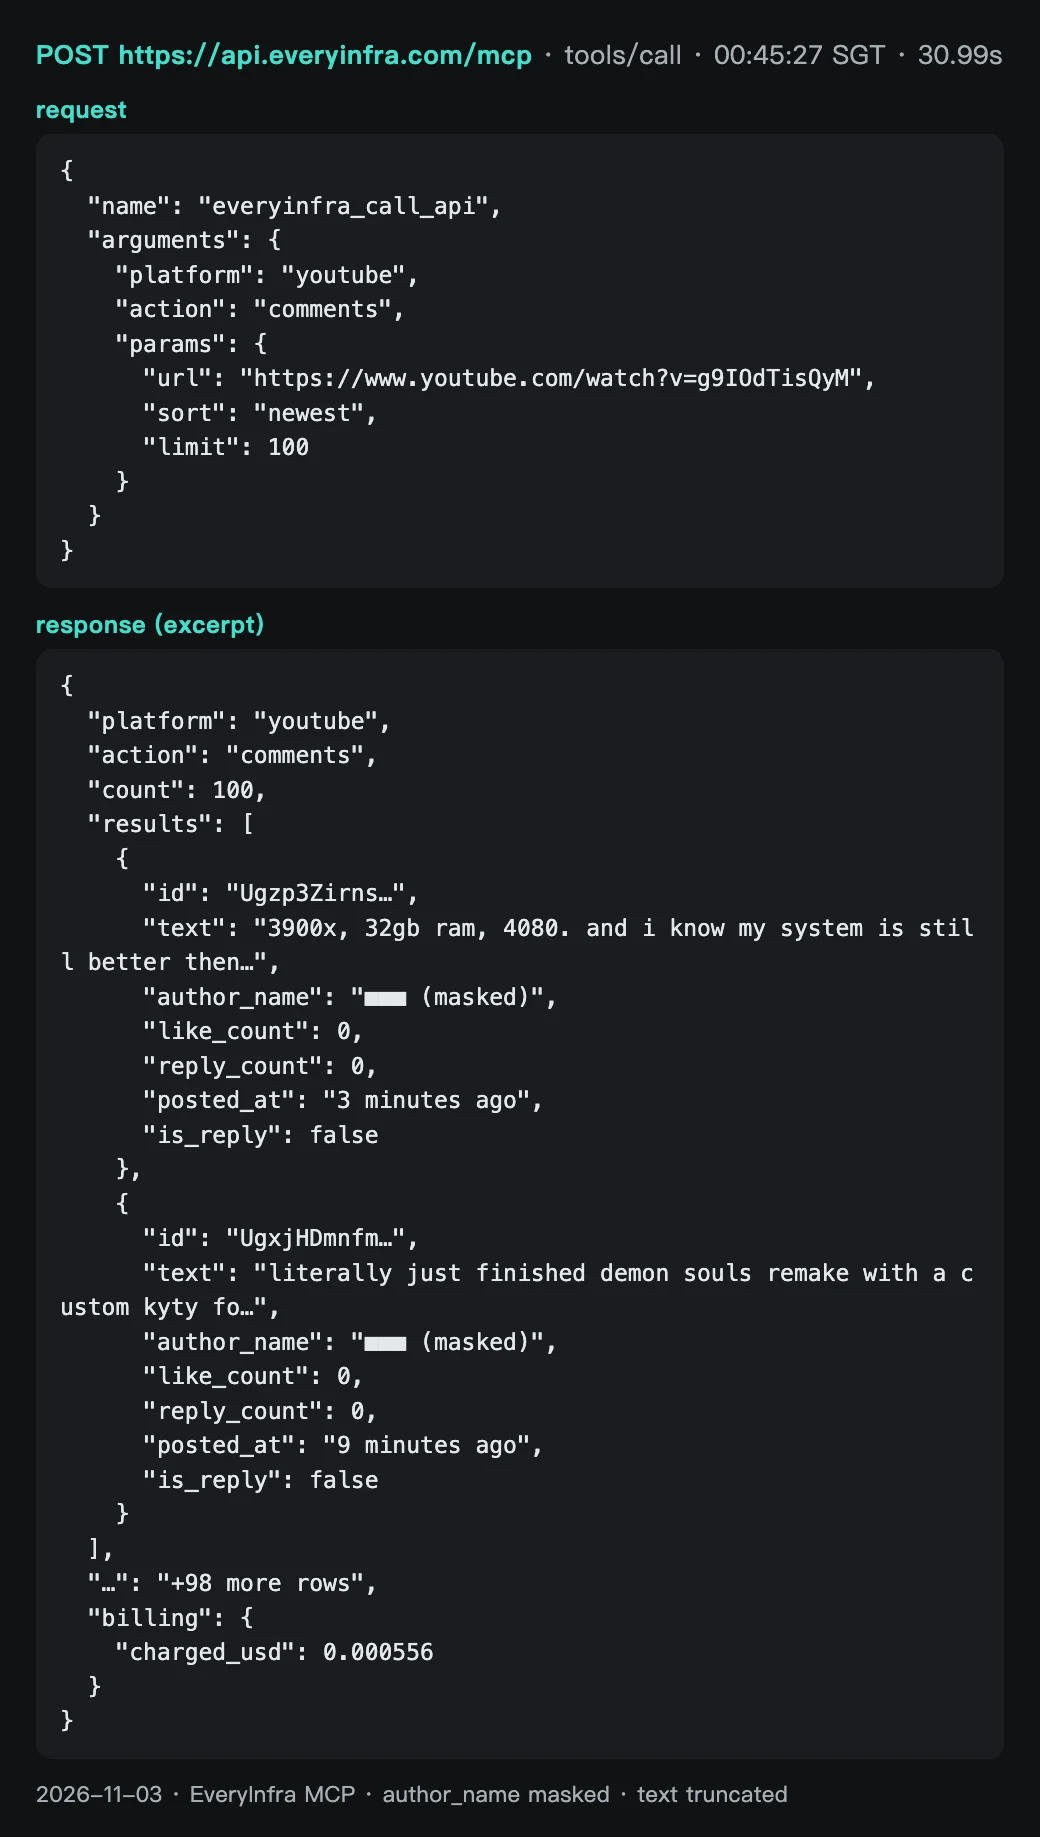
Alle 00:45:27 SGT del 3 novembre abbiamo inviato questa chiamata tools/call con una chiave. Chiede i 100 commenti più recenti del video YouTube:
{
  "jsonrpc": "2.0",
  "id": 7,
  "method": "tools/call",
  "params": {
    "name": "everyinfra_call_api",
    "arguments": {
      "platform": "youtube",
      "action": "comments",
      "params": {
        "url": "https://www.youtube.com/watch?v=g9IOdTisQyM",
        "sort": "newest",
        "limit": 100
      }
    }
  }
}
Il server ha risposto HTTP 200 dopo 30,99 secondi. MCP racchiude il risultato applicativo in result.content[0].text come stringa JSON di 33.915 byte. All'interno ci sono platform, action, count, results e billing. count era 100 e billing.charged_usd era 0.000556. Il primo commento risaliva a 3 minuti prima.
Uno spettatore elencava il proprio PC e diceva che il «PC del gamer medio» della puntata era un po' troppo potente. Il secondo commento risaliva a 9 minuti prima e raccontava di aver finito il remake di un gioco su un emulatore. Lo screenshot qui sotto mostra la risposta reale con due righe. I nomi utente sono oscurati e il testo è troncato.
Tieni conto di queste dimensioni quando scrivi il file di configurazione. Secondo le note di rilascio di Antigravity CLI 1.4.7, i risultati MCP on demand fino a 10 KB arrivano direttamente all'agente. I risultati più grandi finiscono in un file, che l'agente deve leggere con un passaggio in più (note di rilascio 1.4.7). Una pagina di 100 commenti pesa circa 33 KB, quindi passa sempre dal file.
Per un controllo dei commenti è un vantaggio: la risposta grezza la vuoi comunque su disco. La Skill dice all'agente di passare il file a dedupe.py invece di caricare 33 KB di JSON nel contesto.
Puoi anche saltare MCP e chiamare l'endpoint REST. Usa questa strada se lo script del timer recupera i dati prima di avviare agy. Noi l'abbiamo usata per i giri 1 e 3. L'array results ha la stessa struttura di quello contenuto nella risposta MCP:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"youtube","action":"comments","params":{"url":"https://www.youtube.com/watch?v=g9IOdTisQyM","sort":"newest","limit":100}}' \
  > youtube-$(date +%Y%m%d-%H%M).json
Il nostro consiglio: inizia con MCP per vedere com'è fatto un buon report. Quando è stabile, sposta recupero e deduplicazione in uno script e lascia al modello solo la valutazione. La sezione sul prefiltro spiega perché.
Anche gli errori fanno parte del round trip. Abbiamo inviato a bilibili/comments un parametro sort che non supporta. Alle 00:21:33 SGT abbiamo ricevuto HTTP 422 con unknown_param. Il messaggio elencava i parametri consentiti, url e limit, e terminava con «Nothing was charged.» Un modello può leggere questo messaggio e riprovare senza il parametro errato.
Un errore del server ha un aspetto diverso. Nel giro 3, alle 01:22:15 SGT, la chiamata danmaku ha restituito HTTP 503 con fault impostato su service, quindi la richiesta in sé era corretta. Il corpo impostava retryable a true e retry_after a 20 secondi. La riga next_steps diceva che la chiamata non era stata addebitata e che si trattava del fallimento 1 di 3. Abbiamo inviato la stessa richiesta 23 secondi dopo e ottenuto 200 con 100 danmaku, addebitati 0,000556 $. Uno script del timer dovrebbe seguire questi campi: attendere retry_after, fermarsi a max_retries e poi scrivere nel report «Danmaku di Bilibili mancanti in questo giro».
Per altri modi di collegare un server MCP remoto, consulta la guida al server MCP e la Documentazione.
| Questo round trip | Valore misurato |
|---|---|
| Ora della richiesta | 2026-11-03 00:45:27 SGT |
| Strumento | everyinfra_call_api, con platform=youtube e action=comments |
| Durata | 30,99 s (sincrona; qualsiasi chiamata sotto gli 85 s risponde direttamente) |
| Risposta | HTTP 200, count 100, corpo di 33.915 byte |
| Addebito | 0,000556 $ (billing.charged_usd) |
| Rispetto al giro 1 | 91 righe su 100 già viste, 9 nuove |
Monitoraggio dei commenti YouTube: 100 commenti per chiamata e quanto tempo coprono
L'intervallo del controllo dipende da un numero pratico: i nuovi commenti tra due giri supereranno quanto può restituire una sola chiamata? Il catalogo indica per youtube/comments un valore predefinito di 20 righe e un massimo di 100. I parametri facoltativi sono sort (newest o popular) e since (un filtro per data).
I campi sono id, text, author_name, like_count, reply_count, posted_at, is_reply e reply_to_id. Non c'è un parametro di pagina. Quindi 100 righe sono tutto ciò che un giro può vedere.
Il giro 1 è partito alle 00:18 SGT. Erano trascorse 23,6 ore dalla pubblicazione del video, che aveva 1.546 commenti. Abbiamo chiesto i 100 più recenti e la chiamata ha richiesto 22,2 secondi. La riga più recente diceva «1 minute ago» e la più vecchia «5 hours ago». Alla fine del primo giorno, 100 righe coprivano solo le ultime 5 ore.
Tre righe erano risposte (is_reply true) e quattro avevano il suffisso «(edited)». In altre parole, tra la 18ª e la 23ª ora il video guadagnava ancora circa 20 commenti all'ora. Con un giro ogni 6 ore, alcuni commenti cadrebbero tra due recuperi e non comparirebbero mai.
Dopo il primo giorno, i commenti hanno continuato ad arrivare a un ritmo costante di circa 20-45 commenti all'ora.
Nel giro 2, alle 00:45 SGT, 27 minuti dopo il precedente, il video aveva 1.557 commenti, 11 in più. Dei 100 più recenti, 9 erano nuovi e 91 già visti. Le 100 righe coprivano ancora solo le ultime 5 ore.
Nel giro 3, alle 01:20 SGT, 35 minuti dopo il precedente, il video aveva 1.583 commenti, 26 in più. Dei 100 più recenti, 18 erano nuovi rispetto a entrambi i giri precedenti e 82 già visti. Rispetto al solo giro 2, 19 erano nuovi e 81 si sovrapponevano. Le 100 righe coprivano ancora solo le ultime 5 ore.
Le nuove righe sono meno dell'aumento del totale. Le risposte spiegano parte della differenza: nel giro 1 c'erano 3 risposte tra i 100 commenti più recenti, nel giro 2 nessuna e nel giro 3 solo 1. Il resto potrebbe dipendere da commenti nascosti o non espansi. A ogni giro registra entrambi i numeri e segnala qualsiasi differenza nel report.
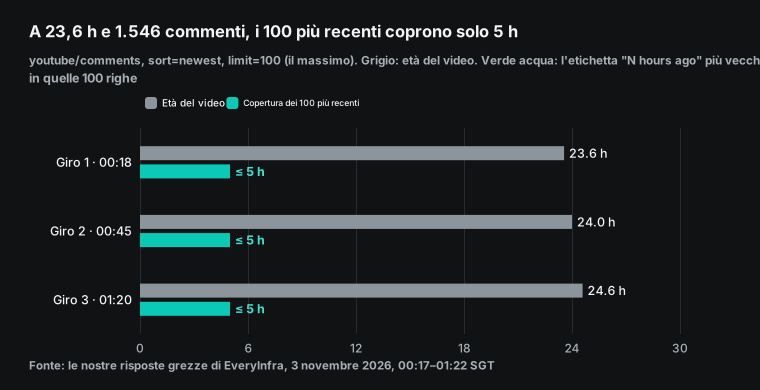
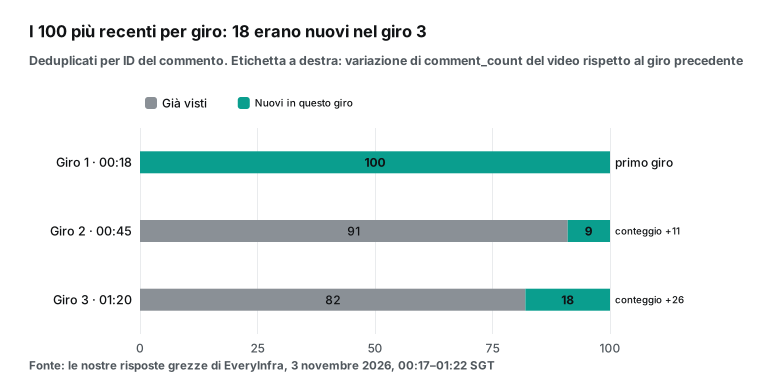
Il parametro sort è facile da trascurare. Nello stesso momento abbiamo recuperato anche 50 commenti ordinati per popolarità. Quella chiamata ha richiesto 70,48 secondi, la nostra chiamata sincrona più lenta. I 50 popolari e i 100 più recenti non avevano nessuna riga in comune.
Nel gruppo dei popolari, 30 righe erano risposte. Le etichette andavano da «9 minutes ago» a «23 hours ago», e il commento in cima aveva 3.500 like. Il compito principale del controllo è non perdere nessun commento nuovo, quindi ogni giro usa newest. L'ordine per popolarità risponde una volta al giorno a un'altra domanda: quali commenti stanno dettando il tono in questo momento?
Il campo posted_at è un'etichetta relativa come «N hours ago», non un timestamp. Lo script deve registrare l'ora del recupero e convertire ogni etichetta in una finestra temporale. Deduplica solo in base all'id del commento. Non usare mai l'ora per farlo.
| Campo | Misurazione del giro 1 | Uso nel monitoraggio |
|---|---|---|
id | 100 valori univoci, nel formato Ugz…AaABAg | L'unica chiave di deduplicazione; salvala in state/seen-<video ID>.json |
text | Testo completo; la riga più lunga contava 1.876 caratteri | Troncalo a 200 caratteri nel report; conserva il testo completo in locale |
posted_at | Da "1 minute ago" a "5 hours ago"; 4 righe riportano "(edited)" | Convertilo al momento del recupero; un commento modificato può avere contenuti nuovi |
like_count e reply_count | Solo 3 delle 100 righe più recenti avevano un like | I commenti nuovi non hanno ancora interazioni; per quelle usa l'ordinamento per popolarità |
is_reply, reply_to_id | 3 risposte | Leggi una risposta insieme al commento padre, altrimenti ne fraintendi il tono |
author_name | Presente | Usalo solo in locale; tienilo fuori dal report |
Il nostro consiglio per YouTube: esegui un giro ogni ora per le prime 6 ore, poi un giro ogni 2 ore. Se un giro trova esattamente 100 righe nuove, scrivi "questo giro potrebbe aver perso dei commenti" nella prima riga del report. Poi anticipa il giro successivo. Questa regola è già nell'albero decisionale della Skill qui sotto. Per tutti i campi e i parametri, consulta l'API per i commenti di YouTube. I totali di commenti e visualizzazioni arrivano dall'API per i video di YouTube.
Bilibili: solo commenti in evidenza, con i danmaku come secondo segnale
Il campione di Bilibili è un caricamento recente. L'account DeepSeek Harness ha pubblicato il suo primo video il 2 novembre alle 21:28 SGT. Dura 200 secondi. Al nostro primo recupero con bilibili/video, alle 00:20 SGT, il video era online da sole 2,9 ore. Aveva già 225.698 visualizzazioni, 22.070 like, 4.075 commenti e 342 danmaku. Un video che esplode nelle prime ore è proprio il caso in cui il monitoraggio conta di più.
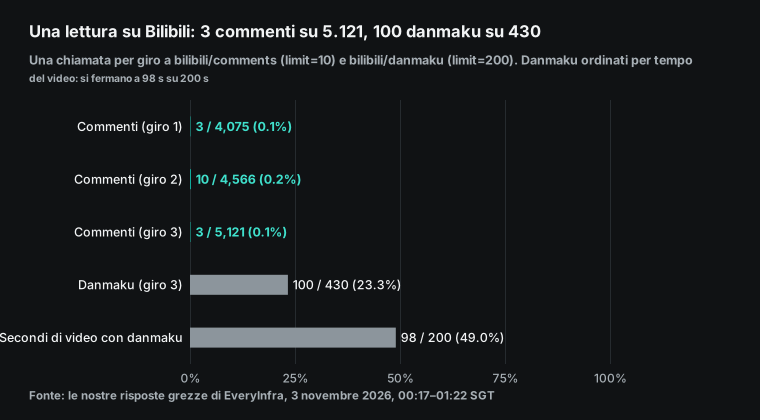
Ma alle 00:21 SGT bilibili/comments ha restituito solo 3 commenti, in 1,26 secondi. Erano tutti e tre commenti in evidenza, con un numero di like tra 48 e 212. Erano stati pubblicati tra 3 e 131 minuti dopo la messa online del video. Nel giro 2, alle 00:46 SGT, la stessa richiesta ha restituito 10 commenti, cioè il massimo.
Sette erano nuovi per noi, con like tra 23 e 1.100. Negli stessi 25 minuti, il conteggio dei commenti del video è salito da 4.075 a 4.566. Sono 491 commenti in più, ovvero oltre mille all'ora. Nel giro 3, alle 01:22 SGT, con limit di nuovo impostato a 10, ne ha restituiti solo 3, e li avevamo già visti tutti e tre.
Il catalogo è chiaro su questo endpoint. Il valore predefinito è 10, il massimo è 10 e un valore più alto viene limitato. Gli unici parametri sono url e limit. Abbiamo provato un parametro sort e abbiamo ottenuto l'errore 422 descritto sopra, senza addebito. Quindi questo endpoint non può darti i commenti più recenti in ordine cronologico.
Ti dà al massimo 10 dei commenti in evidenza del momento, e il numero varia. Ha comunque valore, perché i commenti in evidenza determinano la prima impressione. Un commento in evidenza negativo è un elemento a priorità massima. Ma non sostituisce la lettura di ogni nuovo commento. Il report deve dire "Bilibili: 10 commenti in evidenza visti su 4.566 totali", così nessun lettore presume una copertura completa.
I danmaku sono un secondo segnale. bilibili/danmaku restituisce per impostazione predefinita 50 righe, con un massimo di 200. Ne abbiamo chieste 200 e ne abbiamo ricevute 100. Erano ordinate per tempo del video, dal secondo 0 al secondo 98, quindi coprivano solo la prima metà di un video di 200 secondi. Gli orari di invio andavano dalle 21:35 alle 00:19 SGT.
La nostra regola basata su parole chiave ne ha segnati 29 come domande. Ma 15 di quei 29 erano incitamenti con punti interrogativi, sul genere di "La balena?! La balena è davvero in diretta?!" Il contenuto vero stava in pochi altri. Quattro danmaku chiedevano di una "modalità sopravvivenza", uno chiedeva un'app desktop e uno chiedeva se seguire l'account desse token gratuiti. Un punto interrogativo non è una domanda, e nei danmaku ancora meno.
| Danmaku (parafrasati) | Secondo del video | Etichetta della regola | La nostra revisione |
|---|---|---|---|
| "La balena?! È davvero in diretta?!" | Da 0 a 10 | Domanda | Incitamento, nessuna azione |
| "C'è una modalità sopravvivenza?" | 76 | Domanda | Domanda su una funzionalità, parte di un tema |
| "Stavo proprio cercando un'app desktop" | 8 | Domanda | Domanda su una funzionalità |
| "I follower ricevono token gratuiti?" | 53 | Domanda | Metà battuta, metà domanda |
| "Finirete davvero di lavorare in orario?" | 25 | Domanda | Battuta sul plugin del conto alla rovescia |
Il tema della modalità sopravvivenza è poi comparso anche nei commenti in evidenza del giro 2. Un commento con 352 like faceva notare che il video non menziona mai la modalità sopravvivenza. Quattro danmaku sparsi e un commento in evidenza indicano la stessa cosa. Un buon report li unisce in un'unica riga: gli spettatori continuano a chiedere della modalità sopravvivenza.
Anche nel giro 2 i danmaku erano 100 righe che terminavano al secondo 98. Di queste, 21 erano nuove, e il totale dei danmaku è salito da 342 a 388. Il giro 3 si è fermato di nuovo al secondo 98, con 16 righe nuove e un totale di 430. L'endpoint restituisce i primi 100 danmaku della prima metà del video. Un nuovo danmaku compare solo se cade in quella parte della timeline.
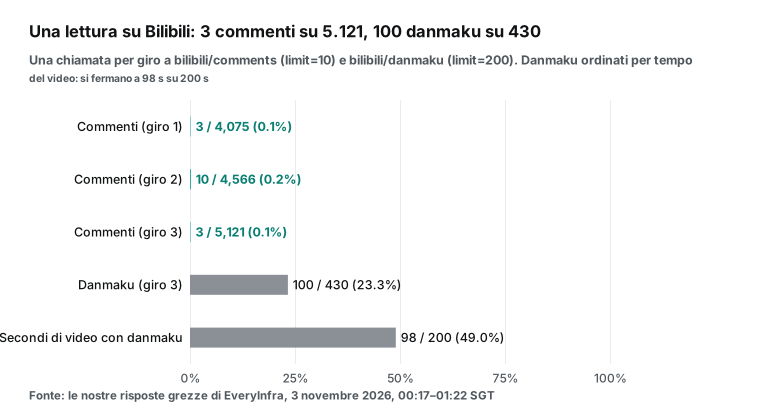
| Funzionalità | Catalogo | Cosa abbiamo ottenuto | Uso nel monitoraggio |
|---|---|---|---|
bilibili/video | 26 campi, tra cui visualizzazioni, like e conteggi di commenti e danmaku | Una chiamata in 35,3 s, tutti i campi presenti | Ogni 4 giri, per seguire la crescita di commenti e danmaku |
bilibili/comments | Predefinito 10, massimo 10; solo url e limit | 3, 10 e 3 commenti in evidenza in tre giri; sort restituisce 422 senza addebito | Un controllo dei commenti in evidenza: segnala quando cambiano o diventano negativi |
bilibili/danmaku | Predefinito 50, massimo 200 | Chiesti 200, ricevuti 100, ordinati per tempo del video, fermi al secondo 98 in tutti e tre i giri | Vedi in quale punto del video gli spettatori esultano o fanno domande, e individua il segmento problematico |
Se gestisci il tuo account Bilibili e ti servono tutti i commenti, usa il Creator Center. Oppure fai richiesta per la Bilibili Open Platform. Questa strada richiede la registrazione come sviluppatore, una verifica dei requisiti e la revisione dell'app (Bilibili Open Platform). È molto più onerosa della YouTube Data API.
Per i video dei concorrenti, o se rinunci alla open platform, accetta la visione "commenti in evidenza più danmaku" e dichiaralo nel report. I dettagli dei parametri sono nelle pagine API per i commenti di Bilibili e API per i danmaku di Bilibili. Le panoramiche delle piattaforme sono nelle pagine API di YouTube e API di Bilibili.
Il monitoraggio come Skill: uno scheletro per .agents/skills/comment-patrol/
In Antigravity, una Skill è una cartella con un file SKILL.md. Nell'intestazione YAML è obbligatorio solo description. Se ometti name, viene usato il nome della cartella. A ogni turno l'agente vede solo i nomi e le descrizioni di tutte le Skill. Legge il testo completo solo quando una Skill sembra pertinente.
La documentazione chiama questo meccanismo progressive disclosure (Agent skills docs). Il formato segue lo standard aperto Agent Skills (agentskills.io). Altri strumenti che lo supportano possono usare la stessa Skill con piccole modifiche ai percorsi. La documentazione dà anche due consigli che si adattano bene a un monitoraggio. Tratta gli script come scatole nere e lascia che l'agente esegua prima --help. Scrivi i flussi complessi come alberi decisionali.
.agents/
  mcp_config.json            # remote MCP config from above (keep out of Git)
  skills/
    comment-patrol/
      SKILL.md
      scripts/
        dedupe.py            # reads state/seen.json, keeps only new rows, turns "2 hours ago" into a window
        prefilter.py         # keyword pre-filter: question, negative, needs reply
      resources/
        report.schema.json   # output schema for --json-schema
state/
  seen-<video ID>.json       # comment IDs already seen, with first-seen time
reports/
<video ID>-<round>.md---
name: comment-patrol
description: Patrol YouTube and Bilibili comments in the 24 hours after a video goes live. Fetch new comments, dedupe, pre-filter, and flag complaints, questions and comments that need a reply. Use when the user asks for a comment patrol, post-launch monitoring, or a check of the comment section.
---
# Comment patrol
## Each round
1. Read `state/seen-<video ID>.json`. Create it in round 1.
2. Call everyinfra_call_api. Use only these capabilities:
- YouTube: platform=youtube, action=comments, params={url, sort: "newest", limit: 100}
- Bilibili: platform=bilibili, action=comments, params={url}; then action=danmaku, params={url, limit: 200}
- Every 4 rounds: youtube/video and bilibili/video, to record comment_count growth
3. Save each response as-is under `data/<round>/`. Run `python3 scripts/dedupe.py --help`, then use it to keep only new rows.
4. Run `scripts/prefilter.py`. Judge only rows it marks as question, negative or needs-reply, plus any theme you see repeated.
5. Output per `resources/report.schema.json`: category, severity, needs_reply, and a draft reply of at most two sentences. Never promise prices or dates.
## Decision tree
- New YouTube rows = 100 (the per-call cap): comments were missed between rounds. Write "this round may have missed comments" on line 1 and suggest a shorter interval.
- Zero new rows: do not call the model. Write "no new comments".
- Refunds, safety, legal or privacy: severity=high, no draft reply, hand to a human.
- Emoji only, "first", or similar: drop it.
## Never
- Never post a comment or reply from the account. This skill is read-only.
- Never put user names or profile links in the report. Use comment IDs only.Perché mettere la deduplicazione e il prefiltro negli script invece di chiedere al modello di contare? Primo, il costo. La risposta grezza per 100 commenti è di circa 8.075 token. Nel giro 2 solo 9 righe erano nuove, circa 505 token. Secondo, puoi verificarlo.
Uno script applica regole fisse, e lo stesso input dà sempre lo stesso output. Riserva il modello al passaggio che richiede comprensione del linguaggio. L'idea di report.schema.json viene da --json-schema in modalità headless. Il flag accetta il percorso di un file di schema. L'oggetto analizzato compare poi nel campo structured_output dell'envelope di output (Headless mode, "Structured output with a schema"). Il tuo script del timer legge solo quel campo e non deve mai estrarre una tabella da testo libero.
Prefiltro: cosa intercettano le regole basate su parole chiave e cosa si lasciano sfuggire
Prima che un modello vedesse qualsiasi commento, abbiamo applicato regole fisse ai 100 commenti di YouTube del giro 1. Abbiamo scritto le regole alle 00:29 SGT e non le abbiamo cambiate dopo aver visto altri dati. Una domanda contiene un punto interrogativo, una parola interrogativa cinese o, all'inizio, una parola interrogativa come how, why, what, is o can. Un commento conta come negativo se contiene una parola di un elenco (bad, worst, disappointed, clickbait, scam, broken e simili).
Richiede una risposta se è una domanda, oppure se è negativo con almeno 10 like. Le regole hanno segnalato 28 domande e 8 commenti negativi, 34 commenti in totale. Sui 100 danmaku hanno segnalato 29 domande e nessun negativo.
| Regola | Definizione | Corrispondenze in 100 commenti di YouTube | Corrispondenze in 100 danmaku |
|---|---|---|---|
| Domanda | Punto interrogativo, una parola interrogativa all'inizio o una parola interrogativa cinese | 28 | 29 |
| Negativo | Una parola dell'elenco dei termini negativi | 8 | 0 |
| Richiede risposta | Una domanda, oppure negativo con almeno 10 like | 28 | 29 |
| Qualsiasi segnalazione | Domanda o negativo | 34 | 29 |
Poi abbiamo letto a mano tutti i 34 commenti segnalati. Il nostro criterio: il commento riguarda questo video e il creator deve saperlo o rispondere. Solo 13 lo soddisfacevano. La maggior parte degli altri 21 erano domande retoriche e discussioni.
"A chi importa se è fatto con l'AI?" ha un punto interrogativo, ma nessuno deve rispondere. Un commento definiva stupida l'argomentazione di un ospite e iniziava con "What", quindi la regola l'ha preso per una domanda. I 13 utili rientrano in tipologie chiare. Uno spettatore ha chiesto perché il video fosse stato caricato a 30 fps.
Due hanno chiesto di una barra di sfocatura a 9:43. Un altro ha notato che lo show aveva promesso di tornare su un test di un gioco e non l'ha mai fatto. Altri hanno chiesto se il video promuova la pirateria. Questi vanno in cima a un report di monitoraggio.
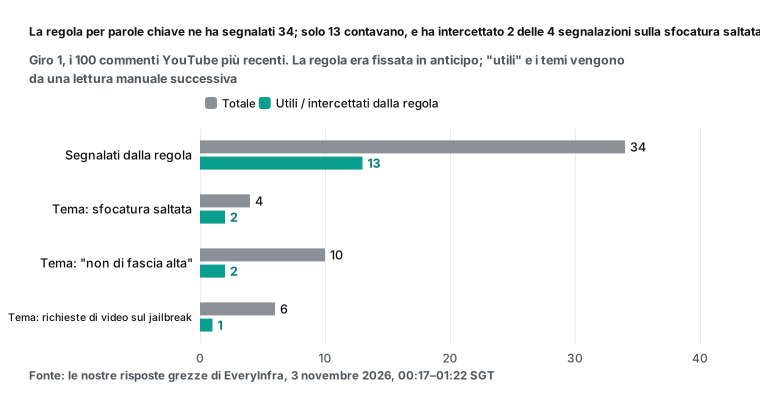
Conta di più ciò che le regole si sono lasciate sfuggire. I 66 commenti non segnalati contenevano almeno tre temi ricorrenti. Primo, una sfocatura è saltata. Quattro commenti dicevano che la sfocatura su una cartella di giochi aveva ceduto per un attimo.
Uno di loro chiedeva al team di ricontrollare il video. È un errore di produzione che il creator deve correggere subito, ma la regola ha intercettato solo i 2 commenti con punto interrogativo. Secondo, "questo non è di fascia alta". Il conduttore aveva detto che il PC di test "non era di fascia altissima", e 10 commenti hanno contestato.
La regola ne ha intercettati 2. Terzo, 6 commenti chiedevano un video sul jailbreak della PS5, cioè uno spunto per un argomento. La regola ne ha intercettato 1.
Abbiamo individuato questi temi dopo aver letto i commenti, quindi non li usiamo per valutare la regola. Mostrano una cosa. Le regole basate su parole chiave sono brave a separare il rumore evidente dalle domande evidenti. Un'opinione ricorrente senza punti interrogativi emerge solo quando un modello legge un gruppo di commenti e li raggruppa per tema.
| Commento (parafrasato, senza nome utente) | Etichetta della regola | La nostra revisione | Cosa dovrebbe dire il report |
|---|---|---|---|
| Perché è stato caricato a 30 fps? | Domanda | Utile | Problema di produzione; rispondi in un commento fissato |
| Cos'è la barra di sfocatura a 9:43? | Domanda | Utile, parte del tema "sfocatura saltata" | Priorità alta: il video potrebbe mostrare qualcosa che non dovrebbe |
| La sfocatura della cartella non ha funzionato, ricontrollate il video | Non segnalato | Utile, stesso tema | Unisci con la riga sopra, conteggio +1 |
| Se questo non è di fascia alta, il mio PC cos'è? | Non segnalato | Utile, tema "non è di fascia alta" | Una riga di sintesi: 10 commenti contestano questa frase |
| Fate un video sul jailbreak della PS5 | Non segnalato | Spunto per un argomento | Va in "gli spettatori vogliono", nessuna risposta necessaria |
| A chi importa se è fatto con l'AI?! | Domanda | Non utile (retorico) | Escludi dal report |
Ecco come potrebbe essere un report del giro 2. L'abbiamo costruito a mano a partire dalle risposte reali dei giri 1 e 2. Mostra l'output desiderato, non un'esecuzione del modello:
| Priorità | Piattaforma | Voce | Prove | Azione |
|---|---|---|---|---|
| Alta | YouTube | La sfocatura su una cartella ha ceduto per un attimo | 4 commenti nel giro 1; la regola ne ha intercettati 2 | Controlla i fotogrammi intorno a 9:43; rimonta il video o fissa una nota |
| Media | YouTube | Gli spettatori contestano la frase "non è di fascia alta" | 10 commenti nel giro 1, altri 2 nel giro 2 | Fissa una breve nota sul PC di test |
| Media | Bilibili | Gli spettatori chiedono della "modalità sopravvivenza" | 4 danmaku più 1 commento in evidenza con 352 like | Rispondi in un commento fissato |
| Bassa | YouTube | Gli spettatori vogliono un video sul jailbreak della PS5 | 6 commenti | Aggiungi all'elenco degli argomenti |
| Info | Entrambi | Copertura di questo giro | YouTube: 9 righe nuove contro +11 sul totale. Bilibili: 10 in evidenza su 4.566 | Mantieni l'intervallo di 2 ore |
Quindi la Skill divide il lavoro così. Lo script deduplica, scarta i commenti composti solo da emoji e i "first", e aggiunge a ogni riga un'etichetta della regola. Il modello riceve "i nuovi commenti di questo giro più le etichette delle regole". Il suo compito è ribaltare i falsi allarmi, unire i commenti su uno stesso tema in un'unica riga con il conteggio e assegnare una gravità a ogni tema.
I dati inviati al modello crescono di poco, ma così si recuperano i temi che sfuggono alle regole. Il giro 2 ha già mostrato perché. Due dei 9 nuovi commenti di YouTube sostenevano di nuovo che il PC di test "medio" fosse troppo potente. Nessuno dei due conteneva le parole "high end".
Cron con Antigravity CLI: eseguire agy -p da launchd, cron o systemd
Antigravity offre due modi integrati per pianificare il lavoro. Nessuno dei due è adatto a chi usa la CLI e vuole un monitoraggio ogni poche ore su un server o un laptop. Con /schedule, l'agente usa lo strumento integrato schedule per impostare un timer o un'espressione cron a cinque campi. All'ora stabilita, l'istruzione torna all'agente come notifica ad alta priorità. La documentazione specifica che la pianificazione appartiene alla conversazione che l'ha creata e termina insieme a essa. Per i job a lungo termine tra sessioni diverse, la documentazione rimanda ai sidecar (/schedule docs).
Un sidecar è un processo in background definito in ~/.gemini/config/sidecars/<name>/sidecar.json. Con "builtin": "schedule" può chiamare agentapi new-conversation secondo un'espressione cron. Ma in cima a quella pagina l'unica piattaforma supportata indicata è l'app desktop di Antigravity. I sidecar sono inoltre disattivati per impostazione predefinita e vanno abilitati uno per uno in ~/.gemini/config/config.json (Sidecars docs). Resta il timer del sistema operativo, che avvia la modalità headless.
| Scheduler | Durata | Contesto per esecuzione | Con la macchina in sospensione | Adatto a questo monitoraggio |
|---|---|---|---|---|
/schedule (dentro la CLI) | Solo la conversazione corrente | Si riattiva con l'intera cronologia della chat | Non viene eseguito se il processo non è più attivo | Va bene per seguire le prime due ore, non 24 |
Sidecar + agentapi | Tra sessioni, gestito dall'app | Una nuova conversazione ogni volta | Richiede che l'app desktop sia in esecuzione | Documentato solo per l'app desktop |
launchd di macOS + agy -p | A livello di sistema, viene eseguito dopo il login | Nuovo processo, nessuno stato | Con StartCalendarInterval viene eseguito una volta al risveglio | Buono, consigliato su Mac |
cron + agy -p | A livello di sistema | Nuovo processo, nessuno stato | Salta le esecuzioni durante sospensione o spegnimento, senza recupero | Va bene sui server, perde giri sui laptop |
Timer systemd + agy -p | A livello di sistema | Nuovo processo, nessuno stato | Persistent=true recupera dopo l'avvio | Consigliato sui server Linux |
La colonna sulla sospensione si basa sulla documentazione dei sistemi operativi. Apple spiega che i job cron non vengono eseguiti mentre la macchina è in sospensione e attendono l'orario pianificato successivo. Un job launchd con StartCalendarInterval che salta il suo orario durante la sospensione viene eseguito al risveglio della macchina. Nessuno dei due viene eseguito a macchina spenta (Apple, "Scheduling Timed Jobs").
Su Linux, lo strumento equivalente è l'opzione Persistent= di un timer systemd (systemd.timer manual). Per la sintassi di cron e le regole sull'ambiente, consulta crontab(5). Cron usa /bin/sh per impostazione predefinita e non legge il profilo della tua shell, quindi scrivi il percorso completo di agy.
Questo esempio di launchd esegue un giro ogni 2 ore su macOS. Metti il file in ~/Library/LaunchAgents/. Tieni script e dati fuori dalle cartelle Scrivania e Documenti, altrimenti la protezione della privacy di macOS li blocca:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE plist PUBLIC "-//Apple//DTD PLIST 1.0//EN" "http://www.apple.com/DTDs/PropertyList-1.0.dtd">
<plist version="1.0"><dict>
  <key>Label</key><string>com.example.comment-patrol</string>
  <key>ProgramArguments</key>
  <array><string>/Users/you/patrol/run.sh</string></array>
  <key>StartCalendarInterval</key>
  <array>
    <dict><key>Minute</key><integer>5</integer><key>Hour</key><integer>0</integer></dict>
    <dict><key>Minute</key><integer>5</integer><key>Hour</key><integer>2</integer></dict>
    <!-- the other 10 even hours follow the same pattern, 12 rounds in total -->
  </array>
  <key>StandardOutPath</key><string>/Users/you/patrol/logs/out.log</string>
  <key>StandardErrorPath</key><string>/Users/you/patrol/logs/err.log</string>
</dict></plist>
Lo script run.sh chiama Antigravity, ed è qui che si concentrano tre trappole:
#!/bin/bash
set -uo pipefail
cd /Users/you/patrol
out=$(/usr/local/bin/agy -p "Use the comment-patrol skill on the videos in videos.txt. This is round ${ROUND:-1}." \
  --output-format json \
  --json-schema .agents/skills/comment-patrol/resources/report.schema.json \
  --model gemini-3.8-flash-medium \
  --print-timeout 15m 2> logs/last-stderr.log)
status=$(echo "$out" | jq -r '.status')
reason=$(echo "$out" | jq -r '.finished_reason // "complete"')
if [ "$status" != "SUCCESS" ] || [ "$reason" != "complete" ]; then
  echo "$(date -u +%FT%TZ) patrol failed: $status $reason" >> logs/alerts.log; exit 1
fi
if grep -qi "permission\|denied" logs/last-stderr.log; then
  echo "$(date -u +%FT%TZ) a tool was soft-denied, check permissions.allow" >> logs/alerts.log; exit 1
fi
echo "$out" | jq '.structured_output' > "reports/$(date +%Y%m%d-%H%M).json"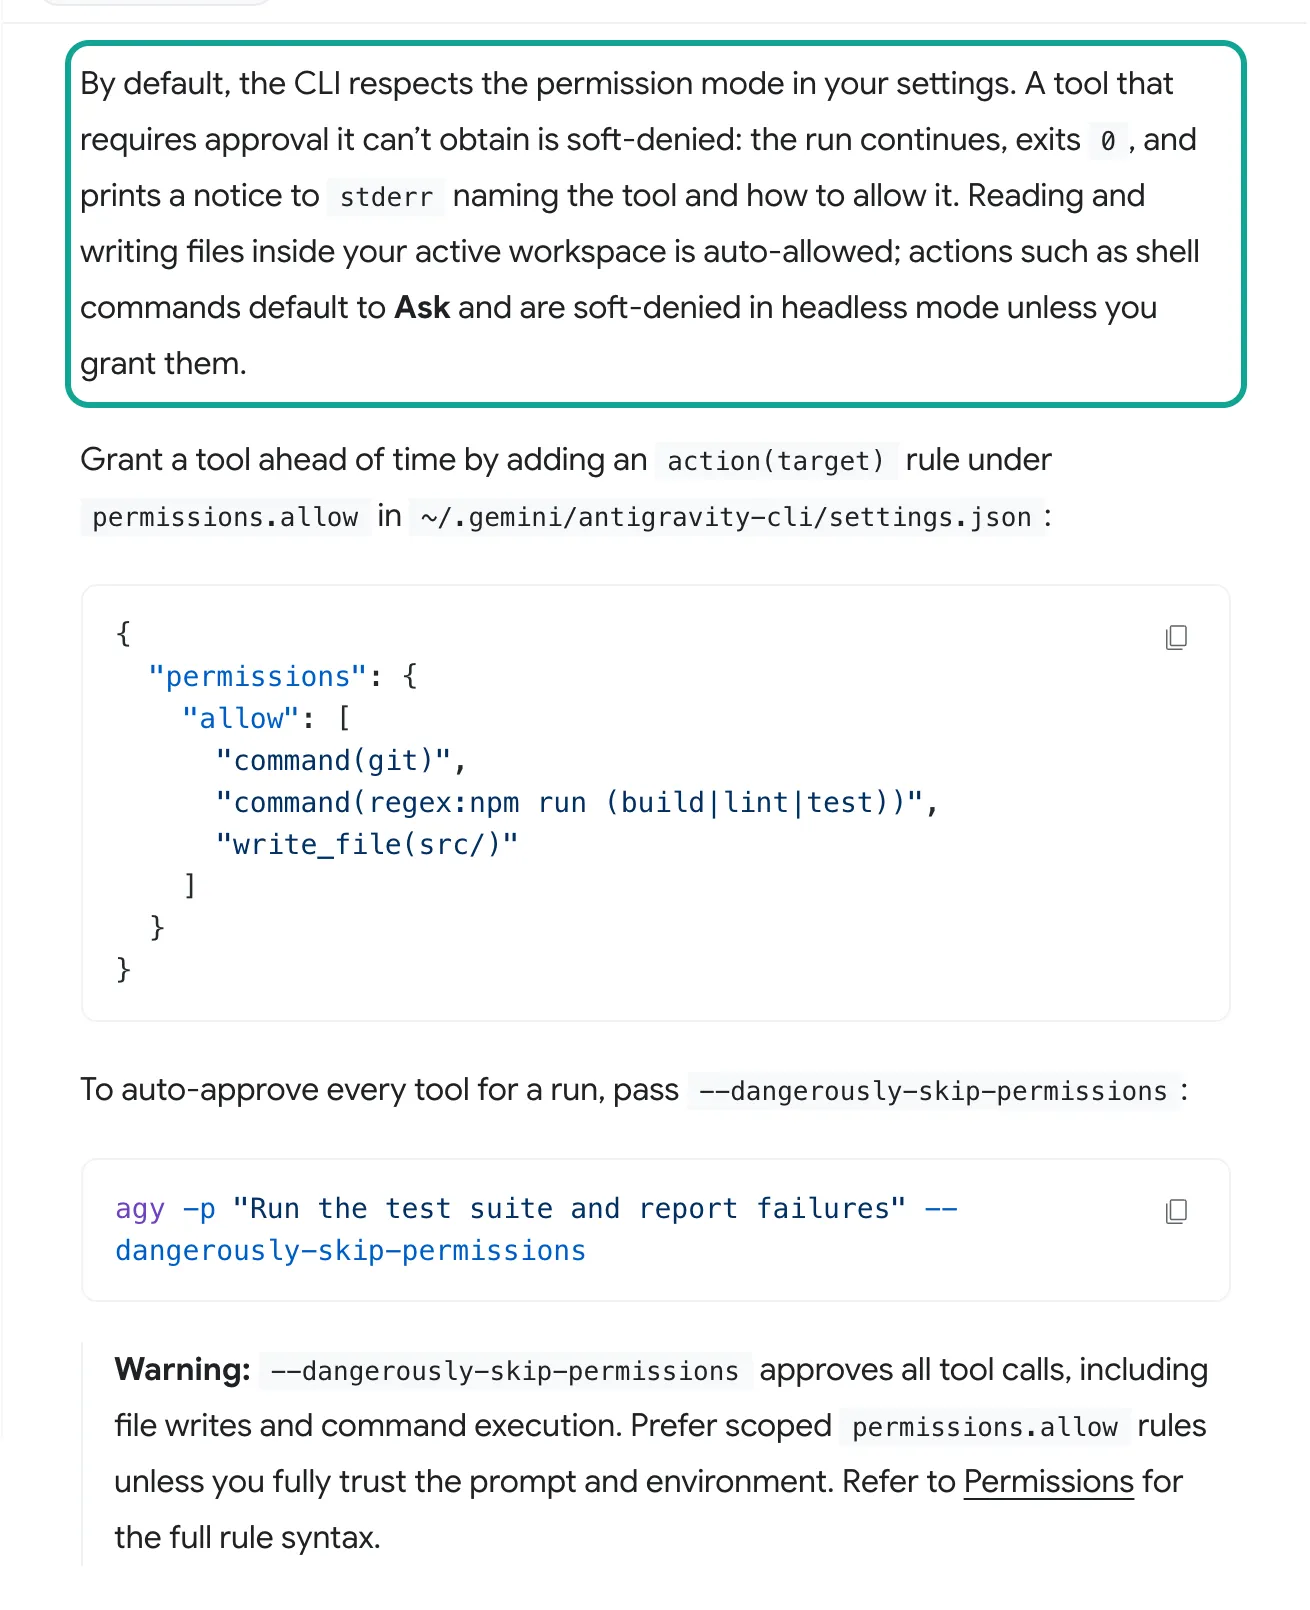
La prima trappola è il soft deny. La documentazione dice che in modalità headless non ci sono prompt interattivi. Uno strumento che richiede un'approvazione che non può ottenere viene rifiutato in modo soft. L'esecuzione prosegue, il processo termina con 0 e un avviso finisce su stderr (Headless mode, "Permissions in headless mode"). Se le tue regole permissions.allow sono sbagliate, ogni esecuzione pianificata "va a buon fine" e ogni report è vuoto.
Per questo lo script deve leggere anche stderr. La documentazione non riporta il testo esatto dell'avviso. Il nostro script cerca delle parole chiave. Prima di andare in produzione, rimuovi di proposito una regola allow, leggi una volta l'avviso reale e adatta la corrispondenza.
La seconda trappola è il login. La modalità headless usa credenziali in cache, quindi esegui agy una volta in modo interattivo per accedere. In un ambiente senza terminale e senza login, fallisce con "authentication required". Il README dice che le credenziali si trovano nel portachiavi di sistema (GitHub README, "Authentication"). Quindi il job launchd deve girare nella sessione dell'utente che ha effettuato l'accesso. Usa un LaunchAgent, non un LaunchDaemon.
La terza trappola è il timeout. --print-timeout è di 5 minuti per impostazione predefinita. Due piattaforme, diverse chiamate e un passaggio del modello possono richiedere di più, quindi il nostro esempio usa 15 minuti. La versione 1.4.11, rilasciata il 30 ottobre 2026 (UTC), ha aggiunto finished_reason all'output JSON. Il campo vale print_timeout quando l'esecuzione è stata interrotta.
Il campo è assente quando il turno termina normalmente (1.4.11 release notes). Ora il tuo script può distinguere un report completo da un report a metà. Qui conta anche una correzione precedente. Dalla 1.2.10 del 24 settembre 2026, un'esecuzione -p che fallisce durante una risposta in streaming termina con codice 3. Non sembra più un successo (1.2.10 release notes).
Costo per 24 ore: tariffe API per chiamata, uso del modello in base a quota o token
Partiamo dal lato dati. Il 3 novembre 2026, nel catalogo le cinque funzionalità di questa guida costavano ciascuna $0,000556 per chiamata: youtube/comments, youtube/video, bilibili/comments, bilibili/danmaku e bilibili/video. Il catalogo è pubblico su GET https://api.everyinfra.com/api/v1/social/catalog e non richiede alcuna chiave. Controlla sempre lì il prezzo il giorno in cui esegui. Un giro di monitoraggio fa tre chiamate principali, che insieme costano $0,001668: i 100 commenti più recenti di YouTube, i commenti in evidenza di Bilibili e i danmaku di Bilibili.
Ogni 4 giri aggiungiamo una chiamata di dettaglio per video per seguire la crescita dei commenti. Le chiamate non riuscite sono gratuite. La nostra richiesta 422 qui sopra non è costata nulla. Per riconciliare gli addebiti per ID richiesta, consulta riconciliazione dei rimborsi per le chiamate non riuscite.
| Intervallo | Giri in 24 h | Chiamate API | Tariffe API (prezzo di listino) | Lato modello (stima ai prezzi API di Gemini 3.8 Flash) |
|---|---|---|---|---|
| Ogni 1 h | 24 | 84 | $0.047 | $0.205 |
| Ogni 2 h | 12 | 42 | $0.023 | $0.103 |
| Ogni 3 h | 8 | 28 | $0.016 | $0.069 |
| Ogni 4 h | 6 | 22 | $0.012 | $0.051 |
| Ogni 6 h | 4 | 14 | $0.008 | $0.034 |
La colonna del modello è una stima: ecco il metodo, così puoi usare i tuoi numeri. Nella documentazione headless di Antigravity, un prompt di una riga mostra nell'output JSON input_tokens pari a 10.415. Di questi, cache_read_tokens è 8.113, e output_tokens è 657 (Headless mode, "JSON output"). Quindi ogni chiamata agy -p si porta dietro circa diecimila token di system prompt e definizioni degli strumenti.
Per ogni giro assumiamo questo input fisso, con 8.113 token al prezzo della cache. Aggiungiamo circa 805 token di dati: 505 per i 9 nuovi commenti di YouTube del giro 2, più circa 300 per istruzioni e righe di Bilibili. Aggiungiamo 1.500 token di output.
I prezzi provengono dalla pagina dei prezzi della Gemini API, aggiornata il 30 ottobre 2026. Gemini 3.8 Flash costa $0,75 per milione di token di input, $3,75 per milione di token di output e $0,075 per milione di token in cache. La pagina dice che questi prezzi valgono fino al 31 dicembre 2026 e raddoppiano dal 1° gennaio 2027 (Gemini API pricing). Stimiamo i token di dati come byte divisi per 4. La documentazione di Gemini dice che un token corrisponde a circa 4 caratteri (Gemini API, "Understand and count tokens"). La stima funziona per i commenti in inglese e risulta bassa per il testo cinese.
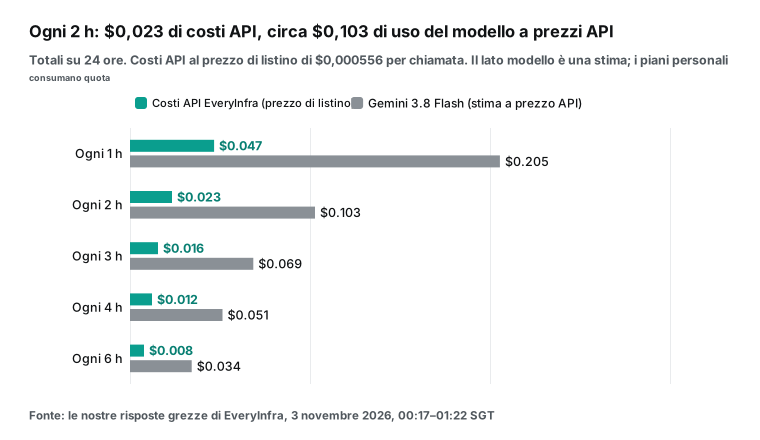
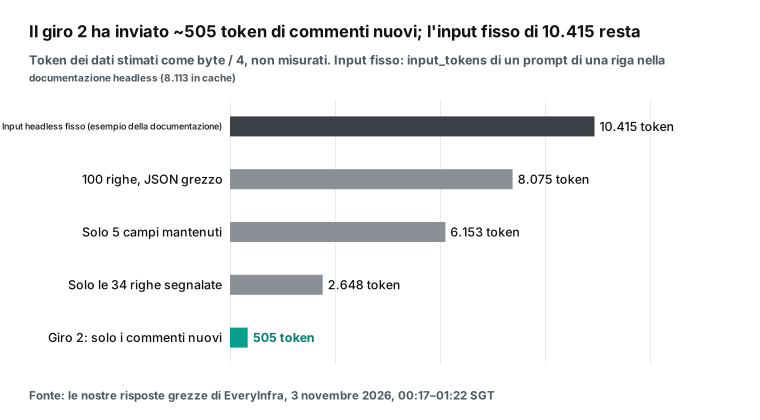
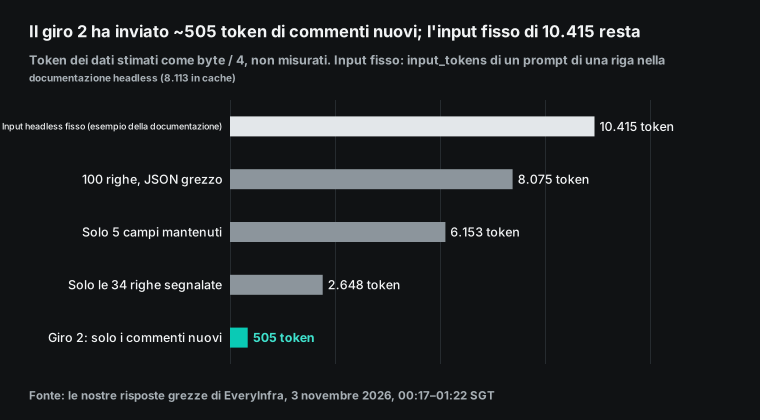
Leggi i due grafici insieme. In questo lavoro i soldi non vanno ai dati, e nemmeno soprattutto ai token dei commenti. Vanno al costo fisso di avviare agy ogni volta. Quindi risparmia in questo ordine.
Primo, allunga l'intervallo: un giro ogni 2 ore costa la metà di uno ogni ora. Secondo, salta il modello nei giri senza nuovi commenti, come indica l'albero decisionale della Skill. Solo dopo riduci i campi per commento.
Fissa inoltre il monitoraggio sul livello Flash con --model. La documentazione sui modelli dice che gli utenti free e Plus hanno solo Gemini 3.8 Flash, mentre Gemini 4 Argon richiede Pro o Ultra (Models docs). Se il tuo modello predefinito è Argon, lo stesso monitoraggio costa molto di più. Nella stessa pagina, Gemini 4 Argon costa $2 per milione di token di input e $10 per milione di token di output fino al 30 novembre 2026. Il prezzo raddoppia dal 1° dicembre.
Gli utenti privati non pagano direttamente questo conto in token. Consumano la quota del piano. La documentazione dei piani di Antigravity elenca tre livelli. Il livello gratuito ha una quota settimanale.
Pro si rinnova ogni 5 ore e ha anche un limite settimanale. Ultra è più alto. L'uso di una chiave propria non è supportato (Plans docs). Il post del blog sui piani del 19 maggio 2026 dice che Pro costa $20 al mese.
Aggiunge un livello Ultra da $100 e abbassa il vecchio Ultra da $250 a $200. I modelli Flash e Pro condividono un unico pool che si esaurisce ai prezzi API. I livelli da $100 e $200 offrono 5 e 20 volte la quota di Pro (Antigravity blog, May 19, 2026). Leggi la colonna del modello come "quanta quota usa questo monitoraggio, in dollari".
YouTube offre anche una strada gratuita. commentThreads.list costa 1 unità di quota per chiamata, e la quota predefinita è di 10.000 unità al giorno (commentThreads.list, quota calculator, updated 2026-10-15). Una chiave API può leggere i commenti dei video pubblici. Solo i commenti in attesa di revisione o probabilmente spam richiedono OAuth da parte del proprietario del video.
Il prezzo da pagare è un progetto Google Cloud, la gestione della tua quota e della logica di paginazione, e niente Bilibili. Se vuoi entrambe le piattaforme in un unico report senza due integrazioni, il pagamento a chiamata è più semplice. Consulta i prezzi per l'elenco completo.
Antigravity CLI vs Gemini CLI: cosa cambiare quando migri
Se eseguivi uno script del timer simile con Gemini CLI, la maggior parte delle modifiche riguarda la posizione dei file di configurazione e i nomi delle chiavi. I file delle regole del workspace restano invariati. Il comando di importazione ufficiale agy plugin import gemini trasforma le vecchie estensioni in plugin e scrive le loro definizioni MCP in mcp_config.json (migration guide, "Converting extensions to plugins"). Al primo avvio, agy rileva anche la vecchia configurazione e propone una checklist.
Devi comunque controllare i server MCP che hai scritto direttamente in ~/.gemini/settings.json. Controlla anche le impostazioni di attendibilità. Abbiamo costruito questa tabella confrontando riga per riga le due documentazioni ufficiali:
| Voce | Gemini CLI | Antigravity CLI | Cosa fare |
|---|---|---|---|
| Comando | gemini -p | agy -p (alias --print, --prompt) | Cambia il comando e il percorso completo negli script |
| Posizione della configurazione MCP | mcpServers nel file ~/.gemini/settings.json | ~/.gemini/config/mcp_config.json o .agents/mcp_config.json | Spostala nel nuovo file |
| Chiave dell'indirizzo remoto | url (SSE) o httpUrl (streamable HTTP) | serverUrl (funziona anche url) | Rinomina la chiave |
| Variabili d'ambiente negli header | $VAR e ${VAR} supportati | Non documentato | Presumi che non sia supportato; conserva la chiave in un file protetto |
| Saltare la conferma | trust: true a livello di server | Regole mcp(server/tool) in permissions.allow | Autorizzazione per singolo tool |
| Allowlist dei tool | includeTools / excludeTools | enabledTools / disabledTools | Rinomina le chiavi |
| Timeout | timeout in ms, predefinito 600.000 | timeoutSeconds, predefinito 180 per chiamata, 300 per la connessione | Cambia l'unità di misura |
| Cartella delle Skill del progetto | .gemini/skills/ | .agents/skills/ | Sposta la cartella |
| File di regole | GEMINI.md, AGENTS.md | Come sopra | Nessuna modifica |
| Accesso | Chiave API di Gemini a pagamento consentita | Account Google nel portachiavi per i privati; progetto Google Cloud per le aziende; niente chiave propria | Verifica il metodo di accesso prima di eseguirlo senza supervisione su un server |
L'ultima riga è la più importante per i job pianificati. La documentazione dei piani dice che non puoi usare una chiave o un endpoint tuoi per aumentare la quota (documentazione dei piani). Nella discussione su GitHub gli sviluppatori lamentano che la nuova CLI non accetta più una chiave API di AI Studio (discussione #27274). L'annuncio di maggio dice anche che Gemini CLI funziona ancora con chiavi API a pagamento e licenze enterprise. Magari il tuo monitoraggio gira su un server cloud headless e hai solo una chiave API. In quel caso la strada più semplice può essere restare su Gemini CLI. Passa ad Antigravity quando la sua documentazione spiegherà l'accesso non presidiato su server.
Non esiste un confronto ufficiale sulla quota. Un utente di Reddit riferisce che Antigravity CLI consuma la quota più in fretta. Vedi la FAQ «quale consuma meno quota» alla fine.
Però è coerente con un dato della documentazione ufficiale. Nell'esempio JSON della modalità headless, un prompt di una sola riga ha già 10.415 token di input, di cui 8.113 in cache (esempio JSON della modalità headless). Dodici esecuzioni al giorno mettono circa 120.000 token solo in overhead fisso. La sezione sui costi qui sopra ne tiene conto.
Una terza differenza riguarda l'accesso ai modelli. Gemini 4 Argon è arrivato nell'app e nella CLI di Antigravity per gli utenti Pro e Ultra il 13 ottobre 2026 (blog di Antigravity). Un thread del forum del 14 ottobre 2026 segnala un problema per alcuni utenti Ultra del piano business: non riuscivano a selezionare Argon né nell'app né nella CLI (forum per sviluppatori Google AI). Per un monitoraggio cambia poco, perché Flash basta. Controlla comunque /model una volta dopo la migrazione e fissa il modello nel tuo script.
Limiti e cosa tenere d'occhio
Sul fronte dei dati valgono quattro limiti. Primo, i commenti che la piattaforma trattiene per la revisione non sono visibili. Secondo la Guida di YouTube, con le impostazioni «Basic» o «Strict» i commenti restano in attesa in YouTube Studio fino a 60 giorni. Restano nascosti finché non vengono approvati (Guida di YouTube, impostazioni dei commenti). Qualsiasi terza parte, noi compresi, vede solo i commenti pubblici. Il proprietario di un canale che vuole i commenti in attesa deve chiamare la YouTube Data API con OAuth e moderationStatus=heldForReview (documentazione di commentThreads.list).
In secondo luogo, su YouTube gli orari sono etichette relative come «2 ore fa», e nel round 1 anche 4 righe riportavano «(modificato)». Un orario convertito è preciso solo all'ora, e sui commenti più vecchi l'errore è maggiore. In terzo luogo, su Bilibili si ottengono solo i commenti più popolari. Ne abbiamo ottenuti 3 e poi 10, a fronte di totali di 4.075 e 4.566. Su Bilibili non è possibile un monitoraggio completo di «ogni nuovo commento», quindi tieni traccia delle variazioni nei commenti più popolari e nei danmaku.
Quarto, il 30 settembre 2026 YouTube ha aggiunto snippet.imageUrl alle risorse dei commenti, come riporta la cronologia delle revisioni della Data API. I commenti con GIF e immagini arrivano a tutti gli utenti a novembre (cronologia delle revisioni della YouTube Data API). L'elenco dei campi di youtube/comments non ha un campo per le immagini. Un commento con solo un'immagine appare come testo vuoto.
Non trattare ogni testo vuoto come rumore. Il 23 settembre 2026 TechCrunch ha anche riportato che YouTube sta testando una moderazione dei commenti regolabile da ogni creator (TechCrunch). Aspettati che l'insieme dei commenti visibili cambi man mano che il test si estende.
Sul fronte Antigravity, la CLI è closed source e cambia in fretta. Questa guida si basa sulla documentazione consultata il 3 novembre 2026 e sulle note di rilascio della 1.4.12. La documentazione dei sidecar elenca solo l'app desktop. La modalità headless dipende dal login in cache, e la documentazione non spiega l'accesso non presidiato su un server cloud.
La quota del piano personale si consuma in base al lavoro svolto, e la documentazione dei piani avverte che le quote possono cambiare. Considera i nostri costi come stime. Il pannello /usage mostra i valori reali (documentazione di /usage).
Infine, ci sono limiti d'uso. La Skill è di sola lettura e non pubblica nulla. EveryInfra legge dati pubblici e non può pubblicare a nome del tuo account. Qualsiasi bozza di risposta la invia una persona da YouTube Studio o dal Bilibili Creator Center. Nei report conserva solo ID e testo dei commenti, mai nomi utente o link ai profili. Rispetta i termini di ogni piattaforma e le leggi sulla privacy del paese in cui operi.
Nemmeno le etichette sono perfette. Le nostre regole basate su parole chiave hanno segnalato 34 commenti, e solo 13 meritavano il tempo del creator. Le regole hanno anche mancato metà dei commenti su «la sfocatura si è spostata».
Non abbiamo testato le etichette del modello. Prima di andare in produzione, etichetta a mano gli stessi 100 commenti e confrontali con l'output del modello. Gli elementi «high» li legge sempre una persona. Il modello si limita a ridurre 100 commenti a una dozzina circa.
Cosa è cambiato di recente
- Il 30 ottobre 2026 (UTC), Antigravity CLI 1.4.11 ha aggiunto
finished_reasona--output-format json. Lo stesso giorno, la 1.4.12 ha corretto le tabelle Markdown rotte nelle risposte lunghe (1.4.11, 1.4.12). Cosa significa per te: uno script con timer ora può distinguere «report completato» da «interrotto per timeout». Usa la 1.4.11 o successive. - Il 29 ottobre 2026, la versione 1.4.10 ha ridotto di circa il 70% le scritture sul terminale in streaming e libera circa 100 MB di memoria dopo l'avvio nella UI interattiva. Le note dicono che le modalità print e headless non sono interessate dalla modifica sulla memoria (1.4.10). Cosa significa per te: molte release riguardano la UI interattiva. Prima di aggiornare un job con timer, cerca in ogni nota le voci sulla modalità headless.
- Il 24 ottobre 2026, la versione 1.4.7 ha ridotto l'uso della CPU nelle esecuzioni headless con
-p. Ha anche portato da 4 KB a 10 KB la dimensione dei risultati MCP on demand restituiti direttamente all'agente (1.4.7). Cosa significa per te: 100 commenti di YouTube pesano circa 33 KB, ancora oltre i 10 KB. Comprimi prima le nuove righe con uno script. - Il 13 ottobre 2026, Gemini 4 Argon è arrivato nell'app e nella CLI di Antigravity per gli utenti Google AI Pro e Ultra (blog di Antigravity). Lo stesso giorno, la versione 1.3.4 ha fatto sì che un nome
--agentsconosciuto termini con codice 1 in modalità headless (1.3.4). Cosa significa per te: Gemini 3.8 Flash basta per smistare i commenti, e un refuso nello script ora genera un errore evidente. - La pagina dei prezzi della Gemini API è stata aggiornata il 30 ottobre 2026. Indica Gemini 3.8 Flash a $0,75 per l'input e $3,75 per l'output per milione di token fino al 31 dicembre. Dal 1° gennaio 2027 i prezzi raddoppiano. Gemini 4 Argon costa $2 e $10 fino al 30 novembre, poi raddoppia (prezzi della Gemini API). Cosa significa per te: la quota del piano si consuma ai prezzi dell'API (post di maggio sui piani). Google non ha detto se i nuovi prezzi dell'API cambiano la velocità di consumo. Tieni d'occhio
/usageper una settimana dopo il lancio.
FAQ
Dove va la configurazione MCP di Antigravity CLI?
Il file globale è ~/.gemini/config/mcp_config.json. Un file di progetto è .agents/mcp_config.json nella root del progetto, come indica la guida alla migrazione. Un utente di Reddit ha trovato la configurazione scritta in ~/.gemini/antigravity-cli/ e ha dovuto copiarla in ~/.gemini/config/ (thread su r/google_antigravity). Il controllo più rapido dopo la configurazione è /mcp. (Domanda tratta dal suggerimento di Google «antigravity cli mcp config».)
Antigravity CLI o Gemini CLI: quale consuma meno quota?
Non esiste un confronto ufficiale. Un post su Reddit con 35 upvote dice che Antigravity CLI ha esaurito due account Pro in due ore di sviluppo web. Gemini CLI ne ha usato circa il 10% in quattro ore (è il resoconto di una persona, non una misurazione). Quello che sappiamo: la quota personale si consuma ai prezzi dell'API, Flash e Pro condividono un unico pool, e ogni chiamata headless porta con sé circa 10.000 token di input fissi. Per job brevi come un monitoraggio, lascia che sia prima uno script a deduplicare e prefiltrare. Manda al modello solo qualche centinaio di token di nuovi commenti e fissa --model su Flash. (Domanda tratta dal suggerimento «antigravity cli vs gemini cli quota» e dal thread su r/GeminiCLI.)
Posso usare /schedule per un cron job di Antigravity CLI?
Può fare un controllo ogni pochi minuti finché una conversazione resta aperta. Non può eseguire un job di 24 ore senza nessuno presente. /schedule accetta espressioni cron a cinque campi e MaxIterations, ma appartiene alla conversazione corrente. La documentazione suggerisce i sidecar per i job lunghi, e i sidecar elencano solo l'app desktop. Chi usa la CLI ottiene un risultato più stabile con launchd, cron o systemd che chiamano agy -p. (Domanda tratta dai suggerimenti «antigravity cli cron job» e «antigravity cli cron expression».)
Cos'è la modalità yolo di Antigravity CLI, e un timer dovrebbe usarla?
Il riferimento della CLI non ha nessun flag chiamato yolo. I più vicini sono --dangerously-skip-permissions, che consente ogni tool, e l'impostazione toolPermission: "always-proceed". Un monitoraggio ha bisogno solo di tre tool MCP e di una cartella per i report. Elencali invece per nome in permissions.allow. (Domanda tratta dal suggerimento «antigravity cli yolo mode». I flag sono nel riferimento della CLI.)
YouTube ha già uno strumento di moderazione dei commenti. Perché costruire un monitoraggio?
La moderazione di YouTube Studio trattiene i commenti sospetti. Risponde alla domanda «cosa deve restare nascosto». Un monitoraggio risponde a «quali commenti pubblici sono domande o lamentele, o richiedono una risposta». Inoltre mette YouTube e Bilibili in un unico report e funziona anche sui video dei concorrenti.
Per il tuo canale usali entrambi: Studio per i commenti in attesa, il monitoraggio per dare seguito a quelli pubblici. (Domanda tratta dal suggerimento «youtube comment moderation tool». Le impostazioni sono nella Guida di YouTube.)
Uno scraper di commenti di Bilibili può ottenere tutti i commenti di un video?
Non con bilibili/comments. Il catalogo indica al massimo 10 per chiamata, e un limite più alto viene ridotto. Nel nostro test ha restituito 3 e poi 10 commenti più popolari, mentre il video ne aveva oltre quattromila. Rifiuta anche un parametro di ordinamento.
Solo il proprietario del video vede tutto, nel Creator Center o tramite un'app approvata della piattaforma aperta. Per un monitoraggio, considera Bilibili come due segnali: commenti più popolari e danmaku. (Domanda tratta da un suggerimento di ricerca cinese che significa «scraper di commenti Bilibili».)
Per iniziare
- Ottieni una chiave API dalla guida rapida. Leggi prima il catalogo gratuito:
GET https://api.everyinfra.com/api/v1/social/catalog?platform=youtube. Fai lo stesso con?platform=bilibili. - Nelle pagine YouTube API e Bilibili API, prova una volta l'endpoint dei commenti con l'URL di un tuo video.
- Scrivi
.agents/mcp_config.jsonepermissions.allowcome mostrato sopra. Eseguiagyuna volta in modalità interattiva e controlla/mcpe/permissions. - Metti la Skill in
.agents/skills/comment-patrol/. Eseguiagy -pa mano una volta. Verifica chestructured_outputcorrisponda allo schema e che stderr non mostri tool negati. - Affidalo a launchd, cron o systemd. Il primo giorno eseguilo ogni 2 ore, controlla se alla riga 1 compare «may have missed comments», poi regola l'intervallo.
Lo stesso approccio funziona in altri strumenti di AI. Per i job pianificati in Claude Code, vedi Le attività pianificate di Claude Code per i pain point di Reddit. Per un altro modo di collegare Gemini a un server MCP remoto, vedi Gemini Deep Research API con MCP remoto. Per la pulizia e l'etichettatura dei commenti, vedi DeepSeek V4 e Claude Code per la pulizia dei commenti.
Abbiamo consultato tutte le fonti esterne di questa guida il 3 novembre 2026 (SGT). Le date nell'elenco dei riferimenti sono quelle di pubblicazione o aggiornamento indicate su ciascuna pagina.
Riferimenti
- Google Developers Blog: «transitioning Gemini CLI to Antigravity CLI», 19 maggio 2026.
- gemini-cli, discussione GitHub #27274.
- «Antigravity CLI migration guide».
- «Antigravity CLI reference».
- «Antigravity CLI headless mode».
- «Antigravity /schedule command».
- «Antigravity sidecars».
- «Antigravity MCP docs» (scheda CLI).
- «Antigravity Agent skills docs» (scheda CLI).
- «Antigravity permissions docs» (scheda CLI).
- «Antigravity plans docs».
- «Antigravity models docs».
- «Antigravity CLI modes».
- «Antigravity CLI /usage command».
- Changelog di Antigravity.
- Repository google-antigravity/antigravity-cli.
- Note di rilascio di Antigravity CLI 1.4.12, 30 ottobre 2026 (UTC).
- Note di rilascio di Antigravity CLI 1.4.11, 30 ottobre 2026 (UTC).
- Note di rilascio di Antigravity CLI 1.4.10, 29 ottobre 2026.
- Note di rilascio di Antigravity CLI 1.4.7, 24 ottobre 2026.
- Note di rilascio di Antigravity CLI 1.3.4, 13 ottobre 2026.
- Note di rilascio di Antigravity CLI 1.2.10, 24 settembre 2026.
- Note di rilascio di Antigravity CLI 1.2.9, 23 settembre 2026.
- «Gemini CLI MCP docs».
- Blog di Antigravity: modifiche ai piani, 19 maggio 2026.
- Blog di Antigravity: Gemini 4 Argon, 13 ottobre 2026.
- Blog di Antigravity: Gemini 3.8 Flash.
- Blog di Google: lancio di Gemini 4 Argon, 30 settembre 2026.
- «Gemini API pricing».
- Gemini API: «understand and count tokens».
- Forum per sviluppatori Google AI: «business Ultra users cannot access Gemini 4 Argon in Antigravity», 14 ottobre 2026.
- «MCP specification 2026-07-28: Transports».
- Standard aperto Agent Skills.
- «YouTube Data API: commentThreads.list».
- «YouTube Data API quota calculator».
- «YouTube Data API revision history».
- Guida di YouTube: impostazioni dei commenti.
- TechCrunch: le funzionalità dei commenti di YouTube, 23 settembre 2026.
- «Bilibili Open Platform».
- Documentazione per sviluppatori Apple: «Scheduling Timed Jobs».
- Manuale di crontab(5).
- Manuale di systemd.timer.
- r/google_antigravity: «Antigravity CLI MCP Servers Pain».
- r/google_antigravity: variabili d'ambiente nella configurazione MCP.
- r/GeminiCLI: perché Antigravity CLI consuma così tanta quota.
- The New Stack: il sostituto di Gemini CLI, 20 giugno 2026.
- Video di esempio su YouTube.
- Video di esempio su Bilibili.
- Catalogo EveryInfra: YouTube.
- Catalogo EveryInfra: Bilibili.
Riferimenti BL-72