Skills в Gemini заменяют Gems: еженедельная сводка популярных постов
17 ноября Gemini Gems станут доступны только для чтения. Перейдите на skills в Gemini на примере еженедельной сводки популярных постов: SKILL.md, три способа получить данные и реальные тесты четырёх API списков трендов.
Что делать сейчас: в личном аккаунте Google (для пользователей от 18 лет) Gemini Gems станут доступны только для чтения 17 ноября 2026 года, то есть через 13 дней. 17 декабря 2026 года Google их удалит. Уже сейчас пересоздайте как skill каждый Gem, которым вы ещё пользуетесь каждую неделю, и скачайте его файлы знаний.
У рабочих и учебных аккаунтов сроки позже: не раньше 1 марта 2027 года и 1 июня 2027 года. Запуск skills в приложениях Workspace тоже «отложен до дальнейшего уведомления». Все эти даты взяты из блога Google Workspace Updates и страниц справки Gemini. В первом разделе для каждой даты указан источник.
В этой статье переход показан на одной реальной задаче. Мы собираем еженедельную сводку популярных постов в виде файла SKILL.md. Каждый понедельник Gemini читает популярные посты Reddit за прошедшую неделю, список трендов Zhihu, горячие запросы Weibo и тренды X и пишет отчёт на одну страницу. По пути мы упираемся в главное ограничение приложения Gemini: скрипты внутри skills не могут выходить в интернет и отправлять запросы на внешние сайты. Поэтому сбор данных должен оставаться за пределами skill.
Мы предлагаем три способа передать данные в Gemini: локальные снимки с загрузкой файла, собственное приложение в Connected Apps и агент на Gemini API с триггером. Мы также проверяем, работает ли тот же SKILL.md в Claude и Codex.
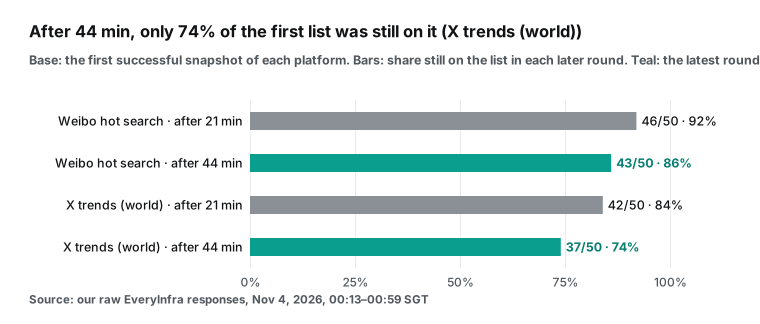
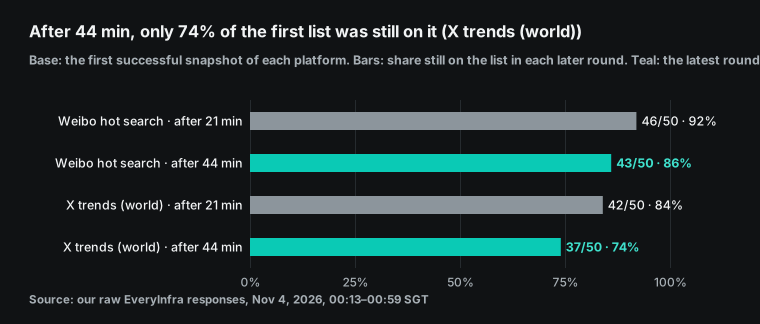
На стороне данных мы делали реальные вызовы. 4 ноября 2026 года с 00:13 до 00:59 SGT мы вызывали reddit/trending_posts, zhihu/hot_list, weibo/trending и twitter/trending в EveryInfra в 3 раунда. Один вызов прошёл через метод tools/call удалённого MCP-сервера. В 02:05 SGT мы ещё раз запросили два списка, которые не ответили. Главный результат: списки быстро меняются. Через 44 минуты в списке Weibo оставалось только 86% прежних позиций.
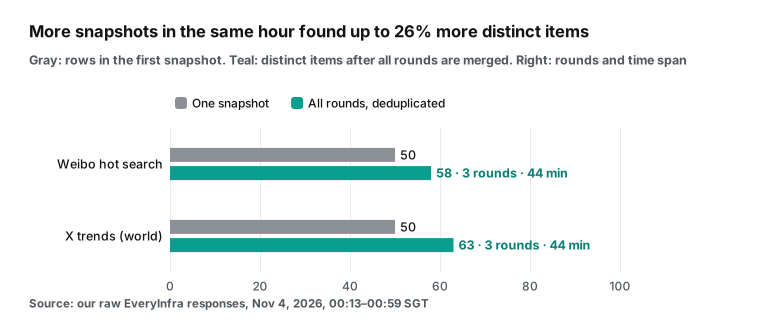
Через 44 минуты в списке X оставалось только 74% прежних позиций. 3 раунда вместе дали на 16% и 26% больше уникальных тем, чем один снимок, поэтому для еженедельной сводки нужно несколько снимков в день.
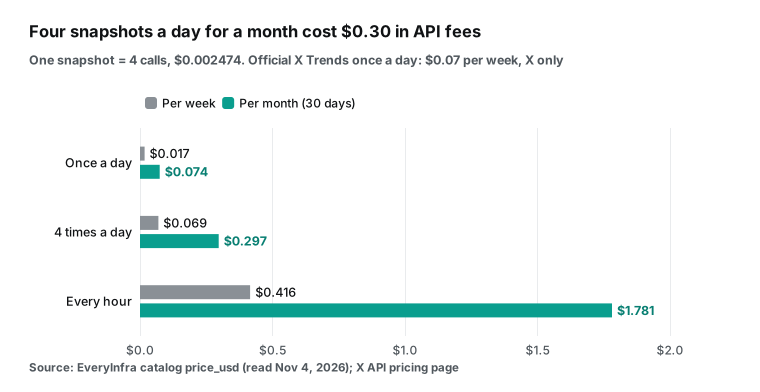
Во время теста список трендов Zhihu и популярные посты Reddit были недоступны. Все 8 запросов к Zhihu вернули 503, а Reddit отдал данные только в раунде 1. За неудачные вызовы плата не списывалась. Поэтому цифры в сводке ниже взяты только из Weibo и X. Это также показывает, почему в skill обязательно должно быть правило «если данных нет, так и скажи». По ценам каталога в нашем примере с четырьмя снимками в день все четыре списка обходятся в $0,297 в месяц.
На нашей тестовой машине вход в Gemini не выполнен. Поэтому загрузка skill, собственное приложение и триггер Gemini API приведены как примеры конфигурации, а не как реальные запуски. Они основаны на официальной документации по состоянию на 4 ноября.


Что делать сейчас: 17 ноября Gemini Gems станут доступны только для чтения
Даты важнее функций, поэтому начнём с них. Страница справки Gemini Apps о переходе говорит об этом прямо. В личных аккаунтах Google пользователей от 18 лет Gems станут доступны только для чтения 17 ноября 2026 года. Открыть их можно будет, но использовать, редактировать и создавать новые нельзя. 17 декабря 2026 года Gems исчезнут из Gemini Apps, и доступ к ним будет потерян (Gemini Apps Help: About the transition from Gems to skills).
У рабочих аккаунтов больше времени. На той же странице для аккаунтов Workspace для бизнеса, предприятий и некоммерческих организаций указан март 2027 года, а для учебных аккаунтов июнь 2027 года. На странице Workspace Admin Help приведены точные дни: 1 марта 2027 года и 1 июня 2027 года (Admin Help). В посте Workspace Updates для обеих дат используется формулировка «no sooner than», то есть «не раньше» (Workspace Updates, 30 сентября 2026 года).
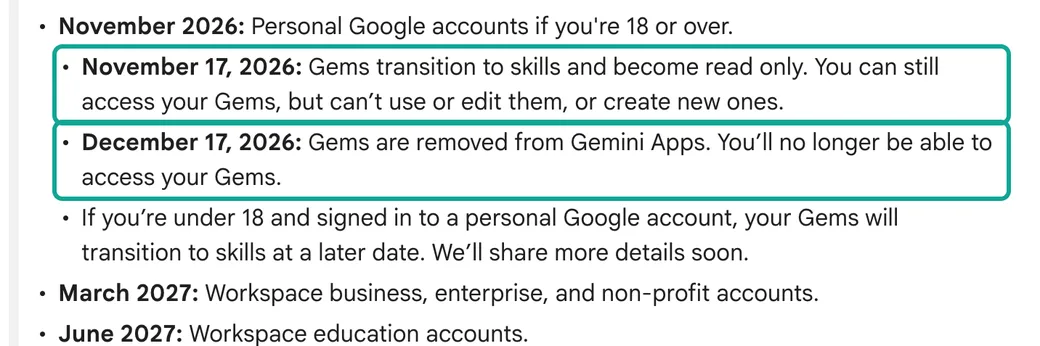
Одна деталь вызывает путаницу. В посте Workspace Updates от 30 сентября есть список «Key dates». В строке о 17 ноября сказано, что Gems переезжают в панель настроек и пользователи по-прежнему могут их создавать, редактировать и использовать. А страница справки для личных аккаунтов для того же дня указывает режим «только для чтения». Эти две строки относятся к разным аккаунтам.
Строка из блога относится к графику Workspace. Строка со страницы справки касается только личных аккаунтов пользователей от 18 лет. Многие пересказы объединяют их в «17 ноября всё станет только для чтения у всех». Источники говорят другое.
| Тип аккаунта | Режим только для чтения или перенос в «Настройки» | Gems перестают работать | Gems удаляются | Источник |
|---|---|---|---|---|
| Личный аккаунт Google пользователя от 18 лет | 2026-11-17, режим только для чтения | 2026-11-17 | 2026-12-17 | Gemini Apps Help |
| Личный аккаунт пользователя младше 18 лет | «Позднее» | Не указано | Не указано | Gemini Apps Help |
| Workspace для бизнеса, предприятий, некоммерческих организаций | 2026-11-17, перенос в раздел «Настройки», пользоваться по-прежнему можно | Не раньше 2027-03-01 | В тот же день; оставшиеся Gems становятся черновиками skills | Workspace Updates, Admin Help |
| Workspace для образования | То же, что выше | Не раньше 2027-06-01 | В тот же день, также Classroom и LTI | То же |
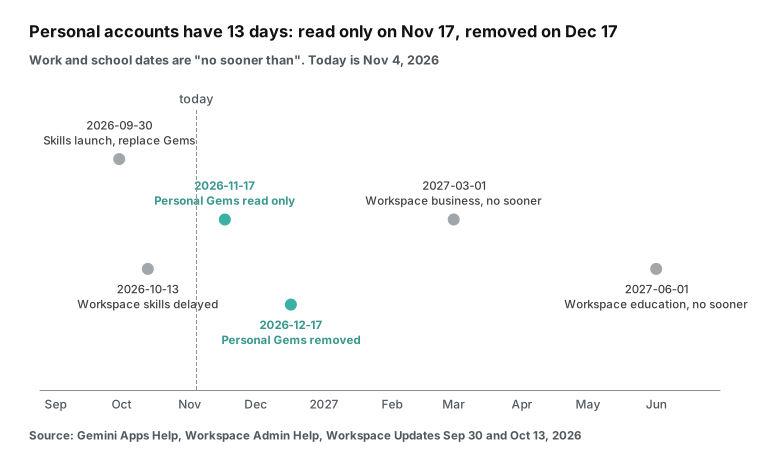
Если у вас личный аккаунт, у вас есть 13 дней с момента написания этой статьи. Мы видим три задачи. Во-первых, скачайте инструкции и файлы знаний каждого Gem, которым вы ещё пользуетесь. Один skill вмещает не более 100 МБ файлов.
Если Gem больше, при автоматической миграции первыми исключаются самые большие файлы. Аудио, видео, архивы, файлы GitHub и файлы старых форматов Office (.doc, .xls, .ppt) не переносятся совсем. После 17 декабря вернуть их не получится (та же страница справки, раздел «Limits on files during the transition»).
Во-вторых, пересоздайте еженедельные Gems как skills вручную. Не ждите автоматической миграции. Миграция создаёт «неактивные черновики», и каждый из них нужно проверить и активировать, прежде чем им можно будет пользоваться или делиться (Admin Help, раздел «How automated migration will work»). В-третьих, проверьте, какие инструменты нужны каждому Gem. На странице справки сказано, что skills пока не работают с Create video, Create music, Canvas, Deep Research и Guided learning. Если Gem зависит от одного из этих инструментов, предусмотрите другой способ.
У рабочих аккаунтов есть время, но кое-что уже изменилось. В Workspace Studio в новый поток нельзя добавить шаг «Ask a Gem». Существующие потоки продолжат работать до 2027 года. Кроме того, запуск skills в приложениях Workspace отложен. В обновлении от 13 октября сказано, что развёртывание для доменов Rapid Release и Scheduled Release «отложено до дальнейшего уведомления» (Workspace Updates, 13 октября 2026 года).
Skills в приложении Gemini выходят по графику. Развёртывание началось 13 октября и должно завершиться к середине ноября. В том же посте сказано, что skills не синхронизируются между приложением Gemini и приложениями Workspace. Каждый skill нужно создать в обоих местах.
Skills или Gems в Gemini: что изменилось
Gem — это отдельная настроенная версия Gemini. Вы открываете его и общаетесь в его собственном окне. Skill — это набор инструкций, который можно подключить в любом чате. Вы вводите / и имя skill, а на странице справки сказано, что позже для вызова будет использоваться @.
Gemini также может сам выбрать skill, если имя и описание подходят к вашему запросу. В одном чате можно комбинировать несколько skills (Create & manage skills for Gemini Apps). В Workspace Updates сказано, что skills «полностью построены на открытом стандарте SKILL.md, основанном на Markdown». Поэтому skills с других платформ можно скопировать в Gemini (Workspace Updates, 30 сентября 2026 года).
| Пункт | Gems | Skills в приложении Gemini (по состоянию на 4 ноября 2026 года) |
|---|---|---|
| Как пользоваться | Открыть Gem в отдельном окне | Ввести / (позже @) в любом чате или позволить Gemini применить skill автоматически |
| Сколько одновременно | Один | Несколько; skill также может ссылаться на другие skills |
| Формат | Веб-форма | Веб-форма или загрузка SKILL.md, папки или .zip |
| Правило именования | Свободный текст | Только строчные буквы и дефисы, например my-new-skill |
| Файлы | Файлы знаний | Всего 100 МБ; только текстовые файлы; без аудио, видео и архивов |
| Инструменты | Видео, музыка, Canvas, Deep Research и другие инструменты | Работают с Connected Apps; пока не работают с видео, музыкой, Canvas, Deep Research, Guided learning |
| Скрипты с доступом в интернет | Неприменимо | Нет: загруженные скрипты не могут выходить в интернет и отправлять запросы на внешние сайты |
| Требуемый тариф | Бесплатно | Skills бесплатны; для запланированных Tasks нужен Google AI Pro или Ultra |
| Совместный доступ | Да | «В ближайшие недели» |
Строка про скрипты описывает проблему, которую решает эта статья. Еженедельной сводке популярных постов нужны внешние данные: популярные посты Reddit, список трендов Zhihu, горячие запросы Weibo и тренды X. В Claude Code или Codex skill может запустить скрипт, который вызывает API, или агент может вызвать MCP-инструмент. Этот способ показан в нашей статье один SKILL.md в четырёх ИИ-инструментах. С приложением Gemini всё иначе.
На странице справки в разделе о загрузке указаны два ограничения. Скрипты, которым нужен доступ в интернет, не поддерживаются. В разделе «Security restrictions» сказано, что скрипты не могут выполнять действия и отправлять запросы на внешние сайты. Поэтому в приложении Gemini skill не собирает данные. Данные должны поступать из другого места.
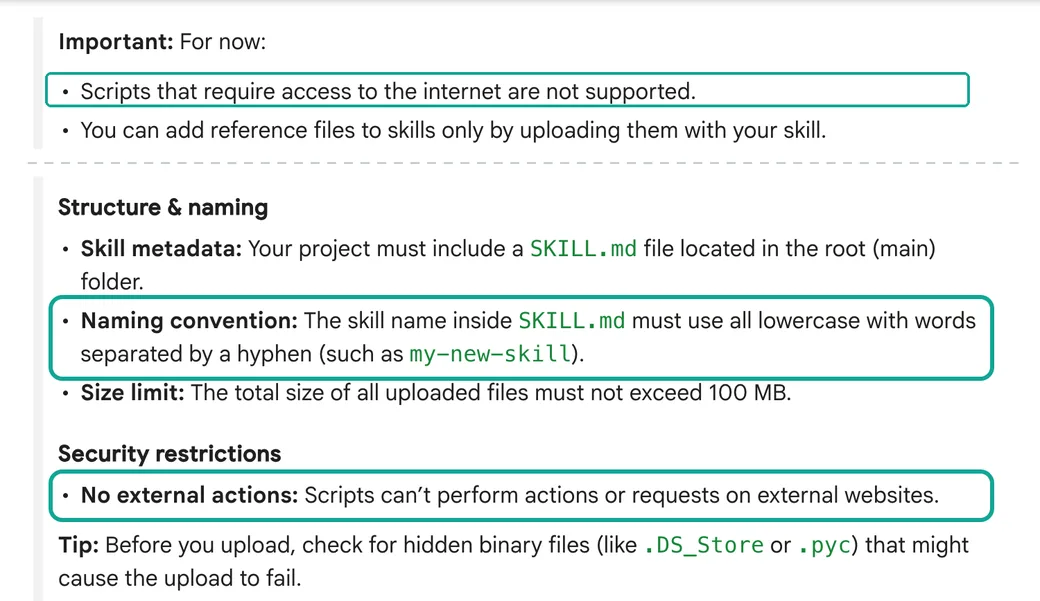
Это ограничение определяет структуру статьи. Skill говорит Gemini, как писать сводку. Данные идут отдельным путём. Сначала мы опишем задачу, а затем три способа передать данные в Gemini.
Как перенести Gem в skill
Страница справки описывает три ручных шага. Откройте Gem и по одному скачайте его файлы знаний. Создайте новый skill и скопируйте в него имя, описание и инструкции из Gem. Чтобы добавить файлы, скачайте skill в виде папки, добавьте в неё файлы и загрузите всю папку (страница справки). На практике четыре части лучше переписать, а не копировать.
Первая часть — имя. Gem может называться как угодно. Имя skill должно состоять из английских слов в нижнем регистре через дефис, например weekly-hot-posts-digest. В справочной статье об эффективных skills советуют начинать имя с глагола. Там же рекомендуют избегать пустых слов вроде helper, tools или data (Write effective skills).
Вторая часть — описание. Описание Gem пишется для людей. Описание skill пишется для Gemini, потому что Gemini решает, подходит ли skill, только по имени и описанию. Пишите его от третьего лица: сначала что делает skill, затем «Используйте, когда…» со списком случаев.
Лимит составляет 1 024 символа. В той же статье советуют записывать шаги в виде чек-листа и указывать Gemini, что делать, если данных нет. Для дайджеста второй пункт критически важен. Пример правила: «если у платформы нет данных за эту неделю, так и скажи и не заполняй их по памяти».
Третья часть — файлы знаний. Gem часто каждый раз читает один большой справочный файл. Skill загружает содержимое только тогда, когда оно нужно. Сначала Gemini читает имя и описание.
Полные инструкции он читает, только если skill выглядит подходящим, а прикреплённые файлы открывает, только когда они нужны на каком-то шаге. Поэтому длинные шаблоны и примеры отчётов кладите в папку references/. А в инструкциях пишите «на шаге 5 используй references/report-template.md».
Четвёртая часть — инструменты. Если Gem использовал Deep Research или Canvas, в skill эта часть пока не работает. Нашей сводке эти инструменты не нужны. От Gemini требуется только прочитать таблицу, сгруппировать записи и написать текст.
Задача: еженедельная сводка популярных постов и сколько снимков для неё нужно
Результат работы — еженедельный отчёт на одну страницу. Он отвечает на три вопроса о последних семи днях на Reddit, Zhihu, Weibo и X. Какие темы держались в списках трендов много дней? Какие темы быстро поднялись и затем пропали?
Появлялась ли одна и та же история на нескольких платформах? Читатели отчёта — специалисты по контент-планированию, команды брендов и PR-команды, а также аналитики рынка. В понедельник утром они открывают одну страницу, и им не нужно читать четыре списка трендов.
Написать отчёт просто. Сложно получить данные за неделю. Список трендов — это снимок, а не журнал. Каждая платформа показывает только текущий топ, и через несколько минут список меняется. Ни одна платформа не отдаёт «все позиции, которые были в списке на этой неделе». Платформы сами пишут об этом в своих правилах.
Weibo сообщает, что список горячих запросов обновляется каждую минуту и показывает топ-50 (правила горячих запросов Weibo). Zhihu сообщает, что список трендов обновляется каждые 10 минут и показывает топ-30 (описание списка трендов Zhihu). Reddit и X частоту обновления не публикуют. В нашем каталоге reddit/trending_posts возвращает около 25 постов на страницу, а токен страницы действует 24 часа. twitter/trending возвращает список для одной локации, и у каждой записи есть время collected_at. В описании поля сказано, что тренды быстро меняются, поэтому свежесть записи оценивайте по этому времени.
| Список трендов | Возможность EveryInfra | Записей за вызов | Как платформа ранжирует | Частота обновления | Цена в каталоге (4 ноября 2026 года) |
|---|---|---|---|---|---|
| Популярные посты Reddit | reddit/trending_posts | Около 25 на страницу; следующие страницы по токену | Не публикуется | Не публикуется | $0,000556 за страницу |
| Список трендов Zhihu | zhihu/hot_list | До 30 | Поиск, чтение, взаимодействия и кликабельность | Каждые 10 минут | $0,000806 за вызов |
| Горячие запросы Weibo | weibo/trending | По умолчанию 20, максимум 200 (в самом списке 50) | (Поиск + обсуждение + распространение) × уровень вовлечённости | Каждую минуту | $0,000556 за вызов |
| Тренды X | twitter/trending | Около 50 для одной локации | Не публикуется | Не публикуется | $0,000556 за вызов |
Поэтому правильный способ для еженедельной сводки — делать много снимков в течение недели и затем объединять их. Для каждой позиции в отчёте нужны три числа: в скольких снимках она встретилась, её лучшее место в списке и максимальное значение популярности. Один снимок всех четырёх списков стоит $0,002474 (3 × $0,000556 + $0,000806, по полю каталога price_usd). Главный вопрос в том, сколько снимков нужно.
Слишком мало — и вы упустите темы. Слишком много — и вы платите за данные, которые не используете. Чтобы ответить на этот вопрос, мы провели 3 раунда реальных вызовов. Результаты приведены ниже, в разделе с тестом.
Сравнение цен также показывает, почему для этой задачи мы не советуем официальные API платформ. В документации для разработчиков X указаны цены с оплатой по факту использования, и эндпоинт Trends стоит $0.010 за запрос (X API pricing). Это примерно в 18 раз больше каталожной цены twitter/trending. Собственный API Reddit сначала требует одобрения заявки. Подробности приведены в примечании «Условия платформ» в разделе об ограничениях.
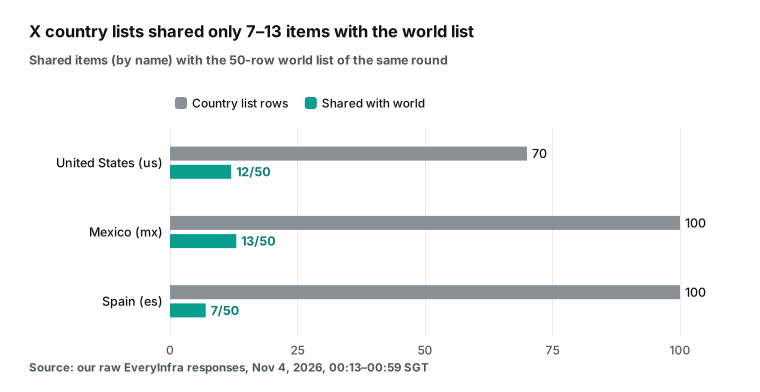
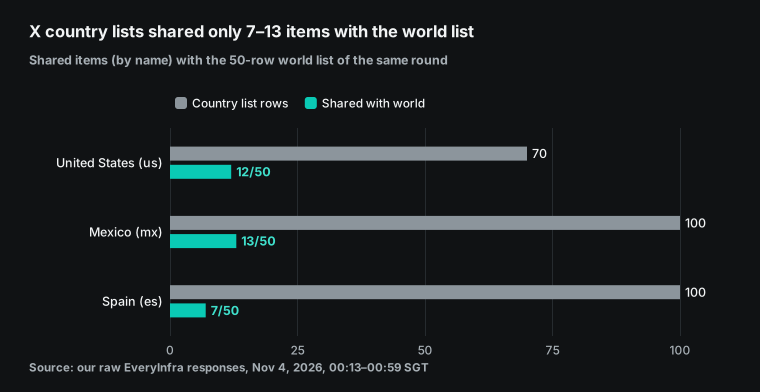
Для читателя из США важна локация X. Список по умолчанию country=world — это глобальная смесь. Во втором раунде мы также вызвали country=us, и он вернул 70 записей вместо 50. Если ваша аудитория в США, используйте us. Другие значения локации перечислены в каталоге.
Скелет SKILL.md: weekly-hot-posts-digest
Ниже приведены полная папка и файл SKILL.md. Skill делает одно: берёт снимки списков трендов за неделю в виде таблицы и пишет дайджест на одну страницу. Он не получает данные, потому что скрипты Skill в приложении Gemini не могут выходить в интернет.
Инструкции мы написали на английском. Примеры на страницах справки Gemini, Claude и Codex тоже на английском, и все три платформы их читают. Если дайджест нужен на другом языке, укажите это при вызове Skill.
weekly-hot-posts-digest/
├── SKILL.md                     # required: name, description, instructions
└── references/
└── report-template.md # output template for step 5---
name: weekly-hot-posts-digest
description: Builds a one-page weekly digest of hot posts and trending topics from Reddit, Zhihu, Weibo and X snapshot data. Use when the user uploads this week's weekly.csv or snapshots.jsonl, or asks for a weekly trending summary across these four platforms.
---
# Weekly hot posts digest
## Inputs
- weekly.csv: one row per post or topic. Columns: platform, key, title, url, community, first_seen, last_seen, times_seen, snapshots_total, best_rank, max_heat.
- If the user gives snapshots.jsonl instead, group rows by platform and key first, then work from the grouped rows.
## Steps
Copy this checklist and track progress:
- [ ] 1. For each platform, count snapshots_total and the date range. Write them at the top of the digest.
- [ ] 2. Rank items by times_seen / snapshots_total first, then by best_rank. An item seen in most snapshots is a "week topic". An item seen once is a "spike".
- [ ] 3. Pick 5 week topics and 3 spikes per platform. Keep the original title. For Zhihu and Weibo, add a one-line English gloss after the title.
- [ ] 4. Group the picked items into at most 6 themes across platforms. A theme needs items from 2 or more platforms.
- [ ] 5. Fill the template in references/report-template.md.
## Rules
- max_heat is only comparable inside one platform. Do not compare Weibo hot_value with Zhihu hot_value or Reddit like_count.
- X trends may have an empty volume. Write "no volume" instead of 0.
- Do not guess why a topic is hot. If the title is not enough, write "reason unclear" and give the url.
- Remove user names from Reddit titles and text if they appear. Keep brand and organization names.
## Missing information
- If a platform has 0 snapshots this week, write "no data for <platform> this week" and continue with the others. Do not fill it from memory or web search.
- If snapshots_total is below 5 for a platform, add the line "low coverage: N snapshots".Файл шаблона короткий. В нём есть строка заголовка с датами недели по SGT и строка покрытия. Затем идут таблица тем, раздел «темы недели» для каждой платформы, раздел «всплески» и примечания. Полный файл занимает 399 байт. Он вынесен отдельно ради постепенного раскрытия (progressive disclosure). Gemini открывает его только на шаге 5, поэтому файл не тратит токены, пока Gemini решает, подходит ли Skill.
Каждое правило в инструкциях основано на том, что мы увидели в реальных вызовах. Правило «max_heat сравнимо только внутри одной платформы» взято из примечаний к полям в каталоге. hot_value у Weibo — это метрика Weibo, которая «сравнима только в пределах списка». hot_value у Zhihu — это текст со страницы, например «индекс популярности 5,97 млн», преобразованный в целое число.
Платформы используют разные формулы. В правилах Weibo указано: «(популярность в поиске + популярность обсуждения + популярность распространения) × коэффициент взаимодействия». На странице Zhihu перечислены популярность в поиске, популярность чтения, популярность взаимодействий и доля кликов (правила горячего поиска Weibo, описание списка трендов Zhihu). Сортировать записи из двух списков по этому показателю бессмысленно.
Правило «у трендов X может быть пустой volume» основано на наших тестах. Цифры приведены ниже, в разделе о полях. Правило «если данных нет, так и напишите» основано на списке трендов Zhihu: во время теста он во всех наших попытках возвращал HTTP 503. Без этого правила Gemini может заполнить пробел старыми записями списка трендов из своей памяти. Тогда дайджест выглядит полным, но часть его выдумана.
| Правило в Skill | Результат теста или документ, на котором оно основано | Без правила |
|---|---|---|
| Сравнивать max_heat только внутри одной платформы | Weibo и Zhihu используют разные формулы популярности; по данным каталога, популярность Weibo сравнима только в пределах её списка | Бессмысленный межплатформенный «рейтинг популярности» |
| Для пустого volume у X писать «нет объёма» | volume у X был пустым во всех наших снимках X | Модель воспринимает пустое значение как 0 |
| Не угадывать; писать «причина неясна» | Список трендов даёт только заголовок и ссылку | Модель придумывает причину по памяти |
| Нет данных — значит, «нет данных» | В этом тесте список трендов Zhihu возвращал 503 на каждый запрос | Модель заполняет пробел старыми записями |
| Меньше 5 снимков — писать «низкое покрытие» | Часть каждого списка меняется за 44 минуты | Читатели думают, что дайджест охватывает всю неделю |
Могут ли Claude и Codex использовать тот же SKILL.md?
Да. Gemini, Claude Code, Codex и Antigravity заявляют, что их Skills следуют открытому стандарту Agent Skills. В спецификации всего два обязательных поля. Поле name состоит из строчных букв, цифр и дефисов, длиной до 64 символов. Поле description вмещает до 1 024 символов (Agent Skills specification).
Claude Code добавляет поля-расширения, например управление вызовом и выполнение в субагенте (документация Claude Code). Codex требует оба поля, name и description (Codex: Build skills). Antigravity позволяет опустить name и тогда берёт имя папки (документация Antigravity). В нашем Skill есть оба поля и нет полей-расширений, поэтому все четыре инструмента читают его без изменений.
Отличие только одно. В Claude Code, Codex и Antigravity CLI тот же Skill может вызывать удалённый MCP-сервер EveryInfra и получать списки трендов. В приложении Gemini Skill не может выходить в интернет, поэтому данные нужно подготовить заранее. В нашей статье один SKILL.md в четырёх ИИ-инструментах: тест на обзоре конкурентов сравниваются папки Skills, способы вызова и сетевые правила. Там показан Skill, который работает вместе с вызовами MCP. В этой статье показано, как разделить данные и инструкции, когда Skill не может выходить в интернет.
Как приложение Gemini получает внешние данные: три способа
Skill не получает данные, поэтому они должны поступать извне. 4 ноября 2026 года мы изучили официальную документацию и нашли три способа. У каждого способа свои требования, и каждый подходит разным пользователям. Каждый способ ниже — это пример конфигурации. На нашей тестовой машине вход в Gemini не выполнен, и ни один шаг на стороне Gemini мы не запускали.
| Способ | Кому доступен | Как поступают данные | Еженедельная автоматизация | Что мы протестировали |
|---|---|---|---|---|
| A. Локальные снимки, загрузка таблицы в выходные | Любой аккаунт с доступом к Skills | weekly.csv как вложение в чате | Сбор автоматический; файл загружает человек | Вызовы API данных (наши 3 раунда) |
| B. Пользовательское приложение Connected App (удалённый MCP-сервер) | 18 лет и старше, США, личный аккаунт, английский язык | Gemini вызывает инструменты MCP | На странице справки сказано, что пользовательские приложения работают в Tasks | Только часть на стороне нашего MCP-сервера |
| C. Gemini API: агент Antigravity и триггер | Разработчики с API-ключом Gemini | Агент вызывает инструмент mcp_server в песочнице | Да, триггер запускается по расписанию cron | Только часть на стороне нашего MCP-сервера |
Доступные вам способы зависят от того, где вы находитесь, и от вашего аккаунта:
| Ваша ситуация | Способы | Почему |
|---|---|---|
| США, личный аккаунт, английский язык | A, B, C | Пользовательские приложения доступны только для личных аккаунтов в США |
| Личный аккаунт в другой стране (например, в Канаде или Сингапуре) | A, C | Пользовательских приложений нет; для Tasks нужен AI Pro или Ultra |
| ЕЭЗ, Швейцария или Великобритания | A (загружает человек), C | Tasks в Gemini по расписанию там недоступны |
| Рабочий аккаунт Workspace | A, C (после запуска Skills в Workspace) | Запуск Skills в Workspace отложен, и два вида Skills не синхронизируются |
Способ A: локальные снимки, загрузка в выходные. У этого способа самые низкие требования, и он даёт больше всего контроля. На своём компьютере или небольшом сервере запускайте скрипт сбора один или несколько раз в день. Скрипт дописывает сырые результаты четырёх списков трендов в snapshots.jsonl.
В выходные скрипт слияния превращает снимки за неделю в weekly.csv. Вы загружаете этот файл в чат Gemini и вводите /weekly-hot-posts-digest. CSV входит в список поддерживаемых типов файлов на странице справки Gemini (Create & manage skills).
Преимущество в том, что сбор и написание полностью разделены. Сбором занимается фиксированная программа, и она записывает в файл каждое списание и каждый сбой. Модель, которая пишет дайджест, видит только одну таблицу, поэтому не может «поискать и заполнить пробел». Недостаток в том, что человеку нужно каждую неделю загружать файл. Наши реальные вызовы в следующем разделе используют те же вызовы API.
Способ B: пользовательское приложение Connected App. В веб-версии Gemini можно добавить «пользовательское приложение» с URL MCP-сервера. После подключения оно работает в мобильном приложении, в веб-версии и в Tasks (страница справки о пользовательских приложениях). Требования однозначны: вам должно быть не менее 18 лет, вы должны находиться в США, войти в личный аккаунт Google и не отключать Keep Activity. Пока функция поддерживает только английский язык, а добавить приложение можно только в веб-версии.
Для аутентификации документация Developer Mode использует Dynamic Client Registration (RFC 7591). Вы настраиваете, как Gemini получает учётные данные клиента и пользователя на вашем MCP-сервере. Есть и отдельное руководство по OAuth 2.1 (Gemini Apps Developer Mode overview). Значит, в этом способе используется вход через OAuth.
Вставлять API-ключ в заголовок запроса не нужно. У удалённого MCP-сервера EveryInfra есть точка входа OAuth https://api.everyinfra.com/mcp/all, а метаданные находятся по адресу /.well-known/oauth-protected-resource/mcp/all. Мы не пробовали подключить его в Gemini, поэтому не можем утверждать, что подключение работает. Если вы в США, пробуете этот способ и подключение не удаётся, пришлите нам текст ошибки.
У способа B есть ещё одна деталь, которая следует из документации, но мы её не проверяли. На странице Developer Mode сказано, что Gemini читает аннотации readOnlyHint и destructiveHint каждого инструмента MCP (спецификация инструментов MCP). По ним и по контексту чата он решает, нужно ли сначала показать карточку подтверждения. На странице справки также сказано, что Gemini всегда просит подтвердить операции записи. 4 ноября мы получили список инструментов MCP EveryInfra через tools/list.
Этот вызов работает без ключа и бесплатен. У общего инструмента данных everyinfra_call_api есть аннотации readOnlyHint: false и destructiveHint: true, потому что за каждый вызов списываются средства. Судя по документации, это, вероятно, значит, что Gemini будет просить подтверждение для каждого вызова списка трендов. Поэтому задача по расписанию без участия человека может остановиться на шаге подтверждения. Проверьте это при подключении приложения.
Способ C: агент Antigravity в Gemini API и триггер. Если вы можете написать несколько строк на Python, используйте этот способ. Только в нём сбор, написание и планирование происходят на стороне Google. Эндпоинт Interactions в Gemini API может использовать удалённый MCP-сервер как инструмент. Поля: type: "mcp_server", name, url, headers и allowed_tools. Поддерживается только Streamable HTTP, SSE не поддерживается, а имя не должно содержать дефис (Gemini API: Function calling, раздел Remote MCP).
Агент Antigravity — это агент общего назначения, который работает в Linux-песочнице под управлением Google. В песочницу можно смонтировать AGENTS.md и Skills из .agents/skills/ (Gemini API: Antigravity agent). В справочнике Interactions API есть пример, где источник inline записывает файл SKILL.md в .agents/skills/<name>/SKILL.md (справочник Interactions API). Согласно разделу «Triggers», триггер объединяет агента, среду, промпт и расписание cron в один постоянный ресурс. Каждый запуск использует ту же среду, поэтому файлы предыдущего запуска сохраняются. Для запусков без участия человека страница советует использовать хранимые учётные данные вместо токена в запросе.
Вместе эти три факта дают конфигурацию, которая каждый понедельник утром пишет дайджест. Ниже приведён пример конфигурации. Имена полей мы скопировали из официальной документации, но код не запускали.
# Configuration example (not run): one snapshot each day at 08:00 SGT,
# and on Mondays also the digest for the last week.
# Sources: ai.google.dev/gemini-api/docs/antigravity-agent (MCP servers, Triggers, Budget controls)
#          ai.google.dev/api/interactions-api (inline sources for an environment)
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY from the environment
SKILL_MD = open("weekly-hot-posts-digest/SKILL.md", encoding="utf-8").read()
TEMPLATE = open("weekly-hot-posts-digest/references/report-template.md", encoding="utf-8").read()

everyinfra = {
    "type": "mcp_server",
    "name": "everyinfra",                     # lowercase letters and digits only
    "url": "https://api.everyinfra.com/mcp",
    "headers": {"Authorization": "Bearer " + EVERYINFRA_API_KEY},  # read from a secret store
    "allowed_tools": ["everyinfra_call_api"],
}
environment = {
    "type": "remote",
    "sources": [
        {"type": "inline", "content": SKILL_MD,
         "target": ".agents/skills/weekly-hot-posts-digest/SKILL.md"},
        {"type": "inline", "content": TEMPLATE,
         "target": ".agents/skills/weekly-hot-posts-digest/references/report-template.md"},
    ],
}
PROMPT = (
    "Step 1: call everyinfra_call_api four times: reddit/trending_posts, zhihu/hot_list (limit 30), "
    "weibo/trending (limit 50), twitter/trending (country us). Append one JSON line per call to "
    "/workspace/snapshots.jsonl with taken_at, platform, http status, charged_usd and results. "
    "If a call fails, write the error and continue. "
    "Step 2: only if today is Monday in Asia/Singapore, use the weekly-hot-posts-digest skill on the "
    "last 7 days of /workspace/snapshots.jsonl and save the digest to /workspace/digests/."
)
trigger = client.triggers.create(
    schedule="0 8 * * *", time_zone="Asia/Singapore", display_name="hot-lists-weekly",
    interaction={
        "agent": "antigravity-preview-09-2026",
        "agent_config": {"type": "antigravity", "model": "gemini-3.5-flash-lite",
                         "max_total_tokens": 300000},
        "environment": environment,
        "tools": [everyinfra],
        "input": PROMPT,
    },
)
print(trigger.id, trigger.next_run_time)
Три части этого примера требуют пояснения. Во-первых, сбор и написание находятся в одном триггере. В документации сказано, что каждый запуск «повторно использует ту же среду», поэтому файлы предыдущего запуска видны. Это предложение относится к одному триггеру. При двух триггерах второй должен ссылаться на среду по её ID, чтобы прочитать снимки. В разделе «Environments» показано, что можно передать существующий ID, например env_abc123, но это ещё один потенциальный источник сбоя.
Во-вторых, в примере используется самая дешёвая модель gemini-3.5-flash-lite и задан лимит max_total_tokens. Агент Antigravity работает в автономном цикле. Для задачи «исследование и сводка» документация оценивает расход в 100 000–500 000 входных токенов. Это примерно от $0.30 до $1.00 за запуск и до примерно $5 для сложных задач. Когда запуск достигает лимита, он останавливается и возвращает status: "incomplete".
В-третьих, не храните ключ в коде. Раздел «Triggers» предписывает для запусков без участия человека ссылаться на хранимые учётные данные. Исходящий прокси считывает их при каждом запуске, поэтому ключ можно заменить, не меняя триггер. Строка headers в примере нужна только для первого ручного теста.
Для способа C также следите за тремя пунктами в истории изменений Gemini API (история изменений Gemini API). С 26 октября 2026 года новые проекты платного уровня по умолчанию сохраняют запросы generateContent (store=true). Если в тексте дайджеста есть пользовательские данные, решите, нужно ли задавать store=false для каждого запроса. 27 октября 2026 года клиент командной строки без сохранения состояния gemini-api вышел в публичную бету. Он может запускать управляемых агентов на эндпоинте Interactions, но мы не проверяли, поддерживает ли он триггеры.
В уведомлении о выводе из эксплуатации от 2 ноября 2026 года сказано, что с 1 декабря запросы к gemini-2.5-flash перенаправляются на gemini-3.5-flash-lite. В function calling есть изменения без обратной совместимости. Если старый скрипт дайджеста жёстко задаёт модель 2.5, до этой даты замените имя модели и протестируйте скрипт заново.
Ещё один способ: Antigravity CLI. Если вы уже работаете в терминале, Antigravity CLI — это инструмент, которым Google заменяет Gemini CLI. Он тоже читает Skills из .agents/skills/. Удалённый MCP-сервер указывается в mcp_config.json, а системный планировщик (cron или launchd) запускает agy -p. Полная настройка описана в нашей статье Antigravity CLI для мониторинга комментариев к видео: тесты и конфигурация.
От способа C он отличается местом запуска. CLI работает на вашей машине, поэтому останавливается, когда машина выключена. Способ C работает в песочнице Google. Наша статья о Gemini Deep Research API с удалённым MCP-сервером посвящена другой задаче: исследованию с цитатами, а не снимкам по расписанию.
Тест: по одному реальному циклу запроса и ответа для каждого из четырёх списков трендов
Этот раздел описывает наш реальный тест. 4 ноября 2026 года с 00:13 до 00:59 SGT мы провели 3 раунда по четырём спискам трендов. В 02:05 SGT мы ещё раз попробовали список трендов Zhihu и популярные посты Reddit, а также вызвали два альтернативных эндпоинта (см. конец раздела).
Всего мы отправили 27 запросов. 13 из них прошли успешно и были оплачены, всего на $0.007228. За 14 неудачных запросов ничего не списано. Мы сохранили сырой ответ, заголовки и время каждого запроса, поэтому каждое число в статье можно проверить по сырому ответу.
Один снимок — это четыре вызова. Ниже приведён пример с curl. Храните ключ в переменной окружения, а не в скрипте.
# One snapshot: one call to each of the four hot lists (as tested on 2026-11-04)
API=https://api.everyinfra.com/api/v1/social
for body in \
  '{"platform":"reddit","action":"trending_posts","params":{}}' \
  '{"platform":"zhihu","action":"hot_list","params":{"limit":30}}' \
  '{"platform":"weibo","action":"trending","params":{"limit":50}}' \
  '{"platform":"twitter","action":"trending","params":{"country":"us"}}'
do
  curl -s -X POST "$API" -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
       -H 'Content-Type: application/json' -d "$body" \
  | jq -c '{platform, action, count, charged: .billing.charged_usd, error: .error.code}'
  sleep 7   # stay under 10 calls per minute
done
Структура ответа одинакова для всех четырёх платформ. results — массив записей, count — число записей, billing.charged_usd — сумма списания за вызов. В неудачном вызове нет results. Вместо этого есть error с полями fault (на чьей стороне проблема), retryable, retry_after (сколько секунд ждать) и следующими шагами. Поля записей на каждой платформе разные. Это самое важное при слиянии данных за неделю.
| Возможность | Ключ записи | Позиция | Поле популярности | Записей в первом успешном снимке | Текст, изображения, объём |
|---|---|---|---|---|---|
reddit/trending_posts | id | Порядок в ответе | like_count, comment_count | 25 | text пуст в 18 записях |
zhihu/hot_list | id | rank | hot_value (текст со страницы вида «10k heat», преобразованный в целое число) | 0 | — |
weibo/trending | Заголовок (нет id) | rank | hot_value | 50 | label пуст в 26 записях |
twitter/trending | Название (нет стабильного id) | rank | volume | 50 | volume пуст в 50 из 50 записей |
Ежедневный скрипт сбора выполняет те же четыре вызова на Python. Он дописывает в snapshots.jsonl по одной строке на снимок.
Ниже приведён пример collect.py с комментариями на английском. Он отправляет те же вызовы API, что и в наших 3 раундах. Скрипт использует только стандартную библиотеку Python (urllib.request) и берёт ключ только из окружения. При ответе 503 с возможностью повтора он ждёт retry_after и делает ещё одну попытку. Если вызов снова не удаётся, он записывает ошибку в файл.
#!/usr/bin/env python3
"""Run once (or a few times) a day: fetch four hot lists and append one snapshot line each to snapshots.jsonl. The key comes only from the EVERYINFRA_API_KEY environment variable."""
import json, os, sys, time, urllib.request, urllib.error
from datetime import datetime, timezone, timedelta

API = "https://api.everyinfra.com/api/v1/social"
LISTS = [
    ("reddit", "trending_posts", {}),
    ("zhihu", "hot_list", {"limit": 30}),
    ("weibo", "trending", {"limit": 50}),
    ("twitter", "trending", {"country": "world"}),
]
SGT = timezone(timedelta(hours=8))

def call(platform, action, params):
    body = json.dumps({"platform": platform, "action": action, "params": params}).encode()
    req = urllib.request.Request(API, data=body, method="POST", headers={
        "Authorization": "Bearer " + os.environ["EVERYINFRA_API_KEY"],
        "Content-Type": "application/json", "User-Agent": "hot-digest/1.0"})
    try:
        with urllib.request.urlopen(req, timeout=120) as r:
            return r.status, json.loads(r.read())
    except urllib.error.HTTPError as e:
        return e.code, json.loads(e.read() or b"{}")

def main(out_path):
    taken_at = datetime.now(SGT).isoformat(timespec="seconds")
    with open(out_path, "a", encoding="utf-8") as out:
        for platform, action, params in LISTS:
            status, data = call(platform, action, params)
            if status == 503 and (data.get("error") or {}).get("retryable"):
                time.sleep(int(data["error"].get("retry_after", 60)))
                status, data = call(platform, action, params)
            row = {"taken_at": taken_at, "platform": platform, "action": action, "http": status,
                   "charged_usd": (data.get("billing") or {}).get("charged_usd", 0),
                   "error": (data.get("error") or {}).get("code"), "results": data.get("results", [])}
            out.write(json.dumps(row, ensure_ascii=False) + "\n")
            print(platform, action, status, len(row["results"]), row["charged_usd"])
            time.sleep(7)  # stay under 10 calls per minute

if __name__ == "__main__":
    main(sys.argv[1] if len(sys.argv) > 1 else "snapshots.jsonl")
В выходные merge.py сводит снимки за неделю в одну таблицу. Правила простые. Записи Reddit и Zhihu сопоставляются по id. У Weibo и X нет стабильного id, поэтому их записи сопоставляются по заголовку.
В каждой записи фиксируются первое появление, последнее появление, число появлений, лучшая позиция и максимальная популярность. Для каждой платформы таблица также хранит число успешных снимков за неделю (snapshots_total). По этому числу Skill проверяет покрытие. На выходе получается стандартный CSV (RFC 4180), а страница справки Gemini указывает CSV среди поддерживаемых типов загрузки.
#!/usr/bin/env python3
"""Merge one week of snapshots.jsonl into weekly.csv: one row per post or topic, with first and last seen, times seen, best rank and highest heat."""
import csv, json, sys
from collections import defaultdict

def key_of(platform, r):
    return r.get("id") if platform in ("reddit", "zhihu") else (r.get("title") or r.get("name"))

def heat_of(platform, r):
    if platform == "reddit": return r.get("like_count")
    if platform in ("zhihu", "weibo"): return r.get("hot_value")
    v = r.get("volume")  # X volume can be an empty string
    return v or None

def main(src, dst):
    rows = [json.loads(l) for l in open(src, encoding="utf-8") if l.strip()]
    snaps = defaultdict(set); items = {}
    for s in rows:
        if s["http"] != 200: continue
        p = s["platform"]; snaps[p].add(s["taken_at"])
        for i, r in enumerate(s["results"], 1):
            k = key_of(p, r)
            if not k: continue
            it = items.setdefault((p, k), {"platform": p, "key": k, "title": r.get("title") or r.get("name"),
                 "url": r.get("url", ""), "community": r.get("community", ""), "first_seen": s["taken_at"],
                 "last_seen": s["taken_at"], "times_seen": 0, "best_rank": None, "max_heat": None})
            it["last_seen"] = max(it["last_seen"], s["taken_at"]); it["first_seen"] = min(it["first_seen"], s["taken_at"])
            it["times_seen"] += 1
            rank = r.get("rank") or i
            it["best_rank"] = rank if it["best_rank"] is None else min(it["best_rank"], rank)
            h = heat_of(p, r)
            if isinstance(h, (int, float)): it["max_heat"] = h if it["max_heat"] is None else max(it["max_heat"], h)
    out = sorted(items.values(), key=lambda x: (x["platform"], -x["times_seen"], x["best_rank"] or 999))
    for it in out: it["snapshots_total"] = len(snaps[it["platform"]])
    with open(dst, "w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, fieldnames=["platform", "key", "title", "url", "community", "first_seen", "last_seen",
                                          "times_seen", "snapshots_total", "best_rank", "max_heat"])
        w.writeheader(); w.writerows(out)
    print(dst, len(out), {p: len(v) for p, v in snaps.items()})

if __name__ == "__main__":
    main(sys.argv[1], sys.argv[2])
Те же возможности работают и через удалённый MCP-сервер. В MCP-клиенте добавьте https://api.everyinfra.com/mcp и вызовите общий инструмент everyinfra_call_api с теми же аргументами, что и в теле запроса выше. На изображении ниже показан наш реальный запрос MCP tools/call к weibo/trending в 00:37:15 SGT (на скриншоте оставлены только 2 записи и сокращённые ссылки). Ответ пришёл за 0,6 секунды, списано $0.000556.
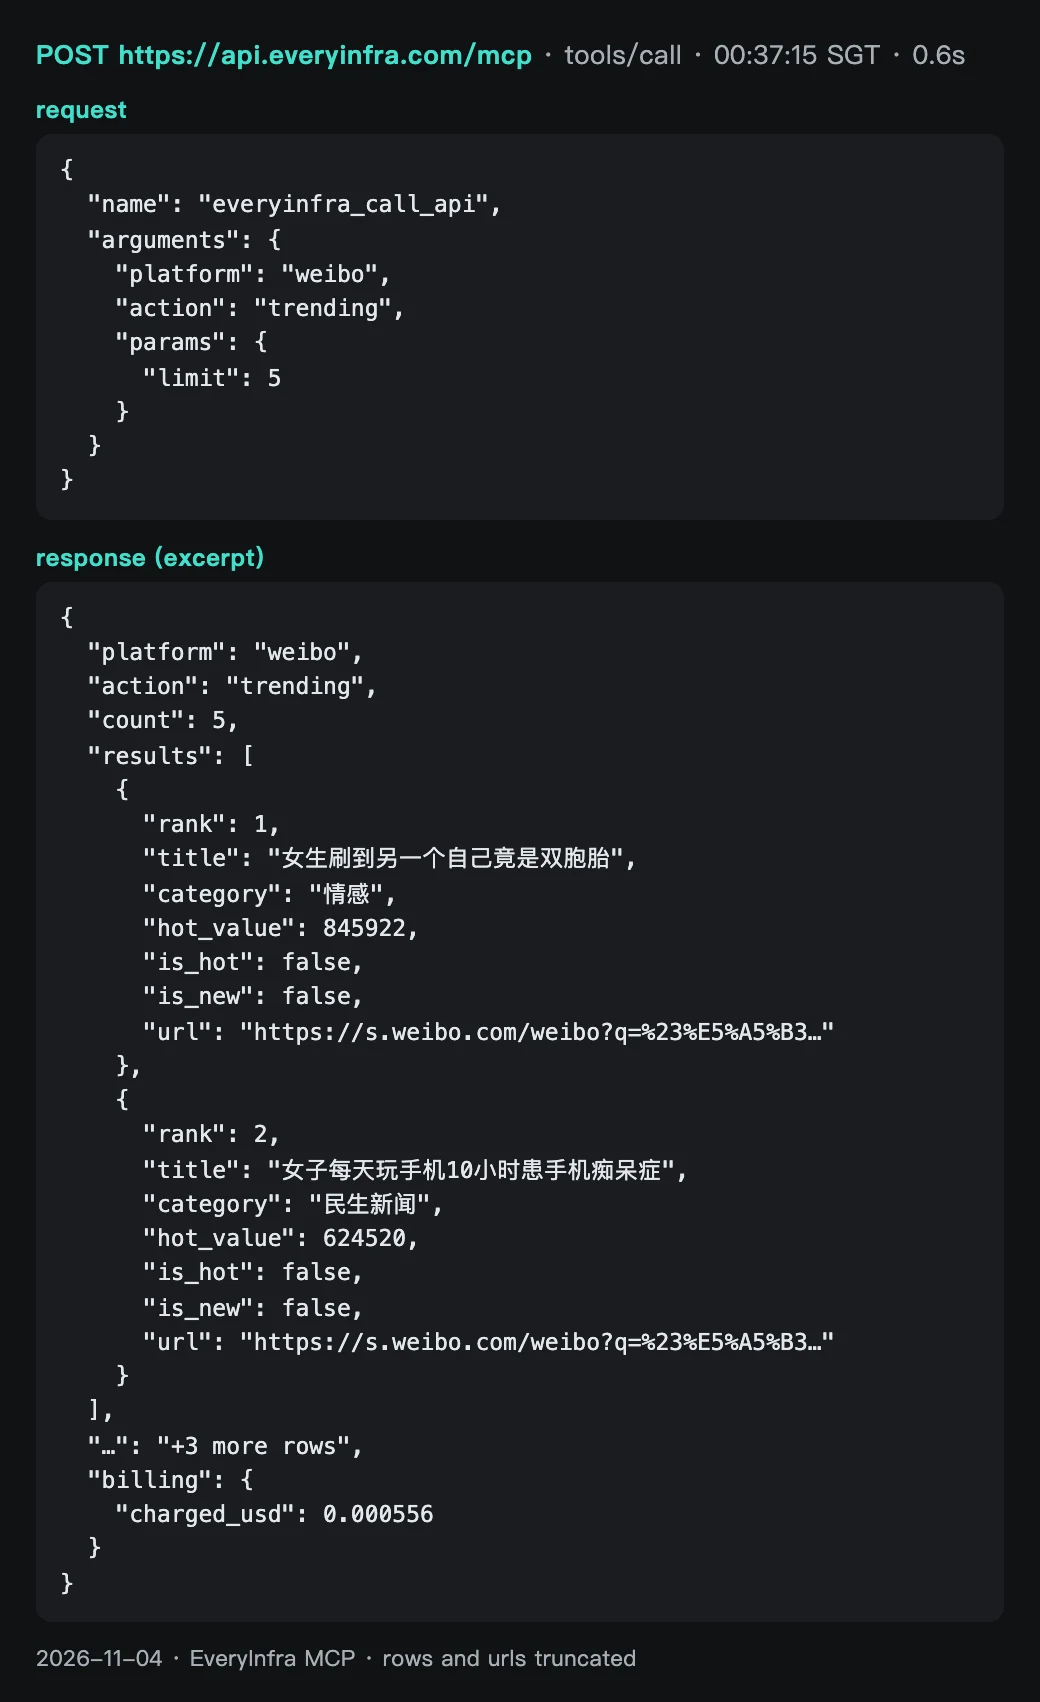
Ниже приведены 3 раунда и их результаты. В каждом раунде четыре списка вызываются в одном и том же порядке, с паузой в несколько секунд между вызовами, чтобы не превышать 10 вызовов в минуту. После сбоя мы ждали 60 секунд, как указывал retry_after, и пробовали ещё раз.
| Раунд (SGT) | Популярное на Reddit | Список трендов Zhihu | Горячий поиск Weibo | Тренды X | Дополнительные вызовы |
|---|---|---|---|---|---|
| Раунд 1, 00:13–00:15 | 25 записей | 503 ×3 | 50 записей | 50 записей | — |
| Раунд 2, 00:35–00:37 | 503 ×3 | 503 ×2 | 50 записей | 50 записей | X us: 70 записей |
| Раунд 3, 00:58–00:59 | 503 ×2 | 503 ×2 | 50 записей | 50 записей | X mx: 100 записей, X es: 100 записей |
| Дополнительно, 00:37 | — | — | 5 записей (MCP, limit=5) | — | Это вызов со скриншота ответа API |
| Повторная попытка, 02:05 | 503 ×1 | 503 ×1 | — | — | Замены: reddit/subreddit_posts — 25 постов, zhihu/search — 20 записей |
Список трендов Zhihu и популярные посты Reddit во время теста были недоступны. С 00:13 до 02:05 все 8 запросов к Zhihu вернули 503 с fault: service и retryable: true, и ни за один из них не было списания. Популярные посты Reddit дали 25 записей в раунде 1. После этого 6 запросов не вернули данных: 4 вызова REST вернули 503, а 2 вызова MCP вернули isError. Ни за один из них не было списания.
В 02:05 ещё одна попытка для каждого списка тоже вернула 503. Поэтому цифры по удержанию, слиянию и полям в следующих разделах получены только по weibo/trending и twitter/trending. Столбцы списков трендов Zhihu и Reddit пусты.
Для дайджеста эта часть важна. Эндпоинт списка трендов может долго быть недоступен. Скрипт сбора должен записывать в файл каждый сбой. Skill должен писать в дайджесте «нет данных по Zhihu за эту неделю» и не позволять модели заполнять пробел.
Если какой-то список трендов недоступен, дайджест может заполнить этот столбец данными из другого эндпоинта, но обязан указать новый источник. В 02:05 SGT мы вызвали два эндпоинта-замены, по $0.000556 за каждый вызов. reddit/subreddit_posts по r/GeminiAI (sort=top, date_range=past_week) вернул 25 постов. Они опубликованы с 28 октября 2026 г. по 3 ноября 2026 г. (SGT) и набрали от 156 до 1 583 голосов «за». В 11 заголовках встречается «Carbon», у 21 поста пустое поле text, а flair был у всех 25.
zhihu/search по запросу «Gemini» с сортировкой по новизне вернул 20 записей: 13 статей и 7 ответов. Они опубликованы с 23 октября 2026 по 4 ноября 2026 года (SGT). Максимальное значение like_count — 294, у 4 записей 0 лайков.
Ни один из этих эндпоинтов не является списком трендов. Первый возвращает самые популярные посты одного сообщества за неделю. Второй возвращает результаты поиска по ключевому слову, отсортированные по времени. Поэтому не называйте их в дайджесте «Популярное на Reddit» или «Список трендов Zhihu». Добавьте в Skill правило: для альтернативного эндпоинта указывать его название после заголовка столбца.
Результаты теста: как быстро меняются списки и сколько снимков нужно за неделю
Наш вопрос был таким: хватит ли для еженедельного дайджеста популярных постов одного сбора в неделю? Правило оценки мы записали до вызовов. Если через несколько десятков минут список почти не меняется, одного-двух сборов в неделю достаточно. Если меняется заметная доля списка, нужно делать много снимков в день и сводить их.
Ответ — второй случай. За основу мы взяли первый успешный снимок каждой платформы. Через 44 минуты в списке горячего поиска Weibo осталось только 86% исходных записей. Через 44 минуты в списке трендов X (world) осталось только 74%. За 44 минуты 3 раунда вместе показали 58 разных тем Weibo и 63 разных тренда X. Это на 16% и 26% больше, чем 50 записей любого отдельного снимка.
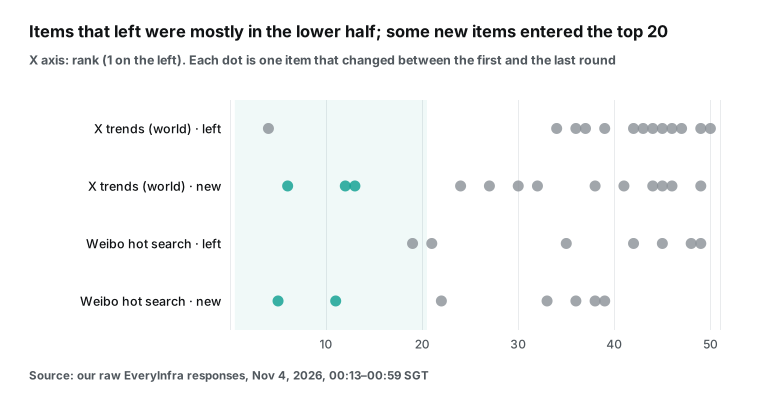
Позиции изменившихся записей тоже показывают закономерность. С первого по последний раунд 5 из 7 записей Weibo, выбывших из списка, находились в нижней половине. У X таких было 12 из 13. Нижняя половина списка меняется быстрее всего.
Но не все новые записи появляются внизу. 2 новые записи Weibo и 3 новые записи X при первом появлении были в топ-20. Это и есть «всплески», которые для дайджеста ценнее всего. Они поднимаются и опускаются между двумя снимками, и единственный список в понедельник утром их не покажет.
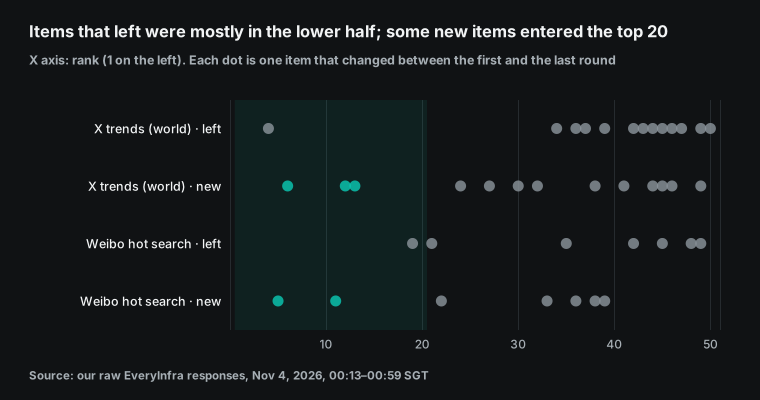
Из этого можно вывести частоту снимков, но только как пример. Мы измеряли всего 44 минуты, поэтому не можем экстраполировать цифры на целую неделю. Удержание через 6 или 24 часа мы тоже не измеряли. Мы можем назвать только нижнюю границу: за 44 минуты изменилось около 26% списка X.
При одном снимке в день между двумя снимками проходит 24 часа, и вы теряете часть тем, которые за это время поднимаются и опускаются. Наша частота для примера — четыре снимка в день, например в 08:00, 13:00, 18:00 и 23:00 по вашему часовому поясу. Это 28 снимков в неделю. При небольшом бюджете делайте один снимок в день и пишите в дайджесте «данные только за одно время суток». Чтобы подобрать свою частоту, в течение одного дня делайте снимок каждый час. Затем проверьте, какая часть списка остаётся через 6 и 24 часа, и снизьте частоту, если большинство записей остаётся.
Какие поля пригодны и какие цифры дайджест показать не может
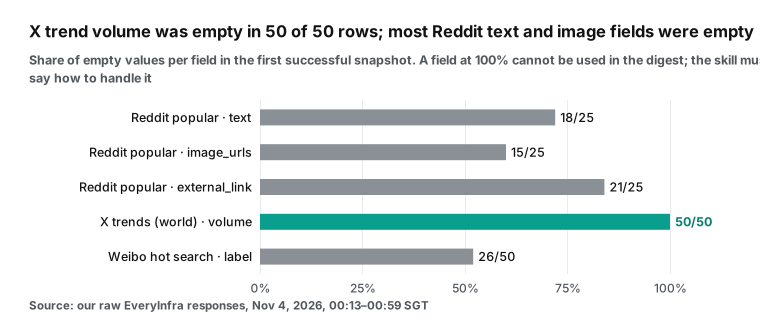
Отсутствующие значения полей определяют правила в Skill. Поле volume у X было пустым во всех 6 снимках по трём локациям, а поле period всегда имело значение «Live». Поэтому для X дайджест может показать только позицию и число появлений, но не объём обсуждения. Из 25 популярных постов Reddit у 18 записей поле text было пустым (в основном это посты с изображением или ссылкой), а у 15 записей было пустым поле image_urls.
Поэтому Skill велит Gemini использовать только заголовок. Поле label у Weibo (отметки вроде «новое» и «горячее») было пустым в 26 записях. У этих записей просто нет отметки в списке. Данные не потеряны.
Выбирайте правильную локацию X. За один и тот же период 50 записей country=world совпали с 70 записями us только в 12 случаях. С mx (100 записей) совпало 13 записей, с es (100 записей) — 7. Список world — это глобальная смесь.
Промежуточные выборы в США прошли 3 ноября 2026 года (по времени США). В тот день «Election Day» был на позиции 1 в списке us и на позиции 6 в списке world того же раунда. Для дайджеста по одному рынку используйте список этой страны.
Сведите данные перед отправкой в Gemini
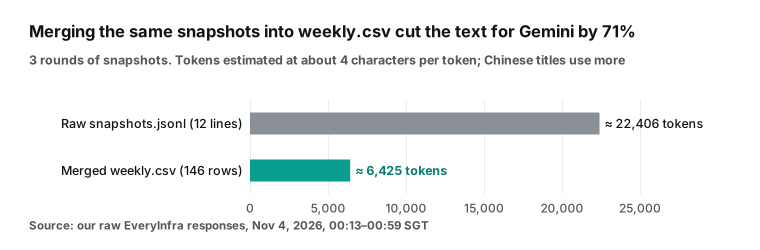
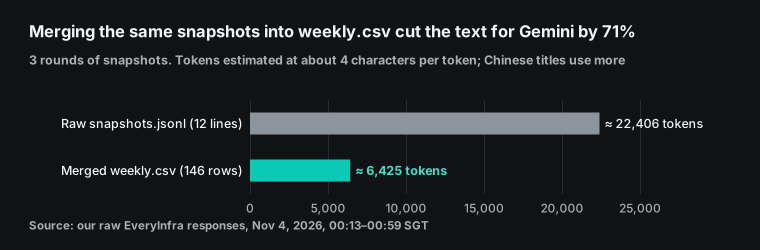
Почему Skill требует weekly.csv, а не исходные снимки? Сырые результаты наших 3 раундов мы записали в snapshots.jsonl в формате collect.py: 12 строк, около 22 406 токенов. После merge.py файл weekly.csv содержит 146 записей и около 6 425 токенов, то есть на 71% меньше. Мы считали по эмпирическому правилу Gemini API: около 4 символов на токен (Understand and count tokens); китайские заголовки расходуют больше токенов. При четырёх снимках в день в течение недели сырые снимки одних только Reddit, Weibo и X занимают около 304 000 токенов (средний размер одного списка в наших раундах × 28).
Сведённая таблица растёт только с числом уникальных записей, потому что повторяющаяся тема занимает одну строку. Ещё важнее то, что слияние выполняет программа с фиксированной логикой. Число появлений, лучшая позиция и максимальная популярность вычисляются заранее. Gemini только отбирает и пишет. Сам он ничего не подсчитывает.
Расходы за неделю и за месяц
Плата за API зависит только от числа снимков в неделю. По каталожной цене price_usd на 4 ноября 2026 года один снимок состоит из четырёх вызовов и стоит $0.002474. Раз в день: $0.017 в неделю и $0.074 в месяц (30 дней). Четыре раза в день: $0.069 в неделю и $0.297 в месяц.
Раз в час: $0.416 в неделю и $1.781 в месяц. Вторая страница Reddit добавляет $0.000556 за снимок. За неудачные вызовы ничего не списывается, поэтому сбои Zhihu не увеличили счёт.
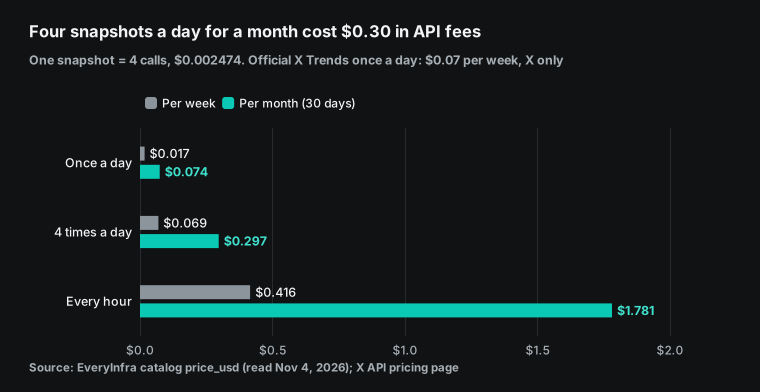
| Частота | Снимков в неделю | Плата за API в неделю | Плата за API в месяц (30 дней) | Для чего подходит |
|---|---|---|---|---|
| Раз в день | 7 | $0.017 | $0.074 | Только «о чём говорили на этой неделе» |
| Четыре раза в день (пример) | 28 | $0.069 | $0.297 | Чтобы отделить темы недели от всплесков |
| Раз в час | 168 | $0.416 | $1.781 | Срочные события и мониторинг бренда |
У стороны Gemini свои расходы. Skills в приложении Gemini не требуют подписки. Запуски по расписанию (Tasks) требуют Google AI Pro или Ultra и личного аккаунта пользователя 18 лет и старше (Manage your tasks & workflows). Для способа C в Gemini API действуют цены за токены. На странице цен для gemini-3.5-flash-lite указано $0.30 за миллион входных токенов и $2.50 за миллион выходных. gemini-3.8-flash стоит $0.75 и $3.75 до 31 декабря 2026 года, а 1 января 2027 года цена удваивается (цены Gemini API).
С 8 октября 2026 года запросы к gemini-3.7-flash перенаправляются на gemini-3.8-flash, поэтому запросы скрипта со старым именем модели уже тарифицируются по новой цене.
Агент Antigravity работает в автономном цикле, поэтому большая часть токенов уходит на его собственные рассуждения и обмены с инструментами. Для задачи «исследование и сводка» документация оценивает расход в 100 000–500 000 входных токенов. По цене входных токенов Flash-Lite это примерно от $0.03 до $0.15 за запуск, то есть примерно в 12–60 раз больше платы за API одного снимка. Мы это не измеряли. Ориентируйтесь на свой счёт.
Ограничения и важные моменты
| Ограничение | Влияние на дайджест | Что делать |
|---|---|---|
| Skills в приложении Gemini не могут выходить в интернет | Skill не может сам получить списки | Получайте данные вне Skill (способ A, B или C) |
| Пользовательские приложения только для личных аккаунтов в США | В других странах способа B нет | Используйте способ A или C |
| Нет Tasks в ЕЭЗ, Швейцарии, Великобритании и Нигерии | Gemini не может сам запускаться каждую неделю | Используйте системный планировщик или триггер Gemini API |
| Эндпоинт списка трендов может долго возвращать 503 | По одной из платформ может не быть данных за неделю | Записывайте сбой в журнал; Skill пишет «нет данных» |
| У трендов X нет объёма | Только позиция и число появлений | Если нужен объём, вызывайте twitter/search |
Ни один шаг на стороне Gemini мы не запускали. Страница Skills, пользовательские приложения, Tasks и триггер Gemini API — всё это примеры конфигурации. Мы составили их по страницам справки и документации для разработчиков, которые изучили 4 ноября 2026 года. За последние два месяца Google часто менял эти продукты (даже ярлык вызова Skill меняется с / на @). Если при вашей попытке интерфейс отличается от описанного в статье, следуйте актуальным на тот день указаниям на официальной странице.
Skill не получает данные и не должен заполнять пробелы. Это жёсткое ограничение приложения Gemini. Поэтому в нашем Skill и сказано: «если данных нет, так и напишите». Главный риск при составлении сводки — не низкое качество текста, а то, что модель выдаст старые записи списков трендов из своей памяти за данные этой недели. Правило в Skill надёжнее напоминания в каждом чате, но строку «покрытие» всё равно нужно читать каждый понедельник.
Список трендов — это рейтинг платформы, а не «реальная популярность». Формула Weibo включает вес коэффициента взаимодействия, а платные размещения в списке помечаются отдельно. Оценка Zhihu учитывает долю кликов. Обе платформы заявляют, что их алгоритмы защищены от манипуляций, но веса не публикуют. Поэтому позиция в дайджесте — это сигнал, а не доля рынка. По этой причине наш Skill ранжирует по «числу появлений» и «лучшей позиции» и не сравнивает значения популярности между платформами.
У трендов X в наших раундах не было объёма. В примечании к полям twitter/trending в каталоге упоминается резервный источник. Когда другие источники недоступны, результаты поступают из него, а он не возвращает значения volume и period. Во всех наших раундах поле volume было пустым во всех записях списков X, а поле period имело значение «Live». Поэтому для X дайджест может показать только позицию и число появлений. Если нужен объём обсуждения, вызовите twitter/search для нескольких тем, которые отобрал дайджест.
Некоторые списки могут быть временно недоступны. В нашем тесте все 8 запросов к zhihu/hot_list вернули HTTP 503, а reddit/trending_posts после раунда 1 не вернул данных в 6 запросах. В это время списки были недоступны, и ни за один из этих вызовов не было списания.
Скрипт сбора должен записать сбой и продолжить работу. Не пропускайте сбой без записи. Иначе в выходные вы не сможете понять, тема Zhihu «не попала в список» или «не была получена».
Список Reddit содержит 25 постов на страницу. reddit/trending_posts возвращает около 25 постов на страницу. Чтобы получить больше, передайте next_page_token; каждая страница оплачивается отдельно, а токен действителен 24 часа. Общий список сайта смешивает много сообществ и смещён к развлечениям и общим темам: в нашем первом раунде 25 постов пришли из 24 сообществ. Для дайджеста по одной отрасли лучше подходит reddit/subreddit_posts по нескольким фиксированным сообществам.
Условия платформ. Responsible Builder Policy от Reddit требует, чтобы каждый разработчик получил одобрение, прежде чем получить доступ к данным, а для коммерческого использования нужно письменное одобрение.
Политика также чётко ограничивает обучение ИИ, коммерческое использование и выявление чувствительных характеристик пользователей. Условия для разработчиков X тоже устанавливают правила использования данных. Безопаснее дайджест, который использует только заголовки, ссылки, позиции и публичные счётчики и не строит профили пользователей. Чтобы понять, как условия применяются к вашему бизнесу, читайте оригинальные тексты или обратитесь к юристу. Эта статья не является юридической консультацией.
Последние изменения: четыре даты, важные для дайджеста
В этот список вошли только изменения, которые влияют на еженедельный дайджест популярных постов. Они идут в хронологическом порядке, даты указаны по официальным страницам.
30 сентября 2026 года: Skills появляются в чатах Gemini и заменяют Gems. В блоге Google сказано, что в этот день Skills запустились в чатах Gemini по всему миру. Клиенты Workspace получат их «в ближайшие недели». В том же посте говорится, что с ноября начнётся вывод Gems для личных аккаунтов из эксплуатации. В тот же период прекратит работу Opal (блог Google). Что это значит: если ваш еженедельный отчёт сделан как Gem, перенесите его сейчас.
13 октября 2026 года: запуск Skills в Workspace отложен. В этот день началось развёртывание Skills в приложении Gemini. Запуск Skills в Workspace Studio и приложениях Workspace «отложен до дальнейшего уведомления». В посте также сказано, что совместный доступ и интеграция с Google Диском появятся позже (Workspace Updates, 13 октября 2026 года). Что это значит: если ваша команда хочет использовать тот же Skill для дайджеста прямо в Google Документах или Таблицах, ей придётся подождать. Пока используйте его в приложении Gemini.
28 октября 2026 года: платформа Connected Apps открывается в режиме предварительной версии. Теперь разработчики могут подключать свои приложения к Gemini и Поиску через облачные MCP-серверы. Они регистрируют, тестируют и отправляют приложения на проверку в Google Connected Console (блог Google). Что это значит: помимо личного «пользовательского приложения» из способа B, сервисы данных позже могут появиться в Gemini как проверенные приложения.
17 ноября 2026 года (через 13 дней): Gems для личных аккаунтов станут доступны только для чтения. См. первый раздел статьи.
Быстрый старт
- Зарегистрируйтесь в EveryInfra и получите API-ключ.
- Следуйте разделу «Быстрый старт». Один раз вызовите
weibo/trendingчерез curl. - Убедитесь, что в ответе есть
resultsиbilling.charged_usd. - Изучите параметры и поля: популярные посты Reddit, список трендов Zhihu, горячий поиск Weibo, тренды X.
- Разместите
collect.pyна компьютере, который включён каждый день. Сохраните ключ вEVERYINFRA_API_KEY. - Настройте cron или launchd, чтобы запускать скрипт от одного до четырёх раз в день.
- Через неделю проверьте
httpиcharged_usdв каждой строкеsnapshots.jsonl. - Упакуйте папку
weekly-hot-posts-digest/в ZIP-архив и загрузите его на странице Skills в Gemini. - В выходные запустите
merge.py, загрузитеweekly.csvв чат и введите/weekly-hot-posts-digest.
На странице каждой платформы перечислены все её возможности. См. API для парсинга Reddit и API для парсинга Zhihu. См. также API для парсинга Weibo и API для парсинга X (Twitter). Для полной автоматизации используйте пример способа C. Можно также запускать задачу на своей машине, как в статье об Antigravity CLI.
Как подключиться, показано на странице MCP-сервера. Как устроена оплата, описано на странице тарифов. Тот же метод в других инструментах описан в статье Задачи по расписанию в Claude Code для поиска болевых точек на Reddit. Прочитайте также статью Задачи по расписанию в ChatGPT как радар спроса.
| Шаг | Где | Стоимость API | Когда |
|---|---|---|---|
| 1. Тест одного вызова | Терминал с curl | $0.000556 | Один раз |
| 2. Сбор четырёх списков | cron или launchd с collect.py | $0,017–$0,069 в неделю (от 1 до 4 снимков в день) | Каждый день |
| 3. Составить дайджест | Чат Gemini с навыком | Без затрат на API; для навыков не нужен тарифный план | Каждый понедельник |
| 4. Автоматизировать всё | Триггер API Gemini | Токены Gemini за каждый запуск, см. раздел о стоимости | Необязательно |
FAQ
Вопросы взяты из поисковых подсказок Google и публичного обсуждения в Gemini Help Community. Ответы основаны на официальных страницах по состоянию на 4 ноября 2026 г.
Навыки Gemini или Gems: нужно ли переделывать Gems уже сейчас?
Если у вас личный аккаунт, да. С 17 ноября 2026 г. Gems доступны только для чтения: использовать и редактировать их нельзя. 17 декабря они будут удалены. Автоматическая миграция превращает каждый Gem в неактивный черновик навыка, и каждый такой черновик нужно проверить и активировать вручную. Файлы больше 100 МБ, аудио, видео, архивы и файлы старых форматов Office не переносятся. Gems, которыми вы пользуетесь каждую неделю, пересоздайте вручную уже сейчас.
Заодно перепишите каждое описание по схеме «что делает навык» плюс «Используйте, когда…». У рабочих и учебных аккаунтов времени больше. Business и Enterprise: не раньше 1 марта 2027 г. Education: не раньше 1 июня 2027 г. (Вопрос из поисковых подсказок «gemini skills vs gems» и «claude skills vs gemini gems».)
Gems в Gemini доступны только для чтения: можно ли по-прежнему экспортировать их после 17 ноября?
Просматривать Gems и скачивать прикреплённые к ним файлы можно, а использовать сами Gems нельзя. На странице справки сказано, что после 17 ноября доступ к Gems сохранится, но использовать и редактировать их, а также создавать новые будет нельзя. Там же владельцам личных аккаунтов советуют до 17 декабря скачать файлы, которые не переносятся. Поэтому месяц в режиме только для чтения — последний шанс сохранить у себя файлы с материалами. (Вопрос из подсказки «gemini gems read only mode».)
Навыки Gemini и MCP: может ли навык в приложении Gemini напрямую вызывать MCP?
Сам навык выходить в интернет не может. На странице справки сказано, что загруженные скрипты не имеют доступа к интернету и не могут отправлять запросы на внешние сайты. Но навык может работать с Connected Apps, а «пользовательское приложение» — это URL MCP-сервера. Для этого вам должно быть не меньше 18 лет, вы должны находиться в США, пользоваться личным аккаунтом и работать на английском языке.
Если вы не соответствуете этим требованиям, получите данные локально и загрузите таблицу. Можно также использовать агента Antigravity в Gemini API (он поддерживает инструмент mcp_server) или Antigravity CLI. (Вопрос из подсказок «gemini skills mcp» и «gemini cli skills mcp».)
Навыки Gemini как у Claude: можно ли загрузить навык Claude в Gemini?
По формату да. Оба основаны на открытом стандарте Agent Skills, и на странице справки Gemini сказано, что можно загрузить SKILL.md, папку или .zip. Проверьте три вещи. Имя должно быть в нижнем регистре, а слова в нём разделяются дефисами.
Gemini не читает специфичные для Claude Code поля расширения, например поля управления вызовом или запуска в субагенте. Если в навыке есть скрипт, который выходит в интернет, в приложении Gemini он не запустится. Наш навык использует только name и description, а получение данных вынесено за пределы навыка. (Вопрос из подсказки «gemini skills like claude».)
Почему Gemini не применяет мой навык автоматически?
Согласно странице справки, Gemini применяет только включённые навыки. Выключить или снова включить навык можно на странице «Навыки». Gemini решает, когда применить навык, только по его названию и описанию. Если описание слишком общее (например, «помощник по данным»), Gemini не понимает, когда применять этот навык.
Надёжнее всего ввести в чате / (или @) и выбрать навык. Кроме того, на странице справки сказано, что навыки уже доступны личным аккаунтам пользователей от 18 лет, а рабочим и учебным аккаунтам станут доступны «скоро». Если в вашем аккаунте Workspace нет страницы «Навыки», возможно, развёртывание до него ещё не дошло. (Вопрос из обсуждения в Gemini Help Community «Will a Skill have an always on state».)
Источники
Все страницы ниже мы прочитали 4 ноября 2026 г. (SGT).
- Gemini Apps Help: «About the transition from Gems to skills»
- Workspace Admin Help: «About the transition from Gems to skills»
- Workspace Updates, 30 сентября 2026 г.: «skills in the Gemini app and Workspace»
- Workspace Updates, 13 октября 2026 г.: «an update on the skills launch»
- Блог Google, 30 сентября 2026 г.: «automate tasks with skills»
- Gemini Apps Help: «release updates» (30 сентября и 13 октября 2026 г.)
- Gemini Apps Help: «Create & manage skills»
- Gemini Apps Help: «Write effective skills»
- Gemini Apps Help: «Manage your tasks & workflows» (ограничения по регионам и тарифам)
- Gemini Apps Help: «limits and upgrades for Google AI subscribers»
- Gemini Apps Help: «Connect & manage custom apps»
- Gemini Help Community: «Will a Skill have an always on state»
- «Google Connected Apps developer documentation»
- «Gemini Apps Developer Mode overview»
- Блог Google, 28 октября 2026 г.: «the Connected Apps platform preview»
- Спецификация MCP: «Tools» (аннотации readOnlyHint, destructiveHint)
- Спецификация MCP: «Transports» (Streamable HTTP)
- RFC 7591: «OAuth 2.0 Dynamic Client Registration»
- RFC 9728: «OAuth 2.0 Protected Resource Metadata»
- Черновик IETF: «The OAuth 2.1 Authorization Framework»
- Gemini API: «Function calling» (раздел Remote MCP)
- Gemini API: «Antigravity agent» (MCP, Triggers, Budget)
- Gemini API: «managed agents overview»
- Gemini API: «Interactions API overview»
- Справочник Gemini API: «Interactions» (встроенные источники окружения)
- «Gemini API pricing»
- Gemini API: «Understand and count tokens»
- «Gemini API changelog»
- Gemini API: «deprecations»
- «Gemini API CLI (gemini-api) guide»
- Gemini API: «Computer Use»
- Gemini API: «Coding agent setup»
- GitHub: google-gemini/gemini-skills
- «Agent Skills specification»
- GitHub: agentskills/agentskills
- Antigravity: «Agent skills»
- Antigravity: «MCP»
- Antigravity CLI: «headless mode»
- Claude Code: «Extend Claude with skills»
- Документация Claude: «Agent Skills overview»
- Claude Help: «Use skills in Claude»
- Codex: «Build skills»
- «Weibo hot search rules»
- «Zhihu hot list introduction»
- «X API pricing»
- X API: «Trends»
- «X Developer Agreement and Policy»
- «Reddit Responsible Builder Policy»
- «Reddit Data API Terms»
- Каталог возможностей EveryInfra (price_usd и примечания к полям; просмотрено 4 ноября 2026 г.)
- Документация Python: urllib.request
- RFC 4180: формат CSV
- Документация Apple для разработчиков: «Scheduling Timed Jobs» (launchd)
Справка BL-82