API per i dati o router di tool? Come EveryInfra e Monid si dividono le chiamate di un agente
Una ricerca su Xiaohongshu eseguita 6 volte: 16 note diverse nelle prime 3 posizioni e $0,005556 ogni volta. Affida i job giornalieri a un'API per i dati e la coda lunga a Monid.
Il 3 novembre 2026, dalle 16:33 alle 16:45 ora di Singapore (SGT), abbiamo inviato la stessa richiesta sei volte. Era diretta alla funzionalità xiaohongshu/search di EveryInfra: la parola chiave cinese per «matcha latte», ordinamento «più apprezzati» (most_liked), prima pagina. Ogni chiamata ha restituito 20 note ed è costata $0,005556, e ogni nome di campo compariva nell'elenco del catalogo. Due delle chiamate sono state cronometrate a parte: hanno impiegato 3,9 e 4,3 secondi. Ma nelle sei esecuzioni, i 18 posti tra i primi tre risultati erano occupati da 16 note diverse.
Questo risultato mostra cosa può restare costante in un job giornaliero di un agente. La forma della richiesta, i nomi dei campi, il prezzo e il formato degli errori possono restare fissi. L'insieme dei risultati no, quindi ogni riga salvata deve conservare la propria posizione nell'ordinamento e il proprio timestamp. Proprio perché questi quattro elementi restano fissi, un job giornaliero è adatto a un'API per i dati dedicata.
Le chiamate che un agente fa una sola volta, senza sapere in anticipo che le avrebbe fatte, vanno su un router di tool come Monid. Il 3 novembre 2026 la sua home page indicava 2.800+ tool. Monid ci ha inviato del materiale il 29 ottobre. Secondo questo materiale, discover e inspect sono gratuiti. run è addebitato per chiamata da un unico saldo, al prezzo indicato sulla scheda del tool.
Questo articolo è nato da una bozza del team di Monid. Ne abbiamo mantenuto la tesi. Le chiamate ai tool di un agente sono di due tipi: ripetute e individuate al bisogno. I due tipi non vanno collegati allo stesso modo. Abbiamo cambiato una cosa e aggiunto i nostri test.
La modifica riguarda la regola di routing. Nell'esempio della bozza, l'elenco giornaliero comprendeva solo tre piattaforme: Xiaohongshu, Douyin e TikTok. Lo abbiamo sostituito con l'intero catalogo di EveryInfra di quel giorno: 106 piattaforme, raggruppate per categoria. Ora al router arriva solo la vera coda lunga. I test aggiunti sono le ricerche sul matcha latte descritte sopra, una chiamata per il dettaglio di una nota, una per i commenti e una ricerca su Douyin. Abbiamo anche inviato due richieste volutamente errate.
Per i numeri su Monid, riportiamo solo due tipi di dati. Il primo comprende le esecuzioni effettuate da Monid sui propri sistemi il 29 ottobre 2026. Il secondo comprende dati con una data precisa tratti dal suo sito. Non abbiamo ripetuto le sue chiamate a pagamento.
Una breve nota sulla piattaforma, per chi legge da fuori dalla Cina. Xiaohongshu, nota all'estero anche come RedNote, è un'app social cinese. Gli utenti vi pubblicano note: post brevi con foto o video, un titolo e dei tag. Ogni nota ha i conteggi di like, salvataggi (collect), commenti e condivisioni.
Brand e analisti la seguono come seguono Instagram o TikTok, ma in cinese. Qui è un buon caso di test: molti team la monitorano ogni giorno e un router generico elenca per questa piattaforma diversi endpoint in concorrenza tra loro.
Due tipi di chiamate ai tool: quelle ripetute e quelle individuate al bisogno
La bozza di Monid si apre con un esercizio. Estrai dal tuo agente le chiamate ai tool della settimana scorsa e ordinale in base a quanto spesso si ripete la stessa chiamata. Per dirla con Monid, le chiamate ripetute sono una lista breve: le piattaforme che monitori, i campi che conservi e la pianificazione che segui. La stessa richiesta viene eseguita più volte al giorno.
Il resto è una coda lunga. Per esempio, un utente chiede il meteo nella sede di un evento il giorno dell'evento. Qualcuno vuole il numero di follower di un creator su una piattaforma che non monitori. Qualcun altro vuole l'ultimo round di finanziamento di un'azienda, o una pagina che una semplice richiesta HTTP non riesce ad aprire. Ogni elemento di questa coda può arrivare da un'azienda diversa, ciascuna con la propria chiave, il proprio schema e una procedura di registrazione separata. La maggior parte viene chiamata poche volte l'anno.
Le due parti vogliono cose opposte. Per le chiamate ripetute, la proprietà più preziosa è che nulla cambi. Nomi dei campi stabili mantengono allineati il codice dell'agente e le tabelle a valle. Un prezzo stabile consente al team finanziario di pianificare il budget in anticipo. Un formato degli errori stabile significa che la logica dei nuovi tentativi la scrivi una volta sola.
La guida di Anthropic «Writing effective tools for agents» tratta un tool come un accordo tra un sistema deterministico e un agente non deterministico. Chiede nomi chiari, confini netti tra i tool e risposte con un contesto utile. Per la coda lunga, la proprietà più preziosa è la copertura. L'agente non sa in anticipo di quale tool avrà bisogno. Quindi non va configurato per ciascuno. Deve trovare il tool quando gli serve, vederne il prezzo, chiamarlo una volta e andare avanti.
L'errore è servire entrambe le parti allo stesso modo. Se integri la coda lunga un fornitore alla volta, l'agente passa la prima settimana a raccogliere chiavi API. Se fai passare il job giornaliero da un router generico, perdi lo schema fisso che lo rendeva economico da mantenere.
C'è anche un costo lato modello: più tool vede un agente, più spesso sceglie quello sbagliato. Il paper RAG-MCP ha eseguito uno stress test MCP. Recuperare i tool pertinenti prima di mostrarli al modello ha alzato l'accuratezza della selezione dal 13,62% al 43,13%. Ha anche ridotto i token del prompt di oltre la metà.
Lavori precedenti come ToolLLM e Gorilla sono arrivati alla stessa conclusione: più API rendono più difficili sia la scelta sia la compilazione degli argomenti. Uno sviluppatore usa 58 server MCP e oltre 680 tool. Su r/mcp di Reddit ha scritto che la scelta dei tool peggiora nettamente oltre i 30–60 tool. La sua soluzione è stata caricare le descrizioni dei tool in modo lazy e dare a ogni agente specializzato solo 10–20 tool.
| Chiamate ripetute | Chiamate individuate al bisogno | |
|---|---|---|
| Con che frequenza | Ogni giorno o ogni ora, di nuovo la stessa richiesta | Poche volte l'anno, senza essere note in anticipo |
| L'agente lo sa in anticipo? | Sì: piattaforma, campi e ordinamento sono definiti | No: lo scopre quando un utente lo chiede |
| Cosa conta di più | Nomi dei campi stabili, prezzo stabile, errori stabili | Ampia copertura, nessuna registrazione per fornitore, pagamento per chiamata |
| Esempio in questo articolo | Report giornaliero sul matcha latte su Xiaohongshu: xiaohongshu/search, xiaohongshu/comments | Il logo di un'azienda a partire dal suo dominio; post su una piattaforma fuori dall'elenco |
| Dove va | Un'API per i dati dedicata: EveryInfra | Un router di tool: Monid (discover, inspect, run) |
Quindi la struttura sensata è una linea diretta per le chiamate ripetute e un router per tutto il resto. Non si tratta di scegliere tra due prodotti. Entrambi i servizi parlano MCP ed entrambi possono stare contemporaneamente nello stesso client dell'agente. Una breve regola dice all'agente quale usare per ogni chiamata. Le prossime sezioni spiegano cos'è Monid e quanto è lungo davvero l'elenco giornaliero di EveryInfra, poi passano in rassegna i test.
Cos'è Monid: tre verbi e un unico saldo
Monid si descrive come l'OpenRouter dei tool per agenti. L'espressione descrive la forma del prodotto, non un legame commerciale. OpenRouter mette molti modelli dietro un'unica chiave e un unico saldo. La sua guida rapida dice che serve centinaia di modelli tramite un singolo endpoint e gestisce automaticamente i fallback. Secondo il materiale di Monid del 29 ottobre, Monid fa la stessa cosa un livello più su. Copre i tool che un agente chiama dopo aver scelto un modello.
La pagina di posizionamento di Monid, consultata il 3 novembre 2026, lo riassume in una riga. OpenRouter è una chiave, tutti i modelli, pagamento a token. Monid è una Skill, tutti i tool, pagamento a chiamata. Usiamo il paragone solo per descrivere la forma del prodotto. Non dice nulla su eventuali rapporti tra le due aziende.
Abbiamo consultato la home page di Monid il 3 novembre 2026. Indicava 2.800+ tool e $1 di credito gratuito per un nuovo account. Il materiale che Monid ci ha inviato il 29 ottobre riportava le stesse due cifre.
Secondo quel materiale del 29 ottobre, il catalogo copre ricerca web, scraping e arricchimento dei dati su persone e aziende. Copre anche dati delle piattaforme social (incluse quelle cinesi), mappe e recensioni, e-commerce, finanza e media generativi. La fatturazione, con le parole di Monid: pagamento per chiamata da un unico saldo, senza abbonamento. Scoprire e ispezionare un tool è gratuito; viene addebitata solo l'esecuzione, al prezzo mostrato sulla scheda del tool.
Nello stesso materiale, il flusso di lavoro si riduce a tre verbi. discover è una ricerca semantica gratuita nel catalogo. L'agente descrive il compito a parole e riceve un elenco ordinato di endpoint, ciascuno con un prezzo e uno stato operativo. Anche inspect è gratuito e restituisce lo schema di input, il prezzo e la documentazione di un endpoint. run è l'unico passaggio a pagamento, addebitato dal saldo prepagato al prezzo mostrato da inspect.
Un agente può raggiungere Monid tramite MCP, un file Skill, uno strumento da riga di comando o un'API REST. La guida rapida MCP di Monid (guida alla configurazione MCP di Monid, consultata il 3 novembre 2026) indica l'indirizzo del server https://mcp.monid.ai/v1 e l'accesso tramite OAuth. Prevede passaggi separati per Claude Code, Codex e altri client. Il file Skill si trova in monid.ai/SKILL.md. Secondo il materiale di Monid, un agente a cui chiedi di «configurare» quell'indirizzo impara da solo i tre verbi. Una panoramica leggibile dalle macchine si trova in monid.ai/llms.txt.
| Verbo | A pagamento? | Cosa restituisce (dal materiale di Monid del 29 ottobre 2026) |
|---|---|---|
discover | Gratis | Endpoint ordinati per pertinenza, ciascuno con un prezzo e uno stato |
inspect | Gratis | Lo schema di input, il prezzo e la documentazione di un endpoint |
run | Addebitato al prezzo della scheda del tool | Il risultato e un ID di esecuzione che si può recuperare in seguito |


L'elenco giornaliero di EveryInfra: 106 piattaforme, 569 funzionalità
La prima riga della regola di routing è «le piattaforme in elenco vanno a EveryInfra», quindi la lunghezza dell'elenco determina quanto è utile la regola. La regola di esempio nella bozza di Monid indicava tre piattaforme: xiaohongshu, douyin, tiktok. Con quella regola, anche le recensioni di Amazon, le recensioni di Google Maps, gli annunci di lavoro di LinkedIn e i post di Reddit restano fuori dall'elenco. Eppure il catalogo di EveryInfra ha campi e prezzo fissi per tutti. Per questo questa sezione riporta l'intero catalogo.
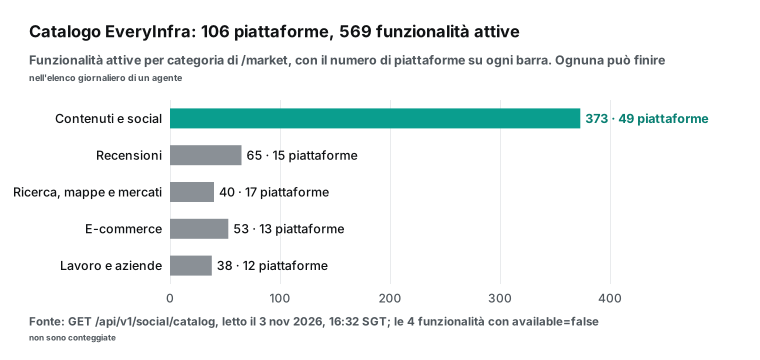
I dati provengono dal catalogo gratuito di EveryInfra, GET /api/v1/social/catalog, consultato il 3 novembre 2026 alle 16:32 SGT. Elenca 106 piattaforme e 573 funzionalità, di cui 569 disponibili quel giorno. Le altre quattro avevano available=false (g2/compare, jd/reviews, temu/search e wechat_oa/wechat_index), quindi per ora lasciale fuori dall'elenco giornaliero. Le categorie seguono le stesse regole della nostra pagina /market: contenuti e social, recensioni, e-commerce, lavoro e aziende, e ricerca, web e mercati. La tabella qui sotto riporta tutte le 106 piattaforme, ordinate all'interno di ogni categoria in base al numero di funzionalità.
| Categoria | Piattaforme | Funzionalità disponibili | Piattaforme (prima quelle con più funzionalità) |
|---|---|---|---|
| Contenuti e social | 49 | 373 | Douyin, TikTok, X (Twitter), Instagram, Xiaohongshu, Facebook, Zhihu, Kuaishou, account ufficiali WeChat, Weibo, GitHub, Bilibili, Reddit, YouTube, Pinterest, Substack, Threads, Spotify, Dailymotion, Quora, Rumble, SoundCloud, Telegram, Toutiao, Twitch, Bluesky, Mastodon, Truth Social, WeChat Channels, DeviantArt, Discord, Douban, Gab, Lemmy, Naver, Odysee, Patreon, Product Hunt, Snapchat, Tumblr, Youku, Dribbble, iQIYI, Medium, NetEase Cloud Music, Behance, Flickr, VK, Eventbrite |
| Recensioni | 15 | 65 | Google Play, App Store, G2, recensioni di Google Maps, Tripadvisor, Zillow, Airbnb, Booking, Expedia, Yelp, Realtor, Clutch, Nextdoor, Upwork, Crexi |
| E-commerce | 13 | 53 | Amazon, AliExpress, JD.com, eBay, Etsy, Taobao, Shopee, Walmart, 1688, Xianyu, Dewu, Temu, Google Shopping |
| Ricerca, web e mercati | 17 | 40 | Yahoo Finance, dati di mercato crypto, dati aziendali, Polymarket, Yandex, Similarweb, notizie crypto, Kalshi, risultati dei motori di ricerca, ricerca Bing, Bing Maps, ricerca DuckDuckGo, DuckDuckGo Maps, Apple Maps, Google News, Google Trends, Google Ads Transparency Center |
| Lavoro e aziende | 12 | 38 | LinkedIn, Glassdoor, Indeed, Xing, Capterra, Trustpilot, Naukri, ThomasNet, StepStone, SEEK, Dice, Craigslist |
Due note sull'uso di questo elenco. Per prima cosa, l'elenco cambia. Il catalogo può aggiungere piattaforme o funzionalità in qualsiasi giorno, e può segnarne una come temporaneamente non disponibile. Quindi non inserire l'elenco in modo fisso nella regola. All'inizio di una sessione, fai chiamare all'agente il tool gratuito everyinfra_list_capabilities o l'endpoint del catalogo. Poi popola l'elenco con i dati restituiti.
In secondo luogo, un elenco di piattaforme resta comunque approssimativo. Su una stessa piattaforma, alcune funzionalità vengono eseguite ogni giorno e altre restituiscono dati solo con certi argomenti. Solo Xiaohongshu ha 17 funzionalità disponibili: ricerca, dettaglio della nota, commenti, risposte ai commenti, profilo utente, note dell'utente e ricerca utenti. Ci sono anche topic, contenuti di tendenza, ricerca prodotti, dettaglio prodotto, recensioni dei prodotti, follower e posizione della nota. Le ultime tre sono commenti in batch per più link, dettaglio video e una classifica dei contenuti dei creator.
Costano tutte $0,005556 per chiamata, tranne la classifica dei contenuti dei creator, a $0,016. Se scrivi l'elenco per funzionalità, l'agente può vedere nella regola il prezzo e gli argomenti di ogni chiamata. I dettagli sono nella pagina dell'API per i dati di Xiaohongshu e nella pagina della funzionalità di ricerca di Xiaohongshu.
Una modifica alla regola di routing: elenca tutto e invia a Monid solo il resto
Con l'elenco a disposizione, la regola può restare breve. Abbiamo riscritto la regola della bozza di Monid mantenendo la stessa struttura. Abbiamo cambiato solo la riga delle piattaforme e aggiunto un fallback: nel dubbio, chiedi prima a EveryInfra e passa a Monid solo in caso di unknown_capability. La regola è in testo semplice, così l'agente può leggerla; può quindi stare in un system prompt o in un file di istruzioni del progetto.
For a daily job on a platform in the list below, call everyinfra_call_api.
Use the platform's own language for keywords. If the task says "this week"
or "today", sort by time. Record platform, action, params, the call time and
charged_usd for every call.
For a platform outside the list, a one-off lookup, or a tool that is not data,
use Monid: discover first, then inspect (both free); run only when the price
fits the budget. Run is billed at the price inspect showed. Record each price
and run id.
If you are not sure a platform is on the list, call EveryInfra first.
If it returns HTTP 400 with error.code unknown_capability (nothing charged),
then use Monid.
List (EveryInfra catalog, read 2026-11-03; refresh at the start of each
session with everyinfra_list_capabilities):
airbnb, alibaba1688, aliexpress, amazon, app_store, apple_maps, behance,
bilibili, bing, bing_maps, bluesky, booking, capterra, clutch, company_data,
craigslist, crexi, crypto_market, crypto_news, dailymotion, deviantart,
dewu, dice, discord, douban, douyin, dribbble, duckduckgo, duckduckgo_maps,
ebay, etsy, eventbrite, expedia, facebook, flickr, g2, gab, github,
glassdoor, google_ads_transparency, google_maps_reviews, google_news,
google_play, google_shopping, google_trends, indeed, instagram, iqiyi, jd,
kalshi, kuaishou, lemmy, linkedin, mastodon, medium, naukri, naver,
netease_music, nextdoor, odysee, patreon, pinterest, polymarket,
producthunt, quora, realtor, reddit, rumble, seek, shopee, similarweb,
snapchat, soundcloud, spotify, stepstone, substack, taobao, telegram, temu,
thomasnet, threads, tiktok, toutiao, tripadvisor, trustpilot, truth_social,
tumblr, twitch, twitter, upwork, vk, walmart, web, wechat_channels,
wechat_oa, weibo, xianyu, xiaohongshu, xing, yahoo_finance, yandex, yelp,
youku, youtube, zhihu, zillow
Abbiamo testato questo fallback. Alle 16:41:00 SGT abbiamo chiesto una piattaforma che non è in elenco, lemon8. EveryInfra ha risposto in 0,24 secondi con HTTP 400. L'error.code era unknown_capability e il campo allowed elencava tutti i 106 nomi di piattaforma. La prima riga di next_steps diceva che non era stato addebitato nulla.
Alle 16:40:52 SGT abbiamo inviato alla ricerca di Xiaohongshu un valore di ordinamento inesistente: hot. È il nome dell'ordinamento del secondo endpoint nella bozza di Monid. L'API ha risposto in 0,11 secondi con HTTP 422 e un did_you_mean pari a most_liked. La sua lista allowed riportava i cinque valori validi e, di nuovo, non è stato addebitato nulla.
La differenza tra i due errori conta per il routing. HTTP 400 unknown_capability significa «questo job non è mio», quindi l'agente deve passare a Monid. HTTP 422 invalid_value significa «questo job è mio, ma un argomento è sbagliato», quindi l'agente deve correggere l'argomento in base ad allowed e riprovare, senza passare a un altro servizio.
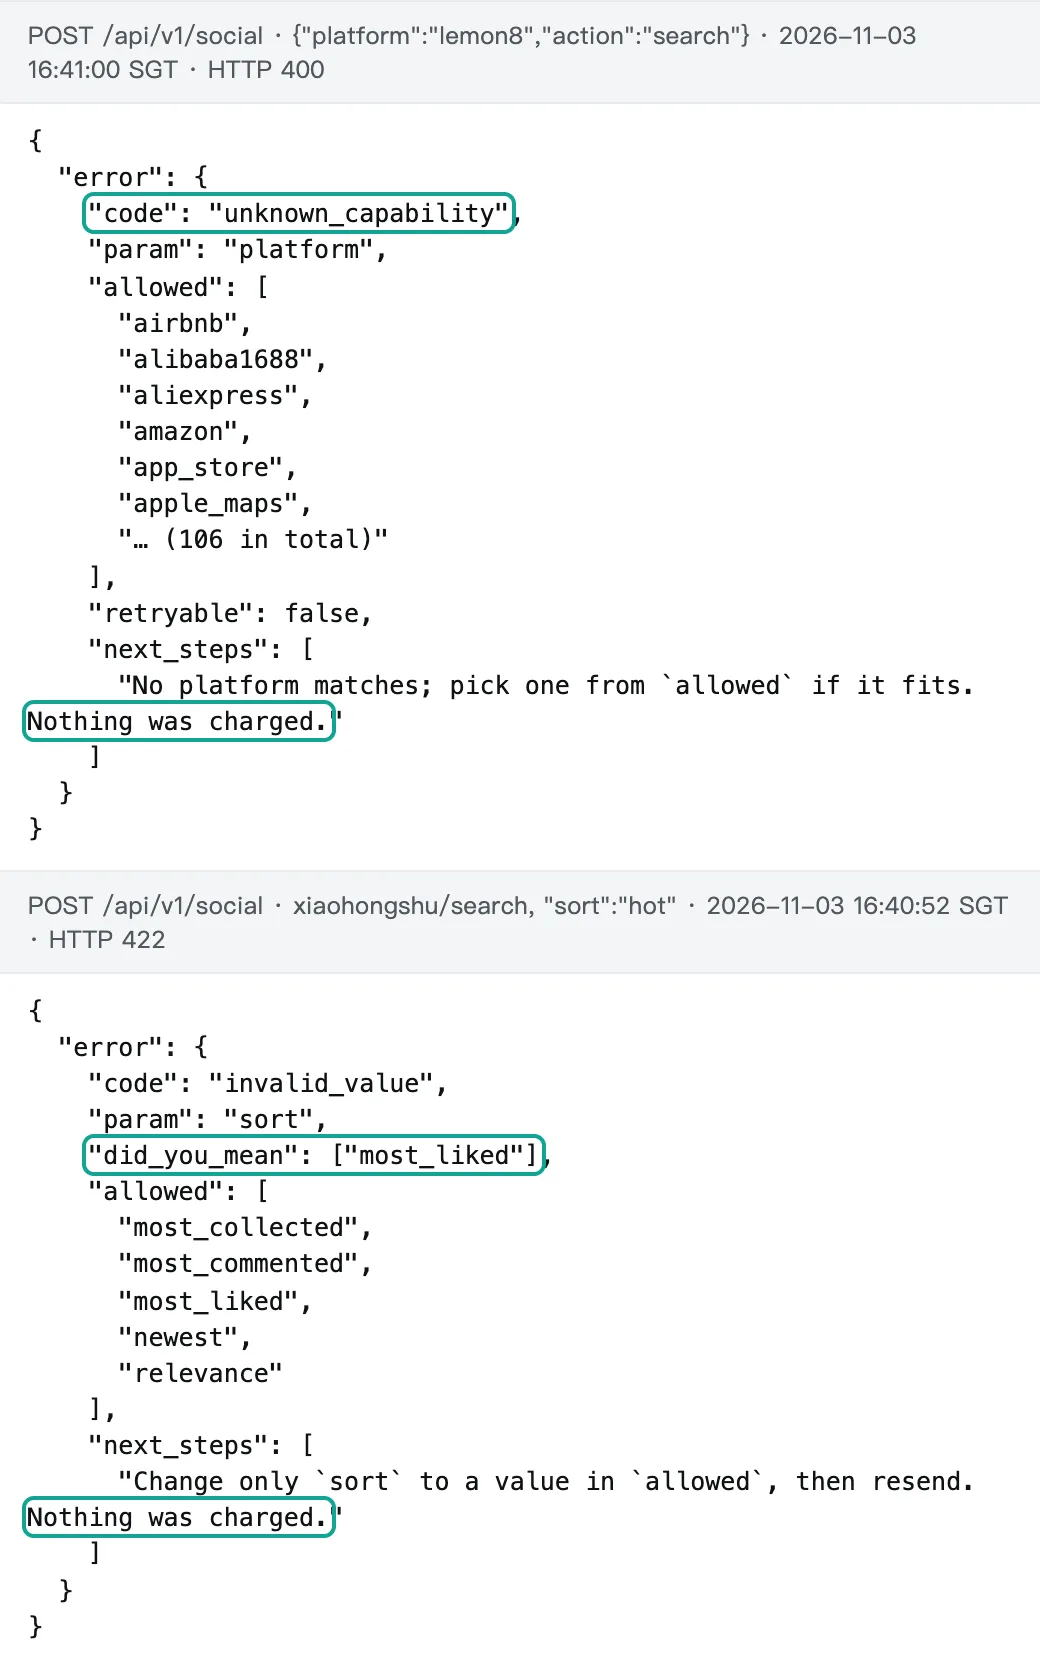
Il fallback permette alla regola di propendere per chiedere prima a EveryInfra. Supponi che l'elenco sia indietro di un giorno. Chiamare prima EveryInfra comporta soltanto un round trip non addebitato di una frazione di secondo, dopodiché la regola inoltra il job.
Per le piattaforme monitorate ogni giorno, non bisogna scegliere prima l'altro ramo. Lo stesso materiale di Monid del 29 ottobre dice che due endpoint per la stessa piattaforma chiamano gli ordinamenti in modo diverso e restituiscono nomi dei campi diversi. Quindi, quando un job si ripete ogni giorno, l'agente ha bisogno di un solo endpoint, un solo ordinamento e un solo schema (la citazione è alla fine di «Test uno», più avanti). Lo stesso consiglio si trova nella sezione della nostra documentazione sull'uso di EveryInfra con Monid e nella scheda di Monid nella nostra pagina dei partner.
Entrambi i server MCP in un solo client
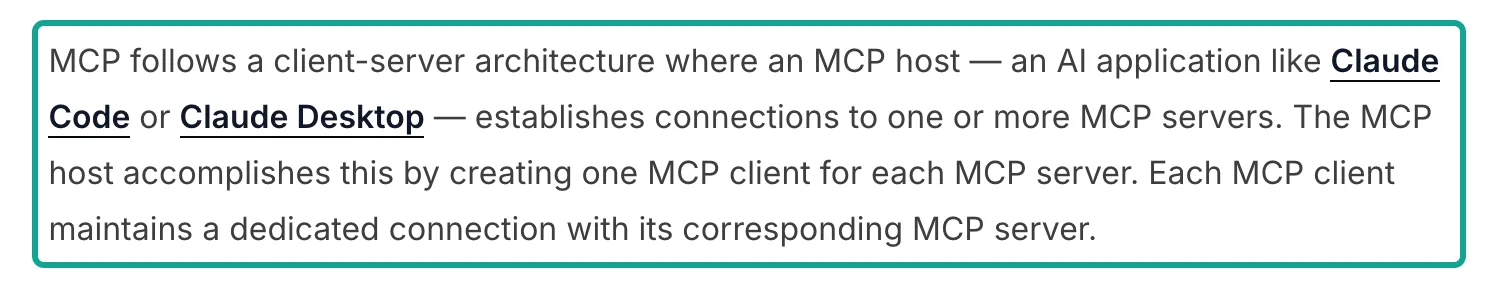
I due servizi possono funzionare fianco a fianco grazie a come è costruito MCP. Lo spiega la panoramica dell'architettura MCP. Un programma host crea un client MCP per ogni server MCP, e ogni client mantiene la propria connessione. L'host può essere Claude Code, Claude Desktop, Cursor, VS Code o un programma scritto da te. Una volta connesso, l'host unisce gli elenchi dei tool di tutti i server e li passa al modello. Il modello sceglie un tool a ogni chiamata.
Così EveryInfra e Monid possono convivere nello stesso host senza sapere l'uno dell'altro. La suddivisione dipende solo dalle descrizioni dei tool che il modello legge e dalla regola che scrivi tu. A livello di protocollo, i messaggi usano JSON-RPC 2.0. I server remoti usano il trasporto Streamable HTTP. L'elenco e la chiamata dei tool seguono la sezione tools della specifica.
In Claude Code bastano due comandi. EveryInfra usa una chiave API, che tieni in una variabile d'ambiente e passi con --header. Il server remoto di Monid usa OAuth, secondo la guida alla configurazione MCP di Monid (consultata il 3 novembre 2026). Dopo averlo aggiunto, digita /mcp in Claude Code, seleziona monid e completa l'accesso. Il flag --scope user rende entrambi i server disponibili in tutti i tuoi progetti.
La documentazione MCP di Claude Code descrive anche gli scope local e project. Lo scope project scrive in .mcp.json nella root del progetto ed è adatto a un team che condivide la stessa configurazione. Sei alle prime armi con MCP? Inizia dalla guida rapida MCP di Claude Code e dalla nostra pagina del server MCP.
# EveryInfra: API key auth; keep the key in an environment variable only
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope user --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"

# Monid: remote MCP with OAuth (then type /mcp in Claude Code, pick monid, sign in)
claude mcp add --transport http monid https://mcp.monid.ai/v1 --scope user
Se il tuo client legge un file mcpServers, la configurazione è simile al blocco qui sotto. C'è un dettaglio che spesso trae in inganno. In un file .mcp.json di Claude Code, un server remoto richiede "type": "http". Una voce con il solo url genera un errore di configurazione al caricamento del file.
Cursor legge un formato quasi identico. VS Code usa la chiave di primo livello servers invece di mcpServers. Gemini CLI usa httpUrl per un indirizzo Streamable HTTP, e Codex usa TOML. La tabella dopo il blocco elenca le differenze tra cinque client diffusi. Ogni riga proviene dalla documentazione ufficiale del client, consultata il 3 novembre 2026.
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    },
    "monid": { "type": "http", "url": "https://mcp.monid.ai/v1" }
  }
}| Client | Dove si trova la configurazione | Come dichiarare un server remoto | Come passare una chiave o accedere | Documentazione |
|---|---|---|---|---|
| Claude Code | claude mcp add oppure .mcp.json nel progetto | "type": "http" più url | --header o headers; per i server OAuth, accedi tramite /mcp | Documentazione MCP di Claude Code |
| Cursor | .cursor/mcp.json nel progetto oppure ~/.cursor/mcp.json | url sotto mcpServers | headers; OAuth è supportato | Documentazione MCP di Cursor |
| Codex | ~/.codex/config.toml oppure .codex/config.toml in un progetto attendibile | url sotto [mcp_servers.name] | bearer_token_env_var indica il nome di una variabile d'ambiente; OAuth con codex mcp login | Documentazione MCP di Codex |
| VS Code | .vscode/mcp.json nel workspace | Chiave di primo livello servers, "type": "http" | headers o variabili di input; OAuth è supportato | Documentazione MCP di VS Code |
| Gemini CLI | mcpServers nel file settings.json | httpUrl | headers; includeTools include solo alcuni tool | Documentazione MCP di Gemini CLI |
Con entrambi i server connessi, il modello vede a ogni turno entrambi i set di descrizioni dei tool, e questo ha un costo. Alle 16:42:41 SGT abbiamo inviato una richiesta tools/list al server MCP di EveryInfra. Ha restituito 12 tool. everyinfra_list_capabilities legge il catalogo, everyinfra_call_api chiama qualsiasi funzionalità per i dati e everyinfra_get_job recupera i risultati asincroni. Gli altri coprono ricerca, risoluzione dei CAPTCHA, chat AI, account e ticket di supporto.
L'intero corpo della risposta era di 16.247 byte. A circa quattro byte per token, sono circa 4.060 token. Il numero è contenuto perché non abbiamo trasformato ciascuna delle 569 funzionalità in un tool a sé. Un unico tool generico everyinfra_call_api più un tool gratuito per il catalogo permettono al modello di cercare prima ciò che gli serve.
Anthropic offre un confronto utile in «Introducing advanced tool use». Caricare subito le descrizioni di oltre 50 tool MCP richiedeva circa 72K token. Caricarle su richiesta tramite la ricerca dei tool ne manteneva solo una piccola parte.
Anche l'host aiuta. La documentazione di riferimento sulle variabili d'ambiente di Claude Code indica che la ricerca dei tool è attiva per impostazione predefinita (ENABLE_TOOL_SEARCH). Le descrizioni dei tool MCP quindi non entrano tutte insieme nel contesto. Se l'output di un tool supera i 10.000 token, viene generato un avviso; il limite predefinito è di 25.000 token (MAX_MCP_OUTPUT_TOKENS).
Nelle nostre prove, le cinque pagine di ricerca da 20 note di Xiaohongshu ciascuna occupavano da 35.538 a 51.999 byte di JSON grezzo. Gran parte del contenuto era costituita da stringhe lunghe che non servono a un'analisi, come URL delle immagini, URL degli avatar e token di pagina. Per i job giornalieri, quindi, fai conservare all'agente solo le colonne che memorizza. In alternativa, esegui l'API HTTP da uno script e scrivi il risultato su un file, così le righe non passano mai dal contesto del modello.
«Code execution with MCP» di Anthropic descrive questo schema. Il modello scrive codice che chiama i tool, e i dati intermedi restano nell'ambiente di esecuzione. Alla conversazione torna solo la conclusione.
Primo test: il matcha latte con tre ordinamenti e due lingue
Queste sono le prove principali di questo articolo. Ogni richiesta è partita da Singapore verso l'API HTTP di EveryInfra su POST /api/v1/social. La piattaforma era xiaohongshu, la funzionalità search e la parola chiave l'equivalente cinese di matcha latte. Abbiamo cambiato solo l'ordinamento, la pagina, l'intervallo di date e, in un caso, la lingua della parola chiave.
Il tempo indicato è quello totale lato client, round trip di rete compreso. Il prezzo è il valore di billing.charged_usd in ogni risposta. Il nostro editor ha eseguito le prime tre righe alle 16:33 SGT; le altre le abbiamo eseguite noi durante la stesura, con la stessa chiave di test.
| Ora (SGT, 3 nov) | Ordinamento o filtro | Pagina | Note | Tempo di risposta | Addebito | Like mediani | Note con meno di 30 giorni |
|---|---|---|---|---|---|---|---|
| 16:33:22 | most_liked | 1 | 20 | 3.91 s | $0.005556 | 1,427.5 | 0 |
| 16:33:26 | newest | 1 | 20 | 3.42 s | $0.005556 | 0 | 20 |
| 16:33:29 | most_liked, parola chiave «matcha latte» in inglese | 1 | 20 | 3.52 s | $0.005556 | 1,011 | 1 |
| 16:40:40 | most_liked (ripetizione) | 1 | 20 | 4.26 s | $0.005556 | 1,513.5 | 2 |
| 16:41:08 | most_liked con il page_token della pagina 1 | 2 | 20 | 2.34 s | $0.005556 | 194.5 | 1 |
| 16:41:18 | most_liked e last_30_days | 1 | 1 | 9.45 s | $0.005556 | 1,857 | 1 |
La richiesta è breve. Ecco la chiamata delle 16:40:40, con la risposta ridotta alla prima nota e al campo di fatturazione. L'elenco completo dei campi è nella pagina della funzionalità di ricerca di Xiaohongshu. Se sei nuovo, puoi ottenere una chiave dalla guida rapida nella nostra documentazione.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"xiaohongshu","action":"search",
"params":{"keyword":"抹茶拿铁","sort":"most_liked"}}'{
"platform": "xiaohongshu", "action": "search", "count": 20,
"pagination": { "page": 1, "has_more": true },
"next_page_token": "pt1.…",
"results": [
{ "id": "69a509f400000000220335a9",
"like_count": 16056, "collect_count": 2657, "comment_count": 6223,
"share_count": 3261, "posted_at": "2026-03-02T04:15:14+00:00",
"is_video": false, "is_cooperation_note": true }
],
"billing": { "charged": true, "charged_usd": 0.005556 }
}Parti dall'ordinamento. «Più like» e «più recenti» rispondono a due domande diverse. La pagina delle 16:33 ordinata per numero di like aveva una mediana di 1.427,5 like e 747,5 salvataggi. Nessuna delle sue 20 note aveva meno di 30 giorni, e la più vecchia era stata pubblicata il 28 maggio 2025. Per età: 0 note sotto i 30 giorni, 12 tra 30 e 179 giorni, 5 tra 180 e 364 giorni, 3 oltre un anno.
La pagina «più recenti» aveva 20 note pubblicate il 2 e il 3 novembre, con una mediana di 0 like. Le due pagine non avevano nessuna nota in comune. Se un agente le salva entrambe come «matcha latte top 20», nessuno a valle può capire quale pagina risponde a «cosa è più popolare» e quale a «di cosa si parla oggi».
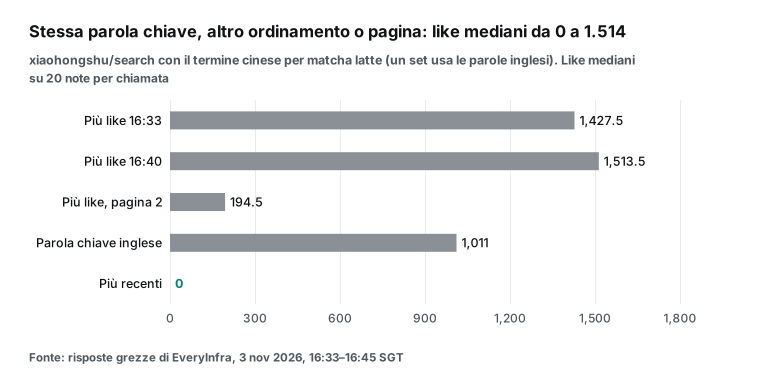
Poi la lingua della parola chiave. La parola chiave inglese «matcha latte», ordinata per numero di like, aveva una mediana di 1.011 like. Undici delle sue 20 note erano video, contro 9 nella pagina della parola chiave cinese. La più vecchia era stata pubblicata il 18 marzo 2023, e cinque avevano più di un anno. Aveva 4 note in comune con la pagina cinese delle 16:33.
Uno stesso argomento restituisce quindi, in cinese e in inglese, due insiemi che si sovrappongono ma restano diversi. La pagina inglese aveva cinque note con più di un anno, quella cinese tre. Per questo la regola di routing dice «usa la lingua della piattaforma per le parole chiave»: così l'agente non cerca per impostazione predefinita in inglese su una piattaforma cinese.
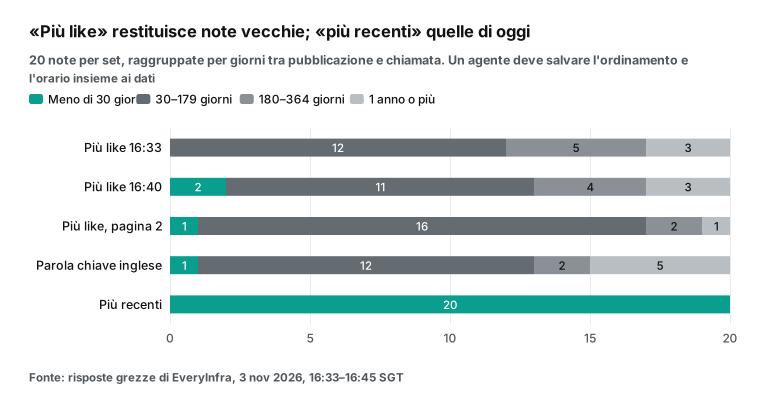
Anche la seconda pagina e il filtro per data meritano un'occhiata. Con il next_page_token della prima pagina, la seconda pagina ha restituito 20 note nuove, senza sovrapposizioni. La mediana è scesa a 194,5 like. Con 2,34 secondi è stata la chiamata più veloce della sessione. Ogni pagina conta come una chiamata, allo stesso prezzo.
Aggiungendo date_range=last_30_days, la pagina è tornata con una sola nota, pubblicata il 9 ottobre e con 1.857 like. La chiamata ha richiesto 9,45 secondi, la più lenta della sessione. Il catalogo è esplicito su questo parametro: un intervallo stretto come gli ultimi 30 giorni può restituire meno di 20 note per pagina. Per avere pagine piene, abbinalo a sort=newest; una pagina senza note non viene addebitata.
Questa pagina aveva una sola nota, quindi è stata addebitata 0,005556 $ come al solito. Supponiamo che il tuo job giornaliero sia «le note sul matcha latte con più like degli ultimi 30 giorni». Un approccio più stabile è scorrere ogni giorno le note più recenti, memorizzarle e ordinarle tu per like. Funziona meglio di un'unica richiesta «ultimi 30 giorni + più like» al giorno.
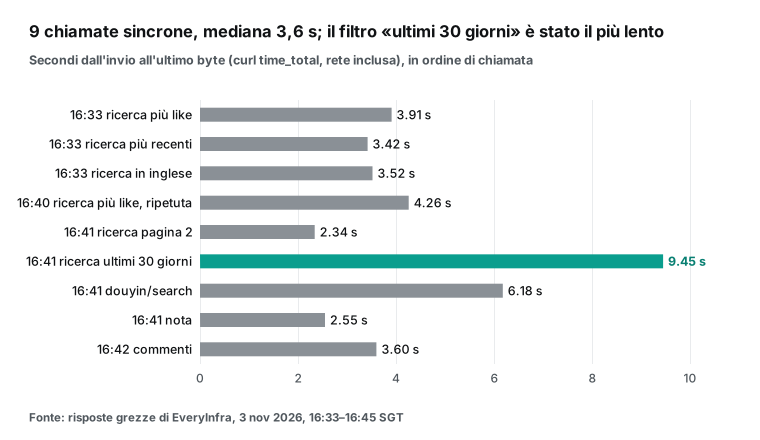
La mediana delle nove chiamate sincrone è stata di 3,6 secondi, con un intervallo da 2,34 a 9,45 secondi. Per un job che gira una volta al giorno è abbastanza veloce. Un agente che fa una dozzina di chiamate in un solo turno di conversazione può aggiungere "mode": "async" alla richiesta. L'API restituisce subito un id del job, e l'agente recupera il risultato con everyinfra_get_job o GET /api/v1/jobs/{job_id}. Lo indica anche il campo async_hint presente in ogni risposta sincrona.
Passiamo ora ai dati delle prove condotte da Monid il 29 ottobre 2026. Per questo test Monid ha usato la pagina dei tool Xiaohongshu di Monid. Ha scelto dal suo catalogo due endpoint di ricerca delle note di Xiaohongshu offerti da due aziende diverse. Li ha eseguiti una volta ciascuno con la stessa parola chiave cinese, e ha rieseguito il primo con la parola chiave inglese. Secondo il materiale di Monid, quel giorno la pagina elencava 49 endpoint.
Il numero di righe, i tempi e i risultati nella tabella seguente provengono dal materiale che Monid ci ha inviato, e gli orari sono nel fuso del Pacifico (USA). Non abbiamo ripetuto queste prove e non le confrontiamo con le nostre: le date sono diverse, i parametri di ordinamento sono diversi e le due parti hanno risposto a domande diverse.
| Data (esecuzione effettuata direttamente da Monid) | Endpoint | Input | Note | Tempo di risposta | Risultato |
|---|---|---|---|---|---|
| 2026-10-29 20:34 | Ricerca delle note della prima azienda | Parola chiave cinese, più like, pagina 1 | 20 | 3.2 s | Mediana di 2.132 like e 1.571 salvataggi; nessuna nota con meno di 30 giorni; la più vecchia con oltre tre anni e mezzo |
| 2026-10-29 20:34 | Ricerca delle note della seconda azienda | Parola chiave cinese, ordinamento «hot» | 20 | 3.2 s | Mediana di 97 like; 5 note su 20 con meno di 30 giorni |
| 2026-10-29 20:35 | Ricerca delle note della prima azienda | «matcha latte», più like | 20 | 2.9 s | Mediana di 2.961 like; metà delle note erano video |
Dalle sue prove Monid ha tratto la stessa conclusione che noi abbiamo tratto dalle nostre: l'ordinamento deve viaggiare insieme ai dati.
Ecco il passaggio del materiale di Monid del 29 ottobre, leggermente rivisto: «Stessa parola chiave, stesso giorno, due endpoint, due risposte a domande diverse. Un agente che le archivia entrambe come “top 20” ha perso l'unica cosa che le rendeva confrontabili.»
Lo stesso materiale osserva che i due endpoint usano nomi diversi sia per gli ordinamenti sia per i campi. Quindi, quando una query diventa una serie giornaliera, l'agente ha bisogno di un solo endpoint, un solo ordinamento e un solo schema. È a quel punto che la chiamata passa dal router alla linea diretta. Monid descrive il proprio metodo nella sua guida su come ottenere i dati di Xiaohongshu tramite un'API.
Secondo test: la stessa richiesta sei volte, 16 note diverse nei primi tre posti
Dalle 16:33 alle 16:45 SGT, la stessa identica richiesta è stata eseguita sei volte sulla prima pagina: {"keyword": <the Chinese keyword>, "sort": "most_liked"}. La prima esecuzione è avvenuta alle 16:33:22. Alle 16:36 il nostro editor ha fatto una prima prova dello script di esempio riportato più sotto. La richiesta è stata eseguita di nuovo alle 16:40:40. Alle 16:45 il nostro editor ha eseguito lo script altre tre volte, una per ogni versione linguistica di questo articolo. Lo script stampa solo i primi tre risultati, quindi sono questi che possiamo confrontare in tutte e sei le esecuzioni.
Nelle sei esecuzioni, le 18 posizioni complessive tra i primi tre risultati sono state occupate da 16 note diverse. La nota con 16.056 like è risultata prima alle 16:33 e alle 16:40. La nota con 20.972 like è risultata terza alle 16:36 e prima nella prima esecuzione delle 16:45. Ognuna delle altre 14 note è comparsa una sola volta. Abbiamo confrontato i primi tre di ogni coppia di esecuzioni: 13 coppie su 15 non avevano note in comune e 2 coppie ne condividevano una. Le pagine complete da 20 note delle 16:33 e delle 16:40 avevano in comune solo 7 note.
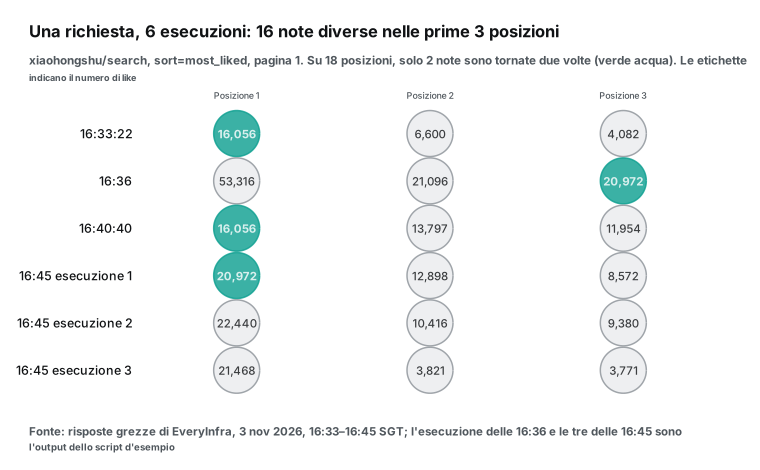
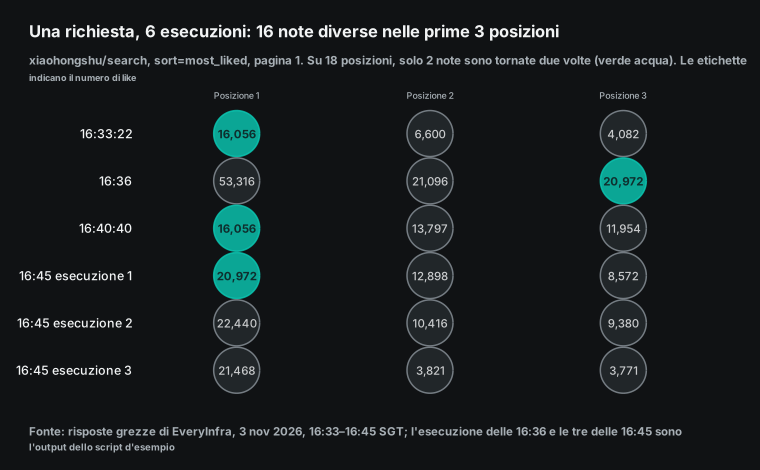
Prima di tutto, chiarisci cosa chiede la richiesta. Il catalogo chiama questo valore di ordinamento «most liked» (most_liked).
EveryInfra restituisce la prima pagina della ricerca di Xiaohongshu, ordinata in quel modo, in quel momento. Non è un ordinamento completo di tutte le note sul matcha latte per numero di like. La prima pagina quindi non garantisce di contenere le note con più like dell'intera piattaforma.
Lo dimostrano le risposte grezze. La prima nota alle 16:33 e alle 16:40 aveva 16.056 like. La prima nota alle 16:36 invece ne aveva 53.316, e le tre esecuzioni delle 16:45 avevano in cima note da 20.972, 22.440 e 21.468 like. Nessuna di queste note compariva nelle pagine complete da 20 note delle 16:33 e delle 16:40.
Le tre esecuzioni delle 16:45 sono avvenute nell'arco di un minuto, e i loro primi tre non avevano note in comune. La pagina uno della piattaforma può quindi cambiare nel giro di pochi minuti, persino entro un minuto. Il lato API invece è rimasto sempre uguale. Ogni chiamata ha restituito HTTP 200 con 20 note, e ognuna è costata gli stessi 0,005556 $. Ogni nome di campo nelle risposte delle 16:33 e delle 16:40 era presente nell'elenco response_fields del catalogo. Qualche campo compare solo quando ha un valore, come poi_id quando una nota indica un luogo.
Per un job giornaliero ci sono tre conseguenze dirette. Primo, distingui ciò che può restare fisso. La forma della richiesta, i nomi dei campi, il prezzo e il formato degli errori possono e devono restare fissi. L'insieme dei risultati no. Non fidarti di nessuna configurazione che promette «le stesse prime 20 note ogni giorno» da un'unica richiesta.
Secondo, memorizza insieme ai dati le condizioni della richiesta e l'orario: l'ordinamento, la pagina, la parola chiave e l'ora della chiamata. Se ne manca una, dopo una settimana non sai più a quale domanda risponde quel blocco di righe.
Terzo, se vuoi una classifica stabile, non affidarti ai primi risultati di una singola richiesta. Scorri ogni giorno qualche pagina in più e unisci le pagine nella tua tabella in base all'id della nota. Poi ordina con una regola che definisci tu, come il numero di like. Quella classifica è riproducibile.
Ecco il terzo punto applicato ai dati di questa sessione. Le prime pagine delle 16:33 e delle 16:40 contenevano 20 note ciascuna. Unite e deduplicate per id della nota, davano 33 note diverse, 13 in più di ciascuna pagina presa da sola. Ordinando per like, la nota da 16.056 like risulta prima, e la successiva operazione di unione può calcolare lo stesso risultato. Non dipende da quale pagina la piattaforma servirà il minuto dopo.
Per ogni riga memorizzata, conserva almeno le colonne seguenti. I valori di esempio vengono dalla prima nota della risposta delle 16:40:40.
| Colonna | Fonte | Valore di esempio (3 nov 2026, 16:40:40 SGT) | Perché memorizzarla |
|---|---|---|---|
| Ora della chiamata | Il tuo log | 2026-11-03 16:40:40 | La stessa richiesta cambia nel giro di minuti; senza l'orario non puoi riprodurla |
| Parola chiave, ordinamento, pagina | Parametri della richiesta | matcha latte (in cinese), most_liked, 1 | «Più like» e «più recenti» rispondono a due domande diverse |
| Posizione | Ordine nei risultati | 1 | Seguire la posizione di una nota in momenti diversi |
| Id della nota | id | 69a509f400000000220335a9 | Deduplicare tra esecuzioni e pagine |
| Engagement | like_count, collect_count e comment_count | 16,056, 2,657, 6,223 | Ordinare con una regola che definisci tu |
| Ora di pubblicazione | posted_at | 2026-03-02 | Distinguere «ciò di cui si parla ora» da «ciò che è popolare da tempo» |
| Sponsorizzata | is_cooperation_note | true | Contare a parte i post a pagamento |
| Addebito | billing.charged_usd | 0.005556 | Riconciliazione di fine mese |
Anche il costo dell'unione è facile da calcolare. La seconda pagina delle 16:41 non aveva note in comune con la prima. La prima e la seconda pagina danno quindi 40 note diverse per parola chiave al giorno. Se esegui entrambe le pagine al mattino e di nuovo al pomeriggio, una parola chiave richiede 4 chiamate al giorno. A 0,005556 $ a chiamata, sono circa 0,022 $ al giorno e 0,67 $ per 30 giorni. Con questa spesa in più ottieni una tabella riproducibile e confrontabile. La settimana dopo puoi ancora vedere quale nota è entrata nelle prime 40 e in quale giorno, e come sono cresciuti i suoi like.
| Quando un job giornaliero ripete una richiesta | Fisso in questo test? | Prove (3 nov 2026, SGT) | Cosa significa per la memorizzazione e le regole |
|---|---|---|---|
| Forma della richiesta (piattaforma, funzionalità, nomi dei parametri) | Fisso | Tutte le 9 chiamate hanno usato la stessa forma platform + action + params | Scrivi la regola e lo script una volta sola |
| Nomi dei campi | Fisso | Ogni campo delle risposte complete delle 16:33 e delle 16:40 era tra i 30 elencati dal catalogo | Prepara in anticipo la tabella a valle |
| Prezzo | Fisso | 10 ricerche su Xiaohongshu, 1 dettaglio di nota e 1 chiamata ai commenti, ciascuna addebitata 0,005556 $ | Prevedi in anticipo il budget del mese |
| Formato degli errori | Fisso | Le risposte HTTP 400 e 422 riportavano entrambe code, allowed e next_steps | Scrivi una volta sola la logica dei nuovi tentativi e del reinstradamento |
| Quali 20 note vengono restituite | Cambia | Le pagine delle 16:33 e delle 16:40 avevano in comune 7 note su 20 | Memorizza ordinamento e orario; unisci per id |
| I primi tre | Cambia | 16 note diverse in 18 posti su 6 esecuzioni; 13 coppie di esecuzioni su 15 senza note in comune | Costruisci classifiche stabili da pagine unite |
Terzo test: dettaglio della nota, commenti e Douyin
I job giornalieri raramente si fermano alla ricerca. Con un gruppo di note in mano, di solito vuoi dettagli e commenti per quelle ai primi posti. A volte vuoi anche la stessa parola chiave su una seconda piattaforma. Le tre chiamate seguenti sono state eseguite tutte tra le 16:41 e le 16:42 SGT, tramite la stessa API e con la stessa forma di richiesta; sono cambiati solo platform e action.
| Ora (SGT, 3 nov) | Funzionalità | Input | Righe | Tempo di risposta | Addebito | Campi da guardare |
|---|---|---|---|---|---|---|
| 16:41:50 | xiaohongshu/note | Link alla nota da 16.056 like | 1 | 2.55 s | $0.005556 | ip_location valorizzato, is_cooperation_note true, 9 tag |
| 16:42:00 | xiaohongshu/comments | Stessa nota, prima i commenti con più like | 15 | 3.60 s | $0.005556 | Primo commento con 1.213 like; 650 risposte complessive ai 15 commenti; has_more true |
| 16:41:36 | douyin/search | Parola chiave cinese per matcha latte, più like | 10 | 6.18 s | $0.008333 | Mediana di 6.179,5 like; primo video 1.178.986 |
Il dettaglio della nota aggiunge campi che la ricerca non restituisce: ip_location dell'autore, gli elenchi completi tags e topics e has_goods, che indica se alla nota è collegato un prodotto.
La prima nota di questa sessione è sponsorizzata: il suo is_cooperation_note era true. Promuove una linea di caffè alla rosa e descrive tre bevande. Una è il matcha latte alla rosa, e la nota dice che piacerà molto agli amanti del matcha. Il titolo però non contiene «matcha», e nessuno dei suoi nove tag lo contiene. Il matcha latte è solo una bevanda della linea.
Da qui chi gestisce un monitoraggio giornaliero ricava due indicazioni. Per decidere se una nota riguarda la parola chiave, leggi il testo, non solo il titolo e i tag. E conta a parte le note sponsorizzate, giudicandone la pertinenza dal testo. Altrimenti uno o due post a pagamento possono alzare la media dei like di un'intera settimana. L'elenco completo dei campi è nella pagina della funzionalità di dettaglio della nota.
La chiamata ai commenti ha restituito 15 commenti di primo livello, da 1.213 like fino a 3. Ognuno riporta un sub_comment_count, e i 15 insieme avevano 650 risposte. La risposta aveva has_more impostato a true, quindi con next_page_token si ottiene la pagina successiva. In questa pagina ogni ip_location era vuoto: la regione di chi commenta non è sempre presente, e le statistiche a valle non devono darla per scontata.
Tra i campi dei commenti c'è anche author_is_ai_agent, che era false per tutti e 15. Per analizzare il sentiment o i punti di forza citati nei commenti, consulta la pagina della funzionalità dei commenti. Il nostro articolo precedente su come leggere i commenti di Xiaohongshu con i workflow dinamici di Claude Code approfondisce il tema.
Una pagina di ricerca di Douyin contiene 10 video e costa 0,008333 $ a chiamata, ovvero 8,33 $ per 1.000 chiamate. La ricerca di Xiaohongshu costa 5,56 $ per 1.000. Sono entrambi prezzi di listino del catalogo. I 10 video avevano una mediana di 6.179,5 like, e il primo ne aveva più di 1,17 milioni. Erano stati pubblicati tra febbraio 2025 e settembre 2026.
I nomi dei campi non sono identici sulle due piattaforme. Douyin aggiunge author_follower_count, music, hashtags e is_pinned. I campi comuni come like_count, comment_count, share_count e posted_at hanno però gli stessi nomi. Una tabella multipiattaforma deve quindi gestire solo le colonne aggiuntive specifiche di ciascuna piattaforma. La pagina dell'API per i dati di Douyin e la pagina della funzionalità di ricerca di Douyin elencano tutti i campi. Le funzionalità corrispondenti di TikTok sono nella pagina dell'API per i dati di TikTok.
Script di esempio: job giornaliero e job una tantum insieme
Il codice Python seguente è l'esempio minimo funzionante dei due servizi insieme, scritto con Requests. La prima metà è il job giornaliero: la chiamata xiaohongshu/search di EveryInfra con una forma di richiesta fissa, che stampa le prime tre note e l'importo addebitato. La seconda metà è un job una tantum: trovare il logo di un'azienda a partire dal suo dominio. Non si tratta di dati giornalieri provenienti da una piattaforma, quindi la richiesta va a Monid: discover, poi inspect, e run solo se il prezzo rientra nel budget. Entrambe le chiavi vengono da variabili d'ambiente, e lo script non contiene chiavi in chiaro.
import os

import requests

EVERYINFRA_API_KEY = os.environ["EVERYINFRA_API_KEY"]
MONID_API_KEY = os.environ["MONID_API_KEY"]
MONID = "https://api.monid.ai/v1"
MONID_HEADERS = {"Authorization": f"Bearer {MONID_API_KEY}"}
MAX_PRICE_USD = 0.01  # do not run a Monid tool that costs more than this per call

# 1. The daily job: EveryInfra xiaohongshu/search, one fixed request shape
resp = requests.post(
    "https://api.everyinfra.com/api/v1/social",
    headers={"Authorization": f"Bearer {EVERYINFRA_API_KEY}"},
    json={"platform": "xiaohongshu", "action": "search",
          "params": {"keyword": "抹茶拿铁", "sort": "most_liked"}},
    timeout=120,
)
resp.raise_for_status()
body = resp.json()
for note in body["results"][:3]:
    print(note["like_count"], note["collect_count"], note["posted_at"][:10], note["url"])
print("EveryInfra:", len(body["results"]), "notes, charged (USD):", body["billing"]["charged_usd"])

# 2. A one-off lookup that is not a daily platform: discover, inspect, run on Monid
found = requests.post(f"{MONID}/discover", headers=MONID_HEADERS, timeout=60,
                      json={"query": "company logo image URL from a domain", "limit": 3}).json()["results"]
# discover adds ranking and price fields to each result; inspect and run take only the fields that name the tool
SHOWN_ONLY = ("providerName", "description", "price", "score", "scoreBreakdown", "tags", "metrics", "hints")
tool = {key: value for key, value in found[0].items() if key not in SHOWN_ONLY}
detail = requests.post(f"{MONID}/inspect", headers=MONID_HEADERS, timeout=60, json=tool).json()
price = detail["price"]["amount"]["value"]
print("Monid tool:", detail["endpoint"], "price (USD):", price)
if price <= MAX_PRICE_USD:
    run = requests.post(f"{MONID}/run", headers=MONID_HEADERS, timeout=120,
                        json={**tool, "input": {"pathParams": {"company": "starbucks.com"}}}).json()
    print("Monid run:", run.get("runId"), run.get("status"), run.get("output"))
Il nostro editor ha eseguito questo script per la prima volta il 3 novembre 2026 alle 16:36 SGT, poi altre tre volte alle 16:45, una per ogni versione linguistica. Ogni esecuzione completa ha richiesto da 6,4 a 7,7 secondi. La parte relativa a EveryInfra ha restituito ogni volta 20 note ed è stata addebitata 0,005556 $. I suoi primi tre risultati corrispondono alle righe delle 16:36 e delle 16:45 nella griglia a punti qui sopra.
Nella metà Monid, il primo risultato di discover in tutte e quattro le esecuzioni è stato un endpoint che restituisce il logo di un'azienda a partire da un dominio. inspect ne indicava un prezzo di 0 $ in quel momento, quindi lo script è passato a run. L'esecuzione è tornata con stato COMPLETED e l'URL dell'immagine di un logo. La riga MAX_PRICE_USD è una protezione semplice ma utile. discover e inspect sono gratuiti, quindi un agente può sempre leggere prima il prezzo. Può saltare qualsiasi tool sopra il budget e lasciare quella decisione a una persona.
Il materiale di Monid del 29 ottobre contiene un avvertimento che calza qui: la discovery è una classifica, non una garanzia. Una frase che descrive una funzionalità, come «Xiaohongshu note search», dà buoni risultati. Una frase lunga e colloquiale che contiene nomi propri può far salire in classifica endpoint che non c'entrano nulla con il compito. Quindi leggi i primi risultati prima di eseguirne uno: leggerli è gratis. I passaggi «discover, poi inspect, poi run solo entro il budget» della nostra regola seguono questo consiglio.
Il conto: quanto costa al mese un job giornaliero
Il vantaggio più diretto di campi e prezzo fissi è che puoi calcolare il conto in anticipo. Di seguito trovi il costo mensile di un monitoraggio del matcha latte su Xiaohongshu ai prezzi di catalogo del 3 novembre 2026. Il calcolo considera un mese di 30 giorni e l'addebito di ogni chiamata. In pratica le chiamate fallite e le pagine vuote non vengono addebitate, quindi queste cifre sono un tetto massimo. Le 16 funzionalità di Xiaohongshu diverse dalla classifica dei contenuti dei creator costano 0,005556 $ a chiamata, e la ricerca di Douyin costa 0,008333 $ a chiamata. Il listino completo è nella pagina dei prezzi.
| Piano | Chiamate al giorno | Costo al giorno | Costo per 30 giorni |
|---|---|---|---|
| A: 3 parole chiave, pagina 1 per ciascuna | 3 × xiaohongshu/search | $0.0167 | $0.50 |
| B: 3 parole chiave, 2 pagine per ciascuna | 6 × xiaohongshu/search | $0.0333 | $1.00 |
| C: B più i commenti sulle prime 5 note | 6 ricerche + 5 × xiaohongshu/comments | $0.0611 | $1.83 |
| D: C più le stesse 3 parole chiave su Douyin | le 11 chiamate precedenti + 3 × douyin/search | $0.0861 | $2.58 |
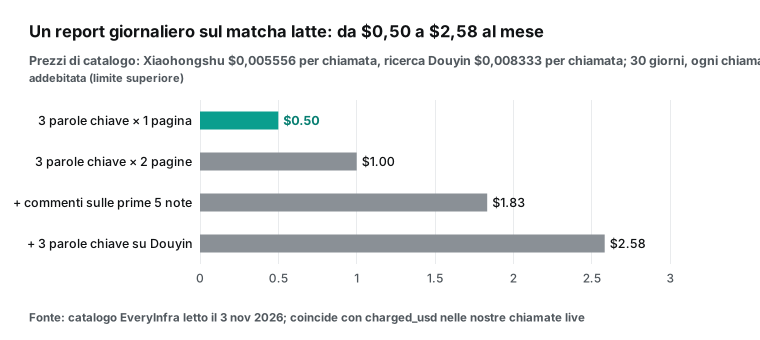
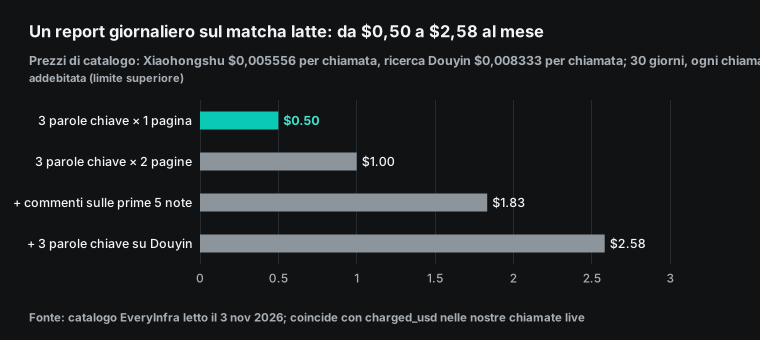
Le cifre sono piccole, ma l'importante è che si possano mettere a budget in anticipo. La richiesta e il prezzo non cambiano, quindi il conto di fine mese non cambia solo perché il modello ha scelto un endpoint diverso.
La coda lunga si contabilizza in un altro modo: controlla il prezzo con inspect prima di ogni run, registra ogni chiamata e a fine mese somma ciò che è successo davvero. Le chiamate addebitate elencate in questo articolo sono in tutto 13, per 0,075005 $. Le nostre 6 chiamate durante la stesura sono costate 0,036113 $. Le 7 chiamate del nostro editor (tre alle 16:33, una alle 16:36 e tre alle 16:45) sono costate 0,038892 $.
Limiti: cosa copre questa suddivisione e cosa no
La regola di routing decide dove va una chiamata. Non decide se dovresti raccogliere quei dati.
L'accordo di servizio per gli utenti e l'informativa sulla privacy di Xiaohongshu stabiliscono i termini d'uso dei contenuti della piattaforma e delle informazioni degli utenti. Il trattamento di informazioni personali nella Cina continentale rientra anche nella Legge sulla protezione delle informazioni personali. Si applica inoltre il Regolamento sulla gestione della sicurezza dei dati di rete, in vigore dal 1° gennaio 2025. Per un job giornaliero, la misura più pratica è memorizzare solo le colonne che usa la tua analisi. Di solito bastano id della nota, titolo, metriche di engagement, ora di pubblicazione, ordinamento e ora della chiamata. Lascia fuori nickname degli autori, avatar e profili di chi commenta, a meno che non ti servano; in quel caso, definisci uno scopo chiaro e un periodo di conservazione.
Anche la regola ha i suoi limiti, e ognuno ha una soluzione semplice.
| Limite | Cosa può andare storto | Cosa fare |
|---|---|---|
| L'elenco diventa obsoleto | Una piattaforma viene aggiunta o sospesa, e dopo qualche settimana 106 nomi scritti nel codice sono sbagliati | Aggiorna con everyinfra_list_capabilities a ogni sessione, oppure affidati al fallback unknown_capability |
| Limiti di frequenza delle richieste | Ogni chiave EveryInfra ha un limite al minuto; se lo superi ricevi HTTP 429 (RFC 6585) | Attendi prima di un nuovo tentativo; non riprovare mai in un ciclo serrato |
| Due modi di autenticarsi | EveryInfra usa una chiave API; il server MCP remoto di Monid usa OAuth (guida alla configurazione MCP di Monid, consultata il 2026-11-03) | Tieni le chiavi nelle variabili d'ambiente, mai in un .mcp.json sottoposto a commit |
Per i server MCP remoti, l'accesso tramite OAuth è definito nella sezione sull'autorizzazione della specifica MCP.
L'ultimo limite è il modello. Per quanto bene siano collegati i tool, un modello può comunque sceglierne uno sbagliato o compilare male un parametro. MCP-Universe ha testato i modelli su server MCP reali, e il risultato migliore, di GPT-5, è stato un tasso di successo del 43,72%. MCP-Bench ha costruito su 28 server e 250 tool attività più vicine al lavoro reale, e valuta a parte le chiamate che coinvolgono più tool e più passaggi.
Per questo la regola di questo articolo è scritta in modo semplice. L'elenco è esplicito, i codici di errore sono distinti e l'agente legge il prezzo prima di spendere. Ognuno di questi elementi toglie una congettura dal lavoro del modello. In Claude strict tool use con un'API per i dati descriviamo un altro approccio: schemi rigidi dei parametri impediscono al modello di costruire una richiesta non valida.
Cosa è cambiato di recente
Il tool calling si è evoluto rapidamente negli ultimi mesi. Ogni riga qui sotto è datata luglio 2026 o successiva. L'ultima colonna indica cosa comporta il cambiamento per la suddivisione «job giornalieri su un'API per i dati, coda lunga su un router».
| Data | Cosa è successo | Cosa significa per te |
|---|---|---|
| 2026-07-28 | Una nuova specifica MCP: un core stateless, gli header di richiesta Mcp-Method e Mcp-Name, indicazioni di cache e un ordine fisso per tools/list, oltre ad aggiornamenti sull'autorizzazione tra cui RFC 9207 e i documenti di metadati del client | Due server remoti in un unico host richiedono meno connessioni e gli elenchi dei tool si possono mettere in cache, così il modello legge a ogni turno un insieme di descrizioni più stabile |
| 2026-10-06 | The Hacker News ha pubblicato un'analisi di 15.465 server MCP pubblici | I server non sono mai stati così tanti, quindi scegliere quei pochi da tenere caricati conta più della possibilità di connettersi |
| 2026-10-16 | Semafor ha dato notizia di un round seed per TrustedRouter, un router di modelli concorrente di OpenRouter | La formula «una chiave davanti a molti backend» continua ad attirare investimenti a livello dei modelli; vale la pena tenere d'occhio la stessa formula a livello dei tool |
| 2026-10-19 | La piattaforma aperta di Xiaohongshu ha pubblicato un avviso di dismissione di un'API di previsione delle categorie | La piattaforma ufficiale resta concentrata su negozi ed e-commerce; per i dati dei contenuti pubblici serve ancora un'altra strada |
| 2026-10-21 | Bloomberg ha descritto la proposta Skills over MCP che ha contribuito a promuovere (SEP-2640); lo stesso giorno Stripe ha lanciato Treasury for agents, utilizzabile tramite MCP | I file Skill e il protocollo MCP stanno convergendo, quindi verifica se un server include anche un file Skill |
| 2026-10-22 | Anthropic ha pubblicato indicazioni su quando riportare i subagent nel loop principale | Pochi tool leggeri per i dati nel loop principale sono di solito più veloci e precisi, quindi due server in un solo agente sono una scelta predefinita sensata |
| 2026-10-30 | Il blog di MCP ha annunciato che l'SDK per Ruby ha raggiunto il Tier 1 | Si possono creare client MCP solidi in più linguaggi, quindi anche il tuo host può ospitare entrambi i server |
FAQ
Xiaohongshu ha un'API ufficiale per la ricerca delle note?
Al 3 novembre 2026, la piattaforma aperta di Xiaohongshu serve soprattutto app ERP per negozi ed e-commerce, con API per ordini, prodotti e assistenza post-vendita. Il 19 ottobre 2026 ha dismesso un'API di previsione delle categorie. Ricerca, dettaglio e commenti delle note pubbliche non ne fanno parte. La funzionalità xiaohongshu/search di EveryInfra costa 0,005556 $ a chiamata; consulta la pagina dell'API per i dati di Xiaohongshu.
Mi viene addebitato qualcosa se la piattaforma non è nell'elenco di EveryInfra?
No. Una piattaforma fuori dall'elenco restituisce HTTP 400 unknown_capability, e un parametro sbagliato restituisce HTTP 422 con did_you_mean. In nessuno dei due casi c'è un addebito; le prove (3 novembre 2026, dalle 16:40 alle 16:41 SGT) sono nella sezione sulla regola di routing più sopra.
Quanti tool dovrebbe caricare un agente?
Non esiste un numero preciso. RAG-MCP ha rilevato che, con molti tool, recuperarli prima e scegliere poi alzava l'accuratezza dal 13,62% al 43,13%. Lo sviluppatore di r/mcp con oltre 680 tool ha visto le scelte peggiorare nettamente oltre i 30-60 tool. Per capire come dividere il lavoro tra subagent e loop principale, leggi Subagent di Claude Code per gli account TikTok.
Riferimenti
- «EveryInfra data capability catalog,
GET /api/v1/social/catalog», EveryInfra, consultato il 2026-11-03 alle 16:32 SGT. - «Architecture overview», documentazione di Model Context Protocol, consultata il 2026-11-03.
- «Release notes for the 2026-07-28 MCP specification», blog di MCP, 2026-07-28.
- «Specification: Tools», specifica MCP, versione 2026-07-28.
- «Specification: Authorization», specifica MCP, versione 2026-07-28.
- «Specification: Transports», specifica MCP, versione 2026-07-28.
- «The MCP Ruby SDK reaches Tier 1», blog di MCP, 2026-10-30.
- «MCP Registry», registro ufficiale di MCP, consultato il 2026-11-03.
- «JSON-RPC 2.0 Specification», JSON-RPC Working Group.
- «Connect Claude Code to tools via MCP», documentazione di Claude Code, consultata il 2026-11-03.
- «MCP quickstart», documentazione di Claude Code, consultata il 2026-11-03.
- «Environment variables», documentazione di Claude Code, consultata il 2026-11-03.
- «Model Context Protocol», documentazione di Cursor, consultata il 2026-11-03.
- «Model Context Protocol», documentazione di OpenAI Codex, consultata il 2026-11-03.
- «Use MCP servers in VS Code», documentazione di VS Code, consultata il 2026-11-03.
- «MCP servers with Gemini CLI», documentazione di Gemini CLI, consultata il 2026-11-03.
- «Connectors and MCP servers», documentazione della piattaforma OpenAI, consultata il 2026-11-03.
- «Quickstart», documentazione di OpenRouter, consultata il 2026-11-03.
- «FAQ», documentazione di OpenRouter, consultata il 2026-11-03.
- «Writing effective tools for agents», Anthropic Engineering.
- «Introducing advanced tool use», Anthropic Engineering.
- «Code execution with MCP», Anthropic Engineering.
- «Building agents: When to fold subagents into your main agent loop», Anthropic, 2026-10-22.
- «RAG-MCP: Mitigating Prompt Bloat in LLM Tool Selection via Retrieval-Augmented Generation», arXiv:2505.03275.
- «ToolLLM: Facilitating Large Language Models to Master 16000+ Real-world APIs», arXiv:2307.16789.
- «Gorilla: Large Language Model Connected with Massive APIs», arXiv:2305.15334.
- «MCP-Universe: Benchmarking Large Language Models with Real-World Model Context Protocol Servers», arXiv:2508.14704.
- «MCP-Bench: Benchmarking Tool-Using LLM Agents with Complex Real-World Tasks via MCP Servers», arXiv:2508.20453.
- «RFC 9110: HTTP Semantics», IETF.
- «RFC 6585: Additional HTTP Status Codes», IETF.
- «RFC 9457: Problem Details for HTTP APIs», IETF.
- «RFC 9728: OAuth 2.0 Protected Resource Metadata», IETF.
- «RFC 8707: Resource Indicators for OAuth 2.0», IETF.
- «RFC 9207: OAuth 2.0 Authorization Server Issuer Identification», IETF.
- «The OAuth 2.1 Authorization Framework, draft 13», IETF.
- «Skills over MCP: How Bloomberg helped standardize agent skills at scale», Bloomberg, 2026-10-21.
- «Treasury for agents», Stripe Newsroom, 2026-10-21.
- Un'analisi di 15.465 server MCP pubblici, The Hacker News, 2026-10-06.
- Un articolo sull'agente Pi, MCP e la code mode, The New Stack.
- «MCP Server and SI Agent Government Hackathon», US General Services Administration, da settembre a novembre 2026.
- Un articolo sul round seed di un concorrente di OpenRouter, Semafor, 2026-10-16.
- Un post sull'uso di 58 server MCP e oltre 680 tool, Reddit r/mcp.
- Requests: Quickstart, documentazione di Requests.
- Contratto di servizio per gli utenti di Xiaohongshu (in cinese), Xiaohongshu, consultato il 2026-11-03.
- Informativa sulla privacy di Xiaohongshu (in cinese), Xiaohongshu, consultata il 2026-11-03.
- Piattaforma aperta di Xiaohongshu (in cinese), Xiaohongshu, consultata il 2026-11-03, compreso l'avviso del 2026-10-19.
- Legge sulla protezione delle informazioni personali della Repubblica Popolare Cinese (in cinese), Cyberspace Administration of China.
- Regolamento sulla gestione della sicurezza dei dati di rete (in cinese), Consiglio di Stato, pubblicato a settembre 2024, in vigore dal 2025-01-01.
- Un articolo di Huxiu su Xiaohongshu e l'AI (in cinese), Huxiu, 2026-10-16.
- Home page di Monid, consultata il 2026-11-03 («Live · 2800+ tools», «Start with $1 in free credit»); il link è nell'articolo.
- Monid, «The OpenRouter for agent tools», pagina sul posizionamento, consultata il 2026-11-03; il link è nell'articolo.
- Monid, guida rapida MCP, documentazione di configurazione, consultata il 2026-11-03; il link è nell'articolo.
- Monid, pagina dello strumento Xiaohongshu, con 49 endpoint elencati al 2026-10-29; il link è nell'articolo.
- Monid, «How to get Xiaohongshu (RedNote) data through an API», guida, consultata il 2026-11-03; il link è nell'articolo.
Riferimenti BL-78