データAPIかツールルーターか:EveryInfraとMonidはエージェントの呼び出しをどう分担するか
同じXiaohongshu検索を6回実行すると、上位3件に入ったノートは計16件にのぼり、料金は毎回$0.005556でした。日次ジョブはデータAPIに、ロングテールはMonidに任せましょう。
2026年11月3日、シンガポール時間(SGT)16:33から16:45にかけて、同じリクエストを6回送信しました。送信先はEveryInfraのxiaohongshu/search機能で、キーワードは「抹茶ラテ」の中国語、並び順は「いいね数順」(most_liked)、1ページ目です。どの呼び出しも20件のノートを返し、料金は$0.005556で、フィールド名はすべてカタログの一覧にありました。うち2回は個別に時間を計測しており、所要時間は3.9秒と4.3秒でした。しかし6回の実行を通じて、上位3件の計18枠には16件の異なるノートが入りました。
この結果から、日次のエージェントジョブで何を一定に保てるかがわかります。リクエストの形、フィールド名、料金、エラー形式は固定できます。一方で結果セットは固定できないため、保存する各行に並び順とタイムスタンプを残す必要があります。この4つが固定されているため、日次ジョブは専用のデータAPIに向いています。
エージェントが事前に想定せず、一度だけ行う呼び出しは、Monidのようなツールルーターに任せるのが適切です。2026年11月3日時点で、Monidのトップページには2,800以上のツールが掲載されていました。Monidからは10月29日に資料を受け取りました。それによると、discoverとinspectは無料です。runは、ツールカードに記載された価格で、共通の残高から呼び出しごとに課金されます。
この記事は、Monidチームの草稿をもとにしています。その主張はそのまま残しました。エージェントのツール呼び出しには、繰り返し行う呼び出しと、その場で見つけて行う呼び出しの2種類があります。この2種類は同じように組み込むべきではありません。私たちは1点を変更し、独自のテスト実行を追加しました。
変更点はルーティングルールです。草稿の例では、日次リストのプラットフォームとしてXiaohongshu、Douyin、TikTokの3つしか挙げていませんでした。これを、当日時点のEveryInfraのカタログ全体、つまりカテゴリ別に分類された106のプラットフォームに置き換えました。これにより、ルーターに回るのは本当のロングテールだけになります。追加した実行は、上記の抹茶ラテの検索、ノート詳細の呼び出し、コメントの呼び出し、Douyinの検索です。また、意図的に誤ったリクエストも2件送りました。
Monidに関する数値については、2種類の事実のみを引用しています。1つ目は、2026年10月29日にMonid側で行った実行です。2つ目は、Monid自身のサイトに掲載された日付付きの事実です。私たちはMonidの課金対象の呼び出しを再実行していません。
中国以外の読者向けに、このプラットフォームについて簡単に説明します。Xiaohongshuは、海外ではRedNoteとしても知られる中国のソーシャルアプリです。ユーザーはそこに「ノート」を投稿します。ノートは、写真や動画、タイトル、タグからなる短い投稿です。各ノートには、いいね、保存(コレクト)、コメント、シェアの数があります。
ブランドやアナリストは、InstagramやTikTokと同じようにこのプラットフォームを注視していますが、こちらは中国語のプラットフォームです。今回のテストケースとしても適しています。多くのチームが毎日追跡しており、汎用ルーターには、このプラットフォーム向けの互いに競合する複数のエンドポイントが掲載されています。
2種類のツール呼び出し:繰り返される呼び出しと、見つけて使う呼び出し
Monidの下書きは、ある1つの演習から始まります。エージェントから先週のツール呼び出しを抽出し、同じ呼び出しが繰り返される頻度で並べ替えるというものです。Monidの言葉を借りれば、繰り返される呼び出しは短いリストに収まります。追跡しているプラットフォーム、保持しているフィールド、実行しているスケジュールです。同じリクエストが1日に何度も実行されます。
残りはロングテールです。たとえば、ユーザーがイベント当日の会場の天気を尋ねます。追跡していないプラットフォームでのクリエイターのフォロワー数を知りたい人もいます。ある企業の最新の資金調達ラウンドや、単純なHTTP取得では開けないページを求める人もいます。こうしたロングテールの各項目は、それぞれ別の会社が提供していることがあり、キー、スキーマ、新規登録の手続きもそれぞれ異なります。そのほとんどは、年に数回しか呼び出されません。
この2種類では、求められる特性が正反対です。繰り返される呼び出しで最も価値があるのは、何も変わらないことです。フィールド名が安定していれば、エージェントのコードと下流のテーブルの整合性が保たれます。価格が安定していれば、経理部門が前もって予算を組めます。エラー形式が安定していれば、リトライ処理は一度書くだけで済みます。
AnthropicのガイドWriting effective tools for agentsは、ツールを決定論的なシステムと非決定論的なエージェントとの間の取り決めとして扱っています。このガイドは、明確な名前、ツール間の明確な境界、有用なコンテキストを含むレスポンスを求めています。ロングテールで最も価値があるのは、カバー範囲の広さです。エージェントは、どのツールが必要になるかを事前に知りません。そのため、ツールごとに設定しておくべきではありません。必要になったときにツールを見つけ、価格を確認し、一度呼び出して先に進むべきです。
よくある誤りは、両者を同じ方法で扱うことです。ロングテールのツールをベンダーごとに個別に統合すると、エージェントは最初の1週間をAPIキーの収集に費やすことになります。日次ジョブを汎用ルーターに通せば、保守コストを低く抑えていた固定スキーマが失われます。
モデル側にもコストがあります。エージェントに見せるツールが多いほど、誤ったツールを選ぶ頻度が高くなります。RAG-MCP論文では、MCPのストレステストを実施しました。モデルに提示する前に関連するツールを検索して絞り込むことで、選択精度は13.62%から43.13%に向上しました。また、プロンプトのトークン数も半分以上削減されました。
ToolLLMやGorillaなどの先行研究でも、同じ結果が出ています。APIが増えるほど、ツールの選択も引数の指定も難しくなります。ある開発者は、58のMCPサーバーと680以上のツールを運用しています。彼はRedditのr/mcpで、ツールが30〜60個を超えるとツール選択が明らかに悪化すると書いています。彼の解決策は、ツールの説明を遅延読み込みし、専門化した各エージェントに10〜20個のツールだけを与えることでした。
| 繰り返される呼び出し | 見つけて使う呼び出し | |
|---|---|---|
| 頻度 | 毎日または毎時、同じリクエストを繰り返す | 年に数回、事前には不明 |
| エージェントは事前に把握しているか | はい:プラットフォーム、フィールド、並び順が決まっている | いいえ:ユーザーに頼まれたときに初めてわかる |
| 最も重要なこと | 変更されないフィールド名、安定した価格、一貫したエラー形式 | 幅広いカバー範囲、ベンダーごとの新規登録が不要、呼び出しごとに課金 |
| この記事での例 | Xiaohongshuの抹茶ラテ日次レポート:xiaohongshu/search、xiaohongshu/comments | ドメインから取得する企業ロゴ、リスト外のプラットフォームの投稿 |
| 送り先 | 専用のデータAPI:EveryInfra | ツールルーター:Monid(discover、inspect、run) |
したがって、合理的な構成は、繰り返される呼び出しには直通の経路を1本、それ以外にはルーターを1つ使う形です。これは2つの製品のどちらかを選ぶ話ではありません。どちらのサービスもMCPに対応しており、同じエージェントクライアントに同時に組み込めます。短いルールで、呼び出しごとにどちらを使うかをエージェントに指示します。以降のセクションでは、Monidとは何か、EveryInfraの日次リストが実際にどれほど長いかを説明し、その後テスト実行を順に見ていきます。
Monidとは:3つの動詞と1つの残高
Monidは自社をエージェントツール向けのOpenRouterと表現しています。この表現は製品の形を表すもので、事業上の提携関係を示すものではありません。OpenRouterは、多数のモデルを1つのキーと1つの残高で提供しています。OpenRouterのクイックスタートによれば、単一のエンドポイントで数百のモデルを提供し、フォールバックを自動で処理します。Monidの10月29日付の資料によると、Monidは1つ上のレイヤーで同じことを行います。対象は、エージェントがモデルを選んだ後に呼び出すツールです。
2026年11月3日に確認したMonidのポジショニングページは、これを一言でまとめています。OpenRouterは「1つのキーで、すべてのモデルを、トークン単位の課金で」。Monidは「1つのスキルで、すべてのツールを、呼び出しごとの課金で」。この比較は、製品の形を説明するためだけに使っています。両社の関係について何かを示すものではありません。
2026年11月3日にMonidのホームページを確認したところ、2,800以上のツールと、新規アカウント向けの1ドル分の無料クレジットが表示されていました。10月29日にMonidから送られてきた資料にも、同じ2つの数字が記載されていました。
その10月29日付の資料によると、カタログはWeb検索、スクレイピング、人物・企業情報のエンリッチメントを網羅しています。さらに、ソーシャルプラットフォームのデータ(中国のプラットフォームを含む)、地図とレビュー、eコマース、金融、生成メディアもカバーしています。課金方式は、Monid自身の言葉では、サブスクリプションなしで1つの残高から呼び出しごとに支払う形です。ツールを見つけることと内容を確認することは無料で、課金されるのは実行のみです。料金はツールカードに表示された価格です。
同じ資料では、ワークフローは3つの動詞で構成されています。discoverは、カタログに対する無料のセマンティック検索です。エージェントが作業内容を平易な言葉で説明すると、ランク付けされたエンドポイントのリストが返され、それぞれに価格とヘルスステータスが付いています。inspectも無料で、1つのエンドポイントの入力スキーマ、価格、ドキュメントを返します。runは唯一の課金ステップで、inspectで表示された価格がプリペイド残高から差し引かれます。
エージェントは、MCP、スキルファイル、コマンドラインツール、REST APIのいずれかでMonidに接続できます。Monid MCPクイックスタート(Monid MCPセットアップガイド、2026年11月3日確認)には、サーバーアドレスhttps://mcp.monid.ai/v1とOAuthによるログインが記載されています。Claude Code、Codex、その他のクライアント向けに個別の手順があります。スキルファイルはmonid.ai/SKILL.mdにあります。Monidの資料によると、このアドレスを「セットアップ」するようエージェントに指示すると、エージェントは3つの動詞を自ら習得します。機械可読な概要はmonid.ai/llms.txtにあります。
| 動詞 | 課金の有無 | 返される内容(Monidの2026年10月29日付資料より) |
|---|---|---|
discover | 無料 | 一致度順に並んだエンドポイント(それぞれに価格とステータス付き) |
inspect | 無料 | 1つのエンドポイントの入力スキーマ、価格、ドキュメント |
run | ツールカードの価格で課金 | 結果と、再取得できる実行ID |


EveryInfraの日常利用リスト:106プラットフォーム、569機能
ルーティングルールの1行目は「リストにあるプラットフォームはEveryInfraへ」なので、ルールがどれだけ役立つかはリストの長さで決まります。Monidの草案にあるルール例では、xiaohongshu, douyin, tiktokの3つのプラットフォームしか挙げていません。このルールでは、Amazonのレビュー、Googleマップのレビュー、LinkedInの求人、Redditの投稿もリストから外れてしまいます。しかし、EveryInfraのカタログでは、これらすべてについてフィールドと料金が固定されています。そこでこのセクションでは、カタログ全体を掲載します。
データは無料のEveryInfraカタログGET /api/v1/social/catalogから、2026年11月3日16:32(SGT)に取得したものです。カタログには106のプラットフォームと573の機能が掲載されており、そのうち当日利用可能だったのは569でした。残る4つ(g2/compare、jd/reviews、temu/search、wechat_oa/wechat_index)はavailable=falseだったため、当面は日常利用リストから外してください。カテゴリは当社の/marketページと同じ基準に従い、コンテンツ・ソーシャル、レビュー、EC、求人・ビジネス、検索・Web・マーケットに分けています。下の表には106のプラットフォームすべてを、カテゴリごとに機能の多い順で並べています。
| カテゴリ | プラットフォーム | 利用可能な機能 | プラットフォーム(機能の多い順) |
|---|---|---|---|
| コンテンツ・ソーシャル | 49 | 373 | Douyin、TikTok、X(Twitter)、Instagram、Xiaohongshu、Facebook、Zhihu、Kuaishou、WeChat公式アカウント、Weibo、GitHub、Bilibili、Reddit、YouTube、Pinterest、Substack、Threads、Spotify、Dailymotion、Quora、Rumble、SoundCloud、Telegram、Toutiao、Twitch、Bluesky、Mastodon、Truth Social、WeChatチャンネル、DeviantArt、Discord、Douban、Gab、Lemmy、Naver、Odysee、Patreon、Product Hunt、Snapchat、Tumblr、Youku、Dribbble、iQIYI、Medium、NetEase Cloud Music、Behance、Flickr、VK、Eventbrite |
| レビュー | 15 | 65 | Google Play、App Store、G2、Googleマップのレビュー、Tripadvisor、Zillow、Airbnb、Booking、Expedia、Yelp、Realtor、Clutch、Nextdoor、Upwork、Crexi |
| EC | 13 | 53 | Amazon、AliExpress、JD.com、eBay、Etsy、Taobao、Shopee、Walmart、1688、Xianyu、Dewu、Temu、Googleショッピング |
| 検索・Web・マーケット | 17 | 40 | Yahoo Finance、暗号資産の市場データ、企業データ、Polymarket、Yandex、Similarweb、暗号資産ニュース、Kalshi、検索エンジンの検索結果、Bing検索、Bingマップ、DuckDuckGo検索、DuckDuckGoマップ、Appleマップ、Googleニュース、Googleトレンド、Google広告透明性センター |
| 求人・ビジネス | 12 | 38 | LinkedIn、Glassdoor、Indeed、Xing、Capterra、Trustpilot、Naukri、ThomasNet、StepStone、SEEK、Dice、Craigslist |
このリストを使ううえでの注意点が2つあります。1つ目は、リストが変わることです。カタログにはいつでもプラットフォームや機能が追加される可能性があり、一時的に利用不可となることもあります。そのため、リストをルールにハードコードしないでください。セッションの開始時に、エージェントに無料のeveryinfra_list_capabilitiesツールかカタログのエンドポイントを呼び出させ、返ってきた内容でリストを埋めてください。
2つ目は、プラットフォーム単位のリストではまだ粒度が粗いことです。同じプラットフォームでも、毎日使う機能もあれば、特定の引数を指定したときにしかデータを返さない機能もあります。Xiaohongshuだけでも利用可能な機能は17あります。検索、ノート詳細、コメント、コメントへの返信、ユーザープロフィール、ユーザーのノート、ユーザー検索に加え、トピック、トレンド、商品検索、商品詳細、商品レビュー、フォロワー、ノートの位置情報があります。残る3つは、複数リンクのコメント一括取得、動画詳細、クリエイターのコンテンツランキングです。
クリエイターのコンテンツランキング($0.016)を除き、いずれも1回の呼び出しあたり$0.005556です。機能単位でリストを書けば、エージェントはルールの中で各呼び出しの料金と引数を確認できます。詳細はXiaohongshuデータAPIのページとXiaohongshu検索機能のページをご覧ください。
ルーティングルールの変更点は1つ:すべてを列挙し、それ以外のみMonidへ
リストがあれば、ルールは短くて済みます。Monidの草案のルールを、同じ構成のまま書き直しました。変更したのはプラットフォームの行だけで、フォールバックを1つ追加しています。迷ったらまずEveryInfraに問い合わせ、unknown_capabilityが返ったときだけMonidに移る、というものです。ルールはエージェントが読むプレーンテキストなので、システムプロンプトにもプロジェクトの指示ファイルにも置けます。
For a daily job on a platform in the list below, call everyinfra_call_api.
Use the platform's own language for keywords. If the task says "this week"
or "today", sort by time. Record platform, action, params, the call time and
charged_usd for every call.
For a platform outside the list, a one-off lookup, or a tool that is not data,
use Monid: discover first, then inspect (both free); run only when the price
fits the budget. Run is billed at the price inspect showed. Record each price
and run id.
If you are not sure a platform is on the list, call EveryInfra first.
If it returns HTTP 400 with error.code unknown_capability (nothing charged),
then use Monid.
List (EveryInfra catalog, read 2026-11-03; refresh at the start of each
session with everyinfra_list_capabilities):
airbnb, alibaba1688, aliexpress, amazon, app_store, apple_maps, behance,
bilibili, bing, bing_maps, bluesky, booking, capterra, clutch, company_data,
craigslist, crexi, crypto_market, crypto_news, dailymotion, deviantart,
dewu, dice, discord, douban, douyin, dribbble, duckduckgo, duckduckgo_maps,
ebay, etsy, eventbrite, expedia, facebook, flickr, g2, gab, github,
glassdoor, google_ads_transparency, google_maps_reviews, google_news,
google_play, google_shopping, google_trends, indeed, instagram, iqiyi, jd,
kalshi, kuaishou, lemmy, linkedin, mastodon, medium, naukri, naver,
netease_music, nextdoor, odysee, patreon, pinterest, polymarket,
producthunt, quora, realtor, reddit, rumble, seek, shopee, similarweb,
snapchat, soundcloud, spotify, stepstone, substack, taobao, telegram, temu,
thomasnet, threads, tiktok, toutiao, tripadvisor, trustpilot, truth_social,
tumblr, twitch, twitter, upwork, vk, walmart, web, wechat_channels,
wechat_oa, weibo, xianyu, xiaohongshu, xing, yahoo_finance, yandex, yelp,
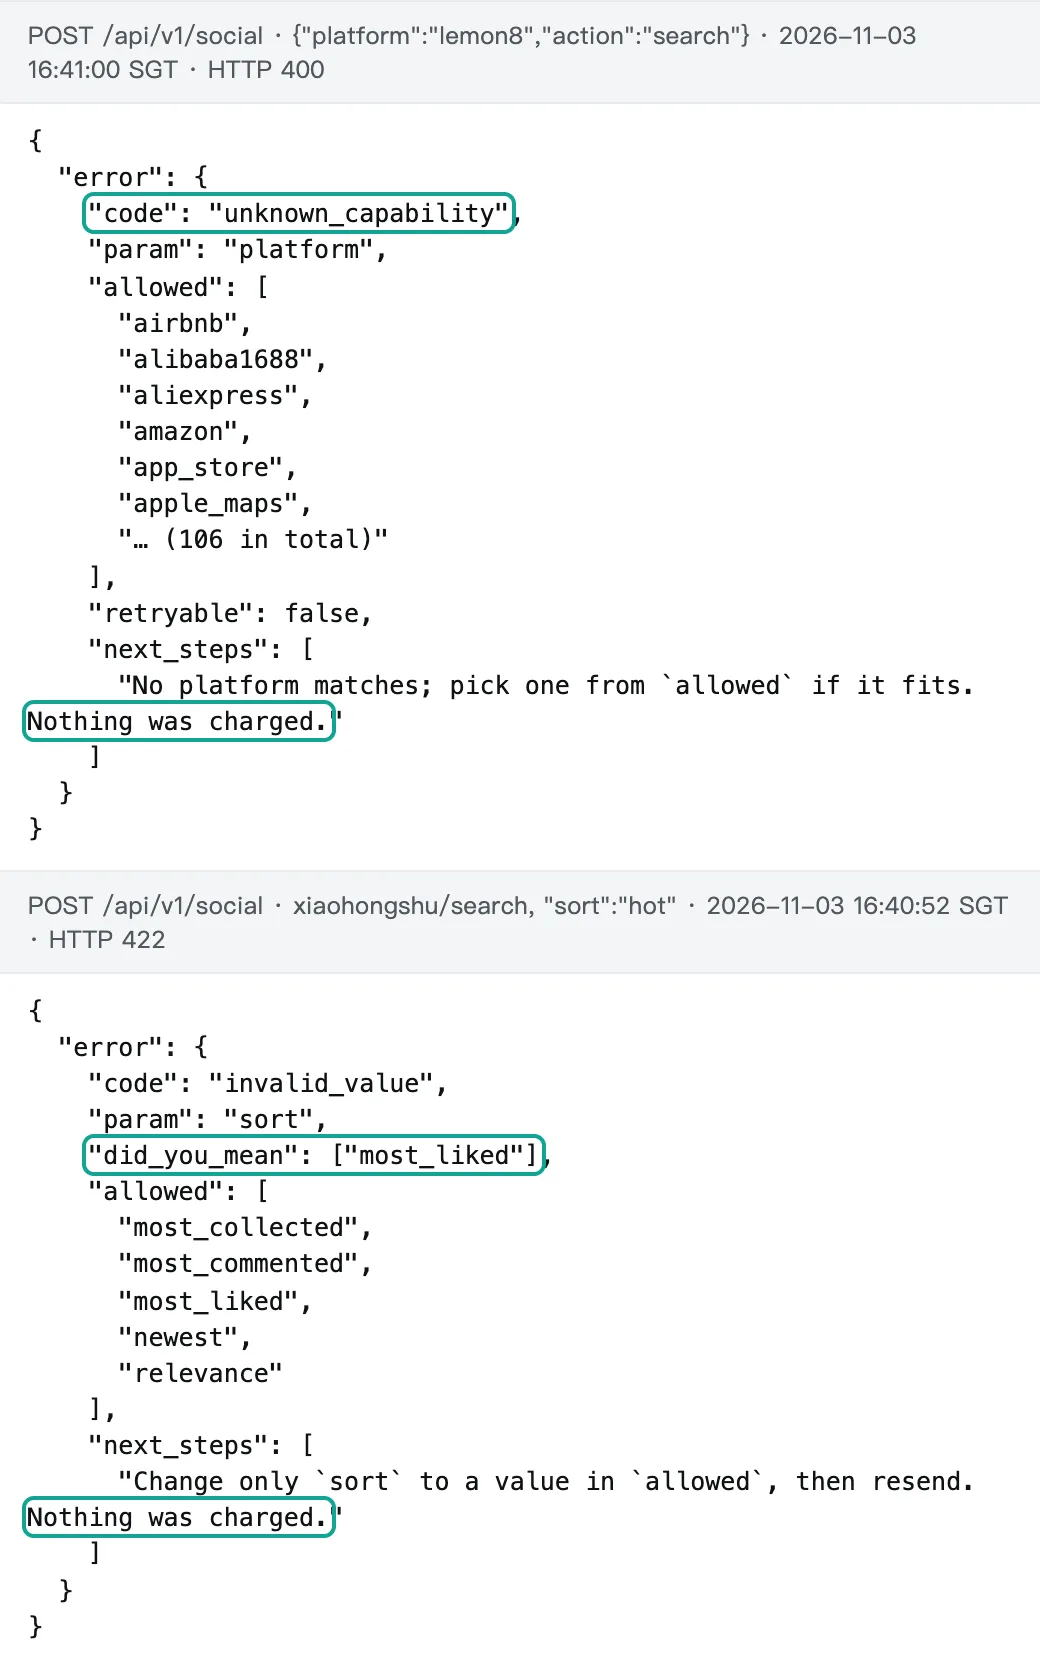
youku, youtube, zhihu, zillowこのフォールバックをテストしました。16:41:00(SGT)に、リストにないプラットフォームlemon8をリクエストしたところ、EveryInfraは0.24秒でHTTP 400を返しました。error.codeはunknown_capabilityで、allowedフィールドには106のプラットフォーム名がすべて含まれていました。next_stepsの1行目には、課金は発生していないと書かれていました。
16:40:52(SGT)には、Xiaohongshuの検索に存在しないソート値hotを送りました。これはMonidの草案にある2つ目のエンドポイントで使われているソート名です。APIは0.11秒でHTTP 422を返し、did_you_meanはmost_likedでした。allowedリストには有効な5つの値が示され、今回も課金はありませんでした。
この2つのエラーの違いは、ルーティングで重要になります。HTTP 400のunknown_capabilityは「このジョブは担当外」という意味なので、エージェントはMonidに移るべきです。HTTP 422のinvalid_valueは「このジョブは担当だが、引数が間違っている」という意味なので、エージェントは移らずにallowedをもとに引数を直して再試行すべきです。
フォールバックがあるので、ルールは「まず問い合わせる」側に寄せられます。仮にリストが1日古かったとしても、先にEveryInfraを呼び出すコストは1秒にも満たない課金なしの往復1回だけで、その後はルールがジョブを次へ回します。
日常的に使うプラットフォームを、最初にもう一方の分岐へ回すべきではありません。Monid自身の10月29日の資料によると、同じプラットフォームでも2つのエンドポイントでソート名が異なり、返すフィールド名も異なります。そのため、ジョブが毎日繰り返されるようになったら、エージェントには1つのエンドポイント、1つのソート、1つのスキーマが必要です(引用は後述の「テスト1」の末尾にあります)。同じ助言は、ドキュメントのMonidとEveryInfraの併用に関するセクションと、パートナーページのMonidの項目にも記載しています。
1つのクライアントで両方のMCPサーバーを利用
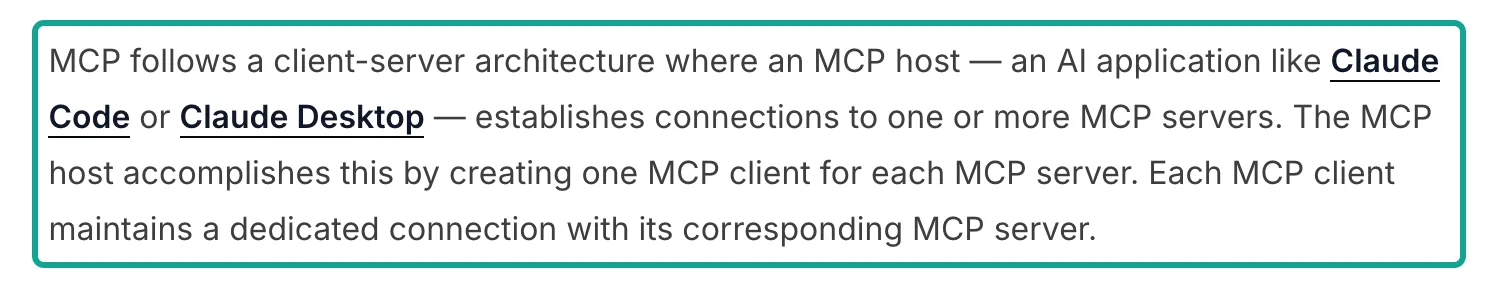
2つのサービスを並行して動かせるのは、MCP自体の設計によるものです。詳しくはMCPアーキテクチャの概要で説明されています。ホストプログラムはMCPサーバーごとにMCPクライアントを1つ作成し、各クライアントがそれぞれ独自の接続を維持します。ホストにはClaude Code、Claude Desktop、Cursor、VS Code、または自作のプログラムを使えます。接続後、ホストはすべてのサーバーのツール一覧をまとめてモデルに渡します。モデルは呼び出しのたびにツールを選びます。
そのため、EveryInfraとMonidは互いを認識しないまま同じホストに共存できます。使い分けは、モデルが読むツールの説明と、自分で書くルールだけで決まります。通信メッセージにはJSON-RPC 2.0を使います。リモートサーバーはStreamable HTTPトランスポートを使います。ツールの一覧取得と呼び出しは、仕様の「ツール」セクションに従います。
Claude Codeでは、コマンド2つで済みます。EveryInfraはAPIキーを使うので、キーを環境変数に保存し、--headerで渡します。MonidのMCPセットアップガイド(2026年11月3日閲覧)によると、MonidのリモートサーバーはOAuthを使います。追加したら、Claude Codeで/mcpと入力してmonidを選択し、サインインを完了してください。--scope userフラグを付けると、両方のサーバーをすべてのプロジェクトで使えるようになります。
Claude Code MCPドキュメントでは、localとprojectのスコープについても説明されています。projectスコープはプロジェクトルートの.mcp.jsonに書き込まれるため、1つの設定をチームで共有する場合に向いています。MCPを初めて使う方は、Claude Code MCPクイックスタートと当社のMCPサーバーのページからお読みください。
# EveryInfra: API key auth; keep the key in an environment variable only
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope user --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"

# Monid: remote MCP with OAuth (then type /mcp in Claude Code, pick monid, sign in)
claude mcp add --transport http monid https://mcp.monid.ai/v1 --scope userクライアントがmcpServers形式のファイルを読み込む場合、設定は次のブロックのようになります。つまずきやすい点が1つあります。Claude Codeの.mcp.jsonファイルでは、リモートサーバーに"type": "http"が必要です。urlだけのエントリは、ファイルの読み込み時に設定エラーになります。
Cursorもほぼ同じ形式を読み込みます。VS CodeではmcpServersの代わりにトップレベルキーserversを使います。Gemini CLIはStreamable HTTPのアドレスにhttpUrlを使い、CodexはTOMLを使います。ブロックの後の表に、よく使われる5つのクライアントの違いをまとめました。各行は、2026年11月3日に確認した各クライアントの公式ドキュメントに基づいています。
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    },
    "monid": { "type": "http", "url": "https://mcp.monid.ai/v1" }
  }
}| クライアント | 設定ファイルの場所 | リモートサーバーの宣言方法 | キーの渡し方・サインイン方法 | ドキュメント |
|---|---|---|---|---|
| Claude Code | claude mcp add、またはプロジェクトの.mcp.json | "type": "http"とurl | --headerまたはheaders。OAuthサーバーは/mcpからサインイン | Claude Code MCPドキュメント |
| Cursor | プロジェクトの.cursor/mcp.json、または~/.cursor/mcp.json | mcpServersの下にurl | headers。OAuthに対応 | Cursor MCPドキュメント |
| Codex | ~/.codex/config.toml、または信頼済みプロジェクトの.codex/config.toml | [mcp_servers.name]の下にurl | bearer_token_env_varで環境変数名を指定。OAuthはcodex mcp loginで利用 | Codex MCPドキュメント |
| VS Code | ワークスペースの.vscode/mcp.json | トップレベルキーservers、"type": "http" | headersまたは入力変数。OAuthに対応 | VS Code MCPドキュメント |
| Gemini CLI | settings.jsonのmcpServers | httpUrl | headers。includeToolsで一部のツールのみ許可 | Gemini CLI MCPドキュメント |
両方のサーバーを接続すると、モデルは毎ターン両方のツール説明を受け取ることになり、その分のコストがかかります。16:42:41(SGT)に、EveryInfra MCPサーバーへtools/listリクエストを1回送信したところ、12個のツールが返されました。everyinfra_list_capabilitiesはカタログを読み込み、everyinfra_call_apiは任意のデータ機能を呼び出し、everyinfra_get_jobは非同期の結果を取得します。残りのツールは、検索、CAPTCHAの解決、AIチャット、アカウント、サポートチケットを扱います。
レスポンスボディ全体は16,247バイトでした。1トークンあたり約4バイトとすると、約4,060トークンです。この数が小さいのは、569個の機能をそれぞれ個別のツールにしていないためです。汎用のeveryinfra_call_apiツール1つと無料のカタログツールを組み合わせることで、モデルは必要なものを先に調べられます。
AnthropicはIntroducing advanced tool useで参考になる比較を示しています。50個以上のMCPツールの説明を最初にすべて読み込むと、約72Kトークンを消費しました。ツール検索で必要に応じて読み込むと、そのごく一部に抑えられました。
ホスト側の機能も役立ちます。Claude Codeの環境変数リファレンスによると、ツール検索はデフォルトで有効です(ENABLE_TOOL_SEARCH)。そのため、MCPツールの説明がすべて一度にコンテキストへ入ることはありません。ツールの出力が10,000トークンを超えると警告が表示され、デフォルトの上限は25,000トークンです(MAX_MCP_OUTPUT_TOKENS)。
今回の実行では、Xiaohongshuのノートを20件ずつ含む5つの検索ページについて、各ページの生のJSONは35,538〜51,999バイトでした。その多くは、画像URL、アバターURL、ページトークンなど、分析に不要な長い文字列です。そのため日次ジョブでは、エージェントが保存する列だけを残すようにしてください。あるいはスクリプトからHTTP APIを呼び出して結果をファイルに書き出せば、行データがモデルのコンテキストを通ることはありません。
AnthropicのCode execution with MCPでは、このパターンが紹介されています。モデルはツールを呼び出すコードを書き、中間データは実行環境内にとどまります。会話に戻るのは結論だけです。
テスト1:抹茶ラテを3種類の並び順と2つの言語で検索
本記事の主なテスト実行は以下のとおりです。すべてのリクエストは、シンガポールからEveryInfra HTTP APIのPOST /api/v1/socialに送信しました。プラットフォームはxiaohongshu、機能はsearch、キーワードは抹茶ラテの中国語表記です。変更したのは並び順、ページ、期間、そして1回だけキーワードの言語です。
時間はネットワークの往復を含むクライアント側の合計時間です。価格は各レスポンスのbilling.charged_usdの値です。最初の3行は編集者がSGTの16:33に実行し、残りは執筆中に同じテスト用キーで実行しました。
| 時刻(SGT、11月3日) | 並び順またはフィルター | ページ | 備考 | 応答時間 | 課金額 | いいね数の中央値 | 投稿から30日未満のノート数 |
|---|---|---|---|---|---|---|---|
| 16:33:22 | most_liked | 1 | 20 | 3.91 s | $0.005556 | 1,427.5 | 0 |
| 16:33:26 | newest | 1 | 20 | 3.42 s | $0.005556 | 0 | 20 |
| 16:33:29 | most_liked、キーワードは英語の「matcha latte」 | 1 | 20 | 3.52 s | $0.005556 | 1,011 | 1 |
| 16:40:40 | most_liked(再実行) | 1 | 20 | 4.26 s | $0.005556 | 1,513.5 | 2 |
| 16:41:08 | most_liked、1ページ目のpage_tokenを指定 | 2 | 20 | 2.34 s | $0.005556 | 194.5 | 1 |
| 16:41:18 | most_liked + last_30_days | 1 | 1 | 9.45 s | $0.005556 | 1,857 | 1 |
リクエストは簡潔です。以下は16:40:40の呼び出しで、レスポンスは最初のノートと課金フィールドのみに絞っています。全フィールドの一覧はXiaohongshu検索機能のページをご覧ください。初めての方は、ドキュメントのクイックスタートからAPIキーを取得できます。
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"xiaohongshu","action":"search",
"params":{"keyword":"抹茶拿铁","sort":"most_liked"}}'{
"platform": "xiaohongshu", "action": "search", "count": 20,
"pagination": { "page": 1, "has_more": true },
"next_page_token": "pt1.…",
"results": [
{ "id": "69a509f400000000220335a9",
"like_count": 16056, "collect_count": 2657, "comment_count": 6223,
"share_count": 3261, "posted_at": "2026-03-02T04:15:14+00:00",
"is_video": false, "is_cooperation_note": true }
],
"billing": { "charged": true, "charged_usd": 0.005556 }
}まずは並び順です。「いいね数順」と「新着順」は、それぞれ別の問いに答えます。16:33のいいね数順ページは、いいね数の中央値が1,427.5、保存数の中央値が747.5でした。20件のノートのうち投稿から30日未満のものは1件もなく、最も古いものは2025年5月28日の投稿でした。投稿からの経過日数別では、30日未満が0件、30〜179日が12件、180〜364日が5件、1年超が3件です。
新着順ページの20件は11月2日と3日に投稿されたノートで、いいね数の中央値は0でした。2つのページに共通するノートは1件もありません。エージェントが両方を「抹茶ラテ トップ20」として保存すると、後工程ではどちらが「何が最も人気か」に答え、どちらが「今日みんなが何を話しているか」に答えるページなのか区別できません。
次はキーワードの言語です。英語キーワード「matcha latte」をいいね数順で検索すると、いいね数の中央値は1,011でした。20件中11件が動画で、中国語キーワードのページでは9件でした。最も古いものは2023年3月18日の投稿で、1年以上前のものが5件ありました。16:33の中国語ページとの共通ノートは4件でした。
つまり、同じトピックでも中国語と英語では、一部が重なりつつも異なる結果が返ります。1年以上前のノートは、英語ページで5件、中国語ページで3件でした。ルーティングルールで「キーワードにはプラットフォーム本来の言語を使う」と定めているのはこのためです。このルールにより、エージェントが中国語のプラットフォームをデフォルトで英語検索してしまうのを防げます。
2ページ目と日付フィルターも見ておく価値があります。1ページ目のnext_page_tokenを使うと、2ページ目では1ページ目と重複しない20件のノートが新たに返りました。いいね数の中央値は194.5に下がりました。所要時間は2.34秒で、このセッションで最も速い呼び出しでした。各ページは同じ料金で1回の呼び出しとしてカウントされます。
date_range=last_30_daysを追加すると、返ってきたノートは1件でした。10月9日に投稿されたノートで、いいね数は1,857です。所要時間は9.45秒で、このセッションで最も遅い呼び出しでした。この引数についてはカタログに明記されています。直近30日のような狭い範囲では、1ページあたりのノートが20件未満になることがあります。ページを埋めたい場合はsort=newestと組み合わせてください。なお、ノートが0件のページは課金されません。
このページにはノートが1件あったため、通常どおり$0.005556が課金されました。たとえば毎日のジョブが「直近30日でいいね数が最も多い抹茶ラテのノート」だとします。より安定するのは、毎日新着順のノートをページ送りで取得して保存し、自分でいいね数順に並べ替える方法です。1日1回「直近30日+いいね数順」でリクエストするよりもうまくいきます。
9回の同期呼び出しの所要時間は、中央値が3.6秒、範囲は2.34〜9.45秒でした。1日1回実行するジョブなら十分な速さです。1回の会話ターンで十数回の呼び出しを行うエージェントは、リクエストに"mode": "async"を追加できます。するとAPIはすぐにジョブIDを返します。エージェントはeveryinfra_get_jobまたはGET /api/v1/jobs/{job_id}で結果を取得します。すべての同期レスポンスに含まれるasync_hintフィールドにも同じことが書かれています。
続いて、Monid側の数値です(2026年10月29日)。MonidはこのテストにMonidのXiaohongshuツールページを使いました。カタログから、異なる2社が提供するXiaohongshuのノート検索エンドポイントを2つ選び、同じ中国語キーワードでそれぞれ1回実行し、さらに1つ目を英語キーワードでもう一度実行しました。Monidの資料によると、当日このツールページには49のエンドポイントが掲載されていました。
下の表の件数、時刻、結果はMonidから提供された資料に基づくもので、時刻は米国太平洋時間です。当社はこれらの実行を再現しておらず、当社の結果との優劣も付けていません。日付もソートの引数も異なり、両者が答えた問いも別のものだからです。
| 日付(Monid側で実行) | エンドポイント | 入力 | 備考 | 応答時間 | 結果 |
|---|---|---|---|---|---|
| 2026-10-29 20:34 | 1社目のノート検索 | 中国語キーワード、いいね数順、1ページ目 | 20 | 3.2 s | いいね数の中央値2,132、保存数の中央値1,571。30日未満のノートはなし。最も古いものは3年半以上前 |
| 2026-10-29 20:34 | 2社目のノート検索 | 中国語キーワード、ソート「hot」 | 20 | 3.2 s | いいね数の中央値97。20件中5件が30日未満 |
| 2026-10-29 20:35 | 1社目のノート検索 | 「matcha latte」、いいね数順 | 20 | 2.9 s | いいね数の中央値2,961。ノートの半数が動画 |
Monidも自社の実行結果から、当社と同じく、ソート順はデータとセットで保持する必要があると結論づけました。
以下は、Monidの10月29日付の資料から、表現を少し整えて引用した一節です。「同じキーワード、同じ日、2つのエンドポイントで、答えた問いは別々。両方を『トップ20』として記録したエージェントは、両者を比較可能にしていた唯一の情報を失っています。」
同じ資料によると、2つのエンドポイントではソート名もフィールド名も異なります。そのため、クエリを日次で継続的に実行する段階になると、エージェントは1つのエンドポイント、1つのソート、1つのスキーマに統一する必要があります。ここが、呼び出しをルーター経由から直接呼び出しに切り替えるタイミングです。Monid自身の手法は、同社のガイド「APIでXiaohongshuのデータを取得する方法」で紹介されています。
テスト2:同じリクエストを6回、上位3件に16種類のノート
16:33から16:45(SGT)にかけて、まったく同じリクエストを6回実行しました。1ページ目に対する{"keyword": <the Chinese keyword>, "sort": "most_liked"}です。1回目は16:33:22です。16:36には、当社の編集者が下のサンプルスクリプトを初めてテスト実行しました。16:40:40にもう一度実行しました。16:45には、この記事の各言語版のために1回ずつ、編集者がスクリプトをさらに3回実行しました。スクリプトは上位3件だけを出力するため、6回すべてで比較できるのは上位3件です。
6回の実行で上位3件の枠は合計18あり、そこに16種類のノートが入りました。いいね数16,056のノートは16:33と16:40に1位でした。いいね数20,972のノートは16:36に3位、16:45の1回目に1位でした。残りの14件はそれぞれ1回ずつ登場しました。すべての実行の組み合わせで上位3件を比べると、15組のうち13組は共通するノートがなく、2組は1件だけ共通していました。16:33と16:40の20件のページ全体でも、共通するノートは7件だけでした。
まず、このリクエストが何を求めているかを明確にしておきます。カタログではこのソート値を「いいね数順」(most_liked)と呼んでいます。
EveryInfraが返すのは、その時点でその順序で並べられたXiaohongshu検索の1ページ目です。抹茶ラテのノートすべてをいいね数で完全に並べ替えた結果ではありません。そのため、1ページ目にプラットフォーム全体で最もいいねの多いノートが含まれるとは限りません。
実際のレスポンスを見ると、このことがわかります。16:33と16:40では同じノートが1位で、いいね数は16,056でした。一方、16:36の1位はいいね数53,316、16:45に行った3回の実行では1位がそれぞれ20,972、22,440、21,468でした。これらのノートはいずれも、16:33と16:40に取得した20件ずつのページには含まれていませんでした。
16:45の3回の実行は1分以内に行われ、各実行の上位3件には重複するノートが1件もありませんでした。そのため、プラットフォームの1ページ目は数分以内、さらには1分以内でも変わることがあります。API側の動作は毎回同じでした。どの呼び出しもHTTP 200で20件のノートを返し、料金も毎回$0.005556でした。16:33と16:40のレスポンスに含まれるフィールド名は、すべてカタログのresponse_fieldsリストに載っていました。ノートに場所が付いている場合のpoi_idのように、値があるときだけ現れるフィールドも1、2個あります。
このことから、日次ジョブについて直接言えることが3つあります。1つ目は、何を固定できるかを明確にすることです。リクエストの形式、フィールド名、料金、エラー形式は固定でき、固定すべきです。結果セットは固定できません。1回のリクエストで「毎日同じトップ20」が得られると謳う仕組みは信用しないでください。
2つ目は、リクエスト条件と時刻をデータと一緒に保存することです。ソート、ページ、キーワード、呼び出し時刻のどれか1つでも欠けると、1週間後にはそのデータ群がどの問いへの答えなのか説明できなくなります。
3つ目は、安定したランキングが必要なら、1回のリクエストの上位数件に頼らないことです。毎日もう少し深いページまで取得し、ノートIDをキーにして自前のテーブルへマージします。そのうえで、いいね数など自分で定めたルールで並べ替えます。こうして作ったランキングなら再現できます。
3つ目のポイントを、このセッションのデータで示します。16:33と16:40の1ページ目には、それぞれ20件のノートがありました。ノートIDでマージして重複を除くと33件になり、どちらか一方のページだけの場合より13件多くなりました。いいね数で並べると、いいね数16,056のノートが1位になり、次回のマージでも同じ結果を算出できます。この順位は、プラットフォームが1分後にどのページを返すかには左右されません。
保存する各行には、少なくとも以下の列を含めてください。サンプル値は16:40:40のレスポンスの最初のノートから取ったものです。
| 列 | 出典 | サンプル値(2026年11月3日16:40:40 SGT) | 保存する理由 |
|---|---|---|---|
| 呼び出し時刻 | 自分のログ | 2026-11-03 16:40:40 | 同じリクエストでも数分で結果が変わるため、時刻がないと再現できない |
| キーワード、ソート、ページ | リクエストの引数 | 抹茶ラテ(中国語)、most_liked、1 | 「いいね数順」と「新着順」は別々の問いに答える |
| 順位 | 結果内の順序 | 1 | 同じノートの時間ごとの位置を追跡する |
| ノートID | id | 69a509f400000000220335a9 | 実行やページをまたいで重複を除く |
| エンゲージメント | like_count、collect_count、comment_count | 16,056, 2,657, 6,223 | 自分で定めたルールで並べ替える |
| 投稿時刻 | posted_at | 2026-03-02 | 「今話題」と「長く人気」を見分ける |
| スポンサー付き | is_cooperation_note | true | 有償投稿を分けて集計する |
| 課金額 | billing.charged_usd | 0.005556 | 月末の照合 |
マージにかかるコストも簡単に計算できます。16:41に取得した2ページ目は、1ページ目と共通するノートが1件もありませんでした。つまり1〜2ページ目で、1キーワードにつき1日40件の異なるノートが得られます。両ページを午前と午後に1回ずつ取得すると、1キーワードにつき1日4回の呼び出しになります。1回あたり$0.005556なので、1日約$0.022、30日で$0.67です。この追加費用で、再現も比較もできるテーブルが手に入ります。翌週になっても、どのノートがどの日に上位40件に入り、いいね数がどう伸びたかを確認できます。
| 日次ジョブで同じリクエストを繰り返す場合 | このテストで固定か | 根拠(2026年11月3日、SGT) | 保存とルールへの影響 |
|---|---|---|---|
| リクエストの形式(プラットフォーム、機能、引数名) | 固定 | 9回の呼び出しすべてが同一のplatform + action + params形式を使用 | ルールとスクリプトは一度書けば済む |
| フィールド名 | 固定 | 16:33と16:40のレスポンス全体に含まれるフィールドは、すべてカタログに記載された30個のフィールドのいずれか | 下流のテーブルを事前に構築できる |
| 料金 | 固定 | Xiaohongshu検索10回、ノート詳細1回、コメント1回の各呼び出しに$0.005556課金 | 1か月分の予算を事前に立てられる |
| エラー形式 | 固定 | HTTP 400と422のいずれにもcode、allowed、next_stepsが含まれる | リトライと振り分けのロジックを一度書けば済む |
| 返される20件のノート | 変動 | 16:33と16:40のページで共通したのは20件中7件 | ソート順と時刻を保存し、idでマージする |
| 上位3件 | 変動 | 6回の実行(計18枠)で異なるノートは16件。実行同士の15通りの組み合わせのうち13通りでは、共通するノートなし | マージしたページから安定したランキングを作る |
テスト3:ノート詳細、コメント、Douyin
日次ジョブが検索だけで終わることはほとんどありません。ノートをまとめて取得したら、通常は上位数件の詳細とコメントも取得したくなります。同じキーワードを別のプラットフォームでも調べたい場合もあります。以下の3つの呼び出しは、いずれもSGTの16:41〜16:42に、同じAPI・同じリクエスト形式で実行しました。変更したのはplatformとactionだけです。
| 時刻(SGT、11月3日) | 機能 | 入力 | 件数 | 応答時間 | 課金額 | 注目すべきフィールド |
|---|---|---|---|---|---|---|
| 16:41:50 | xiaohongshu/note | いいね16,056件のノートのリンク | 1 | 2.55 s | $0.005556 | ip_locationあり、is_cooperation_noteがtrue、タグ9個 |
| 16:42:00 | xiaohongshu/comments | 同じノート、いいね数の多い順 | 15 | 3.60 s | $0.005556 | トップコメントは1,213いいね。15件のコメントへの返信は計650件。has_moreはtrue |
| 16:41:36 | douyin/search | 抹茶ラテを意味する中国語キーワード、いいね数の多い順 | 10 | 6.18 s | $0.008333 | いいね数の中央値6,179.5、トップ動画は1,178,986 |
ノート詳細では、検索では返されないフィールドが追加されます。投稿者のip_location、tagsとtopicsの完全なリスト、そして商品が紐付いているかを示すhas_goodsです。
このセッションのトップノートはスポンサー付きのノートで、is_cooperation_noteがtrueでした。ローズ風味のコーヒーシリーズを宣伝しており、3種類のドリンクを紹介しています。その1つがローズ抹茶ラテで、ノートでは抹茶好きにはたまらないと書かれています。しかし、タイトルにも9個のタグにも「抹茶」という言葉はありません。抹茶ラテはシリーズ内の1ドリンクにすぎません。
このことから、日次モニタリングを運用する人にとって2つのことがわかります。1つは、ノートがキーワードに関するものかを判断するには、タイトルとタグだけでなく本文を読むこと。もう1つは、スポンサー付きのノートは本文から関連性を判断したうえで、別に集計することです。そうしないと、1〜2件の有償投稿で1週間全体の平均いいね数が押し上げられてしまいます。フィールドの一覧はノート詳細の機能ページをご覧ください。
コメントの呼び出しでは、トップレベルのコメントが15件返され、いいね数は1,213から3まででした。各コメントにはsub_comment_countがあり、15件合わせて650件の返信がついていました。レスポンスのhas_moreがtrueだったため、next_page_tokenで次のページを取得できます。このページではip_locationがすべて空でした。コメント投稿者の地域は常に含まれるとは限らないため、下流の統計ではその存在を前提にしないでください。
コメントのフィールドにはauthor_is_ai_agentも含まれ、15件すべてでfalseでした。コメントから感情やセールスポイントを分析するには、コメントの機能ページをご覧ください。以前の記事「Claude Codeの動的ワークフローでXiaohongshuのコメントを読み解く」では、さらに踏み込んで解説しています。
Douyinの検索ページ1件には10本の動画が含まれ、料金は1回の呼び出しあたり$0.008333、1,000回あたり$8.33です。Xiaohongshuの検索は1,000回あたり$5.56です。いずれもカタログに記載された料金です。10本の動画のいいね数の中央値は6,179.5で、最も多い動画は1.17Mを超えていました。投稿時期は2025年2月から2026年9月です。
フィールド名は2つのプラットフォームで完全には一致しません。Douyinにはauthor_follower_count、music、hashtags、is_pinnedが追加されています。ただし、like_count、comment_count、share_count、posted_atなどの共通フィールドは同じ名前です。そのため、クロスプラットフォームの表では、それぞれの追加カラムだけを扱えば済みます。すべてのフィールドはDouyinデータAPIのページとDouyin検索機能のページに掲載しています。対応するTikTokの機能はTikTokデータAPIのページにあります。
サンプルスクリプト:日次ジョブと単発ジョブの組み合わせ
以下のPythonは、2つのサービスを組み合わせた最小限の動作例で、Requestsを使って書いています。前半は日次ジョブです。EveryInfraのxiaohongshu/searchを固定のリクエスト形式で呼び出し、上位3件のノートと課金額を出力します。後半は単発ジョブで、ドメインから企業のロゴを探します。これは日々のプラットフォームデータではないため、Monidに任せます。まずdiscover、次にinspectを実行し、価格が予算内に収まる場合にのみrunを実行します。どちらのキーも環境変数から読み込み、スクリプトにはキーの値を一切含めていません。
import os

import requests

EVERYINFRA_API_KEY = os.environ["EVERYINFRA_API_KEY"]
MONID_API_KEY = os.environ["MONID_API_KEY"]
MONID = "https://api.monid.ai/v1"
MONID_HEADERS = {"Authorization": f"Bearer {MONID_API_KEY}"}
MAX_PRICE_USD = 0.01  # do not run a Monid tool that costs more than this per call

# 1. The daily job: EveryInfra xiaohongshu/search, one fixed request shape
resp = requests.post(
    "https://api.everyinfra.com/api/v1/social",
    headers={"Authorization": f"Bearer {EVERYINFRA_API_KEY}"},
    json={"platform": "xiaohongshu", "action": "search",
          "params": {"keyword": "抹茶拿铁", "sort": "most_liked"}},
    timeout=120,
)
resp.raise_for_status()
body = resp.json()
for note in body["results"][:3]:
    print(note["like_count"], note["collect_count"], note["posted_at"][:10], note["url"])
print("EveryInfra:", len(body["results"]), "notes, charged (USD):", body["billing"]["charged_usd"])

# 2. A one-off lookup that is not a daily platform: discover, inspect, run on Monid
found = requests.post(f"{MONID}/discover", headers=MONID_HEADERS, timeout=60,
                      json={"query": "company logo image URL from a domain", "limit": 3}).json()["results"]
# discover adds ranking and price fields to each result; inspect and run take only the fields that name the tool
SHOWN_ONLY = ("providerName", "description", "price", "score", "scoreBreakdown", "tags", "metrics", "hints")
tool = {key: value for key, value in found[0].items() if key not in SHOWN_ONLY}
detail = requests.post(f"{MONID}/inspect", headers=MONID_HEADERS, timeout=60, json=tool).json()
price = detail["price"]["amount"]["value"]
print("Monid tool:", detail["endpoint"], "price (USD):", price)
if price <= MAX_PRICE_USD:
    run = requests.post(f"{MONID}/run", headers=MONID_HEADERS, timeout=120,
                        json={**tool, "input": {"pathParams": {"company": "starbucks.com"}}}).json()
    print("Monid run:", run.get("runId"), run.get("status"), run.get("output"))
担当編集者はこのスクリプトを2026年11月3日16:36(SGT)に初めて実行し、その後16:45に言語版ごとに1回ずつ、さらに3回実行しました。1回の実行全体にかかった時間は6.4〜7.7秒です。EveryInfra側は毎回20件のノートを返し、課金額は$0.005556でした。その上位3件が、上のドットグリッドにある16:36と16:45の行です。
Monid側では、4回の実行すべてでdiscoverの最初の結果が、ドメインから企業ロゴを返すエンドポイントでした。inspectで確認したその時点の価格は$0だったため、スクリプトはそのままrunに進みました。実行結果のステータスはCOMPLETEDで、ロゴ画像のURLが返されました。MAX_PRICE_USDの行は単純ですが、役に立つ安全策です。discoverとinspectは無料なので、エージェントは常に先に価格を確認できます。予算を超えるツールはスキップし、その判断を人に委ねることができます。
Monidが10月29日に公開した資料には、ここに当てはまる注意点があります。discoveryはランキングであり、結果を保証するものではありません。「Xiaohongshu note search」のように機能を表すフレーズなら、適切な結果が上位に並びます。一方、固有名詞を含む長くくだけた文では、タスクとまったく関係のないエンドポイントが上位に来ることがあります。そのため、実行する前に上位の結果を読んでください。読むだけなら無料です。私たちのルールにある「discover、次にinspect、予算内の場合のみrun」という手順は、この助言に沿ったものです。
請求額:日次ジョブの月額コスト
フィールドと価格が固定されていることの最も直接的なメリットは、請求額を事前に計算できることです。以下は、2026年11月3日時点のカタログ価格で、Xiaohongshuの抹茶ラテをモニタリングする場合の月額コストです。ここでは1か月を30日とし、すべての呼び出しが課金されるものとしています。実際には失敗した呼び出しや空のページは課金されないため、これらの数値は上限です。クリエイターコンテンツランキングを除くXiaohongshuの16の機能は1回あたり$0.005556、Douyin検索は1回あたり$0.008333です。価格の一覧は料金ページに掲載しています。
| 方式 | 1日あたりの呼び出し回数 | 1日あたりのコスト | 30日あたりのコスト |
|---|---|---|---|
| A:3キーワード、各1ページ | 3 × xiaohongshu/search | $0.0167 | $0.50 |
| B:3キーワード、各2ページ | 6 × xiaohongshu/search | $0.0333 | $1.00 |
| C:Bに加えて上位5件のノートのコメント | 検索6回 + 5 × xiaohongshu/comments | $0.0611 | $1.83 |
| D:Cに加えて同じ3キーワードをDouyinでも検索 | 上記11回の呼び出し + 3 × douyin/search | $0.0861 | $2.58 |
金額は小さいですが、重要なのは事前に予算に組み込めることです。リクエストも価格も変わりません。そのため、モデルが別のエンドポイントを選んだことで月末の請求額が変動することはありません。
ロングテールは課金の管理方法が異なります。各runの前にinspectで価格を確認し、呼び出しごとに記録して、月末に実際の利用分を合計します。本記事に掲載した課金対象の呼び出しは、合計13回で$0.075005です。そのうち、執筆中に私たちが行った6回が$0.036113、担当編集者が行った7回(16:33に3回、16:36に1回、16:45に3回)が$0.038892でした。
制約:この分担でカバーできることとできないこと
ルーティングのルールが決めるのは、呼び出しの送り先です。そのデータを収集すべきかどうかを決めるものではありません。
Xiaohongshuのユーザーサービス契約とプライバシーポリシーでは、プラットフォームのコンテンツとユーザー情報の利用条件が定められています。中国本土で個人情報を処理する場合は、個人情報保護法の対象にもなります。2025年1月1日に施行されたネットワークデータセキュリティ管理条例も適用されます。日次ジョブで最も実践的な対策は、分析に使うカラムだけを保存することです。通常は、ノートID、タイトル、エンゲージメント数、投稿時刻、ソート順、呼び出し時刻があれば十分です。投稿者のニックネーム、アバター、コメント投稿者のプロフィールは、必要がない限り保存しないでください。保存する場合は、明確な目的と保存期間を定めてください。
このルールにも固有の制約がありますが、それぞれに簡単な対処法があります。
| 制約 | 起こりうる問題 | 対処法 |
|---|---|---|
| リストが古くなる | プラットフォームが追加または一時停止されると、ハードコードした106個の名前が数週間後には正しくなくなる | セッションごとにeveryinfra_list_capabilitiesで更新するか、unknown_capabilityのフォールバックに任せる |
| レート制限 | EveryInfraのキーにはそれぞれ1分あたりの上限があり、超えるとHTTP 429が返される(RFC 6585) | 待ってから再試行する。間隔を空けずにループで再試行しない |
| 2種類のログイン方式 | EveryInfraはAPIキーを使い、MonidのリモートMCPサーバーはOAuthを使う(Monid MCPセットアップガイド、2026-11-03閲覧) | キーは環境変数に保存し、コミットする.mcp.jsonには絶対に書かない |
リモートMCPサーバーでのOAuthによるログインは、MCP仕様の認可セクションで定義されています。
最後の制約はモデルです。ツールをどれだけうまく接続しても、モデルが誤ったツールを選んだり、引数を誤って指定したりすることはあります。MCP-Universeは、実際のMCPサーバーを使ってモデルを評価しました。最高の結果はGPT-5による成功率43.72%でした。MCP-Benchは、28のサーバーと250のツールを使って、より実際の業務に近いタスクを構築しています。複数のツールやステップにまたがる呼び出しは、それ単体で採点されます。
そのため、本記事のルールはわかりやすさを重視して書いています。リストは明示的で、エラーコードは区別され、エージェントはお金を使う前に価格を確認します。これらはそれぞれ、モデルが推測しなければならないことを1つ減らします。データAPIでのClaudeのstrict tool useでは、別のアプローチを紹介しています。厳密な引数スキーマを使えば、モデルが無効なリクエストを組み立てること自体を防げます。
最近の変化
ツール呼び出しはここ数か月で急速に変化しました。以下の各行は、2026年7月以降の出来事です。最後の列には、その変化が「日次ジョブはデータAPIで、ロングテールはルーターで」という分担にとって何を意味するかを記載しています。
| 日付 | 出来事 | 利用者への影響 |
|---|---|---|
| 2026-07-28 | 新しいMCP仕様:ステートレスなコア、Mcp-MethodとMcp-Nameのリクエストヘッダー、キャッシュヒントとtools/listの固定順序、RFC 9207やクライアントメタデータドキュメントを含む認可の更新 | 1つのホストに2つのリモートサーバーを置いても接続数が少なく済み、ツールリストをキャッシュできるため、モデルが毎ターン読む説明がより安定する |
| 2026-10-06 | The Hacker Newsが、公開MCPサーバー15,465件の分析を公開 | サーバーの数はかつてないほど増えており、接続できるかどうかよりも、常時読み込むサーバーを少数に絞り、どれを選ぶかのほうが重要になっている |
| 2026-10-16 | Semaforが、OpenRouterと競合するモデルルーターTrustedRouterのシードラウンドを報道 | 「多数のバックエンドの前段に1つのキーを置く」構成には、モデル層で引き続き投資資金が集まっている。ツール層の同様の構成にも注目する価値がある |
| 2026-10-19 | Xiaohongshuのオープンプラットフォームが、カテゴリ予測APIの廃止を告知 | 公式プラットフォームは引き続きショップとEコマースに注力しており、公開コンテンツのデータには依然として別の手段が必要 |
| 2026-10-21 | Bloombergが、自社も推進に関わったSkills over MCPの提案(SEP-2640)について説明。同日、StripeがMCP経由で利用できるエージェント向けTreasuryを発表 | スキルファイルとMCPは統合に向かっているため、サーバーがスキルファイルも提供しているかを確認する |
| 2026-10-22 | Anthropicが、サブエージェントをメインループに戻すべきタイミングに関するガイダンスを公開 | メインループに軽量なデータツールを少数置くほうが、通常は速く正確なため、1つのエージェントに2つのサーバーという構成は妥当なデフォルト |
| 2026-10-30 | MCPブログが、Ruby SDKがTier 1に到達したことを発表 | より多くの言語で安定したMCPクライアントを構築できるようになったため、自社のホストでも両方のサーバーを扱える |
FAQ
Xiaohongshuには公式のノート検索APIがありますか?
2026年11月3日時点で、Xiaohongshuオープンプラットフォームは主に店舗やEC向けERPアプリを対象としており、注文、商品、アフターサービスのAPIを提供しています。2026年10月19日には、カテゴリ予測APIが廃止されました。公開ノートの検索、詳細、コメントは対象外です。EveryInfraのxiaohongshu/search機能の料金は、1回の呼び出しあたり$0.005556です。詳しくはXiaohongshuデータAPIのページをご覧ください。
EveryInfraのリストにないプラットフォームを指定した場合、課金されますか?
いいえ。リストにないプラットフォームはHTTP 400 unknown_capabilityを返し、引数が誤っている場合はdid_you_meanを含むHTTP 422を返します。どちらも課金されません。テスト実行(2026年11月3日16:40〜16:41 SGT)の内容は、前述のルーティングルールのセクションに記載しています。
1つのエージェントに読み込ませるツールはいくつが適切ですか?
明確な基準値はありません。RAG-MCPでは、ツールが多い場合、まず関連するツールを検索してから選択することで、精度が13.62%から43.13%に向上しました。680以上のツールを使うr/mcpの開発者は、ツール数が30〜60個を超えたあたりから、選択精度が明らかに低下したと報告しています。サブエージェントとメインループの作業分担については、TikTokアカウント向けのClaude Codeサブエージェントをご覧ください。
参考文献
- EveryInfraデータ機能カタログ、
GET /api/v1/social/catalog、EveryInfra、2026-11-03 16:32 SGT閲覧。 - Architecture overview、Model Context Protocolドキュメント、2026-11-03閲覧。
- 2026-07-28版MCP仕様のリリースノート、MCPブログ、2026-07-28。
- Specification: Tools、MCP仕様、2026-07-28版。
- Specification: Authorization、MCP仕様、2026-07-28版。
- Specification: Transports、MCP仕様、2026-07-28版。
- The MCP Ruby SDK reaches Tier 1、MCPブログ、2026-10-30。
- MCP Registry、MCP公式レジストリ、2026-11-03閲覧。
- JSON-RPC 2.0 Specification、JSON-RPC Working Group。
- Connect Claude Code to tools via MCP、Claude Codeドキュメント、2026-11-03閲覧。
- MCP quickstart、Claude Codeドキュメント、2026-11-03閲覧。
- Environment variables、Claude Codeドキュメント、2026-11-03閲覧。
- Model Context Protocol、Cursorドキュメント、2026-11-03閲覧。
- Model Context Protocol、OpenAI Codexドキュメント、2026-11-03閲覧。
- Use MCP servers in VS Code、VS Codeドキュメント、2026-11-03閲覧。
- MCP servers with Gemini CLI、Gemini CLIドキュメント、2026-11-03閲覧。
- Connectors and MCP servers、OpenAI Platformドキュメント、2026-11-03閲覧。
- Quickstart、OpenRouterドキュメント、2026-11-03閲覧。
- FAQ、OpenRouterドキュメント、2026-11-03閲覧。
- エージェント向けの効果的なツールの書き方、Anthropic Engineering。
- Introducing advanced tool use、Anthropic Engineering。
- Code execution with MCP、Anthropic Engineering。
- エージェント構築:サブエージェントをメインのエージェントループに統合すべきとき、Anthropic、2026-10-22。
- RAG-MCP: Mitigating Prompt Bloat in LLM Tool Selection via Retrieval-Augmented Generation、arXiv:2505.03275。
- ToolLLM: Facilitating Large Language Models to Master 16000+ Real-world APIs、arXiv:2307.16789。
- Gorilla: Large Language Model Connected with Massive APIs、arXiv:2305.15334。
- MCP-Universe: Benchmarking Large Language Models with Real-World Model Context Protocol Servers、arXiv:2508.14704。
- MCP-Bench: Benchmarking Tool-Using LLM Agents with Complex Real-World Tasks via MCP Servers、arXiv:2508.20453。
- RFC 9110: HTTP Semantics、IETF。
- RFC 6585: Additional HTTP Status Codes、IETF。
- RFC 9457: Problem Details for HTTP APIs、IETF。
- RFC 9728: OAuth 2.0 Protected Resource Metadata、IETF。
- RFC 8707: Resource Indicators for OAuth 2.0、IETF。
- RFC 9207: OAuth 2.0 Authorization Server Issuer Identification、IETF。
- The OAuth 2.1 Authorization Framework, draft 13、IETF。
- MCP上のスキル:Bloombergはいかにしてエージェントスキルの大規模な標準化を支援したか、Bloomberg、2026-10-21。
- Treasury for agents、Stripe Newsroom、2026-10-21。
- 15,465件の公開MCPサーバーの分析、The Hacker News、2026-10-06。
- Piエージェント、MCP、コードモードに関する記事、The New Stack。
- MCP Server and SI Agent Government Hackathon、米国一般調達局(GSA)、2026年9月〜11月。
- OpenRouterの競合企業のシードラウンドに関する記事、Semafor、2026-10-16。
- 58のMCPサーバーと680以上のツールの運用に関する投稿、Reddit r/mcp。
- Requests: Quickstart、Requestsドキュメント。
- Xiaohongshuユーザーサービス契約(中国語)、Xiaohongshu、2026-11-03閲覧。
- Xiaohongshuプライバシーポリシー(中国語)、Xiaohongshu、2026-11-03閲覧。
- Xiaohongshuオープンプラットフォーム(中国語)、Xiaohongshu、2026-11-03閲覧(2026-10-19のお知らせを含む)。
- 中華人民共和国個人情報保護法(中国語)、中国国家インターネット情報弁公室。
- ネットワークデータ安全管理条例(中国語)、国務院、2024年9月公布、2025-01-01施行。
- XiaohongshuとAIに関するHuxiuの記事(中国語)、Huxiu、2026-10-16。
- Monidのトップページ、2026-11-03閲覧(「Live · 2800+ tools」「Start with $1 in free credit」)。記事内のリンクをご覧ください。
- Monid「The OpenRouter for agent tools」、ポジショニングを説明するページ、2026-11-03閲覧。記事内のリンクをご覧ください。
- Monid、MCPクイックスタート、セットアップのドキュメント(2026-11-03閲覧)。記事内のリンクをご覧ください。
- Monid、Xiaohongshuのツールページ。2026-10-29時点で49個のエンドポイントを掲載。記事内のリンクをご覧ください。
- Monid、「How to get Xiaohongshu (RedNote) data through an API」、ガイド(2026-11-03閲覧)。記事内のリンクをご覧ください。
参考資料 BL-78