데이터 API일까, 도구 라우터일까? EveryInfra와 Monid가 에이전트 호출을 나누는 방법
같은 Xiaohongshu 검색을 6번 실행하자 상위 3개에 서로 다른 노트 16개가 올라왔고, 비용은 매번 $0.005556이었습니다. 매일 반복하는 작업은 데이터 API에, 롱테일은 Monid에 맡기면 됩니다.
2026년 11월 3일 싱가포르 시간(SGT) 16:33부터 16:45까지 같은 요청을 6번 보냈습니다. 요청 대상은 EveryInfra xiaohongshu/search 기능이었고, 키워드는 “말차 라테”의 중국어, 정렬은 “좋아요 많은 순”(most_liked), 1페이지였습니다. 모든 호출이 노트 20개를 반환했고 비용은 $0.005556이었으며, 모든 필드 이름이 카탈로그 목록에 있었습니다. 그중 두 호출은 따로 시간을 쟀는데, 각각 3.9초와 4.3초가 걸렸습니다. 그런데 6번 실행하는 동안 상위 3개 자리 18곳에는 서로 다른 노트 16개가 올라왔습니다.
이 결과는 매일 실행하는 에이전트 작업에서 무엇을 고정할 수 있는지 보여 줍니다. 요청 형태, 필드 이름, 가격, 오류 형식은 고정할 수 있습니다. 결과 집합은 고정할 수 없으므로, 저장하는 각 행에 정렬 순서와 타임스탬프를 함께 남겨야 합니다. 이 네 가지가 고정되어 있기 때문에 매일 실행하는 작업은 전용 데이터 API에 잘 맞습니다.
에이전트가 한 번만 수행하며 필요할 것임을 미리 알지 못했던 호출은 Monid 같은 도구 라우터에 맡기는 것이 맞습니다. 2026년 11월 3일 기준 Monid 홈페이지에는 2,800개 이상의 도구가 표시되어 있었습니다. Monid는 10월 29일에 저희에게 자료를 보내왔습니다. 이 자료에 따르면 discover와 inspect는 무료입니다. run은 단일 잔액에서 도구 카드에 표시된 가격으로 호출당 과금됩니다.
이 글은 Monid 팀이 보낸 초안에서 출발했습니다. 초안의 주장은 그대로 유지했습니다. 에이전트의 도구 호출은 반복 호출과 발견형 호출, 두 종류로 나뉩니다. 이 두 종류를 같은 방식으로 연결해서는 안 됩니다. 저희는 한 가지를 바꾸고, 직접 실행한 테스트를 추가했습니다.
바꾼 부분은 라우팅 규칙입니다. 초안의 예시는 일일 목록에 Xiaohongshu, Douyin, TikTok 세 플랫폼만 넣었습니다. 저희는 이를 당일 EveryInfra 카탈로그 전체, 즉 카테고리별로 묶은 106개 플랫폼으로 바꿨습니다. 이제 라우터로 가는 것은 진짜 롱테일뿐입니다. 추가한 실행은 위의 말차 라테 검색, 노트 상세 호출, 댓글 호출, Douyin 검색입니다. 일부러 잘못 만든 요청도 두 건 보냈습니다.
Monid 관련 수치는 두 종류의 사실만 인용합니다. 첫째는 Monid가 2026년 10월 29일에 자체적으로 실행한 결과입니다. 둘째는 Monid 사이트에 날짜와 함께 나와 있는 사실입니다. Monid에서 과금되는 호출은 저희가 다시 실행하지 않았습니다.
중국 밖의 독자를 위해 플랫폼을 간단히 소개합니다. Xiaohongshu는 해외에서 RedNote로도 알려진 중국 소셜 앱입니다. 사용자는 이곳에 노트를 올립니다. 노트는 사진이나 동영상, 제목, 태그로 이루어진 짧은 게시물입니다. 노트마다 좋아요, 저장(수집), 댓글, 공유 수가 집계됩니다.
브랜드와 분석가들은 Instagram이나 TikTok을 모니터링하듯 이 앱의 중국어 콘텐츠를 모니터링합니다. 이 앱은 이번 테스트에 잘 맞는 사례입니다. 많은 팀이 이 앱을 매일 추적하며, 범용 라우터에는 이 앱을 위한 서로 경쟁하는 엔드포인트가 여러 개 등록되어 있습니다.
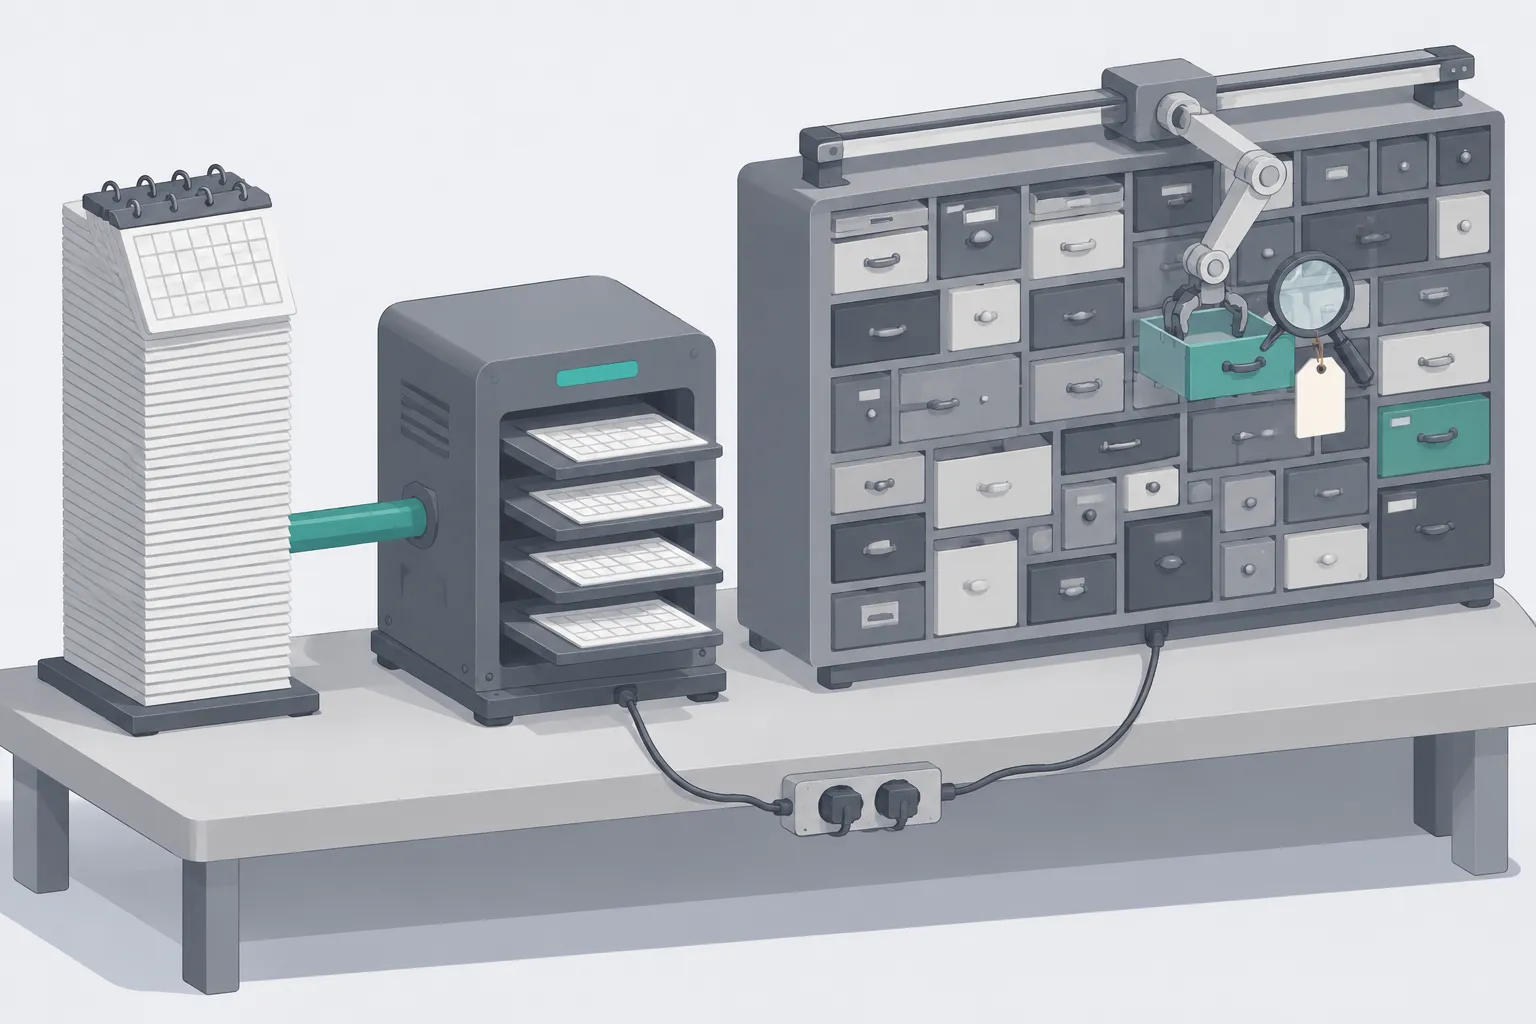
두 종류의 도구 호출: 반복 호출과 발견형 호출
Monid의 초안은 한 가지 연습 과제로 시작합니다. 에이전트가 지난주에 수행한 도구 호출을 뽑아, 같은 호출의 반복 빈도에 따라 정렬해 보는 것입니다. Monid의 표현을 빌리면 반복 호출 목록은 짧습니다. 추적하는 플랫폼, 보관하는 필드, 실행 일정이 전부입니다. 같은 요청이 하루에도 여러 번 실행됩니다.
나머지는 롱테일입니다. 예를 들어 사용자가 행사 당일 행사장의 날씨를 묻습니다. 누군가는 추적하지 않는 플랫폼에서 어떤 크리에이터의 팔로워 수를 알고 싶어 합니다. 또 누군가는 어떤 회사의 최근 투자 라운드나, 단순 HTTP 요청으로는 열리지 않는 페이지를 원합니다. 이 롱테일의 각 항목은 서로 다른 회사에서 제공할 수 있고, 회사마다 키, 스키마, 가입 절차가 따로 있습니다. 대부분은 1년에 몇 번 호출될 뿐입니다.
두 부분이 원하는 것은 정반대입니다. 반복 호출에서 가장 중요한 속성은 아무것도 바뀌지 않는 것입니다. 필드 이름이 안정적이면 에이전트 코드와 다운스트림 테이블이 계속 맞아떨어집니다. 가격이 안정적이면 재무팀이 미리 예산을 세울 수 있습니다. 오류 형식이 안정적이면 재시도 로직을 한 번만 작성하면 됩니다.
Anthropic의 가이드 Writing effective tools for agents는 도구를 결정적 시스템과 비결정적 에이전트 사이의 약속으로 봅니다. 그리고 명확한 이름, 도구 간의 깔끔한 경계, 유용한 맥락을 담은 응답을 요구합니다. 롱테일에서 가장 중요한 속성은 지원 범위입니다. 에이전트는 어떤 도구가 필요할지 미리 알지 못합니다. 따라서 에이전트에 도구를 하나씩 미리 설정해서는 안 됩니다. 필요할 때 도구를 찾아 가격을 확인하고 한 번 호출한 뒤 다음으로 넘어가야 합니다.
실수는 두 부분을 같은 방식으로 처리하는 것입니다. 롱테일을 공급업체 하나씩 연동하면 에이전트는 첫 주를 API 키 모으는 데 씁니다. 매일 하는 작업을 범용 라우터로 돌리면, 유지 비용을 낮춰 주던 고정 스키마를 잃게 됩니다.
모델 쪽 비용도 있습니다. 에이전트가 보는 도구가 많을수록 잘못된 도구를 고르는 일이 잦아집니다. RAG-MCP 논문은 MCP 스트레스 테스트를 진행했습니다. 관련 도구를 먼저 검색한 뒤 모델에 보여 주자 선택 정확도가 13.62%에서 43.13%로 올랐습니다. 프롬프트 토큰도 절반 넘게 줄었습니다.
ToolLLM과 Gorilla 같은 이전 연구도 같은 결과를 얻었습니다. API가 많아질수록 도구 선택과 인자 작성이 모두 어려워집니다. MCP 서버 58개와 도구 680개 이상을 운영하는 한 개발자는 Reddit r/mcp에 도구가 30~60개를 넘으면 도구 선택이 확연히 나빠진다고 썼습니다. 그의 해결책은 도구 설명을 지연 로딩하고, 전문 에이전트마다 도구를 10~20개만 주는 것이었습니다.
| 반복 호출 | 발견형 호출 | |
|---|---|---|
| 빈도 | 매일 또는 매시간, 같은 요청을 반복 | 1년에 몇 번, 미리 알 수 없음 |
| 에이전트가 미리 아는지 | 예: 플랫폼, 필드, 정렬이 정해져 있음 | 아니요: 사용자가 요청할 때 알게 됨 |
| 가장 중요한 것 | 고정된 필드 이름, 고정된 가격, 고정된 오류 형식 | 넓은 커버리지, 공급업체별 가입 불필요, 호출당 과금 |
| 이 글의 예시 | 매일 받는 Xiaohongshu 말차 라테 리포트: xiaohongshu/search, xiaohongshu/comments | 도메인으로 회사 로고 찾기, 목록 밖 플랫폼의 게시물 |
| 보낼 곳 | 전용 데이터 API: EveryInfra | 도구 라우터: Monid(discover, inspect, run) |
따라서 합리적인 구조는 반복 호출용 직통 경로 하나와 나머지 전부를 위한 라우터 하나입니다. 두 제품 중 하나를 고르는 문제가 아닙니다. 두 서비스 모두 MCP를 지원하므로 같은 에이전트 클라이언트에 동시에 연결할 수 있습니다. 짧은 규칙 하나가 호출마다 어느 쪽을 쓸지 에이전트에게 알려 줍니다. 이어지는 섹션에서는 Monid가 무엇인지, EveryInfra 일일 목록이 실제로 얼마나 긴지 설명한 뒤 테스트 실행을 하나씩 살펴봅니다.
Monid란 무엇인가: 동사 세 개와 잔액 하나
Monid는 스스로를 에이전트 도구를 위한 OpenRouter라고 소개합니다. 이 표현은 제품 형태를 설명할 뿐, 사업상 관계를 뜻하지 않습니다. OpenRouter는 여러 모델을 키 하나와 잔액 하나로 묶습니다. OpenRouter의 빠른 시작에 따르면 단일 엔드포인트로 수백 개 모델을 제공하고 폴백을 자동으로 처리합니다. Monid의 10월 29일 자료에 따르면 Monid는 한 계층 위에서 같은 일을 합니다. 에이전트가 모델을 고른 뒤 호출하는 도구를 다룹니다.
2026년 11월 3일에 확인한 Monid의 포지셔닝 페이지는 이를 한 줄로 요약합니다. OpenRouter는 키 하나, 모든 모델, 토큰당 과금입니다. Monid는 스킬 하나, 모든 도구, 호출당 과금입니다. 저희는 이 비교를 제품 형태를 설명하는 데만 사용합니다. 두 회사의 관계에 대해서는 아무것도 말해 주지 않습니다.
2026년 11월 3일에 Monid 홈페이지를 확인했습니다. 2,800개 이상의 도구와 신규 계정용 무료 크레딧 $1가 표시되어 있었습니다. Monid가 10월 29일에 보낸 자료에도 같은 두 수치가 있었습니다.
10월 29일 자료에 따르면 카탈로그는 웹 검색, 스크래핑, 인물·기업 정보 보강을 다룹니다. 소셜 플랫폼 데이터(중국 플랫폼 포함), 지도와 리뷰, 이커머스, 금융, 생성형 미디어도 포함합니다. 과금 방식은 Monid의 표현으로 구독 없이 잔액 하나에서 호출당 과금하는 것입니다. 도구를 찾고 살펴보는 것은 무료이며, 실행에만 도구 카드에 표시된 가격으로 과금됩니다.
같은 자료에서 워크플로는 동사 세 개로 구성됩니다. discover는 카탈로그를 대상으로 하는 무료 시맨틱 검색입니다. 에이전트가 작업을 자연어로 설명하면 가격과 작동 상태가 표시된 엔드포인트 목록을 일치도순으로 받습니다. inspect도 무료이며 엔드포인트 하나의 입력 스키마, 가격, 문서를 반환합니다. run은 유일하게 과금되는 단계로, inspect가 보여 준 가격이 선불 잔액에서 차감됩니다.
에이전트는 MCP, 스킬 파일, 명령줄 도구, REST API로 Monid에 접근할 수 있습니다. Monid MCP 빠른 시작(Monid MCP 설정 가이드, 2026년 11월 3일 확인)은 서버 주소 https://mcp.monid.ai/v1과 OAuth 로그인을 안내합니다. Claude Code, Codex, 기타 클라이언트별로 단계가 따로 있습니다. 스킬 파일은 monid.ai/SKILL.md에 있습니다. Monid의 자료에 따르면, 이 주소를 “설정”하라고 지시받은 에이전트는 세 동사를 스스로 익힙니다. 기계가 읽을 수 있는 개요는 monid.ai/llms.txt에 있습니다.
| 동사 | 과금 여부 | 반환 내용(Monid의 2026년 10월 29일 자료 기준) |
|---|---|---|
discover | Free | 일치도 순으로 정렬된 엔드포인트(각각 가격과 상태 포함) |
inspect | Free | 엔드포인트 하나의 입력 스키마, 가격, 문서 |
run | 도구 카드 가격으로 과금 | 결과, 그리고 다시 조회할 수 있는 실행 ID |


EveryInfra 일일 목록: 플랫폼 106개, 기능 569개
라우팅 규칙의 첫 줄은 “목록에 있는 플랫폼은 EveryInfra로”이므로, 목록의 길이가 규칙의 쓸모를 결정합니다. Monid 초안의 예시 규칙은 xiaohongshu, douyin, tiktok 세 플랫폼만 지정했습니다. 이 규칙대로라면 Amazon 리뷰, Google Maps 리뷰, LinkedIn 채용 공고, Reddit 게시물도 목록에서 빠집니다. 하지만 EveryInfra 카탈로그는 이 모두에 고정된 필드와 고정된 가격을 제공합니다. 그래서 이 섹션에서는 카탈로그 전체를 나열합니다.
데이터는 무료 EveryInfra 카탈로그 GET /api/v1/social/catalog를 2026년 11월 3일 16:32 SGT에 조회한 결과입니다. 카탈로그에는 106개 플랫폼과 573개 기능이 있었고, 그중 당일 사용 가능한 기능은 569개였습니다. 나머지 4개(g2/compare, jd/reviews, temu/search, wechat_oa/wechat_index)는 available=false였으므로 당분간 일일 목록에서 제외해야 합니다. 카테고리는 저희 /market 페이지와 같은 기준을 따릅니다. 콘텐츠·소셜, 리뷰, 이커머스, 채용·비즈니스, 검색·웹·마켓입니다. 아래 표는 106개 플랫폼을 모두 보여 주며, 카테고리 안에서는 기능이 많은 순으로 정렬했습니다.
| 카테고리 | 플랫폼 수 | 사용 가능한 기능 수 | 플랫폼(기능 많은 순) |
|---|---|---|---|
| 콘텐츠·소셜 | 49 | 373 | Douyin, TikTok, X (Twitter), Instagram, Xiaohongshu, Facebook, Zhihu, Kuaishou, WeChat Official Accounts, Weibo, GitHub, Bilibili, Reddit, YouTube, Pinterest, Substack, Threads, Spotify, Dailymotion, Quora, Rumble, SoundCloud, Telegram, Toutiao, Twitch, Bluesky, Mastodon, Truth Social, WeChat Channels, DeviantArt, Discord, Douban, Gab, Lemmy, Naver, Odysee, Patreon, Product Hunt, Snapchat, Tumblr, Youku, Dribbble, iQIYI, Medium, NetEase Cloud Music, Behance, Flickr, VK, Eventbrite |
| 리뷰 | 15 | 65 | Google Play, App Store, G2, Google Maps 리뷰, Tripadvisor, Zillow, Airbnb, Booking, Expedia, Yelp, Realtor, Clutch, Nextdoor, Upwork, Crexi |
| 이커머스 | 13 | 53 | Amazon, AliExpress, JD.com, eBay, Etsy, Taobao, Shopee, Walmart, 1688, Xianyu, Dewu, Temu, Google Shopping |
| 검색·웹·마켓 | 17 | 40 | Yahoo Finance, 암호화폐 시세 데이터, 기업 데이터, Polymarket, Yandex, Similarweb, 암호화폐 뉴스, Kalshi, 검색 엔진 결과, Bing 검색, Bing Maps, DuckDuckGo 검색, DuckDuckGo Maps, Apple Maps, Google News, Google Trends, Google Ads Transparency Center |
| 채용·비즈니스 | 12 | 38 | LinkedIn, Glassdoor, Indeed, Xing, Capterra, Trustpilot, Naukri, ThomasNet, StepStone, SEEK, Dice, Craigslist |
이 목록을 쓸 때 주의할 점이 두 가지 있습니다. 첫째, 목록은 바뀝니다. 카탈로그는 언제든 플랫폼이나 기능을 추가할 수 있고, 일시적으로 사용 불가로 표시할 수도 있습니다. 따라서 규칙에 목록을 하드코딩하면 안 됩니다. 세션을 시작할 때 에이전트가 무료 everyinfra_list_capabilities 도구나 카탈로그 엔드포인트를 호출하게 하고, 반환된 결과로 목록을 채우면 됩니다.
둘째, 플랫폼 목록만으로는 여전히 단위가 큽니다. 한 플랫폼 안에서도 매일 실행되는 기능이 있고, 특정 인자를 줄 때만 데이터를 반환하는 기능이 있습니다. Xiaohongshu 하나만 해도 사용 가능한 기능이 17개입니다. 검색, 노트 상세, 댓글, 댓글 답글, 사용자 프로필, 사용자 노트, 사용자 검색이 있습니다. 토픽, 인기 급상승, 상품 검색, 상품 상세, 상품 리뷰, 팔로워, 노트 위치도 있습니다. 마지막 세 개는 여러 링크의 댓글 일괄 조회, 동영상 상세, 크리에이터 콘텐츠 순위입니다.
크리에이터 콘텐츠 순위($0.016)를 제외하면 모두 호출당 $0.005556입니다. 목록을 기능 단위로 작성하면 에이전트가 규칙에서 호출별 가격과 인자를 확인할 수 있습니다. 자세한 내용은 Xiaohongshu 데이터 API 페이지와 Xiaohongshu 검색 기능 페이지에 있습니다.
라우팅 규칙에서 바꾼 한 가지: 전부 나열하고 나머지만 Monid로 보내기
목록이 있으면 규칙은 짧게 유지할 수 있습니다. 저희는 Monid 초안의 규칙을 같은 구조로 다시 썼습니다. 플랫폼 줄만 바꾸고, 폴백 하나를 추가했습니다. 확실하지 않으면 먼저 EveryInfra에 묻고, unknown_capability가 돌아올 때만 Monid로 넘어갑니다. 규칙은 에이전트가 읽는 일반 텍스트이므로 시스템 프롬프트나 프로젝트 지침 파일에 넣을 수 있습니다.
For a daily job on a platform in the list below, call everyinfra_call_api.
Use the platform's own language for keywords. If the task says "this week"
or "today", sort by time. Record platform, action, params, the call time and
charged_usd for every call.
For a platform outside the list, a one-off lookup, or a tool that is not data,
use Monid: discover first, then inspect (both free); run only when the price
fits the budget. Run is billed at the price inspect showed. Record each price
and run id.
If you are not sure a platform is on the list, call EveryInfra first.
If it returns HTTP 400 with error.code unknown_capability (nothing charged),
then use Monid.
List (EveryInfra catalog, read 2026-11-03; refresh at the start of each
session with everyinfra_list_capabilities):
airbnb, alibaba1688, aliexpress, amazon, app_store, apple_maps, behance,
bilibili, bing, bing_maps, bluesky, booking, capterra, clutch, company_data,
craigslist, crexi, crypto_market, crypto_news, dailymotion, deviantart,
dewu, dice, discord, douban, douyin, dribbble, duckduckgo, duckduckgo_maps,
ebay, etsy, eventbrite, expedia, facebook, flickr, g2, gab, github,
glassdoor, google_ads_transparency, google_maps_reviews, google_news,
google_play, google_shopping, google_trends, indeed, instagram, iqiyi, jd,
kalshi, kuaishou, lemmy, linkedin, mastodon, medium, naukri, naver,
netease_music, nextdoor, odysee, patreon, pinterest, polymarket,
producthunt, quora, realtor, reddit, rumble, seek, shopee, similarweb,
snapchat, soundcloud, spotify, stepstone, substack, taobao, telegram, temu,
thomasnet, threads, tiktok, toutiao, tripadvisor, trustpilot, truth_social,
tumblr, twitch, twitter, upwork, vk, walmart, web, wechat_channels,
wechat_oa, weibo, xianyu, xiaohongshu, xing, yahoo_finance, yandex, yelp,
youku, youtube, zhihu, zillow
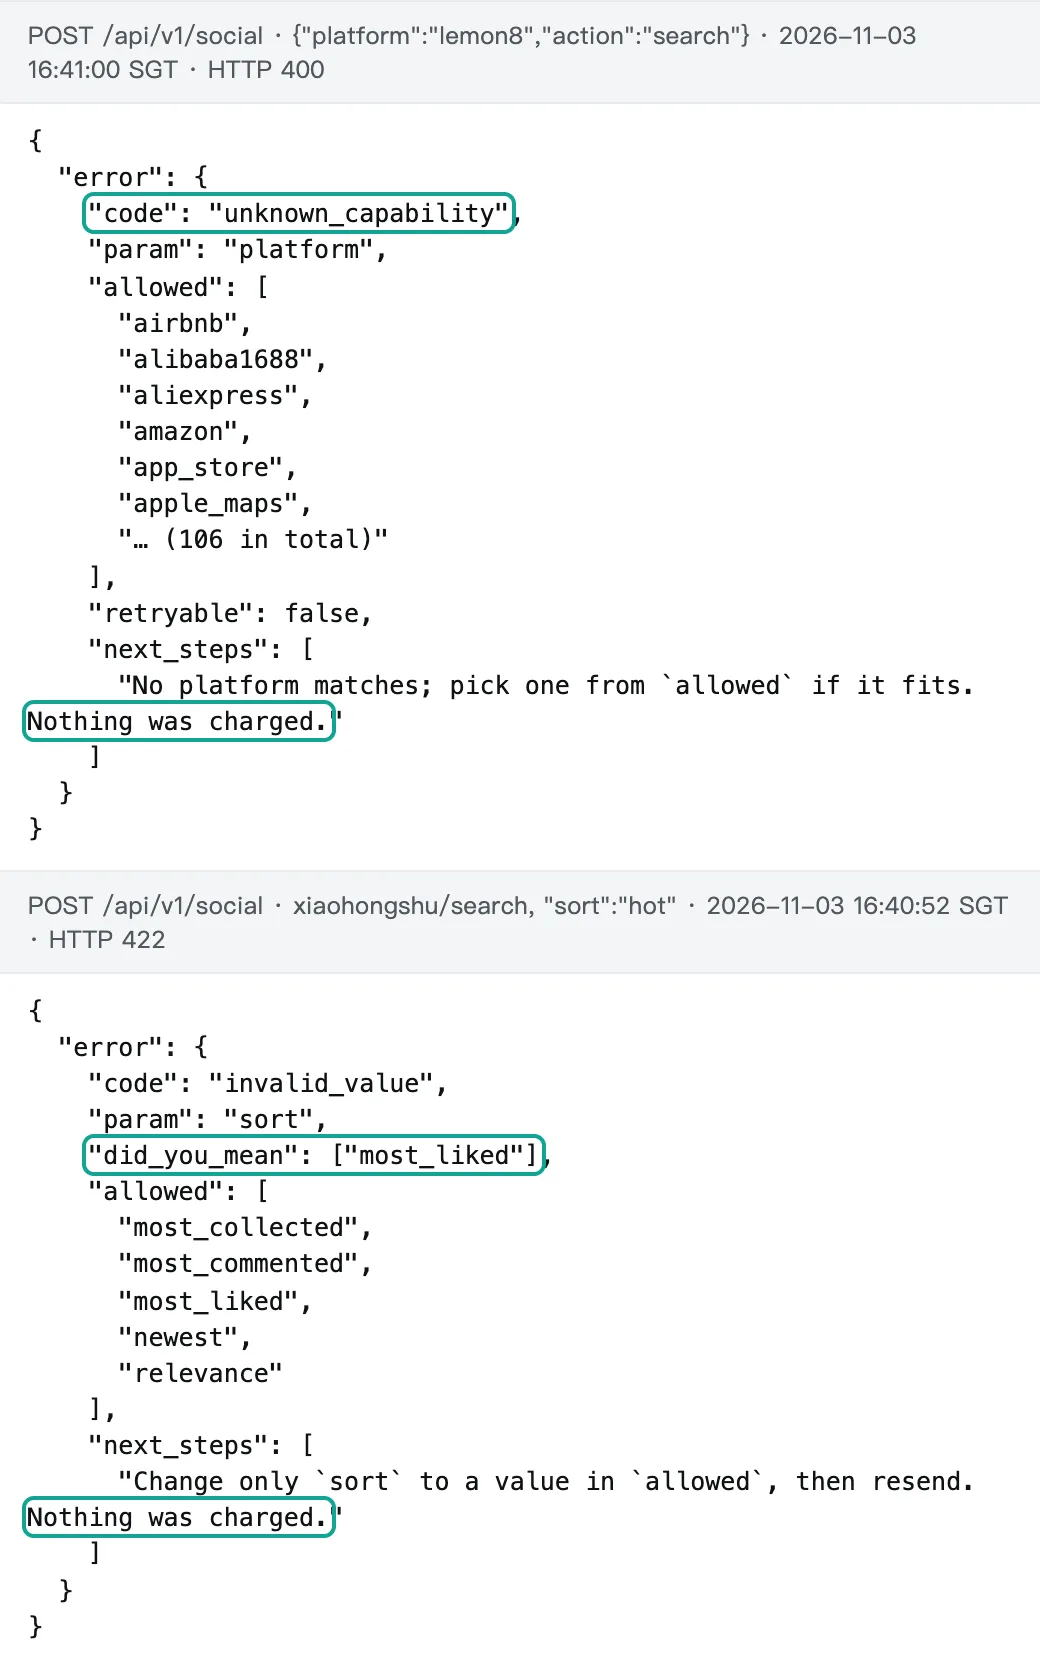
이 폴백을 테스트했습니다. 16:41:00 SGT에 목록에 없는 플랫폼 lemon8을 요청했습니다. EveryInfra는 0.24초 만에 HTTP 400으로 응답했습니다. error.code는 unknown_capability였고, allowed 필드에는 플랫폼 이름 106개가 모두 나열되어 있었습니다. next_steps의 첫 줄은 요금이 청구되지 않았다고 알려 줬습니다.
16:40:52 SGT에는 Xiaohongshu 검색에 존재하지 않는 정렬 값 hot을 보냈습니다. Monid 초안의 두 번째 엔드포인트가 쓰는 정렬 이름입니다. API는 0.11초 만에 HTTP 422와 함께 did_you_mean 값으로 most_liked를 반환했습니다. allowed 목록에는 유효한 값 다섯 개가 있었고, 이번에도 요금은 청구되지 않았습니다.
두 오류의 차이는 라우팅에서 중요합니다. HTTP 400 unknown_capability는 “이 작업은 내 담당이 아니다”라는 뜻이므로 에이전트는 Monid로 넘어가야 합니다. HTTP 422 invalid_value는 “이 작업은 내 담당이지만 인자가 틀렸다”는 뜻이므로, 에이전트는 다른 곳으로 넘어가지 말고 allowed를 보고 인자를 고쳐 다시 시도해야 합니다.
폴백 덕분에 규칙은 먼저 물어보는 쪽으로 기울 수 있습니다. 목록이 하루 전 기준이라고 해 봅시다. 그래도 EveryInfra를 먼저 호출하는 비용은 1초도 걸리지 않는 무과금 왕복 한 번뿐이고, 그다음 규칙이 작업을 넘깁니다.
매일 쓰는 플랫폼은 반대쪽 분기로 먼저 보내면 안 됩니다. Monid의 10월 29일 자료에 따르면, 같은 플랫폼의 두 엔드포인트는 정렬 이름이 서로 다르고 반환하는 필드 이름도 다릅니다. 따라서 작업이 매일 반복되기 시작하면 에이전트에게는 엔드포인트 하나, 정렬 하나, 스키마 하나가 필요합니다(인용문은 아래 “테스트 1” 끝에 있습니다). 같은 조언이 EveryInfra를 Monid와 함께 쓰는 방법을 다룬 문서 섹션과 파트너 페이지의 Monid 항목에도 있습니다.
MCP 서버 두 개를 한 클라이언트에서 함께 쓰기
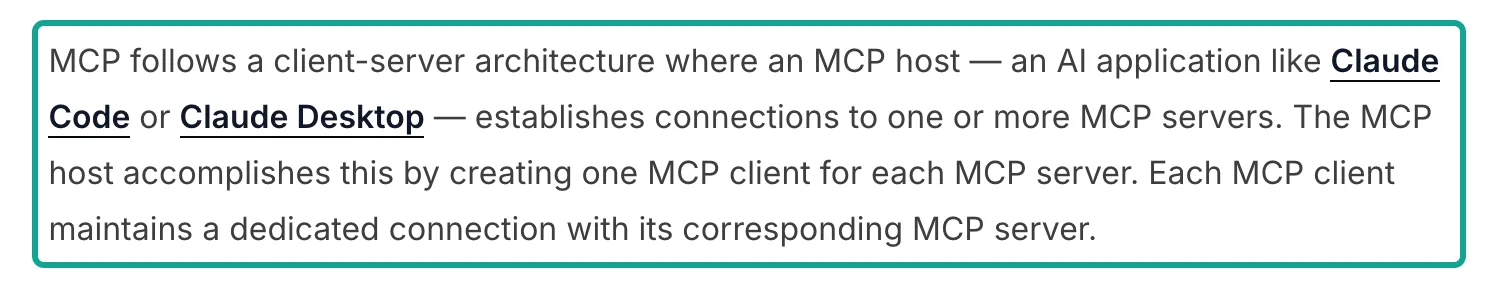
두 서비스를 나란히 실행할 수 있는 것은 MCP 자체의 구조 덕분입니다. MCP 아키텍처 개요가 이를 설명합니다. 호스트 프로그램은 MCP 서버마다 MCP 클라이언트를 하나씩 만들고, 각 클라이언트는 자체 연결을 유지합니다. 호스트는 Claude Code, Claude Desktop, Cursor, VS Code 또는 직접 작성한 프로그램일 수 있습니다. 연결되면 호스트는 모든 서버의 도구 목록을 합쳐 모델에 전달합니다. 모델은 호출할 때마다 도구를 고릅니다.
그래서 EveryInfra와 Monid는 서로를 몰라도 같은 호스트에 공존할 수 있습니다. 둘의 역할 분담은 모델이 읽는 도구 설명과 사용자가 작성한 규칙에만 달려 있습니다. 전송 계층에서 메시지는 JSON-RPC 2.0을 사용합니다. 원격 서버는 Streamable HTTP 전송 방식을 사용합니다. 도구 목록 조회와 호출은 사양의 tools 섹션을 따릅니다.
Claude Code에서는 명령 두 개면 충분합니다. EveryInfra는 API 키를 사용하며, 키는 환경 변수에 두고 --header로 전달합니다. Monid MCP 설정 가이드(2026년 11월 3일 확인)에 따르면 Monid 원격 서버는 OAuth를 사용합니다. 서버를 추가한 뒤 Claude Code에서 /mcp를 입력하고 monid를 선택해 로그인을 완료합니다. --scope user 플래그를 쓰면 두 서버를 모든 프로젝트에서 사용할 수 있습니다.
Claude Code MCP 문서에는 local과 project 스코프도 설명되어 있습니다. project 스코프는 프로젝트 루트의 .mcp.json에 기록하므로, 설정 하나를 공유하는 팀에 적합합니다. MCP가 처음이라면 Claude Code MCP 빠른 시작과 저희 MCP 서버 페이지부터 보시기 바랍니다.
# EveryInfra: API key auth; keep the key in an environment variable only
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope user --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"

# Monid: remote MCP with OAuth (then type /mcp in Claude Code, pick monid, sign in)
claude mcp add --transport http monid https://mcp.monid.ai/v1 --scope user
클라이언트가 mcpServers 파일을 읽는다면 설정은 아래 블록과 같습니다. 자주 실수하는 부분이 하나 있습니다. Claude Code .mcp.json 파일에서 원격 서버에는 "type": "http"가 필요합니다. url만 있는 항목은 파일을 불러올 때 설정 오류로 실패합니다.
Cursor는 거의 같은 형식을 읽습니다. VS Code는 mcpServers 대신 최상위 키 servers를 사용합니다. Gemini CLI는 Streamable HTTP 주소에 httpUrl을 쓰고, Codex는 TOML을 사용합니다. 블록 다음의 표는 흔히 쓰는 클라이언트 다섯 개의 차이를 정리한 것입니다. 각 행은 해당 클라이언트의 공식 문서(2026년 11월 3일 확인)를 근거로 합니다.
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    },
    "monid": { "type": "http", "url": "https://mcp.monid.ai/v1" }
  }
}| 클라이언트 | 설정 위치 | 원격 서버 선언 방법 | 키 전달 또는 로그인 방법 | 문서 |
|---|---|---|---|---|
| Claude Code | claude mcp add 또는 프로젝트의 .mcp.json | "type": "http"와 url | --header 또는 headers, OAuth 서버는 /mcp로 로그인 | Claude Code MCP 문서 |
| Cursor | 프로젝트의 .cursor/mcp.json 또는 ~/.cursor/mcp.json | mcpServers 아래 url | headers, OAuth 지원 | Cursor MCP 문서 |
| Codex | ~/.codex/config.toml 또는 신뢰할 수 있는 프로젝트의 .codex/config.toml | [mcp_servers.name] 아래 url | bearer_token_env_var에 환경 변수 이름 지정, OAuth는 codex mcp login | Codex MCP 문서 |
| VS Code | 워크스페이스의 .vscode/mcp.json | 최상위 키 servers, "type": "http" | headers 또는 입력 변수, OAuth 지원 | VS Code MCP 문서 |
| Gemini CLI | settings.json의 mcpServers | httpUrl | headers, includeTools로 일부 도구만 허용 | Gemini CLI MCP 문서 |
두 서버를 모두 연결하면 모델은 매 턴 두 서버의 도구 설명을 모두 보게 되고, 여기에는 비용이 따릅니다. 16:42:41 SGT에 EveryInfra MCP 서버에 tools/list 요청을 한 번 보냈습니다. 도구 12개가 반환됐습니다. everyinfra_list_capabilities는 카탈로그를 읽고, everyinfra_call_api는 모든 데이터 기능을 호출하며, everyinfra_get_job은 비동기 결과를 가져옵니다. 나머지는 검색, CAPTCHA 해결, AI 채팅, 계정, 지원 티켓을 다룹니다.
전체 응답 본문은 16,247바이트였습니다. 토큰당 대략 4바이트로 계산하면 약 4,060토큰입니다. 이 수치가 작은 이유는 기능 569개를 각각 별도 도구로 만들지 않았기 때문입니다. 범용 everyinfra_call_api 도구 하나와 무료 카탈로그 도구가 있으면, 모델은 필요한 것을 먼저 찾아볼 수 있습니다.
Anthropic의 Introducing advanced tool use에 유용한 비교가 있습니다. MCP 도구 50개 이상의 설명을 미리 로드하자 약 72K 토큰이 들었습니다. 도구 검색으로 필요할 때 로드하자 그중 일부만 남았습니다.
호스트도 도움이 됩니다. Claude Code 환경 변수 레퍼런스에 따르면 도구 검색은 기본으로 켜져 있습니다(ENABLE_TOOL_SEARCH). 따라서 MCP 도구 설명이 한꺼번에 컨텍스트에 들어가지 않습니다. 도구 출력이 10,000토큰을 넘으면 경고가 표시되고, 기본 한도는 25,000토큰입니다(MAX_MCP_OUTPUT_TOKENS).
저희 실행에서 Xiaohongshu 노트가 20개씩 담긴 검색 페이지 5개는 원본 JSON 기준 35,538~51,999바이트였습니다. 상당 부분은 이미지 URL, 아바타 URL, 페이지 토큰처럼 분석에 필요 없는 긴 문자열이었습니다. 따라서 매일 실행하는 작업에서는 에이전트가 저장할 열만 남기게 하는 것이 좋습니다. 또는 스크립트에서 HTTP API를 실행해 결과를 파일에 쓰면, 행이 모델 컨텍스트를 아예 거치지 않습니다.
Anthropic의 Code execution with MCP가 이 패턴을 설명합니다. 모델이 도구를 호출하는 코드를 작성하고, 중간 데이터는 실행 환경에 머뭅니다. 대화로 돌아오는 것은 결론뿐입니다.
테스트 1: 정렬 3가지, 언어 2가지로 말차 라테를 검색하면
이 글의 주요 테스트 실행입니다. 모든 요청은 싱가포르에서 EveryInfra HTTP API POST /api/v1/social로 보냈습니다. 플랫폼은 xiaohongshu, 기능은 search, 키워드는 말차 라테를 뜻하는 중국어였습니다. 바꾼 것은 정렬, 페이지, 기간, 그리고 한 번은 키워드 언어뿐입니다.
시간은 네트워크 왕복을 포함한 클라이언트 측 총 소요 시간입니다. 가격은 각 응답의 billing.charged_usd 값입니다. 처음 세 행은 저희 편집자가 16:33 SGT에 실행했고, 나머지는 글을 쓰면서 같은 테스트 키로 실행했습니다.
| 시간(SGT, 11월 3일) | 정렬 또는 필터 | 페이지 | 비고 | 응답 시간 | 과금 | 좋아요 중앙값 | 30일 미만 노트 |
|---|---|---|---|---|---|---|---|
| 16:33:22 | most_liked | 1 | 20 | 3.91 s | $0.005556 | 1,427.5 | 0 |
| 16:33:26 | newest | 1 | 20 | 3.42 s | $0.005556 | 0 | 20 |
| 16:33:29 | most_liked, 영어 키워드 “matcha latte” | 1 | 20 | 3.52 s | $0.005556 | 1,011 | 1 |
| 16:40:40 | most_liked(반복) | 1 | 20 | 4.26 s | $0.005556 | 1,513.5 | 2 |
| 16:41:08 | 1페이지의 page_token으로 most_liked | 2 | 20 | 2.34 s | $0.005556 | 194.5 | 1 |
| 16:41:18 | most_liked + last_30_days | 1 | 1 | 9.45 s | $0.005556 | 1,857 | 1 |
요청은 짧습니다. 아래는 16:40:40 호출이며, 응답은 첫 번째 노트와 과금 필드만 남기고 줄였습니다. 전체 필드 목록은 Xiaohongshu 검색 기능 페이지에 있습니다. 처음이라면 문서의 빠른 시작에서 키를 발급받을 수 있습니다.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"xiaohongshu","action":"search",
"params":{"keyword":"抹茶拿铁","sort":"most_liked"}}'{
"platform": "xiaohongshu", "action": "search", "count": 20,
"pagination": { "page": 1, "has_more": true },
"next_page_token": "pt1.…",
"results": [
{ "id": "69a509f400000000220335a9",
"like_count": 16056, "collect_count": 2657, "comment_count": 6223,
"share_count": 3261, "posted_at": "2026-03-02T04:15:14+00:00",
"is_video": false, "is_cooperation_note": true }
],
"billing": { "charged": true, "charged_usd": 0.005556 }
}정렬부터 보겠습니다. “좋아요 많은 순”과 “최신순”은 서로 다른 질문에 답합니다. 16:33 좋아요 많은 순 페이지의 좋아요 중앙값은 1,427.5, 저장 중앙값은 747.5였습니다. 노트 20개 중 30일 미만은 하나도 없었고, 가장 오래된 노트는 2025년 5월 28일에 게시됐습니다. 게시 경과일별로는 30일 미만 0개, 30~179일 12개, 180~364일 5개, 1년 초과 3개였습니다.
최신순 페이지에는 11월 2일과 3일에 게시된 노트 20개가 있었고, 좋아요 중앙값은 0이었습니다. 두 페이지에 겹치는 노트는 하나도 없었습니다. 에이전트가 둘 다 “말차 라테 상위 20개”로 저장하면, 다운스트림에서는 어느 페이지가 “무엇이 가장 인기 있는가”에 답하고 어느 페이지가 “오늘 사람들이 무슨 이야기를 하는가”에 답하는지 아무도 구분할 수 없습니다.
다음은 키워드 언어입니다. 영어 키워드 “matcha latte”를 좋아요 많은 순으로 정렬하자 좋아요 중앙값은 1,011이었습니다. 노트 20개 중 11개가 동영상으로, 중국어 키워드 페이지의 9개보다 많았습니다. 가장 오래된 노트는 2023년 3월 18일에 게시됐고, 1년이 넘은 노트가 5개였습니다. 16:33 중국어 페이지와는 노트 4개가 겹쳤습니다.
즉 같은 주제라도 중국어와 영어는 일부 겹치지만 서로 다른 결과 집합을 반환합니다. 영어 페이지에는 1년 넘은 노트가 5개, 중국어 페이지에는 3개 있었습니다. 그래서 라우팅 규칙에 “키워드는 해당 플랫폼의 언어로 작성할 것”이라고 적어 둡니다. 이렇게 하면 에이전트가 중국 플랫폼을 습관적으로 영어로 검색하지 않습니다.
2페이지와 기간 필터도 살펴볼 만합니다. 1페이지의 next_page_token으로 요청한 2페이지는 겹치지 않는 새 노트 20개를 반환했습니다. 좋아요 중앙값은 194.5로 떨어졌습니다. 소요 시간은 2.34초로 세션에서 가장 빠른 호출이었습니다. 페이지마다 같은 가격의 호출 1건으로 계산됩니다.
date_range=last_30_days를 추가하자 노트가 1개만 담긴 페이지가 돌아왔습니다. 10월 9일에 게시된 노트로, 좋아요가 1,857개였습니다. 이 호출은 9.45초가 걸려 세션에서 가장 느렸습니다. 카탈로그는 이 인자에 대해 분명하게 안내합니다. 최근 30일처럼 좁은 기간을 지정하면 페이지당 노트가 20개보다 적을 수 있습니다. 페이지를 꽉 채우려면 sort=newest와 함께 쓰고, 노트가 없는 페이지는 과금되지 않습니다.
이 페이지는 노트가 1개였으므로 평소대로 $0.005556이 과금됐습니다. 매일 하는 작업이 “최근 30일 동안 좋아요가 가장 많은 말차 라테 노트”라고 해 봅시다. 이때는 매일 최신순 노트를 페이지별로 가져와 저장하고, 좋아요 순 정렬은 직접 하는 편이 더 안정적입니다. 하루 한 번 “최근 30일 + 좋아요 많은 순” 요청을 보내는 것보다 낫습니다.
동기 호출 9건의 중앙값은 3.6초였고, 범위는 2.34~9.45초였습니다. 하루 한 번 실행하는 작업이라면 충분히 빠릅니다. 대화 한 턴에 호출을 십여 건 하는 에이전트라면 요청에 "mode": "async"를 추가할 수 있습니다. 그러면 API가 즉시 작업 ID를 반환합니다. 에이전트는 everyinfra_get_job 또는 GET /api/v1/jobs/{job_id}로 결과를 가져옵니다. 모든 동기 응답의 async_hint 필드에도 같은 안내가 있습니다.
이제 2026년 10월 29일 기준 Monid 쪽 수치를 보겠습니다. Monid는 이 테스트에 Monid의 Xiaohongshu 도구 페이지를 사용했습니다. 카탈로그에서 서로 다른 두 회사의 Xiaohongshu 노트 검색 엔드포인트 두 개를 골랐습니다. 같은 중국어 키워드로 각각 한 번씩 실행했고, 첫 번째 엔드포인트는 영어 키워드로 한 번 더 실행했습니다. Monid의 자료에 따르면 당일 이 도구 페이지에는 엔드포인트 49개가 등록되어 있었습니다.
아래 표의 행 수, 시간, 결과는 Monid가 보내 준 자료에서 가져왔으며, 시간은 미국 태평양 시간입니다. 저희는 이 실행을 다시 하지 않았고, 저희 결과와 순위를 매겨 비교하지도 않습니다. 날짜가 다르고, 정렬 인자가 다르며, 양쪽이 답한 질문도 달랐습니다.
| 날짜(Monid가 자체 실행) | 엔드포인트 | 입력 | 비고 | 응답 시간 | 결과 |
|---|---|---|---|---|---|
| 2026-10-29 20:34 | 첫 번째 회사의 노트 검색 | 중국어 키워드, 좋아요 많은 순, 1페이지 | 20 | 3.2 s | 좋아요 중앙값 2,132, 저장 중앙값 1,571, 30일 미만 노트 없음, 가장 오래된 노트는 3년 반 이상 경과 |
| 2026-10-29 20:34 | 두 번째 회사의 노트 검색 | 중국어 키워드, 정렬 “hot” | 20 | 3.2 s | 좋아요 중앙값 97, 20개 중 5개가 30일 미만 |
| 2026-10-29 20:35 | 첫 번째 회사의 노트 검색 | “matcha latte”, 좋아요 많은 순 | 20 | 2.9 s | 좋아요 중앙값 2,961, 노트의 절반이 동영상 |
Monid도 자체 실행에서 저희와 같은 결론을 얻었습니다. 정렬 순서는 항상 데이터와 함께 기록되어야 합니다.
다음은 Monid의 10월 29일 자료에서 가져온 문단으로, 약간 다듬었습니다. “같은 키워드, 같은 날, 두 엔드포인트가 서로 다른 두 질문에 답했습니다. 둘 다 ‘상위 20개’로 저장한 에이전트는 둘을 비교할 수 있게 해 주던 유일한 요소를 잃은 것입니다.”
같은 자료에 따르면 두 엔드포인트는 정렬 이름과 필드 이름이 서로 다릅니다. 따라서 쿼리가 매일 쌓이는 시계열이 되면 에이전트에게는 엔드포인트 하나, 정렬 하나, 스키마 하나가 필요합니다. 바로 이 시점에 호출이 라우터에서 직통 경로로 옮겨 갑니다. Monid는 API로 Xiaohongshu 데이터를 가져오는 방법을 다룬 가이드에서 자체 방식을 설명합니다.
테스트 2: 같은 요청을 6번 보내자 상위 3개에 서로 다른 노트 16개가 올라왔다
16:33부터 16:45 SGT까지 완전히 같은 요청을 6번 실행했습니다. 요청은 1페이지 기준 {"keyword": <the Chinese keyword>, "sort": "most_liked"}입니다. 16:33:22에 한 번 실행했습니다. 16:36에는 편집자가 아래 예제 스크립트를 처음으로 테스트 실행했습니다. 16:40:40에 다시 실행했습니다. 16:45에는 편집자가 이 글의 언어별 버전마다 한 번씩, 스크립트를 세 번 더 실행했습니다. 스크립트는 상위 3개만 출력하므로, 6번의 실행 전체에서 비교할 수 있는 것은 상위 3개입니다.
6번의 실행에서 상위 3개 자리 18곳에 서로 다른 노트 16개가 올라왔습니다. 좋아요 16,056개인 노트는 16:33과 16:40에 1위였습니다. 좋아요 20,972개인 노트는 16:36에 3위, 16:45 첫 실행에서 1위였습니다. 나머지 14개 노트는 각각 한 번씩만 등장했습니다. 모든 실행 쌍의 상위 3개를 비교하자 15쌍 중 13쌍은 겹치는 노트가 없었고, 2쌍은 1개가 겹쳤습니다. 16:33과 16:40의 노트 20개 전체 페이지는 7개만 겹쳤습니다.
먼저 이 요청이 무엇을 묻는지 분명히 해야 합니다. 카탈로그는 이 정렬 값을 “좋아요 많은 순”(most_liked)이라고 부릅니다.
EveryInfra는 그 시점에 그 방식으로 정렬된 Xiaohongshu 검색 결과의 첫 페이지를 반환합니다. 말차 라테 노트 전체를 좋아요 수로 정렬한 결과가 아닙니다. 따라서 첫 페이지에 플랫폼 전체에서 좋아요가 가장 많은 노트가 들어 있다는 보장은 없습니다.
원본 응답이 이를 보여 줍니다. 16:33과 16:40의 1위 노트는 좋아요가 16,056개였습니다. 하지만 16:36의 1위 노트는 53,316개였고, 16:45의 3회 실행에서는 1위가 각각 20,972개, 22,440개, 21,468개였습니다. 이 네 노트는 16:33과 16:40에 받은 노트 20개짜리 전체 페이지 어디에도 없었습니다.
16:45의 3회 실행은 1분 안에 이루어졌는데, 상위 3개 노트가 하나도 겹치지 않았습니다. 플랫폼의 첫 페이지는 몇 분, 심지어 1분 안에도 바뀔 수 있다는 뜻입니다. API 쪽은 매번 같았습니다. 모든 호출이 HTTP 200과 노트 20개를 반환했고, 비용도 모두 같은 $0.005556였습니다. 16:33과 16:40 응답의 모든 필드 이름은 카탈로그의 response_fields 목록에 있었습니다. 노트에 장소가 있을 때의 poi_id처럼, 값이 있을 때만 나타나는 필드도 한두 개 있습니다.
이는 일일 작업에 세 가지 직접적인 영향을 줍니다. 첫째, 무엇을 고정할 수 있는지 분명히 해야 합니다. 요청 형태, 필드 이름, 가격, 오류 형식은 고정할 수 있고 고정해야 합니다. 결과 집합은 고정할 수 없습니다. 요청 하나로 “매일 같은 상위 20개”를 약속하는 구성은 신뢰해서는 안 됩니다.
둘째, 데이터와 함께 요청 조건과 시각을 저장해야 합니다. 정렬, 페이지, 키워드, 호출 시각입니다. 하나라도 빠지면 일주일 뒤에는 그 행 묶음이 어떤 질문에 대한 답인지 알 수 없습니다.
셋째, 안정적인 순위가 필요하다면 한 번의 요청에서 나온 상위 몇 개 결과에 의존해서는 안 됩니다. 매일 조금 더 뒤쪽 페이지까지 가져와 노트 ID를 기준으로 자체 테이블에 병합해야 합니다. 그런 다음 좋아요 수처럼 직접 정한 규칙으로 정렬해야 합니다. 이렇게 만든 순위는 재현할 수 있습니다.
이번 세션 데이터로 세 번째 원칙을 확인해 보겠습니다. 16:33과 16:40의 첫 페이지에는 각각 노트 20개가 있었습니다. 노트 ID를 기준으로 병합하고 중복을 제거하니 서로 다른 노트 33개가 나왔으며, 이는 어느 한 페이지보다 13개 많습니다. 좋아요 수로 정렬하면 좋아요 16,056개 노트가 1위이고, 다음 병합에서도 같은 결과를 계산할 수 있습니다. 플랫폼이 다음 1분 동안 어떤 페이지를 보여 주는지와는 관계없습니다.
저장하는 각 행에는 최소한 아래 열을 남겨 두어야 합니다. 예시 값은 16:40:40 응답의 첫 번째 노트에서 가져왔습니다.
| 열 | 출처 | 예시 값(2026년 11월 3일 16:40:40 SGT) | 저장하는 이유 |
|---|---|---|---|
| 호출 시각 | 자체 로그 | 2026-11-03 16:40:40 | 같은 요청도 몇 분 안에 결과가 바뀌므로, 시각이 없으면 재현할 수 없습니다 |
| 키워드, 정렬, 페이지 | 요청 인자 | 말차 라테(중국어), most_liked, 1 | “좋아요 많은 순”과 “최신순”은 서로 다른 질문에 답합니다 |
| 순위 | 결과 내 순서 | 1 | 한 노트의 시점별 위치 추적 |
| 노트 ID | id | 69a509f400000000220335a9 | 실행과 페이지 간 중복 제거 |
| 참여도 | like_count, collect_count, comment_count | 16,056, 2,657, 6,223 | 직접 정한 규칙으로 정렬 |
| 게시 시각 | posted_at | 2026-03-02 | “지금 화제인” 노트와 “오랫동안 인기 있는” 노트 구분 |
| 협찬 | is_cooperation_note | true | 유료 게시물은 따로 집계 |
| 과금액 | billing.charged_usd | 0.005556 | 월말 정산 |
병합 비용도 쉽게 계산할 수 있습니다. 16:41에 가져온 두 번째 페이지는 첫 페이지와 겹치는 노트가 없었습니다. 따라서 첫 페이지와 두 번째 페이지를 합치면 키워드당 하루에 서로 다른 노트 40개를 얻습니다. 두 페이지를 오전과 오후에 한 번씩 실행하면 키워드 하나에 하루 4회 호출합니다. 호출당 $0.005556이므로 하루 약 $0.022, 30일에 $0.67입니다. 이 추가 비용으로 재현하고 비교할 수 있는 테이블을 얻습니다. 다음 주에도 어떤 노트가 어느 날 상위 40개에 들어왔는지, 좋아요가 어떻게 늘었는지 확인할 수 있습니다.
| 일일 작업이 같은 요청을 반복할 때 | 이번 테스트에서 고정 여부 | 근거(2026년 11월 3일, SGT) | 저장과 규칙에 주는 의미 |
|---|---|---|---|
| 요청 형태(플랫폼, 기능, 인자 이름) | 고정 | 9회 호출 모두 같은 platform + action + params 형태 사용 | 규칙과 스크립트는 한 번만 작성 |
| 필드 이름 | 고정 | 16:33과 16:40 전체 응답의 모든 필드가 카탈로그에 나열된 30개 필드에 포함됨 | 다운스트림 테이블을 미리 구축 |
| 요금 | 고정 | Xiaohongshu 검색 10회, 노트 상세 1회, 댓글 호출 1회, 각각 $0.005556 과금 | 월 예산을 미리 책정 |
| 오류 형식 | 고정 | HTTP 400과 422 모두 code, allowed, next_steps 포함 | 재시도와 경로 변경 로직은 한 번만 작성 |
| 반환되는 노트 20개 | 변동 | 16:33과 16:40 페이지는 20개 중 7개만 겹침 | 정렬과 시각을 저장하고 ID로 병합 |
| 상위 3개 | 변동 | 6회 실행의 18개 자리에 서로 다른 노트 16개, 실행 쌍 15개 중 13개는 겹치는 노트 없음 | 병합한 페이지로 안정적인 순위 구성 |
테스트 3: 노트 상세, 댓글, Douyin
일일 작업은 검색에서 끝나는 경우가 드뭅니다. 노트 묶음을 확보하면 보통 상위 몇 개의 상세 정보와 댓글이 필요합니다. 같은 키워드를 다른 플랫폼에서 확인하고 싶을 때도 있습니다. 아래 3건의 호출은 모두 SGT 16:41~16:42에 같은 API와 같은 요청 형태로 실행했으며, platform과 action만 바꿨습니다.
| 시간(SGT, 11월 3일) | 기능 | 입력 | 행 | 응답 시간 | 과금 | 주목할 필드 |
|---|---|---|---|---|---|---|
| 16:41:50 | xiaohongshu/note | 좋아요 16,056개 노트 링크 | 1 | 2.55 s | $0.005556 | ip_location 값 있음, is_cooperation_note true, 태그 9개 |
| 16:42:00 | xiaohongshu/comments | 같은 노트, 좋아요 많은 순 | 15 | 3.60 s | $0.005556 | 1위 댓글 좋아요 1,213개, 15개 댓글에 달린 답글 650개, has_more true |
| 16:41:36 | douyin/search | 말차 라테의 중국어 키워드, 좋아요 많은 순 | 10 | 6.18 s | $0.008333 | 좋아요 중앙값 6,179.5개, 1위 동영상 좋아요 1,178,986개 |
노트 상세는 검색에서 반환하지 않는 필드를 추가로 제공합니다. 게시자의 ip_location, 전체 tags 및 topics 목록, 상품 연결 여부를 나타내는 has_goods입니다.
이번 세션의 1위 노트는 협찬 노트로, is_cooperation_note가 true였습니다. 장미 향 커피 시리즈를 홍보하며 음료 세 가지를 소개합니다. 그중 하나가 장미 말차 라테이고, 노트에는 말차 팬이라면 좋아할 것이라고 적혀 있습니다. 하지만 제목에도, 태그 9개 중 어디에도 “말차”라는 말은 없습니다. 말차 라테는 시리즈의 음료 중 하나일 뿐입니다.
일일 모니터링을 운영하는 사람이라면 여기서 두 가지를 알 수 있습니다. 노트가 키워드와 관련 있는지 판단하려면 제목과 태그뿐 아니라 본문을 읽어야 합니다. 그리고 협찬 노트는 본문으로 관련성을 판단해 따로 집계해야 합니다. 그렇지 않으면 유료 게시물 한두 개가 한 주 전체의 평균 좋아요를 끌어올릴 수 있습니다. 전체 필드 목록은 노트 상세 기능 페이지에 있습니다.
댓글 호출은 최상위 댓글 15개를 반환했으며, 좋아요는 1,213개부터 3개까지였습니다. 각 댓글에는 sub_comment_count가 있고, 15개 댓글에 달린 답글은 모두 650개였습니다. 응답의 has_more가 true였으므로 next_page_token으로 다음 페이지를 가져옵니다. 이 페이지에서는 ip_location이 모두 비어 있었습니다. 댓글 작성자의 지역 정보가 항상 있는 것은 아니므로, 다운스트림 통계에서 이를 전제해서는 안 됩니다.
댓글 필드에는 author_is_ai_agent도 있으며, 15개 모두 false였습니다. 댓글의 감성이나 셀링 포인트를 분석하려면 댓글 기능 페이지를 참고할 수 있습니다. 이전 글 Claude Code 동적 워크플로로 Xiaohongshu 댓글 읽기에서 더 자세히 다룹니다.
Douyin 검색 페이지 1개에는 동영상 10개가 담기며, 호출당 비용은 $0.008333, 즉 호출 1,000건당 $8.33입니다. Xiaohongshu(RedNote) 검색은 1,000건당 $5.56입니다. 두 가격 모두 카탈로그에 공시된 가격입니다. 동영상 10개의 좋아요 수 중앙값은 6,179.5개였고, 가장 많은 동영상은 1.17M개를 넘었습니다. 게시 시점은 2025년 2월부터 2026년 9월 사이입니다.
두 플랫폼의 필드 이름이 완전히 같지는 않습니다. Douyin에는 author_follower_count, music, hashtags, is_pinned가 추가로 있습니다. 하지만 like_count, comment_count, share_count, posted_at 같은 공통 필드는 이름이 같습니다. 따라서 크로스 플랫폼 테이블은 양쪽의 추가 열만 처리하면 됩니다. Douyin 데이터 API 페이지와 Douyin 검색 기능 페이지에 모든 필드가 나와 있습니다. 대응하는 TikTok 기능은 TikTok 데이터 API 페이지에 있습니다.
예제 스크립트: 일일 작업과 일회성 작업을 함께 실행하기
아래 Python 코드는 Requests로 작성한 두 서비스를 함께 사용하는 최소 동작 예제입니다. 앞부분은 일일 작업으로, 고정된 요청 형태 하나로 EveryInfra xiaohongshu/search를 호출하고 상위 노트 3개와 과금액을 출력합니다. 뒷부분은 일회성 작업으로, 도메인으로 회사 로고를 찾습니다. 이는 매일 쓰는 플랫폼 데이터가 아니므로 Monid로 보냅니다. discover 다음에 inspect를 실행하고, 가격이 예산에 맞을 때만 run을 실행합니다. 두 키 모두 환경 변수에서 가져오며, 스크립트에는 키 값이 들어 있지 않습니다.
import os

import requests

EVERYINFRA_API_KEY = os.environ["EVERYINFRA_API_KEY"]
MONID_API_KEY = os.environ["MONID_API_KEY"]
MONID = "https://api.monid.ai/v1"
MONID_HEADERS = {"Authorization": f"Bearer {MONID_API_KEY}"}
MAX_PRICE_USD = 0.01  # do not run a Monid tool that costs more than this per call

# 1. The daily job: EveryInfra xiaohongshu/search, one fixed request shape
resp = requests.post(
    "https://api.everyinfra.com/api/v1/social",
    headers={"Authorization": f"Bearer {EVERYINFRA_API_KEY}"},
    json={"platform": "xiaohongshu", "action": "search",
          "params": {"keyword": "抹茶拿铁", "sort": "most_liked"}},
    timeout=120,
)
resp.raise_for_status()
body = resp.json()
for note in body["results"][:3]:
    print(note["like_count"], note["collect_count"], note["posted_at"][:10], note["url"])
print("EveryInfra:", len(body["results"]), "notes, charged (USD):", body["billing"]["charged_usd"])

# 2. A one-off lookup that is not a daily platform: discover, inspect, run on Monid
found = requests.post(f"{MONID}/discover", headers=MONID_HEADERS, timeout=60,
                      json={"query": "company logo image URL from a domain", "limit": 3}).json()["results"]
# discover adds ranking and price fields to each result; inspect and run take only the fields that name the tool
SHOWN_ONLY = ("providerName", "description", "price", "score", "scoreBreakdown", "tags", "metrics", "hints")
tool = {key: value for key, value in found[0].items() if key not in SHOWN_ONLY}
detail = requests.post(f"{MONID}/inspect", headers=MONID_HEADERS, timeout=60, json=tool).json()
price = detail["price"]["amount"]["value"]
print("Monid tool:", detail["endpoint"], "price (USD):", price)
if price <= MAX_PRICE_USD:
    run = requests.post(f"{MONID}/run", headers=MONID_HEADERS, timeout=120,
                        json={**tool, "input": {"pathParams": {"company": "starbucks.com"}}}).json()
    print("Monid run:", run.get("runId"), run.get("status"), run.get("output"))
편집자는 이 스크립트를 2026년 11월 3일 16:36 SGT에 처음 실행했고, 16:45에 언어 버전별로 한 번씩 세 번 더 실행했습니다. 전체 실행은 매번 6.4~7.7초 걸렸습니다. EveryInfra 부분은 매번 노트 20개를 반환했고 $0.005556가 과금되었습니다. 그 상위 3개가 위 점 그래프의 16:36 및 16:45 행입니다.
Monid 부분에서는 4회 실행 모두 discover의 첫 번째 결과가 도메인으로 회사 로고를 반환하는 엔드포인트였습니다. inspect로 확인한 당시 가격이 $0였으므로 스크립트는 run으로 진행했습니다. 실행 결과는 COMPLETED 상태와 로고 이미지 URL이었습니다. MAX_PRICE_USD 줄은 단순하지만 유용한 안전장치입니다. discover와 inspect는 무료이므로 에이전트는 항상 가격을 먼저 확인할 수 있습니다. 예산을 넘는 도구는 건너뛰고 그 결정을 사람에게 넘길 수 있습니다.
Monid가 10월 29일에 낸 자료에도 여기에 들어맞는 경고가 있습니다. discovery는 순위일 뿐 보장이 아니라는 것입니다. “Xiaohongshu note search” 같은 기능 문구는 순위가 잘 매겨집니다. 고유명사가 들어간 길고 일상적인 문장은 작업과 전혀 관계없는 엔드포인트를 상위에 올릴 수 있습니다. 그러니 실행하기 전에 상위 결과를 읽어 보세요. 읽는 것은 무료입니다. 저희 규칙의 “discover, inspect를 거쳐 예산 안에서만 run” 단계는 이 조언을 따른 것입니다.
청구 금액: 일일 작업에는 한 달에 얼마가 드나
필드와 가격이 고정되어 있을 때 가장 직접적인 이점은 청구 금액을 미리 계산할 수 있다는 것입니다. 아래는 2026년 11월 3일 카탈로그 가격 기준으로 Xiaohongshu 말차 라테 모니터링에 드는 월 비용입니다. 한 달은 30일이며, 모든 호출이 과금된다고 가정했습니다. 실제로는 실패한 호출과 빈 페이지는 과금되지 않으므로 이 수치는 상한입니다. 크리에이터 콘텐츠 순위를 제외한 Xiaohongshu 기능 16개는 호출당 $0.005556이고, Douyin 검색은 호출당 $0.008333입니다. 전체 가격표는 요금 페이지에 있습니다.
| 요금제 | 일일 호출 수 | 일일 비용 | 30일 비용 |
|---|---|---|---|
| A: 키워드 3개, 각 1페이지 | 3 × xiaohongshu/search | $0.0167 | $0.50 |
| B: 키워드 3개, 각 2페이지 | 6 × xiaohongshu/search | $0.0333 | $1.00 |
| C: B + 상위 노트 5개의 댓글 | 검색 6회 + 5 × xiaohongshu/comments | $0.0611 | $1.83 |
| D: C + Douyin에서 같은 키워드 3개 | 위 11회 호출 + 3 × douyin/search | $0.0861 | $2.58 |
금액은 작지만, 중요한 것은 미리 예산에 넣을 수 있다는 점입니다. 요청과 가격이 바뀌지 않습니다. 따라서 모델이 다른 엔드포인트를 골랐다고 해서 월말 청구 금액이 달라지지 않습니다.
롱테일은 다른 방식으로 과금됩니다. 각 run 전에 inspect로 가격을 확인하고, 호출마다 기록하고, 월말에 실제 발생한 금액을 합산합니다. 이 글에 나온 과금 호출은 모두 13회, $0.075005입니다. 집필 중 저희가 실행한 6회 호출은 $0.036113, 편집자가 실행한 7회 호출(16:33에 3회, 16:36에 1회, 16:45에 3회)은 $0.038892였습니다.
한계: 이 분리 방식이 다루는 것과 다루지 않는 것
라우팅 규칙은 호출을 어디로 보낼지 정합니다. 데이터를 수집해도 되는지는 정하지 않습니다.
Xiaohongshu의 사용자 서비스 약관과 개인정보 처리방침은 플랫폼 콘텐츠와 사용자 정보의 이용 조건을 정합니다. 중국 본토에서의 개인정보 처리에는 중국 개인정보보호법도 적용됩니다. 2025년 1월 1일부터 시행된 네트워크 데이터 보안 관리 조례도 적용됩니다. 일일 작업에서 가장 실용적인 방법은 분석에 쓰는 열만 저장하는 것입니다. 보통 노트 ID, 제목, 반응 수치, 게시 시각, 정렬, 호출 시각이면 충분합니다. 작성자 닉네임, 프로필 사진, 댓글 작성자 프로필은 필요하지 않다면 저장하지 말고, 필요하다면 명확한 목적과 보존 기간을 정해야 합니다.
규칙 자체에도 한계가 있으며, 각각 간단한 대응 방법이 있습니다.
| 한계 | 발생할 수 있는 문제 | 대응 방법 |
|---|---|---|
| 목록이 최신 상태가 아님 | 플랫폼이 추가되거나 일시 중단되면 이름 106개를 하드코딩한 목록이 몇 주 뒤에는 부정확해짐 | 세션마다 everyinfra_list_capabilities로 새로 고치거나 unknown_capability 폴백에 의존 |
| 요청 속도 제한 | EveryInfra 키마다 분당 제한이 있으며, 초과하면 HTTP 429 반환(RFC 6585) | 기다렸다가 다시 시도하고, 대기 없이 재시도를 반복하지 말 것 |
| 두 가지 로그인 방식 | EveryInfra는 API 키를, Monid의 원격 MCP는 OAuth를 사용(Monid MCP 설정 가이드, 2026-11-03 확인) | 키는 환경 변수에 보관하고, 커밋하는 .mcp.json에는 절대 넣지 말 것 |
원격 MCP 서버의 OAuth 로그인은 MCP 사양의 인가 섹션에 정의되어 있습니다.
마지막 한계는 모델입니다. 도구를 아무리 잘 연결해도 모델이 잘못된 도구를 고르거나 인수를 잘못 채울 수 있습니다. MCP-Universe는 실제 MCP 서버로 모델을 테스트했습니다. 가장 좋은 결과는 GPT-5의 성공률 43.72%였습니다. MCP-Bench는 서버 28개와 도구 250개로 실제 업무에 더 가까운 작업을 구성했습니다. 여러 도구와 단계에 걸친 호출은 별도로 채점합니다.
따라서 이 글에서는 규칙을 이해하기 쉽게 작성했습니다. 목록을 명확히 제시하고, 오류 코드를 구분하며, 에이전트는 비용이 발생하기 전에 가격을 확인합니다. 각각의 조치가 모델이 추측해야 할 부분을 하나씩 없앱니다. 데이터 API에 Claude의 엄격한 도구 사용 적용하기에서는 또 다른 접근법을 설명합니다. 엄격한 인수 스키마는 모델이 잘못된 요청을 아예 만들지 못하게 합니다.
최근 달라진 점
도구 호출은 최근 몇 달 사이 빠르게 변했습니다. 아래 표의 각 행에 담긴 내용은 2026년 7월 이후에 나온 것입니다. 마지막 열은 그 변화가 "일일 작업은 데이터 API로, 롱테일은 라우터로"라는 분리 방식에 어떤 의미인지 설명합니다.
| 날짜 | 발생 상황 | 시사점 |
|---|---|---|
| 2026-07-28 | 새 MCP 사양: 무상태(stateless) 코어, Mcp-Method 및 Mcp-Name 요청 헤더, 캐시 힌트와 tools/list의 고정 순서, RFC 9207과 클라이언트 메타데이터 문서를 포함한 인가 업데이트 | 한 호스트에서 원격 서버 두 개를 쓸 때 필요한 연결이 줄고, 도구 목록을 캐시할 수 있어 모델이 매 턴 더 일관된 설명을 읽음 |
| 2026-10-06 | The Hacker News가 공개 MCP 서버 15,465개에 대한 분석을 발표 | 서버가 그 어느 때보다 많아져, 연결할 수 있는지보다 계속 로드해 둘 소수의 서버를 어떻게 고를지가 더 중요해짐 |
| 2026-10-16 | Semafor가 OpenRouter와 경쟁하는 모델 라우터 TrustedRouter의 시드 라운드를 보도 | "여러 백엔드 앞에 키 하나" 구조가 모델 계층에서 계속 투자를 끌어모으고 있으며, 도구 계층의 같은 구조도 주목할 만함 |
| 2026-10-19 | Xiaohongshu 오픈 플랫폼이 카테고리 예측 API 종료 공지를 게시 | 공식 플랫폼은 계속 상점과 이커머스에 집중하며, 공개 콘텐츠 데이터에는 여전히 다른 경로가 필요함 |
| 2026-10-21 | Bloomberg가 자사가 추진에 참여한 Skills over MCP 제안(SEP-2640)을 소개했고, 같은 날 Stripe가 MCP로 쓸 수 있는 Treasury for agents를 출시 | 스킬 파일과 MCP가 수렴하고 있으므로 서버가 스킬 파일도 제공하는지 확인 |
| 2026-10-22 | Anthropic이 서브에이전트를 메인 루프로 다시 합칠 시점에 대한 가이드를 발표 | 메인 루프에 가벼운 데이터 도구 몇 개를 두는 편이 대개 더 빠르고 정확하므로, 에이전트 하나에 서버 두 개는 합리적인 기본값 |
| 2026-10-30 | MCP 블로그가 Ruby SDK의 Tier 1 달성을 발표 | 더 많은 언어로 안정적인 MCP 클라이언트를 만들 수 있으므로, 자체 호스트에서도 두 서버를 함께 운용 가능 |
FAQ
Xiaohongshu에 공식 노트 검색 API가 있나요?
2026년 11월 3일 기준으로 Xiaohongshu 오픈 플랫폼은 주로 상점 및 이커머스 ERP 앱을 대상으로 하며, 주문, 상품, 애프터서비스 API를 제공합니다. 2026년 10월 19일에는 카테고리 예측 API를 종료했습니다. 공개 노트의 검색, 상세, 댓글은 제공하지 않습니다. EveryInfra xiaohongshu/search 기능은 호출당 $0.005556이며, 자세한 내용은 Xiaohongshu 데이터 API 페이지를 참고하세요.
EveryInfra 목록에 없는 플랫폼을 호출해도 과금되나요?
아니요. 목록에 없는 플랫폼은 HTTP 400 unknown_capability를 반환하고, 잘못된 인수는 did_you_mean과 함께 HTTP 422를 반환합니다. 둘 다 과금되지 않습니다. 테스트 실행 내역(2026년 11월 3일 16:40~16:41 SGT)은 위의 라우팅 규칙 섹션에 있습니다.
에이전트 하나에 도구를 몇 개까지 로드해야 하나요?
정해진 숫자는 없습니다. RAG-MCP는 도구가 많을 때 먼저 검색한 뒤 선택하면 정확도가 13.62%에서 43.13%로 올라간다는 결과를 얻었습니다. 도구를 680개 넘게 쓰는 r/mcp 개발자는 30~60개를 넘어서면 선택이 눈에 띄게 나빠졌다고 했습니다. 서브에이전트와 메인 루프 사이에 작업을 나누는 방법은 TikTok 계정을 위한 Claude Code 서브에이전트를 참고하세요.
참고 자료
- EveryInfra 데이터 기능 카탈로그,
GET /api/v1/social/catalog, EveryInfra, 2026-11-03 16:32 SGT 확인. - “Architecture overview”, Model Context Protocol 문서, 2026-11-03 확인.
- “Release notes for the 2026-07-28 MCP specification”, MCP 블로그, 2026-07-28.
- “Specification: Tools”, MCP 사양, 2026-07-28 버전.
- “Specification: Authorization”, MCP 사양, 2026-07-28 버전.
- “Specification: Transports”, MCP 사양, 2026-07-28 버전.
- “The MCP Ruby SDK reaches Tier 1”, MCP 블로그, 2026-10-30.
- “MCP Registry”, 공식 MCP 레지스트리, 2026-11-03 확인.
- “JSON-RPC 2.0 Specification”, JSON-RPC Working Group.
- “Connect Claude Code to tools via MCP”, Claude Code 문서, 2026-11-03 확인.
- “MCP quickstart”, Claude Code 문서, 2026-11-03 확인.
- “Environment variables”, Claude Code 문서, 2026-11-03 확인.
- “Model Context Protocol”, Cursor 문서, 2026-11-03 확인.
- “Model Context Protocol”, OpenAI Codex 문서, 2026-11-03 확인.
- “Use MCP servers in VS Code”, VS Code 문서, 2026-11-03 확인.
- “MCP servers with Gemini CLI”, Gemini CLI 문서, 2026-11-03 확인.
- “Connectors and MCP servers”, OpenAI 플랫폼 문서, 2026-11-03 확인.
- “Quickstart”, OpenRouter 문서, 2026-11-03 확인.
- “FAQ”, OpenRouter 문서, 2026-11-03 확인.
- “Writing effective tools for agents”, Anthropic Engineering.
- “Introducing advanced tool use”, Anthropic Engineering.
- “Code execution with MCP”, Anthropic Engineering.
- “Building agents: When to fold subagents into your main agent loop”, Anthropic, 2026-10-22.
- “RAG-MCP: Mitigating Prompt Bloat in LLM Tool Selection via Retrieval-Augmented Generation”, arXiv:2505.03275.
- “ToolLLM: Facilitating Large Language Models to Master 16000+ Real-world APIs”, arXiv:2307.16789.
- “Gorilla: Large Language Model Connected with Massive APIs”, arXiv:2305.15334.
- “MCP-Universe: Benchmarking Large Language Models with Real-World Model Context Protocol Servers”, arXiv:2508.14704.
- “MCP-Bench: Benchmarking Tool-Using LLM Agents with Complex Real-World Tasks via MCP Servers”, arXiv:2508.20453.
- “RFC 9110: HTTP Semantics”, IETF.
- “RFC 6585: Additional HTTP Status Codes”, IETF.
- “RFC 9457: Problem Details for HTTP APIs”, IETF.
- “RFC 9728: OAuth 2.0 Protected Resource Metadata”, IETF.
- “RFC 8707: Resource Indicators for OAuth 2.0”, IETF.
- “RFC 9207: OAuth 2.0 Authorization Server Issuer Identification”, IETF.
- “The OAuth 2.1 Authorization Framework, draft 13”, IETF.
- “Skills over MCP: How Bloomberg helped standardize agent skills at scale”, Bloomberg, 2026-10-21.
- “Treasury for agents”, Stripe Newsroom, 2026-10-21.
- 공개 MCP 서버 15,465개 분석, The Hacker News, 2026-10-06.
- Pi 에이전트, MCP, 코드 모드에 관한 보도, The New Stack.
- “MCP Server and SI Agent Government Hackathon”, 미국 연방조달청(GSA), 2026년 9월~11월.
- OpenRouter 경쟁사의 시드 라운드에 관한 보도, Semafor, 2026-10-16.
- MCP 서버 58개와 도구 680개 이상을 운용한 경험담, Reddit r/mcp.
- “Requests: Quickstart”, Requests 문서.
- Xiaohongshu 사용자 서비스 약관(중국어), Xiaohongshu, 2026-11-03 확인.
- Xiaohongshu 개인정보 처리방침(중국어), Xiaohongshu, 2026-11-03 확인.
- Xiaohongshu 오픈 플랫폼(중국어), Xiaohongshu, 2026-10-19 공지 포함, 2026-11-03 확인.
- 중화인민공화국 개인정보보호법(중국어), 중국 국가인터넷정보판공실.
- 네트워크 데이터 보안 관리 조례(중국어), 중국 국무원, 2024년 9월 공포, 2025-01-01 시행.
- Xiaohongshu와 AI에 관한 Huxiu 보도(중국어), Huxiu, 2026-10-16.
- Monid 홈페이지, 2026-11-03 확인(“Live · 2800+ tools”, “Start with $1 in free credit”). 링크는 본문 참고.
- Monid, “The OpenRouter for agent tools”, 포지셔닝 페이지, 2026-11-03 확인. 링크는 본문 참고.
- Monid, “MCP quickstart”, 설정 문서, 2026-11-03 확인. 링크는 본문 참고.
- Monid, Xiaohongshu 도구 페이지, 2026-10-29 기준 엔드포인트 49개 등재. 링크는 본문 참고.
- Monid, “How to get Xiaohongshu (RedNote) data through an API”, 가이드, 2026-11-03 확인. 링크는 본문 참고.
참고 BL-78