API de datos o router de herramientas: cómo reparten el trabajo EveryInfra y Monid
Una búsqueda de Xiaohongshu, seis veces: 16 notas distintas en el top 3 y 0,005556 USD cada vez. Lo diario va a una API de datos y lo raro, a Monid.
El 3 nov 2026, entre las 16:33 y las 16:45 hora de Singapur (SGT), enviamos la misma solicitud seis veces. Fue a la capacidad xiaohongshu/search de EveryInfra: la palabra clave china de «matcha latte», con el orden «más me gusta» (most_liked), primera página. Cada llamada devolvió 20 notas y costó 0,005556 USD, y cada nombre de campo estaba en la lista del catálogo. Dos de las llamadas tenían su propio cronómetro: tardaron 3,9 y 4,3 segundos. Pero en las seis tandas, los 18 puestos del top 3 tuvieron 16 notas distintas.
Ese resultado muestra qué puede fijar una tarea diaria de un agente. La forma de la solicitud, los nombres de campo, el precio y el formato de error pueden quedar fijos. El conjunto de resultados no, así que cada fila guardada debe llevar su orden y su hora. Como esas cuatro cosas sí quedan fijas, la tarea diaria encaja en una API de datos dedicada. Las llamadas que un agente hace una sola vez, sin saberlo de antemano, van en un router de herramientas como Monid. El 3 nov 2026 su página de inicio mostraba más de 2.800 herramientas. Según el material que Monid nos envió el 29 oct, discover e inspect son gratis y run se cobra por llamada, desde un solo saldo, al precio de la ficha de la herramienta.
Este artículo nació de un borrador del equipo de Monid. Mantuvimos su idea central. Las llamadas de un agente son de dos tipos: las que se repiten y las que se descubren sobre la marcha. Los dos tipos no deben conectarse igual. Cambiamos una cosa y añadimos nuestras propias pruebas reales.
El cambio está en la regla de reparto. El ejemplo del borrador solo nombraba tres plataformas en la lista diaria: Xiaohongshu, Douyin y TikTok. Lo sustituimos por el catálogo completo de EveryInfra de ese día: 106 plataformas, agrupadas por categoría. Así solo la verdadera cola larga va al router. Las pruebas añadidas son las búsquedas de matcha latte, una llamada de detalle de nota, otra de comentarios y una búsqueda en Douyin. También enviamos dos solicitudes mal hechas a propósito.
Sobre Monid citamos solo dos tipos de datos. El primero son las pruebas que Monid hizo en su lado el 29 oct 2026. El segundo son datos con fecha de su propio sitio. No repetimos sus llamadas de pago.
Una nota sobre la plataforma para quien no la conozca. Xiaohongshu, conocida fuera de China como RedNote, es una red social china. La gente publica «notas»: entradas cortas con fotos o vídeo, un título y etiquetas. Cada nota tiene contadores de «me gusta», guardados, comentarios y veces compartida. Las marcas la siguen como siguen Instagram o TikTok, pero en chino. Es un buen caso de prueba: muchos equipos la siguen a diario, y un router general lista varios endpoints que compiten por ella.
Dos tipos de llamadas: las que se repiten y las que se descubren
El borrador de Monid empieza con un ejercicio: saca las llamadas a herramientas de la semana pasada de tu agente y ordénalas por cuántas veces se repite la misma llamada. Según Monid, las repetidas forman una lista corta: las plataformas que sigues, los campos que guardas, el horario que fijaste. La misma solicitud corre varias veces al día.
El resto es una cola larga. Por ejemplo, un usuario pregunta el tiempo que hará en un recinto el día de un evento. Otro quiere los seguidores de un creador en una plataforma que no sigues. Otro pide la última ronda de financiación de una empresa, o una página que una petición HTTP simple no puede abrir. Cada elemento de esa cola puede venir de una empresa distinta, con su propia clave, su propio esquema y su propio registro. La mayoría se llama unas pocas veces al año.
Las dos partes piden cosas opuestas. En las llamadas repetidas, lo más valioso es que nada cambie: campos, precio y formato de error estables.
La guía de Anthropic Writing effective tools for agents pide nombres claros, límites limpios entre herramientas y respuestas con contexto útil. En la cola larga, lo más valioso es el alcance. El agente no sabe qué herramienta necesitará. No debería estar configurado para cada una. Debería encontrarla cuando la necesite, ver el precio, llamarla una vez y seguir.
El error es tratar las dos partes igual. Si integras la cola larga empresa por empresa, el agente pasa su primera semana reuniendo claves de API. Si mandas la tarea diaria por un router general, pierdes el esquema fijo que la hacía barata de mantener.
También hay un coste del lado del modelo: cuantas más herramientas ve un agente, más veces elige mal. El artículo de RAG-MCP hizo una prueba de estrés con MCP. Recuperar primero las herramientas relevantes subió la precisión de selección del 13,62 % al 43,13 %. También redujo los tokens del prompt a menos de la mitad. Trabajos anteriores como ToolLLM y Gorilla vieron lo mismo: con más API, elegir bien y rellenar bien los argumentos es más difícil.
Un desarrollador que usa 58 servidores MCP y más de 680 herramientas lo contó en r/mcp de Reddit. Según él, la elección empeora claramente a partir de 30 a 60 herramientas. Su solución fue cargar las descripciones solo cuando hacen falta y dar a cada agente especializado solo de 10 a 20 herramientas.
| Llamadas repetidas | Llamadas descubiertas | |
|---|---|---|
| Frecuencia | Cada día o cada hora, la misma solicitud | Pocas veces al año, sin aviso |
| ¿El agente lo sabe antes? | Sí: plataforma, campos y orden están fijados | No: lo sabe cuando alguien pregunta |
| Lo que más importa | Campos, precio y errores estables | Mucho alcance, sin registro por empresa, pago por llamada |
| Ejemplo de este artículo | Informe diario de matcha latte en Xiaohongshu: xiaohongshu/search, xiaohongshu/comments | El logotipo de una empresa a partir de su dominio; publicaciones en una plataforma fuera de la lista |
| Adónde va | Una API de datos dedicada: EveryInfra | Un router de herramientas: Monid (discover, inspect, run) |
La forma sensata es una línea directa para lo repetido y un router para todo lo demás. Los dos servicios hablan MCP y pueden estar a la vez en el mismo cliente. Una regla corta le dice al agente cuál usar en cada llamada.
Qué es Monid: tres verbos y un saldo
Monid se describe como el OpenRouter de las herramientas para agentes. La frase describe la forma del producto, no un vínculo comercial. OpenRouter pone muchos modelos detrás de una clave y un saldo. Su guía de inicio rápido dice que da acceso a cientos de modelos desde un único endpoint y que gestiona solo las alternativas cuando algo falla. Según el material que Monid nos envió el 29 oct, Monid hace lo mismo una capa más arriba, para las herramientas que un agente llama después de elegir modelo.
La página de posicionamiento de Monid, leída el 3 nov 2026, lo resume en una línea. OpenRouter es una clave, todos los modelos, pago por token. Monid es un skill, todas las herramientas, pago por llamada. Usamos la comparación solo para describir la forma del producto. No dice nada sobre la relación entre las dos empresas.
Leímos la página de inicio de Monid el 3 nov 2026. Mostraba más de 2.800 herramientas y 1 USD de crédito gratis para cuentas nuevas. El material que Monid nos envió el 29 oct daba las mismas dos cifras.
Según ese material del 29 oct, el catálogo cubre búsqueda web, extracción de páginas y enriquecimiento de personas y empresas. También cubre datos de redes sociales (incluidas las plataformas chinas), mapas y reseñas, comercio electrónico, finanzas y medios generativos. La facturación, en palabras de Monid: pago por llamada desde un solo saldo, sin suscripción. Descubrir e inspeccionar una herramienta es gratis; solo se cobra la ejecución, al precio de su ficha.
En el mismo material, el flujo son tres verbos. discover es una búsqueda semántica gratuita en el catálogo. El agente describe la tarea con palabras normales y recibe una lista ordenada de endpoints, cada uno con precio y estado. inspect también es gratis y devuelve el esquema de entrada, el precio y la documentación de un endpoint. run es el único paso que se cobra, desde el saldo prepagado, al precio que mostró inspect.
Un agente puede llegar a Monid por MCP, un archivo de skill, la línea de comandos o una API REST. La guía para añadir Monid como servidor MCP (guía de MCP de Monid, leída el 3 nov 2026) da la dirección del servidor, https://mcp.monid.ai/v1, y el inicio de sesión con OAuth. Trae pasos separados para Claude Code, Codex y otros clientes. El archivo de skill está en monid.ai/SKILL.md. Según el material de Monid, si le dices a un agente que haga «set up» con esa dirección, aprende solo los tres verbos. Hay un resumen legible por máquinas en monid.ai/llms.txt.
| Verbo | ¿Se cobra? | Qué devuelve (según el material de Monid del 29 oct 2026) |
|---|---|---|
discover | Gratis | Endpoints ordenados por coincidencia, con precio y estado |
inspect | Gratis | Esquema de entrada, precio y documentación de un endpoint |
run | Al precio de la ficha | El resultado y un id de ejecución que se puede volver a consultar |


La lista diaria de EveryInfra: 106 plataformas, 569 capacidades
La primera línea de la regla dice «las plataformas de la lista van a EveryInfra». Por eso el largo de la lista decide lo útil que es la regla. La regla de ejemplo del borrador de Monid nombraba tres plataformas: xiaohongshu, douyin, tiktok. Con esa regla, las reseñas de Amazon y de Google Maps, las ofertas de LinkedIn y los posts de Reddit también saldrían de la lista. Sin embargo, el catálogo de EveryInfra tiene campos fijos y un precio fijo para todas ellas. Por eso esta sección lista el catálogo completo.
Los datos vienen del catálogo gratuito de EveryInfra, GET /api/v1/social/catalog, leído el 2026-11-03 a las 16:32 SGT. Tenía 106 plataformas y 573 capacidades, de las cuales 569 estaban disponibles ese día. Las otras cuatro tenían available=false: g2/compare, jd/reviews, temu/search y wechat_oa/wechat_index. Déjalas fuera de la lista diaria por ahora.
Las categorías siguen las mismas reglas que nuestra página /market: contenido y redes sociales, reseñas, comercio electrónico, empleo y empresas, y búsqueda, web y mercados. La tabla nombra las 106 plataformas. Dentro de cada categoría van ordenadas por número de capacidades.
| Categoría | Plataformas | Capacidades disponibles | Plataformas (de más a menos capacidades) |
|---|---|---|---|
| Contenido y redes sociales | 49 | 373 | Douyin, TikTok, X (Twitter), Instagram, Xiaohongshu, Facebook, Zhihu, Kuaishou, cuentas oficiales de WeChat, Weibo, GitHub, Bilibili, Reddit, YouTube, Pinterest, Substack, Threads, Spotify, Dailymotion, Quora, Rumble, SoundCloud, Telegram, Toutiao, Twitch, Bluesky, Mastodon, Truth Social, WeChat Channels, DeviantArt, Discord, Douban, Gab, Lemmy, Naver, Odysee, Patreon, Product Hunt, Snapchat, Tumblr, Youku, Dribbble, iQIYI, Medium, NetEase Cloud Music, Behance, Flickr, VK, Eventbrite |
| Reseñas | 15 | 65 | Google Play, App Store, G2, reseñas de Google Maps, Tripadvisor, Zillow, Airbnb, Booking, Expedia, Yelp, Realtor, Clutch, Nextdoor, Upwork, Crexi |
| Comercio electrónico | 13 | 53 | Amazon, AliExpress, JD.com, eBay, Etsy, Taobao, Shopee, Walmart, 1688, Xianyu, Dewu, Temu, Google Shopping |
| Búsqueda, web y mercados | 17 | 40 | Yahoo Finance, datos de mercado cripto, datos de empresas, Polymarket, Yandex, Similarweb, noticias cripto, Kalshi, resultados de buscadores, Bing, Bing Maps, DuckDuckGo, DuckDuckGo Maps, Apple Maps, Google News, Google Trends, Centro de Transparencia de Anuncios de Google |
| Empleo y empresas | 12 | 38 | LinkedIn, Glassdoor, Indeed, Xing, Capterra, Trustpilot, Naukri, ThomasNet, StepStone, SEEK, Dice, Craigslist |
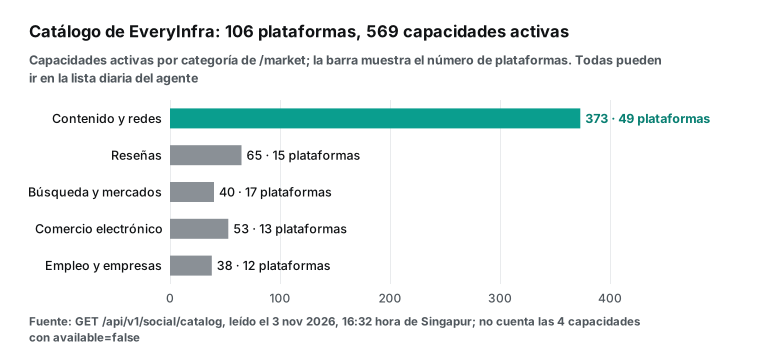
Dos notas para usar esta lista. Primera: la lista se mueve. El catálogo puede sumar plataformas o capacidades cualquier día, y puede marcar una como no disponible durante un tiempo. Así que no la escribas a mano en la regla. Al empezar cada sesión, haz que el agente llame a la herramienta gratuita everyinfra_list_capabilities o al endpoint del catálogo. Luego rellena la lista con lo que vuelva.
Segunda: una lista de plataformas todavía es gruesa. En una misma plataforma, unas capacidades sirven cada día y otras solo devuelven datos con ciertos argumentos. Solo Xiaohongshu tiene 17 capacidades disponibles. Son búsqueda, detalle de nota, comentarios, respuestas a comentarios, perfil, notas de un usuario y búsqueda de usuarios. También temas, tendencias, búsqueda de productos, detalle de producto, reseñas de producto, seguidores y ubicación de la nota. Las tres últimas son comentarios por lotes de muchos enlaces, detalle de vídeo y un ranking de contenido de creadores.
Todas cuestan 0,005556 USD por llamada, salvo el ranking de creadores, a 0,016 USD. Si escribes la lista por capacidad, el agente ve en la regla el precio y los argumentos de cada llamada. Los detalles están en la página de la API de datos de Xiaohongshu y en la página de la capacidad de búsqueda de Xiaohongshu.
Un cambio en la regla de reparto: lista completa y solo el resto a Monid
Con la lista en la mano, la regla puede ser corta. Reescribimos la regla del borrador de Monid con la misma estructura. Solo cambiamos la línea de plataformas y añadimos una salida de respaldo. Si hay duda, el agente pregunta primero a EveryInfra y solo pasa a Monid con unknown_capability. La regla es texto para que el agente lo lea, así que puede ir en el prompt de sistema o en el archivo de instrucciones del proyecto.
Para una tarea diaria en una plataforma de la lista de abajo, llama a
everyinfra_call_api. Usa el idioma de la plataforma en las palabras clave.
Si la tarea dice "esta semana" u "hoy", ordena por fecha. Anota platform,
action, params, la hora de la llamada y charged_usd en cada llamada.
Para una plataforma fuera de la lista, una consulta puntual o una
herramienta que no es de datos, usa Monid: primero discover y luego
inspect (los dos gratis); ejecuta run solo si el precio cabe en el
presupuesto. run se cobra al precio que mostró inspect. Anota cada precio
y cada run id.
Si no sabes si una plataforma está en la lista, llama primero a EveryInfra.
Si responde HTTP 400 con error.code unknown_capability (sin cobro), usa Monid.
Lista (catálogo de EveryInfra, leído el 2026-11-03; actualízala al empezar
cada sesión con everyinfra_list_capabilities):
airbnb, alibaba1688, aliexpress, amazon, app_store, apple_maps, behance,
bilibili, bing, bing_maps, bluesky, booking, capterra, clutch, company_data,
craigslist, crexi, crypto_market, crypto_news, dailymotion, deviantart,
dewu, dice, discord, douban, douyin, dribbble, duckduckgo, duckduckgo_maps,
ebay, etsy, eventbrite, expedia, facebook, flickr, g2, gab, github,
glassdoor, google_ads_transparency, google_maps_reviews, google_news,
google_play, google_shopping, google_trends, indeed, instagram, iqiyi, jd,
kalshi, kuaishou, lemmy, linkedin, mastodon, medium, naukri, naver,
netease_music, nextdoor, odysee, patreon, pinterest, polymarket,
producthunt, quora, realtor, reddit, rumble, seek, shopee, similarweb,
snapchat, soundcloud, spotify, stepstone, substack, taobao, telegram, temu,
thomasnet, threads, tiktok, toutiao, tripadvisor, trustpilot, truth_social,
tumblr, twitch, twitter, upwork, vk, walmart, web, wechat_channels,
wechat_oa, weibo, xianyu, xiaohongshu, xing, yahoo_finance, yandex, yelp,
youku, youtube, zhihu, zillow
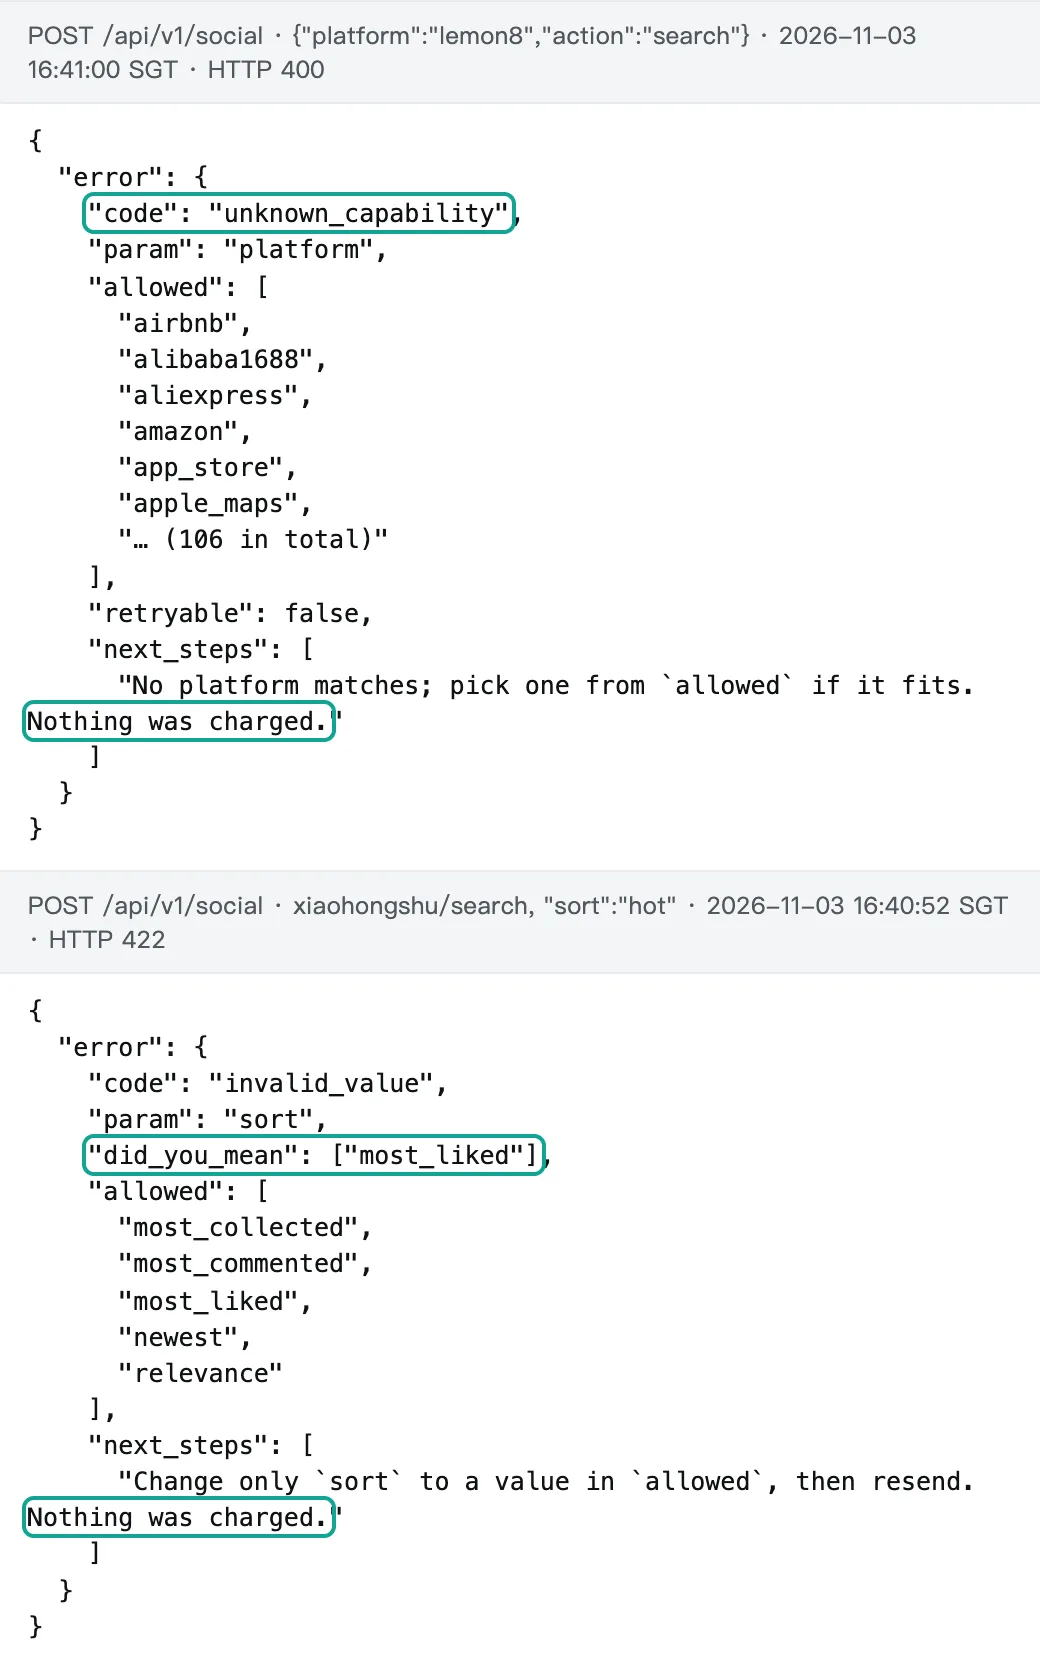
Probamos esa salida de respaldo. A las 16:41:00 SGT pedimos una plataforma que no está en la lista: lemon8. EveryInfra respondió en 0,24 segundos con HTTP 400. El error.code era unknown_capability, y el campo allowed listaba las 106 plataformas. La primera línea de next_steps decía que no se había cobrado nada.
A las 16:40:52 SGT enviamos a la búsqueda de Xiaohongshu un orden que no existe: hot. Es el nombre que usaba el segundo endpoint del borrador de Monid. La API respondió en 0,11 segundos con HTTP 422 y un did_you_mean de most_liked. Su lista allowed daba los cinco valores válidos, y tampoco cobró nada.
La diferencia entre los dos errores importa para el reparto. HTTP 400 unknown_capability significa «esta tarea no es mía», así que el agente debe ir a Monid. HTTP 422 invalid_value significa «esta tarea es mía, pero un argumento está mal». En ese caso el agente corrige el argumento con allowed y repite; no se va.
La salida de respaldo permite que la regla pregunte primero. Supón que la lista lleva un día desactualizada. Llamar antes a EveryInfra cuesta una ida y vuelta sin cobro de una fracción de segundo, y luego la regla manda la tarea fuera. Las plataformas diarias no deberían ir primero por esa otra rama. El propio material de Monid del 29 oct dice que dos endpoints de la misma plataforma llaman distinto a sus órdenes y devuelven campos con otros nombres. Así que, cuando una tarea se repite cada día, el agente necesita un endpoint, un orden y un esquema (la cita está al final de la «Prueba uno»). El mismo consejo está en la sección de nuestra documentación sobre EveryInfra con Monid y en la ficha de Monid de nuestra página de socios.
Los dos servidores MCP en un mismo cliente
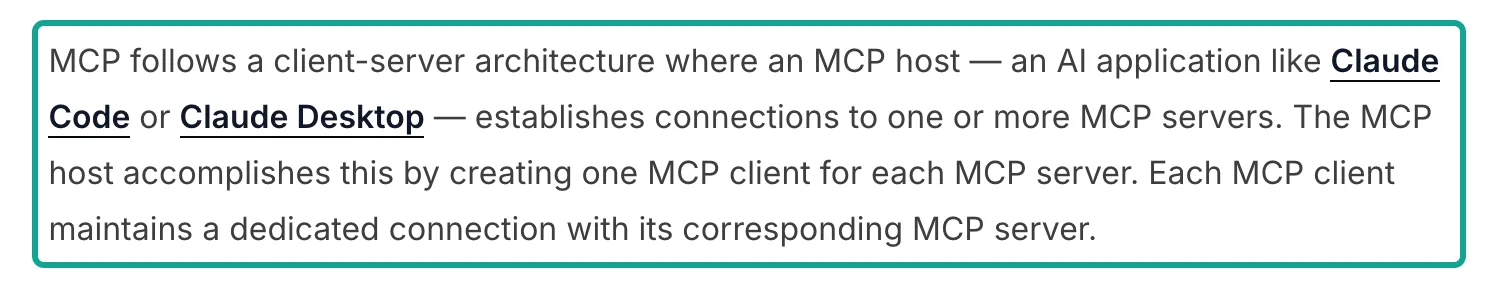
Los dos servicios pueden funcionar juntos por cómo está construido MCP. La vista general de la arquitectura de MCP lo explica. Un programa anfitrión crea un cliente MCP por cada servidor MCP, y cada cliente mantiene su propia conexión. El anfitrión puede ser Claude Code, Claude Desktop, Cursor, VS Code o un programa tuyo. Una vez conectado, junta las listas de herramientas de todos los servidores y se las da al modelo. El modelo elige una herramienta en cada llamada.
Así, EveryInfra y Monid pueden vivir en el mismo anfitrión sin saber nada el uno del otro. El reparto depende solo de las descripciones que lee el modelo y de la regla que escribas. En la red, los mensajes usan JSON-RPC 2.0. Los servidores remotos usan el transporte Streamable HTTP. Listar y llamar herramientas sigue la sección de herramientas de la especificación.
En Claude Code bastan dos comandos. EveryInfra usa una clave de API, que guardas en una variable de entorno y pasas con --header. Según la guía de MCP de Monid (leída el 3 nov 2026), su servidor remoto usa OAuth. Después de añadirlo, escribe /mcp en Claude Code, elige monid y completa la autorización. La opción --scope user deja los dos servidores disponibles en todos tus proyectos.
La documentación de MCP de Claude Code describe también los ámbitos local y project. El ámbito de proyecto escribe en .mcp.json, en la raíz del proyecto, y sirve a equipos que comparten una configuración. Si es tu primer servidor MCP, empieza por la guía rápida de MCP de Claude Code y por nuestra página del servidor MCP.
# EveryInfra: autenticación con clave de API; la clave solo en una variable de entorno
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope user --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"

# Monid: MCP remoto con OAuth (luego escribe /mcp en Claude Code, elige monid e inicia sesión)
claude mcp add --transport http monid https://mcp.monid.ai/v1 --scope user
Si tu cliente lee un archivo mcpServers, la configuración es como el bloque de abajo. Hay un detalle que confunde a mucha gente. En un archivo .mcp.json de Claude Code, un servidor remoto necesita "type": "http". Una entrada con solo url falla con un error de configuración al cargar el archivo.
Cursor lee casi el mismo formato. VS Code usa la clave servers en lugar de mcpServers. Gemini CLI usa httpUrl para una dirección Streamable HTTP, y Codex usa TOML. La tabla de después compara cinco clientes comunes. Cada fila sale de la documentación oficial del cliente, leída el 3 nov 2026.
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    },
    "monid": { "type": "http", "url": "https://mcp.monid.ai/v1" }
  }
}| Cliente | Dónde va la configuración | Cómo se declara un servidor remoto | Cómo se pasa la clave o se inicia sesión | Documentación |
|---|---|---|---|---|
| Claude Code | claude mcp add, o .mcp.json en el proyecto | "type": "http" más url | --header o headers; los servidores OAuth inician sesión con /mcp | MCP en Claude Code |
| Cursor | .cursor/mcp.json en el proyecto, o ~/.cursor/mcp.json | url dentro de mcpServers | headers; admite OAuth | MCP en Cursor |
| Codex | ~/.codex/config.toml, o .codex/config.toml en un proyecto de confianza | url dentro de [mcp_servers.nombre] | bearer_token_env_var con el nombre de una variable; OAuth con codex mcp login | MCP en Codex |
| VS Code | .vscode/mcp.json en el espacio de trabajo | Clave servers, "type": "http" | headers o variables de entrada; admite OAuth | MCP en VS Code |
| Gemini CLI | mcpServers en settings.json | httpUrl | headers; includeTools deja pasar solo algunas herramientas | MCP en Gemini CLI |
Con los dos servidores conectados, el modelo ve las dos tandas de descripciones en cada turno, y eso cuesta. A las 16:42:41 SGT enviamos una solicitud tools/list al servidor MCP de EveryInfra. Devolvió 12 herramientas. everyinfra_list_capabilities lee el catálogo, everyinfra_call_api llama a cualquier capacidad de datos y everyinfra_get_job recoge resultados asíncronos. Las demás cubren búsqueda, resolución de captchas, chat de IA, la cuenta y los tickets de soporte.
El cuerpo completo de la respuesta ocupó 16.247 bytes. Con la regla aproximada de cuatro bytes por token, son unos 4060 tokens. La cifra es pequeña porque no convertimos cada una de las 569 capacidades en una herramienta propia. Una herramienta general, everyinfra_call_api, más una herramienta de catálogo gratuita, permite al modelo consultar primero lo que necesita.
Anthropic da una comparación útil en Introducing advanced tool use. Cargar de entrada las descripciones de más de 50 herramientas MCP ocupaba unos 72.000 tokens. Cargarlas bajo demanda con la búsqueda de herramientas dejaba solo una parte pequeña.
El anfitrión también ayuda. Según la referencia de variables de entorno de Claude Code, la búsqueda de herramientas está activa por defecto (ENABLE_TOOL_SEARCH). Una salida de más de 10.000 tokens genera un aviso; el límite por defecto es 25.000 (MAX_MCP_OUTPUT_TOKENS).
En nuestras pruebas, las cinco páginas de búsqueda de 20 notas de Xiaohongshu ocupaban entre 35.538 y 51.999 bytes de JSON. Mucho era texto largo que un análisis no necesita, como URL de imágenes, URL de avatares y tokens de página. Por eso, en las tareas diarias, haz que el agente guarde solo las columnas que usas. O ejecuta la API HTTP desde un script y escribe el resultado en un archivo, para que las filas no pasen por el contexto del modelo.
El texto de Anthropic Code execution with MCP describe este patrón. El modelo escribe código que llama a las herramientas, y los datos intermedios se quedan en el entorno de ejecución. Solo la conclusión vuelve a la conversación.
Prueba uno: matcha latte con tres órdenes y dos idiomas
Estas son las pruebas principales del artículo. Todas las solicitudes salieron desde Singapur hacia la API HTTP de EveryInfra, POST /api/v1/social. La plataforma fue xiaohongshu, la capacidad search y la palabra clave, la versión china de matcha latte. Solo cambiamos el orden, la página, el rango de fechas y, una vez, el idioma de la palabra clave. El tiempo es el total medido en el cliente, con la ida y vuelta de red. El precio es el valor de billing.charged_usd de cada respuesta. Nuestro equipo editorial lanzó las tres primeras filas a las 16:33 SGT, y nosotros el resto mientras escribíamos, con la misma clave de prueba.
| Hora (SGT, 3 nov) | Orden o filtro | Página | Notas | Tiempo | Cobro | Mediana de «me gusta» | Notas de menos de 30 días |
|---|---|---|---|---|---|---|---|
| 16:33:22 | most_liked | 1 | 20 | 3,91 s | 0,005556 USD | 1427,5 | 0 |
| 16:33:26 | newest | 1 | 20 | 3,42 s | 0,005556 USD | 0 | 20 |
| 16:33:29 | most_liked, palabra «matcha latte» en inglés | 1 | 20 | 3,52 s | 0,005556 USD | 1011 | 1 |
| 16:40:40 | most_liked (repetición) | 1 | 20 | 4,26 s | 0,005556 USD | 1513,5 | 2 |
| 16:41:08 | most_liked con el page_token de la página 1 | 2 | 20 | 2,34 s | 0,005556 USD | 194,5 | 1 |
| 16:41:18 | most_liked + last_30_days | 1 | 1 | 9,45 s | 0,005556 USD | 1857 | 1 |
La solicitud es corta. Abajo está la llamada de las 16:40:40, con la respuesta recortada a la primera nota y al campo de cobro. La lista completa de campos está en la página de la capacidad de búsqueda de Xiaohongshu. Si es tu primera vez, consigue una clave en el inicio rápido de nuestra documentación.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"xiaohongshu","action":"search",
"params":{"keyword":"抹茶拿铁","sort":"most_liked"}}'{
"platform": "xiaohongshu", "action": "search", "count": 20,
"pagination": { "page": 1, "has_more": true },
"next_page_token": "pt1.…",
"results": [
{ "id": "69a509f400000000220335a9",
"like_count": 16056, "collect_count": 2657, "comment_count": 6223,
"share_count": 3261, "posted_at": "2026-03-02T04:15:14+00:00",
"is_video": false, "is_cooperation_note": true }
],
"billing": { "charged": true, "charged_usd": 0.005556 }
}Empecemos por el orden. «Más gustadas» y «más recientes» responden a dos preguntas distintas. La página de más gustadas de las 16:33 tenía una mediana de 1427,5 «me gusta» y 747,5 guardados. Ninguna de sus 20 notas tenía menos de 30 días, y la más antigua era del 28 de mayo de 2025. Por edad: 0 notas de menos de 30 días, 12 de 30 a 179 días, 5 de 180 a 364 días y 3 de más de un año.
La página de más recientes tenía 20 notas publicadas el 2 y el 3 de noviembre, con una mediana de 0 «me gusta». Las dos páginas no compartían ninguna nota. Si un agente guarda las dos como «top 20 de matcha latte», nadie sabrá después cuál responde a «qué gusta más» y cuál a «de qué se habla hoy».
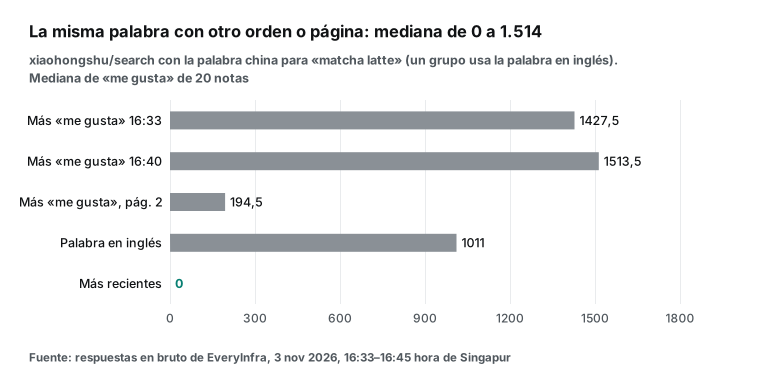
Ahora el idioma de la palabra clave. La palabra inglesa «matcha latte», ordenada por «me gusta», tuvo una mediana de 1011. Once de sus 20 notas eran vídeos, frente a 9 en la página con la palabra china. La más antigua era del 18 de marzo de 2023, y cinco tenían más de un año. Compartía 4 notas con la página china de las 16:33.
O sea, el mismo tema da en chino y en inglés dos conjuntos que se cruzan pero no coinciden. En la página en inglés había cinco notas de más de un año; en la china, tres. Por eso la regla dice «usa el idioma de la plataforma en las palabras clave»: evita que el agente busque en inglés en una plataforma china por defecto.
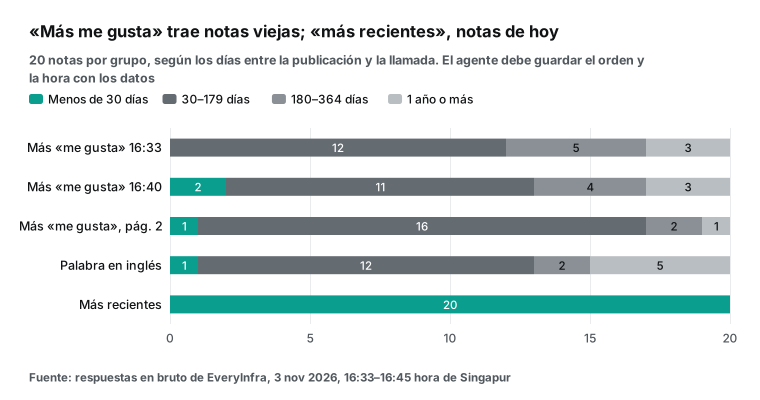
La segunda página y el filtro de fechas también merecen una mirada. Con el next_page_token de la página 1, la página 2 trajo 20 notas nuevas, sin repetir ninguna. La mediana bajó a 194,5 «me gusta». Con 2,34 segundos fue la llamada más rápida de la sesión. Cada página cuenta como una llamada al mismo precio.
Con date_range=last_30_days, la página volvió con una sola nota. Era del 9 de octubre y tenía 1857 «me gusta». La llamada tardó 9,45 segundos, la más lenta de la sesión. El catálogo es claro con este argumento. Un rango estrecho como los últimos 30 días puede traer menos de 20 notas por página. Para páginas llenas, combínalo con sort=newest; una página sin notas no se cobra.
Esta página tenía una nota, así que se cobró 0,005556 USD como siempre. Supón que tu tarea diaria es «las notas de matcha latte con más "me gusta" de los últimos 30 días». Es más estable recorrer cada día las notas más recientes, guardarlas y ordenarlas tú por «me gusta». Funciona mejor que pedir una vez al día «últimos 30 días + más gustadas».
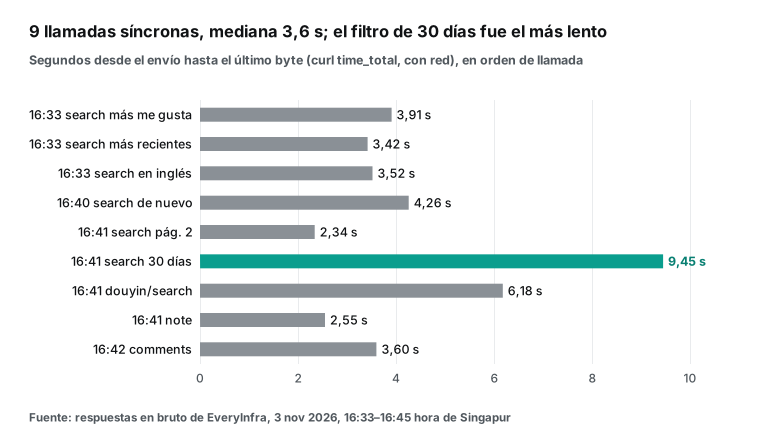
La mediana de las nueve llamadas síncronas fue de 3,6 segundos, con un rango de 2,34 a 9,45 segundos. Para una tarea que corre una vez al día, es suficiente. Un agente que hace una docena de llamadas en un turno puede añadir "mode": "async" a la solicitud. La API devuelve al momento un id de trabajo. El agente recoge el resultado con everyinfra_get_job o GET /api/v1/jobs/{job_id}. El campo async_hint de cada respuesta síncrona lo recuerda.
Ahora, las cifras del lado de Monid, del 29 oct 2026. Monid usó la página de herramientas de Xiaohongshu en Monid para esta prueba. Eligió dos endpoints de búsqueda de notas de Xiaohongshu de dos empresas distintas de su catálogo. Lanzó cada uno una vez con la misma palabra china, y el primero otra vez con la palabra inglesa. Según el material de Monid, esa página listaba 49 endpoints ese día.
El número de notas, los tiempos y los resultados de la tabla vienen del material que Monid nos envió, y las horas son del Pacífico de EE. UU. No repetimos esas pruebas y no las comparamos con las nuestras. Las fechas son otras, los órdenes son otros y cada lado respondía a una pregunta distinta.
| Fecha (prueba de Monid en su lado) | Endpoint | Entrada | Notas | Tiempo | Resultado |
|---|---|---|---|---|---|
| 2026-10-29 20:34 | Búsqueda de notas de la primera empresa | Palabra china, más gustadas, página 1 | 20 | 3,2 s | Mediana de 2132 «me gusta» y 1571 guardados; ninguna de menos de 30 días; la más antigua, de hace más de tres años y medio |
| 2026-10-29 20:34 | Búsqueda de notas de la segunda empresa | Palabra china, orden «hot» | 20 | 3,2 s | Mediana de 97 «me gusta»; 5 de 20 de menos de 30 días |
| 2026-10-29 20:35 | Búsqueda de notas de la primera empresa | «matcha latte», más gustadas | 20 | 2,9 s | Mediana de 2961 «me gusta»; la mitad eran vídeos |
Monid sacó de sus pruebas la misma conclusión que nosotros de las nuestras: el orden tiene que viajar con los datos.
Este es el pasaje del material de Monid del 29 oct, en nuestra traducción y algo editado: «Misma palabra clave, mismo día, dos endpoints, dos preguntas distintas respondidas. Un agente que guarda las dos como “top 20” ha perdido lo único que las hacía comparables». El mismo material dice que los dos endpoints llaman distinto a sus órdenes y devuelven campos con otros nombres. Así que, cuando una consulta se vuelve una serie diaria, el agente necesita un endpoint, un orden y un esquema. En ese momento la llamada pasa del router a la línea directa. Monid explica su propio método en su guía de Monid para obtener datos de Xiaohongshu con una API.
Prueba dos: la misma solicitud seis veces, 16 notas distintas en el top 3
Entre las 16:33 y las 16:45 SGT, la misma solicitud exacta se lanzó seis veces: {"keyword": <la palabra china>, "sort": "most_liked"}, página 1. Corrió una vez a las 16:33:22. A las 16:36 el equipo editorial hizo una primera prueba del script de ejemplo de más abajo. Corrió otra vez a las 16:40:40. A las 16:45 el equipo editorial lanzó el script tres veces más, una por cada versión de idioma de este artículo. El script solo imprime las tres primeras notas, así que lo que podemos comparar en las seis tandas es el top 3.
En las seis tandas, los 18 puestos del top 3 tuvieron 16 notas distintas. La nota de 16.056 «me gusta» salió primera a las 16:33 y a las 16:40. La de 20.972 salió tercera a las 16:36 y primera en la primera tanda de las 16:45. Cada una de las otras 14 notas apareció una sola vez. Comparamos el top 3 de cada par de tandas: 13 de los 15 pares no compartían ninguna nota, y 2 pares compartían una. Las páginas completas de 20 notas de las 16:33 y las 16:40 compartieron solo 7 notas.
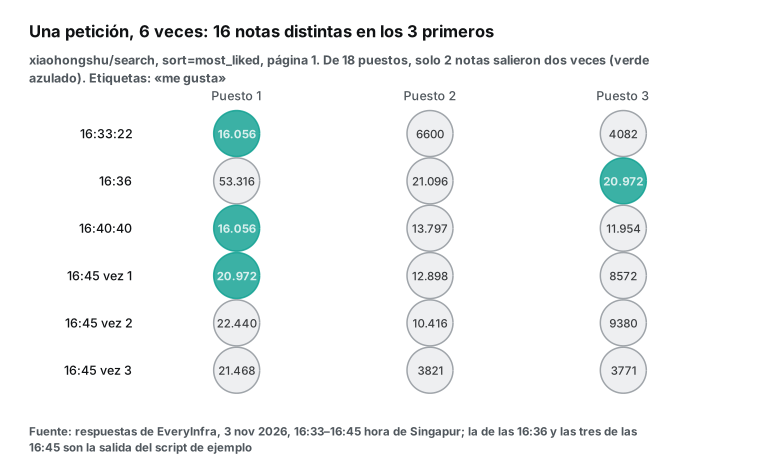
Primero, qué pide exactamente la solicitud. El catálogo llama a este valor de orden «más me gusta» (most_liked). EveryInfra devuelve la primera página de la búsqueda de Xiaohongshu con ese orden, en ese momento. No es un orden completo de todas las notas de matcha latte por número de «me gusta». Por eso la primera página no garantiza tener las notas con más «me gusta» de toda la plataforma.
Las respuestas originales lo muestran. La primera nota de las 16:33 y de las 16:40 tenía 16.056 «me gusta». Pero la primera de las 16:36 tenía 53.316, y las tres tandas de las 16:45 tuvieron arriba 20.972, 22.440 y 21.468. Ninguna de esas notas estaba en las páginas completas de las 16:33 y las 16:40. Las tres tandas de las 16:45 se lanzaron en el mismo minuto y sus top 3 no compartían ninguna nota. La primera página de la plataforma puede cambiar en minutos, incluso dentro de un minuto. Del lado de la API, todo fue igual cada vez: HTTP 200 con 20 notas, 0,005556 USD por llamada y todos los campos de las 16:33 y las 16:40 en la lista response_fields del catálogo. Uno o dos campos solo aparecen cuando tienen valor, como poi_id cuando la nota lleva un lugar.
Esto tiene tres consecuencias directas para una tarea diaria. Primera: ten claro qué se puede fijar. La forma de la solicitud, los nombres de campo, el precio y el formato de error pueden y deben quedar fijos. El conjunto de resultados no. No te fíes de nada que prometa «el mismo top 20 cada día» con una sola solicitud.
Segunda: guarda las condiciones de la solicitud y la hora junto a los datos, es decir, el orden, la página, la palabra clave y la hora de la llamada. Si falta una, en una semana no sabrás a qué pregunta responde ese lote de filas.
Tercera: si quieres un ranking estable, no dependas de los primeros resultados de una sola solicitud. Recorre algo más de páginas cada día y únelas en tu propia tabla por id de nota. Luego ordena con una regla tuya, por ejemplo el número de «me gusta». Ese ranking sí lo puedes reproducir.
Veamos la tercera con los datos de esta sesión. Las primeras páginas de las 16:33 y las 16:40 tenían 20 notas cada una. Unidas y sin duplicados por id de nota, dan 33 notas distintas, 13 más que cualquiera de las dos sola. Ordenadas por «me gusta», la nota de 16.056 queda primera, y la próxima unión puede calcular el mismo resultado. No depende de qué página sirva la plataforma el minuto siguiente.
Para cada fila guardada, conserva al menos las columnas de abajo. Los valores de ejemplo vienen de la primera nota de la respuesta de las 16:40:40.
| Columna | De dónde sale | Valor de ejemplo (3 nov 2026, 16:40:40 SGT) | Por qué guardarla |
|---|---|---|---|
| Hora de la llamada | Tu propio registro | 2026-11-03 16:40:40 | La misma solicitud cambia en minutos; sin la hora no la puedes reproducir |
| Palabra clave, orden, página | Argumentos de la solicitud | matcha latte (en chino), most_liked, 1 | «Más «me gusta»» y «más recientes» responden a preguntas distintas |
| Puesto | Orden en los resultados | 1 | Ver dónde está una nota en momentos distintos |
| Id de nota | id | 69a509f400000000220335a9 | Quitar duplicados entre tandas y páginas |
| Interacción | like_count, collect_count, comment_count | 16.056, 2657, 6223 | Ordenar con una regla tuya |
| Fecha de publicación | posted_at | 2026-03-02 | Separar «de lo que se habla ahora» de «lo que lleva tiempo siendo popular» |
| Patrocinada | is_cooperation_note | true | Contar aparte las publicaciones pagadas |
| Cobro | billing.charged_usd | 0,005556 | Cuadrar la cuenta a fin de mes |
Lo que cuesta unir también se calcula fácil. La segunda página de las 16:41 no compartía ninguna nota con la primera. Así que las páginas 1 y 2 dan 40 notas distintas por palabra clave y día. Si lanzas las dos páginas por la mañana y otra vez por la tarde, una palabra clave usa 4 llamadas al día. A 0,005556 USD por llamada, son unos 0,022 USD al día y 0,67 USD en 30 días. Ese dinero extra compra una tabla que puedes reproducir y comparar: la semana siguiente sigues viendo qué nota entró en el top 40 cada día y cuánto subieron sus «me gusta».
| Si una tarea diaria repite una solicitud | ¿Fijo en esta prueba? | Evidencia (3 nov 2026, SGT) | Qué implica para tu almacenamiento y tus reglas |
|---|---|---|---|
| Forma de la solicitud (plataforma, capacidad, nombres de argumentos) | Fijo | Las 9 llamadas usaron la forma platform + action + params | Escribe la regla y el script una vez |
| Nombres de campo | Fijo | Todos los campos de las respuestas completas de las 16:33 y las 16:40 estaban entre los 30 del catálogo | Crea la tabla de destino de antemano |
| Precio | Fijo | 10 búsquedas, 1 detalle de nota y 1 llamada de comentarios en Xiaohongshu, cada una a 0,005556 USD | Presupuesta el mes por adelantado |
| Formato de error | Fijo | HTTP 400 y 422 traían code, allowed y next_steps | Escribe una vez la lógica de reintento y de cambio de ruta |
| Qué 20 notas vuelven | Cambia | Las páginas de las 16:33 y las 16:40 compartieron 7 de 20 | Guarda orden y hora; une por id |
| El top 3 | Cambia | 16 notas distintas en 18 puestos en 6 tandas; 13 de 15 pares de tandas sin ninguna nota en común | Saca rankings estables de páginas unidas |
Prueba tres: detalle de nota, comentarios y Douyin
Las tareas diarias casi nunca se quedan en la búsqueda. Con un lote de notas, sueles querer el detalle y los comentarios de las primeras. A veces también quieres la misma palabra en otra plataforma. Las tres llamadas de abajo se hicieron entre las 16:41 y las 16:42 SGT, con la misma API y la misma forma de solicitud. Solo cambiaron platform y action.
| Hora (SGT, 3 nov) | Capacidad | Entrada | Filas | Tiempo | Cobro | Campos a mirar |
|---|---|---|---|---|---|---|
| 16:41:50 | xiaohongshu/note | Enlace de la nota de 16.056 «me gusta» | 1 | 2,55 s | 0,005556 USD | ip_location con valor, is_cooperation_note en true, 9 etiquetas |
| 16:42:00 | xiaohongshu/comments | La misma nota, más gustados primero | 15 | 3,60 s | 0,005556 USD | Comentario principal con 1213 «me gusta»; 650 respuestas bajo los 15; has_more en true |
| 16:41:36 | douyin/search | Palabra china de matcha latte, más gustados | 10 | 6,18 s | 0,008333 USD | Mediana de 6179,5 «me gusta»; vídeo principal con 1.178.986 |
El detalle de nota añade campos que la búsqueda no trae. Son el ip_location de quien publica, las listas completas tags y topics, y has_goods, que dice si hay un producto enlazado. La nota que salió primera en esta sesión es una nota patrocinada: su is_cooperation_note era true. Promociona una serie de cafés con sabor a rosa y describe tres bebidas. Una de ellas es el matcha latte de rosa, y la nota dice que a los fans del matcha les va a encantar. Pero el título no dice «matcha», y ninguna de sus nueve etiquetas tampoco. El matcha latte es una bebida dentro de una serie.
Eso le dice dos cosas a quien lleve un seguimiento diario. Para decidir si una nota trata de la palabra clave, lee el texto, no solo el título y las etiquetas. Y cuenta aparte las notas patrocinadas, con la relevancia juzgada por el texto, o una o dos publicaciones pagadas pueden subir la media de «me gusta» de toda la semana. La lista completa de campos está en la página de la capacidad de detalle de nota.
La llamada de comentarios devolvió 15 comentarios de primer nivel, de 1213 «me gusta» a 3. Cada uno trae sub_comment_count, y los 15 sumaban 650 respuestas. La respuesta tenía has_more en true, así que next_page_token trae la página siguiente. En esta página todos los ip_location estaban vacíos. La región de quien comenta no siempre está, y las estadísticas no deberían darla por hecha.
Los campos de comentario incluyen además author_is_ai_agent, que era false en los 15. Para analizar sentimiento o argumentos de venta en comentarios, mira la página de la capacidad de comentarios. Nuestro artículo anterior sobre leer comentarios de Xiaohongshu con flujos dinámicos de Claude Code va más a fondo.
Una página de búsqueda de Douyin trae 10 vídeos y cuesta 0,008333 USD por llamada, o 8,33 USD por cada 1.000 llamadas. La búsqueda de Xiaohongshu cuesta 5,56 USD por cada 1.000. Los dos son precios de catálogo. Los 10 vídeos tuvieron una mediana de 6179,5 «me gusta», y el primero pasó de 1,17 millones. Se publicaron entre febrero de 2025 y septiembre de 2026.
Los nombres de campo no son idénticos en las dos plataformas, pero los comunes se llaman igual. Una tabla entre plataformas solo tiene que manejar las columnas extra de cada lado.
| Campos | `xiaohongshu/search` | `douyin/search` |
|---|---|---|
| Comunes | like_count, comment_count, share_count, collect_count, posted_at | Los mismos nombres |
| Solo en uno | is_cooperation_note, is_goods_note, author_red_id | author_follower_count, music, hashtags, is_pinned |
| Resultados por página | 20 | 10 |
La página de la API de datos de Douyin y la página de la capacidad de búsqueda de Douyin listan todos los campos. Las capacidades equivalentes de TikTok están en la página de la API de datos de TikTok.
Script de ejemplo: la tarea diaria y la puntual, juntas
El Python de abajo es el ejemplo mínimo de los dos servicios juntos, escrito con Requests. La primera mitad es la tarea diaria: la llamada xiaohongshu/search de EveryInfra con una forma fija, que imprime las tres primeras notas y el cobro. La segunda mitad es una tarea puntual: obtener el logotipo de una empresa a partir de su dominio. No son datos diarios de una plataforma, así que van a Monid: discover, luego inspect, y run solo si el precio cabe en el presupuesto. Las dos claves salen de variables de entorno, y el script no contiene ningún valor de clave.
import os

import requests

EVERYINFRA_API_KEY = os.environ["EVERYINFRA_API_KEY"]
MONID_API_KEY = os.environ["MONID_API_KEY"]
MONID = "https://api.monid.ai/v1"
MONID_HEADERS = {"Authorization": f"Bearer {MONID_API_KEY}"}
MAX_PRICE_USD = 0.01  # do not run a Monid tool that costs more than this per call

# 1. The daily job: EveryInfra xiaohongshu/search, one fixed request shape
resp = requests.post(
    "https://api.everyinfra.com/api/v1/social",
    headers={"Authorization": f"Bearer {EVERYINFRA_API_KEY}"},
    json={"platform": "xiaohongshu", "action": "search",
          "params": {"keyword": "抹茶拿铁", "sort": "most_liked"}},
    timeout=120,
)
resp.raise_for_status()
body = resp.json()
for note in body["results"][:3]:
    print(note["like_count"], note["collect_count"], note["posted_at"][:10], note["url"])
print("EveryInfra:", len(body["results"]), "notes, charged (USD):", body["billing"]["charged_usd"])

# 2. A one-off lookup that is not a daily platform: discover, inspect, run on Monid
found = requests.post(f"{MONID}/discover", headers=MONID_HEADERS, timeout=60,
                      json={"query": "company logo image URL from a domain", "limit": 3}).json()["results"]
# discover adds ranking and price fields to each result; inspect and run take only the fields that name the tool
SHOWN_ONLY = ("providerName", "description", "price", "score", "scoreBreakdown", "tags", "metrics", "hints")
tool = {key: value for key, value in found[0].items() if key not in SHOWN_ONLY}
detail = requests.post(f"{MONID}/inspect", headers=MONID_HEADERS, timeout=60, json=tool).json()
price = detail["price"]["amount"]["value"]
print("Monid tool:", detail["endpoint"], "price (USD):", price)
if price <= MAX_PRICE_USD:
    run = requests.post(f"{MONID}/run", headers=MONID_HEADERS, timeout=120,
                        json={**tool, "input": {"pathParams": {"company": "starbucks.com"}}}).json()
    print("Monid run:", run.get("runId"), run.get("status"), run.get("output"))
El equipo editorial lanzó este script por primera vez el 3 nov 2026 a las 16:36 SGT, y tres veces más a las 16:45, una por cada versión de idioma. Cada ejecución completa tardó de 6,4 a 7,7 segundos. La mitad de EveryInfra devolvió 20 notas cada vez y cobró 0,005556 USD. Su top 3 son las filas de las 16:36 y las 16:45 de la cuadrícula de puntos de más arriba.
En la mitad de Monid, el primer resultado de discover fue en las cuatro ejecuciones un endpoint que devuelve el logotipo de una empresa a partir de su dominio. inspect mostró en ese momento un precio de 0 USD, así que el script siguió con run. La ejecución volvió con estado COMPLETED y la URL de una imagen de logotipo. La línea MAX_PRICE_USD es un freno simple pero útil. discover e inspect son gratis, así que un agente siempre puede leer antes el precio. Puede saltarse cualquier herramienta que pase del presupuesto y devolver esa decisión a una persona.
El propio material de Monid del 29 oct trae un aviso que encaja aquí: el descubrimiento es un orden, no una garantía. Una frase de capacidad como «búsqueda de notas de Xiaohongshu» se ordena bien. Una frase larga y coloquial con nombres propios puede poner arriba endpoints que no tienen nada que ver con la tarea. Así que lee los primeros resultados antes de ejecutar uno, algo que es gratis. Los pasos «discover, luego inspect, y run solo dentro del presupuesto» de nuestra regla siguen ese consejo.
La cuenta: cuánto cuesta al mes una tarea diaria
La ventaja más directa de los campos y el precio fijos es que puedes hacer la cuenta antes. Abajo está el coste mensual de un seguimiento de matcha latte en Xiaohongshu con los precios de catálogo del 3 nov 2026. Un mes son 30 días y se cobra cada llamada. En la práctica, las llamadas fallidas y las páginas vacías no se cobran, así que estas cifras son un techo.
Las 16 capacidades de Xiaohongshu distintas del ranking de creadores cuestan 0,005556 USD por llamada, y la búsqueda de Douyin, 0,008333 USD. La lista completa de precios está en la página de precios.
| Plan | Llamadas al día | Coste al día | Coste en 30 días |
|---|---|---|---|
| A: 3 palabras clave, página 1 de cada una | 3 × xiaohongshu/search | 0,0167 USD | 0,50 USD |
| B: 3 palabras clave, 2 páginas de cada una | 6 × xiaohongshu/search | 0,0333 USD | 1,00 USD |
| C: B más comentarios de las 5 notas principales | 6 búsquedas + 5 × xiaohongshu/comments | 0,0611 USD | 1,83 USD |
| D: C más las mismas 3 palabras en Douyin | las 11 llamadas anteriores + 3 × douyin/search | 0,0861 USD | 2,58 USD |
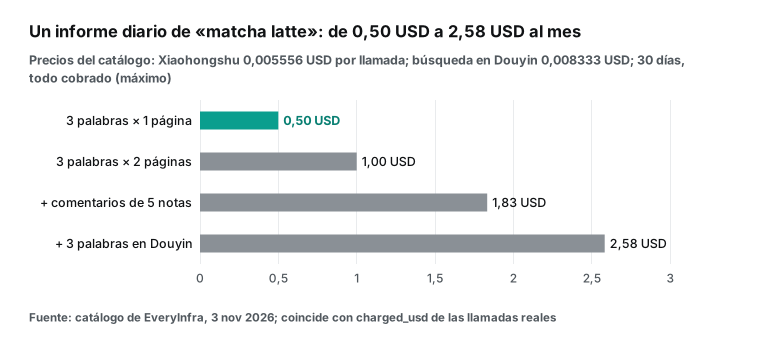
Las cifras son pequeñas, y pueden ir al presupuesto por adelantado. La cola larga se cobra de otra manera: miras el precio con inspect antes de cada run y sumas lo ocurrido a fin de mes. Las llamadas cobradas que aparecen en este artículo suman 13 y 0,075005 USD. Nuestras 6 llamadas al escribir costaron 0,036113 USD. Las 7 del equipo editorial (tres a las 16:33, una a las 16:36 y tres a las 16:45) costaron 0,038892 USD.
Límites: qué cubre este reparto y qué no
La regla de reparto decide adónde va una llamada. No decide si debes recoger esos datos.
El acuerdo de servicio de Xiaohongshu y su política de privacidad fijan condiciones para usar el contenido y los datos de usuarios. Tratar datos personales en China continental está sujeto también a la Ley de Protección de Información Personal. El Reglamento de Gestión de la Seguridad de los Datos de Red también se aplica, en vigor desde el 1 de enero de 2025.
Para una tarea diaria, lo más práctico es guardar solo las columnas que usa tu análisis. Suele bastar con el id de la nota, el título, los contadores, la hora de publicación, el orden y la hora de la llamada. Deja fuera apodos, avatares y perfiles de quien comenta salvo que los necesites. Si los necesitas, ten un fin claro y un plazo de conservación.
La regla tiene sus propios límites, y cada uno tiene una respuesta sencilla.
| Límite | Qué puede fallar | Qué hacer |
|---|---|---|
| La lista se queda vieja | Se añade o se pausa una plataforma, y 106 nombres escritos a mano fallan semanas después | Actualiza con everyinfra_list_capabilities en cada sesión, o confía en el respaldo de unknown_capability |
| Límites de uso | Cada clave de EveryInfra tiene un límite por minuto; al pasarlo vuelve HTTP 429 (RFC 6585) | Espera y reintenta; nunca en un bucle cerrado |
| Dos formas de iniciar sesión | EveryInfra usa clave de API; el MCP remoto de Monid usa OAuth (guía de MCP de Monid, leída el 3 nov 2026) | Claves en variables de entorno, nunca en un .mcp.json que se sube al repositorio |
En los servidores MCP remotos, el inicio de sesión OAuth lo define la sección de autorización de la especificación MCP.
El último límite es el modelo. Por bien conectadas que estén las herramientas, un modelo puede elegir mal o rellenar mal un argumento. MCP-Universe probó modelos con servidores MCP reales. El mejor resultado, de GPT-5, fue una tasa de éxito del 43,72 %. MCP-Bench montó tareas sobre 28 servidores y 250 herramientas, más parecidas al trabajo real. Evalúa aparte las llamadas que cruzan varias herramientas y pasos.
Por eso la regla es sencilla a propósito: lista explícita, errores distintos y precio leído antes de gastar. En Claude strict tool use con una API de datos contamos otra vía: esquemas de argumentos estrictos, que impiden al modelo montar una solicitud inválida.
Qué ha cambiado hace poco
Las llamadas a herramientas han cambiado deprisa en los últimos meses. Cada fila es de julio de 2026 en adelante. La última columna dice qué supone el cambio para el reparto «lo diario a una API de datos, la cola larga a un router».
| Fecha | Qué pasó | Qué supone para ti |
|---|---|---|
| 2026-07-28 | Nueva especificación de MCP: núcleo sin estado, cabeceras Mcp-Method y Mcp-Name, pistas de caché y orden fijo en tools/list, y cambios de autorización como RFC 9207 y documentos de metadatos de cliente | Dos servidores remotos en un anfitrión cuestan menos conexiones, y las listas de herramientas se pueden cachear |
| 2026-10-06 | The Hacker News publicó un análisis de 15.465 servidores MCP públicos | Hay más servidores que nunca; elegir cuáles se quedan cargados importa más que poder conectarse |
| 2026-10-16 | Semafor informó de la ronda semilla de TrustedRouter, un router de modelos que compite con OpenRouter | La forma «una clave delante de muchos backends» sigue atrayendo dinero en la capa de modelos |
| 2026-10-19 | La plataforma abierta de Xiaohongshu anunció la retirada de una API de predicción de categorías | La plataforma oficial sigue centrada en tiendas; el contenido público sigue necesitando otra vía |
| 2026-10-21 | Bloomberg explicó la propuesta Skills over MCP que impulsó (SEP-2640); el mismo día Stripe lanzó Treasury para agentes, usable por MCP | Los archivos de skill y MCP convergen; accesos como el skill de una línea de Monid serán más comunes |
| 2026-10-22 | Anthropic publicó cuándo volver a meter subagentes en el bucle principal | Pocas herramientas de datos en el bucle principal suele ser más rápido y preciso |
| 2026-10-30 | El blog de MCP anunció que el SDK de Ruby llegó al nivel Tier 1 | Más lenguajes pueden construir clientes MCP sólidos, también tu propio anfitrión |
Preguntas frecuentes
¿Tiene Xiaohongshu una API oficial de búsqueda de notas?
A 3 nov 2026, la plataforma abierta de Xiaohongshu sirve sobre todo a apps de tiendas y de gestión de comercio electrónico, con API de pedidos, productos y posventa; el 19 oct 2026 retiró una API de predicción de categorías. La búsqueda, el detalle y los comentarios de notas públicas no forman parte de ella. La capacidad xiaohongshu/search de EveryInfra cuesta 0,005556 USD por llamada; mira la página de la API de datos de Xiaohongshu.
¿Me cobran si la plataforma no está en la lista de EveryInfra?
No. Una plataforma fuera de la lista devuelve HTTP 400 unknown_capability, y un argumento equivocado devuelve HTTP 422 con did_you_mean. Ninguno de los dos se cobra; las pruebas (3 nov 2026, de 16:40 a 16:41 SGT) están en la sección de la regla de reparto.
¿Cuántas herramientas debería cargar un agente?
No hay un número fijo. RAG-MCP vio que, con muchas herramientas, recuperar primero y elegir después subía la precisión del 13,62 % al 43,13 %. El desarrollador de r/mcp con más de 680 herramientas notó que todo empeoraba pasadas las 30 a 60. Sobre cómo repartir trabajo entre subagentes y bucle principal, mira subagentes de Claude Code para cuentas de TikTok.
Referencias
- Catálogo de capacidades de datos de EveryInfra,
GET /api/v1/social/catalog, EveryInfra, leído el 3 nov 2026 a las 16:32 SGT. - Architecture overview, documentación de Model Context Protocol, leída el 3 nov 2026.
- Notas de la especificación MCP 2026-07-28, blog de MCP, 28 jul 2026.
- Specification: Tools, especificación MCP, versión 2026-07-28.
- Specification: Authorization, especificación MCP, versión 2026-07-28.
- Specification: Transports, especificación MCP, versión 2026-07-28.
- El SDK de Ruby de MCP llega a Tier 1, blog de MCP, 30 oct 2026.
- MCP Registry, registro oficial de MCP, leído el 3 nov 2026.
- JSON-RPC 2.0 Specification, JSON-RPC Working Group.
- Connect Claude Code to tools via MCP, documentación de Claude Code, leída el 3 nov 2026.
- MCP quickstart, documentación de Claude Code, leída el 3 nov 2026.
- Environment variables, documentación de Claude Code, leída el 3 nov 2026.
- Model Context Protocol, documentación de Cursor, leída el 3 nov 2026.
- Model Context Protocol, documentación de OpenAI Codex, leída el 3 nov 2026.
- Use MCP servers in VS Code, documentación de VS Code, leída el 3 nov 2026.
- MCP servers with Gemini CLI, documentación de Gemini CLI, leída el 3 nov 2026.
- Connectors and MCP servers, documentación de la plataforma de OpenAI, leída el 3 nov 2026.
- Quickstart, documentación de OpenRouter, leída el 3 nov 2026.
- FAQ, documentación de OpenRouter, leída el 3 nov 2026.
- Writing effective tools for agents, Anthropic Engineering.
- Introducing advanced tool use, Anthropic Engineering.
- Code execution with MCP, Anthropic Engineering.
- Building agents: When to fold subagents into your main agent loop, Anthropic, 22 oct 2026.
- RAG-MCP: Mitigating Prompt Bloat in LLM Tool Selection via Retrieval-Augmented Generation, arXiv:2505.03275.
- ToolLLM: Facilitating Large Language Models to Master 16000+ Real-world APIs, arXiv:2307.16789.
- Gorilla: Large Language Model Connected with Massive APIs, arXiv:2305.15334.
- MCP-Universe: Benchmarking Large Language Models with Real-World Model Context Protocol Servers, arXiv:2508.14704.
- MCP-Bench: Benchmarking Tool-Using LLM Agents with Complex Real-World Tasks via MCP Servers, arXiv:2508.20453.
- RFC 9110: HTTP Semantics, IETF.
- RFC 6585: Additional HTTP Status Codes, IETF.
- RFC 9457: Problem Details for HTTP APIs, IETF.
- RFC 9728: OAuth 2.0 Protected Resource Metadata, IETF.
- RFC 8707: Resource Indicators for OAuth 2.0, IETF.
- RFC 9207: OAuth 2.0 Authorization Server Issuer Identification, IETF.
- The OAuth 2.1 Authorization Framework, borrador 13, IETF.
- Skills over MCP: How Bloomberg helped standardize agent skills at scale, Bloomberg, 21 oct 2026.
- Treasury for agents, Stripe Newsroom, 21 oct 2026.
- Análisis de 15.465 servidores MCP públicos, The Hacker News, 6 oct 2026.
- Reportaje sobre el agente Pi, MCP y el modo de código, The New Stack.
- MCP Server and SI Agent Government Hackathon, Administración de Servicios Generales de EE. UU., septiembre a noviembre de 2026.
- Noticia sobre la ronda semilla de un rival de OpenRouter, Semafor, 16 oct 2026.
- Hilo sobre 58 servidores MCP y más de 680 herramientas, Reddit r/mcp.
- Requests: Quickstart, documentación de Requests.
- Acuerdo de servicio de usuario de Xiaohongshu (en chino), Xiaohongshu, leído el 3 nov 2026.
- Política de privacidad de Xiaohongshu (en chino), Xiaohongshu, leída el 3 nov 2026.
- Plataforma abierta de Xiaohongshu (en chino), Xiaohongshu, leída el 3 nov 2026, con el aviso del 19 oct 2026.
- Ley de Protección de Información Personal de la República Popular China (en chino), Administración del Ciberespacio de China.
- Reglamento de Gestión de la Seguridad de los Datos de Red (en chino), Consejo de Estado, publicado en septiembre de 2024, en vigor desde el 1 ene 2025.
- Artículo de Huxiu sobre Xiaohongshu e IA (en chino), Huxiu, 16 oct 2026.
- Página de inicio de Monid, leída el 3 nov 2026 («Live · 2800+ tools», «Start with $1 in free credit»); ver el enlace en el texto.
- Monid, «The OpenRouter for agent tools», página de posicionamiento, leída el 3 nov 2026; ver el enlace en el texto.
- Monid, MCP quickstart, documentación de configuración, leída el 3 nov 2026; ver el enlace en el texto.
- Monid, página de herramientas de Xiaohongshu, con 49 endpoints el 29 oct 2026; ver el enlace en el texto.
- Monid, «How to get Xiaohongshu (RedNote) data through an API», guía, leída el 3 nov 2026; ver el enlace en el texto.
Referencia BL-78