API данных или маршрутизатор инструментов? Как EveryInfra и Monid распределяют вызовы агента
Один и тот же поиск в Xiaohongshu, запущенный 6 раз: 16 разных заметок в топ-3 и $0,005556 за каждый запуск. Ежедневные задачи отправляйте в API данных, а длинный хвост — в Monid.
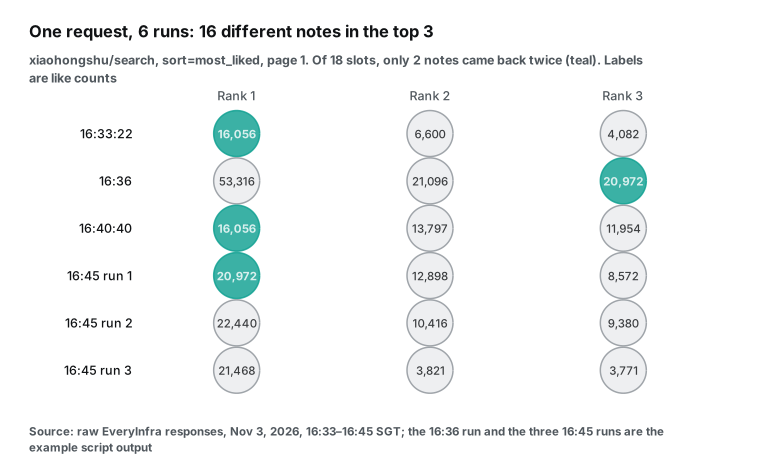
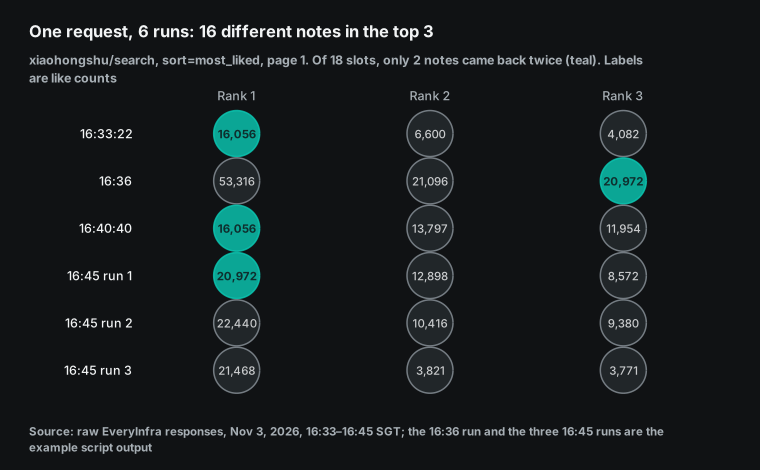
3 ноября 2026 года с 16:33 до 16:45 по сингапурскому времени (SGT) мы шесть раз отправили один и тот же запрос. Он шёл к возможности EveryInfra xiaohongshu/search: ключевое слово «матча-латте» на китайском, сортировка «по лайкам» (most_liked), первая страница. Каждый вызов вернул 20 заметок и стоил $0,005556, и все имена полей были в списке каталога. Для двух вызовов мы отдельно засекли время: 3,9 и 4,3 секунды. Но за шесть запусков на 18 мест в топ-3 пришлось 16 разных заметок.
Этот результат показывает, какие параметры ежедневной задачи агента могут оставаться неизменными. Форма запроса, имена полей, цена и формат ошибок могут быть фиксированными. Набор результатов при этом меняется, поэтому в каждой сохранённой записи нужно хранить порядок сортировки и метку времени. Поскольку первые четыре параметра остаются неизменными, для ежедневной задачи подходит специализированный API данных.
Вызовам, которые агент делает один раз и о которых заранее не знал, место в маршрутизаторе инструментов, например Monid. 3 ноября 2026 года на его главной странице было указано 2 800+ инструментов. Monid прислал нам материалы 29 октября. Согласно им, discover и inspect бесплатны, а run оплачивается за каждый вызов с единого баланса по цене из карточки инструмента.
Эта статья выросла из черновика команды Monid. Мы сохранили его главный тезис. Вызовы инструментов у агента бывают двух видов: повторяющиеся и найденные по ходу работы. Подключать их одинаково не стоит. Мы внесли одно изменение и добавили собственные тестовые запуски.
Изменение касается правила маршрутизации. В примере из черновика для ежедневного списка были названы только три платформы: Xiaohongshu, Douyin и TikTok. Мы заменили этот короткий список полным каталогом EveryInfra на тот день: 106 платформ, сгруппированных по категориям. Теперь в маршрутизатор уходит только настоящий длинный хвост. Добавленные запуски: описанные выше поиски «матча-латте», запрос деталей заметки, запрос комментариев и поиск в Douyin. Мы также отправили два заведомо ошибочных запроса.
О Monid мы приводим только два вида фактов. Первый: запуски, которые Monid выполнил на своей стороне 29 октября 2026 года. Второй: датированные сведения с его собственного сайта. Его платные вызовы мы не повторяли.
Коротко о платформе для читателей за пределами Китая. Xiaohongshu, также известная за рубежом как RedNote, — китайское социальное приложение. Пользователи публикуют там заметки: короткие посты с фото или видео, заголовком и тегами. У каждой заметки есть счётчики лайков, сохранений (collects), комментариев и репостов.
Бренды и аналитики следят за ней так же, как за Instagram или TikTok, только на китайском. Для нашей проверки это удачный пример. Многие команды отслеживают её каждый день, а универсальный маршрутизатор предлагает для неё несколько конкурирующих эндпоинтов.
Два вида вызовов инструментов: повторяющиеся и найденные по ходу работы
Черновик Monid начинается с упражнения. Выгрузите вызовы инструментов вашего агента за прошлую неделю и отсортируйте их по тому, как часто повторяется один и тот же вызов. По словам Monid, повторяющиеся вызовы образуют короткий список: платформы, которые вы отслеживаете, поля, которые сохраняете, расписание, по которому работаете. Один и тот же запрос выполняется несколько раз в день.
Всё остальное составляет длинный хвост. Например, пользователь спрашивает погоду на площадке в день мероприятия. Кому-то нужно число подписчиков автора на платформе, которую вы не отслеживаете. Кому-то ещё нужен последний раунд финансирования компании или страница, которую не открыть обычным HTTP-запросом. Каждый элемент этого хвоста может поступать от отдельной компании, со своим ключом, схемой и процедурой регистрации. К большинству из них обращаются лишь несколько раз в год.
Для этих двух групп важны противоположные свойства. Для повторяющихся вызовов ценнее всего неизменность. Стабильные имена полей сохраняют соответствие между кодом агента и таблицами на следующих этапах обработки. Стабильная цена позволяет финансовому отделу заранее планировать бюджет. Стабильный формат ошибок позволяет написать логику повторных попыток один раз.
В руководстве Anthropic «Writing effective tools for agents» инструмент рассматривается как договор между детерминированной системой и недетерминированным агентом. Руководство требует понятных имён, чётких границ между инструментами и ответов с полезным контекстом. Для длинного хвоста важнее всего охват. Агент заранее не знает, какой инструмент ему понадобится. Поэтому настраивать его под каждый инструмент не нужно. Он должен найти инструмент, когда тот понадобится, увидеть цену, вызвать его один раз и двигаться дальше.
Ошибка в том, чтобы обслуживать обе части одинаково. Если подключать длинный хвост по одному поставщику за раз, агент потратит первую неделю на сбор API-ключей. Если пропускать ежедневную задачу через универсальный маршрутизатор, вы потеряете фиксированную схему, благодаря которой её было дёшево поддерживать.
Есть и издержки на стороне модели: чем больше инструментов видит агент, тем чаще он выбирает не тот. Авторы статьи RAG-MCP провели нагрузочный тест MCP. Когда релевантные инструменты сначала отбирались и только потом показывались модели, точность выбора выросла с 13,62% до 43,13%. Число токенов в промпте при этом сократилось более чем вдвое.
Более ранние работы, например ToolLLM и Gorilla, пришли к тому же: с ростом числа API сложнее и выбрать нужный, и правильно задать аргументы. Один разработчик использует 58 MCP-серверов и более 680 инструментов. В сабреддите r/mcp он написал, что после 30–60 инструментов выбор заметно ухудшается. Он решил проблему так: описания инструментов загружаются лениво, а каждый специализированный агент получает только 10–20 инструментов.
| Повторяющиеся вызовы | Вызовы, найденные по ходу работы | |
|---|---|---|
| Как часто | Один и тот же запрос каждый день или каждый час | Несколько раз в год, заранее неизвестно |
| Знает ли агент заранее? | Да: платформа, поля и сортировка заданы | Нет: узнаёт об этом, когда пользователь формулирует запрос |
| Что важнее всего | Стабильные имена полей, стабильная цена, стабильные ошибки | Широкий охват, без регистрации у каждого поставщика, оплата за вызов |
| Пример в этой статье | Ежедневный отчёт по матча-латте в Xiaohongshu: xiaohongshu/search, xiaohongshu/comments | Логотип компании по её домену; посты на платформе не из списка |
| Куда направлять | Выделенный API данных: EveryInfra | Маршрутизатор инструментов: Monid (discover, inspect, run) |
Поэтому разумная схема такая: прямой канал для повторяющихся вызовов и маршрутизатор для всего остального. Выбирать между двумя продуктами не нужно. Оба сервиса работают по MCP, и оба могут быть одновременно подключены к одному клиенту агента. Короткое правило подсказывает агенту, какой из них использовать для каждого вызова. Дальше мы расскажем, что такое Monid и насколько длинный на самом деле ежедневный список EveryInfra, а затем разберём тестовые запуски.
Что такое Monid: три команды и один баланс
Monid называет себя OpenRouter для инструментов агентов. Эта фраза описывает форму продукта, а не деловую связь. OpenRouter даёт доступ ко многим моделям через один ключ и один баланс. В разделе «Быстрый старт» сказано, что он обслуживает сотни моделей через единый эндпоинт и автоматически переключается на резервные варианты. Согласно материалам Monid от 29 октября, Monid делает то же самое уровнем выше. Он охватывает инструменты, которые агент вызывает после выбора модели.
Страница позиционирования Monid, прочитанная 3 ноября 2026 года, сводит это к одной строке. OpenRouter: один ключ, все модели, оплата за токен. Monid: один Skill, все инструменты, оплата за вызов. Мы используем это сравнение только для описания формы продукта. Об отношениях между двумя компаниями оно ничего не говорит.
Мы изучили главную страницу Monid 3 ноября 2026 года. На ней было указано 2 800+ инструментов и $1 бесплатных кредитов для нового аккаунта. В материалах, которые Monid прислал нам 29 октября, приводились те же две цифры.
Согласно материалам от 29 октября, каталог охватывает веб-поиск, парсинг и обогащение данных о людях и компаниях. В нём также есть данные социальных платформ (включая китайские), карты и отзывы, электронная коммерция, финансы и генеративные медиа. Оплата, по словам самого Monid: за каждый вызов с единого баланса, без подписки. Поиск и просмотр инструмента бесплатны; оплачивается только запуск по цене, указанной в карточке инструмента.
В тех же материалах рабочий процесс сводится к трём командам. discover выполняет бесплатный семантический поиск по каталогу. Агент описывает задачу простыми словами и получает ранжированный список эндпоинтов, у каждого из которых указаны цена и статус работоспособности. inspect тоже бесплатен и возвращает схему входных данных, цену и документацию одного эндпоинта. run — единственный платный шаг: сумма списывается с предоплаченного баланса по цене, которую показал inspect.
Агент может подключиться к Monid через MCP, Skill-файл, утилиту командной строки или REST API. В кратком руководстве по Monid MCP (руководство по настройке Monid MCP, прочитано 3 ноября 2026 года) указаны адрес сервера https://mcp.monid.ai/v1 и вход через OAuth. Для Claude Code, Codex и других клиентов там описаны отдельные шаги. Skill-файл лежит по адресу monid.ai/SKILL.md. Согласно материалам Monid, агент, которому вы скажете «настроить» этот адрес, сам осваивает три команды. Машиночитаемый обзор находится в monid.ai/llms.txt.
| Команда | Платно? | Что возвращается (по материалам Monid от 29 октября 2026 года) |
|---|---|---|
discover | Бесплатно | Эндпоинты, ранжированные по релевантности; для каждого указаны цена и статус работоспособности |
inspect | Бесплатно | Схема входных данных, цена и документация одного эндпоинта |
run | Оплата по цене из карточки инструмента | Результат и идентификатор запуска, по которому его можно получить повторно |


Ежедневный список EveryInfra: 106 платформ, 569 возможностей
Первая строка правила маршрутизации гласит: «платформы из списка идут в EveryInfra», поэтому полезность правила зависит от длины списка. В примере правила из черновика Monid были названы три платформы: xiaohongshu, douyin, tiktok. С таким правилом из списка выпадают и отзывы Amazon, и отзывы Google Maps, и вакансии LinkedIn, и посты Reddit. При этом в каталоге EveryInfra для всех них есть фиксированные поля и фиксированная цена. Поэтому в этом разделе приведён весь каталог.
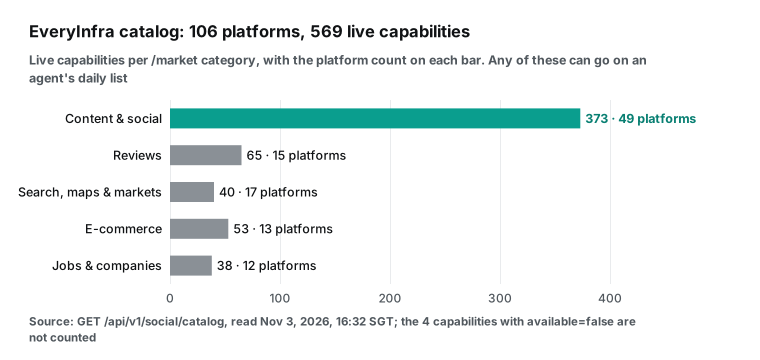
Данные взяты из бесплатного каталога EveryInfra GET /api/v1/social/catalog по состоянию на 3 ноября 2026 года, 16:32 SGT. В нём 106 платформ и 573 возможности, из которых в тот день были доступны 569. Остальные четыре были помечены available=false (g2/compare, jd/reviews, temu/search и wechat_oa/wechat_index), поэтому пока не включайте их в ежедневный список. Категории сформированы по тем же правилам, что и на нашей странице /market: контент и соцсети, отзывы, электронная коммерция, вакансии и бизнес, а также поиск, веб и рынки. В таблице ниже названы все 106 платформ; внутри каждой категории они отсортированы по числу возможностей.
| Категория | Платформы | Доступные возможности | Платформы (сначала с наибольшим числом возможностей) |
|---|---|---|---|
| Контент и соцсети | 49 | 373 | Douyin, TikTok, X (Twitter), Instagram, Xiaohongshu, Facebook, Zhihu, Kuaishou, WeChat Official Accounts, Weibo, GitHub, Bilibili, Reddit, YouTube, Pinterest, Substack, Threads, Spotify, Dailymotion, Quora, Rumble, SoundCloud, Telegram, Toutiao, Twitch, Bluesky, Mastodon, Truth Social, WeChat Channels, DeviantArt, Discord, Douban, Gab, Lemmy, Naver, Odysee, Patreon, Product Hunt, Snapchat, Tumblr, Youku, Dribbble, iQIYI, Medium, NetEase Cloud Music, Behance, Flickr, VK, Eventbrite |
| Отзывы | 15 | 65 | Google Play, App Store, G2, отзывы Google Maps, Tripadvisor, Zillow, Airbnb, Booking, Expedia, Yelp, Realtor, Clutch, Nextdoor, Upwork, Crexi |
| Электронная коммерция | 13 | 53 | Amazon, AliExpress, JD.com, eBay, Etsy, Taobao, Shopee, Walmart, 1688, Xianyu, Dewu, Temu, Google Shopping |
| Поиск, веб и рынки | 17 | 40 | Yahoo Finance, рыночные данные криптовалют, данные о компаниях, Polymarket, Яндекс, Similarweb, криптоновости, Kalshi, поисковая выдача, поиск Bing, Bing Maps, поиск DuckDuckGo, DuckDuckGo Maps, Apple Maps, Google News, Google Trends, Google Ads Transparency Center |
| Вакансии и бизнес | 12 | 38 | LinkedIn, Glassdoor, Indeed, Xing, Capterra, Trustpilot, Naukri, ThomasNet, StepStone, SEEK, Dice, Craigslist |
Два замечания об использовании этого списка. Во-первых, список меняется. Каталог может в любой день добавить платформы или возможности, а может на время пометить какую-то из них как недоступную. Поэтому не прописывайте список в правиле жёстко. В начале сессии пусть агент вызовет бесплатный инструмент everyinfra_list_capabilities или эндпоинт каталога. Затем заполните список по полученному ответу.
Во-вторых, список платформ всё равно слишком грубый. На одной платформе одни возможности используются каждый день, а другие возвращают данные только при определённых аргументах. У одной только Xiaohongshu 17 доступных возможностей. Это поиск, детали заметки, комментарии, ответы на комментарии, профиль пользователя, заметки пользователя и поиск пользователей. Сюда же входят темы, список трендов, поиск товаров, детали товара, отзывы о товарах, подписчики и геолокация заметки. Последние три: пакетное получение комментариев по множеству ссылок, детали видео и рейтинг контента авторов.
Все они стоят $0,005556 за вызов, кроме рейтинга контента авторов за $0,016. Если составить список по возможностям, агент увидит в правиле цену и аргументы каждого вызова. Подробности на странице API данных Xiaohongshu и на странице возможности поиска в Xiaohongshu.
Одно изменение в правиле маршрутизации: перечислите всё, а в Monid отправляйте только остальное
Со списком на руках правило может оставаться коротким. Мы переписали правило из черновика Monid, сохранив его структуру. Изменилась только строка с платформами, и добавился один запасной вариант: если есть сомнения, сначала спросите EveryInfra и переходите к Monid только при unknown_capability. Правило написано простым текстом для агента, поэтому его можно поместить в системный промпт или в файл инструкций проекта.
For a daily job on a platform in the list below, call everyinfra_call_api.
Use the platform's own language for keywords. If the task says "this week"
or "today", sort by time. Record platform, action, params, the call time and
charged_usd for every call.
For a platform outside the list, a one-off lookup, or a tool that is not data,
use Monid: discover first, then inspect (both free); run only when the price
fits the budget. Run is billed at the price inspect showed. Record each price
and run id.
If you are not sure a platform is on the list, call EveryInfra first.
If it returns HTTP 400 with error.code unknown_capability (nothing charged),
then use Monid.
List (EveryInfra catalog, read 2026-11-03; refresh at the start of each
session with everyinfra_list_capabilities):
airbnb, alibaba1688, aliexpress, amazon, app_store, apple_maps, behance,
bilibili, bing, bing_maps, bluesky, booking, capterra, clutch, company_data,
craigslist, crexi, crypto_market, crypto_news, dailymotion, deviantart,
dewu, dice, discord, douban, douyin, dribbble, duckduckgo, duckduckgo_maps,
ebay, etsy, eventbrite, expedia, facebook, flickr, g2, gab, github,
glassdoor, google_ads_transparency, google_maps_reviews, google_news,
google_play, google_shopping, google_trends, indeed, instagram, iqiyi, jd,
kalshi, kuaishou, lemmy, linkedin, mastodon, medium, naukri, naver,
netease_music, nextdoor, odysee, patreon, pinterest, polymarket,
producthunt, quora, realtor, reddit, rumble, seek, shopee, similarweb,
snapchat, soundcloud, spotify, stepstone, substack, taobao, telegram, temu,
thomasnet, threads, tiktok, toutiao, tripadvisor, trustpilot, truth_social,
tumblr, twitch, twitter, upwork, vk, walmart, web, wechat_channels,
wechat_oa, weibo, xianyu, xiaohongshu, xing, yahoo_finance, yandex, yelp,
youku, youtube, zhihu, zillow
Мы проверили этот запасной вариант. В 16:41:00 SGT мы запросили платформу не из списка, lemon8. EveryInfra ответил за 0,24 секунды с HTTP 400. Поле error.code содержало unknown_capability, а в поле allowed были перечислены все 106 названий платформ. Первая строка поля next_steps сообщала, что ничего не списано.
В 16:40:52 SGT мы отправили в поиск Xiaohongshu несуществующее значение сортировки: hot. Так называется сортировка у второго эндпоинта из черновика Monid. API ответил за 0,11 секунды с HTTP 422 и did_you_mean, равным most_liked. В списке allowed было пять допустимых значений, и снова ничего не списано.
Разница между двумя ошибками важна для маршрутизации. HTTP 400 unknown_capability означает «эта задача не моя», поэтому агенту нужно перейти к Monid. HTTP 422 invalid_value означает «задача моя, но аргумент неверный», поэтому агенту нужно исправить аргумент по allowed и повторить попытку, а не уходить.
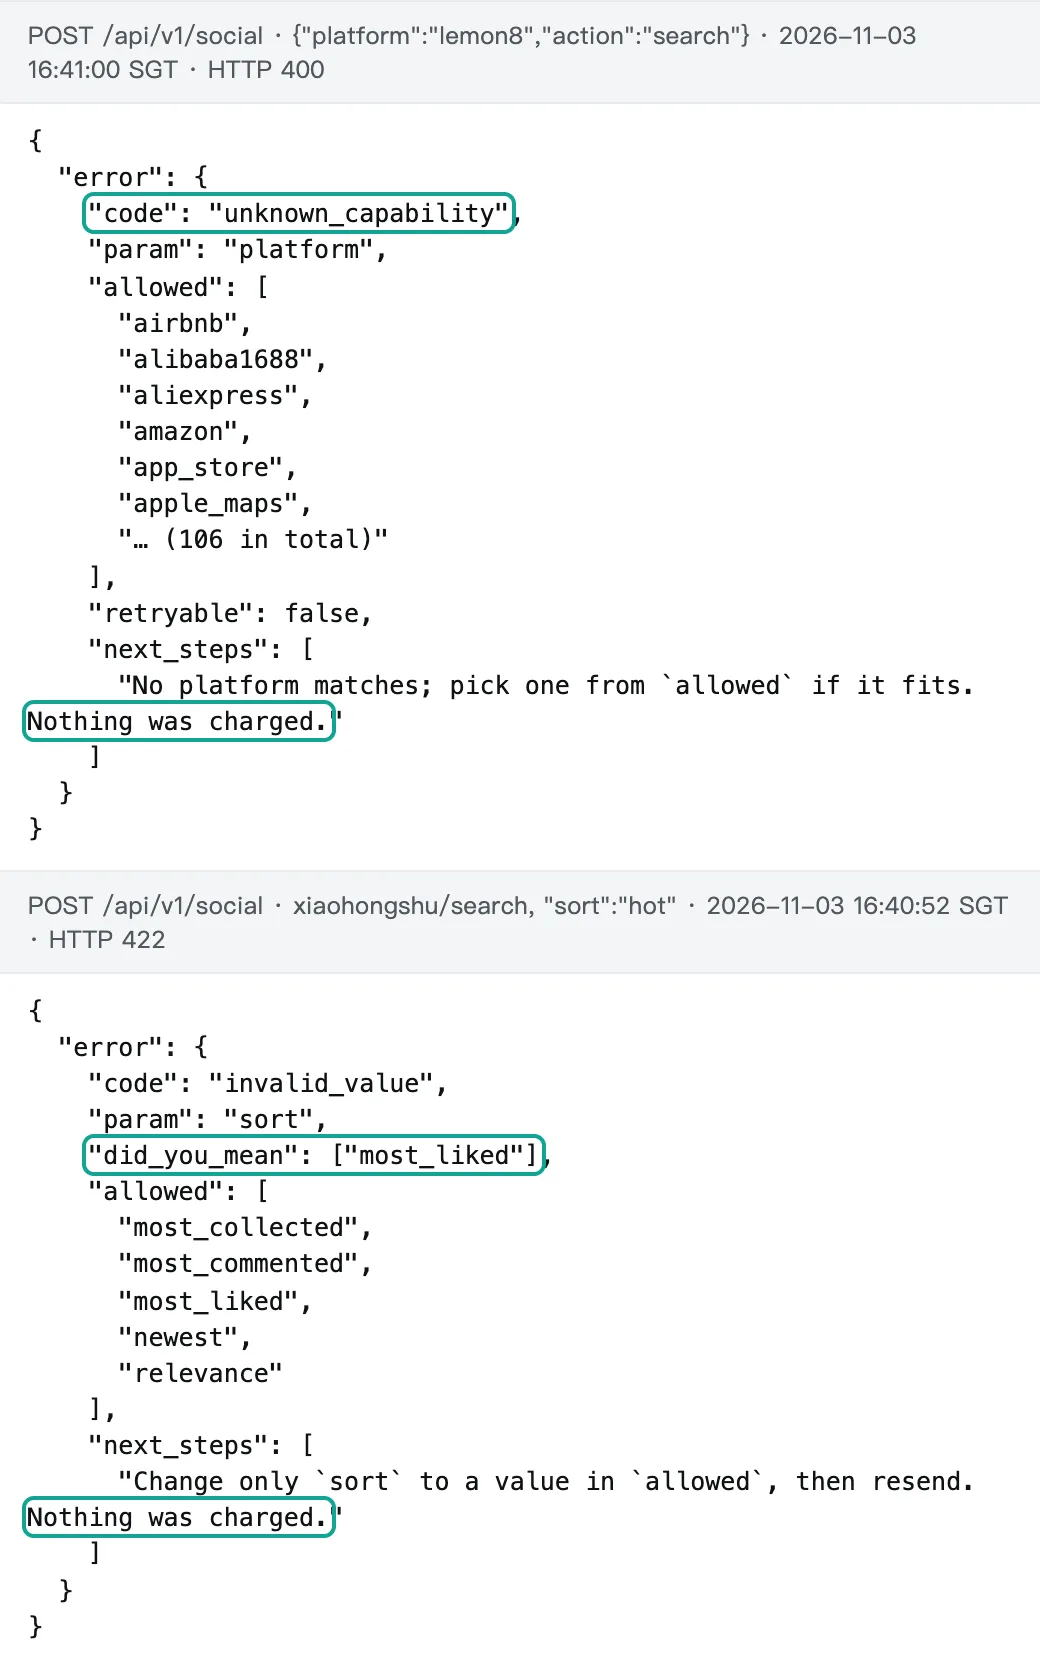
Благодаря запасному варианту правило может склоняться к тому, чтобы сначала спрашивать EveryInfra. Допустим, список устарел на день. Тогда первый вызов EveryInfra потребует одного запроса без списания средств и займёт доли секунды, после чего правило передаст задачу дальше.
Запросы к платформам из ежедневного списка не следует сначала направлять по другой ветке. В материалах самого Monid от 29 октября сказано, что два эндпоинта для одной и той же платформы называют сортировки по-разному и возвращают разные имена полей. Поэтому, как только задача начинает повторяться каждый день, агенту нужны один эндпоинт, одна сортировка и одна схема (цитата приведена в конце раздела «Тест первый» ниже). Тот же совет есть в разделе нашей документации об использовании EveryInfra вместе с Monid и в записи о Monid на нашей странице партнёров.
Оба MCP-сервера в одном клиенте
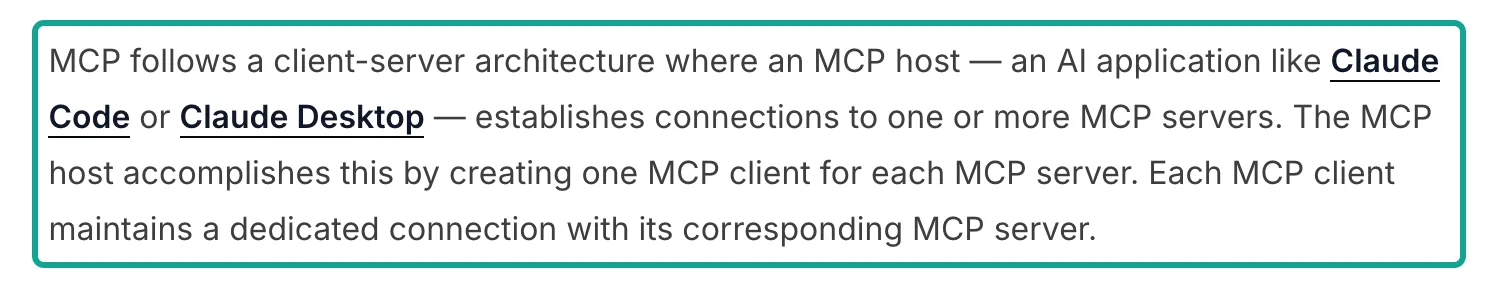
Два сервиса могут работать параллельно благодаря самой архитектуре MCP. Это описано в обзоре архитектуры MCP. Хост-программа создаёт по одному MCP-клиенту для каждого MCP-сервера, и у каждого клиента своё соединение. Хостом может быть Claude Code, Claude Desktop, Cursor, VS Code или ваша собственная программа. После подключения хост объединяет списки инструментов со всех серверов и передаёт их модели. При каждом вызове модель сама выбирает инструмент.
Поэтому EveryInfra и Monid могут работать в одном хосте, ничего не зная друг о друге. Разделение зависит только от описаний инструментов, которые читает модель, и от правила, которое пишете вы. На уровне протокола сообщения передаются в формате JSON-RPC 2.0. Удалённые серверы используют транспорт Streamable HTTP. Получение списка инструментов и их вызов описаны в разделе спецификации, посвящённом инструментам.
В Claude Code достаточно двух команд. EveryInfra использует API-ключ: храните его в переменной окружения и передавайте через --header. Удалённый сервер Monid, согласно руководству Monid по настройке MCP (просмотрено 3 ноября 2026 года), использует OAuth. После добавления введите /mcp в Claude Code, выберите monid и завершите вход. Флаг --scope user делает оба сервера доступными во всех ваших проектах.
В документации Claude Code по MCP также описаны области local и project. Область project записывает настройки в .mcp.json в корне проекта, что удобно для команды с общей конфигурацией. Впервые работаете с MCP? Начните с раздела «Быстрый старт» по MCP для Claude Code и нашей страницы MCP-сервера.
# EveryInfra: API key auth; keep the key in an environment variable only
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope user --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"

# Monid: remote MCP with OAuth (then type /mcp in Claude Code, pick monid, sign in)
claude mcp add --transport http monid https://mcp.monid.ai/v1 --scope user
Если ваш клиент читает файл mcpServers, конфигурация выглядит как в блоке ниже. Здесь часто ошибаются: в файле .mcp.json для Claude Code удалённому серверу нужен "type": "http". Запись только с url при загрузке файла вызывает ошибку конфигурации.
Cursor читает почти такой же формат. В VS Code вместо mcpServers используется ключ верхнего уровня servers. Gemini CLI задаёт адрес Streamable HTTP через httpUrl, а Codex использует TOML. В таблице после блока собраны различия между пятью распространёнными клиентами. Каждая строка основана на официальной документации клиента по состоянию на 3 ноября 2026 года.
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    },
    "monid": { "type": "http", "url": "https://mcp.monid.ai/v1" }
  }
}| Клиент | Где хранится конфигурация | Как объявить удалённый сервер | Как передать ключ или войти | Документация |
|---|---|---|---|---|
| Claude Code | claude mcp add или .mcp.json в проекте | "type": "http" и url | --header или headers; для OAuth-серверов вход выполняется через /mcp | Документация Claude Code по MCP |
| Cursor | .cursor/mcp.json в проекте или ~/.cursor/mcp.json | url внутри mcpServers | headers; поддерживается OAuth | Документация Cursor по MCP |
| Codex | ~/.codex/config.toml или .codex/config.toml в доверенном проекте | url в секции [mcp_servers.name] | bearer_token_env_var задаёт имя переменной окружения; OAuth через codex mcp login | Документация Codex по MCP |
| VS Code | .vscode/mcp.json в рабочей области | Ключ верхнего уровня servers, "type": "http" | headers или входные переменные; поддерживается OAuth | Документация VS Code по MCP |
| Gemini CLI | mcpServers в settings.json | httpUrl | headers; includeTools пропускает только часть инструментов | Документация Gemini CLI по MCP |
Когда подключены оба сервера, на каждом шаге модель видит описания инструментов с обоих серверов, и это увеличивает расход токенов. В 16:42:41 SGT мы отправили один запрос tools/list к MCP-серверу EveryInfra. Он вернул 12 инструментов. everyinfra_list_capabilities читает каталог, everyinfra_call_api вызывает любую возможность сбора данных, а everyinfra_get_job получает результаты асинхронных задач. Остальные отвечают за поиск, решение капчи, ИИ-чат, аккаунт и обращения в поддержку.
Всё тело ответа заняло 16 247 байт. Если грубо считать по четыре байта на токен, это около 4 060 токенов. Объём такой небольшой, потому что мы не стали делать отдельный инструмент для каждой из 569 возможностей. Один общий инструмент everyinfra_call_api и бесплатный инструмент каталога позволяют модели сначала найти то, что ей нужно.
Наглядное сравнение приводит Anthropic в статье «Introducing advanced tool use». Загрузка описаний более 50 MCP-инструментов заранее заняла около 72 тыс. токенов. При загрузке по запросу через поиск инструментов от этого объёма осталась лишь небольшая часть.
Помогает и хост. В справочнике «Claude Code environment variable reference» указано, что поиск инструментов включён по умолчанию (ENABLE_TOOL_SEARCH). Поэтому описания MCP-инструментов не попадают в контекст все сразу. Если вывод инструмента превышает 10 000 токенов, появляется предупреждение, а лимит по умолчанию составляет 25 000 токенов (MAX_MCP_OUTPUT_TOKENS).
В наших прогонах пять страниц поиска по 20 заметок Xiaohongshu в каждой занимали от 35 538 до 51 999 байт сырого JSON. Значительную часть составляли длинные строки, не нужные для анализа: URL изображений, URL аватаров и токены страниц. Поэтому в ежедневных задачах пусть агент оставляет только те столбцы, которые сохраняет. Или запускайте HTTP API из скрипта и записывайте результат в файл, чтобы записи вообще не проходили через контекст модели.
Этот подход описан в статье Anthropic «Code execution with MCP». Модель пишет код, который вызывает инструменты, а промежуточные данные остаются в среде выполнения. В диалог возвращается только итоговый вывод.
Тест первый: матча-латте, три сортировки и два языка
Это основные тестовые прогоны для статьи. Все запросы отправлялись из Сингапура в HTTP API EveryInfra на POST /api/v1/social. Платформа: xiaohongshu, возможность: search, ключевое слово: «матча-латте» на китайском. Мы меняли только сортировку, страницу, диапазон дат и в одном случае язык ключевого слова.
Указано полное время выполнения на стороне клиента, включая сетевой обмен. Цена взята из значения billing.charged_usd в каждом ответе. Первые три строки наш редактор выполнил в 16:33 SGT, остальные мы запускали во время работы над статьёй с тем же тестовым ключом.
| Время (SGT, 3 ноября) | Сортировка или фильтр | Страница | Примечания | Время ответа | Списание | Медиана лайков | Заметки не старше 30 дней |
|---|---|---|---|---|---|---|---|
| 16:33:22 | most_liked | 1 | 20 | 3.91 s | $0.005556 | 1,427.5 | 0 |
| 16:33:26 | newest | 1 | 20 | 3.42 s | $0.005556 | 0 | 20 |
| 16:33:29 | most_liked, ключевое слово «matcha latte» на английском | 1 | 20 | 3.52 s | $0.005556 | 1,011 | 1 |
| 16:40:40 | most_liked (повтор) | 1 | 20 | 4.26 s | $0.005556 | 1,513.5 | 2 |
| 16:41:08 | most_liked с page_token со страницы 1 | 2 | 20 | 2.34 s | $0.005556 | 194.5 | 1 |
| 16:41:18 | most_liked + last_30_days | 1 | 1 | 9.45 s | $0.005556 | 1,857 | 1 |
Запрос короткий. Ниже приведён вызов в 16:40:40, ответ сокращён до первой заметки и поля с данными об оплате. Полный список полей есть на странице возможности поиска Xiaohongshu. Если вы у нас впервые, получите ключ по инструкции из раздела «Быстрый старт» в документации.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"xiaohongshu","action":"search",
"params":{"keyword":"抹茶拿铁","sort":"most_liked"}}'{
"platform": "xiaohongshu", "action": "search", "count": 20,
"pagination": { "page": 1, "has_more": true },
"next_page_token": "pt1.…",
"results": [
{ "id": "69a509f400000000220335a9",
"like_count": 16056, "collect_count": 2657, "comment_count": 6223,
"share_count": 3261, "posted_at": "2026-03-02T04:15:14+00:00",
"is_video": false, "is_cooperation_note": true }
],
"billing": { "charged": true, "charged_usd": 0.005556 }
}Начнём с сортировки. «Больше всего лайков» и «Новые» отвечают на два разных вопроса. На странице «Больше всего лайков» в 16:33 медианное число лайков составило 1 427,5, а сохранений — 747,5. Ни одна из 20 заметок не была опубликована за последние 30 дней, а самая старая опубликована 28 мая 2025 г. По возрасту: 0 заметок младше 30 дней, 12 — от 30 до 179 дней, 5 — от 180 до 364 дней, 3 — старше года.
На странице «Новые» было 20 заметок, опубликованных 2 и 3 ноября, с медианой 0 лайков. Общих заметок у двух страниц не оказалось вовсе. Если агент сохранит обе как «matcha latte top 20», никто дальше по цепочке не поймёт, какая страница отвечает на вопрос «что популярнее всего», а какая — на вопрос «что люди обсуждают сегодня».
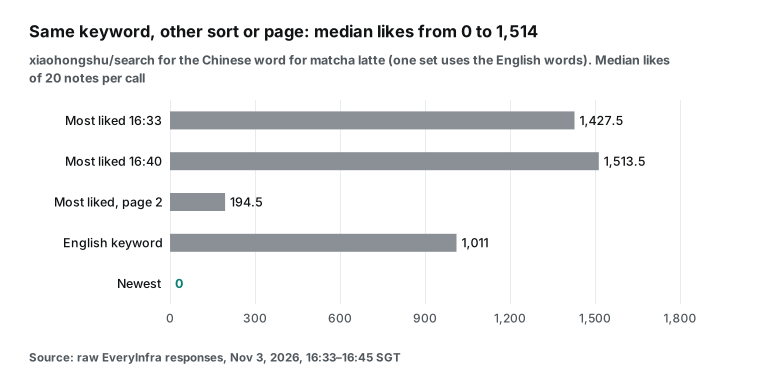
Далее — язык ключевого запроса. У английского запроса «matcha latte» с сортировкой «Больше всего лайков» медиана составила 1 011 лайков. Одиннадцать из 20 заметок содержали видео, против 9 на странице китайского запроса. Самая старая опубликована 18 марта 2023 г., а пять были старше года. С китайской страницей от 16:33 у неё совпали 4 заметки.
Получается, что одна и та же тема на китайском и на английском даёт два пересекающихся, но разных набора. На английской странице было пять заметок старше года, на китайской — три. Поэтому правило маршрутизации гласит: «используйте для ключевых запросов язык самой платформы». Так агент не станет по умолчанию искать на китайской платформе по-английски.
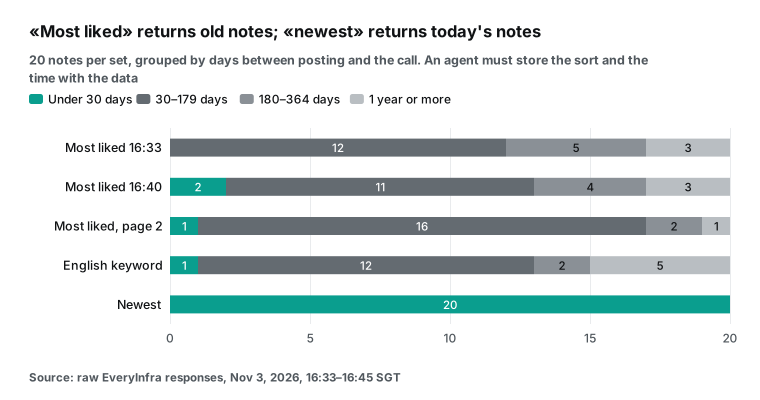
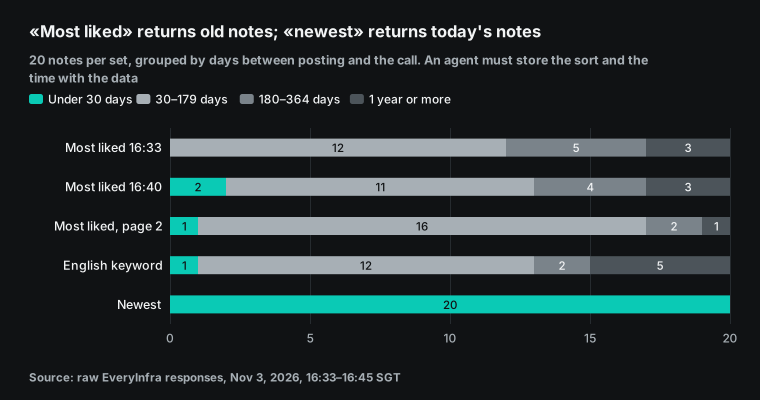
Стоит взглянуть и на вторую страницу, и на фильтр по дате. С next_page_token из первой страницы вторая вернула 20 новых заметок без пересечений. Медиана упала до 194,5 лайка. За 2,34 секунды это был самый быстрый вызов за сессию. Каждая страница считается одним вызовом по той же цене.
С добавленным date_range=last_30_days API вернул страницу с одной заметкой. Она опубликована 9 октября и набрала 1 857 лайков. Вызов занял 9,45 секунды — самый медленный за сессию. Каталог прямо предупреждает об этом аргументе: узкий диапазон, например последние 30 дней, может вернуть меньше 20 заметок на страницу. Чтобы получать полные страницы, сочетайте его с sort=newest; за страницу без заметок плата не списывается.
На этой странице была одна заметка, поэтому за неё, как обычно, списали $0,005556. Допустим, ваша ежедневная задача — «заметки о matcha latte с наибольшим числом лайков за последние 30 дней». Надёжнее каждый день пролистывать новые заметки, сохранять их и сортировать по лайкам самостоятельно. Это работает лучше, чем один запрос «последние 30 дней + больше всего лайков» в день.
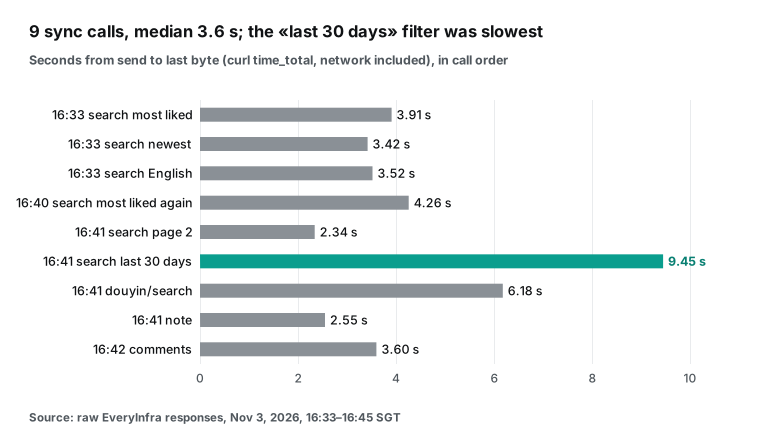
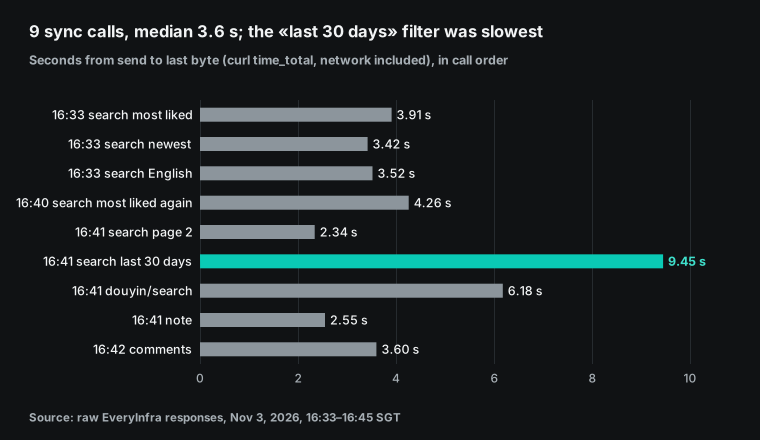
Медиана по девяти синхронным вызовам составила 3,6 секунды при разбросе от 2,34 до 9,45 секунды. Для задачи, которая запускается раз в день, этого достаточно. Агент, который делает десяток вызовов за один ход диалога, может добавить в запрос "mode": "async". Тогда API сразу вернёт идентификатор задачи, а агент получит результат через everyinfra_get_job или GET /api/v1/jobs/{job_id}. То же самое указано в поле async_hint каждого синхронного ответа.
Теперь цифры со стороны Monid, от 29 октября 2026 года. Для этого теста команда Monid использовала страницу инструментов Xiaohongshu в Monid. Она выбрала в своём каталоге два эндпоинта поиска заметок Xiaohongshu от двух разных компаний. Каждый из них команда запустила один раз с одним и тем же ключевым словом на китайском, а первый запустила ещё раз с ключевым словом на английском. По материалам Monid, в тот день на этой странице было 49 эндпоинтов.
Число записей, время и результаты в таблице ниже взяты из материалов, которые нам прислала команда Monid. Время указано по тихоокеанскому времени США. Мы не повторяли эти запуски и не сравниваем их с нашими. Наши и их запуски проводились в разные даты, использовали разные аргументы сортировки и отвечали на разные вопросы.
| Дата (запуск на стороне Monid) | Эндпоинт | Входные данные | Примечания | Время ответа | Результат |
|---|---|---|---|---|---|
| 2026-10-29 20:34 | Поиск заметок от первой компании | Ключевое слово на китайском, по числу лайков, страница 1 | 20 | 3.2 s | Медиана: 2 132 лайка и 1 571 сохранение; ни одной заметки моложе 30 дней; самой старой больше трёх с половиной лет |
| 2026-10-29 20:34 | Поиск заметок от второй компании | Ключевое слово на китайском, сортировка «hot» | 20 | 3.2 s | Медиана: 97 лайков; 5 из 20 заметок моложе 30 дней |
| 2026-10-29 20:35 | Поиск заметок от первой компании | «matcha latte», по числу лайков | 20 | 2.9 s | Медиана: 2 961 лайк; половина заметок — видео |
Команда Monid пришла по своим запускам к тому же выводу, что и мы по нашим: порядок сортировки должен передаваться вместе с данными.
Вот фрагмент из материалов Monid от 29 октября с небольшой правкой: «Одно ключевое слово, один день, два эндпоинта, ответы на два разных вопроса. Агент, который записывает оба результата как „топ-20“, теряет единственное, что делало их сопоставимыми».
В тех же материалах сказано, что у этих двух эндпоинтов разные названия сортировок и разные имена полей. Поэтому, как только запрос превращается в ежедневную серию, агенту нужны один эндпоинт, одна сортировка и одна схема. В этот момент вызов переходит с маршрутизатора на прямое подключение. Monid описывает собственный метод в руководстве о том, как получать данные Xiaohongshu через API.
Тест второй: один и тот же запрос шесть раз, 16 разных заметок в первой тройке
С 16:33 до 16:45 SGT один и тот же запрос выполнялся шесть раз: {"keyword": <the Chinese keyword>, "sort": "most_liked"} на первой странице. Первый запуск прошёл в 16:33:22. В 16:36 наш редактор впервые тестово запустил пример скрипта, приведённый ниже. Ещё один запуск прошёл в 16:40:40. В 16:45 редактор запустил скрипт ещё три раза, по одному разу для каждой языковой версии этой статьи. Скрипт выводит только первую тройку, поэтому сравнить все шесть запусков можно только по ней.
За шесть запусков 18 мест в первой тройке заняли 16 разных заметок. Заметка с 16 056 лайками была первой в 16:33 и в 16:40. Заметка с 20 972 лайками оказалась третьей в 16:36 и первой в первом запуске в 16:45. Каждая из остальных 14 заметок появилась по одному разу. Мы сравнили первые тройки во всех парах запусков: в 13 из 15 пар не нашлось ни одной общей заметки, а в 2 парах совпала одна. Полные страницы из 20 заметок за 16:33 и 16:40 имели только 7 общих заметок.
Прежде всего чётко определите, что именно запрашивается. В каталоге это значение сортировки называется «сначала с наибольшим числом лайков» (most_liked).
EveryInfra возвращает первую страницу поиска Xiaohongshu с такой сортировкой на момент запроса. Это не полная сортировка всех заметок о матча-латте по числу лайков. Поэтому первая страница не гарантирует, что в ней окажутся заметки с наибольшим числом лайков на всей платформе.
Это видно по необработанным ответам. Верхняя заметка в 16:33 и в 16:40 набрала 16 056 лайков. Но у верхней заметки в 16:36 было 53 316 лайков, а в трёх запусках в 16:45 на первом месте оказались заметки с 20 972, 22 440 и 21 468 лайками. Ни одной из этих заметок не было на полных страницах из 20 заметок в 16:33 и 16:40.
Три запуска в 16:45 прошли в пределах одной минуты, и в их тройках лидеров не было ни одной общей заметки. Значит, первая страница платформы может меняться за считаные минуты и даже в пределах одной минуты. Со стороны API всё оставалось одинаковым. Каждый вызов вернул HTTP 200 с 20 заметками, и за каждый списали одни и те же $0,005556. Все имена полей в ответах 16:33 и 16:40 были в списке response_fields каталога. Одно-два поля появляются, только когда у них есть значение, например poi_id, если к заметке привязано место.
Для ежедневной задачи из этого следуют три прямых вывода. Во-первых, чётко определите, что можно зафиксировать. Форма запроса, имена полей, цена и формат ошибок могут и должны оставаться неизменными. Набор результатов зафиксировать нельзя. Не доверяйте никакой схеме, которая обещает «один и тот же топ-20 каждый день» по одному запросу.
Во-вторых, храните вместе с данными условия запроса и время: сортировку, страницу, ключевое слово и время вызова. Если не сохранить хотя бы одно из них, через неделю вы не сможете сказать, на какой вопрос отвечает этот набор записей.
В-третьих, если вам нужен стабильный рейтинг, не полагайтесь на первые несколько результатов одного запроса. Каждый день забирайте чуть больше страниц и объединяйте их в собственную таблицу по id заметки. Затем сортируйте по правилу, которое задаёте сами, например по числу лайков. Такой рейтинг можно воспроизвести.
Вот как третий пункт выглядит на данных этой сессии. Первые страницы в 16:33 и 16:40 содержали по 20 заметок. После объединения и дедупликации по id заметки получилось 33 разные заметки, на 13 больше, чем на любой из страниц по отдельности. При сортировке по лайкам первой идёт заметка с 16 056 лайками, и следующее объединение может получить тот же результат. Он не зависит от того, какую страницу платформа отдаст через минуту.
Для каждой сохраняемой записи храните как минимум перечисленные ниже столбцы. Примеры значений взяты из первой заметки ответа в 16:40:40.
| Столбец | Источник | Пример значения (3 ноября 2026 г., 16:40:40 SGT) | Зачем хранить |
|---|---|---|---|
| Время вызова | Ваш собственный лог | 2026-11-03 16:40:40 | Результаты одного и того же запроса меняются за считаные минуты; без времени их не воспроизвести |
| Ключевое слово, сортировка, страница | Параметры запроса | матча-латте (на китайском), most_liked, 1 | «Сначала с наибольшим числом лайков» и «Сначала новые» отвечают на разные вопросы |
| Позиция | Порядок в результатах | 1 | Отслеживать позицию одной заметки в разное время |
| ID заметки | id | 69a509f400000000220335a9 | Дедупликация между запусками и страницами |
| Вовлечённость | like_count, collect_count, comment_count | 16,056, 2,657, 6,223 | Сортировка по вашему правилу |
| Время публикации | posted_at | 2026-03-02 | Отличать то, что «обсуждают сейчас», от того, что «популярно давно» |
| Рекламная заметка | is_cooperation_note | true | Считать платные публикации отдельно |
| Списание | billing.charged_usd | 0.005556 | Сверка в конце месяца |
Стоимость объединения тоже легко посчитать. Вторая страница в 16:41 не имела ни одной общей заметки с первой. Значит, первая и вторая страницы дают 40 разных заметок на ключевое слово в день. Если запускать обе страницы утром и ещё раз днём, на одно ключевое слово уйдёт 4 вызова в день. При $0,005556 за вызов это около $0,022 в день и $0,67 за 30 дней. За эти дополнительные деньги вы получаете таблицу, которую можно воспроизвести и сравнить. Через неделю вы по-прежнему увидите, какая заметка и в какой день попала в топ-40 и как росли её лайки.
| Что происходит, когда ежедневная задача повторяет один запрос | Неизменно в этом тесте? | Подтверждение (3 ноября 2026 г., SGT) | Что это значит для хранения и правил |
|---|---|---|---|
| Форма запроса (платформа, возможность, имена параметров) | Неизменно | Все 9 вызовов использовали одну форму platform + action + params | Правило и скрипт пишутся один раз |
| Имена полей | Неизменно | Все поля в полных ответах 16:33 и 16:40 входили в 30 полей, перечисленных в каталоге | Таблицу для дальнейшей обработки можно создать заранее |
| Цена | Неизменно | 10 вызовов API поиска по Xiaohongshu, 1 вызов API для получения данных заметки и 1 вызов API для получения комментариев; за каждый списано $0,005556 | Бюджет на месяц можно заложить заранее |
| Формат ошибок | Неизменно | И HTTP 400, и HTTP 422 содержали code, allowed и next_steps | Реализуйте логику повторных попыток и перенаправления один раз |
| Какие 20 заметок возвращаются | Меняется | На страницах за 16:33 и 16:40 совпали 7 заметок из 20 | Храните сортировку и время; объединяйте по id |
| Тройка лидеров | Меняется | 16 разных заметок заняли 18 позиций за 6 запусков; в 13 из 15 пар запусков не было ни одной общей заметки | Стабильный рейтинг стройте из объединённых страниц |
Третий тест: данные заметки, комментарии и Douyin
Ежедневные задачи редко ограничиваются поиском. Получив набор заметок, вы обычно запрашиваете данные и комментарии для нескольких первых. Иногда также нужно найти то же ключевое слово на второй платформе. Все три приведённых ниже вызова были выполнены с 16:41 до 16:42 SGT через один и тот же API и с одной и той же структурой запроса; менялись только platform и action.
| Время (SGT, 3 ноября) | Возможность | Входные данные | Записи | Время ответа | Списание | На какие поля обратить внимание |
|---|---|---|---|---|---|---|
| 16:41:50 | xiaohongshu/note | Ссылка на заметку с 16 056 лайками | 1 | 2.55 s | $0.005556 | ip_location заполнено, is_cooperation_note равно true, 9 тегов |
| 16:42:00 | xiaohongshu/comments | Та же заметка, сначала комментарии с наибольшим числом лайков | 15 | 3.60 s | $0.005556 | У самого популярного комментария 1 213 лайков; под 15 комментариями — 650 ответов; has_more — true |
| 16:41:36 | douyin/search | Ключевое слово «матча-латте» на китайском, сортировка по лайкам | 10 | 6.18 s | $0.008333 | Медиана — 6 179,5 лайка; у самого популярного видео — 1 178 986 лайков |
Детали заметки добавляют поля, которых нет в поиске: ip_location автора, полные списки tags и topics, а также has_goods, которое показывает, прикреплён ли к заметке товар.
Первая заметка в этой сессии — рекламная: поле is_cooperation_note имело значение true. В ней продвигается серия кофе со вкусом розы и описываются три напитка. Один из них — матча-латте с розой; в заметке говорится, что он понравится поклонникам матча. Но слова «матча» нет ни в заголовке, ни в одном из девяти тегов. Матча-латте — лишь один напиток из серии.
Для тех, кто ведёт ежедневный мониторинг, из этого следуют два вывода. Чтобы понять, относится ли заметка к ключевому слову, читайте её текст, а не только заголовок и теги. Рекламные заметки учитывайте отдельно, оценивая релевантность по тексту. Иначе одна-две рекламные публикации могут поднять среднее число лайков за всю неделю. Полный список полей приведён на странице возможности «Детали заметки».
Вызов комментариев вернул 15 комментариев верхнего уровня: от 1 213 лайков до 3. У каждого есть поле sub_comment_count; всего под этими 15 комментариями было 650 ответов. Поскольку has_more имело значение true, следующую страницу можно получить по next_page_token. На этой странице значение ip_location отсутствовало у всех комментариев. Это показывает, что регион комментатора доступен не всегда, поэтому при дальнейших расчётах нельзя считать это поле обязательным.
Среди полей комментария есть и author_is_ai_agent, у всех 15 комментариев оно было false. Чтобы анализировать тональность или преимущества товара в комментариях, смотрите страницу возможности «Комментарии». Подробнее об этом в нашей статье о чтении комментариев Xiaohongshu с помощью динамических воркфлоу Claude Code.
Страница поиска Douyin содержит 10 видео и стоит $0.008333 за вызов, или $8.33 за 1 000 вызовов. Поиск по Xiaohongshu стоит $5.56 за 1 000. Обе цены указаны по каталогу. Медиана лайков у 10 видео составила 6 179.5, а у самого популярного их было больше 1.17 млн. Видео опубликованы в период с февраля 2025 по сентябрь 2026 года.
Имена полей на двух платформах совпадают не полностью. Douyin добавляет author_follower_count, music, hashtags и is_pinned. Но общие поля, например like_count, comment_count, share_count и posted_at, называются одинаково. Поэтому в кросс-платформенной таблице нужно обработать только дополнительные столбцы, специфические для каждой платформы. Все поля перечислены на странице API данных Douyin и странице возможности поиска Douyin. Соответствующие возможности TikTok описаны на странице API данных TikTok.
Пример скрипта: ежедневная и разовая задачи вместе
Ниже — минимальный рабочий пример совместного использования двух сервисов на Python, написанный с помощью Requests. Первая половина выполняет ежедневную задачу: вызов EveryInfra xiaohongshu/search с неизменной структурой запроса выводит три первые заметки и сумму списания. Вторая половина решает разовую задачу: находит логотип компании по её домену. Это не относится к ежедневному сбору данных с платформы, поэтому запрос направляется в Monid: сначала discover, затем inspect, а run — только если цена укладывается в бюджет. Оба ключа берутся из переменных окружения; их значений в скрипте нет.
import os

import requests

EVERYINFRA_API_KEY = os.environ["EVERYINFRA_API_KEY"]
MONID_API_KEY = os.environ["MONID_API_KEY"]
MONID = "https://api.monid.ai/v1"
MONID_HEADERS = {"Authorization": f"Bearer {MONID_API_KEY}"}
MAX_PRICE_USD = 0.01  # do not run a Monid tool that costs more than this per call

# 1. The daily job: EveryInfra xiaohongshu/search, one fixed request shape
resp = requests.post(
    "https://api.everyinfra.com/api/v1/social",
    headers={"Authorization": f"Bearer {EVERYINFRA_API_KEY}"},
    json={"platform": "xiaohongshu", "action": "search",
          "params": {"keyword": "抹茶拿铁", "sort": "most_liked"}},
    timeout=120,
)
resp.raise_for_status()
body = resp.json()
for note in body["results"][:3]:
    print(note["like_count"], note["collect_count"], note["posted_at"][:10], note["url"])
print("EveryInfra:", len(body["results"]), "notes, charged (USD):", body["billing"]["charged_usd"])

# 2. A one-off lookup that is not a daily platform: discover, inspect, run on Monid
found = requests.post(f"{MONID}/discover", headers=MONID_HEADERS, timeout=60,
                      json={"query": "company logo image URL from a domain", "limit": 3}).json()["results"]
# discover adds ranking and price fields to each result; inspect and run take only the fields that name the tool
SHOWN_ONLY = ("providerName", "description", "price", "score", "scoreBreakdown", "tags", "metrics", "hints")
tool = {key: value for key, value in found[0].items() if key not in SHOWN_ONLY}
detail = requests.post(f"{MONID}/inspect", headers=MONID_HEADERS, timeout=60, json=tool).json()
price = detail["price"]["amount"]["value"]
print("Monid tool:", detail["endpoint"], "price (USD):", price)
if price <= MAX_PRICE_USD:
    run = requests.post(f"{MONID}/run", headers=MONID_HEADERS, timeout=120,
                        json={**tool, "input": {"pathParams": {"company": "starbucks.com"}}}).json()
    print("Monid run:", run.get("runId"), run.get("status"), run.get("output"))
Наш редактор впервые запустил этот скрипт 3 ноября 2026 г. в 16:36 SGT, а затем ещё три раза в 16:45, по разу для каждой языковой версии. Каждый полный запуск занимал от 6,4 до 7,7 секунды. Часть EveryInfra каждый раз возвращала 20 заметок, и за неё списывалось $0,005556. Её тройки лидеров соответствуют строкам 16:36 и 16:45 на точечной диаграмме выше.
В части, относящейся к Monid, первым результатом discover во всех четырёх запусках был эндпоинт, который возвращает логотип компании по домену. inspect показал, что на тот момент он стоил $0, поэтому скрипт перешёл к run. Вызов run завершился со статусом COMPLETED и вернул URL изображения логотипа. Строка MAX_PRICE_USD служит простой, но полезной мерой предосторожности. discover и inspect бесплатны, поэтому агент всегда может сначала узнать цену. Инструмент, цена которого превышает бюджет, можно пропустить, оставив решение за человеком.
В материале Monid от 29 октября есть подходящее здесь предупреждение: discovery выдаёт ранжирование, а не гарантию. Запрос в виде названия возможности, например «поиск заметок Xiaohongshu», ранжируется хорошо. Длинное разговорное предложение с именами собственными может поднять наверх эндпоинты, не имеющие отношения к задаче. Поэтому перед запуском просмотрите верхние результаты, это бесплатно. Шаги «сначала discover, затем inspect, затем run только в пределах бюджета» в нашем правиле следуют этому совету.
Расходы: сколько стоит ежедневная задача в месяц
Самая прямая выгода от фиксированных полей и фиксированной цены в том, что счёт можно рассчитать заранее. Ниже приведена месячная стоимость мониторинга матча-латте в Xiaohongshu по ценам каталога на 3 ноября 2026 г. Месяц здесь равен 30 дням, и оплачивается каждый вызов. На практике за неудачные вызовы и пустые страницы средства не списываются, поэтому эти цифры являются верхней границей. 16 возможностей Xiaohongshu, кроме рейтинга контента авторов, стоят $0,005556 за вызов, а поиск Douyin стоит $0,008333 за вызов. Полный прайс-лист приведён на странице тарифов.
| План | Вызовов в день | Стоимость в день | Стоимость за 30 дней |
|---|---|---|---|
| A: 3 ключевых слова, по 1 странице | 3 × xiaohongshu/search | $0.0167 | $0.50 |
| B: 3 ключевых слова, по 2 страницы | 6 × xiaohongshu/search | $0.0333 | $1.00 |
| C: B плюс комментарии к 5 самым популярным заметкам | 6 поисков + 5 × xiaohongshu/comments | $0.0611 | $1.83 |
| D: C плюс те же 3 ключевых слова в Douyin | 11 указанных выше вызовов + 3 × douyin/search | $0.0861 | $2.58 |
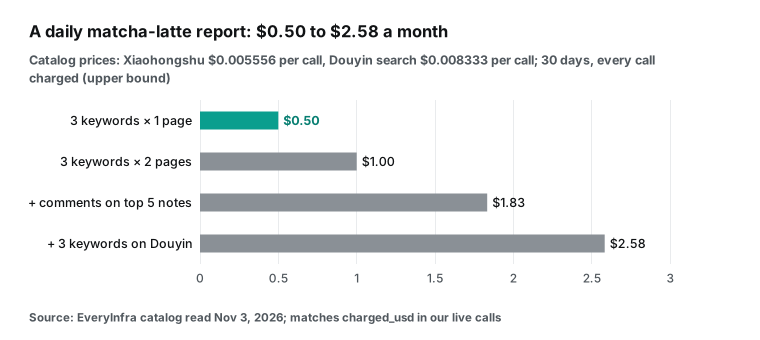
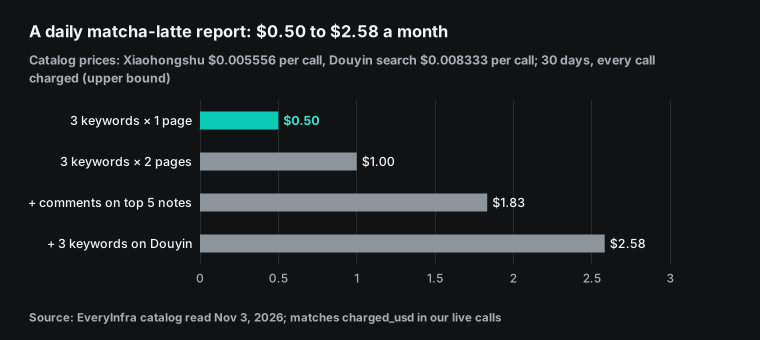
Суммы небольшие, но важно, что их можно заранее заложить в бюджет. Запрос и цена не меняются. Поэтому счёт в конце месяца не изменится из-за того, что модель выбрала другой эндпоинт.
Длинный хвост оплачивается иначе: перед каждым run проверяйте цену через inspect, записывайте каждый вызов, а в конце месяца суммируйте фактические расходы. Платные вызовы, перечисленные в этой статье, в сумме составляют 13 вызовов на $0,075005. Наши 6 вызовов при подготовке статьи стоили $0,036113. Наш редактор сделал 7 вызовов — три в 16:33, один в 16:36 и три в 16:45 — на общую сумму $0,038892.
Ограничения: что охватывает такое разделение, а что нет
Правило маршрутизации решает, куда уходит вызов. Оно не решает, стоит ли вообще собирать эти данные.
Пользовательское соглашение и политика конфиденциальности Xiaohongshu задают условия использования контента платформы и информации о пользователях. Обработка персональной информации в материковом Китае также подпадает под Закон о защите персональной информации. Действуют и Положения об управлении безопасностью сетевых данных, вступившие в силу 1 января 2025 г. Для ежедневной задачи самый практичный шаг: хранить только те столбцы, которые нужны для анализа. Обычно достаточно ID заметки, заголовка, показателей вовлечённости, времени публикации, сортировки и времени вызова. Не сохраняйте никнеймы авторов, аватары и профили комментаторов без необходимости, а если они нужны, определите чёткую цель и срок хранения.
У самого правила тоже есть ограничения, и для каждого есть простое решение.
| Ограничение | Что может пойти не так | Что делать |
|---|---|---|
| Список устаревает | Платформу добавляют или приостанавливают, и через несколько недель 106 жёстко заданных названий оказываются неверными | Обновляйте список через everyinfra_list_capabilities в каждой сессии или полагайтесь на запасной вариант с unknown_capability |
| Лимиты запросов | Для каждого API-ключа EveryInfra действует лимит запросов в минуту; при его превышении возвращается HTTP 429 (RFC 6585) | Подождите и повторите попытку; никогда не отправляйте повторные запросы в цикле без задержки |
| Два способа входа | EveryInfra использует API-ключ, а удалённый MCP-сервер Monid — OAuth (руководство по настройке MCP Monid, просмотрено 03.11.2026) | Храните ключи в переменных окружения и никогда не держите их в .mcp.json, который попадает в репозиторий |
Для удалённых MCP-серверов вход через OAuth описан в разделе об авторизации спецификации MCP.
Последнее ограничение — сама модель. Как бы хорошо ни были подключены инструменты, модель всё равно может выбрать не тот инструмент или неверно задать аргумент. MCP-Universe тестировал модели на реальных MCP-серверах. Лучший результат — 43,72% успешных выполнений — показала GPT-5. В MCP-Bench созданы задачи на основе 28 серверов и 250 инструментов, более похожие на реальную работу. Отдельно оцениваются вызовы, требующие нескольких инструментов и шагов.
Поэтому правило в этой статье намеренно простое. Список задан явно, коды ошибок различаются, а агент узнаёт цену до того, как потратить деньги. Каждый из этих пунктов избавляет модель от одной догадки. В статье о строгом вызове инструментов Claude с API данных мы описываем другой подход: строгие схемы аргументов вообще не дают модели собрать некорректный запрос.
Что изменилось за последнее время
За последние несколько месяцев вызов инструментов быстро развивался. Каждая строка ниже относится к июлю 2026 года или более позднему времени. В последнем столбце сказано, что изменение значит для разделения «ежедневные задачи через API данных, длинный хвост через роутер».
| Дата | Что произошло | Что это значит для вас |
|---|---|---|
| 2026-07-28 | Новая спецификация MCP: ядро без сохранения состояния, заголовки запросов Mcp-Method и Mcp-Name, подсказки по кешированию, фиксированный порядок для tools/list, а также обновления авторизации, включая RFC 9207 и документы с метаданными клиента | Два удалённых сервера в одном хосте требуют меньше соединений, а списки инструментов можно кешировать, поэтому модель на каждом шаге читает более стабильный набор описаний |
| 2026-10-06 | Издание The Hacker News опубликовало анализ 15 465 публичных MCP-серверов | Серверов больше, чем когда-либо, поэтому теперь важнее выбрать несколько серверов, которые останутся загруженными, чем обеспечить саму возможность подключения |
| 2026-10-16 | Semafor сообщил о посевном раунде TrustedRouter, роутера моделей, который конкурирует с OpenRouter | Схема «один ключ для доступа ко множеству бэкендов» продолжает привлекать инвестиции на уровне моделей; за такой же схемой на уровне инструментов стоит следить |
| 2026-10-19 | Открытая платформа Xiaohongshu опубликовала уведомление о выводе из эксплуатации API прогнозирования категорий | Официальная платформа по-прежнему сосредоточена на магазинах и электронной коммерции; для получения данных из публичного контента всё так же нужен другой способ доступа |
| 2026-10-21 | Издание Bloomberg рассказало о предложении Skills over MCP (SEP-2640), продвижению которого оно способствовало; в тот же день Stripe запустила сервис Treasury for agents, доступный через MCP | Файлы Skill и MCP сближаются, поэтому проверяйте, поставляется ли с сервером также файл Skill |
| 2026-10-22 | Anthropic опубликовала рекомендации о том, когда возвращать субагентов в основной цикл | Несколько простых инструментов для работы с данными в основном цикле обычно обеспечивают более высокие скорость и точность, поэтому по умолчанию разумно подключать к одному агенту два сервера |
| 2026-10-30 | В блоге MCP объявили, что SDK для Ruby получил статус Tier 1 | Надёжные MCP-клиенты можно писать на большем числе языков, так что и ваш собственный хост может работать с обоими серверами |
FAQ
Есть ли у Xiaohongshu официальный API для поиска заметок?
На 3 ноября 2026 г. открытая платформа Xiaohongshu в основном обслуживает ERP-приложения для магазинов и электронной коммерции и предлагает API для заказов, товаров и послепродажного обслуживания. 19 октября 2026 г. на ней вывели из эксплуатации API прогнозирования категорий. Поиск, детали и комментарии публичных заметок в неё не входят. Возможность EveryInfra xiaohongshu/search стоит $0,005556 за вызов; подробнее на странице API данных Xiaohongshu.
Списываются ли средства, если платформы нет в списке EveryInfra?
Нет. Для платформы вне списка возвращается HTTP 400 unknown_capability, а неверный аргумент возвращает HTTP 422 с did_you_mean. Ни то, ни другое не оплачивается; тестовые запуски (3 ноября 2026 г., с 16:40 до 16:41 SGT) описаны выше в разделе о правиле маршрутизации.
Сколько инструментов стоит подключать к одному агенту?
Жёсткого числа нет. RAG-MCP показал, что при большом числе инструментов предварительный поиск с последующим выбором повышает точность с 13,62% до 43,13%. Разработчик из r/mcp, у которого больше 680 инструментов, заметил, что после 30–60 инструментов выбор становится заметно хуже. О том, как распределять работу между субагентами и основным циклом, читайте в статье Субагенты Claude Code для аккаунтов TikTok.
Источники
- Каталог возможностей данных EveryInfra,
GET /api/v1/social/catalog, EveryInfra, просмотрено 03.11.2026 в 16:32 SGT. - «Architecture overview», документация Model Context Protocol, просмотрено 03.11.2026.
- «Release notes for the 2026-07-28 MCP specification», блог MCP, 28.07.2026.
- «Specification: Tools», спецификация MCP, версия 2026-07-28.
- «Specification: Authorization», спецификация MCP, версия 2026-07-28.
- «Specification: Transports», спецификация MCP, версия 2026-07-28.
- «The MCP Ruby SDK reaches Tier 1», блог MCP, 30.10.2026.
- «MCP Registry», официальный реестр MCP, дата обращения: 03.11.2026.
- «JSON-RPC 2.0 Specification», рабочая группа JSON-RPC.
- «Connect Claude Code to tools via MCP», документация Claude Code, дата обращения: 03.11.2026.
- «MCP quickstart», документация Claude Code, дата обращения: 03.11.2026.
- «Environment variables», документация Claude Code, дата обращения: 03.11.2026.
- «Model Context Protocol», документация Cursor, дата обращения: 03.11.2026.
- «Model Context Protocol», документация OpenAI Codex, дата обращения: 03.11.2026.
- «Use MCP servers in VS Code», документация VS Code, дата обращения: 03.11.2026.
- «MCP servers with Gemini CLI», документация Gemini CLI, дата обращения: 03.11.2026.
- «Connectors and MCP servers», документация платформы OpenAI, дата обращения: 03.11.2026.
- «Quickstart», документация OpenRouter, дата обращения: 03.11.2026.
- «FAQ», документация OpenRouter, дата обращения: 03.11.2026.
- «Writing effective tools for agents», Anthropic Engineering.
- «Introducing advanced tool use», Anthropic Engineering.
- «Code execution with MCP», Anthropic Engineering.
- «Building agents: When to fold subagents into your main agent loop», Anthropic, 22.10.2026.
- «RAG-MCP: Mitigating Prompt Bloat in LLM Tool Selection via Retrieval-Augmented Generation», arXiv:2505.03275.
- «ToolLLM: Facilitating Large Language Models to Master 16000+ Real-world APIs», arXiv:2307.16789.
- «Gorilla: Large Language Model Connected with Massive APIs», arXiv:2305.15334.
- «MCP-Universe: Benchmarking Large Language Models with Real-World Model Context Protocol Servers», arXiv:2508.14704.
- «MCP-Bench: Benchmarking Tool-Using LLM Agents with Complex Real-World Tasks via MCP Servers», arXiv:2508.20453.
- «RFC 9110: HTTP Semantics», IETF.
- «RFC 6585: Additional HTTP Status Codes», IETF.
- «RFC 9457: Problem Details for HTTP APIs», IETF.
- «RFC 9728: OAuth 2.0 Protected Resource Metadata», IETF.
- «RFC 8707: Resource Indicators for OAuth 2.0», IETF.
- «RFC 9207: OAuth 2.0 Authorization Server Issuer Identification», IETF.
- «The OAuth 2.1 Authorization Framework, draft 13», IETF.
- «Skills over MCP: How Bloomberg helped standardize agent skills at scale», Bloomberg, 21.10.2026.
- «Treasury for agents», Stripe Newsroom, 21.10.2026.
- Анализ 15 465 публичных MCP-серверов, The Hacker News, 06.10.2026.
- Материал об агенте Pi, MCP и code mode, The New Stack.
- «MCP Server and SI Agent Government Hackathon», Администрация общих служб США (GSA), сентябрь–ноябрь 2026 г.
- Материал о посевном раунде конкурента OpenRouter, Semafor, 16.10.2026.
- Пост о работе с 58 MCP-серверами и 680+ инструментами, Reddit r/mcp.
- «Requests: Quickstart», документация Requests.
- Пользовательское соглашение Xiaohongshu (на китайском), Xiaohongshu, дата обращения: 03.11.2026.
- Политика конфиденциальности Xiaohongshu (на китайском), Xiaohongshu, дата обращения: 03.11.2026.
- Открытая платформа Xiaohongshu (на китайском), Xiaohongshu, дата обращения: 03.11.2026, включая уведомление от 19.10.2026.
- Закон КНР о защите персональной информации (на китайском), Администрация киберпространства Китая.
- Положения об управлении безопасностью сетевых данных (на китайском), Госсовет КНР, опубликованы в сентябре 2024 г., действуют с 01.01.2025.
- Материал Huxiu о Xiaohongshu и ИИ (на китайском), Huxiu, 16.10.2026.
- Главная страница Monid, дата обращения: 03.11.2026 («Live · 2800+ tools», «Start with $1 in free credit»); ссылка приведена в статье.
- Monid, «The OpenRouter for agent tools», страница с позиционированием, дата обращения: 03.11.2026; ссылка приведена в статье.
- Monid, «MCP quickstart», документация по настройке, дата обращения: 03.11.2026; ссылка приведена в статье.
- Monid, страница инструмента Xiaohongshu: по состоянию на 29.10.2026 указано 49 эндпоинтов; ссылка приведена в статье.
- Monid, «How to get Xiaohongshu (RedNote) data through an API», руководство, дата обращения: 03.11.2026; ссылка приведена в статье.
Справка BL-78