Alternativa a Reddit Scraper di Apify: abbiamo misurato quanto costano post e commenti per 1.000 righe
Reddit Scraper Lite su Apify costa $4,04 per 1.000 commenti. Noi abbiamo misurato $0,0073 per un elenco piatto senza ID del commento padre. Per gli alberi completi, usa Apify.
Reddit Scraper Lite è lo scraper Reddit con più utenti nell'Apify Store. Al prezzo pubblico del livello Free, 1.000 commenti di Reddit costano $4,04: $0,004 per risultato più un costo di avvio di $0,04. L'alternativa popolare più economica dello Store, automation-lab, costa circa $0,59 per lo stesso lavoro. Il 4 novembre 2026 abbiamo chiamato l'endpoint reddit/comments di EveryInfra per 13 post.
Ogni chiamata è costata $0,000556. Abbiamo ottenuto 997 commenti univoci per $0,007228 in totale, ovvero $0,00725 per 1.000. È 557 volte più economico di Lite e 81 volte più economico di automation-lab. Per i post, la ricerca per parola chiave è costata $0,0293 per 1.000 e gli elenchi dei subreddit $0,0114 per 1.000.
Ci sono però tre lavori per cui Apify è lo strumento migliore, e l'articolo lo dice in ogni test. Primo, restituiamo al massimo 100 commenti per post, quindi da un thread con 771 commenti ne abbiamo ottenuto solo il 13%. Secondo, le nostre righe di commenti includono le risposte di secondo e terzo livello, ma non hanno l'ID del commento padre, quindi non puoi ricostruire l'albero. Terzo, otto ordinamenti sullo stesso subreddit ci hanno dato solo 286 post univoci, non 1.000.
Di seguito testiamo uno alla volta quattro tipi di dati di Reddit. Parliamo anche del «Reddit Scraper» deprecato su Apify e della forbice di prezzo tra i 746 scraper Reddit dello Store. Infine, ripercorriamo le tappe che portano alla chiusura dell'API pubblica per i dati di Reddit.
Come leggere i numeri di questo articolo
In questo articolo, «costo per 1.000» indica la somma effettivamente addebitata, divisa per le righe univoche effettivamente restituite, moltiplicata per 1.000. Risponde a una sola domanda: quanto ti costano 1.000 post o commenti di Reddit? EveryInfra addebita per richiesta, e ogni richiesta restituisce una pagina. La ricerca restituisce fino a 25 righe, gli elenchi dei subreddit e i commenti fino a 100. I post di un utente fino a 50 (vedi max_limit nel catalogo gratuito).
Quasi tutti gli scraper Reddit dell'Apify Store addebitano invece per risultato. Addebitano una volta per ogni riga scritta nel dataset. Puoi confrontare i due modelli solo dopo averli convertiti nella stessa unità.
Da parte nostra, il divisore è sempre il numero di righe dopo la deduplicazione per id. Non dividiamo mai per il limit richiesto. Quindi le chiamate che restituiscono poche righe, o molti duplicati, possono solo far sembrare più alto il nostro prezzo. Per Apify abbiamo usato solo materiale pubblico.
Cioè le pagine dello Store, la pagina dei prezzi, la documentazione e l'endpoint pubblico dei metadati degli Actor, che non richiede un account (documentazione Get Actor API). Actor è il nome che Apify dà a un programma di scraping in cloud. Non ci siamo registrati su Apify e non abbiamo eseguito nessun Actor. Ogni cifra relativa ad Apify in questo articolo è un prezzo di listino pubblico, non un importo rilevato da una fattura effettiva.
Scraper Reddit di Apify vs EveryInfra: la tabella riassuntiva
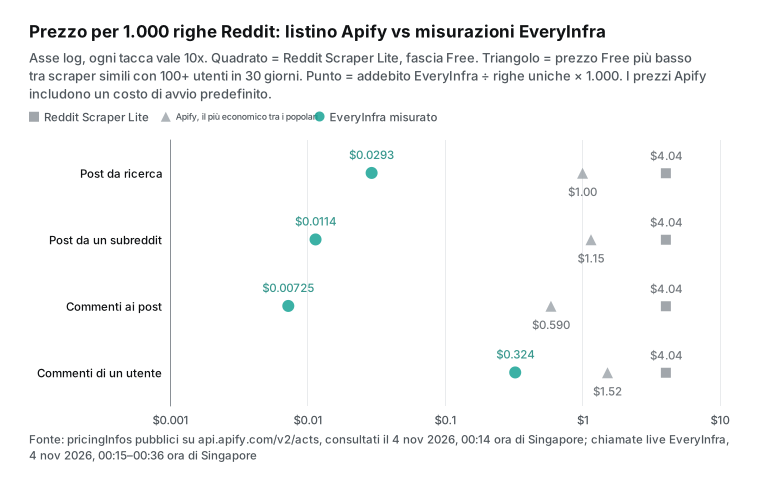
Questa tabella riassume il risultato dell'intero articolo. Ogni riga riporta due prezzi di Apify. Uno è quello di Reddit Scraper Lite, lo scraper Reddit con più utenti. L'altro è il prezzo Free più basso tra gli scraper che fanno lo stesso lavoro e hanno avuto almeno 100 utenti negli ultimi 30 giorni.
Abbiamo letto i prezzi dal campo pricingInfos dei metadati pubblici di Apify alle 00:15 ora di Singapore del 4 novembre 2026. Ogni prezzo di Apify presuppone una sola esecuzione che restituisce 1.000 righe sul livello Free, più il costo di avvio predefinito. Ogni numero di EveryInfra viene dalle nostre chiamate live. L'addebito è billing.charged_usd della risposta, le righe sono results e la deduplicazione è per id.
| Dati | Endpoint EveryInfra | Dati misurati: chiamate / righe / righe univoche / addebito | EveryInfra per 1.000 righe univoche | Reddit Scraper Lite (gratuito) | Rapporto | Il più economico tra i popolari su Apify (Free) | Rapporto |
|---|---|---|---|---|---|---|---|
| Post dalla ricerca per parola chiave | reddit/search | 10 / 195 / 190 / $0.00556 | $0.0293 | $4.04 | 138x | clearpath Search $1,00 | 34x |
| Post di un subreddit | reddit/subreddit_posts | 10 / 837 / 486 / $0.00556 | $0.0114 | $4.04 | 353x | automation-lab $1,15 | 101x |
| Commenti ai post | reddit/comments | 13 / 997 / 997 / $0.007228 | $0.00725 | $4.04 | 557x | automation-lab $0,59 | 81x |
| Commenti di un utente | reddit/user_comments | 1 / 100 / 100 / $0.032403 | $0.324 | $4.04 | 12.5x | harshmaur User $1,52 | 4.7x |
Ogni rapporto è il prezzo di Apify diviso il nostro. Quando leggi la tabella, tieni a mente quattro punti. Primo, la maggior parte della differenza viene da «una richiesta, una pagina». Una chiamata ai commenti restituisce fino a 100 righe, quindi una pagina piena distribuisce il prezzo fisso su molte righe. Quando ogni chiamata restituisce solo una o due righe, il risultato si ribalta, e la sezione sul punto di pareggio più avanti mostra i calcoli.
Secondo, il prezzo di automation-lab per i commenti, $0,59, si basa su $0,000575 per commento, un costo di avvio di $0,003 e 10 righe di post a $0,00115 l'una. La sua pagina nello Store dice che il prezzo Free dei commenti sale a $0,00075 il 17 novembre. Con lo stesso calcolo si arriva a $0,76 (pagina di automation-lab nello Store).
Terzo, costiamo meno su entrambe le righe dei post, ma non sempre arriviamo a 1.000 post. La ricerca copre solo l'ultimo mese e gli elenchi dei subreddit non hanno paginazione. Le prossime sezioni mostrano quanti post abbiamo ottenuto davvero. Quarto, i prezzi di Apify cambiano ogni uno o due mesi, e la sezione «Cosa è cambiato di recente» elenca le date.
Come abbiamo testato e quando un test era superato
Abbiamo scritto i criteri di superamento e fallimento prima della prima chiamata. Ognuno dei quattro tipi di dati richiedeva almeno due chiamate live, distribuite su tre o più momenti diversi. Il costo per 1.000 usava sempre le righe univoche come divisore. Per valutare la copertura dell'albero dei commenti, abbiamo confrontato le nostre righe una per una con la lettura di almeno due pagine di post fatta da un servizio di terze parti.
Non abbiamo dedotto la copertura da un elenco di campi. Se Apify era più economico, più completo o più adatto per un lavoro, il testo e la tabella riassuntiva dovevano dirlo. Dovevamo includere almeno due chiamate che non restituissero dati e registrare quanto era costata ciascuna. Abbiamo fatto al massimo una chiamata live a reddit/user_comments e nessuna chiamata live a reddit/painpoint.
Ogni richiesta è stata inviata a POST https://api.everyinfra.com/api/v1/social. La prima richiesta è partita alle 00:15 ora di Singapore del 4 novembre 2026. Il giro dei commenti si è svolto dalle 00:26 alle 00:32 ora di Singapore, e l'ultima chiamata è terminata alle 00:36 ora di Singapore. Per ogni chiamata abbiamo registrato orario di invio, stato HTTP, durata, numero di righe e charged_usd. Uno script ha poi ricalcolato ogni valore dalle risposte grezze. Tutti i numeri nel testo, nelle tabelle e nei grafici vengono da quello script.
| Caso d'uso | Endpoint e parametri | Chiamate live | Orario (ora di Singapore, 4 novembre) | Cosa abbiamo verificato |
|---|---|---|---|---|
| Ricerca per keyword | reddit/search, limit 25. Sette parole chiave, più gli ordinamenti newest, top e popular per «standing desk» | 10 | Dalle 00:15 alle 00:19 | Righe per chiamata, effetto dell'ordinamento, intervallo di date |
| Post dei subreddit | reddit/subreddit_posts. Otto combinazioni di ordinamento e periodo su r/Python, due su r/smallbusiness, limit 100 | 10 | Dalle 00:20 alle 00:24 | Nuovi post per ogni ordinamento aggiuntivo, il tetto per una community |
| Commenti | reddit/comments. 13 post con da 16 a 771 commenti, limit 100 | 13 | Dalle 00:26 alle 00:32 | Righe per post, percentuale rispetto al conteggio del post, risposte annidate |
| Utenti | reddit/user_posts sette volte su tre account. reddit/user_comments una volta | 8 | Dalle 00:24 alle 00:35 | Fino a quanto indietro nel tempo risale, cosa restituisce una chiamata costosa |
| Dettaglio del post | reddit/post_detail su due post | 2 | 00:33 | Il conteggio corrisponde a quello dell'elenco? |
| Nessun dato | Nessuna chiave, valore di sort errato, parametro in più, subreddit inesistente, post inesistente, utente inesistente | 6 | Dalle 00:25 alle 00:36 | Quali casi costano |
L'articolo ha usato 49 chiamate live, per un addebito totale di $0,056311. Tutte le chiamate hanno usato la stessa chiave di test, con un limite di 10 chiamate al minuto. Durante il test abbiamo ricevuto più volte HTTP 429 (troppe richieste). Il nostro script attendeva 60 secondi e inviava di nuovo la chiamata. Una risposta 429 non comporta addebiti e non è conteggiata nei totali qui sopra.
Test 1: il lavoro più comune per uno scraper Reddit di Apify, 1.000 post dalla ricerca per parola chiave
reddit/search restituisce fino a 25 righe per chiamata. L'intervallo temporale è limitato all'ultimo mese. La nota del catalogo sul parametro sort dice che il periodo resta di un mese qualunque ordinamento tu scelga. Abbiamo cercato sette parole chiave diverse, una volta ciascuna: standing desk, notion alternative, claude code, best vpn, airpods pro 3, home espresso machine e sourdough starter.
Le chiamate hanno restituito 25, 17, 25, 25, 25, 24 e 25 righe, in media 23,7. Ogni post aveva una data tra il 3 ottobre e il 3 novembre 2026, in linea con il periodo di un mese. Le sette chiamate sono costate $0,003892 e nessuna delle 166 righe era un duplicato. Fanno $0,0234 per 1.000.
L'ordinamento ha cambiato molto i conteggi. Per la stessa parola chiave, standing desk, l'ordinamento predefinito per pertinenza ha restituito 25 righe e popular 22. Ma top ne ha restituite solo 4 e newest solo 3, tutte e tre del 3 novembre. Il catalogo spiega il motivo. La ricerca restituisce solo i post che corrispondono alla parola chiave, quindi il conteggio può scendere sotto il limite.
L'addebito di una chiamata con zero righe viene rimborsato perché il risultato è vuoto. Una chiamata con tre righe viene addebitata al prezzo normale di $0,000556. Includendo quelle tre chiamate con ordinamento, le 10 chiamate hanno restituito 195 righe, 190 delle quali univoche, per $0,00556. Fanno $0,0293 per 1.000, e la tabella riassuntiva usa questo valore più prudente.
Per raccogliere 1.000 post a 23,7 per chiamata, servono circa 42 ricerche. Cioè 42 parole chiave o combinazioni di parole chiave diverse, per un costo di circa $0,0234. Se ti interessano solo una o due parole chiave, non arriverai a 1.000. In un mese una parola chiave corrisponde a un numero limitato di post, e la nostra ricerca non va più indietro.
Su Apify è diverso. Il parametro time di Lite accetta all, year, month e altri valori (pagina nello Store, «Advanced parameters»). Lo scraper di ricerca di clearpath supporta cinque ordinamenti e filtri temporali. Costa $0,00099 per risultato più $0,00001 per ogni scrittura nel dataset e un piccolo costo di avvio, quindi $1,00 per 1.000 (pagina di clearpath Search nello Store).
Quindi, per 1.000 post su un argomento degli anni passati, Apify è la scelta migliore. Per monitorare ogni giorno o ogni settimana un insieme di parole chiave sull'ultimo mese, costiamo $0,000556 per 20 o più post a chiamata. È molto più economico.
| Keyword | Ordinamento | Righe | Post più vecchio (UTC) | Addebitato |
|---|---|---|---|---|
| standing desk | predefinito (pertinenza) | 25 | 3 ottobre | $0.000556 |
| standing desk | popular | 22 | 27 ottobre | $0.000556 |
| standing desk | top | 4 | 6 ottobre | $0.000556 |
| standing desk | newest | 3 | 3 novembre | $0.000556 |
| notion alternative | default | 17 | 3 ottobre | $0.000556 |
| Le altre 5 parole chiave | default | Da 24 a 25 | Dal 3 al 6 ottobre | $0,000556 ciascuna |
Test 2: 1.000 post da un solo subreddit, ma ne abbiamo ottenuti 286
reddit/subreddit_posts restituisce fino a 100 righe per chiamata e non ha un parametro di paginazione. Per ottenerne di più puoi solo cambiare l'ordinamento e la finestra temporale. sort accetta newest, popular, top, rising e relevance. date_range si applica solo con sort=top, come dice il catalogo. Abbiamo eseguito otto combinazioni su r/Python, una volta ciascuna. Il grafico mostra quanti nuovi post ha aggiunto ogni combinazione in più.
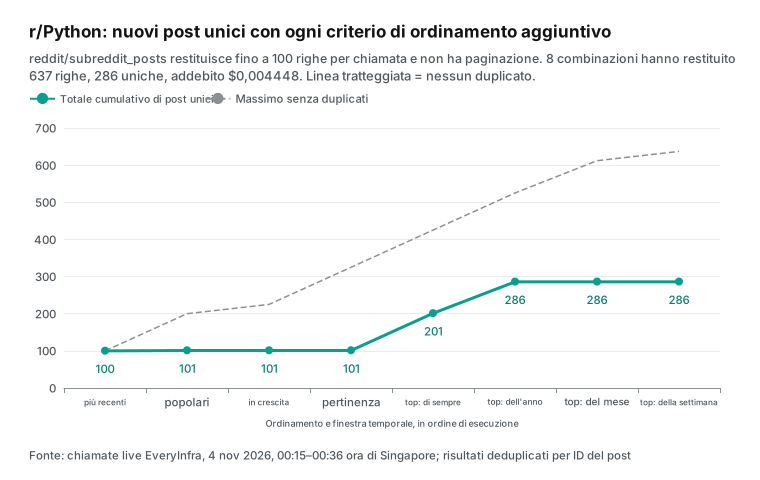
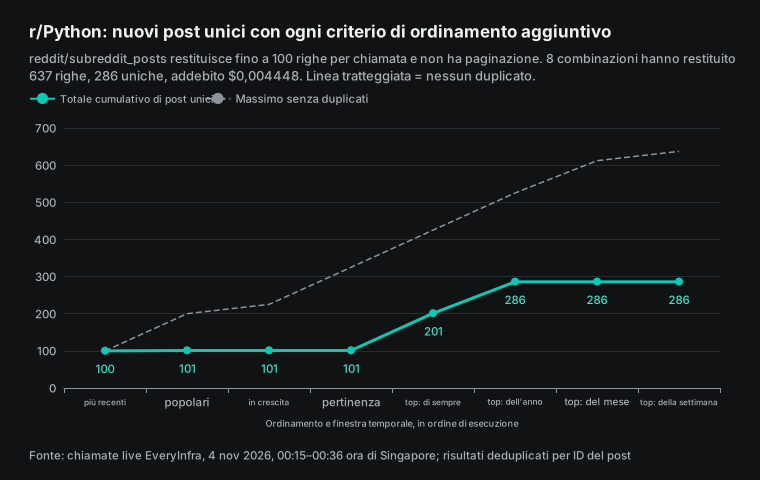
Il risultato è chiaro. Le 100 righe di newest, popular e relevance erano quasi lo stesso insieme, 101 post univoci in tutto. Rising ha restituito 25 righe, tutte già viste. Solo due combinazioni hanno portato nuovi post: top con all_time (100 post, il più vecchio del 2017) e top con past_year (85 nuovi). Le 87 righe di past_month e le 25 di past_week erano tutte duplicati. Le otto chiamate sono costate $0,004448 per 286 post univoci, ovvero $0,0156 per 1.000.
Se sai già che contano solo newest, top di sempre e top dell'ultimo anno, tre chiamate ottengono gli stessi 286 post per $0,001668. Fanno $0,0058 per 1.000. Su r/smallbusiness, due chiamate (newest e top dell'ultimo anno) hanno restituito 100 righe ciascuna senza sovrapposizioni, cioè $0,0056 per 1.000. Tutte e 10 le chiamate sui subreddit hanno restituito insieme 837 righe, 486 univoche, per $0,00556. Fanno $0,0114 per 1.000, il valore della tabella riassuntiva.
Quindi non possiamo fornire «1.000 post da un solo subreddit», e per questo lavoro Apify è più adatto. Gli elenchi di Reddit consentono di recuperare solo circa 1.000 elementi precedenti. Il readme di Lite dice lo stesso e suggerisce di combinare ordinamenti, ricerca e filtri temporali per raccoglierne di più (pagina nello Store, «Reddit's 1,000 items limit»). Uno scraper con paginazione si avvicina a 1.000 righe per ordinamento. Noi restituiamo solo la prima pagina da 100 per ogni ordinamento.
Per un'occhiata quotidiana ai post nuovi e popolari di una community, due chiamate (newest più top dell'ultimo giorno) costano $0,001112. Per esportare una tantum anni di storico di una community, usa Apify, oppure candidati al programma per ricercatori di Reddit.
Test 3: 1.000 commenti e l'albero, il riferimento da battere per uno scraper di commenti Reddit su Apify
I commenti mostrano la differenza di prezzo più grande di questo test. Sono anche l'area in cui Apify ha il vantaggio più netto in termini di funzionalità. reddit/comments accetta l'URL di un post e restituisce fino a 100 commenti per chiamata. Abbiamo scelto 13 post con da 16 a 771 commenti ciascuno ed effettuato una chiamata per ciascun post.
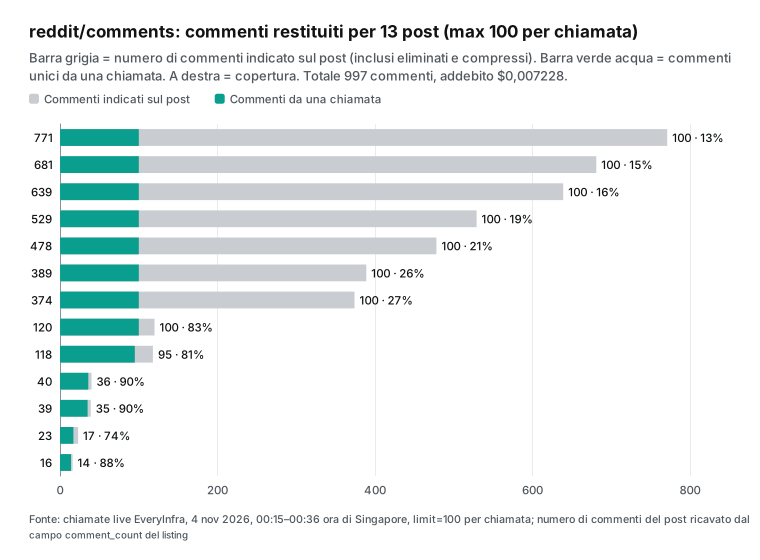
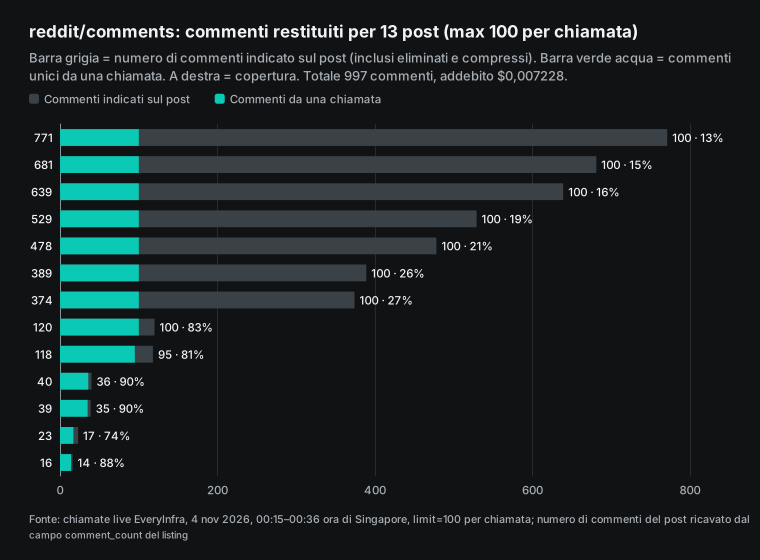
Le 13 chiamate sono costate $0,007228 e hanno restituito 997 commenti senza duplicati. Fanno $0,00725 per 1.000, con due condizioni. Primo, sui post con meno di 100 commenti abbiamo ottenuto dal 74% al 90% del numero mostrato sul post. Una parte della differenza sono commenti eliminati o rimossi, che contano ancora sul post ma non hanno testo. Il resto sono commenti che Reddit nasconde dietro «load more».
Secondo, sui post con più di 100 commenti una chiamata ne restituisce 100. Sul thread da 771 commenti è il 13%. Con il nostro limite non puoi ottenere tutti i commenti di un thread molto attivo. Lo scraper di commenti di clearpath dichiara che maxCommentsPerPost impostato a 0 con expandAllComments attivo restituisce l'albero completo. Sono incluse le risposte annidate a 10 o più livelli dietro «continue this thread» (pagina di clearpath nello Store). Per questo lavoro, Apify è lo strumento migliore.
| Commenti mostrati sul post | Ottenuti | Copertura | Orario (ora di Singapore) | Addebitato |
|---|---|---|---|---|
| 771 | 100 | 13% | 00:26 | $0.000556 |
| 681 | 100 | 15% | 00:27 | $0.000556 |
| 639 | 100 | 16% | 00:27 | $0.000556 |
| 529 | 100 | 19% | 00:28 | $0.000556 |
| 478 | 100 | 21% | 00:28 | $0.000556 |
| 389 | 100 | 26% | 00:29 | $0.000556 |
| 374 | 100 | 27% | 00:29 | $0.000556 |
| 120 | 100 | 83% | 00:30 | $0.000556 |
| 118 | 95 | 81% | 00:30 | $0.000556 |
| 40 | 36 | 90% | 00:31 | $0.000556 |
| 39 | 35 | 90% | 00:32 | $0.000556 |
| 23 | 17 | 74% | 00:32 | $0.000556 |
| 16 | 14 | 88% | 00:32 | $0.000556 |
La domanda «L'albero dei commenti è completo?» ha due parti. La prima è se le risposte annidate vengono restituite. Abbiamo preso i due post con 16 e 23 commenti. Un lettore di pagine di terze parti ha scaricato la pagina di ciascun post con i commenti. Le due pagine mostravano 27 commenti, uno dei quali era il segnaposto di un commento eliminato.
Abbiamo cercato gli altri 26 tra le nostre righe in base all'inizio del testo e li abbiamo trovati tutti e 26. L'insieme comprendeva 12 commenti di primo livello, 10 risposte di secondo livello e 4 di terzo livello. Abbiamo restituito anche 5 commenti che il lettore di pagine non mostrava. Quindi le righe non contengono solo commenti di primo livello. Ci sono anche le risposte di secondo e terzo livello.
La seconda parte è la struttura. Ogni riga di commento in queste 13 chiamate aveva sette campi: id, text, author_username, like_count, url, posted_at e platform. Il catalogo elenca anche community, ma nessuna di queste risposte lo conteneva, quindi non farci affidamento. Per il nome della community, usa community dall'elenco dei post o l'url del commento. Non ci sono né l'ID del commento padre né la profondità.
Sai che 14 di quelle righe sono risposte, ma non chi ha risposto a chi. Su Apify, i record dei commenti di Lite contengono parentId e numberOfReplies (pagina nello Store, «Example Reddit post»). automation-lab include depth e parentId. Dichiara anche che commentCoverage è unverified e non garantisce l'albero completo (pagina nello Store, «Comment fields»). L'aggiornamento di clearpath del 6 ottobre ha corretto depth per le risposte nei thread completamente espansi.
Cosa significa per il tuo caso d'uso? Per conteggi di sentiment, frequenza delle parole chiave, tagging per argomento o ricerca di citazioni di lamentele, basta una tabella piatta di commenti, a $0,00725 per 1.000. Per «chi discute con chi», «quanto sono profonde le catene di risposte» o «a quali domande ha risposto l'autore del post», ti serve uno strumento con parentId. Abbiamo parlato del segnaposto MoreComments di PRAW e di replace_more in perché le esportazioni dei commenti di Reddit sono incomplete (documentazione PRAW). L'albero restituito da Reddit contiene per progettazione sezioni non espanse. La documentazione JSON di Reddit le chiama oggetti more (wiki reddit-archive).
La ricerca accademica ha già incontrato questo problema. Nel 2018 Gaffney e Matias hanno studiato un dataset molto usato che dichiarava di contenere «tutti i commenti pubblici di Reddit». Vi hanno trovato grandi lacune. Secondo loro, il rischio è più alto per gli studi sulle cronologie degli utenti e sulla struttura delle reti (articolo su arXiv). Qualunque strumento usi, salva due numeri con ogni esportazione: quanti commenti hai ottenuto e quanti ne mostra il post.
Abbiamo anche chiamato reddit/post_detail due volte. Per i post da 771 e da 40 commenti, il suo comment_count corrispondeva a quello dell'elenco, e ogni chiamata è costata $0,000556. Se scegli i post prima di scaricare i commenti, ordina per il comment_count dell'elenco. Non serve una chiamata di dettaglio separata.
Test 4: post e commenti di un utente, e quando l'endpoint costoso non conviene
reddit/user_posts restituisce fino a 50 righe per chiamata, allo stesso prezzo di $0,000556 della maggior parte degli endpoint. Abbiamo provato prima spez, l'account del CEO di Reddit, con newest, top di sempre, top dell'ultimo anno e popular. Tutte e quattro le chiamate hanno restituito gli stessi 24 post. Il più vecchio era dell'11 luglio 2015 e il più recente era il post del 29 ottobre sul login wall. Quindi su questo account l'ordinamento non ha avuto effetto, le quattro chiamate sono costate $0,002224 e le chiamate dalla seconda alla quarta sono state inutili.
Un account editoriale, washingtonpost, ha restituito il massimo di 50 post in una sola chiamata, dal 20 aprile al 3 novembre 2026, cioè $0,0111 per 1.000. Una seconda chiamata con top di sempre ha restituito gli stessi 50 post. Anche l'account della NASA, nasa, ha restituito 50 post con newest, dal 5 giugno 2025 al 29 ottobre 2026. Quindi una chiamata si ferma a 50 post dell'utente, e gli altri ordinamenti non arrivano a quelli più vecchi.
Per risalire l'intera cronologia di un account attivo, è più adatto uno scraper di Apify con paginazione. Il Reddit User Scraper di harshmaur dichiara di restituire l'intera cronologia di post e commenti di un utente. Lo scraper di contenuti utente di clearpath dichiara di restituire fino a 1.000 elementi per utente.
reddit/user_comments è un caso diverso. Una chiamata costa $0,032403, 58 volte una chiamata normale, e restituisce fino a 200 righe. L'abbiamo chiamato una volta per spez con limit 200 e abbiamo ottenuto 100 righe, dal 31 luglio 2025 al 29 ottobre 2026. Fanno $0,324 per 1.000. C'è un altro fatto da dire chiaramente.
Il testo di commento più lungo in quelle 100 righe era di esattamente 300 caratteri, e la media era di 160. Il field_note del catalogo per questo endpoint lo spiega. Quando le altre fonti non sono disponibili, i risultati vengono da una fonte di riserva che tronca il testo ai primi 300 caratteri. È ciò che è successo in questa chiamata. Questo risultato va bene per capire dove pubblica una persona, con che frequenza e quanti upvote riceve. Non va bene per analizzare il testo di commenti lunghi.
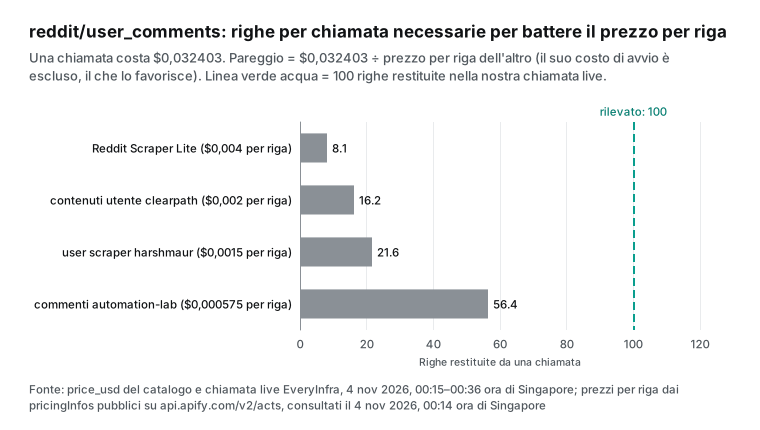
Quando questo endpoint non conviene? Dipende dalle righe per chiamata. Dividi $0,032403 per un prezzo per riga di Apify e ottieni il numero minimo di righe per chiamata con cui costiamo meno. Contro Lite a $0,004, il punto di pareggio è di 8,1 righe.
Contro lo scraper di contenuti utente di clearpath a $0,002 ($0,00199 più $0,00001 per scrittura), sono 16,2 righe. Contro lo scraper di utenti di harshmaur a $0,0015, sono 21,6 righe. Contro il prezzo dei commenti di automation-lab di $0,000575, sono 56,4 righe.
| Prezzo per riga su Apify (Free) | Righe per chiamata al pareggio | La nostra chiamata live ha restituito |
|---|---|---|
| Reddit Scraper Lite, $0,004 | 8.1 | 100 |
| clearpath user content, $0,002 | 16.2 | 100 |
| scraper di utenti di harshmaur, $0,0015 | 21.6 | 100 |
| commenti di automation-lab, $0,000575 | 56.4 | 100 |
Quindi evitalo in tre casi. Primo, quando l'utente ha pochi commenti, ad esempio un account nuovo o uno con una dozzina di post, uno scraper con prezzo per riga costa meno. Secondo, quando ti interessa davvero la discussione sotto un post, usa reddit/comments, che costa 45 volte meno, a $0,00725 per 1.000. Terzo, quando ti serve il testo di commenti lunghi e questa chiamata incappa nel taglio a 300 caratteri, cambia strumento o riprova più tardi.
Per ricerche su larga scala su molti utenti, una chiamata restituisce da 100 a 200 righe. Fanno da $0,16 a $0,32 per 1.000, cioè un costo da 4,7 a 9,4 volte inferiore ai $1,52 dello scraper di utenti di harshmaur. Ma se ti servono anche il karma o l'anzianità dell'account di ogni utente, quello scraper di harshmaur li restituisce in un'unica esecuzione.
reddit/painpoint costa ancora di più: $0,072 per chiamata. Non l'abbiamo chiamato, quindi riportiamo solo ciò che, secondo il catalogo, offre. Trova fino a 15 post per una parola chiave e legge i loro commenti di primo livello. Restituisce una riga di riepilogo con i post trovati, i commenti letti e conteggi approssimativi dei commenti negativi e positivi. La riga elenca anche le parole che si ripetono nei commenti negativi e le community coinvolte.
Restituisce anche i post principali e i commenti negativi con più upvote come citazioni. Secondo il catalogo, negativo e positivo si basano su un elenco di parole. Il sarcasmo e i toni misti non vengono valutati bene, quindi i conteggi sono approssimativi e non rappresentano un tasso di insoddisfazione. Anche parole comuni come «any» o «it's» possono comparire tra le parole più frequenti.
Puoi costruire la stessa cosa da solo con 1 chiamata a reddit/search e 15 chiamate a reddit/comments. Quelle 16 chiamate costano $0,0089, e il tagging può farlo il tuo modello. Costa 8 volte meno di painpoint, e ottieni fino a 100 commenti per post, non solo quelli di primo livello.
| Opzione | Chiamate | Costo | Commenti letti per post | Come viene valutato il tono |
|---|---|---|---|---|
reddit/painpoint | 1 | $0.072 | Solo primo livello | Elenco di parole, conteggi approssimativi |
reddit/search più 15 chiamate a reddit/comments | 16 | $0.0089 | Fino a 100, risposte annidate incluse | Il tuo modello |
painpoint è adatto a chi non vuole scrivere codice e vuole dare un'occhiata veloce alle lamentele su un prodotto. Per un report settimanale, costruirlo da solo costa meno. Abbiamo mostrato il metodo completo in task pianificati di Claude Code per i pain point di Reddit.
Le chiamate non riuscite o senza risultati costano?
Qui le regole di fatturazione di Apify ed EveryInfra differiscono di più. Abbiamo inviato di proposito sei richieste che non potevano restituire dati.
| Caso | Inviata (ora di Singapore) | Stato HTTP | Risposta | Addebitato |
|---|---|---|---|---|
| Nessuna chiave | 00:25 | 401 | missing_key, con l'indicazione di usare l'header Authorization | $0 |
sort impostato su hot | 00:25 | 422 | invalid_value, con i valori ammessi, e did_you_mean popular e top | $0 |
Parametro time_filter in più | 00:25 | 422 | unknown_param, con i parametri obbligatori e facoltativi e un esempio funzionante | $0 |
| Subreddit inesistente | 00:26 | 200 | Una riga segnaposto con solo id, community e platform, addebitata come un risultato | $0.000556 |
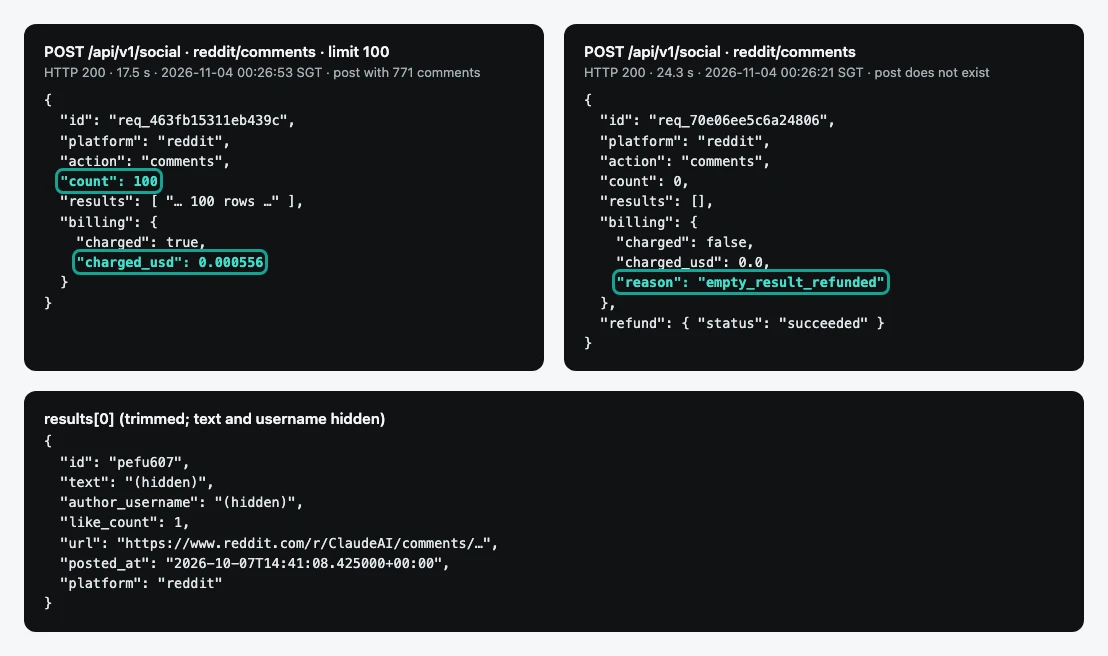
| Post inesistente | 00:26 | 200 | 0 righe, empty_result_refunded, addebito rimborsato | $0 |
| Utente inesistente | 00:36 | 200 | 0 righe, empty_result_refunded | $0 |
I primi tre casi sono errori nei parametri. Verifichiamo prima la chiave e poi i parametri. Una richiesta errata riceve subito un 4xx senza addebito. L'errore spiega come correggere la chiamata, così un client AI può correggerla e inviarla di nuovo. Il quinto e il sesto caso sono normali risultati vuoti: la richiesta è andata a buon fine, ma non c'era nessuna corrispondenza, quindi l'addebito è stato rimborsato subito.
Il quarto caso richiede attenzione. Per un nome di subreddit inesistente, la chiamata restituisce HTTP 200 e count 1. L'unica riga ha un id che inizia con target-status: e contiene solo i campi community e platform, senza titolo, testo o link. Quella chiamata è costata $0,000556, il prezzo di un risultato. Quindi, nei batch di subreddit, scarta questa riga in base al prefisso dell'id prima di contare le righe o calcolare il costo unitario. Se non restano righe, il nome è sbagliato o il subreddit non esiste più. Toglilo dalla lista per non pagarlo di nuovo.
Su Apify, ogni Actor stabilisce le proprie regole. Il Reddit Scraper di Apify prevede un evento «No result» a $0,0005. Copre una community eliminata, una ricerca senza risultati e un post senza commenti. In ognuno di questi casi scrive un record che ne spiega il motivo, a quel prezzo (pagina nello Store).
automation-lab dichiara che le esecuzioni senza risultati non vengono addebitate. Il costo di avvio di Lite, calcolato in base alla memoria, viene addebitato all'avvio dell'esecuzione, anche se non arriva nessun risultato. Con i 2 GB predefiniti sono $0,04.
Le esecuzioni fallite o andate in timeout sono più comuni di quanto pensi. Le prossime sezioni mostrano che il 10% delle 360.000 esecuzioni di Lite negli ultimi 30 giorni è andato in timeout. La documentazione di Apify dice che puoi impostare un addebito massimo per ogni esecuzione, e l'esecuzione si ferma al raggiungimento del limite (Actors in Store). Impostalo prima di un lavoro di grandi dimensioni.
Prezzi di Apify Reddit Scraper Lite: $0,004 per risultato più un costo di avvio per 2 GB
La maggior parte di chi cerca «apify reddit scraper» arriva prima su Reddit Scraper Lite di trudax. Negli ultimi 30 giorni ha avuto 8.543 utenti, più di qualsiasi altro scraper Reddit nello Store. Sono circa il 50% in più del secondo. Applica due tipi di addebito. Ogni risultato scritto nel dataset costa $0,004 sul livello Free, ovvero $4,00 per 1.000. Il livello Bronze (piano Starter) costa $0,0038, Silver (Scale) $0,0036 e Gold (Business) $0,0034.
I numeri di utenti ed esecuzioni in questo articolo provengono dall'API dell'elenco dello Store, letta alle 00:14 ora di Singapore del 4 novembre 2026. Nello stesso momento, l'API di dettaglio di questo Actor indicava 8.540 utenti e 363.964 esecuzioni. Le due fonti differiscono di meno dell'1%.
Ogni esecuzione paga anche un costo di avvio in base alla memoria, a $0,02 per GB. La memoria predefinita è di 2.048 MB, quindi un'esecuzione predefinita parte da $0,04, e la piattaforma fissa $0,04 come addebito minimo per esecuzione. Tutto questo viene dai campi pricingInfos e defaultRunOptions dei metadati pubblici di Lite, letti alle 00:15 ora di Singapore del 4 novembre 2026. La documentazione di Apify associa i livelli ai piani: Free paga il prezzo FREE, Starter paga BRONZE, Scale paga SILVER e Business paga GOLD. PLATINUM e DIAMOND sono riservati ai clienti enterprise (Actor pricing and costs).
| Livello (piano) | Per risultato | 1.000 risultati in un'esecuzione, con il costo di avvio di $0,04 |
|---|---|---|
| FREE (Free) | $0.004 | $4.04 |
| BRONZE (Starter) | $0.0038 | $3.84 |
| SILVER (Scale) | $0.0036 | $3.64 |
| GOLD (Business) | $0.0034 | $3.44 |
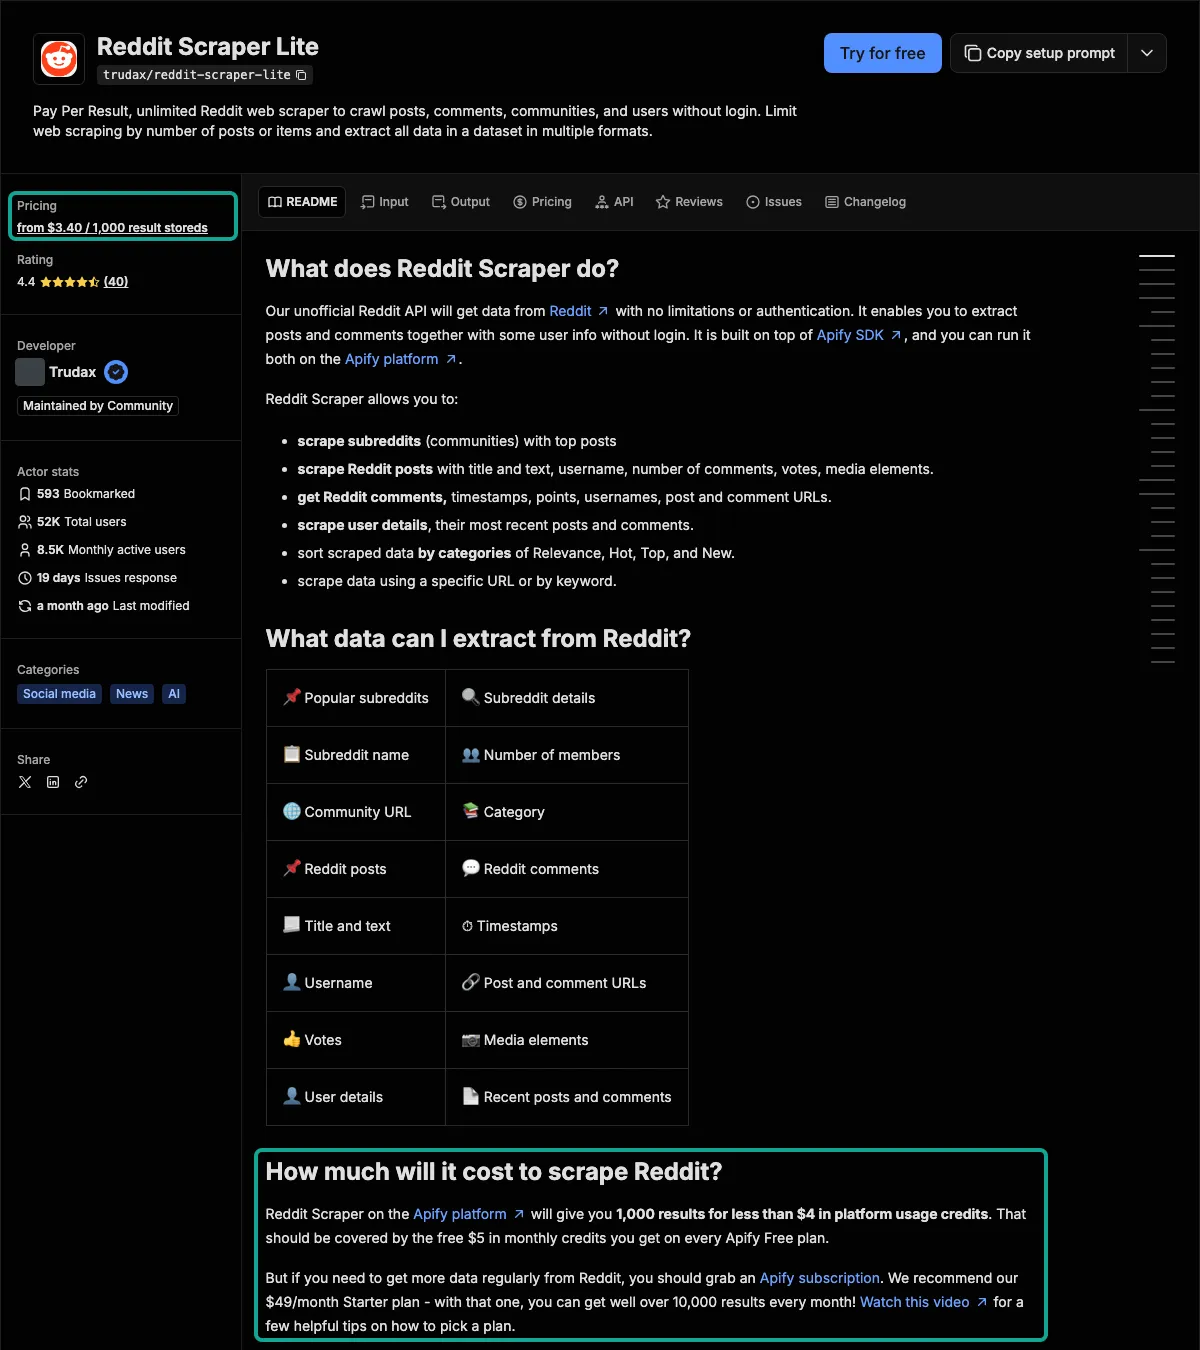
Due parti di questo screenshot si fraintendono facilmente. Primo, «from $3.40 / 1,000» nella barra laterale indica il prezzo del livello con lo sconto più alto. Un utente Free paga $4,00 più $0,04 per esecuzione. Un'esecuzione da 1.000 risultati costa $4,04 su Free e $3,44 su Business.
Secondo, il «$49/month Starter plan» nel testo non corrisponde all'attuale pagina dei prezzi. Quella pagina indica $5 di credito prepagato mensile su Free, Starter da $19, Scale a $199 e Business a $999. Il credito non usato non passa al mese successivo. Il testo del readme non è stato aggiornato insieme alla pagina dei prezzi, quindi per i tuoi calcoli usa la pagina dei prezzi.
C'è un altro dettaglio facile da trascurare. Lite conta «ogni post, commento, utente e community» come un risultato, come dice la sezione «Results» della pagina nello Store. Quindi, se chiedi 100 post da un subreddit e lasci attivi i commenti, scrive nel dataset anche i commenti sotto quei post. Per ciascuno vengono addebitati $0,004. La pagina offre skipComments, maxComments e maxItems. Senza un limite, un'esecuzione da «100 post» può scrivere migliaia di righe.
«Reddit Scraper» è deprecato: dal 21 settembre è riservato agli utenti esistenti
Molti tutorial che parlano di «Apify Reddit Scraper» si riferiscono a un Actor diverso, il Reddit Scraper di trudax. Da febbraio 2022 era a noleggio mensile a $45, con una prova di 1.440 minuti. Il 21 settembre 2026 è passato al prezzo pay-per-event: $0,0001 per risultato e $0,00005 per avvio. La nota sulla modifica dice che Apify sta eliminando gradualmente i prezzi a noleggio mensile. Dice anche che l'Actor non sarà più elencato pubblicamente e che gli utenti esistenti mantengono l'accesso completo. Il testo si trova nel campo reasonForChange dei suoi metadati pubblici, letti il 4 novembre 2026.
Negli stessi metadati isDeprecated è impostato su true, e il titolo nello Store ora riporta «[DEPRECATED]». Negli ultimi 30 giorni aveva ancora 459 utenti, ma i nuovi utenti non possono avviarlo. Quindi oggi, per un nuovo utente, le due scelte con quel nome sono Lite e il Reddit Scraper di Apify.
Lo scraper di Apify applica prezzi distinti a quattro tipi di risultato. I post costano $0,004 su Free e $0,0025 su Gold. I commenti costano $0,0032 su Free e $0,002 su Gold. Le community costano $0,0065, gli utenti $0,002 e ogni avvio $0,001.
Ha anche un raro evento «No result» a $0,0005. Secondo la pagina, copre le richieste senza risultati, come una community eliminata, una ricerca senza risultati o un post senza commenti. In questi casi scrive un record che ne spiega il motivo, a un prezzo più basso di un risultato normale. La pagina dice anche che lo stesso post raggiunto da due input viene scritto due volte e addebitato due volte (pagina nello Store, «How much will it cost?»).
| Evento nel Reddit Scraper ufficiale di Apify | Free | Gold |
|---|---|---|
| Post | $0.004 | $0.0025 |
| Commento | $0.0032 | $0.002 |
| Community | $0.0065 | $0.004 |
| Utente | $0.002 | $0.001 |
| Nessun risultato | $0.0005 | 0,0005 $ (prezzo unico) |
| Avvio | $0.001 | 0,001 $ (prezzo unico) |
746 scraper per Reddit nell'Apify Store: forbice dei prezzi ed esiti delle esecuzioni
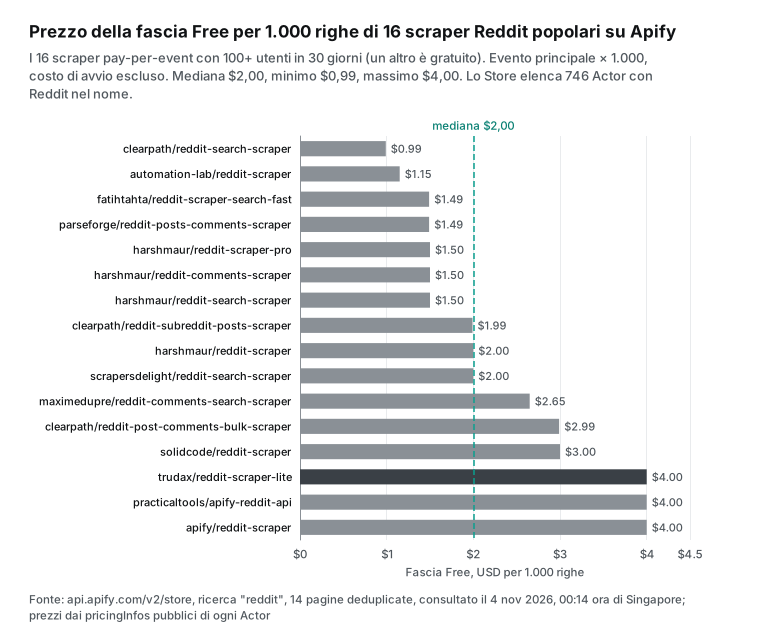
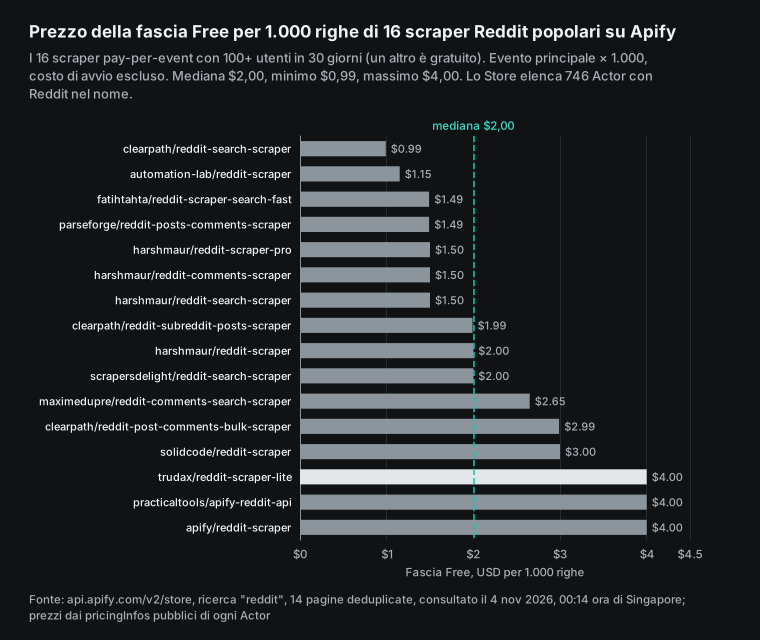
Abbiamo usato l'endpoint pubblico che elenca gli Actor dello Store di Apify (Get list of Actors in Store) per cercare «reddit». Dopo 14 pagine e la rimozione dei duplicati, 746 Actor avevano Reddit nel titolo o nel nome. Di questi, 717 applicano un prezzo per evento e 29 sono gratuiti. Diciassette avevano almeno 100 utenti negli ultimi 30 giorni. Il grafico mostra il prezzo nel piano Free dell'evento principale per i 16 che fanno pagare per risultato. Il diciassettesimo è uno scraper gratuito di red_crawler per le informazioni sulle community e la navigazione.
Il più economico è lo scraper di ricerca di clearpath, a 0,99 $ per 1.000. Il secondo e il terzo per numero di utenti, lo scraper generico di harshmaur e fatihtahta, costano 2,00 $ e 1,49 $. Il Reddit Comment Scraper di harshmaur costa 1,50 $. Tre scraper condividono il prezzo più alto, 4,00 $: Lite, uno di practicaltools e quello ufficiale di Apify. La mediana è di circa 2,00 $. Questi prezzi escludono i costi di avvio, addebitati per esecuzione in base alla memoria: 0,04 $ per Lite, 0,02 $ per harshmaur e 0,00099 $ per clearpath.
Oltre al prezzo, i metadati pubblici di ogni Actor includono le statistiche delle esecuzioni degli ultimi 30 giorni: quante sono riuscite, fallite, andate in timeout o interrotte. Il grafico mostra i quattro con più utenti, più lo scraper ufficiale di Apify.
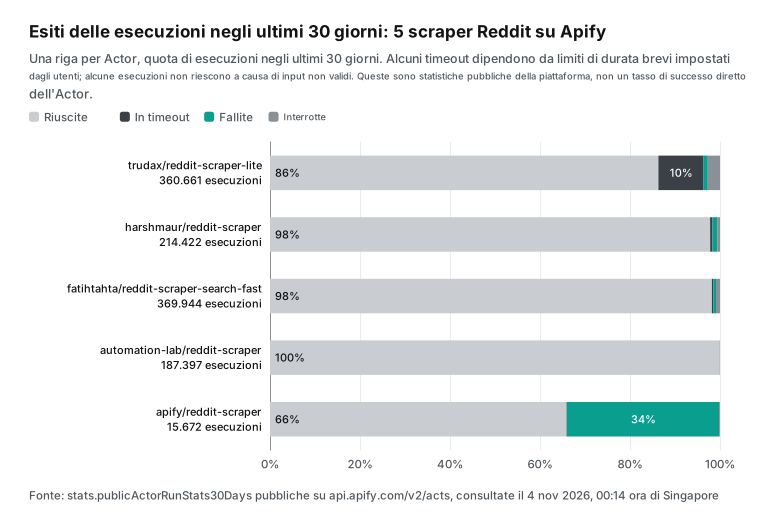
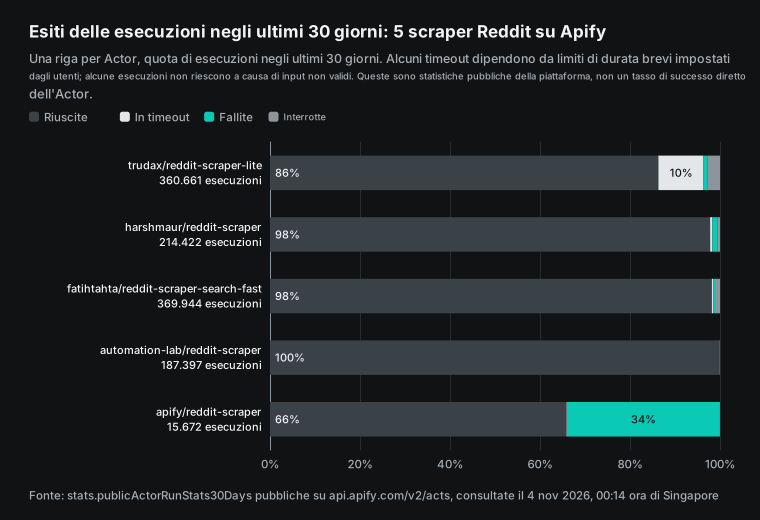
Due numeri vanno letti con attenzione. Primo: 35.919 delle 360.661 esecuzioni di Lite negli ultimi 30 giorni sono andate in timeout. È circa il 10%, un ordine di grandezza in più rispetto agli altri. Sulla causa possiamo solo fare ipotesi. Alcuni utenti potrebbero impostare un limite di tempo breve, altri potrebbero non usare maxItems e chiedere troppi post e commenti in una sola esecuzione. Un'esecuzione andata in timeout viene comunque addebitata per i risultati già presenti nel dataset, e si paga anche il costo di avvio.
Secondo: 5.296 delle 15.672 esecuzioni del Reddit Scraper ufficiale di Apify sono fallite, circa il 34%. La sua pagina dice che i casi «nessun risultato» scrivono un record da 0,0005 $ e non contano come errori. Quindi è più probabile che questi errori dipendano da input sbagliati o da blocchi di Reddit. Sono statistiche pubbliche della piattaforma, non un tasso di successo diretto di ogni Actor. La documentazione di Apify definisce gli stati delle esecuzioni in Runs and builds.
| Actor | Esecuzioni in 30 giorni | Riuscite | In timeout | Fallite |
|---|---|---|---|---|
| trudax/reddit-scraper-lite | 360,661 | 86.3% | 10.0% | 1.0% |
| harshmaur/reddit-scraper | 214,422 | 97.8% | 0.5% | 1.1% |
| fatihtahta/reddit-scraper-search-fast | 369,944 | 98.2% | 0.3% | 0.6% |
| automation-lab/reddit-scraper | 187,397 | 99.9% | 0.0% | 0.0% |
| apify/reddit-scraper | 15,672 | 65.9% | 0.1% | 33.8% |
I 17 Actor popolari hanno registrato in totale 1.526.908 esecuzioni: 95,3% riuscite, 2,6% in timeout, 1,1% fallite e 1,0% interrotte. Apify esegue anche un test automatico giornaliero su ogni Actor pubblico. Un Actor che continua a fallire viene contrassegnato come «under maintenance» (Automated testing). Prima di sceglierne uno, controlla se la sua pagina dello Store riporta questa etichetta.
Dal nostro lato, 46 delle 49 chiamate di questo articolo hanno restituito HTTP 200. Considerando solo quelle 46, ognuna ha richiesto da 6 a 41 secondi, con una mediana di 14 secondi. Le più lente sono state quelle sui post con molti commenti e le chiamate per il dettaglio dei post. Le tre risposte 4xx corrispondono ai parametri sbagliati che abbiamo inviato di proposito.
Nessuna chiamata è andata in timeout o ha restituito un 5xx. Ma 49 chiamate sono troppo poche per calcolare un tasso di successo. Possiamo solo dire che in questa prova non abbiamo visto errori.
| Endpoint | Chiamate | Secondi (mediana) | Intervallo |
|---|---|---|---|
reddit/search | 10 | 6.4 | da 6,0 a 10,2 |
reddit/subreddit_posts | 10 | 17.8 | da 9,5 a 30,7 |
reddit/comments | 13 | 22.4 | da 11,4 a 40,8 |
reddit/user_posts | 7 | 12.5 | da 9,1 a 14,5 |
reddit/post_detail | 2 | 23.6 | da 11,2 a 36,0 |
Campi: le due soluzioni restituiscono gli stessi dati?
Il rovescio della medaglia di un prezzo basso è un numero minore di campi. La tabella qui sotto elenca i campi che le nostre 49 chiamate hanno restituito davvero, non quelli indicati nel catalogo. Dove i due differiscono, lo segnaliamo. Sul fronte Apify, i campi variano molto da uno scraper all'altro.
Lo scraper generico di harshmaur dichiara di restituire 60 o più campi per post, con media e gallerie. I record dei commenti di Lite e automation-lab includono parentId. Per l'elenco completo, controlla l'output di esempio nella pagina dello Store di ciascuno. Non li abbiamo eseguiti, quindi non riportiamo i loro campi.
| Endpoint | Campi effettivamente restituiti | Cosa manca |
|---|---|---|
reddit/search, reddit/subreddit_posts | id, title, text, author_username, community, url, like_count, comment_count, posted_at, platform. I post dei subreddit hanno anche domain e flair | URL di immagini e video, flag di premi e post fissati |
reddit/comments | id, text, author_username, like_count, url, posted_at, platform | ID del commento padre, profondità, numero di risposte. Il catalogo elenca community, ma le risposte reali non lo contenevano. Non farci affidamento |
reddit/user_comments | id, text, author_username, like_count, post_id, post_title, url, posted_at, platform | Il testo può essere troncato a 300 caratteri. Niente karma né anzianità dell'account |
Per la maggior parte delle attività del tipo «cosa dice la gente», queste colonne bastano. I commenti hanno testo, autore, upvote e orario. I post hanno titolo, community e numero di commenti, quindi puoi scegliere i post in base al numero di commenti e poi estrarne i commenti. Puoi passare l'url di un post direttamente a reddit/comments, e l'esempio Python qui sotto concatena le chiamate in questo modo. Se ti servono file multimediali, alberi dei commenti o profili utente, è più adatto uno scraper su Apify con più campi. È quello che paghi con il prezzo per riga.
C'è un altro aspetto che incide sulla fatturazione. Lite viene eseguito con un limite di tempo predefinito di 3.600 secondi e 2.048 MB di memoria (il campo defaultRunOptions nei metadati pubblici di Lite). Più memoria significa un costo di avvio più alto. Secondo Usage and resources, la memoria determina anche quanta CPU riceve un'esecuzione.
Con meno memoria risparmi sul costo di avvio, ma l'esecuzione è più lenta e rischia di più di raggiungere il limite di tempo. Da noi non ci sono limiti di memoria o di tempo da regolare. Una richiesta ha un solo prezzo, e la nostra chiamata più lenta, da 41 secondi, è costata comunque 0,000556 $.
I prezzi su Apify cambiano spesso
Ogni periodo di prezzo nei metadati pubblici dei 15 Actor per Reddit che abbiamo letto riporta una data startedAt. Il Reddit Scraper ufficiale di Apify ha avuto 8 periodi di prezzo dal 2026-09-25 al 2026-10-20, e quattro di questi sono iniziati il solo 1° ottobre 2026. Il periodo attuale è iniziato il 2026-10-20 e la pagina è stata modificata l'ultima volta il 2026-10-27. Il prezzo attuale dello scraper di ricerca commenti di maximedupre è in vigore dal 2026-10-18. automation-lab ha annunciato un aumento del prezzo dei commenti dal 2026-11-17. Il vecchio Reddit Scraper di trudax è passato al prezzo pay-per-event ed è stato deprecato il 2026-09-21.
Al contrario, il prezzo attuale di Lite non è cambiato dal 30 giugno 2026. Cosa significa per te: qualsiasi confronto di prezzi, compreso questo, può diventare obsoleto nel giro di un mese o due. Prima di acquistare, rileggi pricingInfos con l'endpoint Get Actor e annota quando l'hai letto.
| Actor | Inizio del prezzo attuale | Cosa è cambiato |
|---|---|---|
| apify/reddit-scraper | 2026-10-20 | Ottavo periodo di prezzo dal 2026-09-25 |
| maximedupre/reddit-comments-search-scraper | 2026-10-18 | 0,00265 $ per commento nel piano Free |
| automation-lab/reddit-scraper | 2026-08-25, il prossimo il 2026-11-17 | Prezzo dei commenti aumentato del 30% |
| trudax/reddit-scraper | 2026-09-21 | Pay-per-event, poi deprecato |
| trudax/reddit-scraper-lite | 2026-06-30 | Nessuna modifica da allora |
L'elenco completo degli endpoint è nel riferimento API. Le regole della fatturazione per evento sono nella documentazione sul pay-per-event.
Usalo dal codice e dai client AI
Questo codice Python segue lo stesso metodo del nostro test sui commenti. Prende un insieme di URL di post e chiama reddit/comments una volta per ciascuno. Rimuove i duplicati in base all'id del commento e somma il charged_usd di ogni chiamata. Per misurare la copertura, salva anche due numeri per ogni post: il numero di commenti del post e le righe ottenute. Salta tutte le righe il cui id inizia con target-status:, per il motivo spiegato nella sezione sugli errori.
import os, requests

API = "https://api.everyinfra.com/api/v1/social"
HEADERS = {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}

def call(action, **params):
    r = requests.post(API, headers=HEADERS, timeout=120,
                      json={"platform": "reddit", "action": action, "params": params})
    r.raise_for_status()
    body = r.json()
    rows = [x for x in body["results"] if not str(x.get("id", "")).startswith("target-status:")]
    return rows, body["billing"]["charged_usd"]

posts, spent = call("subreddit_posts", subreddit="Python", sort="top", date_range="past_year", limit=100)
seen, coverage = {}, []
for p in posts[:13]:
    rows, cost = call("comments", url=p["url"], limit=100)
    spent += cost
    seen.update({c["id"]: c for c in rows})
    coverage.append((p["url"], p["comment_count"], len(rows)))

print(len(seen), "unique comments, spent", round(spent, 6), "USD")
for url, listed, got in coverage:
    print(f"{got}/{listed}", url)
In un client AI, collega il nostro server MCP remoto all'indirizzo https://api.everyinfra.com/mcp. I nomi dei tool iniziano con everyinfra_ e il modello può decidere se cercare prima i post o estrarre direttamente i commenti. Qui sotto trovi un esempio di configurazione generico. Claude Code, Cursor e gli altri client che supportano MCP remoto usano un formato simile.
Per la sintassi esatta, consulta la documentazione MCP di Claude Code e la documentazione MCP di Cursor. OpenAI ha la sua documentazione MCP. Il protocollo è descritto nella specifica MCP.
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
Apify ha un proprio server MCP che espone gli Actor dello Store come tool per un modello (documentazione MCP di Apify, codice sorgente su GitHub). Per il codice, offre un client Python. La differenza sta nel modo in cui tornano i dati. Con l'MCP di Apify il modello avvia l'esecuzione di un Actor, attende che finisca e poi legge il dataset.
Questo approccio è adatto all'esportazione di decine di migliaia di righe. Il nostro MCP restituisce una pagina di dati per chiamata, il che si adatta alle domande in una chat, una alla volta. Per la configurazione e i client supportati, consulta la pagina del server MCP.
Il conto mensile: tre attività comuni per 30 giorni
Prendi un team di prodotto che vuole sapere ogni giorno cosa si dice su Reddit della sua categoria. Le tre attività qui sotto usano le righe per chiamata che abbiamo misurato. Dal nostro lato, il costo è chiamate × 0,000556 $, oppure × 0,032403 $ per i commenti degli utenti. Sul fronte Apify, abbiamo usato il prezzo di listino nel piano Free di ciascun Actor, con un costo di avvio predefinito per ogni esecuzione dell'attività.
| Attività per 30 giorni | Chiamate e righe | EveryInfra | Reddit Scraper Lite | Scraper popolari più economici su Apify |
|---|---|---|---|---|
| Commenti da 10 thread molto attivi al giorno, 100 per thread | 300 chiamate, 30.000 righe | $0.17 | $121.20 | automation-lab 17,69 $ (22,94 $ dal 17 novembre). harshmaur comments 45,60 $ |
| I 100 post più recenti da 5 subreddit al giorno | 150 chiamate, 15.000 righe | $0.08 | $61.20 | automation-lab 17,34 $. clearpath subreddit 30,02 $ |
| Cronologia dei commenti di 200 utenti a settimana, 100 righe ciascuno | 800 chiamate, 80.000 righe | $25.92 | $320.16 | harshmaur user scraper 120,08 $. clearpath user content 160,00 $ |
Queste stime si basano su tre ipotesi. Prima: ogni chiamata restituisce una pagina piena. Nei nostri test, ogni post con più di 100 commenti ne ha effettivamente restituiti 100. Ma i post piccoli ne restituiscono meno, e la chiamata ai commenti degli utenti con limit 200 ne ha restituiti solo 100.
Quando restituiamo meno righe, il nostro totale resta uguale e il prezzo unitario sale. Seconda: la riga di Lite presuppone che lo scraping dei commenti sia disattivato (skipComments). Se è attivo, le righe dei post si moltiplicano. Terza: nessuna delle attività elimina le sovrapposizioni tra un giorno e l'altro.
Se il giorno dopo estrai di nuovo lo stesso thread molto attivo, la maggior parte dei commenti l'hai già, ed entrambe le soluzioni fanno pagare i duplicati. Su Apify, i filtri temporali possono ridurli. Da noi, rimuovi tu i duplicati in base all'id.
Detto questo, da noi i commenti degli utenti costano 0,032403 $ per chiamata. Se la maggior parte di quei 200 utenti ha solo una dozzina di commenti, il nostro totale resta uguale. Il totale per riga su Apify scende a pochi dollari, e Apify diventa la scelta più conveniente.
L'API ufficiale di Reddit oggi: nessuna nuova richiesta di accesso dal 31 ottobre
Nessun confronto di prezzi è completo senza la Data API ufficiale di Reddit. Il Reddit Data API Wiki indica che gli utenti idonei hanno 100 richieste al minuto per client OAuth, in media su una finestra di 10 minuti. Il traffico senza OAuth viene bloccato. Se un post o un commento viene eliminato, devi eliminare anche la tua copia, e Reddit suggerisce una pulizia almeno ogni 48 ore.
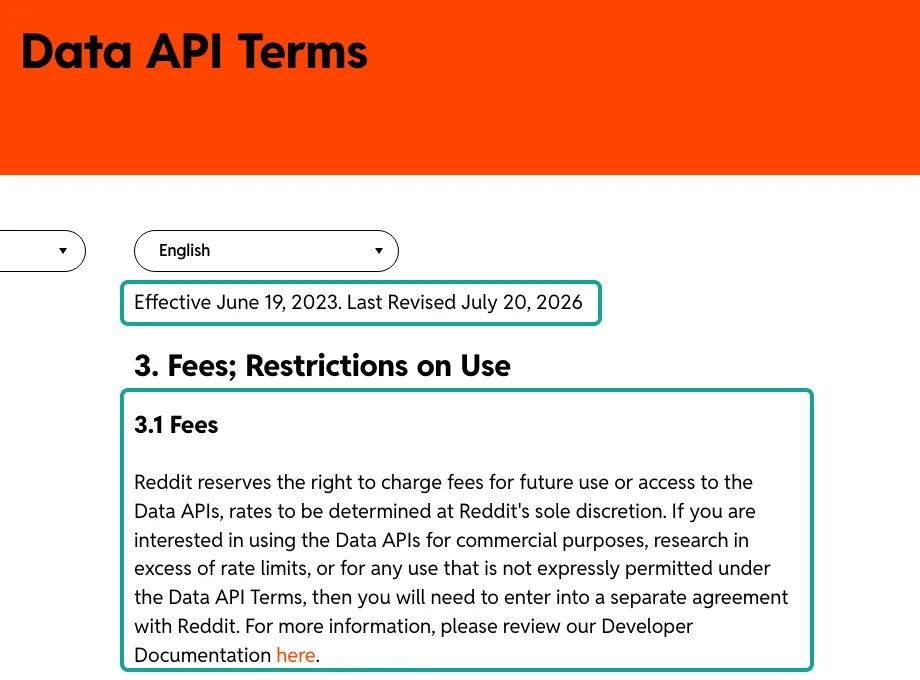
Al di fuori dell'uso gratuito, la sezione 3.1 dei Data API Terms è chiara. Reddit si riserva il diritto di far pagare l'uso futuro, a tariffe stabilite da Reddit stessa. L'uso commerciale, la ricerca oltre i limiti di frequenza delle richieste e qualsiasi uso non consentito dai termini richiedono un accordo separato. I termini sono entrati in vigore il 19 giugno 2023 e sono stati rivisti l'ultima volta il 20 luglio 2026.
| Regola nelle pagine di Reddit | Cosa dice |
|---|---|
| Limite di frequenza delle richieste nel piano gratuito | 100 richieste al minuto per client OAuth, in media su 10 minuti |
| Traffico senza OAuth | Bloccato |
| Contenuti eliminati | Elimina la tua copia, con una pulizia almeno ogni 48 ore |
| Uso commerciale | Accordo separato, a tariffe stabilite da Reddit |
Le attuali pagine pubbliche di Reddit non indicano un prezzo per l'uso commerciale. Developer Platform & Accessing Reddit Data dice soltanto che alcuni sviluppatori che hanno bisogno di un accesso più ampio potrebbero dover pagare. La pagina elenca alcuni esempi di uso commerciale, tra cui app con pubblicità o paywall, servizi o accesso ai dati venduti a pagamento e servizi in abbonamento. Nell'elenco c'è anche la vendita di modelli addestrati sui dati di Reddit.
La cifra di «0,24 $ per 1.000 richieste» che si vede spesso risale al 2023. Il 31 maggio 2023 Reddit ha annunciato su r/redditdev che dal 1° luglio sarebbero entrati in vigore i limiti di frequenza delle richieste del piano gratuito (post). Lo stesso giorno, lo sviluppatore del client Apollo ha raccontato che Reddit gli aveva proposto 12.000 $ per 50 milioni di richieste (post). Sono 0,24 $ per 1.000.
È la testimonianza di un singolo sviluppatore, non un listino di Reddit. A quel prezzo, con 100 righe per richiesta di elenco, 1.000 post costerebbero circa 0,0024 $, meno di qualsiasi terza parte. Ma solo se riesci a ottenere quel contratto.
Quella strada si sta chiudendo. Ad agosto 2026 Reddit ha descritto per la prima volta su r/redditdev i suoi piani per la Data API pubblica (post). Il 30 settembre 2026 ha pubblicato il calendario della dismissione (post).
| Data | Cosa dice il post di Reddit | Cosa significa se raccogli dati |
|---|---|---|
| 2026-10-31 | Nessuna nuova richiesta di accesso all'API pubblica | Un progetto che parte oggi non può ottenere l'accesso |
| 2026-11-10 | Aggiornamento sull'avanzamento della migrazione e promemoria della scadenza | Verifica eventuali proroghe o eccezioni |
| 2026-11-13 | Fine dei feed RSS (post su r/modnews; alternative in dopo la chiusura dei feed RSS di Reddit) | Il monitoraggio dei subreddit basato su RSS smette di funzionare |
| 2026-11-30 | Scadenza per il bonus di migrazione | Solo per le app che passano a Devvit |
| 2027-01-12 | L'accesso inizia a chiudersi per le app e gli utenti che non si sono registrati o non hanno risposto a Reddit | I vecchi script potrebbero smettere di funzionare intorno a questa data |
| 2027-03 | Tutto l'accesso pubblico rimanente viene chiuso (senza un giorno preciso) | Solo partner con accordi scritti, e Devvit |
L'alternativa proposta da Reddit è la sua piattaforma per sviluppatori, Devvit. La guida alla migrazione spiega che è pensata soprattutto per strumenti di moderazione e app per le community. Le app nel programma di migrazione possono ricevere 1.000 $ dopo il passaggio, e il programma è attivo dal 31 marzo al 31 dicembre 2026. Non è un'API per esportare dati da analizzare altrove. Le app Devvit si registrano tramite App registration. Le richieste in uscita seguono le regole di HTTP Fetch, e la guida completa è nella documentazione di Devvit.
Per i ricercatori, la Responsible Builder Policy stabilisce che la ricerca su dati raccolti al di fuori del programma Reddit for Researchers viola la policy. Senza un'approvazione scritta, non puoi vendere o concedere in licenza i dati né usarli per addestrare modelli.
Il 29 ottobre il CEO di Reddit, Steve Huffman, ha scritto sul suo profilo che Reddit passerà a un'esperienza «logged-in first», con il login al primo posto. La testerà prima in alcuni mercati fuori dagli Stati Uniti. Uno dei motivi indicati è che la maggior parte della raccolta dei dati non autorizzata avviene sulle pagine visitate senza login (post). Axios ha riportato lo stesso giorno che la home page resterà accessibile ai visitatori non loggati. Resteranno accessibili anche i post raggiunti dai motori di ricerca o da link esterni, con i limiti esatti definiti durante il test.
L'obbligo di login è un rischio per ogni strumento che legge le pagine senza autenticazione. Questo vale per gli scraper dell'Apify Store e vale anche per noi. Non possiamo garantire che ogni endpoint continui a funzionare dopo le modifiche di Reddit.
Puoi fare tre cose. Primo: le richieste non riuscite non vengono addebitate, quindi non paghi quando Reddit blocca una chiamata. Secondo: quando un endpoint smette di funzionare, il catalogo gratuito lo contrassegna come «temporaneamente non disponibile» con available impostato a false, quindi consulta il catalogo prima di un grosso batch. Terzo: salva dalla tua parte i dati che ti servono a lungo termine, senza dipendere da un unico strumento per recuperarli di nuovo in seguito.
Se puoi raccogliere i dati, e cosa puoi farne, dipende dalla tua giurisdizione, dall'uso che ne fai e dai termini di Reddit. Questo articolo non costituisce consulenza legale. Per un progetto specifico, rivolgiti a un avvocato.
Quando Apify è la scelta migliore
Nel complesso, i test indicano sei attività per cui consigliamo uno scraper dell'Apify Store anziché EveryInfra. Primo: post su un argomento risalenti a più di un mese fa. Il nostro reddit/search copre solo l'ultimo mese, mentre il parametro time di Lite può essere impostato su all. Secondo: più di 1.000 post da un solo subreddit. Restituiamo solo le prime 100 righe per ordinamento, e otto combinazioni su r/Python hanno dato 286 risultati. Uno scraper con paginazione arriva vicino a 1.000 per ordinamento.
Terzo: tutti i commenti di un thread molto attivo, o l'intero albero dei commenti. Noi ci fermiamo a 100 per post senza ID del commento padre, mentre clearpath espande tutto e Lite e automation-lab includono parentId e depth. Quarto: i profili utente. Non abbiamo karma né anzianità dell'account, mentre lo scraper utenti di harshmaur li restituisce in un'unica esecuzione. Quinto: pochi utenti. Sotto i 22 commenti per chiamata, reddit/user_comments costa più dello scraper utenti di harshmaur. Sesto: i team che usano già pianificazioni, dataset e integrazioni di Apify. Passare a noi significa scrivere da soli scheduler e storage, e il risparmio potrebbe non ripagare quel lavoro.
Il caso opposto sono i dati raccolti pagina per pagina, in grandi volumi e con frequenza. Lì costiamo da due a tre ordini di grandezza in meno. Alcuni esempi sono i commenti di centinaia di post al giorno e i nuovi post di decine di community al giorno. Un altro sono le ricerche su Reddit da un client AI in una chat. Abbiamo anche reddit/trending_posts. Restituisce i post di tendenza di tutto il sito, 25 per pagina, scorre le pagine tramite page_token e costa 0,000556 $ per pagina.
Colma in parte il vuoto lasciato dagli elenchi dei subreddit senza paginazione. Ma si tratta dei post di tendenza di tutto il sito, non della cronologia di una singola community. Abbiamo descritto le insidie di entrambi i modelli di fatturazione in come funzionano i prezzi di Apify e alternative ad Apify. Per riconciliare i rimborsi, consulta riconciliazione dei rimborsi per le richieste non riuscite.
Cosa è cambiato di recente
- 2026-11-17: lo scraper per Reddit di automation-lab aumenta il prezzo dei commenti nel piano Free da 0,000575 $ a 0,00075 $, con un aumento del 30% (pagina dello Store di automation-lab). Cosa significa per te: gli 0,59 $ per 1.000 commenti citati in questo articolo diventano 0,76 $.
- 2026-10-29: il post del CEO di Reddit sull'obbligo di login (post). Cosa significa per te: l'accesso senza login si restringe prima in alcuni mercati. Ogni strumento che legge le pagine senza login potrebbe risentirne, sia gli scraper di Apify sia il nostro.
- 2026-10-20: entra in vigore il prezzo attuale del Reddit Scraper ufficiale di Apify, il suo ottavo periodo di prezzo in un mese (pagina dello Store). Cosa significa per te: usa i metadati del giorno in cui li leggi.
- 2026-10-18: entra in vigore il prezzo attuale dello scraper di ricerca commenti di maximedupre, 0,00265 $ per riga nel piano Free. Cosa significa per te: tra gli scraper di ricerca commenti, costa il 77% in più di harshmaur, che è a 0,0015 $.
- 2026-10-16 e 2026-10-06: due aggiornamenti dello scraper dei commenti di clearpath correggono
depthper le risposte profonde nei thread completamente espansi (pagina dello Store di clearpath). Cosa significa per te: per ricostruire gli alberi dadepth, usa una versione successiva a questi aggiornamenti. - 2026-09-21: il Reddit Scraper di trudax passa al prezzo pay-per-event e viene rimosso dallo Store per i nuovi utenti. Cosa significa per te: il piano «45 $ al mese, senza limiti» dei vecchi tutorial non esiste più.
Per iniziare: da una chiamata di prova a un job giornaliero
Le 48 chiamate di questo articolo, esclusa quella sui commenti degli utenti, sono costate in totale circa 0,024 $. Registrati, fai prima un piccolo test e poi decidi se usarlo su larga scala. Ottieni una chiave nella guida rapida. La pagina API di scraping per Reddit elenca tutti gli endpoint. Esegui una volta il playground per ricerca su Reddit, post dei subreddit e commenti di Reddit.
Per il dettaglio dei post e i dati degli utenti, consulta dettaglio del post, post dell'utente e commenti dell'utente. Per una panoramica rapida delle lamentele su un prodotto, usa pain point su Reddit. Per i post di tendenza di tutto il sito, usa post di tendenza. Lo stesso metodo funziona per l'API di scraping per Twitter e l'API di scraping per TikTok. Tutti gli endpoint e i prezzi sono nelle pagine mercato dei dati e Prezzi, e i confronti tra strumenti sono nella pagina delle alternative.
Altri confronti misurati del «costo per 1.000» con Apify: alternativa all'Apify Twitter Scraper, alternativa all'Apify TikTok Scraper e alternativa all'Apify Amazon Scraper.
FAQ
Lo scraper per Reddit di Apify è gratuito?
Il piano Free di Apify offre 5 $ di credito prepagato al mese (pagina dei prezzi). Con Lite a 0,004 $ per risultato più 0,04 $ per esecuzione, corrispondono a circa 1.200 risultati. Lo Store ha anche 29 Actor gratuiti per Reddit, ma solo uno di questi aveva più di 100 utenti negli ultimi 30 giorni. Il Reddit Scraper di trudax a noleggio mensile è deprecato e i nuovi utenti non possono avviarlo. L'API ufficiale di Reddit è gratuita per l'uso non commerciale idoneo, con 100 richieste al minuto per client OAuth. Ma dal 31 ottobre 2026 non accetta più nuove richieste (Data API Wiki).
Qual è l'«Apify Reddit scraper pro» ed è migliore di Lite?
Lo scraper per Reddit con «pro» nel nome e il maggior numero di utenti negli ultimi 30 giorni è reddit-scraper-pro di harshmaur. Il suo titolo parla di lead, brand monitoring e alert. Costa 0,0015 $ per riga nel piano Free e ha avuto 435 utenti in 30 giorni. Il 98,7% delle sue esecuzioni è riuscito (elenco pubblico dello Store, consultato il 4 novembre 2026). Costa oltre il 60% in meno di Lite, con molti meno timeout.
Lite ha più utenti, il readme più completo e parentId nei commenti. Quale sia «migliore» dipende dal fatto che ti servano o meno gli alberi dei commenti. In quel caso, lo scraper dei commenti di clearpath è più completo di entrambi.
Uno scraper di commenti Reddit su Apify può ottenere tutti i commenti di un post?
Sì, se scegli l'Actor giusto e lo configuri bene. Lo scraper dei commenti di clearpath, con maxCommentsPerPost impostato a 0 e l'espansione completa attiva, restituisce l'intero albero, comprese le risposte profonde «continue this thread». Lite imposta il limite con maxComments. L'albero di Reddit contiene per sua natura slot more non espansi (note JSON di Reddit).
Se fai scraping con PRAW, ti serve anche replace_more. Il nostro reddit/comments restituisce fino a 100 righe per post, con risposte di secondo e terzo livello ma senza ID del commento padre. Non è adatto alle attività che richiedono l'intero albero.
Quanto costa un'API di scraping per Reddit, e qual è la più economica?
L'uso commerciale dell'API ufficiale di Reddit richiede un accordo separato, e le attuali pagine pubbliche non indicano alcun prezzo (Developer Platform & Accessing Reddit Data). Gli 0,24 $ per 1.000 richieste citati spesso vengono dalla testimonianza di uno sviluppatore nel 2023. Tra le terze parti, gli scraper per Reddit più popolari dell'Apify Store costano da 0,99 $ a 4,00 $ per 1.000, con una mediana di circa 2,00 $. EveryInfra addebita per richiesta, e in questo articolo il costo è stato da 0,011 $ a 0,029 $ per 1.000 post e di 0,0073 $ per 1.000 commenti. Per il flusso OAuth e l'elenco degli endpoint, consulta le note OAuth2 di Reddit e la documentazione dell'API.
Fare scraping di Reddit senza l'API è legale?
Dipende dalla tua giurisdizione, dall'uso che ne fai e dallo User Agreement, dai Developer Terms e dalla Public Content Policy di Reddit. La Responsible Builder Policy di Reddit stabilisce che la ricerca su dati raccolti al di fuori del programma Reddit for Researchers viola la policy. Senza un'approvazione scritta, non puoi vendere o concedere in licenza i dati né usarli per addestrare modelli. Questo articolo non costituisce consulenza legale. Rivolgiti a un avvocato prima di creare un prodotto commerciale o di addestrare un modello su questi dati.
Esiste uno scraper per Reddit su GitHub, e come si confronta con un servizio API?
Sì. Il codice storico del sito di Reddit e le note sull'API sono archiviati in reddit-archive/reddit, che non riceve più aggiornamenti. Lo strumento pronto più diffuso è la libreria Python PRAW. Usa l'API OAuth di Reddit, è gratuita e offre il maggior numero di campi. Ma è limitata a 100 richieste al minuto, e i nuovi client OAuth non possono ottenere l'accesso dopo il 31 ottobre 2026.
Uno scraper fatto in casa deve gestire l'obbligo di login, i limiti di frequenza delle richieste e i blocchi. Con Apify o con un servizio come il nostro, paghi per evitarti questo lavoro. Qualunque strumento tu scelga, calcola prima il costo per 1.000 e i costi di avvio.
Riferimenti
- Apify / trudax: «Reddit Scraper Lite» (pagina dello Store), consultata il 4 novembre 2026
- API di Apify: metadati pubblici di trudax~reddit-scraper-lite (pricingInfos, stats), consultati il 4 novembre 2026
- [Apify / trudax: «Reddit Scraper [DEPRECATED]» (pagina dello Store), consultata il 4 novembre 2026](https://apify.com/trudax/reddit-scraper)
- API di Apify: metadati pubblici di trudax~reddit-scraper (con la nota sui prezzi del 21 settembre 2026), consultati il 4 novembre 2026
- Apify / harshmaur: «Reddit Scraper» (pagina dello Store), consultata il 4 novembre 2026
- Apify / automation-lab: «Reddit Scraper» (pagina dello Store, con la variazione di prezzo del 17 novembre 2026), consultata il 4 novembre 2026
- Apify / clearpath: «Reddit Post Comments Scraper» (pagina dello Store, con gli aggiornamenti del 6 e del 16 ottobre 2026), consultata il 4 novembre 2026
- Apify / fatihtahta: «Reddit Scraper Enterprise Grade» (pagina dello Store), consultata il 4 novembre 2026
- Apify / harshmaur: «Reddit Comment Scraper» (pagina dello Store), consultata il 4 novembre 2026
- Apify / harshmaur: «Reddit User Scraper» (pagina dello Store), consultata il 4 novembre 2026
- Apify / clearpath: «Reddit User Posts & Comments Scraper» (pagina dello Store), consultata il 4 novembre 2026
- Apify / clearpath: «Reddit Search Scraper» (pagina dello Store), consultata il 4 novembre 2026
- Apify: «Reddit Scraper: Posts, Comments, and Users» (pagina dello Store pubblicata da Apify), consultata il 4 novembre 2026
- Apify: pagina «Pricing» (piani, compute unit, livelli di sconto dello Store), consultata il 4 novembre 2026
- Documentazione Apify: «Pay-per-event pricing model»
- Documentazione Apify: «Actor pricing and costs» (livelli da FREE a DIAMOND)
- Documentazione Apify: «Actors in Store» (modelli di prezzo, etichetta under maintenance, sconti dello Store)
- Documentazione API di Apify: «Get Actor»
- Documentazione API di Apify: «Get list of Actors in Store»
- Documentazione Apify: «Usage and resources» (memoria e compute unit)
- Documentazione Apify: «Runs and builds» (stato delle esecuzioni, timeout)
- Documentazione Apify: «Automated testing» (gli Actor che falliscono ricevono l'etichetta di manutenzione)
- Documentazione Apify: «Dataset»
- Documentazione Apify: «Apify MCP server»
- GitHub: apify/apify-mcp-server
- GitHub: apify/apify-client-python
- Reddit: «Data API Terms» (in vigore dal 19 giugno 2023, rivisti il 20 luglio 2026), consultati il 4 novembre 2026
- Reddit: «Developer Terms»
- Reddit: «User Agreement»
- Reddit Help: «Reddit Data API Wiki» (piano gratuito, 100 QPM)
- Reddit Help: «Responsible Builder Policy»
- Reddit Help: «Developer Platform & Accessing Reddit Data» (uso commerciale e tariffe)
- Reddit Help: «Public Content Policy»
- Reddit Help: «App Migration Program 2026 Terms»
- Reddit Developer Platform: «Migrating apps from the Data API to Devvit»
- Reddit Developer Platform: «App registration»
- Reddit Developer Platform: «HTTP Fetch»
- r/redditdev: «Moving Data API Apps to the Developer Platform: migration dates and next steps» (30 settembre 2026)
- r/modnews: «Continuing our infrastructure updates: what's changing in the coming months» (30 settembre 2026, fine dei feed RSS)
- r/redditdev: «Our Plans for the Future of Reddit's Public Data API» (agosto 2026)
- r/redditdev: «API Update: Enterprise Level Tier for Large Scale Applications» (31 maggio 2023)
- r/apolloapp: «Had a call with Reddit to discuss pricing» (31 maggio 2023, il resoconto di uno sviluppatore sul preventivo)
- u/spez: «About that login screen» (29 ottobre 2026)
- Axios: «Reddit moves to logged-in experience as AI eats search» (29 ottobre 2026)
- GitHub: reddit-archive/reddit (codice open source e wiki archiviati di Reddit)
- Reddit Developer Platform: documentazione di Devvit
- Documentazione API di Apify: «API v2 reference»
- GitHub: wiki di reddit-archive/reddit, «JSON» (l'oggetto more)
- GitHub: wiki di reddit-archive/reddit, «OAuth2»
- GitHub: praw-dev/praw
- Documentazione di PRAW: «Comment Extraction and Parsing»
- Reddit: documentazione dell'API (/dev/api)
- Gaffney e Matias: «Caveat Emptor, Computational Social Science: Large-Scale Missing Data in a Widely-Published Reddit Corpus» (arXiv, 2018)
- Model Context Protocol: «Specification 2025-06-18»
- Documentazione di Claude Code: «Connect Claude Code to tools via MCP»
- Documentazione OpenAI: «Connectors and MCP servers»
- Documentazione di Cursor: «Model Context Protocol»
- EveryInfra: catalogo delle API per i dati (gratuito; price_usd, max_limit), consultato il 4 novembre 2026
Riferimenti BL-84