Reddit disattiva i feed RSS il 13 novembre: cosa cambia per il monitoraggio
Reddit disattiva tutti i feed RSS il 13 novembre 2026. Prima della scadenza abbiamo interrogato i feed RSS e un'API per i dati nello stesso momento. I post coincidevano, mentre campi, limiti di frequenza delle richieste e thread dei commenti erano diversi.
Reddit disattiverà tutti i feed RSS il 13 novembre 2026. La fonte è un post degli amministratori di Reddit su r/modnews del 30 settembre. Il post afferma che per i feed esterni a una community che moderi “non c'è alcuna alternativa”.
Prima della scadenza, il 25 ottobre 2026, dalle 06:36 alle 07:09 UTC (dalle 14:36 alle 15:09 ora di Singapore), abbiamo eseguito un test affiancato. Abbiamo interrogato i feed RSS di Reddit e l'API per i dati di Reddit di EveryInfra nello stesso momento, per 16 volte. I post coincidevano uno per uno: 275 voci di post (202 post unici) e 125 risultati di ricerca, nello stesso ordine. Il post più recente differiva al massimo di 1,6 secondi.
Le differenze effettive riguardavano tre aspetti. I feed RSS non includono né il punteggio né il numero di commenti. L'accesso anonimo ai feed RSS consente una richiesta per IP per ogni minuto dell'orologio. In entrambe le fonti, i commenti arrivano come elenco piatto, quindi non si vede chi ha risposto a chi.
In questo articolo, un “feed RSS di Reddit” è il documento Atom 1.0 che Reddit restituisce quando aggiungi .rss all'URL di un subreddit, di una ricerca, di un post o di un utente. Il formato è RFC 4287. Un feed non richiede login né chiave. Un URL corrisponde a un abbonamento. Dopo il 13 novembre, questo modo di leggere Reddit senza chiave scompare.


A chi è rivolto
Questo articolo si rivolge a quattro gruppi:
- Redazioni e team di social listening che seguono subreddit e parole chiave in Feedly, Inoreader, NewsBlur o tramite un bot Slack.
- Community manager e moderatori che inviano i nuovi post o gli avvisi di moderazione a un canale di chat.
- Ricercatori che raccolgono post e commenti di Reddit per i loro studi.
- Sviluppatori che creano strumenti basati sui feed RSS di Reddit o sull'API pubblica per i dati.
Dopo il 13 novembre ogni gruppo ha un percorso diverso. Li trattiamo nella sezione “Quattro gruppi, quattro percorsi”.
Cosa ha detto Reddit, con le sue parole
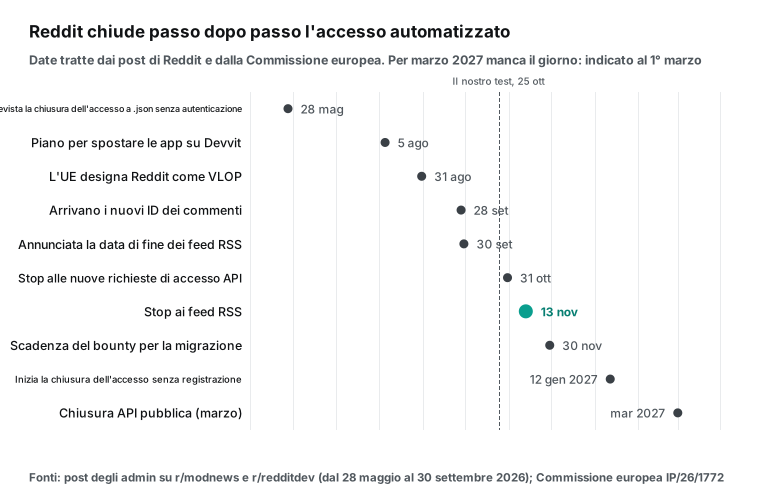
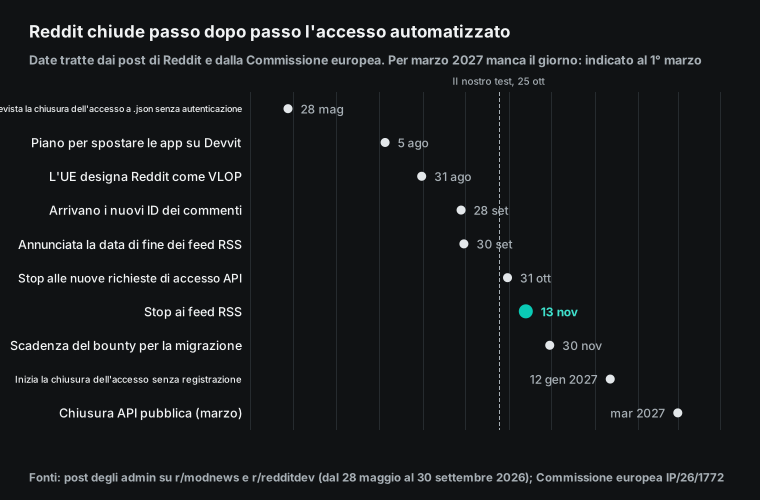
La chiusura degli RSS è un passo di una serie più lunga. Da maggio 2026, Reddit ha chiuso per gradi l'accesso automatizzato senza chiave:
- 28 maggio: in un post su r/modnews, Reddit ha annunciato la chiusura degli endpoint
.jsonnon autenticati. Lo stesso post indicava i feed RSS come “un'altra modalità comune di scraping” e chiedeva ai moderatori come li usassero. - 5 agosto: il CEO ha pubblicato un piano per ripensare Old Reddit, AutoModerator e l'API pubblica. Il post su r/redditdev dello stesso giorno affermava che l'API pubblica per i dati “non è stata progettata per i volumi attuali” e che le app di terze parti devono passare alla Developer Platform, Devvit. Diceva anche che il supporto a Python non è nella roadmap.
- 30 settembre: sono usciti due post insieme. r/modnews ha fissato la data di fine dei feed RSS. r/redditdev ha fissato quattro date per l'API. Dopo il 31 ottobre Reddit non accetta nuove richieste per l'API pubblica. Le iscrizioni alla bounty per la migrazione chiudono il 30 novembre. Il 12 gennaio 2027 inizia la chiusura dell'accesso per le app non registrate e a marzo 2027 termina ogni accesso pubblico. Il post afferma che si sono registrati più di 14.000 tra app e bot.
L'articolo del centro assistenza Reddit per i moderatori ripete la data: “Reddit smetterà di supportare i feed RSS il 13 novembre 2026.” Indica anche una configurazione alternativa da 15-20 minuti, che descriviamo più avanti.
TechCrunch ha dato la notizia il 30 settembre e l'ha collegata al business delle licenze sui dati di Reddit. TechCrunch cita i risultati del Q2 2026 di Reddit: le “altre entrate”, esterne alla pubblicità, sono cresciute del 24% su base annua, arrivando a 43 milioni di dollari. (Il dato è quello riportato da TechCrunch; la fonte è il comunicato sui risultati.)
I criteri di esito positivo o negativo che abbiamo fissato prima del test
Abbiamo scritto sei regole prima di raccogliere qualsiasi dato. La domanda: se passi dagli RSS a un'API per i dati, cosa perdi e cosa guadagni?
- Copertura dei post: l'API per i dati deve restituire almeno il 90% degli ID dei post presenti nel feed RSS per la stessa lista “new”.
- Campi: ogni campo di monitoraggio degli RSS (ID, titolo, autore, link, ora di pubblicazione, testo) deve avere un corrispondente nell'API per i dati.
- Freschezza: il post più recente su ciascun lato deve differire di 5 minuti o meno.
- Thread dei commenti: confronta il numero di commenti del post, quello degli RSS e quello dell'API per i dati. Verifica se è possibile ricostruire chi ha risposto a chi.
- Parole chiave: registra la sovrapposizione per lo stesso termine di ricerca. Nessuna soglia di superamento.
- Limiti dei feed RSS: registra gli header
x-ratelimit-*delle richieste anonime.
Risultati: le regole 1 e 3 sono superate (sovrapposizione del 100%, al massimo 1,6 secondi). La regola 2 è superata e l'API per i dati aggiunge punteggio, numero di commenti e dominio di destinazione, ma non include le miniature. La regola 4 fallisce per entrambe le fonti. La regola 5 raggiunge il 100% di sovrapposizione aggiungendo type=link. La regola 6 rileva una richiesta al minuto. Seguono i dati.
Test 1: stessi post, campi diversi
Il 25 ottobre abbiamo eseguito 11 coppie di acquisizioni su 9 subreddit. Per ogni coppia abbiamo prima scaricato https://www.reddit.com/r/<subreddit>/new/.rss?limit=25. Uno o due secondi dopo abbiamo chiamato l'API per i post dei subreddit di Reddit (reddit/subreddit_posts, sort=newest, limit=25). I subreddit erano r/technology, r/news, r/AskReddit, r/selfhosted, r/datasets, r/rss, r/dji e r/mexico.
- Post: tutte le 275 voci coincidevano, nello stesso ordine. Corrispondono a 202 post unici, perché abbiamo interrogato r/technology e r/selfhosted due volte, a 8 minuti di distanza.
- Freschezza: i 25 post più recenti di r/AskReddit coprivano solo circa 15 minuti (15,6 e 15,3 minuti in due esecuzioni). Al momento del prelievo, il post più recente aveva rispettivamente 40 e 51 secondi. I risultati delle due fonti coincidevano entro circa un secondo. Lo scarto massimo in tutte le 11 coppie è stato di 1,6 secondi.
- Campi aggiunti dall'API per i dati:
like_count(punteggio) era diverso da zero in 179 voci su 275.comment_countera diverso da zero in 222 su 275. I feed RSS non includono nessuno dei due campi. Nel feed RSS,<updated>era uguale a<published>in tutte le 275 voci, quindi non viene fornita alcuna indicazione del fatto che un post sia stato modificato. - Campi assenti nell'API per i dati: 82 voci RSS avevano una miniatura (
media:thumbnail). In questo test l'API per i dati non ha restituito alcun valorethumbnail_url. Né il feed RSS né l'API per i dati hanno restituito il testo del flair.
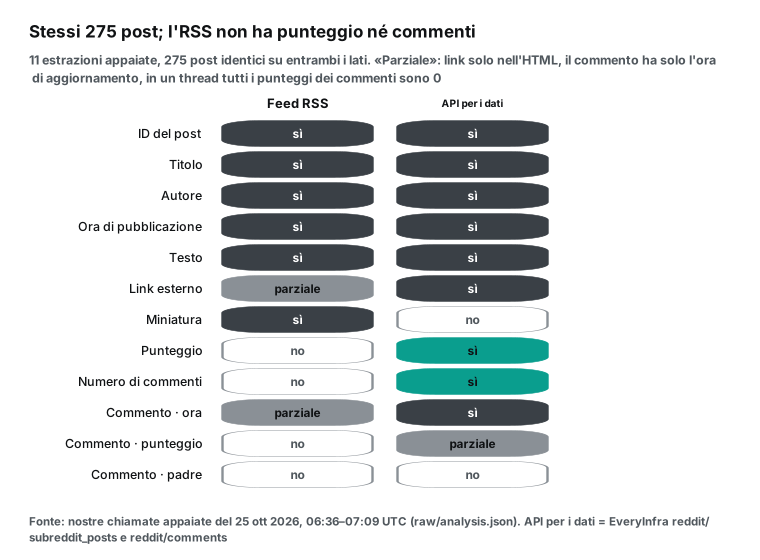
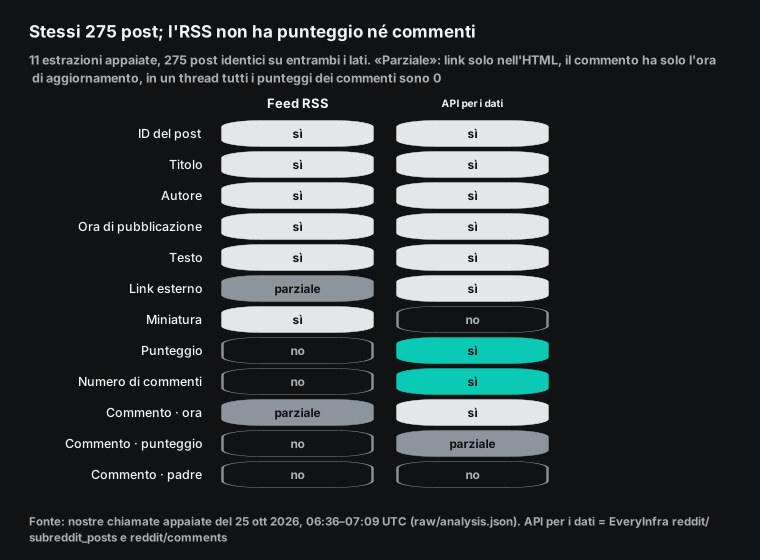
Per un team di monitoraggio, punteggio e numero di commenti determinano classifiche e avvisi. Un nuovo post che passa da 0 a 40 commenti in tre minuti è un evento diverso da un post che resta a 0. Il feed RSS ti dice che un post esiste. Per sapere se è importante devi aprire la pagina del post.
C'è un altro dettaglio. Nel feed RSS, il testo di un post con link è una sola riga: submitted by /u/... [link] [comments]. L'URL esterno è nascosto in quell'HTML. L'API per i dati lo separa in domain ed external_link.
Su r/technology, 24 post su 25 erano post con link. Con il campo domain, basta una riga di codice per contare quali testate vengono condivise di più. Per una redazione che segue dove circolano i propri articoli, è questo il campo che conta.
Cambia anche la precisione temporale. Il feed RSS indica i secondi (06:07:05). Il campo posted_at dell'API per i dati indica i millisecondi (06:07:05.080). Questo non incide sulla deduplicazione in base al primo rilevamento, ma prima di combinare le due fonti normalizza il formato.
Test 2: i feed per parole chiave richiedono type=link
I feed per parole chiave sono la configurazione più comune per il monitoraggio dei media. Qui abbiamo trovato una trappola. Senza type=link, https://www.reddit.com/search.rss?q=rss&sort=new restituisce un mix di community (prefisso ID t5_) e post (t3_). Il primo risultato era una community chiamata “RSS - Really Simple Syndication”. Con type=link, cinque ricerche (rss, "rss feed", DJI, "mercado libre" e feedly) hanno restituito 125 risultati. Tutti e 125 coincidevano con quelli dell'API di ricerca per parole chiave di Reddit (reddit/search, sort=newest).
Il fatto che i risultati coincidano non significa che siano pertinenti. Abbiamo contato quanti risultati contengono la parola chiave nel titolo, nel testo, nel link o nel nome della community:
rss: 25 su 25."rss feed": 19 su 25.DJI: 22 su 25."mercado libre": 24 su 25.feedly: 0 su 25. La ricerca RSS ha restituito gli stessi 25 post.
Se il tuo team monitora il nome di un prodotto, controlla a mano i primi 25 risultati prima di fidarti dell'avviso. Un termine di brand come DJI funziona bene. Un termine come feedly ha prodotto solo rumore il giorno del test. Su Reddit, le ricerche di più parole senza virgolette trovano anche le singole parole; lo abbiamo misurato nel nostro articolo sui campioni per la ricerca sui social media. Secondo il catalogo, reddit/search cerca nei post, non nel testo dei commenti, e copre l'ultimo mese.
Test 3: quanti commenti vengono restituiti e si può vedere il thread?
I commenti sono il punto più debole degli RSS, e un'API per i dati non risolve tutto. Abbiamo scelto tre post:
- L'annuncio del 30 settembre su r/modnews: la pagina del post mostrava 810 commenti. Il feed RSS dei commenti ne ha restituiti 100 con
limit=100e 387 conlimit=500(47,8%). L'API per i commenti di Reddit (reddit/comments) restituisce al massimo 100 commenti per chiamata. Ne ha restituiti 100 (12,3%). - Un post di r/technology del 25 ottobre (46 commenti nell'elenco): il feed RSS ne ha restituiti 41 e l'API per i dati 41, con gli stessi ID (89,1%).
- Un post di r/selfhosted del 25 ottobre (30 commenti): il feed RSS ne ha restituiti 29 e l'API per i dati 30 (100%).
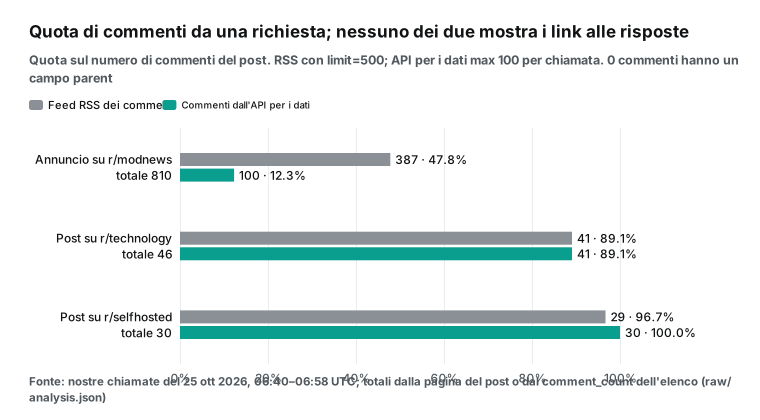
In un thread di grandi dimensioni, una singola richiesta RSS restituisce più commenti di una chiamata all'API per i dati. Va detto chiaramente. Entrambe le fonti presentano però la stessa lacuna: restituiscono un elenco piatto, senza un campo relativo al commento padre.
Abbiamo copiato l'albero dei commenti dalla pagina del post di r/selfhosted, nodo per nodo, e lo abbiamo confrontato. La pagina mostrava 25 commenti visibili: 17 commenti di primo livello e 8 risposte (32%). Una risposta era a due livelli di profondità. Negli elenchi piatti, quelle 8 risposte sembrano commenti di primo livello. Una risposta dell'autore del post sembra un commento nuovo e separato.
Il nostro articolo sulla completezza dei commenti di Reddit spiega perché un albero di commenti non è un problema di “pagina successiva”. Anche il tutorial di PRAW sui commenti tratta le parti non espanse come oggetti MoreComments separati.
Altri due aspetti importanti per gli sviluppatori:
- Gli ID dei commenti sono diventati più lunghi. Il 15 settembre Reddit ha annunciato su r/redditdev che i nuovi ID dei commenti cambiano a partire dalla settimana del 28 settembre. Possono avere fino a 13 caratteri e non sono più crescenti. Il nostro campione lo conferma. Tutti i 100 ID dei commenti del thread del 30 settembre hanno 7 caratteri (ad esempio
pd1ti02). Tutti i 71 ID dei commenti dei due thread del 25 ottobre hanno 13 caratteri (ad esempio19rm1o3qn6ypw). Se il tuo codice ordina i commenti o ne gestisce la paginazione secondo il principio “un ID più alto indica un commento più recente”, modificalo in modo che usi il timestamp. - I commenti nei feed RSS non hanno l'ora di pubblicazione. Le voci dei commenti riportano solo
<updated>, senza<published>. L'API per i dati restituisceposted_at.
Test 4: i feed RSS consentono una richiesta al minuto
Molti pensano che i feed RSS non abbiano limiti. Il 25 ottobre abbiamo inviato 37 richieste RSS da un solo IP e 31 hanno restituito HTTP 200. Ogni risposta 200 riportava x-ratelimit-used: 1 e x-ratelimit-remaining: 0.0. Il valore di x-ratelimit-reset, sommato al secondo della richiesta, cadeva sempre al secondo 58 o 59.
In altre parole, l'accesso anonimo ai feed RSS consente una richiesta per IP per ogni minuto dell'orologio. Una seconda richiesta nello stesso minuto riceve HTTP 429. Ci è successo due volte.
Le altre 4 richieste erano richieste di prova a https://www.reddit.com/r/technology/new.json. Tutte e 4 hanno restituito 403 con il testo “You've been blocked by network security.” Questo corrisponde all'avviso del 28 maggio che ha chiuso gli endpoint .json non autenticati.
I nomi degli header corrispondono alla Reddit Data API Wiki. La wiki fissa un limite di 100 query al minuto per ID client OAuth, come media su una finestra di 10 minuti. Dice anche: “Il traffico che non usa OAuth o credenziali di accesso verrà bloccato.” Nel 2023, l'aggiornamento su r/redditdev concedeva ancora 10 query al minuto ai client senza OAuth.
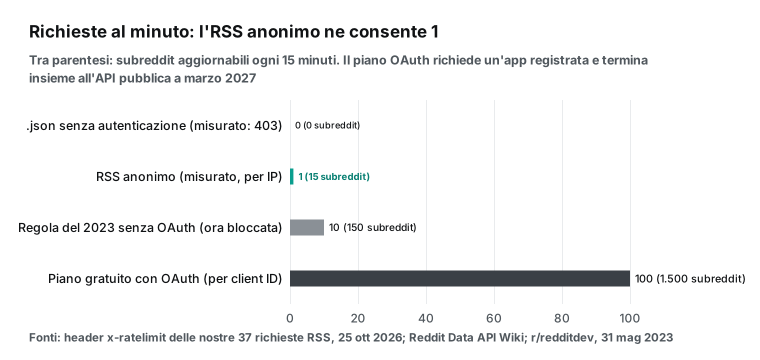
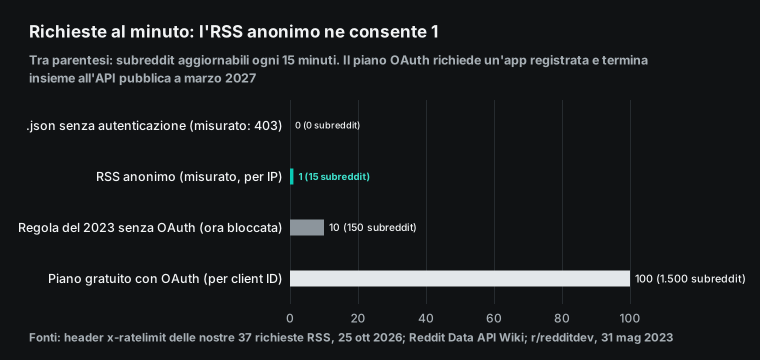
Cosa significa per il monitoraggio: un feed al minuto equivale al massimo a 1.440 richieste al giorno. Se aggiorni ogni 15 minuti, un IP può seguire 15 subreddit. Venti sono troppi. È uno dei motivi per cui i lettori di feed hanno smesso da tempo di interrogare direttamente i feed RSS di Reddit. Un membro dello staff di Feedly ha scritto su r/feedly che Feedly legge Reddit tramite un'API commerciale registrata.
Quattro gruppi, quattro percorsi
Il post di Reddit del 30 settembre divide le persone in due gruppi: i moderatori, che ricevono un'alternativa, e tutti gli altri, che non la ricevono. In pratica, i gruppi sono quattro.
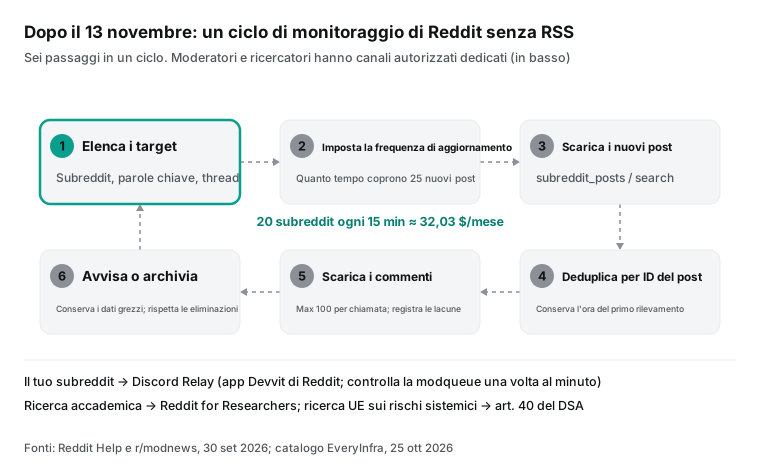
Moderatori: configura Discord Relay, testalo e poi abbandona gli RSS
I passaggi del centro assistenza Reddit sono brevi. Installa l'app Devvit Discord Relay. Crea un canale Discord o Slack privato per il tuo team di moderazione. Copia l'URL del suo webhook e attiva gli avvisi della Modqueue. La pagina di assistenza dice: “L'app controlla la coda di moderazione una volta al minuto.” La pagina dell'app aggiunge tre limiti. Puoi impostare fino a sei destinazioni webhook. La modalità “Front Page” analizza fino a 100 post principali una volta al minuto e non inoltra i commenti. Qualsiasi ritardo degli avvisi diverso da zero deve essere di almeno tre minuti. L'app funziona solo nelle community in cui hai i permessi di moderazione completi.
Sviluppatori e autori di bot: registrati, migra e tieni d'occhio la scadenza della bounty
La tabella delle date su r/redditdev indica tre date per gli sviluppatori. Dopo il 31 ottobre non si accettano nuove richieste per l'API pubblica. Iscriviti alla bounty per la migrazione entro il 30 novembre. Le app non registrate iniziano a perdere l'accesso il 12 gennaio 2027.
Le condizioni della bounty riguardano gli strumenti per le community con almeno 1.000 utenti attivi settimanali. Le app selezionate ricevono $1.000 ciascuna e devono completare la migrazione entro il 31 dicembre 2026. La guida alla migrazione associa i pattern di PRAW agli equivalenti in Devvit Web. Spiega anche come richiedere eccezioni, ad esempio per un accesso più ampio alle richieste HTTP e agli endpoint esterni. Se il tuo bot dipende da PRAW, prevedi il tempo necessario per riscriverlo. Il post di agosto diceva che il supporto a Python non è nella roadmap.
Ricercatori: Reddit accetta una sola strada, l'UE ne aggiunge un'altra
La pagina di Reddit su Developer Platform e accesso ai dati è esplicita: per la ricerca con i dati di Reddit, “l'unico canale ufficiale e autorizzato” è Reddit for Researchers (RFR). RFR richiede l'affiliazione a un'università accreditata, una lettera di approvazione etica e uno sponsor istituzionale. L'accesso avviene tramite BigQuery Analytics Hub, dura al massimo un anno ed è gratuito per i progetti non commerciali. La Responsible Builder Policy stabilisce che la ricerca con dati di Reddit raccolti al di fuori di RFR viola la policy.
Nell'UE, la Commissione europea ha designato Reddit come piattaforma online di dimensioni molto grandi il 31 agosto. Reddit ha quattro mesi, cioè fino a gennaio 2027, per rispettare gli obblighi aggiuntivi. Il Centro europeo per la trasparenza algoritmica spiega la norma nelle sue FAQ sull'accesso ai dati previsto dal DSA. In base all'articolo 40, paragrafo 12, i ricercatori qualificati possono ottenere i dati pubblicamente visibili sulla piattaforma. La ricerca deve riguardare i rischi sistemici nell'UE. Per scegliere e documentare un percorso, vedi il nostro articolo sui campioni per la ricerca.
Anche i metodi di ricerca stanno cambiando. La UK Social Platforms Data Access Taskforce ha pubblicato il suo rapporto finale il 9 settembre. Chiede di passare da accordi controllati dalle piattaforme a un accesso fondato sul diritto pubblico. Un preprint del 15 settembre sul sistema CANDOR propone la donazione dei dati da parte dei partecipanti, visto il calo dell'accesso alle API delle piattaforme. Una rassegna del 21 settembre su 476 articoli di comunicazione computazionale ha rilevato un uso diffuso delle API per la raccolta dei dati e ha avvertito che ciò può compromettere la riproducibilità.
Redazioni, social listening e strumenti per sviluppatori: Reddit non offre alternative
Se segui community altrui, parole chiave di settore o le conversazioni sui concorrenti, il post di Reddit è chiaro: non c'è alcuna alternativa. Restano due opzioni:
- Una licenza commerciale di Reddit. La pagina della Developer Platform elenca “servizi, ricerca o accesso ai dati a pagamento” come uso commerciale. Questo uso richiede un'autorizzazione e un contratto.
- Un'API per i dati di terze parti. Un esempio è l'API di scraping per Reddit che abbiamo usato in questo test. Ogni chiamata API viene addebitata e vengono restituiti sempre gli stessi campi JSON. Puoi collegarla a uno script o a un client AI.
Dopo il 13 novembre, controlla il valore available nel catalogo delle funzionalità quando inizi a sviluppare. Tutti i numeri di questo articolo descrivono la situazione al 25 ottobre.
Quanto costa al mese a un team di monitoraggio
I prezzi provengono dal catalogo delle funzionalità, consultato il 25 ottobre alle 06:34 UTC (per i prezzi attuali consulta la pagina Prezzi). Tutte e cinque le funzionalità di Reddit costano $0,000556 per chiamata. I post dei subreddit e i commenti restituiscono fino a 100 elementi per chiamata; la ricerca per parole chiave e i post degli utenti fino a 50. Prendiamo una redazione che vuole:
- 20 subreddit, aggiornati ogni 15 minuti: 20 × 96 al giorno × 30 giorni = 57.600 chiamate × $0,000556 = $32,03;
- 10 parole chiave, cercate ogni ora: 10 × 24 × 30 = 7.200 chiamate × $0,000556 = $4,00;
- i commenti di 30 post corrispondenti al giorno: 30 × 30 = 900 chiamate × $0,000556 = $0,50.
Il totale è di $36,53 al mese. Le chiamate non riuscite e i risultati vuoti non vengono addebitati. Con aggiornamenti orari, 20 subreddit costano $8,01 al mese. Con i feed RSS anonimi, un IP può scaricare solo 15 feed in 15 minuti, quindi per 20 subreddit serve più di un IP.
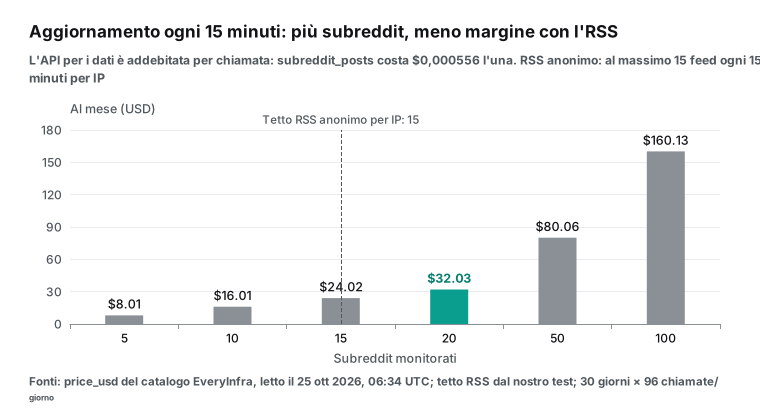
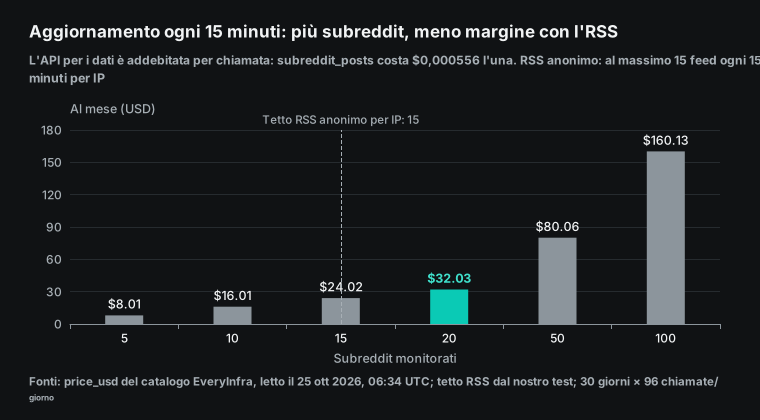
Non usare la stessa frequenza di aggiornamento per tutti i subreddit. Abbiamo misurato quanto tempo coprono i 25 post più recenti: su r/AskReddit circa 15 minuti, su r/technology 11,2 ore, su r/news 51,7 ore, su r/datasets 7 giorni e su r/rss 8,4 giorni. Per r/rss basta un controllo giornaliero. Destina le chiamate risparmiate ai subreddit veloci, oppure porta limit a 100.
Tutti i test live di questo articolo hanno usato 22 chiamate addebitate, per un totale di $0,012232. Altre due richieste, una con un parametro errato e una senza chiave API, non sono state addebitate.
Connettiti tramite codice o un client AI
Una sola chiamata curl restituisce i post più recenti di un subreddit (la chiave è un segnaposto):
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer <API Key>" \
  -H "Content-Type: application/json" \
  -d '{"platform":"reddit","action":"subreddit_posts","params":{"subreddit":"news","sort":"newest","limit":25}}'
Campi della risposta (corrispondono a response_fields nel catalogo):
id: ID del post senza il prefissot3_.reddit/searchrestituisce gli ID con il prefisso, quindi normalizzali prima della deduplicazione.url,title,text: URL, titolo e testo del post. Il testo di un post con link è la riga “submitted by”.author_username: il nome utente dell'autore. Conservalo secondo le tue regole sulla privacy.community: nome del subreddit.subreddit_postslo restituisce senzar/;searchlo restituisce conr/. Normalizza anche questo.like_count,comment_count: punteggio e numero di commenti, i due campi che mancano nell'RSS.posted_at: data e ora di pubblicazione, ISO 8601, UTC.flair,domain,external_link: testo del flair, dominio esterno, URL esterno.thumbnail_url,image_urls: miniatura e immagini. Nel nostro test non hanno restituito valori.platform: semprereddit.
reddit/comments restituisce id, text, author_username, like_count, community, url, posted_at e platform. Nel nostro test, tutti i 100 commenti del thread del 30 settembre avevano like_count pari a 0, che non corrisponde alla pagina. Nei due thread del 25 ottobre, 68 su 71 erano diversi da zero. Verifica i punteggi a campione prima di usarli per gli avvisi.
In Claude Code, crea una chiave API seguendo la guida rapida. Poi aggiungi il server MCP remoto, come descritto nella documentazione MCP di Claude Code:
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header 'Authorization: Bearer ${EVERYINFRA_API_KEY}'
Poi chiedi: “Usa everyinfra_call_api per ottenere i 25 post più recenti di r/news. Raggruppali per dominio esterno ed elenca i domini con più di due post.”
Errori e addebiti (tutti riscontrati in questo test):
- Un valore enum errato, ad esempio
sortimpostato sunew, restituisce 422invalid_valuecon un elencoallowededid_you_mean: ["newest"]. Nessun addebito. - Senza chiave si ottiene 401
missing_key. Nessun addebito. - Se il nome del subreddit inizia a sua volta con “r” (come r/rss), il catalogo indica di inviare l'URL completo,
https://www.reddit.com/r/rss/. Quando abbiamo inviato solorss, abbiamo ottenuto un unico segnaposto di stato e un addebito di $0,000556. Con l'URL completo abbiamo ottenuto 25 post. - Per una chiamata che supera gli 85 secondi, invia
"mode":"async"per ottenere unjob_id, poi interroga/api/v1/jobs/{job_id}. Le chiamate non riuscite e i risultati vuoti vengono rimborsati. Vedi rimborsi in caso di errore e riconciliazione.
Nel 2023 contava il prezzo; nel 2026 conta l'accesso
Nel 2023 il cambiamento riguardava il prezzo. Reddit ha annunciato i nuovi termini per gli sviluppatori sul suo blog aziendale il 18 aprile. Il 31 maggio, r/redditdev ha fissato i limiti del piano gratuito a partire dal 1° luglio: 100 query al minuto con OAuth, 10 senza.
A giugno, il CEO ha scritto su r/reddit che le app ad alto utilizzo avrebbero pagato $0,24 per 1.000 chiamate. Ha scritto anche che Apollo, Reddit is Fun e Sync avrebbero chiuso. Lo sviluppatore di Apollo ha fatto i conti in pubblico il 31 maggio. Apollo aveva effettuato 7 miliardi di richieste in un mese, pari a circa $1,7 milioni al mese a quel prezzo.
Nel 2026 il cambiamento riguarda l'accesso. Le richieste .json non autenticate restituiscono già 403. I feed RSS smettono di funzionare il 13 novembre e l'API pubblica chiude a marzo 2027. Restano Devvit (app eseguite all'interno della piattaforma gestita da Reddit), RFR (solo per accademici) e i contratti commerciali.
Nel 2023 l'accesso si poteva ancora comprare. Dopo il 2026, Reddit non offre alcun percorso autorizzato al di fuori di questi canali.
Per chi usava i feed RSS, il cambiamento del 2023 non contava, perché i feed RSS non passavano dall'API. Questo invece sì.
Novità recenti da tenere d'occhio (agosto-ottobre 2026)
- 31 agosto: l'UE designa Reddit come piattaforma online di dimensioni molto grandi (Commissione europea). Per i ricercatori: entro gennaio 2027, a Reddit si applica l'obbligo previsto dall'articolo 40(12) del DSA di dare accesso ai dati pubblici. Questo offre alla ricerca UE sui rischi sistemici una via legale.
- Settimana del 28 settembre: i nuovi ID dei commenti arrivano fino a 13 caratteri e non sono più crescenti (r/redditdev). Per gli sviluppatori: correggi il codice che controlla la lunghezza degli ID o confronta gli ID per trovare i commenti più recenti. Tutti i 71 nuovi commenti del nostro campione del 25 ottobre avevano ID di 13 caratteri.
- 30 settembre: Reddit fissa la data di fine dei feed RSS e il calendario di chiusura dell'API (r/modnews, r/redditdev). Per tutti: esporta l'elenco dei feed a cui sei iscritto prima del 13 novembre e trova il tuo gruppo in questo articolo.
- Metà ottobre: il fondatore di NewsBlur dice che Reddit rifiuta con 403 le richieste API di NewsBlur (forum di NewsBlur). Aggiunge che le iscrizioni Reddit di NewsBlur che terminano in
.rssusano già l'API autenticata. Per chi usa un lettore di feed: un URL che funziona oggi non garantisce aggiornamenti dopo il 13 novembre. Su r/feedly, un membro dello staff di Feedly ha prima detto che i feed di Reddit avrebbero continuato a funzionare, poi ha scritto che “le nostre prime valutazioni potrebbero essere state sbagliate”. - 9 ottobre: Reddit chiede di escludere il suo ex studio legale da una causa sullo scraping (atto depositato; Reuters, 12 ottobre; S.D.N.Y. 1:25-cv-08736). Per chi usa i dati: Reddit fa valere in tribunale le sue regole di accesso, quindi il rischio previsto dai termini è reale.
Limiti di questo test
- Abbiamo eseguito tutti i confronti in un solo pomeriggio e da un solo IP. “Una richiesta al minuto” è il limite osservato da questo IP. Altri IP o sessioni con login possono comportarsi diversamente.
- “Corrispondenza del 100%” significa che l'ordinamento
newestcoincideva nello stesso momento. Non vale pertoporelevance, né per il periodo successivo al 13 novembre. - Abbiamo confrontato i thread di commenti di un solo post (25 commenti visibili). Abbiamo copiato a mano l'albero della pagina. Non abbiamo verificato commento per commento il thread da 810 commenti.
- La pertinenza per parola chiave è una corrispondenza di stringhe, non un giudizio umano sul significato.
- Citiamo solo i termini di Reddit. Questa non è una consulenza legale.
FAQ
Qual è l'URL del feed RSS di Reddit e funzionerà ancora? Aggiungi .rss a un URL di Reddit, ad esempio https://www.reddit.com/r/news/new/.rss. Per i feed per parola chiave usa https://www.reddit.com/search.rss?q=<term>&sort=new&type=link. Senza type=link ottieni anche le community. Il 25 ottobre questi URL restituivano ancora HTTP 200. Smetteranno di funzionare il 13 novembre 2026. (Fonte della domanda: il suggerimento di ricerca “reddit rss feed url”.)
I feed RSS di Reddit hanno un limite di frequenza delle richieste? Sì. Abbiamo misurato una richiesta per IP per ogni minuto dell'orologio. Gli header erano x-ratelimit-used: 1 e x-ratelimit-remaining: 0.0, e il reset cadeva al secondo 58 o 59. Una seconda richiesta nello stesso minuto restituisce 429. (Fonte della domanda: il suggerimento di ricerca “reddit rss rate limit”.)
Qual è l'alternativa ai feed RSS di Reddit dopo il 13 novembre? Dipende da chi sei: i moderatori possono usare Discord Relay. Gli sviluppatori dovrebbero registrarsi prima del 12 gennaio 2027 e passare a Devvit. I ricercatori accademici usano Reddit for Researchers e la ricerca nell'UE può ricorrere all'articolo 40 del DSA. Per le community che non moderi, Reddit dice che non esiste un'alternativa. Le opzioni sono una licenza commerciale o un'API per i dati di terze parti, dopo aver verificato personalmente i termini. (Fonte della domanda: il suggerimento di ricerca “rss alternative reddit”.)
Letture correlate
- Pagine delle piattaforme: API di scraping per Reddit, API di scraping per X (Twitter)
- Pagine delle funzionalità: API per i post dei subreddit di Reddit, API di ricerca per parola chiave su Reddit, API per i commenti di Reddit, API per i dettagli dei post di Reddit
- Articoli correlati: Completezza dei commenti su Reddit, Dati dei social media come campioni di ricerca, Monitoraggio della reputazione su più piattaforme
Metodo
- Per ogni coppia abbiamo prima recuperato il feed RSS e, uno o due secondi dopo, chiamato l'API per i dati. Le richieste RSS usavano lo User-Agent di un browser desktop, senza login. Le chiamate all'API per i dati usavano una chiave di test passata tramite una variabile d'ambiente.
- Abbiamo verificato la data di ogni post di Reddit con il valore
<published>nell'RSS del post stesso. L'avviso del 28 maggio è delle 17:14 UTC. I due post del 5 agosto sono delle 16:03 e delle 16:05 UTC. L'avviso del 15 settembre sugli ID dei commenti è delle 19:40 UTC. I due post del 30 settembre sono delle 17:37 e delle 17:41 UTC. - Conserviamo le risposte grezze, gli script e
analysis.json. Uno script calcola ogni numero dei grafici a partire dalle risposte grezze.
Riferimenti
- Reddit (r/modnews), «Continuing our infrastructure updates: What’s changing in the coming months», 2026-09-30, https://www.reddit.com/r/modnews/comments/1wubgvt/continuing_our_infrastructure_updates_whats/
- Reddit (r/redditdev), «Moving Data API Apps to the Developer Platform: migration dates and next steps», 2026-09-30, https://www.reddit.com/r/redditdev/comments/1wubcvf/moving_data_api_apps_to_the_developer_platform/
- Reddit Help, «Setting up mod alerts in Discord or Slack», consultato il 2026-10-25, https://support.reddithelp.com/hc/articles/54058188280852/
- Reddit for Developers, pagina dell'app «Discord Relay», consultata il 2026-10-25, https://developers.reddit.com/apps/discord-relay
- Reddit (r/modnews), «Protecting communities from scrapers and platform abuse», 2026-05-28, https://www.reddit.com/r/modnews/comments/1tq9vxo/protecting_communities_from_scrapers_and_platform/
- Reddit (r/redditdev), «Our Plans for the Future of Reddit’s Public Data API and the Developer Platform», 2026-08-05, https://www.reddit.com/r/redditdev/comments/1vgbm9c/our_plans_for_the_future_of_reddits_public_data/
- Steve Huffman (u/spez), «Modernizing Reddit’s infrastructure with you», 2026-08-05, https://www.reddit.com/user/spez/comments/1vgbkge/modernizing_reddits_infrastructure_with_you/
- Reddit (r/redditdev), «Upcoming changes to the comment ID endpoint», 2026-09-15, https://www.reddit.com/r/redditdev/comments/1whal6a/upcoming_changes_to_the_comment_id_endpoint/
- Reddit Help, «Reddit Data API Wiki», consultato il 2026-10-25, https://support.reddithelp.com/hc/en-us/articles/16160319875092-Reddit-Data-API-Wiki
- Reddit Help, «Developer Platform & Accessing Reddit Data», consultato il 2026-10-25, https://support.reddithelp.com/hc/en-us/articles/14945211791892-Developer-Platform-Accessing-Reddit-Data
- Reddit Help, «Responsible Builder Policy», consultato il 2026-10-25, https://support.reddithelp.com/hc/en-us/articles/42728983564564-Responsible-Builder-Policy
- Reddit Help, «Reddit for Researchers Program», consultato il 2026-10-25, https://support.reddithelp.com/hc/en-us/articles/49381918834964-Reddit-for-Researchers-Program
- Reddit for Developers, «Migrating apps from the Data API to Devvit», consultato il 2026-10-25, https://developers.reddit.com/docs/guides/migrate/public-api
- Reddit Help, «Reddit Developer Platform App Migration Program 2026 Terms», consultato il 2026-10-25, https://support.reddithelp.com/hc/en-us/articles/47822311698452-Reddit-Developer-Platform-App-Migration-Program-2026-Terms
- Reddit (r/redditdev), «API Update: Enterprise Level Tier for Large Scale Applications», 2023-05-31, https://www.reddit.com/r/redditdev/comments/13wsiks/api_update_enterprise_level_tier_for_large_scale/
- Steve Huffman (r/reddit), «Addressing the community about changes to our API», 2023-06-09, https://www.reddit.com/r/reddit/comments/145bram/addressing_the_community_about_changes_to_our_api/
- Reddit, Inc., «Creating a Healthy Ecosystem for Reddit Data and Reddit Data API Access», 2023-04-18, https://redditinc.com/news/2023apiupdates
- Christian Selig (r/apolloapp), «Had a call with Reddit to discuss pricing…», 2023-05-31, https://www.reddit.com/r/apolloapp/comments/13ws4w3/had_a_call_with_reddit_to_discuss_pricing_bad/
- Reddit, Inc., «Reddit Reports Second Quarter 2026 Results», consultato il 2026-10-25, https://investor.redditinc.com/news-events/news-releases/news-details/2026/Reddit-Reports-Second-Quarter-2026-Results/default.aspx
- Commissione europea, «Commission designates ChatGPT, Reddit, Roblox under Digital Services Act» (IP/26/1772), 2026-08-31, https://ec.europa.eu/commission/presscorner/detail/en/ip_26_1772
- Centro europeo per la trasparenza algoritmica (JRC), «FAQs: DSA data access for researchers», 2025-07-03, https://algorithmic-transparency.ec.europa.eu/news/faqs-dsa-data-access-researchers-2025-07-03_en
- IETF, RFC 4287, «The Atom Syndication Format», 2005-12, https://www.rfc-editor.org/rfc/rfc4287
- Documentazione di PRAW, «Comment Extraction and Parsing», consultata il 2026-10-25, https://praw.readthedocs.io/en/stable/tutorials/comments.html
- Zhao et al., «Participant-Mediated Collection of Sensitive Digital Trace Data: The CANDOR Research Infrastructure», arXiv:2609.17722, 2026-09-15, https://arxiv.org/abs/2609.17722
- Social Platforms Data Access Taskforce (Smart Data Research UK), «Final Report», 2026-09-09, https://eprints.whiterose.ac.uk/id/eprint/246345/
- Breuer, Knöpfle e Haim, «Just redo it?», Computational Communication Research 8(1), 2026-09-21, DOI 10.5117/CCR2026.1.16.BREU, https://doi.org/10.5117/CCR2026.1.16.BREU
- Avvocati di Reddit, memoria di opposizione nella causa Reddit v. Perplexity e altri (S.D.N.Y. 1:25-cv-08736), 2026-10-09, https://fingfx.thomsonreuters.com/gfx/legaldocs/egpbglggxvq/Reddit%20opposition.pdf
- EveryInfra, catalogo delle funzionalità
GET /api/v1/social/catalog, consultato il 2026-10-25 alle 06:34 UTC, https://api.everyinfra.com/api/v1/social/catalog - Anthropic, «Connect Claude Code to tools via MCP», consultato il 2026-10-25, https://code.claude.com/docs/en/mcp
- TechCrunch, «Reddit is killing RSS feeds and ending public API access because of AI bots», 2026-09-30, https://techcrunch.com/2026/09/30/reddit-is-killing-rss-feeds-ending-public-api-access-because-of-ai-bots/
- Forum di NewsBlur, «Reddit RSS Feeds Error 429/Error 404», risposta n. 2 del fondatore, metà ottobre 2026, https://forum.newsblur.com/t/reddit-rss-feeds-error-429-error-404/13890/2
- r/feedly, «Goodbye», con risposte dello staff di Feedly, dal 2026-09-30, https://www.reddit.com/r/feedly/comments/1wuilij/goodbye/
- Reuters, «Reddit and Perplexity AI clash over law firm's role in data-scraping case», 2026-10-12, https://www.reuters.com/legal/litigation/reddit-perplexity-ai-clash-over-law-firms-role-data-scraping-case-2026-10-12/
Riferimenti BL-38