Alternativa ad Apify Twitter Scraper: ricerca, post dei profili e risposte, con costi misurati per 1.000 righe
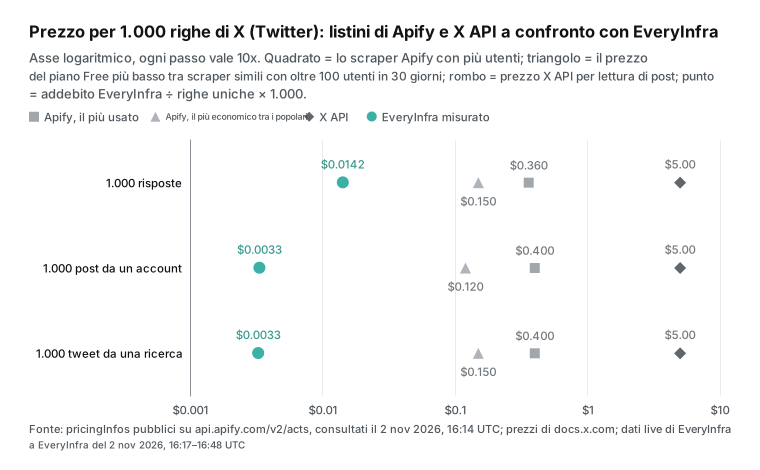
Apify Tweet Scraper V2 ha un prezzo di listino di $0,40 per 1.000 tweet. Il costo di ricerca che abbiamo misurato è stato di $0,0033. Le risposte costavano da 10 a 25 volte meno, ma con un massimo di 50 per post.
Lo scraper di tweet più usato dell'Apify Store è Tweet Scraper V2. Il suo prezzo pubblico è di $0,40 per 1.000 tweet su tutti i piani. Il 3 novembre 2026 abbiamo eseguito 7 ricerche per parola chiave tramite l'endpoint twitter/search di EveryInfra. Ogni chiamata è costata $0,000556 e ha restituito 200 tweet.
Dopo aver rimosso i duplicati, avevamo 1.190 tweet unici per $0,003892. Sono $0,00327 per 1.000, cioè 122 volte meno di V2. Tra gli scraper di tweet più popolari dello Store con ricerca completa per parola chiave, il più economico è xquik a $0,15, quindi lì il divario è di 46 volte.
Per 1.000 post di un singolo account abbiamo misurato $0,00334 per 1.000 post unici. È 120 volte meno di V2 e 36 volte meno dell'opzione popolare più economica ($0,12). Con le risposte il discorso cambia. Il nostro endpoint twitter/comments restituisce al massimo 50 risposte per post.
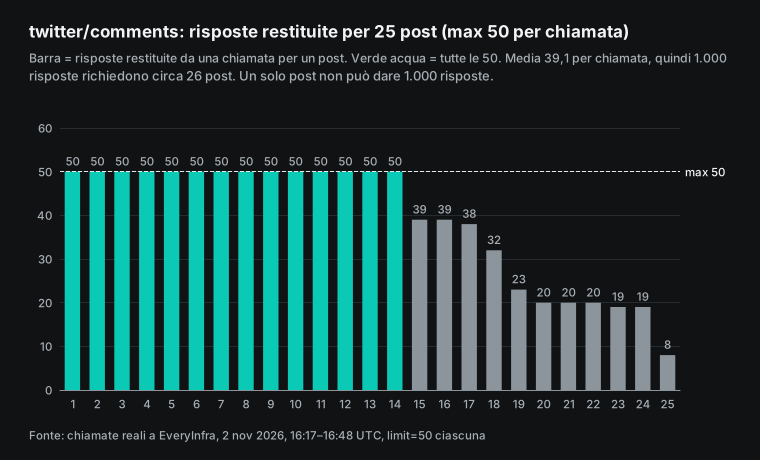
Su 25 post, la media è stata di 39,1 risposte per chiamata, cioè $0,0142 per 1.000 risposte. È da 10 a 25 volte meno degli scraper di risposte Apify di cui abbiamo verificato il prezzo. Però con il nostro endpoint non puoi ottenere 1.000 risposte da un solo post. Per quel lavoro, Apify è lo strumento migliore.
Come leggere i numeri di questo articolo
Il nostro «prezzo per 1.000» è semplice. Prendiamo l'importo effettivamente addebitato, lo dividiamo per le righe effettivamente restituite e moltiplichiamo per 1.000. EveryInfra addebita per richiesta, e una richiesta ha un unico prezzo indipendentemente dal numero di righe. La maggior parte degli scraper Twitter dell'Apify Store addebita per risultato: ogni elemento scritto nel dataset è un addebito. Le due unità sono confrontabili solo con lo stesso denominatore.
Da parte nostra, il denominatore sono le righe uniche, deduplicate per ID del post. Non usiamo mai il valore di limit come denominatore. Quindi, quando una chiamata restituisce meno righe o righe ripetute, in questo articolo il nostro prezzo sale, non scende. Per Apify usiamo solo materiale pubblico: le pagine dello Store, la pagina dei prezzi, la documentazione e l'API pubblica degli actor, che non richiede un account.
Non ci siamo registrati ad Apify e non abbiamo eseguito alcun actor. «Actor» è il nome che Apify dà a un programma di scraping in cloud. Quindi ogni numero Apify riportato sotto è un prezzo di listino, non un addebito misurato.
Apify Twitter scraper ed EveryInfra a confronto: la tabella riassuntiva
Questa tabella è il risultato. Per ogni tipo di dato mostriamo due scraper Apify. Il primo è lo scraper principale, quello con più utenti negli ultimi 30 giorni. Il secondo è lo scraper più economico nella fascia Free tra quelli con almeno 100 utenti negli ultimi 30 giorni. Abbiamo letto tutti i prezzi dal campo pricingInfos dell'API pubblica degli actor alle 16:14 UTC del 2 novembre 2026 (le 00:14 ora di Singapore del 3 novembre).
La documentazione di Apify associa i piani alle fasce di prezzo. Free usa il prezzo Free, Starter usa Bronze, Scale usa Silver e Business usa Gold. Platinum e Diamond sono per i clienti enterprise («Actor pricing and costs»). Per gli scraper Twitter di questo articolo, i prezzi Free e Business sono uguali o differiscono di meno della metà. I nostri numeri provengono tutti da chiamate live. Abbiamo letto l'addebito da billing.charged_usd e le righe da results.
| Dati | Endpoint EveryInfra | Chiamate / righe / righe uniche / importo addebitato | EveryInfra per 1.000 (uniche) | Scraper Apify principale | Differenza | Il più economico tra i popolari | Differenza |
|---|---|---|---|---|---|---|---|
| Ricerca per keyword | twitter/search | 7 / 1,400 / 1,190 / $0.003892 | $0.00327 | Tweet Scraper V2, $0,40 | 122x | xquik, $0,15 | 46x |
| Post di un singolo account | twitter/user_posts + ricerca from: | 8 / 1,592 / 1,330 / $0.004448 | $0.00334 | V2 con twitterHandles, $0,40 | 120x | feedminer, $0,12 | 36x |
| Risposte ai post | twitter/comments | 25 / 977 / 977 / $0.0139 | $0.0142 | Replies Scraper, 20 post x 50, $0,36 | 25x | xquik Reply, $0,15 | 10.5x |
Ogni divario è il prezzo Apify diviso per il nostro. Valgono quattro note. Primo, tutti e tre i divari dipendono dalla dimensione della pagina. La ricerca e i post di un account restituiscono fino a 200 righe per chiamata, le risposte fino a 50. Una pagina piena distribuisce un'unica tariffa su molte righe. Se ti servono una o due righe per chiamata, il risultato si inverte, e la sezione sul punto di pareggio mostra i calcoli.
Secondo, il valore di $0,36 per le risposte applica una regola della pagina dello scraper di risposte di apidojo. Sui piani a pagamento, circa le prime 40 risposte per post sono gratuite. Con 50 risposte per post, un post costa una tariffa per query di $0,014 più 10 elementi a $0,0004. Terzo, il README di xquik dice che Apify addebita l'utilizzo della piattaforma in aggiunta alla tariffa per risultato (README di xquik).
Quindi $0,15 non è il conto completo. Quarto, i prezzi di Apify cambiano spesso. La sezione «Cosa è cambiato di recente» riporta le date.
Il prezzo di $0,15 per la ricerca non è solo di xquik. Lo scraper di tweet di scrape.badger aveva 709 utenti in 30 giorni, con $0,15 sul piano Free e $0,12 su Business. Feedminer è più basso, a $0,12, ma i suoi termini di ricerca per parola chiave senza from: ora provengono dalle X Communities. Per questo usiamo feedminer solo nella riga degli account.
Prezzi degli scraper di tweet Apify: V2, Unlimited e lo scraper di risposte
Chi cerca «apify tweet scraper pricing» di solito trova diversi scraper con nomi simili. Uno sviluppatore, apidojo, ne pubblica tre: Tweet Scraper V2, Twitter (X.com) Scraper Unlimited e Twitter (X) Replies Scraper. Tutti e tre usano il pricing pay-per-event. Lo sviluppatore definisce gli eventi fatturabili, e ogni esecuzione addebita il numero di eventi moltiplicato per il prezzo dell'evento.
La documentazione su pay-per-event spiega chi paga le risorse di calcolo. Per impostazione predefinita, lo sviluppatore paga l'utilizzo della piattaforma con i propri ricavi. Uno sviluppatore può attivare «Pay per event + usage», e in quel caso anche l'utente paga l'utilizzo della piattaforma. Apify copre l'utilizzo della piattaforma per gli utenti del piano gratuito. V2 ha un solo evento. Ogni tweet scritto nel dataset costa $0,0004, cioè $0,40 per 1.000 su tutti e quattro i piani.
La pagina di V2 nello Store contiene una nota sui prezzi con quattro regole. Lo screenshot qui sotto mostra il testo originale.
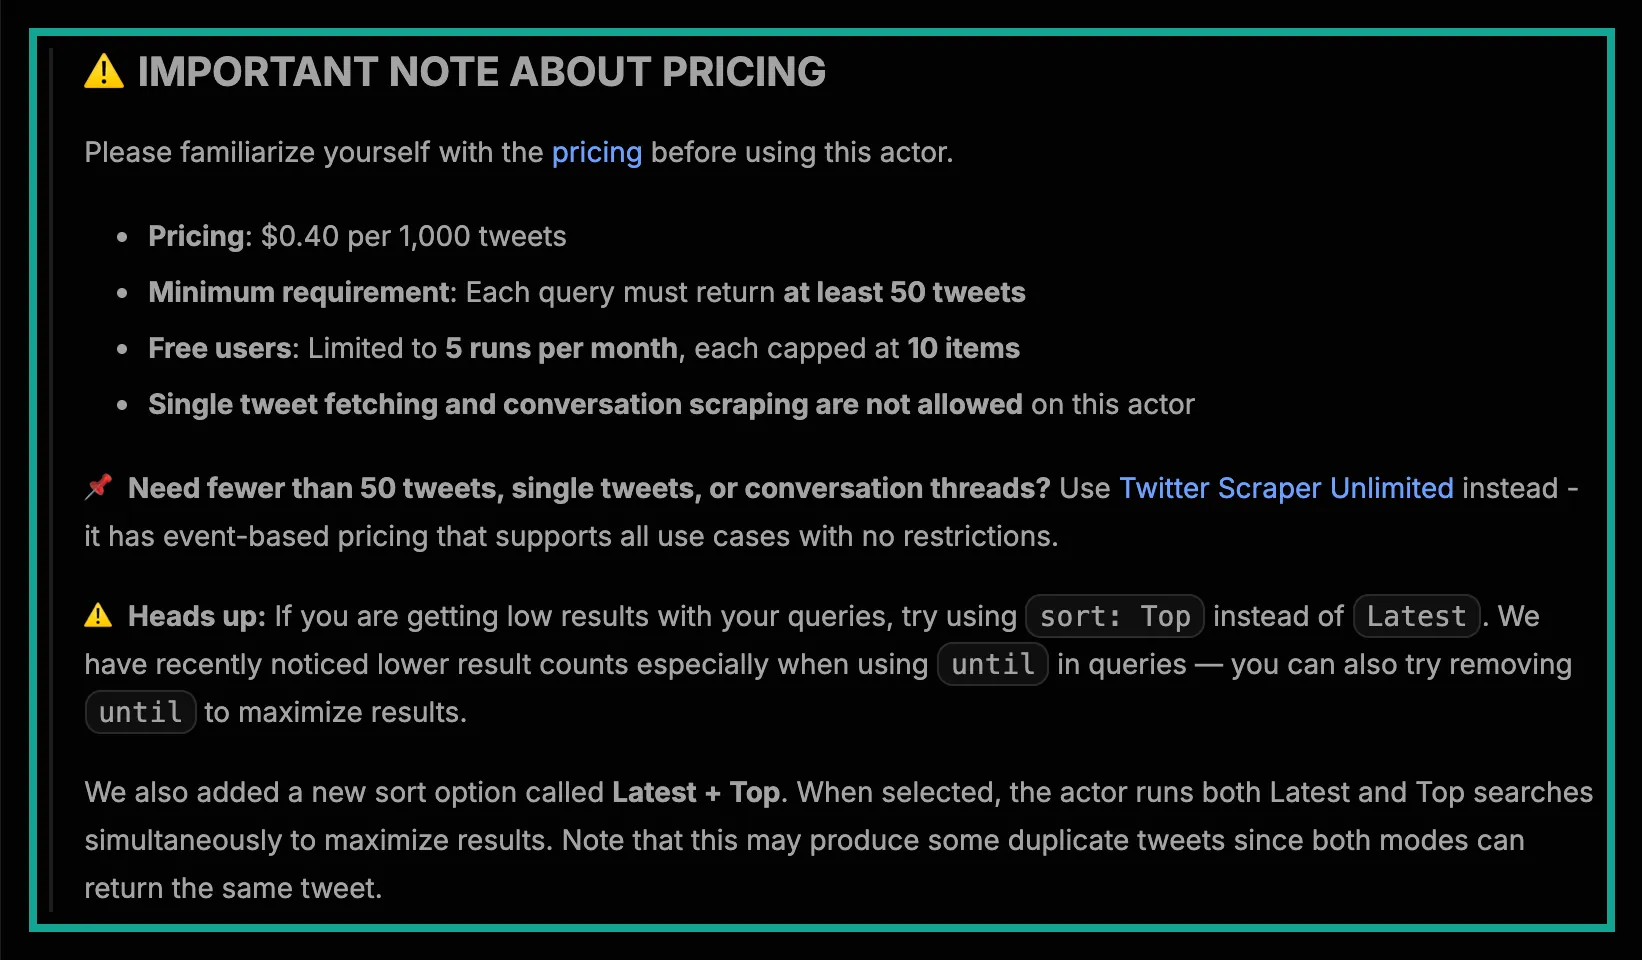
Due di queste regole pesano di più sui costi. La prima è «almeno 50 tweet per query». V2 non è pensato per query piccole e precise, come tre post di un piccolo account questa settimana. La pagina indirizza questi lavori a Unlimited.
La seconda regola è il limite per gli utenti gratuiti di 5 esecuzioni al mese da 10 elementi ciascuna. Il piano gratuito include $5 di credito mensile per la piattaforma (prezzi Apify). Ma V2 concede agli utenti gratuiti solo 50 tweet al mese. La pagina dice anche che gli utenti gratuiti non possono chiamare l'actor tramite API.
Quindi un carico di lavoro reale su V2 richiede almeno il piano Starter. La tabella mostra i piani e la fascia di prezzo usata da ciascuno.
| Piano Apify | Prezzo mensile | Fascia di prezzo per gli actor | Cosa significa per V2 |
|---|---|---|---|
| Gratis | $0, con $5 di credito per la piattaforma | Gratis | Modalità demo: 5 esecuzioni, 10 elementi ciascuna, niente API |
| Starter | Da $19 | Bronze | V2 completo a $0,40 per 1.000 |
| Scale | $199 | Silver | Stesso prezzo di V2 |
| Business | $999 | Gold | Stesso prezzo di V2 |
L'utilizzo incluso in un piano non si trasferisce al ciclo successivo. La pagina di V2 ha anche una sezione «Important Note» con altri due limiti. Puoi avere al massimo 1 esecuzione simultanea con fino a 5 query raggruppate. Inoltre la pagina indica «No monitoring»: non eseguire la stessa query più e più volte a brevi intervalli.
Unlimited ha un prezzo più complesso. Addebita $0,016 per query, cioè per ogni termine di ricerca, handle o lista. Questa tariffa include circa i primi 40 risultati. Gli elementi aggiuntivi costano da $0,0004 a $0,002 ciascuno, e il prezzo dipende da quante query ci sono in un'esecuzione. Con un massimo di 5 query per esecuzione, ogni elemento aggiuntivo costa $0,0004. Con 6-10 query, ogni elemento aggiuntivo costa $0,0008; con 11-30 costa $0,0012; con 31-100 costa $0,0016; con più di 100 costa $0,002.
L'URL di un singolo tweet costa $0,05, e ogni esecuzione ha un minimo di $0,02. Tutti questi dati provengono dai metadati dell'actor Unlimited. Quindi più query in un'esecuzione rendono ogni elemento aggiuntivo più caro. È l'opposto della solita regola per cui all'ingrosso si spende meno. Una query per 1.000 tweet costa $0,016 più 960 elementi a $0,0004, cioè circa $0,40, come V2.
Lo scraper di risposte segue un terzo insieme di regole. La sua pagina dello Store addebita una tariffa per query per ogni post: $0,014 nel flusso predefinito e $0,016 con useSearch. Ogni risposta costa $0,0004. I piani a pagamento includono gratuitamente circa i primi 40 elementi per query.
I piani gratuiti hanno solo una modalità demo, con 5 esecuzioni al mese e 10 elementi per esecuzione. Quindi 1.000 risposte da un solo post costano circa $0,014 + 960 x $0,0004 = $0,398. E 50 risposte da ciascuno di 20 post costano 20 x ($0,014 + 10 x $0,0004) = $0,36.
| Scraper Apify (sviluppatore) | Prezzi degli eventi (dalla fascia Free alla fascia Business) | Tariffa fissa per esecuzione o query | Minimi e limiti (testo della pagina) | Utenti, ultimi 30 giorni |
|---|---|---|---|---|
| Tweet Scraper V2 (apidojo) | $0,0004 per elemento, tutte le fasce | Nessuno | 50 tweet per query; piano gratuito: 5 esecuzioni, 10 elementi | 10,137 |
| Scraper Unlimited (apidojo) | da $0,0004 a $0,002 per elemento aggiuntivo | $0,016 per query; $0,05 per URL di tweet; minimo $0,02 per run | Nessun minimo di righe | 2,366 |
| Replies Scraper (apidojo) | $0,0004 per elemento | $0,014 per post ($0,016 con il flusso di ricerca); circa 40 elementi gratuiti per post sui piani a pagamento | Free: solo modalità demo | 132 |
| Scraper Twitter più economico (kaitoeasyapi) | da $0,00025 a $0,00018 | Nessuno | Nessuno | 5,398 |
| X Tweet Scraper (xquik) | $0,00015, tutti i piani | Nessuno; utilizzo della piattaforma a parte | Nessuno | 3,374 |
| X Reply Scraper (xquik) | $0.00015 | Nessuno; utilizzo della piattaforma a parte | Nessuno | 165 |
| X Tweet Scraper (feedminer) | da $0,00012 a $0,0001 | Nessuno | Vedi la nota sulla ricerca per keyword più sotto | 107 |
| Scraper dei post del profilo (scraper_one) | da $0,0004 a $0,0003 | $0,0025 per run | Nessuno | 389 |
| Twitter Scraper (danek) | da $0,0003 a $0,00024 | Costo di avvio per GB di memoria | Nessuno | 406 |
Abbiamo rilevato tutti i prezzi di questa tabella dai metadati pubblici degli actor tra le 00:14 e le 00:16 ora di Singapore del 3 novembre (dalle 16:14 alle 16:16 UTC del 2 novembre). Il numero di utenti viene da stats.totalUsers30Days della stessa API. La documentazione dell'API Get Actor descrive questo campo. Lo Store conta più di 400 scraper con Twitter o X nel nome. Una sezione più avanti mostra come si distribuiscono i loro prezzi.
Come abbiamo testato e quando un test era superato
Abbiamo definito i criteri di superamento prima di guardare qualsiasi dato. Ogni tipo di dato richiedeva almeno 2 chiamate live in 2 o più momenti diversi. Ogni prezzo per 1.000 doveva basarsi su righe univoche. Se Apify era più economico o migliore per un'attività, la tabella riassuntiva e il testo dovevano dirlo. Per almeno 2 chiamate senza dati doveva essere registrato l'addebito.
Tutte le chiamate sono andate a POST https://api.everyinfra.com/api/v1/social. Per ogni chiamata abbiamo registrato l'orario di invio, lo stato HTTP, la durata, il numero di righe e charged_usd. Poi uno script ha ricalcolato ogni numero dalle risposte grezze. Tutti i numeri nel testo, nelle tabelle e nei grafici vengono da quello script.
| Scenario | Endpoint e parametri | Chiamate live | Orario (UTC, 2 novembre) | Scopo |
|---|---|---|---|---|
| Ricerca per keyword | twitter/search, keyword "openai", limit 200, un ordinamento Latest, cinque finestre temporali | 7 + 1 nuovo test | dalle 16:17 alle 16:31, nuovo test alle 16:47 | Righe per chiamata, sovrapposizione tra ordinamenti, finestre per giorno |
| Post dell'account | twitter/user_posts per NASA, poi 7 ricerche from:NASA | 8 + 1 nuovo test | dalle 16:19 alle 16:33, nuovo test alle 16:47 | Quanto indietro si arriva su un account |
| Risposte | twitter/comments su 25 post, limit 50 | 25 + 1 nuovo test | dalle 16:19 alle 16:40, nuovo test alle 16:48 | Righe per chiamata su post grandi e piccoli |
| Nessun dato | Nessuna chiave, limite di frequenza delle richieste, parametro in più, utente inesistente, post inesistente, URL completo come id | 6 | dalle 16:21 alle 16:29 | Quali richieste non riuscite hanno un costo |
| Altre lingue | Keyword in spagnolo, account di El Pais, keyword in cinese | 3 | dalle 16:40 alle 16:42 | Righe per chiamata in lingue diverse dall'inglese |
Tutti gli orari della tabella sono in UTC del 2 novembre. Aggiungi 8 ore per l'ora di Singapore del 3 novembre. Le 52 chiamate sono costate in totale $0,025576. La nostra chiave di test consente 10 richieste al minuto. Una chiamata ha raggiunto quel limite e la risposta diceva "Nothing was charged". Abbiamo atteso 40 secondi e l'abbiamo inviata di nuovo.
Per scegliere i post di cui raccogliere le risposte, abbiamo preso post da account di brand come OpenAI e NASA e dai risultati di ricerca. Il numero di risposte andava da poche centinaia a oltre 20.000. Come controllo abbiamo scelto anche un piccolo post con 8 risposte. In questo articolo nascondiamo il testo dei post e i nomi degli utenti comuni. Citiamo solo account di brand e istituzionali.
Test 1: il job più comune per uno scraper Twitter di Apify, 1.000 tweet da una ricerca per keyword
Su Apify, una ricerca di tweet di solito parte dagli input V2 searchTerms e maxItems. L'input di esempio nei metadati dell'actor V2 include anche sort (Latest o Top), tweetLanguage, onlyVerifiedUsers e onlyImage. Il nostro endpoint corrispondente è twitter/search. Richiede keyword e accetta limit e sort. Gli operatori di ricerca avanzata di X, come from:, since:, until:, lang: e min_faves:, vanno inseriti in keyword.
La documentazione per sviluppatori di X spiega la sintassi delle query. Un elenco della community su GitHub descrive più nel dettaglio gli operatori di ricerca avanzata. Ecco la prima chiamata che abbiamo inviato.
# 16:17:37 UTC Nov 2 (00:17:37 Singapore time Nov 3): HTTP 200, 41.8 s, count 200, charged_usd 0.000556
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"twitter","action":"search","params":{"keyword":"openai","limit":200}}'
Tutte e 7 le ricerche hanno restituito una pagina completa di 200 righe, quindi 1.400 righe in totale. La prima chiamata usava l'ordinamento predefinito, cioè Top. La seconda usava sort: latest. Le due pagine avevano 137 post in comune, quindi la seconda chiamata ha aggiunto solo 63 post nuovi. Inoltre "Latest" non è un ordine cronologico rigoroso. Il post più vecchio della pagina Latest era di novembre 2023.
La pagina di V2 descrive lo stesso effetto. Il suo nuovo ordinamento "Latest + Top" esegue entrambe le ricerche e "può produrre alcuni tweet duplicati". Con la fatturazione per riga, anche quei duplicati contano come righe.
Poi abbiamo diviso "openai" in cinque finestre di due giorni con since: e until:. Le finestre iniziavano il 2026-10-30, il 2026-10-27, il 2026-10-24, il 2026-10-21 e il 2026-10-18. Ogni chiamata ha comunque restituito 200 righe. I nuovi post univoci per chiamata sono stati 168, 168, 197, 196 e 198. Dopo 7 chiamate avevamo 1.190 post univoci per $0,003892, cioè $0,00327 per 1.000.
Ma le finestre erano poco precise. Nelle prime tre finestre, solo 70, 85 e 48 dei 200 post rientravano nei due giorni. Gli altri erano fuori dalla finestra. Quindi dividere per data è un buon modo per ottenere molti post nuovi, ma non per ottenere esattamente i post di quei due giorni.
Altre tre fonti pubbliche vanno nella stessa direzione. La pagina di V2 dice che i risultati calano quando le query usano until. Il changelog dell'API di X dice che gli endpoint di ricerca sono passati a un nuovo indice di ricerca il 4 maggio 2026. E la pagina dello Store di feedminer dice che a fine settembre X ha iniziato a rifiutare le sue richieste all'indice di ricerca. Quindi al momento i risultati di ricerca di X non sono stabili. Conviene filtrare di nuovo le date dopo averle ottenute da qualsiasi strumento.
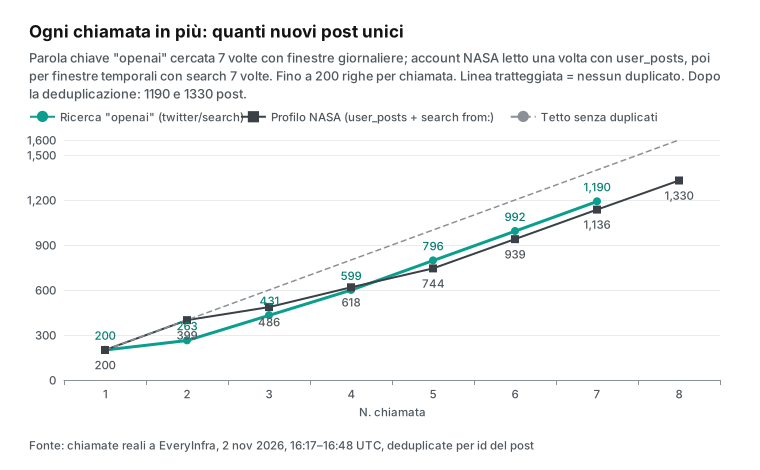
Alle 16:47 UTC (00:47 ora di Singapore), 30 minuti dopo, abbiamo rieseguito la prima ricerca con gli stessi parametri. Dei 200 post, 124 coincidevano con la prima esecuzione e 76 erano nuovi. L'ordinamento Top cambia nel tempo. Per il brand monitoring, un'esecuzione ogni 30 minuti porta qualche post nuovo. Con la fatturazione per riga paghi di nuovo anche i 124 post ripetuti. Da noi la nuova esecuzione è costata $0,000556, come la prima.
Test 2: uno scraper X di Apify per ottenere 1.000 post da un singolo account
Per ottenere i post di un account su V2 usi twitterHandles o un termine from: in searchTerms. Il prezzo resta $0,40 per 1.000. Da noi si parte con twitter/user_posts. Restituisce fino a 200 post per chiamata e non ha cursore. Per i post più vecchi passiamo a twitter/search con from:NASA più gli operatori di data, proprio come suggerisce la documentazione di V2.
La chiamata user_posts delle 16:19 UTC (00:19 ora di Singapore) ha restituito 200 post, dal 2026-09-08 al 2026-10-31. Di questi, 48 erano risposte di NASA ad altri account e 67 erano repost. Corrisponde alla scheda "Posts and replies" del sito di X.
Poi abbiamo inviato 7 ricerche from:NASA per andare più indietro. Abbiamo usato until:2026-09-08, poi until:2026-08-01 e until:2026-04-01. Abbiamo quindi usato finestre per la seconda metà del 2025, la prima metà del 2025 e tutto il 2024. Le 8 chiamate hanno restituito 1.592 righe e 1.330 post univoci, nessuno dei quali di un altro account. L'addebito totale è stato di $0,004448, cioè $0,00334 per 1.000.
I post univoci per anno sono stati 568 nel 2026, 396 nel 2025, 198 nel 2024 e 82 nel 2022. Ce n'erano 23 del 2020, 39 del 2016 e numeri a una cifra per gli altri anni. Per gli anni meno recenti, i post si diradano per lo stesso motivo visto nel Test 1. Le ricerche per data includono post più vecchi e più popolari provenienti da fuori della finestra. Le finestre strette aggiungono meno post nuovi e la terza chiamata ne ha aggiunti solo 87.
Alle 16:47 UTC (00:47 ora di Singapore) abbiamo rieseguito user_posts. Tutti i 200 post coincidevano con l'esecuzione di 28 minuti prima, e il post più recente era lo stesso, delle 22:14 UTC del 31 ottobre. È utile per gli archivi: gli stessi parametri danno un risultato stabile nel breve periodo, quindi un job incrementale deve solo confrontare l'ID del post più recente.
Qui l'API di X ha un limite rigido. L'endpoint della timeline utente restituisce solo i 3.200 post più recenti (documentazione sulle timeline di X). Per i post più vecchi serve la ricerca sull'archivio completo.
Contenuti non in inglese: quante righe tornano
Molti usano uno scraper X di Apify per contenuti non in inglese. Alle 16:40 UTC (00:40 ora di Singapore) abbiamo cercato inteligencia artificial lang:es. La chiamata ha restituito una pagina completa di 200 post, tutti in spagnolo, di 167 autori diversi. Coprivano il periodo dal 2026-10-23 al 2026-11-02, senza repost né risposte.
Alle 16:41 UTC (00:41 ora di Singapore), user_posts per l'account di El Pais ha restituito 200 post. Di questi, 197 erano in spagnolo. Coprivano meno di due giorni, dal 31 ottobre al 2 novembre. Quindi un account di notizie molto attivo riempie 200 righe in circa due giorni. Per archiviare un mese, esegui la chiamata una volta al giorno.
Alle 16:42 UTC (00:42 ora di Singapore) abbiamo cercato un termine cinese che significa "grande modello", con lang:zh. Abbiamo chiesto 200 righe e ne abbiamo ottenute 100, tutte in cinese, di 67 autori. Il post più vecchio era del 2026-10-08. Quella singola chiamata è costata $0,00556 per 1.000, circa il doppio della tariffa in inglese, perché la pagina era piena a metà.
È comunque circa 70 volte meno di V2. Con la fatturazione per riga, mezza pagina non cambia il prezzo unitario. Significa solo che ottieni meno righe.
| Chiamata (ora di Singapore, 3 nov.) | Endpoint e input | Righe | Autori | Intervallo di date | Per 1.000 |
|---|---|---|---|---|---|
| 00:40 | twitter/search, keyword in spagnolo con lang:es | 200, tutti in spagnolo | 167 | dal 2026-10-23 al 2026-11-02 | $0.00278 |
| 00:41 | twitter/user_posts, El País | 200, 197 in spagnolo | 1 | dal 2026-10-31 al 2026-11-02 | $0.00278 |
| 00:42 | twitter/search, keyword in cinese con lang:zh | 100, tutti in cinese | 67 | dal 2026-10-08 al 2026-11-02 | $0.00556 |
Test 3: per le risposte devi dividere il job in due
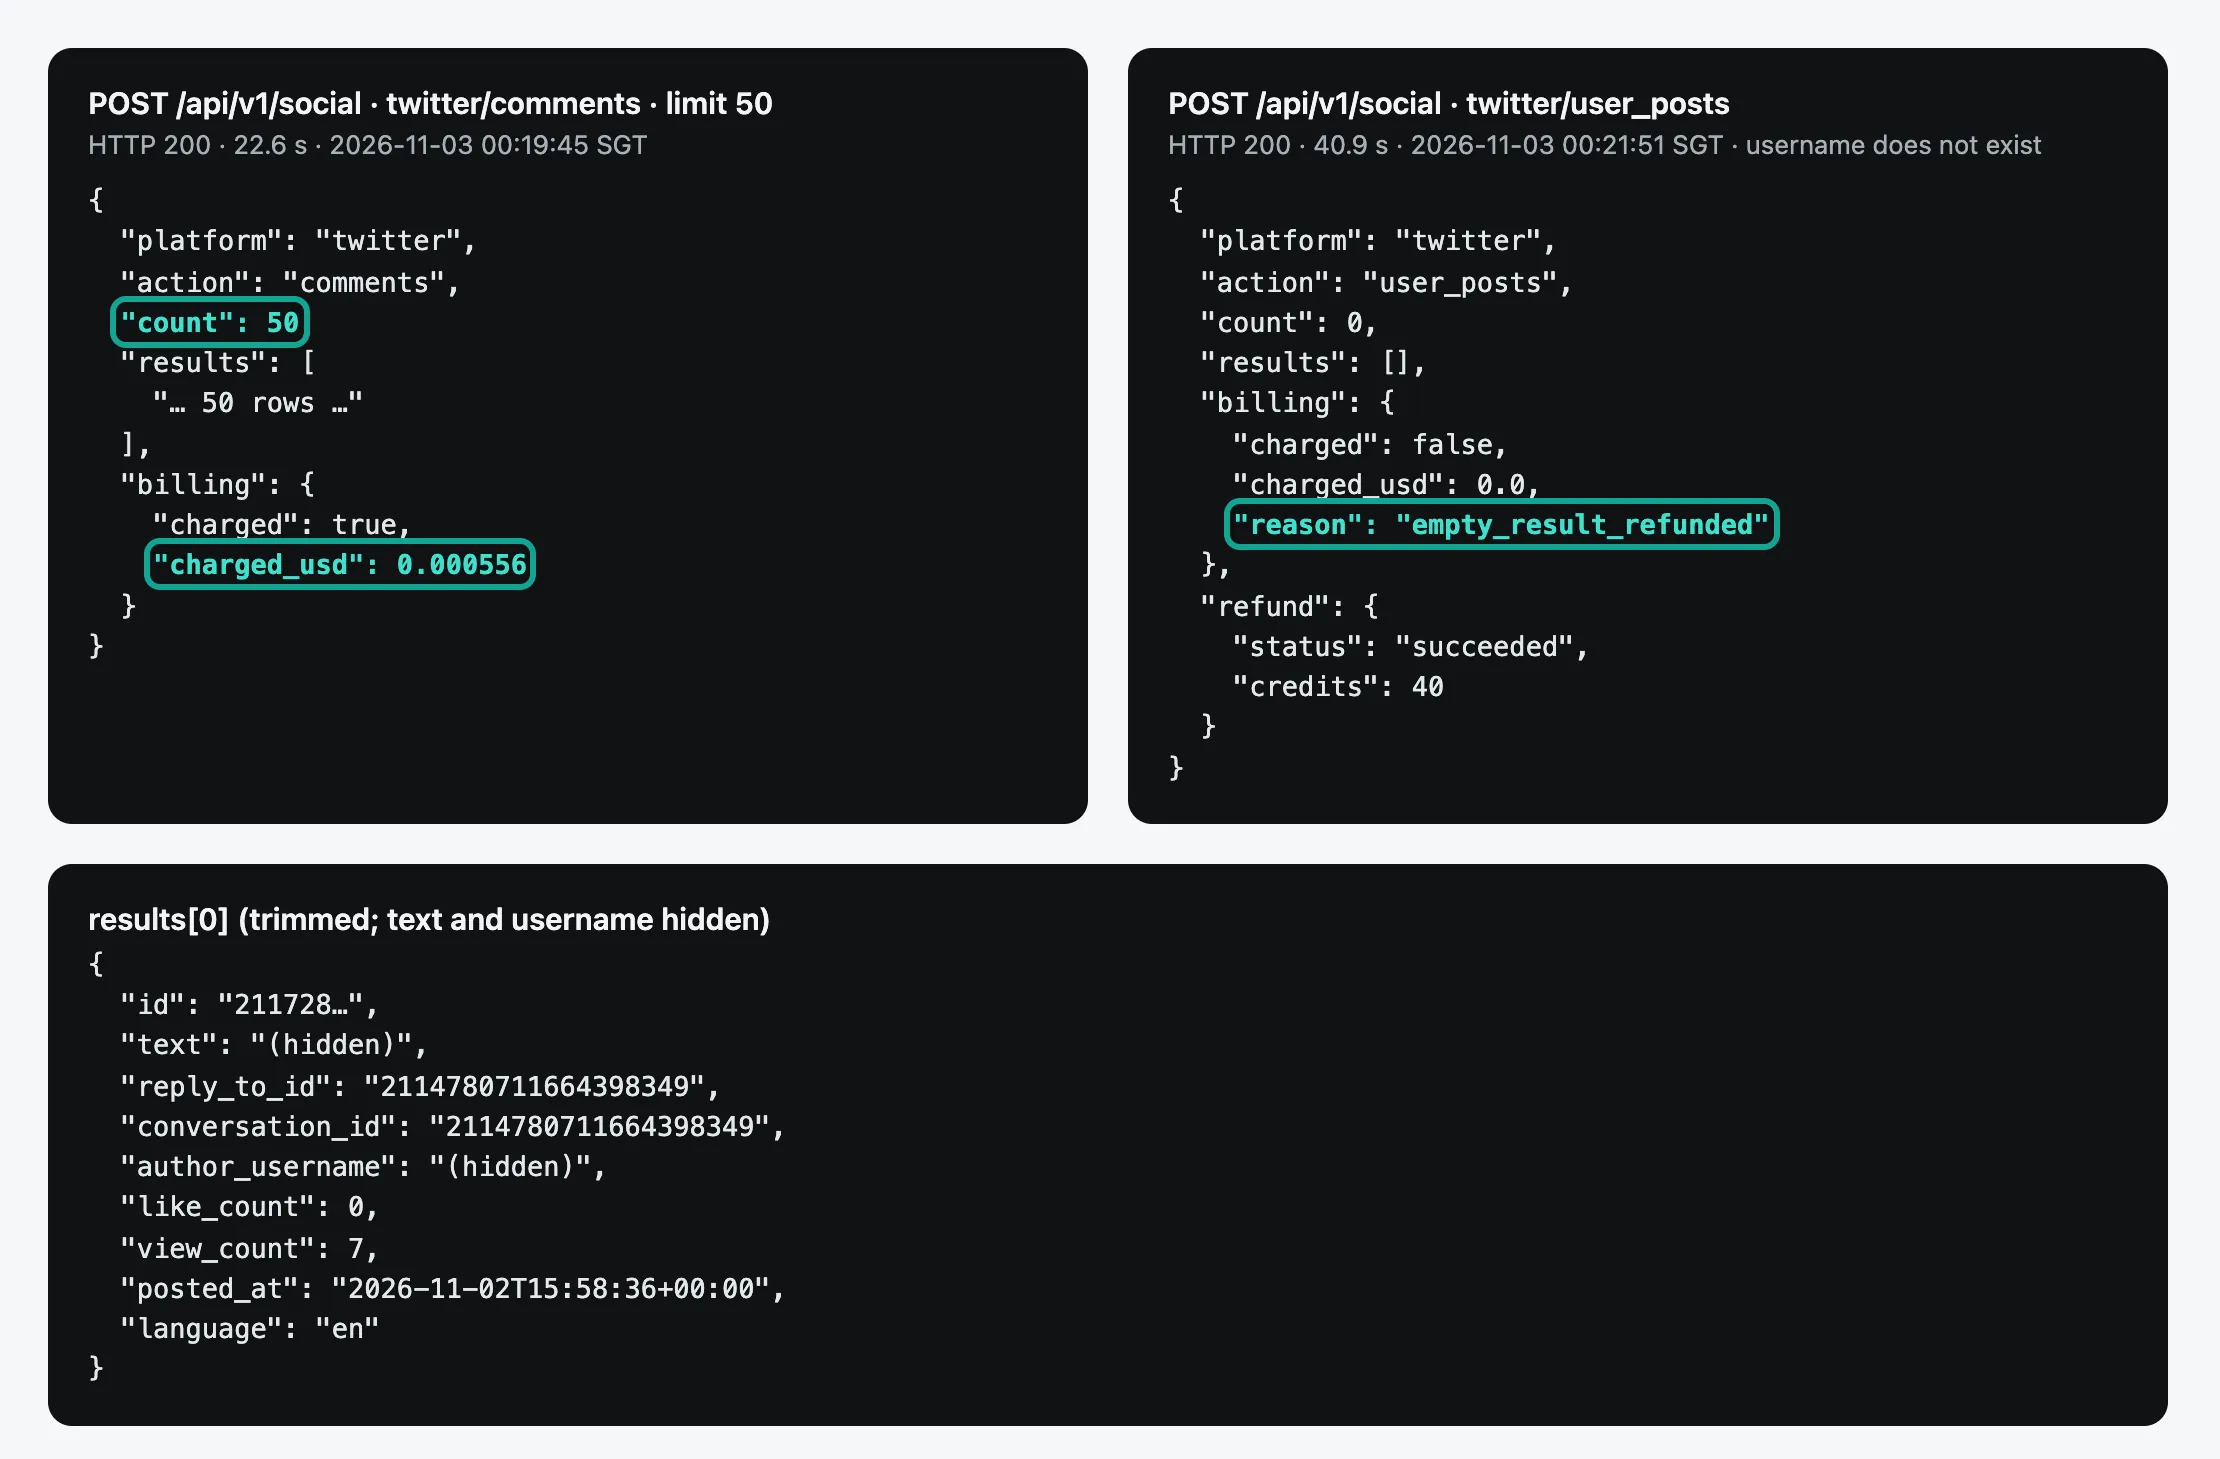
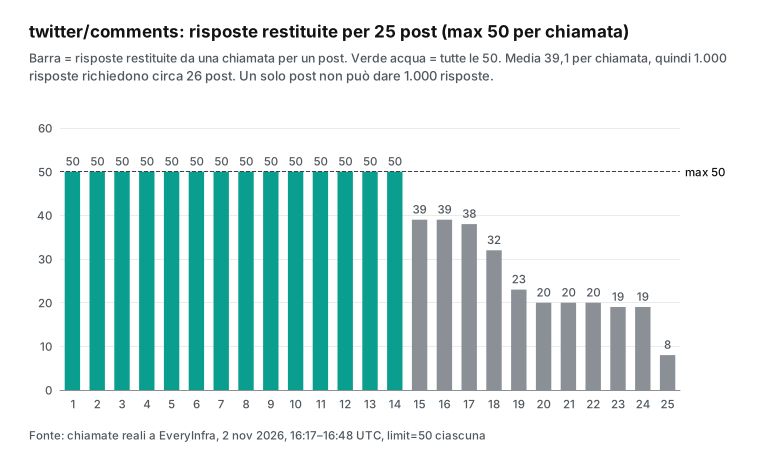
Tra i tre tipi di dati, le risposte presentano il divario minore e sono quelle che dipendono maggiormente dal job. Il nostro endpoint twitter/comments richiede id, cioè il numero dopo /status/ nell'URL del post. Restituisce fino a 50 risposte per chiamata e non ha cursore. L'abbiamo chiamato una volta su ciascuno di 25 post. Abbiamo ottenuto 977 risposte per $0,0139, cioè $0,0142 per 1.000.
Il primo caso è "un batch di risposte da molti post". Un esempio è un'analisi settimanale del feedback sotto 200 post di un brand. Qui addebitiamo $0,000556 per post. Il reply scraper di Apify parte da $0,014 per post, quindi siamo 25 volte più economici. Rispetto all'opzione più economica, il reply scraper di xquik a $0,00015 per risposta, siamo 10,5 volte più economici.
Delle nostre 25 chiamate, 14 hanno restituito tutte le 50 risposte. Le altre 11 ne hanno restituite 39, 39, 38, 32, 23, 20, 20, 20, 19, 19 e 8. Le 8 venivano dal nostro piccolo post di controllo, che ha solo 8 risposte, quindi le abbiamo ottenute tutte. Ma 6 post grandi, con 2.500-6.800 risposte ciascuno, ne hanno restituite solo tra 19 e 23.
Poi abbiamo letto le risposte API grezze dei 24 post grandi. Lo schema è chiaro. Le 14 chiamate complete hanno restituito risposte recenti, con una mediana di 0 like per risposta. Le 10 chiamate incomplete riguardavano post vecchi da qualche settimana a due anni. Le loro risposte erano ordinate per like, con mediane da 6 a 1.880 like.
Quindi sui post nuovi ottieni le risposte più recenti. Sui vecchi post virali ottieni le risposte principali che X mostra per prime, mentre la parte "Mostra altre risposte" resta chiusa. Il nostro team di backend deve ancora confermare la causa. Per pianificare, conta su 50 risposte per i post nuovi e circa 20 per i vecchi post virali.
Il secondo caso è "il maggior numero possibile di risposte da un singolo post". Un esempio è uno studio su migliaia di commenti sotto un post virale. Il nostro endpoint si ferma a 50 per post, quindi non può fare questo job. La pagina del reply scraper di Apify dice che gestisce automaticamente la paginazione delle risposte. Quando il flusso predefinito ne restituisce troppo poche, useSearch ne aggiunge altre tramite una ricerca conversation_id:. Lì un post con 1.000 risposte costa circa $0,398.
Per questo job Apify è la scelta migliore, e noi non abbiamo un endpoint equivalente. Se ti serve solo il thread che l'autore ha pubblicato sotto il proprio post, c'è twitter/thread. Restituisce fino a 100 post per $0,002153 a chiamata. Ma un thread non è l'insieme completo delle risposte.
Anche il mix tra risposte dirette e annidate varia molto. Sul post di OpenAI, 35 delle 50 risposte erano dirette e 15 annidate. Su un post con più di 20.000 risposte, solo 10 delle 50 erano dirette. Su un altro post, 49 su 50 erano risposte annidate di 19 autori, il che fa pensare a un'unica lunga discussione. Per la sentiment analysis, usa reply_to_id per separare i due livelli. È valorizzato sul 99% delle risposte.
Alle 16:48 UTC (00:48 ora di Singapore) abbiamo rieseguito il post di OpenAI. Le 50 risposte erano le stesse di 29 minuti prima.
Campi: le due soluzioni restituiscono gli stessi dati?
Le due soluzioni restituiscono campi diversi. Qui riportiamo solo le nostre percentuali di valorizzazione e i campi di Apify che non abbiamo. Abbiamo controllato ogni campo su 1.400 righe di ricerca, 200 post di account e 977 risposte. view_count, bookmark_count, language, author_follower_count e author_is_verified erano valorizzati sul 100% delle righe. media era valorizzato sul 42%, 44% e 18% delle righe, perché molti post non hanno immagini né video.
hashtags era valorizzato solo su una quota tra l'1% e il 4% delle righe. Abbiamo controllato queste righe una per una. Ogni post con un tag # aveva il campo, e gli altri non avevano tag da riportare.
| Campo | Ricerca (1.400) | Post di account (200) | Risposte (977) | Nota |
|---|---|---|---|---|
view_count, bookmark_count e language | 100% | 100% | 100% | Su ogni riga |
author_follower_count e author_is_verified | 100% | 100% | 100% | I dati dell'autore arrivano con ogni post |
media | 42% | 44% | 18% | Vuoto quando il post non ha media |
mentions | 12% | 84% | 95% | Le risposte menzionano spesso altri account |
links | 22% | 40% | 4% | Quota di post con un link esterno |
reply_to_id | 0% | 24% | 99% | Presente solo nelle risposte |
author_bio, source | 0% | 0% | 0% | Per la bio chiama twitter/profile |
La pagina del reply scraper di Apify dice che ogni risposta include il profilo completo dell'autore, bio compresa, e il client di pubblicazione. I nostri tre endpoint non restituiscono questi due campi. Per la bio serve una chiamata twitter/profile separata. Se la tua analisi raggruppa chi risponde in base alla bio, ad esempio per ruolo professionale, Apify te la fornisce in un solo passaggio.
Anche i nomi dei campi sono diversi, quindi una migrazione richiede una fase di mappatura. Nell'esempio di output di V2, i like sono likeCount, i repost retweetCount e l'orario del post createdAt, nel formato Fri Nov 24 17:49:36 +0000 2023. La lingua è lang, e i dati dell'autore stanno in un oggetto annidato author con userName e followers.
I nostri nomi sono like_count, retweet_count, posted_at e language. L'orario è in ISO 8601 con fuso orario. I dati dell'autore sono piatti, in campi come author_username e author_follower_count. L'esempio di V2 ha anche un campo source per il client di pubblicazione. Nei nostri tre endpoint quel campo è vuoto.
Le chiamate non riuscite o senza risultati costano?
Da noi, tutte e 6 le chiamate senza dati sono costate $0. Rientrano in tre gruppi. Le chiamate del primo gruppo si fermano alla fase di autenticazione o di verifica dei parametri. Una chiamata senza chiave riceve un 401 con il codice missing_key.
Una chiamata con un parametro in più, max_items, riceve un 422. L'errore elenca i parametri consentiti keyword, limit e sort e include una richiesta di esempio funzionante. Una chiamata oltre il limite di frequenza delle richieste riceve un 429 con il tempo di attesa prima di un nuovo tentativo.
Il secondo gruppo è "non trovato". Un username inesistente e un ID di post inesistente hanno restituito ciascuno HTTP 200 dopo circa 40 secondi. count era 0, billing.reason era empty_result_refunded e refund.status era succeeded. Il terzo gruppo è stato un nostro errore.
Abbiamo inserito un URL completo del post in id. Il catalogo dice di non farlo, ma l'API non ha restituito un 422. Ha trattato la chiamata come "non trovato" e l'ha rimborsata. Non è un comportamento chiaro per l'utente, e l'abbiamo registrato come problema.
| Caso | Orario (ora di Singapore, 3 nov.) | HTTP | Codice o motivo | `charged_usd` |
|---|---|---|---|---|
| Nessuna chiave API | 00:21 | 401 | missing_key | 0 |
| Username inesistente | 00:21 | 200 | empty_result_refunded, rimborso riuscito | 0.0 |
| Più di 10 chiamate al minuto | 00:24 | 429 | rate_limited, «Nothing was charged» | 0 |
URL completo in id | 00:28 | 200 | empty_result_refunded | 0.0 |
Parametro in più max_items | 00:29 | 422 | unknown_param, con l'elenco dei parametri consentiti | 0 |
| ID di post inesistente | 00:29 | 200 | empty_result_refunded | 0.0 |
Per Apify citiamo solo il testo delle pagine. V2 dice che ogni query deve restituire almeno 50 tweet, ma non dice quanto addebita quando una query ne restituisce meno. Il reply scraper addebita la tariffa per query "una volta per ogni tweetId o URL elaborato".
Avverte anche che un post senza risposte "restituisce un dataset vuoto e spreca tempo di esecuzione". Non dice se rimborsa la tariffa della query in caso di risultato vuoto. I due scraper di scraper_one addebitano una tariffa fissa di $0,0025 per run, e danek un costo di avvio per GB di memoria.
La documentazione di Apify su utilizzo e risorse spiega come vengono fatturati compute unit, storage e trasferimento dati. La documentazione pay-per-event dice inoltre agli sviluppatori di addebitare i risultati solo dopo averli salvati. Se un run viene interrotto, gli utenti non dovrebbero pagare risultati a cui non possono accedere.
L'API pubblica degli actor mostra anche gli esiti dei run degli ultimi 30 giorni. Per i nove scraper di questo articolo abbiamo convertito i conteggi di run interrotti, scaduti per timeout e falliti in un tasso per 10.000 run.
| Scraper Apify | Run negli ultimi 30 giorni | Interrotti | In timeout | Fallite | Non completati per 10.000 run |
|---|---|---|---|---|---|
| Tweet Scraper V2 | 4,688,523 | 35,721 | 5,536 | 0 | 88.0 |
| Scraper Twitter più economico (kaitoeasyapi) | 2,653,176 | 41,433 | 3,276 | 1,583 | 174.5 |
| X Tweet Scraper (xquik) | 2,820,359 | 228 | 1 | 3 | 0.8 |
| Twitter Scraper (danek) | 2,396,418 | 3,132 | 422 | 0 | 14.8 |
| Scraper Unlimited (apidojo) | 1,552,877 | 418 | 609 | 0 | 6.6 |
| X Tweet Scraper (feedminer) | 58,004 | 1 | 147 | 0 | 25.5 |
| Scraper dei post del profilo (scraper_one) | 36,776 | 17 | 55 | 0 | 19.6 |
| Replies Scraper (apidojo) | 6,118 | 7 | 2 | 0 | 14.7 |
| X Reply Scraper (xquik) | 39,518 | 32 | 0 | 0 | 8.1 |
Molti run interrotti vengono fermati dagli utenti stessi, quindi un'interruzione non è sempre colpa dello scraper. Questa tabella supporta una sola affermazione: il tweet scraper di xquik, il più economico, era il più stabile, con 0,8 run non completati ogni 10.000. V2, lo scraper più usato, ne aveva 88 ogni 10.000.
Kaitoeasyapi aveva il tasso più alto, 174,5. Le pagine non dicono quanto siano costati quei run, e dall'esterno non possiamo saperlo. Per sapere come riconciliamo le chiamate non riuscite e i rimborsi, vedi riconciliazione delle chiamate non riuscite e dei rimborsi.
Più di 400 scraper per Twitter nell'Apify Store: come si distribuiscono i prezzi
Abbiamo usato l'API pubblica di ricerca dello Store (documentazione dell'API dello Store) con quattro termini: twitter, tweet, x scraper e x.com. Dopo aver unito i risultati ed eliminato i duplicati avevamo 406 actor. Di questi, 380 usano il pricing pay-per-event e 372 mostrano un prezzo per risultato. Li abbiamo raggruppati per nome e descrizione: 175 per i tweet, 48 per i profili, 37 per i follower, 36 per le risposte, 36 per i trend e 40 per media e altri dati.
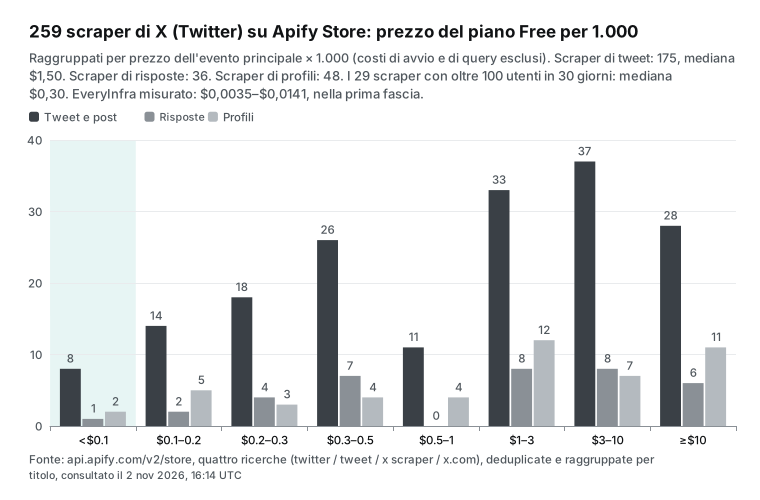
Il prezzo mediano nel piano Free dei 175 scraper di tweet è $1,50 per 1.000, quasi 4 volte il prezzo di V2. Ma molti scraper con pochi utenti alzano la mediana. Se tieni solo i 29 scraper con almeno 100 utenti negli ultimi 30 giorni, la mediana è $0,30. Se ponderi per gli utenti degli ultimi 30 giorni, la media è $1,42 per 1.000.
Gli utenti sono molto concentrati. I primi 5 scraper raccolgono il 68,4% di tutti gli utenti degli ultimi 30 giorni dei 372 scraper (32.822 utenti in totale). Lo scraper più economico indica $0,01 per 1.000, ma ha avuto solo 8 utenti in 30 giorni, quindi non lo abbiamo considerato popolare. In breve, gli scraper per Twitter più usati costano da $0,12 a $0,40 per 1.000. I nostri tre prezzi misurati sono tutti sotto $0,015.
Il nostro articolo precedente Prezzi di Apify spiegati tratta in generale i piani di Apify, le compute unit e le regole pay-per-event. L'articolo sulle alternative ad Apify confronta diverse piattaforme. Questo articolo aggiunge ciò che manca a quei due: i conteggi delle righe di Twitter ottenuti da chiamate live, la distribuzione dei prezzi e i dati sui run degli scraper per Twitter dello Store. Per una visione più ampia, parti dalla nostra panoramica delle alternative.
Punto di pareggio: quando poche righe per chiamata rendono più conveniente la fatturazione per riga
Noi addebitiamo per richiesta, mentre la maggior parte degli scraper per Twitter dello Store addebita per riga. Il punto di pareggio è facile da calcolare: dividi il nostro prezzo per richiesta di $0,000556 per il prezzo per riga dell'altra soluzione. V2 addebita $0,0004 per riga, quindi il pareggio è a 1,39 righe per chiamata.
Xquik addebita $0,00015, quindi il pareggio è a 3,71 righe. Feedminer addebita $0,00012 nel piano Free, quindi 4,63 righe, e 5,56 righe al prezzo Business di $0,0001. L'API di X addebita $0,005 per post, quindi il pareggio è a 0,11 righe.
| Prezzo per riga | Fonte | Righe per chiamata al pareggio | EveryInfra costa meno quando una chiamata restituisce |
|---|---|---|---|
| $0.005 | X API pay-per-use | 0.11 | 1 riga o più |
| $0.0004 | Tweet Scraper V2 | 1.39 | 2 righe o più |
| $0.00015 | xquik | 3.71 | 4 righe o più |
| $0.00012 | feedminer, piano Free | 4.63 | 5 righe o più |
| $0.0001 | feedminer, piano Business | 5.56 | 6 righe o più |
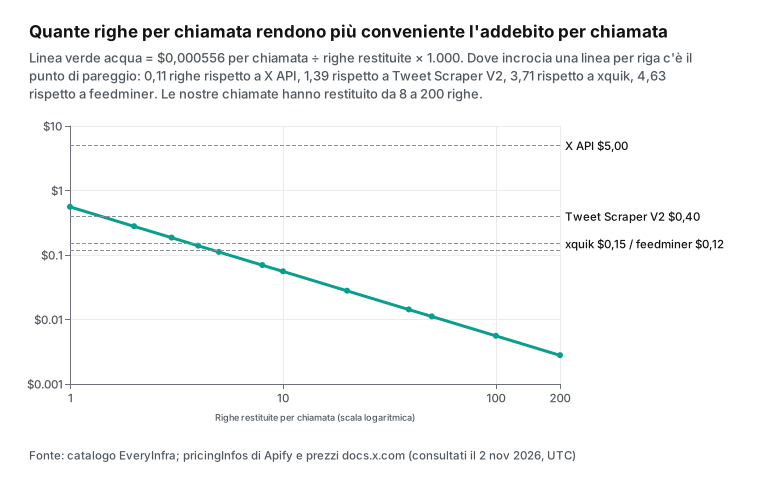
Quando, nel lavoro reale, una chiamata restituisce solo poche righe? Il primo caso è il recupero di un singolo post. Il nostro endpoint twitter/post costa $0,000556 per un post, cioè $0,556 per 1.000. È un costo superiore a quello di xquik o feedminer.
È molto meno del prezzo per singolo tweet su Unlimited, che è $0,05 per tweet, perché V2 non consente richieste per un singolo tweet. Il secondo caso è un piccolo account che pubblica due o tre volte al giorno: ogni controllo trova solo pochi post nuovi.
Il terzo caso è il nostro piccolo post di controllo con 8 risposte. Il costo è stato di $0,0695 per 1.000. Il reply scraper di apidojo addebita una tariffa per query di $0,014, e tutte le 8 risposte rientrano nelle prime 40 gratuite. Sono $1,75 per 1.000.
Xquik costa $0,15 per 1.000. Scraper_one addebita $0,0025 per run più le 8 risposte, cioè $0,5625 per 1.000. Quindi su quel piccolo post restiamo i più economici. Ma sotto circa 3 righe per chiamata, xquik e feedminer costano meno.
Il conto mensile: tre attività comuni per 30 giorni
Ora applichiamo il numero di righe misurato a tre job comuni. Da noi convertiamo il numero di righe in chiamate usando il numero misurato di righe per chiamata, poi moltiplichiamo per $0,000556. Per Apify moltiplichiamo il prezzo di listino per le righe, escludendo l'utilizzo della piattaforma e il canone mensile del piano. Per l'API di X usiamo $0,005 per post, escludendo il tetto di 3 milioni di post al mese e lo sconto per la deduplicazione nello stesso giorno.
| Caso d'uso | Righe in 30 giorni | EveryInfra | V2 o reply scraper di apidojo | xquik | X API pay-per-use |
|---|---|---|---|---|---|
| Monitoraggio del brand: 20 keyword, 200 tweet per ciascuna, ogni giorno | 120,000 | $0,33 (600 chiamate) | $48.00 | $18.00 | $600.00 |
| Archivio di account: 50 account, 1.000 post ciascuno | 50,000 | $0,17 (circa 300 chiamate) | $20.00 | $7.50 | $250.00 |
| Monitoraggio delle risposte: 200 post a settimana, 50 risposte ciascuno | 40,000 | $0,44 (800 chiamate) | $14.40 | $6.00 | $200.00 |
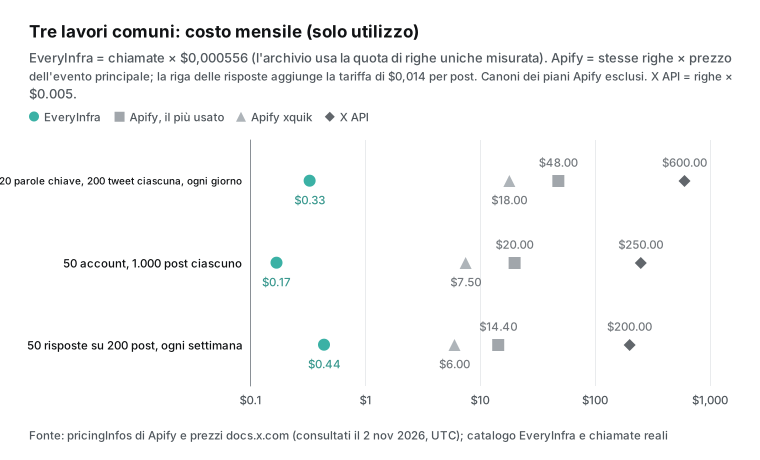
La tabella mostra tre cose. Primo, per i job che riempiono una pagina a ogni chiamata, il divario resta di decine di volte, perché un solo addebito copre 200 righe, o 50 per le risposte. Secondo, al costo di Apify va aggiunto anche il canone del piano. Gli utenti Free di V2 hanno solo 50 tweet al mese, quindi questi job richiedono almeno Starter, che parte da $19 al mese. Noi non abbiamo canone mensile, il saldo ricaricato non scade e le chiamate fallite sono gratuite.
Terzo, la pagina di V2 limita ogni utente a 1 run simultaneo con al massimo 5 query. Dice anche di non usare V2 per il monitoraggio con la stessa query a brevi intervalli. Quindi la riga del brand monitoring non è un caso d'uso supportato da V2. La pagina indirizza questi job verso Unlimited.
Per l'API di X, la pagina dei prezzi di X indica $0,005 per lettura di post e $0,010 per lettura di utente. Le letture hanno un tetto di 3 milioni di post al mese (utilizzo e fatturazione). Lo stesso post letto due volte nello stesso giorno UTC conta una volta sola, quindi i conti reali sono un po' più bassi di quelli in tabella.
Un esempio completo: un report settimanale sulle risposte a un brand in n8n
Molti lettori delle pagine "apify twitter scraper" costruiscono i propri job in n8n. Ecco un report settimanale che combina i tre tipi di dato. Ogni lunedì cerchi 20 keyword con 200 post ciascuna per trovare i post più discussi. Poi scegli 50 post in base a reply_count e ottieni 50 risposte per ciascuno. Infine un modello classifica le risposte in reclami, domande ed elogi.
Da noi sono 20 chiamate twitter/search più 50 chiamate twitter/comments. Le 70 chiamate costano $0,0389 a settimana, cioè circa $0,16 per quattro settimane, assumendo pagine piene o quasi, come nei nostri test. In n8n ogni chiamata è un nodo HTTP Request. Il nodo qui sotto mostra il corpo della richiesta per una ricerca.
{
  "parameters": {
    "method": "POST",
    "url": "https://api.everyinfra.com/api/v1/social",
    "sendHeaders": true,
    "headerParameters": { "parameters": [
      { "name": "Authorization", "value": "=Bearer {{ $env.EVERYINFRA_API_KEY }}" }
    ] },
    "sendBody": true,
    "specifyBody": "json",
    "jsonBody": "={ \"platform\": \"twitter\", \"action\": \"search\", \"params\": { \"keyword\": \"{{ $json.keyword }}\", \"limit\": 200 } }"
  },
  "type": "n8n-nodes-base.httpRequest",
  "name": "EveryInfra twitter/search"
}
Su Apify, lo stesso job ha due strade a prezzi di listino. La prima usa V2 e il reply scraper. La ricerca costa 4.000 righe x $0,0004 = $1,60, e le risposte 50 post x ($0,014 + 10 x $0,0004) = $0,90. Totale: $2,50 a settimana. Ma V2 dice di non rieseguire la stessa query per il monitoraggio, e accetta al massimo 5 query per run. Quindi 20 keyword richiedono 4 run.
La seconda usa Unlimited. Venti query costano 20 x $0,016 = $0,32. Ogni query restituisce 160 righe oltre le 40 gratuite. Con 20 query per run, quelle righe ricadono nella fascia da 11 a 30 query a $0,0012. Sono 3.200 x $0,0012 = $3,84.
Con $0,90 per le risposte, il totale è $5,06 a settimana. Nessuna delle due strade include il canone del piano Starter. Il passaggio del modello costa uguale da entrambe le parti. In questo esempio siamo da 64 a 130 volte più economici. Il divario è più ampio rispetto alla tabella riassuntiva a causa delle fasce di Unlimited.
API di X vs Apify vs EveryInfra
X ha portato la sua API al modello pay-per-use a febbraio 2026. Il 14 agosto ha annunciato che i piani Pro legacy sarebbero passati al pay-per-use dopo il 1° settembre (forum per sviluppatori di X). Il pay-per-use non ha canone mensile, ma costa di più. I post costano $5 per 1.000, cioè 12,5 volte V2 e circa 1.500 volte il nostro prezzo di ricerca misurato.
Ci sono state due modifiche recenti ai crediti gratuiti. Dal 2 ottobre, i nuovi account pay-per-use ricevono $20 dopo il primo acquisto di crediti, e fino a $50 in più con la ricarica automatica. Il 13 ottobre X ha cambiato la regola: una carta salvata da sola non dà più diritto ai $20. I crediti scadono dopo 3 mesi (pagina sui crediti gratuiti).
L'API di X ha anche limiti di frequenza delle richieste e copertura diversi. La ricerca recente consente 450 richieste ogni 15 minuti, e la ricerca sull'archivio completo 1 richiesta al secondo (limiti di frequenza delle richieste). Gli account pay-per-use possono usare la ricerca sull'archivio completo (documentazione sulla ricerca). Le timeline utente si fermano ai 3.200 post più recenti. Dal 4 maggio la ricerca per keyword non restituisce più i repost.
| Voce dell'API di X | Valore | Fonte |
|---|---|---|
| Lettura di post | $0,005 ciascuna | Pagina dei prezzi di X |
| Lettura di utente | $0,010 ciascuna | Pagina dei prezzi di X |
| Tetto mensile | 3 milioni di letture di post | Pagina su utilizzo e fatturazione |
| Stesso post due volte nello stesso giorno UTC | Addebitato una volta | Pagina su utilizzo e fatturazione |
| Profondità della timeline utente | Ultimi 3.200 post | Documentazione sulle timeline |
| Limite di frequenza delle richieste per la ricerca recente | 450 richieste ogni 15 minuti | Pagina sui limiti di frequenza |
| Limite di frequenza delle richieste per la ricerca nell'archivio completo | 1 richiesta al secondo | Pagina sui limiti di frequenza |
| Crediti gratuiti | $20 dopo il primo acquisto, fino a $50 con la ricarica automatica, scadono dopo 3 mesi | Pagina sui crediti gratuiti |
La X API è la soluzione ufficiale, con prezzi fissati da X stessa e le condizioni più chiare. Permette anche di pubblicare post e gestire il tuo account. Consulta la panoramica della X API e la guida all'accesso. X pubblica anche un server MCP open source, xmcp.
Velocità e richieste simultanee
Nei nostri test, una chiamata twitter/search con 200 righe ha richiesto da 35,2 a 53,4 secondi, con una mediana di 39,3 secondi. Una chiamata user_posts con 200 righe ha richiesto circa 33 secondi. Una chiamata comments con 50 righe ha richiesto da 14 a 23 secondi, con una mediana di 19,8 secondi. Un solo processo con chiamate sincrone ottiene circa 300 tweet al minuto. La nostra chiave di test consentiva 10 richieste al minuto; il limite per gli account di produzione è indicato nella console.
| Strumento | Righe per chiamata o esecuzione | Tempo misurato o dichiarato | Righe al minuto |
|---|---|---|---|
EveryInfra twitter/search | 200 | Da 35,2 a 53,4 s, mediana 39,3 s (misurato) | Circa 300 per processo |
EveryInfra twitter/user_posts | 200 | Circa 33 s (misurato) | Circa 360 per processo |
EveryInfra twitter/comments | Fino a 50 | Da 14 a 23 s, mediana 19,8 s (misurato) | Circa 120 per processo con 39,1 righe per chiamata |
| Tweet Scraper V2 | 50 o più per query | Da 30 a 80 tweet al secondo (dal testo della pagina) | Da 1.800 a 4.800 |
La pagina di V2 indica da 30 a 80 tweet al secondo, cioè da 1.800 a 4.800 al minuto. Quindi una singola esecuzione grande di V2 è più veloce. I limiti della piattaforma Apify stabiliscono quanti Actor e quanta memoria può usare contemporaneamente un account. Se ti servono centinaia di migliaia di post il più in fretta possibile, una grande esecuzione Apify batte le nostre chiamate pagina per pagina. Per qualche migliaio di post al giorno con una pianificazione, entrambe le soluzioni finiscono in pochi minuti.
Usarlo dai client AI: la configurazione MCP
Per i client AI, collega il nostro server MCP remoto a https://api.everyinfra.com/mcp. I nomi dei tool iniziano con everyinfra_. Il modello può scegliere da solo twitter/search o twitter/comments.
La configurazione qui sotto è un esempio generico. Claude Code e gli altri client che supportano MCP remoto usano un formato simile. Per la sintassi esatta, consulta la documentazione MCP di Claude Code e la documentazione MCP di OpenAI. Il protocollo è descritto nella specifica MCP.
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
Anche Apify ha un server MCP che trasforma gli Actor dello Store in tool per un modello (documentazione MCP di Apify, codice sorgente su GitHub). I due approcci sono diversi. Con l'MCP di Apify, il modello avvia l'esecuzione di un Actor, attende che finisca e poi legge il dataset. È adatto ai grandi batch.
Con il nostro MCP, ogni chiamata a un tool restituisce subito i dati. È adatto a una chat in cui fai domande e verifichi man mano. La nostra pagina del server MCP elenca i client supportati.
Migrare da Apify: corrispondenza dei parametri
Se usi già V2 o il reply scraper, questa tabella mette in corrispondenza gli input. I nomi dei parametri Apify provengono dall'input di esempio nei metadati pubblici degli Actor e dalle pagine dello Store. I campi di output sono diversi, quindi devi rimapparli con il nostro response_fields.
| Attività | Input Apify | Input EveryInfra | Nota |
|---|---|---|---|
| Ricerca per keyword | V2 searchTerms + maxItems | twitter/search con keyword + limit (max 200) | Una keyword per chiamata; per averne di più, suddividi per data |
| Ordinamento | V2 sort: Latest, Top, Latest + Top | sort: latest, oppure Top (predefinito) | Nel nostro test, 137 righe su 200 si sovrapponevano |
| Lingua | V2 tweetLanguage | lang:es dentro keyword | Esempio: inteligencia artificial lang:es |
| Un singolo account | V2 twitterHandles o from: | twitter/user_posts con username; ricerca from: per i post più vecchi | user_posts max 200 per chiamata |
| Risposte a un post | Reply scraper tweetIds o URL | twitter/comments con id numerico | Max 50 per post; un URL restituisce 0 righe, con rimborso |
| Singolo post | Unlimited con URL del tweet ($0,05) | twitter/post | 0,000556 $ per chiamata |
| Follower | Evento follower dello user scraper di apidojo | twitter/followers_list, fino a 2.000 | 0,000556 $ per chiamata |
La nostra API di scraping per Twitter ha 21 endpoint, tutti già disponibili nel catalogo. Oltre ai tre visti sopra, copre profili, liste di follower e di account seguiti, utenti che hanno fatto retweet, post delle community e trascrizioni dei video. Puoi consultare parametri, campi della risposta e prezzo di ciascuno nel catalogo gratuito (API del catalogo). Il catalogo non richiede una chiave.
Come abbiamo verificato questi numeri
Uno script ha ricalcolato ogni numero di EveryInfra presente nel testo, nelle tabelle e nei grafici a partire dalle 52 risposte grezze. Le righe corrispondono alla lunghezza di results. La deduplicazione usa l'id del post. L'addebito è billing.charged_usd. L'orario è quello locale al momento dell'invio della chiamata, registrato nel fuso orario di Singapore.
Abbiamo letto tutti i prezzi Apify e il numero di utenti e di esecuzioni dai metadati pubblici nello stesso momento, tra le 00:14 e le 00:16 ora di Singapore. Abbiamo anche salvato uno screenshot della nota sui prezzi di V2. I punti di pareggio e le spese mensili combinano solo questi due tipi di numeri. Restano aperte tre questioni.
La causa delle chiamate sulle risposte che restituiscono poche righe per i post vecchi non è ancora chiara; il Test 3 ne mostra lo schema. Non conosciamo l'entità del costo di utilizzo della piattaforma di xquik. E non possiamo verificare dall'esterno che feedminer legga le ricerche per keyword dalle X Communities.
Quando Apify è la scelta migliore
Ecco dove Apify fa meglio, o dove non abbiamo un equivalente. Primo, migliaia di risposte da un solo post. Noi ci fermiamo a 50 per post, mentre il reply scraper di Apify scorre circa 1.000 risposte per circa $0,40. Secondo, da 1 a 3 righe per chiamata. Gli scraper con prezzo per riga come xquik e feedminer costano meno, con punti di pareggio a 3,71 e 4,63 righe.
Terzo, centinaia di migliaia di post il più in fretta possibile. La pagina di V2 indica da 30 a 80 tweet al secondo, e una grande esecuzione Apify può svolgere il lavoro in parallelo. Noi restituiamo una pagina per chiamata sincrona. Quarto, pianificazioni, storage e webhook in un unico posto. Apify offre pianificazioni, dataset e webhook, quindi un'esecuzione può inviare i risultati a Google Sheets o al tuo server. Noi restituiamo solo i dati: pianificazione e storage li gestisci tu.
Quinto, bio dell'autore e client di pubblicazione. La pagina del reply scraper di Apify li riporta entrambi, mentre i nostri tre endpoint non li restituiscono. Sesto, finestre temporali esatte. Nei nostri test con finestre di un giorno, solo da 48 a 85 post su 200 rientravano nella finestra. Anche V2 avverte che until riduce il numero di risultati, ma ha opzioni di data proprie. Se le finestre esatte sono importanti per te, provali entrambi.
| Caso d'uso | Scelta migliore | Perché |
|---|---|---|
| Migliaia di risposte da un solo post | Reply scraper di Apify | Ci fermiamo a 50 risposte per post |
| Da 1 a 3 righe per chiamata | xquik o feedminer | Il prezzo per riga conviene sotto le 3,71 o 4,63 righe |
| Centinaia di migliaia di post, in fretta | Apify | Da 30 a 80 tweet al secondo in un'unica esecuzione |
| Pianificazioni, storage e webhook in un unico posto | Apify | Restituiamo solo i dati |
| Bio dell'autore e client di pubblicazione per ogni risposta | Reply scraper di Apify | I nostri tre endpoint non li restituiscono |
| Pagine complete di ricerca, post di un account o risposte da molti post | EveryInfra | Da 10 a 122 volte più economico per 1.000 righe |
Termini di X, login wall e limiti legali
I Termini di servizio di X sono entrati in vigore il 9 ottobre 2026. Stabiliscono che «crawling or scraping the Services in any form, for any purpose without our prior written consent is expressly prohibited» (Termini di servizio di X). I Developer Terms aggiungono limiti sui dati ottenuti tramite l'API.
Questi termini vincolano chi usa X. Chiedi al tuo avvocato cosa comportano per il tuo progetto. Questo articolo non costituisce consulenza legale.
Puoi consultare tu stesso gli atti pubblici: X Corp. v. Bright Data (fascicolo), hiQ v. LinkedIn (sentenza) e l'azione dell'UE contro X ai sensi del Digital Services Act (comunicato della Commissione, piano d'azione).
Il login wall è una questione separata. La pagina del reply scraper di apidojo dice «no login, no proxy». La pagina di V2 dice che restituisce ciò che mostra la ricerca di X, e che X può modificare in qualsiasi momento ricerca, paginazione e filtri. Da parte nostra, non devi fornirci un account X.
Nessuna delle nostre 52 chiamate ha restituito un errore «login required», e tutte le chiamate ai dati di Twitter hanno restituito HTTP 200.
Cosa è cambiato di recente
| Data | Cambiamento e cosa significa per te | Fonte |
|---|---|---|
| 2026-10-13 | X ha aggiornato la regola sui crediti gratuiti. Una carta salvata non basta più per ottenere $20. Per ricevere il bonus, devi prima acquistare crediti. | «Free credits» |
| 2026-10-09 | Sono entrati in vigore i nuovi Termini di servizio di X. Leggi il testo attuale, perché le citazioni vecchie potrebbero non essere aggiornate. | «X Terms» |
| 2026-10-02 | X ha introdotto crediti sul primo acquisto per gli account pay-per-use, fino a $70, che scadono dopo 3 mesi. Usali prima che scadano. | «X API changelog» |
| 2026-09-24 | Sono entrati in vigore gli attuali prezzi di danek Twitter Scraper, con una tariffa di avvio per GB di memoria. Molte esecuzioni piccole costano di più. | Metadati di danek |
| Fine settembre | La pagina di feedminer dice che X ha iniziato a rifiutare le sue richieste all'indice di ricerca. Le keyword senza from: ora provengono dalle X Communities. I post degli account non sono interessati. | Pagina dello Store di feedminer |
La tendenza principale è che i prezzi cambiano spesso. Dei 14 scraper per Twitter che abbiamo esaminato, 10 hanno prezzi attuali in vigore da metà agosto o più tardi. Alcuni esempi: xquik dal 29 agosto e scraper_one dal 30 e 31 agosto. Ogni periodo di prezzo nei metadati ha una data startedAt. Per te, questo significa che i prezzi Apify in qualsiasi confronto, compreso questo, possono risultare sbagliati entro due o tre mesi. Rileggi i metadati pubblici prima di acquistare e annota l'ora della lettura.
Per iniziare: da una chiamata di prova a un job giornaliero
Metti una stella a entrambi i nostri repository GitHub, everyinfra/everyinfra-agent-plugins e everyinfra/seo-skills, e potrai richiedere $1 di credito di prova nella console. È valido per 24 ore, abbastanza per eseguire tutte le 52 chiamate di questo articolo più di 30 volte. Ottieni la tua chiave nella guida rapida. Apri la pagina API di scraping per Twitter per vedere tutti gli endpoint. Poi prova il playground in tre pagine: l'API di scraping per la ricerca su Twitter, l'API di scraping per i post degli utenti Twitter e l'API di scraping per le risposte su Twitter.
Per i dati dei profili, consulta l'API di scraping per i profili Twitter. Lo stesso schema funziona per l'API di scraping per Reddit e l'API di scraping per Bluesky. Tutti gli endpoint e i prezzi sono nel marketplace dei dati e nella pagina dei prezzi. Per altri confronti per 1.000 con Apify, leggi Alternativa allo scraper TikTok di Apify e Alternativa allo scraper Instagram di Apify. Per far chiamare a un modello gli endpoint di dati con campi esatti, consulta Strict tool use di Claude con un'API per i dati.
FAQ
Lo scraper per Twitter di Apify è gratuito?
Fonte: il suggerimento di ricerca «apify twitter scraper free», consultato il 3 novembre 2026. Il piano gratuito di Apify offre $5 di credito sulla piattaforma ogni mese. Ma le pagine di V2 e del reply scraper di apidojo indicano entrambe che gli utenti gratuiti hanno 5 esecuzioni al mese con al massimo 10 elementi ciascuna. V2 specifica anche che gli utenti gratuiti non possono chiamarlo tramite API.
Quindi il piano «gratuito» basta per vedere il formato dell'output e poco altro. Da parte nostra, la prova da $1 dura 24 ore. Con 200 tweet per chiamata, copre più di 300.000 tweet. Dopo, paghi per richiesta, senza canone mensile.
Quanto costa il tweet scraper di Apify, e perché alcuni post parlano di $0,004 per 1.000?
Fonte: la query di ricerca comune «apify tweet scraper pricing» e un post su r/n8n (thread). V2 costa $0,0004 per tweet, cioè $0,40 per 1.000. Il post su r/n8n riportava $0,004 per 1.000, perdendo due cifre decimali. Usa $0,40, come indicano i metadati pubblici.
Un altro tutorial su r/n8n confrontava V2 con la X API: «40 centesimi per 1.000 tweet contro $200 per 15.000» (thread). Quello era il prezzo del vecchio piano Basic. Ora X usa il pay-per-use a $5 per 1.000 post.
Uno scraper di commenti Twitter di Apify può ottenere tutte le risposte a un post?
Fonte: il suggerimento di ricerca «apify twitter comments scraper», consultato il 3 novembre 2026. La pagina del reply scraper di apidojo dice che scorre le risposte in autonomia. Se il flusso predefinito ne restituisce troppo poche, useSearch aggiunge una ricerca conversation_id:. La pagina specifica anche che i post eliminati e protetti non sono supportati. Il nostro twitter/comments si ferma a 50 risposte per post e non può ottenerle tutte. Per migliaia di risposte da un solo post, Apify è la scelta migliore.
Twitter consente lo scraping, ed è legale fare scraping su X?
Fonte: i suggerimenti di ricerca «does twitter allow scraping» e «is it legal to scrape twitter», consultati il 3 novembre 2026. I Termini di servizio di X del 9 ottobre 2026 vietano lo scraping senza consenso scritto. La sezione legale qui sopra rimanda al fascicolo di X v. Bright Data, alla sentenza hiQ v. LinkedIn e alla multa dell'UE a X.
La risposta dipende dal tuo paese, dai dati e dall'uso che ne fai. Chiedi a un avvocato. Questo articolo non costituisce consulenza legale.
Qual è l'API di scraping per Twitter più economica?
Fonte: il suggerimento di ricerca «twitter scraper api cheapest», consultato il 3 novembre 2026. Abbiamo considerato gli scraper dello Store con almeno 100 utenti in 30 giorni.
In base al prezzo pubblico, i tweet scraper più economici sono xquik e scrape.badger a $0,15 e feedminer a $0,12. Xquik aggiunge un costo di utilizzo della piattaforma, e feedminer ha un limite sulla ricerca per keyword. Il prezzo più basso dello Store è $0,01, ma quello scraper aveva 8 utenti. Noi addebitiamo per richiesta: una pagina completa di 200 righe costa $0,00278 per 1.000, o $0,00327 dopo la deduplicazione. Sotto circa 3 righe per chiamata, gli scraper con prezzo per riga costano meno.
Scraper X di Apify o X API: quale scegliere?
Fonte: la query di ricerca comune «apify x scraper» e un tutorial su r/n8n che confronta le due opzioni (thread). La X API costa $5 per 1.000 post, con un tetto di 3 milioni di post al mese. È la soluzione ufficiale, con prezzi fissati da X stessa e le condizioni più chiare, e permette anche di pubblicare post e gestire il tuo account. Ai prezzi riportati in questo articolo, gli scraper Apify più diffusi costano da $0,12 a $0,40 per 1.000, e noi da $0,003 a $0,014. I termini di X limitano lo scraping, quindi chiedi a un avvocato per il tuo progetto. Usa la X API per gestire il tuo account. Per leggere molte discussioni pubbliche, confronta gli strumenti di scraping in base al prezzo e alle righe per chiamata.
Riferimenti
- Apify / apidojo. «Tweet Scraper V2 - X Scraper / Twitter Scraper / X.com Scraper (Store page)». Consultato il 2026-11-03.
- Apify API. «apidojo~tweet-scraper public actor metadata (pricingInfos, stats)». Consultato il 2026-11-03.
- Apify / apidojo. «Twitter (X.com) Scraper Unlimited: No Limits (Store page)». Consultato il 2026-11-03.
- Apify API. «apidojo~twitter-scraper-lite public actor metadata». Consultato il 2026-11-03.
- Apify / apidojo. «Twitter (X) Replies Scraper API (Store page)». Consultato il 2026-11-03.
- Apify API. «apidojo~twitter-replies-scraper public actor metadata». Consultato il 2026-11-03.
- Apify / kaitoeasyapi. «Cheapest Twitter Scraper / RealTime Twitter Data Scraper API (Store page)». Consultato il 2026-11-03.
- Apify API. «kaitoeasyapi tweet scraper public actor metadata». Consultato il 2026-11-03.
- Apify / xquik. «Twitter Scraper & X Scraper for Tweets & Search (Store page)». Consultato il 2026-11-03.
- Apify API. «xquik~x-tweet-scraper public actor metadata». Consultato il 2026-11-03.
- Apify / xquik. «X Reply Scraper (Store page)». Consultato il 2026-11-03.
- Apify API. «xquik~x-reply-scraper public actor metadata». Consultato il 2026-11-03.
- Apify / feedminer. «X (Twitter) Tweet Scraper $0.12/1K (Store page)». Consultato il 2026-11-03.
- Apify API. «feedminer~x-tweet-scraper public actor metadata». Consultato il 2026-11-03.
- Apify / scraper_one. «X (Twitter) Profile Posts Scraper (Store page)». Consultato il 2026-11-03.
- Apify API. «scraper_one~x-profile-posts-scraper public actor metadata». Consultato il 2026-11-03.
- Apify API. «scraper_one~x-post-replies-scraper public actor metadata». Consultato il 2026-11-03.
- Apify API. «Store search API /v2/store?search=twitter». Consultato il 2026-11-03.
- Apify Docs. «Get list of Actors in Store (API docs)». Consultato il 2026-11-03.
- Apify. «Apify pricing». Consultato il 2026-11-03.
- Apify Docs. «Actors in Store». Consultato il 2026-11-03.
- Apify Docs. «Actor pricing and costs». Consultato il 2026-11-03.
- Apify Docs. «Usage and resources». Consultato il 2026-11-03.
- Apify Docs. «Limits». Consultato il 2026-11-03.
- Apify Docs. «Apify MCP server». Consultato il 2026-11-03.
- GitHub. «apify/apify-mcp-server». Consultato il 2026-11-03.
- Apify Docs. «Schedules». Consultato il 2026-11-03.
- Apify Docs. «Webhooks». Consultato il 2026-11-03.
- GitHub / igorbrigadir. «twitter-advanced-search (search operator list)». Consultato il 2026-11-03.
- X Developer Platform. «X API pay-per-usage pricing and credits». Consultato il 2026-11-03.
- X Developer Platform. «Usage and Billing (3 million monthly cap, same-day dedup)». Consultato il 2026-11-03.
- X Developer Platform. «Search Posts». Consultato il 2026-11-03.
- X Developer Platform. «Timelines (latest 3,200 posts)». Consultato il 2026-11-03.
- X Developer Platform. «X API Rate Limits». Consultato il 2026-11-03.
- X Developer Platform. «Free credit incentives for X API pay-per-use accounts (updated 2026-10-13)». 2026-10-13.
- X Developer Platform. «X API changelog». 2026-10-29.
- X Developers forum. «Important Update: Legacy X API Pro Plans Are Moving to Pay-Per-Use». 2026-08-14.
- X Corp.. «X Terms of Service (effective 2026-10-09)». 2026-10-09.
- X Developer Platform. «Developer Terms». Consultato il 2026-11-03.
- GitHub / X. «xdevplatform/xmcp». Consultato il 2026-11-03.
- Commissione europea. «Commission fines X €120 million under the Digital Services Act». 2025-12-05.
- Commissione europea. «Commission accepts X's action plan to comply with Digital Services Act». 2026-07-16.
- Commissione europea. «Press release IP/25/2934». 2025-12-05.
- EUR-Lex. «Regulation (EU) 2022/2065 (Digital Services Act)». 2022-10-19.
- CourtListener. «X Corp. v. Bright Data Ltd., 3:23-cv-03698 (docket)». 2024-05-09.
- U.S. Court of Appeals for the Ninth Circuit. «hiQ Labs v. LinkedIn, No. 17-16783 (Ninth Circuit opinion)». 2022-04-18.
- Model Context Protocol. «Model Context Protocol Specification 2025-11-25». 2025-11-25.
- Anthropic. «Connect Claude Code to tools via MCP». Consultato il 2026-11-03.
- OpenAI. «Connectors and MCP servers». Consultato il 2026-11-03.
- Reddit r/n8n. «How to easily scrape data from Twitter / X using Apify». Consultato il 2026-11-03.
- Reddit r/n8n. «This Automation Took Me From 0 to 175k Followers in Under 12 Months». Consultato il 2026-11-03.
- EveryInfra. «EveryInfra capability catalog (free, no key)». Consultato il 2026-11-03 alle 00:16.
- GitHub / Xquik. «Xquik-dev/x-twitter-scraper (README: platform usage billed separately)». Consultato il 2026-11-03.
- Apify Docs. «Pay per event». Consultato il 2026-11-03.
- X Developer Platform. «Getting Access». Consultato il 2026-11-03.
- X Developer Platform. «About the X API». Consultato il 2026-11-03.
- X Developer Platform. «Build a query (query syntax)». Consultato il 2026-11-03.
- Apify Docs. «Get Actor (API docs)». Consultato il 2026-11-03.
- Apify API. «danek~twitter-scraper public actor metadata». Consultato il 2026-11-03.
Riferimenti BL-75