ApifyのRedditスクレイパーの代替:投稿とコメントの1,000件あたりコストを実測
ApifyのReddit Scraper Liteでは、コメント1,000件に$4.04かかります。親IDのないフラットなリストなら、実測で$0.0073でした。完全なツリーが必要な場合はApifyを使ってください。
Reddit Scraper Liteは、Apify Storeで最も利用者の多いRedditスクレイパーです。公開されているFreeプランの料金では、Redditのコメント1,000件に$4.04かかります。内訳は1件あたり$0.004と、開始料金$0.04です。Store内で人気のある代替のうち最も安いautomation-labでは、同じ作業が約$0.59です。2026年11月4日、EveryInfraのreddit/commentsエンドポイントを13件の投稿に対して呼び出しました。
1回の呼び出しは$0.000556でした。合計$0.007228でユニークなコメント997件を取得でき、1,000件あたり$0.00725です。これはLiteの557分の1、automation-labの81分の1の価格です。投稿では、キーワード検索が1,000件あたり$0.0293、サブレディットの一覧が1,000件あたり$0.0114でした。
一方で、Apifyのほうが適したジョブも3つあり、この記事では各テストでそれを明記しています。第1に、当社が返すコメントは1投稿あたり最大100件なので、コメントが771件あるスレッドでは13%しか取得できませんでした。第2に、当社のコメントには2階層目と3階層目の返信も含まれますが、親IDがないため、ツリーを再構築できません。第3に、1つのsubredditで8種類の並び順を試しても、一意の投稿は1,000件ではなく286件しか得られませんでした。
以下では、4種類のRedditデータを1つずつテストします。Apifyで非推奨となった「Reddit Scraper」と、Store内にある746件のRedditスクレイパーの価格差についても取り上げます。最後に、Redditの公開データAPIが終了するまでのスケジュールを説明します。
本記事の数値の読み方
この記事でいう「1,000件あたりのコスト」は、実際に課金された金額を実際に返された一意の件数で割り、1,000を掛けたものです。答えるのは、Redditの投稿やコメント1,000件にいくらかかるかという1つの問いです。EveryInfraはリクエストごとに課金し、1回のリクエストで1ページを返します。検索は最大25件、subredditの一覧とコメントは最大100件です。ユーザーの投稿は最大50件です(無料のカタログのmax_limitを参照)。
これに対し、Apify StoreのRedditスクレイパーのほとんどは結果単位で課金します。データセットに書き込まれた1件ごとに1回課金する方式です。2つのモデルは、同じ単位に換算して初めて比較できます。
EveryInfra側では、割る数は常にidで重複を除いた後の行数です。リクエストしたlimitで割ることはありません。そのため、返される行が少ない呼び出しや重複が多い呼び出しは、EveryInfraの価格を高く見せる方向にしか働きません。Apify側では、公開されている情報のみを使用しました。
具体的には、Storeのページ、料金ページ、ドキュメント、そしてアカウント不要で使える公開のActorメタデータエンドポイント(Get Actor API docs)です。Actorとは、Apifyにおけるクラウドスクレイピングプログラムの呼び名です。当社はApifyに登録しておらず、Actorも一切実行していません。この記事のApifyの数値はすべて公開の定価で、実測の請求額ではありません。
ApifyのRedditスクレイパーとEveryInfraの比較:まとめ表
この表は本記事全体の結果をまとめたものです。各行にはApifyの価格を2つ記載しています。1つは、最も利用者の多いRedditスクレイパーであるReddit Scraper Liteの価格です。もう1つは、同じ作業ができ、直近30日間の利用者が100人以上いるスクレイパーのうち、Freeプランで最も安い価格です。
価格は、2026年11月4日00:15(シンガポール時間)に、Apifyの公開メタデータのpricingInfosフィールドから読み取りました。Apifyの価格はすべて、Freeプランで1,000件を返す1回の実行にデフォルトの開始料金を加えたものとしています。EveryInfraの数値はすべて当社自身の実際の呼び出しによるものです。課金額にはレスポンスのbilling.charged_usdを使い、取得件数はresultsを数え、idで重複を除去しました。
| データ | EveryInfraのエンドポイント | 実測:呼び出し数/行数/ユニーク数/課金額 | EveryInfra:重複除去後1,000件あたり | Reddit Scraper Lite(Freeプラン) | 比率 | Apifyの人気スクレイパー中最安(Freeプラン) | 比率 |
|---|---|---|---|---|---|---|---|
| キーワード検索による投稿 | reddit/search | 10 / 195 / 190 / $0.00556 | $0.0293 | $4.04 | 138x | clearpath Search $1.00 | 34x |
| 1つのサブレディットの投稿 | reddit/subreddit_posts | 10 / 837 / 486 / $0.00556 | $0.0114 | $4.04 | 353x | automation-lab $1.15 | 101x |
| 投稿へのコメント | reddit/comments | 13 / 997 / 997 / $0.007228 | $0.00725 | $4.04 | 557x | automation-lab $0.59 | 81x |
| 特定ユーザーのコメント | reddit/user_comments | 1 / 100 / 100 / $0.032403 | $0.324 | $4.04 | 12.5x | harshmaur User $1.52 | 4.7x |
各倍率は、Apifyの価格を当社の価格で割ったものです。表を読むときは4つの点に注意してください。第1に、差の大部分は「1リクエストで1ページ」という方式から生じます。コメントの呼び出しは最大100件を返すので、1ページが埋まれば固定価格が多くの件数に分散されます。1回の呼び出しで1〜2件しか返らない場合は結果が逆転します。その計算は後述の損益分岐点のセクションで示します。
2点目に、automation-labのコメント価格$0.59は、コメント1件あたり$0.000575、開始料金$0.003、投稿行10件(各$0.00115)で算出しています。同スクレイパーのStoreページによると、Freeプランのコメント単価は11月17日に$0.00075へ値上がりします。同じ計算では$0.76になります(automation-labのStoreページ)。
第3に、投稿に関する2行ではどちらも当社のほうが安いものの、常に1,000件の投稿に届くとは限りません。検索は直近1か月のみが対象で、subredditの一覧にはページネーションがありません。実際に何件の投稿を取得できたかは、次のセクションで示します。第4に、Apifyの価格は1〜2か月ごとに変わります。日付は「最近の変更点」セクションにまとめています。
テスト方法と合格の基準
合否の基準は、最初の呼び出しの前に決めておきました。4つのデータ種別それぞれで少なくとも2回の実際の呼び出しを行い、テスト全体を3つ以上の異なる時刻に分けました。1,000件あたりのコストでは、常に一意の件数で割りました。コメントツリーのカバー率を判断するため、少なくとも2つの投稿ページについて、当社のデータをサードパーティによる読み取り結果と1件ずつ照合しました。
網羅性をフィールドの一覧から推測することはしていません。いずれかの用途でApifyのほうが安い、より網羅的、またはより適している場合は、本文とまとめの表にそう明記することにしました。データが返らない呼び出しを少なくとも2回行い、それぞれの費用を記録することも条件としました。reddit/user_commentsへのライブ呼び出しは最大1回とし、reddit/painpointへのライブ呼び出しは行っていません。
すべてのリクエストはPOST https://api.everyinfra.com/api/v1/socialに送信しました。最初のリクエストは2026年11月4日のシンガポール時間00:15に送信しました。コメントのラウンドはシンガポール時間00:26から00:32まで実施し、最後の呼び出しはシンガポール時間00:36に完了しました。各呼び出しについて、送信時刻、HTTPステータス、所要時間、行数、charged_usdを記録しました。その後、スクリプトで生のレスポンスからすべての数値を再計算しました。本文、表、グラフの数値はすべてこのスクリプトによるものです。
| 用途 | エンドポイントとパラメータ | ライブ呼び出し | 時刻(シンガポール時間、11月4日) | 確認した内容 |
|---|---|---|---|---|
| キーワード検索 | reddit/search、limit 25。7つのキーワードに加え、「standing desk」でnewest、top、popularの各ソート | 10 | 00:15〜00:19 | 1回あたりの行数、ソートの影響、日付範囲 |
| サブレディットの投稿 | reddit/subreddit_posts。r/Pythonでソートと期間の組み合わせ8通り、r/smallbusinessで2通り、limit 100 | 10 | 00:20〜00:24 | ソートを追加するごとの新規投稿数、1コミュニティあたりの上限 |
| コメント | reddit/comments。コメント数16〜771件の投稿13件、limit 100 | 13 | 00:26〜00:32 | 投稿あたりの行数、投稿のコメント数に対する割合、ネストされた返信 |
| ユーザー | reddit/user_postsを3アカウントで7回、reddit/user_commentsを1回 | 8 | 00:24〜00:35 | どこまで遡れるか、高額な呼び出し1回で何が返るか |
| 投稿の詳細 | reddit/post_detailを2件の投稿で実行 | 2 | 00:33 | 件数は一覧と一致するか |
| データなし | APIキーなし、不正なsort値、余分なパラメータ、存在しないサブレディット、存在しない投稿、存在しないユーザー | 6 | 00:25〜00:36 | どのケースで課金されるか |
本記事では49回のライブ呼び出しを行い、課金総額は$0.056311でした。すべての呼び出しで、1分あたり10回のレート制限が設定された1つのテスト用APIキーを共有しました。実行中、HTTP 429(リクエスト過多)が何度か発生しました。その場合、スクリプトは60秒待ってから呼び出しを再送しました。HTTP 429は課金されず、上記の合計にも含まれていません。
テスト1:Apify Redditスクレイパーで最も一般的な用途、キーワード検索で投稿1,000件を取得
reddit/searchは1回の呼び出しで最大25件を返します。対象期間は直近1か月に固定されています。カタログのsortパラメータの注記によると、どの並び順を選んでも期間は1か月のままです。7つの異なるキーワードでそれぞれ1回ずつ検索しました。standing desk、notion alternative、claude code、best vpn、airpods pro 3、home espresso machine、sourdough starterです。
返された件数は25件、17件、25件、25件、25件、24件、25件で、平均は23.7件でした。投稿の日付はすべて2026年10月3日から11月3日の間で、1か月の期間と一致しています。7回の呼び出しの料金は$0.003892で、166件に重複は1件もありませんでした。1,000件あたり$0.0234です。
並び順によって件数は大きく変わりました。同じキーワード「standing desk」で、デフォルトの関連度順は25件、popularは22件を返しました。しかし、topは4件、newestは3件しか返さず、その3件はすべて11月3日のものでした。理由はカタログに書かれています。検索はキーワードに一致する投稿だけを返すため、件数がlimitを下回ることがあります。
0件を返した呼び出しは、空の結果として返金されます。3件を返した呼び出しには通常どおり$0.000556が課金されます。これらの並び順の3回を含めると、10回の呼び出しで195件、うち一意の件数は190件、料金は$0.00556でした。1,000件あたり$0.0293で、概要の表ではこの控えめな数値を使っています。
1回あたり23.7件で投稿1,000件を集めるには、約42回の検索が必要です。つまり42通りのキーワードまたはキーワードの組み合わせが必要で、費用は約$0.0234です。対象のキーワードが1〜2個だけなら、1,000件には届きません。1つのキーワードに1か月で一致する投稿数には限りがあり、当社の検索はそれ以上遡れないためです。
この点はApifyが異なります。Liteのtimeパラメータはall、year、monthなどの値を受け付けます(Storeページ、「Advanced parameters」)。clearpathの検索スクレイパーは5種類のソート順と期間フィルターに対応しています。料金は結果1件あたり$0.00099、データセットへの書き込み1件あたり$0.00001、それに少額の開始料金で、1,000件あたり$1.00です(clearpath SearchのStoreページ)。
そのため、過去数年にわたるトピックの投稿を1,000件集めるなら、Apifyのほうが適しています。直近1か月を対象に一連のキーワードを毎日または毎週モニタリングする場合、当社なら1回の呼び出しで20件以上の投稿を$0.000556で取得できます。こちらははるかに安価です。
| キーワード | ソート | 件数 | 最も古い投稿(UTC) | 課金額 |
|---|---|---|---|---|
| standing desk | デフォルト(関連度順) | 25 | 10月3日 | $0.000556 |
| standing desk | popular | 22 | 10月27日 | $0.000556 |
| standing desk | top | 4 | 10月6日 | $0.000556 |
| standing desk | newest | 3 | 11月3日 | $0.000556 |
| notion alternative | default | 17 | 10月3日 | $0.000556 |
| その他5つのキーワード | default | 24〜25 | 10月3日〜6日 | 各$0.000556 |
テスト2:1つのサブレディットから投稿1,000件、取得できたのは286件
reddit/subreddit_postsは1回の呼び出しで最大100件を返し、ページネーションのパラメータはありません。さらに取得するには、並び順と期間を変えるしかありません。sortはnewest、popular、top、rising、relevanceを受け付けます。カタログにあるとおり、date_rangeはsort=topのときだけ適用されます。r/Pythonで8つの組み合わせをそれぞれ1回ずつ実行しました。グラフは、組み合わせを1つ追加するごとに新しい投稿が何件増えたかを示しています。
結果ははっきりしています。newest、popular、relevanceの100件ずつはほぼ同じ集合で、一意の投稿は合計101件でした。risingは25件を返しましたが、すべて既出でした。新しい投稿をもたらした組み合わせは、topとall_time(100件、最も古いものは2017年)、topとpast_year(新規85件)の2つだけでした。past_monthの87件とpast_weekの25件はすべて重複でした。8回の呼び出しの料金は$0.004448で、一意の投稿は286件、1,000件あたり$0.0156です。
newest、top all time、top past yearだけが重要だと事前にわかっていれば、3回の呼び出しで同じ286件の投稿を$0.001668で取得できます。1,000件あたり$0.0058です。r/smallbusinessでは、2回の呼び出し(newestとtop past year)がそれぞれ100件を重複なしで返し、1,000件あたり$0.0056でした。subredditへの10回の呼び出し全体では837件、うち一意の件数は486件、料金は$0.00556でした。1,000件あたり$0.0114で、これが概要の表の数値です。
そのため、当社では「1つのsubredditから1,000件の投稿」を取得できず、このジョブにはApifyのほうが適しています。Reddit自体の一覧は約1,000件までしかさかのぼれません。Liteのreadmeにも同じことが書かれており、さらに多く集めるには並び順、検索、期間フィルターを組み合わせるよう勧めています(Storeページの「Reddit's 1,000 items limit」)。ページネーションできるスクレイパーなら、並び順ごとに1,000件近くを取得できます。当社が返すのは、並び順ごとに最初のページの100件だけです。
コミュニティの新着投稿と人気投稿を毎日確認するなら、2回の呼び出し(newestとtop past day)で$0.001112です。コミュニティの何年分もの履歴を一度にエクスポートしたい場合は、Apifyを使うか、Reddit独自の研究者向けプログラムに申請してください。
テスト3:コメント1,000件とツリー構造、ApifyのRedditコメントスクレイパーが上回るべき基準
今回のテストで価格差が最も大きいのはコメントです。また、Apifyの機能面での優位が最もはっきりしているのもコメントです。reddit/commentsは投稿URLを1つ受け取り、1回の呼び出しで最大100件のコメントを返します。コメント数が16〜771件の投稿を13件選び、それぞれ1回ずつ呼び出しました。
13回の呼び出しの費用は$0.007228で、重複のないコメント997件が返りました。1,000件あたり$0.00725ですが、この数値には2つの条件があります。1つ目に、コメントが100件未満の投稿では、投稿に表示されている件数の74%〜90%を取得できました。差の一部は削除または除去されたコメントで、投稿の件数には含まれますが本文がありません。残りは、Redditで「load more」を選択しないと表示されないコメントです。
第2に、コメントが100件を超える投稿でも、1回の呼び出しで返るのは100件です。771件のコメントがあるスレッドでは13%にあたります。この上限があるため、活発なスレッドのコメントをすべて取得することはできません。clearpathのコメントスクレイパーによると、maxCommentsPerPostを0に設定しexpandAllCommentsをオンにすると、ツリー全体が返ります。これには「continue this thread」の先にある10階層以上の深い返信も含まれます(clearpathのStoreページ)。このジョブにはApifyのほうが適しています。
| 投稿に表示されたコメント数 | 取得数 | カバー率 | 時刻(シンガポール時間) | 課金額 |
|---|---|---|---|---|
| 771 | 100 | 13% | 00:26 | $0.000556 |
| 681 | 100 | 15% | 00:27 | $0.000556 |
| 639 | 100 | 16% | 00:27 | $0.000556 |
| 529 | 100 | 19% | 00:28 | $0.000556 |
| 478 | 100 | 21% | 00:28 | $0.000556 |
| 389 | 100 | 26% | 00:29 | $0.000556 |
| 374 | 100 | 27% | 00:29 | $0.000556 |
| 120 | 100 | 83% | 00:30 | $0.000556 |
| 118 | 95 | 81% | 00:30 | $0.000556 |
| 40 | 36 | 90% | 00:31 | $0.000556 |
| 39 | 35 | 90% | 00:32 | $0.000556 |
| 23 | 17 | 74% | 00:32 | $0.000556 |
| 16 | 14 | 88% | 00:32 | $0.000556 |
「コメントツリーは完全か」という問いには2つの側面があります。1つ目は、ネストされたリプライがそもそも返ってくるかどうかです。コメント数16件と23件の2つの投稿を使いました。サードパーティのページリーダーで各投稿ページをコメントも含めて取得したところ、2ページで27件のコメントが表示され、そのうち1件は削除済みのプレースホルダーでした。
残りの26件について、本文の冒頭部分を手掛かりに取得済みの行を検索したところ、26件すべてが見つかりました。内訳はトップレベルのコメント12件、第2階層のリプライ10件、第3階層のリプライ4件です。また、ページリーダーに表示されなかったコメントも5件返していました。つまり、返る行はトップレベルのコメントだけではなく、第2・第3階層のリプライも含まれています。
2つ目は構造です。この13回の呼び出しで返ったコメント行には、どれもid、text、author_username、like_count、url、posted_at、platformの7つのフィールドがありました。カタログにはcommunityも記載されていますが、今回のレスポンスにはどれも含まれていなかったため、これに依存しないでください。コミュニティ名が必要な場合は、投稿一覧のcommunityかコメントのurlを使ってください。親コメントのIDや階層の深さはありません。
これらの行のうち14件がリプライであることはわかりますが、誰が誰に返信したかはわかりません。Apify側では、LiteのコメントレコードにparentIdとnumberOfRepliesが含まれます(Storeページ、「Example Reddit post」)。automation-labはdepthとparentIdを含みます。ただしcommentCoverageはunverifiedと明記しており、ツリー全体は保証していません(Storeページ、「Comment fields」)。clearpathは10月6日のアップデートで、完全に展開されたスレッドのリプライのdepthを修正しました。
ユースケースにとってこれは何を意味するでしょうか。感情の集計、キーワードの出現頻度、トピックのタグ付け、不満の声の抽出なら、フラットなコメント表で十分で、1,000件あたり$0.00725です。「誰と誰が議論しているか」「リプライの連鎖がどこまで深いか」「投稿者がどの質問に答えたか」を知りたいなら、parentIdを持つツールが必要です。PRAWのMoreCommentsプレースホルダーとreplace_moreについては、Redditのコメントエクスポートが不完全になる理由で解説しました(PRAWドキュメント)。Redditが返すツリーには、仕様として展開されていない枠があります。RedditのJSONドキュメントでは、これをmoreオブジェクトと呼んでいます(reddit-archive wiki)。
この問題は研究分野でも以前から知られています。2018年、GaffneyとMatiasは「Redditの公開コメントをすべて収録」とうたう広く使われているデータセットを調査し、大きな欠落を発見しました。リスクが最も高いのは、ユーザー履歴やネットワーク構造の研究だと指摘しています(arXiv論文)。どのツールを使う場合でも、エクスポートのたびに、取得したコメント数と投稿に表示されているコメント数の2つを記録しておいてください。
reddit/post_detailも2回呼び出しました。コメント771件と40件の投稿で、comment_countは一覧の値と一致し、費用は各$0.000556でした。コメントを取得する前に投稿を選ぶなら、一覧のcomment_countで並べ替えてください。別途詳細を取得する呼び出しは不要です。
テスト4:1人のユーザーの投稿とコメント、高価なエンドポイントが割に合わないケース
reddit/user_postsは1回の呼び出しで最大50件を返し、料金はほとんどのエンドポイントと同じ$0.000556です。まず、RedditのCEOのアカウントであるspezで、newest、top all time、top past year、popularを試しました。4回の呼び出しはすべて同じ24件の投稿を返しました。最も古いものは2015年7月11日、最も新しいものは10月29日のログインウォールに関する投稿でした。つまり、このアカウントでは並び順が効かず、4回の呼び出しで$0.002224かかり、2〜4回目は無駄でした。
パブリッシャーのアカウントであるwashingtonpostでは、1回の呼び出しで上限の50件が返りました。期間は2026年4月20日〜11月3日で、1,000件あたり$0.0111です。top all timeで2回目を呼び出しても、同じ50件が返りました。NASAのアカウントnasaでも、newestで2025年6月5日〜2026年10月29日の50件が返りました。つまり、ユーザー投稿は1回の呼び出しで50件が上限で、ソートを変えてもそれより古い投稿には届きません。
投稿が活発なアカウントの全履歴をさかのぼるなら、ページネーションに対応したApifyのスクレイパーのほうが適しています。harshmaurのReddit User Scraperは、ユーザーの投稿とコメントの全履歴を返すとしています。clearpathのユーザーコンテンツスクレイパーは、ユーザーあたり最大1,000件を返すとしています。
reddit/user_commentsは事情が異なります。1回の呼び出しは$0.032403で通常の呼び出しの58倍ですが、最大200件を返します。spezに対してlimitを200にして1回呼び出したところ、2025年7月31日から2026年10月29日までの100件が返りました。1,000件あたり$0.324です。もう1つ、はっきり述べておくべき事実があります。
この100件のうち最も長いコメント本文はちょうど300文字で、平均は160文字でした。このエンドポイントのカタログのfield_noteに理由が書かれています。他のソースが使えない場合、結果はフォールバックソースから返され、本文は先頭300文字で切り詰められます。この呼び出しで起きたのはそれです。この結果は、ある人がどこに、どれくらいの頻度で投稿し、どれだけupvoteを得ているかを見るには向いています。長いコメント本文の分析には向いていません。
このエンドポイントが割に合わないのはどんなときでしょうか。答えは1回の呼び出しあたりの件数で決まります。$0.032403をApifyの件単位の価格で割ると、当社のほうが安くなる1回あたりの最少件数がわかります。$0.004のLiteに対する損益分岐点は8.1件です。
$0.002($0.00199+書き込み1件あたり$0.00001)のclearpathのユーザーコンテンツスクレイパーに対しては16.2件です。$0.0015のharshmaurのユーザースクレイパーに対しては21.6件です。automation-labのコメント価格$0.000575に対しては56.4件です。
| Apifyでの行単価(Free) | 損益分岐となる1回あたりの行数 | 実際の呼び出しで返された行数 |
|---|---|---|
| Reddit Scraper Lite、$0.004 | 8.1 | 100 |
| clearpath user content、$0.002 | 16.2 | 100 |
| harshmaur user scraper、$0.0015 | 21.6 | 100 |
| automation-lab comments、$0.000575 | 56.4 | 100 |
そのため、次の3つのケースでは使わないほうがよいでしょう。1つ目は、新しいアカウントや投稿が十数件しかないアカウントなど、ユーザーのコメントが少ない場合です。この場合は行単価のスクレイパーのほうが安くなります。2つ目は、本当に必要なのが1つの投稿についた議論である場合です。1,000件あたり$0.00725で45倍安いreddit/commentsを使ってください。3つ目は、長いコメント本文が必要なのに、この呼び出しが300文字の切り詰めに当たった場合です。ツールを変えるか、時間をおいて再試行してください。
多数のユーザーを対象にした大規模な調査では、1回の呼び出しで100〜200件が返ります。1,000件あたり$0.16〜$0.32で、harshmaurのユーザースクレイパーの$1.52より4.7〜9.4倍安くなります。ただし、各ユーザーのkarmaやアカウント作成からの期間も必要なら、harshmaurのスクレイパーは1回の実行でそれらも返します。
reddit/painpointはさらに高く、1回の呼び出しあたり$0.072です。このエンドポイントは呼び出していないため、ここではカタログに記載されている提供内容だけを紹介します。キーワードに対して最大15件の投稿を見つけ、そのトップレベルのコメントを読み取ります。返すのは、見つかった投稿数、読み取ったコメント数、否定的・肯定的なコメントのおおよその数を含む1件の要約です。この1件には、否定的なコメントで繰り返し出てくる語と、関係するコミュニティも含まれます。
上位の投稿と、最も多くアップボートされたネガティブなコメントも引用として返されます。カタログによると、ネガティブとポジティブの判定は単語リストに基づいています。皮肉や肯定・否定が入り混じった表現はうまく判定できないため、件数はあくまで目安であり、不満率ではありません。また、「any」や「it's」のような一般的な単語が上位の単語に入ることもあります。
同じものは、reddit/search 1回とreddit/comments 15回の呼び出しで自作できます。この16回の呼び出しは$0.0089で、タグ付けは自分のモデルで行えます。painpointより8倍安く、トップレベルだけでなく1投稿あたり最大100件のコメントを取得できます。
| オプション | 呼び出し回数 | 費用 | 1投稿あたりの読み込みコメント数 | トーンの判定方法 |
|---|---|---|---|---|
reddit/painpoint | 1 | $0.072 | トップレベルのみ | 単語リスト、おおよその件数 |
reddit/search + 15 × reddit/comments | 16 | $0.0089 | 最大100件、ネストされた返信を含む | 自分のモデル |
painpointは、コードを書かずに製品への不満をざっと確認したい人に向いています。週次レポートであれば、自作したほうが安くなります。手順の全体はClaude Codeの定期タスクでRedditのペインポイントを集める方法で紹介しています。
失敗した呼び出しや空の結果にも料金はかかりますか?
ApifyとEveryInfraの課金ルールが最も異なるのがこの点です。データを返せないリクエストを意図的に6件送信しました。
| ケース | 送信時刻(シンガポール時間) | HTTPステータス | レスポンス | 課金額 |
|---|---|---|---|---|
| APIキーなし | 00:25 | 401 | missing_key。Authorizationヘッダーの使用を促すヒント付き | $0 |
sortをhotに設定 | 00:25 | 422 | invalid_value。許可される値と、did_you_meanとしてpopularとtopを提示 | $0 |
余分なtime_filterパラメータ | 00:25 | 422 | unknown_param。必須・任意のパラメータと動作する例を提示 | $0 |
| 存在しないサブレディット | 00:26 | 200 | id、community、platformのみのプレースホルダー1件、1件の結果として課金 | $0.000556 |
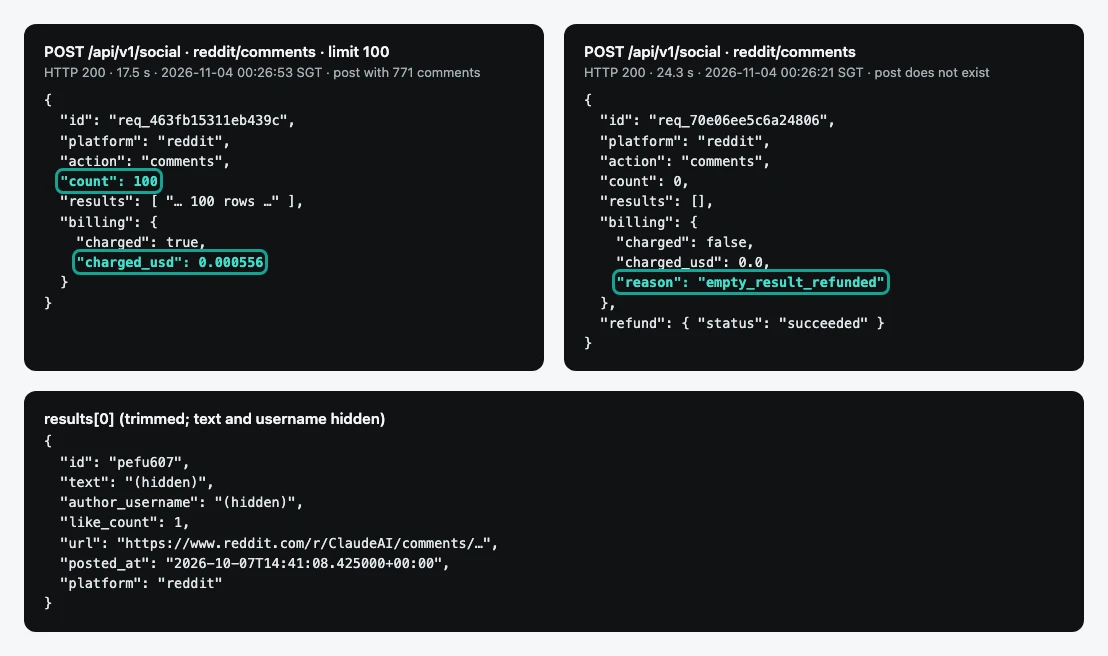
| 存在しない投稿 | 00:26 | 200 | 0件、empty_result_refunded、課金は返金 | $0 |
| 存在しないユーザー | 00:36 | 200 | 0件、empty_result_refunded | $0 |
最初の3つのケースはパラメータエラーです。EveryInfraはまずキーを、次にパラメータをチェックします。誤ったリクエストには即座に4xxが返り、課金はされません。エラーには呼び出しの修正方法が示されるため、AIクライアントは修正して再送信できます。5つ目と6つ目のケースは通常の空の結果です。リクエスト自体は成功しましたが、一致するものがなかったため、料金は即座に返金されました。
4つ目のケースには注意が必要です。存在しないサブレディット名を指定すると、HTTP 200でcountが1のレスポンスが返ります。唯一の行のidはtarget-status:で始まり、communityとplatformのフィールドしかなく、タイトル、本文、リンクはありません。この呼び出しには結果1件分の価格である$0.000556がかかりました。そのため、サブレディットを一括処理する場合は、行数を数えたり単価を計算したりする前に、この行をidのプレフィックスで除外してください。行が1つも残らなければ、名前が間違っているか、そのサブレディットはもう存在しません。再び料金を支払わないよう、リストから削除してください。
Apifyでは、Actorごとに独自のルールが定められています。Apify公式のReddit Scraperには、$0.0005の「No result」イベントがあります。対象は、削除されたコミュニティ、ヒットしなかった検索、コメントのない投稿です。いずれの場合も理由を説明するレコードが1件書き込まれ、その価格で課金されます(Storeページ)。
automation-labは、結果のない実行には課金しないとしています。Liteのメモリ量に応じた起動料金は、結果が返らなくても実行開始時に課金されます。デフォルトの2 GBでは$0.04です。
失敗やタイムアウトに終わる実行は、想像以上に多く発生します。後のセクションで示すとおり、直近30日間のLiteの360,000回の実行のうち10%がタイムアウトしています。Apifyのドキュメントによると、実行ごとに最大課金額を設定でき、その上限に達すると実行は停止します(Actors in Store)。大規模なジョブの前に設定しておいてください。
Apify Reddit Scraper Liteの料金:結果1件あたり$0.004と2 GBの起動料金
「apify reddit scraper」で検索した人の多くが最初にたどり着くのは、trudaxによるReddit Scraper Liteです。直近30日間のユーザー数は8,543人で、Store内のRedditスクレイパーの中で最多です。これは2位より約50%多い数です。課金対象は2つあります。1つはデータセットに書き込まれる結果で、1件ごとにFreeティアでは$0.004、つまり1,000件あたり$4.00かかります。Bronzeティア(Starterプラン)は$0.0038、Silver(Scale)は$0.0036、Gold(Business)は$0.0034です。
この記事のユーザー数と実行回数は、2026年11月4日 00:14(シンガポール時間)にStoreのリストAPIから取得したものです。同時刻に、このActorの詳細APIでは8,540ユーザー、363,964回の実行と表示されていました。両者の差は1%未満です。
もう1つは各実行の起動料金で、メモリ量に応じて1 GBあたり$0.02かかります。デフォルトのメモリは2,048 MBなので、デフォルトの実行は$0.04から始まり、プラットフォームは1回の実行あたりの最低料金を$0.04に設定しています。これらはすべて、2026年11月4日 00:15(シンガポール時間)に取得したLiteの公開メタデータのpricingInfosとdefaultRunOptionsフィールドに基づいています。Apifyのドキュメントでは、ティアとプランが次のように対応しています。FreeはFREE価格、StarterはBRONZE、ScaleはSILVER、BusinessはGOLDの価格を支払います。PLATINUMとDIAMONDはエンタープライズ顧客専用です(Actor pricing and costs)。
| ティア(プラン) | 結果1件あたり | 1回の実行で結果1,000件(起動料金$0.04込み) |
|---|---|---|
| FREE (Free) | $0.004 | $4.04 |
| BRONZE (Starter) | $0.0038 | $3.84 |
| SILVER (Scale) | $0.0036 | $3.64 |
| GOLD (Business) | $0.0034 | $3.44 |
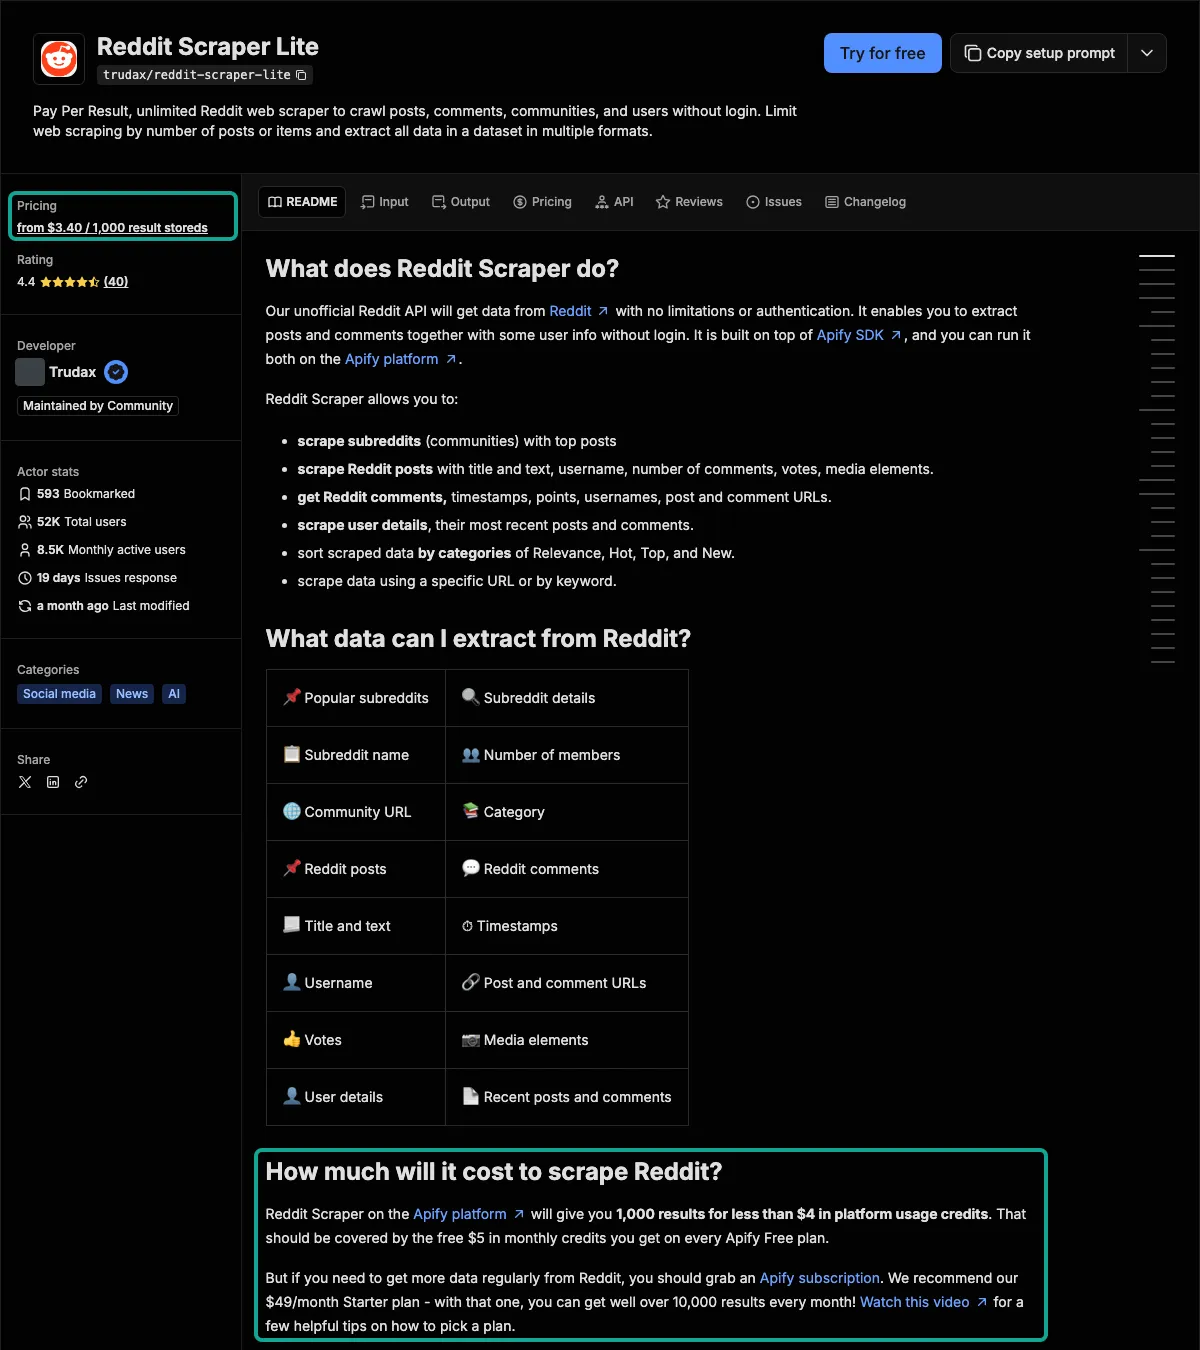
このスクリーンショットには、読み違えやすい点が2つあります。1つ目は、サイドバーの「from $3.40 / 1,000」が最も割引率の高いティアの価格であることです。Freeユーザーは$4.00に加えて、実行1回ごとに$0.04を支払います。1,000件を1回の実行で取得すると、Freeでは$4.04、Businessでは$3.44です。
2つ目は、本文中の「$49/month Starter plan」が現在の料金ページと一致しないことです。料金ページでは、Freeは毎月$5のプリペイドクレジット、Starterは$19から、Scaleは$199、Businessは$999となっています。未使用のクレジットは繰り越されません。readmeの記述は料金ページに合わせて更新されていないため、計算には料金ページの数字を使ってください。
もう1つ見落としやすい点があります。Storeページの「Results」セクションにあるとおり、Liteは「each post, comment, user and community」(投稿、コメント、ユーザー、コミュニティのそれぞれ)を1件の結果として数えます。そのため、あるサブレディットから投稿を100件取得しようとしてコメント取得を有効にしたままにすると、それらの投稿についたコメントもデータセットに書き込まれます。1件ごとに$0.004が課金されます。ページにはskipComments、maxComments、maxItemsが用意されています。上限を設定しないと、「投稿100件」の実行で数千行が書き込まれることもあります。
「Reddit Scraper」自体は非推奨に:9月21日以降は既存ユーザーのみ
「Apify Reddit Scraper」と書かれた多くのチュートリアルが指しているのは、別のActorであるtrudaxのReddit Scraperです。2022年2月からは月額$45のレンタル制で、1,440分のトライアルがありました。2026年9月21日にイベント課金制へ移行し、結果1件あたり$0.0001、開始1回あたり$0.00005になりました。変更メモには、Apifyが月額レンタル料金を段階的に廃止していると書かれています。また、このActorは今後公開リストに掲載されず、既存ユーザーは引き続きすべての機能を利用できるとも書かれています。この記述は、2026年11月4日に確認した公開メタデータのreasonForChangeフィールドにあります。
同じメタデータではisDeprecatedがtrueに設定されており、Storeのタイトルにも「[DEPRECATED]」が付いています。直近30日間のユーザーはまだ459人いましたが、新規ユーザーは実行を開始できません。そのため、いま新しく使い始める場合、この名前の選択肢はLiteとApify公式のReddit Scraperの2つです。
Apify公式のスクレイパーは、4種類の結果をそれぞれ別の価格で課金します。投稿はFreeで$0.004、Goldで$0.0025です。コメントはFreeで$0.0032、Goldで$0.002です。コミュニティは$0.0065、ユーザーは$0.002、開始は1回ごとに$0.001です。
さらに、珍しい「No result」イベント($0.0005)もあります。ページによると、削除されたコミュニティ、ヒットしない検索、コメントのない投稿など、結果のないリクエストが対象です。こうした場合は理由を説明するレコードを1件書き込み、通常の結果より安い価格で課金されます。また、2つの入力から同じ投稿にたどり着いた場合は、2回書き込まれて2回課金されるとも書かれています(Storeページの「How much will it cost?」)。
| Apify公式Reddit Scraperのイベント | Free | Gold |
|---|---|---|
| 投稿 | $0.004 | $0.0025 |
| コメント | $0.0032 | $0.002 |
| コミュニティ | $0.0065 | $0.004 |
| ユーザー | $0.002 | $0.001 |
| 結果なし | $0.0005 | $0.0005(一律) |
| 利用開始 | $0.001 | $0.001(一律) |
Apify StoreのReddit用スクレイパー746件:価格の幅と実行結果
Apifyの公開Store一覧エンドポイント(Get list of Actors in Store)で「reddit」を検索しました。14ページを取得して重複を除くと、タイトルか名前にRedditを含むActorは746件でした。そのうち717件はイベント単位で課金し、29件は無料です。過去30日間の利用者が100人以上のものは17件でした。グラフは、結果単位で課金する16件について、メインイベントのFreeプラン価格を示しています。17件目はred_crawlerによる無料のもので、コミュニティ情報の取得と閲覧に使います。
最も安いのはclearpathの検索スクレイパーで、1,000件あたり$0.99です。ユーザー数で2位と3位のharshmaurの汎用スクレイパーとfatihtahtaは、それぞれ$2.00と$1.49です。harshmaurのReddit Comment Scraperは$1.50です。Lite、practicaltoolsのもの、Apify公式のものの3つが、最高値の$4.00で並んでいます。中央値は約$2.00です。これらの価格には開始料金が含まれていません。開始料金はメモリ量に応じて実行ごとに課金され、Liteは$0.04、harshmaurは$0.02、clearpathは$0.00099です。
価格のほかに、各アクターの公開メタデータには30日間の実行統計があり、成功、失敗、タイムアウト、中断の件数がわかります。グラフは、ユーザー数の多い上位4件とApify公式のスクレイパーを示しています。
2つの数字には注意が必要です。1つ目は、Liteの直近30日間の実行360,661回のうち35,919回がタイムアウトしていることです。これは約10%で、他より1桁多い数字です。原因は推測するしかありません。短い制限時間を設定しているユーザーや、maxItemsを指定せずに1回の実行で投稿やコメントを大量に取得しようとしているユーザーがいるのかもしれません。タイムアウトした実行でも、すでにデータセットに書き込まれた結果は課金され、開始料金もかかります。
2つ目は、Apify公式のReddit Scraperの実行15,672回のうち5,296回、約34%が失敗していることです。ページには、「no result」の場合は$0.0005のレコードが書き込まれ、失敗扱いにはならないと記載されています。そのため、これらの失敗は入力不備やRedditによるブロックが原因である可能性が高いと考えられます。なお、これらはプラットフォームの公開統計であり、各アクターの成功率を直接示すものではありません。Apifyのドキュメントでは、実行状態をRuns and buildsで定義しています。
| Actor | 30日間の実行回数 | 成功 | タイムアウト | 失敗 |
|---|---|---|---|---|
| trudax/reddit-scraper-lite | 360,661 | 86.3% | 10.0% | 1.0% |
| harshmaur/reddit-scraper | 214,422 | 97.8% | 0.5% | 1.1% |
| fatihtahta/reddit-scraper-search-fast | 369,944 | 98.2% | 0.3% | 0.6% |
| automation-lab/reddit-scraper | 187,397 | 99.9% | 0.0% | 0.0% |
| apify/reddit-scraper | 15,672 | 65.9% | 0.1% | 33.8% |
人気の17アクターの実行は合計1,526,908回で、成功95.3%、タイムアウト2.6%、失敗1.1%、中断1.0%でした。Apifyは公開アクターごとに毎日自動テストも実施しています。失敗が続くアクターには「under maintenance」のマークが付きます(Automated testing)。選ぶ前に、Storeページでこのマークがないか確認してください。
当社側では、この記事で行った49回の呼び出しのうち46回がHTTP 200を返しました。この46回だけで見ると、所要時間は6〜41秒、中央値は14秒でした。最も遅かったのは、コメントの多い投稿に対する呼び出しと、投稿詳細の呼び出しです。3件の4xxレスポンスは、意図的に送った不正なパラメータによるものです。
タイムアウトした呼び出しも、5xxを返した呼び出しもありませんでした。ただし、49回では成功率を出すには少なすぎます。言えるのは、今回の実行では失敗が見られなかったということだけです。
| エンドポイント | 呼び出し回数 | 秒数の中央値 | 範囲 |
|---|---|---|---|
reddit/search | 10 | 6.4 | 6.0〜10.2 |
reddit/subreddit_posts | 10 | 17.8 | 9.5〜30.7 |
reddit/comments | 13 | 22.4 | 11.4〜40.8 |
reddit/user_posts | 7 | 12.5 | 9.1〜14.5 |
reddit/post_detail | 2 | 23.6 | 11.2〜36.0 |
フィールド:両者は同じデータを返すか
価格が安い分、フィールド数は少なくなります。下の表は、カタログに記載されたフィールドではなく、49回の呼び出しで実際に返されたフィールドを示しています。両者が異なる場合はその旨を記載しています。Apify側では、スクレイパーによってフィールドが大きく異なります。
harshmaurの汎用スクレイパーは、メディアやギャラリーを含め、投稿1件あたり60以上のフィールドを返すとしています。Liteとautomation-labのコメントレコードにはparentIdが含まれます。全項目は各Storeページのサンプル出力で確認してください。これらは実際には実行していないため、フィールドは掲載していません。
| エンドポイント | 実際に返されたフィールド | 含まれないもの |
|---|---|---|
reddit/search, reddit/subreddit_posts | id, title, text, author_username, community, url, like_count, comment_count, posted_at, platform。サブレディットの投稿にはdomainとflairも含まれます | 画像・動画のURL、アワードとピン留めのフラグ |
reddit/comments | id, text, author_username, like_count, url, posted_at, platform | 親コメントのID、階層の深さ、返信数。カタログにはcommunityが記載されていますが、実際のレスポンスには含まれていませんでした。これに依存しないでください |
reddit/user_comments | id, text, author_username, like_count, post_id, post_title, url, posted_at, platform | テキストは300文字で切り詰められる場合があります。カルマやアカウント作成からの経過期間は含まれません |
「みんなが何と言っているか」を知る用途の多くは、これらの列で十分です。コメントにはテキスト、投稿者、upvote数、投稿日時があります。投稿にはタイトル、コミュニティ、コメント数があるため、コメント数で投稿を選んでから、そのコメントを取得できます。投稿のurlはそのままreddit/commentsに渡せます。後述のPythonの例では、この方法で呼び出しをつないでいます。メディアファイル、コメントツリー、ユーザープロフィールが必要なら、Apifyのフィールド数が多いスクレイパーのほうが適しています。行単位の料金で得られるのはその点です。
課金に影響する点がもう1つあります。Liteはデフォルトで、実行時間の上限3,600秒、メモリ2,048 MBで動作します(Liteの公開メタデータのdefaultRunOptionsフィールド)。メモリを増やすほど開始料金が上がります。Usage and resourcesによると、メモリは実行に割り当てられるCPUの量も決めます。
メモリを減らせば開始料金は抑えられますが、実行は遅くなり、時間制限に達しやすくなります。当社側でメモリや時間制限を調整する項目はありません。1リクエストあたりの料金は固定で、最も遅かった41秒の呼び出しでも費用は$0.000556でした。
頻繁に変わるApifyの料金
調査した15個のRedditアクターの公開メタデータでは、すべての料金期間にstartedAtの日付が付いています。Apify公式のReddit Scraperには2026-09-25から2026-10-20までに8つの料金期間があり、そのうち4つは2026年10月1日だけで開始されています。現在の料金期間は2026-10-20に始まり、ページの最終更新は2026-10-27です。maximedupreのコメント検索スクレイパーでは、現在の料金が2026-10-18から適用されています。automation-labは2026-11-17からのコメント料金の値上げを告知しています。旧trudax Reddit Scraperはイベント課金に移行し、2026-09-21に非推奨となりました。
一方、Liteの現在の料金は2026年6月30日から変わっていません。つまり、この記事を含め、どの料金比較も1〜2か月で古くなる可能性があります。購入前にGet ActorエンドポイントでpricingInfosを改めて確認し、確認した日時を記録しておいてください。
| Actor | 現行料金の適用開始日 | 変更内容 |
|---|---|---|
| apify/reddit-scraper | 2026-10-20 | 8回目の料金期間(2026-09-25から) |
| maximedupre/reddit-comments-search-scraper | 2026-10-18 | Freeプランでコメント1件あたり$0.00265 |
| automation-lab/reddit-scraper | 2026-08-25、次回は2026-11-17 | コメント料金が30%上昇 |
| trudax/reddit-scraper | 2026-09-21 | イベント単位課金に移行後、非推奨 |
| trudax/reddit-scraper-lite | 2026-06-30 | 以降変更なし |
全エンドポイントの一覧はAPIリファレンスにあります。イベント単位課金のルールについては、イベント単位課金のドキュメントをご覧ください。
コードとAIクライアントからの利用
このPythonコードでは、当社のコメントテストで使用したのと同じ方法を使います。投稿URLのセットを受け取り、各URLについてreddit/commentsを1回ずつ呼び出します。コメントのidで重複を除き、各呼び出しのcharged_usdを合計します。また、取得率を確認するため、投稿ごとに投稿のコメント数と取得した行数の2つの数値を保存します。idがtarget-status:で始まる行は、失敗に関するセクションで説明している理由によりスキップします。
import os, requests

API = "https://api.everyinfra.com/api/v1/social"
HEADERS = {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}

def call(action, **params):
    r = requests.post(API, headers=HEADERS, timeout=120,
                      json={"platform": "reddit", "action": action, "params": params})
    r.raise_for_status()
    body = r.json()
    rows = [x for x in body["results"] if not str(x.get("id", "")).startswith("target-status:")]
    return rows, body["billing"]["charged_usd"]

posts, spent = call("subreddit_posts", subreddit="Python", sort="top", date_range="past_year", limit=100)
seen, coverage = {}, []
for p in posts[:13]:
    rows, cost = call("comments", url=p["url"], limit=100)
    spent += cost
    seen.update({c["id"]: c for c in rows})
    coverage.append((p["url"], p["comment_count"], len(rows)))

print(len(seen), "unique comments, spent", round(spent, 6), "USD")
for url, listed, got in coverage:
print(f"{got}/{listed}", url)AIクライアントでは、当社のリモートMCPサーバーhttps://api.everyinfra.com/mcpに接続します。ツール名はeveryinfra_で始まり、投稿を先に検索するか、コメントを直接取得するかはモデルが判断できます。以下は一般的な設定例です。Claude CodeやCursorなど、リモートMCPに対応するクライアントでも同様の形式を使用します。
正確な構文はClaude CodeのMCPドキュメントとCursorのMCPドキュメントを参照してください。OpenAIにも独自のMCPドキュメントがあります。プロトコル自体はMCP仕様に記載されています。
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}Apifyにも、Storeのアクターをツールとしてモデルに公開する独自のMCPサーバーがあります(Apify MCPドキュメント、ソースはGitHub)。コードから使う場合はPythonクライアントがあります。違いはデータの返し方です。ApifyのMCPでは、モデルがアクターの実行を開始し、完了を待ってからデータセットを読み取ります。
これは数万行単位のエクスポートに向いています。当社のMCPは1回の呼び出しで1ページ分のデータを返すため、チャットで質問を1つずつ扱う用途に向いています。設定方法と対応クライアントはMCPサーバーのページをご覧ください。
月額料金の試算:よくある3つのジョブを30日間実行した場合
毎日、自社の製品カテゴリについてRedditで何が語られているかを把握したいプロダクトチームを例にします。以下の3つのジョブの試算には、実測した1回の呼び出しあたりの行数を使っています。当社側の費用は、呼び出し回数×$0.000556(ユーザーコメントの場合は×$0.032403)です。Apify側では、各アクターのFreeプランの定価を使い、ジョブを実行するたびにデフォルトの開始料金を1回分加えています。
| 30日間のジョブ | 呼び出し回数と行数 | EveryInfra | Reddit Scraper Lite | Apifyで人気の安価なスクレイパー |
|---|---|---|---|---|
| 1日10件の活発なスレッドからコメントを取得、1スレッドあたり100件 | 300回の呼び出し、30,000件 | $0.17 | $121.20 | automation-lab:$17.69(11月17日以降は$22.94)。harshmaurのコメントスクレイパー:$45.60 |
| 1日あたり、5つのサブレディットから最新投稿をそれぞれ100件取得 | 150回の呼び出し、15,000件 | $0.08 | $61.20 | automation-lab:$17.34。clearpathのサブレディットスクレイパー:$30.02 |
| 週200ユーザーのコメント履歴(各100件) | 800回の呼び出し、80,000件 | $25.92 | $320.16 | harshmaurのユーザースクレイパー:$120.08。clearpathのユーザーコンテンツスクレイパー:$160.00 |
これらの試算は3つの前提に基づいています。1つ目は、すべての呼び出しで1ページ分(上限件数)のデータが返ることです。当社のテストでは、コメントが100件を超える投稿はすべて100件を返しました。ただし、コメントの少ない投稿ではそれより少なく、limitを200にしたユーザーコメントの呼び出しも100件しか返しませんでした。
当社が返す件数が少なくなると、合計額は変わらず、単価が上がります。第2に、Liteの行はコメント取得をオフにする設定(skipComments)を前提にしています。コメント取得をオンにすると、投稿の件数は数倍に増えます。第3に、どのジョブでも日をまたいだ重複は除去していません。
翌日に同じ活発なスレッドを取得すると、コメントの大半はすでに取得済みのもので、どちらの側でも重複分に料金がかかります。Apifyでは時間フィルターで重複を減らせます。当社側では、idを使ってご自身で重複を除く必要があります。
それでも、当社ではユーザーコメントの呼び出しに1回あたり$0.032403かかります。200ユーザーの大半にコメントが十数件しかない場合でも、当社側の合計額は変わりません。Apifyでは行単位で計算される合計額が数ドルまで下がるため、Apifyのほうがお得です。
Reddit公式APIの現状:10月31日以降、新規アクセス申請は受付停止
料金比較には、Reddit自身のData APIも欠かせません。Reddit Data API Wikiによると、対象ユーザーにはOAuthクライアントごとに毎分100リクエストが許可され、10分間の平均で計算されます。OAuthを使わないトラフィックはブロックされます。投稿やコメントが削除された場合は、手元のコピーも削除する必要があり、Redditは少なくとも48時間ごとのクリーンアップを推奨しています。
無料利用以外については、Data API Termsの3.1項に明記されています。Redditは、将来の利用に対して自社が決める料金で課金する権利を留保しています。商用利用、レート制限を超える研究目的の利用、規約で許可されていない利用には、別途契約が必要です。この規約は2023年6月19日に発効し、最終改訂は2026年7月20日です。
| Reddit公式ページのルール | 記載内容 |
|---|---|
| 無料枠のレート制限 | OAuthクライアントごとに毎分100リクエスト(10分間の平均) |
| OAuthを使わないトラフィック | ブロック |
| 削除されたコンテンツ | 保存したコピーを削除(少なくとも48時間ごとにクリーンアップ) |
| 商用利用 | 別途契約が必要(料金はRedditが設定) |
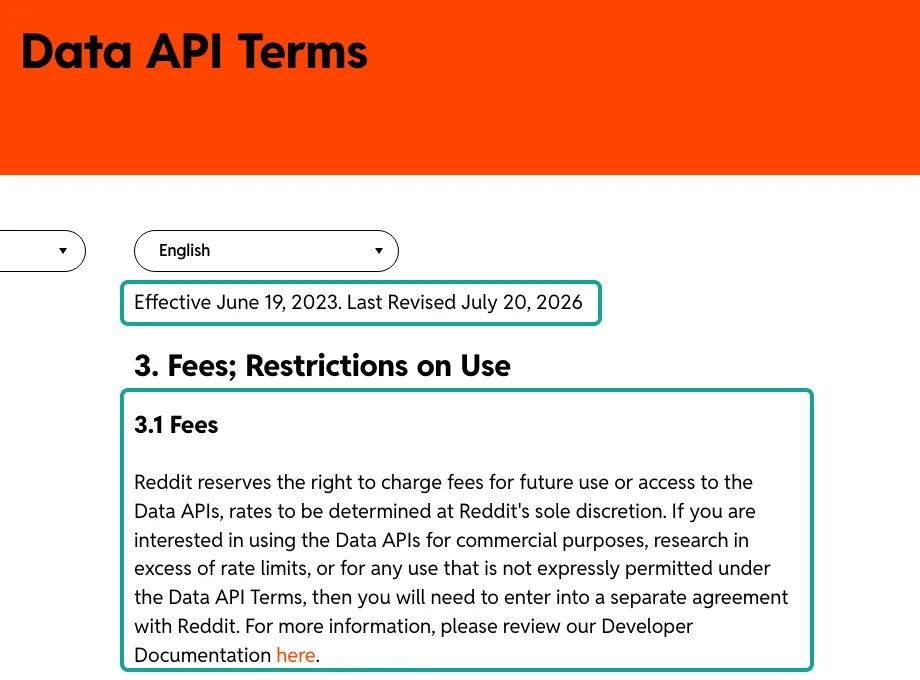
Redditの現在の公開ページには、商用利用の料金は記載されていません。Developer Platform & Accessing Reddit Dataには、より多くのアクセスを必要とする一部の開発者は料金の支払いが必要になる場合がある、とだけ書かれています。このページには商用利用の例が挙げられており、広告やペイウォールのあるアプリ、有料で販売されるサービスやデータアクセス、サブスクリプションサービスなどが含まれます。Redditのデータでトレーニングしたモデルの販売もこのリストに含まれています。
よく見かける「1,000リクエストあたり$0.24」という数字は、2023年に由来します。Redditは2023年5月31日、r/redditdevで7月1日から無料枠のレート制限を適用すると発表しました(投稿)。同じ日、Apolloクライアントの開発者は、Redditから50百万リクエストあたり$12,000の見積もりを提示されたと明かしました(投稿)。これは1,000リクエストあたり$0.24に相当します。
これは1人の開発者の報告で、Redditの料金表ではありません。この価格で一覧リクエスト1回あたり100件なら、投稿1,000件は約$0.0024となり、どのサードパーティよりも安くなります。ただし、その契約を結べればの話です。
その道は閉ざされつつあります。2026年8月、Redditはr/redditdevで公開Data APIの今後の計画を初めて説明しました(投稿)。2026年9月30日には、提供終了のスケジュールを公開しました(投稿)。
| 日付 | Redditの投稿の内容 | データ収集への影響 |
|---|---|---|
| 2026-10-31 | 公開APIへの新規アクセス申請の受付を終了 | 今から始めるプロジェクトはアクセスを取得できない |
| 2026-11-10 | 移行の進捗報告と期限のリマインド | 延長や例外がないか確認 |
| 2026-11-13 | RSSの提供終了(r/modnewsの投稿、代替手段はReddit RSS終了後の対応を参照) | RSSによるサブレディットの監視が機能しなくなる |
| 2026-11-30 | 移行報奨金の締め切り | Devvitに移行するアプリのみ対象 |
| 2027-01-12 | 未登録、またはRedditに未回答のアプリとユーザーについて、アクセス停止が始まる | この頃に古いスクリプトが停止する可能性がある |
| 2027-03 | 残っているすべての公開アクセスが終了(正確な日付は未発表) | 書面契約のあるパートナーとDevvitのみ |
Redditが提供する代替手段は、自社の開発者プラットフォームであるDevvitです。移行ガイドによると、主にモデレーションツールやコミュニティアプリ向けです。移行プログラムに参加したアプリは移行後に$1,000を受け取ることができ、プログラムの期間は2026年3月31日から12月31日までです。データをエクスポートして別の場所で分析するためのAPIではありません。DevvitアプリはApp registrationから登録します。外部へのリクエストはHTTP Fetchのルールに従い、詳しいガイドはDevvitのドキュメントにあります。
研究者向けには、Responsible Builder Policyで、Reddit for Researchersプログラム外で収集したデータを使った研究はポリシー違反になると定められています。書面による承認がない限り、データの販売やライセンス供与、モデルのトレーニングへの利用はできません。
10月29日、RedditのCEOであるSteve Huffman氏は自身のプロフィールで、Redditを「ログイン優先」の体験に移行すると投稿しました。まず米国以外の一部の市場でテストを行います。理由の1つとして、無許可のデータ収集の大半がログアウト状態のページで行われていることを挙げています(投稿)。同日のAxiosの報道によると、ホームページはログアウト状態の訪問者にも引き続き公開されます。検索エンジンや外部リンクから到達した投稿も引き続き公開されますが、具体的な制限はテスト中に決定されます。
ログインウォールは、ログインせずにページを読み取るすべてのツールにとってリスクです。Apify Storeのスクレイパーも、私たちも例外ではありません。Redditの変更後もすべてのエンドポイントが動作し続けるとはお約束できません。
できることは3つあります。第1に、失敗したリクエストは課金されないため、Redditに呼び出しをブロックされても料金はかかりません。第2に、エンドポイントが動かなくなると、無料カタログではavailableがfalseになり、「一時的に利用不可」と表示されます。大量のバッチを実行する前にカタログを確認してください。第3に、長期的に必要なデータは手元に保存し、後で1つのツールで再取得することに頼らないでください。
データを収集してよいか、またそのデータで何をしてよいかは、管轄地域、用途、Redditの規約によって異なります。この記事は法的助言ではありません。具体的なプロジェクトについては弁護士にご相談ください。
Apifyのほうが適しているケース
テスト全体から、EveryInfraではなくApify Storeのスクレイパーを勧めるジョブが6つあります。第1に、1か月以上前のトピックに関する投稿です。当社のreddit/searchは直近1か月のみが対象ですが、Liteのtimeはallに設定できます。第2に、1つのsubredditから1,000件を超える投稿を集める場合です。当社が返すのは並び順ごとに最初の100件だけで、r/Pythonで8つの組み合わせを試した結果は286件でした。ページネーションできるスクレイパーなら、並び順ごとに1,000件近く取得できます。
3つ目は、活発なスレッドのすべてのコメント、またはコメントツリー全体です。私たちは1投稿あたり100件が上限で親IDもありませんが、clearpathはすべてを展開し、Liteとautomation-labはparentIdとdepthを含みます。4つ目は、ユーザープロフィールです。私たちはカルマやアカウント作成後の経過期間を提供していませんが、harshmaurのユーザースクレイパーなら1回の実行で取得できます。5つ目は、少数のユーザーを対象とする場合です。1回の呼び出しで取得するコメントが22件未満なら、reddit/user_commentsはharshmaurのユーザースクレイパーより高くなります。6つ目は、すでにApifyのスケジュール、データセット、インテグレーションを利用しているチームです。乗り換えるとスケジューラーやストレージを自前で構築する必要があり、削減できるコストではその手間を賄えない可能性があります。
逆に、大量のデータを頻繁にページ単位で取得する場合は、私たちの料金のほうが2〜3桁低くなります。たとえば、1日に数百件の投稿からコメントを取得する場合や、1日に数十のコミュニティから新着投稿を取得する場合です。チャット内のAIクライアントによるReddit検索も該当します。reddit/trending_postsもあります。サイト全体のトレンド投稿を1ページ25件で返し、page_tokenを使ってページネーションでき、料金は1ページあたり$0.000556です。
ページネーションのないサブレディット一覧で生じるギャップの一部を埋められます。ただし、これはサイト全体のトレンド投稿であり、特定のコミュニティの履歴ではありません。両方の課金モデルの落とし穴については、Apifyの料金の仕組みとApifyの代替サービスで解説しています。返金の照合については失敗時の返金の照合をご覧ください。
最近の変化
- 2026-11-17:automation-labのRedditスクレイパーが、Freeプランのコメント単価を$0.000575から$0.00075に30%値上げします(automation-labのStoreページ)。影響:この記事のコメント1,000件あたり$0.59は$0.76になります。
- 2026-10-29:RedditのCEOによるログインウォールに関する投稿(投稿)。影響:一部の市場で、まずログアウト状態でのアクセスが制限されます。ログインせずにページを読み取るすべてのツールが影響を受ける可能性があり、Apifyのスクレイパーも私たちのツールも同様です。
- 2026-10-20:Apify公式のReddit Scraperの現行価格が適用されました。この1か月で8つ目の価格適用期間です(Storeページ)。影響:記事を読む当日のメタデータを使用してください。
- 2026-10-18:maximedupreのコメント検索スクレイパーで現行価格が適用され、Freeプランで1件あたり$0.00265になりました。影響:コメント検索スクレイパーの中では、$0.0015のharshmaurより77%高くなります。
- 2026-10-16と2026-10-06:clearpathのコメントスクレイパーで2回のアップデートがあり、完全に展開したスレッド内の深い返信の
depthが修正されました(clearpathのStoreページ)。影響:depthからツリーを再構築する場合は、これらのアップデート以降のバージョンを使用してください。 - 2026-09-21:trudaxのReddit Scraperはイベントごとの従量課金に移行し、新規ユーザー向けには非掲載となりました。影響:古いチュートリアルにある「月額$45、制限なし」のプランは廃止されました。
利用開始:1回のトライアルリクエストから日次ジョブまで
本記事の48回の呼び出し(ユーザーコメントの呼び出しを除く)にかかった費用は、合計約$0.024です。新規登録して、まず小規模なテストを実行してから、大量に使うかどうかを判断してください。APIキーはクイックスタートで取得できます。すべてのエンドポイントはRedditスクレイピングAPIページに掲載しています。Redditの検索、サブレディットの投稿、Redditのコメントのプレイグラウンドを、それぞれ一度実行してみてください。
投稿の詳細やユーザーデータについては、投稿の詳細、ユーザーの投稿、ユーザーのコメントを参照してください。製品に関する不満をすばやく確認するにはRedditのペインポイントを、サイト全体のトレンド投稿にはトレンド投稿を使います。同じ方法はTwitterスクレイピングAPIやTikTokスクレイピングAPIでも使えます。すべてのエンドポイントと料金はデータマーケットと料金のページに、ツールの比較は代替ツールのページにまとめています。
Apifyとの「1,000件あたりのコスト」を実測で比較したその他の記事:Apify Twitter Scraperの代替、Apify TikTok Scraperの代替、Apify Amazon Scraperの代替。
FAQ
ApifyのRedditスクレイパーは無料ですか?
ApifyのFreeプランでは、毎月$5分の前払いクレジットが付与されます(料金ページ)。Liteは1件あたり$0.004に加えて1回の実行ごとに$0.04かかるため、約1,200件分になります。Storeには無料のReddit Actorも29個ありますが、直近30日間のユーザー数が100人を超えていたのは1つだけでした。trudaxの月額レンタル型Reddit Scraperは非推奨となっており、新規ユーザーは開始できません。Reddit自体のAPIは、対象となる非商用利用であれば、OAuthクライアントあたり毎分100リクエストまで無料です。ただし、2026年10月31日に新規申請の受付を停止しました(Data API Wiki)。
「Apify Reddit scraper pro」とはどれのことで、Liteより優れていますか?
名前に「pro」を含むRedditスクレイパーのうち、過去30日間の利用者が最も多いのはharshmaurのreddit-scraper-proです。タイトルにはリード獲得、ブランドモニタリング、アラートが掲げられています。Freeプランで1件あたり$0.0015、30日間の利用者は435人でした。実行の98.7%が成功しています(公開Store一覧、2026年11月4日に確認)。Liteより60%以上安く、タイムアウトもはるかに少なくなっています。
Liteはユーザー数が最も多く、READMEが最も充実しており、コメントにparentIdが含まれます。どちらが「優れている」かは、コメントツリーが必要かどうかで決まります。必要な場合は、clearpathのコメントスクレイパーが両者よりも網羅的です。
ApifyのRedditコメントスクレイパーで、投稿のすべてのコメントを取得できますか?
はい。適切なActorを選び、正しく設定すれば可能です。clearpathのコメントスクレイパーでmaxCommentsPerPostを0に設定し、完全展開を有効にすると、「continue this thread」の先にある深い階層の返信を含むツリー全体が返されます。LiteではmaxCommentsで上限を設定します。Reddit自体のツリーには、仕様上、未展開のmoreスロットが含まれます(RedditのJSONに関する資料)。
PRAWでスクレイピングする場合は、replace_moreも必要です。当社のreddit/commentsは1投稿あたり最大100件を返し、2階層目と3階層目の返信は含みますが、親IDはありません。ツリー全体が必要なジョブには向いていません。
RedditスクレイピングAPIの費用はどのくらいで、どれが安いですか?
Reddit自体のAPIを商用利用するには別途契約が必要で、現在の公開ページには価格が記載されていません(Developer Platform & Accessing Reddit Data)。よく引用される「1,000リクエストあたり$0.24」は、ある開発者による2023年の報告です。サードパーティでは、Apify Storeで人気のRedditスクレイパーは1,000件あたり$0.99〜$4.00で、中央値は約$2.00です。EveryInfraはリクエストごとに課金され、本記事では投稿1,000件あたり$0.011〜$0.029、コメント1,000件あたり$0.0073でした。OAuthフローとエンドポイント一覧については、RedditのOAuth2に関する資料とAPIドキュメントを参照してください。
APIを使わずにRedditをスクレイピングするのは合法ですか?
管轄地域、利用目的、そしてRedditのユーザー契約、開発者規約、公開コンテンツポリシーによって異なります。RedditのResponsible Builder Policyでは、Reddit for Researchersプログラム外で収集したデータを用いた研究はポリシー違反とされています。書面による承認がない限り、データの販売やライセンス供与、データを使ったモデルの学習はできません。本記事は法的助言ではありません。商用製品を構築する前や、データを使ってモデルを学習させる前に、弁護士に相談してください。
GitHubにRedditスクレイパーはありますか?また、APIサービスと比べてどうですか?
あります。Redditの初期のサイトコードとAPIに関する資料はreddit-archive/redditにアーカイブされていますが、現在は更新されていません。最も一般的な既製ツールは、PythonライブラリのPRAWです。RedditのOAuth APIを使用し、無料で、取得できるフィールドも最も多くなっています。ただし、毎分100リクエストに制限されており、2026年10月31日以降、新しいOAuthクライアントはアクセスを取得できません。
自作のスクレイパーでは、ログインウォール、レート制限、ブロックに対処する必要があります。Apifyや当社のようなサービスを使えば、費用を払ってその手間を省けます。どのツールを選ぶ場合も、まず1,000件あたりのコストと実行開始時の料金を算出してください。
参考文献
- Apify / trudax:Reddit Scraper Lite(Storeページ)、2026年11月4日確認
- Apify API:trudax~reddit-scraper-liteの公開メタデータ(pricingInfos、stats)、2026年11月4日確認
- [Apify / trudax:Reddit Scraper [DEPRECATED](Storeページ)、2026年11月4日確認](https://apify.com/trudax/reddit-scraper)
- Apify API:trudax~reddit-scraperの公開メタデータ(2026年9月21日の料金に関する告知を含む)、2026年11月4日確認
- Apify / harshmaur:Reddit Scraper(Storeページ)、2026年11月4日確認
- Apify / automation-lab:Reddit Scraper(Storeページ、2026年11月17日の価格変更を含む)、2026年11月4日確認
- Apify / clearpath:Reddit Post Comments Scraper(Storeページ、2026年10月6日および10月16日の更新を含む)、2026年11月4日確認
- Apify / fatihtahta:Reddit Scraper Enterprise Grade(Storeページ)、2026年11月4日確認
- Apify / harshmaur:Reddit Comment Scraper(Storeページ)、2026年11月4日確認
- Apify / harshmaur:Reddit User Scraper(Storeページ)、2026年11月4日確認
- Apify / clearpath:Reddit User Posts & Comments Scraper(Storeページ)、2026年11月4日閲覧
- Apify / clearpath:Reddit Search Scraper(Storeページ)、2026年11月4日閲覧
- Apify:Reddit Scraper: Posts, Comments, and Users(Apify自身のStoreページ)、2026年11月4日閲覧
- Apify:料金ページ(プラン、コンピュートユニット、Store割引ティア)、2026年11月4日閲覧
- Apifyドキュメント:Pay-per-event料金モデル
- Apifyドキュメント:Actorの料金とコスト(FREE〜DIAMONDティア)
- Apifyドキュメント:StoreのActor(料金モデル、under-maintenanceラベル、Store割引)
- Apify APIドキュメント:Get Actor
- Apify APIドキュメント:Get list of Actors in Store
- Apifyドキュメント:使用量とリソース(メモリとコンピュートユニット)
- Apifyドキュメント:実行とビルド(実行ステータス、タイムアウト)
- Apifyドキュメント:自動テスト(失敗したActorにはメンテナンスラベルが付与される)
- Apifyドキュメント:Dataset
- Apifyドキュメント:Apify MCPサーバー
- GitHub: apify/apify-mcp-server
- GitHub: apify/apify-client-python
- Reddit: Data API Terms(2023年6月19日発効、2026年7月20日改定)、2026年11月4日閲覧
- Reddit: Developer Terms
- Reddit: User Agreement
- Reddit Help: Reddit Data API Wiki(無料枠、100 QPM)
- Reddit Help: Responsible Builder Policy
- Reddit Help: Developer Platform & Accessing Reddit Data(商用利用と料金)
- Reddit Help: Public Content Policy
- Reddit Help: App Migration Program 2026 Terms
- Reddit Developer Platform: Migrating apps from the Data API to Devvit
- Reddit Developer Platform: App registration
- Reddit Developer Platform: HTTP Fetch
- r/redditdev:Data APIアプリのDeveloper Platformへの移行:移行日程と今後の手順(2026年9月30日)
- r/modnews:インフラ更新の続報:今後数か月の変更点(2026年9月30日、RSS提供終了)
- r/redditdev: Our Plans for the Future of Reddit's Public Data API(2026年8月)
- r/redditdev: API Update: Enterprise Level Tier for Large Scale Applications(2023年5月31日)
- r/apolloapp: Had a call with Reddit to discuss pricing(2023年5月31日、開発者による見積もりの報告)
- u/spez: About that login screen(2026年10月29日)
- Axios:AIが検索を侵食する中、Redditはログイン前提の体験へ移行(2026年10月29日)
- GitHub: reddit-archive/reddit(Redditのアーカイブ済みオープンソースコードとWiki)
- Reddit Developer Platform: Devvit docs
- Apify APIドキュメント:API v2リファレンス
- GitHub: reddit-archive/reddit wiki, JSON(moreオブジェクト)
- GitHub: reddit-archive/reddit wiki, OAuth2
- GitHub: praw-dev/praw
- PRAW docs: Comment Extraction and Parsing
- Reddit: API documentation (/dev/api)
- Gaffney and Matias: Caveat Emptor, Computational Social Science: Large-Scale Missing Data in a Widely-Published Reddit Corpus(arXiv、2018年)
- Model Context Protocol: Specification 2025-06-18
- Claude Code docs: Connect Claude Code to tools via MCP
- OpenAI docs: Connectors and MCP servers
- Cursor docs: Model Context Protocol
- EveryInfra:データAPIカタログ(無料、price_usd・max_limit)、2026年11月4日閲覧
参考資料 BL-84