Альтернатива Apify Reddit Scraper: сколько на самом деле стоят 1 000 постов и комментариев
Reddit Scraper Lite на Apify стоит $4.04 за 1 000 комментариев. Наш замер: $0.0073 за плоский список без id родительских комментариев. Если нужны полные деревья, используйте Apify.
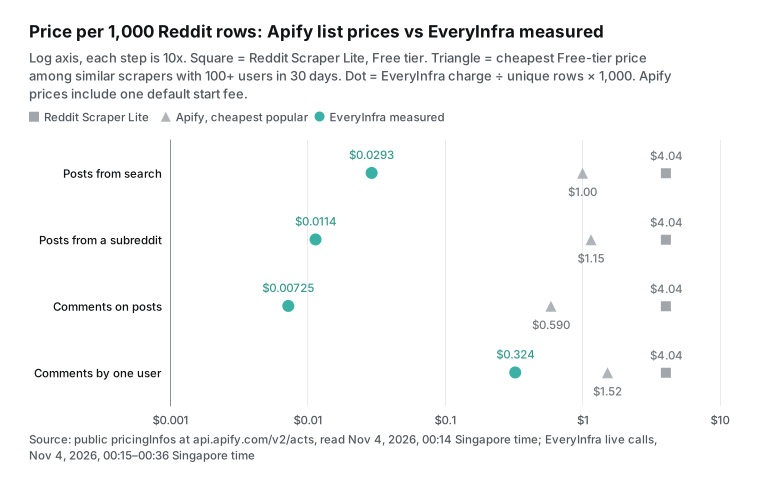
Reddit Scraper Lite — самый популярный по числу пользователей парсер Reddit в Apify Store. По публичной цене тарифа Free 1 000 комментариев Reddit обходятся в $4.04: $0.004 за результат плюс $0.04 за запуск. Самая дешёвая популярная альтернатива в Store, automation-lab, стоит около $0.59 за ту же задачу. 4 ноября 2026 г. мы вызвали эндпоинт EveryInfra reddit/comments для 13 постов.
Каждый вызов стоил $0.000556. Мы получили 997 уникальных комментариев в сумме за $0.007228, то есть $0.00725 за 1 000. Это в 557 раз дешевле, чем Lite, и в 81 раз дешевле, чем automation-lab. Для постов поиск по ключевым словам обошёлся в $0.0293 за 1 000, а списки сабреддитов — в $0.0114 за 1 000.
Есть и три задачи, для которых Apify подходит лучше, и в статье мы отмечаем это в каждом тесте. Во-первых, мы возвращаем не более 100 комментариев на пост, поэтому из ветки с 771 комментарием мы получили только 13%. Во-вторых, в наших записях комментариев есть ответы второго и третьего уровня, но без id родительского комментария, так что восстановить дерево нельзя. В-третьих, восемь вариантов сортировки одного сабреддита дали нам только 286 уникальных постов, а не 1 000.
Ниже мы по очереди тестируем четыре вида данных Reddit. Также разбираем устаревший «Reddit Scraper» в Apify и разброс цен 746 парсеров Reddit в Store. В конце рассказываем, в какие сроки закрывается публичный API данных Reddit.
Как читать цифры в этой статье
В этой статье «стоимость за 1,000» — это фактически списанная сумма, делённая на число реально полученных уникальных записей и умноженная на 1 000. Она отвечает на один вопрос: сколько вам будут стоить 1 000 постов или комментариев Reddit? EveryInfra берёт оплату за каждый запрос, а один запрос возвращает одну страницу. Поиск возвращает до 25 записей, списки сабреддитов и комментарии — до 100. Посты пользователя — до 50 (см. max_limit в бесплатном каталоге).
Почти все парсеры Reddit в Apify Store, наоборот, берут оплату за результат, то есть за каждую запись, сохранённую в датасет. Сравнить две модели можно, только приведя обе к одной единице.
С нашей стороны делитель всегда равен числу записей после удаления дублей по id. Мы никогда не делим на запрошенный limit. Поэтому вызовы, вернувшие мало записей или много дублей, могут лишь повысить рассчитанную стоимость за 1000 записей. Со стороны Apify мы использовали только публичные материалы.
Это страницы Store, страница тарифов, документация и публичный эндпоинт метаданных Actor, которому не нужен аккаунт (Get Actor API docs). Actor в Apify означает облачную программу для парсинга. Мы не регистрировались в Apify и не запускали ни одного Actor. Все цифры Apify в этой статье взяты из публичного прайс-листа, а не из измеренных счетов.
Сравнение парсера Reddit от Apify и EveryInfra: сводная таблица
Эта таблица подводит итог всей статьи. В каждой строке две цены Apify. Первая относится к Reddit Scraper Lite, парсеру Reddit с наибольшим числом пользователей. Вторая показывает самую низкую цену тарифа Free среди парсеров, которые решают ту же задачу и которыми за последние 30 дней пользовались не менее 100 человек.
Цены мы взяли из поля pricingInfos в публичных метаданных Apify в 00:15 по сингапурскому времени 4 ноября 2026 г. Все цены Apify рассчитаны для одного запуска на тарифе Free, который возвращает 1 000 записей, плюс стандартная плата за запуск. Все цифры EveryInfra получены из наших собственных реальных вызовов. Списанная сумма — это billing.charged_usd из ответа, записи — results, дедупликация выполнена по id.
| Данные | Эндпоинт EveryInfra | Замер: вызовы / записи / уникальные записи / списанная сумма | EveryInfra за 1 000 (уникальные) | Reddit Scraper Lite (Free) | Соотношение | Самый дешёвый популярный парсер на Apify (Free) | Соотношение |
|---|---|---|---|---|---|---|---|
| Посты из поиска по ключевому слову | reddit/search | 10 / 195 / 190 / $0.00556 | $0.0293 | $4.04 | 138x | clearpath Search $1,00 | 34x |
| Посты из одного сабреддита | reddit/subreddit_posts | 10 / 837 / 486 / $0.00556 | $0.0114 | $4.04 | 353x | automation-lab $1,15 | 101x |
| Комментарии к постам | reddit/comments | 13 / 997 / 997 / $0.007228 | $0.00725 | $4.04 | 557x | automation-lab $0,59 | 81x |
| Комментарии одного пользователя | reddit/user_comments | 1 / 100 / 100 / $0.032403 | $0.324 | $4.04 | 12.5x | harshmaur User $1,52 | 4.7x |
Каждое соотношение равно цене Apify, делённой на нашу. При чтении таблицы учитывайте четыре момента. Во-первых, большая часть разницы объясняется принципом «один запрос, одна страница». Вызов комментариев возвращает до 100 записей, и на полной странице фиксированная цена распределяется на много записей. Когда вызов возвращает одну-две записи, картина переворачивается; расчёт приведён ниже в разделе о точке безубыточности.
Во-вторых, цена комментариев automation-lab в $0,59 складывается из $0,000575 за комментарий, платы за запуск $0,003 и 10 записей постов по $0,00115. На странице в Store указано, что 17 ноября цена комментария на тарифе Free вырастет до $0,00075. По тому же расчёту это даёт $0,76 (страница automation-lab в Store).
В-третьих, по обоим видам записей постов мы дешевле, но набрать 1 000 постов удаётся не всегда. Поиск охватывает только последний месяц, а у списков сабреддитов нет пагинации. В следующих разделах показано, сколько постов мы получили на самом деле. В-четвёртых, Apify меняет цены каждые один-два месяца; даты перечислены в разделе «Что изменилось недавно».
Как мы тестировали и что считали успешным результатом
Критерии успеха и провала мы сформулировали до первого вызова. Для каждого из четырёх типов данных требовалось не менее двух реальных вызовов в три и более разных момента времени. Стоимость за 1 000 всегда считалась по уникальным записям. Чтобы оценить охват дерева комментариев, мы построчно сверили наши записи с независимым прочтением как минимум двух страниц постов.
Мы не судили о полноте по одному лишь списку полей. Если Apify оказывался дешевле, давал более полные данные или лучше подходил для какой-либо задачи, это нужно было указать в тексте и сводной таблице. По меньшей мере два вызова должны были вернуть пустой результат; для каждого мы должны были записать стоимость. reddit/user_comments мы могли вызвать не более одного раза, а reddit/painpoint не вызывали.
Все запросы шли на POST https://api.everyinfra.com/api/v1/social. Первый запрос ушёл в 00:15 по сингапурскому времени 4 ноября 2026 года. Серия запросов комментариев выполнялась с 00:26 до 00:32 по сингапурскому времени, а последний вызов завершился в 00:36. Для каждого вызова мы записывали время отправки, HTTP-статус, длительность, число записей и charged_usd. Затем скрипт заново рассчитал все показатели по необработанным ответам. Все цифры в тексте, таблицах и диаграммах рассчитаны этим скриптом.
| Задача | Эндпоинт и параметры | Реальные вызовы | Время (по Сингапуру, 4 ноября) | Что проверяли |
|---|---|---|---|---|
| Поиск по ключевому слову | reddit/search, параметр limit: 25. Семь ключевых слов, а также сортировки newest, top и popular для «standing desk» | 10 | 00:15–00:19 | Записей на вызов, влияние сортировки, диапазон дат |
| Посты сабреддита | reddit/subreddit_posts. Восемь комбинаций сортировки и периода для r/Python, две для r/smallbusiness, параметр limit: 100 | 10 | 00:20–00:24 | Новые посты от каждой дополнительной сортировки, потолок для одного сообщества |
| Комментарии | reddit/comments. 13 постов с числом комментариев от 16 до 771, параметр limit: 100 | 13 | 00:26–00:32 | Число записей на пост, доля от счётчика комментариев в посте, вложенные ответы |
| Пользователи | reddit/user_posts вызывали семь раз для трёх аккаунтов, а reddit/user_comments — один раз | 8 | 00:24–00:35 | Насколько далеко в прошлое доступны данные и что возвращает один дорогой вызов |
| Данные поста | reddit/post_detail для двух постов | 2 | 00:33 | Совпадает ли счётчик со значением в списке? |
| Нет данных | Нет ключа, неверное значение сортировки, лишний параметр, несуществующий сабреддит, несуществующий пост, несуществующий пользователь | 6 | 00:25–00:36 | В каких случаях списываются средства |
Для статьи понадобилось 49 реальных вызовов, всего списано $0,056311. Все вызовы шли с одного тестового ключа с лимитом 10 вызовов в минуту. Во время прогона мы несколько раз получили HTTP 429 (слишком много запросов). Скрипт ждал 60 секунд и отправлял вызов повторно. Ответ 429 не оплачивается и не входит в итоги выше.
Тест 1: самая типичная задача для парсера Reddit в Apify, 1 000 постов из поиска по ключевому слову
reddit/search возвращает до 25 записей за вызов. Период поиска фиксирован: последний месяц. В примечании каталога к параметру sort сказано, что период остаётся месячным при любой сортировке. Мы по одному разу искали семь разных ключевых слов: standing desk, notion alternative, claude code, best vpn, airpods pro 3, home espresso machine и sourdough starter.
Вызовы вернули 25, 17, 25, 25, 25, 24 и 25 записей, в среднем 23.7. Все посты датированы периодом с 3 октября по 3 ноября 2026 года, что соответствует диапазону в один месяц. Семь вызовов обошлись в $0.003892, и среди 166 записей не оказалось ни одного дубликата. Это $0.0234 за 1 000.
Сортировка сильно влияла на количество. По одному и тому же ключевому слову standing desk сортировка по релевантности (по умолчанию) вернула 25 записей, а popular вернула 22. Но top вернула только 4, а newest только 3, все три от 3 ноября. Каталог объясняет почему: поиск возвращает только посты, совпадающие с ключевым словом, поэтому записей может быть меньше лимита.
За вызов без единой записи средства возвращаются как за пустой результат. Вызов с тремя записями списывается по обычной цене $0.000556. С учётом этих трёх вызовов с сортировкой 10 вызовов вернули 195 записей, из них 190 уникальных, за $0.00556. Это $0.0293 за 1 000, и в сводной таблице используется именно эта, более осторожная цифра.
Чтобы собрать 1 000 постов при 23.7 на вызов, нужно около 42 поисковых запросов. То есть 42 разных ключевых слова или их сочетания, примерно за $0.0234. Если вас интересуют одно-два ключевых слова, до 1 000 вы не дойдёте. По одному ключевому слову за месяц находится ограниченное число постов, а глубже наш поиск не заглядывает.
Здесь Apify устроен иначе. Параметр time в Lite принимает значения all, year, month и другие (страница в Store, «Advanced parameters»). Парсер поиска clearpath поддерживает пять вариантов сортировки и фильтры по времени. Он стоит $0.00099 за результат плюс $0.00001 за запись в датасет и небольшую плату за запуск, то есть $1.00 за 1 000 (страница clearpath Search в Store).
Поэтому для 1 000 постов по теме за прошлые годы лучше выбрать Apify. Для ежедневного или еженедельного мониторинга набора ключевых слов за последний месяц мы берём $0.000556 за 20 и более постов на вызов. Это намного дешевле.
| Ключевое слово | Сортировка | Записи | Самый ранний пост (UTC) | Списано |
|---|---|---|---|---|
| standing desk | по умолчанию (релевантность) | 25 | 3 октября | $0.000556 |
| standing desk | popular | 22 | 27 октября | $0.000556 |
| standing desk | top | 4 | 6 октября | $0.000556 |
| standing desk | newest | 3 | 3 ноября | $0.000556 |
| notion alternative | default | 17 | 3 октября | $0.000556 |
| Остальные 5 ключевых слов | default | 24–25 | 3–6 октября | По $0,000556 за вызов |
Тест 2: 1 000 постов из одного сабреддита, а мы получили 286
reddit/subreddit_posts возвращает до 100 записей за вызов, и параметра пагинации у него нет. Получить больше можно, только меняя сортировку и временное окно. sort принимает newest, popular, top, rising и relevance. По данным каталога, date_range работает только с sort=top. Мы по одному разу запустили восемь комбинаций на r/Python. На диаграмме видно, сколько новых постов добавила каждая следующая комбинация.
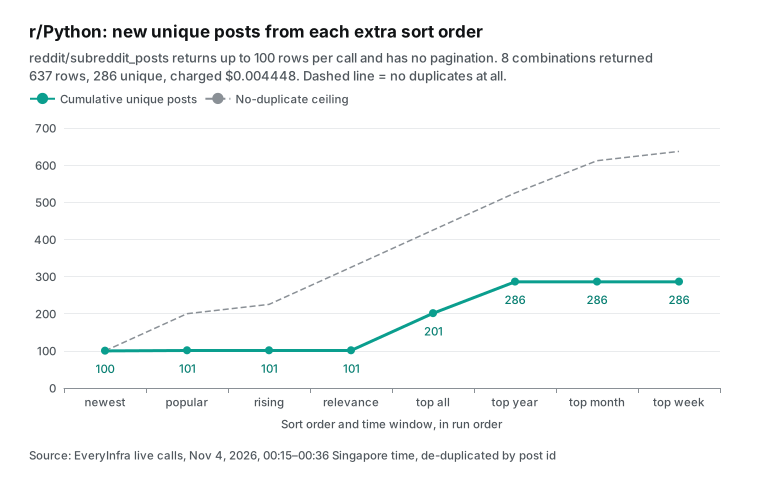
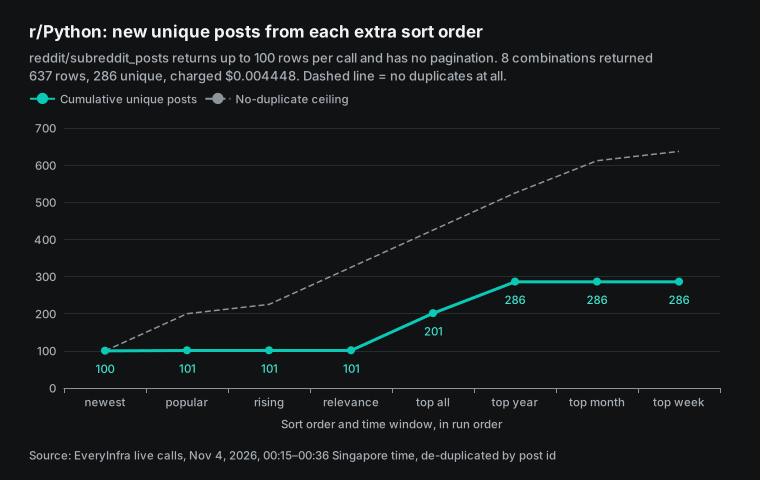
Результат однозначный. 100 записей по сортировкам newest, popular и relevance оказались почти одним и тем же набором, всего 101 уникальный пост. Rising вернул 25 записей, и все они уже встречались. Новые посты дали только две комбинации: top с all_time (100 постов, самый старый из 2017 года) и top с past_year (85 новых). 87 записей из past_month и 25 из past_week оказались дубликатами. Восемь вызовов обошлись в $0.004448 за 286 уникальных постов, то есть $0.0156 за 1 000.
Если заранее известно, что важны только newest, top за всё время и top за прошлый год, три вызова дадут те же 286 постов за $0.001668. Это $0.0058 за 1 000. На r/smallbusiness два вызова (newest и top за прошлый год) вернули по 100 записей без пересечений, это $0.0056 за 1 000. Все 10 вызовов по сабреддитам вместе вернули 837 записей, из них 486 уникальных, за $0.00556. Это $0.0114 за 1 000, именно эта цифра указана в сводной таблице.
Поэтому задачу «1,000 постов из одного сабреддита» мы выполнить не можем, и для неё лучше подходит Apify. Собственные листинги Reddit уходят вглубь лишь примерно на 1 000 элементов. В readme Lite сказано то же самое и предлагается сочетать варианты сортировки, поиск и фильтры по времени, чтобы собрать больше (страница в Store, «Reddit's 1,000 items limit»). Парсер с поддержкой пагинации получает почти 1 000 записей на каждый вариант сортировки. Мы возвращаем только первую страницу из 100 для каждой сортировки.
Для ежедневного просмотра новых и популярных постов сообщества два вызова (newest плюс top за день) стоят $0,001112. Для разовой выгрузки многолетней истории сообщества используйте Apify или подайте заявку в исследовательскую программу самого Reddit.
Тест 3: что должен превзойти парсер комментариев Reddit в Apify — 1 000 комментариев и дерево
В комментариях ценовой разрыв в этом тесте самый большой. И здесь же у Apify самое явное преимущество по возможностям. reddit/comments принимает URL одного поста и возвращает до 100 комментариев за вызов. Мы выбрали 13 постов с числом комментариев от 16 до 771 и для каждого выполнили по одному вызову.
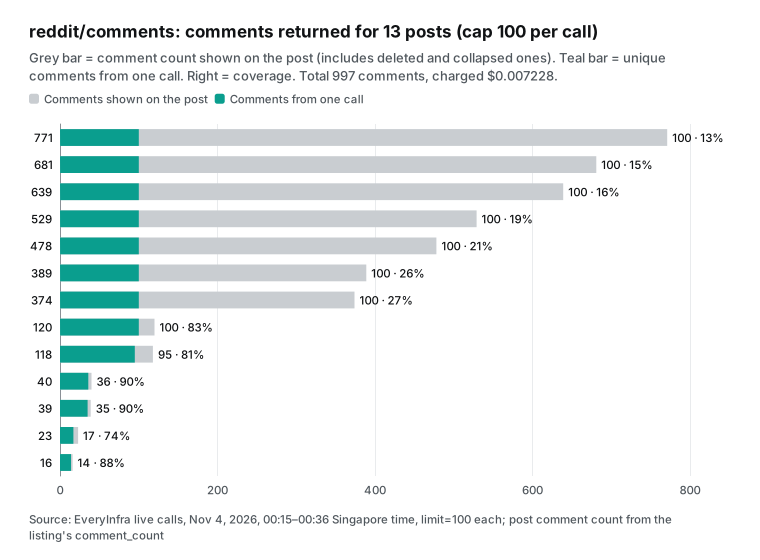
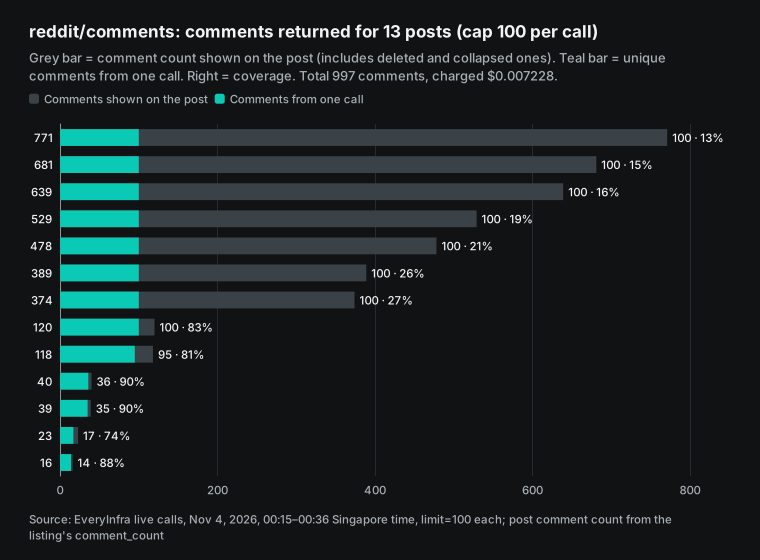
13 вызовов обошлись в $0.007228 и вернули 997 комментариев без дубликатов. Это $0.00725 за 1 000, но с двумя оговорками. Во-первых, на постах с менее чем 100 комментариями мы получили от 74% до 90% от числа, которое показывает пост. Часть разницы приходится на удалённые комментарии: они по-прежнему учитываются в счётчике поста, но текста у них нет. Остальное — комментарии, которые Reddit скрывает за «load more».
Во-вторых, на постах, где больше 100 комментариев, один вызов возвращает 100. В ветке на 771 комментарий это 13 %. С нашим ограничением все комментарии из оживлённой ветки не получить. Парсер комментариев clearpath заявляет, что при maxCommentsPerPost, равном 0, и включённом expandAllComments он возвращает полное дерево, включая ответы с вложенностью 10 уровней и глубже, скрытые за «continue this thread» (страница clearpath в Store). Для этой задачи Apify подходит лучше.
| Количество комментариев, указанное в посте | Мы получили | Покрытие | Время (сингапурское) | Списано |
|---|---|---|---|---|
| 771 | 100 | 13% | 00:26 | $0.000556 |
| 681 | 100 | 15% | 00:27 | $0.000556 |
| 639 | 100 | 16% | 00:27 | $0.000556 |
| 529 | 100 | 19% | 00:28 | $0.000556 |
| 478 | 100 | 21% | 00:28 | $0.000556 |
| 389 | 100 | 26% | 00:29 | $0.000556 |
| 374 | 100 | 27% | 00:29 | $0.000556 |
| 120 | 100 | 83% | 00:30 | $0.000556 |
| 118 | 95 | 81% | 00:30 | $0.000556 |
| 40 | 36 | 90% | 00:31 | $0.000556 |
| 39 | 35 | 90% | 00:32 | $0.000556 |
| 23 | 17 | 74% | 00:32 | $0.000556 |
| 16 | 14 | 88% | 00:32 | $0.000556 |
Вопрос «полное ли дерево комментариев?» состоит из двух частей. Первая: возвращаются ли вложенные ответы вообще. Мы взяли два поста с 16 и 23 комментариями. Сторонний сервис чтения страниц загрузил страницу каждого поста вместе с комментариями. На двух страницах было 27 комментариев, один из них оказался заглушкой удалённого комментария.
Остальные 26 мы искали в наших записях по началу текста и нашли все 26. Среди них было 12 комментариев верхнего уровня, 10 ответов второго уровня и 4 ответа третьего. Ещё мы вернули 5 комментариев, которых этот сервис не показал. Значит, в записях есть не только комментарии верхнего уровня, но и ответы второго и третьего уровня.
Вторая часть касается структуры. У каждой записи комментария в этих 13 вызовах было семь полей: id, text, author_username, like_count, url, posted_at и platform. В каталоге указано и поле community, но ни в одном из этих ответов его не было, так что не полагайтесь на него. Название сообщества берите из community в списке постов или из url комментария. Идентификатора родительского комментария и глубины в записях нет.
Вы знаете, что 14 из этих записей являются ответами, но не знаете, кто кому ответил. В Apify записи комментариев Lite содержат parentId и numberOfReplies (страница в Store, «Example Reddit post»). У automation-lab есть depth и parentId. При этом там указано, что commentCoverage имеет значение unverified, и полное дерево не обещается (страница в Store, «Comment fields»). Обновление clearpath от 6 октября исправило depth для ответов в полностью развёрнутых ветках.
Что это значит для вашей задачи? Для подсчёта тональности, частоты ключевых слов, тематической разметки или поиска цитат с жалобами достаточно плоской таблицы комментариев по $0.00725 за 1 000. Для вопросов «кто с кем спорит», «насколько глубоки цепочки ответов» или «на какие вопросы ответил автор поста» нужен инструмент с parentId. Заглушку MoreComments в PRAW и replace_more мы разбирали в статье почему экспорт комментариев Reddit получается неполным (PRAW docs). Нераскрытые слоты в дереве, которое возвращает Reddit, предусмотрены изначально. В документации Reddit по JSON они называются объектами more (reddit-archive wiki).
Исследователи уже сталкивались с этой проблемой. В 2018 году Гаффни и Матиас изучили популярный датасет, который якобы содержал «все публичные комментарии Reddit». Они нашли в нём большие пробелы и указали, что сильнее всего это угрожает исследованиям истории пользователей и структуры сетей (статья на arXiv). Какой бы инструмент вы ни использовали, сохраняйте с каждой выгрузкой два числа: сколько комментариев вы получили и сколько их показывает пост.
Ещё мы дважды вызвали reddit/post_detail. Для постов с 771 и 40 комментариями его comment_count совпал со значением в списке, и каждый вызов стоил $0,000556. Если вы отбираете посты перед загрузкой комментариев, сортируйте по comment_count из списка. Отдельно запрашивать данные поста не нужно.
Тест 4: посты и комментарии одного пользователя и когда дорогой эндпоинт не окупается
reddit/user_posts возвращает до 50 записей за вызов по той же цене $0,000556, что и большинство эндпоинтов. Сначала мы попробовали spez, аккаунт генерального директора Reddit, с сортировками newest, top за всё время, top за год и popular. Все четыре вызова вернули одни и те же 24 поста. Самый старый был от 11 июля 2015 года, а самый новый — постом об обязательном входе от 29 октября. Значит, на этом аккаунте сортировка ни на что не влияла: четыре вызова стоили $0,002224, и вызовы со второго по четвёртый оказались лишними.
Аккаунт издателя washingtonpost за один вызов вернул полные 50 постов, с 20 апреля по 3 ноября 2026 года, что составляет $0.0111 за 1 000. Второй вызов с сортировкой top all time вернул те же 50 постов. Аккаунт NASA, nasa, с сортировкой newest тоже вернул 50 постов, с 5 июня 2025 года по 29 октября 2026 года. Значит, один вызов ограничен 50 постами пользователя, а другие сортировки до более старых постов не добираются.
Чтобы пройти по всей истории активного аккаунта, лучше подойдёт парсер Apify с пагинацией. По заявлению harshmaur, его Reddit User Scraper возвращает всю историю постов и комментариев пользователя. А парсер пользовательского контента от clearpath, по словам автора, отдаёт до 1 000 записей на пользователя.
С reddit/user_comments ситуация другая. Один вызов стоит $0.032403, то есть в 58 раз дороже обычного, и возвращает до 200 записей. Мы вызвали его один раз для spez с limit 200 и получили 100 записей, с 31 июля 2025 года по 29 октября 2026 года. Это $0.324 за 1 000. Ещё один факт нужно назвать прямо.
Самый длинный текст комментария в этих 100 записях занимал ровно 300 символов, а средний — 160. Это объясняет field_note этого эндпоинта в каталоге. Когда другие источники недоступны, результаты берутся из резервного источника, который обрезает текст до первых 300 символов. Именно это и произошло в нашем вызове. Такой результат годится, чтобы понять, где человек пишет, как часто и сколько положительных голосов получает. Для анализа длинных текстов комментариев он не годится.
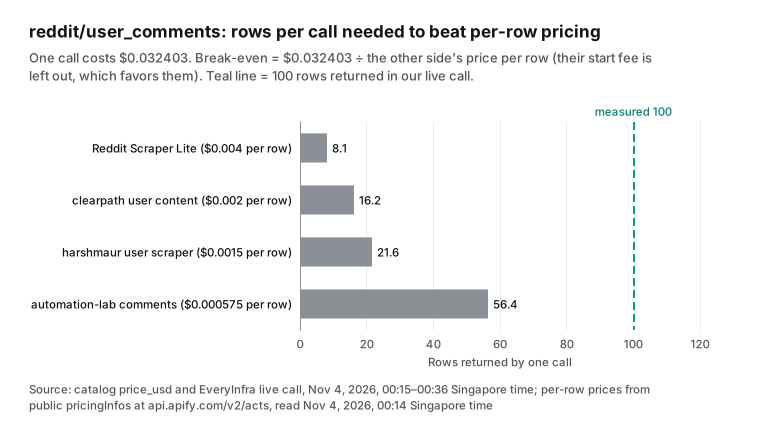
Когда этот эндпоинт не окупается? Ответ зависит от числа записей за вызов. Разделите $0,032403 на цену за запись в Apify и получите минимальное число записей за вызов, при котором мы окажемся дешевле. По сравнению с Lite с ценой $0,004 порог безубыточности составляет 8,1 записи.
По сравнению с парсером пользовательского контента clearpath по цене $0,002 за запись ($0,00199 плюс $0,00001 за запись в датасет) порог составляет 16,2 записи. По сравнению с парсером пользовательских данных harshmaur по цене $0,0015 за запись — 21,6 записи. По сравнению с парсером комментариев automation-lab по цене $0,000575 за запись — 56,4 записи.
| Цена за запись в Apify (Free) | Точка безубыточности, записей за вызов | Наш реальный вызов вернул |
|---|---|---|
| Reddit Scraper Lite, $0,004 | 8.1 | 100 |
| Парсер пользовательского контента clearpath, $0,002 | 16.2 | 100 |
| Парсер пользователей harshmaur, $0,0015 | 21.6 | 100 |
| Парсер комментариев automation-lab, $0,000575 | 56.4 | 100 |
Поэтому в трёх случаях его лучше не использовать. Во-первых, если у пользователя всего несколько комментариев, например это новый аккаунт или аккаунт с десятком постов: парсер с оплатой за каждую запись обойдётся дешевле. Во-вторых, если вам на самом деле нужно обсуждение под одним постом: используйте reddit/comments, он в 45 раз дешевле — $0.00725 за 1 000. В-третьих, если нужны длинные тексты комментариев, а этот вызов упирается в обрезку на 300 символах: смените инструмент или повторите попытку позже.
Для массового исследования по многим пользователям один вызов возвращает от 100 до 200 записей. Это от $0.16 до $0.32 за 1 000, то есть в 4.7–9.4 раза дешевле, чем $1.52 у парсера пользователей от harshmaur. Но если для каждого пользователя вам также нужны карма или возраст аккаунта, этот парсер harshmaur возвращает их за один запуск.
reddit/painpoint стоит ещё дороже: $0,072 за вызов. Мы его не вызывали, поэтому приводим только то, что он даёт по описанию в каталоге. Он находит до 15 постов по ключевому слову и читает их комментарии верхнего уровня. Он возвращает одну сводную запись с числом найденных постов, числом прочитанных комментариев, примерным числом негативных комментариев и примерным числом позитивных комментариев. В записи также перечислены слова, которые повторяются в негативных комментариях, и затронутые сообщества.
Ещё он возвращает самые популярные посты и негативные комментарии с наибольшим числом положительных голосов в виде цитат. По данным каталога, негативная или позитивная тональность определяется по списку слов. Сарказм и смешанную тональность он оценивает плохо, поэтому числа приблизительные и не показывают долю недовольных. В список частых слов могут попадать и слова вроде «any» или «it's».
То же самое можно собрать самостоятельно из 1 вызова reddit/search и 15 вызовов reddit/comments. Эти 16 вызовов стоят $0,0089, а разметку выполнит ваша собственная модель. Это в 8 раз дешевле painpoint, и вы получаете до 100 комментариев на пост, а не только комментарии верхнего уровня.
| Вариант | Вызовы | Стоимость | Прочитанных комментариев на пост | Как оценивается тональность |
|---|---|---|---|---|
reddit/painpoint | 1 | $0.072 | Только верхний уровень | Список слов, приблизительные числа |
reddit/search + 15 × reddit/comments | 16 | $0.0089 | До 100, включая вложенные ответы | Ваша собственная модель |
painpoint подходит тем, кто не хочет писать код и хочет быстро посмотреть на жалобы на продукт. Для еженедельного отчёта дешевле собрать всё самому. Полную методику мы показали в статье как искать проблемы пользователей Reddit с помощью задач Claude Code по расписанию.
Нужно ли платить за вызовы с ошибкой или без данных?
Здесь правила оплаты Apify и EveryInfra различаются сильнее всего. Мы намеренно отправили шесть запросов, которые не могли вернуть данные.
| Сценарий | Отправлено (по сингапурскому времени) | HTTP-статус | Ответ | Списано |
|---|---|---|---|---|
| Нет ключа | 00:25 | 401 | missing_key с подсказкой о необходимости использовать заголовок Authorization | $0 |
sort со значением hot | 00:25 | 422 | invalid_value со списком допустимых значений и did_you_mean: popular и top | $0 |
Лишний параметр time_filter | 00:25 | 422 | unknown_param со списком обязательных и необязательных параметров и рабочим примером | $0 |
| Несуществующий сабреддит | 00:26 | 200 | Одна запись-заглушка только с id, community и platform, с оплатой как за один результат | $0.000556 |
| Несуществующий пост | 00:26 | 200 | 0 записей, empty_result_refunded, средства возвращены | $0 |
| Несуществующий пользователь | 00:36 | 200 | 0 записей, empty_result_refunded | $0 |
Первые три случая — ошибки параметров. Сначала мы проверяем ключ, затем параметры. На неверный запрос сразу приходит ответ 4xx, плата не списывается. Сообщение об ошибке объясняет, как исправить вызов, поэтому ИИ-клиент может исправить его и отправить повторно. В пятом и шестом случаях результат пуст: запрос выполнен, но ничего не найдено, поэтому списанная сумма сразу возвращается.
Четвёртый случай требует внимания. Для несуществующего названия сабреддита вызов возвращает HTTP 200 и count 1. У единственной записи id начинается с target-status:, и в ней есть только поля community и platform, без заголовка, текста и ссылки. Этот вызов стоил $0,000556, как один результат. Поэтому в пакетах по сабреддитам отбрасывайте такую запись по префиксу id, прежде чем считать записи или стоимость за единицу. Если записей не осталось, название неверное или сабреддит удалён. Уберите его из списка, чтобы не платить за него снова.
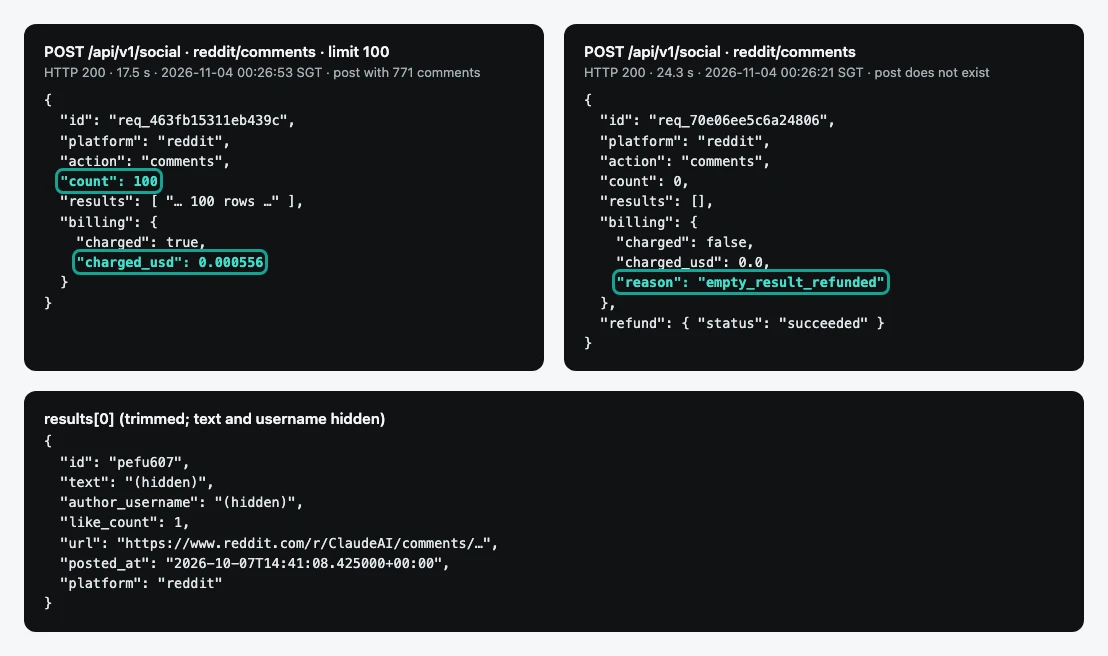
В Apify каждый актор задаёт свои правила. У собственного Reddit Scraper от Apify есть событие «No result» за $0,0005. Оно охватывает удалённое сообщество, поиск без совпадений и пост без комментариев. В каждом таком случае в датасет записывается одна запись с объяснением причины, оплачиваемая по этой цене (страница в Store).
automation-lab заявляет, что запуски без результатов не оплачиваются. Плата за запуск у Lite зависит от памяти и списывается при старте, даже если ни одного результата не вернулось. При памяти по умолчанию 2 ГБ это $0,04.
Неудачные и прерванные по тайм-ауту запуски случаются чаще, чем можно подумать. В следующих разделах видно, что 10% из 360 000 запусков Lite за последние 30 дней завершились по тайм-ауту. В документации Apify сказано, что для каждого запуска можно задать максимальную сумму списания, и запуск остановится на этом пределе (Actors in Store). Задайте её перед большой задачей.
Цены Apify Reddit Scraper Lite: $0,004 за результат плюс плата за запуск с 2 ГБ памяти
Большинство тех, кто ищет «apify reddit scraper», первым делом попадает на Reddit Scraper Lite от trudax. За последние 30 дней у него было 8 543 пользователя, больше, чем у любого другого парсера Reddit в Store, и примерно на 50% больше, чем у ближайшего конкурента. Оплата взимается за две вещи. Каждый результат, записанный в датасет, стоит $0.004 на тарифе Free, то есть $4.00 за 1 000. На уровне Bronze (план Starter) цена составляет $0.0038, на Silver (Scale) $0.0036, на Gold (Business) $0.0034.
Данные о количестве пользователей и запусков в этой статье взяты из API списка Store в 00:14 по сингапурскому времени 4 ноября 2026 года. В тот же момент API с подробными данными этого актора показывал 8 540 пользователей и 363 964 запуска. Расхождение между двумя источниками меньше 1%.
Каждый запуск также оплачивает стартовый сбор, который зависит от объёма памяти: $0.02 за ГБ. Память по умолчанию составляет 2 048 МБ, поэтому запуск с настройками по умолчанию стоит на старте $0.04, и платформа устанавливает $0.04 как минимальную плату за запуск. Все эти данные взяты из полей pricingInfos и defaultRunOptions в публичных метаданных Lite в 00:15 по сингапурскому времени 4 ноября 2026 года. В документации Apify уровни сопоставлены с планами: Free платит по цене FREE, Starter по цене BRONZE, Scale по цене SILVER, Business по цене GOLD. PLATINUM и DIAMOND доступны только корпоративным клиентам (Actor pricing and costs).
| Уровень (план) | За результат | 1 000 результатов за один запуск со стартовым сбором $0.04 |
|---|---|---|
| FREE (Free) | $0.004 | $4.04 |
| BRONZE (Starter) | $0.0038 | $3.84 |
| SILVER (Scale) | $0.0036 | $3.64 |
| GOLD (Business) | $0.0034 | $3.44 |
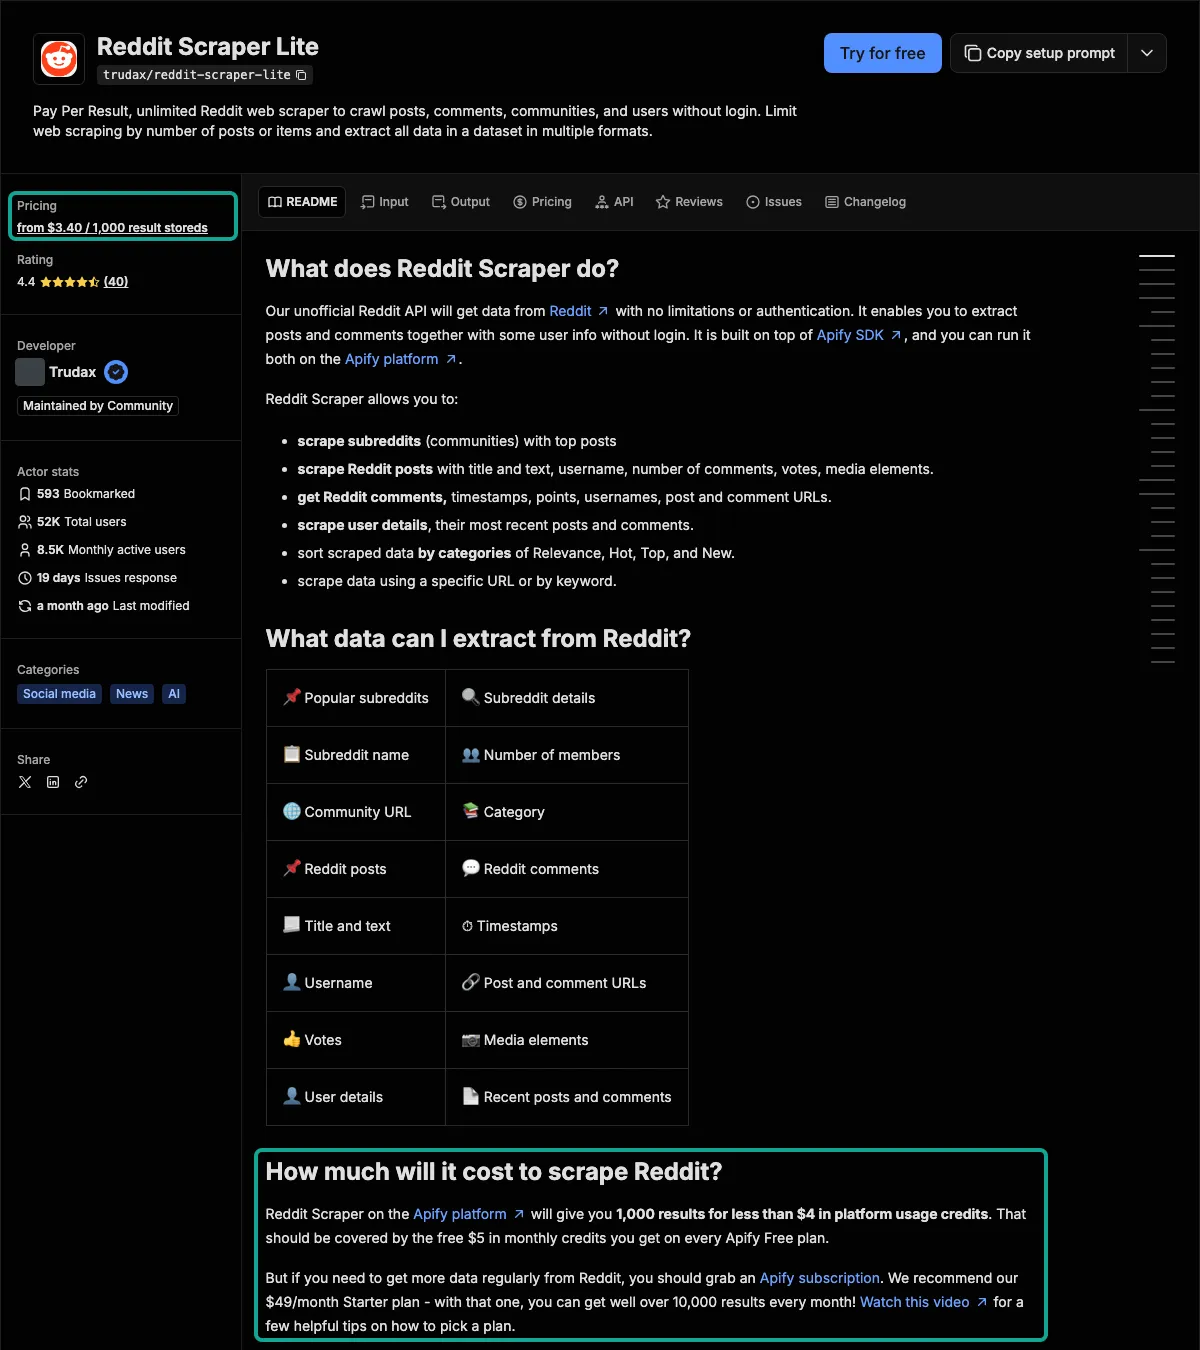
Две детали на этом скриншоте легко понять неверно. Во-первых, «from $3.40 / 1,000» на боковой панели означает самый глубокий уровень скидки. Пользователь тарифа Free платит $4.00 плюс $0.04 за каждый запуск. Один запуск на 1 000 результатов стоит $4.04 на Free и $3.44 на Business.
Во-вторых, «$49/month Starter plan» в тексте не совпадает с текущей страницей тарифов. На ней указаны ежемесячные предоплаченные кредиты на сумму $5 для Free, Starter от $19, Scale за $199 и Business за $999. Неиспользованные кредиты не переносятся. Текст README не обновили вслед за страницей тарифов, поэтому считайте по странице тарифов.
Ещё одну деталь легко упустить. Согласно разделу «Results» на странице в Store, Lite считает отдельным результатом каждый пост, каждый комментарий, каждого пользователя и каждое сообщество. Поэтому если вы запросите 100 постов из сабреддита и не отключите комментарии, в датасет запишутся и комментарии к этим постам. Каждый из них оплачивается по $0,004. На странице есть параметры skipComments, maxComments и maxItems. Без ограничения запуск на «100 постов» может дать тысячи записей.
Сам Reddit Scraper помечен как устаревший: с 21 сентября он доступен только текущим пользователям
Во многих руководствах под «Apify Reddit Scraper» имеется в виду другой Actor: Reddit Scraper от trudax. С февраля 2022 г. он сдавался в аренду помесячно за $45 с пробным периодом 1 440 минут. 21 сентября 2026 г. он перешёл на оплату за события (pay-per-event): $0.0001 за результат и $0.00005 за запуск. В примечании к изменению сказано, что Apify постепенно отказывается от помесячной аренды. Там же указано, что Actor больше не будет публично отображаться в каталоге, а у текущих пользователей сохранится полный доступ. Этот текст находится в поле reasonForChange его публичных метаданных, прочитанных 4 ноября 2026 г.
В тех же метаданных isDeprecated имеет значение true, а в названии в Store теперь есть «[DEPRECATED]». За последние 30 дней у него всё ещё было 459 пользователей, но новые пользователи запустить его не могут. Поэтому сегодня у нового пользователя два варианта с этим названием: Lite и собственный Reddit Scraper от Apify.
Собственный парсер Apify оценивает четыре типа результатов отдельно. Посты стоят $0,004 на Free и $0,0025 на Gold. Комментарии стоят $0,0032 на Free и $0,002 на Gold. Сообщества стоят $0,0065, пользователи — $0,002, а каждый запуск — $0,001.
У него также есть редкое событие «No result» за $0,0005. Оно относится к запросам без результатов, например к удалённому сообществу, поиску без совпадений или посту без комментариев. В таких случаях записывается одна запись с объяснением причины, дешевле обычного результата. На странице также сказано, что один и тот же пост, полученный из двух входных данных, записывается дважды и оплачивается дважды (страница в Store, «How much will it cost?»).
| Событие в собственном Reddit Scraper от Apify | Free | Gold |
|---|---|---|
| Пост | $0.004 | $0.0025 |
| Комментарий | $0.0032 | $0.002 |
| Сообщество | $0.0065 | $0.004 |
| Пользователь | $0.002 | $0.001 |
| No result | $0.0005 | $0,0005 (единая цена) |
| Начало работы | $0.001 | $0,001 (единая цена) |
746 парсеров Reddit в Apify Store: разброс цен и результаты запусков
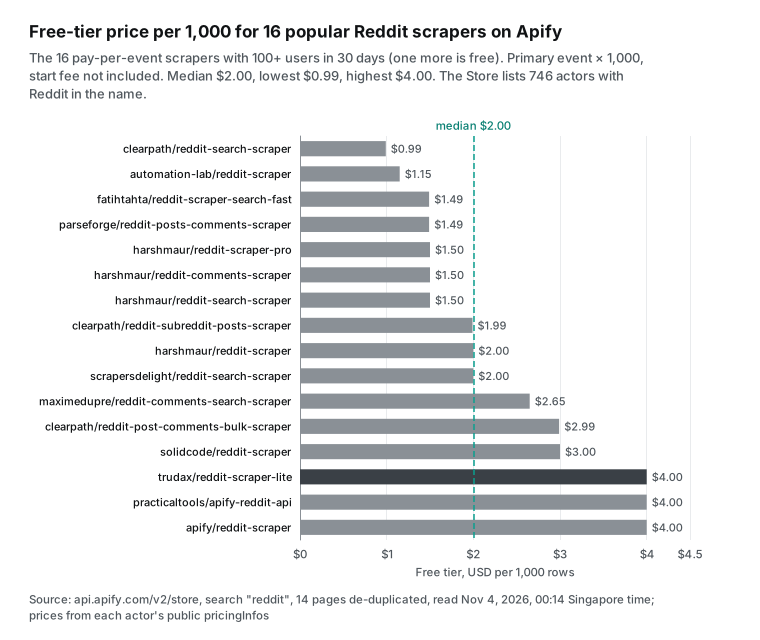
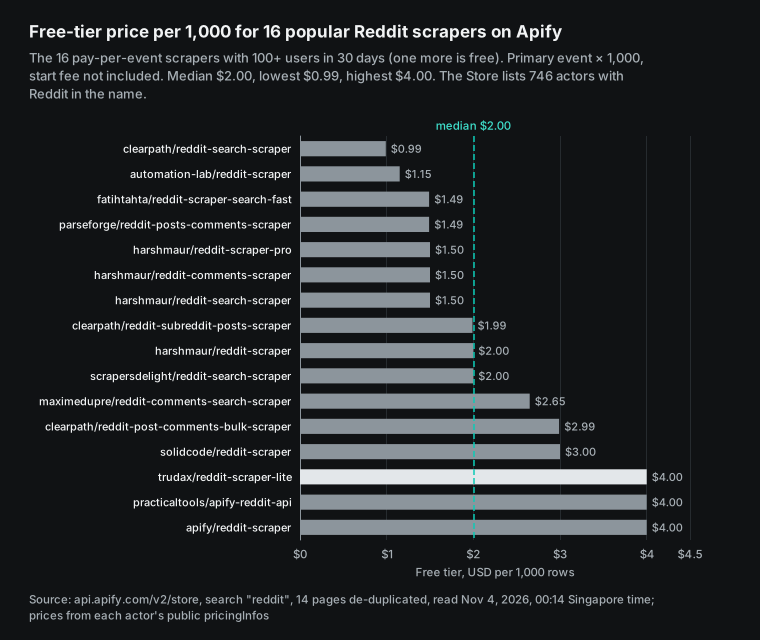
Через публичный эндпоинт списка Store (Get list of Actors in Store) мы искали «reddit». После просмотра 14 страниц и удаления дублей осталось 746 акторов, у которых слово Reddit есть в названии или имени. Из них 717 берут оплату за события, а 29 бесплатны. У семнадцати за последние 30 дней было не меньше 100 пользователей. На диаграмме показана цена основного события на уровне Free для 16 из них, которые берут оплату за результат. Семнадцатый актор от red_crawler бесплатный и предназначен для получения информации о сообществах и их просмотра.
Самый дешёвый вариант — поисковый парсер clearpath за $0.99 за 1 000. Второй и третий по числу пользователей, общий парсер harshmaur и fatihtahta, стоят $2.00 и $1.49. Reddit Comment Scraper от harshmaur стоит $1.50. Максимальную цену $4.00 делят три парсера: Lite, парсер от practicaltools и собственный парсер Apify. Медиана составляет около $2.00. В эти цены не входит плата за старт, которая взимается за каждый запуск в зависимости от объёма памяти: $0.04 у Lite, $0.02 у harshmaur и $0.00099 у clearpath.
Помимо цены, в публичных метаданных каждого актора есть статистика запусков за 30 дней: сколько запусков завершились успешно, с ошибкой, по тайм-ауту или были прерваны. На диаграмме показаны четыре парсера с наибольшим числом пользователей и собственный парсер Apify.
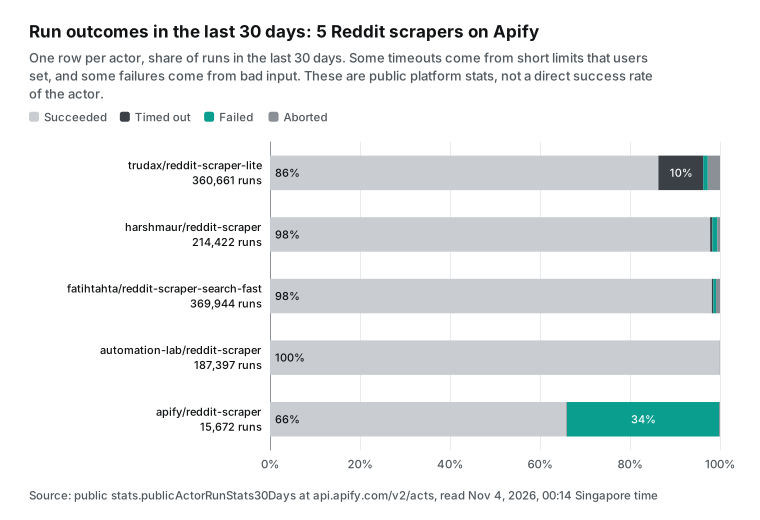
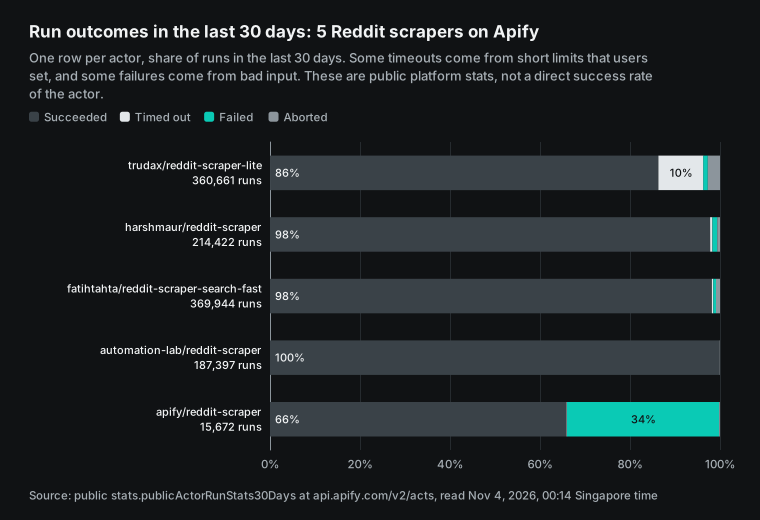
Два числа стоит читать внимательно. Во-первых, 35 919 из 360 661 запуска Lite за последние 30 дней завершились по тайм-ауту. Это около 10%, на порядок больше, чем у остальных. О причине можно только гадать. Возможно, одни пользователи задают короткий лимит времени, а другие не указывают maxItems и запрашивают слишком много постов и комментариев за один запуск. Запуск, завершившийся по тайм-ауту, всё равно оплачивается за результаты, уже попавшие в датасет, и плата за запуск тоже списывается.
Во-вторых, 5 296 из 15 672 запусков собственного Reddit Scraper от Apify завершились с ошибкой, это около 34%. На его странице сказано, что в случаях «No result» создаётся запись стоимостью $0,0005 и это не считается сбоем. Поэтому эти сбои, скорее всего, вызваны некорректными входными данными или блокировками со стороны Reddit. Это общедоступная статистика платформы, а не прямой показатель успешности каждого актора. Статусы запусков описаны в разделе Runs and builds документации Apify.
| Актор | Запусков за 30 дней | Успешно | Тайм-аут | Ошибка |
|---|---|---|---|---|
| trudax/reddit-scraper-lite | 360,661 | 86.3% | 10.0% | 1.0% |
| harshmaur/reddit-scraper | 214,422 | 97.8% | 0.5% | 1.1% |
| fatihtahta/reddit-scraper-search-fast | 369,944 | 98.2% | 0.3% | 0.6% |
| automation-lab/reddit-scraper | 187,397 | 99.9% | 0.0% | 0.0% |
| apify/reddit-scraper | 15,672 | 65.9% | 0.1% | 33.8% |
У 17 популярных акторов в сумме было 1 526 908 запусков: 95,3% завершились успешно, 2,6% — по тайм-ауту, 1,1% — с ошибкой, а 1,0% были прерваны. Кроме того, Apify ежедневно автоматически тестирует каждый публичный актор. Актор, который постоянно завершается с ошибкой, получает отметку «under maintenance» (Automated testing). Прежде чем выбирать актор, проверьте, нет ли этой отметки на его странице в Store.
С нашей стороны 46 из 49 вызовов в этой статье вернули HTTP 200. Если считать только эти 46, каждый занял от 6 до 41 секунды, медиана составила 14 секунд. Самыми медленными были вызовы постов с большим числом комментариев и вызовы для получения подробных сведений о посте. Три ответа с кодами 4xx были вызваны неверными параметрами, которые мы отправили намеренно.
Ни один вызов не завершился по тайм-ауту и не вернул 5xx. Но 49 вызовов слишком мало для оценки успешности. Можно сказать лишь, что в этом прогоне мы не видели сбоев.
| Эндпоинт | Вызовы | Медиана, секунды | Диапазон |
|---|---|---|---|
reddit/search | 10 | 6.4 | от 6,0 до 10,2 |
reddit/subreddit_posts | 10 | 17.8 | от 9,5 до 30,7 |
reddit/comments | 13 | 22.4 | от 11,4 до 40,8 |
reddit/user_posts | 7 | 12.5 | от 9,1 до 14,5 |
reddit/post_detail | 2 | 23.6 | от 11,2 до 36,0 |
Поля: возвращают ли оба сервиса одинаковые данные?
Обратная сторона низкой цены — меньше полей. В таблице ниже перечислены поля, которые фактически вернули наши 49 вызовов, а не поля из каталога. Где они расходятся, мы это отмечаем. У парсеров Apify набор полей сильно различается.
Универсальный парсер harshmaur, судя по описанию, возвращает 60 и более полей на пост, включая медиа и галереи. Записи комментариев у Lite и automation-lab содержат parentId. Полный список смотрите в примере вывода на странице каждого парсера в Store. Мы их не запускали, поэтому не приводим их поля.
| Эндпоинт | Фактически возвращённые поля | Чего нет |
|---|---|---|
reddit/search, reddit/subreddit_posts | id, title, text, author_username, community, url, like_count, comment_count, posted_at, platform. У постов сабреддита также есть domain и flair | URL изображений и видео, флаги наград и закрепления |
reddit/comments | id, text, author_username, like_count, url, posted_at, platform | ID родительского комментария, глубина, число ответов. В каталоге указано community, но в реальных ответах его не было. Не полагайтесь на это поле |
reddit/user_comments | id, text, author_username, like_count, post_id, post_title, url, posted_at, platform | Текст может обрезаться до 300 символов. Нет кармы и возраста аккаунта |
Для большинства задач вида «что говорят люди» этих столбцов достаточно. У комментариев есть текст, автор, апвоуты и время. У постов есть заголовок, сообщество и число комментариев, поэтому можно отобрать посты по числу комментариев, а затем выгрузить их комментарии. url поста можно передать прямо в reddit/comments, и пример на Python ниже связывает вызовы именно так. Если вам нужны медиафайлы, деревья комментариев или профили пользователей, лучше подойдёт парсер на Apify с большим набором полей. За эти дополнительные данные вы и платите в цене каждой записи.
Есть ещё один момент, который влияет на стоимость. По умолчанию Lite запускается с лимитом времени 3 600 секунд и 2 048 MB памяти (поле defaultRunOptions в публичных метаданных Lite). Чем больше памяти, тем выше плата за запуск. Согласно странице «Usage and resources», от объёма памяти зависит и то, сколько CPU получает запуск.
Меньший объём памяти снижает плату за запуск, но запуск идёт медленнее и с большей вероятностью достигает лимита времени. У нас нет настраиваемых параметров памяти и лимита времени. У каждого запроса фиксированная цена, и наш самый медленный вызов длительностью 41 секунда всё равно стоил $0,000556.
Цены на Apify часто меняются
У каждого ценового периода в публичных метаданных 15 изученных нами акторов для Reddit есть дата startedAt. У собственного Reddit Scraper от Apify было 8 ценовых периодов с 2026-09-25 по 2026-10-20, и четыре из них начались в один день, 1 октября 2026 года. Текущий период начался 2026-10-20, а последний раз страница менялась 2026-10-27. Текущая цена парсера поиска комментариев maximedupre действует с 2026-10-18. automation-lab объявил повышение цены за комментарий с 2026-11-17. Старый Reddit Scraper от trudax перешёл на модель оплаты за события (pay-per-event) и 2026-09-21 был помечен как устаревший.
Для сравнения: текущая цена Lite не менялась с 30 июня 2026 года. Это означает, что любое сравнение цен, включая это, через месяц-два может устареть. Перед покупкой снова проверьте поле pricingInfos через эндпоинт Get Actor и запишите дату проверки.
| Актор | Текущая цена действует с | Что изменилось |
|---|---|---|
| apify/reddit-scraper | 2026-10-20 | Восьмой ценовой период с 2026-09-25 |
| maximedupre/reddit-comments-search-scraper | 2026-10-18 | $0,00265 за комментарий на тарифе Free |
| automation-lab/reddit-scraper | 2026-08-25, следующее изменение 2026-11-17 | Повышение цены за комментарий на 30% |
| trudax/reddit-scraper | 2026-09-21 | Переход на оплату за события, затем помечен как устаревший |
| trudax/reddit-scraper-lite | 2026-06-30 | С тех пор без изменений |
Полный список эндпоинтов приведён в справочнике API. Правила оплаты за события описаны в документации по оплате за событие.
Используйте его из кода и через ИИ-клиенты
Этот код на Python повторяет метод нашего теста комментариев. Он принимает набор URL постов и вызывает reddit/comments один раз для каждого. Он удаляет дубликаты по id комментария и суммирует charged_usd по всем вызовам. Для оценки охвата он также сохраняет по два числа на пост: число комментариев к посту и число полученных записей. Записи, у которых id начинается с target-status:, он пропускает по причине, описанной в разделе о сбоях.
import os, requests

API = "https://api.everyinfra.com/api/v1/social"
HEADERS = {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}

def call(action, **params):
    r = requests.post(API, headers=HEADERS, timeout=120,
                      json={"platform": "reddit", "action": action, "params": params})
    r.raise_for_status()
    body = r.json()
    rows = [x for x in body["results"] if not str(x.get("id", "")).startswith("target-status:")]
    return rows, body["billing"]["charged_usd"]

posts, spent = call("subreddit_posts", subreddit="Python", sort="top", date_range="past_year", limit=100)
seen, coverage = {}, []
for p in posts[:13]:
    rows, cost = call("comments", url=p["url"], limit=100)
    spent += cost
    seen.update({c["id"]: c for c in rows})
    coverage.append((p["url"], p["comment_count"], len(rows)))

print(len(seen), "unique comments, spent", round(spent, 6), "USD")
for url, listed, got in coverage:
    print(f"{got}/{listed}", url)
В ИИ-клиенте подключите наш удалённый MCP-сервер по адресу https://api.everyinfra.com/mcp. Имена инструментов начинаются с everyinfra_, и модель сама решает, искать ли сначала посты или сразу выгружать комментарии. Ниже приведён общий пример конфигурации. Claude Code, Cursor и другие клиенты с поддержкой удалённых MCP-серверов используют похожий формат.
Точный синтаксис смотрите в документации Claude Code по MCP и документации Cursor по MCP. У OpenAI есть своя документация по MCP. Сам протокол описан в спецификации MCP.
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
У Apify есть собственный MCP-сервер, который предоставляет модели акторы из Store в качестве инструментов (документация Apify MCP, исходный код на GitHub). Для работы из кода у Apify есть клиент для Python. Разница заключается в способе возврата данных. При работе через MCP Apify модель запускает актор, ждёт завершения его работы, а затем читает датасет.
Это подходит для выгрузки десятков тысяч записей. Наш MCP-сервер возвращает одну страницу данных за вызов. Это удобно, когда вопросы в чате обрабатываются по одному. Настройка и поддерживаемые клиенты описаны на странице MCP-сервера.
Месячный счёт: три типичные задачи на 30 дней
Возьмём продуктовую команду, которая хочет каждый день знать, что на Reddit пишут о её категории. Три задачи ниже рассчитаны по измеренному нами числу записей за вызов. У нас стоимость равна числу вызовов × $0.000556, а для комментариев пользователей — × $0.032403. Для Apify мы брали цену каждого актора по прейскуранту тарифа Free с учётом одной стандартной платы за запуск при каждом выполнении задачи.
| Задача на 30 дней | Вызовы и записи | EveryInfra | Reddit Scraper Lite | Более дешёвые популярные парсеры на Apify |
|---|---|---|---|---|
| Комментарии из 10 активных тредов в день, по 100 на тред | 300 вызовов, 30 000 записей | $0.17 | $121.20 | automation-lab $17.69 ($22.94 с 17 ноября). harshmaur (комментарии) $45.60 |
| 100 новейших постов из 5 сабреддитов в день | 150 вызовов, 15 000 записей | $0.08 | $61.20 | automation-lab $17.34. clearpath (сабреддиты) $30.02 |
| История комментариев 200 пользователей в неделю, по 100 записей на каждого | 800 вызовов, 80 000 записей | $25.92 | $320.16 | harshmaur (пользователи) $120.08. clearpath (контент пользователей) $160.00 |
Эти оценки опираются на три допущения. Первое: каждый вызов возвращает полную страницу. В наших тестах каждый пост с более чем 100 комментариями действительно возвращал 100. Но небольшие посты возвращают меньше, а запрос комментариев пользователя с лимитом 200 вернул только 100.
Если мы возвращаем меньше записей, общая стоимость у нас не меняется, поэтому цена одной записи растёт. Второе: расчёт для Lite предполагает, что сбор комментариев отключён (skipComments). Если его включить, число записей в задаче по постам вырастет в несколько раз. Третье: ни в одной из задач не исключаются пересечения данных между днями.
Если на следующий день вы снова выгружаете тот же активный тред, большая часть комментариев у вас уже есть, и EveryInfra и Apify берут плату за повторы. На Apify повторы можно сократить с помощью фильтров по времени. В EveryInfra дубликаты по id вы удаляете сами.
Даже при этом один вызов для получения комментариев пользователя в EveryInfra стоит $0.032403. Если у большинства из этих 200 пользователей всего около дюжины комментариев, общая стоимость в EveryInfra не изменится. Рассчитанная по числу записей общая стоимость в Apify снизится до нескольких долларов, и Apify окажется выгоднее.
Собственный API Reddit сегодня: новые заявки на доступ не принимаются с 31 октября
Сравнение цен неполно без собственного Data API Reddit. В «Reddit Data API Wiki» сказано, что пользователи, соответствующие требованиям, получают 100 запросов в минуту на OAuth-клиент в среднем за 10-минутное окно. Трафик без OAuth блокируется. Если пост или комментарий удалён, вы тоже должны удалить свою копию, и Reddit рекомендует проводить очистку не реже одного раза в 48 часов.
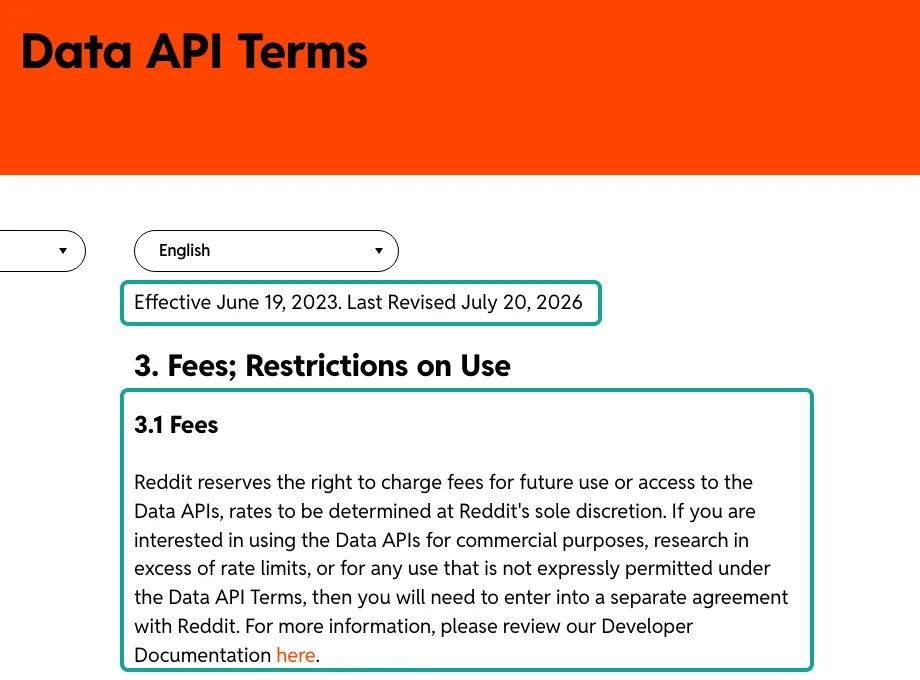
За пределами бесплатного использования раздел 3.1 «Data API Terms» однозначен. Reddit оставляет за собой право взимать плату за будущее использование по ставкам, которые определяет сам. Для коммерческого использования, исследований сверх лимитов запросов и любого использования, не разрешённого условиями, нужно отдельное соглашение. Условия вступили в силу 19 июня 2023 года, последняя редакция вышла 20 июля 2026 года.
| Правило на страницах Reddit | Что сказано |
|---|---|
| Бесплатный лимит запросов | 100 запросов в минуту на OAuth-клиент, в среднем за 10 минут |
| Трафик без OAuth | Блокируется |
| Удалённый контент | Удалять свою копию и проводить очистку не реже одного раза в 48 часов |
| Коммерческое использование | Отдельное соглашение по ставкам, которые устанавливает Reddit |
На текущих публичных страницах Reddit цена коммерческого использования не указана. В «Developer Platform & Accessing Reddit Data» сказано лишь, что некоторым разработчикам, которым нужен расширенный доступ, возможно, придётся платить. Там приведены примеры коммерческого использования: приложения с рекламой или платным доступом, платные сервисы или продажа доступа к данным, сервисы по подписке. В списке есть и продажа моделей, обученных на данных Reddit.
Часто встречающаяся цифра «$0.24 за 1,000 запросов» появилась в 2023 году. 31 мая 2023 года Reddit объявил в r/redditdev, что с 1 июля для бесплатного уровня начнут действовать лимиты запросов (пост). В тот же день разработчик клиента Apollo сообщил, что Reddit назвал ему цену $12 000 за 50 миллионов запросов (пост). Это $0.24 за 1 000.
Это сообщение одного разработчика, а не прайс-лист Reddit. При такой цене и 100 записях на один запрос списка 1 000 постов обошлись бы примерно в $0.0024, то есть дешевле, чем у любого стороннего сервиса. Но только если вам удастся получить такой контракт.
Этот путь закрывается. В августе 2026 года Reddit впервые описал в r/redditdev планы на публичный Data API (пост). 30 сентября 2026 года он опубликовал график отключения (пост).
| Дата | Что сказано в посте Reddit | Что это значит для сбора данных |
|---|---|---|
| 2026-10-31 | Новые заявки на доступ к публичному API не принимаются | Проект, который стартует сегодня, не получит доступ |
| 2026-11-10 | Отчёт о ходе миграции и напоминание о сроке | Проверьте, нет ли продлений или исключений |
| 2026-11-13 | Работа RSS прекращается (пост в r/modnews; варианты замены описаны в статье «Что делать после отключения RSS в Reddit») | Мониторинг сабреддитов через RSS перестаёт работать |
| 2026-11-30 | Крайний срок получения вознаграждения за миграцию | Только для приложений, перешедших на Devvit |
| 2027-01-12 | Доступ начинают закрывать для приложений и пользователей, которые не зарегистрировались или не ответили Reddit | Старые скрипты могут перестать работать примерно в эту дату |
| 2027-03 | Закрывается весь оставшийся публичный доступ (точный день не назван) | Доступ остаётся только у партнёров с письменными соглашениями и через Devvit |
В качестве замены Reddit предлагает собственную платформу для разработчиков: Devvit. Согласно руководству по миграции, она предназначена в основном для инструментов модерации и приложений для сообществ. Приложения, участвующие в программе миграции, могут получить $1 000 после переезда; программа действует с 31 марта по 31 декабря 2026 года. Это не API для выгрузки данных с последующим анализом в другом месте. Приложения Devvit регистрируются через App registration. Исходящие запросы подчиняются правилам HTTP Fetch, а полное руководство есть в документации Devvit.
Для исследователей важно, что согласно «Responsible Builder Policy» исследования на данных, собранных вне программы Reddit for Researchers, нарушают правила. Без письменного разрешения нельзя продавать или лицензировать эти данные либо использовать их для обучения моделей.
29 октября CEO Reddit Стив Хаффман написал в своём профиле, что Reddit перейдёт к формату «logged-in first», ориентированному прежде всего на пользователей, вошедших в аккаунт. Сначала этот формат протестируют на некоторых рынках за пределами США. Одной из причин он назвал то, что большая часть несанкционированного сбора данных происходит на страницах без входа в аккаунт (пост). Axios в тот же день сообщил, что главная страница останется открытой для посетителей без входа. Посты, на которые переходят из поисковиков или по внешним ссылкам, тоже останутся открытыми, а точные ограничения определят в ходе теста.
Обязательный вход создаёт риск для любого инструмента, который читает страницы без авторизации. Это касается и парсеров в Apify Store, и нас. Мы не можем обещать, что после изменений на Reddit все эндпоинты продолжат работать.
Вы можете сделать три вещи. Во-первых, за неудачные запросы плата не списывается, поэтому вы не платите, когда Reddit блокирует вызов. Во-вторых, если эндпоинт ломается, бесплатный каталог помечает его как «временно недоступен» и ставит available в false, поэтому перед большой пакетной выгрузкой проверяйте каталог. В-третьих, храните данные, которые нужны вам надолго, у себя и не рассчитывайте, что один инструмент сможет выгрузить их снова.
Можно ли вам собирать данные и что с ними делать, зависит от вашей юрисдикции, сценария использования и условий Reddit. Эта статья не является юридической консультацией. По конкретному проекту обратитесь к юристу.
Когда Apify подходит лучше
В сумме тесты указывают на шесть задач, для которых мы рекомендуем не EveryInfra, а парсер из Apify Store. Первая: посты по теме старше одного месяца. Наш reddit/search охватывает только последний месяц, а параметр time в Lite можно установить в all. Вторая: более 1 000 постов из одного сабреддита. Мы возвращаем только первые 100 записей для каждой сортировки, и восемь комбинаций на r/Python дали 286. Парсер с пагинацией получает почти 1 000 записей на каждую сортировку.
Третья: все комментарии активного треда или полное дерево комментариев. У нас действует лимит 100 комментариев на пост и нет идентификатора родительского комментария, тогда как clearpath полностью раскрывает дерево, а Lite и automation-lab возвращают parentId и depth. Четвёртая: профили пользователей. У нас нет кармы и возраста аккаунта, а парсер пользователей harshmaur отдаёт их за один запуск. Пятая: несколько пользователей. Если один вызов reddit/user_comments возвращает меньше 22 комментариев, он стоит дороже, чем парсер пользователей harshmaur. Шестая: команды, которые уже работают с расписаниями, датасетами и интеграциями Apify. При переходе вам придётся реализовать собственные планировщик и хранилище, и экономия может не окупить эту работу.
Обратный случай — большие и частые постраничные выгрузки. Здесь мы дешевле на два-три порядка. Примеры: комментарии из сотен постов в день и новые посты из десятков сообществ в день. Ещё один пример — запросы к Reddit из ИИ-клиента в чате. Есть у нас и reddit/trending_posts. Он возвращает трендовые посты по всему сайту по 25 на страницу, поддерживает пагинацию с помощью page_token и стоит $0.000556 за страницу.
Он частично закрывает пробел, оставленный списками постов сабреддитов без пагинации. Но это трендовые посты по всему сайту, а не история одного сообщества. Подводные камни обеих моделей оплаты мы разобрали в статьях «Как устроены цены Apify» и «Альтернативы Apify». Как сверять возвраты средств, описано в руководстве «Сверка возвратов за сбои».
Что изменилось за последнее время
- 2026-11-17: парсер Reddit от automation-lab повышает цену за комментарий на тарифе Free с $0.000575 до $0.00075, то есть на 30% (страница automation-lab в Store). Что это значит для вас: указанные в этой статье $0.59 за 1 000 комментариев превращаются в $0.76.
- 2026-10-29: пост CEO Reddit об обязательном входе (пост). Что это значит для вас: доступ без входа сначала ужесточат на некоторых рынках. Это может затронуть любой инструмент, который читает страницы без авторизации, в том числе парсеры Apify и инструменты EveryInfra.
- 2026-10-20: начинает действовать текущая цена на собственный Reddit Scraper от Apify. Это восьмой ценовой период за месяц (страница в Store). Что это значит для вас: используйте метаданные, актуальные на день просмотра.
- 2026-10-18: начинает действовать текущая цена парсера поиска комментариев maximedupre: $0.00265 за запись на тарифе Free. Что это значит для вас: среди парсеров поиска комментариев он на 77% дороже harshmaur с ценой $0.0015 за запись.
- 2026-10-16 и 2026-10-06: два обновления парсера комментариев clearpath исправляют
depthдля глубоких ответов в полностью раскрытых тредах (страница clearpath в Store). Что это значит для вас: чтобы восстанавливать деревья поdepth, используйте версию после этих обновлений. - 2026-09-21: Reddit Scraper от trudax переходит на модель оплаты за события и скрывается из Store для новых пользователей. Что это значит для вас: тарифа «$45 в месяц без ограничений» из старых руководств больше нет.
С чего начать: от одного пробного вызова до ежедневной задачи
48 вызовов API из этой статьи, не считая вызова для комментариев пользователя, в сумме обошлись примерно в $0.024. Зарегистрируйтесь, сначала проведите небольшой тест и только потом решайте, использовать ли API в больших объёмах. API-ключ можно получить в разделе Быстрый старт. Все эндпоинты перечислены на странице API для парсинга Reddit. В песочнице выполните по одному запросу для поиска по Reddit, постов сабреддита и комментариев Reddit.
Подробности поста и данные пользователей можно получить через эндпоинты детали поста, посты пользователя и комментарии пользователя. Чтобы быстро посмотреть жалобы на продукт, используйте болевые точки Reddit. Трендовые посты по всему сайту отдаёт эндпоинт трендовые посты. Тот же подход работает с API для парсинга Twitter и API для парсинга TikTok. Все эндпоинты и цены собраны на страницах маркетплейса данных и тарифов, а сравнение инструментов приведено на странице альтернатив.
Другие сравнения с Apify по измеренной «стоимости за 1,000»: альтернатива Apify Twitter Scraper, альтернатива Apify TikTok Scraper и альтернатива Apify Amazon Scraper.
FAQ
Бесплатен ли парсер Reddit на Apify?
Бесплатный тариф Apify Free даёт $5 предоплаченного кредита в месяц (страница тарифов). При цене Lite $0.004 за результат плюс $0.04 за запуск это около 1 200 результатов. В Store также есть 29 бесплатных Actors для Reddit, но только у одного из них за последние 30 дней было больше 100 пользователей. Reddit Scraper от trudax с помесячной арендой устарел, и новые пользователи не могут его запустить. Собственный API Reddit бесплатен для подходящего некоммерческого использования с лимитом 100 запросов в минуту на один OAuth-клиент. Но 31 октября 2026 года он перестал принимать новые заявки («Data API Wiki»).
Какой из парсеров Reddit на Apify считается Pro-версией и лучше ли он, чем Lite?
Парсер Reddit со словом «pro» в названии, которым за последние 30 дней воспользовалось больше всего пользователей, — reddit-scraper-pro от harshmaur. В его заголовке говорится о лидах, мониторинге бренда и оповещениях. На тарифе Free одна запись стоит $0.0015; за 30 дней парсером воспользовались 435 пользователей. Успешно завершились 98,7 % его запусков (публичный список Store, просмотрен 4 ноября 2026 года). Он более чем на 60 % дешевле Lite, а таймаутов у него гораздо меньше.
У Lite больше всего пользователей, самый подробный readme и parentId у комментариев. Какой из них «лучше», зависит от того, нужны ли вам деревья комментариев. Если нужны, парсер комментариев clearpath полнее обоих.
Может ли парсер комментариев Reddit на Apify собрать все комментарии к посту?
Да, если выбрать подходящий Actor и правильно его настроить. Парсер комментариев clearpath с параметром maxCommentsPerPost, установленным в 0, и включённым полным раскрытием возвращает всё дерево, включая ответы на большой глубине за ссылками «continue this thread». В Lite лимит задаётся параметром maxComments. В структуре дерева Reddit предусмотрены нераскрытые элементы more (заметки Reddit о JSON).
Если вы собираете данные через PRAW, вам также понадобится replace_more. Наш reddit/comments возвращает до 100 записей на пост, с ответами второго и третьего уровня, но без ID родителя. Для задач, где нужно всё дерево, он не подходит.
Сколько стоит API для парсинга Reddit и что дешевле?
Коммерческое использование собственного API Reddit требует отдельного соглашения, а на текущих публичных страницах цена не указана (Developer Platform & Accessing Reddit Data). Часто цитируемая цена $0.24 за 1 000 запросов взята из отчёта одного разработчика за 2023 год. Среди сторонних решений популярные парсеры Reddit в Apify Store стоят от $0.99 до $4.00 за 1 000, медиана около $2.00. В EveryInfra оплата за каждый запрос, и в этой статье это составило от $0.011 до $0.029 за 1 000 постов и $0.0073 за 1 000 комментариев. Описание OAuth-авторизации и список эндпоинтов см. в заметках Reddit об OAuth2 и документации API.
Законно ли парсить Reddit без API?
Это зависит от вашей юрисдикции, сценария использования и документов Reddit: «User Agreement», «Developer Terms» и «Public Content Policy». Согласно Responsible Builder Policy Reddit, исследования на основе данных, собранных вне программы Reddit for Researchers, нарушают эту политику. Без письменного разрешения вы не можете продавать или лицензировать данные либо обучать на них модели. Эта статья не является юридической консультацией. Прежде чем создавать коммерческий продукт или обучать модель на этих данных, проконсультируйтесь с юристом.
Есть ли парсер Reddit на GitHub и чем он отличается от API-сервиса?
Да. Ранний код сайта Reddit и заметки об API заархивированы в reddit-archive/reddit, и этот репозиторий больше не обновляется. Самый распространённый готовый инструмент — библиотека для Python PRAW. Она работает через OAuth API Reddit, бесплатна и даёт больше всего полей. Но она ограничена 100 запросами в минуту, а новые OAuth-клиенты не смогут получить доступ после 31 октября 2026 года.
Самописный парсер должен справляться с требованием входа, лимитами запросов и блокировками. С Apify или сервисом вроде нашего вы платите за то, чтобы не заниматься этой работой. Какой бы инструмент вы ни выбрали, сначала рассчитайте стоимость за 1 000 и стартовые платежи.
Источники
- Apify / trudax: «Reddit Scraper Lite» (страница в Store), просмотрено 4 ноября 2026 года
- Apify API: публичные метаданные trudax~reddit-scraper-lite (pricingInfos, stats), просмотрено 4 ноября 2026 года
- [Apify / trudax: «Reddit Scraper [DEPRECATED]» (страница в Store), просмотрено 4 ноября 2026 года](https://apify.com/trudax/reddit-scraper)
- Apify API: публичные метаданные trudax~reddit-scraper (с примечанием о ценах от 21 сентября 2026 года), просмотрено 4 ноября 2026 года
- Apify / harshmaur: «Reddit Scraper» (страница в Store), просмотрено 4 ноября 2026 года
- Apify / automation-lab: «Reddit Scraper» (страница в Store, с изменением цены от 17 ноября 2026 года), просмотрено 4 ноября 2026 года
- Apify / clearpath: «Reddit Post Comments Scraper» (страница в Store, с обновлениями от 6 и 16 октября 2026 года), просмотрено 4 ноября 2026 года
- Apify / fatihtahta: «Reddit Scraper Enterprise Grade» (страница в Store), просмотрено 4 ноября 2026 года
- Apify / harshmaur: «Reddit Comment Scraper» (страница в Store), просмотрено 4 ноября 2026 года
- Apify / harshmaur: «Reddit User Scraper» (страница в Store), просмотрено 4 ноября 2026 года
- Apify / clearpath: «Reddit User Posts & Comments Scraper» (страница в Store), просмотрено 4 ноября 2026 года
- Apify / clearpath: «Reddit Search Scraper» (страница в Store), просмотрено 4 ноября 2026 года
- Apify: «Reddit Scraper: Posts, Comments, and Users» (собственная страница Apify в Store), просмотрено 4 ноября 2026 года
- Apify: «Pricing» (тарифы, compute units, уровни скидок Store), просмотрено 4 ноября 2026 года
- Документация Apify: «Pay-per-event pricing model»
- Документация Apify: «Actor pricing and costs» (уровни от FREE до DIAMOND)
- Документация Apify: «Actors in Store» (модели оплаты, метка under maintenance, скидки Store)
- Документация Apify API: «Get Actor»
- Документация Apify API: «Get list of Actors in Store»
- Документация Apify: «Usage and resources» (память и compute units)
- Документация Apify: «Runs and builds» (статус запуска, таймауты)
- Документация Apify: «Automated testing» (Actor, не прошедший проверку, получает метку maintenance)
- Документация Apify: «Dataset»
- Документация Apify: «Apify MCP server»
- GitHub: apify/apify-mcp-server
- GitHub: apify/apify-client-python
- Reddit: «Data API Terms» (действуют с 19 июня 2023 года, редакция от 20 июля 2026 года), просмотрено 4 ноября 2026 года
- Reddit: «Developer Terms»
- Reddit: «User Agreement»
- Reddit Help: «Reddit Data API Wiki» (бесплатный уровень, 100 QPM)
- Reddit Help: «Responsible Builder Policy»
- Reddit Help: «Developer Platform & Accessing Reddit Data» (коммерческое использование и плата)
- Reddit Help: «Public Content Policy»
- Reddit Help: «App Migration Program 2026 Terms»
- Reddit Developer Platform: «Migrating apps from the Data API to Devvit»
- Reddit Developer Platform: «App registration»
- Reddit Developer Platform: «HTTP Fetch»
- r/redditdev: «Moving Data API Apps to the Developer Platform: migration dates and next steps» (30 сентября 2026 года)
- r/modnews: «Continuing our infrastructure updates: what's changing in the coming months» (30 сентября 2026 года, прекращение RSS)
- r/redditdev: «Our Plans for the Future of Reddit's Public Data API» (август 2026 года)
- r/redditdev: «API Update: Enterprise Level Tier for Large Scale Applications» (31 мая 2023 года)
- r/apolloapp: «Had a call with Reddit to discuss pricing» (31 мая 2023 года, рассказ разработчика о предложенной цене)
- u/spez: «About that login screen» (29 октября 2026 года)
- Axios: «Reddit moves to logged-in experience as AI eats search» (29 октября 2026 года)
- GitHub: reddit-archive/reddit (архив открытого кода и вики Reddit)
- Reddit Developer Platform: «Devvit docs»
- Документация Apify API: «API v2 reference»
- GitHub: вики reddit-archive/reddit, «JSON» (объект more)
- GitHub: вики reddit-archive/reddit, «OAuth2»
- GitHub: praw-dev/praw
- Документация PRAW: «Comment Extraction and Parsing»
- Reddit: «API documentation» (/dev/api)
- Gaffney и Matias: «Caveat Emptor, Computational Social Science: Large-Scale Missing Data in a Widely-Published Reddit Corpus» (arXiv, 2018)
- Model Context Protocol: «Specification 2025-06-18»
- Документация Claude Code: «Connect Claude Code to tools via MCP»
- Документация OpenAI: «Connectors and MCP servers»
- Документация Cursor: «Model Context Protocol»
- EveryInfra: каталог API данных (бесплатно; price_usd, max_limit), просмотрено 4 ноября 2026 года
Справка BL-84