Alternativa a Apify Reddit Scraper: coste real por cada 1.000 posts y comentarios
Reddit Scraper Lite de Apify cuesta 4,04 USD por 1.000 comentarios; nosotros medimos 0,0073 USD en lista plana, sin id del padre. Para el árbol, Apify.
Reddit Scraper Lite es el scraper de Reddit con más usuarios en la Apify Store. Con su precio público del nivel Free, 1.000 comentarios de Reddit cuestan 4,04 USD: 0,004 USD por resultado más una cuota de inicio de 0,04 USD. La alternativa popular más barata de la Store, la de automation-lab, cuesta unos 0,59 USD por el mismo trabajo. El 04-11-2026 llamamos 13 veces al endpoint reddit/comments de EveryInfra, una por post. Cada llamada costó 0,000556 USD y entre todas devolvieron 997 comentarios únicos por 0,007228 USD, es decir, 0,00725 USD por cada 1.000. Sale 557 veces más barato que Lite y 81 veces más barato que automation-lab. En posts, la búsqueda por palabra clave salió a 0,0293 USD por 1.000 y el listado de un subreddit a 0,0114 USD por 1.000.
Hay tres trabajos en los que Apify es la mejor opción, y lo decimos en cada prueba. Primero, devolvemos como máximo 100 comentarios por post, así que de un hilo con 771 comentarios solo obtuvimos el 13 %. Segundo, nuestras filas incluyen respuestas de segundo y tercer nivel, pero no traen el id del comentario padre, de modo que no se puede reconstruir el árbol. Tercero, con ocho órdenes distintos en un mismo subreddit solo reunimos 286 posts únicos, no 1.000. A continuación medimos cuatro tipos de datos de Reddit uno por uno. También repasamos el «Reddit Scraper» que Apify retiró en septiembre, la dispersión de precios de 746 scrapers de Reddit en la Store y el calendario de cierre de la Data API pública de Reddit.
Cómo leer los números de este artículo
Aquí, «coste por 1.000» significa el dinero cobrado de verdad, dividido entre las filas únicas devueltas de verdad, por 1.000. Responde a una sola pregunta: cuánto te cuestan 1.000 posts o comentarios de Reddit. EveryInfra cobra por petición y cada petición devuelve una página: hasta 25 filas en búsqueda, hasta 100 en subreddits y comentarios, y hasta 50 en posts de usuario (consulta max_limit en el catálogo gratuito). Casi todos los scrapers de Reddit de la Apify Store cobran por resultado, una vez por cada fila escrita en el dataset. Los dos modelos solo se pueden comparar tras pasarlos a la misma unidad.
De nuestro lado, el divisor es siempre el número de filas tras quitar duplicados por id, nunca el limit pedido. Así, las llamadas que devuelven pocas filas o muchas repetidas solo pueden encarecer nuestro precio. Del lado de Apify usamos solo material público: páginas de la Store, la página de precios, la documentación y el endpoint público de metadatos de actores, que no pide cuenta (documentación de Get Actor). Un actor es el nombre que da Apify a un programa de scraping en la nube. No abrimos cuenta en Apify ni ejecutamos ningún actor, así que todas las cifras de Apify son precios de lista públicos, no facturas medidas.
Apify Reddit scraper frente a EveryInfra: la tabla resumen
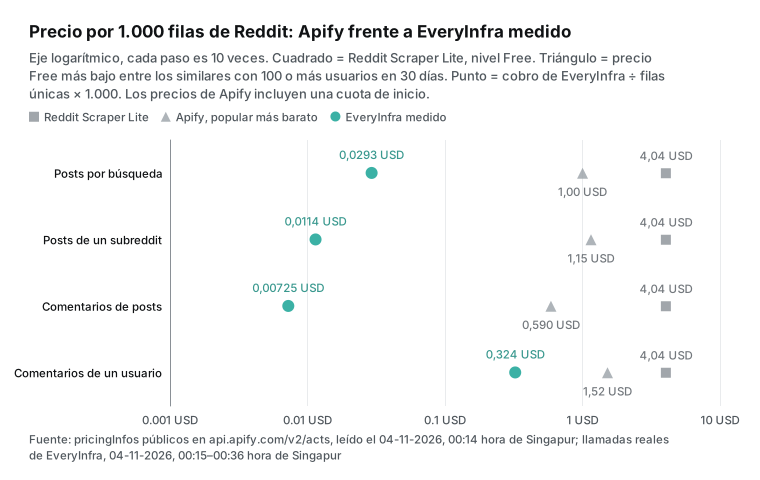
Esta tabla es la conclusión del artículo. Cada fila tiene dos precios de Apify. Uno es Reddit Scraper Lite, el de más usuarios. El otro es el precio Free más bajo entre los scrapers que hacen el mismo trabajo y tuvieron al menos 100 usuarios en los últimos 30 días. Leímos los precios del campo pricingInfos de los metadatos públicos de Apify a las 00:15 hora de Singapur del 04-11-2026. Cada precio de Apify supone una ejecución que devuelve 1.000 filas en el nivel Free, con la cuota de inicio por defecto. Las cifras de EveryInfra salen de nuestras llamadas reales: el cobro es billing.charged_usd, las filas son results y los duplicados se quitan por id.
| Dato | Endpoint de EveryInfra | Medido: llamadas / filas / únicas / cobro | EveryInfra por 1.000 (únicas) | Reddit Scraper Lite (Free) | Veces | Popular más barato en Apify (Free) | Veces |
|---|---|---|---|---|---|---|---|
| Posts por búsqueda | reddit/search | 10 / 195 / 190 / 0,00556 USD | 0,0293 USD | 4,04 USD | 138 | clearpath Search 1,00 USD | 34 |
| Posts de un subreddit | reddit/subreddit_posts | 10 / 837 / 486 / 0,00556 USD | 0,0114 USD | 4,04 USD | 353 | automation-lab 1,15 USD | 101 |
| Comentarios de posts | reddit/comments | 13 / 997 / 997 / 0,007228 USD | 0,00725 USD | 4,04 USD | 557 | automation-lab 0,59 USD | 81 |
| Comentarios de un usuario | reddit/user_comments | 1 / 100 / 100 / 0,032403 USD | 0,324 USD | 4,04 USD | 12,5 | harshmaur User 1,52 USD | 4,7 |
Cada cociente es el precio de Apify dividido entre el nuestro, y hay cuatro matices. Primero, casi toda la diferencia viene de «una petición, una página»: con 100 comentarios por llamada, el precio fijo se reparte mucho. Si cada llamada devuelve una o dos filas, el resultado se invierte, y la sección del punto de equilibrio hace la cuenta. Segundo, los 0,59 USD de automation-lab salen de 0,000575 USD por comentario, 0,003 USD de inicio y 10 filas de post a 0,00115 USD. Su página en la Store anuncia que el comentario Free sube a 0,00075 USD el 17 de noviembre, lo que da 0,76 USD con la misma cuenta (página de automation-lab). Tercero, en posts somos más baratos, pero no siempre llegamos a 1.000: la búsqueda cubre solo el último mes y los subreddits no tienen paginación. Cuarto, Apify cambia precios cada uno o dos meses; las fechas están en «Cambios recientes».
Cómo medimos y qué contaba como aprobado
Escribimos las reglas antes de la primera llamada. Cada tipo de dato necesitaba al menos dos llamadas reales, repartidas en tres o más momentos. El coste por 1.000 siempre se divide entre filas únicas. Para juzgar si el árbol de comentarios está completo, comparamos nuestras filas una por una con la lectura de un tercero de al menos dos páginas de post, sin deducirlo de una lista de campos. Si Apify era más barato, más completo o más adecuado para algún trabajo, el texto y la tabla tenían que decirlo. Al menos dos llamadas debían quedarse sin datos y anotamos lo que costó cada una. A reddit/user_comments le hicimos como mucho una llamada real, y a reddit/painpoint, ninguna.
Todas las peticiones fueron a POST https://api.everyinfra.com/api/v1/social. La primera salió a las 00:15 hora de Singapur del 4 de noviembre de 2026, la tanda de comentarios fue de las 00:26 a las 00:32 hora de Singapur y la última terminó a las 00:36 hora de Singapur. De cada llamada anotamos la hora de envío, el estado HTTP, la duración, las filas y charged_usd. Un script recalculó después todas las cifras desde las respuestas originales, y de ahí salen los números del texto, las tablas y los gráficos.
| Trabajo | Endpoint y parámetros | Llamadas | Hora (de Singapur, 4 nov) | Qué miramos |
|---|---|---|---|---|
| Búsqueda | reddit/search, limit 25. Siete palabras clave, más newest, top y popular para «standing desk» | 10 | 00:15 a 00:19 | Filas por llamada, efecto del orden, rango de fechas |
| Posts de subreddit | reddit/subreddit_posts. Ocho combinaciones en r/Python y dos en r/smallbusiness, limit 100 | 10 | 00:20 a 00:24 | Posts nuevos por orden extra, techo de una comunidad |
| Comentarios | reddit/comments. 13 posts de 16 a 771 comentarios, limit 100 | 13 | 00:26 a 00:32 | Filas por post, parte del total, respuestas anidadas |
| Usuarios | reddit/user_posts siete veces en tres cuentas y reddit/user_comments una vez | 8 | 00:24 a 00:35 | Hasta dónde llega, qué devuelve la llamada cara |
| Detalle de post | reddit/post_detail en dos posts | 2 | 00:33 | Si el número coincide con el listado |
| Sin datos | Sin clave, orden inválido, parámetro de más, subreddit, post y usuario inexistentes | 6 | 00:25 a 00:36 | Qué casos se cobran |
En total hicimos 49 llamadas reales por 0,056311 USD. Todas compartían una clave de prueba limitada a 10 llamadas por minuto, así que recibimos varias respuestas HTTP 429 (demasiadas peticiones). El script esperó 60 segundos y repitió la llamada. Un 429 no se cobra ni entra en los totales.
Prueba 1: el uso más común de un Apify Reddit scraper, 1.000 posts por búsqueda
reddit/search devuelve hasta 25 filas por llamada y su rango de fechas está fijo en el último mes; según el catálogo, el orden elegido no cambia ese rango. Buscamos siete palabras clave una vez cada una: standing desk, notion alternative, claude code, best vpn, airpods pro 3, home espresso machine y sourdough starter. Devolvieron 25, 17, 25, 25, 25, 24 y 25 filas, una media de 23,7. Todos los posts eran del 3 de octubre al 3 de noviembre de 2026, de acuerdo con el rango de un mes. Las siete llamadas costaron 0,003892 USD y ninguna de las 166 filas se repitió: 0,0234 USD por 1.000.
El orden cambió mucho los resultados. Para standing desk, el orden por defecto (relevancia) dio 25 filas y popular 22, pero top solo 4 y newest solo 3, las tres del 3 de noviembre. El catálogo lo explica: la búsqueda devuelve solo posts que encajan con la palabra clave, así que puede quedarse por debajo del límite. Una llamada sin filas se reembolsa como resultado vacío; una con tres filas cuesta los 0,000556 USD normales. Con esas tres llamadas incluidas, las 10 búsquedas dieron 195 filas, 190 únicas, por 0,00556 USD: 0,0293 USD por 1.000, la cifra más prudente que usa la tabla resumen.
Para 1.000 posts a 23,7 por llamada hacen falta unas 42 búsquedas, es decir, 42 palabras clave o combinaciones distintas, por unos 0,0234 USD. Si solo te interesan una o dos palabras, no llegarás a 1.000, porque en un mes no hay tantos posts que coincidan y nuestra búsqueda no va más atrás. Apify es distinto aquí: el parámetro time de Lite admite all, year, month y otros valores (página de la Store, «Advanced parameters»). El scraper de búsqueda de clearpath admite cinco órdenes y filtros de tiempo, y cuesta 0,00099 USD por resultado más 0,00001 USD por escritura y una pequeña cuota de inicio: 1,00 USD por 1.000 (página de clearpath Search). Para 1.000 posts históricos sobre un tema, conviene Apify; para vigilar a diario un grupo de palabras clave del último mes, nuestra llamada de 0,000556 USD con más de 20 posts sale mucho más barata.
| Palabra clave | Orden | Filas | Post más antiguo (UTC) | Cobro |
|---|---|---|---|---|
| standing desk | por defecto (relevance) | 25 | 3 de octubre | 0,000556 USD |
| standing desk | popular | 22 | 27 de octubre | 0,000556 USD |
| standing desk | top | 4 | 6 de octubre | 0,000556 USD |
| standing desk | newest | 3 | 3 de noviembre | 0,000556 USD |
| notion alternative | por defecto | 17 | 3 de octubre | 0,000556 USD |
| Las otras 5 palabras | por defecto | 24 a 25 | 3 a 6 de octubre | 0,000556 USD cada una |
Prueba 2: 1.000 posts de un subreddit, de los que conseguimos 286
reddit/subreddit_posts devuelve hasta 100 filas por llamada y no tiene paginación. Para conseguir más solo puedes cambiar el orden y la ventana de tiempo: sort admite newest, popular, top, rising y relevance, y date_range solo se aplica con sort=top, como dice el catálogo. Probamos ocho combinaciones en r/Python, una vez cada una. El gráfico muestra cuántos posts nuevos añadió cada combinación extra.
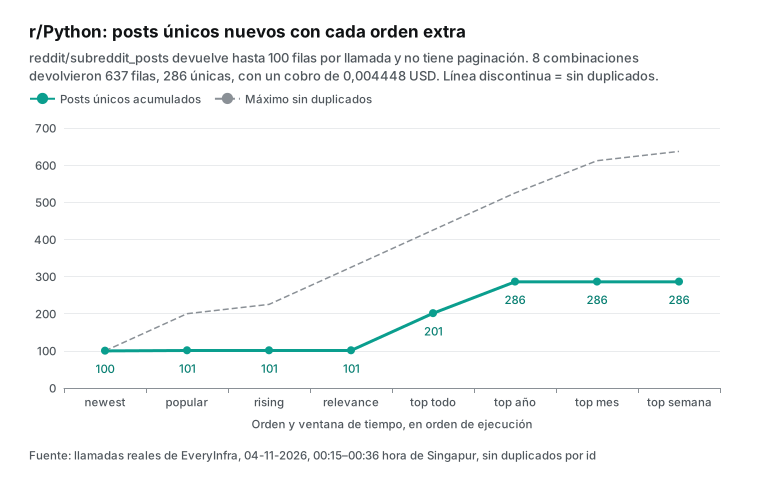
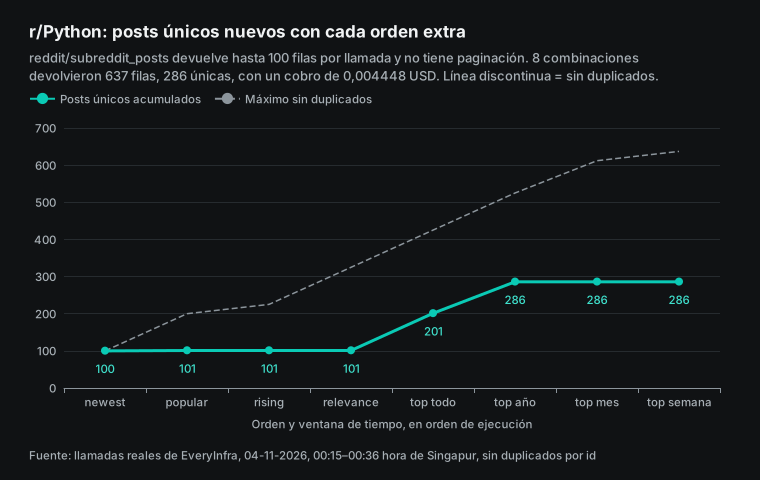
El resultado es claro. Las 100 filas de newest, popular y relevance eran casi el mismo conjunto, 101 posts únicos entre las tres, y rising devolvió 25 ya vistos. Solo dos combinaciones trajeron posts nuevos: top con all_time (100, el más antiguo de 2017) y top con past_year (85 nuevos). Las 87 filas de past_month y las 25 de past_week estaban repetidas. Las ocho llamadas costaron 0,004448 USD por 286 posts únicos, o 0,0156 USD por 1.000. Si sabes de antemano que solo importan newest, top todo y top año, tres llamadas dan los mismos 286 posts por 0,001668 USD, que son 0,0058 USD por 1.000. En r/smallbusiness, dos llamadas (newest y top año) dieron 100 filas cada una sin solaparse. Las 10 llamadas de subreddit sumaron 837 filas, 486 únicas, por 0,00556 USD: los 0,0114 USD por 1.000 de la tabla resumen.
Así que no podemos entregar «1.000 posts de un subreddit», y para eso Apify encaja mejor. Los listados de Reddit solo llegan a unos 1.000 elementos hacia atrás; el readme de Lite lo dice y propone combinar órdenes, búsqueda y filtros de tiempo para reunir más (página de la Store, «Reddit's 1,000 items limit»). Un scraper con paginación se acerca a 1.000 filas por orden, mientras que nosotros damos solo la primera página de 100. Para un vistazo diario a lo nuevo y lo popular de una comunidad, dos llamadas (newest y top del último día) cuestan 0,001112 USD. Para exportar de una vez años de historia de una comunidad, usa Apify o solicita el programa para investigadores de Reddit.
Prueba 3: lo que debe superar un Apify Reddit comment scraper, 1.000 comentarios y el árbol
Los comentarios muestran la mayor diferencia de precio y también la ventaja más clara de Apify en funciones. reddit/comments recibe la URL de un post y devuelve hasta 100 comentarios por llamada. Elegimos 13 posts con entre 16 y 771 comentarios y llamamos una vez a cada uno.
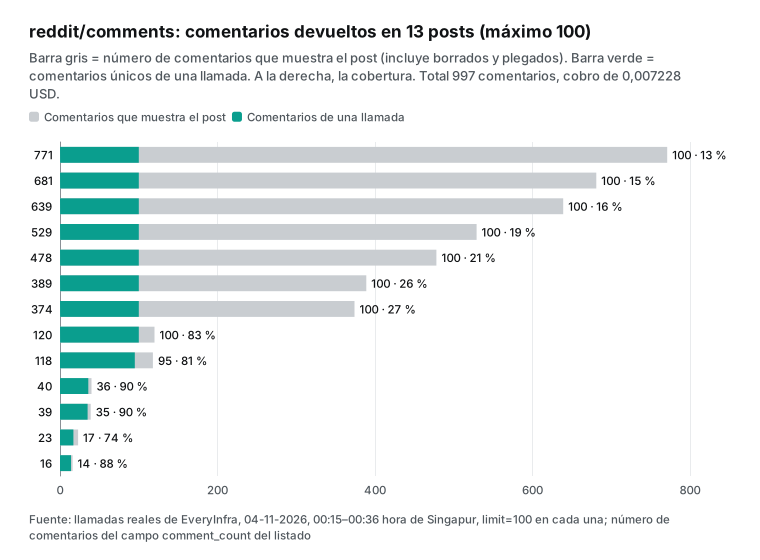
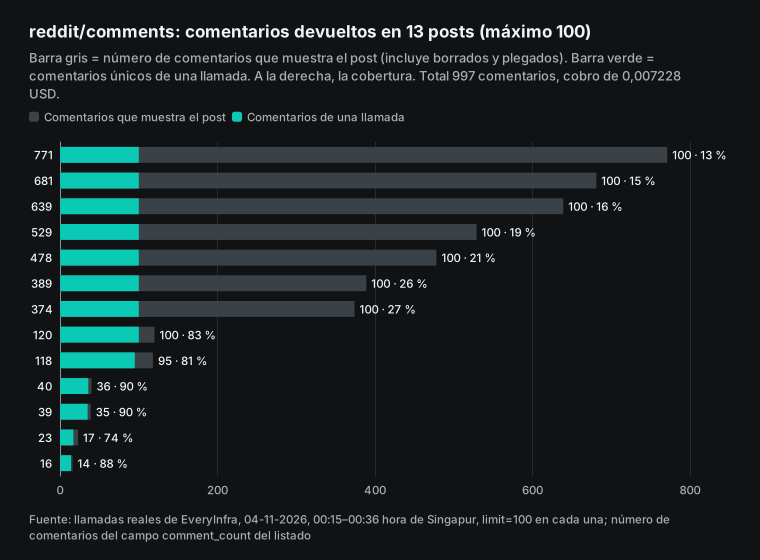
Las 13 llamadas costaron 0,007228 USD y devolvieron 997 comentarios sin repetir: 0,00725 USD por 1.000, con dos condiciones. Primera: en posts con menos de 100 comentarios obtuvimos entre el 74 % y el 90 % del número que muestra el post. Parte de la diferencia son comentarios borrados o eliminados, que siguen contando en el post pero ya no tienen texto, y el resto son comentarios que Reddit pliega tras «cargar más». Segunda: en posts con más de 100 comentarios, una llamada da 100, que en el hilo de 771 es el 13 %. Con nuestro tope no se obtienen todos los comentarios de un hilo con mucha actividad. El scraper de comentarios de clearpath indica que con maxCommentsPerPost en 0 y expandAllComments activado devuelve el árbol completo, incluidas respuestas anidadas 10 niveles o más tras «continue this thread» (página de clearpath). Para este trabajo, Apify es la mejor herramienta.
| Comentarios en el post | Obtuvimos | Cobertura | Hora (de Singapur) | Cobro |
|---|---|---|---|---|
| 771 | 100 | 13 % | 00:26 | 0,000556 USD |
| 681 | 100 | 15 % | 00:27 | 0,000556 USD |
| 639 | 100 | 16 % | 00:27 | 0,000556 USD |
| 529 | 100 | 19 % | 00:28 | 0,000556 USD |
| 478 | 100 | 21 % | 00:28 | 0,000556 USD |
| 389 | 100 | 26 % | 00:29 | 0,000556 USD |
| 374 | 100 | 27 % | 00:29 | 0,000556 USD |
| 120 | 100 | 83 % | 00:30 | 0,000556 USD |
| 118 | 95 | 81 % | 00:30 | 0,000556 USD |
| 40 | 36 | 90 % | 00:31 | 0,000556 USD |
| 39 | 35 | 90 % | 00:32 | 0,000556 USD |
| 23 | 17 | 74 % | 00:32 | 0,000556 USD |
| 16 | 14 | 88 % | 00:32 | 0,000556 USD |
«¿Está completo el árbol?» tiene dos partes. La primera es si vuelven las respuestas anidadas. Tomamos los dos posts de 16 y 23 comentarios y un lector de páginas de terceros descargó cada página con sus comentarios. Las dos páginas mostraban 27 comentarios, uno de ellos un marcador de comentario borrado. Buscamos los otros 26 en nuestras filas por el inicio del texto y aparecieron los 26: 12 de primer nivel, 10 respuestas de segundo nivel y 4 de tercero. Además devolvimos 5 comentarios que el lector no mostró. Así que las filas no son solo comentarios de primer nivel; también traen respuestas de segundo y tercer nivel.
La segunda parte es la estructura. Cada fila de comentario de estas 13 llamadas tenía siete campos: id, text, author_username, like_count, url, posted_at y platform. El catálogo lista también community, pero ninguna de estas respuestas lo traía, así que no dependas de él; para el nombre de la comunidad, usa el community de la lista de posts o la url del comentario. No hay id del comentario padre ni nivel de profundidad: sabes que 14 de esas filas son respuestas, pero no quién respondió a quién. En Apify, los registros de comentario de Lite llevan parentId y numberOfReplies (página de la Store, «Example Reddit post»). automation-lab lleva depth y parentId, y aclara que commentCoverage es unverified y no promete el árbol entero (página de la Store, «Comment fields»). La actualización de clearpath del 06-10-2026 corrigió depth en hilos expandidos por completo.
¿Qué supone esto para tu caso? Para contar sentimiento, frecuencia de palabras, clasificar temas o encontrar citas de quejas, una tabla plana basta, a 0,00725 USD por 1.000. Para saber quién discute con quién, qué profundidad tienen las cadenas de respuestas o qué preguntas contestó el autor, necesitas una herramienta con parentId. Explicamos el marcador MoreComments de PRAW y replace_more en por qué las exportaciones de comentarios de Reddit salen incompletas (documentación de PRAW). El árbol que devuelve Reddit tiene huecos sin expandir por diseño, que su documentación JSON llama objetos more (wiki de reddit-archive). La investigación ya conoce este problema: en 2018, Gaffney y Matias encontraron grandes huecos en un conjunto de datos muy usado que decía contener «todos los comentarios públicos de Reddit», con el mayor riesgo para estudios de historiales de usuario y de redes (artículo en arXiv). Uses la herramienta que uses, guarda dos números con cada exportación: cuántos comentarios obtuviste y cuántos muestra el post.
También llamamos dos veces a reddit/post_detail. Para los posts de 771 y 40 comentarios, su comment_count coincidía con el listado, y cada llamada costó 0,000556 USD. Si eliges posts antes de pedir comentarios, ordénalos por el comment_count del listado; no hace falta otra llamada de detalle.
Prueba 4: posts y comentarios de un usuario, y cuándo no compensa el endpoint caro
reddit/user_posts devuelve hasta 50 filas por llamada al mismo precio de 0,000556 USD. Probamos primero spez, la cuenta del CEO de Reddit, con newest, top de todo el tiempo, top del último año y popular. Las cuatro llamadas dieron los mismos 24 posts, del 11 de julio de 2015 al post sobre el muro de inicio de sesión del 29 de octubre. El orden no cambió nada en esta cuenta: las cuatro llamadas costaron 0,002224 USD y de la segunda a la cuarta sobraban.
La cuenta de un medio, washingtonpost, devolvió 50 posts en una llamada, del 20 de abril al 3 de noviembre de 2026, que son 0,0111 USD por 1.000; con top de todo el tiempo volvieron los mismos 50. La cuenta de la NASA, nasa, también dio 50 posts con newest, del 5 de junio de 2025 al 29 de octubre de 2026. Es decir, una llamada se queda en 50 posts de usuario y otros órdenes no alcanzan los más antiguos. Para recorrer todo el historial de una cuenta activa encaja mejor un scraper de Apify con paginación: el Reddit User Scraper de harshmaur dice devolver el historial completo de posts y comentarios, y el scraper de contenido de usuario de clearpath, hasta 1.000 elementos por usuario.
reddit/user_comments es otro caso: una llamada cuesta 0,032403 USD, 58 veces una normal, y devuelve hasta 200 filas. La llamamos una vez para spez con limit 200 y obtuvimos 100 filas, del 31 de julio de 2025 al 29 de octubre de 2026: 0,324 USD por 1.000. Hay que decir algo más con claridad: el texto más largo de esas 100 filas tenía justo 300 caracteres y la media era de 160. El field_note del catálogo para este endpoint explica que, cuando otras fuentes no están disponibles, los resultados vienen de una fuente de respaldo que corta el texto en los primeros 300 caracteres. Eso pasó en esta llamada. El resultado sirve para ver dónde publica una persona, con qué frecuencia y cuántos votos recibe, no para analizar comentarios largos.
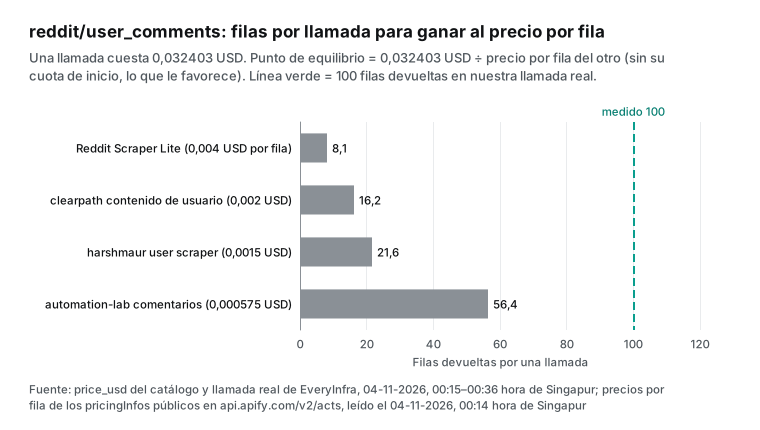
¿Cuándo no compensa este endpoint? Depende de las filas por llamada. Divide 0,032403 USD entre el precio por fila de Apify y obtienes el mínimo de filas para que salgamos más baratos.
| Precio por fila en Apify (Free) | Filas por llamada para empatar | Nuestra llamada real devolvió |
|---|---|---|
| Reddit Scraper Lite, 0,004 USD | 8,1 | 100 |
| clearpath contenido de usuario, 0,002 USD | 16,2 | 100 |
| harshmaur user scraper, 0,0015 USD | 21,6 | 100 |
| automation-lab comentarios, 0,000575 USD | 56,4 | 100 |
Así que evítalo en tres casos. Primero, cuando el usuario tiene pocos comentarios, como una cuenta nueva o una con una docena de mensajes: un scraper por fila sale más barato. Segundo, cuando en realidad quieres la conversación de un post: usa reddit/comments, 45 veces más barato a 0,00725 USD por 1.000. Tercero, cuando necesitas el texto largo y esta llamada cae en el corte de 300 caracteres: cambia de herramienta o reintenta más tarde. Para estudiar muchos usuarios a la vez, una llamada devuelve de 100 a 200 filas, de 0,16 a 0,32 USD por 1.000, entre 4,7 y 9,4 veces menos que los 1,52 USD del user scraper de harshmaur. Pero si también necesitas el karma o la antigüedad de cada cuenta, ese scraper de harshmaur los da en una sola ejecución.
reddit/painpoint cuesta aún más, 0,072 USD por llamada, y no lo llamamos; solo contamos lo que vende según el catálogo. Busca hasta 15 posts para una palabra clave, lee sus comentarios de primer nivel y devuelve una fila resumen: posts encontrados, comentarios leídos, recuentos aproximados de comentarios negativos y positivos, palabras que se repiten en los negativos y comunidades implicadas. También devuelve los posts principales y las citas negativas con más votos. El catálogo aclara que negativo y positivo salen de una lista de palabras, que la ironía y el tono mixto se juzgan mal y que son recuentos aproximados, no una tasa de insatisfacción.
| Opción | Llamadas | Coste | Comentarios leídos por post | Cómo se juzga el tono |
|---|---|---|---|---|
reddit/painpoint | 1 | 0,072 USD | Solo primer nivel | Lista de palabras, recuento aproximado |
reddit/search + 15 × reddit/comments | 16 | 0,0089 USD | Hasta 100, con respuestas anidadas | Tu propio modelo |
Hacerlo tú mismo cuesta 8 veces menos y lee hasta 100 comentarios por post. painpoint sirve a quien no quiere programar y busca un vistazo rápido a las quejas sobre un producto; para un informe semanal, montarlo tú sale más barato. Mostramos el método completo en tareas programadas de Claude Code para detectar problemas en Reddit.
¿Se cobran las llamadas fallidas y vacías?
Aquí es donde más difieren las reglas de cobro de Apify y de EveryInfra. Enviamos a propósito seis peticiones que no podían devolver datos.
| Caso | Enviado (hora de Singapur) | Estado HTTP | Respuesta | Cobro |
|---|---|---|---|---|
| Sin clave | 00:25 | 401 | missing_key, con la pista de usar la cabecera Authorization | 0 USD |
sort igual a hot | 00:25 | 422 | invalid_value, con los valores permitidos y did_you_mean popular y top | 0 USD |
Parámetro time_filter de más | 00:25 | 422 | unknown_param, con parámetros obligatorios y opcionales y un ejemplo que funciona | 0 USD |
| Subreddit inexistente | 00:26 | 200 | Una fila de relleno con solo id, community y platform, cobrada como un resultado | 0,000556 USD |
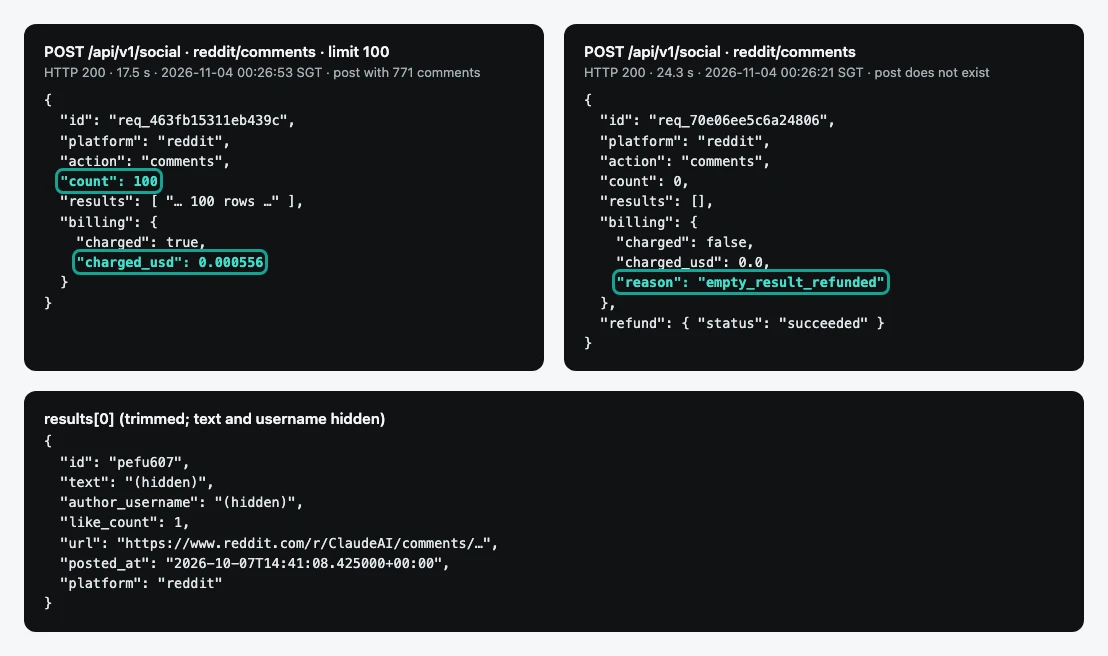
| Post inexistente | 00:26 | 200 | 0 filas, empty_result_refunded, cobro reembolsado | 0 USD |
| Usuario inexistente | 00:36 | 200 | 0 filas, empty_result_refunded | 0 USD |
Los tres primeros son errores de parámetros. Comprobamos primero la clave y después los parámetros; una petición mal formada recibe un 4xx al momento, sin cobro, y el error explica cómo corregirla para que un cliente de IA la arregle y la reenvíe. El quinto y el sexto son resultados vacíos normales: la petición funcionó, pero nada coincidía, y el cobro se reembolsó al instante.
El cuarto pide atención. Con un nombre de subreddit que no existe, la llamada devuelve HTTP 200 y count 1. La única fila tiene un id que empieza por target-status: y solo trae los campos community y platform, sin título, texto ni enlace; esa llamada costó 0,000556 USD, el precio de un resultado. Por eso, en tus lotes de subreddits, descarta esa fila por el prefijo de su id antes de contar filas o calcular el coste unitario. Si no queda ninguna fila, el nombre está mal o el subreddit ya no existe: quítalo de tu lista y no volverás a pagar por él.
En Apify, cada actor fija sus reglas. El Reddit Scraper propio de Apify tiene un evento «No result» de 0,0005 USD: una comunidad borrada, una búsqueda sin coincidencias o un post sin comentarios escriben un registro que explica el motivo, a ese precio (página de la Store). automation-lab dice que las ejecuciones sin resultados no se cobran. La cuota de inicio de Lite, que depende de la memoria, se cobra al arrancar la ejecución aunque no vuelva ningún resultado: 0,04 USD con los 2 GB por defecto. Las ejecuciones fallidas o agotadas por tiempo son más comunes de lo que parece; más abajo verás que el 10 % de las 360.661 ejecuciones de Lite en 30 días agotó el tiempo. La documentación de Apify dice que puedes fijar un cobro máximo por ejecución, que se detiene al llegar a él (Actors in Store); fíjalo antes de un trabajo grande.
Precio de Apify Reddit Scraper Lite: 0,004 USD por resultado más una cuota de inicio de 2 GB
Quien busca «apify reddit scraper» llega casi siempre a Reddit Scraper Lite, de trudax. Tuvo 8.543 usuarios en los últimos 30 días, más que ningún otro scraper de Reddit en la Store y alrededor de un 50 % más que el segundo (usuarios y ejecuciones según la API de listado de la Store, leída el 04-11-2026 a las 00:14 hora de Singapur; la API de detalle del mismo actor daba 8.540 usuarios y 363.964 ejecuciones, menos de un 1 % de diferencia). Cobra dos cosas. Cada resultado escrito en el dataset cuesta 0,004 USD en el nivel Free, o 4,00 USD por 1.000. Además, cada ejecución paga una cuota de inicio según la memoria, de 0,02 USD por GB; con los 2.048 MB por defecto son 0,04 USD, y la plataforma fija 0,04 USD como cobro mínimo por ejecución. Todo sale de los campos pricingInfos y defaultRunOptions de los metadatos públicos de Lite, leídos a las 00:15 hora de Singapur del 04-11-2026. La documentación de Apify asocia los niveles a los planes: Free paga FREE, Starter paga BRONZE, Scale paga SILVER y Business paga GOLD; PLATINUM y DIAMOND son solo para empresas (Actor pricing and costs).
| Nivel (plan) | Por resultado | 1.000 resultados en una ejecución, con 0,04 USD de inicio |
|---|---|---|
| FREE (Free) | 0,004 USD | 4,04 USD |
| BRONZE (Starter) | 0,0038 USD | 3,84 USD |
| SILVER (Scale) | 0,0036 USD | 3,64 USD |
| GOLD (Business) | 0,0034 USD | 3,44 USD |
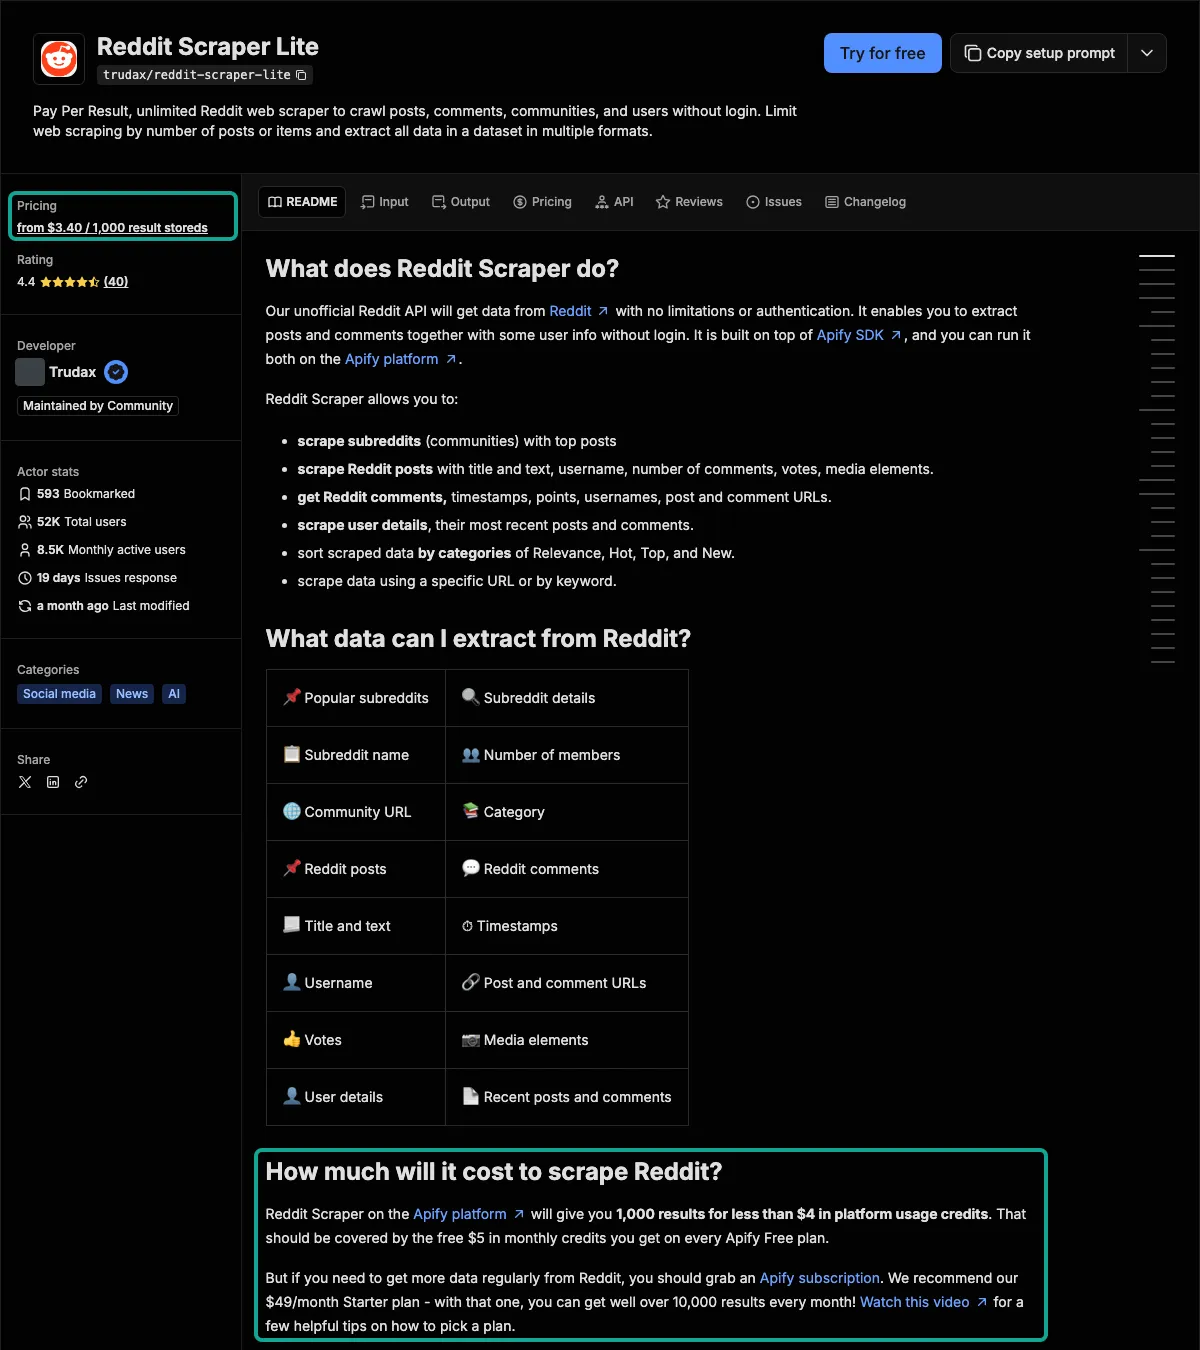
Hay dos detalles fáciles de malinterpretar. Primero, el «from 3.40 / 1,000» de la barra lateral es el nivel con más descuento: un usuario Free paga 4,00 USD más 0,04 USD por ejecución, así que una ejecución de 1.000 resultados cuesta 4,04 USD en Free y 3,44 USD en Business. Segundo, el «plan Starter de 49 USD al mes» del texto no coincide con la página de precios actual, que muestra 5 USD de crédito prepagado mensual en Free, Starter desde 19 USD, Scale a 199 USD y Business a 999 USD, sin acumular el crédito no usado. El readme no se actualizó; para las cuentas, vale la página de precios. Otro detalle: Lite cuenta «cada post, comentario, usuario y comunidad» como un resultado (sección «Results» de la página de la Store). Si pides 100 posts de un subreddit sin desactivar los comentarios, también escribe los comentarios de esos posts y cobra 0,004 USD por cada uno. La página ofrece skipComments, maxComments y maxItems; sin tope, una ejecución de «100 posts» puede escribir miles de filas.
El «Reddit Scraper» original está retirado: desde el 21 de septiembre, solo para usuarios existentes
Muchos tutoriales que dicen «Apify Reddit Scraper» se refieren a otro actor, el Reddit Scraper de trudax. Desde febrero de 2022 era un alquiler mensual de 45 USD con 1.440 minutos de prueba. El 21 de septiembre de 2026 pasó a cobro por evento (0,0001 USD por resultado y 0,00005 USD por inicio). La nota del cambio dice que Apify está eliminando el precio de alquiler mensual, que el actor dejará de listarse públicamente y que los usuarios existentes conservan el acceso completo; está en el campo reasonForChange de sus metadatos públicos, leídos el 04-11-2026. Los mismos metadatos tienen isDeprecated en true y el título de la Store lleva «[DEPRECATED]». Aún tuvo 459 usuarios en 30 días, pero los nuevos no pueden empezar a usarlo. Para alguien que llega hoy, las dos opciones con ese nombre son Lite y el Reddit Scraper propio de Apify.
El scraper propio de Apify pone precio por separado a cada tipo de resultado. Su página dice que, cuando una petición no da resultados, escribe un registro que explica el motivo a un precio menor que un resultado normal, y que el mismo post alcanzado por dos entradas se escribe y se cobra dos veces (página de la Store, «How much will it cost?»).
| Evento del Reddit Scraper propio de Apify | Free | Gold |
|---|---|---|
| Post | 0,004 USD | 0,0025 USD |
| Comentario | 0,0032 USD | 0,002 USD |
| Comunidad | 0,0065 USD | 0,004 USD |
| Usuario | 0,002 USD | 0,001 USD |
| Sin resultado | 0,0005 USD | 0,0005 USD (precio único) |
| Inicio | 0,001 USD | 0,001 USD (precio único) |
746 scrapers de Reddit en la Apify Store: precios y resultados de las ejecuciones
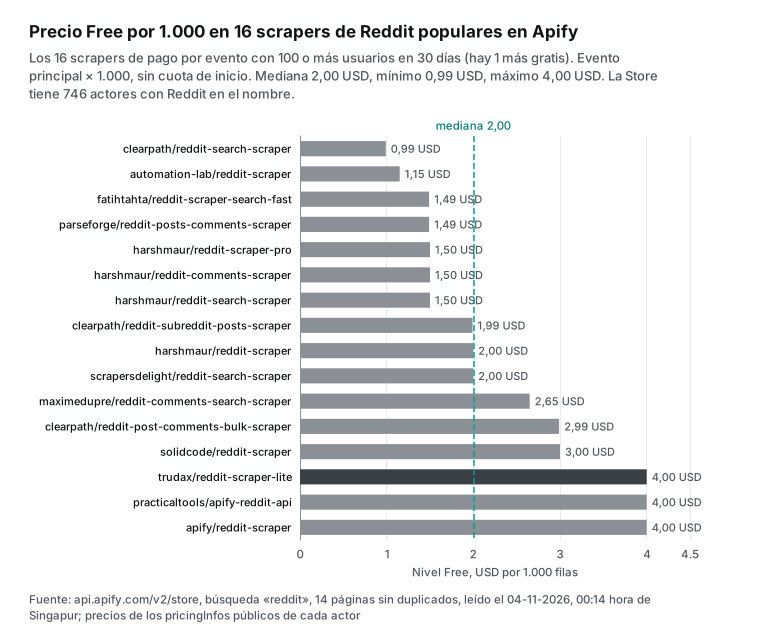
Usamos el endpoint público del listado de la Store (Get list of Actors in Store) para buscar «reddit». Tras 14 páginas y quitar duplicados, 746 actores tenían Reddit en el título o el nombre: 717 cobran por evento y 29 son gratis. Diecisiete tuvieron al menos 100 usuarios en 30 días; el gráfico muestra el precio Free del evento principal de los 16 que cobran por resultado (el decimoséptimo es uno gratuito de red_crawler para información de comunidades). El más barato es el scraper de búsqueda de clearpath, 0,99 USD por 1.000. El segundo y el tercero en usuarios, el scraper general de harshmaur y el de fatihtahta, cuestan 2,00 y 1,49 USD; el Reddit Comment Scraper de harshmaur, 1,50 USD. Tres comparten el precio más alto, 4,00 USD: Lite, uno de practicaltools y el de Apify. La mediana ronda los 2,00 USD. Estos precios no incluyen la cuota de inicio, que se cobra por ejecución según la memoria: 0,04 USD en Lite, 0,02 USD en harshmaur y 0,00099 USD en clearpath.
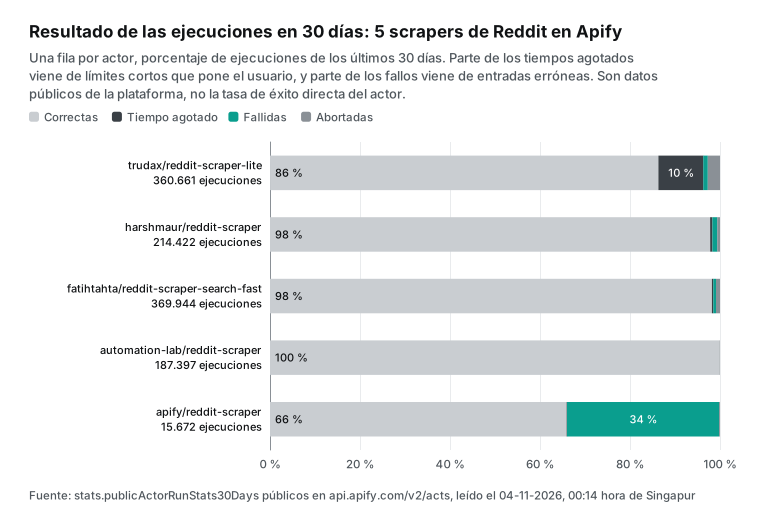
Además del precio, los metadatos públicos de cada actor traen estadísticas de 30 días: cuántas ejecuciones terminaron bien, fallaron, agotaron el tiempo o se abortaron.
| Actor | Ejecuciones en 30 días | Correctas | Tiempo agotado | Fallidas |
|---|---|---|---|---|
| trudax/reddit-scraper-lite | 360.661 | 86,3 % | 10,0 % | 1,0 % |
| harshmaur/reddit-scraper | 214.422 | 97,8 % | 0,5 % | 1,1 % |
| fatihtahta/reddit-scraper-search-fast | 369.944 | 98,2 % | 0,3 % | 0,6 % |
| automation-lab/reddit-scraper | 187.397 | 99,9 % | 0,0 % | 0,0 % |
| apify/reddit-scraper | 15.672 | 65,9 % | 0,1 % | 33,8 % |
Dos cifras merecen cuidado. Primero, 35.919 de las 360.661 ejecuciones de Lite agotaron el tiempo, alrededor del 10 %, un orden de magnitud más que las demás. Solo podemos suponer la causa: algunos usuarios fijan un límite de tiempo corto y otros no ponen maxItems y piden demasiados posts y comentarios de una vez. Una ejecución que agota el tiempo se cobra igual por los resultados ya escritos, y también paga la cuota de inicio. Segundo, 5.296 de las 15.672 ejecuciones del scraper propio de Apify fallaron, alrededor del 34 %. Como su página dice que los casos «sin resultado» escriben un registro de 0,0005 USD y no cuentan como fallo, lo más probable es que se trate de entradas erróneas o bloqueos de Reddit. Son estadísticas públicas de la plataforma, no la tasa de éxito directa de cada actor; la documentación de Apify define los estados en Runs and builds. Los 17 actores populares sumaron 1.526.908 ejecuciones: 95,3 % correctas, 2,6 % con tiempo agotado, 1,1 % fallidas y 1,0 % abortadas. Apify también pasa una prueba automática diaria a cada actor público y marca «en mantenimiento» al que falla seguido (Automated testing); revisa esa marca antes de elegir.
De nuestro lado, 46 de las 49 llamadas devolvieron HTTP 200; contando solo esas 46, las duraciones fueron de 6 a 41 segundos y una mediana de 14. Las tres respuestas 4xx fueron los parámetros erróneos enviados a propósito. Ninguna llamada agotó el tiempo ni devolvió un 5xx, pero 49 llamadas no bastan para una tasa de éxito: solo podemos decir que en esta tanda no vimos fallos.
| Endpoint | Llamadas | Mediana en segundos | Rango |
|---|---|---|---|
reddit/search | 10 | 6,4 | 6,0 a 10,2 |
reddit/subreddit_posts | 10 | 17,8 | 9,5 a 30,7 |
reddit/comments | 13 | 22,4 | 11,4 a 40,8 |
reddit/user_posts | 7 | 12,5 | 9,1 a 14,5 |
reddit/post_detail | 2 | 23,6 | 11,2 a 36,0 |
Campos: ¿devuelven lo mismo los dos lados?
La otra cara del precio bajo son menos campos. La tabla recoge los campos que devolvieron de verdad nuestras 49 llamadas, no los que lista el catálogo, y señala dónde difieren. En Apify los campos varían mucho entre scrapers: el scraper general de harshmaur dice devolver más de 60 campos por post, con multimedia y galerías, y los comentarios de Lite y automation-lab llevan parentId. Consulta la salida de ejemplo de cada página de la Store; no los ejecutamos, así que no listamos sus campos por ellos.
| Endpoint | Campos devueltos de verdad | Qué falta |
|---|---|---|
reddit/search, reddit/subreddit_posts | id, title, text, author_username, community, url, like_count, comment_count, posted_at, platform; los de subreddit, además, domain y flair | URL de imágenes y vídeos, premios y fijados |
reddit/comments | id, text, author_username, like_count, url, posted_at, platform | Id del padre, profundidad, número de respuestas; el catálogo lista community, pero las respuestas reales no lo traían; no dependas de él |
reddit/user_comments | id, text, author_username, like_count, post_id, post_title, url, posted_at, platform | El texto puede venir cortado en 300 caracteres; sin karma ni antigüedad |
Para la mayoría de los trabajos de «qué dice la gente», estas columnas bastan: los comentarios traen texto, autor, votos y hora, y los posts, título, comunidad y número de comentarios, así que puedes elegir posts por comentarios y luego pedirlos. La url de un post va directa a reddit/comments, y el ejemplo de Python de más abajo encadena así las llamadas. Si necesitas archivos multimedia, árboles de comentarios o perfiles, encaja mejor un scraper de Apify con más campos: eso es lo que compra el precio por fila. Otro punto toca al cobro: Lite se ejecuta por defecto con 3.600 segundos de límite y 2.048 MB de memoria (campo defaultRunOptions de los metadatos de Lite). Más memoria es más cuota de inicio y, según Usage and resources, también más CPU; con menos memoria ahorras en el inicio, pero la ejecución va más lenta y se acerca más al límite. Nosotros no tenemos memoria ni límite que ajustar: nuestra llamada más lenta, de 41 segundos, costó también 0,000556 USD.
Los precios en Apify cambian a menudo
Cada periodo de precio en los metadatos de los 15 actores de Reddit que leímos lleva una fecha startedAt.
| Actor | Precio actual desde | Qué cambió |
|---|---|---|
| apify/reddit-scraper | 20-10-2026 | Octavo periodo de precio desde el 25-09-2026 |
| maximedupre/reddit-comments-search-scraper | 18-10-2026 | 0,00265 USD por comentario en Free |
| automation-lab/reddit-scraper | 25-08-2026, el siguiente el 17-11-2026 | Comentario un 30 % más caro |
| trudax/reddit-scraper | 21-09-2026 | Cobro por evento y retirada |
| trudax/reddit-scraper-lite | 30-06-2026 | Sin cambios desde entonces |
El scraper propio de Apify tuvo cuatro de esos periodos solo el 1 de octubre, y su página cambió por última vez el 27-10-2026. Lo que significa para ti: cualquier comparación de precios, esta incluida, puede quedar desfasada en uno o dos meses. Antes de comprar, vuelve a leer pricingInfos con el endpoint Get Actor y anota cuándo lo leíste. La lista completa de endpoints está en la referencia de la API y las reglas del cobro por evento, en la documentación de pay-per-event.
Cómo usarlo desde código y clientes de IA
Este Python sigue el método de nuestra prueba de comentarios. Toma un grupo de URL de posts, llama una vez a reddit/comments por cada uno, quita duplicados por id y suma el charged_usd de cada llamada. También guarda dos números por post, los comentarios que muestra y las filas obtenidas, para medir la cobertura, y salta las filas cuyo id empieza por target-status:, por lo explicado en la sección de fallos.
import os, requests

API = "https://api.everyinfra.com/api/v1/social"
HEADERS = {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}

def call(action, **params):
    r = requests.post(API, headers=HEADERS, timeout=120,
                      json={"platform": "reddit", "action": action, "params": params})
    r.raise_for_status()
    body = r.json()
    rows = [x for x in body["results"] if not str(x.get("id", "")).startswith("target-status:")]
    return rows, body["billing"]["charged_usd"]

posts, spent = call("subreddit_posts", subreddit="Python", sort="top", date_range="past_year", limit=100)
seen, coverage = {}, []
for p in posts[:13]:
    rows, cost = call("comments", url=p["url"], limit=100)
    spent += cost
    seen.update({c["id"]: c for c in rows})
    coverage.append((p["url"], p["comment_count"], len(rows)))

print(len(seen), "comentarios unicos, gasto", round(spent, 6), "USD")
for url, listed, got in coverage:
    print(f"{got}/{listed}", url)
En un cliente de IA, conecta nuestro servidor MCP remoto en https://api.everyinfra.com/mcp. Los nombres de herramienta empiezan por everyinfra_ y el modelo decide si busca posts primero o pide comentarios directamente. Abajo hay un ejemplo de configuración general; Claude Code, Cursor y otros clientes con MCP remoto usan un formato parecido. Para la sintaxis exacta, consulta la documentación MCP de Claude Code, la de Cursor y la de OpenAI; el protocolo está en la especificación MCP.
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
Apify tiene su propio servidor MCP, que ofrece los actores de la Store como herramientas para el modelo (documentación MCP de Apify, código en GitHub), y un cliente de Python para programar. La diferencia está en cómo vuelven los datos: con el MCP de Apify, el modelo lanza una ejecución, espera a que termine y lee el dataset, algo pensado para exportar decenas de miles de filas. Nuestro MCP devuelve una página por llamada, pensado para preguntas en un chat, una a una. La configuración y los clientes compatibles están en la página del servidor MCP.
La factura de un mes: tres trabajos habituales durante 30 días
Pensemos en una agencia de investigación de mercado en Ciudad de México o Madrid que sigue a diario lo que se dice en Reddit de los productos de sus clientes. Los tres trabajos usan las filas por llamada que medimos. De nuestro lado, el coste es llamadas × 0,000556 USD (× 0,032403 USD en comentarios de usuario); del lado de Apify, el precio Free de lista de cada actor, con una cuota de inicio por cada ejecución del trabajo.
| Trabajo durante 30 días | Llamadas y filas | EveryInfra | Reddit Scraper Lite | Scrapers populares más baratos en Apify |
|---|---|---|---|---|
| Comentarios de 10 hilos activos al día, 100 por hilo | 300 llamadas, 30.000 filas | 0,17 USD | 121,20 USD | automation-lab 17,69 USD (22,94 USD desde el 17 de noviembre); harshmaur comentarios 45,60 USD |
| Los 100 posts más nuevos de 5 subreddits al día | 150 llamadas, 15.000 filas | 0,08 USD | 61,20 USD | automation-lab 17,34 USD; clearpath subreddit 30,02 USD |
| Historial de comentarios de 200 usuarios por semana, 100 filas cada uno | 800 llamadas, 80.000 filas | 25,92 USD | 320,16 USD | harshmaur user scraper 120,08 USD; clearpath contenido de usuario 160,00 USD |
Las estimaciones parten de tres supuestos. Primero, que cada llamada devuelve una página llena; en nuestras pruebas, todos los posts de más de 100 comentarios dieron 100, pero los pequeños dan menos y la llamada de comentarios de usuario con limit 200 dio 100. Si devolvemos menos filas, nuestro total no cambia y el precio unitario sube. Segundo, la fila de Lite supone los comentarios desactivados (skipComments); si están activados, las filas de posts se multiplican. Tercero, ningún trabajo quita lo que se repite de un día a otro: si pides mañana el mismo hilo, casi todos los comentarios ya los tienes y los dos lados cobran las repeticiones. En Apify, los filtros de tiempo reducen esas repeticiones; con nosotros, quitas duplicados por id tú mismo. Aun así, los comentarios de usuario nos cuestan 0,032403 USD por llamada: si la mayoría de esos 200 usuarios tiene solo una docena de comentarios, nuestro total no baja, el de Apify por fila cae a unos pocos USD y Apify sale mejor.
La API de Reddit hoy: sin solicitudes nuevas desde el 31 de octubre
Ninguna comparación está completa sin la Data API de Reddit. La Reddit Data API Wiki dice que los usuarios que cumplen los requisitos tienen 100 peticiones por minuto por cliente OAuth, promediadas en ventanas de 10 minutos; el tráfico sin OAuth se bloquea, y si se borra un post o comentario hay que borrar también tu copia, con una limpieza al menos cada 48 horas. Fuera del uso gratuito, la sección 3.1 de los Data API Terms es clara: Reddit se reserva el derecho de cobrar por el uso futuro, con las tarifas que decida, y el uso comercial, la investigación por encima de los límites y cualquier uso no permitido exigen un acuerdo aparte. Los términos entraron en vigor el 19 de junio de 2023 y se revisaron por última vez el 20 de julio de 2026.
| Regla en las páginas de Reddit | Qué dice |
|---|---|
| Límite gratuito | 100 peticiones por minuto por cliente OAuth, promediadas en 10 minutos |
| Tráfico sin OAuth | Bloqueado |
| Contenido borrado | Borrar tu copia, con limpieza al menos cada 48 horas |
| Uso comercial | Acuerdo aparte, con tarifas que fija Reddit |
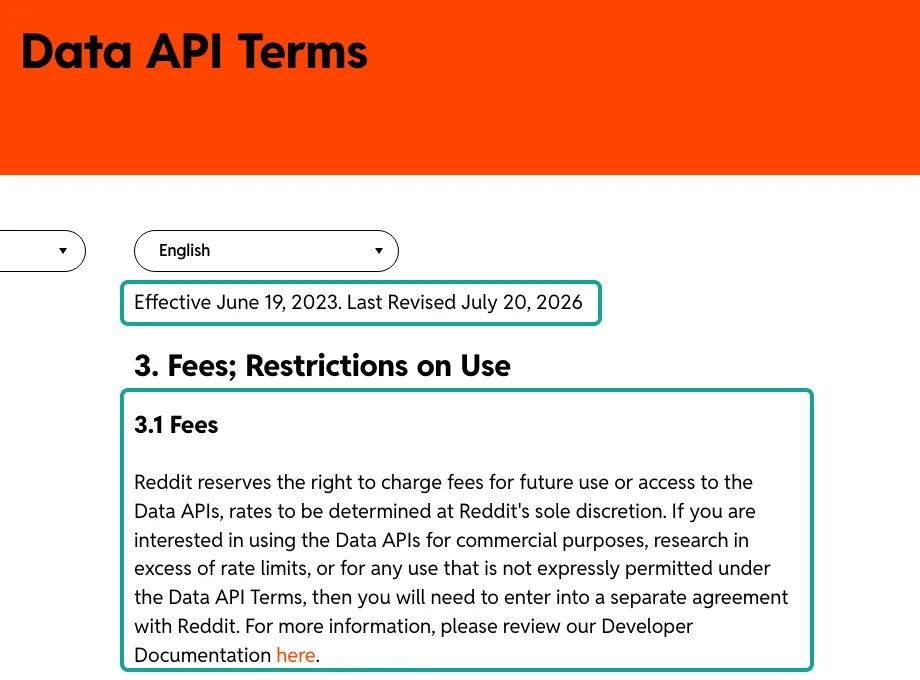
Las páginas públicas actuales de Reddit no dan un precio para el uso comercial. Developer Platform & Accessing Reddit Data solo dice que algunos desarrolladores que necesitan más acceso pueden tener que pagar, y da ejemplos de uso comercial: apps con anuncios o muros de pago, servicios o acceso a datos a cambio de una tarifa, suscripciones y venta de modelos entrenados con datos de Reddit. La cifra de «0,24 USD por 1.000 peticiones» que circula viene de 2023. El 31 de mayo de 2023, Reddit anunció en r/redditdev que los límites del nivel gratuito se aplicarían desde el 1 de julio (post), y ese mismo día el desarrollador del cliente Apollo contó que Reddit le había ofrecido 12.000 USD por 50 millones de peticiones (post). Son 0,24 USD por 1.000, pero es lo que contó un desarrollador, no una lista de precios de Reddit. A ese precio, con 100 filas por petición de listado, 1.000 posts costarían unos 0,0024 USD, menos que cualquier tercero, siempre que consigas ese contrato.
Ese camino se está cerrando. En agosto de 2026, Reddit describió en r/redditdev sus planes para la Data API pública (post), y el 30 de septiembre de 2026 publicó el calendario de cierre (post).
| Fecha | Qué dice el post de Reddit | Qué significa si recoges datos |
|---|---|---|
| 31-10-2026 | No se aceptan solicitudes nuevas de acceso a la API pública | Un proyecto que empieza hoy no puede conseguir acceso |
| 10-11-2026 | Actualización de la migración y recordatorio de plazos | Revisa si hay prórrogas o excepciones |
| 13-11-2026 | Fin del RSS (post de r/modnews; alternativas en después del cierre del RSS de Reddit) | Se rompe el seguimiento de subreddits por RSS |
| 30-11-2026 | Plazo del programa de recompensas de migración | Solo para apps que pasan a Devvit |
| 12-01-2027 | Empieza el cierre para apps y usuarios que no se registraron ni respondieron | Los scripts antiguos pueden dejar de funcionar |
| 03-2027 | Se cierra todo el acceso público restante (sin día exacto) | Solo socios con acuerdo escrito, y Devvit |
La alternativa que ofrece Reddit es su propia plataforma de desarrollo, Devvit. La guía de migración dice que está pensada sobre todo para herramientas de moderación y apps de comunidad. Las apps del programa de migración pueden ganar 1.000 USD al migrar, y el programa va del 31 de marzo al 31 de diciembre de 2026. No es una API para exportar datos y analizarlos fuera: las apps de Devvit se registran en App registration, sus peticiones salientes siguen las reglas de HTTP Fetch y la guía completa está en la documentación de Devvit. Para investigadores, la Responsible Builder Policy dice que investigar con datos recogidos fuera del programa Reddit for Researchers infringe la política y que, sin aprobación por escrito, no puedes vender ni licenciar los datos ni entrenar modelos con ellos.
El 29 de octubre, el CEO de Reddit, Steve Huffman, publicó en su perfil que Reddit pasará a una experiencia «primero con sesión iniciada», que probará antes en algunos mercados fuera de Estados Unidos. Una de las razones que dio es que la mayor parte de la recogida de datos no autorizada ocurre en páginas sin sesión (post). Axios informó ese mismo día de que la portada, y los posts a los que se llega desde buscadores o enlaces externos, seguirán abiertos a visitantes sin sesión, con los límites exactos por definir en la prueba.
El muro de inicio de sesión es un riesgo para cualquier herramienta que lea páginas sin sesión, los scrapers de la Apify Store y también nosotros. No podemos prometer que cada endpoint siga funcionando tras los cambios de Reddit. Puedes hacer tres cosas. Primero, las peticiones fallidas no se cobran, así que no pagas cuando Reddit bloquea una llamada. Segundo, cuando un endpoint falla, el catálogo gratuito lo marca como «no disponible por ahora», con available en false; léelo antes de un lote grande. Tercero, guarda en tu lado los datos que necesites a largo plazo y no dependas de que una sola herramienta pueda volver a traerlos. Si puedes recoger datos, y qué puedes hacer con ellos, depende de tu jurisdicción, de tu uso y de los términos de Reddit. Este artículo no es asesoramiento legal; para un proyecto concreto, consulta a un abogado.
Cuándo conviene más Apify
En conjunto, las pruebas señalan seis trabajos en los que recomendamos un scraper de la Apify Store y no EveryInfra. Uno: posts de un tema de hace más de un mes, porque nuestra reddit/search cubre solo el último mes y el time de Lite admite all. Dos: más de 1.000 posts de un subreddit, porque damos solo las primeras 100 filas por orden y ocho combinaciones en r/Python dieron 286. Tres: todos los comentarios de un hilo grande, o el árbol completo, porque nuestro tope es de 100 por post y sin id del padre, mientras que clearpath lo expande todo y Lite y automation-lab traen parentId y depth. Cuatro: perfiles de usuario, ya que no damos karma ni antigüedad y el user scraper de harshmaur los da en una ejecución. Cinco: unos pocos usuarios, porque por debajo de 22 comentarios por llamada reddit/user_comments cuesta más que ese scraper. Seis: equipos que ya usan las programaciones, datasets e integraciones de Apify, para quienes cambiar supone escribir su propio programador y almacenamiento, y el ahorro puede no cubrir ese trabajo.
El caso contrario son datos en gran volumen, frecuentes y página a página: comentarios de cientos de posts al día, posts nuevos de decenas de comunidades al día o consultas a Reddit desde un cliente de IA en un chat. Ahí somos dos o tres órdenes de magnitud más baratos. También tenemos reddit/trending_posts, que devuelve los posts en tendencia de todo el sitio, 25 por página, pagina con page_token y cuesta 0,000556 USD por página; cubre en parte el hueco de los listados de subreddit sin paginación, aunque son tendencias de todo Reddit, no la historia de una comunidad. Ya contamos las trampas de los dos modelos de cobro en cómo funcionan los precios de Apify y en alternativas a Apify; para cuadrar reembolsos, mira conciliación de reembolsos por fallos.
Cambios recientes
- 17-11-2026: el scraper de automation-lab sube el comentario Free de 0,000575 a 0,00075 USD, un 30 % (página de automation-lab). Lo que significa para ti: los 0,59 USD por 1.000 comentarios de este artículo pasan a 0,76 USD.
- 29-10-2026: post del CEO de Reddit sobre el muro de inicio de sesión (post). Lo que significa para ti: el acceso sin sesión se endurece primero en algunos mercados y puede afectar a cualquier herramienta que lea páginas sin sesión, las de Apify y la nuestra.
- 20-10-2026: entra en vigor el precio actual del Reddit Scraper de Apify, su octavo periodo de precio en un mes (página de la Store). Lo que significa para ti: usa los metadatos del día en que los lees.
- 18-10-2026: entra en vigor el precio actual del scraper de búsqueda de comentarios de maximedupre, 0,00265 USD por fila en Free. Lo que significa para ti: entre los scrapers de búsqueda de comentarios, cuesta un 77 % más que harshmaur a 0,0015 USD.
- 16-10-2026 y 06-10-2026: dos actualizaciones del scraper de comentarios de clearpath corrigen
depthen respuestas profundas de hilos expandidos (página de clearpath). Lo que significa para ti: para reconstruir árboles condepth, usa una versión posterior. - 21-09-2026: el Reddit Scraper de trudax pasa a cobro por evento y deja de listarse para usuarios nuevos. Lo que significa para ti: el plan de «45 USD al mes sin límite» de los tutoriales antiguos ya no existe.
Para empezar: de una llamada de prueba a un trabajo diario
Las 48 llamadas de este artículo, sin contar la de comentarios de usuario, costaron unos 0,024 USD en total. Regístrate, haz primero una prueba pequeña y luego decide si lo usas en volumen. Consigue una clave en el inicio rápido. La página de la API de scraping de Reddit lista todos los endpoints; prueba una vez en el playground la búsqueda de Reddit, los posts de subreddit y los comentarios de Reddit. Para detalle de posts y datos de usuario, mira detalle de post, posts de usuario y comentarios de usuario; para un vistazo rápido a las quejas sobre un producto, problemas en Reddit, y para las tendencias de todo el sitio, posts en tendencia. El mismo método sirve para la API de scraping de Twitter y la de TikTok. Todos los endpoints y precios están en el mercado de datos y en precios, y las comparaciones con otras herramientas, en la página de alternativas.
Otras comparaciones medidas de «coste por 1.000» frente a Apify: alternativa a Apify Twitter Scraper, alternativa a Apify TikTok Scraper y alternativa a Apify Amazon Scraper.
Preguntas frecuentes
¿Es gratis el Apify Reddit scraper?
El plan Free de Apify da 5 USD de crédito prepagado al mes (página de precios); con Lite, a 0,004 USD por resultado más 0,04 USD por ejecución, alcanza para unos 1.200 resultados. La Store también tiene 29 actores de Reddit gratuitos, pero solo uno superó los 100 usuarios en 30 días. El Reddit Scraper de alquiler mensual de trudax está retirado y los usuarios nuevos no pueden usarlo. La API de Reddit es gratuita para usos no comerciales que cumplan los requisitos, con 100 peticiones por minuto por cliente OAuth, pero dejó de aceptar solicitudes nuevas el 31 de octubre de 2026 (Data API Wiki).
¿Cuál es el «Apify Reddit scraper pro» y es mejor que Lite?
El scraper de Reddit con «pro» en el nombre y más usuarios en 30 días es reddit-scraper-pro, de harshmaur, orientado a captación de clientes, seguimiento de marca y alertas. Cuesta 0,0015 USD por fila en Free, tuvo 435 usuarios en 30 días y el 98,7 % de sus ejecuciones terminó bien (listado público de la Store, leído el 04-11-2026). Es más de un 60 % más barato que Lite y agota el tiempo mucho menos; Lite tiene más usuarios, el readme más completo y parentId en los comentarios. Cuál es «mejor» depende de si necesitas árboles de comentarios; si los necesitas, el scraper de comentarios de clearpath es más completo que ambos.
¿Puede un Apify Reddit comment scraper sacar todos los comentarios de un post?
Sí, si eliges bien el actor y lo configuras. El scraper de comentarios de clearpath con maxCommentsPerPost en 0 y la expansión completa activada devuelve el árbol entero, incluidas las respuestas profundas de «continue this thread»; Lite fija su tope con maxComments. El árbol de Reddit tiene huecos more sin expandir por diseño (notas JSON de Reddit), y si usas PRAW también necesitas replace_more. Nuestro reddit/comments devuelve hasta 100 filas por post, con respuestas de segundo y tercer nivel pero sin id del padre, así que no sirve cuando necesitas el árbol entero.
¿Cuánto cuesta una API de scraping de Reddit y cuál sale más barata?
El uso comercial de la API de Reddit exige un acuerdo aparte y las páginas públicas actuales no dan precio (Developer Platform & Accessing Reddit Data); los 0,24 USD por 1.000 peticiones que se citan son lo que contó un desarrollador en 2023. Entre terceros, los scrapers de Reddit populares de la Apify Store cuestan de 0,99 a 4,00 USD por 1.000, con una mediana cercana a 2,00 USD. EveryInfra cobra por petición, y en este artículo salió a entre 0,011 y 0,029 USD por 1.000 posts y 0,0073 USD por 1.000 comentarios. El flujo OAuth y la lista de endpoints están en las notas OAuth2 de Reddit y en la documentación de la API.
¿Es legal hacer scraping de Reddit sin la API?
Depende de tu jurisdicción, de tu uso y del User Agreement, los Developer Terms y la Public Content Policy de Reddit. Su Responsible Builder Policy dice que investigar con datos recogidos fuera del programa Reddit for Researchers infringe la política y que, sin aprobación por escrito, no puedes vender ni licenciar los datos ni entrenar modelos con ellos. Este artículo no es asesoramiento legal; consulta a un abogado antes de crear un producto comercial o entrenar un modelo con esos datos.
¿Hay un scraper de Reddit en GitHub y cómo se compara con un servicio de API?
Sí. El código antiguo del sitio de Reddit y sus notas de API están archivados en reddit-archive/reddit, que ya no se actualiza. La herramienta lista más usada es la librería de Python PRAW: usa la API OAuth de Reddit, es gratis y tiene la mayoría de los campos, pero está limitada a 100 peticiones por minuto y los clientes OAuth nuevos ya no consiguen acceso desde el 31 de octubre de 2026. Un scraper propio tiene que lidiar con el muro de inicio de sesión, los límites y los bloqueos; con Apify o un servicio como el nuestro, pagas para ahorrarte ese trabajo. Uses la herramienta que uses, calcula primero el coste por 1.000 y las cuotas de inicio.
Referencias
- Apify / trudax: Reddit Scraper Lite (página de la Store), leída el 04-11-2026
- Apify API: metadatos públicos de trudax~reddit-scraper-lite (pricingInfos, stats), leídos el 04-11-2026
- [Apify / trudax: Reddit Scraper [DEPRECATED] (página de la Store), leída el 04-11-2026](https://apify.com/trudax/reddit-scraper)
- Apify API: metadatos públicos de trudax~reddit-scraper (con la nota de precio del 21-09-2026), leídos el 04-11-2026
- Apify / harshmaur: Reddit Scraper (página de la Store), leída el 04-11-2026
- Apify / automation-lab: Reddit Scraper (página de la Store, con el cambio de precio del 17-11-2026), leída el 04-11-2026
- Apify / clearpath: Reddit Post Comments Scraper (página de la Store, con cambios del 06-10-2026 y del 16-10-2026), leída el 04-11-2026
- Apify / fatihtahta: Reddit Scraper Enterprise Grade (página de la Store), leída el 04-11-2026
- Apify / harshmaur: Reddit Comment Scraper (página de la Store), leída el 04-11-2026
- Apify / harshmaur: Reddit User Scraper (página de la Store), leída el 04-11-2026
- Apify / clearpath: Reddit User Posts & Comments Scraper (página de la Store), leída el 04-11-2026
- Apify / clearpath: Reddit Search Scraper (página de la Store), leída el 04-11-2026
- Apify: Reddit Scraper: Posts, Comments, and Users (página propia de Apify en la Store), leída el 04-11-2026
- Apify: página de precios (planes, unidades de cómputo, niveles de descuento), leída el 04-11-2026
- Documentación de Apify: Pay-per-event pricing model
- Documentación de Apify: Actor pricing and costs (niveles FREE a DIAMOND)
- Documentación de Apify: Actors in Store (modelos de precio, etiqueta de mantenimiento, descuentos)
- Documentación de la API de Apify: Get Actor
- Documentación de la API de Apify: Get list of Actors in Store
- Documentación de Apify: Usage and resources (memoria y unidades de cómputo)
- Documentación de Apify: Runs and builds (estados de ejecución, tiempos límite)
- Documentación de Apify: Automated testing (los que fallan reciben la etiqueta de mantenimiento)
- Documentación de Apify: Dataset
- Documentación de Apify: Apify MCP server
- GitHub: apify/apify-mcp-server
- GitHub: apify/apify-client-python
- Reddit: Data API Terms (vigentes desde el 19-06-2023, revisadas el 20-07-2026), leídas el 04-11-2026
- Reddit: Developer Terms
- Reddit: User Agreement
- Reddit Help: Reddit Data API Wiki (acceso gratuito, 100 QPM)
- Reddit Help: Responsible Builder Policy
- Reddit Help: Developer Platform & Accessing Reddit Data (uso comercial y tarifas)
- Reddit Help: Public Content Policy
- Reddit Help: App Migration Program 2026 Terms
- Reddit Developer Platform: Migrating apps from the Data API to Devvit
- Reddit Developer Platform: App registration
- Reddit Developer Platform: HTTP Fetch
- r/redditdev: Moving Data API Apps to the Developer Platform: migration dates and next steps (30-09-2026)
- r/modnews: Continuing our infrastructure updates: what's changing in the coming months (30-09-2026, fin del RSS)
- r/redditdev: Our Plans for the Future of Reddit's Public Data API (agosto de 2026)
- r/redditdev: API Update: Enterprise Level Tier for Large Scale Applications (31-05-2023)
- r/apolloapp: Had a call with Reddit to discuss pricing (31-05-2023, relato del desarrollador)
- u/spez: About that login screen (29-10-2026)
- Axios: Reddit moves to logged-in experience as AI eats search (29-10-2026)
- GitHub: reddit-archive/reddit (código abierto archivado de Reddit y su wiki)
- Reddit Developer Platform: documentación de Devvit
- Documentación de la API de Apify: referencia de la API v2
- GitHub: wiki de reddit-archive/reddit, JSON (el objeto more)
- GitHub: wiki de reddit-archive/reddit, OAuth2
- GitHub: praw-dev/praw
- Documentación de PRAW: Comment Extraction and Parsing
- Reddit: documentación de la API (/dev/api)
- Gaffney y Matias: Caveat Emptor, Computational Social Science: Large-Scale Missing Data in a Widely-Published Reddit Corpus (arXiv, 2018)
- Model Context Protocol: Specification 2025-06-18
- Documentación de Claude Code: Connect Claude Code to tools via MCP
- Documentación de OpenAI: Connectors and MCP servers
- Documentación de Cursor: Model Context Protocol
- EveryInfra: catálogo de la API de datos (gratis; price_usd, max_limit), leído el 04-11-2026
Referencia BL-84