Apify Reddit 스크래퍼 대안: 게시물·댓글 1,000행당 비용을 직접 측정해 보니
Apify의 Reddit Scraper Lite로 댓글 1,000개를 수집하면 $4.04가 듭니다. 부모 ID가 없는 평면 목록 기준으로 저희가 측정한 비용은 $0.0073이었습니다. 전체 댓글 트리가 필요하다면 Apify를 사용하세요.
Reddit Scraper Lite는 Apify Store에서 사용자가 가장 많은 Reddit 스크래퍼입니다. 공개된 Free 티어 가격 기준으로 Reddit 댓글 1,000개에 $4.04가 듭니다. 결과당 $0.004에 시작 요금 $0.04를 더한 금액입니다. Store의 인기 대안 중 가장 저렴한 automation-lab은 같은 작업에 약 $0.59가 듭니다. 2026년 11월 4일, 저희는 게시물 13개를 대상으로 EveryInfra reddit/comments 엔드포인트를 호출했습니다.
호출당 비용은 $0.000556이었습니다. 총 $0.007228로 고유 댓글 997개를 받았으니 1,000개당 $0.00725입니다. Lite보다 557배, automation-lab보다 81배 저렴합니다. 게시물의 경우 키워드 검색은 1,000개당 $0.0293, 서브레딧 목록은 1,000개당 $0.0114였습니다.
Apify가 더 나은 작업도 세 가지 있으며, 이 글은 각 테스트에서 이를 밝힙니다. 첫째, 저희는 게시물당 댓글을 최대 100개까지 반환하므로 댓글이 771개인 스레드에서는 13%만 받았습니다. 둘째, 저희 댓글 행에는 2·3단계 답글이 포함되지만 부모 ID가 없어 트리를 재구성할 수 없습니다. 셋째, 서브레딧 하나에 정렬 방식 8가지를 적용해도 고유 게시물은 1,000개가 아닌 286개에 그쳤습니다.
아래에서는 Reddit 데이터 네 종류를 하나씩 테스트합니다. Apify에서 지원 중단된 “Reddit Scraper”와 Store에 있는 Reddit 스크래퍼 746개의 가격 분포도 다룹니다. 마지막으로 Reddit 공개 Data API가 종료되는 일정을 정리합니다.
이 글의 수치를 읽는 법
이 글에서 “1,000건당 비용”은 실제로 청구된 금액을 실제로 반환된 고유 행 수로 나눈 뒤 1,000을 곱한 값입니다. Reddit 게시물이나 댓글 1,000개에 얼마가 드는지라는 한 가지 질문에 답하는 수치입니다. EveryInfra는 요청당 과금하며, 요청 하나는 페이지 하나를 반환합니다. 검색은 최대 25행, 서브레딧 목록과 댓글은 최대 100행을 반환합니다. 사용자 게시물은 최대 50행을 반환합니다(무료 카탈로그의 max_limit 참고).
반면 Apify Store의 Reddit 스크래퍼는 거의 모두 결과당 과금합니다. 데이터셋에 기록되는 행마다 한 번씩 청구하는 방식입니다. 두 방식은 같은 단위로 환산해야만 비교할 수 있습니다.
저희 쪽은 항상 id 기준으로 중복을 제거한 행 수로 나눕니다. 요청한 limit으로 나누지 않습니다. 따라서 행이 적거나 중복이 많은 호출은 저희 가격을 더 높아 보이게 할 뿐입니다. Apify 쪽은 공개 자료만 사용했습니다.
공개 자료란 Store 페이지, 요금 페이지, 문서, 그리고 계정 없이 쓸 수 있는 공개 Actor 메타데이터 엔드포인트(Get Actor API docs)를 말합니다. Actor는 Apify가 클라우드 스크래핑 프로그램을 부르는 이름입니다. 저희는 Apify에 가입하지 않았고 어떤 Actor도 실행하지 않았습니다. 이 글의 Apify 수치는 모두 공개 정가이며, 실제 청구액을 측정한 값이 아닙니다.
Apify Reddit 스크래퍼 vs EveryInfra: 요약 표
이 표는 글 전체의 결과입니다. 각 행에는 Apify 가격이 두 개 있습니다. 하나는 사용자가 가장 많은 Reddit 스크래퍼인 Reddit Scraper Lite의 가격입니다. 다른 하나는 같은 작업을 하면서 최근 30일 사용자가 100명 이상인 스크래퍼 중 가장 낮은 Free 티어 가격입니다.
가격은 2026년 11월 4일 싱가포르 시간 00:15에 Apify 공개 메타데이터의 pricingInfos 필드에서 읽었습니다. Apify 가격은 모두 Free 티어에서 1,000행을 반환하는 실행 1회와 기본 시작 요금을 가정합니다. EveryInfra 수치는 모두 저희가 직접 수행한 실제 호출에서 나왔습니다. 청구액은 응답의 billing.charged_usd, 행은 results이며, 중복 제거는 id 기준입니다.
| 데이터 | EveryInfra 엔드포인트 | 측정값: 호출 수 / 전체 행 수 / 고유 행 수 / 청구액 | EveryInfra 1,000행당(고유 행 기준) | Reddit Scraper Lite(Free) | 배율 | Apify 인기 스크래퍼 최저가(Free) | 배율 |
|---|---|---|---|---|---|---|---|
| 키워드 검색 게시물 | reddit/search | 10 / 195 / 190 / $0.00556 | $0.0293 | $4.04 | 138x | clearpath Search $1.00 | 34x |
| 서브레딧 하나의 게시물 | reddit/subreddit_posts | 10 / 837 / 486 / $0.00556 | $0.0114 | $4.04 | 353x | automation-lab $1.15 | 101x |
| 게시물 댓글 | reddit/comments | 13 / 997 / 997 / $0.007228 | $0.00725 | $4.04 | 557x | automation-lab $0.59 | 81x |
| 사용자 한 명의 댓글 | reddit/user_comments | 1 / 100 / 100 / $0.032403 | $0.324 | $4.04 | 12.5x | harshmaur User $1.52 | 4.7x |
배율은 Apify 가격을 저희 가격으로 나눈 값입니다. 표를 읽을 때 네 가지를 염두에 두세요. 첫째, 격차의 대부분은 “요청 하나에 페이지 하나”라는 방식에서 나옵니다. 댓글 호출은 최대 100행을 반환하므로, 페이지가 꽉 차면 고정 가격이 여러 행에 나뉩니다. 호출마다 한두 행만 반환되면 결과가 뒤집히며, 아래 손익분기 섹션에서 계산을 보여 드립니다.
둘째, automation-lab 댓글 가격 $0.59는 댓글당 $0.000575, 시작 요금 $0.003, 게시물 행 10개(개당 $0.00115)로 계산했습니다. Store 페이지에 따르면 Free 티어 댓글 가격은 11월 17일부터 $0.00075로 오릅니다. 같은 방식으로 계산하면 $0.76입니다(automation-lab Store 페이지).
셋째, 게시물 두 행 모두 저희가 더 저렴하지만 항상 게시물 1,000개에 도달할 수는 없습니다. 검색은 최근 한 달만 다루고, 서브레딧 목록에는 페이지네이션이 없습니다. 실제로 얻은 게시물 수는 다음 섹션에서 보여 드립니다. 넷째, Apify 가격은 한두 달마다 바뀌며, “최근 변경 사항” 섹션에 날짜를 정리했습니다.
테스트 방법과 통과 기준
통과·실패 기준은 첫 호출 전에 정했습니다. 네 가지 데이터 유형마다 실제 호출을 최소 두 번, 서로 다른 세 시점 이상에 나눠 실행해야 했습니다. 1,000건당 비용은 항상 고유 행 수로 나눴습니다. 댓글 트리 커버리지는 게시물 페이지 최소 두 개를 서드파티 도구로 읽은 결과와 저희 행을 하나씩 비교해 판단했습니다.
필드 목록만 보고 커버리지를 추정하지 않았습니다. 어떤 작업에서든 Apify가 더 저렴하거나 더 완전한 데이터를 제공하거나 더 적합하다면 본문과 요약 표에 이를 명시해야 했습니다. 데이터가 반환되지 않는 호출도 최소 두 번 실행하고, 각 호출의 비용을 기록해야 했습니다. reddit/user_comments는 실제 호출을 최대 한 번만 했고, reddit/painpoint는 실제 호출을 하지 않았습니다.
모든 요청은 POST https://api.everyinfra.com/api/v1/social로 보냈습니다. 첫 요청은 2026년 11월 4일 싱가포르 시간 00:15에 보냈습니다. 댓글 테스트는 싱가포르 시간 00:26부터 00:32까지 진행했고, 마지막 호출은 싱가포르 시간 00:36에 끝났습니다. 호출마다 전송 시각, HTTP 상태, 소요 시간, 행 수, charged_usd를 기록했습니다. 이후 스크립트가 원본 응답에서 모든 수치를 다시 계산했습니다. 본문, 표, 차트의 모든 숫자는 이 스크립트에서 나왔습니다.
| 작업 | 엔드포인트와 파라미터 | 실제 호출 | 시각(싱가포르 시간, 11월 4일) | 확인 항목 |
|---|---|---|---|---|
| 키워드 검색 | reddit/search, limit 25. 키워드 7개, 그리고 “standing desk”에 대한 newest, top, popular 정렬 | 10 | 00:15~00:19 | 호출당 행 수, 정렬의 영향, 날짜 범위 |
| 서브레딧 게시물 | reddit/subreddit_posts. r/Python에서 정렬·기간 조합 8가지, r/smallbusiness에서 2가지, limit 100 | 10 | 00:20~00:24 | 정렬을 추가할 때마다 늘어나는 새 게시물 수, 커뮤니티 하나의 상한 |
| 댓글 | reddit/comments. 댓글이 16~771개인 게시물 13개, limit 100 | 13 | 00:26~00:32 | 게시물당 행 수, 게시물 표시 댓글 수 대비 비율, 중첩 답글 |
| 사용자 | 계정 3개에 reddit/user_posts 7회, reddit/user_comments 1회 | 8 | 00:24~00:35 | 얼마나 과거까지 가져오는지, 비싼 호출 한 번이 무엇을 반환하는지 |
| 게시물 상세 | 게시물 두 개에 reddit/post_detail 호출 | 2 | 00:33 | 댓글 수가 목록과 일치하는가? |
| 데이터 없음 | API 키 없음, 잘못된 정렬 값, 추가 파라미터, 없는 서브레딧, 없는 게시물, 없는 사용자 | 6 | 00:25~00:36 | 어떤 경우에 비용이 청구되는가 |
이 글에는 실제 호출 49회가 사용됐고, 총 청구액은 $0.056311이었습니다. 모든 호출에는 분당 10회의 요청 속도 제한이 적용된 테스트용 API 키 하나를 사용했습니다. 실행 중 HTTP 429(요청 과다)를 몇 차례 받았습니다. 스크립트는 60초를 기다린 뒤 같은 호출을 다시 보냈습니다. 429는 과금되지 않으며, 위 합계에도 포함되지 않습니다.
테스트 1: 가장 흔한 Apify Reddit 스크래퍼 작업, 키워드 검색으로 게시물 1,000개 모으기
reddit/search는 호출당 최대 25행을 반환합니다. 검색 기간은 최근 한 달로 고정되어 있습니다. 카탈로그의 sort 파라미터 설명에 따르면 어떤 정렬을 선택하든 기간은 한 달로 유지됩니다. 서로 다른 키워드 7개를 각각 한 번씩 검색했습니다. 검색한 키워드는 standing desk, notion alternative, claude code, best vpn, airpods pro 3, home espresso machine, sourdough starter입니다.
호출 결과는 각각 25, 17, 25, 25, 25, 24, 25행으로 평균 23.7행이었습니다. 모든 게시물의 날짜가 2026년 10월 3일부터 11월 3일 사이로, 한 달 범위와 일치했습니다. 호출 7회의 비용은 $0.003892였고, 166행 중 중복은 하나도 없었습니다. 1,000개당 $0.0234입니다.
정렬 방식에 따라 개수가 크게 달라졌습니다. 같은 키워드 standing desk에 대해 기본 관련도 정렬은 25행, popular는 22행을 반환했습니다. 그러나 top은 4행, newest는 3행만 반환했고, 그 3행은 모두 11월 3일 게시물이었습니다. 카탈로그에 이유가 나와 있습니다. 검색은 키워드와 일치하는 게시물만 반환하므로 개수가 limit보다 적을 수 있습니다.
0행을 반환한 호출은 빈 결과로 환불됩니다. 3행을 반환한 호출에는 정상 요금 $0.000556이 청구됩니다. 이 세 정렬 호출까지 포함하면 호출 10회가 195행을 반환했고, 그중 고유 행은 190개, 비용은 $0.00556이었습니다. 1,000개당 $0.0293이며, 요약 표에는 이 보수적인 수치를 썼습니다.
호출당 23.7개씩 게시물 1,000개를 모으려면 검색을 약 42회 해야 합니다. 즉 서로 다른 키워드나 키워드 조합 42개가 필요하며, 비용은 약 $0.0234입니다. 관심 키워드가 한두 개뿐이라면 1,000개에 도달할 수 없습니다. 키워드 하나가 한 달 동안 일치하는 게시물 수에는 한계가 있고, 저희 검색은 그보다 이전으로 거슬러 가지 않습니다.
이 부분에서는 Apify가 다릅니다. Lite의 time 파라미터는 all, year, month 등의 값을 받습니다(Store 페이지, “Advanced parameters”). clearpath 검색 스크래퍼는 정렬 5가지와 기간 필터를 지원합니다. 가격은 결과당 $0.00099에 데이터셋 기록당 $0.00001과 소액의 시작 요금이 더해져 1,000개당 $1.00입니다(clearpath Search Store 페이지).
따라서 지난 몇 년간의 특정 주제 게시물 1,000개가 필요하다면 Apify가 더 낫습니다. 최근 한 달 동안 키워드 세트를 매일 또는 매주 모니터링한다면, 저희는 호출당 $0.000556에 게시물 20개 이상을 가져옵니다. 이쪽이 훨씬 저렴합니다.
| 키워드 | 정렬 | 행 | 가장 오래된 게시물(UTC) | 과금액 |
|---|---|---|---|---|
| standing desk | 기본(관련도) | 25 | 10월 3일 | $0.000556 |
| standing desk | popular | 22 | 10월 27일 | $0.000556 |
| standing desk | top | 4 | 10월 6일 | $0.000556 |
| standing desk | newest | 3 | 11월 3일 | $0.000556 |
| notion alternative | default | 17 | 10월 3일 | $0.000556 |
| 나머지 키워드 5개 | default | 24~25 | 10월 3~6일 | 각 $0.000556 |
테스트 2: 서브레딧 하나에서 게시물 1,000개 모으기, 결과는 286개
reddit/subreddit_posts는 호출당 최대 100행을 반환하며 페이지네이션 파라미터가 없습니다. 더 많이 가져오려면 정렬과 기간만 바꿀 수 있습니다. sort는 newest, popular, top, rising, relevance를 받습니다. 카탈로그에 따르면 date_range는 sort=top일 때만 적용됩니다. r/Python에서 조합 8가지를 한 번씩 실행했습니다. 차트는 조합을 하나 추가할 때마다 새 게시물이 몇 개 늘었는지 보여 줍니다.
결과는 분명합니다. newest, popular, relevance에서 각각 반환된 100행은 거의 같은 집합이었고, 고유 게시물은 합쳐서 101개였습니다. rising은 25행을 반환했지만 모두 이미 받은 게시물이었습니다. 새 게시물을 가져온 조합은 top과 all_time(게시물 100개, 가장 오래된 것은 2017년), top과 past_year(새 게시물 85개) 두 가지뿐입니다. past_month의 87행과 past_week의 25행은 모두 중복이었습니다. 호출 8회의 비용은 $0.004448로 고유 게시물 286개를 얻었으며, 1,000개당 $0.0156입니다.
newest, top 전체 기간, top 지난 1년만 의미가 있다는 것을 미리 안다면, 호출 3회로 같은 286개를 $0.001668에 얻을 수 있습니다. 1,000개당 $0.0058입니다. r/smallbusiness에서는 호출 2회(newest와 top 지난 1년)가 겹침 없이 각각 100행을 반환했고, 1,000개당 $0.0056이었습니다. 서브레딧 호출 10회를 모두 합치면 837행, 고유 행 486개, 비용 $0.00556입니다. 1,000개당 $0.0114이며, 요약 표에 쓴 수치입니다.
따라서 저희는 “서브레딧 하나에서 게시물 1,000개”를 제공할 수 없으며, 이 작업에는 Apify가 더 적합합니다. Reddit 자체 목록은 약 1,000개 항목까지만 거슬러 올라갑니다. Lite readme도 같은 내용을 언급하며, 더 많이 수집하려면 정렬, 검색, 기간 필터를 조합하라고 권합니다(Store 페이지, “Reddit's 1,000 items limit”). 페이지네이션이 가능한 스크래퍼는 정렬 방식마다 1,000행 가까이 가져옵니다. 저희는 정렬마다 첫 페이지 100개만 반환합니다.
커뮤니티의 새 게시물과 인기 게시물을 매일 확인하는 용도라면 호출 2회(newest와 top 지난 1일)에 $0.001112가 듭니다. 커뮤니티의 수년치 기록을 한 번에 내보내려면 Apify를 쓰거나 Reddit 자체 연구자 프로그램에 신청하세요.
테스트 3: Apify Reddit 댓글 스크래퍼가 넘어야 할 기준, 댓글 1,000개와 트리 구조
이번 테스트에서 가격 차이가 가장 큰 항목은 댓글입니다. 동시에 Apify의 기능 우위가 가장 분명한 항목이기도 합니다. reddit/comments는 게시물 URL 하나를 받아 호출당 최대 100개의 댓글을 반환합니다. 댓글이 16~771개인 게시물 13개를 골라 각각 한 번씩 호출했습니다.
호출 13회의 비용은 $0.007228이었고, 중복 없이 댓글 997개를 반환했습니다. 1,000개당 $0.00725이며, 이 수치에는 두 가지 조건이 붙습니다. 첫째, 댓글이 100개 미만인 게시물에서는 게시물에 표시된 수의 74~90%를 받았습니다. 차이의 일부는 삭제되거나 제거된 댓글로, 게시물의 댓글 수에는 포함되지만 텍스트가 없습니다. 나머지는 Reddit에서 “load more”를 눌러야 표시되는 댓글입니다.
둘째, 댓글이 100개를 넘는 게시물에서는 호출 한 번이 100개를 반환합니다. 댓글 771개 스레드에서는 13%입니다. 저희 상한으로는 활발한 스레드의 댓글을 모두 가져올 수 없습니다. clearpath 댓글 스크래퍼는 maxCommentsPerPost를 0으로 설정하고 expandAllComments를 켜면 전체 트리를 반환한다고 밝힙니다. 여기에는 “continue this thread” 뒤에 10단계 이상 중첩된 답글도 포함됩니다(clearpath Store 페이지). 이 작업에는 Apify가 더 나은 도구입니다.
| 게시물에 표시된 댓글 수 | 받은 개수 | 커버리지 | 시각(싱가포르 시간) | 과금액 |
|---|---|---|---|---|
| 771 | 100 | 13% | 00:26 | $0.000556 |
| 681 | 100 | 15% | 00:27 | $0.000556 |
| 639 | 100 | 16% | 00:27 | $0.000556 |
| 529 | 100 | 19% | 00:28 | $0.000556 |
| 478 | 100 | 21% | 00:28 | $0.000556 |
| 389 | 100 | 26% | 00:29 | $0.000556 |
| 374 | 100 | 27% | 00:29 | $0.000556 |
| 120 | 100 | 83% | 00:30 | $0.000556 |
| 118 | 95 | 81% | 00:30 | $0.000556 |
| 40 | 36 | 90% | 00:31 | $0.000556 |
| 39 | 35 | 90% | 00:32 | $0.000556 |
| 23 | 17 | 74% | 00:32 | $0.000556 |
| 16 | 14 | 88% | 00:32 | $0.000556 |
“댓글 트리가 완전한가?”라는 질문에는 두 부분이 있습니다. 첫째는 중첩 답글이 반환되는지 여부입니다. 댓글이 16개, 23개인 게시물 두 개를 골랐습니다. 서드파티 페이지 리더로 각 게시물 페이지를 댓글과 함께 가져왔습니다. 두 페이지에는 댓글 27개가 보였고, 그중 하나는 삭제된 댓글의 자리 표시자였습니다.
나머지 26개를 텍스트 앞부분으로 저희 행에서 검색했고, 26개를 모두 찾았습니다. 이 26개는 최상위 댓글 12개, 2단계 답글 10개, 3단계 답글 4개였습니다. 페이지 리더에 보이지 않은 댓글 5개도 반환했습니다. 즉 행에는 최상위 댓글 외에 2·3단계 답글도 들어 있습니다.
둘째는 구조입니다. 이번 13회 호출의 모든 댓글 행에는 id, text, author_username, like_count, url, posted_at, platform 필드 7개가 있었습니다. 카탈로그에는 community도 나와 있지만 이번 응답에는 하나도 없었으므로 이 필드에 의존하지 마세요. 커뮤니티 이름은 게시물 목록의 community나 댓글 url에서 얻으세요. 부모 댓글 ID와 깊이 정보는 없습니다.
이 중 14개 행이 답글이라는 것은 알 수 있지만, 누가 누구에게 답했는지는 알 수 없습니다. Apify 쪽을 보면 Lite 댓글 레코드에는 parentId와 numberOfReplies가 있습니다(Store 페이지, “Example Reddit post”). automation-lab에는 depth와 parentId가 있습니다. 다만 commentCoverage가 unverified라고 명시하며 전체 트리를 보장하지 않습니다(Store 페이지, “Comment fields”). clearpath는 10월 6일 업데이트에서 완전히 펼친 스레드의 답글 depth를 수정했습니다.
사용 사례에는 어떤 의미일까요? 감성 집계, 키워드 빈도, 주제 태깅, 불만 인용문 찾기에는 평면 댓글 표로 충분하며, 비용은 1,000개당 $0.00725입니다. “누가 누구와 논쟁하는지”, “답글 체인이 얼마나 깊은지”, “작성자가 어떤 질문에 답했는지”를 보려면 parentId가 있는 도구가 필요합니다. PRAW의 MoreComments 자리 표시자와 replace_more는 Reddit 댓글 내보내기가 불완전한 이유에서 다뤘습니다(PRAW 문서). Reddit이 반환하는 트리에는 설계상 펼쳐지지 않은 자리가 있습니다. Reddit JSON 문서는 이를 more 객체라고 부릅니다(reddit-archive wiki).
연구 분야에서도 이미 이 문제를 다뤘습니다. 2018년 Gaffney와 Matias는 “모든 공개 Reddit 댓글”을 담았다고 주장하는 널리 쓰이는 데이터셋을 연구해, 그 안에서 큰 누락을 발견했습니다. 두 사람은 사용자 이력과 네트워크 구조 연구에서 위험이 가장 크다고 밝혔습니다(arXiv 논문). 어떤 도구를 쓰든 내보낼 때마다 받은 댓글 수와 게시물에 표시된 댓글 수, 두 숫자를 함께 저장하세요.
reddit/post_detail도 두 번 호출했습니다. 댓글이 771개, 40개인 게시물에서 comment_count는 목록과 일치했고, 호출당 비용은 $0.000556이었습니다. 댓글을 가져오기 전에 게시물을 고른다면 목록의 comment_count로 정렬하세요. 별도의 상세 호출은 필요 없습니다.
테스트 4: 사용자 한 명의 게시물과 댓글, 그리고 비싼 엔드포인트가 제값을 못 하는 경우
reddit/user_posts는 대부분의 엔드포인트와 같은 $0.000556에 호출당 최대 50행을 반환합니다. 먼저 Reddit CEO의 계정인 spez를 newest, top 전체 기간, top 지난 1년, popular로 호출했습니다. 네 번 모두 같은 게시물 24개를 반환했습니다. 가장 오래된 것은 2015년 7월 11일 게시물이었고, 가장 최근 것은 로그인 월(login wall)에 관한 10월 29일 게시물이었습니다. 이 계정에서는 정렬이 아무 효과가 없었고, 호출 4회에 $0.002224가 들었으며, 두 번째부터 네 번째 호출은 낭비였습니다.
언론사 계정 washingtonpost는 한 번의 호출로 2026년 4월 20일부터 11월 3일까지 게시물 50개를 꽉 채워 반환했으며, 1,000개당 $0.0111입니다. top 전체 기간으로 실행한 두 번째 호출도 같은 50개를 반환했습니다. NASA 계정 nasa도 newest로 2025년 6월 5일부터 2026년 10월 29일까지 게시물 50개를 반환했습니다. 즉 사용자 게시물은 호출 한 번에 50개가 상한이며, 다른 정렬로도 더 오래된 게시물에는 닿지 않습니다.
활동이 많은 계정의 전체 이력을 거슬러 올라가려면 페이지네이션을 지원하는 Apify 스크래퍼가 더 적합합니다. harshmaur의 Reddit User Scraper는 사용자의 전체 게시물·댓글 이력을 반환한다고 밝힙니다. clearpath의 사용자 콘텐츠 스크래퍼는 사용자당 최대 1,000개 항목을 반환한다고 밝힙니다.
reddit/user_comments는 사정이 다릅니다. 호출 한 번에 $0.032403으로 일반 호출의 58배이며, 최대 200행을 반환합니다. spez에 대해 limit 200으로 한 번 호출해 2025년 7월 31일부터 2026년 10월 29일까지의 100행을 받았습니다. 1,000개당 $0.324입니다. 분명히 밝혀 둘 사실이 하나 더 있습니다.
이 100행 중 가장 긴 댓글 텍스트는 정확히 300자였고, 평균은 160자였습니다. 이 엔드포인트의 카탈로그 field_note에 이유가 나와 있습니다. 다른 소스를 쓸 수 없을 때는 텍스트를 앞 300자로 자르는 대체 소스에서 결과를 가져옵니다. 이번 호출이 그런 경우였습니다. 이 결과는 사용자가 어디에 얼마나 자주 글을 쓰고 추천을 얼마나 받는지 파악하는 데 적합합니다. 긴 댓글 텍스트 분석에는 적합하지 않습니다.
이 엔드포인트는 언제 제값을 못 할까요? 답은 호출당 행 수에 달려 있습니다. $0.032403을 Apify의 행당 가격으로 나누면, 저희가 더 저렴해지는 호출당 최소 행 수가 나옵니다. $0.004인 Lite 대비 손익분기점은 8.1행입니다.
행당 $0.002($0.00199에 쓰기 1회당 $0.00001을 더한 금액)인 clearpath 사용자 콘텐츠 스크래퍼와 비교하면 16.2행입니다. 행당 $0.0015인 harshmaur 사용자 스크래퍼와 비교하면 21.6행입니다. automation-lab의 댓글당 가격 $0.000575와 비교하면 56.4행입니다.
| Apify 행당 가격(Free) | 호출당 손익분기 행 수 | 저희 라이브 호출 결과 |
|---|---|---|
| Reddit Scraper Lite, $0.004 | 8.1 | 100 |
| clearpath 사용자 콘텐츠, $0.002 | 16.2 | 100 |
| harshmaur 사용자 스크래퍼, $0.0015 | 21.6 | 100 |
| automation-lab 댓글, $0.000575 | 56.4 | 100 |
따라서 다음 세 경우에는 이 엔드포인트를 쓰지 마세요. 첫째, 신규 계정이나 게시물이 열두 개 정도인 계정처럼 댓글이 적은 사용자라면 행 단위 과금 스크래퍼가 더 저렴합니다. 둘째, 실제로 원하는 것이 게시물 하나 아래의 토론이라면 1,000개당 $0.00725로 45배 저렴한 reddit/comments를 쓰세요. 셋째, 긴 댓글 텍스트가 필요한데 이 호출이 300자 잘림에 걸린다면 도구를 바꾸거나 나중에 재시도하세요.
여러 사용자를 대상으로 한 대량 조사라면 호출 한 번에 100~200행이 반환됩니다. 1,000개당 $0.16~$0.32로, harshmaur 사용자 스크래퍼의 $1.52보다 4.7~9.4배 저렴합니다. 다만 사용자별 카르마나 계정 생성 후 경과 기간도 필요하다면 harshmaur 스크래퍼는 한 번의 실행으로 이 정보까지 반환합니다.
reddit/painpoint는 더 비싸서 호출당 $0.072입니다. 직접 호출하지는 않았으므로, 카탈로그에 설명된 기능만 소개합니다. 키워드로 게시물을 최대 15개 찾아 최상위 댓글을 읽습니다. 찾은 게시물 수, 읽은 댓글 수, 부정·긍정 댓글의 대략적인 개수를 담은 요약 행 하나를 반환합니다. 이 행에는 부정 댓글에서 반복되는 단어와 관련 커뮤니티도 들어 있습니다.
상위 게시물과 추천을 가장 많이 받은 부정 댓글도 인용문으로 반환합니다. 카탈로그에 따르면 부정·긍정 판단은 단어 목록을 기반으로 합니다. 비꼼이나 복합적인 어조는 잘 판단하지 못하므로, 개수는 대략적인 값이며 불만 비율로 볼 수 없습니다. “any”나 “it's” 같은 흔한 단어가 상위 단어에 나타날 수도 있습니다.
reddit/search 1회와 reddit/comments 15회로 같은 결과를 직접 만들 수 있습니다. 이 16회 호출의 비용은 $0.0089이며, 태깅은 직접 쓰는 모델에 맡기면 됩니다. painpoint보다 8배 저렴하고, 최상위 댓글만이 아니라 게시물당 최대 100개의 댓글을 얻습니다.
| 옵션 | 호출 수 | 비용 | 게시물당 읽는 댓글 | 어조 판단 방식 |
|---|---|---|---|---|
reddit/painpoint | 1 | $0.072 | 최상위 댓글만 | 단어 목록, 대략적인 개수 |
reddit/search + 15 × reddit/comments | 16 | $0.0089 | 최대 100개, 중첩 답글 포함 | 직접 쓰는 모델 |
painpoint는 코드를 작성하지 않고 제품에 대한 불만을 빠르게 훑어보고 싶은 사람에게 맞습니다. 주간 보고서라면 직접 구축하는 편이 더 저렴합니다. 전체 방법은 Reddit 불만 사항을 찾는 Claude Code 예약 작업에서 소개했습니다.
실패한 호출과 빈 결과에도 비용이 청구될까?
Apify와 EveryInfra의 과금 규칙이 가장 크게 다른 부분입니다. 저희는 데이터를 반환할 수 없는 요청 여섯 개를 일부러 보냈습니다.
| 사례 | 전송 시각(싱가포르 시간) | HTTP 상태 | 응답 | 과금액 |
|---|---|---|---|---|
| API 키 없음 | 00:25 | 401 | missing_key, Authorization 헤더를 쓰라는 안내 포함 | $0 |
sort를 hot으로 설정 | 00:25 | 422 | invalid_value, 허용 값 목록과 did_you_mean popular, top 포함 | $0 |
추가 time_filter 파라미터 | 00:25 | 422 | unknown_param, 필수·선택 파라미터와 동작하는 예시 포함 | $0 |
| 존재하지 않는 서브레딧 | 00:26 | 200 | id, community, platform만 있는 자리 표시자 행 1개, 결과 1개로 과금 | $0.000556 |
| 존재하지 않는 게시물 | 00:26 | 200 | 0행, empty_result_refunded, 요금 환불 | $0 |
| 존재하지 않는 사용자 | 00:36 | 200 | 0행, empty_result_refunded | $0 |
처음 세 경우는 파라미터 오류입니다. 저희는 API 키를 먼저 확인한 다음 파라미터를 확인합니다. 잘못된 요청에는 즉시 4xx 응답이 반환되며 과금되지 않습니다. 오류 메시지가 요청을 수정하는 방법을 알려 주므로 AI 클라이언트가 요청을 바로잡아 다시 보낼 수 있습니다. 다섯 번째와 여섯 번째 경우는 정상적인 빈 결과입니다. 요청은 성공했지만 일치하는 항목이 없어 요금이 즉시 환불되었습니다.
네 번째 경우는 주의가 필요합니다. 존재하지 않는 서브레딧 이름을 보내면 HTTP 200과 count 1이 반환됩니다. 유일한 행의 id는 target-status:로 시작하고, community와 platform 필드만 있을 뿐 제목, 텍스트, 링크가 없습니다. 이 호출에는 결과 1개 가격인 $0.000556이 청구되었습니다. 따라서 서브레딧을 일괄 처리할 때는 행 수를 세거나 단가를 계산하기 전에 id 접두사로 이 행을 걸러 내세요. 남는 행이 없다면 이름이 틀렸거나 서브레딧이 사라진 것입니다. 다시 비용을 내지 않도록 목록에서 제거하세요.
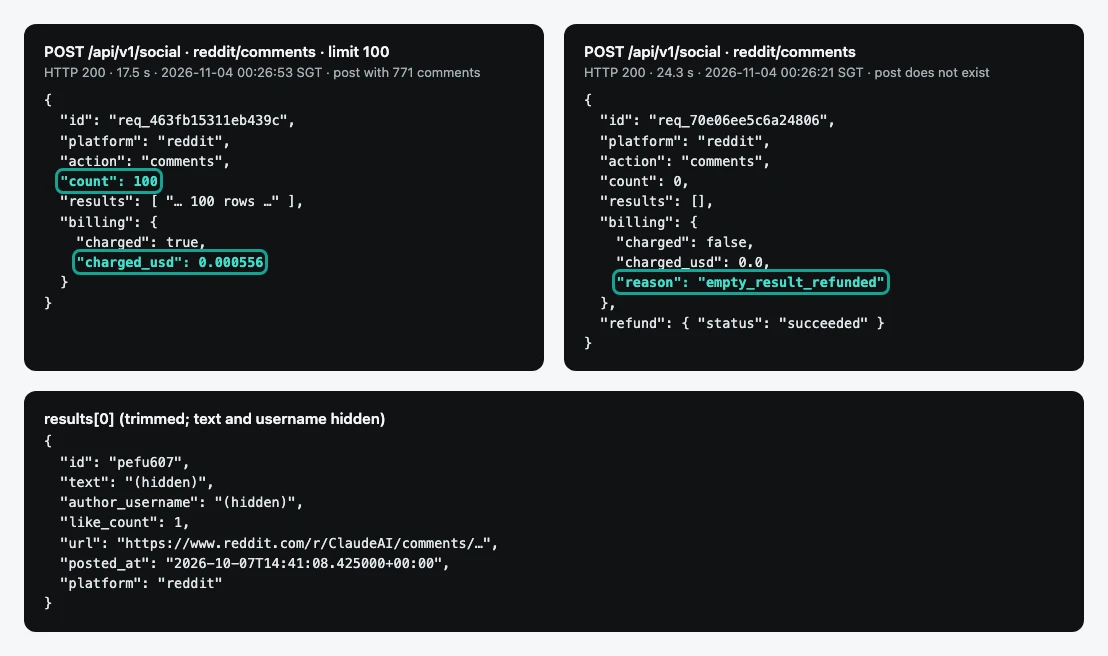
Apify에서는 Actor마다 규칙이 다릅니다. Apify 자체 Reddit Scraper에는 $0.0005짜리 “No result” 이벤트가 있습니다. 삭제된 커뮤니티, 결과가 없는 검색, 댓글이 없는 게시물이 여기에 해당합니다. 각 경우 그 이유를 설명하는 레코드 하나를 이 가격에 기록합니다(Store 페이지).
automation-lab은 결과가 없는 실행에는 과금하지 않는다고 밝힙니다. 메모리 용량에 따라 정해지는 Lite 시작 요금은 결과가 하나도 반환되지 않더라도 실행이 시작될 때 청구됩니다. 기본값인 2 GB에서는 $0.04입니다.
실패하거나 시간 초과된 실행은 생각보다 흔합니다. 다음 섹션에서 보듯이 최근 30일간 Lite 실행 360,000회 중 10%가 시간 초과되었습니다. Apify 문서에 따르면 실행마다 최대 청구액을 설정할 수 있으며, 실행은 그 한도에서 멈춥니다(Actors in Store). 대규모 작업 전에 설정해 두세요.
Apify Reddit Scraper Lite 요금: 결과당 $0.004에 2 GB 메모리 기준 시작 요금 추가
“apify reddit scraper”를 검색하는 사람 대부분은 trudax의 Reddit Scraper Lite를 먼저 만납니다. 최근 30일 사용자가 8,543명으로 Store의 Reddit 스크래퍼 중 가장 많으며, 2위보다 약 50% 많습니다. 과금 항목은 두 가지입니다. 데이터셋에 기록되는 결과마다 Free 티어에서 $0.004, 즉 1,000개당 $4.00입니다. Bronze 티어(Starter 플랜)는 $0.0038, Silver(Scale)는 $0.0036, Gold(Business)는 $0.0034입니다.
이 글의 사용자 수와 실행 수는 2026년 11월 4일 싱가포르 시간 00:14에 Store 목록 API에서 가져온 값입니다. 같은 시각 이 Actor의 상세 API에는 사용자 8,540명, 실행 363,964회가 표시되었습니다. 두 소스의 차이는 1% 미만입니다.
실행마다 메모리 용량에 따라 GB당 $0.02의 시작 요금도 부과됩니다. 기본 메모리는 2,048 MB이므로 기본 설정의 실행은 $0.04부터 시작하며, 플랫폼이 정한 실행당 최소 청구액도 $0.04입니다. 이 내용은 모두 2026년 11월 4일 싱가포르 시간 00:15에 읽은 Lite 공개 메타데이터의 pricingInfos와 defaultRunOptions 필드에서 가져온 것입니다. Apify 문서에서는 티어와 플랜을 다음과 같이 대응시킵니다. Free에는 FREE 가격이, Starter에는 BRONZE 가격이, Scale에는 SILVER 가격이, Business에는 GOLD 가격이 적용됩니다. PLATINUM과 DIAMOND는 엔터프라이즈 고객 전용입니다(Actor pricing and costs).
| 티어(플랜) | 결과당 | 실행 1회에 결과 1,000개, 시작 요금 $0.04 포함 |
|---|---|---|
| FREE (Free) | $0.004 | $4.04 |
| BRONZE (Starter) | $0.0038 | $3.84 |
| SILVER (Scale) | $0.0036 | $3.64 |
| GOLD (Business) | $0.0034 | $3.44 |
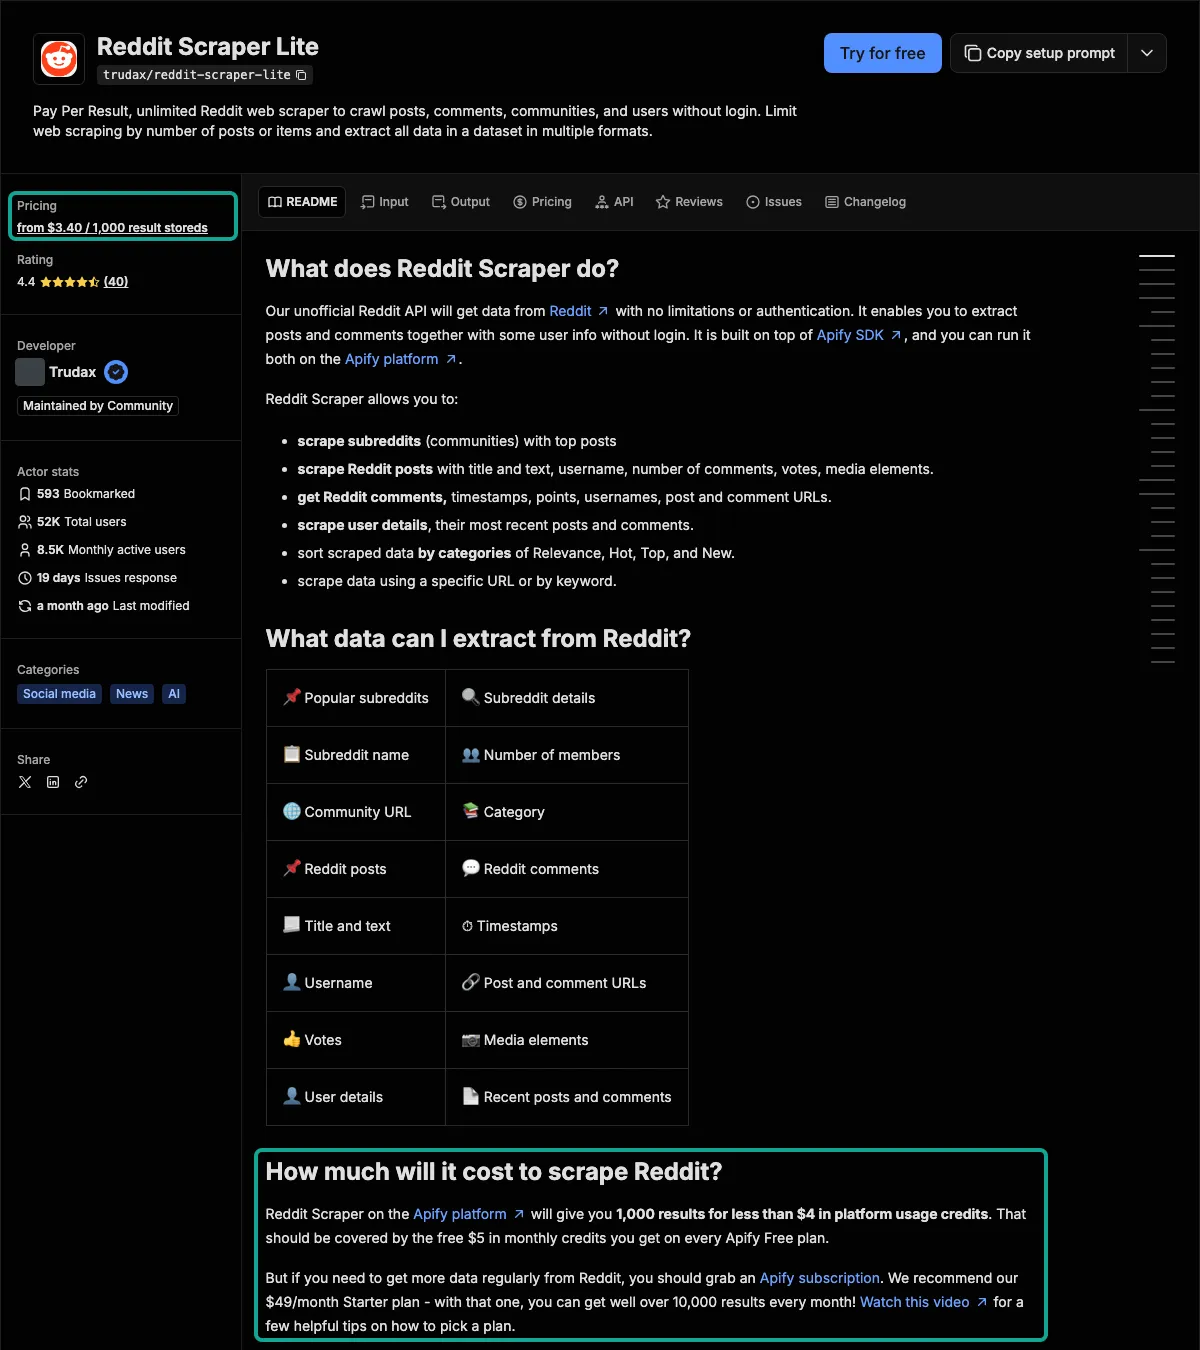
이 스크린샷에는 잘못 읽기 쉬운 부분이 두 군데 있습니다. 첫째, 사이드바의 “from $3.40 / 1,000”은 할인 폭이 가장 큰 티어의 가격입니다. Free 사용자는 $4.00에 실행당 $0.04를 더 냅니다. 결과 1,000개를 얻는 실행 1회의 비용은 Free에서 $4.04, Business에서 $3.44입니다.
둘째, 본문의 “$49/month Starter plan”은 현재 요금 페이지와 일치하지 않습니다. 요금 페이지에는 Free의 월 선불 크레딧 $5, Starter $19부터, Scale $199, Business $999가 나와 있습니다. 사용하지 않은 크레딧은 이월되지 않습니다. readme 본문이 요금 페이지에 맞춰 업데이트되지 않았으므로, 계산할 때는 요금 페이지를 기준으로 하세요.
놓치기 쉬운 점이 하나 더 있습니다. Store 페이지의 “Results” 섹션에 나와 있듯이, Lite는 “게시물, 댓글, 사용자, 커뮤니티 각각”을 결과 하나로 셉니다. 따라서 서브레딧에서 게시물 100개를 요청하면서 댓글 수집을 켜 두면 그 게시물 아래의 댓글도 데이터셋에 기록됩니다. 댓글 하나하나에 $0.004가 청구됩니다. 페이지에는 skipComments, maxComments, maxItems 옵션이 있습니다. 상한을 두지 않으면 “게시물 100개” 실행이 수천 행을 기록할 수 있습니다.
“Reddit Scraper” 자체는 지원 중단: 9월 21일부터 기존 사용자 전용
“Apify Reddit Scraper”라고 쓰는 튜토리얼 상당수는 다른 Actor인 trudax의 Reddit Scraper를 가리킵니다. 이 Actor는 2022년 2월부터 월 $45의 정액 대여 방식이었고, 체험 기간은 1,440분이었습니다. 2026년 9월 21일에는 결과당 $0.0001, 시작당 $0.00005의 이벤트당 과금 방식으로 바뀌었습니다. 변경 안내에 따르면 Apify는 월 대여 요금제를 단계적으로 폐지하고 있습니다. 또한 이 Actor는 더 이상 공개 목록에 표시되지 않으며, 기존 사용자는 계속 모든 기능을 이용할 수 있다고 밝힙니다. 이 내용은 2026년 11월 4일에 읽은 공개 메타데이터의 reasonForChange 필드에 있습니다.
같은 메타데이터에는 isDeprecated가 true로 설정되어 있고, Store 제목에도 이제 “[DEPRECATED]”가 붙어 있습니다. 최근 30일 사용자가 여전히 459명이지만 신규 사용자는 실행할 수 없습니다. 따라서 지금 새로 시작하는 사용자가 이 이름으로 고를 수 있는 것은 Lite와 Apify 자체 Reddit Scraper 두 가지입니다.
Apify 자체 스크래퍼는 결과 유형 네 가지에 가격을 따로 매깁니다. 게시물은 Free에서 $0.004, Gold에서 $0.0025입니다. 댓글은 Free에서 $0.0032, Gold에서 $0.002입니다. 커뮤니티는 $0.0065, 사용자는 $0.002, 시작은 1회당 $0.001입니다.
다른 스크래퍼에서는 보기 드문 $0.0005짜리 “No result” 이벤트도 있습니다. 페이지에 따르면 삭제된 커뮤니티, 결과가 없는 검색, 댓글이 없는 게시물처럼 결과가 없는 요청이 여기에 해당합니다. 이런 경우 이유를 설명하는 레코드 하나를 일반 결과보다 낮은 가격에 기록합니다. 또한 두 입력에서 같은 게시물에 도달하면 두 번 기록되고 두 번 과금된다고 안내합니다(Store 페이지, “How much will it cost?”).
| Apify 자체 Reddit Scraper의 이벤트 | Free | Gold |
|---|---|---|
| 게시물 | $0.004 | $0.0025 |
| 댓글 | $0.0032 | $0.002 |
| 커뮤니티 | $0.0065 | $0.004 |
| 사용자 | $0.002 | $0.001 |
| No result(결과 없음) | $0.0005 | $0.0005(단일 가격) |
| 시작 | $0.001 | $0.001(단일 가격) |
Apify Store의 Reddit 스크래퍼 746개: 가격 분포와 실행 결과
Apify의 공개 Store 목록 엔드포인트(Get list of Actors in Store)로 “reddit”을 검색했습니다. 14페이지를 가져와 중복을 제거하니 제목이나 이름에 Reddit이 들어간 Actor가 746개였습니다. 이 중 717개는 이벤트당 과금하고 29개는 무료입니다. 최근 30일 사용자가 100명 이상인 Actor는 17개였습니다. 차트는 그중 결과당 과금하는 16개의 주요 이벤트 Free 티어 가격을 보여 줍니다. 나머지 하나는 red_crawler의 무료 Actor로, 커뮤니티 정보 조회와 탐색용입니다.
가장 저렴한 것은 1,000개당 $0.99인 clearpath 검색 스크래퍼입니다. 사용자 수 2위와 3위인 harshmaur 범용 스크래퍼와 fatihtahta는 각각 $2.00, $1.49입니다. harshmaur의 Reddit Comment Scraper는 $1.50입니다. Lite, practicaltools의 스크래퍼, Apify 자체 스크래퍼 세 개가 최고가 $4.00로 같습니다. 중앙값은 약 $2.00입니다. 이 가격에는 시작 요금이 빠져 있습니다. 시작 요금은 메모리 기준으로 실행마다 청구되며, Lite는 $0.04, harshmaur는 $0.02, clearpath는 $0.00099입니다.
가격 외에도 각 Actor의 공개 메타데이터에는 30일 실행 통계가 있습니다. 성공, 실패, 시간 초과, 중단된 실행이 각각 몇 회인지 알 수 있습니다. 차트는 사용자가 가장 많은 네 개와 Apify 자체 스크래퍼를 보여 줍니다.
두 숫자는 주의해서 읽어야 합니다. 첫째, Lite의 최근 30일 실행 360,661회 중 35,919회가 시간 초과되었습니다. 약 10%로, 다른 스크래퍼보다 10배가량 높습니다. 원인은 추측할 수밖에 없습니다. 일부 사용자는 시간 제한을 짧게 설정하고, 일부는 maxItems를 지정하지 않아 한 번의 실행에서 게시물과 댓글을 너무 많이 요청했을 수 있습니다. 시간 초과된 실행도 이미 데이터셋에 기록된 결과는 과금되며, 시작 요금도 청구됩니다.
둘째, Apify 자체 Reddit Scraper의 실행 15,672회 중 5,296회, 약 34%가 실패했습니다. 페이지에 따르면 “결과 없음”인 경우에는 $0.0005짜리 레코드를 기록하며 실패로 처리하지 않습니다. 따라서 이 실패는 잘못된 입력이나 Reddit의 차단 때문일 가능성이 큽니다. 이 수치는 공개 플랫폼 통계이며, 각 Actor의 성공률을 직접 나타내지는 않습니다. 실행 상태의 정의는 Apify 문서 Runs and builds에 나와 있습니다.
| Actor | 최근 30일 실행 수 | 성공 | 시간 초과 | 실패 |
|---|---|---|---|---|
| trudax/reddit-scraper-lite | 360,661 | 86.3% | 10.0% | 1.0% |
| harshmaur/reddit-scraper | 214,422 | 97.8% | 0.5% | 1.1% |
| fatihtahta/reddit-scraper-search-fast | 369,944 | 98.2% | 0.3% | 0.6% |
| automation-lab/reddit-scraper | 187,397 | 99.9% | 0.0% | 0.0% |
| apify/reddit-scraper | 15,672 | 65.9% | 0.1% | 33.8% |
인기 Actor 17개의 실행은 총 1,526,908회였으며, 95.3%가 성공, 2.6%가 시간 초과, 1.1%가 실패, 1.0%가 중단되었습니다. Apify는 공개 Actor마다 매일 자동 테스트도 실행합니다. 계속 실패하는 Actor에는 “under maintenance” 표시가 붙습니다(Automated testing). 고르기 전에 Store 페이지에서 이 표시를 확인하세요.
저희 쪽에서는 이 글의 호출 49회 중 46회가 HTTP 200을 반환했습니다. 이 46회만 보면 호출마다 6~41초가 걸렸고, 중앙값은 14초였습니다. 가장 느린 호출은 댓글이 많은 게시물과 게시물 상세 호출이었습니다. 4xx 응답 3회는 일부러 보낸 잘못된 파라미터 때문이었습니다.
시간 초과되거나 5xx를 반환한 호출은 없었습니다. 다만 49회는 성공률을 말하기에는 너무 적습니다. 이번 실행에서 실패를 관찰하지 못했다고만 말할 수 있습니다.
| 엔드포인트 | 호출 수 | 중앙값(초) | 범위 |
|---|---|---|---|
reddit/search | 10 | 6.4 | 6.0~10.2 |
reddit/subreddit_posts | 10 | 17.8 | 9.5~30.7 |
reddit/comments | 13 | 22.4 | 11.4~40.8 |
reddit/user_posts | 7 | 12.5 | 9.1~14.5 |
reddit/post_detail | 2 | 23.6 | 11.2~36.0 |
필드 비교: 양쪽은 같은 데이터를 반환할까?
낮은 가격의 이면은 필드가 적다는 점입니다. 아래 표는 카탈로그에 나열된 필드가 아니라 49건의 호출이 실제로 반환한 필드입니다. 둘이 다른 경우에는 따로 밝혔습니다. Apify 쪽은 스크래퍼마다 필드 차이가 큽니다.
harshmaur의 범용 스크래퍼는 게시물당 미디어와 갤러리를 포함해 60개 이상의 필드를 반환한다고 밝힙니다. Lite와 automation-lab의 댓글 레코드에는 parentId가 있습니다. 전체 목록은 각 Store 페이지의 샘플 출력을 확인하세요. 저희는 이 스크래퍼들을 직접 실행하지 않았으므로 이 스크래퍼들의 필드는 나열하지 않습니다.
| 엔드포인트 | 실제 반환된 필드 | 빠진 항목 |
|---|---|---|
reddit/search, reddit/subreddit_posts | id, title, text, author_username, community, url, like_count, comment_count, posted_at, platform. 서브레딧 게시물에는 domain과 flair도 있음 | 이미지·동영상 URL, 어워드·고정 여부 플래그 |
reddit/comments | id, text, author_username, like_count, url, posted_at, platform | 상위 댓글 ID, 깊이, 답글 수. 카탈로그에는 community가 있으나 실제 응답에는 없음. 이 필드에 의존하지 말 것 |
reddit/user_comments | id, text, author_username, like_count, post_id, post_title, url, posted_at, platform | 텍스트가 300자로 잘릴 수 있음. 카르마와 계정 생성 후 경과 기간 없음 |
“사람들이 무슨 말을 하는지” 파악하는 작업 대부분에는 이 컬럼으로 충분합니다. 댓글에는 텍스트, 작성자, 추천 수, 시간이 있습니다. 게시물에는 제목, 커뮤니티, 댓글 수가 있어 댓글 수로 게시물을 고른 뒤 그 댓글을 가져올 수 있습니다. 게시물 url을 reddit/comments에 그대로 넘길 수 있으며, 아래 Python 예제도 이 방식으로 호출을 연결합니다. 미디어 파일, 댓글 트리, 사용자 프로필이 필요하다면 Apify에서 필드가 더 많은 스크래퍼가 더 적합합니다. 바로 이런 추가 필드에 행당 비용을 지불하는 셈입니다.
과금에 영향을 주는 점이 하나 더 있습니다. Lite는 기본 시간 제한 3,600초, 메모리 2,048MB로 실행됩니다(Lite의 공개 메타데이터의 defaultRunOptions 필드). 메모리가 클수록 시작 요금이 올라갑니다. Usage and resources 문서에 따르면 메모리는 실행에 할당되는 CPU 양도 결정합니다.
메모리를 줄이면 시작 요금은 아낄 수 있지만 실행이 느려지고 시간 제한에 걸릴 가능성이 커집니다. EveryInfra에는 따로 조정해야 할 메모리나 시간 제한이 없습니다. 요청당 요금은 고정되어 있으며, 가장 느렸던 41초짜리 호출도 비용은 $0.000556이었습니다.
Apify 가격은 자주 바뀝니다
저희가 확인한 Reddit Actor 15개의 공개 메타데이터에서 모든 가격 적용 기간에는 startedAt 날짜가 지정되어 있습니다. Apify 자체 Reddit Scraper에는 2026-09-25부터 2026-10-20까지 8개의 가격 적용 기간이 있었고, 그중 4개는 2026년 10월 1일 하루에 시작됐습니다. 현재 가격 적용 기간은 2026-10-20에 시작됐고, 페이지는 2026-10-27에 마지막으로 수정됐습니다. maximedupre 댓글 검색 스크래퍼의 현재 가격은 2026-10-18부터 적용됐습니다. automation-lab은 2026-11-17부터 댓글 가격을 올린다고 예고했습니다. 기존 trudax Reddit Scraper는 2026-09-21에 이벤트당 과금 방식으로 전환되고 지원 중단(deprecated) 상태가 됐습니다.
반면 현재 Lite 가격은 2026년 6월 30일 이후 바뀌지 않았습니다. 따라서 이 글을 포함한 모든 가격 비교는 한두 달 만에 낡은 정보가 될 수 있습니다. 구매 전에 Get Actor 엔드포인트로 pricingInfos를 다시 확인하고, 확인한 시점을 기록해 두세요.
| Actor | 현재 가격 적용 시작일 | 변경 내용 |
|---|---|---|
| apify/reddit-scraper | 2026-10-20 | 2026-09-25 이후 8번째 가격 적용 기간 |
| maximedupre/reddit-comments-search-scraper | 2026-10-18 | Free 티어 기준 댓글당 $0.00265 |
| automation-lab/reddit-scraper | 2026-08-25, 다음 변경 2026-11-17 | 댓글 가격 30% 인상 |
| trudax/reddit-scraper | 2026-09-21 | 이벤트당 과금 전환 후 지원 중단 |
| trudax/reddit-scraper-lite | 2026-06-30 | 이후 변경 없음 |
전체 엔드포인트 목록은 API 레퍼런스에 있습니다. 이벤트당 과금 규칙은 이벤트당 과금 문서에 있습니다.
코드와 AI 클라이언트에서 사용하기
이 Python 코드는 댓글 테스트와 같은 방식입니다. 게시물 URL 목록을 받아 각 URL마다 reddit/comments를 한 번씩 호출합니다. 댓글 id로 중복을 제거하고 각 호출의 charged_usd를 합산합니다. 커버리지 확인을 위해 게시물마다 게시물의 댓글 수와 실제로 받은 행 수, 두 숫자도 저장합니다. 실패 섹션에서 설명한 이유로 id가 target-status:로 시작하는 행은 건너뜁니다.
import os, requests

API = "https://api.everyinfra.com/api/v1/social"
HEADERS = {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}

def call(action, **params):
    r = requests.post(API, headers=HEADERS, timeout=120,
                      json={"platform": "reddit", "action": action, "params": params})
    r.raise_for_status()
    body = r.json()
    rows = [x for x in body["results"] if not str(x.get("id", "")).startswith("target-status:")]
    return rows, body["billing"]["charged_usd"]

posts, spent = call("subreddit_posts", subreddit="Python", sort="top", date_range="past_year", limit=100)
seen, coverage = {}, []
for p in posts[:13]:
    rows, cost = call("comments", url=p["url"], limit=100)
    spent += cost
    seen.update({c["id"]: c for c in rows})
    coverage.append((p["url"], p["comment_count"], len(rows)))

print(len(seen), "unique comments, spent", round(spent, 6), "USD")
for url, listed, got in coverage:
    print(f"{got}/{listed}", url)
AI 클라이언트에서는 원격 MCP 서버 https://api.everyinfra.com/mcp에 연결합니다. 도구 이름은 everyinfra_로 시작하며, 게시물을 먼저 검색할지 댓글을 바로 가져올지는 모델이 판단할 수 있습니다. 아래는 일반적인 설정 예시입니다. Claude Code, Cursor 등 원격 MCP를 지원하는 클라이언트도 비슷한 형식을 씁니다.
정확한 문법은 Claude Code MCP 문서와 Cursor MCP 문서를 참고하세요. OpenAI에도 별도의 MCP 문서가 있습니다. 프로토콜 자체는 MCP 사양에 정의되어 있습니다.
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
Apify에도 Store Actor를 모델의 도구로 노출하는 자체 MCP 서버가 있습니다(Apify MCP 문서, 소스는 GitHub). 코드용으로는 Python 클라이언트가 있습니다. 차이는 데이터를 돌려받는 방식에 있습니다. Apify의 MCP에서는 모델이 Actor 실행을 시작하고, 완료될 때까지 기다린 뒤 데이터셋을 읽습니다.
이 방식은 수만 행 규모의 내보내기에 적합합니다. EveryInfra의 MCP는 호출당 데이터 한 페이지를 반환하므로, 채팅에서 질문을 하나씩 처리하는 용도에 적합합니다. 설정 방법과 지원 클라이언트는 MCP 서버 페이지를 참고하세요.
월 청구액 계산: 흔한 작업 세 가지를 30일 동안 실행하면
매일 자사 카테고리에 대해 Reddit에서 어떤 이야기가 오가는지 알고 싶은 제품 팀을 예로 들어 보겠습니다. 아래 세 작업은 저희가 측정한 호출당 행 수를 기준으로 합니다. EveryInfra 쪽 비용은 호출 수 × $0.000556이며, 사용자 댓글은 호출 수 × $0.032403입니다. Apify 쪽은 각 Actor에 표시된 Free 티어 가격을 적용하고, 작업 실행마다 기본 시작 요금을 한 번씩 더했습니다.
| 30일간 작업 | 호출 수와 행 수 | EveryInfra | Reddit Scraper Lite | Apify의 더 저렴한 인기 스크래퍼 |
|---|---|---|---|---|
| 하루 활발한 스레드 10개의 댓글, 스레드당 100개 | 300회 호출, 30,000행 | $0.17 | $121.20 | automation-lab $17.69(11월 17일부터 $22.94). harshmaur 댓글 스크래퍼 $45.60 |
| 하루 서브레딧 5개의 최신 게시물 100개씩 | 150회 호출, 15,000행 | $0.08 | $61.20 | automation-lab $17.34. clearpath 서브레딧 스크래퍼 $30.02 |
| 주 1회 사용자 200명의 댓글 기록, 사용자당 100행 | 800회 호출, 80,000행 | $25.92 | $320.16 | harshmaur 사용자 스크래퍼 $120.08. clearpath 사용자 콘텐츠 스크래퍼 $160.00 |
이 추정치는 세 가지 가정에 기반합니다. 첫째, 모든 호출이 한 페이지를 가득 채워 반환한다고 가정했습니다. 테스트에서 댓글이 100개를 넘는 게시물은 모두 실제로 100개를 반환했습니다. 하지만 작은 게시물은 그보다 적게 반환하며, limit 200으로 호출한 사용자 댓글은 100개만 반환했습니다.
반환되는 행이 적으면 저희 총액은 그대로이고 단가가 올라갑니다. 둘째, Lite 열은 댓글 스크래핑이 꺼져 있다고(skipComments) 가정합니다. 켜져 있으면 게시물 행 수가 몇 배로 늘어납니다. 셋째, 어느 작업도 날짜 간 중복을 제거하지 않습니다.
다음 날 같은 활발한 스레드를 다시 가져오면 댓글 대부분은 이미 받은 것이며, 양쪽 모두 중복분에도 과금합니다. Apify에서는 시간 필터로 중복을 줄일 수 있습니다. EveryInfra에서는 id로 직접 중복을 제거해야 합니다.
그렇더라도 EveryInfra의 사용자 댓글 호출 비용은 건당 $0.032403입니다. 사용자 200명 대부분이 댓글을 십여 개만 작성했다면 EveryInfra의 총비용은 그대로입니다. Apify에서 행 단위로 계산한 총비용은 몇 달러 수준으로 떨어지므로 Apify가 더 나은 선택입니다.
현재 Reddit 자체 API: 10월 31일부터 신규 접근 신청 중단
Reddit 자체 데이터 API를 빼면 가격 비교는 완전하지 않습니다. Reddit Data API Wiki에 따르면 자격을 갖춘 사용자는 OAuth 클라이언트당 분당 100건을 요청할 수 있으며, 요청 속도는 10분 구간의 평균으로 계산됩니다. OAuth를 사용하지 않은 트래픽은 차단됩니다. 게시물이나 댓글이 삭제되면 보관한 사본도 삭제해야 하며, Reddit은 적어도 48시간에 한 번 정리할 것을 권장합니다.
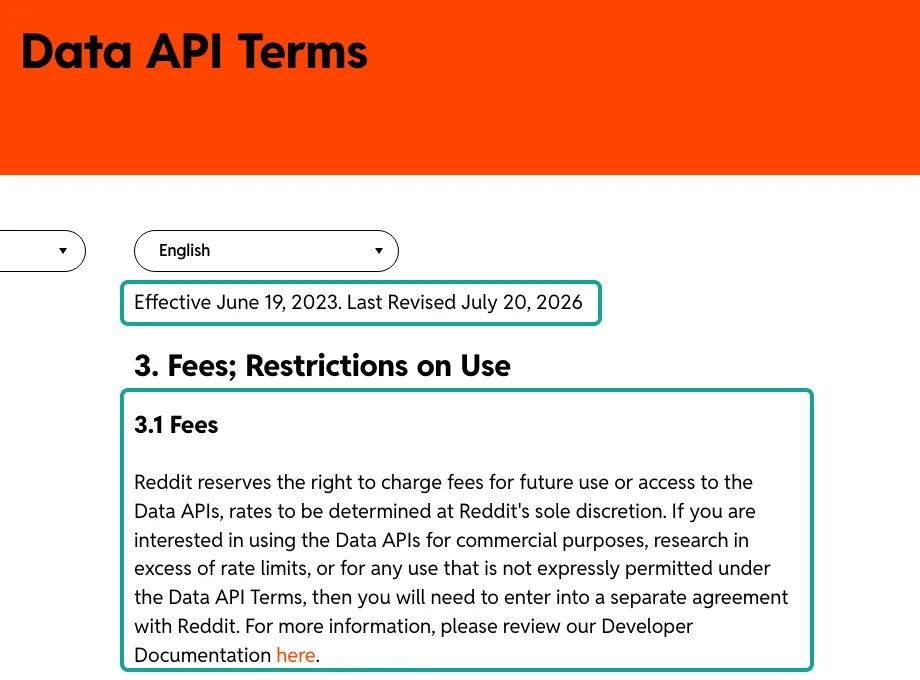
무료 사용을 벗어나는 경우에 대해서는 Data API Terms 3.1항이 명확합니다. Reddit은 향후 사용에 대해 자체적으로 정한 요율로 요금을 부과할 권리를 보유합니다. 상업적 사용, 요청 속도 제한을 넘는 연구, 약관이 허용하지 않는 모든 사용에는 별도 계약이 필요합니다. 이 약관은 2023년 6월 19일 발효됐고 2026년 7월 20일에 마지막으로 개정됐습니다.
| Reddit 공식 페이지의 규칙 | 내용 |
|---|---|
| 무료 요청 속도 제한 | OAuth 클라이언트당 분당 100건, 10분 평균 |
| OAuth 없는 트래픽 | 차단 |
| 삭제된 콘텐츠 | 보관한 사본 삭제, 적어도 48시간에 한 번 정리 |
| 상업적 사용 | 별도 계약, Reddit이 정한 요율 |
Reddit의 현재 공개 페이지에는 상업적 사용 가격이 나와 있지 않습니다. Developer Platform & Accessing Reddit Data에는 더 많은 접근 권한이 필요한 일부 개발자는 비용을 내야 할 수 있다는 내용만 있습니다. 이 페이지에는 상업적 사용 사례도 나와 있습니다. 광고나 페이월이 있는 앱, 유료 서비스나 유료 데이터 접근 권한, 구독 서비스 등이 여기에 해당합니다. Reddit 데이터로 학습한 모델을 판매하는 것도 목록에 있습니다.
흔히 볼 수 있는 “요청 1,000건당 $0.24”라는 수치는 2023년에 나온 것입니다. 2023년 5월 31일, Reddit은 r/redditdev에서 7월 1일부터 무료 등급에 요청 속도 제한을 적용한다고 발표했습니다(게시물). 같은 날 Apollo 클라이언트 개발자는 Reddit이 요청 50,000,000건당 $12,000를 제시했다고 밝혔습니다(게시물). 이는 1,000건당 $0.24에 해당합니다.
이는 개발자 한 명의 보고일 뿐 Reddit의 공식 가격표가 아닙니다. 이 가격에 목록 요청당 100행이라면 게시물 1,000개 비용은 약 $0.0024로, 어떤 서드파티보다 저렴합니다. 단, 그런 계약을 맺을 수 있을 때의 이야기입니다.
그 길도 닫히고 있습니다. 2026년 8월 Reddit은 r/redditdev에서 공개 데이터 API에 대한 계획을 처음 밝혔습니다(게시물). 2026년 9월 30일에는 종료 일정을 게시했습니다(게시물).
| 날짜 | Reddit 게시물 내용 | 데이터 수집에 미치는 영향 |
|---|---|---|
| 2026-10-31 | 공개 API 신규 접근 신청 중단 | 지금 시작하는 프로젝트는 접근 권한을 받을 수 없음 |
| 2026-11-10 | 마이그레이션 진행 상황 업데이트 및 마감일 안내 | 연장이나 예외 여부 확인 |
| 2026-11-13 | RSS 종료(r/modnews 게시물, 대안은 Reddit RSS 종료 이후 참고) | RSS 기반 서브레딧 모니터링 중단 |
| 2026-11-30 | 마이그레이션 보상 프로그램 마감 | Devvit으로 이전하는 앱만 해당 |
| 2027-01-12 | 등록하지 않았거나 Reddit에 응답하지 않은 앱과 사용자부터 접근 차단 시작 | 기존 스크립트가 이 무렵 작동을 멈출 수 있음 |
| 2027-03 | 남은 공개 접근 전면 종료(정확한 날짜 미공개) | 서면 계약을 맺은 파트너와 Devvit만 가능 |
Reddit이 제시하는 대안은 자체 개발자 플랫폼인 Devvit입니다. 마이그레이션 가이드에 따르면 Devvit은 주로 모더레이션 도구와 커뮤니티 앱을 위한 것입니다. 마이그레이션 프로그램에 참여한 앱은 이전을 마치면 $1,000를 받을 수 있으며, 프로그램 기간은 2026년 3월 31일부터 12월 31일까지입니다. Devvit은 데이터를 내보내 다른 곳에서 분석하기 위한 API가 아닙니다. Devvit 앱은 App registration에서 등록합니다. 외부 요청은 HTTP Fetch 규칙을 따르며, 전체 가이드는 Devvit 문서에 있습니다.
연구자의 경우, Responsible Builder Policy는 Reddit for Researchers 프로그램 밖에서 수집한 데이터로 하는 연구를 정책 위반으로 봅니다. 서면 승인 없이는 데이터를 판매하거나 라이선스하거나 모델 학습에 사용할 수 없습니다.
10월 29일 Reddit CEO Steve Huffman은 자신의 프로필에 Reddit이 “로그인 우선(logged-in first)” 환경으로 전환한다고 게시했습니다. 먼저 미국 외 일부 시장에서 이를 테스트할 예정입니다. 그가 든 이유 중 하나는 무단 데이터 수집 대부분이 로그아웃 상태의 페이지에서 일어난다는 것입니다(게시물). 같은 날 Axios 보도에 따르면 홈페이지는 로그아웃한 방문자에게도 계속 공개될 예정입니다. 검색 엔진이나 외부 링크를 통해 접속하는 게시물도 계속 공개되며, 정확한 제한은 테스트 과정에서 정해집니다.
로그인 장벽은 로그인 없이 페이지를 읽는 모든 도구에 위험 요소입니다. Apify Store의 스크래퍼도, EveryInfra도 마찬가지입니다. Reddit의 변경 이후에도 모든 엔드포인트가 계속 작동한다고 보장할 수는 없습니다.
대응 방법은 세 가지입니다. 첫째, 실패한 요청은 과금되지 않으므로 Reddit이 호출을 차단해도 비용을 내지 않습니다. 둘째, 엔드포인트가 작동하지 않으면 무료 카탈로그에 available이 false로 설정되고 “일시적으로 사용 불가”로 표시됩니다. 따라서 대량 작업 전에 카탈로그를 확인하세요. 셋째, 장기적으로 필요한 데이터는 직접 저장해 두고, 나중에 다시 가져올 때 하나의 도구에만 의존하지 마세요.
데이터를 수집해도 되는지, 수집한 데이터로 무엇을 할 수 있는지는 관할 지역, 사용 목적, Reddit 약관에 따라 다릅니다. 이 글은 법률 자문이 아닙니다. 구체적인 프로젝트는 변호사와 상담하세요.
Apify가 더 나은 선택인 경우
테스트 결과를 종합하면, EveryInfra보다 Apify Store의 스크래퍼를 권하는 작업은 여섯 가지입니다. 첫째, 작성된 지 한 달이 넘은 특정 주제의 게시물입니다. reddit/search는 최근 한 달만 다루지만 Lite의 time은 all로 설정할 수 있습니다. 둘째, 한 서브레딧에서 게시물이 1,000개 넘게 필요한 경우입니다. 저희는 정렬 방식마다 처음 100행만 반환하며, r/Python에서 8가지 조합으로 286개를 얻었습니다. 페이지네이션을 지원하는 스크래퍼는 정렬 방식마다 1,000개 가까이 가져옵니다.
셋째, 활발한 스레드의 모든 댓글이나 전체 댓글 트리입니다. 저희는 게시물당 100개로 제한되고 상위 댓글 ID가 없지만, clearpath는 모든 댓글을 펼치고 Lite와 automation-lab은 parentId와 depth를 제공합니다. 넷째, 사용자 프로필입니다. 저희는 카르마나 계정 연령을 제공하지 않지만 harshmaur 사용자 스크래퍼는 한 번의 실행으로 이를 반환합니다. 다섯째, 소수의 사용자입니다. 호출당 댓글이 22개 미만이면 reddit/user_comments가 harshmaur 사용자 스크래퍼보다 비쌉니다. 여섯째, 이미 Apify의 스케줄, 데이터셋, 통합 기능을 쓰고 있는 팀입니다. 전환하면 스케줄러와 저장소를 직접 만들어야 하며, 절감액이 그 작업량을 상쇄하지 못할 수 있습니다.
반대로 대량 데이터를 자주 페이지 단위로 가져오는 경우에는 저희가 100~1,000배 저렴합니다. 하루 수백 개 게시물의 댓글이나 하루 수십 개 커뮤니티의 새 게시물이 그 예입니다. AI 클라이언트의 채팅에서 Reddit을 조회하는 경우도 또 다른 예입니다. reddit/trending_posts도 있습니다. 사이트 전체의 인기 급상승 게시물을 페이지당 25개씩 반환하고, page_token으로 페이지를 넘기며, 페이지당 $0.000556입니다.
이 엔드포인트는 페이지네이션이 없는 서브레딧 목록의 공백을 일부 메웁니다. 다만 특정 커뮤니티의 기록이 아니라 사이트 전체의 인기 급상승 게시물입니다. 두 과금 모델의 함정은 Apify 요금 구조 해설과 Apify 대안에서 다뤘습니다. 환불 내역을 대조하려면 실패 환불 대조를 참고하세요.
최근 달라진 점
- 2026-11-17: automation-lab Reddit 스크래퍼의 Free 등급 댓글 가격이 $0.000575에서 $0.00075로 30% 오릅니다(automation-lab Store 페이지). 영향: 이 글의 댓글 1,000개당 $0.59는 $0.76이 됩니다.
- 2026-10-29: Reddit CEO가 로그인 장벽에 관한 글을 게시했습니다(게시물). 영향: 일부 시장에서 먼저 로그아웃 상태의 접근 제한이 강화됩니다. 로그인 없이 페이지를 읽는 모든 도구가 영향을 받을 수 있으며, Apify 스크래퍼와 EveryInfra도 마찬가지입니다.
- 2026-10-20: Apify 자체 Reddit Scraper의 가격이 한 달 사이 여덟 번째로 바뀌어 현재 가격이 적용됐습니다(Store 페이지). 영향: 메타데이터는 확인한 날짜를 기준으로 사용하세요.
- 2026-10-18: maximedupre 댓글 검색 스크래퍼의 현재 가격이 Free 등급 행당 $0.00265로 적용됐습니다. 영향: 댓글 검색 스크래퍼 중 $0.0015인 harshmaur보다 77% 비쌉니다.
- 2026-10-16, 2026-10-06: clearpath 댓글 스크래퍼의 두 차례 업데이트로 완전히 펼친 스레드의 깊은 답글에서
depth값이 수정됐습니다(clearpath Store 페이지). 영향:depth로 트리를 재구성하려면 이 업데이트 이후 버전을 사용하세요. - 2026-09-21: trudax의 Reddit Scraper가 이벤트당 과금 방식으로 전환됐고, 신규 사용자는 Store 목록에서 볼 수 없게 됐습니다. 영향: 예전 튜토리얼에 나오는 “월 $45, 무제한” 요금제는 더 이상 없습니다.
시작하기: 체험 호출 한 번에서 일일 작업까지
이 글의 호출 48건(사용자 댓글 호출 제외) 비용은 총 약 $0.024입니다. 회원가입 후 먼저 소규모로 테스트한 다음 대량으로 쓸지 결정하세요. API 키는 빠른 시작에서 받을 수 있습니다. Reddit 스크래핑 API 페이지에 모든 엔드포인트가 나와 있습니다. Reddit 검색, 서브레딧 게시물, Reddit 댓글을 플레이그라운드에서 한 번씩 실행해 보세요.
게시물 상세와 사용자 데이터는 게시물 상세, 사용자 게시물, 사용자 댓글을 참고하세요. 제품에 대한 불만을 빠르게 훑어보려면 Reddit 페인 포인트를 사용하세요. 사이트 전체의 인기 급상승 게시물은 인기 급상승 게시물로 가져올 수 있습니다. 같은 방법을 Twitter 스크래핑 API와 TikTok 스크래핑 API에도 적용할 수 있습니다. 모든 엔드포인트와 가격은 데이터 마켓과 요금 페이지에, 도구 비교는 대안 페이지에 있습니다.
Apify와의 다른 “1,000건당 비용” 실측 비교: Apify Twitter Scraper 대안, Apify TikTok Scraper 대안, Apify Amazon Scraper 대안.
FAQ
Apify Reddit 스크래퍼는 무료인가요?
Apify Free 플랜은 매월 $5의 선불 크레딧을 제공합니다(요금 페이지). Lite는 결과당 $0.004에 실행당 $0.04가 붙으므로 약 1,200개 결과에 해당합니다. Store에는 무료 Reddit Actor도 29개 있지만, 최근 30일 사용자가 100명을 넘은 것은 하나뿐입니다. trudax의 월정액 Reddit Scraper는 사용 중단 예정으로 표시됐으며, 신규 사용자는 실행할 수 없습니다. Reddit 자체 API는 자격을 갖춘 비상업적 사용에 한해 OAuth 클라이언트당 분당 100건까지 무료입니다. 하지만 2026년 10월 31일부터 신규 신청을 받지 않습니다(Data API Wiki).
“Apify Reddit scraper pro”는 어떤 것이고, Lite보다 나은가요?
이름에 “pro”가 들어간 Reddit 스크래퍼 중 최근 30일 사용자가 가장 많은 것은 harshmaur의 reddit-scraper-pro입니다. 이 스크래퍼는 제목에서 리드 발굴, 브랜드 모니터링, 알림을 내세웁니다. Free 등급 기준 행당 $0.0015이며, 30일간 사용자는 435명이었습니다. 실행의 98.7%가 성공했습니다(공개 Store 목록, 2026년 11월 4일 확인). Lite보다 60% 넘게 저렴하고 타임아웃도 훨씬 적습니다.
Lite는 사용자가 가장 많고 README가 가장 충실하며 댓글에 parentId가 있습니다. 어느 쪽이 “더 나은지”는 댓글 트리가 필요한지에 따라 다릅니다. 댓글 트리가 필요하다면 clearpath 댓글 스크래퍼가 두 스크래퍼보다 더 완전한 트리를 반환합니다.
Apify Reddit 댓글 스크래퍼로 게시물의 모든 댓글을 가져올 수 있나요?
적절한 Actor를 고르고 제대로 설정하면 가능합니다. clearpath 댓글 스크래퍼에서 maxCommentsPerPost를 0으로 두고 전체 펼치기를 켜면 “continue this thread” 아래의 깊은 답글까지 포함한 전체 트리를 반환합니다. Lite는 maxComments로 상한을 정합니다. Reddit의 댓글 트리 자체에는 설계상 펼쳐지지 않은 more 항목이 있습니다(Reddit JSON 참고 자료).
PRAW로 스크래핑한다면 replace_more도 필요합니다. EveryInfra의 reddit/comments는 게시물당 최대 100행을 반환하며, 2단계와 3단계 답글은 포함하지만 상위 댓글 ID는 없습니다. 전체 트리가 필요한 작업에는 맞지 않습니다.
Reddit 스크래핑 API 비용은 얼마이고, 어느 쪽이 더 저렴한가요?
Reddit 자체 API의 상업적 사용에는 별도 계약이 필요하며, 현재 공개 페이지에는 가격이 나와 있지 않습니다(Developer Platform & Accessing Reddit Data). 자주 인용되는 요청 1,000건당 $0.24는 개발자 한 명의 2023년 보고입니다. 서드파티 중에서는 Apify Store의 인기 Reddit 스크래퍼가 1,000건당 $0.99~$4.00, 중앙값은 약 $2.00입니다. EveryInfra는 요청당 과금하며, 이 글에서는 게시물 1,000개당 $0.011~$0.029, 댓글 1,000개당 $0.0073이었습니다. OAuth 흐름과 엔드포인트 목록은 Reddit OAuth2 참고 자료와 API 문서를 참고하세요.
API 없이 Reddit을 스크래핑해도 합법인가요?
관할 지역, 사용 목적, 그리고 Reddit의 User Agreement, Developer Terms, Public Content Policy에 따라 다릅니다. Reddit의 Responsible Builder Policy는 Reddit for Researchers 프로그램 밖에서 수집한 데이터로 하는 연구를 정책 위반으로 봅니다. 서면 승인 없이는 데이터를 판매하거나 라이선스하거나 이를 바탕으로 모델을 학습할 수 없습니다. 이 글은 법률 자문이 아닙니다. 상용 제품을 만들거나 이 데이터로 모델을 학습하기 전에 변호사와 상담하세요.
GitHub에 Reddit 스크래퍼가 있나요? API 서비스와 비교하면 어떤가요?
있습니다. Reddit의 초기 사이트 코드와 API 문서는 reddit-archive/reddit에 보관되어 있으며, 더 이상 업데이트되지 않습니다. 가장 많이 쓰이는 기성 도구는 Python 라이브러리 PRAW입니다. Reddit의 OAuth API를 사용하고, 무료이며, 필드가 가장 많습니다. 하지만 분당 100건으로 제한되고, 2026년 10월 31일 이후에는 새 OAuth 클라이언트가 접근 권한을 받을 수 없습니다.
직접 만든 스크래퍼는 로그인 장벽, 요청 속도 제한, 차단을 모두 처리해야 합니다. Apify나 EveryInfra 같은 서비스를 이용하면 비용을 내는 대신 그 작업을 직접 처리하지 않아도 됩니다. 어떤 도구를 고르든 먼저 1,000건당 비용과 시작 요금을 계산해 보세요.
참고 자료
- Apify / trudax: “Reddit Scraper Lite” (Store 페이지), 2026년 11월 4일 확인
- Apify API: trudax~reddit-scraper-lite 공개 메타데이터(pricingInfos, stats), 2026년 11월 4일 확인
- [Apify / trudax: “Reddit Scraper [DEPRECATED]” (Store 페이지), 2026년 11월 4일 확인](https://apify.com/trudax/reddit-scraper)
- Apify API: trudax~reddit-scraper 공개 메타데이터(2026년 9월 21일 가격 안내 포함), 2026년 11월 4일 확인
- Apify / harshmaur: “Reddit Scraper” (Store 페이지), 2026년 11월 4일 확인
- Apify / automation-lab: “Reddit Scraper” (Store 페이지, 2026년 11월 17일 가격 변경 포함), 2026년 11월 4일 확인
- Apify / clearpath: “Reddit Post Comments Scraper” (Store 페이지, 2026년 10월 6일·10월 16일 업데이트 포함), 2026년 11월 4일 확인
- Apify / fatihtahta: “Reddit Scraper Enterprise Grade” (Store 페이지), 2026년 11월 4일 확인
- Apify / harshmaur: “Reddit Comment Scraper” (Store 페이지), 2026년 11월 4일 확인
- Apify / harshmaur: “Reddit User Scraper” (Store 페이지), 2026년 11월 4일 확인
- Apify / clearpath: “Reddit User Posts & Comments Scraper” (Store 페이지), 2026년 11월 4일 확인
- Apify / clearpath: “Reddit Search Scraper” (Store 페이지), 2026년 11월 4일 확인
- Apify: “Reddit Scraper: Posts, Comments, and Users” (Apify 자체 Store 페이지), 2026년 11월 4일 확인
- Apify: “Pricing” 페이지(플랜, 컴퓨트 유닛, Store 할인 등급), 2026년 11월 4일 확인
- Apify 문서: “Pay-per-event pricing model”
- Apify 문서: “Actor pricing and costs” (FREE~DIAMOND 등급)
- Apify 문서: “Actors in Store” (가격 모델, under-maintenance 라벨, Store 할인)
- Apify API 문서: “Get Actor”
- Apify API 문서: “Get list of Actors in Store”
- Apify 문서: “Usage and resources” (메모리와 컴퓨트 유닛)
- Apify 문서: “Runs and builds” (실행 상태, 타임아웃)
- Apify 문서: “Automated testing” (테스트에 실패한 Actor에 maintenance 라벨 부여)
- Apify 문서: “Dataset”
- Apify 문서: “Apify MCP server”
- GitHub: apify/apify-mcp-server
- GitHub: apify/apify-client-python
- Reddit: “Data API Terms” (2023년 6월 19일 발효, 2026년 7월 20일 개정), 2026년 11월 4일 확인
- Reddit: “Developer Terms”
- Reddit: “User Agreement”
- Reddit Help: “Reddit Data API Wiki” (무료 등급, 100 QPM)
- Reddit Help: “Responsible Builder Policy”
- Reddit Help: “Developer Platform & Accessing Reddit Data” (상업적 사용과 요금)
- Reddit Help: “Public Content Policy”
- Reddit Help: “App Migration Program 2026 Terms”
- Reddit Developer Platform: “Migrating apps from the Data API to Devvit”
- Reddit Developer Platform: “App registration”
- Reddit Developer Platform: “HTTP Fetch”
- r/redditdev: “Moving Data API Apps to the Developer Platform: migration dates and next steps” (2026년 9월 30일)
- r/modnews: “Continuing our infrastructure updates: what's changing in the coming months” (2026년 9월 30일, RSS 종료)
- r/redditdev: “Our Plans for the Future of Reddit's Public Data API” (2026년 8월)
- r/redditdev: “API Update: Enterprise Level Tier for Large Scale Applications” (2023년 5월 31일)
- r/apolloapp: “Had a call with Reddit to discuss pricing” (2023년 5월 31일, 개발자가 전한 견적 내용)
- u/spez: “About that login screen” (2026년 10월 29일)
- Axios: “Reddit moves to logged-in experience as AI eats search” (2026년 10월 29일)
- GitHub: reddit-archive/reddit (Reddit의 보관된 오픈소스 코드와 위키)
- Reddit Developer Platform: “Devvit docs”
- Apify API 문서: “API v2 reference”
- GitHub: reddit-archive/reddit 위키, “JSON” (more 객체)
- GitHub: reddit-archive/reddit 위키, “OAuth2”
- GitHub: praw-dev/praw
- PRAW 문서: “Comment Extraction and Parsing”
- Reddit: “API documentation” (/dev/api)
- Gaffney, Matias: “Caveat Emptor, Computational Social Science: Large-Scale Missing Data in a Widely-Published Reddit Corpus” (arXiv, 2018)
- Model Context Protocol: “Specification 2025-06-18”
- Claude Code 문서: “Connect Claude Code to tools via MCP”
- OpenAI 문서: “Connectors and MCP servers”
- Cursor 문서: “Model Context Protocol”
- EveryInfra: 데이터 API 카탈로그(무료, price_usd, max_limit), 2026년 11월 4일 확인
참고 BL-84