DeepSeek V4.1 Flash API: limpiar y etiquetar 10.000 comentarios, y cuánto cuesta
907 comentarios reales y DeepSeek V4.1 Flash API probado de verdad: la salida es el 78 % del costo del modelo y la hora valle lo deja en la mitad.
Si etiquetas 10.000 comentarios de YouTube sobre el gusano barrenador con DeepSeek V4.1 Flash, casi todo lo que pagas al modelo es salida. En nuestra prueba real con 100 comentarios en español, las etiquetas que escribe el modelo fueron el 77,6 % de su costo; el texto que lee es apenas el resto. Con JSON completo en hora pico, 10.000 comentarios costarían $0,5383 de modelo; en hora valle, la mitad.
Sacamos estas cifras de dos pruebas reales, el 9 de noviembre de 2026, en hora de Singapur (SGT). Entre las 00:16 y las 00:33, 38 llamadas a la API de datos de EveryInfra devolvieron 907 comentarios en inglés, chino y español; 339 son comentarios en español de cuatro videos de noticias mexicanos y regionales. Entre las 03:21 y las 03:30 mandamos 602 comentarios limpios a deepseek-v4.1-flash-1017 y leímos el campo usage de cada respuesta. El costo real del modelo salió entre un 20 % y un 54 % más alto que nuestra estimación con las proporciones de la documentación; en español, un 54 % más.
Hay dos resultados que van contra el consejo habitual. Limpiar y quitar duplicados eliminó solo el 12,1 % de las filas en español (11,8 % en los tres idiomas), así que el ahorro es pequeño. Y las reglas por palabra clave solo pudieron dar una única etiqueta segura al 34,2 % de los comentarios en español, una cifra inflada por errores de subcadena. Con límite de palabra en todas las palabras clave baja al 30,2 %, y aun así la palabra «carne» no acertó ni una vez cuando la regla buscaba precios.
La pregunta es práctica. Un equipo de comunicación de riesgos de una secretaría de agricultura o de una asociación ganadera quiere la conversación pública sobre una plaga, limpia y etiquetada por un modelo barato, para saber qué rumor corregir primero. ¿Cuánto cuestan 10.000 comentarios y qué paso es el más caro?
Las cifras de EveryInfra salen de respuestas reales de la API. Del lado de DeepSeek, no tenemos una clave oficial de DeepSeek: mandamos las llamadas al modelo por un servicio intermediario de terceros compatible con la API de OpenAI, con el nombre de modelo deepseek-v4.1-flash-1017, y cada respuesta trajo ese mismo nombre en el campo model. Los tokens son los del campo usage; los costos usan la tarifa pública de DeepSeek, así que no son una factura real de DeepSeek. En español medimos solo 100 comentarios y no medimos los códigos cortos; esas cifras y la tabla de tamaños de lote siguen siendo estimaciones y lo indican. Los totales de 10.000 comentarios son extrapolados.
El trabajo: tres temas, tres idiomas, 10.000 comentarios
Primero fijamos el trabajo, porque todas las cifras dependen de él. Elegimos tres temas de octubre y noviembre de 2026 con mucha conversación pública, uno por idioma. La parte que más interesa a un lector hispanohablante es la muestra en español, pero las otras dos sirven de contraste: muestran que el mismo método da cuentas muy distintas según la lengua y la plataforma.
El tema en español es el gusano barrenador del ganado (*Cochliomyia hominivorax*) en México y Centroamérica, más un rumor sobre el aguacate. La OPS publicó una alerta epidemiológica sobre miasis humana el 16 de octubre de 2026 (OPS/OMS, 2026-10-16). El 29 de octubre apareció un cargamento de 26,6 toneladas de aguacate con larvas, y el 4 de noviembre el secretario de Agricultura explicó que no se trataba del gusano barrenador del ganado sino de un barrenador propio del aguacate (The Food Tech, 2026-11-04). Entre esas dos fechas, los comentarios mezclaron ambas plagas sin parar.
El tema en inglés es la gripe aviar H5N1 en vacas lecheras de Washington: el USDA confirmó los dos primeros hatos del estado el 8 de octubre (USDA APHIS, 2026-10-08) y CIDRAP informó el 3 de noviembre de dos casos humanos más en Yakima, uno mortal (CIDRAP, 2026-11-03). El tema en chino es la raíz de angélica (bai zhi) ahumada con azufre, que aparece en 19 de los 21 boletines nacionales de inspección de este año (China Food Safety News, en chino).
Cada tema mezcla hechos y mitos: hay quien culpa al gobierno, quien recomienda ajo o gasolina para sacar larvas y quien cree que la plaga del aguacate se come al ganado. Las reglas no cubren todo eso, así que la prueba es justa para un modelo barato. Y cada tema vive en plataformas distintas: el español casi solo en YouTube, el inglés en Reddit y YouTube, y el chino en Bilibili, Douyin, Zhihu y Weibo.
| Tema | Idioma | Plataformas | Capacidades de comentarios | Filas brutas |
|---|---|---|---|---|
| Gusano barrenador y el rumor del aguacate | Español | YouTube | youtube/comments | 339 |
| H5N1 en vacas lecheras de Washington | Inglés | Reddit, YouTube | reddit/comments, youtube/comments | 230 |
| Angélica (bai zhi) ahumada con azufre | Chino | Bilibili, Douyin, Zhihu, Weibo | bilibili/comments, bilibili/danmaku, douyin/comments, zhihu/content_comments, weibo/comments | 338 |
También fijamos la salida antes de probar. Cada comentario en español recibe de 0 a 3 etiquetas de tema, como ganado_y_moscas, miasis_en_personas, plaga_del_aguacate, remedios_caseros o duda_o_desinformacion. Recibe además un campo especie, propio de la muestra en español, que dice si el comentario habla del gusano barrenador del ganado, del barrenador del aguacate, o si confunde los dos. Y recibe una marca needs_fact_check cuando afirma un hecho sobre la plaga, los casos, los tratamientos o el aguacate, para que una persona lo revise. La lista de etiquetas está en el prompt y no la cambiamos después de ver los resultados.
El tamaño objetivo es de 10.000 comentarios, pero la muestra real tiene unos cientos. Extrapolamos con proporciones de la muestra: filas por llamada, filas que sobreviven a la limpieza y tokens por comentario. Los precios unitarios son reales, pero el sesgo de la muestra también crece con el total. Por eso cada total dice «extrapolado», y la sección de límites explica en qué dirección puede desviarse.
deepseek v4.1 flash api: versión, contexto y precios
Lo primero fue comprobar la versión. Leímos la página de precios en inglés de DeepSeek a las 00:14 SGT del 9 de noviembre de 2026 (DeepSeek Models & Pricing). El nombre del modelo en la API es deepseek-flash, y su versión actual es DeepSeek-V4.1-Flash-1017, con 1M de tokens de contexto y hasta 384K de salida. Admite salida JSON y llamadas a herramientas, y el modo de razonamiento viene activado por defecto. La página en chino dice lo mismo. El nombre antiguo deepseek-v4-flash sigue funcionando, pero esas solicitudes van al mismo V4.1-Flash-1017 y se cobran al precio de Flash.
Este modelo tiene dos fechas de lanzamiento y es fácil confundirlas. V4.1-Flash salió el 10 de septiembre de 2026; la nota de lanzamiento lo describe como un modelo de mezcla de expertos de 552B parámetros, con 8B activos para la entrada y 16B para la salida, y una caché KV que ocupa la cuarta parte de memoria de GPU que el modelo anterior (nota de DeepSeek, 2026-09-10). Los precios nuevos empezaron a las 04:00 UTC de ese día. La versión 1017 llegó el 17 de octubre con pesos nuevos sobre la misma arquitectura; la nota dice que puntúa más alto, termina las tareas antes y escribe respuestas más cortas (nota de DeepSeek, 2026-10-17). Los pesos están en Hugging Face, y el registro de cambios coincide (DeepSeek Change Log).
DeepSeek no explica por qué la versión no se llama V4.2.
| Dato | deepseek-flash (V4.1-Flash-1017) | Fuente |
|---|---|---|
| Contexto / salida máxima | 1M / 384K | Página de precios, leída el 2026-11-09 |
| Entrada con acierto de caché, por 1M de tokens | Pico $0,006, valle $0,003 | Página de precios |
| Entrada sin acierto de caché, por 1M de tokens | Pico $0,30, valle $0,15 | Página de precios |
| Salida, por 1M de tokens | Pico $1,20, valle $0,60 | Página de precios |
| Horas pico | Lunes a viernes, 01:00-04:00 y 06:00-10:00 UTC, salvo festivos de China | Nota al pie de la página de precios |
| Concurrencia por cuenta | 2.500 | Página de límites de uso |
| Modo de razonamiento | Activado por defecto, esfuerzo alto | Página del modo de razonamiento |
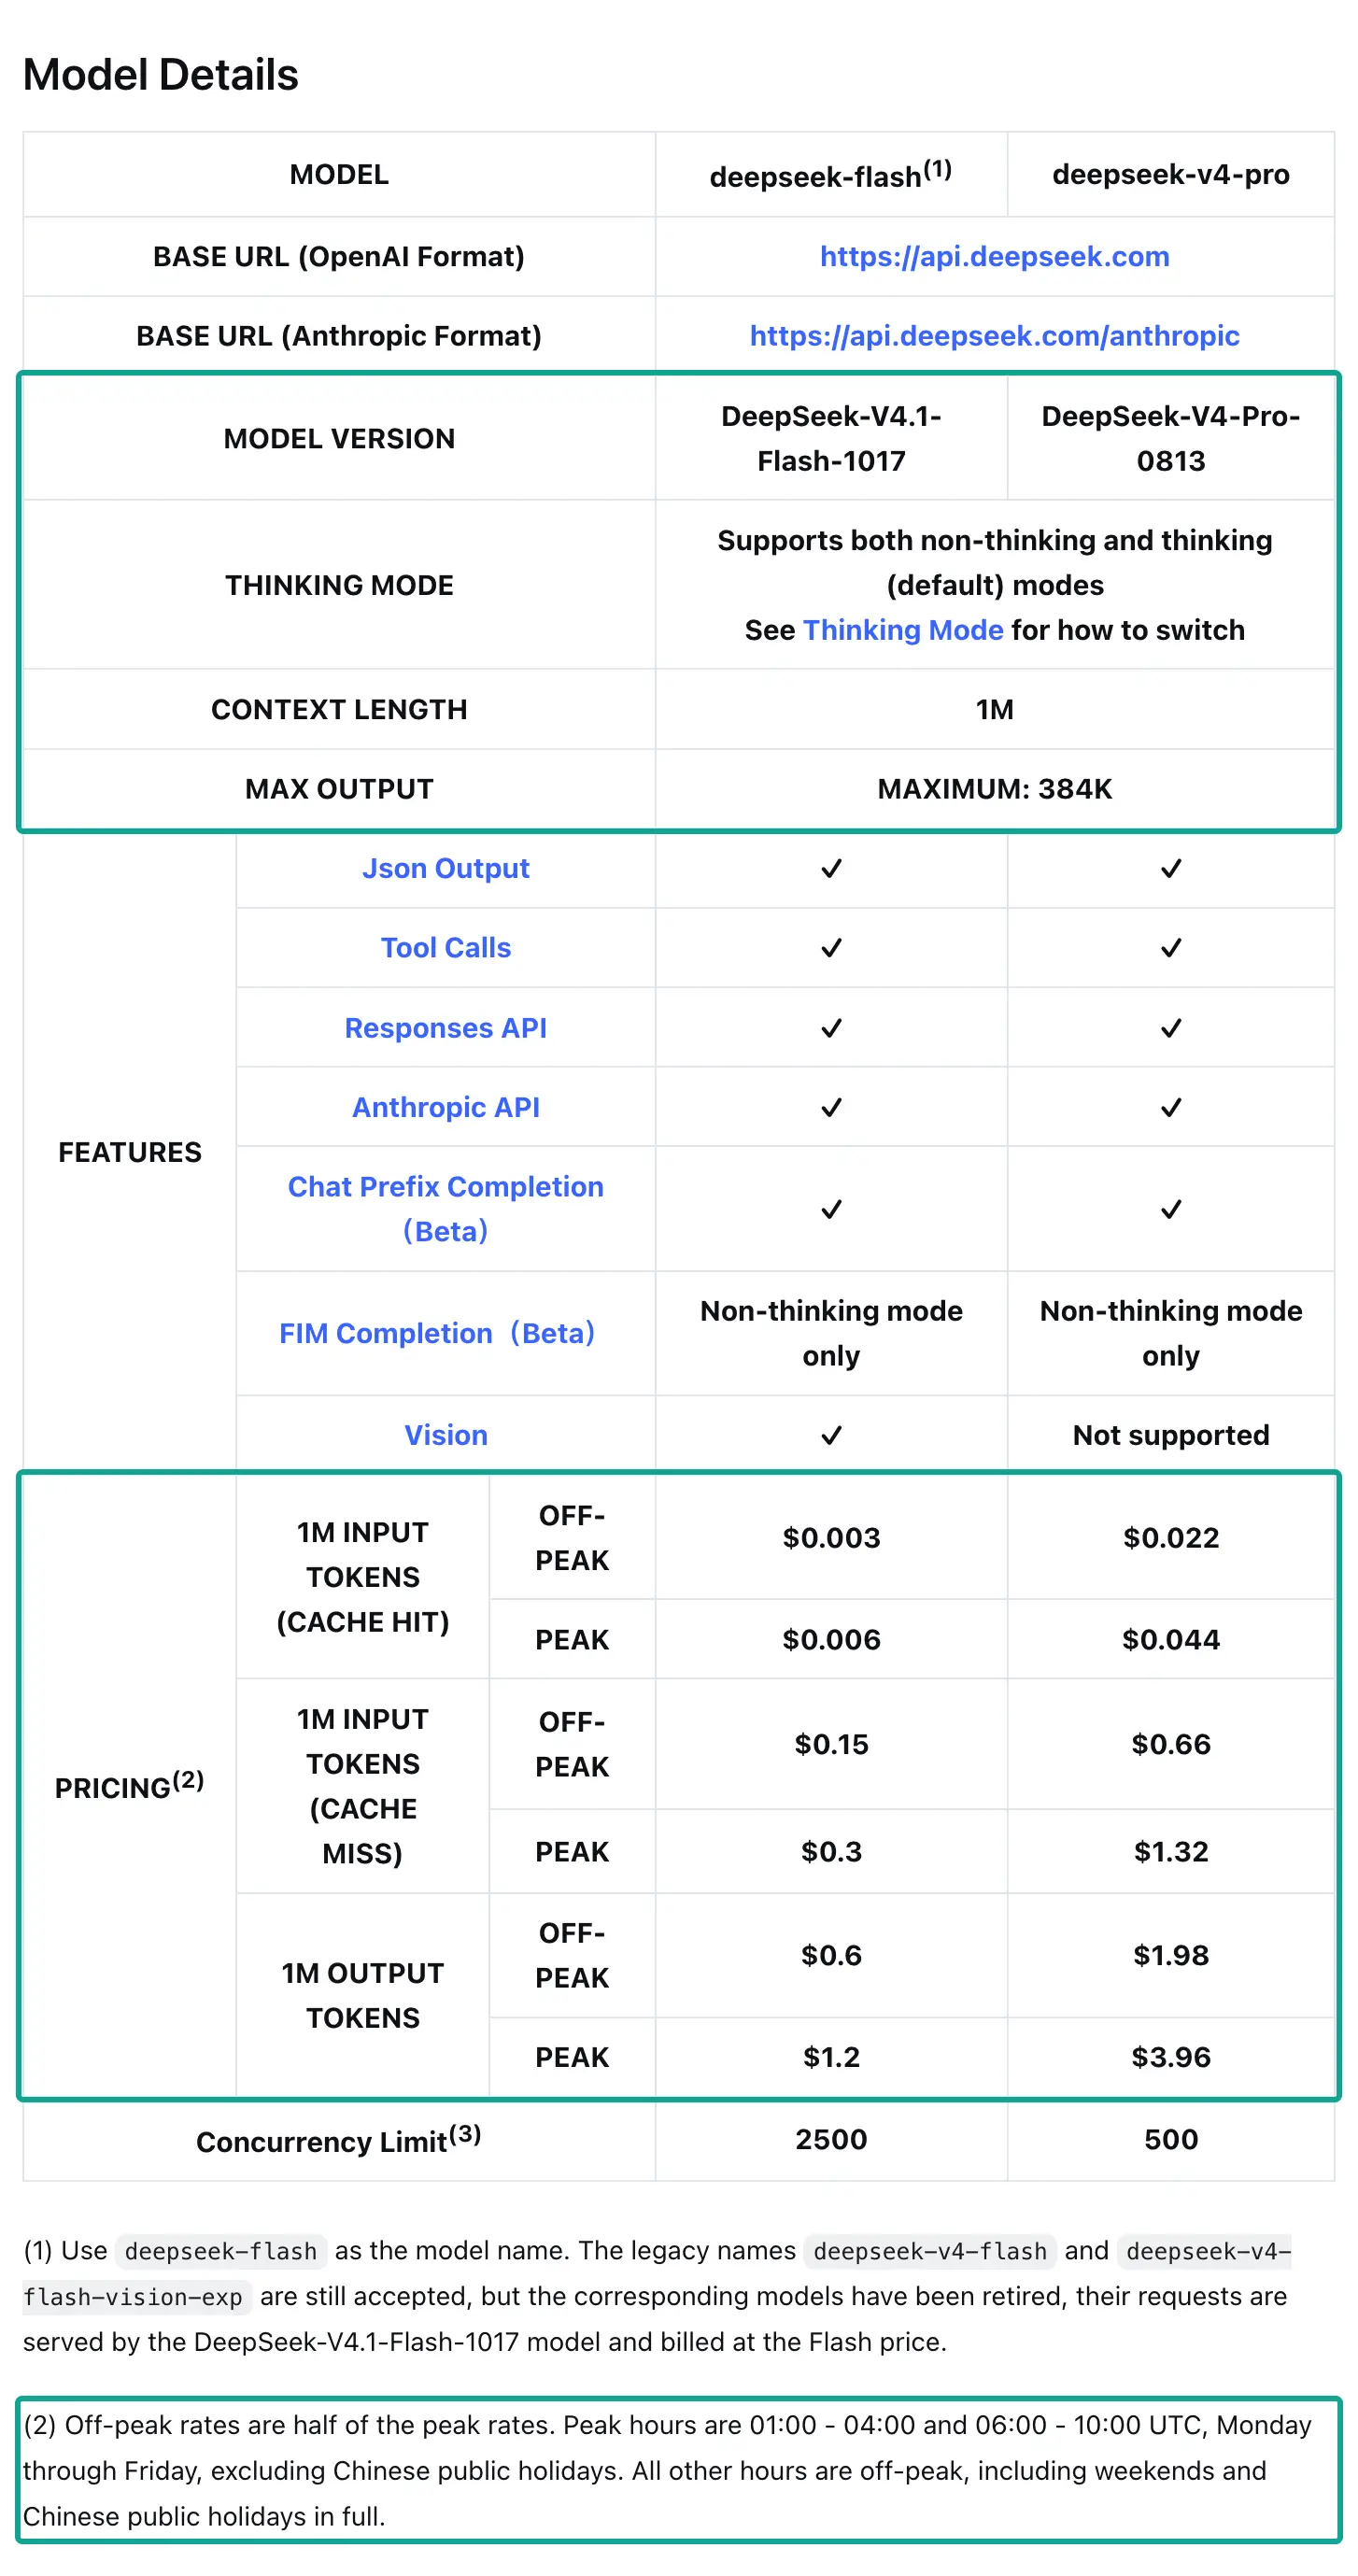
Dos proporciones de esta tabla deciden el costo de un etiquetado masivo. La primera es que la salida cuesta 4 veces la entrada sin caché: en hora pico, un millón de tokens de salida cuesta $1,20 y un millón de tokens de entrada, $0,30. Un comentario en español ocupa en promedio unos 31 tokens de entrada, y la etiqueta JSON que el modelo escribe para él ocupa unos 25. Como la salida es cuatro veces más cara, la etiqueta cuesta más del triple que el comentario.
La segunda es que el precio de valle es exactamente la mitad del de pico. La página lo presenta como regla de cobro, no como una oferta; pero la misma página aclara: «Product prices may vary and DeepSeek reserves the right to adjust them». DeepSeek introdujo los precios de pico y valle con V4-Pro el 13 de agosto (nota de DeepSeek, 2026-08-13), y la nota del 10 de septiembre repite que el valle cuesta el 50 % del pico. Para un trabajo por lotes que puede esperar unas horas, es un descuento del 50 % que no exige nada más que cambiar la hora; revisa la página de precios el día que programes el lote.
¿Cuánto más barato es que el Flash anterior? Un usuario de Hacker News listó los precios de valle de tres modelos de DeepSeek (comentario en Hacker News): el V4 Flash 0731 costaba $0,22 por millón de tokens de entrada sin caché y $0,66 por millón de salida, frente a $0,15 y $0,60 de V4.1 Flash. Guardamos una copia de ese comentario el 9 de noviembre. Las cifras de V4.1 coinciden con la página de precios actual; no encontramos un archivo oficial de los precios antiguos, así que tómalas solo como referencia.
Llamadas de datos: 38 llamadas reales, 907 comentarios
Del lado de EveryInfra, el trabajo tiene dos pasos. Primero, la búsqueda encuentra los videos y publicaciones con más conversación: youtube/search, reddit/search, bilibili/search, douyin/search, zhihu/search y weibo/search. Después, las capacidades de comentarios traen el texto: youtube/comments, reddit/comments, bilibili/comments, bilibili/danmaku, douyin/comments, zhihu/content_comments y weibo/comments.
Antes de llamar leímos el catálogo gratuito, que da nombres de capacidades, parámetros y precios (catálogo de EveryInfra, leído a las 00:14 SGT del 9 de noviembre). Las 13 capacidades tenían available: true. La mayoría cuesta $0,000556 por llamada; weibo/search cuesta $0,000806 y douyin/search, $0,008333. Los comentarios de Douyin se cobran por unidades de 20 filas, a $0,000556 cada unidad. Para la muestra en español, la búsqueda «gusano barrenador» y la búsqueda «gusano barrenador aguacate» en youtube/search devolvieron 20 videos cada una, y de ahí elegimos cuatro: el reportaje de NMás sobre el aguacate (2 de noviembre de 2026), uno de N+ Univision sobre el primer caso humano en Estados Unidos, uno de Aristegui Noticias y un video agropecuario de Agro-Emprende con más de 14 millones de vistas.
Una solicitud se ve así. La clave sale de una variable de entorno, nunca del código:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"youtube","action":"comments",
       "params":{"url":"https://www.youtube.com/watch?v=Ex2F4VyN4ro","limit":100}}'
La tabla resume las 38 solicitudes, todas en hora de Singapur. Primero fue la muestra en inglés, luego dos errores provocados a propósito, después chino y español.
| Hora (SGT) | Capacidad | Llamadas | Filas devueltas | Cobrado | Nota |
|---|---|---|---|---|---|
| 00:16:32-00:16:37 SGT | reddit/search, youtube/search | 2 | 9, 20 | $0,001112 | Buscar publicaciones y videos en inglés |
| 00:16:57 SGT | reddit/comments | 1 | 0 | $0 | 429: esta clave de prueba admite 10 llamadas por minuto |
| 00:20:36-00:22:30 SGT | reddit/comments | 4 | 58, 29, 28, 9 | $0,002224 | Hilos sobre hatos y casos de Washington |
| 00:22:46-00:24:32 SGT | youtube/comments | 5 | 100, 0, 6, 0, 0 | $0,001112 | 3 resultados vacíos, reembolsados |
| 00:25:21-00:26:14 SGT | weibo/search, bilibili/search, zhihu/search | 4 | 16, 20, 20, 20 | $0,002474 | Buscar videos y respuestas en chino |
| 00:26:23-00:27:23 SGT | youtube/search, reddit/search | 5 | 20, 20, 0, 0, 20 | $0,001668 | Búsquedas en español; «gusano barrenador» en Reddit volvió vacía y se reembolsó |
| 00:27:39 SGT | youtube/comments | 1 | 0 | $0 | 422: enviamos sort=top a propósito |
| 00:27:46-00:29:21 SGT | bilibili/comments, bilibili/danmaku, zhihu/content_comments, weibo/comments | 8 | 3, 3, 10, 57, 8, 100, 16, 1 | $0,004448 | Comentarios y comentarios flotantes en chino |
| 00:29:29-00:30:49 SGT | youtube/comments | 4 | 100, 100, 100, 39 | $0,002224 | Comentarios en español |
| 00:31:22-00:32:55 SGT | douyin/search, douyin/comments | 4 | 10, 49, 60, 31 | $0,012778 | Douyin cobra por cada 20 filas |
El total es de 38 solicitudes y $0,028040. Las llamadas de comentarios devolvieron 339 filas en español, 230 en inglés y 338 en chino: 907 en total. La búsqueda devolvió otras 175 filas, que solo usamos para elegir videos y no entran en el etiquetado.
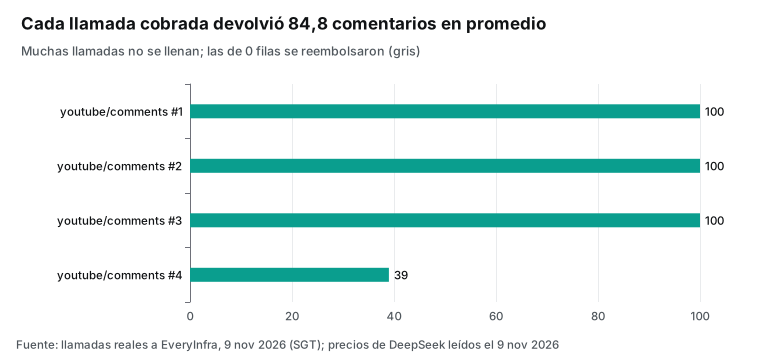
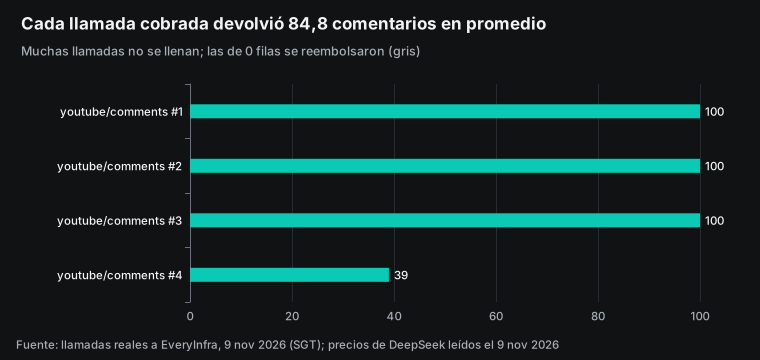
Este gráfico muestra el error más común al estimar costos: contar llamadas a partir de limit. En español, lo que vuelve depende del video: tres de las cuatro llamadas llegaron a 100 filas, el máximo del catálogo para youtube/comments (max_limit: 100), y la cuarta devolvió 39 porque el video de Aristegui Noticias tenía unos 45 comentarios. El promedio fue de 84,8 filas por llamada, frente a 38,3 en inglés y 30,7 en chino. En chino, en cambio, parte de la causa es la API: en el catálogo, bilibili/comments tiene default_limit y max_limit de 10, así que cada llamada trae como mucho 10 filas. Además, la búsqueda mostraba 98 y 80 comentarios en dos videos de Bilibili, y la API devolvió solo 3 de cada uno; ya lo comunicamos al equipo de la API.
| Muestra | Llamadas cobradas | Filas por llamada | Llamadas para 10.000 (extrapolado) | Datos para 10.000: con búsquedas (solo comentarios) |
|---|---|---|---|---|
| Español (YouTube) | 4 | 84,8 | 118 | $0,0984 ($0,0656) |
| Inglés (Reddit, YouTube) | 6 | 38,3 | 261 | $0,2176 ($0,1451) |
| Chino (cinco plataformas) | 11 | 30,7 | 326 | $0,5828 ($0,2636) |
No olvides las búsquedas que encuentran los videos. En la muestra, 12 búsquedas costaron $0,013587, el 48 % del total de $0,028040, y una sola douyin/search costó $0,008333. Por eso la tabla escala la factura completa de la muestra (costo ÷ filas × 10.000) y pone entre paréntesis el costo de solo las llamadas de comentarios, que es el mínimo. La cifra real suele quedar entre las dos, porque un video con más comentarios reparte su búsqueda entre más filas. El chino cuesta más también porque Douyin cobra por cada 20 filas. Si quieres más de 100 comentarios del mismo video, el catálogo de youtube/comments ofrece sort (newest o popular) y since, pero no un cursor de página; pedir el video con los dos órdenes y quitar duplicados por id es una idea que no probamos.
| Idioma | Búsquedas | Costo de búsquedas | Llamadas de comentarios | Costo de comentarios | Filas |
|---|---|---|---|---|---|
| Español | 3 | $0,001112 | 4 | $0,002224 | 339 |
| Inglés | 4 | $0,001668 | 10 | $0,003336 | 230 |
| Chino | 5 | $0,010807 | 11 | $0,008893 | 338 |
| Total | 12 | $0,013587 | 26 | $0,014453 | 907 |
Tres reglas de cobro importan al planificar. Los resultados vacíos no cuestan nada: tres videos en inglés con comentarios cerrados o vacíos y la búsqueda «gusano barrenador» en Reddit devolvieron count: 0, charged: false y reason: empty_result_refunded. Las unidades de Douyin se cobran por filas reales: una llamada con limit: 150 (8 unidades) devolvió 49 filas y cobró 3 unidades ($0,001667). Y un parámetro inválido falla antes de cualquier cobro.
| Caso en nuestras llamadas | HTTP | charged_usd | Qué hace el script |
|---|---|---|---|
| youtube/comments, video de NMás, 100 filas | 200 | 0.000556 | Guarda las filas y suma el cobro al registro |
| youtube/comments, comentarios cerrados | 200 | 0.0 (empty_result_refunded) | Anota el video vacío y sigue |
| douyin/comments, limit 150, 49 filas | 200 | 0.001667 (3 de 8 unidades) | Nada; las unidades sin usar vuelven |
| youtube/comments, sort=top | 422 | ninguno | Usa el valor de did_you_mean y reenvía |
| reddit/comments en el límite de la clave | 429 | ninguno | Espera retry_after y vuelve a intentar |
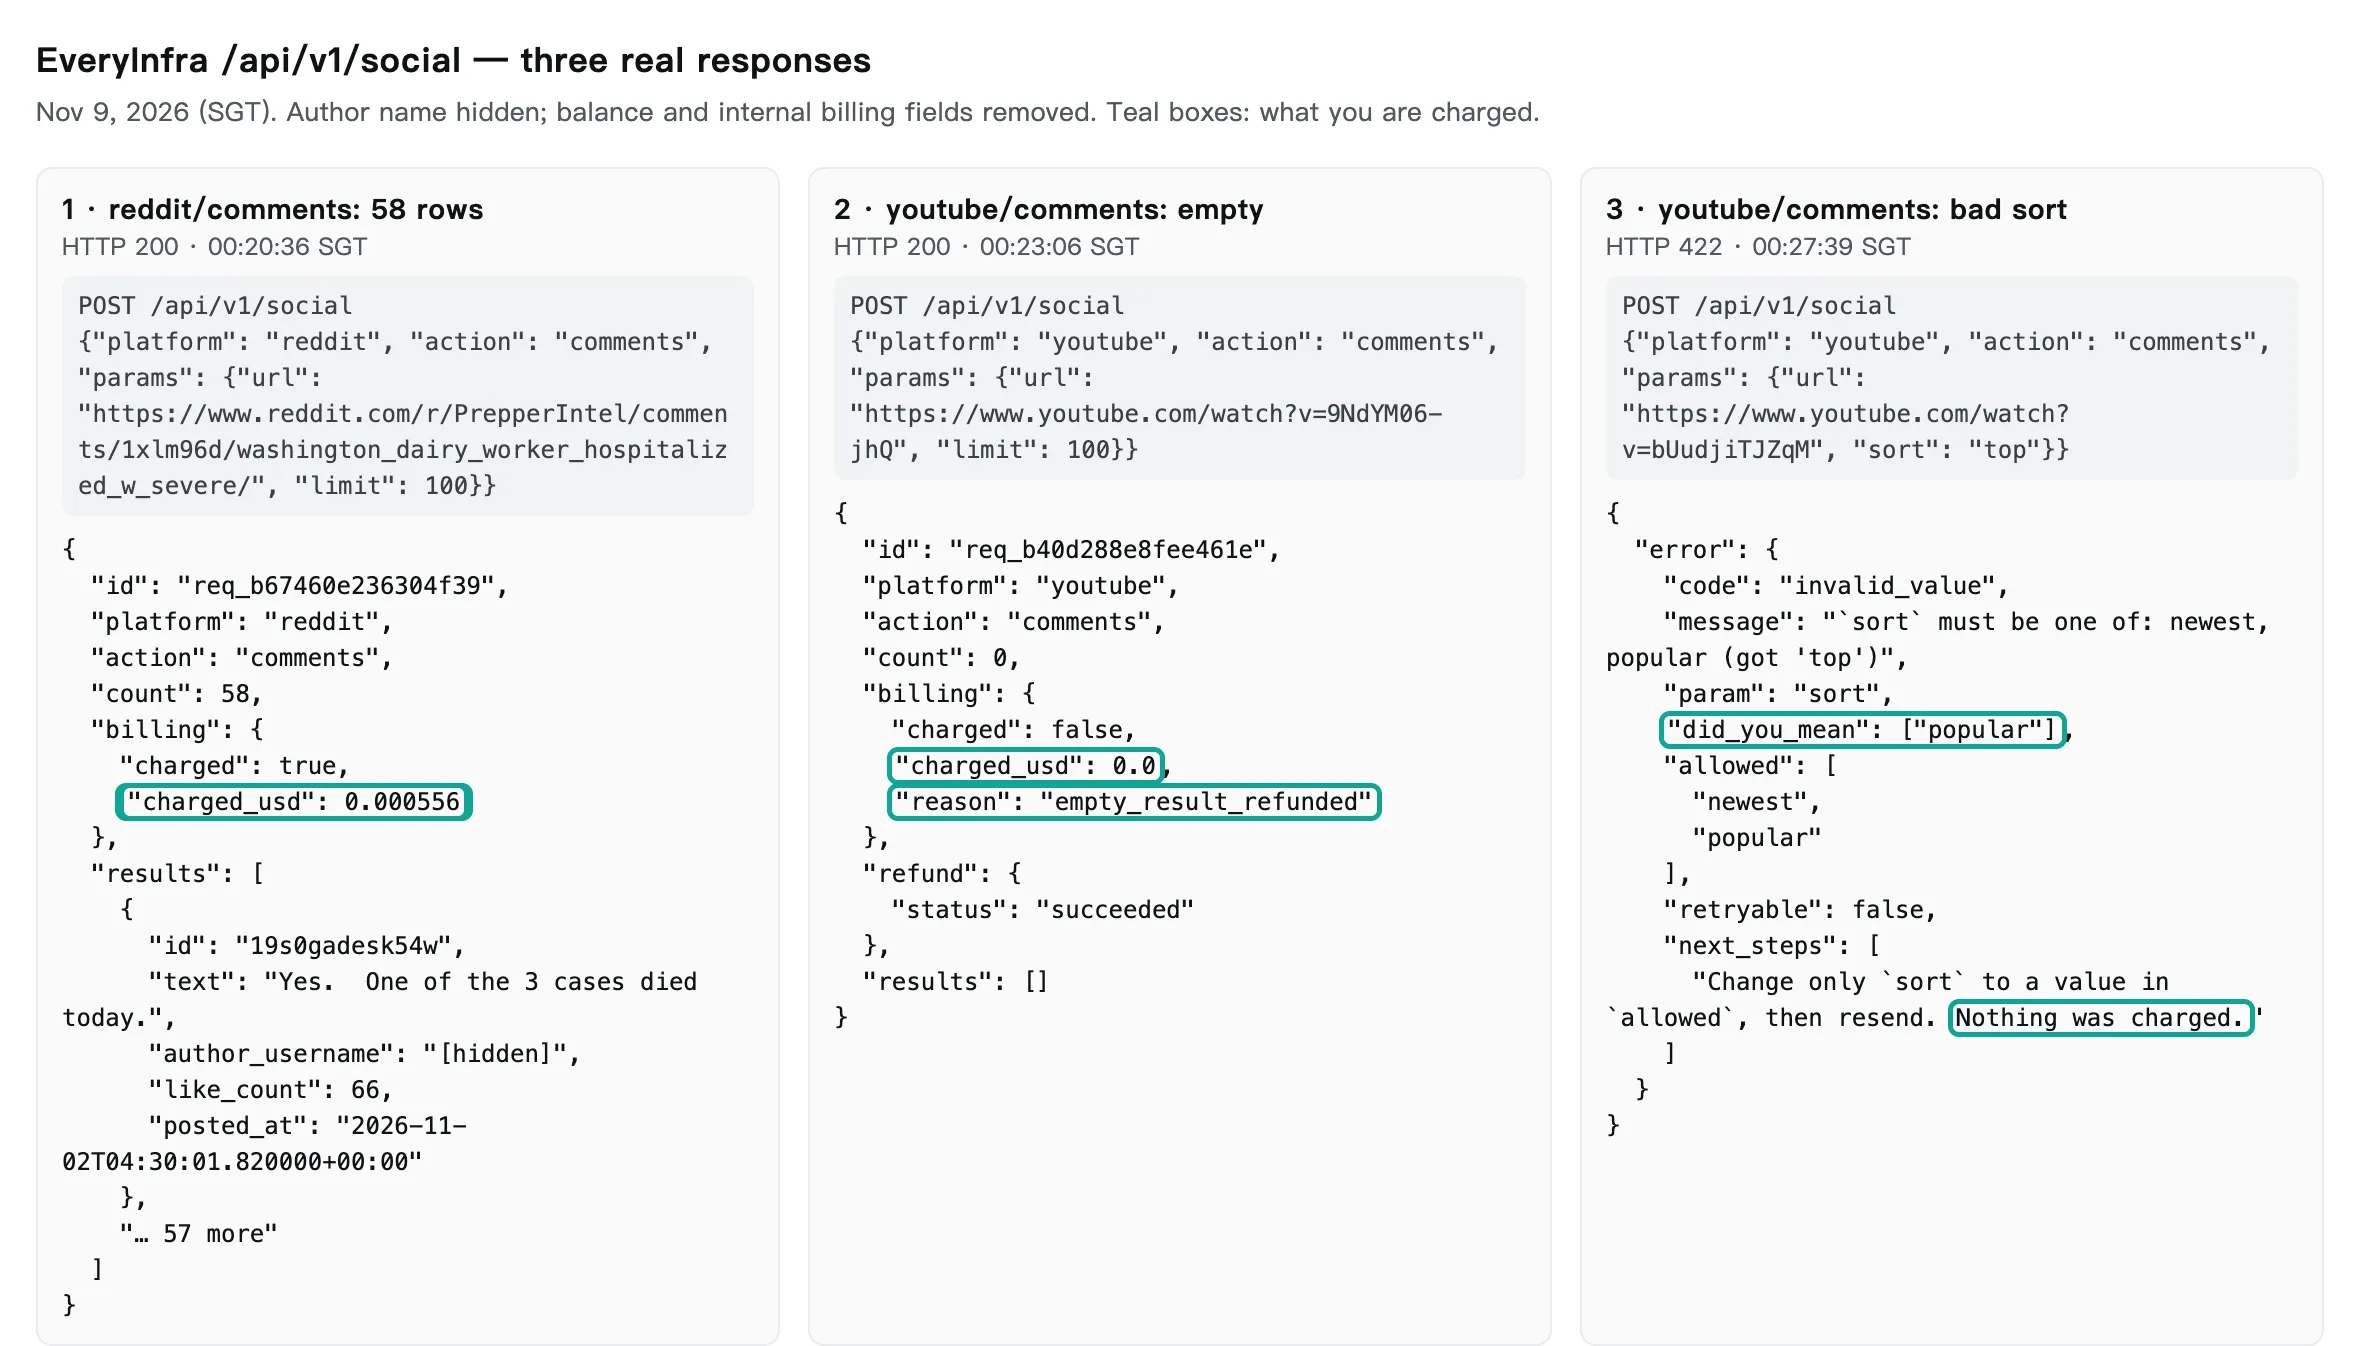
El error provocado es útil. Enviamos sort: top a youtube/comments y la API respondió 422 con el código invalid_value. El campo allowed lista newest y popular, y did_you_mean propone popular. La primera línea de next_steps dice que cambies solo sort, que reenvíes y que no se cobró nada. Un script por lotes puede corregir eso por sí mismo. Lo peor sería una API que ignora el valor incorrecto, cobra igual y te devuelve otro orden sin avisar, porque el error solo aparecería semanas después, en el análisis.
El 429 funcionó igual. La respuesta trae retry_after, limit: 10 y retryable: true; nuestro script esperó, reintentó y la llamada salió bien a las 00:20:36 SGT. Para el manejo de errores, mira cómo se corrigen solos los errores de la API; para conciliar reembolsos, conciliación de reembolsos por fallo.
Limpieza y deduplicación: solo el 12,1 % fuera
El primer paso es la limpieza, que no cuesta nada de modelo. Nuestro script en Python hace siete cosas en orden. Aplica la normalización Unicode NFKC para unir caracteres de ancho completo y compatibles (documentación de Python, unicodedata). Quita caracteres de ancho cero y junta los espacios repetidos. Descarta filas basura: solo enlaces, promociones con tres o más enlaces, solo emojis o signos, y respuestas vacías como «Si» o «Xd». Descarta las filas de menos de 3 palabras en español e inglés, o de menos de 2 caracteres en chino. Luego quita los duplicados exactos, con una clave hecha del texto en minúsculas sin enlaces, puntuación, espacios ni emojis. Por último quita los casi duplicados: corta el texto en trozos de 3 palabras (3 caracteres en chino) y trata como uno solo a dos comentarios con un índice de Jaccard de 0,8 o más.
Comparar todos los pares basta para unos cientos de filas; con 10.000 son unos 50 millones de pares, y MinHash LSH lo deja en tiempo casi lineal (datasketch en GitHub; PyPI). Nuestra pregunta es cuánto costo de modelo ahorra la limpieza. Antes de probar fijamos el umbral en el 15 % de las filas: por encima diríamos «limpia para ahorrar»; por debajo, «limpia por calidad, no por dinero».
| Muestra | Filas brutas | Conservadas | Quitadas | Motivo principal | Cambio de tokens (estimado) |
|---|---|---|---|---|---|
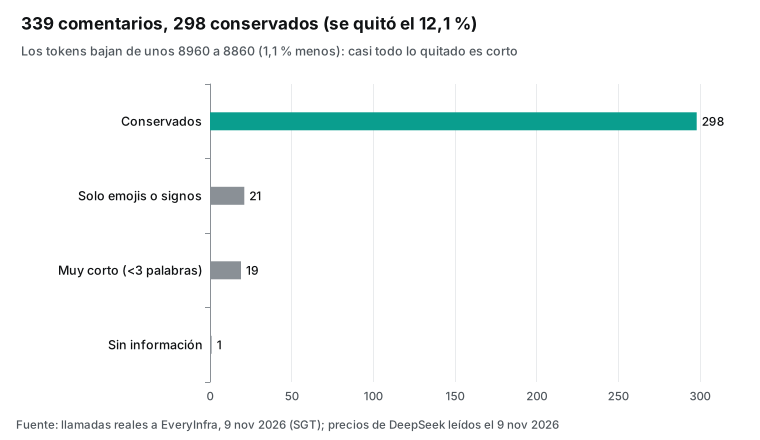
| Español: gusano barrenador | 339 | 298 | 12,1 % | Solo emojis: 21; muy cortos: 19, como «Dios mío» | de unos 8.960 a 8.860 (-1,1 %) |
| Inglés: H5N1 en vacas lecheras | 230 | 213 | 7,4 % | Muy cortos: 12 | de unos 9.323 a 9.107 (-2,3 %) |
| Chino: angélica ahumada con azufre | 338 | 289 | 14,5 % | Duplicados exactos: 37, casi todos comentarios flotantes repetidos | de unos 4.165 a 3.003 (-27,9 %) |
| Total | 907 | 800 | 11,8 % | - | - |
Las tres muestras perdieron 107 filas, el 11,8 %, por debajo del umbral del 15 %. El resultado cae, pues, en la rama de fallo que escribimos antes: la limpieza es por calidad, no por dinero. La muestra en español es el caso más claro. Los 41 descartes son reacciones: 21 filas de emojis («😢😢😢», «😮😮»), 19 frases de una o dos palabras («Que triste», «Horrible», «Exacto») y un «Si». Tienen tan pocos tokens que el texto que entra al modelo baja solo un 1,1 %. En español no encontramos ni un duplicado exacto ni un casi duplicado: los comentarios de YouTube sobre este tema no son spam, son gente que reacciona.
La excepción está en los comentarios flotantes chinos. Bilibili los muestra encima del video, y en un video quitamos 22 de 100 y en otro 23 de 57: casi todos eran dos frases de apoyo a un ídolo pop, pegadas 23 veces en total. Por eso la muestra en chino perdió el 14,5 % de las filas pero el 27,9 % de los tokens, mientras que sus secciones normales de comentarios perdieron solo 4 de 173 filas. La lección es juzgar la limpieza por fuente: las fuentes con mucho spam ahorran un cuarto de la entrada; las secciones de comentarios normales, como las de YouTube en español, casi nada.
El dinero lo deja más claro. Con nuestro primer modelo de costos, que estima los tokens con las proporciones de la documentación, mandar 10.000 comentarios brutos en español al modelo sin limpiar cuesta $0,3877 en hora pico con JSON completo; después de limpiar, $0,3495. El ahorro es del 9,9 %, unos 4 centavos por cada 10.000 comentarios. Y casi todo ese ahorro es de salida, no de entrada: el modelo escribe una etiqueta completa para cada comentario, por corto que sea. Cuando descartas «😢😢😢» no ahorras sus 2 o 3 tokens de entrada, sino los 25 de la etiqueta que el modelo habría escrito.
La limpieza también se equivoca. Revisamos una a una las 107 filas quitadas, y 6 de ellas (un 5,6 %) tenían contenido real. Cinco son de la muestra en español, y tres de esas cinco tienen que ver con la confusión de especies que la muestra en español intenta captar. «Bot flies» y «Los torsalos» nombran otra mosca parásita. Un comentario en ruso dice que son larvas de tábano y que el ajo no sirve; nuestro script solo contaba letras latinas y chinas, así que lo tomó por una fila de signos. Las otras dos son «Falso.», una duda que importa en una campaña contra rumores, y «puro monopolio», una queja sobre el negocio del aguacate. Si copias este script, baja el mínimo a 2 palabras, cuenta cualquier alfabeto como texto y aplica la deduplicación agresiva solo a las fuentes de comentarios flotantes.
Reglas por palabra clave: del 13,1 % al 34,2 %, y un error
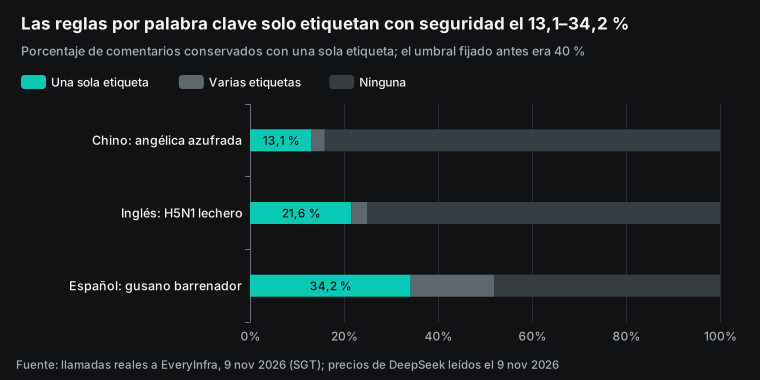
Después de limpiar, la idea siguiente es etiquetar con reglas los comentarios fáciles y mandar al modelo solo los difíciles. Escribimos seis o siete grupos de palabras clave por idioma. Un comentario que coincide con un solo grupo es de «confianza alta» y la regla decide. Uno que coincide con varios o con ninguno va al modelo. Antes de probar fijamos el umbral en un 40 % de cobertura de confianza alta: solo entonces recomendaríamos «reglas primero y el modelo para el resto».
| Muestra | Filas conservadas | Una sola etiqueta | Varias etiquetas | Ninguna | Etiqueta de regla más frecuente |
|---|---|---|---|---|---|
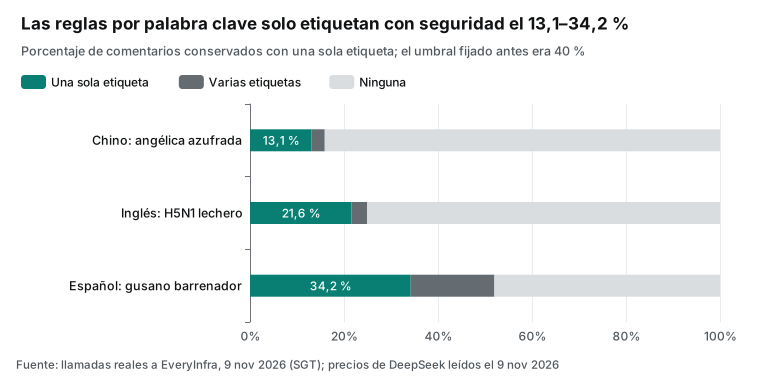
| Español, regla tal como se escribió | 298 | 102 (34,2 %) | 53 (17,8 %) | 143 (48,0 %) | precio_y_exportacion, 45 |
| Español, tras corregir «usa» | 298 | 92 (30,9 %) | 27 (9,1 %) | 179 (60,1 %) | ganado_y_moscas, 38 |
| Inglés | 213 | 46 (21,6 %) | 7 (3,3 %) | 160 (75,1 %) | desconfianza y conspiración, 13 |
| Chino | 289 | 38 (13,1 %) | 8 (2,8 %) | 243 (84,1 %) | uso medicinal y alimentario, 11 |
Ningún idioma llegó al 40 %, así que el resultado va por la rama de fallo: el modelo debe etiquetarlo todo y las reglas solo deben servir de control. En inglés, las reglas no captan la ironía ni las insinuaciones. En chino la cobertura es la más baja porque los comentarios son cortos y coloquiales, y un lector entiende de inmediato que «porque nadie fue fusilado» habla de castigo a los infractores, pero ninguna palabra clave del grupo coincide.
El español tuvo la cobertura más alta y la peor precisión. Encontramos la causa mientras escribíamos esta sección. La etiqueta de precio y exportación tenía la palabra clave «usa», pensada para «USA», pero sin límite de palabra. Así que todo comentario con «gusano» coincidía, porque «gusano» contiene «usa». «Cómo llegó a México ese maldito gusano» quedaba etiquetado como precio y exportación, y 70 de los 298 comentarios en español contienen «gusano». Con la coincidencia por palabra completa, la cobertura de confianza alta en español baja del 34,2 % al 30,9 %, la etiqueta de precio y exportación baja de 45 a 9 comentarios, las filas con varias etiquetas bajan de 53 a 27 y la etiqueta más frecuente pasa a ser ganado y moscas, con 38.
El gráfico conserva el 34,2 % de la regla tal como se escribió, porque ese error es la mejor prueba de que las reglas son frágiles. Un límite de palabra que falta hizo que una etiqueta contara 5 veces más de lo debido, y la regla no dio ningún aviso. Luego pusimos límite de palabra en todas las palabras clave y repetimos las reglas: la cobertura queda en 30,2 %, y precio y exportación conserva 7 comentarios de confianza alta. Los leímos uno a uno y ninguno habla de precio ni de exportación: mencionan «carne» o «USA» en otro sentido. La cifra corregida sigue por debajo del 40 %, así que la conclusión no cambia.
Lo que el español añade: «carne», «preciosa» y el verbo «usa»
La corrección de «usa» no fue el final. Al revisar a mano los 27 comentarios que la regla corregida todavía marca como precio y exportación, encontramos tres trampas más, todas propias del español. Ninguna aparece en la versión inglesa de este artículo, porque en inglés estas palabras no tienen doble sentido.
La primera es «carne». En una conversación sobre ganado, la intuición dice que «carne» habla del precio de la carne de res o de la exportación. Pero el gusano barrenador se alimenta de tejido vivo, y la gente lo dice así: «ese gusano come carne», «comen toda la carne», «comienza a comerse la carne del animal». Otros hablan de comida: un chorizo con gusanos, carne asada, un taco de carne destapado, comer carne cruda. De los 13 comentarios conservados que contienen «carne», ninguno habla del precio. Cinco hablan de la carne viva que come la larva, seis de comer carne o embutidos, uno es una broma política y otro habla de importar ganado sin control. La palabra clave más «obvia» del grupo de precios no acertó ni una vez.
La segunda es la coincidencia dentro de otra palabra, el mismo error de «usa» con otras raíces. «Precio» coincide con «preciosa», y el comentario más votado de toda la muestra que la regla marca como precio, con 87 «me gusta», es una oración: «Me cubro y cubro a toda mi familia con la sangre preciosa de nuestro señor Jesucristo». «Caro» coincide con «sacaron», así que la historia de una señora a la que sacaron del salón de clases por una miasis en la cabeza también cayó en precios. La tercera es la homografía: aun con límite de palabra, «usa» es también el verbo «usar». Un comentario uruguayo explica que la ivermectina «se usa en» ovinos y bovinos, y la regla lo leyó como Estados Unidos.
| Palabra clave | Comentario real (fragmento) | Qué dice de verdad | Etiqueta que dio la regla |
|---|---|---|---|
| usa (sin límite) | «Cómo llegó a México ese maldito gusano» | Origen de la plaga | precio_y_exportacion |
| carne | «ese gusano come carne..en la cabeza y cuerpo» | Miasis en personas | precio_y_exportacion + miasis_en_personas |
| carne | «El comer carne cruda o semi cruda, es un riesgo potente» | Inocuidad de alimentos | precio_y_exportacion |
| precio | «la sangre preciosa de nuestro señor Jesucristo» | Oración | precio_y_exportacion |
| caro | «por eso la sacaron del salón» | Caso de miasis en la cabeza | precio_y_exportacion |
| usa (palabra completa) | «la ivermectina se usa en con uno específico» | Tratamiento en ovinos | 4 etiquetas, entre ellas precio |
| caro | «ahora estará mas caro este producto» | Precio del aguacate | precio_y_exportacion (acierto) |
Sumando todo, de los 27 comentarios que la regla corregida marca como precio y exportación, en nuestra lectura solo 6 hablan de precio, comercio o frontera: la demanda de aguacate en Estados Unidos, dos quejas sobre lo caro del aguacate, la frontera sur abierta al ganado centroamericano y dos comentarios sobre importación de reses sin control. Es una lectura nuestra, no una etiqueta de referencia hecha por varios evaluadores, pero basta para ver el orden de magnitud: una etiqueta de regla en español puede tener tres falsos positivos por cada acierto sin que nada lo avise.
Lo útil para un equipo hispanohablante es que estas trampas son predecibles. Las palabras de un lenguaje de dominio (carne, precio, caro) suelen ser raíces de palabras comunes, y los nombres de países (USA, EU) suelen ser también palabras o siglas comunes: «eu» puede ser Estados Unidos o la Unión Europea, según el país del comentarista. Si mantienes reglas como control, escribe cada palabra clave con límite de palabra, prueba cada grupo contra 50 comentarios reales antes de usarlo y guarda las coincidencias para revisarlas. Las expresiones regulares de Python admiten \b para el límite de palabra (documentación de Python, re).
Tórsalo, nuche, colmoyote: el nombre regional que ninguna regla ve
La etiqueta más útil en español es una que las reglas no pueden dar: ¿el comentario habla del gusano barrenador del ganado, del barrenador del aguacate o confunde ambos? Esa respuesta le dice a un equipo de salud qué mito corregir. Por eso el prompt en español tiene un campo especie propio. Pero al leer la muestra apareció una tercera especie que el prompt no prevé, y que es la confusión más votada de toda la conversación.
En el video de Agro-Emprende, 19 de los 81 comentarios conservados (23,5 %) dicen que la larva que se ve no es gusano barrenador. Uno, con 38 «me gusta»: «Ese no es un gusano barrenador, este es una larba de torsalo que molesta mucho al ganado en algunas zonas». Otro, con 24: «Eso no es gusano barrenador, eso se llama torsalo». Otros explican la diferencia: el barrenador vive en una herida abierta con muchas larvas, y el tórsalo es una sola larva bajo la piel. En toda la muestra en español, 23 de los 298 comentarios conservados (7,7 %) usan un nombre regional de esa otra mosca, y suman 180 «me gusta».
Los nombres cambian por país, y eso es justo lo que una lista de palabras clave escrita en un solo país no cubre. Tórsalo en Costa Rica; nuche en Colombia y Venezuela; colmoyote en Guatemala; tupe en algún otro lugar, según un comentario. El Ministerio de Agricultura de Guatemala publicó una nota para explicar la diferencia: el colmoyote es *Dermatobia hominis*, cuya larva entra bajo la piel después de que otro insecto lleva el huevo, mientras que la mosca del gusano barrenador pone sus huevos directamente en heridas abiertas y sus larvas comen tejido vivo (MAGA Guatemala). El Manual Veterinario MSD llama tórsalo a la misma especie y la describe como uno de los parásitos más importantes del ganado en América Latina, del sur de México al norte de Argentina (Manual Veterinario MSD).
La diferencia biológica también está en la ficha de miasis de los CDC (CDC DPDx, miasis), y es la que un equipo de salud necesita para responder a esos comentarios:
| Tórsalo, colmoyote, nuche (*Dermatobia hominis*) | Gusano barrenador (*Cochliomyia hominivorax*) | |
|---|---|---|
| Cómo llega el huevo | La mosca lo pega a un mosquito u otro insecto que pica | La mosca lo pone en heridas o cerca de ellas |
| Larvas | Una larva bajo la piel, de 5 a 10 semanas, que respira por un orificio | Muchas larvas en la herida, cerca de una semana, que pueden dañar otros tejidos |
| Dónde vive | De México a Sudamérica | De México a Sudamérica |
| Nombre en los comentarios | País que mencionan | Especie | Comentarios en la muestra |
|---|---|---|---|
| tórsalo / torsalo | Costa Rica | *Dermatobia hominis* | 11 |
| colmoyote | Guatemala | *Dermatobia hominis* | 5 |
| nuche | Colombia, Venezuela | *Dermatobia hominis* | 4 |
| bot fly / warble (en inglés) | - | moscas de la familia de los éstridos | 2 |
| tupe | sin país | según el comentario, la misma larva | 1 |
| bichera | Uruguay | *Cochliomyia hominivorax*, el propio gusano barrenador | 1 |
El último renglón es la trampa inversa. En Uruguay, «bichera» no es otra especie: es el nombre local del gusano barrenador del ganado, según el Ministerio de Ganadería, Agricultura y Pesca (MGAP Uruguay). Una regla que busque «gusano barrenador» no ve a un uruguayo que habla de la bichera, y una regla que busque «gusano» sí ve a un costarricense que habla del tórsalo. Las dos fallan en direcciones opuestas.
¿Qué hicieron las reglas con estos 23 comentarios? A 14 no les dieron ninguna etiqueta. A 7 les dieron ganado o miasis, que no está mal pero pierde lo importante. A uno le dieron precio y a otro desinformación. Ninguna regla pudo decir «este comentario corrige la especie», porque no hay palabra clave para eso: la información está en la negación («ese no es»). Es una tarea para el modelo, y aquí hay una mejora concreta para quien copie nuestro prompt. Los valores de especie que fijamos antes de probar son gbg_ganado, barrenador_aguacate, confunde_ambos y no_aplica. Les falta un quinto valor, algo como otra_larva (tórsalo, nuche, colmoyote, *Dermatobia hominis*), y una línea en el prompt que diga que «bichera» es el gusano barrenador. No cambiamos el prompt de la prueba, para no mover el resultado después de verlo, pero si tú empiezas de cero, empieza con cinco valores.
Para un equipo de comunicación de riesgos esto importa más que el costo: si el video más visto muestra otra larva, los comentarios que lo corrigen son aliados, no desinformación.
Las reglas siguen valiendo como control: son gratis y repetibles, y cuando el modelo dice «gobierno» y la regla dice «remedios caseros», que mire una persona. Un estudio de Zúrich de 2023 comparó ChatGPT con trabajadores de plataformas en 2.382 tuits y el modelo fue más preciso en cuatro de cinco tareas, a menos de $0,003 por etiqueta (Gilardi et al., arXiv 2303.15056). El estudio mantuvo revisión humana, y nuestro control con reglas es una forma barata de empezar.
El paso de Flash: script y prueba real
Escribimos este script a partir de la documentación de DeepSeek. Usa el SDK de Python de OpenAI con base_url apuntando a DeepSeek (openai-python en GitHub; openai en PyPI). En nuestra prueba solo cambiamos base_url, la clave y el nombre de modelo deepseek-v4.1-flash-1017. Si tienes una clave oficial de DeepSeek, úsalo tal cual.
import json, os, time
from openai import OpenAI

ds = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"], base_url="https://api.deepseek.com")
SYSTEM = open("prompt_es.txt", encoding="utf-8").read()   # etiquetas + un ejemplo; fijo y al principio para acertar en caché

def label_batch(rows, retries=3):
    user = "\n".join(f"{i}|{r['text']}" for i, r in enumerate(rows, 1))
    for attempt in range(retries):
        resp = ds.chat.completions.create(
            model="deepseek-flash",
            messages=[{"role": "system", "content": SYSTEM},
                      {"role": "user", "content": user}],
            response_format={"type": "json_object"},
            max_tokens=len(rows) * 40 + 200,                # unos 40 tokens de salida por comentario, para no cortar el JSON
            extra_body={"thinking": {"type": "disabled"}},  # etiquetar no necesita cadena de razonamiento
        )
        text = (resp.choices[0].message.content or "").strip()
        if text:                                             # el modo JSON puede devolver contenido hecho solo de espacios
            labels = json.loads(text)["labels"]
            if len(labels) == len(rows):
                return labels, resp.usage
        time.sleep(2 ** attempt)
    raise RuntimeError("JSON vacío o incompleto tras los reintentos")
Cada opción sale de una línea de la documentación:
| Opción o regla | Qué dice la documentación | Qué hace nuestro código |
|---|---|---|
response_format={"type": "json_object"} | El prompt debe contener «json» y un ejemplo; si la salida no es JSON válido, la API la sustituye por espacios aunque finish_reason sea stop (DeepSeek JSON Output) | Quita espacios, comprueba que haya texto y que el número de etiquetas sea el de comentarios; si no, espera y reintenta |
max_tokens | Si es corto, el JSON queda cortado a la mitad | Reserva unos 40 tokens por comentario |
extra_body={"thinking": {"type": "disabled"}} | deepseek-flash razona por defecto con esfuerzo alto y escribe reasoning_content antes de responder (DeepSeek Thinking Mode) | Lo apaga; aun así, 4 de nuestras 9 solicitudes devolvieron razonamiento, así que el script lee reasoning_tokens |
| Concurrencia | 2.500 solicitudes simultáneas por cuenta, no por clave; si la inferencia no empieza en 10 minutos, se cierra la conexión (DeepSeek Rate Limit) | 88 solicitudes para 10.000 comentarios en español, lejos del límite |
| Errores | 402 saldo agotado, 429 límite, 500 y 503 error del servidor (DeepSeek Error Codes) | Reintenta con 429, 500 y 503; se detiene con 402 |
En nuestras 7 solicitudes con JSON completo no hubo ninguna respuesta vacía, y las 602 etiquetas coincidieron con las filas de entrada. Pero el intermediario devolvió dos veces, a los 46 y a los 107 segundos, un aviso de tiempo agotado en texto plano, con un usage redondo de 1.000 tokens y finish_reason en stop. Mirar solo el código de estado lo habría dado por bueno; json.loads (documentación de Python, json) y la comprobación de conteo lo pararon.
El razonamiento es el hallazgo más caro. En una respuesta compatible con OpenAI, el razonamiento aparece en completion_tokens_details.reasoning_tokens, y la documentación de OpenAI aclara que esos tokens se cobran como salida (OpenAI, Reasoning models). Mandamos el ajuste que apaga el razonamiento en todas las solicitudes, pero 4 de 9 devolvieron igual completion_tokens_details.reasoning_tokens de 4.041, 4.046, 6.137 y 8.010. Esas 4 costaron 2 o 3 veces lo normal: las 9 solicitudes costaron $0,0300 a precio de valle, y $0,0133 (44 %) fue razonamiento que no debía existir. No sabemos si el intermediario perdió el ajuste o si el modelo lo ignoró. La regla es clara: lee reasoning_tokens en cada respuesta y, si no es 0, anótalo y reenvía si hace falta.
| Solicitud | Enviada (SGT) | Filas | Segundos | prompt_tokens | completion_tokens | reasoning_tokens | Costo en valle |
|---|---|---|---|---|---|---|---|
| Inglés, lote 1 | 03:21:27 | 100 | 97 | 4.804 | 3.290 | 0 | $0,002685 |
| Inglés, lote 2 | 03:23:04 | 100 | 77 | 4.371 | 3.424 | 0 | $0,002700 |
| Inglés, lote 3 | 03:25:34 | 13 | 45 | 946 | 4.436 | 4.046 | $0,002789 |
| Chino, lote 1 | 03:25:34 | 100 | 44 | 2.058 | 6.564 | 4.041 | $0,004240 |
| Chino, lote 2 | 03:26:18 | 100 | 60 | 1.966 | 8.779 | 6.137 | $0,005555 |
| Chino, lote 3 | 03:27:18 | 89 | 79 | 2.571 | 2.721 | 0 | $0,002009 |
| Español, lote 1 | 03:27:26 | 100 | 86 | 4.570 | 3.961 | 0 | $0,002917 |
| Inglés, códigos cortos | 03:29:30 | 100 | 72 | 4.810 | 1.297 | 0 | $0,001500 |
| Chino, códigos cortos | 03:29:30 | 100 | 56 | 2.063 | 8.860 | 8.010 | $0,005618 |
| Total | 03:21-03:30 | 802 | - | 28.159 | 43.332 | 22.234 | $0,030013 |
El cuello de botella real no es el modelo sino las llamadas de datos. Un lote de 100 comentarios tardó entre 44 y 97 segundos en volver, así que conviene mandar las solicitudes al modelo en paralelo; en cambio, cada clave de EveryInfra tiene un límite por minuto (la nuestra de prueba, 10), así que los datos esperan en cola.
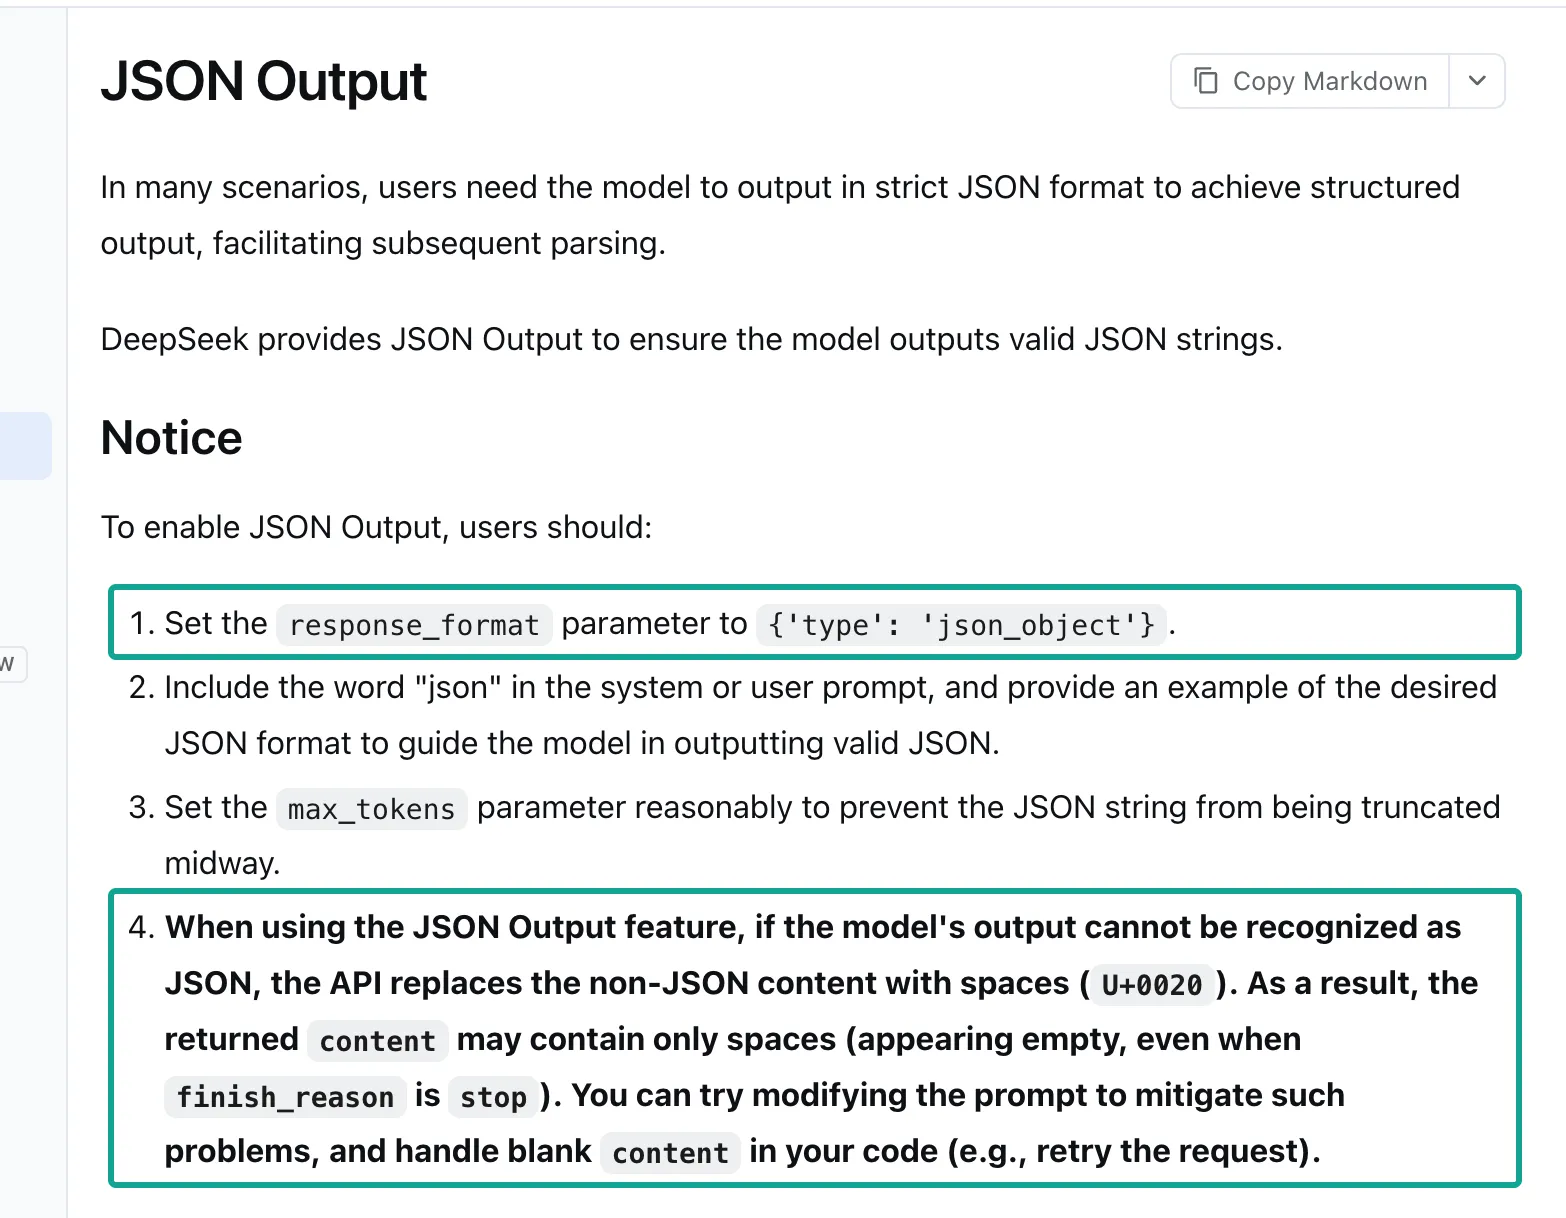
El modo JSON te da JSON válido o texto vacío; no promete los campos correctos ni el número de filas, así que conserva la comprobación de conteo. Para una estructura más estricta, las llamadas a herramientas de DeepSeek tienen un modo strict (DeepSeek Tool Calls): usas la URL base beta y pones strict: true en cada función, y el modelo sigue el JSON Schema de la función. Está en beta y no lo probamos.
Si prefieres una herramienta de programación con IA, puedes conectar el servidor MCP remoto de EveryInfra y dejar que el modelo llame a las herramientas de datos por sí mismo. Esto es un ejemplo de configuración; revisa los nombres de campo en la documentación de tu herramienta:
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
Para un lote de 10.000 comentarios preferimos el script directo. Las llamadas de datos y el etiquetado son pasos fijos y el modelo no tiene que decidir nada entre ellos, y con un script directo puedes casar cada cobro con una línea de tu registro. Para configurar MCP, mira configuración del MCP remoto y la página del servidor MCP.
Un viaje de ida y vuelta: lo que devolvimos y lo que lee el modelo
Este es un viaje completo con un video en español. Primero, el script llama a youtube/comments de EveryInfra con limit: 100 y la URL del reportaje de NMás sobre larvas en aguacate. A las 00:29:29 SGT la API respondió HTTP 200 con count: 100 y billing.charged_usd: 0.000556, en 13,5 segundos. Los campos coinciden con los response_fields del catálogo para youtube/comments: id, text, author_name, like_count, reply_count, posted_at, is_reply, reply_to_id y platform. La primera fila dice «Pobres agricultores es la gente que más la sufre ya que no tienen ningún apoyo por parte del gobierno», con 90 «me gusta» y 3 respuestas. Un detalle práctico: en YouTube, posted_at llega como texto relativo («5 days ago»), así que si vas a ordenar por fecha conviene convertirlo a fecha absoluta en el momento de guardar. Para la limpieza solo conservamos id y text, y ocultamos los nombres de autor al guardar el archivo.
Segundo, los comentarios limpios forman un único mensaje de usuario, una línea «número|texto» por comentario, precedido por el prompt de sistema fijo, que lista 9 etiquetas, los 4 valores de especie y la regla de verificación, con un ejemplo de entrada y salida. Mandamos el primer lote de 100 comentarios en español a las 03:27:26 SGT; volvió en 86 segundos con prompt_tokens: 4570, completion_tokens: 3961 y reasoning_tokens: 0. La etiqueta real de «Pobres agricultores...» fue {"i":1,"tags":["gobierno_y_autoridades"],"especie":"no_aplica","needs_fact_check":false}, y la de «Puras mentiras, el gusano es de ganado no de aguacates», duda_o_desinformacion con especie: gbg_ganado y verificación. El modelo marcó 40 de los 100 para revisión humana. Medido por comentario, la entrada fue de unos 45,7 tokens (con el prompt de sistema repartido) y la etiqueta JSON, de 39,6: casi tan larga como el comentario, y como cada token de salida cuesta cuatro veces más, cuesta más del triple.
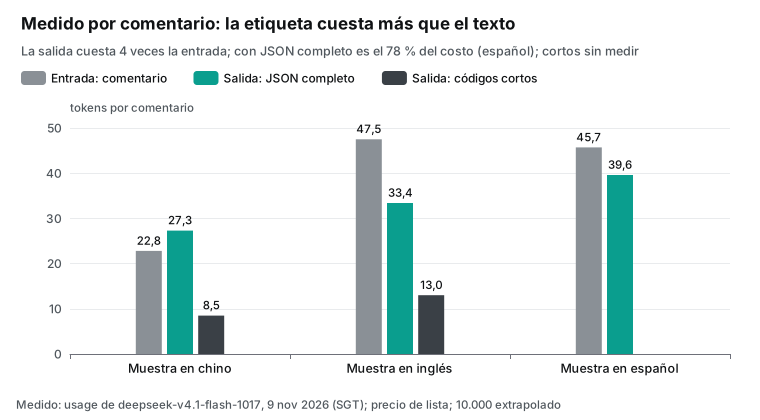
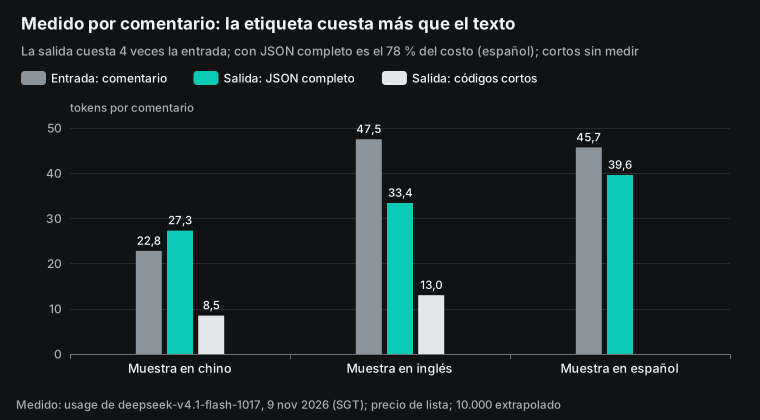
Este gráfico es el origen del hallazgo principal, y también donde la medición se aleja más de nuestra estimación. Antes de la prueba estimamos los tokens con las proporciones de DeepSeek (DeepSeek Token & Token Usage): un carácter de texto latino equivale a unos 0,3 tokens y un carácter chino a unos 0,6. Con el usage real, la entrada en inglés coincidió (0,997 veces la estimación), en español salió un 27 % más alta y en chino un 70 % más. La etiqueta JSON salió más larga en los tres idiomas, sobre todo en español: 39,6 tokens frente a 25,2, porque nuestros nombres de etiqueta son largos (gobierno_y_autoridades, duda_o_desinformacion). En hora pico y con JSON completo, la salida es el 77,6 % del costo del modelo en español, el 73,8 % en inglés y el 82,7 % en chino; la estimación decía 76,1 %, 70,3 % y 87,3 %. El hallazgo se mantiene; cambia el total.
| Muestra | Entrada medida ÷ estimada | Salida JSON por comentario: estimada → medida | 10.000 comentarios, pico, JSON completo: estimado → medido |
|---|---|---|---|
| Español (100 filas) | 1,27 | 25,2 → 39,6 | $0,3495 → $0,5383 (+54 %) |
| Inglés | 0,997 | 26,4 → 33,4 | $0,4176 → $0,5032 (+20 %) |
| Chino | 1,70 | 21,3 → 27,3 | $0,2502 → $0,3386 (+35 %) |
deepseek v4.1 flash api pricing: la cuenta de 10.000 comentarios
Ahora sumamos datos y modelo para 10.000 comentarios brutos. Los datos escalan la factura completa de la muestra, búsquedas incluidas. Los comentarios que van al modelo son 10.000 por la tasa de conservación. Los tokens de entrada y salida son los promedios medidos en usage, sin los tokens de razonamiento de más. Los códigos cortos en español no se midieron, así que esas celdas quedan vacías. Los precios son los de la página de DeepSeek y del catálogo de EveryInfra del 9 de noviembre. La estimación solo escala precios y no añade casos que la muestra no tiene.
| Caso (10.000 comentarios brutos, extrapolado) | Español | Inglés | Chino |
|---|---|---|---|
| Datos de EveryInfra con búsquedas (solo comentarios) | $0,0984 ($0,0656) | $0,2176 ($0,1451) | $0,5828 ($0,2636) |
| Comentarios que van al modelo | 8.791 | 9.261 | 8.550 |
| Flash en pico, JSON completo (tokens medidos) | $0,5383 | $0,5032 | $0,3386 |
| Flash en valle, JSON completo | $0,2691 | $0,2516 | $0,1693 |
| Flash en pico, códigos cortos (tokens medidos) | sin medir | $0,2781 | $0,1400 |
| Flash en valle, códigos cortos | sin medir | $0,1391 | $0,0700 |
| Total, del más alto al más bajo | de $0,6367 a $0,3675 | de $0,7208 a $0,3567 | de $0,9214 a $0,6528 |
| Comparación: primera estimación, pico, JSON completo | $0,3495 | $0,4176 | $0,2502 |
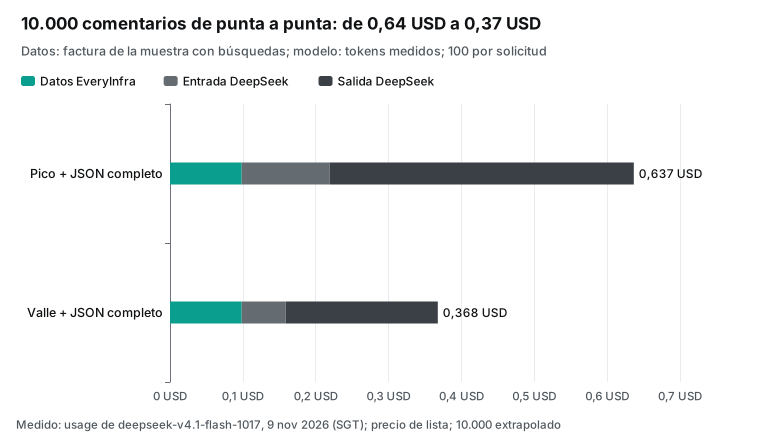
Esta tabla se lee de tres maneras. La primera: el total es bajo. El caso más caro en español, en hora pico y con JSON completo, cuesta $0,6367 por 10.000 comentarios, desde la llamada de datos hasta la etiqueta: unos 6 centavos de dólar por cada 1.000 comentarios. Gilardi y sus colegas situaban ChatGPT por debajo de $0,003 por etiqueta en 2023; con ese tope, 10.000 etiquetas costaban hasta $30. En nuestra muestra en español, el costo medido del modelo Flash es de unos $0,00006 por comentario, unas 50 veces menos que aquel tope. Las tareas y los modelos son distintos, así que esto solo muestra el cambio de escala.
La segunda: qué parte pesa más depende del idioma y de la fuente. En español, los datos cuestan $0,0984 y el modelo en pico más de 5 veces eso, porque los videos de noticias tienen muchos comentarios y cada llamada trae casi el máximo. En chino pasa lo contrario: los datos ($0,5828) son 1,7 veces el modelo en pico ($0,3386), porque los comentarios son cortos, Bilibili da 10 comentarios por llamada y una búsqueda de Douyin costó $0,008333. Así que lo primero que conviene arreglar depende de tus fuentes. Con videos populares y muchos comentarios, como en la muestra en español, pesa el modelo y lo arreglas con el formato de salida. Con muchas publicaciones pequeñas, pesan los datos y lo arreglas eligiendo mejor qué publicaciones pedir y buscando menos, no tocando el prompt.
La tercera: del lado del modelo, las palancas reales son el formato de salida y la hora. El tamaño de lote y la caché casi no importan. Con los mismos 100 comentarios, los códigos cortos bajaron la salida de 3.290 a 1.297 tokens en inglés y de 2.523 a 850 en chino (sin razonamiento). El costo del modelo en pico bajó un 44,7 % en inglés y un 58,7 % en chino, menos que el 61-69 % que estimábamos, porque números de línea, barras y códigos también cuestan tokens. En español no lo medimos; si se comporta como esos dos idiomas, códigos cortos más hora valle dejarían el modelo entre $0,11 y $0,15 por 10.000 comentarios, una estimación.
Tamaño de lote y caché: casi sin efecto (estimación)
Muchas guías de procesamiento por lotes dedican mucho espacio al tamaño de lote y a los aciertos de caché. Estas son las reglas de caché de DeepSeek (DeepSeek Context Caching). Un acierto exige una coincidencia completa con una unidad de prefijo guardada; el sistema guarda unidades en los límites de cada solicitud y en los prefijos comunes que detecta. El campo usage muestra prompt_cache_hit_tokens y prompt_cache_miss_tokens. La caché funciona «en lo posible», sin garantía de acierto, y la que no se usa se borra entre unas horas y unos días. Nuestro prompt de sistema es fijo y va primero, así que desde la tercera solicitud puede acertar. La tabla es nuestra primera estimación y sirve solo para comparar tamaños de lote. En la prueba real, 8 de 9 solicitudes tuvieron entre 0 y 102 cached_tokens, menos que un prompt de sistema completo; la excepción fue el lote en español que reenviamos tras un tiempo agotado del intermediario, con 984 tokens en caché. La caché solo pesa cuando se repite un prefijo entero.
| Tamaño de lote | Solicitudes (español) | Tokens de salida por solicitud (español) | Español en pico, con caché | Español en pico, sin caché | Español en valle, con caché | Inglés en pico, con caché |
|---|---|---|---|---|---|---|
| 25 | 352 | 642 | $0,3538 | $0,3848 | $0,1769 | $0,4220 |
| 50 | 176 | 1.272 | $0,3510 | $0,3663 | $0,1755 | $0,4190 |
| 100 | 88 | 2.532 | $0,3495 | $0,3571 | $0,1748 | $0,4176 |
| 200 | 44 | 5.052 | $0,3488 | $0,3525 | $0,1744 | $0,4168 |
| 400 | 22 | 10.092 | $0,3485 | $0,3502 | $0,1742 | $0,4165 |
De 25 a 400 comentarios por lote, el costo en pico en español baja de $0,3538 a $0,3485: un 1,5 %. Con 100 por lote, la caché ahorra $0,0076, un 2,1 %. La razón es sencilla. El tamaño de lote y la caché solo ahorran la repetición del prompt de sistema, que son unos 300 tokens, una parte pequeña de toda la entrada. Ninguno de los dos toca la salida, que es la parte grande.
Así que elige el tamaño de lote por otras razones. Un lote grande significa que una respuesta JSON vacía te obliga a repetir muchas filas. Con 400 por lote, cada respuesta en español son unos 10.000 tokens de salida, muy por debajo del límite de 384K, pero una respuesta vacía significa repetir las 400 filas. Recomendamos de 50 a 100 comentarios por lote: los reintentos quedan pequeños y el número de solicitudes sigue siendo bajo.
Hora pico y hora valle: el mismo trabajo, la mitad de precio
Las horas pico de DeepSeek son de 01:00 a 04:00 y de 06:00 a 10:00 UTC, de lunes a viernes, salvo los festivos de China (página de precios de DeepSeek). Todas las demás horas son valle, incluidos los fines de semana y los festivos chinos, y el precio de valle es la mitad. Un video lo resume como «fuera del horario laboral de Asia», y no es del todo exacto: en hora de Singapur, el pico es de 09:00 a 12:00 y de 14:00 a 18:00, así que la hora de comida asiática es valle.
Para un equipo en América Latina o en España, la conversión es lo que importa. México eliminó el horario de verano con la Ley de los Husos Horarios publicada el 28 de octubre de 2022 (Diario Oficial de la Federación, 2022-10-28), así que la zona centro, con la Ciudad de México, está todo el año en UTC-6; Quintana Roo está en UTC-5 y solo la frontera norte cambia de hora. Colombia y Perú están en UTC-5, Argentina en UTC-3, y España peninsular en noviembre está en UTC+1.
| Lugar (huso horario) | Horas pico locales (días laborables de DeepSeek) | Ventana recomendada para el lote |
|---|---|---|
| Ciudad de México (UTC-6) | 19:00-22:00 y 00:00-04:00, desde la noche anterior | 04:00-19:00 |
| Bogotá y Lima (UTC-5) | 20:00-23:00 y 01:00-05:00, desde la noche anterior | 05:00-20:00 |
| Buenos Aires (UTC-3) | 22:00-01:00 y 03:00-07:00, desde la noche anterior | 07:00-22:00 |
| Madrid (UTC+1 en noviembre) | 02:00-05:00 y 07:00-11:00 | 11:00 a 02:00 del día siguiente |
| UTC | 01:00-04:00, 06:00-10:00 | 10:00 a 01:00 del día siguiente |
| Singapur (UTC+8) | 09:00-12:00, 14:00-18:00 | Después de las 18:00, o 12:00-14:00 |
Para un equipo en México o Centroamérica, el plan fácil es mandar el etiquetado durante la jornada laboral: el pico de DeepSeek cae de noche y de madrugada. Un equipo de la Ciudad de México que lanza un lote a las 09:00 paga precio de valle, y le quedan diez horas de margen. Ojo con los días: el pico del lunes a la 01:00 UTC empieza en México el domingo a las 19:00, y desde el viernes a las 04:00 no vuelve a haber pico hasta el domingo por la noche. Recuerda también la regla de los festivos: un festivo chino es valle aunque caiga en día laborable. En España la ventana buena es la tarde, a partir de las 11:00.
Si necesitas los resultados para la reunión de la mañana, lanza el lote en una ventana valle del día anterior: el etiquetado casi nunca necesita la hora pico.
El formato de salida es la palanca más grande
Si la salida es entre el 74 % y el 83 % del costo del modelo, el arreglo simple es escribir menos. El JSON completo repite nombres de campo, comillas y nombres completos de etiqueta para cada comentario. Un código corto pone lo mismo en una sola línea separada por barras. En español, «17|gm,dd|ca|1» significaría: comentario 17, etiquetas ganado y moscas y duda o desinformación, especie «confunde ambos», necesita verificación. El script expande los códigos con una tabla de equivalencias. Nuestros prompts de códigos cortos en inglés y en chino usaron este formato, y las 100 líneas de cada uno pasaron la comprobación de formato.
| Formato de salida | Tokens por comentario (español) | Inglés (medido) | Chino (medido) | Ventaja | Costo |
|---|---|---|---|---|---|
JSON completo (json_object) | 39,6 (medido) | 33,4 | 27,3 | La API devuelve JSON válido, fácil de analizar | La salida es el 74-83 % del costo del modelo |
| Códigos cortos (texto plano) | sin medir | 13,0 | 8,5 | Entre 61 % y 69 % menos salida; 100 de 100 líneas válidas | Sin modo JSON, tú compruebas el formato |
| Solo las filas que necesitan verificación | Depende de la proporción | Depende | Depende | La salida mínima | No distingues un «no» de una fila olvidada |
El precio de los códigos cortos es perder la garantía de formato del modo JSON. Recomendamos combinar los dos. Usa códigos cortos en la pasada principal y comprueba cada línea con una expresión regular (documentación de Python, re). Si un lote tiene un número de líneas incorrecto o un código desconocido, repite ese lote una vez en modo JSON completo. Los códigos cortos siguen saliendo más baratos mientras repitas menos de la mitad de los lotes.
El tercer formato parece el más barato, pero es arriesgado en un lote. Si el modelo se salta una fila, no sabes por qué: quizás decidió que no hacía falta verificar, quizás la olvidó. En salud pública, un «échale gasolina para que salgan los gusanos» que se escapa cuesta más que los centavos que ahorras. Los códigos cortos ayudan además con los reintentos: cada línea lleva su número de fila, así que el script encuentra las filas que faltan y reenvía solo esas. En modo JSON completo, una respuesta vacía obliga a repetir el lote entero. Por eso los códigos cortos son más estables con lotes grandes.
Lo que mostró cada tema
Las muestras también tienen hallazgos propios, y deciden cómo diseñar la lista de etiquetas.
| Muestra | Etiqueta de regla más frecuente (una sola coincidencia) | Comentario conservado con más «me gusta» | Fuente oficial para contrastar |
|---|---|---|---|
| Español (límite de palabra) | ganado_y_moscas, 38 | Los agricultores no reciben apoyo, 90 | USDA APHIS, MAGA |
| Inglés | desconfianza y conspiración, 13 | Una afirmación conspirativa, 324 | USDA APHIS, CDC |
| Chino | uso medicinal y alimentario, 11 | Pregunta si presionaron al autor del video tras visitar una fábrica, 673 | China Food Safety News |
En la muestra en español, tras la corrección de «usa», la etiqueta de regla más frecuente fue ganado y moscas, con 38; aguacate quedó con 14 y gobierno con 13. Los comentarios más votados no hablan de la plaga sino de quién paga: «Pobres agricultores... no tienen ningún apoyo por parte del gobierno», con 90. El segundo más votado es la oración de la «sangre preciosa», y el cuarto, con 66, es un remedio casero: machacar cabezas de ajo en agua y dárselo de beber al animal. Hay otros remedios caseros de alto riesgo, como gasolina, creolina o ivermectina sin indicación veterinaria, y son exactamente los comentarios que la marca needs_fact_check debe mandar a una persona. Este artículo no da consejo veterinario; para tratamientos, consulta a SENASICA o a la autoridad sanitaria de tu país.
Para contrastar, la página de estado del USDA sobre el gusano barrenador (USDA APHIS) y la aclaración del secretario de Agricultura del 4 de noviembre sobre el aguacate (enlazada arriba) son las dos fuentes que la marca de verificación debe tener a mano. ¿Cuántos comentarios mezclan las dos plagas? Las reglas casi no los ven: de los 27 comentarios con varias etiquetas, solo 2 tocan a la vez ganado y aguacate. El modelo, en cambio, marcó 14 de los primeros 100 comentarios como confunde_ambos, y por eso existe el campo especie.
En las otras dos muestras, el patrón se repite con otros mitos. En inglés, los tres comentarios más votados (324, 221 y 153 «me gusta») recibieron la etiqueta de regla distrust_conspiracy, y el modelo coincidió con la regla en 35 de 46 filas de confianza alta; la fuente para contrastar es el USDA (USDA APHIS, 2026-11-04). En chino, muchos confunden la norma de la angélica como medicina con la norma como especia, y el modelo coincidió con la regla en 34 de 38. En español la coincidencia fue la más baja, 15 de 38 en los primeros 100, sobre todo por los errores de subcadena de las reglas.
Límites y precauciones
| Límite | Efecto | Qué hicimos |
|---|---|---|
| Sin clave oficial de DeepSeek; prueba real por un intermediario de terceros | Los tokens son usage real, pero el costo usa la tarifa pública, no una factura de DeepSeek; el intermediario puede influir en el ajuste de razonamiento y en los tiempos agotados | Guardamos cada solicitud y respuesta; anotamos aparte los tiempos agotados y el razonamiento |
| Solo 602 comentarios y 9 solicitudes medidas | En español, 100 filas y sin códigos cortos; la tabla de lotes es estimación | Cada celda dice «medido» o «sin medir» |
| 10.000 es una extrapolación | Solo hay 907 filas, 339 en español, y la mezcla de videos llenos y vacíos cambia las filas por llamada y el peso de las búsquedas | Damos dos cifras de datos: con búsquedas y solo comentarios |
| La muestra en español es solo de YouTube | Reddit no devolvió nada para «gusano barrenador»; otras plataformas tendrían otro estilo | Lo decimos; no extrapolamos a otras plataformas en español |
| El razonamiento viene activado y apagarlo puede fallar | 4 de 9 solicitudes lo devolvieron igual, a 2 o 3 veces el costo | Leer reasoning_tokens en cada respuesta |
| El modo JSON puede devolver vacío | Parece correcto pero no trae etiquetas | Quitar espacios, contar, esperar y reintentar |
| La limpieza quita filas buenas | Se pierden filas como «Los torsalos» o un comentario en ruso | Mínimo de 2 palabras y cualquier alfabeto cuenta como texto |
| Sin etiquetas de referencia humanas | Damos la coincidencia con las reglas, no la precisión; los 6 de 27 son lectura nuestra | Las reglas sirven de control; revisa las filas donde reglas y modelo no coinciden |
| Algunas capacidades limitan las filas por llamada | Bilibili da como mucho 10 comentarios por llamada; las publicaciones pequeñas, de 1 a 10 | Usa la búsqueda para elegir las que tienen muchos; en Bilibili, empieza por los comentarios flotantes |
El primer límite es el mayor. Sabemos cuántos tokens y cuántas filas hubo; no sabemos si la API oficial de DeepSeek también ignoraría el ajuste de razonamiento o devolvería los tiempos agotados como texto. Si tienes una clave oficial, manda primero 100 comentarios, compara tu usage con nuestra tabla medida y, si difiere, quédate con tus cifras. Los hallazgos principales son proporciones (la salida cuesta más que la entrada, los códigos cortos son más cortos que el JSON, el valle cuesta la mitad) y los tres se cumplieron en la prueba real; los códigos cortos solo ahorraron menos de lo estimado.
Este artículo trata de métodos de datos y no juzga la verdad médica, veterinaria o legal de ninguna afirmación; para los hechos, usa las páginas oficiales que enlazamos.
Preguntas frecuentes
¿Cuál es el deepseek api precio de V4.1 Flash?
Según la página de precios leída el 9 de noviembre de 2026, deepseek-flash cuesta en hora pico $0,30 por millón de tokens de entrada sin caché, $0,006 con caché y $1,20 por millón de tokens de salida; en hora valle, la mitad (página de precios de DeepSeek). Para etiquetar comentarios, la cifra que manda es la de salida. En nuestra prueba, la salida fue el 77,6 % del costo del modelo en español.
¿Hay una opción deepseek api gratis para un lote grande?
La API de DeepSeek cobra por token y la página de precios no lista una cuota gratuita; consume primero el saldo regalado y después el pagado (página de precios de DeepSeek). Las plataformas de terceros con cuota gratuita suelen tener límites semanales, que no sirven para 10.000 comentarios.
¿Cómo consigo una deepseek v4.1 flash api key y cuánto cuesta?
Creas una cuenta en la plataforma de DeepSeek, recargas saldo y generas una clave; la clave en sí no tiene precio, pagas lo que consumes. Usa deepseek-flash como nombre de modelo. La página de errores dice que 401 significa clave incorrecta y 402 saldo agotado, y enlaza a las páginas de claves y recargas (DeepSeek Error Codes).
¿V4.1 Flash se inventa etiquetas?
No tenemos etiquetas de referencia humanas, así que no damos una cifra de precisión. Sí damos dos controles: las 602 respuestas trajeron exactamente una etiqueta por fila, sin filas de más ni de menos; y en las filas donde una regla dio una sola etiqueta, el modelo coincidió en 34 de 38 en chino, 35 de 46 en inglés y 15 de 38 en español, donde los errores son sobre todo de las reglas. Usa las reglas por palabra clave como control independiente y haz que una persona revise todas las filas con needs_fact_check en verdadero.
¿Apagar el razonamiento lo quita de la factura?
No siempre. Nuestras 9 solicitudes mandaron thinking: disabled, y 4 devolvieron igual entre 4.041 y 8.010 reasoning_tokens, a 2 o 3 veces el costo normal. La página del modo de razonamiento dice que viene activado por defecto (DeepSeek Thinking Mode), y esos tokens se cobran como salida. Lee usage.completion_tokens_details.reasoning_tokens en cada respuesta; si no es 0, anota el costo y piensa en reenviar.
Cómo empezar
- Consigue una clave de la API de EveryInfra en el inicio rápido, lee el catálogo gratuito para ver capacidades y precios, y mira los precios para una visión general.
- Elige capacidades por plataforma. Para la conversación en español, usa comentarios de YouTube y comentarios de Reddit; para la de chino, comentarios flotantes de Bilibili, comentarios de Douyin y comentarios de Zhihu. Páginas de plataforma: API de YouTube, API de Reddit, API de Bilibili, API de Douyin.
- Saca una muestra de 200 a 300 comentarios, pasa el script de limpieza y anota la proporción quitada y los tokens por comentario.
- Prueba cada grupo de palabras clave contra 50 comentarios reales, con límite de palabra, y busca nombres regionales de tu tema (tórsalo, nuche, colmoyote, bichera) antes de fijar la lista de etiquetas.
- Pon la lista en un prompt de sistema fijo, prueba un lote pequeño en JSON completo, lee
reasoning_tokensenusagey luego pasa a códigos cortos. - Programa el lote completo en hora valle (en la Ciudad de México, entre 04:00 y 19:00) y maneja en el script las respuestas vacías, la comprobación de conteo y las esperas por 429.
Lecturas relacionadas
- DeepSeek V4 con Claude Code para limpiar comentarios
- Salidas estructuradas de GPT-6.1 para etiquetar reseñas
- Conciliación de reembolsos por fallo
- Cómo se corrigen solos los errores de la API
Referencias
- Models & Pricing, DeepSeek, leído el 2026-11-09
- Change Log, DeepSeek, entrada del 2026-10-17
- Nota de lanzamiento de DeepSeek-V4.1-Flash-1017, DeepSeek, 2026-10-17
- Nota de lanzamiento de DeepSeek-V4.1-Flash, DeepSeek, 2026-09-10
- Nota de disponibilidad general de DeepSeek-V4-Pro, DeepSeek, 2026-08-13
- JSON Output, DeepSeek, leído el 2026-11-09
- Thinking Mode, DeepSeek, leído el 2026-11-09
- Context Caching, DeepSeek, leído el 2026-11-09
- Rate Limit & Isolation, DeepSeek, leído el 2026-11-09
- Token & Token Usage, DeepSeek, leído el 2026-11-09
- Tool Calls, DeepSeek, leído el 2026-11-09
- Error Codes, DeepSeek, leído el 2026-11-09
- openai-python, OpenAI en GitHub, leído el 2026-11-09
- openai, PyPI, leído el 2026-11-09
- Catálogo de la API social, EveryInfra, leído el 2026-11-09
- Comentario con la comparación de precios de V4.1 Flash, V4 Pro y V4 Flash, Hacker News, septiembre de 2026
- Alerta epidemiológica: miasis por Cochliomyia hominivorax, OPS/OMS, 2026-10-16
- Brote de gusano barrenador del Nuevo Mundo, CDC, 2026-10-29
- Current Status of New World Screwworm, USDA APHIS, 2026-11-05
- USDA Confirms New World Screwworm Detection in Arizona, USDA APHIS, 2026-10-28
- Boletín informativo de avance GBG n.º 11, SENASICA, 2026-03-27
- ¿El gusano barrenador puede atacar frutas?, The Food Tech, 2026-11-04
- Diferencias entre el gusano colmoyote y el gusano barrenador del ganado, MAGA Guatemala, 2025-05-13
- Hipodermiasis por Dermatobia hominis, Manual Veterinario MSD, leído el 2026-11-09
- Decreto por el que se expide la Ley de los Husos Horarios en los Estados Unidos Mexicanos, Diario Oficial de la Federación, 2022-10-28
- Mosca de la bichera o gusano barrenador del ganado, MGAP Uruguay, leído el 2026-11-09
- A(H5) Bird Flu: Current Situation, CDC, leído el 2026-11-09
- A(H5) Bird Flu Surveillance and Human Monitoring, CDC, 2026-11-06
- USDA Confirms HPAI in Two Washington Dairy Herds, USDA APHIS, 2026-10-08
- Update: Genetic Sequencing Results for Washington Dairy Herd, USDA APHIS, 2026-11-04
- USDA Confirms HPAI in a Dairy Herd in Indiana, USDA APHIS, 2026-11-02
- HPAI Confirmed Cases in Livestock, USDA APHIS, leído el 2026-11-09
- Yakima County reports 2 more avian flu cases, 1 death, CIDRAP, 2026-11-03
- Investigation of Avian Influenza A (H5N1) Virus in Dairy Cattle, FDA, leído el 2026-11-09
- HPAI (H5N1) in Cattle Producer Resources-in-cattle-producer-resources), Departamento de Agricultura de Washington, leído el 2026-11-09
- Bird Flu (Avian Influenza), Departamento de Salud de Washington, leído el 2026-11-09
- Avian influenza weekly update, OMS Pacífico Occidental, 2026-10-30
- Gripe (aviar y otras zoonóticas)), OMS, 2026-01-21
- Anuncio de GB 2760-2024 y otras 46 normas nacionales de inocuidad (en chino), Comisión Nacional de Salud de China, 2024-03-12
- Angélica ahumada con azufre vendida como «sin azufre» (en chino), China Food Safety News, noviembre de 2026
- Decomiso de 1,5 toneladas de angélica en Xunyang (en chino), gobierno del distrito de Xunyang, 2026-11-03
- ChatGPT Outperforms Crowd-Workers for Text-Annotation Tasks, Gilardi et al., arXiv, 2023-03-27
- unicodedata, documentación de Python, leído el 2026-11-09
- re, documentación de Python, leído el 2026-11-09
- json, documentación de Python, leído el 2026-11-09
- datasketch, GitHub, leído el 2026-11-09
- datasketch, PyPI, leído el 2026-11-09
- Reasoning models, OpenAI, leída el 2026-11-09
- DPDx: Myiasis, CDC, leída el 2026-11-09
Referencia BL-116