API idempotency key: reintentos de un agente de IA sin cobros dobles
La misma Idempotency-Key enviada 3 veces se cobró una vez; con otros parámetros dio 409; sin clave, el reenvío síncrono se cobró dos. 20 llamadas reales.
El 9 de noviembre de 2026, entre las 00:17 y las 00:22 hora de Singapur, hicimos 20 llamadas reales a la API de datos de EveryInfra (otras 6 las frenó el límite de llamadas, sin cobro). Cada una reproducía un reintento típico de un agente de IA. Con la misma Idempotency-Key enviada tres veces, el registro de la cuenta muestra un solo cobro de $0,000556. Con la misma clave y un parámetro distinto, la API respondió 409 idempotency_conflict, sin ejecutar nada ni cobrar. Con la misma clave mientras la primera llamada seguía en curso, respondió 409 idempotency_in_progress con Retry-After: 5.
Sin clave, dos llamadas síncronas idénticas generaron dos cobros y, además, dos resultados distintos. El OpenAI Agents SDK trae por defecto 5 segundos de lectura MCP. En 30 días, al menos el 22,1 % de las llamadas correctas de nuestra cuenta de prueba tardó más, y en una muestra más lenta de 10 horas (314 llamadas síncronas) fue el 66,6 %. Un agente que reenvía sin clave tras 5 segundos paga dos veces entre una de cada cinco y dos de cada tres llamadas que sí salieron bien. El SDK oficial de Python envía una clave en cada llamada, así que quien usa Python se ahorra ese coste con una instalación.
Este artículo responde a una sola pregunta. Cuando un agente de IA reintenta una llamada a la API de datos de EveryInfra, ¿cómo evitas pagar dos veces y procesar dos veces lo mismo? Cada cifra sale de nuestras respuestas reales, del registro de la cuenta o de documentación oficial. No ejecutamos Claude Code ni el OpenAI Agents SDK en esta prueba, así que sus ajustes aparecen como ejemplos de configuración.
Primero los resultados: 19 llamadas reales en 9 situaciones
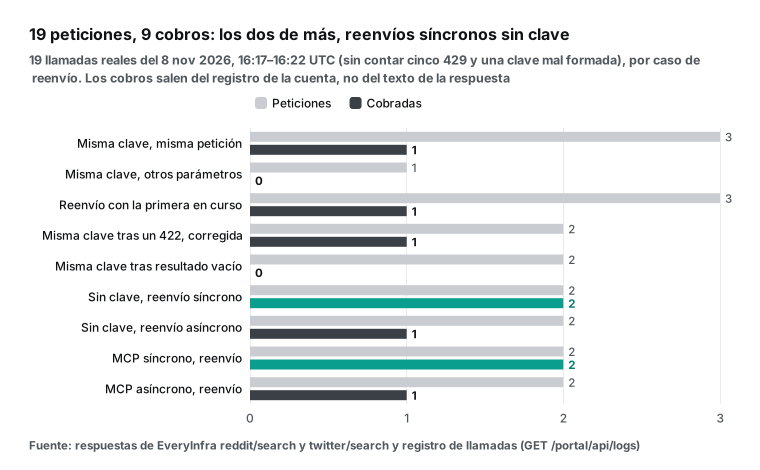
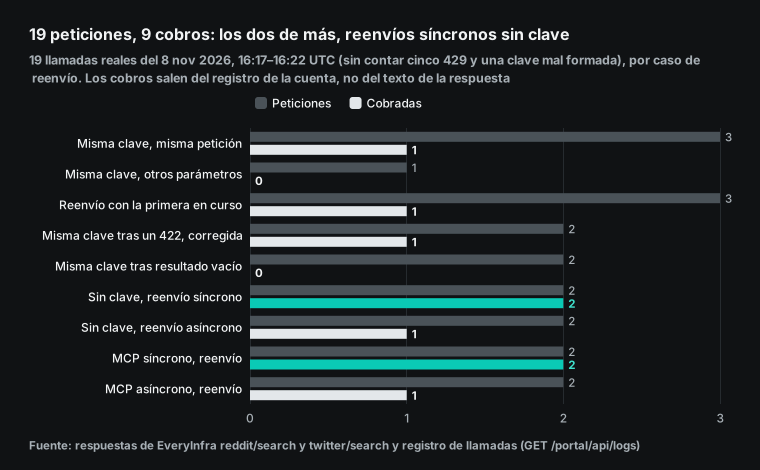
La tabla reúne todas las llamadas; las secciones siguientes explican cada fila. Todas fueron a POST https://api.everyinfra.com/api/v1/social con las capacidades reddit/search y twitter/search, que cuestan $0,000556 por llamada según el catálogo. La columna de cobros reales no sale del cuerpo de la respuesta. Revisamos cada request_id en el registro de la cuenta (GET /portal/api/logs), y solo cuenta como dinero gastado una fila con charged=true.
Lo hicimos así porque un replay copia el objeto billing de la primera llamada, con charged: true y charged_usd: 0.000556. Si solo miras la respuesta, parece que te cobraron otra vez, y no es así. Para el coste manda el registro; para los datos manda la respuesta.
| Situación | Hora de Singapur | Envíos | Respuestas | Cobros reales |
|---|---|---|---|---|
| Misma clave, misma solicitud (una con campos reordenados) | 00:17:18–00:17:37 | 3 | 200, 200 replay, 200 replay | 1 × $0,000556 |
| Misma clave, parámetros cambiados (limit de 10 a 5) | 00:17:44 | 1 | 409 idempotency_conflict | 0 |
| Misma clave con la primera en curso | 00:18:02–00:18:28 | 3 | 200 (23,4 s), 409 en curso, 200 replay | 1 × $0,000556 |
| Misma clave tras un 422, con el parámetro corregido | 00:19:47–00:20:02 | 2 | 422, 200 | 1 × $0,000556 |
| Misma clave tras un resultado vacío | 00:20:15–00:20:26 | 2 | 200 count 0, 200 replay count 0 | 0 |
| Sin clave, reenvío síncrono | 00:19:02–00:19:14 | 2 | 200 (1 fila), 200 (2 filas) | 2 × $0,000556 |
| Sin clave, reenvío asíncrono en menos de 5 minutos | 00:19:31–00:19:40 | 2 | 202, 202 replay | 1 × $0,000556 |
| MCP síncrono reenviado (sin parámetro de clave) | 00:20:40–00:21:52 | 2 | 200, 200 | 2 × $0,000556 |
| MCP asíncrono reenviado en menos de 5 minutos | 00:21:06–00:22:11 | 2 | 200 job, 200 replay | 1 × $0,000556 |
Las 19 llamadas de la tabla generaron 9 cobros, $0,005 en total. Fuera de la tabla quedan dos grupos sin cobro: una prueba del formato de la clave a las 00:17:11 (un 422, se explica más abajo) y 6 llamadas que frenó el límite de 10 por minuto de esta clave de prueba, 4 por REST con HTTP 429 y 2 por MCP con rate_limited. Los dos cobros de más salieron de una sola situación: el reenvío síncrono sin clave, una vez por REST y otra por MCP. Es la conclusión principal. Con clave, o en modo asíncrono, muchos reenvíos siguen costando un cobro. El error caro es una llamada síncrona sin clave que el cliente reenvía tras un corte por tiempo.
AI agent tool call retry: cortes por tiempo, conexiones caídas y el propio modelo
Un reenvío tiene tres causas, y cada una pide un remedio distinto. La primera es el tiempo de espera del cliente. El framework fija un límite para cada llamada a una herramienta y, si no llega respuesta, la da por fallida. Pero ese corte solo dice que el cliente dejó de esperar; el servidor puede terminar el trabajo y cobrarlo. La especificación MCP lo dice en su apartado de cancelación: el aviso de cancelar puede llegar cuando el servidor ya terminó o incluso ya respondió (MCP 2026-07-28, Cancellation).
La segunda causa es una conexión que se cae a mitad de llamada. La referencia de errores de Claude Code tiene una entrada para el caso en que la conexión con el servidor MCP se cierra antes de que llegue la respuesta (errores de Claude Code). Claude Code no puede saber si la herramienta se ejecutó, y repetirla puede repetir su efecto. Desde la versión 2.1.307 (2026-10-21) solo reenvía herramientas de solo lectura o idempotentes (registro de cambios, CHANGELOG.md en GitHub). Antes de esa versión, el propio cliente podía enviar dos veces una llamada de pago.
La tercera causa es la más difícil de frenar: el modelo vuelve a llamar. Recibe un resultado que no entiende, un texto de error por tiempo o nada, y concluye que la primera llamada falló. En un hilo de r/LangChain, una respuesta señala que un error de herramienta sin un mensaje legible para el modelo puede dejarlo atascado en reintentos, y otro desarrollador cuenta que sus agentes martillean la misma herramienta cuando el resultado no tiene la forma esperada (hilo). Una publicación de r/LLMDevs del 2026-10-28 se titula, traducida, «Mi agente pasó toda la noche reintentando una llamada fallida» (publicación). Ningún interruptor de reintentos del framework detiene este caso; solo la API puede ver que dos llamadas son el mismo trabajo.


| Causa | Ejemplo | ¿Lo frena un ajuste de reintentos? | Remedio con EveryInfra |
|---|---|---|---|
| Tiempo de espera del cliente | El Agents SDK corta a los 5 s y el servidor necesita 23 s | Solo si los reintentos están apagados | Misma clave al reenviar, o modo asíncrono |
| Conexión caída | La conexión MCP se cierra antes de la respuesta | Claude Code 2.1.307 o posterior no reenvía herramientas no idempotentes | Misma clave al reenviar por REST |
| El modelo vuelve a llamar | El modelo lee «timeout» y repite la herramienta | No | Una clave fijada por el envoltorio, no por el modelo |
En los tres casos, el cliente no conoce el resultado de la primera llamada cuando reenvía. La clave de idempotencia resuelve justo eso: el cliente da un nombre a una solicitud lógica y lo repite en cada envío, y el servidor hace el trabajo una vez y devuelve el primer resultado. Stripe lo describe como la forma de reintentar sin riesgo tras un error de conexión, sin crear un segundo objeto (Stripe, solicitudes idempotentes). El borrador del IETF para la cabecera Idempotency-Key llegó a la versión 08 el 2026-10-22 (draft-ietf-httpapi-idempotency-key-header-08). Según RFC 9110, GET, PUT y DELETE son idempotentes y POST no lo es, y casi toda consulta a una API de datos es un POST.
Cómo funciona la api idempotency key en EveryInfra: reglas y códigos
EveryInfra publica las reglas en sus notas completas para desarrolladores, en la sección «Retries and idempotency» (llms-full.txt). El documento OpenAPI recoge la misma cabecera y los mismos códigos, y la documentación del sitio usa el mismo texto. Comparamos las tres fuentes regla por regla, coinciden, y después probamos cada regla con llamadas reales.
POST /api/v1/social acepta la cabecera Idempotency-Key, de 1 a 255 caracteres ASCII visibles y sin espacios. Usa una clave nueva por cada solicitud lógica. En llamadas síncronas, si repites la misma solicitud con la misma clave dentro de 24 horas, recibes la primera respuesta correcta: no se ejecuta otra vez ni se cobra otra vez. El cuerpo lleva replayed: true y las cabeceras, Idempotent-Replayed: true.
| Qué envías | Qué devuelve la API | Cobro | Qué hacer después |
|---|---|---|---|
| Clave nueva, primer envío | 200 o 202 normal | Solo si hay éxito con datos | Guardar la clave y el request_id |
| Misma clave y solicitud, dentro de 24 h | 200, replayed true, cabecera Idempotent-Replayed | Sin cobro nuevo | Usar el resultado |
| Misma clave, solicitud distinta | 409 idempotency_conflict, retryable false | Ninguno | Clave nueva para la solicitud nueva |
| Misma clave con la primera en curso | 409 idempotency_in_progress, Retry-After | Ninguno | Esperar y reenviar igual |
| Clave mal formada (espacio, más de 255) | 422 invalid_idempotency_key | Ninguno | Corregir la clave |
| La primera falló (parámetros, saldo, límite, fallo reembolsado) | El código de error original | Ninguno | La clave queda libre; el siguiente envío se ejecuta |
| 504 response_timeout o 502 response_interrupted | Respuesta del borde, request_id empieza por cf- | Posible | Reenviar con la misma clave |
| 503 refund_outcome_unknown o submission_outcome_unknown | El resultado aún se está confirmando | Desconocido | No reenviar; guardar el request_id y consultar después |
Las dos últimas filas importan mucho a quien construye agentes. Si la API no contesta en 100 segundos, el borde devuelve 504 response_timeout, y la documentación dice que la solicitud aún puede terminar, así que hay que reenviarla con la misma clave. Un corte de conexión devuelve 502 response_interrupted con el mismo consejo. Los dos 503 significan lo contrario: el cobro o el envío se están confirmando, y la documentación pide no reenviar y consultar más tarde con el request_id o el job_id. Un agente que reintenta ante cualquier error se equivoca en esos 503. Uno que lee el campo retryable acierta, porque cada error trae fault, retryable, retry_after y next_steps, pensados para que los lea un modelo. Nuestra guía de errores de API que el agente corrige solo muestra cómo usarlos.
El formato de la clave lo eliges tú. En la prueba usamos un prefijo, un número de ejecución y el nombre de la situación. En producción conviene un UUID: RFC 9562 define UUIDv7, que lleva marca de tiempo y se ordena por fecha, más cómodo de indexar que un UUIDv4 aleatorio. Stripe recomienda un UUID V4 u otra cadena aleatoria, y pide no meter datos personales, como un correo, en la clave.
# Una solicitud lógica, una clave. Tras un corte por tiempo o una conexión caída,
# reenvía con la misma clave y el mismo cuerpo.
KEY="agent-run42-step7-$(uuidgen)"
curl -sS https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $KEY" \
  -d '{"platform":"reddit","action":"search","params":{"keyword":"idempotency key","limit":10}}' \
  -D - | grep -i -E "^(HTTP|idempotent-replayed|retry-after|x-request-id)"
Prueba 1: la misma clave tres veces, un solo cobro
A las 00:17:18 hora de Singapur enviamos la primera llamada: reddit/search, palabra clave «idempotency key», limit 10 y con clave. A los 4,4 segundos llegó un 200 con count 3, el id req_876177aa43924339 y billing.charged_usd de 0.000556. La publicación más reciente de las tres era del 3 de noviembre de 2026, hora de Singapur, y hablaba de cinco casos que rompen una implementación ingenua de claves de idempotencia, el mismo tema de este artículo.
A las 00:17:30 enviamos el mismo cuerpo con la misma clave. La respuesta volvió en 0,116 segundos: HTTP 200, cabecera Idempotent-Replayed: true, replayed: true en el cuerpo, el mismo id y las mismas tres publicaciones. A las 00:17:37 lo enviamos una tercera vez con todos los campos del JSON en otro orden (params antes que action y platform, y limit antes que keyword). El replay llegó en 0,142 segundos con el mismo resultado.
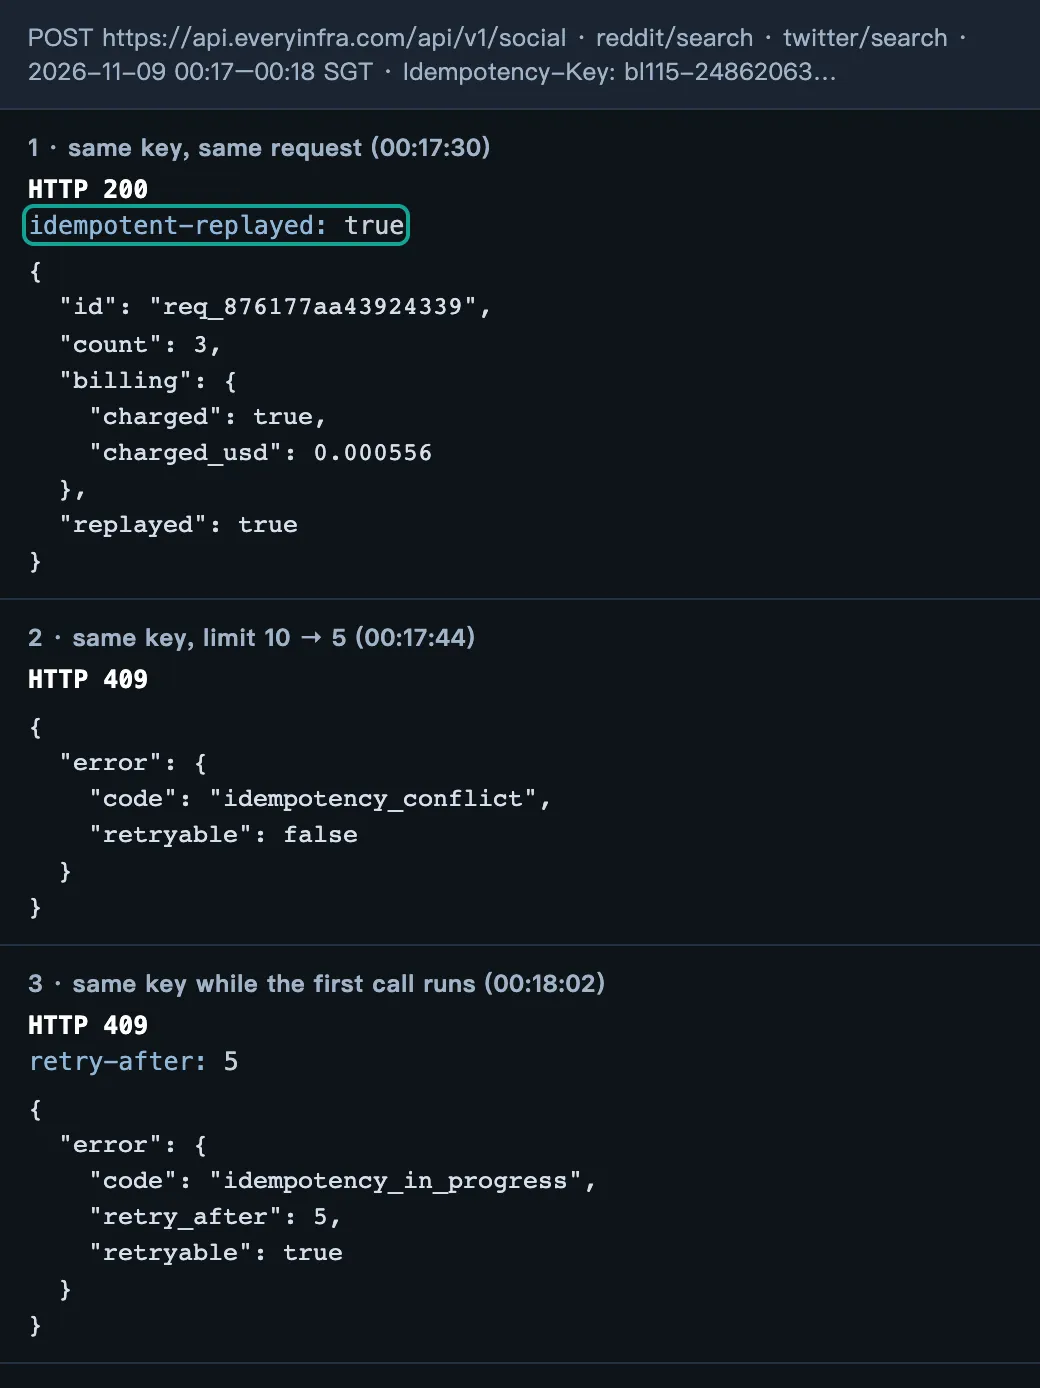
Hay dos detalles que la documentación no menciona y que quien escribe el cliente necesita. El primero: la cabecera X-Request-Id es nueva en cada replay (en el segundo envío fue req_cce7840d402b4dc1), mientras que el id del cuerpo no cambia. Si tus registros usan la cabecera, verás tres identificadores; si usan el id del cuerpo, uno. Para cuadrar cuentas usa el id del cuerpo, y la cabecera solo para seguir un viaje de red concreto.
El segundo: el replay copia el objeto billing entero, incluido balance_after_usd de la primera llamada. Si tu cliente suma charged_usd de cada respuesta, tres envíos con una clave cuentan como tres cobros. Ignora el importe cuando veas replayed: true, o toma GET /portal/api/logs como registro. Lo comprobamos: los tres envíos aparecen como una sola fila, req_876177aa43924339, con charged=true y $0,000556.
Que el JSON reordenado también diera replay indica que la API compara el contenido y no los bytes. Para un agente es clave: cuando el modelo vuelve a escribir los argumentos, el orden de los campos cambia a menudo, y una comparación por bytes trataría la misma intención como otra solicitud y devolvería un 409. Stripe explica que su capa de idempotencia compara los parámetros de la nueva solicitud con los de la original y da error si no coinciden (Stripe). En nuestra prueba, EveryInfra no consideró el orden de los campos como una diferencia.
Prueba 2: misma clave con otros parámetros, 409 sin ejecutar
A las 00:17:44 hora de Singapur usamos la misma clave y solo cambiamos limit de 10 a 5. En 0,146 segundos llegó 409 idempotency_conflict. El mensaje decía que esa clave ya se había usado en las últimas 24 horas para otra solicitud (otra plataforma, acción o parámetros) y pedía una clave nueva. retryable era false y next_steps decía «Nothing was charged» (no se cobró nada). El registro no tiene cobro para esta llamada.
La regla parece estricta, pero protege al agente. Imagina que el modelo pide reddit/search con limit 10, la llamada se corta y en el reintento pone limit 5. Un replay entregaría 10 filas a un agente que pidió 5; una ejecución nueva dejaría la clave sin sentido. Un rechazo claro le dice al cliente que ya no se trata del trabajo original. De aquí sale una exigencia práctica: el framework o el envoltorio de la herramienta debe crear la clave antes de la llamada y fijarla, sin dejar que el modelo invente una nueva en cada intento. Un hilo de r/LangChain de 2026 lo resume bien: crea la clave antes de llamar, guárdala y reutilízala en cada reintento (hilo).
Square sigue la misma regla: la misma clave con una solicitud cambiada da un error, y su documentación avisa de que el comportamiento puede variar según la API (Square).
MDN, en su página de la cabecera, describe otra forma habitual de estos errores (MDN). Propone 409 Conflict cuando una solicitud con la misma clave sigue en proceso y 422 Unprocessable Content cuando la clave ya se usó con otro contenido. EveryInfra usa 409 en ambos casos y los distingue por el código de error, así que tu cliente debe leer el código y no solo el número de estado. También cambia el formato del cuerpo de error: los ejemplos de MDN usan application/problem+json, de RFC 9457, y EveryInfra devuelve JSON normal con code, message, fault, retryable y next_steps; el campo retryable sirve directamente para decidir si reintentar.
| Caso | MDN y borrador IETF 08 | EveryInfra (prueba real) | Qué debe hacer el cliente |
|---|---|---|---|
| Misma clave, aún en proceso | 409 Conflict | 409 idempotency_in_progress, Retry-After 5 | Esperar Retry-After y reenviar igual |
| Misma clave, otro contenido | 422 Unprocessable Content | 409 idempotency_conflict | Parar y usar clave nueva |
| Falta una clave obligatoria | 400 Bad Request | En EveryInfra la clave es opcional | Añadirla en toda llamada que pueda repetirse |
| Clave mal formada | La define el servidor | 422 invalid_idempotency_key | Corregir el formato |
Prueba 3: reenvío con la primera en curso, 409 y Retry-After
Es el caso más común en agentes y el más arriesgado: el cliente se rinde a los 5 segundos y el servidor necesita más de 20. Elegimos una capacidad más lenta, twitter/search, con la misma palabra clave y limit 20, y reenviamos la misma clave 2,5 segundos después de la primera. En el primer intento, ambas llamadas chocaron con el límite de 10 por minuto de la clave de prueba: a las 00:17:55 y 00:17:57 hora de Singapur recibimos dos 429 que pedían esperar 5 y 3 segundos. Esos 429 no costaron nada ni bloquearon la clave.
A las 00:18:02 enviamos las dos llamadas de nuevo casi a la vez. La primera tardó 23,4 segundos y devolvió 200 con count 20 y un cobro de $0,000556. La segunda volvió en 0,107 segundos con 409 y el código idempotency_in_progress, la cabecera Retry-After: 5, retryable true y max_retries 3. El mensaje decía que la primera solicitud con esa clave seguía en marcha y que, repitiendo la misma solicitud 5 segundos después, llegaría su resultado. A las 00:18:28, ya terminada la primera, reenviamos y obtuvimos el replay en 0,131 segundos, con el mismo id y 20 filas.
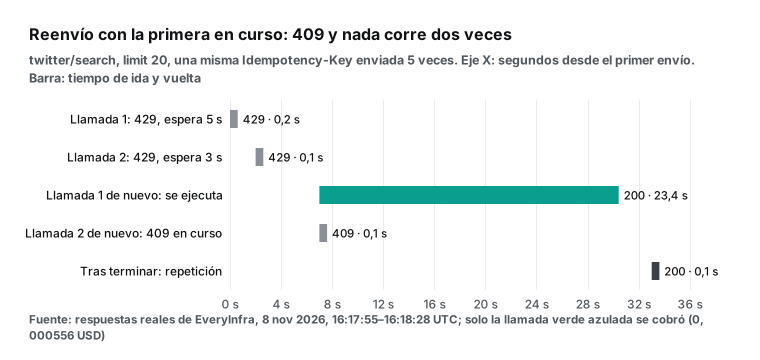
La prueba deja dos resultados. En dinero: tres envíos, un cobro, y el reenvío en curso no lanzó una segunda búsqueda ni un segundo cobro. En comportamiento: un 409 en curso significa «espera», no «error».
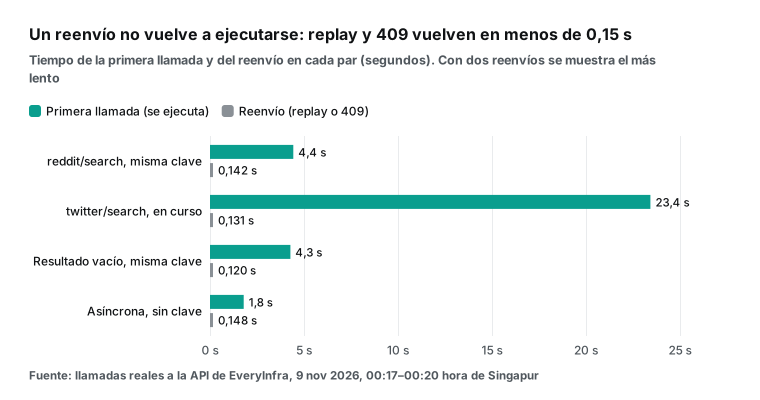
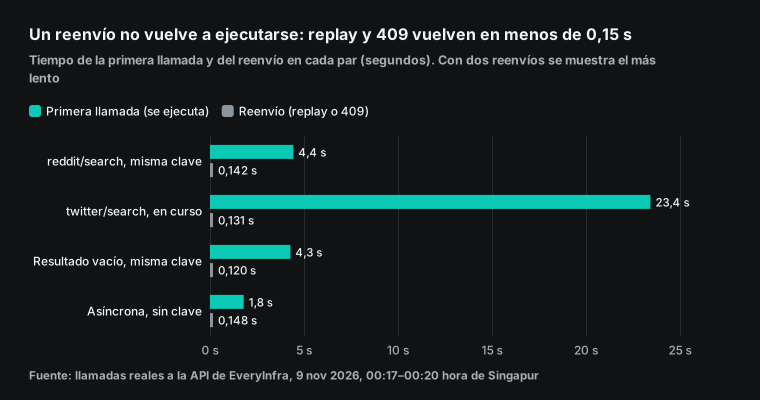
El gráfico pone los cuatro pares lado a lado. Cada primera llamada tardó entre 1,8 y 23,4 segundos porque ejecutó la búsqueda; cada reenvío, entre 0,107 y 0,148 segundos porque no ejecutó nada. Ojo con las bibliotecas de reintentos, porque no tratan el 409 igual. El README del SDK de OpenAI para Python dice que reintenta por defecto dos veces los errores de conexión, 408, 409, 429 y 500 o más, así que el 409 está en su lista. La guía de reintentos de los SDK de AWS decide por clase de error: reintenta errores transitorios, como cortes de red, y errores de límite, y un 409 no es ninguno de los dos. El primer estilo reenvía dos veces para nada un idempotency_conflict; el segundo abandona ante un idempotency_in_progress. No dependas del comportamiento por defecto: trata idempotency_in_progress como un caso propio (lee Retry-After, espera esos segundos y reenvía el mismo cuerpo con la misma clave) y marca idempotency_conflict como parada. Tras tres esperas (max_retries: 3), pasa a modo asíncrono y consulta el trabajo.
| Cliente | 409 idempotency_in_progress | 409 idempotency_conflict | Fuente |
|---|---|---|---|
| SDK de OpenAI para Python (por defecto) | Lo reintenta hasta 2 veces | Lo reintenta hasta 2 veces, para nada | README |
| SDK de AWS (modo estándar) | No lo reintenta: no es error transitorio ni de límite | No lo reintenta, y es lo correcto | Guía de reintentos de AWS |
| El envoltorio de más abajo | Espera Retry-After y reenvía | Se detiene | Nuestro código |
Fallos y resultados vacíos no cuestan nada, y un 422 libera la clave
La documentación fija la regla general: solo se cobra una llamada que termina bien y devuelve datos; los fallos, los resultados vacíos y las solicitudes rechazadas son gratis. La probamos con dos pares de llamadas y, de paso, miramos qué pasa con la clave tras un fallo. A las 00:19:47 hora de Singapur enviamos una clave con un parámetro erróneo: reddit/search con sort igual a bestest. La API devolvió 422 invalid_value en 0,113 segundos, con param: sort, una lista allowed de 6 valores válidos (controversial, newest, popular, relevance, rising y top) y un catalog_url hacia el catálogo. Con esa estructura, un modelo puede corregir sus propios argumentos.
A las 00:20:02 enviamos la misma clave con sort en top. Si la primera llamada siguiera ocupando la clave, habríamos recibido un 409 de conflicto. Llegó un 200: se ejecutó de verdad y costó $0,000556. Queda confirmado que una primera llamada fallida libera la clave. Antes de todo esto también probamos el formato: a las 00:17:11 enviamos una clave con un espacio y la API respondió 422 invalid_idempotency_key, sin cobro.
El par del resultado vacío muestra otra regla. A las 00:20:15 enviamos una clave con una palabra clave imposible. A los 4,3 segundos llegó un 200 con count 0, charged: false, charged_usd: 0, billing.reason igual a empty_result_refunded y refund.status: succeeded. A las 00:20:26 reenviamos la misma clave y recibimos el replay en 0,12 segundos, otra vez con 0 filas y $0. Es decir, la API trata el vacío como un trabajo terminado y no libera la clave: durante 24 horas, esa clave devolverá el mismo vacío. Si tu agente quiere buscar de nuevo unos minutos después, por ejemplo para ver publicaciones nuevas, necesita otra clave. Nuestra guía de conciliación de fallos y reembolsos explica cómo cruzar estos reembolsos con tus propios registros.
Las estadísticas de 30 días de la cuenta de prueba muestran el peso de esta regla. Del 2026-10-10 al 2026-11-08 (UTC) la cuenta hizo 8.201 llamadas: 7.449 con éxito, 245 vacías (2,99 %) y 752 fallidas (9,17 %). De los fallos, 668 tuvieron causa en el servidor, 61 chocaron con el límite y 8 tenían un error en la solicitud; los 15 restantes no tienen categoría (GET /portal/api/quality?days=30).
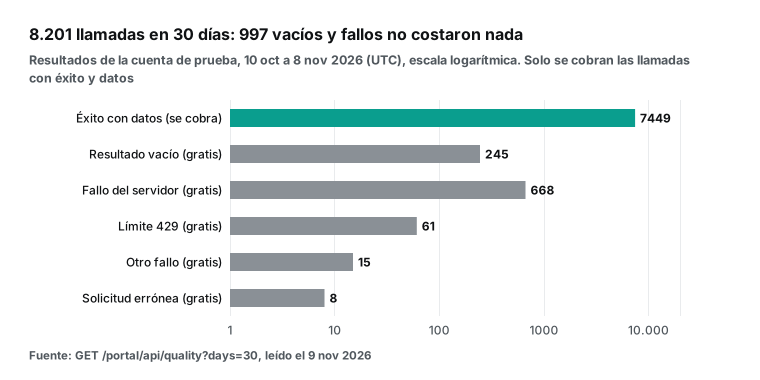
Ninguno de esos vacíos y fallos, cerca del 12 % de las llamadas, costó dinero. Reintentar tras un fallo sale casi gratis. El reintento caro es otro: la primera llamada salió bien y se cobró, pero el cliente no esperó la respuesta.
Qué pasa sin clave: dos cobros en síncrono, una fusión en asíncrono
A las 00:19:02 y 00:19:14 hora de Singapur enviamos dos veces la misma llamada síncrona sin clave: reddit/search, palabras «agent retry duplicate charge», limit 5. Obtuvimos dos id distintos (req_00b3776d1bb5491c y req_a744369a248d4463) y dos cobros de $0,000556. También cambió el contenido: la primera devolvió 1 publicación del 26 de octubre de 2026 y la segunda, 2 publicaciones distintas, del 28 y del 13 de octubre. La misma consulta dio otro resultado en 12 segundos, porque la búsqueda en redes sociales cambia sin parar por el orden, la indexación y la personalización. Así que un reenvío sin clave también puede dar al agente dos conjuntos de datos que no cuadran. Si los guarda los dos, procesa por duplicado; si se queda con el segundo, el primer cobro no sirvió de nada. El replay con clave da una sola respuesta para un solo trabajo.
El modo asíncrono sigue otra regla. A las 00:19:31 enviamos una llamada con "mode": "async" y sin clave; en 1,8 segundos llegó un 202 con status: running, un job_id y un poll_url. A las 00:19:40 la repetimos sin clave y volvió en 0,148 segundos con 202, replayed: true y el mismo job_id, aunque con un id nuevo (req_4832d1bbe32943e8). El registro solo muestra el cobro de la primera. La documentación dice que, sin clave, los envíos asíncronos idénticos dentro de una ventana de 5 minutos se fusionan. Consultar GET /api/v1/jobs/{job_id} es gratis y no cuenta para el límite por minuto; hacia las 00:20 el trabajo estaba en succeeded, con billing_state en charged y refund_state en not_applicable.
De aquí sale una regla práctica. Algunas plataformas de agentes alojadas solo dejan poner una URL y un cuerpo en su herramienta HTTP, sin cabeceras propias, y MCP hoy no tiene parámetro de clave. En los dos casos, manda las capacidades lentas en modo asíncrono y tendrás gratis una ventana de fusión de 5 minutos. Cuesta un paso más para consultar el trabajo, pero los cortes casi desaparecen, porque un envío asíncrono vuelve en unos 2 segundos.
Lado MCP: everyinfra_call_api no tiene parámetro de idempotencia
Muchos agentes no llaman a REST, sino al endpoint MCP remoto https://api.everyinfra.com/mcp. A las 00:14 hora de Singapur leímos la respuesta original de tools/list, con 12 herramientas. La herramienta principal de datos, everyinfra_call_api, acepta cuatro entradas: platform, action, params y mode, sin clave de idempotencia; la de tickets, everyinfra_create_ticket, sí tiene idempotency_key. Las anotaciones de everyinfra_call_api son readOnlyHint: false, destructiveHint: true y openWorldHint: true, sin idempotentHint. Nuestra guía de configuración del MCP remoto explica la conexión paso a paso.
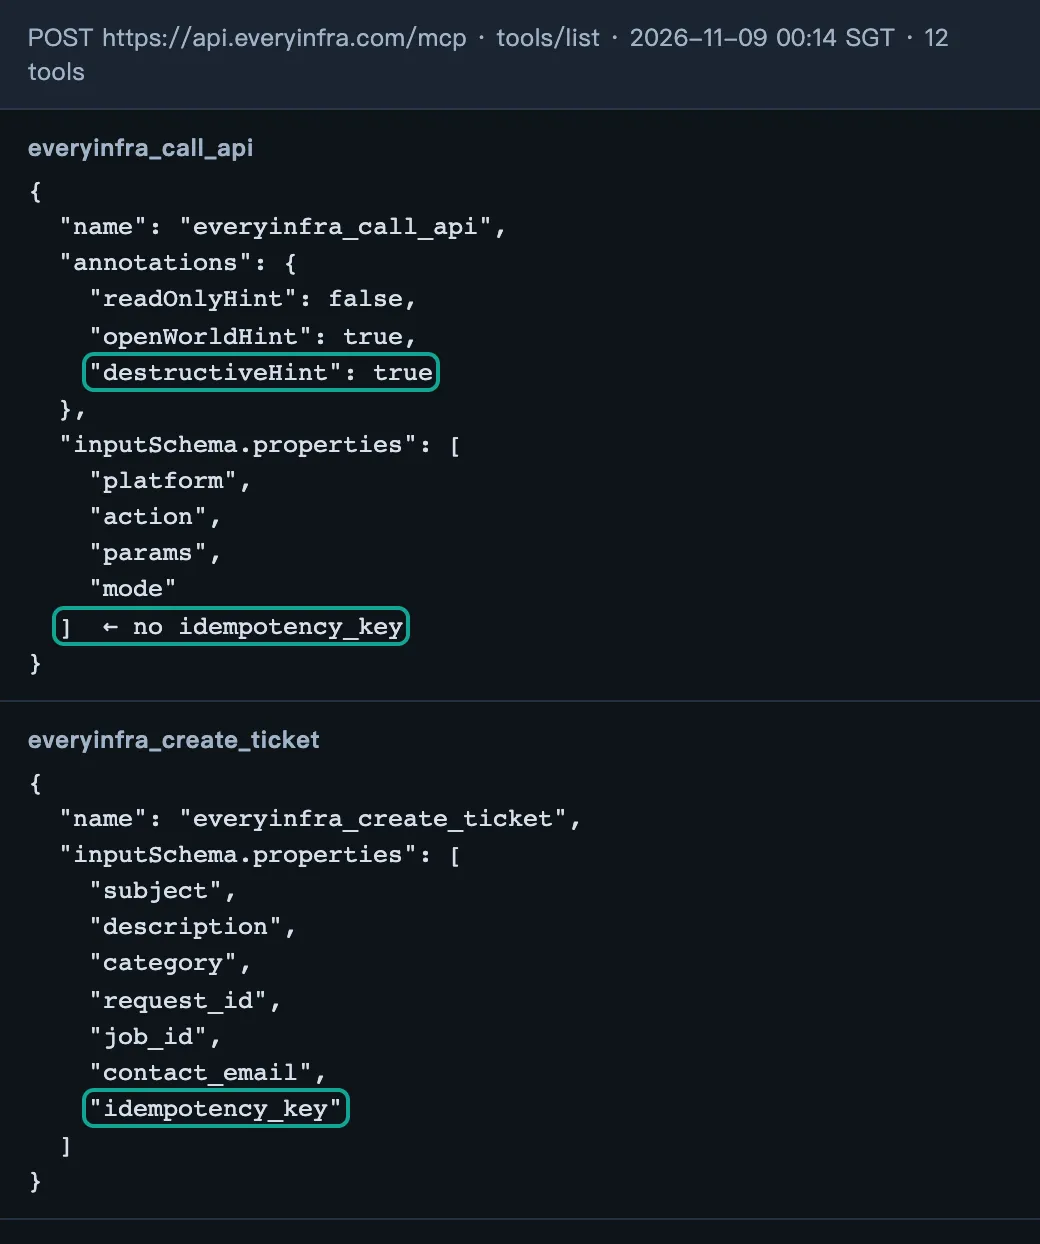
En la especificación MCP, idempotentHint significa que repetir la llamada con los mismos argumentos no tiene efecto adicional. Vale false por defecto, y las anotaciones son solo pistas en las que un cliente no debe confiar si el servidor no es de confianza (esquema MCP 2026-07-28). La documentación MCP de Claude Code tiene un apartado sobre cómo marcar herramientas seguras de llamar dos veces (MCP en Claude Code): tras una caída, solo reenvía las que tienen idempotentHint o readOnlyHint en true. Por eso no reenvía everyinfra_call_api, y está bien, porque una llamada MCP síncrona no lleva clave.
Lo probamos. A las 00:20:40 hora de Singapur llamamos por MCP en síncrono a reddit/search con «mcp tool retry» y limit 5: 5 filas en 5,1 segundos y $0,000556. A las 00:21:52 repetimos (la de las 00:20:52 chocó con el límite): 4,0 segundos, otros $0,000556 y otro id. En el par asíncrono, el primer intento de las 00:20:59 chocó con el límite; a las 00:21:06 llamamos con mode: async y recibimos un job_id; a las 00:22:11 la misma llamada devolvió el mismo job_id con replayed: true, y el registro tiene un solo cobro. MCP se comporta igual que REST.
| Vía | ¿Admite clave? | Misma solicitud dentro de 24 h | Cobros medidos | Para quién |
|---|---|---|---|---|
| REST síncrono con Idempotency-Key | Sí | Replay, sin cobro nuevo | 3 envíos, 1 cobro | Agentes con envoltorio propio |
| REST síncrono sin clave | No | Se ejecuta otra vez | 2 envíos, 2 cobros | No para flujos que reintentan |
| REST asíncrono, con o sin clave | Sí | Fusión en 5 minutos (por clave si la hay) | 2 envíos, 1 cobro | Capacidades lentas, herramientas HTTP alojadas |
| MCP síncrono everyinfra_call_api | No | Se ejecuta otra vez | 2 envíos, 2 cobros | Capacidades rápidas, esperas largas |
| MCP asíncrono everyinfra_call_api más everyinfra_get_job | No, pero se fusiona | Fusión en 5 minutos | 2 envíos, 1 cobro | Clientes MCP con esperas cortas |
Nuestro consejo para MCP: en toda capacidad con latencia mediana de más de unos segundos, pide al agente que pase mode: async y lea el resultado con everyinfra_get_job. Escríbelo en el prompt del sistema o en la descripción de la herramienta; es más fiable que dejarlo al criterio del modelo. También propusimos a nuestro equipo de producto añadir a everyinfra_call_api una entrada idempotency_key como la de everyinfra_create_ticket y declarar después idempotentHint. Hasta que llegue, la tabla describe la situación real. Nuestro artículo sobre la especificación MCP 2026 en producción cubre otras partes de la especificación que pesan en producción.
Reintentos en Claude Code: qué reenvía y qué no
Casi todas las variables de reintento de Claude Code afectan a sus llamadas al modelo y no hacen que tu herramienta MCP se ejecute otra vez. Solo una importa aquí: la nota de CLAUDE_CODE_DISABLE_NONSTREAMING_FALLBACK avisa de que, detrás de algunos proxies o pasarelas, el modo de respaldo sin streaming puede ejecutar una herramienta dos veces, y esa variable lo apaga (variables de entorno).
La propia llamada a la herramienta tiene tres límites de tiempo (MCP en Claude Code). Uno es de reloj: el campo timeout (en milisegundos) de la configuración del servidor o la variable MCP_TOOL_TIMEOUT; sin valor, ronda las 28 horas. Otro es un temporizador por solicitud que, para conectores HTTP, SSE y claude.ai, corre hasta el primer byte de la respuesta y toma el mayor entre 60 segundos, el tiempo de herramienta del servidor y MCP_TIMEOUT, así que nunca baja de 60 segundos. El último es de inactividad: un servidor de red sin respuesta ni avisos de progreso durante 5 minutos se detiene, y CLAUDE_CODE_MCP_TOOL_IDLE_TIMEOUT cambia ese valor. Además, una llamada de más de 2 minutos en la sesión principal pasa a segundo plano.
Compárese con nuestras latencias: los 60 segundos por defecto cubren el 98,4 % de las 314 llamadas síncronas recientes; solo 5 (1,6 %) tardaron más. Sumado a que tras una caída solo reenvía herramientas idempotentes, Claude Code con su configuración por defecto causa pocos cobros dobles por cortes del cliente. El riesgo que queda es el modelo que vuelve a llamar, y eso solo lo frenan el modo asíncrono o un envoltorio con clave. Este es un ejemplo de configuración; no lo ejecutamos en esta prueba y los nombres de campo salen de la documentación oficial.
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" },
      "timeout": 120000
    }
  }
}
El timeout de 120 segundos queda algo por encima del límite de 85 segundos de las llamadas síncronas de EveryInfra. La documentación dice que una llamada síncrona de más de 85 segundos devuelve 503 timeout, gratis, y aconseja bajar limit o pasar a modo asíncrono. Con una espera del cliente más larga que el límite del servidor, el cliente siempre recibe una respuesta clara, éxito o 503, y no abandona mientras el servidor sigue trabajando.
Reintentos en el OpenAI Agents SDK: 5 segundos de lectura por defecto
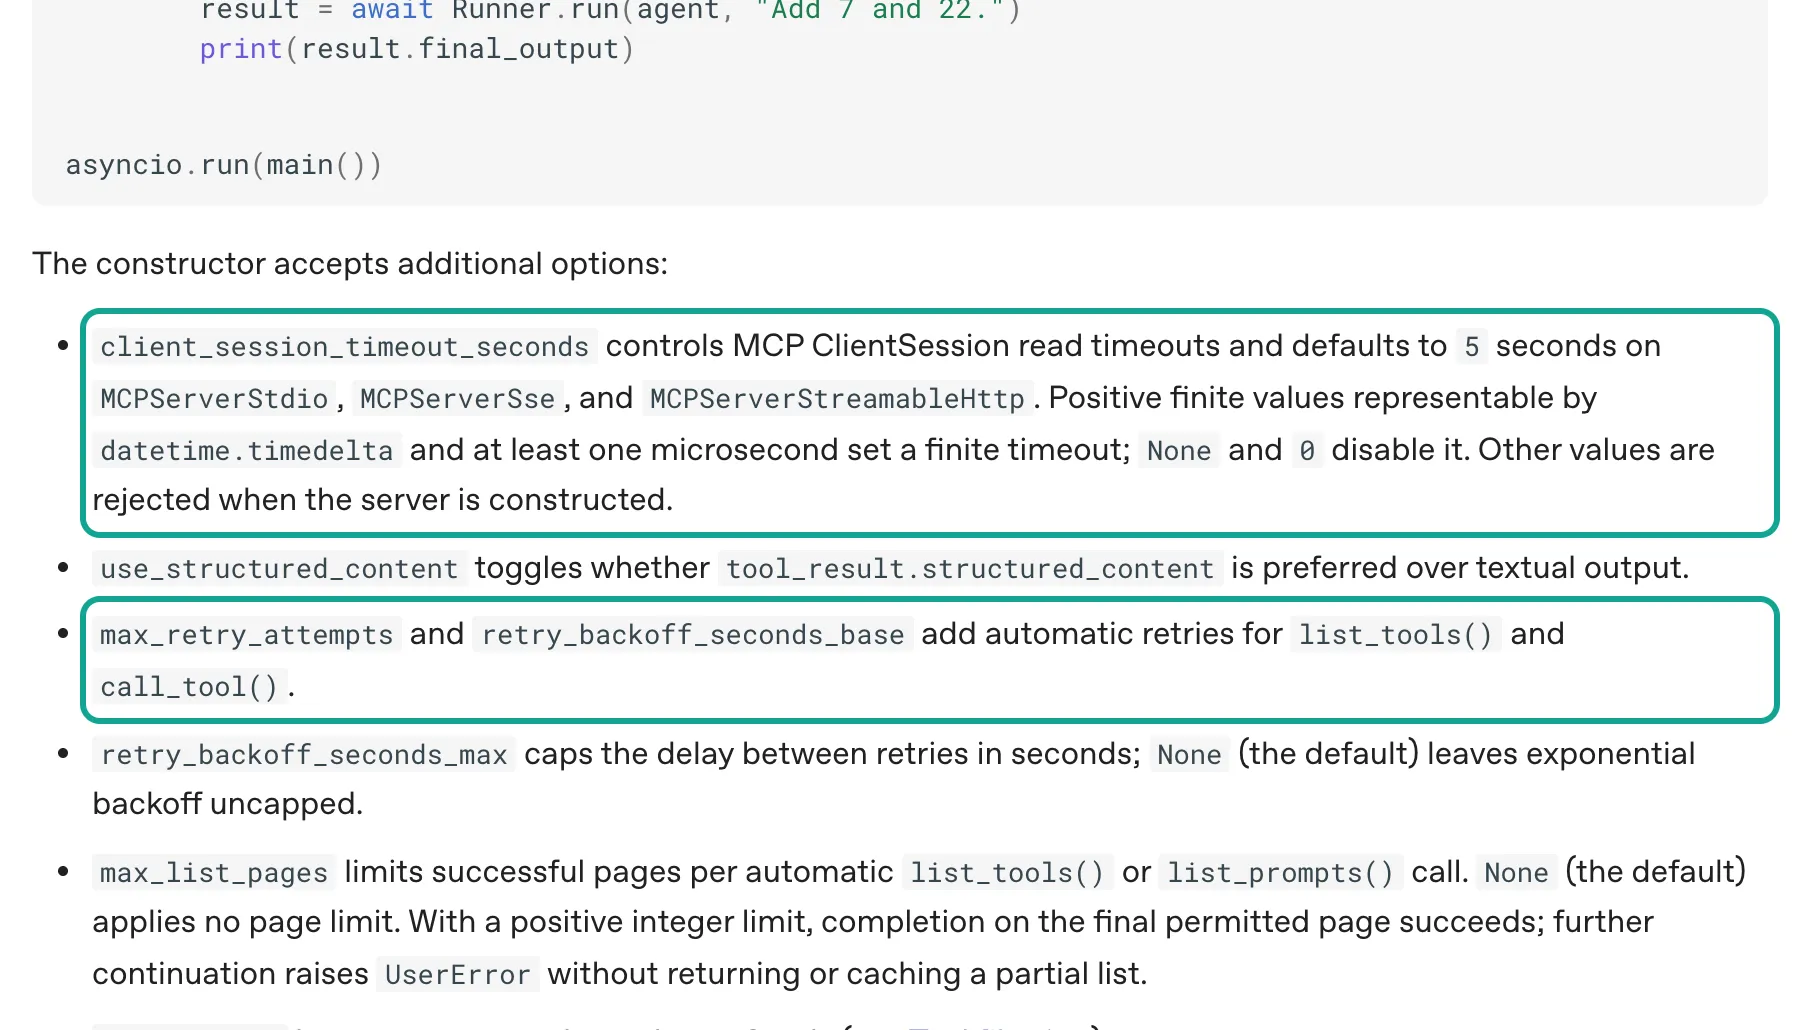
El OpenAI Agents SDK para Python se conecta a servidores MCP con clases como MCPServerStreamableHttp. Su documentación indica que client_session_timeout_seconds fija el tiempo de lectura de la sesión MCP, con 5 segundos por defecto en MCPServerStdio, MCPServerSse y MCPServerStreamableHttp. max_retry_attempts y retry_backoff_seconds_base añaden reintentos automáticos a list_tools() y call_tool(), y retry_backoff_seconds_max no tiene tope por defecto (MCP en el Agents SDK). El ejemplo de la documentación pone max_retry_attempts en 3.
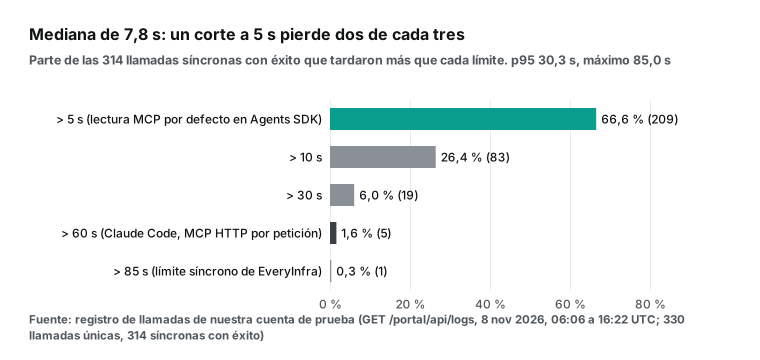
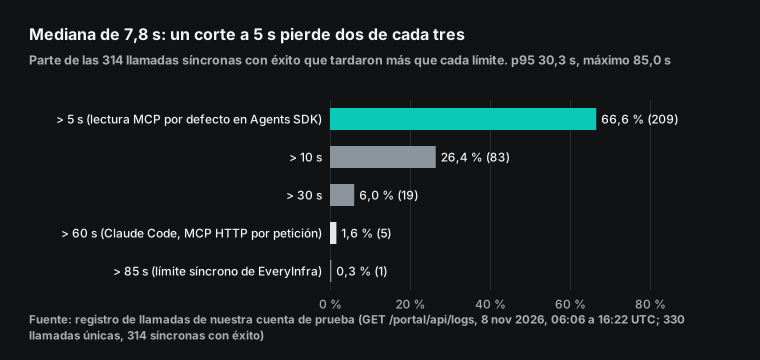
Cinco segundos es poco para una API de datos. La mediana de las 314 llamadas síncronas recientes de nuestra cuenta de prueba fue de 7,8 segundos, y 209 (66,6 %) superaron los 5. Con los valores por defecto, unas dos de cada tres llamadas correctas se cortan en el cliente mientras el servidor las termina y las cobra. Con max_retry_attempts activado, el SDK reenvía la misma llamada tras cada corte, y cada envío es un cobro nuevo; sin él, la misma página dice que un fallo de herramienta MCP devuelve por defecto un texto de error legible para el modelo (con el formateador por defecto si failure_error_function no se fija; con None, lanza una excepción). Un modelo que lee «timeout» a menudo vuelve a llamar. La documentación no dice si un corte por tiempo sigue ese camino ni qué texto ve el modelo, y no lo probamos.
En las llamadas al modelo, el SDK es prudente: los reintentos hay que activarlos, y una petición que ya empezó a emitir o tiene efectos locales no se repite por defecto (modelos en el Agents SDK). Pero la lectura de herramientas MCP remotas sigue en 5 segundos.
Ejemplo de configuración (no lo ejecutamos; los nombres salen de la documentación citada): lectura de 90 segundos, algo más que el límite síncrono de 85 (el SDK oficial de Python espera 300 segundos por defecto al llamar a REST; un cliente MCP debe esperar al menos más de 85), y sin max_retry_attempts, para que los reintentos solo ocurran donde tú controlas la clave. Nuestro artículo sobre un agente de seguimiento de reseñas con el OpenAI Agents SDK construye un agente completo con este SDK, y el envoltorio de más abajo encaja en él.
from agents import Agent, Runner
from agents.mcp import MCPServerStreamableHttp
import os

async def main():
    async with MCPServerStreamableHttp(
        name="everyinfra",
        params={
            "url": "https://api.everyinfra.com/mcp",
            "headers": {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"},
        },
        client_session_timeout_seconds=90,   # por defecto 5 s, menos que la mediana de 7,8 s
        # sin max_retry_attempts: MCP síncrono no lleva clave, y cada reenvío es un cobro nuevo
        cache_tools_list=True,
    ) as server:
        agent = Agent(
            name="researcher",
            instructions="Para capacidades lentas, llama a everyinfra_call_api con mode=async y lee el resultado con everyinfra_get_job.",
            mcp_servers=[server],
        )
        result = await Runner.run(agent, "Busca publicaciones recientes de Reddit sobre claves de idempotencia")
print(result.final_output)| Ajuste | Claude Code (herramientas MCP) | OpenAI Agents SDK (MCPServerStreamableHttp) | Consejo para EveryInfra |
|---|---|---|---|
| Espera por llamada | Temporizador por solicitud de al menos 60 s; reloj de unas 28 h | client_session_timeout_seconds, 5 s por defecto | 90–120 s, por encima del límite síncrono de 85 s |
| Parada por inactividad | 5 minutos en servidores de red | La marca el tiempo de lectura | Modo asíncrono para trabajos largos |
| Reenvío automático tras caída o corte | Solo herramientas con idempotentHint o readOnlyHint, una vez | call_tool solo si se fija max_retry_attempts | Sin reenvío automático para everyinfra_call_api |
| Qué ve el modelo tras un error | Tras una caída, un texto que pide comprobar si se ejecutó | Texto del formateador por defecto (failure_error_function) | Pedir al modelo que mire el registro antes de reintentar |
Qué tan lenta es la API: latencia de 314 llamadas síncronas
Usamos varias veces el «66,6 % por encima de 5 segundos», así que aquí va su origen. Tomamos el registro de la cuenta de prueba entre el 2026-11-08 a las 14:06 y el 2026-11-09 a las 00:22, hora de Singapur (GET /portal/api/logs, dos páginas de 200 filas). Sin request_id duplicados quedaron 330 llamadas, y 314 eran síncronas con HTTP 200. latency_ms es el tiempo que registra el servidor. La mediana fue de 7,8 segundos, el p90 de 20,6, el p95 de 30,3 y la más larga, 85,0 segundos, justo el límite síncrono. Superaron los 5 segundos 209 llamadas (66,6 %), los 10 segundos 83 (26,4 %), los 30 segundos 19 (6,0 %), los 60 segundos 5 (1,6 %) y los 85 segundos 1 (0,3 %). Ocho de esas 314 eran nuestras propias llamadas de prueba (la más larga, 23,3 segundos); sin ellas, el 67,6 % de las 306 restantes pasó de 5 segundos, algo más que el 66,6 %, así que nuestras pruebas no inflan el resultado.
Hay que decir el límite de la muestra: la mezcla de capacidades es lenta. Cinco capacidades con 10 llamadas o más tuvieron una mediana superior a 5 segundos: twitter/comments (71 llamadas), threads/comments (41), youtube/transcript (19), threads/search (14) y youtube/search (10). En cambio, xiaohongshu/comments (71 llamadas) tuvo una mediana de 2,0 segundos y solo el 5,6 % pasó de 5; en reddit/search (13 llamadas) fue el 15,4 % y en xiaohongshu/search (11), el 18,2 %. El 66,6 % describe esta cuenta en estas diez horas; otra mezcla da otra cifra.
Para un mínimo más estable usamos las estadísticas de 30 días. De 95 capacidades con datos de latencia, 67 tenían una mediana de éxito superior a 5 segundos, es decir, al menos la mitad de sus llamadas pasó de 5. Por tanto, al menos el 22,1 % de las 7.449 llamadas correctas de 30 días superó los 5 segundos. Con el mismo método, 19 capacidades tenían un p95 por encima de 60 segundos, así que al menos el 0,48 % de las llamadas pasó de 60.
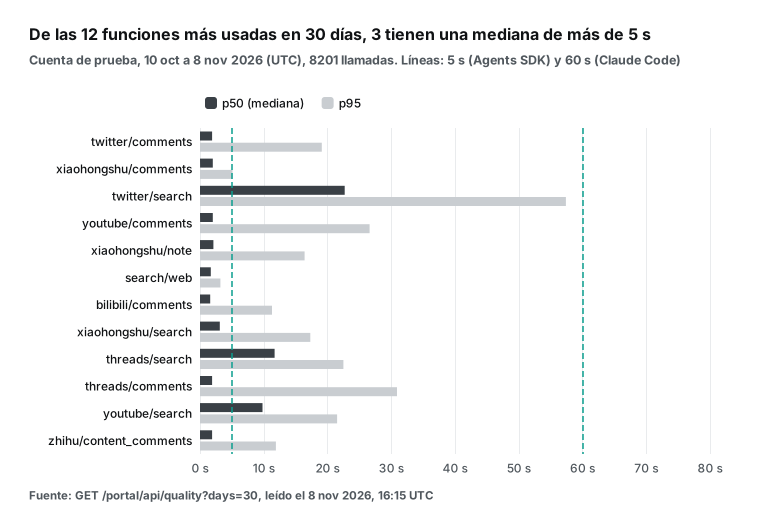
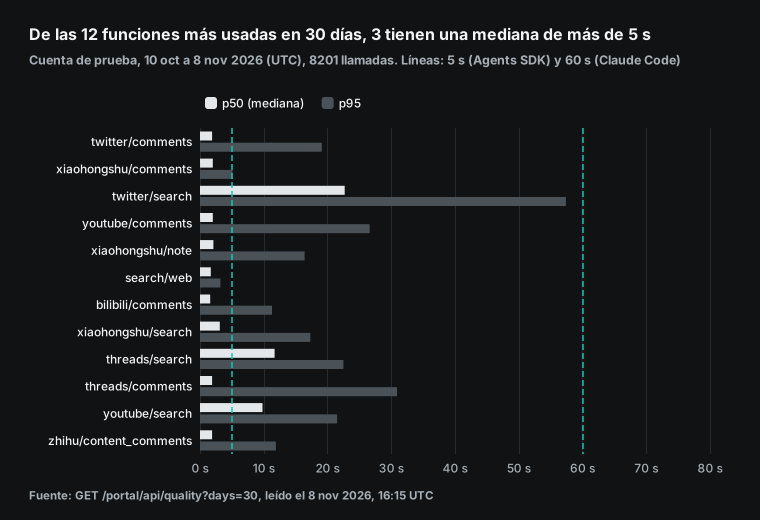
Este gráfico ayuda a decidir qué capacidades van en asíncrono por defecto. twitter/search tiene una mediana de 22,7 segundos, threads/search de 11,7 y youtube/search de 9,8: con 5 segundos de espera, el cliente abandona casi siempre. Otro grupo pide cuidado: mediana rápida y p95 lento. twitter/comments tiene 1,9 y 19,1 segundos, y threads/comments, 1,9 y 30,9. Suelen ser rápidas, pero a veces tardan 20 o 30 segundos, justo cuando un agente cree que la llamada falló. search/web, con 1,7 y 3,2 segundos, rara vez tiene problemas con 5 segundos.
El coste: cuánto paga de más un agente con un X % de reintentos sin clave
Cuánto paga de más un agente sin clave depende de X, la parte de sus llamadas que reenvía cada día, y X depende de la espera del cliente. No quisimos inventar X, así que lo sacamos de las latencias. Supón una espera del cliente de T segundos y un reenvío a ciegas sin clave tras cada corte. Entonces X es la parte de llamadas correctas que tarda más de T, y cada reenvío es un cobro más. Contamos un solo reenvío por corte; en la práctica el reenvío también puede cortarse y provocar otro, así que las cifras son un mínimo. El precio unitario es $0,000556, el de reddit/search y otras 115 capacidades. Las 571 capacidades disponibles en el catálogo tenían una mediana de $0,001389 y un rango de $0,000556 a $0,28.
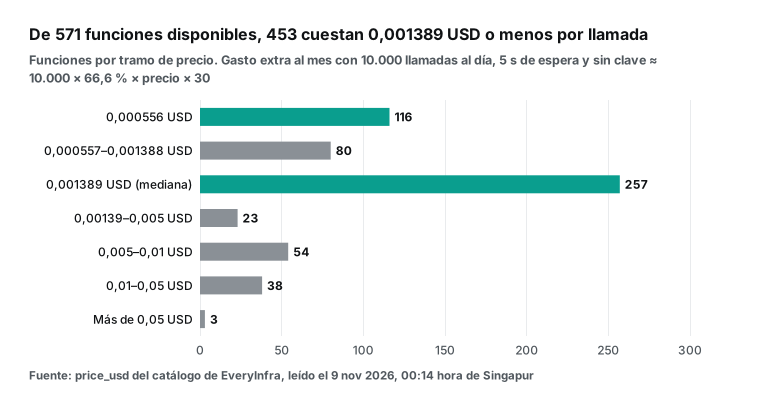
El gráfico muestra que 453 de las 571 capacidades cuestan $0,001389 o menos, así que las dos columnas de precio de la tabla cubren a la mayoría de los agentes reales. Para una capacidad más cara, multiplica la fila por la proporción de precios.
| Espera del cliente T | X (parte que supera T) | 10.000 llamadas/día a $0,000556: extra al mes | 10.000 llamadas/día a la mediana de $0,001389: extra al mes |
|---|---|---|---|
| 5 s (lectura MCP por defecto del Agents SDK) | 66,6 % (mínimo de 30 días: 22,1 %) | $111,02 (mínimo unos $36,8) | $277,36 (mínimo unos $92) |
| 10 s | 26,4 % | $44,09 | unos $110 |
| 30 s | 6,0 % | $10,09 | unos $25 |
| 60 s (temporizador por defecto de Claude Code) | 1,6 % | $2,65 | unos $6,6 |
| 85 s (límite síncrono de EveryInfra) | 0,3 % | $0,53 | unos $1,3 |
| Con Idempotency-Key (cualquier T) | Sin cobro doble | $0,00 | $0,00 |
La fórmula: extra al mes = llamadas al día × X × precio × 30. Para la primera fila, 10.000 × 0,6656 × $0,000556 × 30 = $111,02; con la mediana, 10.000 × 0,6656 × $0,001389 × 30 = $277,36. Las demás celdas de esa columna están redondeadas. También lo contrastamos con el gasto real de la cuenta: de las 314 llamadas síncronas correctas, 291 se cobraron, $0,6588 en total, y las 187 cobradas que pasaron de 5 segundos sumaron $0,2150, el 32,6 %. Un agente con 5 segundos de espera, sin clave y con un reenvío por corte habría subido el coste de esas diez horas de $0,66 a al menos $0,87. La parte en dinero (32,6 %) es menor que la parte en llamadas (66,6 %) porque muchas capacidades lentas son baratas.
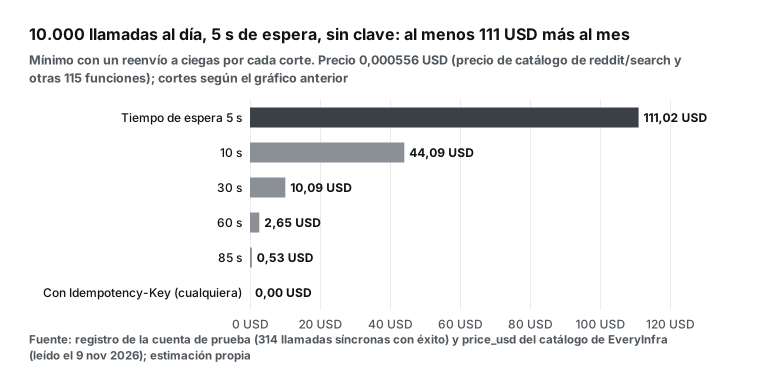
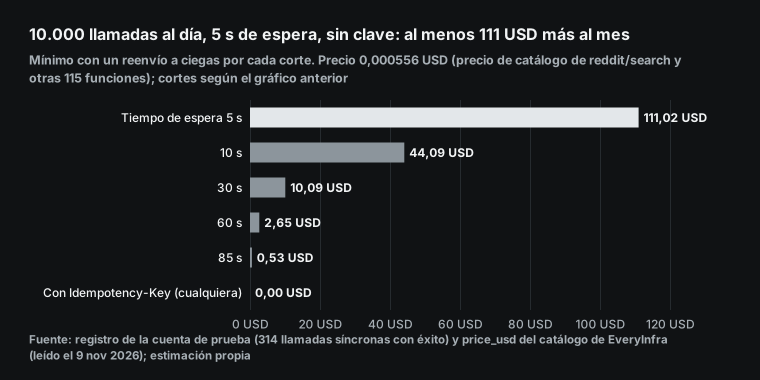
La estimación tiene tres límites. Primero, las latencias vienen de diez horas de una sola cuenta con una mezcla lenta; un agente que use sobre todo capacidades rápidas, como xiaohongshu/comments o search/web, tendrá una cifra mucho menor en la fila de 5 segundos. El mínimo de 30 días es 22,1 %, unos $36,8 al mes como poco. Segundo, suponemos exactamente un reenvío por corte; un agente real puede no reenviar y avisar del fallo, o reenviar muchas veces, como el de la publicación de Reddit que pasó la noche reintentando. Tercero, sin clave el reenvío también trae datos nuevos, como cuando 1 fila pasó a 2 en 12 segundos. El $0 de la fila con clave no depende de ningún supuesto, porque un replay no se ejecuta.
Webhooks: quitar duplicados por X-EveryInfra-Event-Id
El trabajo duplicado también puede ocurrir al revés, cuando la API te avisa a ti. Los webhooks de EveryInfra (Settings → Webhooks en la consola) tienen dos tipos de evento, y cada entrega es un POST con el cuerpo {"id", "type", "created_at", "data"}.
| Evento | Cuándo se envía | Campos principales de data | Qué hacer |
|---|---|---|---|
| balance.low | Una vez por cruce, cuando el saldo baja a tu umbral en USD o por debajo | La documentación no los detalla | Recargar o reducir gasto |
| job.finished | Un trabajo asíncrono termina bien o mal, con el cobro o el reembolso ya cerrados | job_id, request_id, status, result_count, billing_state, refund_state, result_url | Leer las filas con GET /api/v1/jobs/{job_id} y la clave que envió el trabajo |
La documentación promete entrega «al menos una vez»: cualquier 2xx cuenta como entregado y, si no, el evento vuelve a los 30 segundos, 2 minutos, 10 minutos, 30 minutos, 2 horas y 6 horas, 7 intentos en total. El mismo evento puede llegarte dos veces, por ejemplo si tu servicio termina el trabajo pero se corta antes de devolver 200. La documentación pide quitar duplicados por X-EveryInfra-Event-Id y verificar la firma: X-EveryInfra-Signature: v1=<hex> debe coincidir con un HMAC-SHA256 del valor de X-EveryInfra-Timestamp, un punto y el cuerpo original, hecho con tu secreto de firma. Rechaza marcas de tiempo desviadas más de 5 minutos. Stripe da el mismo consejo para sus webhooks: anota los ID de evento procesados y salta los que ya tienes (webhooks de Stripe). El patrón de reintentos de Microsoft también pide que quien recibe mensajes reenviados sea un consumidor idempotente (patrón Retry de Azure).
import hashlib, hmac, json, time

def handle_everyinfra_webhook(headers, raw_body: bytes, secret: bytes, db):
    ts = headers["X-EveryInfra-Timestamp"]
    sig = headers["X-EveryInfra-Signature"].removeprefix("v1=")
    want = hmac.new(secret, ts.encode() + b"." + raw_body, hashlib.sha256).hexdigest()
    if not hmac.compare_digest(sig, want) or abs(time.time() - int(ts)) > 300:
        return 400
    event_id = headers["X-EveryInfra-Event-Id"]
    # Un índice único garantiza que cada evento se procese una vez; si la inserción falla, devuelve 200
    if not db.insert_if_absent("webhook_events", event_id):
        return 200
    event = json.loads(raw_body)
    if event["type"] == "job.finished":
        db.enqueue_fetch(event["data"]["job_id"])   # las filas se leen con GET /api/v1/jobs/{job_id}
    return 200
Un detalle importa para agentes: primero se reserva el ID del evento y después se procesa, no al revés. Una respuesta en el hilo de r/LangChain explica por qué (hilo): si dos entregas llegan casi a la vez, las dos consultan, ninguna encuentra nada y las dos procesan. La clave tiene que funcionar como un cerrojo, y un índice único cierra ese hueco: procesa quien logra insertar y el otro devuelve 200. En Python también puedes verificar la firma con from everyinfra.webhooks import verify_signature del SDK.
Un envoltorio listo para usar: la clave antes de llamar, la misma en cada reintento
En Python, lo más sencillo es el SDK oficial: pip install everyinfra (versión 0.3.0, Python 3.9 o posterior, sin dependencias). Su README dice que data() envía una Idempotency-Key en cada llamada, síncrona o asíncrona: tras una conexión caída el SDK reenvía y recupera la primera respuesta o el mismo trabajo, sin otro cobro. Para reintentar la misma solicitud lógica desde otro proceso, pasa tu propia clave estable con idempotency_key= (everyinfra en PyPI). El README también pide no bajar la espera por defecto de 300 segundos: si el cliente corta antes de que el servidor termine, se da el peor caso, cobro hecho y resultado perdido, que es justo lo que medimos aquí.
import os
from everyinfra import EveryInfra

ei = EveryInfra(os.environ["EVERYINFRA_API_KEY"])
posts = ei.data("reddit", "search", keyword="idempotency key", limit=10,
                idempotency_key="run42-step7")   # el mismo paso usa la misma clave tras un reinicio
Si no usas el SDK de Python (un agente en JavaScript, la herramienta HTTP de una plataforma alojada o un framework donde quieres controlar los reintentos), aplica las mismas reglas tú mismo. Un envoltorio de herramienta de datos para un agente necesita cuatro cosas. Crea la clave antes de la llamada y la fija. Reenvía con la misma clave tras un corte por tiempo, una conexión caída, un 504 o un 502. Espera Retry-After ante un 409 en curso. Y se detiene ante un 409 de conflicto, otros 4xx y los dos 503 de resultado desconocido. El código usa solo la biblioteca estándar de Python y puedes llevarlo a cualquier lenguaje.
import json, os, time, uuid, urllib.error, urllib.request

API = "https://api.everyinfra.com/api/v1/social"
STOP = {"idempotency_conflict", "refund_outcome_unknown", "submission_outcome_unknown"}

def call_social(body: dict, key=None, timeout: float = 90, attempts: int = 4):
    key = key or f"agent-{uuid.uuid4()}"          # una solicitud lógica, una clave; guárdala en el estado de la tarea
    for i in range(attempts):
        req = urllib.request.Request(API, data=json.dumps(body).encode(), method="POST", headers={
            "Authorization": "Bearer " + os.environ["EVERYINFRA_API_KEY"],
            "Content-Type": "application/json",
            "Idempotency-Key": key,
        })
        try:
            with urllib.request.urlopen(req, timeout=timeout) as r:
                data = json.load(r)
                data["_cost_usd"] = 0 if data.get("replayed") else data["billing"]["charged_usd"]
                return data
        except urllib.error.HTTPError as e:
            try:
                err = (json.load(e) or {}).get("error", {})
            except ValueError:                        # cuerpo que no es JSON, como una página HTML del borde
                err = {"retryable": e.code in (502, 504)}
            if err.get("code") in STOP or not err.get("retryable"):
                raise RuntimeError(f"{e.code} {err.get('code')}: {err.get('message')} key={key}")
            time.sleep(float(e.headers.get("Retry-After") or err.get("retry_after") or 2 ** i))
        except (TimeoutError, urllib.error.URLError):
            time.sleep(2 ** i)                        # resultado desconocido: reenviar con la misma clave
    raise RuntimeError(f"gave up after {attempts} tries, Idempotency-Key={key}")
_cost_usd vale 0 en un replay, para que el billing copiado no cuente dos veces. La decisión de reintentar lee primero el campo retryable, así que no necesitas tu propia tabla de códigos: en EveryInfra, el 429, el 409 en curso y los errores de servidor reintentables llevan retryable: true; el 409 de conflicto, 422, 401, 402 y 403 llevan false. El tiempo de espera sale primero de la cabecera Retry-After, que es la práctica común: la guía de códigos de error de OpenAI también pide seguir Retry-After en un 429 cuando aparece (códigos de error de OpenAI). Si el cuerpo del error no es JSON, por ejemplo una página del borde, solo 502 y 504 cuentan como reintentables. La espera por defecto es de 90 segundos (el SDK oficial usa 300, más seguro). Si quien llama pasa una clave, conviene construirla con el ID de ejecución del agente y el número de paso, por ejemplo run42-step7. Así, si el proceso se cae y reinicia, el mismo paso usa la misma clave y recupera el resultado original durante 24 horas sin pagar otra vez; es la misma idea que propone una respuesta del hilo de r/LangChain. La documentación de LangGraph va en la misma línea: tras una interrupción o un reintento, un nodo vuelve a ejecutarse desde el principio y repite sus efectos, por eso recomienda claves de idempotencia, upserts o leer antes de escribir (LangGraph Graph API). Nuestro artículo sobre subagentes de Claude Code para cuentas de marca en TikTok muestra la espera ante errores 429 con la misma lógica de Retry-After.
| Respuesta | retryable | Qué hace el envoltorio | Por qué |
|---|---|---|---|
| 200 con replayed true | — | Devuelve los datos, coste 0 | La primera llamada ya pagó |
| 409 idempotency_in_progress | true | Espera Retry-After y reenvía igual | La primera sigue en curso |
| 429 límite de llamadas | true | Espera Retry-After y reenvía igual | Sin cobro, clave libre |
| 504 response_timeout, 502 response_interrupted | true | Reenvía con la misma clave | El trabajo aún puede terminar |
| Corte del cliente o error de conexión | desconocido | Reenvía con la misma clave | El replay es gratis si terminó |
| 409 idempotency_conflict | false | Se detiene | Ya no es el mismo trabajo |
| 422, 401, 402, 403 | false | Se detiene | La solicitud necesita un arreglo |
| 503 refund_outcome_unknown, submission_outcome_unknown | false | Se detiene y consulta el request_id después | El cobro aún se está confirmando |
Idempotent API retry en otros servicios, de Stripe a Mercado Pago
Comparar EveryInfra con otros servicios ayuda a ver qué reglas son comunes y cuáles piden un trato aparte. Solo anotamos lo que dice la documentación de cada uno, leída el 2026-11-09. Para quien desarrolla en América Latina, el caso más cercano es Mercado Pago: en 2023 anunció que la cabecera X-Idempotency-Key sería obligatoria en sus APIs de Pagos y de Reembolsos para toda integración nueva a partir del 09-01-2024, tras ver más pagos y devoluciones duplicados (aviso de Mercado Pago). Su API de órdenes acepta claves de 1 a 128 caracteres y devuelve idempotency_key_already_used cuando el valor ya se usó (referencia de la API de órdenes).
| Servicio | Cabecera o campo | Longitud de la clave | Conservación | Misma clave, otros parámetros |
|---|---|---|---|---|
| API de datos de EveryInfra | Idempotency-Key | 1–255 caracteres ASCII visibles | 24 horas (fusión de 5 minutos en asíncrono sin clave) | 409 idempotency_conflict |
| Mercado Pago (órdenes) | X-Idempotency-Key | 1–128 caracteres | No indicada | idempotency_key_already_used |
| Stripe API v1 | Idempotency-Key | Hasta 255 caracteres | Se puede borrar tras al menos 24 horas | Error |
| Square | campo idempotency_key | No indicada | No indicada | Error (puede variar según la API) |
| AWS EC2 | ClientToken | Hasta 64 caracteres ASCII | No indicada | Error |
| Google AIP-155 | campo request_id | UUID | Lo fija cada API | Lo fija cada API |
| Borrador IETF 08 | Idempotency-Key | La define el servidor | La publica el servidor | Se sugiere 422 (409 si sigue en curso) |
Fuentes: Stripe, Square, AWS EC2, Google AIP-155 (un campo request_id con UUID, sobre todo para la idempotencia) y el borrador del IETF. «No indicada» significa que la página que leímos no daba la cifra, y no la inventamos. Dos APIs de pago usan otras cabeceras: Adyen usa idempotency-key con hasta 64 caracteres, y PayPal usa PayPal-Request-Id, que devuelve el último estado de la solicitud anterior.
EveryInfra se parece sobre todo a Stripe: el mismo nombre de cabecera, el límite de 255 caracteres, 24 horas y un error para la misma clave con otros parámetros. Hay una diferencia. Stripe API v1 guarda el código y el cuerpo de la primera llamada en cuanto el endpoint empieza a ejecutarse, así que un reintento con la misma clave devuelve incluso un error 500. EveryInfra solo guarda los resultados correctos: un fallo, incluido uno de servidor ya reembolsado, libera la clave y el siguiente envío se ejecuta. Para una API de datos tiene más sentido, porque una búsqueda fallida no debería repetir su fallo durante 24 horas. El artículo «Making retries safe with idempotent APIs» de la Amazon Builders' Library explica además qué debe devolver un replay: un simple error de «el recurso ya existe» no tiene efectos, pero quien llama sigue sin saber si lo creó su propia solicitud, así que lo mejor es devolver durante un tiempo una respuesta equivalente para el mismo identificador (Amazon Builders' Library). EveryInfra hace eso: repite la primera respuesta completa.
Límites y precauciones
Una clave impide que el mismo trabajo se ejecute dos veces, no que un trabajo viejo se ejecute una vez con datos caducados. Una publicación de r/AI_Agents lo explica con claridad (publicación): la clave bloquea una acción repetida, pero no una acción desfasada que se ejecuta una vez y sale mal. Durante 24 horas la misma clave devuelve los primeros datos, así que para datos frescos usa otra. El estado de la tarea del agente debe distinguir un reintento de una consulta nueva.
El día de la prueba, las llamadas MCP síncronas no tenían parámetro de idempotencia: usa el modo asíncrono o pon tu propio envoltorio REST delante del cliente MCP. El replay solo funciona durante 24 horas, y la ventana de fusión asíncrona sin clave es de 5 minutos. Las respuestas 429 no bloquean la clave ni cuestan nada, pero pueden desordenar tus tiempos de reintento; tuvimos 6 llamadas frenadas (4 respuestas 429 por REST y 2 por MCP) porque limitamos la clave de prueba a 10 llamadas por minuto (la cuenta trae 60 por defecto). Un tope de gasto en la clave (spend_limit_usd, que devuelve 403 key_spend_limit_reached) frena el gasto en el servidor, más fiable que un contador dentro del proceso del agente. Una respuesta bajo la publicación de Reddit de la noche de reintentos dice lo mismo: un tope por ejecución se reinicia cuando el trabajo arranca de nuevo, así que el presupuesto diario va en la clave de API (publicación).
Hay cosas que no pudimos probar. La documentación no dice si el servidor detiene o reembolsa un trabajo cuando el cliente se desconecta, así que la estimación de coste supone un cobro en todos esos casos. No probamos Claude Code ni el Agents SDK en esta prueba; si tus propias pruebas dan otro resultado, confía en ellas.
Cambios recientes
Cuatro cambios en clientes y uno en un borrador de estándar afectan a los reintentos de agentes. Las fuentes son el registro de cambios de Claude Code, el datatracker del IETF, las versiones del Agents SDK y PyPI.
| Fecha | Cambio | Qué significa para ti |
|---|---|---|
| 2026-11-06 | Claude Code 2.1.319 puede pasar tareas MCP a segundo plano en el terminal | Las llamadas de datos largas no bloquean la sesión principal, y encaja con el modo asíncrono |
| 2026-11-04 | Claude Code 2.1.318 conserva el turno interrumpido tras un reinicio posterior a reintentos | Se pierden menos resultados, pero el coste sigue estando en el registro de la cuenta |
| 2026-10-22 | Borrador IETF de Idempotency-Key, versión 08, válido hasta el 2027-04-25 | Un cliente que siga la cabecera hoy necesitará pocos cambios mañana |
| 2026-10-21 | Claude Code 2.1.307 solo reintenta herramientas MCP de solo lectura o idempotentes tras una caída | Marca con idempotentHint las herramientas seguras de tu propio servidor MCP |
| Última versión preliminar al 2026-11-09 | Los almacenes de sesión del Agents SDK v0.24.0-alpha.7 pueden señalar llamadas de resultado incierto y no las repiten solos | La clave de idempotencia es la forma de comprobar esa llamada |
Preguntas frecuentes
¿Qué es una clave de idempotencia?
Es un identificador único que el cliente envía en una cabecera para que el servidor reconozca las solicitudes repetidas y procese solo la primera. Mercado Pago la define así en su aviso de 2023. En EveryInfra es la cabecera Idempotency-Key: si repites la misma solicitud con la misma clave en 24 horas, recibes el primer resultado sin un segundo cobro.
¿Cómo genero una api idempotency key?
Usa un UUID, por ejemplo un UUIDv7 de RFC 9562, que se ordena por fecha. Importa más el momento que el formato: créala antes de la primera llamada, guárdala en el estado de la tarea y repítela en cada reintento. EveryInfra exige de 1 a 255 caracteres ASCII visibles sin espacios; si no, devuelve 422 invalid_idempotency_key. No metas datos personales, como un correo, en la clave.
Idempotent api retry: ¿cuánto debe durar la espera?
Con clave, una espera corta solo añade replays gratis. Sin clave, 5 segundos con 10.000 llamadas al día cuestan al menos unos $37 más al mes con datos de 30 días y $111,02 en nuestra muestra lenta; con 60 segundos, $2,65. Para EveryInfra, pon la espera de un cliente MCP en 90–120 segundos, por encima del límite síncrono de 85, deja los 300 segundos por defecto del SDK oficial de Python y usa el modo asíncrono en capacidades lentas. Bibliotecas comunes como HTTPX cortan a los 5 segundos por defecto (tiempos de HTTPX), así que fija un valor mayor en tu herramienta.
¿Un ai agent tool call retry provoca un cobro doble?
Es también la pregunta del hilo de r/LangChain sobre cómo detectar un agente que repite una acción tras un corte (hilo). Depende de cómo reenvíes. En nuestra prueba, tres envíos REST con una clave dieron un cobro; dos envíos síncronos sin clave, por REST o por MCP, dieron dos, y dos envíos asíncronos, uno. Los fallos y los vacíos no cuestan nada. Un replay copia el primer billing, así que charged: true sigue ahí aunque no haya segundo cobro: cuando veas replayed: true, no sumes el importe.
¿Pueden llegar dos veces los webhooks?
Sí, y el apartado sobre eventos duplicados de la documentación de webhooks de Stripe trata el mismo caso. Los webhooks de EveryInfra se entregan al menos una vez: sin un 2xx, el evento vuelve entre 30 segundos y 6 horas después, hasta 7 intentos. Quita duplicados por X-EveryInfra-Event-Id con un índice único (primero insertar, después procesar) y verifica la firma y la ventana de 5 minutos.
Cómo empezar
Primero, crea una clave de API en la consola y guárdala en la variable de entorno EVERYINFRA_API_KEY, fuera de tu código y de tus registros. Después, lee el catálogo gratuito en GET /api/v1/social/catalog para elegir la capacidad, sus parámetros y su price_usd; por ejemplo, la API de datos de Reddit y la API de datos de X (Twitter) tienen búsqueda, comentarios y más.
Luego envía una primera solicitud con Idempotency-Key, como en el ejemplo de curl, repítela y comprueba que aparece la cabecera Idempotent-Replayed: true. Por último, en Python instala pip install everyinfra y llama a ei.data(...), que envía la clave por ti; en otros lenguajes, lleva call_social a una herramienta de tu framework de agentes; en un cliente MCP, sube la lectura a 90 segundos o más y pasa mode: async en las capacidades lentas. La guía rápida completa está en la documentación, los precios por llamada en la página de precios y la lista de capacidades en el mercado de datos.
Referencias
- Notas completas para desarrolladores de EveryInfra (Retries and idempotency, Errors, Webhooks), EveryInfra, consultado el 2026-11-09, https://api.everyinfra.com/llms-full.txt
- Documento OpenAPI de EveryInfra, EveryInfra, consultado el 2026-11-09, https://api.everyinfra.com/openapi.json
- Catálogo de capacidades de datos de EveryInfra, EveryInfra, consultado el 2026-11-09, https://api.everyinfra.com/api/v1/social/catalog
- everyinfra 0.3.0 (SDK oficial de Python; README: envía Idempotency-Key automáticamente, espera por defecto de 300 segundos), PyPI, consultado el 2026-11-09, https://pypi.org/project/everyinfra/
- tools/list del endpoint MCP de EveryInfra, EveryInfra, consultado el 2026-11-09, https://api.everyinfra.com/mcp
- Connect Claude Code to tools via MCP, Anthropic, consultado el 2026-11-09, https://code.claude.com/docs/en/mcp
- Claude Code environment variables, Anthropic, consultado el 2026-11-09, https://code.claude.com/docs/en/env-vars
- Claude Code error reference, Anthropic, consultado el 2026-11-09, https://code.claude.com/docs/en/errors
- Claude Code changelog (2.1.307, 2.1.318, 2.1.319), Anthropic, del 2026-10-21 al 2026-11-06, https://code.claude.com/docs/en/changelog
- Claude Code CHANGELOG.md, Anthropic (GitHub), consultado el 2026-11-09, https://github.com/anthropics/claude-code/blob/main/CHANGELOG.md
- Model context protocol (MCP), documentación del OpenAI Agents SDK, consultado el 2026-11-09, https://openai.github.io/openai-agents-python/mcp/
- Models (reintentos del runner, tiempos de llamada al modelo), documentación del OpenAI Agents SDK, consultado el 2026-11-09, https://openai.github.io/openai-agents-python/models/
- Versiones de openai-agents-python (v0.24.0-alpha.7), OpenAI (GitHub), consultado el 2026-11-09, https://github.com/openai/openai-agents-python/releases
- openai-agents, PyPI, consultado el 2026-11-09, https://pypi.org/project/openai-agents/
- MCP Specification 2026-07-28: Tools, Model Context Protocol, consultado el 2026-11-09, https://modelcontextprotocol.io/specification/2026-07-28/server/tools
- MCP Specification 2026-07-28: Schema (ToolAnnotations), Model Context Protocol, consultado el 2026-11-09, https://modelcontextprotocol.io/specification/2026-07-28/schema
- MCP Specification 2026-07-28: Cancellation, Model Context Protocol, consultado el 2026-11-09, https://modelcontextprotocol.io/specification/2026-07-28/basic/patterns/cancellation
- The Idempotency-Key HTTP Header Field (draft-08), grupo de trabajo HTTPAPI del IETF, 2026-10-22, https://datatracker.ietf.org/doc/draft-ietf-httpapi-idempotency-key-header/
- Idempotency-Key header, MDN Web Docs, consultado el 2026-11-09, https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Idempotency-Key
- El uso de Idempotencia será obligatorio, Mercado Pago Developers, consultado el 2026-11-09, https://www.mercadopago.com.mx/developers/es/news/2023/01/04/Idempotency-key-usage-will-be-mandatory
- Capture order fully (X-Idempotency-Key), Mercado Pago Developers, consultado el 2026-11-09, https://www.mercadopago.com.ar/developers/en/reference/online-payments/checkout-api/capture-order/post
- RFC 9110 HTTP Semantics (Idempotent Methods), IETF, junio de 2022, https://www.rfc-editor.org/rfc/rfc9110#name-idempotent-methods
- RFC 9457 Problem Details for HTTP APIs, IETF, julio de 2023, https://www.rfc-editor.org/info/rfc9457/
- RFC 9562 Universally Unique IDentifiers (UUIDs), IETF, mayo de 2024, https://www.rfc-editor.org/info/rfc9562/
- Idempotent requests, Stripe, consultado el 2026-11-09, https://docs.stripe.com/api/idempotent_requests
- Receive Stripe events in your webhook endpoint, Stripe, consultado el 2026-11-09, https://docs.stripe.com/webhooks
- API idempotency, Adyen, consultado el 2026-11-09, https://docs.adyen.com/development-resources/api-idempotency
- Idempotency, PayPal Developer, consultado el 2026-11-09, https://developer.paypal.com/api/rest/reference/idempotency
- Idempotency, Square Developer, consultado el 2026-11-09, https://developer.squareup.com/docs/build-basics/common-api-patterns/idempotency
- Ensuring idempotency in Amazon EC2 API requests, AWS, consultado el 2026-11-09, https://docs.aws.amazon.com/ec2/latest/devguide/ec2-api-idempotency.html
- Retry behavior, AWS SDKs and Tools, consultado el 2026-11-09, https://docs.aws.amazon.com/sdkref/latest/guide/feature-retry-behavior.html
- Making retries safe with idempotent APIs, Amazon Builders' Library, consultado el 2026-11-09, https://aws.amazon.com/builders-library/making-retries-safe-with-idempotent-apis/
- Retry pattern, Microsoft Azure Architecture Center, consultado el 2026-11-09, https://learn.microsoft.com/en-us/azure/architecture/patterns/retry
- Retry strategy, Google Cloud Storage, consultado el 2026-11-09, https://docs.cloud.google.com/storage/docs/retry-strategy
- AIP-155 Request identification, Google, consultado el 2026-11-09, https://google.aip.dev/155
- Timeouts, HTTPX, consultado el 2026-11-09, https://www.python-httpx.org/advanced/timeouts/
- What is a Temporal Retry Policy?, Temporal, consultado el 2026-11-09, https://docs.temporal.io/encyclopedia/retry-policies
- Graph API overview (RetryPolicy), LangChain, consultado el 2026-11-09, https://docs.langchain.com/oss/python/langgraph/graph-api
- README de openai-python (Retries), OpenAI (GitHub), consultado el 2026-11-09, https://github.com/openai/openai-python
- Error codes, OpenAI API, consultado el 2026-11-09, https://developers.openai.com/api/docs/guides/error-codes
- How do you catch an AI agent repeating an action after a timeout?, Reddit r/LangChain, consultado el 2026-11-09, https://www.reddit.com/r/LangChain/comments/1xcbih6/how_do_you_catch_an_ai_agent_repeating_an_action/
- Has anyone dealt with duplicate tool calls when agents retry the tool calls?, Reddit r/LangChain, consultado el 2026-11-09, https://www.reddit.com/r/LangChain/comments/1pal3x4/has_anyone_dealt_with_duplicate_tool_calls_when/
- My agent spent the whole night retrying one failed tool call, Reddit r/LLMDevs, 2026-10-28, https://www.reddit.com/r/LLMDevs/comments/1xhlg75/my_agent_spent_the_whole_night_retrying_one/
- Your agent's retry logic dies when the agent does, Reddit r/AI_Agents, consultado el 2026-11-09, https://www.reddit.com/r/AI_Agents/comments/1v9vjp2/your_agents_retry_logic_dies_when_the_agent_does/
Referencia BL-115