Kimi K3.1 Pro: contraste de Weibo con los resultados de BYD
Cómo contrastar Weibo y titulares con el informe de BYD usando Kimi K3.1 Pro: ritmo de comentarios, cotejo línea por línea, MCP y costo por empresa.
El 29 de octubre de 2026, BYD publicó sus resultados del tercer trimestre. El 2 de noviembre, entre las 00:17 y las 00:23 (hora de Singapur), descargamos con la API de EveryInfra lo que se decía en Weibo, la red social china más parecida a X. También descargamos los estados financieros de la empresa y los titulares en español sobre el mismo informe. El contraste fue notable.
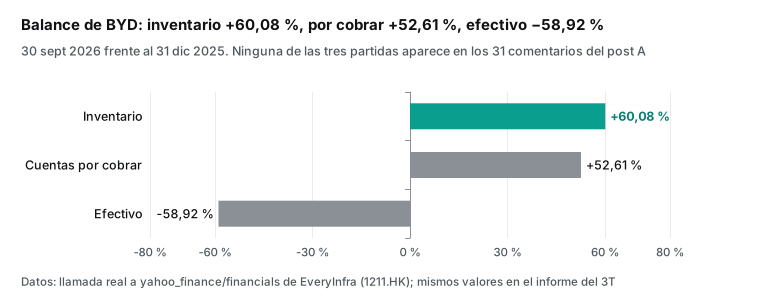
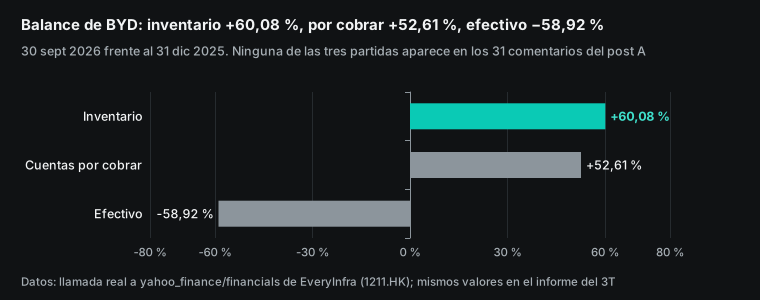
En Weibo, bajo una publicación popular sobre el informe, obtuvimos 31 comentarios. La suma de sus «me gusta» es cero, y once de ellos llegaron dentro de los mismos 18 segundos. Bajo otra publicación larga sobre el mismo informe, 36 comentarios se repartían en más de dos días, con como máximo uno en cualquier ventana de 20 segundos. El segundo hallazgo es que la conversación y el informe miran cifras distintas. Las partidas que más cambiaron en el informe original, inventario +60,08 %, cuentas por cobrar +52,61 % y efectivo −58,92 % desde el inicio del año, vienen con su explicación en el propio informe (por ejemplo, el inventario sube sobre todo por existencias para el negocio en el extranjero), pero no aparecen en esos 31 comentarios. Eso no dice quién tiene razón; dice que un resumen de investigación no puede leer solo los comentarios.
Este artículo explica cómo montar ese contraste con Kimi K3.1 Pro, el modelo de Moonshot AI. El modelo lee en un solo contexto largo las publicaciones, los comentarios y las tablas financieras. Después redacta un resumen de una página en el que cada línea lleva su fuente. EveryInfra aporta los datos originales con weibo/search, weibo/comments, yahoo_finance/financials y otras capacidades. Su propio código hace los conteos antes de que el modelo empiece a escribir.
Este artículo trata de métodos de datos y de configuración de herramientas. No es asesoramiento de inversión. No dice si conviene comprar o vender ninguna acción. Las cifras financieras aparecen solo para mostrar cómo se contrasta una afirmación en redes con una fuente primaria, y el resultado del contraste solo dice si una cifra aparece o no en la conversación, sin valorarla. El equipo de EveryInfra preparó este texto; los conteos se hicieron con scripts y ningún analista financiero con licencia lo revisó. Para cualquier juicio sobre una empresa, consulte sus informes oficiales y a profesionales autorizados. No teníamos una clave de Kimi, así que no ejecutamos Kimi. Todo el código de Kimi es un ejemplo de configuración basado en la documentación de Moonshot que leímos el 2 de noviembre de 2026. Todas las cifras de EveryInfra salen de solicitudes reales y de sus respuestas originales.
La tarea: un resumen de una página entre redes e informe financiero
Empezamos por definir bien la tarea, porque toda la configuración y todos los costos dependen de ella. La entrada es una empresa cotizada y la fecha de su último informe. La recogida de datos trae cuatro cosas. La primera son las publicaciones de Weibo sobre el informe. La segunda, los comentarios bajo las publicaciones con más actividad. La tercera, las tablas financieras trimestrales recientes. La cuarta, los precios diarios alrededor de la fecha del informe.
La salida es un resumen de una página con una estructura fija. Responde cinco preguntas. ¿Qué afirman las publicaciones? ¿Qué dice el informe sobre cada afirmación? ¿Qué afirmaciones no coinciden? ¿Qué publicaciones o comentarios no parecen una conversación natural? ¿Qué límites tiene este resumen? Cada respuesta debe apuntar a un campo de los datos originales o a una página del informe.
Esta tarea encaja con un modelo de contexto largo que llama herramientas, por tres razones. Primero, el material tiene cuatro formas distintas: publicaciones, comentarios, tablas y filas de precios. Cotejarlos a mano obliga a ir y venir entre archivos. Segundo, la regla de contraste se puede escribir con claridad. Por ejemplo: «para cada afirmación financiera de un comentario, busque el campo correspondiente en la tabla y, si no existe, márquelo». Tercero, la decisión final queda en manos de una persona. El modelo entrega una tabla con fuentes, no una recomendación de compra.
Moonshot afirma que K3.1 Pro mejora 11,6 puntos frente a K3 en una evaluación interna de investigación financiera. Según la empresa, esa prueba mide investigación «auditable» bajo límites de evidencia y de fecha (blog técnico de Kimi K3.1 Pro). «Auditable» es justo lo que pide esta tarea. Cada frase del resumen debe poder rastrearse hasta los datos originales.
Elegimos BYD como ejemplo principal por la fecha. BYD publicó su informe del tercer trimestre el 29 de octubre de 2026, después del cierre del mercado continental (informe del 3T 2026 de BYD en CNINFO). Cuando descargamos los datos, el 2 de noviembre, la conversación en Weibo seguía activa y las acciones en Hong Kong ya habían cotizado un día. Tesla sirve de comparación. Presentó su actualización del tercer trimestre ante la SEC el 21 de octubre de 2026 (Tesla, anexo 99.1 del 8-K). Para entonces habían pasado 11 días, y eso mostró cuánto importa el momento de la descarga.
| Entrada o salida | Contenido | Capacidad | Precio del catálogo |
|---|---|---|---|
| Publicaciones de Weibo | Búsqueda por palabra clave, hasta 50 | weibo/search | 0,000806 USD por llamada |
| Alcance de temas | Lecturas y publicaciones por tema | weibo/topic_search | 0,000806 USD por llamada |
| Comentarios | Hasta 50 bajo una publicación | weibo/comments | 0,000556 USD por llamada |
| Tablas financieras | Resultados, balance y flujo de caja, anuales y trimestrales | yahoo_finance/financials | 0,001389 USD por llamada |
| Precios | Filas diarias | yahoo_finance/history | 0,001389 USD por llamada |
| Analistas | Recuento de calificaciones y cambios | yahoo_finance/analyst | 0,001389 USD por llamada |
| Noticias en español | Titulares por país e idioma | google_news/search | 0,000792 USD por llamada |
| Salida | Resumen de una página en JSON y Markdown | Kimi K3.1 Pro | Se cobra por token |
Leímos estos precios en el catálogo gratuito a las 00:13 (hora de Singapur) del 2 de noviembre de 2026. El campo es price_usd (catálogo de Weibo, catálogo de Yahoo Finance, catálogo de Google Noticias). Los campos de cada capacidad están en las páginas de la API de Weibo y de la API de datos de Yahoo Finance. Cada capacidad tiene además su propia página: búsqueda en Weibo, comentarios de Weibo, búsqueda de temas, estados financieros, precios históricos y calificaciones de analistas.
Qué es kimi k3.1 pro: versión, precio y funciones útiles para esta tarea
La tarea nombraba a Kimi K3.1 Pro, así que primero comprobamos en los textos de Moonshot que existe, cómo se llama y cómo se usa. Existe. Moonshot lo lanzó el 23 de octubre de 2026 como primer modelo de la serie K3.1. Lo describe como un modelo de «clase 3T» de parámetros con 1M de tokens de contexto. Según la empresa, mejora mucho en programación, creación 3D, investigación financiera y tareas largas de agentes. Hay también una versión Highspeed de dos a tres veces más rápida. Moonshot promete publicar los pesos completos antes del 4 de noviembre (guía rápida de K3.1 Pro).
Los nombres cambian según el producto, y conviene no confundirlos. En la API de Kimi, los identificadores son kimi-k3.1-pro y kimi-k3.1-pro-highspeed. En Kimi Code, el identificador es k3.1-pro. La documentación de Kimi Code advierte de una trampa: un identificador mal escrito pasa sin aviso a K2.8 Preview sin razonamiento (configuración de modelos de Kimi Code). No recibe un error, solo un modelo más débil.
La tabla resume los parámetros que más importan aquí. Leímos cada línea el 2 de noviembre de 2026.
| Punto | Lo que dice la fuente | Qué significa para esta tarea | Fuente |
|---|---|---|---|
| Contexto | 1.048.576 tokens, mismo precio a cualquier longitud | Caben datos de decenas de empresas en una solicitud | Precios |
| Precio | 2,00 USD entrada, 10,00 USD salida, 2,00 USD escritura en caché, 0,20 USD acierto de caché, por millón de tokens | La entrada larga es barata; razonar y escribir cuesta más | Plataforma de la API de Kimi |
| Highspeed | 4,00 USD entrada, 20,00 USD salida, 0,20 USD acierto de caché | La velocidad cuesta el doble | Plataforma de la API de Kimi |
| Razonamiento | Siempre activo; reasoning_effort low, high o max; por defecto max | El valor por defecto de la API es el más caro | Esfuerzo de razonamiento |
| Límite de salida | max_completion_tokens 131.072 por defecto, máximo 1.048.576 | La salida también ocupa contexto | Guía rápida |
| Parámetros fijos | temperature, top_p y similares son fijos; no los envíe | No se puede bajar la temperatura para un resumen más «estable» | Guía rápida |
| Salida estructurada | json_schema con strict: true; solo se analiza message.content | El resumen puede tener campos fijos | Salida estructurada |
| Batch | 60 % del precio estándar, con completion_window | Un lote nocturno ahorra un 40 % | Precios de Batch |
| Acceso | Se habilita tras una recarga; mínimo 1 USD | Hay que recargar antes de llamar al modelo principal | Recarga y límites |
| Búsqueda web | En actualización; no se recomienda en producción por ahora | No dependa del modelo para buscar datos | Guía rápida |
La última fila merece una nota. El modelo no ve por sí solo los comentarios de Weibo ni las tablas financieras. La idea fácil es activar su búsqueda web. Pero la guía rápida la incluye entre las limitaciones importantes y desaconseja usarla en flujos de producción por ahora. Aun cuando funcione, la búsqueda web devuelve resúmenes de páginas, no una lista limpia de comentarios ni una tabla trimestral. Un contraste línea por línea necesita los datos originales como resultado de herramientas.
Además, la misma prueba de errores aparece con cifras distintas en dos páginas de Moonshot: el blog técnico dice que K3.1 Pro bajó al 8,3 % y la guía rápida dice 6,85 %. Las dos aclaran que es una prueba de estrés con preguntas difíciles. Hasta las cifras del propio fabricante hay que cotejarlas con la fuente.
¿Se puede conectar un servidor MCP remoto? No en las tres API de Kimi
EveryInfra tiene un servidor MCP remoto en https://api.everyinfra.com/mcp, con herramientas cuyos nombres empiezan por everyinfra_. Clientes como Claude y Cursor lo usan solo con la URL. La configuración está en la página del servidor MCP y en nuestra prueba de configuración de MCP remoto. Mucha gente supone que la API de Kimi también acepta una URL de MCP en la solicitud. Revisamos cada referencia de la API de Kimi, y no es así.
La referencia de la Responses API es la más clara. El campo tools admite solo cuatro tipos: function, namespace, custom (solo apply_patch) y web_search. Los tres primeros se ejecutan de su lado. El modelo devuelve la llamada, usted la ejecuta y devuelve el resultado (referencia de la Responses API). Chat Completions usa llamadas a funciones estándar (guía de llamadas a herramientas). La Messages API sigue el formato de Anthropic. Admite herramientas, razonamiento y salida estructurada, pero su referencia no tiene un parámetro de servidor MCP remoto (referencia de la Messages API).
El Playground sí tiene MCP, con un límite. Solo sincroniza servidores MCP alojados en ModelScope mediante un token de ModelScope (MCP de ModelScope en el Playground). Explicamos esa vía en MCP de ModelScope para datos de Xiaohongshu y Douyin.
| Superficie de Kimi | ¿Acepta URL de MCP remoto? | Cómo conectar EveryInfra | Para quién |
|---|---|---|---|
| Chat Completions API | No, solo funciones | Defina una función; su código llama a la API REST | Código propio, lotes |
| Responses API | No, MCP no está entre los cuatro tipos | Igual, o agrupe funciones con namespace | Proyectos con formato Responses |
| Messages API | No | Igual | Proyectos con el SDK de Anthropic |
| Playground | Solo MCP alojado en ModelScope | Aloje en ModelScope y sincronice | Pruebas manuales |
| Kimi Code CLI | Sí, url en mcp.json | Ponga la URL y la clave en una variable de entorno | Desarrolladores en terminal |
| Kimi Work (escritorio) | Sí, con un plugin personal | Dé la URL de MCP a Plugin Builder | Analistas que no programan |
| kimi.com (web) | Los plugins pueden llevar MCP y Skills | Use un plugin publicado o de empresa | Chat normal |
Hay, por tanto, dos caminos. Para programar y ejecutar lotes, use la API de Kimi con una función. Su código llama a la API REST de EveryInfra y limpia los datos antes. Si no programa, use Kimi Code CLI o Kimi Work. Los dos son clientes MCP y se conectan directamente a un servidor MCP remoto. El diagrama muestra el primer camino: el modelo solo decide qué llamar, y la descarga, la limpieza y los cálculos quedan fuera del modelo.


Ejemplo de configuración 1: la API de Kimi con una sola función
Este código es un ejemplo de configuración. Lo escribimos a partir de la guía rápida y de la guía de llamadas a herramientas de Kimi. No lo ejecutamos con una clave de Kimi. El formato de la solicitud a EveryInfra y la forma de la respuesta sí salen de nuestras llamadas reales. La idea es dar al modelo una sola función, everyinfra_social. Sus argumentos son los campos platform, action y params de EveryInfra, y unos enum limitan el modelo a las capacidades que necesita la tarea.
# Ejemplo de configuración: Kimi K3.1 Pro + API de datos de EveryInfra (lado de Kimi no probado)
import json, os, requests
from openai import OpenAI

kimi = OpenAI(api_key=os.environ["MOONSHOT_API_KEY"], base_url="https://api.moonshot.ai/v1")

TOOLS = [{
    "type": "function",
    "function": {
        "name": "everyinfra_social",
        "description": "Datos públicos de redes y finanzas. Weibo: search, topic_search, comments. "
                       "Yahoo Finance: financials, history, analyst; ticker con sufijo, p. ej. 1211.HK. "
                       "google_news: search con country y language. En weibo/comments, url = weibo.com/detail/<id numérico>.",
        "parameters": {
            "type": "object",
            "properties": {
                "platform": {"type": "string", "enum": ["weibo", "yahoo_finance", "google_news"]},
                "action": {"type": "string",
                           "enum": ["search", "topic_search", "comments", "financials", "history", "analyst"]},
                "params": {"type": "object"}
            },
            "required": ["platform", "action", "params"]
        }
    }
}]

def call_everyinfra(args: dict) -> dict:
    r = requests.post("https://api.everyinfra.com/api/v1/social",
                      headers={"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"},
                      json=args, timeout=120)
    body = r.json()
    rows = body.get("results")
    # Limpieza: los tres arreglos financieros traen los mismos registros; se deja uno.
    if isinstance(rows, list) and rows and "income" in rows[0]:
        rows[0].pop("balance_sheet", None); rows[0].pop("cash_flow", None)
    if isinstance(rows, list):
        for x in rows:
            x.pop("author_avatar_url", None)
    return {"status": r.status_code, "results": rows, "error": body.get("error"),
            "charged_usd": (body.get("billing") or {}).get("charged_usd")}

messages = [
    {"role": "system", "content": open("reglas_investigacion.md", encoding="utf-8").read()},
    {"role": "user", "content": "BYD publicó su 3T 2026 el 2026-10-29. Siga las reglas y escriba un contraste de una página."}
]
first = True
while True:
    resp = kimi.chat.completions.create(model="kimi-k3.1-pro", reasoning_effort="high",
                                        messages=messages, tools=TOOLS,
                                        tool_choice="required" if first else "auto")
    msg = resp.choices[0].message
    messages.append(msg)          # La documentación pide devolver el mensaje completo del asistente.
    if not msg.tool_calls:
        break
    for tc in msg.tool_calls:
        result = call_everyinfra(json.loads(tc.function.arguments))
        messages.append({"role": "tool", "tool_call_id": tc.id,
                         "content": json.dumps(result, ensure_ascii=False)})
    first = False
print(msg.content)
Cada decisión de este código tiene una fuente. El primer turno usa tool_choice="required", como sugiere la guía de buenas prácticas de Kimi, para que el modelo llame una herramienta y no responda de memoria. Después vuelve a auto. La documentación indica que cambiar tool_choice no invalida la caché del prefijo (buenas prácticas de llamadas en K3, tool_choice).
En cada turno se añade el mensaje completo del asistente, no solo content. La guía rápida lo exige en conversaciones de varios turnos y con herramientas, porque el mensaje incluye también reasoning_content. El código usa reasoning_effort="high" en lugar del valor predeterminado de la API, que es max. Lo difícil aquí es el contraste, no un cálculo complejo. Un usuario de Reddit contó que K3.1 Pro en high le dio el mismo resultado que K3 en max (hilo de r/kimi). Es la experiencia de una sola persona. Pruebe los dos niveles con su propia muestra antes de una ejecución real.
La limpieza va dentro de call_everyinfra, no dentro del modelo, y nuestras pruebas explican por qué. Los tres arreglos de datos financieros de la respuesta traen los mismos datos. Si se envían los tres, el modelo lee más de 50.000 caracteres de sobra. Kimi también admite la carga dinámica de herramientas: se ponen las tools en un mensaje system sin content, y quedan visibles desde ese mensaje en adelante. El servidor no las guarda, así que las solicitudes siguientes deben repetir ese mensaje (carga dinámica de herramientas). Esta tarea tiene una sola herramienta y no lo necesita. Si quiere exponer cientos de capacidades de EveryInfra, la carga dinámica con una función search_tools ahorra contexto.
Ejemplo de configuración 2: Kimi Code CLI con el servidor MCP remoto
Si no quiere escribir el bucle de herramientas, use Kimi Code CLI. Es un cliente MCP que admite stdio, HTTP y el transporte SSE antiguo. Para un servidor HTTP basta con poner una url en mcp.json. El archivo de usuario es ~/.kimi-code/mcp.json y el de proyecto es .kimi-code/mcp.json dentro del repositorio. Si los dos definen el mismo servidor, gana el del proyecto (documentación MCP de Kimi Code). Este es nuestro ejemplo para la tarea.
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "bearerTokenEnvVar": "EVERYINFRA_API_KEY",
      "enabledTools": ["everyinfra_call_api", "everyinfra_get_job", "everyinfra_list_capabilities"],
      "toolTimeoutMs": 120000
    }
  }
}| Campo | Valor en el ejemplo | Por qué |
|---|---|---|
url | https://api.everyinfra.com/mcp | Transporte HTTP, sin proceso local |
bearerTokenEnvVar | EVERYINFRA_API_KEY | La clave no queda escrita en el archivo |
enabledTools | 3 de 12 herramientas | Menos esquemas de herramientas en el contexto |
toolTimeoutMs | 120000 | Una llamada a financials tardó 35,6 segundos |
El campo bearerTokenEnvVar guarda el nombre de una variable de entorno, no la clave. Así el archivo puede ir al repositorio y cada persona tiene la clave en su propia terminal. enabledTools es una lista de permitidos. A las 00:16 (hora de Singapur) leímos tools/list sin clave y obtuvimos 12 herramientas en 16.724 bytes. Algunas gestionan cuentas, enlaces de recarga o tickets de soporte. Una tarea de investigación no las necesita, y ocupan contexto. Pusimos toolTimeoutMs en 120 segundos porque una llamada a yahoo_finance/financials tardó 35,6 segundos en nuestra prueba. Kimi Code nombra las herramientas MCP como mcp__<servidor>__<herramienta>, y la documentación desaconseja permitir mcp__* de una vez.
Kimi Code también tiene subagentes. Trae tres tipos: coder, que lee y escribe archivos; explore, que solo lee; y plan, que solo planifica y no ejecuta comandos. Cada subagente tiene su propio contexto, ve solo la tarea que le pasa el agente principal y devuelve solo su resultado. Varios pueden trabajar en paralelo (Agents and Sub-Agents). Un subagente propio es un archivo Markdown en .kimi-code/agents/. El siguiente da a cada subagente una sola empresa y una sola herramienta de EveryInfra.
---
name: company-evidence-worker
description: Descarga publicaciones y comentarios de Weibo, titulares en español y tablas financieras de una empresa cotizada. Devuelve una tabla compacta de evidencia. Un trabajador por empresa.
tools:
  - mcp__everyinfra__everyinfra_call_api
  - Write
---
Trabaje solo con la empresa de su tarea. Siga este orden:
1. weibo/search con «empresa + resultados» en chino, limit 50; weibo/topic_search con las mismas palabras.
2. Elija las 2 publicaciones con más comment_count y llame a weibo/comments para cada una, limit 50.
3. google_news/search con country=mx y language=es, con la marca y «ganancias».
4. yahoo_finance/financials, history (period=3mo) y analyst con el ticker.
5. Guarde las respuestas originales en evidence/<ticker>/. De las tablas financieras, guarde solo income.
6. Su último mensaje es la entrega completa: una tabla con, por publicación, número de comentarios,
   «me gusta» totales y máximo en 20 segundos; los titulares en español; e ingresos, beneficio,
   inventario, cuentas por cobrar y efectivo por trimestre. No escriba conclusiones ni consejos de compra.
El paso 6 sigue una nota de la documentación. Un subagente propio no recibe la indicación interna de que su último mensaje es toda la entrega, así que hay que escribirlo en el cuerpo del archivo. Después, el agente principal compara las tablas de todas las empresas en su propio contexto y redacta el resumen. La documentación también recuerda que cada subagente gasta sus propios tokens, y que las tareas simples no los necesitan. Nuestro criterio: dos o tres empresas caben en el agente principal, y a partir de diez vale la pena repartir.
Ejemplo de configuración 3: un plugin de Kimi Work y el centro de tareas
Muchos analistas no programan. Kimi Work es el agente de escritorio de Moonshot. Lee y escribe archivos locales, usa páginas web con una extensión del navegador y ejecuta tareas programadas. Para trabajos grandes, Agent Swarm reparte el trabajo entre varios agentes (página de Kimi Work). K3.1 Pro necesita Kimi Work 3.1.0 o posterior (blog técnico, Availability). La página del producto dice además que Kimi Work obtiene datos en tiempo real de acciones de China continental y de Hong Kong desde fuentes profesionales. Esa mitad de la tarea ya está cubierta en parte. La mitad social, como los comentarios de Weibo, no.
Para añadir un servidor MCP externo se usa un plugin personal. El centro de ayuda de Kimi explica que un plugin puede contener Skills, MCP, Agents, Hooks, Commands y un mensaje de sistema. La versión web solo admite por ahora las partes MCP y Skills, mientras que Kimi Work y Kimi Code admiten todas (qué son los plugins de Kimi). En Kimi Work se llama al Plugin Builder integrado y se describe la necesidad en una frase. El asistente genera los archivos del plugin, los valida y lo registra en la pestaña Personal. Pregunta lo que no puede deducir, como la URL del servidor MCP (cómo crear un plugin personal). También importa un archivo server.json en el formato del registro de MCP.
Dos notas de versión importan aquí. La 3.2.21, del 26 de octubre de 2026, pide confirmación antes de cargar servidores MCP que vienen con un proyecto. La 3.2.22, del 29 de octubre de 2026, cambió el nombre de «Scheduled» a «Task Center» (centro de tareas), donde se gestionan todas las tareas automáticas (notas de versión de Kimi Work).
| Versión | Fecha | Cambio | Efecto en esta tarea |
|---|---|---|---|
| 3.1.0 | Lanzamiento de K3.1 Pro | Versión mínima para usar K3.1 Pro | Actualice antes de elegir el modelo |
| 3.2.21 | 26-10-2026 | Confirmación antes de cargar MCP de un proyecto | La primera ejecución necesita un clic |
| 3.2.22 | 29-10-2026 | «Scheduled» pasa a «Task Center» | Las descargas programadas se gestionan en un solo lugar |
Las tareas pueden ejecutarse cada hora, cada día o al cumplirse una condición. Para ejecuciones nocturnas hay que activar «Keep awake» en la configuración. En esta tarea, la programación importa más que el modelo, como muestra el caso de Tesla más abajo.
Una ida y vuelta real: lo que envía el modelo y lo que devuelve la API
Del lado del modelo, Kimi devuelve una llamada estándar. Cada elemento de tool_calls tiene un id, el nombre de la función y los argumentos como cadena JSON. Con la función de arriba, Kimi enviaría algo como lo siguiente. Es un ejemplo de formato, no una salida real de Kimi.
{"id": "call_0", "type": "function",
 "function": {"name": "everyinfra_social",
              "arguments": "{\"platform\":\"weibo\",\"action\":\"comments\",\"params\":{\"url\":\"https://weibo.com/detail/<numeric_post_id>\",\"limit\":50}}"}}
Su código reenvía los argumentos a EveryInfra tal cual. Enviamos esa misma solicitud a las 00:17:51 (hora de Singapur) del 2 de noviembre de 2026. La respuesta real fue HTTP 200 en 16,6 segundos, con 15.134 bytes. El count fue 31 y billing.charged_usd fue 0,000556. Cada comentario trae diez campos: id, text, like_count, author_id, author_name, author_avatar_url, post_id, post_url, posted_at y platform. Coinciden con la lista response_fields de weibo/comments en el catálogo. La captura muestra los 11 comentarios de los 18 segundos centrales, ordenados por hora.
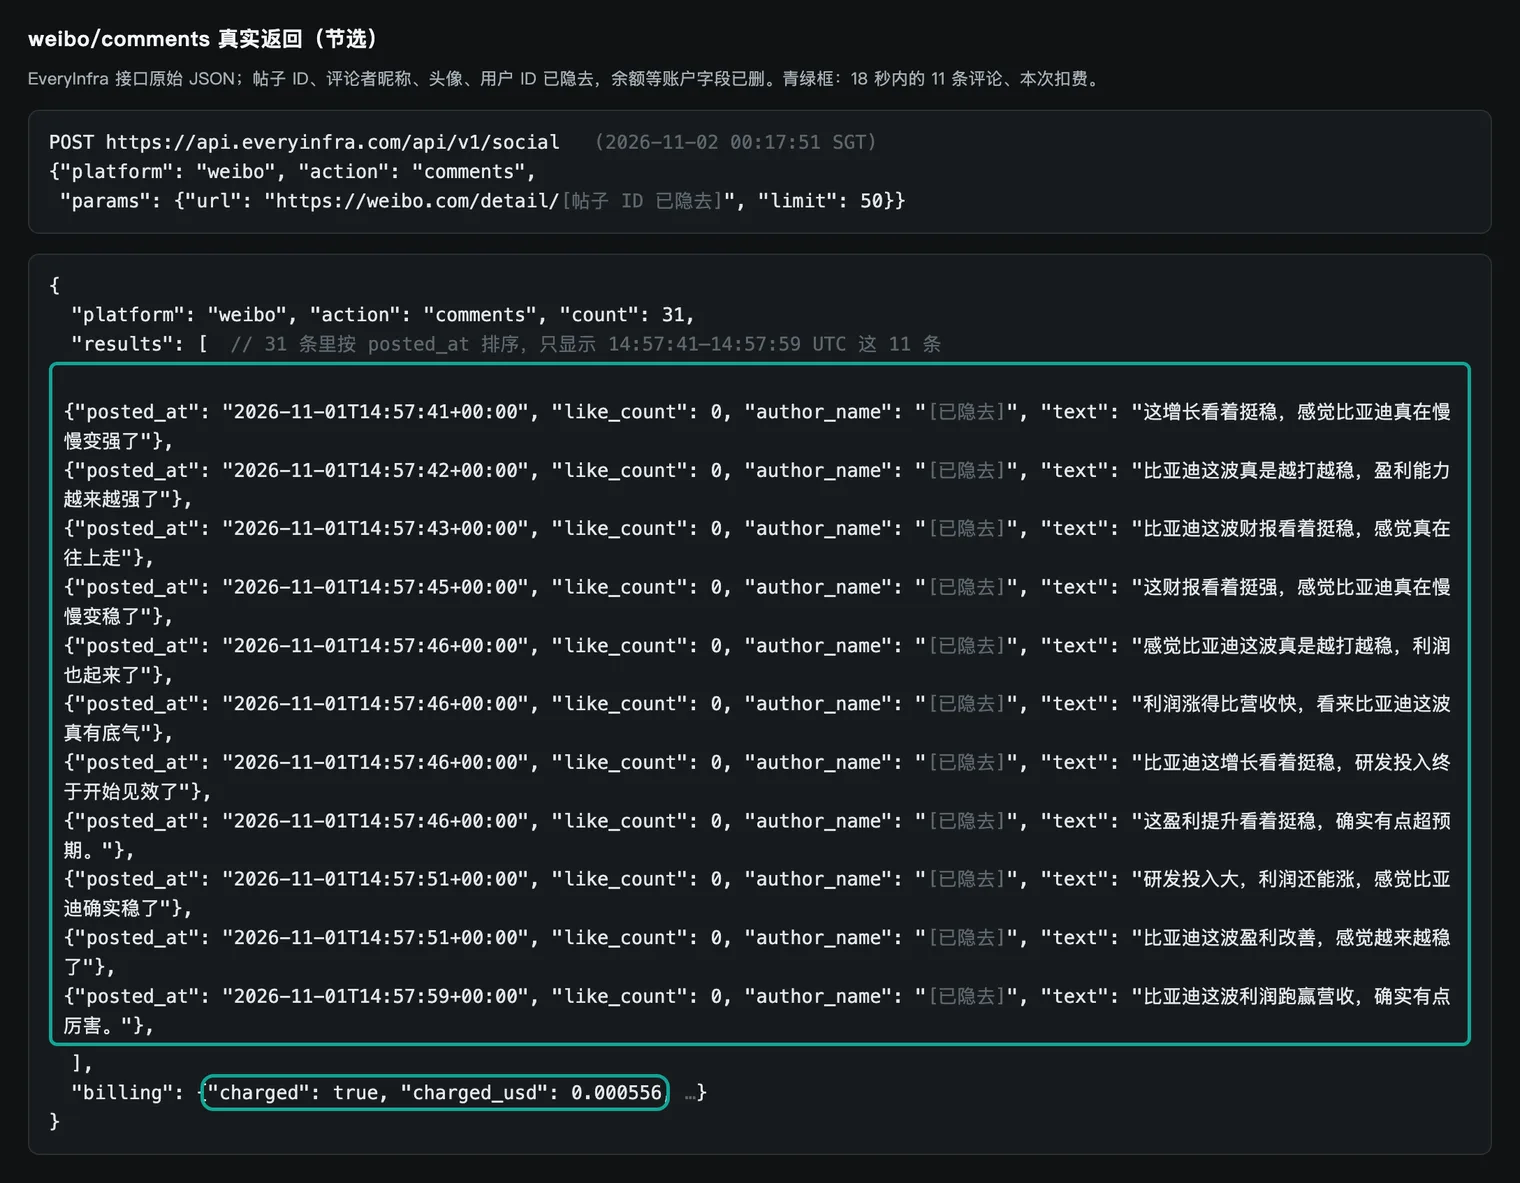
El mismo tipo de solicitud funciona por MCP. A las 00:22:26 (hora de Singapur) llamamos a everyinfra_call_api con tools/call de MCP, usando el identificador numérico de una segunda publicación, la publicación B. Recibimos HTTP 200 y 21.757 bytes. El campo result.content[0].text traía un JSON con la misma forma que la respuesta REST: count 36 y cobro de 0,000556 USD. Esta respuesta no tenía structuredContent, así que los datos están en el texto. La documentación de Kimi Code dice que el agente recibe tanto el texto como la parte estructurada de un resultado MCP. En Kimi Code, las dos vías dan lo mismo. En su propia función, el JSON de REST es más sencillo.
Un detalle de formato afecta la tasa de éxito. El catálogo indica que la url de weibo/comments debe ser un enlace /detail/ con el identificador numérico, o solo el número. Los enlaces cortos con letras no sirven. Los resultados de búsqueda ya traen url en la forma /detail/, y el modelo puede copiarla. Un enlace copiado de la web suele tener la forma corta. Ponga esta regla en la description de la función, como en nuestro ejemplo, y no espere que el modelo lea el catálogo.
Prueba 1: qué trae la búsqueda de BYD en Weibo
La primera prueba fue la búsqueda. A las 00:17:26 (hora de Singapur) llamamos a weibo/search con las palabras en chino de «informe del tercer trimestre de BYD». Pusimos limit en 30 y recibimos 13 publicaciones por 0,000806 USD. El catálogo dice que esta capacidad devuelve 20 por defecto y 50 como máximo. Recibir menos de lo pedido es normal. Se cobra por llamada y no por publicación, así que un resultado corto no sale más caro. Las fechas van del 19 de octubre al 1 de noviembre, y la más reciente es de las 22:31 (hora de Singapur) del 1 de noviembre.
Antes de mirar los datos escribimos dos reglas de palabras clave, para que no decidiera el modelo. Una publicación «habla de resultados» si contiene alguna de nueve palabras como informe, beneficio neto, ingresos o margen, en chino. Es «anuncio de autos» si contiene alguna de seis como prueba de manejo, descuento o visita al concesionario. El resultado: 10 de 13 hablan de resultados, ninguna es un anuncio, y 2 ni siquiera mencionan a BYD. Esas dos son publicaciones de una cuenta de autos inteligentes de Huawei. El ruido de la búsqueda no eran anuncios, sino publicaciones populares de una marca cercana. Antes de dárselo al modelo, filtre por el nombre de la empresa.
Seis de las 13 publicaciones comparten una misma etiqueta, que dice que el informe de BYD da una señal de fuerte crecimiento. Sus autores tienen 1, 3, 9, 80, 198 y 507 seguidores. Las seis suman una sola interacción. Se publicaron en 97 minutos, entre las 20:49 y las 22:26 (hora de Singapur) del 1 de noviembre. La mayoría es un eslogan y un enlace corto. A las 00:21:26 (hora de Singapur) consultamos weibo/topic_search para el informe de BYD. Esa etiqueta tenía unas 11.000 lecturas y 66 publicaciones. Otro tema sobre el informe del 3T 2026 de BYD tenía unas 26.000 lecturas y 58 publicaciones.
| 13 resultados de búsqueda | Número | Cómo se decidió |
|---|---|---|
| Hablan de resultados | 10 | Regla de palabras fijada antes de ver los datos |
| Anuncio de autos | 0 | Regla de palabras fijada antes de ver los datos |
| No mencionan a BYD | 2 | Coincidencia de texto (dos publicaciones de autos inteligentes de Huawei) |
| Misma etiqueta, autores con 507 seguidores o menos | 6 | Etiqueta y número de seguidores |
| Autor verificado | 5 | Campo author_verified de la respuesta |
La etiqueta tiene poco alcance y por sí sola no cambia ninguna conclusión. Pero si esas seis publicaciones se cuentan como «positivas», la proporción positiva sube casi a la mitad más. La regla para Kimi es clara. Primero filtre por nombre de empresa. Después agrupe las publicaciones con la misma etiqueta, pocos seguidores, cero interacciones y un intervalo corto. Informe el tamaño y los rasgos de ese grupo, pero no lo sume al recuento de opinión.
No podemos saber si esas seis publicaciones fueron una promoción organizada. Solo podemos decir que su patrón no se parece a una conversación normal. Para afirmarlo haría falta el historial de las cuentas y su fecha de alta, y eso no se puede probar con datos públicos.
Prueba 2: dos hilos de comentarios con ritmos muy distintos
La publicación con más actividad era un análisis del informe hecho por un bloguero de tecnología verificado. Mostraba 49 comentarios; la llamamos publicación A. A las 00:17:51 (hora de Singapur), weibo/comments devolvió 31. Los demás pueden estar plegados, borrados u ocultos al público, y desde fuera no se distingue.
Como control, a las 00:22:26 (hora de Singapur) obtuvimos por MCP 36 comentarios de otra publicación larga sobre BYD, la publicación B. La escribió otro autor verificado el 30 de octubre, y mostraba 39 comentarios. Las dos hablan del informe y del negocio de BYD, pero el ritmo y la interacción de sus comentarios son muy distintos. No nombramos a los autores ni enlazamos las publicaciones: esta sección muestra una forma de medir, no una valoración de ninguna cuenta.
| Métrica | Publicación A | Publicación B | Cómo se calculó |
|---|---|---|---|
| Comentarios devueltos | 31 | 36 | count |
| «Me gusta» totales | 0 | 43 | Suma de like_count |
| Comentarios con 0 «me gusta» | 31 | 22 | Conteo |
| Del primero al último | 58,2 minutos | 3340,1 minutos (unas 55,7 horas) | posted_at |
| Máximo en cualquier ventana de 20 segundos | 11 | 1 | Ventana móvil |
| Mencionan «estable» o «investigación» | 20 | 0 | Expresión regular sobre el chino |
| Contienen una palabra negativa | 0 | 5 | Expresión regular, lista más abajo |
| Longitud media | 18,9 caracteres | 39,8 caracteres | Conteo de caracteres |
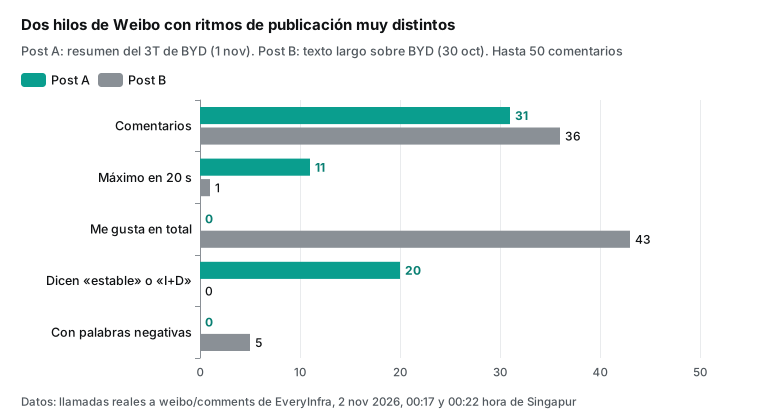
Los 11 comentarios de A llegaron entre las 22:57:41 y las 22:57:59 (hora de Singapur) del 1 de noviembre. Dicen cosas como «este informe se ve fuerte, BYD se vuelve cada vez más estable» o «el beneficio crece más rápido que los ingresos, BYD tiene fuerza de verdad». Las frases se parecen mucho entre sí y repiten las ideas del propio bloguero: beneficio que supera a los ingresos, investigación, gama alta y ventas globales. El hilo de B es variado. Alguien compara residencias y sueldos de los empleados, otros discuten sobre logotipos y hábitos de consumo, uno pide un resumen hecho con IA porque el texto es largo, y hay insultos. Los «me gusta» van de 0 a 9, y los comentarios se reparten en más de dos días.
Hay que reconocer dos puntos débiles del método. Las reglas de «resultados» y «anuncio» se fijaron antes de descargar los datos. La lista de palabras negativas la escribimos después de leer los comentarios de B, así que el «0 frente a 5» es una descripción, no una prueba. Lo mismo vale para la lista de «estable» o «investigación»: la fijamos después de leer la publicación A y sus comentarios, así que el «20 frente a 0» también es solo una descripción. Hay tres cifras que no dependen de ninguna lista: «me gusta» totales, densidad en el tiempo y longitud media. Las tres salen directamente de los campos de la respuesta, y cualquiera que repita las llamadas obtendrá lo mismo.
Esta sección decide cuánto se puede confiar en el resumen. Si se dan los 67 comentarios al modelo y se le pide una puntuación de opinión, lo más probable es un «muy positivo». Si su código calcula antes la densidad y los «me gusta» de cada hilo y marca el grupo concentrado en el tiempo, el modelo escribe otra cosa. Dirá que 11 comentarios de A llegaron en 18 segundos con cero «me gusta» y que se listan aparte, fuera del recuento de opinión, sin sacar conclusiones sobre su origen. En el primer caso, el modelo decide por usted. En el segundo, el modelo deja la evidencia por escrito.
Prueba 3: las cifras de BYD frente al informe original
A las 00:18:38 (hora de Singapur) llamamos a yahoo_finance/financials con 1211.HK, el código de BYD en Hong Kong. La respuesta pesó 78.732 bytes, tardó 35,6 segundos y costó 0,001389 USD. Trae tres arreglos, income, balance_sheet y cash_flow, con 5 registros cada uno. Cubren el año 2025 completo y los cuatro trimestres del 4T 2025 al 3T 2026, en CNY. Los tres arreglos traen los mismos registros. Cada registro une los campos de resultados, balance y flujo de caja, con 137 a 149 campos por trimestre. Esto importa para el tamaño del contexto.
Comparamos la respuesta con el informe del 3T de BYD en CNINFO, línea por línea.
| Línea | Respuesta de la API (1211.HK, 2026-09-30) | Informe del 3T de BYD | ¿Coincide? |
|---|---|---|---|
| Ingresos del 3T | 221.488.251.000 | 221.488.251.000,00 CNY, +13,59 % interanual | Sí |
| Beneficio neto atribuible del 3T | 10.019.570.000 | 10.019.570.000,00 CNY, +28,08 % | Sí |
| Inventario | 221.577.509.000 | 221.577.509.000,00 CNY, +60,08 % desde el inicio del año | Sí |
| Cuentas por cobrar | 56.472.621.000 | 56.472.621.000,00 CNY, +52,61 % | Sí |
| Efectivo | 30.988.011.000 | 30.988.011.000,00 CNY (75.424.747.000,00 al inicio del año) | Sí |
| Gasto en investigación, nueve meses | Suma de tres trimestres, 36.277.138.000 | 36.277.138.000,00 CNY (43.748.447.000,00 un año antes) | Sí |
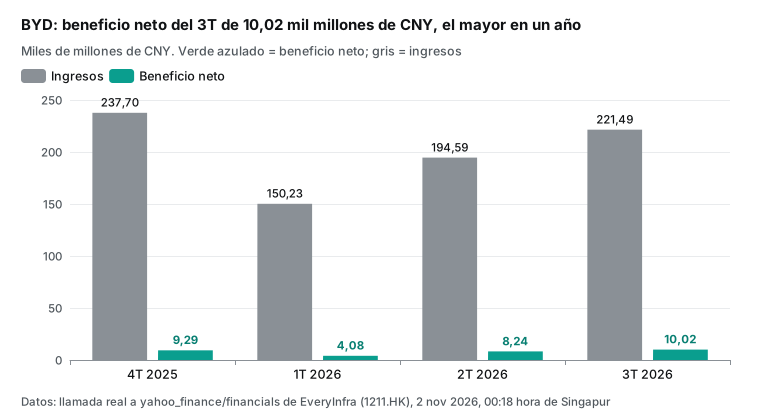
Las seis líneas coinciden. Esta mitad puede salir directamente de la API, sin que el modelo tenga que leer el PDF. Pero el cotejo también muestra lo que la API no trae. El informe tiene una sección que explica cada cambio grande. El inventario subió sobre todo por más existencias para el crecimiento del negocio de autos en el extranjero. Las pérdidas por deterioro subieron un 67,60 % sobre todo por mayores provisiones de inventario. Los pasivos por contratos subieron un 80,58 % sobre todo por más anticipos de clientes de autos. Esas razones solo están en el informe.
Un buen resumen toma las cifras de la API y las razones del informe. Kimi tiene una API de preguntas sobre archivos que extrae el texto de un PDF (preguntas y respuestas sobre archivos). La página de precios indica que la extracción de archivos es gratuita por ahora. El texto extraído sí se cobra como entrada cuando se envía al modelo (precios, lógica de cobro).
El contraste: lo que dicen los comentarios y lo que muestra el informe
Ahora se juntan las dos mitades. La publicación A y sus comentarios hacen tres afirmaciones principales. El beneficio crece más rápido que los ingresos. La inversión en investigación es grande. La empresa es cada vez más estable. Cotejamos cada afirmación con el informe y añadimos las líneas con los mayores cambios que no aparecen en los comentarios. La última columna solo dice si la cifra aparece y si se puede cotejar, sin valorarla. La tabla muestra lo que queremos que Kimi escriba al final. La llenamos a mano con las mismas reglas; no es una salida de Kimi.
| Afirmación en redes | Dato del informe | ¿Aparece en la conversación? ¿Se puede cotejar? |
|---|---|---|
| El beneficio crece más que los ingresos | Ingresos del 3T +13,59 %, beneficio +28,08 % | Aparece; coincide con el dato del trimestre |
| Cifras acumuladas de nueve meses | Ingresos de nueve meses +0,01 %, beneficio −4,24 % | No aparece |
| Mucha investigación | 36.280 millones de CNY en nueve meses, frente a 43.750 millones un año antes (−17,08 %) | Aparece; el monto coincide, la variación interanual no se menciona |
| Cada vez más estable | No hay un campo financiero que mida la «estabilidad» | Aparece; es una valoración y no se puede cotejar |
| Inventario, cuentas por cobrar, efectivo | +60,08 %, +52,61 % y −58,92 % desde el inicio del año; el informe atribuye el inventario a existencias para el negocio en el extranjero | No aparece |
| Pérdida por deterioro | 2710 millones de CNY, +67,60 %; el informe la explica por más provisiones de inventario | No aparece |
Lo que leyó el lector en español
Aquí entra la mirada latinoamericana. A las 00:22:11 (hora de Singapur) llamamos a google_news/search en México, en español, con la marca y la palabra «ganancias». Recibimos 10 resultados por 0,000792 USD, y 6 eran sobre BYD. Para este artículo no reproducimos los titulares: lo que interesa al método es qué temas cubren y qué partidas del informe quedan fuera. Clasificamos los 6 titulares sobre BYD por tema: uno trata de la cotización, uno de las previsiones frente a los resultados, dos dan la cifra del beneficio del trimestre y dos no tienen relación con el informe. En esta respuesta el campo published_at venía vacío, así que no podemos ordenar los titulares por hora; eso también debe quedar en el campo limits del resumen.
| Tema de los titulares sobre BYD (Google Noticias México, 00:22 hora de Singapur) | Titulares |
|---|---|
| Cotización | 1 |
| Previsiones frente a resultados | 1 |
| Beneficio del trimestre | 2 |
| Sin relación con el informe | 2 |
| Resultados que no tratan de BYD | 4 |
Antes, a las 00:22:00 (hora de Singapur), probamos una frase más larga sobre los resultados del tercer trimestre de BYD. La respuesta fue HTTP 200 con results vacío, y billing.reason decía empty_result_refunded, con cobro 0. Una búsqueda vacía no significa «no hay noticias»; solo significa que esas palabras no encontraron nada en ese momento. Las reglas para Kimi deben decir que, ante un resultado vacío, pruebe otras palabras y no lo reporte como ausencia de cobertura.
| Fuente | Temas principales | Partidas del informe que no aparecen |
|---|---|---|
| Comentarios de la publicación A (Weibo) | Beneficio del trimestre, investigación, «estabilidad» | Nueve meses, inventario, efectivo, deterioro |
| Comentarios de la publicación B (Weibo) | Sueldos, marca, consumo, críticas | Casi todas las cifras del informe |
| Titulares en español (Google Noticias México) | Cotización, previsiones, beneficio del trimestre | Detalle del balance |
| Informe del 3T (CNINFO) | Todas las líneas y sus causas | Ninguna |
Para un analista en Ciudad de México, Bogotá o Santiago, este cuadro es útil por lo que muestra en conjunto. Los comentarios en la red china, la prensa en español y el informe original cubren temas distintos. El resumen de Kimi no debe elegir uno; debe poner los tres uno al lado del otro, con su fuente, y señalar qué partidas del informe no aparecen en ninguna conversación, junto con la explicación que da el propio informe.
Hay que marcar bien el límite. Estas tablas solo responden qué se dijo y qué dice el informe; no dicen si a la empresa le va bien o mal, ni cómo se moverá la acción. El informe explica cada cambio grande: el inventario sube por existencias para el extranjero y los pasivos por contratos suben un 80,58 % por más anticipos de clientes. Si se sacan solo los porcentajes sin esas explicaciones, el propio resumen se vuelve una presentación selectiva. Por eso la regla para Kimi es que toda cifra marcada como «no aparece» lleve la explicación y la página del informe, o la nota «el informe no lo explica». También llamamos a las capacidades de cotizaciones y de calificaciones de analistas, pero no forman parte de este cotejo; en este artículo solo cuentan para el tamaño del contexto y el costo. El valor del contraste no es predecir. Es encontrar las cifras de las que nadie habla, con la explicación del informe, para que una persona decida si vale la pena preguntar por ellas.
Prueba 4: Tesla, once días tarde
El caso de Tesla deja la lección más clara sobre el momento de la descarga. A las 00:18:20 (hora de Singapur) llamamos a weibo/search con las palabras en chino de «resultados de Tesla». Devolvió 17 publicaciones por 0,000806 USD. Solo 6 mencionan a Tesla, y solo 3 empiezan hablando de sus resultados. Las fechas van del 19 de octubre al 1 de noviembre, y solo 1 es anterior al 22 de octubre. El resto trata de la caída de las tecnológicas estadounidenses, de los resultados de Google e Intel o de una comparación de márgenes entre BYD y Tesla. La razón es simple: la búsqueda de Weibo trae lo reciente, y Tesla publicó 11 días antes.
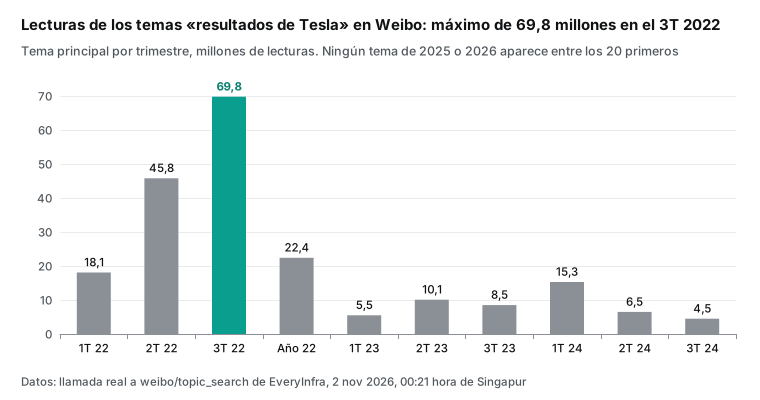
La búsqueda de temas da otra vista. A las 00:21:05 (hora de Singapur), weibo/topic_search con las mismas palabras devolvió 20 temas con sus lecturas totales. Tomamos el tema con más lecturas de cada trimestre. El del 3T 2022 sumaba 69,83 millones de lecturas y 13.000 publicaciones. En el 3T 2024, el mayor tenía 4,48 millones. Ninguno de los 20 temas era de un informe de 2025 o 2026. Esto no prueba que el público chino haya dejado de interesarse por Tesla. No sabemos cómo ordena la búsqueda de temas, y las lecturas son acumuladas, lo que favorece a los temas viejos. Sí muestra que esa búsqueda da una imagen deformada por el tiempo.
Reddit sirvió de control. A las 00:23:42 (hora de Singapur) llamamos a reddit/search con «Tesla Q3 2026 earnings», ordenado por relevancia. Devolvió 8 publicaciones, 7 del 21 y 22 de octubre, con 589 comentarios en total (búsqueda en Reddit). Para la misma pregunta, la búsqueda por relevancia de Reddit llegó a la ventana del informe, y la de Weibo solo a los últimos días.
| Búsqueda (hora de Singapur) | Publicaciones | Sobre resultados de Tesla | Dentro del 21 y 22 de octubre | Comentarios |
|---|---|---|---|---|
| Weibo por palabra clave, 00:18 | 17 | 3 | 1 anterior al 22 de octubre | No usados |
| Reddit por relevancia, 00:23 | 8 | 8 | 7 | 589 |
De aquí sale el método correcto. No busque a posteriori. Descargue el día del informe, 24 horas después y 72 horas después. Una tarea de Kimi Work o su propio cron lanza cada descarga, y Kimi escribe el resumen solo después de la última. Para BYD, eso habría significado descargar el 29 de octubre por la noche, el 30 y el 1 de noviembre. Nuestro dato del 2 de noviembre llega tarde para el primer día, aunque todavía a tiempo para los comentarios.
Las cifras de Tesla también se cotejaron. A las 00:20:40 (hora de Singapur), yahoo_finance/financials con TSLA costó 0,001389 USD. Ingresos de 28.046, beneficio bruto de 5494, beneficio operativo de 718, beneficio neto de 787 y flujo de caja libre de 1531 (millones de USD) coinciden con el resumen financiero del anexo 99.1 que Tesla presentó tras el cierre del 21 de octubre. Solo una cifra no coincide: el flujo de caja libre del 2T, que la API da como −1099 y Tesla como −1092. La diferencia es de 7 millones de USD, pequeña, pero recuerda que hay que revisar cada línea.
Cómo llenar el contexto: cuántas empresas caben en 1M de tokens
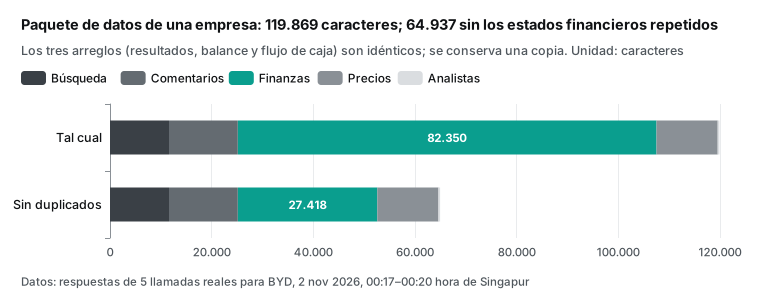
Un contexto de 1M suena ilimitado, así que medimos una empresa. Para BYD, las partes results de cinco llamadas (búsqueda, comentarios, financieros, precios y analistas) suman 119.869 caracteres. Solo las tablas financieras ocupan 82.350, y sus tres arreglos repiten los mismos datos; con uno solo quedan 27.418. El paquete sin duplicados mide 64.937 caracteres. Apenas 1927 son caracteres chinos; el resto son nombres de campo en inglés, números y enlaces.
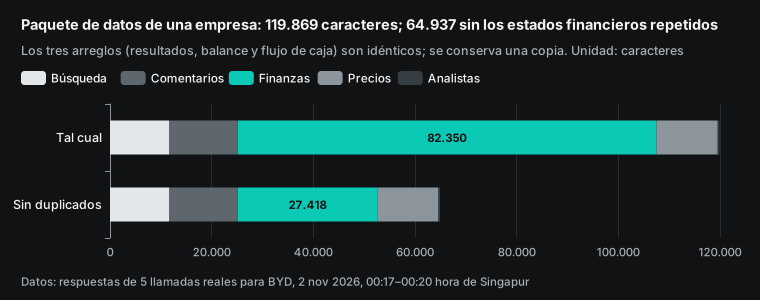
| Parte del paquete de BYD | Tal como llega (caracteres) | Tras la limpieza (caracteres) |
|---|---|---|
| Búsqueda en Weibo | 11.613 | 11.613 |
| Comentarios de Weibo | 13.543 | 13.543 |
| Tablas financieras | 82.350 | 27.418 |
| Precios diarios | 12.033 | 12.033 |
| Analistas | 330 | 330 |
| Total | 119.869 | 64.937 |
Los tokens solo se pueden estimar. La página de conceptos de Kimi dice que un token equivale a unos 3 o 4 caracteres de texto normal en inglés (conceptos principales). Nuestro paquete es sobre todo campos en inglés y números. Con esa relación, 64.937 caracteres son unos 16.234 a 21.646 tokens. Si cada carácter chino cuenta como 2 tokens, el máximo sigue en unos 24.000. Para una cifra exacta, use la API de estimación de tokens de Kimi (estimación de tokens).
Con 16.000 a 24.000 tokens por empresa, la cuenta es esta. Al contexto de 1.048.576 tokens se le restan los 131.072 de salida por defecto, y quedan 917.504. Eso alcanza para 38 a 56 empresas. Sin quitar duplicados, la cifra cae casi a la mitad.
Que quepan no significa que convenga meterlas todas. Proponemos dos capas. Su código o un subagente comprime primero cada empresa en una tabla de evidencia, como en el paso 6 del archivo de Kimi Code. El modelo principal lee solo esas tablas y los pasajes del informe que debe citar. Ponga los comentarios originales de varias empresas en un mismo contexto solo cuando necesite compararlos entre sí.
Kimi guarda el contexto en caché de forma automática, 5 minutos por defecto. Si entre solicitudes pasan más de 5 minutos, elija 1h en prompt_cache_options.ttl para que la caché no caduque (caché de contexto). Ponga al principio las reglas de investigación y la plantilla de salida, que se repiten en cada solicitud. Un acierto de caché cuesta 0,20 USD por millón de tokens, la décima parte del precio normal de entrada.
El costo: una empresa, una ejecución
El lado de EveryInfra es exacto. Una empresa por ejecución usa weibo/search y weibo/topic_search una vez cada una (0,000806 USD × 2), weibo/comments una vez (0,000556 USD) y yahoo_finance/financials, history y analyst una vez cada una (0,001389 USD × 3). El total es 0,006335 USD. Un segundo hilo de comentarios suma 0,000556 USD, y los titulares en español, 0,000792 USD. Se cobra por llamada, no por fila.
El lado de Kimi es una estimación, porque no ejecutamos Kimi. Suponemos 24.000 tokens de entrada por empresa, el máximo estimado arriba, y 8000 tokens de salida y razonamiento. Con los precios públicos que leímos el 2 de noviembre de 2026, son unos 0,048 USD de entrada y 0,08 USD de salida en tiempo real. Con Batch al 60 % del precio estándar, unos 0,0288 USD y 0,048 USD.
| Caso | Llamadas a EveryInfra | Entrada Kimi (est.) | Salida Kimi (est.) | Total |
|---|---|---|---|---|
| Una empresa, tiempo real | 0,006335 USD | 0,048 USD | 0,080 USD | 0,134 USD |
| Una empresa, Batch | 0,006335 USD | 0,0288 USD | 0,048 USD | 0,083 USD |
| 20 empresas cada semana durante 4 semanas, tiempo real | 0,5068 USD | 3,84 USD | 6,40 USD | 10,75 USD |
| 20 empresas cada semana durante 4 semanas, Batch | 0,5068 USD | 2,30 USD | 3,84 USD | 6,65 USD |
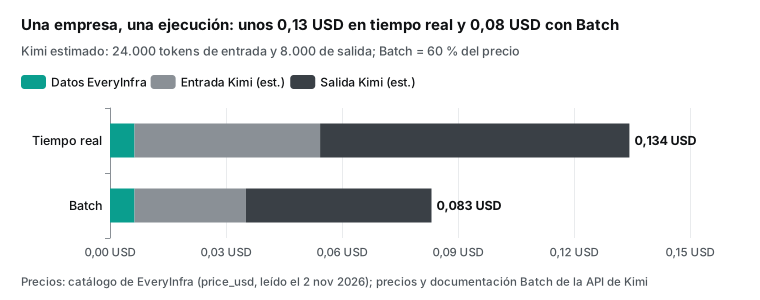
En tiempo real, las llamadas de datos son cerca del 4,7 % del total, y con Batch cerca del 7,6 % (el modelo cuesta un 40 % menos y los datos cuestan lo mismo); lo que manda en el costo son los tokens de salida y de razonamiento. Por eso conviene ahorrar en este orden. Primero, baje reasoning_effort de max a high o low y compruebe que el resumen no empeora. Segundo, comprima cada empresa en una tabla de evidencia. Tercero, considere Batch. Un lote debe terminar dentro de su completion_window o caduca, y los aciertos de caché dentro de un lote no están garantizados (guía de la Batch API). Una ejecución nocturna en temporada de informes encaja bien con Batch. Un resumen del mismo día necesita tiempo real. Nuestros precios están en la página de precios de EveryInfra.
Fallos, límites de velocidad y cero cobro: nuestras 21 solicitudes
Enviamos 21 solicitudes en total. Catorce funcionaron y se cobraron, por 0,014018 USD en total. Siete no se cobraron, y esas siete cubren los casos que encontrará un trabajo en producción. Cada caso debe quedar en las reglas que le dé a Kimi.
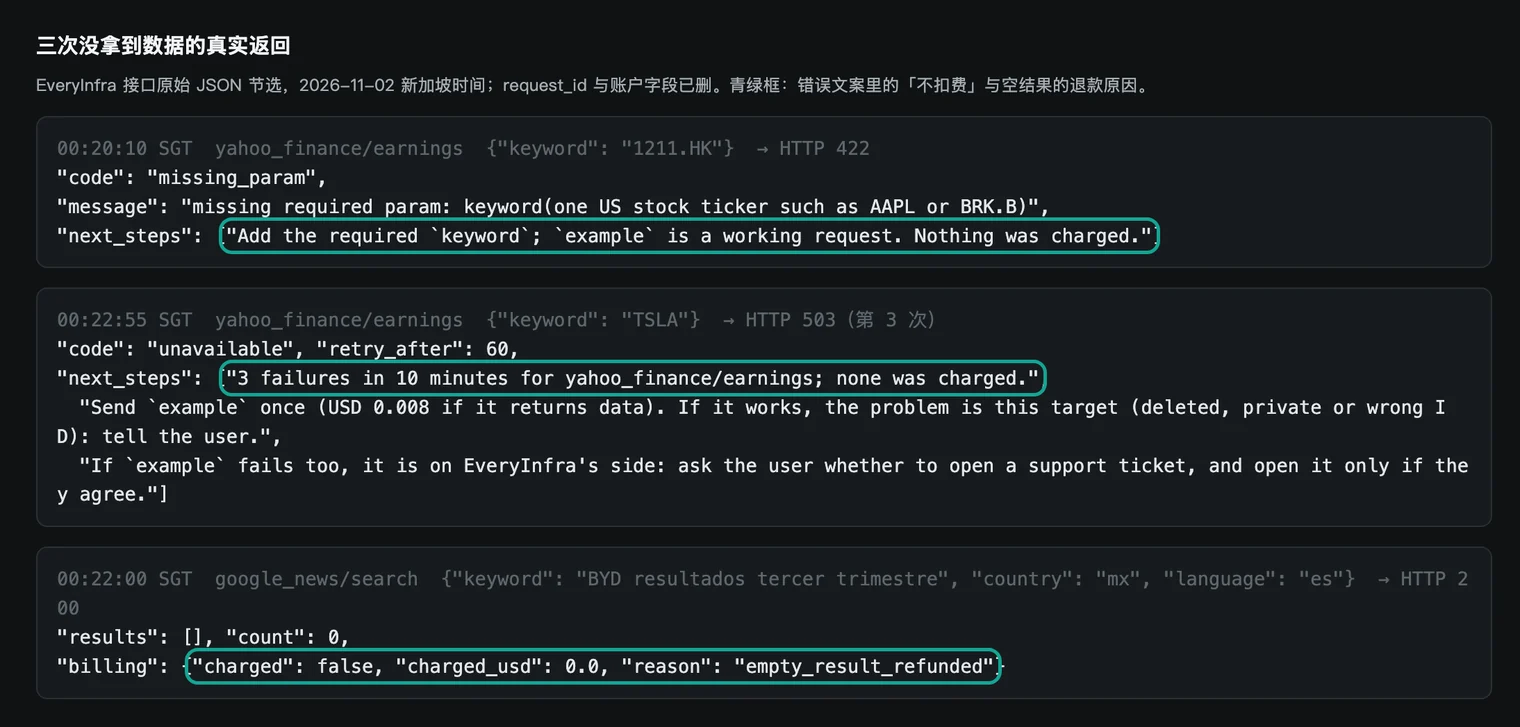
El primer caso es un argumento inválido. El catálogo dice que yahoo_finance/earnings solo admite tickers de EE. UU. A las 00:20:10 (hora de Singapur) enviamos a propósito el código de Hong Kong 1211.HK. En 0,2 segundos volvió un HTTP 422 con el código missing_param. El mensaje pide un ticker estadounidense, da un ejemplo que funciona y dice «Nothing was charged». Es un mensaje pensado para un modelo: Kimi puede cambiar el argumento o la capacidad sin repetir la misma llamada.
El segundo caso es un servicio caído por poco tiempo. A las 00:20:32, 00:21:30 y 00:22:55 (hora de Singapur), yahoo_finance/earnings con TSLA devolvió HTTP 503. Cada respuesta decía que no había cobro y daba un retry_after de 60 segundos. El tercer mensaje cambió y sugería probar una vez la solicitud de ejemplo para saber de qué lado estaba el problema. Lo hicimos a las 00:23:05 (hora de Singapur) con AAPL, y también dio 503. La capacidad entera estaba caída esos minutos; no era culpa del ticker. No abrimos ningún ticket, y tomamos el beneficio por acción de la propia actualización de Tesla.
El tercer caso, el resultado vacío, ya lo vimos con los titulares en español. El cuarto es el límite de velocidad. Si varias tareas comparten una misma clave y corren a la vez, pueden superar el límite por minuto. A las 00:20:58 (hora de Singapur) una búsqueda de temas recibió HTTP 429. El mensaje decía que reintentara en 2 segundos y que no había cobro. Volvimos a enviarla a las 00:21:05 y funcionó.
| Hora (Singapur) | Capacidad | Resultado | Cobro | Regla para Kimi |
|---|---|---|---|---|
| 00:20:10 | yahoo_finance/earnings (1211.HK) | 422, solo tickers de EE. UU. | 0 USD | Lea next_steps y cambie el ticker o la capacidad |
| 00:20:32 / 00:21:30 / 00:22:55 | yahoo_finance/earnings (TSLA) | 503, caída breve | 0 USD | Espere retry_after, dos intentos como máximo, luego el ejemplo |
| 00:20:58 | weibo/topic_search | 429, límite por minuto superado | 0 USD | Espere retry_after y repita la misma llamada una vez |
| 00:22:00 | google_news/search (español) | 200, vacío y reembolsado | 0 USD | Pruebe otras palabras; no informe «sin noticias» |
| 00:23:05 | yahoo_finance/earnings (ejemplo AAPL) | 503 | 0 USD | El ejemplo también falló: el problema está del lado del servicio |
Si varios subagentes de Kimi Code trabajan en paralelo con distintas empresas, ponga estas reglas en el archivo del agente. Ante un 429, espere retry_after y repita una vez con los mismos argumentos. Ante un 503, como máximo dos intentos. Ante un 422, lea next_steps antes de cambiar nada. Las reglas de cero cobro están en la guía de inicio. Para cuadrar cobros y llamadas, vea conciliación de reembolsos por fallos.
La plantilla de salida: que Kimi solo escriba con evidencia
El último paso es el resumen. K3.1 Pro admite json_schema con strict: true para el message.content final (guía rápida, salida estructurada). Recomendamos campos fijos, y que cada afirmación lleve un campo de fuente. Si el modelo no puede dar la fuente, no puede escribir la afirmación.
{
  "type": "json_schema",
  "json_schema": {
    "name": "cross_check_summary",
    "strict": true,
    "schema": {
      "type": "object",
      "additionalProperties": false,
      "required": ["company", "window", "claims", "unmentioned", "timing_clusters", "press_es", "limits"],
      "properties": {
        "company": {"type": "string"},
        "window": {"type": "string"},
        "claims": {"type": "array", "items": {"type": "object", "additionalProperties": false,
          "required": ["social_claim", "social_source_ids", "filing_value", "filing_source", "verdict"],
          "properties": {
            "social_claim": {"type": "string"},
            "social_source_ids": {"type": "array", "items": {"type": "string"}},
            "filing_value": {"type": "string"},
            "filing_source": {"type": "string"},
            "verdict": {"type": "string", "enum": ["respaldada", "respaldada en parte", "no respaldada", "no verificable"]}}}},
        "unmentioned": {"type": "array", "items": {"type": "string"}},
        "timing_clusters": {"type": "array", "items": {"type": "string"}},
        "press_es": {"type": "array", "items": {"type": "string"}},
        "limits": {"type": "array", "items": {"type": "string"}}
      }
    }
  }
}
social_source_ids guarda los id de publicaciones o comentarios, y filing_source el nombre del campo o la página del informe. Así cada fila vuelve a los datos originales. verdict es un enum, para que el modelo no invente adjetivos. El esquema no tiene ningún campo de «recomendación» ni de «calificación», de modo que la propia estructura excluye el consejo de compra. Añadimos press_es para los titulares en español, con su URL. timing_clusters solo registra formas medibles, como comentarios muy concentrados en el tiempo y sin interacción, sin especular sobre su origen. limits es obligatorio: el modelo debe decir, por ejemplo, que la búsqueda de Weibo cubre solo las últimas semanas o que se devolvieron menos comentarios de los que muestra la publicación. La tabla de contraste de arriba es lo que produce esta plantilla con datos reales, llenada a mano.
No es asesoramiento de inversión: los límites que fijamos
Esta tarea está a un paso de recomendar acciones, así que los límites deben formar parte del flujo y no solo de un aviso al final. En China, los reguladores ya actuaron. En 2026, la oficina de Pekín de la Comisión Reguladora de Valores de China (CSRC) multó a dos operadores de medios sociales con 200.000 y 250.000 CNY por inventar y difundir información falsa sobre una empresa cotizada. Uno alegó que el texto falso lo había generado una IA, y el regulador no aceptó esa defensa. La nota dice que quien usa IA generativa debe revisar lo que produce (CSRC Pekín, nota reproducida de Securities Daily).
A mediados de octubre de 2026, la oficina de Jiangsu de la CSRC reprodujo una nota sobre las nuevas normas de contenido financiero de Weibo, WeChat, Douyin y Xiaohongshu. Prohíben predecir el movimiento de acciones concretas y refuerzan la detección de contenido financiero falso hecho con IA (CSRC Jiangsu, revista de prensa).
| Fecha | Autoridad | Medida | Qué implica para un resumen hecho con IA |
|---|---|---|---|
| 2026 | Oficina de Pekín de la CSRC | Multas de 200.000 y 250.000 CNY por información falsa, sin aceptar la excusa de la IA | Quien publica responde por el texto, aunque lo escriba un modelo |
| Mediados de octubre de 2026 | Oficina de Jiangsu de la CSRC | Nota sobre normas de Weibo, WeChat, Douyin y Xiaohongshu contra predicciones de acciones concretas | El resumen no predice precios |
En la práctica usamos cuatro reglas. Primera, el resumen solo dice si las afirmaciones coinciden con los datos, nunca si conviene comprar o vender. Segunda, cada cifra lleva un campo original o una fuente del informe, y se borra toda frase sin fuente. Tercera, los comentarios muy concentrados en el tiempo y sin interacción van en un grupo aparte, no cuentan en la opinión y el resumen no especula sobre su origen.
Cuarta, el resumen es para investigación interna, y antes de publicarlo una persona revisa cada frase contra la fuente. Si usted trabaja en México, tenga en cuenta además las reglas de su propio regulador sobre recomendaciones de inversión. El propio blog técnico de Moonshot aclara que su prueba de errores usa preguntas difíciles y no refleja la tasa de error del uso diario.
Límites y puntos de atención
Primero, no probamos el lado de Kimi. Todo lo de la API de Kimi, Kimi Code y Kimi Work sale de documentación de Moonshot leída el 2 de noviembre de 2026, y el código es un ejemplo de configuración. Moonshot actualiza mucho su documentación desde el lanzamiento de K3.1 Pro. La serie K2 se cerró a usuarios nuevos el 31 de octubre de 2026, y Moonshot prevé retirarla antes de fin de diciembre (precios, serie K2). Vuelva a leer la fuente antes de copiar el código. Los tokens y el costo de Kimi son estimaciones.
Segundo, los datos de Weibo tienen límites de cobertura. La búsqueda por palabra clave trae lo reciente, y con limit en 30 recibimos 13 publicaciones. La llamada de comentarios devolvió menos de los que mostraba cada publicación: 31 de 49 y 36 de 39. Las lecturas de un tema son acumuladas, no las de un día. Para estudiar la ventana del informe, descargue dentro de esa ventana.
Tercero, yahoo_finance/earnings solo admite tickers de EE. UU. Para acciones de Hong Kong o de China continental, tome el beneficio por acción de las tablas financieras o del informe. Además, esa capacidad estuvo caída durante los minutos de nuestra prueba, sin cobro. Cuarto, la API financiera coincide con los informes, pero no explica los cambios; las razones solo están en el informe original. Quinto, las listas de palabras negativas y de «estable» o «investigación» se escribieron después de leer los datos y solo sirven como descripción. Sexto, ocultamos los nombres e identificadores de los comentaristas y los enlaces de las dos publicaciones en el texto y en las capturas, y sus resúmenes tampoco deberían incluir la identidad de usuarios comunes. Séptimo, la muestra es pequeña: una empresa y dos hilos de comentarios. Sirve para mostrar el método, no para sacar conclusiones generales sobre esta empresa ni sobre este tipo de conversación. Un estudio formal necesita varias empresas, varias temporadas de informes y todas las listas de palabras escritas antes de descargar los datos.
Cambios recientes
- 23-10-2026: Moonshot lanzó Kimi K3.1 Pro y su versión Highspeed. La API cuesta 2,00 USD de entrada y 10,00 USD de salida por millón de tokens, y los pesos llegarán antes del 4 de noviembre (plataforma de la API de Kimi, notas de Simon Willison). Para el lector: la entrada de la misma tarea de contexto largo cuesta un tercio menos que con K3.
- 26-10-2026: Kimi Work 3.2.21 pide aprobación antes de cargar servidores MCP de un proyecto. El 29 de octubre, la 3.2.22 llevó las tareas programadas al Centro de tareas (notas de versión de Kimi Work). Para el lector: una descarga programada necesita un clic de una persona en su primera ejecución.
- 31-10-2026: la serie K2 se cerró a usuarios nuevos, con retiro previsto antes de fin de diciembre (precios). Para el lector: migre el código de llamadas de K2 a los modelos K3, y recuerde que en K3.1 Pro el razonamiento no se puede desactivar.
Preguntas frecuentes
¿Cuál es el precio de kimi k3.1 pro en México?
La API de Kimi cobra en dólares estadounidenses, igual en México que en otros países. El 2 de noviembre de 2026, K3.1 Pro costaba 2,00 USD de entrada, 10,00 USD de salida y 0,20 USD por acierto de caché, por millón de tokens (plataforma de la API de Kimi). Batch cuesta el 60 % del precio estándar (precios de Batch). Según nuestra estimación, una empresa por ejecución cuesta unos 0,134 USD en tiempo real, de los que 0,006335 USD son llamadas a EveryInfra. (Pregunta tomada de la sugerencia de búsqueda «kimi k3.1 pro precio en mexico».)
¿Qué tamaño tiene la ventana de contexto de kimi k3.1 pro?
La documentación de la API indica 1.048.576 tokens, con el mismo precio a cualquier longitud (precios). La salida también ocupa contexto, y max_completion_tokens es 131.072 por defecto. En nuestra prueba, los datos de Weibo y financieros de una empresa ocupaban unos 16.000 a 24.000 tokens sin duplicados, así que caben de 38 a 56 empresas. (Sugerencia de búsqueda «kimi k3.1 pro context window».)
¿Cómo obtengo una clave de API de kimi k3.1 pro? ¿Hay que recargar antes?
Se crea en la consola de la plataforma de la API de Kimi. K3.1 Pro es un modelo principal y solo se habilita tras una recarga, de 1 USD como mínimo; el total recargado fija el nivel de la cuenta y los límites de velocidad (guía rápida, requisitos de acceso, recarga y límites). La API se paga por token y es independiente de la suscripción de Kimi y de los planes de Kimi Code (comparación de productos). (Sugerencia «kimi k3.1 pro api key».)
¿kimi k3.1 pro admite herramientas MCP?
No dentro de la solicitud a la API. Chat Completions, Responses y Messages no aceptan un servidor MCP remoto, y la Responses API solo admite los tipos function, namespace, custom y web_search (referencia de la Responses API). Para MCP remoto, use mcp.json en Kimi Code CLI o un plugin personal en Kimi Work. El Playground solo sincroniza servidores alojados en ModelScope. (Sugerencias «kimi k3.1 pro tools» y «kimi k3.1 pro mcps».)
¿De dónde saca Kimi los datos financieros?
El modelo no tiene datos en vivo propios. Kimi Work trae plugins de bases financieras como Wind, Hundsun Gildata y S&P Global Market Intelligence (centro de plugins de Kimi Work). Las publicaciones y comentarios de redes sociales no están en esos plugins. En este artículo, las llamadas weibo/*, google_news/* y yahoo_finance/* de EveryInfra cubren ese hueco. Con la API, todos los datos llegan al modelo mediante llamadas a herramientas.
¿Kimi K3.1 Pro es mejor que K3 para esta tarea?
Moonshot reporta 70,4 frente a 58,8 en su evaluación interna de investigación financiera, una mejora de 11,6 puntos (blog técnico). Además, K3.1 Pro cuesta menos: 2,00 USD de entrada frente a 3,00 USD en K3. Es una evaluación de la propia empresa, sin verificación independiente; compare los dos modelos con su propia muestra. (Sugerencia «kimi k3.1 pro vs k3».)
Referencias
- Guía rápida de Kimi K3.1 Pro, Moonshot AI, leída el 2026-11-02, https://platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart
- Kimi K3.1 Pro Tech Blog, Moonshot AI, 2026-10-23, https://www.kimi.com/blog/kimi-k3-1-pro
- Model Inference Pricing, Moonshot AI, leída el 2026-11-02, https://platform.kimi.ai/docs/pricing/chat
- Plataforma de la API de Kimi (precios de modelos), Moonshot AI, leída el 2026-11-02, https://platform.kimi.ai/
- BatchJob Pricing, Moonshot AI, leída el 2026-11-02, https://platform.kimi.ai/docs/pricing/batch
- Recharge and Rate Limiting, Moonshot AI, leída el 2026-11-02, https://platform.kimi.ai/docs/pricing/limits
- Referencia de la Responses API, Moonshot AI, leída el 2026-11-02, https://platform.kimi.ai/docs/api/responses
- Referencia de la Messages API, Moonshot AI, leída el 2026-11-02, https://platform.kimi.ai/docs/api/messages
- Use Kimi API for Tool Calls, Moonshot AI, leída el 2026-11-02, https://platform.kimi.ai/docs/guide/use-kimi-api-to-complete-tool-calls
- Kimi K3 API Tool Calling Best Practices, Moonshot AI, leída el 2026-11-02, https://platform.kimi.ai/docs/guide/kimi-k3-tool-calling-best-practice
- Tool Choice, Moonshot AI, leída el 2026-11-02, https://platform.kimi.ai/docs/guide/use-tool-choice
- Dynamically Loaded Tools, Moonshot AI, leída el 2026-11-02, https://platform.kimi.ai/docs/guide/use-dynamic-tool-loading
- Reasoning Effort, Moonshot AI, leída el 2026-11-02, https://platform.kimi.ai/docs/guide/use-reasoning-effort
- Structured Output, Moonshot AI, leída el 2026-11-02, https://platform.kimi.ai/docs/guide/response_format
- Context Caching, Moonshot AI, leída el 2026-11-02, https://platform.kimi.ai/docs/guide/context-caching
- Using Batch API for Bulk Processing, Moonshot AI, leída el 2026-11-02, https://platform.kimi.ai/docs/guide/use-batch-api
- Configure ModelScope MCP Server in Playground, Moonshot AI, leída el 2026-11-02, https://platform.kimi.ai/docs/guide/configure-the-modelscope-mcp-server
- Use Kimi API for File-Based Q&A, Moonshot AI, leída el 2026-11-02, https://platform.kimi.ai/docs/guide/use-kimi-api-for-file-based-qa
- Main Concepts, Moonshot AI, leída el 2026-11-02, https://platform.kimi.ai/docs/introduction
- API de estimación de tokens, Moonshot AI, leída el 2026-11-02, https://platform.kimi.ai/docs/api/estimate
- Compare with Other Kimi Products, Moonshot AI, leída el 2026-11-02, https://platform.kimi.ai/docs/guide/product-plans
- Kimi Code: Model Context Protocol, Moonshot AI, leída el 2026-11-02, https://www.kimi.com/code/docs/en/kimi-code-cli/customization/mcp.html
- Kimi Code: Agents and Sub-Agents, Moonshot AI, leída el 2026-11-02, https://www.kimi.com/code/docs/en/kimi-code-cli/customization/agents.html
- Kimi Code: Model Configuration, Moonshot AI, leída el 2026-11-02, https://www.kimi.com/code/docs/en/kimi-code/models.html
- Página de Kimi Work, Moonshot AI, leída el 2026-11-02, https://www.kimi.com/en/products/kimi-work
- Notas de versión de Kimi Work, Moonshot AI, actualizadas el 2026-10-29, https://www.kimi.com/en/help/kimi-work/release-notes
- What Are Kimi Plugins, Moonshot AI, leída el 2026-11-02, https://www.kimi.com/en/help/plugins-and-skills/overview
- How to Create a Personal Plugin, Moonshot AI, leída el 2026-11-02, https://www.kimi.com/en/help/plugins-and-skills/create
- Kimi Work Plugin Center, Moonshot AI, leída el 2026-11-02, https://www.kimi.com/en/help/kimi-work/plugin-center
- Informe del tercer trimestre de 2026 de BYD Company Limited, BYD en CNINFO, 2026-10-30, https://static.cninfo.com.cn/finalpage/2026-10-30/1225641442.PDF
- Tesla Q3 2026 Update (anexo 99.1 del 8-K), Tesla en SEC EDGAR, 2026-10-21, https://www.sec.gov/Archives/edgar/data/1318605/000162828026066738/exhibit9914.htm
- Catálogo de Weibo de EveryInfra, EveryInfra, leído el 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog?platform=weibo
- Catálogo de Yahoo Finance de EveryInfra, EveryInfra, leído el 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog?platform=yahoo_finance
- Catálogo de Google Noticias de EveryInfra, EveryInfra, leído el 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog?platform=google_news
- Catálogo de Reddit de EveryInfra, EveryInfra, leído el 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog?platform=reddit
- Multa de 250.000 yuanes por un texto falso escrito con IA (nota de Securities Daily), oficina de Pekín de la CSRC, 2026-06-18, https://www.csrc.gov.cn/beijing/c105538/c7640109/content.shtml
- Revista de prensa: gobernanza conjunta del contenido financiero, oficina de Jiangsu de la CSRC, 2026-10-15, https://www.csrc.gov.cn/jiangsu/c106440/c7664819/content.shtml
- Notas sobre Kimi K3.1 Pro, Simon Willison, 2026-10-23, https://simonwillison.net/2026/Oct/23/kimi-k31-pro/
- Tesla Q3 2026 earnings report, CNBC, 2026-10-21, https://www.cnbc.com/2026/10/21/tesla-tsla-q3-2026-earnings-report.html
- How good is kimi K3.1 Pro? (hilo), Reddit r/kimi, 2026-10, https://www.reddit.com/r/kimi/comments/1xdkngh/how_good_is_kimi_k31_pro/
- Especificación de Model Context Protocol, Model Context Protocol, leída el 2026-11-02, https://modelcontextprotocol.io/specification/2025-06-18
Referencia BL-67