VS Code Copilot cloud automations: clasificar cada día las reseñas de App Store y Google Play
Una automatización de Copilot en la nube lee cada día reseñas de App Store y Google Play por MCP y las agrupa en fallos, pagos y acceso. API: $0.0056/día.
El 28 de octubre de 2026, GitHub llevó a VS Code las automatizaciones de Copilot en la nube (Copilot cloud automations). Escribes una instrucción, eliges una hora y un agente en la nube de Copilot la ejecuta cada día en GitHub, aunque tu portátil esté apagado. Lo probamos con una tarea muy común en equipos de apps móviles: repartir cada mañana las reseñas negativas nuevas en fallos, pagos y problemas de acceso.
Hicimos llamadas reales a las capacidades app_store/reviews y google_play/reviews de EveryInfra en dos noches: 10 el 11 de noviembre de 2026 con datos de Estados Unidos, y otras el 12 de noviembre con el App Store de México y España. Con una ejecución diaria sobre cuatro fichas de tienda, la API cuesta $0.0056 al día, unos $0.17 en 30 días. Para lectores hispanohablantes hay un dato que pesa más: una lista de palabras clave en inglés solo clasificó 8 de 72 reseñas negativas de Duolingo en México (11%). La misma lista escrita en español clasificó 39 (54%).
No creamos esta automatización en un repositorio de GitHub. Todos los pasos del lado de Copilot salen de la documentación de GitHub y de VS Code, y los marcamos como «ejemplo de configuración». Todas las cifras de EveryInfra salen de llamadas reales, con la hora de Singapur (SGT) de cada una.
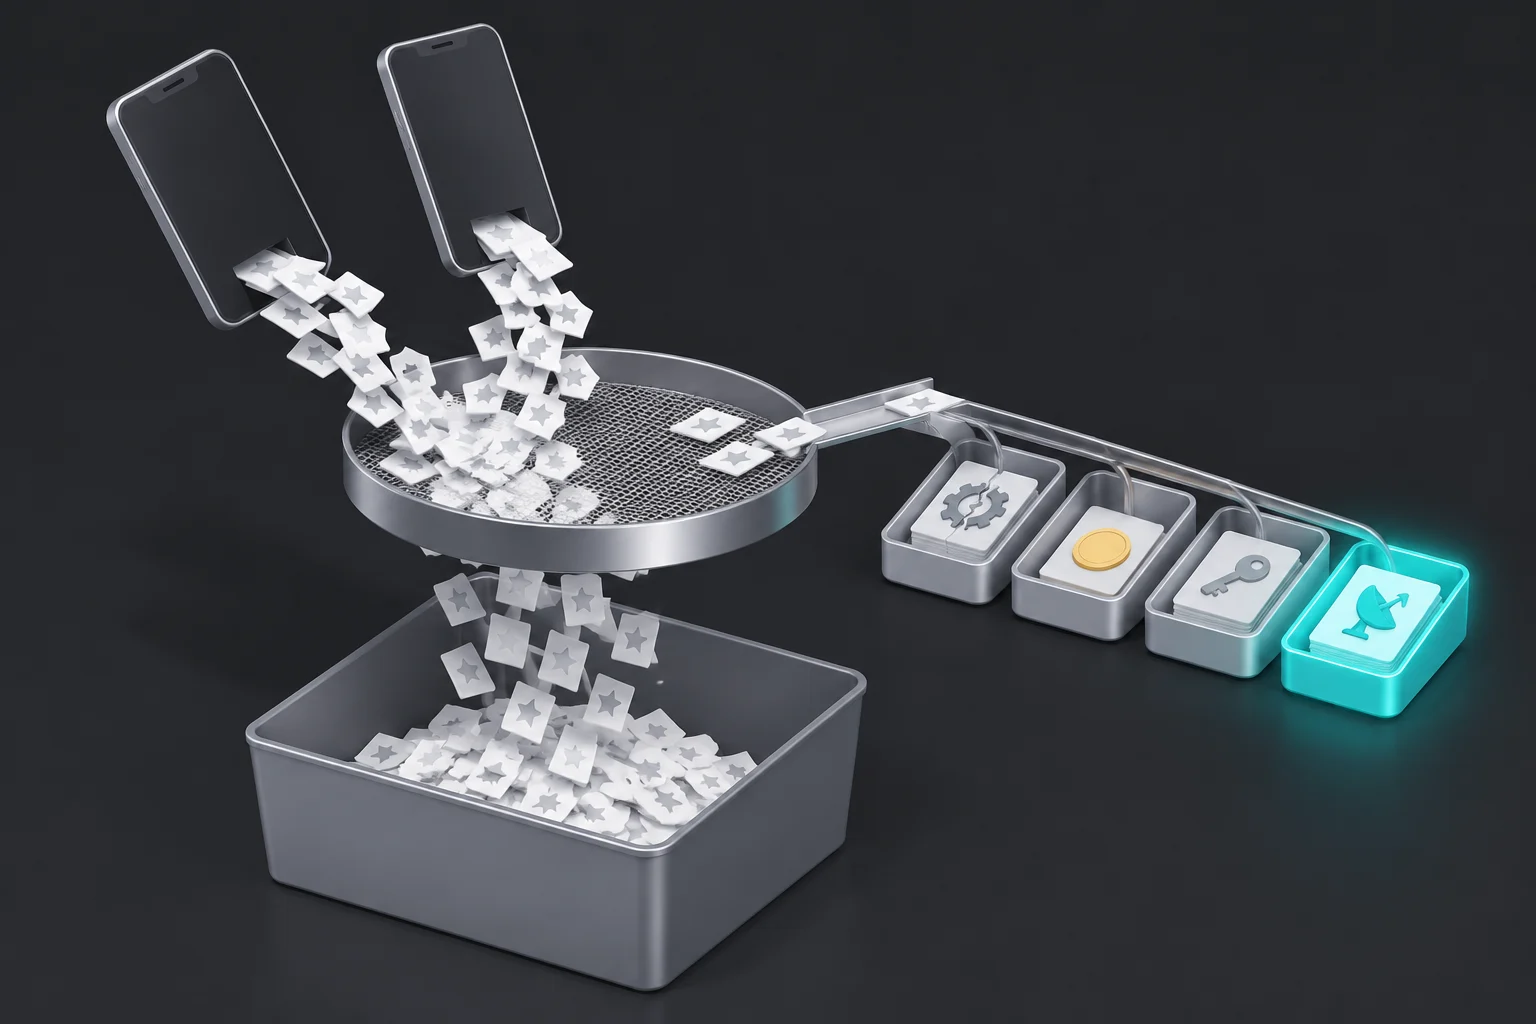
La tarea: un informe de reseñas negativas cada mañana
Un equipo publica una app para iOS y Android. Cada mañana, el repositorio debe tener un informe nuevo con las reseñas de 1 a 3 estrellas aparecidas desde la última ejecución. El informe pone cada reseña en un grupo: fallos y errores, pagos y suscripción, acceso y cuenta, sincronización y dispositivos, anuncios, cambios de diseño u otros. Si un grupo se dispara, por ejemplo una docena de «se cierra después de actualizar» en tres días, la automatización abre una incidencia (issue) con ejemplos y la versión de la app.
La tarea encaja con las automatizaciones de Copilot por tres motivos. Va con horario y debe terminar antes de que el equipo empiece a trabajar. Escribe en el repositorio, y el agente en la nube ya tiene herramientas de GitHub para archivos e incidencias. Sus datos están fuera del repositorio, así que el agente necesita un servidor MCP o un script que los traiga. La API de datos de EveryInfra cubre ese tercer punto.
Elegimos una app grande y una mediana. Duolingo (ID del App Store 570060128, paquete Android com.duolingo) es una app de idiomas con muchísimas reseñas. Strava (ID 426826309, paquete com.strava) registra actividad deportiva y recibe un volumen medio. Solo leímos reseñas públicas, sin iniciar sesión en ninguna cuenta. Las llamadas con datos de Estados Unidos se hicieron el 11 de noviembre de 2026 entre las 00:22 y las 00:42 SGT. Las de México y España, el 12 de noviembre entre las 00:14 y las 00:17 SGT.
¿Qué son las VS Code Copilot cloud automations? El anuncio del 28 de octubre, punto por punto
El registro de cambios de GitHub del 28 de octubre de 2026 anunció Copilot Automations en Visual Studio Code. Según ese texto, hace falta VS Code 1.144 y activar el ajuste chat.automations.cloud.enabled. La función está en los planes Copilot Pro, Pro+, Max, Business y Enterprise, en la pestaña Automations de la ventana Agents. Ese día, la página de descarga de VS Code ofrecía la versión 1.144.1.
La página de automatizaciones de VS Code, con fecha del 11 de noviembre de 2026, ya dice otra cosa sobre los ajustes. Según ella, las automatizaciones y su gestión en la nube vienen activadas por defecto. Solo hay que revisar chat.automations.enabled y chat.automations.cloud.enabled si la opción Run in the Cloud no aparece en el formulario. Citamos las dos fuentes porque quien siga el anuncio puede buscar un ajuste que ya está encendido.
GitHub publicó ese mismo día dos entradas relacionadas: límites de gasto para automatizaciones y automatizaciones compartidas por un equipo. Las secciones de coste y de límites las usan más abajo.
Con todo eso junto, una automatización tiene tres partes: una instrucción, un disparador y un conjunto de herramientas. La instrucción dice qué hacer, qué leer y qué entregar. El disparador es un horario, una ejecución manual o un evento de GitHub, como una incidencia nueva. Las herramientas son las de GitHub más las herramientas MCP configuradas en el repositorio. Cada ejecución abre una sesión del agente en la nube de Copilot en un entorno temporal, y el registro queda en GitHub.
| Dato | Qué dice la fuente | Fuente |
|---|---|---|
| Fecha | 28 de octubre de 2026 | Registro de cambios de GitHub |
| Versión de VS Code | 1.144 o posterior | Registro de cambios, notas de VS Code 1.144 |
| Ajustes | chat.automations.cloud.enabled (anuncio); activado por defecto (documentación del 11 de noviembre de 2026) | Registro de cambios, documentación de VS Code |
| Planes | Copilot Pro, Pro+, Max, Business, Enterprise | Registro de cambios de GitHub |
| Repositorios | Solo privados e internos | Documentación de VS Code |
| Horarios en la nube | Manual, diario, semanal; minutos 00/15/30/45; hora en UTC | Documentación de VS Code |
| Herramientas | Las de GitHub y las MCP de la configuración del repositorio | Documentación de VS Code y de GitHub |
| Cobro | Una sesión del agente por ejecución, en AI credits, más minutos de Actions | Documentación de GitHub |
| API | REST «agent automations», vista previa pública, versión 2026-03-10 | Documentación REST de GitHub |
Hay una fila que se pasa por alto con facilidad. La página de VS Code dice que una automatización en la nube no acepta el modo local, los ajustes de aprobación locales, los agentes personalizados ni la configuración MCP local. Por tanto, el servidor MCP de EveryInfra que tengas en tu VS Code no existe para la automatización. Hay que darlo de alta otra vez en los ajustes del repositorio en GitHub, como explica la sección de MCP más abajo.
¿Con qué frecuencia puede ejecutarse? En la nube, diaria o semanal
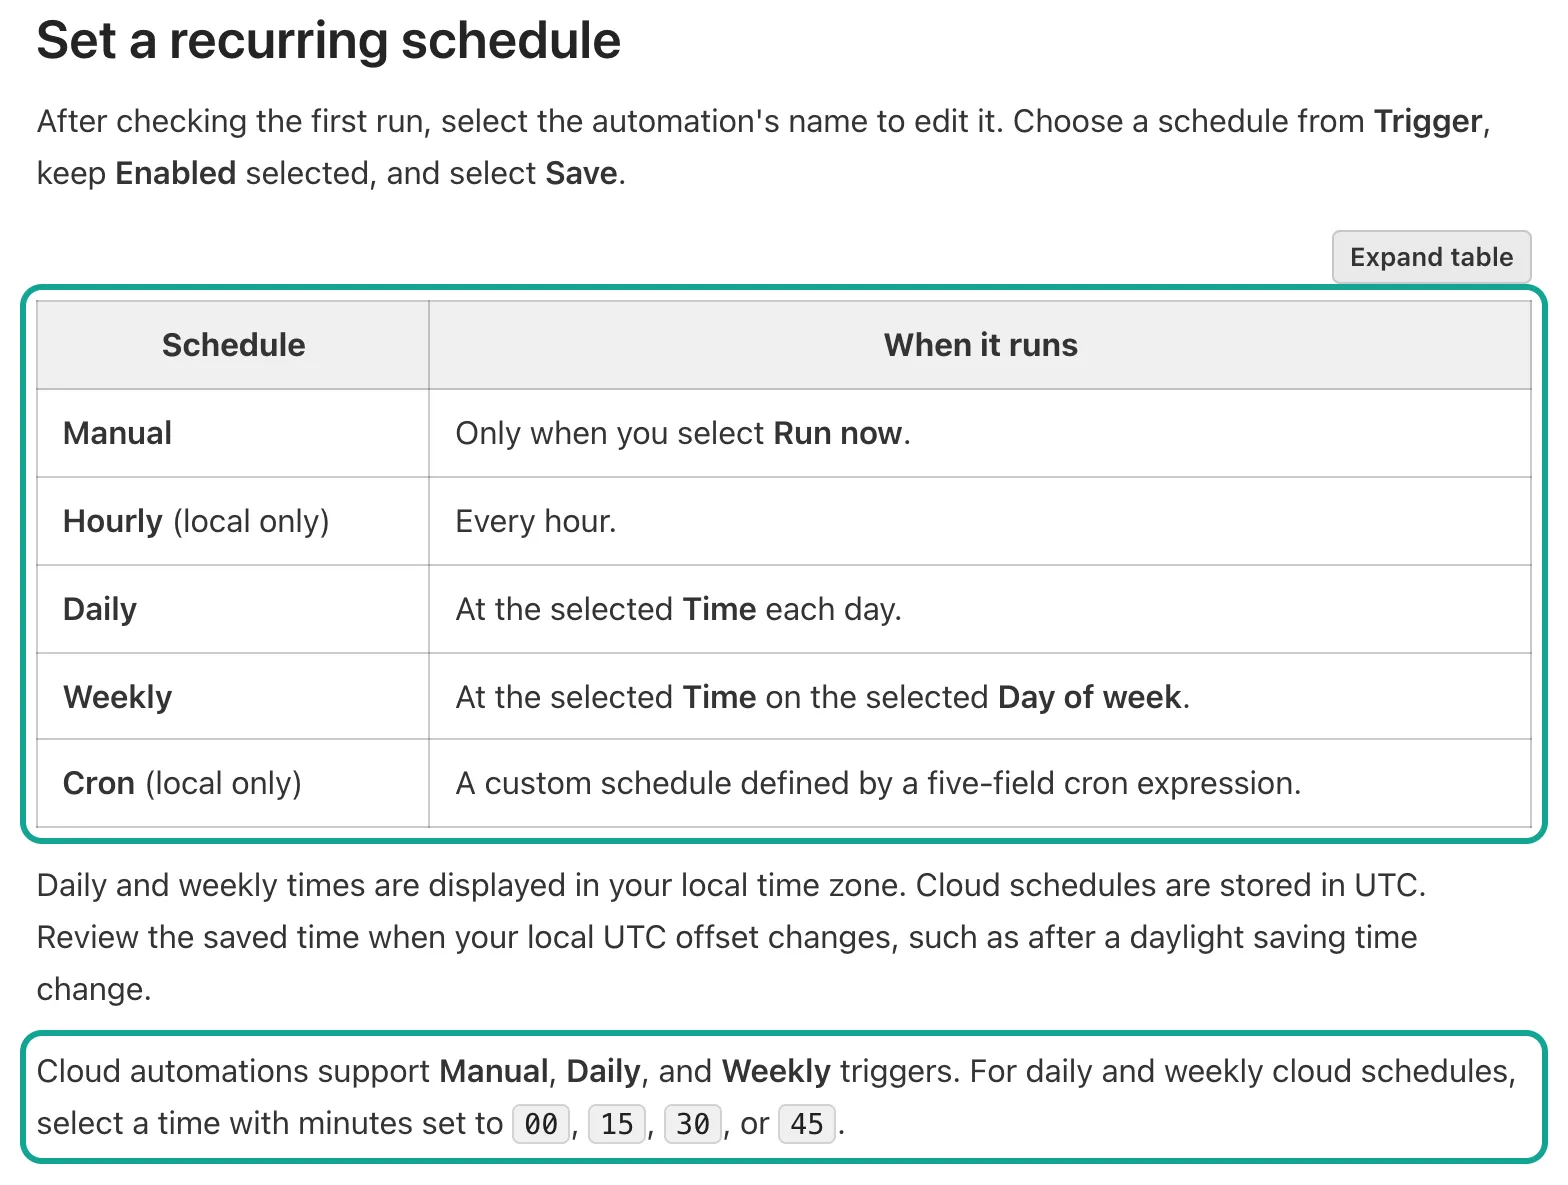
Para una tarea de reseñas, el dato clave es el intervalo más corto. Bajo la tabla «Set a recurring schedule» de la documentación de VS Code, el texto es claro. Las automatizaciones en la nube admiten Manual, Daily y Weekly, y los horarios por hora y con cron son solo para ejecuciones locales. El minuto tiene que ser 00, 15, 30 o 45 y la hora se guarda en UTC. Capturamos ese fragmento de la página.
Dos fuentes no coinciden del todo. La página de GitHub sobre cómo crear automatizaciones incluye horarios por hora, diarios y semanales, disparadores por incidencias y pull requests, y un disparador por API. Una incidencia de prueba de VS Code del 11 de octubre (número 340970) también menciona Hourly y Weekdays. Nuestra lectura es que una automatización creada en la web de GitHub puede ir cada hora, mientras que la creada en VS Code solo ofrece diaria y semanal. La página de VS Code es más reciente que la incidencia, así que seguimos la página.
Guardar la hora en UTC obliga a hacer cuentas según el país. La documentación de VS Code recomienda revisar la hora guardada después de un cambio de horario, algo que afecta a Madrid y no a Ciudad de México.
| Ciudad | Hora UTC para un informe a las 08:00 | Cambio de horario |
|---|---|---|
| Ciudad de México (UTC−6) | 14:00 | No |
| Bogotá (UTC−5) | 13:00 | No |
| Buenos Aires (UTC−3) | 11:00 | No |
| Madrid (CET / CEST) | 07:00 en invierno, 06:00 en verano | Sí, revisar en marzo y octubre |
El flujo completo: seis pasos por ejecución


La figura muestra el flujo que recomendamos. El paso 1 es el horario de GitHub y en el paso 2 el agente lee los archivos de instrucciones del repositorio. El paso 3 trae las reseñas nuevas, por MCP o con un script. El paso 4 quita por ID las ya vistas y deja solo las de 1 a 3 estrellas. En el paso 5 el modelo pone cada reseña en un grupo fijo y compara los recuentos con los días anteriores. El paso 6 escribe el informe y, si hace falta, abre una incidencia.
La decisión de diseño más importante está entre los pasos 3 y 4. Si el agente llama a la API por MCP, cada reseña entra completa en el contexto del modelo, con autor, enlace al avatar y votos de utilidad. Si un script trae, deduplica y filtra antes, el modelo lee un archivo pequeño. Las dos vías funcionan, y la sección «Primero el script» mide los tokens de cada una.
Cómo se conecta el Copilot cloud agent a MCP: el JSON de los ajustes del repositorio
El agente en la nube lee sus servidores MCP de los ajustes del repositorio: Settings, luego Copilot, luego MCP servers, donde se pega un bloque JSON. La página de GitHub sobre servidores MCP describe el formato. El nivel superior es mcpServers, y cada servidor lleva type (local, stdio, http o sse), url y headers si es remoto, y una lista blanca tools. Solo funcionan herramientas MCP, no recursos ni prompts, y los servidores remotos que exigen OAuth todavía no son compatibles. El servidor MCP remoto de EveryInfra usa clave de API y no OAuth, así que encaja. El bloque siguiente es un ejemplo de configuración que no guardamos en ningún repositorio.
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": {
        "Authorization": "Bearer $COPILOT_MCP_EVERYINFRA_KEY"
      },
      "tools": ["everyinfra_list_capabilities", "everyinfra_call_api", "everyinfra_get_job"]
    }
  }
}
La clave no va en el JSON. La página de GitHub sobre secretos del agente explica las reglas. En Secrets and variables existe un tipo Agents. Un secreto cuyo nombre empieza por COPILOT_MCP_ solo llega a los servidores MCP y no se convierte en variable de entorno del agente. Los demás secretos sí llegan como variables de entorno a los comandos y scripts que ejecuta el agente, y los registros ocultan sus valores.
Por eso la vía MCP usa COPILOT_MCP_EVERYINFRA_KEY y la vía del script un nombre sin prefijo, como EVERYINFRA_API_KEY. Con el nombre equivocado, la primera llamada devuelve 401.
En la lista blanca bastan tres herramientas. A las 00:22 SGT del 11 de noviembre enviamos una petición tools/list al servidor MCP de EveryInfra y devolvió 12 herramientas. La clasificación de reseñas solo usa tres: listar capacidades, llamar a la API y consultar un trabajo asíncrono. La lista blanca tiene otro efecto. La especificación MCP da a cada herramienta unas annotations, y readOnlyHint indica que no modifica nada.
En nuestra respuesta, everyinfra_list_capabilities y everyinfra_get_job son de solo lectura, y everyinfra_call_api no lo es porque cobra. La página de GitHub sobre MCP dice que la revisión de código de Copilot solo usa herramientas con readOnlyHint verdadero. Así que la misma configuración no puede llamar a la API durante una revisión de código, pero sí en sesiones del agente y en automatizaciones.
Para probarlo, GitHub propone asignar una incidencia a Copilot y mirar en el registro que el paso «Start MCP Servers» liste el servidor. Hay además un caso abierto. En la discusión 211107, del 27 de octubre de 2026, un usuario cuenta que las herramientas MCP propias arrancan en una automatización pero no se pueden llamar, mientras que en una sesión manual sí funcionan. Sin respuesta de GitHub cuando la leímos, conviene lanzar la primera ejecución a mano y buscar en el registro una llamada real a everyinfra_call_api.
Queda el cortafuegos. La página de GitHub sobre el cortafuegos dice que solo afecta a los procesos que el agente lanza con su herramienta Bash, no a los servidores MCP. La vía MCP no necesita cambios. En la vía del script, la petición sale de Bash y hay que añadir api.everyinfra.com a la lista de permitidos del repositorio. La referencia de la lista de permitidos enumera los dominios por defecto, y el nuestro no está.
Dos capacidades: `app_store/reviews` y `google_play/reviews`
El catálogo gratuito de EveryInfra (GET https://api.everyinfra.com/api/v1/social/catalog, sin coste) tenía 573 capacidades cuando lo leímos. La clasificación usa dos. Otras dos ayudan en la primera configuración: app_store/search encuentra una app del App Store y su ID numérico, y google_play/profile lee la ficha de una app Android. Las cuatro están en las páginas de la API de datos del App Store y la API de datos de Google Play. Las páginas de cada capacidad son reseñas del App Store, reseñas de Google Play, búsqueda en el App Store y ficha de Google Play.
| Punto | `app_store/reviews` | `google_play/reviews` |
|---|---|---|
| ID de la app | app_id numérico, por ejemplo 426826309 | app_id con el paquete, por ejemplo com.strava |
| País e idioma | country elige la tienda del país | country no cambia las reseñas; language sí |
| Orden | newest o most_helpful | newest o top_rated |
| Reseñas por llamada | 30 por defecto, 500 como máximo | 40 por defecto, 200 como máximo |
| Páginas | No pagina, una llamada lo trae todo | page_token, válido 24 horas, tope de 200 |
| Estrellas | rating (y rating_scale) | score |
| Otros campos | id, title, text, author, app_version, helpful_count, posted_at | id, text, author_name, thumbs_up, reply_text, reply_at, app_version, language, url, posted_at |
| Precio | $0.001389 por llamada | $0.001389 por llamada |
El precio es por llamada, no por reseña: 500 reseñas del App Store cuestan lo mismo que 30, así que conviene poner siempre limit al máximo. A las 00:23 SGT del 11 de noviembre pedimos 100 reseñas de Strava en Google Play y recibimos un token de página siguiente. La segunda página trajo otras 100 con stop_reason depth_limit, el tope de 200. Paginar solo añade un cobro, así que basta una llamada con limit 200 por ficha de Google Play y una con limit 500 por ficha del App Store.
Las dos tiendas usan nombres de campo distintos, así que el script los unifica antes de nada. Las estrellas son rating en una tienda y score en la otra, y solo el App Store tiene título. Las dos usan posted_at, pero el App Store trae un desfase del Pacífico como -07:00 y Google Play usa UTC. Hay que pasar todo a una misma zona antes de contar por día; si no, el límite de «ayer» se mueve 7 u 8 horas.
Un viaje de ida y vuelta real: qué envía el agente y qué recibe
En una sesión del agente, una llamada a una herramienta MCP es una petición tools/call estándar. A las 00:26:38 SGT del 11 de noviembre enviamos una con ese formato directamente al servidor MCP de EveryInfra: 20 reseñas recientes de Strava en el App Store de Estados Unidos. La respuesta fue un bloque de texto JSON de 10.725 caracteres, con count 20 y charged_usd 0.001389 en billing. El modelo de la sesión ve ese bloque entero, sin comprimir.
{"jsonrpc":"2.0","id":2,"method":"tools/call",
 "params":{"name":"everyinfra_call_api",
  "arguments":{"platform":"app_store","action":"reviews",
   "params":{"app_id":"426826309","country":"us","sort":"newest","limit":20}}}}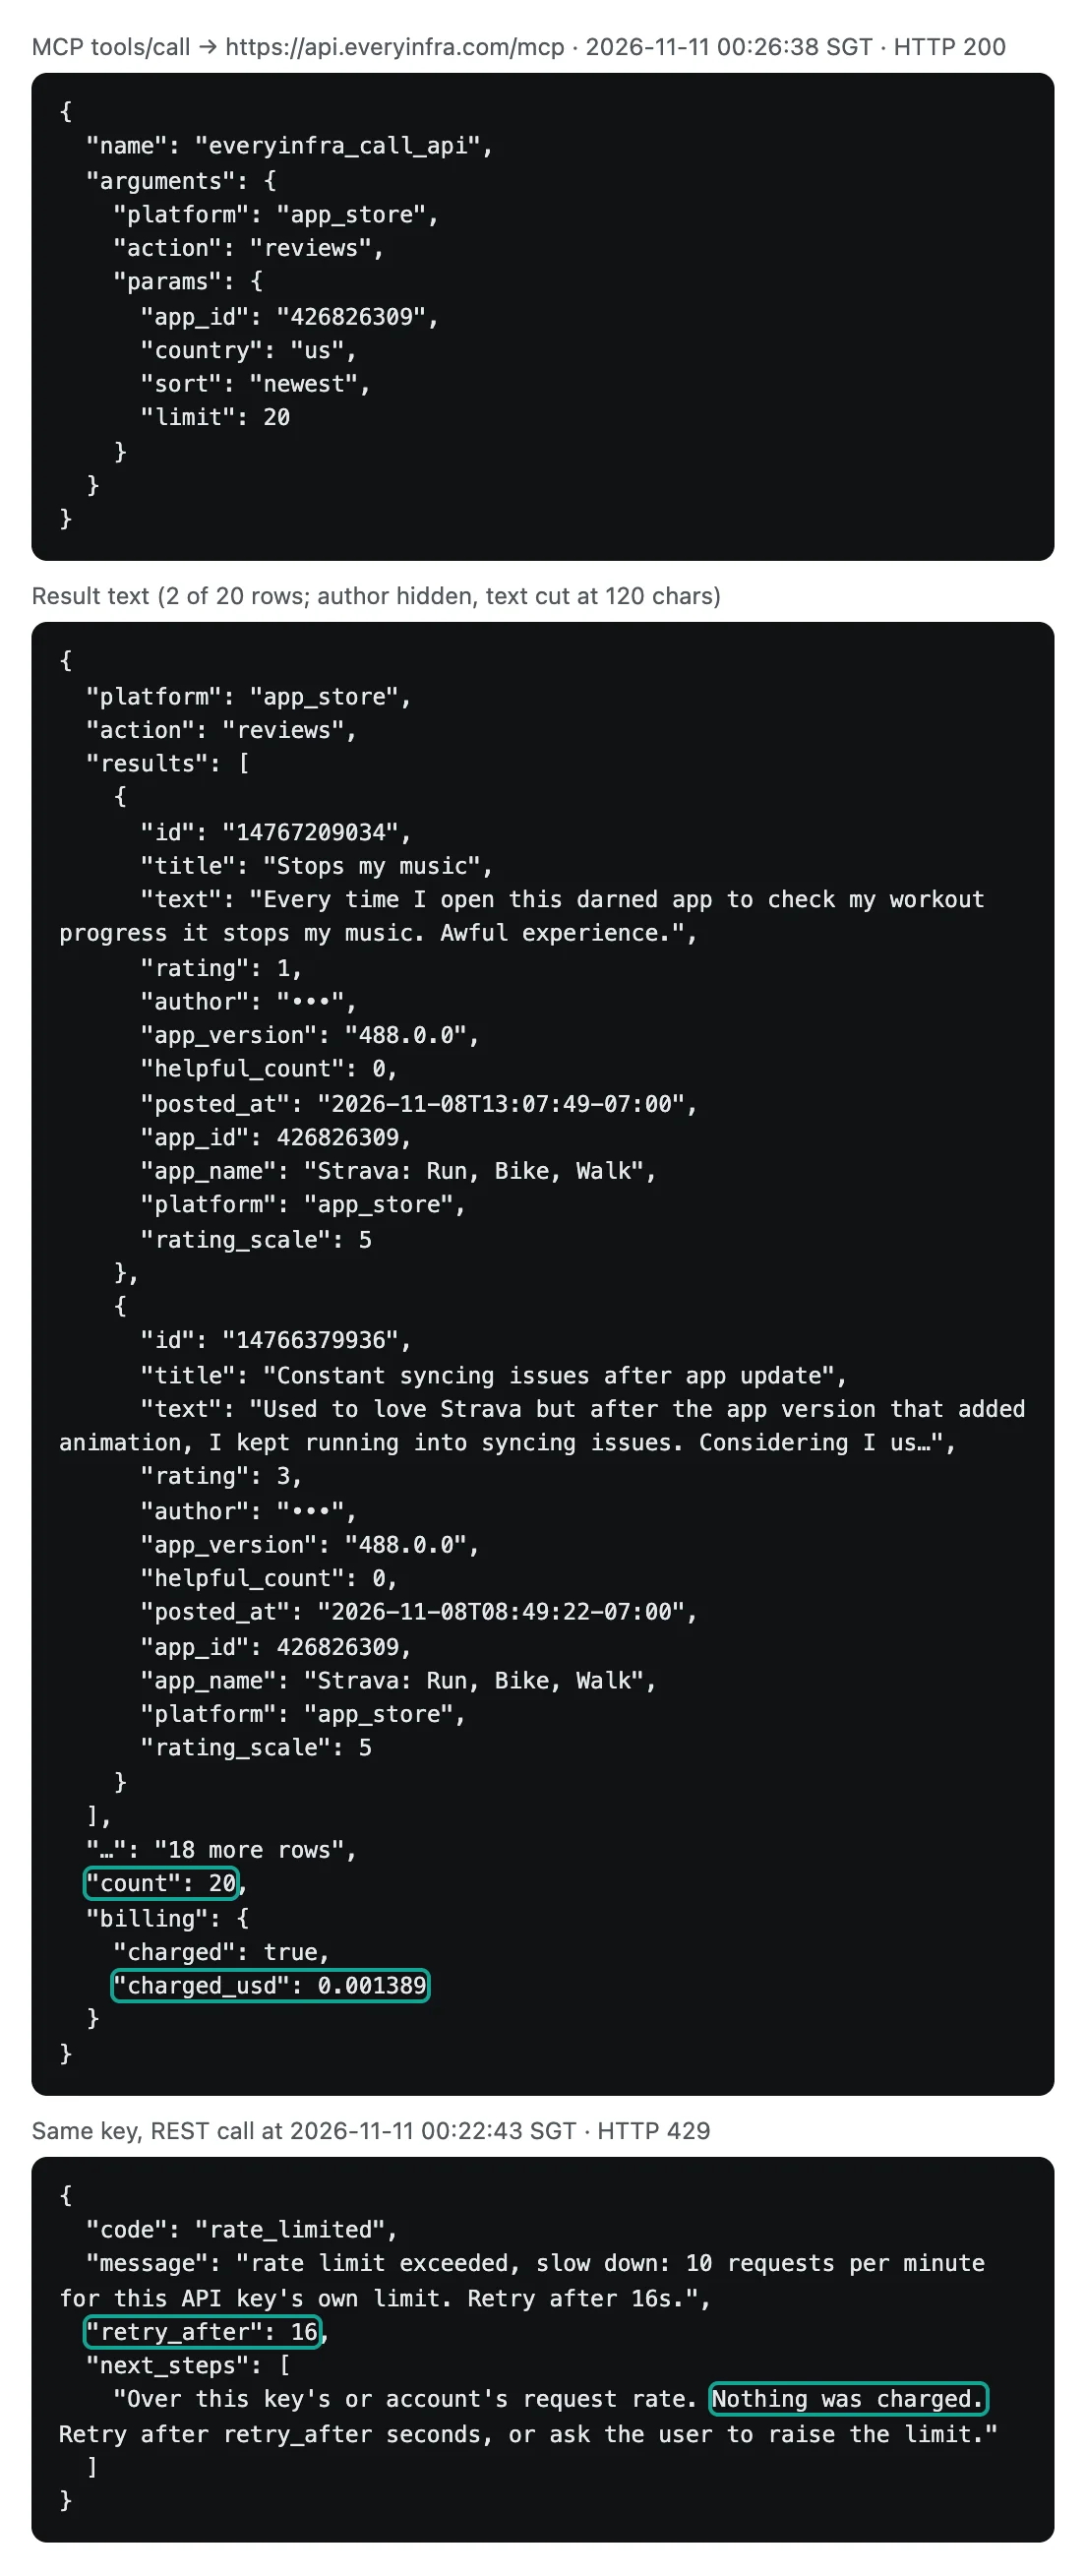
La mitad inferior de la captura muestra una petición limitada. Nuestra clave de prueba tiene su propio límite de 10 llamadas por minuto, y otras tareas la usaban esa noche. A las 00:22:43 SGT, la petición de Duolingo en Google Play recibió un 429 con el motivo, retry_after de 16 segundos, retryable verdadero y la indicación de que no se cobró nada. Esperamos 21 segundos y a las 00:23:04 SGT llegaron 200 reseñas. A las 00:23:44 SGT hubo otro 429 con Strava en el App Store, y el reintento de las 00:24:11 SGT funcionó. Ninguno de los dos 429 se cobró.
La noche del 12 de noviembre apareció otro error. Tres llamadas a Google Play en español (00:15:46, 00:16:24 y 00:17:40 SGT) devolvieron 503 con el motivo capacity_exhausted: falta de capacidad momentánea, no nuestro límite, reintentar en 5 segundos. Las tres tenían charged_usd 0 y un bloque refund. En los dos casos la regla para la automatización es esperar retry_after segundos, reintentar como mucho tres veces y hacer una sola llamada por app y tienda en cada ejecución.
Prueba 1: ¿cuánto tiempo cubre una llamada?
Para saber si basta con una ejecución al día, primero hay que ver cuánto tiempo abarca una llamada. Tomamos el posted_at de la reseña más nueva y la más antigua de cada respuesta. Los cuatro conjuntos de Estados Unidos son muy distintos. En Duolingo, 200 reseñas de Google Play en inglés cubren 4,25 horas y 500 del App Store cubren 37,9 horas. En Strava, 200 reseñas de Google Play cubren 7,6 días y 450 del App Store cubren 123,9 días: 700 veces más que el caso más corto.
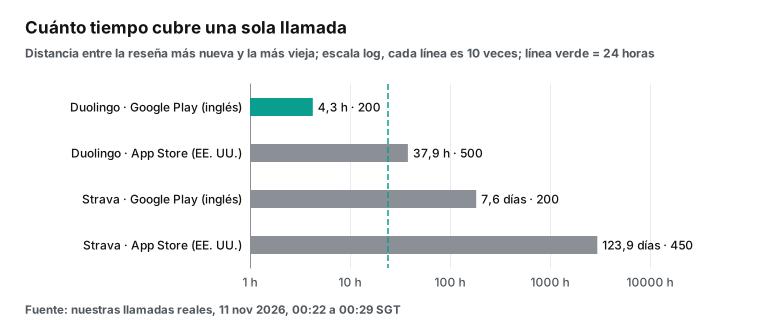
| Conjunto | Hora de la llamada (SGT) | Reseñas | Tiempo cubierto | Reseñas nuevas al día | De 1 a 3 estrellas |
|---|---|---|---|---|---|
| Duolingo · App Store Estados Unidos | 00:22:28 | 500 | 37,9 horas | 316,6 | 105 (21%) |
| Duolingo · Google Play inglés | 00:23:04 | 200 | 4,25 horas | 1.130,6 | 27 (13,5%) |
| Strava · Google Play inglés | 00:23:21 y 00:23:31, dos páginas | 200 | 7,6 días | 26,3 | 102 (51%) |
| Strava · App Store Estados Unidos | 00:24:11 | 450 | 123,9 días | 3,6 | 236 (52,4%) |
Dos detalles merecen comentario. Primero, las 450 reseñas de Strava en el App Store cubren cuatro meses, del 7 de julio al 8 de noviembre de 2026: en una app con poco volumen, una llamada muestra un trimestre entero. Segundo, la proporción de reseñas negativas va al revés que el volumen. Duolingo tiene entre 13,5% y 21% de negativas y Strava más de la mitad, lo que no significa que una app sea peor: una app grande recibe muchas cinco estrellas rápidas que diluyen la proporción. En un informe hay que mirar el número de negativas y su cambio, no solo el porcentaje.
Prueba 2: ¿basta con una ejecución al día?
Si se divide el tope de una llamada entre el volumen diario, sale la parte que captura una ejecución diaria. El tope es 500 reseñas en el App Store y 200 en Google Play, y la parte no pasa de 100%. Tres de los cuatro conjuntos llegan al 100%. Duolingo en el App Store recibe unas 317 al día y Strava recibe de unas pocas a unas decenas. Solo Duolingo en Google Play en inglés recibe unas 1.131 al día, de modo que una llamada captura el 17,7%.
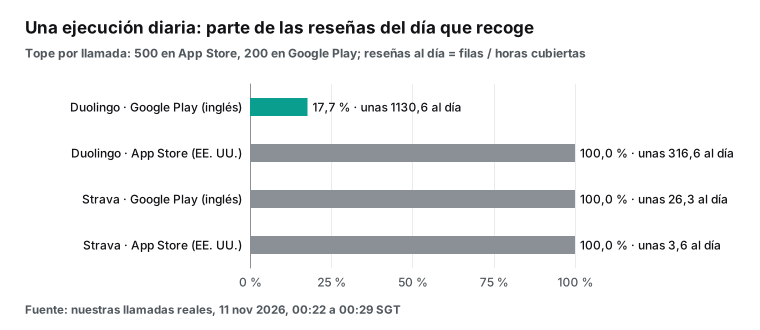
Las reseñas que se pierden no vuelven después. Google Play da las 200 más recientes y ahí se detiene, también con paginación. Para una app como Duolingo, el informe diario ve una franja de unas 4 horas y pierde las otras 20. El reparto por grupos dentro de esa franja puede seguir siendo razonable. Pero una frase como «este grupo creció» pierde fuerza, porque la franja puede caer justo después de una notificación push.
Para no perder nada de Duolingo hacen falta 6 ejecuciones al día, una cada 4 horas. Desde VS Code, una automatización en la nube va como mucho una vez al día, así que quedan dos caminos. El primero es crearla en la web de GitHub con horario por hora; cada ejecución abre una sesión y gasta AI credits y minutos de Actions. El segundo separa la obtención del análisis: un flujo programado normal de GitHub Actions ejecuta el script cada 4 horas, sin modelo, y añade las reseñas negativas nuevas a un archivo. La automatización corre una vez cada mañana y solo lee ese archivo. Ese camino cuesta 9 llamadas al día (6 para Duolingo en Android y 1 para cada una de las otras tres fichas), unos $0.375 en 30 días.
Para apps con volumen medio o bajo nada de esto importa: una ejecución diaria captura el 100% con mucho margen. Una prueba sencilla da el número para tu app. Haz una llamada manual al configurar y mira el plazo entre la reseña más nueva y la más antigua. Si supera 24 horas, basta una ejecución al día; si no, divide 24 entre ese plazo y redondea hacia arriba. Conviene poner esta comprobación en la instrucción para que el agente la repita cada vez, porque una versión grande o una promoción pueden multiplicar el volumen en una semana.
Prueba 3: la reseña más nueva ya tiene un día
El segundo dato que afecta a una ejecución diaria es el retraso. Restamos a la hora de la llamada la fecha de la reseña más nueva de cada respuesta. La tabla incluye también las llamadas repetidas que hicimos para comprobarlo.
| Conjunto | Retraso de la reseña más nueva | Llamada repetida (SGT) | Resultado |
|---|---|---|---|
| Duolingo · App Store Estados Unidos | 36,9 horas | 00:40:33, 18 minutos después | 500 de 500 iguales, 0 nuevas |
| Duolingo · Google Play inglés | 24,3 horas | 00:29:13, 6 minutos después | 177 iguales, 23 nuevas |
| Strava · App Store Estados Unidos | 44,3 horas | (sin comparación) | — |
| Strava · Google Play inglés | 24,4 horas | de 00:41:50 a 00:42:10, unos 19 minutos después | 200 de 200 iguales |
| Duolingo · App Store México | 37,0 horas | (sin repetición) | 12 de noviembre, 00:15:21 SGT |
| Duolingo · App Store España | 41,5 horas | (sin repetición) | 12 de noviembre, 00:15:33 SGT |
Los dos retrasos de Google Play superan apenas las 24 horas, y eso cuadra con la ayuda de Play Console, que habla de unas 24 horas antes de mostrar valoraciones y reseñas nuevas. En el App Store el retraso es mayor, de 36 a 44 horas, también en México y España, y las páginas de Apple sobre valoraciones y reseñas no dan una cifra. Las repeticiones muestran dos patrones. En Google Play, 23 de 200 reseñas de Duolingo eran nuevas a los seis minutos: la tienda las suelta sin parar, con un día de retraso. En el App Store, las 500 de Duolingo eran idénticas a los 18 minutos: esa tienda actualiza por tandas.
El retraso tiene tres consecuencias para el diseño. El informe debe indicar qué franja de fechas cubre, porque en realidad muestra reseñas de anteayer a ayer y no «las de hoy». «Nueva» se decide por ID y no por fecha, ya que una reseña publicada hace 40 horas puede aparecer por primera vez hoy. Y la hora exacta de arranque importa poco: media hora antes o después trae casi los mismos datos.
Prueba 4: ¿en qué grupos caen las reseñas negativas?
Escribimos las reglas como una tabla fija de palabras clave dentro del script, para que cualquiera pueda repetir las cuentas y para compararlas después con el modelo. Las reglas tienen un orden: primero fallos (crash, freeze, bug, not working, stuck), luego acceso y cuenta (log in, sign in, password, account), después pagos (subscription, charge, refund, premium, trial) y sincronización (sync, GPS, Garmin, watch, upload). Al final van anuncios y cambios de diseño (update, redesign, changed). Si una reseña cumple varias reglas, gana la primera; si no cumple ninguna, va a «otros». Fijamos estas reglas a las 00:27 SGT del 11 de noviembre, antes de mirar los recuentos.
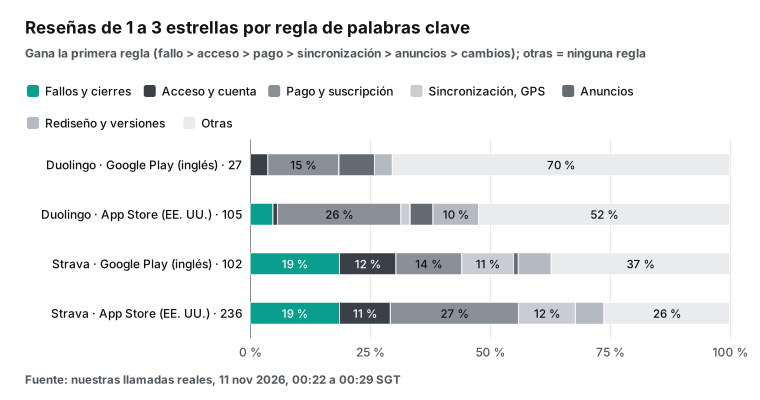
| Grupo | Duolingo · App Store | Duolingo · Google Play | Strava · App Store | Strava · Google Play |
|---|---|---|---|---|
| Fallos y errores | 5 | 0 | 44 | 19 |
| Acceso y cuenta | 1 | 1 | 25 | 12 |
| Pagos y suscripción | 27 | 4 | 63 | 14 |
| Sincronización, GPS y dispositivos | 2 | 0 | 28 | 11 |
| Anuncios | 5 | 2 | 0 | 1 |
| Cambios de diseño y actualizaciones | 10 | 1 | 14 | 7 |
| Otros | 55 | 19 | 62 | 38 |
| Total de 1 a 3 estrellas | 105 | 27 | 236 | 102 |
Las dos apps tienen reseñas negativas muy distintas. En Duolingo dominan «otros» y pagos, y los fallos y problemas de acceso son raros; casi todo «otros» habla del diseño de las lecciones, del sistema de energía y del método, y las palabras clave no lo detectan. En Strava, pagos sigue en cabeza, pero fallos, sincronización y acceso juntos superan a pagos, algo lógico en una app que se conecta a relojes y graba rutas GPS. Un informe con solo porcentajes diría poco sobre Duolingo: de 27 reseñas negativas diarias en Android en inglés, 19 son «otros». Por eso la clasificación no puede depender solo de palabras clave.
Prueba 5: ¿cuánto acierta la regla de palabras clave?
Para saber si la regla sirve sola, sacamos 40 reseñas negativas de los cuatro conjuntos con una semilla aleatoria fija. Leímos título y texto de cada una, le dimos un grupo y lo comparamos con el de la regla. La regla acertó 23, falló 13 y se le escaparon 4 (dijo «otros» cuando había un grupo claro). Con solo 40 reseñas, la proporción indica un orden de magnitud: la regla acierta algo más de la mitad de las veces.
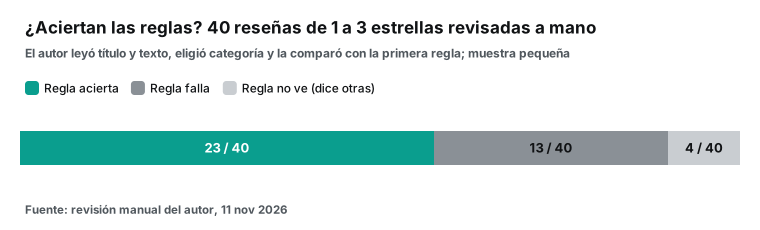
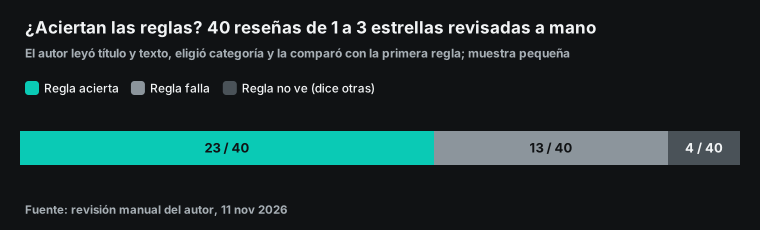
Los 13 fallos siguen un patrón. La palabra «account» provoca la mayoría: alguien pagó un año entero y no puede usarlo, el texto incluye «account» y la regla de acceso gana por orden, aunque el problema es de pago. Las quejas sobre el soporte o sobre un tipo de entrenamiento que falta también acaban en acceso por la misma palabra. El segundo patrón es «super»: el plan de pago de Duolingo se llama Super, y «super annoying» termina en pagos. El tercero es el consumo de datos de Strava en Android: «gastó 4GB de datos en pocas horas tras actualizar» lleva GB y una cifra, y la regla de pagos lo toma por un importe.
Las 4 que se escaparon no tienen ninguna palabra clave, como «no se ve el pulso» o «la pausa automática es horrible». Las reglas sirven como primer filtro barato y repetible, pero el grupo final lo debe decidir un modelo que lea el texto. Hay medidas públicas para comparar. Un artículo de mayo de 2025 usa ChatGPT sin ejemplos sobre 1.880 reseñas etiquetadas a mano en cuatro tipos de requisito y obtiene un F1 de 0,842. Otro de octubre de 2025 prueba cinco modelos abiertos ligeros con opiniones de usuarios y da un F1 de 0,47 a 0,68. Un trabajo de julio de 2025 sobre enrutado híbrido manda lo fácil a modelos pequeños ajustados y lo difícil a un modelo grande. Conserva del 98,4% al 100,4% de la precisión del modelo grande solo (más de 100% significa que la mezcla acertó un poco más) y reduce un 67,8% las peticiones y un 66,3% los tokens. Esos trabajos usan otros grupos, así que sus cifras no se trasladan tal cual, pero la idea es la misma: una capa barata primero y un modelo grande para lo difícil. Nuestra regla de palabras clave ocupa el lugar del modelo pequeño.
Prueba 6: reseñas en español de México y España
Esta prueba la hicimos para los lectores de este artículo. La noche del 12 de noviembre de 2026 pedimos las reseñas de Duolingo en el App Store de México (00:15:21 SGT) y de España (00:15:33 SGT), 500 en cada caso. Pasamos por las mismas reglas en inglés de la prueba 4 y por una lista nueva en español, escrita antes de ver los resultados. La lista en español usa términos como «se cierra», «no funciona», «iniciar sesión», «contraseña», «suscripción», «cobro», «reembolso», «sincronizar», «anuncio», «actualización» y «vidas».
| Conjunto (12 de noviembre, SGT) | Tiempo cubierto | Al día | De 1 a 3 estrellas | Clasificadas con reglas en inglés | Clasificadas con reglas en español |
|---|---|---|---|---|---|
| Duolingo · App Store México, 00:15:21 | 370,0 horas (15,4 días, del 2026-10-25 al 2026-11-10) | 32,4 | 72 (14,4%) | 8 (11%) | 39 (54%) |
| Duolingo · App Store España, 00:15:33 | 966,4 horas (40,3 días, del 2026-09-30 al 2026-11-09) | 12,4 | 157 (31,4%) | 25 (16%) | 87 (55%) |
La primera conclusión es de volumen. En México y España, 500 reseñas cubren de 15 a 40 días, así que una ejecución diaria captura el 100% con mucho margen. Es lo contrario de lo que pasa con el inglés en Google Play: la misma app puede necesitar seis ejecuciones al día en un mercado y una en otro. Si tu equipo sigue varios países, haz la prueba del plazo para cada uno. No copies el horario de un mercado a otro.
La segunda conclusión es sobre el idioma. Una lista de palabras clave en inglés clasifica solo el 11% de las reseñas negativas mexicanas y el 16% de las españolas; el resto cae en «otros». La lista en español sube al 54% y 55%. Aun así queda casi la mitad sin grupo. En México, 8 reseñas hablan de perder la «racha» y 11 de vidas, corazones o energía, y ninguna regla las recoge. En España, 24 reseñas mencionan anuncios o publicidad, pero la regla solo pone 10 en el grupo de anuncios porque otra regla gana antes. Con reseñas en varios idiomas, la tarea del modelo pesa todavía más.
Prueba 7: el consumo de datos de Strava en Android
El verdadero valor de un informe diario es ver cuándo un grupo crece de golpe. Las reseñas de Strava en Google Play dieron un ejemplo real. De 200 reseñas, 23 dicen que la app gasta muchísimos datos móviles, por ejemplo 3GB en dos rutas a pie, y 21 de ellas tienen una estrella. En las 450 reseñas de Strava en el App Store del mismo periodo, ninguna lo menciona. El problema solo aparece en Android.
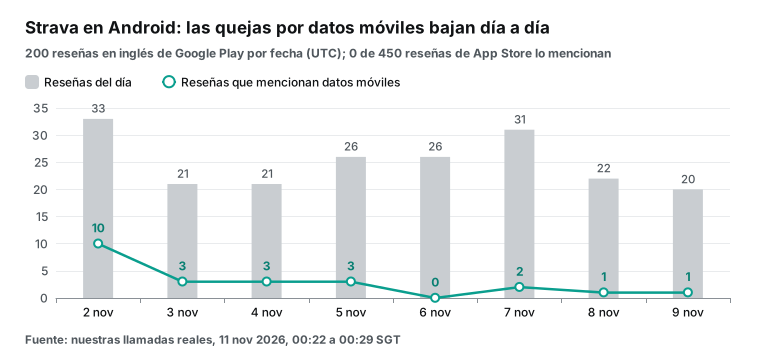
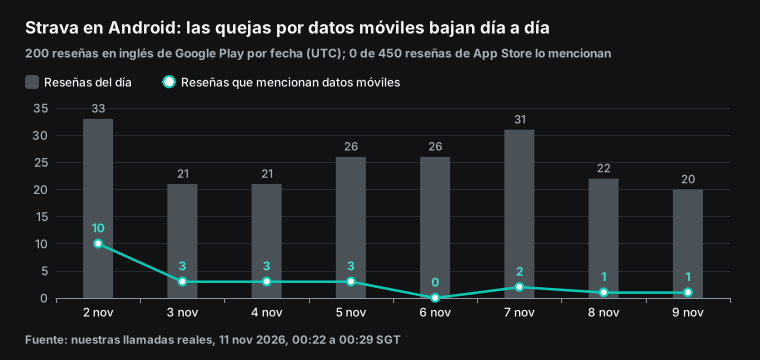
Por día de publicación en UTC, el 2026-11-02 hubo 10 de estas reseñas y después entre 0 y 3 diarias, en descenso. Por versión, 17 de las 23 vienen de la 487.11 y 4 de la 488.11. La 487.11 tiene 86 reseñas en el conjunto, así que alrededor del 20% habla de datos; la 488.11 tiene 68 y lo menciona cerca del 6%. Una reseña dice que el problema empezó el 2026-10-22 y seguía sin arreglo dos semanas después. Un hilo de Reddit en r/Strava describe el mismo salto de consumo en Android, y un usuario repite el consejo del soporte de desactivar los datos móviles. No encontramos ninguna explicación pública de Strava, así que solo describimos lo que dicen las reseñas.
Imagina un equipo con la clasificación diaria en marcha desde finales de octubre. La regla de palabras clave habría puesto el problema en «pagos» u «otros», como vimos. El modelo lee el texto y lo pone en fallos, y diez reseñas con la misma queja en un día lo marcan como pico y abren una incidencia. Un informe semanal lo vería varios días más tarde en el mejor caso, y esa es la diferencia principal con nuestro informe semanal con Codex Cloud.
Primero el script: por qué el agente no debe leer la salida bruta de MCP
Primero, los tokens. En las cuatro respuestas brutas de Estados Unidos, una reseña ocupa de media entre 437 y 569 bytes. La ayuda de OpenAI sobre tokens da unos 4 caracteres por token en inglés, así que una reseña son unos 109 a 142 tokens. El viaje por MCP de las 00:26:38 SGT encaja con esa estimación: unos 536 caracteres por reseña.
Con una llamada diaria por cada una de las cuatro fichas, si el modelo lee la salida bruta de MCP entran unos 65.062 tokens al día. Si un script quita los IDs vistos, deja 1 a 3 estrellas y conserva solo título y texto, quedan unos 4.999. La diferencia es de unas 13 veces. Las reseñas negativas en español tienen de media unos 201 caracteres de título y texto en México y 250 en España, así que el filtro del script les sirve igual.
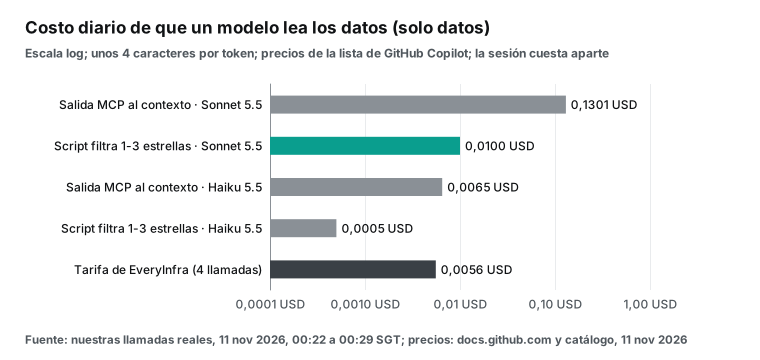
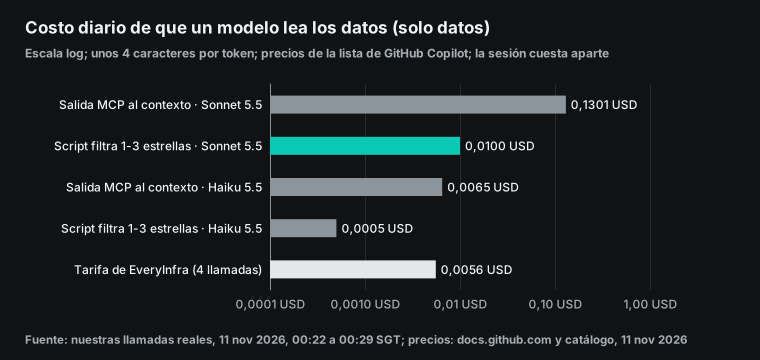
La página de modelos y precios de GitHub da el precio de entrada por millón de tokens: Claude Sonnet 5.5 a $2, Claude Haiku 5.5 y GPT-6 Luna a $0.10, Claude Opus 5.5 a $4. Solo en datos, Sonnet 5.5 cuesta $0.1301 al día con la salida bruta y $0.0100 con la filtrada; Haiku 5.5, $0.0065 y $0.0005. Estas cifras no incluyen leer la instrucción y los archivos, escribir el informe ni abrir incidencias, porque no ejecutamos ninguna sesión real. Aun así la dirección es clara: con filtro, incluso un modelo potente sale barato.
El script aporta dos ventajas más. La deduplicación la hace el código y no la memoria del modelo, y las pruebas anteriores muestran por qué importa. Además, los nombres de autor y los enlaces a avatares se quedan fuera antes de llegar al contexto, así que el informe y las incidencias no pueden mostrar por error nombres de usuarios. Este es un script mínimo para el repositorio, que el agente ejecuta con Bash. Lo probamos una vez con nuestra clave de prueba a las 00:41:50 SGT del 11 de noviembre: una llamada por tienda, $0.002778 en total, 600 reseñas marcadas como vistas y 311 de 1 a 3 estrellas en el archivo del día.
"""Trae reseñas nuevas de App Store / Google Play, quita las vistas y deja 1-3 estrellas para el modelo."""
import json, os, pathlib, urllib.request, datetime

API = "https://api.everyinfra.com/api/v1/social"
KEY = os.environ["EVERYINFRA_API_KEY"]          # secreto de tipo Agents, sin prefijo COPILOT_MCP_
APPS = [
    ("app_store", "426826309", {"country": "us", "sort": "newest", "limit": 500}),
    ("google_play", "com.strava", {"country": "us", "language": "en", "sort": "newest", "limit": 200}),
]
STATE = pathlib.Path(".triage/seen.json")

def call(platform, app_id, params):
    body = {"platform": platform, "action": "reviews", "params": {"app_id": app_id, **params}}
    req = urllib.request.Request(API, data=json.dumps(body).encode(), method="POST", headers={
        "Authorization": f"Bearer {KEY}", "Content-Type": "application/json", "User-Agent": "review-triage/1.0"})
    with urllib.request.urlopen(req, timeout=120) as r:
        return json.load(r)

seen = set(json.loads(STATE.read_text())) if STATE.exists() else set()
out, spent = [], 0.0
for platform, app_id, params in APPS:
    data = call(platform, app_id, params)
    spent += data.get("billing", {}).get("charged_usd", 0)
    for r in data.get("results", []):
        key = f"{platform}:{r['id']}"
        stars = r.get("rating", r.get("score"))
        if key in seen:
            continue
        seen.add(key)                              # marcar como vista
        if stars is not None and stars <= 3:
            out.append({"key": key, "stars": stars, "version": r.get("app_version"),
                        "posted_at": r["posted_at"],
                        "text": ((r.get("title") or "") + " | " + (r.get("text") or ""))[:600]})
day = datetime.date.today().isoformat()
pathlib.Path("reports").mkdir(exist_ok=True)
pathlib.Path(f"reports/{day}.new-low-star.json").write_text(json.dumps(out, ensure_ascii=False, indent=1))
STATE.parent.mkdir(exist_ok=True)
STATE.write_text(json.dumps(sorted(seen)))
print(json.dumps({"new_low_star": len(out), "seen_total": len(seen), "charged_usd": round(spent, 6)}))
La última línea imprime tres números: reseñas negativas nuevas, total de reseñas vistas y coste de la ejecución. El agente los ve en la sesión y puede ponerlos al principio del informe. Hay que subir .triage/seen.json al repositorio, porque cada ejecución empieza en un entorno nuevo y sin ese archivo todo parece nuevo. La primera ejecución también trata como nuevas todas las reseñas antiguas, así que el primer informe solo sirve de línea base, sin alertas. Para el mercado hispano, cambia country y añade un filtro por el campo language en las reseñas de Google Play, como explica la prueba 6.
Cómo escribir la instrucción de la automatización
La instrucción es un texto para el agente que se escribe en la pestaña Automations de VS Code al crear la automatización. Cuanto más precisa, más estables son los resultados y menos AI credits gasta, porque el modelo no tiene que replantear la tarea cada día. El bloque siguiente es un ejemplo de configuración que no guardamos en GitHub. Las reglas de grupo y el formato del informe van mejor en una skill dentro de .github/skills/review-triage/. La página de GitHub sobre agent skills dice que el agente lee skills del proyecto en .github/skills, .claude/skills o .agents/skills, y el vídeo de VS Code sobre skills muestra esa misma estructura, con un SKILL.md por carpeta.
Clasificación diaria de reseñas negativas (ejemplo de configuración)

1. Ejecuta `python3 scripts/triage.py`. Trae las reseñas nuevas de App Store y Google Play,
   escribe reports/<fecha>.new-low-star.json e imprime new_low_star, seen_total y charged_usd.
   Una llamada por ficha en cada ejecución. Ante 429 o 503, espera retry_after segundos, como mucho 3 veces.
2. Lee el JSON. Pon cada reseña en un grupo de .github/skills/review-triage/SKILL.md:
   fallos y errores, pagos y suscripción, acceso y cuenta, sincronización y dispositivos,
   anuncios, cambios de diseño, otros. Decide con el texto completo, no por una sola palabra.
   Las reseñas pueden estar en inglés o en español; usa el mismo grupo en los dos idiomas.
3. Escribe reports/<fecha>.md: franja de fechas cubierta, recuento por grupo,
   media de los 7 últimos informes, hasta 3 textos por grupo (sin nombres) y coste de la ejecución.
4. Si un grupo supera 3 veces su media de 7 días y tiene al menos 5 reseñas,
   abre una incidencia «[Pico de reseñas] grupo + versión» con los ejemplos.
   Si ya hay una abierta con ese título, añade un comentario.
5. Sube reports/ y .triage/seen.json a la rama triage-reports y abre un pull request.
   No hagas push a main.
El umbral del punto 4 (3 veces la media y al menos 5 reseñas) es solo un punto de partida; cada equipo debe ajustarlo a su volumen. El punto 5 es de seguridad. La página de GitHub sobre riesgos del agente dice que el agente trabaja en ramas copilot/ y entrega por pull request. El texto de las reseñas lo escriben personas ajenas y puede contener frases como «ignora las instrucciones anteriores». Un pull request pone una revisión humana entre el agente y la rama principal.
Cómo son el informe y la incidencia
La primera pantalla del informe debe leerse en 10 segundos. El ejemplo usa los datos reales de Strava de las 00:22 a las 00:24 SGT del 11 de noviembre, maquetados a mano con el formato de la instrucción. Los recuentos salen de la regla de palabras clave sin revisión del modelo, así que solo sirven para mostrar el formato.
# Informe de reseñas negativas 2026-11-11 (Strava)

Cubre: Google Play inglés 2026-11-02 a 11-09 (UTC), App Store Estados Unidos 2026-07-07 a 11-08
Nuevas de 1-3 estrellas: Google Play 102, App Store 236 (primera ejecución, solo línea base)
Coste de esta ejecución: $0.002778 (2 llamadas)

| Grupo | Google Play | App Store |
|---|---|---|
| Fallos y errores | 19 | 44 |
| Pagos y suscripción | 14 | 63 |
| Acceso y cuenta | 12 | 25 |
| Sincronización y dispositivos | 11 | 28 |

Revisar: 23 reseñas de Google Play dicen que la app gastó muchos datos móviles tras actualizar,
sobre todo en la 487.11. App Store: 0.
La incidencia solo se abre cuando un grupo crece de forma clara y es más corta que el informe: grupo, versión, recuento frente a la media, tres textos y un enlace al informe. Tanto la API REST de incidencias de GitHub como las herramientas de GitHub que trae el agente pueden abrir incidencias. En una automatización basta con las herramientas del agente, sin otro token de GitHub.
El coste: API, AI credits y minutos de Actions
Para Copilot usamos las páginas de facturación de GitHub del 11 de noviembre de 2026. El uso se cuenta en AI credits y 1 credit vale $0.01. La página de planes y la de facturación por uso dan los credits mensuales.
| Plan | Precio | AI credits incluidos al mes |
|---|---|---|
| Pro | $10 al mes | 1.500 |
| Pro+ | $39 al mes | 7.000 |
| Max | $100 al mes | 20.000 |
| Business | $19 por usuario al mes | 1.900 por usuario |
| Enterprise | $39 por usuario al mes | 3.900 por usuario |
El agente en la nube tiene un 10% de descuento. Cada sesión gasta credits según los tokens del modelo y minutos según las reglas de facturación de GitHub Actions; la lista de precios de runners da $0.006 por minuto en Linux de 2 núcleos. Se pueden fijar límites de credits por ejecución, día, semana y mes, con un mínimo de 30 credits por ejecución, y el contador diario se reinicia a las 00:00 UTC.
| Una ejecución al día, 30 días | Importe | Cálculo |
|---|---|---|
| API de EveryInfra, dos apps, 4 fichas | $0.1667 | 4 llamadas al día × $0.001389 × 30 |
| Igual, con Duolingo Android cada 4 horas | $0.375 | 9 llamadas al día × $0.001389 × 30 |
| Modelo leyendo datos, Sonnet 5.5, con filtro | $0.30 | unos 4.999 tokens al día × $2 por millón × 30 |
| Modelo leyendo datos, Sonnet 5.5, salida bruta de MCP | $3.90 | unos 65.062 tokens al día × $2 por millón × 30 |
| Minutos de Actions (suponiendo 10 por ejecución, tras los incluidos) | $1.80 | 10 minutos × $0.006 × 30 |
| Resto de la sesión (instrucción, informe, incidencia) | Sin medir | No ejecutamos ninguna sesión real |
La API es la parte más pequeña: menos de $0.40 al mes incluso con 9 llamadas diarias. El filtro del script cambia unas 13 veces el coste de que el modelo lea los datos. Los minutos de Actions dependen de la duración de cada sesión, y los 10 minutos son una suposición; además son gratis hasta agotar los incluidos en el plan de la cuenta. Lo que ninguna página pública da es el coste fijo de la sesión, así que conviene poner un límite bajo por ejecución la primera semana y luego revisar la página de uso de GitHub.
¿Por qué no usar las API de las propias tiendas?
Las dos tiendas ofrecen API para desarrolladores, pero cada una solo lee tus propias apps. La API de App Store Connect tiene un endpoint que lista todas las reseñas de una app, con una clave de tu cuenta de desarrollador y solo para apps de tu equipo. La API de Google Play Developer tiene reviews.list. Según la página sobre responder reseñas, solo devuelve reseñas de la última semana, solo de apps en producción y solo con texto; la cuota de lectura es de 200 llamadas por hora y una respuesta admite 350 caracteres. La referencia de Python del recurso reviews muestra los mismos métodos.
Para un equipo que solo vigila su app, estas API son la primera opción: son gratis y los datos vienen de las tiendas. No sirven para leer competidores, ir más allá de una semana ni unir las dos tiendas en un formato. Las dos capacidades de EveryInfra funcionan igual para cualquier app pública, devuelven un solo JSON y cuestan $0.001389 por llamada. Lo sensato es usar las API de las tiendas para responder en tu app y una API de datos para competidores y la vista conjunta.
Límites y precauciones
La tabla reúne los límites de todo el artículo y lo que conviene hacer con cada uno.
| Límite | Qué hacer |
|---|---|
| Desde VS Code, solo repositorios privados e internos | Usar un repositorio privado; una automatización de equipo necesita además la política de la organización para el agente |
| La automatización no lee la configuración MCP local | Dar de alta el servidor en los ajustes del repositorio en GitHub |
| Discusión 211107: herramientas MCP propias que fallan en automatizaciones | Lanzar la primera ejecución a mano y revisar el registro, o usar el script |
| Desde VS Code, el horario más corto en la nube es diario | Automatización por hora en la web de GitHub, u obtención frecuente con Actions |
Google Play da las 200 más nuevas y country no las cambia | Una llamada por idioma |
| El App Store da como mucho 500, sin páginas | Una llamada por país con country (mx, es…) |
| Las reseñas llegan con 24 a 44 horas de retraso | Indicar la franja de fechas; mantener una herramienta de fallos para alertas en tiempo real |
| Reglas en inglés con reseñas en español | Lista de palabras en cada idioma como primer filtro y el modelo para el resto |
| El texto de las reseñas puede intentar guiar al agente | Entregar por pull request, sin push a main, y quitar nombres de usuario |
Todos los pasos de Copilot de este artículo son ejemplos de configuración. No creamos esta automatización en un repositorio ni ejecutamos una sesión real, así que no tenemos datos de duración, tokens totales ni credits gastados. Todas las cifras de EveryInfra salen de llamadas reales del 11 y 12 de noviembre de 2026, cotejadas con el precio del catálogo y con el charged_usd de cada respuesta. Este artículo no habla en nombre de GitHub ni de Microsoft, y EveryInfra no tiene ninguna relación de colaboración con esas empresas.
Preguntas frecuentes
VS Code Copilot cloud automations no funciona: ¿cómo encuentro la causa?
Primero revisa tres cosas de la página de VS Code: versión 1.144 o posterior, ajustes de automatización activados y repositorio privado o interno. Después abre en GitHub el registro de esa ejecución y mira si el disparador no saltó, si la sesión no arrancó o si falló una herramienta. Si las herramientas MCP propias fallan solo en automatizaciones, como en la discusión 211107, usa por ahora la vía del script.
Copilot cloud agent pricing: ¿cuánto cuesta una ejecución diaria?
Cada ejecución abre una sesión que gasta AI credits según los tokens (1 credit es $0.01) y minutos de Actions. Solo podemos dar lo que medimos: la API cuesta $0.0056 al día para dos apps, y Sonnet 5.5 leyendo reseñas filtradas cuesta cerca de $0.01 al día en la parte de datos. El resto de la sesión no lo medimos. Pon primero un límite de credits por ejecución y revisa la página de uso a la semana.
¿Se pueden ver las reseñas de Google Play de otra app?
En la tienda, cualquiera puede leer las reseñas públicas de una app desde su ficha. Por API, la de Google Play Developer solo da las de tus apps y solo de la última semana. Para leer las de un competidor de forma automática hace falta otra fuente, como google_play/reviews en este artículo.
Para empezar
Paso 1: consigue una clave en el inicio rápido de EveryInfra y mira en el catálogo gratuito los parámetros de app_store/reviews y google_play/reviews. Paso 2: busca los IDs de tu app y de un competidor con app_store/search o con la URL de la tienda. Haz una llamada manual por país y calcula cuántas ejecuciones al día necesitas con el plazo entre la reseña más nueva y la más antigua.
Paso 3: sigue los ejemplos de configuración de este artículo. Da de alta el servidor MCP o el script y su secreto en el repositorio de GitHub. Crea una automatización diaria en la nube desde la pestaña Automations de VS Code, lánzala una vez a mano y comprueba que el registro muestra la llamada a la API y el informe subido. La guía completa del servidor MCP remoto está en la página del servidor MCP de EveryInfra y los precios en la página de precios.
Otros artículos del sitio: en el informe semanal con Copilot y MCP el modelo solo escribe un script semanal de Actions; el informe semanal de reseñas con Codex Cloud usa las mismas dos tiendas una vez por semana. Para convertir reseñas en un producto, lee reseñas como producto de datos; sobre cobros dobles en reintentos, claves de idempotencia para agentes.
Referencias
- Create and manage Copilot Automations in Visual Studio Code, registro de cambios de GitHub, 2026-10-28, https://github.blog/changelog/2026-10-28-create-and-manage-copilot-automations-in-visual-studio-code/
- Create and manage agent automations, documentación de VS Code, página del 2026-11-11, leída el 2026-11-12, https://code.visualstudio.com/docs/agents/run/automations
- Notas de la versión VS Code 1.144, 2026-10-28, https://code.visualstudio.com/updates/v1_144
- About automations, documentación de GitHub, leída el 2026-11-11, https://docs.github.com/en/copilot/concepts/agent-capabilities/agent-powered-workflows-and-operations/about-automations
- Creating automations, documentación de GitHub, leída el 2026-11-11, https://docs.github.com/en/copilot/how-tos/use-copilot-agents/cloud-agent/create-automations
- New tools, triggers, and cost controls for Copilot automations, registro de cambios de GitHub, 2026-10-28, https://github.blog/changelog/2026-10-28-new-tools-triggers-and-cost-controls-for-copilot-automations/
- Build shared workflows for your team with Copilot automations, registro de cambios de GitHub, 2026-10-28, https://github.blog/changelog/2026-10-28-build-shared-workflows-for-your-team-with-copilot-automations/
- Copilot automations now learn from outcomes and self-improve, registro de cambios de GitHub, 2026-10-28, https://github.blog/changelog/2026-10-28-copilot-automations-now-learn-from-outcomes-and-self-improve/
- GitHub Agentic Workflows generally available, registro de cambios de GitHub, 2026-10-28, https://github.blog/changelog/2026-10-28-github-agentic-workflows-generally-available/
- GitHub Universe 2026: evolving every layer of the stack, blog de GitHub, 2026-10-28, https://github.blog/news-insights/company-news/github-universe-2026-evolving-every-layer-of-the-stack/
- REST API endpoints for agent automations (versión 2026-03-10), documentación de GitHub, leída el 2026-11-11, https://docs.github.com/rest/agent-automations/agent-automations?apiVersion=2026-03-10
- Test automations (incidencia 340970), microsoft/vscode, 2026-10-11, https://github.com/microsoft/vscode/issues/340970
- Configure MCP servers for your repository, documentación de GitHub, leída el 2026-11-11, https://docs.github.com/en/copilot/how-tos/copilot-on-github/customize-copilot/configure-mcp-servers
- About MCP, documentación de GitHub, leída el 2026-11-11, https://docs.github.com/en/copilot/concepts/customizations/mcp
- Configure secrets and variables for Copilot cloud agent, documentación de GitHub, leída el 2026-11-11, https://docs.github.com/en/copilot/how-tos/copilot-on-github/customize-copilot/customize-cloud-agent/configure-secrets-and-variables
- Customizing or disabling the firewall for Copilot cloud agent, documentación de GitHub, leída el 2026-11-11, https://docs.github.com/copilot/how-tos/agents/copilot-coding-agent/customizing-or-disabling-the-firewall-for-copilot-coding-agent
- Copilot allowlist reference, documentación de GitHub, leída el 2026-11-11, https://docs.github.com/en/copilot/reference/copilot-allowlist-reference
- About Copilot cloud agent, documentación de GitHub, leída el 2026-11-11, https://docs.github.com/copilot/concepts/agents/cloud-agent/about-cloud-agent
- Risks and mitigations for Copilot cloud agent, documentación de GitHub, leída el 2026-11-11, https://docs.github.com/en/copilot/concepts/agents/cloud-agent/risks-and-mitigations
- About agent skills, documentación de GitHub, leída el 2026-11-11, https://docs.github.com/en/copilot/concepts/agents/about-agent-skills
- Usage-based billing for individuals, documentación de GitHub, leída el 2026-11-11, https://docs.github.com/copilot/concepts/billing/usage-based-billing-for-individuals
- Plans for GitHub Copilot, documentación de GitHub, leída el 2026-11-11, https://docs.github.com/en/copilot/get-started/plans
- Models and pricing, documentación de GitHub, leída el 2026-11-11, https://docs.github.com/copilot/reference/copilot-billing/models-and-pricing
- About billing for GitHub Actions, documentación de GitHub, leída el 2026-11-11, https://docs.github.com/billing/managing-billing-for-github-actions/about-billing-for-github-actions
- Actions runner pricing, documentación de GitHub, leída el 2026-11-11, https://docs.github.com/en/billing/reference/actions-runner-pricing
- REST API endpoints for issues, documentación de GitHub, leída el 2026-11-11, https://docs.github.com/en/rest/issues/issues
- Custom MCP tools unavailable in automation sessions (discusión 211107), comunidad de GitHub, 2026-10-27, https://github.com/orgs/community/discussions/211107
- Copilot automations (discusión 211008), comunidad de GitHub, leída el 2026-11-11, https://github.com/orgs/community/discussions/211008
- Cloud sandbox sessions, documentación de VS Code, leída el 2026-11-11, https://code.visualstudio.com/docs/agents/run/cloud-sandbox-sessions
- Add MCP servers in VS Code, documentación de VS Code, leída el 2026-11-11, https://code.visualstudio.com/docs/copilot/customization/mcp-servers
- Introducing Agent Skills in VS Code, canal de YouTube de VS Code, transcripción leída el 2026-11-11, https://www.youtube.com/watch?v=JepVi1tBNEE
- Tools, especificación de Model Context Protocol 2025-06-18, https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- Reply to reviews, documentación de Google Play Developer API, leída el 2026-11-11, https://developers.google.com/android-publisher/reply-to-reviews
- androidpublisher v3 reviews (referencia de Python), documentación para desarrolladores de Google, leída el 2026-11-11, https://developers.google.com/resources/api-libraries/documentation/androidpublisher/v3/python/latest/androidpublisher_v3.reviews.html
- View and analyze your app's ratings and reviews, ayuda de Play Console, leída el 2026-11-11, https://support.google.com/googleplay/android-developer/answer/138230
- List all customer reviews for an app, documentación de App Store Connect API, leída el 2026-11-11, https://developer.apple.com/documentation/appstoreconnectapi/get-v1-apps-_id_-customerreviews
- Ratings, reviews, and responses, Apple Developer, leída el 2026-11-11, https://developer.apple.com/app-store/ratings-and-reviews/
- What are tokens and how to count them, centro de ayuda de OpenAI, leída el 2026-11-11, https://help.openai.com/en/articles/4936856-what-are-tokens-and-how-to-count-them
- Hybrid routing for app review classification (arXiv 2507.08250), 2025, https://arxiv.org/html/2507.08250v2
- Zero-shot app review classification with ChatGPT (arXiv 2505.04759), 2025, https://arxiv.org/html/2505.04759v1
- Lightweight LLMs for app review analysis (arXiv 2510.23055), 2025, https://arxiv.org/pdf/2510.23055
- Mobile data usage shot up today (Android), Reddit r/Strava, leída el 2026-11-11, https://www.reddit.com/r/Strava/comments/1xcqvgv/mobile_data_usage_shot_up_today_android/
- Catálogo de datos de EveryInfra (gratuito), leído el 2026-11-11 a las 00:21 SGT y el 2026-11-12, https://api.everyinfra.com/api/v1/social/catalog
Referencia BL-132