Cómo extraer reseñas de Google Maps: API oficial, Python o API de datos
La API de Places devuelve como máximo 5 reseñas por local. Probamos tres vías, calculamos el coste por cada 1000 reseñas y damos un exportador CSV.
Tacos Chupacabras, en Coyoacán (Ciudad de México), tiene 18 361 reseñas en Google Maps. Si pides sus reseñas con la API oficial de Places, recibes cinco, elegidas por relevancia, y no hay forma de pasar a la siguiente página. Si lo intentas con un script de Python que descarga la página, recibes cero, porque las reseñas se cargan después con JavaScript. Con una API de datos de pago por llamada recibimos 100 reseñas por 0,001389 USD en cada llamada. El 2 de noviembre de 2026 probamos las tres vías con datos reales de Ciudad de México, Singapur y Austin; esta guía explica qué devuelve cada una, cuánto cuesta por cada 1000 reseñas y dónde falla.
Las reseñas pesan cada vez más. El 8 de octubre de 2026, Google publicó sus primeras listas Fan-Favorite de restaurantes, basadas en reseñas, valoraciones y solicitudes de indicaciones, para diez ciudades entre las que está Santiago de Chile [18]. El 21 de octubre de 2026 llevó las conversaciones con Gemini a Google Maps en Apple CarPlay [19], y según las cifras de Google que cita Search Engine Land, Ask Maps puede usar reseñas de más de 500 millones de colaboradores para responder [20]. Cada vez más gente deja que una IA lea las reseñas y le dé una respuesta, así que importa saber qué reseñas lee la IA y qué dicen las recientes; por eso esta guía separa una y otra vez las reseñas más recientes de las ordenadas por relevancia.
Primero, decide qué necesitas
Quien busca «how to scrape google maps» o «cómo extraer datos de Google Maps» suele querer cosas muy distintas. Un equipo comercial quiere el nombre, el teléfono, la web y la valoración de todas las taquerías de una alcaldía para armar una lista de contactos. Una cadena de restaurantes quiere todas las reseñas de sus sucursales para responder rápido a las quejas. Un equipo de producto quiere las reseñas de una estrella de la competencia del último trimestre. Un grupo de investigación quiere la distribución de valoraciones de 500 restaurantes de un barrio. Solo el primer caso es una lista de negocios; los otros tres necesitan reseñas, y la cantidad, el periodo y quién es el dueño de la ficha deciden qué vía funciona.
Por eso conviene responder tres preguntas antes de comparar precios. ¿Cuántas reseñas necesitas por local y te bastan cinco? ¿Son locales tuyos, verificados en tu perfil de Google Business? ¿Hay alguien en tu equipo dispuesto a mantener durante años un scraper con navegador y un grupo de proxies? El diagrama siguiente separa las vías según esas tres preguntas. Cada sección posterior prueba una vía con llamadas reales o revisa línea a línea la documentación oficial.
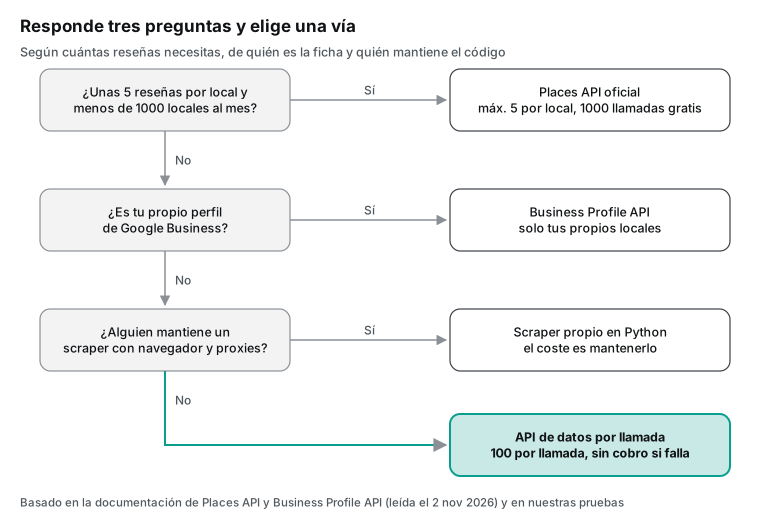
El diagrama incluye la API de Business Profile porque muchos equipos la olvidan. Si las reseñas son de locales que tú gestionas y verificaste, Google ofrece a los propietarios una API que lista todas sus reseñas, ordenadas por valoración o por fecha de actualización, con hasta 50 por página [11][12]. Necesita autorización OAuth y un local verificado, y no sirve para leer a la competencia. La tabla reúne las cuatro opciones; cada celda es un dato que probamos o comprobamos más abajo.
| Opción | Reseñas por local | Orden y paginación | Coste por cada 1000 reseñas | Coste principal |
|---|---|---|---|---|
| API oficial de Places (Place Details) | Hasta 5 | Solo relevancia, sin páginas | 0 USD dentro del cupo gratis; después unos 5,00 USD | Tope fijo y atribución obligatoria |
| API de Business Profile | Todas, solo de tus locales | Valoración o fecha, 50 por página | 0 USD | Solo locales propios verificados |
| Python propio con navegador | Lo que muestre la página | Desplazamiento simulado | Servidores y proxies aparte | Cambios de la página y riesgo legal |
| API de datos de EveryInfra | 400 filas por orden, 100 por llamada | Más recientes o relevancia, con token | 0,01389 USD con 100 por llamada | Pago por llamada; asíncrono después de 200 filas |
Prueba 1: una taquería de Coyoacán, de la ficha a las reseñas
Empezamos por el caso que más interesa a un lector hispanohablante. La ficha de Tacos Chupacabras muestra 4,2 estrellas, 18 361 reseñas, 1875 fotos y un rango de precio de 100 a 200 MXN por persona. Pedimos la ficha con google_maps_reviews/profile a las 00:22:35 (hora de Singapur) y las 200 reseñas más recientes con google_maps_reviews/reviews y lang: es419 a las 00:23:05 y a las 00:23:24 (hora de Singapur). La tercera página la pedimos a las 00:34:37 (hora de Singapur) como tarea asíncrona, porque empieza después de la fila 200.
Las 200 reseñas más recientes promedian 4,275 estrellas, muy cerca de la ficha. Hay 121 de cinco estrellas, 42 de cuatro, 21 de tres, 3 de dos y 13 de una. Solo el 55,5 % tiene texto, la mediana de longitud es de 69 caracteres y el local no respondió a ninguna. Las fechas van del 12 de octubre de 2017 al 1 de noviembre de 2026: 189 de las 200 son de abril a noviembre de 2026 y las otras 11 son reseñas antiguas intercaladas en las páginas.
Un detalle útil para quien trabaja en español: las subvaloraciones de detailed_rating llegan con claves en el idioma de la reseña. Con lang: es419, las claves fueron comida, servicio y ambiente; en las reseñas en inglés de Singapur, food, service y atmosphere. Si unes datos de varios países en una tabla, primero traduce esas claves a un único juego; si no, la misma dimensión «servicio» acaba en dos columnas. El catálogo no lo indica y lo descubrimos al comparar dos respuestas.
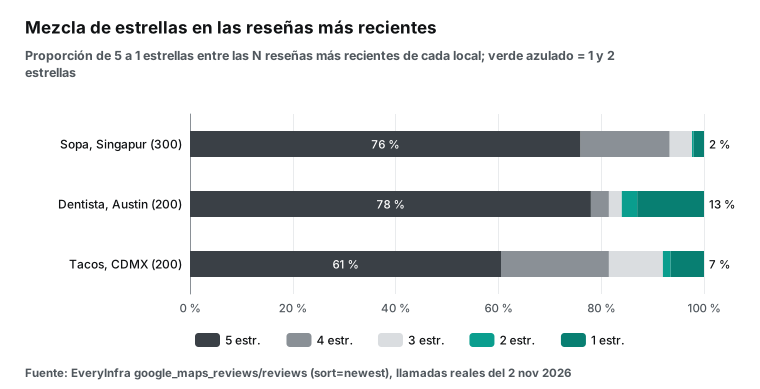
Comparada con los otros dos locales que probamos, la forma de la taquería es distinta. La clínica dental de Austin tiene muchas reseñas de cinco y de una estrella y pocas en medio. La taquería tiene más reseñas de tres y cuatro estrellas, el patrón típico de «la comida es buena, pero la fila es larga». Un promedio esconde las dos formas, y por eso conviene guardar cada reseña con su valoración en lugar de quedarse con el número de la ficha.
La trampa del parámetro de ubicación en Ciudad de México
Las búsquedas en Ciudad de México mostraron un problema con el parámetro de ubicación. A las 00:17:32 (hora de Singapur) buscamos «taquería» con google_maps_reviews/search, el parámetro de ubicación «Ciudad de México», country: mx y language: es. Los 50 resultados estaban en México, pero solo 1 estaba en Ciudad de México; los otros 49 se repartían en 11 estados más, sobre todo Zacatecas (14), Nuevo León (7), Chihuahua (6) y Jalisco (6). A las 00:19:39 (hora de Singapur) metimos el lugar en la palabra clave: «taquería en Coyoacán, Ciudad de México». Los 50 resultados estaban en la ciudad, y 47 de ellos en Coyoacán.
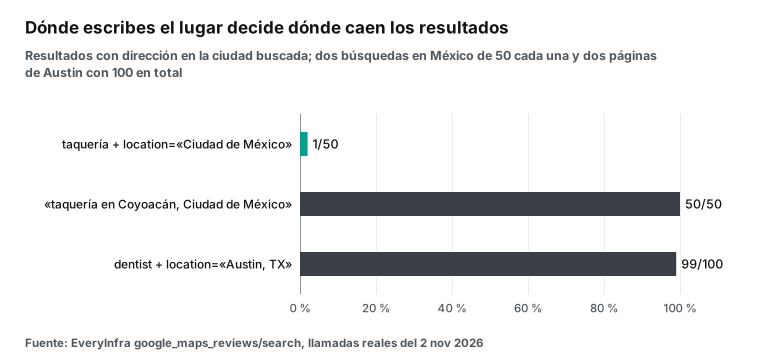
La búsqueda de Austin también usó el parámetro de ubicación, con «Austin, TX», y 99 de 100 resultados estaban en Austin; el que faltaba estaba en West Lake Hills, junto a la ciudad. Todavía no sabemos la causa. Las dos peticiones no difieren en una sola cosa: la de Ciudad de México llevaba además language: es, y la ubicación de Austin incluía la abreviatura del estado, así que una sola comparación no basta para saber qué diferencia pesa. Mientras no lo sepamos, la forma segura es escribir la ciudad, e incluso la alcaldía o el barrio, dentro de la palabra clave. Para una lista de contactos en Guadalajara, Bogotá o Madrid, haz siempre una búsqueda de prueba y cuenta cuántos resultados caen en la ciudad antes de pedir más páginas.
| Hora (SGT) | Palabra clave | Ubicación | Resultados en la ciudad | Cobro |
|---|---|---|---|---|
| 00:17:32 | taquería | parámetro «Ciudad de México» | 1 de 50 | 0,001389 USD |
| 00:19:39 | taquería en Coyoacán, Ciudad de México | dentro de la palabra clave | 50 de 50 | 0,001389 USD |
| 00:17:10 y 00:24:22 | dentist | parámetro «Austin, TX» | 99 de 100 | 0,002778 USD |
La búsqueda también devuelve los datos que un equipo comercial necesita. Cada resultado trae nombre, categoría, dirección, ciudad, código postal, coordenadas, teléfono, web, valoración, número de reseñas y el identificador place_id. Con ese identificador se eliminan duplicados cuando juntas varias búsquedas; lo explicamos en la guía sobre deduplicar con place_id.
Vía 1: lo que da la API oficial de Places
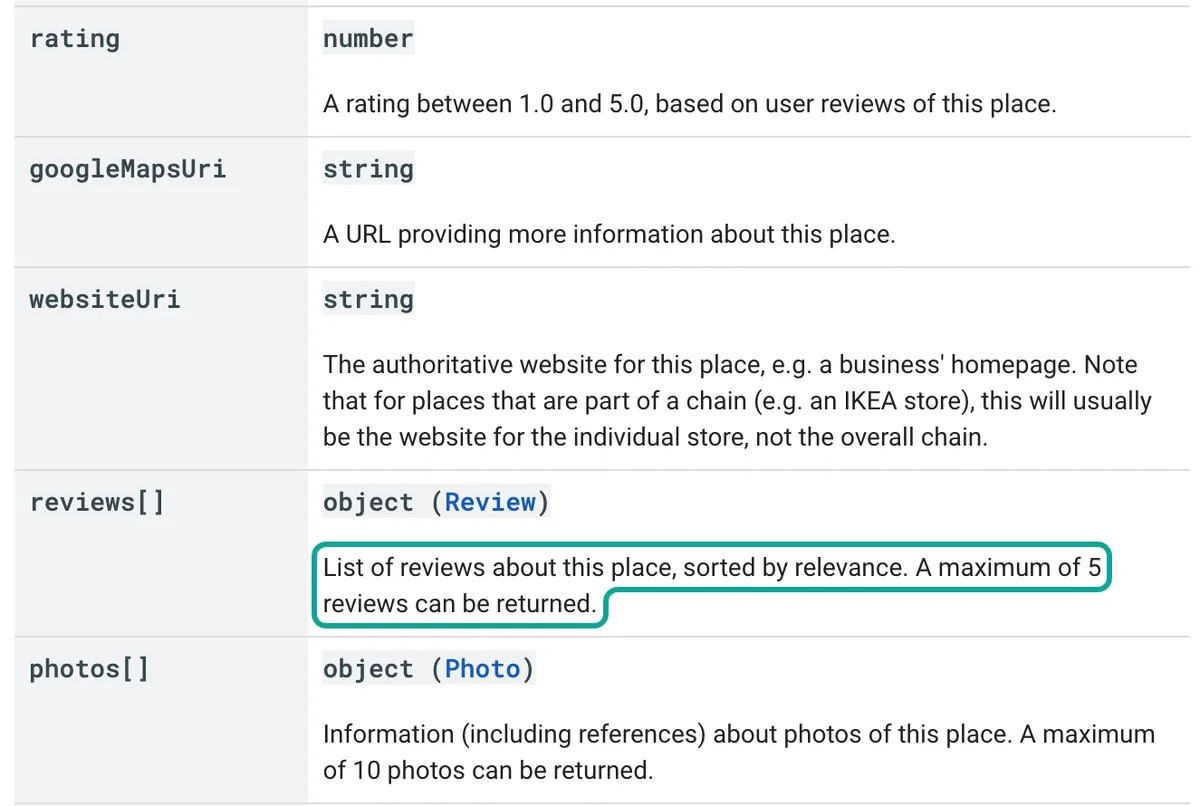
La API de Places (nueva) tiene un recurso Place con un campo reviews. La documentación de referencia dice que es una lista de reseñas del lugar, ordenada por relevancia, y que se pueden devolver como máximo cinco [1]. El tope no cambia con el nivel de precio y no hay token de página para las reseñas. Tomamos una captura de esa línea y la marcamos con un recuadro verde azulado.
La petición es sencilla: Place Details (nueva) es un GET con el place_id en la ruta y una máscara de campos obligatoria en una cabecera [2]. La máscara indica qué campos quieres. Este es un ejemplo de configuración según la documentación oficial; no lo ejecutamos con una clave de Google.
# Ejemplo de configuración (no ejecutado): valoración, número de reseñas y hasta 5 reseñas
curl -s "https://places.googleapis.com/v1/places/ChIJI1fDWIb_0YURkHNSSMavLXY?languageCode=es" \
  -H "X-Goog-Api-Key: $GOOGLE_MAPS_API_KEY" \
  -H "X-Goog-FieldMask: displayName,rating,userRatingCount,reviews"
La máscara de campos decide la factura. Google cobra cada petición según el SKU del campo más caro que pidas, y reviews pertenece al SKU Place Details Enterprise + Atmosphere [3][5]. Desde el 1 de marzo de 2025, el antiguo crédito mensual de 200 USD se sustituyó por cupos gratuitos por SKU: 10 000 llamadas para Essentials, 5000 para Pro y 1000 para Enterprise cada mes [4]. Leímos la lista de precios el 2026-11-02; la página de resumen indica que se actualizó por última vez el 2026-10-30 [4]. La tabla resume las filas que importan aquí, en USD por cada 1000 peticiones.
| SKU (API de Places nueva) | Gratis al mes | Hasta 100 000 | 100 000 a 500 000 | 500 000 a 1 M | 1 M a 5 M | Más de 5 M |
|---|---|---|---|---|---|---|
| Place Details Pro | 5000 | 17,00 | 13,60 | 10,20 | 5,10 | 1,28 |
| Place Details Enterprise | 1000 | 20,00 | 16,00 | 12,00 | 6,00 | 1,51 |
| Place Details Enterprise + Atmosphere (con reseñas) | 1000 | 25,00 | 20,00 | 15,00 | 7,50 | 2,28 |
| Text Search Pro | 5000 | 32,00 | 25,60 | 19,20 | 9,60 | 2,40 |
| Text Search Enterprise + Atmosphere | 1000 | 40,00 | 32,00 | 24,00 | 12,00 | 3,40 |
Con esta tabla, una llamada a Place Details cuesta 0,025 USD y da como máximo cinco reseñas: 5,00 USD por cada 1000 reseñas en el primer tramo de pago. Por encima de cinco millones de llamadas al mes, el precio baja a 2,28 USD por cada 1000 llamadas, que siguen siendo 0,456 USD por cada 1000 reseñas. El cupo gratuito también cuenta: si necesitas cinco reseñas de cada uno de 1000 locales al mes, la API oficial no te cuesta nada. Volvemos a ese caso en la sección sobre cuándo conviene la vía oficial.
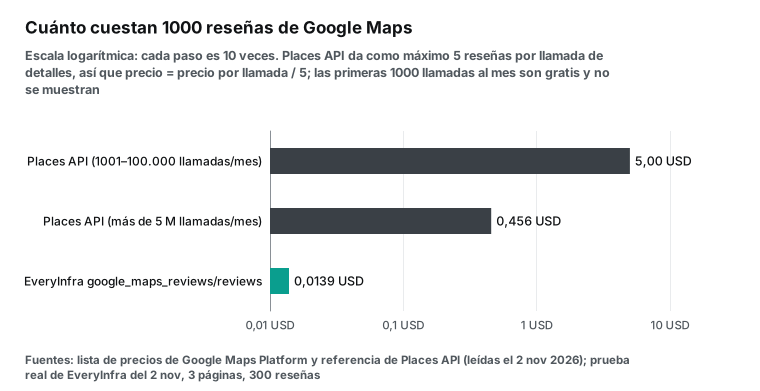
Hay además tres reglas de uso que deciden qué puedes guardar y mostrar. Primera: las políticas de la API de Places exigen mostrar con cada reseña la atribución del autor, con su foto, nombre y enlace al perfil [7]. Segunda: el place_id se puede guardar mucho tiempo, pero casi todo lo demás no se puede almacenar en caché, así que no puedes construir una base de reseñas propia a largo plazo con la API oficial [7]; Google recomienda además renovar los place_id de más de 12 meses [8]. Tercera: el orden de las reseñas es siempre por relevancia.
| Regla de la API de Places | Qué implica para tus datos |
|---|---|
| Atribución del autor con foto, nombre y enlace | No puedes mostrar reseñas anónimas en tu app |
| Sin caché salvo el place_id | No puedes acumular un histórico propio de reseñas |
| Renovar place_id de más de 12 meses | Hay que refrescar identificadores antiguos |
| Orden fijo por relevancia, máximo 5 | No hay forma de pedir las más recientes |
Esa tercera regla es la queja más repetida en los foros. En Stack Overflow, una pregunta de 2016 pide más de cinco reseñas de la API de Places [39] y otra de 2019 pregunta cómo obtener las más recientes [40]; las dos terminan en el mismo tope de cinco. En el subforo r/learnpython de Reddit alguien preguntó lo mismo desde el punto de vista de un principiante [41]. La respuesta no cambió con la nueva versión de la API.
Desde el 8 de mayo de 2025, la API de Places también puede devolver un resumen de reseñas escrito por Gemini [9][10], pero un resumen no son datos originales y no permite contar estrellas.
Vía 2: un scraper propio en Python, y dónde se atasca
Muchos tutoriales para extraer datos de Google Maps con Python empiezan con requests y BeautifulSoup. Probamos ese primer paso el 2 de noviembre de 2026 a las 00:19:50 (hora de Singapur): una petición HTTP GET normal, con la biblioteca estándar de Python, a la página de Maps de un restaurante de Singapur. El estado fue 200; la página pesaba 210 679 bytes, tenía 12 etiquetas script y su título era solo «Google Maps». El nombre del restaurante solo aparecía en el eco de nuestra propia URL; el número de reseñas, 8226, no estaba, y ninguno de los 20 fragmentos de reseñas que obtuvimos de la API aparecía en la página.
Es decir, las reseñas se cargan después de que la página ejecuta JavaScript en un navegador. Un scraper propio necesita automatizar un navegador, por ejemplo con Playwright [37]. El esqueleto siguiente muestra la estructura habitual: abrir la ficha, pulsar la pestaña de reseñas, desplazar el panel y leer el texto de los elementos. No lo ejecutamos, porque la descarga masiva y automática de páginas de Google Maps incumple sus condiciones de servicio; lo mostramos solo para que se vea el trabajo que implica.
# Ejemplo de configuración (no ejecutado): estructura habitual de un scraper de reseñas con navegador
from playwright.sync_api import sync_playwright

PLACE_URL = "https://www.google.com/maps/place/?q=place_id:ChIJI1fDWIb_0YURkHNSSMavLXY&hl=es"

with sync_playwright() as p:
    browser = p.chromium.launch(headless=True)
    page = browser.new_page(locale="es-MX")
    page.goto(PLACE_URL, wait_until="networkidle")
    page.get_by_role("tab", name="Opiniones").click()        # se rompe si cambia la etiqueta
    panel = page.locator("div[role='feed']")                  # selector adivinado que cambia a menudo
    for _ in range(30):                                       # unas 10 reseñas más por desplazamiento
        panel.evaluate("el => el.scrollBy(0, el.scrollHeight)")
        page.wait_for_timeout(1200)
    texts = page.locator("[data-review-id] span").all_inner_texts()
    print(len(texts))
    browser.close()
Cada línea de este esqueleto apuesta a que la página no cambie: el nombre de la pestaña (que además depende del idioma), el selector del panel, el número de reseñas por desplazamiento. Un cambio en la web de Google, o una página de verificación para tu IP, detiene el script. Para medir ese mantenimiento revisamos uno de los scrapers de Google Maps de código abierto con más estrellas en GitHub [32]. El 2026-11-02 tenía 7148 estrellas, 1112 forks y licencia MIT; su último push fue el 2026-10-21.
El proyecto publicó ocho versiones, de la v1.16.3 a la v1.18.1, entre el 13 de julio y el 20 de septiembre de 2026 [36], y desde el 1 de agosto se abrieron 15 issues. La tabla muestra los que tocan las reseñas o paran las tareas; los títulos están parafraseados y los enlaces están en las referencias [33][34][35].
| Fecha | Issue | Qué informaron los usuarios | Estado |
|---|---|---|---|
| 2026-09-01 | #327 | La opción de reseñas extra devuelve solo unas 10 y un endpoint interno de reseñas responde 403 (v1.17.4) | Abierto |
| 2026-09-23 | #331 | Muchos errores del motor de scraping durante la ejecución | Cerrado |
| 2026-10-05 | #337 | Tras pasar a la v1.18.0, la lista de tareas de la interfaz web se queda vacía y el botón de inicio no hace nada | Abierto |
| 2026-10-06 | #338 | Todas las tareas fallan porque la página o el contexto del navegador se cerró | Abierto |
| 2026-10-09 | #341 | El título es «300 Reviews per place» | Abierto |
| 2026-10-22 | #346 | Una tarea web se queda «en curso» porque un contexto del navegador no se cierra | Abierto |
No es una crítica a la calidad del código. Un proyecto con más de 7000 estrellas y ocho versiones en diez semanas sigue encontrando cada pocas semanas problemas como «solo 10 reseñas» o «fallan todas las tareas», y la causa son los cambios del lado de Google. Los issues #337 y #346 [42][43] muestran otro coste, sin relación con Google: el de automatizar un navegador en sí.
Un scraper de reseñas que funcione durante meses es un pequeño servicio con alguien de guardia, no un script de fin de semana. Hay que gestionar el arranque y cierre del navegador, la memoria, la concurrencia, los tiempos de espera, los proxies y las IP de salida. Si lo escribes tú, además pierdes a la comunidad que encuentra los problemas antes que tú. Calcula ese trabajo antes de compararlo con un precio por llamada.
Los scrapers propios también suelen olvidar el archivo robots.txt. Descargamos google.com/robots.txt a la misma hora [16]. La línea 86 dice Disallow: /maps/ y la línea 74, Disallow: /maps?; el archivo también tiene líneas Allow para /maps/place/ y /maps/search/. Según el RFC 9309 gana la regla más larga que coincide, así que las rutas normales de fichas están permitidas, y las demás rutas bajo /maps/ sin línea de permiso quedan prohibidas [17]. El mismo RFC aclara que estas reglas no son una forma de autorización de acceso [17]: el límite real son las condiciones de servicio.
Condiciones, sentencias y datos personales
Empecemos por el contrato. Si eres cliente de Google Maps Platform, la sección 3.2.3(a) de sus condiciones se titula «No Scraping» y prohíbe exportar, extraer o raspar de cualquier otra forma el contenido de Google Maps para usarlo fuera de los servicios [13]. Si eres un usuario normal, las condiciones adicionales de Google Maps, modificadas por última vez el 27 de enero de 2026, prohíben las descargas masivas y los volcados de contenido [14]. También prohíben usar Google Maps para crear o ampliar otros conjuntos de datos cartográficos, y citan expresamente las bases de datos de fichas de negocios [14].
Así que ni la API oficial ni un scraper propio te permiten construir una copia del contenido de Google. Los tribunales de Estados Unidos han tratado la cuestión general. El 18 de abril de 2022, el Noveno Circuito resolvió en hiQ Labs v. LinkedIn que extraer datos web públicos probablemente no es un acceso «sin autorización» según la ley federal de fraude informático [21]. El 23 de enero de 2024, un tribunal federal del norte de California concedió un juicio sumario a una empresa de recopilación de datos que Meta Platforms había demandado (caso 3:23-cv-00077), al considerar que Meta no demostró que sus condiciones prohibieran extraer datos públicos sin iniciar sesión [22].
Estas dos resoluciones se citan a menudo para decir que extraer datos públicos es legal. Responden a cuestiones jurídicas concretas sobre textos contractuales concretos: no dicen que incumplir unas condiciones no tenga consecuencias, y no se aplican fuera de Estados Unidos. Esta guía no es asesoramiento jurídico; consulta con un abogado antes de un uso comercial.
Luego están los datos personales. El nombre, la foto y el enlace al perfil de quien escribe una reseña son datos personales. En México, el Diario Oficial de la Federación publicó el 20 de marzo de 2025 la nueva Ley Federal de Protección de Datos Personales en Posesión de los Particulares [27]. En la Unión Europea, incluida España, se aplica el RGPD [24]; en California, la CCPA, cuya página de la fiscalía general se actualizó el 28 de agosto de 2026 [23]; en Singapur, la PDPA [25][26]. La mayoría de los análisis no necesitan saber quién escribió la reseña: guarda la valoración, la fecha, el texto y la respuesta del local, y descarta nombres y fotos. Nuestro exportador CSV lo hace así.
Si copias reseñas de otros negocios en tu propia página, también se aplica la política de contenido de Google, que prohíbe la interacción falsa [15].
Vía 3: una API de datos de pago por llamada
La tercera vía es una API de datos de pago por llamada. Envías una petición y el servicio devuelve datos estructurados de negocios o reseñas; se encarga de los navegadores, los proxies y los cambios de la página, y cobra por llamada. En este mercado hay varios modelos de cobro: plataformas de scraping en la nube que cobran por resultado, API de resultados de búsqueda que cobran por consulta y API de datos que cobran por llamada. EveryInfra usa el último.
Esta guía es un tutorial, no una tabla de precios de proveedores: se centra en cómo hacer las llamadas, cómo son los datos y dónde fallan. Nuestro precio unitario y nuestra unidad de cobro están en la página de la API de reseñas de Google Maps.
La API de reseñas de Google Maps de EveryInfra tiene cuatro capacidades. google_maps_reviews/search busca locales por palabra clave y ubicación; google_maps_reviews/profile devuelve la ficha de un local; google_maps_reviews/reviews devuelve sus reseñas; google_maps_reviews/contributor_reviews devuelve las reseñas que escribió una persona.
Leímos el catálogo público a las 00:14:03 (hora de Singapur) del 2026-11-02. Las cuatro capacidades cuestan 0,001389 USD por llamada. La búsqueda devuelve hasta 50 locales por llamada y hasta 120 filas en total con paginación. Las reseñas devuelven hasta 100 por llamada y hasta 400 filas en total; una petición síncrona llega hasta la fila 200 y las páginas más profundas necesitan una tarea asíncrona. Hay dos órdenes, newest (más recientes) y relevance (relevancia); since limita las reseñas a las posteriores a una fecha y lang fija el idioma.
Esta es una petición de reseñas para la taquería. Una URL de ficha de Google Maps con place_id es la forma más estable de indicar el local.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"google_maps_reviews","action":"reviews",
       "params":{"url":"https://www.google.com/maps/search/?api=1&query=Tacos%20Chupacabras&query_place_id=ChIJI1fDWIb_0YURkHNSSMavLXY",
                 "lang":"es419","sort":"newest","limit":100}}'
Enviamos esta petición a las 00:23:05 (hora de Singapur): devolvió 100 reseñas y billing.charged_usd fue 0,001389. La respuesta traía pagination.has_more en true y un next_page_token; para la página siguiente, repite la petición con ese token en page_token, tal cual lo recibiste. La captura siguiente es una respuesta real del restaurante de Singapur a las 00:15 (hora de Singapur), con los nombres ocultos.
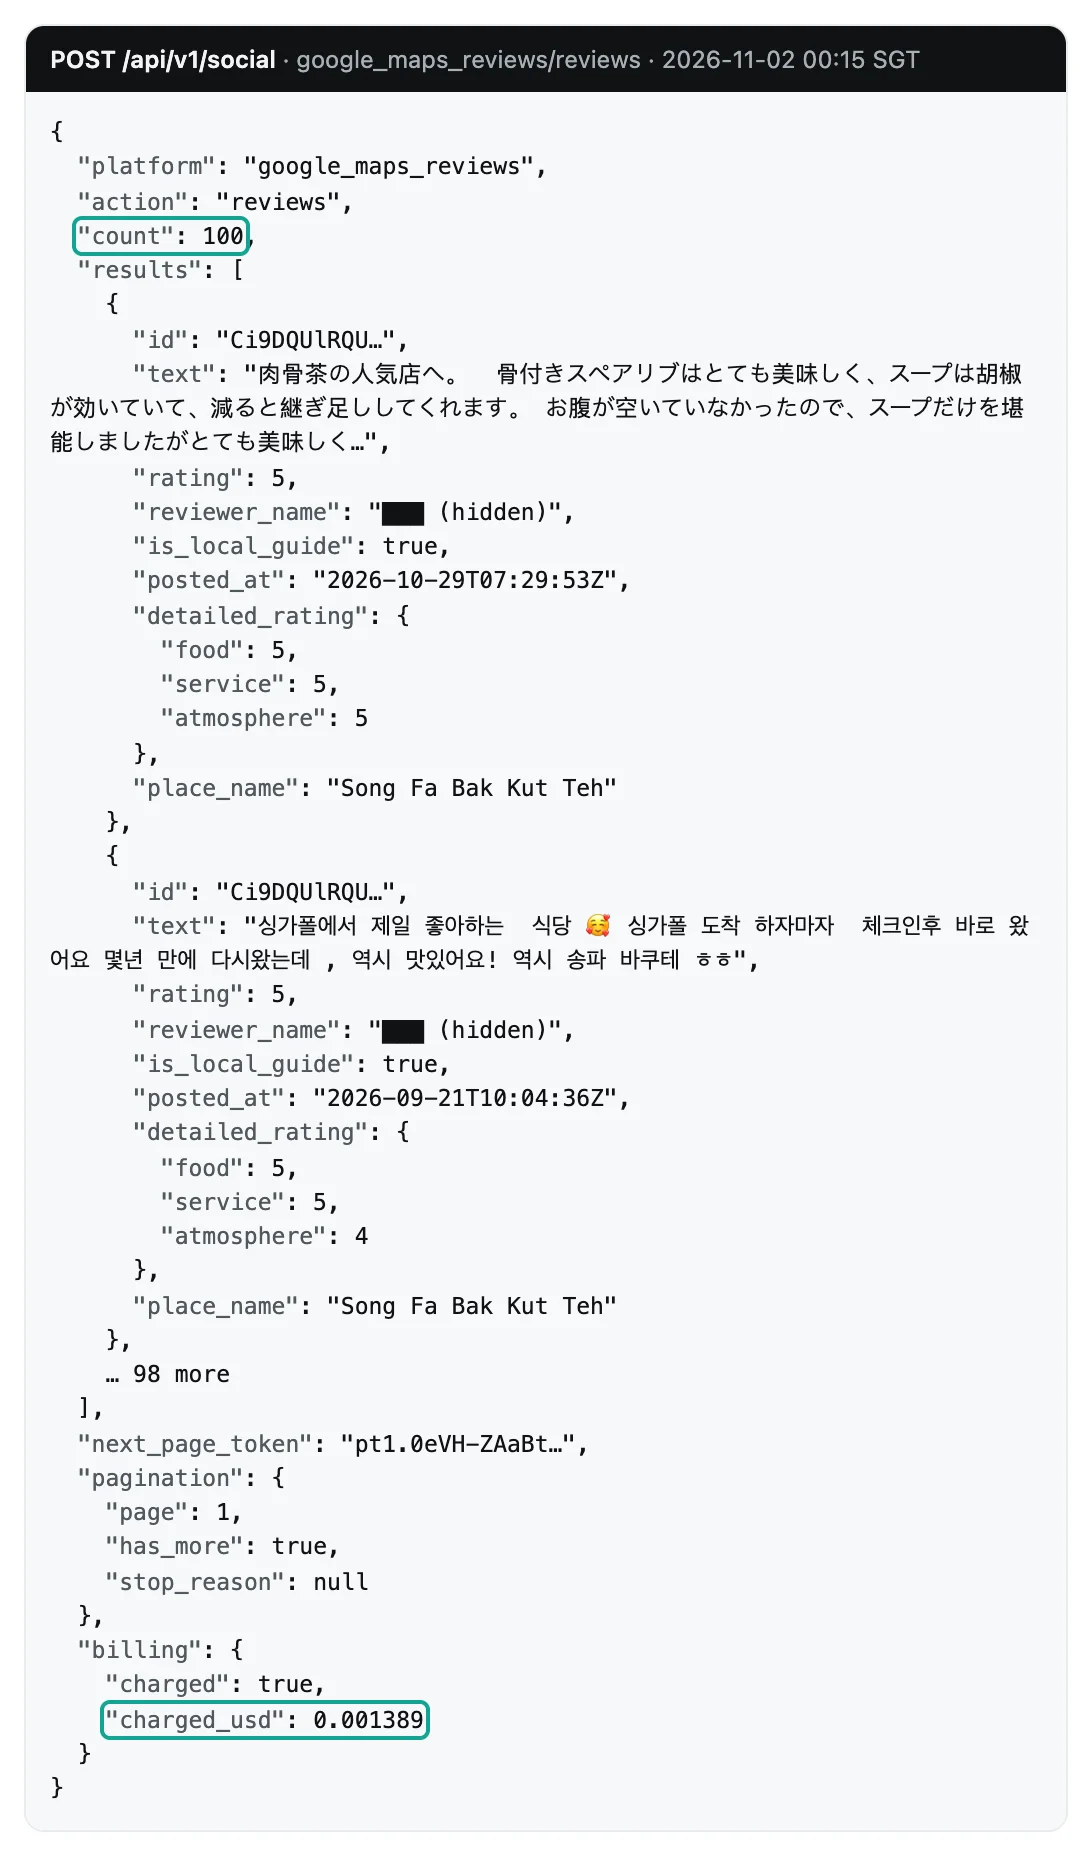
Cada reseña trae los campos que figuran en el catálogo. La tabla muestra los más útiles para analizar, con los recuentos de las 200 reseñas más recientes de la taquería. Dos de ellos, detailed_rating y owner_response, no existen en el objeto de reseña de la API oficial de Places.
| Campo | Significado | En las 200 reseñas recientes de la taquería |
|---|---|---|
rating | De 1 a 5 estrellas | 200 de 200 |
posted_at | Fecha de publicación en UTC | 200 de 200 |
text | Texto; puede venir vacío | 111 con texto (55,5 %) |
owner_response y owner_response_at | Respuesta del local y su fecha | 0 |
detailed_rating | Subvaloraciones (comida, servicio, ambiente) | 129 |
image_urls | Fotos de la reseña | 19 |
is_local_guide y reviewer_review_count | Si es Local Guide y cuántas reseñas escribió | 129 de Local Guides |
like_count | Votos de «útil» | 200 de 200 |
id, url y place_id | Identificadores de la reseña y del local | 200 de 200 |
Prueba 2: cinco reseñas relevantes frente a 300 recientes
La segunda prueba muestra qué hace el tope de cinco reseñas con la imagen que te formas de un local. Usamos Song Fa Bak Kut Teh, en el 11 de New Bridge Road de Singapur: la ficha muestra 4,4 estrellas, 8226 reseñas y 18 685 fotos. Pedimos las 100 primeras por relevancia a las 00:16:10 (hora de Singapur) y las 300 más recientes en tres páginas: dos síncronas a las 00:15:29 y a las 00:16:42, y la tercera como tarea asíncrona a las 00:18:27 (hora de Singapur). Las cinco primeras por relevancia equivalen a las cinco que devolvería la API oficial.
Las cinco primeras promedian 4,8 estrellas; todas tienen texto y fotos, la mediana de longitud es de 517 caracteres, las cinco son de Local Guides y sus fechas van de abril a julio de 2026. Las 100 primeras por relevancia promedian 4,5 estrellas, todas tienen texto y la mediana es de 357 caracteres, con fechas de 2016 a septiembre de 2026. Las 300 más recientes promedian 4,65, solo el 63 % tiene texto y la mediana es de 67 caracteres.
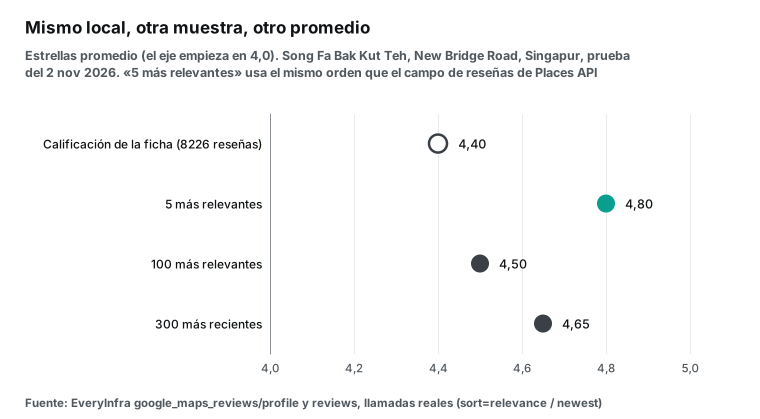
Google no publica cómo calcula la relevancia, pero los datos muestran una preferencia clara por reseñas largas, con fotos y de autores activos, que además tienden a ser positivas. Si juzgas un local por las cinco reseñas de la API oficial, ves los elogios más representativos, no la experiencia media del cliente reciente. Las 100 primeras por relevancia y las 300 más recientes solo comparten 21 reseñas: son casi dos muestras distintas.
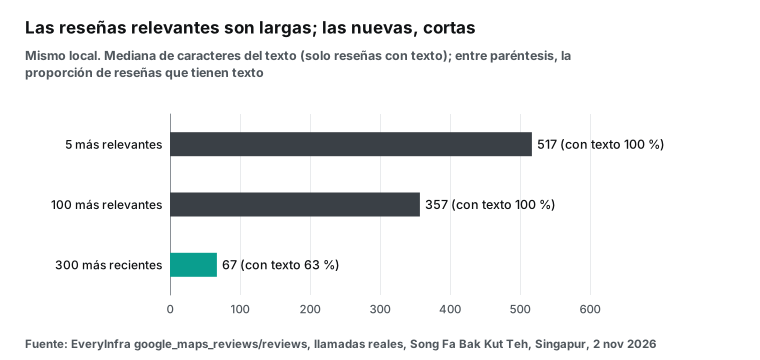
Las reseñas sin texto pasan desapercibidas con facilidad. Entre las 300 más recientes, 111 tienen estrellas y ninguna palabra, el 37 %. Para un análisis de palabras clave o de sentimiento ese 37 % está vacío; para una tendencia de estrellas, en cambio, es la parte de la muestra que no está sesgada por quienes escriben reseñas largas. Los dos análisis necesitan datos distintos, y por eso una API de reseñas debe devolver estrellas y texto, no solo un resumen.
Prueba 3: una clínica dental de Austin
El tercer caso es Swish Dental, en la zona Domain de Austin (Texas). La ficha muestra 4,6 estrellas y 1659 reseñas. Buscamos «dentist» con la ubicación «Austin, TX» a las 00:17:10 (hora de Singapur) y obtuvimos 50 clínicas; la segunda página empieza en la fila 51 y la petición síncrona de las 00:23:59 devolvió un 422 que pedía modo asíncrono. La tarea asíncrona de las 00:24:22 (hora de Singapur) devolvió otras 50: 100 clínicas distintas, 99 con dirección en Austin. Pedimos la ficha a las 00:20:02 y las 200 reseñas más recientes a las 00:20:36 y a las 00:23:41 (hora de Singapur).
Esas 200 reseñas promedian 4,305 estrellas, unas 0,3 menos que la ficha; hay 156 de cinco estrellas y 26 de una, el 13 %. La clínica respondió a 146 de las 200, así que alguien gestiona sus reseñas. El texto cuenta otra historia: de las 26 reseñas de una estrella, 24 tienen texto (92 %), con una mediana de 361,5 caracteres; de las 156 de cinco, solo 89 (57 %), con una mediana de 119. Quien está descontento explica por qué; quien está contento a menudo deja solo las estrellas.
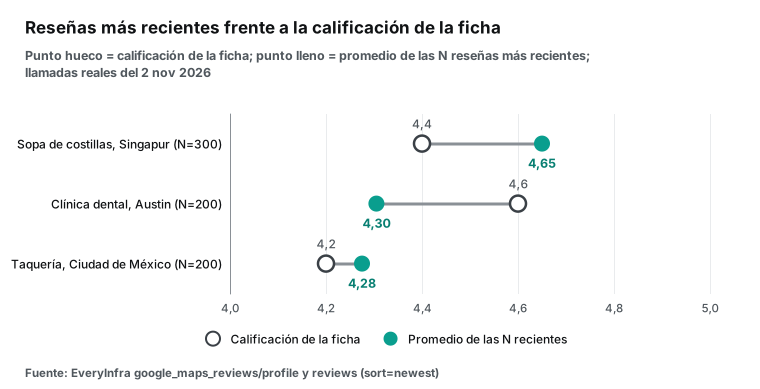
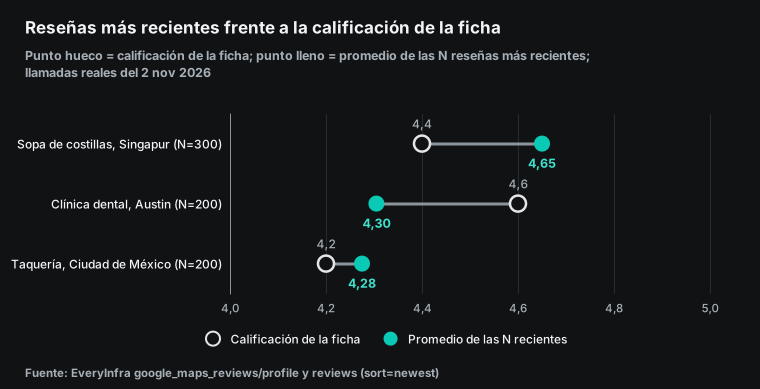
Para un paciente, un inversor o un competidor, las 200 reseñas más recientes dicen más que la valoración general. La ficha acumula muchos años, y un grupo de reseñas nuevas de una estrella puede indicar un cambio de personal, de recepción o de cobros. La API oficial no puede mostrar ese grupo, porque da cinco reseñas elegidas por relevancia. En la taquería ocurre lo contrario: la media reciente y la de la ficha casi coinciden, así que la ficha sí refleja bien el presente.
El orden «más recientes» no es estrictamente por fecha
Quien vigila reseñas suele escribir el mismo bucle: ordenar por más recientes, leer una página y parar en la primera reseña más antigua que la última guardada. Revisamos cada fila de nuestros tres conjuntos ordenados por más recientes; una fila está desordenada si su fecha es posterior a la de la fila anterior. En Singapur hubo 6 de 300, en Ciudad de México 18 de 200 y en Austin 50 de 200, el 25 %. El conjunto de Singapur traía además dos reseñas de 2023 mezcladas con páginas de 2026.
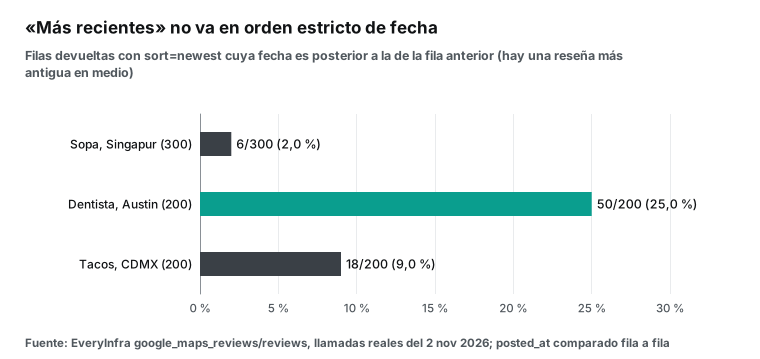
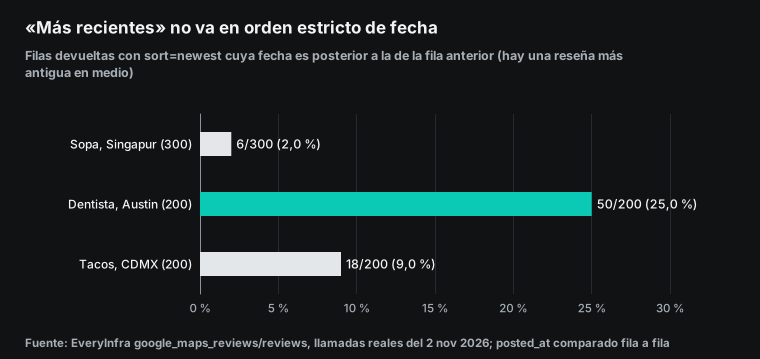
Esto viene de Google Maps, no de la API: las reseñas editadas o con una respuesta nueva del local pueden aparecer fuera de orden. El efecto es real, porque un bucle de «parar en la primera reseña antigua» puede perder datos. Hay dos soluciones: leer una página más antes de parar, o usar since para que la API devuelva solo las reseñas posteriores a una fecha. Después, ordena tú por posted_at; el exportador CSV de más abajo lo hace como último paso.
Fallos y reembolsos: así son los errores reales
El gran temor con el cobro por llamada es pagar por una llamada fallida. Durante las pruebas provocamos seis tipos de error, unos a propósito y otros por descuido. La tabla los recoge tal como respondió la API; todas las horas son de Singapur (SGT) del 2026-11-02.
| Hora (SGT) | Qué hicimos | Respuesta | Cobro | Siguiente paso que indica |
|---|---|---|---|---|
| 00:15:56 | Pedimos la página 2 justo después de la 1, por encima de 10 por minuto | 429 rate_limited, retry_after 4 segundos | Ninguno | Esperar y reintentar |
| 00:16:03 | Devolvimos un token de página vacío | 422 invalid_page_token | Ninguno | Reenviar next_page_token tal cual |
| 00:17:00 | Pedimos la página 3 de reseñas en modo síncrono (después de la fila 200) | 422 async_required | Ninguno | Añadir "mode":"async" y consultar la tarea |
| 00:20:55 | Pusimos since en 2026-11-30, una fecha futura | 200, 0 reseñas, empty_result_refunded | Reembolsado, 0 USD | Ninguno |
| 00:21:38 | Enviamos una URL que no es de Maps | 503, reintentable, retry_after 20 segundos | Reembolsado, 0 USD | Indica que es el fallo 1 de 3 |
| 00:22:07 | Pusimos sort en oldest | 422 invalid_value, valores permitidos newest y relevance | Ninguno | Cambiar solo sort y reenviar |
Uno de estos casos debería funcionar mejor: una URL equivocada devuelve un 503 reintentable, no un 422 que señale el parámetro erróneo. No pagas nada, pero un cliente que reintenta cada 503 tres veces espera un minuto para nada. Los otros cinco errores se comportan como dice la documentación: los errores de parámetros y los límites de ritmo no cuestan nada, los resultados vacíos se reembolsan y cada mensaje indica los valores permitidos y el siguiente paso. Para el caso de la URL basta una comprobación en tu propio código; todos los enlaces de fichas de esta guía empiezan por https://www.google.com/maps/:
if not url.startswith("https://www.google.com/maps/"):
    raise ValueError("no es un enlace de ficha de Google Maps")
Atención al momento del cobro de las tareas asíncronas: se cobran al enviarlas, no al recoger el resultado. Enviamos la tarea de la página 3 de Singapur a las 00:18:27 (hora de Singapur) y la respuesta ya mostraba charged_usd de 0,001389. El estado pasó de running a finalizing y a succeeded, con 100 reseñas. Si una tarea asíncrona falla, se reembolsa con el mismo identificador de cobro.
Exportar reseñas de Google Maps a CSV con Python
El código siguiente es la respuesta corta a «cómo extraer reseñas de Google Maps». Le das el enlace de una ficha; lee las reseñas más recientes página a página y las guarda en CSV. Solo usa la biblioteca estándar de Python, gestiona los límites de ritmo, las páginas profundas asíncronas y los tokens, ordena por fecha al final y no guarda los nombres de quienes reseñan.
"""Export Google Maps reviews of one place to CSV via EveryInfra.
usage: EVERYINFRA_API_KEY=... python3 export_reviews_csv.py "<google maps place url>" reviews.csv [max_pages]
"""
import csv, json, os, sys, time, urllib.request, urllib.error

API = "https://api.everyinfra.com"
KEY = os.environ["EVERYINFRA_API_KEY"]
FIELDS = ["id", "place_name", "rating", "posted_at", "text", "owner_response",
          "owner_response_at", "like_count", "is_local_guide", "reviewer_review_count", "url"]

def call(method, path, body=None):
    req = urllib.request.Request(API + path, method=method,
                                 data=json.dumps(body).encode() if body else None,
                                 headers={"Authorization": f"Bearer {KEY}", "Content-Type": "application/json",
                                          "User-Agent": "reviews-csv/1.0"})
    try:
        with urllib.request.urlopen(req, timeout=120) as r:
            return r.status, json.load(r)
    except urllib.error.HTTPError as e:
        return e.code, json.load(e)

def fetch_page(params):
    body = {"platform": "google_maps_reviews", "action": "reviews", "params": params}
    for attempt in range(4):
        status, data = call("POST", "/api/v1/social", body)
        err = (data.get("error") or {})
        if status == 429 or (err.get("retryable") and status >= 500):
            time.sleep(err.get("retry_after", 20)); continue
        if err.get("code") == "async_required":          # deep pages run as a job
            body["mode"] = "async"; continue
        if status == 202 and data.get("poll_url"):
            billing, poll = data.get("billing"), data["poll_url"]   # async jobs are charged at submit
            while data.get("status") in ("queued", "running", "finalizing"):
                time.sleep(5); status, data = call("GET", poll)
            data["billing"] = data.get("billing") or billing
            return data
        if err:
            raise SystemExit(f"stop: {err.get('code')} {err.get('message')}")
        return data
    raise SystemExit("stop: retries used up")

def main():
    url, out = sys.argv[1], sys.argv[2]
    max_pages = int(sys.argv[3]) if len(sys.argv) > 3 else 2
    params = {"url": url, "sort": "newest", "limit": 100}
    seen, rows, spent = set(), [], 0.0
    for page in range(max_pages):
        data = fetch_page(params)
        spent += (data.get("billing") or {}).get("charged_usd") or 0
        for r in data.get("results") or []:
            if r["id"] in seen:
                continue
            seen.add(r["id"])
            rows.append({k: r.get(k, "") for k in FIELDS})
        token = data.get("next_page_token")
        print(f"page {page + 1}: {data.get('count')} rows, total {len(rows)}")
        if not token or not (data.get("pagination") or {}).get("has_more"):
            break
        params["page_token"] = token
    rows.sort(key=lambda r: r["posted_at"] or "", reverse=True)   # "newest" is not strictly ordered
    with open(out, "w", newline="", encoding="utf-8-sig") as f:
        w = csv.DictWriter(f, fieldnames=FIELDS)
        w.writeheader(); w.writerows(rows)
    print(f"wrote {len(rows)} reviews to {out}; charged: ${spent:.6f}")

if __name__ == "__main__":
    main()
Lo ejecutamos tres veces con Tacos Chupacabras, tres páginas cada vez. La primera ejecución empezó a las 00:32:39 (hora de Singapur): las páginas 1 y 2 funcionaron y la 3 pasó a tarea asíncrona, pero el bucle de consulta falló, porque la respuesta de la consulta no trae poll_url y el código lo leía en cada vuelta. La segunda empezó a las 00:33:18 con esa corrección y la página 3 volvió con cero filas: la tarea tiene un estado finalizing y el código lo tomaba como terminado.
La tercera empezó a las 00:35:21 y terminó a las 00:36:21 (hora de Singapur): tres páginas de 100, 300 reseñas con 300 identificadores distintos y un cobro de 0,004167 USD. El CSV usa utf-8-sig, así que Excel lo abre sin caracteres rotos aunque las reseñas lleven tildes y eñes. Los saltos de línea dentro del texto quedan dentro de la celda, por eso el archivo tiene 374 líneas para 300 filas, y es normal. La documentación del módulo csv de Python explica las opciones de formato [38].
Los dos errores eran invisibles al leer la documentación y evidentes al ejecutar de verdad. Guardamos los registros de las tres ejecuciones. Cuando uses por primera vez una API asíncrona, pruébala con un local con muchas reseñas, llega a la página 3 e imprime cada valor de estado.
Después de exportar: cinco pasos de limpieza
Obtener los datos es la mitad del trabajo; la otra mitad es limpiarlos. En nuestras 700 reseñas de tres locales los problemas fueron de cinco tipos, y cada uno tiene una solución sencilla. Añádela a tu primer script de análisis, no cuando las cifras ya no cuadren.
El primero es la hora. posted_at y owner_response_at vienen en UTC con sufijo de zona horaria. Ciudad de México está en UTC−6 todo el año desde que México eliminó el horario de verano, así que una reseña publicada a las 8 de la noche ya es del día siguiente en UTC. Si cuentas reseñas por día, convierte antes a la hora local del local; si no, cada día se desplaza varias horas y el efecto de fin de semana desaparece. Nuestro CSV guarda la cadena UTC original y el análisis la convierte según la ciudad.
El segundo es el texto vacío: entre el 35 % y el 45 % de las reseñas recientes de nuestros tres locales no tiene texto. Para análisis de texto, descarta esas filas e indica el denominador en tu informe; para tendencias de estrellas, consérvalas. Haz las dos cuentas sobre los mismos datos y compáralas: las cifras de Austin muestran lo lejos que pueden estar los dos grupos.
El tercero son las claves de las subvaloraciones, que siguen el idioma de la reseña, como vimos con comida, servicio y ambiente. Crea una tabla de correspondencia antes de unir países. El cuarto son los duplicados: una reseña puede aparecer en dos páginas, sobre todo si vuelves a ejecutar unas horas después, porque las reseñas nuevas empujan a las antiguas y los bordes de página se solapan. Elimina duplicados por el id de la reseña, como hace el exportador, y los locales por place_id. No uses la url de la reseña como clave, porque lleva un parámetro de idioma como hl=en.
El quinto son los campos de lugar. state y city son el texto que muestra la ficha, no códigos normalizados. En la búsqueda de Ciudad de México con el parámetro de ubicación, un mismo estado aparece escrito de dos formas: Zacatecas figura 13 veces como «Zacatecas» y 1 como «Zac.»; Quintana Roo, 2 veces completo y 2 como «Q.R.»; Nuevo León, Jalisco y Tabasco también tienen abreviaturas. Las 49 filas fuera de la ciudad muestran 16 cadenas de estado, pero solo son 11 estados. En la búsqueda con la palabra clave, state es «Cd. de México» en 42 filas y «CDMX» en 8; en la de Singapur, 2 de 50 filas no traen city. Si agrupas por el state tal cual, un estado se parte en dos filas: mapea las abreviaturas al nombre completo antes de agrupar, o usa la latitud y la longitud para ubicar la zona.
| Problema | Qué vimos | Solución |
|---|---|---|
| Zonas horarias | posted_at viene en UTC | Convertir a hora local antes de contar por día |
| Texto vacío | Del 35 % al 45 % de las filas recientes | Descartar en análisis de texto, conservar en tendencias de estrellas |
| Claves de subvaloración | food en inglés, comida en español | Unificar claves antes de unir países |
| Duplicados | Los bordes de página se solapan entre ejecuciones | Eliminar duplicados por id de reseña y por place_id |
| Campos de lugar | «Zac.» y «Zacatecas», «CDMX» y «Cd. de México» | Unificar abreviaturas antes de agrupar |
El coste en casos reales
Los precios unitarios se entienden mejor dentro de trabajos reales. Las cifras siguientes usan los precios de nuestras pruebas y la lista de precios de Google, sin servidores, horas de personal ni otros costes.
El primer caso es una lista comercial: todas las taquerías de Coyoacán, o todas las clínicas dentales de Austin, con nombre, teléfono, web, valoración y número de reseñas, sin texto. La búsqueda de EveryInfra devuelve 50 locales por 0,001389 USD; nuestras dos páginas de Austin dieron 100 clínicas por 0,002778 USD. Una lista de 1000 locales necesita unas 20 llamadas, unos 0,028 USD, pero una palabra clave pagina como máximo 120 filas, así que divide la ciudad por alcaldías o barrios o varía la palabra clave. Text Search Pro, de la API oficial, tiene 5000 llamadas gratis al mes y luego cuesta 32,00 USD por cada 1000 [3][6]; a este tamaño, el cupo gratuito cubre el trabajo, y la diferencia está en las reglas de caché y de presentación [7].
El segundo caso es vigilar reseñas: una cadena con 50 sucursales revisa las reseñas nuevas de cada una una vez por semana. Si las sucursales son tuyas, la API de Business Profile es gratis y la mejor opción [12]. Si son franquicias, distribuidores o clientes, necesitas una API de datos: una llamada por local y semana, 52 semanas y 50 locales, son 2600 llamadas, unos 3,61 USD al año. La API oficial no puede hacer este trabajo, porque no devuelve las más recientes y sus cinco primeras pueden quedarse igual durante meses.
El tercer caso es investigar: 500 restaurantes de un barrio y las 100 reseñas más recientes de cada uno, 50 000 reseñas en total. Con una API de datos son 500 llamadas de reseñas y unas 15 de búsqueda, unos 0,72 USD. La API oficial da como máximo 2500 reseñas (500 locales por 5) y son una muestra elegida: en nuestra prueba de Singapur, esa muestra superaba en 0,15 estrellas a las reseñas recientes y su texto era más de siete veces más largo. Un scraper propio podría hacerlo en teoría, pero el historial de issues del proyecto de código abierto sugiere que puedes toparte con el problema de «solo 10 reseñas» a mitad de camino [33].
| Trabajo | API oficial de Places | API de datos de EveryInfra |
|---|---|---|
| 1000 locales, solo lista | Dentro del cupo gratuito de Text Search | Unas 20 llamadas, 0,028 USD |
| 50 sucursales, reseñas nuevas cada semana durante un año | No es posible, no hay orden por fecha | 2600 llamadas, unos 3,61 USD |
| 500 restaurantes, 100 reseñas recientes de cada uno | Como máximo 2500 reseñas elegidas | Unas 515 llamadas, unos 0,72 USD |
Cómo elegir un scraper de Google Maps: seis comprobaciones
Quien busca el mejor scraper de Google Maps no necesita la herramienta más famosa, sino una que devuelva sus datos de forma fiable a un coste razonable. Damos comprobaciones por categoría, no por marca; cada una se prueba con una ejecución pequeña que cuesta unos céntimos.
| Comprobación | Cómo probarla | Nuestro valor de referencia |
|---|---|---|
| Reseñas por local y paginación por fecha | Elegir un local con más de 1000 reseñas y llegar a la página 3 | API oficial 5; EveryInfra 400 filas por orden |
| Unidad de cobro y cobro en fallos | Enviar un parámetro erróneo y un since futuro | 422 y 429 gratis; vacíos y fallos reembolsados |
| Coste real por cada 1000 reseñas | Cobro dividido por filas devueltas, por 1000 | 0,01389 USD con 100 por llamada |
| Campos | Buscar respuestas del local, subvaloraciones y fotos | owner_response, detailed_rating, image_urls |
| Precisión de la ubicación | Buscar una ciudad con dos formas de ubicación | Ciudad de México: parámetro 1 de 50, palabra clave 50 de 50 |
| Uso desde herramientas de IA | Buscar un servidor MCP o definiciones de funciones | Sí, un servidor MCP remoto |
La segunda fila es la que más se salta quien compra. Las herramientas que cobran por resultado no suelen cobrar los resultados vacíos, pero las reglas para tareas que se quedan a medias varían; en las API por llamada, comprueba si se reembolsan los vacíos y los fallos. Una prueba de unos céntimos da la respuesta. La tercera fila es parecida: no te fíes del precio de lista y divide el cobro real entre las filas reales, porque muchos precios «por cada 1000» suponen páginas completas y tu local puede tener solo unas decenas de reseñas.
Cuándo conviene la API oficial o un scraper propio
Una API de datos no siempre es la mejor respuesta. En tres casos recomendamos otra vía. Primero, si necesitas cinco reseñas representativas por local para menos de 1000 locales al mes, el cupo gratuito de la API oficial te cubre, y además puedes mostrarlas legalmente en tu app siempre que incluyas la atribución del autor. Segundo, si las reseñas son de tus propias sucursales, usa la API de Business Profile: devuelve todas, permite responder y no cuesta nada, algo que ningún tercero puede igualar. Tercero, si solo necesitas una lista de negocios de una ciudad, empieza por los datos abiertos: en México, el INEGI publica el DENUE, que se puede consultar y descargar por actividad y zona [30]; en Estados Unidos está County Business Patterns, de la Oficina del Censo [31]; en Singapur, data.gov.sg tiene más de 36 000 establecimientos de comida con licencia [28], y la Agencia de Alimentos de Singapur actualizó su página de historial de sanciones el 2026-11-01 [29]. No traen valoraciones ni reseñas; una combinación habitual es usar el DENUE como tabla base y completar con una API de datos las reseñas recientes de los locales que te interesan.
Un scraper propio solo compensa en un caso: tu necesidad es muy específica, por ejemplo un elemento que solo se ve en el navegador, y tu equipo acepta un proyecto de mantenimiento a largo plazo. También tienes que aceptar que puede romperse en cualquier momento y que puede incumplir las condiciones de servicio. Si el único objetivo es ahorrar, las cifras de esta guía dicen lo contrario: a 0,001389 USD por cada 100 reseñas, el tiempo de un ingeniero para arreglar el script una sola vez cuesta más que un año de llamadas.
EveryInfra también tiene límites, y los vimos en estas pruebas. Un orden se detiene en 400 filas: de un local con 18 361 reseñas no puedes obtener todo el historial, solo las 400 más recientes y las 400 primeras por relevancia, que se solapan. Pasada la fila 200 necesitas modo asíncrono y un bucle de consulta. Y en Ciudad de México el parámetro de ubicación dejó solo 1 de 50 resultados dentro de la ciudad, por una causa que aún no conocemos.
Preguntas frecuentes
¿Cómo extraer reseñas de Google Maps gratis?
Hay dos vías legales gratuitas. La API oficial de Places da 1000 llamadas gratis al mes a Place Details con reseñas, con hasta cinco reseñas por llamada [3][4]; y para tus propios locales, la API de Business Profile lee todas las reseñas gratis [11]. Un «scraper gratis» suele ser software de código abierto: la descarga es gratis, pero los servidores, los proxies y el mantenimiento cuestan dinero.
¿Cómo extraer reseñas de Google Maps con Python?
Una petición HTTP normal no devuelve reseñas: en nuestra prueba no apareció ninguno de 20 fragmentos, así que hace falta automatizar un navegador o usar una API de datos. Esta guía incluye un esqueleto con navegador que no ejecutamos y un exportador completo que llama a una API de datos y que sí ejecutamos tres veces. En r/learnpython de Reddit alguien hizo la misma pregunta [41].
¿Es legal hacer scraping de Google Maps?
Las condiciones de Google prohíben las descargas masivas y el scraping del contenido [13][14]. Las resoluciones estadounidenses en hiQ v. LinkedIn y en la demanda de Meta contra una empresa de recopilación de datos favorecieron la extracción de datos públicos, pero responden a cuestiones jurídicas concretas y no eliminan las consecuencias de incumplir unas condiciones [21][22]. Los datos de quienes reseñan están además sujetos a leyes como la LFPDPPP mexicana o el RGPD. Esta guía no es asesoramiento jurídico.
¿Por qué la API de Places solo devuelve cinco reseñas y cómo obtengo las más recientes?
Cinco es un límite de diseño: la referencia dice como máximo cinco reseñas, ordenadas por relevancia, sin token de página [1]. Para tus propios locales, ordena por fecha de actualización en la API de Business Profile [12]; para otros locales, usa una API de datos o un scraper. Las respuestas a las preguntas 39223719 y 55235501 de Stack Overflow se quedan en el mismo tope [39][40].
¿Cuál es el mejor scraper de Google Maps?
No hay una única respuesta: depende de cuántas reseñas necesitas, de si quieres paginar por fecha y de qué modelo de cobro aceptas. Esta guía propone seis comprobaciones que se prueban con unos céntimos: reseñas por local, cobro en fallos, coste real por cada 1000 reseñas, campos, precisión de la ubicación y uso desde herramientas de IA.
¿Cuánto cuesta extraer reseñas de Google Maps con una API?
Con EveryInfra, una llamada devuelve hasta 100 reseñas por 0,001389 USD, así que 1000 reseñas cuestan unos 0,01389 USD. Todas las pruebas de esta guía sumaron 36 peticiones y 26 llamadas cobradas, 0,036113 USD en total. Con la API oficial de Places, 1000 reseñas cuestan unos 5,00 USD por encima del cupo gratuito.
Cómo empezar
Abre el inicio rápido para crear una cuenta y una clave de API; las cuentas nuevas tienen saldo de prueba y la página de precios muestra las condiciones actuales. Lee el catálogo gratuito en GET /api/v1/social/catalog y comprueba los parámetros y el precio de google_maps_reviews. Envía la petición curl de esta guía para un local que conozcas y comprueba que los campos son los que necesitas. Guarda el exportador CSV, ejecútalo con dos páginas y añade más según haga falta.
Para comparar plataformas de reseñas, mira la API de datos de Yelp y la API de datos de Tripadvisor. Si quieres un recorrido completo de construcción, lee nuestro tutorial de la API de reseñas de Google Maps.
Método y límites
Hicimos todas las llamadas a EveryInfra el 2 de noviembre de 2026, entre las 00:14 y las 00:36 (hora de Singapur), con una clave de prueba limitada a 10 peticiones por minuto. Cada una de las tres ciudades tuvo un solo local, así que las muestras son las reseñas de esos locales en ese momento, no de todos los negocios, y los resultados por relevancia y por fecha cambian con el tiempo. Los precios y límites de la API de Places proceden de las páginas de Google tal como estaban el 2026-11-02; no llamamos a la API de Places con una clave. No ejecutamos el código con navegador: solo una petición HTTP normal se ejecutó contra una página de Maps.
Calculamos el coste «por cada 1000 reseñas» así. Del lado de EveryInfra, tomamos charged_usd de cada respuesta, lo dividimos entre las reseñas de esa respuesta y lo multiplicamos por 1000; las nueve páginas de reseñas tenían 100 cada una, así que todas dieron 0,01389 USD. Un local con menos de 100 reseñas, o un limit menor, da un precio por reseña más alto, porque se cobra por llamada. Del lado de la API de Places, dividimos el precio del tramo entre cinco, lo que supone cinco reseñas por llamada. Ninguno de los dos incluye cupos gratuitos ni saldo de prueba. Los recuentos mensuales de reseñas mostraron oscilaciones que no sabemos explicar, así que no dibujamos un gráfico de tendencia.
La tabla recoge todas las llamadas cobradas de esta guía; todas las horas son de Singapur (SGT) del 2026-11-02.
| Hora (SGT) | Capacidad | Objetivo | Devolvió | Cobro |
|---|---|---|---|---|
| 00:14:43 | google_maps_reviews/search | Singapur, bak kut teh | 50 locales | 0,001389 USD |
| 00:15:07 | google_maps_reviews/profile | Song Fa Bak Kut Teh | 1 local | 0,001389 USD |
| 00:15:29, 00:16:42 | google_maps_reviews/reviews | Song Fa, más recientes, páginas 1 y 2 | 100 cada una | 0,001389 USD cada una |
| 00:16:10 | google_maps_reviews/reviews | Song Fa, relevancia | 100 | 0,001389 USD |
| 00:18:27 | google_maps_reviews/reviews asíncrona | Song Fa, más recientes, página 3 | 100 | 0,001389 USD |
| 00:17:10, 00:24:22 | google_maps_reviews/search | Austin, dentist, dos páginas | 50 cada una | 0,001389 USD cada una |
| 00:20:02 | google_maps_reviews/profile | Swish Dental | 1 local | 0,001389 USD |
| 00:20:36, 00:23:41 | google_maps_reviews/reviews | Swish Dental, dos páginas | 100 cada una | 0,001389 USD cada una |
| 00:17:32, 00:19:39 | google_maps_reviews/search | Ciudad de México, dos formas de ubicación | 50 cada una | 0,001389 USD cada una |
| 00:22:35 | google_maps_reviews/profile | Tacos Chupacabras | 1 local | 0,001389 USD |
| 00:23:05, 00:23:24, 00:34:37 | google_maps_reviews/reviews | Chupacabras, tres páginas | 100 cada una | 0,001389 USD cada una |
| 00:32:39 a 00:36:21 | google_maps_reviews/reviews | Tres ejecuciones del exportador CSV | 9 llamadas cobradas | 0,012501 USD |
En total, 26 llamadas cobradas y 0,036113 USD. Otras dos se reembolsaron (un resultado vacío y un fallo) y cinco errores de parámetros o de ritmo no costaron nada.
Referencias
- Google Maps Platform, referencia REST de Places API (New), recurso Place, leída el 2026-11-02. https://developers.google.com/maps/documentation/places/web-service/reference/rest/v1/places
- Google Maps Platform, Place Details (New). https://developers.google.com/maps/documentation/places/web-service/place-details
- Google Maps Platform, lista de precios de los servicios principales. https://developers.google.com/maps/billing-and-pricing/pricing
- Google Maps Platform, resumen de facturación y precios, actualizado el 2026-10-30. https://developers.google.com/maps/billing-and-pricing/overview
- Google Maps Platform, uso y facturación de Places API. https://developers.google.com/maps/documentation/places/web-service/usage-and-billing
- Google Maps Platform, Text Search (New). https://developers.google.com/maps/documentation/places/web-service/text-search
- Google Maps Platform, políticas de Places API. https://developers.google.com/maps/documentation/places/web-service/policies
- Google Maps Platform, Place IDs. https://developers.google.com/maps/documentation/places/web-service/place-id
- Google Maps Platform, resúmenes de reseñas. https://developers.google.com/maps/documentation/places/web-service/review-summaries
- Google Maps Platform, notas de versión de Places API. https://developers.google.com/maps/documentation/places/web-service/release-notes
- Google Business Profile APIs, datos de reseñas. https://developers.google.com/my-business/content/review-data
- Google Business Profile APIs, accounts.locations.reviews.list. https://developers.google.com/my-business/reference/rest/v4/accounts.locations.reviews/list
- Condiciones de servicio de Google Maps Platform, sección 3.2.3(a). https://cloud.google.com/maps-platform/terms
- Condiciones adicionales de Google Maps y Google Earth. https://www.google.com/help/terms_maps/
- Política de contenido de Google Maps, contenido prohibido. https://support.google.com/contributionpolicy/answer/7400114
- robots.txt de google.com, descargado el 2026-11-02. https://www.google.com/robots.txt
- IETF, RFC 9309 Robots Exclusion Protocol. https://www.rfc-editor.org/rfc/rfc9309.html
- Blog de Google, Fan-Favorite Dining List, 2026-10-08. https://blog.google/products-and-platforms/products/maps/google-maps-fan-favorite-dining-list/
- 9to5Google, Gemini en Google Maps para CarPlay, 2026-10-21. https://9to5google.com/2026/10/21/google-maps-carplay-gemini/
- Search Engine Land, Ask Maps y negocios locales. https://searchengineland.com/google-ask-maps-make-your-business-easier-to-recommend-496672
- Tribunal de Apelaciones del Noveno Circuito, hiQ Labs v. LinkedIn, 2022-04-18. https://cdn.ca9.uscourts.gov/datastore/opinions/2022/04/18/17-16783.pdf
- Tribunal de Distrito del Norte de California, caso 3:23-cv-00077 de Meta Platforms, resolución del 2024-01-23. https://www.govinfo.gov/app/details/USCOURTS-cand-3_23-cv-00077/USCOURTS-cand-3_23-cv-00077-7
- Fiscalía General de California, California Consumer Privacy Act. https://oag.ca.gov/privacy/ccpa
- Unión Europea, Reglamento (UE) 2016/679 (RGPD). https://eur-lex.europa.eu/eli/reg/2016/679/oj
- PDPC de Singapur, resumen de la PDPA. https://www.pdpc.gov.sg/about/the-legislation/pdpa-overview
- PDPC de Singapur, Personal Data Protection Act. https://www.pdpc.gov.sg/overview-of-pdpa/the-legislation/personal-data-protection-act
- México, Ley Federal de Protección de Datos Personales en Posesión de los Particulares, DOF 2025-03-20. https://www.ordenjuridico.gob.mx/Documentos/Federal/html/wo125102.html
- data.gov.sg, establecimientos de comida con licencia de la NEA. https://data.gov.sg/datasets/d_227473e811b09731e64725f140b77697/view
- Agencia de Alimentos de Singapur, historial de sanciones, actualizado el 2026-11-01. https://www.sfa.gov.sg/tools-and-resources/track-records
- INEGI, DENUE. https://www.inegi.org.mx/app/mapa/denue/default.aspx
- Oficina del Censo de EE. UU., County Business Patterns. https://www.census.gov/programs-surveys/cbp.html
- GitHub, proyecto de código abierto de scraper de Google Maps, 7148 estrellas. https://github.com/gosom/google-maps-scraper
- GitHub, issue 327, 2026-09-01. https://github.com/gosom/google-maps-scraper/issues/327
- GitHub, issue 338, 2026-10-06. https://github.com/gosom/google-maps-scraper/issues/338
- GitHub, issue 341, 2026-10-09. https://github.com/gosom/google-maps-scraper/issues/341
- GitHub, versiones v1.16.3 a v1.18.1. https://github.com/gosom/google-maps-scraper/releases
- Playwright para Python, instalación. https://playwright.dev/python/docs/intro
- Documentación de Python, módulo csv. https://docs.python.org/3/library/csv.html
- Stack Overflow, más de 5 reseñas con la API de Places. https://stackoverflow.com/questions/39223719/to-get-more-than-5-reviews-from-google-places-api
- Stack Overflow, reseñas más recientes con la API de Places. https://stackoverflow.com/questions/55235501/how-to-get-latest-reviews-using-google-places-api
- Reddit r/learnpython, cómo obtener reseñas de lugares. https://www.reddit.com/r/learnpython/comments/1c94ejb/how_can_i_get_places_reviews/
- GitHub, issue 337, 2026-10-05. https://github.com/gosom/google-maps-scraper/issues/337
- GitHub, issue 346, 2026-10-22. https://github.com/gosom/google-maps-scraper/issues/346
Referencia BL-70