La mejor API de búsqueda web para agentes de IA: seis opciones con precio, texto completo, MCP y fallos
Seis APIs de búsqueda para agentes de IA: precio por 1.000 llamadas, texto de páginas, frescura, límites, MCP y cobro de fallos, con 20 pruebas reales.
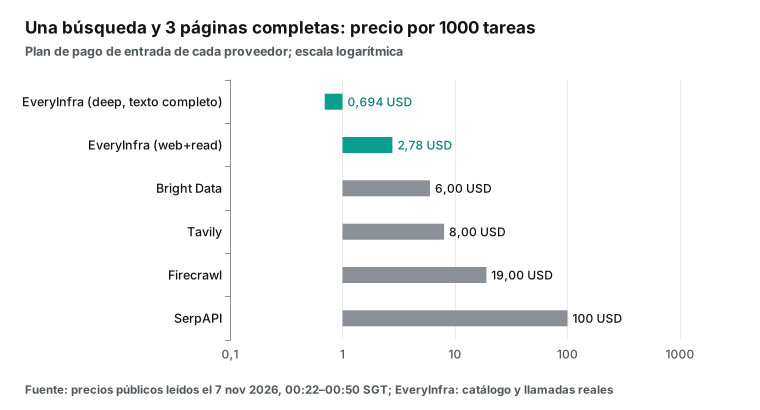
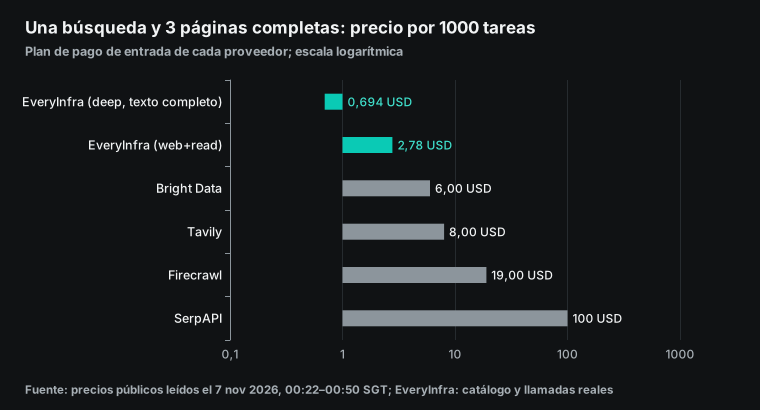
No hay una única mejor API de búsqueda web para agentes de IA, pero sí hay una ganadora clara para cada tarea. Si buscas mucho volumen y solo necesitas enlaces, Serper es la más barata: 0,30 USD por cada 1.000 búsquedas en su paquete más grande, frente a nuestros 0,694 USD. Si tu agente busca una vez y luego lee tres páginas, nosotros costamos 2,78 USD por cada 1.000 tareas, Bright Data 6,00 USD, Tavily 8,00 USD, Firecrawl 19,00 USD y SerpAPI 100 USD.
El 2026-11-07 hicimos 20 llamadas reales contra nuestra propia API. En 8 llamadas web, una de ellas con resultado vacío, la mediana fue de 1,74 segundos. Seis llamadas fallaron o no encontraron nada (401, 422, 429 y un resultado vacío), y ninguna costó dinero. Una verificación cruzada perdió uno de sus cuatro métodos y cobró 0,002083 USD por tres métodos, en lugar del precio de lista de 0,002778 USD.
A los otros cinco proveedores no los llamamos: leímos sus páginas públicas de precios, su documentación y sus versiones en GitHub, y cada dato enlaza a su fuente.
Esta guía es para desarrolladores que eligen una herramienta de búsqueda para un agente. Quien lee los resultados es un modelo, no una persona, así que comparamos según lo que necesita el modelo. Cinco productos son de otros proveedores: Serper, Tavily, SerpAPI, Firecrawl y Bright Data. El sexto es nuestra API de búsqueda, EverySearch (POST /api/v1/search), cuya lista de herramientas se lee gratis y sin clave.
La tabla resumen: la mejor API de búsqueda web para agentes de IA en ocho factores
La tabla pone las seis APIs una al lado de otra en los ocho factores que más pesan para un agente. La fila de precio es el primer plan de pago para 1.000 búsquedas de 10 resultados. Entre paréntesis va el plan público más bajo. Los datos de los proveedores salen de sus páginas de precios y documentación, leídas el 2026-11-07 entre las 00:22 y las 00:50, hora de Singapur. Los nuestros salen de la lista de herramientas y del campo billing.charged_usd de las respuestas reales.
| Factor | EveryInfra | Serper | Tavily | SerpAPI | Firecrawl | Bright Data |
|---|---|---|---|---|---|---|
| Por 1.000 búsquedas (primer plan / más bajo) | 0,694 / 0,694 USD | 1,00 / 0,30 USD | 8,00 / 5,00 USD | 25,00 / 9,17 USD | 7,60 / 1,50 USD | 1,50 / 1,30 USD |
| Uso gratuito | 1 USD por dar estrella a nuestros dos repositorios de GitHub, 24 horas | 2.500 consultas, sin tarjeta | 1.000 créditos al mes y prueba sin clave | 250 búsquedas al mes | 1.000 créditos al mes y prueba sin clave | 5.000 peticiones al mes |
| Lo que recibe el modelo | Título, enlace, fragmento de unos 150 caracteres, fecha | JSON estructurado de la página de resultados | Hasta 3 fragmentos relevantes, texto completo opcional | JSON o Markdown | Título, descripción, destacados, texto opcional | HTML en bruto o JSON analizado |
| Texto completo en una llamada | deep con full=true, o read | No está entre las 10 APIs de su portada | include_raw_content | Llamada aparte a Extract | scrapeOptions, 1 crédito por página | Llamada aparte de extracción |
| Control de frescura | Fechas after / before | La página dice que no usa caché | time_range, max_age_hours | Las búsquedas en caché no cuentan | Filtro de tiempo tbs | Parámetros del buscador |
| Peticiones por minuto, primer plan | 60 (por defecto, por cuenta) | 3.000 (50 por segundo) | 1.000 (clave de producción) | Unas 3,3 (200 por hora) | 100 (/search) | La página dice sin límite |
| MCP remoto | Sí, 12 herramientas, listarlas no pide clave | No aparece en la portada | Sí, OAuth o clave | Sí, clave | Sí, punto sin clave con 3 herramientas | Sí, token en la URL |
| Fallos y resultados vacíos | Fallos a 0 USD, vacíos reembolsados | Solo cobra respuestas correctas | La extracción fallida es gratis | Errores gratis, el vacío cuenta | Sin documento no cobra; 403/404 cuestan 1 crédito | Solo paga el éxito |
La primera fila es la que más se malinterpreta. Nuestros 0,694 USD son un precio fijo, sin planes. Los 0,30 USD de Serper exigen comprar 12,5 millones de consultas por 3.750 USD de una vez, y el paquete caduca a los 6 meses. Los 1,50 USD de Firecrawl salen de su plan Scale, que cuesta 749 USD al mes. Los 1,30 USD de Bright Data son el precio por exceso de su plan Scale.
Así que Serper gana en precio unitario mínimo y nosotros ganamos en primer pago más pequeño. Cada sección de abajo toma un factor. Primero da el texto de la fuente, después nuestras llamadas reales y al final lo que ese factor significa para un agente.
Cómo comparamos: precios públicos, texto original y nuestras propias llamadas
Las seis APIs cobran en unidades distintas, así que fijamos tres reglas. Serper y SerpAPI cuentan búsquedas. Tavily cuenta créditos: 1 por una búsqueda básica y 2 por una avanzada (créditos de Tavily). Firecrawl cobra 2 créditos por cada 10 resultados de búsqueda, redondeando hacia arriba (facturación de Firecrawl). Bright Data cobra 1,5 USD por cada 1.000 peticiones SERP o resultados MCP (precios SERP, precios MCP). Nosotros cobramos 0,000694 USD por llamada de búsqueda y 0,002778 USD por verificación cruzada.
La primera regla es una unidad común: una búsqueda que devuelve 10 resultados, multiplicada por 1.000. La segunda regla son dos precios por proveedor. El primer plan de pago es el plan más pequeño que puedes comprar sin contrato. El plan más bajo es el menor precio unitario público de la página. Dejamos fuera los precios que solo da el equipo de ventas, porque no podemos comprobarlos.
La tercera regla es que nuestros datos salen solo de llamadas reales. El 7 de noviembre de 2026, de 00:15 a 00:29, hora de Singapur, una clave de prueba hizo 20 llamadas con un cargo total de 0,012495 USD. Cada tiempo es el time_total de curl desde Singapur, así que incluye el viaje de red.
Un agente necesita algo más que diez enlaces: qué recibe el modelo
Una persona mira una página de resultados y elige un enlace. Un modelo lee cada carácter, y cada carácter cuesta tokens. Por eso, para juzgar una API de búsqueda para agentes de IA, la forma de la respuesta importa más que la velocidad. Las seis APIs siguen cuatro caminos distintos.
El primer camino es la página de resultados. Serper y SerpAPI convierten la página de resultados en JSON estructurado. El ejemplo de la portada de Serper tiene cuatro bloques: knowledgeGraph, organic, peopleAlsoAsk y relatedSearches. Esta forma es ideal para SEO y seguimiento de posiciones, porque conserva el orden y los cuadros de respuesta. Para un agente suele ser demasiado, porque el modelo solo necesita unas pocas fuentes buenas.
SerpAPI también vio el problema. Su página de salida en Markdown muestra su propia prueba. Una búsqueda de Google ocupó unos 150K tokens en JSON y unos 39K en Markdown, un 74 % menos. Una búsqueda de Google Shopping bajó de 361K a 38K tokens. Puedes pedir Markdown con output=md, con la ruta /search.md o con la cabecera Accept: text/markdown.
El segundo camino son los fragmentos. Cada resultado de Tavily tiene un campo content con hasta 3 fragmentos relevantes. Cada fragmento tiene unos 500 caracteres, o unos 800 en profundidad avanzada (endpoint de búsqueda de Tavily). Tavily elige los fragmentos según lo bien que encajan con la consulta. Con include_answer añade una respuesta breve, y con include_raw_content añade la página entera. La búsqueda de Firecrawl también devuelve destacados por defecto, y highlights=false deja solo una descripción (búsqueda de Firecrawl).
El tercer camino es el texto completo. Si añades scrapeOptions a una búsqueda de Firecrawl, también descarga cada página de resultado, con créditos extra por página. La API SERP de Bright Data devuelve HTML en bruto por defecto, y brd_json=1 devuelve JSON analizado (documentación SERP de Bright Data). Nuestra herramienta deep con full=true devuelve el texto junto con los resultados. A las 00:17:02, hora de Singapur, devolvió 5 resultados sobre la especificación MCP con 47.596 caracteres de texto en total, por 0,000694 USD. El cuarto camino son las fuentes verificadas, que da nuestra herramienta crosscheck, como muestra una sección posterior.
Nuestra herramienta web sigue la forma más simple. Cada resultado tiene cuatro campos: title, url, snippet y published. Nuestras 8 llamadas web con resultados, 7 por REST y 1 por MCP, devolvieron 75 resultados: 72 con fragmento y 39 con fecha. Diez resultados suman menos de 2.000 caracteres, y caben en cualquier ventana de contexto. El precio es menos detalle: no hay panel de conocimiento ni campo de posición. La capacidad web/search de nuestra API de datos añade rank y sub_links por 0,001389 USD, el doble.
| API | Campos principales | Lo que recibe el modelo por resultado | Opciones que ahorran tokens | Fuente |
|---|---|---|---|---|
EveryInfra web | title, url, snippet, published | Fragmento, mediana de unos 150 caracteres | Ya es corto; usa read o deep para el texto | Lista de herramientas |
| Serper | organic[].title/link/snippet/position y más | Fragmento de la página de resultados | No lo indica | Portada de Serper |
| Tavily | results[].title/url/content/score, raw_content opcional | Hasta 3 fragmentos relevantes | chunks_per_source, max_results | Endpoint de búsqueda |
| SerpAPI | organic_results[].position/title/link/snippet | Fragmento de la página de resultados | output=md, cerca de un 50 % menos de tokens | Salida en Markdown |
| Firecrawl | data.web[].title/url/description, markdown opcional | Destacados o descripción | highlights=false, scrapeOptions solo si hace falta | Búsqueda |
| Bright Data | HTML en bruto, o JSON con brd_json=1 | Contenido de la página de resultados | brd_json=1 para quedarse con los campos | Documentación SERP |
Más campos no hacen que una API sea mejor para un agente, porque un contexto lleno de resultados expulsa los datos importantes. Nuestras cifras muestran la diferencia: diez resultados de web suman menos de 2.000 caracteres, y una llamada deep con texto completo devolvió 47.596, unas 24 veces más. Usa fragmentos cortos para encontrar candidatos, por ejemplo nuestro web, Tavily básico o SerpAPI en Markdown. Después lee el texto completo solo de las páginas elegidas, que es el patrón al que la sección siguiente pone precio.
Texto de las páginas: lo que cuesta «buscar una vez y leer tres páginas»
El precio de la búsqueda oculta lo que gasta de verdad un agente, porque casi nunca responde solo con fragmentos. Lo habitual es buscar una vez, elegir de 2 a 5 resultados, leerlos y responder. Tomamos el caso intermedio, una búsqueda más tres lecturas, como una tarea, y calculamos 1.000 tareas en el primer plan de pago de cada proveedor.
| API | Cómo se arma una tarea | Precio unitario usado (primer plan) | Por 1.000 tareas | Fuente |
|---|---|---|---|---|
| EveryInfra | 1 web + 3 read | 0,000694 USD por llamada | 2,78 USD | Lista de herramientas |
| EveryInfra | 1 deep con full=true, 5 resultados con texto | 0,000694 USD por llamada | 0,694 USD | Nuestra llamada de las 00:17:02, hora de Singapur |
| Bright Data | 1 búsqueda MCP + 3 extracciones | 1,50 USD por 1.000 resultados | 6,00 USD | Precios MCP |
| Tavily | 1 búsqueda básica con include_raw_content | 1 crédito a 0,008 USD | 8,00 USD | Créditos |
| Firecrawl | Búsqueda de 10 resultados (2 créditos) + 3 páginas (1 crédito cada una) | Hobby, 19 USD por 5.000 créditos | 19,00 USD | Facturación |
| SerpAPI | 1 búsqueda + 3 llamadas a Extract | Starter, 25 USD por 1.000 búsquedas | 100 USD | Extract API |
| Serper | No hay API de texto entre las 10 de su portada | — | Necesita otro extractor | Portada de Serper |
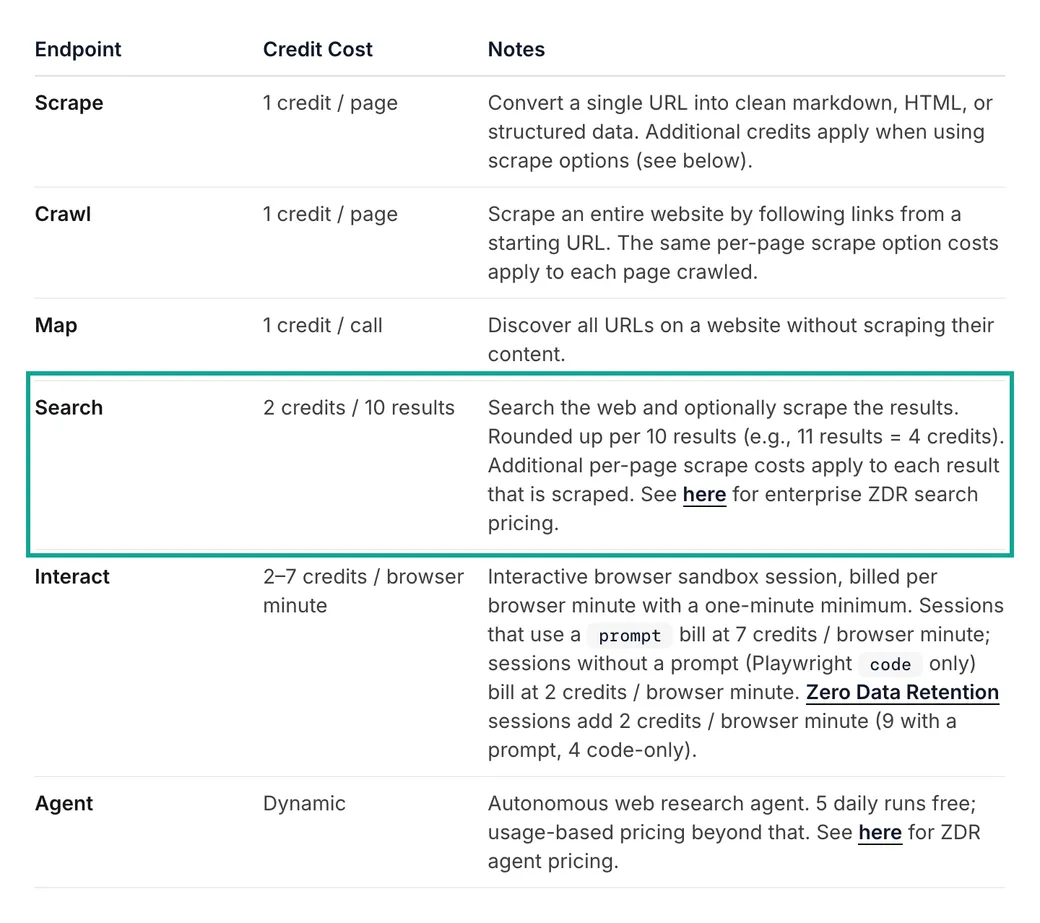
Algunas filas necesitan una nota. Tavily parece barata porque include_raw_content no suma créditos, así que una búsqueda básica trae el texto de todos los resultados. Pero lo trae de todos, y max_results vale 10 por defecto, así que el contexto se llena mucho antes que con tres páginas.
Firecrawl y SerpAPI salen caros porque sus primeros planes tienen precios altos: una tarea gasta 5 créditos de Firecrawl Hobby o 4 búsquedas de SerpAPI Starter. En sus planes públicos más altos la diferencia se reduce mucho. Firecrawl Scale cuesta 749 USD / 1.000.000 = 0,000749 USD por crédito, así que una tarea de 5 créditos sale a 0,003745 USD, es decir, 3,75 USD por 1.000 tareas. SerpAPI Big Data cuesta 275 USD / 30.000 = 0,00917 USD por búsqueda, así que una tarea de 4 búsquedas sale a 0,0367 USD, es decir, 36,67 USD por 1.000 tareas.
Nuestra llamada deep es la fila más barata, pero tardó 16,1 segundos, más de 9 veces la mediana de web. Es demasiado lento para un chat y sirve para tareas nocturnas. A las 00:16:44, hora de Singapur, read leyó un artículo del blog de Firecrawl: 30.957 caracteres en 2,35 segundos. A las 00:21:53 siguió un enlace de redirección hasta serpapi.com/pricing y devolvió 3.450 caracteres en 1,05 segundos.
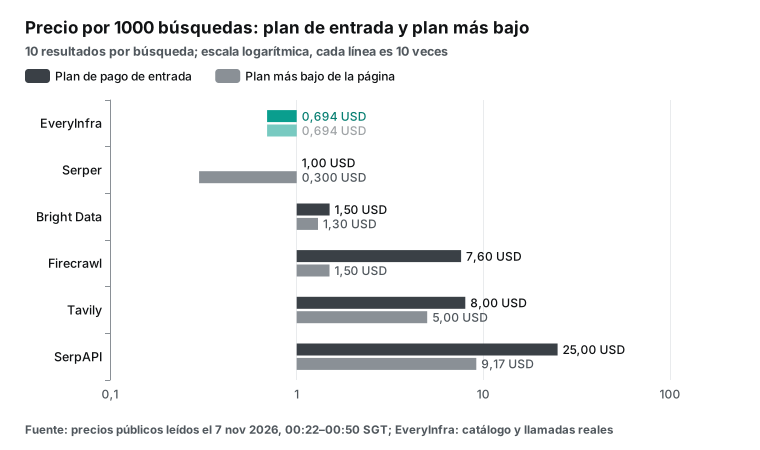
Precio por 1.000 búsquedas: primer plan y plan más bajo
Si el agente solo busca y nunca lee páginas, el orden cambia. Esta sección lista todos los precios públicos que usamos, con su fuente y su plan.
| API | Plan | Precio y volumen | Por 1.000 búsquedas | Validez o periodo | Fuente (leída el 2026-11-07) |
|---|---|---|---|---|---|
| EveryInfra | Sin planes | web, 0,000694 USD por llamada | 0,694 USD | El saldo recargado no caduca | Precios, lista de herramientas |
| Serper | Starter | 50 USD por 50.000, 50 por segundo | 1,00 USD | 6 meses | Portada de Serper |
| Serper | Standard | 375 USD por 500.000, 100 por segundo | 0,75 USD | 6 meses | Igual |
| Serper | Scale | 1.250 USD por 2,5 millones, 200 por segundo | 0,50 USD | 6 meses | Igual |
| Serper | Ultimate | 3.750 USD por 12,5 millones, 300 por segundo | 0,30 USD | 6 meses | Igual |
| Tavily | Pago por uso | 0,008 USD por crédito | 8,00 USD | Mensual | Precios de Tavily |
| Tavily | Project | 30 USD al mes, 4.000 créditos | 7,50 USD | Se reinicia el día 1 | Igual |
| Tavily | Mensual más bajo | 0,005 USD por crédito | 5,00 USD | Mensual | Créditos |
| SerpAPI | Starter | 25 USD al mes, 1.000 búsquedas | 25,00 USD | Mensual | Precios de SerpAPI |
| SerpAPI | Developer | 75 USD al mes, 5.000 búsquedas | 15,00 USD | Mensual | Igual |
| SerpAPI | Production | 150 USD al mes, 15.000 búsquedas | 10,00 USD | Mensual | Igual |
| SerpAPI | Big Data | 275 USD al mes, 30.000 búsquedas | 9,17 USD | Mensual | Igual |
| Firecrawl | Hobby | 19 USD al mes, 5.000 créditos | 7,60 USD | Mensual, sin arrastre | Precios de Firecrawl |
| Firecrawl | Standard | 99 USD al mes, 100.000 créditos | 1,98 USD | Mensual, sin arrastre | Igual |
| Firecrawl | Scale | 749 USD al mes, 1.000.000 de créditos | 1,50 USD | Arrastre de 1 mes | Igual |
| Bright Data | Pago por uso | 1,5 USD por 1.000 | 1,50 USD | Por uso | Precios SERP |
| Bright Data | Scale | 380.000 incluidas, 1,3 USD por 1.000 después | 1,30 USD (exceso) | Mensual | Igual |
Tres puntos merecen una nota clara. Primero, el plan más bajo de Serper sí es más barato que nosotros: 0,30 USD frente a 0,694 USD, 2,3 veces menos. Incluso su plan Standard, a 0,75 USD, está solo un 8 % por encima. Si haces varios cientos de miles de búsquedas al mes y gastas el paquete en 6 meses, Serper es la fila más barata de esta tabla.
Segundo, un crédito de Firecrawl no es una búsqueda: una búsqueda cuesta 2 créditos por cada 10 resultados, y los 5.000 créditos de Hobby compran 2.500 búsquedas. Tercero, Bright Data muestra la cuota mensual de Scale con un control deslizante que no pudimos leer. Por eso la tabla solo muestra su precio por exceso, 1,3 USD.
¿Por qué no tenemos planes? EveryInfra descuenta cada llamada de un saldo prepagado que no caduca, como indica la página de precios. Una recarga de 10 USD y otra de 1.000 USD tienen el mismo precio unitario. Esto ayuda a los agentes pequeños o irregulares, y perjudica a los equipos grandes y estables, porque más volumen no baja el precio.
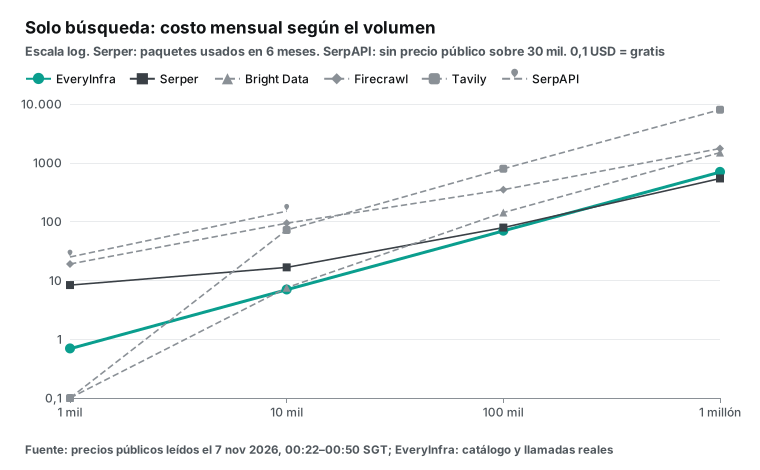
Coste mensual según el volumen: las curvas se cruzan cerca de 300.000 búsquedas
Una tabla de precios unitarios no te dice qué proveedor elegir. Cada uno tiene escalones, caducidades y usos gratuitos distintos. Por eso calculamos el coste de solo buscar con cuatro volúmenes mensuales: 1.000, 10.000, 100.000 y 1 millón de búsquedas. Las reglas van debajo del gráfico.
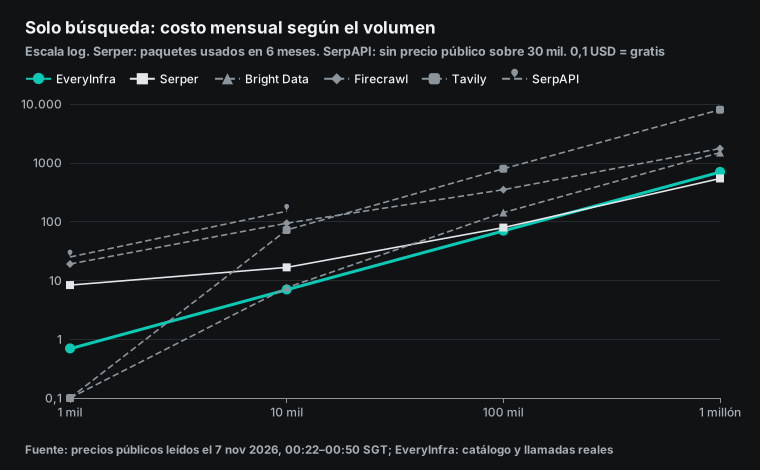
| Búsquedas al mes | EveryInfra | Serper | Bright Data | Firecrawl | Tavily | SerpAPI |
|---|---|---|---|---|---|---|
| 1.000 | 0,69 USD | 8,33 USD | 0 USD (dentro de las 5.000 gratis) | 19 USD | 0 USD (dentro de los 1.000 gratis) | 25 USD |
| 10.000 | 6,94 USD | 16,67 USD | 7,50 USD | 94 USD | 72 USD | 150 USD |
| 100.000 | 69,40 USD | 79,17 USD | 142,50 USD | 349 USD | 792 USD | Sin precio público |
| 1.000.000 | 694,00 USD | 541,67 USD | 1.492,50 USD | 1.749 USD | 7.992 USD | Sin precio público |
Así construimos cada columna, con una fila por proveedor para que puedas repetir la cuenta. Todas las filas cuentan solo búsquedas de 10 resultados. Donde hay uso gratuito, se descuenta primero.
| Proveedor | Uso gratuito | Elección de plan | Por encima del plan |
|---|---|---|---|
| EveryInfra | No se cuenta | Sin planes | 0,000694 USD por llamada |
| Serper | No se cuenta (las 2.500 consultas son de una sola vez) | Seis meses de uso, la combinación más barata de los cuatro paquetes prepagados, dividida entre 6 | Se compra un paquete más. Ejemplo: 10.000 al mes son 60.000 en seis meses, dos paquetes Starter por 100 USD, 16,67 USD al mes |
| Bright Data | Primero se descuentan 5.000 peticiones al mes. El repositorio MCP dice que, agotadas las gratuitas, se cobra por uso si tienes saldo | Pago por uso | 1,5 USD por 1.000 |
| Firecrawl | El plan gratuito da 1.000 créditos al mes, así que hasta 500 búsquedas cuestan 0 USD. El plan gratuito no admite recargas: por encima hace falta un plan de pago, y los planes de pago no suman esos 1.000 (facturación) | 2 créditos por búsqueda; el plan mensual con menor cuota más recargas | 5 USD por recarga: 1.000 créditos en Hobby, 2.000 en Standard, 2.500 en Growth y 5.000 en Scale (preguntas frecuentes de precios). Ejemplo: 10.000 al mes son 20.000 créditos: Hobby por 19 USD con 5.000, más 15 recargas por 75 USD, total 94 USD |
| Tavily | Primero se descuentan 1.000 créditos al mes. La página no dice si se suman al pago por uso; suponemos que sí | Pago por uso. Los planes mensuales bajan a 0,005 USD, pero solo Project tiene un volumen público | 0,008 USD por crédito. Con 1 millón, el precio mensual más bajo daría 5.000 USD |
| SerpAPI | 250 al mes, dentro de cada plan | El plan más pequeño que cubre el volumen | El mayor plan público es de 30.000 al mes; por encima, «sin precio público» |
Con estas reglas, las curvas se cruzan cerca de 300.000 búsquedas al mes: nosotros 208,20 USD y Serper 208,33 USD. Por encima ganan los paquetes de Serper, y con 1 millón es 152,33 USD más barato. Por debajo de 10.000 al mes, lo más barato somos nosotros y los usos gratuitos de Bright Data y Tavily. Los números de Serper suponen que gastas cada paquete en 6 meses, y nuestro saldo no caduca.
Frescura: filtros de tiempo, fechas y caché
Un error frecuente de los agentes es tomar un resultado antiguo como un hecho de hoy. Por eso el tercer factor es si puedes pedir solo resultados recientes y si cada resultado trae fecha.
Aquí las seis APIs difieren mucho. La portada de Serper dice que cada llamada va al buscador a por resultados frescos, con la frase «We do not cache anything». SerpAPI hace lo contrario: usa caché, y las búsquedas servidas desde caché no cuentan en tu plan (preguntas frecuentes de SerpAPI). Eso ahorra dinero cuando el agente repite una pregunta, pero un resultado en caché puede ser más antiguo que uno en vivo. La página no dice cuánto dura la caché.
Tavily añadió el parámetro max_age_hours en su registro de cambios de octubre de 2026. Fija la antigüedad máxima de la copia en caché de cada página, de 1 a 720 horas. El valor 0 obliga a una descarga en vivo cada vez (registro de cambios de Tavily). Un valor bajo no cuesta créditos extra, pero la descarga en vivo es más lenta. En el plan gratuito, la documentación avisa de que con mucha carga puede fallar con un estado 434 (límites de Tavily).
El endpoint de búsqueda de Tavily también filtra con time_range, start_date y end_date. Para ver fechas hay que añadir include_published_date, y la documentación llama a esa fecha una estimación. Firecrawl filtra con tbs, solo en resultados web. Nuestra herramienta web usa after y before, que se combinan con site y location.
Probamos cómo se comporta after. A las 00:16:34, hora de Singapur, buscamos «MCP server web search agents» con after en 2026-10-31. La llamada devolvió 10 resultados en 2,50 segundos, y 9 tenían fecha. Pero casi todas eran relativas, como «1 day ago» o «5 days ago», y el agente tiene que convertirlas. Otras llamadas del mismo lote devolvieron fechas como «Oct 21, 2026». Hay un problema mayor: 7 de los 10 enlaces eran redirecciones del buscador, no la dirección real.
Otra búsqueda a las 00:21:08, hora de Singapur, tenía 6 redirecciones en 10 resultados. En las 8 llamadas web con resultados, 13 de 75 resultados eran redirecciones, un 17 %. La herramienta read las sigue por ti. Si tu agente muestra enlaces al usuario, resuelve antes la redirección.
| API | Filtro de tiempo | Fechas en los resultados | Caché | Fuente |
|---|---|---|---|---|
| EveryInfra | after, before | 39 de 75 con fecha, formatos mezclados | No lo indica | Nuestras llamadas, lista de herramientas |
| Serper | No aparece en la portada | El ejemplo muestra date | Dice que no usa caché | Portada de Serper |
| Tavily | time_range, start_date, end_date | Solo con include_published_date, estimada | max_age_hours fija la antigüedad | Endpoint de búsqueda |
| SerpAPI | Parámetros del buscador | Si la página de resultados la muestra | Usa caché, los aciertos no cuentan | Preguntas frecuentes |
| Firecrawl | tbs, solo resultados web | No lo indica | No indica caché de búsqueda | Búsqueda |
| Bright Data | Parámetros del buscador | Si la página de resultados la muestra | No lo indica | Documentación SERP |
En frescura, Tavily da el control más fino y el «sin caché» de Serper es lo más directo. Nuestro campo de fecha cubre más o menos la mitad de los resultados y con formatos mezclados; es un punto débil y lo reconocemos. Para trabajo urgente como noticias, precios o avisos de caídas, usa una búsqueda de noticias. Nuestra API de datos tiene la capacidad google_news/search para eso. Después usa read sobre la página original para confirmar la fecha.
Límites y latencia: ¿bastan 60 peticiones por minuto?
Un agente de investigación puede enviar de 5 a 10 consultas en paralelo en un turno. Con 20 usuarios a la vez, eso son varios cientos de peticiones por minuto. Si calculas mal el límite, el agente no solo va más lento: recibe errores 429.
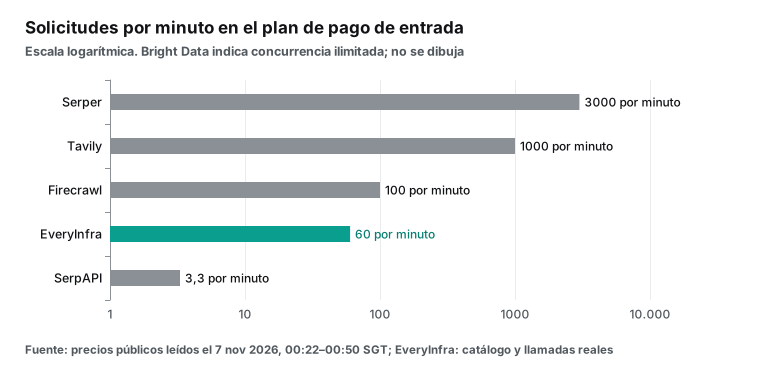
Los primeros planes se separan en tres órdenes de magnitud. Serper permite 50 consultas por segundo en Starter y 300 en Ultimate (portada de Serper). Tavily da 100 peticiones por minuto a una clave de desarrollo y 1.000 a una de producción (límites de Tavily). El /search de Firecrawl permite 10 por minuto en Free, 100 en Hobby y 500 en Standard (límites de Firecrawl). SerpAPI fija un tope por hora: 50 en Free, 200 en Starter y 6.000 en Big Data (precios de SerpAPI). Bright Data dice que su concurrencia SERP no tiene límite (precios SERP).
Nuestro valor por defecto es bajo en este grupo. Cada cuenta tiene 60 peticiones por minuto, compartidas entre todas sus claves. Un impulso de 30 días da 180 por minuto por 10 USD, 600 por 30 USD o 1.800 por 78 USD. Recargas acumuladas de 50, 150 o 750 USD desbloquean esos mismos niveles (precios). Nuestra clave de prueba tenía su propio límite de 10 por minuto, así que recibimos un 429 a las 00:17:55, 00:19:43 y 00:19:51, hora de Singapur.
Cada 429 traía un valor retry_after de 5 u 8 segundos y la frase «Nothing was charged». Los tres costaron 0 USD. Tras esperar 60 segundos, las llamadas de las 00:19:01 y las 00:21:08, hora de Singapur, funcionaron. Un 429 así es fácil de manejar para un agente, pero no sube un límite bajo. Para varios cientos de búsquedas por minuto, los planes de producción de Serper y Tavily empiezan más alto que el nuestro.
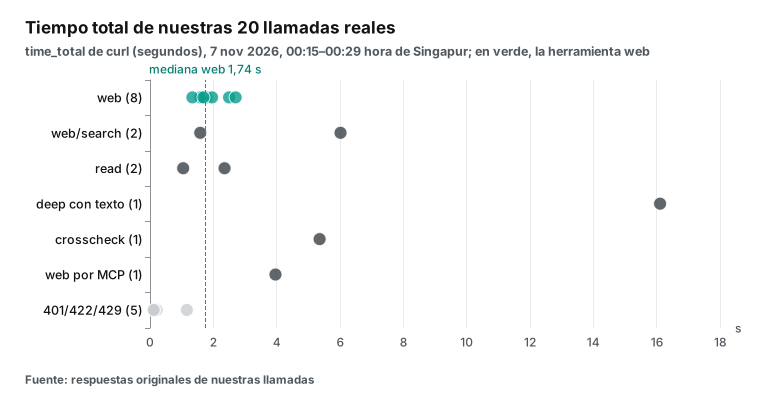
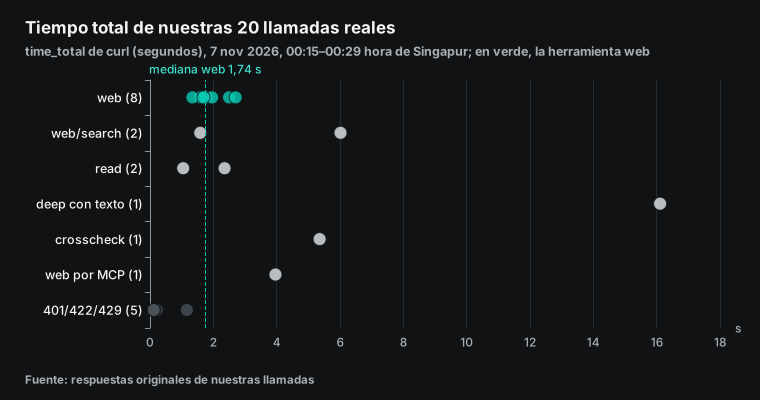
| Nuestras llamadas (2026-11-07, hora de Singapur) | Llamadas | Tiempo total | Resultados por llamada | Cargo por llamada |
|---|---|---|---|---|
web | 8 | 1,34 a 2,70 s, mediana 1,74 s | 0 a 10 | 0,000694 USD (0 USD el resultado vacío) |
web/search (API de datos) | 2 | 6,02 s y 1,59 s | 10 | 0,001389 USD |
read | 2 | 2,35 s y 1,05 s | 1 página, 30.957 y 3.450 caracteres | 0,000694 USD |
deep con full=true | 1 | 16,11 s | 5 con texto, 47.596 caracteres | 0,000694 USD |
crosscheck | 1 | 5,36 s | 3 métodos con 5 cada uno | 0,002083 USD |
tools/call por MCP a web | 1 | 3,96 s | 5 | 0,000694 USD |
| 401 / 422 / 429 | 5 | 0,11 a 1,16 s | 0 | 0 USD |
No medimos a los demás proveedores, así que citamos sus páginas. Serper dice de 1 a 2 segundos. SerpAPI vende Ludicrous Speed al doble de precio y dice que es 2,2 veces más rápido de media (Ludicrous Speed). Bright Data dice «under 5 sec» en una página y «under 1 second per request» en otra.
Nuestra mediana web de 1,74 segundos cumple el objetivo de quedar por debajo de 3 segundos. La primera llamada web/search tardó 6,02 segundos, y la misma consulta en web 1,78, así que para resultados simples usa la API de búsqueda, que cuesta la mitad. La vía de la API de datos tardó 6 segundos en una de nuestras dos llamadas. La llamada por MCP tardó unos 2 segundos más que por HTTP directo, con una sola muestra.
Fallos, resultados vacíos y límites: ¿cuándo pagas?
Los agentes fallan mucho más que las personas: el modelo se equivoca de parámetro, busca en bucle y choca con los límites, o no encuentra nada. Multiplica cada fallo por el volumen del agente y la regla de cobro de los fallos se convierte en dinero real.
| Caso | EveryInfra (nuestras llamadas) | Serper | Tavily | SerpAPI | Firecrawl | Bright Data |
|---|---|---|---|---|---|---|
| Clave o parámetro incorrecto | 401 y 422 a 0 USD, el 422 da la corrección | Solo cobra respuestas correctas | No lo indica | Errores gratis | Sin documento no cobra | Solo paga el éxito |
| Cero resultados | Reembolsado, empty_result_refunded | No lo indica | No lo indica | Cuenta como 1 búsqueda | No lo indica | No lo indica |
| La página devuelve 403/404 | No lo indica para read | No aplica | Extracción fallida gratis | No aplica | 1 crédito | No lo indica |
| Límite 429 | 0 USD, con retry_after | No lo indica | Devuelve Retry-After | No lo indica | No lo indica | No lo indica |
| Éxito parcial | crosscheck cobra por método ejecutado | No aplica | Extract cobra por URL correcta | Crawl cobra por página | Cobra por documento devuelto | No aplica |
| Fuente | Nuestras llamadas | Preguntas de la portada | Créditos | Preguntas de precios | Facturación | Documentación SERP |
Tres celdas importan más a quien construye agentes. Primero, SerpAPI cuenta un resultado vacío como una búsqueda. Sus preguntas frecuentes dicen que una respuesta con 100 resultados y otra con 0 cuentan igual. Cuanto más concretas sean las preguntas del agente, más suma esta fila. Segundo, Firecrawl trata una página 403 o 404 como un documento y cobra 1 crédito, unos 0,0038 USD en Hobby (19 USD por 5.000 créditos). Su documentación sugiere mirar metadata.statusCode y dejar de reintentar las URL que siempre rechazan.
Tercero, nuestro 422 hace algo más que no cobrar: le dice al modelo cómo corregir la llamada. A las 00:15:57, hora de Singapur, enviamos la consulta como query a propósito. La respuesta decía did_you_mean: ["q"] y listaba todos los parámetros válidos: after, before, location, num, page, q, site. El modelo puede corregir la llamada al primer intento. Nuestra guía sobre errores de API que se corrigen solos tiene más ejemplos, y para cuadrar reembolsos mira la conciliación de reembolsos por fallo.
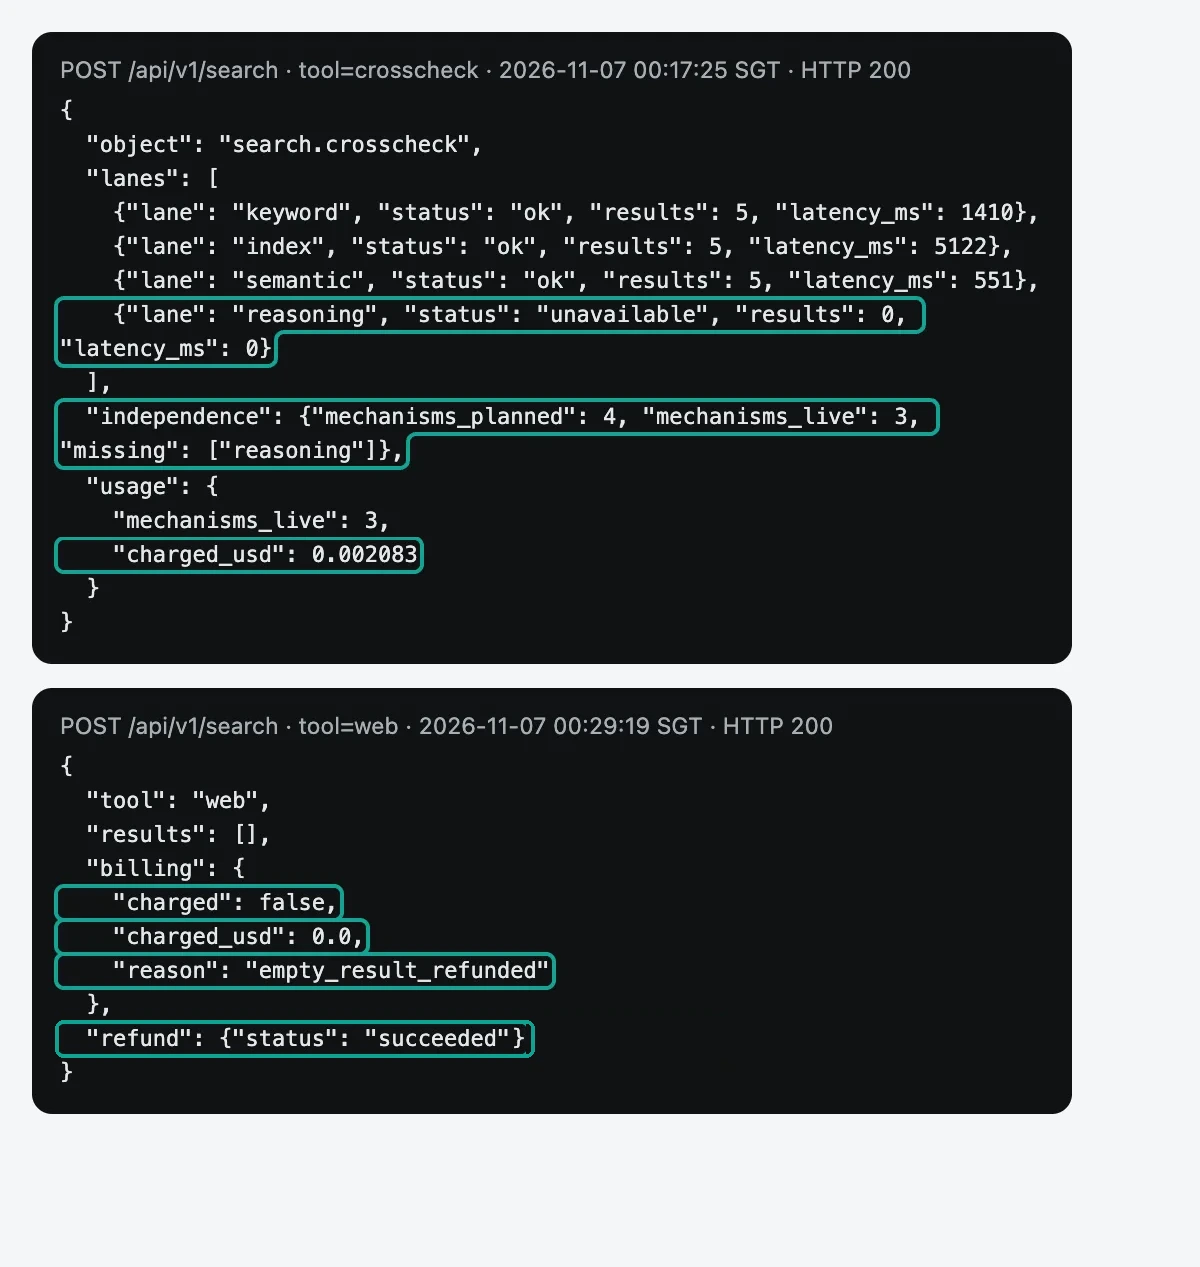
A las 00:29:19, hora de Singapur, buscamos a propósito una cadena larga que no existe. La respuesta fue un 200 con results vacío. Mostraba billing.charged en false y reason en empty_result_refunded, y el bloque refund mostraba el estado succeeded: se devolvieron los 0,000694 USD de esa llamada. Esto explica cómo cobramos a los agentes: primero cargamos y después reembolsamos. El saldo baja un instante y luego vuelve a subir. Tu script de conciliación debe leer el charged_usd final, no el cambio de saldo en el momento de la petición.
MCP: cómo se conecta cada una de las seis a un agente
MCP (Model Context Protocol) es hoy la forma habitual de conectar herramientas a un agente. La última versión de la especificación es la del 2026-07-28 (versiones de MCP, publicaciones de la especificación). Cinco de los seis proveedores tienen su propio servidor MCP remoto. La configuración cambia mucho, y la mayor diferencia es dónde va la clave.
| API | URL remota | Autenticación | Herramientas | Última novedad | Fuente |
|---|---|---|---|---|---|
| EveryInfra | https://api.everyinfra.com/mcp | Cabecera Authorization: Bearer; listar herramientas no pide clave | 12, la búsqueda va por everyinfra_search (17 herramientas) | Leído el 2026-11-07 | Página del servidor MCP |
| Tavily | https://mcp.tavily.com/mcp/ | OAuth, clave en la URL o cabecera sin clave | search, extract, crawl, map, research | README actualizado el 2026-11-05 | MCP de Tavily |
| SerpAPI | https://mcp.serpapi.com/mcp | Cabecera Bearer (recomendada) o clave en la ruta | Búsqueda, Extract y más | v2.2.0 del 2026-11-04 | Repositorio MCP de SerpAPI |
| Firecrawl | https://mcp.firecrawl.dev/v2/mcp | El punto sin clave abre 3 herramientas; con clave, todas | 27 en total, 9 en el punto solo de búsqueda | v3.36.1 del 2026-11-03 | Repositorio MCP de Firecrawl |
| Bright Data | https://mcp.brightdata.com/mcp?token=… | Token en la URL | 30 | v4.6.0 del 2026-11-05 | Repositorio MCP de Bright Data |
| Serper | No aparece en la portada | — | La portada lista integraciones con LangChain, CrewAI, Haystack y otros | — | Portada de Serper |
Dónde va la clave tiene un efecto real en los agentes. Una URL acaba en registros del cliente, del proxy y del navegador, y un modelo puede repetirla en una respuesta. El README de SerpAPI recomienda la cabecera porque así «the key stays out of URLs and logs». Bright Data solo acepta el token en la URL, y Tavily recomienda OAuth.
Nosotros solo aceptamos la cabecera Bearer, y no tenemos prueba sin clave. Tavily sí: con la cabecera X-Tavily-Access-Mode: keyless obtienes búsqueda y extracción gratis con límite (prueba sin clave). El MCP remoto de Firecrawl abre tres herramientas sin clave (límites de Firecrawl). Nuestro MCP lista sus herramientas sin clave: a las 00:17:48, hora de Singapur, tools/list devolvió 12 herramientas en 0,10 segundos.
Para añadir nuestro servidor MCP a Claude Code basta un comando. Guarda la clave en una variable de entorno, no en un archivo de configuración:
# La clave solo vive en una variable de entorno; en Claude Code, /mcp muestra las herramientas
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"
Si tu cliente lee una configuración JSON, puedes añadir dos servidores de búsqueda y dejar que el agente elija según la tarea. En este ejemplo, la entrada de Tavily usa OAuth como indica su documentación, así que no lleva clave:
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    },
    "tavily": { "url": "https://mcp.tavily.com/mcp/" }
  }
}
La configuración completa de cada cliente está en nuestra página del servidor MCP y en la guía de MCP remoto. Lo que implica la especificación de 2026 en producción lo explica el artículo sobre la madurez de MCP 2026 para producción.
Un viaje completo: lo que recibe un agente de everyinfra_search
Este es un viaje MCP completo de nuestra prueba. El agente usa everyinfra_search para saber cuántos créditos cuesta una búsqueda de Tavily. La primera llamada, a las 00:17:55, hora de Singapur, chocó con el límite de 10 por minuto de la clave de prueba. Devolvió isError: true, rate_limited, retry_after: 5 y «Nothing was charged». Esperamos 60 segundos. La segunda llamada, a las 00:19:01, devolvió 5 resultados en 3,96 segundos por 0,000694 USD. Esta es la llamada y su respuesta, sin campos de saldo y con los fragmentos intactos:
// Petición: tools/call
{"name": "everyinfra_search",
 "arguments": {"tool": "web", "params": {"q": "tavily search api credits per request", "num": 5}}}

// Respuesta (extracto)
{"tool": "web",
 "results": [
  {"title": "Credits & Pricing",
   "url": "https://docs.tavily.com/documentation/api-credits",
   "snippet": "You get 1,000 free API Credits every month. No credit card required. Monthly plans: $0.0075 - $0.005 per credit. Each request costs 1 API credit. Advanced ..."},
  {"title": "Tavily Search",
   "url": "https://docs.tavily.com/documentation/api-reference/endpoint/search",
   "snippet": "This uses 2 API credits per request. To avoid the extra cost, you can explicitly set search_depth to basic ..."}
 ],
 "billing": {"charged": true, "charged_usd": 0.000694}}
Este viaje enseña dos cosas. Lo bueno es que los dos primeros resultados son documentación de la propia Tavily. Los fragmentos ya contienen la respuesta (básica 1 crédito, avanzada 2), así que el modelo puede contestar sin leer la página, por 0,000694 USD. Lo arriesgado son los resultados 4 y 5, que vienen de sitios de reseñas. Uno dice «$0.008 a credit» y otro repite una cifra antigua de Tavily.
Un modelo que solo lee fragmentos puede tomar un resumen de terceros por la fuente original. Nuestra recomendación es una regla sencilla para el agente. Para precios, cuotas y otras cifras que cambian, confía solo en resultados del dominio del propio proveedor. O llama una vez a read sobre la página original para confirmarlo. La herramienta de la sección siguiente existe para resolver justo este problema.
Verificación cruzada: dile al agente qué afirmaciones no creer
El mayor riesgo de una API de búsqueda para agentes de IA no es quedarse sin resultados. Es recibir resultados erróneos, viejos o deformados al repetirse, que el modelo no detecta por sí solo. Nuestra herramienta crosscheck lanza cuatro métodos de búsqueda en paralelo sobre la misma pregunta: palabras clave, índice, semántico y razonamiento. Cuenta cuántos métodos encuentran cada fuente y descarga el texto de las mejores. No escribe una conclusión. La lista de herramientas dice que da pruebas, no conclusiones.
Probamos una afirmación que este artículo también necesita comprobar: «Serper free tier gives 2,500 queries». La llamada de las 00:17:25, hora de Singapur, tardó 5,36 segundos en total.
| Método | Estado | Resultados | Tiempo |
|---|---|---|---|
| keyword (palabras clave) | ok | 5 | 1.410 ms |
| index (índice) | ok | 5 | 5.122 ms |
| semantic (semántico) | ok | 5 | 551 ms |
| reasoning (razonamiento) | unavailable | 0 | — |
El nivel de verdict fue scattered. Ninguna fuente apareció en 3 o más métodos, así que el agente no debe fiarse de una sola fuente. Dos páginas de terceros aparecieron a la vez por palabras clave y por índice, y el texto descargado llamaba «one-time» a las 2.500 consultas. La portada de Serper coincide: dice «Get 2,500 free queries» y no dice «al mes». Nuestro artículo sobre el uso gratuito de Serper revisa esta afirmación palabra por palabra.
El precio de lista es de 0,002778 USD. El método de razonamiento no se ejecutó, así que cobramos solo los 3 métodos que funcionaron: 0,002083 USD. El endpoint de investigación de Tavily y el de agente de Firecrawl también buscan en varias rondas. Pero escriben una respuesta y cobran por uso (créditos de Tavily, facturación de Firecrawl). Usa los suyos si quieres una respuesta terminada con citas. Usa el nuestro cuando tu propio modelo deba juzgar las fuentes.
Cuándo te conviene otra API: el mejor uso de cada una
Cada sección anterior tiene algún factor en el que perdemos. Esta tabla los reúne, y las notas de abajo añaden detalles.
| Tu agente necesita | Elige | El coste principal de esa elección |
|---|---|---|
| Más de 300.000 búsquedas al mes, solo la página de resultados | Serper | Paquetes prepagados que caducan a los 6 meses, sin texto de páginas |
| Texto que el modelo pueda leer ya, prueba sin clave | Tavily | 8,00 USD por 1.000 en pago por uso |
| Muchos buscadores, páginas de resultados completas, el proveedor asume el riesgo legal | SerpAPI | 25,00 USD por 1.000 en Starter, los vacíos cuentan |
| Buscar y extraer en una llamada, índices especiales | Firecrawl | Créditos complejos, las páginas 403 y 404 cuestan un crédito |
| Segmentación por ciudad, concurrencia muy alta | Bright Data | Token en la URL, HTML en bruto por defecto |
| Empezar pequeño, fallos gratis, otros datos con la misma clave | EveryInfra | 60 por minuto por defecto, solo fragmentos cortos |
Serper es la capa de búsqueda más barata a gran volumen. Con 1 millón de búsquedas al mes cuesta 152,33 USD menos que nosotros, y no usa caché. Si ya tienes un lector de páginas, empieza por aquí. Nuestros artículos sobre alternativas a la API de Serper y el precio de la API de Serper entran en más detalle.
Tavily elige por relevancia fragmentos de unos 500 caracteres. Una búsqueda básica de 1 crédito puede traer el texto completo y una respuesta breve. El modo sin clave deja que un agente la pruebe antes de registrarte. Su precio es 11,5 veces el nuestro, pero su clave de producción permite 1.000 peticiones por minuto.
SerpAPI cubre más de 100 buscadores, y su salida en Markdown reduce los tokens a la mitad de media. Los planes Production y superiores incluyen U.S. Legal Shield. La página dice que SerpAPI asume hasta 2 millones de USD de responsabilidad legal en Estados Unidos por la extracción lícita de datos públicos de búsqueda (U.S. Legal Shield).
Firecrawl trae el texto completo si añades scrapeOptions a una búsqueda. Sus índices gubernamentales y académicos se consultan gratis, y Alexandria añade fuentes con licencia. Su documentación dice que la categoría research cambia el 2026-11-16 y que los resultados pasan de data.web a data.research. Actualiza antes de esa fecha cualquier código que la lea.
Bright Data cubre 195 países con segmentación por ciudad. La página dice que la concurrencia no tiene límite, a 1,50 USD por 1.000 y con 5.000 peticiones gratis al mes. Nuestra página de alternativas a Bright Data compara más aspectos.
EveryInfra cuesta 0,694 USD por 1.000, sin caducidad ni cuota mensual. Un 401, 422, 429 o resultado vacío no cuesta nada, y la verificación cruzada señala qué afirmaciones no creer. La misma clave llama a 106 plataformas y 573 capacidades de nuestra API de datos, según la descripción de nuestra herramienta MCP. Por ejemplo, bing/search, duckduckgo/search y google_news/search.
Lo que no podemos hacer
Queremos ser claros sobre nuestras carencias. Cada fila de abajo es un límite real de nuestra API de búsqueda hoy, y la última columna dice qué usar si te importa.
| Carencia | Detalle | Usa en su lugar |
|---|---|---|
| Sin página de resultados completa | web solo da título, enlace, fragmento y fecha | Serper o SerpAPI |
| Ubicación solo por país | Una ciudad cuenta como su país | Bright Data |
| 10 resultados por página | Cada página extra es otro cargo | Tavily devuelve hasta 20 |
| Fecha en cerca de la mitad de los resultados | Formatos mezclados, 17 % de enlaces son redirecciones | read, o una búsqueda de noticias |
| 60 peticiones por minuto por defecto | El segundo más bajo de los seis primeros planes | Claves de producción de Serper o Tavily, o nuestro impulso |
| Sin prueba sin clave | Hay que registrarse; dar estrella a nuestros dos repositorios de GitHub da 1 USD durante 24 horas | Modos sin clave de Tavily o Firecrawl |
| No escribimos respuestas | Tu propio modelo escribe la conclusión | include_answer de Tavily |
| Búsqueda con texto lenta | deep tardó 16 segundos; un método de la verificación falló | web más read |
Qué cambió en octubre y noviembre de 2026
Las APIs de búsqueda cambiaron rápido en los dos últimos meses. Bright Data cambió sus herramientas y parámetros MCP cuatro veces en una semana. Si el prompt de tu agente nombra herramientas concretas, fija la versión o vuelve a leer la lista de herramientas en cada arranque.
| Fecha | Proveedor | Cambio | Qué significa para ti |
|---|---|---|---|
| 2026-11-05 | Bright Data | MCP v4.6.0 quitó scrape_as_html y extract (v4.6.0) | Usa scrape_as_markdown con format: 'html' |
| 2026-11-04 | Bright Data | MCP v4.4.0 unificó el formato de errores (v4.4.0) | Revisa el manejo de errores del agente |
| 2026-11-04 | SerpAPI | MCP v2.2.0 añadió la herramienta extract (v2.2.0) | Un servidor busca y lee, a una búsqueda por página |
| 2026-11-03 | Firecrawl | Publicó MCP v3.36.1 (notas) | La categoría research cambia el 2026-11-16 |
| 2026-11-02 | Bright Data | MCP v4.3.0 pasó la búsqueda a la API SERP y renombró geo_location a country (v4.3.0) | Los nombres antiguos devuelven invalid_input |
| 2026-11-01 | Bright Data | MCP v4.2.0 pasó la extracción a una API que no ejecuta JavaScript (v4.2.0) | Las páginas que dependen de JavaScript pueden traer menos texto |
| 2026-10-13 | Bright Data | Alianza con DigitalOcean para agentes alojados (anuncio) | Compara la factura total, no solo el precio unitario |
| Octubre de 2026 | Tavily | Nuevo parámetro max_age_hours (registro de cambios) | Puedes forzar una descarga en vivo por petición |
| Principios de noviembre de 2026 | Firecrawl | Datos de Benzinga en Alexandria (PR Newswire) | Los agentes financieros acceden a datos con licencia |
Desde SerpAPI MCP v2.0.0, del 2026-09-22, una búsqueda fallida devuelve isError: true (v2.0.0). Dos cambios más antiguos siguen pesando en la elección. La Custom Search JSON API de Google ya no acepta clientes nuevos y dejará de funcionar el 1 de enero de 2027 (Google for Developers). Microsoft retiró las Bing Search APIs el 11 de agosto de 2025 (Microsoft Learn) y ahora remite a la búsqueda de Bing dentro de Azure AI Agents. Es decir, ni Google ni Bing ofrecen ya su API oficial de búsqueda general a usuarios nuevos, y un agente nuevo que necesite resultados de búsqueda tiene que usar una API de terceros.
En qué se diferencia este artículo de nuestros otros textos sobre búsqueda
Tenemos otros artículos sobre búsqueda, y este no los repite. Elegir herramientas de búsqueda para agentes explica cómo un agente alterna entre buscar, leer páginas y verificar en cada fase de una tarea. No compara precios. El artículo sobre el uso gratuito de Serper solo trata cuánto duran sus 2.500 consultas gratis. Nuestra comparación de precios de extractores de resultados de Google compara el coste de 1.000 páginas de resultados orgánicos, para equipos de seguimiento de posiciones. Este es el único que compara seis APIs en ocho factores para agentes y pone precio a la tarea «buscar una vez y leer tres páginas». Para comparaciones una a una, mira nuestras páginas de alternativas a SerpAPI, alternativas a Firecrawl y alternativas a Bright Data.
Primeros pasos: conecta la búsqueda a tu agente en tres pasos
El primer paso es ver la salida antes de escribir código. Abre la página del mercado, busca la búsqueda web y prueba una consulta. También puedes leer la página del producto de búsqueda web y el resumen del producto de búsqueda, con las 17 herramientas y sus tres niveles de precio. El segundo paso es seguir el inicio rápido para registrarte y obtener una clave. Una estrella en dos repositorios de GitHub da 1 USD de prueba durante 24 horas, unas 1.440 llamadas web. El tercer paso es poner esta llamada curl en tu script, o añadir el servidor MCP con el comando de una línea de la sección de MCP.
curl -s https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"tool":"web","params":{"q":"best web search api for ai agents","location":"us","num":10}}'
# Devuelve results (hasta 10: title, url, snippet, published), location y billing.charged_usd
# Para leer un resultado: cambia tool a "read" y params a {"url": "<url del resultado>"}
La lista gratuita de herramientas de búsqueda es la referencia de parámetros. Un nombre incorrecto devuelve un 422 con la lista de nombres válidos. Para las capacidades equivalentes de nuestra API de datos, mira el catálogo de capacidades. ¿Eliges una capa de datos para todo el agente, no solo búsqueda? Mira también las páginas de la API de datos de Bing, la API de datos de DuckDuckGo y la API de datos de Google News.
Preguntas frecuentes
¿Hay una web search API for AI agents gratuita?
Sí, pero todas tienen tope. Bright Data da 5.000 peticiones gratis al mes, y Tavily y Firecrawl dan 1.000 créditos al mes más un modo sin clave. En Tavily esos créditos valen unos 8 USD a precio de pago por uso, y en Firecrawl dan para unas 500 búsquedas. Serper da 2.500 consultas al registrarte, sin decir que se renueven. SerpAPI da 250 búsquedas al mes, y nosotros 1 USD por dar estrella a nuestros dos repositorios de GitHub, unas 1.440 búsquedas en 24 horas. (Origen de la pregunta: autocompletado de Google para «free web search api for ai agents», leído el 2026-11-07.)
¿Existe una Google search API for AI agents de la propia Google?
No para proyectos nuevos. La Custom Search JSON API de Google ya no acepta clientes nuevos. Los clientes actuales tienen 100 consultas gratis al día y después pagan 5 USD por 1.000, hasta 10.000 al día. La API se apaga el 1 de enero de 2027 (Google for Developers). Para páginas de resultados al estilo Google, usa Serper, SerpAPI o Bright Data. Para resultados web generales, nuestra herramienta web cuesta 0,694 USD por 1.000. (Origen de la pregunta: autocompletado para «google search api for ai agents».)
Tavily o Serper: ¿cuál elegir?
Depende de si tu agente necesita texto o una página de resultados. Tavily devuelve fragmentos elegidos por relevancia, con texto opcional, a 8,00 USD por 1.000. Serper devuelve JSON estructurado desde 1,00 USD hasta 0,30 USD por 1.000, con paquetes prepagados que caducan a los 6 meses. Elige Tavily para poco volumen con lectura de contenido, y Serper para mucho volumen si ya tienes un lector de páginas. (Origen de la pregunta: autocompletado para «tavily vs serper».)
¿Qué diferencia hay entre Firecrawl y Tavily?
Las dos pueden buscar y leer, pero cobran distinto. En Tavily, una búsqueda básica cuesta 1 crédito con texto incluido. Firecrawl cobra 2 créditos por cada 10 resultados y 1 más por página extraída. Así, «buscar una vez y leer tres páginas» cuesta 8,00 USD por 1.000 tareas en Tavily y 19,00 USD en Firecrawl. Firecrawl es más fuerte en la extracción en sí. (Origen de la pregunta: autocompletado para «firecrawl vs tavily».)
SerpAPI o Serper: ¿cuál es más barata?
Serper es mucho más barata. SerpAPI Starter cuesta 25,00 USD por 1.000 búsquedas, y su plan Big Data 9,17 USD. Serper empieza en 1,00 USD y baja a 0,30 USD. SerpAPI cobra más por cubrir más de 100 buscadores, por la salida en Markdown y por U.S. Legal Shield. Un usuario de r/AI_Agents la llamó cara por «$75/month for just 5k searches» (hilo original). (Origen de la pregunta: autocompletado para «serpapi vs serper».)
¿Cuál es el precio de la API SERP de Bright Data?
La API SERP cuesta 1,5 USD por 1.000 en pago por uso, solo por peticiones correctas. El plan Scale incluye 380.000 peticiones y cobra 1,3 USD por 1.000 a partir de ahí (precios SERP). El servidor MCP da 5.000 peticiones gratis al mes y cobra 1,50 USD por 1.000 resultados (precios MCP). En el mismo hilo de Reddit, un usuario dijo que paga «$1.5 for 1000 searches». (Origen de la pregunta: autocompletado para «bright data serp api pricing».)
¿Cómo comparo la precisión de una search API for AI agents?
Ningún ranking externo está aceptado por todos los proveedores, así que prueba con tus propias preguntas. Elige de 50 a 100 preguntas que tu agente vaya a hacer de verdad y que tengan respuesta clara. Lánzalas en cada API y juzga las respuestas a mano. SimpleQA es una prueba pública de preguntas cortas con una sola respuesta correcta (artículo), y su diseño de preguntas es un buen modelo. (Origen de la pregunta: un hilo de r/LocalLLaMA titulado «What is the most accurate web search API for LLM?», encontrado con una búsqueda en foros el 2026-11-07.)
Referencias
- Portada de Serper (precios, uso gratuito, preguntas frecuentes), Serper, leída el 2026-11-07.
- Serper Terms of Service, Serper, actualizados el 2024-05-29, leídos el 2026-11-07.
- Tavily Pricing, Tavily, leída el 2026-11-07.
- Tavily Credits & Pricing, documentación de Tavily, leída el 2026-11-07.
- Tavily Rate Limits, documentación de Tavily, leída el 2026-11-07.
- Referencia del endpoint Search de Tavily, documentación de Tavily, leída el 2026-11-07.
- Tavily Changelog, documentación de Tavily, entradas de octubre de 2026, leído el 2026-11-07.
- Tavily MCP, documentación de Tavily, leída el 2026-11-07.
- Try Tavily Without an API Key, documentación de Tavily, leída el 2026-11-07.
- tavily-ai/tavily-mcp, GitHub, último cambio el 2026-11-05.
- SerpApi Plans and Pricing, SerpApi, leída el 2026-11-07.
- SerpApi Markdown Output for AI Agents, SerpApi, leída el 2026-11-07.
- SerpApi MCP Integration, SerpApi, leída el 2026-11-07.
- SerpApi Ludicrous Speed, SerpApi, leída el 2026-11-07.
- SerpApi Extract API, SerpApi, leída el 2026-11-07.
- SerpApi U.S. Legal Shield, SerpApi, leída el 2026-11-07.
- serpapi/serpapi-mcp, GitHub, leído el 2026-11-07.
- serpapi-mcp v2.2.0, GitHub, 2026-11-04.
- serpapi-mcp v2.0.0, GitHub, 2026-09-22.
- Firecrawl Pricing, Firecrawl, vigente desde el 2026-09-04, leída el 2026-11-07.
- Firecrawl Billing, documentación de Firecrawl, leída el 2026-11-07.
- Firecrawl Search, documentación de Firecrawl, leída el 2026-11-07.
- Firecrawl Rate Limits, documentación de Firecrawl, leída el 2026-11-07.
- firecrawl/firecrawl-mcp-server, GitHub, leído el 2026-11-07.
- firecrawl-mcp-server v3.36.1, GitHub, 2026-11-03.
- Best Search Tools for AI Agents in 2026, blog de Firecrawl, 2026-09-24, leído el 2026-11-07.
- Bright Data SERP API Pricing, Bright Data, leída el 2026-11-07.
- Bright Data MCP Server Pricing, Bright Data, leída el 2026-11-07.
- Introduction to SERP API, documentación de Bright Data, leída el 2026-11-07.
- brightdata/brightdata-mcp, GitHub, leído el 2026-11-07.
- brightdata-mcp v4.6.0, GitHub, 2026-11-05.
- brightdata-mcp v4.4.0, GitHub, 2026-11-04.
- brightdata-mcp v4.3.0, GitHub, 2026-11-02.
- brightdata-mcp v4.2.0, GitHub, 2026-11-01.
- DigitalOcean and Bright Data Unlock the Web for AI Agents, nota de Business Wire en Yahoo Finance, 2026-10-13.
- Benzinga Collaborates With Firecrawl, PR Newswire, principios de noviembre de 2026.
- Custom Search JSON API, Google for Developers, actualizada el 2026-02-18.
- Bing Search APIs Retiring on August 11, 2025, Microsoft Learn.
- MCP Versioning, Model Context Protocol, versión 2026-07-28.
- Publicaciones de la especificación modelcontextprotocol, GitHub, publicación del 2026-07-28.
- Measuring short-form factuality in large language models (SimpleQA), arXiv, 2024-11-07.
- What's the best tool/API for web search in an agentic stack?, Reddit r/AI_Agents, leído el 2026-11-07.
- Lista de herramientas de búsqueda de EveryInfra, EveryInfra, leída el 2026-11-07 a las 00:15, hora de Singapur.
- Catálogo de capacidades de EveryInfra, EveryInfra, leído el 2026-11-07 a las 00:15, hora de Singapur.
- OpenAPI de EveryInfra, EveryInfra, leída el 2026-11-07.
- everyinfra/everyinfra-agent-plugins, GitHub, uno de los repositorios donde se da la estrella para recibir el saldo de prueba.
Referencia BL-105