Weibo API con Python: tres vías para obtener datos de Weibo, probadas
Tres formas de obtener datos de Weibo con Python: la plataforma oficial, un weibo scraper de GitHub o una API por llamada. Una cadena real: 0,0051 USD.
El 11 de noviembre de 2026, entre las 00:14 y las 00:37 (hora de Singapur), ejecutamos cuatro veces una cadena completa de datos de Weibo con Python y la librería requests. Cada cadena tenía siete pasos: lista de tendencias, búsqueda de temas, búsqueda de publicaciones, detalle de una publicación, comentarios, respuestas a un comentario y republicaciones. Cada petición de esas cuatro cadenas devolvió datos o se reembolsó. Una cadena completa costó 0,005142 USD y tardó entre 19,37 y 33,94 segundos. Más tarde esa noche, y otra vez el 12 de noviembre, repetimos la cadena tres veces para probar los reintentos.
El hallazgo más útil no fue el precio, sino la muestra. En las cuatro primeras pruebas, la publicación que el script eligió como «la más comentada» no tenía la palabra buscada en su texto. Además, una misma palabra puede devolver ventanas muy distintas. Una búsqueda de «gripe» a las 00:14 devolvió 12 publicaciones de siete días. La misma búsqueda a las 00:46 devolvió 50, todas de los últimos 20 minutos.
Las otras dos vías las revisamos con sus documentos de primera mano. La plataforma abierta de Weibo permite 100 peticiones al día por usuario autorizado en una aplicación. Su servicio de comentarios solo devuelve los comentarios de ese usuario. Y prohíbe que terceros guarden datos de usuarios en sus servidores. Los proyectos weibo scraper más populares de GitHub dicen en su README que la búsqueda por palabra clave y las republicaciones necesitan una cookie de sesión. En sus incidencias de los últimos 60 días todavía aparecen respuestas que no son JSON y un tope de 500 resultados por búsqueda.
Este artículo piensa en un lector concreto: un exportador, un analista o una oficina comercial de Chile o de América Latina que quiere escuchar lo que se dice en Weibo sobre su producto en China. Weibo es una red de microblogs de China continental, con 561 millones de usuarios activos al mes según sus resultados del segundo trimestre de 2026. Allí se mezclan noticias, comercio electrónico y opinión. Es distinta de las redes que se usan fuera de China, con otras cuentas y otra plataforma para desarrolladores.
Para la vía oficial y la de código abierto, citamos solo las páginas de open.weibo.com, los README de los proyectos y sus incidencias públicas. Todas las páginas oficiales están en chino; aquí traducimos lo necesario y enlazamos el original. Para la vía de pago por llamada, cada número sale de nuestras propias llamadas. Guardamos los scripts y las respuestas JSON originales, así que cada cifra se puede volver a comprobar.
La respuesta corta: qué vía de «weibo api» te conviene
Las tres vías sirven a personas distintas. La tabla pone lado a lado lo que pide cada una, qué datos alcanza y su riesgo principal. Cada punto tiene una fuente o una prueba más adelante.
| Punto | Plataforma abierta oficial de Weibo | Weibo scraper de código abierto en GitHub | API de datos por llamada (EveryInfra en esta prueba) |
|---|---|---|---|
| Requisitos | Crear una aplicación y pasar revisión; weibo-cli pide verificación facial en la app de Weibo | Ninguno | Registrarse y crear una clave de API |
| De quién son los datos | Del usuario autorizado: sus comentarios, su historial | Lo que muestra una página pública, según la cookie | Tendencias, temas, publicaciones, comentarios, respuestas, republicaciones e historiales públicos |
| Búsqueda por palabra | Búsqueda de temas avanzada, solo los 200 resultados más nuevos; los datos por fila requieren contacto comercial | El README dice que necesita cookie; la web muestra 50 páginas como máximo | weibo/search, weibo/topic_search |
| Ritmo | 100 peticiones al día por usuario autorizado; 15 000 por IP y hora | Lo decides tú; un proyecto usa 8 a 15 segundos por página | Límite por clave; un 429 no se cobra |
| Almacenamiento | Prohibido guardar datos de usuarios en el servidor | Tu decisión y tu riesgo | Según tu uso y la ley que te aplique |
| Coste | Servicios estándar gratuitos; paquetes de weibo-cli desde 69 RMB; la API comercial no publica precios | Código gratis; el coste es tu tiempo y tus cuentas | 0,005142 USD por una cadena de 7 pasos en esta prueba |
Nuestra lectura es esta. Si construyes una herramienta para tu propia cuenta de Weibo, para publicar, responder comentarios o mostrar datos de tus propios usuarios, usa la plataforma oficial. Es la única con permisos de escritura y la más estable.
Si eres estudiante y necesitas unos cientos de publicaciones de una cuenta pública para una tesis, un script de código abierto basta. Pero la cookie caduca a los tres meses, más o menos, y el sitio te puede bloquear en cualquier momento. Si recoges cada día publicaciones públicas por tema y por tendencias, para prensa, comercio exterior o investigación, sin mantener una cookie, una API por llamada es lo que menos trabajo da. Las secciones siguientes dan las pruebas.
Vía 1: la «weibo api» oficial de la plataforma abierta
Muchos tutoriales describen «la API de Weibo» como un servicio donde escribes una palabra y recibes todas las publicaciones del sitio que la contienen. La documentación de open.weibo.com dice otra cosa. Casi todos los servicios de lectura giran en torno a un usuario que autoriza con OAuth2. Tu aplicación pide primero a un usuario de Weibo que inicie sesión y dé su consentimiento. Luego recibe un access_token y lee lo que ese usuario puede ver o lo que ese usuario produjo. El ejemplo de la documentación de access_token muestra una validez de 7200 segundos, es decir, dos horas. Después, el usuario tiene que volver a autorizar.
Qué se puede pedir hoy
Abrimos las páginas de los servicios que más se consultan. El servicio de lista de comentarios 2/comments/show dice que solo devuelve los comentarios del usuario autorizado, con 50 filas por página por defecto. Es decir, no puedes leer todos los comentarios de desconocidos bajo una publicación popular.
El servicio de historial 2/statuses/user_timeline solo acepta el uid del usuario autorizado y devuelve como mucho 5 publicaciones, o 10 con el SDK oficial. La búsqueda de temas 2/search/topics es un servicio avanzado. Solo busca publicaciones con una etiqueta de tema, solo devuelve los 200 resultados más nuevos y da como mucho 50 filas por página. Entre los servicios estándar, la línea de tiempo pública 2/statuses/public_timeline devuelve publicaciones públicas recientes que elige la plataforma, sin filtro por palabra.
Los servicios avanzados se piden aparte. La página de solicitud de servicios avanzados dice que la aplicación debe pasar revisión primero. Weibo atiende cada solicitud en 3 días hábiles, y algunos servicios antiguos ya no aceptan solicitudes. No presentamos ninguna solicitud con una aplicación real, así que aquí solo citamos la página y no decimos nada sobre plazos ni tasas de aprobación.
La lista de servicios de open.weibo.com tiene cuatro grupos: autorización OAuth 2.0, publicaciones, comentarios y usuarios. No tiene un grupo de tendencias.
Ritmo y almacenamiento: 100 peticiones al día, nada en el servidor
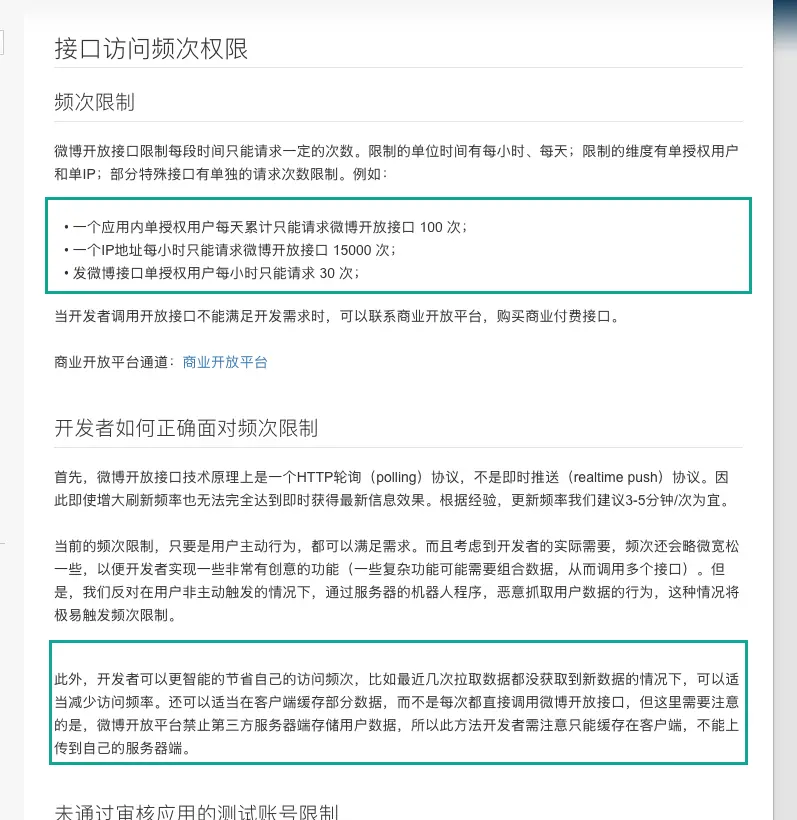
La página de frecuencia de acceso se actualizó por última vez el 15 de mayo de 2025. Da tres ejemplos. Un usuario autorizado en una aplicación puede hacer 100 peticiones al día a los servicios abiertos. Una dirección IP puede hacer 15 000 peticiones por hora. El servicio para publicar permite 30 peticiones por hora y usuario autorizado.
La misma página tiene dos frases que pesan más para la investigación. La plataforma rechaza los programas en un servidor que recogen datos de usuarios sin que el usuario lo pida. Y prohíbe que terceros guarden datos de usuarios del lado del servidor: la caché solo puede quedarse en el cliente. La página recomienda refrescar cada 3 a 5 minutos. Si los servicios abiertos no bastan, remite a la plataforma comercial.
| Límite de la plataforma abierta | Valor | Efecto en un proyecto de datos |
|---|---|---|
| Peticiones por usuario autorizado y día | 100 | Un solo usuario no alcanza para muestreo diario |
| Peticiones por IP y hora | 15 000 | Techo técnico, no el límite que se nota primero |
| Publicaciones por usuario autorizado y hora | 30 | Solo afecta a la escritura |
| Almacenamiento en el servidor de terceros | Prohibido | La caché solo puede vivir en el cliente |
| Frecuencia de refresco recomendada | 3 a 5 minutos | Pensada para aplicaciones, no para archivos |
El acuerdo para desarrolladores entra en más detalle. Para un equipo de inteligencia de mercado o de estudios de opinión, estas cláusulas significan que investigar con los servicios abiertos estándar no encaja en el acuerdo.
| Cláusula del acuerdo | Qué dice (traducción nuestra) | Qué significa para un proyecto de datos |
|---|---|---|
| 2.7.7 | Los datos de la plataforma abierta solo sirven para la aplicación conectada | No puedes llevarlos a otra base de datos de investigación |
| 2.7.8 | Quien recoge o analiza datos para terceros como negocio debe usar la API comercial y firmar un acuerdo | Agencias y consultoras necesitan el contrato comercial |
| 2.5.15 | Borrar todos los datos cuando el servicio termina | Planifica el borrado antes de recoger |
| Cláusula de monitoreo | No pedir datos para monitoreo de opinión gubernamental sin la carta original de encargo | Un proyecto de monitoreo necesita su mandato por escrito |
La API comercial de datos: cobro por fila, sin precio público
La página principal de la API comercial de datos de Weibo enumera tres formas de cobro. La primera es una cuota de datos por fila, para contenido por palabra clave, por usuario y de registros de ubicación, con publicaciones originales, republicaciones y comentarios. La segunda cobra por consulta. La tercera cobra por permiso. El contacto es un correo comercial. No encontramos una lista de precios pública y no pedimos presupuesto como clientes, así que no comparamos su precio con las otras vías. Lo que sí está claro es su público: empresas que firman un contrato. La barrera es el contrato, no el código.
weibo-cli: la puerta nueva de 2026
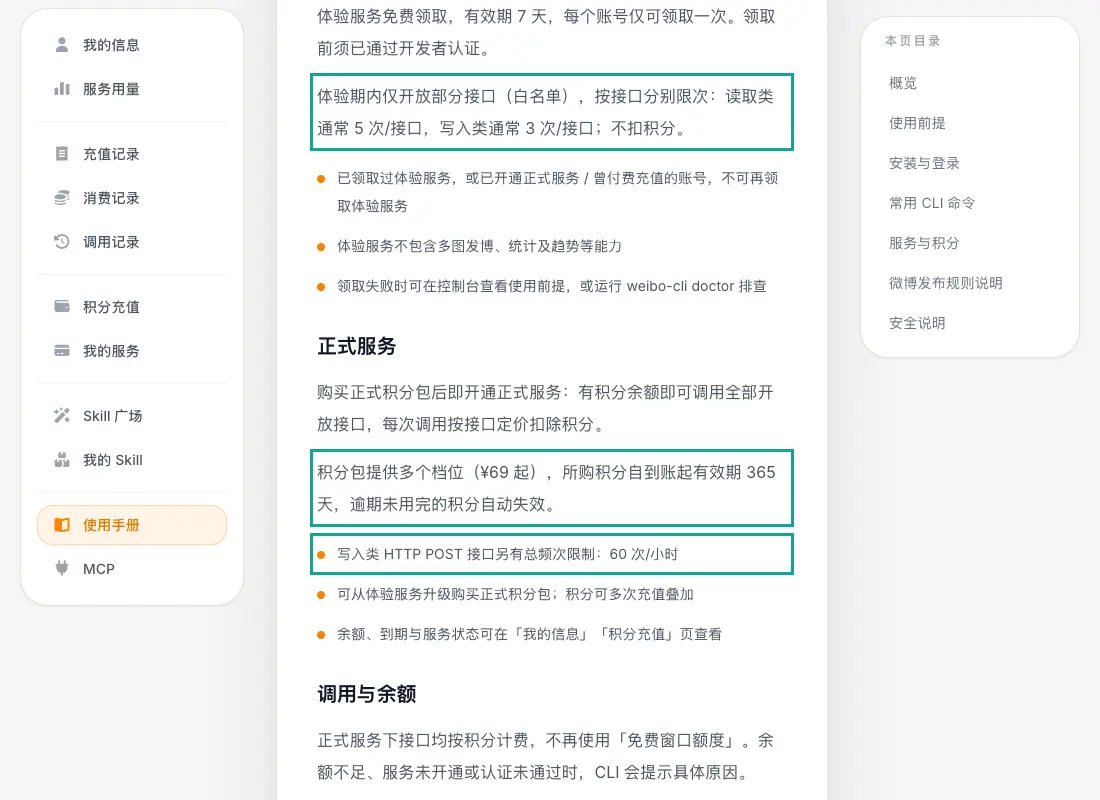
En 2026 la plataforma añadió una herramienta de línea de comandos. El manual de weibo-cli pide Node 18 o superior y un inicio de sesión OAuth. La verificación como desarrollador exige un reconocimiento facial en la app de Weibo. Cada cuenta puede pedir una prueba gratuita de 7 días, abierta solo a una lista de admitidos. En la prueba, los servicios de lectura suelen permitir 5 llamadas cada uno y los de escritura 3.
Después hay que comprar paquetes de créditos desde 69 RMB, válidos 365 días. Los servicios de escritura (POST) permiten 60 llamadas por hora. El contenido hecho con IA se debe declarar al publicarlo. El paquete de npm @weibo-ai/weibo-cli se creó el 25 de mayo de 2026. Su última versión, la 0.9.8, salió el 22 de septiembre de 2026. Una nota de IThome reproducida por Sina Finanzas dice que la herramienta salió el 22 de junio con más de 70 servicios y soporte de MCP.
weibo-cli resuelve un problema: un usuario autorizado que quiere que un asistente de IA trabaje con su propia cuenta. Una prueba de 5 llamadas por servicio no está pensada para recoger datos en volumen. Tampoco es un paquete de Python. Se puede llamar desde Python con subprocess, pero el inicio de sesión, la verificación facial y los créditos siguen ahí.
| Lo que quieres hacer | Servicio oficial | Límite que dice la página original |
|---|---|---|
| Leer todos los comentarios de una publicación popular | 2/comments/show | Solo los del usuario autorizado; 50 por página por defecto |
| Leer el historial de una cuenta pública | 2/statuses/user_timeline | El uid debe ser el del usuario autorizado; 5 publicaciones (10 con el SDK) |
| Buscar publicaciones por palabra | 2/search/topics (avanzado) | Solo temas, los 200 más nuevos; requiere solicitud |
| Recoger datos por palabra en volumen | API comercial de datos | Contrato; cobro por fila o por consulta; sin precio público |
| Dejar que un asistente de IA maneje tu cuenta | weibo-cli | Verificación facial; 5 llamadas de prueba por servicio; paquetes desde 69 RMB |
Vía 2: proyectos weibo scraper de código abierto en GitHub
Si buscas «weibo scraper github», salen varios proyectos de Python que llevan años mantenidos. El 11 de noviembre de 2026, a las 00:23 hora de Singapur, leímos sus estrellas, la fecha del último envío y la licencia con la API de GitHub, y leímos cada README. La tabla recoge solo lo que dicen esos README y esas respuestas.
| Proyecto | Estrellas | Último envío | Licencia | Qué dice el README sobre la sesión |
|---|---|---|---|---|
| dataabc/weibo-crawler | 4694 | 2026-11-06 | No declarada | Cookie opcional; sin ella obtienes la mayoría de publicaciones; la búsqueda por palabra y las republicaciones la necesitan |
| dataabc/weiboSpider | 9750 | 2026-02-04 | No declarada | Cookie obligatoria; caduca a los tres meses, más o menos |
| dataabc/weibo-search | 2339 | 2026-06-05 | No declarada | Cookie obligatoria; una búsqueda muestra 50 páginas como máximo |
| nghuyong/WeiboSpider | 4127 | 2026-06-30 | MIT | Sustituir la cookie de weibo.com y ejecutar |
| NanmiCoder/MediaCrawler | 70 803 | 2026-11-09 | Propia, sin uso comercial | Varias plataformas; inicia sesión con un navegador |
| stay-leave/weibo-public-opinion-analysis | 1057 | 2026-10-24 | No declarada | Flujo completo de análisis de opinión; el README habla de unas 100 000 filas al día |
La cookie: opcional, obligatoria o renovada cada tres meses
El README de dataabc/weibo-crawler explica la cookie con detalle. Para un usuario con menos de 2000 publicaciones, sin cookie obtienes el perfil y la mayoría de publicaciones. Para uno con más de 2000, obtienes la mayoría de las últimas 2000. Su ejemplo es un usuario que entonces tenía 1085 publicaciones: sin cookie, el script obtuvo 1026, cerca del 94,56 %.
El mismo README dice que la búsqueda por palabra clave necesita cookie, y que las republicaciones también. Las preguntas frecuentes del proyecto hermano weiboSpider avisan de que una cookie dura unos tres meses. Después hay que copiar otra. Así que en la vía de código abierto, todo paso que toque búsqueda o republicaciones necesita una cuenta con la sesión iniciada.
Ninguno de los seis README tiene una sección aparte sobre el sistema de visitantes de Weibo. Solo explican cómo copiar la cookie desde las herramientas para desarrolladores del navegador. Sobre la velocidad, la configuración de weibo-crawler pone por defecto una espera de 8 a 15 segundos entre páginas de publicaciones y de 1 a 2 segundos entre peticiones de comentarios.
El README también cubre un bloqueo en mitad de un trabajo grande. Puedes calcular en qué página te quedaste a partir de las filas que ya tienes y seguir desde allí.
Incidencias de los últimos 60 días: respuestas que no son JSON y un tope de 500
Las incidencias muestran el estado real de un proyecto. La incidencia #653 de weibo-crawler se abrió el 26 de septiembre de 2026. El usuario cuenta que el script funcionó cinco meses, pero desde mediados de agosto falla con «Expecting value» tras unas cuantas publicaciones de la primera página. Ese error significa que el servidor ya no devolvía JSON. Los reintentos a 10, 20, 40, 80 y 160 segundos no sirvieron, y una cookie nueva tampoco.
La incidencia #590 de weibo-search se abrió el 13 de octubre de 2026. Dice que ninguna palabra devuelve más de 500 resultados, y el usuario sospecha del límite de 50 páginas de la web. Coincide con el README de weibo-search, que dice que más allá de 50 páginas no se muestra nada. Por eso el proyecto recomienda partir el rango de fechas y usar su parámetro FURTHER_THRESHOLD para decidir cuándo partirlo otra vez.
Los proyectos también se mueven. La petición de cambios #658 de weibo-crawler se abrió el 4 de noviembre de 2026 y se fusionó el 5. Rehízo el flujo de archivo y añadió comprobaciones de comentarios y del estado de las publicaciones. La #659 se fusionó el 6 de noviembre. MediaCrawler fusionó un arreglo, la #1000, el 4 de noviembre.
Que haya trabajo activo muestra que las herramientas aún funcionan. También muestra que el sitio cambia sin parar, y que los scripts tienen que cambiar con él.
| Elemento | Fecha | Qué dice |
|---|---|---|
| Incidencia #653 de weibo-crawler | 26 de septiembre de 2026 | Funcionó cinco meses; desde mediados de agosto, «Expecting value» (no JSON) tras la primera página; ni la cookie nueva ni las esperas ayudaron |
| Incidencia #590 de weibo-search | 13 de octubre de 2026 | Ninguna palabra devuelve más de 500 resultados |
| Petición #658 de weibo-crawler | fusionada el 5 de noviembre de 2026 | Nuevo flujo de archivo; comprobación de comentarios y estado |
| Petición #659 de weibo-crawler | fusionada el 6 de noviembre de 2026 | Segundo cambio grande en dos días |
| Petición #1000 de MediaCrawler | 4 de noviembre de 2026 | Arreglo fusionado |
robots.txt, licencias y dos sentencias
El archivo weibo.com/robots.txt dice Disallow: / para todos los rastreadores que no nombra. Solo deja pasar a los buscadores que nombra. Los rastreadores de IA que nombra solo pueden leer los mapas del sitio y unas pocas rutas. La cabecera del archivo declara además ai-train=no. El sitio móvil, m.weibo.cn/robots.txt, también dice Disallow: / para todos.
Una regla de robots no es una ley, pero los tribunales chinos la han tratado como parte de las decisiones propias de una empresa. Un ejemplo es el caso entre ByteDance y Weibo, en un resumen de un centro de derecho de la Universidad Jiao Tong de Shanghái. En apelación, el Tribunal Superior Popular de Pekín rechazó todas las pretensiones de ByteDance. Consideró que limitar ciertos rastreadores con robots entraba en la autonomía empresarial de Weibo.
Un caso anterior, Sina Weibo contra Maimai, fijó la regla de la «triple autorización». Su número de causa es (2016) Jing 73 Min Zhong 588. Según esa regla, usar datos de la plataforma abierta exige el consentimiento del usuario y el de la plataforma. Maimai tuvo que pagar 2 millones de RMB de indemnización.
Mira también las licencias. Cuatro proyectos de la tabla no declaran ninguna. Con las reglas por defecto de GitHub, eso significa que no tienes permiso para copiar ni redistribuir su código. El README de MediaCrawler dice que el proyecto es solo para aprendizaje y referencia, y prohíbe el uso comercial. Antes de usar un script abierto en tu empresa, resuelve la licencia igual que la cookie.
Vía 3: una «weibo api» de pago por llamada desde Python
En la tercera vía no tienes que mantener cookies, firmas ni el análisis de páginas. Tu código de Python solo envía peticiones HTTP y lee JSON. Usamos el servicio de EveryInfra POST /api/v1/social, con la plataforma weibo, y cambiamos la acción para cada capacidad. Antes de empezar leímos gratis el catálogo en GET /api/v1/social/catalog?platform=weibo para revisar parámetros, precios y el indicador available de cada capacidad.
A las 00:13 hora de Singapur del 11 de noviembre de 2026, el catálogo daba estos precios. weibo/trending y weibo/comments costaban 0,000556 USD por llamada. weibo/search, weibo/topic_search, weibo/post_detail, weibo/comment_replies, weibo/reposts y weibo/user_posts costaban 0,000806 USD por llamada. Ese día el catálogo marcaba weibo/user_post_search (buscar dentro de las publicaciones de un usuario) como available=false, así que no lo usamos. Volvimos a leer el catálogo el 12 de noviembre de 2026 y los precios no habían cambiado.


El script de abajo es la versión final que usamos en las pruebas. Solo necesita requests. Lee la clave solo de una variable de entorno. Guarda en JSON la petición, el tiempo y la respuesta completa de cada paso, para revisar cada cobro después.
Tiene dos cambios respecto a la primera versión, y los dos salieron de las pruebas. Primero, cuando un 503 dice que se puede reintentar, el script espera retry_after segundos y repite la petición. Segundo, filtra las publicaciones por su texto antes de ordenarlas por comentarios. Las dos secciones siguientes explican por qué.
"""Weibo chain: trending -> topic_search -> search -> post_detail -> comments -> comment_replies -> reposts.
pip install requests==2.32.3 ; export EVERYINFRA_API_KEY=... ; python weibo_chain.py 智利车厘子 run4   # = "cerezas chilenas" """
import json, os, sys, time
from pathlib import Path
import requests

API = "https://api.everyinfra.com/api/v1/social"
SESSION = requests.Session()
SESSION.headers["Authorization"] = "Bearer " + os.environ["EVERYINFRA_API_KEY"]  # key stays in the environment


def call(action, params, out_dir, name):
    body = {"platform": "weibo", "action": action, "params": params}
    for _ in range(4):
        t0 = time.time()
        r = SESSION.post(API, json=body, timeout=120)
        data = r.json()
        err = data.get("error") or {}
        # 429 (rate limit) and retryable 503 are not charged: wait as told, then send the same request again
        if r.status_code == 429 or (r.status_code == 503 and err.get("retryable")):
            time.sleep(int(err.get("retry_after") or 60))
            continue
        break
    rec = {"started_sgt": time.strftime("%H:%M:%S", time.localtime(t0)), "elapsed_s": round(time.time() - t0, 2),
           "http_status": r.status_code, "request": body, "response": data}
    out_dir.mkdir(parents=True, exist_ok=True)
    (out_dir / f"{name}.json").write_text(json.dumps(rec, ensure_ascii=False, indent=1))
    rows = data.get("results") or []
    print(name, r.status_code, rec["elapsed_s"], len(rows), (data.get("billing") or {}).get("charged_usd"), flush=True)
    return data, rows


def main(keyword, tag):
    out = Path(os.environ.get("OUT_DIR", ".")) / tag
    call("trending", {"limit": 50}, out, "1_trending")
    call("topic_search", {"keyword": keyword}, out, "2_topic_search")
    _, posts = call("search", {"keyword": keyword, "limit": 50}, out, "3_search")
    # keep only rows whose text really contains the keyword, then take the most-commented one
    on_topic = [p for p in posts if keyword in (p.get("text") or "")] or posts
    post = max(on_topic, key=lambda p: (int(p.get("comment_count") or 0), int(p.get("repost_count") or 0)))
    pid = str(post["id"])
    call("post_detail", {"url": pid}, out, "4_post_detail")
    _, comments = call("comments", {"url": pid, "limit": 50}, out, "5_comments")
    if comments:
        top = max(comments, key=lambda c: int(c.get("like_count") or 0))
        call("comment_replies", {"comment_id": str(top["id"]), "limit": 20}, out, "6_comment_replies")
    call("reposts", {"url": pid, "limit": 20}, out, "7_reposts")


if __name__ == "__main__":
    main(sys.argv[1], sys.argv[2])
Cada paso hace una sola cosa. weibo/trending trae la lista de tendencias: cada fila tiene puesto, título, categoría, índice de calor y una etiqueta como «caliente», «nuevo» o «hirviendo». weibo/topic_search busca temas con etiqueta, cada uno con lecturas y debates. weibo/search busca publicaciones por palabra. weibo/post_detail completa los contadores y el autor de una publicación. weibo/comments trae los comentarios de primer nivel, weibo/comment_replies las respuestas a un comentario y weibo/reposts la lista de republicaciones.
Para seguir el historial de un autor, añade weibo/user_posts. Pagina con page_token, y en cada una de las cuatro primeras pruebas leímos dos páginas.
Weibo se busca mejor en chino, porque casi todo lo que se publica está en chino. Para el caso de este artículo, «cerezas chilenas» se escribe como en el bloque de código de arriba, el nombre comercial que usa el mercado chino para la cereza importada. Pasas la palabra como una cadena normal de Python. requests envía el cuerpo como JSON en UTF-8, así que no hay que codificar nada a mano.
Pruebas reales: cuatro palabras, siete cadenas
Elegimos cuatro palabras. «Gripe» y «vacuna contra la gripe» representan un caso de salud pública. «Día del Soltero» (la fiesta de compras del 11 de noviembre) era el tema de compras más caliente del sitio esa noche. «Cerezas chilenas» es una palabra tranquila de fruta importada, útil para comparar con una palabra caliente.
Las cuatro primeras pruebas usaron la primera versión del script, que elegía directamente la publicación más comentada y esperaba 60 segundos tras un 429. Las tres últimas usaron la versión final de arriba. Las horas son de Singapur. La prueba 7 fue el 12 de noviembre; las demás, el 11 de noviembre de 2026.
| Prueba | Hora | Palabra | Filas de búsqueda (limit 50) | Comentarios de la publicación elegida | Comentarios / respuestas / republicaciones devueltos | Tiempo de 7 pasos | Cobro de 7 pasos |
|---|---|---|---|---|---|---|---|
| 1 | 00:14–00:19 | gripe | 12 | 4 | 2 / 0 (vacío, reembolsado) / 3 | 25,19 s | 0,004336 USD |
| 2 | 00:19–00:21 | Día del Soltero | 17 | 36 | 24 / 1 / 14 | 33,94 s | 0,005142 USD |
| 3 | 00:31–00:33 | vacuna contra la gripe | 11 | 6 | 5 / 1 / 20 | 19,37 s | 0,005142 USD |
| 4 | 00:33–00:37 | cerezas chilenas | 50 | 25 | 12 / 0 (vacío, reembolsado) / dos 503, gratis | 32,87 s | 0,003530 USD |
| 5 | 00:46–00:47 | gripe | 50 | no devuelta (503) | 2 / 1 / 503, gratis | — | 0,002724 USD |
| 6 | 00:47–00:55 | gripe | 38 | 0 | 0 (vacío, reembolsado) / no se llamó / 503, gratis | — (unos 8 min con esperas) | 0,002168 USD |
| 7 (12 nov) | 00:15–00:20 | gripe | 15 | 2 | 1 / 503 (sin capacidad, reembolsado) / 503, gratis | — (unos 5 min con esperas) | 0,003530 USD |
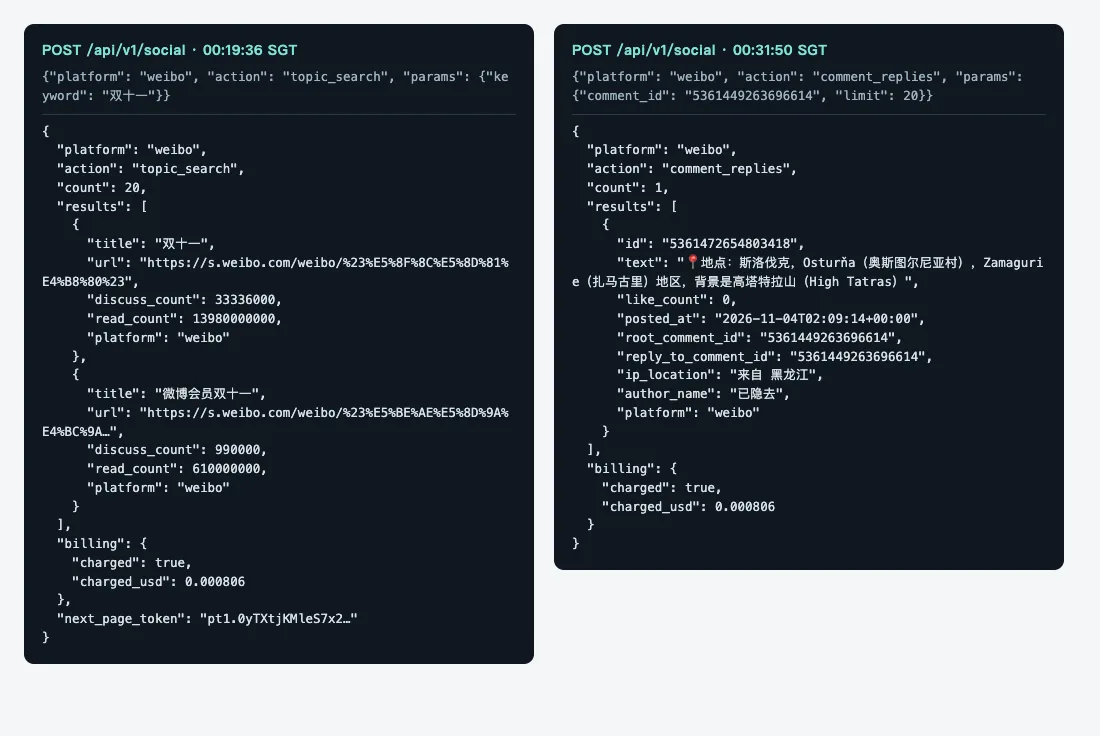
La columna «Cobro de 7 pasos» solo suma las 7 peticiones de la cadena; no incluye las llamadas aparte a weibo/user_posts (0,000806 USD por página), que se cuentan en la sección de paginación. Cada cobro coincidió con el precio del catálogo: 0,000556 USD para tendencias y comentarios, y 0,000806 USD para los demás pasos. Cuando las respuestas devolvieron 0 filas, billing.reason decía empty_result_refunded y el cobro fue 0 USD. Cuando una petición falló con 503, el motivo era request_failed_refunded y el cobro también fue 0 USD.
La mediana de las tres cadenas completas (pruebas 1 a 3) fue de 25,19 segundos. No llegamos a la meta de 20 segundos que fijamos antes de probar. Los pasos lentos fueron la búsqueda de publicaciones (3,95 a 13,95 segundos) y las respuestas (5,91 a 7,23 segundos). El paso de tendencias tardó siempre menos de un segundo. Las esperas por límite de ritmo no entran en estos tiempos: las cuatro primeras pruebas recibieron seis 429, el script esperó 60 segundos cada vez y el reintento funcionó. Un 429 no cuesta nada.
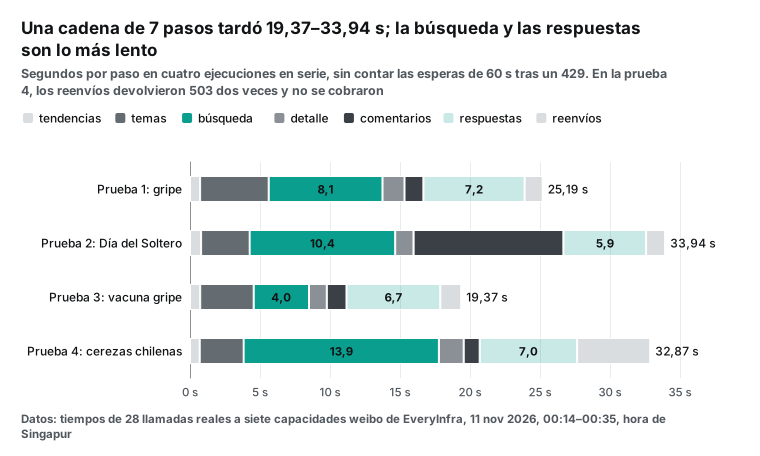
La prueba 5 fue un accidente, pero dejó una muestra útil. A las 00:46 lanzamos el script nuevo con «gripe». La búsqueda de temas, el detalle y las republicaciones devolvieron 503 en 0,13 a 0,23 segundos. El cuerpo del error decía «service temporarily unavailable», retryable true y retry_after 60 segundos. Decía también que era el primer (o segundo) fallo, que no se cobraba y que el tercer fallo explicaría qué revisar. Ninguno de los tres pasos costó dinero; esa prueba solo pagó los cuatro pasos que funcionaron. Después añadimos la regla de esperar y reintentar los 503 reintentables, y la prueba 6 fue la primera con esa regla.
Las pruebas 6 y 7 usaron el script final. En la prueba 6, la búsqueda de temas devolvió 503 tres veces seguidas. El tercer error decía que había 5 fallos en 10 minutos para esa capacidad y que ninguno se cobró. Proponía una petición de ejemplo para saber si el problema era el objetivo o el servicio.
En la prueba 7, las respuestas devolvieron un 503 con el motivo capacity_exhausted: esa capacidad no tenía hueco libre en ese momento del lado del servicio. El texto aclaraba que no era el límite de ritmo de quien llama, y la llamada se reembolsó. En las siete cadenas, tendencias, búsqueda de publicaciones, comentarios e historiales funcionaron siempre. La búsqueda de temas funcionó 5 de 7 veces y el detalle 6 de 7.
| Capacidad | Llamadas en las pruebas 1–7 | HTTP 200 | Vacías (reembolsadas) | Fallidas (gratis) | Cobro total |
|---|---|---|---|---|---|
weibo/trending | 7 | 7 | 0 | 0 | 0,003892 USD |
weibo/topic_search | 7 | 5 | 0 | 2 | 0,004030 USD |
weibo/search | 7 | 7 | 0 | 0 | 0,005642 USD |
weibo/post_detail | 7 | 6 | 0 | 1 | 0,004836 USD |
weibo/comments | 7 | 7 | 1 | 0 | 0,003336 USD |
weibo/comment_replies | 6 | 5 | 2 | 1 | 0,002418 USD |
weibo/reposts | 8 | 3 | 0 | 5 | 0,002418 USD |
weibo/user_posts | 8 | 8 | 0 | 0 | 0,006448 USD |
La trampa: la publicación más comentada no suele ser la tuya
El primer script usaba una regla natural. Tomaba el resultado con más comentarios y prefería las publicaciones con más de 20. En cuatro pruebas, esa regla eligió siempre una publicación sin la palabra buscada.
Con «gripe» eligió un relato de aficionados sobre un anime, que salió en los resultados porque coincidía una etiqueta o la parte de texto largo, no el texto visible. Con «vacuna contra la gripe» eligió una foto de paisaje de una cuenta de fotografía con 5,94 millones de seguidores. Con «Día del Soltero» eligió una publicación sobre lo poco que se puede ahorrar fuera de la comida y la ropa: cerca de la fiesta, pero sin nombrarla. Con «cerezas chilenas» eligió una tarjeta de preventa de una tienda en línea.
Luego contamos cada fila de las cuatro búsquedas, todas con limit 50. Las palabras calientes «gripe», «Día del Soltero» y «vacuna contra la gripe» devolvieron solo 12, 17 y 11 filas. De ellas, 8, 12 y 6 tenían la palabra en el texto: 26 de 40, un 65 %. La palabra tranquila «cerezas chilenas» devolvió las 50 filas, pero solo 24 (48 %) tenían la palabra en el texto. Las demás eran sobre todo las mismas tarjetas de tienda y republicaciones con etiqueta.
Las filas sin la palabra en el texto tenían más comentarios. Las cuentas grandes aparecen más fácilmente por una etiqueta, un texto largo o una publicación original republicada, y además reciben más comentarios.
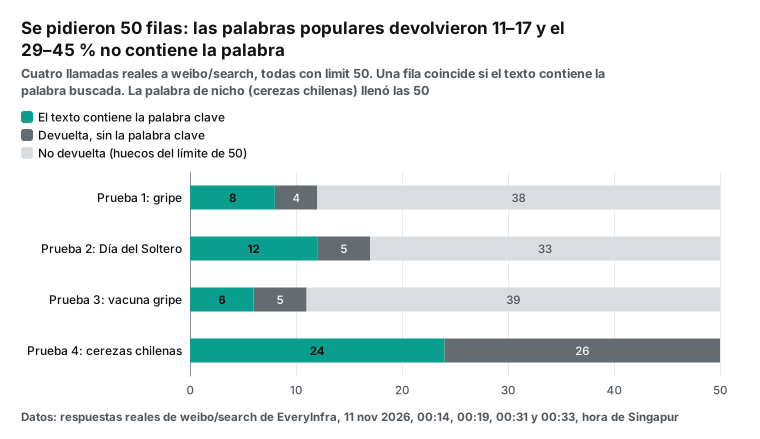
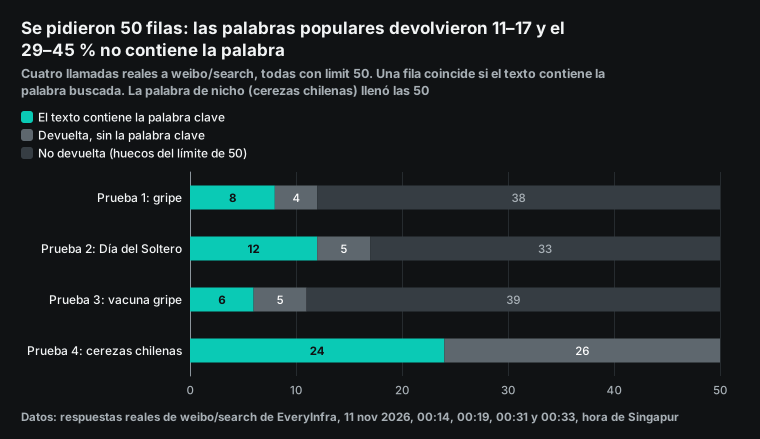
El arreglo es una línea: filtrar primero con keyword in text y luego ordenar por comentarios. Las pruebas 6 y 7 usaron esa línea, y muestran por qué hace falta y por qué no basta. En la prueba 7, la fila con más comentarios de las 15 tenía 312. Era un anuncio de clases de chino en línea para niños en el extranjero, publicado el 17 de enero de 2025, sin «gripe» en el texto. La regla vieja la habría elegido. Con el filtro, el script eligió una publicación corriente con 2 comentarios, de alguien preocupado por un dolor de garganta y la gripe.
En la prueba 6, 37 de 38 filas tenían «gripe» en el texto. Pero todas eran de los 15 minutos entre las 00:36 y las 00:51, y la más comentada tenía 1 comentario. Con el filtro, el script eligió una publicación que un minijuego de preguntas compartió de forma automática (el campo del dispositivo mostraba el nombre del juego). Tenía 0 comentarios, y la llamada de comentarios devolvió una lista vacía, reembolsada. Un filtro evita elegir mal, pero no crea conversación. Para una muestra de comentarios, espera a que las publicaciones acumulen respuestas, o usa antes la búsqueda de temas para encontrar temas con muchos debates.
Para un muestreo de investigación, una línea sigue sin bastar. El código de abajo separa los resultados en dos grupos. El primero coincide en el texto. El segundo coincide solo por una etiqueta o una republicación. Luego cuenta cada grupo, y tú decides si el segundo entra en la muestra. Recomendamos guardar los dos y dar sus cifras por separado. Si no, una foto de paisaje de una cuenta grande puede sesgar tu muestra sobre la vacuna.
import json, sys

def split_rows(path, keyword):
    rows = json.load(open(path))["response"]["results"]
    hit = [r for r in rows if keyword in (r.get("text") or "")]
    other = [r for r in rows if keyword not in (r.get("text") or "")]
    def summary(group):
        return {"rows": len(group),
                "comments": sum(int(r.get("comment_count") or 0) for r in group),
                "verified": sum(1 for r in group if r.get("author_verified")),
                "newest": max((r["posted_at"] for r in group), default=None)}
    return {"keyword_in_text": summary(hit), "keyword_elsewhere": summary(other)}

print(json.dumps(split_rows(sys.argv[1], sys.argv[2]), ensure_ascii=False, indent=1))
El segundo hallazgo tiene que ver con la hora. Con la misma palabra, «gripe», la búsqueda de las 00:14 devolvió 12 filas publicadas entre el 3 y el 10 de noviembre. La de las 00:46 devolvió las 50 filas: 49 tenían «gripe» en el texto y todas eran de los últimos 20 minutos (00:27 a 00:46). Así que weibo/search devuelve una ventana que cambia de un minuto a otro. Con una palabra caliente, a veces solo trae lo más nuevo y a veces mezcla publicaciones más viejas con más interacción. Para investigar, fijar la hora de muestreo cada día importa más que sacar 50 filas en una llamada.
Lo que la búsqueda de «cerezas chilenas» le dice a un exportador
La cereza es la primera fruta fresca que exporta Chile. Según el boletín de fruta de Odepa de febrero de 2026, entre septiembre de 2025 y enero de 2026 Chile exportó cerezas por 2465 millones de dólares FOB y 541 000 toneladas. Fue el 66 % del valor de la fruta fresca exportada en ese periodo. China recibió el 87 % del valor y del volumen, y el precio unitario hacia China fue de 4,56 dólares FOB por kilo, antes de los ajustes de valor.
Para la temporada 2026-2027, Xinhua informó de que el primer vuelo con cerezas llegó a Shanghái el 18 de octubre. Según la misma nota, la asociación de exportadores estima 667 000 toneladas exportadas, un 16 % más, con el pico de oferta en China entre mediados de diciembre y finales de enero.
Nuestra prueba 4 buscó «cerezas chilenas» en Weibo el 11 de noviembre a las 00:33. Las 50 filas se habían publicado el 10 de noviembre (hora UTC). No es una muestra del mercado, sino una foto de lo que Weibo devolvía en ese momento. Aun así, la foto dice cosas concretas.
| Rasgo en las 50 publicaciones | Publicaciones | Lo que sugiere |
|---|---|---|
| Mencionan un calibre (J, JJ, 2J, 3J, 4J) | 29 | El calibre es el idioma de la venta |
| Hablan de caja de regalo | 20 | La cereza se vende como regalo |
| Nombran una tienda de comercio electrónico | 25 | Mucha preventa en línea |
| Dicen «preventa» | 8 | Se vende antes de que llegue la fruta |
| Llevan un precio en yuanes | 12 | Precios de 70 a 199,8 yuanes por caja |
| Textos distintos | 39 | 11 filas repiten un texto ya visto |
| Tienen la palabra completa en el texto | 24 | La otra mitad entra por etiquetas o republicaciones |
El calibre más citado fue J (14 publicaciones), seguido de 4J (13). Varias tarjetas ofrecían una caja de 5 jin (2,5 kg) de calibre 4J por 199,8 yuanes, con canje entre el 25 de diciembre de 2026 y el 25 de enero de 2027. Otra anunciaba una caja de regalo de la variedad Santina. Esas fechas caen dentro del pico de oferta que describe Xinhua, y Santina es la variedad principal de mitad de temporada según la misma nota. Weibo muestra, con un mes de adelanto, qué calibres, formatos y fechas de canje se empujan en la preventa.
Para el exportador hay tres límites. Primero, la muestra la dominan tiendas y cuentas verificadas (31 de 50 autores estaban verificados), no consumidores. Segundo, una búsqueda devuelve como mucho 50 filas y cambia con la hora, así que hay que repetirla a horas fijas durante la temporada. Tercero, los precios de una preventa no son precios mayoristas ni de puerto. Sirven para seguir el discurso de venta, no para reemplazar las cifras de Odepa o de las aduanas.
Con esos límites, el plan es barato. Seis palabras al día durante 4 semanas cuestan unos 0,44 USD de API, como muestra la tabla de escenarios más abajo. El código para contar calibres y cajas es corto:
import json, re, sys
from collections import Counter

rows = json.load(open(sys.argv[1]))["response"]["results"]       # raw/run4/3_search.json
grade = re.compile(r"(\dJ|JJJ|JJ|J)级")                          # calibre: J, JJ, 2J ... 4J
price = re.compile(r"【(\d+(?:\.\d+)?)】|(\d+(?:\.\d+)?)\s*(?:元|块)")  # precio en yuanes
c, grades, prices = Counter(), Counter(), []
for r in rows:
    t = r.get("text") or ""
    g = grade.findall(t)
    if g: c["grade"] += 1; grades.update(set(g))
    if "礼盒" in t: c["gift_box"] += 1                             # caja de regalo
    if "预售" in t: c["presale"] += 1                              # preventa
    p = price.findall(t)
    if p: c["price"] += 1; prices += [a or b for a, b in p]
print(len(rows), dict(c), grades.most_common(), sorted(set(prices)))
Paginación: qué capacidades pasan página
Las capacidades de Weibo no paginan todas igual. Antes de escribir un bucle, revisa el campo page_token en el catálogo. La tabla muestra los parámetros del catálogo del 11 de noviembre de 2026 y las filas que recibimos en cada llamada.
| Capacidad | Límite por llamada | Paginación | Filas por llamada en las pruebas |
|---|---|---|---|
weibo/trending | limit hasta 200 | No; una llamada trae la lista | 50 (pedimos 50) |
weibo/search | limit 20 por defecto, hasta 50 | Sin page_token | 11, 12, 15, 15, 17, 19, 38, 50, 50 |
weibo/topic_search | 20 por página | page_token, válido 24 horas | 18, 20, 19, 19, 18; página 2: 10 |
weibo/comments | limit hasta 50 | Sin page_token | 2, 24, 5, 12, 21, 2, 0, 1 |
weibo/comment_replies | limit hasta 20 | No | 0, 1, 1, 0, 1 |
weibo/reposts | limit hasta 20 | No | 3, 14, 20 |
weibo/user_posts | 20 por página | page_token, válido 24 horas; post_type puede ser all, image, original o video | 10 por página; las dos páginas trajeron 10 |
El catálogo dice que weibo/user_posts da hasta 20 filas por página. En nuestras 8 llamadas devolvió 10 cada vez. El cobro es por llamada, así que calculamos el coste por 1000 filas con 10 filas.
Para topic_search, devuelve el next_page_token tal cual para pedir la página siguiente. La segunda página trajo 10 temas, y después el token vino vacío, que marca el final. weibo/search no tiene parámetro de página. Con la misma palabra, limit 20 devolvió 15 filas, y limit 50 ocho segundos después devolvió 19. Para una muestra mayor, combina más palabras o más horas de muestreo.
Campos: qué devuelve cada paso y qué suele faltar
Las filas de publicaciones salen de search, post_detail, user_posts y reposts. Tienen entre 15 y 19 campos: id, url, text, posted_at, like_count, comment_count, repost_count e image_urls. También traen el id del autor, sus seguidores y seguidos, si está verificado, el texto de verificación, el dispositivo de publicación e is_repost.
post_detail añade is_long_text, que dice si el texto es una publicación larga. Las republicaciones añaden original_post_id. El catálogo dice que post_detail puede traer view_count (lecturas), pero ninguna de nuestras 4 llamadas de detalle de las primeras pruebas lo trajo. En la prueba 4, las 50 filas de búsqueda no tenían la columna de seguidores del autor; solo el detalle la tenía. Si quieres filtrar por seguidores, pide antes el detalle.
Las filas de comentarios tienen solo 10 campos: id, text, like_count, posted_at, id y nombre del autor, avatar, post_id, post_url y platform. No tienen ip_location ni número de respuestas. Por eso no puedes saber desde la lista qué comentarios tienen respuestas; solo puedes elegir por «me gusta».
Las respuestas añaden root_comment_id, reply_to_comment_id e ip_location. En las que recibimos, ip_location mostraba una provincia, como «desde Heilongjiang». Una respuesta mostraba en ese campo el nombre de un bot. Venía de una cuenta de comentarios automáticos de la propia plataforma, que escribió 2 de los 24 comentarios bajo la publicación de la prueba 2 y la única respuesta bajo el comentario con más «me gusta». En un análisis de opinión, marca antes esas cuentas por autor.
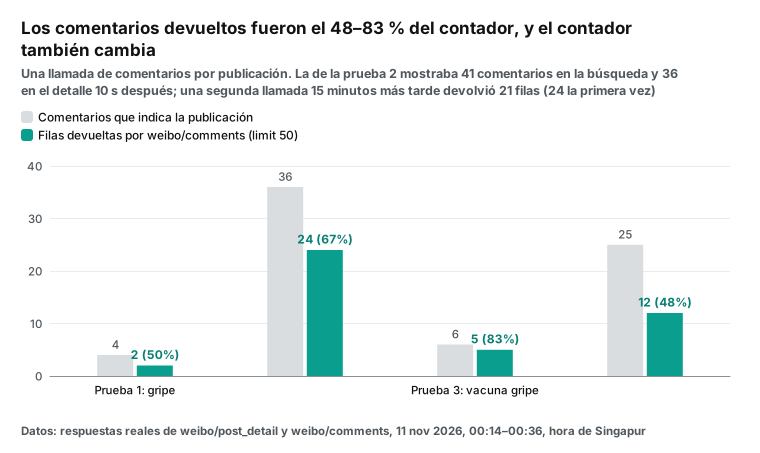
Los contadores también cambian. En la prueba 2, la publicación mostraba 41 comentarios y 447 republicaciones en la búsqueda. Diez segundos después, el detalle mostraba 36 comentarios y 397 republicaciones. Quince minutos más tarde volvimos a pedir sus comentarios y llegaron 21, frente a 24 la primera vez. No sabemos si fue por comentarios borrados, plegados o un retraso del contador. Lo dejamos como límite de los datos: los contadores y la lista de comentarios de una publicación cambian en minutos, y tu informe debe decir la hora de recogida.
| Tipo de fila | Campos | Tiene | No tiene |
|---|---|---|---|
| Publicación (search, user_posts) | 15–19 | texto, hora, me gusta, comentarios, republicaciones, imágenes, contadores del autor, dispositivo | view_count; a veces faltan los seguidores en la búsqueda |
| Detalle de publicación | 17–18 | lo mismo, más is_long_text | view_count (en nuestras llamadas) |
| Republicación | campos de publicación más original_post_id | enlace al original | — |
| Comentario | 10 | texto, me gusta, hora, autor, enlace a la publicación | ip_location, número de respuestas |
| Respuesta | 11 | root_comment_id, reply_to_comment_id, ip_location | número de respuestas |
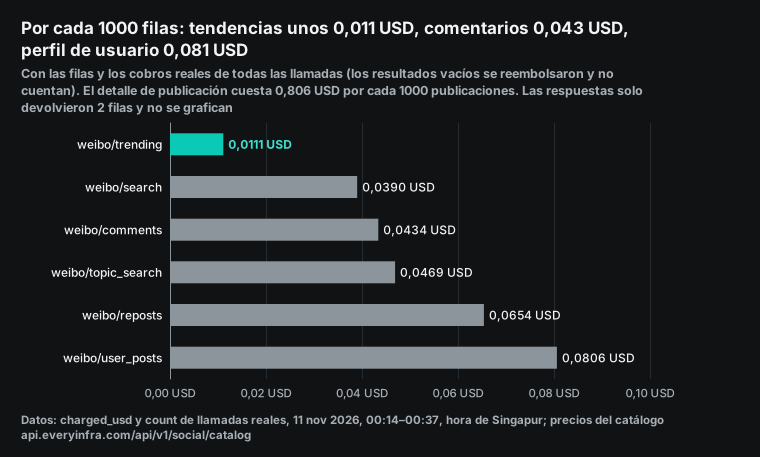
Coste por 1000 filas: las tendencias son lo más barato
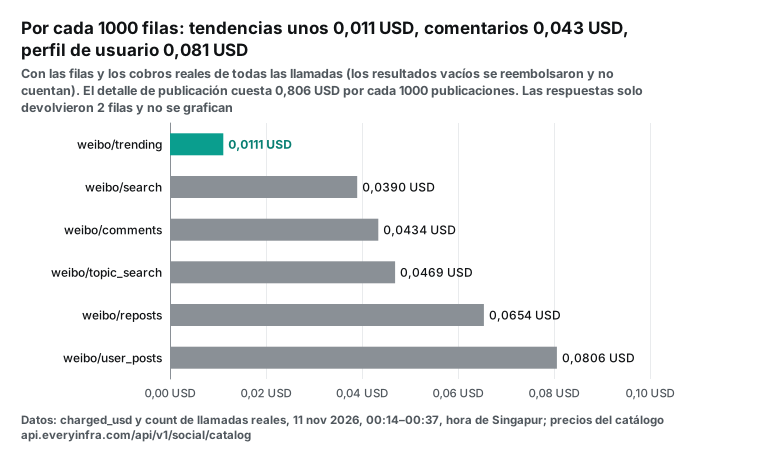
El precio unitario por sí solo engaña, porque las filas por llamada cambian mucho. Sumamos los cobros de todas las llamadas reales y dividimos entre las filas que llegaron. Así sale el coste por 1000 filas. Los vacíos se reembolsaron, así que no cuentan. El cálculo usa solo el JSON original; este es el script.
import glob, json
from collections import defaultdict

agg = defaultdict(lambda: {"calls": 0, "rows": 0, "usd": 0.0})
for f in glob.glob("raw/run*/[1-9]_*.json"):
    d = json.load(open(f))
    resp, action = d["response"], d["request"]["action"]
    a = agg[action]
    a["calls"] += 1
    a["rows"] += len(resp.get("results") or [])
    a["usd"] += (resp.get("billing") or {}).get("charged_usd", 0.0)
for action, a in sorted(agg.items()):
    per_1000 = a["usd"] / a["rows"] * 1000 if a["rows"] else None
    print(f"{action:16} calls={a['calls']:2} rows={a['rows']:4} usd={a['usd']:.6f} per_1000={per_1000}")
Estos son los resultados de las cuatro primeras pruebas y las pruebas extra. La lista de tendencias cuesta unos 0,0111 USD por 1000 filas, porque una llamada de 50 filas cuesta solo 0,000556 USD. La búsqueda de publicaciones cuesta unos 0,039 USD, los comentarios 0,043 USD, la búsqueda de temas 0,047 USD y las republicaciones 0,065 USD. El historial de usuario cuesta unos 0,081 USD, porque cada página traía solo 10 filas.
El detalle cuesta 0,806 USD por 1000 publicaciones. Las respuestas devolvieron solo 3 filas en 6 llamadas, demasiado poco para un coste por 1000. Dicho de otro modo, con 1 USD tienes 1798 capturas de tendencias, unos 23 000 comentarios o el detalle de 1240 publicaciones.
Ejemplo de otro campo: una línea de tiempo de salud pública con la lista de tendencias
La temporada de gripe es buen momento para probar si la lista de tendencias sirve como señal de salud pública. El informe semanal de gripe del Centro Chino para el Control y la Prevención de Enfermedades, con datos al 1 de noviembre de 2026, dice que la positividad bajó un poco en las provincias del sur y subió en las del norte. Registra además 106 brotes de enfermedad tipo gripe en el país. A comienzos de noviembre, gobiernos como el de Pekín y el de Shanghái publicaron avisos de vacunación. Nuestra pregunta era sencilla: en esos mismos días, ¿cuántos temas de gripe se veían en la lista de tendencias de Weibo?
Método: una captura cada 20 minutos
Llamamos a weibo/trending (limit 50) desde las 00:14 hasta las 03:22 hora de Singapur del 11 de noviembre de 2026; es la misma hora que en Pekín. Las cadenas de prueba tomaron 6 capturas y un script en segundo plano tomó otra cada 20 minutos. En total, 16 capturas y 800 filas, por 16 × 0,000556 = 0,0089 USD. Guardamos cada respuesta JSON. El código de abajo arma una tabla de tema × hora con el puesto de cada tema y separa los de salud por palabras clave.
import glob, json, re
from collections import defaultdict

HEALTH = re.compile(r"流感|疫苗|疾控|病毒|感染|呼吸道|支原体|发热|医院|医保|卫健|健康|疫情|肺炎|诺如")  # gripe, vacuna, CDC, virus ...
snaps = []
for f in glob.glob("raw/run*/1_trending.json") + glob.glob("raw/trending/*.json"):
    d = json.load(open(f))
    if d.get("http_status") == 200:
        t = (d.get("started_sgt") or f[-11:-5]).replace(":", "")[:4]
        snaps.append((t[:2] + ":" + t[2:], d["response"]["results"]))
snaps.sort()
ranks = defaultdict(dict)                      # title -> {time: rank}
for t, rows in snaps:
    for r in rows:
        ranks[r["title"]][t] = r["rank"]
health = {k: v for k, v in ranks.items() if HEALTH.search(k)}
print(len(snaps), "snapshots,", len(ranks), "distinct titles,", len(health), "health titles")
for k, v in health.items():
    print(k, [v.get(t) for t, _ in snaps])     # None = not on the list at that moment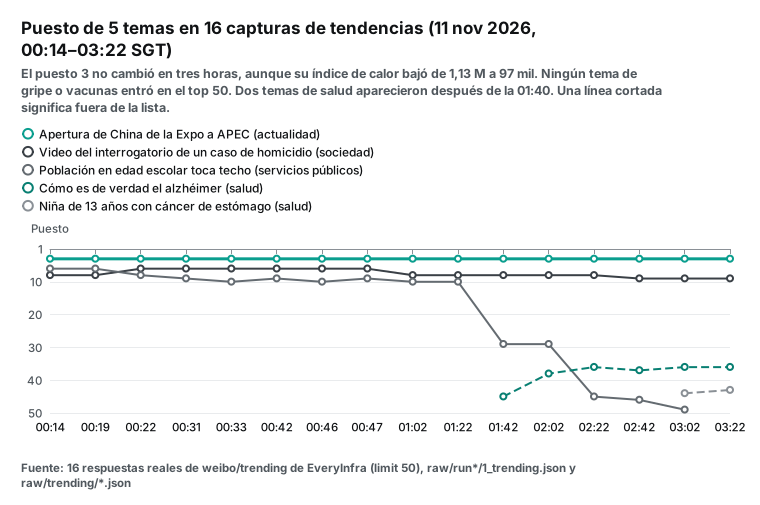
Lo que vimos
Primero: en más de tres horas y 800 filas, ningún tema trató de gripe o vacunas. Nuestra regla de palabras encontró un solo tema, que entró a las 03:02: una niña de 13 años con un año de dolor de estómago que sus padres ignoraron, hasta que le diagnosticaron cáncer. La categoría «salud y medicina» de la propia plataforma tuvo 2 temas. El otro entró a la 01:42 y hablaba de cómo es de verdad el alzhéimer. Los dos estaban por debajo del puesto 36.
| Hora (SGT) | Calor del puesto 1 | Suma del calor del top 50 | Temas con etiqueta «nuevo» | Temas de salud y medicina |
|---|---|---|---|---|
| 00:14 | 1 420 924 | 32 969 020 | 24 | 0 |
| 00:47 | 989 134 | 19 627 245 | 19 | 0 |
| 01:22 | 624 281 | 14 306 377 | 13 | 0 |
| 02:02 | 385 092 | 9 104 366 | 8 | 1 |
| 02:42 | 240 000 | 3 536 945 | 9 | 1 |
| 03:22 | 157 733 | 2 942 261 | 8 | 2 |
En el mismo periodo, weibo/topic_search con «gripe» mostraba el tema #Gripe# con 540 millones de lecturas y 490 000 debates. Un tema sobre protección familiar en temporada de gripe sumaba 78,43 millones de lecturas. Los temas tienen totales enormes, pero la lista de tendencias no los mostraba. La lista enseña lo que sube en este momento, no cuánta gente sigue hablando de un tema. Para estudiar la temporada de gripe, usa como medida principal las lecturas y los debates de la búsqueda de temas, más búsquedas de publicaciones a horas fijas.
Segundo: el índice de calor cae mucho de noche, así que no se puede comparar entre horas. La lista de ganadores de los premios Gallo de Oro estuvo en el puesto 1 en las 16 capturas, pero su calor bajó de 1,42 millones a 158 000. La suma del calor del top 50 pasó de 32,97 millones a 2,94 millones, un 91 % menos. Si dibujas en una línea el calor de distintas horas, ves sobre todo el ritmo diario de los usuarios, no la subida y bajada del tema.
Un estudio de 2022 de Cui y Kertész sobre la lista (arXiv:2208.10176) analiza también cómo el ritmo del día afecta a la popularidad de los temas. Nuestro método: compara puestos entre horas, o el calor relativo dentro de una misma captura (el calor de un tema dividido entre el del puesto 1), y toma las capturas a las mismas horas cada día.
Tercero: el calor no decide del todo el puesto. Los puestos 1, 3 y 4 tuvieron el mismo tema en las 16 capturas. El del puesto 3, sobre la apertura de China de la Expo de importaciones a APEC, tuvo un calor entre 1,13 millones y 97 000. Su cociente con el puesto 1 fue de 0,43 a 0,95, pero su puesto no se movió.
Tres horas de datos no bastan para saber la causa, y no afirmamos nada sobre ella. Para quien investiga, una cosa es segura: el puesto sale de las reglas de la lista, así que no lo trates como una función simple del calor.
Cuarto: un intervalo de 20 minutos pierde los temas de vida corta. Las 16 capturas tuvieron 85 temas distintos; 7 salieron una sola vez y 23 estuvieron en todas. Para estudiar cuánto dura un mensaje de salud en la lista, baja a 5 minutos o menos. El coste crece en proporción directa al número de capturas, al precio unitario de arriba.
| Categoría de la plataforma | Temas distintos en 16 capturas |
|---|---|
| Sociedad | 18 |
| Programas de variedades | 16 |
| Cine | 13 |
| Famosos | 7 |
| Deportes electrónicos | 6 |
| Finanzas | 4 |
| Salud y medicina | 2 |
| Otras categorías | 19 |
Límites de los datos
La página de reglas de la lista dice que el calor se calcula como calor en tiempo real × interés del ámbito × alcance entre públicos × calidad. Dice que la lista se actualiza cada minuto, que muestra el top 50 y que algunos temas llevan una etiqueta de publicidad comercial. En nuestras 800 filas solo vimos las etiquetas «nuevo», «caliente», «hirviendo» y vacío, así que no apareció ningún tema pagado. En una recogida larga, márcalos aparte de todos modos.
Conviene tratar la lista como registro de lo que la plataforma mostró en un momento. Sirve para estudiar agenda y exposición. No representa a una población ni permite estimar cuánta gente está enferma.
Un estudio de 2023 en JMIR (e49300) sobre el sentimiento ante la gripe A usó todas las publicaciones de Weibo relacionadas entre noviembre de 2022 y marzo de 2023, no la lista de tendencias. Es el diseño más seguro. Este artículo no afirma nada sobre cuánto circula una enfermedad, cuánto protege una vacuna ni qué política conviene.
Tres escenarios y su factura mensual
Pusimos los precios y las filas por llamada de las pruebas en tres casos reales. La cuota de API es baja en los tres. El primero es un grupo de salud pública que arma una línea de tiempo de la temporada de gripe: una captura de tendencias cada 10 minutos (4320 al mes), cada día 2 páginas de temas y una búsqueda por cada una de 5 palabras, y el detalle, los comentarios y las republicaciones de 3 publicaciones.
El segundo es una redacción que sigue durante 72 horas una noticia de última hora en China. Toma una captura cada 5 minutos, busca 10 palabras cada hora y lee detalle, comentarios, respuestas y republicaciones de 60 publicaciones. El tercero es el exportador chileno de cerezas de este artículo, que busca 6 palabras cada día durante 4 semanas.
| Escenario | Peticiones | Capturas de tendencias | Búsqueda y búsqueda de temas | Publicaciones, comentarios, republicaciones, historiales | Total |
|---|---|---|---|---|---|
| Línea de tiempo de la gripe (30 días) | 5040 | 2,40 USD | 0,36 USD | 0,20 USD | 2,96 USD |
| Redacción con noticia de última hora (72 horas) | 1854 | 0,48 USD | 0,60 USD | 0,18 USD | 1,26 USD |
| Exportador chileno de cerezas (4 semanas) | 624 | 0,06 USD | 0,15 USD | 0,22 USD | 0,44 USD |
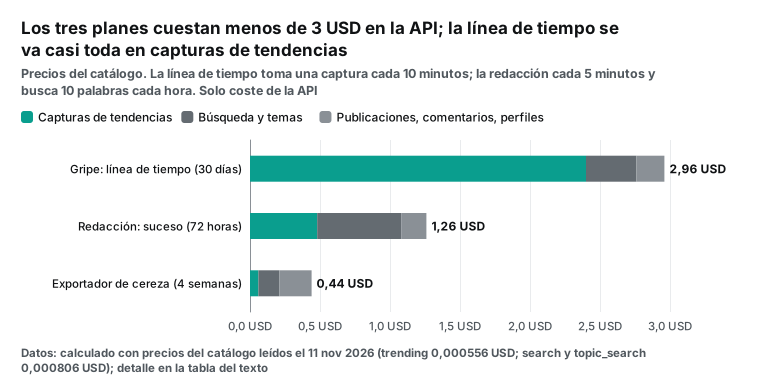
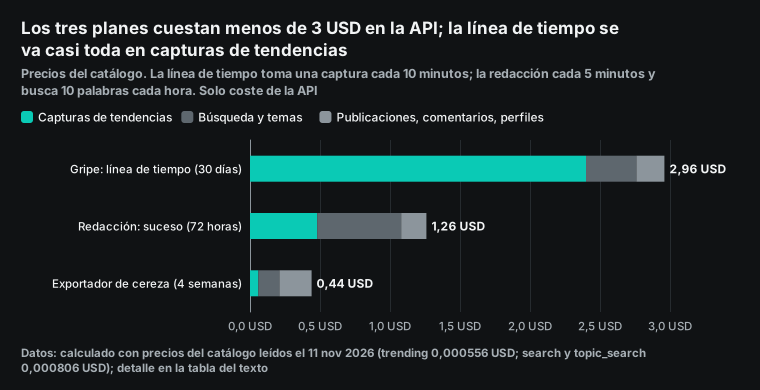
En la línea de tiempo, el 81 % del dinero se va en capturas, así que la frecuencia de captura es lo primero que hay que decidir. La plataforma abierta recomienda refrescar cada 3 a 5 minutos y las reglas de la lista dicen que se actualiza cada minuto. Según nuestra experiencia, una captura cada 10 minutos basta para ver cómo un tema entra, sube y sale. Si duplicas la frecuencia, duplicas el coste. Son solo cuotas de API: no incluyen almacenamiento, análisis ni horas de trabajo.
Errores y cobros: cuándo no pagas nada
Hacia las 00:30 provocamos algunos errores a propósito, y ninguno costó dinero. Una petición sin clave devolvió 401: la API comprueba la clave antes que los parámetros, así que nadie sin clave puede sondear la estructura. weibo/user_posts con post_type originals devolvió 422, con los valores permitidos all, image, original y video, y la sugerencia de que querías decir original. El weibo/user_post_search en pausa devolvió 503 unavailable, sin cobro.
| Prueba | Estado HTTP | Qué dijo la respuesta | Cobro |
|---|---|---|---|
| Sin clave de API | 401 | Falta la clave; no se cobró nada | 0 USD |
weibo/user_posts con post_type originals | 422 | Valores permitidos all, image, original, video; ¿quisiste decir original? | 0 USD |
weibo/user_post_search (en pausa) | 503 | unavailable | 0 USD |
| Límite de ritmo en las pruebas | 429 | Esperar y reintentar | 0 USD |
| Sin capacidad (prueba 7) | 503 | capacity_exhausted; no es tu límite; reintentar a los 25 s | 0 USD |
Esto importa si automatizas. Los reintentos no cuestan, así que tu script puede reintentar tras retry_after sin miedo. Pero si la misma petición sale bien dos veces, pagas dos veces. Reintenta solo ante fallos claros y no reenvíes una respuesta buena, salvo tras un tiempo de espera agotado sin respuesta. Para cuadrar cobros y reembolsos en tus cuentas, lee la conciliación de reembolsos por fallo. Para los reintentos, lee claves de idempotencia para reintentos de agentes de IA.
Cuándo encajan mejor las otras dos vías
Una API por llamada no es la mejor respuesta para todos. Algunas tareas exigen la plataforma oficial: publicar por tus usuarios, responder comentarios, fijar publicaciones o mostrar en tu aplicación los seguidores de tus propios usuarios. Ninguna API de terceros debería hacer eso por ti. Si tu organización va a recoger datos a gran escala y vender análisis a otros, la cláusula 2.7.8 del acuerdo te pide la API comercial y un contrato. Esa vía da un contrato y un alcance de datos que una API por llamada no da.
Un script abierto también tiene su sitio. Quizá necesitas todo el historial de una cuenta pública para una tesis, unas miles de publicaciones, y no te importa dedicar una tarde a la cookie y a las esperas. O necesitas un campo que un proyecto ya procesa, como los videos Live Photo y los informes de archivo de weibo-crawler. Entonces el coste extra de correr un script es casi cero.
En cambio, si tomas una captura de tendencias cada 10 minutos y lanzas decenas de palabras cada día, y no quieres que la cookie de una cuenta sea un punto único de fallo, una API por llamada es más cómoda.
| Tu tarea | Mejor vía | Por qué |
|---|---|---|
| Publicar, responder o mostrar datos de tus usuarios en tu aplicación | Plataforma abierta oficial | Única con escritura y consentimiento del usuario |
| Vender a clientes análisis de datos de Weibo a gran escala | API comercial de datos | La cláusula 2.7.8 pide un acuerdo firmado |
| Bajar una vez una cuenta pública para una tesis | Script de código abierto | Coste extra casi nulo si aceptas el trabajo de la cookie |
| Recoger cada día tendencias, temas y publicaciones para prensa, comercio o investigación | API por llamada | Sin cookie que mantener; fallos y vacíos gratis |
En qué se diferencia de otros artículos
Este artículo responde a una pregunta: qué vías hay para obtener datos de Weibo con Python y qué cuesta cada una. Los límites de ritmo, las publicaciones borradas y el orden de búsqueda pueden sesgar tu muestra; para revisarlo después de tener los datos, lee integridad de la muestra en la investigación con redes sociales. Un asistente de programación con IA también puede escribir scripts de Zhihu y Weibo por ti: nuestra prueba con GLM-5.3 y Claude Code compara la calidad del código de dos modelos.
La misma pregunta para Douyin, con su propio caso de cerezas chilenas, está en Douyin API con Python: tres vías, probadas. Para el método general de vigilar señales de salud en redes, lee monitoreo de señales sociales sobre desinformación en salud.
Cumplimiento y límites
Sea cual sea la vía, algunos límites legales son los mismos. La Ley de Protección de Información Personal de China enumera en su artículo 13 las bases legales para tratar información personal. El artículo 27 permite tratar, en un alcance razonable, información personal ya publicada de forma legal. Hay dos excepciones: que la persona se niegue claramente, o que el tratamiento afecte de forma grave a sus derechos. Los nombres, la ubicación y el texto de los comentarios son información personal.
El artículo 13 de la Ley contra la Competencia Desleal revisada en 2025 prohíbe obtener datos que otros tienen de forma legal por medios contrarios a la buena fe. Romper o esquivar controles técnicos es uno de esos medios. El Reglamento de Gestión de la Seguridad de los Datos de Red, vigente desde el 1 de enero de 2025, detalla los deberes de seguridad de quien trata datos de red. Si trabajas desde Chile, México u otro país, la ley de protección de datos de tu país también puede aplicarse a lo que guardas y publicas.
Nuestra práctica en este artículo fue esta. Solo recogimos contenido público. No iniciamos sesión en ninguna cuenta ni tocamos mensajes privados o publicaciones solo para seguidores. Ocultamos los nombres de quienes comentan. En un informe, cita solo totales o ideas resumidas, no textos originales que permitan identificar a una persona. Este artículo no enseña ningún método para esquivar los límites de la plataforma. Citamos las notas de cookie y velocidad de los proyectos abiertos para mostrar el coste de mantener esa vía, no para recomendarla.
Fechas recientes que conviene seguir
Del lado de los desarrolladores, weibo-cli publicó la versión 0.9.8 el 22 de septiembre de 2026. En el código abierto, weibo-crawler fusionó dos cambios grandes el 5 y el 6 de noviembre, y la incidencia del tope de 500 resultados de weibo-search sigue abierta desde el 13 de octubre.
| Fecha | Hecho | Fuente |
|---|---|---|
| 2026-10-13 | Se abre la incidencia del tope de 500 resultados en weibo-search | GitHub #590 |
| 2026-10-19 | Llegan a China las primeras cerezas chilenas de la temporada 2026-2027 | Xinhua |
| 2026-11-04 | MediaCrawler fusiona el arreglo #1000 | GitHub |
| 2026-11-05 | weibo-crawler fusiona #658; informe de gripe con datos al 2026-11-01 | GitHub; CDC de China |
| 2026-11-06 | weibo-crawler fusiona #659 | GitHub |
| 2026-11-11 | Nuestras pruebas 1 a 6 y las 16 capturas de tendencias | Este artículo |
| 2026-11-12 | Nuestra prueba 7 | Este artículo |
Preguntas frecuentes
¿Hay un ejemplo de weibo api python que pueda ejecutar?
Sí. El script de la sección «Vía 3» funciona tal cual. Instala requests, pon tu clave en la variable de entorno EVERYINFRA_API_KEY y ejecuta python weibo_chain.py "<palabra>" run1. El script llama a las 7 capacidades en orden y guarda en JSON la respuesta de cada paso. Si buscas un ejemplo oficial en Python de la plataforma abierta, la documentación de open.weibo.com describe sobre todo servicios HTTP. Primero hay que completar OAuth para obtener un access_token, y el usuario autorizado limita lo que puedes leer. (Fuente: sugerencias de Google para «weibo api python example» y «weibo api python code».)
¿Existe una api de weibo en español?
No encontramos documentación oficial en español: las páginas de open.weibo.com, el manual de weibo-cli y las reglas de la lista de tendencias están en chino. Este artículo traduce los límites que importan y enlaza cada página original. Con una API por llamada, los nombres de parámetros y campos son los mismos en cualquier idioma, y los mensajes de error que vimos venían en inglés. (Fuente: sugerencia de Google «api de weibo en español».)
¿Cómo consigo una api de weibo para desarrolladores?
En la plataforma oficial obtienes una App Key y una App Secret al crear una aplicación en open.weibo.com; cada llamada pide además un access_token del consentimiento del usuario. Para weibo-cli hace falta la verificación facial en la app de Weibo, y la prueba solo está abierta a una lista de admitidos. En una API por llamada, la clave se crea en la consola. Tengas la que tengas, no la escribas en el código ni la subas a un repositorio; los scripts de este artículo la leen solo de una variable de entorno. (Fuente: sugerencias de Google «api de weibo developer» y «weibo api key».)
¿Qué es Weibo y cómo funciona para quien busca datos?
Weibo es una red de microblogs de China continental con 561 millones de usuarios activos al mes en el segundo trimestre de 2026. Para datos tiene cuatro piezas útiles: la lista de tendencias (top 50, actualizada cada minuto), los temas con etiqueta (con lecturas y debates), las publicaciones con sus comentarios y respuestas, y las republicaciones. Este artículo muestra cómo pedir cada pieza desde Python. (Fuente: sugerencias de Google «weibo que es y como funciona» y «sina weibo que es».)
¿Hay una API gratuita para la lista de tendencias de Weibo?
La lista de servicios de open.weibo.com tiene cuatro grupos (OAuth 2.0, publicaciones, comentarios y usuarios) y ninguno de tendencias. La página de tendencias es pública en un navegador. Con una API por llamada, una llamada weibo/trending de 50 filas cuesta 0,000556 USD, así que una captura cada 10 minutos durante 30 días sale por unos 2,40 USD. Cada fila trae rank, title, category, hot_value, label (nuevo, caliente, hirviendo y otras), is_hot, is_new y el enlace al tema. (Fuente: sugerencias de Google «weibo hot search api free» y «weibo hot search api documentation».)
Primeros pasos
- Crea una clave de API en la consola y guárdala en la variable de entorno
EVERYINFRA_API_KEY. Los pasos están en el inicio rápido. - Lee gratis una vez el catálogo en
GET /api/v1/social/catalog?platform=weiboy revisa parámetros, precios y el indicadoravailable. Los precios también están en la página de precios y en el mercado de datos. Cada capacidad de Weibo se describe en la página de la API de datos de Weibo. - Ejecuta
pip install requests, copia el script de la sección «Vía 3» y lanzapython weibo_chain.py "<palabra>" run1. - Abre los JSON de la carpeta run1 y revisa
billing.charged_usden cada paso. Para seguir el historial de un autor, llama aweibo/user_postsy devuelvenext_page_tokental cual. - Si quieres que un asistente de IA llame directamente a estas capacidades, conecta el servidor MCP. Las herramientas y los precios son los mismos que en la API HTTP.
Páginas de parámetros de cada capacidad: weibo/search, weibo/trending, weibo/topic_search, weibo/post_detail, weibo/comments, weibo/comment_replies, weibo/reposts y weibo/user_posts. Para plataformas parecidas, compara la API de datos de Douyin, la API de datos de Bilibili y la API de datos de Xiaohongshu.
Referencias
- Plataforma abierta de Weibo, frecuencia de acceso a los servicios (en chino), actualizada el 15 de mayo de 2025, leída el 11 de noviembre de 2026, https://open.weibo.com/wiki/%E6%8E%A5%E5%8F%A3%E8%AE%BF%E9%97%AE%E9%A2%91%E6%AC%A1%E6%9D%83%E9%99%90
- Plataforma abierta de Weibo, acuerdo para desarrolladores (en chino), leído el 11 de noviembre de 2026, https://open.weibo.com/wiki/%E5%BC%80%E5%8F%91%E8%80%85%E5%8D%8F%E8%AE%AE
- Plataforma abierta de Weibo, solicitud de servicios avanzados (en chino), leída el 11 de noviembre de 2026, https://open.weibo.com/wiki/%E9%AB%98%E7%BA%A7%E6%8E%A5%E5%8F%A3%E7%94%B3%E8%AF%B7
- Plataforma abierta de Weibo, 2/comments/show (en chino), leída el 11 de noviembre de 2026, https://open.weibo.com/wiki/2/comments/show
- Plataforma abierta de Weibo, 2/statuses/user_timeline (en chino), leída el 11 de noviembre de 2026, https://open.weibo.com/wiki/2/statuses/user_timeline
- Plataforma abierta de Weibo, 2/search/topics (en chino), leída el 11 de noviembre de 2026, https://open.weibo.com/wiki/2/search/topics
- Plataforma abierta de Weibo, 2/statuses/public_timeline (en chino), leída el 11 de noviembre de 2026, https://open.weibo.com/wiki/2/statuses/public_timeline
- Plataforma abierta de Weibo, Oauth2/access_token (en chino), leída el 11 de noviembre de 2026, https://open.weibo.com/wiki/Oauth2/access_token
- Plataforma abierta de Weibo, descripción de la autorización (en chino), leída el 11 de noviembre de 2026, https://open.weibo.com/wiki/%E6%8E%88%E6%9D%83%E6%9C%BA%E5%88%B6%E8%AF%B4%E6%98%8E
- Plataforma abierta de Weibo, lista de servicios de la API (en chino), leída el 12 de noviembre de 2026, https://open.weibo.com/wiki/%E5%BE%AE%E5%8D%9AAPI
- Plataforma abierta de Weibo, Scope (en chino), leída el 11 de noviembre de 2026, https://open.weibo.com/wiki/Scope
- Plataforma abierta de Weibo, códigos de error (en chino), leída el 11 de noviembre de 2026, https://open.weibo.com/wiki/Error_code
- Plataforma abierta de Weibo, manual de weibo-cli (en chino), leído el 11 de noviembre de 2026, https://open.weibo.com/cli/quickstart
- Plataforma abierta de Weibo, lista de comandos de weibo-cli (en chino), leída el 11 de noviembre de 2026, https://open.weibo.com/cli/api/cli/commands
- API comercial de datos de Weibo, página principal (en chino), leída el 11 de noviembre de 2026, https://openapi.sc.weibo.com/
- npm, @weibo-ai/weibo-cli, versión 0.9.8, 22 de septiembre de 2026, https://www.npmjs.com/package/@weibo-ai/weibo-cli
- Sina Finanzas, nota de IThome sobre el lanzamiento de weibo-cli (en chino), 26 de junio de 2026, https://finance.sina.com.cn/tech/digi/2026-06-26/doc-inietsps5205508.shtml
- Tendencias de Weibo, reglas y descripción de datos (en chino), leída el 12 de noviembre de 2026, https://m.s.weibo.com/vtopic/datadescription?tab=rank
- Tendencias de Weibo, página de reglas anterior (en chino), leída el 11 de noviembre de 2026, https://m.s.weibo.com/hot/description
- Weibo, robots.txt, leído el 11 de noviembre de 2026, https://weibo.com/robots.txt
- Sitio móvil de Weibo, robots.txt, leído el 11 de noviembre de 2026, https://m.weibo.cn/robots.txt
- GitHub, README de dataabc/weibo-crawler, leído el 11 de noviembre de 2026, https://github.com/dataabc/weibo-crawler
- GitHub, README de dataabc/weiboSpider, leído el 11 de noviembre de 2026, https://github.com/dataabc/weiboSpider
- GitHub, README de dataabc/weibo-search, leído el 11 de noviembre de 2026, https://github.com/dataabc/weibo-search
- GitHub, README de nghuyong/WeiboSpider, leído el 11 de noviembre de 2026, https://github.com/nghuyong/WeiboSpider
- GitHub, README de NanmiCoder/MediaCrawler, leído el 11 de noviembre de 2026, https://github.com/NanmiCoder/MediaCrawler
- GitHub, README de stay-leave/weibo-public-opinion-analysis, leído el 11 de noviembre de 2026, https://github.com/stay-leave/weibo-public-opinion-analysis
- GitHub, incidencia #653 de weibo-crawler, 26 de septiembre de 2026, https://github.com/dataabc/weibo-crawler/issues/653
- GitHub, incidencia #652 de weibo-crawler, 17 de septiembre de 2026, https://github.com/dataabc/weibo-crawler/issues/652
- GitHub, petición de cambios #658 de weibo-crawler, fusionada el 5 de noviembre de 2026, https://github.com/dataabc/weibo-crawler/pull/658
- GitHub, petición de cambios #659 de weibo-crawler, fusionada el 6 de noviembre de 2026, https://github.com/dataabc/weibo-crawler/pull/659
- GitHub, incidencia #590 de weibo-search, 13 de octubre de 2026, https://github.com/dataabc/weibo-search/issues/590
- GitHub, petición de cambios #1000 de MediaCrawler, 4 de noviembre de 2026, https://github.com/NanmiCoder/MediaCrawler/pull/1000
- EveryInfra, catálogo de la API de datos, leído el 11 de noviembre de 2026 a las 00:13 hora de Singapur, https://api.everyinfra.com/api/v1/social/catalog
- Documentación de requests, Advanced Usage: Session Objects, leída el 11 de noviembre de 2026, https://requests.readthedocs.io/en/latest/user/advanced/#session-objects
- PyPI, requests, leído el 11 de noviembre de 2026, https://pypi.org/project/requests/
- Administración del Ciberespacio de China, Ley de Protección de Información Personal (en chino), 20 de agosto de 2021, https://www.cac.gov.cn/2021-08/20/c_1631050028355286.htm
- Administración Nacional de Propiedad Intelectual de China, Ley contra la Competencia Desleal, revisión de 2025 (en chino), publicada el 20 de mayo de 2026, https://www.cnipa.gov.cn/art/2026/5/20/art_104_206437.html
- Ministerio de Ecología y Medio Ambiente, Decreto 790 del Consejo de Estado, Reglamento de Gestión de la Seguridad de los Datos de Red (en chino), 3 de octubre de 2024, https://www.mee.gov.cn/zcwj/gwywj/202410/t20241003_1087417.shtml
- Centro de Investigación en Derecho y Política de la Competencia, Universidad Jiao Tong de Shanghái, caso ByteDance contra Weibo sobre robots en apelación (en chino), 21 de octubre de 2021, https://cclp.sjtu.edu.cn/Show.aspx?info_lb=672&info_id=5120&flag=648
- Instituto de Propiedad Intelectual, Universidad de Estudios Extranjeros de Guangdong, caso Sina Weibo contra Maimai, (2016) Jing 73 Min Zhong 588 (en chino), leído el 11 de noviembre de 2026, https://sciiip.gdufs.edu.cn/info/1028/1083.htm
- Centro Chino para el Control y la Prevención de Enfermedades, resumen semanal de gripe al 1 de noviembre de 2026 (en chino), 5 de noviembre de 2026, https://www.chinacdc.cn/jksj/jksj04_14249/202611/t20261105_1842732.html
- Gobierno Municipal de Pekín, por qué vacunarse otra vez contra la gripe este año (en chino), 4 de noviembre de 2026, https://www.beijing.gov.cn/fuwu/bmfw/sy/jrts/202611/t20261104_4931879.html
- Gobierno Municipal de Shanghái, reservas de vacuna gratuita contra la gripe en Putuo (en chino), 6 de noviembre de 2026, https://www.shanghai.gov.cn/nw17239/20261106/de579962c67d46c6888397fc74bb9b0d.html
- Cui, H. y Kertész, J., Attention dynamics on the Chinese social media Sina Weibo during the COVID-19 pandemic, EPJ Data Science, 2021, https://doi.org/10.1140/epjds/s13688-021-00263-0
- Cui, H. y Kertész, J., Competition for popularity and interventions on a Chinese microblogging site, arXiv:2208.10176, versión 2, 30 de noviembre de 2022, https://arxiv.org/abs/2208.10176
- PubMed, resumen de Cui y Kertész 2021, leído el 12 de noviembre de 2026, https://pubmed.ncbi.nlm.nih.gov/33552838/
- Journal of Medical Internet Research, sentimiento público ante la gripe A en Weibo (e49300), 2023, https://doi.org/10.2196/49300
- Relación con inversores de Weibo, Weibo Announces Second Quarter 2026 Unaudited Financial Results, 19 de agosto de 2026, http://ir.weibo.com/news-releases/news-release-details/weibo-announces-second-quarter-2026-unaudited-financial-results/
- Odepa, Ministerio de Agricultura de Chile, Boletín de fruta, febrero 2026, 24 de febrero de 2026, https://www.odepa.gob.cl/publicaciones/boletines/boletin-de-fruta-febrero2026
- Xinhua en español, Arriban a China primeros lotes de cerezas chilenas de temporada 2026-27, 19 de octubre de 2026, https://spanish.xinhuanet.com/20261019/982cd37d8722475482a53ccf12faa6f8/c.html
Referencia BL-134