zenrows alternatives 选型清单:按产品线和四个场景比六家每千次价
ZenRows 换不换看你用哪条线:普通网页它最便宜,Google 搜索每千次我们 0.694 美元,TikTok 主页每千个 0.556 美元,附真调
抓 1,000 个普通静态网页,ZenRows 按 2026 年 11 月 19 日读到的公开价只要 0.067 到 0.42 美元,比 ScraperAPI、Firecrawl、Bright Data 和 EveryInfra 都便宜;同样 1,000 次 Google 搜索,ZenRows 落到 1 credit 时最低 0.067 美元,落到 5 credit 就涨到 0.33 到 2.11 美元,EveryInfra 实扣固定 0.694 美元一千次。
社媒按条算差距最大:Bright Data 每千条 1.30 到 1.50 美元,Apify 的 Reddit 工具每千条 3.40 美元起,EveryInfra 的 tiktok/profile 每千个主页 0.556 美元,reddit/subreddit_posts 一次回 10 条帖子,折每千条 0.0556 美元,比两家按条收费的低 2.3 到 61 倍。这个倍数按一次请求固定回 10 条最新帖折算:reddit/subreddit_posts 不能指定条数和时间范围,要拉一个版块的全量帖子或指定条数时,按条收费的工具才是同一种计量,两边不能直接比。
ZenRows 更合适的有三类:JS 渲染页和带反爬的防护站(我们的 read 工具在这两类测试页上一个拿回空壳、一个空结果退款)、住宅代理流量、要真浏览器点按钮登录的页面;EveryInfra 都没有对应产品。
ZenRows 是按 credit 收费的网页数据接口:你给它一个网址,它按页面难度决定要不要渲染 JS、要不要走住宅代理,成功了才扣 credit。普通页 1 credit,渲染 JS 5 credit,高级代理 10 credit,两样一起 25 credit,住宅流量每 GB 25,000 credit;Browser 会话每 GB 25,000 credit,另加每分钟 5 credit(ZenRows 定价文档,2026-11-19 读取)。14 档月费怎么换成每千次、加量包怎么算,站内的 ZenRows 价格详解已经逐档推过,ZenRows 替代页有一个概览。
对方的价取自公开定价页和文档(2026 年 11 月 19 日 00:14 到 00:30 新加坡时间读取,月付价,按额度用满折算);我们的价取自本次真调响应里的 charged_usd,并和当天目录 GET /api/v1/social/catalog 里的 price_usd 对过。六家的字段名、条数上限和翻页方式各不相同,各表只比钱、计费规则和能不能拿到。
先按产品线分:你在 ZenRows 上用的是哪一样
ZenRows 现在把产品拆成五个「原语」:Fetch 取一个页面,Extract 在同一次请求里把页面转成结构化 JSON,Crawl 从一个网址顺着链接把整站翻一遍,Batch 一次提交最多 100,000 个网址,Browser 给一个能点击、能登录的真浏览器会话;另有单独的住宅代理(ZenRows 文档索引,2026 年 11 月版)。它们共用一个 credit 余额,换哪一样、换成谁,答案差得很远。
| 你用的 ZenRows 产品 | 它怎么扣 | 换成谁划算 | 留在 ZenRows 的理由 |
|---|---|---|---|
| Fetch 普通页 | 1 credit,每千页 0.067–0.42 美元 | 一般不用换,它最便宜 | 价格已经是六家最低 |
| Fetch 加 JS 渲染或防护站 | 5 到 25 credit | Bright Data Unlocker 一个价 1.30–1.50 美元 | 自适应模式只扣成功那一档 |
| Extract 现成站点(Amazon、Google、Maps、TikTok、Reddit) | 跟 Fetch 同价,Extract 本身目前免费 | 按条或按次的结构化接口 | 539 个站点有现成字段 |
| Crawl、Batch | 每页按 Fetch 扣,本身不另收 | Firecrawl 的 Crawl 每页 1 credit | 一次 10 万网址、定时和网页回调 |
| Browser | 每 GB 25,000 credit 加每分钟 5 credit | Bright Data Browser API | 要登录、点击、多步表单 |
| 住宅代理 | 每 GB 25,000 credit,老套餐 18,000–54,000 | Bright Data 住宅代理 | 和 Fetch 共用余额 |
ZenRows 的 Amazon ASIN 页、Google 搜索页、Google Maps 页、TikTok 页 和 Reddit 页,写法都一样:请求里带 mode=auto 和 extract=auto,Fetch 用自适应模式打开页面,Extract 把字段交回来。五个页面都写着 2026 年 10 月 20 日的真实请求示例,但没有一个写这类页面会落在 1、5、10 还是 25 credit;它的定价页只说自适应模式「从最轻的配置开始,只在页面需要时加码,只按成功的那一套计费」(ZenRows 价格页)。所以下面所有涉及 ZenRows 结构化页面的价,都只能给 1 到 25 credit 的区间,区间两端差 150 倍以上。
Extract 的站点覆盖:迁移前先查一份清单
用 Extract 的团队换之前要先查一件事:你抓的站在不在它的已备好清单里。ZenRows 的文档把这件事做成了接口:GET /v1/extract/domains 列出 Extract 当前能处理的全部域名,这个接口本身不取页面、不扣 credit;不在清单里的域名,带 extract=auto 请求会回 REQS007,标题写着这个域名还没准备好(ZenRows Extract 接口文档)。没准备好的域名可以自己提交,POST /v1/extract/prepared-domains 带 1 到 5 个示例网址,ZenRows 学会页面结构、核对过字段后状态变成 ready,通常要几分钟;每个账户每月有提交名额,按 UTC 自然月重置,用完回 429(Extract 介绍)。
清单里有、而且你只要标准字段的站,比如 Amazon、Google、TikTok、Reddit,换成按平台给好字段的接口最省事,因为两边都是「给 ID、拿字段」,差别只在价格和字段名;清单里没有、需要你提交准备的长尾站,ZenRows 的自助准备流程是它的长处,这类站我们的目录里大概率也没有对应能力,留在 ZenRows。我们的能力清单同样是公开的:GET /api/v1/social/catalog 不用 Key 就能读,2026 年 11 月 19 日这一天列了 612 个能力,每个能力有 price_usd、params 和 response_fields(能力目录)。两份清单对一遍,交集里的站先换。
| 接口 | 扣 credit | 用途 |
|---|---|---|
GET /v1/extract/domains | 0 | 列出 Extract 当前能处理的域名 |
POST /v1/extract/prepared-domains | 0,占一个月度名额 | 请 ZenRows 准备一个新域名 |
GET /v1/extract/prepared-domains/allowance | 0 | 查本月还剩几个名额 |
GET /api/v1/social/catalog(EveryInfra) | 0,不用 Key | 列出能力、价格和字段 |
总对比表:计费单位、失败扣不扣、最低花费和 MCP
| 服务 | 计费单位 | 普通页每千页(美元) | Google 搜索每千次(美元) | 失败或空结果 | 最低付费 | 免费额度 | 接 AI 工具 |
|---|---|---|---|---|---|---|---|
| ZenRows | credit,1/5/10/25 | 0.067–0.42 | 0.067–10.56(档位未公开) | 失败不扣;404、410 算成功 | Build 19 美元/月 | 每月 5,000 credit | 远程 MCP |
| ScraperAPI | credit,按域名和参数乘倍率 | 0.092–0.49 | 2.30–12.25(25 credit) | 只扣 200、404 和 70 秒内你取消的 | Hobby 49 美元/月 | 试用 7 天 5,000;免费档每月 1,000 | 远程 MCP |
| Firecrawl | credit,一页 1 个 | 0.75–3.80 | 1.50–7.60(每 10 条 2 credit) | 没结果不扣;403、404 照扣 1 | Hobby 19 美元/月 | 每月 1,000 credit | MCP |
| Bright Data | 按成功的请求或记录 | 1.30–1.50(Unlocker) | 1.31–1.50 | 只付成功的 | 按量,无月费 | 每月 5,000 credit | MCP,每月 5,000 次免费 |
| Apify | 按事件,多为每条结果一笔 | 不适用 | 1.80–4.50(按页) | 可设单次运行上限 | Starter 19 美元/月 | 每月 5 美元额度 | 远程 MCP |
| EveryInfra | 按请求,一次一个固定价 | 0.694(read,实扣) | 0.694(web,实扣) | 失败和空结果不扣,缺参数回 422 | 首充 10 美元,余额长期有效 | GitHub 给两个仓库点星送 1 美元,24 小时内用 | 远程 MCP |
区间是同一家最便宜和最贵的自助月付档用满额度折出来的。ZenRows Build B1 档 19 美元 45,000 credit,每千 credit 0.422 美元;Scale S5 档 2,999 美元 4,500 万 credit,每千 credit 0.0666 美元(ZenRows 定价文档)。ScraperAPI 的 Hobby 档 49 美元 10 万 credit,Advanced 档 1,975 美元 2,150 万 credit(ScraperAPI 价格页)。Firecrawl 的 Hobby 档 19 美元 5,000 credit,Scale 档 749 美元 100 万 credit,价格从 2026 年 9 月 4 日起生效(Firecrawl 价格页)。Bright Data 的 Web Unlocker 按量每千次 1.50 美元,Scale 套餐 499 美元含 383,000 次(Web Unlocker 定价);SERP API 按量每千次 1.50 美元,Scale 含 380,000 次(SERP API 定价);免费额度是每月 5,000 credit,Unlocker、SERP 和 Web Scraper 一次请求或一条记录扣 1 个(Bright Data 免费额度文档)。Apify 的价取 Store 里各工具页面公开的分档价,档位跟着 Free、Starter、Scale、Business 四个套餐走(Apify 价格页,Store 计费说明)。
ZenRows 的 credit 倍率:先算出你自己的平均档位
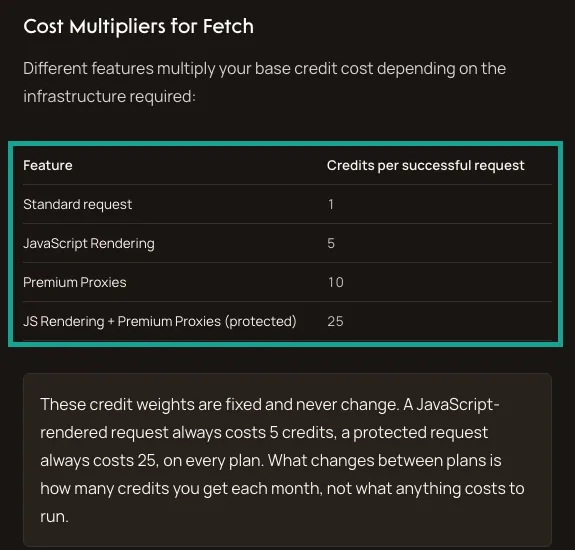
换之前要知道的一个数,是你的请求平均落在几 credit。ZenRows 的倍率写死在文档里:普通请求 1,渲染 JS 5,高级代理 10,两样一起 25,并且注明这些权重「固定不变」,每个套餐都一样,变的只是每月给多少 credit(ZenRows 定价文档)。
倍率乘上每千 credit 的单价,就是每千页的价。我们把 14 个自助档里五个有代表性的档位折出来:
| ZenRows 档位 | 月费(美元) | 每月 credit | 普通页每千页 | 渲染 JS | 高级代理 | 防护站(25) | 住宅流量每 GB |
|---|---|---|---|---|---|---|---|
| Build B1 | 19 | 45,000 | 0.422 | 2.11 | 4.22 | 10.56 | 10.56 |
| Launch L1 | 69 | 250,000 | 0.276 | 1.38 | 2.76 | 6.90 | 6.90 |
| Growth G1 | 199 | 1,200,000 | 0.166 | 0.83 | 1.66 | 4.15 | 4.15 |
| Scale S1 | 549 | 5,000,000 | 0.110 | 0.55 | 1.10 | 2.75 | 2.75 |
| Scale S5 | 2,999 | 45,000,000 | 0.067 | 0.33 | 0.67 | 1.67 | 1.67 |
两件事会让你的实际平均档位偏高。第一件是按域名设的下限:ZenRows 的错误码文档写,某些域名因为防护强,要求必须开 JS 渲染或高级代理,这个要求在抓取前按域名或网址规则检查,参数不够就直接回 REQS002,不扣钱,但轻配置会一直被拒,所以没有「先试便宜档」的省钱余地(ZenRows 错误码文档)。第二件是自适应模式 mode=auto 从最轻的配置往上试,按最后成功的那一档扣,你在请求前不知道会落在哪一档。估平均档位最省事的做法,是拿过去一个月的真实网址抽 200 个,按 mode=auto 跑一遍,看控制台活动日志(ZenRows 2026 年 7 月底上线的 Activity Log,按产品和网址筛选,时间窗从 24 小时到 60 天,见 ZenRows 更新日志)里每条扣了几 credit,再拿这个平均数去乘下面各家的价。
ScraperAPI 也用 credit,倍率规则不一样:普通请求 1,Amazon、Walmart、eBay 5,Google、Bing 搜索 25,LinkedIn 30;render=true 和 premium=true 各 10,两个都开 25;Cloudflare、DataDome、PerimeterX、Akamai 这几类防护的绕过是每次 10;ultra_premium=true 30,再加渲染 75(ScraperAPI credit 文档)。10 月它把 Akamai 防护站改成自动绕过,不用再手动加参数(ScraperAPI 10 月更新说明)。两家同时开 JS 渲染时,ScraperAPI 扣 10、ZenRows 扣 5,同一个 JS 页在 ScraperAPI 上要多扣一倍 credit。
场景一:任意网页,ZenRows 的普通页最便宜,防护站最贵
先看任意网页。我们挑了一个公开的爬虫练习站 ScrapingCourse.com 的三个测试页,用 EveryInfra 的 read 工具各取一次:一个静态的电商列表页、一个要执行 JS 才显示商品的页面、一个带反爬挑战的页面。
2026 年 11 月 19 日 00:17(新加坡时间),静态电商列表页 scrapingcourse.com/ecommerce/ 用时 1.28 秒回来,正文里有「Showing 1–16 of 188 results」和 16 个商品,扣 0.000694 美元,折每千页 0.694 美元。00:17 同一分钟,JS 渲染测试页 scrapingcourse.com/javascript-rendering 用时 11.44 秒,回来的正文只有「JS Rendering Challenge」和「Enable JavaScript to see products」两行,商品一个都没有,照扣 0.000694 美元:我们的 read 工具不执行 JS,这种页面拿回的是外壳。00:18,反爬挑战页 scrapingcourse.com/antibot-challenge 用时 11.98 秒,结果为空,响应里写着 empty_result_refunded,扣 0 美元。
静态页我们能拿,单价比 ZenRows 和 ScraperAPI 的最低档贵;JS 页和防护页我们这里拿不到。ZenRows 对这两类页分别扣 5 和 25 credit,按 B1 到 S5 折每千页 0.33 到 2.11 美元和 1.67 到 10.56 美元;ScraperAPI 渲染 JS 扣 10 credit,折 0.92 到 4.90 美元,绕过反爬每次 10 credit,同样 0.92 到 4.90 美元;Bright Data 的 Web Unlocker 不分难度一次 1.30 到 1.50 美元;Firecrawl 每页 1 credit、渲染不另收,折 0.75 到 3.80 美元。
ZenRows 文档给的用法是逐级加码:先发普通请求,内容不全再开 JS 渲染,还被拦再开高级代理,两样都不够才叠成 25 credit;文档原话是先单开一样,确有需要再叠(ZenRows 入门指南,Fetch 参数表)。照这个思路拆分迁移,静态页可以交给任何一家,JS 页和防护页留在能渲染的服务上。判断一个页面是不是静态,最快的办法是看我们的 read 回来的正文里有没有你要的字段:有,就是静态页;只有「Enable JavaScript」这类提示,就是要渲染的页,这一类别换过来。
ZenRows 的普通页比 ScraperAPI 便宜,到了防护站反过来:ZenRows 的 25 credit 比 ScraperAPI 的 10 credit 绕过贵出一截,B1 档每千页 10.56 美元,ScraperAPI 的 Hobby 档是 4.90 美元。ZenRows 给自己的理由是一组自测:Zim、Glassdoor、Idealista、Indeed 四个防护站,每个站 100 次、每家共 400 次、每秒 2 次,成功率 ZenRows 99.0%、平均 9.1 秒,ScraperAPI 49.0%、平均 36.0 秒。这组数贴在 r/LLMDevs 的一个帖子里,帖子第一句注明作者为 ZenRows 写技术内容、数字来自 ZenRows 内部测试;帖子说一共测了 5 家,只贴出 3 家的结果,完整表格在 ZenRows 自己的博客上。按成功率折算,每个成功页面的价格,ScraperAPI 要乘以 1/0.49,约 2.04 倍;这组数是 ZenRows 自测,换之前用你自己的防护站各跑 100 次再定。
场景二:Amazon 商品页,拿 ZenRows 自己的示例 ASIN 测一遍
ZenRows 的 Amazon ASIN 页拿 B0CRMZHDG8(STANLEY Quencher H2.0 40 oz 保温杯)做示例:10 月 20 日那次请求回了平均评分 4.75、206,884 条评分,完整记录有 34 项商品详情和 6 张图(ZenRows Amazon ASIN 页)。我们 11 月 19 日 00:19(新加坡时间)用 amazon/profile 取同一个商品,用时 7.72 秒,回标题、品牌 STANLEY、价格 42.30 美元、评分 4.7、207,914 条评分、有货,另有类目路径、描述、图片和卖点,扣 0.001389 美元,折每千个商品页 1.389 美元。两次相隔 30 天,评分数多了 1,030 条。
00:34(新加坡时间)换一个商品,Apple AirPods Pro 第二代(B0BDHWDR12),7.56 秒回来,价格 265.78 美元、评分 4.7、57,992 条评分、卖家 6ave,同样扣 0.001389 美元:商品页按次一个价,不随商品热门程度和页面长短变。同一分钟再用 amazon/search 搜「stanley tumbler 40 oz」,4.51 秒回 10 个商品,每个带 ASIN、标题、现价、划线价、评分和评分数,扣 0.002236 美元,折每千次搜索 2.236 美元、每千个商品 0.2236 美元。10 个结果里有 6 个是 Quencher H2.0 的不同颜色,评分数都是 207,914,和 B0CRMZHDG8 那一条完全一样,Amazon 把同一款不同颜色的评分合在一起显示;其中 5 个现价 22.50 美元、划线价 45.00 美元,另一个没给价格,而单取的紫红色款是 42.30 美元,同款不同色的价格差了将近一倍。只要列表价和评分、不要详情的监控任务,搜索页一次 10 个,比逐个取商品页便宜 6.2 倍。
各家每千个商品页的价:ScraperAPI 每页 5 credit,Hobby 档 2.45 美元,Advanced 档 0.46 美元;Bright Data 的 Web Scraper 按条,按量 1.50 美元,Scale 套餐折 1.30 美元;Apify Store 里的 Amazon 工具每条 0.003 到 0.005 美元,折 3.00 到 5.00 美元(Apify Amazon 工具页);Firecrawl 要 JSON 结构化时每页 1 加 4 共 5 credit,折 3.75 到 19.00 美元;ZenRows 不公布 Amazon 落在哪一档,按 1 到 25 credit 算是 0.067 到 10.56 美元。
ZenRows 这条线最长,结论取决于你的 Amazon 请求平均落在几 credit:落在 1 credit,它每千页 0.067 到 0.42 美元,比谁都便宜;落在 5 credit,0.33 到 2.11 美元,和 ScraperAPI 差不多;落在 25 credit,B1 档要 10.56 美元,是我们的 7.6 倍。Amazon 商品页落在哪一档要实测,用你自己的 ASIN 列表跑 200 个看活动日志。后文第三个 YouTube 视频里有一个参照:作者在 ZenRows 控制台对一个 Amazon 搜索页同时勾了高级代理和 JS 渲染,控制台提示这一次请求「只要 0.025」,视频没说单位,也没说按哪个套餐算;两样一起开,对应的是文档里 25 credit 那一档。量大、只要商品详情的团队,ScraperAPI 从 Startup 档(每千页 0.745 美元)起比我们便宜;量小、不想订月付的,按次付费的 Amazon 能力页更省事,amazon/search 和 amazon/reviews 也在同一个余额里扣。
场景三:Google 搜索和 Google Maps,一次搜索一个固定价
ZenRows 的 Google 搜索页示例查的是「best running shoes」(ZenRows Google 搜索页),我们 00:23(新加坡时间)用搜索的 web 工具查同一个词,2.8 秒回 10 条自然结果,有 RunRepeat、Runner's World、Reddit 的 r/runninglifestyle、Nike、YouTube 和 Amazon 畅销榜,扣 0.000694 美元,折每千次 0.694 美元,每千条结果 0.0694 美元。
00:35(新加坡时间)我们又用 web 工具搜了「zenrows alternatives」这个词,1.57 秒回 10 条结果,同样扣 0.000694 美元。排第一的是 ZenRows 自己的替代清单页,第二、三条是 ScraperAPI 和 Apify 写的「ZenRows 替代」页面,10 条里有 8 条出自抓取服务商自己,剩下 1 条是软件点评站、1 条是 Medium 上的清单文章。搜这个词读到的几乎都是利益相关方的说法,各家都把自己排在第一,拿来做决定前要回到各家的价格页和文档核一遍。
各家每千次 Google 搜索:Bright Data SERP API 按量 1.50 美元,Scale 折 1.31 美元;Firecrawl 每 10 条结果 2 credit,折 1.50 到 7.60 美元;Apify 的 Google 搜索工具按结果页收费,每页 0.0018 到 0.0045 美元,折 1.80 到 4.50 美元(Apify Google 搜索工具页);ScraperAPI 每次 25 credit,折 2.30 到 12.25 美元;ZenRows 0.067 到 10.56 美元。
落到 1 credit 时 ZenRows 比我们便宜;但 Google 结果页落在 1 credit 的情况它自己没给过例子,它的示例请求里带着 mode=auto 和 proxy_country=us。只要平均落到 5 credit,B1 档每千次就是 2.11 美元,是我们的 3 倍;落到 25 credit 是 10.56 美元,15 倍。我们的 web 工具不管查什么词都是一个价,也没有档位要猜。
Google Maps 这边,ZenRows 示例查的是「coffee shops in austin tx」,页面说示例只截了返回地点里的 3 个,没写一次搜索回多少家(ZenRows Google Maps 页)。我们 00:24(新加坡时间)用 google_maps_reviews/search 查同一个词,返回 503、没扣费,错误信息里写着这个能力 10 分钟内已有多次失败、都没扣钱,建议过一会儿重试。00:35 和 00:40 又各试一次,仍是 503、没扣费,第二次的错误信息附了一个示例请求,建议先拿它确认是这个目标的问题还是服务的问题。我们换用搜索的 places 工具:00:40 查「coffee shops」,地点填「Austin, TX」,2.41 秒回 20 家,每家有名称、地址、评分、评分数、类别、电话、网站、经纬度、营业时间和 place_id,扣 0.000694 美元,折每千家 0.0347 美元。20 家里评分数最多的是 Mozart's Coffee Roasters(11,016 条,4.5 分),最少的是 Trippy Buck Coffee(47 条,4.9 分)。20 家里 19 家有网站、19 家有营业时间、12 家有电话;评分 4.9 及以上的 8 家,评分数都不超过 435 条,评分数过千的 5 家都在 4.4 到 4.7 分之间,按评分排序拉名单时要把评分数一起看。places 不带评论正文,要评论得等 google_maps_reviews 恢复。
| 店铺(20 家里的 5 家) | 评分 | 评分数 | 类别 |
|---|---|---|---|
| Jo's Coffee – South Congress | 4.4 | 2,013 | Coffee shop |
| Epoch Coffee | 4.5 | 2,543 | Coffee shop |
| Terrible Love Coffee | 4.9 | 435 | Coffee shop |
| Mozart's Coffee Roasters | 4.5 | 11,016 | Coffee shop |
| Summer Moon Coffee | 4.6 | 2,074 | Coffee shop |
按条收费的两家:Bright Data 的 Google Maps 记录每千条 1.30 到 1.50 美元;Apify 的 Google Maps 工具每个地点 0.0015 到 0.004 美元,折每千家 1.50 到 4.00 美元(Apify Google Maps 工具页)。Google 自己的 Places API 按调用计费,Text Search 一次最多 60 家,详情一次最多 5 条评论(Google Maps Platform 价格)。
一次 20 家、每千家 0.0347 美元,比按条收费的两家低 37 到 115 倍。这个差距来自计费单位:places 按请求收,一次请求回多少家都是一个价,Bright Data 和 Apify 按地点条数收。这个倍数按一次请求固定回 20 家、只含基础字段折算;要指定条数、拉一个城市的全量店铺或带评论时,单位不同,不能直接比。如果你的任务是在几百个城市里按类别拉店铺名单、电话和评分,places 这一项最省;如果要每家店的全部评论正文,按条收费的工具或 ZenRows 的 Maps 页面才拿得到。
场景四:TikTok 主页和 Reddit 版块,按页和按条差几十倍
ZenRows 的 TikTok 页只做公开主页:一个主页网址进,一份资料出,示例账号是 zachking,10 月 20 日那次请求的精确值是粉丝 86,820,822、点赞 1,304,199,204、视频 619 个(ZenRows TikTok 页)。我们 00:25(新加坡时间)用 tiktok/profile 取同一个账号,1.83 秒回来:粉丝 86,743,505、点赞 1,307,359,332、视频 622 个、已认证、非私密,扣 0.000556 美元,折每千个主页 0.556 美元。30 天里这个账号粉丝少了 77,317 个,点赞多了 3,160,128 个,视频多了 3 个。
00:35(新加坡时间)再取一个大一倍的账号 khaby.lame,1.74 秒回来,粉丝 162,895,918、点赞 2,695,175,517、视频 1,362 个,扣费还是 0.000556 美元。主页按次计价,账号大小不影响单价;同样一个主页在 ZenRows 上落在哪一档,它的 TikTok 页面没写,社媒监听用例页倒是提到 TikTok 的搜索结果页要在浏览器里渲染。TikTok 自己的 Research API 只对通过审核的学术研究者和非营利机构开放,申请后一般 4 周内答复(TikTok Research API),商业团队走不了这条路。
Reddit 的对照是 r/webscraping。ZenRows 的 Reddit 页拿这个版块做示例,返回版块名、简介、每周活跃用户 22,206、规则和置顶帖(ZenRows Reddit 页)。我们 00:25 用 reddit/subreddit_posts 取同一个版块,2.7 秒回 10 条帖子,每条有标题、正文、作者、点赞数、评论数、发帖时间和标签,第一条是 10 月的每月自荐帖(166 条评论),还有一条 11 月的帖子讲「拦掉字体和媒体文件后住宅代理流量少了 45%」,扣 0.000556 美元。一次 10 条,折每千条帖子 0.0556 美元。这 10 条里,除了置顶的 10 月自荐帖,其余 9 条发在 2026 年 11 月 15 日到 11 月 18 日(UTC)之间,三天多就翻满 10 条;点赞最多的是一条讲作者的开源库收到一家门户网站停止侵权函的帖子(111 赞、71 条评论),另有 eBay 抓取突然连续 403、怎么用浏览器自动化过 DataDome 这类求助帖。像 r/webscraping 这样发帖速度的版块,每天取一次新帖不会漏。
按条收费的两家:Bright Data 的 TikTok 主页、Reddit 帖子都是每千条 1.30 到 1.50 美元;Apify 的 TikTok 工具每条 0.0017 到 0.0037 美元(Apify TikTok 工具页),Reddit Lite 工具每千条 3.40 美元起(Apify Reddit Lite 页)。TikTok 主页一项,我们比 Bright Data 低 2.3 到 2.7 倍,比 Apify 低 3.1 到 6.7 倍;Reddit 帖子一项,Bright Data 是我们的 23 到 27 倍,Apify 是 61 倍。ZenRows 和 ScraperAPI 按页面收费,一个 Reddit 版块页里有几条帖子由页面决定,它们的价不能直接折成每千条;ZenRows 如果落在 1 credit,一个版块页 0.000067 到 0.00042 美元,和我们一次请求的 0.000556 美元同一个量级。Bright Data 和 Apify 拉多少条付多少;我们这一侧一次回 10 条最新帖、不能指定条数,上面这几个倍数只对「定期看最新 10 条」这类用法成立,要全量或按时间段拉的任务不能这样比。
ZenRows 的 Reddit 示例回的是版块资料:简介、每周活跃用户、规则和置顶帖;我们的 reddit/subreddit_posts 回的是帖子列表,两者不是同一种数据。我们没有单独取版块资料的能力,Reddit 一类在目录里列了 8 个:搜索、版块新帖、帖子详情、评论、用户发帖、用户评论、热门帖和痛点归纳,其中搜索和评论每次 0.000792 美元,用户评论每次 0.032403 美元,痛点归纳每次 0.072 美元。TikTok 一类列了 24 个,22 个可用,视频、评论、话题、字幕、粉丝列表和 TikTok Shop 商品搜索都按次计价,多数是 0.000556 美元。ZenRows 的 TikTok 页只做主页,评论在另一个页面;要一个账号的主页、最近视频和每条视频的评论,在我们这里是三个能力各调一次,在 ZenRows 是三个页面各取一次、各按落在的档位扣。
| 能力 | 每次(美元) | 回什么 |
|---|---|---|
reddit/subreddit_posts | 0.000556 | 10 条帖子,带点赞、评论数和标签 |
reddit/comments | 0.000792 | 一条帖子下的评论 |
reddit/search | 0.000792 | 匹配关键词的帖子 |
tiktok/profile | 0.000556 | 一个主页和各项计数 |
tiktok/comments | 0.000556 | 一条视频下的评论 |
tiktok/shop_search | 0.000556 | TikTok Shop 里匹配关键词的商品 |
住宅代理和浏览器:EveryInfra 不卖的部分
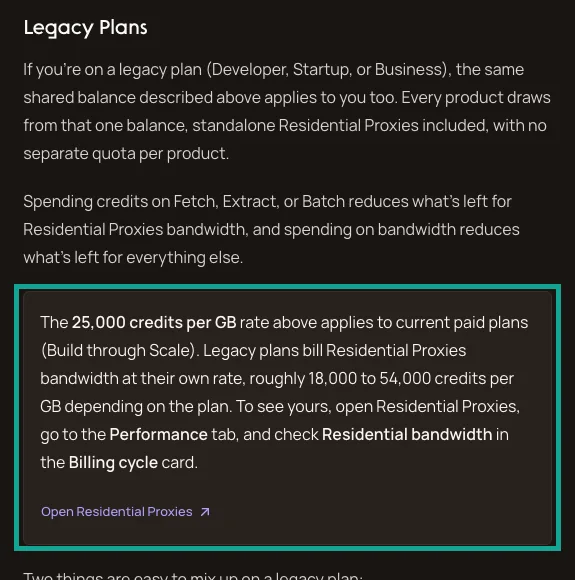
ZenRows 把住宅流量按 25,000 credit 一 GB 计,折成美元,B1 档每 GB 10.56 美元,S5 档 1.67 美元;它的经验换算是 1 GB 约等于 1,000 个防护页(ZenRows 定价文档)。用老套餐(Developer、Startup、Business)的账户是另一个价:每 GB 18,000 到 54,000 credit,按套餐不同,要去住宅代理页的 Performance 标签自己看(同一页 Legacy Plans 一节)。
Bright Data 的住宅代理按量标价每 GB 8 美元,页面上挂着一个半价优惠码,用了是 4 美元;套餐 499 美元含 141 GB,折 3.54 美元,999 美元含 332 GB,折 3.01 美元,1,999 美元含 798 GB,折 2.51 美元(Bright Data 住宅代理定价)。用住宅代理前,Bright Data 要求先过一道 KYC 核验,可能包括一次视频通话;它的 Web Unlocker 不用过 KYC(同一页常见问题)。ZenRows 的独立住宅代理不对免费档开放。
EveryInfra 不卖代理流量,也没有给你接 Puppeteer、Playwright 的远程浏览器。如果你在 ZenRows 上主要用住宅代理或 Browser,这里不是替代;ZenRows 的 Browser 一次会话最长 15 分钟,每分钟 5 credit 加每 GB 25,000 credit(ZenRows Browser 页),对应的是 Bright Data 的 Browser API。上面 Reddit 那条帖子提供了一个跟换不换无关的省钱法:拦掉字体、图片和媒体请求,住宅流量少了约 45%,评论里有人提醒 Playwright 开路由拦截会关掉 HTTP 缓存,要拿同一个域名重复抓一遍对比 GB 数再信(r/webscraping 帖子)。
一次真实往返:请求、返回和字段
换过来以后,调用方式是一个 POST 请求,平台和能力写在请求体里,不用拼目标网址,也不用选渲染和代理参数。下面是 00:25 那次 TikTok 主页请求的原样写法(Key 用环境变量):
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"tiktok","action":"profile","params":{"username":"zachking"}}'
返回的 results 里是这个主页的字段,billing 里是这一次扣的钱。截取如下(头像链接和签名省略):
{
  "platform": "tiktok", "action": "profile",
  "results": {
    "user_id": "68616495085350913", "username": "zachking", "display_name": "Zach King",
    "follower_count": 86743505, "following_count": 185, "like_count": 1307359332,
    "video_count": 622, "is_verified": true, "is_private": false,
    "created_at": "2016-02-29T07:29:22+00:00", "platform": "tiktok"
  },
  "billing": { "charged": true, "credits": 40, "charged_usd": 0.000556 }
}
字段名和当天目录 tiktok/profile 的 response_fields 一一对得上:user_id、username、display_name、bio、url、external_url、follower_count、following_count、like_count、video_count、is_verified、is_private、avatar_url、created_at、platform。ZenRows 的 TikTok 示例把同类数据分在 profile、stats、videos 三组里,迁移时字段要重新映射一遍,两边的结构不一样。
在 Claude、Cursor 这类 AI 工具里用,加一个远程 MCP 地址就行,工具名都以 everyinfra_ 开头:
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
本篇 27 次请求:每次多久、扣了多少
2026 年 11 月 19 日 00:17 到 00:40(新加坡时间),我们发了 27 次请求(另有 00:16 一次被限速回 429,没扣钱,不计在内),覆盖 search/read、search/web、search/places、amazon/profile、amazon/search、tiktok/profile、reddit/subreddit_posts、youtube/search、youtube/comments、youtube/transcript、google_maps_reviews/search 和 zillow/search 十二个能力。15 次扣费,合计 0.012598 美元;12 次没扣:1 次空结果退款,11 次 503。
耗时有两头。成功的请求里,TikTok 主页、Reddit 版块、搜索结果、YouTube 评论都在 1 到 3 秒;Amazon 商品页 7.6 到 7.7 秒,read 抓 JS 页和反爬页 11 到 12 秒,因为这两类要等目标页面响应完。503 都在 1 秒以内回来,响应里写明没扣费、建议多少秒后重试,客户端不用等超时。按扣费的 15 次算,平均每次 0.00084 美元;这 27 次请求在 ZenRows 上按 1 credit 算只要 27 个 credit,免费档的 5,000 credit 足够,按 25 credit 算是 675 个,也够。量上去以后两边差多少,见下面「一个月的账」。
失败、空结果、503 和 429:六家各扣不扣
失败扣不扣钱,直接决定「每个成功结果」的真实单价。ZenRows 写的是失败不扣,404 和 410 算成功照扣(ZenRows 定价文档),REQS002 这种参数不够的拒绝也不扣(ZenRows 错误码文档)。ScraperAPI 只对 200、404 和你在 70 秒内主动取消的请求扣,并发超了回 429 不扣(ScraperAPI 价格页)。Firecrawl 没拿到结果的不扣,但目标页回 403 或 404 时照扣 1 credit(Firecrawl 价格页)。Bright Data 写的是只为成功付费。Apify 的工具大多按结果条数收,运行时可以设一个最高花费,到了就停(Apify Store 计费说明)。
| 我们这次碰到的情况 | 时间(新加坡) | 能力 | 结果 | 扣费(美元) |
|---|---|---|---|---|
| 测试 Key 设的每分钟 10 次单 Key 上限 | 00:16 | read | 429,写明「Nothing was charged」,建议 25 秒后重试 | 0 |
| 反爬挑战页 | 00:18 | read | 200,结果为空,empty_result_refunded | 0 |
| JS 页只拿回外壳 | 00:17 | read | 200,正文两行,没有商品 | 0.000694 |
| Google Maps 搜索 | 00:24 | google_maps_reviews/search | 503,unavailable,「none was charged」 | 0 |
| Zillow 搜索 | 00:26 | zillow/search | 503,没扣 | 0 |
| Google Maps 搜索,第二、三次 | 00:35、00:40 | google_maps_reviews/search | 503,附示例请求,建议先确认是目标还是服务的问题 | 0 |
| YouTube 字幕,三个视频各试两次 | 00:35–00:40 | youtube/transcript | 503,没扣 | 0 |
| Zillow 搜索第二次 | 00:35 | zillow/search | 503,写明「第 2 次,共 3 次」,第 3 次会说该查什么 | 0 |
JS 外壳那一行,页面有内容(两行字),所以不算空结果,照常扣费。拿 read 抓前端渲染的站,先用一两个网址看看返回的正文里有没有你要的东西。503 和 429 两种响应都写明了没扣钱、多久以后重试,客户端照着 retry_after 等就行。失败退款对账那篇讲了怎么拿 charge_id 核对每一笔。
一个月的账:三种 ZenRows 用户各花多少
拿三种常见用量,各家按「够用的最小月付档」或按量价算一个月,EveryInfra 按本次实扣单价乘:
| 每月用量 | ZenRows | ScraperAPI | Firecrawl | Bright Data | Apify | EveryInfra |
|---|---|---|---|---|---|---|
| A:30 万个静态页 + 2 万个 JS 页 | 99(Launch L2,40 万 credit) | 149(Startup) | 399(Growth) | 480(Unlocker 按量) | 不适用 | 208.20(只能做静态的 30 万页) |
| B:5 万个 Amazon 商品页 + 3 万次 Google 搜索 | 29 到 279(全按 1 credit 到全按 25 credit) | 149(Startup,100 万 credit) | 399(Growth) | 120(按量) | 约 275(Starter 档单价) | 90.27 |
| C:每天 300 个 TikTok 主页 + 100 次 Reddit 版块新帖 | 19 到 99(全按 1 到 25 credit) | 未公开 TikTok、Reddit 倍率 | 未单列 | 58.50(按量,3.9 万条) | 约 129(Starter 档单价) | 6.67 |
A 这种以静态页为主、夹一点 JS 页的用量,ZenRows 99 美元最便宜,我们 208.20 美元还做不了那 2 万个 JS 页,留在 ZenRows 是对的。B 的结论取决于 ZenRows 的平均档位:Amazon 和 Google 都落在 1 credit 时它 29 美元最便宜,平均落到 5 credit(40 万 credit)就要 Launch L2 的 99 美元,落到 25 credit 要 279 美元;我们 90.27 美元,不随档位变。C 是社媒巡检,9,000 个 TikTok 主页加 3,000 次 Reddit 请求(每次 10 条,共 3 万条帖子),我们 6.67 美元,Bright Data 按 3.9 万条记录算 58.50 美元;ZenRows 如果全落在 1 credit,最小的 B1 档 19 美元就够,比我们贵 12 美元出头。
# 把你自己的月用量填进去,算 ZenRows(按平均档位)和 EveryInfra(按次)的月账单
ZR = [(19, 45_000), (29, 80_000), (39, 120_000), (69, 250_000), (99, 500_000), (129, 700_000),
      (199, 1_200_000), (279, 2_000_000), (399, 3_000_000), (549, 5_000_000), (749, 8_000_000),
      (999, 12_500_000), (1999, 28_000_000), (2999, 45_000_000)]          # 2026-11-19 读取
EI = {"amazon/profile": 0.001389, "search/web": 0.000694, "search/read": 0.000694,
      "tiktok/profile": 0.000556, "reddit/subreddit_posts": 0.000556}  # 本篇实扣
def zenrows_month(requests, avg_credits):
    need = requests * avg_credits
    return min((p for p, c in ZR if c >= need), default=None)
def everyinfra_month(calls):          # calls = {"amazon/profile": 50_000, ...}
    return round(sum(EI[k] * n for k, n in calls.items()), 2)
print(zenrows_month(80_000, 5), everyinfra_month({"amazon/profile": 50_000, "search/web": 30_000}))
# → 99 90.27
并发、上限和预算:价格表之外的四件事
并发上限会决定你一小时能跑完多少页。ZenRows 按档位给:免费 5,Build 20,Launch 50,Growth 100,Scale 200 到 400,同时在跑的请求超过上限就报错(ZenRows 定价文档,ZenRows 并发文档)。ScraperAPI 是 Hobby 20 到 Advanced 500,超了回 429 不扣钱。Firecrawl 的免费档同时只开 2 个浏览器,Hobby 5 个,排队的任务算进超时时间(Firecrawl 限速文档)。Bright Data 的 Unlocker 和 SERP 写的是并发不限。我们按账户计每分钟次数,默认每分钟 60 次,名下所有 Key 合计,需要更高可以按 30 天买提速包,遇到 429 按返回的等待时间重试(EveryInfra 价格页)。本文测试用的 Key 另设了每分钟 10 次的单 Key 上限,00:16 那次 429 就是碰到了它。
预算上限是 ZenRows 近两个月做得比较细的地方:10 月 2 日起每个 API Key 可以设自己的 credit 上限,按计费周期、天、周、月(UTC)四种窗口,到了只停这把 Key,80% 和 100% 各提醒一次,一个账户最多 10 把 Key(ZenRows Key 上限文档)。额度用完以后,付费档可以买加量包,每个计费周期最多 10 次,加量包的 credit 能顺延一个周期;套餐里的 credit 不顺延,续费时清零。ScraperAPI 的 Hobby、Startup、Business 三档没有按量续用,额度用完就停,除非开自动升档(ScraperAPI 价格页)。我们是预充值,余额长期有效,没有月度清零。
响应大小也有上限:ZenRows 单次响应免费和 Build 档 5 MB,Launch、Growth 10 MB,Scale 20 MB,超了回 413 不交付(同一份定价文档)。抓大页面、长列表页或 PDF 时会碰到。
第四件是迁移成本。ZenRows 的请求是 GET 加一串参数(apikey、url、mode、extract、proxy_country),换成我们是 POST 一个 JSON 体(platform、action、params),返回字段也要重新映射。一个能力一个能力换,先换最贵、最好对账的那一类(通常是 Google 搜索和社媒),Fetch 普通页和防护站留在 ZenRows,两个余额并存一段时间。
ZenRows 每个响应都带 X-Request-Cost 头,写这一次扣了几 credit,设了 Key 上限的还会带 X-Key-Credits-Remaining(ZenRows JS 渲染文档);它的文档也直说渲染 JS 是普通请求的 5 倍、高级代理 10 倍,两样一起 25 倍,建议先单开一样、不够再叠(ZenRows 高级代理文档)。ScraperAPI 可以在请求里带 max_cost,一次请求预计超过这个 credit 数就回 403、不抓(ScraperAPI 花费控制文档),新用户 7 天内不满意可以退款(ScraperAPI 计费问答)。Firecrawl 默认返回两天内的缓存,缓存命中照样扣 1 credit,缓存只省时间不省钱(Firecrawl 抓取文档)。ZenRows 的 Browser 会话默认 3 分钟、最长 15 分钟,按分钟计费的部分要看这个设置(ZenRows 会话时长文档)。我们这边每次响应的 billing 里直接是美元数,没有倍率要换算。
迁移代码:同一批 ID 两边各跑一遍
迁移时最稳的做法是并跑:同一批商品 ID 或账号,ZenRows 和新服务各取一次,比字段完整度和花费,再决定切哪一类。下面这段把 ZenRows 的 Amazon 取法和我们的 amazon/profile 放在一起,ZenRows 那一侧用它响应头里的 X-Request-Cost 记 credit,我们这一侧记 billing.charged_usd:
import os, requests
ZR_KEY, EI_KEY = os.environ["ZENROWS_API_KEY"], os.environ["EVERYINFRA_API_KEY"]
def zenrows(asin):
    r = requests.get("https://api.zenrows.com/v1/", params={
        "apikey": ZR_KEY, "url": f"https://www.amazon.com/dp/{asin}",
        "mode": "auto", "extract": "auto", "proxy_country": "us"}, timeout=120)
    return r.status_code, int(r.headers.get("X-Request-Cost", 0)), r.json() if r.ok else None
def everyinfra(asin):
    r = requests.post("https://api.everyinfra.com/api/v1/social",
        headers={"Authorization": f"Bearer {EI_KEY}"},
        json={"platform": "amazon", "action": "profile", "params": {"url": f"https://www.amazon.com/dp/{asin}"}}, timeout=120)
    body = r.json()
    return r.status_code, body.get("billing", {}).get("charged_usd", 0), body.get("results")
for asin in ["B0CRMZHDG8", "B0BDHWDR12"]:
    zs, credits, _ = zenrows(asin)
    es, usd, res = everyinfra(asin)
    print(asin, "ZenRows", zs, credits, "credits |", "EveryInfra", es, usd, "USD", (res or {}).get("rating_count"))
在 AI 工具里用:六家的 MCP 地址和计费
六家都有 MCP。ZenRows 的远程地址是 https://mcp.zenrows.com/mcp,Fetch、Extract、Batch、Browser 都是工具(npm 页,ZenRows MCP 文档,源码),Python SDK 见 PyPI。Firecrawl 见 npm 页和 Firecrawl MCP 文档。Bright Data 每个新账户每月 5,000 次免费(npm 页,Bright Data MCP 文档)。Apify 的远程地址是 https://mcp.apify.com,可以在 Store 里搜工具再调用(npm 页,Apify MCP 文档)。这四家的 MCP 发版很勤:2026 年 10 月 20 日到 11 月 19 日这 30 天,npm 上的正式版 ZenRows 发了 9 个(最新 2.19.0,11 月 6 日),Firecrawl 10 个(3.40.0,11 月 12 日),Bright Data 9 个(4.8.0,11 月 10 日),Apify 21 个(0.21.12,11 月 17 日),平均三四天一个版本,工具名和参数会跟着变,接进生产流程的团队要在配置里固定版本号,升级前看一遍更新记录。四家的 MCP 源码都在 GitHub 公开:ZenRows MCP(另有命令行工具)、Firecrawl MCP、Bright Data MCP、Apify MCP,接之前可以先看各自的工具列表和更新记录。
| 服务 | MCP 地址 | 工具从哪来 | 按什么扣 |
|---|---|---|---|
| ZenRows | mcp.zenrows.com/mcp | Fetch、Extract、Batch、Browser | 和 API 同一个 credit 余额 |
| Firecrawl | mcp.firecrawl.dev/v2/mcp | 搜索、抓取、爬站、浏览器交互 | 同 API credit |
| Bright Data | 远程或本地 | 搜索、抓取、结构化数据、浏览器 | 每月 5,000 次免费,之后按量 |
| Apify | mcp.apify.com | Store 里的工具 | 各工具的事件价 |
| EveryInfra | api.everyinfra.com/mcp | everyinfra_*,按平台和能力 | 同 API,按次固定价 |
在 AI 工具里让模型自己选工具时,模型不知道一个页面会落在几 credit,每次调用的花费也就没法事先告诉你;按次固定价时,模型调 100 次就是 100 倍单价。ZenRows 的对策是 10 月 5 日上线的代理自助购买:AI 代理可以在 agents.zenrows.com 不建账户就买 Fetch 和 Extract,从 5 美元起,每千 credit 0.50 美元,倍率和账户里一样(ZenRows 代理支付文档)。
选型速查:按你最常抓的那一类
| 你最常抓的 | 先看谁 | 每千次或每千条(美元) | 为什么 |
|---|---|---|---|
| 普通静态网页,量大 | ZenRows Scale 档 | 0.067–0.110 | 六家最低 |
| JS 渲染页 | ZenRows | 0.33–2.11 | 5 credit,ScraperAPI 要 10 |
| 防护站,难度不一 | Bright Data Unlocker | 1.30–1.50 | 不分难度一个价 |
| 网页转 Markdown 喂大模型 | Firecrawl | 0.75–3.80 | 渲染含在 1 credit 里 |
| Amazon 商品详情 | EveryInfra 或 ScraperAPI 大档 | 1.389 / 0.46–2.45 | 一个固定价,或量大时更低 |
| Google 搜索 | EveryInfra | 0.694 | 不随档位变 |
| Google Maps 店铺名单 | EveryInfra places | 0.0347 每家 | 一次 20 家 |
| TikTok 主页、Reddit 帖子 | EveryInfra | 0.556 / 0.0556 | 按请求收,不按条 |
| 住宅代理、真浏览器 | ZenRows 或 Bright Data | 每 GB 1.67–10.56 / 2.51–8.00 | 我们不卖 |
什么时候留在 ZenRows 更合适
下面四种情况,ZenRows 比这里列的其他几家都合适,也比我们合适:
- 以静态页为主的大批量通用抓取。普通页每千页 0.067 到 0.42 美元,六家最低,S5 档比我们的 read 便宜 10 倍。
- JS 渲染页和防护站。我们的 read 在测试页上一个拿回外壳、一个空结果;ZenRows 的自适应模式只按成功的那一档扣,
REQS002拒绝不扣钱(ZenRows 错误码文档)。 - 整站爬取和大批量任务。Crawl 10 月 9 日上线,本身不另收费,每页按 Fetch 扣,
max_pages封住花费(ZenRows Crawl 文档);Batch 一个任务 10 万个网址,可以定时、加网页回调(ZenRows Batch 文档)。 - 要住宅代理或真浏览器。我们都不卖。
另外两种情况别家更合适:只要整页 HTML 和代理、量在每月 500 万 credit 以上,ScraperAPI 的 Scaling 档以上可以按量续用;要把网页直接转成 Markdown 喂给大模型,Firecrawl 每页 1 credit 含渲染。Bright Data 适合要一个供应商同时给代理、Unlocker、SERP 和结构化记录、并且接受 KYC 的团队。
最近 30 天的变化
- 2026 年 11 月 17 日,Firecrawl 发布面向 AI 代理的 UltraSearch,搜索结果附带人物、公司和股票的数据片段;2026 年 11 月 13 日它的公司数据库扩到 7,500 万家以上(Firecrawl 更新日志)。9 月 4 日起执行的价格表没变。对 ZenRows 用户来说,Firecrawl 正往「搜索加数据」走,取单个渲染页的价仍比 ZenRows 的 JS 档高。
- 2026 年 11 月 9 日,ZenRows 更新社媒监听用例页,写明 Reddit、YouTube、TikTok 的搜索页在浏览器里渲染,要自适应模式才拿得到结果(ZenRows 社媒监听页)。意味着社媒搜索在 ZenRows 上大概率落在 5 credit 以上。
- 2026 年 11 月 6 日,ZenRows Python SDK 1.13.0 发布。SDK 说明里有 Crawl 客户端和提交前估算 Batch 花费的方法,重试规则也收紧了:PUT 遇到 429 或 5xx 不再自动重试。意味着升级后要检查自己的重试逻辑,否则失败的任务会直接报错。
- 2026 年 10 月 20 日,ZenRows 的 Amazon、Google、Maps、TikTok、Reddit 等现成页面统一更新了示例,都基于当天的真实请求,Python SDK 同日发了 1.11.0。意味着拿它的示例和别家对照,有了同一天的基准,前面场景二和场景四就是这么比的。
- 2026 年 10 月,ScraperAPI 把 Akamai 防护站改成自动绕过。意味着用 ScraperAPI 抓这类站不用再加参数,但每次仍按 10 credit 的绕过价算。
YouTube 和论坛里怎么讲 zenrows alternative
我们 00:26(新加坡时间)用 youtube/search 搜「zenrows alternatives」,前 10 名里标题带 ZenRows 的有 5 个:第 2、7 名是同一频道的两个教程,讲的是怎么在一款工作流自动化工具里接 ZenRows,重点在那款工具的配置,没取;读的是第 1、4、6 名,三个视频都和 ZenRows 的推广有关。第一个是 2026 年 1 月 20 日的评测(25,533 次观看,22 条评论),简介写明由 ZenRows 赞助;第二个是 2026 年 6 月 4 日发布的对比(13,783 次观看),推的是一款浏览器指纹工具;第三个是 2025 年 12 月 17 日的教程(25,232 次观看),链接带付费推广参数。我们的 youtube/transcript 这几次都回 503、没扣费,字幕改从 YouTube 公开页面的正文读取(下面引的说法都按字幕里的时间点核过),评论用 youtube/comments 取,三次共 0.001668 美元。
| 视频 | 发布日期 | 观看 | 读到的评论 | 推广关系 |
|---|---|---|---|---|
| ZenRows Review - 2026 | 2026-01-20 | 25,533 | 20 | ZenRows 赞助 |
| ZenRows: Why It Fails for Real Scraping | 2026-06-04 | 13,783 | 1 | 推一款浏览器指纹工具 |
| Scrape ANY Website With AI For FREE with ZenRows | 2025-12-17 | 25,232 | 3 | 链接带付费推广参数 |
视频里演示了、网页上没写的步骤有三处。赞助评测从控制台开始:贴网址、点「Add domain」,在面板里勾高级代理和 JS 渲染、选输出格式(JSON、Markdown、HTML 或截图),右侧自动生成 Python 代码,可切到 Node、Java、PHP、Go、Ruby、C 系语言和 curl;高级设置里能改 POST、加 Referer 请求头、用 session ID 在多次请求之间保留 cookie。视频里用的是旧产品名(Universal Scraper API、Scraping Browser),现在的文档改叫 Fetch 和 Browser,照着视频找菜单会对不上。第三个视频说注册后有 14 天免费试用,现行价格页写的是每月 5,000 credit 的免费档,两处说法不一致,以价格页为准。第三个视频的演示对象是 amazon.co.uk 的一个搜索页,作者勾了高级代理、选了国家、开了 JS 渲染,输出选自动解析的 JSON,控制台在运行前提示这次请求「只要 0.025」;输出格式除了 JSON、Markdown、HTML 和截图,还能直接抽图片、链接、标题、邮箱、电话、元数据和表格。
| 视频里的说法 | 现行文档 |
|---|---|
| Universal Scraper API | Fetch |
| Scraping Browser | Browser |
| 14 天免费试用 | 每月 5,000 credit 的免费档 |
| 按尝试扣,失败也扣 | 失败不扣,404 和 410 照扣 |
第二个视频有两处和文档或别的视频对不上。一处是计费:它说 ZenRows 按尝试次数扣、失败也扣,文档写的是失败不扣、404 和 410 照扣。另一处是会话:它说 ZenRows 每个请求都是无状态的,不能保持登录和 cookie,所以登录后才看得到的数据做不了;第一个视频的高级设置里就有 session ID,用来在请求之间保留 cookie,ZenRows 另外还卖能登录、能点击的 Browser 会话。这个视频后半段推的是一款浏览器指纹工具,讲 ZenRows 短处的部分要放在这个背景下读。它讲的「软封锁」倒是换哪家都要防的坑:网站认出是程序后不报错,回 200 和空的或假的内容,这种响应在任何一家都算成功、照常扣钱。我们在 ScrapingCourse 的 JS 页上碰到的是同一类情况:200、两行字、照扣。
评论区的卡点集中在钱和 JS 页。赞助评测下有人直接问「到底要花多少钱」,有人说「量一大,代理费涨得很快」,有人请作者下一期抓一个 JS 很重的电商站,还有人提醒抓取可能违反网站条款;第三个视频下有人请作者找一个免费替代。三个视频的置顶评论都是带优惠码或推广参数的链接,看测评视频时要把这一点算进去。
论坛这边,r/webscraping 2023 年一个问「现在最好用的抓取 API」的老帖有 54 条评论,楼主列了三家在用的,抱怨一家老套餐常回 500、另一家涨价一倍;回帖里有人主张自己写爬虫,也有人说抓取不是核心业务就该买托管服务(r/webscraping 帖子)。这个老帖下有几条回帖被版务删掉,删帖说明写的是版里一般不鼓励讨论付费工具,带免费试用的也算,推销要发在每月自荐帖里。2026 年 11 月 ZenRows 内容合作者发的四个防护站测试,前面已经引过,作者在帖子里写了「其他工具更合适的情况」:要直接、细粒度地管代理选 Bright Data,已经用 Scrapy 框架的选和 Scrapy 配套的那一家。
边界:这些数什么时候不成立
ZenRows 结构化页面的档位没有公开,本篇凡是写到 ZenRows Amazon、Google、社媒的价都是 1 到 25 credit 的区间,实际要看你的网址。各家价格是 11 月 19 日读的月付价、按额度用满折算;用不满时,按月付的几家单价会更高,按次付费的不受影响。ZenRows 的防护站成功率是它自己的测试,不是第三方数据。EveryInfra 的价是本次实扣,各能力单价以当天目录为准。抓取时只取公开数据,评论和主页里有个人信息的,按你所在地区的法律处理,ZenRows 自己的 Google Maps 页也提醒评论者姓名属于个人数据。
上手:拿你自己的网址复算
- 打开快速上手注册,在 GitHub 给两个仓库点星领 1 美元试用额度,24 小时内有效。
- 在 Amazon 能力页、TikTok 能力页、Reddit 能力页 或 基础设施市场的试用台,用你在 ZenRows 上最常抓的 20 个网址对应的商品、账号、版块跑一遍,记下返回条数和
charged_usd。 - 在 ZenRows 控制台活动日志里查同一批网址各扣了几 credit,算出平均档位,填进上面的 Python 片段,比一个月的账。
常见问题
zenrows vs apify 有什么不同?
ZenRows 卖的是「把一个网址取回来」的能力,按页面难度扣 credit;Apify 是一个工具商店,每个工具由各自的作者定价,多数按结果条数收,Amazon 每千条 3.00 到 5.00 美元,TikTok 1.70 到 3.70 美元。要一个平台的大量结构化记录,Apify 现成工具省事;要任意网页,ZenRows 合适。
is zenrows legit,用它安全吗?
ZenRows 的企业档写了 SLA、SOC 2 和 ISO 27001,有公开的状态页和信任中心,MCP 和 CLI 在 GitHub 开源(ZenRows 文档索引,ZenRows 法律条款)。合不合法看你抓什么、怎么用:ZenRows 自己的 TikTok、Google Maps 页都写了只取公开数据、个人数据受 GDPR 和 CCPA 约束,拿不准问律师。
ZenRows 的 credit 用不完能顺延吗?
套餐里的 credit 不顺延,续费时清零;付费档买的加量包可以顺延一个周期。ScraperAPI 月付档也不顺延,年付一次给全年额度、全年随时用;Firecrawl 只有 Scale 档顺延。我们是预充值,余额长期有效,没有月度清零,用量忽高忽低的团队按次付费不会浪费额度。
Reddit 上大家推荐的 zenrows alternative 靠谱吗?
看帖子是谁发的。我们读到的 2026 年 11 月那个四个防护站的对比帖,作者第一句就写明自己为 ZenRows 写技术内容、数据来自 ZenRows 内部测试;r/webscraping 的版务一般不鼓励讨论付费工具,推销要发在每月自荐帖里。拿任何一家的说法前,用你自己的 100 个网址各跑一遍,按每个成功结果算钱。
参考资料
- Pricing,ZenRows,2026-11-19 读取,https://www.zenrows.com/pricing
- Zenrows Pricing(文档),ZenRows,2026-11-19 读取,https://docs.zenrows.com/first-steps/pricing
- Changelog,ZenRows,2026-11-19 读取,https://www.zenrows.com/changelog
- Amazon ASIN scraper,ZenRows,2026-10-20 更新,https://www.zenrows.com/scrape/amazon-asin
- Google Search scraper,ZenRows,2026-10-20 更新,https://www.zenrows.com/scrape/google-search
- Google Maps scraper,ZenRows,2026-10-20 更新,https://www.zenrows.com/scrape/google-maps
- TikTok scraper,ZenRows,2026-10-20 更新,https://www.zenrows.com/scrape/tiktok
- Reddit scraper,ZenRows,2026-10-20 更新,https://www.zenrows.com/scrape/reddit
- API Error Codes,ZenRows 文档,2026-11-19 读取,https://docs.zenrows.com/api-error-codes
- Concurrency,ZenRows 文档,2026-11-19 读取,https://docs.zenrows.com/fetch/features/concurrency
- API Keys and Credit Caps,ZenRows 文档,2026-11-19 读取,https://docs.zenrows.com/first-steps/api-key-credit-caps
- Crawl endpoints,ZenRows 文档,2026-11-19 读取,https://docs.zenrows.com/crawl/endpoints
- Batch REST API,ZenRows 文档,2026-11-19 读取,https://docs.zenrows.com/batch/developer-guide-restapi
- MCP overview,ZenRows 文档,2026-11-19 读取,https://docs.zenrows.com/mcp/overview
- Agentic Payments,ZenRows 文档,2026-11-19 读取,https://docs.zenrows.com/first-steps/agentic-payments
- Browser,ZenRows,2026-11-19 读取,https://www.zenrows.com/products/browser
- Social listening data,ZenRows,2026-11-09 更新,https://www.zenrows.com/use-cases/social-listening
- zenrows-mcp,GitHub,2026-11-19 读取,https://github.com/ZenRows/zenrows-mcp
- @zenrows/mcp 2.19.0,npm,2026-11-06 发布,https://www.npmjs.com/package/@zenrows/mcp
- zenrows 1.13.0,PyPI,2026-11-06 发布,https://pypi.org/project/zenrows/
- Pricing,ScraperAPI,2026-11-19 读取,https://www.scraperapi.com/pricing/
- Credits and Requests Costs,ScraperAPI 文档,2026-11-19 读取,https://docs.scraperapi.com/getting-started/quick-start/credits-and-requests-costs
- Akamai-protected sites now unblocked automatically,ScraperAPI 文档,2026 年 10 月,https://docs.scraperapi.com/resources/release-notes/october-2026/akamai-protected-sites-now-unblocked-automatically
- Pricing,Firecrawl,2026-11-19 读取,https://www.firecrawl.dev/pricing
- Changelog,Firecrawl,2026-11-17 更新,https://www.firecrawl.dev/changelog
- Rate Limits,Firecrawl 文档,2026-11-19 读取,https://docs.firecrawl.dev/rate-limits
- MCP Server,Firecrawl 文档,2026-11-19 读取,https://docs.firecrawl.dev/mcp-server
- firecrawl-mcp 3.40.0,npm,2026-11-12 发布,https://www.npmjs.com/package/firecrawl-mcp
- Web Unlocker Pricing,Bright Data,2026-11-19 读取,https://brightdata.com/pricing/web-unlocker
- SERP API Pricing,Bright Data,2026-11-19 读取,https://brightdata.com/pricing/serp
- Residential Proxies Pricing,Bright Data,2026-11-19 读取,https://brightdata.com/pricing/proxy-network/residential-proxies
- Free tier,Bright Data 文档,2026-11-19 读取,https://docs.brightdata.com/general/account/billing-and-pricing/free-tier
- MCP server overview,Bright Data 文档,2026-11-19 读取,https://docs.brightdata.com/products/mcp-server/overview
- @brightdata/mcp 4.8.0,npm,2026-11-10 发布,https://www.npmjs.com/package/@brightdata/mcp
- Pricing,Apify,2026-11-19 读取,https://apify.com/pricing
- Actors in Store,Apify 文档,2026-11-19 读取,https://docs.apify.com/platform/actors/running/actors-in-store
- Apify MCP server,Apify 文档,2026-11-19 读取,https://docs.apify.com/mcp
- @apify/actors-mcp-server 0.21.12,npm,2026-11-17 发布,https://www.npmjs.com/package/@apify/actors-mcp-server
- Amazon Product Scraper,Apify Store,2026-11-19 读取,https://apify.com/junglee/amazon-crawler
- Google Search Results Scraper,Apify Store,2026-11-19 读取,https://apify.com/apify/google-search-scraper
- Google Maps Scraper,Apify Store,2026-11-19 读取,https://apify.com/compass/crawler-google-places
- TikTok Scraper,Apify Store,2026-11-19 读取,https://apify.com/clockworks/tiktok-scraper
- Reddit Scraper Lite,Apify Store,2026-11-19 读取,https://apify.com/trudax/reddit-scraper-lite
- Google Maps Platform pricing,Google for Developers,2026-11-19 读取,https://developers.google.com/maps/billing-and-pricing/pricing
- Benchmarking 3 scraping APIs across 4 protected sites,Reddit r/LLMDevs,2026 年 11 月,https://www.reddit.com/r/LLMDevs/comments/1xog8dj/benchmarking_3_scraping_apis_across_4_protected/
- Best web scraping api's at the moment?,Reddit r/webscraping,2023 年,https://www.reddit.com/r/webscraping/comments/1016j3l/best_web_scraping_apis_at_the_moment/
- Blocking fonts/media cut our proxy GB usage by 45%,Reddit r/webscraping,2026 年 11 月,https://www.reddit.com/r/webscraping/comments/1xydijg/blocking_fontsmedia_cut_our_proxy_gb_usage_by_45/
- 能力目录,EveryInfra,2026-11-19 读取,https://api.everyinfra.com/api/v1/social/catalog
- ZenRows Review - 2026,YouTube(Daniel | Tech & Data),2026-01-20 发布,https://www.youtube.com/watch?v=Jn_m5tgol7Y
- ZenRows: Why It Fails for Real Scraping,YouTube(Weblab Media),2026-06-04 发布,https://www.youtube.com/watch?v=NZi_50xbtzE
- Scrape ANY Website With AI For FREE with ZenRows,YouTube(The Metaverse Guy),2025-12-17 发布,https://www.youtube.com/watch?v=jb5L2ouXQZo
- Introduction to Extract,ZenRows 文档,2026-11-19 读取,https://docs.zenrows.com/extract/introduction
- Extract API Reference,ZenRows 文档,2026-11-19 读取,https://docs.zenrows.com/extract/endpoints
- JavaScript Rendering,ZenRows 文档,2026-11-19 读取,https://docs.zenrows.com/fetch/features/js-rendering
- Premium Proxy,ZenRows 文档,2026-11-19 读取,https://docs.zenrows.com/fetch/features/premium-proxy
- Session TTL,ZenRows 文档,2026-11-19 读取,https://docs.zenrows.com/browser-sessions/features/session-ttl
- ZenRows CLI,GitHub,2026-11-19 读取,https://github.com/ZenRows/cli
- firecrawl-mcp-server,GitHub,2026-11-19 读取,https://github.com/firecrawl/firecrawl-mcp-server
- brightdata-mcp,GitHub,2026-11-19 读取,https://github.com/brightdata/brightdata-mcp
- apify-mcp-server,GitHub,2026-11-19 读取,https://github.com/apify/apify-mcp-server
- Scrape(缓存与 maxAge),Firecrawl 文档,2026-11-19 读取,https://docs.firecrawl.dev/features/scrape
- Cost Control,ScraperAPI 文档,2026-11-19 读取,https://docs.scraperapi.com/control-and-optimization/cost-control
- Plans & Billing,ScraperAPI 文档,2026-11-19 读取,https://docs.scraperapi.com/resources/faq/plans-and-billing
- Research API,TikTok for Developers,2026-11-19 读取,https://developers.tiktok.com/products/research-api/
- llms.txt,ZenRows 文档,2026-11-19 读取,https://docs.zenrows.com/llms.txt
- Legal,ZenRows,2026-11-19 读取,https://www.zenrows.com/legal
- Getting started guide,ZenRows 文档,2026-11-19 读取,https://docs.zenrows.com/first-steps/getting-started-guide
- Fetch API reference,ZenRows 文档,2026-11-19 读取,https://docs.zenrows.com/fetch/api-reference
引用编号 BL-189