小红书数据采集三条路:主页、笔记和评论各花多少
实测按次付费接口:每千条笔记 0.28 美元、每千条评论 0.37 美元、每千个主页 5.56 美元;对照自写脚本和包月工具各要过的关,失败和空结果不扣费。
2026 年 11 月 20 日新加坡时间 00:15 起,我们用按次付费的 EveryInfra 接口实测小红书(英文名 RedNote)的搜索、笔记、评论和主页四类公开数据:按每页实际返回的行数折算,每 1,000 条笔记摘要花 0.28 美元,每 1,000 条评论花 0.37 美元,每 1,000 个账号主页花 5.56 美元,把新加坡旅游局账号的 419 篇笔记全部拉一遍约 0.12 美元。同一轮里,限速、参数写错和查无此人三类请求都没有扣费,但一个故意乱打的搜索词照样返回了 19 条和它毫不相干的笔记、照常扣了一次费。自己写脚本这条路,第一道关是小红书的 robots.txt:它对所有爬虫写着 Disallow: /,连 Googlebot 也只放行一个世界杯专题目录。
四类公开数据和每次的价格
英文里的 rednote scraper、xiaohongshu scraper api,和中文说的「小红书数据采集」是同一件事:把公开的笔记、评论、账号主页变成表格或 JSON。RedNote 这个英文名在 2025 年 1 月被海外读者熟知,路透社 2025-01-14 报道两天里新增用户超过 70 万;arXiv 2510.18894 分三段研究了迁移用户的发帖,arXiv 2507.14623 用 1,862 篇笔记和 403,054 条评论做情绪分析。平台规模的两个公开数字:Marketing to China 2026-11-08 的汇总转述平台 2026 年 5 月月活超过 4 亿,国际米兰足球俱乐部 开设小红书官方号的公告写的是约 3.5 亿月活、每天 6 亿次搜索。
| 想拿的数据 | EveryInfra 能力 | 每次返回 | 每次费用(美元) | 目录列出的字段数 |
|---|---|---|---|---|
| 关键词搜笔记 | xiaohongshu/search | 20 条 | 0.005556 | 30 |
| 单篇笔记全文 | xiaohongshu/note | 1 篇 | 0.005556 | 28 |
| 笔记评论 | xiaohongshu/comments | 15 条 | 0.005556 | 20 |
| 账号主页 | xiaohongshu/profile | 1 个 | 0.005556 | 21 |
| 账号发过的笔记 | xiaohongshu/user_posts | 20 条 | 0.005556 | 24 |
| 按昵称找账号 | xiaohongshu/search_users | 最多 20 个 | 0.005556 | 10 |
表里的价格和字段数取自 2026-11-20 新加坡时间 00:17 读取的 EveryInfra 目录,每页条数取自同一轮真调的实际返回。目录里小红书一共 17 项能力,只有蒲公英内容广场搜索是每次 0.016 美元,其余 16 项都是每次 0.005556 美元,参数说明和在线试调在 小红书数据接口 页面。
同一份目录里,抖音数据接口 的主页、账号作品、评论三项都是每次 0.000556 美元,B 站和微博的主页也是 0.000556 美元,小红书的同类能力是它们的 10 倍。做跨平台的达人或品牌对比时,小红书这一列的预算要单独算:同样读 1,000 个主页,抖音约 0.56 美元,小红书 5.56 美元;读 1 万个主页,两者相差 50 美元。
RedNote 和小红书的数据是同一份
RedNote 是不是小红书的海外版、数据是不是分开的?据 路透社同一篇报道,RedNote 只维护一个版本的 App,没有像其他中国社交应用那样拆成海外版和国内版。所以美国用户发的英文笔记和国内用户发的中文笔记在同一个社区里,主页、评论的结构完全相同。对采集来说,这意味着一套代码、一份字段表就能覆盖中英文内容,区别只在关键词怎么写。我们这一轮用中文关键词「新加坡旅游攻略」,40 条结果里有 2 条标题是纯英文;xiaohongshu/note 返回的 language 字段会标出这篇笔记的语言,这篇青旅笔记标的是 zh。
英文关键词会搜出什么,我们实测了一次。新加坡时间 00:36 用 xiaohongshu/search 搜英文「Singapore travel tips」,返回 20 条,扣 0.005556 美元;20 条的标题和正文全是中文,没有一条是纯英文笔记。平台把英文词对到了中文的新加坡攻略上。这 20 条和中文词「新加坡旅游攻略」两页 40 条只重合 1 条,点赞中位数 73.5,中文词那 40 条是 541.5,最高的一条 4,218;发布时间从 2025-06-19 到 2026-11-14,2 条是视频,摘要长度 57 到 60 字,和中文词的结果一样被截在约 60 字。换一种语言写同一个意思,拿到的是另一批、互动低一档的笔记。拿英文词去采小红书,拿回来的仍然是中文内容,翻译这一步和它的成本要提前算进去;做中文内容分析的团队用英文词也落在同一个结果池里。
按名字找官方账号,要看认证类型。00:36:50 我们用 xiaohongshu/search_users 搜「皇家马德里」,返回 20 个账号,扣 0.005556 美元:20 个账号的 is_verified 全是 false,也都没有 verification_type 字段(目录写明未认证的账号没有这个字段);按估算粉丝数分,5,000 以上的 3 个(最多约 9,400),1,000 到 4,999 的 3 个,100 到 999 的 5 个,不到 100 的 9 个,看起来是球迷号和资讯号。新加坡旅游局账号的两项能力返回不一样:search_users 里 is_verified 是 true、verification_type 是 business;同一个账号三次调 xiaohongshu/profile,is_verified 都是 false,verification_type 都是 business,verification_text 都是「境外旅游局」。三次读数和搜索结果放在一起看:
| 来源(新加坡时间) | `is_verified` | `verification_type` | `follower_count` |
|---|---|---|---|
search_users,00:15:29 | true | business | 70,000(估算) |
profile,00:16:06 | false | business | 70,497 |
profile,00:50:18 | false | business | 70,497 |
profile,01:35:04 | false | business | 70,499 |
所以给品牌监测、竞品名单筛机构号时,用 verification_type(individual、business、other)加 verification_text 判断,比只看 is_verified 稳,单看 profile 的 is_verified 会把这个真机构号筛掉。粉丝数也有两种:search_users 里这个账号的 follower_count 是 70,000,profile 里是 70,497,目录写明前者按列表上展示的文本换算,后者是精确数。
三条路各要过哪些关
拿小红书公开数据,实际能走的路有三条:自己写脚本(包括改开源脚本)、订一个按月收费的抓取工具、调一个按次付费的接口。三条路的差别在:要不要你自己的账号、失败算不算钱、字段由谁维护。
| 比较项 | 自己写脚本 | 按月订阅的抓取工具 | 按次付费接口(EveryInfra) |
|---|---|---|---|
| 鉴权 | 自己准备账号和 Cookie,账号会被封 | 多数要你提供 Cookie 或账号 | EveryInfra API Key |
| 返回什么 | 自己定 | 工具方定 | 公开页面上能看到的字段 |
| 限速后怎么办 | 自己猜阈值、自己退避 | 看工具 | 429 带 retry_after,等够秒数重试 |
| 计费单位 | 服务器、代理和人工 | 月费加额度,额度按条数或运行时长算 | 每次调用 0.005556 美元 |
| 失败和空结果 | 时间和代理流量照样花掉 | 看各家条款,空跑多数也占额度 | 422、429、空结果实测扣费 0 |
| 字段格式 | 自己定,平台一改就要跟 | 工具方定 | 目录 response_fields 写明 |
| 接 AI 工具 | 自己包一层 | 看工具 | 远程 MCP,工具名 everyinfra_* |
| 上手步数 | 装环境、准备账号、跟页面改版、调限速 | 注册、绑卡、配任务 | 拿 Key、发一个 POST |
EveryInfra 的小红书能力每次 0.005556 美元,失败不扣费,空结果退回。字段在目录里逐个写明含义,例如 like_collect_count 是主页上的「获赞与收藏」,等于 like_count 和 collect_count 之和。
自己写脚本:robots.txt、登录墙和页面改版
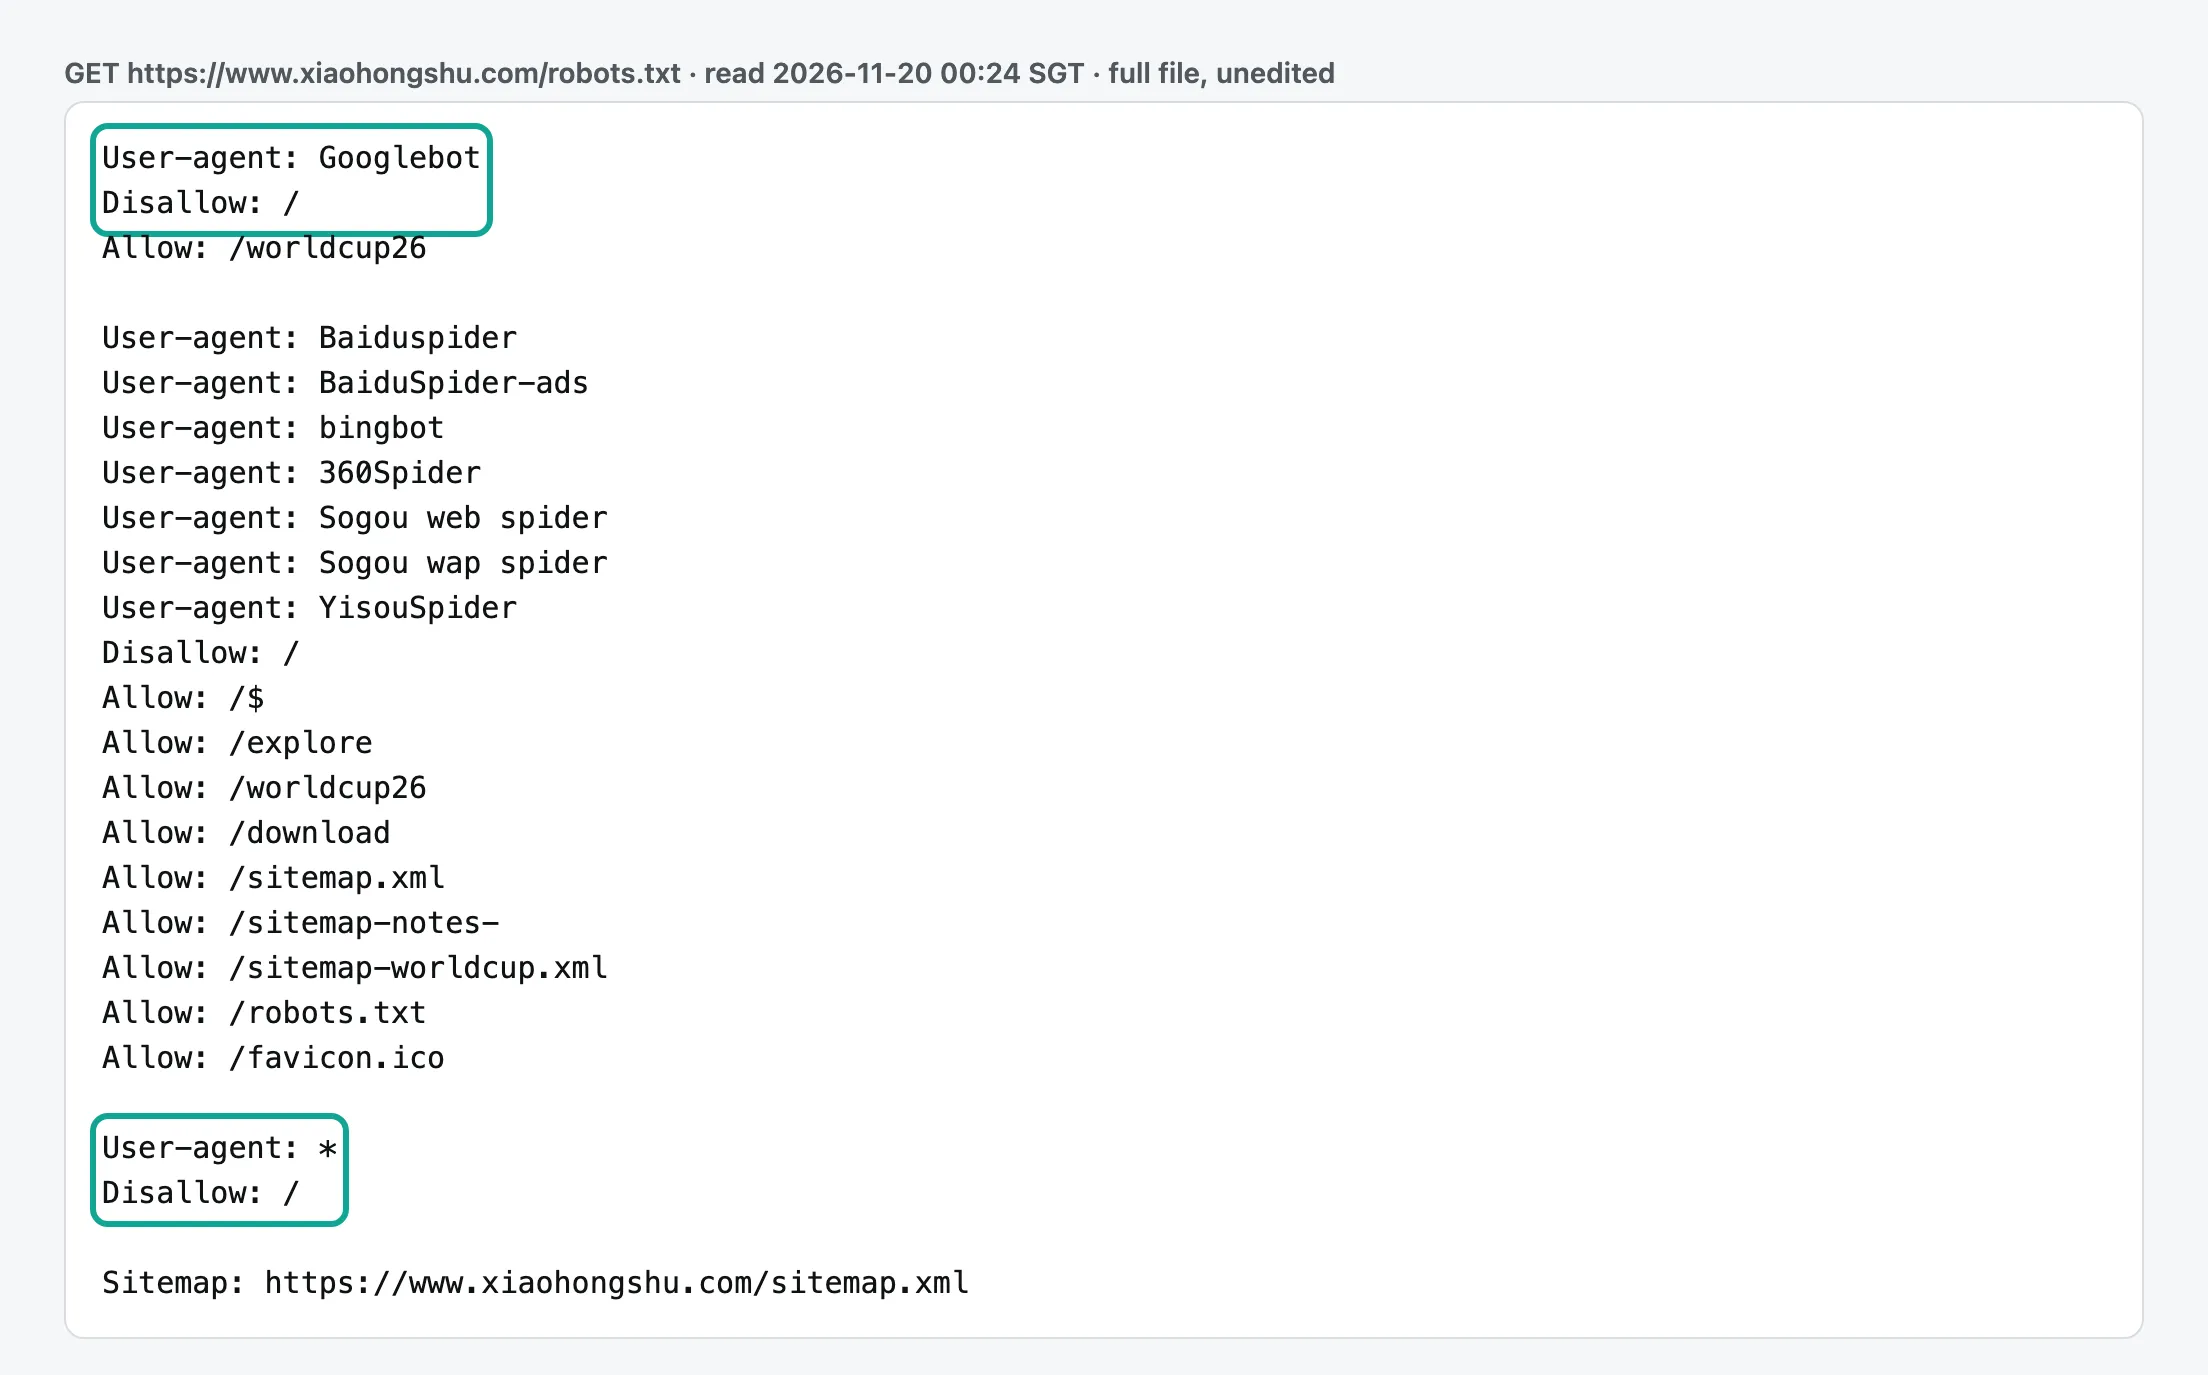
小红书的 robots.txt 在 2026-11-20 新加坡时间 00:24 读取时只有 26 行:对百度、必应、360、搜狗、神马这几家搜索引擎放行首页、/explore、/download 和站点地图,对 Googlebot 只放行 /worldcup26,对其余所有爬虫写 User-agent: * 加 Disallow: /。robots 协议在 2022 年成为 RFC 9309,规范里写明它不是访问授权机制;Python 标准库的 urllib.robotparser 用 can_fetch() 就能判断一个网址对某个 User-agent 是否放行。我们用它对一篇笔记地址和一个账号主页地址各判断一次:自定义的爬虫名两个都返回 False,Googlebot 也是两个 False;bingbot 能读笔记页 /explore/…,读主页 /user/profile/… 仍是 False。也就是说,连被放行的搜索引擎也拿不到账号主页。
robots.txt 之外是登录墙。小红书用户服务协议把「非法抓取、模拟下载、深度链接、假冒注册」等方式获取平台视频、图文和用户信息列为禁止行为。网页版未登录时,搜索和笔记详情会弹登录框;Reddit 上 r/webscraping 一位新手的提问就卡在这一步:网页版弹注册框,手机网页不弹。登录之后是账号风险:r/DataHoarder 的一个帖子说,它见过的限速里小红书最严,带 Cookie 的开源脚本跑一个月后,登录网页版点开第一篇笔记就被踢下线,手机端却一切正常。
再往下是页面改版。小红书网页版的数据请求带着前端脚本算出来的校验参数,脚本经过混淆、会随版本变,自己写的脚本每次改版都要跟着改。用 Playwright 这类通用浏览器自动化框架驱动浏览器时,W3C 的 WebDriver 规范要求被自动化控制的浏览器把 navigator.webdriver 设成 true,网站读得到这个标记;Chrome 的 无头模式文档写明了新旧两种无头模式的行为差异。Playwright 官方的 登录态文档提醒,保存下来的浏览器状态文件里有能冒充你的 Cookie,不要提交进代码仓库:自己写脚本时,账号和 Cookie 的安全也是你自己的事。
以下是条文、判决和平台规则原文的要点,不构成法律意见。2025 年修订的 反不正当竞争法 第十三条新增一款:经营者不得以欺诈、胁迫、避开或者破坏技术管理措施等不正当方式,获取、使用其他经营者合法持有的数据,新法自 2025 年 10 月 15 日施行。网络数据安全管理条例 自 2025 年 1 月 1 日施行,个人信息保护法 对处理已公开的个人信息也有「合理范围」的限制。判决方面:据 知识产权律师网对上海知识产权法院二审的报道,一家公司绕开 Robots 协议、登录验证和访问频率限制,把小红书笔记和用户数据打包成「接口集合」出售,数据调用量 294 万余次、获利 11 万余元,被判赔 110 万元;据 知产财经转载新华日报的报道,另一家公司破解 App 加密算法、伪造请求爬取用户数据并批量发私信,3 人被判刑。最高人民法院先后发布了 2025 年和 2026 年两批人民法院反不正当竞争典型案例,2026 年这批发布于 9 月 9 日,具体判法以原文为准。小红书安全响应中心 2026-08-18 发布的 奖励规则 把「能证明当前仍可实际获取小红书目标数据的爬虫工具、平台或服务」列为威胁情报的收报范围。本文的数据方法是:只读公开页面上能看到的字段,不读私信和登录后才能看的内容,普通用户的昵称和头像不进正文和截图。不论走哪条路,用途是否合规都要读者自己对照小红书最新的用户协议和上面的法规核对,并咨询自己的法务。
自己写脚本的钱主要花在人工上。按 国家统计局 2026-05-15 发布的数据,2025 年城镇非私营单位信息传输、软件和信息技术服务业的年平均工资是 248,752 元,按一年 250 个工作日算每天约 995 元。假设一个人每月花 2 个工作日跟进页面改版和限速变化(这是假设,不是统计数),一个月约 1,990 元,按 欧洲央行 2026-11-19 参考汇率折算的 1 美元兑 6.6667 元,约合 299 美元。这笔钱在按次付费接口上能买约 53,800 次调用,按搜索每页 20 条算是 107 万条笔记摘要。
按月订阅的抓取工具
第二条路是订一个按月收费的抓取工具:网页上点几下,配好关键词或账号链接,工具按计划跑,结果导出成表格。这类工具的计费有几种常见写法:月费里含固定条数,超出按条加价;或者按运行时长、计算单位扣额度;有的再按并发数分档。对小红书这种要登录的平台,不少工具要求你自己提供 Cookie,账号被封的风险仍在你这边。比较各家时可以盯三件事:一次空跑(关键词没结果、账号不存在)扣不扣额度,额度当月不用会不会清零,导出的字段有没有字段说明。
包月工具适合不写代码、任务固定、月用量稳定的人。它的成本结构是「先付再用」,用量低的月份单价就高;用量超出套餐时,超额部分常常按更高的单价算。换算成每 1,000 条的价格时,要用你实际会用到的条数去除月费,不要用套餐写的上限去除:一个月实际只用了套餐额度的三成,每条的真实单价就是标价的三倍多。导出格式也要看:同一个「点赞数」,有的工具导出「1.2万」这样的展示文本,有的导出整数,后者才能直接计算。
实测一:搜索 40 条笔记,正文只有约 60 字
2026-11-20 新加坡时间 00:15:16,我们用 xiaohongshu/search 搜「新加坡旅游攻略」,第一页 4.07 秒返回 20 条,扣费 0.005556 美元;00:15:26 把返回里的 next_page_token 原样传回去,第二页 2.78 秒又是 20 条。两页 40 条没有重复,按每页实测 20 条算,每 1,000 条笔记是 0.28 美元。
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"xiaohongshu","action":"search","params":{"keyword":"新加坡旅游攻略"}}'
40 条的发布时间从 2025-06-03 到 2026-11-17,2026 年发的 33 条;不传 sort 时用的是相关度排序,最近 30 天内发的只有 4 条。想看最新的,目录里的 sort 有 newest,date_range 除了不限时间,还有 last_24_hours 到 last_1_year 五档。40 条里 9 条是视频笔记(is_video),其中只有 4 条带了 video_url,做视频分析时,视频地址的覆盖率要按这一页实际返回单独算;5 条标了带货(is_goods_note),1 条标了品牌合作(is_cooperation_note)。点赞中位数 541.5,最高的一条 12,376。按形式拆开,9 条视频笔记的点赞中位数是 926,31 条图文是 328,同一个话题下视频的互动高出近两倍;5 条带货笔记的点赞从 6 到 1,218 不等,并不比普通笔记高。
正文这一项要注意:目录的字段说明写着搜索返回的 text 是截断的摘要,约 60 字以内。实测 40 条的 text 长度中位数 59 字、最长 60 字,和说明一致。要全文就拿笔记 ID 或链接调 xiaohongshu/note:00:17:04 我们取了 40 条里评论最多的一篇(一篇新加坡青年旅舍的入住体验),返回的正文 638 字、13 张图、6 个话题标签、IP 属地江苏。全文按每篇一次计费,每 1,000 篇 5.56 美元,比只要摘要贵 20 倍。做舆情和选题,摘要加标题加互动数通常够用;做内容分析、训练分类模型,才需要全文。
| 要什么 | 调哪几个能力 | 1,000 篇的调用次数 | 1,000 篇的费用(美元) |
|---|---|---|---|
| 标题、摘要、互动数 | xiaohongshu/search | 50 | 0.28 |
| 加正文全文 | 再加 xiaohongshu/note | 1,050 | 5.83 |
| 再加每篇第一页评论 | 再加 xiaohongshu/comments | 2,050 | 11.39 |
00:19:07 我们用一个不存在的字符串加「rednote」搜最近 24 小时的笔记,返回了 19 条,标题和正文里都没有那串字符,内容是当天新发的随手记,照常扣了一次 0.005556 美元。小红书的搜索会尽量给出结果,返回非空就会计费;拿关键词做监测时,要在自己这边按标题或正文再筛一遍相关性,免得把不相干的笔记算进声量。
同一个词隔 80 分钟再搜一次,结果换了大半。01:35:17 我们用同样的「新加坡旅游攻略」、同样不传 sort 再取第一页,3.56 秒返回 20 条,扣费 0.005556 美元。这 20 条里只有 2 条在 00:15 那两页的 40 条里出现过:00:15 第一页排第 1 的笔记掉到了第 18 位,排第 7 的升到第 4 位;其余 18 条的作者也都不在第一次的 39 个作者里。新的一页更偏近期,最近 30 天发的有 10 条(第一次 40 条里只有 4 条),点赞中位数 149.5,第一次第一页是 539。相关度排序的结果每次都会变,单次搜索只能当一次抽样来用。拿它做声量或排名监测,要么多搜几次、按笔记 id 去重后合并,要么改用 sort=newest 加 date_range 按发布时间取,至少说得清统计的是哪一段时间。反过来,想多攒一些不重复的笔记,隔一段时间重搜同一个词也是个办法,每页的价钱不变。
| 同一个词「新加坡旅游攻略」 | 00:15:16 第 1 页 | 01:35:17 第 1 页 |
|---|---|---|
| 返回条数 | 20 | 20 |
| 两次都出现的笔记 | 2 | 2 |
| 最近 30 天发的 | 2 | 10 |
| 2026 年发的 | 15 | 18 |
| 发布时间范围 | 2025-07-26~2026-11-16 | 2025-03-07~2026-11-19 |
| 点赞中位数 | 539 | 149.5 |
| 点赞过千的 | 7 | 3 |
| 视频笔记 | 4 | 0 |
| 耗时 / 扣费(美元) | 4.07 秒 / 0.005556 | 3.56 秒 / 0.005556 |
实测二:评论按页取,30 条覆盖 8 个月
00:17:13 和 00:17:24,我们对那篇青旅笔记调了两次 xiaohongshu/comments,sort 设成 newest,每页 15 条,两页 30 条不重复,每 1,000 条评论 0.37 美元。笔记详情里写着 221 条评论,两页拿到 13.6%。最新的一条发在 2026-11-10,第 30 条已经回到 2026-03-12:这篇笔记发于 2025-11-30,评论在一年里慢慢累积,按时间取 30 条就覆盖了 8 个月。
30 条评论里,sub_comment_count 加起来是 22,也就是还有 22 条楼中楼回复没展开,要用 xiaohongshu/sub_comments 逐条去取。ip_location 只有 3 条有值(广东、北京、河北),另外 27 条为空;做地域分析的话,评论这一层的属地数据量会比想象的少。评论的点赞中位数是 0,最高 1;2 条带图片,没有一条是笔记作者本人回的。评论正文多数很短,30 条里最长的 69 字、最短的 2 字,中位数 14.5 字,做情绪分析时一条评论往往只有一句话。楼中楼也集中在少数几条上:19 条评论没有回复,有回复的 11 条里,最多的一条挂了 10 条。按月份数,2026 年 5 月最多,有 8 条,其余每个月 2 到 4 条,一篇笔记发出半年后仍在稳定地进评论。
目录对评论排序写得很细:default 是平台的推荐顺序,每次请求都会重排,翻页会漏掉或重复一部分;newest 翻页稳定,但有的笔记平台只给最新的一部分。翻到没有 next_page_token,只说明平台说没有下一页,不保证拿全。要尽量拿全,就用 default 多翻几轮、按评论 id 合并去重。
主页抓取:账号主页和全部笔记
英文里说的 rednote profile scraper,抓的就是账号主页:粉丝数、获赞与收藏、笔记数、认证信息,再加这个账号发过的笔记列表。我们先用 xiaohongshu/search_users 按「新加坡旅游局」找到这个品牌账号(00:15:29,返回 1 个,认证类型 business),再在 00:16:06 调 xiaohongshu/profile。search_users 一行只有 10 个字段(昵称、头像、小红书号、估算粉丝数、认证标记和认证类型、主页链接等),没有获赞与收藏和笔记数,按昵称找到账号之后还得再调一次主页。
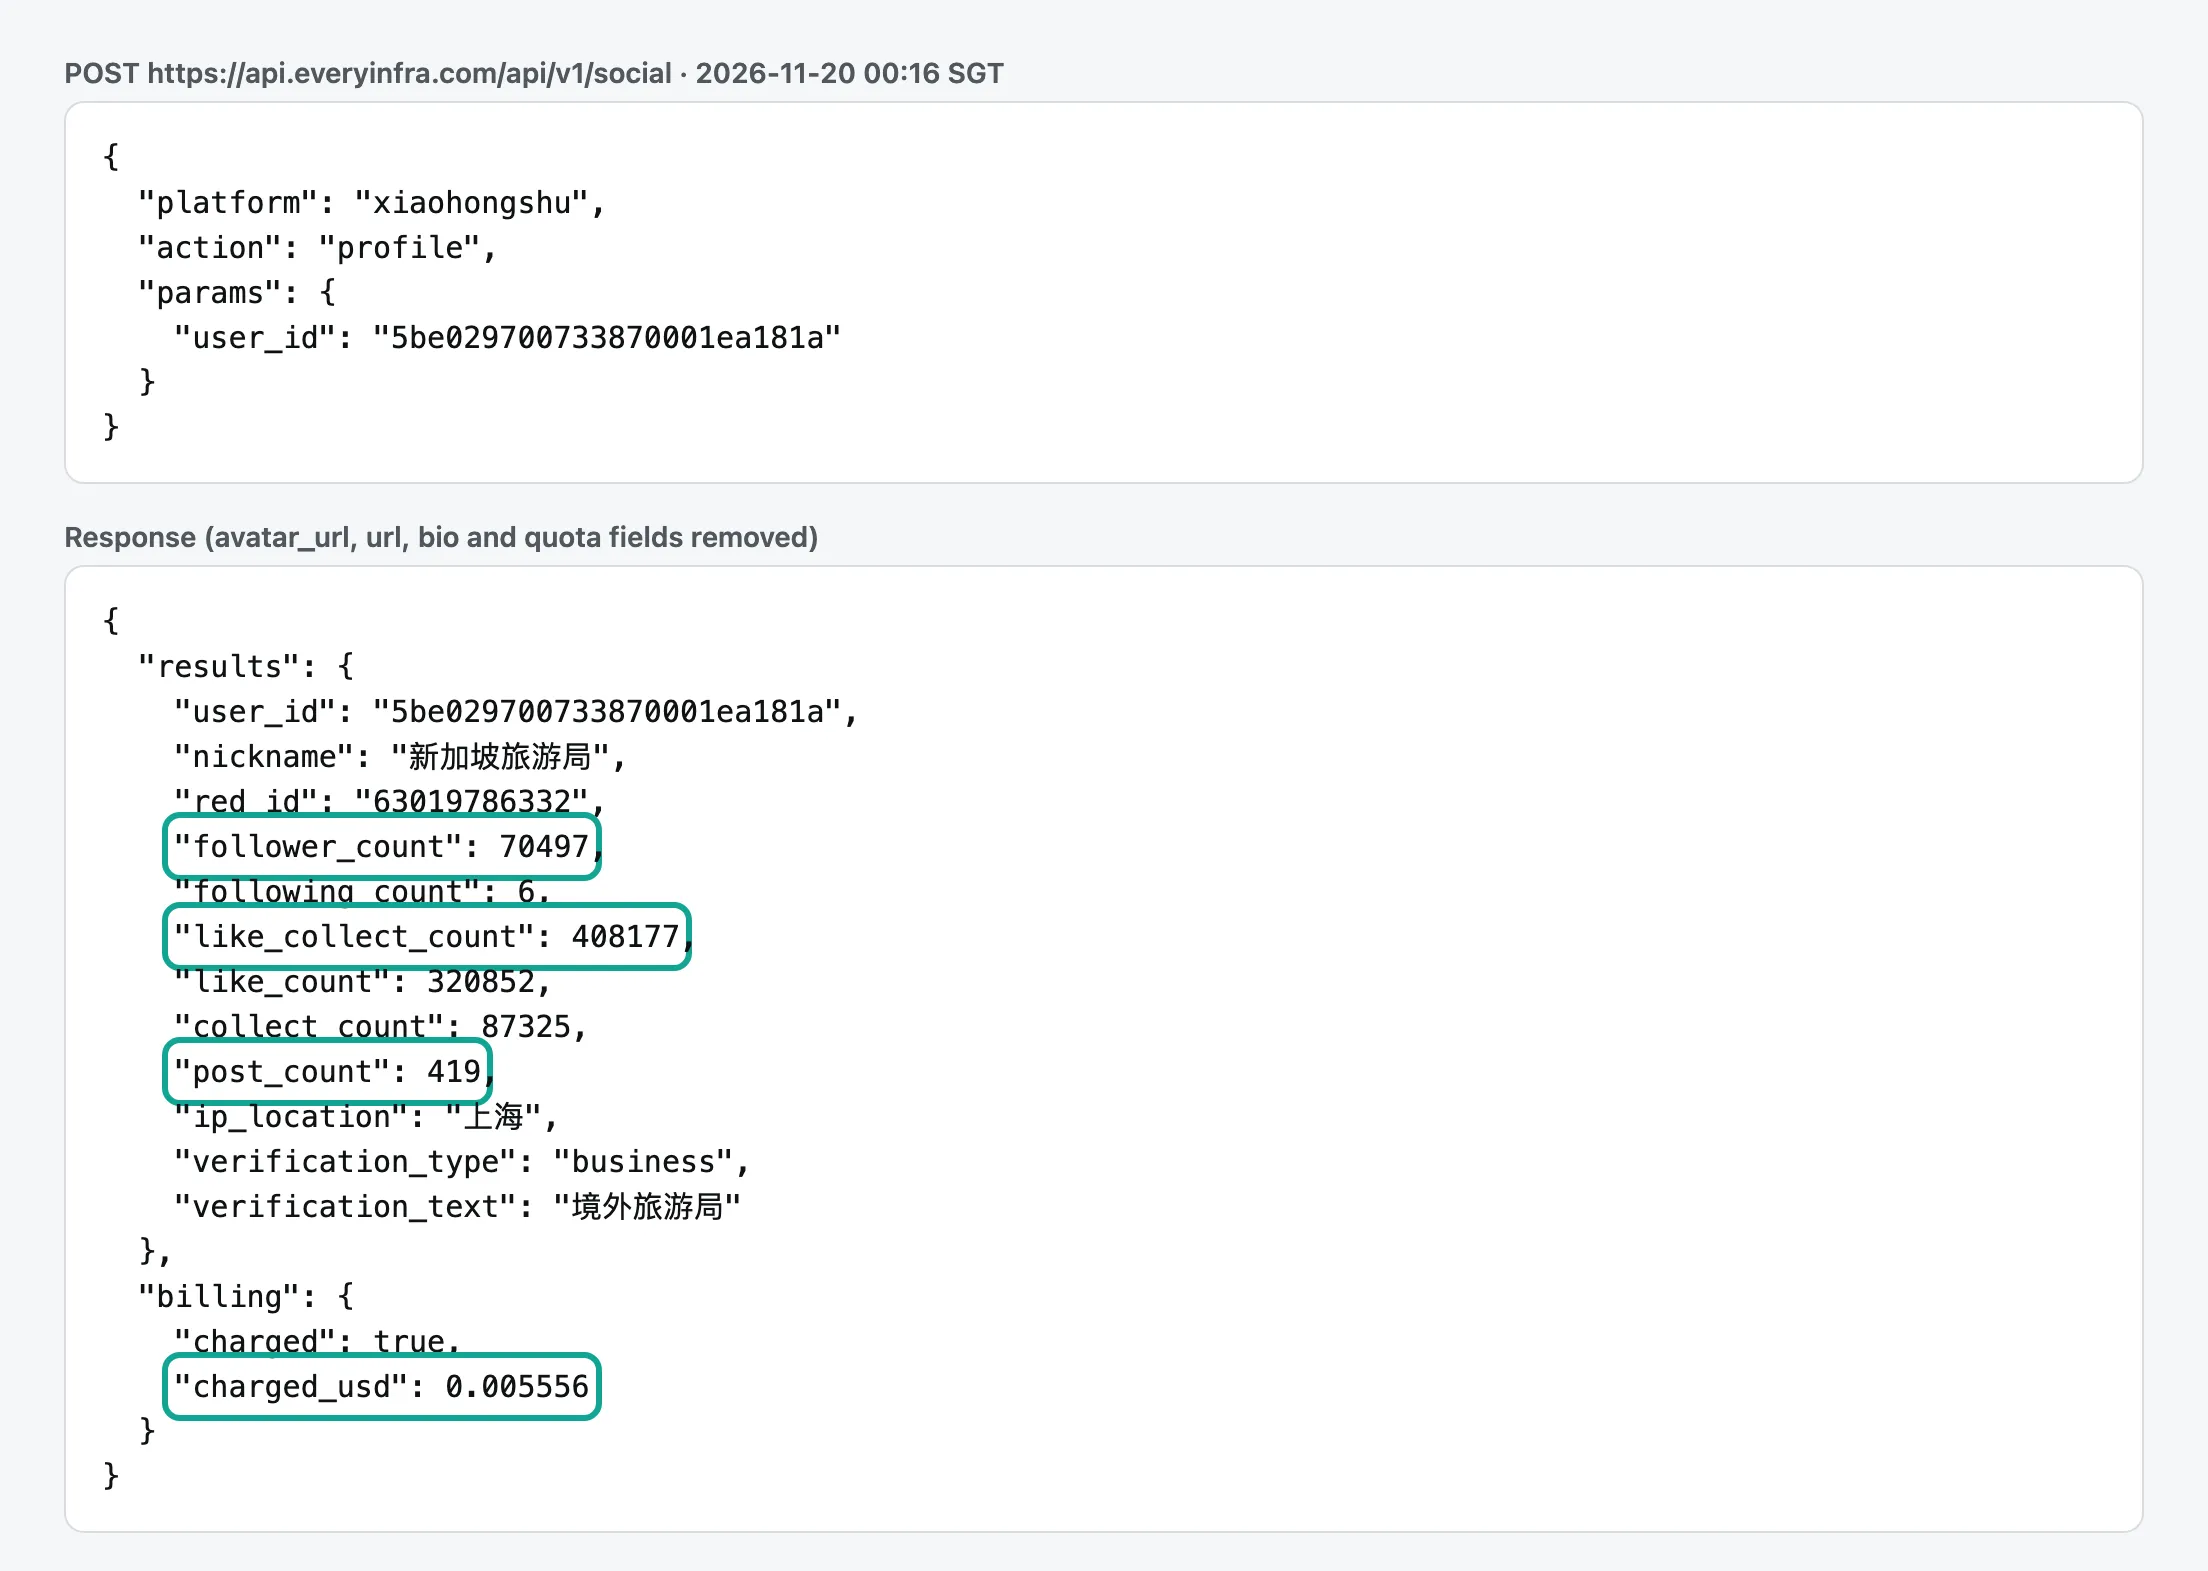
返回里粉丝 70,497,关注 6,获赞与收藏 408,177(点赞 320,852 加收藏 87,325),笔记 419 篇,认证说明「境外旅游局」,IP 属地上海。目录列的 21 个字段里 18 个有值,tags、real_name_info、location 三项为空:这个账号主页上没有填个人标签和地区,品牌号本来就不展示实名信息。普通个人账号的昵称、头像和简介,我们在文章和截图里一律不展示;品牌和机构账号可以写。
接着 00:16:16 调 xiaohongshu/user_posts,第一页 20 篇,发布时间从 2026-09-17 到 2026-11-18,两个月左右。20 篇里 3 篇视频,没有置顶笔记(is_pinned 全为 false;目录提醒置顶笔记排在最前面,按发布时间分析时要排除)。ip_location 只有 1 篇有值,和目录说明「user_posts 只有部分笔记带」一致。
| 实测 | 条数 | 最新一条 | 最早一条 |
|---|---|---|---|
xiaohongshu/search,2 页,按相关度 | 40 | 2026-11-17 | 2025-06-03 |
xiaohongshu/user_posts,第 1 页 | 20 | 2026-11-18 | 2026-09-17 |
xiaohongshu/comments,2 页,newest | 30 | 2026-11-10 | 2026-03-12 |
这 20 篇的点赞中位数是 41,评论中位数 2.5;点赞最多的两篇分别是 10 月 9 日的 5,164 和 11 月 18 日的 4,805,加起来占 20 篇总点赞的 72%。用平均数描述这个账号的「每篇互动」会被两篇爆款拉高很多,做账号对比时用中位数更稳。主页上的累计获赞与收藏 408,177 摊到 419 篇是每篇约 974,和最近 20 篇的中位数 41 差了二十多倍,说明累计数字里有很大一部分来自更早的爆款笔记。
把一个账号的全部历史拉下来要多少钱:1 次 xiaohongshu/profile 加上笔记数除以 20 页的 xiaohongshu/user_posts。419 篇是 21 页,加上主页共 22 次,0.12 美元;每多 100 篇约多 0.03 美元。00:50:28 我们用第一页返回的 next_page_token 取了第 2 页:又是 20 篇,和第一页没有重复,发布时间从 2026-07-10 到 2026-09-16,正好接上第一页最早的 9 月 17 日,响应里仍带着下一页的令牌。第 2 页的点赞中位数是 301,是第一页 41 的 7 倍多,20 篇里 11 篇是视频。第一页 20 篇覆盖 62 天,第二页 20 篇覆盖 68 天,两段时间里这个账号的发帖节奏差不多,都是三天出头一篇。差别主要来自发布时间:两到四个月前的笔记已经攒了更久的互动,最近两个月的还在涨。比较账号或笔记表现时,要拿发布时间相近的笔记比,不要拿新帖和老帖放在一起算平均。
翻页的写法很简单:每一行都带同一个 next_page_token,原样传回去取下一页,为空就停。目录写明同一页每行的游标相同,翻页时其余参数要保持不变。下面这段 Python 把一个账号的笔记全部取完,遇到 429 按返回的 retry_after 等待,遇到 422 直接报错(参数写错了,重试没用)。
import os, time, requests

API = "https://api.everyinfra.com/api/v1/social"
HEAD = {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}

def call(action, params):
    while True:
        r = requests.post(API, headers=HEAD, timeout=120,
                          json={"platform": "xiaohongshu", "action": action, "params": params})
        if r.status_code == 429:
            time.sleep(r.json()["error"].get("retry_after", 30) + 1)
            continue
        r.raise_for_status()
        return r.json()

def all_posts(user_id):
    rows, token, spent = [], None, 0.0
    while True:
        p = {"user_id": user_id, **({"page_token": token} if token else {})}
        d = call("user_posts", p)
        rows += d["results"]
        spent += d["billing"]["charged_usd"]
        token = d.get("next_page_token")
        if not token:
            return rows, spent
按 RFC 6585 的定义,429 表示「请求太多」,服务端可以用 Retry-After 告诉客户端等多久(RFC 9110 定义了这个头);我们的返回把等待秒数直接放进 JSON 的 retry_after,MDN 的 429 说明也是这个用法。本轮这把 Key 的限速是每分钟 10 次,retry_after 给的等待在 9 到 34 秒之间,代码里多加 1 秒是为了避开整秒边界。
同一个主页隔 79 分钟读三次
主页数字多久变一次,决定了主页监测该多久跑一次。我们在新加坡时间 00:16、00:50 和 01:35 三次读同一个账号主页:笔记数不变,粉丝多了 2 个,获赞与收藏涨了 26。
| 读取时刻(新加坡时间) | 粉丝 follower_count | 获赞与收藏 like_collect_count | 点赞 like_count | 收藏 collect_count | 笔记 post_count |
|---|---|---|---|---|---|
| 00:16:06 | 70,497 | 408,177 | 320,852 | 87,325 | 419 |
| 00:50:18 | 70,497 | 408,190 | 320,862 | 87,328 | 419 |
| 01:35:04 | 70,499 | 408,203 | 320,872 | 87,331 | 419 |
三次读数之间,笔记数一直是 419,粉丝只在后 45 分钟里多了 2 个;获赞与收藏每一段都涨 13,79 分钟共涨 26(点赞加 20、收藏加 6),只占总数的 0.006%。这三个点落在中国时间的深夜,白天的速度可能不同,但量级已经够用:对这样一个 7 万粉丝的机构号,按小时读,粉丝数基本不动,获赞与收藏每小时约涨 20,按天读更容易看出趋势。存主页快照时,某个字段这一次是空值,就不要覆盖上一次的有效值,按「这次没拿到」处理,和后文字段表里 null 的处理一样。三次主页读数一共花了 0.0167 美元。
主页数据拿来做什么,多久读一次
达人尽调:品牌投放前看一个博主的粉丝量、获赞与收藏、发帖频率和最近笔记的互动是不是匹配。这类需求一次性读够就行,把最近两三页笔记一起取下来,用中位数而不是平均数判断互动水平。一个账号尽调一次的成本是 1 次主页加 2 到 3 页笔记,3 到 4 次调用,约 0.02 美元。站内的 达人数据尽调 一文写了完整的判断步骤。
竞品和达人监测:盯一批账号的粉丝增长和新笔记,主页按天读一次。新笔记的发现靠 xiaohongshu/user_posts 第一页,这个账号两个月发 20 篇,平均每三天一篇,每周读一次第一页就不会漏。真要做到发帖当天就知道,可以每天读一次第一页,比对 id 有没有新的。
研究抽样:从一个话题出发找出一批作者,再看这批作者的主页分布。这类需求看重覆盖面,单个账号读一次即可,钱主要花在作者数量上。每 1,000 个作者的主页是 5.56 美元,如果再取每人第一页笔记,再加 5.56 美元;现成的公开数据集见文末「什么时候按次付费接口不合适」一节。
| 用途 | 每个账号读什么 | 建议频率 | 每个账号每月调用 | 每个账号每月费用(美元) |
|---|---|---|---|---|
| 达人尽调 | 主页 + 最近 3 页笔记 | 一次 | 4 | 0.02 |
| 竞品监测 | 主页 + 第 1 页笔记 | 每天 | 约 61 | 0.34 |
| 竞品监测(省钱档) | 主页 + 第 1 页笔记 | 每周 | 约 9 | 0.05 |
| 研究抽样 | 主页 | 一次 | 1 | 0.0056 |
字段表:目录写了什么,这次拿到了什么
我们把五项能力的实际返回和目录的 response_fields 逐个对了一遍:返回里没有出现目录以外的字段;目录列出、但这次一行都没有值的字段如下表。
| 能力 | 本次行数 | 目录字段数 | 至少一行有值 | 这次全为空的字段 |
|---|---|---|---|---|
xiaohongshu/profile | 1 | 21 | 18 | tags、real_name_info、location |
xiaohongshu/user_posts | 20 | 24 | 24 | 无 |
xiaohongshu/search | 40 | 30 | 25 | poi_id、poi_name、updated_at、video_width、video_height |
xiaohongshu/note | 1 | 28 | 24 | mentioned_users、lat、lng、updated_at |
xiaohongshu/comments | 30 | 20 | 18 | mentioned_users、comment_tags |
空的字段多半是因为这批数据本身没有那一项:搜索的 poi_id、poi_name 只在笔记卡片标了地点时才有,这 40 条都没标;video_width、video_height 只在视频笔记上有,而这次 9 条视频笔记也没带;updated_at 在笔记没编辑过时可能缺省。笔记的 lat、lng 是笔记图片上带的定位,图片没有定位就没有。字段为空时值是 null,目录写明「null 表示不公开或这次没拿到,不等于 0」,入库时别把 null 当 0 算平均。
还有一处要留意:author_id 在笔记类结果里是 24 位,和主页链接里的 ID 相同;评论类结果里多为 29 位的另一种写法。同一个人的两种写法不同,跨批次按人去重前,要先用 xiaohongshu/profile 换成它返回的 user_id。做「评论区里有哪些人也发过相关笔记」这种交叉分析,先把评论作者统一换成主页返回的 user_id。
入库前要处理的几件事
第一,null 和 0 分开存。表结构里给 like_count、collect_count 这些列留空值,统计时显式排除 null,不要填 0。
第二,链接会过期。搜索、笔记、主页返回的 url 带访问令牌 xsec_token,未登录的浏览器也能打开,但令牌有时效;video_url 带签名,过期就打不开。要留存视频或长期可点的链接,取到后及时下载,或者入库时只存笔记 ID,用时再调 xiaohongshu/note 换一条新链接。用户笔记列表 user_posts 返回的链接不带令牌,在浏览器里打不开,这一点和搜索结果不同。
第三,置顶和时间要处理。user_posts 的 is_pinned 为 true 的笔记排在最前面,按发布时间画趋势时要剔掉;posted_at 和 updated_at 都是 UTC,换成本地时区再按天汇总。按新加坡的 UTC+8 算,一篇 UTC 15:30 发的笔记属于第二天;这个账号第一页 20 篇里,12 篇发在 UTC 10:00 到 10:45 之间(新加坡时间傍晚 6 点前后),5 篇发在 UTC 04:01 到 04:02(新加坡中午 12 点),按 UTC 日期汇总不会错天,但按小时画发帖时段就必须先换时区。
第四,搜索结果按标题和摘要再筛一遍相关性,理由见实测一的乱码词。
第五,粉丝数要记下来源。同一个账号在 search_users 里是 70,000,在 profile 里是 70,497,两种数混在一列里算增长,换一次数据源就会凭空多出 497 个「新粉丝」;表里加一列来源,算增长时只拿同一来源的数相减。
失败和空结果扣不扣钱
本轮有三类请求没拿到数据:连续调用时撞上的 5 次 429 限速、1 次故意多传参数的 422、1 次故意传不存在 ID 的空结果。每次我们都看返回里的 billing.charged_usd。
| 时刻(新加坡时间) | 请求 | HTTP 状态 | 返回要点 | 扣费(美元) |
|---|---|---|---|---|
| 00:15:37、00:15:45、00:16:26、00:17:43、00:19:51 | profile、user_posts、note、profile、youtube/search(这把 Key 每分钟 10 次的限速) | 429 | rate_limited,retry_after 依次为 22、15、34、16、9 秒 | 0 |
| 00:17:35 | profile 多传一个 fields 参数 | 422 | unknown_param,列出允许的参数只有 user_id,附一个能用的示例 | 0 |
| 00:18:03 | profile 传一个不存在的 24 位 ID | 200 | results 为空,reason: empty_result_refunded,refund.status: succeeded | 0 |
| 00:19:07 | search 乱码词、最近 24 小时 | 200 | 返回 19 条不相关的笔记 | 0.005556 |
422 的返回里有三样东西:错误信息的意思是「fields 不是 xiaohongshu/profile 的参数,必填 user_id,没有可选参数」,还给了目录地址和一个能直接跑通的示例请求,next_steps 里写着「Nothing was charged」。这种写法是给程序和 AI 读的,模型拿到以后能自己改对参数。429 的返回带 retry_after,等够秒数重试就行,我们每次都是等完后一次成功。空结果先扣后退,退款状态写在同一个返回里。
计费规则的完整说明在 失败退款对账 一文。
从一个话题到一份账号名单
把前面几项能力串起来,就是英文帖子里常问的那件事:按话题找到一批作者,再把每个作者的主页和笔记历史拉下来。我们这一轮的「新加坡旅游攻略」两页 40 条笔记来自 39 个不同的作者,只有一个作者出现了两次;40 条里点赞 1,000 以上(含)的有 14 条。照这个比例,搜 10 页(200 条笔记)大约能得到近 200 个作者。
流程分四步,每一步都只用公开数据:先用 xiaohongshu/search 翻 10 页,花 0.056 美元拿到 200 条笔记和它们的 author_id;按 author_id 去重,再按笔记互动数排序,挑出前 50 个作者;对这 50 个作者各调一次 xiaohongshu/profile,花 0.28 美元拿到粉丝数、获赞与收藏和认证类型;最后对粉丝数落在你关心区间里的作者各取一页 xiaohongshu/user_posts,看最近 20 篇的点赞中位数。50 个作者全部取一页笔记再花 0.28 美元,整套下来约 0.61 美元。
这条流程里有两处要留意。搜索按相关度排序时会混进一两年前的老笔记(我们这 40 条里最早一篇是 2025-06-03),如果要的是「最近活跃的作者」,搜索时加 sort=newest 或 date_range=last_30_days;目录写明 last_30_days 一页可能不足 20 条,一条都没有的页不收费。另一处是名单里会混进品牌号和机构号。这 40 条搜索结果的 author_is_verified 全是 false,搜索这一层分不出谁是机构号,要到主页再看,用主页的 verification_type(individual、business、other)和 verification_text 把它们分出来,不要只看 is_verified,理由见前面新加坡旅游局账号的两次返回。
一笔月度账:200 个品牌账号每周巡一遍
场景:一个品牌团队盯 200 个竞品和达人账号,每周看一次主页数字、最新一页笔记、最新 3 篇笔记的第一页评论。调用次数和费用是确定的,评论拿到几条取决于笔记本身有多少评论,所以评论一行分两档写:满页档假设每页都返回 15 条;实测档照新加坡旅游局账号最近 20 篇笔记的 comment_count 中位数 2.5 条算。
| 动作 | 每周调用次数 | 每周拿到的行数 | 每周费用(美元) |
|---|---|---|---|
xiaohongshu/profile | 200 | 200 个主页 | 1.11 |
xiaohongshu/user_posts 第 1 页 | 200 | 4,000 篇笔记 | 1.11 |
xiaohongshu/comments 第 1 页 × 3 篇(满页档) | 600 | 至多 9,000 条评论 | 3.33 |
xiaohongshu/comments 第 1 页 × 3 篇(实测中位数档) | 600 | 约 1,500 条评论 | 3.33 |
| 合计(评论取任一档) | 1,000 | 5.56 |
实测档的依据在 user_posts 第一页:这 20 篇的评论数从小到大是 0、0、0、1、1、1、1、2、2、2、3、6、6、6、8、11、19、114、150、1,586,中位数 2.5,17 篇不到 15 条,3 篇一条评论都没有。最新的 3 篇分别是 1,586、3、1 条,第一页最多能拿到 15 加 3 加 1 共 19 条,而不是 45 条。按实测档,评论的实际单价是每千条约 2.22 美元,是满页档 0.37 美元的 6 倍。评论数为 0 的笔记返回空结果,按空结果不扣费的规则不收钱;照 3/20 的比例,600 页里约 90 页不扣费,评论这一行每周降到约 2.83 美元,合计每周约 5.06 美元。
按一个月 4.33 周算,满页档每月约 24.08 美元,扣掉空页约 21.91 美元。同样的活自己写脚本做,人工成本见上文「自己写脚本」一节的估算,约 299 美元一个月,还没算服务器、代理和被封账号的成本。包月工具的价格各家不同,可以用这张表里的行数去对它的额度:每周 200 个主页、4,000 篇笔记,评论按你自己账号的实际评论数算,这个账号约 1,500 条。
盯的对象不同,评论档位也不同。搜索结果里那 40 条旅游攻略的评论数中位数是 27,28 条在 15 条以上;盯的是这类热门笔记时,第一页基本是满页,满页档更接近实际。评论数还和笔记的发布时间有关。同一个账号第 2 页的 20 篇(2026-07-10 到 09-16 发布)评论中位数是 11.5,最多的 201 条,是第一页最近两个月中位数 2.5 的 4.6 倍;每周只取最新 3 篇,拿到的评论会偏少,想看评论区的讨论,可以另挑发布更久的笔记来取。
这个场景里评论占了六成费用。如果只关心「哪个账号最近涨粉快、哪篇笔记爆了」,可以先不取评论,每月降到约 9.63 美元;发现某篇点赞明显高于账号中位数(比如超过中位数 10 倍)时再去取它的评论。实测账号的中位数是 41,10 倍就是 410,最近 20 篇里有 5 篇超过这条线。
平台和规则的近况
- 2026-11-16,台北时报报道,台湾自 2025 年 12 月 4 日起用 DNS 解析限制屏蔽小红书,内政部预计自 12 月 3 日起把这项限制再延长一年。
- 2026-11-13,据 TechNode 和 亿邦动力 报道,小红书在内测独立 App「搭搭」,用户把自己的经验做成 AI 智能体,授权后可读取小红书公开主页信息。
- 2026-11-16,CNBC 写到本土服装品牌靠小红书做发现,并点了几个国际品牌官方号的粉丝数(单个官方号 20 万到 30 多万)。CNBC 这篇用官方号粉丝数做了品牌对比。
- 2026-11-10,据 DoNews 报道,一位公益博主因发联系方式需预存 1 万元广告费而考虑停更;搜狐时间线补充说聚光平台自助开户首充门槛为 10,000 元。主页监测看到某个账号的笔记数不再增长时,原因可能是平台规则,不一定是账号本身。
什么时候按次付费接口不合适
按次付费接口也有做不到的事。要拿登录后才看得到的东西(私信、自己账号的后台数据、蒲公英里的报价),得走平台的 开放平台 或你自己的后台;接口只读公开页面能看到的数据。要做每秒级的实时流,按次调用的延迟(这一轮返回数据的请求单次 1.3 到 13.8 秒)和每分钟限速都不合适。数据量到每天几千万条、并且有自己的法务和数据合规团队时,自建可能更划算,但要算进前面那几道关的长期人工。另外,我们这一轮的样本只有一个关键词、一篇笔记、一个品牌账号,评论属地 3/30、视频地址 4/9、账号评论数中位数 2.5 这类比例,换一篇笔记或一个账号可能完全不同,用之前先拿自己的目标跑一轮。
研究用途还有一条路:现成的公开数据集。RedNote-Vibe 覆盖五年、带互动数,Qilin 是小红书 App 内搜索会话的多模态检索数据集,论文里写平台搜索渗透率超过 70%。做方法研究、训模型,先看这些数据集能不能用。
常见问题
怎么写搜索词,才能找到发某类话题的用户?
r/OSINT 的一个帖子标题前半问的就是这个。本轮的数据:中文词「新加坡旅游攻略」两页 40 条来自 39 个作者;英文词「Singapore travel tips」返回的 20 条全是中文笔记,搜索词按中文写更直接。按昵称找账号用 xiaohongshu/search_users,「新加坡旅游局」一次就返回了目标账号。完整流程见上文「从一个话题到一份账号名单」。
怎么抓用户主页和发帖历史?
同一个 r/OSINT 帖子的后半问的是这个。对每个账号调一次 xiaohongshu/profile,再用 next_page_token 把 xiaohongshu/user_posts 翻完;419 篇的新加坡旅游局账号是 22 次调用、约 0.12 美元,翻页代码见上文。
抓小红书一定要登录吗?
自己写脚本基本要,r/webscraping 的提问卡的就是网页版的注册框。调 EveryInfra 接口的鉴权是 EveryInfra 的 API Key,本轮 24 次请求只带了这把 Key,返回的是公开页面上能看到的字段。
跑久了账号被踢下线怎么办?
r/DataHoarder 的帖子描述的就是这个现象,自建脚本的情况见上文「自己写脚本」一节。接口这边遇到的是这把 Key 每分钟 10 次的限速,返回 429 和 retry_after,本轮 5 次 429 都没扣费。
有没有现成的 YouTube 教程教抓小红书?
我们 2026-11-20 新加坡时间 00:20 用 youtube/search 搜「rednote scraper」,前 10 个结果全是 App 的使用教程、注册登录教程和 2025 年初的新闻片段,例如 2026-11-14 上传的 RedNote 新手教程,没有一个在演示抓取。00:50 我们又用 youtube/search 搜「xiaohongshu scraper」:前 3 条是一款桌面抓取软件 2023 年的 75 秒演示(432 次播放)、一个视频下载工具的演示和一段 2025 年初的新闻,没有一条讲主页抓取或接口调用。
上手步骤
- 在 控制台快速上手 拿一个 API Key,新账号有试用额度。
- 在 小红书数据接口 页面选 主页、账号笔记、评论 或 搜索,在线试调一次,看返回字段。
- 用上面的 curl 或下面的 MCP 配置接进自己的程序或 AI 工具。
想在 Claude、Cursor 这类支持 MCP 的工具里直接问「帮我看看这个账号最近 20 篇笔记的互动」,可以加一条远程 MCP 配置。MCP 是一个开放协议,规范和服务端概念说明都公开;我们的地址和工具清单见 MCP 接入页。
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}站内两篇相关文章:小红书数据采集:搜索、笔记、评论 讲搜索和评论的采集流程,小红书 API 价格 讲计费单位。要做中文社媒的达人筛选,可以接着看 达人数据尽调;要按周出东南亚品牌在小红书上的声量,可以看 东南亚品牌小红书声量周报;官方接口和第三方接口怎么选,见 小红书 API:官方与第三方。
参考资料
- 小红书 robots.txt,小红书,2026-11-20 读取,<https://www.xiaohongshu.com/robots.txt>
- 小红书用户服务协议,行吟信息科技,2026-03-23 版,<https://agree.xiaohongshu.com/h5/terms/ZXXY20220331001/-1>
- 小红书安全响应中心奖励规则,小红书安全,2026-08-18,<https://security.xiaohongshu.com/announcements/23>
- 小红书开放平台 API 文档,小红书,2026-11-20 读取,<https://open.xiaohongshu.com/document/api>
- EveryInfra 数据接口目录(小红书),EveryInfra,2026-11-20 读取,<https://api.everyinfra.com/api/v1/social/catalog?platform=xiaohongshu>
- EveryInfra 数据接口目录(全部),EveryInfra,2026-11-20 读取,<https://api.everyinfra.com/api/v1/social/catalog>
- 中华人民共和国反不正当竞争法(2025 修订),中国证监会北京监管局转载,2025-09-10,<https://www.csrc.gov.cn/beijing/c105536/c7582544/content.shtml>
- 网络数据安全管理条例(国务院令第 790 号),生态环境部转载,2024-10-03,<https://www.mee.gov.cn/zcwj/gwywj/202410/t20241003_1087417.shtml>
- 中华人民共和国个人信息保护法,国家网信办,2021-08-20,<https://www.cac.gov.cn/2021-08/20/c_1631050028355286.htm>
- 最高人民法院发布 2026 年人民法院反不正当竞争典型案例,最高人民法院,2026-09-09,<https://www.court.gov.cn/zixun/xiangqing/511301.html>
- 最高人民法院发布 2025 年人民法院反不正当竞争典型案例,中国证监会北京监管局转载,2025-09-10,<https://www.csrc.gov.cn/beijing/c105537/c7582591/content.shtml>
- 抓取小红书用户数据牟利,被判赔偿 110 万元,知识产权律师网,2025-10-28,<https://www.ciplawyer.cn/articles/157825.html>
- 非法爬取“小红书”数据牟利 650 余万元,3 人被判刑,知产财经转载新华日报,2025-03-14,<https://www.ipeconomy.cn/dongtai/9167.html>
- Taiwan to extend RedNote restrictions again: sources,Taipei Times,2026-11-16,<https://www.taipeitimes.com/News/taiwan/archives/2026/11/16/2003867815>
- Xiaohongshu tests standalone app for users to build and share AI agents,TechNode,2026-11-13,<https://technode.com/2026/11/13/xiaohongshu-tests-standalone-app-for-users-to-build-and-share-ai-agents/>
- “点点”之后再推“搭搭” 小红书 AI 赛道又落一子,亿邦动力,2026-11-13,<https://www.ebrun.com/20261113/720097.shtml>
- As Nike, Lululemon struggle in China, Xiaohongshu helps local brands,CNBC,2026-11-16,<https://www.cnbc.com/2026/11/16/as-nike-lululemon-struggle-in-china-xiaohongshu-helps-local-brands.html>
- Inter expands its digital presence in China with new official channels on Bilibili and REDnote,FC Internazionale Milano,2026-11-20 读取,<https://www.inter.it/en/news/inter-new-official-channels-china-bilibili-rednote>
- 知名公益博主考虑停更小红书:预存 1 万才能发联系方式,DoNews,2026-11-10,<https://www.donews.com/news/detail/1/6771424.html>
- Over half a million ‘TikTok refugees’ flock to China's RedNote,Reuters,2025-01-14,<https://www.reuters.com/technology/over-half-million-tiktok-refugees-flock-chinas-rednote-2025-01-14/>
- Refugees of the Digital Space: Platform Migration from TikTok to RedNote,arXiv 2510.18894,2025-10-19,<https://arxiv.org/abs/2510.18894>
- Rejection or Inclusion in the Emotion-Identity Dynamics of TikTok Refugees on RedNote,arXiv 2507.14623,2025-07-19,<https://arxiv.org/abs/2507.14623>
- RedNote-Vibe: A Dataset for Capturing Temporal Dynamics of AI-Generated Text,arXiv 2509.22055,2026-04-11 第 2 版,<https://arxiv.org/abs/2509.22055>
- Qilin: A Multimodal Information Retrieval Dataset with APP-level User Sessions,arXiv 2503.00501,2025-03-01,<https://arxiv.org/abs/2503.00501>
- RFC 9309: Robots Exclusion Protocol,IETF,2022-09,<https://www.rfc-editor.org/rfc/rfc9309.html>
- RFC 6585: Additional HTTP Status Codes(429 Too Many Requests),IETF,2012-04,<https://datatracker.ietf.org/doc/html/rfc6585>
- RFC 9110: HTTP Semantics(Retry-After),IETF,2022-06,<https://datatracker.ietf.org/doc/html/rfc9110>
- WebDriver(navigator.webdriver),W3C,2026-11-20 读取,<https://www.w3.org/TR/webdriver2/>
- urllib.robotparser,Python 文档,2026-11-20 读取,<https://docs.python.org/3/library/urllib.robotparser.html>
- playwright 1.65.2,PyPI,2026-11-20 读取,<https://pypi.org/project/playwright/>
- Authentication,Playwright 文档,2026-11-20 读取,<https://playwright.dev/docs/auth>
- Model Context Protocol Specification 2025-06-18,MCP,<https://modelcontextprotocol.io/specification/2025-06-18>
- Understanding MCP servers,MCP 文档,2026-11-20 读取,<https://modelcontextprotocol.io/docs/learn/server-concepts>
- Headless Chrome,Chrome for Developers,2026-11-20 读取,<https://developer.chrome.com/docs/chromium/headless>
- 429 Too Many Requests,MDN,2026-11-20 读取,<https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Status/429>
- 2025 年城镇单位就业人员年平均工资情况,国家统计局,2026-05-15,<https://www.stats.gov.cn/sj/zxfb/202605/t20260515_1963707.html>
- Euro foreign exchange reference rates,欧洲央行,2026-11-19,<https://www.ecb.europa.eu/stats/eurofxref/eurofxref-daily.xml>
- Has anyone had success scraping chinese ig/xiaohongshu?,Reddit r/DataHoarder,2026-11-20 读取,<https://www.reddit.com/r/DataHoarder/comments/1mp1t8p/has_anyone_had_success_scraping_chinese/>
- get past registration or access the mobile web version for scrap,Reddit r/webscraping,2026-11-20 读取,<https://www.reddit.com/r/webscraping/comments/1kmbow1/get_past_registration_or_access_the_mobile_web/>
- Rednote (Xiaohongshu) help? Crafting better search terms, scraping user profiles,Reddit r/OSINT,2026-11-20 读取,<https://www.reddit.com/r/OSINT/comments/1jcyu18/rednote_xiaohongshu_help_crafting_better_search/>
- Xiaohongshu Statistics and User Demographics for 2026,Marketing to China,2026-11-08,<https://marketingtochina.com/xiaohongshu-statistics-and-trends/>
- How to Use RedNote App for Beginners (2026),YouTube,2026-11-14,<https://www.youtube.com/watch?v=La3LBsnGb4I>
- 知名公益博主考虑停更小红书(时间线),搜狐,2026-11-10,<https://timeline.sohu.com/news/NHCzZpqLp4?from=news>
引用编号 BL-198