RedNote scraper: coste real de perfiles, notas y comentarios
Probamos un RedNote scraper de pago por llamada: 0,28 USD por 1.000 notas, 0,37 USD por 1.000 comentarios y 5,56 USD por 1.000 perfiles. Fallos: 0 USD.
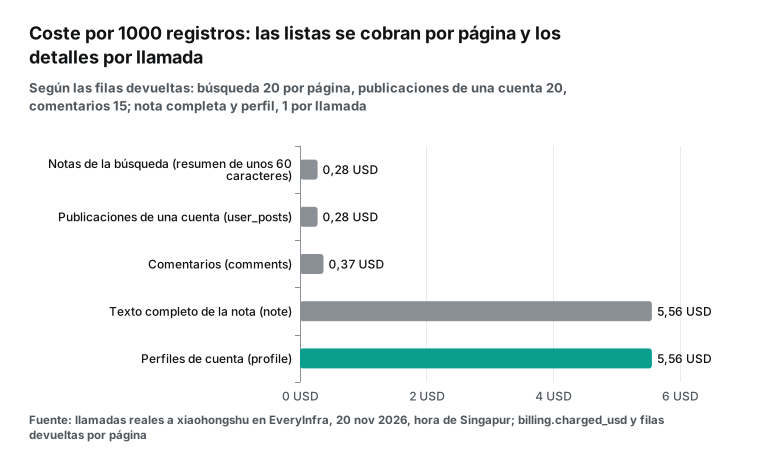
El 20 de noviembre de 2026, desde las 00:15, hora de Singapur, probamos un RedNote (Xiaohongshu) scraper de pago por llamada. Probamos cuatro tipos de datos públicos: resultados de búsqueda, notas completas, comentarios y perfiles de cuentas. Con las filas que devolvió cada página, 1.000 vistas previas de notas cuestan 0,28 USD, 1.000 comentarios cuestan 0,37 USD y 1.000 perfiles cuestan 5,56 USD. El historial completo de la cuenta de la Oficina de Turismo de Singapur, 419 publicaciones, costó unos 0,12 USD. Las llamadas con límite de velocidad, los parámetros erróneos y un usuario inexistente costaron 0 USD. Una palabra clave sin sentido devolvió 19 notas sin relación, y esa llamada sí se cobró.
Qué hace un RedNote scraper o un scraper de Xiaohongshu
RedNote es el nombre en inglés de Xiaohongshu, que en chino significa «librito rojo». Muchos usuarios de Estados Unidos conocieron el nombre en enero de 2025. Reuters informó el 14 de enero de 2025 que más de 700.000 usuarios nuevos se unieron en dos días. Las descargas en Estados Unidos subieron más de un 200 % interanual esa semana.
Después, los investigadores usaron la plataforma como fuente de datos. arXiv 2510.18894 estudia las publicaciones de los usuarios que migraron en tres fases: antes de la prohibición, la ola y la estabilización. arXiv 2507.14623 usa 1.862 publicaciones y 403.054 comentarios para un análisis de emociones.
Un «rednote scraper», un «scraper de xiaohongshu» y una «xiaohongshu scraper api» hacen el mismo trabajo. Convierten notas, comentarios y perfiles públicos en filas que un programa puede leer.
La plataforma es grande. Un resumen de Marketing to China del 8 de noviembre de 2026 dice que la empresa declaró más de 400 millones de usuarios activos mensuales en mayo de 2026. El FC Internazionale Milano anunció su cuenta en RedNote y habló de unos 350 millones de usuarios mensuales y 600 millones de búsquedas al día.
| Dato que buscas | Capacidad de EveryInfra | Filas por llamada | Precio por llamada (USD) | Campos en el catálogo |
|---|---|---|---|---|
| Notas de una palabra clave | xiaohongshu/search | 20 | 0,005556 | 30 |
| Texto completo de una nota | xiaohongshu/note | 1 | 0,005556 | 28 |
| Comentarios de una nota | xiaohongshu/comments | 15 | 0,005556 | 20 |
| Perfil de una cuenta | xiaohongshu/profile | 1 | 0,005556 | 21 |
| Publicaciones de una cuenta | xiaohongshu/user_posts | 20 | 0,005556 | 24 |
| Cuentas de una palabra clave | xiaohongshu/search_users | hasta 20 | 0,005556 | 10 |
Los precios y el número de campos salen del catálogo de EveryInfra para Xiaohongshu, leído a las 00:17, hora de Singapur, del 20 de noviembre de 2026. Las filas por llamada salen de nuestras llamadas reales de la misma sesión. El catálogo tiene 17 capacidades de Xiaohongshu. Dieciséis cuestan 0,005556 USD por llamada y una búsqueda del mercado de creadores cuesta 0,016 USD.
La página de la API de datos de Xiaohongshu tiene los parámetros y una consola de pruebas.
Xiaohongshu es más cara que otras redes chinas del mismo catálogo. La API de datos de Douyin cobra 0,000556 USD por llamada para perfil, publicaciones y comentarios. Los perfiles de Bilibili y Weibo también cuestan 0,000556 USD. El precio de Xiaohongshu es diez veces mayor. En un estudio entre plataformas, calcula el presupuesto de Xiaohongshu aparte: 1.000 perfiles de Douyin cuestan unos 0,56 USD, y 1.000 perfiles de Xiaohongshu, 5,56 USD.
RedNote y Xiaohongshu comparten los mismos datos
¿RedNote es una aplicación internacional con datos propios? El mismo informe de Reuters dice que RedNote mantiene una sola versión de la aplicación. No se divide en una aplicación para el extranjero y otra para China, como hacen otras redes chinas. Las publicaciones en inglés de usuarios de Estados Unidos y las publicaciones en chino conviven en una sola comunidad. Los perfiles y los comentarios tienen una sola estructura. Un scraper y una tabla de campos sirven para los dos idiomas.
Probamos qué pasa con una palabra clave en inglés. A las 00:36, hora de Singapur, buscamos «Singapore travel tips» con xiaohongshu/search. La llamada devolvió 20 notas por 0,005556 USD. Las 20 tenían título y texto en chino. Ninguna fila estaba solo en inglés. La plataforma relacionó la consulta en inglés con guías de viaje en chino.
Un RedNote scraper te da texto en chino aunque tu palabra clave esté en inglés o en español. Añade un paso de traducción y prevé su coste.
La palabra en inglés también trajo otras notas. Solo 1 de las 20 estaba entre las 40 de la palabra china para «guía de viaje de Singapur». La mediana de «me gusta» fue 73,5, frente a 541,5 con la palabra china, y la nota más popular tenía 4.218. Las notas se publicaron entre el 19 de junio de 2025 y el 14 de noviembre de 2026, y 2 eran vídeos. Las vistas previas tenían de 57 a 60 caracteres, el mismo corte que con la palabra china.
En otra búsqueda con una palabra clave en chino, 2 de 40 títulos estaban solo en inglés. El campo language de xiaohongshu/note etiqueta cada nota. La nota que abrimos tenía la etiqueta «zh». Si necesitas publicaciones en otro idioma, filtra por ese campo o por el texto después de recogerlo.
Buscar una cuenta oficial por su nombre
A las 00:36:50, hora de Singapur, buscamos el nombre chino del Real Madrid con xiaohongshu/search_users. La llamada devolvió 20 cuentas por 0,005556 USD. Ninguna de las 20 tenía la marca de verificación: is_verified estaba en false y no había campo verification_type. El catálogo dice que una cuenta sin verificar no tiene ese campo. La cuenta con más seguidores tenía unos 9.400, y la mayoría tenía menos de 1.000. Parecen cuentas de aficionados o de noticias del club.
| Seguidores (estimados) | Cuentas | Verificadas |
|---|---|---|
| 5.000 o más | 3 | 0 |
| De 1.000 a 4.999 | 3 | 0 |
| De 100 a 999 | 5 | 0 |
| Menos de 100 | 9 | 0 |
La cuenta de la Oficina de Turismo de Singapur muestra otro detalle. En search_users, su fila tenía is_verified en true y verification_type en business. Leímos la misma cuenta tres veces con xiaohongshu/profile. Las tres lecturas tenían is_verified en false, verification_type en business y el texto de verificación «oficina de turismo extranjera» (traducción nuestra).
| Fuente (hora de Singapur) | `is_verified` | `verification_type` | `follower_count` |
|---|---|---|---|
search_users, 00:15:29 | true | business | 70.000 (estimado) |
profile, 00:16:06 | false | business | 70.497 |
profile, 00:50:18 | false | business | 70.497 |
profile, 01:35:04 | false | business | 70.499 |
Un filtro que solo mire is_verified en el perfil descartaría esta cuenta institucional real. Para separar cuentas oficiales, usa verification_type (individual, business u other) y verification_text. Los seguidores también cambian según la fuente: search_users daba 70.000 y profile daba 70.497. El catálogo dice que el primero es una estimación sacada del texto visible y el segundo es la cifra exacta.
Tres caminos para obtener datos de RedNote
Hay tres caminos prácticos. Puedes escribir tu propio scraper o adaptar un script de código abierto. Puedes contratar una herramienta de scraping de pago mensual. O puedes llamar a una API de pago por llamada. Los caminos se diferencian en tres puntos: si necesitas tu propia cuenta, quién paga las peticiones fallidas y quién mantiene los campos.
| Punto | Scraper propio | Herramienta mensual | API de pago por llamada (EveryInfra) |
|---|---|---|---|
| Autenticación | Tus cuentas y cookies; las cuentas se bloquean | Muchas herramientas piden tu cookie o tu cuenta | Una clave de API de EveryInfra |
| Qué devuelve | Lo defines tú | Lo define el proveedor | Los campos que muestra una página pública |
| Tras un límite de ritmo | Adivinas el límite y esperas | Según la herramienta | 429 con retry_after; reintenta tras esa espera |
| Unidad de cobro | Servidores, proxies y horas de trabajo | Cuota mensual con un límite de filas o de tiempo | 0,005556 USD por llamada |
| Fallos y resultados vacíos | Se gastan tiempo y tráfico igualmente | Según las condiciones del proveedor | 422, 429 y vacíos: 0 USD en nuestra prueba |
| Formato de campos | Lo defines y lo arreglas tú | Lo define el proveedor | response_fields en el catálogo |
| Herramientas de IA | Tú construyes la conexión | Según la herramienta | MCP remoto con herramientas everyinfra_* |
| Pasos para empezar | Instalar, preparar cuentas, seguir los cambios de la web, ajustar límites | Registrarse, añadir tarjeta, crear tarea | Obtener una clave y enviar un POST |
EveryInfra cobra 0,005556 USD por llamada de Xiaohongshu. Las llamadas fallidas no cuestan nada y los resultados vacíos se devuelven. El catálogo define cada campo. Por ejemplo, like_collect_count es el total de «me gusta y guardados» de un perfil, y equivale a like_count más collect_count.
Camino 1: un scraper propio
La primera barrera es el robots.txt de Xiaohongshu. Lo leímos a las 00:24, hora de Singapur, del 20 de noviembre de 2026. El archivo tiene 26 líneas. Baidu, Bing, 360, Sogou y Shenma pueden leer la portada, /explore, /download y los mapas del sitio. Googlebot solo puede leer /worldcup26. Los demás rastreadores reciben User-agent: * y Disallow: /.
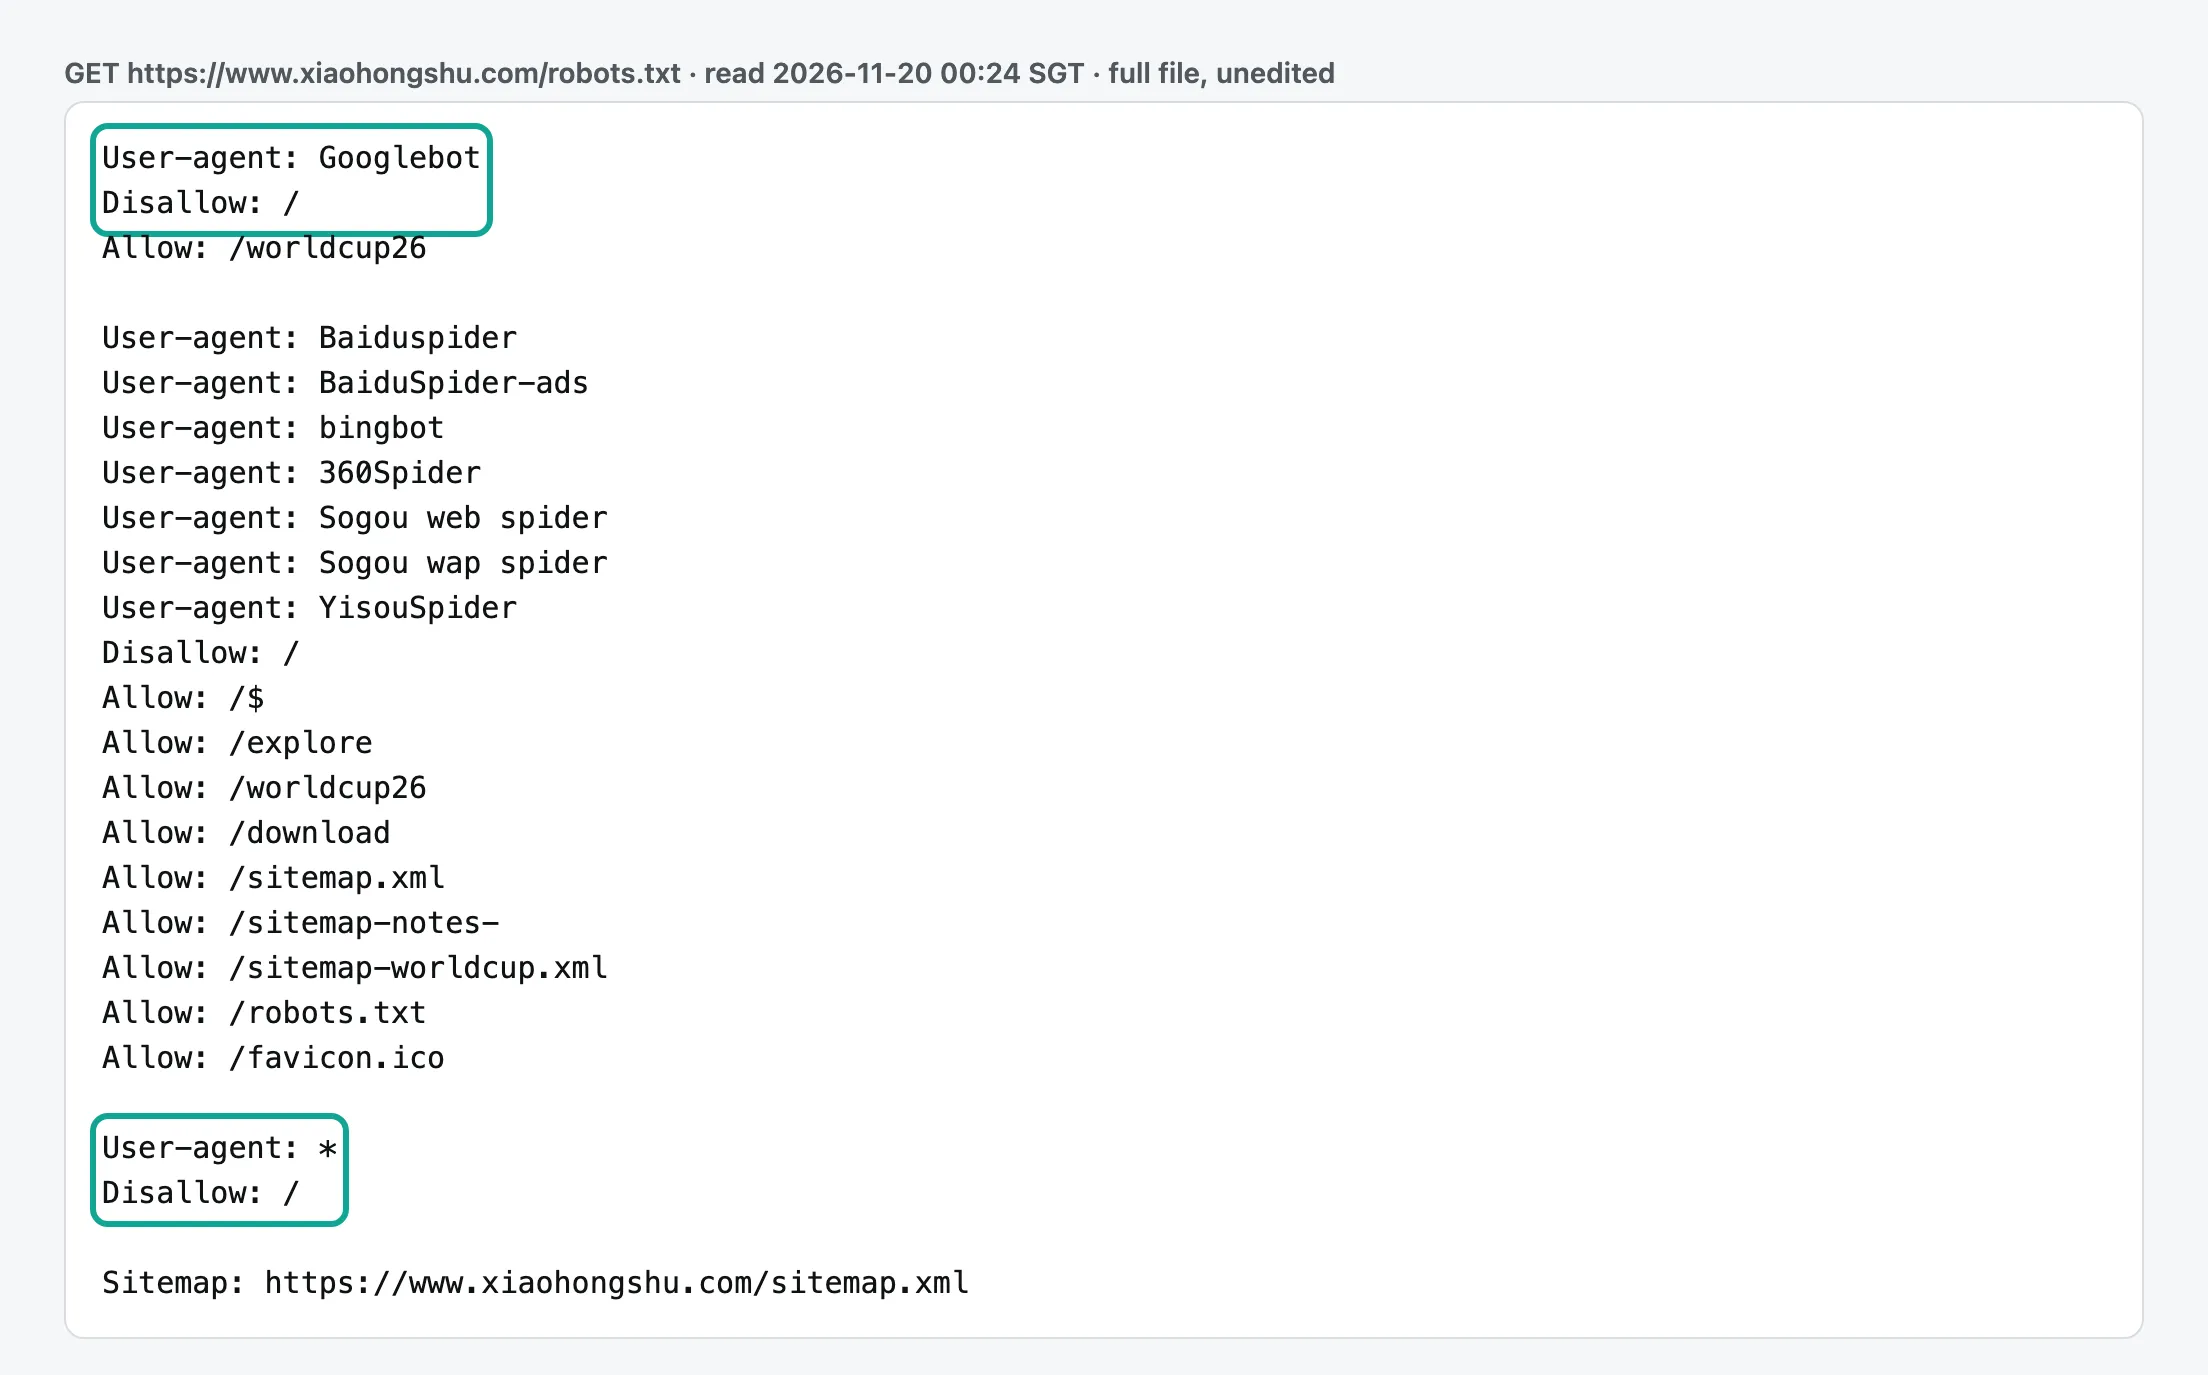
El protocolo de robots se convirtió en RFC 9309 en 2022. El RFC dice que estas reglas no son una forma de autorización de acceso. Python incluye urllib.robotparser, y su método can_fetch() comprueba una URL para un agente.
Comprobamos una URL de nota y una URL de perfil. Un nombre de rastreador propio obtuvo False en las dos. Googlebot también obtuvo False en las dos. Bingbot obtuvo True para la nota bajo /explore/ y False para el perfil bajo /user/profile/. Ni siquiera los buscadores que el archivo permite pueden leer los perfiles.
| Agente | Nota bajo `/explore/` | Perfil bajo `/user/profile/` |
|---|---|---|
| Rastreador propio (nombre inventado) | False | False |
| Googlebot | False | False |
| bingbot | True | False |
La segunda barrera es el muro de inicio de sesión. El acuerdo de usuario de Xiaohongshu prohíbe obtener vídeos, publicaciones o datos de usuarios mediante «scraping ilegal, descargas simuladas, enlaces profundos o registros falsos» (traducción nuestra). La aplicación web muestra un cuadro de inicio de sesión antes de la búsqueda y de las notas.
Un principiante en r/webscraping se topó con ese cuadro. La web lo mostraba y la versión web para móvil no.
La tercera barrera es el riesgo para la cuenta. Una publicación en r/DataHoarder dice que los límites de Xiaohongshu son los más estrictos que el autor había visto. El autor usaba herramientas de código abierto con cookies. Tras un mes sin hacer scraping, un clic en la primera nota de la web cerró su sesión. La aplicación móvil seguía funcionando.
La cuarta barrera son los cambios de la web. Las peticiones de datos de la web llevan valores de control que calcula el código del navegador. Ese código está ofuscado y cambia con cada versión, así que un scraper propio tiene que cambiar con cada versión.
Algunos scrapers manejan un navegador real con un marco general de automatización de navegadores como Playwright. La especificación WebDriver del W3C pone navigator.webdriver en true en un navegador automatizado, y cualquier sitio puede leer ese valor. La documentación del modo headless de Chrome explica en qué se diferencian el modo nuevo y el antiguo.
La guía de autenticación de Playwright avisa de que el archivo de estado guardado contiene cookies que pueden suplantarte. No subas ese archivo a un repositorio. Con un scraper propio, la seguridad de tus cuentas y cookies es cosa tuya.
El marco legal
Estos son los puntos principales de las leyes, las sentencias y las reglas de la plataforma. No son asesoramiento jurídico. China revisó su Ley contra la Competencia Desleal en 2025. El artículo 13 prohíbe ahora obtener o usar datos que otra empresa tiene legalmente mediante fraude, coacción o eludiendo o rompiendo medidas técnicas de gestión. La ley revisada entró en vigor el 15 de octubre de 2025.
El Reglamento de Gestión de la Seguridad de los Datos de Red entró en vigor el 1 de enero de 2025. La Ley de Protección de la Información Personal también limita el tratamiento de información personal que ya es pública.
Los tribunales chinos han resuelto casos de Xiaohongshu. Un informe sobre una apelación ante el Tribunal de Propiedad Intelectual de Shanghái describe una empresa que eludió el robots.txt, las comprobaciones de inicio de sesión y los límites de velocidad. Vendía notas y datos de usuarios de Xiaohongshu como un «paquete de API». El paquete tuvo más de 2,94 millones de llamadas y le dio más de 110.000 CNY. El tribunal fijó una indemnización de 1,1 millones de CNY.
Un segundo informe describe una empresa que rompió el cifrado de la aplicación, falsificó peticiones y envió mensajes privados en masa. Tres personas recibieron condenas penales. El Tribunal Supremo Popular publicó el 9 de septiembre de 2026 una lista de casos típicos de competencia desleal de ese año.
Si tratas datos de personas en la Unión Europea, el RGPD se aplica también a los datos personales públicos. El texto del RGPD en el BOE y la Ley Orgánica 3/2018 de Protección de Datos son las referencias en España. El 21 de julio de 2026, la AEPD publicó una nota técnica sobre exactitud y minimización de datos en sistemas de IA. Es útil si vas a usar comentarios o perfiles recogidos para entrenar o alimentar un modelo.
Las reglas del Centro de Respuesta de Seguridad de Xiaohongshu del 18 de agosto de 2026 aceptan informes sobre «herramientas, plataformas o servicios de scraping que puedan demostrar que todavía obtienen datos de Xiaohongshu» (traducción nuestra). Las mismas reglas dicen que la «información pública del usuario (apodo, avatar, notas públicas, número público de seguidores)» es información pública y no recibe recompensa. Esa regla trata de qué fugas cuentan como vulnerabilidad; no es un permiso para recoger datos.
Nuestro método de datos en este artículo: solo leímos campos que muestra una página pública. No leímos mensajes privados ni contenido que exige iniciar sesión. No mostramos nombres ni avatares de usuarios particulares. Sea cual sea tu camino, contrasta tu uso con el acuerdo de usuario vigente de Xiaohongshu y con las normas de arriba, y consulta a tu propio asesor jurídico.
Cuánto cuesta un scraper propio
La mayor parte del coste son horas de trabajo. Según la Encuesta Anual de Estructura Salarial del INE, el salario medio anual en España fue de 29.540,26 euros en 2024. Es la media de todas las actividades, no solo de informática. Supongamos 1.760 horas de trabajo al año, es decir, unos 16,78 euros por hora. Supongamos también que un desarrollador dedica 16 horas al mes a los cambios de la web y de los límites de ritmo. Las dos cifras son supuestos, no estadísticas.
Con esos supuestos, el mantenimiento cuesta 268,55 euros al mes. Con el tipo de referencia del Banco Central Europeo del 19 de noviembre de 2026, 1 euro = 1,0992 USD, eso son unos 295,19 USD. Es un mínimo, porque un desarrollador suele ganar más que la media y faltan servidores, proxies y cuentas bloqueadas.
En Estados Unidos, la Oficina de Estadísticas Laborales da una mediana de 64,44 USD por hora para desarrolladores de software en 2025. Las mismas 16 horas cuestan allí 1.031,04 USD.
| Base de cálculo | Coste por hora | 16 horas al mes | En USD | Llamadas a 0,005556 USD |
|---|---|---|---|---|
| España, salario medio 2024 (INE), 1.760 h/año | 16,78 EUR | 268,55 EUR | 295,19 | unas 53.000 |
| Estados Unidos, mediana de desarrolladores 2025 (BLS) | 64,44 USD | 1.031,04 USD | 1.031,04 | unas 185.000 |
Con 295,19 USD se pagan unas 53.000 llamadas a 0,005556 USD. En páginas de búsqueda de 20 notas, eso son más de un millón de vistas previas.
Camino 2: una herramienta de pago mensual
El segundo camino es una herramienta mensual. Trabajas en una interfaz web, introduces palabras clave o enlaces de cuentas, y la herramienta se ejecuta según un calendario. El cobro suele tener una de tres formas. Una cuota mensual incluye un número fijo de filas y las filas extra cuestan más. Otras herramientas cobran tiempo de ejecución o unidades de cálculo. Algunas fijan niveles según la concurrencia.
En una plataforma con muro de inicio de sesión como RedNote, muchas herramientas te piden una cookie. El riesgo para la cuenta sigue siendo tuyo.
Cuando compares herramientas, comprueba tres puntos. ¿Una ejecución vacía gasta cuota? ¿La cuota no usada caduca a fin de mes? ¿La exportación viene con definiciones de campos? Divide también la cuota mensual entre las filas que de verdad usarás, no entre el límite del plan. Si usas el 30 % de la cuota, tu precio real por fila es más del triple del precio de lista.
Revisa también el formato de exportación. Una herramienta puede exportar un número de «me gusta» como el texto chino visible para «12 mil», y otra como el entero 12000. Solo el entero sirve para hacer cuentas.
Prueba 1: la búsqueda da 20 notas por página con vistas previas de 60 caracteres
A las 00:15:16, hora de Singapur, buscamos la palabra clave china para «guía de viaje de Singapur» con xiaohongshu/search. La primera página tardó 4,07 segundos y devolvió 20 notas por 0,005556 USD. A las 00:15:26 enviamos el next_page_token de la respuesta. La segunda página tardó 2,78 segundos y devolvió otras 20 notas. Las 40 notas no tenían duplicados. Con 20 filas por página, 1.000 notas cuestan 0,28 USD.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"xiaohongshu","action":"search","params":{"keyword":"Singapore travel tips"}}'
Las 40 notas se publicaron entre el 3 de junio de 2025 y el 17 de noviembre de 2026. Treinta y tres eran de 2026. Sin valor en sort, la búsqueda ordena por relevancia, y solo 4 notas eran de los últimos 30 días. Para publicaciones recientes, pon sort en newest, o pon date_range en una de cinco ventanas de tiempo, de last_24_hours a last_1_year.
Nueve de las 40 notas eran vídeos (is_video), pero solo 4 de las 9 traían video_url. Si analizas vídeo, mide la cobertura de enlaces de vídeo en cada página que recibas. Cinco tenían la marca de producto (is_goods_note) y una tenía la marca de colaboración con una marca (is_cooperation_note). La mediana de «me gusta» fue 541,5 y la nota más popular tenía 12.376. Las 9 notas de vídeo tenían una mediana de 926 «me gusta», y las 31 de imágenes, de 328. Las 5 notas de producto tenían entre 6 y 1.218, así que la marca de producto no significaba más interacción.
El campo text requiere atención. El catálogo dice que la búsqueda devuelve una vista previa recortada de unos 60 caracteres. Nuestras 40 filas tenían una mediana de 59 caracteres chinos y un máximo de 60. Para el texto completo, llama a xiaohongshu/note con el ID o el enlace de la nota.
A las 00:17:04 abrimos la nota con más comentarios, una reseña de un albergue de Singapur. La respuesta tenía 638 caracteres de texto, 13 imágenes, 6 etiquetas y la ubicación IP «Jiangsu». El texto completo cuesta una llamada por nota, es decir, 5,56 USD por 1.000 notas. Es 20 veces el precio de la vista previa.
| Qué necesitas | Capacidades | Llamadas para 1.000 notas | Coste para 1.000 notas (USD) |
|---|---|---|---|
| Título, vista previa, interacción | xiaohongshu/search | 50 | 0,28 |
| Más el texto completo | añadir xiaohongshu/note | 1.050 | 5,83 |
| Más la primera página de comentarios | añadir xiaohongshu/comments | 2.050 | 11,39 |
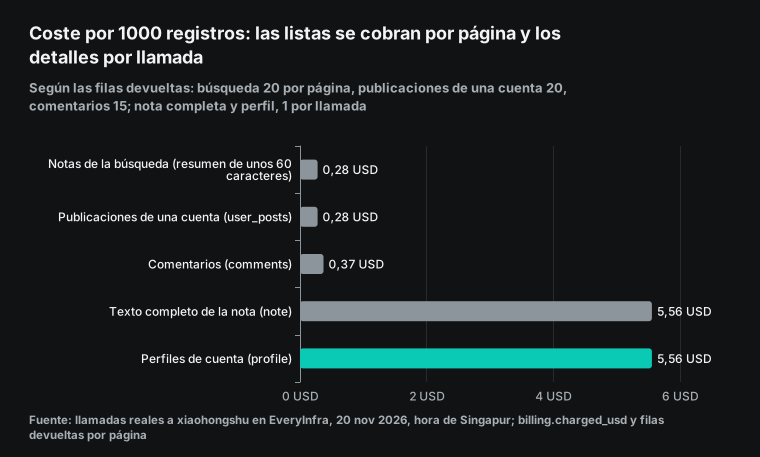
Para estudiar tendencias y temas, el título, la vista previa y las cifras de interacción suelen bastar. El texto completo importa para el análisis de contenido y para entrenar un clasificador.
También probamos una palabra clave sin sentido. A las 00:19:07 buscamos una cadena aleatoria más «rednote» en las últimas 24 horas. La llamada devolvió 19 notas. Ninguna contenía la cadena aleatoria en el título ni en el texto. Eran publicaciones informales de ese día. La llamada se cobró 0,005556 USD.
La búsqueda de la plataforma intenta devolver algo, y un resultado no vacío se cobra. Si vigilas palabras clave, filtra tú mismo las filas por relevancia. Si no lo haces, las publicaciones sin relación inflan tu cuota de voz.
Repetimos la misma búsqueda 80 minutos después, y la mayoría de los resultados eran nuevos. A las 01:35:17 enviamos la misma palabra clave, sin sort, y pedimos otra vez la página 1. Tardó 3,56 segundos y devolvió 20 notas por 0,005556 USD. Solo 2 de las 20 notas estaban entre las 40 de las 00:15. La nota que ocupaba el puesto 1 a las 00:15 bajó al puesto 18, y la del puesto 7 subió al 4. Los autores de las otras 18 notas no estaban entre los 39 autores de la primera búsqueda.
La página nueva traía publicaciones más recientes: 10 notas de los últimos 30 días, frente a 4 de 40 en la primera búsqueda. La mediana de «me gusta» fue 149,5, frente a 539 en la primera página de las 00:15. Una búsqueda por relevancia cambia de una llamada a otra, así que trata cada búsqueda como una muestra. Para medir cuota de voz o posiciones, repite la búsqueda varias veces y une las filas por el id de la nota. Otra opción es usar sort=newest con un date_range, para que cada recuento cubra un periodo conocido. Si quieres reunir más notas distintas, también puedes repetir la búsqueda más tarde: cada página cuesta lo mismo.
| Misma palabra clave («guía de viaje a Singapur» en chino) | Página 1 a las 00:15:16 | Página 1 a las 01:35:17 |
|---|---|---|
| Notas devueltas | 20 | 20 |
| Notas presentes en las dos búsquedas | 2 | 2 |
| Publicadas en los últimos 30 días | 2 | 10 |
| Publicadas en 2026 | 15 | 18 |
| Fechas de publicación | 2025-07-26 a 2026-11-16 | 2025-03-07 a 2026-11-19 |
| Mediana de «me gusta» | 539 | 149,5 |
| Notas con 1.000 «me gusta» o más | 7 | 3 |
| Notas de vídeo | 4 | 0 |
| Tiempo / cobro (USD) | 4,07 s / 0,005556 | 3,56 s / 0,005556 |
Prueba 2: los comentarios llegan de 15 en 15 y abarcan ocho meses
A las 00:17:13 y a las 00:17:24 llamamos dos veces a xiaohongshu/comments sobre la nota del albergue, con sort en newest. Cada página devolvió 15 comentarios: 30 en total, sin duplicados. A ese ritmo, 1.000 comentarios cuestan 0,37 USD. El detalle de la nota indicaba 221 comentarios, así que dos páginas cubrieron el 13,6 %.
El comentario más reciente era del 10 de noviembre de 2026. El comentario número 30 era del 12 de marzo de 2026. La nota se publicó el 30 de noviembre de 2025, y sus comentarios llegaron poco a poco durante el año.
Los 30 comentarios sumaban un sub_comment_count de 22. Son 22 respuestas dentro de hilos, que necesitan llamadas a xiaohongshu/sub_comments. Solo 3 de los 30 comentarios tenían ip_location: Cantón, Pekín y Hebei. Los otros 27 estaban vacíos.
Si planeas un análisis geográfico de comentarios, espera muchos menos datos de ubicación que en las notas. La mediana de «me gusta» por comentario fue 0, y el máximo fue 1. Dos comentarios tenían imágenes. El autor de la nota no respondió a ninguno de los 30.
El catálogo describe con detalle las opciones de orden. default es el orden de la plataforma. Cambia en cada petición, así que al paginar puede saltar o repetir comentarios. newest es estable para paginar, pero en algunas notas la plataforma solo da la parte más reciente.
Que falte next_page_token significa que la plataforma no tiene página siguiente. No demuestra que tengas todos los comentarios. Para obtener el máximo, recorre default varias veces y une los resultados por el id del comentario.
RedNote profile scraper: perfiles e historial completo
Un RedNote profile scraper lee la página de una cuenta: seguidores, «me gusta y guardados», número de publicaciones y verificación. Normalmente también lee la lista de publicaciones de la cuenta. Primero usamos xiaohongshu/search_users con el nombre chino de la Oficina de Turismo de Singapur. A las 00:15:29 devolvió una cuenta verificada como empresa. A las 00:16:06 llamamos a xiaohongshu/profile sobre esa cuenta.
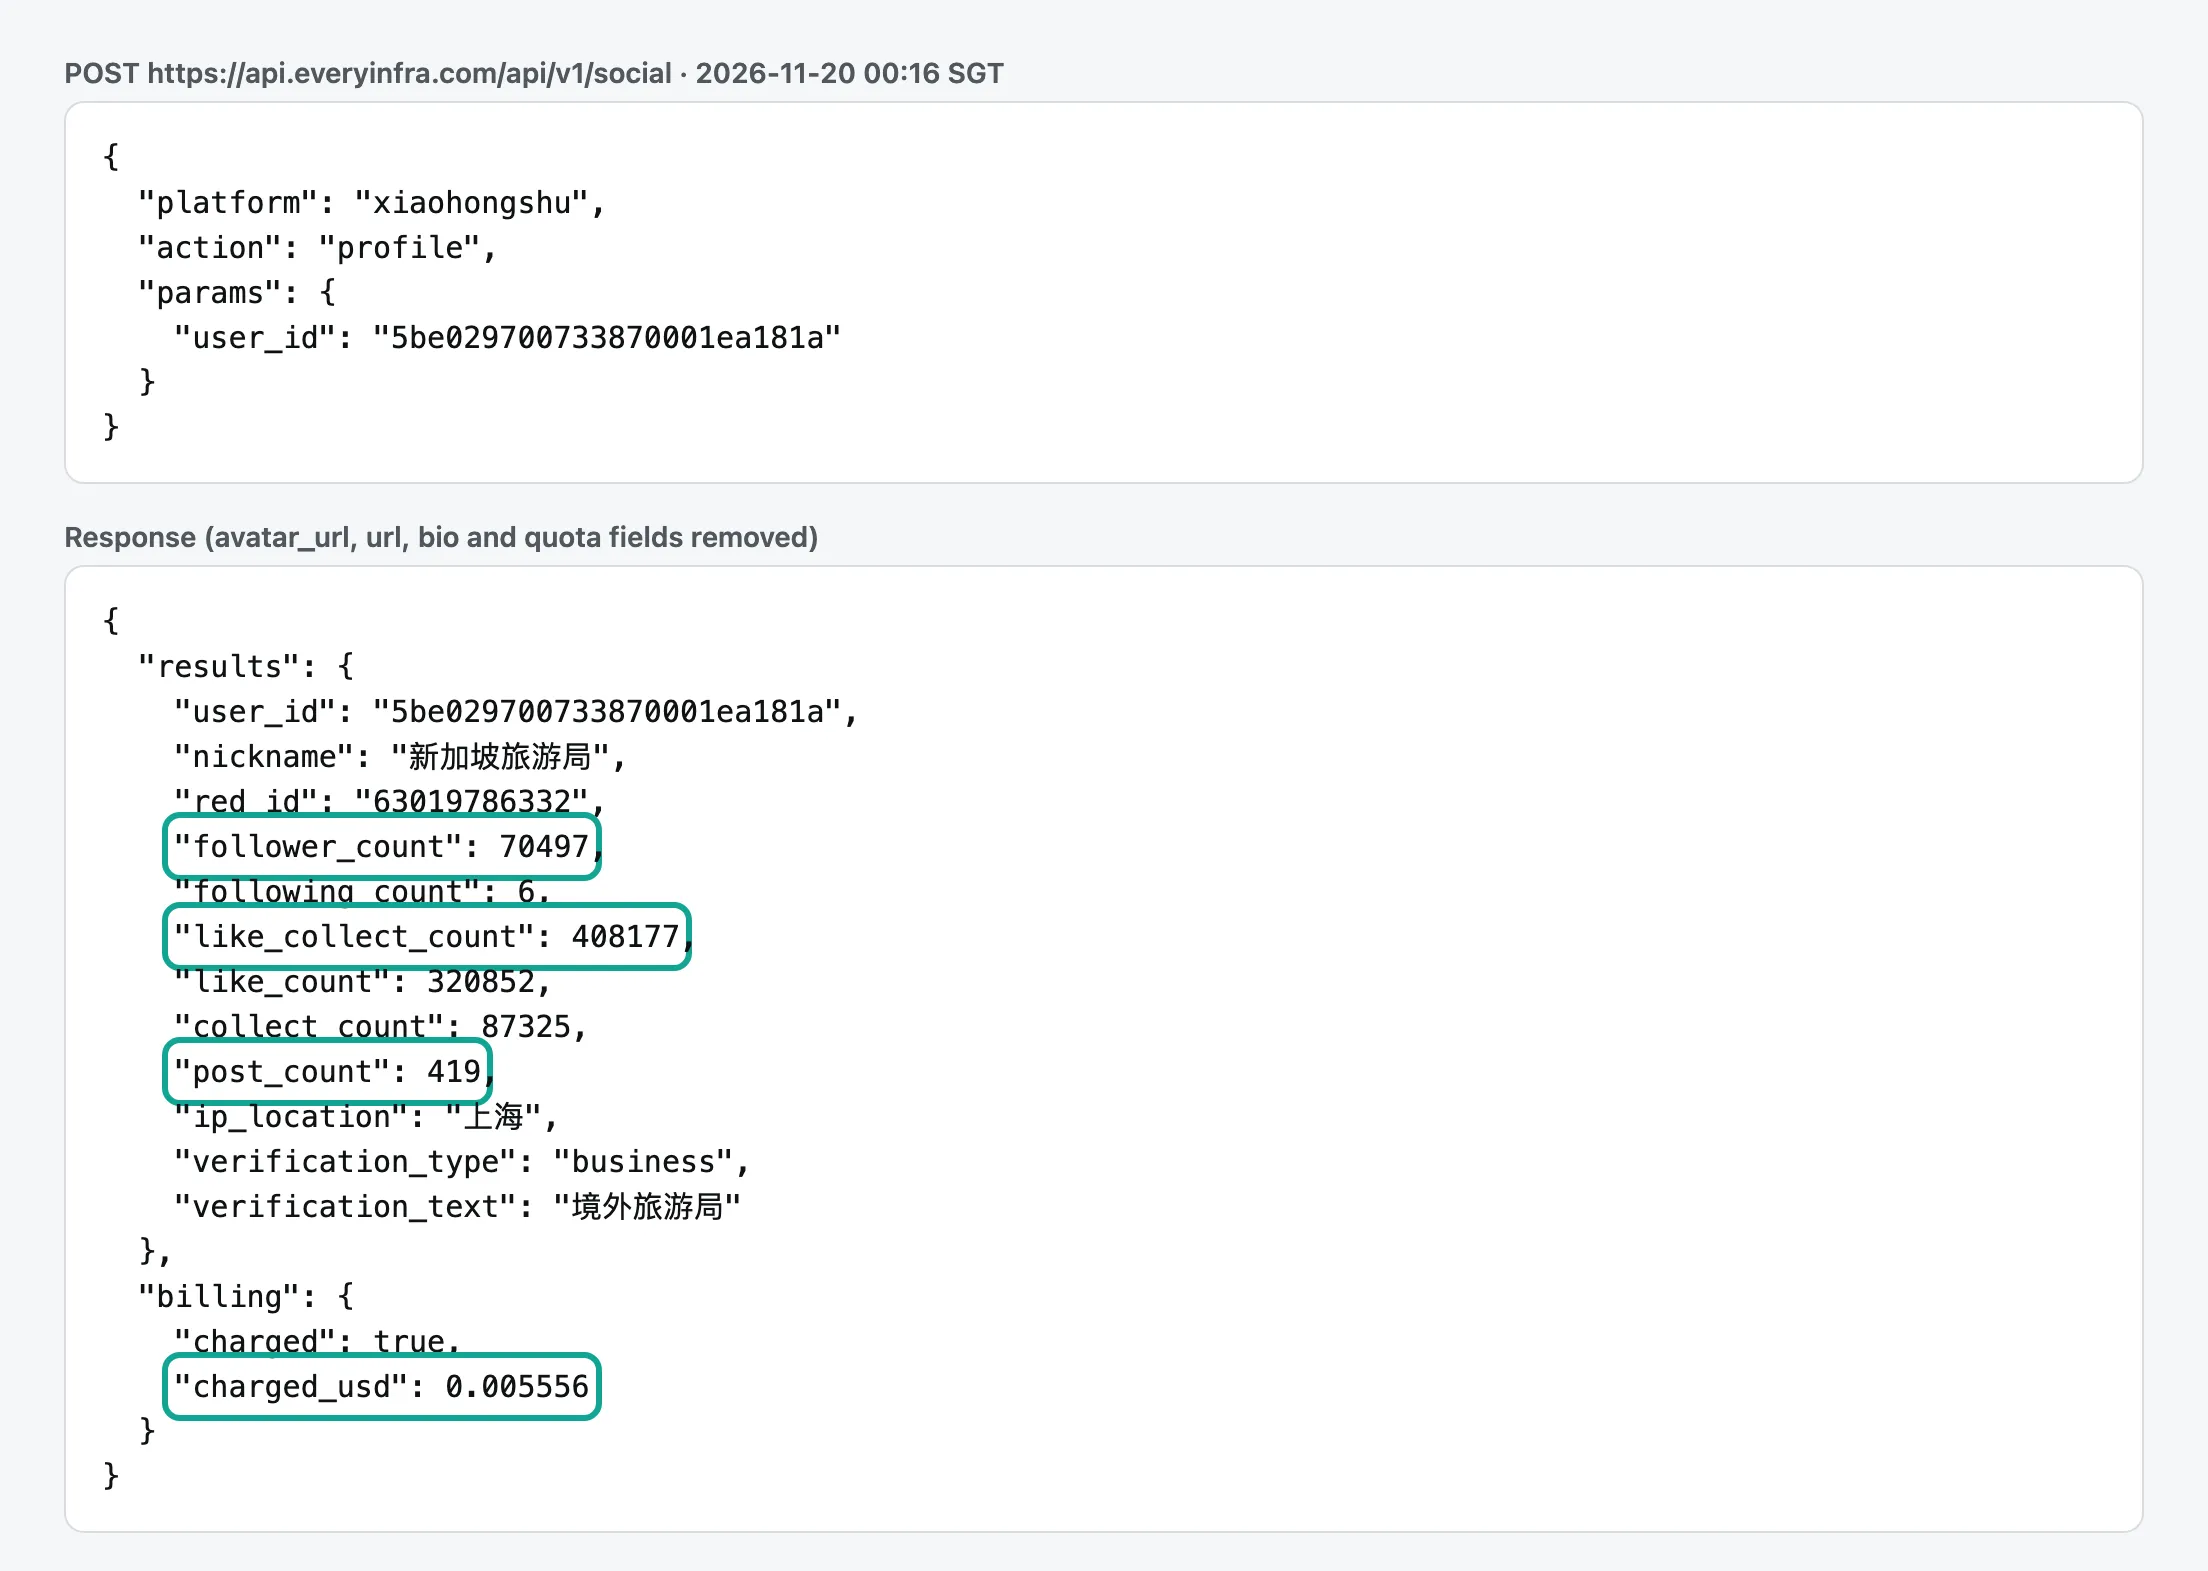
El perfil mostraba 70.497 seguidores y 6 cuentas seguidas. Tenía 408.177 «me gusta y guardados»: 320.852 «me gusta» más 87.325 guardados. Tenía 419 publicaciones. El texto de verificación era «oficina de turismo extranjera» (traducción nuestra), y la ubicación IP era Shanghái.
El catálogo tiene 21 campos de perfil, y 18 tenían valor. Los tres vacíos eran tags, real_name_info y location. Esta cuenta de marca no muestra etiquetas personales ni región, y las cuentas de marca no muestran datos de nombre real. En este artículo no mostramos nombres, avatares ni biografías de usuarios particulares. Las cuentas de marcas e instituciones sí se pueden nombrar.
A las 00:16:16 llamamos a xiaohongshu/user_posts. La primera página devolvió 20 publicaciones del 17 de septiembre al 18 de noviembre de 2026, unos dos meses. Tres eran vídeos. Ninguna estaba fijada: is_pinned era false en las 20. El catálogo avisa de que las publicaciones fijadas salen primero, así que quítalas antes de analizar por fecha. Solo 1 publicación tenía ip_location, como indica el catálogo para user_posts.
| Prueba | Filas | Fecha más reciente | Fecha más antigua |
|---|---|---|---|
xiaohongshu/search, 2 páginas, orden por relevancia | 40 | 2026-11-17 | 2025-06-03 |
xiaohongshu/user_posts, página 1 | 20 | 2026-11-18 | 2026-09-17 |
xiaohongshu/comments, 2 páginas, newest | 30 | 2026-11-10 | 2026-03-12 |
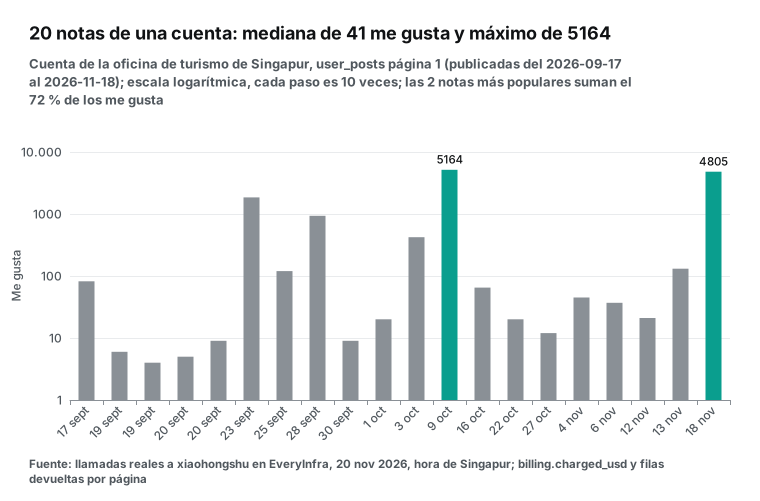
Las 20 publicaciones tenían una mediana de 41 «me gusta» y de 2,5 comentarios. Las dos más populares tenían 5.164 «me gusta» (9 de octubre) y 4.805 (18 de noviembre). Juntas sumaban el 72 % de todos los «me gusta» de las 20. Una media haría parecer esta cuenta mucho más activa de lo que es. Usa la mediana para comparar cuentas.
El total histórico de 408.177 «me gusta y guardados» entre 419 publicaciones da unos 974 por publicación. Es más de 20 veces la mediana reciente de 41. Las publicaciones virales antiguas llevan la mayor parte del total. Una cifra de perfil sola exagera la interacción actual.
El coste de un historial completo es una llamada a xiaohongshu/profile más una llamada a xiaohongshu/user_posts por cada 20 publicaciones. Para 419 publicaciones son 21 páginas más el perfil: 22 llamadas, 0,12 USD. Cada 100 publicaciones más suman unos 0,03 USD. A las 00:50:28 enviamos el next_page_token de la página 1 y obtuvimos la página 2. Tenía otras 20 publicaciones sin repetidos, del 10 de julio al 16 de septiembre de 2026. Empalma justo con el 17 de septiembre, la publicación más antigua de la página 1. La respuesta seguía trayendo un token para la página siguiente. La mediana de «me gusta» en la página 2 fue 301, más de 7 veces la mediana de 41 de la página 1. Once de las 20 publicaciones eran vídeos.
La diferencia se debe sobre todo a la antigüedad: las publicaciones de hace dos a cuatro meses tuvieron más tiempo para sumar «me gusta». Compara publicaciones de edad parecida.
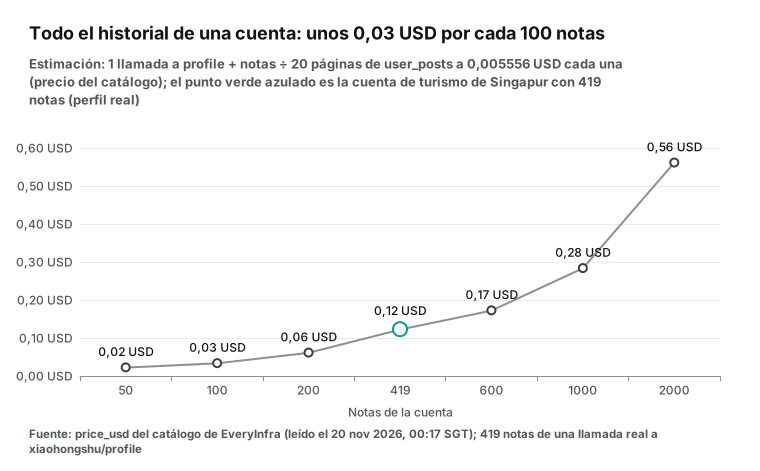
La paginación es sencilla. Cada fila lleva el mismo next_page_token. Envíalo sin cambios para obtener la página siguiente, y para cuando venga vacío. El catálogo dice que los demás parámetros no deben cambiar mientras paginas. El código Python de abajo recoge todas las publicaciones de una cuenta. Espera retry_after ante un 429. Se detiene ante un 422, porque un parámetro erróneo no mejora al reintentar.
import os, time, requests

API = "https://api.everyinfra.com/api/v1/social"
HEAD = {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}

def call(action, params):
    while True:
        r = requests.post(API, headers=HEAD, timeout=120,
                          json={"platform": "xiaohongshu", "action": action, "params": params})
        if r.status_code == 429:
            time.sleep(r.json()["error"].get("retry_after", 30) + 1)
            continue
        r.raise_for_status()
        return r.json()

def all_posts(user_id):
    rows, token, spent = [], None, 0.0
    while True:
        p = {"user_id": user_id, **({"page_token": token} if token else {})}
        d = call("user_posts", p)
        rows += d["results"]
        spent += d["billing"]["charged_usd"]
        token = d.get("next_page_token")
        if not token:
            return rows, spent
El RFC 6585 define el 429 como «Too Many Requests». Un servidor puede enviar Retry-After para decir cuánto esperar, y el RFC 9110 define esa cabecera. Nuestra respuesta pone la espera en el campo JSON retry_after, la misma idea que en la referencia del 429 en MDN. La clave de esta prueba tenía un límite de 10 peticiones por minuto, y retry_after dio esperas de 9 a 34 segundos. El segundo extra del código deja el reintento lejos del límite exacto.
Un perfil leído tres veces en 79 minutos
La frecuencia con la que cambia un perfil indica cada cuánto leerlo. Leímos el mismo perfil a las 00:16, 00:50 y 01:35, hora de Singapur. El número de publicaciones no cambió, los seguidores subieron 2 y los «me gusta y guardados» subieron 26.
| Hora de lectura (hora de Singapur) | follower_count | like_collect_count | like_count | collect_count | post_count |
|---|---|---|---|---|---|
| 00:16:06 | 70.497 | 408.177 | 320.852 | 87.325 | 419 |
| 00:50:18 | 70.497 | 408.190 | 320.862 | 87.328 | 419 |
| 01:35:04 | 70.499 | 408.203 | 320.872 | 87.331 | 419 |
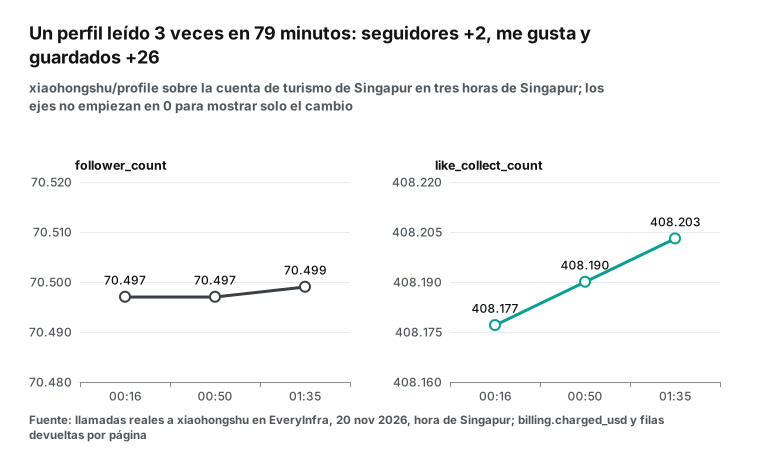
El número de publicaciones se mantuvo en 419 en las tres lecturas. Los seguidores subieron 2, y solo en el segundo intervalo. Los «me gusta y guardados» subieron 13 en cada intervalo: 26 en 79 minutos, es decir, 20 «me gusta» y 6 guardados, el 0,006 % del total. Las lecturas se hicieron de madrugada en China, así que el ritmo de día puede ser otro. En una cuenta de este tamaño, leer cada hora muestra seguidores casi quietos y unos 20 «me gusta y guardados» más por hora; una lectura diaria muestra mejor la tendencia.
Cuando guardes instantáneas de perfiles, no dejes que un valor vacío sustituya al último valor válido: trátalo como «no llegó esta vez», igual que un null en la tabla de campos de abajo. Las tres lecturas del perfil costaron 0,0167 USD.
Tres usos de los datos de perfil y cada cuánto leerlos
El primer uso es la diligencia debida con creadores. Antes de una campaña, una marca comprueba que los seguidores, los «me gusta y guardados», el ritmo de publicación y la interacción reciente de un creador encajan. Basta con una lectura. Descarga el perfil y las dos o tres últimas páginas de publicaciones, y juzga la interacción por la mediana.
Una comprobación cuesta 3 o 4 llamadas, unos 0,02 USD por cuenta. Nuestro artículo sobre diligencia debida con datos de creadores recoge todos los pasos.
El segundo uso es vigilar competidores y creadores. Sigues el crecimiento de seguidores y las publicaciones nuevas de una lista de cuentas. Lee el perfil una vez al día.
Las publicaciones nuevas aparecen en la primera página de xiaohongshu/user_posts. Nuestra cuenta de prueba publicó 20 veces en unos dos meses, más o menos una vez cada tres días. Una lectura semanal de la primera página capta todas las publicaciones nuevas. Una lectura diaria las encuentra el mismo día. Para un informe semanal de marca, lee nuestro informe de cuota de voz en Xiaohongshu para marcas del Sudeste Asiático.
El tercer uso es el muestreo para investigación. Partes de un tema, encuentras un grupo de autores y estudias sus perfiles. Aquí la cobertura importa más que la actualización. Basta una lectura por cuenta, y el coste crece con el número de autores. Los perfiles cuestan 5,56 USD por 1.000 autores, y una página de publicaciones por autor suma otros 5,56 USD.
Los investigadores deberían revisar antes los conjuntos de datos públicos. Qilin es un conjunto multimodal de búsqueda con sesiones de la aplicación de Xiaohongshu. RedNote-Vibe cubre cinco años de publicaciones con cifras de interacción.
| Uso | Qué leer por cuenta | Frecuencia sugerida | Llamadas por cuenta al mes | Coste por cuenta al mes (USD) |
|---|---|---|---|---|
| Diligencia debida | Perfil + 3 últimas páginas | Una vez | 4 | 0,02 |
| Vigilancia | Perfil + página 1 | Diaria | unas 61 | 0,34 |
| Vigilancia, presupuesto bajo | Perfil + página 1 | Semanal | unas 9 | 0,05 |
| Muestreo para investigación | Perfil | Una vez | 1 | 0,0056 |
Tabla de campos: lo que dice el catálogo y lo que llegó
Comparamos las respuestas reales de cinco capacidades con la lista response_fields del catálogo. Ninguna respuesta tenía un campo fuera del catálogo. La tabla muestra qué campos del catálogo estaban vacíos en todas las filas de esta prueba.
| Capacidad | Filas en esta prueba | Campos en el catálogo | Campos con valor en al menos una fila | Campos vacíos en todas las filas |
|---|---|---|---|---|
xiaohongshu/profile | 1 | 21 | 18 | tags, real_name_info, location |
xiaohongshu/user_posts | 20 | 24 | 24 | ninguno |
xiaohongshu/search | 40 | 30 | 25 | poi_id, poi_name, updated_at, video_width, video_height |
xiaohongshu/note | 1 | 28 | 24 | mentioned_users, lat, lng, updated_at |
xiaohongshu/comments | 30 | 20 | 18 | mentioned_users, comment_tags |
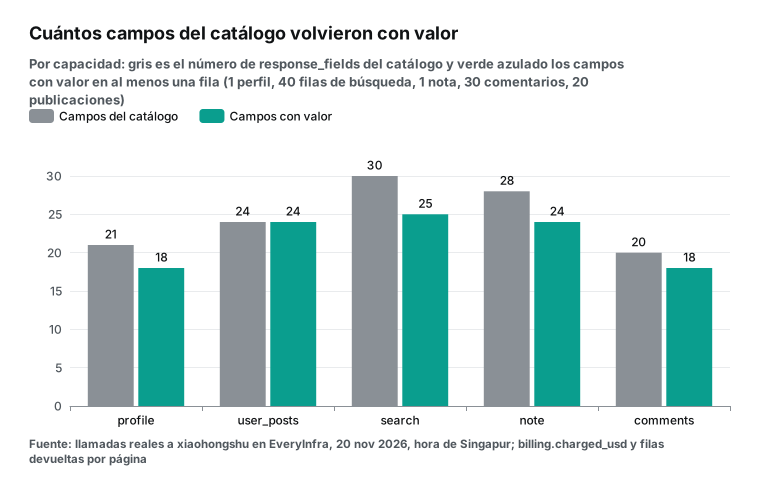
La mayoría de los campos vacíos reflejan los datos, no un fallo. En la búsqueda, poi_id y poi_name solo aparecen cuando la tarjeta de la nota tiene una etiqueta de lugar, y ninguna de las 40 la tenía. video_width y video_height son para notas de vídeo, y los 9 vídeos de esta muestra no los traían. updated_at puede faltar si la nota nunca se editó. Una nota solo tiene lat y lng si sus imágenes llevan una ubicación.
Los valores vacíos llegan como null. El catálogo dice que null significa «no público o no devuelto esta vez, no cero». No cuentes null como cero al calcular medias.
Hay otro punto que afecta al análisis de comentarios. En los resultados de notas, author_id tiene 24 caracteres y coincide con el ID del enlace del perfil. En los comentarios suele tener 29 caracteres con otro formato. Una misma persona puede aparecer con dos ID. Antes de deduplicar personas entre conjuntos de datos, llama a xiaohongshu/profile y usa el user_id que devuelve. Hazlo antes de un cruce como «qué comentaristas también publicaron notas sobre el tema».
Limpia los datos antes de guardarlos
Primero, guarda null y cero por separado. Permite nulls en columnas como like_count y collect_count, exclúyelos de las estadísticas y no los rellenes con cero.
Segundo, los enlaces caducan. El url de búsqueda, nota y perfil lleva un token de acceso llamado xsec_token. Un navegador sin sesión puede abrirlo, pero el token tiene límite de tiempo. video_url lleva una firma y también caduca. Descarga lo que debas conservar. O guarda solo el ID de la nota y llama a xiaohongshu/note para obtener un enlace nuevo cuando lo necesites. Los enlaces de user_posts no llevan token y no se abren en el navegador, a diferencia de la búsqueda.
Tercero, deduplica personas con un solo tipo de ID, como explica la sección de campos. Cuarto, trata las publicaciones fijadas y las zonas horarias. Quita las filas con is_pinned en true antes de dibujar por fecha. posted_at y updated_at están en UTC. Una nota publicada a las 15:30 UTC cae en el día siguiente en Singapur, y a las 16:30 o 17:30 en Madrid, según la época del año.
En la página 1 de nuestra cuenta de prueba, 12 de 20 publicaciones salieron entre las 10:00 y las 10:45 UTC, hacia las 18:00 en Singapur. Otras 5 salieron a las 04:01 o 04:02 UTC, el mediodía en Singapur. Los totales diarios por fecha UTC son correctos para esta cuenta, pero un gráfico por horas necesita antes el cambio de zona horaria.
Quinto, filtra las filas de búsqueda por relevancia en el título y la vista previa, por lo que mostró la palabra sin sentido. Con palabras en español o en inglés, esa comprobación se hace sobre texto chino, así que traduce antes la palabra clave.
Sexto, anota la fuente de cada cifra de seguidores. Para una cuenta, search_users dio 70.000 y profile dio 70.497. Si mezclas las dos en una columna, un cambio de fuente suma 497 «seguidores nuevos». Añade una columna de fuente y calcula el crecimiento solo con valores de una misma fuente.
Fallos y resultados vacíos: qué se cobra
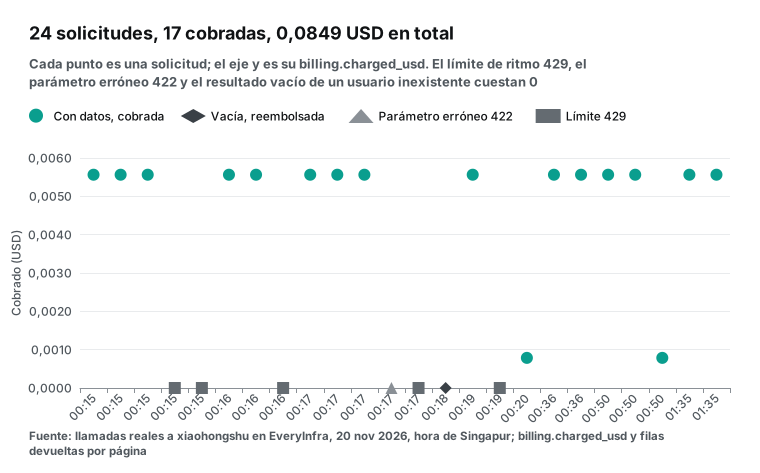
Tres tipos de petición de esta prueba no trajeron datos. Cinco fueron respuestas 429 por límite de ritmo, que llegaron en llamadas seguidas. Una fue un 422 por un parámetro que añadimos a propósito. Otra fue un resultado vacío por un ID inexistente, también a propósito. Leímos billing.charged_usd cada vez.
| Hora (hora de Singapur) | Petición | Estado HTTP | Qué llegó | Cobro (USD) |
|---|---|---|---|---|
| 00:15:37, 00:15:45, 00:16:26, 00:17:43, 00:19:51 | profile, user_posts, note, profile, youtube/search (límite de esta clave: 10 peticiones por minuto) | 429 | rate_limited, retry_after de 22, 15, 34, 16 y 9 s | 0 |
| 00:17:35 | profile con un parámetro extra fields | 422 | unknown_param, solo se permite user_id, con un ejemplo válido | 0 |
| 00:18:03 | profile con un ID de 24 caracteres que no existe | 200 | results vacío, reason: empty_result_refunded, refund.status: succeeded | 0 |
| 00:19:07 | búsqueda con una palabra sin sentido, últimas 24 horas | 200 | 19 notas sin relación | 0,005556 |
La respuesta 422 tiene tres partes. El mensaje dice que fields no es un parámetro de xiaohongshu/profile, que user_id es obligatorio y que no hay parámetros opcionales. Da la URL del catálogo y un ejemplo de petición que funciona. Su campo next_steps dice «Nothing was charged» (no se cobró nada).
Un programa o un modelo de IA puede leer esa respuesta y corregir la llamada. La respuesta 429 lleva retry_after. Esperamos ese tiempo y el reintento funcionó cada vez. El resultado vacío se cobra y luego se devuelve, y el estado de la devolución viene en la misma respuesta.
Las reglas completas de cobro están en nuestra guía de conciliación de devoluciones por fallos.
De un tema a una lista de cuentas
La pregunta en r/OSINT plantea dos cosas. ¿Cómo se encuentran usuarios que publican sobre un tema, y cómo se recogen sus perfiles e historiales? Las capacidades de arriba responden a las dos. Nuestros 40 resultados de búsqueda sobre Singapur venían de 39 autores distintos. Solo un autor aparecía dos veces. Catorce de las 40 notas tenían 1.000 «me gusta» o más. A ese ritmo, 10 páginas (200 notas) dan cerca de 200 autores.
El flujo tiene cuatro pasos, todos con datos públicos. Busca 10 páginas con xiaohongshu/search por 0,056 USD, lo que da 200 notas y sus valores de author_id. Deduplica por author_id, ordena por interacción y quédate con los 50 primeros autores. Llama a xiaohongshu/profile para cada uno de los 50 por 0,28 USD. Después pide una página de xiaohongshu/user_posts por autor, otros 0,28 USD. La lista entera cuesta unos 0,61 USD.
En este flujo importan dos detalles. El orden por relevancia mezcla notas antiguas, y nuestra nota más antigua era del 3 de junio de 2025. Para autores activos hace poco, añade sort=newest o date_range=last_30_days. El catálogo dice que una página de last_30_days puede tener menos de 20 filas, y una página vacía es gratis. Las cuentas de marcas e instituciones también entran en la lista. En nuestras 40 filas de búsqueda, author_is_verified estaba en false en todas, así que la búsqueda no las separa. Lee el perfil y usa verification_type y verification_text, no solo is_verified. El ejemplo de la Oficina de Turismo de Singapur explica por qué.
Un presupuesto mensual: 200 cuentas leídas cada semana
Un equipo de marca sigue 200 cuentas de competidores y creadores. Cada semana lee el perfil, la primera página de publicaciones y la primera página de comentarios de las 3 publicaciones más recientes. Las llamadas y el coste son fijos. El número de comentarios depende de cada nota, así que la tabla da dos filas de comentarios. La fila de páginas llenas supone 15 comentarios en cada página. La fila medida usa la mediana de comment_count, 2,5, de las 20 publicaciones más recientes de la Oficina de Turismo de Singapur.
| Acción | Llamadas por semana | Filas por semana | Coste por semana (USD) |
|---|---|---|---|
xiaohongshu/profile | 200 | 200 perfiles | 1,11 |
xiaohongshu/user_posts página 1 | 200 | 4.000 publicaciones | 1,11 |
xiaohongshu/comments página 1 × 3 publicaciones (páginas llenas) | 600 | hasta 9.000 comentarios | 3,33 |
xiaohongshu/comments página 1 × 3 publicaciones (mediana medida) | 600 | unos 1.500 comentarios | 3,33 |
| Total (cualquiera de las dos filas de comentarios) | 1.000 | 5,56 |
La fila medida sale de la página 1 de user_posts. Siete de esas 20 publicaciones tenían 0 o 1 comentario. Diez tenían de 2 a 19. Las tres últimas tenían 114, 150 y 1.586. La mediana fue 2,5, 17 publicaciones tenían menos de 15 comentarios y 3 no tenían ninguno. Las 3 más recientes tenían 1.586, 3 y 1 comentarios, así que sus primeras páginas podían traer como mucho 15 + 3 + 1 = 19 comentarios, no 45.
Con la fila medida, el precio real es de unos 2,22 USD por 1.000 comentarios, 6 veces el precio de 0,37 USD con páginas llenas. Una nota sin comentarios devuelve un resultado vacío, y los resultados vacíos no se cobran. Con 3 de cada 20, unas 90 de las 600 páginas serían gratis. El coste de los comentarios baja entonces a unos 2,83 USD por semana, y el total, a unos 5,06 USD por semana.
Con 4,33 semanas al mes, el presupuesto con páginas llenas es de unos 24,08 USD al mes, o unos 21,91 USD sin las páginas vacías. Para el coste propio, mira la estimación de horas del camino 1: unos 295 USD al mes con el salario medio español, sin servidores, proxies ni cuentas bloqueadas. Para comparar una herramienta mensual, compara su cuota con estas filas. Cada semana el trabajo lee 200 perfiles y 4.000 publicaciones. Suma los comentarios que reciben de verdad tus cuentas: unos 1.500 en esta cuenta.
La fila correcta depende de lo que sigas. Las 40 notas de viaje de nuestra búsqueda tenían una mediana de 27 comentarios, y 28 tenían 15 o más. Con notas populares como estas, las primeras páginas suelen llegar llenas, y la fila de páginas llenas se acerca más.
La antigüedad también cuenta. La página 2 de la cuenta (publicaciones del 10 de julio al 16 de septiembre de 2026) tenía una mediana de 11,5 comentarios y un máximo de 201. Es 4,6 veces la mediana de 2,5 de la página 1. Una lectura semanal de las 3 publicaciones más nuevas trae pocos comentarios. Para estudiar los hilos de comentarios, elige también publicaciones más antiguas.
Los comentarios son el 60 % de este presupuesto. Si solo quieres saber qué cuenta creció y qué publicación se hizo viral, deja los comentarios al principio. El coste mensual baja a unos 9,63 USD. Pide comentarios solo para una publicación con muchos más «me gusta» que la mediana de la cuenta, por ejemplo 10 veces la mediana. Nuestra cuenta de prueba tiene una mediana de 41, así que el umbral es 410 «me gusta», y 5 de sus últimas 20 publicaciones lo superaron.
Novedades recientes de la plataforma y de las normas
- 16 de noviembre de 2026: el Taipei Times informó de que Taiwán bloquea Xiaohongshu con restricciones de DNS desde el 4 de diciembre de 2025. El Ministerio del Interior prevé prorrogar la restricción un año más desde el 3 de diciembre.
- 13 de noviembre de 2026: TechNode y Ebrun informaron de que Xiaohongshu prueba Dada, una aplicación independiente donde los usuarios convierten su experiencia en agentes de IA. Con el permiso del usuario, un agente puede leer la información pública de su perfil de Xiaohongshu.
- 16 de noviembre de 2026: CNBC escribió que las marcas de moda locales usan Xiaohongshu para darse a conocer. El artículo comparó marcas por los seguidores de sus cuentas oficiales, de 200.000 a más de 300.000 por cuenta.
- 10 de noviembre de 2026: DoNews informó de que una conocida bloguera solidaria pensaba dejar Xiaohongshu. El motivo: publicar datos de contacto exigía un depósito publicitario de 10.000 CNY. Una cronología de Sohu añadió que la cuenta publicitaria de autoservicio pide una primera recarga de 10.000 CNY. Si una cuenta vigilada deja de publicar, la causa puede ser una regla de la plataforma y no la propia cuenta.
- 21 de julio de 2026: la AEPD publicó su nota sobre calidad, exactitud y minimización de datos personales en sistemas de IA.
Cuándo una API de pago por llamada no es la mejor opción
Una API de pago por llamada tiene límites. Solo lee lo que muestra una página pública. Algunos datos están detrás de un inicio de sesión, como los mensajes privados, las estadísticas de tu propia cuenta o las tarifas de los creadores. Para esos datos, usa la plataforma abierta de Xiaohongshu o tu propio panel.
Para un flujo en tiempo real con latencia de segundos, la latencia por llamada y el límite por minuto no encajan. En esta prueba, las llamadas que devolvieron datos tardaron entre 1,3 y 13,8 segundos. Con decenas de millones de filas al día y un equipo jurídico y de cumplimiento de datos propio, un sistema propio puede salir más barato. Al comparar, cuenta las horas a largo plazo que exigen las barreras de arriba.
Nuestra muestra es pequeña. Cubre dos palabras clave, una nota y una cuenta de marca. Algunas proporciones pueden ser muy distintas en otra nota o en otra cuenta. Por ejemplo, 3 de 30 comentarios con ubicación, 4 de 9 vídeos con enlace o una mediana de 2,5 comentarios por publicación. Haz una ronda con tus propios objetivos antes de fijar un presupuesto.
Preguntas frecuentes
¿Cómo escribo búsquedas que encuentren usuarios que publican sobre un tema?
Es la primera parte de una pregunta en r/OSINT. En nuestra prueba, la palabra china para «guía de viaje de Singapur» dio 40 notas de 39 autores. La palabra en inglés «Singapore travel tips» dio 20 notas, todas en chino, y solo 1 coincidía. Escribe las búsquedas en chino para la coincidencia más directa. Para encontrar una cuenta por su nombre, usa xiaohongshu/search_users. El flujo completo está en la sección «De un tema a una lista de cuentas».
¿Cómo se recogen perfiles e historiales de usuarios en RedNote?
Es la segunda parte de la misma pregunta en r/OSINT. Llama a xiaohongshu/profile una vez por cuenta y recorre xiaohongshu/user_posts con next_page_token. La cuenta de 419 publicaciones de la Oficina de Turismo de Singapur necesitó 22 llamadas, unos 0,12 USD. El código de paginación está arriba.
¿Hace falta iniciar sesión para hacer scraping de RedNote?
Para un scraper propio, casi siempre. La pregunta en r/webscraping trata del cuadro de registro de la web. EveryInfra autentica cada llamada con una clave de API de EveryInfra. Nuestras 24 llamadas de prueba solo llevaban esa clave, y las respuestas traían los campos que muestra una página pública.
¿Por qué mi RedNote scraper pierde la sesión?
La publicación en r/DataHoarder lo describe: tras usar un scraper con cookies durante un tiempo, un clic en la web cerró la sesión de la cuenta. El camino 1 de arriba cubre el lado propio. Con la API, el límite que encuentras es el de la clave, 10 peticiones por minuto. Devuelve 429 con retry_after, y nuestras 5 llamadas limitadas costaron 0 USD.
¿Hay algún tutorial en YouTube sobre un rednote scraper?
A las 00:20, hora de Singapur, del 20 de noviembre de 2026, buscamos «rednote scraper» con youtube/search. Los 10 resultados eran tutoriales de la aplicación, guías de registro y noticias de principios de 2025. Un ejemplo es un tutorial de RedNote para principiantes subido el 14 de noviembre de 2026. Ninguno mostraba scraping. A las 00:50 buscamos también «xiaohongshu scraper». Los 3 primeros resultados fueron una demostración de 75 segundos de un programa de escritorio de 2023 (432 visualizaciones), una demostración de un descargador de vídeos y una noticia de principios de 2025. Ninguno trataba de perfiles ni de llamadas a una API.
Primeros pasos
- Obtén una clave de API en el inicio rápido. Las cuentas nuevas reciben un crédito de prueba.
- Abre la página de la API de datos de Xiaohongshu. Elige perfil, publicaciones de usuario, comentarios o búsqueda, y haz una llamada de prueba.
- Conecta tu programa con el ejemplo de curl de arriba, o conecta una herramienta de IA con la configuración MCP de abajo.
MCP es un protocolo abierto. La especificación y la guía de conceptos de servidor son públicas. Nuestro punto de acceso y la lista de herramientas están en la página del servidor MCP. Con esta configuración puedes pedir a Claude o a Cursor que «muestre la interacción de las 20 últimas publicaciones de esta cuenta».
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
Dos artículos anteriores tratan temas cercanos. Recopilación de datos de Xiaohongshu: búsqueda, notas y comentarios explica el flujo de recogida, y Precios de la API de Xiaohongshu explica las unidades de cobro. Para las opciones de API oficial y de terceros, lee API de Xiaohongshu: oficial frente a terceros.
Referencias
- robots.txt de Xiaohongshu, Xiaohongshu, consultado el 2026-11-20, <https://www.xiaohongshu.com/robots.txt>
- Acuerdo de usuario de Xiaohongshu, Xingyin Information Technology, versión del 2026-03-23, <https://agree.xiaohongshu.com/h5/terms/ZXXY20220331001/-1>
- Reglas de recompensa del Centro de Respuesta de Seguridad de Xiaohongshu, Xiaohongshu Security, 2026-08-18, <https://security.xiaohongshu.com/announcements/23>
- Documentación de la API de la plataforma abierta de Xiaohongshu, Xiaohongshu, consultado el 2026-11-20, <https://open.xiaohongshu.com/document/api>
- Catálogo de la API de datos de EveryInfra (Xiaohongshu), EveryInfra, consultado el 2026-11-20, <https://api.everyinfra.com/api/v1/social/catalog?platform=xiaohongshu>
- Catálogo de la API de datos de EveryInfra (completo), EveryInfra, consultado el 2026-11-20, <https://api.everyinfra.com/api/v1/social/catalog>
- Ley contra la Competencia Desleal de la República Popular China (revisión de 2025), Oficina de Pekín de la CSRC, 2025-09-10, <https://www.csrc.gov.cn/beijing/c105536/c7582544/content.shtml>
- Reglamento de Gestión de la Seguridad de los Datos de Red (Decreto 790), Ministerio de Ecología y Medio Ambiente, 2024-10-03, <https://www.mee.gov.cn/zcwj/gwywj/202410/t20241003_1087417.shtml>
- Ley de Protección de la Información Personal, Administración del Ciberespacio de China, 2021-08-20, <https://www.cac.gov.cn/2021-08/20/c_1631050028355286.htm>
- Casos típicos de competencia desleal de 2026, Tribunal Supremo Popular, 2026-09-09, <https://www.court.gov.cn/zixun/xiangqing/511301.html>
- Scraping de datos de usuarios de Xiaohongshu con fines de lucro, indemnización de 1,1 millones de CNY, ciplawyer.cn, 2025-10-28, <https://www.ciplawyer.cn/articles/157825.html>
- Scraping ilegal de datos de Xiaohongshu, tres personas condenadas, ipeconomy.cn, 2025-03-14, <https://www.ipeconomy.cn/dongtai/9167.html>
- Taiwan to extend RedNote restrictions again: sources, Taipei Times, 2026-11-16, <https://www.taipeitimes.com/News/taiwan/archives/2026/11/16/2003867815>
- Xiaohongshu tests standalone app for users to build and share AI agents, TechNode, 2026-11-13, <https://technode.com/2026/11/13/xiaohongshu-tests-standalone-app-for-users-to-build-and-share-ai-agents/>
- «Diandian» y después «Dada»: Xiaohongshu suma otra aplicación de IA, Ebrun, 2026-11-13, <https://www.ebrun.com/20261113/720097.shtml>
- As Nike, Lululemon struggle in China, Xiaohongshu helps local brands, CNBC, 2026-11-16, <https://www.cnbc.com/2026/11/16/as-nike-lululemon-struggle-in-china-xiaohongshu-helps-local-brands.html>
- Inter: nuevos canales oficiales en China en Bilibili y REDnote, FC Internazionale Milano, consultado el 2026-11-20, <https://www.inter.it/en/news/inter-new-official-channels-china-bilibili-rednote>
- Over half a million 'TikTok refugees' flock to China's RedNote, Reuters, 2025-01-14, <https://www.reuters.com/technology/over-half-million-tiktok-refugees-flock-chinas-rednote-2025-01-14/>
- Refugees of the Digital Space: Platform Migration from TikTok to RedNote, arXiv 2510.18894, 2025-10-19, <https://arxiv.org/abs/2510.18894>
- Rejection or Inclusion in the Emotion-Identity Dynamics of TikTok Refugees on RedNote, arXiv 2507.14623, 2025-07-19, <https://arxiv.org/abs/2507.14623>
- RedNote-Vibe: A Dataset for Capturing Temporal Dynamics of AI-Generated Text, arXiv 2509.22055, v2 2026-04-11, <https://arxiv.org/abs/2509.22055>
- Qilin: A Multimodal Information Retrieval Dataset with APP-level User Sessions, arXiv 2503.00501, 2025-03-01, <https://arxiv.org/abs/2503.00501>
- RFC 9309: Robots Exclusion Protocol, IETF, 2022-09, <https://www.rfc-editor.org/rfc/rfc9309.html>
- RFC 6585: Additional HTTP Status Codes, IETF, 2012-04, <https://datatracker.ietf.org/doc/html/rfc6585>
- RFC 9110: HTTP Semantics, IETF, 2022-06, <https://datatracker.ietf.org/doc/html/rfc9110>
- WebDriver, W3C, consultado el 2026-11-20, <https://www.w3.org/TR/webdriver2/>
- urllib.robotparser, documentación de Python, consultado el 2026-11-20, <https://docs.python.org/3/library/urllib.robotparser.html>
- playwright 1.65.2, PyPI, consultado el 2026-11-20, <https://pypi.org/project/playwright/>
- Authentication, documentación de Playwright, consultado el 2026-11-20, <https://playwright.dev/docs/auth>
- Especificación de Model Context Protocol 2025-06-18, MCP, <https://modelcontextprotocol.io/specification/2025-06-18>
- Understanding MCP servers, documentación de MCP, consultado el 2026-11-20, <https://modelcontextprotocol.io/docs/learn/server-concepts>
- Headless Chrome, Chrome for Developers, consultado el 2026-11-20, <https://developer.chrome.com/docs/chromium/headless>
- 429 Too Many Requests, MDN, consultado el 2026-11-20, <https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Status/429>
- Encuesta Anual de Estructura Salarial, año 2024, datos definitivos, INE, consultado el 2026-11-20, <https://www.ine.es/dyngs/Prensa/EAES2024.htm>
- Tipos de cambio de referencia del euro, Banco Central Europeo, 2026-11-19, <https://www.ecb.europa.eu/stats/eurofxref/eurofxref-daily.xml>
- Has anyone had success scraping chinese ig/xiaohongshu?, Reddit r/DataHoarder, consultado el 2026-11-20, <https://www.reddit.com/r/DataHoarder/comments/1mp1t8p/has_anyone_had_success_scraping_chinese/>
- get past registration or access the mobile web version for scrap, Reddit r/webscraping, consultado el 2026-11-20, <https://www.reddit.com/r/webscraping/comments/1kmbow1/get_past_registration_or_access_the_mobile_web/>
- Rednote (Xiaohongshu) help? Crafting better search terms, scraping user profiles, Reddit r/OSINT, consultado el 2026-11-20, <https://www.reddit.com/r/OSINT/comments/1jcyu18/rednote_xiaohongshu_help_crafting_better_search/>
- Xiaohongshu Statistics and User Demographics for 2026, Marketing to China, 2026-11-08, <https://marketingtochina.com/xiaohongshu-statistics-and-trends/>
- How to Use RedNote App for Beginners (2026), YouTube, 2026-11-14, <https://www.youtube.com/watch?v=La3LBsnGb4I>
- Reglamento (UE) 2016/679 (RGPD), EUR-Lex, <https://eur-lex.europa.eu/eli/reg/2016/679/oj>
- Reglamento (UE) 2016/679, texto publicado en el DOUE, BOE, <https://www.boe.es/doue/2016/119/L00001-00088.pdf>
- Ley Orgánica 3/2018, de Protección de Datos Personales y garantía de los derechos digitales, BOE, consultado el 2026-11-20, <https://www.boe.es/buscar/act.php?id=BOE-A-2018-16673>
- La AEPD analiza la calidad, exactitud y minimización de datos personales en tratamientos realizados con sistemas de IA, AEPD, 2026-07-21, <https://www.aepd.es/prensa-y-comunicacion/notas-de-prensa/aepd-analiza-calidad-exactitud-y-minimizacion-de-datos-personales-en-tratamientos-con-ia>
- Software Developers, Quality Assurance Analysts, and Testers, US Bureau of Labor Statistics, consultado el 2026-11-20, <https://www.bls.gov/ooh/computer-and-information-technology/software-developers.htm>
- Una conocida bloguera solidaria piensa dejar Xiaohongshu por un depósito de 10.000 CNY para publicar datos de contacto, DoNews, 2026-11-10, <https://www.donews.com/news/detail/1/6771424.html>
- Bloguera solidaria piensa dejar Xiaohongshu (cronología), Sohu, 2026-11-10, <https://timeline.sohu.com/news/NHCzZpqLp4?from=news>
Referencia BL-198