小红书数据接口每千次请求多少钱
小红书数据接口怎么收费:官方开放平台要企业资质、开源脚本要自养代理、第三方按次 API 每千次 10 到 38 美元,我们实测每千次 5.556 美元。
同样是拿小红书的公开笔记和评论,三条路的价钱和门槛差得很远。官方开放平台(open.xiaohongshu.com)面向商家和服务商,要企业资质、分别申请权限、走审核,笔记和评论这类内容数据并不按次零售给个人;开源脚本的代码是免费的(MediaCrawler 42,000 多颗星),但要你自己养服务器、代理和登录态,签名一变就得重写;第三方按次付费 API 公开定价每 1,000 次请求 $10 到 $38。我们用 EveryInfra 的 xiaohongshu/* 能力在 2026 年 11 月 17 日真调了一轮,标准能力每次请求固定扣 $0.005556,接口自带的 per_1k 字段直接写着每 1,000 次 $5.556——比最便宜的第三方公开价再省约 1.8 倍,而且失败和空结果不扣费、没有月费、余额不过期。
价格用两种单位写清楚——每 1,000 次请求(直接对应接口标价),和每 1,000 条结果(把一次请求的钱摊到这次返回的条数上)。我们这一侧的每个数都来自 2026 年 11 月 17 日的真实调用;三条外部路线只用公开资料,官方文档、GitHub、官网和公开定价页,每条都写了读取日期。
先把三条路放进一张表
下表把三条路和我们的实测放在一起,统一换算到每 1,000 次请求。官方开放平台一栏写的是「不单独零售」,因为它没有面向公众的、按次计费的内容数据接口;开源脚本一栏写的是「代码免费」,因为它给的是代码、不是现成的数据,真实花费在服务器和维护上。第三方按次付费 API 一栏取三家公开定价页在 2026 年 11 月 17 日的现价,泛称「第三方按次付费 API」。
| 路线 | 每 1,000 次请求 | 计费方式 | 失败/空结果 | 最低投入 | 能不能接 MCP/AI |
|---|---|---|---|---|---|
| 官方开放平台 | 不按次零售内容数据 | 按 QPS、按能力授权 | — | 企业资质 + 审核周期 | 否(商家数据接口) |
| 开源脚本 | 代码免费,无按次价 | 自备服务器、代理 | 自己处理 | 服务器 + 代理 + 维护工时 | 要自己封装 |
| 第三方按次付费 API | $10–$38 | 按次(成功才扣) | 多数只对成功计费 | 部分有最低充值/月费 | 看各家 |
| EveryInfra(实测) | $5.556 | 按次($0.005556/次) | 失败和空结果不扣费 | 无月费、无最低充值 | 远程 MCP,工具名 everyinfra_* |
这张表里只有最后一行是真调出来的数字,其余三行是公开资料。要读懂这张表,先记住一件事:每 1,000 次「请求」不等于每 1,000 条「结果」。小红书的多数能力一次请求返回一页,大约 15 到 20 条,想要下一页就带上 page_token 再请求一次。所以同样一笔 $0.005556,搜索能回 20 条、评论能回 15 条,而主页详情只回 1 个账号对象。把钱摊到条数上,差别就出来了,这一点在后面「每 1,000 条结果」一节会逐个算。
按请求算:每 1,000 次请求,我们是 $5.556
我们这一侧的价钱来自真调时接口直接返回的数字,不取网页上的标价。2026 年 11 月 17 日 00:20:24 新加坡时间(SGT),我们用 xiaohongshu/search 搜「护肤」,返回 20 条笔记,响应里的 billing.charged_usd 是 0.005556,同一段 billing.amount.per_1k.USD 写着 5.555556。也就是说,每 1,000 次请求 $5.556 由接口自己报出,我们没有另做换算。这一轮我们一共打了 11 次计费成功请求,覆盖 xiaohongshu/search、xiaohongshu/search_users、xiaohongshu/profile、xiaohongshu/user_posts、xiaohongshu/note、xiaohongshu/comments、xiaohongshu/product_search、xiaohongshu/reviews 八个能力,每一次成功请求都扣 $0.005556,和免费目录里这些能力的 price_usd 完全一致(EveryInfra 目录,2026 年 11 月 17 日读取)。
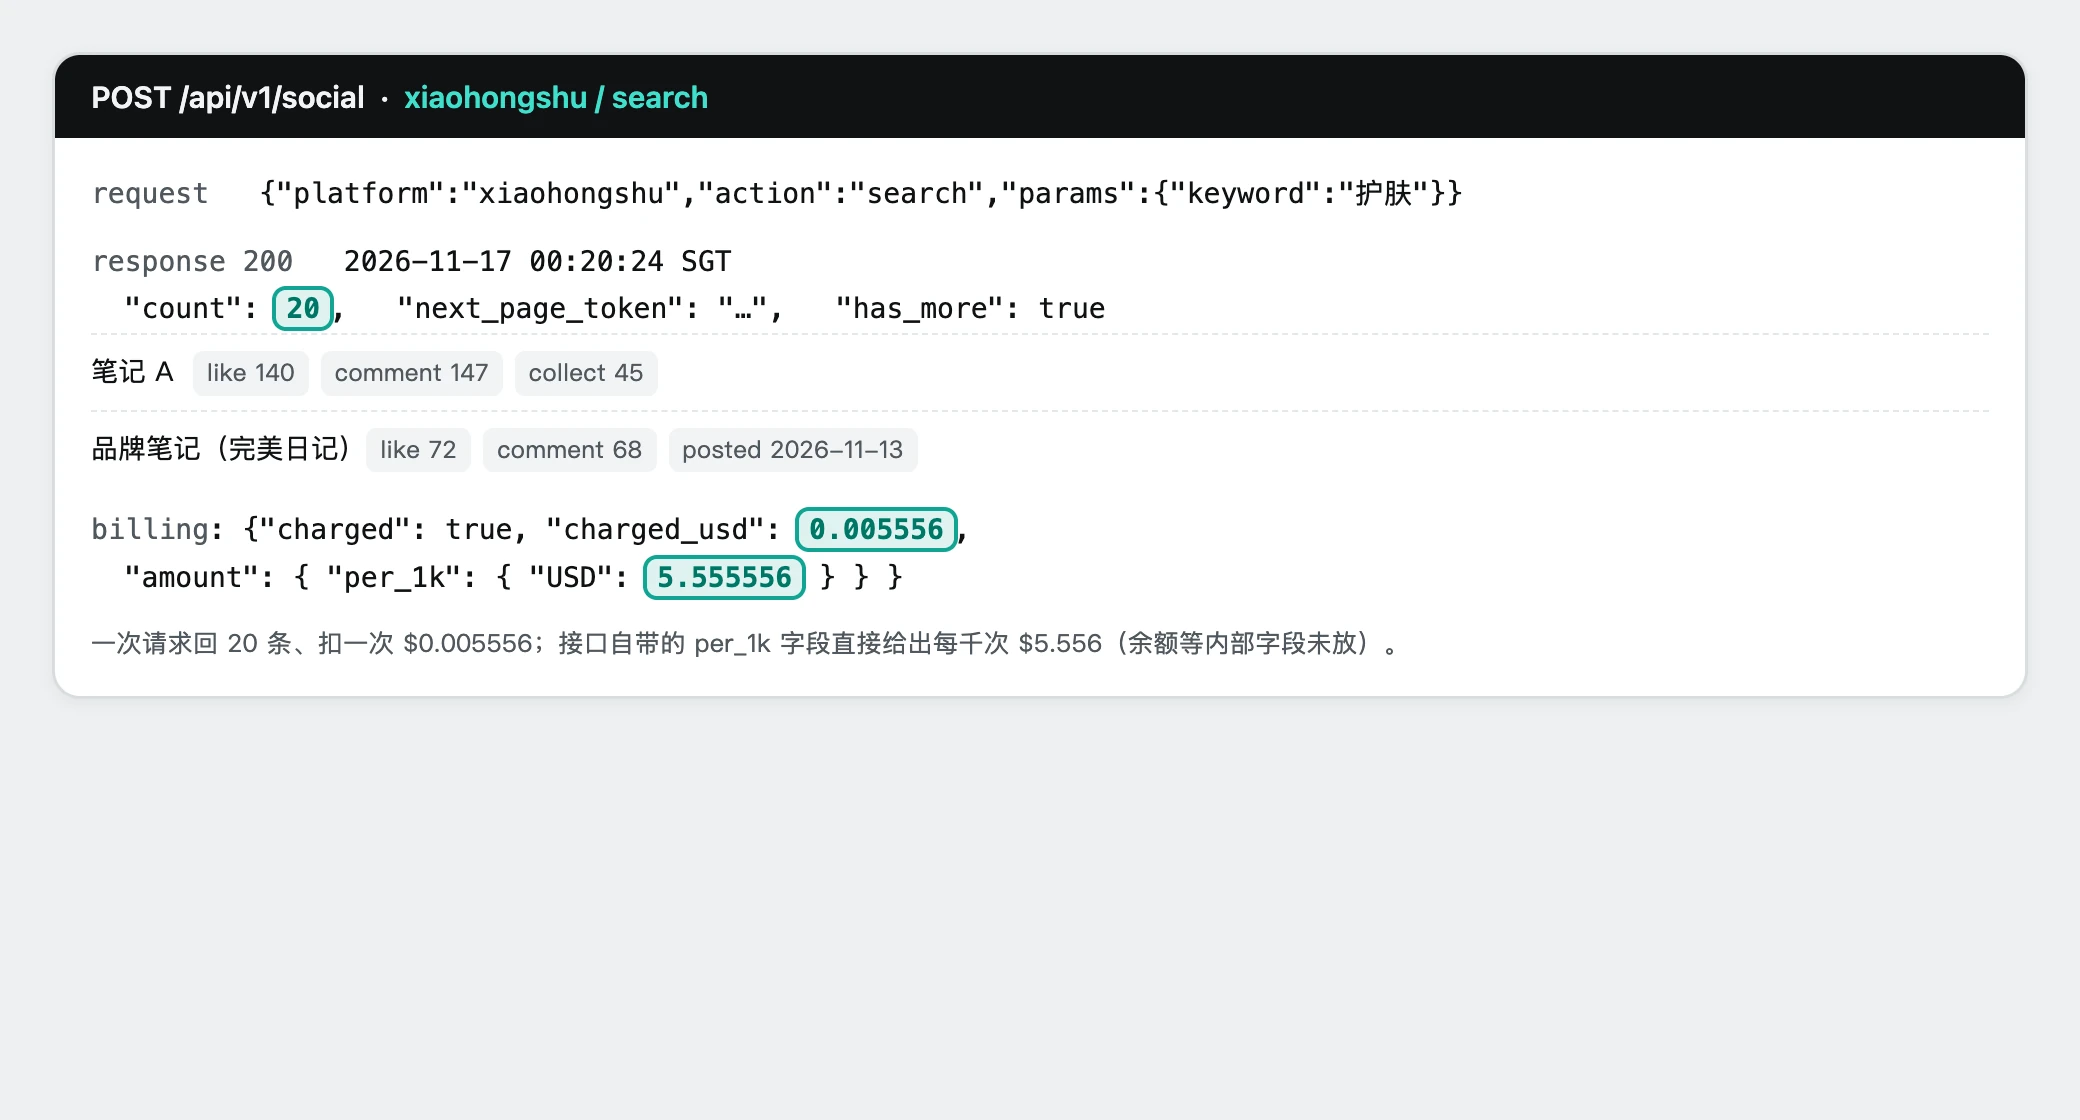
目录里小红书一共有 17 项能力,当天读到的全部 available=true。除了一项「蒲公英内容广场搜索」(xiaohongshu/pgy_content_square)按每次 $0.016(每 1,000 次 $16)算,其余 16 项都是 $0.005556 一次。换句话说,不管你查的是搜索、主页、笔记、评论、用户、话题还是商品,标价都一样,一次请求一个价,不按字段多少、不按功能开关另收钱。这和按条计费的做法不同:按条计费时,一页回得越满单价越低、回得越少单价越高;按次计费时,回 1 条和回 20 条都是同一笔钱。
按次计费对数据团队还有一个好处:参数不牵着账单走。按条或按功能计费时,加一个日期筛选、换一种排序、多取一层回复,都可能是额外的收费项,账单会随参数变化;按次计费下,这些参数用不用都是同一笔 $0.005556,你只需要数请求次数。它也让逐步放量变得简单:先用几十次请求验证字段和覆盖,确认没问题再按天放大,中途不用担心某个参数把单价翻倍。
把第三方按次付费 API 的公开价放进来比。一家第三方 RedNote 数据 API 的定价页写着「note 端点每 1,000 次请求起价 $12.00,按次计费、无订阅、无月度最低」,并说最便宜的端点是每 1,000 次 $10(第三方 RedNote API 文档,2026 年 11 月 17 日读取)。另一家写「最低每次请求 $0.01」,也就是每 1,000 次 $10,「只对成功请求计费」(第三方 RedNote API 文档,2026 年 11 月 17 日读取)。第三家按积分计费,「每次调用 5 积分」,按积分包折算「大约每次 £0.01 到 £0.03」,也就是每 1,000 次约 $13 到 $38(第三方 Xiaohongshu API 文档,2026 年 11 月 17 日读取)。把三家合起来,第三方按次付费 API 的公开价落在每 1,000 次 $10 到 $38 这个区间,最便宜的一档是 $10。
所以按每 1,000 次请求算,我们的 $5.556 比最便宜的第三方公开价 $10 省约 1.8 倍,比中位的 $12 省约 2.16 倍,比高档的 $38 省约 6.84 倍。差距不算夸张,但方向是稳定的:我们的点落在整个第三方公开区间的左边。更要紧的是单价之外的几件事——失败和空结果扣不扣钱、有没有最低充值、余额会不会过期、能不能接进 AI 工具,这些在后面几节逐个写,它们往往比标价更能决定一个月的账单。
按条算:每 1,000 条结果,按能力分开
一次请求的钱是固定的,但一次请求能回多少条不固定,所以「每 1,000 条结果」要按能力分开算。公式很简单:每千条 = 单次价 $0.005556 ÷ 这次实际返回条数 × 1000。我们把当天真调的返回条数代进去,得到下面这张表。搜索一次回 20 条,折合每千条 $0.278;评论一次回 15 条,折合每千条 $0.370;商品评价一次回 20 条,和搜索一样是 $0.278;用户内容一次回 20 条,也是 $0.278。主页和笔记详情一次只回 1 个对象,所以每千条就等于每千次,$5.556。
| 能力 | 一次返回 | 每千条结果 | 真调时间(SGT) | 真调返回 |
|---|---|---|---|---|
xiaohongshu/search 搜索 | 20 条/页 | $0.278 | 00:20:24 | 护肤,20 条 |
xiaohongshu/user_posts 用户内容 | 20 条/页 | $0.278 | 00:22:04 | 某品牌号,20 条 |
xiaohongshu/reviews 商品评价 | 20 条/页 | $0.278 | 00:28:06 | 某面膜,20 条 |
xiaohongshu/product_search 商品搜索 | 18 条/页 | $0.309 | 00:27:34 | 面膜,18 条 |
xiaohongshu/comments 评论 | 15 条/页 | $0.370 | 00:22:52 | 品牌笔记,15 条 |
xiaohongshu/profile 主页 | 1 个对象 | $5.556 | 00:21:55 | 某品牌号 |
xiaohongshu/note 笔记详情 | 1 个对象 | $5.556 | 00:22:43 | 品牌笔记 |
这张表把「每千次」和「每千条」的区别摆清楚了。如果你要的是成批的数据——某个关键词下的一批笔记、一条笔记下的一批评论、一个商品下的一批评价——那么每 1,000 条只要两三毛美元,因为一次请求就回一整页。如果你要的是一个一个对象的精确详情——某个账号的主页资料、某条笔记的完整正文——那么一次只回 1 个,每千条就回到 $5.556。换路之前先想清楚你的活偏哪一种:成批取内容时按次计费便宜得多,逐个查详情时两种计费方式接近。
需要说明一点:小红书这些能力在我们的目录里没有 limit 参数,翻页靠 page_token,所以「一次 20 条」是平台一页的自然条数,不是我们设的上限。我们试过在 xiaohongshu/comments 的请求里多加一个 limit: 200,接口照常返回 15 条、照常扣 $0.005556,limit 被忽略,没有报错也没有多扣钱。想要更多评论,就带 next_page_token 再请求一次,每页再扣 $0.005556。
翻页与去重:两页里有多少是新的
既然要靠翻页累积,就得知道翻页会不会重复。2026 年 11 月 17 日 00:27:04 SGT,我们用上一页的 page_token 翻了搜索「护肤」的第二页,又回 20 条。把两页按笔记 id 去重,40 条里 0 条重复,也就是搜索的两页完全不重叠,40 条全是新的。评论的翻页有少量重叠:同一条品牌笔记,第一页 00:22:52 回 15 条、第二页 00:27:16 又回 15 条,两页按 id 去重后剩 27 条,重复了 3 条,重复率 10%。
这意味着按 page_token 翻页时,搜索可以放心一页页往下取、不用担心重复,而评论要按 id 去重,去掉约一成的重叠。按不重复条数重算,评论两页 30 次返回去重后 27 条,折合每千条约 $0.411,比单页的 $0.370 贵约 11%,仍然远低于按条计费的第三方做法。对需要全量评论的活,这点重复开销可以忽略;主要的限制是没有一次取几百条的参数,深翻一条热门笔记要多发几次请求,好在每次只有 $0.005556。换句话说,要把一条热门笔记下的评论抓全,就顺着翻页一次次往下取、在客户端按条目标识累积去重,整条流程的花费始终跟着请求次数走,不会因为某一页评论特别密就突然变贵,这让「抓多深、花多少」在开工前就能算清楚。
内容会变是另一件要注意的事。同一个关键词「护肤」,我们在 00:20:24 和 00:38:38 各搜了一次,两次各 20 条,只有 1 条重合。价格两次都是 $0.005556,稳得很;但结果是「当时的一批」,不是一张固定的表。做趋势或舆情监控,就按固定时间多抓几次、按 id 去重累积;按次计费下这很便宜,一个关键词一天抓 10 次也只是 $0.056。
拿到手的数据长什么样:字段与新鲜度
价格只是一面,另一面是这笔钱买回的数据有多全、多新。小红书的能力返回的字段,和免费目录里每个能力的 response_fields 逐个对得上(EveryInfra 目录,2026 年 11 月 17 日读取)。搜索(xiaohongshu/search)一条笔记回 30 个字段,包括 id、url、title、text、like_count、collect_count、comment_count、share_count、posted_at、author_name、author_id、is_video、is_goods_note、is_cooperation_note、author_is_verified、poi_id、poi_name 等;评论(xiaohongshu/comments)回 id、text、like_count、posted_at、ip_location、author_name、sub_comment_count、is_author、author_is_ai_agent 等;主页(xiaohongshu/profile)回 nickname、red_id、follower_count、following_count、post_count、like_collect_count、ip_location、is_verified、verification_type 等;商品评价(xiaohongshu/reviews)回 rating、rating_scale、service_rating、logistics_rating、sku、posted_date 等。做舆情要的作者归属、IP 归属、合作笔记标记、商品笔记标记,都在字段里。
| 能力 | 关键字段(节选) | 能回答的问题 |
|---|---|---|
xiaohongshu/search | is_goods_note、is_cooperation_note、poi_name、author_is_verified | 这批内容里有多少是带货、合作、门店笔记 |
xiaohongshu/comments | ip_location、sub_comment_count、author_is_ai_agent | 评论的地域分布、有多少带回复、疑似机器评论 |
xiaohongshu/profile | follower_count、post_count、verification_type、ip_location | 账号体量、认证类型、归属地 |
xiaohongshu/reviews | rating、service_rating、logistics_rating、sku | 商品口碑、服务和物流评分、分 SKU 的反馈 |
新鲜度可以从真调里直接看。2026 年 11 月 17 日搜「护肤」回的那一页里,有 2026-11-15、2026-11-14、2026-11-12、2026-11-10、2026-11-09 发布的笔记;查的那个品牌官方号近一个月的内容覆盖了 2026-11-13、2026-10-29、2026-10-24 等日期;那款面膜的评价里最新一条是 2026-11-16 发布。也就是说,当天这一笔钱买到的是当天的内容,不是一张半年前的快照。对趋势和舆情这很要紧:数据的时间戳越近,判断越准。
用 Python 取这些数据不需要自己处理签名,发一个标准 HTTP 请求即可(用标准库 urllib.request 或第三方的 requests,后者在 PyPI 上):
import requests
r = requests.post("https://api.everyinfra.com/api/v1/social",
    headers={"Authorization": f"Bearer {KEY}"},
    json={"platform": "xiaohongshu", "action": "search", "params": {"keyword": "护肤"}})
data = r.json()
print(data["count"], data["billing"]["charged_usd"])  # 20 0.005556
# 翻页:params["page_token"] = data["next_page_token"],再 POST 一次
和开源脚本那条路比,这里省掉的正是签名、设备注册、登录态和代理——这几样恰好是开源脚本每次 App 更新后要重修的部分。字段的稳定性也值得一提:同一个能力两次调用返回的字段结构一致,response_fields 里列的就是你会拿到的,不会这次有 ip_location、下次没有。对把数据写进数据库或下游分析的团队,字段稳定意味着解析代码一次写好、不用追着平台改版跑,这部分省下的工时同样是实打实的成本,也是按次付费接口相对自建开源脚本最容易被低估的一项长期优势。
路一:官方开放平台,为什么拿不到按次的内容数据
官方开放平台常被默认成一个现成的数据接口,但它的定位不是这个。它面向商家和服务商,覆盖电商经营、内容管理和广告投放三个方向,典型用途是商家把订单接进自己的 ERP 做统一发货和库存管理(CNDev 小红书开放平台,2026 年 11 月 17 日读取)。接入方式是注册开发者账号、创建应用、分别申请对应能力的权限,用 AppKey 和密钥签名调用,访问商家数据还要经商家授权;官方文档也写明「需要企业资质,接口权限需分别申请并说明用途,审核有周期」。换句话说,这是一条给有资质的商家和服务商走的通道,不是给个人按次买公开笔记的货架。
官方的签名方式也印证了这是一套 B2B 接口。开放平台的「获取商品列表」示例要求把 query 和 header 的参数按字母序拼接,接上 app-secret,再用 MD5 生成 sign,带上 app-key、timestamp 一起请求(小红书大学·开放平台请求签名,2026 年 11 月 17 日读取)。这套流程本身不难,难的是前面那一步:拿到 app-key 要先过企业资质和应用审核。对一个想批量取公开笔记、评论做研究或选品的团队来说,这条路要先过企业资质和应用审核,拿到的也只是商家授权范围内的数据;前置门槛比每千次的单价更关键。
那些在技术社区里流传的「小红书笔记详情 API」教程,多数讲的其实是第三方采集方案,而非官方这套。一篇对比文章就把两条路分得很清楚:官方开放平台适用于企业和认证开发者、要企业资质,第三方采集方案适用于个人开发者和中小团队、门槛低但要自己应对风控(CRMEB 小红书笔记详情 API 解析,2026 年 6 月 17 日)。另有教程演示通过腾讯云侧的封装走「资质申请→OAuth2.0 授权→按 QPS 调用」(腾讯云开发者社区,2026 年 8 月 31 日),以及用笔记详情和作品列表接口做竞品分析的流程(阿里云开发者社区,2026 年 1 月 9 日)。这些都说明:要走官方合规通道,前置的资质和授权是真门槛,不是花钱就能当天开通。
还有一层是合规。小红书开放平台明确要求用户和消费者信息的使用符合平台规范与个人信息保护相关法规,这背后是《个人信息保护法》对处理个人信息的约束(全国人大·个人信息保护法)、《数据安全法》对数据处理活动的要求(全国人大·数据安全法),以及《网络数据安全管理条例》对数据处理者的规定(国家网信办)。商家接入开放平台、上线小程序还要过工信部的 ICP 备案(工信部备案)。对把数据用于商业的团队,合规是三条路共同的底线,只是官方通道把它前置成了准入条件。
路二:开源脚本,代码免费不等于数据免费
开源脚本是门槛最低、也最容易低估成本的一条路。最有代表性的是 MediaCrawler,一个支持小红书、抖音、快手、B 站、微博、贴吧、知乎的采集工具,GitHub 上有 42,000 多颗星。它的技术思路是用 Playwright 启动浏览器、保留登录态,通过 JS 表达式拿到签名参数,官方自己称这样「无需逆向复杂的加密算法,大幅降低技术门槛」。另一个常被引用的是 ReaJason/xhs,一个基于小红书 Web 端的请求封装,也发布在 PyPI 上可以 pip install xhs(xhs on PyPI,2026 年 11 月 17 日读取)。
代码免费,但跑起来要花钱和花人。MediaCrawler 的默认模式要连接本机已有的 Chrome(版本要求 ≥144),开启远程调试,扫二维码登录,还要配 IP 代理池来降低风控检测(MediaCrawler 说明,2026 年 11 月 17 日读取)。这几样加起来就是真实成本:一台能长期跑浏览器的服务器、一份住宅或动态代理(按量或按月付给代理服务商)、一个或多个小红书账号(有被风控和封号的风险)、以及最贵的一项——维护工时。社区里把维护成本讲得很直接:平台一旦更新签名算法,走 JS 逆向路线的代码「即报废,维护成本极高」,即便是靠浏览器拿签名的方案,平台改前端 JS 时函数名变更也要同步更新(掘金·MediaCrawler 深度解析,2026 年)。
还有合规和授权这一层,开源作者自己写得很清楚。MediaCrawler 的免责声明写明「仅供学习和参考之用,禁止用于商业用途」,并提醒遵守《网络安全法》等法规;ReaJason 的仓库也在显著位置写着「web crawling may be considered illegal」。这不是客套:把开源脚本用于商业采集,法律责任要自己承担。项目的问题区里,关于登录失效、签名更新、代理被封的讨论一直在更新(MediaCrawler Issues,2026 年 11 月 17 日读取)。开源脚本不按次计价:代码是免费的,数据不是,你付的是服务器、代理、账号和维护的总账,再加上自担的风控和合规风险。
| 这一路要自己出的 | 具体是什么 | 谁来承担 |
|---|---|---|
| 服务器 | 能长期跑 Chrome 的机器(CDP 模式) | 按月付云厂商 |
| 代理 IP 池 | 住宅/动态代理,降低风控 | 按量或按月付代理服务商 |
| 账号 | 登录态、扫码登录,有封号风险 | 自己养号 |
| 维护 | 签名随 App 更新失效,要跟着改 | 自己的工程师工时 |
| 合规 | 免责声明禁止商用,责任自负 | 使用者 |
开源这条路的隐性成本还在运行方式上。MediaCrawler 推荐用 CDP 模式连接你已经登录好的 Chrome,复用浏览器里的 Cookie 和登录态,能降低被风控识别的概率,但代价是你得有一台常开着、带登录态、Chrome 保持较新版本的机器。这些工时是隐性的,不出现在任何「每千次多少钱」的标价里,但它是开源这条路真实的月度成本。
对要不要走这条路,有一个简单的判断:如果你是研究者或学生、数据量小、能接受随时修代码,开源脚本是最省钱的;如果你要稳定、要量、要把数据接进业务,自养这一套的隐性成本往往超过按次付费的接口,而且风险在你这边。
路三:第三方按次付费 API,公开价每千次 $10–$38
第三方按次付费 API 是把上面开源那套的脏活替你包了:请求签名、设备注册、风控对抗、翻页,它来维护,你只管发 HTTP 请求。代价是单价。一家第三方把这笔账算得很直白:自己写采集要「逆向请求签名,App 一更新就重做」「自己处理风控、验证码和访问限制」「端点和字段随时变,得有人维护」「服务器、代理等基础设施另外花钱」,而用它的接口「几分钟拿到 key 就能发第一次请求」「按次付费、只对成功请求计费、没有月费」(第三方 RedNote API 文档,2026 年 11 月 17 日读取)。这段话也正好说明了开源那条路省下的单价,换成了你自己的维护成本。
价格上,前面按请求算的一节已经给了区间:三家公开定价页在 2026 年 11 月 17 日的现价是每 1,000 次 $10 到 $38,最便宜一档 $10。几家的计费细节略有不同,值得单独看。一家按美元钱包扣费,note 端点每 1,000 次起价 $12,并说明「部分失败的、用钱包付费的请求会按成本收一笔处理费,错误响应里会写明收了多少」(第三方 RedNote API 定价,2026 年 11 月 17 日读取)——也就是说,它不是所有失败都免费。另一家强调「只对成功请求计费」。按积分计费的那家给新账号 100 个免费积分,每次调用 5 积分,速率上限每分钟 600 次、并发 50,缓存命中不扣积分(第三方 Xiaohongshu API 文档,2026 年 11 月 17 日读取)。
| 看哪一项 | 第三方按次付费 API(公开资料) | EveryInfra(实测) |
|---|---|---|
| 每 1,000 次请求 | $10–$38 | $5.556 |
| 计费单位 | 按次 / 按积分 | 按次($0.005556/次) |
| 失败/空结果 | 多数只对成功计费,个别失败收处理费 | 失败和空结果不扣费 |
| 免费额度 | 有的给免费积分 | 测试 Key 可试 |
| 最低投入 | 部分有最低充值或月费 | 无月费、无最低充值 |
| 接 AI 工具 | 看各家 | 远程 MCP,工具名 everyinfra_* |
把这张表和我们的实测对读,结论是:第三方按次付费 API 和我们走的是同一种计费方式(按次、成功才扣),所以直接可比;我们的单价落在它们区间的左边,再省约 1.8 倍起步。要注意的是,第三方各家字段、成功率、延迟不同,我们没有注册或购买任何一家的服务,所以这里只用它们的公开标价,不比字段细节。绝不表示我们的数据来自其中任何一家,也不表示两边字段一样。
单价之外,还有三件事会改变一个月的实际账单,值得在选型时一起算。第一件是最低投入。按次付费接口里,有的给免费额度、随用随充,有的要先开月费套餐或最低充值,用量小的月份里月费会把每次的实际成本抬高。一家第三方把企业采购关心的三件事写进了自己的文档:按账期后付、开具带公司抬头的发票、能逐条对账,这说明较大的客户往往走的是预付或后付套餐,不是单纯的随用随付。第二件是失败怎么算。有的接口对「看起来有效、实际会出错」的请求也收处理费,账单里要看它的错误计数;我们这一侧失败和空结果都不扣费,省掉了这部分不确定性。第三件是延迟和成功率。公开资料里,有的接口标了近 30 天约 97% 的成功率和约 1.7 秒的响应中位数,这些是各家自己的测量,不同能力、不同时段会波动,批量跑之前最好用自己的样本量一遍。这三件事合起来,往往比每千次的标价更能决定你一个月实际付出去多少钱。
我们的真调:一笔笔对着看
把前面用到的数字摊开,是这一轮 11 次计费成功请求(每次 $0.005556,合计 $0.061116)和 1 次返回 503、未计费请求的记录。时间都是新加坡时间,分三个时段打,跨度 18 分钟。目标只选品牌和机构账号(某美妆品牌官方号、某面膜商品),个人创作者的昵称和普通评论者的名字一律隐去。
| 能力 | 时间(SGT) | 返回 | 扣费 |
|---|---|---|---|
xiaohongshu/search 护肤 | 00:20:24 | 20 条 | $0.005556 |
xiaohongshu/search_users 某品牌 | 00:20:34 | 20 个账号 | $0.005556 |
xiaohongshu/profile 某品牌号 | 00:21:55 | 1 个账号,粉丝 1,828,871 | $0.005556 |
xiaohongshu/user_posts 某品牌号 | 00:22:04 | 20 条笔记 | $0.005556 |
xiaohongshu/note 品牌笔记(2026-11-13 发布) | 00:22:43 | 1 条,68 条评论 | $0.005556 |
xiaohongshu/comments 第 1 页 | 00:22:52 | 15 条 | $0.005556 |
xiaohongshu/search 护肤 第 2 页 | 00:27:07 | 20 条(与第 1 页 0 重复) | $0.005556 |
xiaohongshu/comments 第 2 页 | 00:27:16 | 15 条(与第 1 页 3 重复) | $0.005556 |
xiaohongshu/pgy_content_square 蒲公英内容广场 | 00:27:23 | 返回 503、未扣费 | $0 |
xiaohongshu/product_search 面膜 | 00:27:34 | 18 个商品 | $0.005556 |
xiaohongshu/reviews 某面膜 | 00:28:06 | 20 条评价 | $0.005556 |
xiaohongshu/search 护肤 复测 | 00:38:38 | 20 条(与首次 1 重复) | $0.005556 |
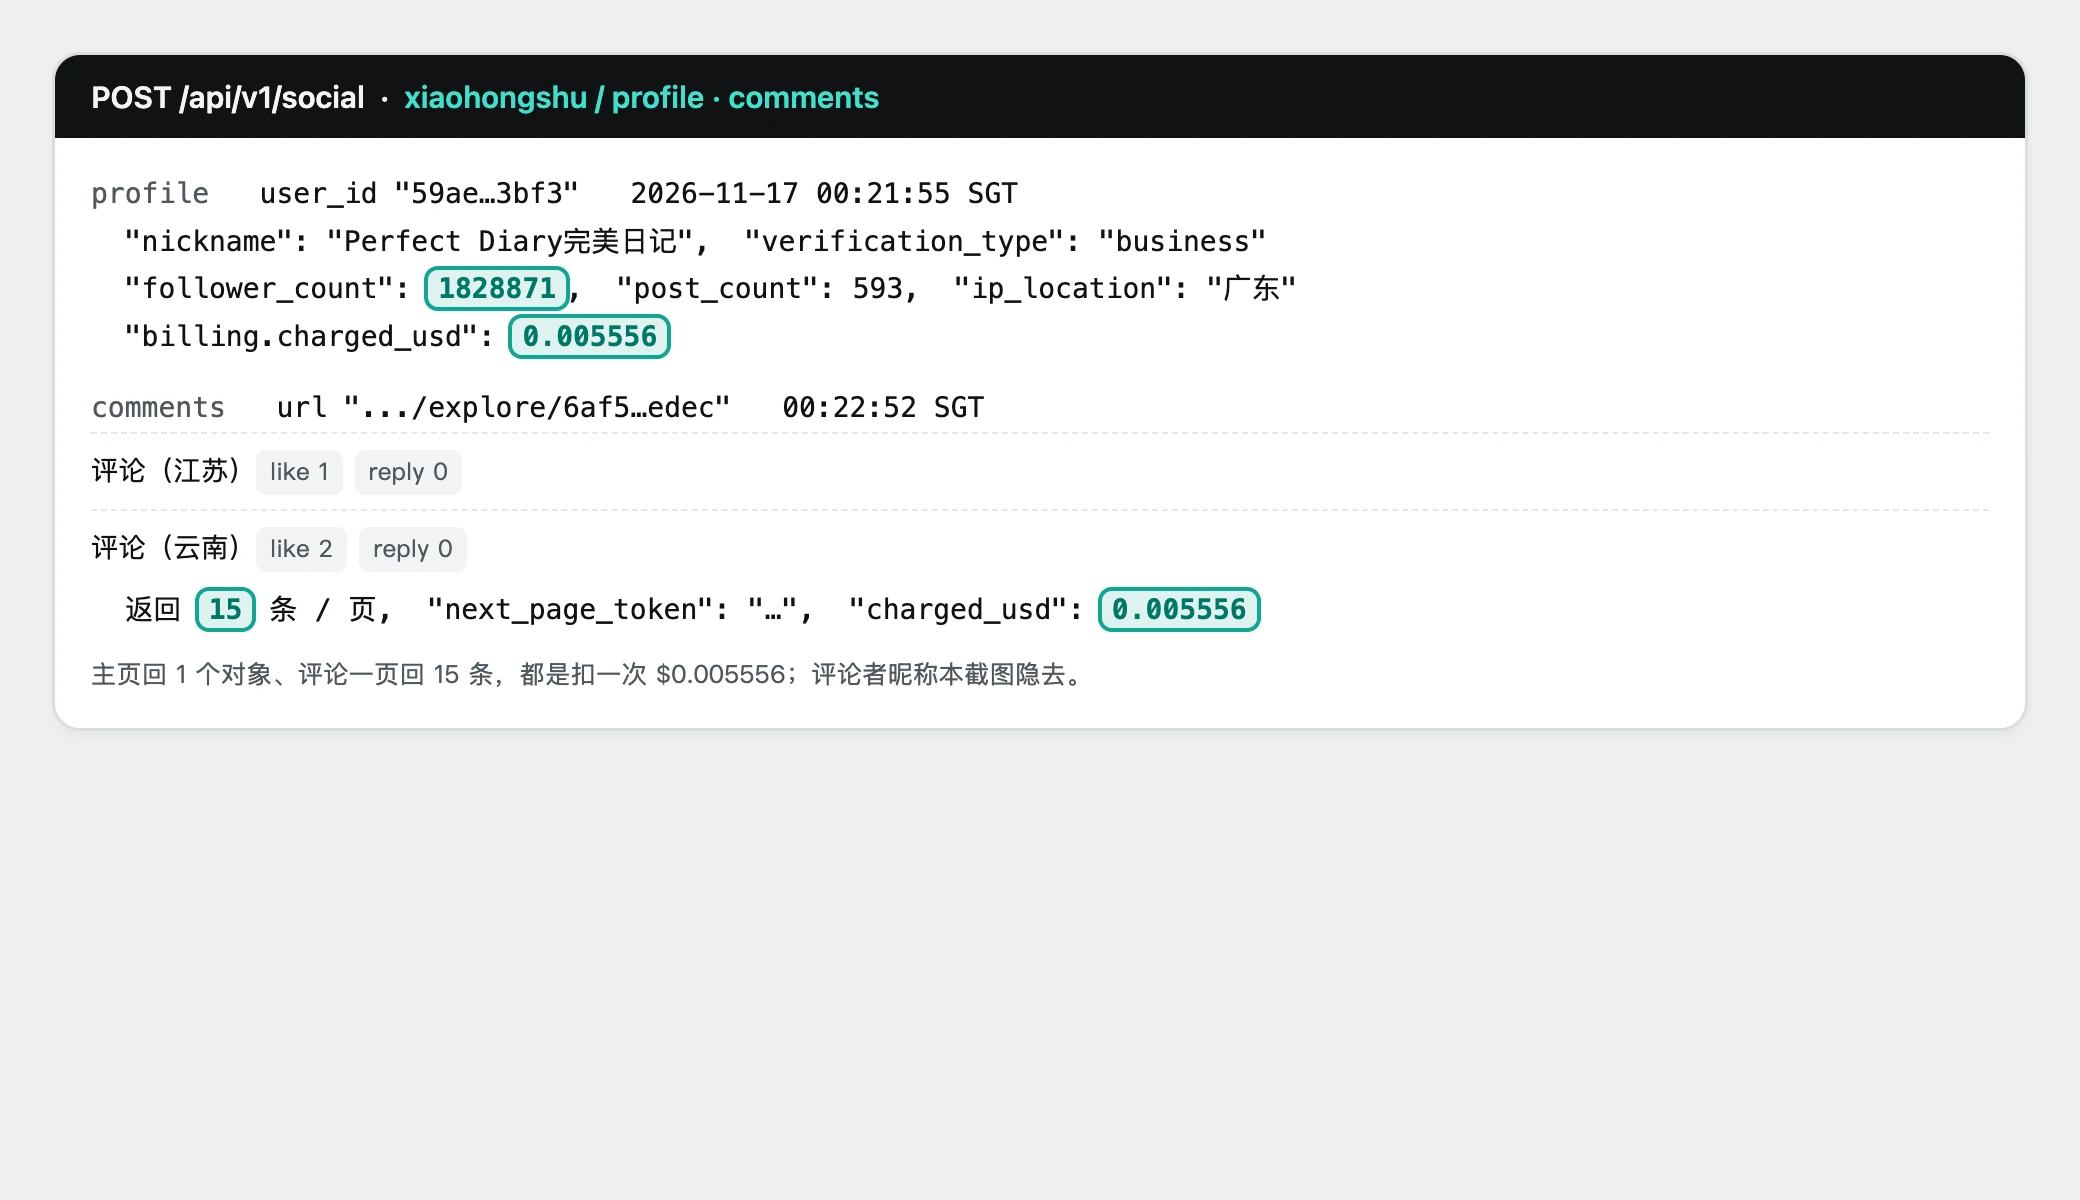
真调里有几处值得单独讲。xiaohongshu/search_users 搜同一个品牌名,一次回 20 个账号,带 red_id、follower_count、is_verified、verification_type 字段,排在第一的就是那个粉丝约 183 万的认证官方号;拿到账号后再用 profile 拉详情,一步按名字找号、一步取资料,两步各一笔 $0.005556,账号筛选这条链的成本一目了然。xiaohongshu/profile 查某美妆品牌官方号,返回 follower_count 1,828,871、post_count 593、verification_type 为 business、ip_location 为广东,一次 $0.005556。xiaohongshu/reviews 查一款月销 18 万的面膜,返回 20 条评价,带 rating、rating_scale、service_rating、logistics_rating 等字段;其中一条的 rating 是 5(满分 5)、service_rating 和 logistics_rating 也都是 5,sku 标着「1 盒 10 片·去黄体验装」,还带 posted_date 和 images,字段细到能直接拿去做口碑和售后分析,最新一条评价的发布日期是 2026 年 11 月 16 日,也是一次 $0.005556。这些都说明:不论回来的是账号资料、笔记正文还是商品评价,一次请求都是同一个价。
商品这一侧也值得单独看一眼,因为它把「内容」和「交易」连了起来。xiaohongshu/product_search 搜「面膜」回 18 个商品,带 price、original_price、sold_count、shop_name 等字段,其中一款就是上面那条月销 18 万、评价带分 SKU 反馈的面膜。对做选品或竞品的团队,这组能力能把「某个品类卖得好不好、口碑在哪、物流被吐槽在哪」一次问清楚,每次请求同样是 $0.005556。商品价格是小红书站内的人民币标价,属于平台的市场数据;我们接口本身的费用只按次记,和商品卖多少钱无关。把搜索、笔记、评论、商品、评价这五类能力串起来,一个选品流程里「找词—看内容—读评论—查商品—读评价」每一步都是一次 $0.005556 的请求,整条流程的成本很容易估。
还有一处是蒲公英内容广场(xiaohongshu/pgy_content_square)。这项能力的标价是每次 $0.016(每 1,000 次 $16),当天真调返回 503、没有扣费。我们记下这个现象:这一档能力当时不可用、未计费。标准的 16 项内容能力当天都正常返回并扣费,这一档是目录里最贵、也是当时唯一没返回数据的一项。2026 年 11 月 18 日起,这项能力只按关键词搜索,keyword 必填。
失败、空结果和限速:扣不扣钱
这件事直接关系到月度账单,我们专门测了几种「没正常拿到数据」的情况。我们的说明文件写着失败的调用和空结果不收费(EveryInfra llms.txt,2026 年 11 月 17 日读取),下面是实际结果。
| 情况 | 时间(SGT) | HTTP | 响应 | 扣费 |
|---|---|---|---|---|
| 不带 Key | 00:38:06 | 401 | missing_key,提示把 Key 放进 Authorization 头 | $0 |
sort 写成不存在的值 | 00:38:08 | 422 | invalid_value,列出允许值和 catalog_url | $0 |
| 不存在的笔记链接 | 00:38:27 | 200 | 空结果,reason 为 empty_result_refunded | $0 |
多加一个 limit 参数 | 00:38:18 | 200 | 照常回 15 条,limit 被忽略 | $0.005556 |
不带 Key 时返回 401 和 missing_key,先鉴权再谈别的,不让没鉴权的请求白跑。参数枚举写错时返回 422 和 invalid_value,错误里直接列出允许的值——sort 的合法值是 most_collected、most_commented、most_liked、newest、relevance,还附上目录地址让你自查,这几种都没扣费。查一条不存在的笔记时,返回 200、空结果、reason 写着 empty_result_refunded,当场退款、扣费为 0。多加一个不影响结果的 limit 参数时,接口不报错、照常返回、照常扣一次钱,因为这项能力本来就按页返回、不看 limit。
限速是另一个和账单相关的点。接口有每分钟的调用上限,短时间打太多会返回 429,这类被限速拒掉的请求不扣费,等一会儿再发就行。我们这一轮里就遇到过一次 429(返回 rate_limited),停 60 秒后继续,账本上没有这笔。对批量任务,这意味着你不必担心偶发的限速把钱扣走,只要在客户端做好退避重试即可;按积分计费的第三方也写明「超过速率上限时拒绝的请求不扣积分」,两边在这一点上一致。最终影响账单的,始终是成功拿到数据的那些请求,限速和空结果都不进账。
和第三方对读,这里有一处差别值得标出来。前面提到,有一家第三方明说「部分失败的、用钱包付费的请求会按成本收一笔处理费」,也就是不是所有失败都免费;按积分计费的那家则是超过速率上限时拒绝的请求不扣积分。我们这一侧的规则是失败和空结果都不扣费,参数错误在扣费前就被拦下。对一个要长期跑的采集任务,这条规则的意义是:你不用为平台偶发的空结果和你自己写错的参数买单,账单只对确实拿到的数据计。
算一笔账:五件常见的活,一个月各花多少
把前面的单价放进五种常见用法,按一个月算。我们这一侧 = 请求次数 × $0.005556;第三方按最便宜的公开档 $10/千次算;官方开放平台因为不按次零售内容数据、要资质和授权,不进这张钱表;开源脚本代码免费、但要另算服务器和代理,也不好按次比,所以这张表只比「第三方按次付费 API」和我们。
| 一个月的活 | 请求数 | 第三方最低公开价 | EveryInfra(实测) |
|---|---|---|---|
| 100 个关键词,每天各搜 1 页 | 3,000 | $30.00 | $16.67 |
| 500 条品牌笔记,每条取 2 页评论 | 1,000 | $10.00 | $5.56 |
| 200 个创作者,每天取主页+1 页内容 | 12,000 | $120.00 | $66.70 |
| 2,000 个商品,各取详情+1 页评价 | 4,000 | $40.00 | $22.20 |
把第一行拆开看,更能说明按次计费的好处。100 个关键词、每天各搜 1 页,一个月就是 100 × 30 = 3,000 次请求,每次 $0.005556,合计 $16.67;每次回 20 条,一个月累计 60,000 条笔记,折合每千条约 $0.278。如果某些关键词当天没有新内容、返回为空,那几次不扣钱,账单还会更低。想把覆盖做深,可以给热门关键词多翻几页:一个关键词一天翻 3 页就是每天 3 次、一个月 90 次,整批 100 个关键词一个月 9,000 次、$50.00,仍然低于第三方最低档的同比价。按次计费的预算因此很好估:先数清楚「每天发几次请求 × 多少天」,乘以 $0.005556 就是上限,实际只会因为空结果更低,不会因为临时加了筛选或排序而突然变贵。
这张表里的倍数稳定在 1.8 倍左右,因为两边都是按次计费,差的就是单价。但要提醒两点。第一,第三方多数还有最低充值或月费,上面没算进去;真实账单里,用量小的时候月费会把单价摊高,这时差距比 1.8 倍更大。第二,我们的余额不过期、失败不扣费,所以实际扣的钱往往比预算还低一点——比如 200 个创作者那行,如果有账号已注销或内容为空,那几次空结果不扣钱,账单会低于 $66.70。想自己试这几笔账,可以在试用台用测试 Key 跑几次,响应里的 charged_usd 会把每一次的实扣写出来。
什么时候别用按次 API
把话说全:有几种情况,按次付费的接口不是最优解。其一,如果你是研究者或学生,数据量很小、能接受随时改代码,那么开源脚本几乎零成本,自己跑最省。其二,如果你是小红书的入驻商家,要的是自己店铺的订单、库存、经营数据,那么官方开放平台才是对的通道,它能给你商家授权范围内的、带后续交易能力的数据,这是任何第三方采集都给不了的。其三,如果你要的是一条热门笔记的全部评论、每条评论的全部回复,而且要一次跑完,那么能自动深翻、按条计费的方案在「省事」上更强,我们一次一页、要你自己带 page_token 翻。
还有一种情况要诚实说清楚:按次付费接口不保证能拿到平台限制访问的那部分数据。登录后才可见的内容、风控更严的接口、需要特定地域才返回的结果,这些无论走哪条第三方路线都可能拿不全。我们这一侧只采公开可见的数据,遇到拿不到的会返回空结果并退款,而不会假装拿到了。选型时把「拿得到什么」和「每千次多少钱」放在一起看,按你要的字段和深度来定。按次计费的好处是可以先用小批量试,确认覆盖和字段满足需求,再放大用量,试错成本很低。
小红书本身也值得花一句说清楚它为什么是个高价值的数据源。平台 2026 年 5 月官宣月活突破 4 亿、日均搜索超 8 亿次(新浪财经,2026 年 5 月 27 日),用户画像集中在高线城市的年轻人(Investing.com·格隆汇)。它的商业生态也成熟:蒲公英平台 2025 年品牌邀约量 2,700 万次、同比增长 34%,平台从商单中抽 10% 服务费(虎嗅·小红书月活破 4 亿,2026 年 5 月 29 日)。对做品牌舆情、选品、达人筛选的团队,小红书的公开笔记和评论是绕不开的一手材料——这也正是三条取数路线存在的原因。
行业动向:最近这段时间发生了什么
- 2026 年 5 月,小红书官宣月活突破 4 亿、日均搜索超 8 亿次,并拿下 2026 年世界杯转播权、押注中长视频(虎嗅,2026 年 5 月 29 日)。对取数的意义:内容形态从图文扩到视频、播客、长图文,笔记字段里视频类字段的权重在上升。
- 2026 年,有研究机构复盘小红书商业化收入约 42 到 52 亿元人民币、广告占比约 76%(雪球·小红书数据,daxue consulting,2026 年)。对取数的意义:平台越商业化,商家对公开舆情和竞品数据的需求越刚性。
- 2025 年 1 月,大量「TikTok 难民」涌入小红书,推动它一度登上美区 App Store 免费榜第一(Reuters,2025 年 1 月 15 日;BBC,2025 年 1 月 14 日)。对取数的意义:平台海外知名度上升,海外团队对小红书数据的兴趣也在涨。
- 2026 年下半年,技术社区里关于小红书采集的讨论仍集中在签名(x-s、x-t)随 App 更新失效、要跟着维护(掘金,2026 年)。对取数的意义:自建采集的维护成本没有下降,这正是按次付费接口的价值所在。
常见问题
小红书 API 多少钱?
分三条路。官方开放平台不按次零售笔记、评论这类内容数据,走的是企业资质 + 审核 + 按 QPS 的商家通道;开源脚本代码免费,但要自备服务器、代理和维护;第三方按次付费 API 公开定价每 1,000 次请求 $10 到 $38。我们用 EveryInfra 实测,标准能力每次 $0.005556,每 1,000 次 $5.556(2026 年 11 月 17 日真调)。这个问题来自联想词「小红书 api 多少钱」。
小红书有官方的数据 API 吗?
有开放平台,但它面向商家和服务商,主打电商、广告和达人合作,访问商家数据要经授权、要企业资质、权限分别申请、审核有周期(CNDev,2026 年 11 月 17 日读取)。它不是给个人按次买公开笔记和评论的货架。想要公开内容数据,多数团队走的是开源脚本或第三方按次付费接口。
用 Python 怎么拿小红书数据?
两种常见做法。一是用开源库,比如 pip install xhs(xhs on PyPI)或跑 MediaCrawler,自己处理登录态、代理和签名。二是调一个按次付费的 HTTP 接口,用 requests 发一个 POST 就行,不用自己维护签名。这个问题来自联想词「小红书 api python」。下面「上手」一节给了用 EveryInfra 的最短示例。
小红书爬虫会被封吗?合法吗?
自建爬虫要自担风控和合规风险。开源项目自己就写明「仅供学习、禁止商用」,并提醒 web crawling 可能违法(MediaCrawler、ReaJason/xhs)。处理个人信息还要守《个人信息保护法》等法规(全国人大)。用第三方按次接口能把采集这一步外包出去,但用途合规仍是使用者的责任。这个问题来自联想词「小红书 api 爬虫」。
每 1,000 条评论要花多少?
按我们的实测,评论一次请求回 15 条、扣 $0.005556,折合每 1,000 条约 $0.370;按 page_token 翻页去重后约 $0.411。第三方按次付费 API 按每 1,000 次请求 $10 到 $38 计,一次也回一页,所以每千条结果同样是我们的约两倍起。这个问题来自对「xiaohongshu api how much does it cost」的实测换算。
上手:三步跑通一次真实调用
第一步,拿一个 Key,到试用台或快速上手按说明开通。第二步,先读免费目录,确认能力名、参数和单价:
curl -s "https://api.everyinfra.com/api/v1/social/catalog?platform=xiaohongshu"
# 看每个能力的 action、required_params、price_usd、response_fields、available
第三步,发一次真实请求。下面是本文搜索那一次的请求,返回 20 条笔记、扣 $0.005556:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"xiaohongshu","action":"search","params":{"keyword":"护肤"}}'
# 响应里 count=20,billing.charged_usd=0.005556,billing.amount.per_1k.USD=5.555556
# 翻页:把响应里的 next_page_token 放进 params.page_token 再请求一次
想取评论就把 action 换成 comments、params 里给 url;想取主页就用 profile 加 user_id;想取商品评价就用 reviews 加 product_id。每个能力的字段和参数都在目录里。在 AI 工具里,EveryInfra 还是一个远程 MCP 服务(MCP 是 AI 客户端调用外部工具的协议,见规范 2025-06-18),工具名都以 everyinfra_ 开头,加一段配置就能让模型自己调(支持这套协议的客户端见 MCP 客户端列表)。各能力页也有逐字段说明:搜索、评论、笔记详情,平台总览见 小红书数据接口,抖音的同类能力见 抖音数据接口。更深的对比可以读 官方开放平台和第三方采集怎么选 和 小红书数据采集的三种做法。
参考资料
- 小红书开放平台,https://open.xiaohongshu.com/ (2026-11-17 读取)
- 小红书大学·开放平台·请求签名示例,https://school.xiaohongshu.com/en/open/quick-start/sign.html (2026-11-17 读取)
- CNDev·小红书开放平台·平台生态 API 接入,https://cndev.cn/platform/xiaohongshu-open/ (2026-11-17 读取)
- 腾讯云开发者社区·小红书开放平台 API 实战,https://developer.cloud.tencent.com/article/2735161 (2026-08-31)
- 阿里云开发者社区·小红书笔记详情 API 在竞品分析中的应用,https://developer.aliyun.com/article/1705081 (2026-01-09)
- CRMEB·小红书笔记详情 API 解析(官方 vs 第三方采集),https://www.crmeb.com/ask/thread/75859 (2026-06-17)
- MediaCrawler(GitHub,NanmiCoder),https://github.com/NanmiCoder/MediaCrawler (2026-11-17 读取)
- MediaCrawler 说明与免责声明,https://github.com/NanmiCoder/MediaCrawler#readme (2026-11-17 读取)
- ReaJason/xhs(GitHub),https://github.com/ReaJason/xhs (2026-11-17 读取)
- xhs(PyPI),https://pypi.org/project/xhs/ (2026-11-17 读取)
- 掘金·MediaCrawler:42.6k stars 的全平台爬虫,https://juejin.cn/post/7595142737513873435 (2026)
- 掘金·MediaCrawler 用 CDP 模式绕开 JS 逆向,https://juejin.cn/post/7667386123949817902 (2026)
- 第三方 RedNote 数据 API·定价页,https://getanyapi.com/api/rednote (2026-11-17 读取)
- 第三方 RedNote 数据 API·文档,https://getanyapi.com/docs (2026-11-17 读取)
- 第三方 RedNote 数据 API·定价与说明,https://rnote.dev/en/ (2026-11-17 读取)
- 第三方 RedNote 数据 API·文档,https://rnote.dev/en/docs/guide (2026-11-17 读取)
- 第三方 Xiaohongshu/RedNote API·文档,https://docs.justoneapi.com/en/api/xiaohongshu-rednote/ (2026-11-17 读取)
- 第三方 Xiaohongshu Scraper API·端点与定价,https://www.socialcrawl.dev/platforms/xiaohongshu (2026-11-17 读取)
- EveryInfra·数据接口目录,https://api.everyinfra.com/api/v1/social/catalog (2026-11-17 读取)
- EveryInfra·llms.txt(失败与空结果不计费说明),https://api.everyinfra.com/llms.txt (2026-11-17 读取)
- EveryInfra·数据接口端点,https://api.everyinfra.com/api/v1/social (2026-11-17 读取)
- EveryInfra·远程 MCP 端点,https://api.everyinfra.com/mcp (2026-11-17 读取)
- Model Context Protocol·规范 2025-06-18,https://modelcontextprotocol.io/specification/2025-06-18 (2026-11-17 读取)
- Model Context Protocol·简介,https://modelcontextprotocol.io/introduction (2026-11-17 读取)
- 全国人大·中华人民共和国个人信息保护法,http://www.npc.gov.cn/npc/c2/c30834/202108/t20210820_313088.html (2021-08-20)
- 全国人大·中华人民共和国数据安全法,http://www.npc.gov.cn/npc/c2/c30834/202106/t20210610_311888.html (2021-06-10)
- 全国人大·中华人民共和国网络安全法,http://www.npc.gov.cn/npc/zgcpfyfx/201611/t20161107_396272.html (2016-11-07)
- 国家网信办·网络数据安全管理条例,http://www.cac.gov.cn/2024-09/30/c_1730513931362305.htm (2024-09-30)
- hiQ Labs, Inc. v. LinkedIn Corp.(法院记录),https://www.courtlistener.com/docket/4315666/hiq-labs-inc-v-linkedin-corporation/ (2026-11-17 读取)
- Reuters·Over half a million TikTok refugees flock to China's RedNote,https://www.reuters.com/technology/over-half-million-tiktok-refugees-flock-chinas-rednote-2025-01-14/ (2025-01-15)
- BBC·TikTok users flock to Chinese app RedNote as US ban looms,https://www.bbc.com/news/articles/c2475l7zpqyo (2025-01-14)
- Business Insider·RedNote and Lemon8 surge as TikTok ban looms,https://www.businessinsider.com/rednote-lemon8-surge-as-tiktok-ban-looms-chinese-social-apps-2025-1 (2025-01-13)
- 虎嗅·小红书彻底爆发了(月活破 4 亿),https://www.huxiu.com/article/4861801.html (2026-05-29)
- 新浪财经·小红书月活突破 4 亿、日均搜索超 8 亿,https://finance.sina.com.cn/jjxw/2026-05-27/doc-inhziqxq9291575.shtml (2026-05-27)
- daxue consulting·Xiaohongshu (RedNote) in China 2026,https://daxueconsulting.com/xiaohongshu-rednote-china (2026)
- CBNData·3 亿月活仍「赚钱难」的小红书,https://www.cbndata.com/information/268560 (2023-02-24)
- 雪球·小红书商业化收入与广告结构记录,https://xueqiu.com/2663709332/396773177 (2026)
- Investing.com·格隆汇·小红书的愿与愁,https://cn.investing.com/analysis/article-200490381 (2025)
- Python 官方文档·urllib.request,https://docs.python.org/3/library/urllib.request.html (2026-11-17 读取)
- requests 文档,https://requests.readthedocs.io/en/latest/ (2026-11-17 读取)
- requests(PyPI),https://pypi.org/project/requests/ (2026-11-17 读取)
- 国家网信办·网络数据安全管理条例,http://www.cac.gov.cn/2024-09/30/c_1730513931362305.htm (2024-09-30)
- 工业和信息化部·ICP/IP 地址/域名信息备案管理系统,https://beian.miit.gov.cn/ (2026-11-17 读取)
- MediaCrawler·问题区(GitHub Issues),https://github.com/NanmiCoder/MediaCrawler/issues (2026-11-17 读取)
- Model Context Protocol·客户端列表,https://modelcontextprotocol.io/clients (2026-11-17 读取)
引用编号 BL-177