Gemini 4 Hydrogen API:千次工具调用估算
Gemini 4 Hydrogen 跑 1,000 次工具调用估算:并行加裁剪约 $6.14,Carbon 12 月价约 $14.94;接口费 $0.85。
Google 在 2026 年 11 月 12 日发布了 Gemini 4 Hydrogen(模型代码 gemini-4-hydrogen),按 AI Studio 价格页每百万 token 输入 $1.50、输出 $7.50,一百万 token 的上下文里价格不分档,免费层也能用。它定位是日常写代码和跑工具的快模型。我们想知道一件具体的事:让它带着 6 个函数去调 EveryInfra 的网页搜索、新闻、Reddit 和 YouTube 接口,做一次「这周大家怎么评价 Hydrogen 的价格」的巡检,1,000 次工具调用要花多少钱,钱花在模型 token 上还是花在接口上。2026 年 11 月 19 日 00:23–00:31(新加坡时间)我们分三轮真调了 10 次接口,花了 $0.007877,然后用这些真实返回的体积估算模型费(模型一侧没有实跑):同样 1,000 次工具调用,整包返回、一次一个地串行调用要 $22.82;把返回裁到只剩需要的字段、让模型同一轮并行调用、再吃上隐式缓存,只要 $6.14;同样做法换成 12 月 1 日涨价后的 Gemini 4 Carbon 是 $14.94。三种算法里接口费都是 $0.85。
我们没有 Gemini API Key,所以模型那一侧没有在本机跑。文中 Gemini 的参数和代码按 Google AI Studio 文档原文写成配置示例,token 数按 Google 文档「约 4 个字符 1 个 token」从接口真实返回的字符数估算,并在每处标明是估算;接口那一侧的数字全部能回到某一次真调的返回体。和我们 11 月写的 Gemini Decisions API 那篇 讲 Gemini Decision 1 的结构化决策不同,这篇只讲一个便宜的快模型怎样跑多步工具循环,以及两笔钱怎么算。
Gemini 4 Hydrogen API 是什么:11 月 12 日发布的快模型
按 blog.google 的发布文,Hydrogen 是 Gemini 4 系列里给所有人用的快模型,默认用在 Gemini 应用和搜索的 AI 模式里,开发者在 Gemini API、AI Studio 和企业版 Agent Platform 都能调。发布文写它在 Artificial Analysis 智能指数上拿 51 分,比四周前发布的 Gemini 4 Argon 的 50 分略高;Terminal-Bench 4.1 是 57%,上一代 3.8 Flash 是 18.2%;速度是 3.8 Flash 的 2.5 倍,编造的说法少了 5 倍以上。发布文还写了它在工具调用失败或搜索返回空结果时能干净地换路子。一次巡检里总有某个接口没数据,模型要能接着往下走。
AI Studio 的模型页给了能用的功能清单。函数调用、结构化输出、让模型自己调 Google 搜索和地图再回答(grounding)、URL context、代码执行、computer use 都支持;上下文窗口是输入、思考、输出共用的 1,048,576 token,单次同步输出默认上限 65,536 token,开 long decode(超长输出模式)可以一路写到一百万。缓存只支持隐式缓存,也就是 API 发现请求开头和之前的请求重复时自动按缓存价计费,不用自己建缓存;显式缓存(cachedContents)不支持。思考档位有 low、medium、high(默认)和新加的 xhigh 四档,传 minimal 会报错。What's new 页写明它是 3.8 Flash 和更早 Gemini 3、2.5 模型的推荐升级对象,也是 Managed Agents 里 Antigravity 代理的默认模型。
| 项目 | Gemini 4 Hydrogen | 出处 |
|---|---|---|
| 模型代码 | gemini-4-hydrogen | AI Studio 模型页 |
| 上下文 | 1,048,576 token,输入、思考、输出共用 | 模型页、long decode 页 |
| 单次输出 | 默认 65,536;long decode 最多到 1,048,576 | 模型页 |
| 思考档位 | low / medium / high(默认)/ xhigh;不收 minimal | What's new 页 |
| 缓存 | 只有隐式缓存,最少 4,096 token 才会命中 | 缓存页 |
| 工具 | 函数调用、结构化输出、Search 和 Maps grounding、URL context、代码执行、computer use、远程 MCP | 模型页、函数调用页 |
| 免费层 | 能用;Search grounding 只在付费层 | 价格页 |
Google DeepMind 在 11 月 12 日同步发了模型卡,写明 Hydrogen 是从 Gemini 4 Carbon 改编而来的模型,所以它和 Carbon 共用一套能力清单和接口设计,只是更小、更快。Carbon 本身是 10 月 28 日宣布的,先只开放给一部分安全研究团队,后来才开放给开发者;Hydrogen 则是发布当天就对所有人开放,免费层也能用。我们拉回的 40 条 YouTube 评论里,点赞第二多的一条(170 个赞)讲的就是这个时间差。
价格:每档和 12 月 1 日之后的差距
价格页写的是每百万 token、美元计。Hydrogen 的标准价输入 $1.50、输出 $7.50,缓存命中的输入 $0.075,相当于输入价打五折之后再打一折,也就是便宜 95%。输出价里包含思考 token,价格页的说明还写着:模型处理的每个 token 都要计费,包括思考 token,以及用 grounding 时内部的工具系统说明和函数声明。换句话说,你写的 6 个函数声明每一轮都会作为输入算钱。
对比的几个模型里,变化最大的是 Carbon 和 Argon。两者现在按推广价 $2/$10,到 11 月 30 日为止;12 月 1 日起变成 $4/$20,翻一倍。3.8 Flash 在 2026 年底前还是 $0.75/$3.75,2027 年 1 月 1 日起改成 $1.50/$7.50,和 Hydrogen 一样。DevOps.com 在 11 月 16 日的文章里把这件事写成 Hydrogen 的价格是今天 3.8 Flash 的两倍,这话只在今年年底前成立。
| 模型(每百万 token,美元) | 输入 | 输出 | 缓存命中 | 免费层 | 备注 |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen 标准 | 1.50 | 7.50 | 0.075 | 有 | 全部上下文同价 |
| Gemini 4 Hydrogen Batch / Flex | 0.75 | 3.75 | 0.0375 | 无 | Flex 目标延迟 1–15 分钟 |
| Gemini 4 Hydrogen Priority | 2.70 | 13.50 | — | 无 | 排在标准和 Flex 前面 |
| Gemini 4 Carbon / Argon(到 11 月 30 日) | 2.00 | 10.00 | 0.10 | 无 | 默认思考 medium |
| Gemini 4 Carbon / Argon(12 月 1 日起) | 4.00 | 20.00 | 0.20 | 无 | 推广价结束 |
| Gemini 3.8 Flash(2026 年内) | 0.75 | 3.75 | 0.075 | 有 | 2027 年 1 月 1 日起 1.50 / 7.50 |
| Gemini 3.5 Flash-Lite | 0.30 | 2.50 | — | 有 | 分类和路由用 |
三种消费方式要分清。Batch API(异步批量提交)打五折,但文档写明它只走 generateContent,不走 Interactions API,适合一次性提交大批互不相关的请求;Flex(用更长的等待换半价的推理档)也打五折,能在 Interactions API 上用(service_tier='flex'),代价是目标延迟 1 到 15 分钟,目前还在预览;Priority(优先排队的推理档)贵 80%,用在必须马上回的客服类请求。多步工具循环每一轮都要等上一轮的结果,Batch 用不上,Flex 能用但每一轮都可能等几分钟,适合夜里跑的定时巡检。
限流页按花钱多少分档:Tier 1 绑卡即可,每 10 分钟可花 $10;每日请求数在太平洋时间午夜重置。新加坡时间是下午 3 点或 4 点(取决于夏令时)。按我们估算的单价,Tier 1 每 10 分钟 $10 足够跑约 300 次巡检,先碰到的上限通常是数据接口每分钟请求数(本轮测试 Key 每分钟 10 次)。
一个巡检任务:6 次工具调用,4 个数据源
我们给模型的任务是一句英文:这周大家怎么评价 Gemini 4 Hydrogen 的价格?查网页、新闻、Reddit 和 YouTube。为了让模型调到数据,我们写了 6 个函数,每个函数背后是 EveryInfra 的一项能力(各平台还能调哪些能力、要哪些参数,见 Reddit 数据接口、YouTube 数据接口、网页搜索接口和 Google 新闻接口四个页面):web/search(网页搜索)、google_news/search(Google 新闻搜索)、reddit/search(Reddit 搜索)、reddit/comments(Reddit 评论)、youtube/search(YouTube 搜索)和 youtube/comments(YouTube 评论)。六项都走同一个入口 POST /api/v1/social,请求体是 platform、action、params 三个字段,返回体里有 results、count、billing 和空结果时的 refund。
一次巡检的顺序是这样排的:第一轮四个搜索互不依赖,可以同一轮并行发出去;第二轮要用第一轮搜到的帖子和视频链接去拉评论;第三轮写报告。串行调用时模型每轮只发一个函数调用,6 次工具调用要 7 次模型请求;并行时只要 3 次。请求次数少一半多,省下的主要是每次请求都要重新带上的上下文。
下面是我们真调的记录。时间是请求发出的时刻,费用是返回体 billing.charged_usd 的原值,请求号可以在控制台的调用记录里查到。
| 新加坡时间(2026-11-19) | 能力 | 参数要点 | 返回条数 | 扣费(美元) | 请求号 |
|---|---|---|---|---|---|
| 00:23:21 SGT | web/search | 「gemini 4 hydrogen pricing」,美国、英文 | 10 | 0.001389 | req_b0eb8916926c4a63 |
| 00:24:12 SGT | google_news/search | 「gemini 4 hydrogen」,一周内 | 20 | 0.000792 | req_46a6a26a4fe94717 |
| 00:25:14 SGT | reddit/search | 「gemini 4 hydrogen」,按相关性 | 4 | 0.000792 | req_52a46a7e4747419c |
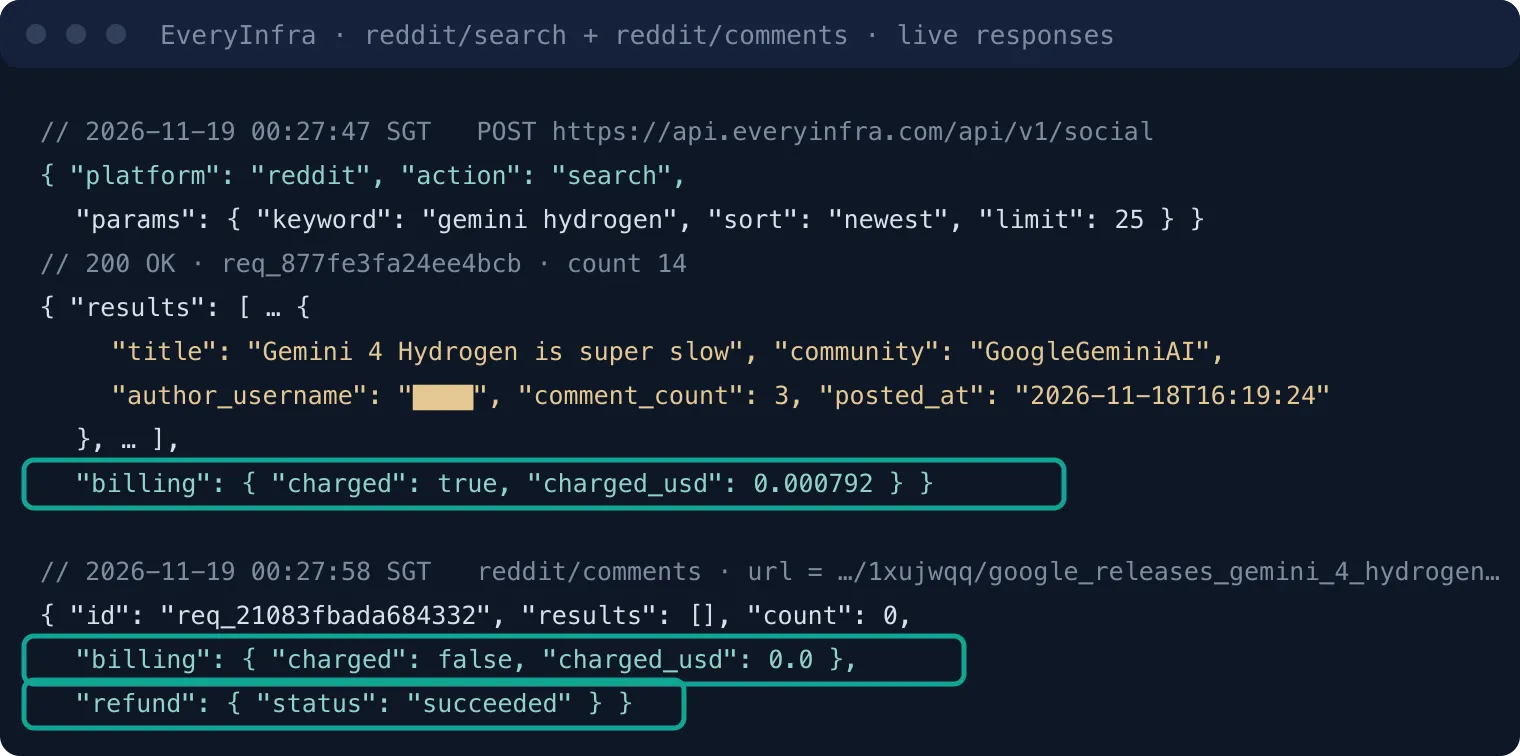
| 00:27:47 SGT | reddit/search | 「gemini hydrogen」,按最新 | 14 | 0.000792 | req_877fe3fa24ee4bcb |
| 00:27:58 SGT | reddit/comments | r/singularity 发布帖 | 0 | 0(已退款) | req_21083fbada684332 |
| 00:28:26 SGT | youtube/search | 「gemini 4 hydrogen」,按相关性 | 10 | 0.000778 | req_86a01257f3cc42d7 |
| 00:28:37 SGT | youtube/comments | 播放量最高的那条视频 | 40 | 0.000556 | req_58f6a18971374aaa |
| 00:30:21 SGT | reddit/comments | r/GoogleGemini 讨论帖 | 0 | 0(已退款) | req_e0151310d137402b |
| 00:30:32 SGT | web/search | 西班牙、西语 | 10 | 0.001389 | req_e0b072de7e274991 |
| 00:31:12 SGT | web/search | 新加坡站、简体中文 | 10 | 0.001389 | req_25bd028939b348a6 |
10 次合计扣 $0.007877。两次 reddit/comments 都返回 0 条、charged 为 false、退款状态 succeeded,但这两个帖子在 Reddit 网页上能看到评论,其中 r/GoogleGemini 那条在我们 00:27 的搜索结果里显示有 12 条评论。我们另外在 00:33 SGT 对三条视频各调了一次 youtube/transcript 取字幕,00:47 SGT 又重试了一次,都返回 503(unavailable)、没扣费,返回体里带着 retry_after: 60 和建议先用示例视频试一次的提示。这两种情况在代码里要分开处理:空评论要标成「这次没取到」,不能当成「没人评论」写进报告;503 按 retry_after 等一会儿再试,或者跳过这一项。
Python 代码:Gemini 4 Hydrogen API 的 function calling 接 /api/v1/social
代码分两层。工具执行层把函数名映射成 EveryInfra 的 platform 和 action,发请求、处理 429、裁剪返回;这一层我们在本机真跑过,上面 10 次调用就是它发的。模型层用 Google GenAI SDK 的 Interactions API:把 6 个函数声明放进 tools,模型返回 function_call 步骤后,本地执行,再把结果以 function_result 交回去,带上 previous_interaction_id 接着上一轮。这一层按 Google 函数调用文档和 Interactions API 说明的写法写成,我们没有 Gemini Key,没有跑过。代码第一行把 SDK 固定在 2.x:PyPI 上的 google-genai 写明 Interactions API 要 2.0 以上,SDK 仓库里 3.0 的说明改了默认 API 版本和 HTTP 客户端,不固定的话哪天自动升到 3.0,客户端初始化的行为会变。
# pip install "google-genai>=2,<3"   (Interactions API needs SDK 2.0 or later)
import json, os, random, time, urllib.request, urllib.error
from google import genai

EI_URL = "https://api.everyinfra.com/api/v1/social"
EI_KEY = os.environ["EVERYINFRA_API_KEY"]

def fn(name, desc, props, required):
    return {"type": "function", "name": name, "description": desc,
            "parameters": {"type": "object", "properties": props, "required": required}}

S = {"type": "string"}
TOOLS = [
    fn("web_search", "Google-style web results (title, url, snippet). Up to 10.",
       {"keyword": S, "country": S, "language": S}, ["keyword"]),
    fn("news_search", "Google News articles, newest first. Up to 20.",
       {"keyword": S, "time_window": {"type": "string", "enum": ["day", "week", "month"]}}, ["keyword"]),
    fn("reddit_search", "Reddit posts from the last month. Use sort=newest for new product names.",
       {"keyword": S, "sort": {"type": "string", "enum": ["relevance", "newest", "top"]}}, ["keyword", "sort"]),
    fn("reddit_comments", "Comments of one Reddit post. Pass a url from reddit_search.", {"url": S}, ["url"]),
    fn("youtube_search", "YouTube videos with views, likes and comment count.",
       {"keyword": S, "sort": {"type": "string", "enum": ["relevance", "newest", "most_viewed"]}}, ["keyword", "sort"]),
    fn("youtube_comments", "Comments of one YouTube video. Pass a url from youtube_search.", {"url": S}, ["url"]),
]
ROUTE = {"web_search": ("web", "search", 10), "news_search": ("google_news", "search", 20),
         "reddit_search": ("reddit", "search", 25), "reddit_comments": ("reddit", "comments", 50),
         "youtube_search": ("youtube", "search", 10), "youtube_comments": ("youtube", "comments", 40)}
KEEP = {"web_search": ["rank", "title", "url", "text", "published_at"],
        "news_search": ["title", "url", "source", "published_at"],
        "reddit_search": ["url", "title", "text", "community", "like_count", "comment_count", "posted_at"],
        "reddit_comments": ["text", "like_count", "posted_at"],
        "youtube_search": ["url", "title", "view_count", "like_count", "comment_count", "posted_at"],
        "youtube_comments": ["text", "like_count", "posted_at"]}

def call_everyinfra(platform, action, params, tries=8):
    body = json.dumps({"platform": platform, "action": action, "params": params}).encode()
    for attempt in range(tries):
        req = urllib.request.Request(EI_URL, data=body, method="POST", headers={
            "Authorization": f"Bearer {EI_KEY}", "Content-Type": "application/json"})
        try:
            with urllib.request.urlopen(req, timeout=120) as r:
                return r.status, json.loads(r.read())
        except urllib.error.HTTPError as e:
            data = json.loads(e.read() or b"{}")
            err = data.get("error") or {}
            if e.code == 429 and attempt < tries - 1:   # 429 is not charged; retry_after sits inside "error"
                time.sleep(int(err.get("retry_after") or 10) + random.uniform(1, 6))
                continue
            return e.code, data
    return 0, {}

def run_tool(name, args):
    platform, action, limit = ROUTE[name]
    status, data = call_everyinfra(platform, action, {"limit": limit, **args})
    if status != 200:                                   # give the model the error text, not an exception
        err = data.get("error") or {}
        return {"error": status, "code": err.get("code"), "message": err.get("message")}
    rows = [{k: r.get(k) for k in KEEP[name] if r.get(k) not in (None, "", [])} for r in data.get("results") or []]
    for r in rows:
        if isinstance(r.get("text"), str) and len(r["text"]) > 280:
            r["text"] = r["text"][:280] + "…"
    return {"count": len(rows), "rows": rows}

SYS = "Call independent tools in parallel. Use at most 8 tool calls. Then write a short report with links."

def agent(task, model="gemini-4-hydrogen", max_turns=6):
    client = genai.Client()                             # reads GEMINI_API_KEY
    cfg = {"thinking_level": "low"}
    it = client.interactions.create(model=model, input=task, tools=TOOLS,
                                    system_instruction=SYS, generation_config=cfg)
    for _ in range(max_turns):
        calls = [s for s in it.steps if s.type == "function_call"]
        if not calls:
            break
        results = [{"type": "function_result", "name": c.name, "call_id": c.id,
                    "result": [{"type": "text", "text": json.dumps(run_tool(c.name, c.arguments), ensure_ascii=False)}]}
                   for c in calls]
        # tools and system_instruction apply to one interaction only: send them again every turn
        it = client.interactions.create(model=model, input=results, tools=TOOLS, system_instruction=SYS,
                                        generation_config=cfg, previous_interaction_id=it.id)
        print("usage:", it.usage)
    return it.output_text

if __name__ == "__main__":
    print(agent("What do people say about Gemini 4 Hydrogen pricing this week? Check web, news, Reddit and YouTube."))
这段代码里有四处是踩过或文档里写明的坑。第一,429 的 retry_after 在返回体的 error 里面,我们第一次跑时从顶层读,结果等了默认时间还是 429,改成读 error.retry_after 再加 1 到 6 秒随机抖动之后才过;同一把 Key 被几个进程共用时,抖动能避免大家在同一秒一起重试。第二,Interactions API 的 tools 和 system_instruction 只对当次请求有效,previous_interaction_id 只接上对话内容,不接上配置,所以每一轮都要重新带上。第三,模型同一轮可能发出多个 function_call,每个结果要用对应的 call_id 交回,顺序可以和调用顺序不同。第四,失败时把错误码和错误文案作为函数结果交回模型,Hydrogen 的发布文说它能在工具失败时换路子,前提是它看得到错误;直接抛异常就什么都换不了。
Google 函数调用文档建议一次带的工具控制在 10 到 20 个以内,参数用强类型、能用枚举就用枚举;声明太复杂、嵌套太深时,在 any 模式下 API 会直接回 400 INVALID_ARGUMENT。我们把排序方式、时间窗都写成枚举,reddit_search 的说明里直接写「新产品名用 newest」,这是从下面 Reddit 那组实测得来的。6 个声明序列化后是 1,810 个字符,约 452 token,加上系统说明和任务约 502 token,这是每一次模型请求的固定底座。
只想先试数据接口、还没有 Gemini Key 的话,用一条 curl 就能看到返回长什么样,参数和函数声明里的一致。Key 从控制台拿,放在环境变量里,不要写进代码文件。
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"reddit","action":"search","params":{"keyword":"gemini hydrogen","sort":"newest","limit":25}}'
并行调用:让模型一轮发出多个函数调用
Google 函数调用文档把同一轮里发出多个互不依赖的调用叫作并行函数调用,把后一个调用依赖前一个结果的叫作组合函数调用。模型会不会并行,主要看两件事:函数之间在说明里看起来是否独立,以及系统说明里有没有要求。我们在系统说明的第一句写了「Call independent tools in parallel」,并让四个搜索函数的参数都只有关键词和枚举,不互相引用;拉评论的两个函数说明里写了「Pass a url from reddit_search」和「Pass a url from youtube_search」,模型就知道它们要等第二轮。
模型并行发出调用,不等于你的代码会并行执行。上面的 agent 函数在一轮里是一个接一个地调 EveryInfra 的,四次搜索加起来大约要几十秒;要缩短这一段,可以用 concurrent.futures.ThreadPoolExecutor 同时发出去。但要先看清你那把 Key 的每分钟请求上限:我们的测试 Key 是每分钟 10 次,几个进程共用时同一秒发 4 个请求很容易撞上 429。模型那一侧的省钱效果只和请求轮数有关,和你本地是否并发执行无关,本地并发只影响等多久。
函数写几个合适:6 个专用函数还是 1 个通用函数
另一种写法是只给模型一个通用函数,参数是 platform、action 和 params,模型自己填。这样声明更短,一个函数就能调 EveryInfra 全部 576 项可用能力;代价是模型要知道每项能力叫什么、要哪些参数,第一次往往要先查目录,多一轮请求,参数填错时还会收到 422 再改一次。我们选 6 个专用函数,是因为巡检任务固定,枚举能把排序方式、时间窗这些容易填错的参数锁住,模型几乎没有填错的空间。
6 个专用函数约 452 token,一个通用函数约一两百 token;每次调用的参数和返回在两种写法里一样多,省下的只是声明那一块。如果任务会变,比如今天查 Reddit,明天要查 TikTok 和 Amazon,通用函数或远程 MCP 更合适;如果任务固定、每天跑几百次,专用函数更省心。Google 的建议是一次带的工具别超过 20 个,超过之后模型选错工具的概率会上升。
预算上限:别让一次跑偏的巡检花掉一天的钱
多步工具循环会跑偏:模型对某个结果不满意,反复换关键词重搜,一次巡检调了几十次工具。三层上限可以一起用。模型那一侧,Google 账单页写明每个计费档位都有账户级的花费上限,Tier 1 是 $250;限流页写明 Tier 1 每 10 分钟最多花 $10。代码那一侧,max_turns 限制轮数,系统说明里写「最多 8 次工具调用」,工具层再数一遍,超过就不再执行、直接把「已到上限」作为结果交回去。接口那一侧,EveryInfra 是预付余额,余额用完请求会被拒,不会透支。
按我们的估算,一次正常的巡检模型费约 $0.032、接口费约 $0.005。如果某一次跑偏到 30 次工具调用,串行整包,单次输入可能涨到十万 token 以上,一次就要好几美元。把每次巡检的 usage 记下来,超过平均值三倍时发一条提醒,比事后对账早发现问题。
工具返回有多大:裁剪前后的 token
模型费的大头是输入,而输入的大头是工具返回。我们把每次真实返回原样序列化、按 4 个字符 1 token 估算,再和只留 KEEP 字段、正文截到 280 个字符之后的体积比较。Google 的 token 文档对 Gemini 模型写的是「一个 token 约等于 4 个字符」,中文、表情和链接会偏离这个比例,所以下面的数只能看量级,误差可能在 20% 上下。
| 返回(估算 token) | 整包 | 裁剪后 | 少了 |
|---|---|---|---|
web/search 美国英文 10 条 | 1,062 | 847 | 20.2% |
google_news/search 20 条 | 2,970 | 1,305 | 56.1% |
reddit/search 按最新 14 条 | 5,302 | 1,919 | 63.8% |
reddit/search 按相关性 4 条 | 8,173 | 622 | 92.4% |
youtube/search 10 条 | 2,171 | 650 | 70.1% |
youtube/comments 40 条 | 3,883 | 1,620 | 58.3% |
reddit/comments 空结果 | 240 | 11 | — |
| 巡检任务的 6 次合计 | 15,628 | 6,352 | 59.4% |
按相关性搜的那次 Reddit 只有 4 条结果,整包却有 8,173 token,因为其中几条是长篇的病例讨论和投资分析帖,正文就有几千字。裁剪对这种返回最有效,留下标题、社区、点赞、评论数和 280 字的开头,模型照样能判断这条帖子有没有在讲 Hydrogen。网页搜索的返回本来只有标题、链接和摘要,裁剪只能去掉排名之外的少数字段,省两成。我们的做法是整包原样存盘,交给模型的只有裁剪版,报告里要引用原文时再去盘里取;这和 Claude Code 子代理拉 TikTok 品牌号那篇把原始数据留在子代理上下文、主会话只收摘要是同一个思路,只是放在函数返回这一层做。
还有一个字段值得在交给模型前处理掉:youtube/comments 的 posted_at 是「5 days ago」这样的相对时间,不是日期。模型拿到它不知道是相对于哪一天,写报告时容易写错。我们的建议是在工具层按抓取时刻换算成日期再交回,或者干脆只交点赞数和正文,时间用视频的发布日期代替。
1,000 次工具调用的成本估算:模型 token 费加接口费
成本分两半。接口费按 EveryInfra 目录里的价格算,是确定的数:一次巡检 6 个工具的标价合计 $0.005099,换算到 1,000 次工具调用(约 167 次巡检)是 $0.85。这次实测按真实扣费算是 $0.004307 一次巡检,我们按标价算,算的是上限。接口费和模型无关,换哪个模型都一样,价格见价格页。
| 能力 | 每次标价(美元) | 每 1,000 次(美元) | 一次巡检用几次 |
|---|---|---|---|
web/search | 0.001389 | 1.389 | 1 |
google_news/search | 0.000792 | 0.792 | 1 |
reddit/search | 0.000792 | 0.792 | 1 |
reddit/comments | 0.000792 | 0.792 | 1 |
youtube/search | 0.000778 | 0.778 | 1 |
youtube/comments | 0.000556 | 0.556 | 1 |
| 一次巡检合计 | 0.005099 | — | 6 |
(标价取自 2026-11-19 00:14 SGT 读取的数据能力目录;空结果自动退款,所以实扣只会更低。)
6 项里网页搜索最贵,占一次巡检接口费的 27%;两项评论加起来 $0.001348,占 26%。巡检任务里那一次 reddit/comments 是空结果、自动退款,所以实扣比标价少 $0.000792,正好是一次 reddit/comments 的标价。
模型费没有实测,是用这个公式估算的:每一次模型请求的输入 token(底座加上之前所有轮次的输出和工具返回)乘输入价,加上输出 token 乘输出价,命中缓存的那部分按缓存价。输出 token 我们没法实测,按 thinking_level=low 假设每个工具轮 500 token(思考加函数调用参数),最后写报告的一轮 1,500 token。缓存按 Google 缓存页的规则算:上一次请求的输入至少 4,096 token 才会被缓存;在代理循环里,新请求比上一次多出至少 2,050 token 时整段命中,否则最后 2,050 token 要按标准价重算。
| 1,000 次工具调用(美元;模型费为估算:输入按 4 字符 / token 估,每个工具轮输出假设 500 token) | 模型费 | 接口费 | 合计 |
|---|---|---|---|
| Carbon 12 月价,串行,整包,无缓存 | 58.59 | 0.85 | 59.44 |
| Hydrogen,串行,整包,无缓存 | 21.97 | 0.85 | 22.82 |
| Hydrogen,串行,整包,有缓存 | 12.08 | 0.85 | 12.93 |
| Hydrogen,串行,裁剪,无缓存 | 14.69 | 0.85 | 15.54 |
| Hydrogen,并行,裁剪,无缓存 | 6.64 | 0.85 | 7.49 |
| Hydrogen,并行,裁剪,有缓存 | 5.29 | 0.85 | 6.14 |
| Carbon 11 月推广价,并行,裁剪,有缓存 | 7.05 | 0.85 | 7.90 |
| Carbon 12 月价,并行,裁剪,有缓存 | 14.09 | 0.85 | 14.94 |
| 3.8 Flash 2026 年价,并行,裁剪,有缓存 | 2.68 | 0.85 | 3.53 |
| Hydrogen Flex,并行,裁剪,有缓存 | 2.64 | 0.85 | 3.49 |
| Hydrogen 上的每一步 | 1,000 次工具调用的模型费 | 变化 |
|---|---|---|
| 串行、整包、无缓存 | $21.97 | 起点 |
| 裁剪返回 | $14.69 | −33% |
| 再改并行调用 | $6.64 | −55% |
| 再吃隐式缓存 | $5.29 | −20% |
其一,同一个模型,写法差三倍多:Hydrogen 串行整包是 $22.82,并行裁剪加缓存是 $6.14。省下的 $16.68 里,并行调用贡献最多,因为串行时第 7 次请求要带着前面 6 次全部的返回,单次输入就到了 19,130 token;并行时最后一次请求只有 7,854 token。其二,接口费在总账里的份额很小,在最省的写法里占 13.8%,在串行整包的写法里只占 3.7%。其三,12 月 1 日以后,同样的写法 Carbon 是 Hydrogen 的 2.4 倍;11 月底以前两者只差 29%,现在用 Carbon 跑巡检的,月底前值得换一次模型再比一遍质量。
假设每天跑 100 次巡检,每次 6 个工具,一个月是 18,000 次工具调用。按上面的数,Hydrogen 并行裁剪加缓存约 $110 一个月,其中接口费约 $15;同样的任务用串行整包的写法是约 $411;换成 12 月价的 Carbon、写法不变,约 $269;用 Flex 跑夜间批次约 $63。月账里接口费的绝对值很小,模型费的差别可以到几百美元,写法和模型的选择都比数据源的单价更值得花时间。
3.8 Flash 的数看着最低,但它的价格在 2027 年 1 月 1 日就会涨到和 Hydrogen 一样;而且 Google 的 What's new 页已经把 Hydrogen 写成 3.8 Flash 的推荐升级。Flex 的 $3.49 是这几种里最便宜的 Hydrogen 用法,代价是每一轮可能等 1 到 15 分钟,一次三轮的巡检最坏要等 45 分钟,只适合不赶时间的夜间任务。
Google 价格页写明函数声明也按输入计费,这笔钱已经在表里:每次请求的 502 token 底座里,有 452 token 是函数声明。串行整包的 7 次请求里,声明合计约 3,164 token,占全部输入约 6.5 万 token 的 4.8%;并行裁剪的 3 次请求里是约 1,356 token,占 14,079 的 9.6%。返回裁得越短,声明在输入里的份额越大,这时再把声明写短、只给这次任务用得上的工具,省下的比例也越高。
每轮输出 token 估错了怎么办:敏感度
上面的账里最没把握的是每个工具轮 500 token 的输出假设。Hydrogen 的思考档位会显著改变思考 token 的数量,Google 思考页写明思考 token 按输出价计费,而且 high 是默认档。如果你没有像我们的代码那样显式设成 low,每轮的输出可能是这个假设的几倍。我们把每轮输出从 250 到 4,000 token 各算一遍,写法固定为并行、裁剪、有缓存。
| 每轮输出 token | Hydrogen | Carbon 12 月价 | 3.8 Flash 2026 年价 |
|---|---|---|---|
| 250 | 5.87 | 14.23 | 3.38 |
| 500 | 6.14 | 14.94 | 3.53 |
| 1,000 | 7.64 | 18.96 | 4.28 |
| 2,000 | 10.65 | 26.99 | 5.80 |
| 4,000 | 16.68 | 43.06 | 8.82 |
(单位:美元,1,000 次工具调用,含接口费 $0.85)
思考 token 每轮多 1,000,Hydrogen 的总账大约多 $3;而从串行改并行,能省 $8 左右。所以先把调用改成并行、把返回裁短,再去调思考档位。上线前用 interaction.usage 里的 total_thought_tokens 和 total_output_tokens 实测一周,把表里的 500 换成你的真实值。
思考档位:low 够不够用
我们的代码用了 thinking_level: low,这是为了省钱,但 low 有代价。OpenRouter 的模型页转引了 Artificial Analysis 对四个档位的评测(第三方数据,Google 没有公布分档分数):AutomationBench(自动化任务)从 low 的 60.5 到 medium 72.0、high 74.4、xhigh 76.1;Terminal-Bench 4.0 差得更远,low 只有 6.6,medium 29.3,high 54.0,xhigh 53.5。智能指数从 low 的 26.9 到 high 的 50.8。
| 思考档位 | AutomationBench | Terminal-Bench 4.0 | 智能指数 |
|---|---|---|---|
| low | 60.5 | 6.6 | 26.9 |
| medium | 72.0 | 29.3 | 41.2 |
| high(默认) | 74.4 | 54.0 | 50.8 |
| xhigh | 76.1 | 53.5 | 53.9 |
我们的巡检任务属于简单路由:函数参数都是关键词和枚举,模型只需要决定调哪几个、第二轮拉哪几条评论,这类任务更接近 AutomationBench 而不是 Terminal-Bench,low 比 high 少约 14 分。如果你的任务要模型读完结果判断哪些帖子跑题、再决定换关键词重搜,建议用 medium;Carbon 和 Argon 的默认档就是 medium,Hydrogen 的默认是 high。Google 思考页还提醒,档位只是思考预算的上限,模型在简单请求上不一定用满。
Search grounding 的价格:为什么要自己接搜索
Gemini API 自带 Google Search grounding,开起来最省事:在 tools 里加一项 google_search,模型自己决定要不要搜。但价格页写得很清楚,Hydrogen 的 Search grounding 只在付费层,每月 5,000 次免费请求由所有 Gemini 3 及以后的模型共用,超过之后每 1,000 次 $14,每天最多 1,500 次;而且一个客户请求可能触发多次搜索,每一次都单独计费。
| 项目 | Google Search grounding | EveryInfra `web/search` |
|---|---|---|
| 免费额度 | 每月 5,000 次,Gemini 3 及以后的模型共用 | 无 |
| 超出后的价格 | 每 1,000 次 $14 | 每 1,000 次 $1.389 |
| 每日上限 | 1,500 次 | 按 Key 的每分钟上限 |
| Gemini 免费层 | Hydrogen 不能用 | 和模型无关 |
| 拿到的东西 | 模型回答里的引用 | 第 1 到第 10 名的标题、链接、摘要原文 |
对比 EveryInfra 的 web/search,每次 $0.001389,1,000 次是 $1.389,grounding 超出免费额度后是它的 10.1 倍。差别还不只是价格:grounding 的结果是模型读过之后给的引用,你拿不到原始的排名列表;web/search 返回的是第 1 到第 10 名的标题、链接和摘要,可以存盘、对比、按国家和语言分别查。我们在 00:30 和 00:31 SGT 分别用西班牙站西语(关键词「gemini 4 hydrogen precio api」)和新加坡站简体中文(关键词「Gemini 4 Hydrogen API 价格」)查了同一个价格问题:西语结果第一名是 OpenRouter 的西语价格页,第二名是 DataCamp 西语版的介绍;中文结果第一名是 AI Studio 价格页,第三名是 Google Cloud 的中文价格页,第五名是一条讲 Carbon 和 Argon 12 月 1 日涨价的 X 帖子。不同语言的人在搜索结果里看到的东西差别很大,做多市场巡检时这一点要分开查。
关键词和排序:Reddit 按相关性 4 条全跑题
00:25 SGT 用「gemini 4 hydrogen」按相关性搜 Reddit,只回 4 条,4 条都在讲别的事,分别来自 CLNE、Joby、BrawlStarsEsports 和 SIBO 四个社区,讲的是氢燃料公司、氢能飞机、一位叫 Gemini 的电竞选手和小肠细菌过度生长的氢气呼气检测。00:27 换成「gemini hydrogen」按最新排序,回了 14 条,其中 6 条在讲这个模型,6 条合计 16 个赞、16 条评论。我们的判读规则是标题里有 hydrogen,且标题或社区名里有 gemini,才算在讲这个模型。
| 搜索时刻 | 关键词 | 排序 | 帖子数 | 在讲这个模型 | 这几条的赞和评论 |
|---|---|---|---|---|---|
| 00:25:14 SGT | gemini 4 hydrogen | 相关性 | 4 | 0 | 0 和 0 |
| 00:27:47 SGT | gemini hydrogen | 最新 | 14 | 6 | 16 和 16 |
一个可能的原因(我们没有验证)是:新模型名字和已有的词撞了,相关性排序会把老帖子里匹配度高的长文排在前面,而新帖子还没有积累互动。对模型来说,它只看到 4 条跑题的结果,很可能会写出「Reddit 上没有讨论」这样的结论,而这个结论是错的。我们在函数说明里直接写了「新产品名用 newest」,并且把 sort 设成必填,让模型每次都要想一下怎么排。
按最新排的 14 条里,另外 8 条被规则排除了,排除得对不对要看原文。2 条讲的是 Gemini 但不是 Hydrogen:r/GeminiAI「Long chats stops responding with Argon」(7 个赞)和「Antigravity turned one today, and the birthday gift was a full usage reset」(22 个赞,14 条里赞最多);其余 6 条是法语科技播客、一个西语编程代理的使用体验、两个第三方 AI 工具的更新公告、一条 Gemini Tasks 的新闻转帖和一条开发者额度的讨论,标题里都只提到 Gemini 4 或 Gemini。也就是说,按最新排序之后噪音还有一半多,但噪音是「讲 Gemini 的别的事」,模型读一遍标题就能分开;按相关性排序时,噪音是氢能和电竞,模型连这个话题有没有人讨论都判断不了。
YouTube 那边没有这个问题。youtube/search 按相关性回的 10 条视频全部在讲 Hydrogen,合计播放 330,691 次。播放最多的是 11 月 12 日发布当天的「Gemini 4 Hydrogen Just Dropped」,193,622 次播放、268 条评论;其次是 11 月 13 日的一条全面测试,97,332 次播放、316 条评论。新闻那边 20 篇里 11 篇是 11 月 12 日发的,到 11 月 17 日只剩 1 篇。
| 发布日期(UTC) | 篇数 | 例子 |
|---|---|---|
| 2026-11-12 | 11 | blog.google 三篇、Ars Technica、The Decoder、9to5Google、SiliconANGLE、VentureBeat |
| 2026-11-13 | 4 | GitHub 更新日志(Copilot 接入)、Mashable、Medium 上和 Claude Haiku 5.5 的对比 |
| 2026-11-15 | 1 | Tom's Guide「免费能做的 5 件事」 |
| 2026-11-16 | 3 | DevOps.com、TechRadar、AI Insider |
| 2026-11-17 | 1 | Google for Developers 博客讲机器人用途 |
20 篇的标题里直接提价格的只有 3 篇:VentureBeat 把它写成更贵的 Flash 继任者,shattered.io 标题写着 $1.50 输入价,Tom's Guide 写它免费。其余 17 篇讲速度、评测分数、搜索默认模型和接入。用新闻回答「大家怎么评价价格」,能拿到的直接证据不多,价格讨论主要在网页搜索的价格页和社区评论里。
用远程 MCP 代替手写函数
Interactions API 支持直接连远程 MCP 服务器,不用自己写函数声明和执行层;不想自己写循环的话,Managed Agents 也能连远程 MCP,做法见 Gemini Managed Agents 和远程 MCP。函数调用文档写明几条限制:只支持 Streamable HTTP 传输,不支持旧的 SSE;服务器名不能带「-」,要用下划线;配置里可以带 headers 放鉴权,用 allowed_tools 限定模型能调哪些工具。EveryInfra 的 MCP 服务走的就是 Streamable HTTP,按 MCP 规范 2025-11-25 版的传输定义实现。
import os
from google import genai

client = genai.Client()
it = client.interactions.create(
    model="gemini-4-hydrogen",
    input="What do people say about Gemini 4 Hydrogen pricing this week? Check web, news, Reddit and YouTube.",
    tools=[{
        "type": "mcp_server",
        "name": "everyinfra",                       # no "-" in the server name
        "url": "https://api.everyinfra.com/mcp",
        "headers": {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"},
        "allowed_tools": ["everyinfra_call_api", "everyinfra_get_job"],
    }],
    generation_config={"thinking_level": "medium"},
)
print(it.output_text)
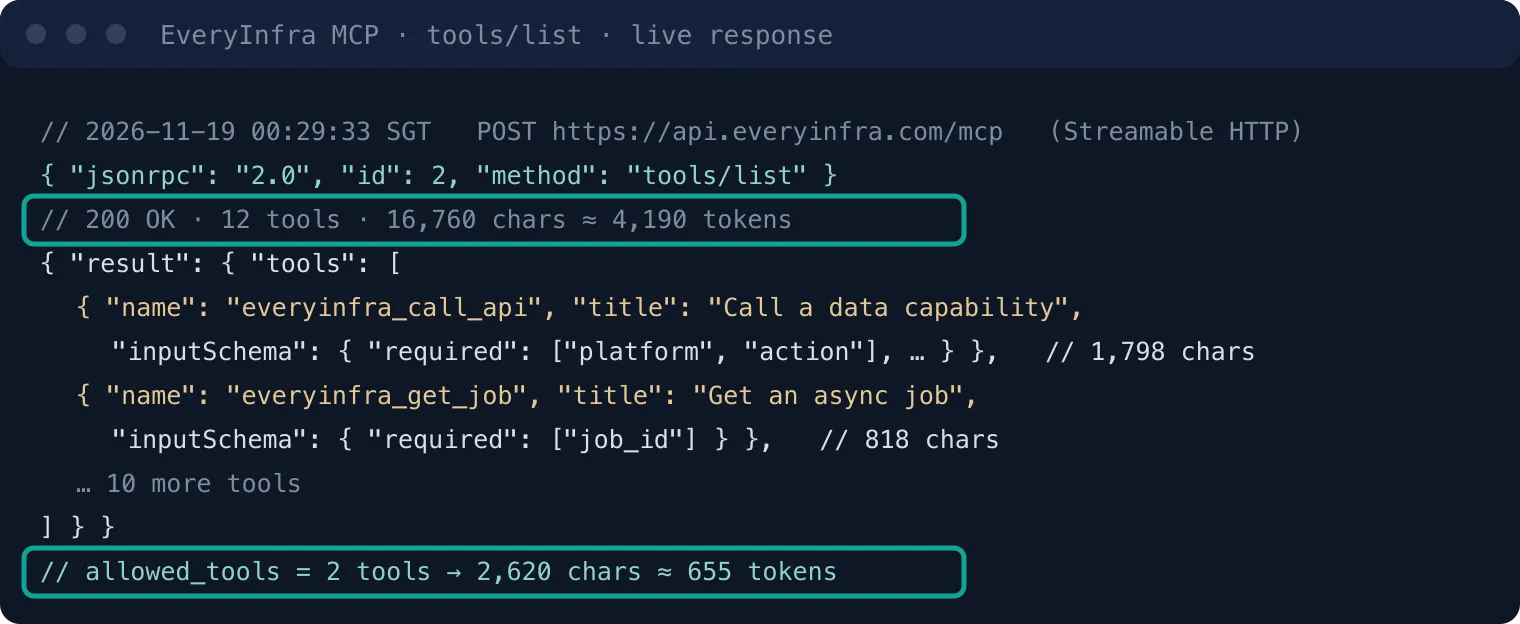
用 MCP 的代价是工具说明的体积。00:29 SGT 我们对 EveryInfra MCP 发了 tools/list,返回 12 个工具、16,760 个字符,约 4,190 token,是我们手写的 6 个函数声明(约 452 token)的 9 倍多。只放行 everyinfra_call_api 和 everyinfra_get_job 两个工具,体积降到 2,620 个字符、约 655 token。用 MCP 时模型要自己从目录里选 platform 和 action,第一次可能先调一次目录查询,多一轮请求;手写函数把能力固定好,模型少想一步。
| 做法 | 工具说明体积 | 一次巡检的轮数 | 谁选能力 |
|---|---|---|---|
| 手写 6 个函数 | 1,810 字符,约 452 token | 并行时 3 轮 | 你的代码 |
| 远程 MCP,全部 12 个工具 | 16,760 字符,约 4,190 token | 3 到 4 轮,可能先查目录 | 模型 |
| 远程 MCP,放行 2 个工具 | 2,620 字符,约 655 token | 3 到 4 轮,可能先查目录 | 模型 |
我们的建议是:固定的定时巡检用手写函数,能力固定、声明短、每一轮都省;探索性的提问用 MCP,让模型自己在 576 项可用能力里找。两者在 EveryInfra 一侧扣的钱一样,差别只在模型那一侧的 token。
视频和社区里大家在抱怨什么
00:28 SGT 按相关性搜 YouTube,回来 10 条视频,全部在讲 Hydrogen,合计 330,691 次播放。下表按接口返回的顺序列出。
| 排名 | 视频 | 发布日期(UTC) | 播放 | 评论 |
|---|---|---|---|---|
| 1 | FREE Gemini 4 Hydrogen vs $100 Claude Fable 5.2 | 2026-11-16 | 11,362 | 157 |
| 2 | Gemini 4 Hydrogen + Antigravity is WILD | 2026-11-17 | 5,524 | 2 |
| 3 | Gemini 4 Hydrogen Just Dropped (Personally Tested) | 2026-11-12 | 193,622 | 268 |
| 4 | NEW Gemini 4 Hydrogen vs. Gemini 4 Argon | 2026-11-17 | 3,704 | 5 |
| 5 | The NEW Gemini 4 Hydrogen is INSANE | 2026-11-12 | 9,171 | 2 |
| 6 | Gemini 4 Hydrogen Is the BEST Flash Model Yet – Full Test! | 2026-11-13 | 97,332 | 316 |
| 7 | Gemini 4 Hydrogen: Google's New General-Purpose Model | 2026-11-16 | 361 | 0 |
| 8 | 13 Gemini 4 Hydrogen Builds: Is It Better Than Opus? | 2026-11-17 | 457 | 0 |
| 9 | Google Just Released Gemini 4 Hydrogen! | 2026-11-15 | 5,958 | 1 |
| 10 | Gemini 4 Hydrogen vs Claude Opus 5.5: 10-Round SHOWDOWN | 2026-11-12 | 3,200 | 2 |
播放量集中在两条:第 3 条和第 6 条合计 290,954 次,占 10 条的 88.0%;其余 8 条加起来不到 4 万次。相关性排序没有把播放最多的排在前面,第 1 名只有 11,362 次播放,所以只取前三条的巡检会漏掉第 6 条那 9.7 万次播放和 316 条评论。10 个标题里有 4 个是和别的模型对比(Claude Fable 5.2、Argon、Opus 各一到两次),没有一个标题提到 API 或函数调用。我们想拉前三条的字幕看视频里讲了什么,三次 youtube/transcript 都是 503,所以下面只写评论里的原话,不写视频内容。
评论只拉了播放最多的第 3 条视频,40 条。按关键词计数,提到用量或额度的 3 条、提到价格的 3 条、讨论命名的 5 条。点赞最多的一条(178 个赞)只有一句话,拿化学式 H2O 开新命名的玩笑;第二(170 个赞)说 Carbon 宣布了好几周还用不上,Hydrogen 突然出现、所有人立刻能用;第三(86 个赞)说终于有一个今天就能用、不用只看宣传的模型。同一条视频下还有一条点赞 11 的评论说 Argon 在 AI Pro 上大约 5 个提示词就到上限,一条点赞 14 的评论说 Carbon 已经能通过 API 用。前三名里两条讲的是能不能马上用上;点赞前八的评论里没有一条讲价格。
| 点赞 | 评论在说什么(节选 6 条) | 归类 |
|---|---|---|
| 178 | 拿 H2O 开命名玩笑 | 命名 |
| 170 | Carbon 宣布几周还用不上,Hydrogen 立刻全员可用 | 可用性 |
| 86 | 终于有今天就能用的模型 | 可用性 |
| 31 | 喜欢新的模型名 | 命名 |
| 14 | Carbon 已经能通过 API 用 | 可用性 |
| 11 | Argon 在 AI Pro 上约 5 个提示词就到上限 | 用量 |
(40 条 youtube/comments 返回,00:28:37 SGT,req_58f6a18971374aaa;评论者名字不写。)
Reddit 那边,r/GoogleGeminiAI「Gemini 4 Hydrogen is super slow」在我们搜到时 0 个赞、3 条评论;r/GoogleGemini「Gemini Hydrogen still hallucinating?」12 个赞、12 条评论。两条帖子的评论我们都没拉到(后者的 reddit/comments 返回 0 条),所以只能说有人在问慢和编造,不能说回帖里多数人怎么看。
一次巡检交回模型的东西长什么样
把 6 次真实返回裁剪之后交给模型,它手上大致有这些:网页搜索前 10 名里,第 1 名是 OpenRouter 的价格和评测页,第 3 名是 Artificial Analysis 的分析页,第 4 名是一篇专门讲 $1.50/$7.50 和每个任务成本的文章,第 5 名是 r/singularity 上的发布帖;新闻 20 篇,11 篇集中在发布当天,来源有 blog.google、Ars Technica、The Decoder、9to5Google、SiliconANGLE、Search Engine Journal 和 GitHub 更新日志;Reddit 按最新排序 14 条,6 条在讲这个模型,标题分别是嫌它慢、问它还会不会编造、说 Antigravity 里上下文翻倍、读文件夹时当成 zip、新评测、API 用量;YouTube 10 条视频和播放最多那条视频的 40 条评论。
这些返回里能直接验收的有两条硬事实:Reddit 按最新排序有 6 条在讲这个模型,YouTube 评论里提到用量或额度的有 3 条。你的代理跑出来的报告如果写「Reddit 上没有讨论」,或者完全没提用量,就说明关键词、排序或裁剪出了问题;这两条都能拿上面的请求号对回原始返回。
同一个问题换语言查,结果差别不小。美国英文的前 5 名全是英文的价格页和发布帖;西班牙西语的前 5 名有 OpenRouter 西语页、DataCamp 西语介绍、LiteLLM 的价格博客、一个第三方价格页和一个西语模型页;新加坡站简体中文的前 5 名里有 AI Studio 价格页、两家第三方价格页、Google Cloud 中文价格页和一条讲 12 月涨价的 X 帖子。做多语言市场的巡检,web_search 的 country 和 language 两个参数要让模型按市场分别填,或者在代码里按市场固定好,不交给模型临场决定。
从 3.8 Flash 迁到 Hydrogen 要改的几处
如果你已经有一个跑在 3.8 Flash 上的工具调用代理,What's new 页列的迁移清单里有几条会直接影响上面的代码和账。第一是模型代码从 gemini-3.8-flash 换成 gemini-4-hydrogen。第二是上下文改成输入、思考、输出共用一个 1,048,576 token 的窗口,3.8 Flash 是输入一百万、输出 64K 分开算;代码里写死的较小 max_output_tokens 要删掉或提到 65,536。第三是默认思考档从 medium 变成 high,还多了 xhigh,传 minimal 会直接报错;如果你的 3.8 Flash 代码里写的是 minimal,迁移后第一件事就是改掉,否则所有请求都会失败。
| 设置 | Gemini 3.8 Flash | Gemini 4 Hydrogen |
|---|---|---|
| 模型代码 | gemini-3.8-flash | gemini-4-hydrogen |
| 上下文 | 输入 1M、输出 64K 分开 | 1,048,576 由输入、思考、输出共用 |
| 默认思考档 | medium | high,另有 xhigh |
| minimal | 接受 | 报错 |
| 显式缓存 | 支持 | 不支持,只有隐式缓存 |
| 免费层 Search grounding | 能用 | 不能用 |
| 2026 年价格 | $0.75 / $3.75 | $1.50 / $7.50 |
第四条容易忽略:Hydrogen 不支持显式缓存。3.8 Flash 的模型页写的是支持上下文缓存,如果你在 3.8 Flash 上用 cachedContents 把一大段固定的系统说明或文档缓存起来,迁到 Hydrogen 之后这段代码会失效,只能靠隐式缓存,而隐式缓存要求前缀至少 4,096 token、在代理循环里每轮新增至少 2,050 token 才能整段命中。我们的巡检任务前两次请求都不到 4,096 token,所以只有第三次请求能吃上缓存,这也是有缓存和无缓存只差约 20% 的原因。固定的系统说明写得越长,缓存越早生效,但每一轮的输入也越大,两者要一起算。
第五条和费用有关:3.8 Flash 在免费层可以用 Search grounding,Hydrogen 不行。依赖 grounding 做搜索的免费层项目,迁移之后要么升级付费层,要么像本文这样自己接搜索函数。
上线前要量的几个数
我们的账里有三个数是估算,上线前都应该换成实测。第一个是 token 数:我们按 4 个字符 1 token 估算,实际上线后读每次请求的 usage,Interactions API 给的字段有 total_input_tokens、total_output_tokens、total_thought_tokens 和 total_cached_tokens,一周的数据就够把估算换掉。第二个是每轮输出,也就是敏感度表里的那一列,思考档位一换,这个数就变。第三个是模型实际发起的工具调用次数:我们假设一次巡检 6 次,模型可能多调,也可能在第一轮结果够用时少调;系统说明里写了「最多 8 次」,再在代码里用 max_turns 卡住轮数,防止某次跑偏后无限循环。
接口那一侧也有两个数要量。一是每把 Key 每分钟的请求上限,同一把 Key 被多个进程共用时容易撞上 429;生产环境里每个代理用自己的 Key,或者在工具层加一个按分钟计数的限速器。二是空结果的比例,这次两次 reddit/comments 都是空结果,如果上线后空结果比例高,要么换参数,要么在报告模板里明确写出哪几项没取到。控制台的调用记录能按能力查每次请求的状态码和是否扣费,对账时以那里为准。
出错时怎么处理
这次实测碰到了四种情况,处理方式各不相同。429:同一把 Key 每分钟有请求数上限,几个进程共用时容易撞上;429 不扣费,返回体 error.retry_after 给出等待秒数,按它等,再加随机抖动。空结果:返回 200、count 为 0、billing.charged 为 false、refund.status 为 succeeded,钱自动退回;但空结果不等于真的没有,要结合别的信号判断(比如搜索结果里显示这条帖子有 12 条评论)。503:返回体 error.code 为 unavailable、retryable 为 true,带 retry_after: 60,没扣费;按提示等一分钟再试,或者在报告里写这一项这次没取到。400:Gemini 那一侧函数声明太复杂时会回 400 INVALID_ARGUMENT,要把嵌套改浅、把可选字段删掉。
| 现象 | 扣费 | 交给模型的内容 | 代码怎么做 |
|---|---|---|---|
| EveryInfra 429 | 不扣 | 不交,工具层自己重试 | 读 error.retry_after,加 1–6 秒抖动 |
200 但 count 为 0 | 自动退款 | {"count": 0} 加一句「这次没取到」 | 报告里不写「没人讨论」 |
| EveryInfra 503 unavailable | 不扣 | 错误码和文案 | 等 retry_after 秒再试,或跳过 |
| Gemini 400 INVALID_ARGUMENT | — | — | 简化函数声明,减少嵌套和枚举 |
| Gemini 免费层到每日上限 | — | — | 太平洋时间午夜重置,或切付费层 |
Hydrogen 发布文强调它在工具失败时能换路子,这个能力要靠你把失败原样交回去。我们的 run_tool 在状态码不是 200 时返回错误码和错误文案;模型看到 unavailable,可以改调 youtube/comments 代替字幕,或者在报告里说明这一项缺了。
这套写法适合哪些活
最适合的是固定问题、固定数据源、每天重复的巡检。比如一个做开发者工具的团队,每天早上想知道竞品新版本发布后一周内,网页、新闻、Reddit 和 YouTube 上的评价往哪边走;一个做跨境电商的团队,想按美国、西班牙、墨西哥三个市场分别看同一个品类的搜索结果和视频评论。这类任务的问题每天一样,模型只需要把结果读一遍、挑出变化、写成几段话,按上面的估算,一次巡检的模型费约 $0.03。
不太适合的是需要深度判断的任务。比如要从几百条评论里归纳出产品缺陷的类别、给每一类估计严重程度,或者要读完长篇分析文章再写出有立场的结论,这时候思考档位要开到 high 甚至 xhigh,每轮的输出会到几千 token,按敏感度表,Hydrogen 的总账会到 $10 到 $17,和 Carbon 的差距仍在,但已经不是几分钱的事。
常见问题
Gemini 4 Hydrogen pricing 是多少?
每百万 token 输入 $1.50、输出 $7.50(输出包含思考 token),缓存命中的输入 $0.075;整个一百万上下文同价,没有长上下文加价。Batch 和 Flex 是 $0.75/$3.75,Priority 是 $2.70/$13.50。数字依据 AI Studio 价格页。
Gemini 4 Hydrogen vs 3.8 Flash,该不该换?
2026 年内 3.8 Flash 的价格是 Hydrogen 的一半,2027 年 1 月 1 日起两者同价。Google 把 Hydrogen 写成 3.8 Flash 的推荐升级,发布文写它速度快 2.5 倍、Terminal-Bench 从 18.2% 到 57%。迁移时要注意默认思考档从 medium 变成 high、不再接受 minimal,输出上限要改到 65,536。依据 What's new 页的迁移清单。
Gemini 4 Hydrogen vs Argon vs Carbon 怎么选?
Google 选模型页的建议是:日常编码、工具调用代理、并行子任务用 Hydrogen;难的架构、调试、科研和安全验证用 Carbon;要长链推理又想比 Carbon 省 token 用 Argon。12 月 1 日后 Carbon 和 Argon 是 Hydrogen 的 2.67 倍单价,按我们的巡检写法总账是 2.4 倍。依据 Choosing a model。
Gemini 4 Hydrogen API 免费层能用工具调用吗?
能。价格页写明 Hydrogen 在免费层可用,函数调用不另收费;但 Google Search grounding 只在付费层,免费层的输入会被用来改进产品。r/GeminiFeedback 有人问 API 用量和聊天模式的区别,两边的额度是分开算的,见 Reddit 讨论帖。
Gemini API 返回 400 怎么办?
函数调用时最常见的原因是声明太复杂:API 会把声明编译成约束生成的状态机,嵌套太深、枚举太多就会回 400 INVALID_ARGUMENT,错误里会写出是哪个字段。把可选字段删掉、嵌套改浅、工具控制在 10 到 20 个以内。依据 函数调用文档的限制一节。
Gemini 4 Hydrogen 真的慢吗?
r/GoogleGeminiAI 有帖子说它很慢,我们搜到时有 3 条评论。我们没有在 API 上测延迟;公开数据里,发布文写它比 3.8 Flash 快 2.5 倍。思考档位从默认的 high 调到 low 或 medium,思考 token 会少,响应通常会快一些,上线前用自己的请求量一次。帖子见 Reddit。
Gemini 4 Hydrogen 还会编造吗?
发布文写它编造的说法比 3.8 Flash 少 5 倍以上,9to5Google 转述的诚实度评分是 96.7%,发布文当前版本写的是 94%;r/GoogleGemini 仍有人发帖问它为什么还在编造。工具调用时让报告带链接、空结果写成「没取到」,能减少把缺数据写成结论的情况。帖子见 Reddit。
参考资料
- Introducing Gemini 4 Hydrogen for Agentic Workflows,blog.google,2026-11-12 发布、2026-11-16 更新,https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/
- Gemini 4 Hydrogen 模型页,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/models/gemini-4-hydrogen
- What's new in Gemini 4 Hydrogen,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/whats-new-gemini-4-hydrogen
- Gemini Developer API pricing,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/pricing
- Function calling,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/function-calling
- Interactions API overview,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/interactions-overview
- Understand and count tokens,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/tokens
- Rate limits,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/rate-limits
- Context caching,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/caching
- Thinking,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/thinking
- Choosing a model,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/choosing-a-model
- Grounding with Google Search,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/google-search
- Batch API,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/batch-api
- Flex inference,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/flex-inference
- Priority inference,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/priority-inference
- Structured outputs,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/structured-output
- URL context,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/url-context
- Text generation,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/text-generation
- Long decode,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/long-decode
- Gemini 4 Carbon 模型页,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/models/gemini-4-carbon
- What's new in Gemini 4 Carbon,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/whats-new-gemini-4-carbon
- Gemini 3.8 Flash 模型页,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/models/gemini-3.8-flash
- Models,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/models
- Billing,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/billing
- Computer use,Google AI Studio 文档,2026-11-19 读取,https://aistudio.google.com/docs/computer-use
- Gemini 4 Hydrogen model card,Google DeepMind,2026-11-12,https://deepmind.google/models/model-cards/gemini-4-hydrogen/
- Introducing Gemini 4 Carbon,blog.google,2026-10-28,https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/
- Gemini 4 Hydrogen in Google Antigravity,Antigravity 博客,2026-11-19 读取,https://antigravity.google/blog/gemini-4-hydrogen-in-google-antigravity/
- Gemini 4 Hydrogen in GitHub Copilot,GitHub 更新日志,2026-11-13,https://github.blog/changelog/2026-11-13-gemini-4-hydrogen-in-github-copilot/
- google-genai,PyPI,2026-11-19 读取,https://pypi.org/project/google-genai/
- googleapis/python-genai,GitHub,2026-11-19 读取,https://github.com/googleapis/python-genai
- Gemini 4 Hydrogen API Pricing and Day 0 Support on LiteLLM,LiteLLM 文档,2026-11-19 读取,https://docs.litellm.ai/blog/gemini-4-hydrogen
- Transports,Model Context Protocol 规范 2025-11-25,2026-11-19 读取,https://modelcontextprotocol.io/specification/2025-11-25/basic/transports
- EveryInfra 数据能力目录,2026-11-19 00:14 SGT 读取,https://api.everyinfra.com/api/v1/social/catalog
- Google rolls out Gemini 4 Hydrogen, finally replacing 3.8 Flash,Ars Technica,2026-11-12,https://arstechnica.com/google/2026/11/google-rolls-out-gemini-4-hydrogen-finally-replacing-3-8-flash/
- Google's Gemini 4 Hydrogen outscores the bigger Argon just four weeks after its launch,The Decoder,2026-11-12,https://the-decoder.com/googles-gemini-4-hydrogen-outscores-the-bigger-argon-just-four-weeks-after-its-launch/
- Google releases Gemini 4 Hydrogen, a lower-cost model said to outscore Argon,SiliconANGLE,2026-11-12,https://siliconangle.com/2026/11/12/google-releases-gemini-4-hydrogen-a-lower-cost-model-said-to-outscore-argon/
- Google announces Gemini 4 Hydrogen,9to5Google,2026-11-12,https://9to5google.com/2026/11/12/gemini-4-hydrogen-launch/
- Google Makes Gemini 4 Hydrogen The Default Model In AI Mode,Search Engine Journal,2026-11-12,https://www.searchenginejournal.com/google-gemini-4-hydrogen-default-ai-mode/597096/
- Google's Gemini 4 Hydrogen Turns Model Choice Into a Routing Decision,DevOps.com,2026-11-16,https://devops.com/googles-gemini-4-hydrogen-turns-model-choice-into-a-routing-decision
- Gemini 4 Hydrogen 价格和评测,OpenRouter,2026-11-19 读取,https://openrouter.ai/google/gemini-4-hydrogen
- Gemini 4 Hydrogen 智能、性能和价格分析,Artificial Analysis,2026-11-19 读取,https://artificialanalysis.ai/models/gemini-4-hydrogen
- Gemini 4 Hydrogen is super slow,Reddit r/GoogleGeminiAI,2026-11-18,https://www.reddit.com/r/GoogleGeminiAI/comments/1xzjcaq/gemini_4_hydrogen_is_super_slow/
- Gemini Hydrogen still hallucinating?,Reddit r/GoogleGemini,2026-11-18,https://www.reddit.com/r/GoogleGemini/comments/1xzg6o7/gemini_hydrogen_still_hallucinating/
- Hydrogen and api usage,Reddit r/GeminiFeedback,2026-11-18,https://www.reddit.com/r/GeminiFeedback/comments/1xzc8ra/hydrogen_and_api_usage_ignoring_in_chat_modes/
- FREE Gemini 4 Hydrogen vs $100 Claude Fable 5.2,YouTube,2026-11-16,https://www.youtube.com/watch?v=-UnVlPimhqY
- Gemini 4 Hydrogen + Antigravity is WILD,YouTube,2026-11-17,https://www.youtube.com/watch?v=XUUbeYlCrKA
- Gemini 4 Hydrogen Just Dropped (Personally Tested),YouTube,2026-11-12,https://www.youtube.com/watch?v=bm8x0hopWTU
引用编号 BL-187