Gemini 4 Hydrogen API: coste estimado de 1000 llamadas a herramientas, entre tokens del modelo y llamadas de datos
Gemini 4 Hydrogen API: 1000 llamadas a herramientas cuestan unos 6,14 USD (estimado) en paralelo, con recorte y caché. Carbon en diciembre: 14,94 USD.
Google lanzó Gemini 4 Hydrogen el 12 de noviembre de 2026. El código del modelo es gemini-4-hydrogen. Según la página de precios de AI Studio, cuesta 1,50 USD por millón de tokens de entrada y 7,50 USD por millón de tokens de salida, con el mismo precio en todo el contexto de un millón de tokens. También está en el nivel gratuito. Google lo presenta como el modelo rápido para programar y usar herramientas a diario.
Queríamos responder una pregunta práctica. El modelo recibe seis funciones que llaman a las API de búsqueda web, noticias, Reddit y YouTube de EveryInfra. Con ellas revisa qué opina la gente esta semana sobre el precio de Hydrogen. ¿Cuánto cuestan 1000 llamadas a herramientas? ¿El dinero se va en tokens del modelo o en las llamadas de datos?
El 2026-11-19, entre las 00:23 y las 00:31 hora de Singapur (SGT), hicimos 10 llamadas reales en tres rondas. Costaron 0,007877 USD en total. Con el tamaño real de cada respuesta estimamos el coste del modelo, que no llegamos a ejecutar. Para 1000 llamadas a herramientas, el método simple cuesta 22,82 USD: el modelo llama a una herramienta por turno y recibe la respuesta completa. El método optimizado cuesta 6,14 USD: recorta cada respuesta a los campos necesarios, deja que el modelo llame en paralelo a las herramientas independientes y aprovecha la caché implícita. El mismo método con Gemini 4 Carbon al precio del 1 de diciembre cuesta 14,94 USD. En los tres casos, las llamadas de datos cuestan 0,85 USD.
No tenemos una clave de la API de Gemini. Por eso no ejecutamos la parte del modelo en nuestro equipo. Los parámetros y el código de Gemini siguen la documentación de Google AI Studio y son ejemplos de configuración. Los tokens son estimaciones a partir de los caracteres reales de cada respuesta, con la regla de Google de «unos 4 caracteres por token». Cada cifra del lado de los datos sale del cuerpo de respuesta de una llamada real.
Nuestro artículo de noviembre sobre la API de Gemini Decisions trata de Gemini Decision 1 y las decisiones estructuradas. Este artículo es distinto: explica cómo un modelo rápido y barato ejecuta un ciclo de herramientas en varios pasos, y cómo se cuentan los dos costes.
Gemini 4 Hydrogen API: el modelo rápido del 12 de noviembre
La publicación de lanzamiento en blog.google llama a Hydrogen el modelo rápido de Gemini 4 para todos. Es el modelo por defecto en la aplicación Gemini y en el modo IA de la Búsqueda. Los desarrolladores pueden usarlo en la API de Gemini, en AI Studio y en Agent Platform para empresas. La publicación le da 51 puntos en el índice de inteligencia de Artificial Analysis, frente a 50 de Gemini 4 Argon, lanzado cuatro semanas antes. En Terminal-Bench 4.1 logra un 57 %, frente al 18,2 % de Gemini 3.8 Flash.
Según Google, es 2,5 veces más rápido que 3.8 Flash y hace más de cinco veces menos afirmaciones inventadas. La publicación añade que se adapta bien cuando una herramienta falla o una búsqueda no devuelve nada. En una revisión de cuatro plataformas suele faltar alguna. El modelo debe seguir sin ella.
La página del modelo en AI Studio enumera las funciones admitidas. Incluye llamadas a funciones, salidas estructuradas, grounding con Google Search y Google Maps (el modelo busca por su cuenta y luego responde), contexto de URL, ejecución de código y uso del ordenador. La ventana de contexto es de 1 048 576 tokens, compartida entre entrada, razonamiento y salida. Una respuesta síncrona admite hasta 65 536 tokens de salida, y con long decode, un modo para salidas muy largas, llega a un millón. Solo hay caché implícita: la API detecta un inicio de solicitud repetido y lo cobra al precio de caché, sin que usted cree la caché. La caché explícita con cachedContents no está disponible.
Hay cuatro niveles de razonamiento: low, medium, high (por defecto) y el nuevo xhigh. Una solicitud con el valor minimal devuelve un error. La página «What's new» presenta Hydrogen como la actualización recomendada desde 3.8 Flash y desde modelos anteriores de Gemini 3 y 2.5. También es el modelo por defecto del agente Antigravity en Managed Agents.
| Dato | Gemini 4 Hydrogen | Origen |
|---|---|---|
| Código del modelo | gemini-4-hydrogen | Página del modelo en AI Studio |
| Contexto | 1 048 576 tokens, compartidos por entrada, razonamiento y salida | Página del modelo y de long decode |
| Salida por respuesta | 65 536 por defecto, hasta 1 048 576 con long decode | Página del modelo |
| Niveles de razonamiento | low, medium, high (por defecto), xhigh. Sin minimal | Página What's new |
| Caché | Solo implícita, con un prefijo de al menos 4096 tokens | Página de caché |
| Herramientas | Funciones, salidas estructuradas, grounding con Search y Maps, contexto de URL, ejecución de código, uso del ordenador, MCP remoto | Página del modelo y de llamadas a funciones |
| Nivel gratuito | Sí. El grounding con Search solo en el nivel de pago | Página de precios |
Google DeepMind publicó la ficha del modelo el 12 de noviembre. Dice que Hydrogen es una adaptación de Gemini 4 Carbon, así que comparte la lista de funciones y el diseño de la API de Carbon en un modelo más pequeño y rápido. Google anunció Carbon el 28 de octubre y al principio solo lo abrió a un grupo de equipos de seguridad. Hydrogen, en cambio, estuvo abierto a todos el día del lanzamiento, también en el nivel gratuito. De los 40 comentarios de YouTube que descargamos, el segundo con más votos (170) habla justo de esa diferencia.
Gemini 4 Hydrogen pricing: cada nivel y la diferencia después del 1 de diciembre
La página de precios da dólares por millón de tokens. El precio estándar de Hydrogen es 1,50 USD de entrada y 7,50 USD de salida. La entrada en caché cuesta 0,075 USD, un 95 % menos que la entrada normal. El precio de salida incluye los tokens de razonamiento. Una nota añade que se factura cada token que procesa el modelo, también los tokens de razonamiento y las declaraciones de funciones. Por eso sus seis declaraciones cuentan como entrada en cada turno.
Entre los modelos que comparamos, Carbon y Argon son los que más cambian. Hasta el 30 de noviembre cuestan 2 y 10 USD con el precio de lanzamiento. Desde el 1 de diciembre cuestan 4 y 20 USD, el doble. Gemini 3.8 Flash sigue a 0,75 y 3,75 USD hasta el final de 2026. Desde el 1 de enero de 2027 cuesta 1,50 y 7,50 USD, igual que Hydrogen.
| Modelo (USD por millón de tokens) | Entrada | Salida | Entrada en caché | Nivel gratuito | Nota |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen estándar | 1,50 | 7,50 | 0,075 | Sí | Mismo precio en todo el contexto |
| Gemini 4 Hydrogen Batch o Flex | 0,75 | 3,75 | 0,0375 | No | Flex apunta a 1 a 15 minutos |
| Gemini 4 Hydrogen Priority | 2,70 | 13,50 | — | No | Se atiende antes que estándar y Flex |
| Gemini 4 Carbon o Argon (hasta el 30 nov) | 2,00 | 10,00 | 0,10 | No | Razonamiento medium por defecto |
| Gemini 4 Carbon o Argon (desde el 1 dic) | 4,00 | 20,00 | 0,20 | No | Termina el precio de lanzamiento |
| Gemini 3.8 Flash (2026) | 0,75 | 3,75 | 0,075 | Sí | 1,50 y 7,50 desde el 1 ene 2027 |
| Gemini 3.5 Flash-Lite | 0,30 | 2,50 | — | Sí | Para clasificar y enrutar |
Hay tres formas de compra. Batch API, que recibe las solicitudes en un lote asíncrono, cuesta la mitad, pero según la documentación solo funciona con generateContent, no con la API de Interactions. Flex, un nivel que cambia más espera por la mitad del precio, también cuesta la mitad y funciona con Interactions mediante service_tier='flex', a cambio de una latencia objetivo de 1 a 15 minutos, y aún está en vista previa. Priority, un nivel que pasa sus solicitudes al frente de la cola, cuesta un 80 % más y sirve para solicitudes que necesitan respuesta inmediata.
Un ciclo de herramientas en varios pasos espera cada turno antes de empezar el siguiente. Por eso Batch no sirve, y Flex sirve solo para revisiones nocturnas que no tienen prisa.
En la página de límites, los límites dependen del gasto. El nivel Tier 1 solo pide una cuenta de facturación y permite gastar 10 USD cada 10 minutos. El recuento diario se reinicia a medianoche del Pacífico, que son las 15:00 o las 16:00 en Singapur según el horario de verano. Con nuestro coste estimado por revisión, 10 USD cada 10 minutos alcanzan para unas 300 revisiones. Lo normal es llegar antes al límite por minuto de la clave de datos (nuestra clave de prueba admite 10 solicitudes por minuto).
Una revisión: seis llamadas a herramientas en cuatro plataformas
La tarea es una frase en inglés: «What do people say about Gemini 4 Hydrogen pricing this week? Check web, news, Reddit and YouTube.» Para que el modelo tenga datos, escribimos seis funciones, cada una ligada a una capacidad de EveryInfra. Las páginas de la API de Reddit, la API de YouTube, la API de búsqueda web y la API de Google News listan las demás capacidades y sus parámetros. Tres son búsquedas: web/search (búsqueda web), google_news/search (búsqueda en Google News) y reddit/search (búsqueda en Reddit). Las otras tres son reddit/comments (comentarios de Reddit), youtube/search (búsqueda en YouTube) y youtube/comments (comentarios de YouTube).
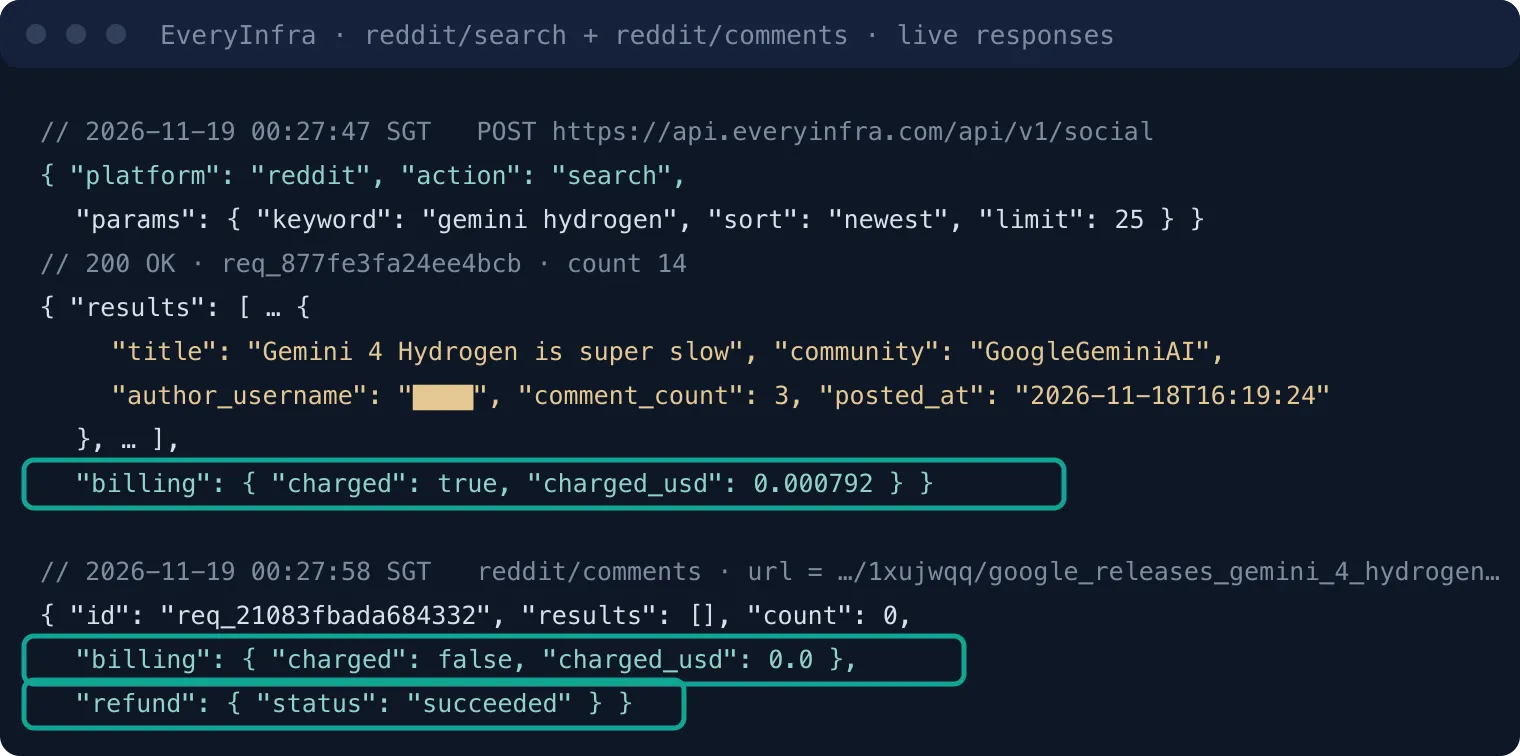
Las seis usan el mismo punto de acceso, POST /api/v1/social. El cuerpo de la solicitud tiene tres campos: platform, action y params. La respuesta trae results, count y billing, y además refund cuando el resultado está vacío.
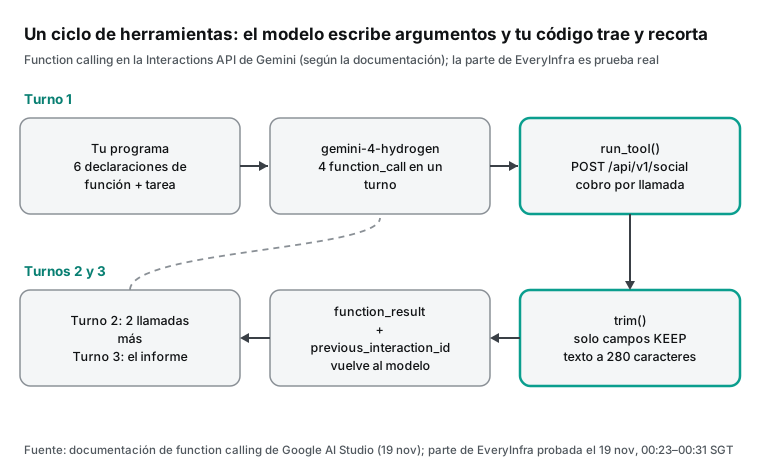
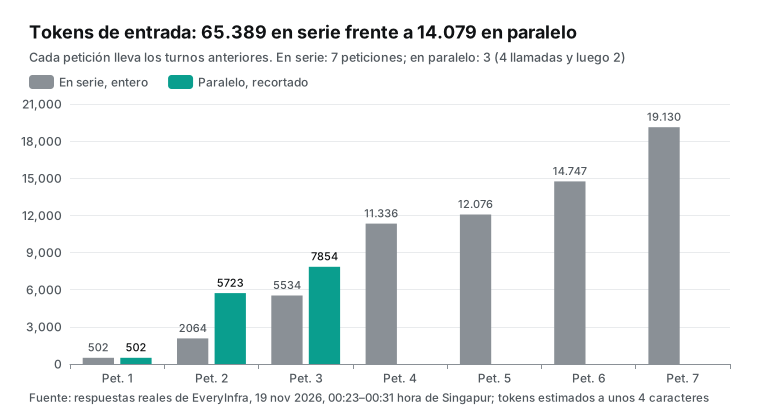
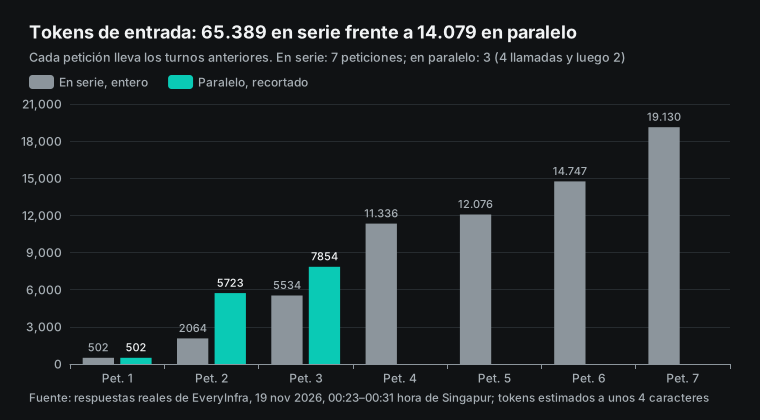
La revisión sigue este orden. En el turno 1, las cuatro búsquedas no dependen entre sí, así que el modelo puede enviarlas en paralelo. En el turno 2 usa los enlaces de publicaciones y vídeos del turno 1 para pedir comentarios. En el turno 3 escribe el informe. En serie, el modelo envía una llamada por turno y seis llamadas necesitan siete solicitudes; en paralelo, tres. Menos solicitudes significan menos contexto reenviado, y ese contexto es la mayor parte del coste.
Este es el registro de nuestras llamadas reales. La hora es la de salida de la solicitud. El coste es el valor billing.charged_usd del cuerpo de respuesta. Cada identificador aparece en el registro de llamadas de la consola.
| Hora de Singapur (2026-11-19) | Capacidad | Parámetros principales | Resultados | Cobro (USD) | Identificador |
|---|---|---|---|---|---|
| 00:23:21 SGT | web/search | «gemini 4 hydrogen pricing», EE. UU., inglés | 10 | 0,001389 | req_b0eb8916926c4a63 |
| 00:24:12 SGT | google_news/search | «gemini 4 hydrogen», última semana | 20 | 0,000792 | req_46a6a26a4fe94717 |
| 00:25:14 SGT | reddit/search | «gemini 4 hydrogen», por relevancia | 4 | 0,000792 | req_52a46a7e4747419c |
| 00:27:47 SGT | reddit/search | «gemini hydrogen», más recientes | 14 | 0,000792 | req_877fe3fa24ee4bcb |
| 00:27:58 SGT | reddit/comments | Publicación del lanzamiento en r/singularity | 0 | 0 (reembolsado) | req_21083fbada684332 |
| 00:28:26 SGT | youtube/search | «gemini 4 hydrogen», por relevancia | 10 | 0,000778 | req_86a01257f3cc42d7 |
| 00:28:37 SGT | youtube/comments | El vídeo más visto | 40 | 0,000556 | req_58f6a18971374aaa |
| 00:30:21 SGT | reddit/comments | Hilo en r/GoogleGemini | 0 | 0 (reembolsado) | req_e0151310d137402b |
| 00:30:32 SGT | web/search | España, español | 10 | 0,001389 | req_e0b072de7e274991 |
| 00:31:12 SGT | web/search | Singapur, chino simplificado | 10 | 0,001389 | req_25bd028939b348a6 |
Las 10 llamadas costaron 0,007877 USD. Las dos llamadas a reddit/comments devolvieron 0 resultados, con charged en false y el reembolso en succeeded. Sin embargo, las dos publicaciones muestran comentarios en la web de Reddit: la de r/GoogleGemini aparecía con 12 comentarios en nuestra búsqueda de las 00:27 SGT. También llamamos a youtube/transcript para tres vídeos a las 00:33 SGT y repetimos una vez a las 00:47 SGT. Todas las llamadas devolvieron 503 (unavailable), no cobró nada y trajo retry_after: 60 con la sugerencia de probar antes un vídeo de ejemplo.
Trate los dos casos de forma distinta. Un resultado vacío de comentarios se marca como «no obtenido esta vez», nunca como «nadie comentó». Ante un 503, espere los segundos de retry_after y repita, o salte ese elemento.
Llamadas en paralelo: varias funciones en un mismo turno
La guía de llamadas a funciones de Google distingue dos casos. Las llamadas en paralelo son varias llamadas independientes en un turno. Las llamadas compuestas son las que dependen de un resultado anterior. Que el modelo llame en paralelo depende de dos cosas: que las funciones parezcan independientes en su descripción y que la instrucción de sistema lo pida.
Nuestra instrucción de sistema empieza con la frase «Call independent tools in parallel». Las cuatro búsquedas solo reciben una palabra clave y valores enumerados, sin referencias entre sí. Las dos funciones de comentarios dicen «Pass a url from reddit_search» y «Pass a url from youtube_search», así que el modelo sabe que deben esperar al turno 2.
Que el modelo pida llamadas en paralelo no hace que su código las ejecute en paralelo. La función agent de abajo llama a EveryInfra de una en una dentro de cada turno, y cuatro búsquedas tardan decenas de segundos. Para acortar ese tiempo, envíelas a la vez con concurrent.futures.ThreadPoolExecutor. Antes, revise el límite por minuto de su clave: la nuestra de prueba admite 10 solicitudes por minuto, y varios procesos que la comparten reciben 429 con facilidad. El ahorro en el modelo depende solo del número de turnos.
Código Python: llamadas a funciones de la Gemini 4 Hydrogen API con /api/v1/social
El código tiene dos capas. La capa de herramientas convierte cada nombre de función en un platform y un action de EveryInfra, envía la solicitud, gestiona el 429 y recorta la respuesta. Esa capa sí la ejecutamos: hizo las 10 llamadas de arriba. La capa del modelo usa la API de Interactions del SDK Google GenAI. Pone las seis declaraciones en tools, ejecuta los pasos function_call que devuelve el modelo y le entrega los resultados como function_result, con previous_interaction_id para seguir desde el turno anterior. La escribimos según la guía de llamadas a funciones y la descripción de la API de Interactions, y no la ejecutamos, porque no tenemos clave de Gemini. La primera línea del código fija el SDK en la versión 2: la página de google-genai en PyPI indica que Interactions pide la 2.0 o posterior, y en el repositorio del SDK las notas de la 3.0 cambian la versión de API y el cliente HTTP por defecto. Sin fijarla, una actualización automática a la 3.0 puede cambiar cómo arranca el cliente.
# pip install "google-genai>=2,<3"   (Interactions API needs SDK 2.0 or later)
import json, os, random, time, urllib.request, urllib.error
from google import genai

EI_URL = "https://api.everyinfra.com/api/v1/social"
EI_KEY = os.environ["EVERYINFRA_API_KEY"]

def fn(name, desc, props, required):
    return {"type": "function", "name": name, "description": desc,
            "parameters": {"type": "object", "properties": props, "required": required}}

S = {"type": "string"}
TOOLS = [
    fn("web_search", "Google-style web results (title, url, snippet). Up to 10.",
       {"keyword": S, "country": S, "language": S}, ["keyword"]),
    fn("news_search", "Google News articles, newest first. Up to 20.",
       {"keyword": S, "time_window": {"type": "string", "enum": ["day", "week", "month"]}}, ["keyword"]),
    fn("reddit_search", "Reddit posts from the last month. Use sort=newest for new product names.",
       {"keyword": S, "sort": {"type": "string", "enum": ["relevance", "newest", "top"]}}, ["keyword", "sort"]),
    fn("reddit_comments", "Comments of one Reddit post. Pass a url from reddit_search.", {"url": S}, ["url"]),
    fn("youtube_search", "YouTube videos with views, likes and comment count.",
       {"keyword": S, "sort": {"type": "string", "enum": ["relevance", "newest", "most_viewed"]}}, ["keyword", "sort"]),
    fn("youtube_comments", "Comments of one YouTube video. Pass a url from youtube_search.", {"url": S}, ["url"]),
]
ROUTE = {"web_search": ("web", "search", 10), "news_search": ("google_news", "search", 20),
         "reddit_search": ("reddit", "search", 25), "reddit_comments": ("reddit", "comments", 50),
         "youtube_search": ("youtube", "search", 10), "youtube_comments": ("youtube", "comments", 40)}
KEEP = {"web_search": ["rank", "title", "url", "text", "published_at"],
        "news_search": ["title", "url", "source", "published_at"],
        "reddit_search": ["url", "title", "text", "community", "like_count", "comment_count", "posted_at"],
        "reddit_comments": ["text", "like_count", "posted_at"],
        "youtube_search": ["url", "title", "view_count", "like_count", "comment_count", "posted_at"],
        "youtube_comments": ["text", "like_count", "posted_at"]}

def call_everyinfra(platform, action, params, tries=8):
    body = json.dumps({"platform": platform, "action": action, "params": params}).encode()
    for attempt in range(tries):
        req = urllib.request.Request(EI_URL, data=body, method="POST", headers={
            "Authorization": f"Bearer {EI_KEY}", "Content-Type": "application/json"})
        try:
            with urllib.request.urlopen(req, timeout=120) as r:
                return r.status, json.loads(r.read())
        except urllib.error.HTTPError as e:
            data = json.loads(e.read() or b"{}")
            err = data.get("error") or {}
            if e.code == 429 and attempt < tries - 1:   # 429 is not charged; retry_after sits inside "error"
                time.sleep(int(err.get("retry_after") or 10) + random.uniform(1, 6))
                continue
            return e.code, data
    return 0, {}

def run_tool(name, args):
    platform, action, limit = ROUTE[name]
    status, data = call_everyinfra(platform, action, {"limit": limit, **args})
    if status != 200:                                   # give the model the error text, not an exception
        err = data.get("error") or {}
        return {"error": status, "code": err.get("code"), "message": err.get("message")}
    rows = [{k: r.get(k) for k in KEEP[name] if r.get(k) not in (None, "", [])} for r in data.get("results") or []]
    for r in rows:
        if isinstance(r.get("text"), str) and len(r["text"]) > 280:
            r["text"] = r["text"][:280] + "…"
    return {"count": len(rows), "rows": rows}

SYS = "Call independent tools in parallel. Use at most 8 tool calls. Then write a short report with links."

def agent(task, model="gemini-4-hydrogen", max_turns=6):
    client = genai.Client()                             # reads GEMINI_API_KEY
    cfg = {"thinking_level": "low"}
    it = client.interactions.create(model=model, input=task, tools=TOOLS,
                                    system_instruction=SYS, generation_config=cfg)
    for _ in range(max_turns):
        calls = [s for s in it.steps if s.type == "function_call"]
        if not calls:
            break
        results = [{"type": "function_result", "name": c.name, "call_id": c.id,
                    "result": [{"type": "text", "text": json.dumps(run_tool(c.name, c.arguments), ensure_ascii=False)}]}
                   for c in calls]
        # tools and system_instruction apply to one interaction only: send them again every turn
        it = client.interactions.create(model=model, input=results, tools=TOOLS, system_instruction=SYS,
                                        generation_config=cfg, previous_interaction_id=it.id)
        print("usage:", it.usage)
    return it.output_text

if __name__ == "__main__":
    print(agent("What do people say about Gemini 4 Hydrogen pricing this week? Check web, news, Reddit and YouTube."))
Hay cuatro detalles que vienen de nuestros errores o de la documentación. Primero, el valor retry_after de un 429 está dentro del objeto error. En la primera prueba lo leíamos en el nivel superior, esperábamos el tiempo por defecto y volvía el 429. Ahora el código lee error.retry_after y suma de 1 a 6 segundos al azar, para que varios procesos con la misma clave no reintenten en el mismo segundo.
Segundo, tools y system_instruction solo valen para una solicitud en la API de Interactions. previous_interaction_id conserva la conversación, no la configuración, así que hay que reenviar ambos en cada turno. Tercero, el modelo puede pedir varios function_call en un turno. Cada resultado vuelve con su call_id, y el orden puede ser distinto.
Cuarto, cuando una llamada falla, devuelva al modelo el código y el mensaje de error como resultado de la función. La publicación de lanzamiento dice que Hydrogen cambia de rumbo cuando una herramienta falla, pero solo puede hacerlo si ve el error. Si su código lanza una excepción, el modelo no puede hacer nada.
Google recomienda como máximo de 10 a 20 herramientas por solicitud, con tipos estrictos y enumeraciones siempre que se pueda. Si las declaraciones son demasiado complejas o anidadas, la API puede devolver 400 INVALID_ARGUMENT en el modo any. Nosotros pusimos el orden y la ventana de tiempo como enumeraciones, y la descripción de reddit_search dice «Use sort=newest for new product names», por la prueba de Reddit de más abajo. Las seis declaraciones ocupan 1810 caracteres, unos 452 tokens. Con la instrucción de sistema y la tarea, la base fija de cada solicitud ronda los 502 tokens.
Puede probar la API de datos antes de tener una clave de Gemini. Un solo comando curl muestra la forma de la respuesta, con los mismos parámetros que las declaraciones. Obtenga su clave en la guía de inicio y guárdela en una variable de entorno, nunca en un archivo de código.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"reddit","action":"search","params":{"keyword":"gemini hydrogen","sort":"newest","limit":25}}'
Cuántas funciones: seis específicas o una general
Otra opción es dar al modelo una sola función general con platform, action y params, que el modelo rellena. La declaración es más corta y una sola función llega a las 576 capacidades disponibles de EveryInfra. El precio es que el modelo debe conocer el nombre y los parámetros de cada capacidad. En la primera llamada suele consultar antes el catálogo, lo que añade un turno, y si se equivoca en un parámetro recibe un 422 y lo intenta de nuevo. Elegimos seis funciones específicas porque la revisión es fija y las enumeraciones bloquean los parámetros que más se equivocan.
Seis funciones específicas ocupan unos 452 tokens, y una general, entre cien y doscientos. Los parámetros y las respuestas pesan lo mismo en los dos diseños. Si la tarea cambia a menudo, use una función general o un servidor MCP remoto. Si es fija y se ejecuta cientos de veces al día, las funciones específicas dan menos trabajo.
Tamaño de las respuestas: tokens antes y después del recorte
La entrada es la mayor parte del coste del modelo, y las respuestas de las herramientas son la mayor parte de la entrada. Serializamos cada respuesta real y estimamos los tokens a 4 caracteres por token. Luego lo comparamos con la versión recortada, que conserva solo los campos de KEEP y corta los textos a 280 caracteres. La guía de tokens de Google dice que un token equivale a unos 4 caracteres en Gemini. El chino, los emojis y los enlaces se apartan de esa proporción, así que las cifras dan el orden de magnitud, con un error de alrededor del 20 %.
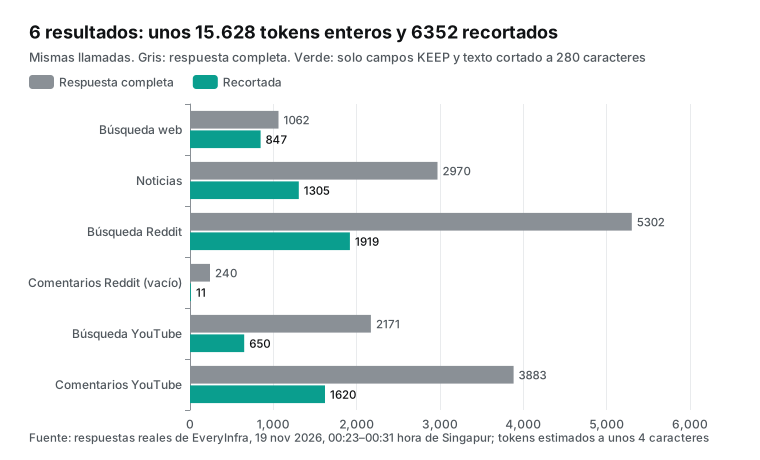
| Respuesta (tokens estimados) | Completa | Recortada | Reducción |
|---|---|---|---|
web/search EE. UU. en inglés, 10 resultados | 1062 | 847 | 20,2 % |
google_news/search, 20 resultados | 2970 | 1305 | 56,1 % |
reddit/search más recientes, 14 resultados | 5302 | 1919 | 63,8 % |
reddit/search por relevancia, 4 resultados | 8173 | 622 | 92,4 % |
youtube/search, 10 resultados | 2171 | 650 | 70,1 % |
youtube/comments, 40 resultados | 3883 | 1620 | 58,3 % |
reddit/comments, vacío | 240 | 11 | — |
| Las seis llamadas de una revisión | 15 628 | 6352 | 59,4 % |
La búsqueda de Reddit por relevancia trajo solo 4 publicaciones, pero la respuesta completa ocupaba 8173 tokens. Algunas eran hilos largos de salud y análisis de inversión con miles de palabras. El recorte funciona mejor con este tipo de respuesta: deja el título, la comunidad, los votos, el número de comentarios y los primeros 280 caracteres, y con eso el modelo sabe si la publicación habla de Hydrogen. Nuestro método es sencillo: guardamos la respuesta completa en disco y al modelo le damos solo la versión recortada. Es la misma idea de Subagentes de Claude Code para cuentas de marca en TikTok, donde los datos originales se quedan en cada subagente y la sesión principal recibe solo resúmenes; aquí el recorte ocurre en los resultados de las funciones.
Hay un campo más que conviene arreglar antes. En youtube/comments, posted_at es un tiempo relativo como «5 days ago», no una fecha. El modelo no sabe respecto a qué día, y el informe puede equivocar las fechas. Conviértalo en fecha en la capa de herramientas, según la hora de la llamada, o use la fecha del vídeo.
Coste estimado de 1000 llamadas a herramientas: tokens del modelo más llamadas de datos
El coste tiene dos partes. Las llamadas de datos usan los precios del catálogo de EveryInfra, así que esa parte es exacta: las seis herramientas de una revisión suman 0,005099 USD de precio de lista. Para 1000 llamadas a herramientas, unas 167 revisiones, son 0,85 USD. En la prueba, la llamada a reddit/comments de la revisión llegó vacía y se reembolsó, así que la revisión costó de verdad 0,004307 USD; usamos el precio de lista como límite superior. Este coste no depende del modelo. Consulte cada precio en la página de precios.
| Capacidad | Precio de lista por llamada (USD) | Por 1000 llamadas (USD) | Llamadas por revisión |
|---|---|---|---|
web/search | 0,001389 | 1,389 | 1 |
google_news/search | 0,000792 | 0,792 | 1 |
reddit/search | 0,000792 | 0,792 | 1 |
reddit/comments | 0,000792 | 0,792 | 1 |
youtube/search | 0,000778 | 0,778 | 1 |
youtube/comments | 0,000556 | 0,556 | 1 |
| Una revisión, total | 0,005099 | — | 6 |
Los precios vienen del catálogo de capacidades de EveryInfra, leído a las 00:14 SGT del 2026-11-19. Los resultados vacíos se reembolsan, así que el cobro real solo puede ser menor.
La búsqueda web es la más cara de las seis: el 27 % del coste de datos de una revisión. Las dos llamadas de comentarios suman 0,001348 USD, un 26 %. El reembolso dejó el cobro real 0,000792 USD por debajo del precio de lista, justo el precio de una llamada a reddit/comments.
El coste del modelo no lo medimos: lo estimamos con una fórmula. En cada solicitud se multiplican los tokens de entrada por el precio de entrada; la entrada es la base más todas las salidas y respuestas anteriores. Se suman los tokens de salida por su precio, y la parte en caché va al precio de caché. Sin ejecutar el modelo tampoco hay tokens de salida medidos. Con thinking_level=low suponemos 500 tokens por turno de herramientas y 1500 para el informe final.
La caché sigue las reglas de la página de caché de Google. Una solicitud solo entra en caché si su entrada tiene al menos 4096 tokens. En un ciclo de agente, la solicitud anterior completa es un acierto solo si la nueva añade al menos 2050 tokens. Si añade menos, los últimos 2050 tokens se vuelven a procesar al precio normal.
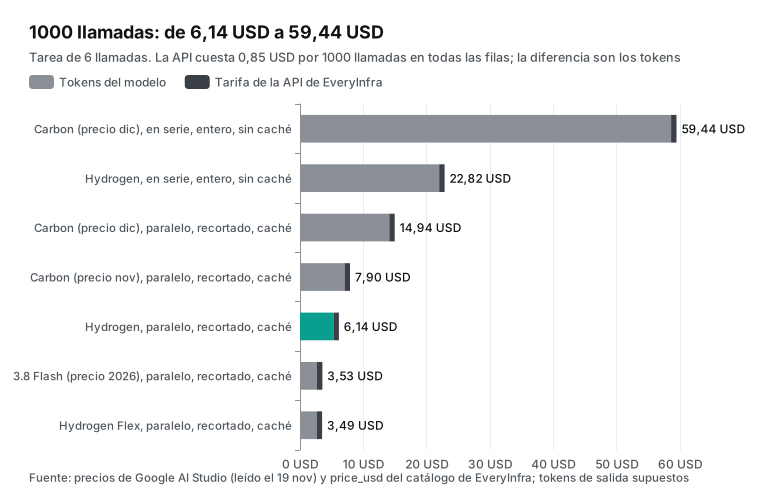
| 1000 llamadas a herramientas (USD; modelo estimado con 4 caracteres por token y 500 tokens de salida por turno) | Modelo | Datos | Total |
|---|---|---|---|
| Carbon, precio de diciembre, en serie, completas, sin caché | 58,59 | 0,85 | 59,44 |
| Hydrogen, en serie, completas, sin caché | 21,97 | 0,85 | 22,82 |
| Hydrogen, en serie, completas, con caché | 12,08 | 0,85 | 12,93 |
| Hydrogen, en serie, recortadas, sin caché | 14,69 | 0,85 | 15,54 |
| Hydrogen, en paralelo, recortadas, sin caché | 6,64 | 0,85 | 7,49 |
| Hydrogen, en paralelo, recortadas, con caché | 5,29 | 0,85 | 6,14 |
| Carbon, precio de noviembre, en paralelo, recortadas, con caché | 7,05 | 0,85 | 7,90 |
| Carbon, precio de diciembre, en paralelo, recortadas, con caché | 14,09 | 0,85 | 14,94 |
| Gemini 3.8 Flash, precio de 2026, en paralelo, recortadas, con caché | 2,68 | 0,85 | 3,53 |
| Hydrogen Flex, en paralelo, recortadas, con caché | 2,64 | 0,85 | 3,49 |
| Paso en Hydrogen | Coste del modelo por 1000 llamadas | Cambio |
|---|---|---|
| En serie, completas, sin caché | 21,97 USD | Inicio |
| Recortar respuestas | 14,69 USD | −33 % |
| Pasar a llamadas en paralelo | 6,64 USD | −55 % |
| Añadir caché implícita | 5,29 USD | −20 % |
Primera: con el mismo modelo, el método cambia el coste más de tres veces, de 22,82 a 6,14 USD. Las llamadas en paralelo dan la mayor parte del ahorro de 16,68 USD, porque en serie la séptima solicitud lleva las seis respuestas anteriores y su entrada sola llega a 19 130 tokens. En paralelo, la última solicitud tiene 7854 tokens.
Segunda: las llamadas de datos son una parte pequeña. Pesan un 13,8 % en el método más barato y solo un 3,7 % en el método en serie. Tercera: desde el 1 de diciembre, Carbon cuesta 2,4 veces más que Hydrogen con el mismo método; hasta el 30 de noviembre la diferencia es solo del 29 %. Si hoy revisa con Carbon, compare la calidad con Hydrogen antes de fin de mes.
Con 100 revisiones al día de seis herramientas, son 18 000 llamadas a herramientas al mes. Hydrogen en paralelo, con recorte y caché, cuesta unos 110 USD al mes, de los que unos 15 USD son llamadas de datos. El mismo trabajo en serie y con respuestas completas cuesta unos 411 USD. Carbon al precio de diciembre con el método optimizado cuesta unos 269 USD, y Flex para lotes nocturnos, unos 63 USD.
Gemini 3.8 Flash parece el más barato, pero su precio sube al de Hydrogen el 1 de enero de 2027. Flex, con 3,49 USD, es la forma más barata de usar Hydrogen, aunque cada turno puede esperar de 1 a 15 minutos; úselo solo de noche.
La página de precios dice que las declaraciones de funciones se facturan como entrada, y ese coste ya está en la tabla: de la base de 502 tokens de cada solicitud, 452 son declaraciones. Las siete solicitudes en serie llevan unos 3164 tokens de declaraciones, el 4,8 % de los unos 65 000 tokens de entrada. Las tres solicitudes en paralelo llevan unos 1356, el 9,6 % de 14 079. Cuanto más cortas son las respuestas recortadas, más pesan las declaraciones, y más ahorra escribirlas cortas y dar solo las herramientas que la tarea necesita.
Tokens de salida por turno: la prueba de sensibilidad
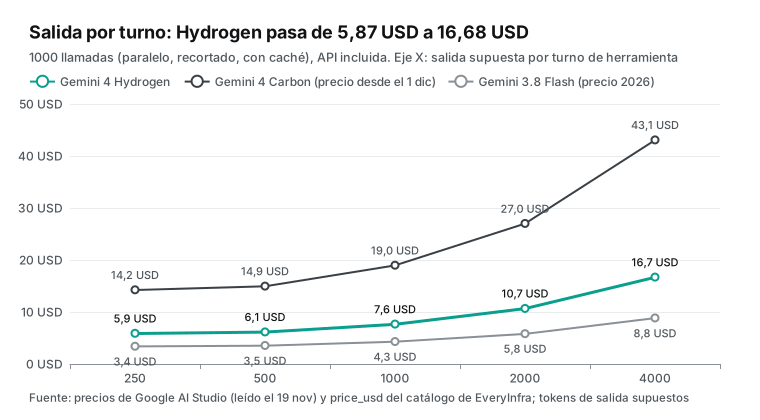
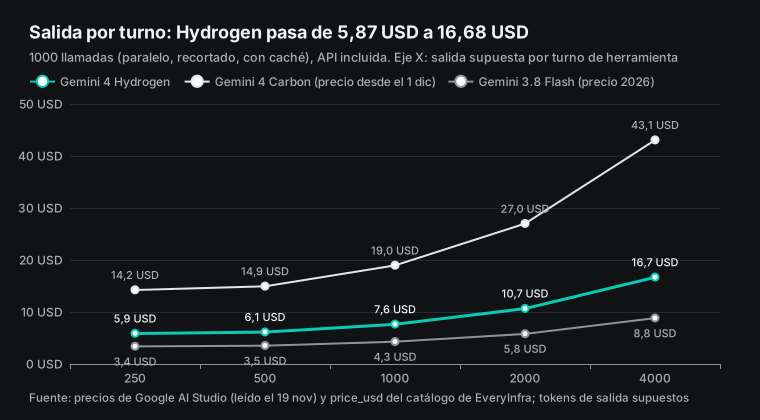
La cifra menos segura de la estimación son los 500 tokens de salida por turno. El nivel de razonamiento de Hydrogen cambia mucho los tokens de razonamiento, que según la página de razonamiento de Google se cobran al precio de salida, y high es el nivel por defecto. Si no fija low en su código, la salida por turno puede ser varias veces nuestro supuesto. Repetimos la estimación con 250 a 4000 tokens por turno, en paralelo, con recorte y caché.
| Tokens de salida por turno | Hydrogen | Carbon, precio de diciembre | Gemini 3.8 Flash, precio de 2026 |
|---|---|---|---|
| 250 | 5,87 | 14,23 | 3,38 |
| 500 | 6,14 | 14,94 | 3,53 |
| 1000 | 7,64 | 18,96 | 4,28 |
| 2000 | 10,65 | 26,99 | 5,80 |
| 4000 | 16,68 | 43,06 | 8,82 |
Todos los valores son USD por 1000 llamadas a herramientas, con 0,85 USD de llamadas de datos.
Cada 1000 tokens de razonamiento extra por turno suman unos 3 USD al total de Hydrogen, mientras que pasar de serie a paralelo ahorra unos 8 USD. Primero ponga las llamadas en paralelo y recorte las respuestas; después ajuste el razonamiento. Antes de salir a producción, mida una semana con total_thought_tokens y total_output_tokens de interaction.usage y cambie nuestros 500 por su valor real.
Niveles de razonamiento: ¿basta con low?
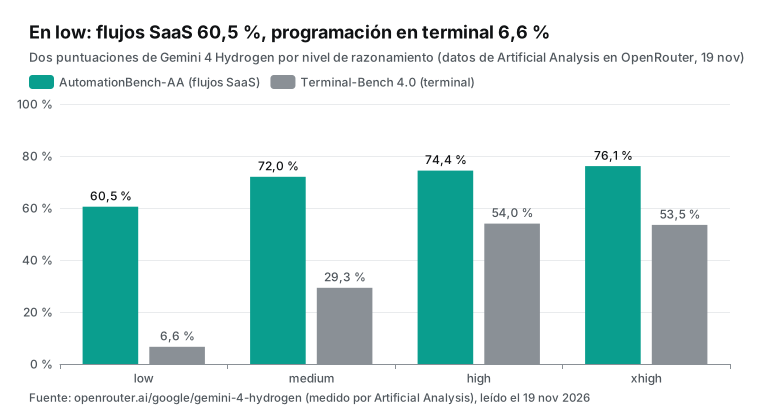
Nuestro código usa thinking_level: low para ahorrar, y low tiene un precio. La página del modelo en OpenRouter cita resultados de Artificial Analysis para los cuatro niveles. Son cifras de terceros: Google no publica notas por nivel. En AutomationBench, la nota va de 60,5 en low a 72,0 en medium, 74,4 en high y 76,1 en xhigh. En Terminal-Bench 4.0 la distancia es mayor: 6,6 en low, 29,3 en medium, 54,0 en high y 53,5 en xhigh. El índice de inteligencia pasa de 26,9 en low a 50,8 en high.
| Nivel de razonamiento | AutomationBench | Terminal-Bench 4.0 | Índice de inteligencia |
|---|---|---|---|
| low | 60,5 | 6,6 | 26,9 |
| medium | 72,0 | 29,3 | 41,2 |
| high (por defecto) | 74,4 | 54,0 | 50,8 |
| xhigh | 76,1 | 53,5 | 53,9 |
Nuestra revisión es un enrutado sencillo: los parámetros son palabras clave y enumeraciones, y el modelo solo decide qué herramientas llamar y qué comentarios pedir en el turno 2. Esa tarea se parece más a AutomationBench que a Terminal-Bench, y allí low queda unos 14 puntos por debajo de high. Use medium cuando el modelo deba leer resultados, descartar publicaciones ajenas al tema y elegir nuevas palabras clave. medium es el nivel por defecto de Carbon y Argon; el de Hydrogen es high. La página de razonamiento de Google añade que el nivel es un techo y que el modelo no siempre lo agota.
Gemini 4 Hydrogen pricing y grounding con Search: por qué conectar su propia búsqueda
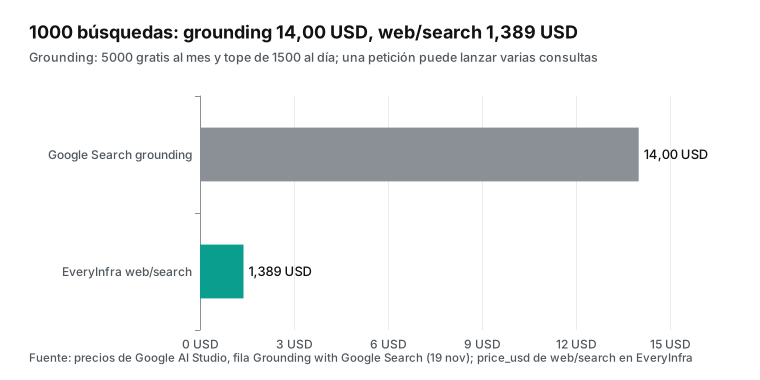
La API de Gemini incluye grounding con Google Search, y es la opción más cómoda: se añade google_search a tools y el modelo decide cuándo buscar. Pero la página de precios es clara. En Hydrogen, el grounding solo está en el nivel de pago. Todos los modelos de Gemini 3 en adelante comparten 5000 solicitudes gratis al mes; después cuesta 14 USD por cada 1000, con un tope de 1500 al día. Una sola solicitud de un cliente puede lanzar varias búsquedas, y cada una se cobra.
| Dato | Grounding con Google Search | EveryInfra `web/search` |
|---|---|---|
| Cuota gratuita | 5000 solicitudes al mes, compartidas por Gemini 3 en adelante | Ninguna |
| Precio después de la cuota | 14 USD por 1000 solicitudes | 1,389 USD por 1000 llamadas |
| Tope diario | 1500 solicitudes | Límite por minuto de la clave |
| Nivel gratuito de Gemini | No disponible con Hydrogen | Funciona con cualquier modelo |
| Qué recibe | Citas dentro de la respuesta del modelo | Posiciones 1 a 10 con título, enlace y fragmento |
EveryInfra web/search cuesta 0,001389 USD por llamada, 1,389 USD por 1000. El grounding, pasada la cuota, cuesta 10,1 veces más. El precio no es la única diferencia: con grounding, el modelo lee los resultados y le da citas, pero no la lista original por posiciones. Con web/search recibe título, enlace y fragmento de las posiciones 1 a 10, y puede guardarlos, compararlos y consultar por país e idioma.
A las 00:30 y 00:31 SGT hicimos la misma pregunta sobre precios en español para España («gemini 4 hydrogen precio api») y en chino simplificado para Singapur. El primer resultado en español fue la página de precios de OpenRouter en español, y el segundo, la guía de DataCamp en español. En chino, el primero fue la página de precios de AI Studio, el tercero la página de precios de Google Cloud en chino y el quinto una publicación en X sobre la subida de Carbon y Argon del 1 de diciembre. Quien busca en otro idioma ve resultados muy distintos, así que en revisiones de varios mercados conviene consultar cada mercado por separado.
Palabras clave y orden: cuatro resultados de Reddit, ninguno sobre el tema
A las 00:25 SGT buscamos en Reddit «gemini 4 hydrogen» por relevancia. Llegaron 4 publicaciones y las 4 hablaban de otra cosa. Venían de las comunidades CLNE, Joby, BrawlStarsEsports y SIBO, sobre una empresa de combustible de hidrógeno, un avión de hidrógeno, un jugador de esports llamado Gemini y una prueba de aliento de hidrógeno para un problema intestinal.
A las 00:27 SGT buscamos «gemini hydrogen» por más recientes. Llegaron 14 publicaciones, y 6 trataban del modelo, con 16 votos y 16 comentarios en total. Nuestra regla fue sencilla: cuenta la publicación cuyo título contiene «hydrogen» y cuyo título o comunidad contiene «gemini».
| Búsqueda (SGT) | Palabra clave | Orden | Publicaciones | Sobre el modelo | Votos y comentarios de esas |
|---|---|---|---|---|---|
| 00:25:14 SGT | gemini 4 hydrogen | relevancia | 4 | 0 | 0 y 0 |
| 00:27:47 SGT | gemini hydrogen | más recientes | 14 | 6 | 16 y 16 |
Una causa posible, que no comprobamos: el nombre nuevo coincide con palabras que ya existen. El orden por relevancia pone primero publicaciones antiguas y largas con mucha coincidencia, y las nuevas aún no tienen votos. El modelo ve solo 4 resultados ajenos y puede escribir que «no hay debate en Reddit», lo cual es falso. Por eso la descripción de la función dice «Use sort=newest for new product names» y sort es obligatorio: el modelo debe elegir el orden cada vez.
En la lista por más recientes, la regla dejó fuera 8 de las 14 publicaciones. Dos hablaban de Gemini pero no de Hydrogen: «Long chats stops responding with Argon», en r/GeminiAI, con 7 votos, y «Antigravity turned one today, and the birthday gift was a full usage reset», con 22, la más votada de las 14. Las otras seis eran un pódcast tecnológico en francés, una experiencia en español con un agente de programación, dos avisos de actualización de herramientas de IA de terceros, una noticia reenviada sobre Gemini Tasks y un hilo sobre créditos para desarrolladores; sus títulos solo nombran Gemini 4 o Gemini.
El orden por más recientes deja todavía más de la mitad de ruido, pero es ruido sobre otras novedades de Gemini, y el modelo lo separa leyendo los títulos. Con el orden por relevancia, el ruido era hidrógeno y esports, y el modelo ni siquiera podía saber si alguien hablaba del tema.
En YouTube no pasó. Los 10 vídeos de youtube/search por relevancia trataban de Hydrogen y sumaban 330 691 visualizaciones. El más visto fue «Gemini 4 Hydrogen Just Dropped», del día del lanzamiento, con 193 622 visualizaciones y 268 comentarios. Lo siguió una prueba completa del 13 de noviembre con 97 332 visualizaciones y 316 comentarios. En noticias, 11 de los 20 artículos salieron el 12 de noviembre y el 17 de noviembre solo hubo uno.
| Fecha (UTC) | Artículos | Ejemplos |
|---|---|---|
| 2026-11-12 | 11 | Tres entradas de blog.google, Ars Technica, The Decoder, 9to5Google, SiliconANGLE, VentureBeat |
| 2026-11-13 | 4 | Registro de cambios de GitHub (Copilot), Mashable, una comparación con Claude Haiku 5.5 en Medium |
| 2026-11-15 | 1 | Tom's Guide, sobre cinco usos gratis |
| 2026-11-16 | 3 | DevOps.com, TechRadar, AI Insider |
| 2026-11-17 | 1 | Blog de Google for Developers, sobre robótica |
Solo 3 de los 20 títulos hablan de precio: VentureBeat llama a Hydrogen un sucesor más caro de Flash, el título de shattered.io da el precio de entrada de 1,50 USD y Tom's Guide dice que es gratis. Los otros 17 tratan de velocidad, notas en pruebas, el modelo por defecto de la Búsqueda e integraciones. Las noticias dan poca evidencia directa sobre qué opina la gente del precio; esa conversación está sobre todo en las páginas de precios de la búsqueda web y en los comentarios.
Qué recibe el modelo en una revisión
Tras el recorte, las seis respuestas reales dan al modelo estos datos. En la búsqueda web, el primer resultado es la página de precios y pruebas de OpenRouter, el tercero la página de Artificial Analysis, el cuarto un artículo sobre los precios de 1,50 y 7,50 USD y el coste por tarea, y el quinto la publicación del lanzamiento en r/singularity. Hay 20 noticias, 11 del día del lanzamiento, de blog.google, Ars Technica, The Decoder, 9to5Google, SiliconANGLE, Search Engine Journal y el registro de cambios de GitHub.
Reddit por más recientes trae 14 publicaciones y 6 tratan del modelo. Sus títulos dicen que es lento y preguntan si aún inventa. Otros hablan del contexto duplicado en Antigravity y de carpetas leídas como zip. Los dos últimos mencionan una prueba nueva y el uso de la API. YouTube aporta 10 vídeos y 40 comentarios del vídeo más visto.
Dos datos firmes de estas respuestas sirven como prueba de aceptación: Reddit por más recientes tiene 6 publicaciones sobre el modelo, y 3 comentarios de YouTube hablan del uso o los límites. Si el informe de su agente dice que en Reddit no hay debate, o no menciona el uso, revise las palabras clave, el orden y el recorte; los dos datos se pueden rastrear hasta la respuesta original por su identificador. En español, entre los cinco primeros resultados web estaba la entrada de precios de LiteLLM. Para mercados en varios idiomas, fije country y language de cada mercado en el código y no deje esa elección al modelo.
Usar un servidor MCP remoto en lugar de funciones propias
La API de Interactions puede conectarse directamente a un servidor MCP remoto, sin declaraciones ni capa de herramientas propias. Si no quiere escribir el ciclo, Managed Agents también se conecta a un MCP remoto: lo explicamos en Gemini Managed Agents con un servidor MCP remoto para vigilar marcas. La guía de llamadas a funciones indica los límites. Solo funciona el transporte Streamable HTTP, no el antiguo SSE. El nombre del servidor no puede llevar «-», así que use guiones bajos. La configuración admite headers para la autenticación y allowed_tools para limitar las herramientas. El servidor MCP de EveryInfra usa Streamable HTTP y sigue las reglas de transporte de la especificación MCP 2025-11-25.
import os
from google import genai

client = genai.Client()
it = client.interactions.create(
    model="gemini-4-hydrogen",
    input="What do people say about Gemini 4 Hydrogen pricing this week? Check web, news, Reddit and YouTube.",
    tools=[{
        "type": "mcp_server",
        "name": "everyinfra",                       # no "-" in the server name
        "url": "https://api.everyinfra.com/mcp",
        "headers": {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"},
        "allowed_tools": ["everyinfra_call_api", "everyinfra_get_job"],
    }],
    generation_config={"thinking_level": "medium"},
)
print(it.output_text)
El precio de MCP es el tamaño de las descripciones de herramientas. A las 00:29 SGT enviamos tools/list al servidor MCP de EveryInfra. Devolvió 12 herramientas en 16 760 caracteres, unos 4190 tokens, más de nueve veces nuestras seis declaraciones. Con solo everyinfra_call_api y everyinfra_get_job permitidas, baja a 2620 caracteres, unos 655 tokens. Con MCP, el modelo elige platform y action del catálogo por su cuenta y puede consultarlo antes, lo que añade un turno.
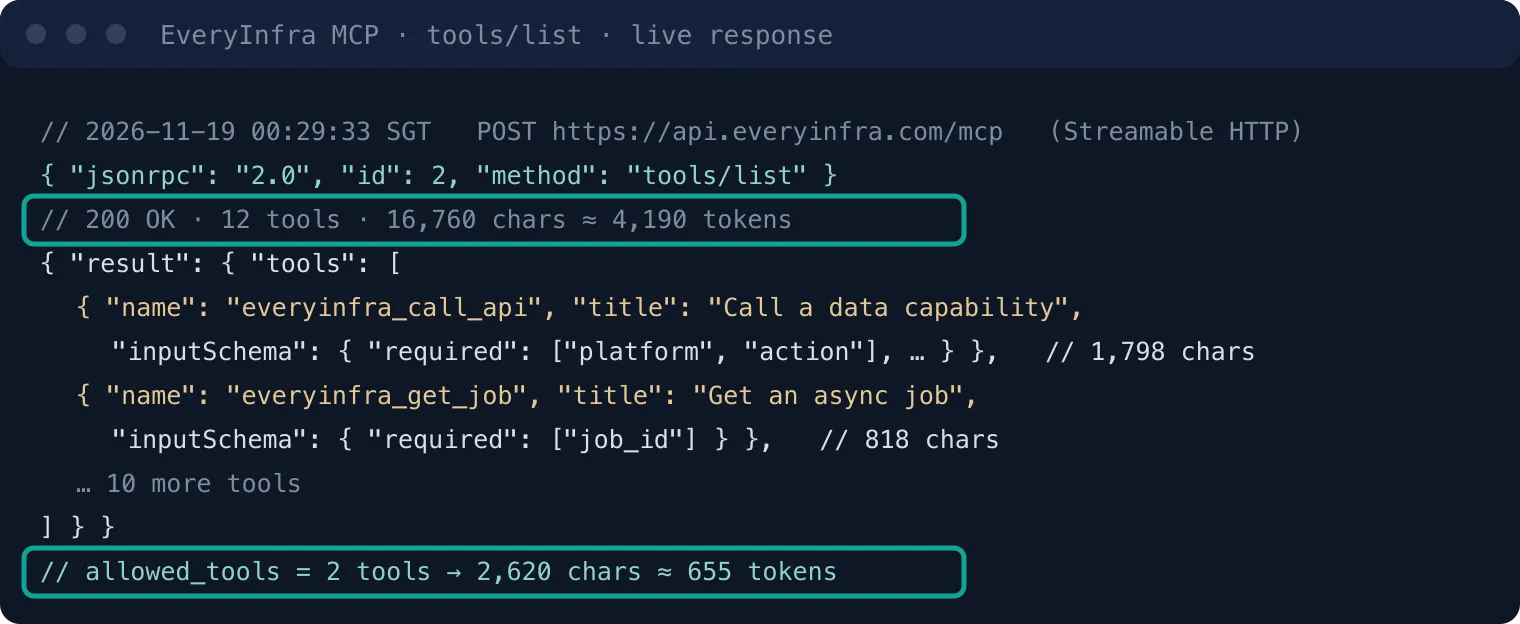
| Método | Tamaño de las descripciones | Turnos por revisión | Quién elige la capacidad |
|---|---|---|---|
| Seis funciones propias | 1810 caracteres, unos 452 tokens | 3 en paralelo | Su código |
| MCP remoto, las 12 herramientas | 16 760 caracteres, unos 4190 tokens | 3 o 4, con consulta al catálogo | El modelo |
| MCP remoto, dos herramientas permitidas | 2620 caracteres, unos 655 tokens | 3 o 4, con consulta al catálogo | El modelo |
Nuestra recomendación: funciones propias para revisiones fijas y programadas, y MCP para preguntas abiertas, en las que el modelo busca entre las 576 capacidades disponibles. Lo que cobra EveryInfra es igual en los dos casos; solo cambian los tokens del modelo.
De qué se queja la gente en vídeos y comentarios
A las 00:28 SGT buscamos en YouTube por relevancia. Los 10 vídeos trataban de Hydrogen y sumaban 330 691 visualizaciones. La tabla sigue el orden de la respuesta de la API.
| Puesto | Vídeo | Fecha (UTC) | Visualizaciones | Comentarios |
|---|---|---|---|---|
| 1 | FREE Gemini 4 Hydrogen vs $100 Claude Fable 5.2 | 2026-11-16 | 11 362 | 157 |
| 2 | Gemini 4 Hydrogen + Antigravity is WILD | 2026-11-17 | 5524 | 2 |
| 3 | Gemini 4 Hydrogen Just Dropped (Personally Tested) | 2026-11-12 | 193 622 | 268 |
| 4 | NEW Gemini 4 Hydrogen vs. Gemini 4 Argon | 2026-11-17 | 3704 | 5 |
| 5 | The NEW Gemini 4 Hydrogen is INSANE | 2026-11-12 | 9171 | 2 |
| 6 | Gemini 4 Hydrogen Is the BEST Flash Model Yet – Full Test! | 2026-11-13 | 97 332 | 316 |
| 7 | Gemini 4 Hydrogen: Google's New General-Purpose Model | 2026-11-16 | 361 | 0 |
| 8 | 13 Gemini 4 Hydrogen Builds: Is It Better Than Opus? | 2026-11-17 | 457 | 0 |
| 9 | Google Just Released Gemini 4 Hydrogen! | 2026-11-15 | 5958 | 1 |
| 10 | Gemini 4 Hydrogen vs Claude Opus 5.5: 10-Round SHOWDOWN | 2026-11-12 | 3200 | 2 |
Dos vídeos concentran casi todo: el 3 y el 6 suman 290 954 visualizaciones, el 88,0 % del total, y los otros ocho no llegan a 40 000 entre todos. El orden por relevancia no puso primero al más visto: el puesto 1 tiene 11 362 visualizaciones, y una revisión que lea solo los tres primeros se pierde el vídeo 6, con 97 332 visualizaciones y 316 comentarios. Cuatro de los 10 títulos comparan Hydrogen con otro modelo (Claude Fable 5.2, Argon u Opus), y ningún título menciona la API ni las llamadas a funciones.
Intentamos descargar los subtítulos de los tres primeros, pero las tres llamadas a youtube/transcript devolvieron 503. Por eso solo contamos lo que dicen los comentarios, no lo que muestran los vídeos.
Descargamos 40 comentarios del vídeo 3, el más visto. Por palabras clave, 3 hablan del uso o los límites, 3 del precio y 5 de los nombres de los modelos. El más votado, con 178 votos, es una broma de una línea sobre los nombres con la fórmula H2O. El segundo, con 170, dice que Carbon se anunció hace semanas y sigue fuera de alcance, mientras que Hydrogen llegó a todos de golpe. El tercero, con 86, celebra tener por fin un modelo que se puede usar hoy y no solo leer sobre él.
En el mismo vídeo, un comentario con 11 votos dice que Argon da unas cinco instrucciones en AI Pro antes de llegar al límite, y otro con 14 dice que Carbon ya está en la API. Dos de los tres más votados tratan del acceso, y ninguno de los ocho más votados habla del precio.
| Votos | Qué dice el comentario (6 elegidos) | Tema |
|---|---|---|
| 178 | Broma sobre H2O y los nombres | Nombres |
| 170 | Carbon anunciado hace semanas y aún fuera de alcance; Hydrogen abierto a todos | Acceso |
| 86 | Por fin un modelo que se puede usar hoy | Acceso |
| 31 | Le gustan los nombres nuevos | Nombres |
| 14 | Carbon ya está en la API | Acceso |
| 11 | Argon da unas cinco instrucciones en AI Pro | Uso |
Son 40 resultados de youtube/comments de las 00:28:37 SGT, identificador req_58f6a18971374aaa. No mostramos los nombres de quienes comentan.
En Reddit, «Gemini 4 Hydrogen is super slow», de r/GoogleGeminiAI, tenía 0 votos y 3 comentarios cuando la encontramos, y «Gemini Hydrogen still hallucinating?», de r/GoogleGemini, 12 votos y 12 comentarios. No obtuvimos los comentarios de ninguna de las dos: la llamada a reddit/comments de la segunda devolvió 0 resultados. Solo podemos decir que hay gente preguntando por la velocidad y las invenciones, no qué opina la mayoría de las respuestas.
Pasar de 3.8 Flash a Hydrogen: qué cambiar
¿Ya tiene un agente con herramientas en Gemini 3.8 Flash? Lea la lista de migración de la página «What's new», porque varios puntos afectan al código y al coste. Primero, cambie el código del modelo de gemini-3.8-flash a gemini-4-hydrogen. Segundo, el contexto pasa a ser una sola ventana de 1 048 576 tokens para entrada, razonamiento y salida, mientras que 3.8 Flash separa un millón de entrada y 64K de salida; elimine cualquier max_output_tokens pequeño fijado a mano o súbalo a 65 536. Tercero, el razonamiento por defecto pasa de medium a high, aparece xhigh y minimal da error: si su código usa minimal, cámbielo antes que nada.
| Ajuste | Gemini 3.8 Flash | Gemini 4 Hydrogen |
|---|---|---|
| Código del modelo | gemini-3.8-flash | gemini-4-hydrogen |
| Contexto | 1M de entrada y 64K de salida, por separado | 1 048 576 compartidos por entrada, razonamiento y salida |
| Razonamiento por defecto | medium | high, más el nuevo xhigh |
| minimal | Se acepta | Da error |
| Caché explícita | Sí | No, solo implícita |
| Grounding con Search en el nivel gratuito | Sí | No |
| Precio en 2026 | 0,75 y 3,75 USD | 1,50 y 7,50 USD |
El cuarto punto es fácil de pasar por alto: Hydrogen no admite caché explícita, aunque la página de 3.8 Flash sí la incluye. Si en 3.8 Flash guarda con cachedContents una instrucción de sistema larga o un documento fijo, ese código deja de funcionar y solo queda la caché implícita. Esa caché pide un prefijo de al menos 4096 tokens y, en un ciclo de agente, al menos 2050 tokens nuevos por turno para un acierto completo. En nuestra revisión, las dos primeras solicitudes no llegan a 4096 tokens y solo la tercera acierta; por eso la caché ahorra solo un 20 %.
El quinto punto es de coste: 3.8 Flash puede usar grounding con Search en el nivel gratuito y Hydrogen no. Un proyecto gratuito que busca con grounding debe pasar al nivel de pago o conectar sus propias funciones de búsqueda.
Qué medir antes de salir a producción
Tres cifras de nuestro cálculo de coste son estimaciones y conviene medirlas. La primera son los tokens: estimamos 4 caracteres por token, y en producción la API de Interactions da total_input_tokens, total_output_tokens, total_thought_tokens y total_cached_tokens en el usage de cada solicitud. Una semana de datos basta. La segunda es la salida por turno, la columna de la tabla de sensibilidad, que cambia con el nivel de razonamiento.
La tercera es el número real de llamadas. Suponemos seis por revisión, pero el modelo puede llamar más, o menos si el turno 1 trae datos de sobra. La instrucción de sistema dice «at most 8 tool calls», y conviene fijar también max_turns en el código para que una revisión desviada no entre en un bucle sin fin.
Del lado de los datos hay dos cifras más. Una es el límite por minuto de cada clave: una clave compartida por varios procesos recibe 429 con facilidad, así que en producción dé a cada agente su propia clave o añada un limitador por minuto. La otra es la proporción de resultados vacíos: si es alta, cambie los parámetros o haga que la plantilla del informe liste lo que no se obtuvo. El registro de llamadas de la consola muestra el código de estado y el cobro de cada solicitud.
Límites de gasto: que una revisión desviada no gaste el presupuesto del día
Un ciclo de herramientas puede desviarse: al modelo no le gusta un resultado y busca una y otra vez con palabras nuevas, hasta hacer decenas de llamadas. Use tres límites a la vez. En el modelo, la página de facturación de Google fija un tope de gasto por nivel, de 250 USD en Tier 1, y la de límites permite como máximo 10 USD cada 10 minutos en ese nivel. En el código, max_turns limita los turnos y la capa de herramientas cuenta las llamadas; al pasar el límite, devuelve «limit reached» como resultado.
En los datos, EveryInfra funciona con saldo prepago: cuando se acaba, las solicitudes se rechazan y no hay forma de gastar de más. Según nuestra estimación, una revisión normal cuesta unos 0,032 USD de modelo y unos 0,005 USD de datos. Una revisión desviada con 30 llamadas en serie y respuestas completas puede superar los 100 000 tokens de entrada en una sola solicitud y costar varios dólares. Registre el usage de cada revisión y envíe una alerta cuando una cueste más del triple de la media.
Errores y cómo tratarlos
La prueba encontró cuatro tipos de error, y cada uno pide una respuesta distinta. Un 429 significa que la clave llegó a su límite por minuto, algo fácil cuando varios procesos la comparten. No cuesta nada, y la respuesta indica la espera en error.retry_after: espere ese tiempo y añada un margen al azar.
Un resultado vacío devuelve 200, con count en 0, billing.charged en false y refund.status en succeeded, y el dinero vuelve solo. Pero un vacío no siempre significa que no haya datos: compruebe otras señales, como una búsqueda que muestra 12 comentarios en esa publicación. Un 503 trae error.code en unavailable, retryable en true y retry_after: 60, y tampoco cobra. Un 400 del lado de Gemini, 400 INVALID_ARGUMENT, indica una declaración demasiado compleja: reduzca el anidamiento y quite campos opcionales.
| Error | Cobro | Qué recibe el modelo | Qué hace el código |
|---|---|---|---|
| EveryInfra 429 | No | Nada, la capa de herramientas reintenta | Lee error.retry_after y suma de 1 a 6 segundos |
200 con count 0 | Reembolsado | {"count": 0} y la nota «no obtenido» | El informe no dice «sin debate» |
| EveryInfra 503 unavailable | No | El código y el mensaje de error | Espera retry_after segundos y reintenta, o salta |
| Gemini 400 INVALID_ARGUMENT | — | — | Simplifica las declaraciones, con menos anidamiento y enumeraciones |
| Límite diario del nivel gratuito de Gemini | — | — | Se reinicia a medianoche del Pacífico, o pase al nivel de pago |
La publicación de lanzamiento dice que Hydrogen cambia de rumbo cuando una herramienta falla, pero eso solo funciona si el fallo le llega tal cual. Nuestro run_tool devuelve el código y el mensaje cuando el estado no es 200. Si el modelo ve unavailable, puede pedir youtube/comments en lugar de los subtítulos, o indicar en el informe que falta ese dato.
Dónde encaja este método
Encaja en revisiones fijas: la misma pregunta y las mismas plataformas cada día. Un equipo de herramientas para desarrolladores quiere saber cada mañana cómo se valora el lanzamiento de un competidor en su primera semana, en la web, las noticias, Reddit y YouTube. Una tienda transfronteriza quiere ver los resultados de búsqueda y los comentarios de vídeos de una categoría en EE. UU., España y México, mercado por mercado. El modelo lee, detecta lo que cambió y escribe unos párrafos; según nuestra estimación, una revisión cuesta unos 0,03 USD de modelo.
Encaja peor cuando la tarea pide criterio profundo, como clasificar cientos de comentarios por tipo de defecto y valorar su gravedad. Entonces el razonamiento debe ser high o xhigh, la salida por turno llega a miles de tokens y, según la tabla de sensibilidad, el total de Hydrogen sube a entre 10 y 17 USD.
Preguntas frecuentes
¿Cuál es el Gemini 4 Hydrogen pricing?
La entrada cuesta 1,50 USD y la salida 7,50 USD por millón de tokens; la salida incluye los tokens de razonamiento. La entrada en caché cuesta 0,075 USD. El precio es el mismo en todo el contexto de un millón de tokens, sin recargo por instrucciones largas. Batch y Flex cuestan 0,75 y 3,75 USD; Priority, 2,70 y 13,50 USD. Las cifras vienen de la página de precios de AI Studio.
Gemini 4 Hydrogen vs 3.8 Flash: ¿conviene cambiar?
En 2026, Gemini 3.8 Flash cuesta la mitad que Hydrogen; desde el 1 de enero de 2027 cuestan lo mismo. Google presenta Hydrogen como la actualización de 3.8 Flash: según la publicación de lanzamiento, es 2,5 veces más rápido y en Terminal-Bench pasa del 18,2 % al 57 %. Al migrar, tenga en cuenta que el razonamiento por defecto pasa de medium a high, que minimal ya no se acepta y que el límite de salida pasa a 65 536. Vea la lista de migración de la página What's new.
Gemini 4 Hydrogen vs Argon vs Carbon: ¿cuál uso?
La guía de modelos de Google aconseja Hydrogen para programar a diario, agentes con herramientas y subtareas en paralelo; Carbon para arquitectura difícil, depuración, ciencia y seguridad; y Argon para razonamientos largos con menos tokens que Carbon. Desde el 1 de diciembre, Carbon y Argon cuestan 2,67 veces el precio unitario de Hydrogen, y 2,4 veces el total con nuestro método. Vea Choosing a model.
¿La Gemini 4 Hydrogen API admite llamadas a herramientas en el nivel gratuito?
Sí. La página de precios indica que Hydrogen está en el nivel gratuito y que las llamadas a funciones no tienen coste extra. El grounding con Google Search es solo de pago, y Google puede usar las entradas del nivel gratuito para mejorar sus productos. En r/GeminiFeedback alguien pregunta cómo se diferencia el uso de la API del de los modos de chat: las dos cuotas se cuentan por separado. Vea el hilo de Reddit.
¿Qué hago si la API de Gemini devuelve 400?
Con llamadas a funciones, la causa más común es una declaración demasiado compleja. La API compila las declaraciones en una máquina de estados que limita la generación, y un anidamiento profundo o demasiadas enumeraciones producen 400 INVALID_ARGUMENT, con el nombre del campo en el error. Quite campos opcionales, reduzca el anidamiento y no pase de 10 a 20 herramientas. Vea los límites de la guía de llamadas a funciones.
¿De verdad es lento Gemini 4 Hydrogen?
Una publicación de r/GoogleGeminiAI dice que es muy lento; cuando la encontramos tenía 3 comentarios. No medimos la latencia en la API. Según la publicación de lanzamiento, es 2,5 veces más rápido que 3.8 Flash. Un nivel de razonamiento más bajo que el high por defecto, como low o medium, gasta menos tokens de razonamiento y suele responder antes; mídalo con sus propias solicitudes antes de salir a producción. Vea la publicación de Reddit.
¿Gemini 4 Hydrogen todavía inventa datos?
La publicación de lanzamiento dice que hace más de cinco veces menos afirmaciones inventadas que 3.8 Flash. 9to5Google citó una nota de honestidad del 96,7 %, y la versión actual de la publicación dice 94 %. En r/GoogleGemini aún hay quien pregunta por qué inventa. En los ciclos con herramientas, pida enlaces en el informe y marque los vacíos como «no obtenido», para que la falta de datos no se convierta en una conclusión. Vea la publicación de Reddit.
Referencias
- Introducing Gemini 4 Hydrogen for Agentic Workflows, blog.google, publicado el 2026-11-12, actualizado el 2026-11-16, https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/
- Página del modelo Gemini 4 Hydrogen, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/models/gemini-4-hydrogen
- What's new in Gemini 4 Hydrogen, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/whats-new-gemini-4-hydrogen
- Gemini Developer API pricing, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/pricing
- Function calling, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/function-calling
- Interactions API overview, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/interactions-overview
- Understand and count tokens, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/tokens
- Rate limits, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/rate-limits
- Context caching, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/caching
- Thinking, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/thinking
- Choosing a model, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/choosing-a-model
- Grounding with Google Search, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/google-search
- Batch API, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/batch-api
- Flex inference, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/flex-inference
- Priority inference, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/priority-inference
- Structured outputs, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/structured-output
- URL context, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/url-context
- Text generation, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/text-generation
- Long decode, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/long-decode
- Página del modelo Gemini 4 Carbon, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/models/gemini-4-carbon
- What's new in Gemini 4 Carbon, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/whats-new-gemini-4-carbon
- Página del modelo Gemini 3.8 Flash, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/models/gemini-3.8-flash
- Models, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/models
- Billing, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/billing
- Computer use, documentación de Google AI Studio, leída el 2026-11-19, https://aistudio.google.com/docs/computer-use
- Ficha del modelo Gemini 4 Hydrogen, Google DeepMind, 2026-11-12, https://deepmind.google/models/model-cards/gemini-4-hydrogen/
- Introducing Gemini 4 Carbon, blog.google, 2026-10-28, https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/
- Gemini 4 Hydrogen in Google Antigravity, blog de Antigravity, leído el 2026-11-19, https://antigravity.google/blog/gemini-4-hydrogen-in-google-antigravity/
- Gemini 4 Hydrogen in GitHub Copilot, registro de cambios de GitHub, 2026-11-13, https://github.blog/changelog/2026-11-13-gemini-4-hydrogen-in-github-copilot/
- google-genai, PyPI, leído el 2026-11-19, https://pypi.org/project/google-genai/
- googleapis/python-genai, GitHub, leído el 2026-11-19, https://github.com/googleapis/python-genai
- Gemini 4 Hydrogen API Pricing and Day 0 Support on LiteLLM, documentación de LiteLLM, leída el 2026-11-19, https://docs.litellm.ai/blog/gemini-4-hydrogen
- Transports, especificación de Model Context Protocol 2025-11-25, leída el 2026-11-19, https://modelcontextprotocol.io/specification/2025-11-25/basic/transports
- Catálogo de capacidades de datos de EveryInfra, leído el 2026-11-19 a las 00:14 SGT, https://api.everyinfra.com/api/v1/social/catalog
- Google rolls out Gemini 4 Hydrogen, finally replacing 3.8 Flash, Ars Technica, 2026-11-12, https://arstechnica.com/google/2026/11/google-rolls-out-gemini-4-hydrogen-finally-replacing-3-8-flash/
- Google's Gemini 4 Hydrogen outscores the bigger Argon just four weeks after its launch, The Decoder, 2026-11-12, https://the-decoder.com/googles-gemini-4-hydrogen-outscores-the-bigger-argon-just-four-weeks-after-its-launch/
- Google releases Gemini 4 Hydrogen, a lower-cost model said to outscore Argon, SiliconANGLE, 2026-11-12, https://siliconangle.com/2026/11/12/google-releases-gemini-4-hydrogen-a-lower-cost-model-said-to-outscore-argon/
- Google announces Gemini 4 Hydrogen, 9to5Google, 2026-11-12, https://9to5google.com/2026/11/12/gemini-4-hydrogen-launch/
- Google Makes Gemini 4 Hydrogen The Default Model In AI Mode, Search Engine Journal, 2026-11-12, https://www.searchenginejournal.com/google-gemini-4-hydrogen-default-ai-mode/597096/
- Google's Gemini 4 Hydrogen Turns Model Choice Into a Routing Decision, DevOps.com, 2026-11-16, https://devops.com/googles-gemini-4-hydrogen-turns-model-choice-into-a-routing-decision
- Precios y pruebas de Gemini 4 Hydrogen, OpenRouter, leído el 2026-11-19, https://openrouter.ai/google/gemini-4-hydrogen
- Análisis de inteligencia, rendimiento y precio de Gemini 4 Hydrogen, Artificial Analysis, leído el 2026-11-19, https://artificialanalysis.ai/models/gemini-4-hydrogen
- Gemini 4 Hydrogen is super slow, Reddit r/GoogleGeminiAI, 2026-11-18, https://www.reddit.com/r/GoogleGeminiAI/comments/1xzjcaq/gemini_4_hydrogen_is_super_slow/
- Gemini Hydrogen still hallucinating?, Reddit r/GoogleGemini, 2026-11-18, https://www.reddit.com/r/GoogleGemini/comments/1xzg6o7/gemini_hydrogen_still_hallucinating/
- Hydrogen and api usage, Reddit r/GeminiFeedback, 2026-11-18, https://www.reddit.com/r/GeminiFeedback/comments/1xzc8ra/hydrogen_and_api_usage_ignoring_in_chat_modes/
- FREE Gemini 4 Hydrogen vs $100 Claude Fable 5.2, YouTube, 2026-11-16, https://www.youtube.com/watch?v=-UnVlPimhqY
- Gemini 4 Hydrogen + Antigravity is WILD, YouTube, 2026-11-17, https://www.youtube.com/watch?v=XUUbeYlCrKA
- Gemini 4 Hydrogen Just Dropped (Personally Tested), YouTube, 2026-11-12, https://www.youtube.com/watch?v=bm8x0hopWTU
Referencia BL-187