Gemini Decisions API 给评论批量判要不要人工跟进
Google 的 Gemini Decisions API 只打分不写文字。我们用它给 90 条真实评论判要不要人工跟进,判一千条约 $0.04。
2026 年 11 月 17 日 00:19–00:23(新加坡时间),我们用 EveryInfra 的三处数据接口拉了 90 条真实公开评论——Google 地图上一家芝加哥牙科诊所 20 条、App Store 上 Uber 的 30 条、Google Play 上 Uber 的 40 条,其中 23 条打了 3 星或更低,占 25.6%,是要人工跟进的候选。这 90 条评论的正文中位数只有 52 字节,平均 96 字节,换成 token 大多在十几到三十几个之间。拿这样一批短评论去走 Google 在 2026 年 11 月 11 日发布的 Gemini Decisions API(按 $0.10 每百万输入 token 计费、输出 token 不收钱),判一千条评论「要不要人工跟进、归哪个队、多严重」合计约 $0.04,其中花在评论正文上的输入成本不到十分之一,九成以上花在你写给模型的三条判断说明上。
商家每天收到的评论里,绝大多数是五星好评,用不着任何人去碰;占用客服时间的是少数差评、投诉和求助。
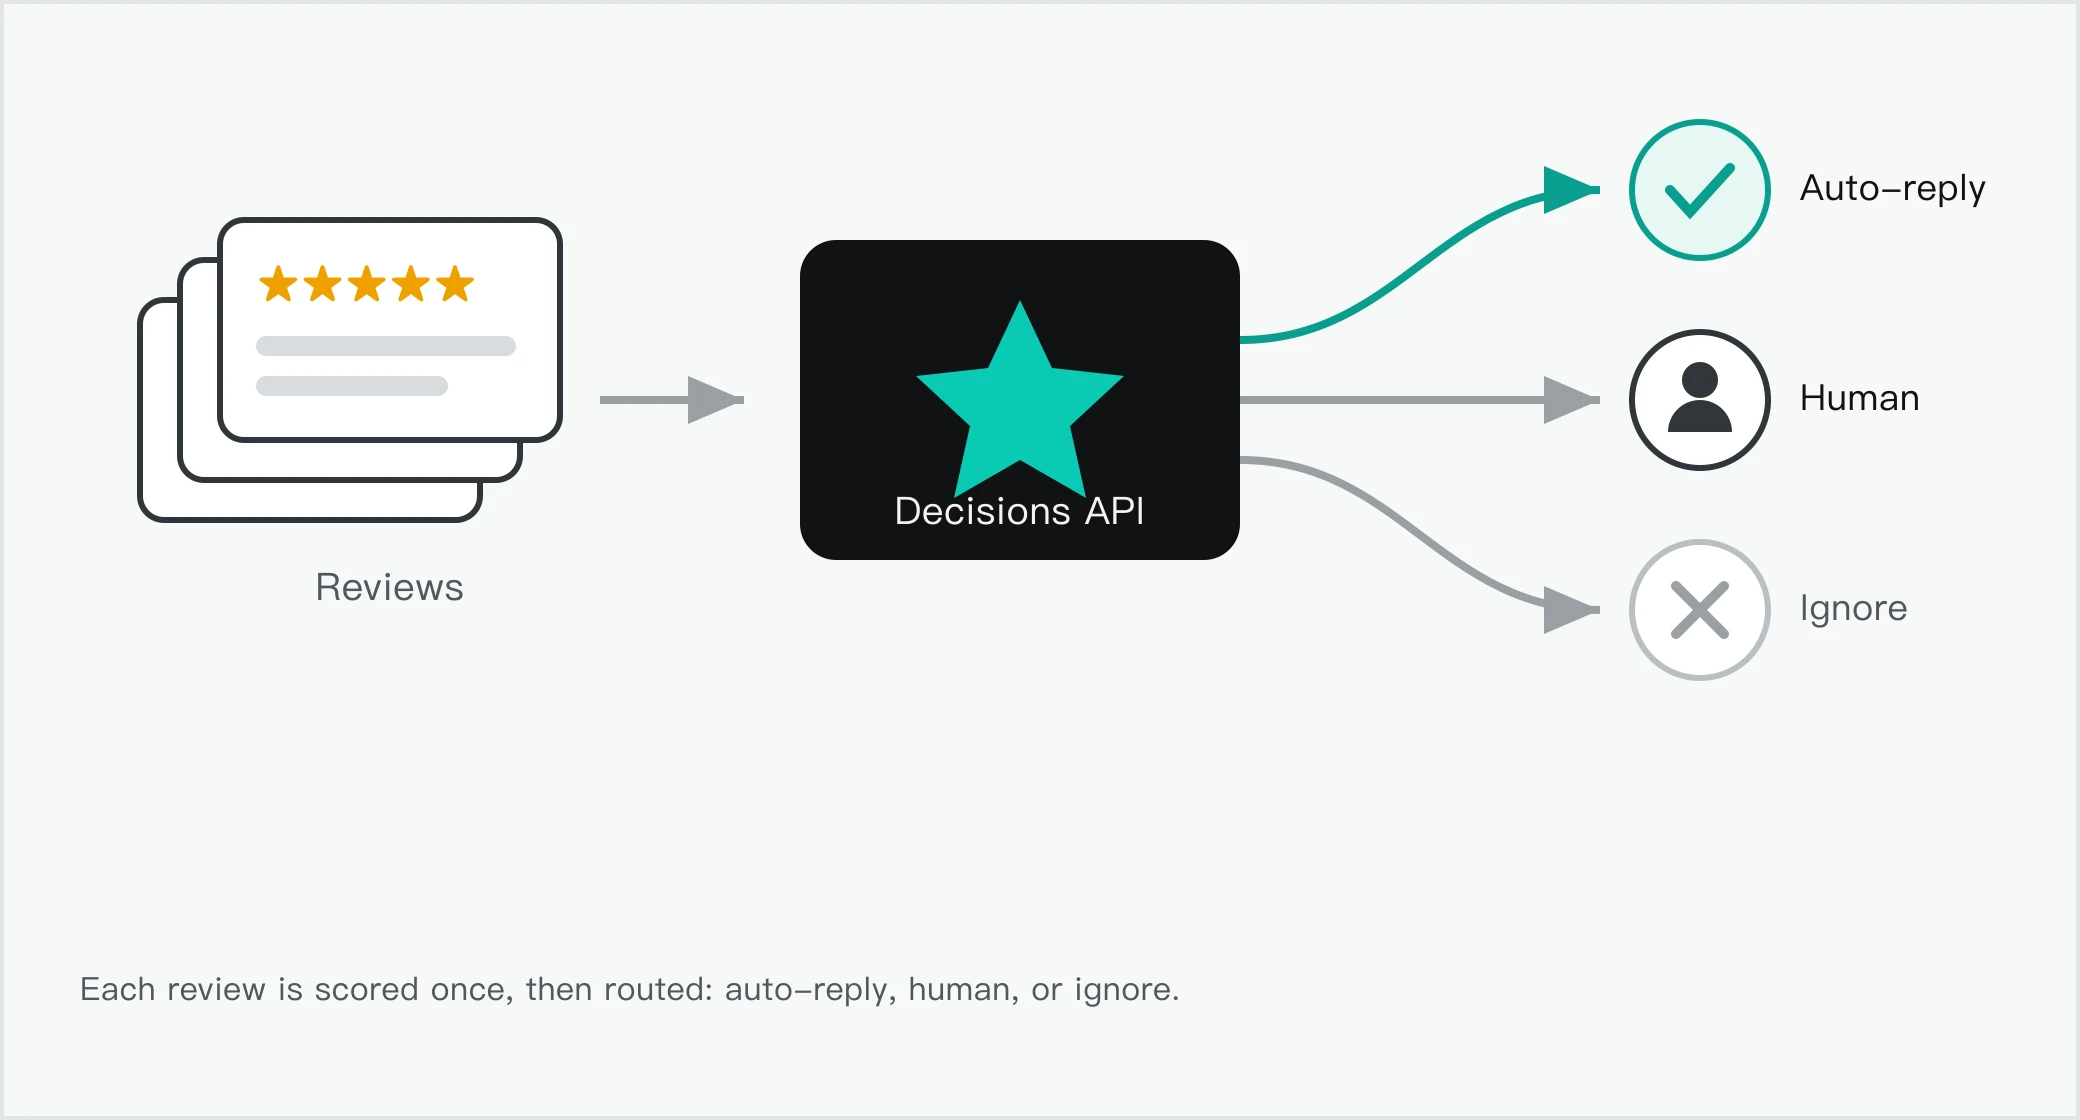
给评论分拣这类活打分、不写文字,正是 Gemini Decisions API 发布时给出的第一类用法。
评论跟进为什么是闭集判断
先看一条真实评论。00:20 新加坡时间我们拉回的 App Store Uber 评论里,有一条一星写着行程被取消还被扣了费、客服只回了模板,另一条五星只写了「Great Ride」。客服要做的判断其实很窄:这条要不要人工跟进(yes/no)、归退款、安全还是客服质量哪个队(多选)、有多急(打个分)。这三件事都有固定的选项,答案能直接拿去走 if 分支,不需要模型写一段话再让程序去解析。Google 在文档里把这类问题叫 bounded choices,并说明生成式模型是为给人读的文字设计的,当你的代码需要一个能直接分支的判断时,让模型先生成文字再解析,既慢又容易因为解析规则而出错(Decisions API 文档)。
评论分拣正好落在这个范围里。一条评论要不要跟进,取决于它是不是投诉、是不是提到安全或扣费、商家有没有回过,这些都是能用一句话描述清楚的条件。把每个条件写成一个独立的问题,模型分别打分,程序再用普通的 if 和权重把几个分数合起来,是文档建议的做法:问窄而单一目的的问题,答案在代码里组合(最佳实践一节)。这和让一个大模型「读完这条评论,输出一个 JSON,告诉我该怎么办」是两条路——后者要生成并解析一段文字,而评论分拣只要几个能打分的判断。
这类判断的量往往很大。一家有 1390 条 Google 地图评论的诊所(我们拉的 Downtown Dental - Loop,Google 地图评论接口),加上它在 App Store 和 Google Play 上可能还有应用,每天新增的评论从几十到上千不等。人工一条条看既慢又贵,而用生成式模型给每条评论写一段分析,成本主要落在它生成的文字上。Decisions API 的卖点是把生成文字这步去掉:它一个输出 token 都不产生,所以这部分不花钱(官方定价说明)。换句话说,评论分拣要的只是判断,而判断可以用打分表达,不必先变成一段文字再被解析回判断。
Gemini Decisions API 是什么:三种判断、一次前向打分
Google 在 2026 年 11 月 11 日(当地时间周三)发布了 Gemini Decisions API,背后是新模型 Gemini Decision 1(gemini-decision-1),通过 Google AI Studio 里的 Gemini API 以 v1beta 端点提供,署名是 Google DeepMind 的 Felix Yu(Google 博客原文)。它给出的是为有限选项定制的判断原语,用于工具选择、策略检查、模型路由、上下文评分这几类活。一次请求可以带一份最多 256K token 的多模态输入(文字、图片、音频、视频、PDF),外加最多 1000 个互相独立的问题。模型在一次前向传播里给候选选项打分,返回概率和置信度,端到端延迟 150–250 毫秒,其中模型计算本身的中位数是 50–100 毫秒,而且从 1 个问题到 100 个问题,延迟几乎不变(官方文档)。
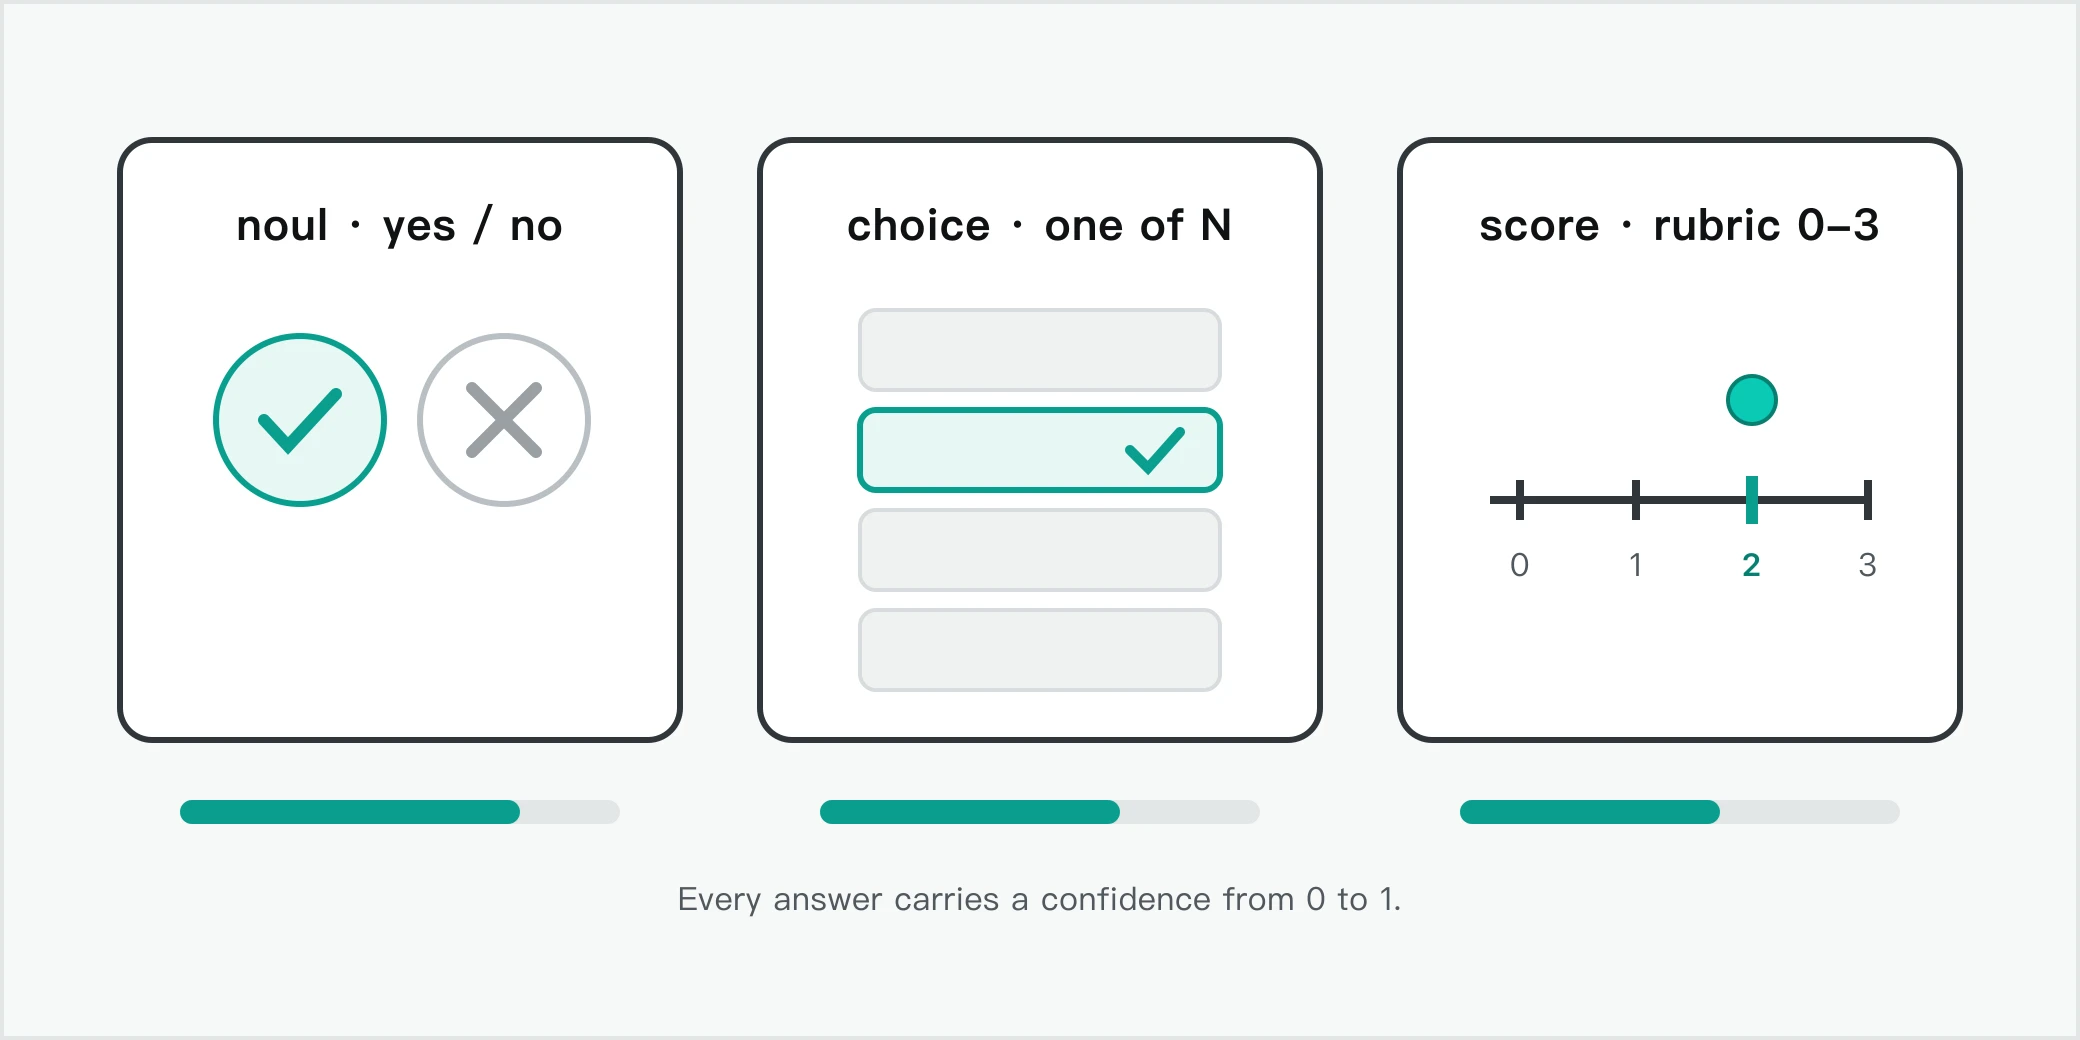
它把三种判断类型放进同一次请求,官方文档的问题类型表写得很清楚。第一种是 noul,yes/no 判断,估计一个条件成立的概率,可以用 true_description 和 false_description 两段文字界定什么算是、什么算不是(noul 一节)。第二种是 choice,从 2 到 255 个选项里选一个,返回胜出项和每个候选的归一化概率(choice 一节)。第三种是 score,按一个从 0 开始的有序评分表给输入打分,返回一个连续的加权分和每一档的概率(score 一节)。每个答案都带一个 0 到 1 的置信度,代码据此把拿不准的判断交给回退流程或人工(置信度一节)。
| 判断类型 | 用途 | 返回 | 评论分拣里的用法 |
|---|---|---|---|
noul(yes/no) | 判断一个条件是否成立 | noul(0.01–0.99)、confidence | 这条评论要不要人工跟进 |
choice(多选) | 从固定清单里选一项 | choice、probabilities、confidence | 归退款、安全、客服质量还是无需处理 |
score(评分) | 按有序评分表打分 | score、probabilities、legend、confidence | 紧急程度 0(无)到 3(涉及安全或扣费) |
计费方式决定了它适合干什么。Decisions API 按 $0.10 每百万输入 token 收费,输出 token 收 $0;一次请求里共享的那份输入只按一次计费,不管你问多少个问题,每多问一个只增加这个问题自己的说明和判定标准的 token(官方博客)。没有输出 token 费、没有变动的思考 token 账单、也没有单独的音频转写和 OCR 费。Google 自己给的对比是:在一套共享的评测集上,Gemini Decision 1 配 Decisions API 比 Gemini 3.5 Flash-Lite 配 Interactions API 便宜近 5 倍,差价来自输出不计费和一份输入在多个问题间共享(Google 博客)。这些评测数字是 Google 自己的、底层评测集没有公开,本文不替它背书,只当作一侧说法。
Google 还在博客里列了四个内部用法,每一个都对应延迟敏感的判断场景:Gemini Notebook 用它做实时路由器,用毫秒级把进来的查询按意图送到合适的模型档位和思考强度,日常查询延迟最多降 40%;设计工具 Stitch 的 rapid canvas 实验用它几秒生成可交互线框;Google Labs 的 CC 用它从 200 多个表情里即时挑一个;Google 搜索把它当作 MCP 工具的安全层,在延迟预算内检测对抗内容(Google 博客)。评论分拣和这些场景同属一类:选项固定、要快、要便宜。模型页也把请求路由、一次对许多规则做策略检查、按评分表给候选打分列为推荐用途(Gemini Decision 1 模型页)。
把评论接进来:三处真调
判断接口要有东西可判,评论从 EveryInfra 的数据接口来。我们先读了免费的目录 GET /api/v1/social/catalog(不需要 Key,目录地址),确认三处评论能力的参数、价格和返回字段。三处的 price_usd 都是 0.001389,即每次调用 $0.001389,一次返回一列评论只算一次调用。Google 地图评论每次默认 20 条、最多 100 条;App Store 评论默认 30 条、最多 500 条;Google Play 评论默认 40 条、最多 200 条(Google 地图评论目录、App Store 目录、Google Play 目录)。
| 能力 | 必填参数 | 本文用法 | 每次价格 | 本文用到的返回字段 |
|---|---|---|---|---|
google_maps_reviews/reviews | url | sort: newest、lang: en | $0.001389 | rating、text、reviewer_name、is_local_guide、owner_response、posted_at |
app_store/reviews | app_id | country: us、sort: newest | $0.001389 | rating、title、text、app_version、posted_at |
google_play/reviews | app_id | country: us、language: en、sort: newest | $0.001389 | score、title、text、reply_text、app_version、posted_at |
第一处要先拿到一个地点链接。00:19 新加坡时间我们调 google_maps_reviews/search,关键词 dentist in Chicago,返回 15 家诊所(Google 地图评论搜索能力),我们挑了评论数最多的 Downtown Dental - Loop(1390 条、4.7 星),把它带 query_place_id 的完整链接传给 reviews。同一时刻 00:19 拉回 20 条最新评论,19 条五星、1 条一星,20 条全部有商家回复(owner_response),其中 6 条来自 Google 本地向导。这家诊所的最新评论几乎全是好评,那条一星就是要人工看的那条。
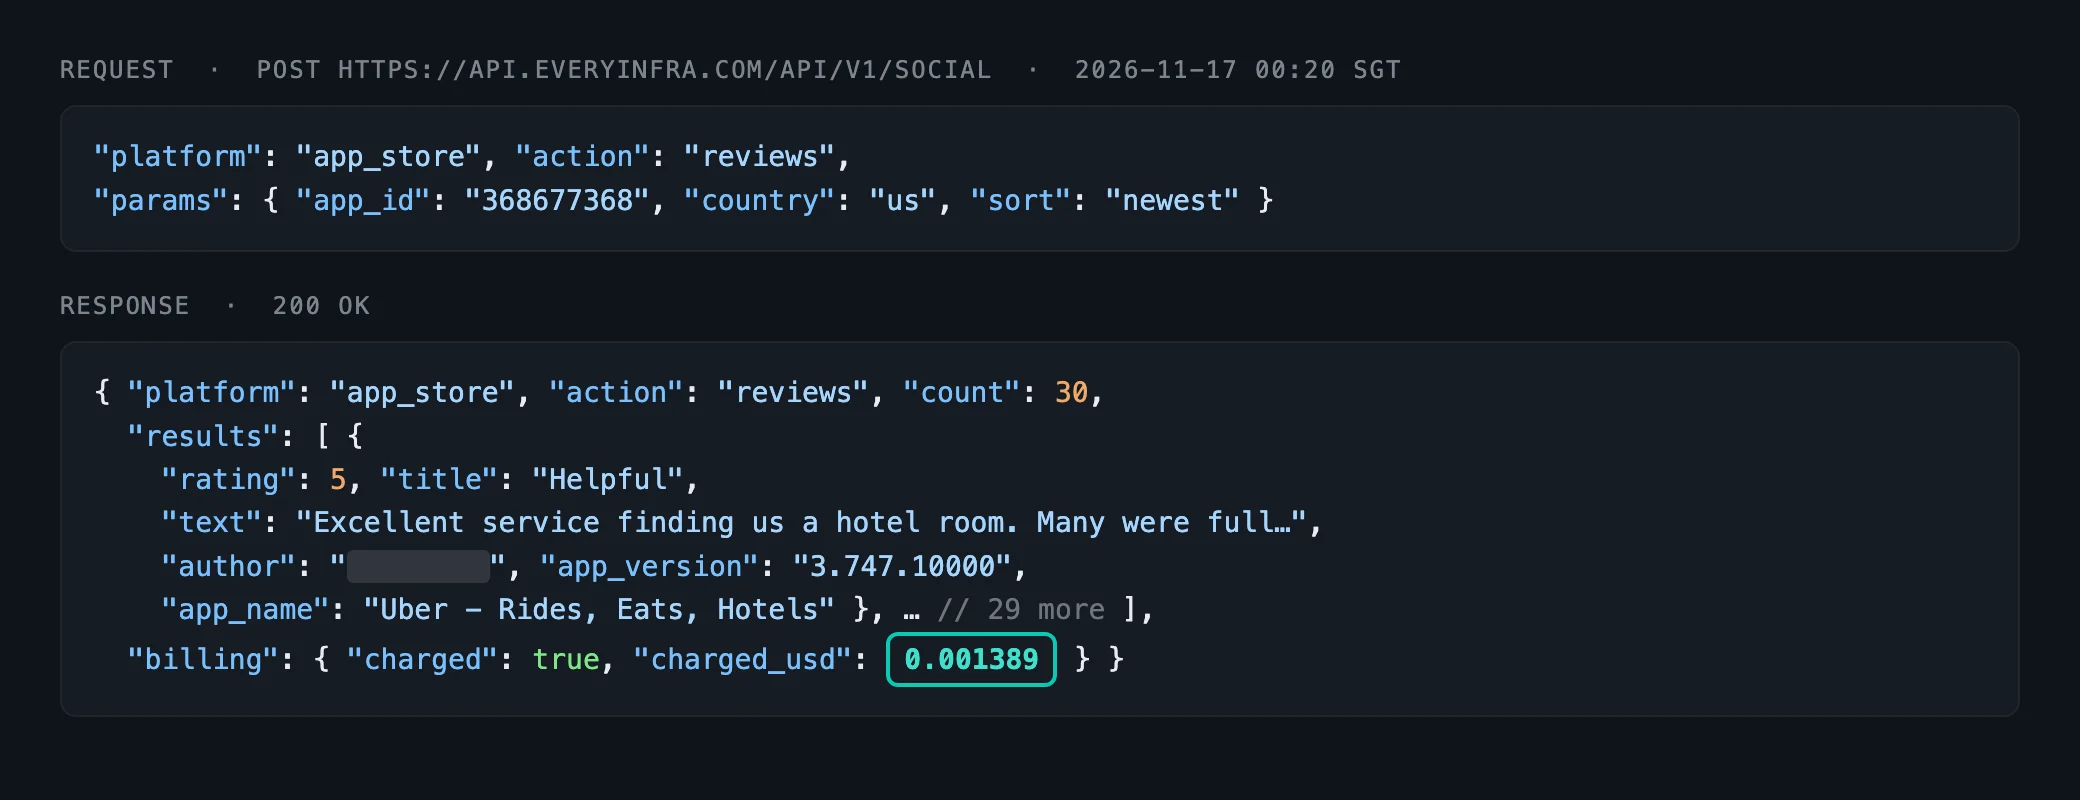
第二处和第三处换成应用评论,因为应用评论的差评比例通常更高。00:20 新加坡时间我们调 app_store/reviews,app_id 用 Uber 的数字 ID 368677368、country: us、sort: newest,拉回 30 条:21 条五星、1 条三星、8 条一星,8 条一星全是行程、扣费、客服一类的抱怨。00:23 新加坡时间我们调 google_play/reviews,app_id 用 Uber 的包名 com.ubercab、language: en,拉回 40 条:25 条五星、2 条四星、1 条三星、2 条两星、10 条一星,差评(≤2 星)12 条。三处的能力分别是 app_store/reviews 和 google_play/reviews。
实测一:90 条真实评论里,23 条要人工跟进
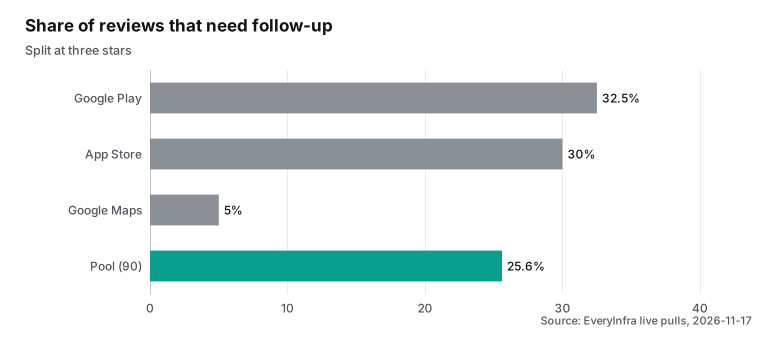
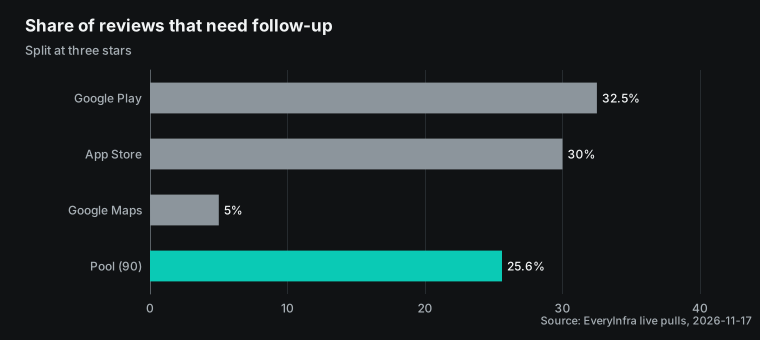
把三处的评论合起来看,一共 90 条,按「≤3 星就要人工跟进」这条简单规则,23 条要跟进,占 25.6%。
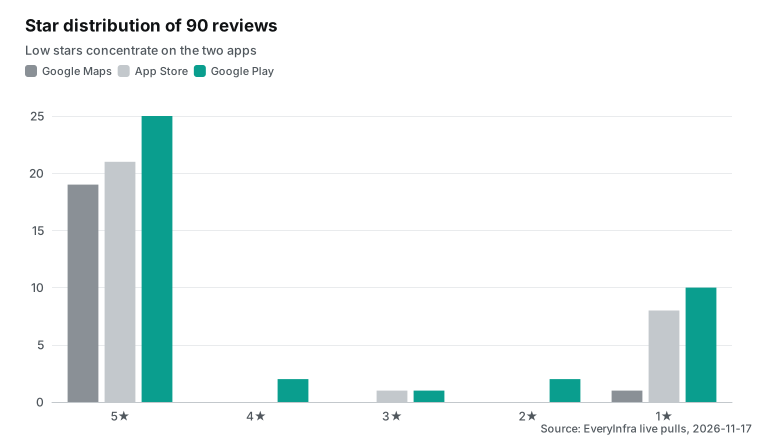
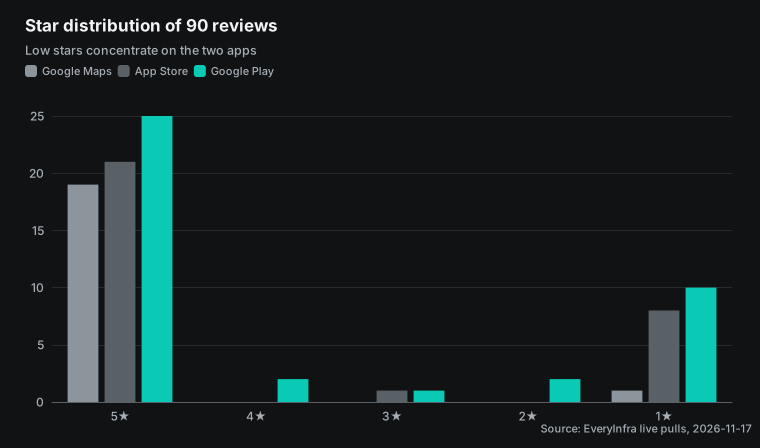
分平台看,Google 地图那家诊所只有 1 条要跟进(5%),而两个应用的差评比例高得多:App Store 的 Uber 30 条里 8 条 ≤2 星、Google Play 的 Uber 40 条里 12 条 ≤2 星。差评往哪里集中,决定了你该先盯哪个渠道。
星级只是粗筛。一条五星评论里也可能藏着问题(「很好,就是停车太难找」),一条一星也可能只是用户下错单。要判的是内容,而不是分数,这是把评论喂给判断接口的理由:让模型读评论正文,判断它是不是投诉、是不是涉及安全或扣费、要不要回。星级可以当一个便宜的预筛,把明显的五星好评挡在判断接口之外,只把拿不准的送进去,这样连判断的钱也能省一截。下面的账会按「全判」和「只判 ≤4 星」两种方式分别算。
这组数的边界要写清楚。90 条是三次单页返回的样本,不是这几家的全部评论;Google 地图那页按最新排序,赶上的是一段好评期,不代表这家诊所长期的差评率。要得到稳定的差评比例,得按分页拉够样本、或用目录里的 mode: async 翻更深,本文只用这 90 条演示判断流程,不用它们下关于某家商户的结论。
三条真实评论怎么分:判定标准下的预期归类
下面拿三条真实拉回的评论,按上一节的判定标准走一遍预期归类。这里的归类是人工按规则判的,用来对照三个问题该怎么设计;本文没有调用 Gemini 接口,所以不写模型实际返回的概率。三条分别来自 App Store Uber 的一条一星、Google 地图诊所的一条五星、Google Play Uber 的一条一星,正文已概述、未逐字引用。
| 评论(概述) | `needs_followup`(yes/no) | `route_to`(多选) | `severity`(0–3) |
|---|---|---|---|
| 行程被取消仍被扣费、客服只回模板(App Store 一星) | 是 | billing(扣费) | 2(服务失败) |
| 夸赞牙医和卫生员、体验很好(Google 地图五星) | 否 | no_action | 0(不急) |
| 应用一直闪退、打不开(Google Play 一星) | 是 | support_quality(功能问题) | 1–2(看是否普遍) |
三条评论的判定标准互不相同,但都能用同一组问题覆盖:needs_followup 把要不要人工挑出来,route_to 决定进哪个队列,severity 决定优先级。按官方说明,三个问题在同一份输入上并行、互相看不见地打分,所以这组设计一次问完不比只问一件慢多少(多问题一节)。设计问题时,判定标准要把边界写清楚:比如「扣费争议、安全问题、未解决的投诉」算要跟进,「表扬、轻微偏好、已解决」算不要跟进,让模型在两段描述之间定位,而不是凭一个模糊的「要不要跟进」去猜。
判定标准怎么写才判得准
把一条评论判对,关键在于你把要判的事拆得够细、说得够清楚;模型聪明与否是次要的。评论分拣里最常见的毛病,是把一个大问题囫囵问出去,比如「这条评论严重吗」。严重对不同的业务意味着不同的东西:对一家餐厅,食品安全最严重;对一个打车应用,司机行为和扣费最严重;对一个电商卖家,假货和退款最严重。模型没法替你定义什么叫严重,所以判定标准要把这些业务含义写进去,用具体的句子描述每一档分别是什么样子,而不是留一个让模型自己揣摩的空词。官方文档把这件事说成「问窄而单一目的的问题」,并建议用原子化的检查,再在代码里用条件和权重把答案组合起来,而不是指望一个问题直接给出最终动作(最佳实践一节)。
拆问题有几条可操作的经验。第一,把一个复合判断拆成几个单一判断。与其问「这条评论要不要紧急处理」,不如分别问「是不是涉及安全」「是不是涉及扣费」「商家回过没有」,再在代码里规定「涉及安全就直接置顶,涉及扣费且商家没回就进退款队列」。这样每个问题都好写判定标准,也好单独核对对错。第二,给 yes/no 问题补上两段描述。noul 允许写 true_description 和 false_description,把容易混的情况提前区分,比如「用户抱怨价格贵」到底算不算产品缺陷,一句「缺陷指产品本身坏了或不能用,价格、尺寸、配送、偏好不算」就能把这类评论挡在缺陷队列之外。第三,评分的每一档都要有一句话定义,而不是只给一个数字范围。评分表从 0 开始,第 0 档写「不急」,第 1 档写「轻微问题」,第 2 档写「扣费或服务失败」,第 3 档写「安全或法律风险」,模型是在这几句话之间定位,描述越具体,打分越稳。同一套 0–3 的档数换个行业不用动,要重写的是每一档那句话:牙科诊所把「拔错牙、术后感染」放进第 3 档,打车应用把「司机骚扰、半路甩客」放进第 3 档,电商卖家把「收到假货、钱货两空」放进第 3 档。这句话就是你把业务知识喂给模型的地方,模型本身不知道对你的生意什么最严重。
判定标准写好以后,要用自己的数据核对,而不是看模型自己报告的置信度就信。把一批已经人工标过的评论喂进去,看模型的判断和人工标注差在哪里,差得多的那几类,往往是判定标准没写清楚,而不是模型不行。有媒体的测试里这个模型只通过了约六成的文档(Tech Times 报道),这类数字提醒的正是:评测要用你自己的样本,别拿别人环境里的通过率当自己的。把判定标准当成一份会迭代的规则来维护,比一次写死更实际。
一次完整往返:EveryInfra 拉评论、Decisions API 打分
先看 EveryInfra 这一侧的真实请求。Key 只从环境变量读,不写进任何文件;返回里的 billing.charged_usd 是这次实际扣的钱。
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"app_store","action":"reviews",
       "params":{"app_id":"368677368","country":"us","sort":"newest"}}'
这一次返回 30 条评论,billing.charged_usd 是 0.001389。每条评论是一个对象,字段有 rating、title、text、app_version、posted_at 等。拿到评论后,把其中一条的正文作为 Decisions API 的输入,三个问题一次问完。下面的 Python 片段按官方文档的写法改写,输入换成一条真实评论的内容(一条行程被取消并扣费的一星评论):
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    input="Driver cancelled after 20 minutes and I was still charged a fee. "
          "Support only sent a template reply.",
    questions={
        "needs_followup": {
            "type": "noul",
            "instructions": "Does this review need a human follow-up?",
            "criteria": {
                "true_description": "Billing dispute, safety issue, or unresolved complaint.",
                "false_description": "Praise, minor preference, or already resolved.",
            },
        },
        "route_to": {
            "type": "choice",
            "instructions": "Which team should handle this review?",
            "criteria": {
                "billing": "Charge, refund, or payment problem.",
                "safety": "Driver behaviour or passenger safety.",
                "support_quality": "Slow or unhelpful customer support, or a broken app.",
                "no_action": "No action needed.",
            },
        },
        "severity": {
            "type": "score",
            "instructions": "Rate how urgent this review is.",
            "criteria": [
                "Not urgent.",
                "Minor issue.",
                "Billing or service failure.",
                "Safety or legal risk.",
            ],
        },
    },
)
按官方文档,REST 的等价写法是向 https://generativelanguage.googleapis.com/v1beta/decisions POST,用 x-goog-api-key 头带 Key(快速开始一节)。返回体是一个 answers 对象加一个 usage 对象。文档给的返回样例里,一个 noul 答案形如 {"type":"noul","noul":0.99,"confidence":0.99},usage 里 total_output_tokens 是 0(官方文档返回样例)。对上面三个问题,程序拿到的是三个带概率的答案:要不要跟进的概率、归哪个队加每个队的概率、紧急分加每一档的概率;再用 if 和阈值把它们合成一个动作。本文没有调用 Gemini 这一侧的接口,上面是按官方文档改写的配置示例,EveryInfra 一侧的每个数字来自真调的原始返回。
实测二:评论很短,判断的钱花在你的问题上
把真实评论的体积量出来,就能看清钱花在哪里。三处评论正文的平均字节分别是:Google 地图 143 字节、App Store 140 字节、Google Play 40 字节;中位数分别是 96、105、19 字节。Google Play 的评论最短,很多只有一句「doesn't work」或「great app」。按 Anthropic 定价页给的「约 4 字节 1 token」比例(定价页 Web fetch 一节),一条 Google 地图评论约 36 个 token,一条 Google Play 评论约 10 个 token。
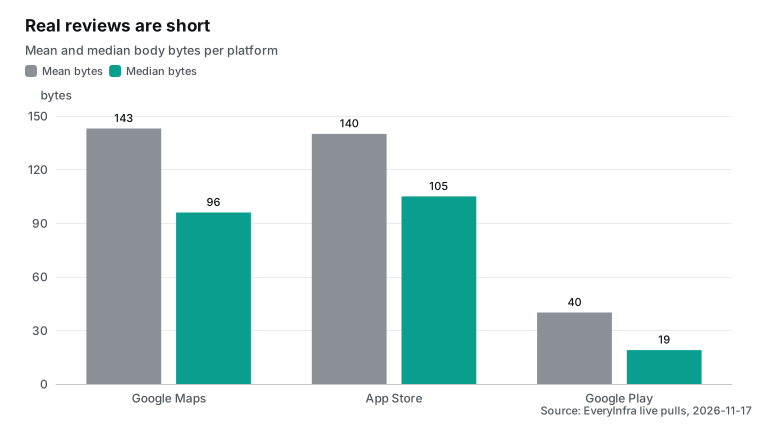
一个判断请求的输入,除了评论正文,还有三条问题的说明和判定标准。把三条说明加上共享的那点前置文字,估成一个固定预算约 320 个 token(这是我们按上面配置片段里三条说明的长度估的,不是实测的计费值)。于是一条 Google 地图评论的请求约 356 个 token,评论正文只占 36÷356 ≈ 10%;一条 Google Play 评论的请求约 330 个 token,评论正文只占 10÷330 ≈ 3%。
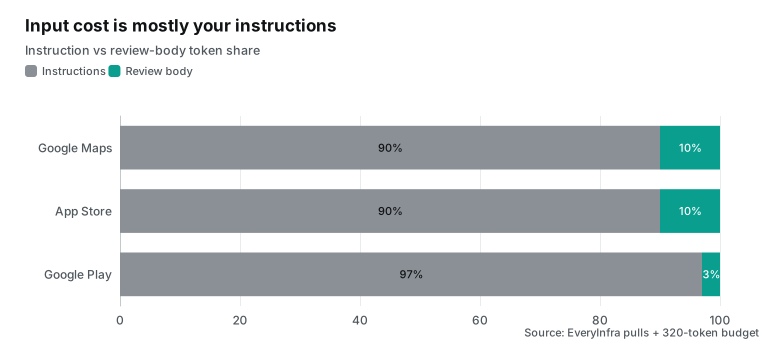
既然评论正文只占输入的个位数到十分之一,再去压缩评论(截断、去标点)省不下多少;要省,得从三条判断说明下手:把说明写短、把判定标准写得精炼,或者把能用星级预筛掉的五星好评挡在判断接口之外。
固定预算只是平均情形,真实评论有长尾。这 20 条 Google 地图评论里,最长一条有 876 字节、约 219 个 token,是中位数 96 字节(约 24 个 token)的九倍;一条这样的长评论,请求会涨到约 539 个 token,而不是平均的 356 个。所以按平均体积估出来的每千条成本是个中间值,评论写得越细、投诉越长的商户,判断那一侧的账会往上走。真要定预算,得按自己渠道的评论长度分布量一遍,而不是套一个平均数。
另一个方向是用一次请求判多条评论——官方允许一次最多 1000 个问题针对同一份共享输入,如果把若干条评论拼成一份输入、每条评论对应几个问题,共享输入只按一次计费,问题只按各自说明计费。这条路要自己把评论拼进一份输入并让每个问题指向对应的评论,适合同一份材料要问很多遍的场景;对一条评论一组问题的简单分拣,一条一次更直观。拼批量也有上限:一次最多 1000 个问题,评论分拣每条要问三个判断,一次最多塞约 333 条评论;而 256K token 的共享输入远吃不满(按中位 96 字节算,333 条正文才八千多 token),所以卡住批量大小的是问题数,不是输入长度。
算一笔账:判一千条评论要多少钱
把两侧的钱合起来,按一千条评论算。EveryInfra 这一侧只和调用次数有关:按每次返回的页大小,一千条 Google 地图评论要约 10 次调用(每次 100 条)、一千条 App Store 评论约 2 次(每次 500 条)、一千条 Google Play 评论约 5 次(每次 200 条),每次 $0.001389。Decisions API 这一侧按输入 token 算:一千条评论乘以每条请求的 token 数,再乘 $0.10 每百万。
| 做法(一千条评论) | Decisions API 打分 | EveryInfra 拉数 | 合计 |
|---|---|---|---|
| Google 地图评论(每条约 356 token) | 约 $0.0356 | 10 次调用 $0.0139 | 约 $0.0495 |
| App Store 评论(每条约 355 token) | 约 $0.0355 | 2 次调用 $0.0028 | 约 $0.0383 |
| Google Play 评论(每条约 330 token) | 约 $0.0330 | 5 次调用 $0.0069 | 约 $0.0399 |
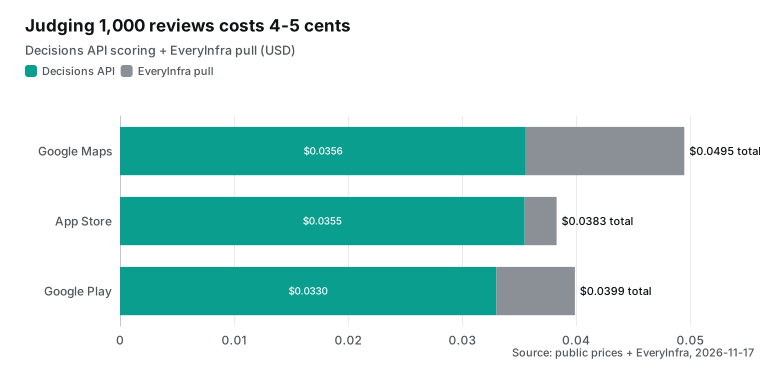
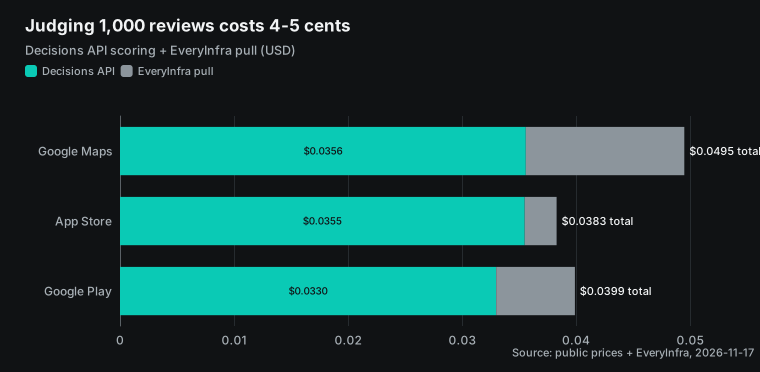
如果先用星级把五星好评挡在判断接口外,只判 ≤4 星的,再省一截。按我们这 90 条的分布,≤4 星的占比大约是 Google 地图 5%、App Store 约 30%、Google Play 37.5%,被送进判断接口的评论少了,Decisions API 那一侧的钱按比例下降,拉数的钱不变。预筛省下来的是判断那一侧的钱,省幅就等于被挡掉的比例。按我们这 90 条的分布,三处合起来约有四分之三是五星好评,星级预筛把它们挡在判断接口外,Decisions API 那一侧的调用量和花费大约降到全判的四分之一,拉数的钱一分不省(评论还是整页拉回来的)。预筛的代价是可能漏掉藏在五星里的问题,所以预筛规则要宽一点(比如把带「但是」「however」的五星也放进去)。两种做法的取舍如下表。
| 做法 | 送进判断的比例 | Decisions 成本(相对全判) | 风险 |
|---|---|---|---|
| 全判 | 100% | 基准 | 不漏,但多花在好评上 |
| 只判 ≤4 星 | 按渠道 5%–37.5% | 按比例下降 | 可能漏掉五星里的问题 |
这个账的边界要说清楚。固定预算 320 token 是估计值,真实计费要以 usage.total_input_tokens 为准,三条说明写长写短会让每条请求上下浮动几十个 token;表里没有算免费额度——Google AI Studio 给了一个免费层可以用来做原型,付费层才按上面的价(Gemini API 定价页);也没有算失败重试和翻页令牌的额外调用。换个角度,这个账说明两侧的钱是同一量级,拉一千条数据的钱(几分钱)和判一千条评论的钱(几分钱)差不多,没有哪一侧贵出一个数量级。
和用生成式模型逐条分类比,差在输出。一个生成式分类器要为每条评论吐出一段判断文字(哪怕只是一个短 JSON),这段输出要按输出价计费,量一大就成了主要成本;Decisions API 对这段输出收 $0,这也是 Google 给出近 5 倍差价的机制来源(Google 博客)。有媒体按「一份输入问 20 个问题」的批量方式算过一个更大的倍数:Tech Times 11 月 13 日报道,因为共享输入只计一次费,对一条 4000 token 的记录做 20 项检查,每一千条记录约 $0.50,而不是 $8.10,把 20 项检查的成本压到约十六分之一(Tech Times 报道)。同一篇也提到,在它的测试里这个模型只通过了 63% 的文档,说明单看价格不够,准确率要按自己的数据核。Google 的近 5 倍和 Tech Times 的约 16 倍并不矛盾:差距取决于一份共享输入上问了几个判断——问得越多,那份输入的费用摊得越薄。Google 的对比接近一条输入问一两个判断,Tech Times 算的是一份 4000 token 的记录问 20 个判断。评论分拣多数是一条评论问三个判断,更接近前一个量级,别拿「16 倍」去估自己的省幅。
置信度决定谁来处理:自动、人工、还是忽略
每个答案都带一个 0 到 1 的置信度,这是把分拣自动化的关键。文档建议用置信度决定一个判断是自动执行还是上报:高置信的直接走分支,低置信的交给回退流程或人工(置信度一节)。放到评论分拣上,一条判断可以这样落地:needs_followup 的 noul 概率高且置信度高,自动建一张工单并按 route_to 归队;概率在中间或置信度低,推给人工复核;概率低且置信度高,归入无需处理,连工单都不建。
| 判断结果 | 置信度 | 动作 |
|---|---|---|
| 要跟进概率高 | 高 | 自动建工单,按 route_to 归队 |
| 要跟进概率中等,或置信度低 | 低 | 推人工复核 |
| 要跟进概率低 | 高 | 归无需处理,不建工单 |
这套做法把人工从「每条都看」变成「只看拿不准的」。按我们这 90 条的分布,明显的五星好评(Google 地图那 19 条、两个应用的 46 条五星)大多会落进「概率低、置信度高」这一格,直接不建工单;进人工队列的是那 23 条低星加上少数置信度不高的。这也呼应文档里「原子检查、代码里组合」的建议:别让模型一次给出最终动作,而是让它给几个有把握的分数,动作由你的代码按阈值定(最佳实践一节)。把阈值写进代码而不是模型,意味着你能在不改模型的情况下调整自动化的边界。一个可行的起点:needs_followup 概率 ≥0.85 且置信度 ≥0.8 才自动建单,两个阈值任一不够就进人工队列,上线后拿人工复核的结果把这两个数往上或往下挪。
有的评论天然落在两类之间。一条一星既抱怨被扣费、又说司机开得吓人,route_to 的概率会在退款和安全两个队列之间分得比较平,置信度随之偏低。判定标准写得再细,也总有这种评论;用置信度把它们交给人工复核,这套流程才不会在模棱两可的地方硬做决定。拿不准还有第二个信号可用:choice 返回的不只是胜出项,还有每个候选的归一化概率。如果前两名贴得很近(比如退款 0.46、安全 0.44),哪怕总的置信度看着还行,也该当成模棱两可处理,和低置信度一样推给人工。置信度看的是模型有多确定,概率分布看的是选项之间差多少,两个一起用比只看一个稳。
本地向导和商家回复这两个字段能进一步收窄人工队列。我们拉的 Google 地图那 20 条里,6 条来自本地向导、20 条全部已有商家回复;一条已经被商家回过的好评,几乎不需要再跟进。把「有没有 owner_response」当成一个预筛条件,或者写成一个 noul 问题(「这条评论商家回过了吗」),能把判断接口的调用量再压一截。这类字段在三处评论能力的 response_fields 里都能查到(Google 地图评论目录)。
三种做法放一起比:人工、生成式模型、打分接口
同样是给评论分拣,常见的做法有三种,各有各的适用场景。第一种是纯人工,客服一条条看。好处是判断最灵活,能读出字里行间的情绪和言外之意;坏处是慢且贵,评论一多就看不过来,而且不同的人标注的尺度容易不一致。第二种是用生成式模型给每条评论写一段分析或一个结构化的判断。好处是能同时给出判断和建议回复,一步到位;坏处是每条都要生成并解析一段文字,输出按量计费,评论一多,输出的钱就成了大头,解析规则也要跟着模型的输出格式维护。第三种是用 Decisions API 这样的打分接口,只做判断、不写文字,判断结果交给代码去决定动作。好处是便宜、快、输出稳定(直接是概率和置信度);坏处是它只能回答你预先定好的闭集问题,写回复、做总结这类开放式的活得另找生成式模型。
| 维度 | 纯人工 | 生成式模型分类 | 打分接口(Decisions API) |
|---|---|---|---|
| 判断灵活度 | 最高 | 高 | 限于预设的闭集问题 |
| 速度 | 慢 | 中(要生成文字) | 快(150–250 毫秒) |
| 成本随量增长 | 线性且高 | 输出占大头 | 只按输入,输出 $0 |
| 结果形态 | 人写的判断 | 要解析的文字 | 概率加置信度,可直接分支 |
| 适合 | 疑难和申诉 | 判断加写回复一步到位 | 大批量的归类、路由、优先级 |
三种做法并不互斥,实际落地往往是分层组合:便宜的规则预筛挡掉明显好评,打分接口做归类和优先级,拿不准的和要回信的才用到人工和生成式模型,每一层只处理它最划算的那部分。下一节把这条分层流程拆成能直接照着搭的五步。
边界:闭集判断能做什么、不能做什么
Decisions API 只处理闭集问题,它替换的是分类器和路由器,不是开放式生成。要让模型写一段给客户的回复、总结一周的评论趋势、或者从评论里抽出具体的产品缺陷描述,仍然要用生成式接口(Interactions API 概览)。评论分拣的合理分工是:判断和归队用 Decisions API,写回复用生成式模型,两步串起来。
评论语言是另一个要注意的地方。我们拉 Google Play 评论时传了 language: en,但目录里写明语言选择不保证所有返回评论都是该语言的原文,country 在 Google Play 评论里也不改变返回哪些评价(目录里有一条 2026-10-25 的实测说明:同一 language 下 us 和 gb 返回的评价相同,要按国家比较评价应换 language,Google Play 目录)。实拉的 40 条里就混着西班牙语。好在 Decisions API 原生多模态、也能处理多语种文本,判定标准用英文写、评论正文保持原文,一般能判;但如果判定标准依赖某种语言的细微措辞,混语种会增加不确定,这时更要靠置信度把拿不准的交给人工。
拉数据本身也有拿不到的时候。目录对 Google Play 评论标注了一条实测说明:对美区英文评论,有些请求每次最多回 100 条,且 reply_text、reply_at、language、url、title 这几个字段可能缺失(Google Play 目录)。我们这次拉的 40 条就没有带商家回复(with_reply 为 0)。这有个直接的成本后果:Google 地图那 20 条全有 owner_response,能用「商家回过没有」这个最便宜的条件先挡一批;Google Play 这一页一个回复都没有,这条预筛就用不上,只能把更多评论直接送进判断接口,判断那一侧的调用量相应高一些。字段缺了,依赖这些字段的预筛条件就要留个兜底,或者换一个该渠道拿得到的字段来筛。遇到接口返回 503、没有扣费的情况,按文档重试即可,失败和空结果不扣费,这类现象能在返回的 billing 里对上。还要记住,Google 给的延迟和成本是它自己环境里的数,评论量大、判定标准复杂时,自己按 usage 和真实耗时重测一遍再定方案。
做成每天自动跑的评论分拣
把上面这些拼起来,就是一条每天自动跑的评论分拣流程,不需要人盯着。第一步是定时拉新评论:对每家商户或每个应用,按最新排序各拉一页,用评论里的发布时间和上次拉到的时间比,只保留新的;评论多的渠道按分页或异步模式翻够当天的量。第二步是预筛:用星级和商家回复字段把明显不用处理的好评挡掉,减少送进判断接口的条数。第三步是打分:把每条评论和三个问题一起发给判断接口,拿回「要不要跟进、归哪队、多严重」三个带概率和置信度的答案。第四步是落地:按置信度和阈值,高置信的自动建工单并归队、排优先级,低置信的进人工复核队列。第五步是回信:需要回客户的,用生成式模型按工单起草一段回复,人工确认后发出。
这条流程里,判断接口的低延迟让它可以放在评论进来的那一刻就跑,而不只是晚上批量跑:一条差评刚发出来,系统几乎立刻就能判出它要不要紧急处理,把要紧的差评在几秒内推到人工面前。对打车、外卖、酒店这类服务,差评跟进越快,挽回成功率越高,不必等第二天的批处理。给同一条评论多加几个判断维度也不会拖长响应,所以这套分拣可以随业务需要往里加问题,不用在延迟和维度之间折中。
成本上,这条流程的两侧都便宜且可预测。拉数按调用次数算,判断按输入 token 算,都不随评论长短剧烈波动,因为评论本来就短。一家每天新增几百条评论的商户,一个月的评论量在一两万条之间,按本文的单价估,拉数加判断的总花费也就几美元,低于一个客服看这些评论半小时的人力成本。换成我们实拉的那家牙科诊所,评论增速低得多,一天新增几条到十几条,一个月几百条,判断加拉数一个月也就几美分。把成本顶上去的是评论量:接口单价始终是零头,像 Uber 这类每天成千上万条的应用,调用次数堆起来才让账变大,也才值得认真算预筛和批量。接口费只是零头,成本的大头是把判定标准调准、把人工队列的阈值定对这两件事;这两件事做好了,花费就压得很低。再往前一步,把结果每天汇成一张「今天有几条要跟进、分别归哪个队」的报告,接到告警和工单系统上,可以参考我们写过的应用评论告警一篇。
开发者社区的上手材料也在跟上。2026-11-15 前后,YouTube 上陆续出现把三种问题类型讲清楚的短视频,演示怎么用一次请求同时问多条判断(YouTube 短视频),对照官方文档一起看,能更快把判定标准写对。
行业动向
- 2026-11-11:Google 发布 Gemini Decisions API 和 Gemini Decision 1,按 $0.10 每百万输入、输出不计费,通过 Google AI Studio 的 Gemini API 提供(Google 博客)。对评论分拣的意思:多了一个专门做闭集判断、按输入计费的便宜选项。
- 2026-11-11:多家科技媒体同日报道,SiliconANGLE 称 Google 正式进入「决策模型」市场,VentureBeat 强调一次请求可对同一份材料打最多 1000 个判断(SiliconANGLE、VentureBeat)。对读者的意思:决策模型作为一类独立接口被确认,不再只是生成式模型的附带用法。
- 2026-11-12:Dataconomy 报道该接口一次调用可回答关于同一材料的最多 1000 个问题,面向需要软件快速做一连串小判断的开发者(Dataconomy)。对评论分拣的意思:同一批材料问很多遍的活,批量更划算。
- 2026-11-13:Tech Times 用「一份输入 20 项检查」算出每千条记录约 $0.50、比生成式路线省约十六倍,同时提醒其测试里模型只通过 63% 的文档(Tech Times)。对读者的意思:价格优势明显,但准确率要按自己的数据验。
- 2026-11-14:开发者社区开始出教程,YouTube 上线《Gemini Decision 1: Practice In Python》等上手视频,演示
noul、choice、score三种问题怎么写(YouTube)。对读者的意思:第三方上手材料跟上,接入门槛进一步降低。 - 2026-11-16:模型路由成为同期热点,devops.com 报道 Gemini 4 Hydrogen 把模型选择变成一次路由决策,和 Decisions API 做路由的用法呼应(devops.com)。对读者的意思:把判断从生成里拆出来、单独做一次快速打分,正在成为一种通用做法。
- 2026-11-11:生态接入同步铺开,Google 列出 OpenRouter、LangChain、Vercel、LiteLLM、Pydantic AI、Pipecat、LiveKit、OpenCode,以及
google-genaiSDK,Gemini in Google Cloud 支持随后到(Google 博客、LangChain 文档)。对读者的意思:已经在用这些框架的,接起来不用从零写。
常见问题
Gemini Decisions API 和普通的 Gemini 对话接口有什么不一样? 它只对闭集问题打分,不生成答案文字。输入一份材料和一组问题,返回每个问题的概率和 0–1 置信度,输出 token 始终是 0,代码可以直接分支、排序、路由(官方文档)。对话接口生成给人读的文字,适合写回复、做总结。
判一千条评论到底多少钱? 按本文的真实评论体积估,三处评论都在每千条 $0.038 到 $0.050 之间,含 Decisions API 打分和 EveryInfra 拉数两侧,按公开价算(Gemini 定价页、EveryInfra 目录)。真实计费以返回里的 usage.total_input_tokens 和 billing.charged_usd 为准。要注意这个估价建立在评论很短的前提上,如果你的输入里还塞了图片、音频或整页的截图,输入 token 会涨上去,判断那一侧的钱也跟着涨,这时就要把多模态输入的分辨率调低来控制 token 数,官方允许对图片和视频输入调分辨率以平衡清晰度和成本。另外免费层只适合原型,上了量要走付费层,额度和限流以你账户的实际为准,上线前最好用真实样本小跑一轮把每条的实际 token 数量出来再推算总价。
为什么说它比生成式模型做分类便宜? 生成式分类器要为每条评论吐出一段判断文字,输出按输出价计费,量大时是主要成本;Decisions API 对输出收 $0,一份共享输入在多个问题间只计一次费。Google 给的对比是比 Gemini 3.5 Flash-Lite 配 Interactions API 便宜近 5 倍(Google 博客)。
评论从哪里来,支持哪些平台? 本文从 EveryInfra 的 google_maps_reviews/reviews、app_store/reviews、google_play/reviews 三处拉了真实公开评论,每次 $0.001389。除了这三处,目录里还有不少带评论的平台,比如 Yelp、TripAdvisor、Trustpilot、Amazon、Etsy、Glassdoor 等,判断流程是同一套,换的只是拉评论的能力名和参数。平台总览见 Google 地图评论接口、App Store 接口、Google Play 接口,全部能力见目录。
置信度低的评论怎么办? 文档建议用置信度分流:高置信的自动走分支,低置信的交给回退流程或人工复核(置信度一节)。评论分拣里,把置信度不高的推进人工队列,比盲目全自动稳妥。
一次能判多少条评论? 一次请求最多带 256K token 的共享输入和最多 1000 个问题(官方文档)。一条评论一组问题的简单做法是一条一次;要把多条评论拼进一份输入批量问,适合同一材料反复判的场景。实际跑批量时,还要结合你账户的每分钟请求上限来排并发:拉评论和打分是两个不同的接口,各有各的限额,拉得太快或判得太快都可能撞到限流,按返回里的提示退避重试即可,不要一股脑并发猛打。
判断结果要不要存下来? 建议把每条评论的三个判断结果连同置信度一起存进自己的库,一方面可以事后复盘哪些判断和人工不一致、据此改判定标准,另一方面同一条评论短期内不用重复判,能省下重复的判断费。存的时候把评论的平台、能力、拉取时间和原始评分一并记下,方便追溯每个判断是基于哪条评论做的。
上手:三步把评论接进判断流程
- 先拉评论。按快速上手用 REST 调
google_maps_reviews/reviews、app_store/reviews或google_play/reviews,返回里的billing.charged_usd是这次扣的钱,失败和空结果不扣费。各家客户端的 MCP 配置见 MCP 服务器页。 - 定判断。按你的业务把「要不要跟进、归哪队、多严重」写成
noul、choice、score三个问题,判定标准写清楚,参考 Decisions API 文档。 - 按置信度落地。高置信自动建工单并归队,低置信推人工,低概率高置信归无需处理。想把评论做成一个每天自动分拣的产品,可以参考评论数据产品化和应用评论分拣两篇。价格和额度见价格页。
参考资料
- Google,《Gemini Decisions API: Fast multimodal decisions》,2026-11-11,https://blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/
- Google AI Studio,《Decisions API》官方文档,2026-11,https://aistudio.google.com/docs/decisions-api
- Google AI Studio,Decisions API「noul(yes/no)」一节,https://aistudio.google.com/docs/decisions-api#noul
- Google AI Studio,Decisions API「choice(多选)」一节,https://aistudio.google.com/docs/decisions-api#choice
- Google AI Studio,Decisions API「score(评分)」一节,https://aistudio.google.com/docs/decisions-api#score
- Google AI Studio,Decisions API「confidence(置信度)」一节,https://aistudio.google.com/docs/decisions-api#confidence
- Google AI Studio,Decisions API「multiple questions」一节,https://aistudio.google.com/docs/decisions-api#multiple-questions
- Google AI Studio,Decisions API「best practices」一节,https://aistudio.google.com/docs/decisions-api#best-practices
- Google AI Studio,Decisions API「quickstart」一节,https://aistudio.google.com/docs/decisions-api#quickstart
- Google AI Studio,《Gemini Decision 1》模型页,2026-11,https://aistudio.google.com/docs/models/gemini-decision-1
- Google AI Studio,《Interactions API overview》,https://aistudio.google.com/docs/interactions-overview
- Google,《Gemini Developer API pricing》,2026-11,https://ai.google.dev/gemini-api/docs/pricing
- Google,《Gemini API rate limits》,https://ai.google.dev/gemini-api/docs/rate-limits
- Google,《Gemini API quickstart》,https://ai.google.dev/gemini-api/docs/quickstart
- Google,《Gemini API billing》,https://ai.google.dev/gemini-api/docs/billing
- Google,《Gemini API models》,https://ai.google.dev/gemini-api/docs/models
- EveryInfra,数据能力目录,2026-11-17 读,https://api.everyinfra.com/api/v1/social/catalog
- EveryInfra,Google 地图评论目录,https://api.everyinfra.com/api/v1/social/catalog?platform=google_maps_reviews
- EveryInfra,App Store 评论目录,https://api.everyinfra.com/api/v1/social/catalog?platform=app_store
- EveryInfra,Google Play 评论目录,https://api.everyinfra.com/api/v1/social/catalog?platform=google_play
- Model Context Protocol,Streamable HTTP 传输规范,2025-06-18,https://modelcontextprotocol.io/specification/2025-06-18/basic/transports
- Model Context Protocol,生命周期规范,2025-06-18,https://modelcontextprotocol.io/specification/2025-06-18/basic/lifecycle
- Claude Code,MCP 文档,https://code.claude.com/docs/en/mcp
- Claude Code,成本文档,https://code.claude.com/docs/en/costs
- Anthropic,定价页(字节与 token 的比例),https://platform.claude.com/docs/en/about-claude/pricing
- GitHub,
googleapis/python-genai,https://github.com/googleapis/python-genai - GitHub,
googleapis/js-genai,https://github.com/googleapis/js-genai - LangChain,Google 集成文档,https://docs.langchain.com/oss/python/integrations/providers/google
- LiteLLM,Gemini 提供方文档,https://docs.litellm.ai/docs/providers/gemini
- Pipecat,Google 分类器文档,https://docs.pipecat.ai/api-reference/server/classifiers/google
- LiveKit,Google 集成文档,https://docs.livekit.io/agents/integrations/google/
- Pydantic AI,Google 模型文档,https://pydantic.dev/docs/ai/models/google/
- OpenRouter,
google/gemini-decision-1,https://openrouter.ai/google/gemini-decision-1 - Vercel AI SDK,Google 提供方,https://ai-sdk.dev/providers/ai-sdk-providers/google
- OpenCode,https://opencode.ai/
- SiliconANGLE,《Google enters the decision model market with Gemini Decisions API》,2026-11-11,https://siliconangle.com/2026/11/11/google-enters-the-decision-market-with-gemini-decisions-api/
- VentureBeat,《Google's Gemini Decision 1 model scores up to 1,000 questions in one API call》,2026-11-11,https://venturebeat.com/technology/googles-gemini-decision-1-model-scores-up-to-1-000-questions-in-one-api-call
- Dataconomy,《Google Launches Gemini Decision 1 API For 1,000 Questions Per Call》,2026-11-12,https://dataconomy.com/2026/11/12/google-launches-gemini-decision-1-api-for-1000-questions/
- Tech Times,《Google Gemini Decisions API Cuts 20-Check Cost 16x...》,2026-11-13,https://www.techtimes.com/articles/330611/20261113/google-gemini-decisions-api-cuts-20-check-cost-16x-top-decision-model-passes-63-documents.htm
- MarkTechPost,《Google Launches Gemini Decisions API With Gemini Decision 1 at $0.10/M Tokens》,2026-11-11,https://www.marktechpost.com/2026/11/11/google-gemini-decisions-api-gemini-decision-1/
- Techzine,《Google introduces Gemini Decision 1 for AI decisions》,2026-11-11,https://www.techzine.eu/news/applications/145770/google-introduces-gemini-decision-1-for-ai-decisions/
- 36Kr,《Google Unveils Its First Decision-Making AI Model》,2026-11-11,https://eu.36kr.com/en/p/4066443558491008
- devops.com,《Google's Gemini 4 Hydrogen Turns Model Choice Into a Routing Decision》,2026-11-16,https://devops.com/googles-gemini-4-hydrogen-turns-model-choice-into-a-routing-decision
- YouTube,《Gemini Decision 1: Practice In Python》,2026-11-14,https://www.youtube.com/watch?v=rgBOfmtFWjQ
- YouTube,《Google's AI That Doesn't Write Text (Decisions API Tutorial)》,2026-11-13,https://www.youtube.com/watch?v=UwaJygCdFW8
- IETF,RFC 9110「HTTP Semantics」(429 与 Retry-After),https://www.rfc-editor.org/rfc/rfc9110
- Python 文档,
json标准库,https://docs.python.org/3/library/json.html - Google AI Studio,Decisions API 文档索引(llms.txt 与 coding agents),https://aistudio.google.com/docs/coding-agents
引用编号 BL-173