Databricks Genie Agent y Databricks Genie MCP: dos formas de sumar reseñas públicas
La documentación de Genie Agent lista 9 conectores MCP integrados. Guarda reseñas de Trustpilot, Google Play y Reddit en Delta por 0,003334 USD al día.
Databricks lanzó la segunda generación de Genie el 11 de noviembre de 2026. Tus tablas de ventas y de tickets ya viven en Unity Catalog. ¿Cómo puede Genie ver también lo que los clientes dicen en público en Trustpilot, Google Play y Reddit?
Leímos el comunicado oficial de Databricks, sus blogs y la documentación de noviembre. Después llamamos a las capacidades de EveryInfra para una marca pública, HelloFresh, en tres rondas el 14 de noviembre. Este artículo da dos rutas que funcionan hoy, un diseño de tabla, un método para quitar duplicados y el coste diario. No ejecutamos nada en un espacio de trabajo de Databricks. Todo el SQL y los pasos de Databricks llevan la etiqueta «ejemplo de configuración».
Qué lanzó Databricks con el nuevo Genie el 11 de noviembre
Databricks presentó la segunda generación de Genie en un comunicado de prensa del 11 de noviembre de 2026. El texto describe a Genie como un agente empresarial siempre activo y autónomo. Le das un objetivo y Genie divide el trabajo, reparte tareas entre subagentes y pide los datos que faltan. Cuando necesita una decisión, te avisa en una bandeja de prioridades o por correo.
El apartado de disponibilidad del comunicado dice lo siguiente: Genie y Genie Ontology están disponibles de forma general para todos los clientes. Genie Search, Ontology Manager y el nuevo Genie siempre activo llegarán «pronto a programas de vista previa y beta». Por eso, el 14 de noviembre lo que puedes usar en un espacio de trabajo normal es el chat de Genie One, los Genie Agents (antes Genie Spaces) y el servidor MCP de Genie One. La capa de tareas siempre activas necesita una plaza en la vista previa.
Esta diferencia importa al planificar. Un diseño que depende de una tarea larga de Genie es un diseño para el próximo trimestre. Un diseño que usa tablas, trabajos programados y Genie Agents funciona hoy.
El blog de producto del mismo día añade dos detalles útiles para este caso. Primero, una tarea larga de Genie puede ejecutarse según un calendario o arrancar con un disparador. El ejemplo del blog es que una métrica baje o que más de 10 clientes pidan la misma función. Segundo, Genie usa conectores MCP integrados para Slack, Jira y GitHub, y llega a otros sistemas «mediante MCP personalizado». Ojo: el blog habla del nuevo Genie siempre activo, que aún no está abierto. Lo que un Genie Agent puede conectar hoy lo dice la documentación de Genie Agents que citamos más abajo.
Elegimos HelloFresh como marca pública para las pruebas. Tiene bastante contenido público en Trustpilot, Google Play y Reddit para comparar tres tipos de fuente. HelloFresh no tiene relación comercial con EveryInfra. Solo usamos reseñas y publicaciones que cualquiera puede ver.
| Elemento | Qué dice la fuente | Estado el 14 nov | Fuente |
|---|---|---|---|
| Genie de segunda generación (siempre activo) | Recibe un objetivo, divide el trabajo, usa subagentes, bandeja y correo | Llegará a vista previa y beta | Comunicado, 11 nov |
| Genie, Genie Ontology | Capa de contexto con definiciones, métricas, personas y procesos | Disponible de forma general | Comunicado, 11 nov |
| Genie Search | Más de 100 fuentes; consulta apps en vivo vía MCP | Llegará a vista previa y beta | Comunicado, 11 nov |
| MCP de Genie One | Expone Genie a agentes externos como servicio MCP | Disponible de forma general desde el 22 sep | Blog y documentación de Databricks |
| Conectores MCP en Genie Agents | El modo Agent llama a conectores integrados | Beta; el administrador lo activa en Previews | Documentación |
| Servicios MCP personalizados (MCP externo) | Se registran en Unity Gateway y se usan en Genie One | Documentado | Documentación |
Databricks Genie MCP significa tres cosas distintas
En la documentación oficial, «databricks genie mcp» abarca tres configuraciones distintas. Una abre Genie a agentes externos. Las otras dejan que Genie llame a servicios externos. Hay que elegir la correcta antes de conectar datos externos.
La primera ruta convierte a Genie en un servidor MCP al que llaman otros agentes. La documentación del servidor MCP de Genie One da esta dirección: https://<workspace-hostname>/ai-gateway/mcp-services/system.ai.genie_one_mcp?o=<workspace-id>. Quien llama necesita EXECUTE sobre system.ai.genie_one_mcp, un objeto protegible de tipo mcp_service. Las herramientas son genie_ask, genie_poll_response y genie_get_query_result, más view_ask en clientes que admiten MCP Apps.
El anuncio de disponibilidad general del 22 de septiembre de 2026 dice que agentes como Claude, ChatGPT y Cursor pueden tratar a Genie como un compañero que conoce los datos. La documentación añade que el antiguo punto de acceso beta /api/2.0/mcp/genie deja de funcionar el 30 de noviembre de 2026. Esta ruta responde a «cómo preguntan los agentes externos por los datos de Databricks». No trae datos de fuera.
La segunda ruta permite que Genie One llame a un servidor MCP externo. La documentación de aplicaciones externas de Genie One enumera tres tipos de servidor: conectores integrados de Databricks, servidores MCP de Databricks Marketplace y «servicios MCP personalizados» que tu organización registra en Unity Catalog. La página de servidores MCP externos explica los pasos.
El servidor debe admitir el transporte Streamable HTTP. En Unity Gateway abres MCPs, eliges «Connect an existing MCP server» y creas una conexión HTTP con la URL y las credenciales. El MCP remoto de EveryInfra en https://api.everyinfra.com/mcp usa Streamable HTTP con una clave en la cabecera Authorization: Bearer. Eso coincide con «Bearer token», el primero de los cinco tipos de autenticación de la página de conexiones HTTP.
La tercera ruta permite que los Genie Agents llamen a conectores en modo Agent. La página de MCP para Genie Agents muestra como fecha de actualización el 9 de noviembre de 2026. Marca la función como beta. Un administrador debe activar «MCP tools in Genie Agents» en la página Previews.
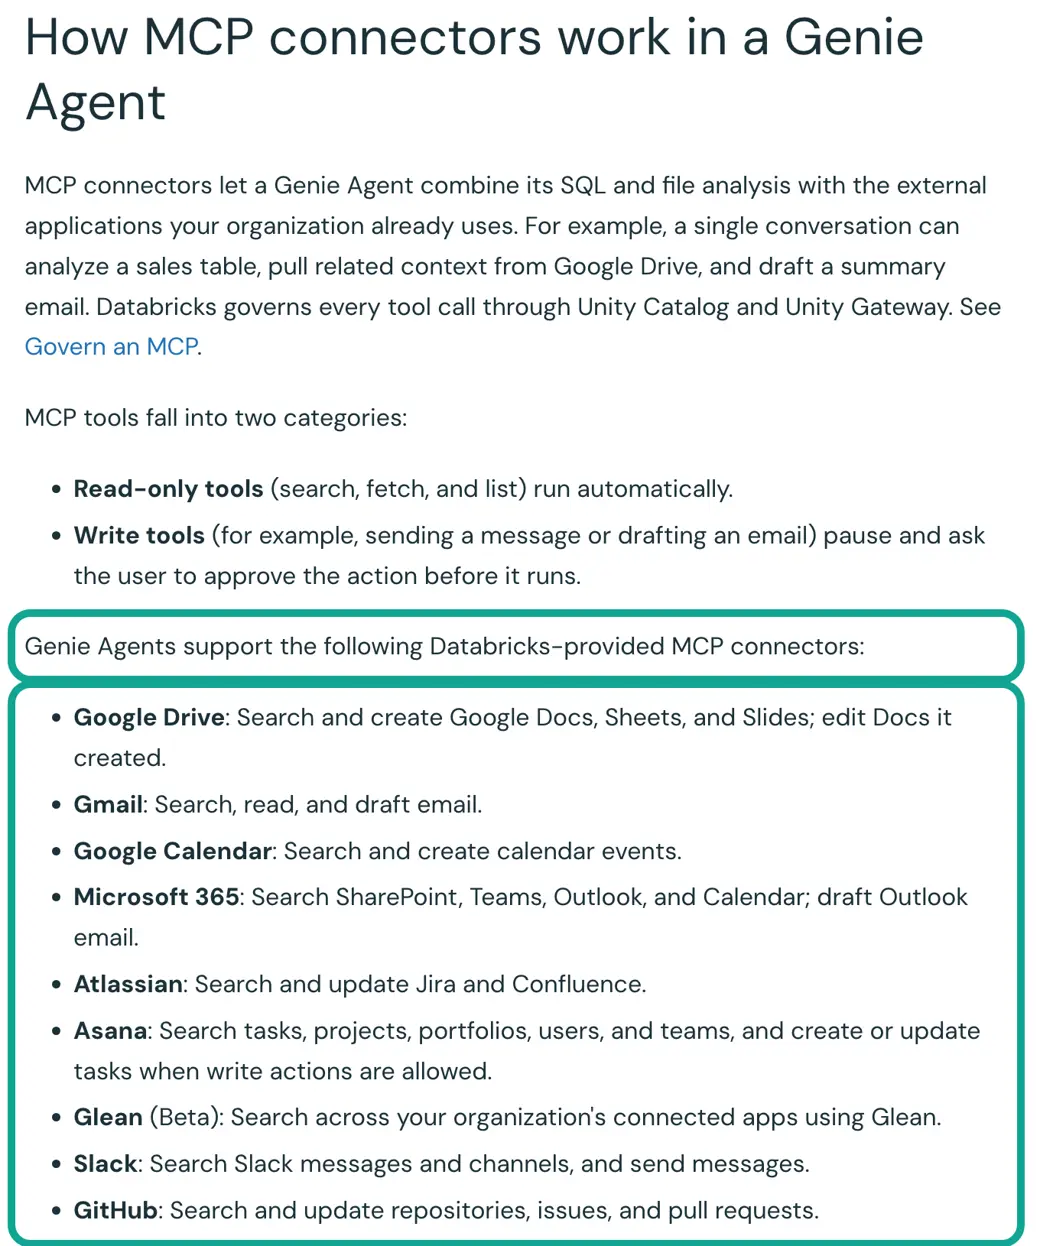
La página enumera nueve conectores: Google Drive, Gmail, Google Calendar, Microsoft 365, Atlassian, Asana, Glean, Slack y GitHub. Los nueve vienen de Databricks. La documentación enumera estos 9 conectores integrados y no menciona servicios MCP personalizados (leída el 14 de noviembre de 2026). Las notas de versión del 12 de noviembre añaden una sección propia de conectores (beta) en la configuración del agente. Esta parte todavía cambia, así que revisa la página otra vez antes de montar nada.
| Ruta | Sentido | Quién la añade | ¿Entran datos de fuera? | Estado |
|---|---|---|---|---|
MCP de Genie One (system.ai.genie_one_mcp) | Un agente externo llama a Genie | Usuario o entidad de servicio con EXECUTE | No; solo envía respuestas | Disponible de forma general |
| Genie One + servicio MCP personalizado | Genie One llama a un servidor externo | Lo registra alguien con CREATE SERVICE; los usuarios lo añaden desde Browse connectors | Sí, en vivo | Documentado |
| Genie Agents + conectores MCP | El Genie Agent llama a conectores integrados | Quien crea el agente, en Sources | La documentación enumera nueve integrados y no menciona el MCP personalizado | Beta |
Fuente mcp en ai_enrich | Una función SQL llama a una herramienta MCP externa por fila | Quien escribe el SQL | Sí, fila a fila | Documentado; requiere Databricks Runtime 18.2 o superior |
La función ai_enrich puede usar un MCP externo registrado como fuente de conocimiento y generar columnas nuevas por fila. Exige una credencial compartida, como una clave del proveedor usada como bearer token, porque la función no puede mostrar una pantalla de inicio de sesión. También avisa de que la consulta creada con cada fila se envía al proveedor externo. Sirve para «añadir un dato externo a cada fila de una tabla de marcas». No sirve para un trabajo que recoge reseñas nuevas cada día.
Por qué las reseñas públicas van junto a tus tablas de ventas
Tus tablas de ventas, devoluciones y tickets registran lo que hicieron tus clientes. Trustpilot, Google Play y Reddit registran lo que dicen en público. Parte de esas personas nunca escribe a tu soporte. Si las dos cosas están en el mismo Unity Catalog, Genie puede cruzarlas. Un ejemplo: «las reseñas de 1 estrella que hablaban de la carne la semana pasada, ¿aparecen también en los tickets de reembolso de esa semana?».
La página de conceptos de Genie Agents dice que un Genie Agent trabaja con tablas, vistas, vistas de métricas y vistas materializadas de Unity Catalog, y que su SQL es de solo lectura. La página de configuración fija un máximo de 50 tablas por agente. La guía de buenas prácticas recomienda cinco o menos. Las reseñas públicas ocupan entre una y tres de esas plazas.
También vimos los vídeos de YouTube mejor situados para esta búsqueda. Un autor dice que «aquí puedes conectar hasta 30 tablas» mientras crea un Genie Agent. La documentación de noviembre dice 50, así que seguimos la documentación. Una demo oficial de Databricks muestra que un servidor MCP externo se guarda en Unity Catalog como conexión HTTP y que también se puede instalar desde Marketplace. El paso 1 de la ruta 1 crea justo ese tipo de conexión HTTP.
Prueba real: tres sitios y tres rondas para HelloFresh
El diseño de la tabla y el horario dependen de datos reales. Así que, antes de escribir configuración, hicimos tres rondas de llamadas para HelloFresh. Cada ronda llamó a tres capacidades. trustpilot/reviews leyó hellofresh.com, por lo más nuevo, 50 filas. google_play/reviews leyó la app Android com.hellofresh.androidapp, por lo más nuevo, 100 filas. reddit/subreddit_posts leyó r/hellofresh, por lo más nuevo, 50 publicaciones.
Cada ronda hizo además una búsqueda global con reddit/search para la palabra «HelloFresh». Las rondas fueron a las 13:08, 13:28 y 13:48 hora de Singapur del 14 de noviembre. La última llamada fue a las 13:49, unos 41 minutos después de la primera.
La ronda T1 es la carga completa. T2 y T3 solo cuentan ID que ninguna ronda anterior devolvió. Quitamos duplicados por plataforma más ID, la misma regla que dedupe_key en la tabla Delta.
| Ronda (hora de Singapur) | Capacidad | Devueltas esta vez | ID nuevos | ID conocidos con cambios | `charged_usd` |
|---|---|---|---|---|---|
| T1 13:08 | trustpilot/reviews | 50 | — | — | 0,001389 USD |
| T1 13:10 | google_play/reviews | 100 | — | — | 0,001389 USD |
| T1 13:11 | reddit/subreddit_posts | 50 | — | — | 0,000556 USD |
| T1 13:08 | reddit/search | 2 | — | — | 0,000792 USD |
| T2 13:28 | trustpilot/reviews | 50 | 0 | 0 | 0,001389 USD |
| T2 13:28 | google_play/reviews | 100 | 0 | 0 | 0,001389 USD |
| T2 13:28 | reddit/subreddit_posts | 50 | 0 | 0 | 0,000556 USD |
| T2 13:28 | reddit/search | 2 | 0 | 1 | 0,000792 USD |
| T3 13:48 | trustpilot/reviews | 50 | 0 | 0 | 0,001389 USD |
| T3 13:48 | google_play/reviews | 100 | 0 | 0 | 0,001389 USD |
| T3 13:49 | reddit/subreddit_posts | 50 | 0 | 0 | 0,000556 USD |
| T3 13:48 | reddit/search | 1 | 0 | 1 | 0,000792 USD |
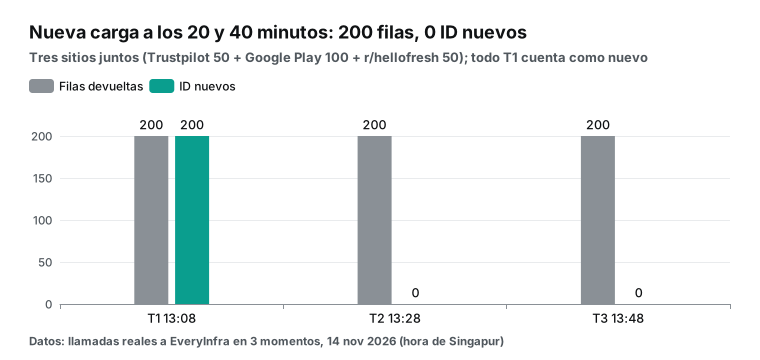
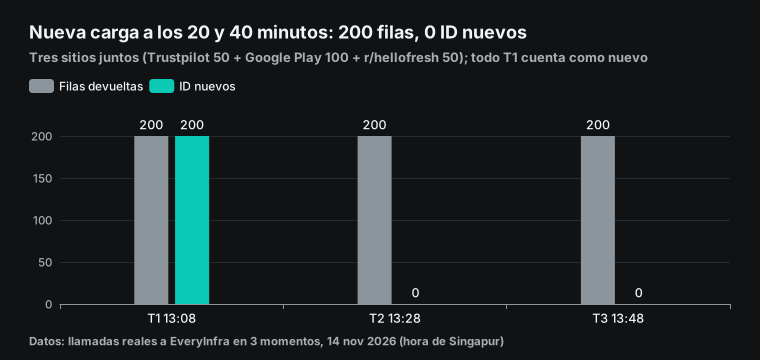
A las 13:28 y a las 13:48, Trustpilot, Google Play y r/hellofresh devolvieron 0 ID nuevos. Devolvieron las mismas filas que T1, y ninguna fila conocida de esos tres sitios cambió. Esto encaja con los ritmos de arriba. Trustpilot recibe unas 7,4 reseñas al día, es decir, una nueva cada tres horas más o menos. La reseña más nueva de Trustpilot en T1 se publicó a las 02:19 UTC, tres horas y media antes de T3.
Solo cambió reddit/search. En T2, una publicación tenía otro número de «me gusta». En T3 la llamada devolvió 1 fila esta vez, y esa publicación tenía nuevos «me gusta» y comentarios. En los datos públicos, lo que más cambia son los contadores de interacción. Por eso el MERGE debe actualizar like_count y comment_count. Pero esas columnas no justifican cargar más a menudo.
El nivel de interacción cambia mucho según la fuente. Solo 9 de las 100 reseñas de Google Play tenían thumbs_up mayor que 0, y la que más tenía sumaba 5. Las 50 publicaciones de r/hellofresh tenían una mediana de 7,5 «me gusta», y la primera llegaba a 78. Los «me gusta» de Google Play casi no distinguen unas reseñas de otras. Si alguien pregunta «qué reseña tuvo más apoyo», indica a Genie en el comentario de la columna que ordene por «me gusta» solo las publicaciones de Reddit.
La mediana del tiempo de respuesta fue de 12,2 segundos (n=12: las 12 llamadas de la tabla anterior, cuatro capacidades). En el chat de Genie One significa que el usuario espera más de diez segundos antes de que Genie tenga los datos y empiece a responder.
El tamaño de la respuesta también cuenta en el chat. En T1, 50 filas de trustpilot/reviews ocupaban 71 697 bytes, unos 1,4 KB por fila. 100 filas de google_play/reviews ocupaban 71 202 bytes, unos 0,7 KB por fila. 50 filas de reddit/subreddit_posts ocupaban 38 531 bytes, unos 0,8 KB por fila. La llamada MCP de las 13:29 solo pidió 10 reseñas de Trustpilot de 1 o 2 estrellas, y la respuesta ocupó 16 447 bytes.
| Llamada | Filas devueltas | Bytes | Bytes por fila (aprox.) |
|---|---|---|---|
trustpilot/reviews, T1 | 50 | 71 697 | 1434 |
google_play/reviews, T1 | 100 | 71 202 | 712 |
reddit/subreddit_posts, T1 | 50 | 38 531 | 771 |
trustpilot/reviews con stars, MCP a las 13:29 | 10 | 16 447 | 1645 |
Una regla aproximada para texto en inglés es 4 bytes por token. Con esa estimación, 50 reseñas de Trustpilot ocupan más de diez mil tokens de contexto en una sola llamada. Para preguntas en vivo, usa un limit pequeño y filtra antes con stars. Para historia y tendencias, usa la ruta de la tabla.
Cómo es cada fuente
Todos los números siguientes salen de las tres rondas sin duplicados por ID. La muestra es una marca en un día y no describe a un sector.
De las 50 reseñas de Trustpilot, 43 tenían verification_level igual a invited y source igual a InvitationLinkApi. La empresa pidió a esos clientes que escribieran mediante un enlace de invitación. Las otras 7 tenían not-verified y Organic. Esos clientes llegaron a Trustpilot por su cuenta. El artículo de ayuda de Trustpilot sobre etiquetas marca las reseñas de la Invitation Link API como «Invited» y las espontáneas como «Unprompted review». La página pública muestra los dos tipos con etiquetas distintas.
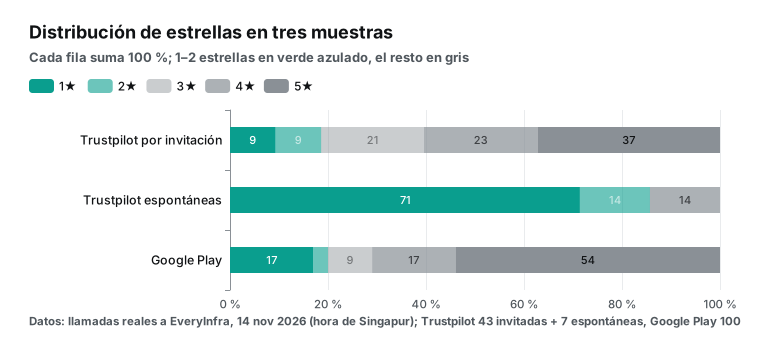
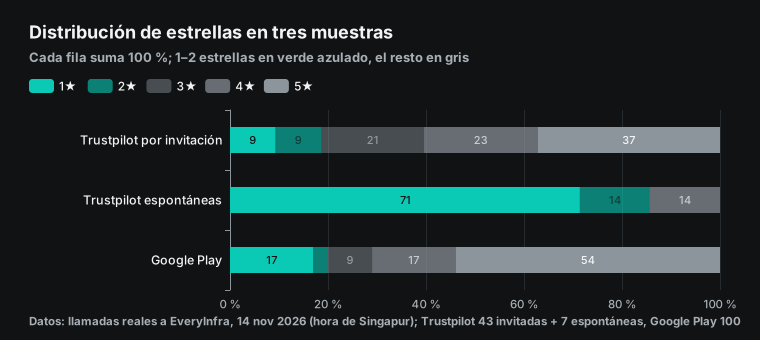
En esta muestra, las puntuaciones de los dos grupos están muy lejos. De las 7 espontáneas, 6 tenían 1 o 2 estrellas, un 85,7 %. De las 43 invitadas, solo 8 tenían 1 o 2 estrellas, un 18,6 %. A las 13:29 usamos MCP para pedir las 10 reseñas más nuevas de 1 o 2 estrellas. Cinco eran espontáneas y cinco invitadas, aunque las espontáneas eran solo 7 de las 50 más nuevas. Si un Genie Agent promedia puntuaciones sin esta división, las invitadas tapan las quejas espontáneas.
En una escala de 1 a 5, las 43 invitadas tienen una media de 3,70 estrellas y las 7 espontáneas, de 1,57. Las 50 juntas dan 3,40. Solo una espontánea tenía 4 estrellas y ninguna tenía 5.
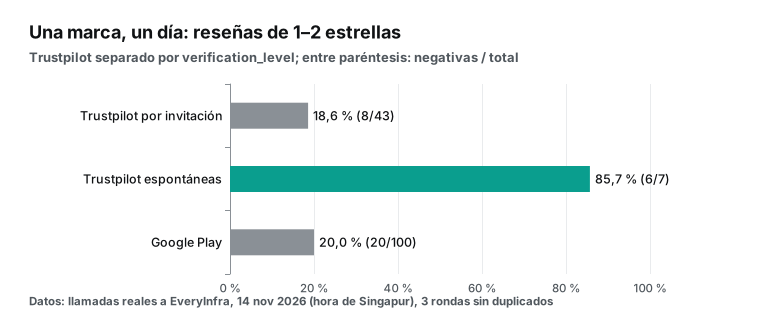
La velocidad de respuesta también cambia. HelloFresh respondió a 42 de las 50 reseñas de Trustpilot. La mediana entre reseña y respuesta fue de 22,1 horas. Por tipo, 38 de las 43 invitadas recibieron respuesta, con una mediana de 22,3 horas, y 4 de las 7 espontáneas, con una mediana de 17,3 horas. Cuatro valores solo dan el orden de magnitud.
En Google Play, el desarrollador respondió a 23 de 100 reseñas, con una mediana de 0,8 horas. De esas 23 respuestas, 11 fueron a reseñas de 1 o 2 estrellas. Respondió a 10 de las 17 reseñas de 1 estrella, pero solo a 4 de las 54 de 5 estrellas. Google Play responde menos, pero rápido; Trustpilot responde casi siempre, pero al día siguiente. Por eso el MERGE debe actualizar filas conocidas: la mayoría de las respuestas de Trustpilot aparecen un día después de que la reseña ya esté en la tabla.
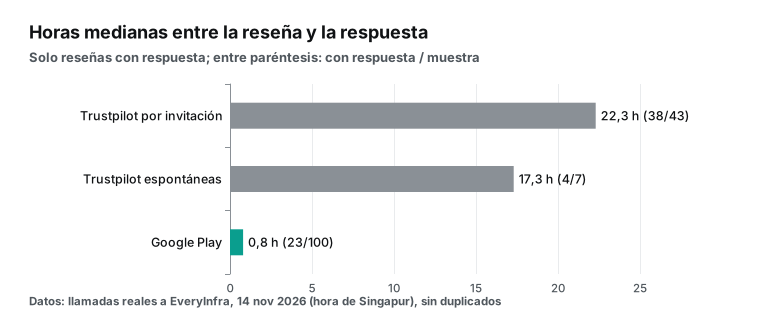
La tasa de respuesta por estrellas muestra hábitos opuestos en las dos plataformas. En Trustpilot, 26 de las 27 reseñas de 4 o 5 estrellas tuvieron respuesta, pero solo 10 de las 14 de 1 o 2 estrellas. En Google Play, 11 de las 20 reseñas de 1 o 2 estrellas tuvieron respuesta (55 %), y solo 8 de las 71 de 4 o 5 estrellas (11 %). La tasa total deja a Trustpilot mucho mejor, 84 % frente a 23 %. Pero ante la pregunta «¿alguien contesta las quejas?», la distancia es mucho menor. Añade «tasa de respuesta a reseñas negativas» como pregunta de referencia propia en el Genie Agent.
| Plataforma | 1–2 estrellas: con respuesta / total | 4–5 estrellas: con respuesta / total | Todas: con respuesta / total |
|---|---|---|---|
| Trustpilot | 10 / 14 | 26 / 27 | 42 / 50 |
| Google Play | 11 / 20 | 8 / 71 | 23 / 100 |
Por score, las 100 reseñas de Google Play tenían 54 de 5 estrellas, 17 de 4, 9 de 3, 3 de 2 y 17 de 1. Las de 1 o 2 estrellas sumaban un 20 %. 85 de las 100 venían de cuatro versiones de la app, de la 26.42 a la 26.45, y 15 de las 20 negativas también.
| `app_version` | Filas en esta muestra | 1–2 estrellas | Porcentaje negativo |
|---|---|---|---|
| 26.42 | 28 | 4 | 14 % |
| 26.44 | 25 | 6 | 24 % |
| 26.45 | 17 | 3 | 18 % |
| 26.43 | 15 | 2 | 13 % |
| Resto (15 filas) | 15 | 5 | — |
Cada versión tiene solo entre 15 y 28 filas, así que estas diferencias no prueban que una versión sea peor. Para ver una tendencia por versión, acumula unas semanas de datos en la tabla. Por eso app_version es una columna propia y no va en extra: cuando Genie agrupa por versión, necesita una columna normal con su comentario.
Las reseñas negativas también son más largas. Medimos la mediana de la longitud del texto en caracteres. Las 14 reseñas de Trustpilot con 1 o 2 estrellas tienen 206,5 caracteres y las 27 con 4 o 5 estrellas, 102. En Google Play, las 20 negativas tienen 162,5 y las 71 de 4 o 5 estrellas, 63. El texto negativo es entre dos y dos veces y media más largo. La llamada MCP de las 13:29 lo confirma: sus 10 reseñas negativas ocupaban unos 1,6 KB por fila, más que los 1,4 KB por fila del lote mixto de T1. Si pides reseñas negativas en el chat, baja todavía más el limit.
Las 50 publicaciones de r/hellofresh no tienen estrellas. La señal está en flair y comment_count. 22 publicaciones no tenían flair, 13 tenían «United States», 8 «Question» y 4 «Picture». Reddit responde a «qué preguntan los clientes», como cancelar, zonas de reparto o cómo cocinar un plato. No lo promedies con las estrellas de las reseñas.
La conversación está concentrada. La mediana es de 4 comentarios por publicación. Las 3 publicaciones con más comentarios tenían 79, 43 y 27, en total 149, el 32,9 % de los 453 comentarios. Un resumen diario que liste las publicaciones más comentadas cubre así un tercio de la conversación.
| Fuente | Muestra | 1–2 estrellas | Con respuesta | Mediana de respuesta | Útil para |
|---|---|---|---|---|---|
trustpilot/reviews (invitadas) | 43 filas | 8 | 38 | 22,3 horas | Satisfacción general de compradores |
trustpilot/reviews (espontáneas) | 7 filas | 6 | 4 | 17,3 horas (4 valores) | Qué dicen quienes se quejan por su cuenta |
google_play/reviews | 100 filas | 20 | 23 | 0,8 horas | Problemas de versión y funciones |
reddit/subreddit_posts | 50 publicaciones | Sin estrellas | Ninguna | Ninguna | Qué preguntan y comentan los clientes |
Diseño de tabla: una tabla Delta para los tres sitios
Las tres fuentes usan nombres de campo distintos. La puntuación se llama rating en Trustpilot y score en Google Play. Los «me gusta» se llaman thumbs_up en Google Play y like_count en las otras dos. Con una tabla por fuente, un Genie Agent tendría que escribir tres bloques UNION para responder «cuántas reseñas de 1 o 2 estrellas tuvimos la semana pasada en todos los canales». Eso duplica las ocasiones de escribir mal la consulta.
Por eso usamos una sola tabla ancha. Los campos comunes son columnas y los campos que solo tiene una fuente van a una columna VARIANT. Las tres columnas de la derecha muestran el nombre del campo en response_fields del catálogo. Un guion significa que esa fuente no tiene el campo. Un script comparó cada campo de este mapa con response_fields del catálogo el 14 de noviembre y no encontró diferencias.
| Columna Delta | `trustpilot/reviews` | `google_play/reviews` | `reddit/subreddit_posts` |
|---|---|---|---|
source_id | id | id | id |
url, title, text | mismo nombre | mismo nombre | mismo nombre |
rating | rating (1–5) | score (1–5) | — |
like_count | like_count | thumbs_up | like_count |
comment_count | — | — | comment_count |
reply_text, reply_at | mismo nombre (respuesta de la empresa) | mismo nombre (respuesta del desarrollador) | — |
posted_at | posted_at | posted_at | posted_at |
updated_at, experience_at | mismo nombre | — | — |
language | language | language | — |
country, verification_level, review_source | country, verification_level, source | — | — |
app_version | — | app_version | — |
community, flair | — | — | community, flair |
author_hash | hash de author_name | hash de author_name | hash de author_username |
Del autor solo guardamos un hash. Muchos compañeros leerán las respuestas de Genie. El nombre de quien escribe la reseña no aporta nada al análisis y sí añade una tarea de privacidad. El hash sigue permitiendo contar cuántas publicaciones hace cada persona. Descartamos las URL de avatar (author_image, author_avatar_url). Añadimos tres columnas propias: dedupe_key (fuente más ID original, por ejemplo trustpilot:6af7a918…), snapshot_ts (momento de la llamada) e ingested_at (momento de la escritura).
-- Ejemplo de configuración: tabla destino en Unity Catalog (no ejecutado en Databricks)
CREATE TABLE IF NOT EXISTS main.voice.public_brand_reviews (
  dedupe_key         STRING NOT NULL COMMENT 'fuente:id_original, p. ej. trustpilot:6af7...; clave de MERGE',
  source             STRING NOT NULL COMMENT 'capacidad de EveryInfra: trustpilot/reviews, google_play/reviews, reddit/subreddit_posts',
  brand              STRING NOT NULL COMMENT 'marca, p. ej. hellofresh',
  source_id          STRING NOT NULL,
  url STRING, title STRING, text STRING,
  rating             INT    COMMENT '1-5 estrellas; NULL en Reddit',
  like_count         INT, comment_count INT,
  reply_text         STRING COMMENT 'respuesta de la empresa o del desarrollador; NULL = sin respuesta',
  reply_at           TIMESTAMP,
  posted_at          TIMESTAMP NOT NULL,
  updated_at         TIMESTAMP, experience_at TIMESTAMP,
  language STRING, country STRING,
  verification_level STRING COMMENT 'Trustpilot: invited = pedida por la empresa, not-verified = espontanea',
  review_source STRING, app_version STRING, community STRING, flair STRING,
  author_hash        STRING COMMENT 'sha256(nombre del autor); no se guarda el nombre',
  extra              VARIANT COMMENT 'resto de campos de la fuente',
  snapshot_ts        TIMESTAMP NOT NULL,
  ingested_at        TIMESTAMP NOT NULL
) CLUSTER BY (brand, source, posted_at)
COMMENT 'Resenas y publicaciones publicas, sin duplicados por dedupe_key, MERGE diario';
CLUSTER BY usa el clustering líquido de Delta. La mayoría de las consultas que escribe Genie filtran por marca, fuente y fecha, así que agrupar por esas tres columnas reduce los datos que lee cada consulta. Escribe comentarios de columna claros. La guía de buenas prácticas de Genie Agents pone las descripciones de tablas y columnas en Unity Catalog en primer lugar entre los factores de precisión. La columna verification_level necesita el comentario más claro, por motivos que la sección «Cómo es cada fuente» muestra con números.
Incremento diario: marca de agua y ventana de revisión
Ninguna de las tres fuentes acepta «dame las reseñas posteriores a esta fecha». trustpilot/reviews tiene un parámetro date, pero solo admite ventanas relativas como last7days o last30days. google_play/reviews y reddit/subreddit_posts ordenan por lo más reciente y devuelven las últimas N filas. Así que el incremento lo construyes tú. Guarda una marca de agua por fuente: el posted_at más reciente que viste la vez anterior. En cada ejecución, pide un lote ordenado por lo más nuevo, quita duplicados por dedupe_key y haz MERGE en la tabla.
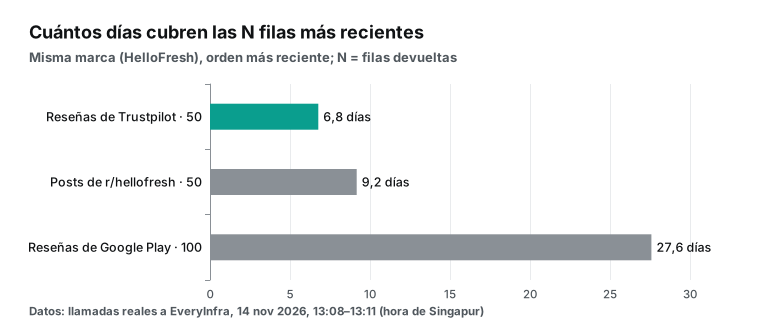
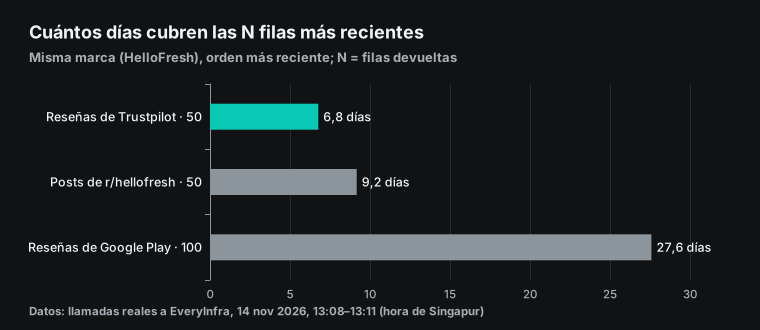
Cuántas filas pedir depende de la velocidad de cada fuente. En la ronda T1, las 50 reseñas más nuevas de Trustpilot cubrían 6,77 días. Las 100 más nuevas de Google Play cubrían 27,59 días. Las 50 publicaciones más nuevas de r/hellofresh cubrían 9,17 días. A ese ritmo, un trabajo diario ve unas 7,4 reseñas de Trustpilot, 3,6 de Google Play y 5,5 publicaciones al día. Un limit de 50 deja varias veces de margen.
Hay una comprobación simple para detectar huecos. Si el posted_at más antiguo del lote sigue siendo posterior a la marca de agua, el lote no llegó lo bastante atrás. En ese caso, pide la página siguiente (Google Play devuelve next_page_token) o sube limit.
| Sitio | Filas por llamada | Días que cubren | Filas nuevas al día (aprox.) | Frecuencia sugerida |
|---|---|---|---|---|
trustpilot/reviews | 50 | 6,77 | 7,4 | Diaria |
google_play/reviews | 100 | 27,59 | 3,6 | Diaria |
reddit/subreddit_posts | 50 | 9,17 | 5,5 | Diaria |
No pongas la marca de agua demasiado estricta. Una reseña de Trustpilot tiene dos fechas, posted_at y updated_at. La primera reseña de T1 tiene posted_at a las 02:19:36 UTC y updated_at a las 02:49:31 UTC. Su autor la editó media hora después de publicarla. Las respuestas de la empresa también llegan después. Si solo insertas los ID más nuevos que la marca de agua, pierdes las respuestas y ediciones posteriores de reseñas antiguas.
Por eso el MERGE tiene dos ramas. Las dedupe_key nuevas se insertan. Las conocidas solo se actualizan si cambió la respuesta, el texto o los «me gusta». La documentación de MERGE en Delta hace dos avisos. Primero, quita los duplicados del propio lote de origen, o todas las filas repetidas del lote se insertarán. Segundo, una condición de fecha reduce la búsqueda de duplicados. Dónde va esa condición importa, como explica la nota tras el código.
-- Ejemplo de configuración: escritura incremental diaria (la tabla staging la llena el trabajo de abajo)
MERGE INTO main.voice.public_brand_reviews AS t
USING (
  SELECT * FROM main.voice.public_brand_reviews_staging
  WHERE posted_at > current_timestamp() - INTERVAL 60 DAYS   -- ventana en el lado del origen
  QUALIFY ROW_NUMBER() OVER (PARTITION BY dedupe_key ORDER BY snapshot_ts DESC) = 1
) AS s
ON t.dedupe_key = s.dedupe_key                                -- coincidencia solo por la clave
WHEN MATCHED AND (t.reply_text IS DISTINCT FROM s.reply_text
               OR t.text IS DISTINCT FROM s.text
               OR t.like_count IS DISTINCT FROM s.like_count) THEN
  UPDATE SET t.reply_text = s.reply_text, t.reply_at = s.reply_at, t.text = s.text,
             t.like_count = s.like_count, t.updated_at = s.updated_at, t.snapshot_ts = s.snapshot_ts
WHEN NOT MATCHED THEN INSERT *;
La ventana de 60 días sale de los datos de Google Play: las 100 filas más nuevas cubrían 27,59 días y lo doblamos para tener margen.
Esa condición de fecha va en la subconsulta USING, sobre los datos de staging, y no en ON. Si la pones en ON, una reseña de hace más de 60 días que llega en staging no coincide con su fila de la tabla. El MERGE la trata como NOT MATCHED y la inserta otra vez cada día, así que la tabla acaba con filas duplicadas. Una fuente con poco movimiento puede devolver reseñas así de antiguas en su página más reciente. Con la condición en el lado del origen, esas reseñas no entran en la fusión y su fila existente se queda como está. Aquí no tratamos las reseñas borradas. Con una sola página ordenada por lo más nuevo, «no aparece en esta página» no significa «borrada».
Varios trabajos escribiendo en la misma tabla
Un trabajo para una marca es sencillo. Pronto marketing añade competidores y soporte añade sus líneas de producto. Entonces cinco o seis trabajos escriben en public_brand_reviews en la misma hora. La documentación de Databricks sobre niveles de aislamiento y conflictos de escritura lo dice sin rodeos. Cuando varios trabajos o usuarios escriben a la vez en la misma tabla, algunas escrituras pueden fallar con una excepción de conflicto. Tampoco lo probamos en Databricks: lo que sigue es un ejemplo de configuración.
| Regla de la documentación | Qué hacemos en esta tabla |
|---|---|
| La concurrencia por filas exige Databricks Runtime 14.3 LTS o superior | Ejecutar los trabajos en 14.3 LTS o superior |
| La concurrencia por filas exige una tabla sin particiones | Usar clustering líquido, no particiones |
| La concurrencia por filas exige vectores de borrado | Activarlos una vez, sin trabajos en marcha |
Los filtros explícitos en la condición del MERGE separan los archivos | Añadir t.brand = '<marca>' a la cláusula ON |
| Solo falla la operación que lee los datos cambiados | Poner el reintento en el paso MERGE |
| Las tablas con columnas de identidad no admiten transacciones concurrentes | Usar la cadena dedupe_key, no una columna de identidad |
| Los cambios de metadatos pueden hacer fallar todas las escrituras en curso | Guardar los campos nuevos de cada sitio en extra (VARIANT) |
La página de concurrencia por filas enumera tres condiciones: Databricks Runtime 14.3 LTS o superior, sin particiones y con vectores de borrado. Si se cumplen las tres, dos MERGE en paralelo que cambian filas distintas del mismo archivo se resuelven sin conflicto. Nuestra tabla ya no tiene particiones. Los vectores de borrado se activan con un ALTER TABLE. Esa sentencia es en sí un cambio de metadatos, así que ejecútala una vez al crear la tabla, sin trabajos en marcha.
-- Ejemplo de configuracion: una sola vez tras CREATE TABLE, fuera del horario de trabajos
ALTER TABLE main.voice.public_brand_reviews SET TBLPROPERTIES ('delta.enableDeletionVectors' = true);
-- En el MERGE de cada marca, anade la marca a la condicion:
--   ON t.brand = 'hellofresh' AND t.dedupe_key = s.dedupe_key
-- El filtro de 60 dias va en la subconsulta USING sobre staging, no en ON.
Da a cada marca su propia tabla staging, por ejemplo public_brand_reviews_staging_hellofresh. Así el INSERT OVERWRITE de un trabajo no borra filas que otro trabajo aún no ha fusionado. El paso de la API ya tiene sus reintentos y su clave de idempotencia, así que repetir no cobra dos veces. Si falla el MERGE, espera unos segundos y ejecuta la misma sentencia otra vez; los datos de staging siguen ahí. Los lectores también están a salvo. La documentación dice que un lector ve una instantánea coherente desde el inicio de su consulta. Una consulta del Genie Agent durante un trabajo no ve datos a medio escribir.
Ruta 1: preguntar en vivo en Genie One mediante el MCP remoto (ejemplo de configuración)
Esta ruta sirve para preguntas puntuales. Una responsable de producto pregunta en Genie One: «¿de qué tratan las 10 reseñas más recientes de 1 y 2 estrellas de HelloFresh en Trustpilot?». Genie llama en ese momento a una herramienta de EveryInfra y recibe los datos. No se escribe nada en una tabla. No ejecutamos estos pasos en un espacio de trabajo de Databricks. Siguen la documentación de servidores MCP externos, actualizada el 27 de octubre de 2026.
El paso 1 es guardar la clave en una conexión HTTP de Unity Catalog. La documentación de conexiones HTTP muestra un SQL que lee el bearer token desde un ámbito de secretos. Así la clave no aparece en el código de nadie. La documentación añade que el token solo se envía al nombre de host configurado en la conexión.
-- Ejemplo de configuración: primero guarda la clave en el ámbito de secretos "everyinfra"
CREATE CONNECTION everyinfra_mcp TYPE HTTP
OPTIONS (
  host 'https://api.everyinfra.com',
  port '443',
  base_path '/mcp',
  bearer_token secret('everyinfra', 'api_key')
);
El paso 2 es registrar el servidor. En Unity Gateway, abre MCPs y pulsa «+ MCP». Elige «Connect an existing MCP server». Escoge un catálogo y un esquema, por ejemplo main.voice. Llama al servicio everyinfra; el nombre no se puede cambiar después. Selecciona la conexión everyinfra_mcp y pulsa «Create & load tools».
El servidor MCP de EveryInfra muestra 12 herramientas. Lo comprobamos con tools/list a las 13:11 hora de Singapur del 14 de noviembre. Para este caso solo necesitas tres herramientas de lectura: everyinfra_list_capabilities, everyinfra_call_api y everyinfra_get_job. Desactiva las demás, como tickets, enlaces de recarga o captcha. Menos herramientas ocupan menos contexto del modelo y eliminan un tipo de llamada errónea.
El nombre completo del servicio queda como main.voice.everyinfra. Su URL es https://<workspace-hostname>/ai-gateway/mcp-services/main.voice.everyinfra. La documentación propone una primera prueba en AI Playground: elige un modelo con herramientas, añade el MCP externo y pídele que llame a una herramienta de lectura.
| Paso | Dónde | Qué hacer |
|---|---|---|
| 1 | Ámbito de secretos + SQL | Guardar la clave y crear la conexión HTTP everyinfra_mcp |
| 2 | Unity Gateway → MCPs → «+ MCP» | Elegir «Connect an existing MCP server», catálogo main.voice, nombre everyinfra |
| 3 | Lista de herramientas | Dejar activas solo everyinfra_list_capabilities, everyinfra_call_api y everyinfra_get_job |
| 4 | AI Playground | Probar una herramienta de lectura antes de abrirlo a usuarios |
| 5 | Permisos | Conceder EXECUTE al grupo que lo usará y fijar el presupuesto |
El paso 3 es el acceso. La documentación de gobierno de MCP en Unity Gateway explica cómo conceder EXECUTE a un grupo. La documentación de aplicaciones externas de Genie One dice que el usuario añade el servicio desde el botón «+» del chat, en «Connectors» y luego «Browse connectors». Antes de cada llamada, la pasarela comprueba que quien llama tiene EXECUTE. También guarda uso y auditoría en tablas del sistema.
La clave de la conexión es una credencial compartida. Todos los usuarios con EXECUTE gastan de la misma cuenta de EveryInfra. Decide los permisos y el presupuesto a la vez.
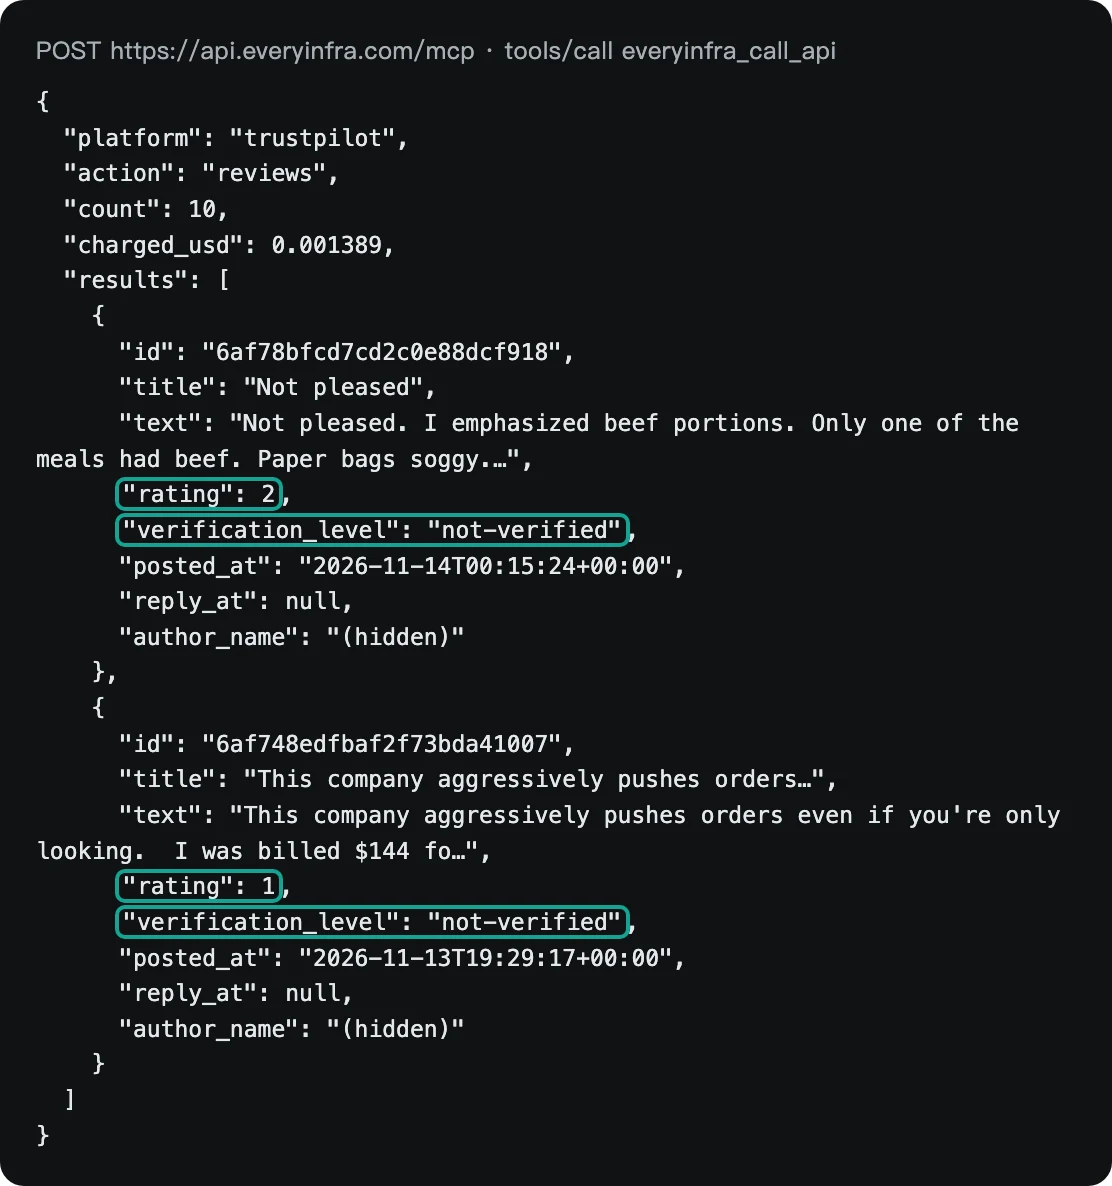
Esta es la llamada que envía Genie. Enviamos exactamente esta petición a las 13:29 hora de Singapur del 14 de noviembre a https://api.everyinfra.com/mcp. Los argumentos coinciden con la pregunta del chat.
{"jsonrpc": "2.0", "id": 3, "method": "tools/call",
 "params": {"name": "everyinfra_call_api",
            "arguments": {"platform": "trustpilot", "action": "reviews",
                          "params": {"company": "hellofresh.com", "stars": ["1", "2"], "limit": 10}}}}
El campo results de la respuesta traía 10 reseñas de 1 o 2 estrellas: 8 de 1 estrella y 2 de 2 estrellas. charged_usd fue 0,001389 USD, el mismo precio que una llamada REST. La llamada se cobra una vez, no por fila. Cinco de las 10 filas tenían verification_level igual a not-verified y cinco igual a invited. Las 10 aparecían también entre las 50 filas más nuevas de la ronda de las 13:28. Para una pregunta rápida como «reseñas negativas recientes», filtra antes con stars y pide 10 filas. El modelo lee mucho menos texto y responde con más foco. La imagen muestra las dos primeras filas de esta respuesta, con los autores ocultos.
Ruta 2: un trabajo programado escribe en Delta mediante REST y un Genie Agent lo consulta (ejemplo de configuración)
Algunas preguntas necesitan historia, como «el mes pasado» o «frente a la misma semana del año anterior». Un Genie Agent, a diferencia del chat de Genie One, también necesita una tabla. Esta ruta usa un trabajo de Lakeflow que corre una vez al día. Llama a la API REST de EveryInfra, escribe una tabla staging y ejecuta el MERGE de la sección «Incremento diario».
La petición no tiene por qué tocar la clave. La documentación de conexiones HTTP describe una dirección proxy: https://<workspace-hostname>/api/2.0/unity-catalog/connections/<nombre-de-conexion>/proxy/<subruta>. Databricks añade la credencial guardada y reenvía la petición. Crea una segunda conexión, everyinfra_api, con base_path igual a /api/v1. El trabajo envía entonces a .../connections/everyinfra_api/proxy/social.
La documentación no dice si el proxy reenvía cabeceras personalizadas sin cambios. Si se pierde la cabecera Idempotency-Key, usa dbutils.secrets.get y llama directamente a https://api.everyinfra.com/api/v1/social. La documentación de secretos confirma que los trabajos pueden leer ámbitos de secretos con dbutils.secrets.
# Ejemplo de configuracion: una tarea Python de un trabajo de Lakeflow.
# Los parametros coinciden con nuestra prueba local del 14 nov; no se ejecuto en Databricks.
import hashlib, json, time, datetime, requests
from pyspark.sql import Row

KEY = dbutils.secrets.get("everyinfra", "api_key")
URL = "https://api.everyinfra.com/api/v1/social"
RUN_DAY = datetime.date.today().isoformat()
JOBS = [
    ("trustpilot", "reviews", {"company": "hellofresh.com", "sort": "newest", "limit": 50}),
    ("google_play", "reviews", {"app_id": "com.hellofresh.androidapp", "sort": "newest", "limit": 100}),
    ("reddit", "subreddit_posts", {"subreddit": "hellofresh", "sort": "newest", "limit": 50}),
]

def call(platform, action, params):
    # Misma clave el mismo dia para la misma llamada: repetir el trabajo no cobra dos veces
    idem = f"hellofresh:{platform}:{action}:{RUN_DAY}"
    for attempt in range(4):
        r = requests.post(URL, timeout=120, json={"platform": platform, "action": action, "params": params},
                          headers={"Authorization": f"Bearer {KEY}", "Idempotency-Key": idem})
        if r.status_code == 429:
            time.sleep(int(r.json()["error"].get("retry_after", 60))); continue
        if r.status_code in (502, 503, 504):
            time.sleep(30 * (attempt + 1)); continue   # las llamadas fallidas no se cobran
        r.raise_for_status()
        return r.json()
    raise RuntimeError(f"{platform}/{action} fallo tras 4 intentos")

rows, snap = [], datetime.datetime.utcnow()
for platform, action, params in JOBS:
    body = call(platform, action, params)
    for x in body["results"]:
        rows.append(Row(
            dedupe_key=f"{platform}:{x['id']}", source=f"{platform}/{action}", brand="hellofresh",
            source_id=x["id"], url=x.get("url"), title=x.get("title"), text=x.get("text"),
            rating=x.get("rating", x.get("score")), like_count=x.get("like_count", x.get("thumbs_up")),
            comment_count=x.get("comment_count"), reply_text=x.get("reply_text"), reply_at=x.get("reply_at"),
            posted_at=x["posted_at"], updated_at=x.get("updated_at"), experience_at=x.get("experience_at"),
            language=x.get("language"), country=x.get("country"),
            verification_level=x.get("verification_level"), review_source=x.get("source"),
            app_version=x.get("app_version"), community=x.get("community"), flair=x.get("flair"),
            author_hash=hashlib.sha256((x.get("author_name") or x.get("author_username") or "").encode()).hexdigest(),
            extra=json.dumps({k: v for k, v in x.items() if k in ("author_review_count", "is_verified", "domain", "external_link")}),
            snapshot_ts=snap.isoformat(), ingested_at=datetime.datetime.utcnow().isoformat()))

spark.createDataFrame(rows).createOrReplaceTempView("batch")
spark.sql("""INSERT OVERWRITE main.voice.public_brand_reviews_staging
             SELECT dedupe_key, source, brand, source_id, url, title, text, CAST(rating AS INT),
                    CAST(like_count AS INT), CAST(comment_count AS INT), reply_text, CAST(reply_at AS TIMESTAMP),
                    CAST(posted_at AS TIMESTAMP), CAST(updated_at AS TIMESTAMP), CAST(experience_at AS TIMESTAMP),
                    language, country, verification_level, review_source, app_version, community, flair,
                    author_hash, parse_json(extra), CAST(snapshot_ts AS TIMESTAMP), CAST(ingested_at AS TIMESTAMP)
             FROM batch""")
# Despues, ejecuta el MERGE de la seccion "Incremento diario"
Explicamos la clave de idempotencia en otro artículo: cómo usar Idempotency-Key para que los reintentos de un agente no se cobren dos veces. El horario se define en «Schedules & Triggers», como explica la documentación de trabajos programados. El modo avanzado acepta sintaxis cron de Quartz y una zona horaria. La documentación avisa del horario de verano. Un trabajo horario en una zona con cambio de hora puede saltarse o retrasarse una o dos horas ese día. Un trabajo diario no se ve afectado. Para un equipo en Madrid, ese aviso se aplica a la zona Europe/Madrid.
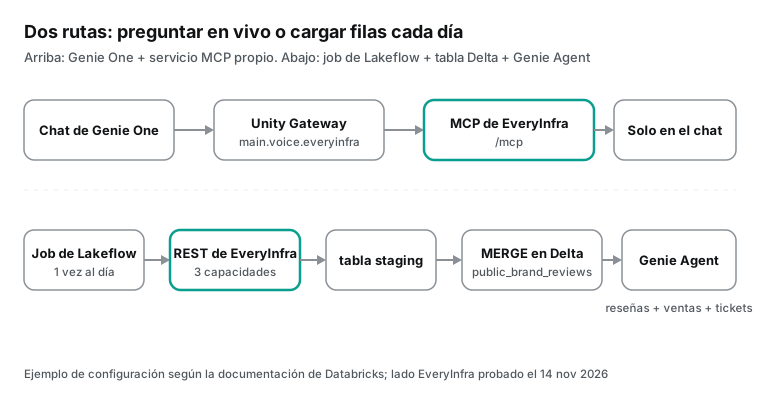
Cuando la tabla exista, añade public_brand_reviews al Genie Agent junto a tus tablas de ventas y tickets. Después escribe unas instrucciones. La página de conceptos de Genie Agents explica el modelo de acceso. El SQL corre en un SQL warehouse con las credenciales de cómputo que incluyó el autor. El acceso a datos sigue los permisos de Unity Catalog de quien pregunta. Así puedes dar la tabla de reseñas solo a los equipos de marketing y soporte.
Proponemos estas tres líneas en las instrucciones del agente:
1. «Reseña negativa» significa
ratingigual a 1 o 2. Las publicaciones de Reddit no tienen estrellas y no cuentan como reseñas negativas. 2. En Trustpilot,verification_level = 'invited'significa que la empresa pidió la reseña.'not-verified'significa reseña espontánea. Si alguien pregunta qué dicen los clientes por su cuenta, usa solo las espontáneas. 3. Usaposted_atpara las fechas. «Reciente» significa los últimos 7 días, salvo que la pregunta diga otra cosa.
Qué puedes preguntar a un Databricks Genie Agent: SQL de ejemplo
La guía de buenas prácticas de Genie Agents prefiere otro método. Define el significado de negocio con expresiones SQL y consultas SQL de ejemplo. Deja las instrucciones de texto para lo que el SQL no puede expresar. El SQL de ejemplo permite a Genie emparejar una pregunta con una consulta verificada y aprender de ella para preguntas parecidas. Así que, tras crear la tabla, añade SQL de ejemplo para las preguntas más comunes. La tabla muestra tres que diseñamos con los datos de HelloFresh. La tabla de tickets main.support.tickets es una estructura supuesta; cámbiala por la tuya.
| Pregunta | Filtro o método clave | Comprobación con nuestra prueba |
|---|---|---|
| ¿Qué dijeron la semana pasada las reseñas negativas espontáneas? | verification_level = 'not-verified' y rating <= 2, por posted_at | 8 de las 14 negativas eran invitadas, así que filtra primero |
| ¿Qué versión de la app acumula más reseñas negativas en Google Play? | Agrupar por app_version | 26.44: 6 de 25; 26.42: 4 de 28; 26.45: 3 de 17; 26.43: 2 de 15 |
| ¿En qué canal respondemos más lento? | Mediana de reply_at menos posted_at por fuente, más la tasa de respuesta a 1–2 estrellas | Unas 22 horas en Trustpilot, menos de 1 hora en Google Play; tasa negativa 10/14 y 11/20 |
-- Ejemplo de configuracion: SQL de ejemplo "resenas negativas por version de la app"
SELECT app_version,
       count(*) AS reviews,
       count_if(rating <= 2) AS negative,
       round(100.0 * count_if(rating <= 2) / count(*), 1) AS negative_pct
FROM main.voice.public_brand_reviews
WHERE brand = 'hellofresh' AND source = 'google_play/reviews'
GROUP BY app_version
ORDER BY negative DESC;
Si la respuesta de Genie se aleja mucho de la columna de la derecha, probablemente contó reseñas sin respuesta o mezcló reseñas invitadas y espontáneas. Añade estas tres preguntas como preguntas de referencia (benchmark).
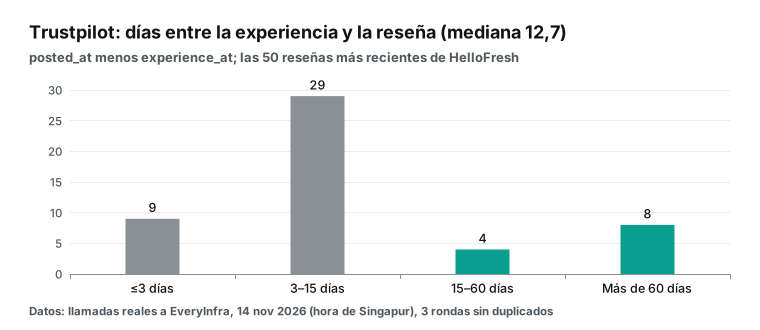
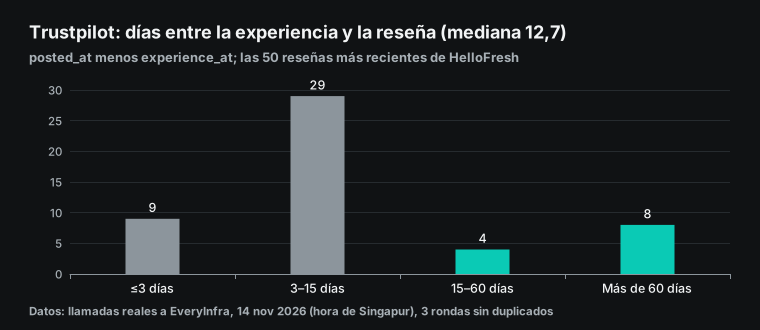
La primera pregunta también necesita la columna de fecha correcta. Cada reseña de Trustpilot tiene experience_at (la fecha de la experiencia del cliente) y posted_at (cuándo se publicó). En las 50 reseñas de T1, la mediana entre experiencia y publicación fue de 12,7 días. 9 llegaron en 3 días o menos, 29 entre 3 y 15 días, 4 entre 15 y 60, y 8 después de más de 60 días. El caso más largo fue de 304,8 días.
Si «la semana pasada» se calcula con experience_at, el recuento de esa semana sigue subiendo durante dos o tres semanas más, y la misma pregunta da respuestas distintas esta semana y la siguiente. Con posted_at, el número queda casi cerrado al acabar la semana. Por eso el SQL de ejemplo y las instrucciones del agente usan posted_at. Usa experience_at solo para «qué día tuvo el problema el cliente».
La guía propone añadir las preguntas revisadas como benchmarks, probarlas con distintas formulaciones y medir la precisión. La documentación de monitorización de Genie Agents añade una vía de comentarios. Los usuarios pueden marcar una respuesta para revisión. Quien tiene permiso CAN MANAGE la confirma o corrige en la página de monitorización.
El texto de una reseña a veces incluye números de pedido, teléfonos o direcciones que escribió el propio cliente. La documentación de filtros de filas y máscaras de columnas describe una máscara de columna para ese caso. Por ejemplo, solo el grupo de soporte ve el text original y el resto ve una versión sin cadenas de dígitos. Un Genie Agent aplica los permisos de quien pregunta, así que la máscara funciona junto con el agente.
Un resumen diario de reseñas: tareas programadas de Genie One
Cuando la tabla y el agente existen, la siguiente petición suele ser «mándamelo sin que tenga que preguntar». El Genie siempre activo aún necesita plaza en la vista previa, pero Genie One ya tiene tareas programadas. La documentación del chat de Genie One dice que una tarea programada corre a una hora fija y publica el resultado en un hilo del chat. También te envía un correo con gráficos y un PDF. Desde el 12 de noviembre, una tarea programada puede enviar correo a otras personas de tu organización. La documentación usa este caso como ejemplo: un resumen diario de las reseñas nuevas de una tienda.
Puedes crear la tarea en el chat con lenguaje normal, o a mano en Schedules con «Create manually». El formulario manual pide título, instrucciones, conexiones, horario y zona horaria. Preferimos el formulario manual, porque unas instrucciones fijas mantienen el resumen igual cada día. Este es un ejemplo para nuestra tabla (ejemplo de configuración):
Ejecuta cada día a las 9 de la mañana, hora de Madrid. Usa la tabla public_brand_reviews con brand = 'hellofresh'. Parte 1: filas nuevas por fuente en las últimas 24 horas, por posted_at. Parte 2: todas las reseñas espontáneas de Trustpilot (verification_level = 'not-verified') con 1 o 2 estrellas, una frase por reseña, indicando si tiene respuesta. Parte 3: las versiones de la app (app_version) que aparecen en reseñas de Google Play con 1 o 2 estrellas, ordenadas por número. Parte 4: las 3 publicaciones de r/hellofresh con más comentarios. Si una parte no tiene datos nuevos, escribe «sin novedades». No inventes datos.
Programa el resumen después del trabajo de reseñas, por ejemplo el trabajo a las 8 y el resumen a las 9. Así queda tiempo para el MERGE y los reintentos. El resumen solo lee la tabla, así que más destinatarios no añaden coste de API.
Cada filtro del resumen sale de un resultado de la prueba. Las espontáneas tienen su propia parte porque, en esta muestra, los dos grupos tenían porcentajes negativos muy distintos (6 de 7 frente a 8 de 43). Google Play tiene una parte por versión porque 85 de las 100 reseñas venían de las cuatro últimas versiones, que puedes cruzar con tu registro de lanzamientos. Reddit aporta las publicaciones más comentadas porque no tiene estrellas y las 3 primeras concentraban un tercio de los comentarios.
Qué ruta elegir para un Databricks Genie Agent
Crea la tabla primero. Después, abre las consultas en vivo del chat a un grupo pequeño si las necesita.
| Punto | Ruta 1: Genie One + MCP personalizado | Ruta 2: trabajo a tabla + Genie Agent |
|---|---|---|
| Frescura | En el momento de preguntar | Hasta un ciclo de retraso (24 horas con un trabajo diario) |
| Historia y tendencias | No; cada llamada trae el último lote | Sí; la tabla crece con el tiempo |
| Cruce con ventas y tickets | El modelo combina resultados en el chat | Un solo JOIN en SQL |
| Quién lo usa | Usuarios de Genie One que lo añaden desde Browse connectors | Todos los usuarios del Genie Agent, con permisos de tabla |
| Funciona en un Genie Agent | El MCP personalizado no está en la lista documentada | Sí; es una tabla normal de Unity Catalog |
| Coste de API | Un cobro por pregunta | Un número fijo de llamadas al día; ver la sección siguiente |
| Auditoría | Registros de uso y auditoría de la pasarela por llamada | Historial de ejecuciones del trabajo y versiones de la tabla |
| Estado | Documentado | Solo usa piezas disponibles de forma general (trabajos, Delta, Genie Agents) |
Cuánto cuesta una ejecución diaria
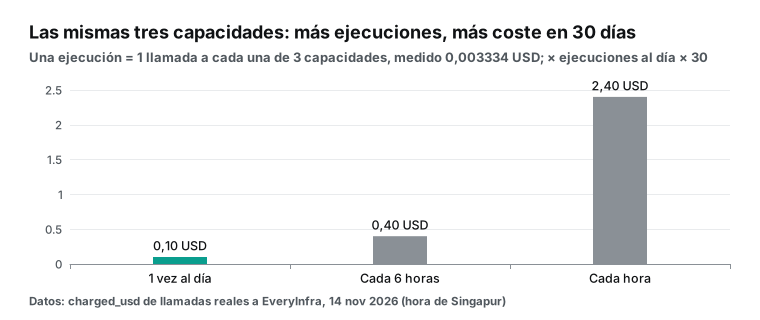
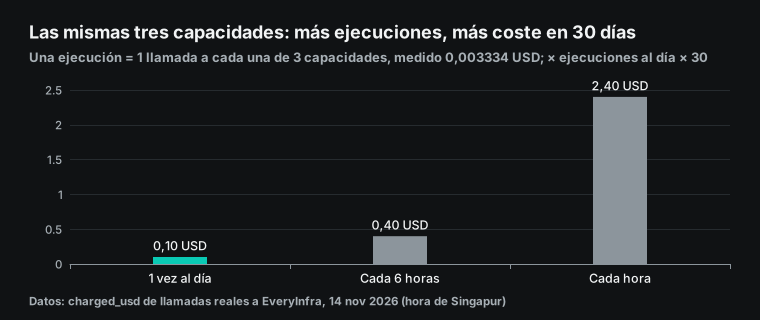
En el lado de EveryInfra usamos price_usd del catálogo y el campo charged_usd de cada respuesta. El 14 de noviembre, los precios del catálogo eran 0,001389 USD por llamada para trustpilot/reviews, 0,001389 USD para google_play/reviews y 0,000556 USD para reddit/subreddit_posts. Cada llamada devuelve hasta limit filas y se cobra una vez. En la ronda T1, los tres valores de charged_usd coincidieron con el catálogo. Su suma fue 0,003334 USD. Ese es el coste de API de una ejecución.
| Horario | Llamadas al día | Coste de API al día | Coste de API en 30 días |
|---|---|---|---|
| Una vez al día | 3 | 0,003334 USD | 0,10 USD |
| Cada 6 horas | 12 | 0,013336 USD | 0,40 USD |
| Cada hora | 72 | 0,080016 USD | 2,40 USD |
El cálculo es 0,001389 + 0,001389 + 0,000556 = 0,003334 USD, por ejecuciones al día, por 30 días.
Una ejecución cada hora no tiene sentido para esta marca. Trustpilot recibe unas 7,4 reseñas nuevas al día. Casi todas las ejecuciones horarias devolverían ID que ya tienes. Pagas, pero no recibes datos nuevos. Las rondas T2 y T3 de la sección de pruebas lo confirman. Las cargas a los 20 y 40 minutos de T1 devolvieron 0 ID nuevos en los tres sitios.
El lado de Databricks tiene tres costes separados. El primero es Genie. La documentación de Genie dice que Genie One y Genie Agents son gratis para los usuarios hasta el 31 de enero de 2027. Las entidades de servicio no entran en esa oferta y pagan la tarifa estándar.
En la ruta 2, una entidad de servicio ejecuta el trabajo. Pero el trabajo solo llama a EveryInfra y escribe una tabla. No llama a Genie, así que no genera cargos de Genie. Cuando los usuarios preguntan al Genie Agent, ese uso es suyo.
Una nota de la página de precios de Genie aclara que el uso gratuito solo cubre el modelo de lenguaje de Genie. Las consultas que escribe Genie corren en un SQL warehouse, y el warehouse se cobra. La página da una conversión: «150 DBU = 10,50 USD en US East». La documentación de Azure Databricks sobre costes da SQL para seguir el uso gratuito mediante el SKU GENIE_FREE_USAGE.
El segundo coste es el cómputo del trabajo. Depende de si usas cómputo serverless o tu propio clúster, así que no lo estimamos. El tercero es el almacenamiento. Una marca añade unos pocos miles de filas al año, así que puedes ignorarlo.
| Coste | Quién paga | Qué sabemos el 14 nov |
|---|---|---|
| Llamadas a la API de EveryInfra | Tu cuenta de EveryInfra | 0,003334 USD por ejecución diaria, medido |
| Preguntas de usuarios a Genie | Gratis hasta el 31 ene 2027 | Solo cubre el modelo de lenguaje de Genie |
| SQL warehouse para las consultas de Genie | Tu cuenta de Databricks | Se cobra; 150 DBU = 10,50 USD en US East (ejemplo de la página de precios) |
| Cómputo del trabajo | Tu cuenta de Databricks | Depende de serverless o clúster; no estimado |
| Almacenamiento | Tu cuenta en la nube | Unos pocos miles de filas al año por marca |
Límites y puntos de atención
Primero, la documentación de MCP para Genie Agents dice que la API del modo Agent solo puede usar herramientas de lectura. Los usuarios tampoco pueden completar el inicio de sesión de un conector desde la API. Si tu aplicación pregunta a un Genie Agent por API, el conector ya debe estar autorizado en la interfaz.
Segundo, si añades a Genie One un servicio MCP personalizado con OAuth por usuario, cada usuario debe iniciar sesión una vez. Con un bearer token compartido te ahorras ese paso. Pero todos gastan de la misma cuenta.
| Límite | Qué implica | Fuente |
|---|---|---|
| Conectores MCP de Genie Agents en beta; la documentación enumera 9 integrados y no menciona el MCP personalizado | La ruta confirmada para llevar reseñas públicas a un Genie Agent es una tabla | Documentación de Genie Agents (09-11-2026, leída el 14-11-2026) |
| La API del modo Agent solo usa herramientas de lectura | La autorización de conectores se hace antes en la interfaz | Misma página, sección Limitations |
| OAuth por usuario exige un inicio de sesión por persona | Un bearer token compartido lo evita, pero comparte la cuenta | Documentación de Genie One |
ai_enrich envía la consulta de cada fila al proveedor | Sirve para enriquecer filas, no para recoger reseñas nuevas | Documentación de ai_enrich |
Los datos también tienen límites. En la ronda T1, reddit/search con la palabra «HelloFresh» y orden por lo más nuevo devolvió 2 filas esta vez. En el mismo momento, reddit/subreddit_posts sobre r/hellofresh devolvió 50 filas. Usa la búsqueda para encontrar menciones en otras comunidades. Usa la comunidad para el incremento diario.
Las 50 filas de Trustpilot de hellofresh.com en T1 tenían country igual a US. Para ver otros países, pon en company el dominio del sitio de ese país y consulta cada uno por separado.
Por último, las reglas de cada plataforma. Muchos equipos usan reseñas públicas para análisis interno y mejora de producto. Pero republicar el texto, entrenar modelos con reseñas o publicar datos de los autores es otra cuestión. Cada plataforma tiene sus términos, por ejemplo los términos de la Data API de Reddit y las directrices de Trustpilot para autores de reseñas. Para equipos en la Unión Europea, el tratamiento de nombres de autores también entra en el RGPD. Consulta a tu equipo legal. Este artículo no es asesoramiento legal. La tabla solo guarda un hash del nombre del autor para reducir ese riesgo.
En qué se diferencia de nuestros artículos anteriores
Tenemos dos artículos cercanos. Airbyte MCP con datos sociales muestra que el MCP de Airbyte consulta pedidos y devoluciones en tu almacén, pero no reseñas públicas. Su foco es cruzar reseñas con pedidos. Google Data Agent Kit con datos sociales trata el diseño de tablas en BigQuery. Un tercero, alertas de reseñas por SMS con MCP, envía avisos tras quitar duplicados por ID de reseña.
Este artículo cubre el lado de Databricks. Explica qué hace cada una de las tres rutas MCP de Genie. Muestra cómo una tabla cubre el hueco mientras la documentación de Genie Agent no menciona el MCP personalizado. Explica cómo un MERGE de Delta recoge respuestas que llegan tarde. También muestra por qué las reseñas invitadas y espontáneas de Trustpilot deben tratarse por separado. Para convertir datos de reseñas en un producto, lee cómo convertir datos de reseñas en un producto.
Novedades recientes
- 11 de noviembre de 2026: Databricks lanzó la segunda generación de Genie. También publicó plugins de Genie para ChatGPT, Claude, Microsoft Copilot Cowork y Grok Bot (blog de los plugins). Genie Ontology pasó a disponibilidad general el mismo día. Para ti, significa que otros agentes pueden leer tu almacén a través de Genie. Añadir datos externos al almacén sigue siendo tarea tuya.
- 12 de noviembre de 2026: las notas de versión de AI/BI y Genie One dicen que la configuración del Genie Agent tiene una sección propia de conectores (beta). Las tareas programadas de Genie One también pueden enviar correos a otras personas. Un resumen diario de reseñas puede llegar directamente al equipo.
- 5 de noviembre de 2026: las mismas notas dicen que un usuario con acceso solo a parte de las conexiones MCP de un Genie Agent ya no queda bloqueado. El agente responde con las fuentes a las que ese usuario tiene acceso. Puedes dar la tabla de reseñas y los conectores a equipos distintos.
- 2 de noviembre de 2026 (02-11-2026): las notas de versión dicen que un Genie Agent puede analizar archivos en volúmenes de Unity Catalog (vista previa pública), como PDF, presentaciones e imágenes. Las respuestas citan la página de origen. Capturas de reseñas o fotos de tiendas podrían entrar en el mismo agente. Los campos estructurados, como estrellas y fechas, siguen funcionando mejor en una tabla.
- 29 de octubre de 2026 (29-10-2026): las notas de versión añaden un flujo guiado para crear un Genie Agent. Un equipo que crea su primer agente de reseñas puede seguirlo y después añadir el SQL de ejemplo de este artículo.
- 30 de noviembre de 2026 (próximo): el antiguo punto de acceso beta del MCP de Genie,
/api/2.0/mcp/genie, deja de funcionar (documentación del MCP de Genie One). Los equipos que conectan Claude o Cursor con la dirección antigua deben pasar a la URL de Unity Gateway antes de fin de mes. El alcance OAuth cambia degenieaai-gateway. - 20 de octubre de 2026: Databricks presentó la memoria de agentes en Agent Bricks. Estados como «qué reseñas ya leímos» podrían pasar a la plataforma más adelante. Aun así, recomendamos guardar las reseñas originales en una tabla.
Preguntas frecuentes
¿Dónde encuentro la URL del servidor Databricks Genie MCP?
En tu espacio de trabajo, abre Unity Gateway y luego MCPs. La lista muestra cada MCP y su URL. La dirección del servidor MCP de Genie es https://<workspace-hostname>/ai-gateway/mcp-services/system.ai.genie_one_mcp?o=<workspace-id>. El ID del espacio de trabajo sale de la parte o= de su URL (documentación del MCP de Genie One).
¿Cómo configuro OAuth para el Databricks Genie MCP?
Para llamar al MCP de Genie One sirve cualquier token de Databricks en la cabecera Authorization: Bearer. Eso incluye OAuth U2M, OAuth M2M y tokens de acceso personal. El OAuth en nombre del usuario necesita el alcance ai-gateway. En sentido contrario, cuando Genie llama a un MCP externo como EveryInfra, la autenticación sale de la conexión HTTP de Unity Catalog. Para EveryInfra basta un bearer token.
¿Puede un Databricks Genie Agent usar mi propio servidor MCP?
La documentación marca los conectores MCP de Genie Agents como beta. Enumera nueve conectores integrados de Databricks y no menciona el MCP personalizado (leída el 14 de noviembre de 2026; página actualizada el 9 de noviembre). La configuración del MCP personalizado está en la documentación de Genie One. Para dar datos externos a un Genie Agent, la ruta que podemos confirmar es guardarlos antes en una tabla de Unity Catalog.
¿Cómo funciona el precio de un Databricks Genie Agent?
El uso de usuarios es gratis hasta el 31 de enero de 2027 y las entidades de servicio pagan la tarifa estándar (detalles en «Cuánto cuesta una ejecución diaria»). La misma página de Genie dice que Genie Code pasó a pago por uso el 8 de julio de 2026, con una cuota gratuita mensual por usuario. El cómputo del SQL warehouse siempre se cobra aparte. El comunicado dice que se paga por uso, no por puesto, y que los administradores pueden fijar límites de gasto por equipo o usuario en Unity Gateway.
¿Puede la API de un Databricks Genie Agent llamar a conectores MCP?
Puede llamar a herramientas de lectura. No puede llamar a herramientas de escritura ni completar el inicio de sesión de un conector. La aprobación de herramientas de escritura y el inicio de sesión se hacen en la interfaz (sección Limitations de la documentación). Si tu aplicación pregunta por API a un Genie Agent con conectores, pide antes a los usuarios que autoricen los conectores en la interfaz.
Primeros pasos
- Regístrate en la consola de EveryInfra y obtén una clave de API. Recarga saldo o usa el crédito de prueba. Consulta la página de precios.
- En el catálogo de capacidades, revisa los parámetros y precios de
trustpilot/reviews,google_play/reviewsyreddit/subreddit_posts. También puedes leer sus páginas: reseñas de Trustpilot, reseñas de Google Play, publicaciones de subreddit y búsqueda en Reddit. - Ejecuta una vez en tu equipo el ejemplo en Python de la sección «Ruta 2». Comprueba que las capacidades devuelven filas y que
charged_usdcoincide con el catálogo. - En Databricks, guarda la clave en un ámbito de secretos. Crea la tabla
public_brand_reviewsy el trabajo, y ejecútalo a diario. - Si alguien necesita respuestas en vivo en Genie One, registra el MCP remoto como en la sección «Ruta 1». Los detalles del MCP de EveryInfra están en la página del servidor MCP.
Páginas generales por plataforma: API de Trustpilot, API de Google Play y API de Reddit.
Referencias
Abrimos y revisamos cada página el 14 de noviembre de 2026 (hora de Singapur). La fecha es la de publicación. Si la página no tiene fecha de publicación, damos la fecha de actualización o la de consulta. Las entradas 1 a 33 se citan en el texto. El resto son páginas adicionales que revisamos al escribir.
- Databricks Launches New Always-on Genie: Autonomous AI for Complex Enterprise Work — Databricks, 2026-11-11
- The new Genie: autonomous AI for complex enterprise work — Databricks, 2026-11-11
- Genie One MCP server — Databricks Docs, 2026-11-12
- The Genie One MCP is now Generally Available — Databricks, 2026-09-22
- Connect Genie One to external applications with MCP — Databricks Docs, 2026-11-09
- External MCP servers — Databricks Docs, 2026-10-27
- Transports: Streamable HTTP — Model Context Protocol, 2026-11-14
- Connect to external HTTP services — Databricks Docs, 2026-11-14
- Connect a Genie Agent to MCP tools and sources — Databricks Docs, 2026-11-09
- ai_enrich function — Databricks Docs, 2026-11-14
- Genie Agents concepts — Databricks Docs, 2026-11-14
- Set up and manage a Genie Agent — Databricks Docs, 2026-11-14
- Curate an effective Genie Agent — Databricks Docs, 2026-11-14
- Trustpilot's review labels — Trustpilot Help Center, 2026-11-14
- Use liquid clustering for tables — Databricks Docs, 2026-11-14
- Upsert into a Delta Lake table using merge — Databricks Docs, 2026-11-14
- Isolation levels and write conflicts — Databricks Docs, 2026-11-14
- Row-level concurrency — Databricks Docs, 2026-11-14
- Govern an MCP — Databricks Docs, 2026-11-14
- Secret management — Databricks Docs, 2026-11-14
- Run jobs on a schedule — Databricks Docs, 2026-11-14
- Monitor a Genie Agent — Databricks Docs, 2026-11-14
- Row filters and column masks — Databricks Docs, 2026-11-14
- Chat in Genie One — Databricks Docs, 2026-11-14
- Genie — Databricks Docs, 2026-11-14
- Genie pricing — Databricks, 2026-11-14
- Monitor and understand your Genie cost — Microsoft Learn, 2026-11-14
- Data API Terms — Reddit, Inc., 2026-11-14
- Guidelines for reviewers — Trustpilot, 2026-11-14
- Bring your business context to ChatGPT, Claude, Microsoft Copilot Cowork and Grok Bot — Databricks, 2026-11-11
- Announcing GA of Genie Ontology — Databricks, 2026-11-11
- AI/BI and Genie One release notes 2026 — Databricks Docs, 2026-11-12
- Introducing Agent Memory on Databricks — Databricks, 2026-10-20
- View and analyze your app's ratings and reviews — Play Console Help, 2026-11-14
- Trustpilot Developers — Trustpilot, 2026-11-14
- EveryInfra social catalog — EveryInfra, 2026-11-14
- MCP Apps overview — Model Context Protocol, 2026-11-14
- Host an MCP server on Databricks Apps — Databricks Docs, 2026-11-12
- MCP authentication — Databricks Docs, 2026-11-14
- MCP networking — Databricks Docs, 2026-11-14
- Supported coding and work agents — Databricks Docs, 2026-11-14
- Databricks-provided MCPs — Databricks Docs, 2026-11-14
- Analyze files in volumes with a Genie Agent — Databricks Docs, 2026-11-14
- Databricks AI assistive features trust and safety — Databricks Docs, 2026-11-14
- Get access to data products and MCP servers in Databricks Marketplace — Databricks Docs, 2026-11-14
- Monitor Genie Code and Genie One with the unified trace table — Databricks Docs, 2026-11-05
- MERGE INTO — Databricks Docs, 2026-11-14
- Call MCP tools from a Python agent — Databricks Docs, 2026-11-14
- Databricks' new AI agent tells CEO Ali Ghodsi the unvarnished truth — TechCrunch, 2026-11-11
- Databricks turns Genie into always-on agent for complex work — TechTarget, 2026-11-11
- Databricks Launches Native Genie Plugins for Four AI Agents — Unite.AI, 2026-11-11
- Table deletes, updates, and merges — Delta Lake, 2026-11-14
- HelloFresh: Meal Kit & Recipes — Google Play, 2026-11-14
- r/hellofresh — Reddit, 2026-11-14
- Lakeflow Connect — Databricks Docs, 2026-11-14
- Embed a Genie Agent in an external app — Databricks Docs, 2026-11-14
- Databricks Designated Services — Databricks Docs, 2026-11-14
- Databricks preview releases — Databricks Docs, 2026-11-14
Referencia BL-151