Альтернатива парсерам Twitter в Apify: замерили стоимость поиска, постов профиля и ответов за 1 000 записей
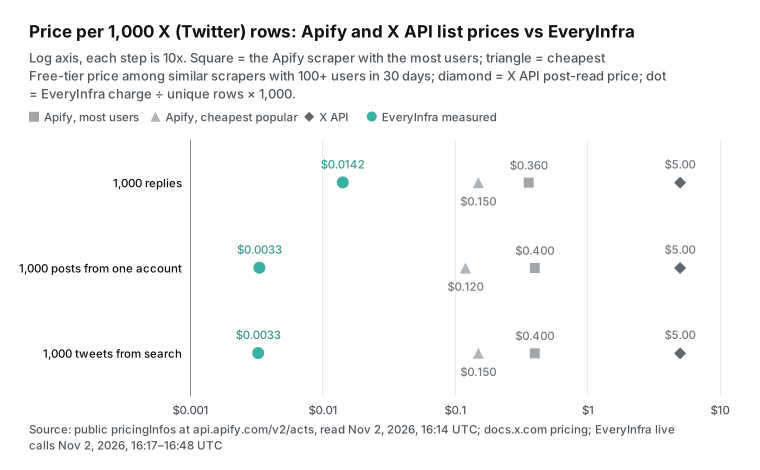
Apify Tweet Scraper V2 стоит $0.40 за 1 000 твитов. Поиск у нас по замерам обошёлся в $0.0033. Ответы оказались в 10-25 раз дешевле, но не больше 50 на пост.
Самый популярный парсер твитов в Apify Store называется Tweet Scraper V2. Его публичная цена составляет $0.40 за 1 000 твитов на любом тарифе. 3 ноября 2026 года мы выполнили 7 поисковых запросов по ключевым словам через эндпоинт EveryInfra twitter/search. Каждый вызов стоил $0.000556 и возвращал 200 твитов.
После удаления дубликатов у нас осталось 1 190 уникальных твитов за $0.003892. Это $0.00327 за 1 000, то есть в 122 раза дешевле, чем V2. Среди популярных парсеров твитов в Store с полноценным поиском по ключевым словам самый дешёвый вариант — xquik за $0.15, поэтому разница с ним составляет 46 раз.
Для 1 000 постов одного аккаунта мы получили $0.00334 за 1 000 уникальных постов. Это в 120 раз дешевле, чем V2, и в 36 раз дешевле самого дешёвого популярного варианта ($0.12). С ответами ситуация другая. Наш эндпоинт twitter/comments возвращает не более 50 ответов на пост.
По 25 постам в среднем выходило 39.1 ответа на вызов, или $0.0142 за 1 000 ответов. Это в 10-25 раз дешевле парсеров ответов в Apify, цены которых мы сравнили. Но получить 1 000 ответов к одному посту через наш эндпоинт нельзя. Для такой задачи Apify подходит лучше.
Как читать цифры в этой статье
Нашу «цену за 1,000» мы считаем просто. Берём фактически списанную сумму, делим её на число реально полученных записей и умножаем на 1 000. В EveryInfra оплата за каждый запрос, и у одного запроса одна цена независимо от количества записей. Большинство парсеров Twitter в Apify Store берут оплату за результат: каждая запись, сохранённая в датасет, оплачивается отдельно. Эти две единицы можно сравнивать только при одинаковом знаменателе.
С нашей стороны знаменатель — уникальные записи с дедупликацией по ID поста. Значение limit мы никогда не берём в знаменатель. Поэтому, если вызов возвращает меньше записей или повторяет их, наша цена в этой статье растёт, а не падает. Со стороны Apify мы используем только публичные материалы: страницы Store, страницу тарифов, документацию и публичный API для Actor, доступный без аккаунта.
Мы не регистрировались в Apify и не запускали ни одного Actor. Actor — так в Apify называют облачную программу для парсинга. Поэтому все приведённые ниже цифры Apify — прейскурантные цены, а не фактические расходы по замерам.
Парсинг Twitter: Apify и EveryInfra — сводная таблица
В этой таблице собран итог. Для каждого типа данных указаны два парсера Apify. Первый — основной, с наибольшим числом пользователей за последние 30 дней. Второй — самый дешёвый на тарифе Free среди тех, у кого не меньше 100 пользователей за последние 30 дней. Все цены мы взяли из поля pricingInfos публичного API для Actor в 16:14 UTC 2 ноября 2026 года (00:14 по сингапурскому времени 3 ноября).
Документация Apify сопоставляет тарифы с ценовыми уровнями. Free использует цену Free, Starter — Bronze, Scale — Silver, а Business — Gold. Platinum и Diamond предназначены для корпоративных клиентов (тарификация и расходы Actor). Для парсеров Twitter из этой статьи цены Free и Business совпадают или различаются меньше чем наполовину. Все наши цифры получены из реальных вызовов. Списание мы брали из billing.charged_usd, а записи — из results.
| Данные | Эндпоинт EveryInfra | Вызовы / записи / уникальные записи / сумма списания | EveryInfra за 1K (уникальные) | Основной парсер Apify | Разница | Самый дешёвый из популярных | Разница |
|---|---|---|---|---|---|---|---|
| Поиск по ключевому слову | twitter/search | 7 / 1,400 / 1,190 / $0.003892 | $0.00327 | Tweet Scraper V2, $0.40 | 122x | xquik, $0.15 | 46x |
| Посты одного аккаунта | twitter/user_posts + поиск с from: | 8 / 1,592 / 1,330 / $0.004448 | $0.00334 | V2 с twitterHandles, $0.40 | 120x | feedminer, $0.12 | 36x |
| Ответы на посты | twitter/comments | 25 / 977 / 977 / $0.0139 | $0.0142 | Replies Scraper, 20 постов × 50, $0.36 | 25x | xquik Reply, $0.15 | 10.5x |
Каждое значение показывает отношение цены Apify к нашей цене. Здесь есть четыре оговорки. Во-первых, все три соотношения объясняются размером страницы. Поиск и посты аккаунта возвращают до 200 записей за вызов, ответы — до 50. Полная страница позволяет распределить стоимость одного вызова между множеством записей. Если вам нужны одна-две записи за вызов, соотношение меняется в пользу Apify; расчёты приведены в разделе о точке безубыточности.
Во-вторых, цифра $0.36 для ответов рассчитана по правилу со страницы парсера ответов apidojo. На платных тарифах примерно первые 40 ответов на пост бесплатны. При 50 ответах на пост один пост стоит $0.014 за запрос плюс 10 записей по $0.0004. В-третьих, в README xquik указано, что Apify взимает плату за использование платформы сверх платы за результаты (xquik README).
Значит, $0.15 — это ещё не весь счёт. В-четвёртых, цены Apify часто меняются. Даты указаны в разделе «Что изменилось недавно».
Цена поиска $0.15 есть не только у xquik. У парсера твитов scrape.badger было 709 пользователей за 30 дней, а цена составляла $0.15 на Free и $0.12 на Business. У feedminer цена ниже, $0.12, но его запросы по ключевым словам без from: теперь берут данные из X Communities. Поэтому feedminer мы указываем только в строке про аккаунты.
Цены на парсеры твитов в Apify: V2, Unlimited и парсер ответов
Те, кто ищет «apify tweet scraper pricing», обычно видят несколько парсеров с похожими названиями. Один разработчик, apidojo, публикует три из них: Tweet Scraper V2, Twitter (X.com) Scraper Unlimited и Twitter (X) Replies Scraper. Все три используют тарификацию pay-per-event. Разработчик задаёт тарифицируемые события, и за каждый запуск списывается число событий, умноженное на цену события.
В документации по модели pay-per-event объясняется, кто платит за вычислительные ресурсы. По умолчанию разработчик оплачивает использование платформы из своей выручки. Разработчик может включить режим «Pay per event + usage», и тогда за использование платформы платит и пользователь. Для пользователей бесплатного плана использование платформы покрывает Apify. В V2 есть одно событие. Каждый твит, записанный в датасет, стоит $0.0004, то есть $0.40 за 1 000 на всех четырёх планах.
На странице V2 в Store есть примечание о ценах с четырьмя правилами. На скриншоте ниже — оригинальный текст.
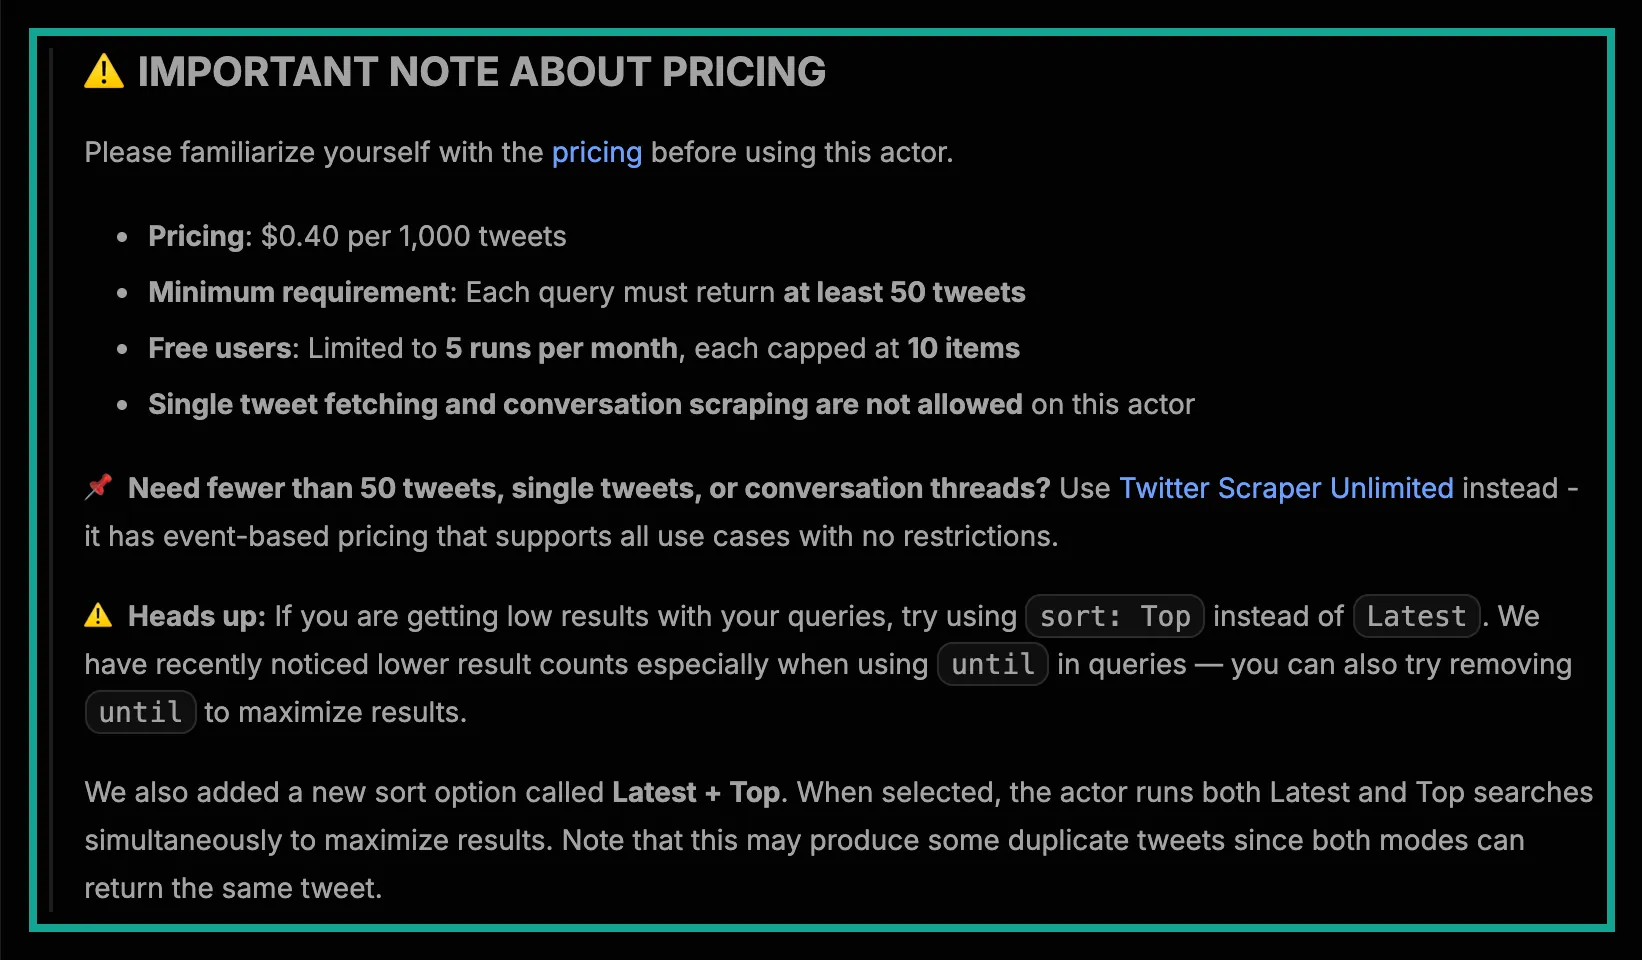
Для стоимости важнее всего два правила. Первое — «не меньше 50 твитов на запрос». V2 не рассчитан на небольшие точные запросы, например три поста небольшого аккаунта за эту неделю. Такие задачи страница перенаправляет в Unlimited.
Второе — лимит для бесплатных пользователей: 5 запусков в месяц по 10 записей. Бесплатный тариф включает $5 кредитов на использование платформы в месяц (тарифы Apify). Но V2 даёт бесплатным пользователям всего 50 твитов в месяц. На странице также сказано, что бесплатные пользователи не могут запускать актор через API.
Поэтому для реальной нагрузки на V2 нужен как минимум тариф Starter. В таблице показаны тарифы и ценовой уровень, который использует каждый из них.
| Тариф Apify | Цена в месяц | Ценовой уровень для акторов | Что это значит для V2 |
|---|---|---|---|
| Бесплатно | $0; включено $5 кредитов на использование платформы | Бесплатно | Демо-режим: 5 запусков по 10 записей, без API |
| Starter | От $19 | Bronze | Полный V2 по $0.40 за 1 000 |
| Scale | $199 | Silver | Та же цена V2 |
| Business | $999 | Gold | Та же цена V2 |
Включённый в тариф объём использования не переносится на следующий период. На странице V2 есть ещё раздел «Important Note» с двумя ограничениями. Доступен максимум 1 параллельный запуск, в котором можно объединить до 5 запросов. Кроме того, на странице указано «No monitoring»: нельзя раз за разом запускать один и тот же запрос с короткими интервалами.
У Unlimited цена устроена сложнее. Он берёт $0.016 за запрос, то есть за каждый поисковый термин, хендл или список. В эту плату входят примерно первые 40 результатов. Дополнительные записи стоят от $0.0004 до $0.002, и цена зависит от числа запросов в одном запуске. При числе запросов до 5 на запуск каждая дополнительная запись стоит $0.0004. При 6–10 запросах — $0.0008, при 11–30 — $0.0012, при 31–100 — $0.0016, а при более чем 100 — $0.002.
Один URL твита стоит $0.05, а у каждого запуска минимальная стоимость $0.02. Все эти данные взяты из метаданных actor Unlimited. Поэтому чем больше запросов в одном запуске, тем дороже обходится каждая дополнительная запись. Это противоположно привычному правилу «оптом дешевле». Один запрос на 1 000 твитов стоит $0.016 плюс 960 записей по $0.0004, то есть около $0.40, столько же, сколько в V2.
У парсера ответов свой набор правил. Согласно его странице в Store, для каждого поста взимается плата за запрос: $0.014 в стандартном сценарии и $0.016 с useSearch. Каждый ответ стоит $0.0004. На платных тарифах примерно первые 40 ответов по каждому запросу бесплатны.
На бесплатных планах доступен только демо-режим: 5 запусков в месяц и 10 записей за запуск. Поэтому 1 000 ответов к одному посту стоят около $0.014 + 960 x $0.0004 = $0.398. А по 50 ответов к каждому из 20 постов обойдутся в 20 x ($0.014 + 10 x $0.0004) = $0.36.
| Парсер Apify (разработчик) | Стоимость событий (от уровня Free до уровня Business) | Фиксированная плата за запуск или запрос | Минимальные объёмы и ограничения (по тексту страницы) | Пользователи за последние 30 дней |
|---|---|---|---|---|
| Tweet Scraper V2 (apidojo) | $0.0004 за запись, на всех уровнях | Нет | 50 твитов на запрос; бесплатно: 5 запусков по 10 записей | 10,137 |
| Scraper Unlimited (apidojo) | От $0.0004 до $0.002 за дополнительную запись | $0.016 за запрос; $0.05 за URL твита; минимум $0.02 за запуск | Без минимального числа записей | 2,366 |
| Replies Scraper (apidojo) | $0.0004 за запись | $0.014 за пост ($0.016 в сценарии с поиском); на платных тарифах около 40 бесплатных записей на пост | Бесплатно: только демо-режим | 132 |
| Cheapest Twitter Scraper (kaitoeasyapi) | От $0,00025 до $0,00018 | Нет | Нет | 5,398 |
| X Tweet Scraper (xquik) | $0,00015 для всех тарифов | Нет; использование платформы оплачивается отдельно | Нет | 3,374 |
| X Reply Scraper (xquik) | $0.00015 | Нет; использование платформы оплачивается отдельно | Нет | 165 |
| X Tweet Scraper (feedminer) | От $0,00012 до $0,0001 | Нет | См. примечание о поиске по ключевым словам ниже | 107 |
| Profile Posts Scraper (scraper_one) | От $0,0004 до $0,0003 | $0,0025 за запуск | Нет | 389 |
| Twitter Scraper (danek) | От $0,0003 до $0,00024 | Стартовая плата за каждый ГБ памяти | Нет | 406 |
Все цены в этой таблице мы взяли из публичных метаданных Actor с 00:14 до 00:16 по сингапурскому времени 3 ноября (с 16:14 до 16:16 UTC 2 ноября). Число пользователей взято из stats.totalUsers30Days в том же API. Это поле описано в документации Get Actor API. В Store больше 400 парсеров с Twitter или X в названии. Разброс их цен показан в одном из следующих разделов.
Как мы тестировали и что считали успешным результатом
Критерии прохождения мы сформулировали до того, как посмотрели на какие-либо данные. Для каждого типа данных требовалось не менее 2 живых вызовов в 2 или более разных момента времени. Каждая цена за 1 000 должна была рассчитываться по уникальным записям. Если Apify оказывался дешевле или лучше для задачи, это нужно было указать и в итоговой таблице, и в тексте. Как минимум для 2 вызовов без данных нужно было зафиксировать списанную сумму.
Все вызовы шли на POST https://api.everyinfra.com/api/v1/social. Для каждого вызова мы записывали время отправки, HTTP-статус, длительность, число записей и charged_usd. Затем скрипт пересчитал все цифры по сырым ответам. Все цифры в тексте, таблицах и графиках получены этим скриптом.
| Сценарий | Эндпоинт и параметры | Реальные вызовы | Время (UTC, 2 ноября) | Назначение |
|---|---|---|---|---|
| Поиск по ключевому слову | twitter/search, ключевое слово «openai», limit 200, один вызов с сортировкой Latest, пять окон по датам | 7 + 1 повторный тест | 16:17–16:31, повторный тест в 16:47 | Записи на вызов, пересечение сортировок, дневные окна |
| Посты аккаунта | twitter/user_posts для NASA, затем 7 поисков from:NASA | 8 + 1 повторный тест | 16:19–16:33, повторный тест в 16:47 | Насколько глубоко можно уйти в историю одного аккаунта |
| Ответы | twitter/comments для 25 постов, limit 50 | 25 + 1 повторный тест | 16:19–16:40, повторный тест в 16:48 | Записи на вызов для крупных и небольших постов |
| Нет данных | Нет ключа, превышен лимит запросов, лишний параметр, неизвестный пользователь, неизвестный пост, полный URL вместо id | 6 | 16:21–16:29 | Какие ошибки стоят денег |
| Другие языки | Ключевое слово на испанском, аккаунт El Pais, ключевое слово на китайском | 3 | 16:40–16:42 | Записи на вызов для неанглийских запросов |
Все значения времени в этой таблице указаны по UTC за 2 ноября. Чтобы получить сингапурское время 3 ноября, прибавьте 8 часов. 52 вызова в сумме стоили $0,025576. Наш тестовый ключ допускает 10 запросов в минуту. Один вызов упёрся в этот лимит, и в ответе было сказано «Nothing was charged». Мы подождали 40 секунд и отправили его снова.
Чтобы выбрать посты для сбора ответов, мы взяли посты из аккаунтов брендов, например OpenAI и NASA, а также из результатов поиска. Число ответов под ними составляло от нескольких сотен до более чем 20 000. В качестве контрольного мы взяли ещё один небольшой пост с 8 ответами. Текст постов и имена обычных пользователей в статье скрыты. Мы называем только аккаунты брендов и организаций.
Тест 1: самая частая задача для apify twitter scraper, 1 000 твитов из поиска по ключевому слову
В Apify поиск твитов обычно начинается с входных параметров V2 searchTerms и maxItems. В примере входных данных в метаданных Actor V2 есть также sort (Latest или Top), tweetLanguage, onlyVerifiedUsers и onlyImage. Наш аналог — эндпоинт twitter/search. Он требует keyword и принимает limit и sort. Операторы расширенного поиска X, такие как from:, since:, until:, lang: и min_faves:, указываются внутри keyword.
В документации X для разработчиков описан синтаксис запросов. Расширенные операторы поиска подробнее разобраны в списке от сообщества на GitHub. Вот наш первый вызов.
# 16:17:37 UTC Nov 2 (00:17:37 Singapore time Nov 3): HTTP 200, 41.8 s, count 200, charged_usd 0.000556
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"twitter","action":"search","params":{"keyword":"openai","limit":200}}'
Все 7 поисковых запросов вернули полную страницу из 200 записей, итого 1 400 записей. Первый вызов использовал сортировку по умолчанию, то есть Top. Второй использовал sort: latest. На двух страницах совпали 137 постов, поэтому второй вызов добавил всего 63 новых поста. К тому же «Latest» не означает строгий хронологический порядок: самый старый пост на странице Latest был опубликован в ноябре 2023 года.
На странице V2 описан тот же эффект. Новая сортировка «Latest + Top» выполняет оба поиска и «может давать дубликаты твитов». При оплате за каждую запись эти дубликаты тоже считаются записями.
Затем мы разбили запрос «openai» на пять двухдневных окон с помощью since: и until:. Окна начинались 2026-10-30, 2026-10-27, 2026-10-24, 2026-10-21 и 2026-10-18. Каждый вызов по-прежнему возвращал 200 записей. Новых уникальных постов за вызов: 168, 168, 197, 196 и 198. За 7 вызовов мы получили 1 190 уникальных постов за $0.003892, то есть $0.00327 за 1 000.
Но окна оказались неточными. В первых трёх окнах в пределы двух дней попали только 70, 85 и 48 постов из 200. Остальные были за пределами окна. Поэтому разбивка по датам хорошо подходит, чтобы получить много новых постов, но не годится, чтобы получить именно посты за эти два дня.
На то же указывают ещё три публичных источника. На странице V2 сказано, что при использовании until результатов становится меньше. В истории изменений X API указано, что 4 мая 2026 года эндпоинты поиска перешли на новый поисковый индекс. А на странице feedminer в Store говорится, что в конце сентября X начал отклонять его запросы к поисковому индексу. Так что сейчас результаты поиска X нестабильны. Какой бы инструмент вы ни использовали, повторно фильтруйте полученные результаты по датам.
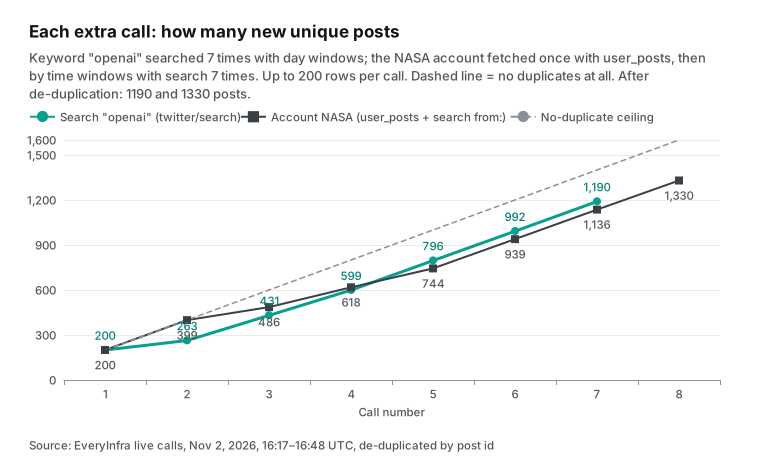
Через 30 минут, в 16:47 UTC (00:47 по сингапурскому времени), мы повторили первый поиск с теми же параметрами. Из 200 постов 124 совпали с первым запуском, а 76 оказались новыми. Сортировка Top со временем меняется. Для мониторинга бренда запуск каждые 30 минут даёт некоторое количество новых постов. При оплате за каждую запись вы снова платите и за 124 повторных поста. У нас повторный запуск стоил $0,000556, столько же, сколько первый.
Тест 2: apify x scraper для 1 000 постов одного аккаунта
Чтобы получить посты одного аккаунта в V2, используется twitterHandles или условие from: в searchTerms. Цена та же: $0.40 за 1 000. У нас первым идёт twitter/user_posts. Он возвращает до 200 постов за вызов и не поддерживает курсор. Для более старых постов мы переходим на twitter/search с from:NASA и операторами дат, как и советует документация V2.
Вызов user_posts в 16:19 UTC (00:19 по сингапурскому времени) вернул 200 постов за период с 2026-09-08 по 2026-10-31. Из них 48 были ответами NASA другим аккаунтам, а 67 были репостами. Это совпадает с вкладкой «Посты и ответы» на сайте X.
Затем мы отправили 7 поисковых запросов from:NASA, чтобы уйти дальше в прошлое. Сначала until:2026-09-08, затем until:2026-08-01 и until:2026-04-01. Потом мы использовали окна за второе полугодие 2025 года, первое полугодие 2025 года и весь 2024 год. 8 вызовов вернули 1 592 записи и 1 330 уникальных постов. Ни один из них не относился к другому аккаунту. Общее списание составило $0.004448, то есть $0.00334 за 1 000.
Уникальных постов по годам: 568 за 2026 год, 396 за 2025-й, 198 за 2024-й и 82 за 2022-й. Ещё 23 поста были из 2020 года, 39 — из 2016-го, а по остальным годам счёт шёл на единицы. Чем старше год, тем меньше постов, по той же причине, что и в тесте 1: поиск с датами подмешивает более старые и популярные посты из-за пределов окна. Узкие окна добавляют меньше новых постов, а третий вызов добавил только 87.
В 16:47 UTC (00:47 по сингапурскому времени) мы снова запустили user_posts. Все 200 постов совпали с результатами запуска 28 минутами ранее, а самым новым остался тот же пост, опубликованный 31 октября в 22:14 UTC. Это полезно для архивов: при тех же параметрах результат на коротком интервале стабилен, поэтому инкрементальному заданию достаточно сравнить ID самого нового поста.
У X API здесь жёсткое ограничение: эндпоинт ленты пользователя возвращает только последние 3 200 постов (документация X по лентам). Для более старых постов нужен поиск по полному архиву.
Контент не на английском: сколько записей возвращается
Многие используют парсер X на Apify для контента не на английском языке. В 16:40 UTC (00:40 по сингапурскому времени) мы искали inteligencia artificial lang:es. Вызов вернул полную страницу из 200 постов: все они были на испанском и принадлежали 167 разным авторам. Посты охватывали период с 2026-10-23 по 2026-11-02; среди них не было репостов и ответов.
В 16:41 UTC (00:41 по сингапурскому времени) user_posts для аккаунта El Pais вернул 200 постов, из них 197 на испанском. Они охватывали меньше двух дней, с 31 октября по 2 ноября. То есть активный новостной аккаунт заполняет 200 записей примерно за два дня. Чтобы собрать архив за месяц, запускайте вызов раз в день.
В 16:42 UTC (00:42 по сингапурскому времени) мы искали китайский термин со значением «большая модель» с lang:zh. Мы запросили 200 записей и получили 100, все на китайском, от 67 авторов. Самая старая была от 2026-10-08. Этот единственный вызов обошёлся в $0.00556 за 1 000, примерно вдвое дороже, чем для английского, потому что страница была заполнена наполовину.
Это всё равно примерно в 70 раз дешевле, чем V2. При оплате за каждую запись неполная страница не меняет цену за единицу. Вы просто получаете меньше записей.
| Вызов (по сингапурскому времени, 3 ноября) | Эндпоинт и входные данные | Записи | Авторы | Период | За 1 000 |
|---|---|---|---|---|---|
| 00:40 | twitter/search, испанское ключевое слово с lang:es | 200, все на испанском | 167 | С 2026-10-23 по 2026-11-02 | $0.00278 |
| 00:41 | twitter/user_posts, El Pais | 200, из них 197 на испанском | 1 | С 2026-10-31 по 2026-11-02 | $0.00278 |
| 00:42 | twitter/search, китайское ключевое слово с lang:zh | 100, все на китайском | 67 | С 2026-10-08 по 2026-11-02 | $0.00556 |
Тест 3: ответы — задача, которую приходится делить на две части
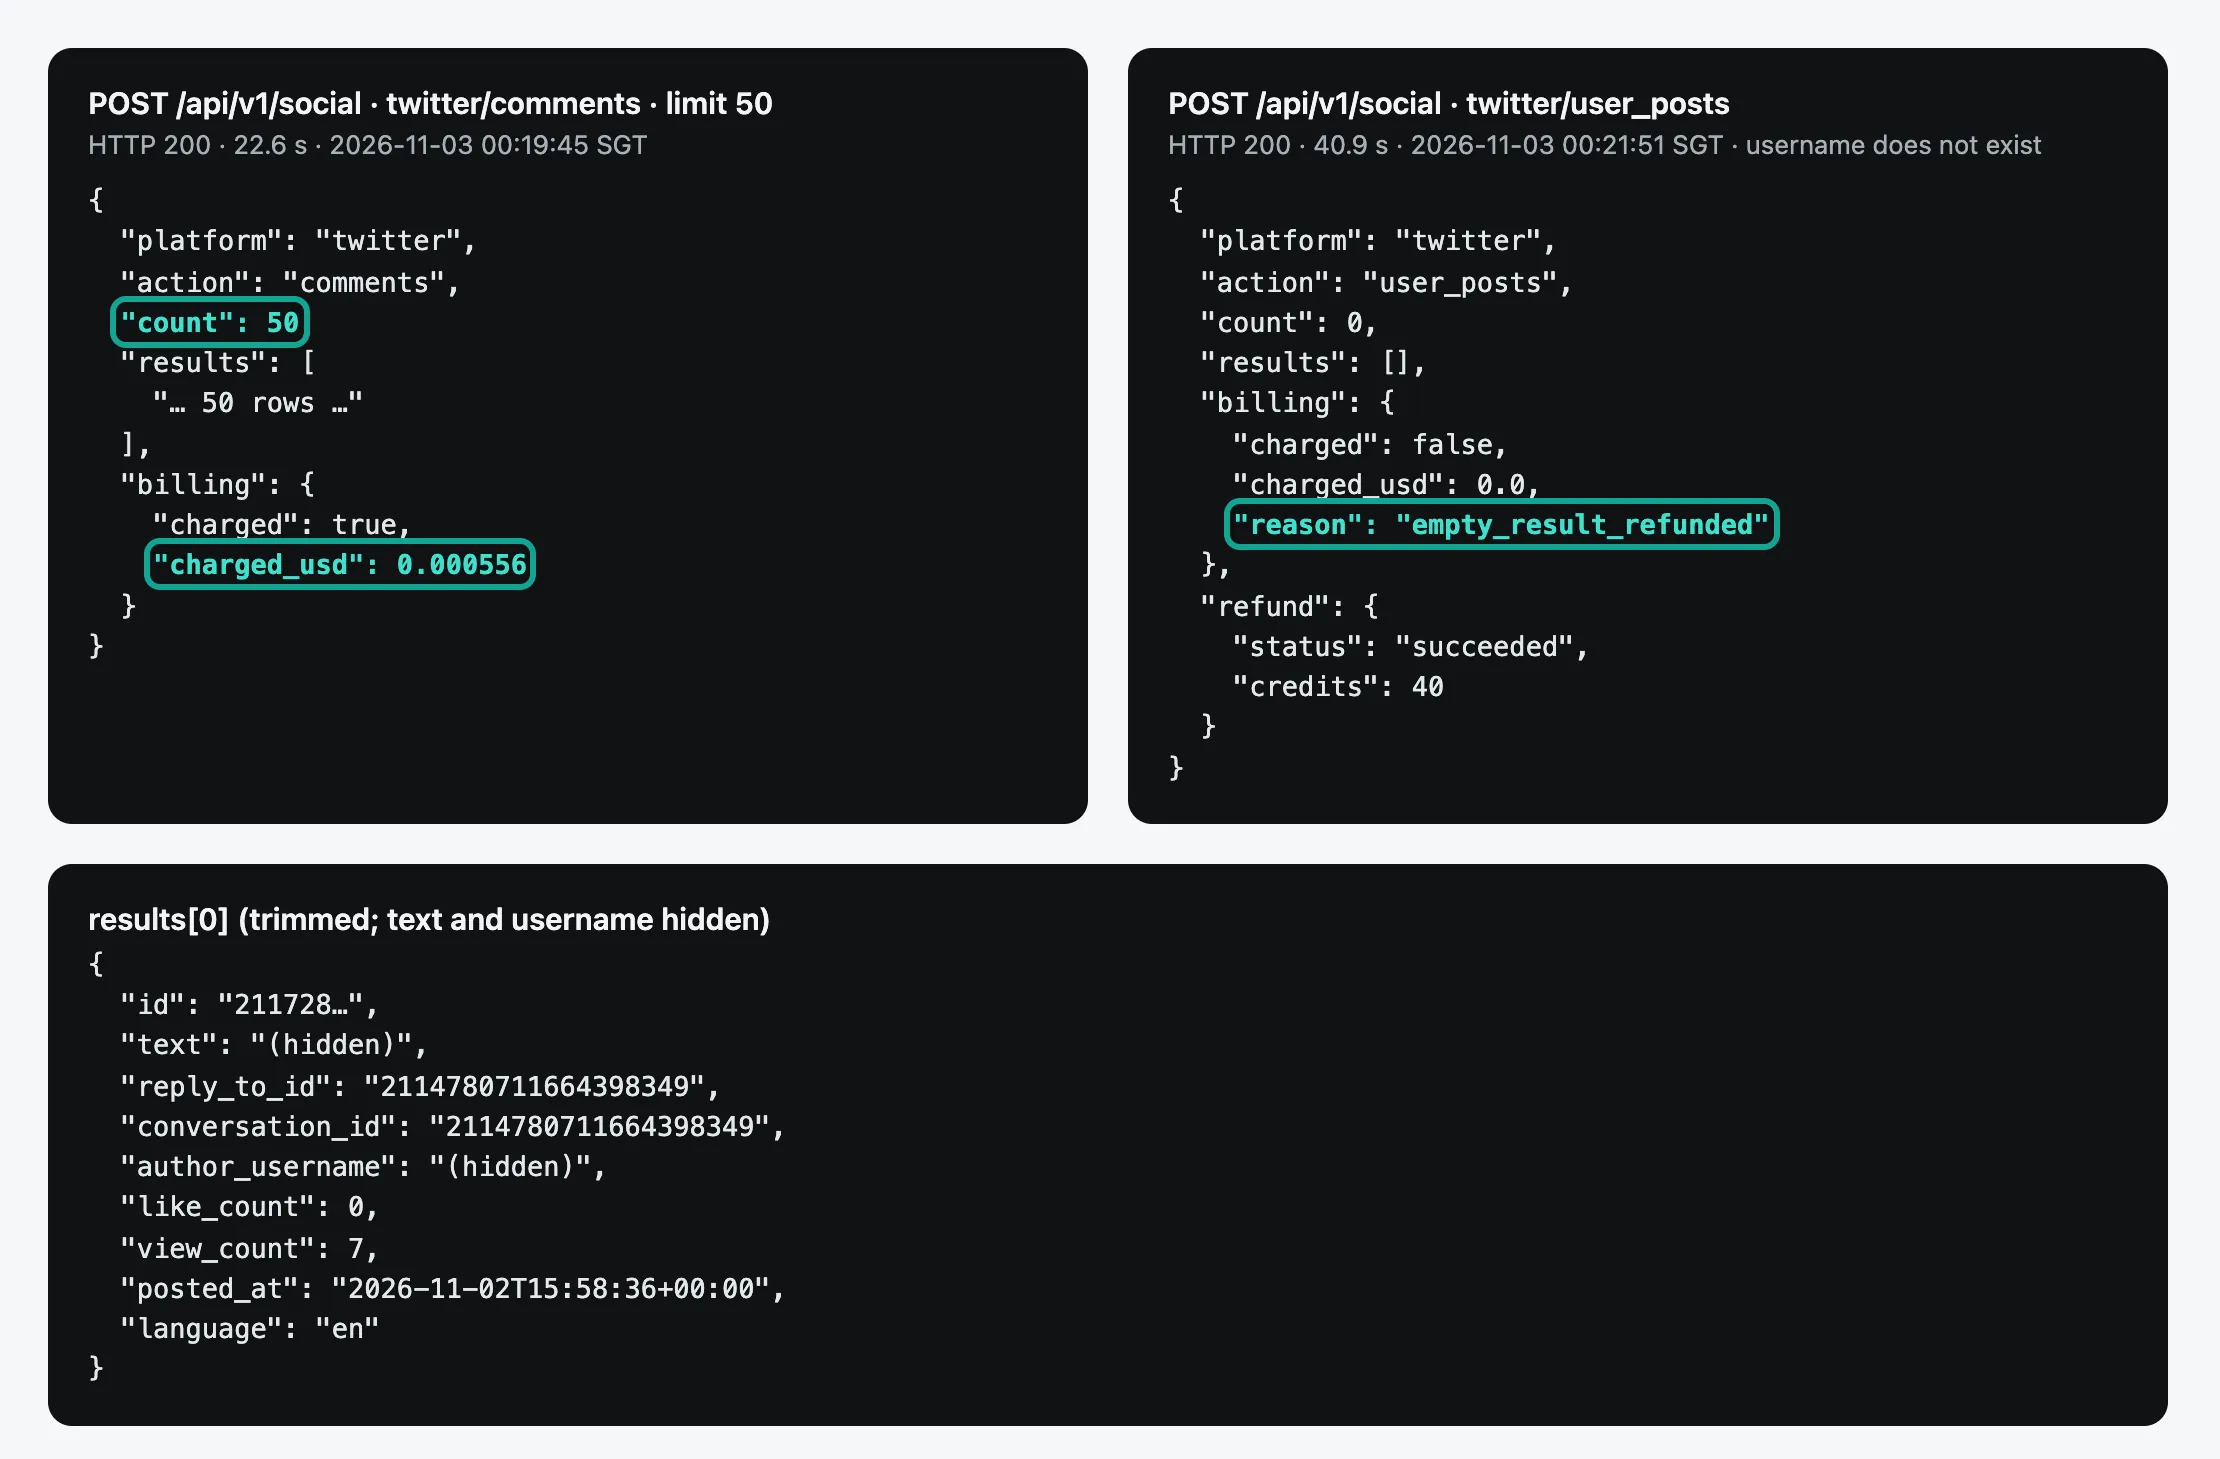
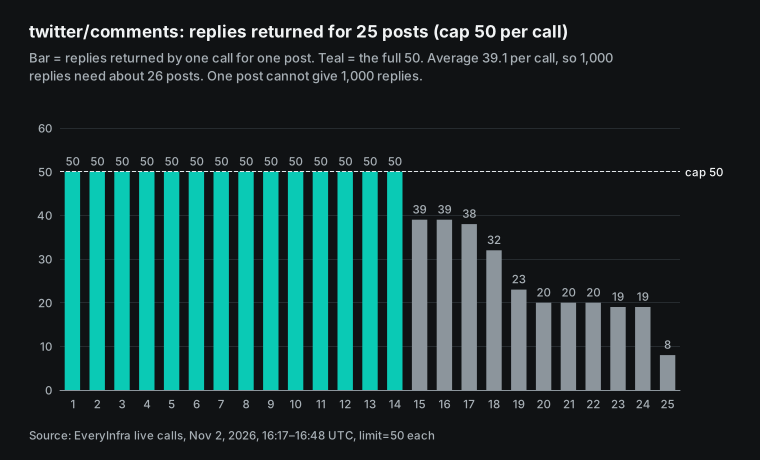
У ответов разрыв наименьший из трёх типов данных, и сильнее всего они зависят от задачи. Нашему эндпоинту twitter/comments нужен id, то есть число после /status/ в URL поста. Он возвращает до 50 ответов за вызов и не поддерживает курсор. Мы вызвали его по одному разу для каждого из 25 постов и получили 977 ответов за $0.0139, то есть $0.0142 за 1 000.
Первый случай — «пакет ответов со многих постов». Например, еженедельный анализ обратной связи под 200 постами бренда. Здесь мы берём $0,000556 за пост. Парсер ответов Apify стоит от $0,014 за пост, так что мы дешевле в 25 раз. По сравнению с самым дешёвым вариантом, парсером ответов xquik за $0,00015 за ответ, мы дешевле в 10,5 раза.
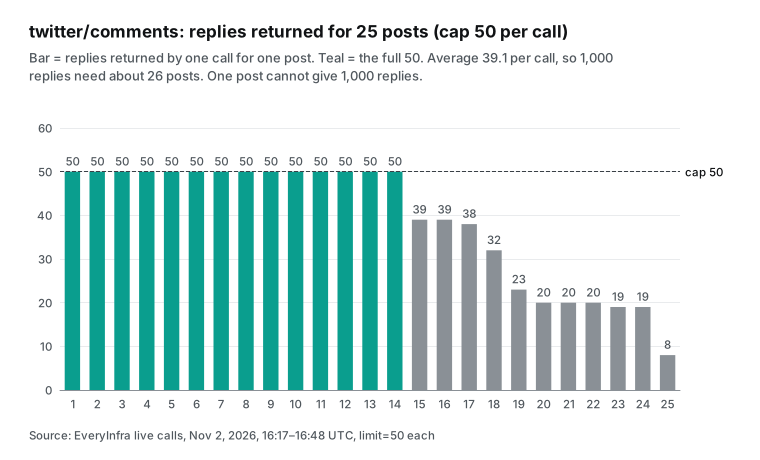
Из наших 25 вызовов 14 вернули полные 50 ответов. Остальные 11 вернули 39, 39, 38, 32, 23, 20, 20, 20, 19, 19 и 8. Результат 8 дал наш небольшой контрольный пост, у которого всего 8 ответов, так что мы получили их все. А вот 6 крупных постов, у каждого из которых от 2 500 до 6 800 ответов, вернули только от 19 до 23.
Затем мы изучили сырые ответы по 24 крупным постам. Закономерность очевидна. 14 полных вызовов вернули свежие ответы с медианой 0 лайков на ответ. 10 неполных вызовов пришлись на посты возрастом от нескольких недель до двух лет. Ответы в них были отсортированы по лайкам, а медиана лайков составляла от 6 до 1 880.
Значит, для новых постов вы получаете последние ответы. Для старых вирусных постов вы получаете топовые ответы, которые X показывает первыми, а блок «Показать больше ответов» остаётся закрытым. Нашей команде бэкенда ещё предстоит подтвердить первопричину. При планировании рассчитывайте на 50 ответов для новых постов и около 20 для старых вирусных.
Второй сценарий: «как можно больше ответов к одному посту». Например, исследование тысяч комментариев под одним вирусным постом. Наш эндпоинт останавливается на 50 ответах на пост, поэтому с такой задачей не справится. На странице Apify reply scraper указано, что он автоматически листает ответы постранично. Если стандартный сценарий возвращает слишком мало, useSearch добирает остальное через поиск conversation_id:. Один пост с 1 000 ответов обходится там примерно в $0.398.
Для этой задачи Apify подходит лучше, а подходящего эндпоинта у нас нет. Если вам нужна только ветка, которую автор опубликовал под собственным постом, у нас есть twitter/thread. Он возвращает до 100 постов за $0.002153 за вызов. Но ветка не равна полному набору ответов.
Соотношение прямых и вложенных ответов тоже сильно меняется. У поста OpenAI 35 из 50 ответов были прямыми, а 15 вложенными. У одного поста с более чем 20 000 ответов прямыми были только 10 из 50. У другого поста 49 из 50 оказались вложенными ответами от 19 авторов, что похоже на один длинный спор. Для анализа тональности разделяйте два уровня по reply_to_id. Это поле заполнено у 99% ответов.
В 16:48 UTC (00:48 по сингапурскому времени) мы повторили запрос для поста OpenAI. Все 50 ответов совпали с полученными 29 минутами ранее.
Поля: возвращают ли оба сервиса одинаковые данные?
Поля в ответах двух сервисов различаются. Здесь мы приводим только долю заполненности наших полей и поля Apify, которых у нас нет. Мы проверили каждое поле на 1 400 записях поиска, 200 постах аккаунтов и 977 ответах. Поля view_count, bookmark_count, language, author_follower_count и author_is_verified были заполнены в 100% записей. Поле media заполнено в 42%, 44% и 18% записей, поскольку во многих постах нет изображений или видео.
Поле hashtags было заполнено только в 1–4% записей. Мы проверили эти записи по одной. У каждого поста с тегом # поле было заполнено, а у остальных просто не было тегов.
| Поле | Поиск (1 400) | Посты аккаунта (200) | Ответы (977) | Примечание |
|---|---|---|---|---|
view_count, bookmark_count, language | 100% | 100% | 100% | В каждой записи |
author_follower_count, author_is_verified | 100% | 100% | 100% | Данные автора приходят с каждым постом |
media | 42% | 44% | 18% | Пусто, если в посте нет медиа |
mentions | 12% | 84% | 95% | В ответах часто упоминаются другие аккаунты |
links | 22% | 40% | 4% | Доля постов с внешней ссылкой |
reply_to_id | 0% | 24% | 99% | Есть только у ответов |
author_bio, source | 0% | 0% | 0% | Для био вызовите twitter/profile |
На странице парсера ответов Apify сказано, что каждый ответ содержит полный профиль автора, включая био, а также данные о клиенте, из которого он был опубликован. Наши три эндпоинта эти два поля не возвращают. Для био нужен отдельный вызов twitter/profile. Если в вашем анализе авторы ответов группируются по био, например по должности, Apify даёт эти данные за один проход.
Названия полей тоже различаются, поэтому при переходе нужен шаг сопоставления. В примере вывода V2 лайки хранятся в likeCount, репосты в retweetCount, а время публикации в createdAt. Время выглядит так: Fri Nov 24 17:49:36 +0000 2023. Язык хранится в lang, а данные автора лежат во вложенном объекте author с полями userName и followers.
У нас это like_count, retweet_count, posted_at и language. Время у нас в формате ISO 8601 с часовым поясом. Данные автора лежат на верхнем уровне, в полях вроде author_username и author_follower_count. В примере V2 есть ещё поле source, в котором указан клиент, использованный для публикации. В наших трёх эндпоинтах это поле пустое.
Нужно ли платить за вызовы с ошибкой или без данных?
У нас все 6 вызовов без данных стоили $0. Они делятся на три группы. Вызовы первой группы отклоняются на этапе проверки аутентификации или параметров. Вызов без ключа возвращает статус 401 с кодом missing_key.
Вызов с лишним параметром max_items завершается ошибкой 422. В сообщении об ошибке перечислены допустимые параметры keyword, limit и sort, а также приведён рабочий пример запроса. При превышении лимита запросов вызов завершается ошибкой 429 с указанием времени ожидания до повторной попытки.
Вторая группа — «не найдено». Несуществующее имя пользователя и несуществующий ID поста вернули HTTP 200 примерно через 40 секунд. count был равен 0, billing.reason — empty_result_refunded, а refund.status — succeeded. Третья группа — наша ошибка.
Мы передали в id полный URL поста. Каталог предупреждает, что так делать нельзя, но API не вернул 422. Он обработал вызов как «не найдено» и вернул средства. Для пользователя это неудобно, и мы зарегистрировали это как проблему.
| Сценарий | Время (по сингапурскому времени, 3 ноября) | HTTP | Код или причина | `charged_usd` |
|---|---|---|---|---|
| Нет API-ключа | 00:21 | 401 | missing_key | 0 |
| Несуществующее имя пользователя | 00:21 | 200 | empty_result_refunded, возврат средств выполнен | 0.0 |
| Более 10 вызовов в минуту | 00:24 | 429 | rate_limited, «Плата не списывалась» | 0 |
Полный URL в id | 00:28 | 200 | empty_result_refunded | 0.0 |
Лишний параметр max_items | 00:29 | 422 | unknown_param, показан список допустимых параметров | 0 |
| Несуществующий ID поста | 00:29 | 200 | empty_result_refunded | 0.0 |
В случае с Apify мы только цитируем текст страниц. В описании V2 сказано, что каждый запрос должен возвращать не менее 50 твитов. При этом не указано, сколько списывается, если запрос возвращает меньше. Парсер ответов взимает плату за запрос «один раз за каждую обработанную запись с tweetId или URL».
Там же предупреждают, что пост без ответов «возвращает пустой датасет и впустую расходует время выполнения». Возвращается ли плата за запрос при пустом результате, не сказано. Два парсера scraper_one берут фиксированные $0.0025 за запуск, а danek взимает стартовую плату за каждый ГБ памяти.
В документации Apify об использовании и ресурсах объясняется, как тарифицируются вычислительные единицы, хранилище и передача данных. В документации по модели pay-per-event разработчикам также советуют брать плату за результаты только после их сохранения. Если запуск прерван, пользователи не должны платить за результаты, к которым у них нет доступа.
Публичный API акторов также показывает результаты запусков за последние 30 дней. Для девяти парсеров из этой статьи мы пересчитали количество прерванных, завершившихся по тайм-ауту и завершившихся с ошибкой запусков в показатель на 10 000 запусков.
| Парсер Apify | Запуски за последние 30 дней | Прерваны | Тайм-аут | Ошибка | Незавершённых запусков на 10 000 |
|---|---|---|---|---|---|
| Tweet Scraper V2 | 4,688,523 | 35,721 | 5,536 | 0 | 88.0 |
| Cheapest Twitter Scraper (kaitoeasyapi) | 2,653,176 | 41,433 | 3,276 | 1,583 | 174.5 |
| X Tweet Scraper (xquik) | 2,820,359 | 228 | 1 | 3 | 0.8 |
| Twitter Scraper (danek) | 2,396,418 | 3,132 | 422 | 0 | 14.8 |
| Scraper Unlimited (apidojo) | 1,552,877 | 418 | 609 | 0 | 6.6 |
| X Tweet Scraper (feedminer) | 58,004 | 1 | 147 | 0 | 25.5 |
| Profile Posts Scraper (scraper_one) | 36,776 | 17 | 55 | 0 | 19.6 |
| Replies Scraper (apidojo) | 6,118 | 7 | 2 | 0 | 14.7 |
| X Reply Scraper (xquik) | 39,518 | 32 | 0 | 0 | 8.1 |
Многие прерванные запуски пользователи останавливают сами, так что прерывание не всегда вина парсера. Эта таблица подтверждает только одно утверждение. Самый дешёвый парсер твитов xquik оказался самым стабильным: 0,8 незавершённого запуска на 10 000. У V2, самого популярного парсера, таких запусков 88 на 10 000.
Самый высокий показатель у kaitoeasyapi: 174,5. На страницах не указано, сколько стоили эти запуски, и извне это определить невозможно. О том, как мы сверяем неудачные вызовы и возвраты средств, читайте в статье сверка возвратов за сбои.
Более 400 парсеров Twitter в Apify Store: как распределяются цены
Мы воспользовались публичным API поиска в Store (документация Store API) с четырьмя поисковыми запросами: twitter, tweet, x scraper и x.com. После объединения результатов и удаления дубликатов осталось 406 акторов. Из них 380 используют модель pay-per-event, а 372 указывают цену за результат. Мы сгруппировали их по названию и описанию: 175 для твитов, 48 для профилей, 37 для подписчиков, 36 для ответов, 36 для трендов и 40 для медиаконтента и других данных.
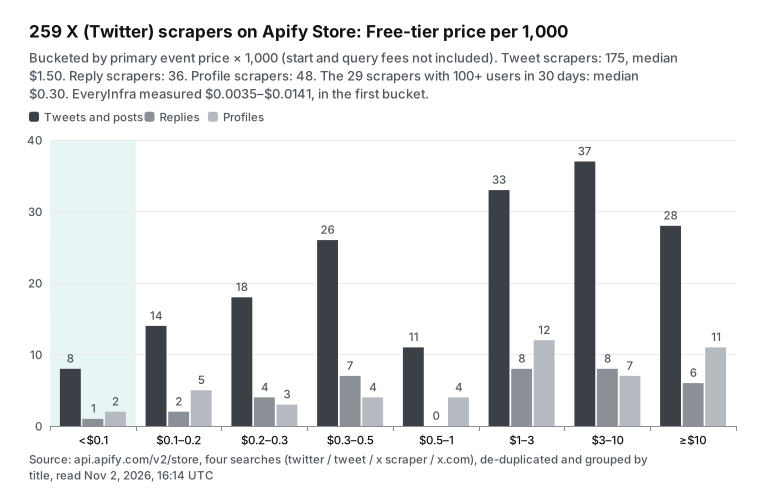
Медианная цена 175 парсеров твитов на тарифе Free составляет $1.50 за 1 000. Это почти в 4 раза больше цены V2. Однако медиану завышают многочисленные парсеры с небольшим числом пользователей. Если оставить только 29 парсеров, у которых за последние 30 дней было не менее 100 пользователей, медиана составит $0.30. При взвешивании по числу пользователей за последние 30 дней среднее значение равно $1.42 за 1 000.
Пользователи сильно сконцентрированы. На 5 крупнейших парсеров приходится 68.4% всех пользователей за 30 дней среди 372 парсеров (всего 32 822 пользователя). Самый дешёвый парсер указывает цену $0.01 за 1 000, но за 30 дней у него было всего 8 пользователей, поэтому мы не считали его популярным. Итого: самые популярные парсеры Twitter стоят от $0.12 до $0.40 за 1 000. Все три наши измеренные цены ниже $0.015.
В нашей предыдущей статье о ценах Apify в целом разобраны тарифы Apify, вычислительные единицы и правила pay-per-event. В статье об альтернативах Apify сравниваются несколько платформ. Эта статья содержит данные, которых нет в двух предыдущих: количество записей Twitter, полученных при реальных вызовах, а также распределение цен и данные о запусках парсеров Twitter из Store. Чтобы увидеть картину шире, начните с нашего обзора альтернатив.
Точка безубыточности: когда при малом числе записей за вызов оплата за каждую запись выходит дешевле
Мы берём плату за каждый запрос, а большинство парсеров Twitter в Store берут плату за каждую запись. Точку безубыточности посчитать просто: разделите нашу цену запроса $0,000556 на цену записи у другой стороны. V2 берёт $0,0004 за запись, так что точка безубыточности составляет 1,39 записи за вызов.
Xquik берёт $0,00015, значит, 3,71 записи. Feedminer берёт $0,00012 на тарифе Free, это 4,63 записи, а при цене тарифа Business $0,0001 получается 5,56 записи. X API берёт $0,005 за пост, поэтому точка безубыточности составляет 0,11 записи.
| Цена за запись | Источник | Точка безубыточности, записей за вызов | EveryInfra дешевле, если вызов возвращает |
|---|---|---|---|
| $0.005 | X API с оплатой по факту использования | 0.11 | От 1 записи |
| $0.0004 | Tweet Scraper V2 | 1.39 | От 2 записей |
| $0.00015 | xquik | 3.71 | От 4 записей |
| $0.00012 | feedminer, тариф Free | 4.63 | От 5 записей |
| $0.0001 | feedminer, тариф Business | 5.56 | От 6 записей |
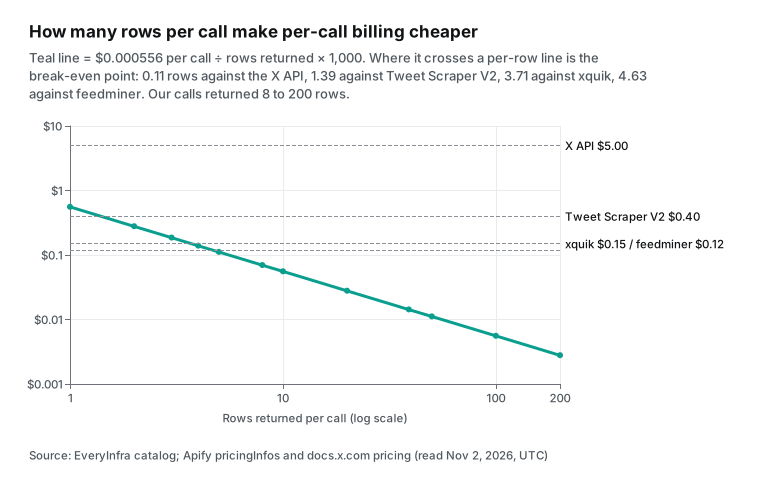
В каких реальных задачах вызов возвращает всего несколько записей? Первый случай: запрос одного поста. Наш эндпоинт twitter/post стоит $0.000556 за один пост, то есть $0.556 за 1 000. Это дороже, чем у xquik или feedminer.
Но это намного дешевле цены за отдельный твит в Unlimited, которая составляет $0,05 за твит, потому что V2 не принимает отдельные твиты. Второй случай — небольшой аккаунт, который публикует два-три поста в день. Каждая проверка находит лишь несколько новых постов.
Третий случай: наш небольшой контрольный пост с 8 ответами. Мы списали за него $0.0695 за 1 000. Парсер ответов apidojo взимает единоразовую плату $0.014 за запрос, а все 8 ответов укладываются в первые 40 бесплатных. Получается $1.75 за 1 000.
У xquik цена $0.15 за 1 000. Scraper_one берёт $0.0025 за запуск плюс плату за 8 ответов, то есть $0.5625 за 1 000. Так что на этом небольшом посте мы всё равно дешевле всех. Но если вызов возвращает меньше примерно 3 записей, xquik и feedminer обходятся дешевле.
Месячный счёт: три типичные задачи на 30 дней
Теперь подставим измеренное число записей в три типовые задачи. Для EveryInfra мы переводим записи в вызовы по измеренному числу записей на вызов, затем умножаем на $0,000556. Для Apify мы умножаем прейскурантную цену на число записей. Сюда не входят плата за использование платформы и ежемесячная плата за тариф. Для X API мы берём $0,005 за пост. Сюда не входят лимит в 3 миллиона постов в месяц и скидка за дедупликацию в тот же день.
| Задача | Записей за 30 дней | EveryInfra | V2 или парсер ответов apidojo | xquik | X API с оплатой по факту использования |
|---|---|---|---|---|---|
| Мониторинг бренда: 20 ключевых слов по 200 твитов, ежедневно | 120,000 | $0,33 (600 вызовов) | $48.00 | $18.00 | $600.00 |
| Архив аккаунтов: 50 аккаунтов по 1 000 постов | 50,000 | $0,17 (около 300 вызовов) | $20.00 | $7.50 | $250.00 |
| Мониторинг ответов: 200 постов в неделю по 50 ответов | 40,000 | $0,44 (800 вызовов) | $14.40 | $6.00 | $200.00 |
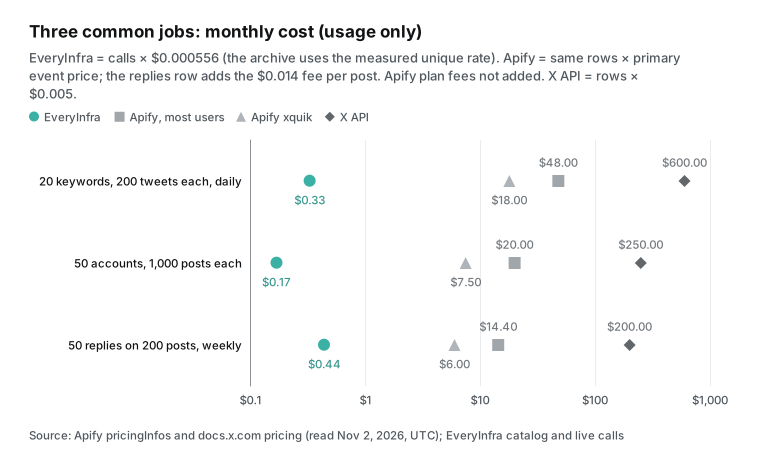
Из таблицы видно три вещи. Во-первых, в задачах, где каждый вызов заполняет страницу, разрыв по-прежнему исчисляется десятками раз. Причина в том, что за одно списание можно получить 200 записей, а в случае ответов — 50 записей. Во-вторых, к счёту Apify нужно добавить плату за тариф. Бесплатные пользователи V2 получают только 50 твитов в месяц, поэтому для этих задач нужен как минимум тариф Starter, который стоит от $19 в месяц. У нас нет ежемесячной платы, основной баланс не сгорает, а плата за неуспешные вызовы не взимается.
В-третьих, страница V2 ограничивает каждого пользователя 1 параллельным запуском с не более чем 5 запросами. Там же сказано не использовать V2 для мониторинга одним и тем же запросом с короткими интервалами. Так что строка про мониторинг бренда описывает сценарий, который V2 не поддерживает. Для таких задач страница рекомендует Unlimited.
Для X API на странице цен X указано $0,005 за чтение поста и $0,010 за чтение пользователя. Количество чтений постов ограничено 3 миллионами в месяц (использование и оплата). Если один и тот же пост прочитан дважды за одни сутки по UTC, это считается одним чтением, поэтому реальные счета немного ниже, чем в таблице.
Полный пример: еженедельный отчёт по ответам на посты бренда в n8n
Многие читатели страниц про «парсер Twitter от Apify» автоматизируют свои задачи в n8n. Вот еженедельный отчёт, в котором собраны все три типа данных. Каждый понедельник вы находите по 200 постов для каждого из 20 ключевых слов, чтобы определить самые обсуждаемые посты. Затем отбираете 50 постов по reply_count и получаете по 50 ответов на каждый. В конце модель распределяет ответы по категориям: жалобы, вопросы и похвала.
У нас это 20 вызовов twitter/search плюс 50 вызовов twitter/comments. Эти 70 вызовов стоят $0,0389 в неделю, или около $0,16 за четыре недели. Расчёт предполагает полные или почти полные страницы, как в наших тестах. В n8n каждый вызов выполняется одним узлом HTTP Request. Ниже показано тело запроса для одного поиска в этом узле.
{
  "parameters": {
    "method": "POST",
    "url": "https://api.everyinfra.com/api/v1/social",
    "sendHeaders": true,
    "headerParameters": { "parameters": [
      { "name": "Authorization", "value": "=Bearer {{ $env.EVERYINFRA_API_KEY }}" }
    ] },
    "sendBody": true,
    "specifyBody": "json",
    "jsonBody": "={ \"platform\": \"twitter\", \"action\": \"search\", \"params\": { \"keyword\": \"{{ $json.keyword }}\", \"limit\": 200 } }"
  },
  "type": "n8n-nodes-base.httpRequest",
  "name": "EveryInfra twitter/search"
}
На Apify ту же задачу по прейскурантным ценам можно решить двумя способами. Первый: V2 плюс парсер ответов. Поиск обходится в 4 000 записей x $0.0004 = $1.60, ответы в 50 постов x ($0.014 + 10 x $0.0004) = $0.90. Итого $2.50 в неделю. Но V2 не рекомендует повторно запускать один и тот же запрос для мониторинга и принимает не более 5 запросов за запуск. Поэтому для 20 ключевых слов нужно 4 запуска.
Второй способ: Unlimited. Двадцать запросов стоят 20 x $0.016 = $0.32. Каждый запрос возвращает 160 записей сверх 40 бесплатных. При 20 запросах за запуск эти записи тарифицируются по диапазону от 11 до 30 запросов, то есть по $0.0012. Итого 3 200 x $0.0012 = $3.84.
С учётом $0,90 за ответы итог составляет $5,06 в неделю. Ни в одном из вариантов не учтена плата за тариф Starter. Шаг с моделью стоит одинаково в обоих вариантах. В этом примере мы дешевле в 64–130 раз. Разрыв больше, чем в сводной таблице, из-за диапазонов цен Unlimited.
X API, Apify и EveryInfra: сравнение
В феврале 2026 года X перевела свой API на оплату по факту использования (pay-per-use). 14 августа компания объявила, что после 1 сентября на эту модель перейдут и устаревшие тарифы Pro (форум разработчиков X). У pay-per-use нет абонентской платы, но обходится он дороже. Посты стоят $5 за 1 000, что в 12.5 раза дороже V2 и примерно в 1 500 раз дороже цены поиска по нашим замерам.
Недавно правила бесплатных кредитов менялись дважды. С 2 октября новые аккаунты pay-per-use получают $20 после первой покупки кредитов и до $50 дополнительно за подключение автопополнения. 13 октября компания X изменила правило: одна лишь сохранённая карта больше не даёт $20. Кредиты сгорают через 3 месяца (страница о бесплатных кредитах).
У X API также другие лимиты запросов и охват. Поиск по недавним постам допускает 450 запросов за 15 минут, а поиск по полному архиву — 1 запрос в секунду (лимиты запросов). Аккаунтам с оплатой pay-per-use доступен поиск по полному архиву (документация по поиску). Ленты пользователей ограничены 3 200 последними постами. С 4 мая поиск по ключевым словам больше не возвращает репосты.
| Характеристика X API | Значение | Источник |
|---|---|---|
| Чтение поста | $0,005 за каждое | Страница цен X |
| Чтение пользователя | $0,010 за каждое | Страница цен X |
| Месячный лимит | 3 миллиона чтений постов | Страница об использовании и оплате |
| Один и тот же пост дважды за сутки по UTC | Оплачивается один раз | Страница об использовании и оплате |
| Глубина пользовательской ленты | Последние 3 200 постов | Документация по лентам |
| Лимит запросов для поиска по недавним постам | 450 запросов за 15 минут | Страница о лимитах запросов |
| Лимит запросов для поиска по полному архиву | 1 запрос в секунду | Страница о лимитах запросов |
| Бесплатные кредиты | $20 после первой покупки, до $50 за автопополнение, сгорают через 3 месяца | Страница о бесплатных кредитах |
X API — это вариант, цены на который устанавливает сама компания X; его условия наиболее прозрачны. Через него также можно публиковать посты и управлять собственным аккаунтом. Подробнее см. в разделах «Об X API» и «Получение доступа». X также публикует xmcp — MCP-сервер с открытым исходным кодом.
Скорость и параллельные запросы
У нас один вызов twitter/search на 200 записей занимал от 35,2 до 53,4 секунды, медиана составила 39,3 секунды. Вызов user_posts на 200 записей занимал около 33 секунд. Вызов comments на 50 записей занимал от 14 до 23 секунд, медиана составила 19,8 секунды. Один процесс с синхронными вызовами получает около 300 твитов в минуту. Наш тестовый API-ключ допускал 10 запросов в минуту, а лимит для продакшен-аккаунтов указан в консоли.
| Инструмент | Записей за вызов или запуск | Измеренное или заявленное время | Записей в минуту |
|---|---|---|---|
EveryInfra twitter/search | 200 | 35,2–53,4 с, медиана 39,3 с (измерено) | Около 300 на процесс |
EveryInfra twitter/user_posts | 200 | Около 33 с (измерено) | Около 360 на процесс |
EveryInfra twitter/comments | До 50 | 14–23 с, медиана 19,8 с (измерено) | Около 120 на процесс при 39,1 записи за вызов |
| Tweet Scraper V2 | От 50 на запрос | 30–80 твитов в секунду (по тексту страницы) | От 1 800 до 4 800 |
На странице V2 указано от 30 до 80 твитов в секунду, то есть от 1 800 до 4 800 в минуту. Поэтому один большой запуск V2 работает быстрее. Лимиты платформы Apify определяют, сколько actors один аккаунт может запускать одновременно и сколько памяти им доступно. Если вам нужны сотни тысяч постов как можно быстрее, один крупный запуск Apify обойдёт наши постраничные вызовы. Если же нужно несколько тысяч постов в день по расписанию, оба варианта справятся за считаные минуты.
Использование в ИИ-клиентах: настройка MCP
Для ИИ-клиентов подключите наш удалённый MCP-сервер по адресу https://api.everyinfra.com/mcp. Названия инструментов начинаются с everyinfra_. Модель может сама выбрать twitter/search или twitter/comments.
Конфигурация ниже приведена как общий пример. Claude Code и другие клиенты с поддержкой удалённого MCP используют похожий формат. Точный синтаксис смотрите в документации Claude Code по MCP и документации OpenAI по MCP. Протокол описан в спецификации MCP.
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
У Apify тоже есть MCP-сервер, который превращает акторов из Store в инструменты для модели (документация Apify MCP, исходный код на GitHub). Эти два подхода различаются. С Apify MCP модель запускает актор, ждёт завершения запуска, а затем читает набор данных. Это подходит для крупных пакетных задач.
С нашим MCP каждый вызов инструмента сразу возвращает данные. Это удобно в чате, где вы спрашиваете и проверяете результат по ходу. Поддерживаемые клиенты перечислены на странице MCP-сервера.
Переход с Apify: соответствие параметров
Если вы уже используете V2 или парсер ответов, в этой таблице показано соответствие входных параметров. Названия параметров Apify взяты из примеров входных данных в публичных метаданных акторов и со страниц Store. Поля выходных данных различаются, поэтому их нужно заново сопоставить с помощью нашего параметра response_fields.
| Задача | Входные данные Apify | Входные данные EveryInfra | Примечание |
|---|---|---|---|
| Поиск по ключевому слову | V2 searchTerms + maxItems | twitter/search с keyword + limit (не больше 200) | Одно ключевое слово на вызов; чтобы получить больше, разбивайте по датам |
| Сортировка | V2 sort: Latest, Top, Latest + Top | sort: latest или Top по умолчанию | В нашем тесте совпали 137 из 200 записей |
| Язык | V2 tweetLanguage | lang:es внутри keyword | Пример: inteligencia artificial lang:es |
| Один аккаунт | V2 twitterHandles или from: | twitter/user_posts с username; для старых постов поиск с from: | user_posts: не больше 200 за вызов |
| Ответы на пост | Парсер ответов: tweetIds или URL | twitter/comments с числовым id | Максимум 50 на пост; запрос по URL возвращает 0 записей, средства возвращаются |
| Один пост | Unlimited по URL твита ($0,05) | twitter/post | $0,000556 за вызов |
| Подписчики | Событие подписчика в парсере пользователей apidojo | twitter/followers_list, до 2 000 | $0,000556 за вызов |
У нашего API для парсинга Twitter 21 эндпоинт, и все они уже доступны в каталоге. Помимо трёх описанных выше, он охватывает профили, списки подписчиков и подписок, ретвитнувших пользователей, посты сообществ и транскрипты видео. Параметры, поля ответа и цену каждого эндпоинта можно посмотреть в бесплатном каталоге (API каталога). Для каталога ключ не нужен.
Как мы проверяли эти цифры
Скрипт заново рассчитал по 52 исходным ответам все цифры EveryInfra в тексте, таблицах и графиках. Число записей равно длине results. Дедупликация выполняется по id поста. Списанная сумма берётся из billing.charged_usd. Время указано по локальным часам на момент отправки вызова и записано по сингапурскому времени.
Все цены Apify, число пользователей и число запусков мы считали из публичных метаданных в одно и то же время, с 00:14 до 00:16 по сингапурскому времени. Мы также сделали скриншот примечания о ценах V2. При расчёте точек безубыточности и месячных счетов использовались только эти два вида данных. Три вопроса остаются открытыми.
Причина того, что вызовы ответов на старые посты возвращают мало записей, пока не установлена; закономерность показана в тесте 3. Мы не знаем размер платы за использование платформы для xquik. И мы не можем проверить извне, что feedminer берёт результаты поиска по ключевым словам из X Communities.
Когда Apify подходит лучше
Вот где Apify справляется лучше или где у нас нет аналога. Во-первых, тысячи ответов на один пост. Мы останавливаемся на 50 ответах на пост, а парсер ответов Apify проходит примерно 1 000 ответов примерно за $0.40. Во-вторых, от 1 до 3 записей за вызов. Парсеры с оплатой за запись, такие как xquik и feedminer, обходятся дешевле: точки безубыточности составляют 3.71 и 4.63 записи.
В-третьих, сотни тысяч постов можно получить максимально быстро. На странице V2 указана скорость 30–80 твитов в секунду, а один крупный запуск Apify может выполнить задачу параллельно. Мы возвращаем одну страницу за синхронный вызов. В-четвёртых, расписания, хранилище и вебхуки доступны в одном месте. У Apify есть расписания, датасеты и вебхуки, поэтому запуск может отправлять результаты в Google Sheets или на ваш сервер. Мы возвращаем только данные, а расписание и хранение данных вы организуете сами.
В-пятых, описания профилей авторов и клиенты, из которых опубликованы посты. На странице парсера ответов Apify указано и то и другое, а наши три эндпоинта эти данные не возвращают. В-шестых, точные диапазоны дат. В наших тестах с однодневным окном в него попали только от 48 до 85 из 200 постов. V2 тоже предупреждает, что until уменьшает число результатов, но предлагает собственные параметры дат. Если вам важны точные диапазоны, протестируйте оба варианта.
| Задача | Что выбрать | Почему |
|---|---|---|
| Тысячи ответов на один пост | Парсер ответов Apify | Мы возвращаем не более 50 ответов на один пост |
| 1–3 записи на вызов | xquik или feedminer | Тариф с оплатой за запись выгоднее, если вызов возвращает меньше 3,71 или 4,63 записи |
| Быстро получить сотни тысяч постов | Apify | 30–80 твитов в секунду в одном запуске |
| Расписания, хранилище и вебхуки в одном месте | Apify | Мы возвращаем только данные |
| Описание профиля автора и клиент, через который опубликован каждый ответ | Парсер ответов Apify | Наши три эндпоинта их не возвращают |
| Полные страницы с результатами поиска, постами аккаунта или ответами на разные посты | EveryInfra | В 10–122 раза дешевле за 1 000 записей |
Условия X, обязательный вход в аккаунт и правовые ограничения
Условия обслуживания X вступили в силу 9 октября 2026 года. В них сказано: «обход или парсинг Сервисов в любой форме и для любых целей без нашего предварительного письменного согласия прямо запрещён» (X Terms of Service). Отдельные Developer Terms вводят дополнительные ограничения на данные из API.
Эти условия обязательны для пользователей X. Что они значат для вашего проекта, уточните у юриста. Эта статья не является юридической консультацией.
Публичные материалы можно изучить самостоятельно: X Corp. v. Bright Data (материалы дела), hiQ v. LinkedIn (решение суда) и меры ЕС в отношении X по Закону о цифровых услугах (DSA) (новость Еврокомиссии, план действий).
Требование входа в аккаунт — отдельный вопрос. На странице парсера ответов apidojo сказано, что вход и прокси не требуются. На странице V2 сказано, что он возвращает то, что показывает поиск X, и что X может в любой момент изменить поиск, пагинацию и фильтры. С нашей стороны вам не нужно передавать нам аккаунт X.
Ни один из наших 52 вызовов не вернул ошибку «login required», а при всех вызовах для получения данных Twitter сервер вернул код HTTP 200.
Что изменилось за последнее время
| Дата | Что изменилось и что это значит для вас | Источник |
|---|---|---|
| 2026-10-13 | X обновил правило бесплатных кредитов. Одна только сохранённая карта больше не даёт $20. Чтобы получить бонус, сначала нужно купить кредиты. | Free credits |
| 2026-10-09 | Вступили в силу новые Условия обслуживания X. Читайте актуальный текст: старые цитаты могут быть устаревшими. | X Terms |
| 2026-10-02 | X добавил кредиты за первую покупку для аккаунтов с оплатой по факту использования, до $70; они сгорают через 3 месяца. Используйте их до истечения срока. | X API changelog |
| 2026-09-24 | Начали действовать текущие цены danek Twitter Scraper со стартовой платой за каждый ГБ памяти. Множество небольших запусков обходится дороже. | Метаданные danek |
| Конец сентября | На странице feedminer сказано, что X начал отклонять его запросы к поисковому индексу. Результаты по ключевым словам без from: теперь берутся из X Communities. Посты аккаунтов это не затрагивает. | Страница feedminer в Store |
Главная тенденция в том, что цены меняются часто. Из 14 изученных нами парсеров Twitter у 10 текущие цены действуют с середины августа или позже. Например, у xquik с 29 августа, у scraper_one с 30 и 31 августа. У каждого ценового периода в метаданных есть дата startedAt. Для вас это значит, что цены Apify в любом сравнении, включая это, через два-три месяца могут оказаться неверными. Перед покупкой заново проверьте публичные метаданные и запишите время проверки.
С чего начать: от одного пробного вызова до ежедневной задачи
Поставьте звезду обоим нашим репозиториям на GitHub, everyinfra/everyinfra-agent-plugins и everyinfra/seo-skills, и сможете получить в консоли пробные кредиты на $1. Они действуют 24 часа: этого хватит, чтобы выполнить все 52 вызова из этой статьи более 30 раз. Получите API-ключ в разделе Быстрый старт. Откройте страницу API для парсинга Twitter, чтобы увидеть все эндпоинты. Затем попробуйте песочницу на трёх страницах: API для парсинга поиска Twitter, API для парсинга постов аккаунта Twitter и API для парсинга ответов в Twitter.
Данные профилей смотрите в API для парсинга профилей Twitter. Тот же подход работает для API для парсинга Reddit и API для парсинга Bluesky. Все эндпоинты и цены собраны в маркетплейсе данных и на странице тарифов. Другие сравнения с Apify в пересчёте на 1 000 записей: альтернатива парсеру TikTok от Apify и альтернатива парсеру Instagram от Apify. О том, как заставить модель вызывать эндпоинты данных с точными полями, читайте в статье Строгий вызов инструментов Claude с API данных.
FAQ
Бесплатен ли парсер Twitter от Apify?
Источник: поисковая подсказка «apify twitter scraper free», проверено 3 ноября 2026 года. Бесплатный план Apify ежемесячно даёт $5 в виде кредитов платформы. Но на страницах V2 и парсера ответов apidojo сказано, что бесплатным пользователям доступно 5 запусков в месяц, не более 10 записей в каждом. В V2 также указано, что бесплатные пользователи не могут вызывать его через API.
Так что «бесплатного» хватает, чтобы посмотреть формат вывода, и не более. У нас пробные кредиты на $1 действуют 24 часа. При 200 твитах на вызов их хватает более чем на 300 000 твитов. Дальше действует оплата за каждый запрос без ежемесячной платы.
Сколько стоит парсер твитов Apify и почему в некоторых постах пишут $0.004 за 1 000?
Источник: популярный поисковый запрос «apify tweet scraper pricing» и пост в r/n8n (ветка). V2 стоит $0.0004 за твит, то есть $0.40 за 1 000. В посте на r/n8n указано $0.004 за 1 000: там потеряны два знака после запятой. Ориентируйтесь на $0.40, как указано в публичных метаданных.
Ещё в одном руководстве на r/n8n V2 сравнивали с X API так: «40 центов за 1,000 твитов против $200 за 15,000» (ветка). Это была цена старого тарифа Basic. Сейчас X использует оплату по факту использования: $5 за 1 000 постов.
Может ли парсер комментариев Twitter от Apify получить все ответы на пост?
Источник: поисковая подсказка «apify twitter comments scraper», проверено 3 ноября 2026 года. На странице парсера ответов apidojo сказано, что он сам выполняет пагинацию по ответам. Если стандартный сценарий возвращает слишком мало, useSearch добавляет поиск conversation_id:. Там же сказано, что удалённые и защищённые посты не поддерживаются. Наш twitter/comments останавливается на 50 ответах на пост и не может получить их все. Для тысяч ответов на один пост Apify подходит лучше.
Разрешает ли Twitter парсинг и законно ли парсить X?
Источник: поисковые подсказки «does twitter allow scraping» и «is it legal to scrape twitter», проверено 3 ноября 2026 года. Условия обслуживания X от 9 октября 2026 года запрещают парсинг без письменного согласия. В правовом разделе выше есть ссылки на материалы дела X v. Bright Data, решение по делу hiQ v. LinkedIn и штраф ЕС в отношении X.
Ответ зависит от вашей страны, данных и способа их использования. Проконсультируйтесь с юристом. Эта статья не является юридической консультацией.
Какой API для парсинга Twitter самый дешёвый?
Источник: поисковая подсказка «twitter scraper api cheapest», проверено 3 ноября 2026 года. Мы рассматривали парсеры из Store, у которых не менее 100 пользователей за 30 дней.
Самые дешёвые парсеры твитов по публичным ценам: xquik и scrape.badger за $0.15 и feedminer за $0.12. Xquik дополнительно берёт плату за использование платформы, а у feedminer есть ограничение на поиск по ключевым словам. Самая низкая цена в Store составляет $0.01, но у этого парсера было 8 пользователей. У нас оплата за каждый запрос: полная страница из 200 записей стоит $0.00278 за 1 000, или $0.00327 после дедупликации. Если за вызов получается меньше примерно 3 записей, парсеры с оплатой за запись обходятся дешевле.
Парсер X от Apify или X API: что выбрать?
Источник: популярный поисковый запрос «apify x scraper» и руководство на r/n8n, где сравниваются оба варианта (ветка). X API стоит $5 за 1 000 постов с лимитом 3 млн постов в месяц. Цены на этот способ устанавливает сама X, условия у него самые понятные, и через него также можно публиковать посты и управлять собственным аккаунтом. По ценам из этой статьи популярные парсеры Apify стоят от $0.12 до $0.40 за 1 000, а наши цены составляют от $0.003 до $0.014. Условия X ограничивают парсинг, поэтому проконсультируйтесь с юристом по вашему проекту. Для управления собственным аккаунтом используйте X API. Чтобы читать большие объёмы публичных обсуждений, сравните инструменты для парсинга по цене и количеству записей за вызов.
Источники
- Apify / apidojo. «Tweet Scraper V2 - X Scraper / Twitter Scraper / X.com Scraper» (страница в Store). Дата обращения: 2026-11-03.
- Apify API. Публичные метаданные актора apidojo~tweet-scraper (pricingInfos, stats). Дата обращения: 2026-11-03.
- Apify / apidojo. «Twitter (X.com) Scraper Unlimited: No Limits» (страница в Store). Дата обращения: 2026-11-03.
- Apify API. Публичные метаданные актора apidojo~twitter-scraper-lite. Дата обращения: 2026-11-03.
- Apify / apidojo. «Twitter (X) Replies Scraper API» (страница в Store). Дата обращения: 2026-11-03.
- Apify API. Публичные метаданные актора apidojo~twitter-replies-scraper. Дата обращения: 2026-11-03.
- Apify / kaitoeasyapi. «Cheapest Twitter Scraper / RealTime Twitter Data Scraper API» (страница в Store). Дата обращения: 2026-11-03.
- Apify API. Публичные метаданные актора kaitoeasyapi для парсинга твитов. Дата обращения: 2026-11-03.
- Apify / xquik. «Twitter Scraper & X Scraper for Tweets & Search» (страница в Store). Дата обращения: 2026-11-03.
- Apify API. Публичные метаданные актора xquik~x-tweet-scraper. Дата обращения: 2026-11-03.
- Apify / xquik. «X Reply Scraper» (страница в Store). Дата обращения: 2026-11-03.
- Apify API. Публичные метаданные актора xquik~x-reply-scraper. Дата обращения: 2026-11-03.
- Apify / feedminer. «X (Twitter) Tweet Scraper $0.12/1K» (страница в Store). Дата обращения: 2026-11-03.
- Apify API. Публичные метаданные актора feedminer~x-tweet-scraper. Дата обращения: 2026-11-03.
- Apify / scraper_one. «X (Twitter) Profile Posts Scraper» (страница в Store). Дата обращения: 2026-11-03.
- Apify API. Публичные метаданные актора scraper_one~x-profile-posts-scraper. Дата обращения: 2026-11-03.
- Apify API. Публичные метаданные актора scraper_one~x-post-replies-scraper. Дата обращения: 2026-11-03.
- Apify API. Поиск в Store через API /v2/store?search=twitter. Дата обращения: 2026-11-03.
- Apify Docs. «Get list of Actors in Store» (документация API). Дата обращения: 2026-11-03.
- Apify. «Apify pricing». Дата обращения: 2026-11-03.
- Apify Docs. «Actors in Store». Дата обращения: 2026-11-03.
- Apify Docs. «Actor pricing and costs». Дата обращения: 2026-11-03.
- Apify Docs. «Usage and resources». Дата обращения: 2026-11-03.
- Apify Docs. «Limits». Дата обращения: 2026-11-03.
- Apify Docs. «Apify MCP server». Дата обращения: 2026-11-03.
- GitHub. apify/apify-mcp-server. Дата обращения: 2026-11-03.
- Apify Docs. «Schedules». Дата обращения: 2026-11-03.
- Apify Docs. «Webhooks». Дата обращения: 2026-11-03.
- GitHub / igorbrigadir. twitter-advanced-search (список поисковых операторов). Дата обращения: 2026-11-03.
- X Developer Platform. «X API pay-per-usage pricing and credits». Дата обращения: 2026-11-03.
- X Developer Platform. «Usage and Billing» (лимит 3 млн в месяц, дедупликация в пределах дня). Дата обращения: 2026-11-03.
- X Developer Platform. «Search Posts». Дата обращения: 2026-11-03.
- X Developer Platform. Timelines (latest 3 200 posts). Дата обращения: 2026-11-03.
- X Developer Platform. «X API Rate Limits». Дата обращения: 2026-11-03.
- X Developer Platform. «Free credit incentives for X API pay-per-use accounts» (обновлено 2026-10-13). 2026-10-13.
- X Developer Platform. «X API changelog». 2026-10-29.
- Форум X Developers. «Important Update: Legacy X API Pro Plans Are Moving to Pay-Per-Use». 2026-08-14.
- X Corp. «X Terms of Service» (действуют с 2026-10-09). 2026-10-09.
- X Developer Platform. «Developer Terms». Дата обращения: 2026-11-03.
- GitHub / X. xdevplatform/xmcp. Дата обращения: 2026-11-03.
- Европейская комиссия. «Commission fines X €120 million under the Digital Services Act». 2025-12-05.
- Европейская комиссия. «Commission accepts X's action plan to comply with Digital Services Act». 2026-07-16.
- Европейская комиссия. «Press release IP/25/2934». 2025-12-05.
- EUR-Lex. «Regulation (EU) 2022/2065 (Digital Services Act)». 2022-10-19.
- CourtListener. «X Corp. v. Bright Data Ltd., 3:23-cv-03698» (материалы дела). 2024-05-09.
- Апелляционный суд девятого округа США. «hiQ Labs v. LinkedIn, No. 17-16783» (решение Апелляционного суда девятого округа). 2022-04-18.
- Model Context Protocol. «Model Context Protocol Specification 2025-11-25». 2025-11-25.
- Anthropic. «Connect Claude Code to tools via MCP». Дата обращения: 2026-11-03.
- OpenAI. «Connectors and MCP servers». Дата обращения: 2026-11-03.
- Reddit r/n8n. «How to easily scrape data from Twitter / X using Apify». Дата обращения: 2026-11-03.
- Reddit r/n8n. «This Automation Took Me From 0 to 175k Followers in Under 12 Months». Дата обращения: 2026-11-03.
- EveryInfra. Каталог возможностей EveryInfra (бесплатно, без API-ключа). Дата обращения: 2026-11-03 00:16.
- GitHub / Xquik. Xquik-dev/x-twitter-scraper (README: плата за использование платформы взимается отдельно). Дата обращения: 2026-11-03.
- Apify Docs. «Pay per event». Дата обращения: 2026-11-03.
- X Developer Platform. «Getting Access». Дата обращения: 2026-11-03.
- X Developer Platform. «About the X API». Дата обращения: 2026-11-03.
- X Developer Platform. «Build a query» (синтаксис запросов). Дата обращения: 2026-11-03.
- Apify Docs. «Get Actor» (документация API). Дата обращения: 2026-11-03.
- Apify API. Публичные метаданные актора danek~twitter-scraper. Дата обращения: 2026-11-03.
Справка BL-75