Apify Twitter 스크레이퍼 대안: 검색, 프로필 게시물, 답글의 1,000행당 비용 실측
Apify Tweet Scraper V2의 표시 가격은 트윗 1,000개당 $0.40입니다. 저희가 측정한 검색 비용은 $0.0033이었습니다. 답글은 10~25배 저렴했지만 게시물당 50개로 제한됩니다.
Apify Store에서 가장 많이 쓰이는 트윗 스크레이퍼는 Tweet Scraper V2입니다. 공개 가격은 모든 요금제에서 트윗 1,000개당 $0.40입니다. 저희는 2026년 11월 3일에 EveryInfra twitter/search 엔드포인트로 키워드 검색 7회를 실행했습니다. 호출당 비용은 $0.000556이었고 매번 트윗 200개가 반환되었습니다.
중복을 제거하니 고유 트윗 1,190개가 남았고 비용은 $0.003892였습니다. 1,000개당 $0.00327로, V2보다 122배 저렴합니다. 전체 키워드 검색을 지원하는 인기 Store 트윗 스크레이퍼 중 가장 저렴한 것은 $0.15인 xquik이며, 이와 비교하면 차이는 46배입니다.
한 계정의 게시물 1,000개는 고유 게시물 1,000개당 $0.00334로 측정되었습니다. V2보다 120배, 가장 저렴한 인기 옵션($0.12)보다 36배 저렴합니다. 답글은 사정이 다릅니다. 저희 twitter/comments 엔드포인트는 게시물당 최대 50개의 답글을 반환합니다.
게시물 25개에서 호출당 평균 답글은 39.1개였고, 답글 1,000개당 $0.0142였습니다. 저희가 가격을 비교한 Apify 답글 스크레이퍼보다 10~25배 저렴합니다. 하지만 저희 엔드포인트로는 게시물 하나에서 답글 1,000개를 가져올 수 없습니다. 그런 작업에는 Apify가 더 적합합니다.
이 글의 수치를 읽는 법
저희가 말하는 “1,000건당 가격”의 계산법은 간단합니다. 실제로 과금된 금액을 실제로 반환된 행 수로 나눈 뒤 1,000을 곱합니다. EveryInfra는 요청당 과금하며, 요청 하나의 가격은 행 수와 관계없이 같습니다. Apify Store의 Twitter 스크레이퍼 대부분은 결과당 과금합니다. 데이터셋에 기록되는 항목마다 한 번씩 과금됩니다. 두 단위는 분모가 같을 때만 비교할 수 있습니다.
저희 쪽 분모는 게시물 ID로 중복을 제거한 고유 행입니다. limit 값은 분모로 쓰지 않습니다. 따라서 호출이 더 적은 행을 반환하거나 중복 행을 반환하면, 이 글에서 저희 가격은 내려가지 않고 올라갑니다. Apify 쪽은 공개 자료만 사용합니다. Store 페이지, 요금 페이지, 문서, 그리고 계정 없이 쓸 수 있는 공개 actor API입니다.
저희는 Apify에 회원가입하지 않았고 actor도 실행하지 않았습니다. actor는 Apify에서 클라우드 스크래핑 프로그램을 부르는 이름입니다. 따라서 아래의 모든 Apify 수치는 실제 청구액이 아닌 표시 가격입니다.
Apify Twitter 스크레이퍼와 EveryInfra 비교: 요약 표
이 표가 결과입니다. 데이터 유형마다 Apify 스크레이퍼 두 개를 보여 줍니다. 첫 번째는 최근 30일 사용자 수가 가장 많은 대표 스크레이퍼입니다. 두 번째는 최근 30일 사용자가 100명 이상인 스크레이퍼 중 Free 등급 가격이 가장 저렴한 것입니다. 모든 가격은 2026년 11월 2일 16:14 UTC(싱가포르 시간 11월 3일 00:14)에 공개 actor API의 pricingInfos 필드에서 읽었습니다.
Apify 문서는 요금제를 가격 등급에 대응시킵니다. Free는 Free 가격, Starter는 Bronze, Scale은 Silver, Business는 Gold를 사용합니다. Platinum과 Diamond는 엔터프라이즈 고객용입니다(“Actor pricing and costs”). 이 글에서 다루는 Twitter 스크레이퍼는 Free 가격과 Business 가격이 같거나 차이가 절반 미만입니다. 저희 수치는 모두 실제 호출에서 나왔습니다. 과금액은 billing.charged_usd에서, 행 수는 results에서 읽었습니다.
| 데이터 | EveryInfra 엔드포인트 | 호출 수 / 행 수 / 고유 행 수 / 과금액 | EveryInfra 고유 행 1,000개당 비용 | Apify 대표 스크레이퍼 | 차이 | 가장 저렴한 인기 스크레이퍼 | 차이 |
|---|---|---|---|---|---|---|---|
| 키워드 검색 | twitter/search | 7 / 1,400 / 1,190 / $0.003892 | $0.00327 | Tweet Scraper V2, $0.40 | 122x | xquik, $0.15 | 46x |
| 한 계정의 게시물 | twitter/user_posts + from: 검색 | 8 / 1,592 / 1,330 / $0.004448 | $0.00334 | twitterHandles를 사용한 V2, $0.40 | 120x | feedminer, $0.12 | 36x |
| 게시물 답글 | twitter/comments | 25 / 977 / 977 / $0.0139 | $0.0142 | Replies Scraper, 게시물 20개 × 답글 50개, $0.36 | 25x | xquik Reply, $0.15 | 10.5x |
각 차이는 Apify 가격을 저희 가격으로 나눈 값입니다. 참고할 사항이 네 가지 있습니다. 첫째, 세 가지 차이는 모두 페이지 크기에서 나옵니다. 검색과 계정 게시물은 호출당 최대 200행, 답글은 최대 50행을 반환합니다. 페이지가 가득 차면 한 번의 요청 요금이 여러 행에 분산됩니다. 호출당 1~2행만 필요하다면 결과가 뒤집히며, 손익분기점 섹션에서 계산을 보여 드립니다.
둘째, 답글 비용 $0.36은 apidojo 답글 스크레이퍼 페이지의 규칙을 적용한 수치입니다. 유료 요금제에서는 게시물당 처음 약 40개의 답글이 무료입니다. 게시물당 답글이 50개라면 게시물 하나의 비용은 쿼리 요금 $0.014에 항목 10개 × $0.0004를 더한 금액입니다. 셋째, xquik README에는 Apify가 결과 요금과 별도로 플랫폼 사용료를 청구한다고 적혀 있습니다(xquik README).
따라서 $0.15가 전체 청구액은 아닙니다. 넷째, Apify 가격은 자주 바뀝니다. 날짜는 “최근 변경 사항” 섹션에 정리되어 있습니다.
$0.15 검색 가격은 xquik만의 것이 아닙니다. scrape.badger 트윗 스크레이퍼는 30일 사용자가 709명이며, Free에서 $0.15, Business에서 $0.12입니다. feedminer는 $0.12로 더 저렴하지만, from: 없는 키워드 검색은 이제 X Communities에서 데이터를 가져옵니다. 그래서 feedminer는 계정 행에만 사용합니다.
Apify 트윗 스크레이퍼 요금: V2, Unlimited, 답글 스크레이퍼
“apify tweet scraper pricing”을 검색하면 보통 이름이 비슷한 스크레이퍼 여러 개가 보입니다. 개발자 apidojo가 그중 세 개를 게시합니다. Tweet Scraper V2, Twitter (X.com) Scraper Unlimited, Twitter (X) Replies Scraper입니다. 세 가지 모두 이벤트당 과금 방식을 사용합니다. 개발자가 과금 대상 이벤트를 정의하며, 실행할 때마다 이벤트 수에 이벤트당 가격을 곱한 금액이 청구됩니다.
이벤트당 과금 문서에서는 컴퓨팅 비용을 누가 부담하는지 설명합니다. 기본적으로 개발자는 수익금에서 플랫폼 사용료를 부담합니다. 개발자가 “Pay per event + usage”를 활성화하면 사용자도 플랫폼 사용료를 부담합니다. Free 요금제 사용자의 플랫폼 사용료는 Apify가 부담합니다. V2에는 이벤트가 하나뿐입니다. 데이터셋에 기록되는 트윗 하나당 $0.0004가 부과되므로 네 가지 요금제 모두 트윗 1,000개당 $0.40입니다.
V2 Store 페이지에는 네 가지 규칙이 담긴 요금 안내가 있습니다. 아래 스크린샷에서 원문을 볼 수 있습니다.
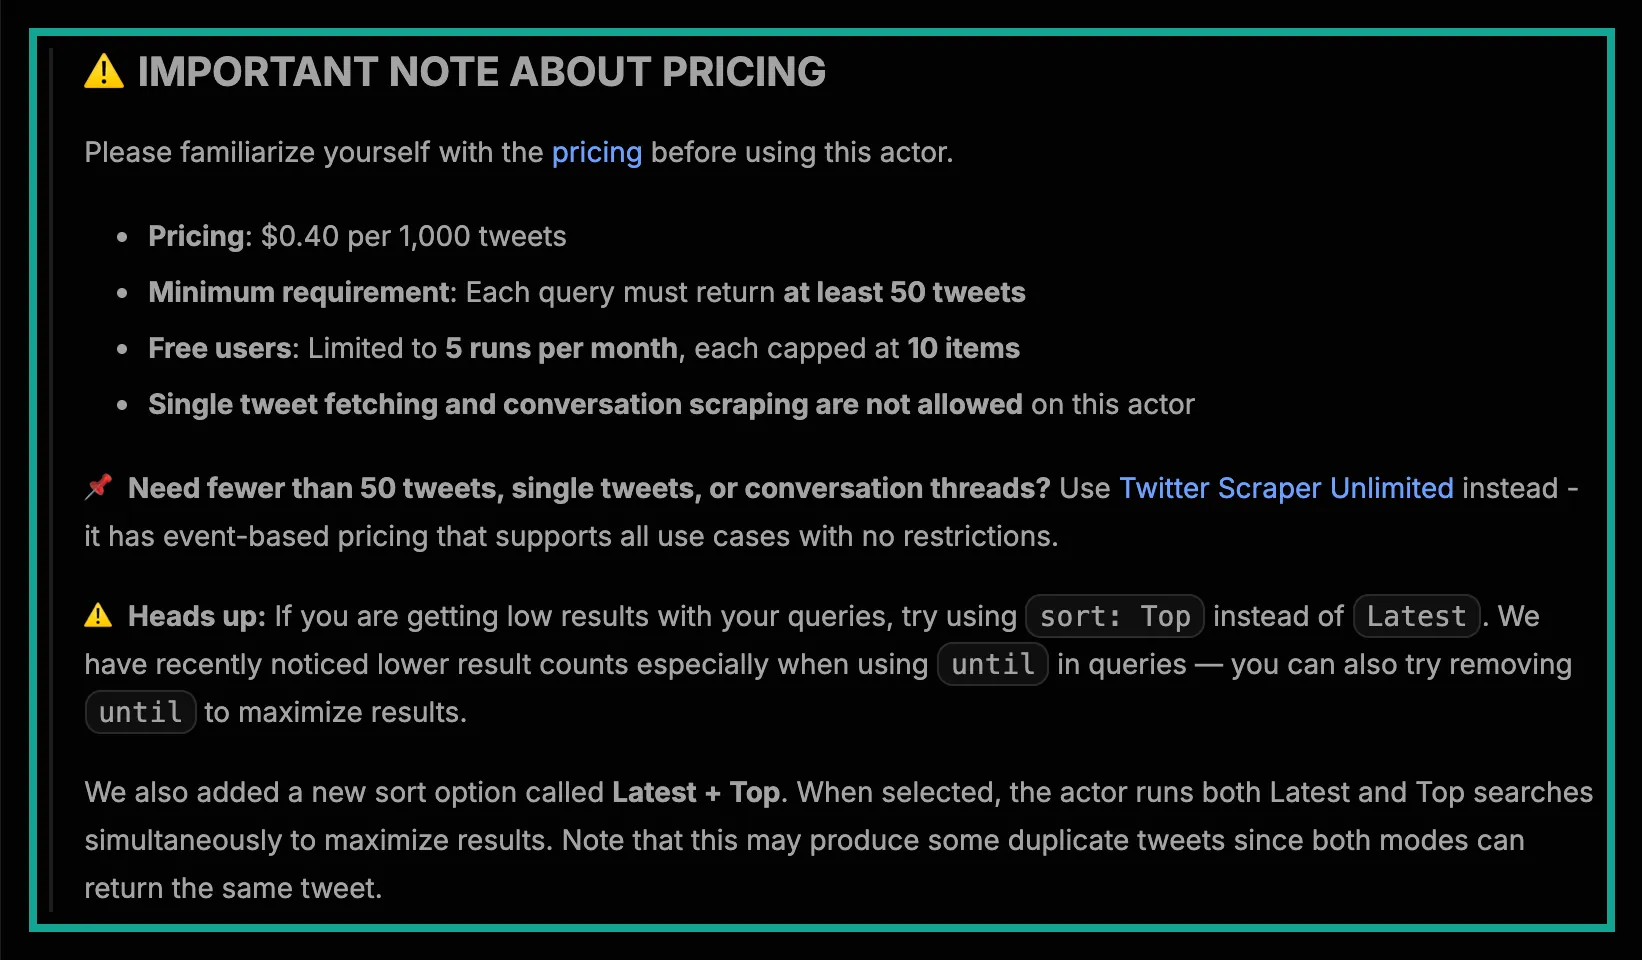
이 중 비용에 가장 큰 영향을 주는 규칙은 두 가지입니다. 첫 번째는 “쿼리당 최소 50개 트윗” 규칙입니다. V2는 이번 주 소규모 계정의 게시물 3개처럼 작고 정확한 쿼리용으로 만들어지지 않았습니다. 페이지에서는 이런 작업에 Unlimited를 쓰라고 안내합니다.
두 번째는 무료 사용자에게 적용되는 월 5회 실행, 실행당 10개 항목 제한입니다. Free 요금제에는 매월 $5의 플랫폼 크레딧이 포함됩니다(Apify pricing). 하지만 V2에서 무료 사용자는 한 달에 트윗 50개만 받을 수 있습니다. 페이지에는 무료 사용자가 API로 actor를 호출할 수 없다는 내용도 있습니다.
따라서 V2를 실제 작업에 쓰려면 최소 Starter 요금제가 필요합니다. 아래 표에 요금제와 각 요금제가 사용하는 가격 등급을 정리했습니다.
| Apify 플랜 | 월 요금 | actor 가격 등급 | V2에서의 의미 |
|---|---|---|---|
| Free | $0, 플랫폼 크레딧 $5 포함 | Free | 데모 모드: 5회 실행, 실행당 10개 항목, API 사용 불가 |
| Starter | $19부터 | Bronze | 1,000개당 $0.40로 V2 전체 기능 사용 |
| Scale | $199 | Silver | V2 가격 동일 |
| Business | $999 | Gold | V2 가격 동일 |
요금제에 포함된 사용량은 다음 주기로 이월되지 않습니다. V2 페이지의 “Important Note” 섹션에는 제한이 두 가지 더 있습니다. 동시 실행은 최대 1개이며 일괄 처리 쿼리는 최대 5개입니다. 또한 페이지에는 “No monitoring”이라고 되어 있으므로, 같은 쿼리를 짧은 간격으로 반복 실행하면 안 됩니다.
Unlimited는 가격 구조가 더 복잡합니다. 쿼리당 $0.016를 부과하며, 여기서 쿼리는 검색어, 핸들, 리스트 하나하나를 말합니다. 이 요금에는 처음 약 40개 결과가 포함됩니다. 추가 항목은 개당 $0.0004~$0.002이며, 가격은 한 번의 실행에 포함된 쿼리 수에 따라 달라집니다. 실행당 쿼리가 5개 이하면 추가 항목은 개당 $0.0004입니다. 쿼리가 6~10개면 $0.0008, 11~30개면 $0.0012, 31~100개면 $0.0016, 100개를 넘으면 $0.002입니다.
단일 트윗 URL은 $0.05이며, 실행마다 최소 $0.02가 부과됩니다. 이 내용은 모두 Unlimited actor 메타데이터에서 확인했습니다. 즉 한 번의 실행에 쿼리가 많을수록 추가 항목 단가가 올라갑니다. 흔히 말하는 “대량일수록 저렴하다”는 원칙과 정반대입니다. 쿼리 하나로 트윗 1,000개를 가져오면 비용은 $0.016 + 960 × $0.0004, 즉 약 $0.40이며 V2와 같습니다.
답글 스크레이퍼는 또 다른 규칙을 따릅니다. Store 페이지에 따르면 게시물마다 쿼리 요금이 부과되며, 기본 흐름에서는 $0.014, useSearch를 사용하면 $0.016입니다. 답글은 개당 $0.0004입니다. 유료 요금제에서는 쿼리당 처음 약 40개 항목이 무료입니다.
Free 요금제는 데모 모드만 제공되며, 월 5회 실행에 실행당 10개 항목입니다. 따라서 게시물 하나에서 답글 1,000개를 가져오면 약 $0.014 + 960 × $0.0004 = $0.398입니다. 게시물 20개에서 각각 답글 50개를 가져오면 20 × ($0.014 + 10 × $0.0004) = $0.36입니다.
| Apify 스크레이퍼(개발자) | 이벤트 가격(Free 등급~Business 등급) | 실행 또는 쿼리당 고정 요금 | 최소 조건 및 제한(페이지 문구) | 최근 30일 사용자 수 |
|---|---|---|---|---|
| Tweet Scraper V2 (apidojo) | 항목당 $0.0004, 전 등급 | 없음 | 쿼리당 트윗 50개 이상, 무료: 5회 실행, 10개 항목 | 10,137 |
| Scraper Unlimited (apidojo) | 추가 항목당 $0.0004~$0.002 | 쿼리당 $0.016, 트윗 URL당 $0.05, 실행당 최소 $0.02 | 최소 행 수 없음 | 2,366 |
| Replies Scraper (apidojo) | 항목당 $0.0004 | 게시물당 $0.014(검색 흐름 $0.016), 유료 요금제는 게시물당 약 40개 항목 무료 | Free: 데모 모드만 제공 | 132 |
| Cheapest Twitter Scraper (kaitoeasyapi) | $0.00025~$0.00018 | 없음 | 없음 | 5,398 |
| X Tweet Scraper (xquik) | $0.00015, 전 등급 | 없음, 플랫폼 사용료 별도 | 없음 | 3,374 |
| X Reply Scraper (xquik) | $0.00015 | 없음, 플랫폼 사용료 별도 | 없음 | 165 |
| X Tweet Scraper (feedminer) | $0.00012~$0.0001 | 없음 | 키워드 검색: 아래 참고 사항 참조 | 107 |
| Profile Posts Scraper (scraper_one) | $0.0004~$0.0003 | 실행당 $0.0025 | 없음 | 389 |
| Twitter Scraper (danek) | $0.0003~$0.00024 | 메모리 GB당 시작 요금 | 없음 | 406 |
이 표의 모든 가격은 11월 3일 싱가포르 시간 00:14~00:16(11월 2일 16:14~16:16 UTC)에 공개 actor 메타데이터에서 읽었습니다. 사용자 수는 같은 API의 stats.totalUsers30Days에서 가져왔습니다. 이 필드는 Get Actor API 문서에 설명되어 있습니다. Store에는 이름에 Twitter나 X가 들어간 스크레이퍼가 400개 넘게 있습니다. 이들의 가격 분포는 뒤의 섹션에서 보여 드립니다.
테스트 방법과 통과 기준
통과 규칙은 데이터를 보기 전에 정했습니다. 데이터 유형마다 서로 다른 2개 이상의 시점에 최소 2회 실제 호출을 해야 했습니다. 1,000건당 가격은 모두 고유 행을 기준으로 해야 했습니다. 어떤 작업에서 Apify가 더 저렴하거나 더 나으면 요약 표와 본문에 그렇게 밝혀야 했습니다. 데이터가 없는 호출 최소 2회에 대해 과금액을 기록해야 했습니다.
모든 호출은 POST https://api.everyinfra.com/api/v1/social로 보냈습니다. 호출마다 전송 시각, HTTP 상태, 소요 시간, 행 수, charged_usd를 기록했습니다. 그런 다음 스크립트로 원시 응답에서 모든 수치를 다시 계산했습니다. 본문, 표, 차트의 모든 수치는 이 스크립트에서 나왔습니다.
| 시나리오 | 엔드포인트와 파라미터 | 실제 호출 | 시간(UTC, 11월 2일) | 용도 |
|---|---|---|---|---|
| 키워드 검색 | twitter/search, 키워드 "openai", limit 200, Latest 정렬 1회, 날짜 구간 5개 | 7 + 재테스트 1 | 16:17~16:31, 재테스트 16:47 | 호출당 행 수, 정렬 간 중복, 날짜 구간 |
| 계정 게시물 | NASA 대상 twitter/user_posts, 이어서 from:NASA 검색 7회 | 8 + 재테스트 1 | 16:19~16:33, 재테스트 16:47 | 한 계정에서 얼마나 과거까지 조회되는지 |
| 답글 | 게시물 25개에 twitter/comments, limit 50 | 25 + 재테스트 1 | 16:19~16:40, 재테스트 16:48 | 큰 게시물과 작은 게시물의 호출당 행 수 |
| 데이터 없음 | API 키 없음, 요청 속도 제한, 불필요한 파라미터, 존재하지 않는 사용자, 존재하지 않는 게시물, id에 전체 URL 사용 | 6 | 16:21~16:29 | 어떤 실패에 비용이 발생하는지 |
| 기타 언어 | 스페인어 키워드, El Pais 계정, 중국어 키워드 | 3 | 16:40~16:42 | 영어 외 언어의 호출당 행 수 |
이 표의 시간은 모두 11월 2일 UTC 기준입니다. 싱가포르 시간(11월 3일)은 8시간을 더하면 됩니다. 52회 호출의 총비용은 $0.025576입니다. 저희 테스트 키는 분당 10회 요청을 허용합니다. 한 호출이 이 한도에 걸렸고, 응답에는 “Nothing was charged”라고 표시되었습니다. 40초를 기다린 뒤 다시 보냈습니다.
답글 대상으로는 OpenAI, NASA 같은 브랜드 계정과 검색 결과에서 게시물을 골랐습니다. 답글 수는 수백 개부터 20,000개 이상까지 다양했습니다. 대조군으로 답글이 8개인 작은 게시물 하나도 골랐습니다. 이 글에서는 게시물 본문과 일반 사용자 이름을 가렸습니다. 이름은 브랜드와 기관 계정만 밝힙니다.
테스트 1: 가장 흔한 Apify Twitter 스크레이퍼 작업, 키워드 검색으로 트윗 1,000개 수집
Apify에서 트윗 검색은 보통 V2 입력값 searchTerms와 maxItems로 시작합니다. V2 actor 메타데이터의 예시 입력에는 sort(Latest 또는 Top), tweetLanguage, onlyVerifiedUsers, onlyImage도 있습니다. 이에 대응하는 저희 엔드포인트는 twitter/search입니다. keyword가 필수이며 limit과 sort를 받습니다. from:, since:, until:, lang:, min_faves: 같은 X 고급 검색 연산자는 keyword 안에 넣습니다.
X 개발자 문서에서 쿼리 문법을 설명합니다. GitHub의 커뮤니티 목록은 고급 검색 연산자를 더 자세히 다룹니다. 다음은 저희가 보낸 첫 번째 호출입니다.
# 16:17:37 UTC Nov 2 (00:17:37 Singapore time Nov 3): HTTP 200, 41.8 s, count 200, charged_usd 0.000556
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"twitter","action":"search","params":{"keyword":"openai","limit":200}}'
7번의 검색 모두 200행으로 꽉 찬 페이지를 반환해 총 1,400행이 나왔습니다. 첫 번째 호출은 기본 정렬인 Top을 사용했습니다. 두 번째 호출은 sort: latest를 사용했습니다. 두 페이지에 겹치는 게시물이 137개여서 두 번째 호출로 새로 얻은 게시물은 63개뿐이었습니다. "Latest"도 엄격한 시간순이 아닙니다. Latest 페이지에서 가장 오래된 게시물은 2023년 11월 게시물이었습니다.
V2 페이지도 같은 현상을 설명합니다. 새로 추가된 "Latest + Top" 정렬은 두 검색을 모두 실행하며 "일부 트윗이 중복될 수 있다"고 적혀 있습니다. 행 단위 과금에서는 이런 중복도 행으로 집계됩니다.
다음으로 "openai" 검색을 since:와 until:로 이틀 단위 구간 5개로 나눴습니다. 각 구간의 시작일은 2026-10-30, 2026-10-27, 2026-10-24, 2026-10-21, 2026-10-18입니다. 호출마다 여전히 200행이 반환되었습니다. 호출별로 새로 얻은 고유 게시물은 168, 168, 197, 196, 198개였습니다. 7번 호출한 뒤 고유 게시물 1,190개를 $0.003892에 확보했으며, 이는 1,000개당 $0.00327입니다.
하지만 구간 경계는 느슨했습니다. 처음 세 구간에서 200개 게시물 중 해당 이틀 안에 들어간 것은 각각 70, 85, 48개뿐이었습니다. 나머지는 구간 밖의 게시물이었습니다. 따라서 날짜 분할은 새 게시물을 많이 얻는 데는 좋은 방법입니다. 그러나 정확히 그 이틀 동안의 게시물만 얻는 데는 적합하지 않습니다.
다른 공개 자료 세 가지도 같은 방향을 가리킵니다. V2 페이지는 쿼리에 until을 쓰면 결과가 줄어든다고 설명합니다. X API 변경 내역에 따르면 검색 엔드포인트는 2026년 5월 4일 새 검색 인덱스로 옮겨졌습니다. 또한 feedminer Store 페이지에는 9월 말부터 X가 feedminer에서 검색 인덱스로 보내는 요청을 거부하기 시작했다고 적혀 있습니다. 즉 현재 X 검색 결과는 안정적이지 않습니다. 어떤 도구를 쓰든 결과를 받은 뒤 날짜로 다시 필터링해야 합니다.
30분 뒤인 16:47 UTC(싱가포르 시간 00:47)에 같은 파라미터로 첫 번째 검색을 다시 실행했습니다. 200개 게시물 중 124개는 첫 실행과 같았고 76개는 새로운 게시물이었습니다. Top 정렬 결과는 시간에 따라 바뀝니다. 브랜드 모니터링이라면 30분마다 실행해도 새 게시물이 어느 정도 나옵니다. 행 단위 과금에서는 반복된 게시물 124개에도 다시 비용을 내야 합니다. EveryInfra에서는 재실행 비용이 이전과 같은 $0.000556이었습니다.
테스트 2: apify x scraper로 한 계정의 게시물 1,000개 수집하기
V2에서 한 계정의 게시물을 가져오려면 twitterHandles를 쓰거나 searchTerms에 from: 조건을 넣습니다. 가격은 여전히 1,000개당 $0.40입니다. EveryInfra에서는 twitter/user_posts로 시작합니다. 이 엔드포인트는 호출당 최대 200개 게시물을 반환하며 커서가 없습니다. 더 오래된 게시물은 V2 문서가 권장하는 방식과 똑같이 twitter/search에 from:NASA와 날짜 연산자를 함께 써서 가져옵니다.
16:19 UTC(싱가포르 시간 00:19)의 user_posts 호출은 게시물 200개를 반환했습니다. 기간은 2026-09-08부터 2026-10-31까지였습니다. 이 중 48개는 NASA가 다른 계정에 단 답글이었고 67개는 리포스트였습니다. 이는 X 웹사이트의 "게시물 및 답글" 탭과 일치합니다.
이어서 더 과거로 거슬러 올라가기 위해 from:NASA 검색을 7번 보냈습니다. until:2026-09-08, until:2026-08-01, until:2026-04-01을 차례로 사용했습니다. 그다음 2025년 하반기, 2025년 상반기, 2024년 전체 구간을 사용했습니다. 8번의 호출로 1,592행, 고유 게시물 1,330개를 얻었습니다. 다른 계정의 게시물은 하나도 없었습니다. 총 비용은 $0.004448로, 1,000개당 $0.00334입니다.
연도별 고유 게시물 수는 2026년 568개, 2025년 396개, 2024년 198개, 2022년 82개였습니다. 2020년은 23개, 2016년은 39개였고 나머지 연도는 한 자릿수였습니다. 오래된 연도로 갈수록 수가 줄어드는 이유는 테스트 1과 같습니다. 날짜를 지정한 검색에는 구간 밖의 더 오래되고 인기 있는 게시물이 섞입니다. 구간이 좁을수록 새로 추가되는 게시물이 적으며, 세 번째 호출은 87개만 추가했습니다.
16:47 UTC(싱가포르 시간 00:47)에 user_posts를 다시 실행했습니다. 200개 게시물 모두 28분 전 실행 결과와 같았고, 최신 게시물도 10월 31일 22:14 UTC에 올라온 같은 게시물이었습니다. 이는 아카이브 작업에 유용합니다. 짧은 시간 안에는 같은 파라미터로 안정적인 결과를 얻으므로, 증분 작업은 최신 게시물 ID만 비교하면 됩니다.
X API에는 여기에 엄격한 제한이 있습니다. 사용자 타임라인 엔드포인트는 최근 게시물 3,200개만 반환합니다(X 타임라인 문서). 그보다 오래된 게시물은 전체 아카이브 검색을 사용해야 합니다.
영어가 아닌 콘텐츠: 몇 행이나 반환될까
많은 사용자가 영어가 아닌 콘텐츠에 apify x scraper를 사용합니다. 16:40 UTC(싱가포르 시간 00:40)에 inteligencia artificial lang:es를 검색했습니다. 호출은 게시물 200개로 꽉 찬 페이지를 반환했으며, 모두 스페인어였고 작성자는 167명이었습니다. 기간은 2026-10-23부터 2026-11-02까지였고 리포스트나 답글은 없었습니다.
16:41 UTC(싱가포르 시간 00:41)에 El Pais 계정에 대해 호출한 user_posts는 게시물 200개를 반환했습니다. 이 중 197개가 스페인어였습니다. 기간은 10월 31일부터 11월 2일까지로 이틀이 채 되지 않았습니다. 즉 활동이 많은 뉴스 계정은 약 이틀이면 200행이 찹니다. 한 달치를 아카이브하려면 하루에 한 번 호출하면 됩니다.
16:42 UTC(싱가포르 시간 00:42)에는 "대형 모델"을 뜻하는 중국어 검색어를 lang:zh와 함께 검색했습니다. 200행을 요청했지만 100행이 반환되었고, 모두 중국어였으며 작성자는 67명이었습니다. 가장 오래된 게시물은 2026-10-08 게시물이었습니다. 페이지가 절반만 찼기 때문에 이 호출의 비용은 1,000개당 $0.00556으로, 영어의 약 2배였습니다.
그래도 V2보다 약 70배 저렴합니다. 행 단위 과금에서는 페이지가 절반만 차도 단가가 바뀌지 않습니다. 받는 행 수가 줄어들 뿐입니다.
| 호출(싱가포르 시간, 11월 3일) | 엔드포인트 및 입력 | 행 | 작성자 | 기간 | 1,000행당 |
|---|---|---|---|---|---|
| 00:40 | twitter/search, 스페인어 키워드 + lang:es | 200, 모두 스페인어 | 167 | 2026-10-23~2026-11-02 | $0.00278 |
| 00:41 | twitter/user_posts, El Pais | 200, 스페인어 197 | 1 | 2026-10-31~2026-11-02 | $0.00278 |
| 00:42 | twitter/search, 중국어 키워드 + lang:zh | 100, 모두 중국어 | 67 | 2026-10-08~2026-11-02 | $0.00556 |
테스트 3: 작업을 둘로 나눠야 하는 답글 수집
답글은 세 가지 데이터 유형 중 격차가 가장 작고, 작업 성격에 가장 크게 좌우됩니다. EveryInfra의 twitter/comments 엔드포인트에는 게시물 URL에서 /status/ 뒤에 오는 숫자인 id가 필요합니다. 호출당 최대 50개 답글을 반환하며 커서가 없습니다. 게시물 25개에 각각 한 번씩 호출했습니다. 답글 977개를 $0.0139에 얻었으며, 이는 1,000개당 $0.0142입니다.
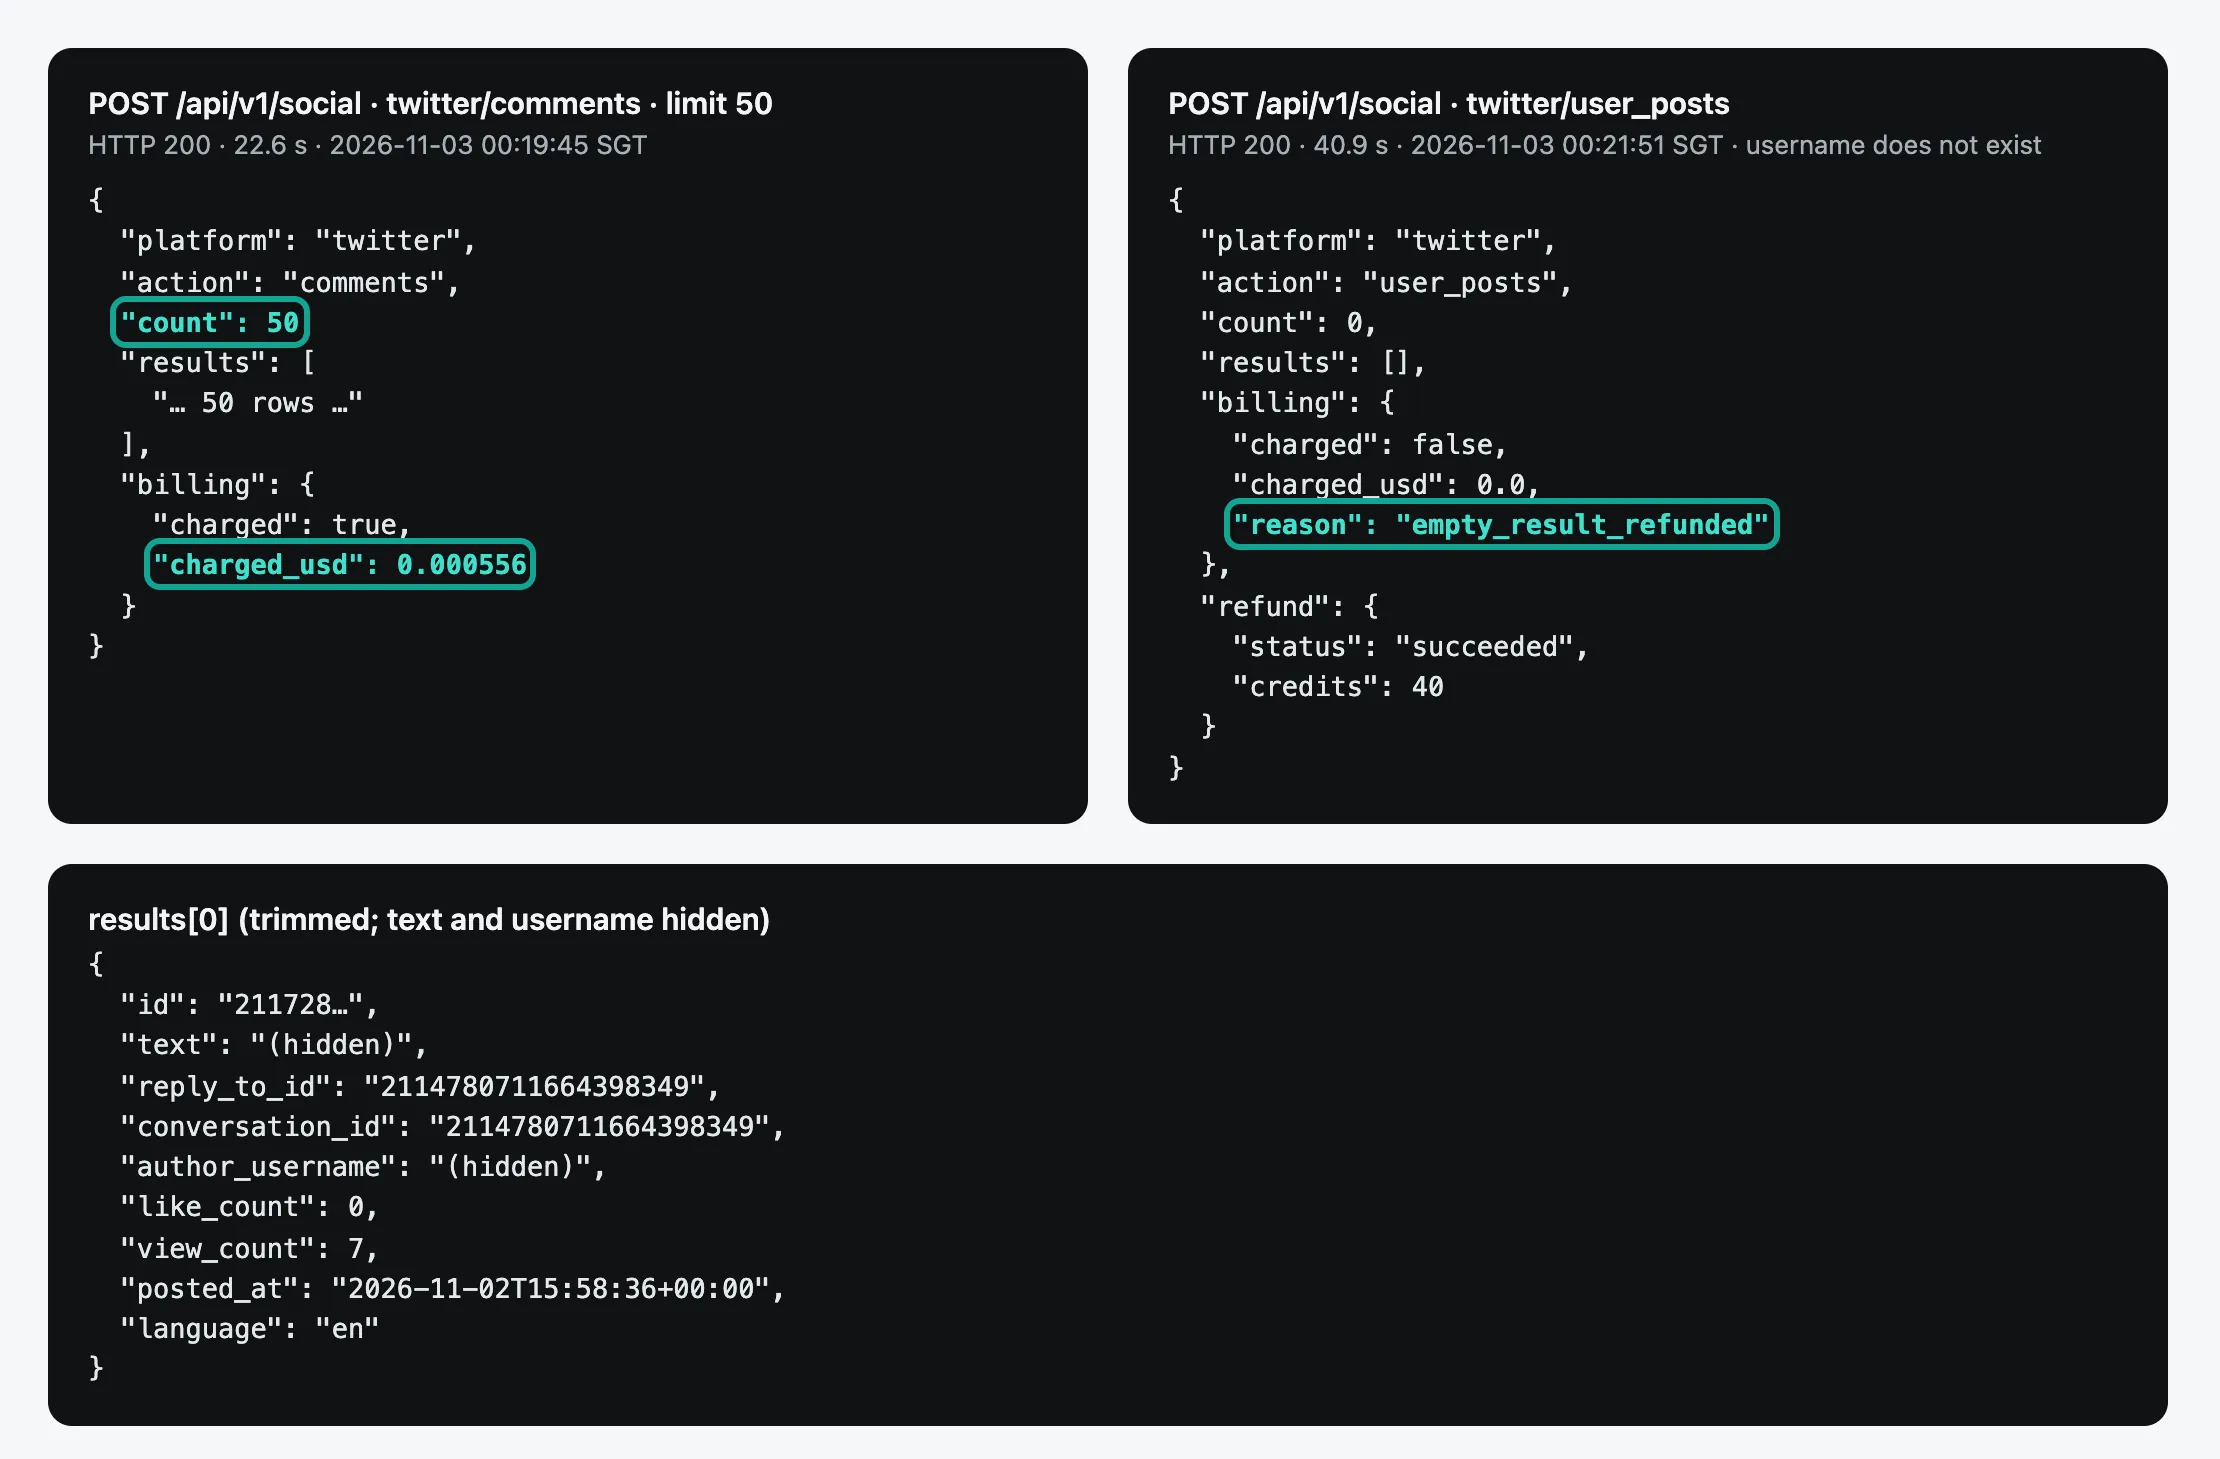
첫 번째 경우는 "여러 게시물의 답글을 일괄 수집"하는 작업입니다. 브랜드 게시물 200개에 달린 피드백을 매주 살펴보는 경우가 그 예입니다. 이 경우 EveryInfra는 게시물당 $0.000556을 과금합니다. Apify 답글 스크레이퍼는 게시물당 $0.014부터 시작하므로 EveryInfra가 25배 저렴합니다. 가장 저렴한 옵션인 답글당 $0.00015의 xquik 답글 스크레이퍼와 비교해도 10.5배 저렴합니다.
25번의 호출 중 14번은 답글 50개를 모두 반환했습니다. 나머지 11번은 39, 39, 38, 32, 23, 20, 20, 20, 19, 19, 8개를 반환했습니다. 8개는 답글이 8개뿐인 소규모 대조군 게시물에서 나왔으므로 전부 받은 것입니다. 하지만 답글이 각각 2,500~6,800개인 대형 게시물 6개는 19~23개만 반환했습니다.
이어서 대형 게시물 24개의 원본 응답을 살펴봤습니다. 패턴은 분명합니다. 50개를 모두 받은 14번의 호출은 최근 답글을 반환했으며, 답글당 좋아요 수의 중앙값은 0이었습니다. 적게 받은 10번의 호출은 몇 주에서 2년 된 게시물에 대한 것이었습니다. 이 답글들은 좋아요 순으로 정렬되어 있었고, 좋아요 수 중앙값은 6에서 1,880까지였습니다.
즉 새 게시물에서는 최신 답글을 받습니다. 오래된 바이럴 게시물에서는 X가 먼저 보여 주는 인기 답글을 받으며, "답글 더 보기" 부분은 펼쳐지지 않습니다. 근본 원인은 아직 백엔드 팀의 확인이 필요합니다. 계획을 세울 때는 새 게시물에서 50개, 오래된 바이럴 게시물에서 약 20개를 예상하면 됩니다.
두 번째 경우는 "한 게시물에서 가능한 한 많은 답글"을 수집하는 작업입니다. 바이럴 게시물 하나에 달린 댓글 수천 개를 분석하는 연구가 그 예입니다. EveryInfra 엔드포인트는 게시물당 50개에서 멈추므로 이 작업에는 쓸 수 없습니다. Apify 답글 스크래퍼 페이지는 답글을 자동으로 페이지네이션한다고 설명합니다. 기본 흐름으로 반환되는 답글이 너무 적으면 useSearch가 conversation_id: 검색으로 더 가져옵니다. 이 스크래퍼로 답글 1,000개짜리 게시물 하나를 수집하면 약 $0.398이 듭니다.
이 작업에는 Apify가 더 나은 선택이며, EveryInfra에는 대응하는 엔드포인트가 없습니다. 작성자가 자신의 게시물 아래에 올린 스레드만 필요하다면 twitter/thread를 쓸 수 있습니다. 호출당 $0.002153에 최대 100개 게시물을 반환합니다. 다만 스레드가 전체 답글은 아닙니다.
직접 답글과 중첩 답글의 비율도 크게 달라집니다. OpenAI 게시물에서는 답글 50개 중 35개가 직접 답글, 15개가 중첩 답글이었습니다. 답글이 20,000개가 넘는 한 게시물에서는 50개 중 직접 답글이 10개뿐이었습니다. 또 다른 게시물에서는 50개 중 49개가 작성자 19명의 중첩 답글로, 긴 논쟁 하나처럼 보였습니다. 감성 분석에서는 reply_to_id로 두 단계를 구분하면 됩니다. 이 필드는 답글의 99%에 값이 있습니다.
16:48 UTC(싱가포르 시간 00:48)에 OpenAI 게시물에 대해 다시 호출했습니다. 답글 50개는 29분 전과 같았습니다.
필드 비교: 양쪽은 같은 데이터를 반환할까?
양쪽이 반환하는 필드는 서로 다릅니다. 여기서는 저희의 필드 채움률과 저희에게는 없는 Apify 필드만 다룹니다. 검색 결과 1,400행, 계정 게시물 200건, 답글 977건에서 각 필드를 확인했습니다. view_count, bookmark_count, language, author_follower_count, author_is_verified는 100%의 행에 값이 있었습니다. media는 각각 42%, 44%, 18%의 행에만 값이 있었는데, 이미지나 동영상이 없는 게시물이 많기 때문입니다.
hashtags는 1~4%의 행에만 값이 있었습니다. 해당 행을 하나씩 확인했습니다. # 태그가 있는 게시물에는 모두 이 필드가 있었고, 나머지 게시물에는 표시할 태그가 없었습니다.
| 필드 | 검색(1,400) | 계정 게시물(200) | 답글(977) | 비고 |
|---|---|---|---|---|
view_count, bookmark_count, language | 100% | 100% | 100% | 모든 행에 있음 |
author_follower_count, author_is_verified | 100% | 100% | 100% | 게시물마다 작성자 데이터 포함 |
media | 42% | 44% | 18% | 미디어가 없는 게시물은 비어 있음 |
mentions | 12% | 84% | 95% | 답글은 다른 계정을 자주 멘션함 |
links | 22% | 40% | 4% | 외부 링크가 있는 게시물 비율 |
reply_to_id | 0% | 24% | 99% | 답글에만 있음 |
author_bio, source | 0% | 0% | 0% | 프로필 소개는 twitter/profile 호출 필요 |
Apify 답글 스크래퍼 페이지에 따르면 각 답글에는 소개를 포함한 전체 작성자 프로필과 게시 클라이언트 정보가 들어 있습니다. EveryInfra의 세 엔드포인트는 이 두 필드를 반환하지 않습니다. 소개가 필요하면 twitter/profile을 따로 호출해야 합니다. 답글 작성자를 소개 내용(예: 직함)으로 묶어 분석한다면 Apify에서는 한 번에 얻을 수 있습니다.
필드 이름도 달라서 이전하려면 매핑 단계가 필요합니다. V2 출력 예시에서 좋아요는 likeCount, 리포스트는 retweetCount, 게시 시간은 createdAt입니다. 시간 형식은 Fri Nov 24 17:49:36 +0000 2023입니다. 언어는 lang이며, 작성자 데이터는 userName과 followers가 들어 있는 중첩 author 객체에 있습니다.
EveryInfra의 필드 이름은 like_count, retweet_count, posted_at, language입니다. 시간은 시간대를 포함한 ISO 8601 형식입니다. 작성자 데이터는 중첩 없이 author_username, author_follower_count 같은 필드에 들어 있습니다. V2 예시에는 게시 클라이언트를 나타내는 source 필드도 있습니다. EveryInfra의 세 엔드포인트에서는 이 필드가 비어 있습니다.
실패한 호출과 빈 결과에도 비용이 청구될까?
EveryInfra에서는 데이터가 없는 호출 6건 모두 비용이 $0이었습니다. 이 호출들은 세 그룹으로 나뉩니다. 첫 번째 그룹은 인증이나 파라미터 검사 단계에서 멈춘 경우입니다. 키 없이 호출하면 코드 missing_key와 함께 401이 반환됩니다.
허용되지 않은 파라미터 max_items를 넣은 호출은 422를 받습니다. 오류에는 허용되는 파라미터 keyword, limit, sort가 나열되고, 바로 쓸 수 있는 예시 요청도 포함됩니다. 요청 속도 제한을 넘은 호출은 재시도 시간과 함께 429를 받습니다.
두 번째 그룹은 "찾을 수 없음"입니다. 존재하지 않는 사용자 이름과 존재하지 않는 게시물 ID는 각각 약 40초 후 HTTP 200을 반환했습니다. count는 0, billing.reason은 empty_result_refunded, refund.status는 succeeded였습니다. 세 번째 그룹은 저희의 실수였습니다.
id에 게시물 URL 전체를 넣었습니다. 카탈로그에는 그렇게 하지 말라고 되어 있지만 API는 422를 반환하지 않았습니다. 대신 "찾을 수 없음"으로 처리하고 환불했습니다. 사용자에게 친절한 동작이 아니므로 이슈로 등록했습니다.
| 사례 | 시간(싱가포르 시간, 11월 3일) | HTTP | 코드 또는 사유 | `charged_usd` |
|---|---|---|---|---|
| API 키 없음 | 00:21 | 401 | missing_key | 0 |
| 존재하지 않는 사용자 이름 | 00:21 | 200 | empty_result_refunded, 환불 성공 | 0.0 |
| 분당 10회 초과 호출 | 00:24 | 429 | rate_limited, "Nothing was charged" | 0 |
id에 전체 URL 입력 | 00:28 | 200 | empty_result_refunded | 0.0 |
허용되지 않은 파라미터 max_items | 00:29 | 422 | unknown_param, 허용 목록 표시 | 0 |
| 존재하지 않는 게시물 ID | 00:29 | 200 | empty_result_refunded | 0.0 |
Apify 쪽은 페이지에 적힌 내용만 인용합니다. V2는 각 쿼리가 최소 50개의 트윗을 반환해야 한다고 명시합니다. 쿼리가 그보다 적게 반환할 때 어떻게 과금하는지는 밝히지 않습니다. 답글 스크래퍼는 쿼리 요금을 "처리된 tweetId 또는 URL 항목당 한 번" 부과합니다.
또한 답글이 없는 게시물은 "빈 데이터셋을 반환하고 실행 시간을 낭비한다"고 경고합니다. 빈 결과에 대해 쿼리 요금을 환불하는지는 밝히지 않습니다. scraper_one의 스크래퍼 두 개는 실행당 고정 $0.0025를 과금하고, danek는 메모리 GB당 시작 요금을 과금합니다.
Apify 사용량 및 리소스 문서는 compute unit, 스토리지, 데이터 전송의 과금 방식을 설명합니다. pay-per-event 문서는 개발자에게 결과를 저장한 뒤에만 과금하라고 안내합니다. 실행이 중단되면 사용자는 접근할 수 없는 결과에 비용을 내지 않아야 합니다.
공개 Actor API는 최근 30일간의 실행 결과도 보여 줍니다. 이 글에서 다룬 스크래퍼 9개에 대해 중단, 시간 초과, 실패 건수를 실행 10,000건당 비율로 환산했습니다.
| Apify 스크래퍼 | 최근 30일 실행 수 | 중단 | 시간 초과 | 실패 | 10,000건당 미완료 |
|---|---|---|---|---|---|
| Tweet Scraper V2 | 4,688,523 | 35,721 | 5,536 | 0 | 88.0 |
| Cheapest Twitter Scraper (kaitoeasyapi) | 2,653,176 | 41,433 | 3,276 | 1,583 | 174.5 |
| X Tweet Scraper (xquik) | 2,820,359 | 228 | 1 | 3 | 0.8 |
| Twitter Scraper (danek) | 2,396,418 | 3,132 | 422 | 0 | 14.8 |
| Scraper Unlimited (apidojo) | 1,552,877 | 418 | 609 | 0 | 6.6 |
| X Tweet Scraper (feedminer) | 58,004 | 1 | 147 | 0 | 25.5 |
| Profile Posts Scraper (scraper_one) | 36,776 | 17 | 55 | 0 | 19.6 |
| Replies Scraper (apidojo) | 6,118 | 7 | 2 | 0 | 14.7 |
| X Reply Scraper (xquik) | 39,518 | 32 | 0 | 0 | 8.1 |
중단된 실행 중 상당수는 사용자가 직접 멈춘 것이므로, 중단이 항상 스크래퍼 탓은 아닙니다. 이 표로 뒷받침할 수 있는 주장은 하나뿐입니다. 가장 저렴한 xquik 트윗 스크래퍼가 가장 안정적이었으며, 미완료 실행이 10,000건당 0.8건이었습니다. 가장 많이 쓰이는 스크래퍼인 V2는 10,000건당 88건이었습니다.
Kaitoeasyapi는 174.5건으로 비율이 가장 높았습니다. 이 실행들에 비용이 얼마나 들었는지는 페이지에 나와 있지 않고, 외부에서 확인할 수도 없습니다. EveryInfra가 실패한 호출과 환불 내역을 대사하는 방법은 실패 호출 환불 대사를 참고하세요.
Apify Store의 Twitter 스크래퍼 400여 개, 가격은 어떻게 분포할까
공개 Store 검색 API(Store API 문서)로 twitter, tweet, x scraper, x.com 네 가지 검색어를 조회했습니다. 결과를 합치고 중복을 제거하니 Actor 406개가 남았습니다. 이 중 380개가 pay-per-event 가격을 사용하고, 372개가 결과당 가격을 표시합니다. 이름과 설명을 기준으로 분류한 결과 트윗 175개, 프로필 48개, 팔로워 37개, 답글 36개, 트렌드 36개, 미디어 및 기타 데이터 40개였습니다.
트윗 스크래퍼 175개의 Free 플랜 가격 중앙값은 1,000개당 $1.50입니다. V2 가격의 거의 4배입니다. 하지만 사용자가 적은 스크래퍼가 많아 중앙값을 끌어올립니다. 최근 30일 사용자가 100명 이상인 스크래퍼 29개만 보면 중앙값은 $0.30입니다. 최근 30일 사용자 수로 가중하면 평균은 1,000개당 $1.42입니다.
사용자는 소수 스크래퍼에 크게 몰려 있습니다. 상위 5개 스크래퍼가 372개 스크래퍼의 30일 사용자 전체(총 32,822명) 중 68.4%를 차지합니다. 가장 저렴한 스크래퍼는 1,000개당 $0.01을 표시하지만 30일 동안 사용자가 8명뿐이어서 인기 스크래퍼로 보지 않았습니다. 요약하면 가장 많이 쓰이는 Twitter 스크래퍼의 가격은 1,000개당 $0.12~$0.40입니다. EveryInfra에서 측정한 세 가지 가격은 모두 $0.015 미만입니다.
이전 글 Apify 요금 체계 해설에서는 Apify 요금제, compute unit, pay-per-event 규칙 전반을 다룹니다. Apify 대안 글은 여러 플랫폼을 비교합니다. 이 글은 두 글에 없는 실제 호출 기반의 Twitter 데이터 행 수와 Store의 Twitter 스크래퍼 가격 분포 및 실행 데이터를 추가로 다룹니다. 더 넓게 살펴보려면 대안 개요부터 보시기 바랍니다.
손익분기점: 호출당 반환 행 수가 적을 때는 행 단위 과금이 더 저렴하다
EveryInfra는 요청당 과금하고, Store의 Twitter 스크래퍼 대부분은 행 단위로 과금합니다. 손익분기점은 쉽게 계산할 수 있습니다. EveryInfra의 요청당 가격 $0.000556을 상대의 행당 가격으로 나누면 됩니다. V2는 행당 $0.0004를 과금하므로 손익분기점은 호출당 1.39행입니다.
Xquik은 $0.00015이므로 3.71행입니다. Feedminer는 Free 플랜에서 $0.00012이므로 4.63행이고, Business 가격 $0.0001에서는 5.56행입니다. X API는 게시물당 $0.005이므로 손익분기점은 0.11행입니다.
| 행당 가격 | 출처 | 호출당 손익분기 행 수 | EveryInfra가 더 저렴해지는 호출당 반환 행 수 |
|---|---|---|---|
| $0.005 | X API pay-per-use | 0.11 | 1행 이상 |
| $0.0004 | Tweet Scraper V2 | 1.39 | 2행 이상 |
| $0.00015 | xquik | 3.71 | 4행 이상 |
| $0.00012 | feedminer, Free 플랜 | 4.63 | 5행 이상 |
| $0.0001 | feedminer, Business 플랜 | 5.56 | 6행 이상 |
실제 작업에서 호출이 몇 행만 반환하는 경우는 언제일까요? 첫 번째는 단일 게시물 조회입니다. EveryInfra의 twitter/post 엔드포인트는 게시물 하나에 $0.000556, 즉 1,000개당 $0.556입니다. xquik이나 feedminer보다 비쌉니다.
V2는 단일 트윗 조회를 허용하지 않으므로 비교 대상은 Unlimited의 단일 트윗 가격인 트윗당 $0.05이며, 이보다는 훨씬 저렴합니다. 두 번째는 하루에 두세 번 게시하는 소규모 계정입니다. 확인할 때마다 새 게시물은 몇 개뿐입니다.
세 번째는 답글이 8개인 소규모 대조군 게시물입니다. EveryInfra는 이 게시물에 1,000개당 $0.0695를 과금했습니다. apidojo 답글 스크래퍼는 쿼리 요금 $0.014를 한 번 과금하며, 답글 8개는 모두 무료로 제공되는 처음 40개 안에 들어갑니다. 이는 1,000개당 $1.75입니다.
Xquik은 1,000개당 $0.15입니다. Scraper_one은 실행당 $0.0025에 답글 8개 비용이 더해져 1,000개당 $0.5625입니다. 따라서 이 소규모 게시물에서도 EveryInfra가 가장 저렴합니다. 하지만 호출당 약 3행 미만이면 xquik과 feedminer가 더 저렴합니다.
월 청구액 계산: 흔한 작업 세 가지를 30일 동안 실행하면
이제 측정한 행 수를 흔히 하는 작업 세 가지에 적용해 봅니다. 저희 쪽은 측정한 호출당 행 수로 행을 호출 수로 환산한 뒤 $0.000556를 곱합니다. Apify 쪽은 정가에 행 수를 곱합니다. 여기에는 플랫폼 사용료와 월 요금제 비용이 빠져 있습니다. X API는 게시물당 $0.005를 적용합니다. 여기에는 월 게시물 3백만 건 상한과 같은 날 중복 제거 할인이 반영되지 않았습니다.
| 작업 | 30일간 행 수 | EveryInfra | V2 또는 apidojo 답글 | xquik | X API pay-per-use |
|---|---|---|---|---|---|
| 브랜드 모니터링: 키워드 20개, 키워드당 트윗 200개, 매일 | 120,000 | $0.33(600회 호출) | $48.00 | $18.00 | $600.00 |
| 계정 아카이브: 계정 50개, 계정당 게시물 1,000개 | 50,000 | $0.17(약 300회 호출) | $20.00 | $7.50 | $250.00 |
| 답글 모니터링: 주당 게시물 200개, 게시물당 답글 50개 | 40,000 | $0.44(800회 호출) | $14.40 | $6.00 | $200.00 |
표에서 세 가지를 알 수 있습니다. 첫째, 호출할 때마다 페이지를 가득 채우는 작업에서는 격차가 수십 배로 유지됩니다. 요금 한 번으로 200행, 답글은 50행을 받기 때문입니다. 둘째, Apify 비용에는 요금제 비용도 더해야 합니다. Free 플랜의 V2 사용자는 월 50개 트윗만 받을 수 있으므로, 이런 작업에는 월 $19부터 시작하는 Starter 이상이 필요합니다. EveryInfra는 월 요금이 없고, 유료 잔액은 만료되지 않으며, 실패한 호출은 무료입니다.
셋째, V2 페이지는 사용자당 동시 실행을 1개, 쿼리를 최대 5개로 제한합니다. 또한 같은 쿼리를 짧은 간격으로 반복하는 모니터링에는 V2를 쓰지 말라고 안내합니다. 따라서 브랜드 모니터링 행은 V2가 지원하는 사용 사례가 아닙니다. 해당 페이지는 이런 작업에 Unlimited를 권합니다.
X API의 경우 X 요금 페이지에 게시물 읽기당 $0.005, 사용자 읽기당 $0.010로 나와 있습니다. 읽기는 월 게시물 3백만 건으로 제한됩니다(사용량 및 과금). 같은 UTC 날짜에 같은 게시물을 두 번 읽으면 한 번으로 계산되므로, 실제 청구 금액은 표보다 조금 낮습니다.
전체 예시: n8n으로 만드는 주간 브랜드 답글 리포트
"apify twitter scraper" 페이지를 찾는 독자 중 상당수는 n8n으로 작업을 구성합니다. 다음은 세 가지 데이터 유형을 함께 쓰는 주간 리포트입니다. 매주 월요일 키워드 20개를 각각 게시물 200개씩 검색해 논의가 가장 활발한 게시물을 찾습니다. 그다음 reply_count 기준으로 게시물 50개를 골라 각각 답글 50개를 가져옵니다. 마지막으로 모델이 답글을 불만, 질문, 칭찬으로 분류합니다.
EveryInfra에서는 twitter/search 20회와 twitter/comments 50회를 호출합니다. 70회 호출 비용은 주당 $0.0389, 4주에 약 $0.16입니다. 테스트에서처럼 페이지가 가득 차거나 거의 찬다고 가정한 값입니다. n8n에서는 호출 하나가 HTTP Request 노드 하나입니다. 아래 노드는 검색 한 번의 요청 본문을 보여 줍니다.
{
  "parameters": {
    "method": "POST",
    "url": "https://api.everyinfra.com/api/v1/social",
    "sendHeaders": true,
    "headerParameters": { "parameters": [
      { "name": "Authorization", "value": "=Bearer {{ $env.EVERYINFRA_API_KEY }}" }
    ] },
    "sendBody": true,
    "specifyBody": "json",
    "jsonBody": "={ \"platform\": \"twitter\", \"action\": \"search\", \"params\": { \"keyword\": \"{{ $json.keyword }}\", \"limit\": 200 } }"
  },
  "type": "n8n-nodes-base.httpRequest",
  "name": "EveryInfra twitter/search"
}
Apify에서는 정가 기준으로 같은 작업을 두 가지 방법으로 처리할 수 있습니다. 첫 번째 방법은 V2와 답글 스크래퍼를 쓰는 것입니다. 검색은 4,000행 x $0.0004 = $1.60, 답글은 게시물 50개 x ($0.014 + 10 x $0.0004) = $0.90입니다. 합계는 주당 $2.50입니다. 하지만 V2는 모니터링을 위해 같은 쿼리를 반복 실행하지 말라고 안내하며, 실행당 쿼리는 최대 5개입니다. 따라서 키워드 20개에는 실행 4번이 필요합니다.
두 번째 방법은 Unlimited를 쓰는 것입니다. 쿼리 20개는 20 x $0.016 = $0.32입니다. 각 쿼리는 무료 40행을 넘는 160행을 반환합니다. 실행당 쿼리가 20개이므로 이 행들에는 11~30쿼리 구간 가격인 $0.0012가 적용됩니다. 3,200 x $0.0012 = $3.84입니다.
답글 $0.90을 더하면 합계는 주당 $5.06입니다. 두 방법 모두 Starter 요금제 비용은 포함하지 않았습니다. 모델 단계 비용은 양쪽이 같습니다. 이 예시에서 EveryInfra는 64~130배 저렴합니다. Unlimited 가격 구간 때문에 요약 표보다 격차가 더 큽니다.
X API vs Apify vs EveryInfra
X는 2026년 2월 API를 pay-per-use로 전환했습니다. 8월 14일에는 기존 Pro 요금제가 9월 1일 이후 pay-per-use로 전환된다고 발표했습니다(X 개발자 포럼). pay-per-use는 월 요금이 없지만 비용은 더 높습니다. 게시물은 1,000개당 $5로, V2의 12.5배이자 EveryInfra에서 측정한 검색 가격의 약 1,500배입니다.
최근 무료 크레딧과 관련해 두 가지 변경이 있었습니다. 10월 2일부터 신규 pay-per-use 계정은 첫 크레딧 구매 후 $20를, 자동 충전을 설정하면 최대 $50를 추가로 받습니다. 10월 13일 X는 규칙을 바꿔, 카드 저장만으로는 더 이상 $20를 받을 수 없게 했습니다. 크레딧은 3개월 후 만료됩니다(무료 크레딧 페이지).
X API는 요청 속도 제한과 수집 범위도 다릅니다. 최근 검색은 15분당 450회, 전체 아카이브 검색은 초당 1회 요청할 수 있습니다(요청 속도 제한). pay-per-use 계정도 전체 아카이브 검색을 사용할 수 있습니다(검색 문서). 사용자 타임라인은 최근 게시물 3,200개까지만 제공됩니다. 5월 4일부터 키워드 검색은 리포스트를 반환하지 않습니다.
| X API 항목 | 값 | 출처 |
|---|---|---|
| 게시물 읽기 | 건당 $0.005 | X 요금 페이지 |
| 사용자 읽기 | 건당 $0.010 | X 요금 페이지 |
| 월 한도 | 게시물 읽기 3백만 건 | 사용량 및 과금 페이지 |
| 같은 UTC 날짜에 같은 게시물 2회 읽기 | 1회만 과금 | 사용량 및 과금 페이지 |
| 사용자 타임라인 범위 | 최근 게시물 3,200개 | 타임라인 문서 |
| 최근 검색 요청 속도 제한 | 15분당 요청 450회 | 요청 속도 제한 페이지 |
| 전체 아카이브 검색 요청 속도 제한 | 초당 요청 1회 | 요청 속도 제한 페이지 |
| 무료 크레딧 | 첫 구매 후 $20, 자동 충전 시 최대 $50, 3개월 후 만료 | 무료 크레딧 페이지 |
X가 직접 가격을 책정하는 X API는 이용 조건이 가장 명확합니다. 게시물을 작성하고 자신의 계정을 관리할 수도 있습니다. X API 소개와 액세스 권한 얻기를 참고하세요. X는 오픈소스 MCP 서버인 xmcp도 공개하고 있습니다.
속도와 동시 요청 수
EveryInfra에서 200행을 반환하는 twitter/search 호출 한 번은 35.2~53.4초, 중앙값 39.3초가 걸렸습니다. 200행 user_posts 호출은 약 33초가 걸렸습니다. 50행 comments 호출은 14~23초, 중앙값 19.8초가 걸렸습니다. 동기 호출을 쓰는 프로세스 하나로 분당 약 300개 트윗을 얻을 수 있습니다. 테스트 키는 분당 10회 요청까지 허용되었으며, 프로덕션 계정의 한도는 콘솔에서 확인할 수 있습니다.
| 도구 | 호출 또는 실행당 행 수 | 측정 또는 명시된 시간 | 분당 행 수 |
|---|---|---|---|
EveryInfra twitter/search | 200 | 35.2~53.4초, 중앙값 39.3초(측정) | 프로세스당 약 300 |
EveryInfra twitter/user_posts | 200 | 약 33초(측정) | 프로세스당 약 360 |
EveryInfra twitter/comments | 최대 50개 | 14~23초, 중앙값 19.8초(측정) | 호출당 39.1행 기준 프로세스당 약 120 |
| Tweet Scraper V2 | 쿼리당 50 이상 | 초당 트윗 30~80개(페이지 기재) | 1,800~4,800 |
V2 페이지에는 초당 트윗 30~80개, 즉 분당 1,800~4,800개라고 나와 있습니다. 따라서 대규모 V2 실행 한 번이 더 빠릅니다. Apify 플랫폼 제한은 한 계정이 동시에 실행할 수 있는 Actor 수와 메모리 양을 정합니다. 게시물 수십만 개를 최대한 빨리 받아야 한다면 Apify의 대규모 실행 한 번이 EveryInfra의 페이지 단위 호출보다 낫습니다. 하루 수천 개 게시물을 일정에 따라 수집한다면 양쪽 모두 몇 분 안에 끝납니다.
AI 클라이언트에서 사용하기: MCP 설정
AI 클라이언트에서는 원격 MCP 서버 https://api.everyinfra.com/mcp에 연결합니다. 도구 이름은 everyinfra_로 시작합니다. 모델이 twitter/search나 twitter/comments를 스스로 선택할 수 있습니다.
아래 설정은 일반적인 예시입니다. Claude Code를 비롯해 원격 MCP를 지원하는 클라이언트는 비슷한 형식을 사용합니다. 정확한 문법은 Claude Code MCP 문서와 OpenAI MCP 문서를 참고하세요. 프로토콜은 MCP 사양에 정의되어 있습니다.
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
Apify에도 Store Actor를 모델용 도구로 바꿔 주는 MCP 서버가 있습니다(Apify MCP 문서, GitHub 소스). 두 설계는 서로 다릅니다. Apify MCP에서는 모델이 Actor 실행을 시작하고 완료될 때까지 기다린 다음 데이터셋을 읽습니다. 대규모 일괄 작업에 적합한 방식입니다.
EveryInfra MCP에서는 도구 호출마다 데이터를 바로 반환합니다. 질문하고 확인하면서 진행하는 채팅에 적합합니다. 지원 클라이언트 목록은 MCP 서버 페이지에서 확인할 수 있습니다.
Apify에서 이전하기: 파라미터 매핑
이미 V2나 답글 스크래퍼를 쓰고 있다면 이 표에서 입력값의 대응 관계를 확인할 수 있습니다. Apify 파라미터 이름은 공개 Actor 메타데이터의 예시 입력과 Store 페이지에서 가져왔습니다. 출력 필드는 서로 다르므로 EveryInfra의 response_fields로 다시 매핑해야 합니다.
| 작업 | Apify 입력 | EveryInfra 입력 | 비고 |
|---|---|---|---|
| 키워드 검색 | V2 searchTerms + maxItems | twitter/search의 keyword + limit(최대 200) | 호출당 키워드 1개, 더 받으려면 날짜로 분할 |
| 정렬 | V2 sort: Latest, Top, Latest + Top | sort: latest 또는 기본값 Top | 테스트에서 200행 중 137행 중복 |
| 언어 | V2 tweetLanguage | keyword 안에 lang:es | 예: inteligencia artificial lang:es |
| 단일 계정 | V2 twitterHandles 또는 from: | username을 사용하는 twitter/user_posts; 오래된 게시물은 from: 검색 | user_posts는 호출당 최대 200 |
| 게시물 답글 | 답글 스크래퍼 tweetIds 또는 URL | twitter/comments, 숫자 id 사용 | 게시물당 최대 50개, URL을 넣으면 0행 반환 후 환불 |
| 단일 게시물 | Unlimited 트윗 URL($0.05) | twitter/post | 호출당 $0.000556 |
| 팔로워 | apidojo 사용자 스크래퍼 팔로워 이벤트 | twitter/followers_list, 최대 2,000명 | 호출당 $0.000556 |
EveryInfra의 Twitter 스크래핑 API는 21개 엔드포인트를 제공하며, 현재 모두 카탈로그에서 사용할 수 있습니다. 위의 세 가지 외에도 프로필, 팔로워 및 팔로잉 목록, 리트윗한 사용자, 커뮤니티 게시물, 동영상 트랜스크립트까지 지원합니다. 각 엔드포인트의 파라미터, 응답 필드, 가격은 무료 카탈로그(카탈로그 API)에서 확인할 수 있습니다. 카탈로그는 API 키 없이 사용할 수 있습니다.
이 수치를 어떻게 검증했나
본문, 표, 차트에 나온 EveryInfra 수치는 모두 원본 응답 52건을 바탕으로 스크립트로 다시 계산했습니다. 행 수는 results의 길이이며, 중복 제거에는 게시물 id를 사용했습니다. 과금액은 billing.charged_usd입니다. 호출 시각은 호출을 보낸 순간을 기준으로 싱가포르 현지 시간으로 기록했습니다.
Apify의 가격, 사용자 수, 실행 횟수는 모두 싱가포르 시간 00:14~00:16 사이에 공개 메타데이터에서 확인했습니다. V2 가격 안내 문구의 스크린샷도 남겼습니다. 손익분기점과 월 비용은 이 두 종류의 수치만 조합해 계산했습니다. 아직 확인되지 않은 사항이 세 가지 있습니다.
오래된 게시물에 대한 답글 호출에서 결과가 적게 반환되는 근본 원인은 아직 밝혀지지 않았으며, 테스트 3에서 그 패턴을 확인할 수 있습니다. xquik의 플랫폼 사용료가 얼마인지도 알 수 없습니다. 또한 feedminer가 X Communities에서 키워드 검색 결과를 가져온다는 점은 외부에서 검증할 수 없습니다.
Apify가 더 나은 선택인 경우
Apify가 더 나은 경우, 또는 저희가 대응하지 못하는 경우는 다음과 같습니다. 첫째, 게시물 하나에서 답글 수천 개를 가져올 때입니다. 저희는 게시물당 50개에서 멈추지만, Apify 답글 스크래퍼는 약 $0.40에 여러 페이지를 순회해 답글 약 1,000개를 수집합니다. 둘째, 호출당 1~3행만 필요할 때입니다. xquik, feedminer처럼 행 단위로 과금하는 스크래퍼가 더 저렴하며, 손익분기점은 각각 3.71행과 4.63행입니다.
셋째, 게시물 수십만 개를 최대한 빨리 수집할 때입니다. V2 페이지에는 초당 트윗 30~80개라고 나와 있으며, Apify의 대규모 실행 한 번으로 작업을 병렬 처리할 수 있습니다. 저희는 동기 호출 한 번에 한 페이지를 반환합니다. 넷째, 스케줄, 저장소, 웹훅을 한곳에서 관리하고 싶을 때입니다. Apify에는 스케줄, 데이터셋, 웹훅이 있어 실행 결과를 Google Sheets나 사용자 서버로 보낼 수 있습니다. 저희는 데이터만 반환하므로 스케줄 실행과 데이터 저장은 직접 처리해야 합니다.
다섯째, 작성자 소개와 게시 클라이언트 정보가 필요할 때입니다. Apify 답글 스크래퍼 페이지에는 두 항목이 모두 나와 있지만, 저희 엔드포인트 세 개는 이를 반환하지 않습니다. 여섯째, 정확한 날짜 범위가 필요할 때입니다. 저희의 일 단위 범위 테스트에서는 게시물 200개 중 48~85개만 범위 안에 들어왔습니다. V2도 until을 쓰면 결과 수가 줄어든다고 경고하지만, 자체 날짜 옵션을 제공합니다. 정확한 날짜 범위가 중요하다면 두 가지를 모두 테스트해 보세요.
| 작업 | 더 나은 선택 | 이유 |
|---|---|---|
| 게시물 하나의 답글 수천 개 | Apify 답글 스크래퍼 | EveryInfra는 게시물당 답글 50개까지 |
| 호출당 1~3행 | xquik 또는 feedminer | 3.71행 또는 4.63행 미만이면 행당 과금이 유리 |
| 게시물 수십만 개를 빠르게 수집 | Apify | 실행 1회에 초당 트윗 30~80개 |
| 스케줄, 저장소, 웹훅 통합 관리 | Apify | EveryInfra는 데이터만 반환 |
| 답글별 작성자 소개와 게시 클라이언트 | Apify 답글 스크래퍼 | EveryInfra 엔드포인트 3개에서는 반환하지 않음 |
| 검색, 계정 게시물, 여러 게시물의 답글을 전체 페이지 단위로 수집 | EveryInfra | 1,000행당 10~122배 저렴 |
X 약관, 로그인 장벽, 법적 제약
X 서비스 약관은 2026년 10월 9일에 시행되었습니다. 약관에는 "사전 서면 동의 없이 어떠한 형태로든, 어떠한 목적으로든 서비스를 크롤링하거나 스크래핑하는 행위는 명시적으로 금지된다"고 적혀 있습니다(X 서비스 약관). 개발자 약관은 API로 받은 데이터에 대한 제한을 추가로 규정합니다.
이 약관은 X를 이용하는 사람에게 적용됩니다. 프로젝트에 어떤 의미가 있는지는 변호사에게 문의하세요. 이 글은 법률 자문이 아닙니다.
다음 공개 기록을 직접 확인할 수 있습니다. X Corp. v. Bright Data(소송 기록), hiQ v. LinkedIn(판결문), 그리고 디지털 서비스법(DSA)에 따라 EU가 X에 취한 조치(집행위원회 발표, 이행 계획)입니다.
로그인 장벽은 별개의 문제입니다. apidojo 답글 스크래퍼 페이지에는 "로그인 불필요, 프록시 불필요"라고 적혀 있습니다. V2 페이지에는 X 검색에 표시되는 결과를 반환하며, X가 검색, 페이지네이션, 필터를 언제든 변경할 수 있다고 나와 있습니다. EveryInfra를 사용할 때는 X 계정을 제공할 필요가 없습니다.
저희가 보낸 호출 52건 중 "login required" 오류를 반환한 호출은 없었으며, Twitter 데이터 호출은 모두 HTTP 200을 반환했습니다.
최근 달라진 점
| 날짜 | 변경 내용과 사용자에게 미치는 영향 | 출처 |
|---|---|---|
| 2026-10-13 | X가 무료 크레딧 규정을 변경했습니다. 이제 카드 등록만으로는 $20를 받을 수 없으며, 보너스를 받으려면 먼저 크레딧을 구매해야 합니다. | 무료 크레딧 |
| 2026-10-09 | 새 X 서비스 약관이 시행되었습니다. 예전 인용문은 최신이 아닐 수 있으므로 현행 약관을 확인하세요. | X 약관 |
| 2026-10-02 | X가 pay-per-use 계정에 최대 $70의 첫 구매 크레딧을 추가했으며, 이 크레딧은 3개월 후 만료됩니다. 만료 전에 사용하세요. | X API 변경 내역 |
| 2026-09-24 | danek Twitter Scraper의 현행 가격이 적용되기 시작했으며, 메모리 GB당 실행 시작 요금이 부과됩니다. 소규모 실행을 여러 번 하면 비용이 늘어납니다. | danek 메타데이터 |
| 9월 하순 | feedminer 페이지에 따르면 X가 검색 인덱스 요청을 거부하기 시작했습니다. 이제 from: 없는 키워드 검색어는 X Communities에서 가져옵니다. 계정 게시물은 영향을 받지 않습니다. | feedminer Store 페이지 |
가장 두드러진 흐름은 가격이 자주 바뀐다는 점입니다. 저희가 확인한 Twitter 스크래퍼 14개 중 10개는 현행 가격이 8월 중순 이후에 적용되었습니다. 예를 들어 xquik은 8월 29일, scraper_one은 8월 30일과 31일입니다. 메타데이터의 가격 기간마다 startedAt 날짜가 있습니다. 따라서 이 글을 포함해 어떤 비교 글에 나온 Apify 가격이든 두세 달 뒤에는 틀릴 수 있습니다. 구매 전에 공개 메타데이터를 다시 확인하고, 확인한 시각을 기록해 두세요.
시작하기: 체험 호출 한 번에서 일일 작업까지
GitHub 저장소 everyinfra/everyinfra-agent-plugins와 everyinfra/seo-skills에 모두 스타를 누르면 콘솔에서 $1 체험용 크레딧을 받을 수 있습니다. 크레딧은 24시간 동안 유효하며, 이 글의 호출 52건을 30번 넘게 실행할 수 있는 금액입니다. API 키는 빠른 시작에서 발급받으세요. Twitter 스크래핑 API 페이지에서 전체 엔드포인트를 확인할 수 있습니다. 그다음 세 페이지에서 플레이그라운드를 사용해 보세요. Twitter 검색 스크래핑 API, Twitter 사용자 게시물 스크래핑 API, Twitter 답글 스크래핑 API입니다.
프로필 데이터는 Twitter 프로필 스크래핑 API를 참고하세요. Reddit 스크래핑 API와 Bluesky 스크래핑 API도 같은 방식으로 사용할 수 있습니다. 모든 엔드포인트와 가격은 데이터 마켓과 요금 페이지에서 확인할 수 있습니다. Apify와의 다른 1,000건당 비교는 Apify TikTok 스크래퍼 대안과 Apify Instagram 스크래퍼 대안을 읽어 보세요. 모델이 정확한 필드로 데이터 엔드포인트를 호출하게 하려면 Claude strict tool use로 데이터 API 호출하기를 참고하세요.
FAQ
Apify Twitter 스크래퍼는 무료인가요?
출처: 2026년 11월 3일에 확인한 검색 추천어 "apify twitter scraper free". Apify 무료 플랜은 매월 $5의 플랫폼 크레딧을 제공합니다. 하지만 V2와 apidojo 답글 스크래퍼 페이지에는 모두 무료 사용자는 월 5회, 회당 최대 10개 항목까지만 실행할 수 있다고 나와 있습니다. V2는 무료 사용자가 API로 호출할 수 없다고도 밝히고 있습니다.
따라서 "무료" 플랜으로는 출력 형식을 확인하는 정도가 전부입니다. EveryInfra의 $1 체험용 크레딧은 24시간 동안 유효합니다. 호출당 트윗 200개 기준으로 300,000개가 넘는 트윗을 수집할 수 있습니다. 그 이후에는 월 구독료 없이 요청당 과금됩니다.
Apify 트윗 스크래퍼 요금은 얼마이며, 왜 일부 글에서는 1,000건당 $0.004라고 하나요?
출처: 자주 검색되는 검색어 "apify tweet scraper pricing"과 r/n8n 게시물(스레드). V2는 트윗당 $0.0004, 즉 1,000건당 $0.40입니다. r/n8n 게시물에는 1,000건당 $0.004로 적혀 있는데, 이는 소수점이 두 자리 어긋난 값입니다. 공개 메타데이터에 나온 대로 $0.40을 기준으로 삼으세요.
다른 r/n8n 튜토리얼은 V2와 X API를 "트윗 1,000개당 40센트 대 15,000개에 $200"으로 비교했습니다(스레드). 이는 예전 Basic 플랜 가격입니다. 현재 X는 게시물 1,000개당 $5의 pay-per-use를 적용합니다.
Apify Twitter 댓글 스크래퍼로 게시물의 답글을 모두 가져올 수 있나요?
출처: 2026년 11월 3일에 확인한 검색 추천어 "apify twitter comments scraper". apidojo 답글 스크래퍼 페이지에 따르면 이 스크래퍼는 답글 페이지를 자동으로 넘기며 수집합니다. 기본 방식으로 반환되는 답글이 너무 적으면 useSearch가 conversation_id: 검색을 추가합니다. 삭제되었거나 비공개인 게시물은 지원하지 않는다고도 나와 있습니다. EveryInfra의 twitter/comments는 게시물당 답글 50개에서 멈추므로 전부 가져올 수는 없습니다. 게시물 하나에서 답글 수천 개가 필요하다면 Apify가 더 나은 선택입니다.
Twitter는 스크래핑을 허용하나요? X 스크래핑은 합법인가요?
출처: 2026년 11월 3일에 확인한 검색 추천어 “does twitter allow scraping”과 “is it legal to scrape twitter”. 2026년 10월 9일자 X 서비스 약관은 서면 동의 없는 스크래핑을 금지합니다. 위의 법률 관련 섹션에는 X v. Bright Data 소송 기록, hiQ v. LinkedIn 판결문, EU의 X 벌금 관련 링크가 있습니다.
답은 국가, 데이터, 용도에 따라 달라집니다. 변호사와 상담하세요. 이 글은 법률 자문이 아닙니다.
가장 저렴한 Twitter 스크래핑 API는 무엇인가요?
출처: 2026년 11월 3일에 확인한 검색 추천어 “twitter scraper api cheapest”. 최근 30일 사용자가 100명 이상인 Store 스크래퍼를 대상으로 살펴봤습니다.
공개 가격 기준으로 가장 저렴한 트윗 스크래퍼는 $0.15인 xquik과 scrape.badger, 그리고 $0.12인 feedminer입니다. 단, xquik은 플랫폼 사용료가 추가되고, feedminer는 키워드 검색에 제한이 있습니다. Store 최저가는 $0.01이지만 해당 스크래퍼의 사용자는 8명이었습니다. EveryInfra는 요청당 과금하며, 200행짜리 전체 페이지 기준 1,000행당 $0.00278, 중복 제거 후에는 $0.00327입니다. 호출당 약 3행 미만이면 행당 과금 스크래퍼가 더 저렴합니다.
Apify X 스크래퍼와 X API 중 무엇을 선택해야 하나요?
출처: 자주 검색되는 검색어 “apify x scraper”와 두 방식을 비교한 r/n8n 튜토리얼(스레드). X API는 게시물 1,000개당 $5이며, 월 3백만 개의 게시물 상한이 있습니다. X가 직접 가격을 책정하는 경로라 약관이 가장 명확하고, 내 계정에 게시하고 계정을 관리하는 기능도 제공합니다. 이 글의 가격 기준으로 인기 Apify 스크래퍼는 1,000개당 $0.12~$0.40, EveryInfra는 $0.003~$0.014입니다. X 약관은 스크래핑을 제한하므로 프로젝트에 대해서는 변호사와 상의하세요. 내 계정을 운영하려면 X API를 사용하세요. 공개 토론을 대량으로 읽으려면 스크래핑 도구를 가격과 호출당 행 수로 비교하세요.
참고 자료
- Apify / apidojo. “Tweet Scraper V2 - X Scraper / Twitter Scraper / X.com Scraper” (Store 페이지). 2026-11-03 열람.
- Apify API. apidojo~tweet-scraper 공개 Actor 메타데이터(pricingInfos, stats). 2026-11-03 열람.
- Apify / apidojo. “Twitter (X.com) Scraper Unlimited: No Limits” (Store 페이지). 2026-11-03 열람.
- Apify API. apidojo~twitter-scraper-lite 공개 Actor 메타데이터. 2026-11-03 열람.
- Apify / apidojo. “Twitter (X) Replies Scraper API” (Store 페이지). 2026-11-03 열람.
- Apify API. apidojo~twitter-replies-scraper 공개 Actor 메타데이터. 2026-11-03 열람.
- Apify / kaitoeasyapi. “Cheapest Twitter Scraper / RealTime Twitter Data Scraper API” (Store 페이지). 2026-11-03 열람.
- Apify API. kaitoeasyapi 트윗 스크래퍼 공개 Actor 메타데이터. 2026-11-03 열람.
- Apify / xquik. “Twitter Scraper & X Scraper for Tweets & Search” (Store 페이지). 2026-11-03 열람.
- Apify API. xquik~x-tweet-scraper 공개 Actor 메타데이터. 2026-11-03 열람.
- Apify / xquik. “X Reply Scraper” (Store 페이지). 2026-11-03 열람.
- Apify API. xquik~x-reply-scraper 공개 Actor 메타데이터. 2026-11-03 열람.
- Apify / feedminer. “X (Twitter) Tweet Scraper $0.12/1K” (Store 페이지). 2026-11-03 열람.
- Apify API. feedminer~x-tweet-scraper 공개 Actor 메타데이터. 2026-11-03 열람.
- Apify / scraper_one. “X (Twitter) Profile Posts Scraper” (Store 페이지). 2026-11-03 열람.
- Apify API. scraper_one~x-profile-posts-scraper 공개 Actor 메타데이터. 2026-11-03 열람.
- Apify API. scraper_one~x-post-replies-scraper 공개 Actor 메타데이터. 2026-11-03 열람.
- Apify API. Store 검색 API /v2/store?search=twitter. 2026-11-03 열람.
- Apify Docs. “Get list of Actors in Store” (API 문서). 2026-11-03 열람.
- Apify. “Apify pricing”. 2026-11-03 열람.
- Apify Docs. “Actors in Store”. 2026-11-03 열람.
- Apify Docs. “Actor pricing and costs”. 2026-11-03 열람.
- Apify Docs. “Usage and resources”. 2026-11-03 열람.
- Apify Docs. “Limits”. 2026-11-03 열람.
- Apify Docs. “Apify MCP server”. 2026-11-03 열람.
- GitHub. apify/apify-mcp-server. 2026-11-03 열람.
- Apify Docs. “Schedules”. 2026-11-03 열람.
- Apify Docs. “Webhooks”. 2026-11-03 열람.
- GitHub / igorbrigadir. twitter-advanced-search(검색 연산자 목록). 2026-11-03 열람.
- X Developer Platform. “X API pay-per-usage pricing and credits”. 2026-11-03 열람.
- X Developer Platform. “Usage and Billing”(월 3백만 건 한도, 당일 중복 제거). 2026-11-03 열람.
- X Developer Platform. “Search Posts”. 2026-11-03 열람.
- X Developer Platform. “Timelines” (최근 게시물 3,200개). 2026-11-03 열람.
- X Developer Platform. “X API Rate Limits”. 2026-11-03 열람.
- X Developer Platform. “Free credit incentives for X API pay-per-use accounts” (2026-10-13 업데이트). 2026-10-13.
- X Developer Platform. “X API changelog”. 2026-10-29.
- X Developers forum. “Important Update: Legacy X API Pro Plans Are Moving to Pay-Per-Use”. 2026-08-14.
- X Corp. “X Terms of Service” (2026-10-09 시행). 2026-10-09.
- X Developer Platform. “Developer Terms”. 2026-11-03 열람.
- GitHub / X. xdevplatform/xmcp. 2026-11-03 열람.
- European Commission. “Commission fines X €120 million under the Digital Services Act”. 2025-12-05.
- European Commission. “Commission accepts X's action plan to comply with Digital Services Act”. 2026-07-16.
- European Commission. 보도자료 IP/25/2934. 2025-12-05.
- EUR-Lex. “Regulation (EU) 2022/2065” (디지털 서비스법). 2022-10-19.
- CourtListener. “X Corp. v. Bright Data Ltd., 3:23-cv-03698” (소송 기록). 2024-05-09.
- U.S. Court of Appeals for the Ninth Circuit. “hiQ Labs v. LinkedIn, No. 17-16783” (제9연방순회항소법원 판결문). 2022-04-18.
- Model Context Protocol. “Model Context Protocol Specification 2025-11-25”. 2025-11-25.
- Anthropic. “Connect Claude Code to tools via MCP”. 2026-11-03 열람.
- OpenAI. “Connectors and MCP servers”. 2026-11-03 열람.
- Reddit r/n8n. “How to easily scrape data from Twitter / X using Apify”. 2026-11-03 열람.
- Reddit r/n8n. “This Automation Took Me From 0 to 175k Followers in Under 12 Months”. 2026-11-03 열람.
- EveryInfra. EveryInfra 기능 카탈로그(무료, API 키 불필요). 2026-11-03 00:16 열람.
- GitHub / Xquik. Xquik-dev/x-twitter-scraper(README: 플랫폼 사용료 별도 청구). 2026-11-03 열람.
- Apify Docs. “Pay per event”. 2026-11-03 열람.
- X Developer Platform. “Getting Access”. 2026-11-03 열람.
- X Developer Platform. “About the X API”. 2026-11-03 열람.
- X Developer Platform. “Build a query” (쿼리 문법). 2026-11-03 열람.
- Apify Docs. “Get Actor” (API 문서). 2026-11-03 열람.
- Apify API. danek~twitter-scraper 공개 Actor 메타데이터. 2026-11-03 열람.
참고 BL-75