Apify Twitter Scraperの代替:検索、プロフィール投稿、返信の1,000件あたりの費用を実測
Apify Tweet Scraper V2の表示価格は1,000ツイートあたり$0.40です。実測した検索コストは$0.0033でした。リプライは10〜25倍安価でしたが、1投稿あたり50件が上限です。
Apify Storeで最も使われているツイートスクレイパーはTweet Scraper V2です。公開価格はすべてのプランで1,000ツイートあたり$0.40です。2026年11月3日、EveryInfraのtwitter/searchエンドポイントで7件のキーワード検索を実行しました。1回の呼び出しあたりの費用は$0.000556で、200件のツイートが返されました。
重複を除くと、$0.003892で1,190件のユニークなツイートが得られました。1,000件あたり$0.00327で、V2の122分の1です。完全なキーワード検索に対応するStoreの人気ツイートスクレイパーのうち最も安いのはxquikの$0.15で、こちらとの差は46倍です。
1つのアカウントの投稿1,000件では、ユニーク投稿1,000件あたり$0.00334でした。V2の120分の1、人気の選択肢のうち最安のもの($0.12)の36分の1です。リプライは事情が異なります。当社のtwitter/commentsエンドポイントが返すリプライは、1投稿あたり最大50件です。
25件の投稿で、1回の呼び出しあたりの平均は39.1件のリプライ、1,000リプライあたり$0.0142でした。これは、価格を調べたApifyのリプライスクレイパーより10〜25倍安価です。ただし、当社のエンドポイントでは1つの投稿から1,000件のリプライを取得することはできません。その用途にはApifyのほうが適しています。
本記事の数値の読み方
この記事の「1,000件あたりの価格」の計算はシンプルです。実際に課金された金額を実際に返された行数で割り、1,000を掛けます。EveryInfraはリクエストごとに課金し、1リクエストの価格は行数にかかわらず一定です。Apify StoreのTwitterスクレイパーの多くは結果ごとに課金し、データセットに書き込まれる1アイテムが1課金単位です。両者を比較するには、分母をそろえる必要があります。
当社側の分母は、投稿IDで重複を除いたユニーク行数です。limitの値を分母に使うことはありません。そのため、呼び出しで返る行が少なかったり重複していたりすると、この記事での当社の価格は下がるのではなく上がります。Apify側については公開情報のみを使用しています。Storeページ、料金ページ、ドキュメント、そしてアカウント不要の公開アクターAPIです。
Apifyには新規登録しておらず、アクターも一切実行していません。アクターとは、Apifyにおけるクラウドスクレイピングプログラムの呼び名です。そのため、以下のApifyの数値はすべて表示価格であり、実測の請求額ではありません。
Apify TwitterスクレイパーとEveryInfraの比較:まとめ表
結果を以下の表にまとめます。データの種類ごとに、Apifyのスクレイパーを2つ示します。1つ目は主要スクレイパーで、直近30日間の利用者数が最も多いものです。2つ目は、直近30日間に100人以上が利用したスクレイパーのうち、Freeティアで最も安いものです。価格はすべて、2026年11月2日16:14 UTC(シンガポール時間11月3日00:14)に公開アクターAPIのpricingInfosフィールドから取得しました。
Apifyのドキュメントでは、プランと価格帯が対応付けられています。FreeはFree価格、StarterはBronze、ScaleはSilver、BusinessはGoldを使います。PlatinumとDiamondはエンタープライズ顧客向けです(「Actor pricing and costs」)。この記事で扱うTwitterスクレイパーでは、Free価格とBusiness価格は同じか、差が半分未満です。当社の数値はすべて実際の呼び出しによるものです。課金額はbilling.charged_usdから、件数はresultsから読み取りました。
| データ | EveryInfraのエンドポイント | 呼び出し数/行数/ユニーク数/課金額 | EveryInfraの1,000件あたり料金(ユニーク) | Apifyの主要スクレイパー | 価格差 | 人気スクレイパーの最安値 | 価格差 |
|---|---|---|---|---|---|---|---|
| キーワード検索 | twitter/search | 7 / 1,400 / 1,190 / $0.003892 | $0.00327 | Tweet Scraper V2、$0.40 | 122x | xquik、$0.15 | 46x |
| 1アカウントの投稿 | twitter/user_posts + from:検索 | 8 / 1,592 / 1,330 / $0.004448 | $0.00334 | V2(twitterHandles指定)、$0.40 | 120x | feedminer、$0.12 | 36x |
| 投稿へのリプライ | twitter/comments | 25 / 977 / 977 / $0.0139 | $0.0142 | Replies Scraper、20投稿×50件、$0.36 | 25x | xquik Reply、$0.15 | 10.5x |
各倍率は、Apifyの価格を当社の価格で割った値です。注意点が4つあります。第1に、3つの差はいずれもページサイズから生じています。検索とアカウントの投稿は1回の呼び出しで最大200件、返信は最大50件を返します。ページが上限件数まで埋まれば、1回分の料金を多数の結果に分散できます。1回の呼び出しで1〜2件しか必要ない場合は結果が逆転します。その計算は損益分岐点のセクションで示します。
第2に、返信の$0.36という数値は、apidojoの返信スクレイパーのページにあるルールに基づいています。有料プランでは、1投稿あたり最初の約40件の返信が無料です。1投稿あたり50件の返信なら、1投稿の費用は$0.014のクエリ料金に、$0.0004のアイテム10件分を加えた額です。第3に、xquikのREADMEによると、Apifyは結果の料金に加えてプラットフォームの利用料も請求します(「xquik README」)。
そのため、$0.15が請求額のすべてではありません。4つ目に、Apifyの価格は頻繁に変わります。変更日は「最近の変更点」セクションにまとめています。
検索の$0.15という価格はxquikに限りません。scrape.badgerのツイートスクレイパーは30日間のユーザー数が709人で、Freeプランでは$0.15、Businessプランでは$0.12です。Feedminerは$0.12とさらに安価ですが、from:を含まないキーワード検索の結果は現在X Communitiesから取得されています。そのため、feedminerはアカウントの行でのみ使用しています。
Apifyのツイートスクレイパーの料金:V2、Unlimited、リプライスクレイパー
「apify tweet scraper pricing」で検索すると、たいてい似た名前のスクレイパーがいくつも表示されます。そのうち3つは、同じ開発者apidojoが公開しているTweet Scraper V2、Twitter (X.com) Scraper Unlimited、Twitter (X) Replies Scraperです。3つともpay-per-event(イベント課金)方式です。開発者が課金対象のイベントを定義し、実行ごとにイベント数×イベント単価が請求されます。
pay-per-eventのドキュメントには、コンピューティング費用を誰が負担するかが説明されています。デフォルトでは、開発者が収益からプラットフォーム使用料を支払います。開発者が「Pay per event + usage」を有効にすると、ユーザーもプラットフォーム使用料を支払います。無料プランのユーザーのプラットフォーム使用料はApifyが負担します。V2のイベントは1種類です。データセットに書き込まれるツイート1件ごとに$0.0004、つまり4つのプランすべてで1,000件あたり$0.40です。
V2のStoreページには、4つのルールを記載した料金に関する注意書きがあります。原文は下のスクリーンショットのとおりです。
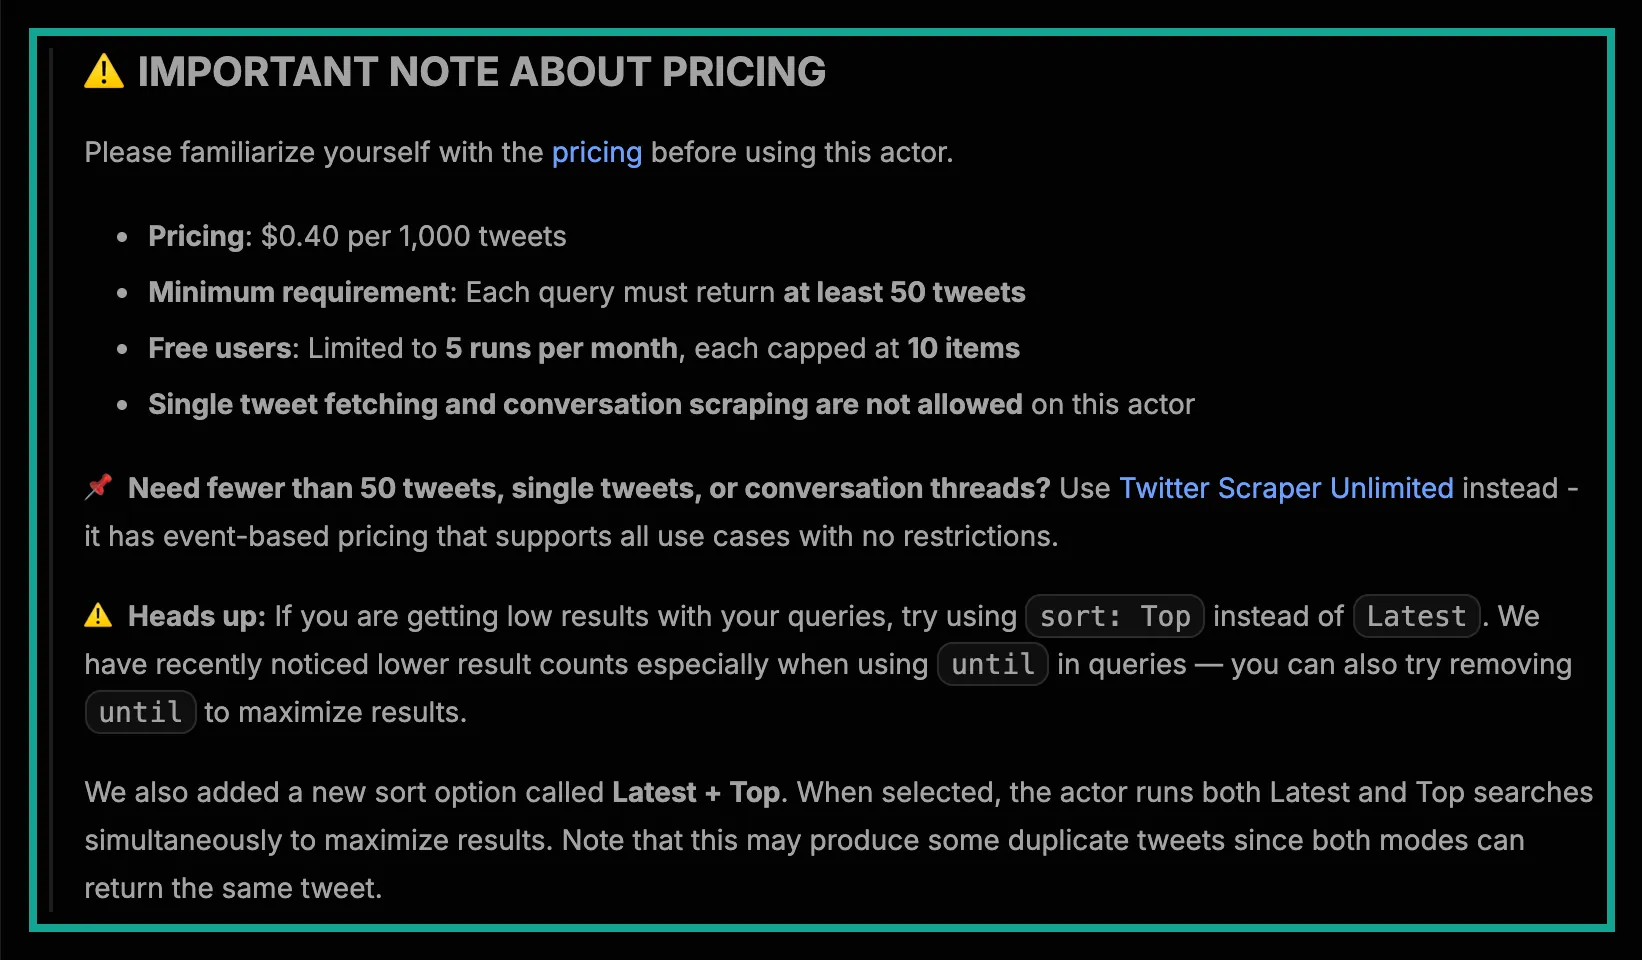
コストに特に影響するのは、このうち2つのルールです。1つ目は「1クエリあたり最低50件のツイート」です。V2は、小規模なアカウントの今週の投稿3件のような、少量かつピンポイントのクエリ向けには作られていません。ページではそうした用途にはUnlimitedを案内しています。
2つ目は、無料ユーザーに対する月5回、各10件までという上限です。無料プランには毎月$5分のプラットフォームクレジットが含まれます(Apifyの料金)。しかしV2では、無料ユーザーが取得できるのは月50件のツイートだけです。また、無料ユーザーはAPI経由でアクターを呼び出せないとも記載されています。
そのため、V2を実際に利用するには、少なくともStarterプランが必要です。各プランと、それぞれに適用される価格ティアを下の表に示します。
| Apifyのプラン | 月額料金 | アクターの価格ティア | V2への影響 |
|---|---|---|---|
| 無料 | $0(プラットフォームクレジット$5付き) | 無料 | デモモード:5回の実行、各10件、API不可 |
| Starter | $19〜 | Bronze | V2の通常利用:1,000件あたり$0.40 |
| Scale | $199 | Silver | V2の価格は同じ |
| Business | $999 | Gold | V2の価格は同じ |
プランに含まれる使用量は次の請求サイクルに繰り越されません。V2のページには「Important Note」セクションもあり、さらに2つの制限が書かれています。同時実行数は最大1件で、1回にまとめられるクエリは最大5件です。また「No monitoring」とあり、同じクエリを短い間隔で何度も実行しないよう求めています。
Unlimitedの料金体系はより複雑です。1クエリ(検索語、ハンドル、リストのそれぞれ)ごとに$0.016がかかり、この料金には最初の約40件の結果が含まれます。それ以降のアイテムは1件$0.0004〜$0.002で、単価は1回の実行に含まれるクエリ数で決まります。1回の実行あたり5クエリまでは追加アイテム1件$0.0004です。6〜10クエリでは$0.0008、11〜30クエリでは$0.0012、31〜100クエリでは$0.0016、100クエリを超えると$0.002です。
単一ツイートのURLは1件$0.05で、各実行には$0.02の最低料金があります。いずれもUnlimitedのアクターメタデータに基づきます。つまり、1回の実行に含めるクエリが多いほど、追加アイテム1件あたりの単価が上がります。一般的な「まとめるほど安い」とは逆です。1クエリで1,000ツイートを取得する場合は、$0.016に960件×$0.0004を加えた約$0.40で、V2と同じです。
リプライスクレイパーには、また別のルールがあります。Storeページによると、投稿ごとにクエリ料金がかかり、デフォルトのフローでは$0.014、useSearchを使う場合は$0.016です。リプライは1件$0.0004です。有料プランでは、1クエリあたり最初の約40件が無料です。
無料プランではデモモードのみ利用でき、月5回、1回あたり10件までです。そのため、1つの投稿から1,000件のリプライを取得すると約$0.014 + 960 x $0.0004 = $0.398です。20件の投稿からそれぞれ50件のリプライを取得すると20 x ($0.014 + 10 x $0.0004) = $0.36です。
| Apifyのスクレイパー(開発者) | イベント単価(Free〜Businessティア) | 実行またはクエリごとの固定料金 | 最低条件と制限(ページの記載) | ユーザー数(過去30日間) |
|---|---|---|---|---|
| Tweet Scraper V2(apidojo) | 1件あたり$0.0004(全ティア共通) | なし | 1クエリあたり50ツイート。無料プラン:5回の実行、10件 | 10,137 |
| Scraper Unlimited(apidojo) | 追加1件あたり$0.0004〜$0.002 | 1クエリあたり$0.016、ツイートURL1件あたり$0.05、1回の実行あたり最低$0.02 | 最低行数なし | 2,366 |
| Replies Scraper(apidojo) | 1件あたり$0.0004 | 1投稿あたり$0.014(検索フローは$0.016)。有料プランでは1投稿あたり約40件が無料 | 無料プラン:デモモードのみ | 132 |
| Cheapest Twitter Scraper (kaitoeasyapi) | $0.00025〜$0.00018 | なし | なし | 5,398 |
| X Tweet Scraper (xquik) | $0.00015(全プラン共通) | なし(プラットフォーム利用料は別途) | なし | 3,374 |
| X Reply Scraper (xquik) | $0.00015 | なし(プラットフォーム利用料は別途) | なし | 165 |
| X Tweet Scraper (feedminer) | $0.00012〜$0.0001 | なし | キーワード検索については下記の注記を参照 | 107 |
| Profile Posts Scraper (scraper_one) | $0.0004〜$0.0003 | 1回の実行あたり$0.0025 | なし | 389 |
| Twitter Scraper (danek) | $0.0003〜$0.00024 | メモリ1GBあたりの起動料金 | なし | 406 |
この表の価格はすべて、シンガポール時間11月3日00:14〜00:16(UTCでは11月2日16:14〜16:16)に、公開されているActorのメタデータから読み取りました。ユーザー数は、同じAPIのstats.totalUsers30Daysから取得しました。このフィールドは「Get Actor API docs」で説明されています。Storeには、名前にTwitterまたはXを含むスクレイパーが400以上あります。価格の分布は後のセクションで示します。
テスト方法と合格の基準
合格基準は、データを確認する前に決めました。各データ型について、異なる2つ以上の時点で少なくとも2回、実際にAPIを呼び出すことを要件としました。1,000件あたりの価格は、すべて重複のない行に基づいて算出することとしました。あるタスクでApifyのほうが安い、または優れている場合は、まとめの表と本文にそのことを明記することとしました。データが返らない呼び出しを少なくとも2回行い、それぞれの課金額を記録することとしました。
すべての呼び出しはPOST https://api.everyinfra.com/api/v1/socialに送信しました。各呼び出しについて、送信時刻、HTTPステータス、所要時間、行数、charged_usdを記録しました。その後、スクリプトで生のレスポンスからすべての数値を再計算しました。本文、表、グラフの数値はすべてこのスクリプトによるものです。
| シナリオ | エンドポイントとパラメータ | ライブ呼び出し | 時刻(UTC、11月2日) | 用途 |
|---|---|---|---|---|
| キーワード検索 | twitter/search、キーワード「openai」、上限200件、Latest順での並べ替え1回、1日単位の期間指定5回 | 7回+再テスト1回 | 16:17〜16:31、再テスト16:47 | 呼び出しあたりの行数、並べ替え間の重複、1日単位の期間 |
| アカウントの投稿 | NASAに対するtwitter/user_posts、続いてfrom:NASAでの検索7回 | 8回+再テスト1回 | 16:19〜16:33、再テスト16:47 | 1つのアカウントでどこまで過去の投稿を取得できるか |
| リプライ | 25件の投稿に対するtwitter/comments、上限50件 | 25回+再テスト1回 | 16:19〜16:40、再テスト16:48 | 規模の大きい投稿と小さい投稿での呼び出しあたりの行数 |
| データなし | APIキーなし、レート制限、余分なパラメータ、存在しないユーザー、存在しない投稿、idに完全なURLを指定 | 6 | 16:21〜16:29 | 課金対象となる失敗 |
| その他の言語 | スペイン語キーワード、El Paisアカウント、中国語キーワード | 3 | 16:40〜16:42 | 英語以外での1回あたりの取得件数 |
この表の時刻はすべて11月2日(UTC)です。11月3日のシンガポール時間に換算するには、8時間を足してください。52回の呼び出しの費用は合計$0.025576でした。テスト用キーには1分あたり10リクエストのレート制限があります。1回の呼び出しがこのレート制限にかかり、レスポンスには「Nothing was charged」と表示されました。40秒待ってから再送しました。
返信の取得対象には、OpenAIやNASAなどのブランドアカウントの投稿と、検索結果の投稿を選びました。返信数は数百件から20,000件超までさまざまです。対照として、返信が8件の小さな投稿も1件選びました。本記事では投稿本文と一般ユーザーの名前を伏せており、名前を出しているのはブランドと機関のアカウントのみです。
テスト1:apify twitter scraperで最も一般的なジョブ、キーワード検索で1,000件のツイートを取得
Apifyでツイートを検索する場合、通常はV2の入力searchTermsとmaxItemsから始めます。V2 actorのメタデータにある入力例には、sort(LatestまたはTop)、tweetLanguage、onlyVerifiedUsers、onlyImageもあります。これに対応する当社のエンドポイントはtwitter/searchです。keywordが必須で、limitとsortを指定できます。from:、since:、until:、lang:、min_faves:などのXの高度な検索演算子は、keywordの中に記述します。
Xの開発者ドキュメントではクエリ構文が解説されています。GitHubでコミュニティが公開しているリストでは、高度な検索演算子がさらに詳しくまとめられています。最初に送信した呼び出しは次のとおりです。
# 16:17:37 UTC Nov 2 (00:17:37 Singapore time Nov 3): HTTP 200, 41.8 s, count 200, charged_usd 0.000556
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"platform":"twitter","action":"search","params":{"keyword":"openai","limit":200}}'7回の検索はすべて200件のフルページを返し、合計1,400件になりました。1回目はデフォルトのソート(Top)を使い、2回目はsort: latestを使いました。2つのページでは137件の投稿が重複していたため、2回目で増えた新しい投稿は63件だけでした。また、「Latest」は厳密な時系列順ではありません。Latestのページで最も古い投稿は2023年11月のものでした。
V2のページにも同じ現象が書かれています。新しい「Latest + Top」ソートは両方の検索を実行するため、「一部のツイートが重複する可能性がある」とのことです。件数単位の課金では、こうした重複も1件として数えられます。
次に、since:とuntil:を使って「openai」を2日間ずつ5つの期間に区切りました。各期間の開始日は2026-10-30、2026-10-27、2026-10-24、2026-10-21、2026-10-18です。どの呼び出しも200件を返しました。1回あたりの新しいユニーク投稿数は168、168、197、196、198件でした。7回の呼び出しで1,190件のユニーク投稿を$0.003892、つまり1,000件あたり$0.00327で取得できました。
ただし、期間の区切りは厳密ではありませんでした。最初の3つの期間では、200件のうち指定した2日間に収まったのはそれぞれ70件、85件、48件だけで、残りは期間外の投稿でした。日付で区切る方法は、新しい投稿を大量に集めるには有効ですが、その2日間の投稿だけを正確に取得するには向きません。
ほかに3つの公開情報も同じ傾向を示しています。V2のページには、クエリでuntilを使うと結果が減ると書かれています。X APIの変更履歴によると、検索エンドポイントは2026年5月4日に新しい検索インデックスへ移行しました。さらにfeedminerのStoreページには、9月下旬からXが検索インデックスへのリクエストを拒否するようになったとあります。つまり、現在Xの検索結果は安定していません。どのツールを使う場合でも、返された結果を改めて日付でフィルタリングしてください。
30分後の16:47 UTC(シンガポール時間00:47)に、同じパラメータで最初の検索を再実行しました。200件のうち124件は1回目と一致し、76件は新しい投稿でした。Topソートの結果は時間とともに変わります。ブランドモニタリングでは、30分ごとに実行すれば新しい投稿がある程度得られます。ただし件数単位の課金では、重複した124件にも再び料金がかかります。当社では、再実行の費用は前回と同じ$0.000556でした。
テスト2:apify x scraperで1つのアカウントから1,000件の投稿を取得
V2で1つのアカウントの投稿を取得するには、twitterHandlesを使うか、searchTermsにfrom:を含めます。料金は同じく1,000件あたり$0.40です。当社ではまずtwitter/user_postsを使います。1回の呼び出しで最大200件の投稿を返し、カーソルはありません。それより古い投稿は、V2のドキュメントが勧めているのと同じように、twitter/searchに切り替えてfrom:NASAと日付演算子を組み合わせて取得します。
16:19 UTC(シンガポール時間00:19)のuser_postsの呼び出しでは200件の投稿が返り、期間は2026-09-08から2026-10-31まででした。このうち48件はNASAによる他アカウントへの返信、67件はリポストでした。これはXのWebサイトの「Posts and replies」タブの内容と一致します。
さらに古い投稿まで遡るため、from:NASAの検索を7回送りました。まずuntil:2026-09-08、次にuntil:2026-08-01とuntil:2026-04-01を使い、その後は2025年下半期、2025年上半期、2024年全体の期間を指定しました。8回の呼び出しで1,592件が返り、ユニーク投稿は1,330件でした。他のアカウントの投稿は1件も含まれていませんでした。合計料金は$0.004448、1,000件あたり$0.00334でした。
ユニーク投稿の年別内訳は、2026年が568件、2025年が396件、2024年が198件、2022年が82件でした。2020年は23件、2016年は39件で、その他の年は1桁でした。古い年ほど件数が少ないのは、テスト1と同じ理由です。日付を指定した検索には、期間外の古くて人気のある投稿が混ざります。期間を狭くすると新しく増える投稿は少なくなり、3回目の呼び出しで増えたのは87件だけでした。
16:47 UTC(シンガポール時間00:47)にuser_postsを再実行しました。200件すべてが28分前の結果と一致し、最新の投稿も同じ10月31日22:14 UTCのものでした。これはアーカイブ用途に役立ちます。短時間であれば同じパラメータで安定した結果が得られるため、差分取得のジョブでは最新の投稿IDを比較するだけで済みます。
X APIのユーザータイムラインエンドポイントで取得できるのは、直近3,200件の投稿までです(Xのタイムラインに関するドキュメント)。それより古い投稿を取得するには、フルアーカイブ検索が必要です。
英語以外のコンテンツ:何件返ってくるか
英語以外のコンテンツにapify x scraperを使う人も多くいます。16:40 UTC(シンガポール時間00:40)にinteligencia artificial lang:esで検索しました。200件のフルページが返り、すべてスペイン語で、投稿者は167人でした。期間は2026-10-23から2026-11-02までで、リポストや返信は含まれていませんでした。
16:41 UTC(シンガポール時間00:41)にEl Paisのアカウントに対してuser_postsを実行すると、200件の投稿が返りました。このうち197件がスペイン語でした。期間は10月31日から11月2日までの2日足らずです。つまり、投稿の多いニュースアカウントでは約2日で200件が埋まります。1か月分をアーカイブするには、1日1回呼び出してください。
16:42 UTC(シンガポール時間00:42)に、「大規模モデル」を意味する中国語の語句をlang:zh付きで検索しました。200件を指定したところ返ったのは100件で、すべて中国語、投稿者は67人でした。最も古い投稿は2026-10-08のものでした。ページが半分しか埋まらなかったため、この1回の呼び出しは1,000件あたり$0.00556となり、英語の約2倍でした。
それでもV2の約70分の1です。件数単位の課金であれば、ページが半分でも単価は変わりません。取得できる件数が少なくなるだけです。
| 呼び出し(シンガポール時間、11月3日) | エンドポイントと入力 | 件数 | 投稿者数 | 期間 | 1,000件あたり |
|---|---|---|---|---|---|
| 00:40 | twitter/search、lang:es付きのスペイン語キーワード | 200件、すべてスペイン語 | 167 | 2026-10-23〜2026-11-02 | $0.00278 |
| 00:41 | twitter/user_posts、El Pais | 200件、うち197件がスペイン語 | 1 | 2026-10-31〜2026-11-02 | $0.00278 |
| 00:42 | twitter/search、lang:zh付きの中国語キーワード | 100件、すべて中国語 | 67 | 2026-10-08〜2026-11-02 | $0.00556 |
テスト3:返信ではジョブを2つに分ける必要がある
返信は3種類のデータのうち差が最も小さく、ジョブの内容に最も左右されます。当社のtwitter/commentsエンドポイントではidが必須で、これは投稿URLの/status/の後にある数字です。1回の呼び出しで最大50件の返信を返し、カーソルはありません。25件の投稿それぞれに1回ずつ呼び出し、977件の返信を$0.0139、つまり1,000件あたり$0.0142で取得しました。
1つ目のケースは「多数の投稿からリプライをまとめて取得する」場合です。たとえば、ブランドの投稿200件に付いたフィードバックを毎週確認する用途です。この場合、当社の料金は投稿1件あたり$0.000556です。Apifyのリプライスクレイパーは投稿1件あたり$0.014からなので、当社のほうが25倍安くなります。最も安い選択肢であるxquikのリプライスクレイパー(リプライ1件あたり$0.00015)と比べても、当社のほうが10.5倍安くなります。
25回の呼び出しのうち、14回は上限の50件すべてのリプライを返しました。残りの11回は39、39、38、32、23、20、20、20、19、19、8件でした。8件は、リプライが8件しかない小規模な対照用の投稿のもので、すべて取得できています。一方、リプライが2,500〜6,800件ある大規模な投稿6件では、19〜23件しか返りませんでした。
次に、大規模な投稿24件の生のレスポンスを確認しました。傾向ははっきりしています。50件すべてが返った14回の呼び出しでは最近のリプライが返り、リプライあたりのいいね数の中央値は0でした。件数が少なかった10回は、公開から数週間〜2年が経過した投稿を対象としていました。これらのリプライはいいね数順に並んでおり、いいね数の中央値は6〜1,880でした。
つまり、新しい投稿では最新のリプライが取得されます。過去にバズった投稿では、Xが最初に表示する上位のリプライが取得され、「さらに返信を表示」の部分は展開されません。根本原因については、当社のバックエンドチームによる確認がまだ必要です。計画を立てる際は、新しい投稿で50件、過去にバズった投稿で約20件を見込んでください。
2つ目のケースは「1件の投稿からできるだけ多くのリプライを取得する」場合です。たとえば、バズった1件の投稿に付いた数千件のコメントを調査する用途です。当社のエンドポイントは投稿1件あたり50件が上限なので、この用途には対応できません。Apifyのリプライスクレイパーのページには、リプライを自動でページングすると記載されています。通常の処理で返る件数が少なすぎる場合は、useSearchがconversation_id:検索で追加取得します。リプライが1,000件ある投稿1件の費用は、Apifyでは約$0.398です。
この用途ではApifyのほうが適しており、当社には相当するエンドポイントがありません。投稿者が自分の投稿の下に投稿したスレッドだけが必要な場合は、twitter/threadを利用できます。1回の呼び出しあたり$0.002153で、最大100件の投稿を返します。ただし、スレッドはリプライ全体ではありません。
直接のリプライとネストされたリプライの比率も大きく変わります。OpenAIの投稿では、50件中35件が直接のリプライ、15件がネストされたリプライでした。リプライが20,000件を超えるある投稿では、50件中直接のリプライは10件だけでした。別の投稿では、50件中49件が19人の投稿者によるネストされたリプライで、1つの長い議論のように見えます。感情分析では、reply_to_idを使って2つの階層を分けてください。このフィールドは99%のリプライに値があります。
16:48 UTC(シンガポール時間00:48)に、OpenAIの投稿に対して再度呼び出しを実行しました。返った50件のリプライは、29分前と同じでした。
フィールド:両者は同じデータを返すか
両者が返すフィールドは異なります。ここでは、当社の充足率と、当社にないApifyのフィールドだけを示します。検索1,400件、アカウントの投稿200件、返信977件で各フィールドを確認しました。view_count、bookmark_count、language、author_follower_count、author_is_verifiedは100%の件に値がありました。mediaに値があったのはそれぞれ42%、44%、18%で、画像や動画のない投稿が多いためです。
hashtagsに値があったのは1%〜4%だけでした。該当する件を1件ずつ確認したところ、#タグのある投稿にはすべてこのフィールドがあり、それ以外の投稿には報告すべきタグがありませんでした。
| フィールド | 検索(1,400) | アカウントの投稿(200) | リプライ(977) | 備考 |
|---|---|---|---|---|
view_count、bookmark_count、language | 100% | 100% | 100% | すべての行に値あり |
author_follower_count、author_is_verified | 100% | 100% | 100% | 各投稿に投稿者データが含まれる |
media | 42% | 44% | 18% | 投稿にメディアがない場合は空 |
mentions | 12% | 84% | 95% | リプライでは他のアカウントへのメンションが多い |
links | 22% | 40% | 4% | 外部リンクを含む投稿の割合 |
reply_to_id | 0% | 24% | 99% | リプライのみに存在 |
author_bio、source | 0% | 0% | 0% | プロフィール文はtwitter/profileを呼び出して取得 |
Apifyのリプライスクレイパーのページによると、各リプライにはプロフィール文を含む投稿者の完全なプロフィールと、投稿に使われたクライアントが含まれます。当社の3つのエンドポイントは、この2つのフィールドを返しません。プロフィール文を取得するには、別途twitter/profileを呼び出す必要があります。リプライした人をプロフィール文(たとえば職種)でグループ分けする分析なら、Apifyでは1回で取得できます。
フィールド名も異なるため、移行にはマッピングの手順が必要です。V2の出力例では、いいね数はlikeCount、リポスト数はretweetCount、投稿日時はcreatedAtです。日時はFri Nov 24 17:49:36 +0000 2023のような形式です。言語はlangで、投稿者データはuserNameとfollowersを持つネストされたauthorオブジェクトに含まれます。
当社のフィールド名はlike_count、retweet_count、posted_at、languageです。日時はタイムゾーン付きのISO 8601形式です。投稿者データはフラットな構造で、author_usernameやauthor_follower_countなどのフィールドに入ります。V2の例には、投稿に使われたクライアントを示すsourceフィールドもあります。当社の3つのエンドポイントでは、このフィールドは空です。
失敗した呼び出しや空の結果にも料金はかかりますか?
当社側では、データが返らなかった6回の呼び出しはすべて$0でした。これらは3つのグループに分かれます。1つ目のグループは、認証またはパラメータのチェックで止まるものです。APIキーなしの呼び出しには、コードmissing_key付きの401が返ります。
余分なパラメータmax_itemsを付けた呼び出しには、422が返ります。エラーには使用できるパラメータkeyword、limit、sortが示され、動作するリクエスト例も含まれます。レート制限を超えた呼び出しには、再試行までの待機時間が示された429が返ります。
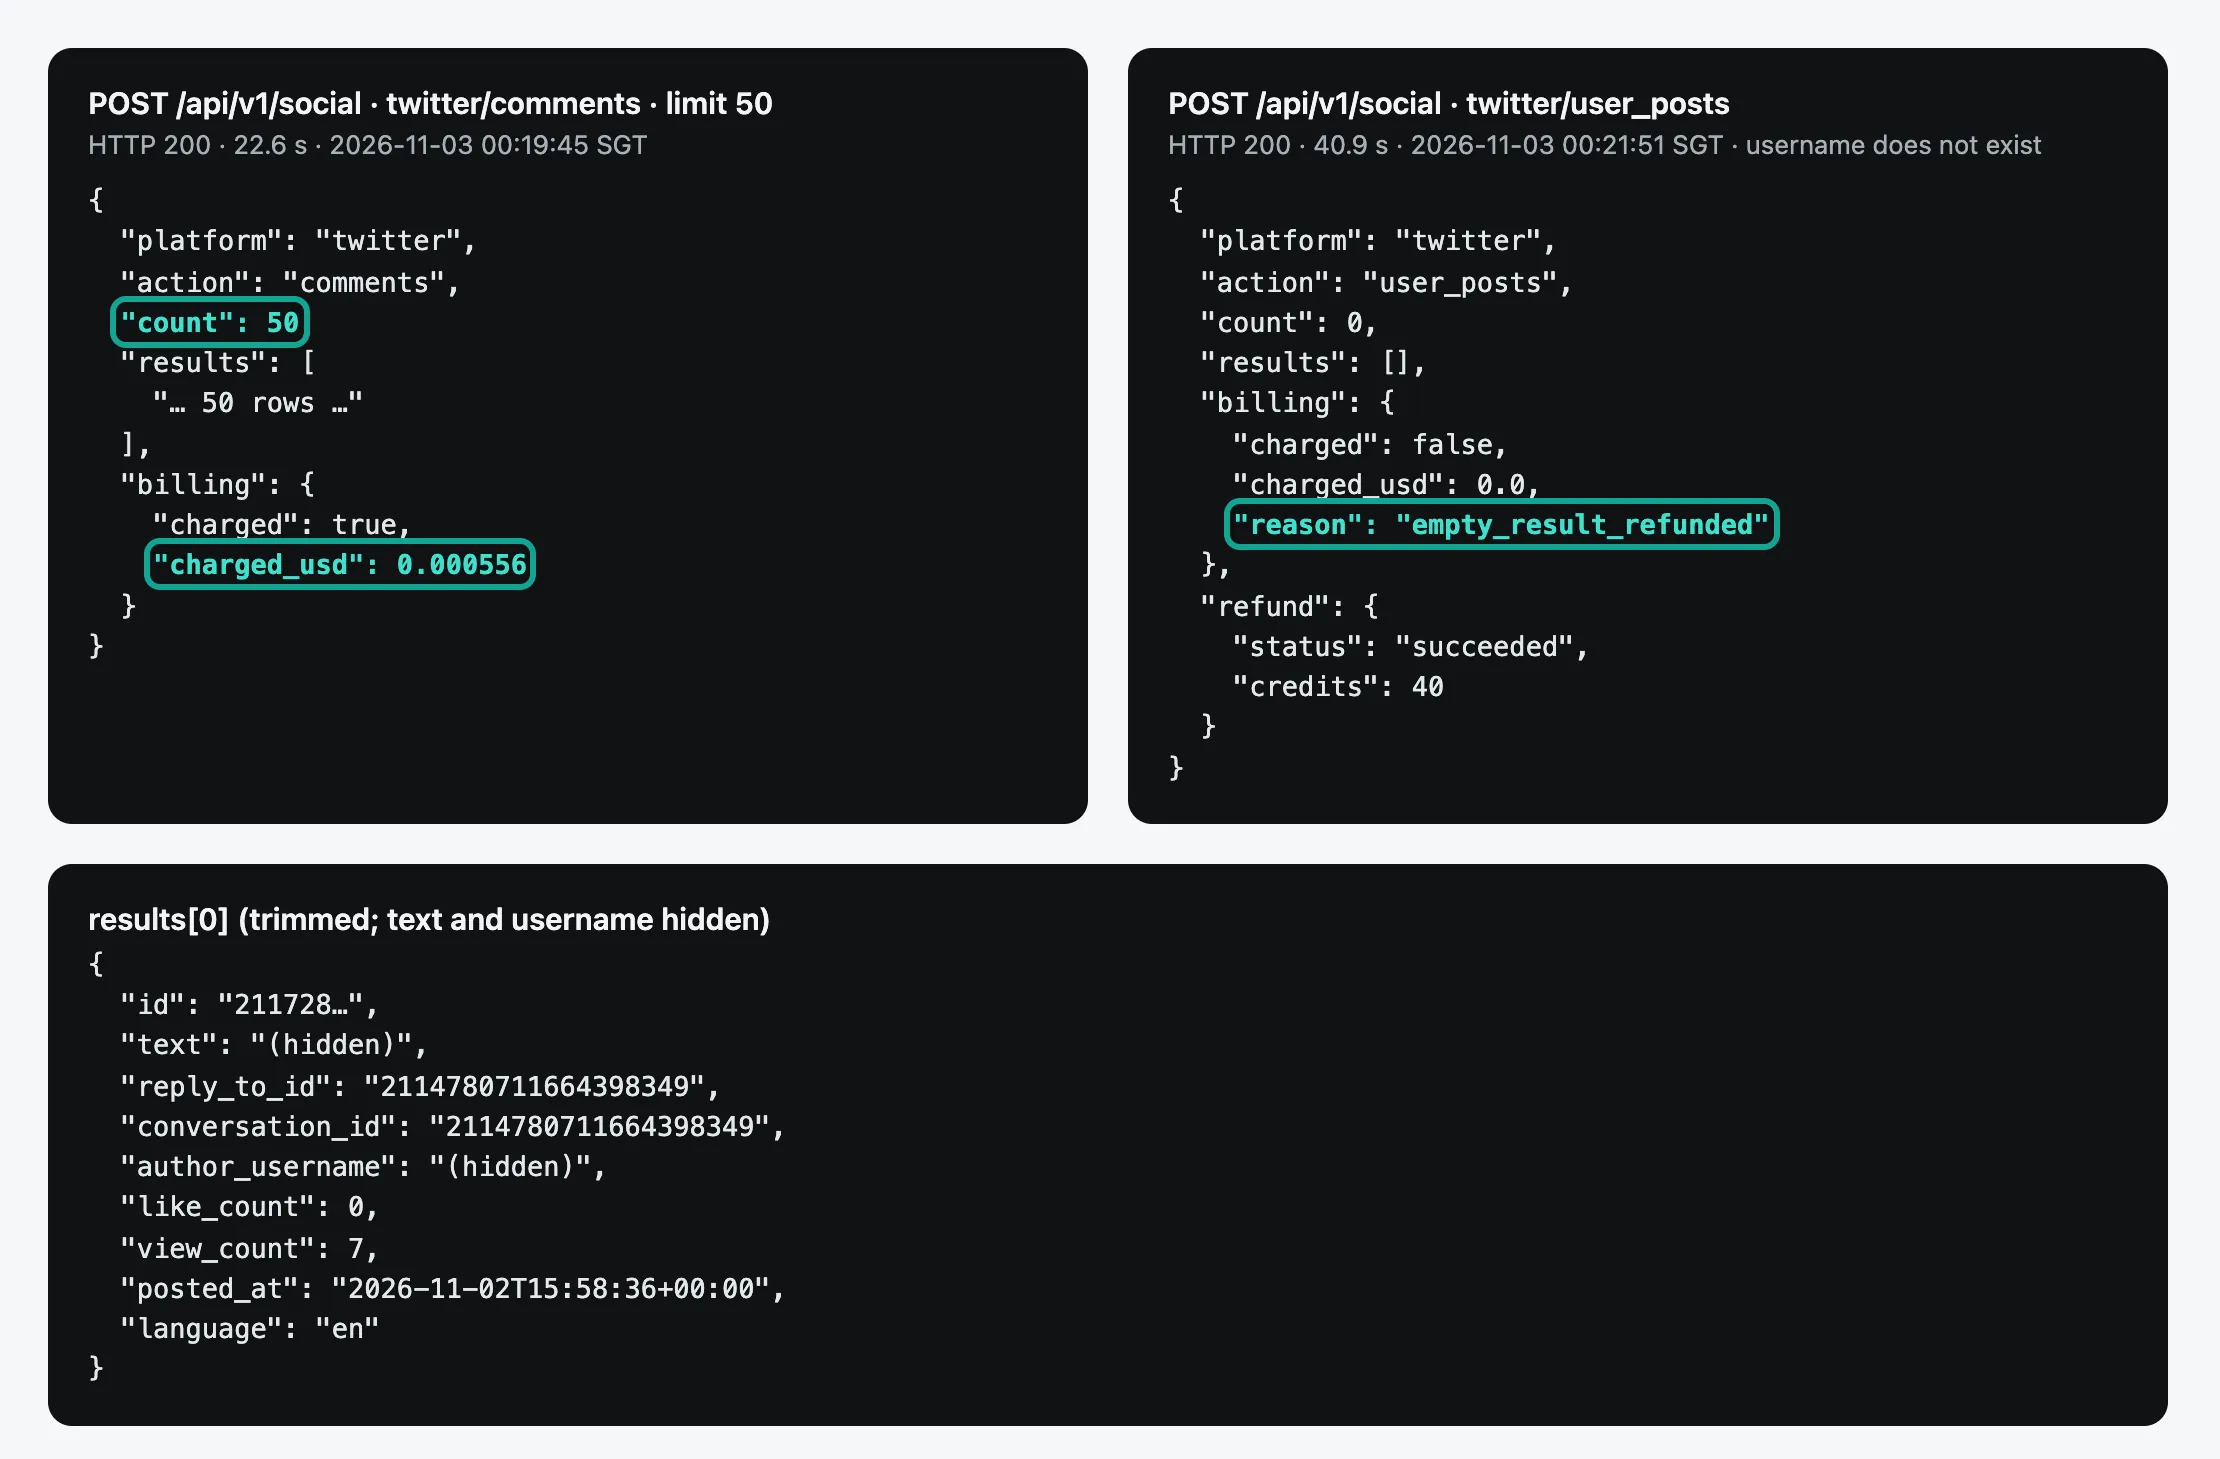
2つ目のグループは「見つからない」場合です。存在しないユーザー名と存在しない投稿IDは、いずれも約40秒後にHTTP 200を返しました。countは0、billing.reasonはempty_result_refunded、refund.statusはsucceededでした。3つ目のグループは当社自身のミスです。
idに投稿の完全なURLを入れてしまいました。カタログではそうしないよう案内していますが、APIは422を返しませんでした。この呼び出しは「見つからない」として扱われ、返金されました。これはユーザーにとって親切とはいえないため、課題として記録しました。
| ケース | 時刻(シンガポール時間、11月3日) | HTTP | コードまたは理由 | `charged_usd` |
|---|---|---|---|---|
| APIキーなし | 00:21 | 401 | missing_key | 0 |
| 存在しないユーザー名 | 00:21 | 200 | empty_result_refunded、返金成功 | 0.0 |
| 1分あたり10回を超える呼び出し | 00:24 | 429 | rate_limited、「課金されませんでした」 | 0 |
idに完全なURL | 00:28 | 200 | empty_result_refunded | 0.0 |
余分なパラメータmax_items | 00:29 | 422 | unknown_param、許可されているパラメータの一覧を表示 | 0 |
| 存在しない投稿ID | 00:29 | 200 | empty_result_refunded | 0.0 |
Apify側については、ページの記載のみを引用します。V2のページには、各クエリで少なくとも50件のツイートを返す必要があると書かれています。返る件数がそれより少ない場合の課金については記載がありません。返信スクレイパーは、クエリ料金を「処理したtweetIdまたはURLの入力1件につき1回」課金します。
また、返信が0件の投稿は「空のデータセットを返し、実行時間を無駄にする」とも注意しています。結果が空の場合にクエリ料金を返金するかどうかは書かれていません。scraper_oneの2つのスクレイパーは1回の実行ごとに固定で$0.0025を課金し、danekはメモリ1GBあたりの起動料金を課金します。
Apifyの使用量とリソースに関するドキュメントでは、コンピュートユニット、ストレージ、データ転送の課金方法を説明しています。pay-per-eventのドキュメントでも、結果への課金は保存が完了してから行うよう開発者に求めています。実行が中断された場合、ユーザーがアクセスできない結果に料金を支払うべきではないとしています。
公開されているActor APIでは、過去30日間の実行結果も確認できます。本記事で取り上げる9つのスクレイパーについて、中断、タイムアウト、失敗となった実行の件数を、10,000回の実行あたりに換算しました。
| Apifyスクレイパー | 実行回数(過去30日間) | 中断 | タイムアウト | 失敗 | 未完了(10,000回あたり) |
|---|---|---|---|---|---|
| Tweet Scraper V2 | 4,688,523 | 35,721 | 5,536 | 0 | 88.0 |
| Cheapest Twitter Scraper (kaitoeasyapi) | 2,653,176 | 41,433 | 3,276 | 1,583 | 174.5 |
| X Tweet Scraper (xquik) | 2,820,359 | 228 | 1 | 3 | 0.8 |
| Twitter Scraper (danek) | 2,396,418 | 3,132 | 422 | 0 | 14.8 |
| Scraper Unlimited(apidojo) | 1,552,877 | 418 | 609 | 0 | 6.6 |
| X Tweet Scraper (feedminer) | 58,004 | 1 | 147 | 0 | 25.5 |
| Profile Posts Scraper (scraper_one) | 36,776 | 17 | 55 | 0 | 19.6 |
| Replies Scraper(apidojo) | 6,118 | 7 | 2 | 0 | 14.7 |
| X Reply Scraper (xquik) | 39,518 | 32 | 0 | 0 | 8.1 |
中断された実行の多くはユーザー自身が停止したものなので、中断が必ずしもスクレイパーの問題とは限りません。この表から言えるのは1点だけです。最も安価なxquikのツイートスクレイパーが最も安定しており、未完了の実行は10,000回あたり0.8回でした。最も利用されているV2は10,000回あたり88回でした。
最も高かったのはKaitoeasyapiで、174.5でした。これらの実行にかかった費用はページに記載がなく、外部からは確認できません。失敗した呼び出しと返金の照合方法については、失敗時の返金照合をご覧ください。
Apify Storeにある400以上のTwitterスクレイパー:価格の分布
公開されているStore検索API(Store APIドキュメント)で、twitter、tweet、x scraper、x.comの4つの語を検索しました。結果を統合して重複を除くと、Actorは406件になりました。そのうち380件がpay-per-eventの料金体系を採用し、372件が結果ごとの価格を表示しています。名前と説明をもとに分類したところ、ツイート用が175件、プロフィール用が48件、フォロワー用が37件、返信用が36件、トレンド用が36件、メディアなどその他のデータ用が40件でした。
ツイートスクレイパー175件のFreeプラン価格の中央値は、1,000件あたり$1.50です。これはV2の価格のほぼ4倍です。ただし、利用者の少ないスクレイパーが多数あり、それらが中央値を押し上げています。過去30日間の利用者が100人以上の29件に絞ると、中央値は$0.30です。過去30日間の利用者数で加重すると、平均は1,000件あたり$1.42です。
利用者は一部のスクレイパーに大きく集中しています。上位5件が、372件全体の30日間の利用者(合計32,822人)の68.4%を占めています。最も安いスクレイパーは1,000件あたり$0.01ですが、30日間の利用者は8人だけだったため、人気のあるスクレイパーとしては扱いませんでした。まとめると、よく使われているTwitterスクレイパーの価格は1,000件あたり$0.12〜$0.40です。当社が計測した3つの価格は、いずれも$0.015未満です。
以前の記事Apifyの料金解説では、Apifyのプラン、コンピュートユニット、pay-per-eventのルール全般を取り上げました。Apifyの代替サービスの記事では、複数のプラットフォームを比較しています。本記事では、その2本にない情報を加えます。実際の呼び出しで得たTwitterの行数と、Store上のTwitterスクレイパーの価格分布および実行データです。より幅広く比較するには、代替サービスの概要からご覧ください。
損益分岐点:1回の呼び出しで返る行が少ないと、行単位の課金のほうが安くなる
当社はリクエストごとに課金し、Storeの多くのTwitterスクレイパーは件数ごとに課金します。損益分岐点は簡単に計算できます。当社のリクエスト単価$0.000556を、相手の1件あたりの価格で割ります。V2は1件あたり$0.0004なので、損益分岐点は1回の呼び出しあたり1.39件です。
Xquikは$0.00015なので3.71件です。FeedminerはFreeティアで$0.00012なので4.63件、Business価格の$0.0001なら5.56件です。X APIは投稿1件あたり$0.005なので、損益分岐点は0.11件です。
| 1件あたりの価格 | 出典 | 損益分岐となる1回あたりの行数 | EveryInfraが安くなる条件(1回の呼び出しで返る行数) |
|---|---|---|---|
| $0.005 | X API従量課金 | 0.11 | 1件以上 |
| $0.0004 | Tweet Scraper V2 | 1.39 | 2件以上 |
| $0.00015 | xquik | 3.71 | 4件以上 |
| $0.00012 | feedminer(Freeプラン) | 4.63 | 5件以上 |
| $0.0001 | feedminer(Businessプラン) | 5.56 | 6件以上 |
実際の業務で、1回の呼び出しで返る行が少ないのはどのような場合でしょうか。1つ目は、単一の投稿を取得する場合です。当社のtwitter/postエンドポイントは投稿1件で$0.000556、1,000件あたり$0.556です。これはxquikやfeedminerより高くなります。
V2は単一ツイートの取得に対応していないため、比較対象となるUnlimitedの単一ツイート価格(1ツイートあたり$0.05)と比べると、はるかに安くなります。2つ目は、1日に2〜3回投稿する小規模なアカウントです。チェックのたびに見つかる新しい投稿はわずかです。
3つ目は、返信が8件ある小規模な対照用の投稿です。当社の料金は1,000件あたり$0.0695でした。apidojoの返信スクレイパーはクエリ料金$0.014を1回課金し、8件の返信はすべて無料の最初の40件に収まります。これは1,000件あたり$1.75になります。
xquikは1,000件あたり$0.15です。Scraper_oneは1回の実行につき$0.0025に返信8件分の料金が加わり、1,000件あたり$0.5625です。つまり、返信数の少ないこの投稿でも当社が最安です。ただし、1回の呼び出しあたり約3件を下回ると、xquikとfeedminerのほうが安くなります。
月額料金の試算:よくある3つのジョブを30日間実行した場合
次に、計測した行数をよくある3つのジョブに当てはめます。当社側は、計測した1回あたりの行数を使って行数を呼び出し回数に換算し、$0.000556を掛けます。Apify側は、表示価格に行数を掛けます。この計算にはプラットフォーム使用料と月額プラン料金は含まれません。X APIは1投稿あたり$0.005で計算します。この計算には月300万投稿の上限と、同日内の重複排除による割引は含まれません。
| 用途 | 30日間の行数 | EveryInfra | V2またはapidojo(返信) | xquik | X API従量課金 |
|---|---|---|---|---|---|
| ブランドモニタリング:20キーワード、各200ツイート、毎日 | 120,000 | $0.33(600回の呼び出し) | $48.00 | $18.00 | $600.00 |
| アカウントのアーカイブ:50アカウント、各1,000投稿 | 50,000 | $0.17(約300回の呼び出し) | $20.00 | $7.50 | $250.00 |
| 返信モニタリング:週200投稿、各50返信 | 40,000 | $0.44(800回の呼び出し) | $14.40 | $6.00 | $200.00 |
この表からわかることは3つあります。第1に、毎回の呼び出しで1ページが埋まるジョブでは、差は数十倍のまま変わりません。1回の課金で200件、返信なら50件をまかなえるためです。第2に、Apifyの請求額にはプラン料金も加わります。無料のV2ユーザーが取得できるのは月50ツイートだけなので、これらのジョブには少なくとも月$19からのStarterが必要です。当社には月額料金がなく、チャージした残高に有効期限はありません。失敗した呼び出しは無料です。
3つ目に、V2のページには、各ユーザーの同時実行数は1、1回の実行につきクエリは最大5件と記載されています。また、同じクエリを短い間隔で実行するモニタリングにはV2を使わないよう記載されています。つまり、ブランドモニタリングの行はV2がサポートする用途ではありません。このページでは、そうしたジョブにはUnlimitedを使うよう案内しています。
X APIについては、Xの料金ページに、投稿の読み取り1件あたり$0.005、ユーザーの読み取り1件あたり$0.010と記載されています。読み取りの上限は月3百万件です(使用量と請求)。同じ投稿をUTCの同じ日に2回読み取っても1回とカウントされるため、実際の請求額は表より少し低くなります。
実例:n8nで作る週次のブランド返信レポート
「apify twitter scraper」のページを読む方の多くは、n8nでジョブを構築しています。ここでは、3種類のデータをまとめた週次レポートを紹介します。毎週月曜日に20個のキーワードでそれぞれ200件の投稿を検索し、最も議論の多い投稿を見つけます。次にreply_countで50件の投稿を選び、それぞれから50件の返信を取得します。最後に、モデルが返信を苦情、質問、称賛に分類します。
当社側では、twitter/searchの呼び出しが20回、twitter/commentsの呼び出しが50回です。70回の呼び出しの費用は週$0.0389、4週間で約$0.16です。これは、当社のテストと同様に、各ページで上限件数またはそれに近い件数が返ることを前提としています。n8nでは、各呼び出しが1つのHTTP Requestノードになります。下のノードは、1回の検索のリクエストボディを示しています。
{
  "parameters": {
    "method": "POST",
    "url": "https://api.everyinfra.com/api/v1/social",
    "sendHeaders": true,
    "headerParameters": { "parameters": [
      { "name": "Authorization", "value": "=Bearer {{ $env.EVERYINFRA_API_KEY }}" }
    ] },
    "sendBody": true,
    "specifyBody": "json",
    "jsonBody": "={ \"platform\": \"twitter\", \"action\": \"search\", \"params\": { \"keyword\": \"{{ $json.keyword }}\", \"limit\": 200 } }"
  },
  "type": "n8n-nodes-base.httpRequest",
  "name": "EveryInfra twitter/search"
}
Apifyでは、同じジョブを定価で実行する方法が2つあります。1つ目の方法では、V2と返信スクレイパーを使います。検索が4,000件×$0.0004=$1.60、返信が50投稿×($0.014+10×$0.0004)=$0.90です。合計で週$2.50になります。ただし、V2は監視目的で1つのクエリを繰り返し実行しないよう案内しており、1回の実行で受け付けるクエリは最大5件です。そのため、20キーワードには4回の実行が必要です。
2つ目の方法では、Unlimitedを使います。20クエリで20×$0.016=$0.32です。各クエリは無料分の40件を超えて160件を返します。1回の実行が20クエリなので、これらの件数には11〜30クエリ帯の$0.0012が適用されます。3,200×$0.0012=$3.84です。
返信の$0.90を加えると、合計は週$5.06です。どちらの方法にもStarterプランの料金は含まれていません。モデルのステップの費用はどちらも同じです。この例では、当社のほうが64〜130倍安くなります。Unlimitedの価格帯があるため、差はまとめの表よりも大きくなっています。
X API、Apify、EveryInfraの比較
Xは2026年2月にAPIを従量課金制に移行しました。8月14日には、従来のProプランを9月1日以降に従量課金制へ移行すると発表しています(Xの開発者フォーラム)。従量課金制には月額料金がありませんが、費用は高くなります。投稿は1,000件あたり$5で、V2の12.5倍、当社で測定した検索料金の約1,500倍です。
無料クレジットについては最近2つの変更がありました。10月2日以降、従量課金制の新規アカウントは初回のクレジット購入後に$20を受け取り、自動チャージでさらに最大$50を受け取れます。10月13日にXはルールを変更し、カードを登録しただけでは$20を受け取れなくなりました。クレジットの有効期限は3か月です(無料クレジットのページ)。
X APIはレート制限と対応範囲も異なります。直近の検索は15分あたり450リクエスト、全アーカイブ検索は1秒あたり1リクエストまでです(レート制限)。従量課金制のアカウントは全アーカイブ検索を利用できます(検索のドキュメント)。ユーザーのタイムラインは最新の3,200件の投稿までです。5月4日以降、キーワード検索ではリポストが返されなくなりました。
| X APIの項目 | 値 | 出典 |
|---|---|---|
| 投稿の読み取り | 1件あたり$0.005 | Xの料金ページ |
| ユーザーの読み取り | 1件あたり$0.010 | Xの料金ページ |
| 月間上限 | 投稿の読み取り3百万件 | 使用量と請求のページ |
| UTC基準の同一日に同じ投稿を2回読み取り | 1回分のみ課金 | 使用量と請求のページ |
| ユーザータイムラインの取得範囲 | 最新の3,200件のポスト | タイムラインのドキュメント |
| 最近の検索に対するレート制限 | 15分あたり450リクエスト | レート制限のページ |
| 全アーカイブ検索のレート制限 | 1秒あたり1リクエスト | レート制限のページ |
| 無料クレジット | 初回購入後に$20、自動チャージで最大$50、有効期限は3か月 | 無料クレジットのページ |
X APIは、X自身が料金を設定して提供しており、利用条件が最も明確です。自分のアカウントへの投稿や、そのアカウントの管理もできます。X APIについてとアクセス権の取得をご覧ください。XはオープンソースのMCPサーバーであるxmcpも公開しています。
速度と同時実行数
当社側では、200件を返すtwitter/searchの呼び出し1回に35.2〜53.4秒かかり、中央値は39.3秒でした。200件のuser_postsの呼び出しは約33秒でした。50件のcommentsの呼び出しは14〜23秒で、中央値は19.8秒でした。同期呼び出しを使う1プロセスで、1分あたり約300ツイートを取得できます。テスト用キーの上限は1分あたり10リクエストで、本番アカウントの上限はコンソールで確認できます。
| ツール | 1回の呼び出し・実行あたりの件数 | 所要時間(実測値または公表値) | 1分あたりの行数 |
|---|---|---|---|
EveryInfra twitter/search | 200 | 35.2〜53.4秒、中央値39.3秒(実測) | 1プロセスあたり約300 |
EveryInfra twitter/user_posts | 200 | 約33秒(実測) | 1プロセスあたり約360 |
EveryInfra twitter/comments | 最大50件 | 14〜23秒、中央値19.8秒(実測) | 1プロセスあたり約120(1回の呼び出しあたり39.1件の場合) |
| Tweet Scraper V2 | 1クエリあたり50以上 | 毎秒30〜80ツイート(ページ記載値) | 1,800〜4,800 |
V2のページには毎秒30〜80ツイート、つまり毎分1,800〜4,800ツイートと記載されています。そのため、V2を大規模に1回実行するほうが高速です。Apifyのプラットフォームの制限により、1つのアカウントで同時に実行できるアクターの数とメモリ量が決まります。数十万件の投稿をできるだけ速く取得したい場合は、当社のページ単位の呼び出しよりも、Apifyを大規模に1回実行するほうが高速です。スケジュールを設定して1日数千件程度の投稿を取得するなら、どちらも数分で完了します。
AIクライアントから使う:MCPの設定
AIクライアントからは、リモートMCPサーバーhttps://api.everyinfra.com/mcpに接続します。ツール名はeveryinfra_で始まります。モデルはtwitter/searchとtwitter/commentsのどちらを使うかを自分で選べます。
以下の設定は一般的な例です。Claude Codeやその他のリモートMCP対応クライアントも同様の形式を使います。正確な構文はClaude CodeのMCPドキュメントとOpenAIのMCPドキュメントを参照してください。プロトコルはMCP仕様に記載されています。
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}ApifyにもStoreのアクターをモデル用のツールに変換するMCPサーバーがあります(Apify MCPドキュメント、GitHubのソースコード)。この2つは設計が異なります。Apify MCPでは、モデルがアクターの実行を開始し、完了を待ってからデータセットを読み取ります。これは大規模なバッチ処理に向いています。
当社のMCPでは、ツールを呼び出すたびにすぐにデータが返ります。質問しながらその都度確認するチャットに向いています。対応クライアントはMCPサーバーのページに記載しています。
Apifyからの移行:パラメータの対応表
すでにV2や返信スクレイパーを使っている場合は、この表で入力の対応を確認できます。Apifyのパラメータ名は、公開されているアクターのメタデータにある入力例とStoreページから取得しています。出力フィールドは異なるため、当社のresponse_fieldsで再マッピングする必要があります。
| タスク | Apifyの入力 | EveryInfraの入力 | 備考 |
|---|---|---|---|
| キーワード検索 | V2 searchTerms + maxItems | twitter/searchでkeyword + limit(最大200) | 1回の呼び出しにつき1キーワード。さらに取得するには日付で区切ります |
| 並び替え | V2 sort:Latest、Top、Latest + Top | sort:latest、またはデフォルトのTop | 当社のテストでは200件中137件が重複 |
| 言語 | V2 tweetLanguage | keyword内にlang:es | 例:inteligencia artificial lang:es |
| 単一アカウント | V2 twitterHandlesまたはfrom: | twitter/user_postsでusernameを指定。古い投稿はfrom:で検索 | user_postsは1回の呼び出しにつき最大200件 |
| 投稿への返信 | 返信スクレイパーのtweetIdsまたはURL | twitter/commentsで数値のidを指定 | 1投稿あたり最大50件。URLを指定すると0件になり、返金されます |
| 単一の投稿 | Unlimited tweet URL($0.05) | twitter/post | 1回の呼び出しあたり$0.000556 |
| フォロワー数 | apidojo user scraperのフォロワーイベント | twitter/followers_list、最大2,000件 | 1回の呼び出しあたり$0.000556 |
当社のTwitterスクレイピングAPIには21のエンドポイントがあり、すべて現在カタログで利用できます。上記の3つに加えて、プロフィール、フォロワーとフォローしているアカウントの一覧、リツイートしたユーザー、コミュニティの投稿、動画の文字起こしにも対応しています。各エンドポイントのパラメータ、レスポンスフィールド、料金は無料のカタログ(カタログAPI)で確認できます。カタログの利用にAPIキーは不要です。
数値の検証方法
本文、表、グラフに含まれるEveryInfraのすべての数値は、52件の生レスポンスからスクリプトで再計算しました。件数はresultsの長さです。重複排除には投稿のidを使います。課金額はbilling.charged_usdです。時刻は呼び出しを送信した時点のローカル時刻で、シンガポール時間で記録しています。
Apifyの料金、ユーザー数、実行回数は、すべて同じ時間帯(シンガポール時間00:14〜00:16)に公開メタデータから取得しました。V2の料金に関する注記のスクリーンショットも保存しています。損益分岐点と月額料金は、この2種類の数値を組み合わせただけのものです。未解決の項目が3つあります。
古い投稿に対する返信の呼び出しで件数が少なくなる根本原因は不明で、その傾向はテスト3で示しています。xquikのプラットフォーム利用料の金額はわかっていません。また、feedminerがキーワード検索の結果をX Communitiesから取得していることは、外部から検証できません。
Apifyのほうが適しているケース
Apifyのほうが優れているケース、または当社に同等の機能がないケースは次のとおりです。1つ目は、1つの投稿から数千件の返信を取得する場合です。当社は1投稿あたり50件までですが、Apifyの返信スクレイパーは約$0.40で約1,000件の返信をページ送りで取得できます。2つ目は、1回の呼び出しで1〜3件しか取得しない場合です。xquikやfeedminerなどの件数課金のスクレイパーのほうが安く、損益分岐点はそれぞれ3.71件と4.63件です。
3つ目は、数十万件の投稿をできるだけ速く取得する場合です。V2のページには毎秒30〜80ツイートと記載されており、Apifyの大規模な1回の実行で並列処理できます。当社は同期呼び出し1回につき1ページを返します。4つ目は、スケジュール、ストレージ、Webhookを1か所で管理したい場合です。Apifyにはスケジュール、データセット、Webhookがあり、実行結果をGoogle Sheetsや自社サーバーに送信できます。当社はデータを返すだけなので、スケジュールとストレージはご自身で運用する必要があります。
5つ目は、投稿者のプロフィール文と投稿に使われたクライアントです。Apifyの返信スクレイパーのページにはどちらも記載されていますが、当社の3つのエンドポイントはこれらを返しません。6つ目は、厳密な日付範囲です。当社の1日単位の範囲指定テストでは、200件中、範囲内に収まった投稿は48〜85件でした。V2もuntilを使うと結果件数が減ると注意書きしていますが、V2には独自の日付オプションがあります。厳密な日付範囲が重要な場合は、両方を試してください。
| 用途 | おすすめ | 理由 |
|---|---|---|
| 1つの投稿から数千件の返信 | Apifyの返信スクレイパー | 当社は1投稿あたり返信50件まで |
| 1回の呼び出しあたり1〜3件 | xquikまたはfeedminer | それぞれ3.71件、4.63件未満なら件数課金が有利 |
| 数十万件の投稿を高速に取得 | Apify | 1回の実行で毎秒30〜80件のツイート |
| スケジュール、ストレージ、Webhookを一元管理 | Apify | 当社はデータのみを返します |
| 各返信の投稿者プロフィール文と投稿クライアント | Apifyの返信スクレイパー | 当社の3つのエンドポイントでは返されません |
| 検索結果、アカウントの投稿、または多数の投稿への返信をフルページで取得 | EveryInfra | 1,000件あたりの料金が10分の1〜122分の1 |
Xの規約、ログインウォール、法的な制限
X利用規約は2026年10月9日に発効しました。規約には「当社の事前の書面による同意なく、いかなる形式・目的であれ本サービスをクロールまたはスクレイピングすることは明示的に禁止されています」と記載されています(X利用規約)。開発者規約では、APIから取得したデータにも制限が加えられています。
これらの規約はXの利用者を拘束します。ご自身のプロジェクトにどう関わるかは弁護士にご相談ください。本記事は法的助言ではありません。
公開されている記録はご自身でも確認できます。X Corp. v. Bright Data(訴訟記録)、hiQ v. LinkedIn(判決文)、デジタルサービス法に基づくEUのXに対する措置(欧州委員会の発表、行動計画)です。
ログインウォールは別の問題です。apidojoの返信スクレイパーのページには「ログイン不要、プロキシ不要」と記載されています。V2のページには、Xの検索に表示される内容を返すこと、またXが検索、ページング、フィルターをいつでも変更する可能性があることが記載されています。当社の場合、Xアカウントをご提供いただく必要はありません。
当社が実行した52回の呼び出しで「login required」エラーが返されたことは一度もなく、Twitterデータの呼び出しはすべてHTTP 200を返しました。
最近の変化
| 日付 | 変更内容と影響 | 出典 |
|---|---|---|
| 2026-10-13 | Xは無料クレジットのルールを更新しました。カードを登録するだけでは$20を受け取れなくなりました。ボーナスを受け取るには、先にクレジットを購入する必要があります。 | 無料クレジット |
| 2026-10-09 | 新しいX利用規約が発効しました。以前の引用は古くなっている可能性があるため、最新の本文を確認してください。 | X利用規約 |
| 2026-10-02 | Xは従量課金アカウント向けに初回購入クレジット(最大$70、有効期限3か月)を追加しました。期限切れになる前に使い切ってください。 | X API変更履歴 |
| 2026-09-24 | danekのTwitter Scraperの現行料金が適用され、メモリ1GBあたりの起動料金が設定されました。小規模な実行を何度も行うとコストが高くなります。 | danekのメタデータ |
| 9月下旬 | feedminerのページによると、Xはfeedminerからの検索インデックスへのリクエストを拒否し始めました。from:を含まないキーワード検索の結果は、現在Xのコミュニティから取得されています。アカウントの投稿には影響はありません。 | feedminerのStoreページ |
主な傾向として、料金が頻繁に変わっています。調べた14件のTwitterスクレイパーのうち10件は、現行料金が8月中旬以降に適用されたものです。例えば、xquikは8月29日、scraper_oneは8月30日と31日です。メタデータの各料金期間にはstartedAtの日付があります。つまり、本記事を含め、比較記事に掲載されたApifyの料金は2〜3か月後には正しくなくなっている可能性があります。購入前に公開メタデータを改めて確認し、確認した日時を記録しておいてください。
利用開始:1回のトライアルリクエストから日次ジョブまで
GitHubリポジトリ「everyinfra/everyinfra-agent-plugins」と「everyinfra/seo-skills」の両方にスターを付けると、コンソールで$1のトライアルクレジットを受け取れます。有効期間は24時間で、本記事の52回の呼び出しを30回以上実行できる額です。APIキーはクイックスタートで取得してください。すべてのエンドポイントはTwitterスクレイピングAPIのページで確認できます。続いて、Twitter検索スクレイピングAPI、Twitterユーザー投稿スクレイピングAPI、Twitter返信スクレイピングAPIの3つのページでプレイグラウンドを試してください。
プロフィールデータについてはTwitterプロフィールスクレイピングAPIをご覧ください。同じ方法はRedditスクレイピングAPIやBlueskyスクレイピングAPIでも使えます。すべてのエンドポイントと料金はデータマーケットと料金ページに掲載しています。Apifyとの1,000件あたりの比較は、ほかにApifyのTikTokスクレイパーの代替とApifyのInstagramスクレイパーの代替もご覧ください。モデルに指定どおりのフィールドでデータエンドポイントを呼び出させるには、データAPIでのClaudeのstrict tool useをご覧ください。
FAQ
ApifyのTwitterスクレイパーは無料ですか?
出典:検索候補「apify twitter scraper free」(2026年11月3日に確認)。Apifyの無料プランでは毎月$5分のプラットフォームクレジットが付与されます。ただし、V2とapidojoの返信スクレイパーのページにはいずれも、無料ユーザーが実行できるのは月5回までで、1回につき最大10件と記載されています。V2のページには、無料ユーザーはAPI経由で呼び出せないとも記載されています。
つまり「無料」枠で確認できるのは出力形式くらいです。EveryInfraでは、$1のトライアルクレジットを24時間ご利用いただけます。1回の呼び出しで200件のツイートを取得する場合、合計で300,000件以上を取得できます。その後はリクエストごとに課金され、月額料金はかかりません。
Apifyのツイートスクレイパーの料金はいくらですか?また、1,000件あたり$0.004と書いている投稿があるのはなぜですか?
出典:よく検索されるクエリ「apify tweet scraper pricing」とr/n8nの投稿(スレッド)。V2は1ツイートあたり$0.0004、つまり1,000件あたり$0.40です。r/n8nの投稿では1,000件あたり$0.004と書かれており、小数点が2桁ずれています。公開メタデータに示されている$0.40を使ってください。
別のr/n8nのチュートリアルでは、V2とX APIを「1,000ツイートあたり40セント対15,000件で$200」と比較していました(スレッド)。これは旧Basicプランの料金です。現在のXは従量課金制で、1,000投稿あたり$5です。
ApifyのTwitterコメントスクレイパーで、投稿へのすべての返信を取得できますか?
出典:検索候補「apify twitter comments scraper」(2026年11月3日に確認)。apidojoの返信スクレイパーのページによると、返信のページングは自動で行われます。デフォルトの処理で取得件数が少なすぎる場合は、useSearchでconversation_id:検索が追加されます。削除済みの投稿と保護された投稿には対応していないとも記載されています。当社のtwitter/commentsは1投稿あたり50件の返信が上限で、すべてを取得することはできません。1つの投稿から数千件の返信を取得するなら、Apifyのほうが適しています。
Twitterはスクレイピングを許可していますか?Xのスクレイピングは合法ですか?
出典:検索候補「does twitter allow scraping」と「is it legal to scrape twitter」(2026年11月3日に確認)。2026年10月9日付のX利用規約では、書面による同意のないスクレイピングが禁止されています。上記の法律に関するセクションに、X v. Bright Dataの訴訟記録、hiQ v. LinkedInの判決文、EUがXに科した制裁金へのリンクがあります。
答えは、お住まいの国、データ、用途によって異なります。弁護士にご相談ください。本記事は法的助言ではありません。
最も安いTwitterスクレイピングAPIはどれですか?
出典:検索候補「twitter scraper api cheapest」(2026年11月3日に確認)。直近30日間のユーザー数が100人以上のStoreスクレイパーを対象に調べました。
公開価格で見ると、最も安いツイートスクレイパーは$0.15のxquikとscrape.badger、そして$0.12のfeedminerです。xquikにはプラットフォーム利用料が加わり、feedminerにはキーワード検索の制限があります。Storeの最低価格は$0.01ですが、そのスクレイパーの利用者は8人でした。当社はリクエストごとに課金します。200件が埋まった1ページで1,000件あたり$0.00278、重複除去後は$0.00327です。1回の呼び出しあたり約3件を下回ると、件単位のスクレイパーのほうが安くなります。
ApifyのXスクレイパーとX API、どちらを選ぶべきですか?
出典:よく使われる検索クエリ「apify x scraper」と、両者を比較したr/n8nのチュートリアル(スレッド)。X APIは1,000投稿あたり$5で、上限は月3百万投稿です。X自身が料金を設定している手段で、利用条件が最も明確なうえ、自分のアカウントでの投稿や管理もできます。本記事の価格では、人気のApifyスクレイパーは1,000件あたり$0.12〜$0.40、EveryInfraは$0.003〜$0.014です。Xの利用規約はスクレイピングを制限しているため、ご自身のプロジェクトについては弁護士にご相談ください。自分のアカウントを運用するならX APIを使いましょう。公開されている議論を大量に読み取るなら、スクレイピングツールを価格と1回の呼び出しあたりの行数で比較してください。
参考文献
- Apify / apidojo:Tweet Scraper V2 - X Scraper / Twitter Scraper / X.com Scraper(ストアページ)(2026-11-03閲覧)
- Apify API:apidojo~tweet-scraperの公開Actorメタデータ(pricingInfos、stats)(2026-11-03閲覧)
- Apify / apidojo:Twitter (X.com) Scraper Unlimited: No Limits(ストアページ)(2026-11-03閲覧)
- Apify API:apidojo~twitter-scraper-liteの公開Actorメタデータ(2026-11-03閲覧)
- Apify / apidojo:Twitter (X) Replies Scraper API(ストアページ)(2026-11-03閲覧)
- Apify API:apidojo~twitter-replies-scraperの公開Actorメタデータ(2026-11-03閲覧)
- Apify / kaitoeasyapi:Cheapest Twitter Scraper / RealTime Twitter Data Scraper API(ストアページ)(2026-11-03閲覧)
- Apify API:kaitoeasyapi tweet scraperの公開Actorメタデータ(2026-11-03閲覧)
- Apify / xquik:Twitter Scraper & X Scraper for Tweets & Search(ストアページ)(2026-11-03閲覧)
- Apify API:xquik~x-tweet-scraperの公開Actorメタデータ(2026-11-03閲覧)
- Apify / xquik:X Reply Scraper(ストアページ)(2026-11-03閲覧)
- Apify API:xquik~x-reply-scraperの公開Actorメタデータ(2026-11-03閲覧)
- Apify / feedminer:X (Twitter) Tweet Scraper $0.12/1K(ストアページ)(2026-11-03閲覧)
- Apify API:feedminer~x-tweet-scraperの公開Actorメタデータ(2026-11-03閲覧)
- Apify / scraper_one:X (Twitter) Profile Posts Scraper(ストアページ)(2026-11-03閲覧)
- Apify API:scraper_one~x-profile-posts-scraperの公開Actorメタデータ(2026-11-03閲覧)
- Apify API:scraper_one~x-post-replies-scraperの公開Actorメタデータ(2026-11-03閲覧)
- Apify API:ストア検索API /v2/store?search=twitter(2026-11-03閲覧)
- Apify Docs:Get list of Actors in Store(APIドキュメント)(2026-11-03閲覧)
- Apify:Apify pricing(2026-11-03閲覧)
- Apify Docs:Actors in Store(2026-11-03閲覧)
- Apify Docs:Actor pricing and costs(2026-11-03閲覧)
- Apify Docs:Usage and resources(2026-11-03閲覧)
- Apify Docs:Limits(2026-11-03閲覧)
- Apify Docs:Apify MCP server(2026-11-03閲覧)
- GitHub:apify/apify-mcp-server(2026-11-03閲覧)
- Apify Docs:Schedules(2026-11-03閲覧)
- Apify Docs:Webhooks(2026-11-03閲覧)
- GitHub / igorbrigadir:twitter-advanced-search(検索演算子一覧)(2026-11-03閲覧)
- X Developer Platform:X APIの従量課金制の料金とクレジット(2026-11-03閲覧)
- X Developer Platform。使用量と請求(月3百万件の上限、同日の重複除外)。2026-11-03閲覧。
- X Developer Platform:Search Posts(2026-11-03閲覧)
- X Developer Platform:Timelines(最新3,200件のポスト)(2026-11-03閲覧)
- X Developer Platform:X API Rate Limits(2026-11-03閲覧)
- X Developer Platform:X APIの従量課金制アカウント向け無料クレジット特典(2026-10-13更新)(2026-10-13)
- X Developer Platform:X API changelog(2026-10-29)
- X Developersフォーラム:Important Update: Legacy X API Pro Plans Are Moving to Pay-Per-Use(2026-08-14)
- X Corp.:X Terms of Service(2026-10-09発効)(2026-10-09)
- X Developer Platform:Developer Terms(2026-11-03閲覧)
- GitHub / X:xdevplatform/xmcp(2026-11-03閲覧)
- 欧州委員会:Commission fines X €120 million under the Digital Services Act(2025-12-05)
- 欧州委員会:欧州委員会、デジタルサービス法の遵守に向けたXの行動計画を承認(2026-07-16)
- 欧州委員会:プレスリリースIP/25/2934(2025-12-05)
- EUR-Lex:Regulation (EU) 2022/2065(デジタルサービス法)(2022-10-19)
- CourtListener:X Corp. v. Bright Data Ltd., 3:23-cv-03698(訴訟記録)(2024-05-09)
- 米国第9巡回区控訴裁判所:hiQ Labs v. LinkedIn, No. 17-16783(第9巡回区控訴裁判所の判決文)(2022-04-18)
- Model Context Protocol:Model Context Protocol Specification 2025-11-25(2025-11-25)
- Anthropic:Connect Claude Code to tools via MCP(2026-11-03閲覧)
- OpenAI:Connectors and MCP servers(2026-11-03閲覧)
- Reddit r/n8n:Apifyを使ってTwitter / Xからデータを簡単にスクレイピングする方法(2026-11-03閲覧)
- Reddit r/n8n:This Automation Took Me From 0 to 175k Followers in Under 12 Months(2026-11-03閲覧)
- EveryInfra:EveryInfra機能カタログ(無料、APIキー不要)(2026-11-03 00:16閲覧)
- GitHub / Xquik:Xquik-dev/x-twitter-scraper(README:プラットフォーム利用料は別途課金)(2026-11-03閲覧)
- Apify Docs:Pay per event(2026-11-03閲覧)
- X Developer Platform:Getting Access(2026-11-03閲覧)
- X Developer Platform:About the X API(2026-11-03閲覧)
- X Developer Platform:Build a query(クエリ構文)(2026-11-03閲覧)
- Apify Docs:Get Actor(APIドキュメント)(2026-11-03閲覧)
- Apify API:danek~twitter-scraperの公開Actorメタデータ(2026-11-03閲覧)
参考資料 BL-75