Alternativa a Apify Twitter Scraper: coste real por cada 1.000 tuits, respuestas y posts de una cuenta
Tweet Scraper V2 de Apify cuesta 0,40 USD por 1.000 tuits y nuestra búsqueda medida, 0,0033 USD. Para miles de respuestas de un solo post, gana Apify.
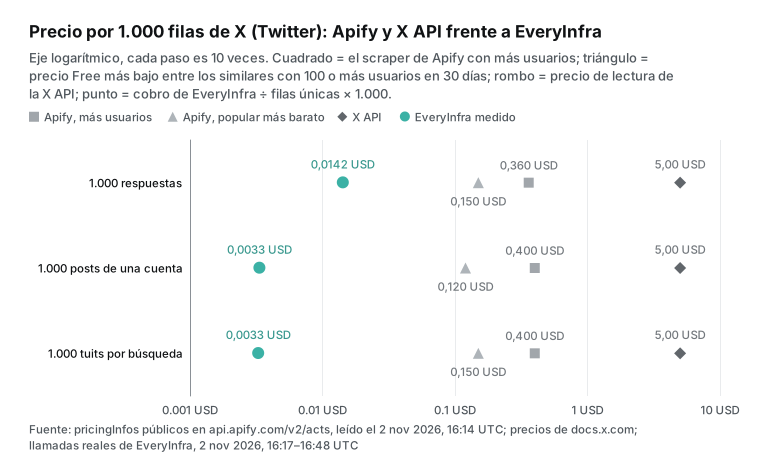
El scraper de tuits más usado de la Apify Store es Tweet Scraper V2, y su precio público es de 0,40 USD por cada 1.000 tuits en todos los planes. El 3 de noviembre de 2026 hicimos siete búsquedas reales con el endpoint twitter/search de EveryInfra. Cada llamada costó 0,000556 USD y devolvió 200 tuits. Tras quitar duplicados nos quedaron 1.190 tuits únicos por 0,003892 USD, es decir, 0,00327 USD por cada 1.000: 122 veces menos que V2. Frente al más barato de los scrapers populares de la Store con búsqueda por palabra clave completa, xquik (0,15 USD), la diferencia es de 46 veces.
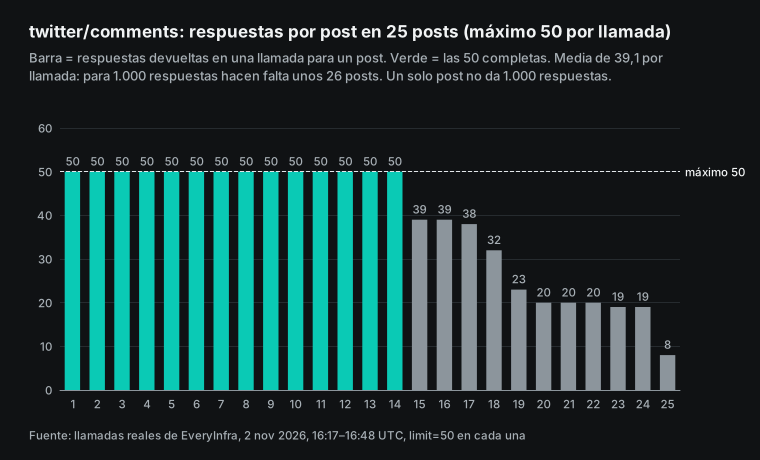
Para 1.000 posts de una misma cuenta medimos 0,00334 USD por cada 1.000 únicos: 120 veces menos que V2 y 36 veces menos que la opción popular más barata (0,12 USD). Con las respuestas la historia cambia. Nuestro endpoint twitter/comments devuelve como máximo 50 respuestas por post, y en 25 posts la media fue de 39,1 por llamada, o 0,0142 USD por cada 1.000. Eso es entre 10 y 25 veces más barato que los scrapers de respuestas de Apify que analizamos. Pero si necesitas 1.000 respuestas de un solo post, con nosotros no se puede: ahí Apify es mejor opción.
Cómo leer los números de este artículo
Nuestro «precio por cada 1.000» es una cuenta sencilla: lo que se cobró de verdad, dividido entre las filas que de verdad llegaron, multiplicado por 1.000. EveryInfra cobra por petición, y una petición tiene el mismo precio devuelva las filas que devuelva. La mayoría de los scrapers de Twitter de la Apify Store cobran por resultado: cada elemento escrito en el dataset es un cargo. Solo se pueden comparar si se ponen sobre el mismo denominador.
En nuestro lado, el denominador son las filas únicas, deduplicadas por el ID del post. Nunca usamos el valor de limit como denominador, así que, cuando una llamada devuelve menos filas o repite filas, nuestro precio sube en este artículo, no baja. En el lado de Apify solo usamos material público: páginas de la Store, la página de precios, la documentación y la API pública de actores, que no pide cuenta. No nos registramos en Apify ni ejecutamos ningún actor (así llama Apify a sus programas de scraping en la nube). Por eso todas las cifras de Apify son precios de lista, no facturas medidas.
Apify Twitter scraper frente a EveryInfra: la tabla resumen
Esta tabla es el resultado. Para cada tipo de dato mostramos dos scrapers de Apify: el principal, el que más usuarios tuvo en los últimos 30 días, y el más barato en el plan Free entre los que tuvieron al menos 100 usuarios en ese periodo. Leímos todos los precios del campo pricingInfos de la API pública a las 00:14 hora de Singapur del 3 de noviembre de 2026 (16:14 UTC del 2 de noviembre). Según la documentación de Apify, el plan Free usa el precio Free, Starter usa Bronze, Scale usa Silver y Business usa Gold; Platinum y Diamond son para empresas (precios y costes de los actores).
| Dato | Endpoint de EveryInfra | Llamadas / filas / únicas / cobrado | EveryInfra por 1.000 (únicas) | Scraper principal de Apify | Diferencia | Más barato popular | Diferencia |
|---|---|---|---|---|---|---|---|
| Búsqueda por palabra clave | twitter/search | 7 / 1.400 / 1.190 / 0,003892 USD | 0,00327 USD | Tweet Scraper V2, 0,40 USD | 122 veces | xquik, 0,15 USD | 46 veces |
| Posts de una cuenta | twitter/user_posts + búsqueda from: | 8 / 1.592 / 1.330 / 0,004448 USD | 0,00334 USD | V2 con twitterHandles, 0,40 USD | 120 veces | feedminer, 0,12 USD | 36 veces |
| Respuestas | twitter/comments | 25 / 977 / 977 / 0,0139 USD | 0,0142 USD | Replies Scraper, 20 posts × 50, 0,36 USD | 25 veces | xquik Reply, 0,15 USD | 10,5 veces |
Cada diferencia es el precio de Apify dividido entre el nuestro. Hay cuatro matices. El primero: las tres diferencias salen del tamaño de página. Búsqueda y posts de cuenta devuelven hasta 200 filas por llamada, y respuestas hasta 50; una página llena reparte una sola tarifa entre muchas filas. Si solo necesitas una o dos filas por llamada, el resultado se invierte, como explica la sección del punto de equilibrio.
El segundo: los 0,36 USD de respuestas salen de una regla de la página del scraper de respuestas de apidojo, según la cual en los planes de pago las primeras 40 respuestas de cada post son gratis. Con 50 respuestas por post, un post cuesta 0,014 USD de consulta más 10 elementos a 0,0004 USD. El tercero: el README de xquik dice que Apify cobra aparte el uso de plataforma (README de xquik), así que 0,15 USD no es la factura completa. El cuarto: los precios de Apify cambian a menudo, y la sección de cambios recientes recoge las fechas.
Los 0,15 USD de búsqueda no son solo de xquik: el scraper de tuits de scrape.badger tuvo 709 usuarios en 30 días, con 0,15 USD en Free y 0,12 USD en Business. Feedminer es más barato (0,12 USD), pero desde finales de septiembre sus palabras clave sin from: salen de las Comunidades de X, así que solo lo usamos en la fila de posts de una cuenta.
Apify tweet scraper pricing: V2, Unlimited y el scraper de respuestas
Quien busca «apify tweet scraper pricing» suele encontrarse varios scrapers con nombres parecidos. Un mismo desarrollador, apidojo, publica tres: Tweet Scraper V2, Twitter (X.com) Scraper Unlimited y Twitter (X) Replies Scraper. Los tres cobran por evento: el desarrollador define eventos facturables y cada ejecución cobra el número de eventos por su precio. Según la documentación del pago por evento, el uso de plataforma lo paga por defecto el desarrollador con sus ingresos; si activa «Pay per event + usage», el usuario paga además ese uso, y a los usuarios del plan gratuito se lo cubre Apify.
V2 tiene un único evento: cada tuit escrito en el dataset cuesta 0,0004 USD, es decir, 0,40 USD por cada 1.000 en los cuatro planes. Su página en la Store incluye una nota de precios con cuatro reglas; la captura de abajo muestra el texto original.
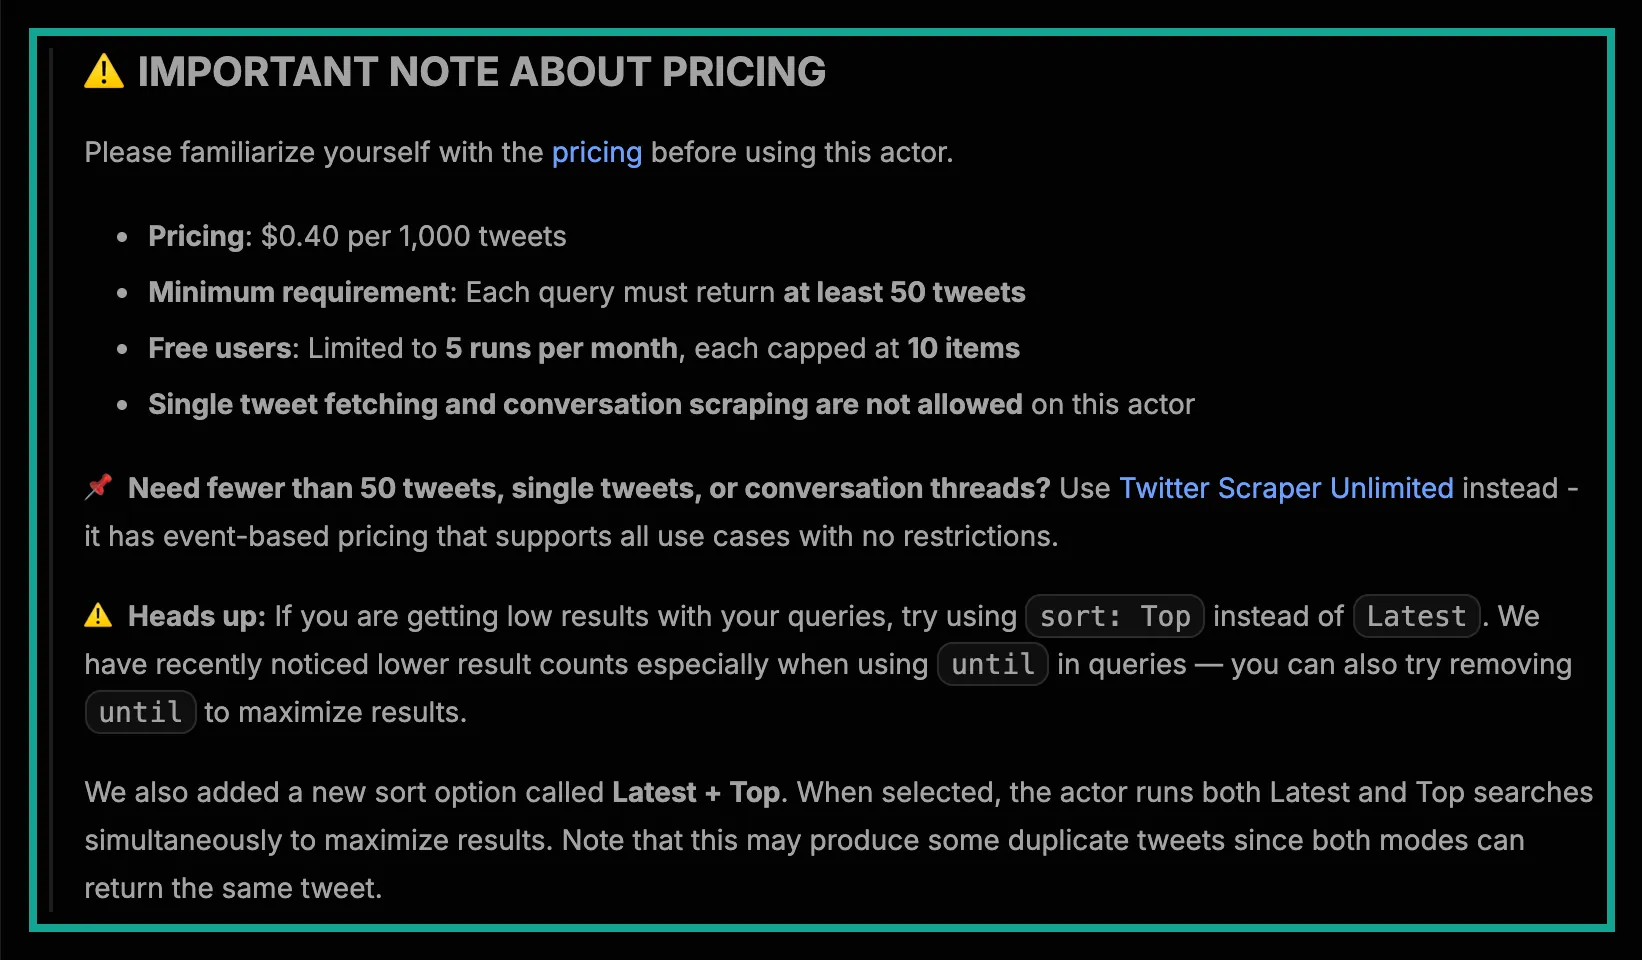
Dos de esas reglas pesan más en el coste. La primera, «al menos 50 tuits por consulta», hace que V2 no sirva para consultas pequeñas y exactas, como los tres posts de esta semana de una cuenta pequeña; la página manda esos casos a Unlimited. La segunda es el tope gratuito de 5 ejecuciones al mes con 10 elementos cada una. El plan Free incluye 5 USD de crédito mensual de plataforma (precios de Apify), pero con V2 solo da para 50 tuits al mes, y la página dice además que los usuarios gratuitos no pueden llamar al actor por API.
| Plan de Apify | Precio mensual | Tramo de precio de actores | Qué supone para V2 |
|---|---|---|---|
| Free | 0 USD, con 5 USD de crédito | Free | Modo demo: 5 ejecuciones de 10 elementos, sin API |
| Starter | Desde 19 USD | Bronze | V2 completo a 0,40 USD por cada 1.000 |
| Scale | 199 USD | Silver | Mismo precio de V2 |
| Business | 999 USD | Gold | Mismo precio de V2 |
El uso incluido en un plan no pasa al ciclo siguiente. La sección «Important Note» de V2 añade dos límites más: como máximo 1 ejecución simultánea con hasta 5 consultas por lote, y «No monitoring», es decir, no repetir la misma consulta a intervalos cortos.
Unlimited tiene un precio más enrevesado. Cobra 0,016 USD por consulta (cada término de búsqueda, cuenta o lista), con unos 40 resultados incluidos. Los elementos extra cuestan entre 0,0004 y 0,002 USD según cuántas consultas haya en la ejecución: 0,0004 USD hasta 5 consultas, 0,0008 USD de 6 a 10, 0,0012 USD de 11 a 30, 0,0016 USD de 31 a 100 y 0,002 USD por encima de 100. Un tuit suelto por URL cuesta 0,05 USD y cada ejecución tiene un mínimo de 0,02 USD, según los metadatos públicos de Unlimited. O sea, cuantas más consultas metes en una ejecución, más caro sale cada elemento extra, justo lo contrario de «al por mayor es más barato».
El scraper de respuestas sigue un tercer juego de reglas. Su página en la Store cobra una tarifa por cada post (0,014 USD en el flujo normal y 0,016 USD con useSearch) y 0,0004 USD por respuesta. Los planes de pago reciben gratis unas 40 respuestas por consulta, y el plan gratuito solo tiene modo demo. Así, 1.000 respuestas de un solo post cuestan unos 0,014 + 960 × 0,0004 = 0,398 USD, y 50 respuestas de cada uno de 20 posts cuestan 20 × (0,014 + 10 × 0,0004) = 0,36 USD.
| Scraper de Apify (desarrollador) | Precio por evento (Free → Business) | Tarifa fija por ejecución o consulta | Mínimos y límites (texto de la página) | Usuarios, últimos 30 días |
|---|---|---|---|---|
| Tweet Scraper V2 (apidojo) | 0,0004 USD por elemento | Ninguna | 50 tuits por consulta; gratis: 5 ejecuciones de 10 | 10.137 |
| Scraper Unlimited (apidojo) | 0,0004–0,002 USD por elemento extra | 0,016 USD por consulta; 0,05 USD por tuit; mínimo 0,02 USD | Sin mínimo de filas | 2.366 |
| Replies Scraper (apidojo) | 0,0004 USD por elemento | 0,014 USD por post; unas 40 gratis en planes de pago | Gratis: solo modo demo | 132 |
| Cheapest Twitter Scraper (kaitoeasyapi) | 0,00025 → 0,00018 USD | Ninguna | Ninguno | 5.398 |
| X Tweet Scraper (xquik) | 0,00015 USD | Ninguna; uso de plataforma aparte | Ninguno | 3.374 |
| X Reply Scraper (xquik) | 0,00015 USD | Ninguna; uso de plataforma aparte | Ninguno | 165 |
| X Tweet Scraper (feedminer) | 0,00012 → 0,0001 USD | Ninguna | Nota sobre búsquedas más abajo | 107 |
| Profile Posts Scraper (scraper_one) | 0,0004 → 0,0003 USD | 0,0025 USD por ejecución | Ninguno | 389 |
| Twitter Scraper (danek) | 0,0003 → 0,00024 USD | Tarifa de arranque por GB de memoria | Ninguno | 406 |
Todos los precios de la tabla salen de los metadatos públicos, leídos entre las 00:14 y las 00:16 hora de Singapur del 3 de noviembre. Los usuarios vienen de stats.totalUsers30Days de la misma API, que se describe en la documentación de Get Actor.
Cómo probamos y qué contaba como aprobado
Escribimos las reglas antes de mirar ningún dato. Cada tipo de dato necesitaba al menos dos llamadas reales en dos momentos distintos; todo precio por cada 1.000 debía usar filas únicas; si Apify salía más barato o mejor para una tarea, la tabla y el texto tenían que decirlo; y al menos dos llamadas sin datos debían registrar su cargo. Todas las llamadas fueron a POST https://api.everyinfra.com/api/v1/social, y de cada una anotamos hora de envío, estado HTTP, duración, filas y charged_usd. Un script recalculó todas las cifras a partir de las respuestas originales.
| Escenario | Endpoint y parámetros | Llamadas | Hora de Singapur, 3 de noviembre | Para qué |
|---|---|---|---|---|
| Búsqueda | twitter/search, «openai», limit 200, una con Latest, cinco ventanas de días | 7 + 1 repetición | 00:17 a 00:31; repetición 00:47 | Filas por llamada, solapamiento, ventanas |
| Posts de una cuenta | twitter/user_posts de NASA y 7 búsquedas from:NASA | 8 + 1 repetición | 00:19 a 00:33; repetición 00:47 | Hasta dónde llega una cuenta |
| Respuestas | twitter/comments en 25 posts, limit 50 | 25 + 1 repetición | 00:19 a 00:40; repetición 00:48 | Filas en posts grandes y pequeños |
| Sin datos | Sin clave, límite, parámetro sobrante, usuario o post inexistente, URL en id | 6 | 00:21 a 00:29 | Qué fallos cuestan dinero |
| Contenido en español | Búsqueda en español, cuenta de El País | 2 | 00:40 a 00:41 | Filas por llamada en español |
Las 52 llamadas costaron 0,025576 USD en total. Nuestra clave de prueba admite 10 peticiones por minuto; una llamada chocó con ese límite, la respuesta decía «Nothing was charged», esperamos 40 segundos y la repetimos. Para las respuestas elegimos posts de cuentas de marca como OpenAI y NASA y de resultados de búsqueda, con entre unos cientos y más de 20.000 respuestas, y un post pequeño de 8 respuestas como control. Ocultamos el texto de los posts y los nombres de usuarios particulares; solo nombramos cuentas de marcas e instituciones.
Prueba 1: lo más habitual con un apify twitter scraper, 1.000 tuits de una búsqueda
En Apify, una búsqueda suele empezar con los campos searchTerms y maxItems de V2; el ejemplo de entrada de sus metadatos públicos incluye además sort (Latest o Top), tweetLanguage, onlyVerifiedUsers y onlyImage. Nuestro equivalente es twitter/search, que pide keyword y acepta limit y sort. Los operadores de búsqueda avanzada de X (from:, since:, until:, lang:, min_faves:) van dentro de keyword; la sintaxis está en la documentación de consultas de X y en una lista de operadores mantenida en GitHub.
# 00:40:55 hora de Singapur del 3 de noviembre (16:40:55 UTC): HTTP 200, 38,6 s, count 200, charged_usd 0.000556
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"twitter","action":"search","params":{"keyword":"inteligencia artificial lang:es","limit":200}}'
Esa búsqueda en español devolvió 200 tuits, todos en español, de 167 autores distintos, publicados entre el 23-10-2026 y el 02-11-2026, sin reposts ni respuestas. Es el caso típico de quien monitoriza un tema en el mundo hispanohablante: una página llena por 0,000556 USD, o 0,00278 USD por cada 1.000.
Para la medición principal usamos la palabra clave «openai», porque mueve volumen en todos los idiomas. Las siete búsquedas devolvieron páginas llenas de 200 filas: 1.400 en total. La primera usó el orden por defecto (Top) y la segunda sort: latest; ambas compartían 137 posts, así que la segunda solo añadió 63 nuevos. Además, «Latest» no es un orden cronológico estricto: el post más antiguo de esa página era de noviembre de 2023. La página de V2 describe lo mismo: su nueva ordenación «Latest + Top» lanza las dos búsquedas y «puede producir tuits duplicados», y con cobro por fila esos duplicados también se pagan.
Después partimos «openai» en cinco ventanas de dos días con since: y until:, que empezaban el 30-10-2026, el 27-10-2026, el 24-10-2026, el 21-10-2026 y el 18-10-2026. Cada llamada siguió devolviendo 200 filas, con 168, 168, 197, 196 y 198 posts nuevos. Tras siete llamadas teníamos 1.190 únicos por 0,003892 USD, o 0,00327 USD por cada 1.000. Pero las ventanas eran laxas: en las tres primeras solo 70, 85 y 48 de los 200 posts caían dentro de los dos días. Cortar por fechas sirve para conseguir muchos posts nuevos, no para conseguir exactamente los de esos dos días.
Otras tres fuentes públicas apuntan en la misma dirección. La página de V2 avisa de que los resultados bajan al usar until; el registro de cambios de la X API dice que la búsqueda pasó a un índice nuevo el 4 de mayo de 2026; y la página de feedminer cuenta que X empezó a rechazar sus peticiones al índice de búsqueda a finales de septiembre. Los resultados de búsqueda de X no están estables ahora mismo, así que conviene volver a filtrar por fecha lo que devuelva cualquier herramienta.
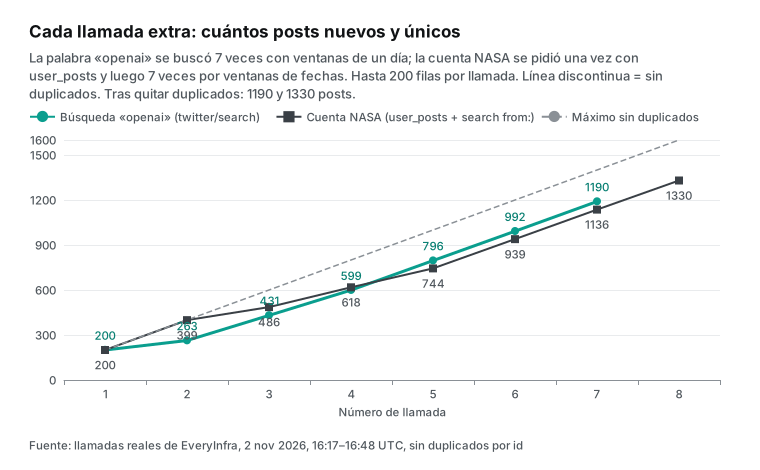
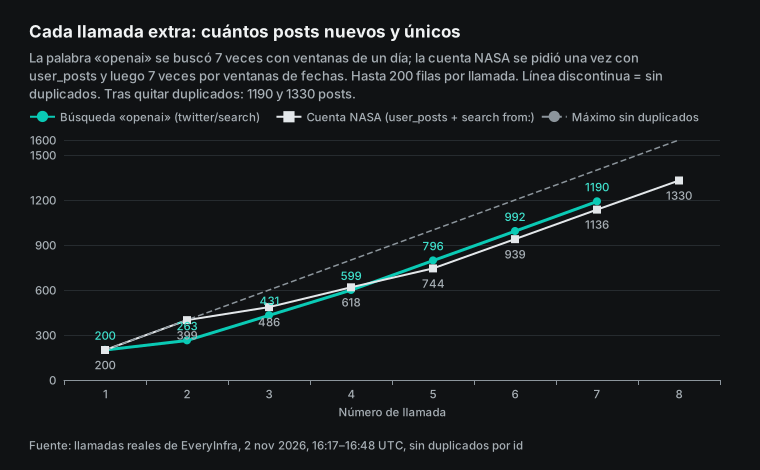
A las 00:47 hora de Singapur, media hora después, repetimos la primera búsqueda con los mismos parámetros: de los 200 posts, 124 coincidían y 76 eran nuevos. El orden Top cambia con el tiempo. Para monitorizar una marca, una ejecución cada media hora trae algo nuevo; con cobro por fila, además, vuelves a pagar los 124 repetidos. En nuestro lado, la repetición costó lo mismo que la primera: 0,000556 USD.
Prueba 2: apify x scraper para 1.000 posts de una cuenta
Para sacar los posts de una cuenta con V2 se usa twitterHandles o un término from: en searchTerms, al mismo precio de 0,40 USD por cada 1.000. En nuestro lado empezamos con twitter/user_posts, que devuelve hasta 200 posts por llamada y no tiene cursor; para posts más antiguos pasamos a twitter/search con from:NASA y operadores de fecha, igual que sugiere la propia documentación de V2. La llamada user_posts de las 00:19 hora de Singapur devolvió 200 posts del 08-09-2026 al 31-10-2026; 48 eran respuestas de NASA a otras cuentas y 67 eran reposts, lo mismo que se ve en la pestaña «Posts y respuestas» de la web de X.
Luego lanzamos siete búsquedas from:NASA hacia atrás: until:2026-09-08, until:2026-08-01, until:2026-04-01 y ventanas para el segundo semestre de 2025, el primero de 2025 y todo 2024. Las ocho llamadas devolvieron 1.592 filas y 1.330 posts únicos, ninguno de otra cuenta, por 0,004448 USD: 0,00334 USD por cada 1.000. Por años, hubo 568 posts de 2026, 396 de 2025, 198 de 2024, 82 de 2022, 23 de 2020 y 39 de 2016; el resto, cifras de un dígito. Los años antiguos salen más finos por la misma razón que en la prueba 1: las búsquedas con fecha mezclan posts más antiguos y populares de fuera de la ventana.
A las 00:47 hora de Singapur repetimos user_posts y los 200 posts eran idénticos a los de 28 minutos antes; el más reciente seguía siendo el del 31 de octubre a las 22:14 UTC. Eso es útil para archivar: con los mismos parámetros, el resultado es estable a corto plazo, y una tarea incremental solo necesita comparar el ID más reciente. La X API tiene aquí un límite duro, porque la línea de tiempo de un usuario solo devuelve los 3.200 posts más recientes (documentación de timelines).
Un medio en español: El País en dos días
Muchos lectores en español quieren archivar medios o cuentas institucionales. A las 00:41 hora de Singapur pedimos user_posts de El País: 200 posts, 197 en español, 2 en inglés y 1 en rumano, con 12 reposts y 2 respuestas. Cubrían menos de dos días, del 31-10-2026 al 02-11-2026. Una cuenta de noticias con mucha actividad llena 200 filas en unos dos días; para archivar un mes basta con una llamada diaria, unas 30 al mes por 0,0167 USD.
| Llamada (hora de Singapur, 3 de noviembre) | Endpoint y entrada | Filas | Autores | Fechas | Por cada 1.000 |
|---|---|---|---|---|---|
| 00:40 | twitter/search, «inteligencia artificial lang:es» | 200, todas en español | 167 | 23-10-2026 a 02-11-2026 | 0,00278 USD |
| 00:41 | twitter/user_posts, El País | 200, 197 en español | 1 | 31-10-2026 a 02-11-2026 | 0,00278 USD |
| 00:19 | twitter/user_posts, NASA | 200 | 1 | 08-09-2026 a 31-10-2026 | 0,00278 USD |
Con V2, ese archivo de El País costaría 6.000 tuits al mes × 0,0004 = 2,40 USD, más el plan Starter si lo quieres por API. La regla «No monitoring» de V2 desaconseja además repetir la misma consulta a diario con poco intervalo; para este uso la propia página remite a Unlimited.
Prueba 3: respuestas, donde hay que distinguir dos casos
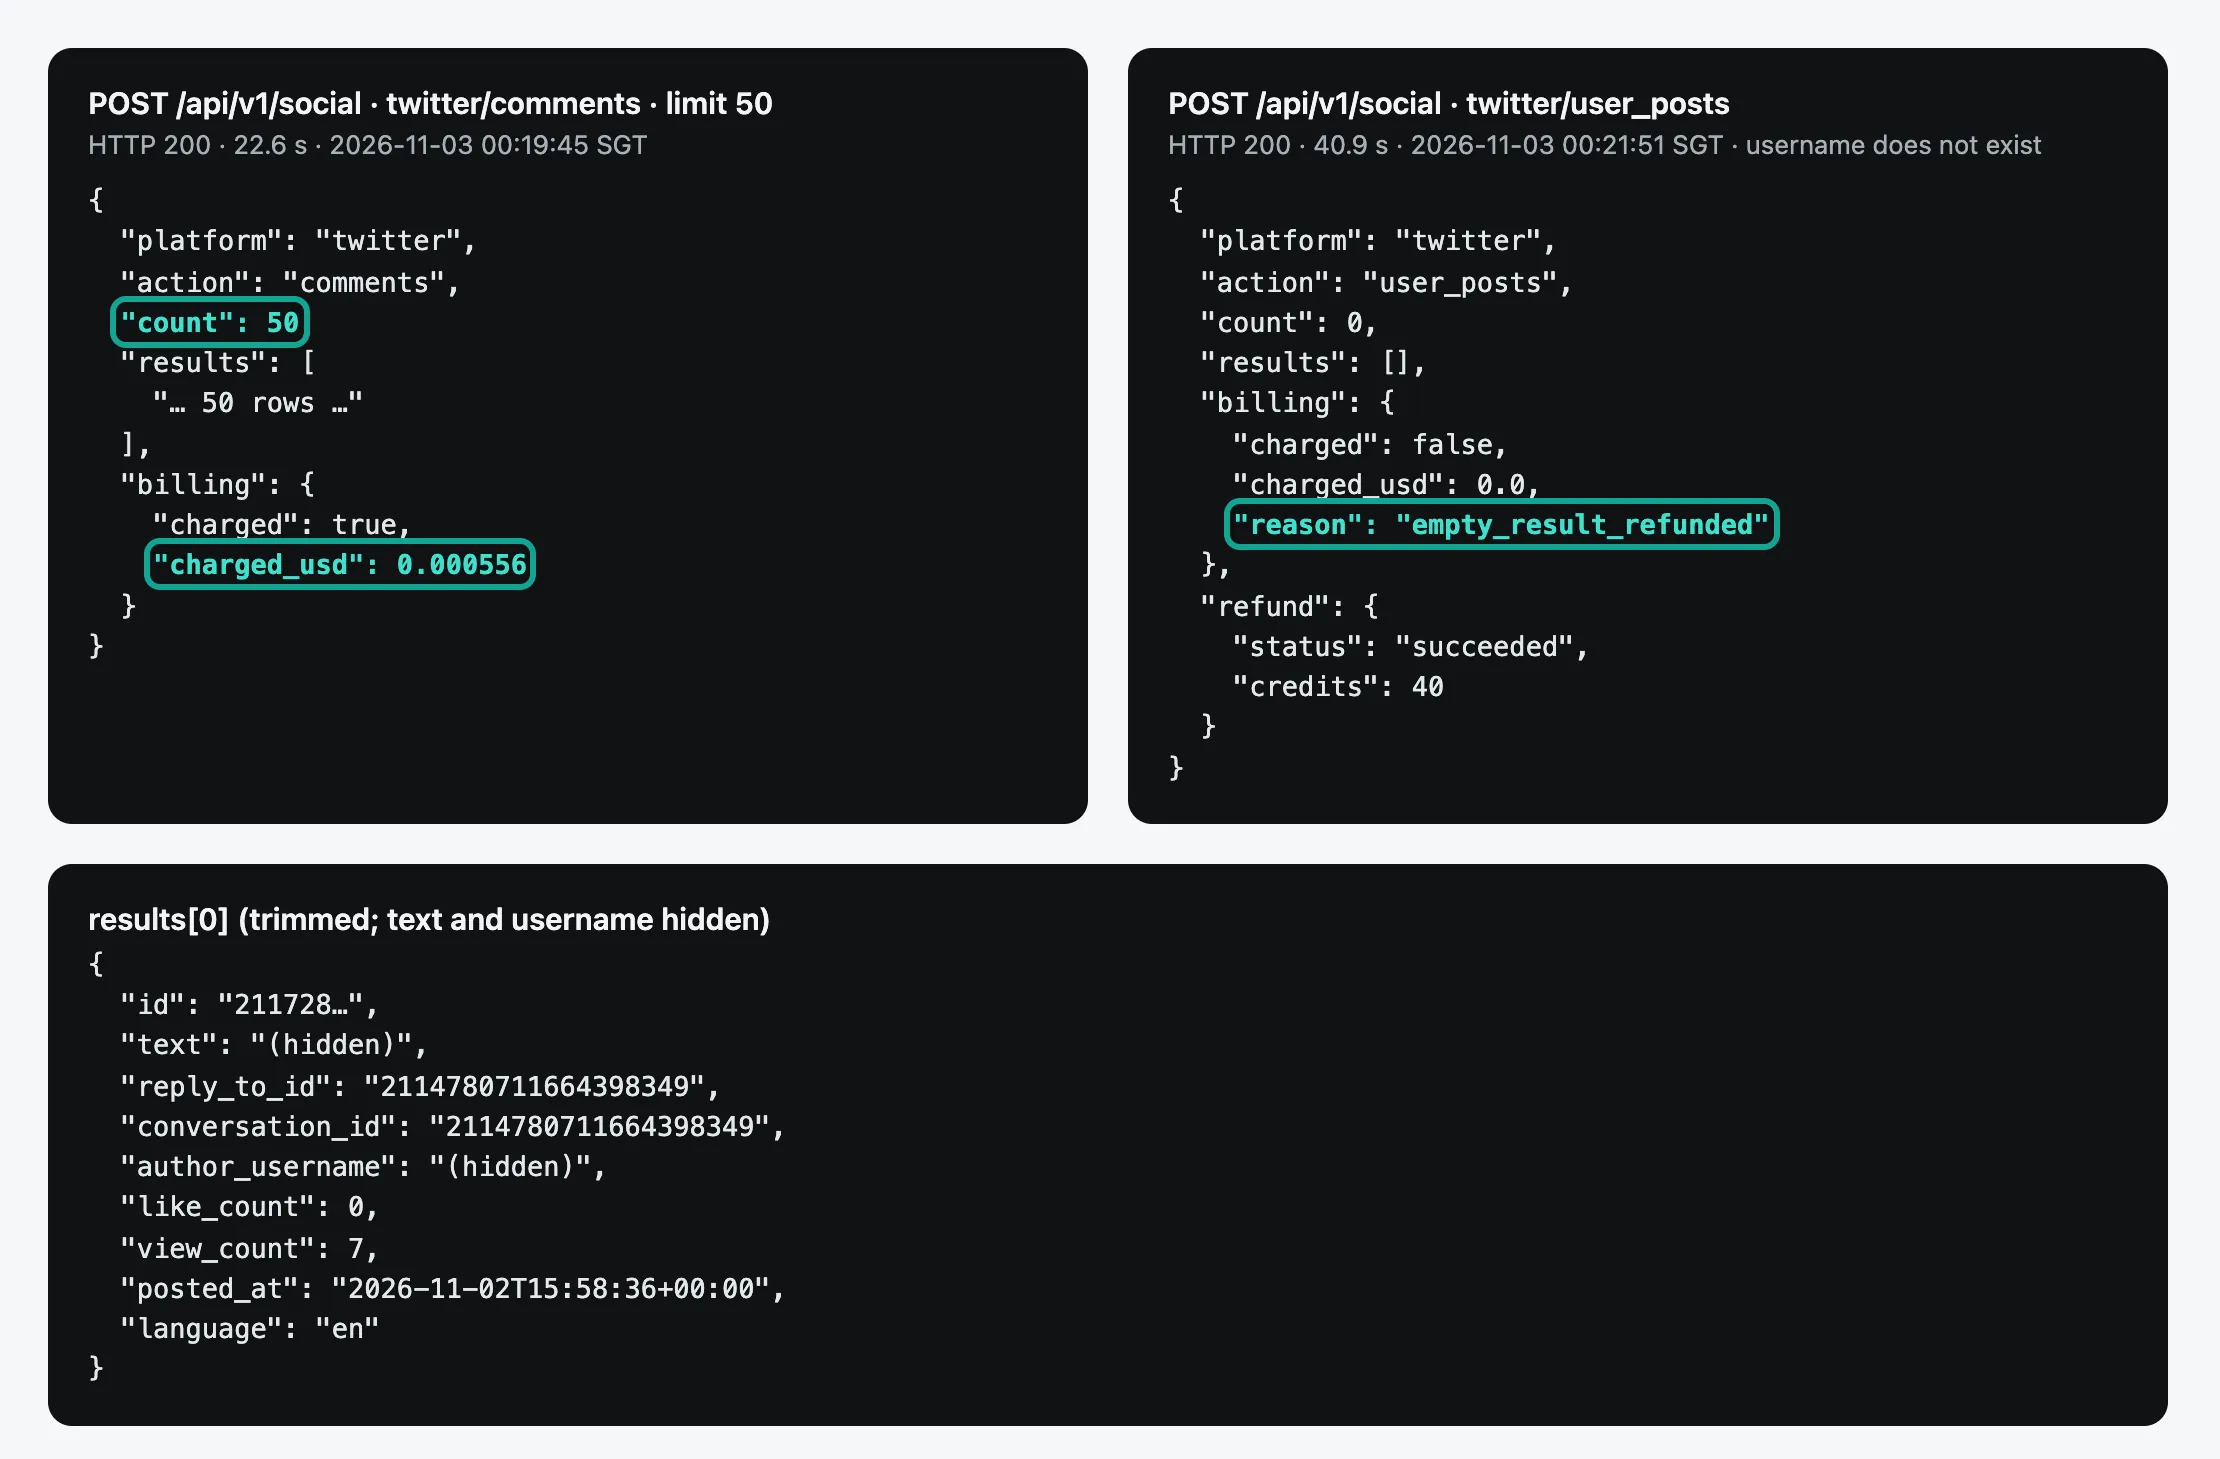
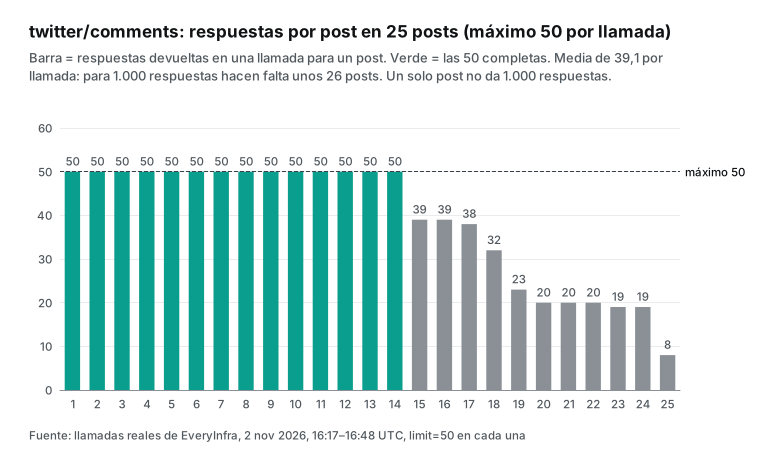
Las respuestas son el tipo de dato con menos diferencia y el que más depende del trabajo. Nuestro twitter/comments pide id, el número que va tras /status/ en la URL del post, y devuelve hasta 50 respuestas por llamada, sin cursor. Lo llamamos una vez en cada uno de 25 posts y obtuvimos 977 respuestas por 0,0139 USD, o 0,0142 USD por cada 1.000.
El primer caso es «un lote de respuestas de muchos posts», por ejemplo revisar cada semana lo que se comenta bajo 200 posts de una marca. Aquí cobramos 0,000556 USD por post; el scraper de respuestas de Apify empieza en 0,014 USD por post, así que somos 25 veces más baratos, y frente al de xquik (0,00015 USD por respuesta), 10,5 veces. De nuestras 25 llamadas, 14 devolvieron las 50 respuestas completas y las otras 11 devolvieron 39, 39, 38, 32, 23, 20, 20, 20, 19, 19 y 8. Las 8 son del post de control, que solo tiene 8 respuestas. Pero seis posts grandes, con entre 2.500 y 6.800 respuestas, devolvieron solo entre 19 y 23.
Después revisamos las respuestas originales de los 24 posts grandes, y el patrón es claro. Las 14 llamadas completas trajeron respuestas recientes, con una mediana de 0 «me gusta» por respuesta. Las 10 incompletas eran de posts con semanas o hasta dos años de antigüedad, y sus respuestas venían ordenadas por «me gusta», con medianas de entre 6 y 1.880. En posts nuevos recibes las respuestas más recientes; en posts virales antiguos, las destacadas que X muestra primero, sin desplegar «mostrar más respuestas». La causa exacta aún debe confirmarla nuestro equipo de backend. Para planificar, cuenta con 50 respuestas en posts nuevos y unas 20 en posts virales antiguos.
El segundo caso es «todas las respuestas posibles de un solo post», por ejemplo estudiar miles de comentarios bajo un post viral. Nuestro endpoint se para en 50 por post y no sirve para esto. La página del scraper de respuestas de Apify dice que pagina solo y que, si el flujo normal trae pocas, useSearch completa con una búsqueda conversation_id:; 1.000 respuestas de un post salen por unos 0,398 USD. Para este trabajo Apify es mejor opción y nosotros no tenemos equivalente. Si solo te interesa el hilo que el autor escribió bajo su propio post, existe twitter/thread, con hasta 100 posts por 0,002153 USD, pero un hilo no es el conjunto de respuestas.
La mezcla de respuestas directas y anidadas también varía mucho. En el post de OpenAI, 35 de 50 eran directas y 15 anidadas; en un post con más de 20.000 respuestas, solo 10 de 50 eran directas; y en otro, 49 de 50 eran respuestas anidadas de 19 autores, lo que parece una única discusión larga. Para análisis de sentimiento, reply_to_id separa los dos niveles y tiene valor en el 99 % de las respuestas. A las 00:48 hora de Singapur repetimos el post de OpenAI y las 50 respuestas eran las mismas que 29 minutos antes.
Campos: ¿devuelven lo mismo los dos lados?
Los campos no son los mismos, así que aquí solo damos nuestras tasas de relleno y los campos de Apify que no tenemos. Revisamos cada campo en 1.400 filas de búsqueda, 200 posts de cuenta y 977 respuestas.
| Campo | Búsqueda (1.400) | Posts de cuenta (200) | Respuestas (977) | Nota |
|---|---|---|---|---|
view_count, bookmark_count, language | 100 % | 100 % | 100 % | En todas las filas |
author_follower_count, author_is_verified | 100 % | 100 % | 100 % | Datos del autor con cada post |
media | 42 % | 44 % | 18 % | Vacío si el post no lleva imagen ni vídeo |
mentions | 12 % | 84 % | 95 % | Las respuestas mencionan a otros a menudo |
links | 22 % | 40 % | 4 % | Posts con enlace externo |
reply_to_id | 0 % | 24 % | 99 % | Solo en respuestas |
author_bio, source | 0 % | 0 % | 0 % | Para la bio, llama a twitter/profile |
hashtags solo tenía valor en el 1 % al 4 % de las filas; las revisamos una a una y todos los posts con # lo traían, los demás simplemente no tenían etiquetas. La página del scraper de respuestas de Apify dice que cada respuesta trae el perfil completo del autor, con la bio, y el cliente desde el que se publicó; nuestros tres endpoints no devuelven esos dos campos. Si agrupas a quienes responden por su bio, por ejemplo por profesión, Apify te lo da en una sola pasada.
Los nombres también cambian. En el ejemplo de salida de V2, los «me gusta» son likeCount, los reposts retweetCount, la fecha createdAt (con formato Fri Nov 24 17:49:36 +0000 2023), el idioma lang, y el autor va en un objeto anidado author con userName y followers. Los nuestros son like_count, retweet_count, posted_at (ISO 8601 con zona horaria) y language, con el autor en campos planos como author_username y author_follower_count. El ejemplo de V2 incluye también source, el cliente de publicación, que en nuestros tres endpoints está vacío.
¿Cuestan dinero las llamadas fallidas o vacías?
En nuestro lado, las 6 llamadas sin datos costaron 0 USD. Las que no superan la autenticación o la validación se cortan antes: sin clave hay un 401 con el código missing_key; con un parámetro sobrante, max_items, un 422 que enumera los parámetros admitidos (keyword, limit, sort) e incluye una petición de ejemplo que funciona; por encima del límite de ritmo, un 429 con el tiempo de espera. Un usuario inexistente y un ID de post inexistente devolvieron HTTP 200 tras unos 40 segundos, con count 0, billing.reason igual a empty_result_refunded y refund.status igual a succeeded. El tercer grupo fue un error nuestro: poner la URL completa del post en id. El catálogo dice que no se haga, pero la API no devolvió un 422: lo trató como «no encontrado» y lo reembolsó, algo poco amable para quien se equivoca y que hemos anotado.
| Caso | Hora de Singapur, 3 de noviembre | HTTP | Código o motivo | `charged_usd` |
|---|---|---|---|---|
| Sin clave | 00:21 | 401 | missing_key | 0 |
| Usuario inexistente | 00:21 | 200 | empty_result_refunded, reembolso hecho | 0.0 |
| Más de 10 llamadas por minuto | 00:24 | 429 | rate_limited, «Nothing was charged» | 0 |
URL completa en id | 00:28 | 200 | empty_result_refunded | 0.0 |
Parámetro sobrante max_items | 00:29 | 422 | unknown_param, lista de admitidos | 0 |
| ID de post inexistente | 00:29 | 200 | empty_result_refunded | 0.0 |
En el lado de Apify solo citamos las páginas. V2 exige al menos 50 tuits por consulta y no dice qué cobra si salen menos. El scraper de respuestas cobra la consulta «una vez por cada tweetId o URL procesado» y avisa de que un post sin respuestas «devuelve un dataset vacío y desperdicia tiempo de ejecución», sin decir si devuelve esa tarifa. Los dos scrapers de scraper_one cobran 0,0025 USD fijos por ejecución y el de danek, una tarifa de arranque por GB de memoria. La documentación de uso y recursos explica cómo se cobran unidades de cómputo, almacenamiento y transferencia, y la del pago por evento pide a los desarrolladores cobrar los resultados solo después de guardarlos.
La API pública también muestra cómo terminaron las ejecuciones de los últimos 30 días. Convertimos las abortadas, las que agotaron el tiempo y las fallidas en una tasa por cada 10.000 ejecuciones para los nueve scrapers de este artículo.
| Scraper de Apify | Ejecuciones, 30 días | Abortadas | Tiempo agotado | Fallidas | Sin terminar por cada 10.000 |
|---|---|---|---|---|---|
| Tweet Scraper V2 | 4.688.523 | 35.721 | 5.536 | 0 | 88,0 |
| Cheapest Twitter Scraper (kaitoeasyapi) | 2.653.176 | 41.433 | 3.276 | 1.583 | 174,5 |
| X Tweet Scraper (xquik) | 2.820.359 | 228 | 1 | 3 | 0,8 |
| Twitter Scraper (danek) | 2.396.418 | 3.132 | 422 | 0 | 14,8 |
| Scraper Unlimited (apidojo) | 1.552.877 | 418 | 609 | 0 | 6,6 |
| X Tweet Scraper (feedminer) | 58.004 | 1 | 147 | 0 | 25,5 |
| Profile Posts Scraper (scraper_one) | 36.776 | 17 | 55 | 0 | 19,6 |
| Replies Scraper (apidojo) | 6.118 | 7 | 2 | 0 | 14,7 |
| X Reply Scraper (xquik) | 39.518 | 32 | 0 | 0 | 8,1 |
Muchas ejecuciones abortadas las detiene el propio usuario, así que no siempre son culpa del scraper. La tabla solo respalda una idea: el scraper de tuits de xquik, el más barato, fue el más estable, con 0,8 ejecuciones sin terminar por cada 10.000; V2, el más usado, tuvo 88, y kaitoeasyapi, 174,5. Las páginas no dicen cuánto costaron esas ejecuciones y desde fuera no se puede ver. Cómo conciliamos nosotros fallos y reembolsos se explica en conciliación de reembolsos por fallo.
Más de 400 scrapers de Twitter en la Apify Store: cómo se reparten los precios
Con la API pública de búsqueda de la Store (documentación) buscamos cuatro términos: twitter, tweet, x scraper y x.com. Al juntar y quitar duplicados quedaron 406 actores; 380 cobran por evento y 372 muestran un precio por resultado. Por nombre y descripción, 175 son de tuits, 48 de perfiles, 37 de seguidores, 36 de respuestas, 36 de tendencias y 40 de medios y otros datos.
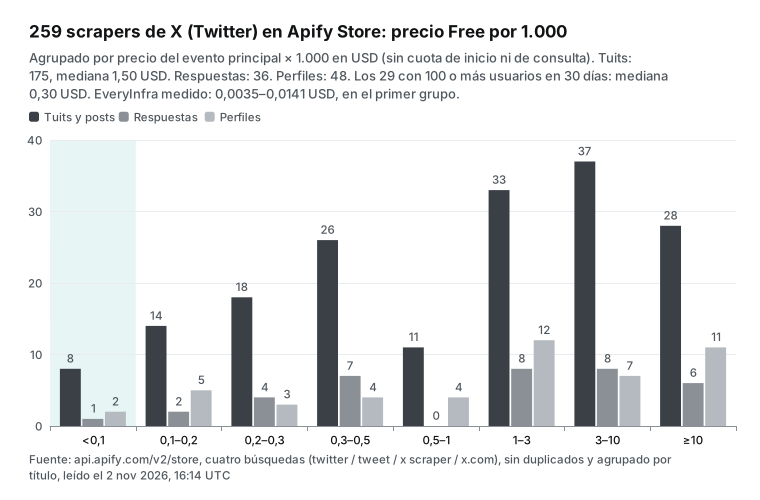
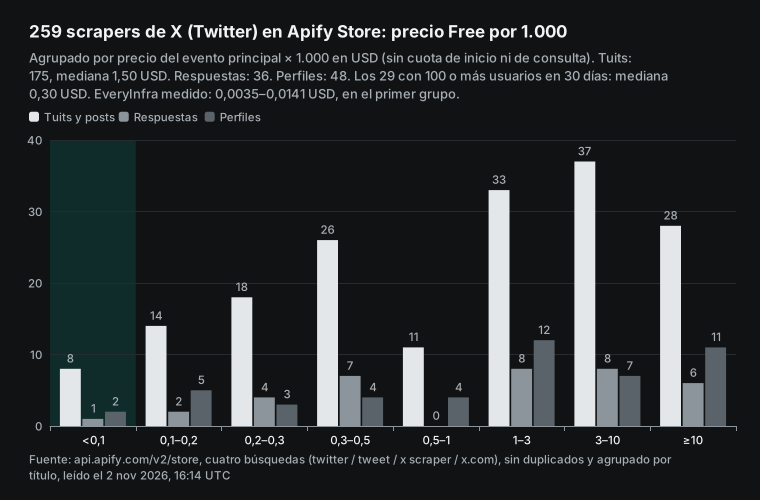
La mediana del plan Free de los 175 scrapers de tuits es de 1,50 USD por cada 1.000, casi cuatro veces el precio de V2, pero la inflan muchos scrapers con pocos usuarios. Si solo cuentas los 29 con al menos 100 usuarios en 30 días, la mediana baja a 0,30 USD; ponderada por usuarios, la media es de 1,42 USD. Los usuarios están muy concentrados: los cinco primeros se quedan con el 68,4 % de los usuarios de 30 días de los 372 scrapers (32.822 en total). El más barato cobra 0,01 USD por cada 1.000, pero solo tuvo 8 usuarios. En resumen, los scrapers de Twitter que más se usan cuestan entre 0,12 y 0,40 USD por cada 1.000, y nuestros tres precios medidos quedan por debajo de 0,015 USD.
Nuestro artículo sobre los precios de Apify explicados cubre planes, unidades de cómputo y reglas del pago por evento en general, y el de alternativas a Apify compara varias plataformas. Este añade lo que aquellos no tienen: filas reales de Twitter por llamada y el reparto de precios y ejecuciones de los scrapers de Twitter de la Store. Para una vista general, empieza por nuestra página de alternativas.
Punto de equilibrio: cuándo conviene pagar por fila
Cobramos por petición y la mayoría de los scrapers de la Store cobran por fila, así que el punto de equilibrio se calcula dividiendo nuestro precio por petición, 0,000556 USD, entre el precio por fila del otro.
| Precio por fila | Herramienta | Filas por llamada en el equilibrio | EveryInfra sale más barato si una llamada devuelve |
|---|---|---|---|
| 0,005 USD | X API, pago por uso | 0,11 | 1 fila o más |
| 0,0004 USD | Tweet Scraper V2 | 1,39 | 2 filas o más |
| 0,00015 USD | xquik | 3,71 | 4 filas o más |
| 0,00012 USD | feedminer, plan Free | 4,63 | 5 filas o más |
| 0,0001 USD | feedminer, plan Business | 5,56 | 6 filas o más |
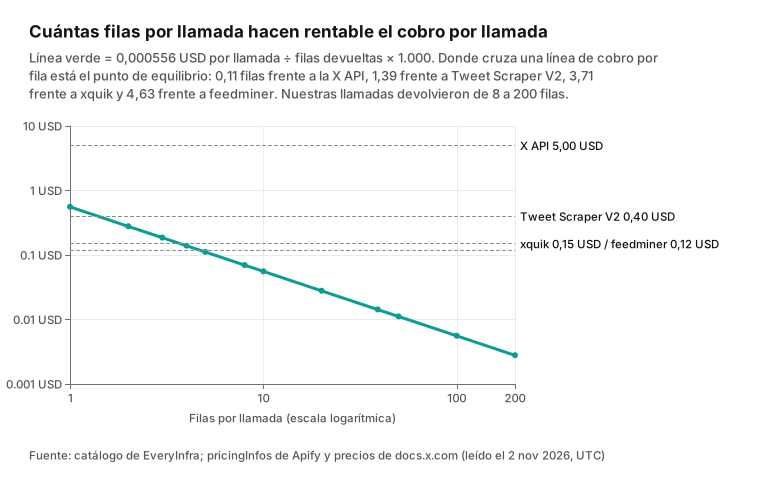
¿Cuándo devuelve una llamada pocas filas en la vida real? Al consultar un post suelto: twitter/post cuesta 0,000556 USD por post, o 0,556 USD por cada 1.000, más que xquik o feedminer pero mucho menos que los 0,05 USD por tuit suelto de Unlimited (V2 no admite tuits sueltos). También al vigilar una cuenta pequeña que publica dos o tres veces al día. Y en nuestro post de control con 8 respuestas: nos salió a 0,0695 USD por cada 1.000; el scraper de respuestas de apidojo cobra una consulta de 0,014 USD (las 8 entran en las 40 gratuitas), o 1,75 USD por cada 1.000; xquik, 0,15 USD; scraper_one, 0,0025 USD por ejecución más 8 respuestas, 0,5625 USD. En ese post seguimos siendo los más baratos, pero por debajo de unas 3 filas por llamada ganan xquik y feedminer.
La factura de un mes: tres trabajos habituales
Aplicamos las filas medidas a tres trabajos comunes. En nuestro lado convertimos filas en llamadas con las filas medidas por llamada y multiplicamos por 0,000556 USD. En el de Apify multiplicamos el precio de lista por las filas, sin uso de plataforma ni cuota del plan. Para la X API usamos 0,005 USD por post, sin el tope mensual de 3 millones ni el descuento por leer el mismo post dos veces en un día UTC.
| Trabajo | Filas en 30 días | EveryInfra | V2 o respuestas de apidojo | xquik | X API, pago por uso |
|---|---|---|---|---|---|
| Monitorizar marca: 20 palabras clave, 200 tuits cada una, a diario | 120.000 | 0,33 USD (600 llamadas) | 48,00 USD | 18,00 USD | 600,00 USD |
| Archivar: 50 cuentas, 1.000 posts cada una | 50.000 | 0,17 USD (unas 300 llamadas) | 20,00 USD | 7,50 USD | 250,00 USD |
| Respuestas: 200 posts a la semana, 50 respuestas cada uno | 40.000 | 0,44 USD (800 llamadas) | 14,40 USD | 6,00 USD | 200,00 USD |
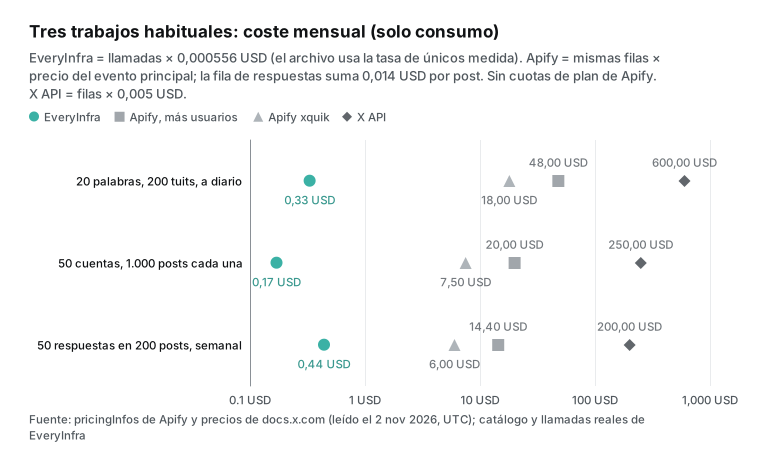
La tabla deja tres ideas. En trabajos que llenan la página en cada llamada, la diferencia se mantiene en decenas de veces, porque un solo cargo cubre 200 filas (50 en respuestas). La factura de Apify necesita además un plan: con V2 gratis solo hay 50 tuits al mes, así que estos trabajos piden al menos Starter, desde 19 USD al mes; nosotros no tenemos cuota mensual, el saldo pagado no caduca y las llamadas fallidas no se cobran. Y V2 limita a cada usuario a una ejecución simultánea con hasta 5 consultas y pide no usarlo para monitorizar con la misma consulta a intervalos cortos, de modo que la fila de marca no es un uso admitido de V2. La página de precios de X fija 0,005 USD por post leído y 0,010 USD por usuario, con un tope de 3 millones de posts al mes (uso y facturación).
La X API frente a Apify y EveryInfra
X pasó su API al pago por uso en febrero de 2026, y el 14 de agosto anunció que los planes Pro antiguos pasarían a ese modelo después del 1 de septiembre (foro de X Developers). No tiene cuota mensual, pero los posts cuestan 5 USD por cada 1.000: 12,5 veces V2 y unas 1.500 veces nuestro precio medido de búsqueda.
| Elemento de la X API | Valor | Fuente |
|---|---|---|
| Lectura de post | 0,005 USD | Página de precios |
| Lectura de usuario | 0,010 USD | Página de precios |
| Tope mensual | 3 millones de posts leídos | Uso y facturación |
| Mismo post dos veces en un día UTC | Se cobra una vez | Uso y facturación |
| Profundidad de la línea de tiempo | Últimos 3.200 posts | Documentación de timelines |
| Búsqueda reciente | 450 peticiones cada 15 minutos | Límites de ritmo |
| Búsqueda en todo el archivo | 1 petición por segundo | Límites de ritmo |
| Créditos gratis | 20 USD tras la primera compra y hasta 50 USD por recarga automática; caducan a los 3 meses | Créditos gratis |
Hubo dos cambios recientes en los créditos: desde el 2 de octubre, las cuentas nuevas reciben 20 USD tras su primera compra y hasta 50 USD más por activar la recarga automática; el 13 de octubre X cambió la regla y guardar una tarjeta ya no basta (créditos gratis). Los límites de ritmo y la documentación de búsqueda completan la tabla; desde el 4 de mayo, la búsqueda por palabra clave ya no devuelve reposts. La X API es la vía con precio fijado por la propia X y con los términos más claros; además permite publicar y gestionar tu propia cuenta. Más en acerca de la X API, cómo obtener acceso y el servidor MCP de código abierto de X, xmcp.
Velocidad y concurrencia
| Herramienta | Filas por llamada o ejecución | Tiempo medido o declarado | Filas por minuto |
|---|---|---|---|
EveryInfra twitter/search | 200 | 35,2 a 53,4 s, mediana 39,3 s (medido) | Unas 300 por proceso |
EveryInfra twitter/user_posts | 200 | Unos 33 s (medido) | Unas 360 por proceso |
EveryInfra twitter/comments | Hasta 50 | 14 a 23 s, mediana 19,8 s (medido) | Unas 120 por proceso con 39,1 filas por llamada |
| Tweet Scraper V2 | 50 o más por consulta | 30 a 80 tuits por segundo (texto de la página) | 1.800 a 4.800 |
Una ejecución grande de V2 es más rápida, y los límites de la plataforma de Apify fijan cuántos actores y cuánta memoria puede usar a la vez una cuenta. Si necesitas cientos de miles de posts cuanto antes, una ejecución grande de Apify gana a nuestras llamadas página a página. Para unos miles de posts al día con un horario fijo, los dos lados terminan en minutos. Nuestra clave de prueba admitía 10 peticiones por minuto; la consola muestra el límite de las cuentas de producción.
Scraper API de Twitter en clientes de IA: configurar MCP
En clientes de IA, conecta nuestro servidor MCP remoto en https://api.everyinfra.com/mcp; las herramientas empiezan por everyinfra_ y el modelo elige solo entre twitter/search o twitter/comments. La configuración de abajo es un ejemplo general; Claude Code y otros clientes con MCP remoto usan un formato parecido, y la sintaxis exacta está en la documentación MCP de Claude Code, la de OpenAI y la especificación MCP.
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
Apify tiene también un servidor MCP que convierte los actores de la Store en herramientas (documentación, código en GitHub). Con él, el modelo lanza una ejecución, espera a que termine y lee el dataset, lo que encaja con lotes grandes; con el nuestro, cada llamada devuelve datos al momento, lo que encaja con una conversación en la que preguntas y compruebas sobre la marcha. Los clientes compatibles están en nuestra página del servidor MCP.
Pasar desde Apify: equivalencia de parámetros
| Tarea | Entrada en Apify | Entrada en EveryInfra | Nota |
|---|---|---|---|
| Búsqueda | V2 searchTerms + maxItems | twitter/search con keyword + limit (máx. 200) | Una palabra clave por llamada; para más, corta por fechas |
| Orden | V2 sort: Latest, Top, Latest + Top | sort: latest o Top por defecto | 137 de 200 filas coincidieron en la prueba |
| Idioma | V2 tweetLanguage | lang:es dentro de keyword | Ejemplo: inteligencia artificial lang:es |
| Una cuenta | V2 twitterHandles o from: | twitter/user_posts con username; from: para lo antiguo | Máx. 200 por llamada |
| Respuestas | tweetIds o URL del scraper de respuestas | twitter/comments con id numérico | Máx. 50 por post; una URL da 0 filas, reembolsadas |
| Post suelto | URL en Unlimited (0,05 USD) | twitter/post | 0,000556 USD por llamada |
| Seguidores | Evento de seguidores del scraper de usuarios de apidojo | twitter/followers_list, hasta 2.000 | 0,000556 USD por llamada |
Nuestra API de scraper de Twitter tiene 21 endpoints, todos disponibles hoy en el catálogo, que también cubren perfiles, listas de seguidores y seguidos, quién repostea, posts de comunidades y transcripciones de vídeo. Los parámetros, campos y precio de cada uno se leen gratis en el catálogo, sin clave.
Cómo comprobamos estas cifras
Un script recalculó cada cifra de EveryInfra del texto, las tablas y los gráficos a partir de las 52 respuestas originales: las filas son la longitud de results, la deduplicación usa el id del post, el cargo es billing.charged_usd y la hora es el reloj local al enviar, anotado en hora de Singapur. Todos los precios, usuarios y ejecuciones de Apify salen de metadatos públicos leídos a la vez, entre las 00:14 y las 00:16 hora de Singapur, más una captura de la nota de precios de V2. Los puntos de equilibrio y las facturas mensuales solo combinan esos dos tipos de cifras. Quedan tres puntos abiertos: la causa exacta de que los posts virales antiguos devuelvan unas 20 respuestas (la prueba 3 describe el patrón), cuánto suma el uso de plataforma de xquik y si feedminer lee de verdad las búsquedas desde las Comunidades de X.
Cuándo conviene más Apify
| Trabajo | Mejor opción | Por qué |
|---|---|---|
| Miles de respuestas de un solo post | Scraper de respuestas de Apify | Nos paramos en 50 por post |
| 1 a 3 filas por llamada | xquik o feedminer | El precio por fila gana por debajo de 3,71 o 4,63 filas |
| Cientos de miles de posts, rápido | Apify | 30 a 80 tuits por segundo en una ejecución |
| Programación, almacenamiento y webhooks en un sitio | Apify | Nosotros solo devolvemos datos |
| Bio del autor y cliente de publicación en cada respuesta | Scraper de respuestas de Apify | Nuestros tres endpoints no los traen |
| Páginas llenas de búsqueda, posts de cuenta o respuestas de muchos posts | EveryInfra | Entre 10 y 122 veces menos por cada 1.000 filas |
Apify tiene programaciones, datasets y webhooks, de modo que una ejecución puede enviar los resultados a Google Sheets o a tu servidor; con nosotros, la programación y el almacenamiento los montas tú. También hay que mirar las ventanas de fechas: en nuestras pruebas solo entre 48 y 85 de 200 posts caían dentro de la ventana, y V2 avisa de que until reduce resultados, aunque tiene sus propias opciones de fecha. Si la ventana exacta es importante para ti, prueba las dos.
Términos de X, muro de inicio de sesión y límites legales
Los Términos de Servicio de X entraron en vigor el 9 de octubre de 2026. Dicen que el rastreo o scraping de los Servicios en cualquier forma y con cualquier fin sin consentimiento previo por escrito está expresamente prohibido (Términos de Servicio de X). Los Developer Terms añaden límites a los datos de la API. Estos términos obligan a quien usa X; qué suponen para tu proyecto debe decírtelo tu abogado. Este artículo no es asesoramiento jurídico.
Los registros públicos se pueden leer en el original: la actuación de la Comisión Europea sobre X en virtud de la Ley de Servicios Digitales (nota de la Comisión, comunicado de prensa, texto del Reglamento, plan de acción), el caso X contra Bright Data (expediente) y hiQ contra LinkedIn (sentencia).
El muro de inicio de sesión es otra cuestión. La página del scraper de respuestas de apidojo dice «no login, no proxy», y la de V2 dice que devuelve lo que muestra la búsqueda de X y que X puede cambiar búsqueda, paginación y filtros en cualquier momento. En nuestro lado no tienes que darnos una cuenta de X. Ninguna de nuestras 52 llamadas devolvió un error de «inicio de sesión necesario» y todas las llamadas de datos de Twitter devolvieron HTTP 200.
Cambios recientes
| Fecha | Cambio y qué supone para ti | Fuente |
|---|---|---|
| 13-10-2026 | X cambió la regla de créditos gratis: guardar una tarjeta ya no da 20 USD. Para el bono hay que comprar créditos antes. | Créditos gratis |
| 09-10-2026 | Entraron en vigor los nuevos Términos de Servicio de X. Lee el texto vigente: las citas antiguas pueden estar desfasadas. | Términos de X |
| 02-10-2026 | X añadió créditos por primera compra para cuentas de pago por uso, hasta 70 USD, que caducan a los 3 meses. Hay que usarlos antes. | Registro de cambios de la X API |
| 24-09-2026 | Entraron en vigor los precios actuales del Twitter Scraper de danek, con tarifa de arranque por GB de memoria. Muchas ejecuciones pequeñas encarecen la factura. | Metadatos de danek |
| Finales de septiembre | La página de feedminer dice que X empezó a rechazar sus peticiones al índice de búsqueda; las palabras clave sin from: salen ahora de las Comunidades de X. Los posts de una cuenta no se ven afectados. | Página de feedminer |
La tendencia principal es que los precios cambian a menudo. De los 14 scrapers de Twitter que leímos, 10 tienen precios vigentes que empezaron a mediados de agosto o después, como xquik el 29 de agosto y scraper_one el 30 y 31; cada tramo de precio de los metadatos lleva una fecha startedAt. Para ti, esto significa que los precios de Apify de cualquier comparativa, esta incluida, pueden quedar desfasados en dos o tres meses: vuelve a leer los metadatos públicos antes de comprar y anota la hora de lectura.
Empezar: de una llamada de prueba a una tarea diaria
Si das una estrella a nuestros dos repositorios de GitHub, everyinfra/everyinfra-agent-plugins y everyinfra/seo-skills, puedes pedir 1 USD de crédito de prueba en la consola, válido 24 horas: da para repetir las 52 llamadas de este artículo más de 30 veces. Consigue tu clave en el inicio rápido y abre la página de la API de scraper de Twitter para ver todos los endpoints. Prueba el área de pruebas en la API de búsqueda de Twitter, la API de posts de usuario de Twitter y la API de respuestas de Twitter; para perfiles, la API de perfiles de Twitter.
El mismo esquema sirve para la API de scraper de Reddit y la de Bluesky. Todos los endpoints y precios están en el mercado de datos y en la página de precios. Hay más comparaciones por cada 1.000 filas con Apify en alternativa a Apify TikTok Scraper y alternativa a Apify Instagram Scraper. Para que un modelo llame a una API de datos con campos exactos, lee uso estricto de herramientas de Claude con una API de datos.
Preguntas frecuentes
¿Es gratis el scraper de Twitter de Apify?
Fuente: la sugerencia de búsqueda «apify twitter scraper free», leída el 3 de noviembre de 2026. El plan gratuito de Apify da 5 USD de crédito de plataforma al mes, pero las páginas de V2 y del scraper de respuestas de apidojo dicen que los usuarios gratuitos tienen 5 ejecuciones al mes de 10 elementos como máximo, y V2 añade que no pueden llamarlo por API. «Gratis» da para ver el formato de salida y poco más. En nuestro lado, la prueba de 1 USD dura 24 horas y, a 200 tuits por llamada, cubre más de 300.000 tuits; después se paga por petición, sin cuota mensual.
¿Cuánto cuesta Apify tweet scraper pricing y por qué algunos hablan de 0,004 USD por cada 1.000?
Fuente: la consulta «apify tweet scraper pricing» y un hilo de r/n8n (hilo). V2 cuesta 0,0004 USD por tuit, es decir, 0,40 USD por cada 1.000. Ese hilo escribió 0,004 USD por cada 1.000, con dos decimales de menos; vale el dato de los metadatos públicos. Otro tutorial de r/n8n comparaba V2 con la X API como «40 centavos por 1.000 tuits frente a 200 dólares por 15.000» (hilo); ese era el precio del antiguo plan Basic, y X cobra ahora 5 USD por cada 1.000 posts en pago por uso.
¿Un scraper de Twitter puede sacar todas las respuestas de un post?
Fuente: la sugerencia de búsqueda «apify twitter comments scraper», leída el 3 de noviembre de 2026. La página del scraper de respuestas de apidojo dice que pagina solo y que, si el flujo normal trae pocas, useSearch completa con una búsqueda conversation_id:; también dice que no admite posts borrados ni protegidos. Nuestro twitter/comments se para en 50 respuestas por post, así que para miles de respuestas de un solo post Apify es mejor opción.
¿Es legal el scraping de Twitter y lo permite X?
Fuente: las sugerencias «scraping de twitter» y «is it legal to scrape twitter», leídas el 3 de noviembre de 2026. Los Términos de Servicio de X vigentes desde el 9 de octubre de 2026 prohíben el scraping sin consentimiento escrito. La sección legal enlaza la multa de la Comisión Europea, el caso X contra Bright Data y la sentencia hiQ contra LinkedIn. La respuesta depende de tu país, de los datos y del uso que les des; consulta a un abogado. Este artículo no es asesoramiento jurídico.
¿Cuál es la scraper API de Twitter más barata?
Fuente: la sugerencia «scraper api twitter», leída el 3 de noviembre de 2026. Por precio público por cada 1.000, entre los scrapers de la Store con al menos 100 usuarios en 30 días, los más baratos para tuits son xquik (0,15 USD, más uso de plataforma), scrape.badger (0,15 USD en Free y 0,12 USD en Business) y feedminer (0,12 USD, con una limitación en las búsquedas por palabra clave). El precio más bajo de la Store es 0,01 USD, pero ese scraper tuvo 8 usuarios. Nosotros cobramos por petición: una página llena de 200 filas sale a 0,00278 USD por cada 1.000, o 0,00327 USD tras deduplicar; por debajo de unas 3 filas por llamada, los que cobran por fila salen más baratos.
¿Apify X scraper o la X API?
Fuente: la consulta «apify x scraper» y el tutorial de r/n8n que compara ambos (hilo). La X API cuesta 5 USD por cada 1.000 posts con un tope de 3 millones al mes; es la vía con precio fijado por la propia X y con los términos más claros, y además permite publicar y gestionar tu propia cuenta. Con los precios de este artículo, los scrapers populares de Apify cuestan entre 0,12 y 0,40 USD por cada 1.000 y nosotros entre 0,003 y 0,014 USD. Los términos de X limitan el scraping; para tu proyecto, consulta a un abogado. Para gestionar tu cuenta, usa la X API; para leer mucha conversación pública, compara las herramientas de scraping por precio y filas por llamada.
Referencias
- Apify / apidojo. Tweet Scraper V2 - X Scraper / Twitter Scraper / X.com Scraper (página de la Store). leído el 03-11-2026.
- Apify API. apidojo~tweet-scraper metadatos públicos del actor (pricingInfos, stats). leído el 03-11-2026.
- Apify / apidojo. Twitter (X.com) Scraper Unlimited: No Limits (página de la Store). leído el 03-11-2026.
- Apify API. apidojo~twitter-scraper-lite metadatos públicos del actor. leído el 03-11-2026.
- Apify / apidojo. Twitter (X) Replies Scraper API (página de la Store). leído el 03-11-2026.
- Apify API. apidojo~twitter-replies-scraper metadatos públicos del actor. leído el 03-11-2026.
- Apify / kaitoeasyapi. Cheapest Twitter Scraper / RealTime Twitter Data Scraper API (página de la Store). leído el 03-11-2026.
- Apify API. scraper de tuits de kaitoeasyapi metadatos públicos del actor. leído el 03-11-2026.
- Apify / xquik. Twitter Scraper & X Scraper for Tweets & Search (página de la Store). leído el 03-11-2026.
- Apify API. xquik~x-tweet-scraper metadatos públicos del actor. leído el 03-11-2026.
- Apify / xquik. X Reply Scraper (página de la Store). leído el 03-11-2026.
- Apify API. xquik~x-reply-scraper metadatos públicos del actor. leído el 03-11-2026.
- Apify / feedminer. X (Twitter) Tweet Scraper $0.12/1K (página de la Store). leído el 03-11-2026.
- Apify API. feedminer~x-tweet-scraper metadatos públicos del actor. leído el 03-11-2026.
- Apify / scraper_one. X (Twitter) Profile Posts Scraper (página de la Store). leído el 03-11-2026.
- Apify API. scraper_one~x-profile-posts-scraper metadatos públicos del actor. leído el 03-11-2026.
- Apify API. scraper_one~x-post-replies-scraper metadatos públicos del actor. leído el 03-11-2026.
- Apify API. API de búsqueda de la Store /v2/store?search=twitter. leído el 03-11-2026.
- Apify Docs. Get list of Actors in Store (documentación de la API). leído el 03-11-2026.
- Apify. Apify pricing. leído el 03-11-2026.
- Apify Docs. Actors in Store. leído el 03-11-2026.
- Apify Docs. Actor pricing and costs. leído el 03-11-2026.
- Apify Docs. Usage and resources. leído el 03-11-2026.
- Apify Docs. Limits. leído el 03-11-2026.
- Apify Docs. Apify MCP server. leído el 03-11-2026.
- GitHub. apify/apify-mcp-server. leído el 03-11-2026.
- Apify Docs. Schedules. leído el 03-11-2026.
- Apify Docs. Webhooks. leído el 03-11-2026.
- GitHub / igorbrigadir. twitter-advanced-search (lista de operadores de búsqueda). leído el 03-11-2026.
- X Developer Platform. X API pay-per-usage pricing and credits. leído el 03-11-2026.
- X Developer Platform. Usage and Billing (tope de 3 millones al mes, sin doble cobro en el mismo día). leído el 03-11-2026.
- X Developer Platform. Search Posts. leído el 03-11-2026.
- X Developer Platform. Timelines (últimos 3.200 posts). leído el 03-11-2026.
- X Developer Platform. X API Rate Limits. leído el 03-11-2026.
- X Developer Platform. Free credit incentives for X API pay-per-use accounts (actualizado el 13-10-2026). 13-10-2026.
- X Developer Platform. X API changelog. 29-10-2026.
- foro de X Developers. Important Update: Legacy X API Pro Plans Are Moving to Pay-Per-Use. 14-08-2026.
- X Corp.. X Terms of Service (vigente desde el 09-10-2026). 09-10-2026.
- X Developer Platform. Developer Terms. leído el 03-11-2026.
- GitHub / X. xdevplatform/xmcp. leído el 03-11-2026.
- European Commission. Commission fines X €120 million under the Digital Services Act. 05-12-2025.
- European Commission. Commission accepts X's action plan to comply with Digital Services Act. 16-07-2026.
- European Commission. Press release IP/25/2934. 05-12-2025.
- EUR-Lex. Regulation (EU) 2022/2065 (Digital Services Act). 19-10-2022.
- CourtListener. X Corp. v. Bright Data Ltd., 3:23-cv-03698 (expediente). 09-05-2024.
- U.S. Court of Appeals for the Ninth Circuit. hiQ Labs v. LinkedIn, No. 17-16783 (sentencia del Noveno Circuito). 18-04-2022.
- Model Context Protocol. Model Context Protocol Specification 2025-11-25. 25-11-2025.
- Anthropic. Connect Claude Code to tools via MCP. leído el 03-11-2026.
- OpenAI. Connectors and MCP servers. leído el 03-11-2026.
- Reddit r/n8n. How to easily scrape data from Twitter / X using Apify. leído el 03-11-2026.
- Reddit r/n8n. This Automation Took Me From 0 to 175k Followers in Under 12 Months. leído el 03-11-2026.
- EveryInfra. Catálogo de capacidades de EveryInfra (gratis, sin clave). leído el 03-11-2026 00:16.
- GitHub / Xquik. Xquik-dev/x-twitter-scraper (README: el uso de plataforma se cobra aparte). leído el 03-11-2026.
- Apify Docs. Pay per event. leído el 03-11-2026.
- X Developer Platform. Getting Access. leído el 03-11-2026.
- X Developer Platform. About the X API. leído el 03-11-2026.
- X Developer Platform. Build a query (sintaxis de consultas). leído el 03-11-2026.
- Apify Docs. Get Actor (documentación de la API). leído el 03-11-2026.
- Apify API. danek~twitter-scraper metadatos públicos del actor. leído el 03-11-2026.
Referencia BL-75