Apify Twitter Scraper 替代:每千条实测
同样 1,000 条推文,Apify Tweet Scraper V2 卖 $0.40,我们实测 $0.0033;单帖要上千条回复时 Apify 更合适。
同样拿 1,000 条推文,Apify Store 里用户最多的 Tweet Scraper V2 公开价是每千条 $0.40,所有套餐同价;我们在 2026 年 11 月 3 日用 EveryInfra 的 twitter/search 真调 7 次,一次 $0.000556 拿回 200 条,去重后 1,190 条,折合每千条 $0.00327,差 122 倍;和 Store 里近 30 天用户不少于 100 个、关键词搜索不受限的推文 scraper 里最便宜的 xquik($0.15)比,差 46 倍。某个账号的 1,000 条帖子,我们每千条 $0.00334,比 V2 便宜 120 倍、比最便宜的常用档($0.12)便宜 36 倍。回复这一项差距缩到 10 到 28 倍:twitter/comments 一次最多 50 条,25 个热帖平均每次只回 39.1 条,每千条 $0.0142;而且一个帖子最多只能拿 50 条回复,要从同一个帖子拿 1,000 条回复,只能用 Apify 的回复 scraper,这一项 Apify 更合适。下面把三种数据逐个实测,连同失败扣不扣钱、X 的条款和登录墙、Apify Store 里 400 多个 Twitter scraper 的价格分布和运行成功率、接 MCP 的写法,一起写清楚。
本文的「每千条价」,是把实际扣掉的钱,除以实际返回的条数,再乘 1,000。它回答一个问题:拿到 1,000 条 X(原 Twitter)上的帖子要花多少钱。EveryInfra 按请求计费,一次请求回多少条都收一个价;Apify Store 里的 Twitter scraper 大多按结果计费,每写进数据集一条收一次钱。两种单位只有换到同一个分母才能比。我们这一侧的分母一律用去重后的条数,不用请求里写的 limit,所以回得少、重复多的那几次,我们的价格只会被算高。Apify 一侧只用公开材料:Store 页面、价格页、文档,以及不需要账号就能读的公开 actor 接口;我们没有注册 Apify,也没有跑它的 actor(Apify 对云端抓取程序的叫法),所以表里 Apify 的数字都是公开单价,不是实测账单。
先看总表:Apify Twitter Scraper 和 EveryInfra,每 1,000 条推文多少钱
下表是本文的结论。Apify 一侧每行列两个 scraper:一个是这类数据里近 30 天用户最多的主力 scraper,另一个是 Store 里近 30 天用户不少于 100 个的同类 scraper 中 Free 档最便宜的那个。价格从 Apify 公开 actor 接口的 pricingInfos 字段读出,2026-11-03 00:14 新加坡时间(11 月 2 日 16:14 UTC)读取。档位对应关系按 Apify 文档:Free 套餐用 Free 价,Starter 对应 Bronze,Scale 对应 Silver,Business 对应 Gold,另有 Platinum、Diamond 两档只给企业客户(Actor 定价与成本)。本文列出的几个 Twitter scraper,Free 和 Business 两档价格大多相同或相差不到一半。EveryInfra 一侧全部是本文真调,实扣金额取响应里的 billing.charged_usd,条数取 results,去重按帖子 ID。
| 数据 | EveryInfra 能力 | 实测:次数 / 条数 / 去重 / 实扣 | EveryInfra 每千条(去重) | Apify 主力 scraper | 倍数 | Store 常用最低价 | 倍数 |
|---|---|---|---|---|---|---|---|
| 关键词搜索 | twitter/search | 7 / 1,400 / 1,190 / $0.003892 | $0.00327 | Tweet Scraper V2 $0.40 | 122 倍 | xquik $0.15 | 46 倍 |
| 某账号的帖子 | twitter/user_posts + from: 搜索 | 8 / 1,592 / 1,330 / $0.004448 | $0.00334 | Tweet Scraper V2(twitterHandles)$0.40 | 120 倍 | feedminer $0.12 | 36 倍 |
| 帖子回复 | twitter/comments | 25 / 977 / 977 / $0.0139 | $0.0142 | Twitter Replies Scraper(20 帖 × 50 条)$0.36 | 25 倍 | xquik Reply $0.15 | 10.5 倍 |
倍数都用 Apify 的价格除以我们的价格。读这张表要注意四件事。第一,三行差距都来自「一次请求回一页」:搜索和账号帖子一次最多 200 条,回复一次最多 50 条,一页越满,我们的单价摊得越薄;如果你每次只要一两条,结论会反过来,下文「分界点」一节算给你看。第二,回复一行的主力价 $0.36,是按 apidojo 回复 scraper 页面写的「付费套餐每个帖子前约 40 条免费」算的:每帖 50 条时,一个帖子收 $0.014 查询费加 10 条 × $0.0004;免费套餐只能跑演示模式。第三,xquik 的 GitHub 说明写着 Apify 会另收平台用量,$0.15 只是结果费,不是全部账单(xquik 的 README)。第四,Apify 的价格两三个月就会变一次,下面「最近的变化」一节列了日期。另外,搜索一行的 $0.15 不只 xquik 一家:scrape.badger 的推文 scraper 近 30 天有 709 个用户,Free 档同样每千条 $0.15,Business 档降到 $0.12;feedminer 的 Free 档 $0.12 更低,但它页面写明 9 月下旬起不带 from: 的关键词改从 X 社区读取,搜索结果的范围和 X 搜索页不同,所以搜索一行没有用它,只放在账号帖子一行。
Apify tweet scraper pricing:V2、Unlimited、回复 scraper 各怎么收
搜「apify tweet scraper pricing」的人,多半是在 Store 里看到了好几个名字相近的 scraper,不知道该选哪个。Apify 上同一家开发者 apidojo 就挂着三个:Tweet Scraper V2、Twitter (X.com) Scraper Unlimited 和 Twitter (X) Replies Scraper。三者都是按事件计费(pay per event),也就是 actor 作者定义若干个收费事件,跑一次就按事件次数乘单价扣钱,按 Apify 的按事件计费文档,这种模式下计算资源等平台用量默认由开发者从收入里承担,开发者也可以打开「按事件加用量」开关,让用户另付平台用量;免费套餐用户的平台用量由 Apify 承担。V2 只有一个事件:每写进数据集一条推文收 $0.0004,也就是每千条 $0.40,Free、Starter、Scale、Business 四档同价。它的 Store 页面在价格说明里写了四条规则,下面这张截图是原文。
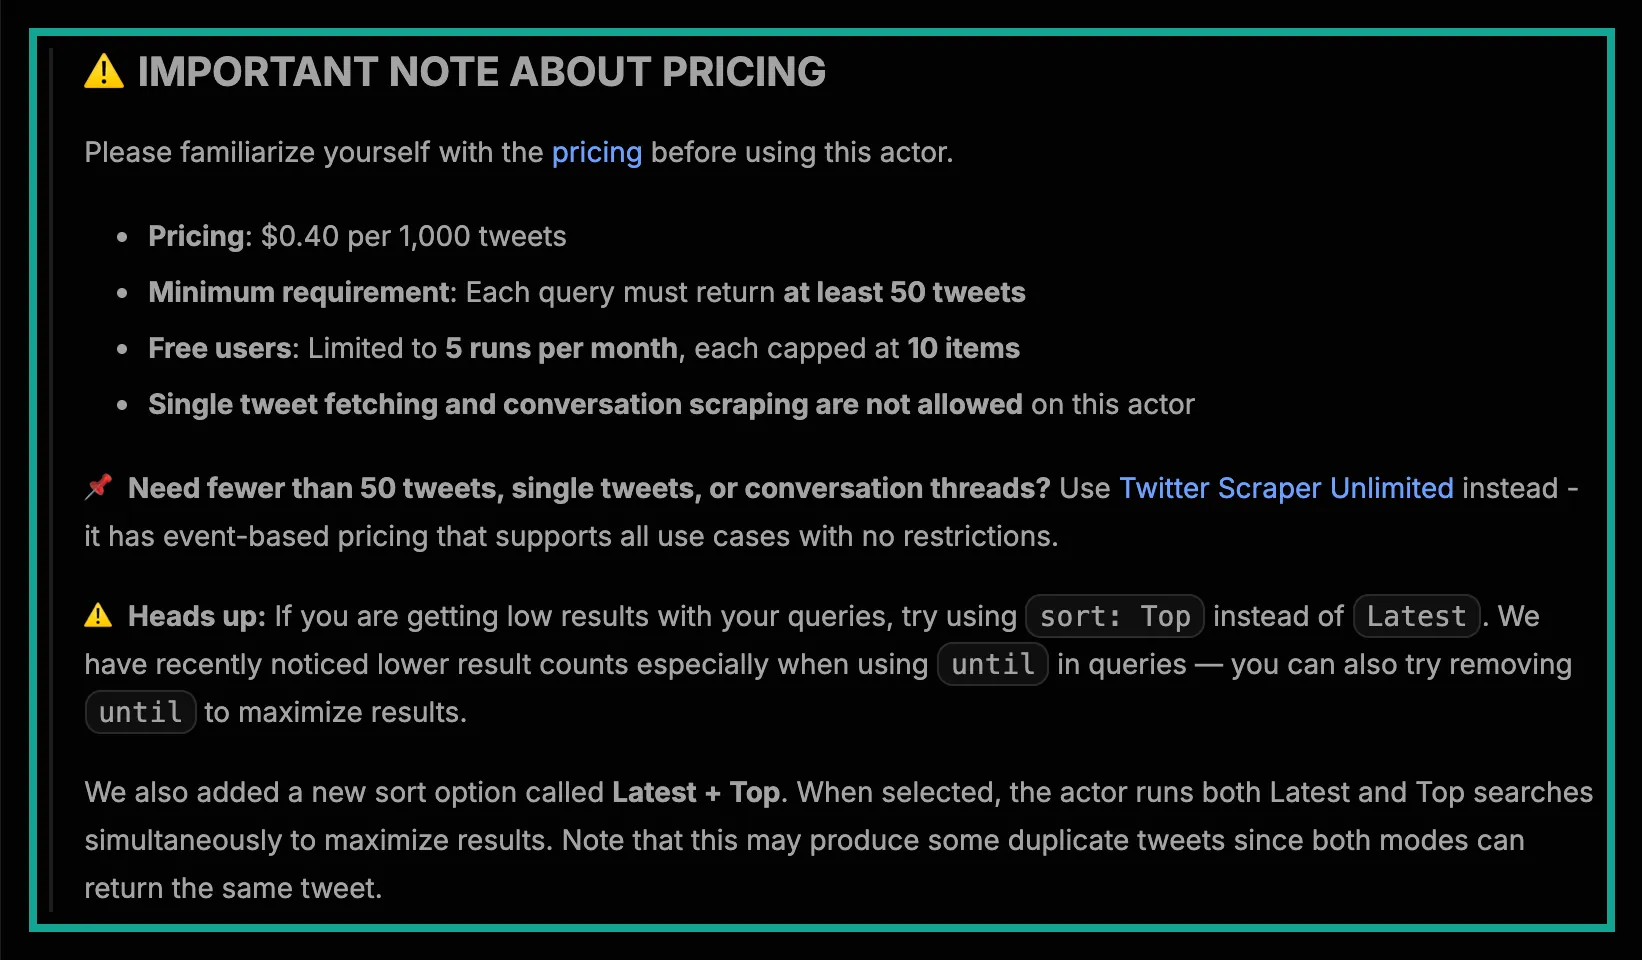
这四条规则里,对算账影响最大的是「每个查询至少返回 50 条」和「免费用户每月 5 次、每次 10 条」。前者意味着 V2 不适合少量、精确的查询:比如只想查某个小账号这周发的三条帖子,页面让你改用 Unlimited。后者意味着 Apify 的 Free 套餐虽然每月给 $5 平台额度(Apify 价格页),但用 V2 一个月最多只能拿 50 条推文,而且页面写着免费用户不能通过 API 调用,等于只够看一眼输出格式。真要用 V2 跑业务,至少要上 Starter 套餐;Apify 价格页写的是 Starter 每月 $19 起、Scale $199、Business $999,套餐里含的用量额度当月用完不结转。
Unlimited 的收费更复杂。它按「查询」收费,每处理一个搜索词、账号或列表收 $0.016,含前约 40 条结果;超出部分按条收费,单价随一次运行里的查询数量分五档:5 个查询以内每条 $0.0004,6 到 10 个 $0.0008,11 到 30 个 $0.0012,31 到 100 个 $0.0016,100 个以上 $0.002;抓单条推文链接每条 $0.05;每次运行最低收 $0.02(以上全部来自 Unlimited 的公开元数据)。也就是说,一次运行塞的查询越多,每条反而越贵,这和大多数人「批量更便宜」的直觉相反。按一个查询拿 1,000 条算,$0.016 加 960 条 × $0.0004,约 $0.40,和 V2 一样;但如果一次运行里放 20 个关键词、每个只拿 50 条,超出那 10 条按 $0.0012 收,每千条接近 $0.33,看起来便宜,实际是因为每个查询前 40 条摊薄了。
回复 scraper 是第三套规则。页面原文写的是:每个帖子收一次查询费(默认流程 $0.014,开 useSearch 的搜索流程 $0.016),每条回复 $0.0004;付费套餐每个查询前约 40 条免费;免费套餐只能跑演示模式,每月 5 次、每次 10 条。所以从一个热帖拿 1,000 条回复,大约 $0.014 + 960 × $0.0004 = $0.398;从 20 个帖子各拿 50 条,是 20 × ($0.014 + 10 × $0.0004) = $0.36。这两个数就是总表里回复一行的来源。
| Apify scraper(开发者) | 收费事件和单价(Free 档 → Business 档) | 每次运行或每个查询的固定费 | 最低量和限制(页面原文) | 近 30 天用户 |
|---|---|---|---|---|
| Tweet Scraper V2(apidojo) | 每条 $0.0004(各档同价) | 无 | 每个查询至少 50 条;免费用户每月 5 次、每次 10 条 | 10,137 |
| Twitter Scraper Unlimited(apidojo) | 超出部分每条 $0.0004–$0.002,按每次运行的查询数分档 | 每个查询 $0.016(含约 40 条);单条推文 $0.05;每次运行最低 $0.02 | 无最低条数 | 2,366 |
| Twitter Replies Scraper(apidojo) | 每条 $0.0004 | 每个帖子 $0.014(搜索流程 $0.016);付费套餐每帖前约 40 条免费 | 免费套餐演示模式每月 5 次、每次 10 条 | 132 |
| Cheapest Twitter Scraper(kaitoeasyapi) | 每条 $0.00025 → $0.00018 | 无 | 无 | 5,398 |
| X Tweet Scraper(xquik) | 每条 $0.00015(各档同价) | 无;README 写明平台用量另计 | 无 | 3,374 |
| X Reply Scraper(xquik) | 每条 $0.00015 | 无;平台用量另计 | 无 | 165 |
| X Tweet Scraper(feedminer) | 每条 $0.00012 → $0.0001 | 无 | 关键词搜索的说明见下文 | 107 |
| X Profile Posts Scraper(scraper_one) | 每条 $0.0004 → $0.0003 | 每次运行 $0.0025 | 无 | 389 |
| Twitter Scraper(danek) | 每条 $0.0003 → $0.00024 | 每次启动按内存每 GB $0.0001 → $0.00005 | 无 | 406 |
表里所有单价都来自各 scraper 的公开元数据,2026-11-03 00:14 到 00:16 新加坡时间读取,读取地址列在文末参考资料里。近 30 天用户取同一接口的 stats.totalUsers30Days,字段含义见 Apify 的 Get Actor 接口文档。这张表只列了本文用到的九个,Store 里叫 Twitter 或 X 的 scraper 有 400 多个,后面一节专门讲它们的价格分布。
我们怎么测,和怎么判对错
动笔之前,我们先写下判据:三种数据各至少真调 2 次、分布在 2 个以上不同时刻;每千条价一律用去重后的条数做分母;只要某一项 Apify 更便宜或更合适,正文和总表都要照写;至少 2 次「没拿到数据」的请求要记下扣费金额。所有请求都发到 POST https://api.everyinfra.com/api/v1/social,每次记下发出时间、HTTP 状态、用时、条数和 charged_usd,然后用脚本从原始响应重新算一遍,正文、表和图的数字都从脚本输出里取。
| 场景 | 能力和参数 | 真调次数 | 时间(新加坡时间,11 月 3 日) | 说明 |
|---|---|---|---|---|
| 关键词搜索 | twitter/search,keyword=openai,limit 200,含 sort=latest 一次、按天 since:/until: 五次 | 7(另 1 次复测) | 00:17 到 00:31,复测 00:47 | 看每次条数、两种排序的重叠、按天切片能不能拿到新数据 |
| 账号帖子 | twitter/user_posts username=NASA,limit 200;再用 from:NASA 加 until:/since: 往前翻 7 次 | 8(另 1 次复测) | 00:19 到 00:33,复测 00:47 | 看一个账号能往前翻多远、翻页重复多少 |
| 回复 | twitter/comments id=帖子 ID,limit 50,25 个不同的帖子 | 25(另 1 次复测) | 00:19 到 00:40,复测 00:48 | 热帖、小帖都测,看每次实际回几条 |
| 没拿到数据 | 无 Key、限速、多余参数、不存在的账号、不存在的帖子、把完整网址填进 id | 6 | 00:21 到 00:29 | 看哪些情况扣钱 |
| 其他语言 | 西语关键词、El País 账号、中文关键词 | 3 | 00:40 到 00:42 | 看非英语内容每次回多少 |
52 次真调合计实扣 $0.025576。我们用的测试 Key 每分钟限 10 次,其中 1 次撞到限速,响应写着「Nothing was charged」,等 40 秒后重发成功。回复一项选帖子的办法是:先从 OpenAI、NASA 等品牌账号和搜索结果里挑出回复数从几百到两万多的帖子,再挑一个只有 8 条回复的小帖做对照。帖子正文和普通用户的账号名在本文里都隐去,只写品牌和机构账号。
实测一:apify twitter scraper 最常见的用法,关键词搜索 1,000 条
在 Apify 上搜推文,最常见的输入是 V2 的 searchTerms 加 maxItems,它的示例输入里还有 sort(Latest、Top)、tweetLanguage、onlyVerifiedUsers、onlyImage 等过滤项(见 V2 的公开元数据里的 exampleRunInput)。我们这一侧对应的是 twitter/search,必填 keyword,可选 limit 和 sort;X 的高级搜索语法(from:、since:、until:、lang:、min_faves: 等)直接写进 keyword,语法规则见 X 开发者文档的查询语法和社区整理的高级搜索清单。
# 2026-11-03 00:17:37 新加坡时间:HTTP 200,用时 41.8 秒,count 200,billing.charged_usd 0.000556
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"twitter","action":"search","params":{"keyword":"openai","limit":200}}'
7 次搜索每次都回满 200 条,共 1,400 条。第一次是默认排序(热门),第二次加 sort: latest,两次的 200 条里有 137 条重合,只多出 63 条新帖。这说明「最新」排序并不严格按时间倒序:第二次结果里最早的一条是 2023 年 11 月的帖子。V2 的页面也写了类似的现象:它新增的 Latest + Top 排序会同时跑两种搜索,「可能产生重复推文」,而按条计费时,重复的那部分同样算进条数。
接下来我们用 since: 和 until: 把 openai 切成五个两天的窗口(分别从 2026-10-30、2026-10-27、2026-10-24、2026-10-21、2026-10-18 开始),每个窗口拿 200 条。结果是:每次仍然回满 200 条,新增的不重复帖子分别是 168、168、197、196、198 条,七次累计去重 1,190 条,实扣 $0.003892,每千条 $0.00327。但窗口本身并不严:前三个窗口里,真正落在两天之内的只有 70、85、48 条,其余是窗口外的帖子。也就是说,用日期切片去「翻页」,能拿到大量新数据,但不能保证拿到的是那两天的数据。V2 的页面同样提醒「最近用 until 时结果数偏低」,X 自己的更新日志写着 2026 年 5 月 4 日起搜索接口迁到新的索引(X API changelog),feedminer 的页面则说 X 从 9 月下旬开始拒绝它对搜索索引的请求。三处独立的说法指向同一件事:X 的搜索结果最近不太稳定,任何一家的日期过滤都要自己再筛一遍。
30 分钟后,我们在 00:47(新加坡时间)用同样的参数重跑了第一次搜索:200 条里 124 条和第一次相同,76 条是新的。热门排序会随时间变化,如果你做的是品牌监测,每隔半小时跑一次就能拿到一部分新内容,而这在按条计费的 scraper 上意味着重复的 124 条也要付钱;在我们这一侧,这次重跑同样是 $0.000556。
实测二:apify x scraper 拿某个账号的 1,000 条帖子
拿某个账号的帖子,V2 的写法是 twitterHandles 或在 searchTerms 里写 from:账号,价格同样是每千条 $0.40。我们这一侧先用 twitter/user_posts,一次最多 200 条,不带翻页游标;要更早的帖子,就像 V2 一样改用 twitter/search 加 from:NASA 和日期条件往前翻。00:19(新加坡时间)的 user_posts 回了 200 条,时间从 2026-09-08 到 2026-10-31,其中 48 条是 NASA 回复别人的帖子、67 条是转发,这和 X 网页上「帖子与回复」页能看到的内容一致。
然后用 7 次 from:NASA 搜索往前翻:先 until:2026-09-08,再 until:2026-08-01、until:2026-04-01,再按 2025 年下半年、2025 年上半年、2024 年切片。8 次请求共 1,592 条,去重后 1,330 条,没有一条是别的账号的帖子,实扣 $0.004448,每千条 $0.00334。去重后的帖子按年份分布是:2026 年 568 条、2025 年 396 条、2024 年 198 条、2022 年 82 条、2020 年 23 条、2016 年 39 条,其余年份个位数。越往前越稀,原因和实测一相同:带日期的搜索会混进窗口外、热度更高的旧帖,切片越窄,新增越少(第三次只新增 87 条)。
00:47(新加坡时间)我们重跑了一次 user_posts,200 条和半小时前完全相同,最新一条仍是 10 月 31 日 22:14 UTC 那条。这是好事:做账号存档时,同样的参数在短时间内结果稳定,增量抓取只要比较最新一条的 ID 就行。X 自己的接口有一个硬上限:用户时间线只能拿到最近 3,200 条(X 时间线文档),更早的只能靠全量搜索。
西语读者常问的 El País,我们在 00:41(新加坡时间)也测了一次:user_posts 回 200 条,197 条是西语,覆盖 10 月 31 日到 11 月 2 日不到两天,说明新闻类高频账号 200 条只够两天;要存档一个月,一天跑一次即可。
非英语内容:西语和中文关键词每次回多少
很多人用 apify x scraper 不是为了英文内容。我们在 00:40(新加坡时间)用 inteligencia artificial lang:es 搜了一次西语,回满 200 条,全部是西语,来自 167 个不同作者,时间从 2026-10-23 到 2026-11-02,没有转发和回复;00:42 用 大模型 lang:zh 搜中文,同样请求 200 条,只回了 100 条,全部是中文,来自 67 个作者,最早一条是 2026-10-08。中文这一次每千条是 $0.00556,比英文高一倍,因为 X 上中文讨论本来就少,一次搜不满。这一点在按条计费的 scraper 上不会体现为单价变化,只会体现为拿不够数;在我们这一侧,回得少的那一次单价会被摊高,但仍然只有 V2 的七十分之一左右。如果你主要做中文或小语种监测,建议放宽关键词、去掉 lang: 之外的过滤,让每次尽量回满。
实测三:回复,这一项要分两种情况看
回复是三项里差距最小、也最需要分情况的一项。twitter/comments 必填 id,即帖子网址里 /status/ 后面那串数字;一次最多 50 条,没有翻页。我们挑了 25 个帖子各调一次,合计 977 条,实扣 $0.0139,每千条 $0.0142。
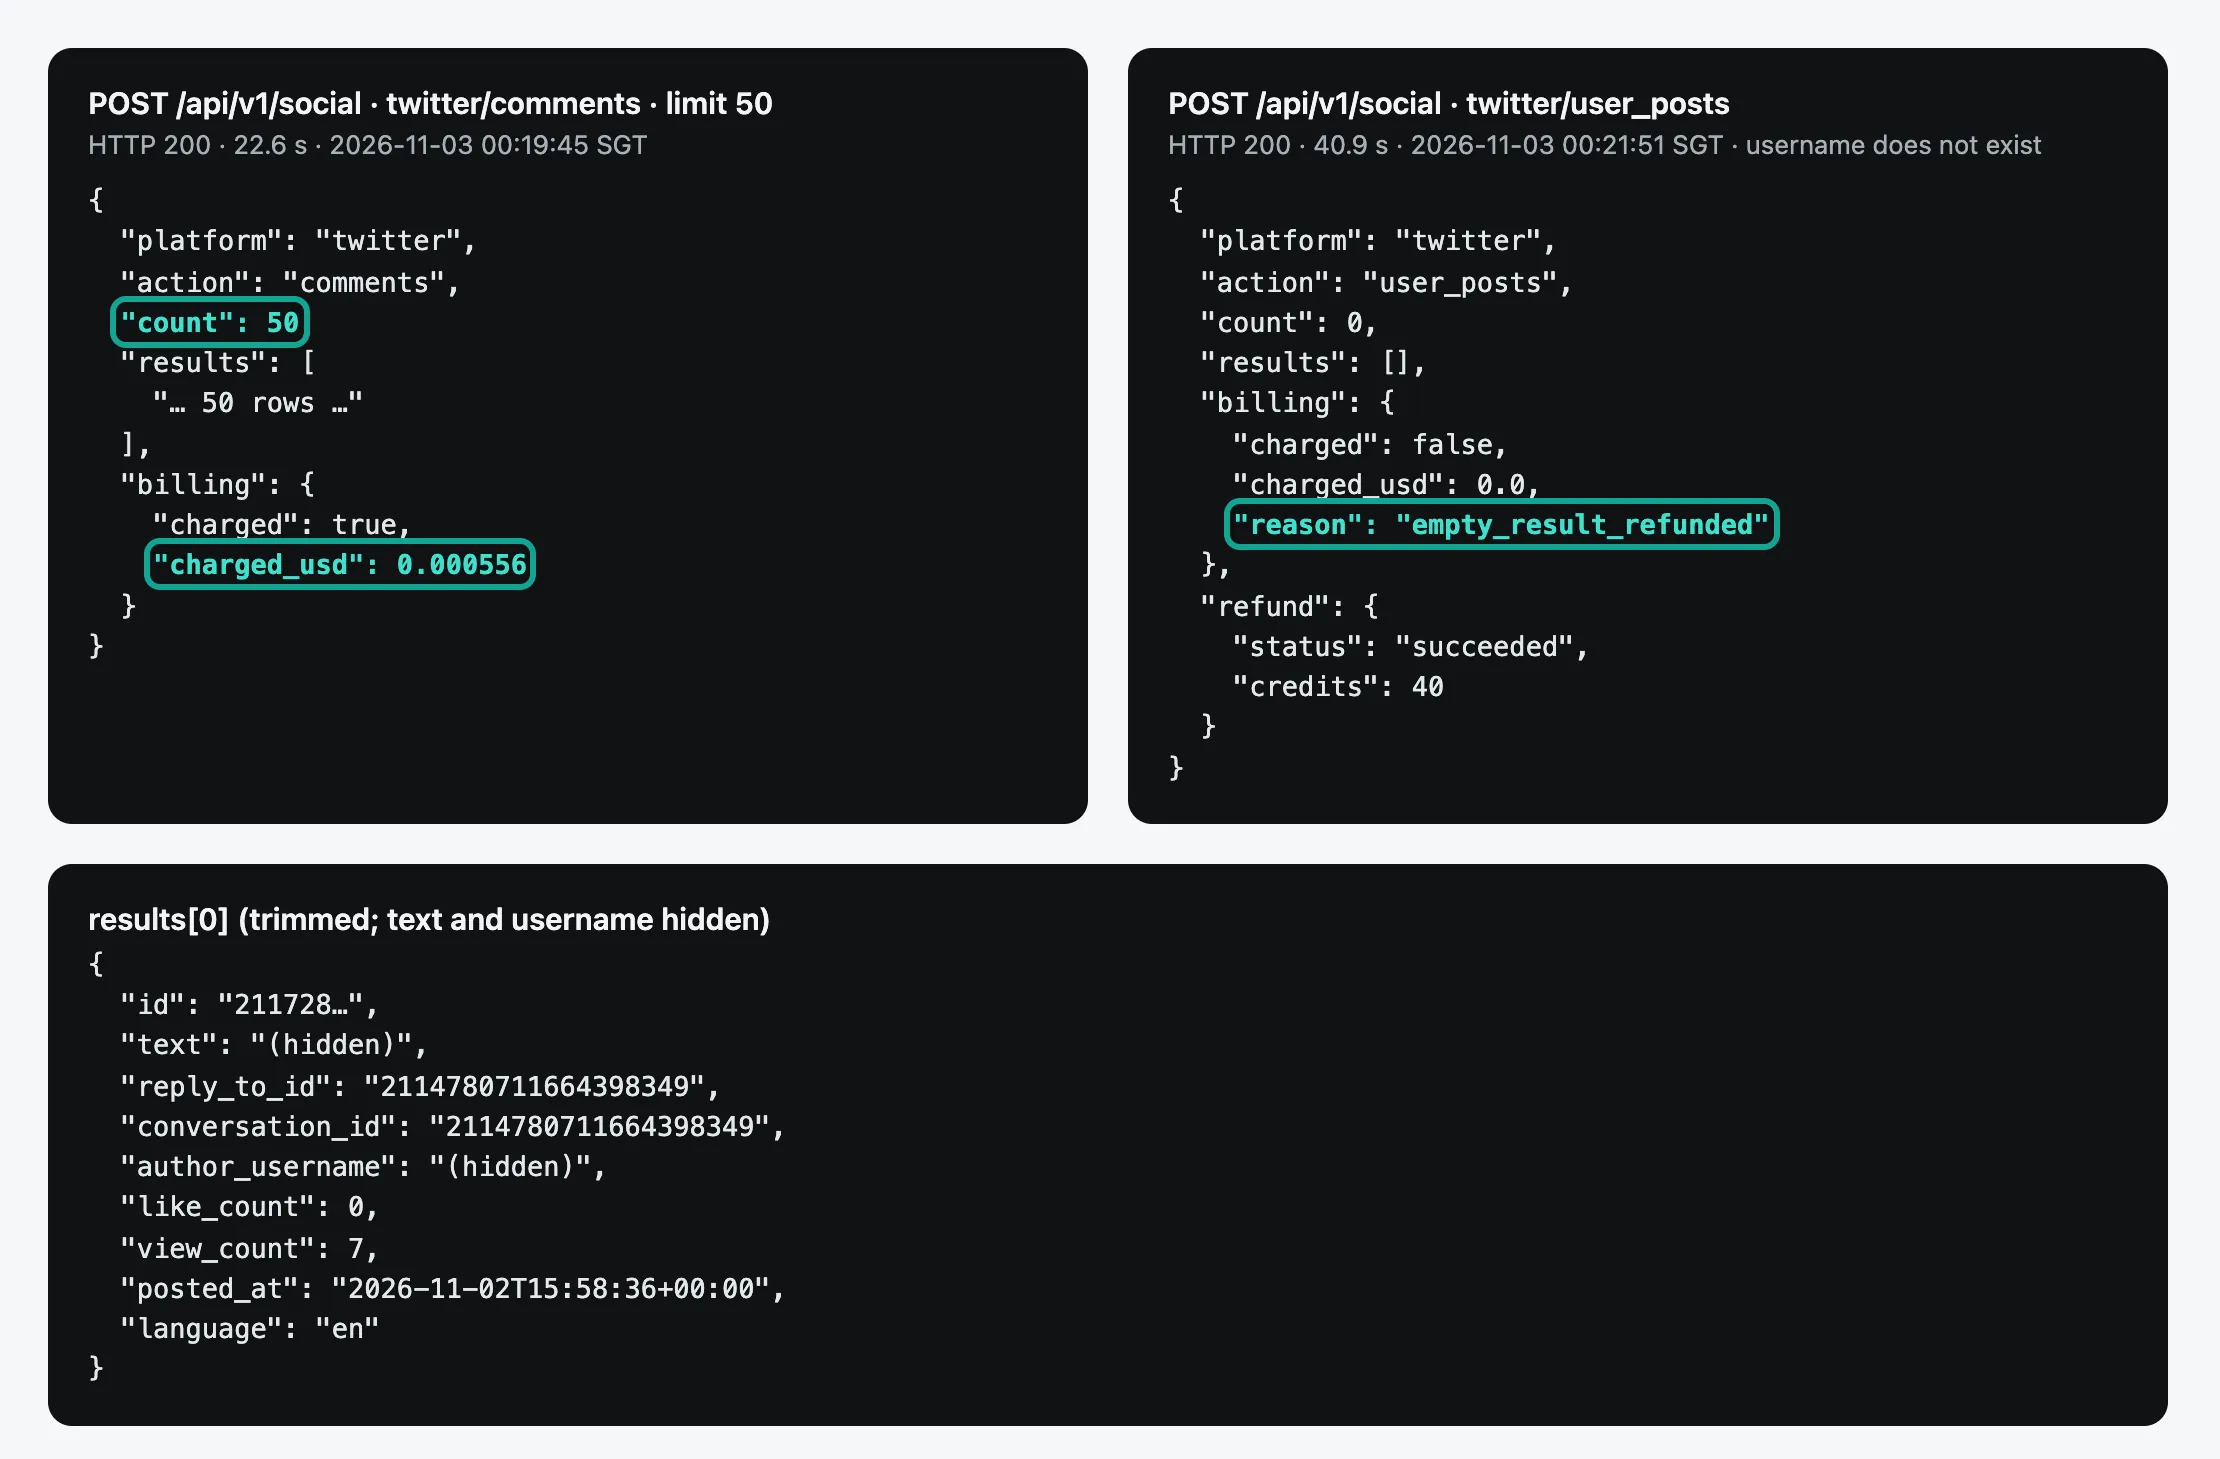
第一种情况:你要的是「很多帖子下面各一批回复」,比如每周看 200 条品牌帖子下的反馈。这时我们每帖一次 $0.000556,Apify 回复 scraper 每帖 $0.014 起,便宜 25 倍;和 Store 里最便宜的 xquik 回复 scraper(每条 $0.00015)比,也便宜 10.5 倍。25 次里有 14 次回满 50 条,其余 11 次分别是 39、39、38、32、23、20、20、20、19、19、8 条。最少的 8 条是我们特意挑的小帖,它本来只有 8 条回复,拿全了;但有 6 个回复数在 2,500 到 6,800 之间的热帖,只回了 19 到 23 条。我们回头逐条看了 24 个热帖(不含那个小帖)的原始响应,规律很清楚:回满 50 条的 14 个,回复几乎都是最近几天发的,回复的点赞数中位数是 0(只有一个是 5);没回满的 10 个,都是发出几周到两年多的老帖,回复按点赞排在前面,点赞数中位数从 6 到 1,880 不等,那 6 个只回 19 到 23 条的,最早一条回复在 2023 年 11 月到 2026 年 4 月之间。也就是说,新帖拿到的是按时间排的最新回复,老的热帖拿到的是 X 默认展示的那一批高赞回复,后面要点「显示更多回复」的部分没有展开。确切的根因还要后端确认;对你来说,结论是:盯新帖的回复,每次基本能回满 50 条;要拿老爆款帖下的回复,按每帖约 20 条预估,不够就换 Apify 能翻页的回复 scraper。
第二种情况:你要的是「一个帖子下面尽量多的回复」,比如分析一条爆款帖下的几千条评论。这时我们一个帖子最多 50 条,做不到;Apify 的回复 scraper 页面写的是自动翻页,并且在默认流程拿得少时可以开 useSearch 用 conversation_id: 搜索补齐,单帖 1,000 条约 $0.398。这一项 Apify 更合适,我们没有对应的能力。如果你只需要同一个作者在帖子下面接着发的那串帖子(thread),我们有 twitter/thread,一次最多 100 条,单价 $0.002153,但它不是全部回复。
拿回来的 50 条里有多少是直接回复原帖、多少是「回复里的回复」,差别也很大:OpenAI 那条帖子 50 条里 35 条直接回复、15 条嵌套;有一个两万多回复的帖子,50 条里只有 10 条直接回复;还有一个帖子 50 条里 49 条是嵌套回复,来自 19 个作者,基本是一场争论。做舆情的时候,建议用 reply_to_id 区分两层:它在 99% 的回复里有值。00:48(新加坡时间)我们重跑了 OpenAI 那条帖子,50 条和 29 分钟前完全一样。
字段:两边拿到的东西一样多吗
两边字段不一样,下面只说我们这一侧实测的填充率,以及 Apify 页面上写了、我们没有的字段。我们把 1,400 条搜索结果、200 条账号帖子和 977 条回复里每个字段「有值」的比例算了一遍:浏览量 view_count、收藏数 bookmark_count、语言 language、作者粉丝数 author_follower_count、作者是否认证 author_is_verified 都是 100%;媒体 media 在搜索、账号帖子、回复里分别是 42%、44%、18%,这是因为很多帖子本来就没有图片视频;话题标签 hashtags 只有 1% 到 4%,我们逐条看过,有 # 的帖子都填了,没有 # 的自然为空。
| 字段 | 搜索(1,400 条) | 账号帖子(200 条) | 回复(977 条) | 说明 |
|---|---|---|---|---|
view_count、bookmark_count、language | 100% | 100% | 100% | 每条都有 |
author_follower_count、author_is_verified | 100% | 100% | 100% | 作者信息随帖子一起回 |
media | 42% | 44% | 18% | 没有图片视频的帖子为空 |
mentions | 12% | 84% | 95% | 回复和账号帖子里提到别人的多 |
links | 22% | 40% | 4% | 正文带外链的比例 |
reply_to_id | 0% | 24% | 99% | 回复才有 |
author_bio、source | 0% | 0% | 0% | 这三类请求都没有,要简介请另调 twitter/profile |
Apify 回复 scraper 的页面写着每条回复带完整作者资料(含简介)和发帖客户端,这两项我们这三个能力都拿不到:作者简介要另调一次 twitter/profile,发帖客户端只在部分能力的部分帖子里有。如果你的分析依赖作者简介做分类,例如把回复者按职业分组,Apify 一次拿全会更方便。
两边的字段名也不一样,迁移时要逐个改。V2 页面的输出示例里,点赞数叫 likeCount、转发数叫 retweetCount、发帖时间叫 createdAt(格式是 Fri Nov 24 17:49:36 +0000 2023)、语言叫 lang、作者信息放在嵌套的 author 对象里(userName、followers);我们这一侧对应的是 like_count、retweet_count、posted_at(ISO 8601 格式,带时区)、language,作者信息平铺成 author_username、author_follower_count 等字段。V2 的输出示例里有发帖客户端 source,我们这三个能力里这个字段为空。
失败和空结果扣不扣钱
我们这一侧,6 次没拿到数据的请求全部 0 扣费,分三类。第一类在鉴权和参数检查阶段就被拦下:不带 Key 回 401,错误码 missing_key;多写一个不存在的参数 max_items 回 422,错误里列出允许的参数 keyword、limit、sort,并附一个能直接跑的示例请求;撞到限速回 429,写明多久后重试。第二类是查不到:不存在的用户名、不存在的帖子 ID,各等了约 40 秒后回 200,count 为 0,billing.reason 是 empty_result_refunded,refund.status 是 succeeded。第三类是我们自己填错:把帖子的完整网址填进 id,目录里写明不要这样做,但接口没有报 422,而是当作查不到、0 条退款,这一点对使用者不够友好,我们记下来了。
| 情况 | 时间(新加坡时间) | HTTP | 错误码或原因 | `charged_usd` |
|---|---|---|---|---|
| 不带 Key | 00:21 | 401 | missing_key | 0 |
| 用户名不存在 | 00:21 | 200 | empty_result_refunded,退款成功 | 0.0 |
| 每分钟超过 10 次 | 00:24 | 429 | rate_limited,「Nothing was charged」 | 0 |
| 帖子 id 填成完整网址 | 00:28 | 200 | empty_result_refunded | 0.0 |
多写参数 max_items | 00:29 | 422 | unknown_param,列出允许的参数 | 0 |
| 帖子 ID 不存在 | 00:29 | 200 | empty_result_refunded | 0.0 |
Apify 一侧,我们只引页面原文。V2 写的是每个查询至少返回 50 条,没说结果不足 50 条时怎么收;回复 scraper 写的是查询费按「每处理一个帖子 ID」收,并提醒「回复数为 0 的帖子会返回空数据集,浪费运行时间」,没说空结果退不退查询费;scraper_one 的两个 scraper 每次运行固定收 $0.0025 初始化费;danek 的 scraper 每次启动按内存收费。Apify 的用量与资源文档写了平台用量(计算单元、存储、数据传输)怎么计;按事件计费的 actor 默认由作者承担这部分,打开「按事件加用量」的(比如 xquik)则由用户另付。按事件计费文档还要求作者「结果保存后再收费」,被中止的运行里用户拿不到的结果不该收钱。另一个能公开查到的数是运行结果:Apify 公开接口里每个 actor 都有近 30 天的运行统计,我们把本文九个 scraper 的「中止、超时、失败」次数换成每 1 万次运行的比例。
| Apify scraper | 近 30 天运行次数 | 中止 | 超时 | 失败 | 每 1 万次没跑成 |
|---|---|---|---|---|---|
| Tweet Scraper V2 | 4,688,523 | 35,721 | 5,536 | 0 | 88.0 |
| Cheapest Twitter Scraper(kaitoeasyapi) | 2,653,176 | 41,433 | 3,276 | 1,583 | 174.5 |
| X Tweet Scraper(xquik) | 2,820,359 | 228 | 1 | 3 | 0.8 |
| Twitter Scraper(danek) | 2,396,418 | 3,132 | 422 | 0 | 14.8 |
| Twitter Scraper Unlimited | 1,552,877 | 418 | 609 | 0 | 6.6 |
| X Tweet Scraper(feedminer) | 58,004 | 1 | 147 | 0 | 25.5 |
| X Profile Posts Scraper(scraper_one) | 36,776 | 17 | 55 | 0 | 19.6 |
| Twitter Replies Scraper(apidojo) | 6,118 | 7 | 2 | 0 | 14.7 |
| X Reply Scraper(xquik) | 39,518 | 32 | 0 | 0 | 8.1 |
「中止」多数是用户自己停掉的,不一定是 scraper 的错,所以这张表只说明一件事:最便宜的 xquik 推文 scraper 运行最稳,每 1 万次只有 0.8 次没跑成;用户最多的 V2 每 1 万次有 88 次中止或超时;kaitoeasyapi 最高,每 1 万次 174.5 次。至于中止和超时的那几次扣了多少钱,页面没有写,我们也没法从外部查到。我们这一侧失败退款怎么对账,见失败退款对账实战。
Apify Store 里 400 多个 Twitter scraper:价格怎么分布
用 Store 的公开搜索接口(接口文档)分别搜 twitter、tweet、x scraper、x.com,合并去重后得到 406 个 actor,其中 380 个按事件计费,372 个能读出每条结果的价格。我们按名称和说明把它们分成推文 175 个、账号资料 48 个、粉丝和关注 37 个、回复 36 个、趋势 36 个、媒体和其他 40 个,再把推文、回复、账号资料三类的 Free 档每千条价格画成分布。
推文类 175 个 scraper 的 Free 档中位数是每千条 $1.50,比 V2 的 $0.40 贵将近 4 倍;但这个中位数被大量没人用的 scraper 拉高了。只看近 30 天用户不少于 100 个的 29 个,中位数是 $0.30;按近 30 天用户数加权,平均每千条 $1.42。用户高度集中:用户最多的 5 个 scraper 占了这 372 个里近 30 天用户总数(32,822)的 68.4%。最便宜的一个每千条只要 $0.01,但近 30 天只有 8 个用户,我们没有把它当作「常用」。换句话说,Apify 上真正被大量使用的 Twitter scraper,价格集中在每千条 $0.12 到 $0.40 之间,我们实测的三个数都在 $0.015 以下。
站内已有的 Apify 价格详解讲过 Apify 的套餐、计算单元和按事件计费的通用规则,Apify 替代方案比较了多个平台;本篇是 Twitter 专项,补的是这两篇没有的 Twitter 实测条数、Store 里 Twitter scraper 的价格分布和运行统计。Apify 各家的总体对比,可以从替代方案总览进入。
分界点:每次只要几条时,按条计费更便宜
我们按请求收费,Apify Store 的 Twitter scraper 大多按条收费,两者的分界点很好算:用我们一次请求的价格 $0.000556,除以对方每条的价格。V2 每条 $0.0004,分界点是每次 1.39 条;xquik 每条 $0.00015,分界点 3.71 条;feedminer Free 档每条 $0.00012,分界点 4.63 条,Business 档 $0.0001 时是 5.56 条;X API 每条 $0.005,分界点 0.11 条,也就是只要回 1 条以上,我们就更便宜。
实际业务里,什么时候每次只回几条?一是查单条帖子:我们有 twitter/post,一次 $0.000556 拿一条,等于每千条 $0.556,比 xquik、feedminer 贵,比 V2 的单条用法(V2 不支持单条,要用 Unlimited,每条 $0.05)便宜得多。二是监测小账号:一个每天只发两三条的账号,每次拿到的新帖很少。三是我们实测里那个只有 8 条回复的小帖:我们每千条 $0.0695;apidojo 回复 scraper 收一次 $0.014 查询费(8 条在免费的前 40 条以内),每千条 $1.75;xquik 每千条 $0.15;scraper_one 每次运行 $0.0025 加 8 条,每千条 $0.5625。所以在这个小帖上我们仍然最便宜,但如果每次只回 3 条以下,xquik 和 feedminer 更划算。
算一笔账:三件常见的活,30 天各花多少钱
把实测条数套进三种常见任务。每一行的我们这一侧,按实测的每次条数换算请求次数,再乘 $0.000556;Apify 一侧按公开单价乘条数,不含平台用量和套餐月费;X API 按每条 $0.005 计,不含每月 300 万条上限和日内去重带来的折扣。
| 任务 | 30 天条数 | EveryInfra | Tweet Scraper V2 或 apidojo 回复 scraper | xquik | X API 按量 |
|---|---|---|---|---|---|
| 品牌监测:20 个关键词,每天各拿 200 条 | 120,000 | $0.33(600 次) | $48.00 | $18.00 | $600.00 |
| 账号存档:50 个账号各拿 1,000 条历史帖子 | 50,000 | $0.17(约 300 次) | $20.00 | $7.50 | $250.00 |
| 回复监测:每周 200 个帖子,各拿 50 条回复 | 40,000 | $0.44(800 次) | $14.40 | $6.00 | $200.00 |
这张表说明三件事。第一,在「每次回一整页」的任务上,差距稳定在几十倍,主要因为我们一次 200 条(回复 50 条)只收一次钱。第二,Apify 一侧的账单还要加上套餐月费:V2 的免费用户每月只能拿 50 条,跑这三件活至少要 Starter 套餐,每月 $19 起。我们这一侧没有月费,余额长期有效,失败不扣钱。第三,V2 页面的「Important Note」一节写了两条使用限制:同一时间最多 1 个运行、每次最多 5 个查询;不要在短时间内反复跑同一个查询做监测(No monitoring)。所以品牌监测这一行,在 V2 上本来就不是推荐用法,页面建议这类场景换 Unlimited。X API 一侧,按 X 的定价页,读帖子每条 $0.005,读用户每条 $0.010,每月最多读 300 万条(用量与计费说明);同一 UTC 日内重复读同一条只算一次,所以真实账单会比表里略低。
一个完整例子:每周一份品牌回复报告
把前面三种数据串起来,看一件真实的活要花多少。假设你每周一做一份报告:先用 20 个关键词各搜 200 条,找出这一周讨论最多的帖子;再从里面按 reply_count 挑 50 个帖子,各拿 50 条回复;最后把回复交给模型分类,挑出投诉、提问和夸奖。我们这一侧是 20 次 twitter/search 加 50 次 twitter/comments,共 70 次请求,每周 $0.0389,一个月四周约 $0.16,前提是每次都像实测一样回满或接近回满。
同样的活放在 Apify 上,按公开单价有两种走法。走 V2 加回复 scraper:搜索 4,000 条 × $0.0004 = $1.60,回复 50 个帖子 × ($0.014 + 10 × $0.0004) = $0.90,每周 $2.50;但 V2 页面写了不要拿同一查询反复做监测,每次运行最多 5 个查询,20 个关键词要拆成 4 次运行。走 Unlimited:20 个查询 × $0.016 = $0.32,每个查询超出前 40 条的 160 条按「11 到 30 个查询」那一档 $0.0012 收,共 3,200 × $0.0012 = $3.84,加上回复 $0.90,每周 $5.06。两种走法都还没算 Starter 套餐的月费。模型分类那一步,两边一样,取决于你用哪个模型。这个例子里我们便宜 64 到 130 倍,差距比总表还大,主要原因是 Unlimited 的分档:一次运行里查询越多,超出部分每条越贵。
和 X API 比:贵,但它是 X 自己定价、条款最明确的途径
X 自己的 API 从 2026 年 2 月起改成按量付费,旧的 Pro 套餐 8 月 14 日宣布停售,9 月 1 日后迁到按量计费(X 开发者论坛公告)。它按量计价的好处是没有月费;坏处是贵:每千条帖子 $5,是 V2 的 12.5 倍、我们的 1,500 倍左右。近期还有两项变化:10 月 2 日起,新账号首次买额度可得 $20 赠送,开自动充值再送最多 $50;10 月 13 日更新为只加卡、不买额度不再给 $20,赠送额度 3 个月后过期(免费额度说明)。
X API 的限速和覆盖范围也和 scraper 不同:最近 7 天搜索每 15 分钟 450 次,全量归档搜索每秒 1 次(限速文档);全量归档搜索对按量付费账户开放(搜索文档);用户时间线最多拿最近 3,200 条。另外,5 月 4 日之后关键词搜索不再返回转发帖。X 官方 API 是 X 自己定价、条款最明确的途径,还能发帖、管理自己的账号,这两件事 scraper 都做不了。接入方式见 X API 入门和获取访问权限,X 自己还开源了一个 MCP 服务 xmcp。
速度和并发:一天能跑完多少
我们这一侧,twitter/search 每次 200 条用时 35.2 到 53.4 秒,中位数 39.3 秒;user_posts 200 条约 33 秒;comments 50 条 14 到 23 秒,中位数 19.8 秒。按同步请求算,一个进程一分钟大约能拿 300 条推文。我们这次用的测试 Key 每分钟限 10 次请求,正式账户的限速见控制台。V2 的页面写的是每秒 30 到 80 条,也就是每分钟 1,800 到 4,800 条,单次大批量更快;Apify 的平台限制文档规定了每个账户能同时跑多少个 actor 和多少内存。如果你一次要拿几十万条,Apify 上一个大运行会比我们串行调用快;如果是每天定时拿几千条,两边都在几分钟内完成。
Twitter scraper API:在代码、自动化和 AI 客户端里怎么调
下面这段 Python 是我们实测用的思路:先 user_posts 拿最近 200 条,再用 from: 加 until: 往前翻,按帖子 ID 去重,直到拿够 1,000 条。每次请求都把 charged_usd 加起来,空结果自动是 0。
import os, requests

API = "https://api.everyinfra.com/api/v1/social"
HEADERS = {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}

def call(action, **params):
    r = requests.post(API, headers=HEADERS, timeout=120,
                      json={"platform": "twitter", "action": action, "params": params})
    r.raise_for_status()
    body = r.json()
    return body["results"], body["billing"]["charged_usd"]

seen, spent = {}, 0.0
rows, cost = call("user_posts", username="NASA", limit=200)
spent += cost
seen.update({p["id"]: p for p in rows})

windows = ["until:2026-09-08", "until:2026-08-01", "since:2025-07-01 until:2026-01-01"]
for w in windows:
    if len(seen) >= 1000:
        break
    rows, cost = call("search", keyword=f"from:NASA {w}", limit=200)
    spent += cost
    seen.update({p["id"]: p for p in rows if p["author_username"] == "NASA"})

print(len(seen), "unique posts, spent", round(spent, 6), "USD")
在 AI 客户端里用,就接我们的远程 MCP 服务 https://api.everyinfra.com/mcp,工具名以 everyinfra_ 开头,模型可以自己决定调 twitter/search 还是 twitter/comments。下面是一份通用的配置示例,Claude Code、Cursor 等支持远程 MCP 的客户端格式相近,具体写法以各客户端文档为准(Claude Code 的 MCP 文档、OpenAI 的 MCP 文档,协议本身见 MCP 规范)。
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
Apify 也有自己的 MCP 服务,能把 Store 里的 actor 当工具给模型用(Apify MCP 文档,源码在 GitHub)。两者的区别在于:Apify 的 MCP 是让模型去启动一个 actor 运行,等它跑完再读数据集,适合大批量;我们的 MCP 每次调用直接回数据,适合对话里边问边查。MCP 服务的说明和支持的客户端列表见 MCP 服务页。
从 Apify 换过来:参数怎么对
如果你已经在 Apify 上用 V2 或回复 scraper,下表是输入参数的对应关系。Apify 一侧的参数名来自它们公开元数据里的示例输入和 Store 页面;输出字段两边不同,不能直接替换,需要按我们的 response_fields 重新映射。
| 想做的事 | Apify 一侧的输入 | EveryInfra 的写法 | 备注 |
|---|---|---|---|
| 关键词搜索 | V2 searchTerms + maxItems | twitter/search 的 keyword + limit(最多 200) | 每次一个关键词;要更多就用日期切片 |
| 排序 | V2 sort: Latest / Top / Latest + Top | sort: latest 或默认热门 | 两种排序 200 条里实测重合 137 条 |
| 语言过滤 | V2 tweetLanguage | 在 keyword 里写 lang:es | 例:inteligencia artificial lang:es |
| 某账号的帖子 | V2 twitterHandles 或 from: | twitter/user_posts 的 username,更早的用 from: 搜索 | user_posts 一次最多 200 条 |
| 一个帖子的回复 | 回复 scraper tweetIds 或网址 | twitter/comments 的 id(只填数字) | 每帖最多 50 条;填网址会 0 条退款 |
| 单条帖子 | Unlimited 单条网址($0.05) | twitter/post | 一次 $0.000556 |
| 粉丝列表 | apidojo 用户 scraper 的 follower 事件 | twitter/followers_list,一次最多 2,000 | 单价 $0.000556 |
我们的 Twitter 爬虫 API 一共有 21 项能力,目录里全部可用,除了上面三项,还有账号资料、粉丝和关注列表、转发者、社区帖子、视频转写等。每项的参数、返回字段和单价,可以免费读目录 GET https://api.everyinfra.com/api/v1/social/catalog?platform=twitter(目录接口),不需要 Key。
我们怎么核对这些数
正文、表、图里的每一个 EveryInfra 数字,都由脚本从 52 个原始响应重新算出:条数取 results 的长度,去重按帖子 id,实扣取 billing.charged_usd,时间取发出请求时的本机时钟,按新加坡时间记录。Apify 的单价、用户数、运行统计都从同一时刻(00:14 到 00:16 新加坡时间)读取的公开元数据里取;Store 页的价格说明另外截了图。分界点和月账单都是把上述两类数代进公式,没有用任何第三类数。没核完的有三项:老热帖只回约 20 条的确切根因(实测三写了从原始响应看到的规律);xquik 的平台用量具体多少;feedminer 的关键词搜索走 X 社区的说法,我们没法从外部验证。
什么时候 Apify 更合适
我们照实写 Apify 做得更好、或者我们没有的地方。第一,单个帖子要上千条回复:我们每帖最多 50 条,Apify 回复 scraper 能自动翻页,单帖 1,000 条约 $0.40。第二,每次只要 1 到 3 条:按条计费的 xquik、feedminer 比我们便宜,分界点在每次 3.71 条和 4.63 条。第三,一次要几十万条、越快越好:V2 页面写的是每秒 30 到 80 条,Apify 一个大运行可以并行跑完,我们是一页一页同步拿。第四,需要定时、存储、Webhook 一站式:Apify 有定时任务、数据集和 Webhook,跑完直接推到 Google Sheets 或你的服务器;我们只回数据,定时和存储要你自己做。第五,需要作者简介和发帖客户端:Apify 回复 scraper 页面写了这两项,我们这三个能力没有。第六,需要精确的日期窗口:我们实测按天切片时,200 条里只有 48 到 85 条落在窗口内;V2 也提醒 until 会让结果变少,但它有专门的日期参数,你可以自己验证哪边更准。
X 条款、登录墙和法律边界
X 的服务条款(2026 年 10 月 9 日生效)写着,未经事先书面同意,以任何形式、为任何目的爬取或抓取服务都被明确禁止(X 服务条款)。开发者协议对通过 API 拿到的数据另有使用限制(Developer Terms)。这些条款约束的是使用 X 服务的人,对你自己的项目意味着什么,要问你的律师;本文不提供法律意见。
相关的公开记录有 X 诉 Bright Data 案(案卷)、hiQ 诉 LinkedIn 案(判决书),以及欧盟委员会依据《数字服务法》对 X 的处罚和整改(欧盟新闻稿、整改计划),可以自己读原文。
登录墙是另一回事。apidojo 回复 scraper 的页面写着「no login, no proxy」,V2 页面写着它返回的就是 X 搜索页展示的内容,X 随时可能改变搜索、翻页和过滤方式;我们这一侧调用时也不需要你提供 X 账号。这次 52 次真调里,没有一次返回「需要登录」类的错误。这次 Twitter 的请求全部是 HTTP 200,没有出现登录墙挡住、0 条退款的情况。
最近的变化
- 价格变得很勤:我们读的 14 个 Twitter scraper 里,有 10 个的当前价格是 8 月中旬以后才开始生效的(公开元数据里每段价格都带
startedAt),比如 xquik 推文 scraper 从 8 月 29 日起、scraper_one 三个 scraper 从 8 月 30 日、31 日起。对你意味着:任何一篇比价文章(包括本文)里的 Apify 单价,过两三个月就可能不准,下单前要重新读公开元数据,并记下读取时间。 - 2026-10-13:X API 免费额度规则更新,只加卡、不买额度不再赠送 $20(免费额度说明)。对你意味着:想用赠送额度试 X API,要先真付一笔钱。
- 2026-10-09:X 新版服务条款生效(X 服务条款)。对你意味着:条款里关于爬取的那一段,以现行版本为准,旧文章里引用的条款原文可能已经过时。
- 2026-10-02:X API 推出按量付费账户的首充赠送,最多 $70,3 个月过期(X API changelog)。对你意味着:拿赠送额度试用要在 3 个月内用完。
- 2026-09-24:danek 的 Twitter Scraper 当前价格开始生效,含每次启动按内存收费的事件(danek 公开元数据)。对你意味着:它的账单除了按条收费,还要加上启动次数乘内存费,小批量跑得越频繁越贵。
- 9 月下旬:feedminer 页面写明 X 开始拒绝它对搜索索引的请求,不带
from:的关键词改从 X 社区读取(feedminer Store 页)。对你意味着:拿它做关键词监测,结果范围和 X 搜索页不一样,拿某个账号的帖子不受影响。 - 2026-08-14:X 宣布旧 Pro 套餐转按量计费。对你意味着:网上按 $200 一个月给 15,000 条算 X API 成本的旧教程已经不适用。
上手:从一次试用到每天自动跑
在 GitHub 给 everyinfra/everyinfra-agent-plugins 和 everyinfra/seo-skills 两个仓库都点星,可以在控制台领 $1 试用额度,24 小时内有效,够把本文的 52 次请求跑 30 多遍。步骤是:在快速上手拿 Key;在 Twitter 爬虫 API 页面看全部能力,分别打开 Twitter 搜索爬虫 API、Twitter 用户帖子爬虫 API、Twitter 回复爬虫 API 的试用台各跑一次;需要账号资料的,再看 Twitter 账号资料爬虫 API;同样的做法还能用在 Reddit 爬虫 API 和 Bluesky 爬虫 API;全部能力和单价在数据市场和价格页。
同样按「每千条实测价」比 Apify 的,还有 Apify TikTok Scraper 替代和 Apify Instagram Scraper 替代。要让模型稳定地按字段调数据接口的,看 Claude 严格工具调用接数据接口。
常见问题
Apify Twitter scraper 免费吗?
出处:搜索联想词「apify twitter scraper free」,2026-11-03 读取。Apify 的 Free 套餐每月给 $5 平台额度,但 Tweet Scraper V2 和 apidojo 回复 scraper 的页面都写了:免费用户每月只能跑 5 次、每次最多 10 条,V2 还写明免费用户不能通过 API 调用。所以「免费」只够看输出格式。我们这一侧,点星领 $1 试用额度,24 小时内有效,按实测一次 200 条算,能拿 30 多万条推文;之后按请求付费,没有月费。
Apify tweet scraper pricing 是多少,为什么有人说每千条 $0.004?
出处:常见搜索词「apify tweet scraper pricing」,以及 Reddit r/n8n 帖子(原帖)。V2 是每条 $0.0004,也就是每千条 $0.40;r/n8n 那篇帖子写成了每千条 $0.004,少了两位小数,按公开元数据应以 $0.40 为准。另一篇 r/n8n 教程把它和 X API 比较,写的是「每千条 40 美分,X 要 $200 才给 15,000 条」,那是旧 Basic 套餐的价格,X 现在已改成按量计费、每千条 $5(原帖)。
Apify twitter comments scraper 能拿一条帖子的全部回复吗?
出处:搜索联想词「apify twitter comments scraper」,2026-11-03 读取。apidojo 回复 scraper 的页面写的是自动翻页,拿得少时可以开 useSearch 用 conversation_id: 搜索补齐,但也写了已删除、受保护的帖子不支持。我们的 twitter/comments 每帖最多 50 条,拿不到全部;如果你要从一个帖子拿上千条回复,用 Apify 更合适。
抓取 Twitter 合法吗,X 允许爬取吗?
出处:搜索联想词「does twitter allow scraping」「is it legal to scrape twitter」,2026-11-03 读取。X 2026 年 10 月 9 日生效的服务条款明确禁止未经书面同意的爬取,美国法院在 X 诉 Bright Data、hiQ 诉 LinkedIn 两案中对抓取公开数据的态度,欧盟对 X 条款的处罚,正文都列了原文链接。是否合法取决于你所在的司法辖区、抓什么、怎么用,请咨询律师;本文不提供法律意见。
最便宜的推特爬虫 / Twitter scraper API 是哪个?
出处:搜索联想词「twitter scraper api cheapest」,2026-11-03 读取。按每千条公开单价,Apify Store 里近 30 天用户不少于 100 个的 Twitter scraper 中,推文类最便宜的是 xquik($0.15,平台用量另计)、scrape.badger(Free 档 $0.15、Business 档 $0.12)和 feedminer($0.12,关键词搜索有限制);Store 里最低的一个是 $0.01,但只有 8 个用户。我们按请求收费,每次 200 条时每千条 $0.00278,去重后 $0.00327;每次只回 3 条以下时,按条计费的会更便宜。
Apify x scraper 和 X 自己的 API 怎么选?
出处:常见搜索词「apify x scraper」,以及 r/n8n 教程里拿两者比价的讨论(原帖)。X API 每千条帖子 $5,每月上限 300 万条,它是 X 自己定价、条款最明确的途径,还能发帖和管理自己的账号;按本文的实测和公开单价,Apify Store 里常用的 scraper 每千条 $0.12 到 $0.40,我们每千条 $0.003 到 $0.014,都比它便宜十几到上千倍。X 条款对抓取有限制,涉及你项目的,问律师。要做自己账号的运营,用 X API;要大量读公开讨论,两类工具里按价格和条数选。
参考资料
- Apify / apidojo:Tweet Scraper V2 - X Scraper / Twitter Scraper / X.com Scraper(Store 页),2026-11-03 读取。
- Apify API:apidojo~tweet-scraper 公开元数据(pricingInfos、stats),2026-11-03 读取。
- Apify / apidojo:Twitter (X.com) Scraper Unlimited: No Limits(Store 页),2026-11-03 读取。
- Apify API:apidojo~twitter-scraper-lite 公开元数据,2026-11-03 读取。
- Apify / apidojo:Twitter (X) Replies Scraper API(Store 页),2026-11-03 读取。
- Apify API:apidojo~twitter-replies-scraper 公开元数据,2026-11-03 读取。
- Apify / kaitoeasyapi:Cheapest Twitter Scraper / RealTime Twitter Data Scraper API(Store 页),2026-11-03 读取。
- Apify API:kaitoeasyapi 推文 scraper 公开元数据,2026-11-03 读取。
- Apify / xquik:Twitter Scraper & X Scraper for Tweets & Search(Store 页),2026-11-03 读取。
- Apify API:xquik~x-tweet-scraper 公开元数据,2026-11-03 读取。
- Apify / xquik:X Reply Scraper(Store 页),2026-11-03 读取。
- Apify API:xquik~x-reply-scraper 公开元数据,2026-11-03 读取。
- Apify / feedminer:X (Twitter) Tweet Scraper $0.12/1K(Store 页),2026-11-03 读取。
- Apify API:feedminer~x-tweet-scraper 公开元数据,2026-11-03 读取。
- Apify / scraper_one:X (Twitter) Profile Posts Scraper(Store 页),2026-11-03 读取。
- Apify API:scraper_one~x-profile-posts-scraper 公开元数据,2026-11-03 读取。
- Apify API:scraper_one~x-post-replies-scraper 公开元数据,2026-11-03 读取。
- Apify API:Store 搜索接口 /v2/store?search=twitter,2026-11-03 读取。
- Apify Docs:Get list of Actors in Store(接口文档),2026-11-03 读取。
- Apify:Apify pricing,2026-11-03 读取。
- Apify Docs:Actors in Store,2026-11-03 读取。
- Apify Docs:Actor pricing and costs,2026-11-03 读取。
- Apify Docs:Usage and resources,2026-11-03 读取。
- Apify Docs:Limits,2026-11-03 读取。
- Apify Docs:Apify MCP server,2026-11-03 读取。
- GitHub:apify/apify-mcp-server,2026-11-03 读取。
- Apify Docs:Schedules,2026-11-03 读取。
- Apify Docs:Webhooks,2026-11-03 读取。
- GitHub / igorbrigadir:twitter-advanced-search(搜索语法整理),2026-11-03 读取。
- X Developer Platform:X API pay-per-usage pricing and credits,2026-11-03 读取。
- X Developer Platform:Usage and Billing(每月 300 万条上限、日内去重),2026-11-03 读取。
- X Developer Platform:Search Posts,2026-11-03 读取。
- X Developer Platform:Timelines(最近 3,200 条),2026-11-03 读取。
- X Developer Platform:X API Rate Limits,2026-11-03 读取。
- X Developer Platform:Free credit incentives for X API pay-per-use accounts(2026-10-13 更新),2026-10-13。
- X Developer Platform:X API changelog,2026-10-29。
- X Developers 论坛:Important Update: Legacy X API Pro Plans Are Moving to Pay-Per-Use,2026-08-14。
- X Corp.:X Terms of Service(2026-10-09 生效),2026-10-09。
- X Developer Platform:Developer Terms,2026-11-03 读取。
- GitHub / X:xdevplatform/xmcp,2026-11-03 读取。
- European Commission:Commission fines X €120 million under the Digital Services Act,2025-12-05。
- European Commission:Commission accepts X's action plan to comply with Digital Services Act,2026-07-16。
- European Commission:Press release IP/25/2934,2025-12-05。
- EUR-Lex:Regulation (EU) 2022/2065 (Digital Services Act),2022-10-19。
- CourtListener:X Corp. v. Bright Data Ltd., 3:23-cv-03698(案卷),2024-05-09。
- U.S. Court of Appeals for the Ninth Circuit:hiQ Labs v. LinkedIn, No. 17-16783(第九巡回法院判决),2022-04-18。
- Model Context Protocol:Model Context Protocol Specification 2025-11-25,2025-11-25。
- Anthropic:Connect Claude Code to tools via MCP,2026-11-03 读取。
- OpenAI:Connectors and MCP servers,2026-11-03 读取。
- Reddit r/n8n:How to easily scrape data from Twitter / X using Apify,2026-11-03 读取。
- Reddit r/n8n:This Automation Took Me From 0 to 175k Followers in Under 12 Months,2026-11-03 读取。
- EveryInfra:EveryInfra 能力目录(免费,无需 Key),2026-11-03 00:16 读取。
- GitHub / Xquik:Xquik-dev/x-twitter-scraper(README:平台用量另计),2026-11-03 读取。
- Apify Docs:Pay per event,2026-11-03 读取。
- X Developer Platform:Getting Access,2026-11-03 读取。
- X Developer Platform:About the X API,2026-11-03 读取。
- X Developer Platform:Build a query(搜索查询语法),2026-11-03 读取。
- Apify Docs:Get Actor(接口文档),2026-11-03 读取。
- Apify API:danek~twitter-scraper 公开元数据,2026-11-03 读取。
引用编号 BL-75