Gemini Deep Research APIとリモートMCPサーバーで、検証できるソーシャルデータを使う
Gemini Deep Research APIはリモートMCPサーバーに対応していますが、カスタム関数は使えません。ソーシャルデータのライブ呼び出し7回で$0.0046。設定、料金、引用の確認方法を解説します。
結論から言うと、可能です。Gemini Deep Research APIは現時点でリモートMCPサーバーを呼び出せます。カスタム関数の宣言は受け付けず、構造化出力にも対応していません。この3点はいずれも、GoogleのDeep Researchページの「Limitations」セクションに記載されています(Deep Researchドキュメント、2026-10-13更新)。そのため、EveryInfraのリモートMCPサーバーhttps://api.everyinfra.com/mcpを指定できます。
2026-11-02の00:16〜00:20 SGTには、当社のソーシャル・ニュースデータAPIを実際に7回呼び出しました。合計131件が返り、費用は$0.0046でした。データからわかったのは、検証できる引用の弱点はモデルにはなく、データそのものにあるということです。英語ニュースの日付は0〜1日遅れており、スペイン語ニュースは10件すべてで日付が空でした。YouTubeのコメント50件にはリンクが1件もなく、Redditのコメント35件にはすべてパーマリンクがありました。
この記事では、実務上の疑問に1つ答えます。Gemini Deep Researchに、公開されているトピックについてのレポートを書かせたいとします。さらに、そのレポート内のソーシャルメディアに関する主張すべてを、読者が開いて確認できるデータ行に紐づけたいとします。これを実現するには、構造化されたソーシャルデータをどのようにエージェントに渡せばよいでしょうか。
テストのトピックには、ニューヨーク市の電動自転車バッテリー火災を選びました。2026-10-28にブロンクスのアパートで起きた火災で男の子が亡くなり、その後さらに3人が亡くなりました。数日のうちに英語とスペイン語のニュース、Redditのスレッド、YouTube動画が出そろったため、4種類のソースを試すのに適しています。
本記事のGoogleに関する事実はすべて、ai.google.dev、Google Cloudのドキュメント、Googleブログのページに基づいています。GeminiのAPIキーは保有しておらず、Deep Researchも実行していません。以下のGeminiのコードはすべて設定例であり、テスト結果ではありません。EveryInfraの数値はすべて、実際に行った呼び出しの生レスポンスに基づいています。
Gemini Deep Research APIはリモートMCPサーバーに接続できますか?
はい。Deep Researchのページには5種類のツールが記載されています。そのうちgoogle_search、url_context、code_executionの3つはデフォルトで有効です。残りのmcp_serverとfile_searchの2つは追加する必要があります(Deep Researchドキュメント「Supported tools」)。この機能は、新しいDeep Researchエージェントとともに2026-04-21にリリースされました。変更履歴のエントリには、共同での計画立案、可視化、MCPサーバー統合、File Searchが挙げられています(Gemini API変更履歴)。
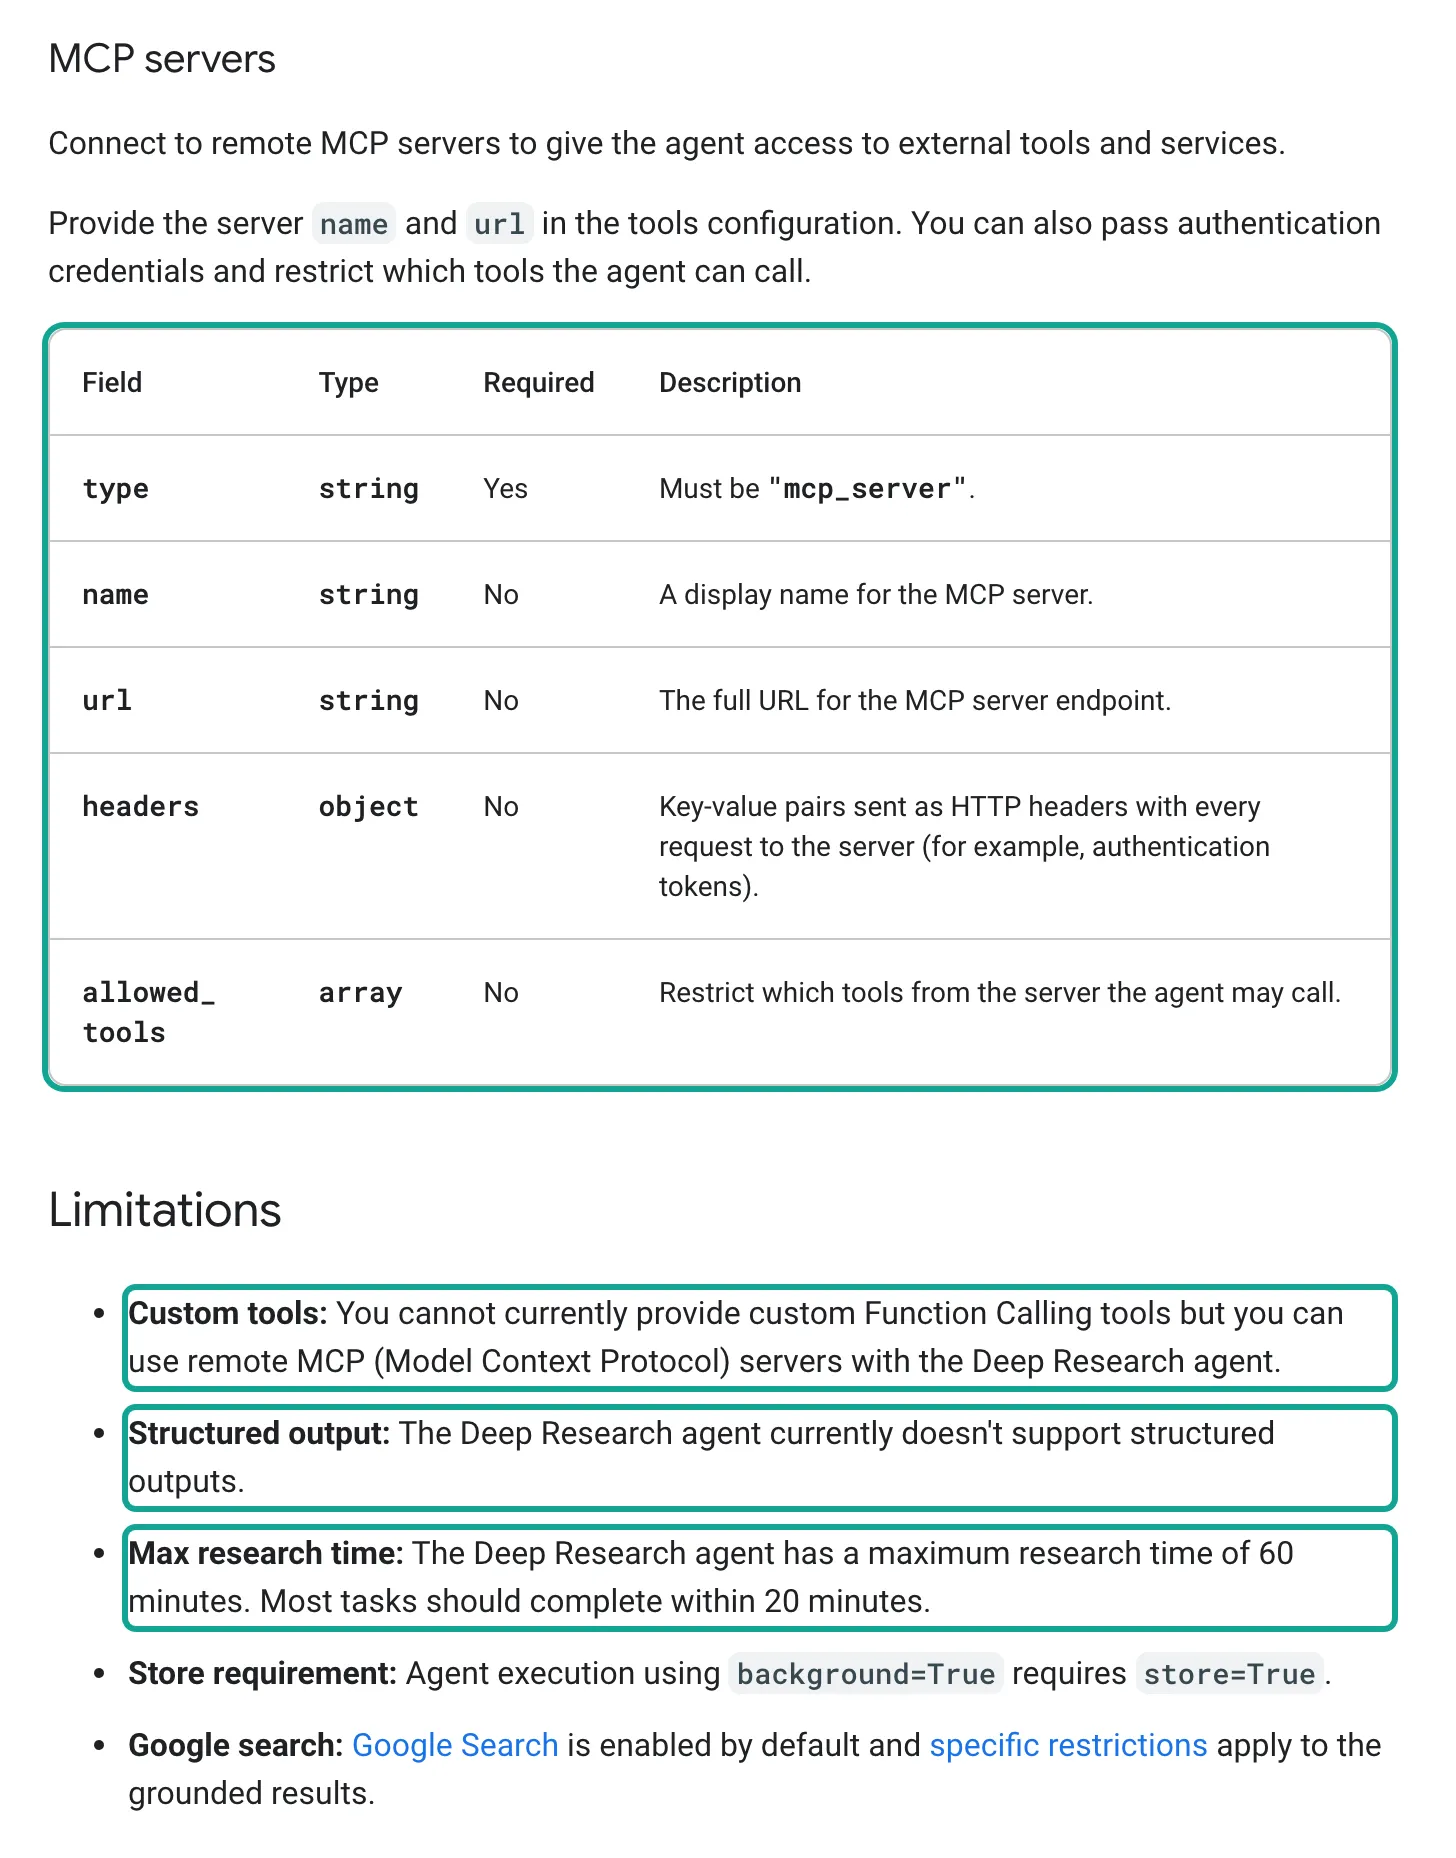
mcp_serverツールには5つのフィールドがあります。typeは必須で、値は"mcp_server"でなければなりません。nameは表示名、urlはMCPエンドポイントの完全なURLです。headersにはすべてのリクエストに付与されるHTTPヘッダーを指定し、ドキュメントでは認証トークンが例として挙げられています。allowed_toolsは、そのサーバー上のツールのうちエージェントが呼び出せるものを制限します。
カスタム関数は事情が異なります。同じページの1つ目の制限事項には、現在Deep ResearchにカスタムのFunction Callingツールを渡すことはできないと書かれています。代わりにリモートMCPサーバーを使えるとも付け加えられています。2つ目の制限事項は、構造化出力に対応していないことです。3つ目はリサーチ時間の上限が60分であることで、ほとんどのタスクは20分以内に完了するはずだとされています。
Googleのページには、読者を混乱させかねない記述がほかに2つあります。Deep Research MaxについてのGoogleブログ記事には、Deep Researchは「任意のツール定義に対応している」("supports arbitrary tool definitions")と書かれています(Googleブログ、2026-04-21)。ドキュメントと照らし合わせると、これはリクエスト内の関数宣言ではなく、MCP経由で公開されるツールを指しています。また、Interactions APIの概要ページには、Gemini 3はまだリモートMCPに対応していないとも書かれています(Interactions API概要、2026-10-15更新)。この注記はmodelパラメータで呼び出すモデルについてのものです。Deep Researchはagentパラメータで呼び出すエージェントなので、この注記は当てはまりません。
| 質問 | Googleドキュメントでの回答 | 出典と日付 |
|---|---|---|
| リモートMCPサーバーへの対応は? | 対応。headersとallowed_toolsを持つツールタイプmcp_server | Deep Researchのドキュメント、2026-10-13 |
| カスタム関数への対応は? | 現時点では非対応 | 同ページの「Limitations」セクション |
| 構造化されたJSON出力への対応は? | 不要 | 同ページの「Limitations」セクション |
| 最大実行時間は? | 60分(大半は20分以内) | 同ページの「Limitations」セクション |
| バックグラウンドモードは必須? | 必須。background=trueとstore=trueを併用 | 同ページ、バックグラウンド実行のドキュメント |
| コンテキストと出力の上限 | 入力1,048,576トークン、出力65,536トークン | モデルページ、2026-10-29 |
| エージェント名 | deep-research-preview-04-2026、deep-research-max-preview-04-2026 | モデルページ、変更履歴 |
つまり、今回のプランのルートはどちらも機能しますが、処理の順序が変わります。ルートAでは、当社のMCP URLをtoolsに指定します。するとエージェントは実行中、Redditを検索するタイミングやニュースを取得するタイミングを自ら判断します。ルートBでは、まずプログラムからPOST /api/v1/socialを呼び出します。結果を表にまとめ、その表を入力として、またはFile Searchのドキュメントとしてエージェントに渡します。
ルートBは必須ではありませんが、検証可能な引用を得るにはより安全な方法です。その理由はGeminiではなく、データ側にあります。
Gemini Deep Research APIの呼び出しの仕組み:バックグラウンドモード、ポーリング、ストリーミング
Deep ResearchはInteractions API経由でのみ実行でき、従来のgenerateContentメソッドでは実行できません。Interactions APIは2025-12-11に公開され、2026年6月に一般提供が開始されました。Googleは現在、これを新規プロジェクトのデフォルトのインターフェースと位置づけています(Interactions API概要)。
Deep Researchの呼び出しは、通常のモデル呼び出しと3つの点で異なります。modelではなくagentパラメータを使います。background=trueの指定が必須で、APIはidを含む部分的なオブジェクトを即座に返します。その後、そのidでポーリングするか、ストリームを開きます。
以下のブロックは、ドキュメントのREST例に沿ったものです。当社では実行していない設定例です。
# Configuration example: start Deep Research with the EveryInfra remote MCP server (not run by us)
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "Content-Type: application/json" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -d '{
    "agent": "deep-research-preview-04-2026",
    "input": "Research how e-bike battery fires in New York City were discussed in news, Reddit and YouTube in October 2026. For every claim about social media, quote the row id and url from the EveryInfra tool result. If a date is approximate, say so.",
    "tools": [
      {"type": "google_search"},
      {"type": "url_context"},
      {"type": "mcp_server",
       "name": "EveryInfra",
       "url": "https://api.everyinfra.com/mcp",
       "headers": {"Authorization": "Bearer '"$EVERYINFRA_API_KEY"'"},
       "allowed_tools": ["everyinfra_list_capabilities", "everyinfra_call_api", "everyinfra_get_job"]}
    ],
    "agent_config": {"type": "deep-research", "thinking_summaries": "auto"},
    "background": true
  }'

# Poll (replace INTERACTION_ID with the id from the first response)
curl "https://generativelanguage.googleapis.com/v1beta/interactions/INTERACTION_ID" \
-H "x-goog-api-key: $GEMINI_API_KEY"バックグラウンドのインタラクションには、in_progress、requires_action、completed、failed、cancelledの5つの状態があります(バックグラウンド実行のドキュメント)。background=trueにはstore=trueが必要で、バックグラウンドモードでstore=falseを指定すると400エラーが返ります。保存されたインタラクションは、有料ティアでは55日間、無料ティアでは1日保持されます。有料プロジェクトでは、AI Studioでこの期間を7日、14日、28日に変更できます。これはデータの扱いに関わります。headersに含めたEveryInfraのキーはインタラクションに表示されませんが、エージェントが取得したソーシャルデータの行はすべてステップとして保存されます。
ストリーミングにはstream=trueとbackground=trueの両方が必要です。実行中に思考の要約を確認するには、agent_config.thinking_summariesも"auto"に設定します。ドキュメントの例では、接続の切断に対応しています。interaction_idと最後のevent_idを保存しておき、切断後にGET /interactions/{id}?stream=true&last_event_id=...を呼び出して再開します。ドキュメントでは切断の原因の1つとして600秒のタイムアウトが挙げられているため、長時間の実行ではこの再接続ロジックが欠かせません。
| `agent_config`フィールド | デフォルト | 内容 | ここでのポイント |
|---|---|---|---|
type | 必須、"deep-research" | Deep Researchの呼び出しであることを示す | — |
thinking_summaries | "none" | "auto"でストリームに各ステップを表示 | エージェントがMCPを呼び出すタイミングを確認できる |
visualization | "auto" | グラフを使用可能にする。ただし描画するのはプロンプトで指示した場合のみ | プロンプトでグラフを指示する |
collaborative_planning | false | 最初にプランを返す。previous_interaction_idで編集し、最後のターンでfalseに設定する。設定を切り替えずに「問題ありません」のように返信しても、レポートは生成されない(Philipp Schmid, 2026-04-29) | プランの段階で機能を絞り込む |
Gemini Deep Research APIの料金:1タスクあたり$1〜$3、Maxは$3〜$7
GoogleはDeep Research単体の料金を設定していません。モデルの推論とツールの使用に対して個別に支払います(料金ページ「Pricing for agents」、2026-10-30更新)。推論はすべてGeminiの標準料金で課金され、エージェントループ内の中間トークンも対象です。ツールはそれぞれの料金で課金されます。Google検索の結果はトークンとしてカウントされませんが、URL ContextとFile Searchのコンテンツはカウントされます。
Deep Researchのページには費用の目安が記載されています(Deep Researchドキュメント「Estimated costs」)。中程度の分析を行う標準タスクでは、検索が約80回、入力トークンが約250,000(うち50%〜70%がキャッシュ)、出力トークンが約60,000で、合計は約$1〜$3です。詳細な競合分析を行うMaxタスクでは、最大で検索が約160回、入力トークンが約900,000、出力トークンが約80,000となり、目安は約$3〜$7です。
料金ページにはGoogle検索の料金も掲載されています。Gemini 3以降のモデルは、月5,000回の無料検索枠を共有します。それを超えると1,000回あたり$14がかかり、各プロジェクトにはデフォルトで1日1,500回の上限があります。Deep Research内の検索がこの料金で課金されるのか、1日の上限にカウントされるのかは、ドキュメントに記載されていません。カウントされる場合、1件あたり80回の検索とすると、上限内で作成できるレポートは1日約18件です。当社ではDeep Researchを実行していないため、ご自身の請求でusageを確認してください。
支出上限は見落としがちです。レート制限のページによると、Gemini APIでは10分間のローリングウィンドウで支出も制限されます。上限はTier 1で$10、Tier 2で$50、Tier 3で$200です。上限を超えたプロジェクトには429 RESOURCE_EXHAUSTEDが返されます(レート制限、2026-10-28更新)。1タスク$3の場合、Tier 1のプロジェクトでは10分間に3〜4タスクで上限に達する可能性があります。
有料ティアを利用するには、最初に手続きが必要です。請求ページによると、無料ティアから有料ティアに移行するには請求先アカウントをリンクします。新規アカウントはデフォルトでプリペイドプランとなり、最低チャージ額は$5です(請求ドキュメント)。プリペイド残高がなくなると、リクエストは失敗します。定期的にレポートを実行するプロジェクトでは、十分な残高を維持するか、自動チャージを有効にしてください。
大量のレポートを作成するチームは、Google Cloudも検討するとよいでしょう。Google CloudのDeep Researchページでは、stream=falseの場合に使えるservice_tier="deferred"オプションが説明されています。このオプションはバックグラウンドタスクをオフピークの時間帯に回し、料金は半額になります(Google Cloud Deep Researchドキュメント)。
| 費用項目 | 料金(2026-11-02時点) | Deep Researchタスク1件での使用量 |
|---|---|---|
| モデルの推論 | Geminiの標準料金(中間トークンを含む) | 入力約250k、出力約60k(Maxは900k、80k) |
| Google検索 | 月5,000回まで無料、以降1,000回あたり$14、1日1,500回の上限 | 検索約80回(Maxは約160回) |
| URL Context | コンテンツは入力トークンとして課金 | 読み込むページ数による |
| File Search | インデックス作成はエンベディング1Mトークンあたり$0.15。ストレージとクエリのエンベディングは無料 | ファイルをアップロードした場合のみ |
| コード実行 | コードと結果はトークンとして課金 | エージェントが計算やグラフ作成を行う場合 |
| EveryInfraのソーシャルデータ | カタログのprice_usdを呼び出しごとに課金、失敗や空の結果は課金なし | レポート1件で23回の呼び出し、約$0.0135 |
請求額のうち、ソーシャルデータの部分はわずかです。2026-11-02時点のカタログ価格では、google_news/searchは呼び出しごとに$0.000792です。reddit/search、reddit/comments、youtube/search、youtube/commentsは呼び出しごとに$0.000556です。料金は行数にかかわらず、呼び出しごとに一律です。たとえば、あるレポートでニュース検索を3回、Reddit検索を3回、Redditスレッド10件のコメント取得、YouTube検索を2回、動画5本のコメント取得を行うとします。合計23回の呼び出しで$0.0135となり、Deep Researchタスク1件の0.45%〜1.35%に相当します。
つまり、レポートの費用を左右するのはデータ呼び出しではなくDeep Researchです。注目すべきは、データを検証できるかどうかです。
| 機能 | カタログ価格(1回あたり) | レポート1件での呼び出し回数 | 小計 |
|---|---|---|---|
google_news/search | $0.000792 | 3(英語、スペイン語、中国語) | $0.002376 |
reddit/search | $0.000556 | 3 | $0.001668 |
reddit/comments | $0.000556 | 10 | $0.005560 |
youtube/search | $0.000556 | 2 | $0.001112 |
youtube/comments | $0.000556 | 5 | $0.002780 |
| 合計 | — | 23 | $0.013496 |
所要時間:Deep Researchは数分、7回の呼び出しは77秒
Deep Researchの実行には数分かかります。ドキュメントの比較表では、通常のモデルのレイテンシは秒単位、Deep Researchのレイテンシは分単位で、非同期かつバックグラウンドで実行されると記載されています。上限は60分で、ほとんどのタスクは20分以内に完了します。
2026-03-05に、コンプライアンス調査の仕組みを構築しているフォーラムユーザーが、旧エージェントの1回の実行には約7分かかったと報告しました。その後、同様のプロンプトでの実行はin_progressのまま止まりました。ストリームには4〜5つの思考ステップが表示され、その後エラーなしで接続が切断されました(開発者フォーラムのスレッド)。ポーリングコードには、completedとfailedのハンドラだけでなく、in_progress状態に対するタイムアウト処理も必要です。
7回の呼び出しは、順番に実行して約77秒かかりました。最も遅かったのはコメントで、YouTubeコメント50件に30.1秒、Redditコメント35件に19.3秒かかりました。ニュース検索はそれぞれ3.7〜4.7秒でした。ルートAでは、エージェントは呼び出しごとに完了を待ちます。コメントの呼び出しが十数回あると、もともと何分もかかる実行がさらに数分延びます。
コメントのような時間のかかるリクエストで、エージェントを待たせるべきではありません。everyinfra_call_apiツールの説明に、エージェントがとるべき対応が書かれています。時間のかかるタスクやlimitの値が大きい場合は、mode=asyncを渡すよう指示しています。するとエージェントはすぐにjob_idを受け取り、無料のeveryinfra_get_jobで結果を取得します。
7回の同期レスポンスにはそれぞれ、非同期モードを案内するasync_hintも含まれていたため、エージェントはそれを読み取れます。ルートBでは、プログラム側で呼び出しを並列実行できます。数十回の呼び出しが1〜2分で完了し、その後すべてをまとめてDeep Researchに渡します。
引用形式:url_citation、file_citation、バイトオフセット
Deep Researchはレポート本文に脚注を入れません。引用は出力ステップのannotations配列に付与されます。Interactions APIのリファレンスには、複数のアノテーションタイプが記載されています(APIリファレンス、2026-10-28更新)。ここで重要なのはそのうち2つです。url_citationにはurl、title、start_index、end_indexの4つのフィールドがあります。file_citationにはdocument_uri、file_name、source、custom_metadata、page_number、media_idに加え、同じ2つのインデックスフィールドがあります。
リファレンスによると、インデックスはバイト単位で数え、end_indexはその位置を含みません。これは非ASCIIテキストを含むレポートで問題になります。UTF-8では、カーリークォートは3バイト、アクセント付きのスペイン語の文字は2バイトです。これらのインデックスでPythonの文字列をスライスすると、最初の特殊文字以降のすべての引用がずれます。まずテキストをバイト列にエンコードしてから、スライスしてください。以下のコードはリファレンスのフィールド名を使った設定例です。
# Configuration example: map Deep Research citations back to text spans (field names from the Interactions API reference)
def cited_spans(interaction):
    out = []
    for step in interaction["steps"]:
        if step.get("type") != "model_output":
            continue
        for block in step.get("content", []):
            if block.get("type") != "text":
                continue
            raw = block["text"].encode("utf-8")          # indexes count bytes
            for a in block.get("annotations", []):
                span = raw[a["start_index"]:a["end_index"]].decode("utf-8", "replace")
                meta = {m["key"]: m.get("string_value", m.get("numeric_value"))
                        for m in a.get("custom_metadata", [])}
                out.append({"type": a["type"], "text": span,
                            "url": a.get("url") or meta.get("source_url"),
                            "row_id": meta.get("row_id")})
return outMCPの呼び出しと結果は、さらに2つのステップタイプとして表示されます。mcp_server_tool_callにはname、server_name、arguments、idがあります。mcp_server_tool_resultにはcall_idとresultがあり、call_idで対応する呼び出しに紐づきます。MCPの結果からurl_citationエントリが生成されるかどうかは、リファレンスに記載がありません。そのためルートAでは、Redditスレッドについての文に、そのスレッドのURLが引用として付くとは想定しないでください。
より確実なのは、行のidとurlを文中に書くようエージェントに指示する方法です。実行後、それぞれを保存済みのmcp_server_tool_resultステップと照合します。File Searchを使うルートBでは、各ドキュメントに追加したcustom_metadataがfile_citationで返されます(File Searchのドキュメント「Citations」、2026-10-13更新)。独自の行IDを引用内で返す方法として、ドキュメントに記載されているのはこれだけです。
| 引用テキストの出典 | アノテーションタイプ | 返される内容 | 確認方法 |
|---|---|---|---|
| Google SearchまたはURL Contextが読み込んだページ | url_citation | URL、タイトル、バイト範囲 | URLを開いて文と照合 |
| File Search内の独自ドキュメント | file_citation | ファイル名、custom_metadata、バイト範囲 | メタデータ内の行IDで元の行を特定 |
| リモートMCPサーバーが返した行 | ドキュメントに記載なし | ステップ内の完全なmcp_server_tool_result | 本文にidとurlを書かせて照合 |
ルートA:Gemini Deep Research APIにEveryInfra MCPサーバーを渡す
ルートAは、上記のcurlの例にあるmcp_serverブロックです。3つのフィールドを詳しく見ていきます。urlはhttps://api.everyinfra.com/mcpで、2026-07-28付のMCP仕様に準拠した公開HTTPSエンドポイントです。このバージョンではinitializeハンドシェイクが廃止されました。各リクエストがそれぞれプロトコルバージョンを持ち、Streamable HTTPでは各メッセージが1回のPOSTになります(MCPの変更履歴、トランスポート)。
headersにはAuthorization: Bearer <your EveryInfra key>を指定します。EveryInfraのエンドポイントはこの形式を受け付け、Googleのドキュメントにある例も同じ形式です。MCP仕様では認証は任意で、OAuth 2.1トークンも同じヘッダーに入れます(MCPの認可)。仕様全体はMCP 2026-07-28の目次から確認でき、サーバー、クライアント、トランスポートの各セクションがあります。
最も注意が必要なのはallowed_toolsです。2026-11-02 00:15 SGTに、APIキーなしでtools/listを呼び出しました。返された12個のツールを含むレスポンスは16,247バイトでした。
調査に関係するのはそのうち3つだけです。everyinfra_list_capabilitiesはプラットフォームと機能の一覧を返し、everyinfra_call_apiはあらゆるデータ機能を呼び出し、everyinfra_get_jobは非同期の結果を取得します。残りの9つは、Web検索ツール1つとアカウント管理用のツールです。調査タスクにはこれらは不要です。
無人で動く調査エージェントにとって、これら9つのツールは何の役にも立ちません。第一に、ツール定義はコンテキストを消費します。12個すべての定義で約16,610バイト、調査用の3つのツールは3,309バイトで、約80%少なくなります。第二に、everyinfra_call_apiは費用が発生するため、destructiveHintがtrueに設定されています。誰も見ていないバックグラウンドタスクから、アカウント関連のアクションを実行するべきではありません。
MCP仕様のツールセクションには警告もあります。信頼できるサーバーから提供されたものでない限り、クライアントはツールのアノテーションを信頼できないものとして扱わなければなりません(MCPツール仕様)。したがって、Deep ResearchがdestructiveHintを見て慎重になるとは期待しないでください。確実に使える制御手段は、allowed_toolsに自分で記述する許可リストです。
| ツール | 定義サイズ(バイト) | 調査で使用 | 理由 |
|---|---|---|---|
everyinfra_list_capabilities | 816 | 可能 | 無料。先に名前とパラメータを確認 |
everyinfra_call_api | 1,695 | 可能 | データを取得。呼び出しごとに課金、失敗時は課金なし |
everyinfra_get_job | 798 | 可能 | 無料。非同期の結果を取得 |
everyinfra_search | 2,632 | 不要 | Web検索はGoogle Searchでカバー済み |


プロンプトはツールと連携させる必要があります。Deep Researchページのベストプラクティスのセクションでは、データがない場合の対応をエージェントに指示することが推奨されています。例えば、数値を推測せず、不明であると書くよう指示します。
ソーシャルデータを扱う場合、プロンプトには少なくとも3つのことを書いておく必要があります。第1に、ソーシャルプラットフォームに関する各主張には、根拠となる件のidとurlを付けます。第2に、正確でない日付には、エージェントが「約」と書きます。第3に、エージェントは新しい機能を使う前に毎回everyinfra_list_capabilitiesを呼び出し、パラメータを推測しません。
3つ目のルールには理由があります。EveryInfraは、不明なパラメータや無効な値に対して422を返します。エラーには許可される値と修正案が含まれ、課金は発生しません。エラーを読んだエージェントは自分で呼び出しを修正でき、次のセクションに実例があります。エラー処理の詳細はAPIエラーと自己修復をご覧ください。他のクライアントでのMCPのセットアップについては、リモートMCPのセットアップとMCPサーバーのページをご覧ください。
実際の1往復:エージェントが送る内容と返ってくる内容
Deep Researchは実行していません。ただし、クライアントがサーバーに送るリクエストの形式はMCP仕様で定められています。ツールのnameとargumentsを含むJSON-RPCのtools/callです。同じJSON-RPC形式のリクエストを、テストキーを使って当社のMCPエンドポイントに送信しました。
ここで示すのはサーバー側のみ、つまりサーバーが何を受け取り、何を返すかです。Deep Research側はテストしていません。どのツールを選び、引数をどう埋めるかはわかりません。また、行をどう読み取るか、それを引用に変換するかどうかもわかりません。確認するには、ご自身でタスクを1つ実行し、mcp_server_tool_callとmcp_server_tool_resultを読んでください。
2026-11-02 00:16:51 SGTに、platform=reddit、action=searchでeveryinfra_call_apiを呼び出しました。クエリはe-bike battery fireで、sort=relevance、limit=10を指定しました。レスポンスは6.0秒で返り、ステータスは200、countは6でした。
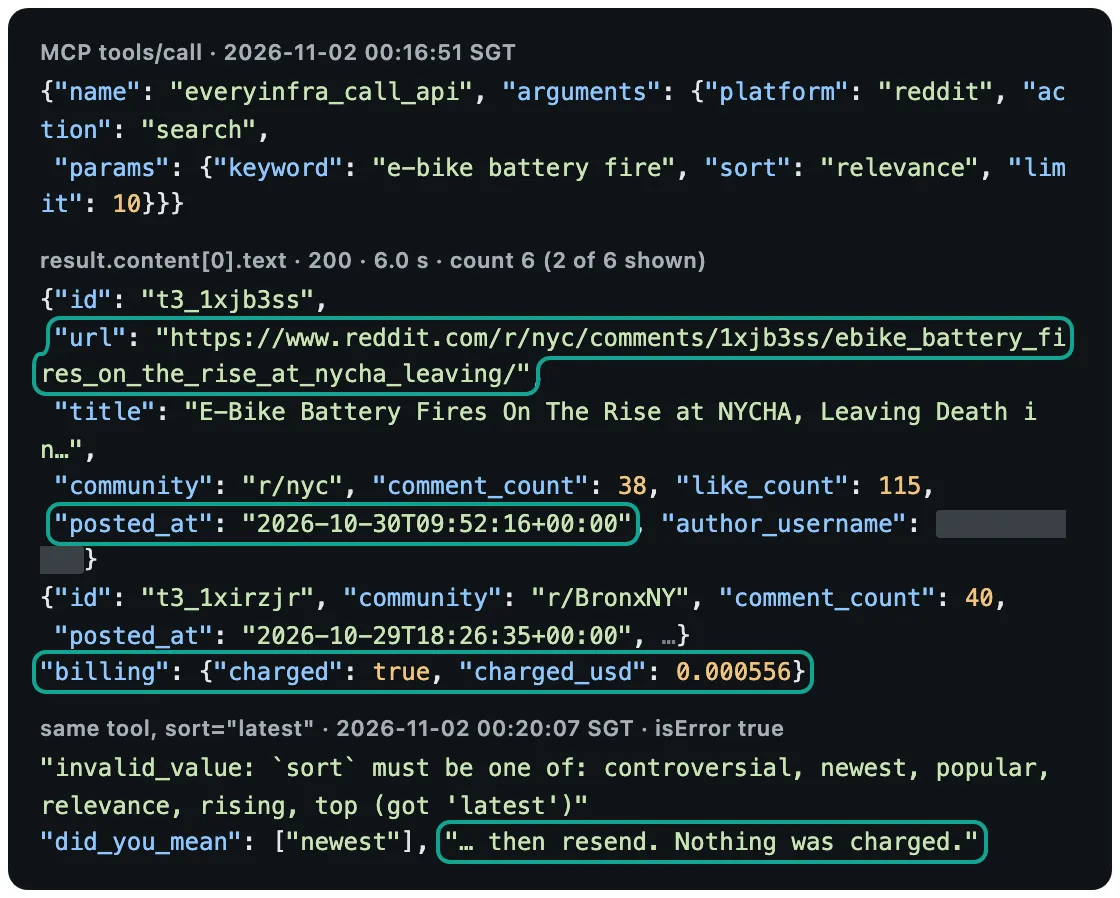
この6件からは3つのことがわかります。第1に、limitは10でしたが、返ったスレッドは6件だけでした。この機能は、クエリに一致するスレッドだけを返します。カタログには3種類の一致が記載されています。単語がタイトルかコミュニティ名に含まれる場合、スレッド全体のどこかに含まれる場合、本文中で隣り合っている場合です。期間は直近1か月に固定されています。
第2に、6件のスレッドはr/nyc、r/BronxNY、r/ebikes、r/interesting、r/MTBの5つのコミュニティからのものでした。コメントは合計1,293件です。リチウム火災の消火の難しさを扱ったr/interestingのスレッド1件だけで、コメントは1,137件ありました。タイトルだけを読むエージェントは、こうした人気のスレッドに引き寄せられ、ブロンクスの火災から離れてしまうおそれがあります。
3つ目に、すべての行にurlと、秒単位まで正確なposted_atがあります。本記事で後に行う検証はすべて、この2つのフィールドに基づいています。フィールドの詳細はRedditの検索機能ページをご覧ください。
同じ1分のうちに、無料の呼び出しを2回行いました。00:20:00 SGTに、Reddit向けのeveryinfra_list_capabilitiesが0.28秒で返りました。
00:20:07 SGTには、意図的にsortをlatestに設定しました。レスポンスは0.19秒で返り、isError: trueと「sort must be one of: controversial, newest, popular, relevance, rising, top (got 'latest')」というメッセージが含まれていました。did_you_meanはnewestで、メッセージの末尾は「Nothing was charged」でした。無人で動くエージェントにとって、このメッセージは呼び出しを修正して再試行できることを意味します。失敗した呼び出しを「Redditでの議論なし」と記録することはありません。
ルートB:先に構造化されたソーシャルデータを取得し、Gemini Deep Research APIに渡す
ルートBでは、データ収集をエージェントに任せず、ご自身のプログラムで行います。00:16から00:19 SGTの間に、1件のレポートのために7回の有料呼び出しを行いました。対象は3言語のニュース、Redditのスレッドとコメント、YouTubeの動画とコメントです。下の表に各呼び出しを示します。charged_usdはbillingフィールドの値です。
| 時刻 | 機能 | 主なパラメータ | 件数 | 課金額 | 所要時間 |
|---|---|---|---|---|---|
| 00:16:32 SGT | google_news/search | e-bike battery fire、us / en、直近1か月 | 10 | $0.000792 | 4.3 s |
| 00:16:51 SGT | reddit/search(MCP経由) | e-bike battery fire、relevance | 6 | $0.000556 | 6.0 s |
| 00:17:23 SGT | reddit/comments | r/nycのスレッド1件、limit 50 | 35 | $0.000556 | 19.3 s |
| 00:18:02 SGT | youtube/search | e-bike battery fire、relevance | 10 | $0.000556 | 8.6 s |
| 00:18:29 SGT | youtube/comments | FDNYの動画1本、popular、limit 50 | 50 | $0.000556 | 30.1 s |
| 00:19:16 SGT | google_news/search | incendio batería bicicleta eléctrica、mx / es | 10 | $0.000792 | 4.7 s |
| 00:19:36 SGT | google_news/search | 電動自転車のバッテリー火災に関する中国語クエリ、hk / zh | 10 | $0.000792 | 3.7 s |
| 合計 | 5つの機能 | — | 131 | $0.004600 | 76.9 s |
これら5つの機能のパラメータ、指定可能な値、フィールドは、プラットフォーム別のカタログに掲載されており、APIキーは不要です。Redditのカタログ、YouTubeのカタログ、Google Newsのカタログをご覧ください。本記事に記載した料金、limitの上限、フィールドに関する注記は、2026-11-02時点のこれらのカタログに基づいています。APIを呼び出す当日のカタログにあるprice_usdの値を使用してください。
呼び出しの後、フィールドの異なる行を、すべての行を検証できる1つの表にまとめます。列は少なくとも6つ用意します。row_idはプラットフォームとソースIDを結合したもので、例えばreddit:t3_1xjb3ssです。source_urlはその項目そのものを開くURLです。さらにplatform、published_at、date_precision、fetched_atを加えます。date_precisionは秒、日、週、不明のいずれかを示し、fetched_atは呼び出した時刻です。精度の列が必要な理由は、以下の4つのテストでわかります。
表の渡し方は2通りあります。1つ目はinputに入れる方法です。
Deep Researchはマルチモーダル入力に対応しており、GoogleのブログにはPDF、CSV、画像、音声、動画が挙げられています。ドキュメントでは、ファイルを{"type": "document", "uri": ..., "mime_type": "application/pdf"}の形で渡します。131件の表は約20,000トークンで、100万トークンのウィンドウからすれば小さな量です。2つ目の方法はFile Searchストアです。各件または各ソースをドキュメントとしてアップロードし、custom_metadataにrow_id、source_url、date_precisionを入れます。すると引用は、これらのフィールドを含むfile_citationエントリとして返ってきます。
# Configuration example: turn EveryInfra responses into checkable rows for Deep Research (Gemini side not run)
import csv

def rows_from(resp, platform, fetched_at):
    for r in resp["results"]:
        url = r.get("url")
        if platform == "youtube_comments":            # comment rows have no url, so build one from the video url and comment id
            url = f'{resp["_video_url"]}&lc={r["id"]}'
        exact = isinstance(r.get("posted_at"), str) and r["posted_at"][:4].isdigit()
        yield {"row_id": f'{platform}:{r.get("id") or r.get("rank")}',
               "source_url": url, "platform": platform,
               "published_at": r.get("posted_at") or r.get("published_at") or "",
               "date_precision": "second" if exact and platform != "news" else ("day" if exact else "unknown"),
               "fetched_at": fetched_at,
               "text": (r.get("title") or r.get("text") or "")[:500]}

with open("evidence.csv", "w", newline="") as f:
    w = csv.DictWriter(f, fieldnames=["row_id", "source_url", "platform", "published_at",
                                      "date_precision", "fetched_at", "text"])
    w.writeheader()
    # for each saved response: w.writerows(rows_from(resp, "...", "2026-11-02T00:16:51+08:00"))
Googleのページ間で1点食い違いがあるため、先に検証してください。File Searchの制限事項には、組み込みの検索ツールは組み合わせられないと書かれています。例えば、File SearchはGoogle SearchやURL Contextと同じリクエスト内では使用できません。一方Googleのブログには、Deep ResearchはGoogle Search、リモートMCP、URL Context、コード実行、File Searchを同時に使用できると書かれています。Deep ResearchのページにあるFile Searchの例は、社内レポートと最新のWebニュースを比較するものですが、そのコードで有効にしているのはFile Searchだけです。
Googleがこの点を明確にするまでは、file_searchとgoogle_searchの両方を指定した小さなタスクを1つ実行してください。失敗した場合は、表をFile Searchではなくinputに入れてください。
テスト1:ニュースの日付は「何日前」ラベルから算出されている
google_news/searchの英語と中国語の結果では、published_atが完全なISOタイムスタンプになっており、一見正確に見えます。しかし、英語の結果10件はすべて時刻が16:16:35 UTC、中国語の結果10件はすべて16:19:38 UTCでした。これらのリクエストを送信したのは16:16:32 UTCと16:19:36 UTC、つまり00:16 SGTと00:19 SGTです。したがってこのフィールドは、リクエスト時刻から「何日前」の値を差し引いたものです。日付部分には意味がありますが、時刻部分には意味がありません。
日付部分をURLパス内の日付と照合しました。URLに日付を含む英語の結果4件のうち、3件は1日遅れ、1件は一致していました。The New York Timesの記事はURLが2026/10/28で、published_atは2026-10-29でした。NY1の記事はURLが10/30、フィールドが2026-10-31でした。Billy PennはURLが10/17、フィールドが2026-10-18でした。The City Reporterは一致していました。
| 英語メディア | URL内の日付 | `published_at`の日付 | 遅れ(日数) |
|---|---|---|---|
| The New York Times | 2026-10-28 | 2026-10-29 | 1 |
| Spectrum News NY1 | 2026-10-30 | 2026-10-31 | 1 |
| Billy Penn at WHYY | 2026-10-17 | 2026-10-18 | 1 |
| The City Reporter | 2026-10-30 | 2026-10-30 | 0 |
中国語の結果はずれがさらに大きく、最大4日でした。「1週間前」のような粗い表記が元になっていると考えられます。スペイン語の結果は、別の意味で問題がありました。10件すべてでpublished_atがnullで、URLに日付を含むものも1件しかありませんでした。
レポートへの影響は具体的です。たとえば、英語メディアがブロンクスの火災を1日以内に報じた、とレポートに書くとします。英語の日付は1日遅れることがあるため、この主張にはURLの日付か記事本文での確認が必要です。
スペイン語は日付が空なので、スペイン語のタイムラインはこのフィールドからはまったく作れません。表では、date_precisionを英語は「日単位、1日遅れの可能性あり」、スペイン語は「不明」とします。URLに日付がある場合は、URLの日付を優先してください。フィールドの注意点はGoogle News検索の機能ページにあります。
テスト2:1件の火災、4つの情報源、3通りの死者数
確認できる行同士でも、内容が一致するとは限りません。ブロンクスの火災がその例です。2026-10-28、The New York Timesは、Patterson Housesのアパートで電動自転車のバッテリー火災が発生し、11歳の男の子が死亡したと報じました。消防局長のLillian Bonsignore氏は、これが今年401件目の電動自転車バッテリー火災だと述べています(The New York Times, 2026-10-28)。Gothamistも同日、FDNYの調査結果を報じました(Gothamist, 2026-10-28)。
2026-10-31、New York Daily Newsは、同じ火災でさらに3人が死亡したと報じました。同紙は、今年のリチウムバッテリー火災による死者を9人としています(New York Daily News, 2026-10-31)。スペイン語メディアのSpectrum Noticiasは、消防局長が以前に示した数字を引用しました。今年は火災401件、負傷者74人、死者6人で、昨年は火災292件、負傷者51人、死者1人というものです(Spectrum Noticias, 2026-10-31)。2026-10-14には、Streetsblog NYCが、その時点までに5人が死亡し、火災件数が41%増加したと報じていました(Streetsblog NYC, 2026-10-14)。
| 出典 | 公開日 | 今年の火災件数 | 今年の死者数 | 数字の出典 |
|---|---|---|---|---|
| Streetsblog NYC | 2026-10-14 | 41%増 | 5 | FDNYのデータ |
| The New York Times | 2026-10-28 | 401件目の火災 | 年間合計なし | 消防局長 |
| Spectrum Noticias | 2026-10-31 | 401 | 6 | 消防局長(2026-10-28の会見) |
| New York Daily News | 2026-10-31 | 401(先週時点) | 9 | FDNY当局者 |
これらの数字は矛盾していません。同じ数字を異なる時点で切り取ったものです。5人は10月中旬時点、6人は火災当日時点、9人はその後さらに3人が亡くなった後の数字です。しかし、レポートに「スペイン語メディアは今年の死者を6人と報じた」と書き、2026-10-31の記事にリンクしたとします。読者がリンクを開くと引用は一致しますが、その情報はすでに古くなっています。
そのため、表には数値用の列がもう1つ必要です。記事の公開日だけでなく、その数値がいつ述べられたものかを示す列です。これは研究でも裏付けられています。2026年5月の論文では、14モデルが作成したディープリサーチレポートを評価しました。引用リンクが有効だった割合は94%超、関連性があった割合は80%超でした。しかし、事実の正確性は39%から77%にとどまりました(arXiv 2605.06635)。
同じ論文では、ツール呼び出しが2回から150回に増えるにつれて、ファクトチェックの正確性が平均で約42%低下することも示されています。リンクが機能していても、その文が正しいとは限りません。上の表の数値はニュース報道に基づくもので、引用が古くなっていく様子を示しています。火災や死傷者の正確な数値については、FDNYの公式発表を参照してください。公営住宅での火災を報じたThe City Reporterの2026-10-30付の記事も、レポートが引用できる情報源の1つです(The City Reporter, 2026-10-30)。
テスト3:コメントの出典をたどれるか?Redditは35件中35件、YouTubeは50件中0件
ニュース以外のソーシャルメディア調査では、コメントが主な対象になります。今回は2つのデータセットを取得しました。1つは公営住宅での電動自転車火災に関するr/nycスレッドのコメント、もう1つは電動自転車店の火災を扱ったFDNYのYouTube動画の人気コメントです。この2つのデータセットは、追跡可能性の点で大きく異なりました。
35件のRedditコメントにはそれぞれurlがあり、形式はreddit.com/r/nyc/comments/1xjb3ss/comment/19rvuy7xzfh7n/です。このURLを開くと、そのコメントが表示されます。posted_atはいずれもミリ秒単位まで正確で、例えば2026-10-30T14:43:08.086000+00:00のようになっていました。「r/nycのコメント投稿者は……と述べた」と書くレポートなら、その特定のコメントにリンクでき、読者はワンクリックで確認できます。
スレッド自体には38件のコメントが表示されていましたが、取得できたのは35件でした。不足分は削除されたか、折りたたまれていた可能性があります。Redditのコメント数が異なる理由は、Redditコメントの網羅性で検証しています。r/nycのスレッド自体は公開されています(r/nycスレッド)。
50件のYouTubeコメントにはurlフィールドがありませんでした。posted_atには「1 year ago」や「7 months ago」のような相対時間が入っていました。50件のうち、15件が「year」、4件が「(edited)」を含み、14件が返信でした。
これには2つの影響があります。1つ目は、コメントに直接リンクできないことです。今回の表では、動画のURLに&lc=<comment id>を付けてリンクを作成しました。これはYouTubeのWebサイトでコメントを開く一般的な方法です。ただし、返されたフィールドではなく、このパラメータに関するGoogleのドキュメントも見つからなかったため、「作成」と表記しています。
| フィールドの確認 | Redditのコメント(35件) | YouTubeのコメント(50件) |
|---|---|---|
各コメントへの直接リンク(url) | 35 | 0 |
絶対時刻のposted_at | 35件、ミリ秒単位 | 0件、相対表記のみ |
| 「year」を含む時刻 | 0 | 15 |
| 「(edited)」の表記あり | 表示されない | 4 |
| セット内の返信 | スレッドに表示 | 14 |
第二に、「1 year ago」は年または月単位でしか正確ではなく、しかもリクエスト時点からの相対的な値です。「過去1か月のYouTubeでの議論」に関するレポートで確認できるのは、この50件のコメントのうち「1 hour ago」「2 weeks ago」と2件の「3 weeks ago」の4件だけです。youtube/commentsのカタログの注記によると、sinceパラメータでコメントの日付による絞り込みができるため、取得時に範囲を限定できます。返信のページネーションについてはYouTubeコメントの返信とページネーションで解説しています。フィールドの詳細はYouTubeコメントの機能ページをご覧ください。
テスト4:YouTubeの関連度順検索では古い動画が大半を占める
時間の問題は、YouTubeの検索結果でより明確になります。同じクエリe-bike battery fireで、同じ1分以内に検索しました。ニュースの結果10件は、すべて過去30日以内のものでした。一方、関連度順のyoutube/search上位10件は、2022年が2件、2023年が4件、2024年が2件、2025年が1件、2026年が1件でした。中央値は2023年です。2026年の1件も公開日は2026-09-09で、やはり過去30日の範囲外です。
データが間違っているわけではありません。YouTubeの関連度順ランキングは、再生回数が多く、公開からの期間が長い動画を優先します。10件のうち最も再生された動画は510,000回再生で、2022年のものでした。しかし、エージェントがこの10本の動画へのコメントを現在の世論として扱うと、レポートには3〜4年前の議論が混ざることになります。
対処は簡単です。最近の議論を調べるなら、sort=newestを使うか、表上でposted_atを使って行を絞り込みます。長期的な議論を扱う場合は、レポートに期間を明記します。この種のサンプルの偏りについてはソーシャルメディア調査におけるサンプルの妥当性で解説しています。検索のフィールドはYouTube検索の機能ページをご覧ください。
コンテキスト予算:131件で約20,000トークン、一般的なタスクの8%
ルートBはデータを入力に含めるため、そのサイズを把握しておく必要があります。7回の呼び出しで得た生のJSONは79,787バイトでした。1トークンあたり約4バイトとすると、19,947トークンです。モデルのページには、入力ウィンドウが1,048,576トークン、出力上限が65,536トークンと記載されています。ドキュメントでは、入力トークン数を標準タスクで約250,000、Maxタスクで約900,000と見積もっています。このデータは一般的なタスク入力の8%なので、エージェント自身の検索や読み込みに使える余地が十分に残ります。
整理した表はさらに小さくなります。生のレスポンスには、サムネイルのURL、チャンネルの統計、課金の詳細など、リサーチに不要なフィールドが多く含まれています。当社の6列と最大500文字のテキストに絞ると、131件は元のサイズの半分未満になります。
逆の注意点もあります。ベストプラクティスによると、マルチモーダル入力はコストを増やし、コンテキストをあふれさせることがあります。本当のリスクは131件ではなく、数十のスレッドから集めた1,000件のコメントです。それほど多い場合は、データをinputに入れる前に、まずトピックと期間で絞り込むか、File Searchで必要なデータを取得してください。
構造化されたソーシャルデータで引用を検証できるようにする方法
4つのテストから、1つのシンプルな方法が導かれます。目標は、ソーシャルメディアに関する各主張を、読者が1つの行までたどれるようにすることです。その行には、項目がプラットフォーム上のどこにあるか、そして時刻がどの程度正確かが示されている必要があります。
第一に、各行には項目を開けるリンクが必要です。Redditのスレッドとコメント、YouTubeの動画、ニュースはこの条件を満たします。YouTubeのコメントは満たさないため、動画URLとコメントIDからリンクを組み立て、組み立てたものであることを明記します。第二に、各行で時刻の精度を示す必要があります。このテストでは4つのレベルが見られました。Redditのコメントはミリ秒、RedditのスレッドとYouTubeの動画は秒、英語ニュースは日です。最後のレベルである相対時刻または時刻なしは、YouTubeのコメントとスペイン語ニュースに該当しました。
第三に、fetched_at、つまり呼び出した時刻を記録します。相対時刻や「今年401件目の火災」のような数値は、この時刻があって初めて意味を持ちます。
第四に、数値を含む主張には「誰がいつ言ったか」が必要です。死者数の例が示すように、リンクが有効でも数値が最新とは限りません。第五に、引用にも行IDを含めます。File Searchではcustom_metadataに入れます。MCPやinputを使う場合は、各文の後にrow_idを書くようエージェントに指示します。
| 判明したこと | レポートへの影響 | 表での対処 |
|---|---|---|
ニュースのpublished_atはリクエスト時刻を使用。英語ニュースでは日付が0〜1日遅れる | タイムラインが不正確になる | date_precision=day。URL内の日付を優先 |
| スペイン語ニュースの日付は10件すべて空 | タイムラインを作成できない | date_precision=unknown。記事を開いて日付を確認 |
| YouTubeコメント:リンクありは50件中0件、時刻は相対表記 | 引用から情報源にたどり着けない | リンクを組み立て、その旨を明記。sinceまたはsortで期間を限定 |
| YouTubeの関連度順検索:10件中9件が2026年より前 | 古い話題を最新として扱ってしまう | posted_atで絞り込むか、sort=newestを使用 |
| 日付によって異なる死者数:5人、6人、9人 | リンクは有効だが、数値は最新ではない | 「その数値が述べられた時点」の列を追加 |
| Reddit検索:5つのコミュニティから6スレッド、うち1件はコメント1,137件 | エージェントが人気のある別の話題にそれる | communityを保持し、トピックで絞り込む |
これらの手順に、Geminiの新機能は必要ありません。現在の引用タイプで十分です。Webページにはurl_citation、File Searchにはメタデータ付きのfile_citationを使います。足りないのは、検証可能な入力データです。そのため、利用できる場合はルートBをおすすめします。
ルートAでは、エージェントは生のレスポンスを受け取ります。YouTubeコメントの時刻が相対表記であることに気づくかどうかは、その実行時のエージェントの判断次第です。ルートBでは、プログラムがこうした判断を一度だけ行い、すべての行で共通の列に書き込みます。エージェントはそれを引用するだけで済みます。
カタログを確認:38件のコメント系機能のうち、リンクを返すのは10件
テスト3ではRedditとYouTubeしか扱っていません。他のプラットフォームのコメントから情報源にたどり着けるかを確認するために、プラットフォームごとにライブ呼び出しを行う必要はありません。無料のカタログには、機能ごとのresponse_fieldsが掲載されています。2026-11-02 00:28 SGTにGET /api/v1/social/catalogを取得したところ、573件の機能が掲載され、そのうち569件が利用可能でした。利用可能な機能のうち、アクション名に「comment」または「replies」を含むコメント系の機能は38件です。
38件すべてに時刻フィールド(posted_atまたはcreated_at)があります。しかし、コメントごとにurlを返すのは10件だけで、残りの28件にはリンクがありません。その28件のうち27件は、少なくともコメントID(id)を返します。これらについては、YouTubeで行ったように、投稿URLとコメントIDからリンクを組み立てられます。リンクもコメントIDも返さない機能が1件あります。
| コメント系の機能 | 各行の`url` | 機能(カタログ名) |
|---|---|---|
| リンクあり | 10 | reddit/comments、reddit/user_comments、twitter/comments、threads/comments、instagram/comments、linkedin/comments、github/issue_comments、netease_music/comments、gab/replies、truth_social/replies |
| リンクなし、コメントIDあり | 27 | youtube/comments、tiktok/comments、facebook/comments、weibo/comments、douyin/comments、xiaohongshu/commentsなど |
| リンクなし、コメントIDなし | 1 | naver/comments |
したがって、表のリンク列には「情報源へのリンク」と「投稿リンク+コメントID」の2種類の値が必要です。後者の場合は「この投稿のコメントを参照」と書くようエージェントに指示してください。読者がクリックするだけでコメントに直接アクセスできるかのように、レポートに書かせないでください。
カタログにフィールドがあっても、値が正確だとは限りません。カタログにはyoutube/commentsのposted_atも掲載されていますが、ライブ呼び出しでは「1 year ago」のような相対時刻が返されました。カタログからわかるのはフィールドの有無で、精度はライブ呼び出しでわかります。カタログは無料で、MCPではeveryinfra_list_capabilitiesとして利用できます。そのため、コメントを取得する前にカタログを確認するよう、プロンプトでエージェントに指示できます。
ニューヨークの読者向けの2つ目の例:1件の火災にとどまらず、バッテリーの安全性を考える
同じ方法は関連するトピックにも使えます。NYCは2023年からリチウムバッテリーの安全プログラムを実施しています。2024-07の市長室のページには、2023年の数値が掲載されています。この年、リチウムバッテリー火災の59%は充電中ではないバッテリーから発生しました(NYC Mayor's Office, 2024-07)。
他の都市も同じ問題を抱えています。2026年10月のCBCの解説記事は、消防士のアドバイスをまとめています(CBC, 2026-10)。Billy Pennは2026-10-17にフィラデルフィアの火災安全について報じました(Billy Penn at WHYY, 2026-10-17)。
公的なアドバイスが時間とともにどう変わったかをまとめるレポートでは、3種類の行が混在します。市のページには、日付が明記された公式声明が掲載されています。ニュースには日付付きの記事がありますが、その日付は今回のテストで最大1日遅れていました。ソーシャル投稿には意見が含まれ、時刻はRedditでは正確、YouTubeでは相対表記です。種類ごとにdate_precisionを設定し、注記なしで1つのタイムラインに混在させないよう、プロンプトでエージェントに指示してください。
うまくいかない点と注意点
第一に、構造化出力は指定できません。この制限は明記されているため、「JSONの表を返して」と指示しても機能しません。機械可読な結果が必要な場合は、固定形式のMarkdown表を指定してパースしてください。または、ドキュメントに従い、通常のモデルでprevious_interaction_idを使います。ドキュメントの例ではgemini-4-argonが使われており、通常のモデルは構造化出力に対応しています。
第二に、エージェントのバージョンは廃止されます。現在のエージェント名はどちらもpreviewと04-2026を含みます。2025年12月のエージェントdeep-research-pro-preview-12-2025は、2026-10-08に非推奨となり、2026-10-23に提供終了しました。リリースから約10か月半です(変更履歴、非推奨)。エージェント名はコードではなく設定に置いてください。
第三に、Google検索の結果には利用ルールがあります。Gemini API追加利用規約では、Grounding with Google Searchの結果は検索候補とともにエンドユーザーに表示する必要があるとされています。また、キャッシュ、再販、分析、学習への利用も禁止されています。一部のケースでは最大2年間の保存が認められています(Gemini API追加利用規約)。レポートをアーカイブまたは再利用する場合は、まずこのセクションを読んでください。このセクションの対象はGoogle検索の結果で、自社のMCPサーバーやファイルのデータにはそれぞれの規約が適用されます。本記事は法的助言ではありません。
第四に、セキュリティを考慮してください。Deep Researchページの安全性に関するセクションでは、3つのリスクが挙げられています。ファイル内のプロンプトインジェクション、危険なWebコンテンツ、そしてエージェントが社内データとWebを同時に読む際のデータ漏えいです。ソーシャルのコメントは公開されたユーザーのテキストで、AIに向けた指示が含まれている場合があります。当社のMCPサーバーはユーザーのテキストをそのまま返すため、コメントのテキストは指示ではなくデータであることをエージェントに伝えてください。
headersに入れたEveryInfraのAPIキーは、MCPリクエストのたびに当社のサーバーに送信されます。Deep Research用に、利用額の上限を設定した別のAPIキーを作成してください。そうすれば、そのキーだけを無効にできます。
第五に、コストはusageで確認します。どれだけ読み、検索するかはエージェントが決めるため、事前には見積もりしかできません。Googleは、プロンプトで範囲を限定することを推奨しています。
Google開発者フォーラムでは、この機能のプロダクトマネージャーがユーザーに回答しています。最終的な使用量はInteractionオブジェクトのusageフィールドに表示され、countTokensはエージェントでは使えません(開発者フォーラムのスレッド、2025-12-21)。EveryInfraでは、各レスポンスのbilling.charged_usdにコストが表示されます。料金ページにあるとおり、結果が空の場合や失敗した場合は無料です。
6つ目に、URL Contextには制限があります。ドキュメントによると、1リクエストあたり最大20個のURLを処理でき、1URLあたりの上限は34MBです。ペイウォールでアクセスが制限されたコンテンツやYouTube動画には対応していません(URL Contextのドキュメント)。そのため、Deep ResearchはYouTube動画のページを読んでもコメントを取得できません。先にyoutube/commentsでコメントを取得するのはこのためです。
| 制約 | ドキュメントの記載 | 対処法 |
|---|---|---|
| 構造化出力 | 非対応 | 固定形式のMarkdownテーブルをパースするか、結果を通常のモデルに渡す |
| エージェントのバージョン | プレビュー版の名前。2025年12月のエージェントは2026-10-23に提供終了 | エージェント名を設定で管理する |
| Google検索の結果 | 検索候補と併せて表示。キャッシュや分析は不可 | レポートを保存する前に利用規約を確認する |
| プロンプトインジェクション | ファイルやWebページのリスクとして明記 | コメント本文はデータであるとエージェントに伝える |
| コスト | 実行後にusageで初めて判明 | 調査範囲を絞り、上限を設定したEveryInfra専用のAPIキーを使う |
| URL Context | URLは20個まで、各34MBまで、YouTube動画は非対応 | 先にyoutube/commentsでコメントを取得する |
最近の変更点
2026-10-27、Googleはベータ版のコマンドラインツールgemini-apiをリリースしました。スクリプトやCIからInteractions APIやホスト型エージェントを呼び出せます(Gemini API CLIのドキュメント)。つまり、定期的なDeep ResearchレポートにPythonプログラムは不要です。コマンド1つとスケジューラーがあれば十分です。
2026-10-23に旧Deep Researchエージェントが提供終了となり、2026-10-13にはGemini 4 Argonが一般提供となりました。そのため、12月版のエージェント名を使い続けているコードは動作しなくなっています。deep-research-preview-04-2026に変更してください。
FAQ
PythonからGemini Deep Research APIを呼び出すにはどうすればよいですか?
google-genaiパッケージを使います。Interactions APIにはバージョン2.3.0以降が必要で(Interactions APIの概要)、ソースコードはpython-genaiリポジトリにあります。client.interactions.create(agent="deep-research-preview-04-2026", input=..., background=True)を呼び出し、ステータスがcompletedまたはfailedになるまでclient.interactions.get(id)をループで呼び出します。MCPを追加するには、toolsに{"type": "mcp_server", "url": ..., "headers": ...}を入れます。この質問は、Googleのオートコンプリート候補「gemini deep research api python」から取り上げました。
Gemini Deep Research APIの料金体系は?無料枠はありますか?
個別の料金設定はありません。モデルの推論とツールの利用分を支払う形で、Googleの見積もりでは標準タスク1件あたり$1〜$3、Maxタスク1件あたり$3〜$7です。Googleのブログによると、パブリックプレビューは有料ティアで提供されるため、課金を有効にする必要があります。Google検索は月5,000回まで無料で、それ以降は1,000回あたり$14です。この質問は、オートコンプリート候補「gemini deep research api pricing」と「deep research api free」から取り上げました。
Gemini Deep Research APIはVertexで使えますか?
はい。Google Cloudには専用のDeep Researchページがあります。aiplatform.googleapis.comのグローバルなv1beta1エンドポイント、Google Cloudのアクセストークン、半額になるservice_tier="deferred"オプションを使います。料金ページによると、VertexでのGoogle検索のデフォルト割り当ては1日1,000,000回です。Gemini Developer APIのデフォルトは1日1,500回です(Vertexのグラウンディングのドキュメント)。この質問は、オートコンプリート候補「gemini deep research api vertex」から取り上げました。
Deep Researchのタスクがin_progressのまま進まない場合はどうすればよいですか?
2026年3月、旧エージェントを使っていたフォーラムのユーザーがこの問題を報告しています。インタラクションは開始されたものの、使用量が記録されないままin_progressの状態が続きました。ドキュメントではlast_event_idを保存しながらストリーミングする方法が推奨されており、接続が切れても再開できます。あわせて独自のタイムアウトも設定してください。ドキュメント記載の最大時間である60分を過ぎたら、タスクをキャンセルしてログに記録します。この質問は、フォーラムのスレッドとオートコンプリート候補「gemini deep research stuck on starting research」から取り上げました。
Deep Researchは単独でRedditやYouTubeのコメントを読み取れますか?
Google検索とURL Contextを使えば、公開ページは読めます。ただし、URL ContextのドキュメントにはYouTube動画は非対応と記載されており、ページ上で後から読み込まれるコメントは取得できない場合があります。安定したコメントデータが必要な場合は、reddit/commentsとyoutube/commentsから取得した構造化された行データを、MCPまたは事前に用意したテーブルでエージェントに渡してください。この質問は、MCP向けの本格的なディープリサーチツールはあるのかを尋ねるRedditのスレッドから取り上げました(r/LocalLLMのスレッド)。
Gemini Deep ResearchのAPIキーとEveryInfraのAPIキーはそれぞれどこに設定しますか?
GeminiのAPIキーはx-goog-api-keyヘッダーに設定するか、SDKに環境変数GEMINI_API_KEYから読み込ませます。EveryInfraのAPIキーは、mcp_serverツールのheadersにAuthorization: Bearer <key>として設定します。どちらのAPIキーもプロンプト本文には含めないでください。この質問は、オートコンプリート候補「gemini deep research api key」から取り上げました。
始め方
第1に、EveryInfraに新規登録してAPIキーを取得します。インフラマーケットプレイスでは、カタログを閲覧し、1回の呼び出しを無料で試せます。クイックスタートはドキュメントにあります。第2に、最初はGeminiを使わずに進めます。curlでreddit/searchまたはgoogle_news/searchを呼び出し、url、posted_at、billingがこの記事の例と同じ形になっているかを確認します。各プラットフォームのページはRedditデータAPI、YouTubeデータAPI、Google News APIです。
3つ目に、ルートAの例を使います。Deep Researchのtoolsにhttps://api.everyinfra.com/mcpを指定し、allowed_toolsには3つのツールだけを残します。範囲の狭いトピックで実行し、mcp_server_tool_callのステップを確認してください。4つ目に、読者が検証できるレポートが必要な場合はルートBを使います。データを取得して6つの列を作成し、そのテーブルをDeep Researchに渡します。サブエージェントを使った並列データ取得については、TikTokアカウント向けのClaude Codeサブエージェントを参照してください。新しいMCP仕様の本番運用については、MCP 2026仕様と本番環境への対応を参照してください。
参考文献
- Gemini Deep Researchエージェント、Google AI for Developers、2026-10-13更新、https://ai.google.dev/gemini-api/docs/deep-research
- Deep Researchプレビューモデルのページ、Google AI for Developers、2026-10-29更新、https://ai.google.dev/gemini-api/docs/models/deep-research-preview-04-2026
- Interactions APIの概要、Google AI for Developers、2026-10-15更新、https://ai.google.dev/gemini-api/docs/interactions-overview
- Interactions APIリファレンス、Google AI for Developers、2026-10-28更新、https://ai.google.dev/api/interactions-api
- バックグラウンド実行、Google AI for Developers、https://ai.google.dev/gemini-api/docs/background-execution
- Gemini Developer APIの料金、Google AI for Developers、2026-10-30更新、https://ai.google.dev/gemini-api/docs/pricing
- レート制限、Google AI for Developers、2026-10-28更新、https://ai.google.dev/gemini-api/docs/rate-limits
- File Search、Google AI for Developers、2026-10-13更新、https://ai.google.dev/gemini-api/docs/file-search
- Google検索によるグラウンディング、Google AI for Developers、2026-10-28更新、https://ai.google.dev/gemini-api/docs/google-search
- URLコンテキスト、Google AI for Developers、2026-10-13更新、https://ai.google.dev/gemini-api/docs/url-context
- Gemini API変更履歴、Google AI for Developers、2026-10-30の項目、https://ai.google.dev/gemini-api/docs/changelog
- Geminiの非推奨情報、Google AI for Developers、2026-10-22更新、https://ai.google.dev/gemini-api/docs/deprecations
- Gemini API CLI、Google AI for Developers、2026-10-28更新、https://ai.google.dev/gemini-api/docs/cli
- 請求、Google AI for Developers、https://ai.google.dev/gemini-api/docs/billing
- Gemini API追加利用規約、Google、https://ai.google.dev/gemini-api/terms
- Gemini Deep Researchエージェント、AI Studioドキュメント、Google、https://aistudio.google.com/docs/deep-research
- Gemini Deep Researchエージェントを使用する、Google Cloud、https://docs.cloud.google.com/gemini-enterprise-agent-platform/agents/use-deep-research
- Google検索によるグラウンディング、Google Cloud、https://docs.cloud.google.com/vertex-ai/generative-ai/docs/grounding/grounding-with-google-search
- Deep Researchを使い始める、Gemini cookbookのノートブック、https://github.com/google-gemini/cookbook/blob/main/quickstarts/Get_started_Deep_Research.ipynb
- python-genai、Google、https://github.com/googleapis/python-genai
- Deep ResearchとDeep Research Maxの紹介、Googleブログ、2026-04-21、https://blog.google/innovation-and-ai/models-and-research/gemini-models/next-generation-gemini-deep-research/
- Gemini Deep Researchを使った開発、Googleブログ、2025-12-11、https://blog.google/innovation-and-ai/technology/developers-tools/deep-research-agent-gemini-api/
- Gemini APIでDeep Researchを使用する方法、Philipp Schmid、2026-04-29、https://www.philschmid.de/deep-research-update
- Deep Research APIのインタラクションがin_progressのまま停止、Google開発者フォーラム、2026-03-05、https://discuss.ai.google.dev/t/deep-research-api-interaction-stuck-in-progress-for-some-domains/129020
- Google Gemini Deep Researchのコスト、Google開発者フォーラム、2025-12-21、https://discuss.ai.google.dev/t/google-gemini-deep-research-costs/112804
- Deep ResearchエージェントAPIのレート制限とコストに関する質問、Google開発者フォーラム、2025-12-12、https://discuss.ai.google.dev/t/deep-research-agent-api-questions-for-rate-limitsand-costs/111904
- MCP仕様2026-07-28版の目次、Model Context Protocol、https://modelcontextprotocol.io/specification/2026-07-28
- MCP仕様2026-07-28版の変更履歴、Model Context Protocol、https://modelcontextprotocol.io/specification/2026-07-28/changelog
- MCPのトランスポート、Model Context Protocol、https://modelcontextprotocol.io/specification/2026-07-28/basic/transports
- MCPの認可、Model Context Protocol、https://modelcontextprotocol.io/specification/2026-07-28/basic/authorization
- MCPのツール、Model Context Protocol、https://modelcontextprotocol.io/specification/2026-07-28/server/tools
- 引用されているが検証されていない:ディープリサーチエージェントにおける出典の帰属、arXiv、2026-05-07、https://arxiv.org/html/2605.06635v1
- ディープサーチおよびディープリサーチエージェントのベンチマークとエラー分析、arXiv、2026-10-21、https://arxiv.org/html/2610.29346v1
- DeepResearch Bench:ディープリサーチエージェント向けベンチマーク、arXiv、https://arxiv.org/abs/2506.11763
- EveryInfraのデータ機能カタログ、2026-11-02閲覧、https://api.everyinfra.com/api/v1/social/catalog
- EveryInfraのRedditカタログ、2026-11-02閲覧、https://api.everyinfra.com/api/v1/social/catalog?platform=reddit
- EveryInfraのYouTubeカタログ、2026-11-02閲覧、https://api.everyinfra.com/api/v1/social/catalog?platform=youtube
- EveryInfraのGoogle Newsカタログ、2026-11-02閲覧、https://api.everyinfra.com/api/v1/social/catalog?platform=google_news
- ブロンクスのアパートで電動自転車のバッテリー火災、11歳の少年が死亡、The New York Times、2026-10-28、https://www.nytimes.com/2026/10/28/nyregion/fire-e-bike-battery-bronx.html
- ブロンクスで少年が死亡した火災の原因はリチウムイオン電池、FDNYが発表、Gothamist、2026-10-28、https://gothamist.com/news/lithium-ion-battery-caused-bronx-fire-that-killed-11-year-old-fdny-says
- 電動自転車の火災がNYC全域で急増、New York Daily News、2026-10-31、https://www.nydailynews.com/2026/10/31/as-bronx-family-reels-from-devastating-blaze-that-killed-4-e-bike-fires-have-skyrocketed-across-nyc/
- NYCHAで電動自転車のバッテリー火災が増加、The City Reporter、2026-10-30、https://www.thecityreporter.nyc/2026/10/30/e-bike-battery-fires-on-the-rise-at-nycha-leaving-death-in-their-wake/
- リチウムイオン電池の火災が41%増加、公的な対策は停滞、Streetsblog NYC、2026-10-14、https://nyc.streetsblog.org/2026/10/14/everyone-should-be-furious-lithium-ion-battery-fires-are-up-41-as-public-fix-stalls
- ブロンクスで電動自転車のバッテリー火災、4人が死亡、Spectrum Noticias、2026-10-31、https://spectrumnoticias.com/ny/nyc/noticias/2026/10/31/cuatro-muertos-tras-un-incendio-en-la-bateria-de-una-bicicleta-electrica-en-el-bronx--nypd
- ブロンクスで電動自転車のバッテリーによる火災、11歳の少年が死亡、Univision、2026-10-29、https://www.univision.com/local/nueva-york-wxtv/muere-nino-de-11-anos-en-incendio-provocado-por-bateria-de-bicicleta-electrica-en-el-bronx
- アダムス市長、リチウムイオン電池火災の防止に向けた新たな措置を講じる、NYC市長室、2024-07、https://www.nyc.gov/mayors-office/news/2024/07/mayor-adams-takes-new-actions-prevent-deadly-lithium-ion-battery-fires-promote-safe-e-bike
- リチウム電池の火災について消防士が知ってほしいこと、CBC、2026-10、https://www.cbc.ca/news/science/lithium-battery-fire-faq-9.7371004
- フィラデルフィアでリチウムイオン電池の火災を防ぐには、Billy Penn at WHYY、2026-10-17、https://billypenn.com/2026/10/17/lithium-ion-battery-fire-safety-philadelphia/
- NYCHAで電動自転車のバッテリー火災が増加、r/nycのスレッド、Reddit、2026-10-30、https://www.reddit.com/r/nyc/comments/1xjb3ss/ebike_battery_fires_on_the_rise_at_nycha_leaving/
- MCP向けの本格的なディープリサーチツールはあるか、r/LocalLLMのスレッド、Reddit、https://www.reddit.com/r/LocalLLM/comments/1pw1ukl/is_there_a_true_deep_research_mcp_deep_research/
参考資料 BL-66