


































Amazon 评论 API:从商品链接到有原文证据的问题清单
逐步接入 Amazon 评论读取,核对国家站点与商品身份,分离评论、变体和观察记录,处理去重与缺失,再用可验证的原文片段建立问题分类。
阅读完整文章数据采集 API、AI 搜索和网页验证码识别,覆盖 90 个平台的 413 项数据能力。
从支持的平台爬取内容、评论和商品,每条都带字段和来源。
识别网页验证码,按类型返回凭证、坐标或文本;失败退款。
按成功结果计费
用数据分析 Skill 把采集结果整理成商品对比、内容表现、分类标签和评价洞察。
免费下载,用你自己的 AI 工具和模型。
Skill 本身不采集数据;用 EveryData 采集另行按次计费。
ecommerce-product-analysissocial-content-performancecontent-analysis-taggingreview-insights充值过的账户可以免费调用 AI 接口:清洗、去重、分类、提取字段、写摘要,格式由你定。接口兼容 OpenAI,换个 base_url 就能用。
调用免费,不扣余额。分档按累计充值计算,试用额度和额度码不计入。
AI 接口用来整理你在万有引擎采集的数据。如果用在别的地方,或者调用明显异常,我们可能会暂停这个账号的 AI 接口;账号本身、其他接口和余额都不受影响。
from openai import OpenAI
import os

client = OpenAI(base_url="https://api.everyinfra.com/api/v1",
                api_key=os.environ["EVERYINFRA_API_KEY"])
rows = open("reviews.jsonl").read()  # 你用万有引擎采集到的数据
prompt = "把这些评论去重,按正面、负面、中性分类,输出 JSON:"
reply = client.chat.completions.create(
    model="gemini-3.6-flash",
    messages=[{"role": "user", "content": prompt + "\n" + rows}],
)
print(reply.choices[0].message.content) app_store12
 instagram9
 amazon8
 youtube6
 tiktok6
| source | record | field | type | value |
|---|---|---|---|---|
| app_store | 1557175442 | app_id | number | 1557175442 |
| instagram | nasa | username | string | nasa |
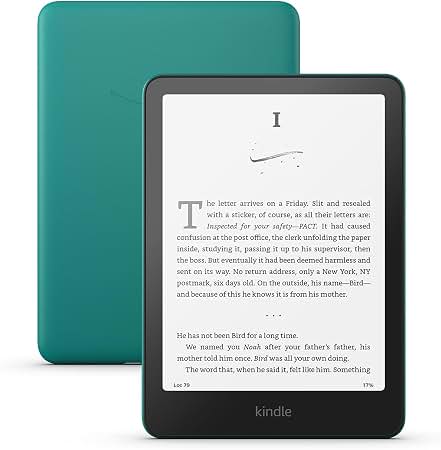
| amazon | B0CFPHV9ZN | title | string | Kindle Paperwhite 16GB |
| youtube | @NASA | name | string | NASA |
| tiktok | @nasa | username | string | nasa |
| app_store | 1557175442 | name | string | Obsidian - Connected Notes |
| instagram | nasa | name | string | NASA |
| amazon | B0CFPHV9ZN | brand | string | Amazon |
| youtube | @NASA | handle | string | @NASA |
| tiktok | @nasa | name | string | NASA |
| app_store | 1557175442 | rating | number | 4.4 |
| app_store | 1557175442 | developer | string | Dynalist Inc. |
| app_store | 1557175442 | version | string | 1.13.7 |
| app_store | 1557175442 | rating_count | number | 1103 |
| app_store | 1557175442 | category | string | 效率 |
| app_store | 1557175442 | price | number | 0 |
| app_store | 1557175442 | content_rating | string | 4+ |
| app_store | 1557175442 | size_display | string | 39.6 MB |
| app_store | 1557175442 | min_os | string | iOS 15.6 |
| app_store | 1557175442 | url | string | https://apps.apple.com/cn/app/obsidian-connected-notes/id1557175442 |
| instagram | nasa | followers_display | string | 104M |
| instagram | nasa | following_count | number | 91 |
| instagram | nasa | is_verified | boolean | true |
| instagram | nasa | posts_count | number | 4931 |
| instagram | nasa | bio | string | Making the seemingly impossible, possible. ✨ |
| instagram | nasa | website | string | https://www.nasa.gov/ |
| instagram | nasa | url | string | https://www.instagram.com/nasa/ |
| amazon | B0CFPHV9ZN | color | string | Jade |
| amazon | B0CFPHV9ZN | asin | string | B0CFPHV9ZN |
| amazon | B0CFPHV9ZN | storage | string | 16 GB |
| amazon | B0CFPHV9ZN | display | string | 7-inch |
| amazon | B0CFPHV9ZN | price | null | — |
| amazon | B0CFPHV9ZN | url | string | https://www.amazon.com/clp/B0CFPHV9ZN |
| youtube | @NASA | subscribers_display | string | 15.1M |
| youtube | @NASA | videos_display | string | 6.1K |
| youtube | @NASA | website | string | https://www.nasa.gov/ |
| youtube | @NASA | url | string | https://www.youtube.com/@NASA/streams |
| tiktok | @nasa | followers_display | string | 1.8M |
| tiktok | @nasa | likes_display | string | 9.4M |
| tiktok | @nasa | bio | string | Making the seemingly impossible, possible.✨ |
| tiktok | @nasa | url | string | https://www.tiktok.com/@nasa |
一把 API Key 接入数据采集、全网搜索和验证码识别。下面六类用法,各附一个可以直接发出的请求。
通过 MCP 把 EveryInfra 接进 Claude、Cursor 这类 AI 客户端,或在你自己的智能体里直接调 API。智能体需要数据时自己搜、自己取,拿回结构化 JSON 再做判断,不用你写采集代码。
示例Claude 通过 MCP 调用 everyinfra_call_api,在小红书搜「小户型收纳」,按点赞和收藏挑出最受欢迎的笔记,总结常见做法。
{
  "platform": "xiaohongshu",
  "action": "search",
  "params": {"keyword": "小户型收纳"}
}
titlelike_countcollect_countcomment_counturl用 EverySearch 检索网页、新闻和学术资料,取回标题、链接、摘要和发布时间,需要时再抓取正文。模型回答时引用这些结果,每一条都能追溯到原始出处。
示例回答「欧盟 AI 法案第 50 条的透明度义务」之前,先检索相关网页,把标题、链接和摘要交给模型,回答里标明出处。
{
  "tool": "web",
  "params": {"q": "EU AI Act Article 50 transparency obligations", "num": 10}
}
titleurlsnippetpublished按平台批量采集评价、评论和帖子正文,字段统一成结构化 JSON,直接进清洗和标注流程。大多数列表能力一次调用取回多条、只算一次;失败或空结果不扣费。
示例取 WhatsApp 在 Google Play 最新的 200 条评价:每条自带星级,可以直接当情感分类的标注数据。
{
  "platform": "google_play",
  "action": "reviews",
  "params": {"app_id": "com.whatsapp", "sort": "newest", "limit": 200}
}
textscoreapp_versionposted_at选品、价格监控、竞品分析这类产品,可以直接把 EveryInfra 当数据层:一把 Key 调所有平台,按实际调用计费,不用自己维护爬虫、平台账号和代理。
示例价格监控工具每天读一次 Amazon 商品详情,记录价格、评分、评分人数和库存的变化。
{
  "platform": "amazon",
  "action": "profile",
  "params": {"url": "https://www.amazon.com/dp/B09B8V1LZ3"}
}
priceratingrating_countin_stockseller_name定时读取热榜、搜索结果和评论,再用 AI 接口归类话题、判断情绪、提取实体,做成舆情或内容分析看板。AI 接口对充值过的账户免费。
示例每小时读取一次微博热搜,用 AI 接口把上榜话题分类,看板按类别统计热度。
{
  "platform": "weibo",
  "action": "trending",
  "params": {}
}
ranktitlehot_valuelabel在你自己的定时任务、工作流和浏览器自动化脚本里调用同一套接口:采集数据、搜索网页,遇到验证码交给 EverySolve 识别,只按成功结果计费。
示例Playwright 脚本遇到 Cloudflare Turnstile 时,把页面地址和 sitekey 发给识别接口,拿回 token 填进表单,流程接着跑。下面用的是 Cloudflare 官方演示页和测试 sitekey。
{
  "type": "turnstile",
  "website_url": "https://demo.turnstile.workers.dev/",
  "website_key": "1x00000000000000000000AA"
}
token贴给你的 AI 助手(Claude、ChatGPT、Cursor 都行):它会先问清你要做什么,查我们的能力目录,把方案和费用讲给你确认,再写代码。
我想用 EveryInfra 万有引擎的 API 采集平台数据、搜索网页或识别验证码。请你当我的接入助手,按下面三步来。

第一步:先不要写代码。一轮一轮地问我,每次只问 1–3 个问题,直到下面这些都清楚:
1. 我要做什么,结果拿来干什么;
2. 从哪些平台或网站拿,具体是关键词、链接还是账号,一共多少;
3. 要哪些字段、多少条、什么时间范围;
4. 结果存成什么、存在哪里;
5. 脚本用什么语言、在哪里运行,跑一次还是定时跑;
6. 这次最多愿意花多少钱。
我答得含糊或前后矛盾,就继续追问;我说不知道,就给出建议让我确认。

第二步:先读 EveryInfra 写给 AI 的接入说明 https://everyinfra.com/agents.md,再到能力目录里找对应的能力、参数和价格(都不需要 Key):
- 平台数据:GET https://api.everyinfra.com/api/v1/social/catalog?platform=<平台名>
- 网页搜索:GET https://api.everyinfra.com/api/v1/search/tools
- 验证码:GET https://api.everyinfra.com/api/v1/captcha/types
然后把方案讲给我确认:用哪些能力、要发哪些请求、大约调用多少次、按目录价格大约花多少钱、结果长什么样。

第三步:我确认后再写代码,并遵守下面的约定:
- 请求:平台数据 POST https://api.everyinfra.com/api/v1/social,请求体 {"platform", "action", "params"};网页搜索 POST https://api.everyinfra.com/api/v1/search,请求体 {"tool", "params"};验证码 POST https://api.everyinfra.com/api/v1/captcha,请求体 {"type", 其他参数}。参数名和取值按目录原样使用,不要猜。
- 鉴权:请求头 Authorization: Bearer <API Key>,Key 从环境变量 EVERYINFRA_API_KEY 读取,不要写进代码、日志或提交记录。我还没有 Key 的话,提醒我去 https://everyinfra.com/app#keys 创建。
- 先用一个目标、少量条数试一次,确认返回结构再放大;一次传多个目标时按目标个数计费。
- 平台数据的慢任务或数据量大时,在请求体加 "mode": "async":接口先返回 202 和 job_id,再轮询 GET https://api.everyinfra.com/api/v1/jobs/{job_id},直到 status 为 succeeded 或 failed。202 不是成功。同步请求返回超时错误时,加上 "mode": "async" 重发同一个请求。
- 平台数据结果里有 next_page_token 时,把它作为 page_token 传回拿下一页,其他参数不变;每页算一次调用。
- 失败或空结果不形成最终扣费,已预扣的会自动退回;以响应里的 billing 和 refund 字段为准。
- 返回 422 时,按错误信息里的候选参数名和允许值修正,不要自行猜测参数。
- 返回 429 或 503 时,按 Retry-After 等待后再试;没有 Retry-After 就逐步拉长间隔。
- 网络中断或结果未知时,保留 request_id / job_id 并先查询,不要自动重发请求。

如果你能连接远程 MCP 服务器,也可以直接连 https://api.everyinfra.com/mcp(请求头 Authorization: Bearer <API Key>),用里面的工具完成同样的事,计费和规则与 API 相同。每个接口页还有专属提示词,比如 小红书搜索
选择一个工具,查看连接步骤
逐步接入 Amazon 评论读取,核对国家站点与商品身份,分离评论、变体和观察记录,处理去重与缺失,再用可验证的原文片段建立问题分类。
阅读完整文章按具体能力的计费单位结算,查看价格后再开始调用。
价格与支持类型读自各家官方定价页(2026-09-26),价格统一折算为每 1,000 个计费单位。
| 服务商 | 计费单位 | 起步价 | 最低公开价 | 我们的优势 |
|---|---|---|---|---|
EveryInfra(我们)按次付费,无月费,失败不扣费 | 每千次请求 | $0.6944 | $0.6944 | |
Serper预付,$50.00 起 | 每千次请求 | $1.00 | $0.30 |
|
| 每千次请求 | $25.00 | $1.96 |
| |
Tavily按月订阅,$30.00/月起 | 每千次请求 | $7.50 | $5.00 |
|
Exa按量付费 | 每千次请求 | $7.00 | $7.00 |
|
Brave Search API按量付费 | 每千次请求 | $5.00 | $5.00 |
|
| 每千次请求 | $5.00 | $1.00 |
| |
Jina AI Search预付,$50.00 起 | 每千次请求 | $0.50 | $0.45 |
|
Firecrawl Search按月订阅,$19.00/月起 | 每千次请求 | $7.60 | $1.20 |
|
Linkup按量付费 | 每千次请求 | $5.00 | $5.00 |
|
| 每千次请求 | $5.00 | $5.00 |
| |
| 每千页结果(每页 10 条) | $2.00 | $0.60 |
| |
SearchApi.io按月订阅,$40.00/月起 | 每千次请求 | $4.00 | $1.00 |
|
| 每千次请求 | $1.50 | $1.00 |
| |
Oxylabs (Google)按月订阅,$49.00/月起 | 每千页结果(每页 10 条) | $1.00 | $0.50 |
|
Scrapingdog按月订阅,$40.00/月起 | 每千次请求 | $1.00 | $0.136 |
|
Zenserp按月订阅,$49.99/月起 | 每千次请求 | $2.00 | $0.90 |
|
| 服务商 | 计费单位 | 起步价 | 最低公开价 | 我们的优势 |
|---|---|---|---|---|
EveryInfra(我们)按次付费,无月费;一次调用返回一整页结果 | 每千条结果 | $0.05556 | $0.05556 | |
Apify Store按月订阅,$19.00/月起 | 每千条结果 | $0.40–$5.00 | $0.30–$3.00 |
|
| 每千条结果 | $1.50 | $1.10 |
| |
TikHub预付,$5.00 起 | 每千次请求 | $1.00 | $0.50 |
|
| 每千个页面 | $3.80 | $0.599 |
| |
| 每千个额度 | $0.49 | $0.083 |
| |
ScrapeCreators预付,$47.00 起 | 每千次请求 | $1.88 | $0.99 |
|
EnsembleData按月订阅,$100.00/月起 | 每千个单位 | $2.22 | $0.93 |
|
ScrapingBee按月订阅,$19.00/月起 | 每千个额度 | $0.253 | $0.075 |
|
Oxylabs Web Scraper API按月订阅,$49.00/月起 | 每千个页面 | $1.15 | $0.25 |
|
Zyte API按量付费 | 每千个页面 | $0.13 | $0.060 |
|
验证码按覆盖对照:✓ 表示该服务商的定价页列出了这一类型。
| 服务商 | reCAPTCHA v2 | reCAPTCHA v3 | Turnstile | hCaptcha | 图形验证码 | 我们的优势 |
|---|---|---|---|---|---|---|
EveryInfra(我们)按成功识别付费,无月费 | 已列出 | 已列出 | 已列出 | 已列出 | 已列出 | |
2Captcha按量付费,价格随负载浮动 | 已列出 | 已列出 | 已列出 | 未列出 | 已列出 |
|
CapSolver按量付费 | 已列出 | 已列出 | 已列出 | 未列出 | 已列出 |
|
Anti-Captcha按量付费 | 已列出 | 已列出 | 已列出 | 未列出 | 已列出 |
|
CapMonster Cloud按量付费 | 已列出 | 已列出 | 已列出 | 未列出 | 已列出 |
|
DeathByCaptcha预付,$6.95 起 | 已列出 | 已列出 | 已列出 | 未列出 | 已列出 |
|
NextCaptcha按量付费 | 已列出 | 已列出 | 已列出 | 未列出 | 未列出 |
|
SolveCaptcha按量付费,价格随负载浮动 | 已列出 | 已列出 | 已列出 | 未列出 | 已列出 |
|
EzCaptcha按量付费 | 已列出 | 已列出 | 已列出 | 已列出 | 未列出 |
|
Capzy按量付费 | 已列出 | 已列出 | 已列出 | 未列出 | 已列出 |
|
AZcaptcha预付,$5.00 起 | 已列出 | 已列出 | 已列出 | 未列出 | 已列出 |
|
| 已列出 | 已列出 | 已列出 | 已列出 | 已列出 |
| |
TrueCaptcha预付,$1.00 起 | 未列出 | 未列出 | 未列出 | 未列出 | 已列出 |
|
NopeCHA按月订阅,$4.99/月起 | 按订阅额度计费,定价页不分类型标价 |
| ||||
按订阅额度计费,定价页不分类型标价
竞品价格按 2026-09-26 各家官方定价页记录,之后的调价不另行更新。数据采集的「每千条结果」按每次调用只返回 10 条保守折算,多数接口一次最多返回 50–200 条。我们的价格为公开标准价。
EveryInfra(万有引擎)是面向 AI 应用的基础设施平台。一把 API Key 就能调用数据采集(90 个平台、413 项能力)、AI 搜索、网页验证码识别,以及充值后免费使用的 OpenAI 兼容 AI 接口。
浏览基础设施市场覆盖小红书、抖音、微信公众号、TikTok、Amazon、淘宝、LinkedIn、谷歌地图点评等 90 个平台,分内容与社交、电商、点评、招聘商业和搜索网页几类。每个平台都有自己的接口文档页,写明参数和返回字段。
按品类查看全部平台按能力单价计费。数据采集 $0.56–$5.56 / 千次,按单次请求扣费,少数列表能力按条数分档计费(单价旁注明每多少条算一次);参数错误、失败或空结果不计费。验证码识别 $0.14–$4.58 / 千次成功解答,只按成功计费。
查看完整定价不需要。你只发送平台、能力和参数,就能拿回结构化 JSON,不用自己维护爬虫、平台账号或代理。
能。远程 MCP 服务器地址是 https://api.everyinfra.com/mcp,用 API Key 鉴权,Claude、Cursor、ChatGPT 等客户端可以直接调用全部能力;不用 MCP 时也可以直接调 REST API。
查看 MCP 配置从一项能力开始,将基础设施接入你的项目。
添加微信后回复「API」领取,注册后在控制台「余额与充值」兑换,进入赠送余额,24 小时内有效;普通注册不自动赠送。