Douyin API con Python: tres vías para obtener datos de Douyin, probadas
Tres formas de obtener datos de Douyin con Python: la plataforma oficial, scripts de código abierto o una API por llamada. Una cadena real: 0,0106 USD.
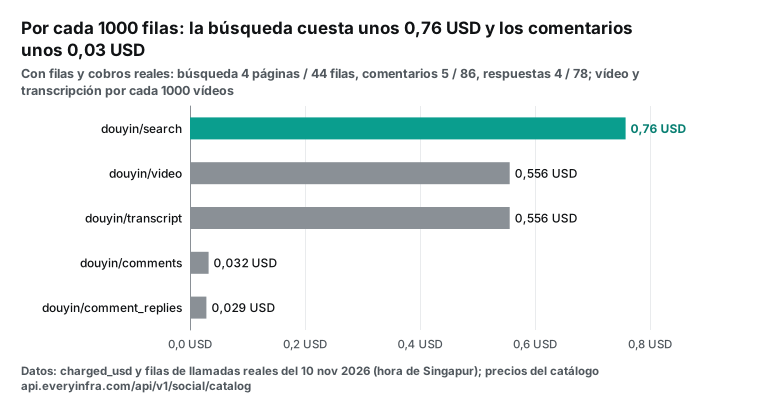
El 10 de noviembre de 2026, entre las 00:14 y las 00:34 (hora de Singapur), ejecutamos cuatro veces una cadena completa de datos de Douyin con Python y la librería requests. Cada cadena tenía cinco peticiones: búsqueda por palabra clave, detalle del vídeo, comentarios, respuestas a un comentario y transcripción del audio. Las 20 peticiones terminaron con HTTP 200. Cada cadena costó 0,010557 USD, y la búsqueda se llevó el 79 % de ese importe. Por cada 1000 filas, la búsqueda cuesta unos 0,76 USD, los comentarios unos 0,032 USD y las respuestas unos 0,029 USD.
Las otras dos vías las revisamos con sus documentos de primera mano. La plataforma abierta de Douyin entrega datos casi siempre con consentimiento del usuario, reserva parte de ellos a empresas y organismos públicos, y no tiene SDK de servidor para Python. Los proyectos de código abierto más populares en GitHub dicen en su propio README que necesitan una sesión iniciada o firmas de petición. Sus incidencias de los últimos 30 días muestran bloqueos y verificaciones nuevas.
Este artículo es para un lector concreto: un exportador, un analista o una oficina comercial de Chile que quiere escuchar lo que se dice en Douyin sobre la cereza chilena. Douyin es la aplicación de vídeo corto que se usa en China continental. Es distinta de TikTok, con otras cuentas, otro contenido y otra plataforma para desarrolladores. Lo que se comenta allí llega antes que muchas cifras de importación, porque mayoristas, minoristas y consumidores publican vídeos y comentarios todos los días de la temporada.
Explicamos qué pide cada vía, qué devuelve y cuánto cuesta. Describimos tres tipos de método: la plataforma oficial de Douyin, los scripts de código abierto y una API de datos de pago por llamada.
Por qué un exportador busca una «douyin api alternative»
La temporada 2026-2027 empezó con señales mezcladas. Según Xinhua, el primer envío aéreo de cerezas chilenas llegó a Shanghái el 18 de octubre de 2026, y la asociación de exportadores estimaba una producción de 727 000 toneladas y exportaciones de 667 000 toneladas, un 16 % más que la temporada anterior (Xinhua en español). A comienzos de noviembre, una consultora del sector citada por Green Network situaba la cifra en 574 000 toneladas, unos 115 millones de cajas de 5 kg, por las lluvias de El Niño.
La logística también se complicó. Un paro de camioneros en San Antonio obligó a mover a Valparaíso la operación del primer Cherry Express, que tenía carga prevista el 7 de noviembre y salida el 9 de noviembre (AgroLatam). Las navieras anunciaron salidas directas desde San Antonio y Valparaíso hacia Nansha y Hong Kong, con travesías de unos 23 días (MasContainer).
China sigue siendo el destino central. En el boletín de fruta de marzo de 2026, ODEPA informó que entre septiembre de 2025 y febrero de 2026 Chile exportó cerezas por 2602 millones de dólares FOB y 569 000 toneladas. China tuvo el 87 % del valor y del volumen, con un precio medio de 4,56 dólares FOB por kilo. Con esa dependencia, saber cómo reacciona el comprador chino cada semana tiene valor práctico.
Las cifras oficiales llegan con semanas de retraso. Lo que dicen los mayoristas de Guangzhou o los fruteros de Shanghái en Douyin llega el mismo día. Por eso muchos equipos buscan una "douyin api alternative": una forma de leer esos vídeos y comentarios sin tener una empresa en China ni un ingeniero dedicado a mantener un raspador. La tabla compara las tres vías.
| Pregunta | Plataforma abierta de Douyin | Scripts de código abierto | API por llamada (EveryInfra, probada aquí) |
|---|---|---|---|
| Quién puede usarla | Desarrolladores registrados; algunos datos solo para empresas y organismos públicos | Cualquiera | Cualquiera con una clave de API |
| Datos de qué cuentas | Solo de usuarios que dan su consentimiento | Lo que muestra la web pública, según la sesión | Vídeos, comentarios, respuestas y transcripciones públicas |
| Búsqueda por palabra clave | Solo el último día, o un programa beta | Un proyecto grande no la ofrece | douyin/search, desde 1 día hasta sin límite de fecha |
| Tiempo de aprobación | De 2 a 7 días hábiles por capacidad | Ninguno | Ninguno |
| Python | Sin SDK de servidor para Python | La mayoría son proyectos en Python | HTTPS simple |
| Riesgo principal | Las capacidades se pueden retirar | Sesiones, firmas y bloqueos cambian a menudo | Se paga por llamada; los fallos no se cobran |
Vía 1: la plataforma abierta de Douyin
Muchos tutoriales presentan la plataforma abierta de Douyin como una API general para cualquier dato. Los documentos oficiales no dicen eso. Casi todas las capacidades de datos dependen del consentimiento del usuario. Tu aplicación pide a un usuario de Douyin que inicie sesión y autorice el acceso. Después, la aplicación puede leer los vídeos, seguidores e interacciones de ese usuario, y de nadie más.
El documento de inicio de sesión y autorización (en chino) fija la duración de los tokens que muestra la tabla. La misma página indica que el usuario debe autorizar las capacidades de datos de negocio desde un ordenador.
| Token | Para qué sirve | Duración |
|---|---|---|
| access_token | APIs que necesitan consentimiento del usuario | 15 días |
| client_token | APIs sin consentimiento del usuario | 2 horas |
| refresh_token | Renovar el access_token, hasta 5 veces | 30 días; 195 días como máximo en total |
Quién puede pedir las capacidades de datos
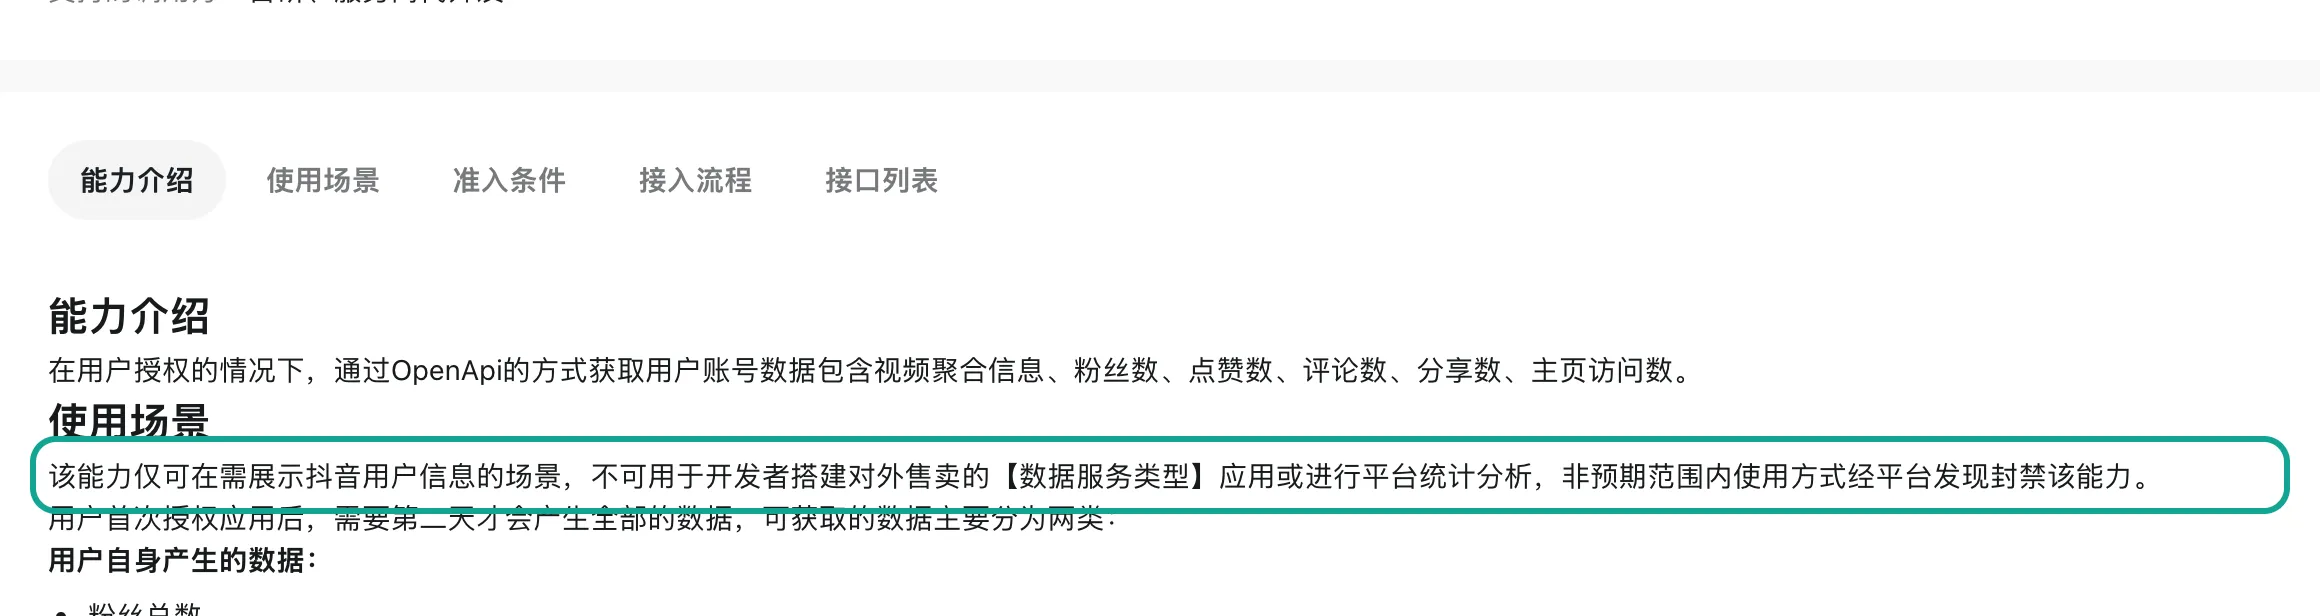
Abrimos cada página de capacidad. La de "datos de interacción del usuario" solo se abre a empresas, organismos de gobierno e instituciones públicas. Su apartado de uso dice que sirve solo para mostrar información del usuario de Douyin. No se puede usar para crear productos de datos que se vendan a terceros ni para estadísticas de la plataforma. La página advierte que el uso indebido lleva a la suspensión de la capacidad.
La capacidad de "datos de vídeo" también exige consentimiento. Con él, la aplicación lee el título, la portada, si el vídeo está fijado y la fecha de creación. También lee los recuentos oficiales de me gusta, reproducciones, compartidos y comentarios de ese usuario. Las aplicaciones móviles y web deben pedir dos capacidades a la vez, y la revisión tarda de 2 a 3 días hábiles. El endpoint de la lista de vídeos de la cuenta autorizada pide un token de usuario y, según la página, todavía no admite filtro por fecha.
Para los comentarios, la guía de gestión de comentarios de vídeo enumera cuatro endpoints: lista de comentarios, lista de respuestas, responder y fijar un comentario. El permiso es video.comment. La guía describe una herramienta interna que muestra en tiempo real los comentarios de una cuenta conectada. Es decir, tu propia cuenta o una cuenta que te autorizó. No da acceso a los comentarios de cualquier vídeo público.
Búsqueda: un día de resultados o un programa beta
La búsqueda es lo más importante para escuchar un tema. La plataforma tiene dos productos de búsqueda, y leímos los documentos de ambos. El primero es la "búsqueda de vídeos por palabra clave", con el permiso video.search. Pide solicitud de permiso y consentimiento del usuario. Antes hay que crear las palabras clave en una consola. La página dice que el endpoint solo devuelve vídeos del último día.
La plataforma de socios describe el mismo producto en su página de gestión de búsqueda de vídeos. El desarrollador registra palabras clave relacionadas con su negocio, busca vídeos públicos con esas palabras en el título y responde comentarios. Los resultados incluyen solo vídeos públicos del último día. La tabla de tipos de usuario y permisos marca este permiso como especial y desactivado por defecto.
El segundo producto es la "búsqueda de vídeos de Douyin", en el grupo de capacidades de búsqueda. La lista de OpenAPI la describe como los resultados de búsqueda para la consulta de un usuario. El resumen del SDK de OpenAPI le asigna el permiso aweme.dy.video_search_v2. Su página de producto dice que el acceso empieza con un formulario de prueba beta. Está pensado para aplicaciones que muestran contenido de Douyin a sus usuarios, no para estudios de mercado.
El acceso beta tiene su propio riesgo. El apartado 10.4.2 de las normas de operación de miniaplicaciones dice que el equipo de la plataforma puede retirar el acceso a una API en beta. Un seguimiento de temporada que depende de ese acceso puede quedarse sin datos a mitad de diciembre, justo en el pico de llegadas.
| Capacidad oficial | Permiso | Consentimiento | Regla de acceso o límite (según la página) | Revisión |
|---|---|---|---|---|
| Datos de interacción del usuario | data.external.user | Sí | Solo empresas, gobierno e instituciones públicas; no productos de datos a la venta | 2 a 3 días hábiles |
| Datos de vídeo | video.data.bind y otros | Sí | Dos capacidades a la vez | 2 a 3 días hábiles |
| Gestión de comentarios de vídeo | video.comment | Sí | Permiso de gestión de interacciones | No indicada |
| Búsqueda de vídeos por palabra clave | video.search | Sí | Permiso especial; solo el último día | No indicada |
| Búsqueda de vídeos de Douyin | aweme.dy.video_search_v2 | No (client_token) | Formulario de beta | No indicada |
| Cualquier capacidad | Varía | Varía | Indicar el caso de uso | 5 a 7 días hábiles |
La última fila viene del resumen de capacidades, que da de 5 a 7 días hábiles para pedir una capacidad o un aumento de cuota. La página para crear una aplicación añade que toda aplicación nueva empieza en modo de prueba, sin efecto en producción. Solo una aplicación publicada se puede usar con fines comerciales. Las normas de la capacidad de publicación piden aún más: capital registrado de al menos 500 000 yuanes y al menos 1 año desde el registro.
La vía oficial y Python
Quien busca "douyin api python" suele pasar por alto un dato. El SDK de servidor de la plataforma solo existe para Java, NodeJS y Go. No hay SDK para Python.
Aun así, puedes llamar a los endpoints oficiales desde Python, porque son HTTPS normal. Tendrás que escribir tú el intercambio, la renovación y la caducidad de los tokens. El obstáculo real no es el lenguaje. Sin una empresa registrada en China y sin usuarios que te den su consentimiento, la mayoría de los endpoints de datos no te van a responder.
Para un exportador chileno, esta vía sirve en un caso concreto: gestionar la cuenta oficial de la propia marca en Douyin. Con ella puedes leer y contestar los comentarios de tus vídeos y ver tus estadísticas. Lo que no puedes hacer es leer lo que dicen los mayoristas y los consumidores en sus propias cuentas.
Vía 2: proyectos douyin scraper de código abierto en GitHub
Si buscas "douyin scraper" o "douyin scraper github", arriba aparece siempre el mismo grupo de proyectos. El 10 de noviembre de 2026, a las 00:22 (hora de Singapur), consultamos la API pública de GitHub para seis proyectos habituales. Anotamos estrellas, fecha del último cambio y licencia. Después leímos cada README y las incidencias de los últimos 30 días. Esta sección solo recoge lo que dicen esas páginas públicas. No valoramos los proyectos.
| Proyecto | Estrellas | Último cambio | Licencia | Requisitos según el README |
|---|---|---|---|---|
| MediaCrawler | 70 735 | 2026-11-09 | Propia; el README prohíbe el uso comercial | Inicio de sesión con Playwright que guarda la sesión; código QR |
| Douyin_TikTok_Download_API | 21 313 | 2026-11-09 | Apache-2.0 | La versión 5 crea identidades de invitado con un navegador sin interfaz; firmas en Python puro |
| douyin-downloader | 12 576 | 2026-11-09 | MIT | Python 3.9 o superior; guardar cookies tras iniciar sesión en el navegador |
| TikTokDownload | 8892 | 2024-06-28 | MIT | Sin cambios desde hace más de un año |
| f2 | 2729 | 2026-10-19 | Apache-2.0 | Configurar cookies; parte del contenido pide sesión |
| Crawler | 1478 | 2026-10-19 | Licencia no comercial | Añadir tu cookie a un archivo de prueba; se recomienda un grupo de proxies |
Sesiones y firmas: un coste que no desaparece
El README de MediaCrawler explica su método sin rodeos. Usa Playwright para iniciar sesión y guardar el estado, y obtiene los valores de firma desde el navegador con JavaScript. Por defecto se conecta al Chrome del propio usuario en modo CDP, para reutilizar sus cookies y reducir el riesgo de detección. Su aviso legal dice que el código es solo para aprendizaje y referencia, y prohíbe el uso comercial. Una empresa exportadora no debería apoyar un servicio de pago en ese código.
El README de Douyin_TikTok_Download_API explica el gran problema de su versión 4. Los endpoints fallaban sin aviso cuando caducaban las cookies, cambiaban las firmas o llegaban límites de ritmo. Los usuarios se enteraban cuando alguien abría una incidencia. La versión 5 crea identidades de invitado con un navegador sin interfaz, mantiene un grupo de identidades y calcula varias firmas en Python puro. Para desplegarla hacen falta PostgreSQL con TimescaleDB, Redis 8 y Python 3.12.
Una línea de ese README importa mucho para escuchar un mercado. Bajo la tabla de funciones, el autor dice que Douyin no da resultados de búsqueda ni de etiquetas a los invitados. Tampoco ha probado si una identidad con sesión iniciada los obtiene. Por eso el proyecto no ofrece búsqueda por palabra clave en Douyin.
La actividad reciente muestra la carga de mantenimiento. La petición #821, integrada el 5 de noviembre de 2026, aceleró un 9,5 % un paso del cálculo de firmas. La incidencia #825, del 9 de noviembre de 2026, informa de una larga cola de peticiones de contenido sin procesar.
El README de douyin-downloader también es directo. Las comprobaciones de Douyin bloquean ahora las descargas por línea de comandos de vídeos sueltos, colecciones, música, me gusta y favoritos. Para las páginas de autor existe un plan B con Playwright, sin garantía. El README dice que renovar cookies o reintentar no resuelve estos bloqueos. La incidencia #257, del 25 de octubre de 2026, cuenta que las descargas de comentarios a veces dan archivos vacíos, sobre todo tras más de 50 descargas seguidas.
La incidencia #258, del 26 de octubre de 2026, muestra que Douyin rechaza la primera página de la lista de vídeos de un autor. El error dice que la comprobación de seguridad solo acepta peticiones hechas desde la propia página web, y que reintentar o volver a iniciar sesión no sirve. La incidencia #263, del 9 de noviembre de 2026, dice que una sesión nueva tampoco devuelve el detalle del vídeo, cuando unas semanas antes sí funcionaba.
Las verificaciones también cambian. La incidencia #996 de MediaCrawler, del 28 de octubre de 2026, describe una prueba nueva en la búsqueda web de Douyin. Una ventana tapa los resultados y pide elegir, en una cuadrícula de nueve imágenes, las que coinciden con un texto, y arrastrarlas a una zona. Quien la reportó escribió que no intentó resolverla de forma automática. La petición #998, del 2 de noviembre de 2026, corrige cómo se leen los identificadores en los enlaces de publicaciones con fotos.
No explicamos cómo saltarse estas comprobaciones, ni lo recomendamos. Las enumeramos por un motivo. El coste principal de un raspador propio no es escribir la primera versión. Es el trabajo semanal de seguir los cambios de la plataforma, y el riesgo de quedarse sin datos a mitad de la temporada.
Dos datos que se pasan por alto: robots.txt y licencias
Leímos el archivo robots.txt de la web de Douyin el 10 de noviembre de 2026, a las 00:35 (hora de Singapur). Nombra 26 rastreadores de buscadores y de IA. Para ese grupo prohíbe rutas como /follow y las páginas de búsqueda con el parámetro general_search. Un segundo grupo prohíbe rutas como /video/ y /search/. El archivo no tiene un grupo comodín para todos los rastreadores. Un robots.txt no es un texto legal, pero muestra la postura de la plataforma sobre sus páginas de búsqueda.
En cuanto a licencias, dos de los seis proyectos de la tabla prohíben el uso comercial. Un exportador que usa los datos para vender mejor hace un uso comercial. Consulta con tu equipo legal. Este artículo no es asesoría legal.
Vía 3: una cadena douyin api python de pago por llamada
La tercera vía deja en manos del proveedor de la API las sesiones, las firmas, las verificaciones y los cambios de página. Tú envías peticiones HTTP y pagas por llamada. Probamos la API de datos de EveryInfra con cinco capacidades. Son douyin/search para buscar, douyin/video para el detalle, douyin/comments para los comentarios, douyin/comment_replies para las respuestas y douyin/transcript para el texto hablado. El resumen está en la página de la API de Douyin.
Los nombres, parámetros, precios y campos vienen del catálogo gratuito, que leímos a las 00:13 (hora de Singapur). En el catálogo, douyin/search cuesta 0,008333 USD por página. Las otras cuatro cuestan 0,000556 USD por llamada. Comentarios y respuestas se cobran por tramos de 20 filas, y un tramo sin filas no se cobra.


Este es el script que ejecutamos. Solo necesita requests y lee la clave desde una variable de entorno. Elige el resultado con más comentarios y, dentro de él, el comentario con más respuestas. Guarda cada petición y la respuesta completa en un archivo JSON, para poder revisar cada número después. Si recibe un 429, espera 60 segundos y lo intenta de nuevo, porque nuestra clave de prueba admite 10 peticiones por minuto.
"""Douyin chain: search -> video -> comments -> comment_replies -> transcript."""
import json, os, sys, time
from pathlib import Path
import requests

API = "https://api.everyinfra.com/api/v1/social"
KEY = os.environ["EVERYINFRA_API_KEY"]          # never hard-code the key
SESSION = requests.Session()
SESSION.headers.update({"Authorization": f"Bearer {KEY}", "Content-Type": "application/json"})

def call(action, params, tag, name):
    body = {"platform": "douyin", "action": action, "params": params}
    for attempt in range(3):
        t0 = time.time()
        r = SESSION.post(API, json=body, timeout=120)
        dt = round(time.time() - t0, 2)
        if r.status_code == 429:                  # rate limited: wait, then retry
            time.sleep(60)
            continue
        break
    data = r.json()
    Path(tag).mkdir(exist_ok=True)
    Path(tag, f"{name}.json").write_text(json.dumps(
        {"elapsed_s": dt, "http_status": r.status_code, "request": body, "response": data},
        ensure_ascii=False, indent=1))
    print(name, r.status_code, dt, (data.get("billing") or {}).get("charged_usd"))
    return data

def rows_of(data):
    rows = data.get("results") or []
    return rows if isinstance(rows, list) else [rows]

def main(keyword, tag):
    s = call("search", {"keyword": keyword, "sort": "most_liked",
                        "publish_time": "half_year", "page_token": ""}, tag, "1_search")
    url = max(rows_of(s), key=lambda v: v.get("comment_count") or 0)["url"]
    call("video", {"url": url}, tag, "2_video")
    c = call("comments", {"url": url, "page_token": ""}, tag, "3_comments")
    top = max([x for x in rows_of(c) if not x.get("is_reply")], key=lambda x: x.get("reply_count") or 0)
    call("comment_replies", {"url": url, "comment_id": str(top["id"]), "page_token": ""}, tag, "4_replies")
    call("transcript", {"url": url}, tag, "5_transcript")

if __name__ == "__main__":
    main(sys.argv[1], sys.argv[2])
Define la clave con export EVERYINFRA_API_KEY=... y ejecuta el script con una palabra clave y el nombre de una carpeta. Hay tres detalles del código que conviene explicar. Primero, requests.Session reutiliza conexiones. La documentación de requests explica que varias peticiones al mismo servidor pueden reutilizar la conexión TCP, lo que acelera mucho. Las cinco peticiones de la cadena van a la misma dirección.
Segundo, mantén timeout=120. El servidor da 85 segundos a cada petición síncrona, así que el cliente debe esperar más. Tercero, envía page_token como cadena vacía. El catálogo dice que la cadena vacía empieza en la página uno y que la respuesta trae next_page_token. Si omites el parámetro, obtienes una sola llamada sin página siguiente.
Usamos requests 2.34.2, que pide Python 3.10 o superior. Python 3.15.2, publicado el 25 de octubre de 2026, es una versión urgente de seguridad con arreglos en ssl y tarfile. Conviene actualizar las máquinas que ejecutan tareas de datos largas.
Si tu equipo prefiere trabajar con un asistente de IA, puedes conectar las mismas capacidades por MCP remoto. MCP es una forma estándar de que las herramientas de IA llamen a servicios externos. La configuración de abajo es un ejemplo. Los nombres de campo cambian un poco entre clientes, y la clave sale otra vez de una variable de entorno. Con la conexión hecha, el asistente usa la herramienta everyinfra_call_api con la misma plataforma, acción y parámetros. La página MCP de Douyin lista las herramientas.
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
Prueba real: tres palabras clave, cuatro cadenas
Elegimos tres palabras clave de campos distintos, para que el mismo script se enfrentara a contenidos distintos. La principal para este artículo es "cerezas chilenas", que en chino se dice "zhili chelizi". Las otras dos fueron "naranjas de Gannan", una fruta china cuya cosecha de 2026 empezó el 6 de noviembre, y "vacuna contra la gripe", un tema de salud pública en plena temporada.
| Prueba | Hora (Singapur) | Palabra clave (traducida) | Filas de búsqueda | Comentarios | Respuestas | Transcripción | Tiempo en serie | Cargo |
|---|---|---|---|---|---|---|---|---|
| 1 | 00:14 | Naranjas de Gannan | 10 | 18 | 20 | 1502 caracteres | 48,18 s | 0,010557 USD |
| 2 | 00:24 | Vacuna contra la gripe | 11 | 20 | 20 | 13 caracteres | 35,85 s | 0,010557 USD |
| 3 | 00:28 | Cerezas chilenas | 10 | 19 | 18 | 526 caracteres | 38,84 s | 0,010557 USD |
| 4 (en paralelo) | 00:34 | Naranjas de Gannan | 11 | 20 | 20 | no contado | 33,49 s de reloj | 0,010557 USD |
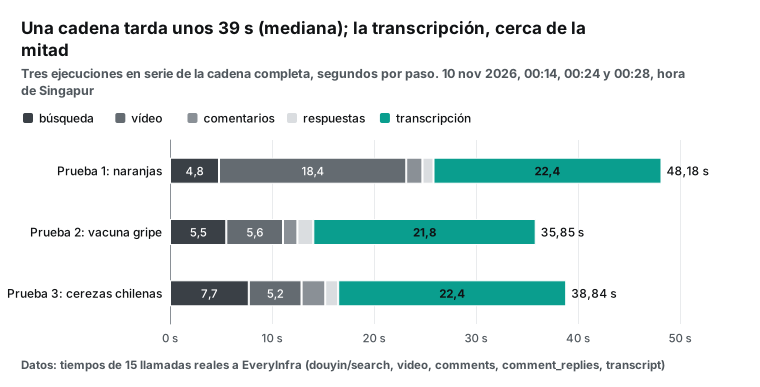
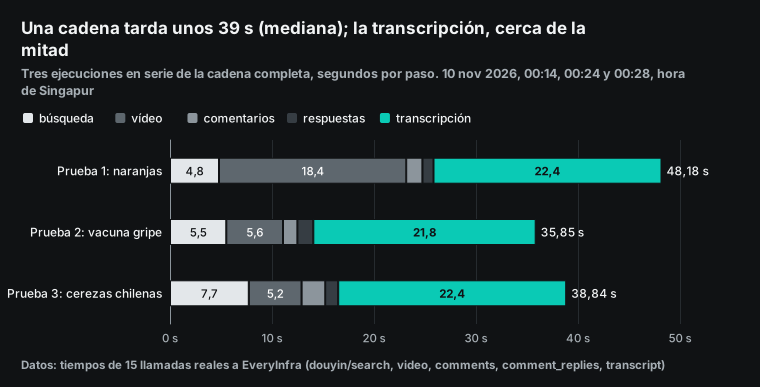
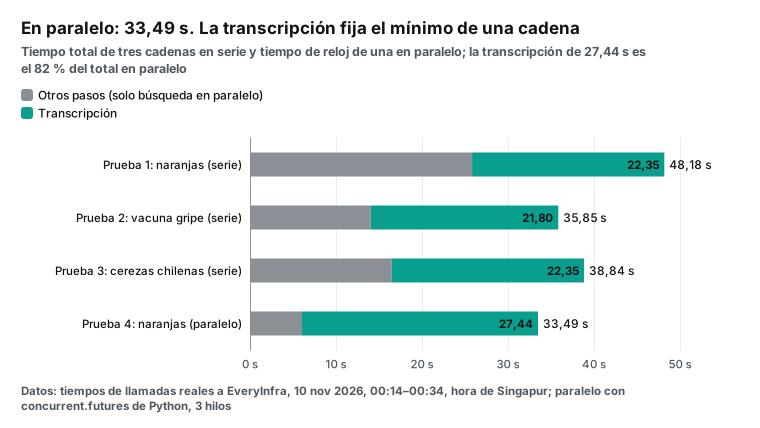
Las 20 peticiones terminaron con HTTP 200. El cargo fue idéntico en todas las cadenas: 0,008333 USD por la búsqueda y cuatro llamadas de 0,000556 USD. Las tres cadenas en serie tardaron 35,85, 38,84 y 48,18 segundos, con una mediana de 38,84 segundos. Antes de la prueba fijamos como meta una mediana de 30 segundos o menos, y no la cumplimos. La causa principal fue la transcripción, con 22,35, 21,8 y 22,35 segundos, es decir, el 46,4 %, el 60,8 % y el 57,5 % del tiempo en serie.
Una aclaración sobre esos tiempos. El tiempo en serie es la suma de los cinco pasos, sin esperas por límite de ritmo. En cada prueba en serie, al menos un paso recibió primero un HTTP 429. Nuestra clave de prueba admite 10 peticiones por minuto. El script esperó 60 segundos y el reintento funcionó. Desde la búsqueda hasta la transcripción, el reloj marcó unos 108, 97 y 99 segundos. Los 429 no se cobraron.
La transcripción descarga primero el audio y luego convierte la voz en texto, así que su duración no sigue a la del vídeo. El vídeo de la prueba 2 duraba 5 segundos y su transcripción tardó 21,8 segundos. El detalle del vídeo de la prueba 1 tardó 18,36 segundos, mientras que en las otras tres cadenas tardó entre 5,17 y 10,06 segundos. Una llamada suelta puede variar bastante.
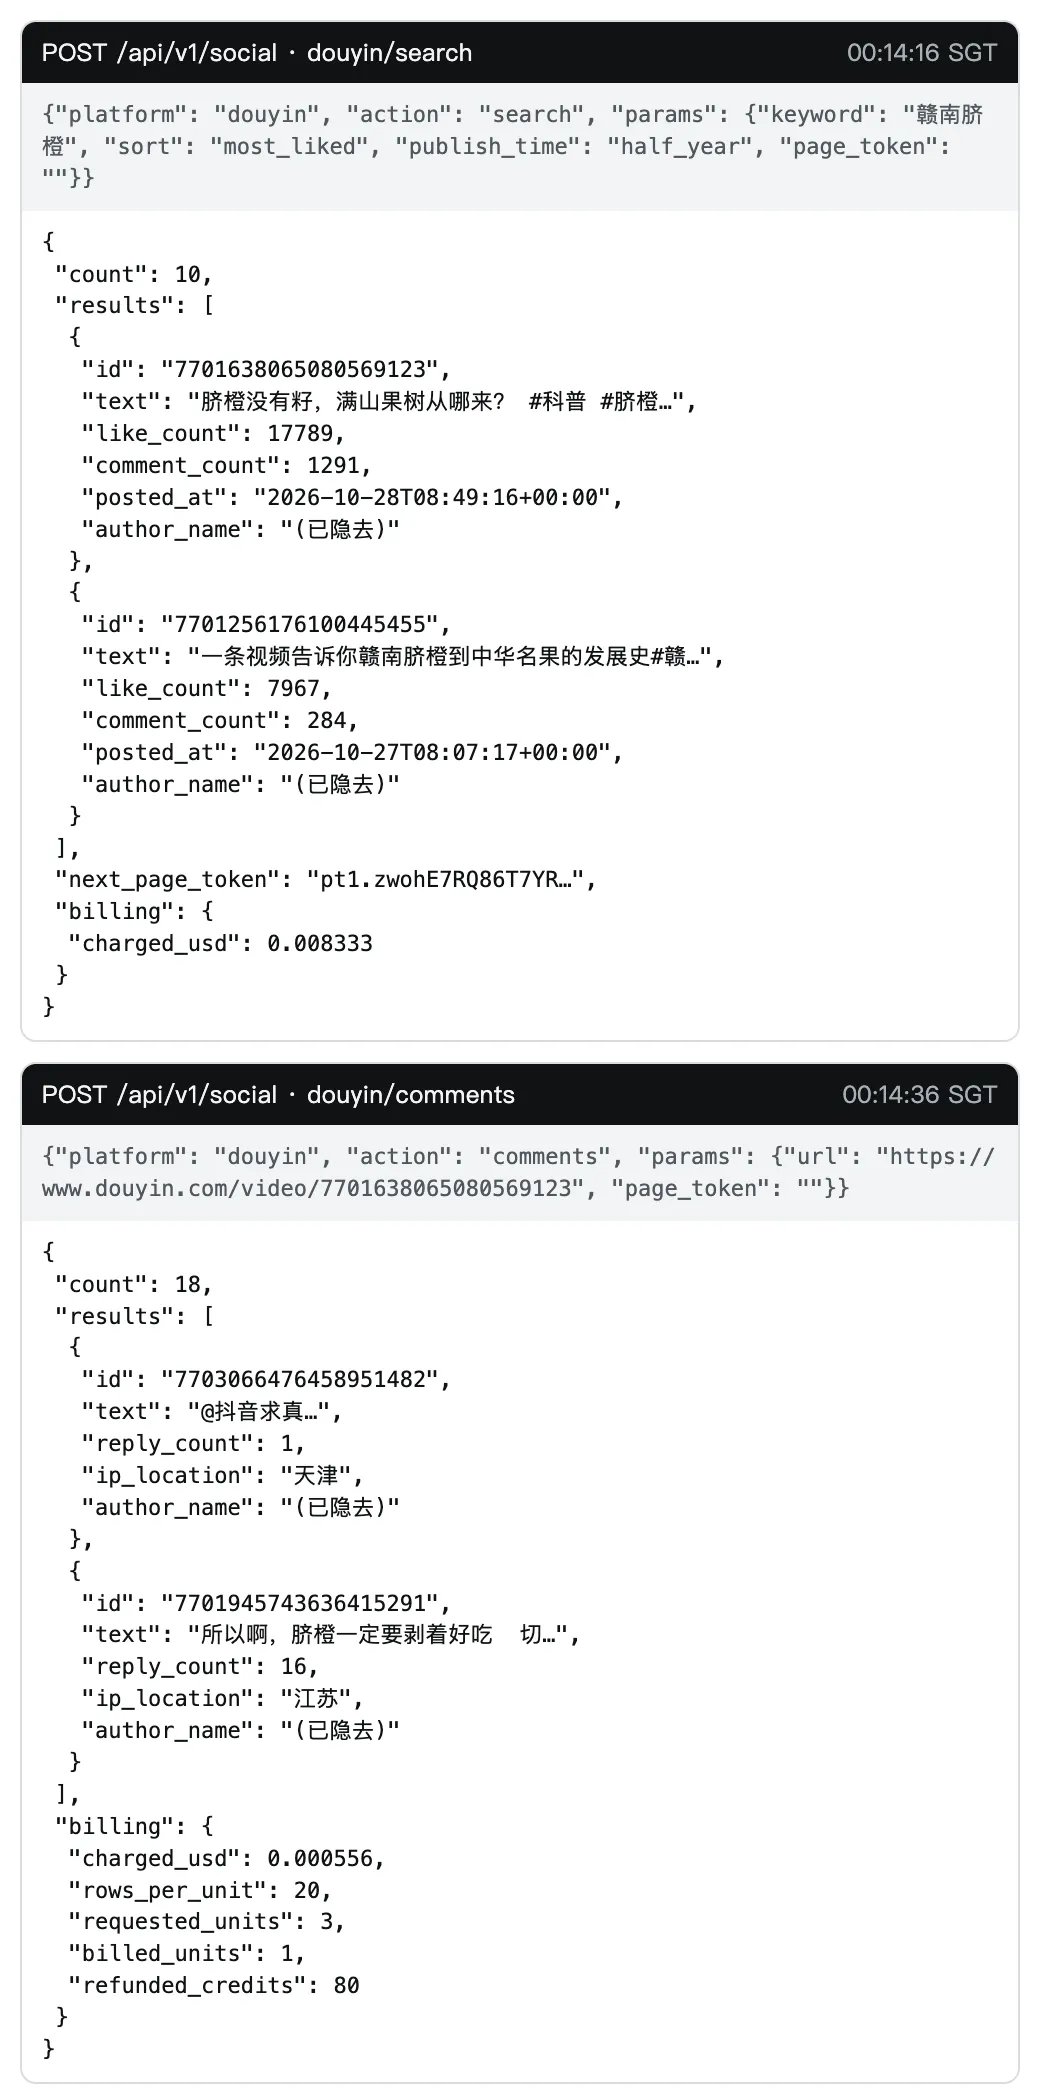
La captura muestra respuestas reales de la prueba 1. Arriba está la petición de búsqueda con sus dos primeros resultados. Abajo está la petición de comentarios con el detalle de facturación. Ocultamos los nombres de usuario y quitamos los campos de saldo de la cuenta.
Lo que la cadena de la cereza le dice a un exportador
La prueba 3 es la más útil para un exportador chileno. La búsqueda "cerezas chilenas", ordenada por más me gusta en el último medio año, devolvió 10 vídeos. Todos se publicaron entre el 3 y el 9 de noviembre de 2026, es decir, en la primera semana de la carga aérea. Los me gusta iban de 1560 a 32. La tabla resume los cinco primeros, con el tema traducido del texto del vídeo.
| Puesto por me gusta | Me gusta | Comentarios | Duración | Publicado (UTC) | Tema del texto (traducido) |
|---|---|---|---|---|---|
| 1 | 1560 | 626 | 120 s | 2026-11-03 | Un mayorista: la carga aérea empezó con el mercado parado |
| 2 | 409 | 31 | 21 s | 2026-11-09 | La primera cereza aérea ya está a la venta, más barata que otros años |
| 3 | 240 | 51 | 66 s | 2026-11-07 | Guangzhou sigue siendo el centro de la cereza; calendario de barcos |
| 4 | 235 | 5 | 41 s | 2026-11-09 | Más de 80 toneladas llegan a Shanghái en un vuelo chárter |
| 5 | 228 | 78 | 91 s | 2026-11-04 | "El año más difícil": de 140 a 115 millones de cajas |
El vídeo del puesto 5 menciona una caída de 140 a 115 millones de cajas. Esa cifra de 115 millones coincide con la estimación revisada que publicó Green Network a comienzos de noviembre. Es un ejemplo útil: una cifra del sector chileno ya circulaba entre los comerciantes chinos en Douyin una semana después.
El script eligió el vídeo con más comentarios, que también fue el de más me gusta. Lo publicó un mayorista de fruta el 3 de noviembre de 2026, con 1560 me gusta, 626 comentarios y 2224 compartidos. Sus etiquetas, traducidas, eran "precios de la nueva temporada de cereza", "las penas del frutero", "día a día del mayorista de fruta" y "cereza por avión". La transcripción devolvió 526 caracteres en 57 segmentos, sin signos de puntuación, que es lo normal en un reconocimiento de voz.
En el audio, el mayorista hace sus cuentas en voz alta, caja por caja. La tabla recoge sus cifras tal como las dice. Cuenta que compró 120 cajas a 360 yuanes y que, a ese precio, no gana dinero. Dice además que la caja vale más de 100 yuanes menos que en la misma fecha del año anterior.
| Concepto, según el vídeo | Cifra dicha | Por caja |
|---|---|---|
| Flete aéreo | 6 dólares por kilo, 5,7 kg brutos, cambio de unos 6,7 | unos 229 yuanes |
| Despacho de aduana | unos 21 yuanes | unos 21 yuanes |
| Impuestos | unos 25 yuanes | unos 25 yuanes |
| Subtotal sin gastos del mercado chino | unos 275 yuanes | |
| Precio de compra en el mercado mayorista | 360 yuanes | 360 yuanes |
Son afirmaciones del autor del vídeo, no datos verificados por nosotros. Aun así, un exportador puede compararlas con sus propias liquidaciones. Este tipo de detalle casi nunca aparece en un informe de mercado, y aquí llegó una semana después del primer vuelo.
Los comentarios añaden contexto. La primera página devolvió 19 comentarios de 8 ubicaciones IP, con Guangdong (5) y Yunnan (4) a la cabeza. La mediana de me gusta fue 0, y los tres comentarios con más me gusta reunieron el 55,6 % del total. Muchos vienen de fruteros: uno dice que en su tienda nadie compra, ni barato ni caro. Otro avisa de que la carga marítima sale de San Antonio el 9 de noviembre y llega a Nansha el 2 de diciembre. La salida coincide con el primer barco directo a Nansha que anunció MasContainer.
El comentario con más respuestas marcaba un reply_count de 17, y la página devolvió 18 filas, así que el contador puede ir un poco por detrás. De esas 18, 16 contestaban a otra respuesta del hilo, con el campo reply_to_reply_id. En ese hilo, varios comerciantes dicen que este año también bajan las fresas, los arándanos y algunos cítricos. Si solo lees los comentarios de primer nivel, te pierdes esta conversación entre comerciantes, que es justo la que interesa a un exportador.
Paginación con next_page_token
Los hilos de comentarios y los resultados de búsqueda de Douyin son largos, y la paginación es donde más se equivocan los scripts de Python. El 10 de noviembre de 2026, de 00:16 a 00:17 (hora de Singapur), usamos los tokens de la prueba 1 para pedir más páginas. Pedimos la página 2 de búsqueda, las páginas 2 y 3 de comentarios y la página 2 de respuestas.
tok = first_page["next_page_token"]          # from the response of page 1
while tok:
    d = call("comments", {"url": url, "page_token": tok}, "pages", f"comments_{n}")
    tok = d.get("next_page_token")            # missing key = last page
    n += 1
Los resultados coincidieron con el catálogo, con una sorpresa. La página 2 de búsqueda devolvió 13 filas, más que las 10 por defecto, sin repetir ninguna de la página 1. El catálogo dice que la búsqueda toma páginas enteras de Douyin sin recortarlas y descarta los vídeos ya entregados. Las tres páginas de comentarios devolvieron 18, 9 y 20 filas, 47 en total y sin duplicados. El vídeo tenía 1291 comentarios, cifra que incluye las respuestas.
El catálogo permite hasta 50 comentarios de primer nivel por página. Cada página trajo solo entre 9 y 20, así que cada una cobró un tramo. La respuesta mostró requested_units 3, billed_units 1 y refunded_credits 80. Dicho de forma simple, la llamada precobró tres tramos y devolvió dos porque llegaron menos filas. Las dos páginas de respuestas trajeron 20 filas cada una, 40 en total y sin duplicados. El comentario padre tenía un reply_count de 66, así que dos páginas cubrieron el 61 % del hilo.
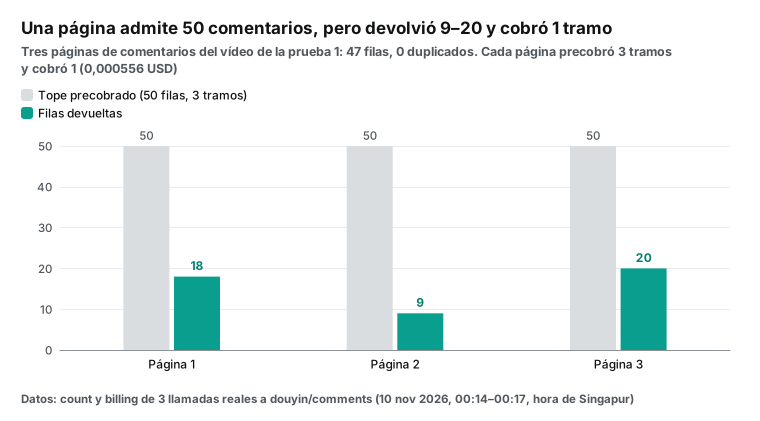
Esto cambia dos cosas en tu script. Primero, no calcules con 50 filas por página. Nuestras tres páginas promediaron 15,7 filas, así que usa unas 16. Segundo, no pagas por 50 filas cuando llegan 9, porque el cobro sigue a las filas reales. El token vale 24 horas y deja de servir si cambia cualquier parámetro. Si el script se detiene a mitad, vuelve a la página uno.
Campos: qué devuelve cada paso
La tabla lista los campos principales que devolvió cada paso en nuestras pruebas. Revisamos cada campo con response_fields del catálogo. Solo mostramos los que más usa un analista; la lista completa está en el catálogo.
| Capacidad | Campos por fila (medidos) | Campos habituales | Notas |
|---|---|---|---|
douyin/search | 29 a 30 | id, url, text, like_count, comment_count, share_count, collect_count, posted_at, author_follower_count, hashtags | Sin view_count; next_page_token arriba y en cada fila |
douyin/video | 30 o 46 | Los de búsqueda más duration_sec, music, video_tags, city, location | La prueba 1 trajo 46 campos; la 2 y la 3, 30, según el vídeo |
douyin/comments | 16 | id, text, like_count, reply_count, ip_location, liked_by_author, posted_at | 18 de 18, 20 de 20 y 19 de 19 filas con ubicación IP |
douyin/comment_replies | 14 a 16 | id, text, like_count, reply_to_id, reply_to_reply_id, posted_at | reply_to_reply_id solo en respuestas a respuestas; 0 de 58 respuestas con ip_location |
douyin/transcript | 21 | text, segments (start, end, text), duration_sec, audio_url | 170, 2 y 57 segmentos en las pruebas 1 a 3 |
Ninguna fila de búsqueda trajo view_count. El catálogo explica que Douyin no publica las reproducciones. La mayoría de los resultados no tienen ese campo, y un valor 0 no significa cero vistas. Para medir alcance usa me gusta, comentarios y compartidos. En la prueba 1, el detalle mostró view_count 0 junto a 17 789 me gusta y 10 584 compartidos.
El campo posted_at usa ISO 8601 con zona horaria, por ejemplo 2026-11-03T12:27:19+00:00 para el vídeo de la cereza. pandas y la mayoría de las bases de datos lo leen directamente. Los campos video_url y audio_url llevan firma y caducan, así que descarga pronto lo que quieras guardar. Los nombres y avatares de quienes comentan son datos personales. Aquí los ocultamos y recomendamos hacer lo mismo.
Unir los cinco pasos en una tabla con pandas
Recoger datos es solo el primer paso. Con pandas unimos los cinco JSON de cada cadena en una tabla con una fila por comentario. A cada comentario le añadimos los me gusta y la fecha del vídeo, y calculamos las horas desde la publicación, la dispersión de ubicaciones IP y la concentración de me gusta. El código para leer los archivos es corto.
import json, pandas as pd
v = json.load(open("run3/2_video.json"))["response"]["results"]
c = pd.DataFrame(json.load(open("run3/3_comments.json"))["response"]["results"])
c["posted_at"] = pd.to_datetime(c["posted_at"])
c["hours_after_video"] = (c["posted_at"] - pd.to_datetime(v["posted_at"])).dt.total_seconds() / 3600
summary = {"ip_top": c["ip_location"].value_counts().head(4).to_dict(),
           "lag_median_h": c["hours_after_video"].median(),
           "top3_like_share": c["like_count"].nlargest(3).sum() / c["like_count"].sum()}
Las primeras páginas de comentarios de los tres vídeos fueron muy distintas, como muestra la tabla. En el vídeo de naranjas, 8 de 18 comentarios venían de la propia provincia productora. El vídeo de la gripe recibió comentarios de muchos más lugares y durante semanas. El de la cereza reunió a comerciantes de pocas provincias en pocos días.
| Primera página de comentarios | Comentarios | Ubicaciones IP | Mediana de horas tras publicar | Me gusta de los 3 primeros | Mediana de me gusta |
|---|---|---|---|---|---|
| Prueba 1, naranjas | 18 | 7 | 21,4 | 84,6 % | 6,5 |
| Prueba 2, gripe | 20 | 14 | 402,9 | 45,9 % | 104,5 |
| Prueba 3, cerezas | 19 | 8 | 38,3 | 55,6 % | 0 |
Estos números dejan dos lecciones. Primera: la primera página de comentarios no sigue el orden temporal. Es el conjunto de comentarios destacados según la clasificación de Douyin. Muestra dónde se concentra la conversación, pero no sirve para tendencias en el tiempo ni para cuotas regionales. Para cuotas, recorre todas las páginas.
Segunda: la ubicación IP solo aparece en los comentarios de primer nivel. Los 57 comentarios de primer nivel de nuestras pruebas tenían ip_location, y ninguna de las 58 respuestas lo tenía, aunque el catálogo lo lista para respuestas. Para un análisis regional, usa solo comentarios de primer nivel y asigna cada respuesta a la región de su comentario padre, o déjalas fuera. Para un exportador esto importa: saber si la queja viene de Guangdong o de Yunnan ayuda a leer qué canal está saturado.
Coste por 1000 filas: la búsqueda es cara, los comentarios baratos
Muchas personas que buscan una "douyin api alternative" quieren un solo número: cuánto cuestan 1000 filas. No dividimos el precio del catálogo entre el límite de la página. Usamos las filas reales y los cargos reales de nuestras llamadas. La muestra son las tres cadenas en serie (pruebas 1 a 3) más las cuatro páginas extra que pedimos con los tokens de la prueba 1: la página 2 de búsqueda, las páginas 2 y 3 de comentarios y la página 2 de respuestas. Son 19 peticiones. La prueba 4 repitió en paralelo la palabra clave de la prueba 1, así que la dejamos fuera para no contar dos veces el mismo tema. Por eso la tabla muestra 4 llamadas de búsqueda, 5 de comentarios y 4 de respuestas.
| Capacidad | Regla de cobro (catálogo) | Llamadas | Filas devueltas | Cargo | Coste por 1000 filas |
|---|---|---|---|---|---|
douyin/search | 0,008333 USD por página | 4 | 44 | 0,033332 USD | unos 0,76 USD |
douyin/comments | 0,000556 USD por tramo de 20 filas | 5 | 86 | 0,002780 USD | unos 0,032 USD |
douyin/comment_replies | 0,000556 USD por tramo de 20 filas | 4 | 78 | 0,002224 USD | unos 0,029 USD |
douyin/video | 0,000556 USD por llamada | 3 | 3 vídeos | 0,001668 USD | 0,556 USD por 1000 vídeos |
douyin/transcript | 0,000556 USD por llamada | 3 | 3 vídeos | 0,001668 USD | 0,556 USD por 1000 vídeos |
La búsqueda cuesta unos 0,76 USD por 1000 filas. Es 23 veces lo que cuestan los comentarios y 27 veces lo que cuestan las respuestas. La razón es sencilla. Una página de búsqueda trae entre 10 y 13 filas por 0,008333 USD, mientras que un tramo de comentarios trae hasta 20 filas por 0,000556 USD.
Por eso un diseño barato usa muchas palabras clave, una página de búsqueda por palabra y mucha profundidad en los comentarios de los vídeos encontrados. Un diseño con pocas palabras y muchas páginas de búsqueda cuesta bastante más. Nuestra comparación de precios de la API de Douyin compara 37 capacidades una a una, así que no la repetimos aquí.
Otra muestra no cambia el resultado. Si sumamos la prueba 4 y contamos las 24 peticiones, la búsqueda son 5 llamadas, 55 filas y 0,041665 USD, unos 0,76 USD por 1000 filas. Los comentarios son 6 llamadas, 106 filas y 0,003336 USD, unos 0,031 USD. Las respuestas son 5 llamadas, 98 filas y 0,00278 USD, unos 0,028 USD. La búsqueda sigue costando 24 veces lo que los comentarios y 27 veces lo que las respuestas.
Cuánto tiempo ahorra trabajar en paralelo
La transcripción es el paso más lento, y el detalle, la transcripción y los comentarios no dependen entre sí. La idea natural es lanzarlos a la vez después de la búsqueda. Cambiamos el script con concurrent.futures, de la librería estándar de Python. Lo ejecutamos una vez el 10 de noviembre de 2026, a las 00:34 (hora de Singapur).
from concurrent.futures import ThreadPoolExecutor

def comments_then_replies():
    c = call("comments", {"url": url, "page_token": ""}, tag, "3_comments")
    top = max(rows_of(c), key=lambda x: x.get("reply_count") or 0)
    call("comment_replies", {"url": url, "comment_id": str(top["id"]), "page_token": ""}, tag, "4_replies")

with ThreadPoolExecutor(max_workers=3) as pool:
    jobs = [pool.submit(call, "video", {"url": url}, tag, "2_video"),
            pool.submit(call, "transcript", {"url": url}, tag, "5_transcript"),
            pool.submit(comments_then_replies)]
    for j in jobs:
        j.result()
La cadena en paralelo tardó 33,49 segundos de reloj. La suma de los cinco pasos fue 47,52 segundos. Frente a la mediana en serie de 38,84 segundos, solo ganó un 14 %. En esta ejecución la transcripción tardó 27,44 segundos, así que la cadena duró casi exactamente la búsqueda (6,05 segundos) más la transcripción. El trabajo en paralelo esconde los comentarios, las respuestas y el detalle dentro de la espera de la transcripción. No puede hacer una cadena más corta que la transcripción.
Para procesar más vídeos por minuto, lanza varios vídeos en paralelo y respeta el límite por minuto de tu clave. Nuestra clave de prueba admite 10 peticiones por minuto y una cadena son 5 peticiones, así que caben como mucho 2 cadenas por minuto. Para transcripciones muy lentas, añade "mode": "async" al cuerpo de la petición. Recibes un identificador de trabajo y consultas el resultado después, sin dejar la conexión abierta.
Presupuesto para seguir una temporada de cereza
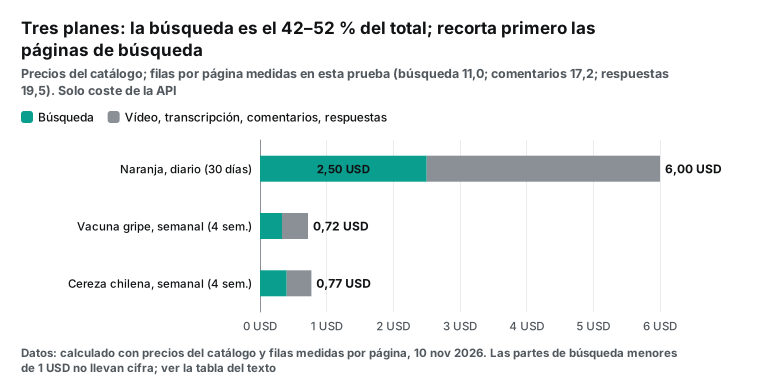
Los precios unitarios solos cuestan de leer, así que calculamos tres planes realistas. Los precios vienen del catálogo y las filas por página, de los promedios de la misma muestra que la tabla de costes: 11,0 en búsqueda, 17,2 en comentarios y 19,5 en respuestas. El plan de la cereza es el que haría un exportador durante la temporada. Los otros dos muestran cómo cambia la factura con la frecuencia.
| Plan | Cada ejecución | Peticiones | Coste por ejecución | Filas por ejecución | Frecuencia | Total |
|---|---|---|---|---|---|---|
| Informe semanal de cereza chilena | 6 palabras clave, 2 páginas de búsqueda cada una; 4 vídeos por palabra con detalle, transcripción y 3 páginas de comentarios; respuestas de 2 comentarios destacados por vídeo | 180 | 0,1934 USD | 2354 | Semanal, 4 semanas | 0,77 USD |
| Informe diario de naranja | 10 palabras clave, 1 página cada una; 3 vídeos por palabra, mismos pasos | 220 | 0,2001 USD | 2888 | Diario, 30 días | 6,00 USD |
| Informe semanal de gripe | 5 palabras clave, 2 páginas cada una; 5 vídeos por palabra, mismos pasos | 185 | 0,1806 USD | 2425 | Semanal, 4 semanas | 0,72 USD |
El plan de la cereza reúne unas 2354 filas por semana por 0,1934 USD. La búsqueda es el 51,7 % de ese coste, la proporción más alta de los tres planes. Una temporada completa, de mediados de octubre a mediados de febrero, son unas 18 semanas. El mismo plan costaría unos 3,48 USD en tarifas de API. Es una proyección nuestra con los precios medidos, no un resultado de la prueba.
En los tres planes, la búsqueda pesa entre el 41,6 % y el 51,7 % del coste. Si el presupuesto aprieta, recorta primero las páginas de búsqueda, no la profundidad de los comentarios. Estas cifras solo incluyen la API, no tus servidores, tu almacenamiento ni las horas del equipo.
Errores y cobros: cuándo no pagas nada
Cuando un script falla, la pregunta difícil es si el fallo costó dinero y si conviene reintentar. El 10 de noviembre de 2026, a las 00:30 (hora de Singapur), hicimos tres llamadas erróneas a propósito. La tabla las junta con lo que vimos en las pruebas reales.
| Caso | Estado HTTP | Respuesta | Cargo |
|---|---|---|---|
| Sin clave | 401 | missing_key; next_steps dice que no se cobró nada | 0 |
| sort con el valor hottest | 422 | invalid_value; lista most_liked, newest y relevance; did_you_mean propone most_liked | 0 |
| Comentarios con un enlace de perfil de usuario | 200 | count 0; reason empty_result_refunded; reembolso correcto | 0 |
| Página de comentarios con 9 a 20 filas | 200 | requested_units 3, billed_units 1, 80 créditos devueltos | 1 tramo |
| Por encima del límite por minuto | 429 | Al menos una vez en cada prueba en serie; el script esperó 60 segundos y el reintento funcionó | 0 |
La fila del 422 es útil para equipos que dejan que un asistente de IA escriba y corrija scripts. El error lista los valores permitidos y el más parecido, así que un modelo puede leerlo y corregir la llamada. La tercera fila muestra que una entrada válida pero equivocada devuelve un resultado vacío con reembolso, no un error. Por eso tu script debe revisar count, no solo el estado. Para reintentar sin cobros dobles, lee claves de idempotencia y reintentos y conciliación de reembolsos por fallos.
Cuándo encajan mejor las otras dos vías
Una API por llamada no es la respuesta para todo. La vía oficial es mejor en tres casos. El primero es cuando necesitas escribir: responder comentarios, fijarlos o publicar vídeos. Solo la plataforma abierta lo permite, y una API de datos es de solo lectura. El segundo es cuando necesitas datos privados de una cuenta, como el perfil de seguidores, las visitas al perfil o las reproducciones diarias. Esos datos son del dueño de la cuenta y solo deben llegarte por un flujo de consentimiento.
El tercer caso es una empresa que quiere mostrar contenido de Douyin en su propio producto durante años y puede esperar la revisión. La beta oficial de búsqueda exige mucho, pero da la estabilidad que aprueba la plataforma. Una marca chilena con cuenta propia en Douyin y socio local en China es un buen ejemplo. Puede leer y contestar los comentarios de sus vídeos con los endpoints oficiales.
Los scripts de código abierto también tienen su lugar. Quizá solo necesitas unos pocos vídeos que ya puedes ver, para una presentación interna o un archivo personal. En ese caso, un descargador es más rápido que cualquier registro. Puedes leer y cambiar el código, y los datos se quedan en tu ordenador.
Algunos equipos tienen un ingeniero que mantiene raspadores y acepta el trabajo continuo con sesiones, firmas, proxies y verificaciones. Para ellos, una herramienta propia da control total. Cuenten ese tiempo como coste. Las incidencias de este artículo son todas de los últimos 30 días.
Una API por llamada encaja con el gran grupo del medio. Ese grupo necesita vídeos y comentarios públicos de otras cuentas con un calendario fijo, no necesita escribir y no tiene un ingeniero de raspadores. Quiere fallos gratis y datos que vayan directo a una hoja de cálculo o a una base de datos. Los límites son reales. No lee datos privados de cuentas. Una transcripción tarda más de 20 segundos. La búsqueda se cobra por página, así que un plan con muchas páginas de búsqueda sube rápido.
¿Quieres consultar Douyin desde una herramienta de IA sin programar? Lee ModelScope MCP para Xiaohongshu y Douyin, atajos de campo en Feishu Base o conectores de WorkBuddy. Para Xiaohongshu, lee API de Xiaohongshu: oficial frente a terceros. El mismo código sirve para la API de TikTok y la API de Xiaohongshu si cambias la plataforma y la acción; los precios de TikTok están en precios de la API de TikTok.
Cumplimiento y límites
Esta sección trata solo de métodos y límites de datos. No es asesoría legal. Las tres vías se enfrentan a las mismas leyes chinas.
Los artículos 13 y 27 de la Ley de Protección de Información Personal permiten tratar, en un ámbito razonable, la información personal que una persona ha hecho pública. La excepción es que la persona lo rechace con claridad. Si el tratamiento afecta mucho a los derechos de la persona, hace falta su consentimiento. Los nombres, avatares y ubicaciones IP de quienes comentan son datos personales. Para estudios de mercado, guarda el texto y las estadísticas, no los nombres ni los avatares.
La Ley contra la Competencia Desleal reformada, vigente desde el 15 de octubre de 2025, añadió un párrafo a su artículo 13. Las empresas no deben obtener ni usar datos que otra empresa posee legalmente mediante fraude, coacción o eludiendo o rompiendo medidas técnicas de control. Las firmas, verificaciones y comprobaciones de la sección de código abierto son ese tipo de medidas, y por eso solo las describimos. El Reglamento de Seguridad de Datos en la Red, vigente desde el 1 de enero de 2025, fija reglas generales para el tratamiento de datos en la red.
Los datos tienen límites que nuestras pruebas confirman. Douyin no publica las reproducciones, así que no te fíes de ningún campo de reproducciones. Los enlaces de vídeo y audio caducan. Las páginas de comentarios traen solo entre 9 y 20 filas, así que un vídeo con miles de comentarios necesita muchas páginas. Los resultados de búsqueda siguen la clasificación y la deduplicación de Douyin. No son un censo completo, así que no sirven para estimar cuántos vídeos hay sobre un tema.
Cambios recientes que conviene seguir
La tabla reúne cambios con fecha de los últimos 30 días que afectan a un proyecto de datos de Douyin o a la temporada de la cereza. Cada fila termina con lo que significa para tu trabajo.
| Fecha | Cambio | Qué significa para ti |
|---|---|---|
| 09-11-2026 | Incidencia #263 de douyin-downloader: una sesión nueva sigue sin traer el detalle del vídeo | Un script con cookies puede fallar por causas del lado de la plataforma |
| Inicio de noviembre | Paro en San Antonio: el primer Cherry Express pasa a Valparaíso (AgroLatam) | Los comerciantes chinos comentan las fechas de llegada; vigila esos hilos |
| 05-11-2026 | Douyin_TikTok_Download_API integra #821: firmas un 9,5 % más rápidas | Gran parte del mantenimiento de código abierto se va en firmas |
| 28-10-2026 | Incidencia #996 de MediaCrawler: prueba de arrastre con nueve imágenes en la búsqueda web | Las herramientas propias necesitan tiempo para trabajo manual |
| 19-10-2026 | Llega a Shanghái el primer envío aéreo de la temporada (Xinhua) | La conversación en Douyin empieza con la carga aérea, antes que los barcos |
Preguntas frecuentes
¿Existe un SDK oficial para «douyin api python»?
No. El SDK de servidor solo existe para Java, NodeJS y Go, así que desde Python escribes tú el código de tokens, como explica la sección «La vía oficial y Python». (Pregunta tomada de las sugerencias de Google para "douyin api python" y "douyin python".)
¿Siguen funcionando los proyectos douyin scraper de GitHub?
Muchos aún descargan vídeos sueltos. La búsqueda por palabra clave y los comentarios en volumen piden sesión y firmas, y las incidencias de los últimos 30 días hablan de peticiones rechazadas y verificaciones nuevas (ver la vía 2). (Pregunta tomada de las sugerencias de Google para "douyin scraper github".)
¿Hay una douyin api alternative gratuita?
El código abierto es gratis, pero tú pones la sesión y te ocupas de firmas y verificaciones, y algunas licencias prohíben el uso comercial. La plataforma oficial no cobra por llamada, pero pide aprobación y consentimiento, y prohíbe los productos de datos a la venta. Una API por llamada cuesta dinero: una cadena completa de cinco pasos costó 0,010557 USD en nuestra prueba. (Pregunta tomada de las sugerencias de Google para "douyin api alternative free" y "douyin api alternatives".)
¿Cómo obtengo las respuestas a los comentarios de Douyin con Python?
Llama primero a la capacidad de comentarios. Cada comentario de primer nivel trae reply_count. Para los que tienen un valor mayor que cero, llama a douyin/comment_replies con la URL del vídeo y el identificador del comentario. Recibes hasta 20 respuestas por página y usas next_page_token para seguir. En nuestras pruebas, tres llamadas trajeron 20, 20 y 18 respuestas, y 15, 11 y 16 de ellas contestaban a otra respuesta. (Pregunta tomada de las sugerencias de Google para "douyin comment scraper".)
¿Puedo convertir en texto lo que se dice en un vídeo de Douyin?
Sí. douyin/transcript devuelve el texto completo y segmentos con tiempo. En la prueba 3, un vídeo de 120 segundos dio 526 caracteres en 57 segmentos, sin puntuación. Cada llamada tardó unos 22 segundos y costó 0,000556 USD. Para traducir el texto al español necesitas un paso aparte, con tu propio traductor o modelo. (Pregunta tomada de las sugerencias de Google para "douyin transcripts scraper".)
¿Sirve la API de investigación de TikTok para Douyin?
No. La API de investigación de TikTok devuelve datos públicos de TikTok, y Douyin es otra aplicación con su propia plataforma para desarrolladores. Además, sus preguntas frecuentes dicen que los usuarios comerciales, anunciantes y creadores no pueden pedir acceso. (Pregunta tomada de las sugerencias de Google para "douyin api" y "tiktok research api".)
Primeros pasos
- Crea una clave de API en la consola. Guárdala en la variable de entorno
EVERYINFRA_API_KEY, como indica el inicio rápido. - Lee gratis el catálogo en
GET /api/v1/social/catalog?platform=douyin. Revisa parámetros, precios yavailable, o mira la página de precios y el mercado de datos. - Instala requests con pip. Copia el script de la vía 3 y ejecútalo con tu palabra clave.
- Abre los cinco JSON de la carpeta de salida. Revisa
billing.charged_usden cada paso y devuelvenext_page_tokensin cambios para pedir más páginas.
Referencias
- Plataforma abierta de Douyin, página de datos de interacción del usuario (en chino), leída el 2026-11-10, https://developer.open-douyin.com/capacity-center-page/capacity-detail/7180284622729658424
- Plataforma abierta de Douyin, página de datos de vídeo (en chino), leída el 2026-11-10, https://developer.open-douyin.com/capacity-center-page/capacity-detail/7180522194714230845
- Plataforma abierta de Douyin, inicio de sesión y autorización (en chino), leída el 2026-11-10, https://developer.open-douyin.com/docs/resource/zh-CN/dop/develop/sdk/mobile-app/permission/overall-permission
- Plataforma abierta de Douyin, lista de vídeos de la cuenta autorizada (en chino), leída el 2026-11-10, https://developer.open-douyin.com/docs/resource/zh-CN/dop/develop/openapi/video-management/douyin/search-video/account-video-list
- Plataforma abierta de Douyin, guía de gestión de comentarios de vídeo (en chino), leída el 2026-11-10, https://open.douyin.com/platform/resource/docs/ability/interaction-management/video-comment-management-solution
- Plataforma abierta de Douyin, búsqueda de vídeos por palabra clave (en chino), leída el 2026-11-10, https://developer.open-douyin.com/docs/resource/zh-CN/dop/develop/openapi/search-management/keywords-video-list/keywords-video
- Plataforma de socios de Douyin, gestión de búsqueda de vídeos (en chino), leída el 2026-11-10, https://partner.open-douyin.com/docs/resource/zh-CN/dop/ability/search-management/video
- Plataforma abierta de Douyin, tipos de usuario y permisos (en chino), leída el 2026-11-10, https://open.douyin.com/platform/resource/docs/accession-guide/type-and-permission
- Plataforma abierta de Douyin, lista de OpenAPI (en chino), leída el 2026-11-10, https://developer.open-douyin.com/docs/resource/zh-CN/dop/develop/openapi/list
- Plataforma abierta de Douyin, resumen del SDK de OpenAPI (en chino), leída el 2026-11-10, https://developer.open-douyin.com/docs/resource/zh-CN/dop/develop/openapi/sdk-overview
- Plataforma abierta de Douyin, página de producto de la búsqueda (en chino), leída el 2026-11-10, https://developer.open-douyin.com/product/search
- Plataforma abierta de Douyin, normas de operación de miniaplicaciones (en chino), leída el 2026-11-10, https://developer.open-douyin.com/docs/resource/zh-CN/mini-app/operation/management/specification/standard
- Plataforma abierta de Douyin, resumen de capacidades (en chino), leída el 2026-11-10, https://developer.open-douyin.com/docs/resource/zh-CN/dop/ability/common-solution
- Plataforma abierta de Douyin, crear aplicaciones móviles y web (en chino), leída el 2026-11-10, https://developer.open-douyin.com/docs/resource/zh-CN/dop/develop/app-mgmt/create-mobile-and-web-app
- Plataforma abierta de Douyin, normas de la capacidad de publicación (en chino), leída el 2026-11-10, https://developer.open-douyin.com/docs/resource/zh-CN/dop/operation-standard/platform-capabilities/useclue
- TikTok for Developers, preguntas frecuentes de la API de investigación (en inglés), leída el 2026-11-10, https://developers.tiktok.com/docs/en/research-api-faq
- GitHub, README de NanmiCoder/MediaCrawler, leído el 2026-11-10, https://github.com/NanmiCoder/MediaCrawler
- GitHub, README de Evil0ctal/Douyin_TikTok_Download_API, leído el 2026-11-10, https://github.com/Evil0ctal/Douyin_TikTok_Download_API
- GitHub, README de jiji262/douyin-downloader, leído el 2026-11-10, https://github.com/jiji262/douyin-downloader
- GitHub, Johnserf-Seed/TikTokDownload, leído el 2026-11-10, https://github.com/Johnserf-Seed/TikTokDownload
- GitHub, README de Johnserf-Seed/f2, leído el 2026-11-10, https://github.com/Johnserf-Seed/f2
- GitHub, README de ShilongLee/Crawler, leído el 2026-11-10, https://github.com/ShilongLee/Crawler
- GitHub, Douyin_TikTok_Download_API, petición #821, 2026-11-05, https://github.com/Evil0ctal/Douyin_TikTok_Download_API/pull/821
- GitHub, Douyin_TikTok_Download_API, incidencia #825, 2026-11-09, https://github.com/Evil0ctal/Douyin_TikTok_Download_API/issues/825
- GitHub, douyin-downloader, incidencia #257, 2026-10-25, https://github.com/jiji262/douyin-downloader/issues/257
- GitHub, douyin-downloader, incidencia #258, 2026-10-26, https://github.com/jiji262/douyin-downloader/issues/258
- GitHub, douyin-downloader, incidencia #263, 2026-11-09, https://github.com/jiji262/douyin-downloader/issues/263
- GitHub, MediaCrawler, incidencia #996, 2026-10-28, https://github.com/NanmiCoder/MediaCrawler/issues/996
- GitHub, MediaCrawler, petición #998, 2026-11-02, https://github.com/NanmiCoder/MediaCrawler/pull/998
- Douyin, robots.txt, leído el 2026-11-10, https://www.douyin.com/robots.txt
- EveryInfra, catálogo de la API de datos, leído el 2026-11-10 a las 00:13 hora de Singapur, https://api.everyinfra.com/api/v1/social/catalog
- Documentación de requests, Advanced Usage: Session Objects, leída el 2026-11-10, https://requests.readthedocs.io/en/latest/user/advanced/#session-objects
- PyPI, requests 2.34.2, 2026-05-14, https://pypi.org/project/requests/
- Python Software Foundation, Python 3.15.2, 2026-10-25, https://www.python.org/downloads/release/python-3152/
- Documentación de Python, concurrent.futures, leída el 2026-11-10, https://docs.python.org/3/library/concurrent.futures.html
- Documentación de pandas, pandas.to_datetime, leída el 2026-11-10, https://pandas.pydata.org/docs/reference/api/pandas.to_datetime.html
- ODEPA, Boletín de fruta, marzo 2026, 2026-03-31, https://www.odepa.gob.cl/publicaciones/boletines/boletin-de-fruta-marzo2026
- Xinhua en español, «Arriban a China primeros lotes de cerezas chilenas de temporada 2026-27», 2026-10-19, https://spanish.xinhuanet.com/20261019/982cd37d8722475482a53ccf12faa6f8/c.html
- Green Network, «El Niño resta cerezas, pero deja agua para al menos tres temporadas en el norte», leído el 2026-11-10, https://greennetwork.cl/el-nino-resta-cerezas-pero-deja-agua-para-al-menos-tres-temporadas-en-el-norte
- AgroLatam, «Chile: un paro portuario complica el inicio de las exportaciones de cerezas a China», leído el 2026-11-10, https://www.agrolatam.com/chile/mercados-chile/chile-un-paro-portuario-complica-el-inicio-de-las-exportaciones-de-cerezas-a-china/
- MasContainer, «Chile acelera su autopista de cerezas: ONE y MSC anuncian zarpes directos hacia China», leído el 2026-11-10, https://mascontainer.com/chile-acelera-su-autopista-de-cerezas-one-y-msc-anuncian-zarpes-directos-hacia-china/
- Administración del Ciberespacio de China, Ley de Protección de Información Personal (en chino), 2021-08-20, https://www.cac.gov.cn/2021-08/20/c_1631050028355286.htm
- Administración Nacional de Propiedad Intelectual de China, Ley contra la Competencia Desleal, reforma de 2025 (en chino), 2026-05-20, https://www.cnipa.gov.cn/art/2026/5/20/art_104_206437.html
- Ministerio de Ecología y Medio Ambiente de China, reproducción del Decreto 790 del Consejo de Estado, Reglamento de Seguridad de Datos en la Red (en chino), 2024-10-03, https://www.mee.gov.cn/zcwj/gwywj/202410/t20241003_1087417.shtml
Referencia BL-127