GLM 5.3 en Claude Code: un script de opinión para Zhihu y Weibo
Configura GLM 5.3 en Claude Code con una clave de Zhipu y deja que escriba un script que compara respuestas de Zhihu y comentarios de Weibo, con costes.
Quien sigue el mercado de la inteligencia artificial en China acaba leyendo dos sitios. Zhihu es una plataforma de preguntas y respuestas donde la gente escribe textos largos, realiza cálculos y explica sus motivos. Weibo es un microblog donde la reacción cabe en una línea. Por separado cuentan media historia. Juntos dicen qué se discute y por qué.
En este artículo probamos una forma concreta de leer los dos a la vez. Configuramos Claude Code para que use GLM-5.3 o GLM-5.3-Flash, los modelos de Zhipu. Después le pedimos que escriba un script, topic_pulse.py, que trae respuestas de Zhihu y comentarios de Weibo sobre un mismo tema mediante la API de EveryInfra. Al final, GLM lee el resultado y redacta un resumen comparativo.
El tema elegido es la subida de precio del Coding Plan, la suscripción de Zhipu para herramientas de programación. El 2026-07-30 Zhipu pasó ese plan a un sistema de créditos, y la discusión sigue viva en los dos sitios. Es un buen caso de prueba: es un tema estrecho, técnico y muy cercano a la herramienta que usamos.
Conviene separar lo que ejecutamos de lo que no. En la máquina de prueba no tenemos cuenta de Zhipu. Por eso, todo lo que pone a Claude Code a funcionar con GLM es un ejemplo de configuración, escrito a partir de la documentación de BigModel y de Z.ai que leímos el 2026-11-04. No ejecutamos GLM dentro de Claude Code.
La parte de datos sí es real. Entre las 00:16 y las 02:08 hora de Singapur del 2026-11-04 enviamos 52 peticiones a la API de EveryInfra. Treinta y cuatro devolvieron datos y se cobraron, por un total de 0,020404 USD; las otras 18 fallaron o volvieron vacías y no se cobraron. Una de esas 52 se hizo mediante el método tools/call de MCP.
El script completo corrió tres veces. La segunda pasada, que además leía el texto completo de las respuestas, costó 0,00581 USD en 12 peticiones. La tercera es el script final: 7 peticiones, todas correctas, por 0,004142 USD.
Qué puede hacer una configuración glm 5.3 claude code en este caso
La tarea tiene dos mitades: la API trae los datos y GLM los lee. La primera mitad necesita registros estructurados, una fila por respuesta o comentario, con «me gusta», fecha y la pregunta o publicación a la que pertenece. Con esas filas, un script cuenta y ordena sin ningún modelo.
La segunda mitad es leer los datos. Hay que separar los comentarios que son solo emojis, los que se repiten, los que se quejan del precio y los que hacen cuentas de cuota. Esa parte necesita un modelo.
Claude Code une las dos mitades. Describes el trabajo en una frase, y el modelo escribe el script, lo ejecuta, lee la salida y te informa. Elegimos GLM-5.3 porque Zhipu publica una guía para Claude Code y sus precios por token son públicos; las secciones siguientes citan cada página. Además, para lectores fuera de China, el sitio internacional Z.ai vende los mismos modelos en dólares.
La tabla siguiente resume cada capacidad que llamamos. La columna de filas indica cuántos elementos devolvió cada respuesta. El precio es el de catálogo de EveryInfra por petición. Las peticiones fallidas y los resultados vacíos no se cobran.
| Capacidad | Llamadas el 2026-11-04 | Precio de catálogo | Resultado |
|---|---|---|---|
weibo/search | 6 (una vía MCP) | 0,000806 USD | 20 publicaciones cada vez |
weibo/comments | 9 con datos, 1 vacía | 0,000556 USD | de 2 a 43 comentarios por publicación |
zhihu/search | 5 | 0,000556 USD | 20 respuestas con extractos de 51 a 86 caracteres |
zhihu/content_comments | 7 | 0,000556 USD | de 3 a 26 comentarios por respuesta |
zhihu/content_detail (opcional) | 7 con datos, 1 con límite de ritmo | 0,000556 USD | texto completo, hasta 756 caracteres |
El script final solo usa las cuatro primeras filas. En Zhihu parte de zhihu/search, que ya trae el título de la pregunta, el enlace, el extracto y los «me gusta»; después zhihu/content_comments lee los comentarios de las respuestas más votadas. Si necesitas el texto completo de una respuesta, añade una llamada a zhihu/content_detail. La tabla no incluye llamadas a GLM porque esa parte no la ejecutamos.
GLM-5.3 y GLM-5.3-Flash en pocas líneas
GLM-5.3 es el modelo de texto insignia de Zhipu. Llegó a la plataforma BigModel el 2026-08-19. Su ficha dice que solo acepta texto, que tiene una ventana de contexto de 1M de tokens y que devuelve hasta 128K tokens de salida (ficha de GLM-5.3). El razonamiento está siempre activo. Se puede elegir entre low, high y max, con max por defecto, pero no se puede apagar.
La misma ficha incluye un aviso que se pasa por alto con facilidad. Quien tiene un Coding Plan, incluso caducado, solo puede llamar a la API del modelo con el protocolo OpenAI Chat Completion. El aviso se refiere a la API directa y no afecta al punto de acceso compatible con Anthropic que usa Claude Code. Aun así, recuerda que Zhipu aplica reglas distintas a suscriptores y a clientes de pago por uso.
GLM-5.3-Flash llegó una semana después, el 2026-08-26. Es un modelo multimodal que mezcla atención lineal y atención dispersa (notas de versión de BigModel). Tiene 320B parámetros en total y 18B activos, y según Zhipu necesita mucho menos cálculo y caché KV que GLM-5.3. La ficha recomienda temperature 1, top_p 0,95 y reasoning_effort en max (ficha de GLM-5.3-Flash). Para un script de datos, la diferencia que más importa es el precio: con la misma sesión, Flash cuesta cerca de la novena parte.
| Dato | GLM-5.3 | GLM-5.3-Flash | Fuente leída el 2026-11-04 |
|---|---|---|---|
| Lanzamiento | 2026-08-19 | 2026-08-26 | notas de versión de BigModel |
| Entrada | solo texto | texto e imágenes | fichas de modelo |
| Contexto | 1M tokens | 1M tokens con [1m] | ficha y guía de cambio |
| Razonamiento | siempre activo: low, high, max | siempre activo, se recomienda max | fichas de modelo |
| BigModel por 1M tokens | 8 CNY entrada, 2 CNY caché, 28 CNY salida | 0,8 CNY entrada, 0,23 CNY caché, 2,8 CNY salida | precios de BigModel |
| Z.ai por 1M tokens | 1,4 USD entrada, 0,26 caché, 4,4 salida | 0,15 USD entrada, 0,03 caché, 0,50 salida | precios de Z.ai |
| Factores de crédito del plan | 6,9; 1,7; 24 | 2,3; 0,56; 8 | resumen del Coding Plan |
Los precios en yuanes salen de la página de precios de BigModel, que añade dos datos útiles. El almacenamiento de caché es gratis durante un tiempo limitado. Y un token equivale a unos 1,6 caracteres chinos, la proporción que usamos para estimar tokens en todo el artículo. Los precios en dólares salen de la página de precios de Z.ai. Al tipo central del 2026-11-03, 6,7150 CNY por dólar, 8 CNY son unos 1,19 USD (tipo central de SAFE). Los dos sitios cobran, por tanto, importes parecidos.
Cada herramienta usa su propia URL base, y conviene no mezclarlas. Claude Code usa el punto de acceso compatible con Anthropic. Codex y otras herramientas compatibles con OpenAI usan rutas de programación propias. La API normal de pago por uso tiene otra ruta, y esa no consume cuota del plan.
| Herramienta | URL base | Consume cuota del plan | Leído el |
|---|---|---|---|
| Claude Code en BigModel | https://open.bigmodel.cn/api/anthropic | sí | 2026-11-04 |
| Claude Code en Z.ai | https://api.z.ai/api/anthropic | sí | 2026-11-04 |
| Codex en BigModel | https://open.bigmodel.cn/api/v1 | sí | 2026-11-04 |
| Otras herramientas compatibles con OpenAI | https://open.bigmodel.cn/api/coding/paas/v4 | sí | 2026-11-04 |
| API de pago por uso | https://open.bigmodel.cn/api/paas/v4 | no | 2026-11-04 |
Encontramos además una discrepancia entre dos páginas de Zhipu. La guía de Claude Code de BigModel todavía muestra glm-5.2[1m] para el modelo principal y glm-4.7 para el modelo pequeño. La guía de cambio de modelo, más reciente, pone glm-5.3-flash[1m] en las tres ranuras y dice que se verificó con Claude Code 2.1.140.
El resumen del Coding Plan explica por qué el ejemplo antiguo sigue funcionando. Las llamadas a GLM-5.2 o GLM-5.1 pasan a GLM-5.3, y las llamadas a GLM-5-Turbo o GLM-4.7 pasan a GLM-5.3-Flash. Es decir, la configuración vieja funciona, pero el modelo que corre no es el que crees. Nuestra recomendación es usar los nombres nuevos y comprobar la línea del modelo con /status.
Las dos páginas tampoco coinciden en los niveles de esfuerzo. La nueva es la que vale. Si se desactiva el razonamiento, se aplica low; minimal, light y low dan low; medium y high dan high; xhigh, max y ultra dan max. Un valor explícito de esfuerzo manda sobre el interruptor de razonamiento, y por defecto se usa max. En Claude Code, el comando /effort permite bajar a high para que cada turno sea más corto y más barato.
| Valor que envía la herramienta | Nivel real | Fuente leída el 2026-11-04 |
|---|---|---|
razonamiento sin indicar, enabled o adaptive | max | guía de cambio de modelo |
razonamiento disabled u off | low | guía de cambio de modelo |
minimal, light, low | low | guía de cambio de modelo |
medium, high | high | guía de cambio de modelo |
xhigh, max, ultra | max | guía de cambio de modelo |
Niveles del Coding Plan, créditos y horas punta
Desde el 2026-07-30, el Coding Plan cuenta el uso en créditos. En la página del GLM Coding Plan leímos el 2026-11-04 los precios mensuales del plan individual. Lite cuesta 118 CNY, Pro 538 CNY y Max 1078 CNY. Al tipo de 6,7150, son unos 17,57 USD, 80,12 USD y 160,54 USD. La facturación trimestral descuenta un 20 % y la anual un 30 %. En Z.ai, la documentación dice que los planes empiezan «at just 18 USD per month» (resumen del plan en Z.ai); su página de planes no cargó en nuestro navegador sin interfaz, así que no citamos cada nivel en dólares.
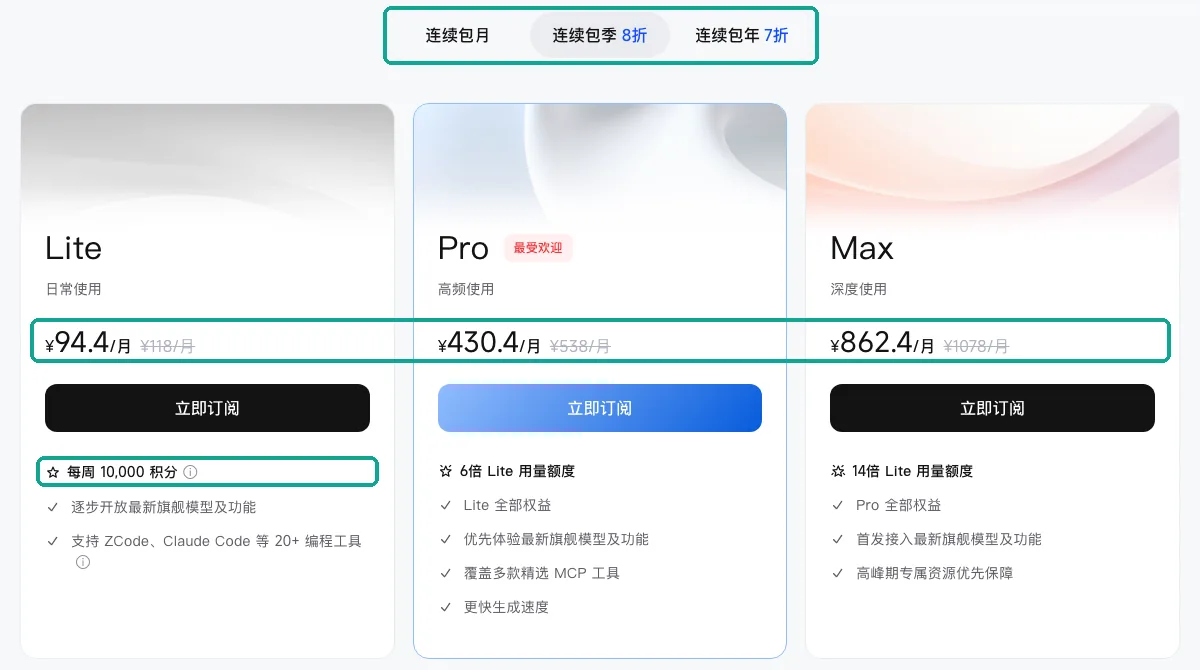
Cada plan tiene dos límites: uno por cada 5 horas y otro semanal. Lite da 2.000 créditos cada 5 horas y 10.000 por semana. Pro da 12.000 y 60.000. Max da 28.000 y 140.000. La ventana de 5 horas se renueva 5 horas después de cada consumo, y la semanal dura 7 días desde la fecha de compra. Si se agota, toca esperar: el plan no tira del saldo de la cuenta.
La fórmula de créditos es pública. Se multiplican los tokens de entrada, de caché y de salida por sus factores, se suman y se divide entre 10.000. Cada llamada a las herramientas MCP del plan cuesta 1,2 créditos. Fuera de hora punta, las llamadas al modelo cuestan la mitad. La hora punta va de lunes a viernes, de 14:00 a 18:00 hora de Singapur según Z.ai; BigModel da la misma franja en UTC+8, que es la misma zona horaria.
| Nivel | Precio mensual el 2026-11-04 | En USD aprox. | Créditos por 5 h | Créditos por semana | Sesiones GLM-5.3 por semana en hora punta |
|---|---|---|---|---|---|
| Lite | 118 CNY | 17,57 USD | 2.000 | 10.000 | unas 48 |
| Pro | 538 CNY | 80,12 USD | 12.000 | 60.000 | unas 288 |
| Max | 1078 CNY | 160,54 USD | 28.000 | 140.000 | unas 673 |
La última columna usa la sesión de ejemplo de la sección de costes. Esa sesión consume unos 207,8 créditos con GLM-5.3 y 68,7 con Flash. Fuera de hora punta, la cifra se duplica. Tómala como un orden de magnitud y no como una garantía.
Tres reglas del plan condicionan el diseño del script. La primera: el plan solo vale en las herramientas admitidas, y una llamada desde cualquier otro sitio no consume cuota del plan. La política de uso de Z.ai lo resume como «Use limited to supported tools» (política de uso de Z.ai). Las preguntas frecuentes de BigModel añaden que las aplicaciones, webs, bots y productos SaaS propios deben usar la API estándar (preguntas frecuentes del plan).
La segunda regla: desde el 2026-10-16, las claves de la API estándar y las del plan se gestionan por separado. Una clave estándar dentro de una herramienta de programación no consume cuota del plan (aviso sobre claves). La tercera: el plan no admite reembolsos ni cuentas compartidas, y el límite de concurrencia sube de Lite a Max (notas de uso).
La primera regla es la que más pesa. Una idea tentadora sería que topic_pulse.py llamara a GLM para clasificar los comentarios y así correr solo con un temporizador. Con las reglas del plan, esas llamadas no contarían como uso del plan y se pagarían a precio de API estándar. Por eso el script hace solo dos cosas: trae los datos y calcula estadísticas sencillas que no necesitan modelo. La lectura y el resumen se hacen dentro de Claude Code, donde sí se aplica el plan. De paso, el script funciona en cualquier máquina, incluso sin acceso a un modelo.
Ejemplo de configuración: how to use glm 5.3 in claude code
Este es un ~/.claude/settings.json de ejemplo para BigModel. Sigue la guía de cambio de modelo de Zhipu, que pone Flash en las tres ranuras, y la referencia de variables de entorno de Claude Code. No lo ejecutamos porque no tenemos cuenta. Las claves son marcadores.
{
  "env": {
    "ANTHROPIC_AUTH_TOKEN": "tu-clave-del-coding-plan",
    "ANTHROPIC_BASE_URL": "https://open.bigmodel.cn/api/anthropic",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "glm-5.3-flash[1m]",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "glm-5.3-flash[1m]",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "glm-5.3-flash[1m]",
    "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000",
    "API_TIMEOUT_MS": "3000000",
    "CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC": "1",
    "EVERYINFRA_API_KEY": "tu-clave-de-everyinfra"
  }
}
Hemos elegido Flash en las tres ranuras para este ejemplo porque un script de unas cien líneas no necesita el modelo grande, y así se gastan menos créditos. Si Flash se atasca con un error, basta con cambiar las ranuras de opus y sonnet a glm-5.3[1m], como hace la guía de Z.ai. Claude Code envía ANTHROPIC_AUTH_TOKEN como token Bearer en la cabecera Authorization (variables de entorno de Claude Code). Aquí va la clave del plan, no la de la API estándar.
El sufijo [1m] es obligatorio en la práctica. Claude Code no reconoce el identificador glm-5.3-flash. Según su documentación de modelos, ante un identificador desconocido supone una ventana de 200K tokens y lo avisa al arrancar (configuración de modelos de Claude Code). Con [1m] supone 1M, que es la ventana real de GLM-5.3. Sin el sufijo, la conversación se compacta demasiado pronto, y se nota sobre todo cuando el modelo lee resultados largos.
CLAUDE_CODE_AUTO_COMPACT_WINDOW fija cuánto puede llenarse el contexto antes de compactar, entre 100.000 y 1.000.000 tokens. API_TIMEOUT_MS en 3.000.000 milisegundos es la recomendación de Zhipu, porque GLM puede pensar mucho rato con esfuerzo máximo. CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC desactiva la telemetría y otras peticiones opcionales. La última línea, EVERYINFRA_API_KEY, es para el script: los procesos que lanza Claude Code la heredan, el script la lee de os.environ y la clave nunca entra en el código.
| Variable | Valor del ejemplo | Para qué sirve | Fuente leída el 2026-11-04 |
|---|---|---|---|
ANTHROPIC_BASE_URL | https://open.bigmodel.cn/api/anthropic | enviar las peticiones a BigModel | guía de cambio de modelo |
ANTHROPIC_AUTH_TOKEN | clave del plan | token Bearer | referencia de Claude Code |
ANTHROPIC_DEFAULT_*_MODEL | glm-5.3-flash[1m] | modelo detrás de cada alias | guía de cambio de modelo |
CLAUDE_CODE_AUTO_COMPACT_WINDOW | 1000000 | umbral de compactación | referencia de Claude Code |
API_TIMEOUT_MS | 3000000 | tiempo máximo por petición | guía de Claude Code de BigModel |
Hay un dato que conviene decir sin rodeos. La documentación de pasarelas de Claude Code dice que sirve cualquier pasarela con un formato de API admitido, y también que Anthropic «doesn't support routing Claude Code to non-Claude models through any gateway» (pasarelas LLM de Claude Code). Es decir, Claude Code funciona con GLM porque Zhipu construyó un punto de acceso compatible. Si algo falla, hay que acudir a la documentación y al soporte de Zhipu.
El 2026-11-04, la versión más reciente de Claude Code era la 2.1.317, publicada el 2026-11-03 (registro de cambios de Claude Code). La página de Zhipu se verificó con la 2.1.140, y entre las dos hay muchas versiones. Ante un error raro, revisa los dos registros de cambios.
Quien prefiera un asistente puede usar npx @z_ai/coding-helper (paquete en npm). Zhipu también ofrece un script de instalación, claude_code_env.sh. Tras configurar, abre una terminal nueva, ejecuta claude y escribe /status. El origen de la configuración debe ser tu ~/.claude/settings.json, y la línea del modelo debe mostrar glm-5.3-flash o glm-5.3-flash[1m].
Dos juegos de herramientas MCP a la vez
MCP significa Model Context Protocol, un protocolo abierto que permite a un modelo llamar a herramientas externas (especificación de MCP). El Coding Plan trae sus propias herramientas MCP. El 2026-11-04 la documentación enumeraba búsqueda web (webSearchPrime), lectura de páginas (webReader), un lector de repositorios llamado zread y un servidor de visión. El servidor de visión corre en local con el paquete npm @z_ai/mcp-server, cuya versión 0.1.6 salió el 2026-10-29 (paquete en npm).
Las páginas de búsqueda web y de lectura comparten una frase. Con el Coding Plan en Claude Code, las dos herramientas ya vienen integradas en el servicio del modelo y no hay que instalarlas (MCP de búsqueda web, MCP de lectura de páginas). Solo se añaden a mano si quieres usarlas con otro modelo.
| Herramienta integrada | Qué devuelve | Créditos por llamada | Versión o fecha |
|---|---|---|---|
webSearchPrime | título, URL, resumen, nombre del sitio, icono | 1,2 | documentación leída el 2026-11-04 |
webReader | título, texto, metadatos, enlaces | 1,2 | documentación leída el 2026-11-04 |
| zread | search_doc, get_repo_structure, read_file | 1,2 | documentación leída el 2026-11-04 |
| servidor de visión | análisis de imagen y vídeo, en local | se cuenta como Flash | 0.1.6 del 2026-10-29 |
Esto basta para programar: buscar una biblioteca, leer un hilo sobre un error, abrir un README. Un script de opinión necesita datos con otra forma: una fila por respuesta o comentario, con «me gusta», respuestas, fecha y la pregunta o publicación a la que pertenece. Con esas filas el script ordena, quita ruido y calcula medianas. La tabla compara los campos que devuelve cada tipo de herramienta. La columna de las herramientas integradas sale solo de la documentación de Zhipu, porque no tenemos cuenta; la de EveryInfra recoge los campos que devolvieron nuestras llamadas reales.
| Lo que necesitas | Búsqueda o lector integrados (documentación de Zhipu) | Campos de EveryInfra (llamadas reales) | Comprobado |
|---|---|---|---|
| Respuestas de Zhihu sobre un tema | título de página, URL, resumen, nombre del sitio | zhihu/search: título de la pregunta, enlace, extracto, «me gusta», comentarios, guardados, fecha (20 por llamada) | 2026-11-04 |
| Texto completo de una respuesta | título, texto, metadatos, enlaces | zhihu/content_detail: texto completo con «me gusta», comentarios y guardados | 2026-11-04 |
| Comentarios de una respuesta | una página de texto | zhihu/content_comments: una fila por comentario con text, like_count y reply_count (de 3 a 26 filas) | 2026-11-04 |
| Búsqueda en Weibo | título de página, URL, resumen | weibo/search: id, url, text, posted_at y recuentos de comentarios, reenvíos y «me gusta» (20 por llamada) | 2026-11-04 |
| Comentarios de Weibo | lo mismo | weibo/comments: una fila por comentario (de 2 a 43 filas) | 2026-11-04 |
| Noticias, documentación, GitHub | encaja bien | no es el uso de estas capacidades | 2026-11-04 |
Los dos sitios también tienen sus propias plataformas para desarrolladores, útiles si solo necesitas los datos de tu propia cuenta o si te integras mediante la autorización de la plataforma. La búsqueda de la plataforma de datos de Zhihu usa un token Bearer y una cabecera de marca de tiempo, con Count máximo de 10, ContentText como extracto y HasMore siempre en false (búsqueda en la plataforma de Zhihu). En Weibo, el punto comments/show devuelve comentarios del usuario autorizado (API de Weibo: comments/show), y search/topics es una API avanzada que da los 200 elementos más recientes (API de Weibo: search/topics). La nueva herramienta weibo-cli pide una verificación facial del desarrollador, ofrece 7 días de prueba con unas 5 lecturas por interfaz, y sus paquetes de cuota empiezan en 69 CNY (CLI de Weibo).
Así que los dos juegos de MCP se reparten el trabajo. Las herramientas de Zhipu cubren documentación, noticias y páginas públicas, a 1,2 créditos por llamada. El servidor MCP o la API de EveryInfra cubren datos estructurados dentro de las plataformas, a un precio en dólares por petición. Los dos pueden estar conectados en la misma sesión, y el modelo elige según la descripción de cada herramienta. Así se añade el servidor MCP remoto de EveryInfra; nosotros ejecutamos initialize y tools/list contra él y devolvió 12 herramientas.
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header "Authorization: Bearer $EVERYINFRA_API_KEY"

# Comprobar la conexión: debe aparecer everyinfra con sus herramientas
claude mcp list
De las 12 herramientas, el script de opinión solo necesita dos. everyinfra_list_capabilities lista plataformas, capacidades y parámetros, y everyinfra_call_api ejecuta una capacidad. A las 00:23 hora de Singapur llamamos a weibo/search mediante tools/call de MCP, con la palabra clave «Zhipu Coding Plan» en chino. Devolvió 20 publicaciones y costó 0,000806 USD, igual que una llamada directa. El texto devuelto tenía 15.103 caracteres.
Ese tamaño importa. Claude Code avisa cuando un resultado de MCP pasa de 10.000 tokens y lo corta por defecto en 25.000, aunque el límite se cambia con MAX_MCP_OUTPUT_TOKENS. Los resultados de texto de más de 50.000 caracteres se guardan en un archivo en vez de entrar en el contexto (MCP en Claude Code). Veinte publicaciones caben de sobra. Pero si el modelo pide 50 comentarios y 20 respuestas por MCP, una llamada tras otra, el contexto se llena enseguida. Por eso dejamos que GLM escriba un script: el script reduce decenas de llamadas a un JSON pequeño, y el modelo solo lee ese archivo.
Un último detalle afecta a las pasarelas. Claude Code activa por defecto la búsqueda de herramientas, de modo que las herramientas MCP se cargan bajo demanda y las peticiones llevan campos defer_loading y bloques tool_reference. Detrás de ANTHROPIC_BASE_URL, Claude Code espera que la pasarela los deje pasar. Desde la versión 2.1.305, si la pasarela responde 400 o 422, Claude Code reintenta sin búsqueda de herramientas y carga todas las herramientas desde el principio. No pudimos comprobar si el punto de acceso de Zhipu acepta esos campos. Si con muchos servidores MCP el contexto aparece lleno nada más empezar, la causa puede estar aquí.
El recorrido de una comparación


Todo el trabajo sigue una sola línea. Primero le das a Claude Code una frase, por ejemplo: «Escribe un script que compare cómo hablan Zhihu y Weibo de la subida del Coding Plan y luego dime la diferencia». Después, GLM lee la petición, consulta everyinfra_list_capabilities o la documentación para saber los parámetros y escribe topic_pulse.py. A continuación Claude Code ejecuta el script, que llama por turnos a la búsqueda y los comentarios de Weibo y a la búsqueda y los comentarios de Zhihu, y guarda en un JSON los resultados y el coste de cada llamada. Por último, GLM lee ese archivo y redacta el resumen.
Dos cifras destacan en este recorrido. La primera es la compresión. En la segunda pasada, el JSON bruto de la API tenía 50.859 caracteres, unos 14.543 tokens. El script conservó solo los campos de texto y quedaron 4315 caracteres, unos 2207 tokens: un 85 % menos. GLM vuelve a leer su contexto en cada turno, así que ese ahorro se repite muchas veces en una sesión.
La segunda cifra es el tiempo. La segunda pasada fue de las 00:33:55 a las 00:37:01 hora de Singapur, algo más de 3 minutos. Casi todo fue espera planificada: el script espacia las llamadas para no pasar de 10 peticiones por minuto, y además esperó tras una respuesta HTTP 429.
El script que debe escribir GLM
Esta es la instrucción que daríamos a Claude Code. Puedes usarla tal cual.
Escribe un script de Python, topic_pulse.py, solo con la biblioteca estándar. Recibe una palabra clave. Llama a la API de EveryInfra en POST https://api.everyinfra.com/api/v1/social con la clave de la variable EVERYINFRA_API_KEY. Busca 20 publicaciones con weibo/search, se queda con las que tienen al menos 3 comentarios y contienen una palabra dada, y lee 50 comentarios de cada una con weibo/comments. Busca 20 respuestas con zhihu/search y las agrupa por pregunta. Se queda con las preguntas cuyo título cumple un patrón dado y, para las 3 con más «me gusta», lee 50 comentarios de la respuesta más votada con zhihu/content_comments.
Espera 6,5 segundos entre llamadas. Ante un 429 o un 503 espera lo que indique retry_after y reintenta. Cuando recent_failures llegue a 3, deja de llamar a esa capacidad. Descarta comentarios de solo emojis, repetidos, muy cortos o de bots. Escribe un JSON con recuentos, longitudes medianas, los 5 comentarios con más «me gusta» y cada llamada con su estado HTTP y su charged_usd.
Cada línea tiene un motivo. Usar solo la biblioteca estándar permite correr el script en cualquier sitio sin instalar nada. Los 6,5 segundos mantienen el ritmo por debajo del límite por defecto de 10 peticiones por minuto. Las reglas de reintento y la de recent_failures llegaron después de la primera pasada, que tardó más de 7 minutos, y el filtro por título después de la segunda; lo contamos más abajo. La regla de bots existe porque Weibo tiene un asistente de búsqueda automático que responde dentro de los hilos, y sus respuestas largas distorsionarían las cuentas.
Este es el núcleo de la tercera versión, que escribimos a partir de esa instrucción y ejecutamos. El archivo completo tiene unas 120 líneas; aquí solo va la lógica de llamada, de reintento y de Zhihu.
API = "https://api.everyinfra.com/api/v1/social"
KEY = os.environ["EVERYINFRA_API_KEY"]
GAP = 6.5            # segundos entre llamadas: menos de 10 por minuto
DOWN = set()         # capacidades con 3 fallos en 10 minutos

def call(platform, action, params, tries=3):
    if f"{platform}/{action}" in DOWN:
        return None
    body = json.dumps({"platform": platform, "action": action, "params": params}).encode()
    for attempt in range(tries):
        req = urllib.request.Request(API, data=body, method="POST", headers={
            "Authorization": f"Bearer {KEY}", "Content-Type": "application/json"})
        try:
            with urllib.request.urlopen(req, timeout=120) as r:
                code, d = r.status, json.load(r)
        except urllib.error.HTTPError as e:
            code, d = e.code, json.loads(e.read() or b"{}")
        log(platform, action, code, d)       # filas y billing.charged_usd
        time.sleep(GAP)
        err = d.get("error") or {}
        if code == 200:
            return d
        if (err.get("recent_failures") or 0) >= 3:   # el error dice: no reintentes
            DOWN.add(f"{platform}/{action}")
            return None
        if code in (429, 503) and err.get("retryable") and attempt < tries - 1:
            time.sleep(min(err.get("retry_after", 30), 60))
            continue
        return None

# Zhihu: buscar, agrupar por pregunta, filtrar por título y leer los comentarios de la mejor respuesta
for q in top_questions:
    answers += by_q[q]                   # filas de búsqueda: título, enlace, extracto, «me gusta»
    best = max(by_q[q], key=lambda x: x.get("like_count") or 0)
    zcomments += rows(call("zhihu", "content_comments", {"url": best["url"], "limit": 50}))
Lo esencial es cómo lee los errores. Un error de EveryInfra es un objeto JSON con campos, no un mensaje suelto. fault dice de quién es el problema. retryable y retry_after dicen si se puede reintentar y cuánto esperar. recent_failures dice cuántas veces falló la capacidad hace poco, next_steps explica en lenguaje llano qué hacer, y example da una petición que se sabe que funciona. Un script que lee esos campos decide mejor que uno que solo cuenta códigos HTTP. Y GLM puede leer los mismos campos dentro de Claude Code y cambiar de plan sin entrar en un bucle de reintentos. En la segunda pasada llegó un HTTP 429 a las 00:35:34 hora de Singapur; el script esperó lo que indicaba la respuesta y el reintento, 33 segundos después, funcionó sin cobro.
Las reglas de ruido son sencillas y salieron de leer el primer lote real. Primero se quita el prefijo «respuesta a alguien». Un comentario de 4 caracteres o menos cuenta como corto. Uno que solo tiene etiquetas de emoji, espacios, cifras, un «sí» o una risa cuenta como emoji o repetición. Y uno cuyo autor lleva en el nombre la etiqueta del asistente de búsqueda de Weibo cuenta como bot. No son perfectas, porque un «cierto» de dos caracteres también cae como corto, pero bastan para contar cuánta gente dice algo con contenido.
Ida y vuelta real en los dos sitios
Antes de lanzar el script llamamos a mano a cada capacidad para comprobar parámetros y formatos. La tabla recoge las llamadas principales en orden. Todas las horas son de Singapur, el 2026-11-04.
| Hora (SGT) | Capacidad | Objetivo | HTTP | Filas | Cobro |
|---|---|---|---|---|---|
| 00:16:49 | weibo/search | palabra clave «Coding Plan subida de precio» | 200 | 20 | 0,000806 USD |
| 00:17:03 | zhihu/search | la misma palabra clave | 200 | 20 | 0,000556 USD |
| 00:18:41 | weibo/comments | una publicación sobre modelos en local | 200 | 13 | 0,000556 USD |
| 00:21:42 | zhihu/content_detail | una respuesta con 47 «me gusta» | 200 | 1 | 0,000556 USD |
| 00:21:56 | zhihu/content_comments | la misma respuesta | 200 | 7 | 0,000556 USD |
| 00:22:37 | weibo/comments | una publicación sobre la subida de DeepSeek | 200 | 43 | 0,000556 USD |
| 00:22:57 | weibo/comments | código corto de letras en vez de ID numérico | 200 | 0 | 0 USD, vacío reembolsado |
Weibo funcionó bien. Cada publicación de weibo/search trae id, url, text, posted_at y recuentos de comentarios, reenvíos y «me gusta». Las 20 publicaciones de nuestra palabra clave iban del 2026-08-17 al 2026-10-26. weibo/comments acepta un ID numérico o un enlace que lo contenga. A las 00:18:41 hora de Singapur leímos 13 comentarios bajo una publicación que defendía los modelos en local. Uno preguntaba si, contando la electricidad, la ventaja local seguía siendo grande. Otro respondía con una comparación: hay mucha gente que compra cafetera y las cafeterías no cierran por eso.
La única trampa fue el formato del enlace. Enviamos a propósito un código corto de letras. La API devolvió 200 con cero filas y el motivo empty_result_refunded, sin cobro. Si usas el campo id de los resultados de búsqueda, no te pasa.
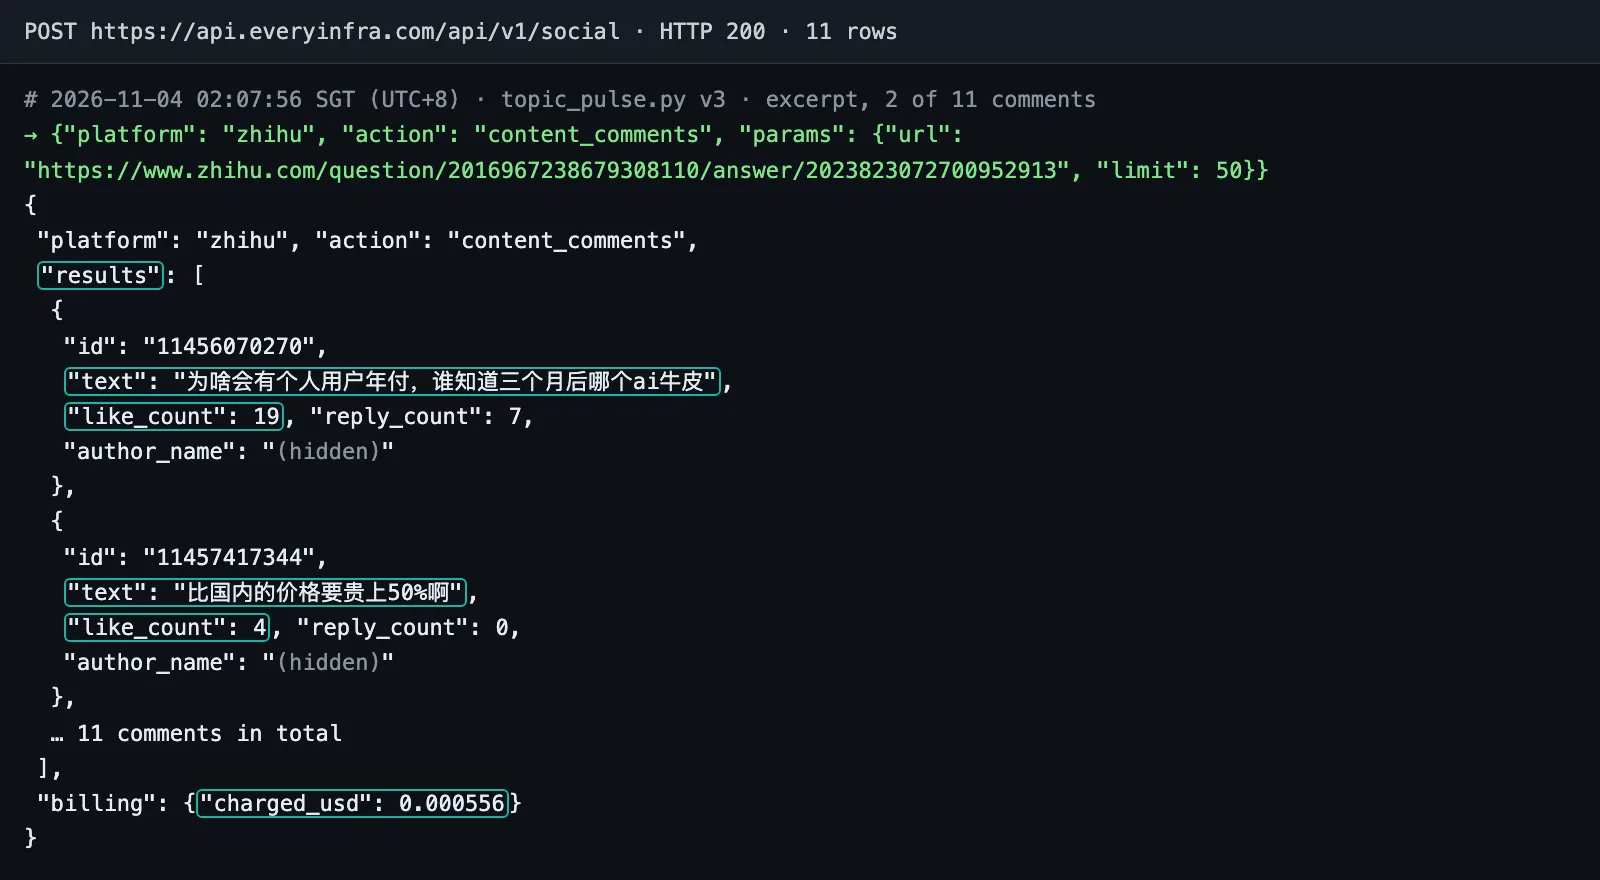
La búsqueda de Zhihu también funcionó: 20 respuestas con título de la pregunta, enlace, extracto, «me gusta», comentarios, guardados y fecha. Eso basta para dos pasos: agrupar las respuestas por el ID de pregunta que va en cada enlace y elegir la más votada de cada grupo. zhihu/content_comments recibe el enlace de una respuesta y devuelve sus comentarios de primer nivel, cada uno con texto, «me gusta» y respuestas.
La respuesta que leímos con zhihu/content_detail a las 00:21:42 era de alguien que renovaba un plan Max: el día anterior pagaba 422 CNY al mes en la modalidad trimestral y al día siguiente, «ocho o novecientos». Tenía 47 «me gusta» y 28 comentarios, y a las 00:21:56 leímos 7 de ellos. zhihu/content_detail solo hace falta cuando el extracto no basta, a una petición por respuesta.
Tres pasadas del script: desvío de palabra clave, límite de ritmo y filtro por título
La primera pasada usó la palabra clave «Zhipu Coding Plan» en chino. Fue de las 00:24:58 a las 00:32:37 hora de Singapur: 7 minutos y 39 segundos, 15 peticiones y 6 cobros, en total 0,003586 USD. Las otras 9 fallaron y no se cobraron. Fue lenta porque esa versión esperaba 60 segundos tras cada fallo y no leía recent_failures.
La palabra clave también se desvió. En Weibo, la publicación con más comentarios para esa búsqueda era una venta en directo sin relación con el tema, y el script leyó sus comentarios.
La segunda pasada corrigió tres cosas. Añadió la regla de recent_failures y la opción --must "coding plan", que exige esa frase en el texto de la publicación de Weibo. Además usamos una palabra clave más estrecha, «Coding Plan subida de precio» en chino. Esta versión también leía el texto completo de las respuestas con zhihu/content_detail. Fue de las 00:33:55 a las 00:37:01 hora de Singapur: 3 minutos y 6 segundos, 12 peticiones, 10 cobros y 0,00581 USD; entre las dos gratuitas estaba el 429 de las 00:35:34. Las cifras de la comparación más abajo salen de esta pasada y de las llamadas manuales.
| Pasada | Palabra clave | Hora (SGT) | Peticiones | Cobradas | Coste |
|---|---|---|---|---|---|
| Primera | Zhipu Coding Plan | 00:24:58 a 00:32:37 | 15 | 6 | 0,003586 USD |
| Segunda | Coding Plan subida de precio | 00:33:55 a 00:37:01 | 12 | 10 | 0,00581 USD |
| Tercera, final | la misma, con filtro por título en Zhihu | 02:06:32 a 02:08:22 | 7 | 7 | 0,004142 USD |
La segunda pasada salió más limpia, pero dejó ver un defecto de elegir preguntas por «me gusta». De las 20 respuestas de Zhihu, 8 tenían títulos que nombraban a Zhipu o a GLM; una, por ejemplo, preguntaba por qué el plan cuesta más en China que fuera. El script, en cambio, eligió las 3 preguntas con más «me gusta» en total. La primera, con 523, preguntaba por qué OpenAI pausó su plan Pro de 200 dólares. La segunda, con 378, dónde comprar hoy un plan de programación que valga la pena. La tercera, con 235, trataba del fin de las renovaciones del plan Lite de Alibaba Cloud. Las tres hablan de precios de planes, pero ninguna de Zhipu.
| Pregunta elegida por el script | «Me gusta» de la respuesta | Comentarios | Nombra a Zhipu |
|---|---|---|---|
| pausa del plan Pro de 200 USD de OpenAI | 523 | 59 | no |
| dónde comprar hoy un buen plan de programación | 378 | 72 | no |
| fin de las renovaciones del plan Lite de Alibaba Cloud | 235 | 52 | no |
Si lo que quieres es saber qué piensa la gente de la subida de Zhipu, añade un filtro por título que exija el nombre de Zhipu o de GLM. Es justo el tipo de cambio que Claude Code hace bien. Lees el primer resumen y dices «solo preguntas sobre Zhipu»; GLM cambia una línea y vuelve a correr el script por menos de un céntimo.
En Weibo el problema fue más claro. De las 20 publicaciones, solo 7 mencionaban coding plan en el texto, y solo 2 de ellas tenían 3 comentarios o más. Una era de alguien que canceló otro plan y probó alternativas. La otra decía que GLM 5.3 había mejorado mucho, pero que la subida había sido excesiva. Entre las dos dieron solo 5 comentarios. Uno de ellos, con el único «me gusta», contaba que su autor ya ejecutaba en local un modelo de 27B a 44 tokens por segundo con una sola tarjeta de 16 GB; otro le contestaba que 44 t/s ya es usable.
Los temas técnicos de nicho se discuten poco en Weibo, y la mayor parte de la conversación está en Zhihu. Para tener una muestra equilibrada, juntamos 4 lotes de comentarios de Weibo elegidos a mano (73 comentarios) con los 5 de la segunda pasada, en total 78. En Zhihu juntamos los 71 comentarios de la segunda pasada con 7 de la fase manual, también 78. Con el mismo número de comentarios, las proporciones se comparan sin trampa.
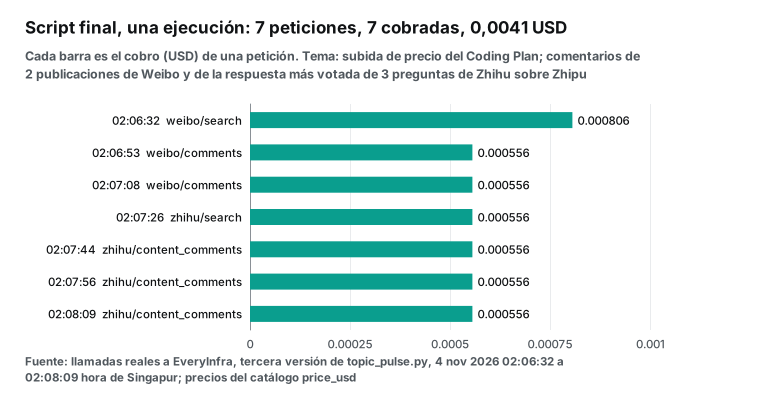
La tercera pasada añadió el filtro por título y es el script final de este artículo. Quitamos el paso del texto completo, dejamos cuatro capacidades y añadimos --zhihu-title con un patrón para Zhipu, GLM y un apodo habitual de Zhipu. Fue de las 02:06:32 a las 02:08:22 hora de Singapur del 2026-11-04: 1 minuto y 50 segundos, 7 peticiones con respuesta 200 y 7 cobros, en total 0,004142 USD. En Weibo leyó las mismas 2 publicaciones y 5 comentarios que la segunda pasada.
En Zhihu, las 3 preguntas elegidas ya trataban de Zhipu. Una preguntaba cómo valorar el cambio a créditos del 2026-07-30 (respuesta más votada: 47 «me gusta», 28 comentarios). Otra, dónde suscribirse al plan de programación de GLM-5 y por qué el modelo tiene tanto éxito (36 «me gusta»). La tercera, por qué el Coding Plan de Zhipu es tan caro (7 «me gusta»). Bajo esas tres respuestas el script leyó 7, 11 y 3 comentarios, 21 en total; las reglas de ruido no quitaron ninguno y la mediana fue de 26 caracteres. El comentario más votado, con 19 «me gusta», preguntaba por qué alguien paga un año entero si nadie sabe qué IA irá en cabeza dentro de tres meses. Otro, con 4, decía que el plan internacional cuesta «un 50 % más que el precio nacional».
Qué dicen Zhihu y Weibo
Esta sección muestra lo que GLM debería escribir tras leer los resultados. Para que el modelo no se ponga nota a sí mismo, todas las cifras las calcula analysis.py a partir de las respuestas brutas, sin modelo de por medio. El texto es nuestro, basado en esas cifras.
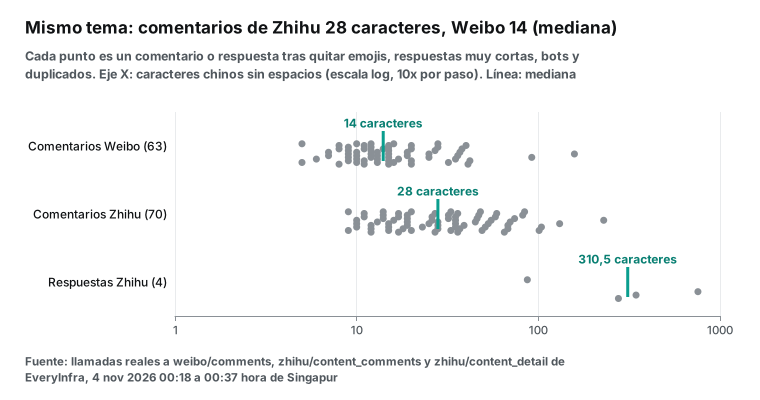
Empecemos por la longitud. Tras quitar el ruido, el comentario mediano de Weibo tiene 14 caracteres; nueve de cada diez tienen 36 o menos, y el más largo 158. El comentario mediano de Zhihu tiene 28; nueve de cada diez tienen 70 o menos, y el más largo 229. Las cuatro respuestas de Zhihu tienen una mediana de 310,5 caracteres y un máximo de 756. Un comentario de Zhihu dobla en longitud a uno de Weibo, y una respuesta de Zhihu lo multiplica otra vez por diez. Weibo da el ánimo; las razones están en las respuestas de Zhihu.
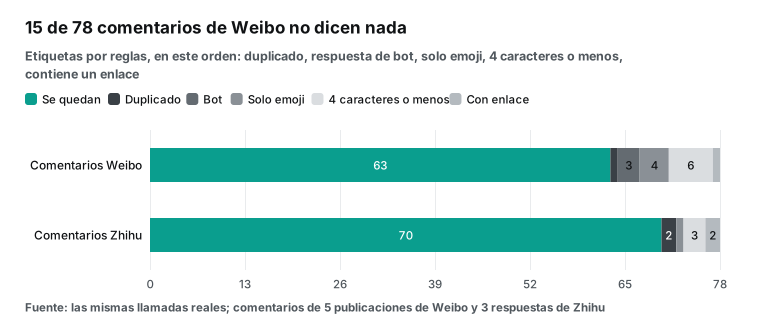
Sigamos con el ruido. De los 78 comentarios de Weibo, las reglas quitaron 15: 6 demasiado cortos, 4 de solo emojis, 3 respuestas del asistente de búsqueda de Weibo, 1 repetido y 1 que era solo un enlace. De los 78 de Zhihu quitaron 8: 3 cortos, 2 enlaces, 2 repetidos y 1 de emojis. El ruido es del 19 % en Weibo y del 10 % en Zhihu.
Las respuestas del bot merecen una nota. En Weibo, cualquiera puede mencionar al asistente en un comentario y preguntarle, por ejemplo, cuánto subió DeepSeek su precio. El asistente responde con un texto largo que además sube en el orden por «me gusta». Sin la regla de bots, acabarías citando lo que dijo el asistente como si lo hubiera dicho la gente.
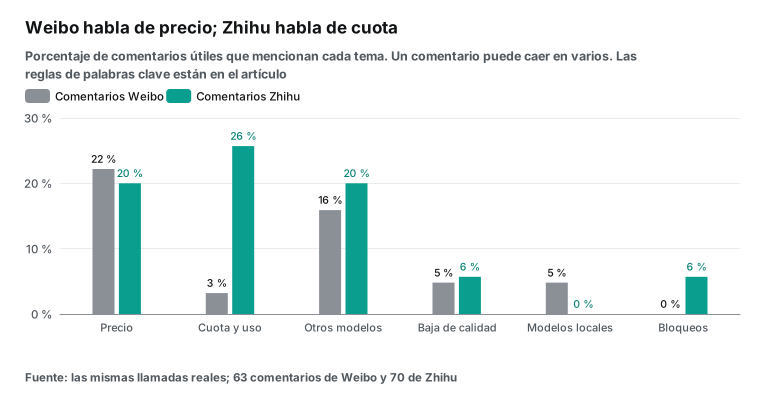
Por último, los temas. Escribimos una lista de palabras para cada uno de seis temas. Precio incluye subida, caro, cuánto, yuanes y dólares. Cuota incluye cuota, uso, agotar, 5 horas, semana, créditos y reinicio. Calidad incluye «modelo atontado» y cuantizado. Rivales incluye DeepSeek, Kimi, Codex, Claude, Qwen y MiniMax. Local incluye local, VRAM y desplegar. Bloqueos incluye cierre de cuentas, control de riesgo y límites. Un comentario puede caer en varios temas.
De los 63 comentarios conservados de Weibo, el 22,2 % habla de precio y el 15,9 % compara con rivales; calidad y modelos locales tienen un 4,8 % cada uno, y la cuota solo un 3,2 %. De los 70 de Zhihu, el 25,7 % habla de cuota, precio y rivales un 20 % cada uno, calidad y bloqueos un 5,7 % cada uno, y los modelos locales no aparecen.
| Medida | Weibo, 78 comentarios | Zhihu, 78 comentarios y 4 respuestas | Lectura | Datos del |
|---|---|---|---|---|
| Conservados tras el filtro | 63 | 70 | Weibo tiene el doble de ruido | 2026-11-04 |
| Longitud mediana | 14 caracteres | 28 en comentarios, 310,5 en respuestas | las razones están en Zhihu | 2026-11-04 |
| «Me gusta» en lo conservado | 112 | 349 en comentarios, 1183 en respuestas | en Zhihu se concentran en pocas respuestas | 2026-11-04 |
| Tema principal | precio, 22,2 % | cuota, 25,7 % | «¿es caro?» frente a «¿me llega?» | 2026-11-04 |
| Tema que solo aparece en un lado | local, 4,8 % | bloqueos, 5,7 % | muestra pequeña, solo una pista | 2026-11-04 |
Con estas cifras, un resumen de GLM podría quedar así. Es un texto de ejemplo nuestro, no una salida del modelo.
Los dos sitios hablan de precio, pero de forma distinta. En Weibo, la gente da un veredicto en una línea, del tipo «los precios son cada vez más absurdos», y casi nunca explica por qué. Uno de cada seis comentarios nombra a otro proveedor. En Zhihu, la gente hace cuentas. Una respuesta con 378 «me gusta» sostiene que hoy Codex es el único proveedor generoso, y que ningún plan iguala su relación entre precio y uso, aunque prevé que no durará.
Los comentarios más votados de Zhihu hablan de cuota; uno con 74 «me gusta» dice que el uso disponible bajó a la mitad «desde lo de las tarjetas de reinicio». En Zhihu, un 5,7 % habla de bloqueos y control de riesgo, y en Weibo nadie. En Weibo, en cambio, algunos se preguntan si un modelo local puede sustituir al plan. La muestra es pequeña, 78 comentarios por sitio, y las respuestas de Zhihu salen de las preguntas con más «me gusta».
Solo citamos texto público de comentarios, sin nombres de usuario, y los «me gusta» vienen del campo like_count. Conviene repetir el límite. Es un tema, una noche y 78 comentarios por sitio. Las reglas de temas son listas de palabras que escribimos nosotros; GLM puede clasificar mejor o equivocarse. El resultado responde a «en qué se diferencia la conversación en los dos sitios», no a «qué porcentaje de la gente apoya la subida».
Costes: datos, tokens de GLM y créditos del plan
Primero, los datos. La segunda pasada hizo 12 peticiones. weibo/search costó 0,000806 USD y cada una de las otras 9 peticiones con datos, 0,000556 USD; las dos fallidas, una de ellas un 429, fueron gratis. En total, 0,00581 USD por 79 filas de texto (5 comentarios de Weibo, 3 respuestas de Zhihu y 71 comentarios de Zhihu) más 40 filas de búsqueda. Sale a 0,0735 USD por cada 1000 filas de texto.
El script final quita el paso del texto completo: una pasada son 7 peticiones por 0,004142 USD y devuelve 5 comentarios de Weibo, 21 comentarios de Zhihu y 40 filas de búsqueda. Una pasada diaria del tamaño de la segunda cuesta 0,1743 USD al mes; con el script final, 0,12426 USD al mes.
| Escenario | Peticiones | USD | Base |
|---|---|---|---|
| Segunda pasada, con texto completo | 12 enviadas, 10 cobradas | 0,00581 | charged_usd |
| Tercera pasada, script final | 7 enviadas, 7 cobradas | 0,004142 | charged_usd |
| Por cada 1000 filas de texto | n/d | 0,0735 | 79 filas |
| Diaria durante 30 días | 360 | 0,1743 | 30 × 0,00581 |
| Lectura del resumen con Flash en BigModel | 1 | 0,000888 | 3707 tokens |
Después, el modelo. Sin cuenta no pudimos medir una sesión real, así que tomamos prestada una sesión de ejemplo de la documentación de costes de Claude Code: 1,2k tokens de entrada, 5,3k de salida, 940k de lectura de caché y 50k de escritura de caché. Esa forma se parece a «escribir un script de cien líneas, ejecutarlo dos veces y corregirlo una». Dominan las lecturas de caché, porque cada turno vuelve a leer el contexto. Zhipu no tiene precio aparte para escribir en caché, así que lo contamos como entrada normal.
| Modelo y sitio | Sesión de ejemplo | En USD aprox. | Una lectura de resumen | Créditos en hora punta |
|---|---|---|---|---|
| GLM-5.3 en BigModel | 2,438 CNY | 0,3631 USD | 0,008884 USD | 207,8 |
| GLM-5.3 en Z.ai | 0,3394 USD | 0,3394 USD | 0,00969 USD | 207,8 |
| GLM-5.3-Flash en BigModel | 0,272 CNY | 0,0405 USD | 0,000888 USD | 68,7 |
| GLM-5.3-Flash en Z.ai | 0,0385 USD | 0,0385 USD | 0,001081 USD | 68,7 |
| Una pasada de datos en EveryInfra | n/d | 0,00581 USD | n/d | n/d |
La columna de lectura de resumen supone 2207 tokens de entrada (el texto limpio de la segunda pasada) y 1500 de salida. Es el coste extra de cada día, una vez escrito el script, para que GLM lea datos nuevos. Los importes en yuanes usan el tipo del 2026-11-03, 6,7150.
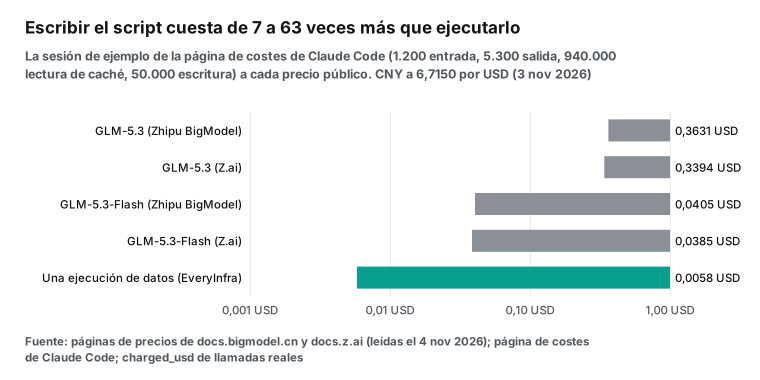
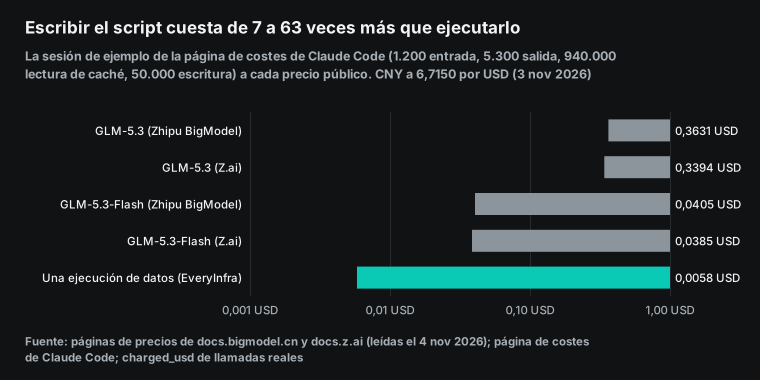
El gráfico deja una idea clara. En este tipo de tarea, casi todo el dinero se va en escribir y corregir código, no en traer datos. Con GLM-5.3, una sesión cuesta unas 60 veces los datos; con Flash, unas 7. Una vez escrito el script, el coste diario es la pasada de datos más una lectura de resumen: con Flash en BigModel, menos de 0,007 USD al día.
Con un Coding Plan, el coste del modelo se convierte en créditos. Lite da 10.000 por semana: unas 48 sesiones como la del ejemplo con GLM-5.3 o unas 145 con Flash, todas en hora punta. Fuera de hora punta, ambas cifras se duplican. La búsqueda web integrada cuesta 1,2 créditos por llamada, así que unas cuantas consultas de documentación apenas tocan la cuota.
Queda un coste fácil de pasar por alto: darle al modelo la respuesta bruta de la API. El JSON bruto de la segunda pasada tenía unos 14.543 tokens. Al precio de entrada de GLM-5.3 en BigModel, 8 CNY por millón, una lectura cuesta unos 0,116 CNY, unos 0,017 USD, cerca de tres veces el coste de los datos. Y cada turno extra la vuelve a leer. Que el script comprima primero, para que el modelo lea solo unos 2207 tokens, es el mayor ahorro de toda la configuración.
Límites
Primero, zhihu/question_answers, que lee todas las respuestas de una pregunta, no estaba disponible durante nuestras pruebas, y las peticiones fallidas no se cobraron. Por eso el script parte de zhihu/search y, de cada pregunta, lee solo las respuestas que encontró la búsqueda y sus comentarios.
Segundo, no probamos nada del lado de Zhipu. La configuración sigue la documentación del 2026-11-04, y esa documentación se contradice en dos puntos. No tenemos datos de qué script escribiría GLM-5.3, cuántas correcciones necesitaría ni cuántos tokens gastaría. El coste del modelo es una estimación a partir de una sesión de ejemplo de la documentación de Claude Code, no una medida.
Tercero, la muestra es pequeña: 78 comentarios por sitio. En Weibo, 73 vienen de publicaciones elegidas a mano, no por el script, y en Zhihu solo hay 4 respuestas. Las reglas de temas son listas de palabras, y palabras cortas como «semana» pueden coincidir por accidente. Usa los resultados como pistas, no como porcentajes de opinión.
Cuarto, la cuota del plan solo vale en herramientas admitidas. Un temporizador que lance el script y pida a GLM el resumen sin una persona delante queda fuera del plan y necesitaría la API estándar. Nuestro diseño solo programa el script; el resumen espera a que abras Claude Code y pidas a GLM que lea el último archivo.
Quinto, los comentarios de weibo/comments no traen la ubicación por IP. Las respuestas dentro de un hilo salen de weibo/comment_replies, que cuesta 0,000806 USD por llamada y sí incluye la ubicación. Si necesitas una vista por regiones, añade esa llamada.
| Límite | Efecto en este artículo | Qué hacer |
|---|---|---|
| sin todas las respuestas de cada pregunta | solo las respuestas que da la búsqueda | partir de zhihu/search |
| sin cuenta de Zhipu | GLM no se ejecutó | tratar la configuración como ejemplo |
| 78 comentarios por sitio | proporciones poco estables | más temas y más noches |
| cuota solo en herramientas admitidas | sin resúmenes automáticos | programar solo el script |
sin ubicación en weibo/comments | sin vista regional | añadir weibo/comment_replies |
Cambios recientes en torno a GLM-5.3 y el Coding Plan
En el lado de los modelos, QbitAI informó el 2026-10-12 de que Zhipu añadió GLM-5.3-Highspeed a ZCode 3.15.1, y un usuario midió unos 490 tokens por segundo (QbitAI). Por ahora solo está en ZCode, y la documentación del plan no lo ofrece para Claude Code. El paquete MCP de visión pasó a la versión 0.1.6 el 2026-10-29.
En seguridad, Anthropic publicó el 2026-09-29 una investigación según la cual GLM-5.3 puede construir por sí solo exploits completos y salió sin salvaguardas sólidas (investigación de Anthropic). El 2026-10-30, Help Net Security contó una evaluación de Irregular: GLM-5.3 no rechazó ninguno de 13 escenarios, y los evaluadores aconsejan probar las restricciones antes de darle más autonomía (Help Net Security). Para esta configuración, eso significa mínimo privilegio: el script necesita una carpeta y una API, nada más.
En precios, Zhipu separó las claves estándar de las del plan el 2026-10-16. El 2026-10-23, 36Kr contó que Zhipu fue de los pocos con un descuento real por el Día del Soltero: la tarjeta mensual Lite bajó de 118 CNY a 115 CNY (36Kr). A finales de octubre, la comunidad de BAAI informó de que algunos suscriptores recibieron tarjetas de reinicio de cuota como compensación por una bajada de calidad (BAAI Hub), lo que encaja con el comentario de Zhihu citado arriba. No encontramos las reglas de esas tarjetas en la documentación de Zhipu.
| Fecha | Cambio | Fuente |
|---|---|---|
| 2026-09-29 | investigación de Anthropic sobre GLM-5.3 | Anthropic |
| 2026-10-12 | GLM-5.3-Highspeed en ZCode 3.15.1 | QbitAI |
| 2026-10-16 | claves estándar y del plan separadas | aviso de BigModel |
| 2026-10-23 | Lite mensual de 118 CNY a 115 CNY | 36Kr |
| 2026-10-29 | @z_ai/mcp-server 0.1.6 | npm |
| 2026-10-30 | evaluación de Irregular | Help Net Security |
| 2026-11-03 | Claude Code 2.1.317 | registro de cambios de Claude Code |
Primeros pasos
Los pasos 1 a 3 son un ejemplo de configuración; los pasos 4 a 6 los ejecutamos.
- Contrata un Coding Plan y crea una clave del plan (desde el 2026-10-16, una clave estándar no sirve).
- Edita
~/.claude/settings.jsoncomo en el ejemplo de configuración. - Abre una terminal nueva, ejecuta
claudey escribe/statuspara comprobar el modelo. - Consigue una clave de EveryInfra en el inicio rápido y añádela como
EVERYINFRA_API_KEY. - Da a Claude Code la instrucción del script con
--weibo-posts 2 --zhihu-questions 2y--zhihu-titlepara una primera pasada pequeña. - Pide a GLM que lea el JSON y escriba el resumen; luego añade un filtro por título y repite.
Los parámetros y campos de cada capacidad están en la página de la API de Zhihu y en la página de la API de Weibo. Para Zhihu, consulta búsqueda, comentarios y, como opción, detalle de contenido. Para Weibo, búsqueda y comentarios. La lista de herramientas MCP está en la página del servidor MCP, y los precios de catálogo en la página de precios.
Lecturas relacionadas: para ver cómo rinden los modelos al limpiar comentarios y cuánto cuesta, lee DeepSeek V4 en Claude Code para limpiar comentarios; el JSON de topic_pulse.py sirve directamente como entrada de ese flujo. Para otro patrón de datos con Claude Code, mira los flujos dinámicos de Claude Code con comentarios de Xiaohongshu. El sesgo de elegir por «me gusta» se explica en la integridad de la muestra en redes sociales, y los reembolsos de llamadas fallidas en la conciliación de reembolsos por fallo.
Preguntas frecuentes
«how to use glm 5.3 in claude code»: ¿qué hay que configurar y por qué el sufijo [1m]?
Los valores del bloque env de ~/.claude/settings.json, como en el ejemplo de configuración de arriba. Lo que más se olvida es el sufijo [1m]: Claude Code no reconoce el identificador de GLM y, sin el sufijo, supone 200K tokens y compacta pronto. Después del cambio, abre una terminal nueva y comprueba la línea del modelo con /status. Origen de la pregunta: sugerencias de búsqueda para «how to use glm 5.3 in claude code» y «glm 5.3 claude code», consultadas el 2026-11-04. Base: guía de cambio de modelo de BigModel, configuración de modelos de Claude Code.
¿Puede mi propio script usar la cuota del Coding Plan?
No. El plan solo vale en herramientas admitidas, y las aplicaciones, webs, bots o productos SaaS propios necesitan la API estándar. Además, desde el 2026-10-16 los dos tipos de clave van por separado. Por eso nuestro script solo trae datos y el resumen lo escribe GLM en Claude Code. Origen de la pregunta: sugerencias para «glm coding plan limits», consultadas el 2026-11-04. Base: resumen del Coding Plan, política de uso de Z.ai.
¿Cuánto cuesta el GLM Coding Plan y cuándo consume menos?
El 2026-11-04, el plan individual mensual costaba 118 CNY (Lite), 538 CNY (Pro) y 1078 CNY (Max), con un 20 % de descuento trimestral y un 30 % anual. Fuera de hora punta, el modelo consume la mitad de créditos; la hora punta es de lunes a viernes, de 14:00 a 18:00 hora de Singapur. No hay reembolsos. Origen de la pregunta: sugerencias para «glm coding plan pricing», consultadas el 2026-11-04. Base: página del GLM Coding Plan, notas de uso del plan.
¿GLM-5.3-Flash o GLM-5.3 para escribir el script?
En BigModel, la entrada y la salida de Flash cuestan la décima parte que las de GLM-5.3. Según nuestra estimación, una sesión de escritura cuesta unos 0,04 USD con Flash y 0,36 USD con GLM-5.3. Para un script de datos de cien líneas, empieza con Flash y pasa a GLM-5.3 solo si Flash no consigue arreglar un error. Origen de la pregunta: sugerencias para «glm 5.3 flash vs glm 5.3» y «glm 5.3 flash cost», consultadas el 2026-11-04. Base: precios de BigModel, precios de Z.ai.
¿Qué devuelve la búsqueda web integrada del GLM Coding Plan?
Según la documentación de Zhipu, la búsqueda devuelve títulos, URL, resúmenes, nombres de sitio e iconos, y el lector devuelve título, texto, metadatos y enlaces. Eso sirve para documentación y noticias. Un script de opinión necesita una fila por respuesta o comentario, con «me gusta» y fecha, y para eso usamos zhihu/search, zhihu/content_comments, weibo/search y weibo/comments. No tenemos cuenta de Zhipu, así que no probamos las herramientas integradas. Origen de la pregunta: sugerencias para «glm coding plan web search», consultadas el 2026-11-04. Base: MCP de búsqueda web, MCP de lectura de páginas.
¿Zhihu tiene API?
Sí. La plataforma de datos de Zhihu ofrece búsqueda y lista de tendencias; la búsqueda da como mucho 10 extractos por llamada con comentarios destacados y usa un token Bearer con marca de tiempo, así que encaja cuando te integras mediante la autorización de la plataforma. Nuestro script usa zhihu/search para 20 respuestas por llamada y zhihu/content_comments para los comentarios. El 2026-11-04, la pasada final leyó 21 comentarios de Zhihu y la parte de Zhihu costó 0,002224 USD. Origen de la pregunta: sugerencias para «zhihu com api», consultadas el 2026-11-04. Base: búsqueda en la plataforma de Zhihu, página de búsqueda de Zhihu.
Referencias
- BigModel: guía de cambio de modelo, leída el 2026-11-04
- BigModel: guía de Claude Code
- BigModel: introducción a Claude Code
- BigModel: resumen del Coding Plan
- BigModel: inicio rápido del Coding Plan
- BigModel: notas de uso del Coding Plan
- BigModel: preguntas frecuentes del Coding Plan
- BigModel: aviso de revisión del plan
- BigModel: aviso sobre claves, 2026-10-16
- BigModel: MCP de búsqueda web
- BigModel: MCP de lectura de páginas
- BigModel: MCP zread
- BigModel: MCP de visión
- BigModel: herramientas admitidas
- BigModel: ficha de GLM-5.3
- BigModel: ficha de GLM-5.3-Flash
- BigModel: precios
- BigModel: notas de versión
- BigModel: preguntas sobre facturación
- BigModel: preguntas sobre la API
- Página del GLM Coding Plan, precios leídos el 2026-11-04
- Z.ai: guía de Claude Code
- Z.ai: resumen del Coding Plan
- Z.ai: cambio al modelo más reciente
- Z.ai: política de uso
- Z.ai: inicio rápido
- Z.ai: precios
- Blog de Z.ai: GLM-5.3
- Claude Code: pasarelas LLM
- Claude Code: configuración de modelos
- Claude Code: variables de entorno
- Claude Code: MCP
- Claude Code: ajustes
- Claude Code: costes
- Claude Code: registro de cambios, 2.1.317 del 2026-11-03
- Repositorio de Claude Code: CHANGELOG
- Especificación de MCP, 2026-07-28
- glm-cookbook de Zhipu: ejemplo con Claude Code
- npm: @z_ai/mcp-server
- npm: @z_ai/coding-helper
- Plataforma de datos de Zhihu
- Plataforma de datos de Zhihu: búsqueda
- Plataforma de datos de Zhihu: lista de tendencias
- CLI de la plataforma abierta de Weibo
- CLI de Weibo: inicio rápido
- API de Weibo: comments/show
- API de Weibo: search/topics
- API de Weibo: límites de frecuencia
- Catálogo de capacidades de EveryInfra, leído el 2026-11-04
- SAFE: tipos centrales del renminbi
- Anthropic: GLM-5.3 and the spread of advanced cyber capabilities, 2026-09-29
- Help Net Security: evaluación de Irregular sobre GLM-5.3, 2026-10-30
- QbitAI: GLM-5.3-Highspeed a 490 tokens por segundo, 2026-10-12
- 36Kr: planes de tokens en el Día del Soltero, 2026-10-23
- BAAI Hub: bajada de calidad y tarjetas de reinicio
Referencia BL-81