API de Threads con Python: qué lee la API oficial y cómo obtener publicaciones y respuestas públicas
La API oficial de Threads solo busca sus propias publicaciones hasta la revisión. Probamos en Python una cadena de posts y respuestas en tres momentos.
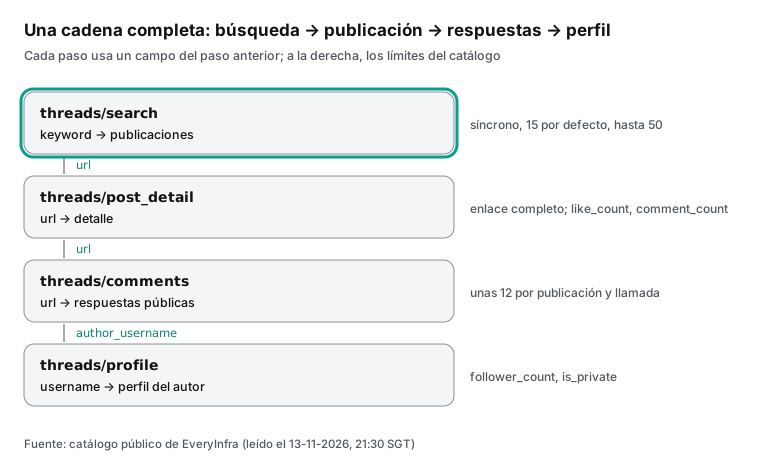
La API oficial de Threads de Meta está pensada sobre todo para que una cuenta gestione su propio contenido. Si la aplicación no está aprobada, la búsqueda por palabra clave solo encuentra las publicaciones propias; para leer perfiles y publicaciones de otras personas hace falta acceso avanzado, y el objeto de publicación oficial no trae número de «me gusta» ni de respuestas. En tres momentos, a las 22:31 y a las 23:00 del 13-11-2026 y a las 00:24 del 14-11-2026 (hora de Singapur), llamamos con Python a las capacidades de Threads de EveryInfra y recorrimos la cadena «búsqueda → publicación → respuestas → perfil del autor».
En la tercera ronda, el script completo hizo 4 llamadas, costó 0,002446 USD y devolvió 82 filas, es decir, 0,0298 USD por cada 1000 filas. Una búsqueda de «threads api» devolvió 50 publicaciones y ninguna hablaba de la API de Threads; media hora después, otra búsqueda devolvió 50 publicaciones distintas. Por eso conviene buscar varias veces, quitar duplicados y filtrar por el texto.
Tres vías: la API oficial de Threads, un scraper propio o una API de datos de terceros
En noviembre de 2026 hay tres vías para leer con código publicaciones y respuestas públicas de Threads. Los precios de EveryInfra salen del catálogo público del 13-11-2026, y el cargo de cada llamada es el valor charged_usd de la respuesta real.
| Vía | Qué lee (comprobado en la documentación oficial, en repositorios abiertos o en nuestras llamadas) | Qué necesita | Costo | Qué conviene saber |
|---|---|---|---|---|
| API oficial de Threads | Publicaciones, respuestas e Insights propios. Tras la revisión: búsqueda por palabra clave en publicaciones públicas y consulta de cuentas públicas con 100 seguidores o más | Una app de desarrollador de Meta y tokens OAuth de usuario; acceso avanzado para leer a otras personas; una app de empresa debe hacerse antes Tech Provider | Sin cobro por llamada; 4800 × impresiones llamadas cada 24 horas | Sin aprobación, la búsqueda solo encuentra lo propio; el objeto de publicación no tiene contadores de «me gusta» ni de respuestas |
| Scraper propio | El contenido que la página muestra al público | Mantener usted las solicitudes, el analizador y las salidas de red | El código es gratis; proxies y horas de mantenimiento aparte | Cada cambio de diseño rompe el código |
| API de datos de terceros (en este artículo, EveryInfra) | Búsqueda de publicaciones públicas, publicaciones de una cuenta, detalle, respuestas públicas, perfiles y descubrimiento de perfiles | Una clave de API; no inicia sesión en ninguna cuenta de Threads | Búsqueda: 0,000778 USD por llamada; el resto: 0,000556 USD; fallos y resultados vacíos no se cobran | Solo devuelve contenido que el público puede ver |
| Las tres vías | Las Condiciones de uso de Threads, punto 3(a)(iv), y las Condiciones del servicio de Meta, punto 3.2, limitan la recogida automatizada; robots.txt indica Disallow: / a los rastreadores que no nombra | Revise las condiciones y las leyes de su país antes de empezar | — | Las citas están en la sección «Términos de Meta» |
Solo la API oficial sirve para gestionar la cuenta de su marca, publicar y ver las visualizaciones de sus propias publicaciones. Para leer publicaciones y respuestas públicas de otras personas, la vía oficial exige antes una revisión de permisos; una API de datos de terceros necesita una clave, y los documentos de la última fila de la tabla también se le aplican.
Qué puede leer la API de Threads: la documentación oficial, punto por punto
Meta resume el propósito de la API de Threads en una frase: sirve para que una aplicación publique contenido en nombre de una persona y muestre esas publicaciones «solo a la persona que las creó» (Threads API overview, actualizada el 22-12-2025). La parte de lectura sigue la misma lógica: con GET /me/threads se leen las publicaciones propias, con GET /{media-id}/replies las respuestas a esas publicaciones y con los endpoints de insights las métricas propias. El 13-11-2026 abrimos una por una las páginas de la documentación que tratan de leer datos. El resultado es este:
| Qué quiere leer | Endpoint oficial | Permiso | Qué obtiene sin acceso avanzado | Límite |
|---|---|---|---|---|
| Publicaciones de su propia cuenta | GET /{user-id}/threads | threads_basic | Solo la cuenta que le dio el token | Cuota de la app: 4800 × impresiones cada 24 horas |
| Publicaciones de cualquier perfil público | GET /profile_posts?username= | threads_basic + threads_profile_discovery | Solo algunas cuentas oficiales de Meta; la documentación cita @meta, @threads, @instagram y @facebook | 1000 solicitudes por usuario cada 24 horas; solo perfiles públicos con 100 seguidores o más |
| Un perfil público | GET /profile_lookup?username= | Igual que arriba | Igual que arriba | Igual que arriba |
| Publicaciones por palabra clave o etiqueta de tema | GET /keyword_search | threads_basic + threads_keyword_search | Solo sus propias publicaciones | 2200 consultas por usuario cada 24 horas, sumando todas las apps |
| Una publicación por ID | GET /{media-id} | threads_basic | Solo publicaciones de un tester de Threads | Cuota de la app |
| Respuestas de una publicación | GET /{media-id}/replies, /conversation | threads_basic + threads_read_replies | Respuestas a publicaciones que usted gestiona | Cuota de la app |
| Publicaciones que lo mencionan | GET /{user-id}/mentions | threads_manage_mentions | Solo menciones de testers | Cuota de la app |
| Temas en tendencia y sus publicaciones | GET /trending_topics, /{trend-id}/posts | Token de app + la función Trending Topics | Solo la lista de temas; las publicaciones exigen acceso avanzado; solo EE. UU. y Japón | Los temas cambian como mucho una vez por hora |
Las fuentes de cada fila son Retrieve user posts (actualizada el 14-04-2026), Threads profiles, Keyword and topic tag search (actualizada el 21-01-2026), Retrieve media replies and conversations, Mentions y Trending topics. La fórmula de la cuota está en la página de resumen: «Calls within 24 hours = 4800 * Number of Impressions», y Meta cuenta como mínimo 10 impresiones. Una cuenta recién creada tiene, por tanto, al menos 48.000 llamadas al día. Para leer contenido de otras personas, primero hay que superar una revisión de permisos.
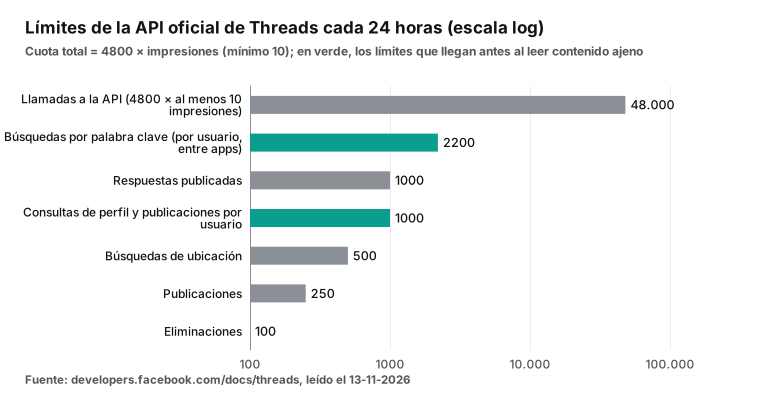
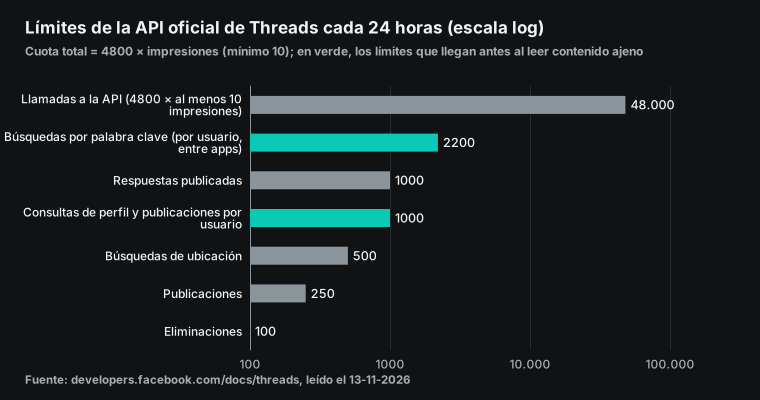
La tabla deja ver un patrón. Cada forma de leer datos de otras personas tiene su propio permiso, y sin acceso avanzado (Advanced Access) ese permiso solo funciona con usted, con sus testers o con unas pocas cuentas de Meta. La página Access Levels (actualizada el 30-06-2026) explica que el acceso estándar solo sirve para personas con un rol en la app, mientras que el avanzado exige verificar la empresa y, en algunos permisos, pasar además una revisión de la app (App Review). Así que la respuesta a «¿la API de Threads puede leer publicaciones de otros?» depende de que tenga acceso avanzado en cada permiso. La documentación no ofrece una vía para que un desarrollador independiente lea publicaciones públicas a escala.
El campo permalink desaparece cuando la publicación tiene material con derechos de autor, y el campo owner solo aparece en sus propias publicaciones de primer nivel. Además, la consulta de perfiles y la lista de publicaciones públicas solo devuelven perfiles públicos con al menos 100 seguidores; Meta bajó ese umbral de 1000 a 100 el 20-11-2025 (Threads changelog). Las cuentas con menos de 100 seguidores quedan fuera de la vía oficial.
Búsqueda por palabra clave en la API de Threads: antes de la aprobación solo encuentra lo tuyo
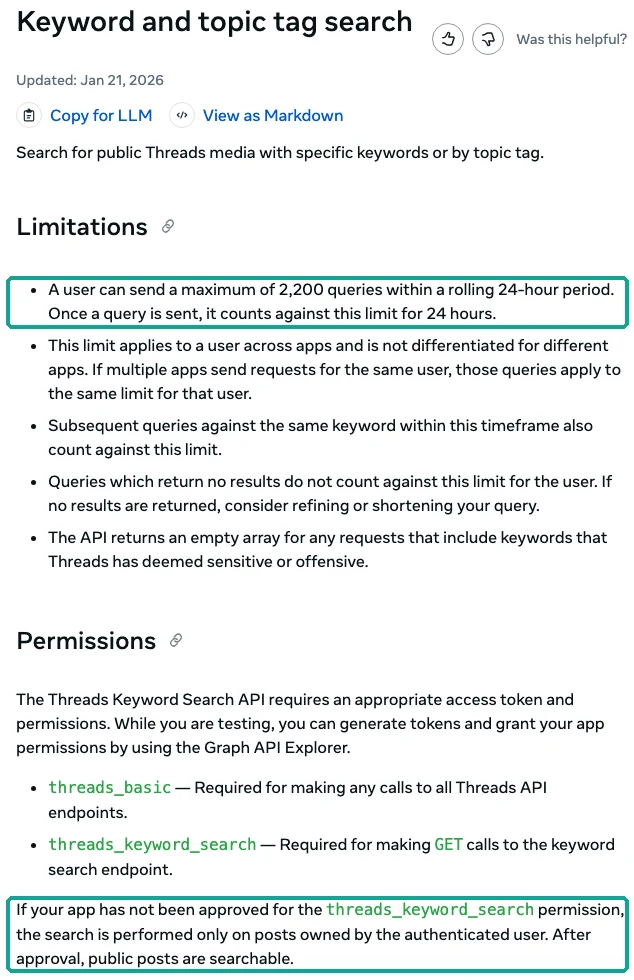
En las sugerencias de Google para «api de threads» y «threads api» aparecen «threads api keyword search» y «threads api search» (consultadas el 13-11-2026). La documentación lo dice sin rodeos: «If your app has not been approved for the threads_keyword_search permission, the search is performed only on posts owned by the authenticated user. After approval, public posts are searchable.» Es decir, si su app no está aprobada, /keyword_search solo devuelve publicaciones de su propia cuenta.
En el foro de desarrolladores de Meta hay varias personas que lo comprobaron y publicaron el resultado. En Threads keyword_search returns only my own posts, un desarrollador envió q=tarot, search_type=RECENT y limit=100: la API respondió HTTP 200 con 100 publicaciones, todas de su propia cuenta. Otra consulta, How can a self-use Threads app get public keyword search approval, registra seis búsquedas hechas a las 00:38 (hora de Japón) del 21-10-2026 con tres palabras japonesas de uso común: las seis devolvieron un arreglo vacío, aunque el mismo token leía sin problema el perfil y las publicaciones del dueño. En el panel, threads_keyword_search figuraba como «Ready for testing», no como aprobado. Una tercera consulta, returns the same post and repeats the same pagination cursor, cuenta que el cursor after devolvía otra vez la misma publicación propia y el mismo cursor.
Para buscar publicaciones públicas hay que pasar App Review, y los mensajes del foro coinciden en el obstáculo: al pulsar «Add to App Review», el panel pide convertir la empresa en Tech Provider y avisa de que la decisión no se puede deshacer (consulta de una marca, consulta de una app interna). La página Tech Providers de Meta define un Tech Provider como una empresa que necesita acceder a datos de otras empresas para prestarles servicios, y pone siete permisos de Threads, entre ellos threads_basic, threads_keyword_search y threads_read_replies, en la lista de los que una app empresarial no puede obtener si no es Tech Provider o si el usuario no tiene un rol en la app. Un equipo de marca que solo trabaja para sí mismo tiene dos opciones: convertirse en Tech Provider o usar la app solo con personas que tengan un rol en ella. Hasta el 13-11-2026, en los hilos que leímos, ningún empleado de Meta había propuesto otra vía.
Una vez aprobada, la cuota es de 2200 consultas por usuario en una ventana móvil de 24 horas. Repetir la misma palabra clave cuenta otra vez; una consulta sin resultados no cuenta. Las palabras que Threads considera sensibles u ofensivas devuelven siempre un arreglo vacío. Los parámetros son search_type (TOP o RECENT), search_mode=TAG para etiquetas de tema, media_type para texto, imagen o video, y since y until; el valor más antiguo de since es 1688540400, que corresponde al 05-07-2023. El limit por defecto es 25 y el máximo, 100. Desde el 20-01-2026, author_username filtra los resultados a una sola cuenta. El campo owner nunca se devuelve.
Qué campos trae una publicación de Threads: API oficial frente a API de pago por llamada
El objeto de publicación de la API oficial de Threads no tiene número de «me gusta», de respuestas ni de visualizaciones. La página Retrieve user posts enumera 27 campos de medios (con id, que se devuelve por defecto), desde id, text y timestamp hasta poll_attachment y ghost_post_status, y ninguno es un contador. El ejemplo de la página de búsqueda por palabra clave pide solo id,text,media_type,permalink,timestamp,username,has_replies,is_quote_post,is_reply. Los contadores están en otro endpoint, /{threads-media-id}/insights, y la primera frase de la documentación de Insights dice que sirve para leer las estadísticas de «users' own Threads posts and profiles»: las publicaciones de la cuenta que le dio acceso, con el permiso threads_manage_insights.
Eso significa que, aunque su app consiga acceso avanzado a la búsqueda por palabra clave y al descubrimiento de perfiles, con la API oficial no puede ordenar las publicaciones de otras personas por «me gusta» o por respuestas: solo ve el texto, la hora y si hay respuestas (has_replies). El único sitio oficial donde se ve la actividad de otra cuenta es profile_lookup, que devuelve la suma de «me gusta», citas, republicaciones y visualizaciones de todas las publicaciones de una cuenta pública en los últimos 7 días. Es un total de la cuenta, no un dato por publicación (Threads profiles).
| Lo que necesita | API oficial de Threads | Capacidades de Threads en EveryInfra (response_fields del catálogo) |
|---|---|---|
| ID, texto, hora y enlace | id, text, timestamp, permalink (se omite si hay contenido con derechos de autor) | id, text, posted_at, url |
| Autor | username; owner solo en sus propias publicaciones de primer nivel | author_username, author_name, author_id, author_is_verified |
| «Me gusta» y respuestas en publicaciones ajenas | No hay campo; Insights solo lee las propias | like_count, comment_count (search, user_posts, post_detail) |
| Visualizaciones, republicaciones, citas, envíos | Solo en Insights de las publicaciones propias | view_count, repost_count, quote_count, share_count (el catálogo los lista en user_posts y post_detail) |
| Árbol de respuestas | has_replies, root_post, replied_to, is_reply, hide_status | reply_to, author_name; el catálogo no dice si devuelve respuestas anidadas y no lo probamos por separado |
| Temas, menciones, enlaces | topic_tag, link_attachment_url | hashtags, mentions, links |
| Perfil | profile_lookup: seguidores y totales de 7 días | threads/profile: follower_count, bio, is_private, external_url |
| Marca de colaboración pagada | No aparece en la documentación | is_paid_partnership (post_detail) |
La columna de la derecha sale del catálogo público de EveryInfra, leído el 13-11-2026 a las 21:30 (hora de Singapur). Cada capacidad tiene su propia lista response_fields, y la tabla solo recoge nombres que aparecen en ella. Los dos lados comparten ID, texto, hora y autor; las diferencias están en los contadores y en la estructura de respuestas. Los campos oficiales de respuesta son más completos (separan respuestas directas y anidadas y muestran si una respuesta está oculta); la API de pago por llamada tiene la ventaja de leer contadores en publicaciones ajenas. Para ordenar publicaciones ajenas por número de respuestas, hace falta una API con campos de contadores.
El registro de cambios de la API de Threads: 20 de 89 entradas son de lectura y cada una trajo un permiso nuevo
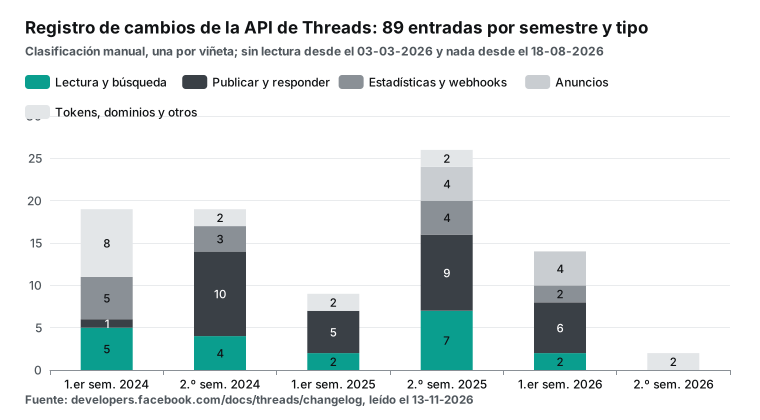
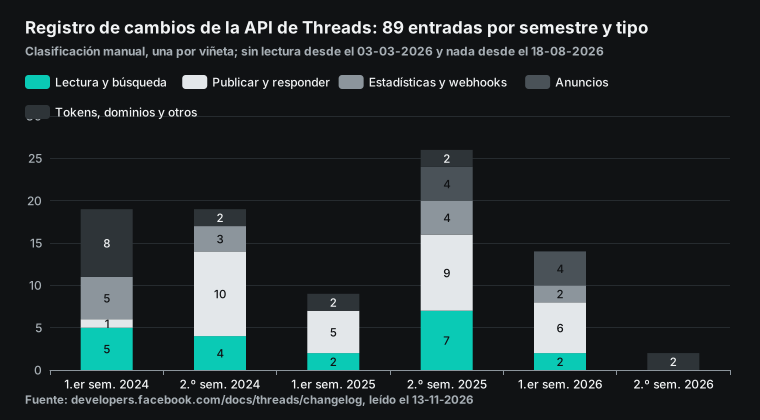
Para estimar si la lectura oficial se abrirá pronto, clasificamos las 89 entradas del Threads Changelog hasta el 13-11-2026 (la más antigua es del 08-04-2024, antes de que la API se abriera a todos los desarrolladores el 18-06-2024), en cinco grupos: lectura y búsqueda (búsquedas, perfiles, lectura de respuestas, campos nuevos en endpoints de lectura), publicar y responder, estadísticas y webhooks, anuncios, y tokens y otros. Cada viñeta bajo una fecha cuenta una vez, y la clasificamos a mano por el título y la primera frase.
| Tipo | Entradas | Primera | Más reciente | Últimos 12 meses (13-11-2025 a 13-11-2026) |
|---|---|---|---|---|
| Publicación (posts, respuestas, citas, republicaciones, formatos) | 31 | 2024-05-02 | 2026-03-25 | 9 |
| Lectura (consulta, búsqueda, menciones, perfiles, lectura de respuestas, campos nuevos de lectura) | 20 | 2024-04-18 | 2026-03-03 | 4 |
| Otros (tokens, dominios, documentación, depuración) | 16 | 2024-04-08 | 2026-08-18 | 2 |
| Insights y webhooks | 14 | 2024-04-26 | 2026-01-30 | 2 |
| Anuncios de Threads | 8 | 2025-08-15 | 2026-04-21 | 4 |
| Total | 89 | — | — | 21 |
Las entradas de lectura con más efecto son la búsqueda por palabra clave y la lista de menciones (09-12-2024); la consulta de perfiles y publicaciones por nombre de usuario, la búsqueda por etiqueta de tema y los filtros de fecha (14-07-2025); la bajada del mínimo de seguidores para el descubrimiento de perfiles de 1000 a 100 (20-11-2025); y el parámetro author_username en la búsqueda (20-01-2026). La última entrada de lectura es del 03-03-2026: la API de oEmbed deja de pedir token de acceso. Después del 18-08-2026 el registro no tiene ninguna entrada nueva; el 13-11-2026 eso son casi tres meses.
La lectura es el segundo grupo: tiene menos entradas que publicar (31) y más que estadísticas (14) y anuncios (8). Las funciones para leer contenido ajeno crecen, pero cada una llega con un permiso y una revisión nuevos. Del 03-03-2026 al 13-11-2026 no se añadió ninguna función de lectura en 8 meses. La entrada de aprobación de respuestas la contamos en publicar.
Threads API con Python: una cadena en tres momentos
Llamamos a las capacidades de Threads de EveryInfra en tres momentos (hora de Singapur): la primera ronda, de 22:31 a 22:46 del 13-11-2026; la segunda, de 23:00 a 23:07; y la tercera, de 00:24 a 00:31 del 14-11-2026. Cada ronda siguió la misma cadena: threads/search con la palabra clave «threads api», la publicación con más respuestas, su detalle con threads/post_detail, sus respuestas con threads/comments y el perfil del autor con threads/profile. Para ver cómo cambia una misma publicación con el tiempo, cada ronda leyó además el detalle de dos publicaciones de medios: una de The New York Times (@nytimes) del 12 de noviembre sobre una caída de los servicios de Microsoft, y otra de BBC Chinese (@bbcchinese) del 11 de noviembre sobre un funcionario británico con cinco empleos a la vez.
Este es el script completo. Solo necesita requests y lee la clave de una variable de entorno. Lo ejecutamos a partir de las 00:31:25 del 14-11-2026 (hora de Singapur); su salida real va debajo del código.
"""One chain of public Threads data: keyword search -> post details -> replies -> author profile.
Usage: EVERYINFRA_API_KEY=... python3 threads_chain.py "keyword" [output_dir]
Needs only requests; the key comes only from the environment."""
import csv, json, os, sys, time
import requests

API = "https://api.everyinfra.com/api/v1/social"
KEY = os.environ["EVERYINFRA_API_KEY"]
S = requests.Session()
S.headers.update({"Authorization": f"Bearer {KEY}", "Content-Type": "application/json"})
spent = 0.0


def call(action, **params):
    """Call threads/<action> once; up to three tries; wait 60 s after a 429 and retry_after seconds after a retryable 503."""
    global spent
    for _ in range(3):
        r = S.post(API, json={"platform": "threads", "action": action, "params": params}, timeout=180)
        body = r.json()
        if r.status_code == 429:
            time.sleep(60); continue
        if r.status_code == 503 and body.get("error", {}).get("retryable"):
            time.sleep(min(body["error"].get("retry_after", 60), 300)); continue
        break
    spent += (body.get("billing") or {}).get("charged_usd") or 0
    if r.status_code != 200:
        raise RuntimeError(f"threads/{action} {r.status_code}: {body.get('error', {}).get('message')}")
    return body


def full_link(post):
    """Full post link https://www.threads.com/@username/post/<code>, for post details."""
    code = post["url"].rstrip("/").split("/")[-1]
    return f"https://www.threads.com/@{post['author_username']}/post/{code}"


def main(keyword, out="."):
    posts = call("search", keyword=keyword, limit=50)["results"]
    print(f"search: {len(posts)} posts")
    top = max(posts, key=lambda p: p.get("comment_count") or 0)   # the post with the most replies
    detail = call("post_detail", url=full_link(top))["results"]
    detail = detail[0] if isinstance(detail, list) else detail
    replies = call("comments", url=top["url"])["results"]   # short link as it is
    author = call("profile", username=top["author_username"])["results"]
    author = author[0] if isinstance(author, list) else author
    print(f"post_detail: like={detail.get('like_count')} reply={detail.get('comment_count')}")
    print(f"comments: {len(replies)} replies; profile: follower_count={author.get('follower_count')}")
    with open(os.path.join(out, "posts.csv"), "w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, ["id", "url", "posted_at", "like_count", "comment_count", "author_username", "text"], extrasaction="ignore")
        w.writeheader(); w.writerows(posts)
    with open(os.path.join(out, "replies.csv"), "w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, ["id", "posted_at", "like_count", "comment_count", "reply_to", "author_name", "text"], extrasaction="ignore")
        w.writeheader(); w.writerows(replies)
    rows = len(posts) + 1 + len(replies) + 1
    print(f"total {rows} rows, spent ${spent:.6f}, ${spent / rows * 1000:.4f} per 1,000 rows")


if __name__ == "__main__":
main(sys.argv[1], sys.argv[2] if len(sys.argv) > 2 else ".")search: 50 posts
post_detail: like=10315 reply=799
comments: 30 replies; profile: follower_count=112
total 82 rows, spent $0.002446, $0.0298 per 1,000 rowsLa búsqueda devolvió 50 publicaciones. La que tenía más respuestas sumaba, en el detalle, 799 respuestas y 10.315 «me gusta»; la llamada de respuestas devolvió 30, cada una con reply_to y author_name, y el perfil del autor tenía 112 seguidores. Las cuatro llamadas costaron 0,002446 USD en total (0,000778 la búsqueda y 0,000556 cada una de las otras tres), es decir, 0,0298 USD por cada 1000 filas para 82 filas.
| Ronda (hora de Singapur) | Búsqueda devolvió | Publicaciones que ya habían salido antes | Publicación del NYT: «me gusta» / respuestas | Publicación de BBC Chinese: «me gusta» / respuestas | Cargo de la ronda |
|---|---|---|---|---|---|
| Ronda 1, 13-11, 22:31–22:46 | 50 | 47 entre las de 22:31:06 y 22:31:40 | 216 / 18 | 864 / 35 | 0,009340 USD |
| Ronda 2, 13-11, 23:00–23:07 (sin la ejecución del script de las 23:05) | 50 | 0 (frente a las dos de las 22:31) | 215 / 19 | 864 / 35 | 0,007116 USD |
| Ronda 3, 14-11, 00:24–00:31 (búsqueda, dos publicaciones de medios y script) | 44 | 0 (frente a las cinco del 13-11) | 216 / 19 | 864 / 35 | 0,005448 USD |
Los contadores de las dos publicaciones de medios casi no se movieron: la del NYT pasó de 18 a 19 respuestas y se quedó en 215 o 216 «me gusta»; la de BBC Chinese tuvo 864 «me gusta» y 35 respuestas las tres veces. Eran publicaciones de uno o dos días, y sus números apenas cambiaron en dos horas.
En la tercera ronda leímos las respuestas de esas dos publicaciones con el método que se explica abajo. La del NYT devolvió 17 respuestas, todas dirigidas a la publicación; la de BBC Chinese devolvió 28: 22 respondían a la publicación y 6 a otros usuarios. Las cuatro llamadas de medios de esta ronda tardaron entre 6,7 y 25,2 segundos; los dos detalles, menos de 8 segundos, y las dos lecturas de respuestas, más de 20.
La misma publicación volvió a salir en la segunda ejecución del script (desde las 00:31:25). Su fila de búsqueda pasó de 10.298 «me gusta» y 797 respuestas a 10.311 y 799, y el detalle dio 10.315 y 799. Los contadores de una publicación muy activa cambian todo el tiempo, así que conviene guardar la hora de lectura y los contadores en la misma fila.
El autor de esa publicación tenía 112 seguidores, y la publicación que eligió el script de las 23:05 del 13-11 (1838 respuestas) era de una cuenta con 7. En estas dos muestras, cuentas pequeñas tenían publicaciones sueltas con cientos o miles de respuestas; si filtra cuentas por seguidores, puede perder publicaciones así. En esta ronda, 26 de los 50 resultados de búsqueda tenían 0 respuestas, y los tres mayores números de respuestas fueron 797, 763 y 173.
Qué enlace pasar a cada capacidad
Recomendamos este método: para leer respuestas, pase a threads/comments el enlace que devuelve la búsqueda (https://threads.com/t/<código>) tal cual; para leer el detalle, use el enlace completo https://www.threads.com/@usuario/post/<código>, que es el formato que indica el catálogo para el parámetro de post_detail. La función full_link() del script arma el enlace completo con author_username y el código, y el script solo la usa para el detalle.
Entre las 00:24 y las 00:27 del 14-11-2026 (hora de Singapur) usamos este método con una publicación de cada una de tres cuentas de medios: The New York Times (11 de noviembre), BBC Chinese (12 de noviembre) y CNN en Español (13 de noviembre). Las llamadas devolvieron 30, 30 y 9 respuestas, cada una con reply_to (la cuenta a la que responde) y author_name.
El campo reply_to muestra los niveles. En la publicación del NYT, 28 de las 30 respuestas iban dirigidas a @nytimes y 2 a otros usuarios; en la de BBC Chinese, 25 de 30 iban a @bbcchinese y 5 a otros usuarios. Es decir, el resultado trae respuestas directas y también parte de las respuestas a respuestas; para separar los dos grupos, compare reply_to con el autor de la publicación.
| Publicación (14-11-2026, hora de Singapur) | Respuestas devueltas | `reply_to` = autor de la publicación | `reply_to` = otro usuario |
|---|---|---|---|
| The New York Times, 11 de noviembre (00:24) | 30 | 28 | 2 |
| BBC Chinese, 12 de noviembre (00:25) | 30 | 25 | 5 |
| CNN en Español, 13 de noviembre (00:27) | 9 | 9 | 0 |
| The New York Times, 12 de noviembre (00:28, ronda 3) | 17 | 17 | 0 |
| BBC Chinese, 11 de noviembre (00:29, ronda 3) | 28 | 22 | 6 |
Los resultados de búsqueda cambian entre llamadas
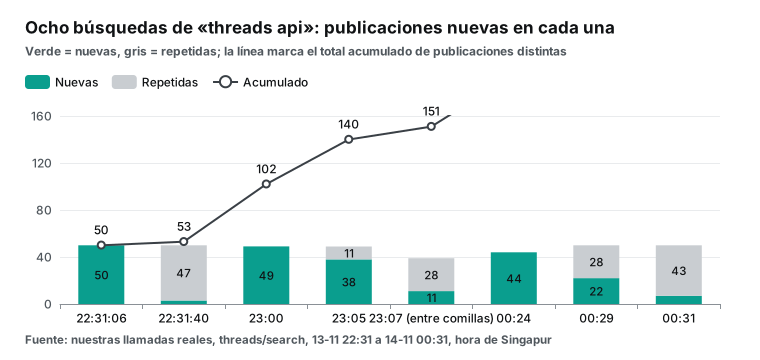
No hay cursor de páginas y la misma palabra clave da publicaciones muy distintas cada vez. threads/search solo tiene el parámetro keyword, limit llega como mucho a 50 y el catálogo indica que no se puede filtrar por fecha. Buscamos dos veces, a las 22:31:06 y a las 22:31:40, y 47 publicaciones coincidieron. La búsqueda de las 23:00 no compartió ninguna con las dos de las 22:31; la del script de las 23:05 compartió 11 con la de las 23:00. El 14-11, la búsqueda de las 00:24 devolvió 44 publicaciones y ninguna estaba en las cinco búsquedas de la noche anterior.
Cuántas coinciden depende del tiempo entre dos búsquedas:
| Dos búsquedas (hora de Singapur) | Tiempo entre ellas | Publicaciones en común |
|---|---|---|
| 13-11, 22:31:06 y 22:31:40 | 34 segundos | 47 |
| 14-11, 00:29:59 y 00:31:25 | minuto y medio | 43 |
| 14-11, 00:24:07 y 00:29:59 | unos 6 minutos | 28 |
| 14-11, 00:24:07 y 00:31:25 | unos 7 minutos | 21 |
| 13-11, 23:00:13 y 23:05:32 | unos 5 minutos | 11 |
| Dos búsquedas cualesquiera separadas por más de una hora | más de 1 hora | 0 |
Las búsquedas separadas por pocos minutos traen sobre todo las mismas publicaciones. Para reunir más, repita la búsqueda tras un tiempo (en nuestros datos, alrededor de una hora) y una los resultados por id. Nuestras 8 búsquedas (una de ellas entre comillas) sumaron 224 publicaciones distintas; la búsqueda costó 0,006224 USD en total, unos 0,0278 USD por cada 1000 publicaciones distintas (0,006224 USD ÷ 224 × 1000).
La búsqueda coincide por palabras, no por frases
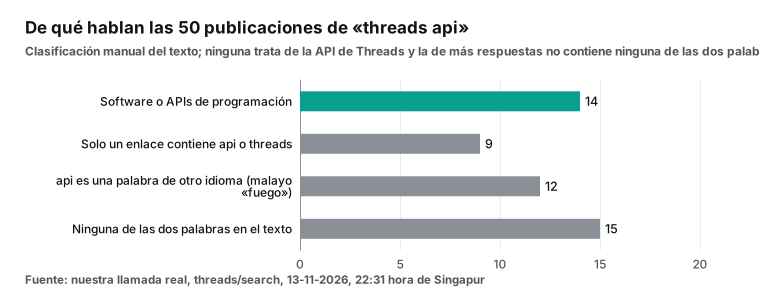
La palabra clave coincide por palabras sueltas, no por la frase. El gráfico recoge nuestra revisión manual de los 50 resultados de las 22:31: 14 publicaciones hablaban de software o de API; 9 solo tenían api o threads dentro de un enlace del texto, como api.whatsapp.com o ?api=1; en 12, api era una palabra de otro idioma (en malayo e indonesio api significa «fuego», y kereta api es «tren»); y 15 no contenían ninguna de las dos palabras. Ninguna de las 50 hablaba de la API de Threads, y la que tenía más respuestas (1696) no contenía ninguna de las dos palabras. A las 23:07 volvimos a buscar con comillas inglesas, "threads api": devolvió 39 publicaciones y ninguna contenía la frase. Solo revisamos a mano esas 50; el resto de resultados lo filtramos únicamente con la regla de texto de abajo.
Por eso hay que volver a filtrar en su lado. El código de abajo une los CSV de varias ejecuciones, quita duplicados y conserva una publicación solo si su texto cumple las dos reglas. Lo ejecutamos con seis ejecuciones (22:31, 23:00 y 23:05 del 13-11; 00:24, 00:29 y 00:31 del 14-11): los 6 archivos sumaban 210 publicaciones distintas y ninguna contenía a la vez threads y API en mayúsculas.
"""Merge the posts.csv files of several runs, remove duplicates, then filter on the text. Usage: python3 merge_filter.py runs/posts_*.csv"""
import csv, re, sys

MUST = [re.compile(r"\bthreads?\b", re.I), re.compile(r"\bAPI\b")]   # both must match; change them for your topic

seen, kept = {}, []
for path in sys.argv[1:]:
    with open(path, encoding="utf-8") as f:
        for row in csv.DictReader(f):
            seen.setdefault(row["id"], row)          # keep the first row for each post
for row in seen.values():
    if all(rx.search(row["text"] or "") for rx in MUST):
        kept.append(row)
print(f"{len(sys.argv) - 1} files, {len(seen)} unique posts, {len(kept)} with both threads and API in the text")
Para reducir el ruido, use un término más concreto (nombre de producto, de evento o una etiqueta) o parta de las cuentas y lea con threads/user_posts las que le interesan.
Costo por cada 1000 filas y tiempo por llamada
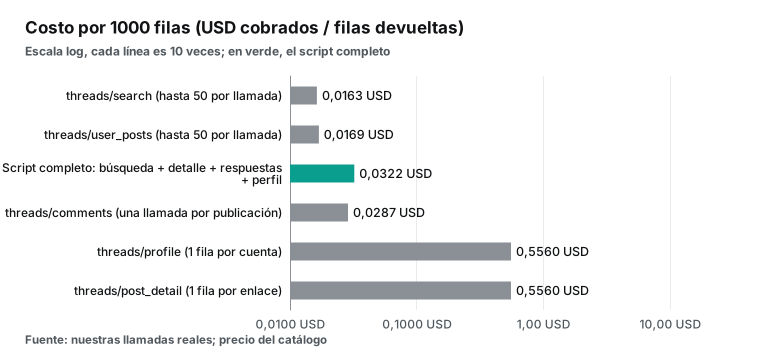
La tabla de costos incluye las 60 llamadas correctas del artículo, desde las 22:31 del 13-11 hasta las 00:31 del 14-11, con un cargo total de 0,032356 USD. El costo por cada 1000 filas es «cargo total ÷ filas devueltas × 1000»; contamos las filas que devolvió la API, y cada llamada de una capacidad de una sola fila (detalle, perfil) cuenta como 1 fila.
| Capacidad | Llamadas correctas | Filas devueltas | Cargo total | Por cada 1000 filas |
|---|---|---|---|---|
| threads/search (hasta 50 por llamada) | 8 | 383 | 0,006224 USD | 0,0163 USD |
| threads/user_posts (hasta 50 por llamada) | 12 | 230 | 0,003892 USD | 0,0169 USD |
| threads/comments (una llamada por publicación) | 17 | 329 | 0,009452 USD | 0,0287 USD |
| threads/post_detail (1 fila por enlace) | 17 | 17 | 0,009452 USD | 0,5560 USD |
| threads/profile (1 fila por cuenta) | 6 | 6 | 0,003336 USD | 0,5560 USD |
| Script completo: búsqueda + detalle + respuestas + perfil | 3 × 4 | 228 | 0,007338 USD | 0,0322 USD |
threads/search y threads/user_posts devuelven hasta 50 filas por llamada, así que 1000 filas cuestan menos de 2 centavos; threads/comments devolvió 329 filas en 17 llamadas, unos 3 centavos por cada 1000 filas; post_detail y profile devuelven 1 fila por llamada, 0,556 USD por cada 1000. Por eso, si una llamada de lista ya trae un campo («me gusta», respuestas, fecha), no pida el detalle de cada publicación. Las tres ejecuciones del script completo devolvieron 228 filas y costaron 0,007338 USD, es decir, 0,0322 USD por cada 1000 filas.
Un ejemplo con supuestos nuestros: si ejecuta este script una vez por hora para una palabra clave, un día son 24 × 0,002446 = 0,0587 USD y 30 días, unos 1,76 USD; si cada ejecución lee además la lista de publicaciones de una cuenta, sume 0,000556 USD por ejecución, unos 0,40 USD más en 30 días. El costo real es el charged_usd de cada respuesta. Para su propio volumen, multiplique la última columna de la tabla por sus filas al mes y divida entre 1000.
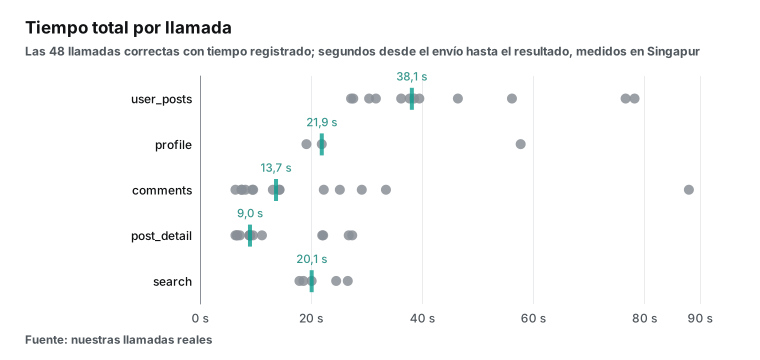
Los tiempos solo cubren las 48 llamadas correctas con tiempo registrado por llamada; las tres ejecuciones del script completo solo guardaron el inicio y el final. search tardó de 17,9 a 26,6 segundos, mediana 20,1 segundos; post_detail, de 6,4 a 27,4 segundos, mediana 9,0 segundos; comments, de 6,4 a 88,0 segundos, mediana 13,7 segundos; profile, de 19,2 a 57,7 segundos, mediana 21,9 segundos; y user_posts, de 27,2 a 78,2 segundos, mediana 38,1 segundos. Todas son llamadas síncronas, así que un tiempo de espera de 180 segundos en el script basta. Para consultar muchas cuentas a la vez, añada "mode": "async" al cuerpo de la solicitud, reciba un identificador de tarea y consúltelo después; la pista de la API lo explica.
La función call() del script trata dos errores. Un 429 significa que su propia clave superó su límite de ritmo: espere 60 segundos y vuelva a intentar. Cuando la API devuelve 503, charged_usd es 0, retryable es true y retry_after da una espera sugerida en segundos; espere ese tiempo, reintente y obtendrá el resultado. No registre un 503 como «sin datos». La función lo intenta tres veces y solo lanza un error si fallan las tres; en una tarea programada puede anotar las palabras clave que fallaron y repetirlas en la ronda siguiente.
Las respuestas forman un árbol: replies y conversation en la API oficial
En Threads una respuesta puede tener respuestas, y esas a su vez otras. La API oficial maneja ese árbol con dos endpoints. GET /{media-id}/replies devuelve solo el primer nivel; cada respuesta trae un campo has_replies que indica si hay más niveles debajo, y para bajar uno más hay que volver a llamar. GET /{media-id}/conversation aplana todos los niveles en una sola lista ordenada por fecha (el parámetro reverse fija el orden; por defecto, de la más nueva a la más antigua). La documentación aclara que conversation solo se usa en publicaciones de primer nivel que tienen respuestas (Retrieve media replies and conversations).
La documentación oficial añade tres límites para estos dos endpoints. username y permalink solo se devuelven para usuarios públicos y para su propio usuario; is_verified y profile_picture_url solo están en las respuestas directas (Meta añadió estos campos el 16-12-2025); y hide_status tiene seis valores, NOT_HUSHED, UNHUSHED, HIDDEN, COVERED, BLOCKED y RESTRICTED, así que conviene filtrar por este campo antes de contar. Para leer respuestas hace falta threads_read_replies, que también está en la lista de Tech Provider (Retrieve and manage replies). La capacidad threads/comments de EveryInfra no necesita esos permisos: cuesta 0,000556 USD por llamada y devuelve respuestas públicas con reply_to; el catálogo no indica en qué orden.
Desde el 13-02-2026, el autor de una publicación puede activar además la aprobación de respuestas: las nuevas quedan ocultas hasta que él las aprueba, y las lee con GET /{media-id}/pending_replies, con estado pending o ignored (Reply management). Esto afecta a cualquier análisis externo: en una publicación con aprobación activada, lo que el público ve son solo las respuestas aprobadas, y el contador de respuestas puede no coincidir con las que se pueden leer.
Términos de Meta, robots.txt y los límites de los datos públicos
Antes de leer con código datos públicos de Threads, conviene leer tres documentos de Meta. Los leímos el 13-11-2026 y el 14-11-2026, y se aplican igual a un scraper propio que a una API de datos de terceros (EveryInfra incluida). Este artículo no es asesoramiento legal; antes de empezar, revise las condiciones de Meta y las leyes de su país.
El primero son las Condiciones de uso de Threads. El punto 3(a) enumera lo que no se puede hacer, y el apartado (iv) prohíbe usar «any robot, spider, crawlers, scraper or other automatic device, process, software or queries» para acceder al servicio de Threads «to monitor, extract, copy or collect information or data», y también «any manual process to do the same». El inicio del mismo punto prohíbe además provocar o permitir que un tercero lo haga.
El segundo es el robots.txt de Threads. La copia que guardamos a las 21:37 del 13-11-2026 (hora de Singapur) tiene 389 líneas. Las cuatro primeras líneas de comentario prohíben recoger datos de Threads por medios automatizados sin permiso escrito de Threads, y dicen que los rastreadores de la lista deben cumplir las Automated Data Collection Terms de Meta. Al final, el archivo indica User-agent: * y Disallow: / para todos los rastreadores que no nombra.
El tercero son las Condiciones del servicio de Meta. El punto 3.2, apartado 3, dice que no se puede acceder a datos de los productos de Meta ni recogerlos por medios automatizados sin su permiso previo, y añade que esto se aplica «regardless of whether such automated access or collection is undertaken while logged-in to a Facebook account». En la parte superior, la página indica que las nuevas condiciones entrarán en vigor el 20-01-2027.
Las capacidades de Threads de EveryInfra solo devuelven contenido que el público puede ver: no inician sesión en ninguna cuenta y no leen mensajes privados, cuentas privadas ni publicaciones solo para amigos. El campo is_private de threads/profile indica si una cuenta es privada. El 29-10-2026 Threads empezó a probar «Threads Friends» en Irlanda, Italia y Japón, una función para compartir una publicación con un máximo de 50 amigos (Social Media Today, 29-10-2026; Engadget); esas publicaciones tampoco son datos públicos.
| Contenido | API oficial con acceso avanzado | Capacidades de Threads de EveryInfra |
|---|---|---|
| Publicaciones y respuestas de cuentas públicas | Sí, tras App Review; la consulta de perfiles exige 100 seguidores o más | Sí |
| Publicaciones de cuentas privadas | Solo su propia cuenta | No |
| Publicaciones solo para amigos (prueba «Threads Friends») | No aparece en la documentación que leímos | No |
| Mensajes privados | No hay endpoint de lectura en la documentación que leímos | No |
| Respuestas pendientes de aprobación | Solo el autor de la publicación (pending_replies) | No |
| Insights: visualizaciones, datos demográficos | Publicaciones propias y de cuentas que dieron acceso | No; user_posts devuelve view_count de publicaciones públicas |
Las redacciones y los organismos públicos suelen seguir cuatro reglas con este tipo de datos: guardar solo los campos que el análisis necesita (ID de la publicación, hora, texto, contadores) y no guardar fotos ni enlaces de perfil; aplicar un hash a los nombres de usuario de particulares o borrarlos, y conservar los de cuentas de organizaciones; fijar un plazo de conservación y borrar los datos al vencer; y publicar solo resultados agregados, sin capturas de respuestas de particulares. Si su análisis incluye a personas de la UE o del Reino Unido, lea antes la guía de la autoridad local de protección de datos.
Cuándo conviene más la API oficial de Threads o las herramientas de investigación de Meta
Hay tres casos en los que la vía oficial encaja mejor que una API de datos de terceros.
El primero es cuando gestiona su propia cuenta o una que un cliente le autorizó. Publicar, responder, ocultar respuestas, aprobarlas y ver insights (visualizaciones, me gusta, respuestas, republicaciones, citas, seguidores y datos demográficos de seguidores) solo se puede hacer con la API oficial. Una API de datos de terceros lee datos públicos: no publica y no ve las visualizaciones ni los datos demográficos de insights. La API oficial no cobra por llamada; la cuota es de 4800 × impresiones llamadas al día, así que una cuenta con 10.000 impresiones tiene 48 millones de llamadas diarias.
El segundo es cuando investiga desde una universidad o una organización sin ánimo de lucro. La herramienta web de Meta Content Library incluye publicaciones de perfiles públicos de Threads con 100 seguidores o más, con gráficos de tendencia por palabra clave y listas de autores. Las solicitudes las revisa de forma independiente el Secure Data Access Center (CASD) de Francia, y su uso dentro del Meta Secure Research Environment es gratuito. Los límites: solo pueden pedirlo investigadores académicos o de entidades sin ánimo de lucro, el análisis se hace en un entorno controlado y los endpoints de Content Library API que enumera esa página no incluyen Threads (la herramienta web sí). Esta vía tiene una fuente de datos documentada y el CASD revisa cada solicitud, así que sirve para investigaciones que necesitan una fuente rastreable y reproducible, con revisión ética.
El tercero es cuando solo necesita temas en tendencia de Estados Unidos o Japón. /trending_topics devuelve los títulos con un token de app y acceso básico, y los temas cambian como mucho una vez por hora; leer las publicaciones de un tema exige acceso avanzado. La documentación también prohíbe transferir o modificar esos datos.
En los demás casos (leer publicaciones de cualquier cuenta pública sin su token, buscar por palabra clave lo que publican otros, leer las respuestas a publicaciones ajenas), la vía oficial exige acceso avanzado. La tabla resume la vía más adecuada para cada caso.
| Qué necesita | Vía más adecuada | Motivo principal |
|---|---|---|
| Publicar, responder, ocultar o aprobar respuestas en su cuenta | API oficial | Solo la API oficial puede escribir |
| Visualizaciones y datos demográficos de su cuenta | Insights de la API oficial | Insights solo lee cuentas que dieron acceso |
| Un estudio académico con revisión ética | Meta Content Library | Fuente documentada en un entorno controlado |
| Títulos de temas en tendencia en Estados Unidos o Japón | /trending_topics oficial | El acceso básico basta para los títulos |
| Publicaciones y respuestas públicas de otras cuentas | API de datos de terceros | No necesita app de desarrollador de Meta; los tres documentos de arriba también se aplican |
Uso en otros campos: el tono de las respuestas a organismos públicos y medios
Para puntuar las respuestas públicas a un aviso o a una noticia se puede seguir un método de cuatro pasos; cada uno usa una de las capacidades descritas arriba.
Paso 1: elegir las publicaciones. Con threads/user_posts se obtienen las publicaciones recientes de la cuenta del organismo (hasta 50 por llamada); se ordenan por comment_count y se eligen las que tienen suficientes respuestas. En una publicación con pocas respuestas, la puntuación cambia mucho con cada respuesta. Paso 2: obtener las respuestas. Se llama a threads/comments para cada publicación y se obtiene el texto, la hora, los «me gusta» y reply_to. Paso 3: limpiar. Se quitan las respuestas de la propia cuenta del organismo (filtrando por author_username), las que solo tienen emojis o enlaces, y se agrupan por idioma. Paso 4: puntuar. Para las respuestas en inglés se puede empezar con un modelo de sentimiento basado en diccionario y reglas como VADER, que da una puntuación de -1 a 1 (Hutto y Gilbert, ICWSM 2014); no necesita datos de entrenamiento y sus autores lo ajustaron para textos cortos de redes sociales. Para el español y otros idiomas hay que usar un modelo de ese idioma, o un modelo de lenguaje grande con una instrucción fija que clasifique cada respuesta como positiva, negativa o neutra.
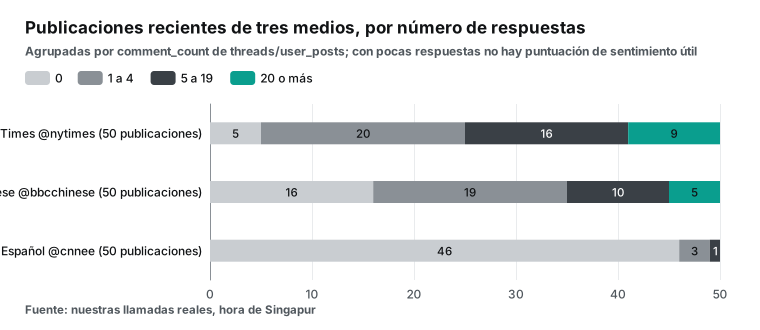
Probamos el paso 1 con tres medios. El 13-11-2026, de 23:03 a 23:05 (hora de Singapur), tomamos con threads/user_posts las 50 publicaciones más recientes de cada cuenta y las agrupamos por número de respuestas. CNN en Español (@cnnee) tuvo 46 publicaciones sin ninguna respuesta, y la que más tuvo llegó a 10; The New York Times, 9 publicaciones con 20 respuestas o más, una mediana de 5 y un máximo de 68; BBC Chinese, 5 con 20 o más, mediana de 1 y máximo de 186. Es decir, entre medios hay grandes diferencias en cuántas publicaciones se pueden puntuar, y la cuenta en español apenas dio muestra útil. Las tres llamadas costaron 0,001668 USD en total.
| Cuenta (hora de Singapur) | Publicaciones | 0 respuestas | 1 a 4 | 5 a 19 | 20 o más | Mediana | Máximo | Total de respuestas |
|---|---|---|---|---|---|---|---|---|
| The New York Times (23:03) | 50 | 5 | 20 | 16 | 9 | 5 | 68 | 561 |
| BBC Chinese (23:03) | 50 | 16 | 19 | 10 | 5 | 1 | 186 | 529 |
| CNN en Español (23:04) | 50 | 46 | 3 | 1 | 0 | 0 | 10 | 14 |
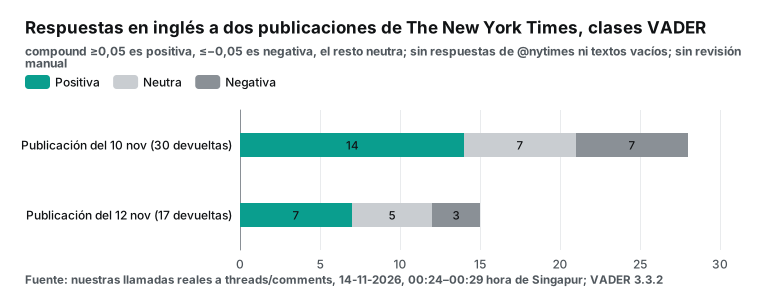
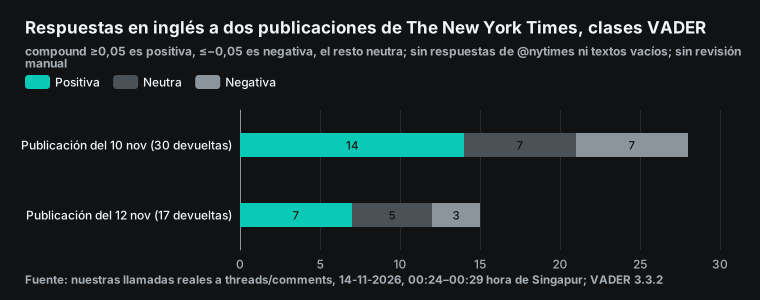
Después probamos los pasos 2 a 4 con dos publicaciones de The New York Times. A las 00:24 y a las 00:28 del 14-11-2026 (hora de Singapur) usamos threads/comments con el método recomendado: la publicación del 11 de noviembre devolvió 30 respuestas y la del 12 de noviembre, 17. Quitamos los textos vacíos y las respuestas de @nytimes, y quedaron 28 y 15. Las puntuamos con vaderSentiment 3.3.2 y su diccionario por defecto, sin cambiar ningún ajuste: un compound de 0,05 o más es positivo, de -0,05 o menos es negativo y el resto, neutro.
De las 28 respuestas, 14 fueron positivas, 7 neutras y 7 negativas, con una media de 0,131; de las 15, 7 positivas, 5 neutras y 3 negativas, con una media de 0,149. Cada muestra tiene solo entre 15 y 28 respuestas y no revisamos las puntuaciones a mano, así que el resultado solo sirve como demostración del método: no dice qué piensan los lectores de esas dos noticias. Las dos medias se diferencian en 0,018, y en muestras tan pequeñas una o dos respuestas negativas más bastan para borrar esa diferencia; antes de comparar dos publicaciones, reúna muestras del mismo tamaño y compruebe si la diferencia se mantiene.
Los «me gusta» no se reparten por igual entre respuestas, y eso afecta a cómo ponderar. El 11-11-2026, las 30 respuestas devueltas de la publicación del NYT sumaban 1053 «me gusta»; la primera tenía 901 y la mediana de las otras 29 era 1. El 12-11-2026, las 30 respuestas devueltas de una publicación de BBC Chinese sumaban 4424; la primera tenía 1896 y la mediana era 2,5. Si pondera por «me gusta», una o dos respuestas deciden el resultado; si no pondera, una respuesta sin «me gusta» pesa lo mismo que una con cientos. Calcule las dos versiones y dé ambas en el informe.
Las respuestas en chino necesitan otro modelo. En la publicación de BBC Chinese leída a las 00:25, 25 de las 30 respuestas tenían caracteres chinos y 14 de ellas, caracteres tradicionales comunes; una no tenía texto y la longitud media era de 17 caracteres. A las 00:29, otra publicación de BBC Chinese devolvió 28 respuestas: 22 con caracteres chinos y 5 sin texto. Son respuestas cortas, mezclan caracteres simplificados y tradicionales y muchas están vacías, así que un modelo de diccionario en inglés no sirve: use un modelo que admita chino o un modelo de lenguaje grande con una instrucción fija de tres clases, y revise después una muestra a mano. Las 9 respuestas devueltas de la publicación de CNN en Español estaban todas en español, con una longitud media de 27 caracteres, y también necesitan un modelo en español. Agrupe por idioma antes de puntuar, informe de cada grupo por separado y no promedie puntuaciones de idiomas distintos.
El método tiene cinco límites de datos, y el informe debe mencionarlos todos.
Los cinco límites son la cobertura, el sesgo de orden, la aprobación y las respuestas ocultas, quién responde y el error del modelo; la tabla de abajo explica cada uno y qué anotar en el informe. Dos datos ayudan a dimensionarlos. Según el Digital News Report 2026 del Reuters Institute, en la media de 48 mercados las redes sociales y las plataformas de video superan por primera vez a las webs y apps de los medios como forma de informarse en internet (54 % frente a 51 %), pero quienes responden bajo una publicación son un grupo mucho más pequeño (Reuters Institute Digital News Report 2026, 16-06-2026). Además, el sarcasmo, las preguntas retóricas y la jerga son donde más fallan los modelos de sentimiento, así que antes de publicar conviene revisar a mano al menos cien o doscientas respuestas.
Los cinco límites y qué escribir en el informe:
| Límite | Cómo cambia el resultado | Qué escribir en el informe |
|---|---|---|
| Cobertura | Una llamada no siempre trae todas las respuestas | «M de N respuestas» |
| Sesgo de orden | Solo llega una parte de las respuestas y pueden faltar las primeras o las más votadas | Qué parte obtuvo y cuándo |
| Aprobación y respuestas ocultas | Los resultados públicos solo muestran respuestas aprobadas y no ocultas, y el tono sale más positivo | Si la aprobación estaba activa; las ocultas no están en la muestra |
| Quién responde | Quien responde no representa al público ni a quien no usa Threads | Limitar la conclusión a «quienes responden en Threads» |
| Error del modelo | La ironía, las preguntas retóricas y los términos técnicos causan más errores | Cuántas respuestas revisó a mano y el grado de acuerdo |
Sobre los problemas de muestreo, puede seguir con nuestros artículos Datos de redes sociales para investigar: estabilidad y Desinformación en salud: el paracetamol, un año después. Con estos cinco límites por escrito, este tipo de análisis sirve para preguntas relativas, como «en la misma cuenta, qué temas reciben respuestas más negativas», y no para preguntas absolutas, como «está satisfecha la gente con este organismo». Si trabaja con datos de personas residentes en la Unión Europea, lea también las guías de la autoridad de protección de datos de su país antes de empezar.
Primeros pasos: de una llamada a una ejecución diaria
Para partir de una cuenta y leer publicaciones y comentarios de Instagram, vea Instagram scraper Python: extraer posts y comentarios de Instagram por tres vías.
Paso 1: regístrese, cree una clave de API y busque las capacidades de Threads y sus precios en el mercado de APIs; luego siga el inicio rápido de la documentación y llame una vez a threads/search con curl para comprobar que la clave funciona. Paso 2: guarde el script de Python de este artículo, ponga su clave en la variable de entorno EVERYINFRA_API_KEY y ejecútelo una vez; revise los campos de posts.csv y replies.csv. Paso 3: para una ejecución diaria, use cron o su propio programador, escriba cada día en un archivo distinto y elimine duplicados al unirlos. Los parámetros, ejemplos y campos de respuesta de cada capacidad de Threads están en sus páginas: búsqueda, perfil, publicaciones de una cuenta, detalle de publicación, respuestas y descubrir perfiles. La vista general está en la página de la API de Threads.
Si usa una herramienta de IA compatible con MCP, como Claude o Cursor, no necesita escribir código: añada https://api.everyinfra.com/mcp como servidor MCP remoto con la misma clave y aparecerá la herramienta everyinfra_call_api, con la que puede pedir en lenguaje natural que busque publicaciones de Threads y lea respuestas. La configuración está en la página de MCP. La misma API lee datos públicos de Instagram, Reddit y otras plataformas, y todos los precios están en la página de precios.
Novedades: cuatro hechos de los últimos 30 días que afectan a los datos de Threads
10-11-2026: Threads estrena filtros de búsqueda avanzada. La cuenta @threads anunció que la barra de búsqueda tiene ahora un menú de filtros por rango de fechas, comunidad y tipo de publicación, además de una opción de coincidencia exacta (publicación de @threads; Social Media Today, el mismo día). Qué significa: la búsqueda manual en la app ya permite acotar por fecha. El endpoint /keyword_search para desarrolladores tiene since y until desde el 14-07-2025, pero los filtros de la app y los de la API no coinciden: el filtro de «comunidad» no tiene parámetro en la documentación.
30-10-2026: entran en vigor las nuevas condiciones comerciales de Meta. Permiten a Meta usar software automatizado para rastrear sitios web asociados a cuentas empresariales, con fines de publicidad y productos comerciales. Casi todos los medios tienen una cuenta empresarial de Meta para gestionar páginas de Facebook, cuentas de Threads y perfiles de Instagram, y asociaciones como la News Media Association del Reino Unido se opusieron en público (Nieman Lab, octubre de 2026; texto previo de las condiciones). Qué significa: en Threads, un medio es a la vez objeto de análisis y parte de las condiciones de datos de Meta, así que antes de analizar los datos de su propia cuenta conviene revisar qué versión de las condiciones comerciales firmó.
29-10-2026: Threads prueba «Threads Friends». La función permite compartir una publicación con un máximo de 50 amigos y se está probando en Irlanda, Italia y Japón (Social Media Today). Qué significa: Threads suma otro tipo de contenido no público. Si mide la conversación en Threads, las publicaciones solo para amigos quedan fuera de la muestra, igual que las de cuentas privadas, y conviene decirlo en el informe.
21-10-2026: Meta presenta sus resultados del tercer trimestre. El comunicado indica que las personas activas a diario en las apps de Meta promediaron 3640 millones en septiembre de 2026, un 3 % más que un año antes (Meta Reports Third Quarter 2026 Results). En la llamada con analistas de ese día, Mark Zuckerberg dijo que Threads ya superaba a X en usuarios mensuales, sin dar una cifra (la transcripción dice que Threads «has now overtaken X in monthly actives»: transcripción de la llamada del tercer trimestre de 2026; Music Ally publicó la frase el 22-10-2026: Music Ally); el último dato publicado por Meta fue de 500 millones de usuarios mensuales el 16-06-2026 (según 24/7 Wall St. en Yahoo Finance). Qué significa: la conversación pública en Threads sigue creciendo, pero no hay una cifra oficial reciente con la que contrastar. Threads no publica su número de usuarios, así que una muestra no se puede ponderar al conjunto de internautas.
Preguntas frecuentes
¿La API de Threads es gratis? ¿Cuánto cuesta?
La pregunta sale de las sugerencias de Google «threads api free», «threads api pricing» y «api de threads» (leídas el 13-11-2026). Meta no cobra por llamada en la API de Threads y la documentación no tiene tarifas. Los límites son la cuota (4800 × impresiones cada 24 horas) y los permisos: para leer datos públicos de otras personas hay que pasar App Review y, si la app es de una empresa, convertirse en Tech Provider. Eso no cuesta dinero, pero sí tiempo, y la aprobación no está garantizada. Una API de pago por llamada funciona al revés: sin revisión, y se paga cada llamada. En el catálogo público de EveryInfra del 13-11-2026, threads/search cuesta 0,000778 USD por llamada y las otras seis capacidades de Threads, 0,000556 USD. Las llamadas fallidas y los resultados vacíos no se cobran.
¿Cómo consigo una clave o un token de la API de Threads?
La pregunta sale de las sugerencias «threads api key» y «threads api token». La API oficial no tiene una clave única: usa tokens de acceso de usuario con OAuth. Primero se crea en el panel de Meta una app con el caso de uso de Threads; el usuario acepta los permisos en la ventana de autorización y la app recibe un código, que se cambia por un token de corta duración (1 hora) y luego por uno de larga duración (60 días), renovable antes de que venza (Get started). Un permiso concedido desde un perfil público dura 90 días y se prorroga al renovar el token; el de un perfil privado no se puede prorrogar. Los temas en tendencia usan otro tipo de token, el token de app.
¿Por qué la búsqueda por palabra clave de la API de Threads solo encuentra mis publicaciones?
La pregunta sale de mensajes del foro de desarrolladores de Meta (3633404910150925, 1476322604349910). Porque su app no tiene aprobado threads_keyword_search. Según la documentación, sin aprobación «the search is performed only on posts owned by the authenticated user». Que el panel diga «Ready for testing» no significa que esté aprobado: la aprobación pasa por App Review, y a una app de empresa se le pide antes convertirse en Tech Provider.
¿La API de Threads puede leer las respuestas a publicaciones de otras personas?
La pregunta sale de Stack Overflow, «Does Meta Threads API Allow Reading Timeline Posts and Liking Others' Posts?», que el 13-11-2026 seguía con 0 respuestas. La documentación dice que la API de gestión de respuestas es para las respuestas a las publicaciones propias del usuario, y sin acceso avanzado a threads_basic la consulta de una publicación solo devuelve las de testers. Para leer respuestas públicas en publicaciones ajenas, la vía oficial necesita acceso avanzado a esos permisos; una API de pago por llamada las lee a partir del enlace de la publicación, por ejemplo con threads/comments.
¿Hay un scraper de Threads gratis? ¿Sirven los de GitHub?
La pregunta sale de las sugerencias «threads scraper free» y «threads scraper github». Uno de los primeros clientes no oficiales de Threads en GitHub, junhoyeo/threads-api, indica en su README que el desarrollo se detuvo el 08-09-2023 tras una comunicación de Meta y que el repositorio está archivado; su autor advierte que usar o distribuir el código podría infringir las condiciones de servicio de Meta. Los tres documentos de Meta citados arriba se aplican tanto a un scraper propio como a una API de datos de terceros; con un scraper propio hay que añadir el trabajo de adaptarlo a cada cambio de diseño.
¿Existe un SDK oficial de Python para la API de Threads?
La pregunta sale de las sugerencias «threads api python» y «threads api example». Meta ofrece una app de ejemplo de código abierto escrita en Node.js, fbsamples/threads_api, y una colección de Postman; la documentación no muestra un SDK oficial de Python. El README de la app de ejemplo avisa además de que las apps de Threads no aceptan URL de redirección con localhost, así que para probar en local hay que asignar un dominio en el archivo hosts. El primer video de YouTube para «threads api python» (publicado el 28-01-2025, unos 19 minutos) también trata de crear la app y configurar los tokens de la API oficial. Desde Python, la API oficial se llama con peticiones GET de requests; una API de pago por llamada, con un POST. El script de este artículo solo usa requests.
Referencias
- Threads API overview, Meta for Developers, 22-12-2025, <https://developers.facebook.com/documentation/threads/overview>
- Get started (Threads API), Meta for Developers, <https://developers.facebook.com/documentation/threads/get-started>
- Retrieve user posts, Meta for Developers, 14-04-2026, <https://developers.facebook.com/documentation/threads/retrieve-and-discover-posts/retrieve-posts>
- Threads profiles, Meta for Developers, <https://developers.facebook.com/documentation/threads/threads-profiles>
- Keyword and topic tag search, Meta for Developers, 21-01-2026, <https://developers.facebook.com/documentation/threads/keyword-search>
- Retrieve media replies and conversations, Meta for Developers, <https://developers.facebook.com/documentation/threads/retrieve-and-manage-replies/replies-and-conversations>
- Retrieve and manage replies, Meta for Developers, <https://developers.facebook.com/documentation/threads/retrieve-and-manage-replies>
- Reply management, Meta for Developers, <https://developers.facebook.com/documentation/threads/reply-management>
- Mentions, Meta for Developers, <https://developers.facebook.com/documentation/threads/threads-mentions>
- Trending topics, Meta for Developers, <https://developers.facebook.com/documentation/threads/trending-topics>
- Threads Insights API, Meta for Developers, <https://developers.facebook.com/documentation/threads/insights>
- Embed a Threads post (oEmbed), Meta for Developers, <https://developers.facebook.com/documentation/threads/tools-and-resources/embed-a-threads-post>
- Threads Changelog, Meta for Developers, 18-08-2026, <https://developers.facebook.com/documentation/threads/changelog>
- Access Levels, Meta for Developers, 30-06-2026, <https://developers.facebook.com/documentation/development/graph-api/overview/access-levels>
- Tech Providers, Meta for Developers, <https://developers.facebook.com/docs/development/release/tech-providers/>
- The Threads API is finally here, Meta for Developers blog, 18-06-2024, <https://developers.facebook.com/blog/post/2024/06/18/the-threads-api-is-finally-here/>
- Threads keyword_search returns only my own posts, Meta Developer Community, <https://developers.facebook.com/community/threads/3633404910150925/>
- How can a self-use Threads app get public keyword search approval, Meta Developer Community, 21-10-2026, <https://developers.facebook.com/community/threads/2883329558707631/>
- keyword_search returns the same post and repeats the same pagination cursor, Meta Developer Community, <https://developers.facebook.com/community/threads/1476322604349910/>
- Threads App Review for a first-party brand app, Meta Developer Community, <https://developers.facebook.com/community/threads/1094128013493014/>
- Threads App Review for an internal business app, Meta Developer Community, <https://developers.facebook.com/community/threads/2580213639125398/>
- Does Meta Threads API Allow Reading Timeline Posts and Liking Others' Posts?, Stack Overflow, <https://stackoverflow.com/questions/79455370/does-meta-threads-api-allow-reading-timeline-posts-and-liking-others-posts>
- fbsamples/threads_api (sample app), GitHub, <https://github.com/fbsamples/threads_api>
- Threads API Postman collection, Meta on Postman, <https://www.postman.com/meta/threads/overview>
- junhoyeo/threads-api (archived), GitHub, 08-09-2023, <https://github.com/junhoyeo/threads-api>
- Threads Terms of Use, Instagram Help Center, <https://help.instagram.com/769983657850450>
- threads.com robots.txt, Threads, 13-11-2026, <https://www.threads.com/robots.txt>
- Automated Data Collection Terms, Meta, <https://www.facebook.com/legal/automated_data_collection_terms>
- Meta Terms of Service, Meta, <https://www.facebook.com/terms/>
- Commercial Terms (preview), Meta, <https://www.facebook.com/legal/commercial_terms_preview>
- Meta Content Library, Meta Transparency Center, <https://transparency.meta.com/researchtools/meta-content-library/>
- Meta Content Library and API documentation, Meta for Developers, <https://developers.facebook.com/docs/content-library-and-api/>
- Centre d'accès sécurisé aux données (CASD), CASD, <https://www.casd.eu/en/>
- Meta Reports Third Quarter 2026 Results, Meta Investor Relations, 21-10-2026, <https://investor.atmeta.com/investor-news/press-release-details/2026/Meta-Reports-Third-Quarter-2026-Results/default.aspx>
- Meta's Threads Now Has More Monthly Users Than X, 24/7 Wall St. on Yahoo Finance, 16-06-2026, <https://finance.yahoo.com/media-advertising/articles/meta-threads-now-more-monthly-161328077.html>
- @threads post on advanced search filters, Threads, 10-11-2026, <https://www.threads.com/@threads/post/DfkgGO8Jedq>
- Threads adds advanced search filters, Social Media Today, 10-11-2026, <https://www.socialmediatoday.com/news/threads-adds-advanced-search-filters/874339/>
- Threads tests smaller group sharing option, Social Media Today, 29-10-2026, <https://www.socialmediatoday.com/news/threads-tests-smaller-group-sharing-option/873271/>
- Meta Is Testing 'Threads Friends' For Sharing Posts With Smaller Groups, Engadget, 29-10-2026, <https://www.engadget.com/2301804/meta-is-testing-threads-friends-for-sharing-posts-with-smaller-groups/>
- Third Quarter 2026 Results Conference Call (transcript), Meta Investor Relations, 21-10-2026, <https://s21.q4cdn.com/399680738/files/content_files/META-Q3-2026-Earnings-Call-Transcript.pdf>
- Meta says Threads now has more monthly active users than X, Music Ally, 22-10-2026, <https://musically.com/2026/10/22/meta-says-threads-now-has-more-monthly-active-users-than-x/>
- Legal experts warn Meta's new terms still grant broad scraping permissions, Nieman Lab, 10-2026, <https://www.niemanlab.org/2026/10/legal-experts-warn-metas-new-terms-still-grant-broad-scraping-permissions-despite-language-changes/>
- Digital News Report 2026: executive summary, Reuters Institute, 16-06-2026, <https://reutersinstitute.politics.ox.ac.uk/digital-news-report/2026/dnr-executive-summary>
- VADER: A Parsimonious Rule-based Model for Sentiment Analysis of Social Media Text (Hutto & Gilbert, ICWSM 2014), AAAI / ICWSM, 2014, <https://doi.org/10.1609/icwsm.v8i1.14550>
- cjhutto/vaderSentiment, GitHub, <https://github.com/cjhutto/vaderSentiment>
- Requests: HTTP for Humans, Python Software Foundation / Requests docs, <https://requests.readthedocs.io/en/latest/>
- EveryInfra public catalog (Threads capabilities), EveryInfra, 13-11-2026, <https://api.everyinfra.com/api/v1/social/catalog>
Abrimos y comprobamos todos los enlaces el 13-11-2026 (hora de Singapur). Las fechas son las de actualización o publicación que muestra cada página.
Referencia BL-142