Instagram scraper Python: extraer posts y comentarios de Instagram por tres vías
Extraer posts y comentarios de Instagram con Python: API oficial, librerías de código abierto y API por llamada, con pruebas reales y coste por mil filas.
Si en noviembre de 2026 quieres extraer posts y comentarios de Instagram con Python, solo hay tres vías. La API oficial de Instagram solo lee cuentas profesionales que son tuyas o que un cliente ha autorizado. Las librerías de código abierto son gratis, pero en la más usada 11 de las 16 incidencias abiertas entre el 1 de octubre y el 9 de noviembre trataban de bloqueos o de inicios de sesión fallidos. Una API de pago por llamada sí funcionó cuando la probamos el 10 de noviembre: en la cuenta de la Organización Panamericana de la Salud (OPS, opspaho) obtuvimos 50 posts en una sola llamada y, en otra prueba con un script completo, 90 filas costaron 0,002224 USD, unos 0,025 USD por cada mil filas. El límite que debes conocer antes de empezar está en los comentarios: en 10 posts, el endpoint de comentarios nunca devolvió más de 15 por post, así que de un post con 959 comentarios obtuvimos el 1,6 %.
Todos los números sobre nuestra API vienen de llamadas reales hechas entre las 00:14 y las 00:51 (hora de Singapur) del 10-11-2026; todos los datos sobre Meta y los proyectos de código abierto enlazan a una página oficial, a GitHub o a una nota de versión que abrimos ese mismo día.
Las tres vías de un vistazo
La tabla compara las tres vías. La columna de datos incluye solo lo que confirmamos en la documentación oficial, en el repositorio de cada librería o en una llamada real. La columna de fallos recoge la forma más común en que se rompe cada vía, no todas. Los precios de EveryInfra vienen del catálogo público del día de la prueba y cada cobro coincide con el campo charged_usd de las respuestas reales.
| Vía | Qué obtienes | Qué necesitas | Coste | Dónde falla |
|---|---|---|---|---|
| API oficial de Instagram (Graph API) | Todos los posts, comentarios y respuestas de cuentas profesionales tuyas o que autorizaron tu app; de otras cuentas de empresa o creador, solo la lista de posts con recuentos | App de desarrollador de Meta, cuenta profesional, y App Review más verificación del negocio si atiendes cuentas ajenas | Sin tarifa por llamada; con límite de frecuencia | Sin texto de comentarios de cuentas que no te autorizaron; las apps nuevas ya no pueden usar Instagram Login |
| Librerías de código abierto (instaloader, instagrapi y otras) | Perfiles públicos, posts, comentarios e historias, según versión y sesión | Entorno de Python; casi todo exige iniciar sesión con una cuenta de Instagram | La librería es gratis; cuentas, proxies y mantenimiento no | 429, 401, 400 feedback_required, redirecciones 302; esperar una versión nueva tras cada cambio |
| API de pago por llamada (EveryInfra en esta guía) | Posts públicos, detalle de post, comentarios y posts por hashtag; las respuestas a comentarios están en el catálogo, sin probar en esta guía | Una clave de API; ninguna cuenta de Instagram | Desde 0,000556 USD por llamada; los fallos no se cobran | Máximo 15 comentarios por post en la prueba; el detalle se cobra por URL; los trabajos asíncronos tardan de 38 a 66 segundos |
Qué contiene un post y un comentario
Antes de escribir código, decide qué columnas necesitas. Los campos básicos de un post son casi iguales en las tres vías: identificador o código corto, URL, texto, tipo de contenido, likes, número de comentarios, fecha y autor. Las diferencias están en los bordes. La API oficial devuelve métricas como alcance y reproducciones para tus propias cuentas, pero pocos campos de cuentas ajenas. Una librería devuelve lo que exponga el endpoint web o móvil que analiza. Nuestra API devuelve los campos de response_fields del catálogo; cuando la fuente principal no está disponible, faltan algunos campos y el field_note del catálogo dice cuáles.
| Dato que quieres | Campo oficial (otras cuentas vía Business Discovery) | Campo de EveryInfra | Medido en esta guía |
|---|---|---|---|
| Texto del post | caption | text | Presente en los 50 posts de la OPS |
| Likes y número de comentarios | like_count, comments_count | like_count, comment_count | Presente en todos |
| Fecha de publicación | timestamp | posted_at (UTC) | Presente en todos |
| Autor | Solo la cuenta consultada | author_username, author_name, author_id | En colaboraciones aparece quien la inició |
| Texto de comentarios | Solo cuentas propias o autorizadas | text de instagram/comments | Máximo 15 por post |
| Respuestas a un comentario | Expansión del campo replies o /replies | instagram/comment_replies | Sin probar aquí |
| Comentarios destacados del post | No existe | top_comments de instagram/post | 10 y 7 en dos posts de la OPS |
Dos filas merecen una advertencia. Primera: el número de comentarios no es el número de comentarios que puedes obtener. El Centro de ayuda de Instagram dice que los comentarios ocultados por el filtro "Ocultar comentarios no deseados" siguen contando en el total, y ese filtro viene activado por defecto. Nadie fuera de la cuenta sabe cuántos de los 959 comentarios de un post son visibles de verdad. Segunda: author_username no siempre es la cuenta que pediste. La prueba tres lo muestra con datos de la OPS.
Primera vía: la API oficial solo lee cuentas que te autorizaron
Conviene aclarar un malentendido muy extendido. Hace tiempo que no existe una API oficial de Instagram para leer posts públicos de cualquiera. En una entrada del blog para desarrolladores del 04-09-2024, Meta anunció que la Instagram Basic Display API dejaría de funcionar el 04-12-2024 y que después ya no habría APIs de Instagram para apps de consumo. Todas las APIs oficiales que quedan son para cuentas profesionales (empresas y creadores) y están pensadas para actuar en nombre del dueño de la cuenta: publicar, moderar comentarios, responder mensajes y leer métricas.
La forma de conectarse cambió otra vez en octubre de 2026. La descripción general de Instagram Platform, actualizada el 29-10-2026, enumera tres configuraciones: Unified Login, Instagram Login y Facebook Login, y recomienda Unified Login para integraciones nuevas. La página de Unified Login, actualizada el 13-10-2026, dice que las funciones nuevas de la API de Instagram solo salen para esa configuración. La guía de migración, actualizada el 01-10-2026, añade una regla clave para proyectos nuevos: las apps creadas a partir de ahora no pueden configurar la API de Instagram con Instagram Login. Si creas una app hoy, planifica desde el inicio un portafolio comercial y Unified Login.
Leer comentarios por la vía oficial exige el token de quien creó el post
Las reglas están en la referencia de Comments, actualizada el 20-10-2026. Una petición a GET /<IG_MEDIA_ID>/comments necesita un token de acceso del usuario que creó el objeto multimedia. Por defecto los resultados llegan en orden cronológico inverso. Solo se devuelven comentarios de primer nivel y las respuestas se piden expandiendo el campo replies. Cada consulta devuelve como máximo 50 comentarios y no se puede filtrar por fecha. La captura muestra la página en inglés tal como la abrió nuestro navegador sin interfaz el 10 de noviembre, con las líneas relevantes marcadas en verde azulado.
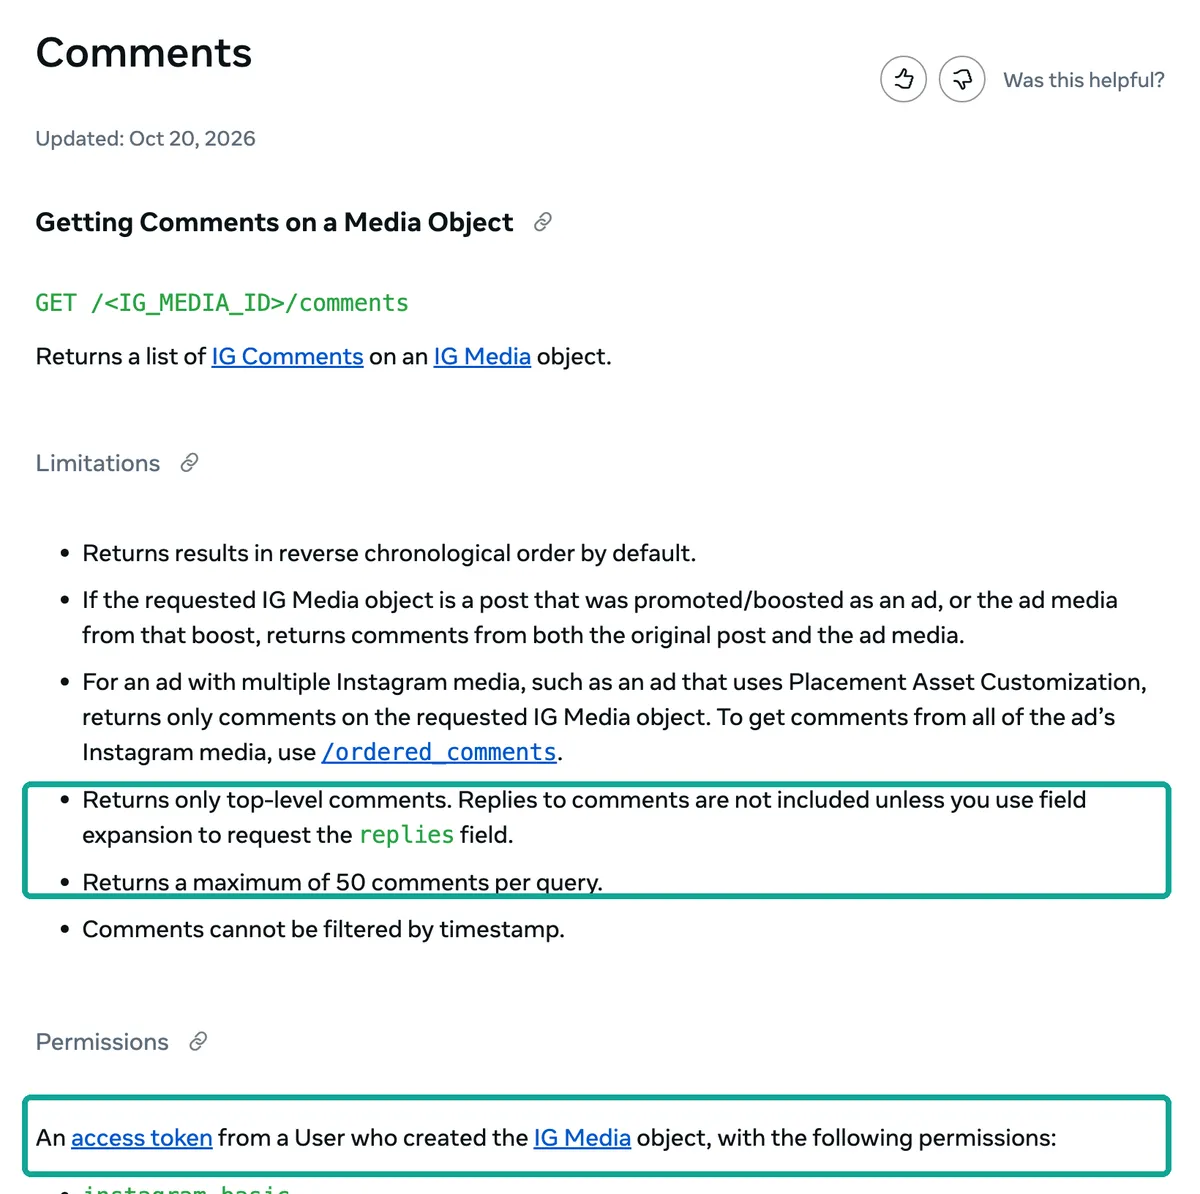
La referencia de respuestas a comentarios pide lo mismo: un token autorizado por la cuenta dueña del comentario, y no se pueden obtener respuestas de comentarios borrados. En la práctica, la API oficial de comentarios sirve para un caso: gestionas tu propia cuenta de marca o un cliente ha autorizado tu app. En ese caso es la vía más completa, más estable y con permiso más claro. Obtienes todos los comentarios de primer nivel, de 50 en 50, más las respuestas, y nunca te bloquean.
Otras cuentas: Business Discovery da números, no palabras
Para seguir a la competencia o a organismos parecidos, la puerta oficial es Business Discovery. Usas tu cuenta profesional para consultar otra cuenta de empresa o creador y obtienes seguidores, número de publicaciones y publicaciones recientes. Cada publicación puede incluir comments_count y like_count, y el ejemplo de la documentación muestra también view_count. Nunca obtienes el texto de los comentarios, no puedes consultar cuentas personales y las cuentas de empresa con restricción de edad no devuelven nada.
La otra puerta es el hashtag. IG Hashtag Search exige la función Instagram Public Content Access, que la descripción general asocia a descubrir contenido de tus campañas con hashtag, entender la opinión pública sobre tu marca y encontrar participantes de concursos. El límite duro es de 30 hashtags distintos cada siete días, y los hashtags sensibles devuelven un error genérico.
| Límite oficial | Fuente | Qué significa al extraer datos |
|---|---|---|
| Comentarios con token de quien creó el post | Comments, actualizada el 20-10-2026 | Solo cuentas propias o autorizadas |
| Máximo 50 comentarios por consulta | Misma página | Paginar con cursores |
| Otras cuentas solo dan recuentos | Business Discovery, actualizada el 12-08-2026 | Tasas de interacción sí, análisis de comentarios no |
| 30 hashtags distintos cada 7 días | IG Hashtag Search | Elegir hashtags con cuidado |
| Atender cuentas ajenas exige Advanced Access | Descripción general, 29-10-2026 | App Review y verificación del negocio |
| Las apps nuevas no pueden usar Instagram Login | Guía de migración, 01-10-2026 | Proyectos nuevos con Unified Login |
La vía oficial en Python (ejemplo de configuración)
El fragmento lee todos los comentarios de un post de tu propia cuenta. No tenemos un token de cuenta profesional para ejecutarlo, así que es un ejemplo de configuración escrito a partir de la documentación oficial; los nombres de campo y la paginación siguen las páginas de referencia.
# Ejemplo de configuración: leer todos los comentarios de un post de tu cuenta profesional (o autorizada)
# IG_TOKEN sale de Unified Login; MEDIA_ID sale de /{ig-user-id}/media
import os, requests
GRAPH = "https://graph.facebook.com/v27.0"
url = f"{GRAPH}/{os.environ['MEDIA_ID']}/comments"
params = {"fields": "id,text,timestamp,like_count,replies{id,text,timestamp}",
          "access_token": os.environ["IG_TOKEN"]}
rows = []
while url:
    page = requests.get(url, params=params, timeout=30).json()
    rows += page.get("data", [])
    url = page.get("paging", {}).get("next")   # máximo 50 por página; seguir el cursor
    params = None                              # el enlace next ya lleva todos los parámetros
print(len(rows), "comentarios de primer nivel")
Usamos v27.0 porque Meta publicó Graph API v27.0 en una entrada del 04-11-2026. La misma entrada anuncia que v21.0 se retira el 21-01-2027 y v22.0 el 20-05-2027. Además bloquea varias funciones antiguas para apps nuevas, entre ellas las peticiones con varios identificadores y los alias de campo: si copias un fragmento viejo que usa ?ids= para pedir varios posts a la vez, una app nueva recibirá un error.
Segunda vía: librerías de código abierto, gratis pero en pelea con la plataforma
Los tutoriales en vídeo que aparecen primero suelen ser antiguos: buscamos "scrape instagram comments python" con youtube/search de EveryInfra, y el más visto es de 2021 y usa una librería ya archivada en GitHub; ninguno enseña a paginar comentarios, a manejar un 429 ni cuánto cuestan mil filas. Las sugerencias de búsqueda para "instagram scraper python github" apuntan sobre todo a dos proyectos: instaloader (unas 13.800 estrellas, licencia MIT) e instagrapi (unas 7.090 estrellas). Los dos README son francos. El de instaloader dice que descarga perfiles públicos y privados, hashtags, historias, feeds y comentarios, y que los perfiles privados exigen --login; su aviso legal dice que no tiene relación con Instagram ni está autorizado por ella y que se usa bajo tu propio riesgo. El de instagrapi dice que combina endpoints web públicos y endpoints móviles privados, y advierte que automatizar la API privada es frágil en producción porque la confianza de la cuenta, los proxies, el estado del dispositivo, los desafíos de seguridad y los límites de frecuencia cambian por separado. Recomienda las APIs oficiales para flujos de la propia cuenta y dice que el proyecto sirve sobre todo para pruebas, investigación y automatización interna controlada.
32 incidencias en 100 días: la mayoría recientes son bloqueos o inicios de sesión
La prueba más directa de si una librería funciona es su lista de incidencias. Con la API de búsqueda de GitHub sacamos las 32 incidencias de instaloader abiertas entre el 01-08-2026 y el 09-11-2026 y clasificamos cada una a mano por título y primer párrafo. "Bloqueo de la plataforma" incluye 429, 401, 400 feedback_required, redirecciones 302 y JSON vacío. "Sesión" incluye inicios de sesión fallidos, importación de cookies, puntos de control y verificación en dos pasos. "Funciones y otros" es el resto. En agosto y septiembre, 7 de 16 eran bloqueos o sesión; del 1 de octubre al 9 de noviembre, 11 de 16, el 69 %.
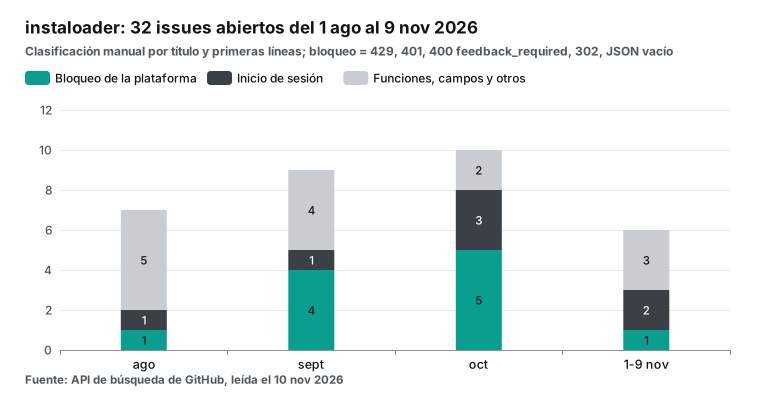
La cronología dice más que el recuento. La incidencia #2750, del 10-10-2026, informa de un 429 en web_profile_info. La #2767, del 13-10-2026, dice que el inicio de sesión devuelve feedback_required. En la #2786, del 21-10-2026, una persona investigadora pregunta si instaloader sigue funcionando de forma fiable en 2026: recoge posts públicos de cuentas de gobiernos y municipios para un estudio y recibe 429 una y otra vez, incluso en un entorno limpio y con la versión actual. Los mantenedores publicaron una beta de 4.16 el 21 de octubre, la 4.15.5 el 24 y la versión 4.16 el 26-10-2026, que corrige Profile.get_posts() con y sin sesión. Cuatro días después, la #2792, del 30-10-2026, informa de que el inicio de sesión y la importación de cookies del navegador vuelven a fallar. Un parche de la comunidad, el PR #2795, funcionó según varios usuarios el 02-11-2026, aunque uno dijo al día siguiente que solo le duró un día. La #2794 cuenta varios días de 401 al descargar sin sesión, y quienes actualizaron a 4.16 dicen que se resolvió. La #2803, del 07-11-2026, describe descargas redirigidas a la portada con un 302 mientras un navegador en la misma IP funciona con normalidad.
| Fecha | Suceso | Fuente |
|---|---|---|
| 10-10-2026 | 429 Too Many Requests en web_profile_info | Incidencia #2750 |
| 13-10-2026 | El inicio de sesión devuelve feedback_required | Incidencia #2767 |
| 21-10-2026 | Investigación: 429 persistente en entorno limpio | Incidencia #2786 |
| 24-10-2026 | Sale la versión 4.15.5 | GitHub Releases |
| 26-10-2026 | Sale la 4.16, corrige get_posts() | GitHub Releases |
| 30-10-2026 | Fallan el inicio de sesión y las cookies | Incidencia #2792 |
| 02-11-2026 | El parche PR #2795 funciona según usuarios | PR #2795 |
| 07-11-2026 | Redirección 302 a la portada; el navegador va bien | Incidencia #2803 |
instagrapi tampoco lo tiene fácil. Publicó dos versiones seguidas, la 3.2.7 el 7 de noviembre y la 3.2.8 el 09-11-2026 según PyPI. La incidencia #2920, del 03-11-2026, cuenta que un endpoint previo al inicio de sesión empezó a devolver 404, así que el login falla antes de enviar la contraseña. La #2890, del 18-10-2026, describe un bucle de challenge_required que empieza justo después de un inicio de sesión correcto, cuando el cliente hace sus peticiones de calentamiento. Citamos estas incidencias solo por su título y los hechos que contienen, sin juzgar a ningún proyecto. Los mantenedores corrigen rápido; el origen del problema está en la plataforma y puede cambiar en cualquier momento.
El riesgo para tu cuenta: qué dicen las condiciones y el Centro de ayuda
Pocos tutoriales mencionan el riesgo para la cuenta de Instagram con la que inicias sesión. La sección 4.2 de las Condiciones de uso de Instagram dice que no puedes acceder a información ni recopilarla de forma no autorizada, incluida la recopilación automatizada sin permiso expreso, con o sin sesión iniciada. El Centro de ayuda tiene un artículo específico, por qué tu cuenta se restringió por extracción de datos, que dice que Meta tiene equipos que detectan, investigan y bloquean patrones de extracción, y que las cuentas pueden quedar restringidas y en revisión. La parte superior de las condiciones indica además que entrarán en vigor unas nuevas el 20-01-2027, y la vista previa ya está publicada.
Así que la segunda vía no cuesta cero. Necesitas cuentas que estés dispuesto a arriesgar, resolver puntos de control y verificaciones en dos pasos, actualizar la librería tras cada cambio de la plataforma y aceptar que algunos días nada funciona. La propia página de solución de problemas de instaloader dice que su control de frecuencia supone que es el único programa que envía peticiones, de modo que reiniciarlo a menudo provoca 429 con facilidad, y que los servidores en la nube, las VPN y los proxies públicos sufren límites anónimos bastante más estrictos.
# Ejemplo de configuración (no ejecutado para esta guía): posts recientes de una cuenta pública con instaloader
import instaloader                       # pip install instaloader==4.16
L = instaloader.Instaloader(download_pictures=False, download_videos=False,
                            save_metadata=False, max_connection_attempts=1)
# L.load_session_from_file("tu_cuenta")   # muchas funciones exigen sesión iniciada
profile = instaloader.Profile.from_username(L.context, "opspaho")
for i, post in enumerate(profile.get_posts()):
    print(post.shortcode, post.date_utc, post.likes, post.comments)
    if i >= 49:
        break
No ejecutamos este fragmento. Enviar muchas peticiones automáticas desde nuestra propia cuenta de Instagram incumpliría la cláusula citada, así que no lo demostramos. Está aquí para compararlo con el script de la tercera vía y ver la diferencia en el código: con una librería gestionas tú los nombres de clase, el archivo de sesión y los reintentos de conexión. En uno de los tutoriales de instaloader que revisamos, el presentador recibe en directo el error "module object is not callable" porque escribió un nombre de clase con las mayúsculas mal.
Tercera vía: API de pago por llamada y un script completo para extraer posts de Instagram con Python
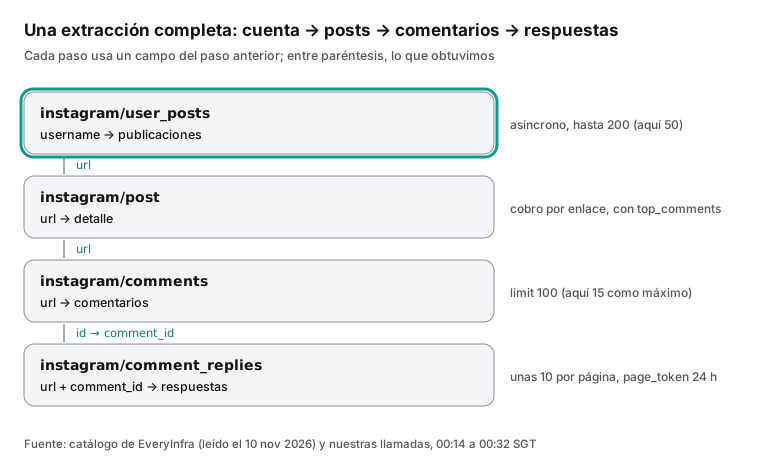
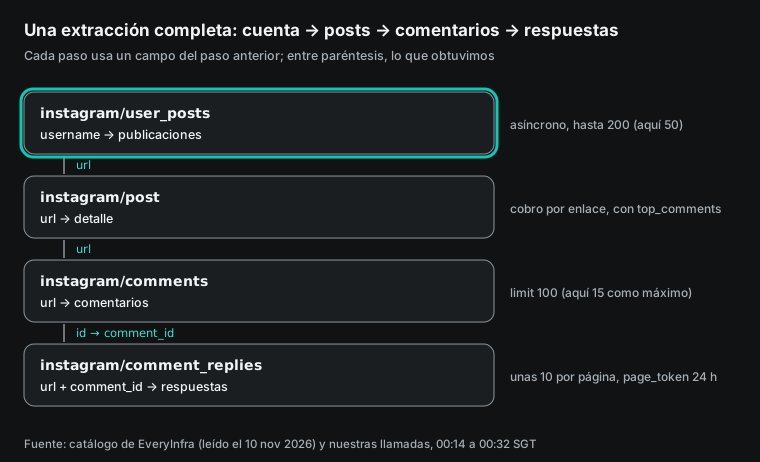
La tercera vía deja el "cómo lo consigo" a una API, y tú solo decides qué pedir y cuánto. Cuatro capacidades de EveryInfra forman una cadena completa: instagram/user_posts lista los posts de una cuenta, instagram/post trae el detalle de un post por URL, instagram/comments trae los comentarios de un post e instagram/comment_replies trae las respuestas de un comentario. Puedes consultar cada parámetro, precio y campo en el catálogo público sin clave, o en la página de la API de Instagram y en las páginas de posts de usuario, detalle de post, comentarios, respuestas y hashtags.
| Capacidad | Parámetro obligatorio | Modo | Precio por llamada | Máximo por llamada | Devuelto en la prueba |
|---|---|---|---|---|---|
instagram/user_posts | username | Asíncrono | 0,000556 USD | 200 posts | 50 (limit 50) |
instagram/post | urls (lista) | Síncrono, por URL | 0,000556 USD por URL | 11 URL | 1 por URL |
instagram/comments | url | Síncrono | 0,000556 USD | 100 | Entre 7 y 15 |
instagram/comment_replies | url, comment_id | Síncrono, por página | 0,000875 USD por página | Unas 10 | Sin probar |
instagram/hashtag | hashtag | Síncrono | 0,000556 USD | 100 | 27 y 30 (limit 50) |
Prueba uno: la cuenta de la OPS, paso a paso
Empezamos por la OPS, llamada a llamada, para ver cada respuesta en bruto. A las 00:30 (hora de Singapur) enviamos instagram/user_posts para opspaho con limit en 50. El trabajo asíncrono devolvió 50 posts en 65,8 segundos (el primer intento chocó con un 429 y se reintentó solo). Los posts iban del 13-10-2026 al 09-11-2026: 29 imágenes y 21 vídeos, 134 comentarios en total y una mediana de 83 likes. Se cobró 0,000556 USD una vez, al enviar el trabajo.
A las 00:31 y a las 00:32 (hora de Singapur) pedimos los comentarios de dos posts propios de la OPS. El primero, del 22-10-2026, invitaba a profesionales de enfermería y medicina de 17 países a responder una encuesta; tenía 17 comentarios y la API devolvió 15. El segundo, del 30-10-2026, anunciaba que Barbados había eliminado la transmisión maternoinfantil del VIH como problema de salud pública; tenía 7 comentarios y la API devolvió los 7. Cada llamada costó 0,000556 USD y tardó entre 9 y 11 segundos. A las 00:32 pedimos también el detalle de esos dos posts con instagram/post (0,001111 USD, dos URL): devolvió 10 y 7 comentarios destacados en top_comments, y los hashtags HIV y Barbados del segundo.
| Post de la OPS | Publicado | Tema | Likes | Comentarios | Devueltos por `comments` | `top_comments` en `post` |
|---|---|---|---|---|---|---|
| DezQWVGFzlA | 22-10-2026 | Encuesta a profesionales de enfermería y medicina | 617 | 17 | 15 (88,2 %) | 10 |
| DfH3PTSFz5_ | 30-10-2026 | Barbados elimina la transmisión maternoinfantil del VIH | 668 | 7 | 7 (100 %) | 7 |
Leer esos 15 comentarios fue lo más útil de toda la prueba. Al menos 11 de los 15 preguntaban dónde estaba el enlace de la encuesta o cómo participar: "¿Dónde está la encuesta?", "¿Y dónde nos inscribimos?", "¿A qué link?", e incluso alguien que preguntaba si la encuesta incluía su país. Otro comentario avisaba de que el enlace volvía a funcionar. Es decir, la conversación revelaba un problema operativo, un enlace que no se encontraba, mucho antes que cualquier métrica de likes. En el post de Barbados, en cambio, casi todo eran aplausos con emojis y menciones a otras cuentas. Si gestionas la comunicación de un organismo de salud, este es el tipo de señal que justifica leer comentarios cada día, aunque solo veas los 15 más recientes.
Un script de Python que puedes ejecutar tal cual
Este es el script exacto que ejecutamos a las 00:26 (hora de Singapur) del 10-11-2026 sobre la cuenta de los CDC de Estados Unidos (cdcgov). Solo depende de requests y lee la clave únicamente de la variable de entorno EVERYINFRA_API_KEY, nunca del código. Hace cuatro cosas: trae los 50 posts más recientes de una cuenta y se queda con los que publicó esa cuenta; elige los tres posts con más comentarios y trae sus comentarios; guarda posts y comentarios en dos CSV; e imprime el coste por mil filas. Para la OPS basta con cambiar el nombre de usuario en la línea de comandos.
"""Scrape Instagram posts and comments with Python via EveryInfra (pay per call).

usage: EVERYINFRA_API_KEY=... python ig_posts_comments.py <username> [top_k]
writes posts.csv and comments.csv; prints cost per 1,000 rows
"""
import csv, os, sys, time
import requests

API = "https://api.everyinfra.com"
S = requests.Session()
S.headers.update({"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"})
spent = 0.0


def social(action, params, mode=None):
    """One call. Retries 429 and retryable 503; follows async jobs."""
    global spent
    body = {"platform": "instagram", "action": action, "params": params}
    if mode:
        body["mode"] = mode
    for _ in range(4):
        r = S.post(f"{API}/api/v1/social", json=body, timeout=120)
        d = r.json()
        err = d.get("error") or {}
        if r.status_code == 429 or (r.status_code == 503 and err.get("retryable")):
            time.sleep(err.get("retry_after", 15) + 1)
            continue
        break
    if "error" in d:
        raise RuntimeError(f"{action}: {r.status_code} {err.get('code')} {err.get('message')}")
    while d.get("job_id") and d.get("status") not in ("succeeded", "failed"):
        time.sleep(5)
        d = S.get(f"{API}/api/v1/jobs/{d['job_id']}", timeout=60).json()
    spent += (d.get("billing") or {}).get("charged_usd", 0.0)
    return d


def main(username, top_k=3):
    posts = social("user_posts", {"username": username, "limit": 50}, mode="async")["results"]
    own = [p for p in posts if p["author_username"] == username]   # collab posts carry the partner's name
    with open("posts.csv", "w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, ["post_id", "url", "posted_at", "media_type", "like_count", "comment_count", "author_username", "text"],
                           extrasaction="ignore")
        w.writeheader(); w.writerows(posts)
    rows = []
    for p in sorted(own, key=lambda p: p.get("comment_count") or 0, reverse=True)[:top_k]:
        got = social("comments", {"url": p["url"], "limit": 100})["results"]
        print(f"{p['url']}  comment_count={p['comment_count']}  returned={len(got)}")
        rows += got
    with open("comments.csv", "w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, ["post_url", "id", "posted_at", "like_count", "text"], extrasaction="ignore")
        w.writeheader(); w.writerows(rows)
    n = len(posts) + len(rows)
    print(f"posts={len(posts)} own={len(own)} comments={len(rows)} rows={n} charged=${spent:.6f} "
          f"(user_posts is billed per call: +$0.000556 if not shown) per_1k=${(spent + 0.000556) / n * 1000:.4f}")


if __name__ == "__main__":
    main(sys.argv[1], int(sys.argv[2]) if len(sys.argv) > 2 else 3)
Tres partes del script están ahí porque antes tropezamos con el problema. Una: requests.Session reutiliza conexiones y envía la cabecera de autenticación en cada llamada, como recomienda la documentación de Requests. Dos: ante un 429 o un 503 reintentable, el script espera los segundos de retry_after y vuelve a intentarlo; nuestra clave de prueba permite 10 peticiones por minuto, y durante la prueba nos topamos con varios 429. Tres: el resultado de un trabajo asíncrono no incluye el campo billing; el cobro aparece en la primera respuesta, al enviar el trabajo, y por eso la última línea suma aparte los 0,000556 USD de user_posts. Si necesitas cuadrar cuentas al céntimo, guarda billing.charged_usd de la primera respuesta. Los CSV se escriben con csv.DictWriter de la biblioteca estándar, y extrasaction="ignore" evita errores por campos de más.
Prueba dos: el script completo, 90 filas por 0,002224 USD
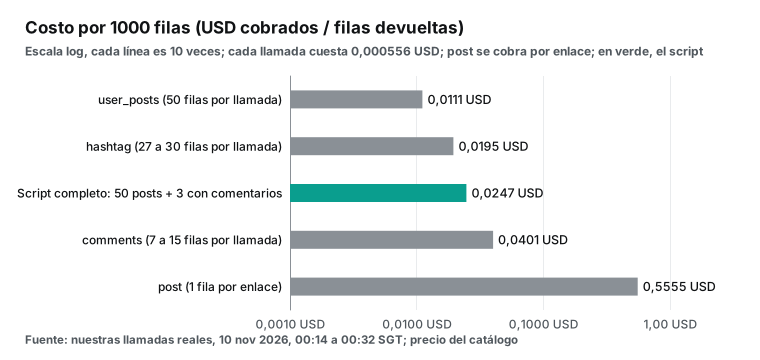
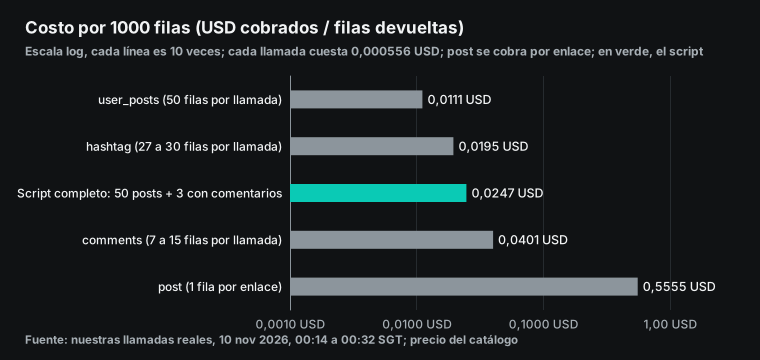
El script empezó a las 00:26:10 y terminó a las 00:27:35 (hora de Singapur), 85 segundos en total. Devolvió 50 posts de los CDC publicados entre el 07-10-2026 y el 09-11-2026, todos propios, con 502 comentarios entre todos. Luego hizo una llamada de comentarios por cada uno de los tres posts con más comentarios: dos posts de 36 comentarios devolvieron 10 y 15, y uno de 34 devolvió 15. En total, 90 filas por 0,002224 USD (una llamada de user_posts más tres de comments, a 0,000556 USD cada una), es decir, 0,0247 USD por mil filas.
Ese número hay que leerlo con sus supuestos, porque el coste por mil filas depende casi por completo de cuántas filas devuelve cada llamada. La lista de posts devuelve 50 filas por llamada, así que cuesta 0,0111 USD por mil filas. Si subes limit al máximo del catálogo, 200, podría bajar a unos 0,0028 USD por mil filas, pero no probamos 200 y es una estimación. Los comentarios devuelven como mucho 15 filas por llamada, así que cuestan al menos 0,037 USD por mil filas. El detalle de post se cobra por URL y devuelve una fila por URL: 0,556 USD por mil filas. El gráfico reúne los costes medidos.
Prueba tres: cuántos comentarios obtienes de verdad
Para ver el límite con posts más grandes probamos también la cuenta de la Organización Mundial de la Salud (who). El trabajo de user_posts enviado a las 00:14 (hora de Singapur) devolvió 50 posts en 43,6 segundos, con 5.706 comentarios en total. Elegimos cinco posts con muchos comentarios y pedimos los comentarios de cada uno con limit en 100. Junto con los dos de la OPS y los tres de los CDC, fueron 10 posts. Ninguna llamada devolvió más de 15. El post con 959 comentarios, del 08-10-2026, sobre un posible caso de peste neumónica en un trabajador de laboratorio en Rusia, devolvió 15: el 1,6 %. Los posts con 470, 466, 210 y 55 comentarios devolvieron 15 cada uno. El de la OPS con 17 devolvió 15 y el de 7 devolvió los 7. Los 10 posts sumaban 2.290 comentarios y obtuvimos 137, alrededor del 6,0 %.
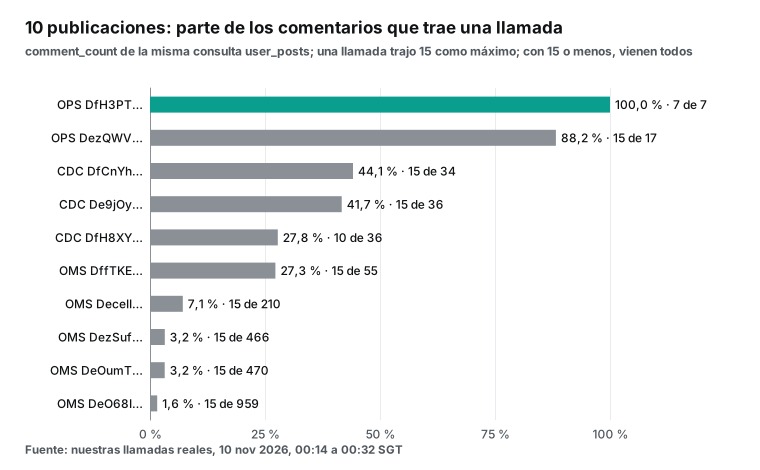
¿Qué 15 comentarios llegan? Las fechas muestran un patrón. El post de 959 comentarios se publicó el 8 de octubre y los 15 recibidos se escribieron entre el 19 de octubre y el 2 de noviembre. El de 466 comentarios se publicó el 22 de octubre y sus 15 comentarios caen todos entre el 1 y el 9 de noviembre. Parece una ventana reciente, no los comentarios con más likes ni los primeros. En el post de 959, ninguno de los 15 tenía likes. Coincide con lo que medimos el 26-10-2026 en nuestra comparación de precios por resultado y por llamada para Instagram: desde fuera se alcanzan unos 15 comentarios por post. Dos semanas después el número no se ha movido.
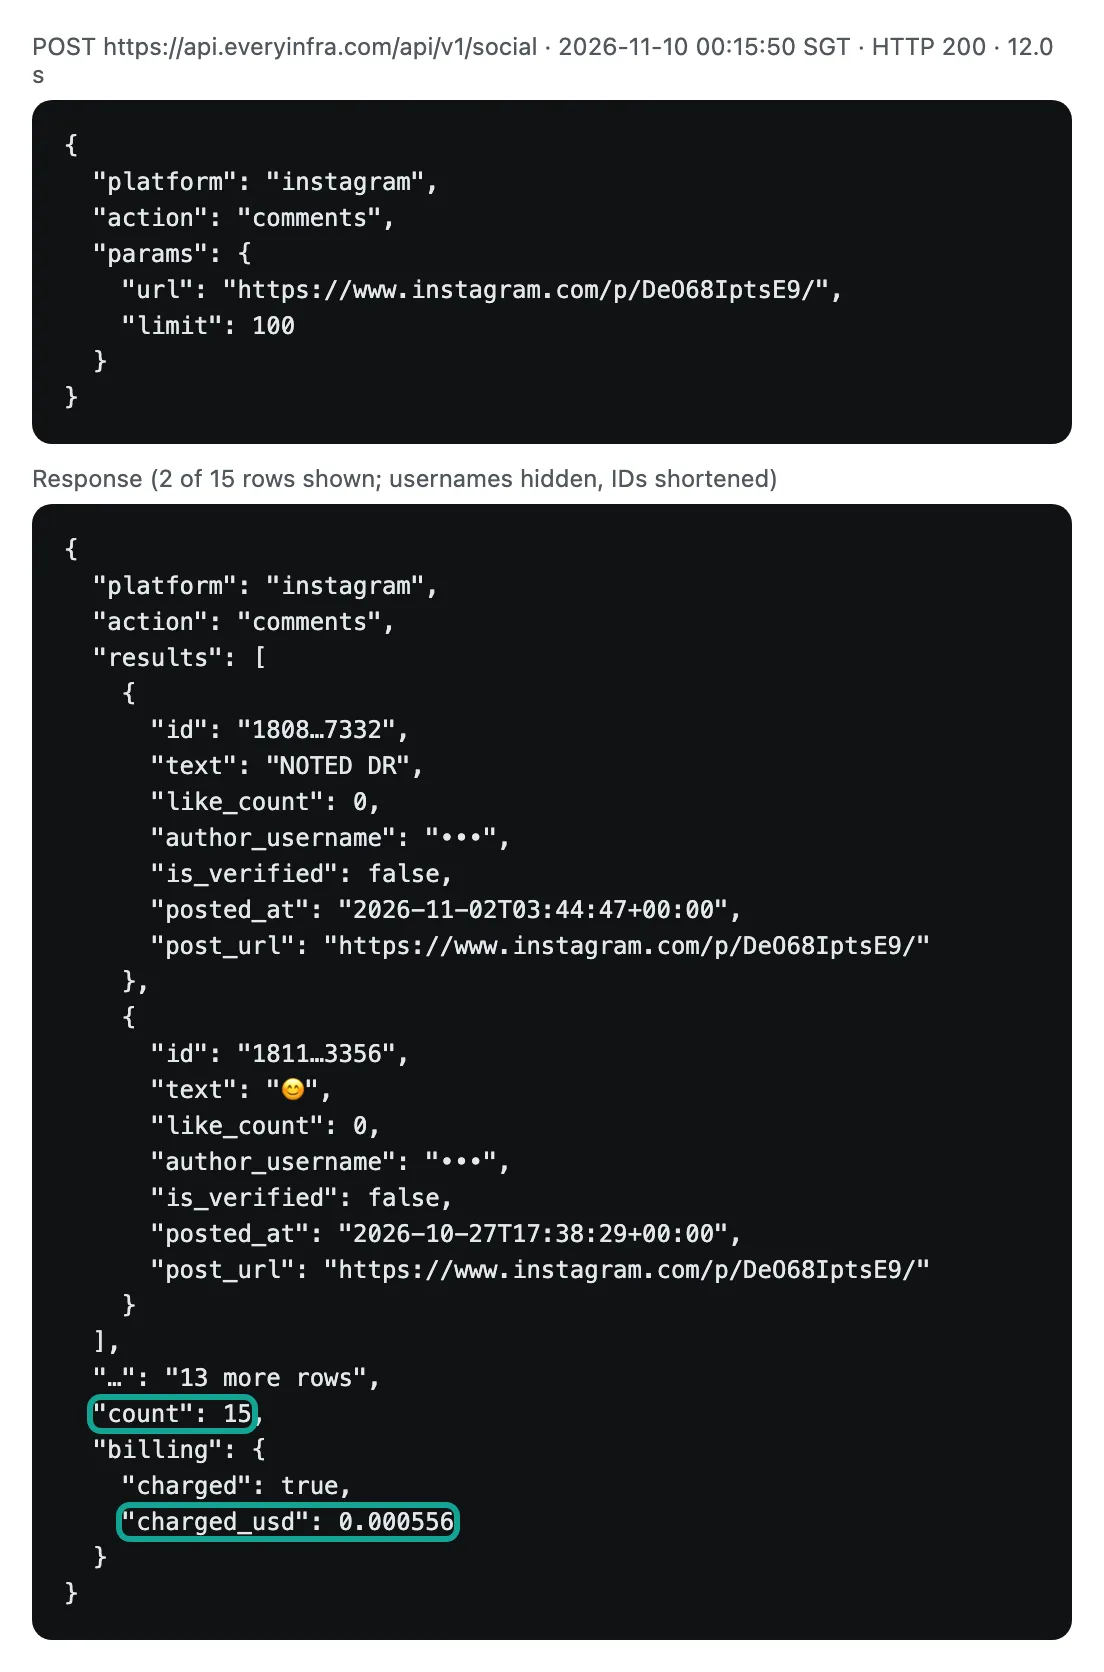
Ese límite decide para qué sirve la tercera vía. Sirve para la amplitud: decenas o cientos de cuentas, el tramo más reciente de comentarios de cada post, para medir el tono, detectar problemas nuevos a tiempo, como el enlace roto de la encuesta de la OPS, y sacar muestras para revisión humana. No sirve para la profundidad: si necesitas los cientos de comentarios de un post viral para un análisis de corpus completo, esta vía no llega, y debes mirar la primera (pedir autorización al dueño de la cuenta) o los canales de investigación que se describen más abajo. El field_note del catálogo indica además que, cuando la fuente principal cae, los comentarios bajan todavía más (como máximo 80 o 30); en la práctica, el techo que encontramos fue 15.
Cómo son los 137 comentarios
La cobertura es una pregunta; la forma de los comentarios es otra, y decide cómo analizarlos. Juntamos los 137 comentarios de esta ronda: 75 de cinco posts de la OMS, 22 de dos posts de la OPS y 40 del script sobre los CDC.
| Medida (137 comentarios) | Valor |
|---|---|
| Identificadores repetidos | 0 |
| Solo emojis, sin letras ni cifras | 15 (10,9 %) |
| Longitud mediana | 46 caracteres |
| 10 caracteres o menos | 28 |
| Más de 200 caracteres | 38 (el más largo, 2.177) |
| Sin ningún like | 107 (78 %), máximo 20 |
| Con mención @ | 8 |
| Con enlace | 3 |
| Escritos en octubre / noviembre | 96 / 41 |
De ahí salen tres reglas. No tires los comentarios de solo emojis: bajo una cuenta de salud pública, una fila de aplausos o una cara llorando ya es una señal de tono, así que usa un modelo de sentimiento que entienda emojis o conviértelos antes a texto. Los comentarios largos suelen ser historias personales u objeciones y aportan mucha más información que los cortos; si muestreas para revisión humana, empieza por el quinto más largo. Guarda cada comentario con id como clave primaria y posted_at en UTC, y conserva solo un hash de author_username. Todos los comentarios que mostramos en esta guía tienen el nombre de usuario oculto y el identificador acortado; haz lo mismo en todo lo que publiques.
Prueba cuatro: el 26 % del feed de la OPS no lo publicó la OPS
Al mirar los 50 posts de opspaho apareció un detalle fácil de pasar por alto. Solo 37 tenían opspaho como author_username. Los otros 13 eran colaboraciones iniciadas por otras cuentas: tres por la cuenta de la dirección de la OPS, tres por el Instituto Nacional de Salud de Colombia, una por el Ministerio de Salud de Colombia, una por la Secretaría de Salud de Honduras, una por la oficina regional de ONUSIDA, una por la Cumbre de las Américas, una por una sociedad panamericana de trauma y dos por cuentas personales. En la OMS pasó lo mismo: 36 propios y 14 colaboraciones, 11 de ellas iniciadas por la cuenta personal verificada de su director general. Los 50 de los CDC eran todos propios.
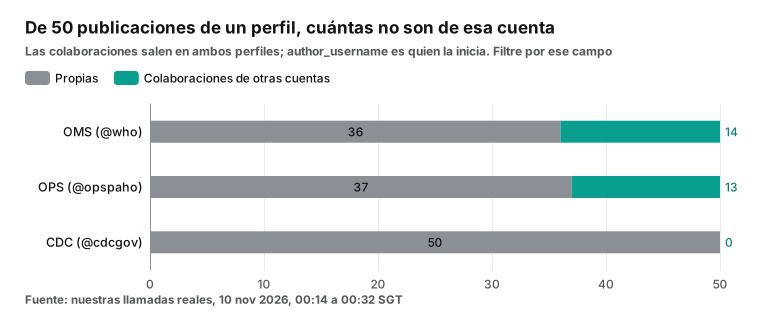
Esto cambia las estadísticas. En la OPS, el post con más comentarios del feed (30) era una colaboración iniciada por una cuenta personal sobre la polio, y el tercero (15), una colaboración del instituto colombiano sobre el primer entrenamiento en español de la red mundial de alerta ante brotes de la OMS. Las 13 colaboraciones reunían 73 de los 134 comentarios, más de la mitad, aunque su mediana de likes (65) era menor que la de los 37 posts propios (93). En la OMS, las 14 colaboraciones reunían 2.324 de 5.706 comentarios, el 41 %. Si calculas "comentarios medios de los últimos 50 posts de la OPS" sin filtrar por autor, más de la mitad del resultado viene del público de otras cuentas. Por eso el script tiene la línea own = [p for p in posts if p["author_username"] == username]. Para estudiar el alcance propio de un organismo, filtra primero por autor; para estudiar lo que su feed muestra a quien lo visita, quédate con todo.
El volumen de comentarios también cambia mucho entre cuentas. Con la misma lectura de 50 posts, la OMS sumaba 5.706 comentarios, los CDC 502 (del 7 de octubre al 9 de noviembre, UTC) y la OPS 134: la OMS reúne más de 40 veces los comentarios de la OPS. Si repartes un presupuesto de comentarios entre cuentas, suma antes comment_count por cuenta y decide después cuántos posts de cada una necesitan una llamada de comentarios.
| Cuenta | Propios | Colaboraciones | Comentarios en colaboraciones | Mediana de likes, propios / colaboraciones |
|---|---|---|---|---|
OPS (opspaho) | 37 | 13 | 73 de 134 (54 %) | 93 / 65 |
OMS (who) | 36 | 14 | 2.324 de 5.706 (41 %) | 1.917,5 / 2.412,5 |
CDC (cdcgov) | 50 | 0 | 0 de 502 | No aplica |
Prueba cinco: #saludpublica frente a #publichealth
A las 00:28 (hora de Singapur) pedimos instagram/hashtag para saludpublica con limit en 50 y obtuvimos 27 posts, publicados entre las 11:34 y las 16:26 UTC del 09-11-2026, unas cinco horas. Venían de 26 cuentas distintas, todos eran imágenes, la mediana de likes era 2, el más popular tenía 46 y entre todos sumaban 36 comentarios; 4 llevaban ubicación. A las 00:20 habíamos pedido publichealth: 30 posts que cubrían solo 17 minutos, de 28 cuentas, con mediana de 0 likes y 7 comentarios en total. Cada llamada costó 0,000556 USD.
| Hashtag | Hora de Singapur | Filas (limit 50) | Periodo cubierto | Cuentas distintas | Mediana de likes | Comentarios totales |
|---|---|---|---|---|---|---|
saludpublica | 00:28 | 27 | Unas 5 horas | 26 | 2 | 36 |
publichealth | 00:20 | 30 | 17 minutos | 28 | 0 | 7 |
La lección es doble. El endpoint de hashtag devuelve lo más nuevo, no lo más popular: para vigilar un hashtag hay que consultarlo a menudo y en pasos cortos, deduplicando por post_id. Y el ritmo depende del idioma: el hashtag en español avanza mucho más despacio que el inglés, así que una consulta cada pocas horas basta para saludpublica, mientras que publichealth exigiría consultas cada pocos minutos para no perder posts. Si quieres los posts con más influencia bajo un hashtag, una sola petición no los encuentra; combínala con una lista de cuentas y instagram/user_posts.
Cómo extraer comentarios de Instagram: respuestas y paginación
Quien busca en inglés "how to scrape instagram comments" suele atascarse aquí. Los comentarios tienen dos capas: primer nivel y respuestas. La API oficial expande replies como campo. La nuestra tiene una capacidad aparte, instagram/comment_replies, que recibe la URL del post y el identificador del comentario (el id de los resultados de instagram/comments). Devuelve unas 10 respuestas por página; para la siguiente página se envía el next_page_token de la respuesta, que vale 24 horas, y cada página es una llamada de 0,000875 USD.
Con el precio del catálogo, un comentario con 24 respuestas necesita 3 páginas, unos 0,0026 USD. Ojo: los resultados de instagram/comments traen id, text, like_count, posted_at, author_username, is_verified y poco más, pero no el número de respuestas. No puedes saber de antemano qué comentarios tienen respuestas, y pedirlas para 100 comentarios son 100 llamadas. Sale más barato elegir primero los comentarios que quieres leer a fondo, por likes o por longitud, y pedir respuestas solo para esos.
No pudimos probar este paso: en esta ronda lo pedimos una vez para cada uno de 9 comentarios de tres posts, las 9 llamadas devolvieron 503 y ninguna se cobró. Por eso esta guía no da campos medidos de respuestas. El catálogo enumera, entre otros, id, text, like_count, posted_at, author_username, reply_to_id y next_page_token. El código de paginación sigue la misma estructura que los comentarios de primer nivel y se repite hasta que no hay next_page_token.
# Paginar respuestas: unas 10 por página, una llamada por página; parar cuando no hay next_page_token
def all_replies(post_url, comment_id, max_pages=20):
    out, token = [], None
    for _ in range(max_pages):
        p = {"url": post_url, "comment_id": comment_id}
        if token:
            p["page_token"] = token          # válido 24 horas
        d = social("comment_replies", p)
        out += d.get("results", [])
        token = d.get("next_page_token")
        if not token:
            break
    return out
En septiembre de 2026 publicamos un tutorial para extraer comentarios de TikTok, donde la capacidad de respuestas devolvió entonces un hilo completo de 24 respuestas. Volveremos a probar las respuestas de Instagram y actualizaremos este apartado. Mientras tanto, si tu análisis necesita las respuestas, la primera vía, con autorización del dueño de la cuenta, es la única que garantiza obtenerlas todas.
Fallos, límites y cobros: 16 peticiones que no costaron nada
La pregunta más común sobre el pago por llamada es si los fallos se cobran. En esta ronda provocamos varios errores a propósito y nos encontramos otros reales. Todos llegaron como un error estructurado con code, message, request_id y retryable. Los errores de parámetros indicaban además qué faltaba o qué valores se aceptan, con un ejemplo de petición correcta.
| Situación | HTTP | Respuesta | Cobro | Veces |
|---|---|---|---|---|
| Sin clave de API | 401 | missing_key, con la pista de usar la cabecera Authorization | 0 USD | 1 |
username enviado a comentarios | 422 | missing_param: url, con ejemplo correcto | 0 USD | 1 |
urls vacío en el detalle de post | 422 | missing_param: urls | 0 USD | 1 |
results_type con valor posts | 422 | invalid_value, allowed es reel, reels | 0 USD | 1 |
| Más de 10 peticiones por minuto | 429 | rate_limited, retry_after de 7 a 17 segundos | 0 USD | 3 (y 4 más absorbidos por reintentos automáticos) |
| Respuestas a comentarios | 503 | Ver el apartado de respuestas | 0 USD | 9 |
| Cuenta inexistente (dos veces) | 200 | results vacío, refund_state: refunded | Cobrado y reembolsado | 2 |
La última fila merece una explicación. user_posts es asíncrono, así que los 0,000556 USD se cobran al enviar el trabajo. Si termina sin resultados, se reembolsan, y el resultado muestra billing_state: charged junto con refund_state: refunded. Nos pasó con un nombre de cuenta mal escrito y con un usuario inventado. Para recorrer listas de cuentas esto importa: un error de escritura en tu lista no te cuesta nada, pero al cuadrar cuentas hay que mirar refund_state y no solo el cobro inicial.
| Código | `retryable` | Qué debe hacer tu código |
|---|---|---|
missing_key | false | Corregir la cabecera Authorization |
missing_param, invalid_value | false | Corregir la petición con el ejemplo del mensaje |
rate_limited (429) | true | Esperar retry_after segundos y reintentar |
unavailable (503) | true | Reintentar tras retry_after; tras 3 fallos, saltar y registrar |
results vacío con refund_state: refunded | no es error | Revisar el nombre de usuario de tu lista |
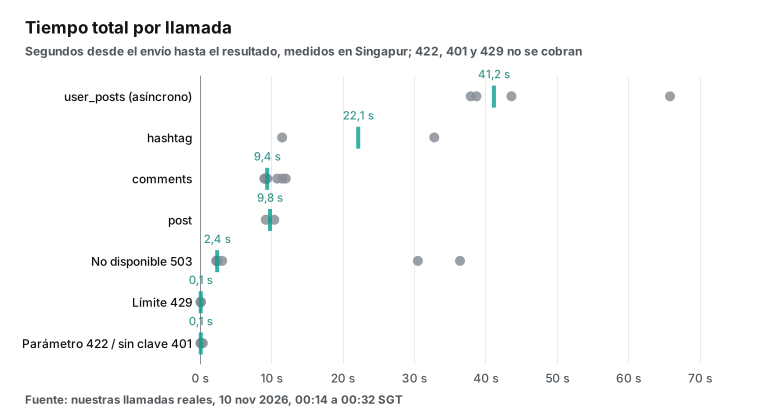
En tiempos, los comentarios y el detalle de post tardaron entre 9 y 12 segundos, y una llamada de hashtag 11,5 segundos (la otra, 32,8 segundos, porque antes esperó un 429). Los trabajos asíncronos de user_posts tardaron entre 38 y 66 segundos desde el envío hasta el resultado. Los errores de parámetros volvieron en 0,1 a 0,4 segundos y sin cobro, así que durante el desarrollo puedes tantear el formato de la petición sin miedo. Si usas un agente de IA que reintenta solo, el campo retryable le dice si debe repetir: missing_param e invalid_value son false; 429 y 503 son true.
Las cuentas: 10.000 comentarios y un mes de seguimiento
Pasemos las mediciones a dos trabajos habituales.
Trabajo uno: reunir 10.000 comentarios públicos para un análisis de sentimiento. En la tercera vía, a los 0,0401 USD por mil filas medidos (7 llamadas sueltas de comentarios, 97 filas; si se suman las 3 del script de los CDC, 10 llamadas y 137 filas dan 0,0406 USD), son unos 0,40 USD, siempre que haya posts suficientes: con un máximo de 15 comentarios por post hacen falta al menos 667 posts, y con la media medida de 13,7 por post, unos 730. Si quieres todos los comentarios de diez posts virales, la tercera vía no llega. En la primera vía, si esos posts son tuyos o de tu cliente, la API no cobra; 10.000 comentarios son unas 200 páginas de 50, y el coste real es App Review y tiempo de desarrollo. La segunda vía no tiene tarifa; el coste está en cuentas, proxies y mantenimiento, y la cronología de octubre muestra varios tramos en que no funcionó.
Trabajo dos: vigilar cada día tres cuentas de salud pública, por ejemplo la OPS, la OMS y los CDC, con una lectura diaria de sus 50 posts más recientes y los comentarios de los diez posts con más comentarios del día. Son 3 llamadas de user_posts y 30 de comments, 33 al día: unos 0,0183 USD diarios al precio de catálogo de 0,000556 USD, unos 0,55 USD en un mes de 30 días. A esta escala el dinero ya no decide nada; decide si 15 comentarios por post bastan para tu pregunta.
| Trabajo | API oficial | Librería de código abierto | Pago por llamada (EveryInfra) |
|---|---|---|---|
| 10.000 comentarios, un tramo de muchos posts | Solo cuentas propias o autorizadas; 0 USD de API | 0 USD de API; cuentas y proxies; tramos bloqueados | Unos 0,40 USD (0,0401 USD por mil filas, medido) |
| 10.000 comentarios, todos los de pocos posts virales | Sí, en cuentas autorizadas, 50 por página | Depende de la sesión y la versión | No es posible (máximo 15 por post) |
| Seguimiento diario de 3 cuentas durante 30 días | De cuentas ajenas, solo recuentos | Sesión y límites cada día | Unos 0,55 USD (33 llamadas al día) |
| Metadatos de 10.000 posts | Recuentos de cuentas ajenas con Business Discovery | Posible, con 429 | Unos 0,11 USD con 50 por llamada; unos 0,028 USD con limit 200 (estimación, no probado) |
Estas cifras cubren solo tarifas de API, no personas. Los precios por llamada son los del catálogo, que volveremos a revisar antes de publicar; el precio vigente cada día está en la página de precios y en el catálogo. Las recargas y los descuentos por volumen no están en esta tabla.
Exportar los comentarios a Excel
Una de las búsquedas sugeridas más frecuentes en español es "extraer comentarios de instagram a excel". El script de esta guía escribe CSV en UTF-8, que Excel abre directamente. Si Excel muestra caracteres raros en las tildes, las eñes o los emojis, no abras el archivo con doble clic: usa Datos, Obtener datos desde texto o CSV, y elige UTF-8 como origen del archivo. Si tu Excel usa la coma como separador decimal y el punto y coma como separador de listas, el asistente de importación te deja elegir la coma como delimitador. Para un sorteo, otra de las búsquedas frecuentes ("extraer comentarios de instagram para sorteo"), recuerda el límite medido: con 15 comentarios por post solo verías una parte de los participantes de un sorteo con cientos de comentarios. Para sorteos en tu propia cuenta, la API oficial con tu token es la vía correcta, porque devuelve todos los comentarios de primer nivel.
| Búsqueda sugerida | Qué responde esta guía | Vía recomendada |
|---|---|---|
| extraer comentarios de instagram a excel | CSV en UTF-8 e importación desde Datos | Cualquiera; el script da CSV |
| exportar comentarios de instagram gratis | API oficial en tu cuenta o librería con riesgo | Oficial si la cuenta es tuya |
| extraer comentarios de instagram para sorteo | Hacen falta todos los comentarios | Oficial con tu token |
| python instagram scraper | Las tres vías con código | Según la cuenta y el volumen |
Conectar una herramienta de IA: el servidor MCP remoto
Si tu script de Python solo prepara datos para un asistente de IA, puedes saltarte el script y añadir el servidor MCP remoto de EveryInfra a cualquier cliente compatible con MCP. El 10 de noviembre, la llamada tools/list devolvió 12 herramientas. La configuración está en la página del servidor MCP:
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}| Herramienta MCP | Qué hace | Para qué sirve aquí |
|---|---|---|
everyinfra_list_capabilities | Lista plataformas, capacidades, parámetros y precios | Descubrir las capacidades instagram/* |
everyinfra_call_api | Llama a una capacidad | Posts, comentarios y hashtags |
everyinfra_get_job | Recoge el resultado de un trabajo asíncrono | Terminar trabajos de user_posts |
everyinfra_list_requests | Lista las llamadas recientes con su cobro | Cuadrar lo cobrado |
Una vez conectado, puedes pedir al asistente que traiga los últimos 50 posts de la OPS, elija los tres con más comentarios, lea sus comentarios y los agrupe por tema; llamará a user_posts y después a comments. Valen las mismas dos precauciones: los comentarios se detienen en 15 por post, así que un asistente que diga "aquí están todos los comentarios" te está engañando, y tienes que indicar en la instrucción si las colaboraciones cuentan o no.
Para investigación: una cuarta puerta
Si trabajas en una universidad o una organización sin ánimo de lucro en investigación de interés público, hay una puerta que no incluimos en la tabla principal: la Content Library y su API de Meta. Cubre contenido público de Facebook, Instagram y canales de WhatsApp. En Instagram incluye posts de cuentas de empresa y creador, y de cuentas personales verificadas o con al menos 100 seguidores. Los endpoints incluyen cuentas, posts y comentarios de Instagram, con hasta 100.000 resultados por consulta, pero los datos solo se analizan dentro de un entorno seguro, y las solicitudes las revisa de forma independiente el centro francés de acceso seguro a datos CASD. En una nota de actualización, Meta dice que ahora se pueden buscar comentarios de un post por palabra clave y ordenarlos y filtrarlos por fecha.
| Canal de investigación | Quién puede usarlo | Comentarios de Instagram | Dónde quedan los datos |
|---|---|---|---|
| API de Meta Content Library | Investigación aprobada tras revisión independiente | Sí, con búsqueda por palabra clave dentro de un post | Solo en entorno seguro |
| Acceso del artículo 40 de la DSA | Personas investigadoras acreditadas, procedimiento de la UE | Según la solicitud | Según cada aprobación |
| Graph API oficial | Dueños de cuentas y apps autorizadas | Solo cuentas propias o autorizadas | En tus sistemas |
| API pública por llamada | Cualquiera con una clave | Tramo reciente, hasta 15 por post en la prueba | En tus sistemas |
En la Unión Europea, el artículo 40 de la Ley de Servicios Digitales obliga a las plataformas muy grandes a dar acceso a datos públicos a investigadores acreditados, y el acto delegado sobre acceso a datos de la Comisión Europea fija el procedimiento y puso en marcha un portal de acceso. Estos canales tienen fallos. Un artículo de arXiv actualizado el 23-09-2026 comparó lo que ven los usuarios con lo que devuelven las interfaces de investigación y halló que la Meta Content Library y la API de investigación de TikTok pueden perder hasta cerca de la mitad del contenido, quitar hasta cerca del 83 % de los metadatos de contexto y limitar el uso a unas 1.000 peticiones por semana. Para un proyecto de investigación, lo prudente es seguir ambos caminos: pedir el acceso formal y usar APIs públicas para muestras pequeñas y verificaciones cruzadas, anotando la fuente y la cobertura de cada conjunto de datos en la sección de métodos. Nuestro artículo sobre integridad de muestras de investigación con datos sociales muestra cómo la misma búsqueda repetida dos minutos después cambia a la mitad, y el de vigilancia de desinformación sanitaria explica cómo los equipos de salud pública convierten señales sociales en un triaje humano. Los dos encajan con las cifras de cobertura de esta guía.
Cumplimiento: un comentario público sigue siendo un dato personal
Público no significa libre para cualquier uso. El 29-10-2024, la Oficina del Comisionado de Información de Australia y otras 16 autoridades de protección de datos publicaron una declaración conjunta de seguimiento sobre la extracción de datos. Pide a las plataformas que sigan desplegando medidas contra la extracción y que la extracción con fines comerciales o de interés público se haga con garantías legales y contractuales estrictas. Como usuario de esos datos, haz al menos tres cosas. Recoge solo los campos que la tarea necesita: un análisis de sentimiento no necesita la foto de perfil de quien comenta. Seudonimiza los nombres de usuario al guardar y al mostrar, como hacen todas las capturas y datos de esta guía. No recojas cuentas privadas ni sortees muros de inicio de sesión o restricciones técnicas.
El script de esta guía sigue esa regla: el archivo de comentarios tiene cinco columnas, post_url, id, posted_at, like_count y text, y el nombre de usuario de quien comenta no se guarda en disco. Si necesitas agrupar varios comentarios de la misma persona, guarda un hash del nombre, no el nombre.
Por el lado de la plataforma, la cláusula clave es la sección 4.2 de las Condiciones de uso citada antes. Las condiciones de Meta también se mueven. A mediados de octubre de 2026, Meta añadió a sus condiciones comerciales un texto sobre extraer contenido de sitios web vinculados a cuentas de empresa. TechCrunch informó el 17-10-2026 de que ese texto se retiró, y MediaPost informó el 06-11-2026 de que la actualización quedó en pausa indefinida y no entraría en vigor el 20 de noviembre como estaba previsto. El episodio no trata de extraer posts de Instagram, pero deja algo claro: las condiciones cambian, y un proyecto largo debe revisarlas con calendario fijo. Esta guía trata solo métodos y límites de datos y no es asesoramiento legal; para un uso concreto, consulta con un abogado de tu jurisdicción.
En qué se diferencia de nuestro otro artículo sobre Instagram
El precio unitario de cada tipo de dato de Instagram está en la página de la API de datos de Instagram; el tope de 15 comentarios por post que medimos hace dos semanas no ha cambiado. Las otras apps de Meta, Facebook y Threads, usan la misma forma de petición; solo cambia el valor de platform.
Cambios recientes, octubre y noviembre de 2026
| Fecha | Cambio | Qué significa para ti |
|---|---|---|
| 01-10-2026 | Guía de migración: las apps nuevas no pueden usar Instagram Login | Diseñar proyectos nuevos con Unified Login y portafolio comercial |
| 13-10-2026 | Unified Login: las funciones nuevas solo salen ahí | Planificar la migración de proyectos antiguos |
| 26-10-2026 | Sale instaloader 4.16 | Actualizar desde 4.15.x, aunque el 30 de octubre volvieron los fallos de sesión |
| 04-11-2026 | Sale Graph API v27.0; v21.0 se retira el 21-01-2027 | Cambiar versiones fijas en el código; apps nuevas sin peticiones de varios ID |
| 06-11-2026 | Meta pausa sin fecha la actualización de condiciones sobre extracción | Las condiciones cambian; revisarlas con calendario |
| 09-11-2026 | Sale instagrapi 3.2.8, tras la incidencia #2920 sobre el inicio de sesión | Fijar versiones de librerías de API privada y tener vuelta atrás |
Dos datos de contexto. La hoja informativa del Pew Research Center sobre redes sociales, actualizada el 19-10-2026, muestra que alrededor de la mitad de los adultos de Estados Unidos usa Instagram. Un artículo de arXiv del 05-10-2026 estudia la interacción con más de 15 millones de posts patrocinados de Instagram, lo que recuerda que los grandes conjuntos de posts de Instagram siguen siendo material habitual de investigación y que los metadatos de post (likes, recuentos, textos) se consiguen mucho más fácilmente que el texto de los comentarios.
Cómo combinar las tres vías
En la práctica muchos proyectos combinan vías: los comentarios de tus cuentas de marca por la API oficial, las cuentas del sector por pago por llamada, y un equipo de investigación que pide aparte el acceso formal para el análisis completo. Si combinas, añade una columna "fuente" a cada tabla, anota la cobertura de cada fuente y nunca sumes recuentos de comentarios de fuentes distintas como si fueran comparables. En esta guía, el pago por llamada cubrió el 6,0 % de los comentarios de 10 posts, mientras que la API oficial, con una cuenta autorizada, puede en principio recorrer todos los comentarios públicos de primer nivel. Si ambos van a la misma tabla, añade al menos tres columnas (fuente, momento de la recogida y total de comentarios del post) y calcula las proporciones de sentimiento por fuente antes de mezclar.
Para empezar: de una llamada de prueba a una tarea diaria
La forma más rápida de empezar es ejecutar una vez instagram/user_posts con tu propia clave desde el mercado de APIs o siguiendo el inicio rápido de la documentación, y comprobar que los campos son los que necesitas. Después guarda el script como ig_posts_comments.py, define EVERYINFRA_API_KEY y ejecuta python ig_posts_comments.py opspaho 3. Para ejecutarlo a diario, déjalo en el programador de tareas de tu sistema y cambia el script para que añada y deduplique por post_id y por id de comentario en lugar de sobrescribir. Los nombres mal escritos de tu lista se reembolsan solos, pero registra refund_state para detectarlos.
Hay dos decisiones que piden pensar. La primera: ¿basta la cobertura de comentarios? Prueba con cinco a diez posts representativos y calcula "comentarios devueltos entre número de comentarios", como en esta guía. Si los posts que te importan tienen unas decenas de comentarios, como casi todos los de la OPS, la tercera vía devuelve casi todos; si tienen cientos o miles, prepara la primera vía o un canal de investigación. La segunda: decide cómo cuentas las colaboraciones y pon la regla en el código.
Preguntas frecuentes
¿Se pueden extraer datos de Instagram con Python?
Fuente: sugerencia de búsqueda "can you scrape data from instagram". Técnicamente sí, pero distingue los tres métodos. La API oficial solo lee cuentas profesionales propias o autorizadas. Las librerías de código abierto llaman directamente a endpoints web o móviles; la sección 4.2 de las Condiciones de uso de Instagram prohíbe la recopilación automatizada sin permiso, y la cuenta con la que inicias sesión puede quedar restringida. Una API de pago por llamada no necesita tu cuenta de Instagram. Elijas lo que elijas, toca solo contenido público, nunca cuentas privadas, y reduce al mínimo los datos personales de quien comenta.
¿Cómo extraer comentarios de Instagram a Excel?
Fuente: sugerencia de búsqueda "extraer comentarios de instagram a excel". El script de esta guía escribe un CSV en UTF-8 que Excel abre directamente. Si ves caracteres raros en tildes, eñes o emojis, importa desde Datos, Obtener datos desde texto o CSV, y elige UTF-8. Recuerda que, por la vía de pago por llamada, cada post da como máximo 15 comentarios en nuestra prueba.
¿Se pueden exportar comentarios de Instagram gratis?
Fuente: sugerencia de búsqueda "exportar comentarios de instagram gratis". Solo de dos maneras. La API oficial lee los comentarios de tu propia cuenta profesional sin tarifa por llamada, pero exige crear una app y pasar la revisión. Las librerías de código abierto son gratis, pero asumes el riesgo de la cuenta y desde octubre ha habido muchos tramos en que no funcionaban. El pago por llamada no es gratis, pero los comentarios de un post cuestan 0,000556 USD por llamada, las pruebas cuestan unos céntimos como mucho y los fallos y resultados vacíos no se cobran.
¿Sirve para un sorteo de Instagram?
Fuente: sugerencia de búsqueda "extraer comentarios de instagram para sorteo". Solo si el post tiene pocos comentarios. Un sorteo necesita la lista completa de participantes, y la vía por llamada devolvió como máximo 15 comentarios por post en nuestra prueba. Si el sorteo es en tu propia cuenta, usa la API oficial con tu token, que pagina todos los comentarios de primer nivel de 50 en 50.
¿Qué hago si instaloader devuelve 401 o 429?
Fuente: sugerencia de búsqueda "instaloader 401" y las incidencias #2794 y #2786 de GitHub. En la lista de incidencias, los usuarios actualizaron primero a 4.16 y algunos 401 se resolvieron así. El 429 depende del tipo de IP, de la concurrencia y de cuántas veces reinicias; la página de solución de problemas desaconseja ejecutar varias instancias a la vez y reiniciar a menudo. Los fallos de sesión tras el 30 de octubre (#2792) tienen un parche de la comunidad, pero no ha sido estable. Si tu proyecto no tolera paradas, no dependas solo de una librería de código abierto.
¿La Graph API de Instagram da los comentarios de posts ajenos?
Fuente: sugerencia de búsqueda "instagram graph api get comments". No. La referencia de Comments dice que leer comentarios exige un token de acceso del usuario que creó el objeto multimedia. De otras cuentas de empresa o creador, Business Discovery devuelve recuentos de comentarios y likes, nunca el texto.
Referencias
- Instagram Platform overview, Meta for Developers, actualizada el 29-10-2026, <https://developers.facebook.com/documentation/instagram-platform/overview>
- Comments (referencia de IG Media), Meta for Developers, actualizada el 20-10-2026, <https://developers.facebook.com/documentation/instagram-platform/instagram-graph-api/reference/ig-media/comments>
- IG Comment Replies, Meta for Developers, <https://developers.facebook.com/documentation/instagram-platform/instagram-graph-api/reference/ig-comment/replies>
- IG User Business Discovery, Meta for Developers, actualizada el 12-08-2026, <https://developers.facebook.com/documentation/instagram-platform/instagram-graph-api/reference/ig-user/business_discovery>
- IG Hashtag Search, Meta for Developers, <https://developers.facebook.com/documentation/instagram-platform/instagram-graph-api/reference/ig-hashtag-search>
- Instagram API with Unified Login, Meta for Developers, actualizada el 13-10-2026, <https://developers.facebook.com/documentation/instagram-platform/instagram-api-with-unified-login>
- Migrate your App (guía de migración de Instagram Login), Meta for Developers, actualizada el 01-10-2026, <https://developers.facebook.com/documentation/instagram-platform/instagram-api-with-instagram-login/migration-guide>
- Update on Instagram Basic Display API, blog de Meta for Developers, 04-09-2024, <https://developers.facebook.com/blog/post/2024/09/04/update-on-instagram-basic-display-api/>
- Introducing Graph API v27.0 and Marketing API v27.0, blog de Meta for Developers, 04-11-2026, <https://developers.facebook.com/blog/post/2026/11/04/introducing-graph-api-v27-and-marketing-api-v27/>
- Rate Limits, documentación de Graph API, Meta for Developers, <https://developers.facebook.com/docs/graph-api/overview/rate-limiting>
- Changelog, Graph API, Meta for Developers, <https://developers.facebook.com/docs/graph-api/changelog>
- Changelog for Instagram Platform, Meta for Developers, actualizado el 28-10-2026, <https://developers.facebook.com/documentation/instagram-platform/changelog>
- Condiciones de uso, Centro de ayuda de Instagram, <https://help.instagram.com/581066165581870>
- Vista previa de las Condiciones de uso (vigentes desde el 20-01-2027), Centro de ayuda de Instagram, <https://help.instagram.com/2159268501666222>
- Cuenta restringida por extracción de datos, Centro de ayuda de Instagram, <https://help.instagram.com/740480200552298>
- Ocultar comentarios o solicitudes de mensajes no deseados, Centro de ayuda de Instagram, <https://help.instagram.com/700284123459336>
- Meta Content Library and API, Meta Transparency Center, <https://transparency.meta.com/researchtools/meta-content-library/>
- Updates to Meta Content Library and API in Support of Independent Research, Meta Transparency Center, <https://transparency.meta.com/researchtools/meta-content-library/MCL-API-update-supporting-independent-research/>
- Repositorio y README de instaloader, GitHub, <https://github.com/instaloader/instaloader>
- Notas de la versión 4.16 de instaloader, GitHub, 26-10-2026, <https://github.com/instaloader/instaloader/releases/tag/v4.16>
- Notas de la versión 4.15.5 de instaloader, GitHub, 24-10-2026, <https://github.com/instaloader/instaloader/releases/tag/v4.15.5>
- Incidencia #2750 de instaloader, 429 Too Many Requests, GitHub, 10-10-2026, <https://github.com/instaloader/instaloader/issues/2750>
- Incidencia #2767 de instaloader, feedback_required al iniciar sesión, GitHub, 13-10-2026, <https://github.com/instaloader/instaloader/issues/2767>
- Incidencia #2786 de instaloader, fiabilidad en 2026, GitHub, 21-10-2026, <https://github.com/instaloader/instaloader/issues/2786>
- Incidencia #2792 de instaloader, login y cookies rotos, GitHub, 30-10-2026, <https://github.com/instaloader/instaloader/issues/2792>
- PR #2795 de instaloader, GitHub, confirmado por usuarios el 02-11-2026, <https://github.com/instaloader/instaloader/pull/2795>
- Incidencia #2794 de instaloader, descargas sin sesión, GitHub, 31-10-2026, <https://github.com/instaloader/instaloader/issues/2794>
- Incidencia #2803 de instaloader, descarga abortada con 302, GitHub, 07-11-2026, <https://github.com/instaloader/instaloader/issues/2803>
- Troubleshooting, documentación de instaloader, <https://instaloader.github.io/troubleshooting.html>
- instaloader, PyPI, <https://pypi.org/project/instaloader/>
- Repositorio y README de instagrapi, GitHub, <https://github.com/subzeroid/instagrapi>
- Incidencia #2920 de instagrapi, GitHub, 03-11-2026, <https://github.com/subzeroid/instagrapi/issues/2920>
- Incidencia #2890 de instagrapi, GitHub, 18-10-2026, <https://github.com/subzeroid/instagrapi/issues/2890>
- instagrapi, PyPI (3.2.8, 09-11-2026), <https://pypi.org/project/instagrapi/>
- Repositorio de instascrape (archivado), GitHub, <https://github.com/chris-greening/instascrape>
- Search (REST API), GitHub Docs, <https://docs.github.com/en/rest/search/search>
- Advanced Usage, documentación de Requests, <https://requests.readthedocs.io/en/latest/user/advanced/>
- csv, lectura y escritura de archivos CSV, documentación de Python, <https://docs.python.org/3/library/csv.html>
- Platforms' Research API Data Access: What Users See vs. What Researchers can Retrieve, arXiv, v2 23-09-2026, <https://arxiv.org/abs/2601.12390>
- Predicting Engagement with Sponsored Content Across Account Types on Instagram, arXiv, 05-10-2026, <https://arxiv.org/abs/2610.06164>
- Social-HUMINT: An LLM-Augmented Unified Framework for Measuring Social Media Exposure, arXiv, 22-10-2026, <https://arxiv.org/abs/2610.31573>
- Delegated act on data access under the Digital Services Act, Comisión Europea, <https://digital-strategy.ec.europa.eu/en/library/delegated-act-data-access-under-digital-services-act-dsa>
- Reglamento (UE) 2022/2065 (Ley de Servicios Digitales), EUR-Lex, <https://eur-lex.europa.eu/eli/reg/2022/2065/oj>
- Global privacy authorities issue follow-up joint statement on data scraping, Oficina del Comisionado de Información de Australia, 29-10-2024, <https://www.oaic.gov.au/news/media-centre/global-privacy-authorities-issue-follow-up-joint-statement-on-data-scraping>
- Meta removes language that raised scraping and AI training concerns, TechCrunch, 17-10-2026, <https://techcrunch.com/2026/10/17/meta-removes-language-that-raised-scraping-and-ai-training-concerns/>
- Meta Pauses Data-Scraping Terms Following Criticism, MediaPost, 06-11-2026, <https://www.mediapost.com/publications/article/419294/meta-pauses-data-scraping-terms-following-criticis.html>
- Americans' Use of Social Media, Pew Research Center, 19-10-2026, <https://www.pewresearch.org/internet/fact-sheet/social-media/>
- Catálogo de datos sociales de EveryInfra (público, sin clave), consultado el 10-11-2026, <https://api.everyinfra.com/api/v1/social/catalog>
Referencia BL-128