Antigravity CLI 做视频评论巡检:实测与配置
Antigravity CLI 巡检 YouTube、B 站评论:最新 100 条只盖住 5 小时,B 站一次最多 10 条热评,一天接口费 $0.023。
视频发出后的头 24 小时,评论区里最要紧的是三类东西:负面反馈、观众的提问、不回就显得冷淡的评论。本文用 Antigravity CLI(Google 用来接替 Gemini CLI 的终端智能体,命令是 agy)搭一个「每隔几小时自动看一遍新评论、写一份巡检报告」的流程,数据从 EveryInfra 的远程 MCP 拉:YouTube 用 youtube/comments 和 youtube/video,B 站用 bilibili/comments、bilibili/danmaku 和 bilibili/video。数据这一侧我们真调了:2026 年 11 月 3 日 00:17 到 01:22(新加坡时间),对两条正在发酵的视频跑了三轮,共 20 次付费调用,接口费合计 $0.01137。Antigravity 一侧本机没有安装,文中的 mcp_config.json、skill 和定时脚本都是按 11 月 3 日读到的官方文档写的配置示例,不是我们跑过的结果。
先说几个实测出来、文档里看不到的数字。一条发布 23.6 小时、已有 1,546 条评论的 YouTube 视频,按最新排序一次最多拉 100 条,只盖住最近 5 个小时;27 分钟后的第二轮里,100 条中只有 9 条是新的,评论总数涨了 11 条。B 站那条发布不到 3 小时的视频,评论 4,075 条,bilibili/comments 三轮分别只回 3、10、3 条热评,没有按时间排序的参数(加了 sort 会被拒绝,不扣费);弹幕一次 100 条,只到视频第 98 秒。事先写好的关键词规则在 100 条 YouTube 评论里挑出 34 条,逐条读下来只有 13 条值得作者看,而 4 条指出「打码没做好」的评论只抓到 2 条。按每 2 小时一轮算,24 小时的接口费是 $0.023;模型一侧按 Gemini 3.8 Flash 的公开 API 价估算约 $0.103,大头是每次叫醒 agy 都有的一万多 token 固定输入。
这件活是什么:视频发出后 24 小时,评论区要看几次
视频发出去后的头一天,评论区里有三类东西需要人尽快看到:负面反馈(画质、价格、内容出错、对品牌的不满),提问(「这个在哪买」「为什么用 30 帧上传」),以及虽然不负面、但不回会显得冷淡的评论(合作方点名、老观众的长评)。剩下的大多数是表情、玩梗和「第一」,看了也不用处理。巡检要做的,就是每隔几小时把新评论拉下来,把这三类挑出来,写成一份能在手机上读完的报告,而不是让运营在后台一条条往下翻。
我们用的样本是两条正在发酵的视频。YouTube 一侧是 Linus Tech Tips 频道 11 月 2 日 00:45(新加坡时间)发布的「GTA 6 on PC May be Coming Sooner than We Thought」,第一轮拉取时视频已发布 23.6 小时,播放 794,104 次、评论 1,546 条(视频页);B 站一侧是 DeepSeek Harness 官方账号 11 月 2 日 21:28 发布的入驻视频,第一轮时只发布了 2.9 小时,就已经有 225,698 次播放、4,075 条评论和 342 条弹幕(视频页)。一条在 24 小时窗口的尾巴,一条在开头,正好覆盖巡检最常见的两种状态。
| 巡检报告的一行 | 来自哪里 | 说明 |
|---|---|---|
| 评论 ID、平台、视频 | youtube/comments 的 id,bilibili/comments 的 id 和 video_id | 只留 ID,不留昵称 |
| 原文(截短到 200 字) | text | 弹幕另列一栏 |
| 发布时间区间 | YouTube 是「2 hours ago」这类相对时间,B 站是 ISO 时间 | YouTube 要按拉取时刻换算 |
| 热度 | like_count、reply_count | 新评论多为 0 |
| 类别 | 脚本预筛 + 模型判断 | 负面 / 提问 / 需要回复 / 其他 |
| 严重程度、建议回复 | 模型按 JSON schema 输出 | 高风险不起草回复,交给人 |


Antigravity CLI 是什么:接替 Gemini CLI 的时间线和这次用到的四个功能
先把产品交代清楚,因为不少人搜「antigravity cli」时还把它当成 Gemini CLI 的新名字。Google 在 2026 年 5 月 19 日的开发者博客里宣布,个人用户的终端工具从 Gemini CLI 迁到 Antigravity CLI:新工具当天对所有人开放,6 月 18 日起 Gemini CLI 和 Gemini Code Assist 的 IDE 扩展不再为 Google AI Pro、Ultra 和免费用户处理请求;用 Gemini Code Assist 企业许可或付费 API Key 的组织不受影响(Google 开发者博客,2026-05-19;同日的 GitHub 讨论帖 #27274 写了同样的时间线)。博客原文说新工具用 Go 重写、命令名是 agy,保留了 Agent Skills、Hooks、子代理和扩展(扩展改叫插件),而且和桌面应用 Antigravity 2.0 共用同一套智能体内核。
这件事对本文的影响有两点。第一,Antigravity CLI 不开源,官方 GitHub 仓库只放安装说明、发行说明和社区讨论(google-antigravity/antigravity-cli),所以本文所有关于它的行为都以官方文档和发行说明为准,不靠读源码推断。第二,它更新得非常快:按 GitHub 发行接口,从 10 月 6 日的 1.3.0 到 10 月 30 日(UTC)的 1.4.12,25 天里发了 20 个版本(1.4.12 发行说明);中间几个节点是 2026-10-16 的 1.4.0、2026-10-21 的 1.4.4、2026-10-27 的 1.4.8 和 2026-10-29 的 1.4.10,几乎隔一两天一版。我们本机没有安装它,也没有运行它;下面的配置文件、skill 和定时脚本都是按 11 月 3 日读到的官方文档写的「配置示例」,发布前请对照你本机 agy --version 再核一遍。
| 这次要用的功能 | 官方怎么写 | 出处(读取于 2026-11-03) |
|---|---|---|
无头模式 agy -p | 单次提示、打印结果后退出;--output-format json 输出带 status、usage 的信封;--json-schema 强制结构化输出 | Headless mode |
| 远程 MCP | 配置文件 mcp_config.json,远程服务器用 serverUrl 加 headers;可用 enabledTools 只放行部分工具 | MCP、迁移指南 |
| Agent Skills | 工作区 skill 放 .agents/skills/,全局放 ~/.gemini/skills/ 或 ~/.gemini/antigravity-cli/skills/ | 迁移指南、Agent skills |
| 定时 | /schedule 只活在当前对话里;跨会话的定时任务用 sidecar(文档标注只在桌面应用上可用);CLI 一侧可以交给系统定时器调用 agy -p | /schedule、Sidecars |
antigravity cli mcp 配置:mcp_config.json 写在哪、写什么
Antigravity CLI 把 MCP 服务器从主设置文件里拆了出来,单独放在 mcp_config.json:全局的在 ~/.gemini/config/mcp_config.json,只对某个项目生效的在项目根目录的 .agents/mcp_config.json(迁移指南「MCP config formatting changes」)。远程服务器的地址键从 Gemini CLI 的 url 或 httpUrl 改成了 serverUrl,MCP 文档补充说 url 也认;鉴权用 headers 里的自定义请求头;enabledTools 是白名单,设了以后这台服务器的其他工具对智能体不可见;timeoutSeconds 默认是连接 300 秒、每次工具调用 180 秒(MCP 文档「MCP configuration properties」)。下面是给巡检用的配置示例,放在巡检项目自己的 .agents/mcp_config.json:
{
  "mcpServers": {
    "everyinfra": {
      "serverUrl": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer <你的 EveryInfra API Key>" },
      "enabledTools": ["everyinfra_call_api", "everyinfra_get_job", "everyinfra_list_capabilities"],
      "timeoutSeconds": 120
    }
  }
}每一行都有取舍。enabledTools 只留三个工具,是因为我们在 11 月 3 日 00:22 不带 Key 调 tools/list,EveryInfra 的远程 MCP 一共暴露 12 个工具,其中验证码、客服工单、账户查询这些和巡检无关,留着只会占上下文、让模型多一次选择(工具清单原始返回见下文「一次真实往返」)。timeoutSeconds 设成 120 而不是默认的 180,是因为我们实测最慢的一次同步调用(youtube/comments 按热门排 50 条)用了 70.48 秒;超过 85 秒的慢任务应该改走异步(请求里加 "mode":"async",再用 everyinfra_get_job 轮询,这个工具不计费),而不是把超时一路调大。
Key 放在哪是这份配置里最需要小心的一行。官方文档的远程服务器示例就是把 Bearer YOUR_API_TOKEN 直接写在 headers 里,文档没有写 headers 支持 ${环境变量} 展开;而旧的 Gemini CLI 文档明确支持在 headers 里写 $VAR_NAME 或 ${VAR_NAME}(Gemini CLI MCP 文档)。Reddit 上有用户报告在 Antigravity 里写 ${MY_VAR} 会被原样当成字符串发出去(r/google_antigravity 讨论帖)。在官方文档写明之前,我们按「不展开」处理:要么把 Key 写进全局 ~/.gemini/config/mcp_config.json 并把文件权限设成只有自己可读,要么写进项目文件但把 .agents/mcp_config.json 加进 .gitignore,绝不提交进仓库。
第二个要改的文件是权限。MCP 文档写得很清楚:没有配置过的 MCP 工具默认是「Ask」,每次调用都要人点同意;放行规则的写法是 mcp(服务器名/工具名) 或 mcp(服务器名/*)(MCP 文档「permissions and access control」,权限文档)。无头模式下没有人点同意,所以要在 CLI 的设置文件 ~/.gemini/antigravity-cli/settings.json 里提前写好:
{
  "permissions": {
    "allow": [
      "mcp(everyinfra/everyinfra_call_api)",
      "mcp(everyinfra/everyinfra_get_job)",
      "mcp(everyinfra/everyinfra_list_capabilities)",
      "write_file(reports/)"
    ]
  }
}
这里没有用 mcp(everyinfra/*) 一次放行,也没有用 --dangerously-skip-permissions。原因是白名单比黑名单安全:以后服务器新增了工具,按名字放行的规则不会自动覆盖它们。Reddit 上另一位用户遇到的正是这一步:配置了 MCP、显示连接成功,智能体却说连不上,最后发现要去 /permissions 显式放行,而且配置文件被写到了 ~/.gemini/antigravity-cli/ 下面、不在文档说的 ~/.gemini/config/(r/google_antigravity,「Antigravity CLI MCP Servers Pain」)。所以装好以后先进交互界面跑一次 /mcp 看服务器状态,再跑一次 /permissions 看规则是否生效,两步都确认了再交给定时器。
一次真实往返:智能体发出什么调用,我们回了什么
Antigravity 本机没装,但它连上远程 MCP 服务器以后发出去的是标准的 MCP 请求:先 tools/list 拿工具清单,再按需要发 tools/call。MCP 规范把这种「HTTP POST 一条 JSON-RPC 消息、服务器回 JSON 或 SSE 流」的方式叫 Streamable HTTP(MCP 规范 2026-07-28 版「Transports」)。所以我们绕开客户端,直接用同样的请求打 EveryInfra 的 MCP 地址,看到的是服务器回给智能体的原始内容;智能体实际读到的还要经过 CLI 自己的处理,比如 1.4.7 版发行说明写明 10 KB 以上的工具结果会存成文件,这一层本文没有跑过。11 月 3 日 00:22(新加坡时间),不带 Key 的 tools/list 回了 12 个工具;00:45:27,我们带 Key 发了下面这条 tools/call,让它按最新排序拉 LTT 那条视频的 100 条评论:
{
  "jsonrpc": "2.0",
  "id": 7,
  "method": "tools/call",
  "params": {
    "name": "everyinfra_call_api",
    "arguments": {
      "platform": "youtube",
      "action": "comments",
      "params": {
        "url": "https://www.youtube.com/watch?v=g9IOdTisQyM",
        "sort": "newest",
        "limit": 100
      }
    }
  }
}
服务器 30.99 秒后回了 HTTP 200。MCP 的返回把业务结果包在 result.content[0].text 里,是一段 JSON 字符串,长 33,915 字节;解开以后是 platform、action、count、results、billing 等字段,count 为 100,billing.charged_usd 为 0.000556。第一条评论是 3 分钟前发的,内容是一位观众列出自己的配置,说节目里所谓「普通玩家的电脑」有点太强了;第二条是 9 分钟前,讲自己用模拟器打通了《恶魔之魂》重制版。下图是这次返回的截图,只保留两条,昵称已打码、正文截短。
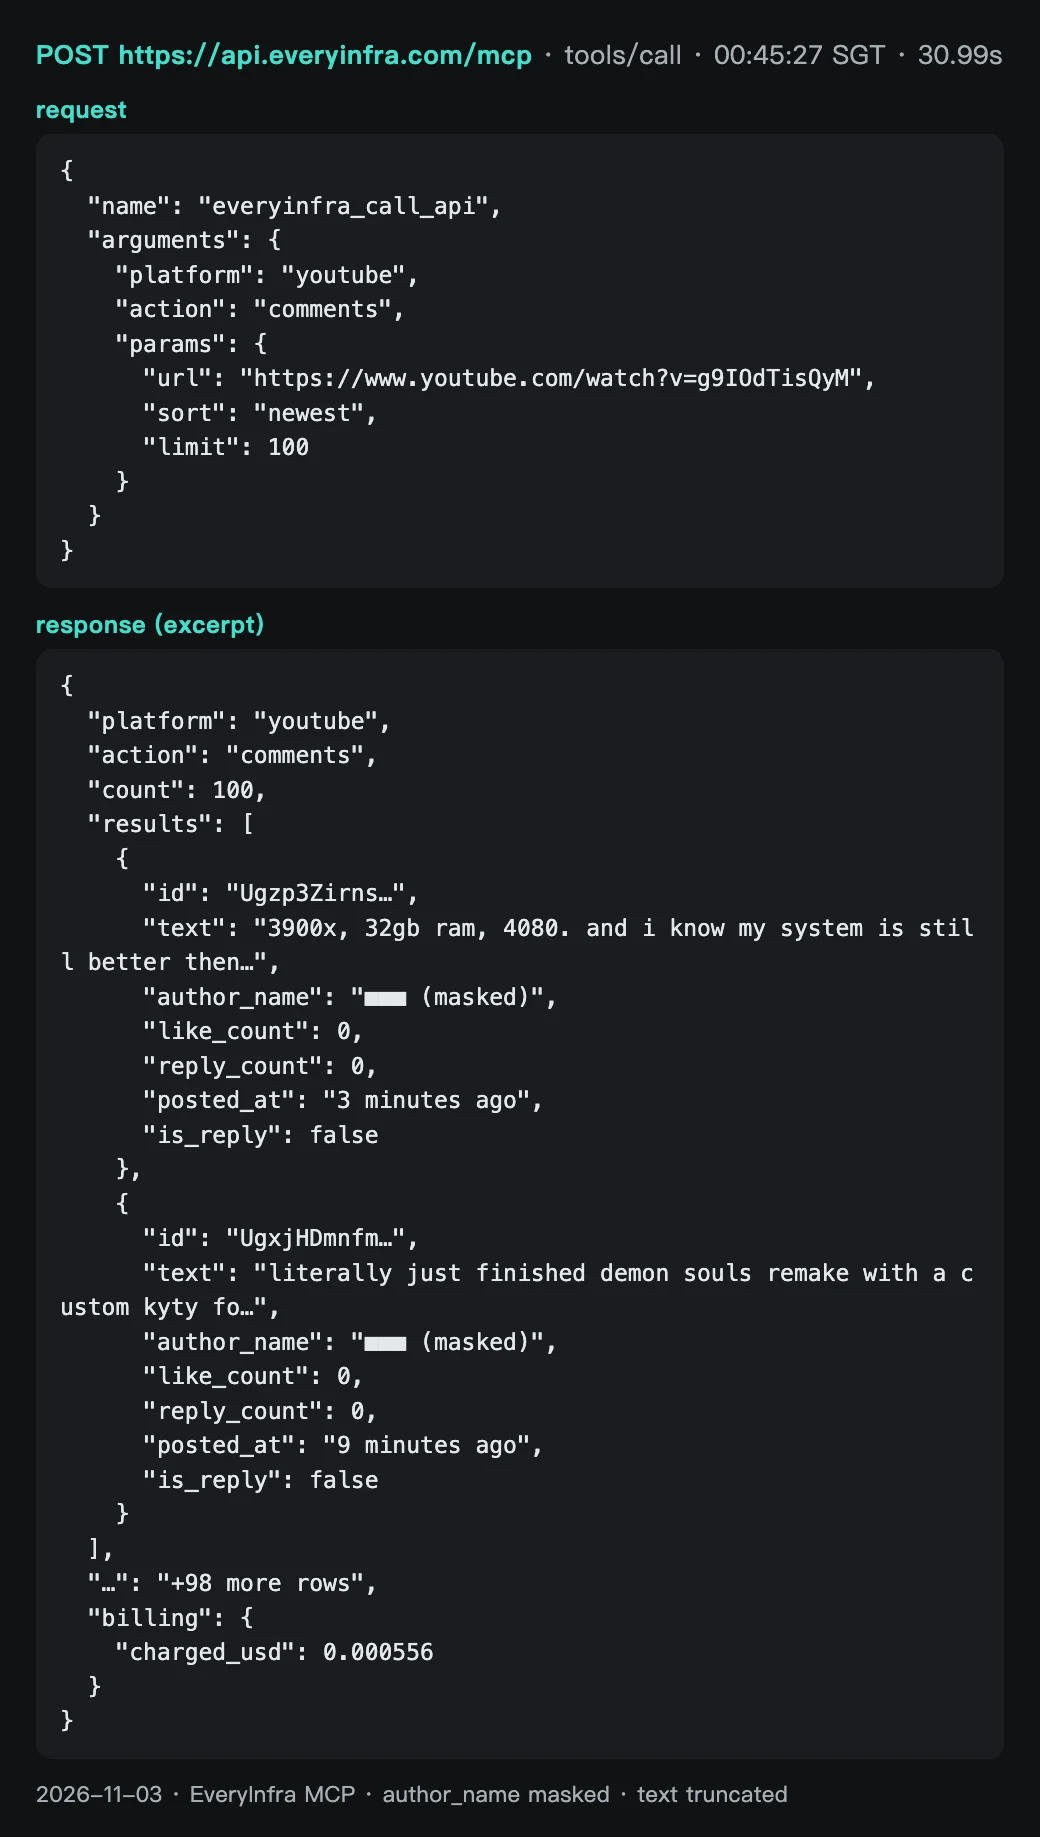
这个返回大小值得在配置时就想到。Antigravity CLI 1.4.7 的发行说明写着,按需加载的 MCP 工具结果在 10 KB 以内会直接交给智能体,超过的会存成文件、让智能体再读一次(1.4.7 发行说明)。一次 100 条评论约 33 KB,必然走「存成文件」那条路。这对巡检其实是好事:原始返回本来就该落盘留档,skill 里让智能体把文件交给 dedupe.py,而不是把 33 KB 的 JSON 读进上下文。
同一件事也可以不经过 MCP,直接用 REST 接口做。定时脚本如果想在叫醒 agy 之前先把数据拉好,用下面这条 curl 就行;我们第 1 轮和第 3 轮用的就是这条路,返回的 results 结构和 MCP 里解开的一样:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"youtube","action":"comments","params":{"url":"https://www.youtube.com/watch?v=g9IOdTisQyM","sort":"newest","limit":100}}' \
  > raw-$(date +%Y%m%d-%H%M).json
我们的建议是先用 MCP 跑通、看清报告长什么样,稳定以后再把拉数据和去重挪进脚本,模型只做判断(理由见预筛一节)。
错误也是往返的一部分。我们给 bilibili/comments 故意加了一个它不支持的 sort 参数,00:21:33 拿到 HTTP 422,error 写的是 unknown_param,并列出允许的参数只有 url 和 limit,最后一句是「Nothing was charged.」。这种错误信息是写给模型看的:智能体读到以后可以自己去掉多余参数重试,不需要人介入。
还有一种错误是服务端临时失败。第 3 轮 01:22:15 拉弹幕时拿到 HTTP 503,error.fault 是 service(服务端的问题,不是请求写错了),retryable 为 true、retry_after 是 20 秒,next_steps 写明这次没有扣费、这是 3 次里的第 1 次失败;我们 23 秒后原样重试,200,100 条弹幕正常回来,这次按 $0.000556 计费。定时脚本照这几个字段办就行:可重试的按 retry_after 等一下再试,最多试到 max_retries,还不行就在报告里写「这一轮 B 站弹幕没拿到」,不要当成「没有新弹幕」。
更多远程 MCP 的接入方式见 MCP 服务器说明 和 文档。
| 这次往返 | 实测值 |
|---|---|
| 请求时刻 | 2026-11-03 00:45:27(新加坡时间) |
| 工具 | everyinfra_call_api,platform=youtube,action=comments |
| 耗时 | 30.99 秒(同步调用,85 秒内都会直接返回) |
| 返回 | HTTP 200,count 100,正文 33,915 字节 |
| 扣费 | $0.000556(billing.charged_usd) |
| 和上一轮比 | 100 条里 91 条第 1 轮已经见过,9 条是新的 |
YouTube 评论监控:一次最多 100 条,够不够看 24 小时
巡检间隔怎么定,取决于一个很实际的数字:两轮之间新增的评论会不会超过一次能拉的上限。youtube/comments 的目录写着默认 20 条、最多 100 条,可选 sort(newest 或 popular)和 since(按日期过滤),返回字段是 id、text、author_name、like_count、reply_count、posted_at、is_reply、reply_to_id。没有翻页参数,所以「一次 100 条」就是每轮能看到的全部。
第一轮 00:18(新加坡时间),视频发布 23.6 小时、评论 1,546 条,我们按最新排序拉满 100 条,用时 22.2 秒。这 100 条里最新的是「1 minute ago」,最旧的是「5 hours ago」:也就是说,到了发布第一天的尾巴,100 条只盖住最近 5 个小时;其中 3 条是回复(is_reply 为 true),4 条带「(edited)」后缀。把这个比例倒过来算,这条视频在第 18 到 23 小时之间平均每小时还在新增 20 条左右;如果按每 6 小时巡检一次,就会有一段评论两边都拉不到。后面几轮的数字说明,发布满一天以后评论还在稳定地进来,每小时 20 到 45 条:第 2 轮 00:45(新加坡时间,距上一轮 27 分钟):评论总数 1,557,比上一轮多 11 条;最新 100 条里 9 条是新的、91 条上一轮已经见过,100 条覆盖的仍是最近 5 小时;第 3 轮 01:20(新加坡时间,距上一轮 35 分钟):评论总数 1,583,比上一轮多 26 条;最新 100 条里 18 条前两轮都没见过、82 条之前见过(只和第 2 轮比是 19 条新、81 条重合),100 条覆盖的仍是最近 5 小时。新出现的条数比总数的增量少,差额多半是回复(第 1 轮的 100 条里有 3 条回复,第 2 轮一条都没有,第 3 轮 1 条)或者被折叠的评论,所以「新评论条数」和「评论总数的增量」要同时记,两者对不上时在报告里写出来。
另一个容易被忽略的参数是 sort。同一时刻我们又按热门排序拉了 50 条,用时 70.48 秒,是这次最慢的一次同步调用。热门 50 条和最新 100 条一条都不重合:热门那一组里 30 条是回复,相对时间从「9 minutes ago」到「23 hours ago」都有,点赞最高的一条有 3,500 个赞。巡检的主任务是「别漏掉新评论」,所以每轮用 newest;热门排序适合每天看一次,回答「评论区现在被哪几条定调」这个问题。posted_at 是「N hours ago」这样的相对时间,不是时间戳,所以脚本要在拉取的那一刻记下时间,换算成「某时到某时之间」的区间,而去重一律用评论 id,不要用时间。
| 字段 | 第 1 轮实测 | 巡检里的用法 |
|---|---|---|
id | 100 条各不相同,形如 Ugz…AaABAg | 去重的唯一依据,写进 state/seen-<视频ID>.json |
text | 原文,最长的一条 1,876 个字符 | 截短到 200 字进报告,原文留在本地 |
posted_at | 「1 minute ago」到「5 hours ago」,4 条带「(edited)」 | 按拉取时刻换算成区间;编辑过的评论可能内容变了 |
like_count、reply_count | 最新 100 条里只有 3 条点赞不为 0 | 新评论看不出热度,热度要看热门排序 |
is_reply、reply_to_id | 3 条是回复 | 回复要和原评论放在一起读,单看会误判语气 |
author_name | 有 | 只在本地用,报告里不写 |
所以对 YouTube 这一侧,我们的建议是:发布后前 6 小时每小时一轮,之后每 2 小时一轮;每一轮如果新评论条数等于 100,就在报告第一行写「本轮可能漏数」,同时把下一轮提前。这条规则已经写进下一节 skill 的决策树。字段和参数的完整说明见 YouTube 评论接口,评论数和播放数这些视频级数字来自 YouTube 视频详情接口。
B 站这一侧:评论只有热评,弹幕要另算
B 站的样本是一条刚发出来的视频:DeepSeek Harness 账号 11 月 2 日 21:28(新加坡时间)发布的入驻视频,时长 200 秒。第一轮 00:20 拉 bilibili/video 时它只发布了 2.9 小时,已经有 225,698 次播放、22,070 个赞、4,075 条评论和 342 条弹幕。这种「头几个小时就爆」的视频,正是巡检最该盯的时候。
然而 bilibili/comments 在 00:21 只回了 3 条评论,用时 1.26 秒。三条热评点赞 48 到 212,发布时间在视频发出后 3 到 131 分钟之间。25 分钟后的第 2 轮(00:46)同一个请求回了 10 条,正好是上限,其中 7 条第 1 轮没见过,点赞从 23 到 1,100 不等;同一时间视频详情里的评论数从 4,075 涨到 4,566,25 分钟多了 491 条,折合每小时一千多条。目录里这个能力写得很直白:默认 10 条、最多 10 条、多填会被截到 10,可选参数只有 url 和 limit。我们试着加了一个 sort 参数,接口回了 422,错误信息列出允许的参数只有 url 和 limit,并写明「Nothing was charged.」,这一次没有扣费。换句话说,用这个能力拿不到「按时间排的最新评论」,它是「这条视频此刻最热的至多 10 条评论」,而且条数会变:第 3 轮(01:22)同样填了 limit: 10,又只回 3 条,三条前两轮都见过,这时评论总数已经是 5,121。对巡检来说,这仍然有用:热评决定了评论区的第一印象,如果热评是负面的,那就是最高优先级。但它不能代替「每一条新评论都看过」,报告里要如实写成「B 站:看到热评 10 条 / 共 4,566 条」,不要让读报告的人以为全看了。
弹幕是另一条信号。bilibili/danmaku 默认 50 条、最多 200 条,我们请求 200,实际回了 100 条,按视频内时间从 0 秒排到 98 秒,只覆盖了 200 秒视频的前一半;发送时间从 21:35 到 00:19(新加坡时间)。用同一套关键词规则过一遍,29 条被判成「提问」,但其中 15 条是「哦?鲸鲸?!」「开播了?真的假的」这类带问号的起哄;真正有内容的是另外几条,比如有 4 条在问「有没有生存模式」,有人问有没有桌面版、关注会不会送 token。这又一次说明,问号不等于问题,弹幕尤其如此。有意思的是,「生存模式」在第 2 轮的热评里也出现了:一条点赞 352 的评论说「整个视频都没有提到生存模式」。弹幕里零散的 4 句和热评里的一条指向同一件事,这正是巡检报告该合并成一条「观众在追问生存模式」的信号。第 2 轮的弹幕仍是 100 条、仍然停在第 98 秒,其中 21 条是新的,弹幕总数从 342 涨到 388;第 3 轮还是停在第 98 秒,新的 16 条,总数到了 430:接口每次给的是「视频前半段的前 100 条」,新弹幕只有落在这一段里才看得到。
| 能力 | 目录写的 | 我们这次拿到的 | 巡检里怎么用 |
|---|---|---|---|
bilibili/video | 播放、点赞、评论数、弹幕数等 26 个字段 | 一次 35.3 秒,字段齐全 | 每 4 轮看一次评论数、弹幕数涨了多少 |
bilibili/comments | 默认 10、最多 10;只收 url、limit | 三轮分别 3、10、3 条热评;加 sort 返回 422 且不扣费 | 当「热评监控」:热评换了、出现负面就报 |
bilibili/danmaku | 默认 50、最多 200 | 请求 200 回 100,按视频时间排、三轮都停在第 98 秒 | 看观众在第几秒起哄或提问,配合时间轴定位问题片段 |
如果你管的是自己的 B 站账号,想看全部评论,正路是创作中心,或者走 B 站开放平台:开放平台要求先注册开发者、做资质认证、再创建应用接入(B 站开放平台),流程比 YouTube 的 Data API 重得多。巡检想看竞品视频,或者不想走开放平台的申请,就接受「热评 + 弹幕」这个视角,并在报告里写清楚。能力的参数说明见 B 站评论接口 和 B 站弹幕接口。
把巡检写成一个 skill:.agents/skills/comment-patrol/ 的骨架
Skill 在 Antigravity 里是一个带 SKILL.md 的文件夹,开头的 YAML 只有 description 必填,name 不写就用文件夹名;智能体每一轮只看到所有 skill 的名字和描述,觉得相关才去读全文,官方叫这种做法「渐进披露」(Agent skills 文档)。这个格式来自开放标准 Agent Skills(agentskills.io),所以同一份 skill 稍改路径也能放进其他支持该标准的工具。文档还给了两条写法建议,正好对上巡检:脚本当黑盒用,让智能体先跑 --help 而不是读源码;复杂流程写成决策树。下面是目录和 SKILL.md 的配置示例:
.agents/
  mcp_config.json            # 上一节的远程 MCP 配置(不进 Git)
  skills/
    comment-patrol/
      SKILL.md
      scripts/
        dedupe.py            # 读上一轮的 seen.json,只留新评论;把「2 hours ago」换算成时间区间
        prefilter.py         # 关键词预筛:提问、负面、需要回复
      resources/
        report.schema.json   # 给 --json-schema 用的输出结构
state/
  seen-<视频ID>.json         # 已见过的评论 ID 和首次看到的时间
reports/
<视频ID>-<轮次>.md---
name: comment-patrol
description: 视频发布后 24 小时内巡检 YouTube 和 B 站评论。拉新评论、去重、预筛,挑出负面、提问和需要回复的评论,写成巡检报告。用户提到评论巡检、发布后监控、评论区有没有问题时使用。
---
# 评论巡检
## 每一轮做什么
1. 读 `state/seen-<视频ID>.json`,没有就新建(第一轮)。
2. 用 everyinfra_call_api 拉数据,每个平台只调下面这几项,不要调别的能力:
- YouTube:platform=youtube, action=comments, params={url, sort: "newest", limit: 100}
- B 站:platform=bilibili, action=comments, params={url};再调 action=danmaku, params={url, limit: 200}
- 每 4 轮调一次 youtube/video、bilibili/video,记录 comment_count 的变化
3. 把返回原样存进 `raw/<轮次>/`,再运行 `python3 scripts/dedupe.py --help` 看用法,用它只留新评论。
4. 运行 `scripts/prefilter.py`,只把被标成「提问」「负面」「需要回复」的评论交给你判断。
5. 按 `resources/report.schema.json` 输出:每条评论给 category、severity、是否需要回复、建议回复(不超过两句,不承诺价格和日期)。
## 决策树
- 新评论条数 = 100(YouTube 一次的上限):说明两轮之间漏了评论,在报告第一行写「本轮可能漏数」,并建议缩短间隔。
- 一轮新评论为 0:不调用模型,直接写「无新评论」。
- 涉及退款、安全、法律、隐私的评论:severity=high,不起草回复,交给人。
- 只有表情或「第一」「打卡」这类:丢弃,不进报告。
## 不要做的事
- 不要替账号发评论或回复;这个 skill 只读。
- 报告里不写评论者的昵称和主页链接,只写评论 ID。为什么要把去重和预筛写成脚本,而不是让模型自己数:一是省额度,后文会算到,一次 100 条的原始返回约 8,075 个 token,而第 2 轮只留新评论后只有 9 条、约 505 个 token;二是可复查,脚本的判定规则是死的,同一份输入两次跑出来一样,模型的判断留给真正需要理解语义的那一步。report.schema.json 的思路来自无头模式的 --json-schema:官方文档说这个参数可以接一个 schema 文件路径,解析后的对象出现在输出信封的 structured_output 字段里(Headless mode「Structured output with a schema」),定时脚本只读这个字段,不用再从自由文本里抠表格。
预筛:关键词规则能挑出什么、会漏掉什么
在让模型看评论之前,我们先用一组死规则把第一轮的 100 条 YouTube 评论过了一遍。规则在 00:29(新加坡时间)写定、跑数据之前没有再改:带问号、以 how / why / what / is / can 等疑问词开头、或者含「怎么」「为什么」「吗」等中文疑问词的算「提问」;命中一张负面词表(bad、worst、disappointed、clickbait、scam、broken、「失望」「翻车」「割韭菜」等)的算「负面」;提问,或者负面且点赞不少于 10 的,算「需要回复」。结果是提问 28 条、负面 8 条、两者合计 34 条;同样的规则用在 B 站的 100 条弹幕上,挑出 29 条「提问」、0 条负面,3 条热评一条也没挑中。
规则挑中的 34 条我们逐条读了一遍,标准是「这条评论针对的是视频本身,作者需要知道或回应」。只有 13 条符合,其余 21 条大多是反问和骂战:「谁在乎它是不是 AI 做的」这种句子带着问号,但没有人需要回答它;一条开头就骂「这段讨论很蠢」的评论因为以疑问词 what 开头被当成提问,其实是对嘉宾观点的吐槽。真正有用的 13 条里有几类很典型:有人问为什么这期按 30 帧上传;有人问第 9 分 43 秒那块遮挡是怎么回事;有人提醒节目说过要回头讲 Bloodborne 的 DLSS 效果、最后没讲;还有人质疑节目在「推广盗版」。这些正是巡检报告应该放在最前面的东西。
规则漏掉的东西更要紧。没被挑中的 66 条里,至少有三个成片出现的主题。第一,「打码失效」:4 条评论指出视频里遮挡游戏文件夹的打码没做好、有一帧露了出来,其中一条直接说「如果遮挡这么重要,请重新检查视频」——这是一个需要作者马上处理的制作失误,但 4 条里只有 2 条带问号被规则抓到。第二,「这不叫高端配置」:主持人说测试机「不算特别高端」,10 条评论反驳这句话(9800X3D 加 RTX 5070 Ti 不算高端?),规则只抓到 2 条。第三,6 条评论请求出一期 PS5 越狱的视频,这是选题线索,规则只抓到 1 条。这三个主题都是读完以后才归纳出来的,所以我们不拿它来给规则打分,只用来说明一件事:关键词规则适合把明显的噪声和明显的提问先分开,但「成片出现的同一个意见」只有让模型看一组评论、按主题归类才找得到。
| 评论(转述,不含昵称) | 规则判定 | 复核结论 | 报告里应该怎么写 |
|---|---|---|---|
| 为什么这期按 30 帧上传 | 提问 | 有用 | 制作问题,作者回应或在置顶评论说明 |
| 第 9 分 43 秒那块遮挡是什么 | 提问 | 有用,并属于「打码失效」主题 | 高优先级:可能露出了不该露的画面 |
| 打码没做好,请重新检查视频 | 未挑中 | 有用,同一主题 | 和上一条合并,计数加一 |
| 这配置都不算高端,那我的算什么 | 未挑中 | 有用,「不算高端」主题 | 汇总成一条:10 条在反驳这句台词 |
| 请出一期 PS5 越狱视频 | 未挑中 | 选题线索 | 进「观众想看」一栏,不需要回复 |
| 谁在乎它是不是 AI 做的?! | 提问 | 无用(反问) | 不进报告 |
下面是按第 1、2 轮真实返回手工拼出来的一份「第 2 轮巡检报告」样子,用来说明目标输出长什么样,不是模型跑出来的结果:
| 优先级 | 平台 | 事项 | 依据 | 建议动作 |
|---|---|---|---|---|
| 高 | YouTube | 游戏文件夹的打码有一帧失效 | 第 1 轮 4 条评论,规则只抓到 2 条 | 检查 9 分 43 秒前后画面,重新剪辑或置顶说明 |
| 中 | YouTube | 观众反驳「不算高端」这句台词 | 第 1 轮 10 条,第 2 轮又多 2 条(都没写 high end) | 置顶一条说明测试机配置 |
| 中 | B 站 | 观众追问「生存模式」 | 4 条弹幕 + 1 条 352 赞的热评 | 置顶评论回应 |
| 低 | YouTube | 想看 PS5 越狱视频 | 6 条评论 | 记入选题清单 |
| 说明 | 两边 | 本轮覆盖情况 | YouTube 新 9 条、总数 +11;B 站热评 10 条 / 共 4,566 条 | 保持每 2 小时一轮 |
所以 skill 里的分工是这样定的:脚本负责去重、去掉纯表情和「第一」,并给每条加上规则标签;模型拿到的是「本轮新评论 + 规则标签」,任务是改判规则的误报、把同一主题的评论合并计数、给每个主题定严重程度。这样模型看到的数据量只比「只送挑中的」多一点,却能找回被规则漏掉的主题。后文算成本时两种做法都算了:只送挑中的 34 条约 2,648 token,送全部 100 条精简字段约 6,153 token,差别在每轮几千 token,对 Flash 档模型来说是几分之一美分的事。
antigravity cli cron:用 launchd 或 cron 定时调 agy -p
Antigravity 自己提供两种定时,但都不完全适合「CLI 用户在服务器或自己电脑上每隔几小时跑一次」。/schedule 让智能体用内置的 schedule 工具设一个计时器或五段式 cron 表达式,到点把指令当高优先级通知发回给智能体;文档明确说它属于创建它的那段对话,对话结束就跟着结束,跨会话的长期任务应该用 sidecar(/schedule 文档)。Sidecar 是一个放在 ~/.gemini/config/sidecars/<名字>/sidecar.json 的后台进程定义,"builtin": "schedule" 可以按 cron 表达式调用 agentapi new-conversation 开新对话,但这一页顶部标的适用范围只有 Antigravity 桌面应用,而且默认关闭,要在 ~/.gemini/config/config.json 里逐个启用(Sidecars 文档)。剩下的路是让操作系统的定时器去调用无头模式。
| 定时方式 | 活多久 | 每次的上下文 | 机器睡眠时 | 适合本文的巡检吗 |
|---|---|---|---|---|
/schedule(CLI 内) | 只在当前对话里 | 带着整段对话历史醒来 | 进程不在就不跑 | 发布后头两小时守着看可以,24 小时不行 |
Sidecar + agentapi | 跨会话,应用管理重启 | 每次开新对话 | 依赖桌面应用在运行 | 文档只写了桌面应用,CLI 用户不适用 |
macOS launchd + agy -p | 系统级,开机后一直在 | 每次新进程、无状态 | StartCalendarInterval 醒来后补跑一次 | 适合,推荐 |
cron + agy -p | 系统级 | 每次新进程、无状态 | 睡眠和关机时都不跑,也不补 | 服务器上可以,笔记本上会漏轮 |
systemd timer + agy -p | 系统级 | 每次新进程、无状态 | Persistent=true 时开机后补跑 | Linux 服务器推荐 |
表里「睡眠时」一列来自操作系统文档。Apple 的说明是:机器睡眠时 cron 任务不执行,要等到下一个预定时间;用 StartCalendarInterval 定时的 launchd 任务如果在睡眠时错过,会在醒来时运行;关机时两者都不跑(Apple「Scheduling Timed Jobs」)。Linux 上的对应物是 systemd 计时器的 Persistent= 选项(systemd.timer 手册)。cron 本身的格式和环境变量规则见 crontab(5),要注意 cron 默认用 /bin/sh、不读你的 shell 配置,agy 要写绝对路径。下面是 macOS 上每 2 小时一轮的 launchd 配置示例(文件放 ~/Library/LaunchAgents/,脚本和数据不要放在桌面和文稿目录,否则会被系统隐私保护挡住):
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE plist PUBLIC "-//Apple//DTD PLIST 1.0//EN" "http://www.apple.com/DTDs/PropertyList-1.0.dtd">
<plist version="1.0"><dict>
  <key>Label</key><string>com.example.comment-patrol</string>
  <key>ProgramArguments</key>
  <array><string>/Users/you/patrol/run.sh</string></array>
  <key>StartCalendarInterval</key>
  <array>
    <dict><key>Minute</key><integer>5</integer><key>Hour</key><integer>0</integer></dict>
    <dict><key>Minute</key><integer>5</integer><key>Hour</key><integer>2</integer></dict>
    <!-- 其余 10 个整点同理,共 12 轮 -->
  </array>
  <key>StandardOutPath</key><string>/Users/you/patrol/logs/out.log</string>
  <key>StandardErrorPath</key><string>/Users/you/patrol/logs/err.log</string>
</dict></plist>
run.sh 是真正调用 Antigravity 的地方,也是三个坑集中的地方:
#!/bin/bash
set -uo pipefail
cd /Users/you/patrol
out=$(/usr/local/bin/agy -p "用 comment-patrol skill 巡检 videos.txt 里的视频,这是第 ${ROUND:-1} 轮" \
  --output-format json \
  --json-schema .agents/skills/comment-patrol/resources/report.schema.json \
  --model gemini-3.8-flash-medium \
  --print-timeout 15m 2> logs/last-stderr.log)
status=$(echo "$out" | jq -r '.status')
reason=$(echo "$out" | jq -r '.finished_reason // "complete"')
if [ "$status" != "SUCCESS" ] || [ "$reason" != "complete" ]; then
  echo "$(date -u +%FT%TZ) 巡检失败:$status $reason" >> logs/alerts.log; exit 1
fi
if grep -qi "permission\|denied" logs/last-stderr.log; then
  echo "$(date -u +%FT%TZ) 有工具被软拒绝,检查 permissions.allow" >> logs/alerts.log; exit 1
fi
echo "$out" | jq '.structured_output' > "reports/$(date +%Y%m%d-%H%M).json"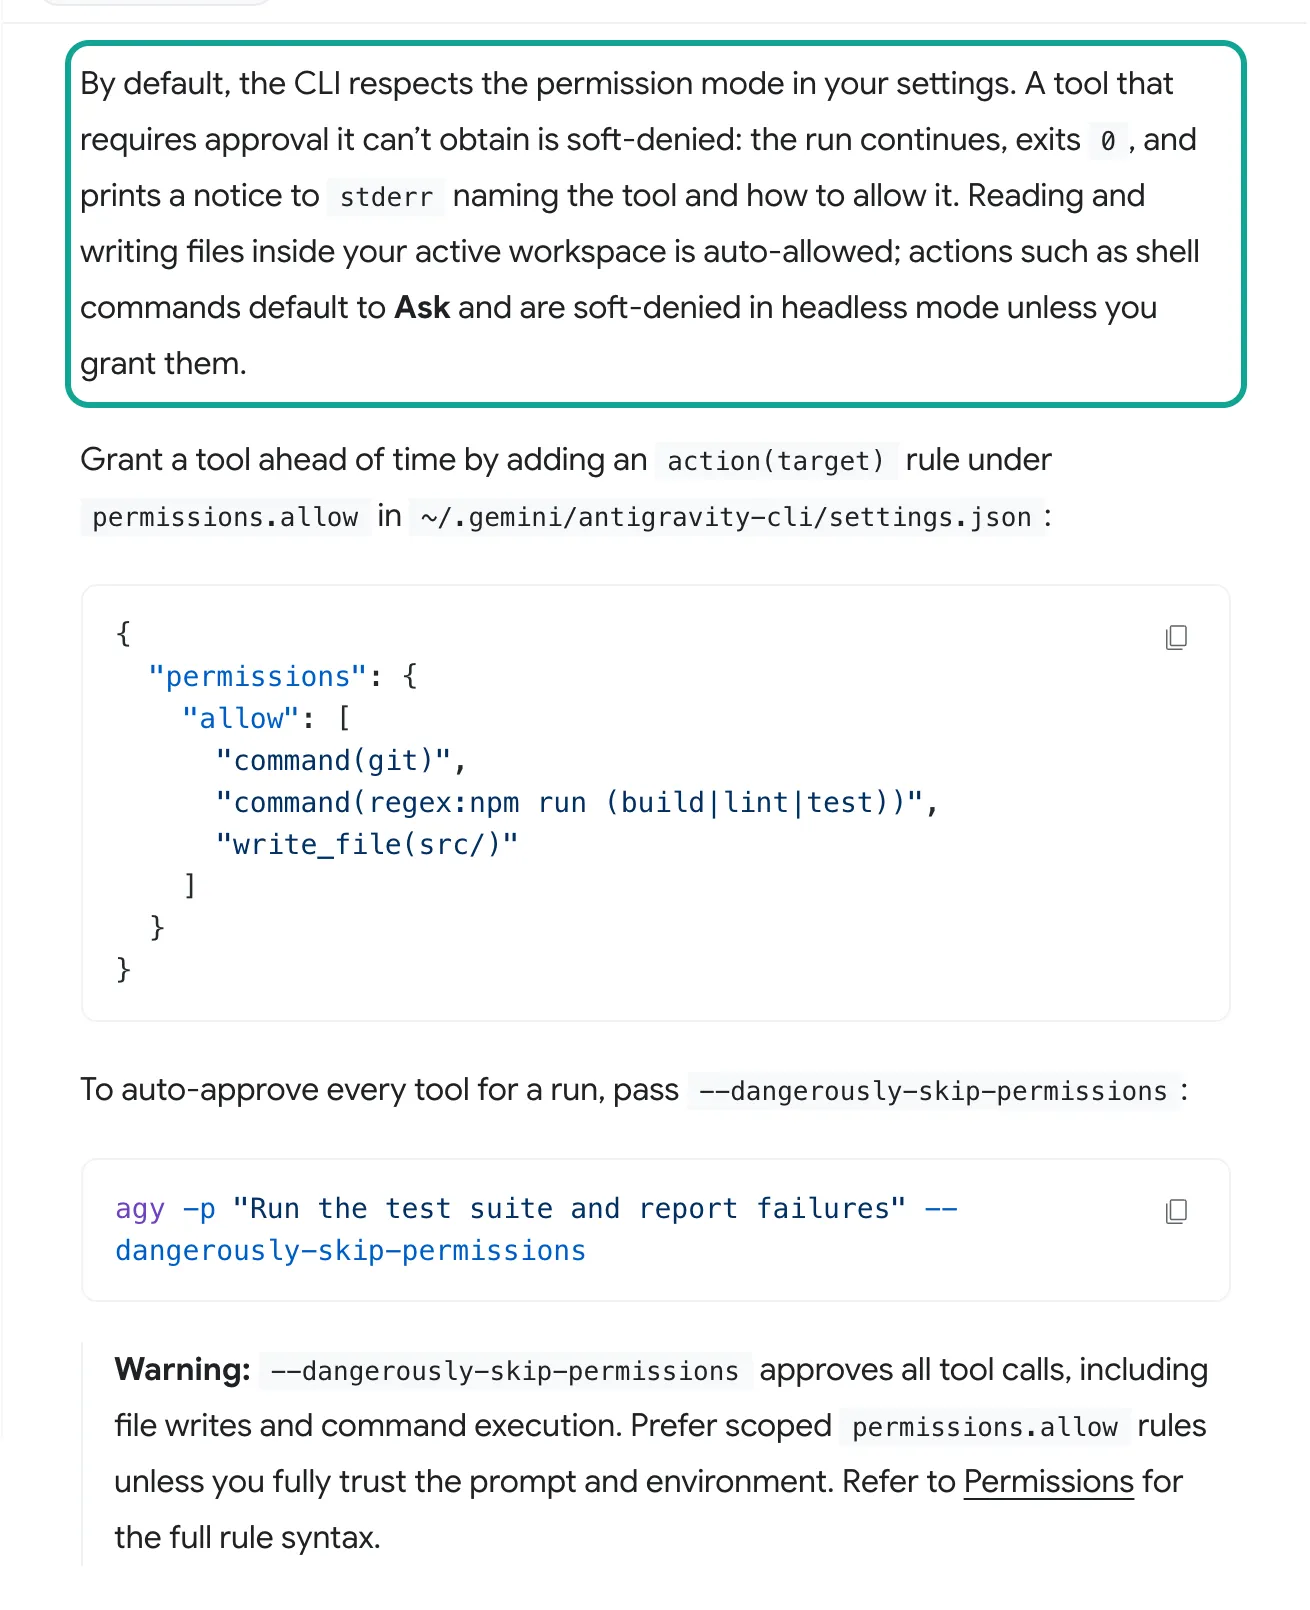
第一个坑是「软拒绝」。官方文档原话的意思是:无头模式没有交互提示,需要批准却拿不到批准的工具会被软拒绝,运行继续、进程以 0 退出,只在 stderr 打印一条提示(Headless mode「Permissions in headless mode」)。如果上一节的 permissions.allow 没写对,定时任务每次都「成功」,报告却是空的,所以脚本要同时看 stderr;提示的确切措辞文档没有给出,上面脚本按关键词匹配,上线前请在本机故意删掉一条放行规则,看一次真实提示再改匹配词。第二个坑是登录:无头模式用的是缓存的登录凭据,必须先交互运行一次 agy 完成登录,没有终端又没登录的环境会直接报 authentication required;README 写的是凭据存在系统钥匙串里(GitHub README「Authentication」),所以 launchd 任务要跑在登录用户的会话里(LaunchAgents,不是 LaunchDaemons)。第三个坑是超时:--print-timeout 默认 5 分钟,两个平台、多次调用加上模型判断可能超过,上面的脚本放宽到 15 分钟;10 月 30 日的 1.4.11 版在 JSON 结果里加了 finished_reason 字段,超时被截断时会写 print_timeout,正常结束时不出现这个字段(1.4.11 发行说明),脚本据此区分「完整报告」和「半截报告」。更早的修复也和定时有关:9 月 24 日的 1.2.10 版起,流到一半出错的 -p 运行改为以 3 退出,不再假装成功(1.2.10 发行说明)。
24 小时要花多少:接口费按次,模型一侧按额度或 token
先算数据这一侧。这次用到的五个能力在 11 月 3 日的目录里都是每次 $0.000556:youtube/comments、youtube/video、bilibili/comments、bilibili/danmaku、bilibili/video(目录是公开接口 GET https://api.everyinfra.com/api/v1/social/catalog,不需要 Key,价格以当天目录为准)。一轮巡检的核心是三次调用:YouTube 最新 100 条、B 站热评、B 站弹幕,合计 $0.001668;另外每 4 轮查一次两条视频的详情,看评论数涨了多少。按这个组合,24 小时的接口费如下表。失败的调用不扣费:我们这次那个 422 的请求就没有扣钱,按单号对账的做法见 失败退款对账。
| 巡检间隔 | 24 小时轮数 | 接口调用次数 | 接口费(目录价) | 模型一侧(按 Gemini 3.8 Flash API 价估算) |
|---|---|---|---|---|
| 每 1 小时 | 24 | 84 | $0.047 | $0.205 |
| 每 2 小时 | 12 | 42 | $0.023 | $0.103 |
| 每 3 小时 | 8 | 28 | $0.016 | $0.069 |
| 每 4 小时 | 6 | 22 | $0.012 | $0.051 |
| 每 6 小时 | 4 | 14 | $0.008 | $0.034 |
模型一侧的数字是估算,算法写在这里方便你换成自己的数:Antigravity 无头模式文档里,一句话的提示在 JSON 输出里显示 input_tokens 10,415、其中 cache_read_tokens 8,113、output_tokens 657(Headless mode「JSON output」),也就是说每次调用 agy -p 光是系统提示和工具说明就有一万出头的固定输入。我们按每轮「固定输入 10,415(其中 8,113 按缓存价)+ 本轮数据约 805(第 2 轮新评论约 505,加上约 300 token 的说明和 B 站数据) token + 输出 1,500 token」算,价格取 Gemini API 价格页 2026 年 10 月 30 日版的 Gemini 3.8 Flash:输入每百万 token $0.75、输出 $3.75、缓存 $0.075,这个价格写明有效到 2026 年 12 月 31 日,2027 年 1 月 1 日起翻倍(Gemini API 价格页)。数据 token 按「字节数除以 4」粗估,依据是 Gemini 文档「一个 token 约 4 个字符」的说法(Gemini API 文档「Understand and count tokens」),英文评论适用,中文评论会偏低。
两张图放在一起看,结论很清楚:在这件活里,钱主要不花在拉数据上,也不主要花在评论本身的 token 上,而是花在「每次叫醒 agy 的固定开销」上。所以省钱的顺序是:先拉长间隔(每 2 小时一轮比每小时一轮省一半),再让「没有新评论」的轮次根本不调用模型(skill 的决策树里已经写了),最后才是精简每条评论的字段。还有一个容易忽略的细节:用 --model 把巡检固定在 Flash 档。模型文档写明免费和 Plus 用户只能用 Gemini 3.8 Flash,Gemini 4 Argon 需要 Pro 或 Ultra(Models 文档),如果默认模型是 Argon,同样的巡检会贵很多;Gemini 4 Argon 的 API 价在 11 月 30 日前是输入 $2、输出 $10,12 月 1 日起翻倍(同一价格页)。
个人用户其实不直接付这笔 token 钱,而是消耗套餐额度。Antigravity 的套餐文档写了三档:免费版按周给额度,Pro 每 5 小时刷新一次、另有每周上限,Ultra 更高;而且不支持自带 API Key(Plans 文档)。5 月 19 日的套餐调整博客写明 Pro 每月 $20,新增 $100 一档 Ultra、原来 $250 的 Ultra 降到 $200,Flash 和 Pro 模型共用一个额度池,按 API 价格折算扣减,$100 档是 Pro 的 5 倍、$200 档是 20 倍(Antigravity 博客,2026-05-19)。所以上表的「模型一侧」可以理解为「这次巡检会吃掉多少等值额度」。YouTube 这一侧还有一条不花钱的路:YouTube Data API 的 commentThreads.list 每次只扣 1 个配额单位、每天默认 10,000 单位(配额页 2026-10-15 更新;commentThreads.list,配额计算表),公开视频的评论用 API Key 就能读,只有看「待审核」「疑似垃圾」这类被扣住的评论才要视频主人的 OAuth 授权;代价是要建 Google Cloud 项目、自己管配额和翻页,而且 B 站不在其中。两个平台放进同一份报告、又不想维护两套接入时,按次付费的接口更省事。完整价格见 价格页。
antigravity cli vs gemini cli:从 Gemini CLI 迁过来要改什么
如果你原来就用 Gemini CLI 跑过类似的定时脚本,迁移时要改的地方集中在配置文件的位置和键名上,工作区规则文件不用动。官方给了一条导入命令 agy plugin import gemini,会把旧扩展转成插件、把扩展里的 MCP 定义写进 mcp_config.json(迁移指南「Converting extensions to plugins」);首次运行 agy 时也会检测旧配置并给一个勾选清单。但直接写在 ~/.gemini/settings.json 里的 MCP 服务器、以及「信任」这类权限设置,导入后仍要逐项核对。下表是我们逐条对照两边官方文档整理的差异:
| 项目 | Gemini CLI | Antigravity CLI | 迁移时要做的事 |
|---|---|---|---|
| 命令 | gemini -p | agy -p(别名 --print、--prompt) | 改定时脚本里的命令和绝对路径 |
| MCP 配置位置 | ~/.gemini/settings.json 的 mcpServers | ~/.gemini/config/mcp_config.json 或 .agents/mcp_config.json | 搬到新文件 |
| 远程地址键 | url(SSE)或 httpUrl(流式 HTTP) | serverUrl(也认 url) | 改键名 |
| 请求头里的环境变量 | 支持 $VAR 和 ${VAR} | 文档未写 | 按不支持处理,Key 写进受保护的文件 |
| 免确认 | 服务器级 trust: true | permissions.allow 里的 mcp(服务器/工具) 规则 | 改成按工具放行 |
| 工具白名单 | includeTools / excludeTools | enabledTools / disabledTools | 改键名 |
| 超时 | timeout,毫秒,默认 600,000 | timeoutSeconds,秒,默认调用 180、连接 300 | 换单位 |
| 项目 skill 目录 | .gemini/skills/ | .agents/skills/ | 搬目录 |
| 规则文件 | GEMINI.md、AGENTS.md | 相同 | 不用改 |
| 登录方式 | 可用付费 Gemini API Key | 个人用 Google 账号(钥匙串);企业可接 Google Cloud 项目;文档写明不支持自带 Key | 服务器上无人值守时先确认登录方式 |
最后一行对定时任务影响最大。Plans 文档写明目前不支持「自带 Key 或自带端点」来提高额度(Plans 文档),GitHub 讨论帖里也有开发者抱怨新 CLI 不能再用 AI Studio 的 API Key 登录(讨论帖 #27274 的回复)。反过来,5 月的公告说 Gemini CLI 对付费 API Key 和企业许可继续可用。所以如果你的巡检跑在一台没有图形界面的云服务器上、又只有 API Key,最省事的做法可能是继续用 Gemini CLI,等 Antigravity 一侧的服务器登录方式在文档里写清楚再迁。
额度差别官方没有对比数字,Reddit 上有用户反映 Antigravity CLI 耗额度更快,见文末问答「哪个更省额度」。
做不到和要注意的地方
先说数据一侧。第一,被平台扣住待审的评论看不到。YouTube 帮助中心写明,按「基本」「严格」审核扣下的评论在 YouTube Studio 里最多保留 60 天,批准前不公开显示(YouTube 帮助「Learn about comment settings」);我们和任何第三方拿到的都只是公开评论。频道主要看待审评论,得用 YouTube Data API 带授权请求 moderationStatus=heldForReview(commentThreads.list 文档)。第二,YouTube 评论的时间是「2 hours ago」这样的相对时间,4 条还带「(edited)」后缀,换算成绝对时间只能精确到小时这一档,越早的评论误差越大。第三,B 站评论一次只回热评,前文实测两轮分别回了 3 条和 10 条,而总数是 4,075 和 4,566 条,所以 B 站一侧的「新评论巡检」做不到全量,只能看热评和弹幕的变化。第四,YouTube 在 2026 年 9 月 30 日的 Data API 修订记录里给评论资源加了 snippet.imageUrl,GIF 和图片评论 11 月对所有用户开放(YouTube Data API 修订记录);我们的 youtube/comments 目录字段里没有图片字段,只有图片没有文字的评论会表现成空文本,巡检规则里不要把空文本一律当噪声丢掉。
再说 Antigravity 一侧。CLI 闭源、迭代快,本文引用的参数和行为以 11 月 3 日读到的文档和 1.4.12 版发行说明为准;sidecar 文档目前只标了桌面应用;无头模式靠缓存登录,云服务器上的无人值守登录方式文档没写清楚。个人套餐的额度按「做了多少活」消耗,Plans 文档说额度「可能调整」,所以本文的成本数字是估算,以你账号 /usage 面板的实数为准(/usage 文档)。
最后是用法上的边界。这个 skill 只读,不发回复:EveryInfra 的接口是公开数据的读取接口,不能替你的账号发评论;起草的回复要由人在 YouTube Studio 或 B 站创作中心里发。报告里只留评论 ID 和文本,不留昵称和主页链接,按各平台条款和你所在地的个人信息规定处理数据。分类也不是百分之百可靠:我们的关键词规则挑出的 34 条里只有 13 条值得作者看,还漏了一半「打码失效」的评论;模型分类这一步本文没有实测,上线前请拿同样 100 条先人工标一遍,再和模型的结果对一次。「高风险」一类始终要人看,模型只负责把 100 条缩到十几条。
最近的变化
- 2026 年 10 月 30 日(UTC),Antigravity CLI 1.4.11 在
--output-format json的结果里加了finished_reason,同日 1.4.12 修了长回复里 Markdown 表格错位的问题(1.4.11、1.4.12)。对读者意味着:定时脚本终于能分清「报告写完了」和「超时截断了」,升级到 1.4.11 以上再上线巡检。 - 2026 年 10 月 24 日,1.4.7 版让无头
-p运行少用很多 CPU,并把按需加载的 MCP 工具直接返回给智能体的结果上限从 4 KB 提到 10 KB,超过的仍会存成文件让智能体多读一步(1.4.7)。对读者意味着:一次 100 条 YouTube 评论约 33 KB,仍超过 10 KB,用脚本先压缩成「只留新评论的精简 JSON」更划算。 - 2026 年 10 月 13 日,Gemini 4 Argon 进入 Antigravity 桌面应用和 CLI,面向 Google AI Pro 和 Ultra 订阅用户(Antigravity 博客)。对读者意味着:分类评论这种量大、判断简单的活用 Gemini 3.8 Flash 就够,Argon 留给需要写长回复或分析原因的少数评论。
- 2026 年 10 月 30 日更新的 Gemini API 价格页写明,Gemini 3.8 Flash 每百万输入 token $0.75、输出 $3.75,有效期到 12 月 31 日,2027 年 1 月 1 日起翻倍;Gemini 4 Argon 的 $2 / $10 到 11 月 30 日为止,12 月 1 日起翻倍(Gemini API 价格页)。对读者意味着:Antigravity 的个人额度按 API 价格折算消耗(5 月的套餐公告),API 价格调整后同样的巡检会不会更快耗完额度,官方没有说明,上线后用
/usage盯一周。 - 2026 年 9 月 30 日,YouTube Data API 给评论加了图片和 GIF 字段,11 月对所有用户开放(修订记录);9 月 23 日的 Made on YouTube 活动上,YouTube 还宣布在试验按创作者定制的评论审核(TechCrunch,2026-09-23)。对读者意味着:评论区里纯图片评论会变多,文本巡检要给空文本单独留一类。
常见问题
antigravity cli mcp config 到底放在哪个文件?
全局放 ~/.gemini/config/mcp_config.json,只给某个项目用的放项目根目录的 .agents/mcp_config.json,这是迁移指南写的位置。有用户在 Reddit 上反映配置被写进了 ~/.gemini/antigravity-cli/ 下面,复制到 ~/.gemini/config/ 后才生效;装好后用 /mcp 看一眼服务器状态最直接。(问题来自 Google 联想词「antigravity cli mcp config」和 r/google_antigravity 讨论帖。)
antigravity cli vs gemini cli,哪个更省额度?
没有官方对比数字。Reddit 上一个 35 赞的帖子说,同样写网页代码,Antigravity CLI 两小时用完了两个 Pro 账号的额度,换回 Gemini CLI 四小时只用了约 10%,这是个人体验,不是测量。能确定的是:Antigravity 的个人额度按 API 价格折算、Flash 和 Pro 共用一个池子;每次无头调用有约一万 token 的固定输入。对巡检这种短任务,省额度的办法是让脚本先去重、预筛,模型只看新评论里的十几条,并用 --model 固定在 Flash 档。(问题来自联想词「antigravity cli vs gemini cli quota」和 r/GeminiCLI 讨论帖。)
antigravity cli cron job 能直接用 /schedule 做吗?
能做「这段对话还开着时每隔几分钟看一次」,做不了 24 小时无人值守。/schedule 支持五段式 cron 表达式和 MaxIterations,但它属于当前对话;文档建议长期任务用 sidecar,而 sidecar 目前只标了桌面应用。CLI 用户用 launchd、cron 或 systemd 定时调 agy -p 更稳。(问题来自联想词「antigravity cli cron job」「antigravity cli cron expression」。)
antigravity cli yolo mode 是什么,定时任务要不要开?
CLI 参考表里没有叫 yolo 的参数,最接近的是 --dangerously-skip-permissions(放行全部工具)和设置项 toolPermission: "always-proceed"。巡检只需要三个 MCP 工具和写报告目录,按名字写进 permissions.allow 就够了,不需要放行全部。(问题来自联想词「antigravity cli yolo mode」,参数见 CLI 参考。)
youtube comment moderation tool 已经有了,为什么还要自己巡检?
YouTube Studio 的审核是「扣住可疑评论」,解决的是「不该显示的别显示」;巡检解决的是「已经公开的评论里,哪些是提问、抱怨和该回的」,并且能把 YouTube 和 B 站放在同一份报告里,也能看竞品视频。管自己频道的话,两者一起用:Studio 管待审,巡检管公开评论的跟进。(问题来自联想词「youtube comment moderation tool」,设置说明见 YouTube 帮助。)
b站评论爬虫能拉到一条视频的全部评论吗?
用 bilibili/comments 不能:目录写明一次最多 10 条、多填会被截到 10,本文实测三轮分别回 3、10、3 条热评(后两轮都填了 limit: 10),而视频当时已有四千多条评论;也不接受排序参数。要看全量,只有视频作者在创作中心或经授权的开放平台应用里看。巡检一侧可以把 B 站当作「热评 + 弹幕」两条信号来用。(问题来自联想词「b站评论爬虫」「b站评论爬取」。)
上手步骤
- 在 快速上手 里拿到 API Key,先用免费的目录接口
GET https://api.everyinfra.com/api/v1/social/catalog?platform=youtube看一遍youtube/comments的参数和字段,B 站同理(?platform=bilibili)。 - 在 YouTube 数据接口页 和 B 站数据接口页 的试用台里各跑一次评论接口,确认你的视频链接能拿到数据;能力说明见 YouTube 评论接口、YouTube 视频详情接口、B 站评论接口、B 站弹幕接口。
- 按本文写好
.agents/mcp_config.json和permissions.allow,交互运行一次agy,用/mcp、/permissions确认连接和放行规则;远程 MCP 的通用接法见 MCP 服务器说明。 - 把 skill 放进
.agents/skills/comment-patrol/,手动跑一次agy -p,看structured_output是否符合 schema、stderr 里有没有被拒的工具。 - 交给 launchd、cron 或 systemd,第一天按 2 小时一轮跑,看报告第一行有没有「本轮可能漏数」,再决定缩短还是放宽间隔。
同一套思路也能用在别的 AI 工具里:Claude Code 的定时任务做法见 Claude Code 定时任务:每天自动整理 Reddit 痛点,Gemini 一侧接远程 MCP 的另一种用法见 Gemini Deep Research API 接远程 MCP,评论清洗和分类的细节见 DeepSeek V4 加 Claude Code 清洗评论。失败和空结果不扣费的对账方法见 失败退款对账。
本文引用的外部资料均在 2026 年 11 月 3 日(新加坡时间)读取;参考资料里标的日期是页面自己写的发布或更新日期。
参考资料
- Google 开发者博客:Gemini CLI 迁往 Antigravity CLI,2026-05-19,迁移时间线和 6 月 18 日停止服务的范围。
- gemini-cli GitHub 讨论帖 #27274,同一时间线的社区公告。
- Antigravity CLI 迁移指南,MCP 配置文件位置、键名变化、skills 和上下文文件。
- Antigravity CLI 参数参考,
-p、--output-format、--print-timeout、--dangerously-skip-permissions等参数。 - Antigravity CLI 无头模式,JSON 信封、
--json-schema、无头模式下的权限软拒绝。 - Antigravity /schedule 命令,对话内定时任务的字段和限制。
- Antigravity Sidecars,跨会话定时任务,标注只在桌面应用可用。
- Antigravity MCP 文档(CLI 页签),
serverUrl、headers、enabledTools、timeoutSeconds和权限规则。 - Antigravity Agent skills 文档(CLI 页签),skill 目录、
SKILL.md格式和渐进披露。 - Antigravity 权限文档(CLI 页签),允许、询问、拒绝规则的写法。
- Antigravity 套餐文档,免费版、Pro、Ultra 的额度刷新方式,不支持自带 Key。
- Antigravity 模型文档,各套餐可用的模型。
- Antigravity CLI 运行模式,default、accept-edits、auto、plan 四种模式。
- Antigravity CLI /usage 命令,查看额度用量。
- Antigravity 更新日志,桌面应用和 CLI 的版本记录入口。
- google-antigravity/antigravity-cli 仓库,安装说明、发行说明和社区讨论,不含源码。
- Antigravity CLI 1.4.12 发行说明,2026-10-30(UTC)。
- Antigravity CLI 1.4.11 发行说明,2026-10-30(UTC),新增
finished_reason。 - Antigravity CLI 1.4.10 发行说明,2026-10-29,交互界面流式输出和内存的改进,打印和无头模式不受内存改动影响。
- Antigravity CLI 1.4.7 发行说明,2026-10-24,无头模式省 CPU,MCP 结果直接返回上限提到 10 KB。
- Antigravity CLI 1.3.4 发行说明,2026-10-13,无头模式下未知
--agent以退出码 1 结束。 - Antigravity CLI 1.2.10 发行说明,2026-09-24,流式回复中途出错以退出码 3 结束。
- Antigravity CLI 1.2.9 发行说明,2026-09-23,无头模式等待后台任务直到超时。
- Gemini CLI MCP 文档,旧版
url、httpUrl、trust和请求头里的环境变量展开。 - Antigravity 博客:套餐调整,2026-05-19,Pro $20、Ultra $100 和 $200 两档,额度按 API 价格折算。
- Antigravity 博客:Gemini 4 Argon 上线,2026-10-13,面向 Pro 和 Ultra 用户。
- Antigravity 博客:Gemini 3.8 Flash 上线,Flash 档模型在 Antigravity 中可用。
- Google 博客:Gemini 4 Argon 发布,2026-09-30。
- Gemini API 价格页,2026-10-30 更新,Gemini 3.8 Flash 与 Gemini 4 Argon 的价格和调价日期。
- Gemini API 文档:理解和计算 token,2026-10-13 更新,「一个 token 约 4 个字符」。
- Google AI 开发者论坛:企业版用户在 Antigravity 中用不了 Gemini 4 Argon,2026-10-14,套餐与模型权限的实际问题。
- MCP 规范 2026-07-28 版:Transports,Streamable HTTP 的请求和返回方式。
- Agent Skills 开放标准,skill 文件夹格式的公共规范。
- YouTube Data API:commentThreads.list,
maxResults、order、moderationStatus参数。 - YouTube Data API 配额计算表,
commentThreads.list每次 1 个单位。 - YouTube Data API 修订记录,2026-09-30 新增评论图片字段。
- YouTube 帮助:评论设置,待审评论最多保留 60 天。
- TechCrunch:YouTube 评论区新功能,2026-09-23,按创作者定制的评论审核试验。
- B 站开放平台,开发者注册、资质认证和应用接入流程。
- Apple 开发者文档:Scheduling Timed Jobs,launchd 的
StartCalendarInterval与睡眠时的行为。 - crontab(5) 手册页,cron 表达式和环境变量。
- systemd.timer 手册页,
Persistent=补跑错过的任务。 - r/google_antigravity:Antigravity CLI MCP Servers Pain,MCP 配置位置和
/permissions放行的踩坑。 - r/google_antigravity:MCP 配置里的环境变量,
${VAR}被原样发送的报告。 - r/GeminiCLI:Antigravity CLI 为什么这么费额度,迁移后额度消耗的讨论。
- The New Stack:Gemini CLI 的替代者,2026-06-20,迁移的行业报道。
- 本文 YouTube 样本视频,2026-11-02 00:45(新加坡时间)发布。
- 本文 B 站样本视频,2026-11-02 21:28(新加坡时间)发布。
- EveryInfra 能力目录:YouTube,
youtube/comments、youtube/video的参数、字段和单价。 - EveryInfra 能力目录:B 站,
bilibili/comments、bilibili/danmaku、bilibili/video的参数、字段和单价。
引用编号 BL-72