Claude Sheets MCP:评论、社媒、搜索进一张表
Claude Sheets 不能直接调连接器。远程 MCP 实测取 458 行公开数据,表格侧按帮助页配置;500 行表接口费 $0.011–$0.046。
Anthropic 在 2026 年 11 月 10 日放出的 Claude Sheets 测试版,帮助页的「当前限制」里写着一句:表格不能从已连接的应用里拉实时数据(Claude Sheets 帮助页,2026-11-16 更新)。所以「在表格里直接调连接器」这条路走不通,能走的是先在对话里调远程 MCP 取数,再让 Claude 把这些行写进表。我们在 2026 年 11 月 18 日 00:17–00:29(新加坡时间)对 EveryInfra 的远程 MCP 和数据接口真调 5 次,拿回 458 行公开数据,合计扣费 $0.005751;按这几次调用每次给的行数算,一张 500 行的表接口费在 $0.0113 到 $0.0462 之间,差别几乎全由「搜索结果占几行」决定。
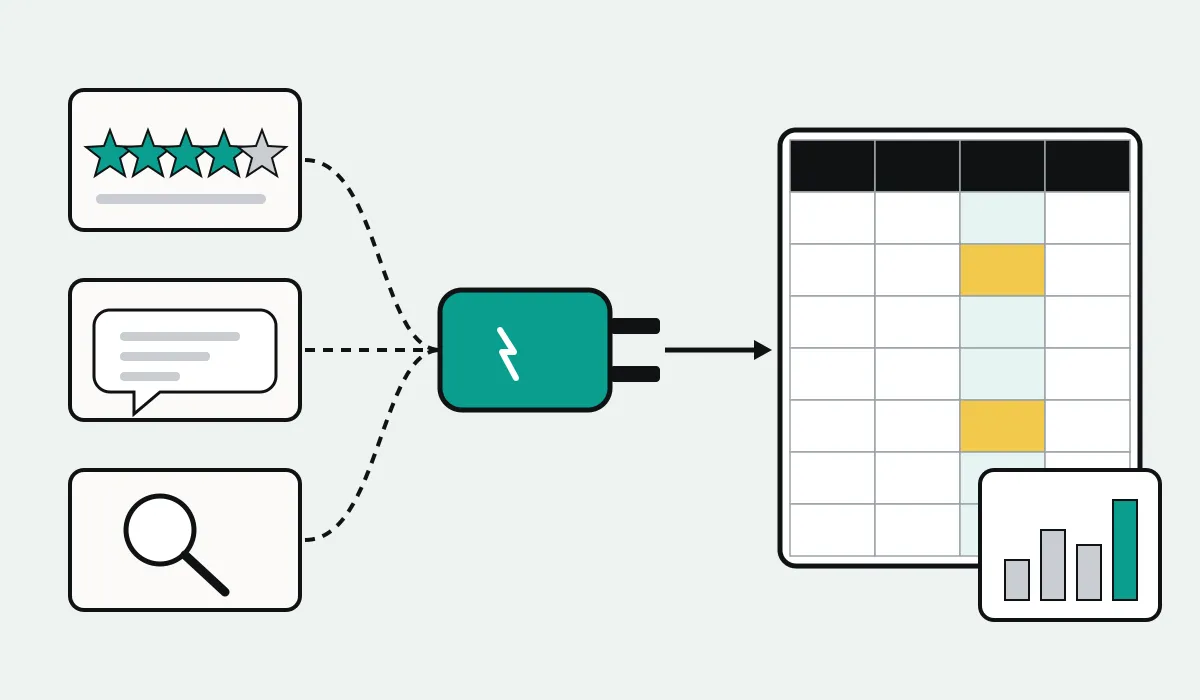
例子选的是运动服品牌 Gymshark:它在 Trustpilot 上评价多、在 Reddit 有自己的讨论社区、网页搜索里也有大量测评,三类数据都能取到,正好拿来拼一张「口碑周表」。取数一侧的数字都来自这 5 次真调;Claude 一侧(加连接器、建表、提示词、公式)按 Anthropic 的帮助页和公开视频写成配置示例,我们没有在 Claude Sheets 里实测,读到这些步骤时请按配置示例看待。
Claude Sheets 是什么:2026 年 11 月 10 日的测试版
Claude Sheets 是做在 Claude 里的电子表格。按 Anthropic 发布文的说法,Claude 能从一句提示生成带多个标签页、公式、格式和下拉框的表,比如活动跟踪表或招聘预算;它在单元格里改动,每次改动都会框出来,方便你看它改了什么;表格可以分享给团队,你、同事和 Claude 在同一批单元格里一起改(Anthropic 发布文,2026-11-10)。同一天上线的还有 Claude Whiteboards,Claude Dashboards 改名为 Claude Data 并结束测试(Claude 官方 X 帖,2026-11-10)。TechCrunch 当天的报道把这几样放在 Anthropic 旧金山发布会的同一批工作产品里(TechCrunch 2026-11-10)。
套餐和开关写在帮助页里:Claude Sheets 在 Pro、Max、Ultra、Team、Enterprise 套餐以测试版提供,Team 默认开启,Enterprise 默认关闭,要 Owner 在 Organization settings > Artifacts 的 Templates 里打开(Claude Sheets 帮助页)。价格页上 Pro 是按年付每月 $17、按月付 $20,Sheets 和 Whiteboards 列在 Pro 的权益里,Free 套餐没有(Claude 价格页,2026-11-18 读)。表格的用量算进套餐的使用上限,和平时对话共用一份额度(用量上限说明)。
帮助页列出的能力和限制,和我们要做的事直接相关的有这几条。
| 项目 | 帮助页原文要点(2026-11-18 读) | 对「把公开数据拉进表」的影响 |
|---|---|---|
| 表格能力 | 多标签页、跨标签页公式、条件格式、下拉框、复选框、图表 | 分类列、均值、计数、出图都能在表里做 |
| 容量 | 一张表至少能放 200,000 个已填单元格 | 500 行 × 15 列 = 7,500 格,远在范围内 |
| 图表 | 柱状、折线、饼图,另有 Claude 能生成的其他类型 | 星级分布、主题占比、周趋势都能画 |
| 暂不支持 | 数据透视表、受保护区域、共享筛选视图、多选下拉、导出 PDF | 透视要靠公式或 Claude 另建汇总页 |
| 实时数据 | 表格不能从已连接的应用拉实时数据;文档、演示、仪表板也不能把表格当数据源 | 数据要先在对话里取到,再写进表 |
| 平台 | 网页和桌面端支持,手机端功能有限 | 建表和改表在电脑上做 |
| 数据控制 | 测试版暂不支持 HIPAA 和 ZDR | 敏感数据不要放进来 |
容量这一条在一周里改过一次。2026 年 11 月 11 日有第三方指南逐行读了帮助页,记下的是「单表最多 100,000 个单元格」(Fynl 指南);我们 11 月 18 日读到的版本写的是「至少 200,000 个已填单元格」,页面的修改时间是 2026-11-16 23:07 UTC。测试版的数字还在变,规划大表时以当天的帮助页为准。作为参照,Google Sheets 单个文件上限是 2,000 万个单元格(Google Drive 文件上限),Excel 单个工作表是 1,048,576 行 × 16,384 列(Excel 规格与限制)。Claude Sheets 定位在轻量的共享表,帮助页自己也建议文件已经在 Excel 或 Google Sheets 里、或者要用完整功能时,改用 Claude for Excel 或 Claude for Google Workspace。
Claude Sheets 能不能直接调 MCP 连接器
不能。帮助页「Current limitations」一节原句是「Sheets can’t pull live data from connected apps, and docs, decks, and dashboards can’t use a sheet as a data source」(Claude Sheets 帮助页)。这句话限定的是表格本身:它不像 Claude Data 那样绑定一个连接器并按周期刷新。Claude Data 需要一个数据连接器(数仓或 CRM),图表会显示数据最后刷新的时间(Claude Data 帮助页,Anthropic 10 月 8 日发布文);Whiteboards 的帮助页也写了 Claude 只按白板上的内容工作,不用已连接应用的上下文(Claude Whiteboards 帮助页)。
连接器本身在对话里照常可用。帮助中心对连接器的定义是让 Claude 访问你的应用和服务、取回数据、在里面执行操作,自定义连接器连的就是一个远程 MCP 服务器,可以在对话的「+」菜单里逐个开关(连接器帮助页)。帮助页还说,连上一个应用之后,Claude 会在合适的时候自己把它用进对话(Claude 如何建议已连接的应用)。把这两条放在一起,路径就清楚了:取数这一步发生在对话里,写表这一步发生在 Sheets 里,中间由同一段对话的上下文接起来。
路径一靠 Claude 记得对话里的数据,路径二靠一个文件做中转。两条路的终点一样,差别在可追溯性:路径一里每一行都还留在对话的工具返回里,你可以让 Claude 回头核对某一行;路径二的文件是一份快照,导入以后表和对话之间就只剩文件名这一条线索。ZDNET 的作者 11 月 16 日的测试里,在一个新会话里贴上已有表格的链接,让 Claude 加一个新标签页,Claude 接着在原表上改了(ZDNET 测评)。这说明表格可以跨会话续写:今天的新数据在今天的对话里取,再追加到上周那张表里。
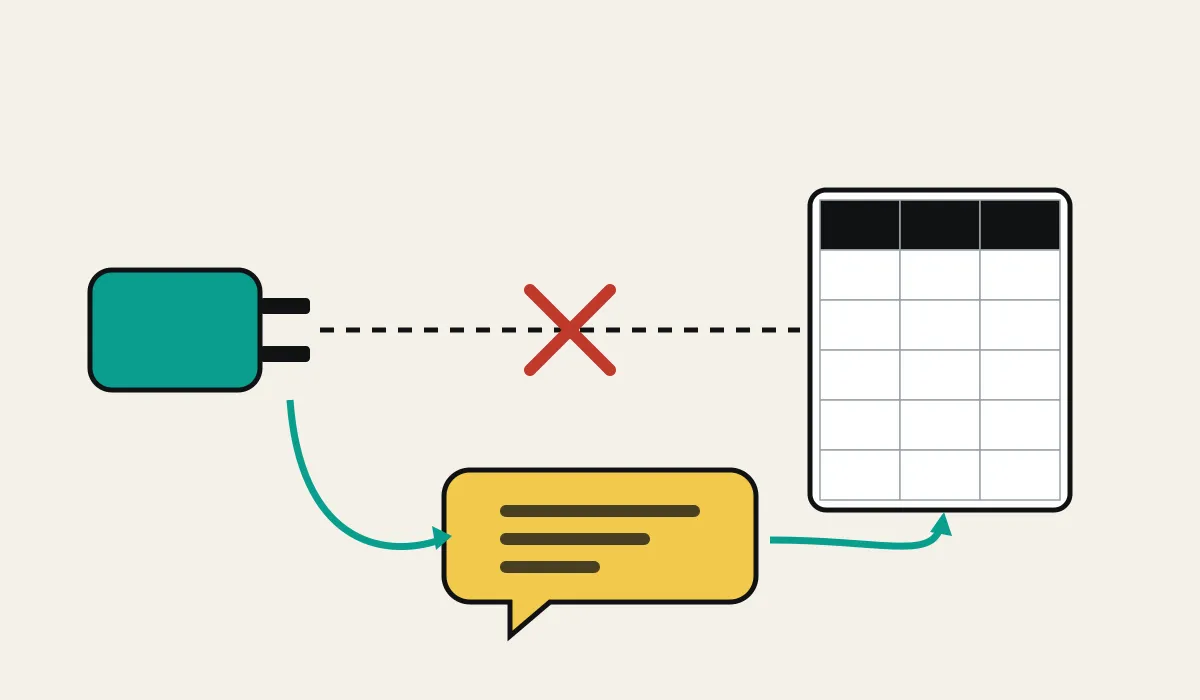
为什么 Anthropic 要这样分?帮助页没有解释,下面是我们的推断,不是官方说法:表格是多人同时编辑的文件,如果它能自己调连接器,每个打开表格的人都会用某个人的连接器权限去取数,权限边界会变得模糊。Claude Data 的「实时分享」就专门处理了这个问题:查看者只看到你批准过的查询结果,不能用你的权限跑别的查询(Anthropic 发布文)。Sheets 目前没有这一层,所以数据进表只能经过某个人在对话里的一次显式调用。
把 EveryInfra 加成 claude sheets connector:两种接法
要在对话里取到公开数据,EveryInfra 的远程 MCP 有两个入口。https://api.everyinfra.com/mcp 认请求头里的 API Key;https://api.everyinfra.com/mcp/all 走 OAuth,每个人用自己的 EveryInfra 账号登录(MCP 服务器说明)。我们在 2026-11-18 00:19(新加坡时间)读了 /mcp/all 的受保护资源元数据,授权服务器是 https://auth.everyinfra.com/oidc,权限范围包括 data:call 和 search:call(受保护资源元数据);同一时刻不带凭据请求 /mcp/all 返回 401,WWW-Authenticate 头里带着这份元数据的地址。这是 MCP 授权规范规定的发现方式(MCP 授权规范),元数据格式由 RFC 9728 定义(RFC 9728)。
在 Claude 里加自定义连接器的步骤,Anthropic 文档写得很细(添加未上架连接器)。Pro、Max、Ultra 个人套餐在 Customize > Connectors 里点「+ Add」再选「Add custom connector」,填名称和服务器地址;Team 和 Enterprise 由 Owner 在组织设置里加,加完后每个成员自己点一次 Connect(自定义连接器帮助页,2026-11-13 更新)。Free 套餐只能加一个自定义连接器。连接由 Anthropic 的云端发起,服务器要能从公网经 443 端口访问(Anthropic IP 地址),EveryInfra 的两个入口都满足。
配置示例(Customize > Connectors > + Add > Add custom connector)

接法 A:OAuth,每人用自己的账号
  Name:            EveryInfra
  MCP server URL:  https://api.everyinfra.com/mcp/all
  Authentication:  Sign in when needed
  OAuth client:    Use Claude's published identity(服务器不支持时改 Register automatically)

接法 B:请求头里放 API Key,全组织共用一个钱包
  Name:            EveryInfra
  MCP server URL:  https://api.everyinfra.com/mcp
  Authentication:  No sign-in
  Request headers: Authorization = Bearer <你的 EveryInfra API Key>
接法 B 有一个前提容易漏:请求头凭据这种认证方式还在测试阶段,只开放给一部分组织,没有开放的组织在添加对话框里根本看不到 Request headers 这一栏(连接器认证文档)。看不到就用接法 A。填请求头时,Claude 会把值原样发出去,不会替你加「Bearer 」前缀,要连空格一起填;认证方式加完不能改,换方式只能删掉连接器重加(添加未上架连接器)。
| 比较项 | 接法 A:`/mcp/all` + OAuth | 接法 B:`/mcp` + 请求头 Key |
|---|---|---|
| 谁付钱 | 谁调用,扣谁自己的 EveryInfra 钱包 | 全组织共用一个 Key 对应的钱包 |
| Claude 里的认证选项 | Sign in when needed | No sign-in + Request headers |
| 开放范围 | 所有能加自定义连接器的套餐 | 请求头认证仍在测试,部分组织可见 |
| 适合 | 多人各自拉数、各自出表 | 一个运营账号统一拉数,再把表分享出去 |
| 换方式 | 删掉连接器重加 | 删掉连接器重加 |
如果你用的是 Free 套餐,情况有点特别:帮助页允许 Free 套餐加一个自定义连接器,所以对话里取数这一步可以做,但 Free 套餐没有 Claude Sheets,取到的数据只能走路径二,让 Claude 生成 CSV 或 xlsx 文件后在 Excel 或 Google Sheets 里打开;文件生成功能在哪些套餐可用、要不要先在设置里打开,以创建文件的帮助页为准。Team 套餐由 Owner 加好连接器后,每个成员仍要自己点一次 Connect;用接法 A 时,每个人登录的是自己的 EveryInfra 账号,扣费也各算各的。
两种接法连上以后,tools/list 里能看到同样的 12 个工具,我们 00:16 对 /mcp 发 initialize 返回的协议版本是 2025-06-18。取数用的是三个:everyinfra_list_capabilities 查目录,everyinfra_call_api 调一项能力,everyinfra_get_job 取异步任务结果。MCP 规范里,工具通过 tools/list 公开,客户端用 tools/call 调用,结果放在 content 数组里返回(MCP 工具规范);传输走 Streamable HTTP(MCP 传输规范)。
一次真实往返:Claude 发出的 tools/call 和返回的 200 条评价
Claude 在对话里调连接器时,发给服务器的是一个 JSON-RPC 请求。我们在 2026-11-18 00:17:08(新加坡时间)用同样的格式对 https://api.everyinfra.com/mcp 发了一次,请求 Gymshark 在 Trustpilot 上最近三个月的评价,按时间倒序取 200 条。下面是请求和返回的节选,返回体里的 JSON 字符串已经解开,评价作者名删去。
{"jsonrpc":"2.0","id":3,"method":"tools/call",
 "params":{"name":"everyinfra_call_api",
  "arguments":{"platform":"trustpilot","action":"reviews",
   "params":{"company":"gymshark.com","limit":200,"date":"last3months","sort":"recency"}}}}

// result.content[0].text 解开后的节选
{"id":"req_3cd99d6652cc4b7d","platform":"trustpilot","action":"reviews","count":200,
 "results":[{"title":"Gymshark order HELL!","rating":1,"country":"GB",
             "posted_at":"2026-11-17T12:03:33+00:00","is_verified":false,
             "experience_at":"2026-11-10T00:00:00+00:00", "...": "..."}],
 "billing":{"charged":true,"charged_usd":0.001389}}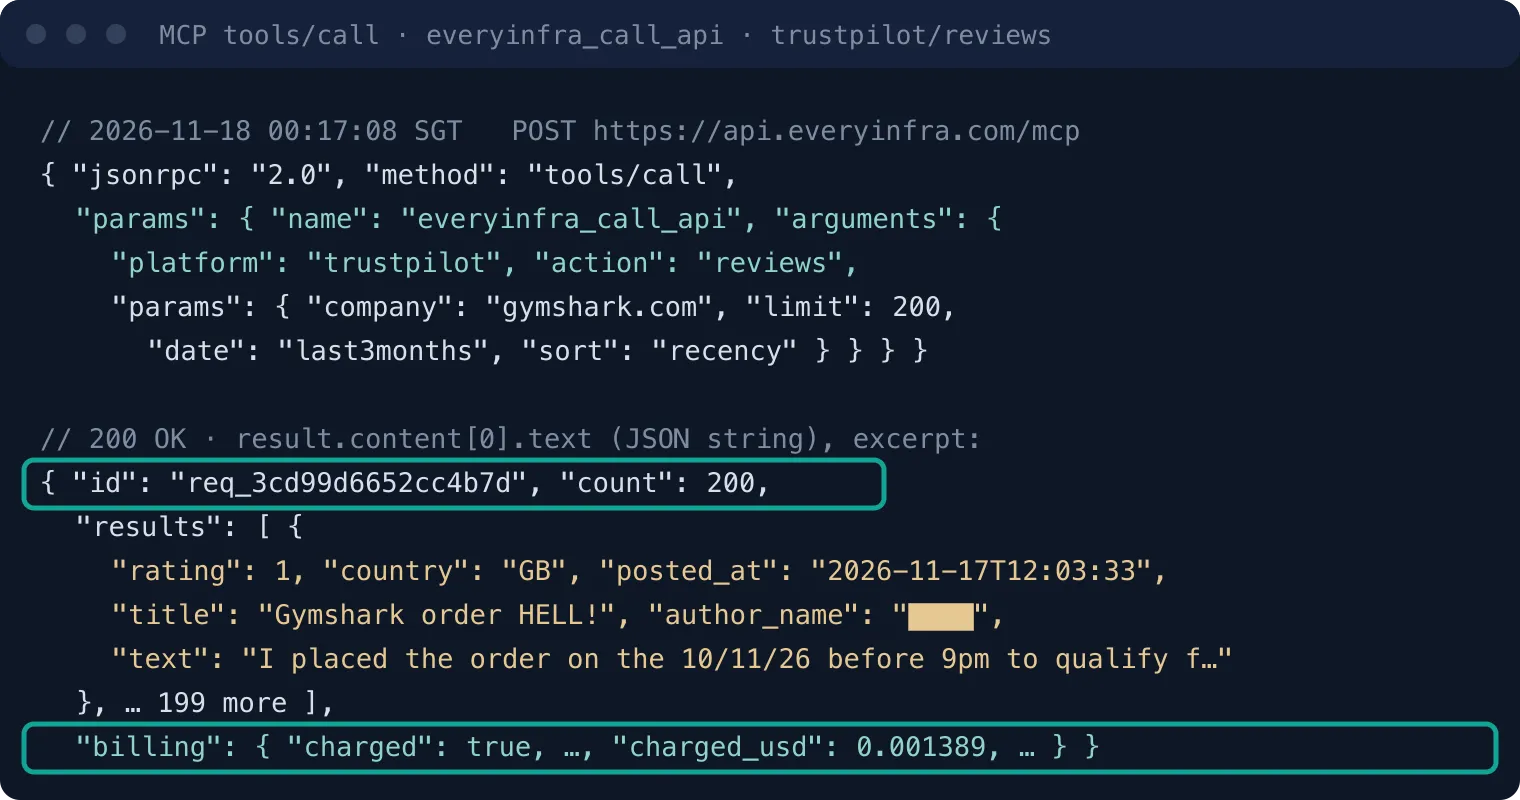
200 条评价只扣一次 $0.001389,和目录里 trustpilot/reviews 的 price_usd 一致(EveryInfra 能力目录),按次计费,不按条。这次同步调用从发出到拿到 200 条用了 86 秒。trustpilot/reviews 的目录说明里没有写等待上限,目录里只有少数能力(比如淘宝商品详情)写明同步调用最长约 85 秒;这次响应里带的 async_hint 字段则提示,慢任务和大 limit 可以在请求里加 "mode":"async",立即拿到 job_id 再轮询。放在 Claude 的对话里,一个工具调用卡一分半,体验并不好;对话里取大批评价时,让 Claude 用异步模式提交、再用 everyinfra_get_job 取结果更稳。
我们 00:28:28(新加坡时间)照这个做法又发了一次:reddit/search 按最新排序、mode 设为 async。提交 1.9 秒就返回了 status: running 和 job_id,之后每隔几秒调一次 everyinfra_get_job,00:29:01 状态是 finalizing,00:29:09 变成 succeeded,拿回 23 行。everyinfra_get_job 本身不收费,也不算进每分钟的调用次数。整个过程里没有一次工具调用超过 2 秒,Claude 可以在等待期间先把表头建好。
5 次真调的明细如下,时间都是 2026-11-18 新加坡时间。
| # | 时间 | 入口 | 能力 | 参数要点 | 返回行数 | charged_usd |
|---|---|---|---|---|---|---|
| 1 | 00:17:08 | MCP 同步 | trustpilot/reviews | gymshark.com,limit 200,最近 3 个月,按时间 | 200 | $0.001389 |
| 2 | 00:18:53 | REST | reddit/search | gymshark,limit 25,按相关性 | 25 | $0.000792 |
| 3 | 00:19:25 | REST | web/search | gymshark reviews 2026,us,en | 10 | $0.001389 |
| — | 00:19:52 | REST | trustpilot/reviews | 星级筛选写成数字数组 | 0(429 限速) | $0 |
| 4 | 00:20:17 | REST | trustpilot/reviews | 只取 1–2 星,limit 200 | 200 | $0.001389 |
| 5 | 00:28:28 | MCP 异步 | reddit/search | gymshark,limit 25,按最新 | 23 | $0.000792 |
| 458 | $0.005751 |
00:19:52 那一次碰到每分钟 10 次的限速,返回 429,响应里写明没有扣费,并给了 8 秒后重试的建议;我们等了 25 秒重发成功。那次请求还把星级写成了数字数组,目录对 stars 参数的说明是字符串数组,例如 ["1","2"],重发时改了过来。
实测一:200 条最新评价,均分 4.36
第一次调用拿回的 200 条评价,发布时间从 2026-11-03 21:47 UTC 到 11-17 12:03 UTC,正好两周。星级分布很偏:5 星 158 条,4 星 9 条,3 星 4 条,2 星 5 条,1 星 24 条;均分 4.36,中位数 5,1–2 星合计 29 条,占 14.5%。Claude 在表里用 AVERAGE 和 COUNTIF 就能算出这些数,算之前要知道这 200 条只覆盖两周。
按国家拆开看。返回里 country 字段是评价者所在国家,200 条里英国 77 条、美国 40 条、荷兰 12 条、加拿大 11 条。英国 77 条的均分是 4.06,美国 4.38,荷兰 12 条全是 5 星,加拿大 4.45。英国的低分更多,和第一条评价写的「下单后一周没送到」能对上,下面的差评主题里配送也排在前面。样本只有两周,荷兰、加拿大十几条的均分波动会很大,表里最好同时放上条数,别只放均分。
| 国家 | 条数 | 均分 | 说明 |
|---|---|---|---|
| 英国 GB | 77 | 4.06 | 两周里差评最集中 |
| 美国 US | 40 | 4.38 | 接近总均分 |
| 荷兰 NL | 12 | 5.00 | 条数少,均分不稳 |
| 加拿大 CA | 11 | 4.45 | 条数少,均分不稳 |
| 全部 | 200 | 4.36 | 2026-11-03 至 11-17 |
还有两列在表里值得保留。is_verified 为真的只有 41 条,占 20.5%,但这不等于其余 159 条是顾客自发写的:同一批返回里还有一个 verification_level 字段,41 条已验证的全部是 invited,未验证的 159 条里也有 148 条是 invited,标为 not-verified、没有经过商家邀请的只有 11 条,占 5.5%。也就是说,这两周的 200 条评价里有 189 条(94.5%)来自商家发出的邀请,表里如果只放 is_verified,会把「被邀请但没走验证流程」的评价误当成自发评价;两列都保留,按 verification_level 分组算均分,邀请带来的偏差一眼就能看出来:148 条「邀请但未验证」的均分 4.59,41 条「邀请且已验证」的均分 3.95,11 条未经邀请的均分只有 2.82,其中 6 条是 1–2 星。第四次调用只取 1–2 星时,这个比例反过来了:200 条差评里有 79 条(39.5%)是 not-verified,远高于全量样本里的 5.5%。差评更多来自没被邀请、自己找上门来写的顾客,所以按邀请状态分组算出来的均分差距,比把所有评价混在一起算一个总均分更能说明口碑的真实走向。Trustpilot 对这类标签有自己的规则,商家可以在它的商业接口里邀请顾客评价、回复评价(Trustpilot 开发者文档)。评价长度和星级明显相关:1 星评价正文中位 258 个字符,5 星只有 77.5 个,差评写得长,分类时信息也多,所以 Claude 在表里给差评打主题标签比给好评打更可靠。
Trustpilot 的返回里还有一个容易被忽略的字段 experience_at,表示消费发生的日期,和发布时间 posted_at 是两回事。这 200 条里,从消费日到写评价的间隔中位数是 0.84 天,131 条在一天之内写完;超过 7 天才写的有 13 条,最长的隔了约 98 天。1–2 星评价的间隔中位数是 1.44 天,5 星是 0.83 天,差评往往是等了几天、问题没解决才写的。如果你的表要按「哪一周的订单出了问题」来汇总,用 experience_at 分组比用 posted_at 更贴近实际;要看「哪一周口碑变差」,用发布时间。两列都放进表里,汇总页注明用的是哪一列。
实测二:差评主题和回复率,被取数窗口带偏的数
第四次调用只取 1–2 星,200 条覆盖 2026-09-22 到 11-17,共 56 天:1 星 182 条、2 星 18 条,英国 109 条,美国 24 条。这一批里我们用关键词规则做了多标签归类(一条可以同时落进几类),规则写在复算脚本里:提到客服、联系不上、回复模板的算「客服」,提到送达、快递、物流跟踪的算「配送」,以此类推。这是我们写的规则,Claude 在表里做同样的分类会用它自己的判断,结果会有出入,但量级可以拿来对照。
客服出现在 128 条里,占 64%;配送和退款/退货各 92 条,占 46%;质量 90 条,45%;下单/付款 50 条,25%;尺码 36 条,18%;没有命中任何一类的 8 条。客服排第一,读几条原文就能理解:差评很少只抱怨一件事,通常是「没送到」加上「联系客服只得到模板回复」,配送问题会顺带引出客服问题。这也说明做成表时,主题列要允许一格多值(比如用逗号分隔),或者每个主题单独一列 0/1,单选下拉框会丢信息;Claude Sheets 目前不支持多选下拉框(Claude Sheets 帮助页),用 0/1 列更稳。
接下来是一个在表里很容易算错的数:商家回复率。第一次调用的 200 条里,1 星 24 条只有 12 条有回复,看上去只有一半;第四次调用的 200 条差评里却有 181 条有回复,占 90.5%。两个数都没错,差别来自评价的新旧。
以第一次调用窗口的起点 11 月 3 日 21:47 UTC 为界,之后发布的 30 条差评只有 14 条有回复(47%),之前的 170 条有 167 条有回复(98%)。181 条已回复的差评里,回复和发布的间隔中位数是 90.7 小时,约 3.8 天;24 小时内回复的 24 条,72 小时内的 53 条,最慢的一条隔了 36 天。切点挪几个小时,比例就跟着变:改按新加坡时间 11 月 3 日零点(即 UTC 11 月 2 日 16:00)切,之后是 35 条、19 条有回复,占 54%;按 UTC 11 月 10 日零点切,之后 19 条里 13 条有回复,占 68%。同一批 200 条数据,换一个切点就能算出 47%、54%、68% 三个回复率,表里写回复率时一定要同时写明切点和时区。所以最近一周的差评看起来「没人管」,多半只是还没轮到。Claude 在表里算回复率时,如果直接用 COUNTIF(回复列,"<>")/COUNTA(…),结果会随你取数的日期剧烈变化;更稳的写法是只统计发布满 7 天的评价,或者按发布周分组看。
按周看差评条数,W40 最多(39 条),之后回落到二十几条,W45 只有 13 条,W46 又回到 20 条。这条线有两个截断要标在图上:W39 只从 9 月 22 日算起,因为 200 条的上限在那里截住了;W47 只有 11 月 16、17 两天。把周趋势放进表时,第一周和最后一周要单独标出来,否则读的人会以为差评在 W47 断崖式下降。
实测三:Reddit 帖子和搜索结果,进表前要先洗
第二次调用按相关性搜「gymshark」,返回 25 条帖子,发布时间从 2026-10-22 到 11-17。reddit/search 的时间范围固定为最近一个月,排序不改变这一范围,目录在参数说明里写明了这一点(EveryInfra 能力目录)。25 条里 19 条来自 r/Gymshark,标题带「Black Friday」「BF」或「sale」的 11 条,评论数合计 511;点赞最多的一条是 r/unitedkingdom 里一则关于商标纠纷的新闻帖(400 赞、93 条评论)。点赞中位数只有 7,热度集中在少数几条上。
第五次调用换成按最新排序,23 条结果分散在 16 个社区,只有 6 条来自 r/Gymshark,和相关性排序的结果只重合 2 条;其中 3 条是礼品卡交易帖,标题里的「[H]」「[W]」是交易社区的买卖记号,品牌名只是出现在商品清单里。这类行直接进表会拉低情绪均值、污染主题统计。让 Claude 写表之前先按社区和关键词过滤一遍,或者在表里加一列「相关」由 Claude 标注,再只对相关行做统计。
第三次调用的 10 条网页搜索结果,域名包括 Trustpilot、Reddit、女性健康杂志的测评、TikTok、YouTube 视频、品牌官网和 Instagram。日期字段 published_at 的写法不统一:4 条为空,4 条是「11 months ago」这样的相对时间,2 条是「Jun 12, 2026」这样的绝对日期。进表时要么让 Claude 统一换成日期(相对时间按取数当天换算,并在表头注明),要么留空,不能把三种写法混在一列里排序。
这 10 条结果本身也可以分成两类看:Trustpilot 和 Reddit 两条指向我们已经直接取过的平台,进表时可以去掉,免得同一个来源算两遍;女性健康杂志、thingtesting、theadultman 这几条是第三方测评,正文需要另外打开阅读;TikTok、YouTube 和 Instagram 几条指向视频和社媒帖子,适合在表里标出来,之后用对应平台的能力单独取评论,比如 YouTube 评论每次 $0.000556。
| 来源能力 | 进表的列(来自目录 `response_fields`) | 进表前要处理的事 |
|---|---|---|
trustpilot/reviews | id、rating、title、text、country、posted_at、is_verified、reply_text、reply_at | 按 id 去重;作者名不进表;回复率按发布满 7 天统计 |
reddit/search | id、community、title、like_count、comment_count、posted_at、url | 过滤交易帖等无关行;个人账号名的社区隐去 |
web/search | rank、title、url、text、published_at | 日期写法统一;同一域名多条时只留排名最高的 |
去重这一步有实测数据支撑:第一次和第四次调用都取了 Gymshark 的 Trustpilot 评价,前者里的 29 条 1–2 星评价全部也出现在后者里,两次合起来 400 行,去重后是 371 条不同的评价。表里不按 id 去重,差评会被重复计数,低星占比会被高估。
取数参数怎么选:让每一行都落在你要的范围里
表里的每一行都受取数参数影响,参数写错了,后面的均值和占比再准也没意义。下面三项能力的参数都来自 EveryInfra 能力目录的说明(EveryInfra 能力目录),我们把对表格结果影响最大的几项挑出来。
trustpilot/reviews 的 company 填公司官网域名,例如 gymshark.com,不填中文名。date 只接受 last7days、last30days、last3months、last6months、last12months 五个值,分别往前推 7、30、92、183、366 天,不接受具体日期,传别的值会回 422。stars 是字符串数组,["1","2"] 表示只取一、二星,它不是「最低星级」的意思。语言这一项容易忽略:不传 lang 或 language 时返回的是 Trustpilot 默认的英语评价。所以我们表里荷兰的 12 条、加拿大的 11 条,都是这些国家的用户用英语写的评价;要看德语或法语评价,得另取一次,比如 lang 传 ["de","fr"],并在表里加一列语言,汇总时分开算。
reddit/search 只有 keyword 和 sort 两个参数。时间范围固定为最近一个月,sort 可以选 relevance、newest、popular、rising、top、controversial,排序只改变顺序,不改变时间范围。它只返回关键词对得上的帖子,所以条数可能少于 limit:我们按最新排序要 25 条,回来 23 条。一条都没有时按空结果退款。
web/search 的 country 和 language 是结果偏好,影响搜索结果的地域和语言,不会把正文翻译成你要的语言,也不保证每条结果都来自这个国家。每次最多 10 条,要更多结果就翻页,每页算一次调用。返回的 published_at 由搜索引擎提取,目录也注明了它可能缺失或不准,这和我们看到的 4 条为空、4 条为相对时间相符。
在表里让 Claude 分类、算均值、出图(配置示例)
下面这组提示词按 Claude Sheets 帮助页给的用法写成:在对话里让 Claude 建表,在表里选中区域后问它问题,或者直接让它加列、加标签页(Claude Sheets 帮助页)。我们没有在 Claude 里实测这组提示词,只列出它们依赖的表格能力。
对话里(EveryInfra 连接器已打开):
1. 用 everyinfra_call_api 取 trustpilot/reviews,company=gymshark.com,limit=200,
   date=last3months,mode=async;再取一次只要 1–2 星的(stars=["1","2"])。
   用 everyinfra_get_job 等两个任务完成。
2. 用 reddit/search 取 gymshark,limit=25;用 web/search 取 "gymshark reviews 2026"。
3. 新建一个 Claude Sheet,三个标签页:Reviews / Reddit / Search。
   Reviews 按 id 去重,不要作者名;Reddit 去掉交易帖;Search 的日期统一成 YYYY-MM-DD,
   相对时间按 2026-11-18 换算,在表头注明。

表里(选中 Reviews 标签页):
4. 加 6 列主题(客服、配送、退款/退货、质量、下单/付款、尺码),每列填 0 或 1,一条可以多个 1。
5. 新建 Summary 标签页:按国家算条数和均分;按发布周算 1–2 星条数;
   回复率只统计发布满 7 天的评价。
6. 画三张图:星级分布柱状图、主题占比条形图、每周差评折线图。
表里的公式可以留给 Claude 写,帮助页说公式会留在单元格里,可以点开检查每个数是怎么算的。均分是 AVERAGE(Reviews!C:C),国家均分可以用 AVERAGEIF,主题占比是每一列 SUM 除以差评条数,回复率是 COUNTIFS 加一个发布日期早于取数日 7 天的条件。Sheets 暂不支持数据透视表,按国家、按周的汇总都要用这类条件公式写,或者让 Claude 直接生成汇总页。
公开视频里有一个可以借用的细节。一位作者在视频里从 Excel 导入一份有 120 个公式的文件,公式全部保留,但图表、下拉框和条件格式在导入时丢了,导出回 Excel 时界面会提示有三处不同(Mervin Praison 实测视频,2026-11-12)。另一位作者演示了「Import from Google Sheets」:已经连好 Google Sheets 连接器时,导入窗口直接列出账号里的表(Brock Mesarich 视频,2026-11-10)。这两点帮助页都没写,都是视频里看到的现象,测试版随时可能变。
一张口碑周表的列怎么排
表的结构决定了 Claude 后面算得准不准。我们建议把「原始行」和「算出来的列」分开放:Reviews、Reddit、Search 三个标签页只放接口返回的字段,一行对应一条返回记录,Claude 不在这些列里改值;主题标签、相关性标注、统一后的日期放在原始列的右边,表头加一个前缀(比如「派生·」),一眼能看出哪些是 Claude 写的;所有汇总放在 Summary 标签页,公式只引用前面几页。这样一来,你让 Claude 重打标签时,原始数据不会被动到;某个均值看着不对,也能沿着公式找回具体的行。
Reviews 页的列顺序可以按「定位 → 打分 → 内容 → 回复」排:id、posted_at、country、rating、is_verified、verification_level、title、text、reply_at、reply_text,再接 6 列主题 0/1 和一列「发布满 7 天」。verification_level 紧挨着 is_verified 放,汇总页按它分成三组,各算条数和均分;前面那 200 条最新评价分成三组后,均分分别是 4.59、3.95 和 2.82,放在一起比一个总均分 4.36 更能看出差别。posted_at 返回的是带时区的 UTC 时间,按新加坡时间看要加 8 小时,跨午夜的评价会落到下一天;按周汇总时用哪个时区要在表头写明,不然两个人算出来的周数据会差几条。正文列会很长:200 条差评的正文平均 474 个字符,合计约 9.5 万字符,全部放进单元格没有问题,但选中整列让 Claude 一次分析时,它要读的内容也是这么多,分批选 50 行一组会更稳。
Reddit 页要保留 community 和 url 两列:我们这次相关性排序的 25 条里,有 1 条来自以个人名字命名的社区,进表时社区名要隐去;最新排序的 23 条里有 3 条礼品卡交易帖,留着 url 才能在被 Claude 标为「无关」后人工点开核一遍。Search 页按 rank 排序,同一个域名出现两次时(这次 YouTube 出现了 2 次)保留排名靠前的一条即可,另一条留在原始页、不进汇总。
主题标签怎么核:Claude 的分类和关键词规则对一对
主题分类靠 Claude 判断,需要一个外部参照:我们的关键词规则在 200 条差评里有 8 条一个主题都没命中。逐条读原文,这 8 条都很短(标题加正文 45 到 155 个字符):两条写的是「还没收到订单」,按意思属于配送,但规则里没有 received 这个词;三条抱怨没人理会、得不到答复,属于客服,规则只认 customer service、support 这类词,漏掉了 answer;一条写「服务和顾客体验很差」,因为 service 前面隔着词,也没命中;一条说商家质疑他的诚信;只有一条通篇只有 horrible 加一串感叹号,确实说不出原因。也就是说,规则的漏判主要来自措辞,Claude 按语义读,这几条大多能归进去,表里要能看出它把每一条归到了哪里。
一个简单的核对办法是在 Reviews 页并排放两组主题列:一组由 Claude 按语义填,一组由公式按关键词填(REGEXMATCH 或 SEARCH 都行),再加一列计算两组是否一致。一致率低于八成的主题,挑 20 条不一致的行人工读,看是 Claude 理解得更对,还是关键词更准。我们的规则里「客服」命中最多(128 条),也最可能被高估:200 条差评里有 5 条提到 emailed,规则会把它们都算进客服,可「发过邮件」只说明联系过,不一定在抱怨客服本身。这种边界情况正好适合让 Claude 来判断,规则只负责给出一个可复现的下限。核完以后,把最终采用的标签和判定说明写进表头的批注里。帮助页提到表格支持评论,团队成员可以在单元格上留言,Claude 会看到这些评论(Claude Sheets 帮助页);下周换一个人接手时,他读批注就知道「客服」这一列是怎么判的,不用重新约定标准。
每周续写:同一张表追加新数据
ZDNET 的测试里,作者在新会话里贴上已有表格的链接,Claude 在原表上加了新标签页(ZDNET 测评)。按这个做法,每周一在新对话里打开 EveryInfra 连接器,取过去 7 天的数据,再贴上表格链接,让 Claude 把新行追加到 Reviews 页末尾、按 id 跳过已有的行,最后刷新 Summary。
追加时有两处重复要防。Trustpilot 这边,按时间倒序取 200 条通常会和上周的结果重叠:我们两次调用之间就重合了 29 条,相当于第二次返回的 14.5%。Reddit 这边更明显:reddit/search 的时间范围固定是最近一个月,每周取一次,相邻两周的结果大约有三周是重叠的,按相关性排序时重复会更多;我们这次相关性排序和最新排序两组结果只重合 2 条,说明按最新排序取增量更合适。去重写在 Claude 的指令里,同时在表里放一个 COUNTIF(id 列, id)>1 的检查列,出现大于 1 的值就说明有重复漏进来了。
如果只追加评价和 Reddit,不再每周重新搜网页,续写的费用还会再低一截,因为搜索行在 A 配比里占了 61.4% 的费用。网页搜索结果变化慢,每月更新一次通常就够。
算账:一张 500 行表的接口费
按次计费意味着每一行的成本取决于这个能力每次给多少行。我们 5 次真调里,trustpilot/reviews 一次给 200 行、扣 $0.001389;reddit/search 一次最多 25 行、扣 $0.000792;web/search 一次 10 行、扣 $0.001389。折成每 1,000 行,评价约 $0.0069,Reddit 约 $0.0317,网页搜索约 $0.1389,搜索行比评价行贵 20 倍。
所以「一张 500 行的表多少钱」没有单一答案,要看三类数据各占多少行。我们按目录价算了三种配比,调用次数都按每次返回上限向上取整。
| 配比 | 评价行 | Reddit 行 | 搜索行 | 调用次数 | 接口费 | 搜索占费用 |
|---|---|---|---|---|---|---|
| A 评价为主 | 400 | 50 | 50 | 9 | $0.011307 | 61.4% |
| B 三类均衡 | 200 | 150 | 150 | 22 | $0.026976 | 77.2% |
| C 搜索为主 | 100 | 100 | 300 | 35 | $0.046227 | 90.1% |
三种配比里,搜索结果都是费用的大头,在 C 配比里占到九成。如果你的表主要是给口碑做定量统计,评价行越多越划算;搜索结果的价值在于找到别处的测评和讨论入口,10 到 30 行通常就够,没必要拉满。每周更新一次,A 配比一年 52 次合计约 $0.59,B 约 $1.40,C 约 $2.40;每天更新一次,一个月分别约 $0.34、$0.81、$1.39。这是我们这一侧的接口费,Claude 一侧的费用是套餐月费,Sheets 和对话共用使用上限,不单独计费(用量上限说明)。
还有两项不花钱的事会影响成本。第一,失败和空结果不扣费:00:19:52 那次 429 返回里写明没有扣费,reddit/search 的参数说明也写了一条结果都没有时按空结果退款。第二,everyinfra_list_capabilities 和 everyinfra_get_job 都免费,让 Claude 先查目录确认 max_limit,再决定调几次,比盲目重试省钱。
路径二:在对话里导出 CSV 或 xlsx,再导入 Sheets
如果你更想要一份能留档的原始文件,可以让 Claude 在对话里把取到的行写成 CSV 或 xlsx,再在 Sheets 里用「Import a CSV file」导入。Claude 在对话里能用代码执行生成 Excel、PowerPoint、Word 和 PDF 文件,这个功能要在 Settings > Capabilities 里打开「Code execution and file creation」(创建和编辑文件帮助页)。Sheets 的导入入口有四个:导入 CSV、从 Google Sheets 导入、从 Excel 导入、空白表,也支持从 Excel 或 Google Sheets 直接粘贴;导出有 .xlsx 和 CSV 两种,「Send to」能把表交给 Airtable、Asana、monday.com、Smartsheet 继续做(Claude Sheets 帮助页,Anthropic 发布文)。
CSV 的格式由 RFC 4180 描述:字段里有逗号、引号或换行时要用双引号包起来,引号本身写成两个引号(RFC 4180)。评价正文里换行和引号都很多,第一条 Gymshark 差评就有 28 处换行,生成 CSV 时这一点处理不好,导入后一条评价会被拆成好几行。xlsx 是 ECMA-376 定义的 Office Open XML 格式(ECMA-376),单元格里的换行不会破坏行结构,正文长的数据用 xlsx 中转更安全。
Claude Sheets、Google Sheets 连接器、Claude for Excel 怎么选
Anthropic 现在有三条路,各自适合的数据不一样。
| 方式 | 数据放在哪 | 能不能边取数边写 | 适合 |
|---|---|---|---|
| Claude Sheets | Claude 的 Artifacts 里 | 不能在表里调连接器;在对话里取数再写表 | 轻量共享表,团队都用 Claude |
| Google Sheets 连接器(实时编辑测试版) | 你的 Google Drive | 对话里可以同时开 EveryInfra 和 Google Sheets 两个连接器 | 表已经在 Google Sheets、协作者没有 Claude 账号 |
| Claude in Google Sheets 扩展 | 打开的那一个 Google 表 | 扩展只能看到当前文件 | 在已有表里改公式、做分析 |
| Claude for Excel | Excel 文件 | 在 Excel 里用 Claude | 要透视表、宏、Power Query |
Google Workspace 连接器的帮助页写着,Claude 可以在对话旁边的面板里实时编辑 Google Docs、Sheets、Slides,这是独立于 Google Drive 的连接器,要在对话的「Connectors」里分别打开(Google Workspace 连接器帮助页)。Claude in Google Sheets 扩展则相反,Google 把它限制在打开它的那一个文件里,除非你另外连了 Google Drive 的 MCP(Claude 在 Google 文档中的帮助页)。对「把公开数据拉进表」这件事来说,第二条路最接近「表格直接接数据」:同一段对话里,EveryInfra 连接器取数,Google Sheets 连接器写表,表留在 Google Drive,协作者用 Google 账号就能打开。
The AI Advantage 频道的测评也提到分享这一点:Google Sheets 人人有账号,Claude Sheets 要邀请对方进 Claude 或者公开链接(The AI Advantage 视频,2026-11-13)。ZDNET 的作者站在另一边,认为在 Claude 里原生建表省去了在两个工具之间搬数据的限制,一份数据可以同时喂给表、白板和幻灯片(ZDNET 测评)。选哪条路看你的协作者在哪。
边界和注意事项
第一,审批次数。自定义连接器的每次工具调用默认可能要你点批准。GitHub 上有 Team 套餐用户报告,在 Cowork 里自定义远程 MCP 连接器每次调用都弹确认,「本任务全部允许」是灰的(claude-ai-mcp issue #491)。拉一张 500 行的表,按 A 配比要 9 次调用,按 C 配比要 35 次,点 35 次批准不现实。可以把 everyinfra_list_capabilities、everyinfra_get_job 设为总是允许(免费),把 everyinfra_call_api 留着批准;或者把批量部分移到 Claude API 的 MCP connector 上跑,它能在 Messages API 里直接连远程 MCP 服务器,目前只支持工具调用,要带测试版请求头(MCP connector 文档)。在终端里取数的团队,也可以把 EveryInfra 作为 HTTP 类型的服务器挂到 Claude Code 上,跑完再把文件交给 Sheets 导入(Claude Code MCP 文档)。
第二,测试版的数据控制。帮助页写明 Sheets 暂不支持 HIPAA 和 ZDR;Enterprise 默认关闭 Sheets,要管理员打开,管理员还能用自定义角色限制给特定用户组(Artifacts 管理指南)。公开评价里有个人名字和经历描述,进表时不带作者名,分享前确认对方的访问级别(分享 Artifacts 帮助页)。
第三,能取到什么。amazon/reviews 的目录说明写明,美国站评论要登录才能看,现在取不到,别的站点每个商品通常只有十几条精选评论;所以电商评价我们选了 Trustpilot。reddit/search 固定最近一个月,搜不到更早的帖子。web/search 每次最多 10 条,更多结果要翻页,每页算一次调用。平台自己的数据条款也要看,比如 Reddit 有单独的数据接口条款(Reddit Data API Terms)。
第四,调用频率。我们这次用的测试 Key 每分钟最多 10 次调用,超出就回 429,不扣费,响应里带着建议的重试等待秒数。按 C 配比拉一张 500 行的表要 35 次调用,在这个频率下至少要分 4 分钟发完;让 Claude 在对话里连续发请求时,可以在指令里写明「每分钟不超过 8 次,碰到 429 按返回的秒数等待后重试」。异步模式下 everyinfra_get_job 不算进每分钟的次数,所以批量提交、集中取结果更不容易撞上限制。
第五,Claude 在表里做的分类和统计需要抽查。帮助页说每次改动会被框出来,公式留在单元格里,版本历史可以回到早先的版本(Claude Sheets 帮助页)。我们的建议是每次让 Claude 打完主题标签后,随机抽 20 条人工看一遍,和上面的关键词规则比一比,差得多就让它重打。
行业动向
- 2026-11-10,Claude Sheets、Whiteboards 测试版上线,Dashboards 改名 Claude Data(Anthropic 发布文)。对读者:表格进了 Claude 的 Artifacts,但取数仍在对话里完成。
- 2026-11-10,交互式连接器可以整页打开:Adobe、Atlassian、Box、Notion 等工具能在对话旁边全屏打开,底层是 MCP Apps 扩展(Anthropic 文章,MCP Apps 概览)。对读者:如果一个数据服务做成 MCP App,以后可能直接在对话旁边显示可交互的结果表。
- 2026-11-16,Claude Sheets 帮助页更新:单表容量写成至少 200,000 个已填单元格,11 月 11 日第三方读到的是 100,000(Claude Sheets 帮助页)。对读者:测试版限制按周在变,规划前看当天的页面。
- 2026-10-28,Google Sheets 的 Fill with Gemini 给每个单元格标出网页出处,单次请求能处理 3,000 个单元格(Google Workspace 更新博客)。对读者:表格里的 AI 填数开始带来源;用接口取数时,
url列起的是同样的作用。 - 2026-10-16,ChatGPT Slides 在 Space 里上线,据 MIXED 转述 OpenAI 发布说明(MIXED 报道)。对读者:几家 AI 产品都在把文档类产出留在自己的工作区里,数据怎么进来成了共同的问题。
- 2026-10-08,Claude Dashboards 测试版上线,连接 BigQuery、Snowflake 等数据平台并保持更新(Anthropic 发布文)。对读者:需要定时刷新的看板走 Claude Data,一次性的整理和分类走 Sheets。
常见问题
Claude Sheets 能直接用 MCP 连接器刷新数据吗?
不能。帮助页的当前限制写明表格不能从已连接的应用拉实时数据。做法是在开着连接器的对话里取数,再让 Claude 建表或追加标签页;要定时刷新的看板改用 Claude Data。依据 Claude Sheets 帮助页。
claude sheets connector 怎么加?
Claude 里没有专给 Sheets 的连接器,加的是对话用的自定义连接器:Customize > Connectors > + Add > Add custom connector,填 https://api.everyinfra.com/mcp/all 并选 Sign in when needed,或者填 /mcp 加请求头里的 Key。依据 自定义连接器帮助页和添加未上架连接器。
Claude Sheets 和 Google Sheets 比,为什么要换?
Reddit r/claude 的发布帖里有人问了同样的问题,帖子里没有官方回答(r/claude 讨论帖)。从帮助页看,Claude Sheets 适合轻量、团队都在 Claude 里的表;表已经在 Google Sheets、协作者没有 Claude 账号时,用 Google Sheets 连接器更合适。
claude google sheets mcp 和 Claude Sheets 是一回事吗?
不是一回事。前者是 Google Workspace 的 Sheets 连接器,Claude 在你的 Google Drive 里改表;后者是 Claude 自己的表格。两者都能和 EveryInfra 连接器放在同一段对话里。依据 Google Workspace 连接器帮助页。
一张 500 行的表要花多少钱?
我们这一侧按目录价算,评价为主约 $0.0113,三类均衡约 $0.0270,搜索为主约 $0.0462;Claude 一侧是套餐月费,Pro 按月付 $20。依据本文 5 次真调和 Claude 价格页。
Claude Sheets 能导出 Excel 吗?导入会丢什么?
能导出 .xlsx 和 CSV,PDF 暂不支持。公开视频里,从 Excel 导入时公式保留,图表、下拉框和条件格式丢了。依据 Claude Sheets 帮助页和 Mervin Praison 实测视频。
上手:三步把公开数据拉进一张表
- 在 EveryInfra 控制台拿到 API Key,或者直接用 OAuth 入口
/mcp/all登录;能力和价格在能力目录里查。 - 在 Claude 里加自定义连接器(见上文配置示例),在对话的「+」菜单里打开它。
- 让 Claude 按上文的提示词取 Trustpilot 评价、Reddit 搜索和网页搜索,再建一张 Claude Sheet。
想看同一套连接器在别的 Claude 功能里的用法:会上调竞品数据见 Claude Meetings 篇,会前调研演讲人见 RainFocus 连接器篇,用 Claude 整理商品评价并导出表格见 Yandex Market 评价篇。平台总览在 Trustpilot 爬虫页、Reddit 爬虫页和网页搜索页。
参考资料
- Get started with Claude Sheets,Anthropic 帮助中心,2026-11-16 更新,2026-11-18 读取,https://support.claude.com/en/articles/18324300-get-started-with-claude-sheets
- Claude Whiteboards, Claude Sheets, and Claude Data,Anthropic,2026-11-10,https://claude.com/resources/articles/sheets-whiteboards-data
- Working with Claude Sheets, Whiteboards, and Interactive Connectors,Anthropic,2026-11-10,https://claude.com/resources/articles/more-ways-to-work-with-claude-sheets-whiteboards-and-interactive-connectors
- Open your apps in Claude and work in them together,Anthropic,2026-11-10,https://claude.com/resources/articles/interactive-connectors-full-tool
- Claude 官方 X 发布帖,2026-11-10,https://x.com/claudeai/status/2120206365759094857
- Plans & pricing,Anthropic,2026-11-18 读取,https://claude.com/pricing
- Use connectors to extend Claude's capabilities,Anthropic 帮助中心,2026-11-06 更新,https://support.claude.com/en/articles/11176164-use-connectors-to-extend-claude-s-capabilities
- Get started with custom connectors using remote MCP,Anthropic 帮助中心,2026-11-13 更新,https://support.claude.com/en/articles/11175166-get-started-with-custom-connectors-using-remote-mcp
- Add a connector that isn't in the directory,Claude 文档,2026-11-18 读取,https://claude.com/docs/connectors/custom/add-unlisted
- Authentication for connectors,Claude 文档,2026-11-18 读取,https://claude.com/docs/connectors/building/authentication
- Connectors overview,Claude 文档,2026-11-18 读取,https://claude.com/docs/connectors/overview
- How Claude suggests connected apps,Anthropic 帮助中心,2026-11-18 读取,https://support.claude.com/en/articles/14730684-how-claude-suggests-connected-apps
- Use Google Workspace connectors,Anthropic 帮助中心,2026-11-18 读取,https://support.claude.com/en/articles/10166901-use-google-workspace-connectors
- Use Claude in Google Docs, Sheets, and Slides,Anthropic 帮助中心,2026-11-18 读取,https://support.claude.com/en/articles/16951679-use-claude-in-google-docs-sheets-and-slides
- Create and edit files with Claude,Anthropic 帮助中心,2026-11-18 读取,https://support.claude.com/en/articles/12111783-create-and-edit-files-with-claude
- How do usage and length limits work,Anthropic 帮助中心,2026-11-18 读取,https://support.claude.com/en/articles/11647753-how-do-usage-and-length-limits-work
- Get started with Claude Whiteboards,Anthropic 帮助中心,2026-11-18 读取,https://support.claude.com/en/articles/18324319-get-started-with-claude-whiteboards
- Get started with Claude Data,Anthropic 帮助中心,2026-11-18 读取,https://support.claude.com/en/articles/17454700-get-started-with-claude-data
- Sharing artifacts,Anthropic 帮助中心,2026-11-18 读取,https://support.claude.com/en/articles/9547008
- Artifacts admin guide for Team and Enterprise plans,Anthropic 帮助中心,2026-11-18 读取,https://support.claude.com/en/articles/16994751
- Build live dashboards and animate explainers with Claude,Anthropic,2026-10-08,https://claude.com/resources/articles/dashboards-and-motion
- MCP connector,Claude 平台文档,2026-11-18 读取,https://platform.claude.com/docs/en/agents-and-tools/mcp-connector
- IP addresses,Claude 平台文档,2026-11-18 读取,https://platform.claude.com/docs/en/api/ip-addresses
- Connect Claude Code to tools via MCP,Claude Code 文档,2026-11-18 读取,https://code.claude.com/docs/en/mcp
- Release notes(Claude apps),Anthropic,2026-11-18 读取,https://docs.anthropic.com/en/release-notes/claude-apps
- Tools(MCP 规范 2025-06-18),Model Context Protocol,https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- Transports(MCP 规范 2025-06-18),Model Context Protocol,https://modelcontextprotocol.io/specification/2025-06-18/basic/transports
- Authorization(MCP 规范 2025-11-25),Model Context Protocol,https://modelcontextprotocol.io/specification/2025-11-25/basic/authorization
- MCP Apps overview,Model Context Protocol,2026-11-18 读取,https://modelcontextprotocol.io/extensions/apps/overview
- RFC 9728:OAuth 2.0 Protected Resource Metadata,IETF,https://datatracker.ietf.org/doc/html/rfc9728
- RFC 4180:Common Format and MIME Type for CSV Files,IETF,https://datatracker.ietf.org/doc/html/rfc4180
- ECMA-376 Office Open XML File Formats,Ecma International,https://ecma-international.org/publications-and-standards/standards/ecma-376/
- Custom remote MCP connector prompts on every tool call(issue #491),GitHub anthropics/claude-ai-mcp,2026-11-18 读取,https://github.com/anthropics/claude-ai-mcp/issues/491
- Model Context Protocol 规范仓库,GitHub,https://github.com/modelcontextprotocol/modelcontextprotocol
- EveryInfra 能力目录,EveryInfra,2026-11-18 00:14 读取,https://api.everyinfra.com/api/v1/social/catalog
- EveryInfra /mcp/all 受保护资源元数据,EveryInfra,2026-11-18 00:19 读取,https://api.everyinfra.com/.well-known/oauth-protected-resource/mcp/all
- EveryInfra 远程 MCP 地址,EveryInfra,2026-11-18 00:16 调用,https://api.everyinfra.com/mcp
- Files you can store in Google Drive,Google 帮助中心,2026-11-18 读取,https://support.google.com/docs/answer/37603
- Excel specifications and limits,Microsoft 支持,2026-11-18 读取,https://support.microsoft.com/en-us/office/excel-specifications-and-limits-1672b34d-7043-467e-8e27-269d656771c3
- Fill with Gemini now provides cell-level citations for web sources,Google Workspace Updates,2026-10-28,https://workspaceupdates.googleblog.com/2026/10/fill-with-gemini-now-provides-cell-level-citations-for-web-sources-and-supports-larger-requests.html
- Trustpilot API documentation,Trustpilot,2026-11-18 读取,https://developers.trustpilot.com/
- Data API Terms,Reddit,2026-11-18 读取,https://redditinc.com/policies/data-api-terms
- Claude's New Whiteboards, Sheets & Data,The AI Advantage(YouTube),2026-11-13,https://www.youtube.com/watch?v=SDipcfxxa8s
- Anthropic Just Dropped Claude Whiteboard, Sheets and Data,Brock Mesarich(YouTube),2026-11-10,https://www.youtube.com/watch?v=7LLCexpekZI
- Claude Sheets Just Took On Excel. I REALLY Tested It,Mervin Praison(YouTube),2026-11-12,https://www.youtube.com/watch?v=rTCQKw3NjFI
- Introducing Claude Whiteboards, Sheets, and Data,Claude(YouTube),2026-11-10,https://www.youtube.com/watch?v=YewAJPawE7I
- 4 ways Anthropic's new Claude Sheets beat using a Google Sheets connector,ZDNET,2026-11-16,https://www.zdnet.com/innovation/claude-sheets-review-ai-spreadsheet-tool/
- Anthropic Takes On Google And Microsoft With Claude Sheets,Engadget,2026-11-10,https://www.engadget.com/2312177/anthropic-takes-on-google-and-microsoft-with-claude-sheets/
- Anthropic launches Claude Meetings,TechCrunch,2026-11-10,https://techcrunch.com/2026/11/10/anthropic-launches-claude-meetings-to-turn-workplace-discussions-into-plans-and-tasks/
- Anthropic Launches Claude Whiteboards and Sheets in Beta,Unite.AI,2026-11-10,https://www.unite.ai/anthropic-launches-claude-whiteboards-and-sheets-in-beta/
- Introducing Claude Whiteboards, Claude Sheets, and Claude Data(讨论帖),Reddit r/claude,2026-11-18 读取,https://www.reddit.com/r/claude/comments/1xsv0tu/introducing_claude_whiteboards_claude_sheets_and/
- ChatGPT Slides has shipped,MIXED,2026-10,https://mixed-news.com/en/chatgpt-slides-launch-windows-10-powerpoint-mxc-component/
- Claude Sheets and Whiteboards: How To Start,Fynl,2026-11-11,https://fynl.io/guides/claude-sheets-whiteboards
引用编号 BL-178