Gemini Decisions API para clasificar reseñas en lote
Google lanzó la Gemini Decisions API el 2026-11-11. La usamos para triar 90 reseñas reales; juzgar 1000 cuesta unos 0,04 USD.
El 2026-11-17, entre las 00:19 y las 00:23 hora de Singapur, usamos tres endpoints de datos de EveryInfra para traer 90 reseñas públicas reales: 20 de una clínica dental de Chicago en Google Maps, 30 de Uber en la App Store y 40 de Uber en Google Play. Veintitrés de ellas tienen tres estrellas o menos, es decir el 25,6 %, y esas son las candidatas a seguimiento humano. Los cuerpos de las reseñas son diminutos: la mediana es de 52 bytes y la media de 96 bytes, entre diez y cuarenta tokens cada una. Pasar un lote así por la Gemini Decisions API que Google lanzó el 2026-11-11, con un precio de 0,10 USD por millón de tokens de entrada y cero tokens de salida facturados, cuesta unos 0,04 USD por cada 1000 reseñas para decidir «necesita seguimiento, a qué cola, qué urgencia». Menos de una décima parte del coste de entrada es el texto de la reseña. Más de nueve décimas son las tres instrucciones de juicio que tú escribes.
La mayoría de las reseñas que un negocio recibe cada día son elogios de cinco estrellas que nadie necesita tocar. Lo que consume el tiempo de soporte es la pequeña parte de quejas y disputas.
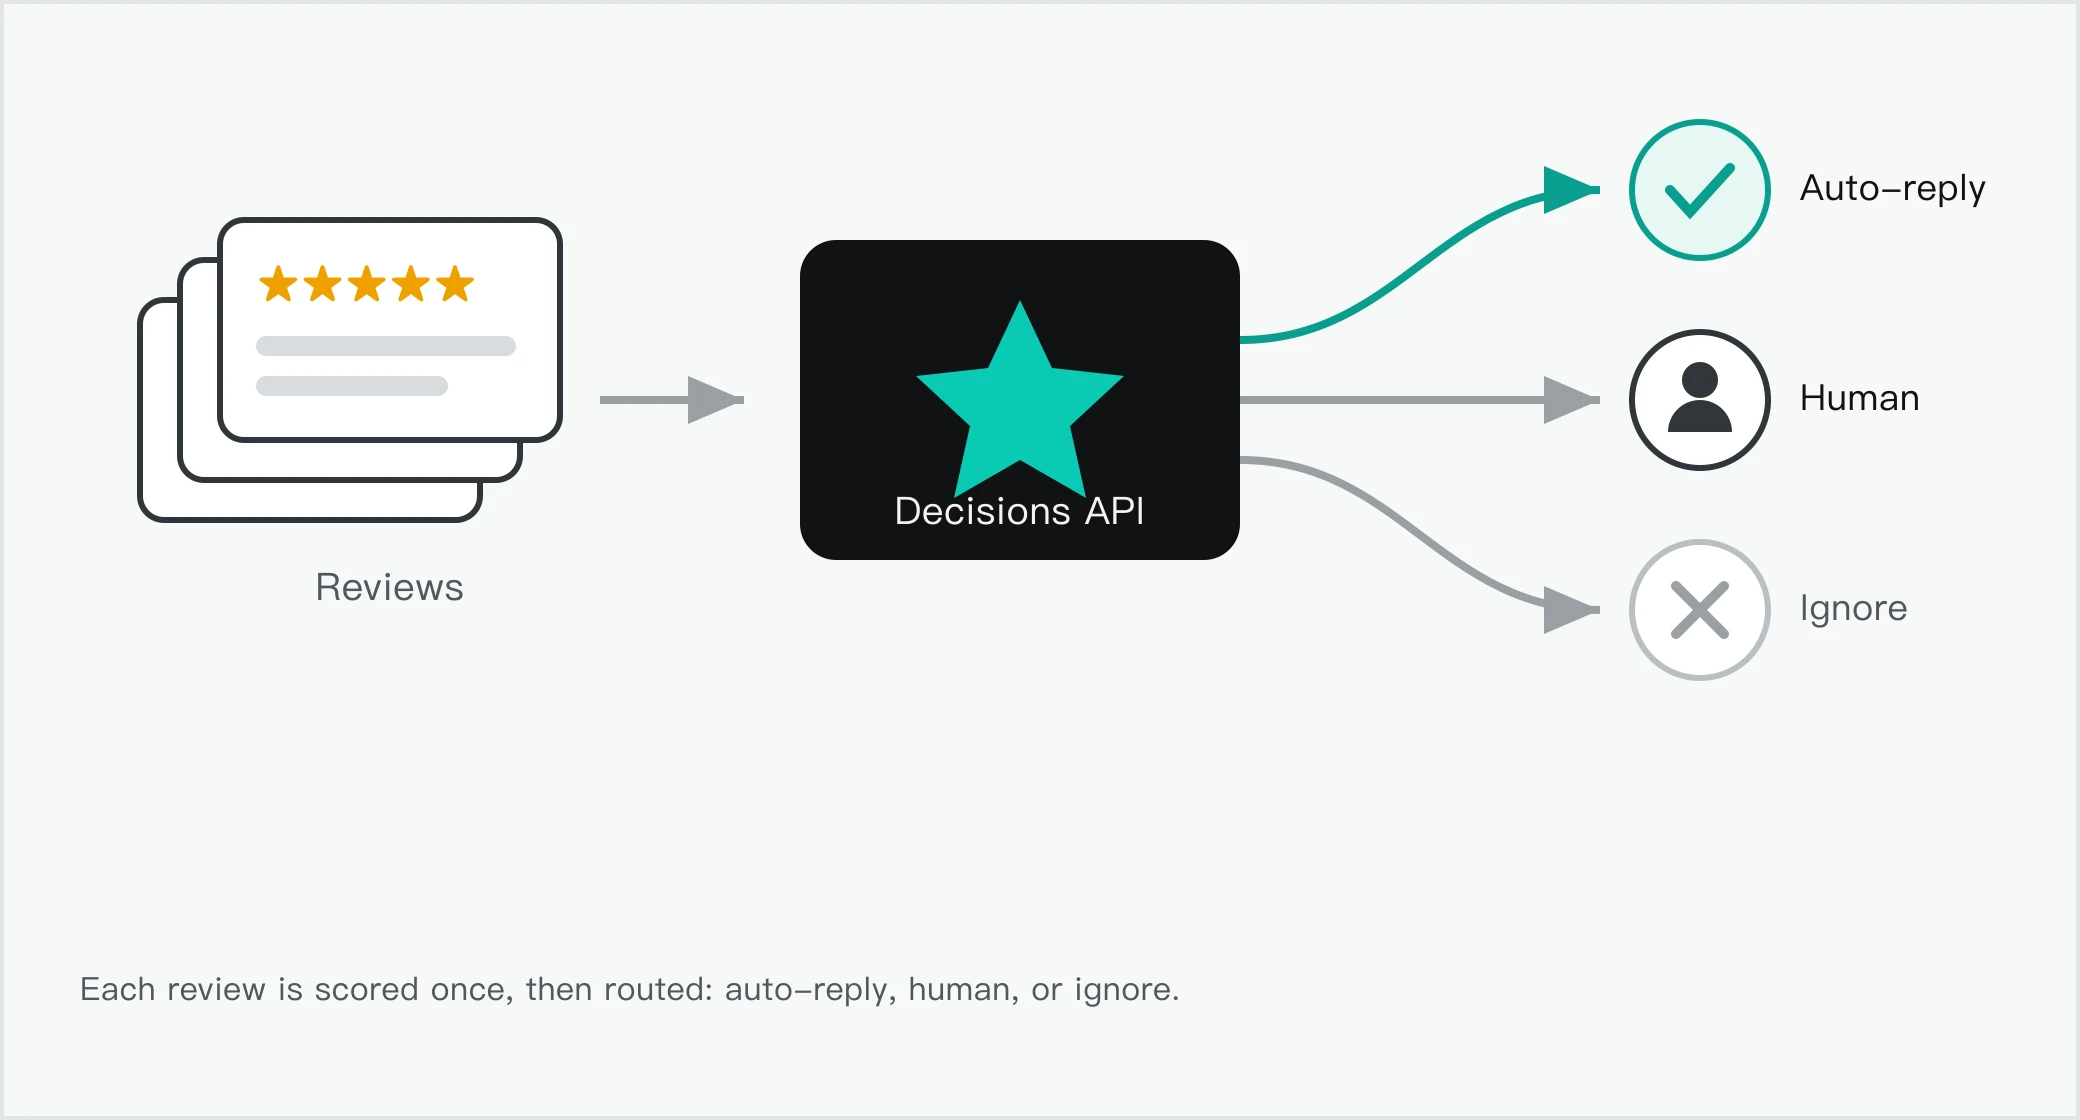
Entregar esa tarea de clasificación a una interfaz que solo puntúa y nunca escribe texto es el primer caso de uso que Google nombró en el lanzamiento.
Por qué el seguimiento de reseñas es un juicio de conjunto cerrado
Empecemos por una reseña real. Trajimos el lote de Uber en la App Store a las 00:20 hora de Singapur. Una reseña de una estrella dice que el viaje se canceló y aun así cobraron una tarifa, y que soporte solo envió una respuesta plantilla. Otra de cinco estrellas solo dice «Great Ride». El juicio que necesita un equipo de soporte es estrecho: ¿necesita esta seguimiento humano (sí/no)?, ¿pertenece a la cola de reembolso, seguridad o soporte (opción múltiple)?, ¿qué urgencia tiene (una puntuación)? Las tres tienen un conjunto fijo de opciones. Las respuestas pueden alimentar una rama if directamente, sin que el modelo escriba un párrafo que luego un programa analice. Google llama a esto elecciones acotadas, y explica que los modelos generativos están hechos para producir texto que la gente lee, así que cuando tu código necesita un juicio sobre el que ramificar, generar texto y analizarlo añade latencia y lógica frágil (documentación de la Decisions API).
La clasificación de reseñas cae de lleno en ese rango. Que una reseña necesite seguimiento depende de unas pocas condiciones: si es una queja, si menciona seguridad o facturación, si el negocio ya respondió. Cada una es una condición que puedes expresar en una sola frase. Puedes escribir cada condición como su propia pregunta, dejar que el modelo las puntúe por separado y combinar las puntuaciones en código con if y pesos. Eso es lo que recomienda la documentación: haz preguntas estrechas y de un solo propósito y compón las respuestas en código (sección de buenas prácticas). El otro camino pide a un modelo grande que lea la reseña y devuelva un JSON. Ese camino tiene que generar y analizar texto, mientras que la clasificación de reseñas solo necesita unas puntuaciones.
El volumen suele ser grande. Nuestra clínica, Downtown Dental - Loop, tiene 1390 reseñas en Google Maps (endpoint de reseñas de Google Maps). Súmale las apps que un negocio pueda tener en la App Store y en Google Play. Las reseñas nuevas van de decenas a miles al día. Que una persona lea cada una es lento y caro. Que un modelo generativo escriba un párrafo de análisis por reseña pone el coste en el texto que genera. La Decisions API quita ese paso de texto: produce cero tokens de salida, así que esa parte no cuesta nada (nota de precios oficial). La clasificación de reseñas solo quiere un juicio, y un juicio puede ser una puntuación, no un párrafo que se vuelve a analizar como juicio.
Qué es la Gemini Decisions API: tres tipos de juicio, una pasada
Google lanzó la Gemini Decisions API el miércoles 2026-11-11 hora local. La respalda un modelo nuevo, Gemini Decision 1 (gemini-decision-1), servido a través de la Gemini API en Google AI Studio como endpoint v1beta, con la firma de Felix Yu, científico principal en Google DeepMind (entrada del blog de Google). Ofrece primitivas de juicio para elecciones acotadas: selección de herramienta, comprobación de políticas, enrutamiento de modelo y calificación de contexto. Una petición lleva una única entrada de hasta 256K tokens que mezcla texto, imágenes, audio, vídeo y PDF, más hasta 1000 preguntas independientes. El modelo puntúa tus opciones en una sola pasada hacia adelante y devuelve probabilidades y confianza, con una latencia extremo a extremo de 150-250 ms, de los cuales el cómputo del modelo tiene una mediana de 50-100 ms, y la latencia se mantiene casi plana de una pregunta a cien (documentación oficial).
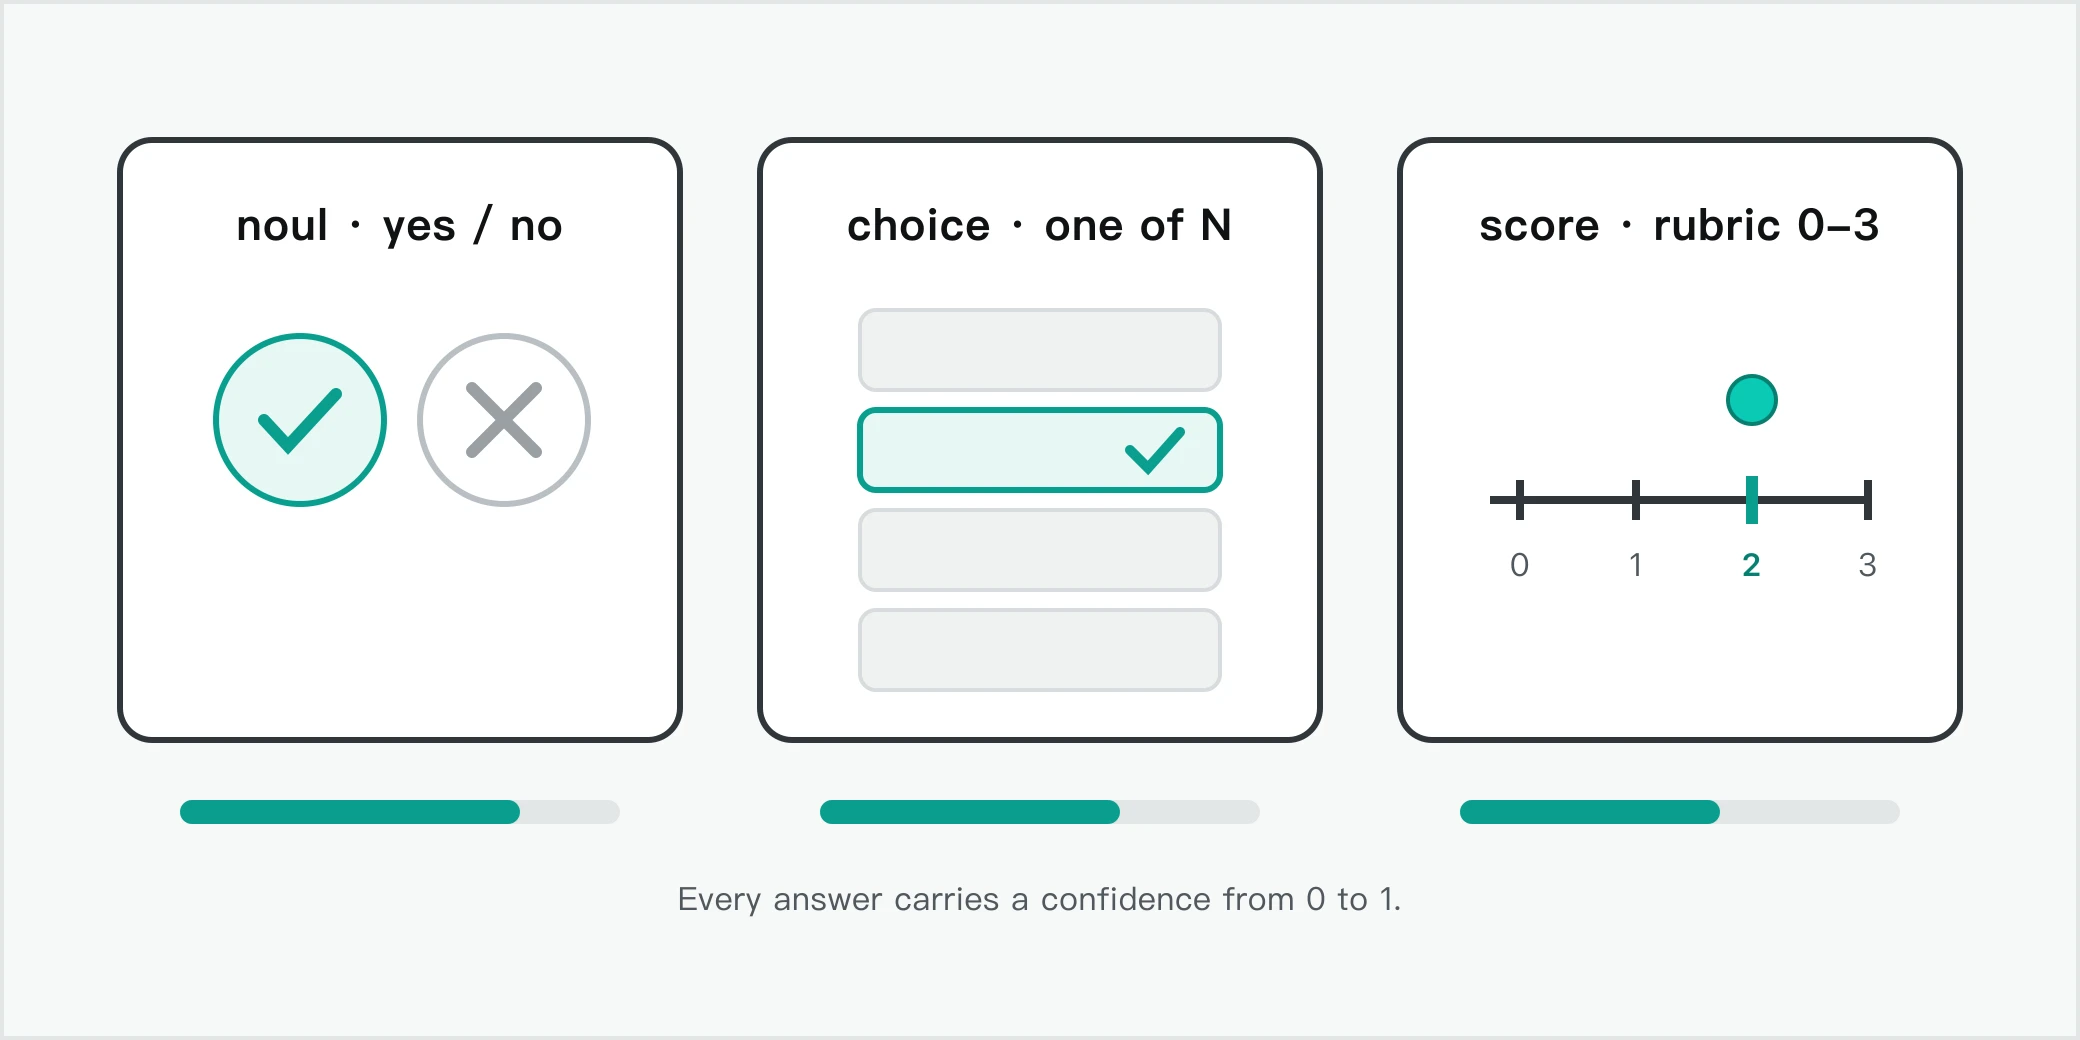
Pone los tres tipos de juicio en una petición, y la tabla oficial de tipos los detalla. El primero es noul, un juicio sí/no que estima la probabilidad de que una condición se cumpla, y puedes añadir true_description y false_description para definir cada lado (sección noul). El segundo es choice, que elige una de 2 a 255 opciones y devuelve la ganadora y probabilidades normalizadas para cada candidata (sección choice). El tercero es score, que califica la entrada contra una rúbrica ordenada que empieza en 0 y devuelve una puntuación ponderada continua y la probabilidad de cada nivel (sección score). Cada respuesta lleva una confianza de 0 a 1, así que tu código puede enviar los juicios ambiguos a un plan alternativo o a una persona (sección de confianza).
| Tipo de pregunta | Propósito | Devuelve | Uso en la clasificación de reseñas |
|---|---|---|---|
noul (sí/no) | Comprobar si una condición se cumple | noul (0,01-0,99), confidence | ¿Necesita seguimiento esta reseña? |
choice (opción múltiple) | Elegir una de una lista fija | choice, probabilities, confidence | Reembolso, seguridad, soporte o ninguno |
score (rúbrica) | Calificar contra una rúbrica ordenada | score, probabilities, legend, confidence | Urgencia de 0 (ninguna) a 3 (cobro o seguridad) |
El modelo de facturación decide para qué sirve. La Decisions API cobra 0,10 USD por millón de tokens de entrada y 0 USD por los de salida. La entrada compartida de una petición se factura una sola vez, por muchas preguntas que hagas, y cada pregunta extra solo añade sus propios tokens de instrucción y criterios (blog oficial). No hay cargos por tokens de salida, ni facturas variables de tokens de pensamiento, ni tarifas aparte de transcripción de audio u OCR. La comparación de Google sobre un conjunto de pruebas compartido es que Gemini Decision 1 con la Decisions API es casi cinco veces más barato que Gemini 3.5 Flash-Lite con la Interactions API, y la diferencia viene de no facturar la salida y de compartir una entrada entre preguntas (blog de Google). Esos números son de Google y el conjunto no se publicó, así que este artículo los trata como la afirmación de una parte.
Google también lista cuatro usos internos en el blog, cada uno un juicio sensible a la latencia. Gemini Notebook lo usa como enrutador en tiempo real que clasifica la intención en milisegundos y baja la latencia diaria hasta un 40 %. El experimento rapid canvas de Stitch lo usa para generar wireframes jugables en segundos. CC de Google Labs lo usa para elegir un emoji entre más de 200 opciones. Google Search lo usa como capa de seguridad para las herramientas MCP dentro de su presupuesto de latencia (blog de Google). La clasificación de reseñas pertenece a la misma familia: opciones fijas, rápido y barato. La página del modelo también lista el enrutamiento de peticiones, las comprobaciones de políticas sobre muchas reglas a la vez y la puntuación de candidatos como usos recomendados (página del modelo Gemini Decision 1).
Conectar las reseñas: tres llamadas reales
Una interfaz de juicio necesita algo que juzgar, y las reseñas vienen de los endpoints de EveryInfra. Primero leímos el catálogo gratuito en GET /api/v1/social/catalog (dirección del catálogo), que no necesita clave. Confirmamos los parámetros, el precio y los campos de retorno de las tres capacidades de reseñas. Las tres tienen un price_usd de 0,001389, es decir 0,001389 USD por llamada, y una llamada que devuelve una lista sigue contando como una llamada. Las reseñas de Google Maps traen 20 por llamada por defecto y hasta 100. Las de la App Store traen 30 por defecto y hasta 500. Las de Google Play traen 40 por defecto y hasta 200 (catálogo de Google Maps, catálogo de la App Store, catálogo de Google Play).
| Capacidad | Parámetro obligatorio | Cómo la usamos | Precio por llamada | Campos de retorno usados |
|---|---|---|---|---|
google_maps_reviews/reviews | url | sort: newest, lang: en | 0,001389 USD | rating, text, reviewer_name, is_local_guide, owner_response, posted_at |
app_store/reviews | app_id | country: us, sort: newest | 0,001389 USD | rating, title, text, app_version, posted_at |
google_play/reviews | app_id | country: us, language: en, sort: newest | 0,001389 USD | score, title, text, reply_text, app_version, posted_at |
Las cuatro llamadas reales y sus cargos están abajo. Las cinco entradas se facturan, por 0,005556 USD en total.
| # | Hora (SGT) | Capacidad | Parámetros | Devolvió | charged_usd |
|---|---|---|---|---|---|
| 1 | 00:19 | google_maps_reviews/search | dentist in Chicago | 15 lugares | 0,001389 |
| 2 | 00:19 | google_maps_reviews/reviews | Downtown Dental - Loop, newest | 20 reseñas | 0,001389 |
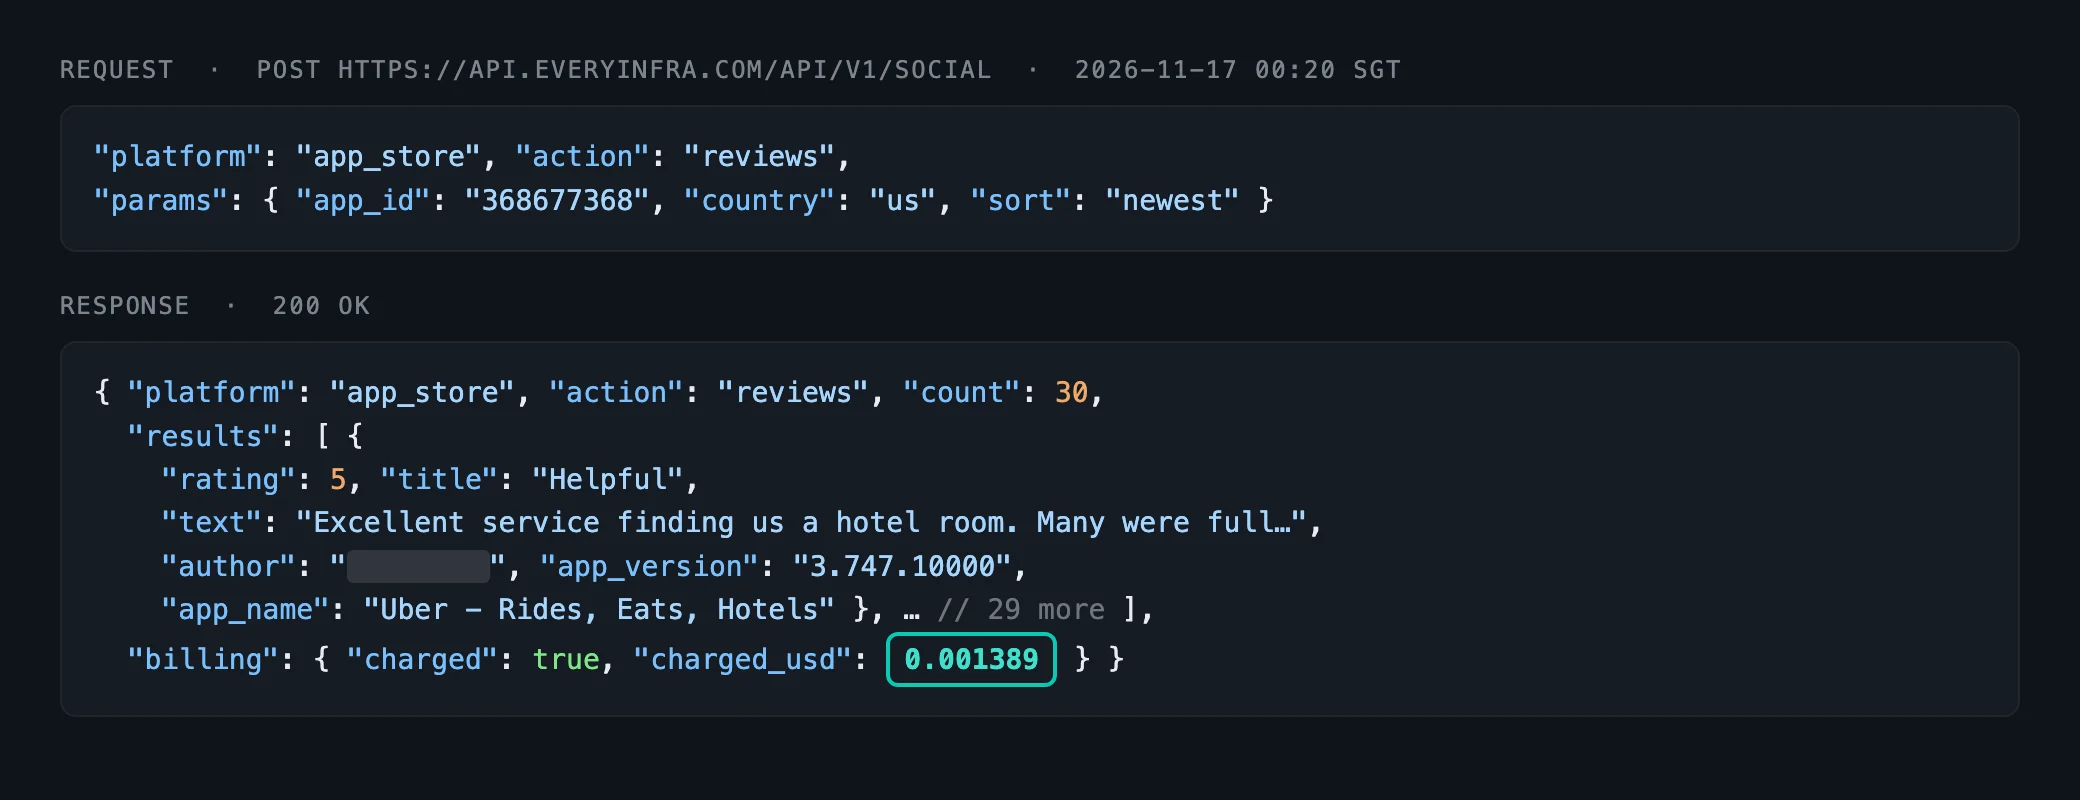
| 3 | 00:20 | app_store/reviews | 368677368, newest | 30 reseñas | 0,001389 |
| 4 | 00:23 | google_play/reviews | com.ubercab, newest | 40 reseñas | 0,001389 |
La primera fuente necesita un enlace de lugar. A las 00:19 hora de Singapur llamamos a google_maps_reviews/search con la palabra dentist in Chicago y devolvió 15 clínicas (capacidad de búsqueda de reseñas de Google Maps). Elegimos la de más reseñas, Downtown Dental - Loop (1390 reseñas, 4,7 estrellas), y pasamos su enlace completo con query_place_id a reviews. En el mismo momento 00:19 trajimos 20 reseñas recientes: 19 de cinco estrellas y 1 de una estrella, las 20 con respuesta del negocio (owner_response), y 6 de ellas de Google Local Guides. Las reseñas recientes de la clínica son casi todas elogios, y esa única de una estrella es la que una persona debería leer.
La segunda y la tercera fuente cambian a reseñas de apps, porque las apps suelen tener más reseñas negativas. A las 00:20 hora de Singapur llamamos a app_store/reviews con el ID numérico de Uber 368677368, country: us, sort: newest, y devolvió 30 reseñas: 21 de cinco estrellas, 1 de tres y 8 de una, y las 8 de una estrella se quejan de viajes, cobros o soporte. A las 00:23 hora de Singapur llamamos a google_play/reviews con el nombre de paquete de Uber com.ubercab y language: en, y devolvió 40 reseñas: 25 de cinco estrellas, 2 de cuatro, 1 de tres, 2 de dos y 10 de una, es decir 12 reseñas negativas de dos estrellas o menos. Las dos capacidades son app_store/reviews y google_play/reviews.
Prueba uno: 23 de 90 reseñas reales necesitan seguimiento
La distribución de estrellas en las tres fuentes está abajo. El total de 23 con tres estrellas o menos es 1 de Google Maps, 9 de la App Store y 13 de Google Play.
| Plataforma | 5★ | 4★ | 3★ | 2★ | 1★ | ≤3★ |
|---|---|---|---|---|---|---|
| Google Maps (20) | 19 | 0 | 0 | 0 | 1 | 1 |
| App Store (30) | 21 | 0 | 1 | 0 | 8 | 9 |
| Google Play (40) | 25 | 2 | 1 | 2 | 10 | 13 |
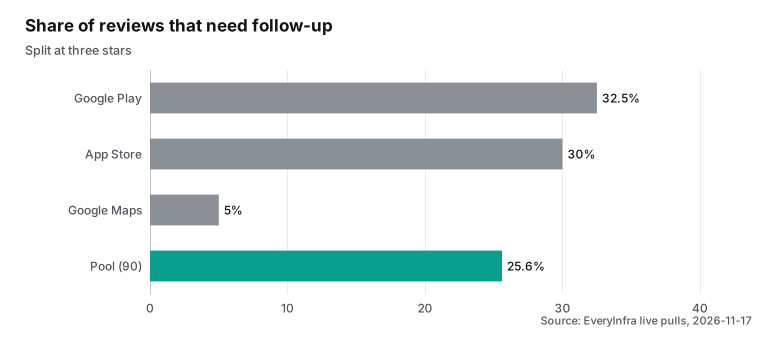
En conjunto, las tres fuentes dan 90 reseñas. Por la regla simple «tres estrellas o menos necesita seguimiento», 23 lo necesitan, el 25,6 %.
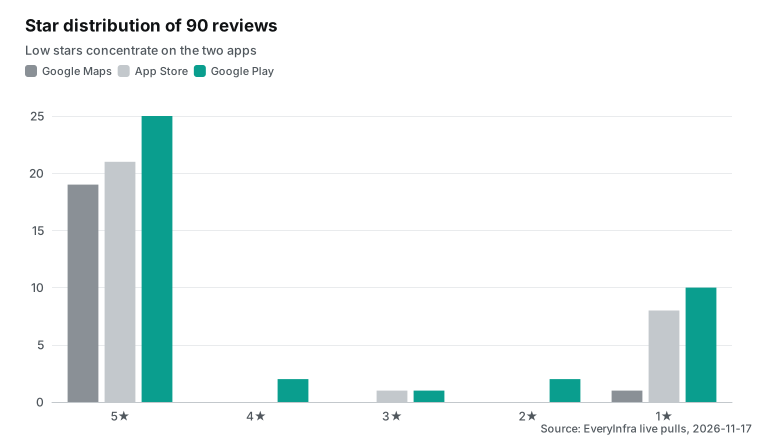
Por plataforma, la clínica solo tiene 1 reseña a seguir (5 %). Las dos apps tienen muchas más: 8 de las 30 de la App Store son de dos estrellas o menos, y 12 de las 40 de Google Play lo son. Dónde se concentran las negativas te dice qué canal vigilar primero.
Las estrellas son solo un filtro grueso. Una reseña de cinco estrellas puede esconder un problema, como «muy bien, pero el aparcamiento es difícil de encontrar». Una de una estrella puede ser solo un usuario que pidió lo que no era. Lo que quieres juzgar es el contenido, no el número. Esa es la razón de pasar la reseña a una interfaz de juicio: el modelo lee el cuerpo y decide si es una queja, si toca seguridad o facturación, y si necesita respuesta. Las estrellas pueden servir de prefiltro barato que deja fuera los elogios obvios y solo envía los dudosos, lo que también ahorra en el coste del juicio. La cuenta de abajo se hace de las dos formas: «juzgar todo» y «juzgar solo cuatro estrellas o menos».
Los límites de esta muestra deben quedar claros. Las 90 reseñas son tres descargas de una sola página, no el historial completo de estos negocios. La página de Google Maps está ordenada por más reciente y pilló una racha de elogios, así que no representa la tasa de quejas a largo plazo de la clínica. Una tasa estable de negativas necesita más muestra, paginando o usando el mode: async del catálogo. Este artículo usa las 90 solo para demostrar el flujo, no para sacar conclusiones sobre ningún negocio.
Cómo se clasifican tres reseñas reales: enrutamiento esperado según los criterios
Aquí van tres reseñas reales, recorridas por su enrutamiento esperado. Una persona aplicó la regla, para mostrar cómo deben diseñarse las tres preguntas. Este artículo no llamó a Gemini, así que no reporta probabilidades del modelo. Las tres son una de una estrella de Uber en la App Store, una de cinco de la clínica en Google Maps y una de una de Uber en Google Play. Están parafraseadas, no citadas.
| Reseña (parafraseada) | `needs_followup` | `route_to` | `severity` |
|---|---|---|---|
| Viaje cancelado, aun así cobrado, respuesta plantilla (App Store, una estrella) | Sí | billing | 2 (fallo de servicio) |
| Elogia al dentista y a la higienista (Google Maps, cinco estrellas) | No | no_action | 0 (no urgente) |
| La app se cierra, no abre (Google Play, una estrella) | Sí | support_quality | 1-2 |
Los criterios difieren en las tres reseñas, pero un solo conjunto de preguntas las cubre. needs_followup saca las que necesitan a una persona. route_to decide la cola. severity fija la prioridad. Las tres preguntas puntúan en paralelo contra la misma entrada y no se ven entre sí, así que preguntar las tres es apenas más lento que preguntar una (sección de múltiples preguntas). Al diseñar las preguntas, escribe claros los límites de los criterios: por ejemplo, «disputa de cobro, problema de seguridad o queja sin resolver» cuenta como seguimiento, y «elogio, preferencia menor o ya resuelto» cuenta como no. El modelo ubica la reseña entre dos descripciones en vez de adivinar desde una pregunta vaga.
Cómo escribir criterios que juzguen bien
Juzgar bien una reseña depende menos de lo listo que sea el modelo y más de lo fino que partas la tarea y lo claro que la expreses. El error común es preguntar una cosa grande entera, como «¿es seria esta reseña?». Seria significa cosas distintas según el negocio. Para un restaurante, la seguridad alimentaria es lo más serio. Para una app de transporte, el comportamiento del conductor y el cobro lo son. Para un vendedor de comercio electrónico, las falsificaciones y los reembolsos lo son. El modelo no puede definir «serio» por ti. Los criterios tienen que llevar esos significados de negocio, describiendo cada nivel con frases concretas en lugar de dejar una palabra vaga. La documentación lo plantea como hacer preguntas estrechas y de un solo propósito, y recomienda comprobaciones atómicas compuestas en código, no una pregunta que te entregue la acción final (sección de buenas prácticas).
Hay unas reglas prácticas para partir preguntas. Primera, divide un juicio compuesto en varios simples. En vez de «¿necesita atención urgente?», pregunta por separado si toca seguridad, si toca cobro y si el negocio ya respondió. Luego decide en código: la seguridad lo fija arriba, y el cobro sin respuesta va a la cola de reembolso. Cada pregunta es entonces fácil de escribir y fácil de verificar por sí sola. Segunda, da dos descripciones a las preguntas sí/no. noul permite true_description y false_description, que separan antes los casos que se confunden. Una queja de «el precio es muy alto» puede quedarse fuera de la cola de defectos con una línea como «un defecto significa que el producto está roto; precio, talla, envío y preferencia no cuentan». Tercera, da a cada nivel de rúbrica una frase, no solo un rango de números. La rúbrica empieza en 0: nivel 0 «no urgente», nivel 1 «problema menor», nivel 2 «fallo de cobro o de servicio», nivel 3 «riesgo de seguridad o legal». El modelo ubica la reseña entre esas frases, y descripciones más concretas dan una puntuación más estable. Los mismos niveles 0 a 3 no cambian al cambiar de sector; lo que reescribes es la frase de cada nivel: una clínica dental pone «diente equivocado extraído, infección posoperatoria» en el nivel 3, una app de transporte pone «acoso del conductor, abandono a mitad de viaje» en el nivel 3, y un vendedor de comercio electrónico pone «producto falsificado, dinero y mercancía perdidos» en el nivel 3. Esa frase es donde le das al modelo tu conocimiento del negocio, porque el modelo no sabe qué es lo más grave para ti.
Comprueba los criterios con tus propios datos una vez escritos, y no confíes solo en la confianza que el modelo reporta de sí mismo. Mete un lote de reseñas que la gente ya etiquetó y mira dónde el modelo difiere de la etiqueta humana. Las clases que más difieren suelen ser donde los criterios están poco claros, no donde el modelo flojea. En la prueba de un medio el modelo pasó solo unos seis de cada diez documentos (reportaje de Tech Times). Números así recuerdan que la evaluación va sobre tu propia muestra y que no se toma prestada una tasa de acierto de otro entorno. Trata los criterios como un conjunto de reglas que iteras.
Una ida y vuelta completa: traer con EveryInfra, puntuar con la Decisions API
Empecemos por la petición real del lado de EveryInfra. La clave se lee solo de una variable de entorno y nunca se escribe en un archivo. El campo billing.charged_usd es lo que costó esta llamada.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"app_store","action":"reviews",
       "params":{"app_id":"368677368","country":"us","sort":"newest"}}'
Esta llamada devolvió 30 reseñas, con billing.charged_usd de 0,001389. Cada reseña es un objeto con campos como rating, title, text, app_version y posted_at. Después tomas un cuerpo como entrada de la Decisions API y haces tres preguntas a la vez. El fragmento de Python de abajo está adaptado de la documentación oficial, con la entrada reemplazada por una reseña real: una de una estrella sobre un viaje cancelado que aun así se cobró.
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    input="Driver cancelled after 20 minutes and I was still charged a fee. "
          "Support only sent a template reply.",
    questions={
        "needs_followup": {
            "type": "noul",
            "instructions": "Does this review need a human follow-up?",
            "criteria": {
                "true_description": "Billing dispute, safety issue, or unresolved complaint.",
                "false_description": "Praise, minor preference, or already resolved.",
            },
        },
        "route_to": {
            "type": "choice",
            "instructions": "Which team should handle this review?",
            "criteria": {
                "billing": "Charge, refund, or payment problem.",
                "safety": "Driver behaviour or passenger safety.",
                "support_quality": "Slow or unhelpful support, or a broken app.",
                "no_action": "No action needed.",
            },
        },
        "severity": {
            "type": "score",
            "instructions": "Rate how urgent this review is.",
            "criteria": [
                "Not urgent.",
                "Minor issue.",
                "Billing or service failure.",
                "Safety or legal risk.",
            ],
        },
    },
)
El equivalente REST es un POST a https://generativelanguage.googleapis.com/v1beta/decisions, con la clave en una cabecera x-goog-api-key (sección de inicio rápido). El cuerpo de la respuesta es un objeto answers más un objeto usage. En el ejemplo de la documentación, una respuesta noul se ve como {"type":"noul","noul":0.99,"confidence":0.99}, y usage trae total_output_tokens de 0 (ejemplo de respuesta oficial). Para las tres preguntas, el programa recibe tres respuestas con probabilidades: si seguir, a qué cola con su probabilidad y una puntuación de urgencia con la de cada nivel. Luego las combina con if y umbrales en una acción. Este artículo no llamó al lado de Gemini; el fragmento es un ejemplo de configuración de la documentación oficial, y cada número del lado de EveryInfra viene de una respuesta real.
Prueba dos: las reseñas son cortas, así que el coste cae en tus preguntas
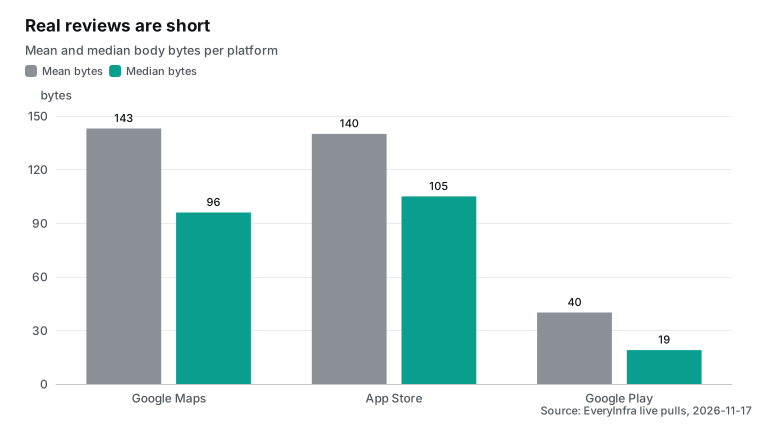
Medir el tamaño real de las reseñas muestra adónde va el dinero. La media de bytes del cuerpo es 143 (Google Maps), 140 (App Store) y 40 (Google Play). Las medianas son 96, 105 y 19 bytes. Las reseñas de Google Play son las más cortas, muchas de una sola línea. Con la proporción de unos cuatro bytes por token de la página de precios de Anthropic (página de precios, sección web fetch), una reseña de Google Maps son unos 36 tokens y una de Google Play unos 10.
| Plataforma | Reseñas | Media bytes | Mediana bytes | ~tokens (media / 4) |
|---|---|---|---|---|
| Google Maps | 20 | 143 | 96 | 36 |
| App Store | 30 | 140 | 105 | 35 |
| Google Play | 40 | 40 | 19 | 10 |
Una petición de juicio tiene además las instrucciones y los criterios de las tres preguntas. Contando las tres más un pequeño preámbulo compartido como un presupuesto fijo de unos 320 tokens (estimado del fragmento de arriba, no una factura medida), una petición de reseña de Google Maps son unos 356 tokens y el cuerpo es 36 de 356, un 10 %. Una petición de reseña de Google Play son unos 330 tokens y el cuerpo es 10 de 330, un 3 %.
| Plataforma | Tokens de reseña | Tokens de instrucción | Parte de la reseña |
|---|---|---|---|
| Google Maps | 36 | 320 | 10 % |
| App Store | 35 | 320 | 10 % |
| Google Play | 10 | 320 | 3 % |
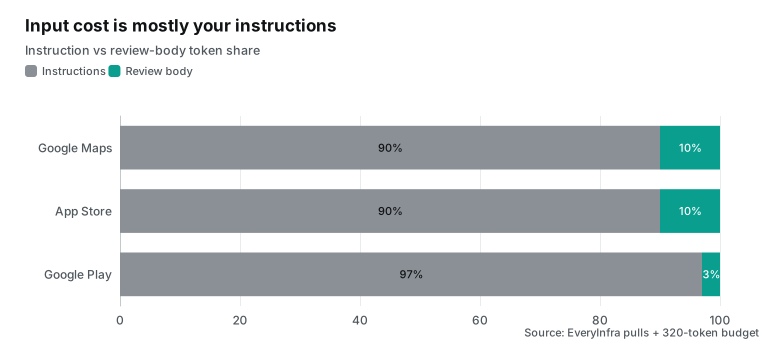
El cuerpo de la reseña es solo del uno por ciento a una décima parte de la entrada. Comprimir reseñas ahorra poco. Para ahorrar, trabaja las tres instrucciones: hazlas cortas, ajusta los criterios o deja los elogios obvios fuera con un prefiltro de estrellas.
El presupuesto fijo es solo el caso medio, porque las reseñas reales tienen una cola larga. La más larga de estas 20 reseñas de Google Maps son 876 bytes, unos 219 tokens, nueve veces la mediana de 96 bytes (unos 24 tokens). Una reseña así de larga sube la petición a unos 539 tokens, no a la media de 356. Así que un coste por mil estimado desde el tamaño medio es un punto intermedio: los negocios con quejas más largas y detalladas quedan más arriba en el lado del juicio, y para presupuestar conviene medir la distribución de longitud de tu propio canal en vez de aplicar una media.
Otro camino juzga varias reseñas en una petición. La API permite hasta 1000 preguntas contra una entrada compartida. Metes varias reseñas en una entrada con unas preguntas por reseña, la entrada compartida se factura una vez y las preguntas solo cuestan sus instrucciones. Ese camino exige que montes la entrada y apuntes cada pregunta a la reseña correcta. Sirve para cuando una misma materia se pregunta muchas veces; para el caso simple, una reseña a la vez es más claro. El lote también tiene tope: una petición admite hasta 1000 preguntas, y la clasificación pregunta tres por reseña, así que caben unas 333 reseñas a la vez. Los 256K tokens de entrada compartida quedan lejos de llenarse, porque con la mediana de 96 bytes, 333 cuerpos son solo unos ocho mil tokens, de modo que lo que limita el lote es el número de preguntas, no la longitud de la entrada.
La cuenta: cuánto cuesta juzgar mil reseñas
Junta los dos lados por cada mil reseñas. El lado de EveryInfra depende solo del número de llamadas. Por tamaño de página, 1000 reseñas de Google Maps son unas 10 llamadas, las de la App Store unas 2 y las de Google Play unas 5, a 0,001389 USD cada una. El lado de la Decisions API va por token de entrada: 1000 reseñas por los tokens de cada petición, por 0,10 USD por millón.
| Plataforma | Por defecto / máx. por llamada | Llamadas por 1000 | Coste de datos por 1000 |
|---|---|---|---|
| Google Maps | 20 / 100 | 10 | 0,0139 USD |
| App Store | 30 / 500 | 2 | 0,0028 USD |
| Google Play | 40 / 200 | 5 | 0,0069 USD |
| Enfoque (1000 reseñas) | Puntuación Decisions API | Descarga EveryInfra | Total |
|---|---|---|---|
| Google Maps (unos 356 tokens) | unos 0,0356 USD | 10 llamadas 0,0139 USD | unos 0,0495 USD |
| App Store (unos 355 tokens) | unos 0,0355 USD | 2 llamadas 0,0028 USD | unos 0,0383 USD |
| Google Play (unos 330 tokens) | unos 0,0330 USD | 5 llamadas 0,0069 USD | unos 0,0399 USD |
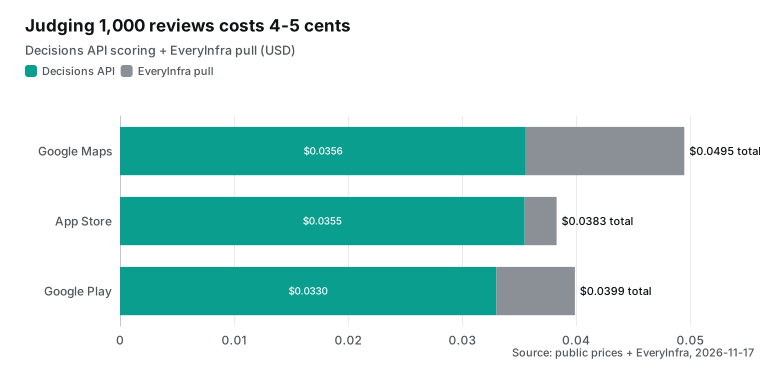
Si usas las estrellas para dejar fuera los elogios de cinco y juzgas solo cuatro estrellas o menos, ahorras más. Por la distribución de nuestras 90, esa parte es de un 5 % (Google Maps), un 30 % (App Store) y un 37,5 % (Google Play). Entran menos reseñas a la interfaz de juicio, el lado de la Decisions API baja en proporción y el de datos no cambia. Lo que ahorra un prefiltro equivale a la parte que deja fuera: por la distribución de nuestras 90, unas tres cuartas partes son elogios de cinco estrellas, y dejarlos fuera baja el volumen y el gasto de la Decisions API a cerca de un cuarto de juzgar todo, mientras el coste de datos no se mueve porque las reseñas siguen llegando de página entera. El prefiltro tiene un coste: puedes perder un problema escondido en una de cinco estrellas. Así que deja la regla holgada y deja pasar las de cinco con «pero» o «sin embargo». La compensación está en la tabla de abajo.
| Enfoque | Parte enviada a juicio | Coste Decisions (vs juzgar todo) | Riesgo |
|---|---|---|---|
| Juzgar todo | 100 % | base | sin pérdidas, paga sobre elogios |
| Juzgar cuatro estrellas o menos | 5 %-37,5 % por canal | baja en proporción | puede perder un problema de cinco estrellas |
Los límites de esta cuenta deben quedar claros. El presupuesto fijo de 320 tokens es una estimación, y la factura real sigue usage.total_input_tokens. Instrucciones más largas o más cortas mueven cada petición en decenas de tokens. La tabla no cuenta el nivel gratuito: Google AI Studio ofrece un nivel gratuito para prototipos, y el nivel de pago es al que aplican estos precios (página de precios de la Gemini API). Tampoco cuenta reintentos ni tokens de paginación. Visto de otro modo, los dos lados son del mismo orden de magnitud: traer mil reseñas cuesta unos centavos y juzgar mil cuesta unos centavos, y ningún lado es un orden de magnitud más caro.
Comparado con clasificar cada reseña con un modelo generativo, la diferencia es la salida. Un clasificador generativo emite un trozo de texto de juicio por reseña, aunque sea un JSON corto. Esa salida se factura por volumen y a escala se vuelve el coste principal. La Decisions API cobra 0 USD por esa salida, y ese es el mecanismo detrás de la diferencia de casi cinco veces de Google (blog de Google). Un medio calculó un múltiplo mayor sobre una base por lote: Tech Times informó el 2026-11-13 que, como la entrada compartida se factura una vez, 20 comprobaciones sobre un registro de 4000 tokens cuestan unos 0,50 USD por mil registros en vez de 8,10 USD, lo que recorta las 20 comprobaciones a cerca de una dieciseisava parte (reportaje de Tech Times). El mismo texto señala que en su prueba el modelo pasó solo el 63 % de los documentos: el precio no basta y el acierto se verifica con tus propios datos. El casi cinco veces de Google y el cerca de 16 de Tech Times no se contradicen: la diferencia depende de cuántos juicios comparten una entrada, y cuantas más preguntas, más se reparte el coste de esa entrada. La comparación de Google está cerca de uno o dos juicios por entrada, mientras que Tech Times cuenta 20 juicios sobre un registro de 4000 tokens. La clasificación de reseñas suele ser tres juicios por reseña, más cerca del múltiplo pequeño, así que no dimensiones tu ahorro sobre el 16x.
La confianza decide quién lo atiende: automático, humano o ignorar
Cada respuesta lleva una confianza de 0 a 1, y esa es la clave para automatizar la clasificación. La documentación sugiere usar la confianza para decidir si un juicio corre solo o escala: alta confianza toma la rama, baja confianza va a un plan alternativo o a una persona (sección de confianza). En la clasificación de reseñas, un juicio aterriza por una regla simple. Alta probabilidad de seguimiento y alta confianza crea un ticket solo y lo enruta. Probabilidad media o baja confianza va a revisión humana. Baja probabilidad y alta confianza se marca sin acción, sin ticket.
| Juicio | Confianza | Acción |
|---|---|---|
| Alta probabilidad de seguimiento | Alta | Crear ticket, enrutar por route_to |
| Probabilidad media o baja confianza | Baja | Enviar a revisión humana |
| Baja probabilidad de seguimiento | Alta | Marcar sin acción, sin ticket |
Esto convierte el trabajo humano de «leerlas todas» en «leer solo las dudosas». Por la distribución de nuestras 90, los elogios obvios caen casi todos en «baja probabilidad, alta confianza»: las 19 de Google Maps y las 46 de las dos apps. No reciben ticket. A la cola humana van las 23 reseñas de pocas estrellas más unas pocas de baja confianza. Esto concuerda con el consejo de la documentación de comprobaciones atómicas compuestas en código: no dejes que el modelo te dé la acción final, deja que dé unas puntuaciones firmes y que tu código fije la acción por umbrales (sección de buenas prácticas). Los umbrales en código, no en el modelo, te dejan ajustar el límite de automatización sin cambiar el modelo. Un punto de partida viable: crea un ticket solo cuando la probabilidad de needs_followup sea de al menos 0,85 y la confianza de al menos 0,8; si cualquiera se queda corta, va a la cola humana, y tras el lanzamiento mueves esos dos números según los resultados de la revisión humana.
Algunas reseñas caen entre dos clases por naturaleza. Una de una estrella que se queja de un cobro y a la vez dice que el conductor condujo peligroso reparte route_to pareja entre reembolso y seguridad, y la confianza baja. Por fino que escribas los criterios, estas reseñas existen, y usar la confianza para dárselas a una persona evita que el flujo fuerce una decisión donde la señal está mezclada.
Hay una segunda señal de incertidumbre. Una respuesta choice devuelve no solo la ganadora, sino una probabilidad normalizada por candidata. Si las dos primeras quedan muy cerca, por ejemplo reembolso 0,46 y seguridad 0,44, trátalo como ambiguo aunque la confianza global parezca correcta. La confianza mide cuán seguro está el modelo, y el reparto de probabilidad mide cuánto distan las opciones, y usar ambas es más estable que usar una.
Dos campos estrechan más la cola humana: Local Guide y respuesta del negocio. De las 20 reseñas de Google Maps, 6 eran de Local Guides y las 20 ya tenían respuesta del negocio. Un elogio al que el negocio ya respondió apenas necesita seguimiento. Trata «¿hay owner_response?» como prefiltro, o escríbelo como pregunta noul, «¿respondió el negocio a esta reseña?». Eso recorta otra vez el volumen de llamadas a la interfaz de juicio. Esos campos están en los response_fields de las tres capacidades de reseñas (catálogo de Google Maps).
Tres enfoques lado a lado: personas, modelos generativos, puntuación
Clasificar reseñas se suele hacer de tres maneras, cada una con su encaje. La primera es solo humana, con soporte leyendo cada una. La ventaja es el juicio más flexible, que lee el tono y lo implícito. La desventaja es que es lento y caro, no escala según crecen las reseñas, y distintas personas etiquetan con criterios distintos. La segunda usa un modelo generativo que escribe un párrafo o un juicio estructurado por reseña. La ventaja es el juicio y una respuesta sugerida en un paso. La desventaja es que cada reseña genera y analiza texto, la salida se factura por volumen y a escala se vuelve el coste principal, y el análisis sigue el formato del modelo. La tercera usa una interfaz de puntuación como la Decisions API, que solo juzga y nunca escribe texto, dejando la acción al código. La ventaja es barato, rápido y salida estable. La desventaja es que es de conjunto cerrado; escribir respuestas y resúmenes necesita un modelo generativo aparte.
| Dimensión | Solo humano | Clasificación generativa | Interfaz de puntuación |
|---|---|---|---|
| Flexibilidad de juicio | máxima | alta | limitada al conjunto cerrado |
| Velocidad | lenta | media | rápida (150-250 ms) |
| Crecimiento del coste con el volumen | lineal y alto | la salida domina | solo entrada, salida 0 USD |
| Forma del resultado | juicio humano | texto a analizar | probabilidad y confianza |
| Encaje | casos difíciles y apelaciones | juicio más respuesta | clasificación de alto volumen |
Los tres no se excluyen; en la práctica se combinan por capas: reglas baratas prefiltran los elogios obvios, la interfaz de puntuación clasifica y prioriza, y las personas y el modelo generativo solo tocan las dudosas y las respuestas, de modo que cada capa atiende solo la parte en la que es más barata. La siguiente sección parte este flujo por capas en cinco pasos concretos.
Límites: qué puede y qué no el juicio de conjunto cerrado
La Decisions API solo maneja preguntas de conjunto cerrado y reemplaza clasificadores y enrutadores, no la generación abierta. Escribir una respuesta a un cliente sigue necesitando una interfaz generativa, igual que resumir una semana de tendencias o extraer una descripción de defecto (resumen de la Interactions API). Un reparto sensato juzga y enruta con la Decisions API y escribe respuestas con un modelo generativo, encadenados en dos pasos.
El idioma de la reseña es otra cosa a vigilar. Pasamos language: en para las reseñas de Google Play, pero el catálogo advierte que la elección de idioma no garantiza el idioma original de cada reseña devuelta. En las reseñas de Google Play, country tampoco cambia qué reseñas vuelven. Una nota de prueba del 2026-10-25 en el catálogo es explícita: con el mismo language, us y gb devuelven las mismas reseñas, y para comparar por país hay que cambiar language (catálogo de Google Play). Las 40 que trajimos incluían algo de español. La Decisions API es multimodal nativa y maneja texto multilingüe, así que escribir los criterios en inglés suele juzgar bien, pero si los criterios dependen de matices de un idioma, la mezcla añade incertidumbre, y ahí te apoyas en la confianza y empujas las dudosas a una persona.
Traer los datos también tiene huecos. El catálogo lleva una nota de prueba sobre las reseñas de Google Play: para reseñas en inglés de EE. UU., algunas peticiones devuelven como mucho 100 por vez y los campos reply_text, reply_at, language, url y title pueden faltar (catálogo de Google Play). Las 40 que trajimos esta vez no traían respuesta del negocio (with_reply en 0). Esto tiene un efecto directo en el coste: las 20 de Google Maps tenían todas owner_response, lo que permite soltar un lote con el filtro más barato, «¿respondió el negocio?», pero esta página de Google Play no traía ninguna respuesta, así que ese prefiltro no sirve aquí y más reseñas entran directas a la interfaz de juicio, con lo que su volumen de llamadas sube en consecuencia. Cuando falta un campo, un prefiltro que dependa de él necesita un plan alternativo. Cuando la interfaz devuelve un 503 sin cargo, reintenta según la documentación; los fallos y los resultados vacíos no se facturan y eso se concilia en el objeto billing. Recuerda además que la latencia y el coste de Google son de su propio entorno, así que con mucho volumen y criterios complejos, mide primero con usage y tiempos reales.
Montar una clasificación de reseñas diaria
Junta todo esto y tienes una clasificación de reseñas que corre sola. El paso uno es una descarga programada de reseñas nuevas. Para cada negocio o app, trae una página ordenada por más reciente, compara la hora de publicación con la última descarga y quédate solo con las nuevas, paginando o usando el modo asíncrono para los canales con más volumen. El paso dos es el prefiltro: usa estrellas y el campo de respuesta del negocio para soltar los elogios obvios. El paso tres es la puntuación: envía cada reseña con las tres preguntas y recibe las tres respuestas con probabilidad y confianza. El paso cuatro es aterrizar: por confianza y umbral, crea y enruta solos los tickets de alta confianza y manda los de baja confianza a una cola humana. El paso cinco es la respuesta: un modelo generativo la redacta desde el ticket y una persona la confirma antes de enviarla.
En esta tubería, la baja latencia permite ejecutarla en cuanto llega una reseña, no solo en un lote nocturno: una reseña negativa recién publicada se juzga casi al instante y las urgentes llegan a una persona en segundos. Para transporte, reparto y hoteles, cuanto más rápido el seguimiento, mayor la tasa de recuperación. Añadir unas dimensiones de juicio no estira la respuesta, así que la clasificación puede sumar preguntas según lo necesite el negocio.
En coste, los dos lados son baratos y predecibles. La descarga va por número de llamadas y el juicio por token de entrada, y ninguno oscila mucho con la longitud de la reseña, porque las reseñas son cortas. Un negocio con unos cientos de reseñas nuevas al día tiene de diez a veinte mil al mes, y a los precios unitarios de aquí, descargar más juzgar son unos pocos dólares, por debajo del coste de un agente leyéndolas media hora. La tarifa de la interfaz es insignificante. El coste real es acertar los criterios y fijar los umbrales de la cola, y una vez hechas esas dos cosas, el gasto se queda bajo. En la clínica dental que trajimos, las reseñas crecen mucho más despacio, de unas pocas a una docena al día y unos cientos al mes, y juzgar más descargar cuesta unos centavos al mes; lo que sube el coste es el volumen, no la tarifa unitaria, y son las apps como Uber, con miles al día, las que hacen que el prefiltro y el lote importen. Haz que esto emita un informe diario de cuántas necesitan seguimiento y a qué cola va cada una, y para conectarlo a alertas y a un sistema de tickets, mira nuestro texto sobre alertas de reseñas de apps.
El material de la comunidad también avanza. Hacia el 2026-11-15 aparecieron en YouTube vídeos cortos que explican los tres tipos de pregunta (vídeo corto de YouTube). Leídos junto a la documentación oficial, ayudan a escribir antes los criterios.
Preguntas frecuentes
¿En qué se diferencia la Gemini Decisions API de una API de chat normal de Gemini? Solo puntúa preguntas de conjunto cerrado y no escribe texto de respuesta. Pasas una entrada y un conjunto de preguntas, y devuelve la probabilidad de cada una y una confianza de 0 a 1, con tokens de salida siempre a 0, así que tu código ramifica, ordena y enruta directo (documentación oficial). Una API de chat genera texto para leer, lo que encaja con escribir respuestas y resúmenes.
¿Cuánto cuesta juzgar mil reseñas? Estimado a partir del tamaño real de las reseñas de este artículo, las tres fuentes caen entre 0,038 USD y 0,050 USD por mil, contando la puntuación de la Decisions API y la descarga de EveryInfra a precios públicos (página de precios de Gemini, catálogo de EveryInfra). La factura real sigue usage.total_input_tokens y billing.charged_usd. La estimación supone reseñas cortas; imágenes, audio o capturas de página entera suben los tokens de entrada y el coste del juicio, así que ajusta la resolución de las entradas multimodales.
¿Por qué es más barato que un modelo generativo para clasificar? Un clasificador generativo emite texto de juicio por reseña, la salida se factura por volumen y domina a escala. La Decisions API cobra 0 USD por la salida y factura una entrada compartida una vez entre preguntas. La comparación de Google es casi cinco veces más barata que Gemini 3.5 Flash-Lite con la Interactions API (blog de Google).
¿De dónde vienen las reseñas y qué plataformas se admiten? Este artículo trajo reseñas públicas reales de google_maps_reviews/reviews, app_store/reviews y google_play/reviews, a 0,001389 USD cada una. El catálogo trae muchas más plataformas con reseñas, como Yelp, TripAdvisor, Trustpilot, Amazon, Etsy y Glassdoor; el flujo de juicio es el mismo y solo cambian la capacidad y los parámetros. Mira el endpoint de Google Maps, el endpoint de la App Store, el endpoint de Google Play y el catálogo.
¿Qué pasa con las reseñas de baja confianza? La documentación sugiere enrutar por confianza: alta confianza toma la rama sola, baja confianza va a un plan alternativo o a revisión humana (sección de confianza). En la clasificación de reseñas, empujar las de baja confianza a una persona es más seguro que automatizar todo.
¿Cuántas reseñas puede juzgar una petición? Una petición lleva hasta 256K tokens de entrada compartida y hasta 1000 preguntas (documentación oficial). El enfoque simple es una reseña a la vez; meter varias en una entrada sirve cuando se juzga la misma materia muchas veces. Al correr lotes, ajusta la concurrencia al tope de peticiones por minuto de tu cuenta y reintenta con las pistas de las respuestas.
¿Hay que guardar los resultados del juicio? Guarda las tres respuestas de cada reseña con la confianza en tu propia base de datos. Así puedes revisar dónde el modelo y una persona no coincidieron y saltarte volver a juzgar la misma reseña un tiempo, lo que ahorra el coste repetido. Anota la plataforma, la capacidad, la hora de descarga y la valoración original junto a cada resultado.
Movimientos del sector
- 2026-11-11: Google lanzó la Gemini Decisions API y Gemini Decision 1 a 0,10 USD por millón de entrada, sin facturar la salida, por la Gemini API en Google AI Studio (blog de Google). Para la clasificación de reseñas suma una opción barata, facturada por entrada, para el juicio de conjunto cerrado.
- 2026-11-11: varios medios informaron el mismo día; SiliconANGLE dijo que Google entró en el mercado de «modelos de decisión» y VentureBeat destacó hasta 1000 juicios sobre una materia por petición (SiliconANGLE, VentureBeat). Confirma el modelo de decisión como su propia clase de interfaz.
- 2026-11-12: Dataconomy informó que la interfaz responde hasta 1000 preguntas sobre la misma materia en una llamada, para quien necesita juicios pequeños y rápidos (Dataconomy). Preguntar la misma materia muchas veces es donde el lote rinde.
- 2026-11-13: Tech Times calculó unos 0,50 USD por mil registros en base por lote, unas 16 veces más barato que una ruta generativa, y señaló que el modelo pasó solo el 63 % de los documentos en su prueba (Tech Times). La ventaja de precio es clara, pero el acierto se verifica con tus datos.
- 2026-11-14: aparecieron tutoriales de desarrollo, con vídeos como «Gemini Decision 1: Practice In Python» que muestran cómo escribir los tres tipos de pregunta (YouTube). El material de terceros se pone al día.
- 2026-11-16: el enrutamiento de modelos fue tema paralelo; devops.com informó que Gemini 4 Hydrogen convierte la elección de modelo en una decisión de enrutamiento (devops.com). Sacar el juicio de la generación a una puntuación rápida se vuelve común.
- 2026-11-11: las integraciones del ecosistema se desplegaron; Google listó OpenRouter, LangChain, Vercel, LiteLLM, Pydantic AI, Pipecat, LiveKit y OpenCode, con los SDK
google-genai(blog de Google, documentación de LangChain). Para quien ya usa esos marcos, conectarlo no es de cero.
Primeros pasos: tres pasos para conectar reseñas al juicio
- Trae las reseñas. Según el inicio rápido, llama a
google_maps_reviews/reviews,app_store/reviewsogoogle_play/reviewspor REST. El campobilling.charged_usdes lo que costó la llamada, y los fallos y resultados vacíos no se facturan. La configuración MCP por cliente está en la página del servidor MCP. - Define el juicio. Convierte «seguir o no, qué cola, qué urgencia» en las tres preguntas
noul,choiceyscore, con criterios claros, según la documentación de la Decisions API. - Resuelve según la confianza. Alta confianza crea y enruta un ticket, baja confianza va a una persona, y baja probabilidad con alta confianza es sin acción. Para convertir las reseñas en un producto diario, mira productizar datos de reseñas y clasificación de reseñas de apps. Precios y cuotas en la página de precios.
Referencias
- Google, «Gemini Decisions API: Fast multimodal decisions», 2026-11-11, https://blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/
- Google AI Studio, documentación «Decisions API», 2026-11, https://aistudio.google.com/docs/decisions-api
- Google AI Studio, sección «noul (sí/no)» de la Decisions API, https://aistudio.google.com/docs/decisions-api#noul
- Google AI Studio, sección «choice» de la Decisions API, https://aistudio.google.com/docs/decisions-api#choice
- Google AI Studio, sección «score» de la Decisions API, https://aistudio.google.com/docs/decisions-api#score
- Google AI Studio, sección «confidence» de la Decisions API, https://aistudio.google.com/docs/decisions-api#confidence
- Google AI Studio, sección «multiple questions» de la Decisions API, https://aistudio.google.com/docs/decisions-api#multiple-questions
- Google AI Studio, sección «best practices» de la Decisions API, https://aistudio.google.com/docs/decisions-api#best-practices
- Google AI Studio, sección «quickstart» de la Decisions API, https://aistudio.google.com/docs/decisions-api#quickstart
- Google AI Studio, página del modelo «Gemini Decision 1», 2026-11, https://aistudio.google.com/docs/models/gemini-decision-1
- Google AI Studio, «Interactions API overview», https://aistudio.google.com/docs/interactions-overview
- Google, «Gemini Developer API pricing», 2026-11, https://ai.google.dev/gemini-api/docs/pricing
- Google, «Gemini API rate limits», https://ai.google.dev/gemini-api/docs/rate-limits
- Google, «Gemini API quickstart», https://ai.google.dev/gemini-api/docs/quickstart
- Google, «Gemini API billing», https://ai.google.dev/gemini-api/docs/billing
- Google, «Gemini API models», https://ai.google.dev/gemini-api/docs/models
- EveryInfra, catálogo de capacidades de datos, leído 2026-11-17, https://api.everyinfra.com/api/v1/social/catalog
- EveryInfra, catálogo de reseñas de Google Maps, https://api.everyinfra.com/api/v1/social/catalog?platform=google_maps_reviews
- EveryInfra, catálogo de reseñas de la App Store, https://api.everyinfra.com/api/v1/social/catalog?platform=app_store
- EveryInfra, catálogo de reseñas de Google Play, https://api.everyinfra.com/api/v1/social/catalog?platform=google_play
- Model Context Protocol, especificación de transporte Streamable HTTP, 2025-06-18, https://modelcontextprotocol.io/specification/2025-06-18/basic/transports
- Model Context Protocol, especificación de ciclo de vida, 2025-06-18, https://modelcontextprotocol.io/specification/2025-06-18/basic/lifecycle
- Claude Code, documentación MCP, https://code.claude.com/docs/en/mcp
- Claude Code, documentación de costes, https://code.claude.com/docs/en/costs
- Anthropic, página de precios (proporción bytes-token), https://platform.claude.com/docs/en/about-claude/pricing
- GitHub,
googleapis/python-genai, https://github.com/googleapis/python-genai - GitHub,
googleapis/js-genai, https://github.com/googleapis/js-genai - LangChain, documentación de integración con Google, https://docs.langchain.com/oss/python/integrations/providers/google
- LiteLLM, documentación del proveedor Gemini, https://docs.litellm.ai/docs/providers/gemini
- Pipecat, documentación del clasificador de Google, https://docs.pipecat.ai/api-reference/server/classifiers/google
- LiveKit, documentación de integración con Google, https://docs.livekit.io/agents/integrations/google/
- Pydantic AI, documentación del modelo de Google, https://pydantic.dev/docs/ai/models/google/
- OpenRouter,
google/gemini-decision-1, https://openrouter.ai/google/gemini-decision-1 - Vercel AI SDK, proveedor Google, https://ai-sdk.dev/providers/ai-sdk-providers/google
- OpenCode, https://opencode.ai/
- SiliconANGLE, «Google enters the decision model market with Gemini Decisions API», 2026-11-11, https://siliconangle.com/2026/11/11/google-enters-the-decision-market-with-gemini-decisions-api/
- VentureBeat, «Google's Gemini Decision 1 model scores up to 1,000 questions in one API call», 2026-11-11, https://venturebeat.com/technology/googles-gemini-decision-1-model-scores-up-to-1-000-questions-in-one-api-call
- Dataconomy, «Google Launches Gemini Decision 1 API For 1,000 Questions Per Call», 2026-11-12, https://dataconomy.com/2026/11/12/google-launches-gemini-decision-1-api-for-1000-questions/
- Tech Times, «Google Gemini Decisions API Cuts 20-Check Cost 16x...», 2026-11-13, https://www.techtimes.com/articles/330611/20261113/google-gemini-decisions-api-cuts-20-check-cost-16x-top-decision-model-passes-63-documents.htm
- MarkTechPost, «Google Launches Gemini Decisions API With Gemini Decision 1 at $0.10/M Tokens», 2026-11-11, https://www.marktechpost.com/2026/11/11/google-gemini-decisions-api-gemini-decision-1/
- Techzine, «Google introduces Gemini Decision 1 for AI decisions», 2026-11-11, https://www.techzine.eu/news/applications/145770/google-introduces-gemini-decision-1-for-ai-decisions/
- 36Kr, «Google Unveils Its First Decision-Making AI Model», 2026-11-11, https://eu.36kr.com/en/p/4066443558491008
- devops.com, «Google's Gemini 4 Hydrogen Turns Model Choice Into a Routing Decision», 2026-11-16, https://devops.com/googles-gemini-4-hydrogen-turns-model-choice-into-a-routing-decision
- YouTube, «Gemini Decision 1: Practice In Python», 2026-11-14, https://www.youtube.com/watch?v=rgBOfmtFWjQ
- YouTube, «Google's AI That Doesn't Write Text (Decisions API Tutorial)», 2026-11-13, https://www.youtube.com/watch?v=UwaJygCdFW8
- IETF, RFC 9110 «HTTP Semantics» (429 y Retry-After), https://www.rfc-editor.org/rfc/rfc9110
- Python, biblioteca estándar
json, https://docs.python.org/3/library/json.html - Google AI Studio, índice de documentación de la Decisions API (llms.txt y coding agents), https://aistudio.google.com/docs/coding-agents
Referencia BL-173