Alternativas a Bright Data: datos o proxies, seis proveedores por cada 1.000 resultados
Alternativas a Bright Data: primero decide si quieres datos o proxies. Prueba del 16/11: posts de Instagram a 0,0028 USD por 1.000; Bright Data, 1,50 USD.
Bright Data cobra sus scrapers listos para usar a 1,50 USD por cada 1.000 registros en pago por uso. El 16 de noviembre de 2026, entre las 00:21 y las 00:31 hora de Singapur (SGT), hicimos llamadas reales a EveryInfra sobre Instagram, Amazon y Google Maps. Por cada 1.000 resultados, los posts de una cuenta de Instagram costaron 0,0028 USD y las reseñas de Google Maps, 0,0139 USD. Los lugares de Google Maps salieron a 0,0278 USD y los productos de una búsqueda en Amazon, a 0,0447 USD. Es decir, entre 33,5 y 540 veces menos que la tarifa de lista de Bright Data.
La diferencia más pequeña aparece en un perfil suelto de Instagram. Nuestra llamada devuelve un solo perfil, así que 1.000 perfiles cuestan 0,556 USD, 2,7 veces menos que Bright Data. Con el código API60 que muestra su página de precios, Bright Data baja a 0,60 USD durante tres meses, solo un 8 % por encima. El otro tipo de comprador busca tráfico de proxy. El tráfico residencial de Bright Data cuesta 8 USD por GB (4 USD con un código del 50 %), y el plan Scale S5 de ZenRows sale a 1,67 USD por GB. Nuestra página de precios lista proxies IP vendidos por paquetes de tráfico, pero el 16 de noviembre nuestro catálogo de proxies marcaba todos los tipos como no disponibles.
Quien busca «alternativas a Bright Data» suele querer una de dos cosas. El primer grupo usa la Web Scraper API de Bright Data, sus datasets o Scraper Studio. Quiere perfiles de Instagram, productos de Amazon y lugares de Google Maps en filas limpias, y paga por fila. El segundo grupo usa los proxies de Bright Data o su Web Unlocker. Escribe sus propios scrapers, solo necesita IP limpias y desbloqueo, y paga por GB, por IP o por solicitud.
Pusimos las cinco alternativas en esos mismos dos grupos. Apify está en los dos, porque su Store vende scrapers que cobran por resultado y además vende proxies. ZenRows, ScraperAPI y Firecrawl venden sobre todo scraping general: una solicitud devuelve una página web y se cobra en créditos. EveryInfra está sobre todo en el primer grupo: cobra por llamada y devuelve nombres de campo fijos. En el segundo grupo tiene la herramienta read para páginas sueltas, a 0,694 USD por cada 1.000, y los proxies IP de su lista no estaban disponibles el día de la prueba. Cada tabla de precios de este artículo compara proveedores dentro de un solo grupo.
Ya publicamos un análisis de los precios de Bright Data. Ese artículo cubre ocho productos de Bright Data y el punto de equilibrio del plan Scale. Probó fichas de Amazon, posts de TikTok y la búsqueda de Google. La página de alternativas a Bright Data es un resumen de una sola pantalla. Aquí sumamos las cinco alternativas y probamos trabajos nuevos: perfiles, posts y comentarios de Instagram, lugares y reseñas de Google Maps, y la búsqueda de Amazon en modo rápido.
Todos los precios de los proveedores salen de sus páginas públicas de precios, su documentación y sus fichas en la Store. Los leímos el 16 de noviembre de 2026, entre las 00:16 y las 00:40 SGT. No abrimos cuentas con los cinco proveedores ni llamamos a sus API. Por eso la columna del proveedor muestra el precio público de lista. La columna de EveryInfra muestra lo cobrado en esta prueba, tomado de billing.charged_usd en cada respuesta.
Alternativas a Bright Data en dos grupos: qué vende cada proveedor
Las seis empresas venden cosas muy distintas. La página general de precios de Bright Data agrupa sus productos en cuatro bloques. El acceso web incluye Unlocker, Crawl, SERP y Browser API. El bloque de datos incluye Scraper API, Scraper Studio, datasets y Data Firehose. Después vienen la analítica de datos, la recolección gestionada y los proxies.
| Producto en el menú de Bright Data | Precio «desde» en el menú | Lo que dice la página del producto |
|---|---|---|
| Unlocker y SERP | 1 USD por cada 1.000 solicitudes | La página de SERP muestra tramos por cada 1.000 resultados |
| Scraper API | 1 USD, tachado, a 0,75 USD por cada 1.000 registros | Pago por uso 1,50 USD; excedente de Scale 1,30 USD |
| Datasets | 250 USD por 100.000 registros | Hasta 80 % menos con actualización mensual |
| Proxies residenciales | 5 USD, tachado, a 2,50 USD por GB | Pago por uso 8 USD, o 4 USD con código |
| Proxies de centro de datos | 0,90 USD por IP | Por IP |
| Proxies ISP | 1,30 USD por IP | Por IP |
Casi todos los precios «desde» del menú son de los tramos altos o de promociones. Las páginas de cada producto muestran la tarifa de pago por uso, la que pagas sin compromiso mensual. En este artículo usamos esas tarifas.
| Proveedor | Registros listos | Scraping general (devuelve páginas) | Proxies | Datasets históricos | Unidad de cobro |
|---|---|---|---|---|---|
| Bright Data | Web Scraper API, 1.301 scrapers | Unlocker, Crawl, Browser API | Residencial, centro de datos, ISP | Sí, desde 250 USD por 100.000 | Por registro, por solicitud, por GB, por IP |
| Apify | Scrapers de la Store por resultado o por uso | Website Content Crawler y otros | Residencial 7–8 USD por GB, IP de centro de datos | No | Por resultado, por unidad de cómputo, por GB |
| ZenRows | Sin campos por plataforma; Extract devuelve JSON | Fetch, Crawl, Batch, Browser | Residencial a 25.000 créditos por GB | No | Créditos por página |
| ScraperAPI | Endpoints estructurados de Amazon, Google, Walmart | API estándar, Crawler, DataPipeline | No se vende aparte | No | Créditos por solicitud |
| Firecrawl | Sin campos por plataforma; el formato JSON cuesta más | Scrape, Crawl, Map, Search | No | No | Créditos por página |
| EveryInfra | 106 plataformas, 574 capacidades, campos fijos | Herramienta read para páginas sueltas, cobro por llamada | En la lista; no disponibles el 16 nov | No | Precio fijo en USD por llamada |
El conteo de scrapers de Bright Data sale de su archivo scrapers.json, que se actualiza cada día. El 16 de noviembre listaba 1.301 scrapers en 1.207 dominios. De ellos, instagram.com tenía 4 (comentarios, posts, perfiles y Reels), amazon.com tenía 5 y google.com, 10. Nuestras cifras salen del catálogo de EveryInfra, leído a las 00:16:37 SGT del mismo día: 106 plataformas y 574 capacidades, 539 de ellas disponibles.
ZenRows y Firecrawl pueden convertir una página en JSON. Pero los dos cobran por página, no por registro. Una página de búsqueda de Amazon contiene decenas de productos, y ambos la cobran como una sola página. Los campos los elige un modelo o una regla, así que sus nombres pueden cambiar de una ejecución a otra.
Empieza con una pregunta: ¿en qué se va hoy la mayor parte de tu factura de Bright Data? Si se va en tráfico residencial, ZenRows y Apify son sustitutos directos; EveryInfra hoy no te sirve ahí, porque su catálogo de proxies no estaba disponible el 16 de noviembre. Si se va en registros de Instagram, Amazon o Google Maps, los sustitutos directos son Apify y EveryInfra. Los endpoints estructurados de ScraperAPI también cubren una parte de ese trabajo.
La tabla general: unidades, fallos, gasto mínimo, nivel gratuito y MCP
| Concepto | Bright Data | Apify | ZenRows | ScraperAPI | Firecrawl | EveryInfra |
|---|---|---|---|---|---|---|
| Entrada mínima de pago | Pago por uso sin cuota, con saldo previo | Starter 19 USD/mes | Build B1 19 USD/mes | Hobby 49 USD/mes | Hobby 19 USD/mes | Sin cuota mensual; primera recarga 10 USD |
| Nivel gratuito | 5.000 créditos/mes | 5 USD de crédito/mes | 5.000 créditos/mes | 5.000 créditos por 7 días, luego 1.000/mes | 1.000 créditos/mes | 1 USD una vez, 24 horas |
| Precio por registro | 1,50 USD por 1.000 (1,30 USD en excedente de Scale) | 1,50–5,00 USD por 1.000 (tres scrapers) | No aplica | Página de Amazon 5 créditos, Google 25 | No aplica | 0,000556–0,002236 USD por llamada (esta prueba) |
| Proxies | Residencial 8 USD/GB, 4 USD con código | Residencial 7–8 USD/GB | 25.000 créditos por GB | No se vende aparte | No | No |
| Solicitudes fallidas | Entregas fallidas gratis; registros con entrada errónea se cobran | Los eventos se cobran al ejecutarse | Gratis; 404 y 410 cuentan como éxito | Se cobran 200 y 404 | Sin resultado no cobra; 403 y 404 cuestan 1 crédito | Fallos y resultados vacíos gratis, con reembolso en la respuesta |
| Créditos sin usar | El nivel gratuito no se acumula | El crédito del plan es mensual | Vencen; los paquetes extra pasan una vez | No se acumulan | Scale acumula un mes | El saldo no vence |
| MCP | MCP remoto, 5.000 solicitudes gratis/mes | https://mcp.apify.com | https://mcp.zenrows.com/mcp | https://mcp.scraperapi.com/mcp | Firecrawl MCP v3 | https://api.everyinfra.com/mcp |
Tres diferencias pesan más que el resto. La primera: Bright Data y EveryInfra no tienen cuota mensual. Recargas saldo y se descuenta según lo usas. Apify, ZenRows, ScraperAPI y Firecrawl son suscripciones, y lo que no gastas en el mes casi siempre se pierde.
La documentación de precios de ZenRows dice que los créditos del plan vencen en cada renovación. El archivo de precios de ScraperAPI no ofrece acumulación de créditos en ningún plan. Firecrawl solo acumula un mes en el plan Scale. Nuestra página de precios indica que el saldo recargado no vence.
La segunda: cada proveedor define «fallo» a su manera. La página de precios de Firecrawl dice que una página que devuelve 403 o 404 cuesta igual 1 crédito. ZenRows cuenta 404 y 410 como resultados válidos. ScraperAPI cobra 200 y 404, y también las solicitudes que cancelas después de 70 segundos. La tercera: los seis ofrecen MCP. Lo que los separa es la unidad que cobra cada llamada MCP.
El grupo de datos: cuánto cuestan 1.000 resultados
En el primer grupo, la unidad es 1.000 resultados. La página de la Web Scraper API de Bright Data da tres cifras. El nivel gratuito ofrece 5.000 registros al mes, y el pago por uso cuesta 1,50 USD por cada 1.000. El plan Scale cuesta 499 USD al mes con 384.000 registros incluidos, y luego 1,30 USD por cada 1.000. La página también muestra el código API60, con un 60 % de descuento en la Scraper API durante tres meses.
| Opción de la Web Scraper API de Bright Data | Precio por 1.000 registros | Condición |
|---|---|---|
| Nivel gratuito | 0 USD | 5.000 registros al mes, no se acumulan |
| Pago por uso | 1,50 USD | Sin cuota mensual |
| Pago por uso con API60 | 0,60 USD | Primeros tres meses |
| Volumen incluido en Scale | 1,30 USD (unos 499 USD / 384.000) | 499 USD al mes |
| Excedente de Scale | 1,30 USD | Por encima de 384.000 registros |
Los scrapers de la Apify Store cobran por evento. Un mismo scraper tiene un precio distinto en cada plan. Leímos cada tramo en los datos de precios de tres fichas: el Instagram Scraper, el Amazon Product Scraper y el Google Maps Scraper.
| Scraper de Apify, por cada 1.000 resultados | Free | Starter | Scale | Business |
|---|---|---|---|---|
| Instagram Scraper (por resultado) | 2,70 USD | 2,30 USD | 1,90 USD | 1,50 USD |
| Amazon Product Scraper (por producto) | 5,00 USD | 4,00 USD | 3,50 USD | 3,00 USD |
| Google Maps Scraper (por lugar) | 4,00 USD | 3,00 USD | 2,00 USD | 1,50 USD |
| Complemento de reseñas de Google Maps (por reseña) | 0,50 USD | 0,50 USD | 0,37 USD | 0,26 USD |
| Inicio de ejecución de Google Maps (por ejecución) | 0,007 USD | 0,007 USD | 0,007 USD | 0,007 USD |
Del lado de EveryInfra, la cuenta es sencilla. Tomas charged_usd de una llamada, lo divides entre las filas que volvieron y multiplicas por 1.000. Dividimos entre las filas devueltas y no entre el limit que enviamos. La llamada al hashtag de Instagram pidió 100 filas y devolvió 24. Si dividiéramos entre 100, nuestro precio parecería más de cuatro veces menor.
| Hora (SGT) | Capacidad | Entrada | Filas | Tiempo | Cobrado | Por 1.000 |
|---|---|---|---|---|---|---|
| 00:21:11 | instagram/profile | nasa | 1 | 12,4 s | 0,000556 USD | 0,556 USD |
| 00:21:32 | instagram/hashtag | coldbrew, limit 100 | 24 | 8,1 s | 0,000556 USD | 0,0232 USD |
| 00:22:46 | amazon/search | robot vacuum, limit 50 | 50 | 44,3 s | 0,002236 USD | 0,0447 USD |
| 00:25:02 | google_maps_reviews/search | dentist, Denver CO, limit 50 | 50 | 8,1 s | 0,001389 USD | 0,0278 USD |
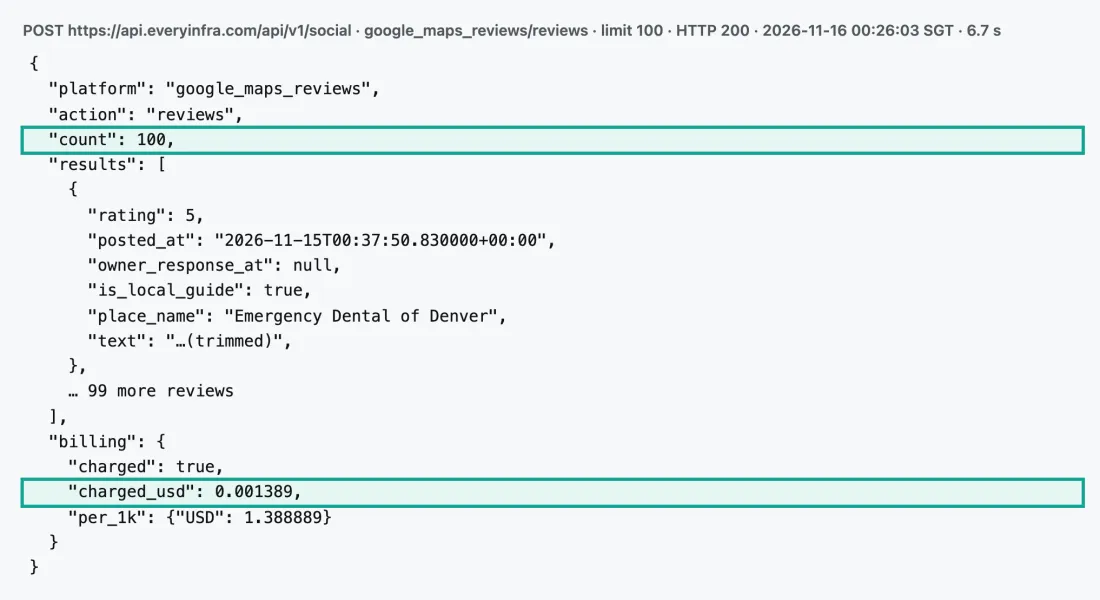
| 00:26:03 | google_maps_reviews/reviews | una clínica, limit 100 | 100 | 6,7 s | 0,001389 USD | 0,0139 USD |
| 00:26:43 | instagram/user_posts | nasa, limit 200, asíncrono | 200 | 74 s hasta el resultado | 0,000556 USD | 0,0028 USD |
| 00:29:30 | google_maps_reviews/search | la misma, página 2, asíncrono | 50 | 64 s hasta el resultado | 0,001389 USD | 0,0278 USD |
| 00:29:39 | amazon/search | la misma, fast: true | 48 | 8,5 s | 0,002236 USD | 0,0466 USD |
| 00:31:04 | instagram/comments | un post de NASA, limit 100 | 30 | 17,5 s | 0,000792 USD | 0,0264 USD |
La tabla recoge nueve llamadas cobradas del 16 de noviembre, entre las 00:21 y las 00:31 SGT. La de las 00:29:30 es la página 2 de la búsqueda de las 00:25:02 y se cobra como llamada propia. Los nueve cobros suman 0,011099 USD. Otras siete solicitudes no costaron nada: dos respuestas 429 por límite de peticiones, un 422 que pedía modo asíncrono y cuatro errores 503 (dos de reseñas de Amazon y dos de una misma cuenta de Instagram inexistente). Cada cobro coincidió con el price_usd del catálogo para esa capacidad.
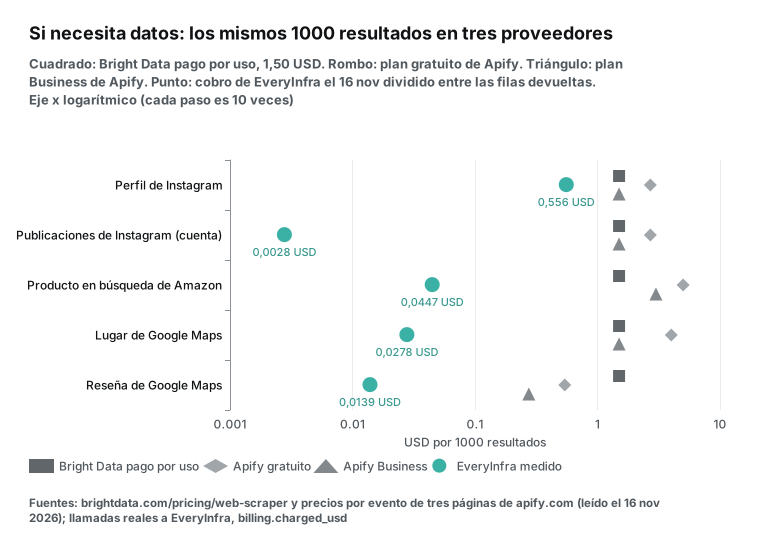
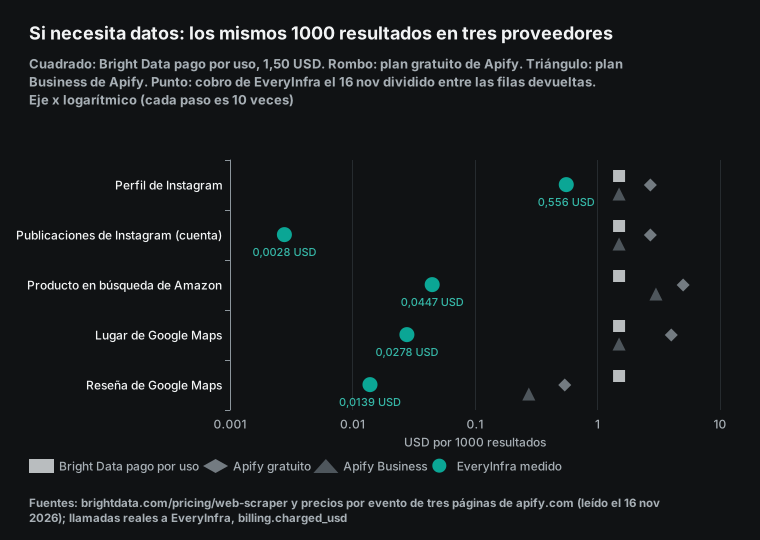
La fila del perfil de Instagram es la más cercana. Nuestros 0,556 USD quedan 2,7 veces por debajo de Bright Data y 4,9 veces por debajo de Apify Free. Las otras cuatro filas están a uno o dos órdenes de magnitud. La causa es la unidad de cobro: Bright Data y Apify cobran cada fila, y nosotros cobramos cada llamada.
| Trabajo, por cada 1.000 filas | EveryInfra (real) | Bright Data pago por uso | Razón | Apify Business | Razón |
|---|---|---|---|---|---|
| Perfil de Instagram | 0,556 USD | 1,50 USD | 2,7x | 1,50 USD | 2,7x |
| Posts de una cuenta de Instagram | 0,0028 USD | 1,50 USD | 540x | 1,50 USD | 540x |
| Posts de un hashtag | 0,0232 USD | 1,50 USD | 64,7x | 1,50 USD | 64,7x |
| Comentarios de Instagram | 0,0264 USD | 1,50 USD | 56,8x | 1,50 USD | 56,8x |
| Productos de búsqueda en Amazon | 0,0447 USD | 1,50 USD | 33,5x | 3,00 USD | 67,1x |
| Lugares de Google Maps | 0,0278 USD | 1,50 USD | 54x | 1,50 USD | 54x |
| Reseñas de Google Maps | 0,0139 USD | 1,50 USD | 108x | unos 0,275 USD | 19,8x |
Caso 1: perfiles, posts y comentarios de Instagram
A las 00:21:11 SGT llamamos a instagram/profile con la cuenta de NASA. Tardó 12,4 segundos y devolvió un objeto. La cuenta tenía 104.331.773 seguidores, seguía a 91 cuentas y sumaba 5.010 publicaciones; las marcas de verificada y de empresa estaban en verdadero. El objeto traía además 5 enlaces externos y los posts recientes. El catálogo lista 19 campos para esta capacidad, como follower_count, post_count, is_verified y recent_posts.
El catálogo agrega una advertencia: algunas llamadas no devuelven recent_posts, avatar_hd_url, category ni highlight_count. Un perfil es una llamada de 0,000556 USD, así que 1.000 perfiles cuestan 0,556 USD.
La documentación del scraper de Instagram de Bright Data separa perfiles, posts, Reels y comentarios en cuatro identificadores de dataset. Un registro de perfil incluye campos como followers, posts_count, is_verified y biography. El registro de ejemplo de la documentación tiene fecha del 6 de septiembre de 2026. En pago por uso, 1.000 perfiles cuestan 1,50 USD.
El Instagram Scraper de Apify cuenta un perfil como un resultado: 2,70 USD por cada 1.000 en Free y 1,50 USD en Business. Imagina que tu trabajo es actualizar cada semana los seguidores de unos miles de creadores. En ese caso, los tres proveedores se diferencian en unos pocos dólares al mes. A ese tamaño importan más los campos y la estabilidad que el precio.
A las 00:26:43 enviamos un trabajo asíncrono de instagram/user_posts para NASA con limit 200. En 1,9 segundos recibimos un 202 y un poll_url, y la llamada cobró 0,000556 USD. La consulta de las 00:27:57 mostró 200 posts: 137 imágenes y 63 videos, publicados entre el 9 de junio y el 14 de noviembre de 2026 (SGT). La consulta de estado no se cobra.
Cada uno de los 200 posts tenía texto, número de «me gusta», número de comentarios, fecha y URL de imagen. Los 63 videos traían además la URL del video. Dos campos faltaron en las 200 filas: view_count y top_comments. El catálogo incluye los dos entre los campos que algunas llamadas no devuelven. Con 200 filas, el precio es de 0,0028 USD por cada 1.000, 540 veces menos que los 1,50 USD de Bright Data y de Apify Business.
Los hashtags y los comentarios quedan en medio. A las 00:21:32 llamamos a instagram/hashtag con #coldbrew y limit 100. Tardó 8,1 segundos y devolvió 24 filas, así que el precio es de 0,0232 USD por cada 1.000. De las 24 filas, 19 tenían nombre de autor y 8, ubicación. A las 00:31:04 llamamos a instagram/comments sobre el post de NASA con más comentarios (19.543).
Pedimos 100 comentarios y recibimos 30 en 17,5 segundos. La llamada cobró 0,000792 USD, es decir, 0,0264 USD por cada 1.000. El catálogo fija los límites: algunas llamadas devuelven como máximo 80 comentarios, y otras, 30. Esta prueba llegó justo a 30. Si analizas el sentimiento de un post viral, una llamada no trae todos los comentarios, así que reparte el trabajo entre más posts.
Bright Data y Apify cobran por fila: más filas, más costo. La profundidad de cada ejecución la deciden sus scrapers. La ficha de Apify añade que el plan Free solo obtiene una página de comentarios por post, unos 15. La comparación de campos de seis métodos está en nuestro ranking de scrapers de Instagram.
Caso 2: productos de una búsqueda en Amazon, y cuándo ScraperAPI sale más barato
A las 00:22:46 SGT llamamos a amazon/search con «robot vacuum» y limit 50. Tardó 44,3 segundos, devolvió 50 productos y cobró 0,002236 USD, o 0,0447 USD por cada 1.000. A las 00:29:39 repetimos la búsqueda con "fast": true. Tardó 8,5 segundos, devolvió 48 productos y cobró lo mismo, o 0,0466 USD por cada 1.000. El catálogo indica que el modo rápido quita 8 campos por fila y mantiene el precio.
| Grupo de campos | Modo completo (50 filas) | Modo rápido (48 filas) |
|---|---|---|
| ASIN, título, URL, valoración, número de valoraciones | 50 de 50 | 48 de 48 |
| Marca, stock, categoría, características, ranking de más vendidos | 50 de 50 | No vienen |
| Precio | 44 de 50 | 48 de 48 |
| Nombre del vendedor | 45 de 50 | No viene |
| Precio de lista | 38 de 50 | 37 de 48 |
| Descripción | 20 de 50 | No viene |
| Campos por fila | 20 | 12 |
| Tiempo | 44,3 s | 8,5 s |
El modo rápido bajó la espera de 44,3 a 8,5 segundos y los campos de 20 a 12. Usa el modo completo si necesitas vendedores o descripciones. Usa el rápido para seguir posiciones y precios.
El scraper de productos de Amazon de Bright Data abre cada resultado y devuelve la ficha completa, a 1,50 USD por cada 1.000. El Amazon Product Scraper de Apify cobra 5,00 USD por cada 1.000 en Free y 3,00 USD en Business. Sus registros tienen más campos que nuestras filas de lista, como variantes y resúmenes de reseñas. Si necesitas fichas completas, compáralos con nuestra capacidad amazon/profile. Su precio de catálogo es de 0,001389 USD por llamada, o 1,389 USD por cada 1.000.
Eso queda apenas un 7,4 % por debajo del pago por uso de Bright Data, y por encima del excedente de 1,30 USD del plan Scale. Nuestro análisis de precios de Bright Data ya probó este caso, así que aquí no lo repetimos.
El endpoint de búsqueda de Amazon de ScraperAPI se cobra como una solicitud normal. Un dominio de Amazon cuesta 5 créditos por llamada, y cada llamada devuelve una página de búsqueda. La documentación no dice cuántos productos trae una página. Estimamos 48 por página, la cifra que devolvió nuestra llamada en modo rápido.
| Plan de ScraperAPI | Cuota mensual | Por 1.000 solicitudes a Amazon | Por 1.000 productos (48 por página, estimado) | Frente a nuestros 0,0447 USD |
|---|---|---|---|---|
| Hobby | 49 USD | 2,45 USD | 0,051 USD | Nosotros, 1,14 veces menos |
| Startup | 149 USD | 0,745 USD | 0,0155 USD | Nosotros, 2,88 veces más |
| Business | 299 USD | 0,498 USD | 0,0104 USD | Nosotros, 4,3 veces más |
| Advanced | 1.975 USD | 0,459 USD | 0,0096 USD | Nosotros, 4,67 veces más |
Esta tabla depende de dos condiciones. Tienes que gastar todos los créditos del mes. Además, cada página tiene que traer unos 48 productos, y las categorías pequeñas o las páginas profundas traen menos. Con esas condiciones, un equipo con mucho volumen mensual que solo necesita listas de búsqueda de Amazon paga menos en los planes medios y altos de ScraperAPI.
En esta prueba no obtuvimos reseñas de Amazon. A las 00:26:16 y a las 00:28:20 SGT llamamos a amazon/reviews con dos aspiradoras robot Shark. Tras 20,5 y 23,9 segundos, las dos devolvieron 503 con el motivo access_blocked. Eso significa que el producto pide inicio de sesión o tiene restricciones. Ambas llamadas se reembolsaron y charged_usd quedó en 0. Bright Data y la Apify Store listan scrapers de reseñas de Amazon.
Caso 3: lugares y reseñas de Google Maps
A las 00:25:02 SGT llamamos a google_maps_reviews/search para buscar dentistas en Denver, con limit 50. Tardó 8,1 segundos, devolvió 50 lugares y cobró 0,001389 USD. Los 19 campos tenían valor en las 50 filas. Entre ellos están el identificador del lugar, nombre, categoría, dirección, coordenadas, teléfono, sitio web, valoración y número de reseñas. La respuesta incluía además un next_page_token.
A las 00:28:12 pedimos la página 2 en modo síncrono. A los 0,2 segundos volvió un 422 async_required, porque la página 2 supera las 60 filas desde el inicio. Esa llamada no costó nada. A las 00:29:30 la reenviamos con "mode": "async", y la consulta de las 00:30:34 devolvió otros 50 lugares por otros 0,001389 USD. Un lugar apareció en las dos páginas, así que hay 99 lugares únicos.
En los 99 lugares, la valoración mediana fue 4,8. La mediana de reseñas fue 371, con un rango de 8 a 2.263. Las 100 filas tenían teléfono y 98 tenían sitio web. A las 00:26:03 llamamos a google_maps_reviews/reviews para la primera clínica de la página 1, con limit 100. Tardó 6,7 segundos, devolvió 100 reseñas y cobró 0,001389 USD, o 0,0139 USD por cada 1.000.
De las 100 reseñas, 94 tenían cinco estrellas, 2 tenían cuatro, 1 tenía tres y 3 tenían una. Había texto en 70, y el negocio había respondido a 88. Las fechas iban del 8 de octubre de 2022 al 15 de noviembre de 2026. Una agencia local puede usar estos datos tal cual: ordena los negocios de una ciudad y luego mira dónde se concentran sus quejas. Para 100 lugares con 100 reseñas cada uno, son 102 llamadas, unos 0,14 USD a precio de catálogo.
El Google Maps Scraper de Apify cobra por evento, como muestra la tabla de tramos de arriba. La nota de precios del centro de ayuda de Apify usa la tarifa base de 4 USD por cada 1.000 lugares. Los filtros, como categoría, estrellas mínimas o «tiene sitio web», suman 0,001 USD por lugar y por filtro. Así, 1.000 dentistas de Denver cuestan al menos 4,00 USD en Apify Free, y 5,00 USD con el filtro de sitio web.
En reseñas, el precio unitario de Apify es mucho más bajo. Toma nuestra forma de trabajo: un lugar con 100 reseñas. Apify Free sale a 0,54 USD por cada 1.000 reseñas, que es la tarifa de un lugar más 100 reseñas, dividida entre 100. Apify Business sale a 0,275 USD. El scraper de reseñas de Google Maps de Bright Data cobra 1,50 USD por cada 1.000. Su documentación de scrapers de Google dice que puedes filtrar reseñas por una ventana de días hacia atrás.
El endpoint de búsqueda de Google Maps de ScraperAPI cuesta 25 créditos por llamada en un dominio de Google. La URL de paginación de su documentación avanza de 20 en 20, así que estimamos 20 lugares por página.
| Proveedor y plan | 1.000 lugares de Google Maps | 1.000 reseñas (1 lugar, 100 reseñas por ejecución) |
|---|---|---|
| EveryInfra (real) | 0,0278 USD | 0,0139 USD |
| Bright Data pago por uso | 1,50 USD | 1,50 USD |
| Apify Free | 4,00 USD (más 0,007 USD por ejecución) | 0,54 USD |
| Apify Business | 1,50 USD (más 0,007 USD por ejecución) | 0,275 USD |
| ScraperAPI Hobby (20 por página, estimado) | 0,61 USD | No leímos endpoint de reseñas |
| ScraperAPI Startup (estimado) | 0,19 USD | No leímos endpoint de reseñas |
| ScraperAPI Advanced (estimado) | 0,11 USD | No leímos endpoint de reseñas |
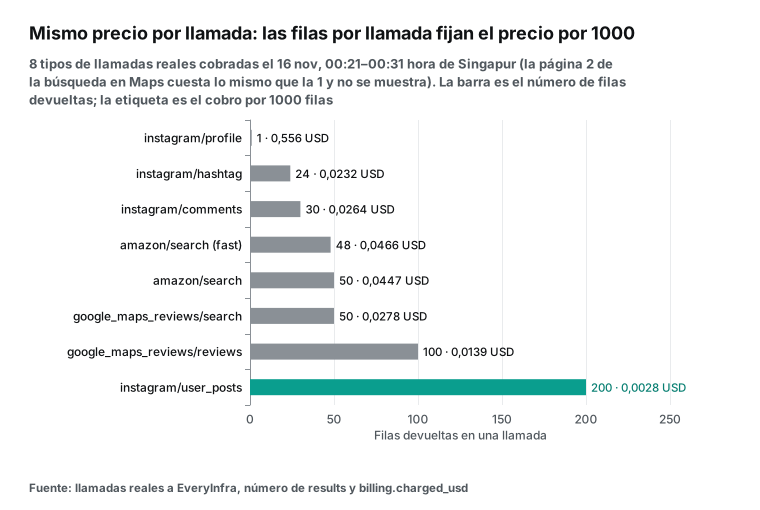
Una lista de precios por llamada muestra un solo número, como 0,000556 USD para Instagram. Por cada 1.000 filas, en cambio, el perfil cuesta 0,556 USD y los posts, 0,0028 USD. Son 200 veces de diferencia, porque una llamada devuelve 1 fila y la otra, 200. Para estimar tu factura, convierte primero cada llamada en precio por 1.000 filas, con las filas que ese tipo de llamada suele devolver.
El grupo de proxies y scraping general: por GB y por crédito de página
En el segundo grupo, las unidades son GB de tráfico y créditos por página. Empecemos por los proxies. El 16 de noviembre, la página de precios de proxies residenciales de Bright Data mostraba cuatro tramos. Los cuatro anuncian el código RESIGB50 con un 50 % de descuento. La página dice también que Bright Data iguala tu primer depósito hasta 500 USD.
| Tramo residencial de Bright Data | Tráfico incluido | Por GB | Por GB con RESIGB50 |
|---|---|---|---|
| Pago por uso | Ninguno | 8 USD | 4 USD |
| 499 USD al mes | 141 GB (a precio con código) | 7 USD | 3,54 USD (se muestra 4) |
| 999 USD al mes | 332 GB (a precio con código) | 6 USD | 3,01 USD (se muestra 3) |
| 1.999 USD al mes | 798 GB (a precio con código) | 5 USD | 2,51 USD (se muestra 3) |
Los GB incluidos en cada plan se calculan con el precio con código, no con el de lista: 499 USD entre 141 GB dan 3,54 USD, que la página redondea a 4. Sin el código, 499 USD a 7 USD por GB compran solo 71 GB, más o menos la mitad de lo que muestra la página, así que confirma que el código vale para tu cuenta. El menú general dice «desde 5 USD, ahora 2,50 USD por GB»: es el precio de lista y el precio con código del plan de 1.999 USD.
Un ejemplo con 100 GB de tráfico residencial al mes. En Bright Data, el pago por uso cuesta 400 USD con el código y 800 USD sin él. El plan de 499 USD cuesta 499 USD aunque no lo agotes, así que por debajo de unos 125 GB al mes (499 / 4), el pago por uso con código sale más barato. En Apify Scale, a 7 USD por GB, los mismos 100 GB cuestan 700 USD.
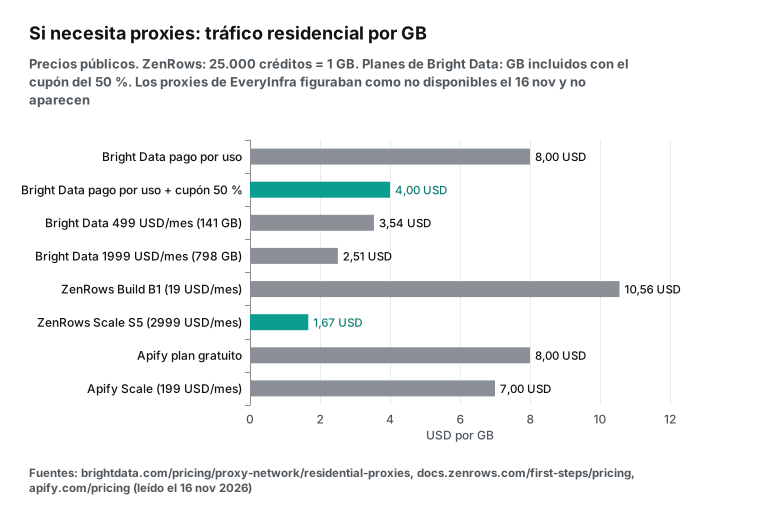
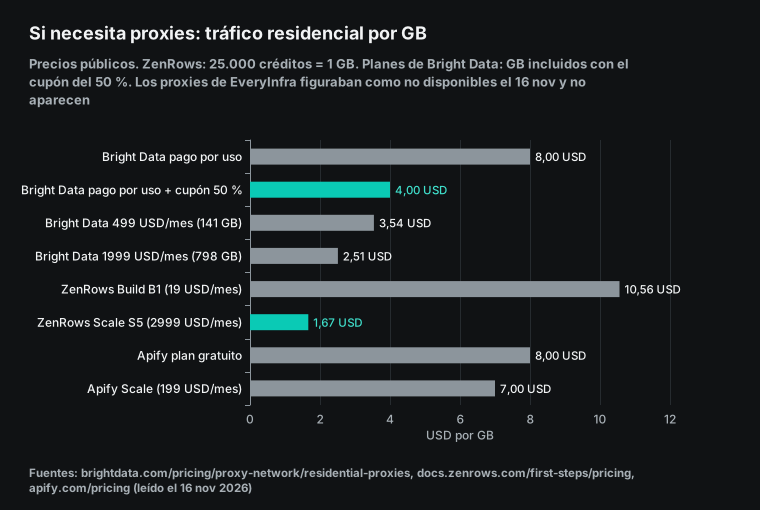
ZenRows no publica un precio por GB aparte. Su documentación de precios dice que los planes de pago cobran el tráfico residencial a 25.000 créditos por GB. También da una regla práctica: 1 GB equivale a 25.000 créditos, que equivalen a 1.000 páginas protegidas. Por eso el precio por GB depende del plan. Build B1 cuesta 19 USD al mes por 45.000 créditos, que alcanzan para 1,8 GB como máximo, o 10,56 USD por GB.
Scale S5 cuesta 2.999 USD al mes por 45 millones de créditos, o 1,67 USD por GB. Es la tarifa más baja del gráfico. Pero solo la obtienes si gastas 1.800 GB al mes en tráfico residencial. La página de precios de Apify lista el proxy residencial a 8 USD por GB en Free, 7,50 USD en Starter y 7 USD en Scale. Las IP de centro de datos empiezan en 0,60 USD cada una como complemento.
Bright Data también subió una barrera para los proxies residenciales el mes pasado. Sus notas de versión del 19 de octubre de 2026 dicen que la red residencial ya no admite acceso inmediato sin KYC (verificación de identidad). El 24 de octubre pidió pasar los proxies de acceso inmediato que quedaban a proxies ISP o a Web Unlocker. Esos proxies salieron de las cuentas desde el 9 de noviembre de 2026. La documentación de proxies residenciales trata el KYC como un paso aparte, y para un desarrollador independiente ese paso puede pesar más que el precio.
El scraping general cobra créditos por página, y los tres proveedores publican sus multiplicadores. ZenRows cobra 1 crédito por página normal, 5 con renderizado JS, 10 con proxies premium y 25 con las dos cosas. Su documentación dice que esos multiplicadores son iguales en todos los planes. La documentación de créditos de ScraperAPI da 1 por página normal, 5 por Amazon, 25 por Google, 30 por LinkedIn y 10 por renderizado. Firecrawl cobra 1 crédito por página, 4 más por el formato JSON y 2 créditos por cada 10 resultados de búsqueda.
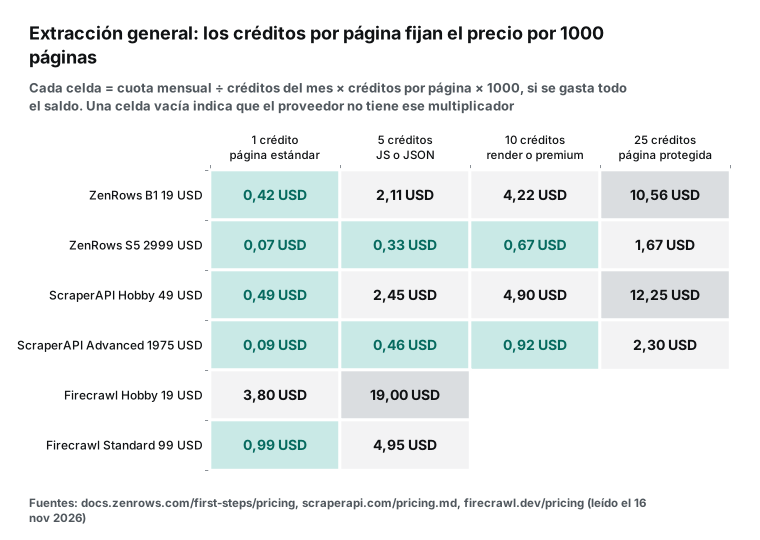
| Plan | Cuota mensual | Créditos al mes | Página normal por 1.000 | Página protegida (25 créditos) por 1.000 | Estructurado (JSON o comercio) |
|---|---|---|---|---|---|
| ZenRows Build B1 | 19 USD | 45.000 | 0,42 USD | 10,56 USD | Extract no suma cargo; se cobra el Fetch usado |
| ZenRows Scale S5 | 2.999 USD | 45.000.000 | 0,07 USD | 1,67 USD | Igual |
| ScraperAPI Hobby | 49 USD | 100.000 | 0,49 USD | 12,25 USD | Página de Amazon 2,45 USD por 1.000 |
| ScraperAPI Advanced | 1.975 USD | 21.500.000 | 0,09 USD | 2,30 USD | Página de Amazon 0,46 USD por 1.000 |
| Firecrawl Hobby | 19 USD | 5.000 | 3,80 USD | Sin ese multiplicador | Formato JSON 19,00 USD por 1.000 |
| Firecrawl Standard | 99 USD | 100.000 | 0,99 USD | Sin ese multiplicador | Formato JSON 4,95 USD por 1.000 |
La tabla de calor deja una idea clara. En scraping general, el multiplicador mueve el precio más que el plan. En ZenRows B1, una página normal cuesta 0,42 USD por cada 1.000 y una protegida, 10,56 USD: 25 veces más. Las preguntas frecuentes de ZenRows dicen que Adaptive Stealth Mode empieza por la configuración más ligera y solo cobra la que funciona. Por eso no sabes de antemano cuántos créditos costará una página.
| Plan de ZenRows | Pago mensual | Pago anual mostrado por mes | Créditos al mes |
|---|---|---|---|
| Build B1 | 19 USD | 16 USD | 45.000 |
| Launch L1 | 69 USD | 58 USD | 250.000 |
| Growth G1 | 199 USD | 166 USD | 1.200.000 |
| Scale S1 | 549 USD | 458 USD | 5.000.000 |
| Scale S5 | 2.999 USD | Unos 2.499 USD | 45.000.000 |
El pago anual equivale a 12 meses por el precio de 10. La página de precios de ZenRows muestra por defecto esos precios anuales, como 16 y 58 USD. Para comparar, usa los precios mensuales; si no, calcularás ZenRows cerca de un 17 % por debajo de lo real.
Cada grupo tiene su terreno. Si sacas un perfil de Instagram como página protegida de ZenRows, 1.000 perfiles cuestan 10,56 USD en B1 o 1,67 USD en S5, y además escribes tu propio parser. En EveryInfra, instagram/profile cuesta 0,556 USD por cada 1.000, y en Bright Data, 1,50 USD. Ahora invierte el trabajo: 10.000 páginas comunes de blogs, documentación o noticias. ZenRows S5 cobra 0,07 USD por cada 1.000 páginas y ScraperAPI Advanced, 0,09 USD; en EveryInfra esas páginas pasan por la herramienta read, a 0,694 USD por cada 1.000, entre 7,7 y 9,9 veces esos dos planes.
bright data alternatives free: qué compra cada nivel gratuito
La búsqueda «bright data alternatives free» (alternativas gratis a Bright Data) pregunta una sola cosa: ¿se puede hacer esto sin pagar? Todos los proveedores tienen nivel gratuito. Pero la unidad, los productos que cubre y el ciclo de renovación cambian en cada caso.
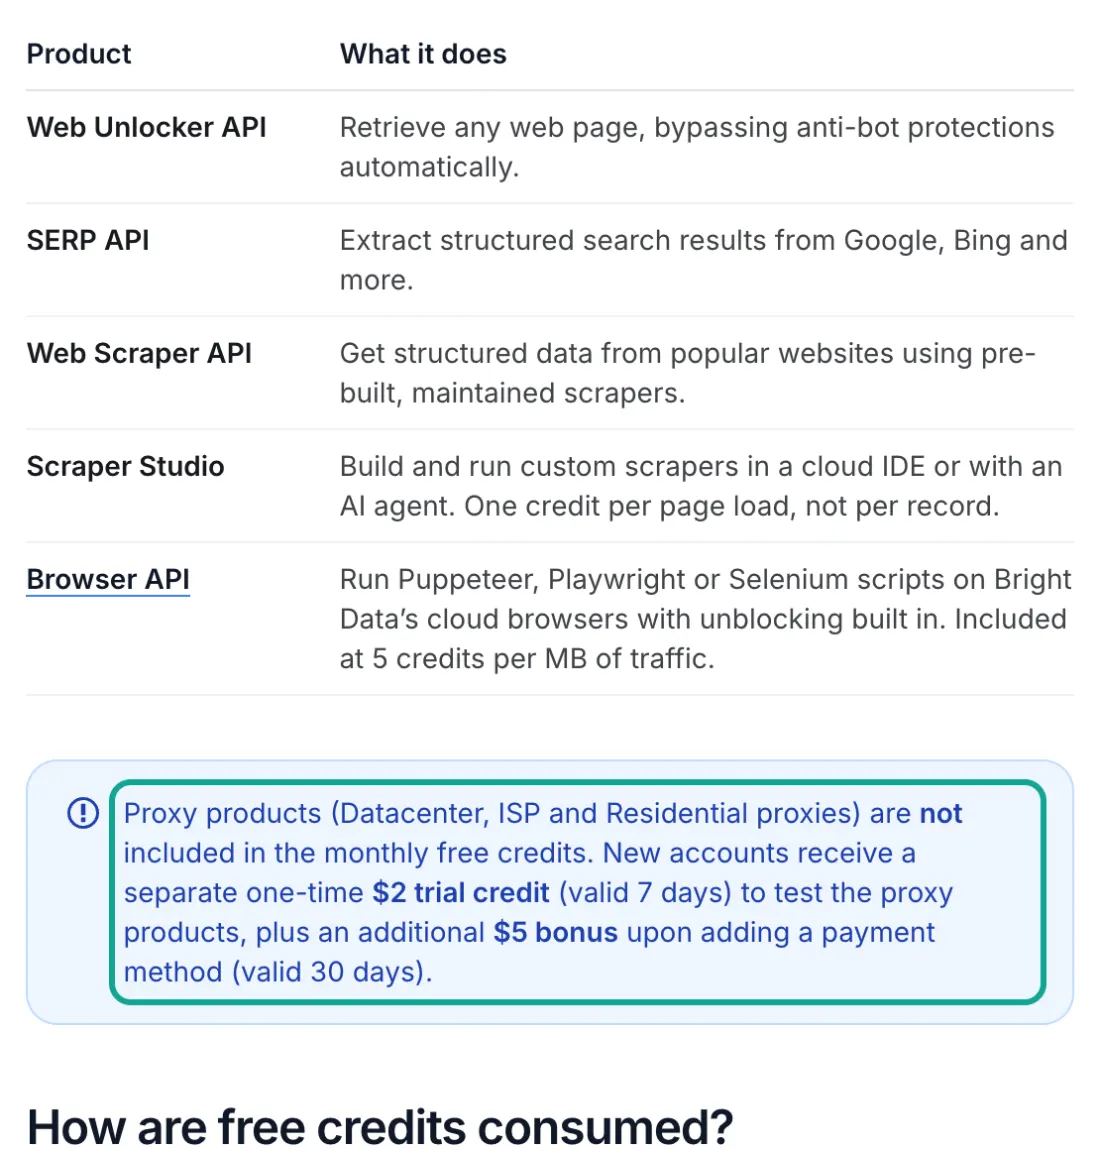
La documentación del nivel gratuito de Bright Data da a cada cuenta nueva 5.000 créditos al mes, unos 7,50 USD, sin tarjeta de crédito. Los créditos sirven para Web Unlocker, SERP, Web Scraper API, Scraper Studio y Browser API. En los tres primeros, un crédito es una solicitud o un registro. Browser API consume 5 créditos por MB.
La misma página fija tres límites. Los proxies quedan fuera del nivel gratuito. Solo reciben una prueba única de 2 USD por 7 días, más 5 USD por 30 días cuando agregas un método de pago. Las cuentas gratis sin depósito tienen un tope de 1.000 solicitudes por minuto en SERP, Unlocker y proxies. Las cuentas con compromiso mensual no reciben los créditos gratis.
La documentación del MCP de Bright Data dice que las 5.000 solicitudes MCP gratis al mes salen del mismo saldo. Es decir, si usas el MCP desde un asistente de IA, esas llamadas restan de los mismos 5.000 créditos.
| Proveedor | Nivel gratuito | Renovación | Qué compra en los trabajos de este artículo |
|---|---|---|---|
| Bright Data | 5.000 créditos/mes, unos 7,50 USD | El día 1 de cada mes, no se acumula | 5.000 registros de Instagram, Amazon o Google Maps; sin proxies |
| Apify | 5 USD de crédito/mes | Mensual | Unos 1.851 resultados de Instagram, o 1.250 lugares de Maps, o 1.000 productos de Amazon a tarifa Free |
| ZenRows | 5.000 créditos/mes, 5 en paralelo | Mensual, no se acumula | 5.000 páginas normales o 200 protegidas; sin proxy residencial aparte |
| ScraperAPI | 5.000 créditos por 7 días, luego 1.000/mes | Mensual | 200 solicitudes a Amazon o 40 a Google al mes en Free |
| Firecrawl | 1.000 créditos/mes | Mensual | 1.000 páginas normales, o 200 en JSON, o 5.000 resultados de búsqueda |
| EveryInfra | 1 USD una vez, válido 24 horas tras reclamarlo | No se renueva | 1.798 llamadas a instagram/profile, o 719 búsquedas en Maps (unos 36.000 lugares a 50 cada una) |
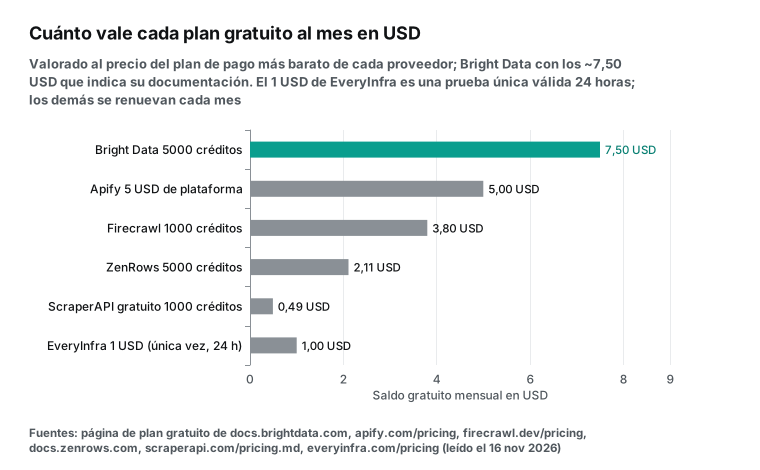
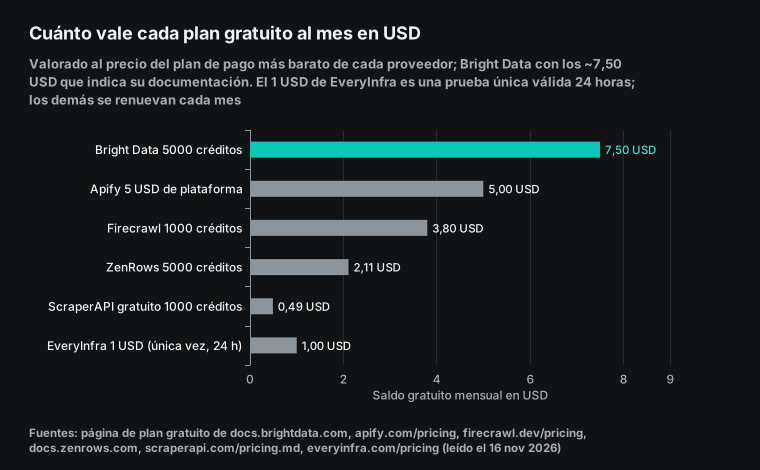
En USD al mes, Bright Data tiene el nivel gratuito más grande, unos 7,50 USD. Cobra por registro, así que 5.000 créditos son 5.000 registros. Los 5 USD de Apify compran 1.851 resultados de Instagram o 1.250 lugares de Maps a tarifa Free. En un hilo de r/apify, un usuario preguntó si le alcanzaba para 8 a 10 perfiles de LinkedIn al día. Una respuesta le dijo que los 5 USD gratis bastan.
El nivel gratuito de ScraperAPI se agota rápido en sitios con multiplicador alto, porque 1.000 créditos solo dan para 40 solicitudes a Google. El 1 USD de EveryInfra es el nivel más pequeño y dura solo 24 horas. Pero el cobro por llamada rinde más filas en las solicitudes de lista: 719 búsquedas en Maps a 50 lugares cada una son unos 36.000 lugares, más que los 5.000 registros de Bright Data. En llamadas de una fila, como perfiles de Instagram, ese dólar alcanza para 1.798.
Un nivel gratuito sirve para una prueba con tu propia muestra. Las condiciones de todos los proveedores prohíben varias cuentas por persona, y sumar cuentas gratis puede terminar en un cierre.
Un mes de trabajo: 420.000 resultados
Ahora junta las tres plataformas en la necesidad mensual de un equipo pequeño. El equipo necesita 20.000 perfiles de Instagram, 100.000 posts de Instagram y 50.000 productos de búsqueda en Amazon. También necesita 50.000 lugares y 200.000 reseñas de Google Maps. En total, 420.000 resultados.
| Necesidad mensual | Bright Data pago por uso | Apify Scale (199 USD/mes, con uso incluido) | Llamadas a EveryInfra | Costo en EveryInfra |
|---|---|---|---|---|
| 20.000 perfiles de Instagram | 30,00 USD | 38,00 USD | 20.000 | 11,12 USD |
| 100.000 posts de Instagram | 150,00 USD | 190,00 USD | 500 (200 cada una) | 0,28 USD |
| 50.000 productos de búsqueda en Amazon | 75,00 USD | 175,00 USD | 1.000 (50 cada una) | 2,24 USD |
| 50.000 lugares de Google Maps | 75,00 USD | 100,00 USD | 1.000 (50 cada una) | 1,39 USD |
| 200.000 reseñas de Google Maps | 300,00 USD | 74,00 USD | 2.000 (100 cada una) | 2,78 USD |
| Nivel gratuito | −7,50 USD | No se cuenta | No se cuenta | No se cuenta |
| Total | 622,50 USD | 577,00 USD | 24.500 | 17,80 USD (suma sin redondear) |
En el plan Scale de Bright Data, 499 USD cubren 384.000 registros. Los otros 36.000 cuestan 1,30 USD por cada 1.000, así que el total es de 545,80 USD. El punto de equilibrio está en unos 332.667 registros al mes; por debajo, el pago por uso sale más barato. El plan Scale de Apify incluye 199 USD de uso, así que para este trabajo pagas 378 USD extra. EveryInfra cuesta 17,80 USD, y 11,12 USD de esa cifra se van en los 20.000 perfiles.
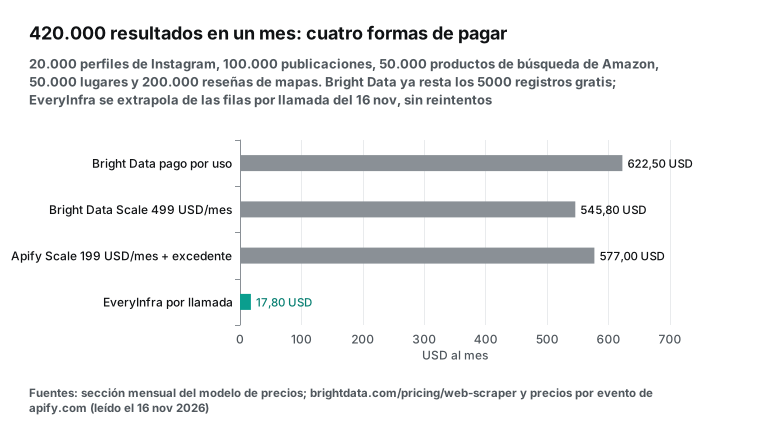
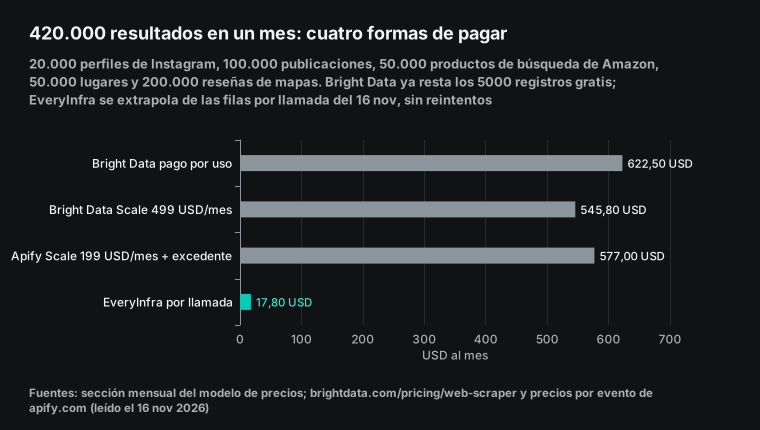
Esta factura descansa en tres condiciones. Primero, las filas por llamada salen de la prueba del 16 de noviembre. Si una llamada devuelve solo 48 posts, el caso bajo que indica el catálogo, la línea de posts sube de 0,28 a unos 1,16 USD. Segundo, no contamos reintentos: los fallos no se cobran, pero esperar y reintentar alarga la entrega. Tercero, no contamos promociones: con API60, los mismos 420.000 resultados en Bright Data cuestan unos 244,50 USD después del nivel gratuito.
Con poco volumen, la cuenta se invierte. Supón un proyecto personal que necesita 5.000 resultados al mes: 1.000 perfiles, 2.000 posts, 1.000 productos de Amazon y 1.000 lugares. El nivel gratuito de Bright Data lo cubre todo, así que cuesta 0 USD. En EveryInfra, el mismo trabajo cuesta unos 0,63 USD, y después de la prueba de 24 horas la primera recarga es de 10 USD. Con las tarifas Free de Apify cuesta 17,10 USD, más que los 5 USD gratis, así que necesitas Starter de 19 USD.
| 5.000 resultados al mes | Bright Data | Apify | EveryInfra |
|---|---|---|---|
| 1.000 perfiles de Instagram | Nivel gratuito | 2,70 USD (tarifa Free) | 0,556 USD |
| 2.000 posts de Instagram | Nivel gratuito | 5,40 USD (tarifa Free) | 0,0056 USD |
| 1.000 productos de búsqueda en Amazon | Nivel gratuito | 5,00 USD (tarifa Free) | 0,0447 USD |
| 1.000 lugares de Google Maps | Nivel gratuito | 4,00 USD (tarifa Free) | 0,0278 USD |
| Total | 0 USD | 17,10 USD, o 13,90 USD en Starter | Unos 0,63 USD |
Para unos pocos miles de filas al mes, sin necesidad de datos frescos, el nivel gratuito de Bright Data es lo más barato. Pasadas las 5.000 filas al mes empieza la tarifa de 1,50 USD, y se abren las brechas de la tabla grande.
Fallos y resultados vacíos: 7 solicitudes que no costaron nada
Enviamos 16 solicitudes en total: nueve se cobraron y siete no. La tabla las detalla una por una.
| Hora (SGT) | Capacidad | HTTP | Motivo | Cobrado |
|---|---|---|---|---|
| 00:21:41 | amazon/search | 429 | Tope por minuto que pusimos a la clave de prueba; reintento a los 19 s, como indicaba la respuesta | 0 USD |
| 00:23:56 | google_maps_reviews/search | 429 | Igual; reintento a los 4 s | 0 USD |
| 00:26:16 | amazon/reviews | 503 | access_blocked, el producto pide inicio de sesión o está restringido; reembolsado | 0 USD |
| 00:28:12 | google_maps_reviews/search | 422 | async_required, la página 2 es demasiado profunda para modo síncrono | 0 USD |
| 00:28:20 | amazon/reviews | 503 | Igual que a las 00:26:16, segundo producto | 0 USD |
| 00:29:03 | instagram/profile | 503 | Consulta de una cuenta inexistente; reembolsado | 0 USD |
| 00:29:52 | instagram/profile | 503 | La misma cuenta otra vez; reembolsado | 0 USD |
Las dos últimas filas son una sola prueba. Consultamos un nombre de usuario de Instagram que no existe, para ver cómo se cobra un «usuario inexistente». A las 00:29:03 y a las 00:29:52, los dos intentos devolvieron 503 y se reembolsaron. No devolvieron un 404 ni un resultado vacío. Si revisas un lote de cuentas que quizá ya no existen, reintenta cada 503 más tarde; si unos minutos después sigue en 503, abre la página del perfil y compruébalo.
Los demás proveedores tienen reglas distintas. La página de la Web Scraper API de Bright Data dice que solo pagas las entregas exitosas. Sus preguntas frecuentes de la Scraper API añaden que los registros que fallan por una entrada errónea sí se cobran. El cobro por evento de Apify factura cada fila escrita en el dataset, y la tarifa de inicio siempre se cobra. ZenRows y ScraperAPI cobran el 404 como éxito, y Firecrawl cobra 1 crédito por 403 y por 404.
En un hilo de reseñas en r/automation, el autor puso un tope de filas a un scraper de YouTube en Apify. El scraper trajo igual miles de filas extra, y el autor no recibió reembolso. Antes de comparar precios unitarios, calcula qué parte de tus filas serán 404 o vacías. En revisiones de cuentas o en monitoreo de productos dados de baja, esa parte puede ser alta.
Puesta en marcha: pasos para el mismo trabajo en seis proveedores
Toma como trabajo 1.000 lugares de Google Maps. En Bright Data, abres una cuenta, obtienes una clave de API y buscas el identificador del dataset en scrapers.json. Envías las palabras clave a /datasets/v3/trigger y descargas el snapshot cuando termina el trabajo asíncrono. La página de límites de la Scraper API dice que una solicitud síncrona espera como máximo 1 minuto.
En Apify, eliges un scraper de la Store, completas el JSON de entrada, inicias una ejecución y lees el dataset. En los scrapers con cobro por evento, revisa también el precio de cada complemento. ZenRows, ScraperAPI y Firecrawl devuelven páginas o JSON extraído, así que tú armas la URL de búsqueda, recorres las páginas y procesas la salida. En EveryInfra, el trabajo es una sola solicitud POST:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"google_maps_reviews","action":"search","params":{"keyword":"dentist","location":"Denver, CO","limit":50}}'
# Devuelve results (50 lugares), next_page_token y billing.charged_usd
# Desde la página 2, agrega "mode":"async" y consulta el poll_url
Para la página siguiente, reenvía next_page_token sin cambios. El catálogo dice que el token dura 24 horas y que cada página se cobra como una llamada. Los nombres de campo coinciden con los response_fields del catálogo. La capacidad google_maps_reviews/search devuelve 22 campos, como place_id, name, lat, lng, rating y review_count. La capacidad google_maps_reviews/reviews devuelve 18, como rating, text, posted_at y owner_response.
En asistentes de IA como Claude o Cursor, los seis proveedores se conectan por MCP. El 16 de noviembre, la llamada tools/list al MCP remoto de EveryInfra devolvió 12 herramientas. Usa everyinfra_call_api para pedir datos y everyinfra_get_job para leer resultados asíncronos:
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
Esta configuración sigue el transporte Streamable HTTP de la especificación de MCP. La clave va en una cabecera y no en la URL. Un mismo cliente puede tener varios servidores, y el modelo elige uno según la tarea. Nuestra página del servidor MCP tiene configuraciones para más clientes.
| Proveedor | Servidor MCP | Código fuente |
|---|---|---|
| Bright Data | MCP remoto, 5.000 solicitudes gratis al mes | brightdata-mcp |
| Apify | https://mcp.apify.com | apify-mcp-server |
| ZenRows | https://mcp.zenrows.com/mcp | zenrows-mcp |
| ScraperAPI | https://mcp.scraperapi.com/mcp | documentación del MCP |
| Firecrawl | Firecrawl MCP v3 | firecrawl-mcp-server |
| EveryInfra | https://api.everyinfra.com/mcp, 12 herramientas | página del servidor MCP |
Salir de Bright Data: cuatro cambios en tu código
Si hoy usas la Web Scraper API de Bright Data, la migración toca cuatro partes del código. La primera es el modelo de trabajo. Los scrapers de Bright Data son casi siempre asíncronos: envías un lote, recibes un snapshot_id, revisas el avance y descargas el snapshot. Su documentación de solicitudes asíncronas muestra el flujo. La página de límites dice que los snapshots siguen disponibles 30 días después de terminar el trabajo.
EveryInfra es síncrono por defecto: una solicitud devuelve el resultado. Por encima de 60 filas, o en páginas profundas, agregas "mode": "async" y consultas el poll_url. Así obtuvimos los 200 posts de Instagram y la página 2 de Maps. El código que descarga snapshots por lotes puede pasar a una solicitud por entrada o conservar un bucle de consulta.
| Concepto en Bright Data | Equivalente en EveryInfra | Qué cambiar |
|---|---|---|
| Identificador de dataset | platform más action | Asigna cada dataset a una capacidad |
| Arreglo de URL o palabras clave | Objeto params, una entrada por llamada | Recorre las entradas en un bucle |
snapshot_id y descarga | Resultado síncrono, o poll_url en modo asíncrono | Mantén el bucle de consulta solo para asíncrono |
Campos como followers | response_fields del catálogo, como follower_count | Reescribe el parser |
| Cobro por registro entregado | billing.charged_usd en cada respuesta | Regístralo y súmalo por día |
El segundo cambio es la entrada. Bright Data recibe un arreglo de URL o palabras clave. Nosotros recibimos tres partes: platform, action y params. Los nombres de parámetro siguen el catálogo: la búsqueda en Maps usa keyword y location, y el perfil de Instagram usa username. Si un parámetro está mal escrito o no existe, devolvemos 422 de inmediato con los valores admitidos, y la llamada no cuesta nada.
El tercer cambio es el mapeo de campos. Los dos lados usan nombres distintos y no hay una correspondencia uno a uno. Elige entre 20 y 50 registros típicos de tus datos y llama a los dos lados con las mismas entradas. Alinea cada campo y anota cuántas veces falta. Después decide qué campos necesitas sacar de otra fuente.
El cuarto cambio es el control de facturación. Cada respuesta de EveryInfra trae un objeto billing con charged, charged_usd y el estado del reembolso. Durante las dos primeras semanas, corre los dos sistemas en paralelo y manda un 10 % del lote al nuevo. Compara el costo real por cada 1.000 filas y la tasa de campos vacíos. Cambia cuando las cifras se mantengan estables.
Migra primero los trabajos de lista: posts, lugares y reseñas de Maps, y búsquedas de Amazon. Ahí la diferencia es de decenas a cientos de veces por cada 1.000 filas, así que la factura baja más rápido. Los perfiles sueltos y las fichas de producto devuelven una fila por llamada y la brecha es pequeña, así que van después. Deja el tráfico de proxy y los sitios de cola larga con tu proveedor actual.
Entre los competidores de Bright Data (bright data competitors): cuándo conviene Bright Data u otro proveedor
En la mayoría de los trabajos del primer grupo, EveryInfra cuesta uno o dos órdenes de magnitud menos. Pero en los casos de abajo conviene Bright Data u otro proveedor. Cada caso sale del material público de los proveedores.
| Tu situación | Mejor opción | Evidencia pública |
|---|---|---|
| Necesitas proxies | Bright Data, ZenRows, Apify | Proxies residenciales, de centro de datos e ISP en autoservicio |
| Tu sitio no está en nuestro catálogo | Bright Data, Apify, ZenRows | 1.301 scrapers de Bright Data en 1.207 dominios |
| Necesitas un histórico masivo | Datasets de Bright Data | Desde 250 USD por 100.000 registros |
| Necesitas reseñas de Amazon esta semana | Bright Data, Apify | Nuestras dos llamadas a amazon/reviews devolvieron 503 |
| Tienes mucho volumen de búsquedas en Amazon | ScraperAPI Startup o superior | Unos 0,0096 a 0,0155 USD por 1.000 productos (estimado) |
| Necesitas muchísimas solicitudes en paralelo | Bright Data, ZenRows, ScraperAPI | Ilimitadas, de 200 a 400, y 500 en paralelo |
| Necesitas certificaciones de cumplimiento | Bright Data, ZenRows Enterprise | ISO 27001, SOC 2, informe SOC 3, DPA |
| Quieres pasar cualquier página a un modelo | Firecrawl, ZenRows | 1 crédito por página, salida en Markdown |
Necesitas proxies. Bright Data vende proxies residenciales, de centro de datos e ISP sin cuota mensual en pago por uso, y ZenRows y Apify también venden tráfico residencial. Nuestra página de precios lista proxies IP (POST /api/v1/proxy/order, por paquetes de tráfico), pero a las 01:45 SGT del 16 de noviembre nuestro catálogo de proxies marcaba los cinco tipos como no disponibles. Para comprar GB según los uses, hoy elige uno de esos tres proveedores.
Tu sitio no está en nuestro catálogo. Nuestro catálogo cubre 106 plataformas, así que la mayoría de los sitios de cola larga no aparecen. Web Unlocker apunta a abrir cualquier URL pública, y la Apify Store tiene miles de scrapers de la comunidad. Por el contrario, la lista de Bright Data no tiene scrapers de Xiaohongshu, Douyin, Taobao, JD.com, Weibo ni Kuaishou, y nuestro catálogo sí los cubre.
Necesitas un histórico masivo de una sola vez. La página de precios de datasets de Bright Data empieza en 250 USD por 100.000 registros, o 2,50 USD por cada 1.000. Su Marketplace Dataset API permite filtrar y descargar. Para decenas de millones de registros, un dataset listo es más rápido que pedirlos uno por uno.
Necesitas muchísimas solicitudes en paralelo. La página de la Web Scraper API de Bright Data anuncia concurrencia ilimitada. ZenRows Scale admite de 200 a 400 solicitudes simultáneas, y ScraperAPI Advanced, 500. Por defecto, nosotros permitimos 60 solicitudes por minuto por cuenta, y los paquetes de velocidad o las recargas acumuladas lo suben a 180 o a 600.
Tu área de compras pide certificaciones. La página de seguridad y cumplimiento de Bright Data menciona ISO 27001 y SOC 2. Su política de seguridad se alinea con ISO 27001:2022, ISO 27017 e ISO 27018, y la página añade un informe SOC 3 de una firma de la red Deloitte, del 1 de junio de 2024 al 31 de mayo de 2025. El plan Enterprise de ZenRows también lista SOC 2, ISO 27001 y un DPA (acuerdo de tratamiento de datos). Cuando un proceso de compra pide estos documentos, esos proveedores los tienen listos.
Tu trabajo es pasarle cualquier página web a un modelo. Firecrawl cobra 1 crédito por página y devuelve Markdown por defecto, así que el plan Standard sale a 0,99 USD por cada 1.000 páginas. Su MCP v3, publicado el 12 de noviembre de 2026, anuncia más de 3.000 herramientas y límites de velocidad 60 veces mayores. A gran volumen, ZenRows S5 cobra 0,07 USD por cada 1.000 páginas comunes, muy por debajo de los 0,694 USD de nuestra herramienta read. Para lotes pequeños de documentación, read basta y cuesta menos que los 0,99 USD por cada 1.000 páginas de un plan Standard de Firecrawl usado al completo. Mira nuestra comparación de alternativas a Firecrawl.
Cambios de los últimos 30 días
| Fecha | Proveedor | Cambio | Qué significa para ti |
|---|---|---|---|
| 2026-11-12 | Firecrawl | MCP v3 con límites de velocidad más altos | Los agentes que leen páginas pueden hacer más llamadas |
| 2026-11-10 | Bright Data | Scraper de Perplexity no disponible | Un scraper listo puede detenerse como categoría completa |
| 2026-11-08 | Bright Data | Nuevos errores de proxy peer_30060 (501) y policy_20231 (402) | En tus scripts, trata el 402 como «no reintentar» |
| 2026-11-05 | Bright Data | El puerto de la extensión pasa a 44445; el 22225 deja de funcionar después del 2026-11-25 | Actualiza las configuraciones viejas antes de fin de mes |
| 2026-10-30 | Apify | La API de búsqueda de la Store cambia de backend el 2026-11-15 | Vuelve a probar los flujos que buscan scrapers por palabra clave |
| 2026-10-27 | Bright Data | La API de tasa de éxito de Unlocker suma filtros por fecha y P90 | Sigue la tasa de éxito por patrón de URL |
| 2026-10-24 | Bright Data | Terminan los proxies residenciales de acceso inmediato; se eliminan desde el 2026-11-09 | Completa el KYC o pasa a proxies ISP |
| 2026-10-09 | ZenRows | Lanza Crawl | Los rastreos de sitio completo ya corren dentro de ZenRows |
| Octubre de 2026 | ScraperAPI | Los sitios con Akamai se desbloquean sin el parámetro premium | Quita premium=true en sitios con Akamai y vuelve a probar |
Los cambios de Bright Data salen de sus notas de versión. El de Apify sale de su registro de cambios de la Store API. El de ZenRows sale de su registro de cambios, que además cuenta que desde el 5 de octubre los agentes de IA pueden comprar Fetch y Extract en agents.zenrows.com. El de ScraperAPI sale de su nota de versión de octubre de 2026.
La caída del scraper de Perplexity deja la lección más útil para quien compra. Un scraper listo para usar del que dependes puede detenerse sin aviso, incluso en un proveedor grande. Para trabajos críticos, ten un segundo proveedor que devuelva el mismo tipo de registro. Pruébalo una vez al mes con una muestra pequeña, para que el cambio tome horas y no semanas.
Qué dicen en los foros
Si buscas «bright data alternatives» en Reddit, los hilos principales son de dos tipos. En un hilo de r/proxies, el autor usaba proxies dedicados de centro de datos e ISP de Bright Data y los encontraba caros. Casi todas las respuestas eran de vendedores de proxies que se ofrecían. Una respuesta advirtió que muchos de esos hilos los publican los propios vendedores. Esa es una necesidad de proxies.
En el hilo de reseñas de r/automation, el autor comentó que Bright Data tiene una tasa de errores baja y es constante, pero que sus precios son «bastante agresivos» para un usuario individual. El texto del hilo lista problemas con un scraper de YouTube de la Apify Store: superó en miles de filas el máximo fijado, devolvió videos viejos en vez de los recientes y el autor no obtuvo reembolso. Antes de comparar precios, pregunta dos cosas: si una ejecución puede pasarse del tope de filas y si te devuelven el dinero cuando pasa. Las capacidades de EveryInfra de este artículo cobran por llamada, así que una llamada cuesta lo mismo devuelva las filas que devuelva. Nuestra página de precios aclara además que unas pocas capacidades de lista cobran por bloques de filas e indican el tamaño del bloque junto al precio.
El hilo de precios de r/apify plantea otra duda común. El autor quería correr un solo scraper de 4 USD por cada 1.000 y preguntaba si necesitaba el plan Starter de 29 USD. Una respuesta le dijo que el nivel gratuito de 5 USD alcanzaba. La cifra de 29 USD ya está desactualizada, porque Apify bajó Starter a 19 USD el 11 de septiembre de 2026. El rastreador de precios UsagePricing registró el cambio, y la documentación de cambios de suscripción de Apify usa 19 USD en su ejemplo. Revisa la fecha de cada hilo, porque los precios cambian en pocos meses.
Límites: dónde no valen estos resultados
Todos los precios de los proveedores salen de páginas públicas leídas el 16 de noviembre de 2026, entre las 00:16 y las 00:40 SGT. No nos registramos, no iniciamos sesión ni llamamos a ninguna API de los proveedores. Los precios empresariales, las promociones combinadas y los precios dentro de la cuenta pueden ser distintos. El pie de la página de precios de Bright Data dice que las monedas locales son solo de referencia y que el cobro se hace en USD.
El lado de EveryInfra se apoya en 9 solicitudes cobradas, una o dos por trabajo: es una muestra pequeña. Los posts de Instagram devolvieron 200 filas esta vez, pero el catálogo indica que algunas llamadas devuelven como máximo 48. La llamada al hashtag pidió 100 filas y recibió 24. La búsqueda de Amazon tardó 44,3 segundos, y las ejecuciones lentas tardan más. Las filas por página de ScraperAPI (48 en Amazon, 20 en Google Maps) son estimaciones nuestras.
Además, una «fila» no significa lo mismo en cada lado. En Bright Data o en Apify, un producto o un lugar suele ser un registro de detalle completo, y nuestras filas de lista tienen menos campos. Para registros de detalle, usa una capacidad de detalle como amazon/profile, donde el precio es de 1,389 USD por cada 1.000. Este artículo no compara si los datos de ambos lados son iguales y no es asesoría legal. Antes de extraer datos públicos, revisa las condiciones del sitio de destino.
Preguntas frecuentes
¿Qué alternativas gratis a Bright Data hay?
Fuente: sugerencia de Google «bright data alternatives free». El nivel gratuito más grande es el de la propia Bright Data: 5.000 créditos al mes, unos 7,50 USD. Apify da 5 USD al mes, ZenRows 5.000 créditos y Firecrawl 1.000 créditos. ScraperAPI da 5.000 créditos por 7 días y luego 1.000 al mes. EveryInfra da 1 USD una sola vez, válido 24 horas. Un nivel gratuito cubre una prueba pequeña; el uso constante requiere un plan de pago en todos los casos.
¿Quiénes son los competidores de Bright Data y en qué se diferencian?
Fuente: sugerencias de Google «bright data competitors» y «bright data competition». Ordénalos por lo que compras. Para registros listos, las alternativas son la Apify Store y EveryInfra, y ScraperAPI cubre una parte. Para scraping general, las alternativas son ZenRows, ScraperAPI y Firecrawl. Para proxies, son ZenRows, Apify y otros vendedores de proxies.
Bright Data vs Apify: ¿cuál sale más barato?
Fuente: sugerencia de Google «bright data vs apify». En Instagram, los dos rondan 1,50 USD por cada 1.000 (Apify Business 1,50 USD, Apify Free 2,70 USD). Los productos de Amazon cuestan más en Apify, de 3,00 a 5,00 USD. Los lugares de Google Maps cuestan 4,00 USD en Apify Free y 1,50 USD en Business. El complemento de reseñas de Apify cuesta solo de 0,26 a 0,50 USD por cada 1.000, menos que los 1,50 USD de Bright Data. Apify suma además una cuota mensual y tarifas de inicio.
Bright Data vs Firecrawl: ¿cómo elegir?
Fuente: sugerencia de Google «bright data vs firecrawl». Firecrawl solo vende scraping general. Cobra 1 crédito por página y devuelve Markdown, lo que sirve para pasar páginas a un modelo. Bright Data vende los dos grupos. Para campos de plataformas como Instagram o Amazon, Firecrawl necesita el formato JSON, y en Hobby eso sale a 19,00 USD por cada 1.000 páginas.
¿Bright Data es gratis?
Fuente: sugerencia de Google «is bright data free». Sí: 5.000 créditos al mes, pero no sirven para proxies. Los detalles están en la sección de niveles gratuitos.
¿Bright Data es legítimo y seguro?
Fuente: sugerencias de Google «is bright data legit» e «is bright data safe». Bright Data menciona ISO 27001, SOC 2 y un informe de auditoría SOC 3 en su página de seguridad. Los proxies residenciales piden KYC para el acceso completo, y en octubre de 2026 endureció el acceso inmediato. Que tu uso sea seguro depende además de qué extraes y cómo. Los datos públicos siguen sujetos a las condiciones de cada sitio y a la ley local, y este artículo no da asesoría legal.
¿Valen la pena las alternativas más baratas que recomiendan en Reddit?
Fuente: sugerencias de Google «cheaper alternative to bright data» y «bright data alternatives reddit», más el hilo de r/proxies. La mayoría de las recomendaciones en hilos de proxies vienen de vendedores, y una respuesta lo dice sin rodeos. Revisa si el proveedor publica un precio por GB o por fila. Revisa también si cobra los fallos y si los créditos vencen. Después prueba tu propia muestra en el nivel gratuito.
Para empezar: rehaz el cálculo con tu propia muestra
Primero, regístrate y obtén una clave de API en el inicio rápido. Después reclama la prueba de 1 USD en la página de precios dando estrella a dos repositorios de GitHub. La prueba dura 24 horas.
Segundo, busca la capacidad que necesitas en la página de la API de Instagram, la de Amazon o la de reseñas de Google Maps. También puedes leer price_usd, max_limit y response_fields en el catálogo de capacidades. El mercado de API lista las capacidades por plataforma.
Tercero, corre el curl de arriba de 5 a 10 veces con tus propias palabras clave o cuentas. Anota billing.charged_usd y las filas devueltas en cada llamada, y calcula el precio por cada 1.000 filas. Compara esa cifra con tu factura actual de Bright Data y decide si mueves todo, una parte o solo los trabajos de lista.
Referencias
- Bright Data Pricing (página general), Bright Data, leída el 2026-11-16
- Web Scraper API Pricing, Bright Data, leída el 2026-11-16
- Datasets Pricing, Bright Data, leída el 2026-11-16
- Residential Proxies Pricing, Bright Data, leída el 2026-11-16
- SERP API Pricing, Bright Data, leída el 2026-11-16
- Free tier, documentación de Bright Data, leída el 2026-11-16
- Release notes, documentación de Bright Data, última entrada 2026-11-10, leída el 2026-11-16
- Instagram Scraper API, documentación de Bright Data, leída el 2026-11-16
- Google Scraper API, documentación de Bright Data, leída el 2026-11-16
- Scraper API FAQs, documentación de Bright Data, leída el 2026-11-16
- Scraper API limits, documentación de Bright Data, leída el 2026-11-16
- MCP server overview, documentación de Bright Data, leída el 2026-11-16
- scrapers.json (lista de scrapers), documentación de Bright Data, actualización diaria, leída el 2026-11-16
- Security and compliance, documentación de Bright Data, leída el 2026-11-16
- Async requests, documentación de Bright Data, leída el 2026-11-16
- SERP API rate limits, documentación de Bright Data, leída el 2026-11-16
- Marketplace Dataset API, documentación de Bright Data, leída el 2026-11-16
- Residential proxies introduction, documentación de Bright Data, leída el 2026-11-16
- Proxy error catalog, documentación de Bright Data, leída el 2026-11-16
- brightdata-mcp, Bright Data, GitHub, leída el 2026-11-16
- ZenRows Pricing, ZenRows, leída el 2026-11-16
- Zenrows Pricing (documentación), documentación de ZenRows, leída el 2026-11-16
- Changelog, ZenRows, última entrada 2026-10-09, leída el 2026-11-16
- MCP tool reference, documentación de ZenRows, leída el 2026-11-16
- Agentic Payments, documentación de ZenRows, leída el 2026-11-16
- Crawl endpoints, documentación de ZenRows, leída el 2026-11-16
- zenrows-mcp, ZenRows, GitHub, leída el 2026-11-16
- ScraperAPI Pricing, ScraperAPI, leída el 2026-11-16
- pricing.md, ScraperAPI, leída el 2026-11-16
- Credits and Requests costs, documentación de ScraperAPI, leída el 2026-11-16
- Google Maps Search API, documentación de ScraperAPI, leída el 2026-11-16
- Amazon Search API, documentación de ScraperAPI, leída el 2026-11-16
- Akamai-protected sites now unblocked automatically, documentación de ScraperAPI, octubre de 2026, leída el 2026-11-16
- Release Notes, documentación de ScraperAPI, leída el 2026-11-16
- ScraperAPI MCP Server, documentación de ScraperAPI, leída el 2026-11-16
- Apify pricing, Apify, leída el 2026-11-16
- Instagram Scraper, Apify Store, leída el 2026-11-16
- Google Maps Scraper, Apify Store, leída el 2026-11-16
- Amazon Product Scraper, Apify Store, leída el 2026-11-16
- Apify Store API: new search backend and breaking changes, Apify, 2026-10-30
- Documentación de la Apify Store (ejecutar scrapers de la Store), documentación de Apify, leída el 2026-11-16
- Apify MCP server, documentación de Apify, leída el 2026-11-16
- Google Maps Scraper is going to pay-per-event pricing, centro de ayuda de Apify, leída el 2026-11-16
- Subscription changes, documentación de Apify, leída el 2026-11-16
- apify-mcp-server, Apify, GitHub, leída el 2026-11-16
- Firecrawl Pricing, Firecrawl, vigente desde 2026-09-04, leída el 2026-11-16
- Billing, documentación de Firecrawl, leída el 2026-11-16
- Introducing Firecrawl MCP v3, Firecrawl, 2026-11-12
- Firecrawl MCP Server, documentación de Firecrawl, leída el 2026-11-16
- firecrawl-mcp-server, Firecrawl, GitHub, leída el 2026-11-16
- MCP Specification 2025-11-25, Model Context Protocol, leída el 2026-11-16
- Catálogo de capacidades de EveryInfra, EveryInfra, leído el 2026-11-16 a las 00:16 SGT
- Catálogo de herramientas de búsqueda de EveryInfra, EveryInfra, leído el 2026-11-16
- Whats a better/cheaper alternative to Brightdata?, Reddit r/proxies, leída el 2026-11-16
- Reviews after getting into web scrape tools, Reddit r/automation, leída el 2026-11-16
- Confusion on Apify Pricing!, Reddit r/apify, leída el 2026-11-16
- Apify cuts the Starter plan from $29 to $19, UsagePricing, 2026-09-11
Referencia BL-170