Apify Instagram 爬虫替代:每千条价格实测
Apify Instagram Scraper 公开价对26次真调:帖子每千条约 $0.003,对方 $1.50–$2.70;主页差 2.9–4.7 倍。
同样拿 1,000 条 Instagram 帖子,Apify Instagram Scraper 的公开价是 $1.50(Business 档)到 $2.70(Free 档);我们在 2026 年 10 月 26 日用 EveryInfra 的 instagram/user_posts 真调,一次请求 $0.000556、拿回 200 条,折合每 1,000 条约 $0.003–$0.006,差了两三百倍到近一千倍。这个差距只在「一次请求能回很多条」的数据上成立:帖子、Reels 列表、评论、粉丝列表差 13 到 970 倍;按账号一个一个读的主页(profile)和按链接一条一条读的单帖详情(post),每条单独计费,只便宜 1.8 到 4.9 倍。下面把五种数据逐个实测,连同条数上限、私密账号、失败扣不扣钱和 Apify 更合适的场合,一起写清楚。
本文说的「每千条价」,是把一次请求实际扣掉的钱,除以这次实际返回的条数,再乘 1,000。它回答的是「拿到 1,000 条结果要花多少钱」,不回答「发 1,000 次请求要多少钱」:EveryInfra 按请求计费、Apify 的 Instagram Scraper 按结果计费,两家的计量单位不同,只有换算成同一个分母才能比。分母用的是实际返回条数,不是请求时填的 limit,所以回得少的那几次,我们的价格会被算高,不会被算低。


先看总表:五种 Instagram 数据,每 1,000 条各多少钱
下表把最常用的五种 Instagram 数据放在一起。Apify 一侧取的是公开价格:主力的 Instagram Scraper 对所有结果类型统一按条收费,另有一组按数据类型分开的专项 scraper,价格各不相同,我们都从 Apify 公开 API 的 pricingInfos 字段读出(2026-10-26 13:31 新加坡时间读取,不需要账号,见 Instagram Scraper 元数据)。EveryInfra 一侧全部是本文的真调结果:实扣金额来自每次响应的 billing.charged_usd 和控制台调用记录,条数来自响应里的 results。
| 数据 | EveryInfra 能力 | 实测:请求次数 / 返回条数 / 实扣 | EveryInfra 每千条 | Apify 同类每千条(Free → Business) | 倍数 |
|---|---|---|---|---|---|
| 主页 | instagram/profile | 5 / 5 / $0.002780 | $0.556 | Profile Scraper $2.60 → $1.60 | 2.9–4.7 倍 |
| 帖子 | instagram/user_posts | 3 / 495 / $0.001668 | $0.0034 | Instagram Scraper $2.70 → $1.50 | 445–801 倍 |
| 单帖详情 | instagram/post | 1 / 11 / $0.006111 | $0.556 | Post Scraper $1.70 → $1.00 | 1.8–3.1 倍 |
| Reels(话题) | instagram/hashtag(results_type=reels) | 2 / 60 / $0.001112 | $0.0185 | Reel Scraper $2.60 → $1.00 | 54–140 倍 |
| Reels(关键词) | instagram/reels_search | 1 / 92 / $0.007194 | $0.0782 | Reel Scraper $2.60 → $1.00 | 12.8–33 倍 |
| 评论 | instagram/comments | 3 / 45 / $0.001668 | $0.0371 | Comments Scraper $2.60 → $1.90 | 51–70 倍 |
| 粉丝列表 | instagram/followers_list | 2 / 92 / $0.001112 | $0.0121 | Followers and Following Scraper $2.00 → $1.15 | 95–166 倍 |
倍数一律用 Apify 的价格除以我们的价格,两端分别对应 Apify 的 Business 档和 Free 档。读这张表要注意两件事。第一,倍数差得最多的那几行,都是「一次请求返回一页数据」的能力,一页越满,单价摊得越薄;我们这一侧每次请求的价钱是固定的,回 1 条和回 200 条一样收 $0.000556。第二,主页和单帖详情这两行,EveryInfra 是按目标计费的:post 的请求体里放 11 个链接,就按 11 个目标扣 11 次,profile 一次只读一个账号。这两行和 Apify 一样是「一条一个价」,所以差距只剩 2 到 5 倍。
图里 EveryInfra 的点散开在 $0.003 到 $0.56 之间,原因是每次请求能回的条数不同。这也说明了本文的方法边界:如果你的需求是「给我 10 万个账号的主页」,按我们的价格算每千个主页 $0.556,Apify Profile Scraper 的 Business 档是 $1.60,差距约 2.9 倍,而不是标题里的几百倍。
Apify Instagram Scraper 价格:按结果怎么收钱
Apify 的 Instagram Scraper 用的是按事件计费(pay-per-event)。它的 Store 页写得很直接:一条结果就是一个抓到的对象,可能是一条帖子、一条 Reel、一条评论、一个主页、一个话题或一个地点;Free 档每 1,000 条 $2.70,Starter 档 $2.30,Scale 档 $1.90,Business 档 $1.50。我们读到的公开 API 数据和页面一致,并且多给了两档企业价:PLATINUM $0.90、DIAMOND $0.50,这个价格自 2026 年 2 月 20 日起生效(见 pricingInfos 的 startedAt)。Apify 文档说明,每个付费套餐对应一个商店折扣档,Starter 是 Bronze、Scale 是 Silver、Business 是 Gold(Actors in Store)。
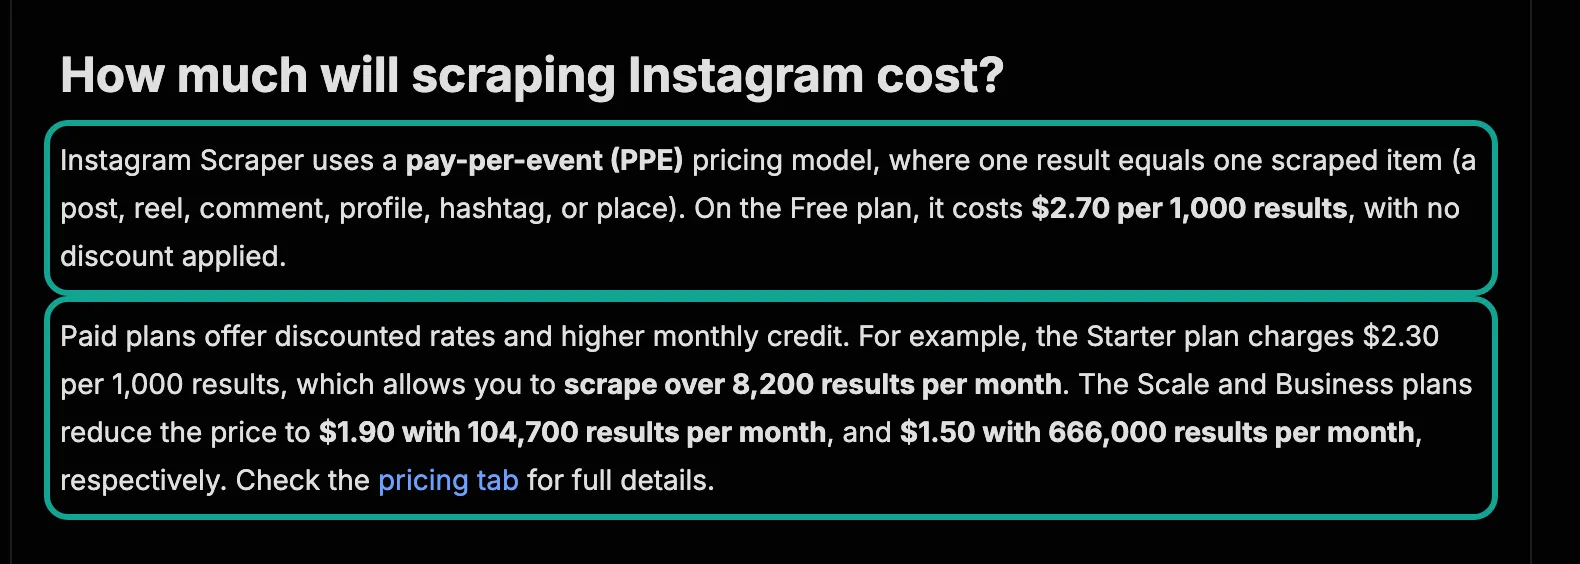
页面里那句「每月可抓 8,200 多条」,其实是用套餐月费反推出来的:Starter 套餐月费 $19,按 $2.30 每千条,正好约 8,260 条;Scale 套餐 $199 对应 104,700 条,Business 套餐 $999 对应 666,000 条。Apify 价格页把四档套餐写成「预付用量」:Free 每月 $5、Starter $19、Scale $199、Business $999,超出部分按量记到下一张账单。同一页还写了一句对算账很重要的话:没用完的预付额度不结转,账期结束就作废;Free 套餐用完额度以后,会被停到下一个月度周期开始。帮助中心 2026 年 9 月 4 日更新的《Reaching platform limits》也写明,Free 套餐不能把平台上限提到 $5 以上。
专项 scraper 的价格各不相同,下表全部来自 2026-10-26 读到的公开元数据,单位是每 1,000 个事件的美元价。
| Apify actor | 主要事件 | Free | Starter | Scale | Business | 另收的事件 |
|---|---|---|---|---|---|---|
| Instagram Scraper | 每条结果 | $2.70 | $2.30 | $1.90 | $1.50 | 无 |
| Instagram Profile Scraper | 每个主页 | $2.60 | $2.30 | $2.00 | $1.60 | 账号信息附加项 $7.00 → $4.00 |
| Instagram Post Scraper | 每条帖子 | $1.70 | $1.50 | $1.30 | $1.00 | 帖子详情 $1.00 → $0.60;音乐数据 $7.00 → $4.00 |
| Instagram Reel Scraper | 每条 Reel | $2.60 | $2.30 | $1.40 | $1.00 | 每次启动 $0.001;分享数 $7.00 → $4.00;转写每分钟 $0.048 → $0.027;视频下载每 MB $0.02 → $0.01 |
| Instagram Comments Scraper | 每条评论 | $2.60 | $2.30 | $2.10 | $1.90 | 无 |
| Followers and Following Scraper | 每个账号 | $2.00 | $1.75 | $1.40 | $1.15 | 无 |
| Instagram Hashtag Scraper | 每条结果 | $2.60 | $2.30 | $2.10 | $1.90 | 无 |
这张表里有一个最近的变化:Instagram Post Scraper 的现行价格从 2026 年 10 月 7 日开始生效(Post Scraper 元数据里的 startedAt),比主力 Instagram Scraper 每条便宜 $0.50–$1.00,但把「帖子详情」拆成了一个另收费的事件。也就是说,如果你要的是带详细字段的帖子,在 Post Scraper 上一条要同时付 post 和 post-details 两个事件,Free 档合计 $2.70,Business 档合计 $1.60,和主力 scraper 差不多。另外,大多数按事件计费的 actor 已经把平台用量算在事件价里,但 Apify 文档也提醒,有些 actor 会另收平台用量,要看各自的定价说明(Actors in Store)。我们核对过上表 7 个 actor 的公开元数据,都是 PAY_PER_EVENT,没有另列平台用量。
Apify 自己从这些事件收入里拿多少?它给开发者的文档写的是:开发者拿事件收入的 80%,再减去平台成本(Pay-per-event pricing model);公开元数据里每个 actor 都有 apifyMarginPercentage: 0.2。也就是说,你付的每条结果价里,五分之一归平台,其余归写这个 actor 的开发者。
EveryInfra 怎么收钱:按次,不按条
EveryInfra 的数据接口按请求计费。2026-10-26 读到的能力目录里,Instagram 一共 15 项能力,其中 10 项单价都是每次 $0.000556,reels 每次 $0.001194(当天暂停),user_search 每次 $0.004806,reels_search 每次 $0.007194,tagged_posts 每次 $0.007444,similar_profiles 每次 $0.008806。按用户名读帖子的 user_posts 默认回 30 条、最多 200 条;comments 默认 50、最多 100;followers_list 默认 50、最多 500。这几个能力的目录条目都没有「按条数分档」的标注,所以无论 limit 填多少,一次就是一个价。多目标的能力例外:post 接收一个 urls 数组,按链接个数计费。


账户这一侧,EveryInfra 没有月费。价格页写的是:充值从 $10 起,充进钱包的钱不清零、不设有效期;新账户可以在 GitHub 点星领 $1 试用额度,24 小时内有效;参数错误、鉴权失败这类异常请求不扣费。速率方面,我们这次用的测试 Key 每分钟 10 次、账户每分钟 60 次,这是账户接口 /api/v1/account 返回的默认值,充值越多上限越高。和 Apify 对比,最大的结构差别有两个:一是 Apify 的预付额度按月作废,EveryInfra 的余额不过期;二是 Apify 按结果收钱、我们按请求收钱,所以「一次请求能回几条」直接决定了我们这边的每千条价。
我们怎么算
对方的价格只用公开材料:Apify 公开 API 的 pricingInfos(读法见 Apify 的 Get Actor 接口文档)和 Store 页原文,我们没有注册、没有付费、没有用对方的 Key。我们这边的每千条价只用实测:分母是实际返回条数而不是 limit,返回 0 条的请求不进分母,单独记扣费和退款;倍数同时写 Apify Business 档和 Free 档两端,倍数小于 3 的项照实写进正文和总表。每个 limit 都看实际回了多少条,回到请求数的 90% 以上才算「拿满」;我们主动试了 6 种失败或空结果,只要有一次该退没退就写出来;同一个能力在不同时刻至少跑两次,两次相差 20% 以内才叫「稳定」。这几条规则在 2026-10-26 13:40(新加坡时间)真调之前就定好了。结果先说在这里:评论、粉丝列表和 natgeo 的帖子三项没拿满;不存在的账号被扣费,试了两次都是这样;帖子因为 natgeo 只回 95 条,三次之间的每千条价相差超过 20%,所以正文写区间,不写一个数。
实测一:主页(profile),按账号计费,只便宜 3 到 5 倍
我们在 2026-10-26 13:35 到 13:44(新加坡时间)读了 5 个机构和品牌账号的主页:nasa、natgeo、nike、realmadrid、djiglobal。每次请求读一个账号,每次扣 $0.000556,5 次合计 $0.00278,折合每 1,000 个主页 $0.556。返回字段和目录 response_fields 一致:粉丝数、关注数、帖子数、是否认证、是否商家号、简介外链、高清头像、精选快拍个数,以及一个 recent_posts 数组。读到的数字本身也可以拿来核对:nasa 粉丝 104,378,884、帖子 4,979;nike 粉丝 290,902,811;realmadrid 帖子 22,000;djiglobal 粉丝 6,798,738。
对照 Apify 的 Instagram Profile Scraper,每 1,000 个主页 Free 档 $2.60、Business 档 $1.60,我们便宜 2.9 到 4.7 倍;用主力 Instagram Scraper 的 details 模式读主页,按每条结果 $1.50–$2.70 算,便宜 2.7 到 4.9 倍。这就是本文最不夸张的一组数:只要计费单位是「一个账号一笔」,两家的差距就是几倍,而不是几百倍。如果你需要账号加入时间和所在国家,Apify 的 Profile Scraper 有一个另收费的「About account」附加项,Free 档每千个 $7.00;我们的 profile 不返回这两个字段。
主页返回里有一个边界要先说清楚:recent_posts 里 nasa 的 12 条帖子,like_count 和 comment_count 都是 0,posted_at 只到日期、时间都是 00:00。也就是说,主页附带的最近帖子只是一份预览,适合看账号最近发了什么类型的内容(12 条里 4 条是视频),不适合拿来算互动率。要算互动,得用下一节的 user_posts。
实测二:帖子(user_posts),一次 200 条,这是差几百倍的来源
2026-10-26 13:35:55(新加坡时间)我们用异步方式请求 instagram/user_posts,参数是 username=nasa、limit=200;任务在 13:36:44 完成,返回 200 条,post_id 去重后仍是 200 条,没有重复。控制台的调用记录显示这次请求扣了 $0.000556,异步任务没有因为条数多而多收钱。200 条的每一条都带了点赞数、评论数、正文、发布时间、作者和图片链接,字段非空率 100%。折算每 1,000 条帖子 $0.00278;Apify Instagram Scraper 的 Business 档是 $1.50,Free 档是 $2.70,相差 540 到 971 倍。
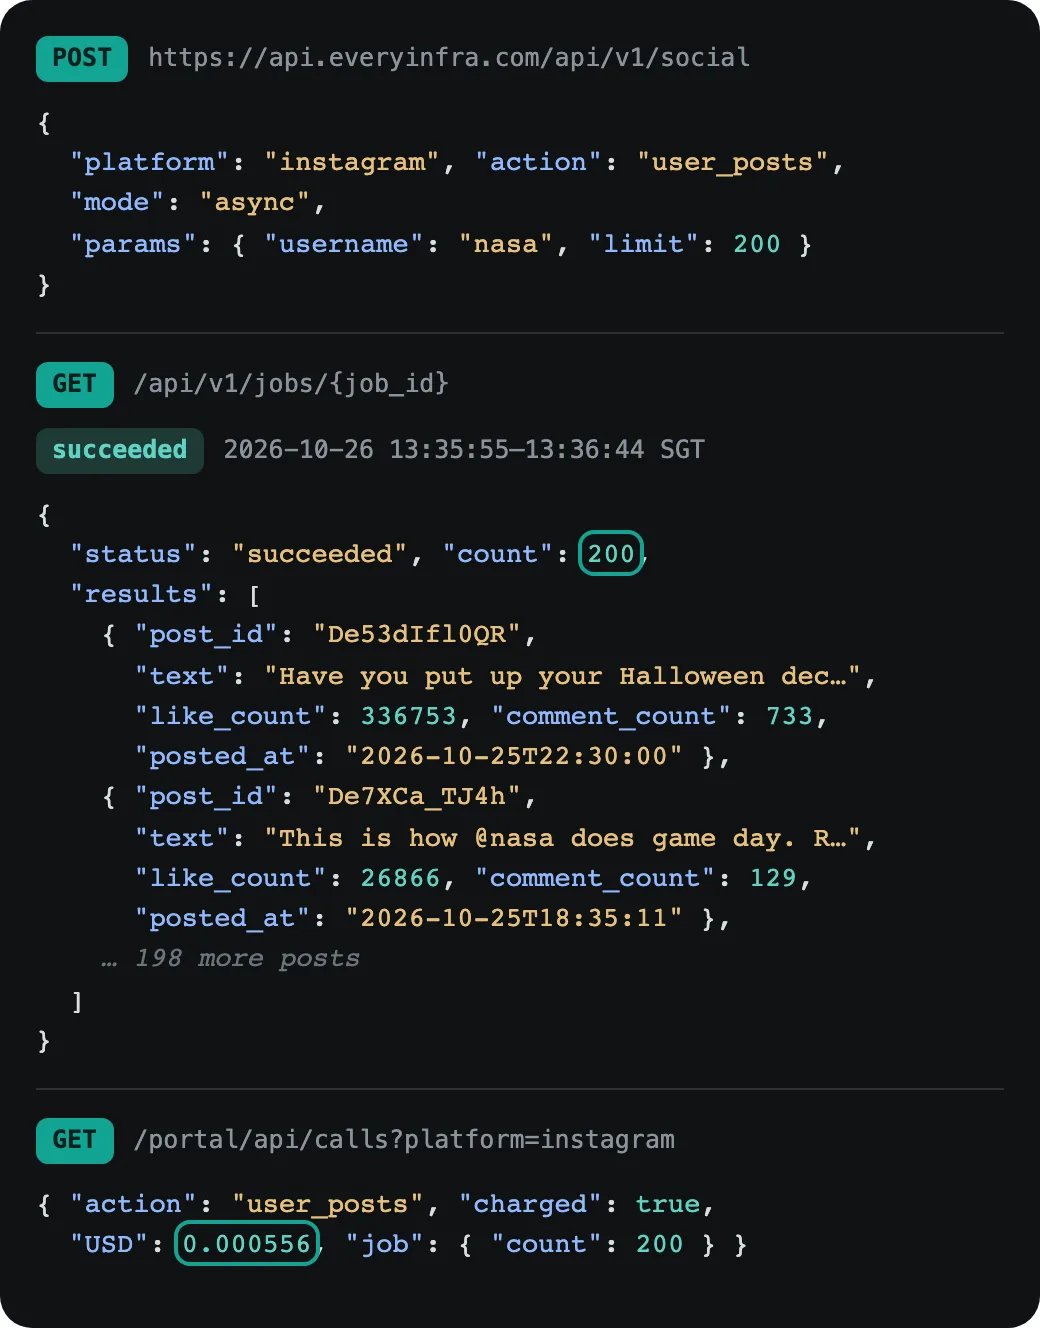
第二个账号的结果没那么满。13:41:46 我们对 natgeo 发了同样 limit=200 的请求,返回 95 条,扣费同样是 $0.000556,折合每千条 $0.00585。95 条覆盖的是 9 月 28 日到 10 月 25 日这 4 周,natgeo 发帖很密,它的主页显示帖子数 32,000。为什么没回满 200 条,接口没有给出原因,我们也没有猜,这一次记为「没拿满」,按实际 95 条计价。即使按这个较差的结果算,对 Apify Business 档仍然便宜 256 倍。
两个账号放在一起,还能看出一次请求能覆盖多长时间。nasa 这 200 条从 5 月 7 日到 10 月 25 日,平均每天 1.17 条,一次覆盖 171 天;natgeo 平均每天约 3.5 条,即使拿满 200 条也只覆盖 57 天左右,这一次 95 条只覆盖了 27 天。做竞品监测时,可以用对方的发帖频率估算多久读一次才不漏帖:像 natgeo 这样一天三四条的账号,每周读一次约 24 条新帖,远低于一次 200 条的上限,一个月 4 到 5 次请求,约 $0.0024;像 nasa 这样一天一条的账号,每月读一次也不会漏。
为了检查价格和结果是不是稳定,我们在 25 分钟后(14:00:42,新加坡时间)对 nasa 又发了一次一模一样的请求。第二次同样返回 200 条、扣 $0.000556,两次的 200 个 post_id 完全一致,每千条价都是 $0.00278,按前面的标准算「稳定」。但数字本身在变:200 条里有 100 条的点赞数和第一次不同,变化最大的是 10 月 25 日那条满月帖,点赞从 336,753 涨到 347,872,评论从 733 涨到 751。这提醒做监测的人,Instagram 的互动数是读取那一刻的快照,同一条帖子隔半小时就会不同,存数据时要把读取时间一起存下。
变的是哪些帖子,按发布时间分组看得很清楚。最近 7 天发布的 12 条全部变了,点赞数的中位数涨了 128 个,最多的一条涨了 11,119 个;7 到 30 天的 33 条里有 24 条变了,中位数只涨 13.5 个;30 到 90 天的 73 条里有 33 条变了,中位数涨 1 个;90 天以前的 82 条里有 31 条变了,中位数反而是少了 1 个。200 条里一共有 31 条的点赞数比 25 分钟前更少。
| 第一次读取时的帖龄 | 帖子数 | 点赞数变了的 | 变了的帖子点赞变化中位数 | 最大涨幅 |
|---|---|---|---|---|
| 最近 7 天 | 12 | 12 | +128.5 | +11,119 |
| 7 到 30 天 | 33 | 24 | +13.5 | +354 |
| 30 到 90 天 | 73 | 33 | +1 | +10 |
| 90 天以前 | 82 | 31 | −1 | +38 |
对监测互动数的人,这意味着需要反复重读的只是最近 30 天的帖子,发布一个月以上的帖子,点赞数基本只剩个位数的上下浮动。对 nasa 这样一天一条的账号,默认 limit 30 条正好覆盖一个月,每天读一次就够了。三次 user_posts 合计 495 条、$0.001668,每千条 $0.0034,对 Apify Instagram Scraper 的 $1.50–$2.70 便宜 445 到 801 倍。
上图是 nasa 那 200 条帖子的时间分布:最早一条是 2026 年 5 月 7 日,最晚是 10 月 25 日,一次请求覆盖了 5 个半月。对做竞品监测的人,这意味着一个账号的半年发帖历史,一次请求就能读完;之后每天只要再读最近的 30 条(默认 limit)就能接上。对 Apify 来说,同样 200 条要付 200 个结果事件,Business 档 $0.30、Free 档 $0.54。
这一节还有一个要写出来的发现:13:35 这次请求里,user_posts 的 media_type 标错了,200 条全部是 image;而同一时刻 profile 返回的最近 12 条里有 4 条是视频(例如 DeTUk4sDSp-、De7XCa_TJ4h),它们在 user_posts 里也被标成了 image。我们把这个问题报给了工程团队,10 月 26 日已修复:16:01(新加坡时间)我们对 nasa 重新请求 user_posts(limit=12),12 条里 4 条标成 video、8 条标成 image,和 profile 一致。修复前拿到的数据可以用 video_url 区分视频:200 条里有 56 条带 video_url,那 4 条视频都在其中;当时我们也用 instagram/post 把其中 11 条按链接逐条读了一次(13:43,新加坡时间),4 条视频都标成了 video。按 video_url 分开以后还能看出一点:nasa 这 56 条带视频地址的帖子,点赞数中位数是 96,512,其余 144 条是 255,039,前者不到后者的四成;评论数中位数却差不多,分别是 919 和 1,007。只看 media_type 的话,这个差别根本看不出来。这次 11 个链接的 post 请求按 11 个目标分别计费,合计扣 $0.006111,折合每千条 $0.556,对 Apify Post Scraper 的 $1.00–$1.70 只便宜 1.8–3.1 倍,和主页一样属于「按目标计费」的那一类。
实测三:Reels,按账号读暂停,按话题和关键词可用
Reels 是这次唯一一个我们按账号读不了的数据。目录里 instagram/reels(按用户名读 Reels,每次 $0.001194)当天标着 available=false。我们 13:38:07 照样发了一次请求,得到 503,错误码 unavailable,原因 temporarily_unavailable,retry_after 是 900 秒,billing.charged_usd 为 0。也就是说这个能力暂停期间调用会被拒绝,但不扣钱。按账号批量拿 Reels,现在应该用 Apify 的 Instagram Reel Scraper,或者先用 user_posts 拿到帖子链接,再用 post 按链接读出哪些是视频。
按话题和关键词找 Reels 是可用的。13:39:47 我们用 instagram/hashtag,hashtag=coffee、results_type=reels、limit=100,回了 30 条短视频,扣 $0.000556;14:01:34 换成 travel 再试一次,同样是 30 条、$0.000556,两次合计 60 条,每千条 $0.0185;13:40:19 用 instagram/reels_search 搜关键词 coffee,limit=200,回了 92 条,扣 $0.007194,每千条 $0.0782。reels_search 单次更贵,但每条带 play_count、duration_sec 这类播放字段,适合挑选播放量高的视频。Apify Reel Scraper 每千条 Free 档 $2.60、Business 档 $1.00,另外每次启动收 $0.001;比下来我们按话题读便宜 54 到 140 倍,按关键词搜便宜 12.8 到 33 倍。
Apify Reel Scraper 有几样我们没有的东西,要照实写:它能另付费拿分享数(Free 档每千条 $7.00)、拿视频转写(每分钟 $0.048 起)、直接下载视频文件(每 MB $0.02 起),也能按账号把 Reels 一次拉完。我们的 reels_search 目录字段里有 transcript、music 这些名字,但本次 92 条结果里这两个字段一条都没有值,要转写和配乐,目前只能用 Apify。92 条里有值的是播放数和时长:播放数从 26.7 万到 1.94 亿,中位数 352 万,其中 78 条过百万;时长中位数 21.6 秒;发布时间从 7 月 28 日到 10 月 25 日。也就是说,按关键词搜出来的基本是近三个月里已经跑出量的热门短视频,适合找爆款参考,不适合找刚发布、还没起量的新视频。
实测四:评论,每次 15 条,单价低但量也少
评论是「limit 不是承诺」最明显的一项。我们对三个帖子各调了一次 instagram/comments:nasa 10 月 25 日那条(733 条评论,limit=100)、nasa 评论最多的一条(12,782 条评论,limit=50)、natgeo 评论最多的一条(4,093 条评论,limit=50),时间在 13:37:47、13:39:10 和 13:44:20(新加坡时间)。三次都只回了 15 条,各扣 $0.000556。合计 45 条、$0.001668,折合每 1,000 条评论 $0.0371,比 Apify Comments Scraper 的 $1.90–$2.60 便宜 51 到 70 倍。
但这里便宜的是单价,不是能力。一个有 12,782 条评论的帖子,我们一次只拿到 15 条,约 0.12%;这是 Instagram 的边界:每个帖子对外公开的评论只有约 15 条,limit 写得再大也不会更多。Apify 这一侧,Instagram Scraper 的 Store 页常见问题写的是:Free 套餐每个帖子只能拿一页评论,大约 15 条,付费套餐没有这个限制,还可以按最新排序、抓楼中楼回复(Instagram Scraper)。如果你的任务是「把一个热门帖子的评论全部拿下来做情感分析」,Apify 付费套餐更合适;如果是「每天看 500 个帖子各自最新的一屏评论有没有负面苗头」,一次 15 条已经够用,按我们的价格每天 $0.278。
这 15 条是哪 15 条,也要看清楚。nasa 10 月 25 日那条帖子的 15 条评论,发布时间都在我们请求前约 20 分钟之内(13:19 到 13:37,新加坡时间);natgeo 那条的 15 条落在当天凌晨到上午(新加坡时间 01:41 到 11:27);三次合计 45 条里,43 条点赞数是 0,只有 1 位评论者是认证账号。所以 comments 一次给的是最新的一屏,不是按点赞排的热评:拿来看「刚刚有没有人在骂」正合适,拿来找最有代表性的观点就不够。
实测五:粉丝列表,每次四五十个,空结果会退款
instagram/followers_list 目录写的是默认 50、最多 500。13:37:58 我们请求 nasa 的粉丝列表,limit=500,回了 49 个账号;13:38:49 请求 natgeo,limit=200,回了 43 个;两次各扣 $0.000556,合计 92 个账号、$0.001112,每千个 $0.0121。和 Apify Followers and Following Scraper 的 $1.15–$2.00 比,便宜 95 到 166 倍。这个 Apify actor 是 2026 年 6 月 30 日上架的,现行价格 8 月 6 日起生效,近 30 天有 1,117 个用户。
同样要说清楚边界:nasa 有 1.04 亿粉丝,49 个只是很小的一片。这同样是 Instagram 的边界:认证账号和部分商业账号的粉丝列表对外只开放第一页,没有翻页游标,nasa 和 natgeo 都是认证账号;非认证的公开账号能拿到更多。所以「导出一个认证大号的全部粉丝」做不到。关注列表是另一回事,nasa 只关注 90 个账号,13:39:27 的 following_list 一次回了 90 个,正好是全部。第三次试探(13:44:50)我们用异步方式请求 realmadrid 的粉丝列表,任务成功结束但 0 条结果,任务状态里 refund_state 是 refunded,钱退回来了。
这一页里是什么人也值得看一眼。nasa 的 49 个粉丝里 21 个是私密账号,natgeo 的 43 个里 10 个是私密账号,合计 92 个里 31 个,约三分之一,没有一个是认证账号。做粉丝画像时,私密账号只能拿到用户名和头像,主页和帖子都读不到,所以真正能往下分析的样本大约只有三分之二;要估算粉丝里有多少是活跃的真实用户,得先按 is_private 把这一部分分出来。
把五节的条数放到一张图里,规律很清楚:只有 user_posts 能拿满,其余能力多数回一页左右。这不影响「每次只收一次钱」,但会影响每千条价。所以本文所有倍数都按实际返回条数算,而不是按 limit 算;如果按 limit 算,评论会被说成每千条 $0.0056,那是不对的。
失败和空结果扣不扣钱:我们的 6 次试探
我们故意做了 6 种不正常的请求,结果如下。
| 情况 | 时间(新加坡时间) | 返回 | 实扣 |
|---|---|---|---|
| 不带 Key | 13:35:31 | 401 missing_key,提示里写着没有扣费 | $0 |
参数名写错(results_limit) | 13:38:32 | 422 unknown_param,列出允许的参数 username、limit 和一个能用的示例 | $0 |
能力暂停(reels) | 13:38:07 | 503 unavailable,retry_after 900 秒 | $0 |
| 每分钟超过 10 次 | 13:38:56 | 429 rate_limited | $0 |
| 粉丝列表 0 条(异步) | 13:44:50 | 任务成功,count 0,refund_state 为 refunded | 退回 |
不存在的用户名(profile,换了两个名字各试一次) | 13:38:07、14:02:12 | 200,results 里只有我们传进去的用户名,没有别的字段 | 每次 $0.000556,未退(修复前) |
| 不存在的用户名(修复后复测,随机生成的名字) | 16:00:53 | 200,results 为空,billing.reason 为 empty_result_refunded | $0 |
最后一行是要照实写的问题。按 EveryInfra 的规则,空结果应该退款;这两次返回体都不是空的,里面有一个 username 字段,但那只是把请求参数原样带回来,并没有读到任何账号数据,结果被当成成功扣了钱;隔 24 分钟换一个不存在的名字重试,结果一样,说明不是偶发。我们把这两次的请求号交给工程团队,10 月 26 日已修复:16:00:53(新加坡时间)我们用一个随机生成、不存在的用户名复测,返回 200、results 为空、billing.charged 为 false、原因是 empty_result_refunded,这次没有扣费。
Apify 那边,按事件计费的规则是「写进数据集的结果才计费」,失败的运行不产生结果事件,所以理论上也不收结果费;它还允许在启动运行时设一个最大花费上限,到上限就停(Pay-per-event pricing model)。但实际使用中也有人遇到过相反的情况:Reddit 上一位用户说,他用的一个 actor 不总是遵守设定的条数上限,多抓了上千条并被计费,申诉没有结果(r/automation 帖子)。那个帖子说的是 YouTube actor,不是 Instagram Scraper,我们只把它当作「按条计费的风险在于条数失控」的一个例子。
Apify 在公开元数据里给出了每个 actor 近 30 天的运行结果,上图是我们读出来算的;失败、超时、中止三种终止状态的含义见 Apify 运行文档。主力 Instagram Scraper 30 天跑了 18,216,872 次,其中 1,117 次失败、70,933 次超时、12,424 次中止,没跑成的占 0.46%,绝大部分是超时。这个数说明两件事:一是 Apify 的 Instagram scraper 用量非常大,30 天有 58,198 个用户;二是每 1 万次运行大约有 46 次没跑成,对需要每天定时跑的人,最好在工作流里加一个重试。这些是对方公开的数,不是我们测的,也不能和我们 26 次真调直接比较成功率。
我们怎么核对这些数
价格对比最容易出错的地方,是把「请求成功」当成「数据可用」。所以每一次真调,我们都按同一套步骤核对,原始返回和复算脚本存档备查。第一步,金额只认两个来源:同步请求看响应里的 billing.charged_usd,异步任务的响应里没有金额,就到控制台的调用记录里按请求编号查实扣,三次 user_posts 和两次异步粉丝列表都是这样核的。第二步,条数只认 results 数组的实际长度,再按 post_id 或账号 ID 去重;nasa 两次各 200 条、去重后都是 200,natgeo 95 条、去重后 95 条。第三步,看字段是不是真的有值,而不是只有键名:nasa 那 200 条里,正文、点赞、评论、发布时间、作者、图片的非空率都是 100%,播放数、地点这几个目录里有的字段本次没有返回,视频地址只在 56 条上有值,我们在字段表里写明了。
第四步,用另一个能力交叉核对同一批数据。profile 返回的 nasa 帖子总数是 4,979,200 条约占 4%,所以「一次覆盖 5 个半月」说的是最近这段时间,不是全部历史;natgeo 帖子总数 32,000,95 条只覆盖最近 4 周。第五步,对方的价格只从公开元数据读,并和 Store 页原文对照:Instagram Scraper 页面上写的 $2.70、$2.30、$1.90、$1.50,和 API 里 FREE、BRONZE、SILVER、GOLD 四档完全一致;页面上「8,200 条、104,700 条、666,000 条」三个数,我们用月费除以单价复算,误差都在 1% 以内。这样做的目的,是让每个倍数都能被别人用同样的公开材料重算一遍。
算一笔账:每月 1 千条到 100 万条帖子
把两家的计费规则放进同一个月,Apify 要加上套餐月费:Free 套餐每月有 $5 额度,超出就停;Starter 套餐 $19、Scale 套餐 $199、Business 套餐 $999 都是预付,用不完作废,超出部分按各自档位单价另计。我们按「最省的那个套餐」算 Apify 的月成本,按本文帖子的实测每千条价算 EveryInfra,不加代理、存储和数据传输费。
| 每月帖子数 | Apify 最省套餐 | Apify 月成本 | EveryInfra 月成本 |
|---|---|---|---|
| 1,000 | Free(用掉 $2.70 免费额度) | $2.70 | $0.0034 |
| 10,000 | Starter | $23.00 | $0.034 |
| 100,000 | Scale | $199.00 | $0.34 |
| 500,000 | Scale | $950.00 | $1.69 |
| 1,000,000 | Business | $1,500.00 | $3.37 |
这张表里 EveryInfra 一列很小,原因是 user_posts 一次能回 200 条。要提醒两点。第一,实际业务很少只要帖子:如果你同时要每个账号的主页,这部分按每千个 $0.556 另算;每天监测 1,000 个账号的主页加最近 30 条帖子,一个月是 30,000 次主页和 30,000 次帖子请求,合计约 $33.36,用 Apify 做同样的事(30,000 个主页加 900,000 条帖子),Business 档约 $1,398,Free 档用不了。第二,我们的实测里有一次只回了 95 条,所以真实的每千条价会在 $0.003 到 $0.006 之间浮动,上表用的是三次合计的平均,即 3 次请求、495 条、$0.001668。
再看三个常见用法,都按本文的实测单价算,不含人工。达人筛选:给 500 个候选达人各读一次主页和最近 30 条帖子,算平均点赞和发帖频率,一共 1,000 次请求,$0.556;Apify 上同样是 500 个主页加 15,000 条帖子,Business 档 $23.30,Free 档 $41.80,后者已经超过 Free 套餐每月 $5 的额度。品牌声量:每天读 3 个品牌话题下的帖子和短视频各一次,再给其中 20 条热门帖各读一屏评论,一天 26 次请求,一个月约 $0.43;如果这些请求都拿满(话题每次 30 条、评论每次 15 条),Apify 上每月约 14,400 条结果,按 Instagram Scraper Business 档每千条 $1.50 算约 $21.60。竞品内容复盘:每周读 50 个竞品账号最近 200 条帖子,一个月 200 次请求,$0.11;Apify 上一个月 40,000 条结果,Business 档 $60。三个例子里差距最小的是达人筛选,因为它有一半请求是按目标计费的主页。
上手要几步:注册、试用、接 MCP 和自动化工具
Apify Store 页给出的上手步骤是 8 步:注册账号、打开 Instagram Scraper、选要抓的内容类型、粘贴 URL、设每个 URL 的结果上限、可选的日期过滤、点开始、下载数据集(Instagram Scraper)。Free 套餐不用信用卡。它的优点是界面完整:可视化输入、定时运行、Webhook、导出 JSON/CSV/Excel/XML,以及 Zapier、Make、n8n、Google Sheets 等现成集成(n8n integration),还有 Python 客户端和 API v2。
| 对比项 | Apify Instagram Scraper | EveryInfra |
|---|---|---|
| 计费单位 | 每条结果(事件) | 每次请求;多链接按链接数 |
| 月费 | Free $0(含 $5 额度)/ $19 / $199 / $999 | 无月费 |
| 最低付费 | Starter 套餐 $19/月 | 充值 $10 起 |
| 额度有效期 | 当期用完作废 | 不过期 |
| 免费额度 | 每月 $5,不用信用卡 | GitHub 点星领 $1,24 小时有效 |
| 失败、空结果 | 不产生结果就不收结果费;可设单次花费上限 | 401、422、429、503 不扣;空结果退款;修复前不存在的账号会被扣,10 月 26 日已修复,复测不扣 |
| MCP | mcp.apify.com,OAuth 或 Token | api.everyinfra.com/mcp,Bearer Key |
| 无代码 | Console 界面、定时、Zapier、Make、n8n 节点 | 控制台试用台;n8n 等用 HTTP 请求节点调用 |
| 覆盖 | Instagram 地点、提及、话题统计、转写、视频下载 | Instagram 15 项能力,另有相似账号、账号搜索等 |
EveryInfra 的上手是三步:在快速上手文档注册并拿到 API Key;在控制台试用台里直接点一次(例如 user_posts 文档页上的一键试用,默认读 nasa 的帖子);把同样的请求写进代码或 AI 客户端。没有可视化的输入表单和定时调度,自动化要靠你自己的脚本,或在 n8n 里用通用的 HTTP Request 节点。这是 Apify 实打实的优势,下面「什么时候 Apify 更合适」一节还会再说。
Instagram 爬虫 API:在代码和 AI 客户端里调用
本文用到的入口都在 Instagram 爬虫 API 平台页,每个能力有自己的说明页:用户内容、主页、单条内容、评论、粉丝列表、话题内容、Reels 关键词搜索。下面是实测二那次请求,换 username 就能读别的账号。
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer ${EVERYINFRA_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{
    "platform": "instagram",
    "action": "user_posts",
    "mode": "async",
    "params": { "username": "nasa", "limit": 200 }
  }'
# 返回 202 和 job_id;再 GET https://api.everyinfra.com/api/v1/jobs/<job_id> 取结果
user_posts 返回的字段和目录 response_fields 逐个对应如下;本次 nasa 那 200 条里,没有返回 view_count、location、hashtags、top_comments 这几个键,video_url 只在 56 条上有值。
| 字段 | 含义 | 本次 200 条的情况 |
|---|---|---|
post_id / id / url | 短码、数字 ID、帖子链接 | 200 条全有,去重后 200 |
text | 正文 | 200 条全有 |
media_type | 类型 | 13:35 这次全部是 image;10 月 26 日已修复,16:01 复测 12 条里 4 条是 video |
like_count / comment_count | 点赞数、评论数 | 200 条全有,点赞 21,732 到 2,754,686 |
posted_at | 发布时间(UTC) | 2026-05-07 到 2026-10-25 |
author_username / author_name / author_id | 作者 | 200 条全有 |
image_url / width / height | 封面图和尺寸 | 200 条全有 |
video_url | 视频地址 | 56 条有值,4 条已知视频都在其中;判断视频看它 |
view_count / location / hashtags / top_comments / is_comments_disabled / author_follower_count | 播放、地点、话题、热评等 | 本次未返回 |
在 AI 客户端里用,把 EveryInfra 的 MCP 服务加进配置就行(MCP 的协议见 Model Context Protocol 规范,各客户端写法见 MCP 接入和远程 MCP 配置指南):
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${env:EVERYINFRA_API_KEY}" }
    }
  }
}
然后可以直接说:「用 EveryInfra 读 nasa 最近 200 条 Instagram 帖子,按月统计帖子数和平均点赞数。」Apify 也有自己的 MCP 服务 mcp.apify.com,可以用 OAuth 登录,也能用 tools=apify/instagram-scraper 只加载 Instagram Scraper 一个工具(Apify MCP server,源码在 GitHub)。两家在 AI 客户端里的用法差不多,区别仍然是计费:通过 MCP 让模型多拉几页,Apify 按条加钱,我们按次加钱。在 Cursor 里的用法,见我们之前写的 Cursor 里用 MCP 拿 TikTok、Instagram、Amazon 数据。
官方 Instagram API 能不能替代这两家
很多人问的第一个问题是:为什么不用 Meta 自己的接口?答案是官方接口能读的范围很窄。Instagram 平台 API 主要服务于你自己管理的专业账号:发帖、读自己的评论和洞察数据。读别人账号,只有 Business Discovery,而且只能读其他商家号和创作者号的公开资料和帖子;按话题找帖子要用 Hashtag Search,每个账号在任意 7 天内最多查 30 个不同的话题。普通用户的粉丝列表、别人帖子下的全部评论,官方接口都不给。原来给个人账号用的 Basic Display API,Meta 已经在 2024 年 12 月 4 日停掉(Meta 开发者博客,2024-09-04)。Instagram 平台变更日志最近一条也是围绕自己的账号:2026 年 10 月 20 日新增的 /ordered_comments 只对广告素材按显示顺序返回评论。所以如果你的任务是读别人的公开数据,官方接口基本帮不上忙,这正是 Apify 和 EveryInfra 这类服务存在的原因。
按条计费什么时候反而更便宜
把两种计费方式的公式写出来,就能看清楚分界线在哪。Apify 一侧,每千条成本等于档位单价,和一次运行拿多少条无关(Reel Scraper 另有每次启动 $0.001)。EveryInfra 一侧,每千条成本等于单次价格除以每次返回条数再乘 1,000。两边相等的地方,就是「每次请求至少要回几条,我们才不比 Apify 贵」。用 user_posts 的 $0.000556 去比 Apify Instagram Scraper Business 档的 $1.50,每次只要回 0.37 条就打平,也就是说只要回 1 条就已经便宜;用 reels_search 的 $0.007194 去比 Reel Scraper Business 档的 $1.00,每次要回 7.2 条才打平,我们实测回了 92 条;similar_profiles 每次 $0.008806,对 Profile Scraper Business 档的 $1.60,每次要回 5.5 个账号才打平,目录写的默认是 20 个。
真正的例外出现在 Apify 的企业档。公开元数据里,Instagram Scraper 还有 PLATINUM 每千条 $0.90、DIAMOND 每千条 $0.50 两档;Profile Scraper 的 DIAMOND 是 $0.50,Post Scraper 的 DIAMOND 是 $0.40。这两档不在公开套餐表里,Apify 文档说企业客户可以有额外折扣(Actors in Store),定价与成本文档写明 PLATINUM、DIAMOND 两档只给 Enterprise 客户。如果你已经是 Apify 的企业客户、拿到了 DIAMOND 档,那么按目标计费的两种数据会反过来:读 1,000 个主页,Apify $0.50,我们 $0.556;按链接读 1,000 条单帖详情,Apify Post Scraper $0.40,我们 $0.556。也就是说,在「一个目标一笔钱」的场景里,大客户在 Apify 上可能比在我们这里便宜 10% 到 28%。帖子、Reels 列表、评论、粉丝列表这些一次回一页的数据,即使对 DIAMOND 档(帖子每千条 $0.50),我们按实测的 $0.0034 仍便宜约 148 倍。
另一个容易忽略的成本是「没用上的条数」。按次计费的好处是多拿不加钱,但如果你只需要每个账号最新 1 条帖子,仍然要为一次请求付 $0.000556,这时每条有用数据的成本就是每千条 $0.556,和读主页一样,对 Apify Business 档只便宜 2.7 倍。反过来,按条计费的好处是只为拿到的东西付钱,坏处是拿多了就多付:Apify 的 resultsLimit 是每个 URL 的上限,如果你给 500 个账号都设 200,一次运行最多会产生 10 万条结果事件,Business 档就是 $150。规划用量时,按条计费要先想清楚「最多要多少条」,按次计费要先想清楚「最少要发几次请求」。
什么时候 Apify 更合适
下面 7 条都是可以核实的事实,不是客气话。第一,你要的是 Instagram 的地点数据(坐标、地址、地点下的帖子)、话题的发帖量和相关话题分层,或者「谁提到了某个品牌」的提及数据:Apify Instagram Scraper 的 Store 页把这些列为输出类型,我们的 15 项能力里没有地点和话题统计。第二,你要按账号批量拿 Reels,或者要 Reel 的分享数、转写和视频文件:我们的 reels 当天暂停,Apify 的 Reel Scraper 有这些附加项。第三,你要一个热门帖子的大量评论或楼中楼回复:Apify 付费套餐不限一页,我们一次给的是 Instagram 每帖对外公开的约 15 条。
第四,你要导出一个大号的全部粉丝:Apify 的 Followers and Following Scraper 按每个账号计费,认证大号的粉丝列表对外只开放第一页,一次四五十个。第五,你不写代码,想在网页上填表、定时跑、接 Zapier 或 Make:Apify 的 Console 和现成集成比我们完整。第六,你的工作流已经在 Apify 上,同时用到 Instagram 以外的很多 actor:Apify Store 有上万个 actor,迁移本身有成本。第七,你是 Apify 的企业客户,拿到了 DIAMOND 档:按目标计费的主页和单帖详情,在 Apify 上每千条 $0.40–$0.50,比我们的 $0.556 便宜一到三成,这一类读取没有必要换。反过来,如果你的主要用量是帖子、话题和关键词下的 Reels、每个帖子最新一屏的评论、主页基础数据,并且是用代码或 AI 客户端在调,那么按本文实测,EveryInfra 在这些数据上便宜几倍到几百倍。
合规边界:公开数据、私密账号和平台条款
先说私密账号。我们只读公开数据:profile 返回的 is_private 字段会告诉你账号是不是私密的,私密账号的帖子、粉丝列表我们不读。Apify 的常见问题也写明,一般不能抓私密主页,唯一的例外是私密账号被标为某个公开帖子的合作者时,那条帖子会被当成公开帖子(Instagram Scraper)。
再说条款和判例。Instagram 的使用条款明确不允许未经许可用自动化方式访问或收集信息;Meta 在 2021 年专门发文介绍它怎么对抗抓取(How We Combat Scraping),开发者使用官方接口还要遵守 Meta 平台条款。法院层面,美国加州北区联邦地区法院 2024 年 1 月在 Meta 诉 Bright Data 案中认定,未登录状态下抓取公开数据不违反 Meta 的条款(案卷);第九巡回上诉法院 2022 年 4 月 18 日在 hiQ 诉 LinkedIn 案中认为,读取公开网页不属于《计算机欺诈和滥用法》说的「未经授权」(判决原文)。这些判决只说明了美国法院在特定案情下的看法,不是普遍许可。
个人信息是另一层。公开的个人数据仍然受 GDPR 和《个人信息保护法》这类法律约束。前面实测五那两页粉丝里,三分之一是私密账号,剩下的也大多是普通个人用户,这类数据最需要小心。我们不提供法律意见,只建议三件事:只取任务需要的字段,粉丝列表这类涉及普通用户的数据去掉用户名再存,保留每次请求的时间和来源。
最近的变化(2026 年 9–10 月)
| 日期 | 变化 | 对读者意味着什么 |
|---|---|---|
| 2026-10-23 | 路透社报道,Meta 把新商业条款的生效日从 10 月 30 日推迟到 11 月 20 日;同日美国参议员 Blackburn 公开质疑条款里的抓取授权(路透社) | Meta 对「谁能抓谁」的规则正在改,商家号用户 11 月 20 日前要看一遍新条款 |
| 2026-10-20 | Instagram 平台新增 /ordered_comments,只对广告素材按显示顺序返回评论(变更日志) | 官方接口仍只覆盖自己的账号和广告,读别人的评论还得靠第三方 |
| 2026-10-17 | Meta 删除了商业条款中「可用抓取内容训练 AI」的表述(TechCrunch;最早由 Nieman Lab 2026-10-15 报道,条款原文见 Meta 商业条款和更新说明) | Meta 的商业条款还在改,和抓取有关的表述可能再变,签约或接入前读当时的原文 |
| 2026-10-07 | Apify Instagram Post Scraper 启用新价:每条帖子 $1.00–$1.70,帖子详情另收 $0.60–$1.00(公开元数据) | 对方在把一个结果拆成多个收费事件,比价时要把附加事件加进去 |
对买数据的人,这几条里最直接的是 Apify Post Scraper 那一条:Apify 在把一个结果拆成多个收费事件,比价时只看每条结果的标价已经不够,要把附加事件、月费和作废的额度一起算进去,才是真实成本。
上手:从试用到每天自动跑
如果你现在在用 Apify Instagram Scraper,想试一下按次计费,最省事的路径是:先在快速上手拿到 Key,在试用台里用你最常读的那个账号跑一次 user_posts(一键试用),把返回条数和扣费和你在 Apify 上同一个账号的运行记录对一下。然后挑出你工作流里「每次能回很多条」的那几步换过来,主页、地点、全部评论这类仍留在原处。多平台一起用的读者,可以再看 TikTok 爬虫 API 和 Threads 爬虫 API,计费方式相同;把多个平台的数据放进一个统一结构的做法,见统一数据接口指南,做达人背调的思路见达人数据尽调,多平台口碑监测见多平台口碑监测。完整的竞品对比页在替代方案。
常见问题
Apify Instagram Scraper 免费吗?
部分免费。这个问题来自 Google 联想词「is apify instagram scraper free」。Apify 的 Free 套餐每月给 $5 平台额度,不需要信用卡,按 Instagram Scraper Free 档每千条 $2.70 算,大约够 1,850 条结果;额度当月作废,用完会停到下个月(Apify 价格页)。同样 $5 在 EveryInfra 上大约是 9,000 次请求,按 user_posts 一次 200 条算是上百万条帖子;但 EveryInfra 没有每月赠送,只有 GitHub 点星的 $1 试用额度。
Apify Instagram Scraper 合法吗?
这个问题来自联想词「is apify instagram scraper legal」。Apify 自己的回答是只抓公开数据、不碰私密内容,并提醒公开数据也可能是 GDPR 下的个人数据。我们的看法写在上面「合规边界」一节:美国有 Meta 的一起抓取诉讼和 hiQ 诉 LinkedIn 两个对公开数据抓取有利的判决,但 Instagram 条款本身不允许未经许可的自动化收集,个人信息保护法律照样适用。这不是法律意见。
能抓私密 Instagram 账号吗?
不能。这个问题来自联想词「can you scrape private instagram」。Apify 和 EveryInfra 都只读公开数据;profile 会返回 is_private,私密账号只能拿到公开可见的主页字段。Apify 提到的唯一例外是私密账号作为合作者出现在某个公开帖子里。
Apify 能抓 Instagram 粉丝列表吗,多少钱?
能。这个问题来自联想词「apify instagram follower scraper」。Apify 有一个 2026 年 6 月上架的 Followers and Following Scraper,每个账号 $0.00115–$0.002,即每千个 $1.15–$2.00。我们的 followers_list 一次 $0.000556,实测一次回 43–49 个,每千个约 $0.012;nasa、natgeo 是认证账号,Instagram 对认证账号的粉丝列表只开放第一页,所以拿不到这类大号的全部粉丝,非认证的公开账号能拿到更多。
用 Apify 是只付 actor 的钱,还是还要买套餐?
这个问题来自 Reddit r/apify 的一个帖子:提问者用的是一个读 LinkedIn 主页的 actor(每千个 $4),每天只读 8 到 10 个主页,看到 $29 的 Starter 套餐觉得太多(原帖;我们 10 月 26 日读到的 Starter 价格是 $19)。问的虽然是 LinkedIn,计费规则对 Instagram 的 actor 一样适用。回答是:按事件计费的 actor 费用从你套餐的预付额度里扣,Free 套餐的 $5 也能用,用量小可以不买套餐。另一个帖子里也有人问「最省钱的 Instagram actor」,回答提到同类 actor 价格差别很大,并建议看最近更新时间(原帖)。
Apify Instagram Scraper 是怎么工作的?
这个问题来自联想词「how does apify instagram scraper work」。按它的 Store 页说明,Instagram Scraper 是一个在 Apify 云上运行的程序(actor):你给它一组 Instagram 链接或一个搜索词,选一种要抓的内容(帖子、Reels、评论、提及或详情),设每个链接的条数上限,它以未登录访客能看到的页面为准抓取,把结果写进一个数据集,按写进去的条数计费。一次运行只能产出一种内容;帖子和评论都要,就得跑两次。EveryInfra 的做法是每种数据一个接口能力,一次请求一种数据,返回统一的 JSON 字段,按请求计费。两者都只读公开数据,读到的点赞数、评论数都是读取那一刻的快照。
怎么用 API 调 Instagram scraper?
这个问题来自联想词「apify instagram scraper api」。Apify 一侧是启动一个 actor 运行,再读它的数据集,有 Python 和 Node.js 客户端;EveryInfra 一侧是一个 POST 请求,参数见上面的 curl,慢的请求加 "mode":"async" 再按 job_id 取结果。两边都能接 MCP。
参考资料
- Instagram Scraper(Store 页,含「How much will scraping Instagram cost?」和常见问题),Apify,2026-10-26 读取。https://apify.com/apify/instagram-scraper
- Apify 价格页(套餐、CU、代理、存储价),Apify,2026-10-26 读取。https://apify.com/pricing
- Instagram Scraper 公开元数据(pricingInfos、stats),Apify API,2026-10-26 13:31 SGT 读取。https://api.apify.com/v2/acts/apify~instagram-scraper
- Instagram Post Scraper 公开元数据(2026-10-07 起的新价),Apify API,2026-10-26 读取。https://api.apify.com/v2/acts/apify~instagram-post-scraper
- Instagram Profile Scraper,Apify,2026-10-26 读取。https://apify.com/apify/instagram-profile-scraper
- Instagram Post Scraper,Apify,2026-10-26 读取。https://apify.com/apify/instagram-post-scraper
- Instagram Reel Scraper,Apify,2026-10-26 读取。https://apify.com/apify/instagram-reel-scraper
- Instagram Comments Scraper,Apify,2026-10-26 读取。https://apify.com/apify/instagram-comment-scraper
- Instagram Followers and Following Scraper,Apify,2026-10-26 读取。https://apify.com/apify/instagram-followers-following-scraper
- Instagram Hashtag Scraper,Apify,2026-10-26 读取。https://apify.com/apify/instagram-hashtag-scraper
- Actors in Store(按事件计费、按用量计费、商店折扣档),Apify 文档。https://docs.apify.com/platform/actors/running/actors-in-store
- Pay-per-event pricing model(开发者分成 80%、actor-start 事件),Apify 文档。https://docs.apify.com/platform/actors/publishing/monetize/pay-per-event
- Apify MCP server,Apify 文档。https://docs.apify.com/mcp
- n8n integration,Apify 文档。https://docs.apify.com/platform/integrations/n8n
- Apify API v2 参考,Apify 文档。https://docs.apify.com/api/v2
- Reaching platform limits,Apify 帮助中心,2026-09-04。https://help.apify.com/en/articles/11079614-reaching-platform-limits
- apify-mcp-server 源码,GitHub。https://github.com/apify/apify-mcp-server
- apify-client-python 源码,GitHub。https://github.com/apify/apify-client-python
- Changelog for Instagram Platform(2026-09-28、10-05、10-20 等条目),Meta for Developers。https://developers.facebook.com/documentation/instagram-platform/changelog
- Hashtag Search(每个账号 7 天内最多 30 个话题),Meta for Developers。https://developers.facebook.com/documentation/instagram-platform/instagram-api-with-facebook-login/hashtag-search
- Business Discovery,Meta for Developers。https://developers.facebook.com/docs/instagram-platform/instagram-api-with-facebook-login/business-discovery
- Update on Instagram Basic Display API,Meta for Developers,2024-09-04。https://developers.facebook.com/blog/post/2024/09/04/update-on-instagram-basic-display-api/
- Meta Platform Terms,Meta for Developers。https://developers.facebook.com/terms/
- Instagram Terms of Use,Instagram 帮助中心。https://help.instagram.com/581066165581870
- How We Combat Scraping,Meta,2021-04-15。https://about.fb.com/news/2021/04/how-we-combat-scraping/
- Meta Commercial Terms,Meta。https://www.facebook.com/legal/commercial_terms
- 商业条款更新说明,Meta 商务帮助中心。https://www.facebook.com/business/help/2481113349080785
- Meta Platforms, Inc. v. Bright Data Ltd., 3:23-cv-00077 案卷,CourtListener。https://www.courtlistener.com/docket/66706470/meta-platforms-inc-v-bright-data-ltd/
- hiQ Labs v. LinkedIn,美国联邦第九巡回上诉法院,2022-04-18。https://cdn.ca9.uscourts.gov/datastore/opinions/2022/04/18/17-16783.pdf
- 条例 (EU) 2016/679(GDPR),欧盟官方公报。https://eur-lex.europa.eu/eli/reg/2016/679/oj
- 《中华人民共和国个人信息保护法》,全国人大,2021-08-20。http://www.npc.gov.cn/npc/c2/c30834/202108/t20210820_313088.html
- Model Context Protocol 规范(2025-06-18 版)。https://modelcontextprotocol.io/specification/2025-06-18
- HTTP Request 节点,n8n 文档。https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.httprequest/
- EveryInfra 能力目录(price_usd、response_fields),2026-10-26 读取。https://api.everyinfra.com/api/v1/social/catalog
- 「Meta 新商业条款将允许抓取新闻网站」,Nieman Lab,2026-10-15。https://www.niemanlab.org/2026/10/metas-new-commercial-terms-will-allow-the-scraping-of-news-sites-legal-experts-say/
- 「Meta 删除引发抓取和 AI 训练担忧的条款」,TechCrunch,2026-10-17。https://techcrunch.com/2026/10/17/meta-removes-language-that-raised-scraping-and-ai-training-concerns/
- 「参议员称 Meta 商业条款更新可能伤害美国企业」,路透社,2026-10-23。https://www.reuters.com/world/senator-says-planned-meta-commercial-terms-update-could-harm-us-businesses-2026-10-23/
- 「Best Cost-Efficient Apify Actor for Instagram and X Profile Search?」,Reddit r/apify。https://www.reddit.com/r/apify/comments/1s81nhe/best_costefficient_apify_actor_for_instagram_and/
- 「Confusion on Apify Pricing!」,Reddit r/apify。https://www.reddit.com/r/apify/comments/1sxx2qu/confusion_on_apify_pricing/
- 「Reviews after getting into web scrape tools」,Reddit r/automation。https://www.reddit.com/r/automation/comments/1sgmbyq/reviews_after_getting_into_web_scrape_tools_apify/
- Get Actor 接口,Apify API 文档。https://docs.apify.com/api/v2/actor-get
- Actor pricing and costs(PLATINUM、DIAMOND 为 Enterprise 专用),Apify 文档。https://docs.apify.com/platform/actors/publishing/monetize/pricing-and-costs
- Runs and builds(运行状态),Apify 文档。https://docs.apify.com/platform/actors/running/runs-and-builds
引用编号 BL-47