Apify vs Firecrawl:每千次抓取和搜索实测比价
1,000 条网页结果,Apify 0.045 到 0.45、Firecrawl 0.12 到 0.64、我们真调每千条 0.069 美元,比爬取和失败扣费
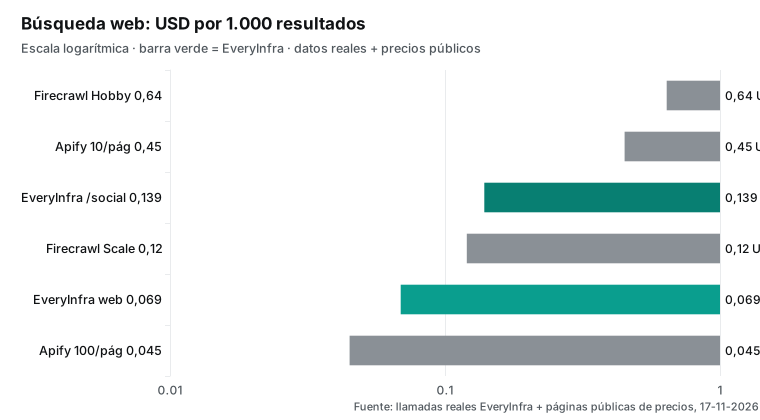
同样拿 1,000 条网页搜索结果,Apify 的 Google Search Results Scraper 按公开事件价算约 0.045 到 0.45 美元(看一页抓 100 条还是 10 条),Firecrawl 的 Search 接口按每 10 条 2 个 credit 折成 0.12(Scale 档)到 0.64 美元(Hobby 年付),我们在 2026 年 11 月 17 日用 EveryInfra 真调 web/search,一次 0.000694 美元回 10 条,折每千条 0.069 美元。差距更大的一类是整站爬取:Firecrawl 的 Crawl 按每页 1 个 credit,每千页 0.60(Scale)到 3.20 美元(Hobby),我们的 crawl 一次请求回多页只收 0.000694 美元,本文两次分别回 10 页和 3 页,折每千页 0.069 到 0.231 美元,比 Firecrawl 便宜几倍到几十倍。差距最小的是抓单页正文:一次只回 1 页,我们按请求计的 0.694 美元就不占便宜,Firecrawl 在 Standard、Scale 档(每千页 0.599 到 0.83 美元)反而更低,前提是先付 83 到 599 美元月费、额度到期清零;其余四类成批返回的活,按请求计费都更省。
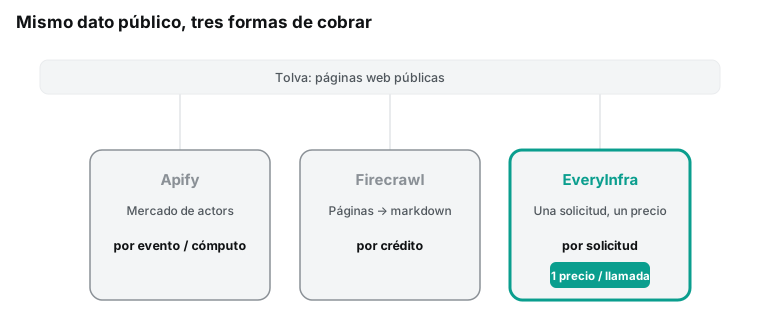
本文的「每千条价」,是把一次请求实际扣掉的钱,除以这次实际返回的条数或页数,再乘 1,000;它回答「拿到 1,000 条结果要花多少钱」。EveryInfra 按请求计费,Firecrawl 按 credit 计费,Apify Store 里的抓取程序(actor)按事件或按算力计费,三种单位只有换到同一个分母才能比。分母一律用实际返回的条数或页数,不用请求里写的上限,所以回得少的那几次,我们这一侧的价格只会被算高。对方两家我们只用公开材料:Firecrawl 的定价页和文档、Apify 的价格页和两个 actor 的公开元数据,以及不需要账号就能读的公开接口;我们没有注册这两家、没有买它们的套餐、没有跑它们的任何 actor,所以表里对方的数字都是「公开单价」,不是「实测账单」,也和我们自己的数据没有任何关系。
先看总表:五类活,每千条各多少钱
把五类最常用的取数活放在一起看。Apify 一侧取的是公开价:平台算力按算力单位(compute unit,1 GB 内存跑一小时)计,Free 和 Starter 档 0.2 美元一个,Business 档 0.13 美元(Apify 价格页,2026-11-17 读取);Store 里的现成 actor 另按自己的事件价收,例如 Google Search Results Scraper 按「成功抓到的一页搜索结果」收费,Free 档一页 0.0045 美元、Business(Gold)档 0.00245 美元(Google Search Results Scraper 元数据,2026-11-17 读取)。Firecrawl 一侧取自定价页:1 个 credit 等于基础抓取或爬取的一页、或一次 Map 调用,Search 是每 10 条结果 2 个 credit,每个 credit 的价钱随套餐从 0.0032(Hobby 年付)降到 0.000599 美元(Scale 年付)(Firecrawl 定价页,2026-09-04 生效,2026-11-17 读取)。EveryInfra 一侧全部是本文真调:实扣金额来自响应里的 charged_usd,条数取响应里 results 的长度。
| 一类活 | EveryInfra 能力 | 我们真调:次数 / 条数 / 实扣(美元) | 我们每千条 | Firecrawl 公开价(每千条,年付) | Apify 公开价(每千条) |
|---|---|---|---|---|---|
| 网页搜索 | web/search | 2 / 20 / 0.001388 | 0.069 | Search:0.12(Scale)到 0.64(Hobby) | Google Search Scraper:0.045 到 0.45 |
| 抓单页正文 | read | 2 / 2 / 0.001388 | 0.694 | Scrape:0.599(Scale)到 3.20(Hobby) | Website Content Crawler:按算力,无固定每页价 |
| 整站爬取 | crawl | 2 / 13 / 0.001388 | 0.069 到 0.231 | Crawl:0.599(Scale)到 3.20(Hobby) | Website Content Crawler:按算力 |
| 列站点地图 | map | 1 / 50 URL / 0.000694 | 0.694(每千次调用) | Map:0.599 到 3.20(每千次调用) | Website Content Crawler:按算力 |
| 结构化平台数据 | amazon/search | 1 / 25 / 0.002236 | 0.089 | 无原生平台接口,要抓页面再抽取 | 现成 actor 约 2.30(示例) |
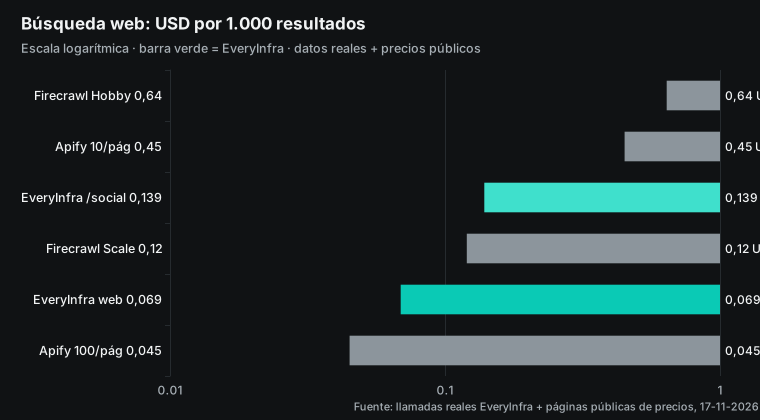
倍数一律用对方的每千条价除以我们的每千条价。读这张表要先分清两件事。第一,搜索、整站爬取、结构化数据这几类,我们每次请求能一口气回很多条或很多页,按请求收一次钱,条数越多单价摊得越薄,所以差得最多。第二,抓单页正文是「一次一个目标」,一次只回 1 页,这时我们的 0.694 美元就不占便宜了:Firecrawl 在 Standard、Growth、Scale 档的每页价(0.599 到 0.83 美元)比我们低,前提是先按 83 到 599 美元一个月预付、且当月没用完的额度到期作废。哪种更省,取决于你的活属于哪一种,这一点在每一类活里都会算清。
我们怎么算
每千条价等于这次请求的实扣金额除以实际返回条数再乘 1,000;同一类活跑了几次,就把金额和条数分别加总再除。返回 0 条的请求不进分母,单独看它扣没扣钱。Firecrawl 一侧,先把它的 credit 规则换成每千条的 credit 数(抓取、爬取每页 1 个,Map 每次 1 个,搜索每 10 条 2 个),再乘以每个 credit 的套餐价;套餐价取年付,年付比月付便宜约 16.7%。Apify 一侧,平台用量按算力单位乘单价,Store actor 按它公开元数据里 pricingInfos 的最后一个已生效版本逐个事件记。对方公开接口里开始时间晚于读取时刻的定价,是已经公布、还没生效的新价,单独标出,不当现价用。
真调用的是一个测试 Key,同一个 Key 当天还有别的写作同事在调,所以我们没有用「余额前后差」算花费,而是按每次请求响应里的 charged_usd 直接记。这把 Key 每分钟只允许 10 次请求,超过就回 429、不扣费,所以本文的真调分成 00:20、00:24、00:38 三个时刻(新加坡时间 SGT)隔开发出,不并发猛打。目标只选稳定的公开页面和品牌、机构类关键词,个人创作者的账号名一律不写。所有算出来的每千条价、倍数、每月成本,都由一个复算脚本从原始返回现算,图上的每个数由画图脚本直接读同一份结果。
实测一:网页搜索,一次回 10 条,每千条 0.069 美元
网页搜索是三家都做的活,先从这里比。2026 年 11 月 17 日 00:21(新加坡时间 SGT),我们用 web/search 搜「web scraping api pricing comparison」,一次回 10 条,用时约 1.5 秒,扣 0.000694 美元。每条带标题、链接和一段摘要,和目录里写的返回字段对得上;想要更多就带 page 翻页,我们在 00:38(新加坡时间)翻到第 2 页,又回 10 条、又扣 0.000694 美元,说明翻页是又一次请求、又一个固定价。按一次 10 条算,每千条结果是 100 次请求、0.069 美元。下面是这一次搜索的请求写法:
curl -s https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"tool":"web","params":{"q":"web scraping api pricing comparison","num":10,"location":"us"}}'
# 返回 200,results 里 10 条,billing.charged_usd 为 0.000694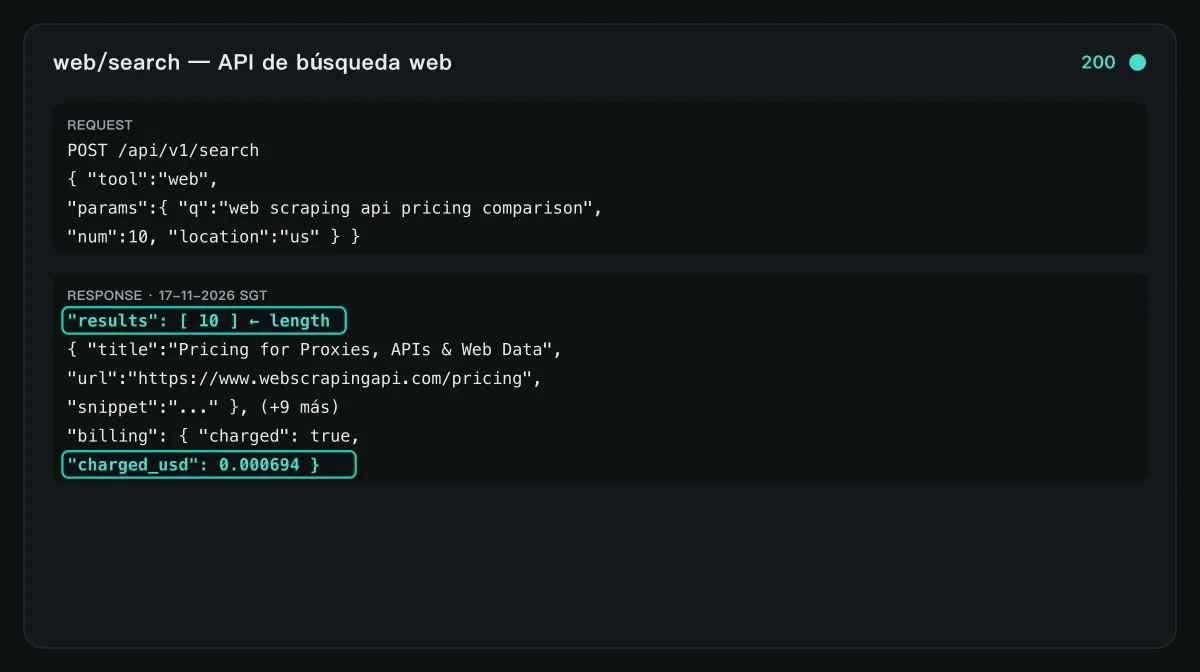
Firecrawl 的 Search 接口把搜索和抓取合在一个调用里:默认只回搜索结果的标题、链接、摘要,每 10 条收 2 个 credit;如果在同一个调用里打开抓取选项,它会把每条结果的页面也抓成 markdown 一起返回,这时每条又多算抓取的 credit(Firecrawl Search 接口文档、Firecrawl Search 功能页)。只算搜索本身,每千条是 200 个 credit,折成每千条 0.12(Scale 年付)到 0.64 美元(Hobby 年付),Free 套餐每月 1,000 个 credit 够搜 5,000 条。Firecrawl 把 Search 定位成「搜索加抓取一步到位」,适合先搜后读的研究型 agent。
Apify 这一侧没有一个「网页搜索」的统一接口,而是用 Google Search Results Scraper 这个 actor 抓 Google 结果页。它现在按事件计费:每成功抓一页搜索结果,Free 档 0.0045 美元、Bronze(Starter)0.0035、Gold(Business)0.00245、企业 Diamond 档 0.0014 美元,另有每次运行 0.002 美元的启动费和 0.5 美元的最低计费(Google Search Results Scraper 元数据,2026-11-17 读取)。一页 Google 结果可以设成 10 条或 100 条:按 100 条一页算,每千条是 10 页、0.045 美元(Free),比我们还低;按 10 条一页算,每千条是 100 页、0.45 美元,比我们高。这个 actor 累计跑了 1.37 亿次、近 30 天 27,143 个用户、评分 4.65(同一份公开元数据)。所以搜索这一类,三家在同一个数量级:按次计费的我们居中偏低,Apify 在「一页抓满 100 条」时最低,Firecrawl 在低套餐时最高。
实测二:抓单页正文,一次一页,这一项要看承诺量
把一个网址抓成干净正文,是 Firecrawl 的看家本事,也是和它比最关键的一节。2026 年 11 月 17 日 00:21(新加坡时间),我们用 read 抓 Model Context Protocol 官网的一页介绍,约 7 秒返回,回一页正文(标题、链接、正文三段),扣 0.000694 美元,折每千页 0.694 美元。00:38(新加坡时间)我们又抓了同一页做稳定性复测,这次约 2.6 秒、仍是一页、仍扣 0.000694 美元,正文一致,价格稳。read 的做法是多家抓取源互为备份,一家取不到自动换下一家,取回的是清理过的正文文本。
Firecrawl 的 Scrape 每页 1 个 credit,渲染 JavaScript 是默认行为,返回的是直接能喂给大模型的 markdown,官方称这种 markdown 比原始 HTML 少用约 67% 的 token(Firecrawl Scrape 功能页、Firecrawl 博客:最好的网页数据 API,2026-08-11)。每千页按套餐从 3.20(Hobby 年付)、0.83(Standard)、0.666(Growth)到 0.599 美元(Scale),Free 套餐每月 1,000 页免费。把这几档和我们的 0.694 美元放在一起看:在 Hobby 档,我们便宜约 4.6 倍;到了 Standard 和 Scale 档,Firecrawl 的每页价比我们低,但你得先承诺 83 到 599 美元一个月,而且当月没抓完的 credit,除了 Scale 和企业档能延一个月,其余到期清零(Firecrawl 定价页)。也就是说,这一项谁便宜取决于你的量稳不稳:量大且每月稳定地用满,Firecrawl 的高档单价更低;量小、波动、或者只是偶尔抓几页,我们一次 0.000694 美元、不设月费、余额不过期更划算。
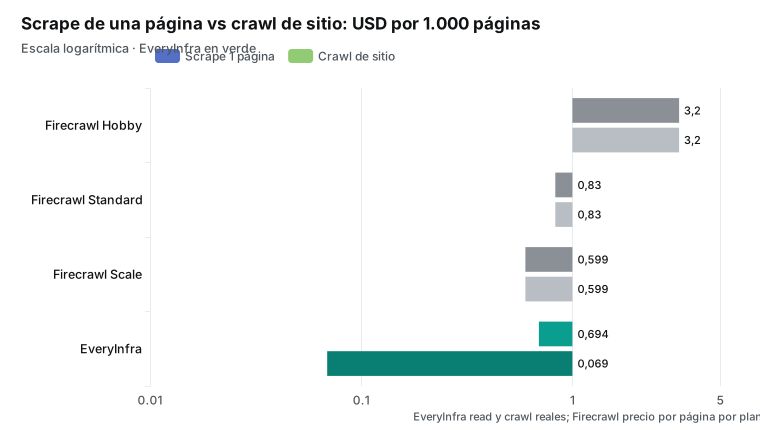
Apify 这一侧对应的是 Website Content Crawler 这个 actor,它正是为「把整站内容抓成 markdown 喂给大模型、向量库、RAG」做的(Website Content Crawler 元数据,2026-11-17 读取,最近更新 2026-11-16)。它按算力计费,没有固定的每页价,成本等于这次运行用掉的算力单位乘以单价,取决于渲染方式和页面大小,所以要先试跑一次才知道一页多少钱。它的能力比单纯抓正文宽:能处理无限滚动、读受登录保护的页面、下载 PDF 和 Office 文件、截图、做按页变化的增量抓取、甚至每页生成一段 AI 摘要以减少后续 token。这个 actor 累计跑了近 5,000 万次、近 30 天约 1.2 万个用户、评分 4.59;公开的近 30 天运行统计里,成功 3,612,346 次、失败 3,109 次、超时 108,485 次、中止 21,530 次,没跑成的约占 3.5%,多数是超时,说明网页抓取本身并不稳定,哪家都要处理重试。
实测三:整站爬取,一次回多页,这里差几倍到几十倍
整站爬取是本文差距最大的一节。2026 年 11 月 17 日 00:24(新加坡时间),我们用 crawl 爬 Model Context Protocol 官网,用自然语言指定「只要讲协议的文档页」,约 9.4 秒返回 10 页,每页带标题、链接和正文,一共扣 0.000694 美元。关键在这里:这是一次请求的价钱,一次回了 10 页,所以每页只有 0.0000694 美元,折每千页 0.069 美元。00:38(新加坡时间)我们又爬了一次 Firecrawl 的文档站,num 设成 20、指定「功能和定价文档页」,这次回了 3 页、同样扣 0.000694 美元,折每千页 0.231 美元。两次说明一件事:crawl 一次回几页由站点结构和自然语言指令决定,但不论回 3 页还是 10 页都是一个固定价,所以每页价在 0.069 到 0.231 美元之间,都远低于 Firecrawl 的每页 credit。
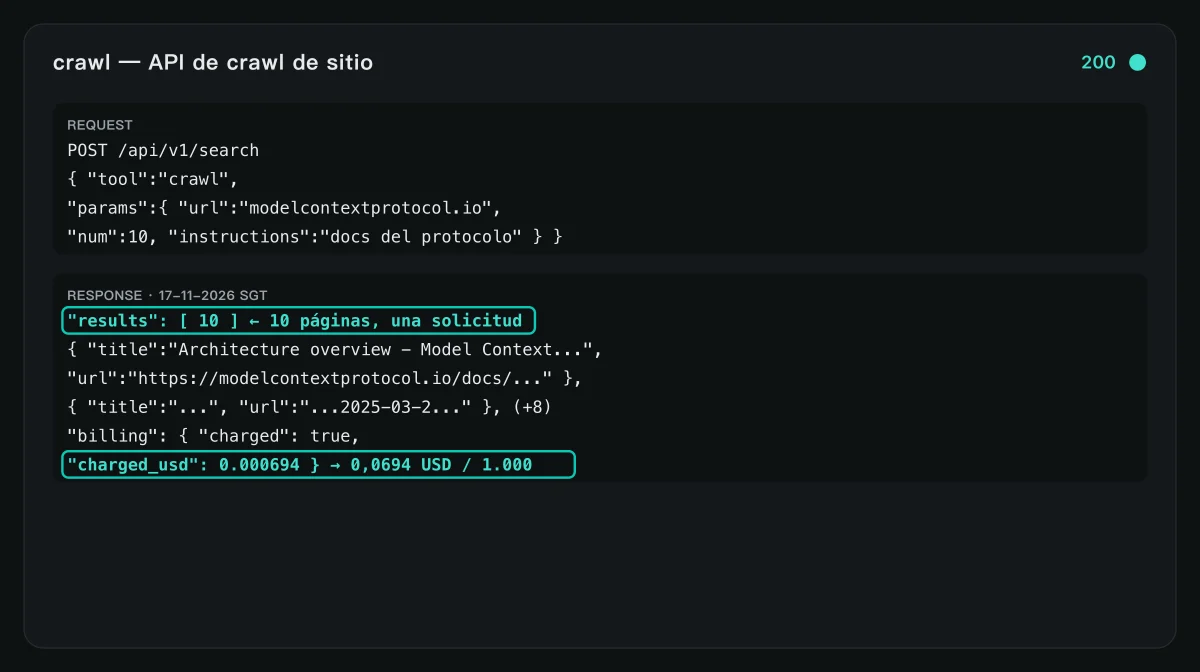
Firecrawl 的 Crawl 按爬到的每一页收 1 个 credit,它会自己发现并抓完一个域名下的所有子页,返回整站的 markdown 或 JSON(Firecrawl Crawl 功能页、Firecrawl Crawl 产品页,2026-10-29)。对一个 100 页的站点,Firecrawl 要收 100 个 credit,按 Hobby 年付是 0.32 美元、Standard 是 0.083 美元、Scale 是 0.0599 美元。同样抓 100 页,我们用 crawl 把 num 设到一页回多少、分几次请求就行,按一次回 10 页算是 10 次请求、0.00694 美元,比 Firecrawl 的 Standard 档便宜约 12 倍、比 Hobby 档便宜约 46 倍。放到我们的真调上:两次 crawl 分别回 10 页和 3 页,折每千页 0.069 和 0.231 美元,同一批页面在 Firecrawl 的 Hobby 年付要 3.20 美元,差约 14 到 46 倍。要说明边界:我们一次回的页数有上限、深站要多发几次请求拼起来,而 Firecrawl 的 Crawl 能一条命令抓完整站、不用你管翻页和去重,这是它省心的地方。
Apify 这边同样用 Website Content Crawler,按算力收费,深爬一个大站的总成本要看它跑了多少算力,没有「每页一价」可比。它的强项在深度和细节:增量爬取能只抓变化过的页,带 cookie 能进登录区,还能下载附件(Website Content Crawler 元数据)。所以整站爬取这一类,比的是「便宜」还是「省心加全面」:要把成本压到最低、且能接受自己分页,我们最省;要一条命令抓完整站、还要处理登录和增量,Firecrawl 和 Apify 更合适。
实测四:列站点地图,一次 50 个链接
有时你只要一个站点有哪些页面,不要正文。2026 年 11 月 17 日 00:24(新加坡时间),我们用 map 列 Model Context Protocol 官网的页面,约 0.3 秒回 50 个链接,扣 0.000694 美元。Firecrawl 的 Map 也是「只出链接、很快」,但它按每次调用 1 个 credit 收,和抓一页同价(Firecrawl Map 功能页、Firecrawl 定价页)。所以这一项两边其实接近:都按一次调用一价,我们每千次调用 0.694 美元,Firecrawl 每千次 0.599 到 3.20 美元;差别在我们一次回 50 个链接是固定价,Firecrawl 一次 Map 返回的链接数由站点决定。对要先看站点结构、再决定抓哪些页的活,Map 加 Crawl 的组合两家都能走,成本仍然是我们按请求、Firecrawl 按页数的那套差别。
实测五:结构化平台数据,Firecrawl 做不了的那一类
搜索和抓正文之外,还有一类活是「从某个平台拿结构化字段」,比如 Amazon 的商品价格、评分,Reddit 的帖子。2026 年 11 月 17 日 00:25(新加坡时间),我们用 amazon/search 搜「usb c cable」,约 54 秒回 25 条,每条带 ASIN、标题、品牌、价格、币种、评分、评价数、是否有货、卖家、榜单排名等 18 个字段,扣 0.002236 美元,折每千条 0.089 美元;同一时刻用 reddit/search 搜「firecrawl vs apify」,回 1 条(这个词在 Reddit 上讨论少),扣 0.000792 美元。这类数据每个字段都是解析好的,不是一页 markdown,拿来做比价、选品、舆情可以直接用。详见亚马逊数据接口和 Reddit 数据接口的字段说明。
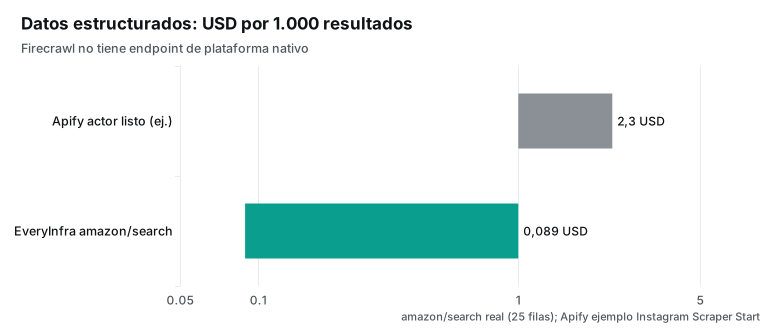
这次 amazon/search 回的 25 条里,带价格的商品价从几美元到二十几美元不等,每条都标了品牌、评分、评价数和是否有货,还有「亚马逊之选」和榜单排名这类标记,拿来做选品和比价可以直接按字段筛,不用自己从页面里抠。换成抓整页再解析,既要处理 Amazon 的反爬和改版,又要自己写解析规则,字段还不保证齐;换成 Firecrawl 抓页再抽取,JSON 格式每页多 4 个 credit,一个商品页就比我们一次请求贵一截。结构化平台数据这一类,省的不只是钱,还有把 markdown 变成字段的后处理工夫。
这正是三家定位的分界。Apify 的核心就是这类活:Store 里有几千个针对具体网站的 actor,社媒、电商、地图、招聘各有专门的抓取程序,现成 actor 的事件价常见在每千条 1 到 3 美元之间,官方价格页举的 Instagram Scraper 示例是 Starter 档每千条 2.30 美元(Apify 价格页、Apify Instagram Scraper)。Firecrawl 没有「平台接口」这个东西,要拿 Amazon 的结构化字段,得先抓商品页再用它的抽取功能把 markdown 转成 JSON,而 JSON 格式每页要另加 4 个 credit(Firecrawl Extract 功能页、Firecrawl 定价页),既贵又要自己拼页面。我们把常见平台做成了固定能力,一次请求回一页结构化结果,按请求收一次钱,所以这一类我们的每千条在 0.089 美元一档,比 Apify 现成 actor 低一两个数量级。要强调的是:我们和 Apify 的字段、和 Firecrawl 的 markdown,都是各自独立做出来的,彼此没有任何数据往来,字段也不一样。
返回什么:markdown、结构化字段、搜索摘要
价格之外,三家返回的东西也不一样,选型要连这个一起看。Firecrawl 的 Scrape 和 Crawl 返回的是整页的 markdown,把导航、页脚、广告清掉,留下正文,适合直接塞进大模型的上下文;要结构化就再加抽取,按 schema 转成 JSON。Apify 的 actor 按每个 actor 自己的输出走:Website Content Crawler 给 markdown 或纯文本加元数据,Google Search Results Scraper 给解析好的搜索结果字段(有机结果、广告、相关提问、价格、评价),各站专用 actor 给各自的字段。我们这边分两类:搜索类工具(web、read、crawl、map)返回标题、链接、正文或摘要,结构化平台能力返回解析好的字段,比如我们在亚马逊数据接口拿到的 18 个字段、在 Reddit 数据接口拿到的帖子字段。三者的取舍很直接:要喂大模型读的整页正文,markdown 最省事;要按字段入库、做比价和筛选,结构化字段最省后处理;要先看搜索结果再决定读哪条,搜索摘要加按需抓取最省钱。
要字段入库,就选按请求计费的结构化能力;要整页喂 RAG,就选能直接产出 markdown 的工具。如果你要的是一个商品的价格和评分,用 Firecrawl 得抓整页 markdown、再花 4 个 credit 抽成 JSON,用我们的结构化能力一次请求就回字段;如果你要的是一篇文档的全文喂给 RAG,Firecrawl 的 markdown 直接可用,我们的 read 给清理过的正文也够,但重排版的前端渲染页面 Firecrawl 抓得更全。把格式需求放进成本一起算,才不会只看单价选错工具。
两家的成功率:Apify 公开的运行统计
Apify 把每个 actor 近 30 天的运行结果公开在元数据里,可以直接读。Website Content Crawler 近 30 天跑了 3,745,470 次,其中成功 3,612,346 次、失败 3,109 次、超时 108,485 次、中止 21,530 次,没跑成的约 3.5%,超时占了大头(Website Content Crawler 元数据)。Google Search Results Scraper 近 30 天跑了 9,742,552 次,成功 9,551,726 次、失败 440 次、超时 171,838 次、中止 18,548 次,没跑成的约 2.0%(Google Search Results Scraper 元数据)。这两个比例说明网页抓取本身不稳定,超时是常态,不论用哪家都要做失败重试和报警,不能只看「运行成功」就当拿到了数据。
这也提醒一件事:比价时的「每千条」是按成功返回的条数算的,没算进去重试的成本。按事件计费的平台上,失败的运行一般不产生结果事件,但一次没跑成就要重跑一次、多等一次;我们按请求计费,失败不扣费、重试也只是再发一次请求。把重试算进来,稳定性差的目标站会让按次数、按事件的成本都往上走,这部分谁都躲不掉,差别只在失败那一次扣不扣钱。第三方评测也开始把成功率和成本放在一起看,而不只比标价(Firecrawl 博客:最好的网页搜索 API,2026-10-21;G2 上的 Firecrawl 评价,2026-11-15 读取)。
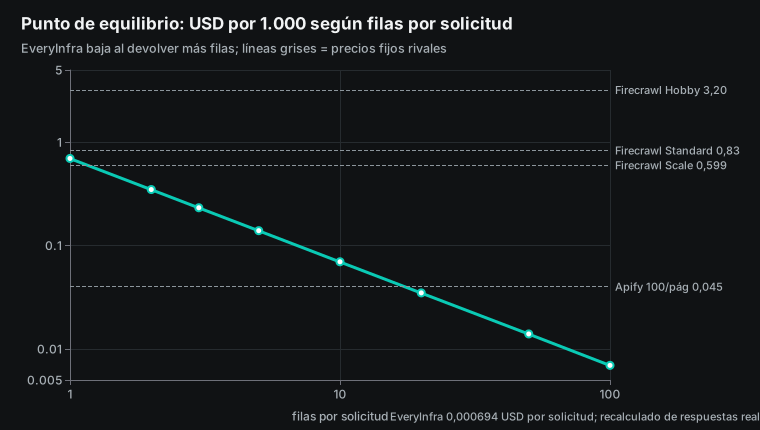
打平点:一次请求回几条,按次计费才划算
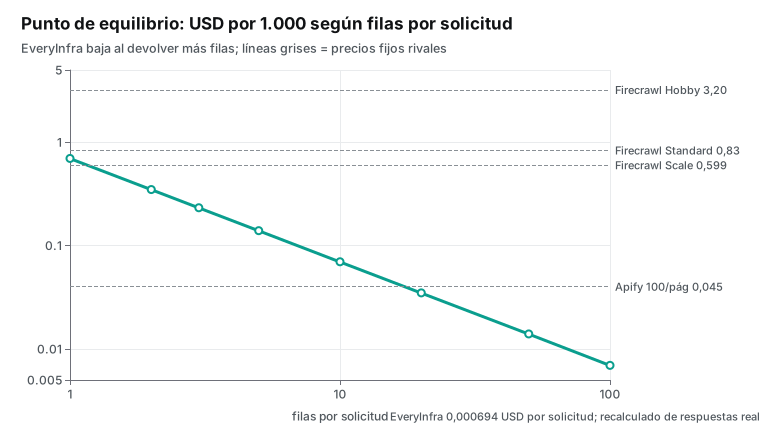
两种计费方式的分界线可以用一个数算出来:我们一次请求 0.000694 美元,对方按页或按条一个价,用我们的单次价除以对方的每条(每页)价,就是「一次请求至少要回几条,我们才更便宜」。
| 对方每千条(页) | 例子 | 打平条数 | 意思 |
|---|---|---|---|
| 3.20 美元 | Firecrawl Scrape/Crawl,Hobby 年付 | 0.22 | 只要回 1 条,我们就更便宜 |
| 0.83 美元 | Firecrawl,Standard 年付 | 0.84 | 一次回 1 条打平,回 2 条就更便宜 |
| 0.599 美元 | Firecrawl,Scale 年付 | 1.16 | 一次要回 2 条以上我们才更便宜 |
| 0.45 美元 | Apify Google Search,一页 10 条 Free | 1.54 | 一次要回 2 条以上 |
| 0.045 美元 | Apify Google Search,一页 100 条 Free | 15.4 | 一次要回 16 条以上 |
打平条数把五类活分成两边:抓单页正文一次只回 1 页,所以输给 Firecrawl 的 Scale 档和 Apify「一页 100 条」的算法;搜索一次回 10 条、爬取一次回几页、结构化一次回几十条,都远超打平条数,所以差得很多。换之前先数一数你的活平均每次请求能回几条,再对照上面的打平表看你落在划算的那一边。
算一笔账:三件常见的活,一个月各花多少钱
按三种常见用法算一个月(30 天)的钱。Firecrawl 一侧按「能装下这份用量的最省套餐」:成本等于套餐月费和用量按 credit 折算后取较大值,年付价。Apify 一侧按现成 actor 的事件价加套餐月费。EveryInfra 一侧等于请求次数乘 0.000694 美元(结构化平台能力按各自单价)。
| 一个月的活 | 条数 / 页数 | Firecrawl 最省 | Apify 最省 | EveryInfra |
|---|---|---|---|---|
| 每天爬一个 200 页的文档站做 RAG | 6,000 页 | 16 美元(Hobby,6,000 credit) | 按算力,需试跑估算 | 约 0.42 美元(按一次回 10 页、600 次请求) |
| 每天搜 20 个关键词各取 100 条 | 60,000 条 | 83 美元(Standard,Search 12,000 credit) | 2.70 美元(一页 100 条、600 页 Free 档) | 4.17 美元(6,000 次请求) |
| 每天抓 1,000 个商品页取结构化字段 | 30,000 条 | 不原生支持,需抓页加抽取 | 约 69 美元(现成 actor 2.30/千条) | 2.68 美元(按一次 25 条、1,200 次请求) |
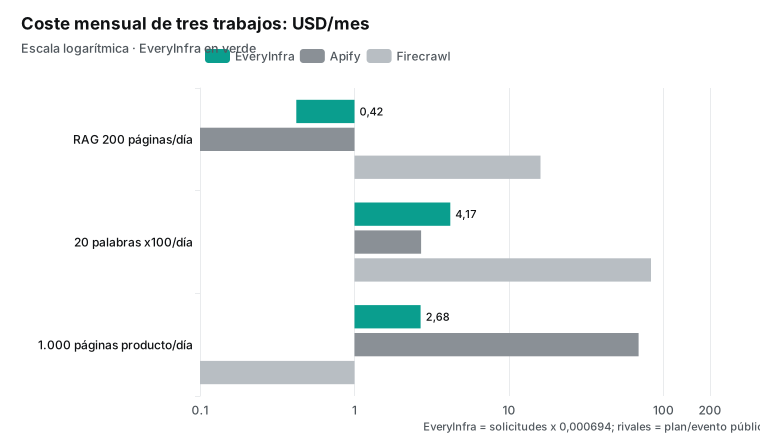
第一行要多说一句:文档站 RAG 这类活,Firecrawl 的 Crawl 一条命令抓完、每页 1 个 credit,6,000 页刚好用满 Hobby 的 5,000 credit 要升一档或买加量,我们按一次回 10 页估 600 次请求,约 0.42 美元。第二行搜索,Apify「一页 100 条」在量大时最省,我们次之,Firecrawl 因为套餐月费起步 83 美元最贵。第三行结构化商品数据,Firecrawl 没有原生接口,要先抓页再抽取、每页多付 4 个 credit,不划算;Apify 用现成 actor 清楚但贵,我们最省。还要提醒:Firecrawl 和 Apify 的套餐月费是预付用量,当月没用完不结转,账期结束作废;我们的余额不清零、不设有效期(Firecrawl 定价页、Apify Console Billing)。
计费单位、失败扣费、免费额度:三种模式的差别
把钱的规则并排看,三家是三种模式。EveryInfra 按请求计费,一次请求一个固定价,余额不设有效期;Firecrawl 按 credit 计费,买套餐送月度 credit,用完按 5 美元一档加买,除 Scale 和企业档外当月 credit 到期清零;Apify 按事件或按算力计费,套餐里的预付用量当月不结转、到期作废(Apify 价格页、Firecrawl 定价页)。
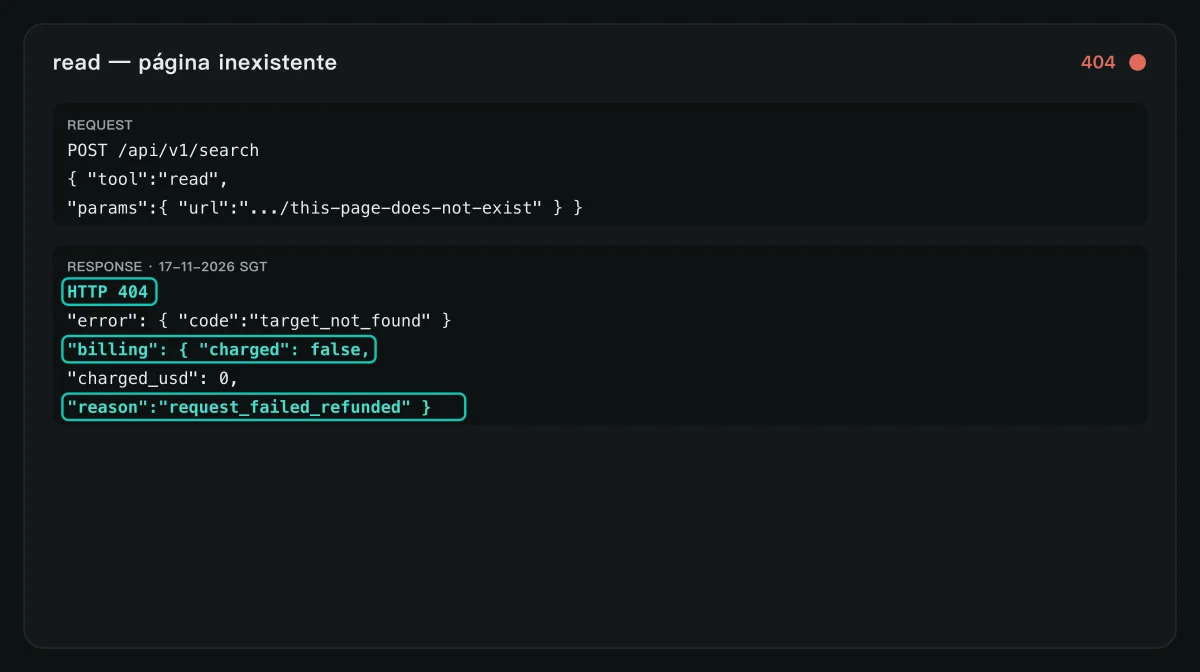
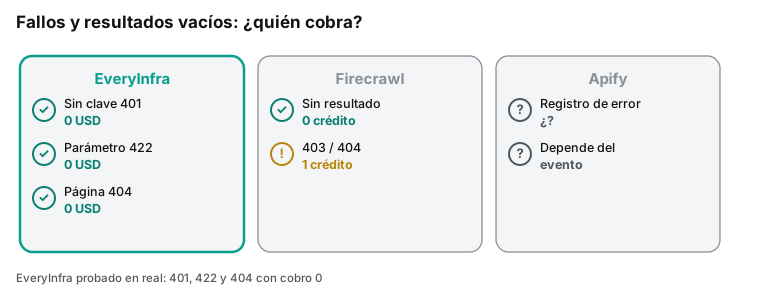
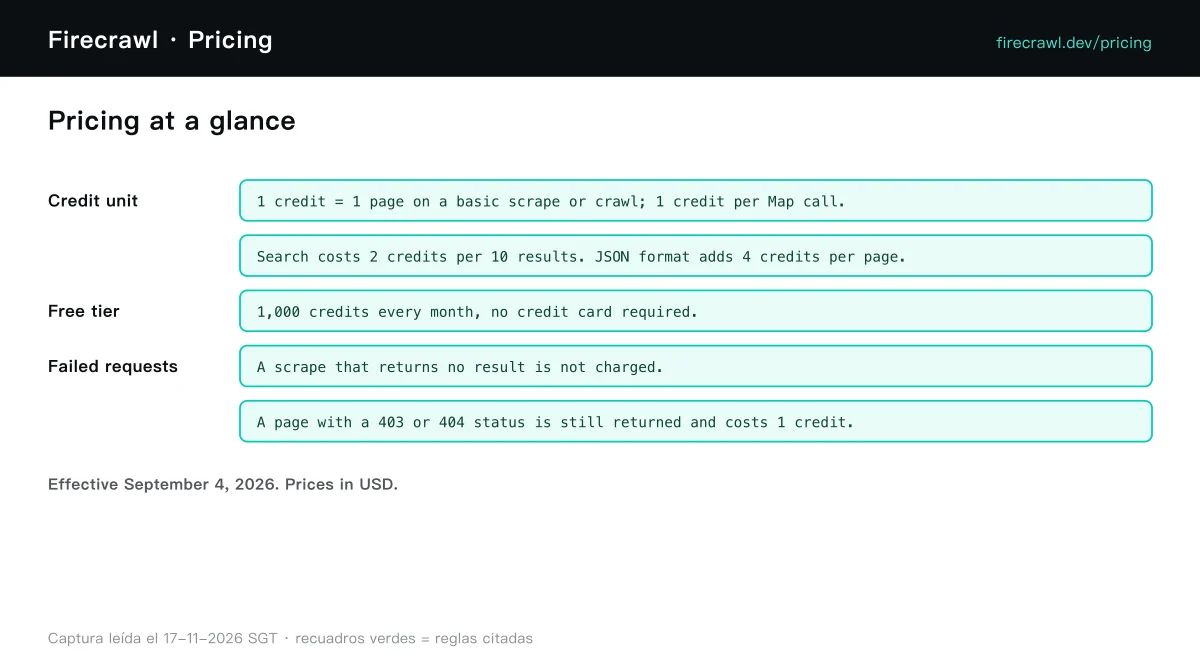
失败和空结果扣不扣钱,是这三种模式里最容易被忽略、却最影响实际账单的一条。我们专门测了三种「没拿到数据」的情况:2026 年 11 月 17 日 00:20(新加坡时间)不带 Key 发请求,回 401,错误里写明「Nothing was charged」;同一时刻把参数名写错,回 422,错误里列出允许的参数、给了一个能用的示例,也没扣费;00:26(新加坡时间)用 read 抓一个不存在的页面,回 404,响应里 charged 是 false、原因写 request_failed_refunded,扣 0 美元。三种都没扣钱。Firecrawl 的定价页写得很直接:抓取没有返回结果的不收费,但页面返回 403、404 这类错误状态时,内容照样返回给你、并收 1 个 credit(Firecrawl 定价页)。Apify 按事件计费的 actor 里,错误记录收不收钱取决于作者怎么定义事件,要看运行后的事件计数(Apify 按事件计费文档)。
免费额度和最低充值也不一样。Firecrawl 每月送 1,000 个 credit、不要信用卡,够抓约 1,000 页或搜约 5,000 条,还有一个不用注册、按 IP 限量的 Keyless 入口可以直接试(Firecrawl 博客:最好的网页数据 API)。Apify Free 套餐每月送 5 美元的平台用量,不要信用卡。我们这边在控制台给两个开源仓点星可领一次试用额度,正式用从充值起步,余额不过期。把这三条放在一起:偶尔试几次,三家的免费额度都够;长期跑,就要算清楚哪种计费模式配得上你的量和波动。
| 比法 | EveryInfra | Firecrawl | Apify |
|---|---|---|---|
| 计费单位 | 按请求,一次一价 | 按 credit(页、调用、每 10 条结果) | 按事件或按算力单位 |
| 失败 / 空结果 | 401、422、404 实测均 0 扣费 | 无结果不收费;403、404 收 1 credit | 看 actor 的事件定义 |
| 月费 | 无,充值余额不过期 | Hobby 16 到 Scale 599 美元/月,credit 多数到期清零 | Starter 19 到 Business 999 美元/月,预付用量不结转 |
| 免费额度 | 点星领一次试用 | 每月 1,000 credit,另有免注册 Keyless | 每月 5 美元平台用量 |
| 接 MCP | 远程 MCP,工具名 everyinfra_* | 官方 MCP,服务名 firecrawl | 官方 MCP,mcp.apify.com |
在 AI 工具里调用:三家都能接 MCP
三家都提供 MCP 服务(Model Context Protocol,AI 客户端调用外部工具的协议,见规范 2025-06-18)。EveryInfra 是一个远程 MCP,工具名都以 everyinfra_ 开头,在客户端配置里加一段就能用:
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${env:EVERYINFRA_API_KEY}" }
    }
  }
}
Firecrawl 的 MCP 服务名是 firecrawl,支持免注册的 Keyless、账号登录或 API Key 三种接法,把 scrape、crawl、search、map、extract 都暴露成工具(Firecrawl MCP 文档、firecrawl-mcp-server 源码)。Apify 的 MCP 在 mcp.apify.com,推荐用 OAuth 登录,模型可以在 Store 里搜 actor 再运行(Apify MCP 文档、apify-mcp-server 源码)。三家在 AI 客户端里的用法接近,区别仍然是计费:让模型多抓几页、多搜几条,Firecrawl 按 credit 加、Apify 按事件或算力加、我们按请求加。要在聊天里直接说「用 EveryInfra 搜一下这个词的前 10 条,再把第一条抓成正文」,模型会先调 web/search 再调一次抓取,两次请求、两次 0.000694 美元。配置细节见我们之前写的远程 MCP 接入验收。
从对方换过来:要改的几处
价格算清楚以后,决定迁移成本的是工程细节。从 Firecrawl 换过来,第一处是取数单位:Firecrawl 的 Scrape、Crawl 以「页」为单位,返回 markdown;我们的搜索类能力以「请求」为单位,返回结构化字段或正文文本,你原来按 markdown 解析的脚本要改成按字段读。第二处是整站爬取的翻页:Firecrawl 一条 Crawl 命令抓完整站,我们要把 num 设大、必要时分几次请求把一个站拼起来。第三处是格式:Firecrawl 默认给渲染后的 markdown,适合直接喂模型;我们的 read 给清理过的正文文本,重排版的单页应用页面可能抓得不如专门渲染的全,拿不准就先试一页看看。
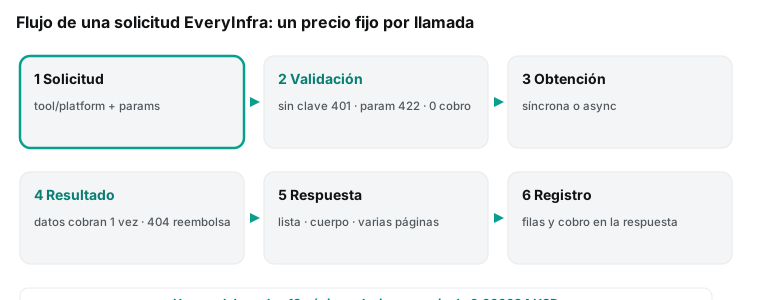
从 Apify 换过来,主要是把「启动一次 actor 运行、再取数据集」换成「发一次请求、直接拿结果」。Apify 的一次运行可以处理一批输入、结果写进数据集,未命名的数据集有保留期(Apify Dataset 文档);我们是一个目标一次请求、同步就回。失败处理也不同:Apify 的错误是数据集里一条带错误码的记录,要自己筛出来;我们的错误是 HTTP 状态码加错误码,401、422、404 都不扣费,空结果在响应里写明退款原因。速率上,我们每个账户默认每分钟若干次、所有 Key 共用,充值到一定额度后自动提速,大批量前先算好速率,可参考 Apify 平台限制和 Apify 用量与资源对照两边的并发和限额。
什么时候 Firecrawl 更合适
Firecrawl 更合适的场景也很清楚,下面五种里它比我们强,或者是我们目前还做不到的。第一,你要把大量现代网站(React、Vue 这类前端渲染的单页应用)抓成干净 markdown 喂给大模型,Firecrawl 默认渲染 JavaScript、输出 LLM 友好的 markdown,还号称比原始 HTML 少用约 67% 的 token,这对 RAG 流水线很实在。第二,你要在抓取时做交互:点「加载更多」、填表单、翻页后再取内容,Firecrawl 的 Interact 功能用自然语言或代码完成这些动作(Firecrawl Interact 功能页)。第三,你要按 schema 把页面抽成结构化 JSON、或者监控页面变化,Firecrawl 有对应的抽取和 Monitor,只是都要另加 credit。第四,你的量大且稳定,愿意按月预付:Standard、Scale 档的每页价比我们低。第五,你要企业级的零数据保留、单点登录、IP 和 Key 白名单,Firecrawl 的企业版提供这些(Firecrawl 企业版)。Firecrawl 在 2026 年 9 月拿了 7,500 万美元的 B 轮融资、发布了 Alexandria(Wowtale 报道,2026-09-23),产品迭代很快。
什么时候 Apify 更合适
Apify 更合适的情况也很清楚。第一,你要抓的是某个具体网站、而且这个站冷门,Store 里几千个 actor 覆盖的长尾网站远比我们的固定能力宽,第三方开发者还在不断加新 actor(Apify Store 里的 actor 说明)。第二,你要深爬一个大站并带上登录、增量、下载附件、截图、每页 AI 摘要这些细活,Website Content Crawler 做得比我们全。第三,你要平台自带的定时任务、webhook、和现成的云存储、自动化集成,Apify 的控制台做得更完整;并发也宽,Business 套餐最多同时跑 256 个运行。第四,你是一个带加密钱包的自动 agent,想不注册账号就付费用,Apify 支持用 x402、MPP 这类协议直接按次付(Apify 价格页)。反过来,我们更合适的场景是:同一类数据要很多条、每次只要最新一页,要把成本压到最低,要固定的结构化字段,在意「没拿到数据就不扣钱」这条规则是写死的、能在响应里看到退款原因,或者要把搜索、爬取直接接进 AI 工具让模型自己调。
最近的变化(2026 年 9 月到 11 月)
| 日期 | 事件 | 对读者意味着什么 |
|---|---|---|
| 2026-11-16 | Apify 的 Website Content Crawler 和 Google Search Results Scraper 的公开元数据都在这天更新 | actor 的输入和价格随时会改,比价要读当天的公开元数据 |
| 2026-11-11 | 一份 agent 搜索接口评测把 Firecrawl 和 Exa、Tavily、Perplexity 等放在一起测准确率、成本和延迟(AIMultiple) | 搜索类接口的选型越来越看综合成本,不只看单价 |
| 2026-11-05 | 第三方对比把 Firecrawl 定位成「整站抓取和可配置抽取更强、有专门的 Map 和 Crawl」(TinyFish 对比) | Firecrawl 的强项在整站和抽取,不在最低单价 |
| 2026-11-02 | Firecrawl 更新了它的「2026 年最好的网页抽取工具」清单,把自己和 Apify 等并列比较(Firecrawl 博客) | 两家都把对方当竞品,功能在互相靠拢 |
| 2026-10-29 | Firecrawl 的 Crawl 产品页更新,强调一条命令抓完整站、返回干净 markdown(Firecrawl Crawl) | 整站爬取是 Firecrawl 主推的场景 |
| 2026-10-24 | 第三方按 Firecrawl 的 5-credit JSON 规则算每千页成本,指出打开高级格式后单价翻几倍(WebCrawlerAPI 对比) | 打开 JSON、抽取等高级格式前要先算附加 credit |
| 2026-09-23 | Firecrawl 拿 7,500 万美元 B 轮、发布 Alexandria(Wowtale) | 资金和团队在扩张,产品迭代会更快 |
| 2026-09-04 | Firecrawl 的现行定价生效:1 credit 一页、Search 每 10 条 2 credit、403/404 收 1 credit(Firecrawl 定价页) | 现行价以这版为准,旧文章里的数字可能过期 |
速率、并发和批量上限
大批量抓取前,速率和并发决定你一小时能跑多少,和单价一样影响能不能用。Firecrawl 的速率按套餐和接口分:Free 套餐抓取每分钟 10 次、爬取每分钟 2 次、同时渲染 2 个页面,Standard 套餐抓取每分钟 500 次、爬取每分钟 100 次、同时渲染 25 个,Scale 套餐分别到每分钟 10,000 次和同时 100 个(Firecrawl 定价页、Firecrawl 速率限制文档)。Apify 按同时运行数算并发,Free 套餐最多同时跑 5 个 actor 运行、Starter 32 个、Business 256 个,单次运行能处理一批输入,所以它的「并发」是运行级的(Apify 平台限制)。我们是请求级的速率,每个账户默认每分钟若干次、所有 Key 共用,充值累计到一定额度自动提速。
这三种速率不能直接比,因为计量单位不同:Firecrawl 按接口分别限流、一次抓一页,Apify 按运行数限流、一次运行抓一批,我们按请求限流、一次请求回一页或一批。把它们换算到「一小时能拿多少条」,要先看你的活是一页一页抓还是一次抓一批。一页一页抓时,Firecrawl 的高套餐每分钟几百上千次最快;一次抓一批时,Apify 的一个运行就能跑完几百个目标,并发数反而不是瓶颈;我们按请求、一次回一页或几十条,适合把目标摊成很多次请求、用自动提速跑量。大批量上线前,把速率、并发和每千条价放在一张表里一起算,比单看价格更准。
合规边界:公开数据、平台条款和个人数据
三家抓的都是公开网页,但抓取受两层约束。一层是目标网站自己的条款:很多平台的服务条款禁止未经许可的自动化抓取,抓之前要看目标站的条款和 robots 规则。另一层是个人数据保护法:抓回来的内容里如果有姓名、评论、联系方式这类个人数据,在欧盟要按《通用数据保护条例》处理(Regulation (EU) 2016/679),存储和使用按你所在地的法律来。Firecrawl 的企业版提供零数据保留、可以从抓取结果里去掉个人信息(Firecrawl 企业版);Apify 的 actor 页面也提示结果里可能含个人数据、受法律保护。我们这边只读公开页面,私密内容拿不到,结果里的个人数据同样要按当地法律处理。三家的工具都只是把公开页面取回来,合规的责任在使用者:抓之前确认目标站允许、抓之后按用途和存储期限守当地法律,这一点和用哪家、花多少钱无关。本文只写数据方法和成本,不构成法律意见。
我们怎么核对这些数
每一个数字都能回到原始返回。第一步,对方的价格不从宣传话术抄,而是读公开接口和定价页:Apify 的每事件价读两个 actor 公开元数据里 pricingInfos 的最后一个已生效版本,Firecrawl 的 credit 规则和失败扣费读定价页的 Pricing at a glance 那一段,都记下读取的日期。第二步,我们这边每次请求的实扣金额来自响应里的 charged_usd,条数按响应里 results 数组的长度数,不看请求里写的上限。第三步,每千条价、倍数、每月成本用同一个复算脚本从原始返回现算,图上的每一个数由画图脚本直接读这个结果,和正文逐个对过。第四步,失败和空结果的扣费按三种真实情况验:无 Key、参数写错、页面不存在,三种响应里的 charged 都是 false。
我们没做的事也写清楚:没有注册 Firecrawl 和 Apify、没有买它们的套餐、没有跑它们的任何 actor,所以对方一侧只有公开单价,没有实测账单、成功率和数据质量;我们这边的真调只覆盖了搜索、抓取、爬取、列站点地图和两个结构化平台能力,没有覆盖目录里的全部能力。crawl 一次回几页由站点和指令决定,本文只测到 3 页和 10 页两种,更深的站点要多测几次才能给出稳定的每页价。这些边界不影响「按请求计费在成批返回的数据上更省」这个结论,但读者按自己的目标站复算时,要用自己的返回条数,不照搬本文的数字。
上手:从一次试用到按量使用
第一步,拿到 API Key。在控制台注册后,给两个开源仓点星可以领一次试用额度,按一次请求 0.000694 美元算够跑一两千次;正式使用从充值起步,余额不过期(快速上手、价格页)。第二步,挑一类活跑一次:要网页搜索就调 web/search,要抓一页正文就调 read,要爬整站就调 crawl 并把 num 设到你要的页数。第三步,看响应里的 charged_usd 和返回条数,用「实扣除以条数再乘 1,000」算出你这个场景的每千条价,再和你现在 Firecrawl 或 Apify 的账单比。常用能力见网页搜索,结构化平台数据可以对照亚马逊数据接口和 Reddit 数据接口,或者在数据市场里按平台找。已经在用 Firecrawl、Apify 的,可以看我们的 Firecrawl 替代方案和 Apify 替代方案总览。
常见问题
Apify 和 Firecrawl 有什么区别,该选哪个?
问题来自 Google 联想词「apify or firecrawl」。两家定位不同:Firecrawl 是把任意网页抓成大模型可读 markdown 的接口,渲染 JavaScript、适合抓取、爬取、搜索加抽取一步到位,按 credit 计费;Apify 是一个抓取程序市场,有几千个针对具体网站的 actor,覆盖面最宽,按事件或算力计费。研究型、RAG 型、要干净 markdown 的活偏 Firecrawl;抓具体冷门网站、要深度细节的偏 Apify。如果你要的是固定结构化字段加网页搜索、还想把成本压到最低,可以把按请求计费的 EveryInfra 当第三个选项一起比。
Firecrawl 一次抓取多少钱,免费额度够用吗?
问题来自联想词「firecrawl pricing」。Firecrawl 基础抓取和爬取每页 1 个 credit,Map 每次 1 个,Search 每 10 条 2 个,JSON 等高级格式每页另加 4 个(Firecrawl 定价页)。每个 credit 的价随套餐从 Hobby 年付的 0.0032 美元降到 Scale 的 0.000599 美元。免费额度每月 1,000 个 credit、不要信用卡,够抓约 1,000 页或搜约 5,000 条;偶尔用够,长期跑要上付费套餐,注意多数套餐的 credit 当月到期清零。
Apify 的 Google Search Results Scraper 搜索怎么收费?
问题来自联想词「apify google search scraper」。它按事件计费,每成功抓一页搜索结果,Free 档 0.0045 美元、Starter(Bronze)0.0035、Business(Gold)0.00245、企业 Diamond 档 0.0014 美元,另加每次运行 0.002 美元启动费和 0.5 美元最低计费(Google Search Results Scraper 元数据)。一页可以设 10 条或 100 条,按 100 条一页算每千条约 0.045 美元(Free),按 10 条一页算约 0.45 美元。我们的 web/search 一次 0.000694 美元、最多 10 条,每千条 0.069 美元。
为什么整站爬取差几十倍,抓单页却差不多?
问题来自本文的实测。整站爬取里,Firecrawl 按爬到的每一页收 1 个 credit,我们的 crawl 一次请求回多页只收一次钱,所以一次回的页越多,差得越大,本文一次回 10 页就差几十倍。抓单页正文是一次只回 1 页,这时我们按请求的 0.694 美元和 Firecrawl 按页的高档单价(0.599 到 0.83 美元)接近,Firecrawl 在高套餐时反而更低。所以比价之前先看你的活一次能回几条或几页:回得多,按请求计费省;一次一个目标,就要连套餐月费一起算。
抓取失败或页面不存在,会扣钱吗?
问题来自联想词「does firecrawl charge for failed requests」。我们实测无 Key 回 401、参数写错回 422、页面不存在回 404,三种都 0 扣费,响应里写明退款原因。Firecrawl 的规则是抓取没有返回结果的不收费,但页面返回 403、404 这类错误状态时内容照样返回、收 1 个 credit(Firecrawl 定价页)。Apify 按事件计费的 actor,错误记录收不收钱看作者怎么定义事件,要看运行后的事件计数(Apify 按事件计费文档)。大批量抓取前,这条规则比标价更影响最终账单。
Firecrawl 和 Apify 能接进 Claude、Cursor 这些 AI 工具吗?
问题来自联想词「firecrawl mcp」。能,三家都提供 MCP 服务:Firecrawl 的服务名是 firecrawl,支持免注册 Keyless、账号或 API Key(Firecrawl MCP 文档);Apify 的在 mcp.apify.com,用 OAuth 登录后模型能在 Store 里搜 actor 再跑(Apify MCP 文档);我们是远程 MCP,工具名 everyinfra_*,配一段 URL 和 Key 就能用。三家在 AI 工具里的差别仍是计费方式:模型多调几次,各家按自己的单位加钱。
参考资料
- Firecrawl 定价页(credit 规则、套餐、失败扣费),Firecrawl,2026-09-04 生效,2026-11-17 读取。https://www.firecrawl.dev/pricing
- Firecrawl Search 接口文档(搜索加抓取、返回字段),Firecrawl 文档,2026-11-17 读取。https://docs.firecrawl.dev/api-reference/endpoint/search
- Firecrawl Search 功能页,Firecrawl 文档。https://docs.firecrawl.dev/features/search
- Firecrawl Scrape 功能页(渲染、markdown 输出),Firecrawl 文档。https://docs.firecrawl.dev/features/scrape
- Firecrawl Crawl 功能页(整站爬取、每页计费),Firecrawl 文档。https://docs.firecrawl.dev/features/crawl
- Firecrawl Map 功能页(只出链接),Firecrawl 文档。https://docs.firecrawl.dev/features/map
- Firecrawl Extract 功能页(schema 抽取、JSON 格式),Firecrawl 文档。https://docs.firecrawl.dev/features/extract
- Firecrawl Interact 功能页(点击、填表、翻页),Firecrawl 文档。https://docs.firecrawl.dev/features/interact
- Firecrawl 速率限制文档,Firecrawl 文档。https://docs.firecrawl.dev/rate-limits
- Firecrawl Crawl 接口文档,Firecrawl 文档。https://docs.firecrawl.dev/api-reference/endpoint/crawl-post
- Firecrawl MCP 入门(Keyless、账号、API Key),Firecrawl 文档,2026-11-17 读取。https://docs.firecrawl.dev/mcp-server
- firecrawl-mcp-server 源码,GitHub。https://github.com/firecrawl/firecrawl-mcp-server
- Pay-per-event pricing model(错误记录是否收费),Apify 文档。https://docs.apify.com/actors/publishing/monetize/pay-per-event
- Actors in Apify Store(按事件、按算力两种模型),Apify 文档。https://docs.apify.com/actors/running/actors-in-store
- Apify MCP server,Apify 文档。https://docs.apify.com/platform/integrations/mcp
- apify-mcp-server 源码,GitHub。https://github.com/apify/apify-mcp-server
- Apify Console Billing(预付用量、超额开票),Apify 文档。https://docs.apify.com/platform/console/billing
- Apify Usage and resources(算力单位、存储、代理),Apify 文档。https://docs.apify.com/platform/actors/running/usage-and-resources
- Apify Dataset(数据集保留期、导出),Apify 文档。https://docs.apify.com/platform/storage/dataset
- Apify Platform limits(并发、速率),Apify 文档。https://docs.apify.com/platform/limits
- Apify n8n integration,Apify 文档。https://docs.apify.com/platform/integrations/n8n
- Get Actor 接口(读 actor 公开信息),Apify 文档。https://docs.apify.com/api/v2/actor-get
- Actor runs and builds(运行状态定义),Apify 文档。https://docs.apify.com/platform/actors/running/runs-and-builds
- Model Context Protocol 规范 2025-06-18。https://modelcontextprotocol.io/specification/2025-06-18
- Regulation (EU) 2016/679(通用数据保护条例 GDPR),EUR-Lex。https://eur-lex.europa.eu/eli/reg/2016/679/oj
- EveryInfra 能力目录(price_usd、max_limit、返回字段),2026-11-17 读取。https://api.everyinfra.com/api/v1/social/catalog
- EveryInfra 搜索工具目录(tool、价格、参数),2026-11-17 读取。https://api.everyinfra.com/api/v1/search/tools
- EveryInfra llms.txt(失败和空结果不收费)。https://api.everyinfra.com/llms.txt
- Firecrawl Crawl 产品页(一条命令抓整站),Firecrawl,2026-10-29。https://www.firecrawl.dev/crawl
- 8 Best Web Scraping APIs in 2026(Keyless、67% token),Firecrawl 博客,2026-08-11。https://www.firecrawl.dev/blog/best-web-scraping-api
- Best Web Extraction Tools for AI in 2026(与 Apify 并列比较),Firecrawl 博客,2026-11-02。https://www.firecrawl.dev/blog/best-web-extraction-tools
- Firecrawl 企业版(零数据保留、SSO、IP 白名单),Firecrawl。https://www.firecrawl.dev/enterprise
- Apify 价格页(算力、套餐、代理、存储、Store 折扣、x402),Apify,2026-11-17 读取。https://apify.com/pricing
- Website Content Crawler 公开元数据(计费模型、运行统计、更新日期),Apify API,2026-11-17 读取。https://api.apify.com/v2/acts/apify~website-content-crawler
- Google Search Results Scraper 公开元数据(按事件价、运行统计),Apify API,2026-11-17 读取。https://api.apify.com/v2/acts/apify~google-search-scraper
- Apify Instagram Scraper(价格示例),Apify。https://apify.com/apify/instagram-scraper
- Agentic Search API Benchmark(Firecrawl 与 Exa、Tavily、Perplexity 对比),AIMultiple,2026-11-11。https://aimultiple.com/agentic-search
- TinyFish vs Firecrawl(Firecrawl 强在整站和抽取),TinyFish,2026-11-05。https://www.tinyfish.ai/blog/tinyfish-vs-firecrawl
- Firecrawl Pricing vs WebCrawlerAPI: Cost per 1000 Pages,WebCrawlerAPI,2026-10-24。https://webcrawlerapi.com/blog/firecrawl-pricing
- Firecrawl Review: Costs, Limits, and What I'd Use Instead,thunderbit,2026-11-11。https://thunderbit.com/blog/firecrawl-review-and-alternatives
- Firecrawl Raises 75M Series B, Launches Alexandria,Wowtale,2026-09-23。https://en.wowtale.net/2026/09/23/235198/
- Best Web Search APIs for AI Applications in 2026(成功率与成本一起比),Firecrawl 博客,2026-10-21。https://www.firecrawl.dev/blog/best-web-search-apis
- Firecrawl Reviews 2026(真实使用评价),G2,2026-11-15 读取。https://www.g2.com/products/firecrawl/reviews
引用编号 BL-176