Apify vs Firecrawl: precios por 1.000 medidos, con una tercera columna
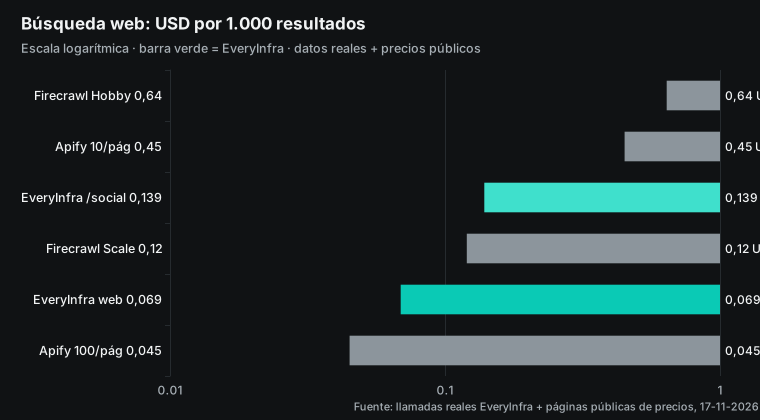
Los mismos 1.000 resultados web cuestan de 0,045 a 0,45 USD en Apify y de 0,12 a 0,64 en Firecrawl; nuestras llamadas reales dieron 0,069 USD por 1.000.
Tomemos los mismos 1.000 resultados de búsqueda web. El Google Search Results Scraper de Apify sale, con sus precios públicos por evento, a entre 0,045 y 0,45 USD, según si una página devuelve 100 o 10 resultados. El endpoint Search de Firecrawl cobra 2 créditos por cada 10 resultados, lo que queda entre 0,12 USD (Scale) y 0,64 USD (Hobby, anual). El 17 de noviembre de 2026 llamamos de verdad a web/search de EveryInfra: una solicitud, 0,000694 USD, 10 resultados, es decir 0,069 USD por 1.000. La diferencia es mayor en el crawl de sitio completo. El Crawl de Firecrawl cobra 1 crédito por página, de modo que 1.000 páginas cuestan de 0,60 (Scale) a 3,20 USD (Hobby). Nuestro crawl devuelve varias páginas por una sola solicitud de 0,000694 USD; dos de nuestros crawls devolvieron 10 y 3 páginas, o sea de 0,069 a 0,231 USD por 1.000, de varias a decenas de veces más barato. Abajo medimos cinco trabajos uno a uno, con la unidad de cobro, el cobro de fallos y resultados vacíos, los planes gratuitos, la recarga mínima y el soporte de MCP.
El «precio por 1.000» de este artículo divide lo que una solicitud cobró de verdad entre las filas o páginas que devolvió, y lo multiplica por 1.000; responde a una sola pregunta: cuánto cuesta conseguir 1.000 resultados. EveryInfra cobra por solicitud, Firecrawl por crédito y los programas de scraping (actors) de la tienda de Apify por evento o por cómputo, así que las tres unidades solo se comparan cuando comparten un denominador. El denominador es siempre las filas devueltas, nunca el límite escrito en la solicitud, de modo que las llamadas que devolvieron menos filas solo encarecen nuestro lado. De los otros dos usamos solo material público: la página de precios y la documentación de Firecrawl, la página de precios de Apify, los metadatos públicos de los dos actors y endpoints públicos que no piden cuenta. No nos registramos en ninguno, no compramos plan ni ejecutamos ningún actor, así que sus cifras son precios de lista públicos, no facturas medidas, y no tienen nada que ver con nuestros propios datos.
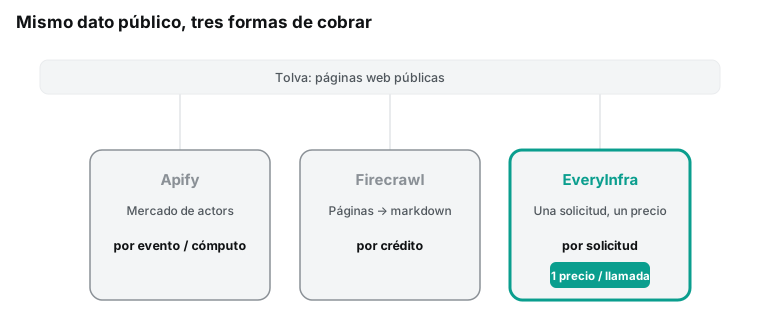
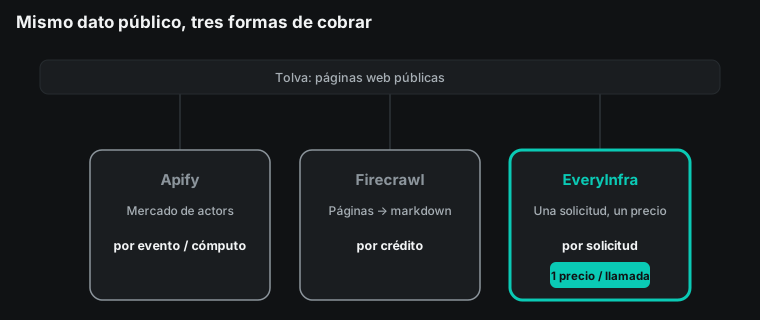
Tabla general: cinco trabajos, coste por 1.000
Aquí están los cinco trabajos de datos más comunes uno al lado del otro. El lado de Apify usa precios públicos: el cómputo de la plataforma se cobra por unidad de cómputo (1 GB de RAM durante una hora), a 0,2 USD en Free y Starter y a 0,13 USD en Business (precios de Apify, leído el 17 de noviembre de 2026); los actors de la tienda añaden sus propios precios por evento, por ejemplo el Google Search Results Scraper cobra por «página de resultados de búsqueda raspada con éxito», a 0,0045 USD por página en Free y 0,00245 en Business (Gold) (metadatos del Google Search Results Scraper, leído el 17 de noviembre de 2026). El lado de Firecrawl sale de su página de precios: 1 crédito equivale a una página en un scrape o crawl básico, o a una llamada de Map, y Search cuesta 2 créditos por cada 10 resultados, con cada crédito desde 0,0032 USD (Hobby anual) hasta 0,000599 USD (Scale anual) (precios de Firecrawl, vigente desde el 4 de septiembre de 2026, leído el 17 de noviembre de 2026). El lado de EveryInfra son todas llamadas reales: el importe cobrado sale de charged_usd y el número de filas de la longitud de results.
| Operación Firecrawl | Créditos |
|---|---|
| Scrape | 1 por página |
| Crawl | 1 por página |
| Map | 1 por llamada |
| Search | 2 por 10 resultados |
| Formato JSON | +4 por página |
| Trabajo | Capacidad EveryInfra | Llamadas reales: nº / filas / cobrado (USD) | Nuestro por 1.000 | Firecrawl público (por 1.000, anual) | Apify público (por 1.000) |
|---|---|---|---|---|---|
| Búsqueda web | web/search | 2 / 20 / 0,001388 | 0,069 | Search: 0,12 (Scale) a 0,64 (Hobby) | Google Search Scraper: 0,045 a 0,45 |
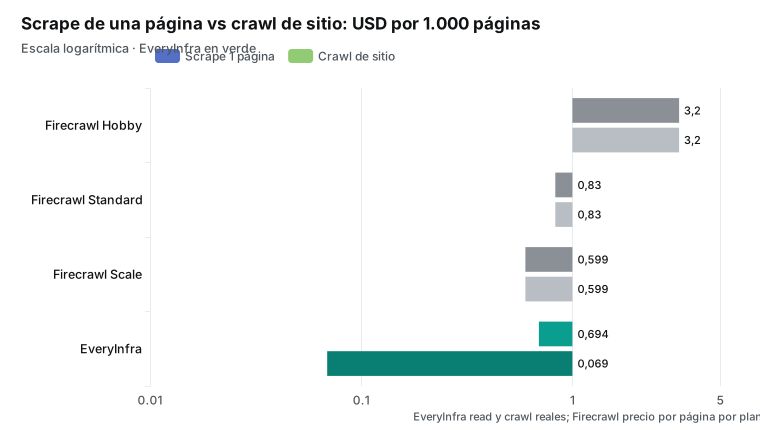
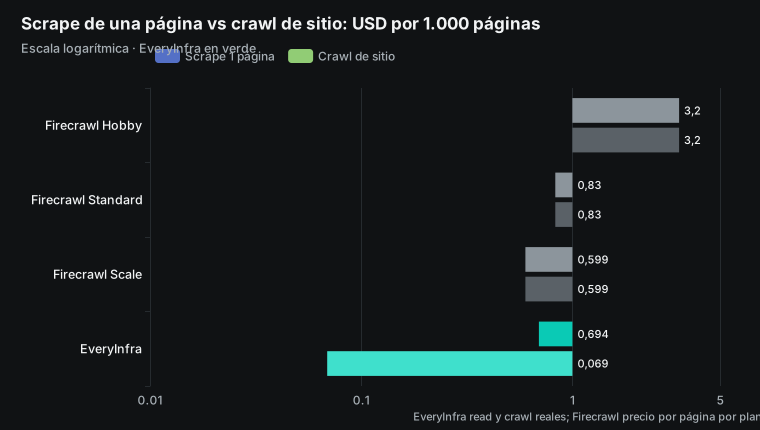
| Scrape de una página | read | 2 / 2 / 0,001388 | 0,694 | Scrape: 0,599 (Scale) a 3,20 (Hobby) | Website Content Crawler: por cómputo |
| Crawl de sitio | crawl | 2 / 13 / 0,001388 | 0,069 a 0,231 | Crawl: 0,599 (Scale) a 3,20 (Hobby) | Website Content Crawler: por cómputo |
| Mapa de sitio | map | 1 / 50 URL / 0,000694 | 0,694 (por 1.000 llamadas) | Map: 0,599 a 3,20 (por 1.000 llamadas) | Website Content Crawler: por cómputo |
| Datos estructurados | amazon/search | 1 / 25 / 0,002236 | 0,089 | Sin endpoint nativo; scrape y luego extraer | Actor listo unos 2,30 |
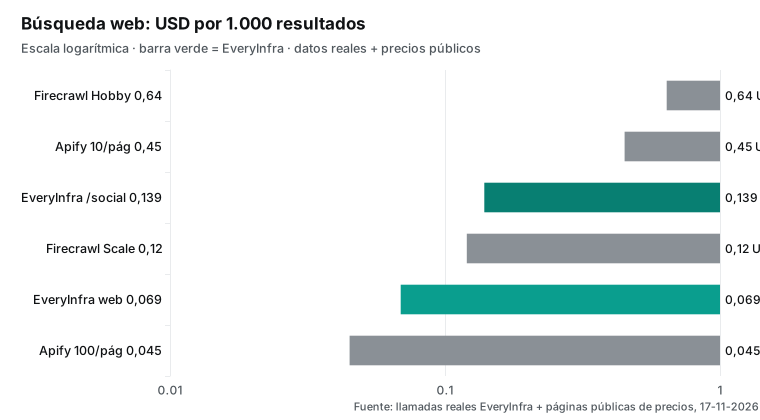
Los múltiplos siempre dividen el precio por 1.000 del otro lado entre el nuestro. Hay que leer la tabla con dos cosas en mente. Primero, la búsqueda, el crawl de sitio y los datos estructurados devuelven muchas filas por cobro; cuantas más filas, más fino el precio por unidad, y por eso la diferencia es mayor ahí. Segundo, raspar una página es un trabajo de un solo objetivo que devuelve una página, y ahí nuestros 0,694 USD no son la ganga: el precio por página de Firecrawl en Standard, Growth y Scale (0,599 a 0,83 USD) es más bajo, siempre que se prepaguen de 83 a 599 USD al mes y se acepte que los créditos sin usar caducan. Cuál sale más barato depende de qué tipo de trabajo tengas, y cada sección de abajo lo calcula.
Cómo calculamos
El precio por 1.000 es el importe cobrado por una solicitud, dividido entre las filas devueltas y multiplicado por 1.000; cuando un trabajo se ejecutó varias veces, los importes y las filas se suman antes de dividir. Una solicitud que devuelve cero filas se deja fuera del denominador y se revisa aparte para ver si cobró. En el lado de Firecrawl convertimos primero sus reglas de crédito en créditos por 1.000 filas (1 por página en scrape y crawl, 1 por llamada de Map, 2 por cada 10 resultados de búsqueda) y luego multiplicamos por el precio del crédito según el plan; los precios de plan usan facturación anual, un 16,7 % por debajo de la mensual. En el lado de Apify, el uso de plataforma es unidades de cómputo por el precio unitario, y los actors de la tienda se leen evento por evento de la última versión vigente de pricingInfos en sus metadatos públicos. Un precio cuyo inicio es posterior a la hora de lectura está anunciado pero aún no vigente, y lo marcamos en lugar de usarlo como actual.
Las llamadas reales usaron una clave de prueba compartida con otros redactores ese día, así que en vez de un saldo antes y después anotamos charged_usd directamente de cada respuesta. La clave solo permite 10 solicitudes por minuto y por encima devuelve 429 sin cobrar, de modo que las llamadas salieron en tres momentos: 00:20, 00:24 y 00:38 hora de Singapur (SGT), no en paralelo. Los objetivos fueron páginas públicas estables y palabras de marca o institucionales; no se nombra ningún identificador de creador individual. Un único script recalcula cada precio por 1.000, múltiplo y coste mensual a partir de las respuestas originales, y cada número de los gráficos lo lee el script de dibujo de ese mismo resultado.
Prueba uno: búsqueda web, 10 resultados por llamada, 0,069 USD por 1.000
La búsqueda web es un trabajo que hacen los tres, así que empezamos ahí. El 17 de noviembre de 2026 a las 00:21 hora de Singapur (SGT) llamamos a web/search con «web scraping api pricing comparison», devolvió 10 resultados en unos 1,5 segundos y cobró 0,000694 USD. Cada resultado trae título, enlace y un fragmento, que coinciden con los campos del catálogo; para obtener más se pagina con page, y a las 00:38 hora de Singapur pasamos a la página 2, que devolvió otras 10 filas y cobró otros 0,000694 USD, confirmando que una página es otra solicitud al mismo precio fijo. A 10 por llamada, 1.000 resultados son 100 solicitudes, o sea 0,069 USD. Esta es la solicitud:
curl -s https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"tool":"web","params":{"q":"web scraping api pricing comparison","num":10,"location":"us"}}'
# devuelve 200, 10 filas en results, billing.charged_usd de 0,000694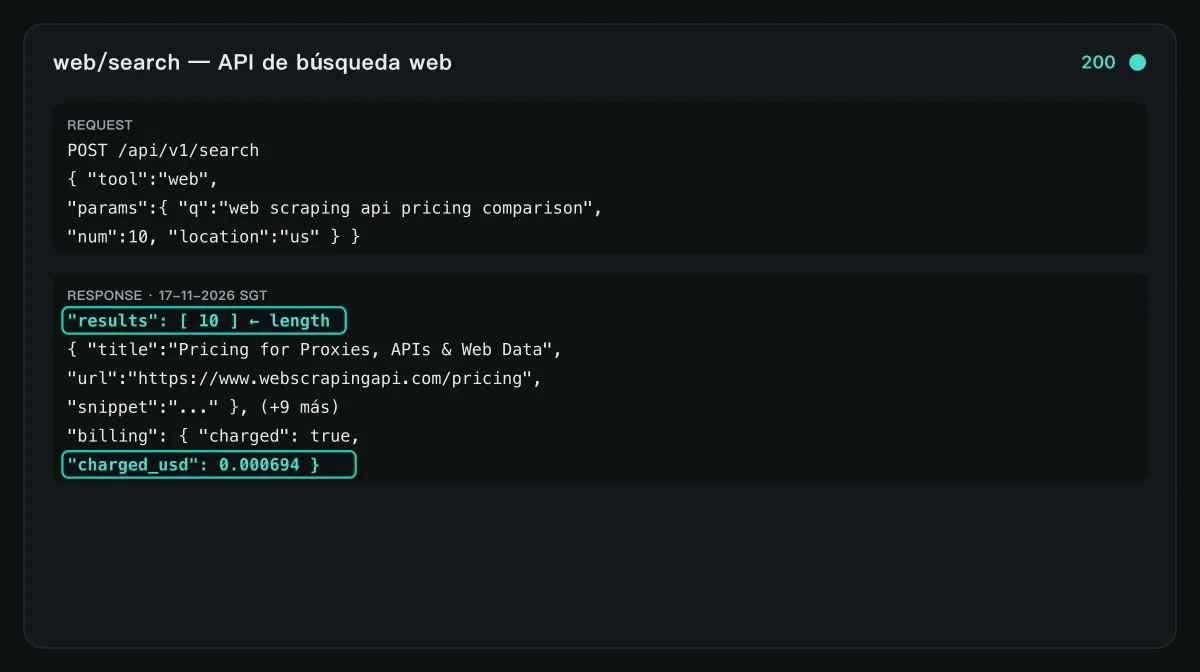
El endpoint Search de Firecrawl junta búsqueda y scrape en una llamada: por defecto devuelve título, enlace y fragmento de cada resultado a 2 créditos por cada 10; si se activan las opciones de scrape en la misma llamada, también trae cada página como markdown, sumando el crédito de scrape por resultado (API Search de Firecrawl, función Search de Firecrawl). Solo la búsqueda, 1.000 resultados son 200 créditos, es decir de 0,12 (Scale anual) a 0,64 USD (Hobby anual), y los 1.000 créditos mensuales del plan Free cubren 5.000 resultados. Firecrawl posiciona Search como «búsqueda más scrape en un paso», pensado para un agente de investigación que lee antes de responder.
Apify no tiene un endpoint único de búsqueda web; en su lugar el actor Google Search Results Scraper raspa páginas de resultados de Google. Ahora cobra por evento: por cada página de resultados raspada, 0,0045 USD en Free, 0,0035 en Bronze (Starter), 0,00245 en Gold (Business) y 0,0014 en el nivel empresarial Diamond, más una tarifa de inicio de 0,002 USD por ejecución y un cargo mínimo de 0,5 USD (metadatos del Google Search Results Scraper, leído el 17 de noviembre de 2026). Una página de Google se puede fijar en 10 o 100 resultados: a 100 por página, 1.000 resultados son 10 páginas, 0,045 USD en Free, más bajo que nosotros; a 10 por página son 100 páginas, 0,45 USD, más alto.
| Nivel Apify Google Search | Por página de resultados (USD) |
|---|---|
| Free | 0,0045 |
| Bronze (Starter) | 0,0035 |
| Gold (Business) | 0,00245 |
| Diamond | 0,0014 |
Ese actor se ha ejecutado 137 millones de veces, con 27.143 usuarios en los últimos 30 días y una valoración de 4,65. Así que en búsqueda los tres están en una misma banda: el cobro por solicitud nos pone en la zona media-baja, Apify es el más bajo cuando una página lleva 100 resultados, y Firecrawl es el más alto en los planes bajos.
Prueba dos: scrape de una página, una por llamada, aquí cuenta el compromiso
Convertir una URL en texto limpio es la especialidad de Firecrawl y la sección más importante frente a él. El 17 de noviembre de 2026 a las 00:21 hora de Singapur llamamos a read sobre una página del sitio de Model Context Protocol, devolvió una página de texto (título, enlace, cuerpo) en unos 7 segundos y cobró 0,000694 USD, o sea 0,694 USD por 1.000 páginas. A las 00:38 hora de Singapur releímos la misma página como prueba de estabilidad: unos 2,6 segundos, una página, los mismos 0,000694 USD y el texto coincidió, así que el precio es estable. read prueba varias fuentes de obtención por turno, cambiando a la siguiente cuando una no logra la página, y devuelve el cuerpo ya limpio.
El Scrape de Firecrawl es 1 crédito por página, renderiza JavaScript por defecto y devuelve markdown listo para un modelo, que según Firecrawl usa alrededor de un 67 % menos de tokens que el HTML original (función Scrape de Firecrawl, Firecrawl: mejor API de scraping, 11 de agosto de 2026). Por 1.000 páginas va de 3,20 (Hobby anual), pasando por 0,83 (Standard) y 0,666 (Growth), hasta 0,599 USD (Scale), con el plan Free cubriendo 1.000 páginas al mes.
| Plan Firecrawl | Mensual (USD) | Créditos | Por 1.000 páginas (USD) |
|---|---|---|---|
| Free | 0 | 1.000 | 0 |
| Hobby | 16 | 5.000 | 3,20 |
| Standard | 83 | 100.000 | 0,83 |
| Scale | 599 | 1.000.000 | 0,599 |
Junto a nuestros 0,694 USD: en Hobby somos unas 4,6 veces más baratos; en Standard y Scale el precio por página de Firecrawl queda por debajo del nuestro, pero hay que comprometer de 83 a 599 USD al mes y los créditos sin usar caducan, salvo en Scale (un mes) y Enterprise (precios de Firecrawl). Es decir, esto depende de lo estable que sea tu volumen: grande y lleno cada mes favorece los niveles altos de Firecrawl; pequeño, irregular u ocasional favorece nuestros 0,000694 USD por solicitud, sin cuota mensual y con saldo que no caduca.
En el lado de Apify esto corresponde al actor Website Content Crawler, hecho justo para «rastrear el contenido de un sitio a markdown para modelos, bases vectoriales y RAG» (metadatos del Website Content Crawler, leído el 17 de noviembre de 2026, última modificación el 16 de noviembre de 2026). Cobra por cómputo sin precio fijo por página, de modo que el coste es las unidades de cómputo de una ejecución por el precio unitario, según el renderizado y el tamaño de la página, así que hay que hacer una ejecución de prueba para saber el precio por página. Hace más que extraer texto: scroll infinito, páginas protegidas con login, descargas de PDF y Office, capturas, crawls incrementales por cambio de página e incluso un resumen con IA por página. Se ha ejecutado casi 50 millones de veces, con unos 12.000 usuarios en los últimos 30 días y una valoración de 4,59; en las estadísticas públicas de los últimos 30 días, 3.612.346 tuvieron éxito, 3.109 fallaron, 108.485 expiraron y 21.530 se abortaron, así que cerca de un 3,5 % no tuvo éxito, casi todo por expiración, lo que indica que el scraping web en sí no es estable y todo proveedor necesita reintentos.
Prueba tres: crawl de sitio, varias páginas por llamada, de varias a decenas de veces más barato
El crawl de sitio es la sección con la mayor diferencia. El 17 de noviembre de 2026 a las 00:24 hora de Singapur llamamos a crawl sobre el sitio de Model Context Protocol, pidiéndole en lenguaje natural que tomara solo las páginas de documentación del protocolo, y devolvió 10 páginas en unos 9,4 segundos, cada una con título, enlace y cuerpo, por un cobro de 0,000694 USD. El punto está aquí: ese es el precio de una solicitud, y una solicitud devolvió 10 páginas, así que cada página son 0,0000694 USD, o sea 0,069 USD por 1.000. A las 00:38 hora de Singapur rastreamos el sitio de documentación de Firecrawl con num en 20 y pidiendo páginas de funciones y precios; esta vez devolvió 3 páginas, de nuevo por 0,000694 USD, o sea 0,231 USD por 1.000. Las dos ejecuciones muestran una cosa: cuántas páginas devuelve un crawl depende del sitio y de la instrucción, pero devuelva 3 o 10, es un precio fijo, de modo que el precio por página queda entre 0,069 y 0,231 USD, muy por debajo del crédito por página de Firecrawl.
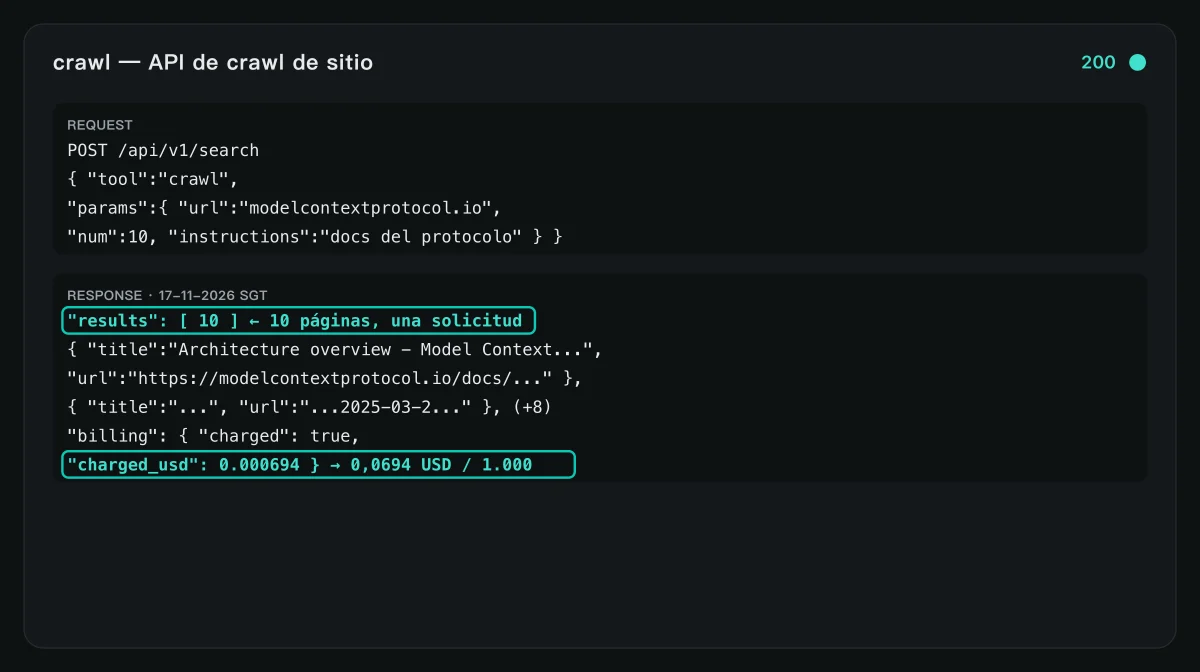
El Crawl de Firecrawl cobra 1 crédito por cada página que rastrea, descubre y raspa cada subpágina de un dominio y devuelve el sitio como markdown o JSON (función Crawl de Firecrawl, página Crawl de Firecrawl, 29 de octubre de 2026). Para un sitio de 100 páginas Firecrawl cobra 100 créditos, es decir 0,32 USD en Hobby anual, 0,083 en Standard y 0,0599 en Scale. Para rastrear esas mismas 100 páginas fijamos num por llamada y dividimos en solicitudes; a 10 páginas por llamada son 10 solicitudes, 0,00694 USD, unas 12 veces más barato que el nivel Standard de Firecrawl y unas 46 veces más barato que Hobby. La causa es la misma de antes: Firecrawl cobra de forma lineal por página y nosotros por solicitud, y cuantas más páginas devuelve una solicitud, más barata la página. El límite: nuestro número de páginas por llamada tiene tope y un sitio profundo necesita varias solicitudes unidas, mientras que el Crawl de Firecrawl termina un sitio entero con un comando y gestiona la paginación y la deduplicación por ti, que es donde ahorra esfuerzo.
Apify vuelve a usar el Website Content Crawler, cobrado por cómputo, así que el coste de rastrear a fondo un sitio grande depende del cómputo que use, sin una cifra por página comparable. Sus fuertes son la profundidad y el detalle: crawls incrementales que toman solo las páginas cambiadas, cookies para zonas con login y descargas de adjuntos (metadatos del Website Content Crawler). Así que el crawl de sitio se reduce a «más barato» frente a «más cómodo y completo»: para llevar el coste al suelo y aceptar tu propia paginación, somos los más baratos; para rastrear un sitio entero con un comando y con login e incrementales, Firecrawl y Apify encajan mejor.
Prueba cuatro: mapa de sitio, 50 enlaces por llamada
A veces solo quieres la lista de páginas de un sitio, no el cuerpo. El 17 de noviembre de 2026 a las 00:24 hora de Singapur llamamos a map sobre el sitio de Model Context Protocol, devolvió 50 enlaces en unos 0,3 segundos y cobró 0,000694 USD. El Map de Firecrawl también es «solo URL y rápido», pero cobra 1 crédito por llamada, igual que raspar una página (función Map de Firecrawl, precios de Firecrawl). Así que este está cerca: ambos cobran un precio por llamada, el nuestro 0,694 USD por 1.000 llamadas, el de Firecrawl de 0,599 a 3,20 USD; la diferencia es que devolvemos 50 enlaces por llamada a precio fijo, mientras que el número de enlaces por llamada de Map en Firecrawl depende del sitio. Para un trabajo que primero mapea un sitio y luego obtiene páginas elegidas, ambos pueden combinar Map y Crawl, y el coste sigue siendo nuestra solicitud frente a la página de Firecrawl.
Prueba cinco: datos estructurados de plataforma, lo que Firecrawl no puede hacer
Más allá de buscar y raspar hay un trabajo distinto: sacar campos estructurados de una plataforma concreta, como precios y valoraciones de productos de Amazon o publicaciones de Reddit. El 17 de noviembre de 2026 a las 00:25 hora de Singapur llamamos a amazon/search con «usb c cable», devolvió 25 filas en unos 54 segundos, cada una con ASIN, título, marca, precio, moneda, valoración, número de reseñas, stock, vendedor y puesto en el ranking de ventas, 18 campos en total, por 0,002236 USD, es decir 0,089 USD por 1.000; en el mismo momento reddit/search con «firecrawl vs apify» devolvió 1 fila (el término apenas se discute en Reddit) por 0,000792 USD. Cada campo aquí viene ya analizado, no una página de markdown, así que entra directo en comparación de precios, selección de producto o análisis de opinión. Mira las notas de campo de la API de datos de Amazon y de la API de datos de Reddit.
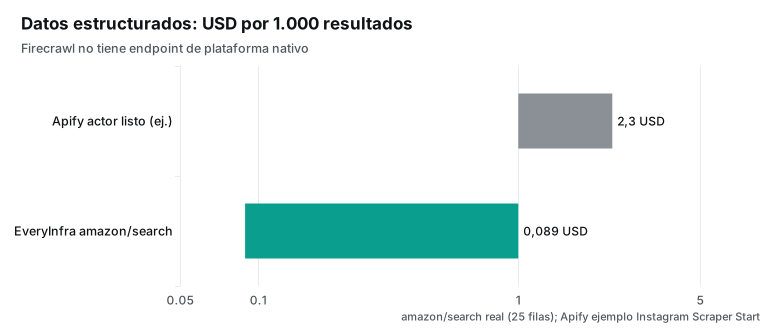
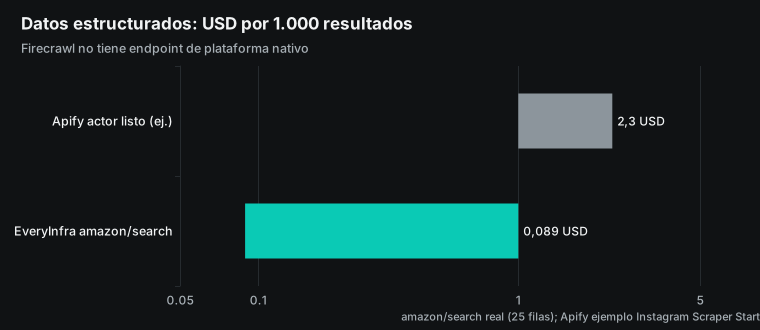
De las 25 filas que devolvió este amazon/search, los artículos con precio iban de unos pocos a algo más de veinte dólares, cada uno con marca, valoración, número de reseñas, stock, una marca de «Amazon's Choice» y un puesto de ventas, así que la selección y la comparación de precios pueden filtrar por campo sin desarmar una página. Raspar la página entera, en cambio, obliga a lidiar con el antibot y los cambios de maquetación de Amazon y a escribir tu propio analizador, sin garantía de que los campos estén completos; hacerlo con Firecrawl obliga a raspar la página y luego extraer, con JSON a 4 créditos por página, de modo que una sola página de producto ya cuesta más que una de nuestras solicitudes. En los datos estructurados el ahorro no es solo dinero, también es el trabajo de convertir markdown en campos.
Aquí es donde divergen los tres productos. El núcleo de Apify es este trabajo: la tienda tiene miles de actors para sitios concretos, con scrapers dedicados a redes sociales, comercio, mapas y empleo, y los precios por evento de los actors listos suelen ir de 1 a 3 USD por 1.000; el ejemplo del Instagram Scraper en la página de precios es 2,30 USD por 1.000 en Starter (precios de Apify, Instagram Scraper de Apify). Firecrawl no tiene «endpoint de plataforma»: para obtener los campos estructurados de Amazon hay que raspar la página del producto y luego usar su extracción para convertir markdown en JSON, a 4 créditos por página (función Extract de Firecrawl, precios de Firecrawl), lo que sale más caro y con más montaje. Nosotros integramos las plataformas comunes en capacidades fijas que devuelven una página de resultados estructurados por solicitud a un precio, así que esta clase queda cerca de 0,089 USD por 1.000, uno o dos órdenes de magnitud por debajo de un actor listo. Para que quede claro: nuestros campos, los campos de Apify y el markdown de Firecrawl se construyen de forma independiente, sin flujo de datos entre ellos, y los campos no son iguales.
Qué recibes: markdown, campos estructurados, fragmentos de búsqueda
Más allá del precio, los tres devuelven cosas distintas, y la elección debe pesar eso también. El Scrape y el Crawl de Firecrawl devuelven una página de markdown, sin navegación, pie ni anuncios, y conservan el cuerpo, ideal para soltarlo en el contexto de un modelo; para estructura se añade extracción y se convierte a JSON por esquema. Los actors de Apify siguen la salida de cada actor: el Website Content Crawler da markdown o texto con metadatos, el Google Search Results Scraper da campos de búsqueda analizados, y los actors de un sitio dan sus propios campos. Nuestro lado se divide en dos: las herramientas de búsqueda (web, read, crawl, map) devuelven títulos, enlaces y cuerpo o fragmento, y las capacidades de plataforma devuelven campos analizados, como los 18 campos de la API de datos de Amazon o los campos de publicación de la API de datos de Reddit.
| Necesidad | Mejor formato | A quién le encaja |
|---|---|---|
| Cuerpo de página para un modelo | markdown | Firecrawl Scrape/Crawl; nuestro read |
| Campos para una base de datos | campos analizados | nuestras capacidades; actors de Apify |
| Buscar y luego obtener bajo demanda | fragmentos más una obtención | nuestro web más read; Firecrawl Search |
| Un sitio concreto y poco común | el actor de ese sitio | tienda de Apify |
| JSON de cualquier página por esquema | complemento de extracción | Firecrawl Extract (4 créditos extra) |
Así que «cuál es más barato» hay que preguntarlo junto con «qué formato». Para el precio y la valoración de un producto, con Firecrawl hay que raspar una página y luego gastar 4 créditos para extraer JSON, mientras que nuestra capacidad estructurada devuelve los campos en una solicitud. Para el texto completo de un documento hacia RAG, el markdown de Firecrawl es directamente usable y el cuerpo limpio de nuestro read basta, aunque Firecrawl obtiene una página muy renderizada de forma más completa. Mete la necesidad de formato dentro del coste y no elegirás mal por el precio unitario solo.
Tasas de éxito: las estadísticas públicas de Apify
Apify publica en sus metadatos los resultados de ejecución de cada actor de los últimos 30 días, y se pueden leer directamente. El Website Content Crawler se ejecutó 3.745.470 veces en los últimos 30 días, de las cuales 3.612.346 tuvieron éxito, 3.109 fallaron, 108.485 expiraron y 21.530 se abortaron, así que cerca de un 3,5 % no tuvo éxito, casi todo por expiración (metadatos del Website Content Crawler). El Google Search Results Scraper se ejecutó 9.742.552 veces, con 9.551.726 con éxito, 440 fallidas, 171.838 expiradas y 18.548 abortadas, un 2,0 % sin éxito (metadatos del Google Search Results Scraper). Ambas proporciones dicen que el scraping web en sí es inestable, que las expiraciones son normales y que, uses el proveedor que uses, necesitas reintentos y alertas, sin fiarte de un «ejecución con éxito» a secas.
Eso señala algo: un precio por 1.000 se calcula sobre las filas devueltas con éxito y deja fuera el coste de los reintentos. En una plataforma por evento una ejecución fallida suele no producir evento de resultado, pero un fallo igual implica repetir y esperar de nuevo; nosotros cobramos por solicitud, un fallo no se cobra y un reintento es otra solicitud. Mete los reintentos y un objetivo inestable sube el coste en ambos modelos; esa parte no la evita nadie, la diferencia está solo en si el intento fallido cobró. Las evaluaciones de terceros ya pesan juntas la tasa de éxito y el coste, no el precio de lista solo (Firecrawl: mejores API de búsqueda web, 21 de octubre de 2026; reseñas de Firecrawl en G2, leído el 15 de noviembre de 2026).
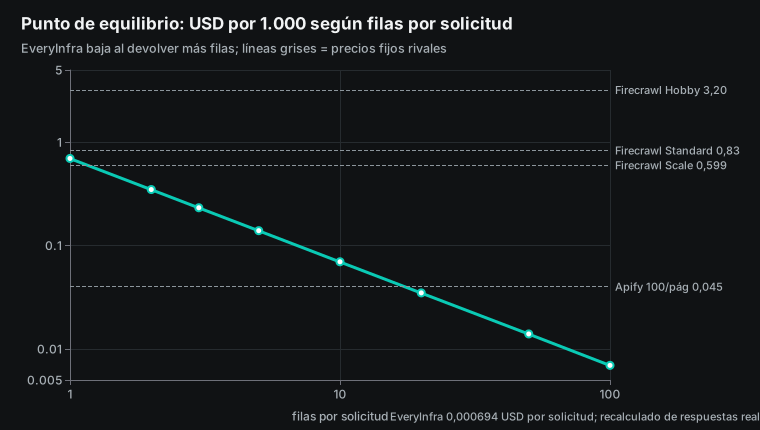
Punto de equilibrio: cuántas filas por solicitud para que gane el cobro por solicitud
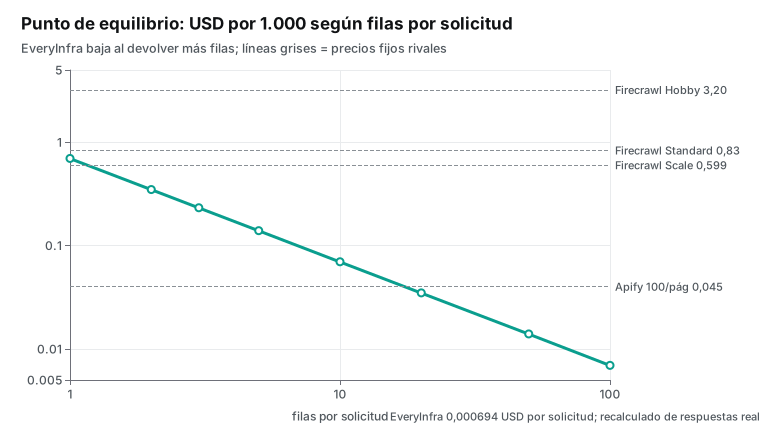
La línea entre los dos estilos de cobro sale de un número: nuestra solicitud son 0,000694 USD, el otro lado cobra por página o por fila, y dividir nuestro precio por llamada entre su precio por fila da «cuántas filas debe devolver una solicitud para que seamos más baratos».
| Otro lado por 1.000 | Ejemplo | Filas de equilibrio |
|---|---|---|
| 3,20 USD | Firecrawl Scrape, Hobby | 0,22 |
| 0,83 USD | Firecrawl Standard | 0,84 |
| 0,599 USD | Firecrawl Scale | 1,16 |
| 0,45 USD | Apify 10 por página Free | 1,54 |
| 0,045 USD | Apify 100 por página Free | 15,4 |
La tabla une todos los resultados: raspar una página devuelve una página, así que pierde frente al nivel Scale de Firecrawl y a la cuenta de «100 por página» de Apify; la búsqueda devuelve 10, el crawl varias páginas y lo estructurado decenas, todos muy por encima del equilibrio, de ahí la gran diferencia. Antes de cambiar, cuenta cuántas filas devuelve una solicitud de media; ese número decide la respuesta más que cualquier precio de lista.
Una cuenta mensual: tres trabajos comunes
Aquí va un mes (30 días) para tres usos comunes. Firecrawl toma el plan más barato que cabe el volumen, precio anual; Apify toma el precio por evento del actor listo más una cuota de plan; EveryInfra equivale a solicitudes por 0,000694 USD, con las capacidades estructuradas a su propio precio.
| Trabajo mensual | Filas | Firecrawl | Apify | EveryInfra |
|---|---|---|---|---|
| RAG: sitio de 200 páginas a diario | 6.000 | 16 USD | por cómputo | 0,42 USD |
| 20 palabras, 100 cada una a diario | 60.000 | 83 USD | 2,70 USD | 4,17 USD |
| 1.000 páginas de producto a diario | 30.000 | scrape y extraer | 69 USD | 2,68 USD |
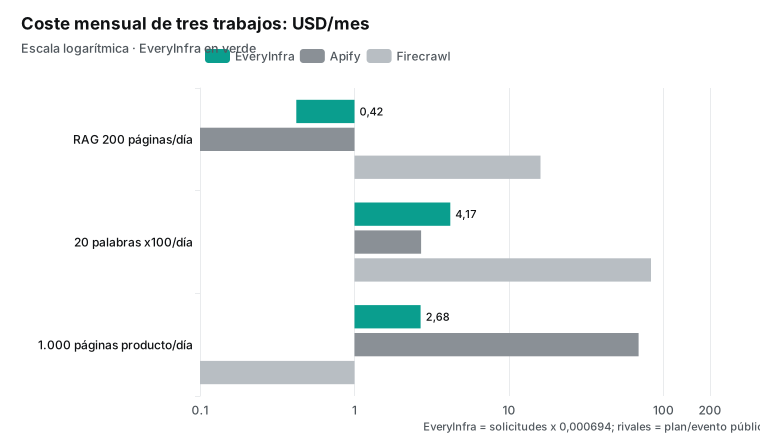
La primera fila pide una nota: para RAG de un sitio de documentación, el Crawl de Firecrawl termina con un comando a 1 crédito por página, y 6.000 páginas apenas superan los 5.000 créditos de Hobby, así que recargas o subes de nivel; nosotros estimamos 600 solicitudes a 10 páginas cada una, unos 0,42 USD. La segunda fila es búsqueda: el «100 por página» de Apify es el más barato con volumen, nosotros el siguiente y Firecrawl el más caro porque el plan arranca en 83 USD al mes. La tercera fila son datos de producto estructurados: Firecrawl no tiene endpoint nativo y obliga a raspar y extraer con 4 créditos extra por página; el actor listo de Apify es claro pero caro, y nosotros los más baratos. Un recordatorio más: las cuotas de plan de Firecrawl y Apify son uso prepagado que no se arrastra y caduca al cierre del periodo, mientras que nuestro saldo no caduca (precios de Firecrawl, facturación de la consola de Apify).
Unidad de cobro, cargos por fallo, planes gratuitos: tres modelos
Uno al lado del otro, los tres son tres modelos. EveryInfra cobra por solicitud a un precio fijo, con saldo que nunca caduca; Firecrawl cobra por crédito, vende créditos mensuales con un plan y recargas de 5 USD, y los créditos caducan a fin de mes salvo en Scale y Enterprise; Apify cobra por evento o por cómputo, y el uso prepagado del plan no se arrastra y caduca (precios de Apify, precios de Firecrawl).
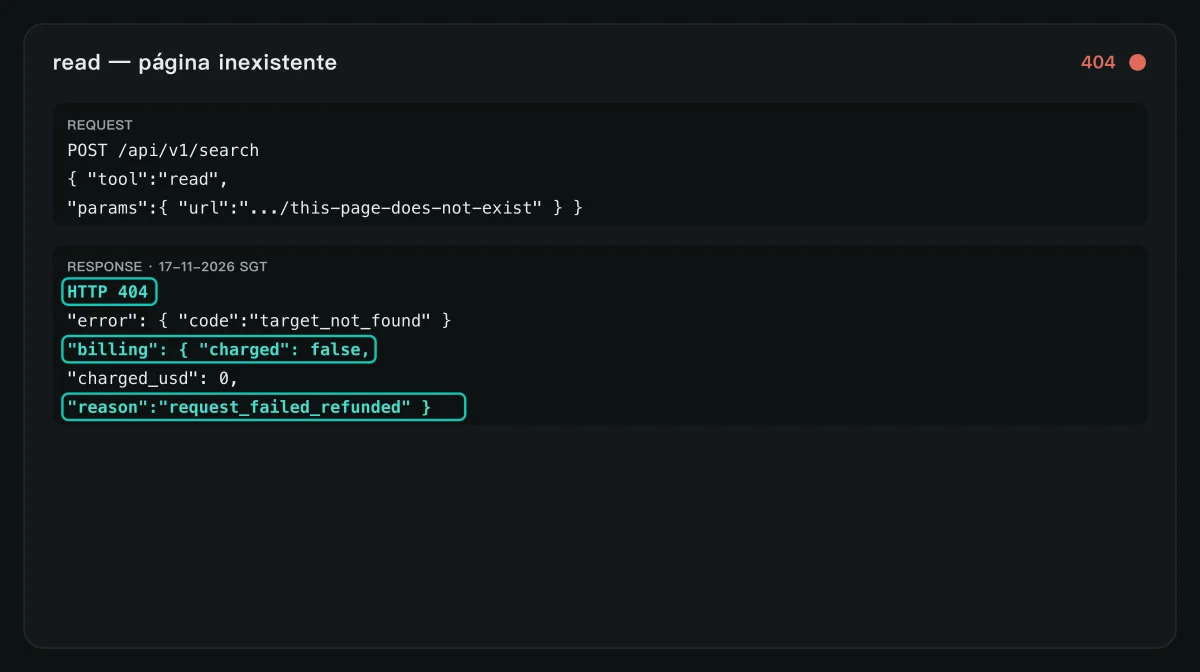
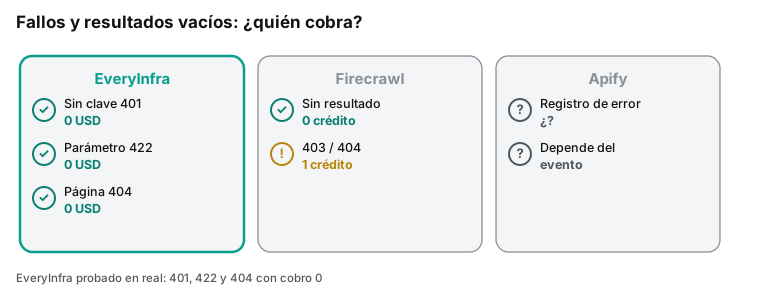
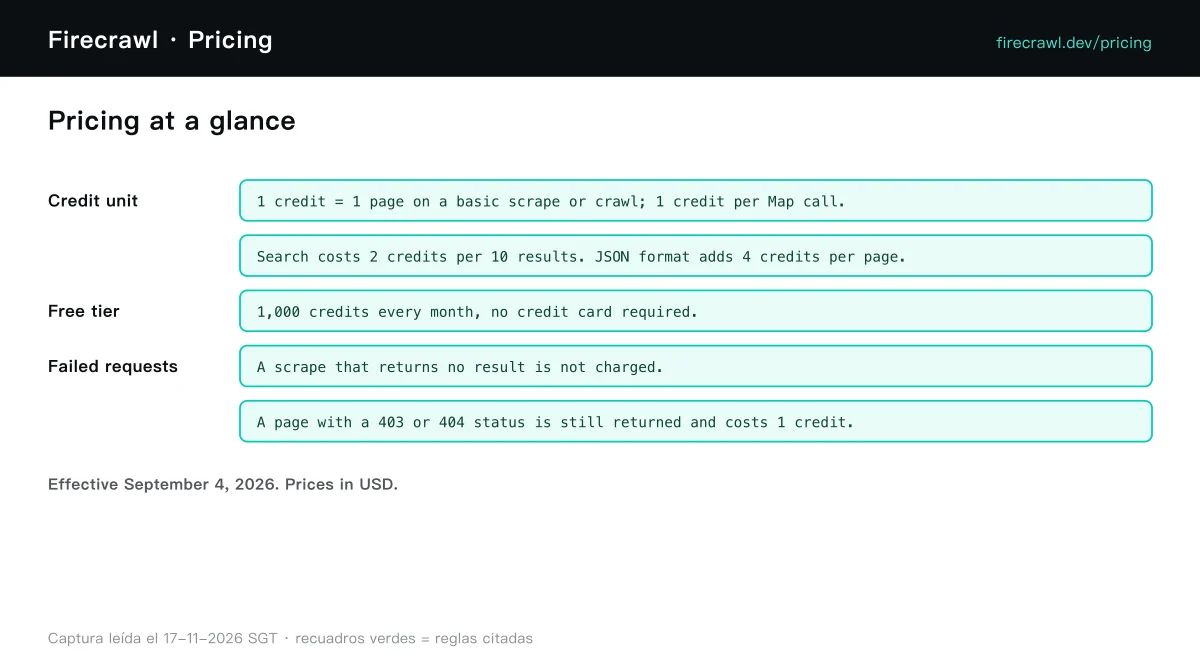
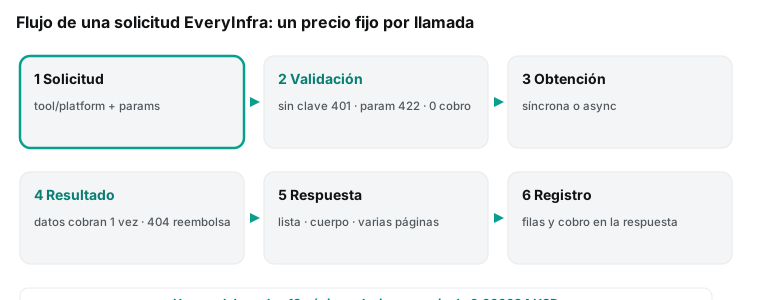
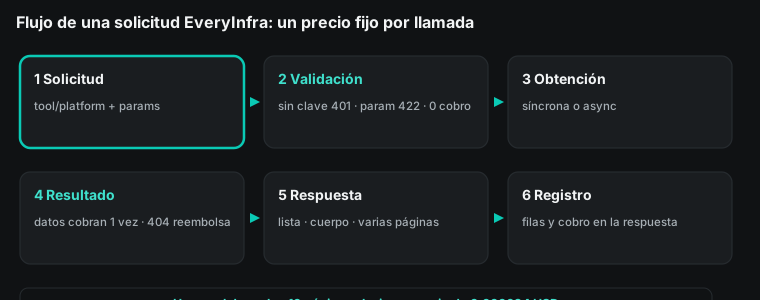
Si los fallos y los resultados vacíos cobran es la línea más olvidada y la que más mueve la factura real. Probamos tres casos de «sin datos»: el 17 de noviembre de 2026 a las 00:20 hora de Singapur una solicitud sin clave devolvió 401 con «Nothing was charged»; en el mismo momento un parámetro mal escrito devolvió 422, con la lista de parámetros permitidos y un ejemplo que funciona, sin cobro; a las 00:26 hora de Singapur un read sobre una página inexistente devolvió 404, con charged en false y el motivo request_failed_refunded, cobro 0. Ninguno cobró. La página de precios de Firecrawl es clara: un scrape que no devuelve resultado no se cobra, pero una página que responde con un estado de error como 403 o 404 se te devuelve igual y cuesta 1 crédito (precios de Firecrawl). En un actor por evento de Apify, si un registro de error cobra depende de cómo el autor defina los eventos, y se lee del recuento de eventos de la ejecución después (cobro por evento de Apify).
Los planes gratuitos y las recargas mínimas también difieren. Firecrawl da 1.000 créditos al mes sin tarjeta, unas 1.000 páginas o 5.000 búsquedas, y además una entrada Keyless sin registro y limitada por IP para probar directamente (Firecrawl: mejor API de scraping). El plan Free de Apify da 5 USD de uso de plataforma al mes sin tarjeta. Nosotros damos un crédito de prueba de una vez por marcar con estrella dos repositorios de código abierto en la consola, con uso de pago desde una recarga y saldo que no caduca. Juntos: para pruebas ocasionales los tres planes gratuitos bastan; para un uso largo hay que ajustar el modelo de cobro al volumen y a su irregularidad.
| Dimensión | EveryInfra | Firecrawl | Apify |
|---|---|---|---|
| Unidad de cobro | por solicitud, un precio | por crédito (página, llamada, por 10) | por evento o por cómputo |
| Fallo / vacío | 401, 422, 404 todos cobro 0 en pruebas | sin resultado no cobra; 403, 404 cuesta 1 crédito | depende de la definición del evento |
| Cuota mensual | ninguna, saldo no caduca | Hobby 16 a Scale 599 USD/mes, créditos caducan | Starter 19 a Business 999 USD/mes, sin arrastre |
| Plan gratuito | prueba única por estrellas en repos | 1.000 créditos/mes, más Keyless sin registro | 5 USD de uso de plataforma/mes |
| MCP | MCP remoto, herramientas everyinfra_* | MCP oficial, servidor firecrawl | MCP oficial, mcp.apify.com |
Llamar desde herramientas de IA: los tres hablan MCP
Los tres ofrecen MCP (Model Context Protocol, el protocolo con que un cliente de IA llama a herramientas externas, ver la especificación 2025-06-18). EveryInfra es un MCP remoto cuyas herramientas empiezan por everyinfra_, y se añade con un bloque en la configuración del cliente:
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${env:EVERYINFRA_API_KEY}" }
    }
  }
}
El servidor MCP de Firecrawl se llama firecrawl y admite Keyless sin registro, inicio de sesión con cuenta o una clave de API, exponiendo scrape, crawl, search, map y extract como herramientas (documentación de MCP de Firecrawl, fuente de firecrawl-mcp-server). El MCP de Apify está en mcp.apify.com, recomienda inicio con OAuth y deja que un modelo busque un actor en la tienda y lo ejecute (documentación de MCP de Apify, fuente de apify-mcp-server). El uso en un cliente de IA es parecido en los tres, y la diferencia sigue siendo el cobro: cuanto más obtiene un modelo, Firecrawl suma créditos, Apify suma eventos o cómputo y nosotros sumamos solicitudes. Puedes decir en el chat «usa EveryInfra para buscar los 10 primeros de este término y luego raspa el primero» y el modelo llama a web/search y luego a una obtención, dos solicitudes a 0,000694 USD cada una. Los detalles de configuración están en nuestra guía de aceptación de MCP remoto.
Migrar desde el otro lado: qué cambiar
Una vez claro el precio, el coste de migración está en los detalles de ingeniería. Desde Firecrawl, el primer cambio es la unidad: el Scrape y el Crawl de Firecrawl trabajan en «páginas» y devuelven markdown, mientras que nuestras capacidades de búsqueda trabajan en «solicitudes» y devuelven campos estructurados o cuerpo de texto, así que un script que analizaba markdown pasa a leer campos. El segundo es la paginación del crawl: Firecrawl termina un sitio entero con un comando de Crawl y nosotros fijamos num alto y dividimos en solicitudes. El tercero es el formato: Firecrawl da markdown renderizado por defecto, ideal para un modelo, y nuestro read da cuerpo limpio que puede perder partes de una aplicación de página única muy renderizada, así que prueba una página cuando dudes.
Desde Apify, el cambio principal es sustituir «iniciar una ejecución y luego traer el dataset» por «enviar una solicitud y recibir el resultado». Una ejecución de Apify procesa un lote de entradas en un dataset, y los datasets sin nombre tienen un periodo de retención (documentación de Dataset de Apify); nosotros devolvemos un solo objetivo de forma síncrona por solicitud. El manejo de errores también difiere: el error de Apify es un registro con un código de error en el dataset que hay que filtrar, y el nuestro es un estado HTTP más un código de error, con 401, 422 y 404 sin cobro y un resultado vacío que declara el motivo del reembolso en la respuesta. En cuanto a la tasa de solicitudes, cada cuenta tiene por defecto un límite compartido entre claves que aumenta con las recargas, así que dimensiona la tasa antes de una tirada grande; compara los dos lados en límites de plataforma de Apify y uso y recursos de Apify.
Cuándo encaja mejor Firecrawl
Es fácil escribir una comparación que solo adule tu propio lado. Estos son los casos en que Firecrawl encaja mejor, o en que aún no llegamos. Primero, convertir muchos sitios modernos (React, Vue y otras aplicaciones de página única renderizadas en el front) en markdown limpio para un modelo: Firecrawl renderiza JavaScript por defecto y devuelve markdown apto para LLM, que según dice usa alrededor de un 67 % menos de tokens que el HTML original, una ventaja real para una tubería RAG. Segundo, interactuar al raspar: pulsar «cargar más», rellenar un formulario o paginar antes de obtener, que la función Interact de Firecrawl hace en lenguaje natural o código (función Interact de Firecrawl). Tercero, extraer páginas a JSON estructurado por esquema o vigilar cambios de página, que la extracción y Monitor de Firecrawl hacen, cada uno con créditos extra. Cuarto, volumen grande y estable con prepago mensual: los precios por página de Standard y Scale baten a los nuestros. Quinto, retención de datos cero empresarial, inicio de sesión único y listas blancas de IP y de clave, que el plan empresarial de Firecrawl ofrece (Firecrawl empresarial). Firecrawl levantó una ronda Serie B de 75 millones de USD y lanzó Alexandria en septiembre de 2026 (Wowtale, 23 de septiembre de 2026), así que itera rápido.
Cuándo encaja mejor Apify
Los casos de Apify son igual de claros. Primero, cuando tu objetivo es un sitio concreto y poco común: los miles de actors de la tienda cubren sitios de cola larga mucho más allá de nuestras capacidades fijas, y terceros siguen añadiendo más (actors en la tienda de Apify). Segundo, rastrear a fondo un sitio grande con login, actualizaciones incrementales, descargas de adjuntos, capturas y resúmenes con IA por página: el Website Content Crawler lo hace más a fondo que nosotros. Tercero, programaciones y webhooks integrados e integraciones listas de almacenamiento en la nube y automatización: la consola de Apify es más completa, con amplia concurrencia, hasta 256 ejecuciones a la vez en Business. Cuarto, ser un agente autónomo con una cartera cripto que paga por uso sin cuenta: Apify lo admite con x402 y MPP (precios de Apify). Nosotros encajamos en lo contrario: una clase de datos que necesita muchas filas con solo la última página cada vez, el coste al suelo, campos estructurados fijos, la regla de «sin datos no hay cobro» fija y visible como motivo de reembolso en la respuesta, o búsqueda y crawl conectados directo en una herramienta de IA para que el modelo llame.
Cambios recientes (septiembre a noviembre de 2026)
| Fecha | Suceso | Qué significa para ti |
|---|---|---|
| 2026-11-16 | Los metadatos del Website Content Crawler y del Google Search Results Scraper de Apify se actualizaron este día | las entradas y precios de un actor cambian cuando sea; lee los metadatos públicos del día al comparar |
| 2026-11-11 | Una evaluación de API de búsqueda para agentes puso a Firecrawl junto a Exa, Tavily y Perplexity en precisión, coste y latencia (AIMultiple) | la elección de una API de búsqueda pesa cada vez más el coste total, no el precio unitario solo |
| 2026-11-05 | Una comparación de terceros situó a Firecrawl como más fuerte en ingesta de sitio completo y extracción configurable (TinyFish) | el fuerte de Firecrawl es el sitio completo y la extracción, no el precio unitario más bajo |
| 2026-11-02 | Firecrawl renovó su lista de mejores herramientas de extracción web de 2026, comparándose con Apify (blog de Firecrawl) | ambos se tratan como competidores, con funciones que convergen |
| 2026-10-29 | La página Crawl de Firecrawl se actualizó, recalcando un comando para un sitio entero (Crawl de Firecrawl) | el crawl de sitio es el escenario estrella de Firecrawl |
| 2026-10-24 | Un tercero calculó el coste por 1.000 páginas con la regla de 5 créditos de JSON de Firecrawl (WebCrawlerAPI) | calcula los créditos extra antes de activar JSON o extracción |
| 2026-09-23 | Firecrawl levantó una Serie B de 75 millones de USD y lanzó Alexandria (Wowtale) | financiación y equipo en expansión, iteración más rápida |
| 2026-09-04 | Entraron en vigor los precios actuales de Firecrawl: 1 crédito por página, Search 2 créditos por 10, 403/404 cuesta 1 crédito (precios de Firecrawl) | los precios actuales son esta versión; los artículos viejos pueden estar desfasados |
Límite de cumplimiento: datos públicos, términos del sitio, datos personales
Los tres obtienen páginas web públicas, pero el scraping está atado por dos capas. Una son los términos de cada sitio: muchas plataformas prohíben el scraping automatizado no autorizado, así que lee primero los términos y las reglas de robots del sitio objetivo. La otra es la ley de datos personales: si lo que obtienes contiene nombres, comentarios o datos de contacto, en la UE debes tratarlo bajo el Reglamento General de Protección de Datos (Reglamento (UE) 2016/679), y almacenarlo y usarlo según tu ley local. El plan empresarial de Firecrawl ofrece retención de datos cero y puede quitar información personal de la salida (Firecrawl empresarial); las páginas de actor de Apify avisan de que los resultados pueden contener datos personales protegidos por ley. Nosotros leemos solo páginas públicas, no alcanzamos contenido privado y los datos personales en los resultados deben tratarse según la ley local. Las tres herramientas solo traen de vuelta páginas públicas; el deber de cumplimiento recae en quien las usa, que confirma que el sitio objetivo lo permite antes de obtener y sigue la ley local sobre uso y retención después, con independencia del proveedor. Este artículo cubre método de datos y coste, y no es asesoramiento legal.
Cómo verificamos estas cifras
Cada número vuelve a una respuesta original. Primero, los precios del otro lado salen de endpoints públicos y páginas de precios, no de material de marketing: los precios por evento de Apify de la última versión vigente de pricingInfos en los metadatos de los dos actors, y las reglas de crédito y el cargo por fallo de Firecrawl del bloque Pricing at a glance, cada uno con su fecha de lectura. Segundo, nuestro cobro por solicitud sale de charged_usd en la respuesta, y el número de filas de la longitud del array results, no del límite. Tercero, un único script recalcula cada precio por 1.000, múltiplo y coste mensual de las respuestas originales, y cada número de los gráficos se lee de ese resultado y se coteja con el texto. Cuarto, el cobro de fallos y vacíos se verifica en tres casos reales: sin clave, un parámetro mal escrito y una página inexistente, los tres con charged en false.
También dejamos claro lo que no hicimos: no nos registramos en Firecrawl ni en Apify, no compramos plan ni ejecutamos ningún actor, así que su lado tiene solo precios de lista públicos, sin facturas medidas, tasas de éxito ni calidad de datos; nuestras llamadas reales cubren búsqueda, scrape, crawl, mapa de sitio y dos capacidades estructuradas, no todas las capacidades del catálogo. Cuántas páginas devuelve un crawl depende del sitio y de la instrucción, y solo probamos 3 y 10 páginas, así que un sitio más profundo necesita varias pruebas para fijar un precio por página. Estos límites no cambian la conclusión de que el cobro por solicitud es más barato en datos que vuelven por lotes, pero recalcula con tus propias filas devueltas en vez de copiar las nuestras.
Tasa, concurrencia y límites de lote
Antes de una tirada grande, la tasa y la concurrencia deciden cuánto mueves por hora y pesan tanto como el precio unitario. La tasa de Firecrawl es por plan y por endpoint: Free permite 10 scrapes y 2 crawls por minuto con 2 navegadores, Standard 500 scrapes y 100 crawls por minuto con 25 navegadores, y Scale llega a 10.000 por minuto y 100 navegadores (precios de Firecrawl, límites de tasa de Firecrawl). Apify cuenta la concurrencia como ejecuciones simultáneas, hasta 5 en Free, 32 en Starter y 256 en Business, y una ejecución procesa un lote de entradas, así que su concurrencia es a nivel de ejecución (límites de plataforma de Apify). Nosotros somos a nivel de solicitud: cada cuenta tiene por defecto algunas por minuto compartidas entre claves y acelera con recargas acumuladas.
| Proveedor | Qué se limita | Nivel bajo | Nivel alto |
|---|---|---|---|
| Firecrawl | por endpoint | 10 scrapes, 2 crawls/min | 500 a 10.000/min |
| Apify | ejecuciones a la vez | 5 (Free), 32 (Starter) | 256 (Business) |
| EveryInfra | por solicitud | algunas/min | más tras recargas |
Estas tres tasas no se comparan directo porque la unidad difiere: Firecrawl limita por endpoint y obtiene una página a la vez, Apify limita por ejecución y una ejecución obtiene un lote, nosotros limitamos por solicitud y una solicitud devuelve una página o un lote. Para pasarlas a «filas por hora» hay que saber primero si tu trabajo raspa página a página o por lotes. Página a página, los niveles altos de Firecrawl a cientos o miles por minuto son los más rápidos; por lotes, una ejecución de Apify maneja cientos de objetivos y la concurrencia no es el cuello de botella; devolviendo una página o decenas de filas por solicitud, a nosotros nos encaja repartir objetivos en muchas solicitudes con aceleración automática. Antes de un lanzamiento grande, pon tasa, concurrencia y precio por 1.000 en una tabla, que es más preciso que el precio solo.
Empezar: de una prueba al uso continuo
Primero, consigue una clave de API. Tras registrarte en la consola, marca con estrella dos repositorios de código abierto para reclamar un crédito de prueba de una vez, que cubre de mil a dos mil solicitudes a 0,000694 USD cada una; el uso de pago empieza desde una recarga y el saldo no caduca (inicio rápido, precios). Segundo, elige un trabajo y ejecútalo una vez: web/search para búsqueda web, read para raspar una página, crawl con num según tu número de páginas para rastrear un sitio. Tercero, mira charged_usd y el número de filas en la respuesta, calcula el precio por 1.000 de tu caso como cobro entre filas por 1.000, y compáralo con tu factura actual de Firecrawl o Apify. Las capacidades comunes están en búsqueda web, los datos estructurados en la API de datos de Amazon y la API de datos de Reddit, o busca por plataforma en el mercado de datos. Si ya usas Firecrawl o Apify, mira nuestras alternativas a Firecrawl y el resumen de alternativas a Apify.
Preguntas frecuentes
¿Qué diferencia hay entre Apify y Firecrawl y cuál elegir?
De la sugerencia de Google «apify or firecrawl». Están posicionados distinto: Firecrawl convierte cualquier página en markdown listo para un modelo, renderiza JavaScript, encaja en scrape, crawl y búsqueda más extracción en un paso, y cobra por crédito; Apify es un mercado de programas de scraping con miles de actors para sitios concretos, la cobertura más amplia, cobrando por evento o cómputo. Los trabajos de investigación, RAG y markdown limpio tiran hacia Firecrawl; raspar sitios concretos y poco comunes con profundidad tira hacia Apify. Si quieres campos estructurados fijos más búsqueda web y el menor coste, añade EveryInfra por solicitud como tercera opción.
¿Cuánto cuesta un scrape de Firecrawl y basta el plan gratuito?
De la sugerencia «firecrawl pricing». El scrape y el crawl básicos de Firecrawl son 1 crédito por página, Map 1 por llamada, Search 2 por cada 10 resultados, y formatos avanzados como JSON suman 4 créditos por página (precios de Firecrawl). Cada crédito va de 0,0032 USD en Hobby anual a 0,000599 en Scale. El plan gratuito son 1.000 créditos al mes sin tarjeta, unas 1.000 páginas o 5.000 búsquedas; basta para uso ocasional, mientras que un uso largo necesita plan de pago, y ten en cuenta que los créditos de casi todos los planes caducan a fin de mes.
¿Cómo cobra la búsqueda el Google Search Results Scraper de Apify?
De la sugerencia «apify google search scraper». Cobra por evento: cada página de resultados raspada son 0,0045 USD en Free, 0,0035 en Starter (Bronze), 0,00245 en Business (Gold) y 0,0014 en Diamond, más una tarifa de inicio de 0,002 USD por ejecución y un mínimo de 0,5 USD (metadatos del Google Search Results Scraper). Una página puede llevar 10 o 100 resultados, así que 1.000 resultados son unos 0,045 USD a 100 por página (Free) y unos 0,45 a 10 por página. Nuestro web/search son 0,000694 USD por hasta 10 resultados, 0,069 USD por 1.000.
¿Por qué el crawl de sitio difiere decenas de veces y el scrape de una página apenas?
De las pruebas de este artículo. En el crawl de sitio, Firecrawl cobra 1 crédito por página y nuestro crawl devuelve varias páginas por solicitud a un cobro, así que cuantas más páginas por llamada, mayor la diferencia, decenas de veces con 10 páginas aquí. Raspar una página devuelve una página, y ahí nuestros 0,694 USD por solicitud quedan cerca del precio por página de los niveles altos de Firecrawl (0,599 a 0,83 USD), donde Firecrawl es de hecho más bajo. Así que mira primero cuántas filas devuelve una solicitud: muchas, y gana el cobro por solicitud; un objetivo a la vez, y cuentas también la cuota de plan.
¿Me cobran un scrape fallido o una página inexistente?
De la sugerencia «does firecrawl charge for failed requests». En nuestras pruebas, sin clave devolvió 401, un parámetro malo 422 y una página inexistente 404, todos con cobro 0 y el motivo del reembolso en la respuesta. La regla de Firecrawl es que un scrape sin resultado no se cobra, pero una página que devuelve un estado de error como 403 o 404 se te devuelve igual y cuesta 1 crédito (precios de Firecrawl). En un actor por evento de Apify, si un registro de error cobra depende de la definición del autor, y se lee del recuento de eventos de la ejecución. Antes de una tirada grande, esta regla mueve la factura final más que el precio de lista.
¿Firecrawl y Apify se conectan a Claude, Cursor y otras herramientas de IA?
De la sugerencia «firecrawl mcp». Sí, los tres ofrecen MCP: el servidor de Firecrawl es firecrawl y admite Keyless sin registro, cuenta o clave de API (documentación de MCP de Firecrawl); el de Apify está en mcp.apify.com, y tras OAuth un modelo puede buscar un actor en la tienda y ejecutarlo (documentación de MCP de Apify); nosotros somos un MCP remoto con herramientas everyinfra_*, que se añade con una URL y una clave. La diferencia en una herramienta de IA sigue siendo el cobro: cuanto más llama un modelo, cada uno suma coste por su unidad.
Referencias
- Precios de Firecrawl (reglas de crédito, planes, cobro por fallo), Firecrawl, vigente 2026-09-04, leído 2026-11-17. https://www.firecrawl.dev/pricing
- API Search de Firecrawl (búsqueda más scrape, campos), documentación de Firecrawl, leído 2026-11-17. https://docs.firecrawl.dev/api-reference/endpoint/search
- Función Search de Firecrawl, documentación de Firecrawl. https://docs.firecrawl.dev/features/search
- Función Scrape de Firecrawl (renderizado, salida markdown), documentación de Firecrawl. https://docs.firecrawl.dev/features/scrape
- Función Crawl de Firecrawl (crawl de sitio, cobro por página), documentación de Firecrawl. https://docs.firecrawl.dev/features/crawl
- Función Map de Firecrawl (solo URL), documentación de Firecrawl. https://docs.firecrawl.dev/features/map
- Función Extract de Firecrawl (extracción por esquema, formato JSON), documentación de Firecrawl. https://docs.firecrawl.dev/features/extract
- Función Interact de Firecrawl (clic, rellenar, paginar), documentación de Firecrawl. https://docs.firecrawl.dev/features/interact
- Límites de tasa de Firecrawl, documentación de Firecrawl. https://docs.firecrawl.dev/rate-limits
- API Crawl de Firecrawl, documentación de Firecrawl. https://docs.firecrawl.dev/api-reference/endpoint/crawl-post
- Inicio de MCP de Firecrawl (Keyless, cuenta, clave de API), documentación de Firecrawl, leído 2026-11-17. https://docs.firecrawl.dev/mcp-server
- Fuente de firecrawl-mcp-server, GitHub. https://github.com/firecrawl/firecrawl-mcp-server
- Modelo de cobro por evento (si los registros de error cobran), documentación de Apify. https://docs.apify.com/actors/publishing/monetize/pay-per-event
- Actors en la tienda de Apify (modelos por evento y por cómputo), documentación de Apify. https://docs.apify.com/actors/running/actors-in-store
- Servidor MCP de Apify, documentación de Apify. https://docs.apify.com/platform/integrations/mcp
- Fuente de apify-mcp-server, GitHub. https://github.com/apify/apify-mcp-server
- Facturación de la consola de Apify (uso prepagado, facturación por exceso), documentación de Apify. https://docs.apify.com/platform/console/billing
- Uso y recursos de Apify (unidades de cómputo, almacenamiento, proxies), documentación de Apify. https://docs.apify.com/platform/actors/running/usage-and-resources
- Dataset de Apify (retención, exportación), documentación de Apify. https://docs.apify.com/platform/storage/dataset
- Límites de plataforma de Apify (concurrencia, tasa), documentación de Apify. https://docs.apify.com/platform/limits
- Integración n8n de Apify, documentación de Apify. https://docs.apify.com/platform/integrations/n8n
- Endpoint Get Actor (leer la info pública de un actor), documentación de Apify. https://docs.apify.com/api/v2/actor-get
- Ejecuciones y builds de actor (definiciones de estado), documentación de Apify. https://docs.apify.com/platform/actors/running/runs-and-builds
- Especificación de Model Context Protocol 2025-06-18. https://modelcontextprotocol.io/specification/2025-06-18
- Reglamento (UE) 2016/679 (RGPD), EUR-Lex. https://eur-lex.europa.eu/eli/reg/2016/679/oj
- Catálogo de capacidades de EveryInfra (price_usd, max_limit, campos), leído 2026-11-17. https://api.everyinfra.com/api/v1/social/catalog
- Catálogo de herramientas de búsqueda de EveryInfra (tool, precio, parámetros), leído 2026-11-17. https://api.everyinfra.com/api/v1/search/tools
- EveryInfra llms.txt (fallos y vacíos no se cobran). https://api.everyinfra.com/llms.txt
- Página Crawl de Firecrawl (un comando para un sitio entero), Firecrawl, 2026-10-29. https://www.firecrawl.dev/crawl
- 8 Best Web Scraping APIs in 2026 (Keyless, 67 % de tokens), blog de Firecrawl, 2026-08-11. https://www.firecrawl.dev/blog/best-web-scraping-api
- Best Web Extraction Tools for AI in 2026 (comparada con Apify), blog de Firecrawl, 2026-11-02. https://www.firecrawl.dev/blog/best-web-extraction-tools
- Firecrawl empresarial (retención de datos cero, SSO, lista blanca de IP), Firecrawl. https://www.firecrawl.dev/enterprise
- Precios de Apify (cómputo, planes, proxies, almacenamiento, descuentos de tienda, x402), Apify, leído 2026-11-17. https://apify.com/pricing
- Metadatos públicos del Website Content Crawler (modelo de cobro, estadísticas, fecha de modificación), API de Apify, leído 2026-11-17. https://api.apify.com/v2/acts/apify~website-content-crawler
- Metadatos públicos del Google Search Results Scraper (precios por evento, estadísticas), API de Apify, leído 2026-11-17. https://api.apify.com/v2/acts/apify~google-search-scraper
- Instagram Scraper de Apify (precio de ejemplo), Apify. https://apify.com/apify/instagram-scraper
- Agentic Search API Benchmark (Firecrawl vs Exa, Tavily, Perplexity), AIMultiple, 2026-11-11. https://aimultiple.com/agentic-search
- TinyFish vs Firecrawl (Firecrawl fuerte en sitio completo y extracción), TinyFish, 2026-11-05. https://www.tinyfish.ai/blog/tinyfish-vs-firecrawl
- Firecrawl Pricing vs WebCrawlerAPI: Cost per 1000 Pages, WebCrawlerAPI, 2026-10-24. https://webcrawlerapi.com/blog/firecrawl-pricing
- Firecrawl Review: Costs, Limits, and What I'd Use Instead, thunderbit, 2026-11-11. https://thunderbit.com/blog/firecrawl-review-and-alternatives
- Firecrawl Raises 75M Series B, Launches Alexandria, Wowtale, 2026-09-23. https://en.wowtale.net/2026/09/23/235198/
- Best Web Search APIs for AI Applications in 2026 (tasa de éxito y coste juntos), blog de Firecrawl, 2026-10-21. https://www.firecrawl.dev/blog/best-web-search-apis
- Firecrawl Reviews 2026 (reseñas reales de usuarios), G2, leído 2026-11-15. https://www.g2.com/products/firecrawl/reviews
Referencia BL-176