Serper API key 和文档:从登录到第一条结果
Serper 没有独立文档站,Playground 就是文档,Key 只能建、改名和重置。我们用 29 次真调对照参数、报错、填 Key 和泄露后怎么换。
搜「serper api key」「serper api docs」「serper api login」的人,多半卡在同一个地方:Serper 没有独立的文档站(serper.dev/docs 在 2026 年 11 月 5 日返回 404),它的「文档」就是登录后才能用的 Playground,参数说明、计费规则和示例代码都写在这个页面的脚本里。我们读了 serper.dev 公开页面和前端脚本,又在同一天新加坡时间 00:18–00:26 对 EveryInfra 搜索接口真调 29 次:16 次拿到结果、扣费合计 $0.011799,其余 13 次是故意写错的参数、没带对的 Key、超速和空结果,全部 $0。
这篇不比价,比的是上手:从注册到第一条结果各要几步,Key 放在哪、能建几把、泄露了怎么换,q、gl、hl、num、page、type 这几个参数在我们这边对应什么,报错长什么样,以及在 Python、n8n、MCP 客户端里各怎么填 Key。价格请看本站前三篇 Serper 文章。
这篇回答什么,价格看哪里
价格结论只用一句话带过:Serper 四档每千次 $0.30–$1.00、额度 6 个月有效,EveryInfra 网页搜索按次扣 $0.000694(每千次 $0.694),余额不过期。每千次价格和过期规则见 Serper API 替代:每千次价格、免费额度和过期实测,2,500 次免费额度能用多久见 Serper 免费额度与免费替代,四档怎么买见 Serper API pricing:四档预付怎么买最省。
这一篇写给已经决定试试 Serper、或者已经在用 Serper 的开发者,只讲上手和排错:Key 在哪拿、怎么用,文档和参数在哪看,出错了怎么办,Key 漏了怎么换。
Serper 一侧只用公开材料:serper.dev 的首页、注册页、登录页、条款和隐私政策,以及这些页面加载的前端脚本(任何人打开网页都会下载到浏览器里的那份代码)。我们没有注册 Serper 账号,没有用过它的 Key,也没有调用它的搜索接口,所以凡是「登录后看到什么」的描述,都来自脚本里的文字和公开的第三方原帖,正文里会写明出处。EveryInfra 一侧的每个数都来自 2026 年 11 月 5 日的真调响应。
先看总表:拿 Key、看文档、发第一次请求
下面这张表只放能核对的事实:Serper 一列来自 serper.dev 页面和脚本(2026 年 11 月 5 日读取),EveryInfra 一列来自 docs、定价页、OpenAPI、公开目录和本次真调(docs、定价页和 OpenAPI 在 2026 年 11 月 5 日 01:25 新加坡时间重读过一次,原文存档)。
| 项 | Serper | EveryInfra |
|---|---|---|
| 注册方式 | 姓名、邮箱、密码,加一道人机验证;注册后要验证邮箱 | 邮箱,或用 GitHub、Google 账号继续 |
| 登录方式 | 邮箱 + 密码,可开两步验证(验证器 App 生成的验证码) | 同注册方式 |
| 免费额度 | 2,500 次查询,不用信用卡 | 给两个 GitHub 仓库点星,领 $1 试用额度,24 小时内有效 |
| Key 在哪 | 控制台 API Keys 页 | 控制台 API Keys;完整 Key 只在创建时显示一次 |
| 一个账号几把 Key | 可以新建多把,每把有名字 | 可以按环境、用途建多把 |
| Key 能做什么管理 | 新建、改名、复制、重置 | 新建、限权(按产品)、停用、IP 白名单、轮换 |
| 请求头 | X-API-KEY: <key>(GET 写法可放网址参数 apiKey) | Authorization: Bearer <key> |
| 接口地址 | https://google.serper.dev/<type> | https://api.everyinfra.com/api/v1/search |
| 文档在哪 | Playground(登录后用),没有独立文档站 | /docs、/llms.txt、/openapi.json、免 Key 的工具目录 |
| 机器能读的说明 | 没有找到 OpenAPI 或 llms.txt | OpenAPI 3.0.3(61 个路径)、llms.txt、工具目录 JSON |
| MCP | Serper 自己没有;社区有本地运行的开源服务器 | 我们运行的远程 MCP:https://api.everyinfra.com/mcp |
| 错误长什么样 | {"message": "...", "statusCode": 403}(第三方原帖) | {"error": {"code", "message", "fault", "retryable", "next_steps", ...}} |
这张表里要先看三行。第一是「文档在哪」:Serper 把参数、示例代码和计费都放进了一个要登录的交互页面,这对人很方便,写代码的 AI 助手要读就得多绕一步,后面会详细说。第二是「Key 能做什么管理」:Serper 的 Key 页面只有新建、改名、复制和重置四个动作,没有删除,也没有给某一把 Key 限制权限或来源 IP。第三是请求头:两边的写法不一样,从 Serper 换过来时这是最容易漏改的一处,我们的实测里把 X-API-KEY 原样发过来,会收到 401。
Serper API login:注册和登录要做哪些事
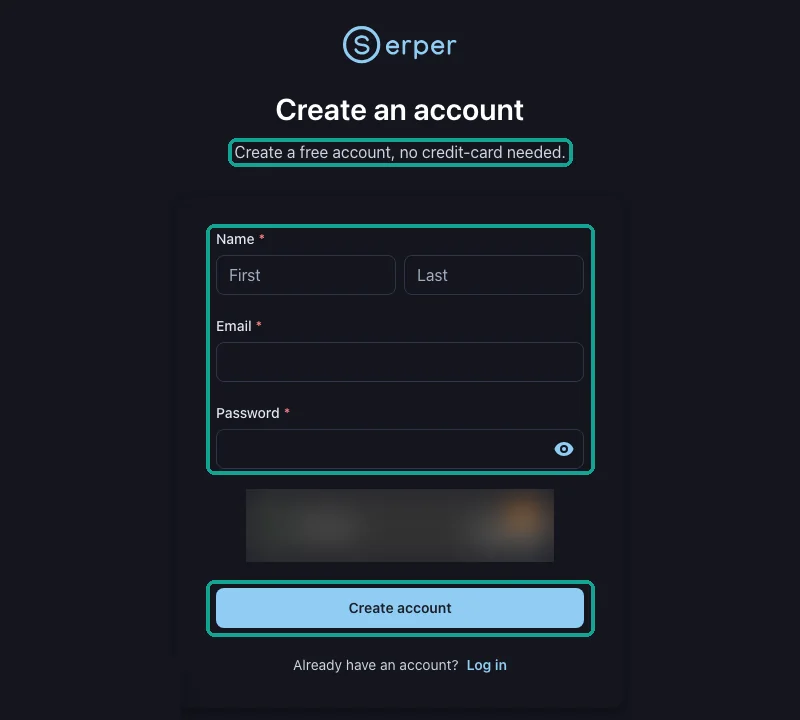
Serper 的注册页标题是「Create an account」,副标题「Create a free account, no credit-card needed.」,表单有三项必填:姓名(First、Last 两格)、邮箱和密码(serper.dev/signup,2026 年 11 月 5 日读取)。表单下面有一道人机验证,通过以后才能点「Create account」。页面脚本里提交注册的接口带着两种人机验证的令牌,提交后会进入一个「Please verify your email account」的页面,可以重发验证邮件或者登出;验证链接打开后显示「Your email has been verified.」,链接失效时显示「The verification link is invalid or has expired.」。
登录页是「Log in to your account」,只有邮箱、密码、「Remember me」和「Forgot password?」(serper.dev/login)。如果在设置页打开了两步验证,登录后还要输入验证器 App 里的验证码,设置页的说明是「Scan the QR code below with your authenticator app」。我们在注册页和登录页的脚本里都没有找到用 Google 或 GitHub 账号登录的入口,所以「serper api login」只有一种走法:邮箱加密码。有一个细节值得知道:直接打开 serper.dev/api-keys,没登录时页面显示的就是登录表单,这也是为什么搜「serper api login」时,排在前面的结果常常标题是「Log in to your account」、网址却是 /api-keys。
Serper 的服务条款(页面写「Updated on May 29, 2024」)里有两条和账号直接相关。一条是「Register more than one account at any point in time」被列为不允许的行为,也就是同一时间只能有一个账号,想靠多注册几个号多拿免费额度是违反条款的。另一条是不允许「Attempt to circumvent any restrictions or limits placed on your Serper API key or account」。条款还写明 Serper 是面向企业的服务(business-to-business),不面向个人消费者。隐私政策最后审阅日期是 2025 年 11 月 5 日,写明登录后会收集访问日志和活动日志。
EveryInfra 的注册入口在页面右上角的「免费开始」,注册页只有一个邮箱框和一个选填的推荐码,下面是「通过 GitHub 继续」「通过 Google 继续」两个按钮。我们同样没有新建账户,所以注册后的那一屏只按页面和文档写:docs 快速开始写的是注册后在控制台创建 API Key,「完整 Key 仅在创建时显示一次」。
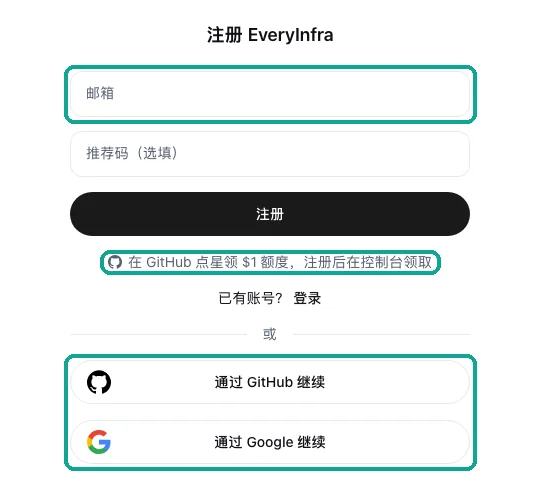
两边上手的差别主要在一步:Serper 注册后要先去邮箱打开验证链接,再用邮箱密码登录;EveryInfra 可以直接用 GitHub 或 Google 账号继续,不用等验证邮件。要领 EveryInfra 的 $1 试用额度,还要去 GitHub 给两个仓库点星,再回控制台领取,这一步只和额度有关,不影响建 Key。对一个由 AI 助手代你操作的流程来说,少一次「去邮箱点链接」就少一次要人介入。
Serper API key 在哪、能建几把、怎么重置
Serper 的 Key 在控制台的 API Keys 页,页面标题「API Keys」,副标题「Your keys to unlock the power of Serper」。我们读了这个页面的脚本,里面一共只调用三个账户接口:列出 Key、新建 Key(必须填名字,提示是「Name is required」)、改名,另外每把 Key 有一个「Reset」动作。重置前会弹出确认框,原文是「Are you sure you want to reset this API key? This action cannot be undone and any applications using this key will stop working.」,重置成功后提示「The old API key is not valid anymore. Replace it with the new one.」。页面上有一个复制按钮,点了提示「API key copied to clipboard」,也就是说完整的 Key 在页面上随时可以再复制。
脚本里没有删除 Key 的接口,也没有给单把 Key 设权限、设额度上限或设来源 IP 的选项。设置页(Settings)里能改的是姓名、密码、两步验证和付款卡。另有一个「Activity logs」页,按时间列出最近的请求,列是 Time、Query、Type、Page、Num、Credits、Response time (ms),可以按 Key 筛选,还有一个「Anonymize queries」开关,打开后日志里不保存查询词。用量页(Dashboard)可以按日期、按 Key 看每日用量。
| 管理动作 | Serper(API Keys 页脚本) | EveryInfra(docs、定价页、OpenAPI 原文) |
|---|---|---|
| 新建 | 有,必须起名 | 有,按环境或用途分开建 |
| 改名 | 有 | 有(OpenAPI 的 PATCH /portal/api/keys/{key_id}) |
| 再次查看完整 Key | 页面有复制按钮 | 完整 Key 只在创建时显示一次 |
| 重置 / 轮换 | 有,旧 Key 立刻失效 | 有,只能在控制台做 |
| 停用但保留 | 没有找到 | 有,停用后调用回 401 |
| 删除 | 没有找到 | 控制台建的 Key 只能停用;经 Key 新建的 Key 可以删除 |
| 按产品限权 | 没有找到 | 有,被关掉的产品回 403 capability_denied |
| IP 白名单 | 没有找到 | 有,只能在控制台改 |
| 按 Key 看日志 | 有,Activity logs 可按 Key 筛选 | 有,控制台调用记录;OpenAPI 有单把 Key 的用量接口 |
| 单把 Key 的花费上限、过期时间 | 没有找到 | 有,spend_limit_usd、expires_at(OpenAPI) |
这张表的意思不是 Serper 少了功能就不能用。一个人自己用一把 Key 跑脚本,新建、重置这两个动作完全够了。差别出在多人、多环境和交给 AI 用的时候:如果一把 Key 同时放在本地开发机、CI 和一个给客户演示的 Notebook 里,其中一处泄露,Serper 只能整把重置,三处一起换;而能按环境分开建、单独停用的 Key,只要停掉漏的那一把。EveryInfra 的文档把这个设计讲得很直白:一把 Key 像配电板上的总闸,可以在「API Keys → 权限限制」里给它拉下某一路产品,停用这把 Key 则所有产品一起断(docs 鉴权一节)。
让脚本管 Key:EveryInfra OpenAPI 里的 Key 接口
除了控制台,EveryInfra 的 OpenAPI 文件在 Account 一节列了一组 Key 管理接口(2026 年 11 月 5 日 01:25 新加坡时间读取)。它们都不计费,和其他账户接口一起算每账户每分钟 60 次。读接口要 Key 带账户读取权限:没限产品的 Key 默认有 account:read、requests:read、billing:read 三项,限了产品的 Key 要账户所有者在控制台打开。写接口要 keys:write 写权限,这项默认关闭,只能由账户所有者登录控制台勾选,用 Key 做的每次修改都会出现在控制台的消息里。
| 接口 | 做什么 | 原文里的限制 |
|---|---|---|
GET /portal/api/keys | 列出每把 Key 的名字、遮住的前缀、状态、权限范围、每分钟上限、美元花费上限和最后使用时间 | 不返回完整 Key |
POST /portal/api/keys | 新建一把 Key,完整 Key 只返回一次;可以设 ip_allow、expires_at、spend_limit_usd | 经 Key 新建的 Key 不会比发起的那把更宽,也不带写权限;每账户每个 UTC 日最多 20 把;带花费上限的 Key 不能再建 Key |
PATCH /portal/api/keys/{key_id} | 改名、改备注、把过期时间提前 | 只对经 Key 新建的 Key 或发起请求的那把;控制台建的 Key 只能停用 |
POST /portal/api/keys/{key_id}/disable | 立刻停用账户里任意一把 Key | 只有账户所有者能在控制台重新启用 |
DELETE /portal/api/keys/{key_id} | 永久删除 | 只对经 Key 新建的 Key 或发起请求的那把 |
GET /portal/api/keys/{key_id}/usage | 单把 Key 近几天的成功和失败次数、扣费、最后一次调用 | 要 requests:read |
这几条和 Key 泄露的处理直接相关。spend_limit_usd 是这把 Key 的累计美元上限(扣费减去退款,不会重置),给 CI 或演示 Notebook 用的 Key 设一个小上限,漏了以后损失就有封顶;expires_at 让临时 Key 到期自动失效;ip_allow 让 Key 只在你自己的服务器出口 IP 上有效。Serper 的 API Keys 页脚本里,我们没有找到对应的选项。这一节按 OpenAPI 原文写,我们没有另建测试 Key 去逐条调用。
Serper API documentation 在哪:Playground 就是文档
我们先确认了 Serper 有没有独立文档。2026 年 11 月 5 日,serper.dev/docs、serper.dev/llms.txt、serper.dev/openapi.json 和 serper.dev/sitemap.xml 都返回 404。首页底部的「Product」一栏只有 Playground、Dashboard,以及 Haystack、Jan AI、CrewAI、LangChain 四个集成链接,没有「Docs」或「API reference」。Serper 在 GitHub 上的组织 Serper-API 有 7 个仓库,GitHub 标注全部是别的开源项目的分叉(Auto-GPT、chat-ui、Perplexica 等),没有自己的 SDK 或接口说明。
所以「serper api documentation」实际上指的是 Playground。它是一个表单:左边选结果类型、填查询词和参数,右边出结果和代码。我们读了它的脚本,整理出下面几件和写代码直接相关的事。
第一,结果类型不是请求体里的参数,而是网址的一段。脚本把选中的类型拼进 https://google.serper.dev/<type>,发出去之前把 type 从请求体里删掉。菜单里的类型有 search、images、videos、places、news、shopping、scholar、patents、autocomplete、product-reviews、lens、maps、reviews(其中个别类型按账号开放),网页抓取 webpage 走另一个地址 https://scrape.serper.dev,还有一个 0 credit 的「Resolve links」。第二,参数有默认值,等于默认值时不发:gl 是 us、hl 是 en、page 是 1、num 是 10、autocorrect 是开。第三,普通搜索的结果条数下拉框现在只有一个选项 10,图片可选 10 或 100,购物默认 40。第四,有一个「Mini-batch (up to 100 queries)」开关,打开后一个请求里放一组查询,最多 100 条。
第五是计费。Playground 有一个实时显示「Credits: N」的小部件,脚本里写着每种类型扣几个 credit:maps 3 个、lens 3 个、shopping 2 个、product-reviews 2 个、网页抓取 2 个(难抓的页面 6 或 10 个,原文「Most webpages typically incur 2 credits, but for harder-to-scrape pages ... the cost can be 6 or 10 credits」),图片要 10 条以上时翻倍,其余类型 1 个。首页定价卡上写的是「credits」,这个对照表只在 Playground 里能看到。
第六是示例代码。Playground 右边的代码面板用的是 Postman 开源的 postman-code-generators 库,语言列表直接取这个库的 getLanguageList(),默认显示 Node.js,可以切成 cURL、Python Requests 等。请求方式可以选 POST 或 GET:POST 把 Key 放在 X-API-KEY 请求头里,GET 则把所有参数和 apiKey 一起拼进网址。把 Key 写在网址里,会让它出现在服务器访问日志、浏览器历史和代理日志里,所以除非框架只支持 GET,否则用 POST。n8n 社区一个 2025 年 7 月 26 日的帖子就是这个坑:用户用 GET 方法加请求头,收到 403,回复里解释用 GET 时 Key 要放在网址参数里,换成 POST 才能用请求头(n8n 社区原帖)。
第七是地点。Playground 的 location 输入框提示「You can find a list of supported locations here」,链接到 api.serper.dev/locations。我们下载了这份公开列表:一共 100,029 条,覆盖 240 个国家和地区,其中 48,384 条是邮政编码、37,208 条是城市、4,309 条是街区。这比 EveryInfra 的 location 细得多:我们的工具目录写的是「写国家名或两位国家代码;写城市按所在国家」。
| Serper Playground 里的规则 | 原文或脚本位置 | 对写代码的意义 |
|---|---|---|
| 类型在网址里,不在请求体里 | https://google.serper.dev/ + type | 换类型就是换网址 |
| 默认 gl=us、hl=en、num=10、page=1 | 生成代码前删掉等于默认值的参数 | 不写也会按美国英文搜 |
| 普通搜索 num 只有 10 一个选项 | 结果条数下拉框 | 要更多条用 page 翻页 |
| 每种类型的 credit 数不同 | 「Credits: N」小部件 | maps、lens 一次 3 个 |
| 一次请求最多 100 条查询 | Mini-batch 开关 | 批量时 credit 按条数算 |
| GET 写法把 apiKey 放进网址 | 代码面板 GET / POST 切换 | 用 POST,Key 放请求头 |
| 地点列表 100,029 条 | api.serper.dev/locations | 能到城市、邮编级 |
这种「文档在交互页面里」的做法有一个后果,我们用一次搜索量了出来。2026 年 11 月 5 日 00:18:40 和 00:19:06(新加坡时间),我们用 EveryInfra 网页搜索查「serper api documentation」,location 设为 us,取前两页共 20 条。serper.dev 自己的网址只有 3 条:首页、/api-keys(没登录时就是登录页)和 /signup,没有一条是文档页。另外 8 条是别人家的文档:CrewAI、LangChain(3 条,含一个旧版镜像)、Langflow、Haystack、Sim、Aikeedo;4 条是 API 目录和市场类网站;其余 5 条是 GitHub 组织页、一篇 Medium 文章、一个 YouTube 视频、一个第三方 MCP 介绍页和另一家搜索接口的首页。
| 前 20 条结果的来源 | 条数 | 例子 |
|---|---|---|
| serper.dev 自己的页面 | 3 | 首页、/api-keys、/signup |
| 框架和平台的集成文档 | 8 | docs.crewai.com、reference.langchain.com、docs.haystack.deepset.ai、docs.langflow.org |
| API 目录和市场 | 4 | apitracker.io、apis.io 等 |
| 其他 | 5 | github.com/Serper-API、medium.com、youtube.com |
换句话说,搜 Serper 文档的人,大多数会被带到某个框架的文档里,而每个框架对 Serper 的说法不完全一样,下面就会碰到。
让 AI 编程助手写接入代码的人,用得上的是公开、机器能读的说明。EveryInfra 这边,免 Key 的工具目录把 17 个搜索工具的参数、默认值、上限、三种语言的参数说明和单价都写成 JSON;OpenAPI 文件是 3.0.3 版,2026 年 11 月 5 日有 61 个路径,包括搜索、工具目录和 Key 管理;/llms.txt 是给大模型读的索引,第一段就写了基址、请求头和「参数错误会带 did_you_mean 和 allowed」。这些文件的作用是让 AI 助手在动手前先查清楚参数,而不是凭记忆猜,猜错的代价就是后文那种 422。Serper 的参数说明只在 Playground 里,AI 助手能读到的多半是第三方文档里的二手说法,比如 CrewAI 文档至今写的是「n_results 默认 10」,而 Playground 普通搜索的条数选项已经只剩 10 一个,要更多条只能翻页。
Serper API docs 里的端点和参数:和 EveryInfra 逐项对照
先说结论:两边都是「发一个 JSON,拿回一个 JSON」,但参数名、结果类型的选法和返回字段都不一样,换过来要逐个改,不能只换网址。我们把 Playground 脚本里普通搜索用到的参数,和 EveryInfra 网页搜索工具 web 的参数(工具目录,2026 年 11 月 5 日 00:16 读取,免 Key)逐项对了一遍。
| Serper 参数 | Serper 含义(Playground) | EveryInfra 对应 | 说明 |
|---|---|---|---|
q | 查询词 | q(web 工具);数据目录入口用 keyword | 名字相同,含义相同 |
gl | 国家,两位代码,默认 us | location | 写 gl 回 422;location 只到国家一级 |
hl | 界面语言,默认 en | web 工具没有;web/search 用 language | 写 hl 回 422 |
num | 每页条数,普通搜索只有 10 | num,最多 10,写更大按 10 返回 | 名字相同 |
page | 页码,从 1 开始 | page,从 1 开始,每页扣一次 | 名字相同 |
type | 网址的一段:search、news、images 等 | 请求体的 tool:web、news、media 等 | 写在请求体里的 type 回 422 |
tbs | 时间范围,qdr:h/d/w/m/y | after、before(具体日期) | 写法不同,要换算 |
location | 城市、街区、邮编,列表 100,029 条 | location 只按国家生效 | 同名不同义,要注意 |
autocorrect | 自动纠错,默认开 | 没有 | 去掉 |
| — | — | site(只搜某个域名) | Serper 要在 q 里写 site: |
表里有两行要特别小心。一是 location:两边同名,含义却不一样。Serper 的 location 是城市级的精确地点,国家由 gl 管;EveryInfra 的 location 管的就是国家,写城市也只按所在国家算。所以从 Serper 换过来时,正确的改法是把 gl 的值搬到 location,而不是保留原来的 location。二是 hl:web 工具没有语言参数,要指定结果语言,可以改用数据目录里的 web/search,它的参数是 keyword、country、language,单价 $0.001389,是 web 的 2 倍。
结果类型也要换。Serper 的 type 在网址里,EveryInfra 的搜索产品只有一个地址 POST /api/v1/search,用请求体里的 tool 选 17 种工具中的一种。下表是我们按工具目录的说明逐个对的,「对应」只说明用途相近,不说两边返回的内容一样。
| Serper 类型 | EveryInfra 搜索工具 | 数据目录里还可以用 |
|---|---|---|
| search | web | web/search、bing/search、duckduckgo/search |
| news | news | google_news/search |
| images、videos | media(kind 取 image 或 video) | — |
| places、maps | places | — |
| shopping | shopping | google_shopping/search |
| scholar、patents | scholar(kind 取 papers 或 patents) | — |
| autocomplete | suggest | — |
| lens | lens | — |
| webpage | read | — |
| reviews、product-reviews | 搜索产品里没有 | 地图点评、商品评论在数据目录里按平台找 |
按每种类型的 credit 数算,Serper 的每千次价格会随类型变:Starter 档每千个 credit $1.00,maps 和 lens 一次 3 个 credit,就是每千次 $3.00;Ultimate 档每千个 credit $0.30,maps 每千次 $0.90。EveryInfra 搜索工具除交叉验证外都是一次 $0.000694。这张图只是把两边的公开单价按类型摆在一起,详细的买法和过期规则请看 Serper API pricing。
第一次请求:两边的 curl 各怎么写
Serper 的第一次请求,按 Playground 生成的 POST 写法,是下面这样(我们没有 Serper 的 Key,没有执行这一段,它是按页面脚本和 CrewAI 源码整理的配置示例):
# Serper:配置示例(本文没有执行)
curl -s https://google.serper.dev/search \
  -H "X-API-KEY: $SERPER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"q":"serper api documentation","gl":"us","hl":"en","num":10}'
EveryInfra 的同一件事,是下面这一段。我们在 2026 年 11 月 5 日 00:18:40(新加坡时间)执行,HTTP 200,耗时 1.55 秒,回 10 条,响应里 billing.charged_usd 是 0.000694:
# EveryInfra:本文实测
curl -s https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"tool":"web","q":"serper api documentation","location":"us","num":10}'两段对比下来要改四处:地址、请求头、gl 改成 location、去掉 hl。另有一处容易忽略的小差别:EveryInfra 的 docs 搜索 API 一节把参数写在请求体顶层({"tool":"web","q":...}),而远程 MCP 的 everyinfra_search 工具把参数放在 params 对象里({"tool":"web","params":{"q":...}}),两种都能用,但不能混着写,下文 MCP 一节有一次写错的实测。
还有一个迁移时会碰到的问题:Serper 的 Mini-batch 可以在一个请求里放最多 100 条查询,EveryInfra 的搜索接口一次只收一条。如果你原来用一个批量请求查 100 个关键词,换过来就要发 100 个请求,按每分钟次数上限排队发:账户默认每分钟 60 次,100 个词大约两分钟发完;需要更快可以买提速包,最高每分钟 1,800 次(定价页)。费用不会因为拆成单条而变多,每条照样 $0.000694,100 个词 $0.0694。拆开发还有一个好处:每条请求单独计费、单独报错,某一个词参数写错只会让那一条回 422,不会让整批失败。
返回字段对照:organic 和 results
Serper 首页的示例响应是一个大对象,顶层有 knowledgeGraph(知识面板)、organic(自然结果)、peopleAlsoAsk(相关问题)、relatedSearches(相关搜索),每条自然结果有 title、link、snippet、position,有时带 sitelinks、date 和 attributes(serper.dev 首页示例)。Playground 显示结果前会删掉响应里的 searchParameters,说明真实响应里还会回显一份请求参数。LangChain 的封装里按类型取不同的键:search 取 organic、news 取 news、places 取 places、images 取 images(LangChain 源码)。
EveryInfra web 工具的响应是 {"id","tool","location","results","billing","quota"},每条结果只有 title、url、snippet,有日期时多一个 published。我们 00:19:06 那次第 2 页的 10 条里,3 条带 published。数据目录入口 web/search 的字段多一些,是 title、url、text、rank、published_at、image_url、sub_links(数据目录),00:20:09 那次 10 条里 3 条带 published_at。
| 用途 | Serper(search) | EveryInfra `web` | EveryInfra `web/search` |
|---|---|---|---|
| 标题 | organic[].title | results[].title | results[].title |
| 链接 | organic[].link | results[].url | results[].url |
| 摘要 | organic[].snippet | results[].snippet | results[].text |
| 名次 | organic[].position | 数组顺序 | results[].rank |
| 日期 | organic[].date(有时有) | results[].published(有时有) | results[].published_at(有时有) |
| 知识面板、相关问题 | knowledgeGraph、peopleAlsoAsk | 没有 | 没有 |
| 本次扣了多少 | 首页写「每次成功响应扣 credit」,响应字段没有公开说明 | billing.charged_usd | billing.charged_usd |
最后一行是两边在对账上的差别。Serper 首页 FAQ 写的是「Every time you receive successful responses to queries, we will deduct credits from your account balance」,余额到零就不再接受新查询;扣了多少要去 Dashboard 和 Activity logs 看。EveryInfra 每个响应都带 billing,写明 charged(扣没扣)、charged_usd(扣了多少美元)和 balance_after_usd(扣完还剩多少),跑批量时直接读响应就能对账,失败和空结果写 charged: false。知识面板和相关问题这两块,EveryInfra 的 web 不返回,依赖这些字段的程序换过来要改逻辑,这一点我们在「什么时候 Serper 更合适」里还会说。
实测一:把 Serper 风格的请求原样发过来
一个从 Serper 换过来的人最可能犯的错,是只换地址和请求头,参数照旧。我们故意这样做了几次,看接口怎么回。
00:18:28(新加坡时间),请求体 {"tool":"web","q":"serper api documentation","gl":"us","hl":"en","num":10}。回 HTTP 422,0.20 秒,error.code 是 unknown_param,message 写「gl is not a parameter of tool web Supported: after, before, location, num, page, q, site」,allowed 列出 7 个合法参数,next_steps 写「Remove gl; the parameters are listed at catalog_url. Nothing was charged.」。一次只报第一个不认识的参数:去掉 gl、保留 hl 再发(00:18:47),回的是同样的 422,param 换成了 hl。
00:19:00,把 location 故意拼成 locaton。回 422,0.11 秒,这次多了 did_you_mean: ["location"],next_steps 第一条是「Rename locaton to location (did_you_mean), then resend. Nothing was charged.」,第二条说如果目录里确实有你发的这个参数,那就是我们这边的问题,可以开工单。00:19:14,在请求体里写 "type":"news",回 422,type 不是 web 的参数。00:19:20,给 media 工具传 kind: "videos"(多了一个 s),回 422,code 是 invalid_value,allowed 是 image、video,did_you_mean 是 video。
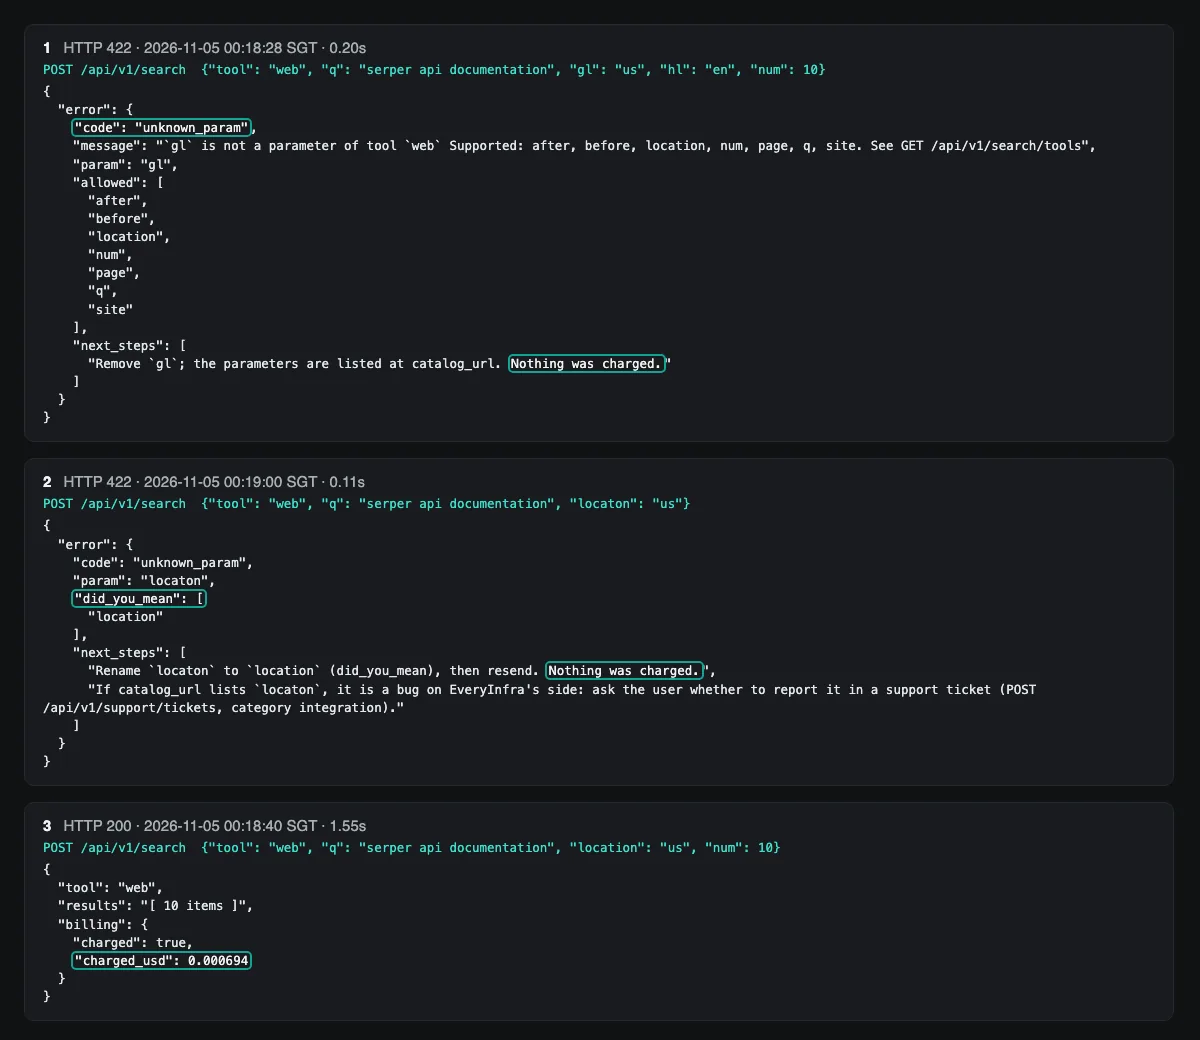
这类报错的设计目标是让写代码的 AI 能自己改对。一个只会看 HTTP 状态码的程序,看到 422 就知道是请求的问题、不用重试;一个会读 JSON 的 AI 助手,读到 allowed 和 did_you_mean 就能把参数改好再发一次。HTTP 规范把 422 定义为「服务器理解请求的格式,但无法处理其中的指令」(MDN 422,定义见 RFC 9110 第 15.5.21 节),正好对应「参数名或取值不对」。我们的错误体没有采用 RFC 9457 的 problem+json 格式,而是自己的 error 对象,字段在 docs 错误码一节有表。
实测二:没带 Key、带错请求头、超速
00:18:21,不带任何请求头调 web:HTTP 401,0.12 秒,code 是 unauthorized,message 是「Missing API key」,fault 是 account,retryable 是 false,next_steps 写「This API key is not accepted; ask the user for a working key (console: API keys). Nothing was charged.」。00:18:34,把一把有效的 Key 放进 X-API-KEY 请求头(就是 Serper 的写法)再发一次:同样 401、同样「Missing API key」。这一点要照实说:我们的报错没有提示「请改用 Authorization: Bearer」,从 Serper 换过来的人要自己对照本文的请求头一行改。
Serper 一侧,我们没有它的 Key,只能引用公开原帖。n8n 社区那个帖子贴出的响应是 HTTP 403,正文 {"message":"Unauthorized. Sign up for a free account.","statusCode":403};CrewAI 仓库一个 2024 年的问题 #633,标题就是「Unauthorized Error (403) when Using SERPER_API_KEY」,最后发现是用户填了另一家服务的 Key。额度用完时,一个开源项目 2026 年 10 月 23 日的提交说明里记录的是 400 {"message":"Not enough credits"}(neo1415/q #339),另一个项目 2026 年 10 月 22 日的待办里写的是「400 "Not enough credits" 或 403」,还没核实(dbhq-uk/gannet #12)。我们在 serper.dev 的公开页面上没有找到错误码表,所以上面这几个状态码只能当作用户贴出来的现象,不能当成 Serper 的正式说明。
超速是本次真调里自然碰到的。这把测试 Key 有自己的每分钟 10 次上限,多个写作任务共用,00:19:55、00:20:56、00:22:38、00:24:51 四次收到 HTTP 429,code 是 rate_limited,retry_after 依次是 5、4、22、9 秒,max_retries 是 3,next_steps 写「Nothing was charged. Retry after retry_after seconds」。我们的脚本遇到 429 一律等 60 秒再发,四次都在下一次成功。Retry-After 的语义见 MDN,429 状态码的定义在 RFC 6585。
| 情况 | Serper(公开原帖) | EveryInfra(本次实测) | 扣费 |
|---|---|---|---|
| 没带 Key 或 Key 无效 | 403 Unauthorized. Sign up for a free account. | 401 unauthorized,Missing API key | 两边都不扣 |
| 用错请求头 | GET 时要把 Key 放网址参数 | 用 X-API-KEY 回 401 | 不扣 |
| 余额不足 | 400 Not enough credits(第三方记录) | 402 quota_exhausted(docs) | 不扣 |
| 参数名不认 | 没有公开说明 | 422 unknown_param,带 allowed、did_you_mean | 不扣 |
| 取值不对 | 没有公开说明 | 422 invalid_value,带 allowed | 不扣 |
| 超速 | 每档每秒 50–300 次(首页) | 429 rate_limited,带 retry_after | 不扣 |
| 空结果 | 首页写「成功响应」才扣 | 200,charged: false,reason: empty_result_refunded | 不扣 |
空结果那一行,我们在 00:20:17 用一串不存在的词加引号查了一次,回 HTTP 200,results 是空数组,billing.charged 是 false,reason 是 empty_result_refunded,refund.status 是 succeeded。失败和空结果怎么对账,可以看 失败退款对账指南。
实测三:换 10 个国家查同一个词
gl 改成 location 以后,它到底有没有生效?00:22–00:26(新加坡时间),我们用 web 查同一个词「google search api」,location 依次设为 us、gb、de、fr、es、mx、br、jp、sg、in,每次 num 为 10。10 次都是 HTTP 200,各扣 $0.000694,合计 $0.00694;美国那次回了 9 条,其余每次 10 条。
拿美国的 9 个网址做基准,看其他国家的结果里有几个和美国一样:新加坡和英国 9 个全在,印度、日本、法国各 7 个,巴西、西班牙各 6 个,墨西哥和德国只剩 5 个。德国的结果里多了一个 .de 域名的个人站和 YouTube,日本多了 qiita.com,墨西哥多了 rapidapi.com。说明国家参数确实改变了结果,而且英语国家之间的差别小,非英语国家差别大,这和搜索引擎按地区排序的常识一致。
这个实测也划出了边界。我们只测了国家一级,因为 EveryInfra 的 location 本来就只到国家;Serper 能精确到城市和邮编,要做「纽约某个邮编的本地搜索结果」这种需求,EveryInfra 的 web 做不到。另外,样本只有一个查询词、每个国家一次,名次会随时间变,这里的重合数只说明参数生效,不代表两国结果的长期差异。
实测四:耗时,和出错时有多快
把 29 次请求按结果分开看耗时(curl 的总耗时,从新加坡发出,含网络往返)。16 次扣费成功的请求在 1.31 到 2.48 秒之间,中位 1.80 秒,平均 1.83 秒;空结果那一次 2.12 秒,因为它也真的去搜了一遍;11 次被直接拒绝的请求(401、422、429)都在 0.09 到 0.20 秒之间返回,因为它们在鉴权和参数检查这一步就停了,不会去搜。Serper 首页写的是「In general, all queries are returned in 1 to 2 seconds」,有时重试要 2–4 秒;我们没有测 Serper,不做速度对比。
出错快这件事,对写代码的人有实际意义:参数写错不用等两秒才知道,0.1 秒就能拿到 422 和改法,AI 助手可以在一轮对话里自己改完重发。反过来,如果你的程序把所有非 200 都当成「服务暂时不可用」去重试,就会在 422 上白白重试几次,所以重试只应该对 retryable: true 的错误做,比如 429 和 503。
实测五:联想词、新闻和数据目录入口各回什么
Serper 的 autocomplete、news 两种类型,在 EveryInfra 分别是 suggest 和 news 工具。00:20:01(新加坡时间)我们用 suggest 查「serper api key」,回 10 条,每条只有一个 title 字段,内容是「serper api key free」「serper api key pricing」「serper api key crewai」「get serper api key」等,扣 $0.000694。00:21:28 用 news 查「Model Context Protocol」,回 10 条,每条都带 published,写法是「17 hours ago」「2 days ago」这种相对时间,而不是具体日期;要存进数据库按日期排序,需要用请求时间自己换算,或者改用数据目录里的 google_news/search,它的 published_at 是 UTC 的 ISO 8601 时间,单价 $0.000792。
00:20:09 我们又用数据目录入口 web/search 查「serper api key」,参数写 keyword、country: us、language: en,回 10 条,扣 $0.001389。这个入口的好处是能指定语言,字段是 text 和 rank,和数据目录里其他平台的搜索结果放在同一套结构里,适合要把网页结果和别的平台数据一起入库的人。如果只要网页结果、不需要语言参数,用 web 工具更省一半。这次 web/search 的前三条是 serper.dev 首页、另一家搜索接口的首页和 serper.dev/api-keys,第七条是 Clay 社区那篇「怎么从 Serper 控制台取 Key」的帖子。我们这次没有用 web 工具查同一个词,所以不比较两个入口的结果顺序;两个入口的参数、字段和单价都不同,选的时候按要不要语言参数、要不要和其他平台数据放进同一张表来选,不要假定两边会逐条返回同样的结果。
在 Python 里填 Key:环境变量名不统一
Key 最好只放在环境变量里,不写进代码,这是 十二要素应用 和 OWASP 密钥管理清单 都写的做法;本地开发可以用 python-dotenv 从 .env 文件读,.env 加进 .gitignore。麻烦在于,Serper 没有自己的 SDK,各个框架给它的环境变量起了不同的名字。我们读了四个框架的当前源码和文档:
| 框架 | Serper 的环境变量名 | 出处 |
|---|---|---|
LangChain(GoogleSerperAPIWrapper) | SERPER_API_KEY | LangChain 文档 |
CrewAI(SerperDevTool) | SERPER_API_KEY | CrewAI 文档 |
Haystack(SerperDevWebSearch) | SERPERDEV_API_KEY | Haystack 源码、文档 |
| LiteLLM(搜索) | SERPER_API_KEY | LiteLLM 文档 |
Haystack 那个名字多了「DEV」。同一台机器上同时跑 LangChain 和 Haystack 的人,要么设两个变量,要么在 Haystack 里显式写 Secret.from_env_var("SERPER_API_KEY")。参数名也不统一:CrewAI 的 SerperDevTool 用 country、locale、n_results,在源码里分别映射成 Serper 的 gl、hl、num,搜索类型只允许 search 和 news(CrewAI 2026 年 11 月 3 日发布了 1.15.35,我们读的是当天主干源码);LangChain 用 k、gl、hl、type;Haystack 用 top_k 和 search_params。所以每接一个框架,都要把它的变量名和参数名单独学一遍。
EveryInfra 在 Python 里不需要专门的包,用 requests 就能调。下面这段的 raise_for_status 之前先看 retryable,只对能重试的错误重试:
import os, time, requests

KEY = os.environ["EVERYINFRA_API_KEY"]          # 只从环境变量读
URL = "https://api.everyinfra.com/api/v1/search"

def web_search(q, location="us", page=1):
    body = {"tool": "web", "q": q, "location": location, "num": 10, "page": page}
    for _ in range(3):
        r = requests.post(URL, json=body, timeout=90,
                          headers={"Authorization": f"Bearer {KEY}"})
        data = r.json()
        if r.status_code == 200:
            return data["results"], data["billing"]["charged_usd"]
        err = data.get("error", {})
        if not err.get("retryable"):              # 401、422 不重试,按 next_steps 改
            raise ValueError(f'{err.get("code")}: {err.get("next_steps")}')
        time.sleep(err.get("retry_after", 5))     # 429、503 按 retry_after 等
    raise RuntimeError("retries exhausted")
在 n8n 里填 Key:HTTP Request 和 MCP Client Tool
n8n 没有内置的 Serper 节点(n8n.io 的 Serper 集成页在 2026 年 11 月 5 日返回 404),大家用通用的 HTTP Request 节点调。Key 放在凭据里:凭据类型选 Header Auth,名字填 X-API-KEY,值填 Key(n8n HTTP Request 凭据文档);方法要选 POST,前面那个 403 的帖子就是因为用了 GET。下面的配置按 2026 年 11 月 5 日读到的 n8n 文档写。
接 EveryInfra 有两种做法。一种和上面一样用 HTTP Request:Header Auth 的名字填 Authorization,值填 Bearer 加 Key(注意 Bearer 后面有一个空格),地址填 https://api.everyinfra.com/api/v1/search,请求体照上面的 curl。另一种是 AI Agent 工作流里的 MCP Client Tool 节点:端点填 https://api.everyinfra.com/mcp,认证选 Bearer,Key 填进凭据,Agent 就能自己列出 everyinfra_search 等工具并决定什么时候调。这一段 n8n 侧我们没有在本机跑,是按 n8n 文档写的配置示例。
在 MCP 客户端里填 Key:远程和本地的差别
Serper 自己没有 MCP 服务器。GitHub 上有几个社区版本,比如 marcopesani/mcp-server-serper(MIT 许可,171 星,最后推送 2025 年 3 月 13 日)和 garylab/serper-mcp-server(39 星,最后推送 2025 年 11 月 10 日)。它们都是在你自己的电脑上用 npx 或 uvx 起一个本地进程,Key 写在客户端配置文件的 env 里,变量名是 SERPER_API_KEY。这意味着 Key 以明文存在配置文件里,每台装了客户端的机器都有一份。
EveryInfra 的 MCP 是我们运行的远程服务器,地址 https://api.everyinfra.com/mcp,按 MCP 规范 2026-07-28 版 的 HTTP 方式接入,Key 放在 Authorization 请求头里。在 Claude Code 里一行就能加(Claude Code MCP 文档),其他客户端的写法见 MCP 接入说明:
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header "Authorization: Bearer $EVERYINFRA_API_KEY"
不带 Key 也能列工具:00:21 左右(新加坡时间)我们不带 Key 调 tools/list,回 12 个工具,其中 everyinfra_search 的输入是 tool(17 选 1)加一个 params 对象。00:21:40 我们故意把 q 写在 params 外面,回的是 HTTP 200、isError: true,文本是「missing_param: q is required」和「Next steps: Add the required q. Nothing was charged.」,没有扣费。00:21:58 按正确结构 {"tool":"web","params":{"q":"serper api login","location":"us","num":5}} 再调,回 5 条,第一条正是 serper.dev/api-keys(标题「Log in to your account」),charged_usd 0.000694,和直接调接口的价格一样。
MCP 规范对远程服务器的授权有专门一节(Authorization),推荐 OAuth;我们目前用的是静态 Bearer Key,好处是所有客户端都能配,代价是 Key 要自己保管好,下一节讲泄露了怎么办。想把搜索交给 AI 助手、又不确定该选哪种检索方式的,可以看 Agent 搜索工具怎么选。
Key 泄露了怎么办:两边怎么换
先看一个最近的真实案例。LiteLLM 2026 年 10 月 23 日发布的事故复盘写到:5 月 27 日,一把内部管理 Key 随配置文件被提交到公开仓库,约三小时后文件被删、Key 被记为需要吊销,但因为人为疏忽一直没有吊销;10 月 10 日攻击者用这把仍然有效的 Key 进入系统,10 月 21 日 LiteLLM 的发布流程发出了被篡改的 1.107.0(LiteLLM 事故复盘)。同一天,Railway 发布安全公告,说有第三方可能访问了存客户环境变量的系统,建议所有用户立即更换存放在 Railway 的环境变量,包括 API Key(Railway 安全公告,2026-10-21)。
教训很明确:从代码里删掉 Key 不等于 Key 失效,必须在服务方那边让旧 Key 作废。两边的做法如下。
在 Serper:登录后打开 API Keys,找到漏掉的那把,点「Reset」,确认后旧 Key 立刻失效,页面给出新 Key,再把用到它的地方逐个换掉。如果这把 Key 同时用在几个地方,几个地方会一起断,因为不能只停其中一处。之后到 Activity logs 按 Key 筛选,看泄露期间有没有不认识的查询;如果打开过「Anonymize queries」,日志里看不到查询词,只能看次数和 credit。
在 EveryInfra:在控制台停用漏掉的那把(停用后调用回 401),或者用一把有 keys:write 写权限的 Key 调 POST /portal/api/keys/{key_id}/disable 立刻停用,停用后只有账户所有者能在控制台重新启用;再新建一把替换;如果是按环境分开建的 Key,其他环境不受影响。轮换、改权限和 IP 白名单只能在控制台做,不能用 Key 自己改自己(docs 鉴权一节)。之后在调用记录里看泄露期间的请求和花费,也可以用 GET /api/v1/account 看近 24 小时用量,这个接口不计费。
想提前防一手,可以这样分:每个环境一把独立的 Key,CI 和演示用的 Key 设上美元花费上限和过期时间,生产环境的 Key 设 IP 白名单。这样任何一把漏了,停掉它就够了,其余几把照常用,损失也不会超过那把 Key 的上限。
还有一件事要知道:没人会自动替你发现。GitHub 的密钥扫描会在仓库里识别已登记格式的 Key,属于合作服务商的还会通知对方吊销;我们 2026 年 11 月 5 日数了它的支持列表,一共 207 家服务商,里面没有 Serper,也没有 EveryInfra。开源扫描工具 TruffleHog(v3.99.8,2026-11-02)的检测器里有其他几家搜索接口,没有 Serper;Gitleaks 的默认规则里也没有。GitHub 2026 年 10 月 13 日刚把两类 Anthropic Key 加进推送时默认拦截(GitHub 更新日志),10 月 28 日又推出了不依赖固定格式、按上下文判断的 AI 检测拦截,但默认关闭、要单独开启(GitHub 更新日志)。在那之前,用这两家的人如果用 GitHub 高级安全功能,可以给自己的 Key 格式写自定义规则。
| 泄露后的动作 | Serper | EveryInfra |
|---|---|---|
| 让旧 Key 失效 | API Keys → Reset,立刻失效 | 控制台停用,回 401 |
| 只断一处、不影响其他用途 | 不行,整把重置 | 按环境分开建的 Key 可以 |
| 限制损失 | 没有按 Key 设上限或 IP 的选项 | 按产品限权、IP 白名单、单把 Key 美元花费上限、过期时间 |
| 查泄露期间的调用 | Activity logs 按 Key 筛选 | 控制台调用记录、/api/v1/account |
| 公开仓库自动识别 | GitHub、TruffleHog、Gitleaks 都没有 | 同样没有 |
什么时候 Serper 更合适
照实写,下面这些场景 Serper 比 EveryInfra 更合适。
第一,要城市、街区或邮编级的本地搜索结果。Serper 的地点列表有 100,029 条,能精确到邮编;EveryInfra 的 location 只到国家。做本地 SEO 排名监控、按城市看搜索结果的,Serper 是对的选择。第二,要知识面板、相关问题和相关搜索这些结果页模块。Serper 的响应把 knowledgeGraph、peopleAlsoAsk、relatedSearches 作为单独的字段给你,EveryInfra 的 web 只回标题、链接、摘要和日期。第三,要高并发。Serper 最低一档每秒 50 次,最高每秒 300 次;EveryInfra 账户默认每分钟 60 次,买提速包最高每分钟 1,800 次(定价页),一秒内要发几百个请求的场景,Serper 明显更强。
第四,要地图点评和商品评论这类结果。Serper 的 reviews、product-reviews、maps 是搜索接口里的类型,EveryInfra 的搜索产品里没有,要去数据目录按平台找别的能力,换用法的成本更高。第五,要一次请求放 100 条查询的批处理,Serper 的 Mini-batch 支持,EveryInfra 的搜索接口一次一条。第六,已经有大量代码按 Serper 的字段写好,又只用美国英文搜索结果,换过来要改的地方多于省下的钱,这种情况先别换;如果是给 AI 助手加搜索,或者要同一把 Key 同时调数据、搜索和别的能力,再考虑换。
边界:这些结论什么时候不成立
第一,Serper 一侧的「登录后看到什么」来自页面脚本里的文字,不是我们登录后看到的画面。脚本里有、页面上没显示的功能(例如只对 Serper 员工邮箱开放的 Bing 搜索、Search Full 类型),我们没有写进对照表;脚本里没有、但服务端另外支持的功能,我们也看不到。第二,Serper 的错误响应来自第三方原帖,时间从 2025 年 7 月到 2026 年 10 月不等,现在可能已经变了。第三,EveryInfra 的注册后流程和 Key 管理功能按页面、docs、定价页和 OpenAPI 原文写,没有新建账户走一遍,也没有用一把限权的 Key 真调去看 403。第四,本文 29 次真调用的是一把测试 Key,它有自己的每分钟 10 次上限,和普通账户的默认值不同。第五,location 实测只有一个词、每国一次,耗时是从新加坡发出的单次测量,不能代表其他地区和其他时间。第六,本文不比两边搜索结果的质量和覆盖面。
常见问题
serper api key free:Serper 的免费 Key 怎么拿,能多注册几个号吗?
注册就送 2,500 次查询,不用信用卡(serper.dev 首页)。但服务条款明确不允许同一时间注册多个账号,也不允许绕开 Key 或账号上的限制,所以多注册几个号拿免费额度是违反条款的。2,500 次能用多久,见 Serper 免费额度与免费替代。
serper api key crewai:在 CrewAI 里报 403 Unauthorized 怎么办?
先确认填的是 serper.dev 的 Key,CrewAI 的问题 #633 最后就是因为用户填了另一家服务的 Key。再确认环境变量名是 SERPER_API_KEY(CrewAI 源码直接读这个名字),以及请求走的是 POST。错误正文如果是「Unauthorized. Sign up for a free account.」,基本就是 Key 不对或没传到。
serper api reference:Serper 有没有完整的接口参考文档?
2026 年 11 月 5 日我们没有找到:serper.dev/docs、/llms.txt、/openapi.json 都是 404,GitHub 组织里也没有 SDK。参数、类型和 credit 规则都在 Playground 里,示例代码由 Playground 生成。第三方框架的文档(CrewAI、LangChain、Haystack、LiteLLM、Langflow)各自写了一部分。
serper api login:可以用 Google 或 GitHub 账号登录 Serper 吗?
我们在注册页和登录页的脚本里没有找到第三方账号登录,只有邮箱加密码,可以另开两步验证。EveryInfra 支持邮箱,以及用 GitHub、Google 账号继续。
上手:从拿 Key 到第一次结果
如果你只是想试一下:在 everyinfra.com 注册,给两个 GitHub 仓库点星后在控制台领 $1 试用额度(24 小时内有效),在 API Keys 建一把 Key,按上面的 curl 发第一次请求,看响应里的 billing.charged_usd。要先看参数不花钱,打开免 Key 的搜索工具目录;要看数据目录里的搜索类能力,看 网页数据平台页、Bing 平台页、DuckDuckGo 平台页、Google 新闻平台页 和 Google 购物平台页;要在控制台里点一下就调,用基础设施市场的试用台。
如果你正在从 Serper 迁过来,按这个顺序改:地址换成 /api/v1/search;请求头从 X-API-KEY 换成 Authorization: Bearer;type 从网址挪进请求体的 tool;gl 的值搬到 location,去掉 hl 和 autocorrect,tbs 换成 after、before;结果从 organic[].link 改读 results[].url;最后用一个故意写错的参数发一次,确认你的程序能读懂 422 里的 allowed 和 did_you_mean。各家方案的整体对比见替代方案总览和为什么选 EveryInfra。
参考资料
- Serper 首页(定价、FAQ、示例响应),Serper,2026-11-05 读取
- Create an account,Serper,2026-11-05 读取
- Log in to your account,Serper,2026-11-05 读取
- API Keys,Serper,2026-11-05 读取(未登录显示登录页)
- Playground,Serper,2026-11-05 读取页面脚本
- Terms of Service,Serper,2024-05-29 更新,2026-11-05 读取
- Privacy Policy,Serper,2025-11-05 审阅,2026-11-05 读取
- Supported locations,Serper,2026-11-05 读取
- Serper 状态页,Serper,2026-11-05 读取
- Serper-API GitHub 组织,GitHub,2026-11-05 读取
- serper.dev 网页存档索引,Internet Archive,2026-11-05 读取
- postman-code-generators,Postman,2026-11-05 读取
- Serper.dev authentication issues,n8n 社区,2025-07-26
- Unauthorized Error (403) when Using SERPER_API_KEY #633,CrewAI,2024-05-17
- Research: read a spent plan or refused key as what it is #339,GitHub,2026-10-23
- Live checks with real keys before release #12,GitHub,2026-10-22
- Google Serper Search(SerperDevTool),CrewAI,2026-11-05 读取
- serper_dev_tool.py,CrewAI,2026-11-05 读取
- CrewAI 1.15.35,CrewAI,2026-11-03
- GoogleSerperAPIWrapper,LangChain,2026-11-05 读取
- google_serper.py,LangChain,2026-11-05 读取
- SerperDevWebSearch,deepset,2026-11-05 读取
- Haystack serperdev websearch.py,deepset,2026-11-05 读取
- Serper Search,LiteLLM,2026-11-05 读取
- Serper bundle,Langflow,2026-11-05 读取
- HTTP Request node,n8n,2026-11-05 读取
- HTTP Request credentials,n8n,2026-11-05 读取
- MCP Client Tool node,n8n,2026-11-05 读取
- n8n 2.46.6,n8n,2026-11-04
- mcp-server-serper,GitHub,2026-11-05 读取
- serper-mcp-server,GitHub,2026-11-05 读取
- Model Context Protocol Specification 2026-07-28,MCP,2026-11-05 读取
- MCP Authorization,MCP,2026-11-05 读取
- Connect Claude Code to tools via MCP,Anthropic,2026-11-05 读取
- RFC 9110: HTTP Semantics,IETF,2022-06
- RFC 6585: Additional HTTP Status Codes,IETF,2012-04
- RFC 9457: Problem Details for HTTP APIs,IETF,2023-07
- 422 Unprocessable Content,MDN,2026-11-05 读取
- Retry-After,MDN,2026-11-05 读取
- Supported secret scanning patterns,GitHub,2026-11-05 读取
- Secret scanning blocks Anthropic keys by default, adds Salesforce,GitHub,2026-10-13
- Push protection beyond predefined secret patterns,GitHub,2026-10-28
- Defining custom patterns for secret scanning,GitHub,2026-11-05 读取
- TruffleHog v3.99.8,Truffle Security,2026-11-02
- Gitleaks,Gitleaks,2026-11-05 读取
- The attack chain behind the v1.107.0 LiteLLM release,LiteLLM,2026-10-23
- Security Disclosure: Wednesday October 21st,Railway,2026-10-21
- How to Retrieve Your API Key from Serper.dev Dashboard,Clay 社区,2025-05-10
- Secrets Management Cheat Sheet,OWASP,2026-11-05 读取
- The Twelve-Factor App: Config,12factor.net,2026-11-05 读取
- python-dotenv,PyPI,2026-11-05 读取
- Requests Quickstart,Requests,2026-11-05 读取
- EveryInfra 搜索工具目录,EveryInfra,2026-11-05 00:16 读取
- EveryInfra 数据能力目录,EveryInfra,2026-11-05 00:16 读取
- EveryInfra OpenAPI,EveryInfra,2026-11-05 读取
引用编号 BL-92