Alternativa a Apify LinkedIn Scraper: coste por cada 1000 resultados
1000 perfiles de LinkedIn cuestan 4,00 USD con el scraper más usado de Apify y 0,556 USD con EveryInfra. Empleos: 0,0033 USD por cada 1000. Pruebas reales.
Supongamos que necesitas 1000 perfiles de LinkedIn. El scraper de perfiles más usado en Apify Store es LinkedIn Profile Scraper, de harvestapi, con 15 718 usuarios en los últimos 30 días. Su precio público es 4,00 USD por cada 1000 perfiles en los niveles Free y Starter, 3,20 USD en Business y 10,00 USD si añades la búsqueda de email. El 5 de noviembre de 2026 probamos linkedin/person_profile de EveryInfra con llamadas reales. Cada llamada devuelve un perfil y cuesta 0,000556 USD, así que 1000 perfiles salen por 0,556 USD: 7,2 veces menos que el nivel Free.
La diferencia crece mucho con los datos que llegan por páginas. En Singapur, 11 búsquedas con linkedin/jobs devolvieron 1853 ofertas únicas por 0,006116 USD en total, es decir, 0,0033 USD por cada 1000. Es 606 veces menos que el scraper de empleos más usado en el nivel Free. También hay que contar la otra cara. En la Store hay una API de perfiles con solo 132 usuarios que cobra 0,02 USD por cada 1000 perfiles, 27,8 veces menos que nosotros para perfiles sueltos. Y nuestro linkedin/job_detail devolvió 503 en las cinco pruebas, sin cobrar nada: para el detalle de una oferta concreta, hoy Apify es mejor opción.
En este artículo, «precio por cada 1000» significa lo que una llamada cobró de verdad (charged_usd en la respuesta), dividido entre las filas únicas que devolvió y multiplicado por 1000. Responde a una pregunta concreta: ¿cuánto cuestan 1000 resultados útiles? EveryInfra cobra por petición, y una petición cuesta lo mismo si devuelve 1 fila o 200. La mayoría de los scrapers de LinkedIn en Apify Store cobra por resultado, así que cada fila extra suma un cargo. Solo se pueden comparar los dos modelos con el mismo denominador. Del lado de Apify usamos únicamente material público: páginas de la Store, la página de precios, la documentación y el endpoint público api.apify.com/v2/acts/<autor>~<nombre>. No creamos cuenta en Apify ni ejecutamos ningún actor (así llama Apify a sus programas de extracción en la nube). Por eso todas las cifras de Apify son precios unitarios públicos, no facturas medidas. Todas las cifras de EveryInfra salen de llamadas reales.
apify linkedin scraper frente a EveryInfra: la tabla resumen
La tabla contiene solo dos tipos de cifras. Por un lado, el precio unitario público de Apify Store, leído entre las 00:16 y las 00:40 hora de Singapur del 5 de noviembre de 2026, con el nivel indicado en cada celda. Por otro, nuestro resultado real: hora de Singapur, capacidad, filas y charged_usd. Los niveles de Apify dependen de tu plan mensual. El plan Free da 5 USD de uso al mes sin descuento en la Store. Starter cuesta 19 USD al mes y corresponde a Bronze. Scale cuesta 199 USD y corresponde a Silver. Business cuesta 999 USD y corresponde a Gold. Platinum y Diamond son contratos a medida.
| Dato | Scraper de Apify (usuarios en 30 días) | Apify por cada 1000: Free / Diamond | Capacidad de EveryInfra | Prueba real (hora de Singapur, filas, cobro) | EveryInfra por cada 1000 | Diferencia (Apify Free / nosotros) |
|---|---|---|---|---|---|---|
| Perfil | LinkedIn Profile Scraper, harvestapi (15 718) | 4,00 / 2,20 USD | linkedin/person_profile | 00:14-00:18, 5 llamadas de 1 fila, 0,000556 USD cada una | 0,556 USD | 7,2 veces |
| Perfil + email | Igual, modo con búsqueda de email | 10,00 / 10,00 USD | linkedin/person_profile (campo email) | Igual, 3 de 5 con email | 0,556 USD | 18 veces |
| Empresa | LinkedIn Company Details Scraper, harvestapi (8071) | 4,00 / 1,20 USD | linkedin/company_profile | 00:14-00:22, 4 llamadas de 1 fila | 0,556 USD | 7,2 veces |
| Lista de empleos | Linkedin Jobs Scraper, curious_coder (15 193) | 2,00 / 1,00 USD | linkedin/jobs | 00:14-00:53, 11 llamadas, 1853 únicas, 0,006116 USD | 0,0033 USD | 606 veces |
| Lista de empleos (la más barata) | Rapid Linkedin Jobs Scraper modo rápido, worldunboxer (632) | 0,10 / 0,10 USD | linkedin/jobs | Igual | 0,0033 USD | 30,3 veces |
| Detalle de un empleo | Igual, modo detallado | 0,35 / 0,30 USD | linkedin/job_detail | 00:25-01:10, 5 llamadas, todas 503, 0 USD | Precio de catálogo 1,194 USD (hoy falló) | Apify 3,4 veces más barato |
| Búsqueda de personas | LinkedIn Profile Search Scraper, harvestapi (8094) | short 4,00 / 1,00 USD | linkedin/profile_search | 00:26, 1 llamada asíncrona, 78 personas, 0,000556 USD | 0,0071 USD | 561 veces |
| Empleados de una empresa | LinkedIn Company Employees Scraper, harvestapi (6420) | short 3,00 / 1,15 USD, más 0,02 USD por arranque | linkedin/employees | 00:22, 1 llamada, 200 personas, 0,000556 USD | 0,0028 USD | 1079 veces |
| Perfil (el más barato) | LinkedIn Profile API, johnvc (132) | 0,02 / 0,02 USD | linkedin/person_profile | Igual que la fila 1 | 0,556 USD | Apify 27,8 veces más barato |
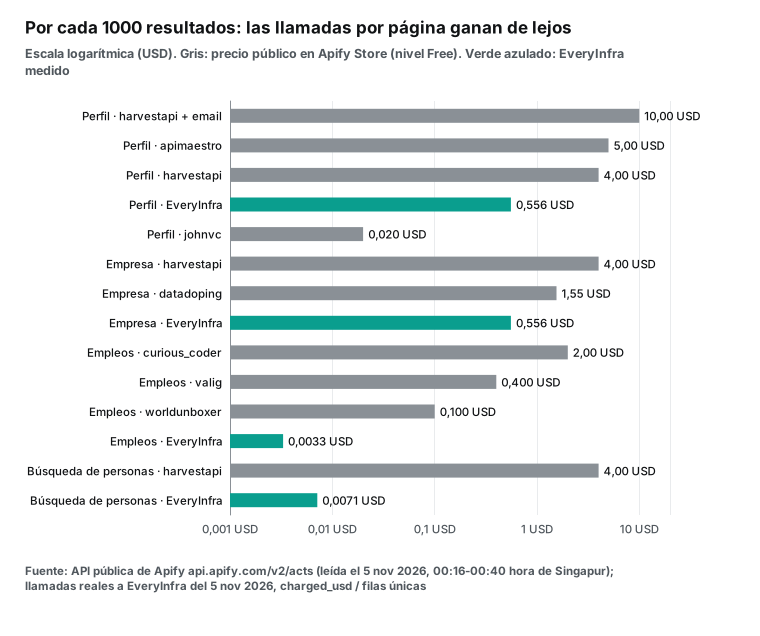
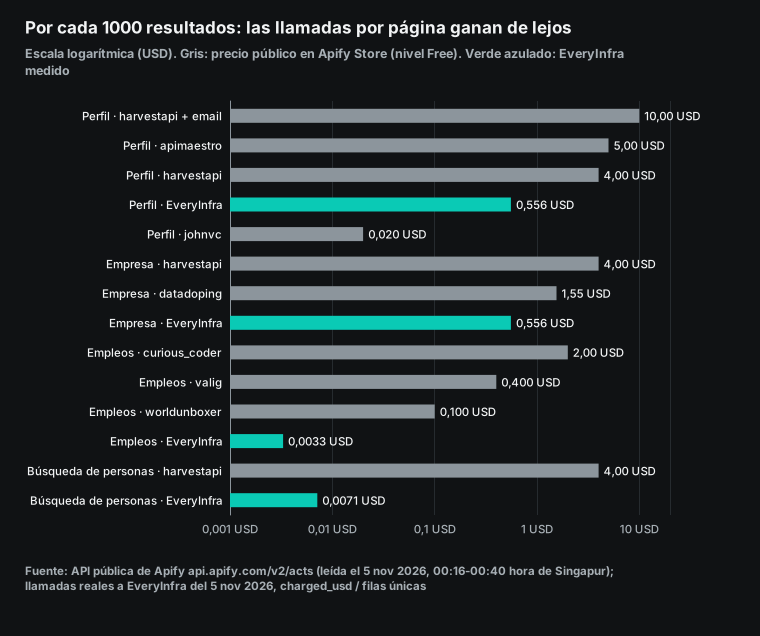
Esta tabla se malinterpreta de tres maneras. La primera: los campos no son iguales en los dos lados. La diferencia indica cuánto cuesta un resultado, no que ambos resultados contengan los mismos datos. Por eso, en cada prueba separamos nuestras tasas de campos con valor de lo que describen las páginas de Apify, y nunca decimos que sean lo mismo. La segunda: un precio de Apify es un precio unitario de la Store multiplicado por 1000. Una factura real depende además de mínimos, tarifas de arranque, reintentos y el límite de ejecuciones del plan Free. Nuestro lado divide cobros reales entre filas reales, de modo que las llamadas vacías y fallidas siguen contando. La tercera: las diferencias grandes vienen de capacidades que devuelven una página por llamada. En perfiles y empresas sueltos la diferencia es solo de 7,2 veces, y frente al scraper más barato de la Store salimos más caros.
Cómo probamos y cómo calculamos
Hicimos todas las llamadas reales de madrugada el 5 de noviembre de 2026, de las 00:14 a las 01:17 hora de Singapur. Usamos una clave de prueba compartida con un límite de 10 peticiones por minuto, que otros redactores usaban a la vez. Por eso esperamos 8 segundos entre llamadas. Ante un 429 (demasiadas peticiones), esperamos 62 segundos y repetimos, y esos intentos no cuentan como resultados. Perfiles, empresas y empleos tuvieron cinco llamadas o más cada uno: cinco perfiles públicos y un usuario inexistente; cuatro empresas y un nombre inexistente (Microsoft, Grab y Santander recibieron primero un 429 y la tabla solo cuenta el reintento); y 11 búsquedas de empleo en Singapur con 10 palabras clave, porque data engineer se repitió. Además hicimos cuatro llamadas de detalle, una búsqueda de personas síncrona y otra asíncrona (solo funcionó la asíncrona) y una lista de empleados; estas tres muestras son pequeñas y sirven solo como orientación. Añadimos una llamada sin clave y otra con un parámetro mal escrito para ver si los fallos se cobran. Para el público hispanohablante hicimos además una ronda propia entre las 00:59 y las 01:06, hora de Singapur, con empleos en Madrid y Ciudad de México y con empresas como BBVA y Mercado Libre; sus resultados aparecen en cada sección.
Cada precio por cada 1000 usa la misma fórmula: cobro total dividido entre filas únicas, por 1000. Las llamadas vacías y fallidas suman en el numerador, pero sus filas no entran en el denominador, así que una llamada floja solo puede encarecer nuestro precio. Eliminamos duplicados de empleos por id y de personas por URL de perfil. Para Apify leímos pricingInfos y stats de cada actor en el endpoint público. pricingInfos da el precio de cada evento de cobro en cada nivel, y stats da usuarios, ejecuciones y tasa de éxito de los últimos 30 días. Tomamos el precio del evento principal por resultado y lo multiplicamos por 1000. Si un actor cobra además por arranque o por página de búsqueda, repartimos esa tarifa según el tamaño de página que indica su ficha y lo señalamos en la tabla.
La regla de selección quedó fijada antes de escribir. Para cada tipo de dato tomamos el actor con más usuarios en 30 días y, además, el más barato en el nivel Free entre los que tienen al menos 100 usuarios. Así evitamos elegir a propósito un rival débil, y precisamente esa regla destapó el único caso en que Apify nos gana con claridad.
| Escenario | Llamadas | Con datos | Filas devueltas | Cobro total | Hora de Singapur |
|---|---|---|---|---|---|
linkedin/person_profile | 7 | 5 | 5 | 0,002780 USD | 00:14-00:25 |
linkedin/company_profile | 5 (más 3 con 429, no contadas) | 4 (1 vacía también se cobró) | 4 | 0,002780 USD | 00:14-00:22 |
linkedin/jobs | 12 | 11 | 1970 (1853 únicas) | 0,006116 USD | 00:14-00:53 |
linkedin/job_detail | 4 | 0 | 0 | 0 USD | 00:25-00:28 |
linkedin/profile_search | 2 | 1 | 78 | 0,000556 USD | 00:23-00:26 |
linkedin/employees | 1 | 1 | 200 | 0,000556 USD | 00:22 |
| Ronda en español (Madrid, Ciudad de México, BBVA, Mercado Libre) | 5 | 5 | 459 | 0,002780 USD | 00:59-01:06 |
| Empleos en Estados Unidos y reintento de job_detail | 2 | 1 | 198 | 0,000556 USD | 00:56-01:10 |
| A través de MCP (1 con clave, 2 sin clave) | 3 | 1 | 1 | 0,000556 USD | 01:02-01:17 |
| Total | 41 | 29 | 2915 | 0,016680 USD | 00:14-01:17 |
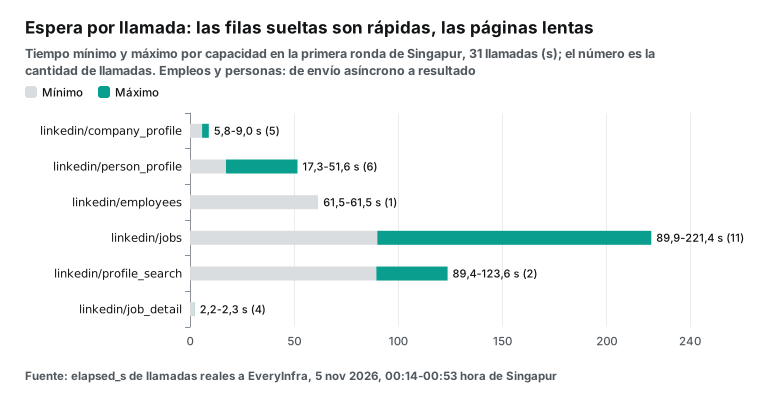
Todas las llamadas reales de este artículo costaron 0,016680 USD en total, por debajo del límite de 0,10 USD que fijamos antes de empezar. Dos ilustraciones salieron de un servicio de imágenes a unos 0,03 USD cada una. No repetimos llamadas para mejorar cifras. La primera búsqueda síncrona de personas agotó el tiempo a los 89 segundos con un 503 y sin cobro. Dejamos ese resultado y, siguiendo la pista del propio error, repetimos la búsqueda en modo asíncrono.
apify linkedin scraper cost: cómo leer los precios de la Store
Buscamos «linkedin» en Apify Store a las 00:17 hora de Singapur del 5 de noviembre de 2026 y aparecieron 370 resultados. Los leímos todos a través de la API pública. De ellos, 109 tenían al menos 100 usuarios en 30 días. De esos 109, 78 dicen en el título o en la descripción «No cookies», «No login» o algo parecido, de modo que no tienes que entregar tu sesión de LinkedIn. En cuanto al modelo de cobro, 31 de los 370 usan «pay per event + usage»: pagas por resultado y además por cómputo, proxy y almacenamiento. Entre los 109 con al menos 100 usuarios solo 4 cobran así; los otros 105 cobran solo por evento. Si tomamos los 12 scrapers de perfiles con al menos 100 usuarios, su precio mediano en Free es de 5,00 USD por cada 1000 perfiles, con un mínimo de 0,02 USD y un máximo de 10,00 USD (con email).
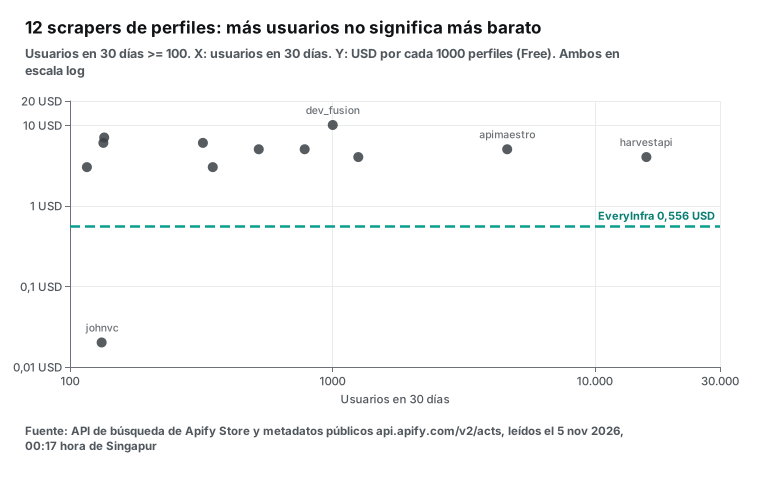
Los precios de Apify esconden cuatro trampas. La primera es el nivel. La página de precios de Apify dice que el plan Free da 5 USD al mes con «No Apify Store discount», y que los planes de pago abren los niveles de descuento Bronze, Silver y Gold. Cada autor decide el descuento de cada nivel. El scraper de perfiles de harvestapi cuesta 4,00 USD en Free y Bronze, 3,60 en Silver, 3,20 en Gold, 2,60 en Platinum y 2,20 en Diamond. El de empleos de curious_coder cuesta 2,00 USD en Free y 1,00 USD en cualquier plan de pago: el nivel Free paga el doble. Un usuario individual y un cliente Business pueden ver precios que casi se duplican para el mismo actor, así que conviene saber en qué nivel estás antes de comparar.
| Plan de Apify | Cuota mensual | Uso incluido | Nivel de descuento en la Store | Precio por unidad de cómputo |
|---|---|---|---|---|
| Free | 0 USD | 5 USD | Ninguno | 0,2 USD / CU |
| Starter | 19 USD | 19 USD | Bronze | 0,2 USD / CU |
| Scale | 199 USD | 199 USD | Silver | 0,16 USD / CU |
| Business | 999 USD | 999 USD | Gold | 0,13 USD / CU |
| Enterprise | A medida | A medida | A medida | A medida |
La tabla sale de la página de precios de Apify, leída a las 00:39 hora de Singapur del 05-11-2026. Cuando se agota el uso incluido pagas según consumo, y puedes fijar un límite. Una unidad de cómputo (CU) equivale a 1 GB de memoria durante 1 hora. Los actores de pago por evento no suelen sumar CU; los 31 de «pay per event + usage» que hay entre los 370, sí (solo 4 de ellos tienen al menos 100 usuarios).
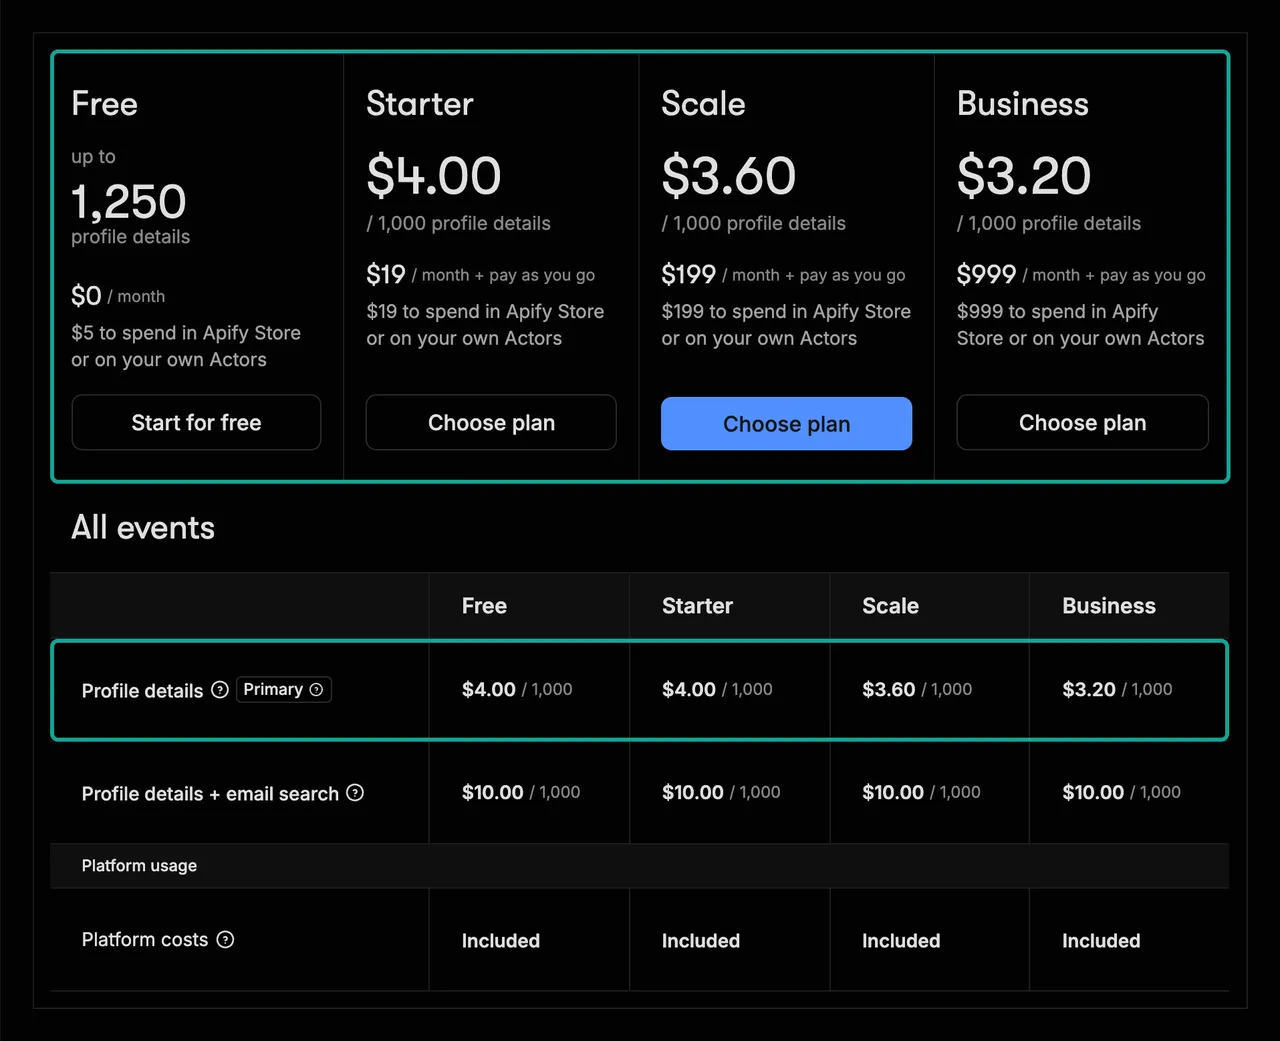
La segunda trampa es el precio del titular. Algunos actores ponen en el título o la descripción un precio bajo que suele ser el de un nivel alto. El scraper de perfiles de datadoping dice «For just $3 per 1,000 profiles», pero la API pública marca 4,00 USD en Free, 3,50 en Bronze y 3,00 solo desde Gold. Su scraper de empresas anuncia «$1.2 per 1,000 companies» y en Free cuesta 1,55 USD. La ficha de curious_coder dice «Pricing from $1.00 / 1,000 results»: ese «from» significa Bronze o superior, y quien usa el plan Free paga 2,00 USD. No es un error de los autores, pero hay que leer el «from» con atención.
La tercera trampa son las tarifas por arranque y por página. El scraper de empleados de harvestapi cobra 0,02 USD por cada arranque. Su buscador de personas cobra 0,10 USD por página de búsqueda, con un máximo de 25 personas por página, y la ficha aclara que se cobra «regardless of how many profiles were found on the page». Repartimos esa tarifa sobre una página llena de 25 personas, lo que da 4,00 USD por cada 1000: el mejor caso para Apify. Una búsqueda estrecha con pocas personas por página sale más cara. El scraper de empleos de valig cobra 0,001 USD por arranque y la API de fantastic-jobs, 0,01 USD por arranque en Free. En una ejecución de miles de filas estas tarifas apenas pesan. Pero muchos flujos de n8n arrancan una ejecución por cada contacto, y ahí la tarifa de arranque puede convertirse en el coste principal.
La cuarta trampa es el límite de ejecuciones del plan Free. La ficha de perfiles de harvestapi dice «Users on free-tier plans are limited to 50 runs in total». Los 5 USD del plan Free compran 1250 perfiles a 4,00 USD por cada 1000, y de ahí sale el «up to 1,250» de la captura. En r/n8n, alguien compartió un flujo «gratis» para encontrar ofertas en publicaciones de LinkedIn, que extrae publicaciones con el plan Free de Apify, y otra persona respondió que «the apify $5 just went away in a few minutes» y que cada ejecución le costaba más de 1 dólar. En otro hilo, dos usuarios recomendaban el scraper de empleos de curious_coder y afirmaban que su nivel Free da unos 5000 empleos al mes. No podemos verificar esas facturas. Con el precio actual de curious_coder en Free, 2,00 USD por cada 1000, 5 USD alcanzan solo para 2500 empleos. Ese precio rige desde el 14-08-2026, así que el comentario quizá cite uno antiguo. Los precios de la Store cambian: revisa la pestaña Pricing antes de fiarte de un testimonio.
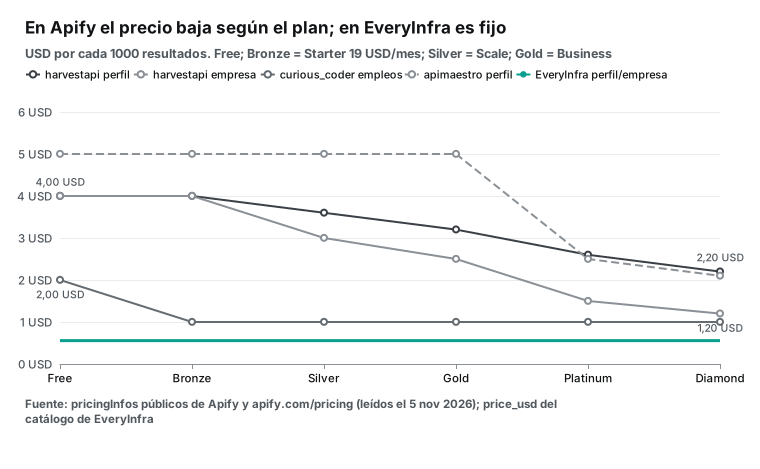
EveryInfra no tiene niveles. En LinkedIn, person_profile, company_profile, jobs, profile_search y employees cuestan 0,000556 USD por llamada, job_detail cuesta 0,001194 USD y person_posts 0,004 USD. No hay plan ni cuota mensual: pagas lo que usas. Para probar, das una estrella a dos repositorios de EveryInfra en GitHub y recibes 1 USD de crédito válido 24 horas. Las recargas de pago empiezan en 10 USD. Cada página de capacidad muestra su precio, por ejemplo la API de perfiles de LinkedIn y la API de empleos de LinkedIn.
| Capacidad de LinkedIn en EveryInfra | Precio por llamada | Filas máximas por llamada | Por cada 1000 (páginas llenas) |
|---|---|---|---|
linkedin/person_profile | 0,000556 USD | 1 | 0,556 USD |
linkedin/company_profile | 0,000556 USD | 1 | 0,556 USD |
linkedin/followers (recuento) | 0,000556 USD | 1 | 0,556 USD |
linkedin/job_detail | 0,001194 USD | 1 | 1,194 USD |
linkedin/search (publicaciones) | 0,000556 USD | 50 | 0,011 USD |
linkedin/profile_search | 0,000556 USD | 100 | 0,0056 USD |
linkedin/jobs | 0,000556 USD | 200 | 0,0028 USD |
linkedin/employees | 0,000556 USD | 200 | 0,0028 USD |
linkedin/comments | 0,000556 USD | 200 | 0,0028 USD |
linkedin/company_posts | 0,002319 USD | 50 | 0,046 USD |
linkedin/person_posts | 0,004 USD | 50 | 0,080 USD |
La última columna supone que cada llamada vuelve llena, y en la práctica no siempre es así. En esta prueba, las búsquedas de empleo devolvieron 179 filas de media, así que el precio real fue de 0,0033 USD y no de 0,0028 USD. La búsqueda de personas devolvió 78 perfiles en vez de 100, y el precio real fue de 0,0071 USD en vez de 0,0056 USD. Con cobro por petición, el precio real depende de cuántas filas trae cada llamada.
Prueba 1: 1000 perfiles de LinkedIn
Empezamos con linkedin/person_profile sobre cinco personas con un papel empresarial público: Satya Nadella, de Microsoft; Reid Hoffman, cofundador de LinkedIn; Bill Gates; Jeff Weiner, ex consejero delegado de LinkedIn, y Ryan Roslansky, directivo de LinkedIn. El parámetro username acepta el identificador de la ruta del perfil o la URL completa. En la tercera llamada enviamos la URL completa y el resultado fue el mismo. Las cinco llamadas devolvieron 200 y cobraron 0,000556 USD cada una, con tiempos de 17,3 a 51,6 segundos. La más lenta, a las 00:18 hora de Singapur, llegó sin experiencia laboral ni formación. El catálogo explica ese caso: cuando la fuente principal no está disponible responde una fuente de respaldo, y algunos campos pueden quedar vacíos.
| Campo | Filas con valor (de 5) | Nota |
|---|---|---|
| headline, about, location, current_company | 5 / 5 | Texto público del perfil |
| follower_count, connection_count | 5 / 5 | Seguidores y contactos |
| experience | 4 / 5 | 5, 5, 3 y 7 entradas |
| education | 4 / 5 | 2, 2, 2 y 1 entradas |
| 3 / 5 | Catálogo: email de trabajo deducido de datos públicos y verificado | |
| open_to_work, account_created_at | 4 / 5 | Pueden faltar con la fuente de respaldo |
| top_skills | 0 / 5 | Vacío en los cinco |
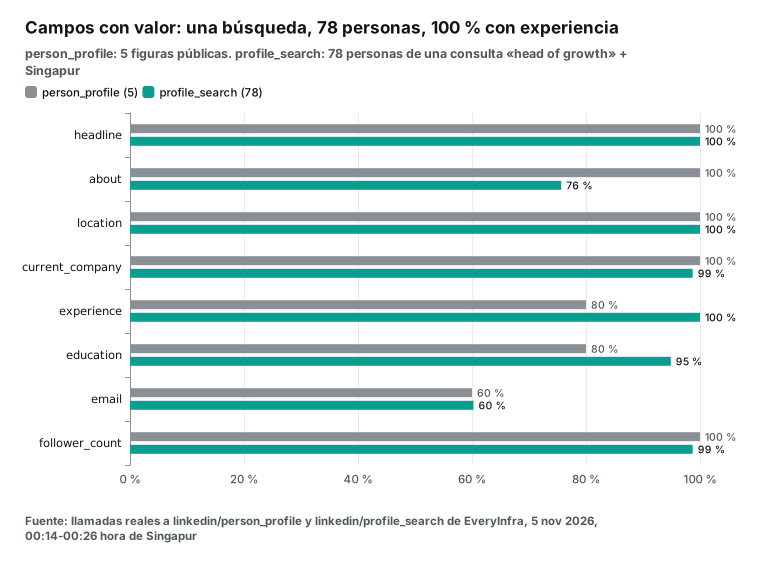
Después enviamos un nombre de usuario inexistente a las 00:19 hora de Singapur. A los 32 segundos la API devolvió 503 con el código unavailable, y el bloque de facturación indicaba charged en false y reason en request_failed_refunded: 0 USD. Es decir, una persona inexistente aparece como «no disponible ahora», no como un 200 vacío, y no pagas nada. Pero una sola respuesta no distingue si la persona no existe o si la llamada falló esta vez. El campo next_steps dice «Not charged» y propone reintentar tras retry_after segundos; al tercer fallo explica qué revisar.
Apify tiene la oferta más amplia de scrapers de perfiles. El más usado, de harvestapi, cuesta 4,00 USD por cada 1000, o 10,00 USD con búsqueda de email. Su ficha dice «No cookies or account required» y acepta identificadores, URLs de perfil o ID internos. El modo con email hace comprobaciones SMTP, y si un perfil es demasiado pobre para buscar el email, la ficha dice que no cobra esa búsqueda. Profile Details Scraper, de apimaestro, cuesta 5,00 USD por cada 1000 y 2,10 USD en Diamond, con 4636 usuarios en 30 días y un 100 % de ejecuciones correctas.
El más barato es LinkedIn Profile API, de johnvc. Cobra 0,00001 USD por perfil más 0,00001 USD por elemento del conjunto de datos, es decir, 0,02 USD por cada 1000, y otros 0,00001 USD por arranque. Solo tiene 132 usuarios y un 91,12 % de ejecuciones correctas en 30 días, frente al 99,97 % de harvestapi. Solo por precio, este actor es 27,8 veces más barato que nuestra llamada de perfil suelto. No lo ejecutamos, así que no sabemos lo completos que son sus campos; su ficha enumera nombre, titular, ubicación, empresa actual, experiencia, formación y seguidores.
Para perfiles sueltos el balance es mixto. Somos de 7 a 9 veces más baratos que los scrapers más usados de la Store y más caros que el más barato. Si tu única tarea es completar cada día una lista de URLs de perfil y aceptas una tasa de éxito menor, prueba primero ese actor de 0,02 USD. Si además necesitas buscar personas, empleos y empresas, una sola cuenta y una sola clave te ahorran tiempo de conciliación y de mantenimiento de varios actores. También puedes empezar por la búsqueda de personas: una búsqueda devuelve decenas de perfiles con la experiencia completa, a un coste por persona mucho menor. La prueba 4 da las cifras.
Prueba 2: 1000 páginas de empresa
Llamamos a linkedin/company_profile para cuatro empresas: Stripe, Microsoft, Grab y Santander (enviada como URL completa). Las cuatro devolvieron 200 en 6 a 9 segundos y cobraron 0,000556 USD cada una. Stripe muestra 16 694 empleados, un employee_count_range de 5001-10000 y 14 oficinas. Microsoft, 231 125 empleados, 29 447 391 seguidores y 45 oficinas. Grab, 58 341 empleados, sede en Singapur y fundación en 2012. Santander, 131 291 empleados y sede en Boadilla del Monte (Madrid).
Para el público hispanohablante añadimos BBVA y Mercado Libre a las 01:05. BBVA devolvió 131 160 empleados, 1 761 167 seguidores, sede en Bilbao y 13 oficinas en 11,2 segundos. Mercado Libre devolvió 70 349 empleados, 3 608 626 seguidores, sede en Buenos Aires y 22 oficinas en 6,0 segundos. Las dos cobraron 0,000556 USD. Un detalle importante: latitude y longitude no siempre marcan la sede. En BBVA apuntan a la zona de Zúrich, donde está la primera oficina de la lista offices, y en Mercado Libre a un punto del centro de Argentina, a unos 600 km de Buenos Aires. Si vas a situar sedes en un mapa, usa headquarters y headquarters_postal_code y geocodifícalos tú.
Ojo: employee_count y employee_count_range pueden no coincidir. El primero cuenta a los miembros de LinkedIn que indican esa empresa como trabajo actual. El segundo es el tramo de tamaño que eligió la empresa. En Stripe y en Grab, el número de miembros supera el tramo declarado. Si puntúas contactos comerciales, usa los dos campos por separado.
| Empresa | employee_count | employee_count_range | follower_count | Sede | Oficinas |
|---|---|---|---|---|---|
| Stripe | 16 694 | 5001-10000 | 1 805 161 | South San Francisco, US | 14 |
| Microsoft | 231 125 | 10001+ | 29 447 391 | Redmond, US | 45 |
| Grab | 58 341 | 5001-10000 | 1 056 756 | Singapur | 16 |
| Santander | 131 291 | 10001+ | 2 240 169 | Boadilla del Monte, ES | 3 |
| BBVA | 131 160 | 10001+ | 1 761 167 | Bilbao, ES | 13 |
| Mercado Libre | 70 349 | 10001+ | 3 608 626 | Buenos Aires, AR | 22 |
Las cuatro primeras filas tenían description, website, industries, headquarters y offices. Solo dos tenían founded_year y ninguna tenía crunchbase_url ni latest_funding_round. El catálogo avisa de que la fuente de respaldo puede omitir financiación, enlaces de Crunchbase y coordenadas. Si compras datos de empresa sobre todo por las rondas de financiación, no cuentes con esos dos campos de nuestra parte.
En esta prueba hay un problema que debemos contar. A las 00:20 hora de Singapur enviamos el nombre de una empresa que no existe. La API devolvió HTTP 200 con cadenas vacías en todos los campos y cobró 0,000556 USD. Nuestra propia regla dice que los resultados vacíos no se cobran, así que es un fallo nuestro y ya lo pasamos al equipo técnico. Hasta que se corrija, revisa la lista de empresas antes de enviarla, o anota las llamadas con results.name vacío junto con su request_id y pídenos que las revisemos. Contando esa llamada vacía, el coste real de estas cinco llamadas fue de 0,695 USD por cada 1000 empresas, un 25 % más que los 0,556 USD que solo cuentan las filas buenas.
En Apify, el actor de empresas más usado es LinkedIn Company Details Scraper, de harvestapi, con 8071 usuarios. Cuesta 4,00 USD por cada 1000 en Free y 1,20 USD en Diamond, más 0,00005 USD por arranque. Su ficha dice «No cookies or account required» y también encuentra en lote las URLs de empresa a partir del nombre. El más barato es Linkedin Company Details Scraper, de datadoping, a 1,55 USD en Free y 1,20 USD desde Gold, con 116 usuarios y un 99,99 % de éxito. Somos 2,8 veces más baratos que datadoping y 7,2 veces más que harvestapi. Al ser una empresa por llamada, la diferencia es pequeña. Puedes probarlo en la página de la API de empresas de LinkedIn.
Prueba 3: 1000 ofertas de empleo (apify linkedin scraper jobs)
Los empleos son la necesidad más común en LinkedIn y donde más se separan los dos modelos de cobro. linkedin/jobs tiene tres parámetros: keyword es el término de búsqueda o una URL completa de búsqueda de empleos de LinkedIn, location es el lugar y limit llega hasta 200. Hicimos una búsqueda por cada una de 10 palabras clave en Singapur (data engineer se repitió después, 11 en total), siempre con limit 200: data engineer, software engineer, product manager, data scientist, data analyst, marketing manager, account executive, business analyst, devops engineer y finance manager. Las búsquedas grandes son lentas: la primera llamada síncrona tardó 89,9 segundos. A partir de ahí añadimos "mode": "async", la API devolvió un job_id al instante y consultamos poll_url cada 8 segundos.
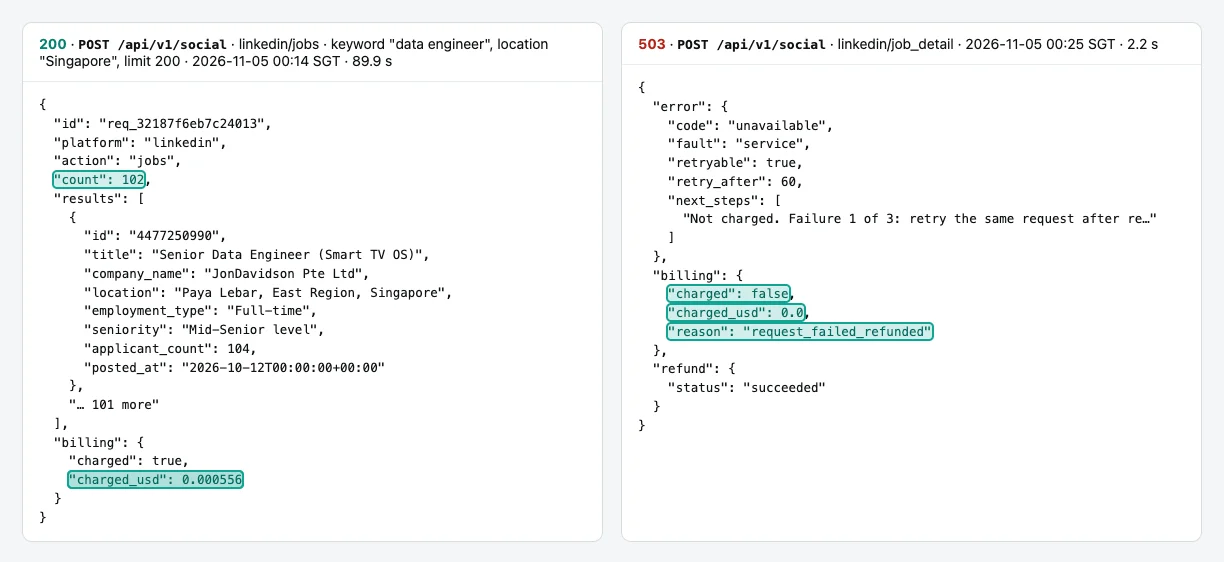
Las 11 búsquedas salieron bien: 10 palabras clave y una repetición de data engineer 39 minutos después. Cada una cobró 0,000556 USD, 0,006116 USD en total. Devolvieron entre 102 y 200 filas, 1970 en total, y tras eliminar duplicados por id quedaron 1853, es decir, 0,0033 USD por cada 1000. Los trabajos asíncronos tardaron de 115 a 221 segundos. Tras la séptima búsqueda ya teníamos 1193 ofertas únicas: reunir 1000 ofertas distintas en Singapur nos costó 7 peticiones y 0,003892 USD. Casi todos los duplicados salieron de la repetición. A las 00:14, la búsqueda síncrona de data engineer devolvió solo 102 filas; a las 00:53, la asíncrona con la misma palabra devolvió 198, y 101 coincidían con la primera. Entre palabras distintas solo hubo 14 duplicados, de data analyst y business analyst.
Para lectores de España y México repetimos la prueba fuera de Singapur. «analista de datos» en Madrid devolvió 199 ofertas de 165 empresas en 181,1 segundos; 185 (el 93 %) se publicaron en octubre o noviembre de 2026 y solo 3 traían salary, en euros al año. «data analyst» en Ciudad de México devolvió 158 ofertas de 126 empresas en 148,6 segundos, y 10 traían salario en pesos mexicanos, casi siempre al mes. Cada búsqueda cobró 0,000556 USD, así que 1000 ofertas de Madrid salen a 0,0028 USD y 1000 de Ciudad de México a 0,0035 USD. Como contraste, «software engineer» en todo Estados Unidos devolvió 198 ofertas, pero de solo 31 empresas: Affirm tenía 100, AWS 32 y JPMorganChase 20. Una búsqueda amplia a escala de país se llena con unas pocas empresas que publican mucho; para ver un mercado conviene buscar por ciudad.
| Búsqueda | Hora de Singapur | Filas | Empresas distintas | Con `salary` | Publicadas en oct.-nov. | Mediana de candidatos | Segundos |
|---|---|---|---|---|---|---|---|
| analista de datos, Madrid | 00:59 | 199 | 165 | 3 | 185 | 145 | 181,1 |
| data analyst, Ciudad de México | 01:03 | 158 | 126 | 10 | 139 | 122,5 | 148,6 |
| software engineer, Estados Unidos | 00:56 | 198 | 31 | 16 | 197 | 43,5 | 180,7 |
| Palabra clave | Hora de Singapur | Filas | Únicas nuevas | Únicas acumuladas | Segundos |
|---|---|---|---|---|---|
| data engineer (síncrona) | 00:14 | 102 | 102 | 102 | 89,9 |
| software engineer | 00:29 | 194 | 194 | 296 | 131,9 |
| product manager | 00:31 | 200 | 200 | 496 | 221,4 |
| data scientist | 00:35 | 196 | 196 | 692 | 140,4 |
| data analyst | 00:37 | 198 | 192 | 884 | 156,6 |
| marketing manager | 00:40 | 189 | 189 | 1073 | 164,2 |
| account executive | 00:43 | 120 | 120 | 1193 | 115,4 |
| business analyst | 00:45 | 199 | 191 | 1384 | 197,3 |
| devops engineer | 00:48 | 200 | 200 | 1584 | 149,4 |
| finance manager | 00:51 | 174 | 174 | 1758 | 123,9 |
| data engineer (repetición) | 00:53 | 198 | 95 | 1853 | 156,1 |
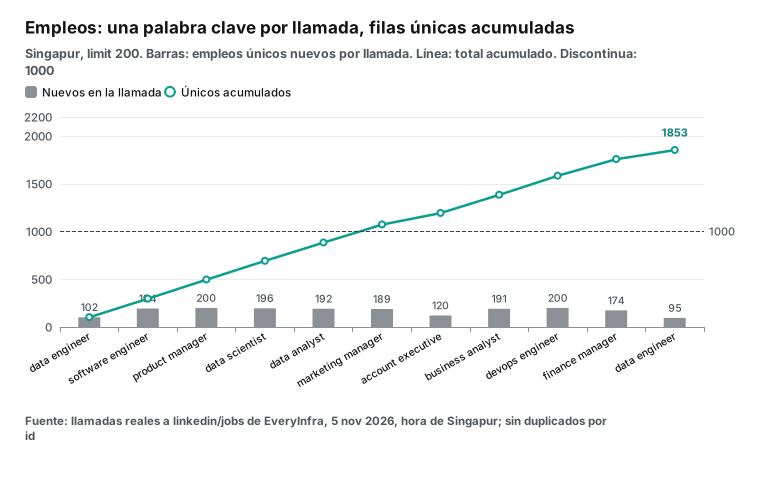
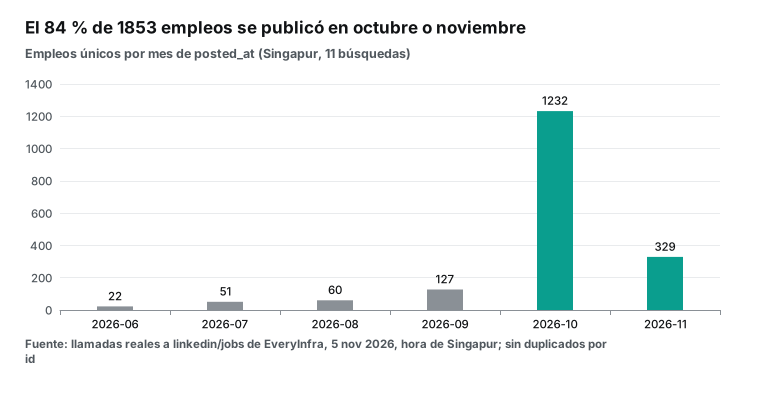
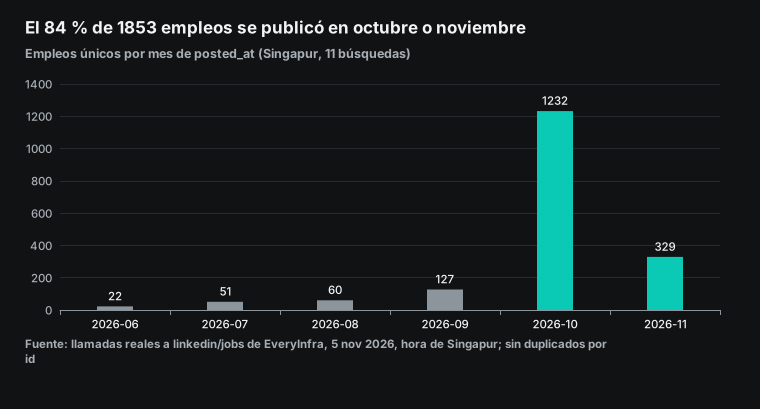
En cuanto a campos, de las 1970 filas de Singapur, title, text (la descripción completa), company_name, location, employment_type, seniority, applicant_count y posted_at estaban siempre. Solo 66 (3,4 %) tenían salary, siempre como rango mensual o anual en dólares de Singapur. 1884 eran a jornada completa, 1046 tenían Not Applicable en seniority y la mediana de applicant_count fue 101,5. Las 1853 ofertas únicas venían de 817 empresas, encabezadas por OCBC (35), GovTech Singapore y Shopee (33 cada una). Por mes de publicación, 1232 de las 1853 ofertas eran de octubre y 329 de los primeros días de noviembre, el 84 % en total. La más antigua era de agosto de 2024, así que entre los resultados pueden colarse ofertas viejas que siguen abiertas: para alertas de empleos nuevos, filtra otra vez por posted_at.
Apify tiene la mayor variedad de scrapers de empleo. El más usado es Linkedin Jobs Scraper, de curious_coder, con 15 193 usuarios: 2,00 USD por cada 1000 en Free y 1,00 USD desde Bronze. Su ficha dice que puede añadir quién publicó la oferta y datos de la empresa, y recoge un límite de LinkedIn: «Linkedin limits number of jobs per search to 1000». Para pasar de ahí, activas «Split search urls by location» y el actor lanza una búsqueda por ciudad y elimina duplicados. LinkedIn Jobs Scraper, de valig, con 8091 usuarios, cuesta 0,40 USD por cada 1000 más 0,001 USD por arranque. cheap_scraper dice «No login or cookies needed» y cuesta 0,70 USD.
Rapid Linkedin Jobs Scraper, de worldunboxer, cuesta 0,10 USD por cada 1000 en modo rápido y 0,35 USD en modo detallado, y su ficha menciona «cron schedules, webhooks and MCP for AI agents». Advanced LinkedIn Job Search API, de fantastic-jobs, es otro tipo de producto: se presenta como una base de datos con más de 10 millones de ofertas nuevas al mes, con datos del reclutador y campos enriquecidos con IA, a 5,00 USD por cada 1000 en Free y 1,50 USD desde Gold.
Frente a ellos, nuestro linkedin/jobs cuesta 0,0033 USD por cada 1000: 606 veces menos que curious_coder en Free, 121 veces menos que valig y 30 veces menos que la opción más barata de 0,10 USD. El detalle de una oferta va al revés. linkedin/job_detail tiene un precio de catálogo de 0,001194 USD por llamada, 1,194 USD por cada 1000, y las cuatro primeras pruebas devolvieron 503 sin cobro: dos ID reales, uno inexistente y el ID de ejemplo que daba el propio error. La quinta, a las 01:10, usó otro ID real sacado de nuestra búsqueda de data engineer: otro 503 en 2,2 segundos, sin cobro, con retryable en true y la indicación de volver a probar pasados 60 segundos. El modo detallado de worldunboxer cuesta 0,35 USD por cada 1000, 3,4 veces menos que nuestro precio de catálogo. Nuestro campo text ya trae la descripción completa, así que la mayoría de proyectos no necesita la llamada de detalle. Si necesitas el enlace de candidatura o los beneficios, que solo aparecen en la página de detalle, hoy Apify es mejor opción.
| Prueba de `linkedin/job_detail` | Hora de Singapur | HTTP | Segundos | Cobro |
|---|---|---|---|---|
| ID real, como URL completa | 00:25 | 503 | 2,2 | 0 USD |
| ID real, solo el número | 00:25 | 503 | 2,3 | 0 USD |
| ID que no existe | 00:25 | 503 | 2,2 | 0 USD |
| ID de ejemplo del propio mensaje de error | 00:28 | 503 | 2,3 | 0 USD |
| Otro ID real de la búsqueda de data engineer | 01:10 | 503 | 2,2 | 0 USD |
Prueba 4: búsqueda de personas y lista de empleados
linkedin/profile_search busca personas por cargo actual y ubicación: keyword es el cargo, location el lugar y limit llega hasta 100. Buscamos «head of growth» en «Singapore» con limit 100. La primera llamada síncrona devolvió 503 timeout a los 89,4 segundos, sin cobro, y la respuesta aconsejaba añadir "mode":"async" para límites grandes. A las 00:26 hora de Singapur enviamos la versión asíncrona y unos dos minutos después teníamos 78 personas por 0,000556 USD, es decir, 0,0071 USD por cada 1000.
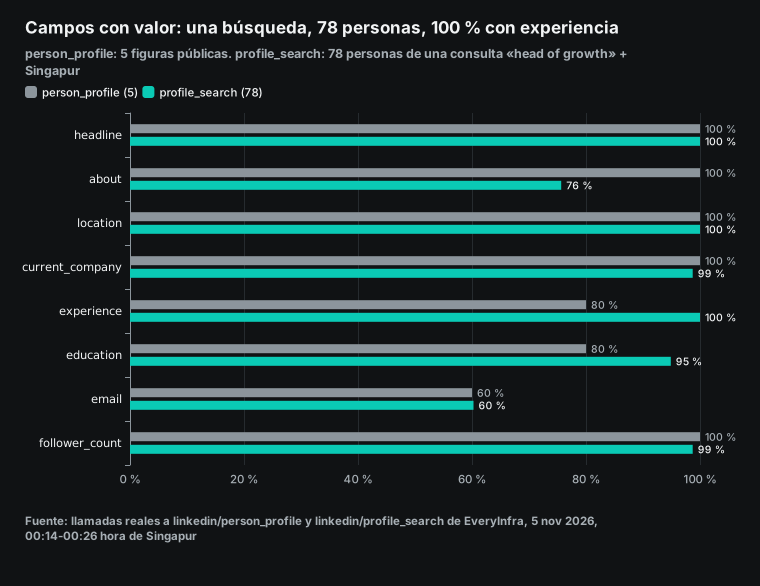
De esas 78 personas, todas tenían experience, con una mediana de 7 entradas; 74 tenían education, 59 about y 47 email, y 27 tenían is_premium en true. Una búsqueda devuelve, por tanto, perfiles completos con historial laboral, unas 78 veces más barato por persona que llamar a person_profile de uno en uno.
Ojo: location no significa «vive hoy en esta ciudad». De las 78 personas, solo 27 tenían Singapur en location; el resto estaba en Sídney, Nueva York, San Francisco, Bombay, Londres, Hong Kong o París. Pero 48 de los 78 registros nombraban Singapur en algún campo, así que también parecen entrar quienes trabajaron allí. En la ronda en español buscamos data scientist en Madrid con limit 100 en modo asíncrono: 229,4 segundos, 100 perfiles únicos y 0,000556 USD, es decir, 0,0056 USD por cada 1000. De esos 100, 55 tenían Madrid en location, 77 nombraban Madrid en algún campo y 94 tenían data scien en headline; 99 traían experience (mediana de 5 entradas), 76 about y 31 email. Si necesitas a quienes están hoy en la ciudad, filtra tú por location: con estas proporciones, aprovecharás más o menos la mitad. Son personas privadas, así que no mostramos nombres ni correos.
| Búsqueda de personas | Perfiles | Con la ciudad en `location` | Nombran la ciudad en algún campo | Título en `headline` | Con `email` | Segundos | Cobro |
|---|---|---|---|---|---|---|---|
| head of growth, Singapur | 78 | 27 | 48 | 66 | 47 | 123,6 | 0,000556 USD |
| data scientist, Madrid | 100 | 55 | 77 | 94 | 31 | 229,4 | 0,000556 USD |
linkedin/employees lista a las personas de una empresa. Pedimos Stripe con limit 200 y en 61,5 segundos llegaron 200 personas por 0,000556 USD, 0,0028 USD por cada 1000. Las 200 tenían headline y location; ninguna tenía email, porque el catálogo indica que el email de los empleados solo aparece si la persona lo hace público, y 106 tenían is_premium en true. Estas llamadas devuelven nombres y empleos de particulares, así que en este artículo no mostramos ningún nombre ni email.
En Apify, LinkedIn Profile Search Scraper, de harvestapi (8094 usuarios), tiene un modo short a 0,10 USD por página de hasta 25 personas; con páginas llenas, 4,00 USD por cada 1000. El modo full suma 0,004 USD por persona, 8,00 USD por cada 1000, y con email cuesta más. Su punto fuerte son los filtros: empresa, sector, centro de estudios y años de experiencia, y harvestapi tiene otro actor que busca por nombre. Company Employees Scraper, de harvestapi, cuesta 3,00 USD por cada 1000 en modo short más 0,02 USD por arranque, y 8,00 USD en modo full; su ficha dice «This actor can try to find contact emails». Frente al modo short, nuestra búsqueda de personas es 561 veces más barata y nuestra lista de empleados 1079 veces. Pero solo ofrecemos dos filtros, cargo y ubicación, y employees solo filtra por empresa. Para audiencias muy acotadas, esos actores de Apify encajan mejor.
Una cesta: 1000 perfiles, 1000 empresas y 1000 empleos
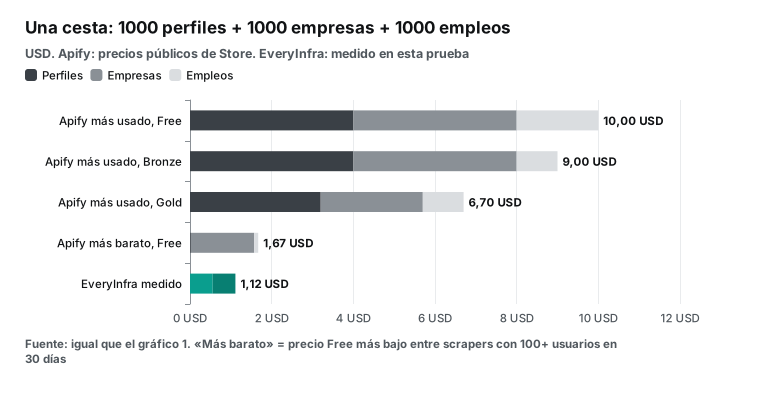
Si juntamos las tres necesidades más comunes, el resultado depende de cómo elijas en Apify. Con el actor más usado de cada tipo, el nivel Free cuesta 4,00 + 4,00 + 2,00 = 10,00 USD; Starter (Bronze), 9,00 USD, y Business (Gold), 6,70 USD. El plan Free solo da 5 USD al mes, así que no cubre esta cesta y necesitas al menos Starter, de 19 USD. Con el actor más barato en Free de cada tipo (con 100 usuarios o más) salen 0,02 + 1,55 + 0,10 = 1,67 USD. Nuestro coste es 0,556 + 0,556 + 0,0033 = 1,12 USD.
| Opción | Perfiles | Empresas | Empleos | Total | Diferencia frente a EveryInfra |
|---|---|---|---|---|---|
| Apify más usado, Free | 4,00 USD | 4,00 USD | 2,00 USD | 10,00 USD | 9,0 veces |
| Igual, Starter (Bronze) | 4,00 USD | 4,00 USD | 1,00 USD | 9,00 USD | 8,1 veces |
| Igual, Business (Gold) | 3,20 USD | 2,50 USD | 1,00 USD | 6,70 USD | 6,0 veces |
| Apify más barato por tipo, Free | 0,02 USD | 1,55 USD | 0,10 USD | 1,67 USD | 1,5 veces |
| EveryInfra medido | 0,556 USD | 0,556 USD | 0,0033 USD | 1,12 USD | - |
La última opción de Apify queda solo 1,5 veces por encima de nosotros, y la razón es sencilla: el actor de perfiles más barato está 27,8 veces por debajo y se come casi toda nuestra ventaja en empleos. Si tu cesta es sobre todo de perfiles, elegir «el más barato por tipo» en Apify puede ahorrarte dinero, a cambio de mantener tres actores con autores, entradas y tasas de éxito distintas. Si predominan los empleos, las búsquedas de personas o las listas de empleados, el cobro por petición gana cada mes por más margen.
Veamos un caso más cotidiano. Un equipo de selección o de ventas lanza cada día una tarea durante 30 días: busca empleos con 10 palabras clave, actualiza 50 empresas objetivo y completa 20 perfiles de candidatos. Para los dos lados usamos las 179 filas por búsqueda de esta prueba; solo cambia la forma de cobro.
| Tarea diaria | EveryInfra (al mes) | Apify más usado, Free (al mes) | Igual, Starter o Bronze (al mes) | Apify más barato, Free (al mes) |
|---|---|---|---|---|
| 10 búsquedas de empleo, unas 1790 filas | 0,17 USD | 107,42 USD | 53,72 USD | 5,39 USD |
| 50 páginas de empresa | 0,83 USD | 6,00 USD | 6,00 USD | 2,33 USD |
| 20 perfiles | 0,33 USD | 2,40 USD | 2,40 USD | 0,01 USD |
| Total | 1,33 USD | 115,82 USD | 62,12 USD | 7,72 USD |
La tabla deja una idea clara: cuando una rutina incluye datos que llegan por páginas, esos datos dominan la factura por resultado. Con los actores más usados, los 19 USD de crédito de Starter no alcanzan y pagas unos 43 USD más según consumo. Con los más baratos, el mes cuesta unos 8 USD; el nuestro, 1,33 USD, 5,8 veces menos. Las tarifas de arranque ya están incluidas por ejecución y son pequeñas.
apify linkedin scraper api frente a la API de EveryInfra
Todos los actores de Apify se ejecutan con la misma API REST. La llamada más habitual ejecuta un actor y devuelve su conjunto de datos en una sola petición: POST https://api.apify.com/v2/acts/<autor>~<nombre>/run-sync-get-dataset-items. El cuerpo es la entrada de ese actor, y cada actor tiene sus propios campos, que se consultan en la pestaña Input de su ficha. Entre los parámetros de consulta están timeout, memory, maxItems y maxTotalChargeUsd.
Según la documentación de Apify, maxItems fija el máximo de elementos que pagas, pero no garantiza que el actor devuelva solo esa cantidad. maxTotalChargeUsd limita el coste total de una ejecución en cualquier modelo de precio. Estos dos controles son un punto fuerte real de Apify. Nosotros no tenemos un tope de coste por ejecución, porque cada petición tiene un precio fijo. El bloque siguiente es un ejemplo de configuración de Apify: no lo ejecutamos, y el archivo de entrada depende del actor que elijas.
# Ejemplo de configuración (no ejecutado): lanzar un actor de empleos de LinkedIn en Apify, pagar como máximo 1000 elementos y gastar como máximo 2 USD
curl -X POST \
  "https://api.apify.com/v2/acts/curious_coder~linkedin-jobs-scraper/run-sync-get-dataset-items?maxItems=1000&maxTotalChargeUsd=2" \
  -H "Authorization: Bearer $APIFY_TOKEN" \
  -H "Content-Type: application/json" \
  -d @input.json   # los campos de entrada salen de la pestaña Input del actor
EveryInfra usa una sola URL para todas las plataformas: POST https://api.everyinfra.com/api/v1/social. El cuerpo lleva siempre tres claves, platform, action y params, y para cambiar de plataforma o de capacidad solo cambias esos valores. Para peticiones lentas añades "mode": "async": la API devuelve al momento un job_id y un poll_url, y consultas con GET. La primera respuesta ya muestra el cobro, y si el trabajo falla se reembolsa el mismo registro de cobro. Esta es la llamada que usamos en la ronda en español; la clave sale de una variable de entorno.
# Llamada real: buscar empleos de analista de datos en Madrid, asíncrona, hasta 200 filas
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"linkedin","action":"jobs","mode":"async",
       "params":{"keyword":"analista de datos","location":"Madrid, Spain","limit":200}}'
# 202: {"job_id":"...","status":"running","poll_url":"/api/v1/jobs/...","billing":{"charged_usd":0.000556,...}}
curl -s "https://api.everyinfra.com/api/v1/jobs/<job_id>" -H "Authorization: Bearer $EVERYINFRA_API_KEY"
# consulta hasta status=succeeded; results contiene la lista de empleos
Los errores también funcionan distinto. A las 00:25 hora de Singapur escribimos a propósito locaton en lugar de location. En 0,1 segundos la API devolvió 422 con el código unknown_param, la lista de parámetros admitidos y la sugerencia «did you mean location», sin cobro. Una llamada sin clave devolvió 401 missing_key, también por 0 USD. Escribimos esos mensajes pensando en clientes de IA: un modelo que lee el 422 puede corregir el parámetro y reenviar la llamada. En Apify, cada autor define la entrada del actor con un JSON Schema, y la plataforma comprueba tipos y campos obligatorios antes de arrancar. Lo que haga cada actor con campos sobrantes depende del actor; eso no lo probamos.
Apify tiene además clientes oficiales para JavaScript y Python, una CLI, integraciones con n8n, Make y Zapier, programaciones (Schedules) y webhooks. EveryInfra ofrece un archivo OpenAPI, un llms.txt, nodos HTTP Request normales en n8n y el servidor MCP remoto que veremos más abajo. Si vas a migrar un flujo de n8n, lee nuestra guía alternativa a Apify en n8n, que explica cómo cambiar cada nodo.
¿Hace falta iniciar sesión o entregar tus cookies?
LinkedIn muestra la mayor parte de los perfiles solo a miembros con sesión iniciada, así que la primera pregunta ante cualquier scraper de LinkedIn es si tienes que entregar tus propias cookies. Nuestra respuesta es sencilla: todas las capacidades de LinkedIn de EveryInfra usan solo tu clave de API de EveryInfra. No necesitan ni aceptan tu cuenta, tu contraseña ni tus cookies de LinkedIn, y ningún parámetro pide un inicio de sesión.
En Apify, casi todos los actores populares que leímos dicen en el título que no necesitan cookies. Los cuatro de harvestapi (perfiles, empresas, búsqueda y empleados) dicen «No cookies or account required». apimaestro dice «No Cookies» y «No login required». cheap_scraper, «No login or cookies needed». worldunboxer, «without login cookies». lergassy, «No account at risk». Las fichas de curious_coder y valig que leímos no lo indican, así que para ellas escribimos «la ficha no lo indica». En la Store también hay actores que piden tu cookie li_at. De los 109 actores con 100 usuarios o más, 31 no dicen «sin cookies» en el título ni en la descripción. Revisa cada uno antes de usarlo.
| Scraper | Texto de la ficha | ¿Hay que dar la cookie de LinkedIn? |
|---|---|---|
| harvestapi perfiles, empresas, búsqueda, empleados | No cookies or account required | No |
| apimaestro perfiles, empleados | No Cookies; No login required | No |
| cheap_scraper empleos | No login or cookies needed | No |
| worldunboxer empleos | without login cookies | No |
| lergassy perfiles | No account at risk | No |
| curious_coder empleos, valig empleos | La ficha no lo indica | No consta |
| EveryInfra, todas las capacidades de LinkedIn | Solo la clave de API de EveryInfra | No, y no se aceptan |
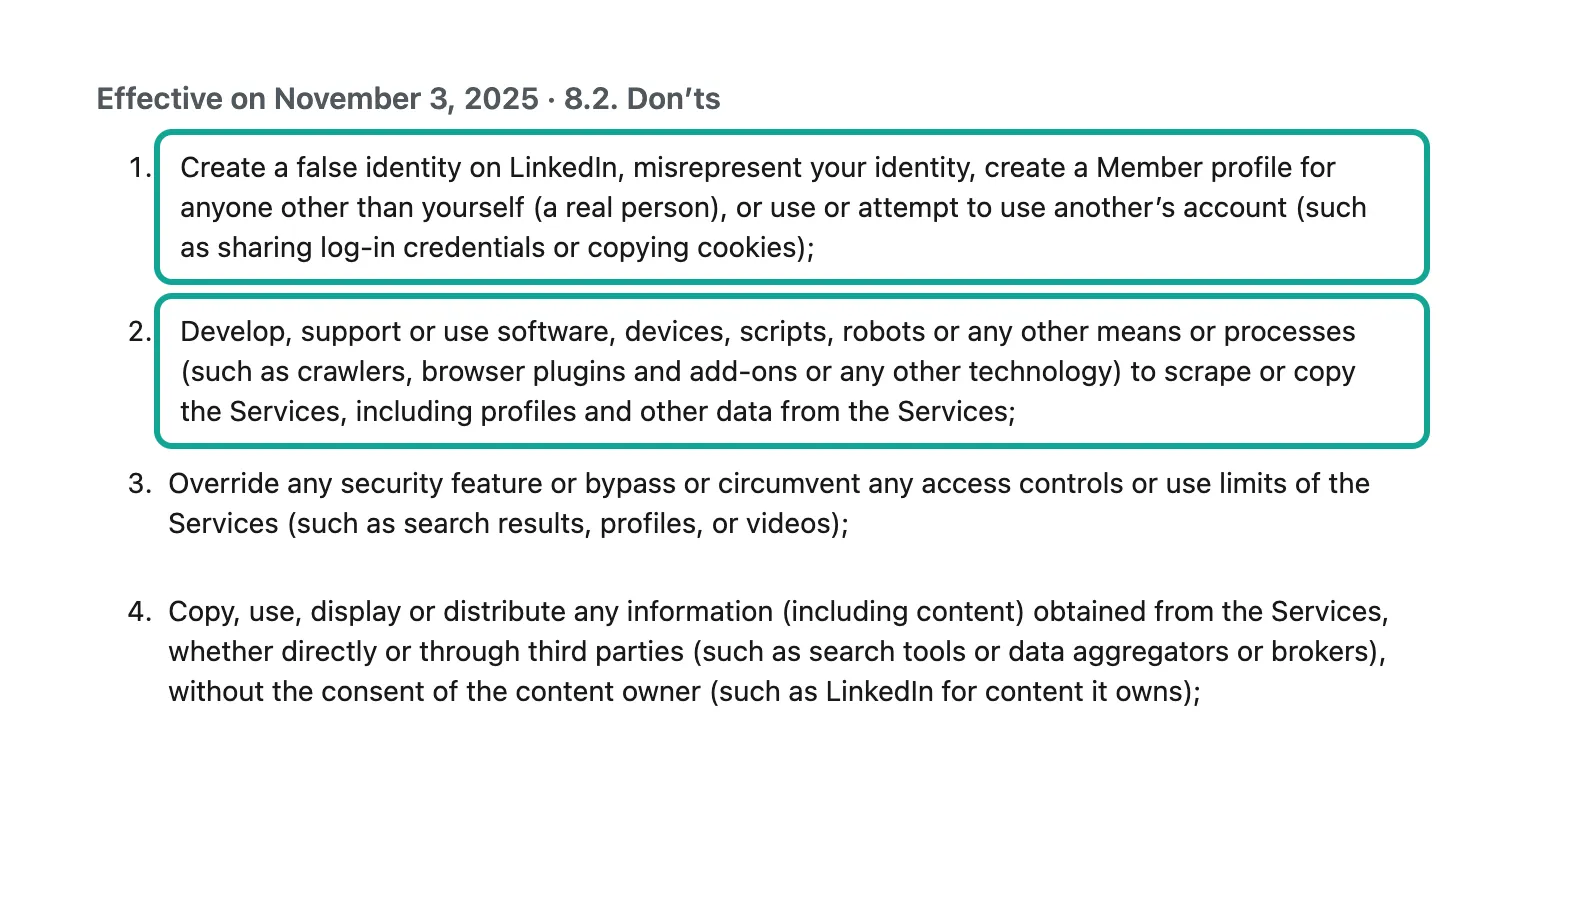
¿Por qué importa? El punto 2 de la sección 8.2 de las Condiciones de uso de LinkedIn prohíbe usar rastreadores, scripts o complementos del navegador para extraer o copiar los Servicios (lo citamos en la sección siguiente). Si das la cookie de tu cuenta a una herramienta de terceros, la extracción se hace con tu cuenta, y si LinkedIn la limita o la cierra, la pérdida es tuya. Con la cookie de otra persona chocas además con el punto 1, que dice que no debes «use or attempt to use another's account (such as sharing log-in credentials or copying cookies)», es decir, usar la cuenta de otro compartiendo credenciales o copiando cookies.
Qué dicen las Condiciones de uso de LinkedIn sobre la extracción
Leímos la versión vigente en linkedin.com/legal/user-agreement, que indica «Effective on November 3, 2025» (en vigor desde el 3 de noviembre de 2025). Lo más relevante es la sección 8.2, «Don'ts». Bajo «You agree that you will not», el punto 2 menciona software, dispositivos, scripts, robots, rastreadores, complementos del navegador y extensiones, y prohíbe usarlos «to scrape or copy the Services, including profiles and other data from the Services». El punto 3 prohíbe saltarse controles de acceso o límites de uso, por ejemplo en resultados de búsqueda o perfiles. Otro punto prohíbe copiar o distribuir información de los Servicios a través de terceros y nombra a los «data aggregators or brokers». La sección 5 dice que la sección 8.2 sigue vigente cuando termina el contrato.
Estas condiciones obligan a quien usa LinkedIn y acepta el contrato. Durante años, los tribunales de Estados Unidos discutieron qué pasa con las visitas a páginas públicas sin iniciar sesión. En hiQ Labs contra LinkedIn, el Tribunal de Apelaciones del Noveno Circuito dijo el 18-04-2022 que extraer perfiles visibles públicamente probablemente no es un acceso «sin autorización» según la ley federal CFAA, tras la sentencia Van Buren del Tribunal Supremo de 2021 sobre «exceder el acceso autorizado». Ese mismo año, el tribunal de distrito del norte de California concluyó que hiQ había incumplido las Condiciones de uso, y el caso terminó con un acuerdo.
El 24-01-2025, LinkedIn demandó a Nubela, la empresa detrás de Proxycurl, en el Distrito Norte de California (caso 3:25-cv-00828), por usar cientos de miles de cuentas falsas para extraer datos de miembros. Proxycurl anunció su cierre el 04-07-2025. En octubre de 2025, LinkedIn demandó a ProAPIs y Netswift por usar millones de cuentas falsas para extraer y revender datos. Según The Record, el tribunal aprobó después una sentencia de conformidad: las empresas deben dejar de extraer, vender y transferir datos de miembros, dejar de usar cuentas falsas y borrar lo extraído. En todos estos casos, las acusaciones giraban en torno a cuentas falsas o formas de saltarse el muro de inicio de sesión.
LinkedIn publica además unas Crawling Terms (revisadas por última vez el 25-05-2017) y un robots.txt, según los cuales el rastreo automático sin permiso no está permitido, salvo para buscadores autorizados. La documentación oficial de la API de LinkedIn en Microsoft Learn solo abre unos pocos permisos a la mayoría de desarrolladores: iniciar sesión, leer tu propio perfil básico y tu email, y publicar en nombre de un miembro. Buscar personas o leer perfiles completos de otros miembros exige programas de socios como Sales Navigator o Talent Solutions, con revisión previa. Es decir, LinkedIn no ofrece una vía abierta para leer datos públicos en masa, y por eso existe un mercado de scrapers de terceros.
No damos asesoramiento jurídico. Si usas estos datos y cómo lo haces depende de tu negocio, de tu país y de la finalidad; consulta con un abogado de tu jurisdicción. Los hechos que sí podemos afirmar son estos: las capacidades de LinkedIn de EveryInfra que usamos aquí devuelven solo información que muestran las páginas públicas y no necesitan tu cuenta. En person_profile y profile_search, el campo email es un email de trabajo deducido de datos públicos y verificado; en employees, el email solo aparece si la persona lo hace público. Trata los datos personales según la ley aplicable: en España, el RGPD y la Ley Orgánica 3/2018 (LOPDGDD), con la Agencia Española de Protección de Datos como autoridad; en América Latina, la ley de protección de datos de cada país. Comprueba el consentimiento antes de usarlos para marketing.
¿Se cobran los fallos y los resultados vacíos?
Las reglas de fallo deciden lo que te cuesta un mal día. En esta prueba vimos cuatro tipos de fallo.
| Caso | Hora de Singapur | HTTP | Código de error | Cobro de EveryInfra | Regla pública de Apify |
|---|---|---|---|---|---|
| Sin clave de API | 00:25 | 401 | missing_key | 0 USD | Sin token no hay ejecución |
Parámetro mal escrito (locaton) | 00:25 | 422 | unknown_param | 0 USD | Validación por esquema; cada actor varía |
| Persona inexistente | 00:19 | 503 | unavailable | 0 USD | Pago por evento: sin evento de resultado no hay cargo por resultado; el arranque se cobra |
| Detalle de empleo no disponible (4 llamadas) | 00:25-00:28 | 503 | unavailable | 0 USD | Igual |
| Tiempo agotado en búsqueda síncrona | 00:23 | 503 | timeout | 0 USD | Tu timeout corta la ejecución; los eventos ya producidos se cobran |
| Empresa inexistente | 00:20 | 200 | ninguno | 0,000556 USD (fallo nuestro) | - |
Nuestra regla es esta: cuando confirmamos un fallo o un resultado vacío, reembolsamos el mismo charge_id al mismo monedero; cuando el resultado es incierto, mantenemos el estado real y lo comprobamos antes. La única llamada que incumplió la regla fue el 200 vacío de la empresa inexistente. En el modelo de pago por evento de Apify, la documentación explica que el actor cobra cada vez que su código registra un evento. Sin resultado no hay evento de resultado, pero sí se cobran eventos de arranque como «Actor start» y eventos por página como «search page». El buscador de harvestapi cobra 0,10 USD por página «regardless of how many profiles were found», y su modo con email dice que no cobra la búsqueda si el perfil es demasiado pobre. En Apify, cada autor fija el coste de un fallo, así que hay que leer cada ficha.
MCP y herramientas de IA
Los dos lados admiten MCP (Model Context Protocol, un estándar para que los clientes de IA llamen a herramientas externas). El servidor MCP de Apify está en https://mcp.apify.com. Según su documentación, la primera conexión abre el navegador para iniciar sesión con OAuth, aunque también admite un token Bearer. Por defecto carga herramientas para buscar actores, ejecutarlos y consultar la documentación, y con ?tools= en la URL puedes cargar solo algunos actores. Sin cuenta solo funcionan herramientas como la búsqueda de actores y la documentación. Por seguridad, los actores que piden permisos completos quedan fuera del MCP. También admite «agentic payments» por petición, solo para actores de pago por evento. El 5 de noviembre de 2026 llamamos a https://mcp.apify.com sin token y devolvió 401, tal como indica la documentación.
El servidor MCP remoto de EveryInfra está en https://api.everyinfra.com/mcp. El 5 de noviembre de 2026, tools/list devolvió 12 herramientas, todas con nombre everyinfra_*. everyinfra_list_capabilities lista capacidades y precios, everyinfra_call_api llama a cualquier capacidad, everyinfra_get_job lee trabajos asíncronos y everyinfra_get_account muestra el saldo. A las 01:02 hora de Singapur del 5 de noviembre de 2026 enviamos un tools/call por MCP a everyinfra_call_api con {"platform":"linkedin","action":"company_profile","params":{"company":"openai"}}. La respuesta llegó en 6,4 segundos y el texto de content traía el mismo JSON que la API REST, unos 3300 caracteres: OpenAI aparecía con un employee_count de 11 489, un tramo de tamaño de 1001-5000 y 12 126 872 seguidores. El cobro fue de 0,000556 USD, igual que por REST. En Claude Code se añade con un bloque:
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}| Aspecto | MCP de Apify | MCP de EveryInfra |
|---|---|---|
| URL | https://mcp.apify.com | https://api.everyinfra.com/mcp |
| Autenticación | OAuth por defecto, o token Bearer | Clave de API (Bearer) |
| Una llamada a herramienta | Arranca una ejecución de actor y devuelve el dataset | Una petición a la API que devuelve JSON |
| Cobro | Según el actor (casi siempre por resultado) | Por petición; en LinkedIn casi siempre 0,000556 USD |
| Sin credenciales | Solo búsqueda de actores y documentación | Probado a las 01:04 y a las 01:17: isError, código unauthorized, «Nothing was charged» |
| En esta prueba | 401 sin token | 01:02, empresa, 6,4 segundos, 0,000556 USD |
En un cliente de IA, la pregunta clave es cuánto devuelve una llamada a una herramienta. Una llamada MCP de Apify arranca una ejecución de actor y devuelve su conjunto de datos al terminar. Una llamada MCP de EveryInfra es una petición a la API y devuelve el JSON que ya vimos. Para un agente, «buscar empleos y traer 200 filas» es una llamada de 0,000556 USD en nuestro lado; en Apify es una ejecución de actor que se cobra por resultado. La configuración para cada cliente está en la página del servidor MCP de EveryInfra.
Cuándo conviene más Apify
Esta sección recoge lo que Apify tiene y nosotros no, y dónde es más barato. Primero, los perfiles sueltos: LinkedIn Profile API, de johnvc, cuesta 0,02 USD por cada 1000, 27,8 veces menos que nosotros. Su tasa de éxito es del 91,12 %, pero las filas fallidas no pagan cargo por resultado, así que sigue siendo más barato por fila buena. Si tu única tarea es completar URLs de perfil, pruébalo primero. Segundo, el detalle de un empleo: nuestro linkedin/job_detail devolvió 503 en las cinco pruebas y su precio de catálogo es de 1,194 USD por cada 1000, mientras que el modo detallado de worldunboxer cuesta 0,35 USD y funciona.
Tercero, los filtros finos. Los actores de búsqueda y de empleados de harvestapi filtran por empresa, sector, centro de estudios y antigüedad, y uno busca por nombre; nuestro profile_search solo filtra por cargo y ubicación, y employees solo por empresa. Cuarto, la búsqueda de emails: el modo con verificación SMTP de harvestapi y el «verified email» y «phone number» de dev_fusion son productos dedicados. Para nosotros, el email es solo un campo del perfil; en esta prueba apareció en 3 de 5 perfiles públicos y en 47 de 78 resultados de búsqueda.
Quinto, una base de empleos grande y lista para usar: fantastic-jobs dice sumar más de 10 millones de ofertas nuevas al mes, con datos del reclutador y campos con IA, y para análisis del mercado laboral su modelo de datos encaja mejor. Sexto, el control de ejecuciones: maxTotalChargeUsd limita el coste de una ejecución, Schedules lanza actores con horario, los webhooks avisan al terminar y los datasets guardan resultados y exportan CSV o Excel. No tenemos esas funciones de plataforma, así que hay que montarlas con cron y una base de datos. Séptimo, la variedad: la Store lista 370 actores de LinkedIn, con herramientas específicas para publicaciones de empresa, eventos, grupos y Sales Navigator, frente a nuestras 11 capacidades de LinkedIn.
| Caso de uso | Encaja mejor | Motivo |
|---|---|---|
| Solo completar una lista de URLs de perfil | Apify (johnvc) | 0,02 USD por cada 1000, 27,8 veces menos que nosotros |
| Detalle de una oferta y enlace de candidatura | Apify (worldunboxer detallado) | 0,35 USD por cada 1000; nuestras 4 pruebas dieron 503 |
| Audiencias por sector, centro de estudios o antigüedad | Apify (buscador de harvestapi) | Nosotros solo filtramos por cargo y ubicación |
| Búsqueda de emails con verificación SMTP | Apify (harvestapi, dev_fusion) | Nosotros solo damos el campo email del perfil |
| Muchos empleos, personas o empleados por llamada | EveryInfra | De 0,0028 a 0,0071 USD por cada 1000, cientos de veces menos |
| Varias plataformas con una clave y precio fijo en clientes de IA | EveryInfra | Un solo formato de petición y precio fijo por llamada |
Nosotros encajamos mejor en otros casos. El primero, los datos que llegan con muchas filas por llamada, como empleos, búsquedas de personas, listas de empleados y comentarios: ahí la diferencia va de 10 a más de 1000 veces. El segundo, los proyectos que necesitan LinkedIn y otras plataformas, como Instagram, TikTok o X, con una sola clave, un solo formato de petición y una sola cuenta. El tercero, el uso por MCP en clientes de IA, donde cada llamada tiene un precio fijo y el coste no crece con el tamaño del resultado. El cuarto, cuando no quieres mantener varios actores con autores, entradas y precios cambiantes. En esta prueba, los cuatro actores de harvestapi estrenaban precio desde el 27-10-2026, apimaestro desde el 02-11-2026 y worldunboxer desde el 29-10-2026, y cheap_scraper tenía un precio nuevo previsto para el 07-11-2026.
En qué se diferencia de nuestros otros artículos sobre Apify
Tenemos otros artículos sobre Apify y cada uno trata un tema. Precios de Apify explicados cubre planes, unidades de cómputo y pago por evento, para quien empieza con Apify. Alternativas a Apify repasa opciones por plataforma. Alternativa a Apify Twitter Scraper y alternativa a Apify Reddit Scraper comparan precios para X y Reddit. Este artículo trata solo LinkedIn y aporta tres cosas que los otros no tienen: la diferencia de precio entre llamadas de una fila y de una página en LinkedIn, la cuestión de las cookies y las Condiciones de uso, y el actor de perfiles de la Store que es más barato que nosotros. Todas las páginas comparativas están en /alternatives.
Cambios recientes
Para elegir herramienta importan dos tipos de cambio. El primero viene de LinkedIn: su Centro de ayuda explica que la búsqueda de empleo con IA sustituye poco a poco a la búsqueda clásica desde septiembre. Describes con tus palabras el trabajo que buscas, y eso puede cambiar los resultados de las búsquedas por palabra clave. Si vigilas un mercado con linkedin/jobs o con un actor de empleos de Apify, revisa de vez en cuando cuántas filas devuelve un mismo grupo de palabras clave.
El segundo viene de Apify: los actores de LinkedIn más usados cambiaron de precio varias veces en el último mes (ver la tabla), así que revisa la pestaña Pricing antes de fiarte de un precio de un artículo o comentario antiguo. El 30-10-2026, el blog de la Agentic AI Foundation publicó un artículo del equipo MCP de Apify: probaron 30 días el formato TOON, que ahorra tokens, en su servidor MCP, no vieron una mejora estable y volvieron a JSON. La página de precios de Apify dice ahora «We're live on x402», para que los agentes de IA paguen por ejecución.
| Fecha | Hecho | Fuente |
|---|---|---|
| 07-10-2026 | Entra en vigor el precio actual de LinkedIn Profile API de johnvc | API pública de Apify |
| 15-10-2026 | Entra en vigor el precio actual del actor de perfiles de lergassy | API pública de Apify |
| 22-10-2026 | Entra en vigor el precio actual del actor de empleados de johnvc | API pública de Apify |
| 27-10-2026 | Precios nuevos en cuatro actores de LinkedIn de harvestapi | API pública de Apify |
| 29-10-2026 | Precio nuevo del actor de empleos de worldunboxer | API pública de Apify |
| 30-10-2026 | El equipo MCP de Apify retira TOON tras 30 días | Agentic AI Foundation |
| 02-11-2026 | Precios nuevos en los actores de perfiles y empresas de apimaestro | API pública de Apify |
Preguntas frecuentes
¿Cuál es el apify linkedin scraper cost?
Precios públicos de la Store el 5 de noviembre de 2026: los scrapers de perfiles cuestan de 0,02 a 10,00 USD por cada 1000; el más usado, de harvestapi, 4,00 USD en Free y 10,00 USD con email. Los de empresas, de 1,55 a 5,00 USD. Los de empleos, de 0,10 a 5,00 USD; el más usado, de curious_coder, 2,00 USD en Free y 1,00 USD en planes de pago. El coste real depende también del nivel, las tarifas de arranque y las tarifas por página. En EveryInfra, cada llamada de LinkedIn cuesta 0,000556 USD (0,001194 USD el detalle de empleo): 0,556 USD por cada 1000 perfiles o empresas, 0,0033 USD por cada 1000 empleos y 0,0071 USD por cada 1000 personas buscadas.
¿Cómo se llama a la apify linkedin scraper api?
Cada actor de Apify se ejecuta con POST /v2/acts/<autor>~<nombre>/run-sync-get-dataset-items, que lo lanza y devuelve los resultados. Los campos de entrada se rellenan según la pestaña Input del actor, y puedes añadir maxItems y maxTotalChargeUsd para limitar el gasto. Apify también tiene clientes para JavaScript y Python. EveryInfra usa una sola URL, POST /api/v1/social, con platform, action y params en el cuerpo.
¿Cuántos resultados da apify linkedin scraper jobs por búsqueda?
La ficha de curious_coder dice que LinkedIn limita cada búsqueda de empleo a 1000 resultados; para más, divide la búsqueda por ciudades y elimina duplicados. Nuestro linkedin/jobs admite un limit de hasta 200 por llamada, y en esta prueba las 11 búsquedas de Singapur devolvieron 179 filas de media. El catálogo indica que la fuente de respaldo devuelve como máximo 25 filas por llamada.
¿Hay algún scraper de LinkedIn gratis?
El plan Free de Apify da 5 USD al mes: a 4,00 USD por cada 1000 alcanza para unos 1250 perfiles, pero harvestapi limita a 50 ejecuciones en total a los usuarios del plan Free. En GitHub hay scripts de código abierto para extraer LinkedIn, pero el inicio de sesión, los proxies y los cambios de la página los mantienes tú, y si los usas con tu cuenta te obligan igualmente las Condiciones de uso. La prueba de EveryInfra da 1 USD durante 24 horas por dar una estrella a dos repositorios en GitHub: a 0,000556 USD por llamada son unas 1798 peticiones.
¿LinkedIn permite la extracción de datos?
La sección 8.2 de las Condiciones de uso de LinkedIn prohíbe usar rastreadores, scripts o herramientas parecidas para extraer o copiar los Servicios, y copiar cookies para usar la cuenta de otra persona. Las Crawling Terms dicen que el rastreo automático sin permiso no está permitido. Los tribunales han fallado de forma distinta sobre las páginas públicas vistas sin iniciar sesión, y LinkedIn sigue demandando a empresas que extraen datos con cuentas falsas. Este artículo no es asesoramiento jurídico: consulta con un abogado de tu país.
¿Cuánto cuesta la API oficial de LinkedIn?
LinkedIn no publica una tarifa por llamada para datos de miembros. La mayoría de desarrolladores solo puede usar el inicio de sesión, su propio perfil básico y email, y la publicación en nombre de un miembro. Buscar personas o leer perfiles completos de otros exige programas de socios como Sales Navigator o Talent Solutions, y los socios aprobados pagan según contrato.
¿Cómo se usa en n8n o en Claude?
En n8n basta un nodo HTTP Request que llame a POST /api/v1/social; Apify tiene su propio nodo de n8n. En clientes MCP como Claude Code o Claude Desktop puedes añadir https://api.everyinfra.com/mcp o https://mcp.apify.com: el nuestro usa una clave de API y el de Apify inicia sesión con OAuth por defecto.
Primeros pasos
Paso 1: consigue una clave de API. Da una estrella a dos repositorios de EveryInfra en GitHub y recibirás 1 USD de crédito de prueba válido 24 horas. Las recargas de pago empiezan en 10 USD, que dan para unas 17 986 peticiones de LinkedIn a 0,000556 USD cada una (inicio rápido, precios). Paso 2: abre la página de una capacidad y lanza una llamada desde su recuadro de prueba: búsqueda de empleos, búsqueda de personas, perfiles, empresas o empleados de una empresa. Paso 3: mira charged_usd y el número de filas de la respuesta, divide el cobro entre las filas y multiplica por 1000 para obtener tu propio precio por cada 1000, y compáralo con tu factura actual.
Las 11 capacidades de LinkedIn están en la página de la API de datos de LinkedIn. La misma clave sirve para la API de datos de TikTok y la API de datos de Instagram, y puedes ver todas las plataformas en el mercado de datos.
Si vienes de Apify, la tabla muestra qué cambiar. Con cobro por petición, cuantas más filas por llamada, menor es el precio por fila, así que conviene reunir un lote y buscar una vez.
| En Apify | En EveryInfra |
|---|---|
| Cada actor tiene sus propios campos de entrada | Tres claves fijas: platform, action, params |
| Ejecutar el actor, esperar y leer el dataset | Una petición síncrona, o "mode": "async" y consultas a poll_url |
maxItems y maxTotalChargeUsd limitan el gasto | Cada petición tiene precio fijo: basta contar peticiones |
| Una ejecución por cada contacto nuevo | Reunir un lote y buscar una vez |
| Schedules y webhooks | Tu propio cron o una programación de n8n |
Referencias
- LinkedIn Profile Scraper (ficha y pestaña Pricing), Apify / harvestapi, captura del 5 de noviembre de 2026, 00:28 hora de Singapur. https://apify.com/harvestapi/linkedin-profile-scraper
- Metadatos públicos de LinkedIn Profile Scraper (pricingInfos, stats), API de Apify, leídos el 5 de noviembre de 2026, 00:16 hora de Singapur. https://api.apify.com/v2/acts/harvestapi~linkedin-profile-scraper
- LinkedIn Company Details Scraper, Apify / harvestapi. https://apify.com/harvestapi/linkedin-company
- LinkedIn Profile Search Scraper (25 por página, 0,10 USD por página), Apify / harvestapi. https://apify.com/harvestapi/linkedin-profile-search
- LinkedIn Company Employees Scraper, Apify / harvestapi. https://apify.com/harvestapi/linkedin-company-employees
- Profile Details Scraper for LinkedIn + EMAIL, Apify / apimaestro. https://apify.com/apimaestro/linkedin-profile-detail
- LinkedIn Profile API, Apify / johnvc. https://apify.com/johnvc/linkedin-profile-api
- Linkedin Profile Scraper with Email and Company Data, Apify / datadoping. https://apify.com/datadoping/linkedin-profile-scraper
- Linkedin Company Details Scraper, Apify / datadoping. https://apify.com/datadoping/linkedin-company-scraper
- Linkedin Jobs Scraper (límite de 1000 empleos por búsqueda), Apify / curious_coder. https://apify.com/curious_coder/linkedin-jobs-scraper
- LinkedIn Jobs Scraper, Apify / valig. https://apify.com/valig/linkedin-jobs-scraper
- Rapid Linkedin Jobs Scraper, Apify / worldunboxer. https://apify.com/worldunboxer/rapid-linkedin-scraper
- LinkedIn Jobs Scraper, Apify / cheap_scraper. https://apify.com/cheap_scraper/linkedin-job-scraper
- Advanced LinkedIn Job Search API, Apify / fantastic-jobs. https://apify.com/fantastic-jobs/advanced-linkedin-job-search-api
- Página de precios de Apify (Free 5 USD, Starter 19 USD, Scale 199 USD, Business 999 USD, niveles de descuento), leída el 5 de noviembre de 2026, 00:39 hora de Singapur. https://apify.com/pricing
- Run Actor synchronously and get dataset items (maxItems, maxTotalChargeUsd), documentación de la API de Apify. https://docs.apify.com/api/v2/act-run-sync-get-dataset-items-post
- Get Actor, documentación de la API de Apify. https://docs.apify.com/api/v2/act-get
- Get list of Actors in Store, documentación de la API de Apify. https://docs.apify.com/api/v2/store-get
- Actors in Store (los autores fijan los descuentos por nivel), documentación de Apify. https://docs.apify.com/platform/actors/running/actors-in-store
- Monetize your Actor (reglas del pago por evento), documentación de Apify. https://docs.apify.com/platform/actors/publishing/monetize
- Usage and resources, documentación de Apify. https://docs.apify.com/platform/actors/running/usage-and-resources
- Apify MCP server, documentación de Apify, leída el 5 de noviembre de 2026. https://docs.apify.com/platform/integrations/mcp
- apify-mcp-server, GitHub. https://github.com/apify/apify-mcp-server
- Schedules, documentación de Apify. https://docs.apify.com/platform/schedules
- Webhooks, documentación de Apify. https://docs.apify.com/platform/integrations/webhooks
- Dataset, documentación de Apify. https://docs.apify.com/platform/storage/dataset
- Limits, documentación de Apify. https://docs.apify.com/platform/limits
- Integración con n8n, documentación de Apify. https://docs.apify.com/platform/integrations/n8n
- Integración con Zapier, documentación de Apify. https://docs.apify.com/platform/integrations/zapier
- Cliente de la API de Apify para JavaScript, documentación de Apify. https://docs.apify.com/api/client/js
- Apify CLI, documentación de Apify. https://docs.apify.com/cli
- LinkedIn User Agreement (Effective on November 3, 2025, sección 8.2), captura del 5 de noviembre de 2026. https://www.linkedin.com/legal/user-agreement
- LinkedIn Crawling Terms and Conditions. https://www.linkedin.com/legal/crawling-terms
- Política de privacidad de LinkedIn. https://www.linkedin.com/legal/privacy-policy
- Política de cookies de LinkedIn. https://www.linkedin.com/legal/cookie-policy
- Políticas de la Comunidad Profesional de LinkedIn. https://www.linkedin.com/legal/professional-community-policies
- LinkedIn API Terms of Use. https://www.linkedin.com/legal/l/api-terms-of-use
- Getting Access to LinkedIn APIs, Microsoft Learn. https://learn.microsoft.com/en-us/linkedin/shared/authentication/getting-access
- Sign In with LinkedIn using OpenID Connect, Microsoft Learn. https://learn.microsoft.com/en-us/linkedin/consumer/integrations/self-serve/sign-in-with-linkedin-v2
- Documentación para desarrolladores de LinkedIn Sales Navigator, Microsoft Learn. https://learn.microsoft.com/en-us/linkedin/sales/
- Job Posting API overview, Microsoft Learn. https://learn.microsoft.com/en-us/linkedin/talent/job-postings/api/overview
- API rate limiting, Microsoft Learn. https://learn.microsoft.com/en-us/linkedin/shared/api-guide/concepts/rate-limits
- LinkedIn Developer Solutions. https://developer.linkedin.com/
- hiQ Labs v. LinkedIn Corp., Tribunal de Apelaciones del Noveno Circuito de EE. UU., 18-04-2022. https://cdn.ca9.uscourts.gov/datastore/opinions/2022/04/18/17-16783.pdf
- Van Buren v. United States, Tribunal Supremo de EE. UU., 2021. https://www.supremecourt.gov/opinions/20pdf/19-783_k53l.pdf
- hiQ v. LinkedIn Wrapped Up: Web Scraping Lessons Learned, ZwillGen. https://www.zwillgen.com/alternative-data/hiq-v-linkedin-wrapped-up-web-scraping-lessons-learned
- Demanda de LinkedIn contra ProAPIs, Distrito Norte de California (CourtListener). https://storage.courtlistener.com/recap/gov.uscourts.cand.457309/gov.uscourts.cand.457309.1.0.pdf
- LinkedIn wins court order blocking mass scraping of user data, The Record. https://therecord.media/linkedin-wins-court-order-blocking-mass-scraping
- Proxycurl Shuts Down, Nubela, 04-07-2025. https://nubela.co/blog/goodbye-proxycurl/
- Reglamento General de Protección de Datos (RGPD), EUR-Lex. https://eur-lex.europa.eu/eli/reg/2016/679/oj
- Ley Orgánica 3/2018, de Protección de Datos Personales y garantía de los derechos digitales, BOE. https://www.boe.es/buscar/act.php?id=BOE-A-2018-16673
- Agencia Española de Protección de Datos. https://www.aepd.es/
- Catálogo de LinkedIn de EveryInfra (price_usd, response_fields, field_note), leído el 5 de noviembre de 2026, 00:12 hora de Singapur. https://api.everyinfra.com/api/v1/social/catalog
- llms.txt de EveryInfra. https://api.everyinfra.com/llms.txt
- OpenAPI de EveryInfra. https://api.everyinfra.com/openapi.json
- MCP remoto de EveryInfra (tools/list), leído el 5 de noviembre de 2026. https://api.everyinfra.com/mcp
- Introducción a Model Context Protocol. https://modelcontextprotocol.io/introduction
- Connect Claude Code to tools via MCP, documentación de Claude Code. https://code.claude.com/docs/en/mcp
- Nodo HTTP Request, documentación de n8n. https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.httprequest/
- TOON (Token-Oriented Object Notation), GitHub. https://github.com/toon-format/toon
- We Added TOON to Our MCP Server, Then Removed It, Agentic AI Foundation, 30-10-2026. https://aaif.io/blog/we-added-toon-to-our-mcp-server-then-removed-it
- Búsqueda de empleo con IA (retirada progresiva de la búsqueda clásica desde septiembre), Ayuda de LinkedIn. https://www.linkedin.com/help/linkedin/answer/a6889044
- r/n8n: flujo gratuito de empleos de LinkedIn y la respuesta sobre 5 USD agotados en minutos (nombres de usuario ocultos). https://www.reddit.com/r/n8n/comments/1t4lk7a/i_built_a_100_free_linkedin_job_scraper_using_n8n/
- r/n8n: ayuda con un flujo de empleos de LinkedIn (nombres de usuario ocultos). https://www.reddit.com/r/n8n/comments/1t9trjv/n8n_linkedin_job_scraper_workflow_help/
- LinkedIn Copyright Policy. https://www.linkedin.com/legal/copyright-policy
- Resumen de las Condiciones de uso de LinkedIn. https://www.linkedin.com/legal/user-agreement-summary
- Documentación de LinkedIn Talent Solutions, Microsoft Learn. https://learn.microsoft.com/en-us/linkedin/talent/
- Documentación de LinkedIn Marketing API, Microsoft Learn. https://learn.microsoft.com/en-us/linkedin/marketing/
- Runs and builds, documentación de Apify. https://docs.apify.com/platform/actors/running/runs-and-builds
- Billing, documentación de Apify. https://docs.apify.com/platform/console/billing
- Cliente de la API de Apify para Python, documentación de Apify. https://docs.apify.com/api/client/python
- Integración con Make, documentación de Apify. https://docs.apify.com/platform/integrations/make
- Apify Proxy, documentación de Apify. https://docs.apify.com/platform/proxy
Referencia BL-91