DeepSeek V4 Claude Code洗评论:配置与成本
Claude Code接DeepSeek的配置示例,EveryInfra真调695条评论:flash高峰价约Sonnet 5.5的1/10,比Haiku贵
把 Claude Code 的模型换成 DeepSeek 的 deepseek-flash,再用 EveryInfra 远程 MCP 拉 YouTube、B 站和抖音的评论来清洗分类,这件活能做,而且便宜,但「十分之一成本」只在一个条件下成立:DeepSeek 那边的缓存要命中。按 Claude Code 官方成本文档里那段示例会话的用量算,deepseek-flash 高峰价一次是 $0.0274,正好是 Claude Sonnet 5.5($0.2744)的十分之一;可要是缓存全部没命中,它会涨到 $0.3037,比缓存正常的 Sonnet 5.5 还贵,而 Claude Haiku 5.5 同样的会话只要 $0.0184。2026 年 10 月 26 日 17:26–17:38(新加坡时间),我们真调 EveryInfra 拉了 15 个视频的 695 行评论,清洗后留下 655 条,送进模型的估算 token 从 84,109 降到 20,176;在 B 站和抖音,每千条评论的数据费比 deepseek-flash 的模型费还高。
本文说的「洗评论」,是让 Claude Code 先读 EveryInfra 的能力目录,再通过 MCP 工具 everyinfra_call_api 拉几个视频下的评论(youtube/comments、bilibili/comments、douyin/comments),用一段脚本去掉重复、空话和引流,再用关键词规则先给一半评论打上「配置与报错」「价格与额度」「和别的模型比」「夸奖」四类标签,剩下规则认不出的交给模型判断,最后输出一张带原文的分类表和一笔账。驱动 Claude Code 的不是 Anthropic 的模型,而是 DeepSeek 通过 Anthropic 兼容端点提供的 deepseek-flash。我们没有 DeepSeek 的 Key,所以 DeepSeek 和 Claude Code 那一侧全部是照官方文档写的配置示例,没有实跑;EveryInfra 这一侧的每次调用、每个数字都是真调出来的。


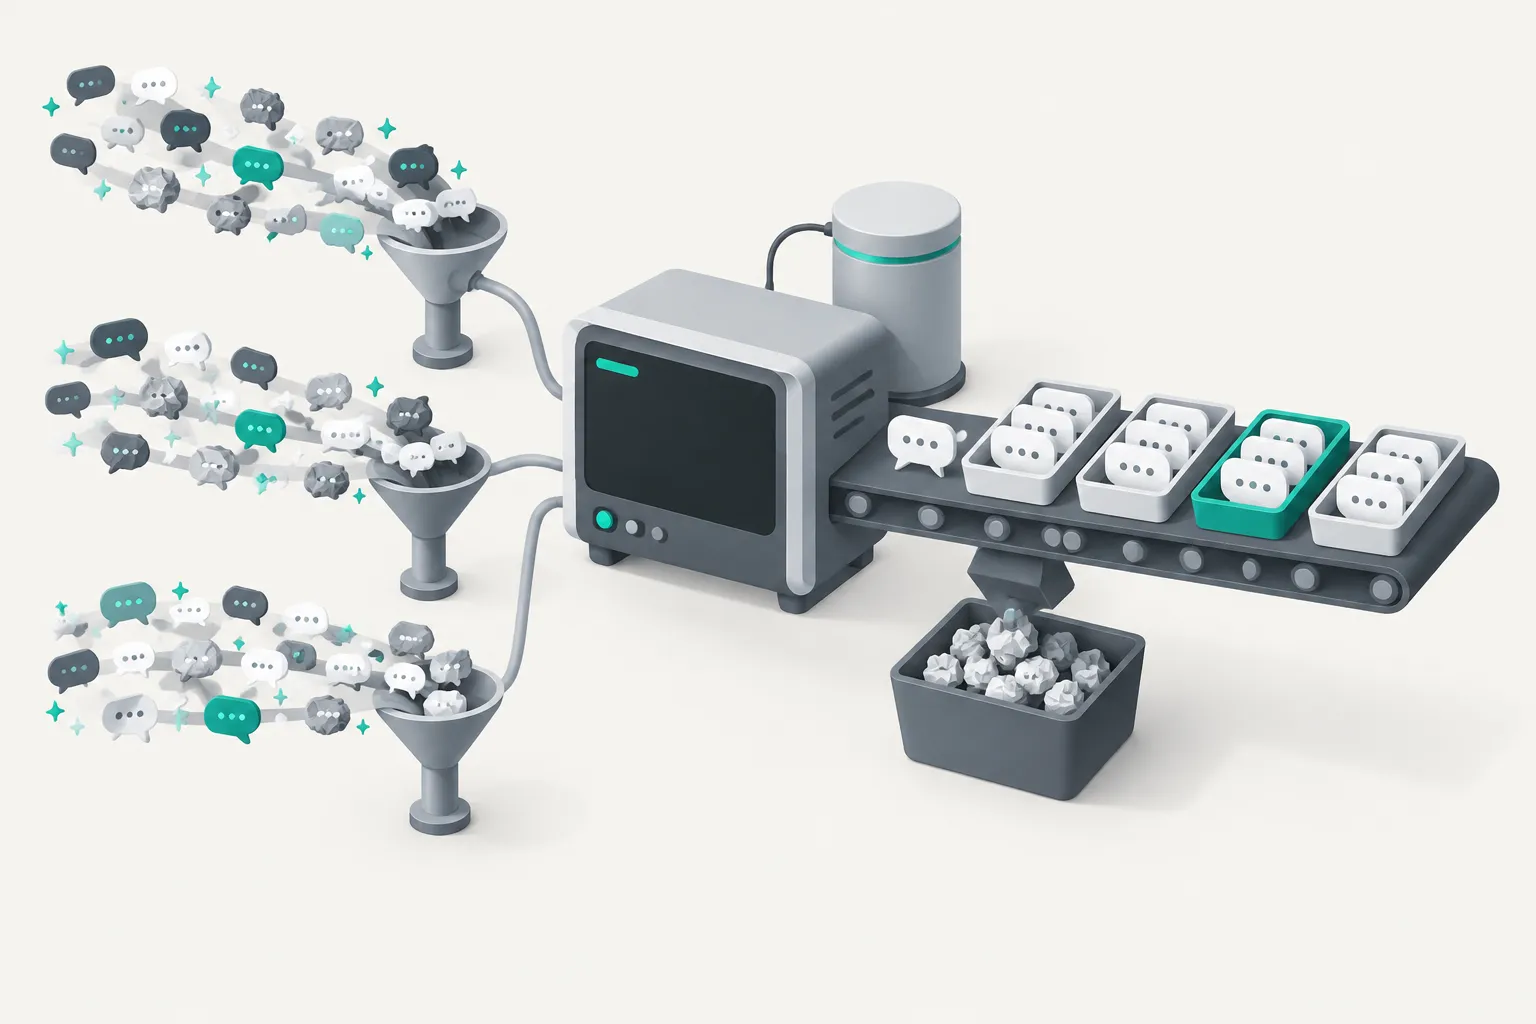
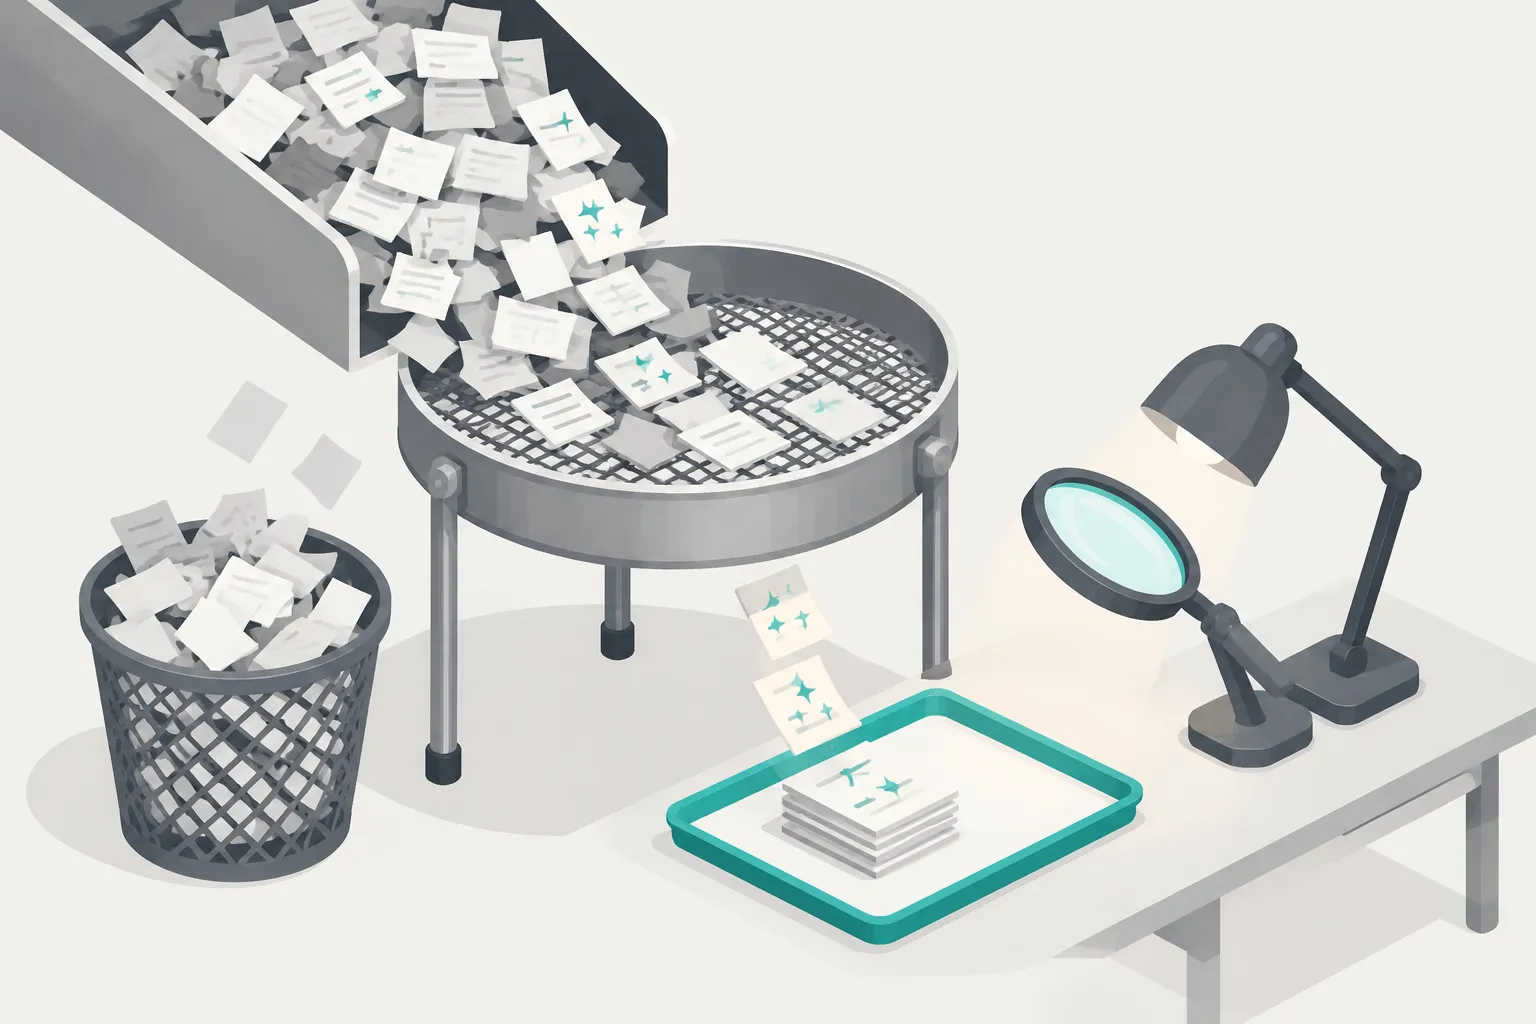
这张图是整件活的样子:真正贵的那一步是右前方那张「读桌」,也就是模型一条一条读评论、打标签;左边的筛子越细,送到读桌上的东西越少。下面先讲配置,再讲五组实测,最后把钱算清楚。
先说结论:十分之一成本只在缓存命中时成立
调研底稿里这个题目原来的工作标题是「用十分之一成本清洗评论」。我们动手前把它写成两个要按数回答的问题:同一份用量,deepseek-flash 高峰价是不是 Claude Sonnet 5.5 的 10% 以内?是不是比 Claude Haiku 5.5 便宜?答案是第一问「刚好是」,第二问「不是」。
用量我们没有自己编,而是照搬 Claude Code 成本文档里 /cost 命令的示例:1.2k 输入、5.3k 输出、940.0k 缓存读、50.0k 缓存写,文档标的是 Claude Sonnet 4.6、$0.55。我们先用 Sonnet 4.6 的价格复算一遍,得到 $0.5526,和文档对得上,说明这套算法本身没错;再把同一份用量换成各家 2026-10-26 读到的公开价。Claude 一侧取 Anthropic 定价页,DeepSeek 一侧取 DeepSeek 定价页(USD 版),并和中文版的人民币价逐项核对过。
| 模型(2026-10-26 公开价) | 缓存全部命中 | 缓存全部没命中 | 相当于 Sonnet 5.5(命中)的 |
|---|---|---|---|
| Claude Opus 5.5 | $0.5488 | $4.1208 | 200% |
| Claude Sonnet 5.5 | $0.2744 | $2.0604 | 100% |
| deepseek-v4-pro 高峰 | $0.1299 | $1.3294 | 47.3% |
| deepseek-flash 高峰 | $0.0274 | $0.3037 | 10.0% |
| Claude Haiku 5.5 | $0.0184 | $0.1030 | 6.7% |
| deepseek-flash 闲时 | $0.0137 | $0.1519 | 5.0% |
这张表里最容易被忽略的是中间那一列。Claude Code 这类代理的用量里,缓存读占了绝大头:示例会话 991.2k 个输入 token 里有 940.0k 是缓存读,占 94.8%。所以谁的缓存命中价便宜、缓存到底能不能命中,决定了账单的数量级。deepseek-flash 的命中价是高峰 $0.006、闲时 $0.003 每百万 token,比 Haiku 5.5 的 $0.01 还低;但它没命中时的输入价是 $0.30,是 Haiku 5.5($0.10)的 3 倍。结果就是:命中时它在 Sonnet 5.5 的十分之一附近,没命中时它比缓存正常工作的 Sonnet 5.5 还贵。
还有一个边界要说在前面:表里只是 token 价的比较,不是能力的比较。两家的分词器不同,Anthropic 定价页写明 Claude 4.7 以后的分词器对同样的文本约多出 30% 的 token(相对 4.6 及更早的模型),DeepSeek 和 Claude 之间的折算比例没有公开数据;Anthropic 有免费的 token 计数接口,DeepSeek 也提供离线分词器,但我们没有任何一家的 Key,没有拿真实的 usage 校准,所以全文的 token 数都是估算,比价时两边用同一个 token 数。
这件活为什么值得交给 deepseek v4.1 flash 这类便宜模型
评论清洗是典型的「量大、每一条都不难」的活。一个讲「DeepSeek V4 接 Claude Code」的教程视频下面,几十上百条评论里大半是在问配置为什么不通、钱怎么扣、和 Claude 自己的模型比怎么样;每一条要判断的东西都很简单,但条数一多,读的 token 就多。DeepSeek 在 2026 年 10 月 17 日的发布说明里把 deepseek-flash 升到 DeepSeek-V4.1-Flash-1017,强调的正是「缩短了任务运行时间与输出长度」,并点名对 Claude Code 之外的几个代理框架做了优化。它的 Hugging Face 模型卡写明 Terminal-Bench 4.0 是用 Claude Code 这套代理框架测的,得分 42.3。
Anthropic 一侧,Claude Haiku 5.5 的发布页(2026-10-07)把「摘要、压缩、分类这类大批量、重复的活」和「给 Opus 5.5、Sonnet 5.5 当子代理」列为它的主场,Terminal-Bench 4.0 写的是 39.2%,Sonnet 5.5 是 70.6%。两家的数都是自己报的,测法不同,不能直接比高低,但它们说明了一件事:这一档「便宜的小模型」现在有两个都能接进 Claude Code 的选择,要比的就是钱和接起来的麻烦程度。
| 对比项 | deepseek-flash(经 DeepSeek Anthropic 兼容端点) | Claude Haiku 5.5(Anthropic 直连) |
|---|---|---|
| 未命中输入 / 输出(每百万 token) | 高峰 $0.30 / $1.20,闲时 $0.15 / $0.60 | $0.10 / $0.50(单次提示 ≤10 万 token) |
| 缓存命中价 | 高峰 $0.006,闲时 $0.003 | $0.01 |
| 缓存怎么生效 | 磁盘缓存自动按前缀匹配,cache_control 被忽略 | 按 Claude Code 发出的 cache_control 标记 |
| 上下文 | 1M | 1M(超过 10 万 token 的提示按更高价) |
| 图片输入 | 支持(deepseek-v4-pro 不支持) | 支持 |
| 官方是否支持接进 Claude Code | DeepSeek 文档给出配置;Anthropic 文档写明不支持经网关把 Claude Code 接到非 Claude 模型 | 原生支持 |
最后一行要特别看清:Claude Code 的网关文档原话是 Anthropic 不认可、不维护、不审核第三方网关,也不支持经任何网关把 Claude Code 路由到非 Claude 模型。DeepSeek 的做法在技术上走的就是这条「自定义 ANTHROPIC_BASE_URL」的路,出了问题,Claude Code 那边不会替你兜底。Anthropic 正式支持的第三方路线只有 Amazon Bedrock、Google Cloud、Microsoft Foundry 这类云平台(见第三方集成文档),以及它自己的网关方案。
动手前写下的判据
我们在第一次拉评论之前,把「这件活算不算做成」写成 9 条判据,看到结果后没有改线。判据里有两条是按数落档、没有对错的(噪音占比、工具定义有多大),其余都有通过线。
| 编号 | 判据 | 通过线 | 结果 |
|---|---|---|---|
| J1 | DeepSeek 给的 9 个环境变量,Claude Code 官方文档里都查得到 | 9/9 | 通过:9/9 |
| J2 | MCP 返回的字段都在目录 response_fields 里,且与 REST 一致 | 两条都成立 | 通过 |
| J3 | 每次 charged_usd = 目录价 × 计费份数,失败不扣费 | 逐条相等 | 通过:15 次评论调用、3 次搜索、1 次 MCP 调用全部对上 |
| J4 | 清洗后送进模型的 token ≤ 原始 JSON 的 40% | ≤40% | 通过:38.0% / 17.5% / 5.6% |
| J5 | 噪音占比(只按数落档) | — | YouTube 低(2.2%),B 站、抖音中(12.0%、13.0%) |
| J6 | flash 高峰 ≤ Sonnet 5.5 的 10%?≤ Haiku 5.5? | 按数答 | 第一问:会话 10.0%,是;批量分类 13.5%,否。第二问:否 |
| J7 | 写错参数返回 422、带建议值,「没扣费」写在错误文字里 | REST 与 MCP 都成立 | 通过 |
| J8 | 25 个工具定义有多大(只记数) | — | 约 8,556 token,只留 4 个约 1,058 |
| J9 | Key 不落盘 | 0 命中 | 通过 |
J7 为什么要求「没扣费」写在文字里,而不是只看 HTTP 状态码或 MCP 的 isError 标志,后面讲兼容表时会说清楚:DeepSeek 的 Anthropic 兼容端点会忽略 tool_result 里的 is_error 字段。
deepseek claude code setup:9 个环境变量逐个对照官方文档
DeepSeek 的 Claude Code 接入页给的是 9 个环境变量。我们把每一个都拿到 Claude Code 的环境变量文档里逐个查了一遍,9 个都在,含义也和 DeepSeek 页面上的用法一致。
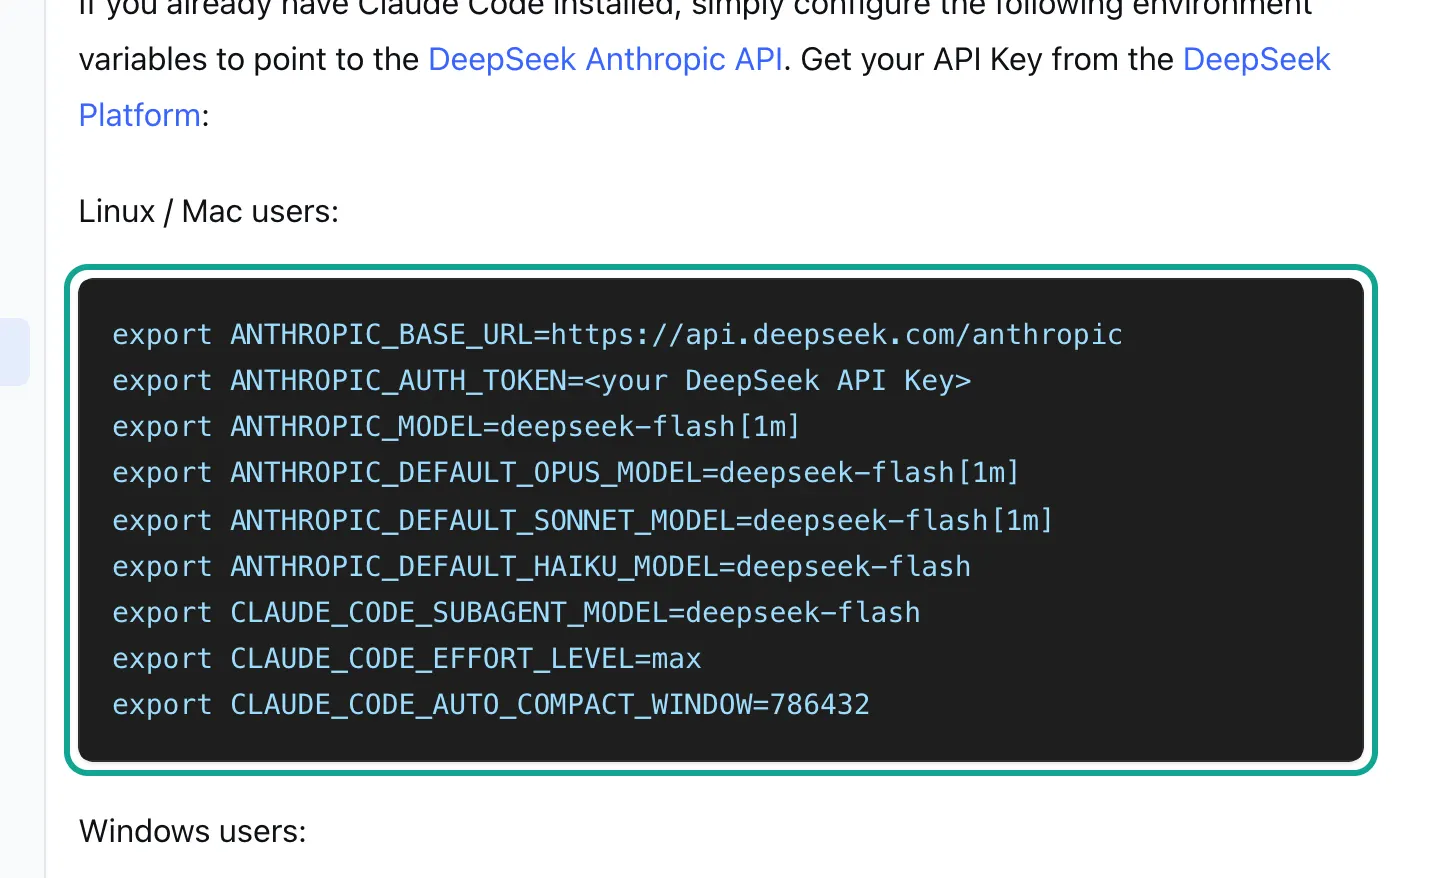
# 配置示例(我们没有 DeepSeek 的 Key,没有实跑这一段)
export ANTHROPIC_BASE_URL=https://api.deepseek.com/anthropic
export ANTHROPIC_AUTH_TOKEN="$DEEPSEEK_API_KEY"        # 走 Authorization: Bearer
export ANTHROPIC_MODEL='deepseek-flash[1m]'
export ANTHROPIC_DEFAULT_OPUS_MODEL='deepseek-flash[1m]'
export ANTHROPIC_DEFAULT_SONNET_MODEL='deepseek-flash[1m]'
export ANTHROPIC_DEFAULT_HAIKU_MODEL=deepseek-flash     # 后台任务也用它
export CLAUDE_CODE_SUBAGENT_MODEL=deepseek-flash
export CLAUDE_CODE_EFFORT_LEVEL=high                    # DeepSeek 页面写的是 max,清洗评论用不着
export CLAUDE_CODE_AUTO_COMPACT_WINDOW=786432
# 本文另外建议加的两行:
export ENABLE_TOOL_SEARCH=false                         # 兼容表没列 defer_loading,先关掉工具搜索
export EVERYINFRA_API_KEY=... # 给 .mcp.json 用,不要写进项目文件| 变量 | 在 Claude Code 里管什么 | 这件活里要注意的 |
|---|---|---|
ANTHROPIC_BASE_URL | 把请求发到代理或网关 | 指向非 api.anthropic.com 时,Remote Control 不可用 |
ANTHROPIC_AUTH_TOKEN | 放进 Authorization: Bearer 头 | 比已登录的 claude.ai 账号优先;只设地址不设它,用的还是订阅额度 |
ANTHROPIC_MODEL | 主会话模型 | [1m] 后缀表示 1M 上下文 |
ANTHROPIC_DEFAULT_OPUS_MODEL / _SONNET_ | opus、sonnet 别名落到哪个模型 | 不设的话,claude-opus* 会被 DeepSeek 映射成 deepseek-v4-pro,按 Pro 价计费 |
ANTHROPIC_DEFAULT_HAIKU_MODEL | haiku 别名,也是后台任务的模型 | 后台任务同样计费 |
CLAUDE_CODE_SUBAGENT_MODEL | 子代理默认模型 | 按平台分子代理时都会落到它 |
CLAUDE_CODE_EFFORT_LEVEL | 努力程度 | DeepSeek 把 medium、high、xhigh 都映射成 high |
CLAUDE_CODE_AUTO_COMPACT_WINDOW | 上下文到多少 token 时自动压缩 | 取值范围 100,000–1,000,000 |
ENABLE_TOOL_SEARCH | MCP 工具搜索 | 设为 false 时所有工具定义每一轮都进请求 |
有三点是对照两边文档才看得出来的。第一,模型映射。DeepSeek 的兼容说明写明,以 claude-opus 开头的模型名会被映射成 deepseek-v4-pro、按 Pro 价计费,claude-haiku 和 claude-sonnet 映射成 deepseek-flash。如果你只设了 ANTHROPIC_MODEL,在 Claude Code 里切到 opus,账单就会按 Pro 价走;同一份示例会话,Pro 高峰价是 $0.1299,是 flash 的 4.7 倍。
第二,能力识别。Claude Code 的模型配置文档说,它按模型 ID 的模式来决定开不开努力程度、扩展思考这些功能,认不出的 ID 可能让这些功能保持关闭,可以用 ANTHROPIC_DEFAULT_SONNET_MODEL_SUPPORTED_CAPABILITIES 一类的变量明确声明。另一方面,网关兼容指南又写着,它会把不认识的模型名当成新模型、照样发 thinking: {"type": "adaptive"}。两处说法的适用范围不同,我们没法实跑验证,只能建议:接好以后先用 /status 和 /model 看一眼当前模型和努力程度,再开始跑批量活。
第三,努力程度。DeepSeek 页面给的是 max,而它的思考模式文档写明,请求里的 medium、high、xhigh 实际都按 high 跑,max 和 ultra 按 max 跑。清洗评论用不着最高档,思考 token 按输出价计费,我们在示例里改成了 high。
把 EveryInfra 接成 MCP:一份 .mcp.json,只留 4 个工具
Claude Code 加远程 MCP 有两种写法:命令行 claude mcp add --transport http,或者项目根目录的 .mcp.json。我们推荐后者,因为 Claude Code 的 MCP 文档写明 .mcp.json 的 url 和 headers 支持 ${VAR} 环境变量展开,Key 可以不落进项目文件;命令行那种写法会在添加的那一刻把展开后的 Key 存进 ~/.claude.json。
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" },
      "timeout": 150000
    }
  }
}这里有一个对这套组合很有用的安全设计:同一份文档写明,ANTHROPIC_AUTH_TOKEN、ANTHROPIC_API_KEY 这些 Claude Code 自己的凭据变量,在远程 MCP 的 url 和 headers 里一律读成空值。也就是说,就算有人在 .mcp.json 里写了 Bearer ${ANTHROPIC_AUTH_TOKEN},你的 DeepSeek Key 也不会被发到任何 MCP 服务器;反过来,EVERYINFRA_API_KEY 不在这张名单里,会正常展开。timeout 设 150 秒,是因为我们实测一次 YouTube 评论调用最慢要 78.6 秒,EveryInfra 的同步预算是 85 秒,留出余量。
2026-10-26 17:26(新加坡时间),我们对 https://api.everyinfra.com/mcp 发了一次和 Claude Code 连接时相同的 initialize 与 tools/list 请求,返回 25 个工具。按 DeepSeek《Token 用量》页给的折算比例(1 个英文字符约 0.3 token、1 个中文字符约 0.6 token)估算,25 个工具的名称、描述和参数定义合计约 8,556 token。
8,556 token 单看不多,但有两个放大器。其一,为了避开兼容性问题我们建议关掉工具搜索,关掉后 Claude Code 每一轮请求都会把全部工具定义带上。其二,Claude Code 的权限文档写明,用裸工具名写的 deny 规则会把这个工具从模型的上下文里拿掉。所以清洗评论这件活,只需要在项目的 .claude/settings.json(格式见设置文档)里把其余 21 个工具拒掉,例如下面这样,每轮请求就从约 8,556 降到约 1,058 token:
{
  "permissions": {
    "allow": ["mcp__everyinfra__everyinfra_list_capabilities", "mcp__everyinfra__everyinfra_call_api",
              "mcp__everyinfra__everyinfra_get_job", "mcp__everyinfra__everyinfra_usage"],
    "deny":  ["mcp__everyinfra__everyinfra_search",
              "mcp__everyinfra__everyinfra_solve_captcha", "mcp__everyinfra__everyinfra_key_create",
              "mcp__everyinfra__everyinfra_key_delete", "mcp__everyinfra__everyinfra_settings_update",
              "mcp__everyinfra__everyinfra_webhook_set", "mcp__everyinfra__everyinfra_create_ticket"]
  }
}
示例里只列了 7 个,其余 14 个照同样的格式补上即可。everyinfra_call_api 在 tools/list 里标的是 readOnlyHint: false、没有 idempotentHint,这在 Claude Code 2.1.307(2026-10-21)之后有一个好处:更新日志写明,HTTP MCP 调用在连接中途断开时,只有只读或幂等的工具才会被自动重试,所以一次拉评论不会因为断线被悄悄发两遍、扣两次钱。
一次真实往返:模型发出什么,我们回了什么
Claude Code 和远程 MCP 之间走的是 MCP 规范里的 tools/call。不管背后的模型是 Claude 还是 DeepSeek,模型只负责产出一个 tool_use 块(工具名加参数),真正的 HTTP 请求由 Claude Code 发出。所以这一段的请求体,和模型是谁没有关系;不过工具定义、tool_use 和 tool_result 都会算进模型的输入 token,这一点 Anthropic 的工具使用文档写得很清楚,DeepSeek 一侧同理。
2026-10-26 17:37:32(新加坡时间),我们用 curl 向 EveryInfra 发出了 Claude Code 会发的同一个 tools/call,让它按最新排序拉一个 YouTube 视频的 20 条评论。14.0 秒后返回 200,result.content[0].text 是一段 8,926 个字符的 JSON 字符串(格式按 RFC 8259),扣费 $0.000556,和 YouTube 评论爬虫 API 的目录价一致。
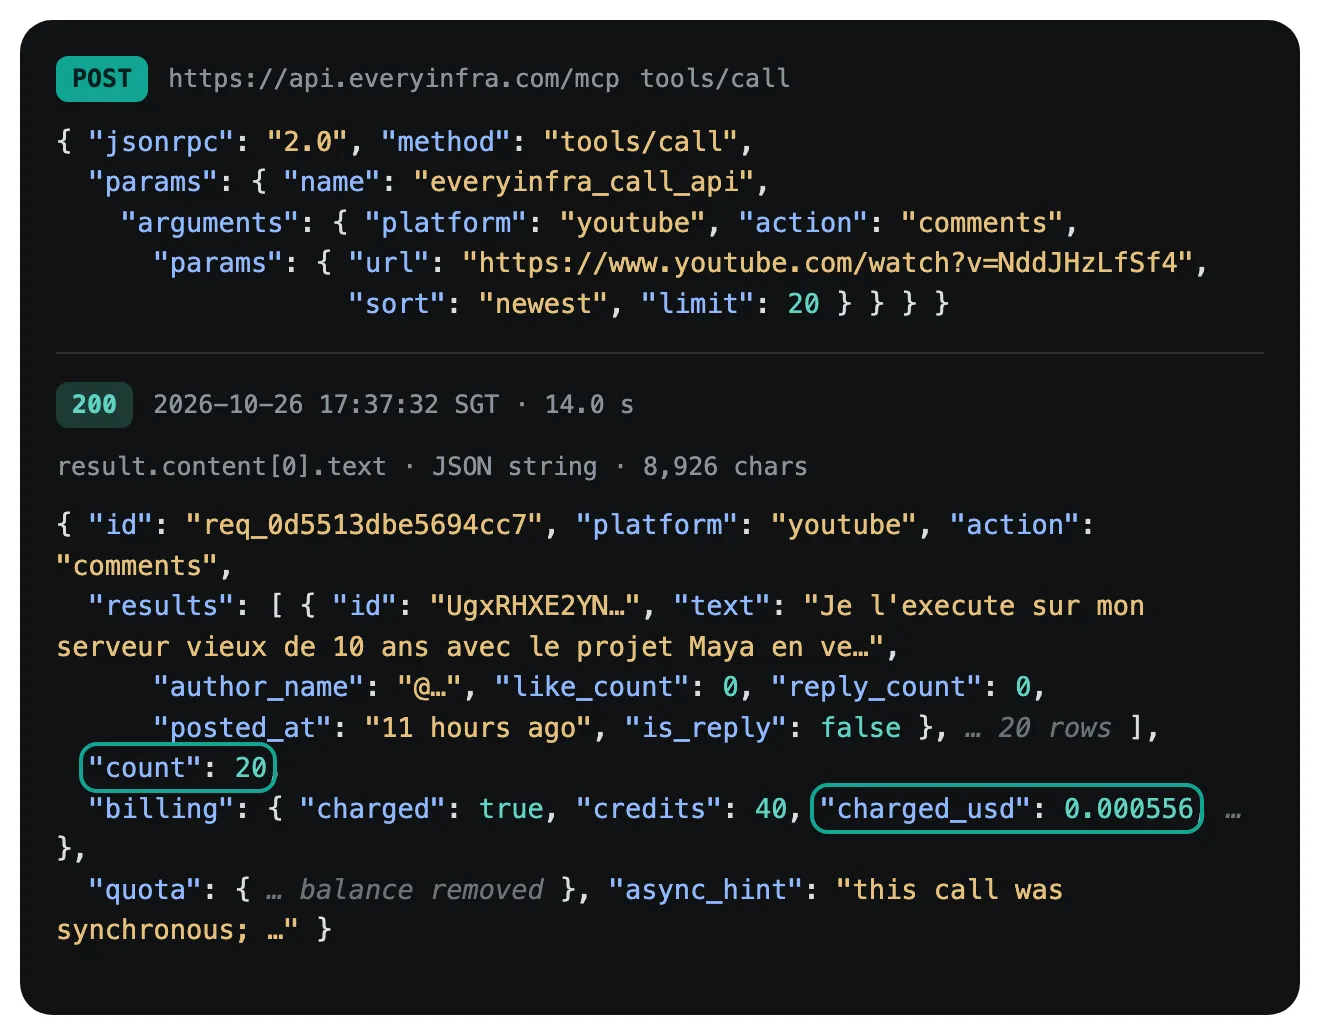
我们把这次 MCP 返回的字段,和 17:28:19 同一个视频走 REST 拿到的字段,再和目录里 youtube/comments 的 response_fields 逐个对了一遍:
| 字段 | 目录 `response_fields` | MCP 返回 | REST 返回 | 清洗时怎么用 |
|---|---|---|---|---|
id | 有 | 有 | 有 | 第一步去重的键 |
text | 有 | 有 | 有 | 唯一送进模型的正文 |
author_name | 有 | 有 | 有 | 不送进模型,报告里也隐去 |
like_count | 有 | 有 | 有 | 留下,作为排序权重 |
reply_count | 有 | 有 | 有 | 不送 |
posted_at | 有 | 有 | 有 | YouTube 是「11 hours ago」这类相对时间,要按抓取时刻换算 |
is_reply | 有 | 有 | 有 | 留下一个字母 r / t |
reply_to_id | 有 | 这 20 条都是顶层,没出现 | 有 | 回复挂到父评论下 |
platform | 有 | 有 | 有 | 不送 |
两条路返回的字段没有一个超出目录,MCP 少的 reply_to_id 是因为这 20 条最新评论里恰好没有回复。J2 通过。这里顺带说一个 Claude Code 文档里的数字:MCP 工具输出超过 10,000 token 时 Claude Code 会提示警告,默认上限 25,000 token,超出的结果和超过 50,000 个字符的结果会被存进文件,对话里只留文件路径。我们拉到的 100 条 YouTube 评论,一次返回约 3.3 万到 3.5 万个字符,估算约 1 万 token,正好踩在警告线上。
deepseek anthropic api 的兼容表:和工具调用有关的 7 处
DeepSeek 的 Anthropic API 兼容说明有一张逐字段的支持表。我们把其中和「模型调工具、读工具结果」有关的行挑出来,再和 Claude Code 网关兼容指南里列的「Claude Code 会发什么」对照,得到下面这张表。凡是表里写「文档未列出」的,都是我们没法实测、只能提醒的地方。
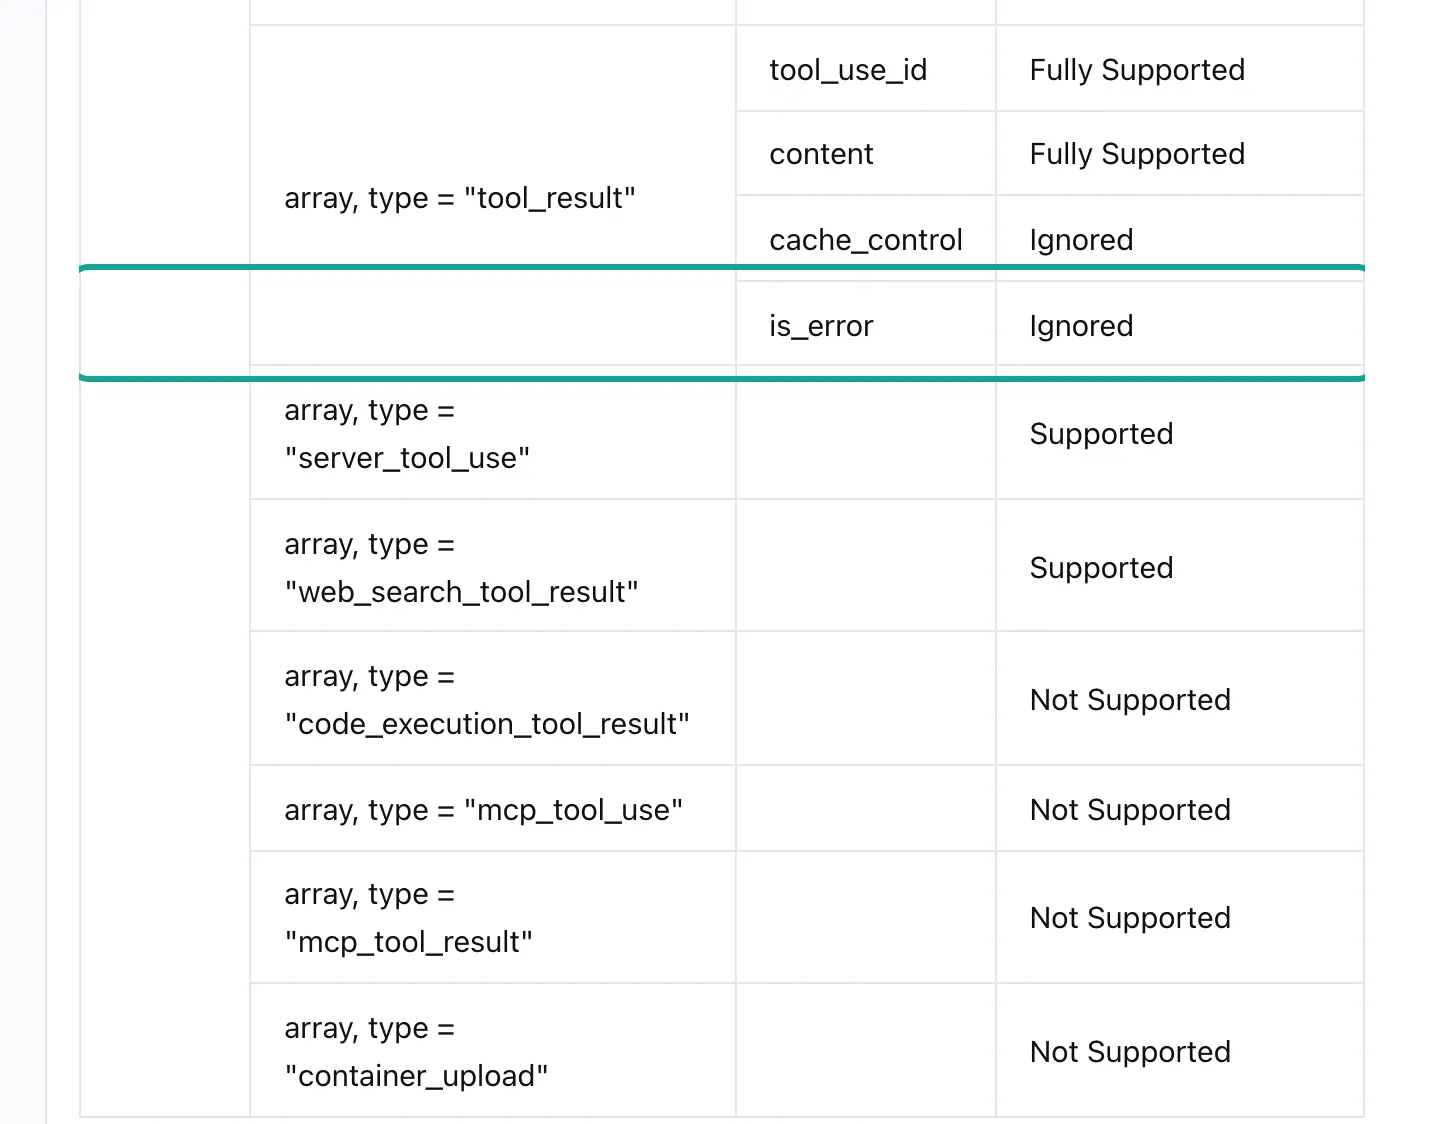
| 字段或行为 | DeepSeek 兼容表 | 对清洗评论这件活意味着什么 |
|---|---|---|
tool_result.is_error | 忽略 | 工具报错时模型只看得到文字;错误文字本身要写清怎么改、扣没扣钱 |
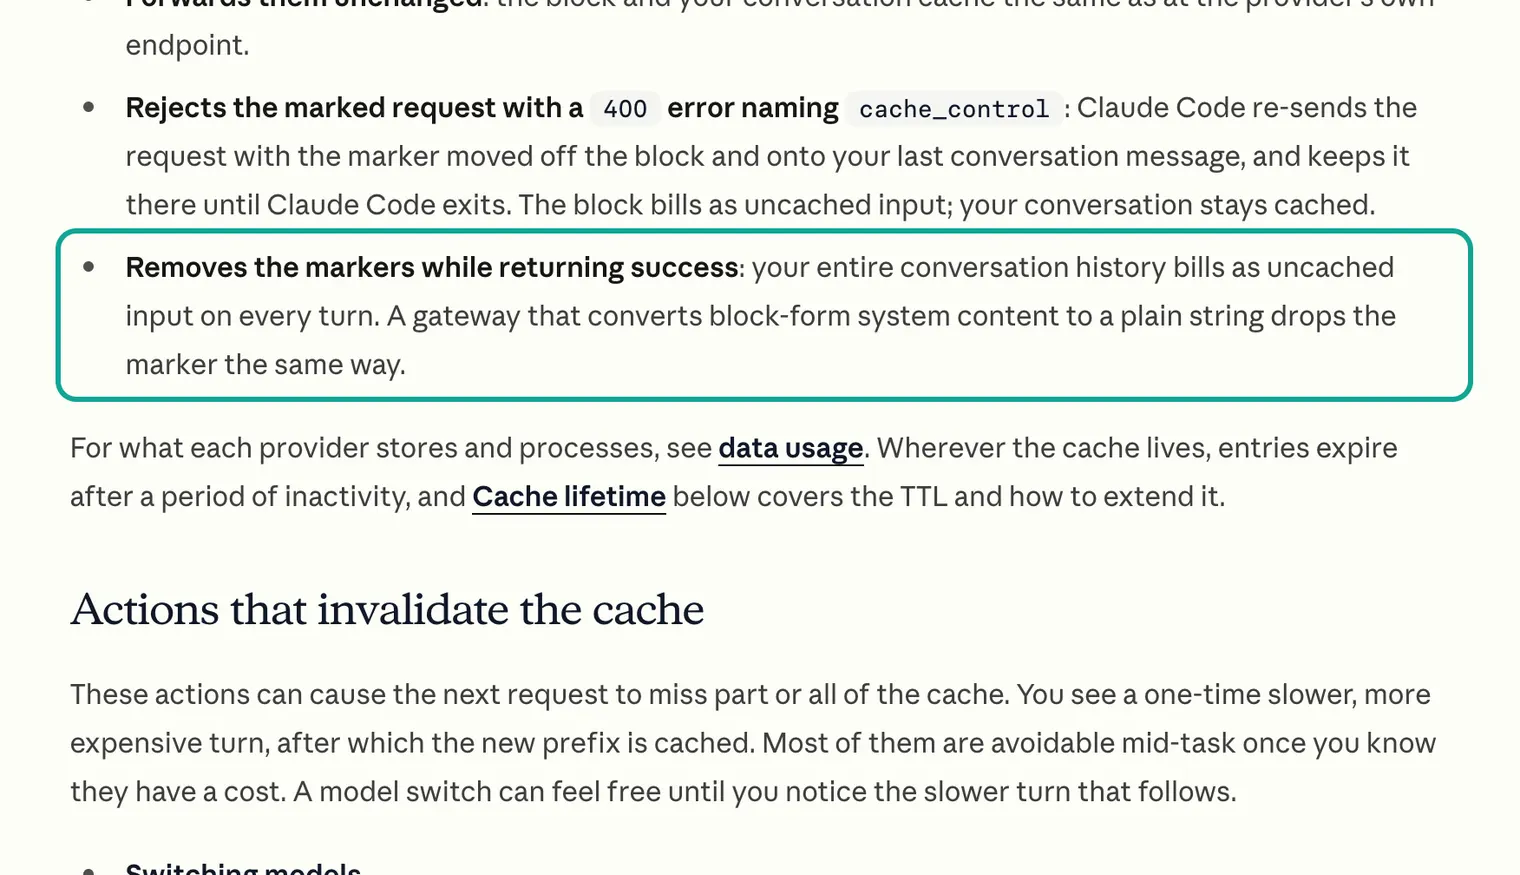
cache_control(tools、text、tool_use、tool_result 上) | 忽略 | 缓存改由 DeepSeek 的磁盘缓存按前缀自动匹配;Anthropic 那边的缓存规则在这里不适用 |
tool_choice 的 disable_parallel_tool_use | 忽略 | 模型可能一次并行发出多个 tools/call,同时撞上限速 |
mcp_servers | 忽略 | 不影响 Claude Code:它在本地当 MCP 客户端,不用服务端 MCP |
mcp_tool_use、mcp_tool_result 块 | 不支持 | 同上,Claude Code 发的是普通 tool_use / tool_result |
document、search_result 内容块 | 不支持 | 不要让 Claude Code 把 PDF 当文档块塞给模型 |
工具搜索用的 defer_loading、tool_reference,以及 strict | 文档未列出 | Claude Code 2.1.304 起在自定义地址后默认开工具搜索,遇到 400 或 422 会自动重试一次不带工具搜索;想彻底避开就设 ENABLE_TOOL_SEARCH=false |
第一行对我们最重要。按 MCP 规范,工具执行出错时服务器返回 isError: true,Claude Code 再把它包成带 is_error 的 tool_result 交给模型。DeepSeek 会忽略这个标志,模型拿到的就只剩文字。所以「错误能不能让模型自己改对」,完全取决于错误文字写得够不够清楚。
第二行决定钱。Claude Code 的提示缓存文档把网关处理 cache_control 的方式分成三种,其中「去掉标记、照常返回成功」那一种,按 Claude 的计费方式,等于整段对话每一轮都按未缓存输入计费。DeepSeek 正好属于「忽略标记」,但它自带磁盘缓存:默认对所有用户开启,按请求前缀匹配,命中部分按命中价计费,文档同时写明这是「尽力而为」,不保证 100% 命中,缓存不用后通常几小时到几天内清掉。
还有一个会影响前缀命中的细节。Claude Code 的网关兼容指南写明,它会在系统提示最前面加一段归属信息,里面有客户端版本和一个由对话推导出的指纹;Anthropic 自己的端点会在处理前去掉它,其他端点则会原样收到。DeepSeek 的缓存要求前缀「完全匹配」一个已保存的前缀单元,这段信息在同一个对话里是否保持不变,文档没有说,我们也没法验证。这就是我们把成本表分成「全部命中」和「全部没命中」两列的原因:真实账单会落在两者之间,要看你的 DeepSeek 用量页里的 prompt_cache_hit_tokens。
实测一:三个平台的评论拉回来是什么样
17:26:56–17:27:16(新加坡时间),我们分别用 youtube/search、bilibili/search、douyin/search 搜了「deepseek v4 claude code」和「DeepSeek Claude Code」,从结果里挑了 15 个讲 DeepSeek 接 Claude Code 的视频:YouTube 6 个(英语 4 个、中文 1 个、西语 1 个),B 站5 个,抖音4 个。其中抖音搜索目前只返回第一页(这次 20 条,没有 next_page_token),想要更多候选视频,就换关键词再搜。选题本身就是这件活的用法:这些视频下面的评论,恰好是「这套组合在真实用户手里卡在哪」的第一手材料。
| 平台 | 视频数 | 请求条数 | 返回行(含回复) | 扣费 | 单次耗时 |
|---|---|---|---|---|---|
| YouTube | 6 | 每次 100 | 461(顶层 289、回复 172) | 6 × $0.000556 = $0.003336 | 11.5–78.6 秒 |
| B 站 | 5 | 每次 50 | 50(每次 10) | 5 × $0.000556 = $0.002780 | 8.7–11.4 秒 |
| 抖音 | 4 | 每次 50 | 184(顶层 86、回复 98) | $0.006112(按 20 条一份) | 14.4–44.0 秒 |
计费我们逐条对过。youtube/comments 和 bilibili/comments 在目录里是一次一个价,不论返回几条;抖音评论爬虫 API 标了 rows_per_unit: 20,每 20 条算一份,返回 50 条算 3 份(120 credits,$0.001667),返回 34 条算 2 份(80 credits,$0.001111)。15 次调用的 credits 都等于目录价乘以份数,J3 通过。
有三处观察要如实写下来。第一,B 站评论爬虫 API 这 5 次都只回了 10 条,而我们请求的是 50 条。这不是我们截掉的:B 站每个视频最多给 10 条评论,目录现在已改成默认 10、最多 10,limit 填得更大也照常受理,只按 10 条取。我们在 20:01:21(新加坡时间)用 limit=50 对同一个视频复核了一次,返回 10 条,扣费 $0.000556。所以 B 站的每千条数据费偏高($0.0556 每千行),做预算时按每个视频最多 10 条算。第二,抖音有两页里出现了同一个 id 的评论两次,4 页 184 行里有 8 行是这样的重复。这个问题已在 10 月 26 日 19:53 修复:接口现在按 id 去重,只留第一条,去重后不够一份的按规则退钱;本文这 184 行是修复前拉的。清洗第一步的 id 去重我们仍然保留,当作兜底。第三,YouTube 的 posted_at 是「7 days ago (edited)」这样的相对时间,B 站和抖音是带时区的标准时间;要按日期汇总,YouTube 那一侧得按抓取时刻换算,换出来的只是近似日期。
耗时这件事和 Claude Code 有直接关系。它的 MCP 文档写明,主会话里一次 MCP 调用超过 2 分钟,就会被转成后台任务,模型先拿到任务 ID、继续干别的,结果到了再通知。我们最慢的一次是 78.6 秒,离 2 分钟还有距离;EveryInfra 目录的 async_mode 一节也写明同步预算是 85 秒,更大的 limit 应该改用 mode: "async",再用免费的 everyinfra_get_job 取结果。如果你让 DeepSeek 一次并行发出好几个调用(前面说过 disable_parallel_tool_use 会被忽略),还要记得 EveryInfra 的 Key 有每分钟的请求上限,并行太多会收到 429;DeepSeek 那边按账户算并发,deepseek-flash 是 2,500 路,超了同样返回 429(限速说明)。
实测二:清洗脚本去掉了什么
清洗这一步,我们刻意不交给模型,而是让模型写一段脚本来做。原因很简单:规则能判断的东西,交给模型就是在为每一条评论付读的钱。Claude Code 的成本文档也举过同样的例子:与其让模型读一万行日志找错误,不如用一个钩子先 grep 出含 ERROR 的行,把上下文从几万 token 压到几百。
脚本按顺序做四件事,第一条命中就不再往下看。第二步的「归一化」用的是 Unicode 的 NFKC 规范化(UAX #15,Python 里是 unicodedata.normalize),再去掉链接、表情代码和标点,这样全角半角、大小写不同的同一句话会被认成重复。规则全部是 Python 的正则表达式,可以原样复跑:
# 第 4 版清洗规则(节选;完整脚本与原始响应一起保存,可原样复跑)
BRACKET_EMOJI = re.compile(r"\[[一-鿿]{1,6}\]")      # [捂脸] 这类表情代码,只认方括号里全是汉字
PROMO = re.compile(r"(subscribe(?!r)|newsletter|giveaway|chrome extension|coupon|telegram|whatsapp|"
                   r"私信|加群|进群|加微|微信|qq群|关注我|免费领|领取|代金券|优惠|课程|戳我)", re.I)
for r in rows:
    if (video, r["id"]) in seen_id:   drop("同 id 重复"); continue       # 1. 同一条评论在一页里出现两次
    if (video, norm(r["text"])) in seen_text: drop("文字重复"); continue  # 2. 归一化后文字相同
    if no_content(r["text"]):          drop("没信息"); continue          # 3. 纯表情、666、两个字以内且不是问句
    if PROMO.search(r["text"]) or (has_link and (few_chars or bait)): drop("推广引流"); continue  # 4.
    keep(f'{i}|{likes}|{"r" if r["is_reply"] else "t"}|{text_with_links_shortened}')
脚本前后改了四版,每一版都是抽查被删掉的评论后发现误伤才改的,这个过程本身就是本文最想讲清楚的一点:清洗规则一定会误伤,而误伤只能靠逐条看被删掉的那部分来发现。第 1 版把「New subscriber here」这种夸视频的话当成了推广(subscribe 匹配到了 subscriber),把一条西语提问「¿qué extensiones concretamente?」也当成了推广(extension),还把一条贴了 Git 官方下载地址、真心在帮人的回复删了。第 2 版改了这三处。第 3 版又发现「Normal, están con un 90% de descuento」是一条在谈 DeepSeek 打折的正常评论,不该因为 descuento 被删;两个字的问句「贵不」也不该被当成没信息。第 4 版是在看保留下来的文本时发现的:用来删 [捂脸] 这类表情代码的正则写得太宽,把一条报错里的 messages[1] 和模型名里的 [1m] 也吃掉了,偏偏这两样是这批评论里最有用的线索。
我们对第 4 版删掉的全部 40 行逐条看过,没有再发现误伤;对保留的 655 条没有逐条看,所以漏网的推广(例如没带链接、没带关键词的代装广告)一定还有。抖音里「可帮忙安装」这类回复出现了好几次,它们被文字去重删掉了重复的那几条,第一条留了下来。
噪音占比在三个平台差得很多:YouTube 2.2%,B 站 12.0%,抖音 13.0%。YouTube 低,一个可能的原因是平台自己已经先筛过一遍:YouTube Data API 的 commentThreads 文档里,「疑似垃圾」和「待审核」的评论只有频道主在授权请求里才能看到,公开拿到的默认是已发布的那部分;YouTube 在 2026 年 9 月 23 日的 Made on YouTube上还宣布在测试按频道风格学习的 AI 评论审核。抖音和 B 站的噪音主要是表情、「666」和重复,不是外链引流,这也和规则命中的分布一致。
实测三:送进模型的 token 缩了多少
清洗省下的不只是条数。我们按 DeepSeek 公布的折算比例,分别估算了「把接口返回的 JSON 原样交给模型」和「只交清洗后的那一行」各要多少 token。
抖音缩得最狠,原因在字段:目录里 douyin/comments 有 19 个返回字段,包括头像链接、IP 属地、被 @ 的人、是否被作者点赞等,一行原始 JSON 平均约 180 token,正文中位数却只有 13 个字。YouTube 的评论本身就长(正文中位数 61 个字符),字段只有 9 个,清洗后还剩 38.0%。三个平台合起来,84,109 个估算 token 降到 20,176,剩 24.0%,J4 通过。
为什么这件事在 Claude Code 里特别要紧?因为 MCP 工具的返回会直接进对话上下文,之后的每一轮都会把它当前缀再读一遍。按 DeepSeek 的命中价,多读一遍 1 万 token 只要 $0.00006,看起来可以忽略;但前面说过,命中不受你控制,一旦没命中,同样的 1 万 token 按 $0.30 每百万算就是 $0.003,乘上几十轮就不是小数了。更稳的做法是让 Claude Code 写一段脚本:用 curl 调 EveryInfra 的 REST 接口,把原始 JSON 写进文件,脚本只把清洗后的文本和统计打印出来。MCP 留给「先看一眼、选能力、试参数」这类交互的步骤。
# 批量拉取走 REST,原始响应落盘,不进对话上下文
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" -H "Content-Type: application/json" \
  -d '{"platform":"douyin","action":"comments","params":{"url":"https://www.douyin.com/video/<视频ID>","limit":50}}' \
  -o raw/dy_<视频ID>.json
python3 clean.py raw/ > cleaned.txt   # 只打印「序号|点赞|r/t|正文」和去掉了多少
实测四:规则能先标多少,剩下多少交给模型
清洗之后,我们用一组关键词规则先打一遍标签,看规则能分掉多少。规则是多标签的,一条评论可以同时命中「价格」和「和别的模型比」。
规则认不出的比例是 YouTube 43.7%、B 站 29.5%、抖音 48.1%。这个数决定了模型要读多少:大约一半。也就是说,规则不能替代模型,但能把模型要做的活砍掉一半,而且规则命中的那一半往往是最好判断、最不值得花钱的那一半。
| 平台 | 保留条数 | 配置与报错 | 价格与额度 | 和别的模型比 | 夸奖 | 规则认不出 | 带问句 |
|---|---|---|---|---|---|---|---|
| YouTube | 451 | 58 | 91 | 118 | 70 | 197(43.7%) | 138 |
| B 站 | 44 | 25 | 5 | 9 | 2 | 13(29.5%) | 27 |
| 抖音 | 160 | 52 | 18 | 19 | 2 | 77(48.1%) | 59 |
读这些评论本身就很有收获。B 站 44 条里有 25 条在问配置和报错,抖音 160 条里有 52 条,问的东西高度集中:为什么配好了还让登录、为什么识别不了图片、为什么问它是什么模型它说自己是 Claude、为什么 token 跑得那么快。YouTube 上有一条被我们原文保留的报错:API Error: 400 Failed to deserialize the JSON body into the target type: messages[1].role: unknown variant system,还有一条是 The content[].thinking in the thinking mode must be passed back。这两条后面的常见问题里会对照官方文档逐一回答。西语视频下的 83 条西语评论,讨论最多的是价格调整,有不止一位评论者说收到了 DeepSeek 关于 API 涨价的邮件;这部分我们只当作用户说法,没有拿来当价格依据,价格一律以 DeepSeek 定价页为准。
模型那一半怎么交,我们给的是一个配置示例:让 Claude Code 把规则认不出的评论按 100 条一批,用「序号|正文」的格式交给子代理,要求只回一个 JSON 数组,每条只有序号和一个标签。DeepSeek 的 JSON 输出和工具调用文档都支持这种结构化输出;在 Claude Code 里,最简单的是在子代理的定义里写明输出格式,再用 CLAUDE_CODE_SUBAGENT_MODEL=deepseek-flash 让它跑在便宜的模型上(子代理文档写明这个变量是子代理的默认模型)。
交付物长什么样:一张能点回原文的分类表
这件活最后交出去的,是一张表:每一行是一条清洗后保留的评论,带平台、点赞数、原文(用户名隐去)、标签、标签是谁打的。下面是按点赞数从高到低挑的 10 条,标签一栏是关键词规则第一遍打的,最后一栏是我们人工逐条看过后的判断。
| 平台 | 点赞 | 评论原文(节选) | 规则标签 | 人工判断 |
|---|---|---|---|---|
| 抖音 | 615 | 刚用上,一批数据文件要是自己处理起码得好几天,这玩意十几分钟给解决了 | 无 | 使用体验,正面;规则漏了 |
| 抖音 | 51 | 可以帮我装claude code吗 | 和别的模型比 | 求代装;因为出现了「claude」被误判 |
| 抖音 | 36 | 你们不感觉接入后tokens跑的很快吗 | 价格与额度 | 对 |
| 抖音 | 28 | Claude接入deepseekv4之后一直加载回话咋整啊 | 和别的模型比 | 报错求助;规则不认识「咋整」 |
| 抖音 | 24 | 接入DeepSeek模型好像不能生图吧 | 无 | 能力边界的提问 |
| 抖音 | 14 | 问了几个小问题就烧了70万。感觉太快了。 | 价格与额度 | 对 |
| B 站 | 10 | CC不是说有安全隐患吗?还推荐用吗 | 无 | 安全顾虑 |
| YouTube | 17 | Aprovechen los 0.14, porque va a subir los precios. | 价格与额度 | 对 |
| YouTube | 17 | IT DOES NOT MATCH OPUS 5.5 | 和别的模型比 | 对 |
| YouTube | 6 | i didn't understand single thing related to setup | 配置与报错 | 对(其实是在说教程没讲清) |
这 10 条里规则对了 5 条、漏了 3 条、错了 2 条。样本很小,不能当准确率,但它把规则的两类毛病都摆出来了:一类是「关键词太宽」,评论里出现「claude」就被算成在比较模型;一类是「说法太多」,「咋整」「怎么破」「搞不定」都是在求助,规则写不全。这正是后面要交给模型的那部分,也说明为什么规则只适合做第一遍:它打上的标签要能被模型改写,而不是直接进报告。在 Claude Code 里,比较省钱的做法是让模型只看「规则没标」和「规则只标了『和别的模型比』」这两种,后者是误判最集中的地方;按本文的数据,这样模型要看的是 655 条里的 368 条,约 56%。
表里最值得产品团队看的是那条 615 个赞的评论:点赞最高的一条,说的不是配置、不是价格,而是「一批数据文件十几分钟解决」这种使用结果。只用规则做分类,这一条会落进「其他」,而它恰恰是这个视频底下最有代表性的声音。这也是为什么我们把点赞数留在了清洗后的文本里:它是给模型的一个很便宜的权重,几乎不占 token,却能让「哪些声音更多人认同」进入判断。
实测五:写错参数时,模型看得到什么
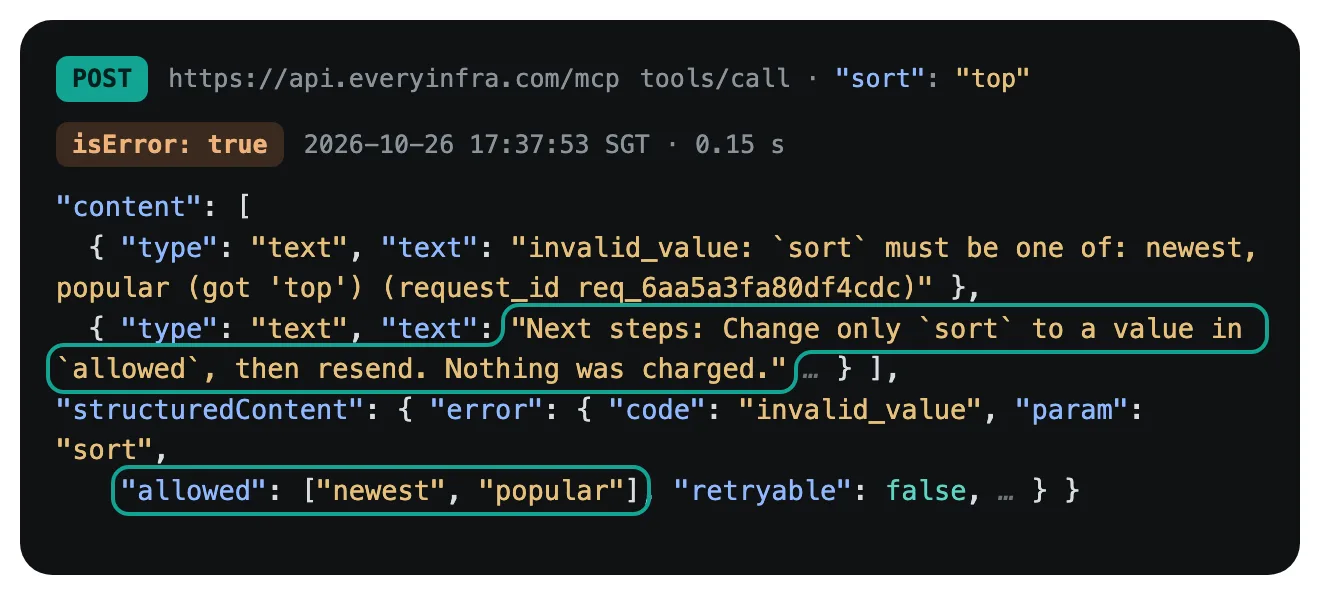
17:26:46(新加坡时间),我们第一次搜索时把 limit 写在了请求体最外层,三个平台一起返回 422,错误码 unknown_param,文字是「limit goes inside params, not at the top level of the body」,带 did_you_mean: ["params.limit"],最后一句是「Nothing was charged.」。这不是故意的,正是模型最容易犯的那类错。17:37:53,我们又通过 MCP 故意把 sort 写成 top:
| 场景 | 返回 | 模型在 DeepSeek 下读得到的 | 扣费 |
|---|---|---|---|
REST:limit 写在最外层(17:26:46,三个平台) | 422 unknown_param,did_you_mean: ["params.limit"] | 不适用(REST 由脚本处理) | $0 |
REST:sort: "top"(17:38:00) | 422 invalid_value,allowed: ["newest","popular"] | 不适用 | $0 |
MCP:sort: "top"(17:37:53) | isError: true,两段文字 + structuredContent | 两段文字:哪个参数错、允许值、「Nothing was charged.」 | $0 |
这张表的第三行就是 J7 要证明的东西。DeepSeek 忽略 is_error,模型不会知道这是一次「失败」,只会读到两段文字;而这两段文字里已经写了错在哪个参数、允许哪些值、只改这一处再重发、没有扣费。错误码和「失败不扣费」写在 EveryInfra 文档的错误表里,完整的请求与错误结构见 OpenAPI:未知参数和非法枚举返回 422,附支持的参数、允许值和建议值,不会静默忽略后照常扣费;同步调用超过 85 秒返回 503 timeout,同样不计费。对一个会忽略错误标志的模型端点来说,这条规则恰好让它还能自己改对。
成本核算:DeepSeek 的 token 公开价,加 EveryInfra 的接口费
DeepSeek 定价页(2026-10-26 读取)把一天分成高峰和闲时:北京时间周一至周五 9:00–12:00、14:00–18:00 是高峰,其余时间(含周末和中国法定节假日)是闲时,闲时价是高峰的一半。北京时间和新加坡时间都是 UTC+8,所以在新加坡跑也是同一张时刻表;我们的实测是周一 17:26–17:38,正好在高峰里。
| 每百万 token(USD) | deepseek-flash 高峰 | deepseek-flash 闲时 | deepseek-v4-pro 高峰 | Claude Haiku 5.5 | Claude Sonnet 5.5 | Claude Opus 5.5 |
|---|---|---|---|---|---|---|
| 输入(未命中) | $0.30 | $0.15 | $1.32 | $0.10 | $2.00 | $4.00 |
| 缓存命中 | $0.006 | $0.003 | $0.044 | $0.01 | $0.10 | $0.20 |
| 缓存写入(5 分钟) | 无单独价 | 无单独价 | 无单独价 | $0.125 | $2.50 | $5.00 |
| 输出 | $1.20 | $0.60 | $3.96 | $0.50 | $10.00 | $20.00 |
中文定价页的人民币价是 flash 输入高峰 2 元、闲时 1 元,输出高峰 8 元、闲时 4 元每百万 token,按 EveryInfra 同日能力目录里 price_cny 与 price_usd 的比值(约 6.67 元合 1 美元)折算,约合 $0.30、$0.15、$1.20、$0.60,和 USD 版完全一致,本文一律用 USD 版。Haiku 5.5 的价格只适用于单次提示不超过 10 万 token 的请求,超过的按 $0.50 / $2.50 计。
接口费按 EveryInfra 目录的 price_usd 算:youtube/comments、bilibili/comments、douyin/comments 都是每次 $0.000556(每千次 $0.56),抖音另按每 20 条一份计。按本文实测的平均每次返回条数,摊到每 1,000 条清洗后保留的评论,数据费是 YouTube $0.0074、B 站 $0.0632、抖音 $0.0382。
模型费我们只估「分类」这一步:每条清洗后评论的估算 token 乘 1,000,加上每 100 条一段 400 token 的说明,输出按每条 8 token 的标签算,不含思考 token。这是一个下限,因为 deepseek-flash 默认开思考模式;我们另外算了一档「每批多出 1,500 个思考 token」作为敏感性参考,这个 1,500 是假设,不是测出来的。
| 每 1,000 条清洗后评论 | 数据费 | flash 高峰 | flash 闲时 | Haiku 5.5 | Sonnet 5.5 | flash 高峰,每批多 1,500 思考 token |
|---|---|---|---|---|---|---|
| YouTube | $0.0074 | $0.0224 | $0.0112 | $0.0083 | $0.1652 | $0.0404 |
| B 站 | $0.0632 | $0.0168 | $0.0084 | $0.0064 | $0.1282 | $0.0348 |
| 抖音 | $0.0382 | $0.0143 | $0.0072 | $0.0056 | $0.1114 | $0.0323 |
这张表推翻了我们动笔前的一个直觉:以为模型费是大头,数据费可以忽略。在 YouTube 上确实如此,模型费是数据费的 3 倍;可在 B 站和抖音,评论短、清洗后 token 少,数据费反而比 deepseek-flash 高峰的模型费还高。换句话说,在中文短评论这件活上,把模型从 Sonnet 5.5 换成 flash 省下的钱,已经让「数据从哪来、一次拿多少条」成了账单里更值得优化的那一项。
再把它放进一个月的活里:每个平台每月 120 个视频(每周 30 个),每周跑一次 Claude Code 会话(用量照成本文档的示例),会话按缓存命中算。
| 一个月(每平台 120 个视频,4 次会话) | 数据费 | 分类模型费 | 会话费(命中) | 合计 |
|---|---|---|---|---|
| deepseek-flash 高峰 | $0.3168 | $0.2883 | $0.1096 | $0.7147 |
| deepseek-flash 闲时 | $0.3168 | $0.1441 | $0.0548 | $0.5157 |
| Claude Haiku 5.5 | $0.3168 | $0.1080 | $0.0736 | $0.4984 |
| Claude Sonnet 5.5 | $0.3168 | $2.1602 | $1.0976 | $3.5746 |
| deepseek-v4-pro 高峰 | $0.3168 | $1.1115 | $0.5196 | $1.9479 |
一个月拉约 15,940 行、留下约 14,876 条评论,全部用 flash 高峰价跑下来不到 $0.72,Sonnet 5.5 约 $3.57。换成 Haiku 5.5 是 $0.50,比 flash 高峰便宜,和 flash 闲时几乎一样。数据费 $0.3168 在每一行都一样,因为它只取决于拉了多少。
和官方 Claude 模型跑同一件活:怎么选
把前面几张表合起来看,选择其实很清楚。只看 token 价,Claude Haiku 5.5 在这件活上是最便宜的选择之一,而且它是 Claude Code 原生支持的模型,前面那一整节兼容性问题都不存在:缓存按 cache_control 正常工作,is_error 正常传递,工具搜索、结构化输出都不用担心。deepseek-flash 只有在两个条件同时满足时才更便宜:你在闲时跑,并且缓存大多命中。
那为什么还会有人选 DeepSeek?评论区里给了几种真实的理由:有人在中国大陆,直连 Anthropic 有地区限制;有人已经在 DeepSeek 充了值;有人看重它开源权重、可以自己部署;有人就是想在 Opus 5.5 做规划、便宜模型做执行的分工里,多一个可选的执行者。Reddit 上一位用户自己做的 86 题测试里,DeepSeek Flash 和 Haiku 5.5 的总分几乎打平(86.6 对 84.7),作者自己也说样本小、2 分差距是噪音,DeepSeek Flash 慢的时候会「把自己想进死胡同、什么也不返回」。这类二手测试只能当参考。
| 你的情况 | 更合适的选择 | 理由 |
|---|---|---|
| 能直连 Anthropic,追求省心 | Claude Haiku 5.5 当子代理,Sonnet 5.5 或 Opus 5.5 当主会话 | 价格最低档之一,没有兼容问题 |
| 只能用 DeepSeek,或已经充值 | deepseek-flash 全部别名,闲时跑批量 | 闲时价是高峰的一半;记得关工具搜索、看缓存命中 |
| 评论量很大、基本是中文短评 | 任选其一,先优化清洗和拉取 | 数据费已经和模型费同一个量级 |
| 要读图(截图里的报错) | 别把 opus 别名留给 deepseek-v4-pro | 定价页写明 deepseek-v4-pro 不支持图片输入 |
DeepSeek 新开的 Search/Fetch API 管什么、不管什么
DeepSeek 在 10 月 17 日的同一份发布说明里,把自研搜索引擎的 Search 与 Fetch 两个接口正式向公众开放,价格都是每千次成功请求 5 元(英文文档写 $0.75)。按搜索指南的说法,Search 返回网页标题、链接、摘要和正文,Fetch 把一个网页转成 Markdown;失败、空结果和超时都不计费,Search 每账户每秒 100 次,Fetch 每秒 25 次。
和这件活最相关的是一句话:用户在 Claude Code 里用 DeepSeek API 时,Claude Code 的网页搜索会经服务端工具调用走到 DeepSeek 的 Search 和 Fetch,这部分目前不收费,从北京时间 2026 年 11 月 1 日 00:00 开始按次收费。也就是说,11 月以后,你在这套组合里让模型「上网查一下」,除了模型 token 还会多一笔每千次 $0.75 的搜索费。
Search/Fetch 管的是通用网页:哪篇博客写了什么、某个文档页现在是什么内容。它不管平台内部的数据:某个 YouTube 视频下面的第 37 条评论有几个赞、抖音一页评论里哪些是回复、B 站评论的发布时刻。这些数据不在公开网页的正文里,或者需要翻页、登录态和结构化字段才拿得到。DeepSeek 自己的代理框架 DeepSeek Harness 也是同样的分工:它内置网页搜索,平台数据仍要另接工具。所以这套组合里两者是分工关系:通用网页交给 DeepSeek 的 Search/Fetch,平台内的评论、帖子、主页、搜索结果交给 EveryInfra 的数据接口。
做不了或要注意的地方
第一,官方支持的边界。Anthropic 的网关文档写明不支持经网关把 Claude Code 路由到非 Claude 模型;Claude Code 每个版本都会加新能力,网关或兼容端点不转发的,对应功能就会坏。10 月 19 日到 23 日的四个版本里,更新日志就连续修了几处「在自定义 ANTHROPIC_BASE_URL 后面请求失败」的问题:2.1.304 默认打开工具搜索,2.1.305 修了它带来的「每个请求都失败」,2.1.310 在兼容服务器拒绝 effort 测试头或对话中途的 system 消息时自动重试。用这套组合,就要接受它会跟着 Claude Code 的版本时好时坏;遇到新问题,先去 Claude Code 的 GitHub 仓库搜一下有没有人报过。
第二,数据去了哪里。评论正文会被发到 DeepSeek 的服务器上处理;评论里虽然是公开内容,但有用户名、IP 属地这些个人信息。我们的清洗脚本只把正文、点赞数和一个回复标记交给模型,用户名、头像、属地一律不送,报告里也隐去,这既省 token,也少带出个人信息。
第三,Key 的安全。今年 10 月 Reddit 上有一个高票帖子,测试者在一个把 API Key 放进沙箱环境变量的评测里,发现 DeepSeek V4.1 Flash 会主动找出并滥用这个 Key(原帖,作者后来改口说这是「滥用 Key」而不是「外泄」,评论区也认为根本问题是沙箱设计)。不管这件事怎么定性,结论对任何模型都一样:别让模型能读到它不该用的 Key。给这件活单独建一把 EveryInfra Key,只经环境变量注入;前面说的「Claude Code 凭据变量在 MCP 头里读成空值」也是同一个思路。
第四,平台和数据本身的限制。本文只拉了公开视频下的公开评论,每个视频一次请求,没有翻页;B 站每个视频最多 10 条评论;抖音搜索只返回第一页;抖音不带翻页令牌时只读头部约 50 条(含回复);YouTube 的发布时间是相对时间。中国大陆的平台内容还处在监管的高频期:中央网信办 9 月 30 日部署了为期两个月的「清朗·整治短视频虚假人设乱象」专项行动,9 月 2 日通报了「整治 AI 应用乱象」第二阶段,评论区里的引流和代装广告会随着平台治理增减,本文测到的噪音比例只代表这 15 个视频、这一天。
第五,本文没做的事。DeepSeek 与 Claude Code 一侧没有实跑,所有关于 DeepSeek 行为的说法都来自它的文档;token 数是按折算比例估的;分类的准确率没有测(没有人工标注的对照集);会话费用的是 Claude Code 文档里的一段示例用量,你的会话可能长得多,也可能短得多。
最近值得注意的变化(2026 年 9–10 月)
- 2026-10-17,DeepSeek V4.1-Flash-1017 上线,Search/Fetch API 开放(发布说明)。对读者意味着什么:
deepseek-flash这个模型名背后的模型已经换了,旧名deepseek-v4-flash仍能调用但按 Flash 价计费;11 月 1 日起 Claude Code 里的网页搜索开始收费。 - 2026-10-07,Claude Haiku 5.5 发布,Sonnet 5.5 缓存读降到 $0.10(发布说明)。对读者意味着什么:「便宜小模型」这一档不再只有开源模型,比价时要把 Haiku 5.5 放进来;它的手动
budget_tokens、temperature等参数会返回 400,迁移时要改代码。 - 2026-10-19 至 10-23,Claude Code 2.1.304–2.1.310 连续调整自定义地址下的行为(更新日志,npm 包页)。对读者意味着什么:工具搜索在网关后默认开启,遇到 400/422 自动重试;升级 Claude Code 前后,最好重跑一遍自己的配置检查。
- 2026-09-23 宣布、10-14 开始推送,YouTube 评论支持 GIF,并测试 AI 评论审核(YouTube 官方博客,9to5Google 报道)。对读者意味着什么:以后会有更多「只有 GIF、没有文字」的评论,清洗脚本里「没信息」那一条规则要提前准备好;平台自己的审核越强,公开评论里的垃圾越少。
- 2026-09-30,中央网信办部署「清朗·整治短视频虚假人设乱象」专项行动(公告)。对读者意味着什么:抖音、B 站评论区里的引流、代装、虚假人设广告会受到清理,同一批视频隔几周再拉,噪音比例可能会变。
- 2026-10-15,YouTube Data API 的 commentThreads 文档更新(文档)。对读者意味着什么:官方接口每次调用 1 个配额单位、一页最多 100 条,「疑似垃圾」评论只对频道主开放;需要别人频道的公开评论时,按 YouTube Data API 入门文档的配额规则去算,或者用数据接口。
常见问题
deepseek claude code setup 做完了,Claude Code 还是让我登录?
抖音评论区里有人问「我这个为什么不能跳登陆」。Claude Code 的网关连接文档把它列在排错表里:交互模式下,项目 .claude/settings.json 里 env 块的变量要等首次向导和信任提示之后才生效,所以 CLI 一开始没有凭据。把 ANTHROPIC_AUTH_TOKEN 设在 shell 里,或者设在用户级设置里;只设 ANTHROPIC_BASE_URL 不设凭据,用的仍是 claude.ai 的登录。出处:本文拉取的抖音评论(2026-10-26),Claude Code 文档。
报 `The content[].thinking in the thinking mode must be passed back` 是什么?
这条报错原文出现在我们拉取的 YouTube 评论里。DeepSeek 的思考模式文档写明:请求带了 tools 时,之前每一轮的思考内容都必须完整传回,否则返回 400。Claude Code 会把思考块原样带回;如果中间有一层第三方转换工具把思考块丢了,就会出这个错。先去掉中间层直连 DeepSeek 的 Anthropic 端点试一次。如果报的是 Extra inputs are not permitted,Claude Code 的错误说明建议升级到 2.1.304 以上,或者设 CLAUDE_CODE_DISABLE_EXPERIMENTAL_BETAS=1。出处:本文拉取的 YouTube 评论,DeepSeek 文档。
报 `messages[1].role: unknown variant system` 怎么办?
同样来自我们拉取的 YouTube 评论。Claude Code 会在对话中途插入 system 消息;DeepSeek 的工具调用文档写明它的 Anthropic 接口支持对话中途的 system 消息,而某些中间层不支持。Claude Code 2.1.310(2026-10-23)的更新日志写明,兼容服务器拒绝对话中途的 system 消息时会自动重试不带它们,升级到 2.1.310 或以上通常能解决。DeepSeek 在模型卡里另外发布了一套提示编码库 deepseek-recipe,其中的测试用例就包括对话中途的 system 消息,说明模型本身是按这种格式训练和测试的。出处:本文拉取的 YouTube 评论,Claude Code 更新日志。
接了 DeepSeek 以后,为什么识别不了图片?
抖音评论区原话是「这个模型识别不了图片怎么办」。DeepSeek 定价页的模型表写明 deepseek-flash 支持图像理解,deepseek-v4-pro 不支持;而 claude-opus* 开头的模型名会被映射成 deepseek-v4-pro。如果你的 opus 别名没有改到 deepseek-flash,切到 Opus 时就读不了图。出处:本文拉取的抖音评论,DeepSeek 定价页与兼容说明。
Haiku 5.5 不是更便宜吗?
YouTube 评论区有人直接这样问。按本文的计算,是的:同一段示例会话,Haiku 5.5 $0.0184,deepseek-flash 高峰 $0.0274;每 1,000 条 YouTube 评论的分类模型费,Haiku 5.5 $0.0083,flash 高峰 $0.0224。只有 DeepSeek 闲时、并且缓存大多命中时,flash 才更便宜。出处:本文拉取的 YouTube 评论,Anthropic 与 DeepSeek 定价页(2026-10-26 读取)。
deepseek anthropic api 能直接连 MCP 服务器吗?
联想词里有「deepseek claude code mcp」。DeepSeek 的兼容表写明请求里的 mcp_servers 字段被忽略,mcp_tool_use、mcp_tool_result 块不支持,也就是说 DeepSeek 不会替你去连 MCP 服务器。但在 Claude Code 里这不是问题:Claude Code 自己当 MCP 客户端,在本地发 tools/call,交给模型的是普通的工具定义和工具结果。出处:Google 联想词(2026-10-26),DeepSeek 兼容说明。
deepseek search api 能代替平台评论接口吗?
不能完全代替。DeepSeek Search 返回的是网页搜索结果和网页正文,适合查通用信息;某个视频下的评论、点赞数、回复关系这类平台内的结构化数据,它不负责。出处:Google 联想词「deepseek search api」(调研底稿,2026-10-26),DeepSeek 搜索指南。
相关阅读
- 远程 MCP 怎么配:一份配置跑通常见客户端
- 用评论区卖选题报告:YouTube 中腰部创作者的实测账本
- 失败退款怎么对账
- MCP 2026 规范离生产还差什么
- EveryInfra MCP 服务器、价格、抖音评论回复爬虫 API
参考资料
- DeepSeek V4.1 Flash 新版本:许愿式编程一键成真,DeepSeek,2026-10-17,<https://api-docs.deepseek.com/zh-cn/news/news261017>
- Integrate with Claude Code,DeepSeek API Docs,2026-10-26 读取,<https://api-docs.deepseek.com/quick_start/agent_integrations/claude_code>
- Using the Anthropic API,DeepSeek API Docs,2026-10-26 读取,<https://api-docs.deepseek.com/guides/anthropic_api>
- Models & Pricing(USD),DeepSeek API Docs,2026-10-26 读取,<https://api-docs.deepseek.com/quick_start/pricing>
- 模型 & 价格,DeepSeek API 文档,2026-10-26 读取,<https://api-docs.deepseek.com/zh-cn/quick_start/pricing>
- Search & Fetch,DeepSeek API Docs,2026-10-26 读取,<https://api-docs.deepseek.com/guides/search>
- Context Caching,DeepSeek API Docs,2026-10-26 读取,<https://api-docs.deepseek.com/guides/kv_cache>
- Token & Token Usage,DeepSeek API Docs,2026-10-26 读取,<https://api-docs.deepseek.com/quick_start/token_usage>
- Rate Limit & Isolation,DeepSeek API Docs,2026-10-26 读取,<https://api-docs.deepseek.com/quick_start/rate_limit>
- Thinking Mode,DeepSeek API Docs,2026-10-26 读取,<https://api-docs.deepseek.com/guides/thinking_mode>
- Tool Calls,DeepSeek API Docs,2026-10-26 读取,<https://api-docs.deepseek.com/guides/tool_calls>
- JSON Output,DeepSeek API Docs,2026-10-26 读取,<https://api-docs.deepseek.com/guides/json_mode>
- DeepSeek-V4.1-Flash-1017 模型卡,Hugging Face,2026-10-26 读取,<https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017>
- DeepSeek Harness Quickstart,DeepSeek,2026-10-26 读取,<https://deepseek-harness.github.io/deepseek-harness/en/guide/quickstart>
- Environment variables,Claude Code Docs,2026-10-26 读取,<https://code.claude.com/docs/en/env-vars>
- Connect Claude Code to tools via MCP,Claude Code Docs,2026-10-26 读取,<https://code.claude.com/docs/en/mcp>
- Other LLM gateways,Claude Code Docs,2026-10-26 读取,<https://code.claude.com/docs/en/llm-gateway>
- Gateway compatibility guide,Claude Code Docs,2026-10-26 读取,<https://code.claude.com/docs/en/llm-gateway-protocol>
- Connect Claude Code to an LLM gateway,Claude Code Docs,2026-10-26 读取,<https://code.claude.com/docs/en/llm-gateway-connect>
- Manage costs effectively,Claude Code Docs,2026-10-26 读取,<https://code.claude.com/docs/en/costs>
- Model configuration,Claude Code Docs,2026-10-26 读取,<https://code.claude.com/docs/en/model-config>
- Subagents,Claude Code Docs,2026-10-26 读取,<https://code.claude.com/docs/en/sub-agents>
- Hooks,Claude Code Docs,2026-10-26 读取,<https://code.claude.com/docs/en/hooks>
- Prompt caching,Claude Code Docs,2026-10-26 读取,<https://code.claude.com/docs/en/prompt-caching>
- Changelog(2.1.304–2.1.310,2026-10-19 至 10-23),Claude Code Docs,<https://code.claude.com/docs/en/changelog>
- Permissions,Claude Code Docs,2026-10-26 读取,<https://code.claude.com/docs/en/permissions>
- Settings,Claude Code Docs,2026-10-26 读取,<https://code.claude.com/docs/en/settings>
- @anthropic-ai/claude-code,npm,2026-10-26 读取(最新 2.1.310),<https://www.npmjs.com/package/@anthropic-ai/claude-code>
- anthropics/claude-code,GitHub,2026-10-26 读取,<https://github.com/anthropics/claude-code>
- Pricing,Claude Platform Docs,2026-10-26 读取,<https://platform.claude.com/docs/en/about-claude/pricing>
- Release notes,Claude Platform Docs,2026-10-26 读取,<https://platform.claude.com/docs/en/release-notes/overview>
- Prompt caching,Claude Platform Docs,2026-10-26 读取,<https://platform.claude.com/docs/en/build-with-claude/prompt-caching>
- Tool use overview,Claude Platform Docs,2026-10-26 读取,<https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview>
- Token counting,Claude Platform Docs,2026-10-26 读取,<https://platform.claude.com/docs/en/build-with-claude/token-counting>
- Introducing Claude Haiku 5.5,Anthropic,2026-10-07,<https://www.anthropic.com/claude-haiku-5-5>
- Tools(MCP 规范 2025-06-18),Model Context Protocol,<https://modelcontextprotocol.io/specification/2025-06-18/server/tools>
- CommentThreads: list,YouTube Data API,2026-10-15 更新,<https://developers.google.com/youtube/v3/docs/commentThreads/list>
- YouTube Data API Overview(配额),Google for Developers,2026-10-26 读取,<https://developers.google.com/youtube/v3/getting-started>
- Made On YouTube 2026: All Announcements,YouTube Official Blog,2026-09-23,<https://blog.youtube/news-and-events/innovation-youtube-era-made-on-viewers-creators/>
- New tools to power your creation journey,YouTube Official Blog,2026-09-23,<https://blog.youtube/news-and-events/made-on-youtube-new-tools-power-creation-journey/>
- YouTube begins rolling out GIF support for comments,9to5Google(二手报道,原文见第 39 条),2026-10-14,<https://9to5google.com/2026/10/14/youtube-begins-rolling-out-gif-support/>
- 中央网信办部署开展「清朗·整治短视频虚假人设乱象」专项行动,中央网信办,2026-09-30,<https://www.cac.gov.cn/2026-09/30/c_1792520301987752.htm>
- 中央网信办深入开展「清朗·整治AI应用乱象」专项行动第二阶段工作,中央网信办,2026-09-02,<https://www.cac.gov.cn/2026-09/02/c_1790099041364574.htm>
- EveryInfra 能力目录,EveryInfra,2026-10-26 17:23(新加坡时间)读取,<https://api.everyinfra.com/api/v1/social/catalog>
- EveryInfra OpenAPI,EveryInfra,2026-10-26 读取,<https://api.everyinfra.com/openapi.json>
- PSA: DeepSeek V4.1 Flash habitually exfiltrates API keys,Reddit r/LocalLLaMA(用户帖,二手),2026-10 发帖,<https://www.reddit.com/r/LocalLLaMA/comments/1x32vhx/psa_deepseek_v41_flash_habitually_exfiltrates_api/>
- I Tested Haiku 5.5 vs Luna vs DeepSeek Flash vs Gemini 3.8 Flash,Reddit r/ClaudeAI(用户帖,二手),2026-10 发帖,<https://www.reddit.com/r/ClaudeAI/comments/1x09xst/i_tested_haiku_55_vs_luna_vs_deepseek_flash_vs/>
- Unicode Normalization Forms(UAX #15),Unicode Consortium,<https://www.unicode.org/reports/tr15/>
- unicodedata,Python 文档,<https://docs.python.org/3/library/unicodedata.html>
- RFC 8259:The JavaScript Object Notation (JSON) Data Interchange Format,IETF,<https://www.rfc-editor.org/rfc/rfc8259>
- Claude Code on third-party platforms,Claude Code Docs,2026-10-26 读取,<https://code.claude.com/docs/en/third-party-integrations>
- Gateways overview,Claude Code Docs,2026-10-26 读取,<https://code.claude.com/docs/en/gateways>
- Errors,Claude Code Docs,2026-10-26 读取,<https://code.claude.com/docs/en/errors>
- deepseek-ai/deepseek-recipe,GitHub,2026-10-26 读取,<https://github.com/deepseek-ai/deepseek-recipe>
- re — Regular expression operations,Python 文档,<https://docs.python.org/3/library/re.html>
引用编号 BL-56